
تعد معالجة البيانات وتنقيتها في جداول البيانات الإلكترونية، ولا سيما عبر برنامج مايكروسوفت إكسيل (Microsoft Excel)، ركيزة أساسية لا غنى عنها في بنية التحليل الكمي المعاصر والبحث العلمي التطبيقي. إن سلامة القرارات المستندة إلى البيانات ترتبط ارتباطاً وثيقاً بمدى نقاء المدخلات الأولية وخلوها من التكرارات غير المضبوطة والتشوهات الإحصائية؛ إذ يؤدي تراكم القيود المكررة إلى تحريف مقاييس النزعة المركزية والتشتت، وإرباك نماذج التقدير والاستدلال، وإهدار الموارد الحاسوبية في معالجة معلومات زائدة لا تضيف وزناً معرفياً جديداً. ومن هنا، يبرز استخلاص القيم المميزة (Distinct Values) كإجراء منهجي تحويلي ينقل مجموعات البيانات من حالتها الخام الفوضوية إلى نسق تصنيفي منظم يتيح بناء أطر نمذجة تتسم بالدقة والموثوقية العالية.
تاريخياً، شهدت بيئة إكسيل الحسابية تحولات بنيوية عميقة في كيفية التعامل مع المصفوفات والقيم غير المتكررة؛ فمنذ إطلاق واجهات إكسيل الأولى وصولاً إلى النسخ الحديثة المدعومة بمحركات المصفوفات الديناميكية ونماذج البيانات الضخمة، تنوعت الأدوات وتطورت من معادلات مصفوفية تقليدية معقدة تتطلب حوسبة مضنية، إلى دوال مرنة وتقنيات تكاملية متقدمة مثل محرر الاستعلامات Power Query ونماذج الجداول المحورية وقواعد البرمجة النصية عبر لغة فيجوال بيسك للتطبيقات (VBA). هذا التنوع الإجرائي يفرض على الباحثين ومحللي البيانات ضرورة الإلمام بالأسس المعرفية والرياضية التي تحكم كل أداة، واستيعاب الفروق الدقيقة بين مختلف المفاهيم التحليلية لاختيار المسار التقني الأمثل والموثوق وفقاً لحجم البيانات وسياق المعالجة، وهو ما يعزز الثقة في الأنظمة التقنية المستخدمة وفق ما أشار إليه الباحثون في دراسات التفاعل مع النظم الحاسوبية (Lankton et al., 2015).
يهدف هذا الدليل الأكاديمي الشامل إلى تقديم تفصيل منهجي وعملي معمق لكافة آليات واستراتيجيات استخراج القيم المميزة من الأعمدة في برنامج إكسيل. ينطلق المقال من تأصيل الأسس النظرية لجودة البيانات والتمييز الدقيق بين مفهومي “المميز” و”الفريد”، ثم ينتقل عبر استعراض تشريحي موسع للأدوات الحديثة والتقليدية، متناولاً دالة UNIQUE الحديثة، وأداة إزالة التكرارات المدمجة، والتصفية المتقدمة، والجداول المحورية، ومحرر Power Query، والصيغ المصفوفية التاريخية، وانتهاءً بالأتمتة المتقدمة وحلول استكشاف الأخطاء وتطهير السجلات، ليكون مرجعاً متكاملاً يدعم المعايير الأكاديمية والمؤسسية الصارمة.
1. الأسس النظرية لمعالجة وتدقيق البيانات في برنامج إكسيل
1.1 أهمية استخراج القيم المميزة في التحليل الإحصائي
يمثل استخراج القيم المميزة حجر الزاوية في بناء الهياكل الإحصائية الرصينة؛ إذ إن التحليل الاستدلالي السليم ينطلق من تحديد الفضاء العيني الحقيقي للمتغيرات قيد الدراسة دون تضخيم اصطناعي ناجم عن تكرار المفردات المتطابقة. في مجموعات البيانات الكبيرة، يؤدي وجود سجلات متكررة غير مبررة إلى انحياز غير مقصود في تقدير المعلمات وتشتيت أوزان الانحدار، مما يضعف كفاءة النماذج التنبؤية ويقلل من دقة الفحوص الإحصائية. عند استخلاص القيم المميزة، يتحقق التجانس التصنيفي للمتغيرات الفئوية (Categorical Variables)، مما يمكن المحلل من عزل كل تصنيف مستقل ودراسة خصائصه البنيوية بصورة منعزلة، وهو ما يعزز موثوقية المؤشرات المستخرجة ويدعم كفاءة التحليل التوزيعي للمتغيرات المتعددة، متماشياً مع متطلبات المعالجة الحوسبية للنظم الكبيرة (Nijhawan et al., 2022).
علاوة على ذلك، يسهم التجريد الدقيق للبيانات في تيسير عمليات النمذجة القياسية المعقدة؛ فعندما يتم تمثيل كل مستوى من مستويات المتغير لمرة واحدة فقط كعنصر فئوي مرجعي، يصبح من الممكن بناء جداول التقاطع التكراري (Contingency Tables) وتطبيق اختبارات استقلال المتغيرات واختبارات مربع كاي ومصفوفات التباين والتباين المشترك بدرجة متقدمة من الثقة الرياضية. إن غياب هذه الخطوة التأسيسية قد يؤدي إلى تخصيص درجات حرية غير واقعية للنماذج، مما يسفر عن أخطاء من النوع الأول (Type I errors) ويدفع الباحثين نحو استنتاجات مضللة تتعلق بوجود فروق ذات دلالة إحصائية في حين أنها لا تعدو كونها أثراً لتكرار غير خاضع للرقابة المنهجية في البيانات المدخلة.
1.2 مفهوم جودة البيانات وتأثير التكرارات على موثوقية النتائج
ترتبط جودة البيانات (Data Quality) ارتباطاً عضوياً بأبعاد الدقة والشمول والاتساق؛ حيث إن تكرار القيود بصورة غير واعية يخل بسلامة هذه الأبعاد الثلاثة مجتمعة. في سياقات البحث التجريبي والميداني، قد تنشأ التكرارات عن عيوب في أدوات جمع البيانات، كإرسال الاستبانات الإلكترونية أكثر من مرة من قبل المستجيب ذاته، أو نتيجة دمج قواعد بيانات متعددة تحتوي على مساحات تداخل غير منقحة. يؤدي هذا الإدخال المتكرر إلى تضخيم أحجام العينات بشكل زائف (Spurious Sample Inflation)، وهو تشوه منهجي يعطي انطباعاً مضللاً باتساع القاعدة التجريبية، بينما تظل التباينات الملاحظة مجرد انعكاسات مكررة لنقاط بيانات متماثلة لا تمثل تبايناً حقيقياً في المجتمع الإحصائي الأصلي المستهدف بالدراسة.
إن الامتثال للمعايير الصارمة لإعداد وتنظيف قواعد البيانات يقتضي تطهير المتغيرات المستقلة والتابعة من الشوائب الإدخالية قبل الشروع في أي معالجة استدلالية. تتطلب النزاهة التحليلية توثيق كل عملية حذف أو استبعاد للتكرار ضمن بروتوكولات تدقيق قابلة للمراجعة والتحقق المستقل، وذلك لضمان خلو النتائج النهائية من التباينات الناتجة عن أخطاء الإدخال البشري أو الخلل التقني في نظم استيراد السجلات. تسهم هذه الممارسة الصارمة في رفع قدرة النماذج على التعميم وتقليل التباين الإحصائي المتبقي (Residual Variance)، مما يمنح التقديرات التنبؤية درجة عالية من المصداقية المعرفية المنسجمة مع المعايير المعرفية للممارسات العلمية (Teodoridis et al., 2018).
1.3 نظرة شمولية على الأدوات والوظائف المتاحة لاستخراج البيانات
مرت أدوات استخراج البيانات وتدقيقها في بيئة برنامج إكسيل بتطور تاريخي وتقني متسارع يعكس التغيرات الجذرية في معمارية البرمجيات الحاسوبية. في المراحل الأولى لتطوير البرنامج، كانت معالجة القيم المكررة تعتمد كلياً على صياغة معادلات مصفوفية يدوية شديدة التعقيد تجمع بين دوال البحث والإحصاء، مما كان يشكل عبئاً حاسوبياً هائلاً على ذاكرة الأجهزة المحدودة. لاحقاً، ومع إطلاق حزمة أوفيس 2007، أدمجت شركة مايكروسوفت واجهات مستخدم مخصصة ضمن شريط الأدوات، أبرزها أداة إزالة التكرارات المباشرة وتطوير نافذة التصفية المتقدمة لتسهيل العمليات التشغيلية دون الحاجة إلى صياغة برمجية معقدة.
أما النقلة النوعية الكبرى فقد تبلورت في سبتمبر 2018 (وأتيحت بصورة عامة ومستقرة في مطلع عام 2020) تحت إشراف مهندسي ومعماريي البرمجيات في مايكروسوفت عبر إطلاق محرك المصفوفات الديناميكية (Dynamic Array Engine)، والذي قدم دوالاً أصيلة مثل دالة UNIQUE. تتيح هذه التطورات اليوم مفاضلة منهجية واعية بين ثلاثة أنماط رئيسية من الحلول: الحلول الديناميكية القائمة على الصيغ التلقائية المتجددة، والحلول الساكنة التي تحذف أو تفلتر البيانات فيزيائياً في موضعها، والحلول التحويلية المتقدمة مثل Power Query ولغة M. ويتطلب الاختيار بين هذه المسارات تقييماً شاملاً لحجم البيانات، وطبيعة سير العمل، وما إذا كان المشروع يتطلب مخرجات تفاعلية تتجدد لحظياً أم قيوداً ثابتة موجهة للتقارير الختامية المستقرة.
2. التمييز المفاهيمي بين القيم المميزة (Distinct) والقيم الفريدة (Unique)
2.1 التعريف الرياضي والإحصائي للقيم الفريدة المطلقة
يعد الخلط الاصطلاحي بين مفهوم “القيم الفريدة” (Unique Values) ومفهوم “القيم المميزة” (Distinct Values) من أكثر الأخطاء المفاهيمية شيوعاً في التحليل الرقمي واستخدامات إكسيل. من الناحية الرياضية ونظرية المجموعات، يشير مصطلح “القيمة الفريدة المطلقة” إلى ذلك العنصر المحدد الذي يظهر في الفضاء العيني أو النطاق لمرة واحدة فقط ودون أي تكرار على الإطلاق؛ فإذا احتوت القائمة الرقمية على العناصر التالية: [أ، أ، ب، ج، ج]، فإن القيمة الفريدة الوحيدة بالمعنى الرياضي الصارم هي العنصر [ب]، نظراً لأن العناصر الأخرى قد تم تكرارها داخل النطاق نفسه بمعدل ظهور يتجاوز الوحدة الواحدة.
يكتسب هذا التحديد الدقيق أهمية بالغة في سياقات التدقيق الأمني ومراقبة الجودة وفحص الشذوذ الإحصائي؛ إذ يُلجأ إلى عزل القيم الفريدة المطلقة للكشف عن الحالات الاستثنائية النادرة، مثل المعاملات المالية الفردية التي لم تتكرر في سجلات التدقيق المحاسبي، أو استجابات المرضى ذات الأنماط النادرة التي تتطلب دراسة إكلينيكية منفصلة، أو مدخلات الاستشعار التي تشير إلى أعطال مفاجئة ومؤقتة. إن العزل التام للمفردات التي لا تشترك في أي تكرار يسهم في رصد الأخطاء الشاذة واكتشاف الانحرافات المعيارية الحرجة داخل النظم الحوسبية الصارمة التي تتطلب مراقبة مستمرة للمدخلات الشاذة (Duff, 2012).
2.2 المفهوم المنهجي للقيم المميزة (غير المكررة)
على النقيض من ذلك، يعبر مفهوم “القيم المميزة” (Distinct Values) – والتي توصف غالباً في الأدبيات التطبيقية بالقوائم غير المكررة – عن عملية تجريد شاملة لعناصر النطاق بهدف عرض كل قيمة ظهرت في القائمة لمرة واحدة فقط، بغض النظر عن عدد مرات تكرارها الفعلي في البيانات الخام الأصلية. وبالعودة إلى المثال السابق المكون من [أ، أ، ب، ج، ج]، فإن مجموعة القيم المميزة الناتجة عن التجريد الرياضي هي المجموعة المنظمة: [أ، ب، ج]. إن كل عنصر هنا يتم تمثيله ككيان نوعي مستقل داخل القائمة المستخلصة، محتفظاً بهويته التصنيفية دون النظر إلى كونه فريداً في أصله أو متكرراً مئات المرات.
يمثل استخلاص القيم المميزة الأساس المنطقي لبناء القوائم المرجعية الموحدة (Master Lists) وتحديد المتغيرات المستقلة في الأبحاث الاجتماعية والاقتصادية، فضلاً عن تطبيقات إعداد القوائم المنسدلة للتحقق من صحة إدخال البيانات (Data Validation Lists) في بيئات العمل الإدارية. ومن خلال هذا التجريد، يتمكن المحلل من هيكلة الترميز الفئوي وتحديد الأبعاد المتمايزة التي ستبنى عليها أطر التحليل اللاحقة، مما يمنع التداخل اللفظي أو العددي بين الفئات ويوفر قالباً صلباً لعمليات النمذجة والاستعلام الهيكلي (Schyns, 1991).
2.3 دراسة مقارنة توضيحية للفروق الجوهرية
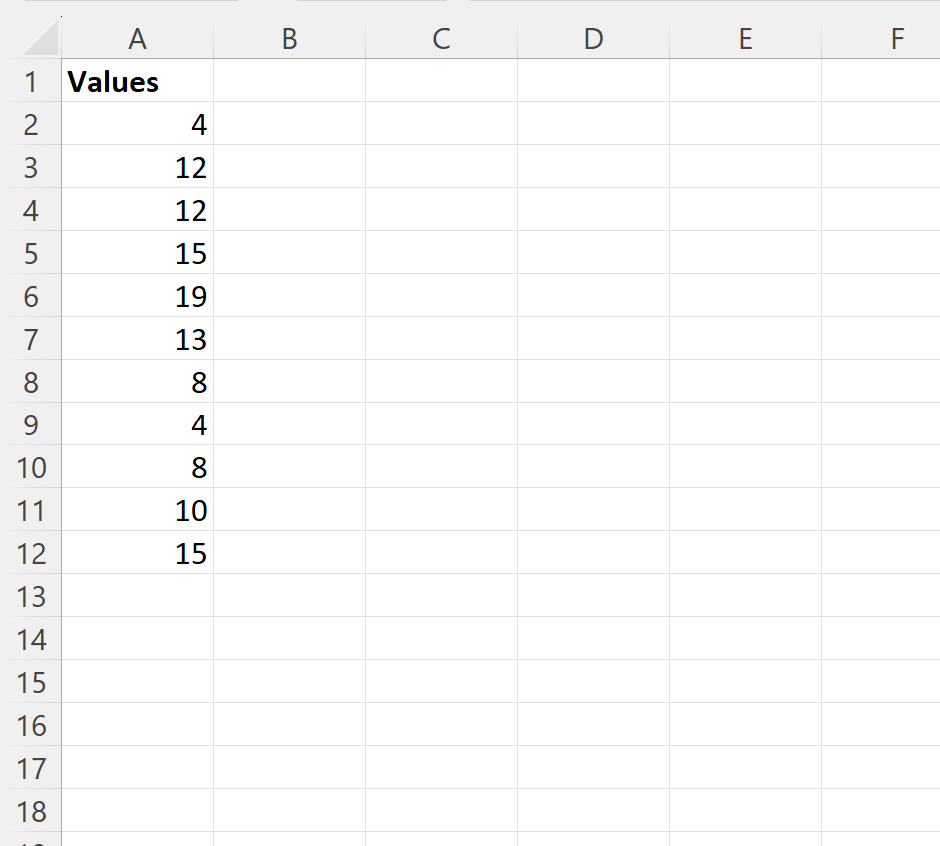
لتوضيح التباين الجوهري بين المفهومين في التطبيق العملي، لنفترض وجود عمود بيانات في إكسيل يمثل أسماء المندوبين المشرفين على مناطق بيعية معينة، ويتضمن المدخلات التالية بالتتابع: [“خالد”، “أحمد”، “خالد”، “سارة”، “فاطمة”، “أحمد”]. إذا طبق الباحث منطق الاستخلاص الفريد الصارم (Unique strictly)، فإن النتيجة ستقتصر على: [“سارة”، “فاطمة”]، حيث استُبعد “خالد” و”أحمد” تماماً لتكرار كل منهما مرتين. أما إذا طبق منطق استخراج القيم المميزة (Distinct)، فإن القائمة المستخلصة ستضم: [“خالد”، “أحمد”، “سارة”، “فاطمة”]، حيث تم الإبقاء على ظهور واحد لكل اسم تواجد في العمود الأصلي.
إن الخلط المفاهيمي بين هذين المسارين يقود إلى أخطاء فادحة في تفسير المؤشرات الإحصائية؛ فاستخدام دالة ترجع القيم الفريدة بدلاً من المميزة عند بناء قائمة العملاء سيؤدي إلى استبعاد أفضل العملاء وأكثرهم ولاءً بحجة أنهم كرروا عمليات الشراء، بينما استخدام القيم المميزة عند فحص التكرارات غير المصرح بها سيعمي بصر المحقق عن حقيقة تكرار القيود. لذا، فإن الإدراك النظري الواعي لهذا التباين يمثل خطوة وقائية إلزامية قبل تطبيق أي معادلة أو أداة برمجية داخل بيئة إكسيل، لحماية النتائج من التفسير الخاطئ والانحيازات التحليلية غير المبررة.
3. استخراج القيم المميزة باستخدام دالة UNIQUE الديناميكية
3.1 البنية التركيبية والمعاملات المحددة لدالة UNIQUE
تعد دالة UNIQUE إحدى أبرز الإضافات البرمجية التي أحدثت ثورة في بنية الحسابات داخل مايكروسوفت إكسيل مع إطلاق محرك المصفوفات الديناميكية. تعمل هذه الدالة بصورة غير مدمرة (Non-destructive) وتعتمد على الصيغة العامة المحددة كالتالي:
=UNIQUE(array, [by_col], [exactly_once])
حيث تتولى المعاملات والوسائط المختلفة توجيه سلوك الدالة بدقة حسابية عالية وفق الضوابط التالية:
- array: تمثل النطاق الأساسي أو المصفوفة المستهدفة بالمعالجة، وتكون غالباً عموداً مفرداً أو عدة أعمدة متجاورة يراد تدقيقها.
- [by_col]: وسيطة اختيارية تأخذ قيمة منطقية؛ حيث تمثل القيمة الافتراضية
FALSEالمقارنة عبر الصفوف (وهو النمط المعياري للتعامل مع الأعمدة الرأسية)، في حين تستخدم القيمةTRUEعندما يراد استخراج القيم المميزة عبر مصفوفة أفقية من الأعمدة. - [exactly_once]: وسيطة اختيارية محورية تحسم التمييز المفاهيمي؛ حيث تعني القيمة الافتراضية
FALSEاسترجاع كافة القيم المميزة (Distinct Values) بحيث يظهر كل عنصر لمرة واحدة، بينما تؤدي القيمةTRUEإلى استرجاع القيم الفريدة فقط (Unique Values) التي لم تتكرر قط داخل النطاق المصدر.
3.2 خطوات التطبيق العملي على عمود بيانات مفرد
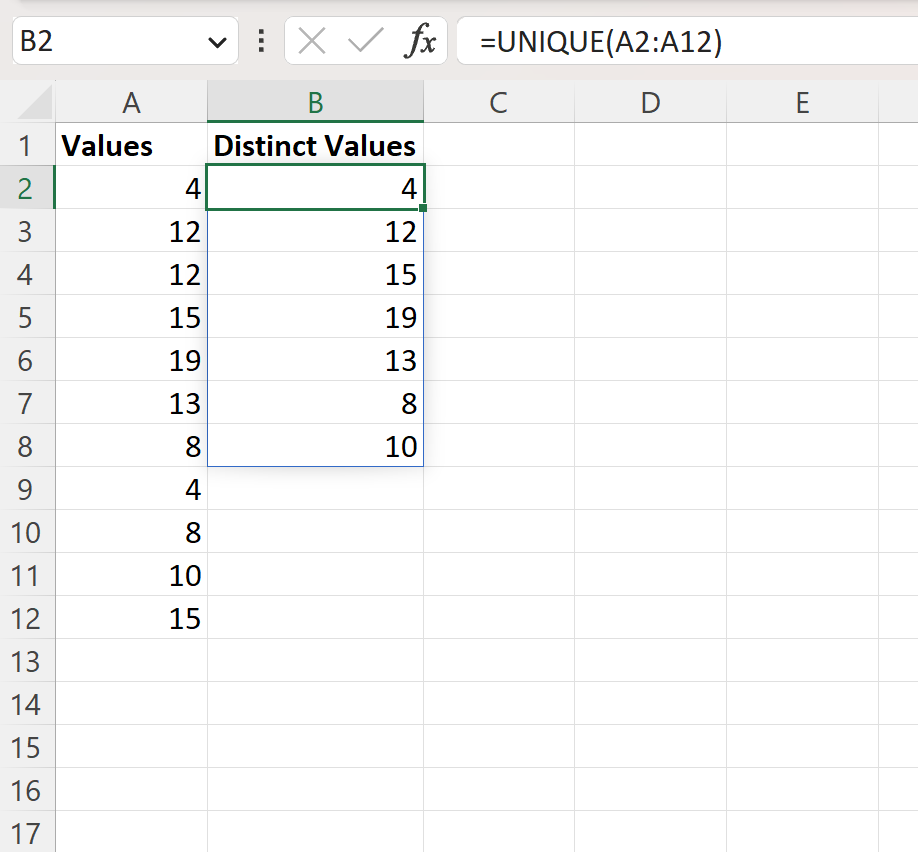
لتطبيق دالة UNIQUE لاستخلاص القيم المميزة من عمود مفرد، يبدأ المحلل باختيار خلية إخراج فارغة تماماً تقع في عمود مستقل، مثل الخلية C2، بافتراض أن البيانات الأولية تشغل النطاق من A2 إلى A100. يقوم المستخدم بكتابة الصيغة الرياضية التالية مباشرة:
=UNIQUE(A2:A100)
بمجرد الضغط على مفتاح الإدخال (Enter)، تتجلى قدرة المحرك الديناميكي الحديث؛ حيث تتمدد النتائج تلقائياً نحو الأسفل عبر ما يعرف بخاصية “الانسكاب” (Spill)، دون الحاجة إلى تحديد مسبق لحجم النطاق المستهدف أو استخدام التركيبات القديمة لمفاتيح المصفوفات.
يتميز هذا الإجراء بالحفاظ الكامل والشامل على سلامة النطاق الأولي؛ إذ تبقى البيانات في العمود A كما هي دون حذف أو تعديل، مما يوفر بيئة تحليلية آمنة تتيح متابعة التغيرات ومقارنة المخرجات المستخلصة مع المصدر الخام. وعلاوة على ذلك، تتميز هذه المخرجات بالديناميكية التامة؛ فإذا تم تعديل أي قيمة داخل النطاق A2:A100 أو تم استبدالها بمدخل جديد، تنعكس التغييرات فورياً ولحظياً في مصفوفة النتائج المستخلصة في العمود C، مما يضمن تدفقاً تحليلياً متواصلاً وخالياً من الأخطاء التشغيلية اليدوية.
3.3 التعامل مع سلوك المصفوفات وخطأ الانسكاب (#SPILL!)
على الرغم من المرونة الاستثنائية لمحرك المصفوفات الديناميكية، إلا أن هناك تحديات إجرائية ترتبط بسلوك تدفق النتائج، ويأتي في مقدمتها ظهور خطأ الانسكاب الشهير #SPILL!. ينشأ هذا الخطأ عندما يعترض مسار تمدد المصفوفة أي عائق مادي داخل ورقة العمل؛ مثل وجود نص مدخل، أو معادلة أخرى، أو خلية مدمجة (Merged Cell) في إحدى الخلايا الواقعة ضمن المدى الذي تسعى الدالة إلى إشغاله تلقائياً. لحل هذا الإشكال، يتعين على المحلل تحديد الخلية التي تحتوي على الخطأ؛ حيث سيظهر إطار منقط يحدد النطاق المتوقع للانسكاب، ويجب عندها إخلاء هذا النطاق كلياً بحذف المحتويات المعيقة أو نقلها، لتتدفق البيانات فوراً وتزول رسالة الخطأ الحسابي.
إضافة إلى ذلك، وفرت مايكروسوفت أداة مرجعية متقدمة للإشارة إلى المصفوفات المنسكبة في العمليات الحسابية اللاحقة، وذلك باستخدام رمز التجزئة أو الوسم (Spill Range Operator: #). فإذا كانت الدالة مكتوبة في الخلية C2 وتنسكب حتى C15، يمكن للمحلل كتابة صيغ لاحقة تعتمد على هذه المصفوفة المستخلصة بكتابة =C2# فقط دون الحاجة لتحديد المدى الثابت C2:C15. هذه الإمكانية تتيح إدماج النتائج في دوال أخرى بسهولة فائقة، مثل فرز القيم المميزة تلقائياً عبر تركيب الدالة: =SORT(UNIQUE(A2:A100))، مما يولد قائمة مميزة ومفرزة أبجدياً أو رقمياً بحركة برمجية واحدة وأنيقة.
4. استخدام أداة إزالة التكرارات المدمجة (Remove Duplicates)
4.1 الآلية الوظيفية لأداة إزالة التكرار في تبويب البيانات
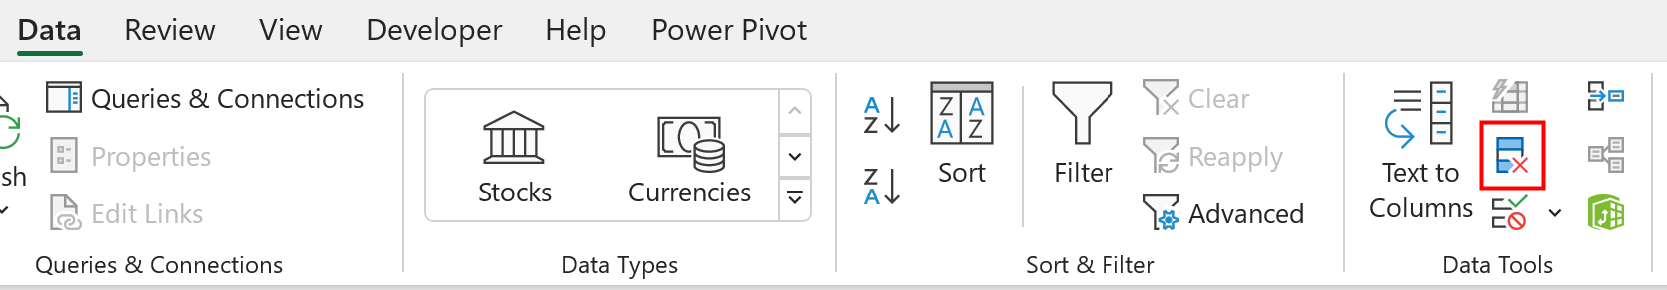
تمثل أداة إزالة التكرارات (Remove Duplicates) خياراً ساكناً ومباشراً مضمناً بصورة أصلية في واجهة إكسيل الرسومية منذ إصدار عام 2007، حيث تقع ضمن تبويب “بيانات” (Data) في قسم “أدوات البيانات” (Data Tools). تعتمد هذه الأداة على آلية مسح خطية تفحص النطاق المحدد أو الجدول بأسره، وتقوم بحذف السجلات المكررة بصورة دائمة ومباشرة من موقعها فيزيائياً، مع الإبقاء على الظهور الأول لكل قيمة كما ورد في الترتيب الرأسي للمصفوفة الأصلية، وإلغاء كافة الظهورات اللاحقة المتطابقة مع ذلك الظهور.
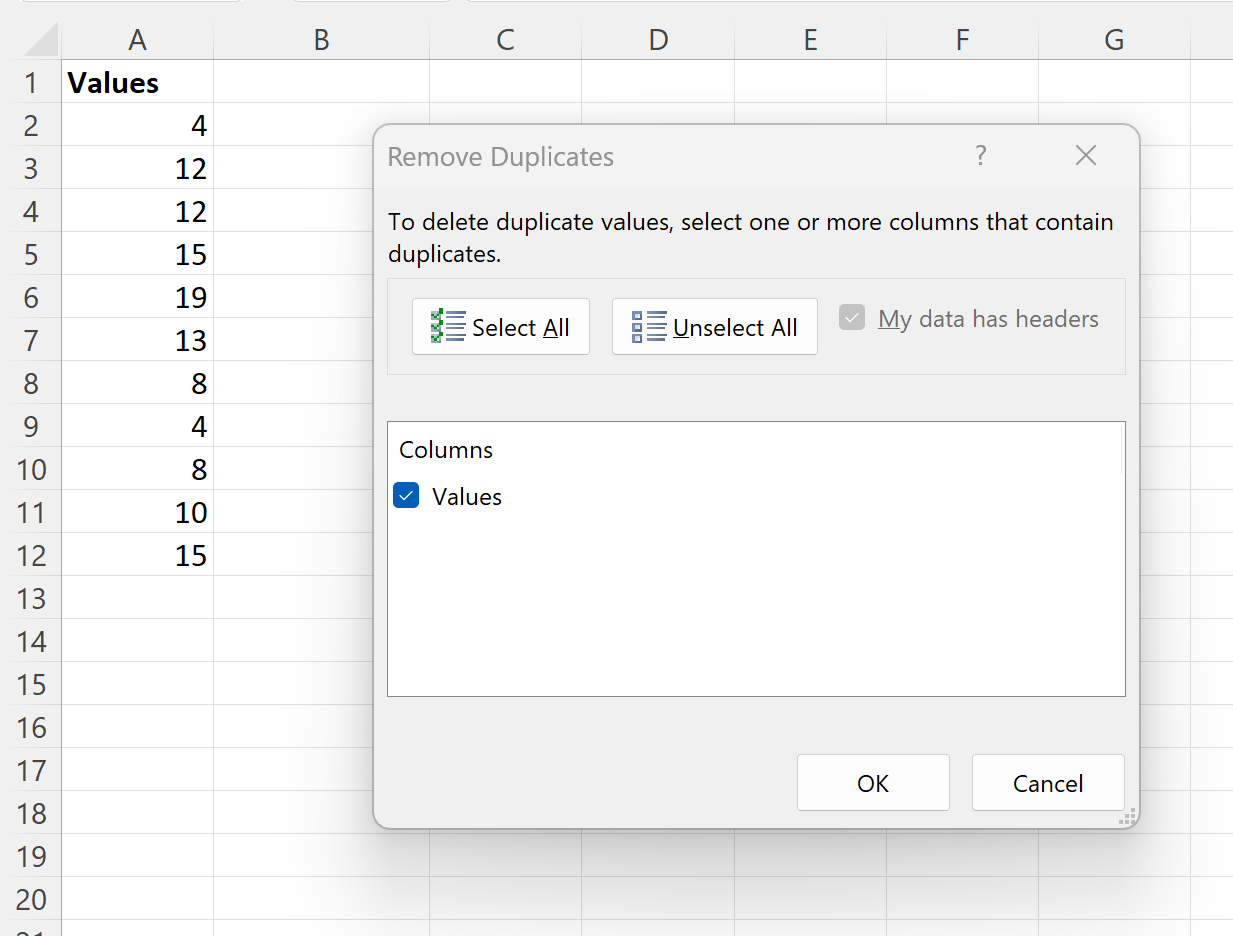
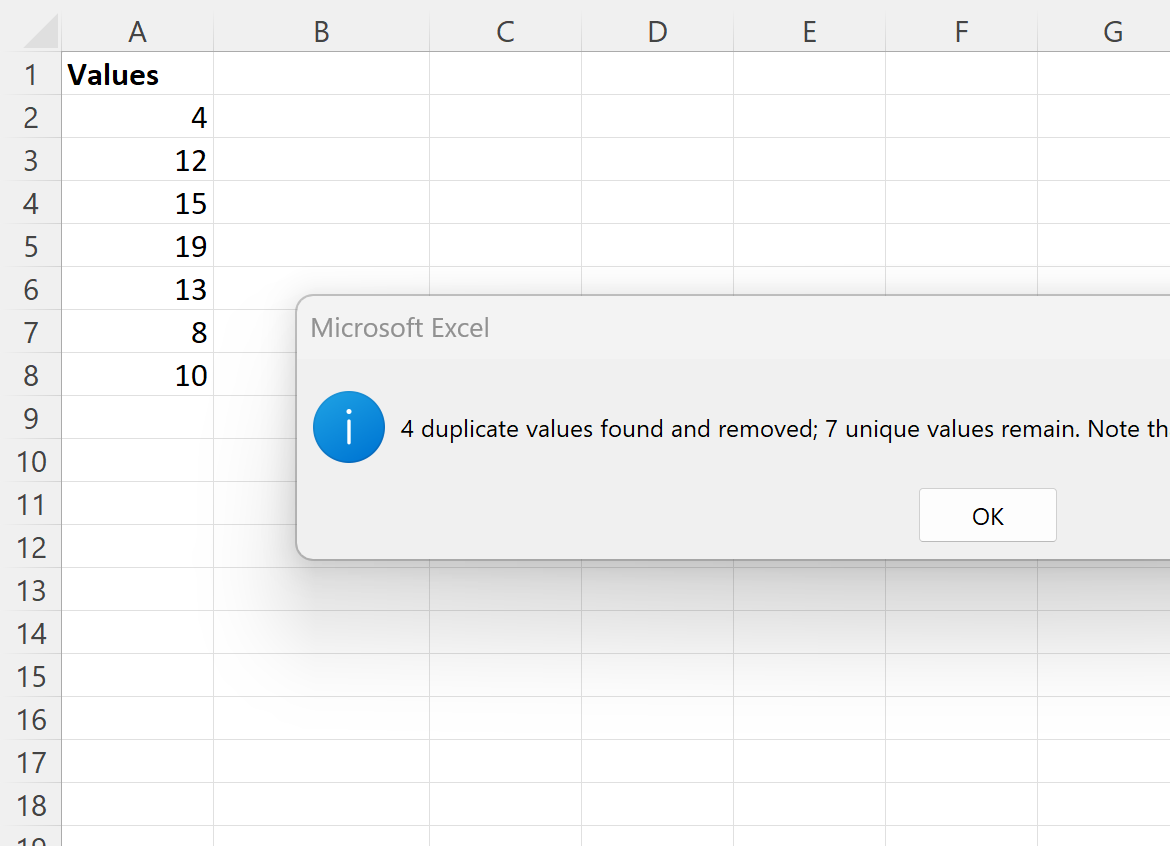
عند النقر على الأداة، تظهر نافذة تحكم تتيح للمستخدم تحديد ما إذا كانت البيانات تحتوي على صف للرؤوس (My data has headers)؛ وهو خيار ذو أهمية قصوى لمنع معاملة اسم العمود كقيمة نصية عادية قد تتعرض للحذف أو التداخل مع السجلات. وبمجرد المصادقة على تنفيذ الإجراء، يقوم محرك إكسيل بإجراء عمليات المقارنة المتتالية، ثم يعرض نافذة تقرير رقمية موجزة توضح بشكل دقيق ومحدد عدد القيم أو الصفوف المكررة التي تم العثور عليها وحذفها نهائياً، إلى جانب عدد القيم المميزة المتبقية داخل ورقة العمل، مما يوفر توثيقاً فورياً للأثر العددي لعملية التنظيف المجراة.
4.2 خطوات التنفيذ الإجرائية مع حماية البيانات الأصلية
نظراً لطبيعة هذه الأداة الهدامة (Destructive Method) التي تغير بنية البيانات بصورة لا تقبل الاسترجاع بمجرد إغلاق الملف، يتوجب اتباع بروتوكول إجرائي صارم لحماية البيانات المصدرية. تبدأ الخطوات بنسخ العمود المراد استخلاص قيمه المميزة ولصقه في عمود جديد منفصل أو في ورقة عمل مستقلة مخصصة للمعالجة والتنقية. هذا الفصل العازل يضمن بقاء السجل التاريخي الأولي سليماً ومتاحاً للتدقيق والمراجعة، ويمنع أي فقدان عرضي للمعلومات المتصلة بالسجلات المتجاورة في قواعد البيانات متعددة الحقول.
بعد لصق العمود في موقعه المعزول، يحدد المحلل كامل النطاق الجديد، ثم يتوجه إلى تبويب Data ويختار Remove Duplicates. في حال كان العمود المستهدف محاذياً لأعمدة أخرى غير منسوخة، سيظهر تحذير استباقي يسأل المستخدم عما إذا كان يرغب في توسيع نطاق التحديد (Expand the selection) ليشمل البيانات المجاورة، أو الاقتصار على النطاق المحدد حالياً (Continue with the current selection). لحماية مصفوفة العمود الفردي وعزل قيمه المميزة حصراً، يختار المستخدم الخيار الثاني، ثم يضغط زر التأكيد. وبذلك تثبت النتائج النهائية في مظهرها غير المكرر والمستقل تماماً عن أي ارتباطات سياقية أخرى.
4.3 المحددات المنهجية والمخاطر المترتبة على استخدام الأداة
على الرغم من بساطة وسرعة أداة إزالة التكرارات، إلا أنها محفوفة بالعديد من المخاطر والمحددات التشغيلية التي تقلل من ملاءمتها في بيئات التحليل الإحصائي المتقدمة ومشاريع المعالجة المعقدة. يكمن الخطر الأكبر في فقدان المسار التراجعي للبيانات؛ ففي حال نسيان أخذ النسخة الاحتياطية وإجراء الحذف، يُحرم المحلل من مراجعة السياق الذي جاءت فيه القيود المكررة أو تقييم ما إذا كان التكرار ناتجاً عن خلل منهجي في القياس أو تشابه عارض بين حالات مستقلة بالفعل.
يتمثل المحدد المنهجي الثاني في انعدام الديناميكية؛ فالنتائج المستخلصة عبر هذه الأداة تعد مخرجات ساكنة ومتجمدة لحظياً (Static Snapshots). إذا تم إدخال سجلات جديدة في ورقة البيانات الأصلية في وقت لاحق، فلن يتم تحديث قائمة القيم المميزة تلقائياً، بل سيضطر المحلل إلى إعادة تنفيذ كافة الخطوات اليدوية مراراً وتكراراً، مما يرفع احتمالية الخطأ البشري ويهدر الوقت المخصص للتحليل الفعلي. لذا، لا يُنصح باستخدام هذه الوسيلة في لوحات القيادة التفاعلية (Dashboards) أو خطوط إنتاج التقارير المحدثة دورياً، بل يُقتصر استخدامها على المعالجات السريعة لمرة واحدة فقط (Ad-hoc tasks).
5. تطبيق التصفية المتقدمة (Advanced Filter) لاستخلاص السجلات
5.1 المتطلبات المسبقة لإعداد العمود المراد تصفيته
تمثل أداة التصفية المتقدمة (Advanced Filter) في إكسيل واحدة من أقدم وأقوى تقنيات التصفية غير التدميرية، حيث ظلت لعقود طويلة الحل المعياري المفصل قبل إدخال الدوال الديناميكية الحديثة. لتحقيق النجاح التشغيلي الكامل لهذه الأداة، تتطلب العملية استيفاء متطلبات إعداد مسبقة ذات طابع هيكلي دقيق؛ حيث يجب في المقام الأول التأكد من احتواء العمود المستهدف على صف رأس واضح ومحدد وفريد نصياً، إذ إن محرك التصفية المتقدمة يعتمد على تسمية الرأس لتعريف حدود السجلات ومنع اختلاط العناوين بالمدخلات العادية.
كما يشترط الإعداد الهندسي للنطاق خلوه تماماً من الخلايا المدمجة (Merged Cells)، والتي تتسبب حتماً في تعطيل مصفوفات المقارنة وإرجاع نتائج ناقصة أو غير صحيحة. وإلى جانب ذلك، يتعين على المحلل تحديد الموقع الجغرافي المسبق الذي ستنقل إليه السجلات المستخلصة داخل ورقة العمل النشطة؛ مع مراعاة أن التصفية المتقدمة تتطلب تشغيل الإجراء انطلاقاً من ورقة العمل المستهدفة باللصق في حال كان النقل سيتم عبر أوراق عمل مختلفة، لتجنب قيود الأمان البرمجية التي تمنع تصدير النتائج عبر أوراق منفصلة عند انطلاق الأمر من ورقة المصدر.
5.2 إجراءات التصفية وتفعيل خيار السجلات الفريدة فقط
لتنفيذ استخراج القيم المميزة عبر هذا المسار، يتبع المحلل تسلسلاً إجرائياً منظماً يبدأ بالانتقال إلى تبويب “بيانات” (Data)، ومن ثم اختيار أمر “متقدم” (Advanced) الموجود ضمن مجموعة الفرز والتصفية (Sort & Filter). يؤدي هذا الإجراء إلى فتح مربع الحوار الخاص بالتصفية المتقدمة، والذي يتضمن خيارات تحكم تفصيلية في تدفق البيانات. في أعلى النافذة، يحدد المستخدم خيار “نسخ إلى موقع آخر” (Copy to another location)، وهو الاختيار الضامن لبقاء البيانات المصدرية كما هي دون المساس بترتيبها الأصلي أو إخفاء صفوفها.
في الحقل المسمى “نطاق القائمة” (List range)، يتم إدراج نطاق العمود شاملاً صف الرأس (مثل A1:A100). يُترك حقل “نطاق المعايير” (Criteria range) فارغاً تماماً في هذه الحالة، نظراً لأن الهدف هو التجريد الشامل دون شروط إضافية. وفي حقل “النسخ إلى” (Copy to)، يُحدد مرجع الخلية العلوية في النطاق الجديد المستهدف (مثل C1). والخطوة الحاسمة والجوهرية في هذا الإجراء تكمن في تفعيل والتأشير الإلزامي على مربع الاختيار المعنون “السجلات الفريدة فقط” (Unique records only). وبمجرد النقر على زر “موافق”، يتم استخلاص كافة القيم المميزة وإدراجها كقائمة جديدة خالية من أي تكرار.
5.3 مزايا استخدام التصفية المتقدمة في الإصدارات القديمة
تتمتع التصفية المتقدمة بمكانة رفيعة في أوساط المطورين ومحللي النظم الذين يتعاملون مع بيئات عمل تقنية متنوعة ومتفاوتة الإصدارات؛ إذ تبرز ميزتها الكبرى في توافقيتها الشاملة والمطلقة مع كافة إصدارات مايكروسوفت إكسيل التاريخية والحديثة على حد سواء (من إصدارات Excel 97 القديمة وحتى Microsoft 365)، دون التعرض لأي قيود برمجية أو رسائل خطأ ترتبط بعدم التعرف على الدوال الحديثة عند فتح المصنف في أجهزة أخرى.
إلى جانب ذلك، توفر التصفية المتقدمة حلاً سريعاً وعالي الكفاءة لا يستهلك موارد المعالج الحسابية في عمليات إعادة الحساب المستمرة التي قد تفرضها الدوال التقليدية المعقدة في مجموعات البيانات الكبيرة. كما تتيح الأداة، عند الحاجة، مرونة استثنائية في الجمع المتزامن بين استخراج القيم المميزة وتطبيق معايير فرز وتصفية شرطية معقدة (عبر تحديد نطاق معايير criteria range مسبق)، مما يجعلها أداة مرنة للغاية للمهام التخصصية السريعة والتقارير المستقرة غير المتغيرة باستمرار.
6. استخراج القيم المميزة عبر الجداول المحورية (Pivot Tables)
6.1 هيكلة الجدول المحوري لعزل المتغيرات المكررة
تعد الجداول المحورية (Pivot Tables) من أضخم محركات التجميع الإحصائي المضمنة في إكسيل، وتتميز بقدرتها الفطرية على دمج السجلات المتطابقة وعزل المتغيرات المكررة كجزء أساسي من فلسفتها التصميمية المبنية على تجميع الفئات المتشابهة. لاستخراج القيم المميزة، يبدأ المحلل بتحديد نطاق العمود المصدر بالكامل، ثم يتوجه إلى تبويب “إدراج” (Insert) ويختار “جدول محوري” (PivotTable)، مع تحديد موضع إدراجه في ورقة عمل جديدة أو ضمن ورقة العمل الحالية.
بمجرد ظهور نافذة حقول الجدول المحوري (PivotTable Fields)، يقوم المستخدم بسحب اسم العمود المعني وإسقاطه حصراً في منطقة “الصفوف” (Rows)، مع الإبقاء على منطقة “القيم” (Values) فارغة في حال كان الهدف هو مجرد استخراج القائمة النصية المجردة. بحكم الطبيعة الوظيفية للجداول المحورية، يقوم المحرك بمسح كافة السجلات وضغط آلاف القيود المتكررة، ليعرض كل قيمة مميزة في صف مستقل لمرة واحدة فقط، مما يحول على الفور تدفق البيانات المعقد إلى قائمة تصنيفية محكمة ونقية من أي شوائب تكرارية.
6.2 توظيف نموذج البيانات (Data Model) لقياس العدد المميز
في كثير من الحالات التحليلية، لا يقتصر الهدف على استخلاص أسماء القيم المميزة فحسب، بل يتعداه إلى قياس التكرار النسبي أو إجراء ما يعرف إحصائياً بـ “العد المميز” (Distinct Count). لتحقيق هذا الغرض الاحترافي، يجب التأشير بعناية على خيار “إضافة هذه البيانات إلى نموذج البيانات” (Add this data to the Data Model) أثناء مربع الحوار الأولي لإنشاء الجدول المحوري، وهي ميزة متوفرة منذ إصدار إكسيل 2013 وتعتمد على محرك تحليل الذاكرة المتقدم (xVelocity Engine المعروف مسبقاً بـ Power Pivot).
عند تفعيل هذا الخيار ووضع العمود في منطقة الصفوف، يمكن للمحلل سحب حقل فرعي أو الحقل ذاته إلى منطقة “القيم” (Values)، ثم النقر فوق الحقل المضاف واختيار “إعدادات حقل القيمة” (Value Field Settings). عبر التمرير إلى أسفل قائمة الدوال التلخيصية، تظهر الدالة الحسابية المتقدمة “Distinct Count”. يوفر هذا الإجراء قياساً كمياً رصيناً يجمع بين استخراج القوائم وتحديد عدد العناصر المتمايزة التابعة لكل تصنيف فرعي، مما يتيح دراسة التوزيعات التكرارية للعينات بدرجة متناهية من الدقة والعمق الرياضي.
6.3 إدارة تحديث البيانات والمزامنة الدورية للنتائج
من أهم السمات المنهجية لاستخدام الجداول المحورية هي قدرتها على التوفيق بين استقرار البيانات وسهولة المزامنة؛ فالجدول المحوري ينشئ نسخة ذاكرة وسيطة تسمى “ذاكرة التخزين المؤقت للمحور” (Pivot Cache)، مما يمنع بطء الحساب التلقائي المستمر. وعند إضافة سجلات جديدة أو تعديل البيانات في العمود المصدر، يكفي النقر بزر الفأرة الأيمن داخل الجدول واختيار “تحديث” (Refresh)، أو النقر على اختصار لوحة المفاتيح Alt + F5، ليعيد المحرك فحص العمود واستيعاب أي قيم مميزة جديدة ظهرت في المصدر.
كما تتيح الجداول المحورية خيارات تنسيق وفرز فورية عبر القوائم المنسدلة في خلايا النتائج، مما يسمح بترتيب القيم المستخلصة تصاعدياً أو تنازلياً بنقرة زر واحدة. وعند الرغبة في استخدام هذه المخرجات كنطاق بيانات تقليدي لتغذية أدوات أخرى، يمكن تحديد عمود المخرجات بالكامل واستخدام خيار “نسخ”، ثم “لصق كقيم” (Paste as Values) في عمود مستقل، مما يفك الارتباط المؤقت مع محرك الجدول المحوري ويوفر مصفوفة قيم مميزة نهائية وقابلة لإعادة الاستخدام في التحليلات الإحصائية المستقلة.
7. استخدام محرر الاستعلامات Power Query للتحويل والتصفية
7.1 استيراد بيانات العمود إلى بيئة Power Query
يمثل محرر الاستعلامات Power Query (المعروف في تبويب البيانات بـ “الحصول على البيانات وتحويلها” – Get & Transform Data) الأداة الأقوى والأكثر تطوراً على المستوى المؤسسي للتعامل مع دورة حياة استخراج وتحويل وتحميل البيانات (ETL). لبدء العملية، يقوم المحلل بتحويل العمود المستهدف إلى جدول إكسيل رسمي عبر اختصار Ctrl + T، ثم يتوجه إلى تبويب “بيانات” (Data) وينقر على خيار “من ورقة العمل / النطاق” (From Sheet/Range). يؤدي هذا الإجراء إلى تشغيل واجهة Power Query المعزولة تماماً عن ورقة العمل المادية.
داخل محرر الاستعلامات، تُعرض البيانات في مصفوفة نقية، ويقوم المحرك تلقائياً بتعيين نوع البيانات (Data Type) للعمود (كنص، أو رقم صحيح، أو تاريخ). يعد التحقق من تعيين النوع البياني الصحيح خطوة إلزامية في هذه المرحلة؛ إذ إن إكسيل في بيئة Power Query يعتمد على لغة M الصارمة، والتي تفرق بين الرقم المخزن كنص والرقم المخزن كقيمة عددية، مما يضمن أن تتم عمليات التصفية على أساس منطقي متسق يمنع تكرار القيم ذات المظاهر المتباينة شكلياً والمتطابقة جوهرياً.
7.2 تطبيق أمر إزالة التكرارات داخل الاستعلام
بمجرد تهيئة العمود داخل الواجهة، تصبح عملية استخلاص القيم المميزة خطوة مباشرة وفائقة القوة؛ حيث يكتفي المحلل بالنقر بزر الفأرة الأيمن على رأس العمود المستهدف واختيار الأمر المباشر “إزالة التكرارات” (Remove Duplicates)، أو الوصول إليه من التبويب الرئيسي Home عبر مسار: Remove Rows ثم Remove Duplicates. في هذه اللحظة، يقوم المحرك بمسح كافة السجلات في ثوانٍ معدودة وحذف التكرارات بناءً على بنية استعلامية ثابتة تسجل كخطوة في لوحة “خطوات مطبقة” (Applied Steps).
تجدر الإشارة إلى حقيقة تقنية بالغة الأهمية تتعلق ببيئة Power Query، وهي أن محرك الاستعلام ولغة M يتميزان بحساسية افتراضية لحالة الأحرف (Case Sensitive) عند معالجة النصوص اللاتينية؛ مما يعني أن كلمتي “Excel” و”excel” ستُعاملان كقيمتين مميزتين مختلفتين، على عكس سلوك إكسيل التقليدي في أوراق العمل. وإذا رغب المحلل في توحيد هذه المدخلات كقيمة مميزة واحدة بصرف النظر عن حالة الأحرف، يتعين عليه إضافة خطوة تحويل استباقية بالنقر بزر الفأرة الأيمن واختيار “تحويل” (Transform) ثم تحويل النص بالكامل إلى أحرف كبيرة (UPPERCASE) أو صغيرة (lowercase) قبل تطبيق أمر إزالة التكرارات.
7.3 تحميل البيانات المستخلصة وإنشاء مسار تدفق مؤتمت
بعد الانتهاء من تصفية العمود واقتصاره على القيم المميزة النقية، ينتقل المحلل إلى مرحلة تصدير النتائج عبر النقر على زر “إغلاق وتحميل” (Close & Load) واختيار “إغلاق وتحميل إلى…” (Close & Load To…). تتيح هذه النافذة تحديد كيفية إدراج البيانات وموقعها، حيث يفضل اختيار إدراجها كجدول (Table) في ورقة عمل جديدة أو في موضع محدد من ورقة العمل الحالية، مع إمكانية ربطها بنموذج بيانات المصنف.
تكمن العبقرية الهندسية لاستخدام Power Query في بناء مسارات مؤتمتة بالكامل وقابلة للتكرار اللانهائي (Automated Data Pipelines). إن الخطوات المسجلة بلغة M تظل مخزنة في خلفية المصنف؛ فإذا تغيرت بيانات العمود الأصلي، أو تم لصق آلاف السجلات الجديدة غداً، فلن يحتاج المستخدم لإعادة أي من خطوات التصفية، بل يكتفي بالضغط على “تحديث الكل” (Refresh All) من تبويب البيانات، ليعيد محرك الاستعلام سحب البيانات الخام وتطبيق خطوات التحويل وإزالة التكرارات وتحديث مصفوفة المخرجات بصورة آنية، مما يجعله الحل القياسي المفضل في المنشآت المؤسسية والمشاريع التحليلية المستدامة.
8. الصيغ التقليدية القديمة لاستخراج القيم المميزة
8.1 تركيب دالتي INDEX و MATCH مع الدالة الإحصائية COUNTIF
قبل الثورة التقنية للمصفوفات الديناميكية وظهور دالة UNIQUE، كان استخراج القيم المميزة عبر المعادلات يتطلب بناء صيغ تركيبية معقدة للغاية تعتمد على التضافر الوظيفي بين دوال الفهرسة والبحث والإحصاء الشرطي. يقوم هذا النمط التقليدي على توظيف ثلاث دوال أساسية: دالة INDEX لاسترجاع القيمة، ودالة MATCH لتحديد موقع أول ظهور، ودالة COUNTIF لتتبع القيم التي تم استخراجها مسبقاً وتجاوزها تدريجياً.
البنية التركيبية القياسية لهذه المعادلة، بافتراض أن البيانات المصدرية تشغل النطاق من $A$2:$A$10 وأن الإخراج سيبدأ من الخلية C2، تتخذ الشكل الرياضي التالي:
=INDEX($A$2:$A$10, MATCH(0, COUNTIF($C$1:C1, $A$2:$A$10), 0))
يقوم المنطق الحسابي هنا على استخدام النطاق المتمدد $C$1:C1 داخل دالة COUNTIF؛ حيث تفحص الدالة ما إذا كانت قيم النطاق الأصلي قد ظهرت في الخلايا المستخرجة سابقاً في العمود C. تُرجع COUNTIF مصفوفة من الأصفار والآحاد، حيث يمثل الصفر أول قيمة في النطاق A لم تظهر بعد في النطاق C. بعد ذلك، تبحث دالة MATCH عن أول ظهور للقيمة 0 بدقة تامة، لتمرر موضع الصف المكتشف إلى دالة INDEX التي تقوم فوراً باسترداد النص المقابل وإدراجه في الخلية الحالية.
8.2 معالجة نطاقات الإدخال باستخدام مفاتيح Ctrl + Shift + Enter
نظراً لأن هذه الصيغة تتعامل مع مصفوفة كاملة من الحسابات داخل دالة COUNTIF بدلاً من وسيطة فردية، فإن إصدارات إكسيل الكلاسيكية السابقة لإصدار 2020 لا تستطيع معالجتها عبر مفتاح الإدخال العادي (Enter)، بل تتطلب إلزامياً تفعيل نمط صيغ المصفوفات القديمة (CSE Formulas) عبر الضغط المتزامن على مفاتيح لوحة المفاتيح: Ctrl + Shift + Enter. عند تطبيق هذا الاختصار بنجاح، يُحيط إكسيل المعادلة تلقائياً بأقواس معقوفة من النمط {...} كدلالة برمجية على دخول الصيغة في معمارية الحساب المصفوفي.
بعد إدخال المعادلة بنجاح في الخلية الأولى C2، يقوم المحلل بسحب مقبض التعبئة (Fill Handle) رأسياً نحو الأسفل لملء باقي الخلايا بالقيم المميزة المتتالية. وعند استنفاد كافة القيم المميزة الموجودة في النطاق A، ستعجز دالة MATCH عن إيجاد القيمة 0، مما يؤدي إلى توليد خطأ القيمة غير المتاحة (#N/A). لمعالجة هذا المظهر السلبي وضمان المظهر الأكاديمي المتقن للورقة، تُدمج الدالة الوقائية IFERROR لتطويق المعادلة بالكامل بالشكل التالي:
=IFERROR(INDEX($A$2:$A$10, MATCH(0, COUNTIF($C$1:C1, $A$2:$A$10), 0)), "")
مما يضمن إرجاع فراغ نصي نقي بدلاً من رسائل الخطأ الحسابية بمجرد اكتمال استخلاص القائمة المميزة.
8.3 تقييم الكفاءة الحسابية والأداء مقارنة بالدوال الحديثة
على الرغم من البراعة الفكرية التي تميز هذه الصيغ المصفوفية الكلاسيكية، إلا أن تقييم كفاءتها الحسابية يظهر عيوباً هيكلية جسيمة في مقاييس الأداء والأمان البرمجي. يكمن القصور الأكبر في التعقيد الحسابي الذي يتبع التعقيد التربيعي المتصاعد $O(N^2)$؛ ففي كل خلية جديدة يتم ملؤها في عمود الإخراج، تضطر دالة COUNTIF إلى إعادة فحص مصفوفة الإدخال كاملة ومقارنتها بكافة النتائج السابقة. في مجموعات البيانات الكبيرة التي تحتوي على عشرات الآلاف من الصفوف، يؤدي هذا العبء إلى تجميد معالج الحاسوب واستنزاف ذاكرة الوصول العشوائي (RAM)، مما يجعل فتح المصنف أو تعديله عملية شاقة وبطيئة للغاية.
يضاف إلى ذلك تدني قابلية الصيانة وتدقيق المعادلات (Formula Auditing)؛ إذ يجد معظم المستخدمين وصناع القرار صعوبة بالغة في فك تشفير هذا التركيب المعقد في حال حدوث خطأ أو عند الرغبة في توسيع نطاق البيانات ليشمل صفوفاً جديدة. ومن ثم، فإن الممارسة الأكاديمية والمهنية الرشيدة توصي بالابتعاد التام عن هذه الصيغ في العصر الحالي، وحصر اللجوء إليها في حدود بيئات العمل المعزولة التي تفرض العمل على إصدارات أثرية من إكسيل تفتقر إلى محرك المصفوفات الديناميكية ومحرر الاستعلامات Power Query.
9. أتمتة استخراج القيم المميزة بواسطة لغة Visual Basic for Applications (VBA)
9.1 استخدام كائن القاموس (Scripting.Dictionary) البرمجي
توفر لغة البرمجة المدمجة Visual Basic for Applications (VBA) بيئة احترافية متقدمة لأتمتة العمليات التحليلية وبناء إجراءات فائقة السرعة تتجاوز حدود الواجهات التقليدية. في سياق استخراج القيم المميزة، يمثل كائن القاموس Scripting.Dictionary – المنبثق عن مكتبة مايكروسوفت لنصوص وقت التشغيل (Microsoft Scripting Runtime) – الأداة البرمجية الأكثر كفاءة وأناقة هندسية على الإطلاق، نظراً لاعتماده على خوارزميات جداول التجزئة (Hash Tables) التي توفر زمناً حسابياً شبه خطي $O(N)$ لإتمام عمليات البحث والمقارنة.
تستند الفلسفة البنيوية لكائن القاموس إلى مبدأ رياضي صارم: لا يمكن لكائن القاموس أن يحتوي على مفتاحين متطابقين؛ فكل مفتاح (Key) يجب أن يكون فريداً مطلقاً داخل فهرسه البرمجي. لتطبيق هذا الإجراء، يكتب المطور إجراءً فرعياً (Subroutine) يقوم بقراءة بيانات عمود الإكسيل وتمريرها داخل حلقة تكرارية تفحص كل خلية؛ فإذا لم يكن المفتاح موجوداً في القاموس، يتم إلحاقه فوراً عبر الأمر dict.Add cellValue, Nothing، أما إذا كان المفتاح موجوداً مسبقاً، فإن الكائن يتجاوزه تلقائياً دون تكرار. وفي نهاية الإجراء، يتم تفريغ مصفوفة المفاتيح المستخلصة دفعة واحدة في نطاق الخلايا المستهدف في ورقة العمل باستخدام دالة الإسقاط Transpose السريعة.
9.2 توظيف كائن المجموعات (Collection) كبديل برمجي مباشر
كبديل محلي أصيل لا يتطلب تفعيل مكتبات خارجية أو الارتباط بكائنات نظام التشغيل ويندوز (مما يجعله متوافقاً تماماً مع بيئات العمل على أجهزة ماك Mac)، يمكن للمطور توظيف كائن المجموعات (Collection) الأصيل في لغة VBA. يتشابه كائن المجموعة مع القاموس في خاصية جوهرية: عند إضافة عنصر جديد مع تعيين مفتاح نصي له (Key)، يمنع المحرك البرمجي تكرار ذلك المفتاح، ويولد خطأ وقت التشغيل (Runtime Error 457) إذا تمت محاولة إضافة مفتاح موجود بالفعل.
يوظف المبرمجون هذا السلوك بذكاء عبر تقنية معالجة الأخطاء الاستباقية؛ حيث يتم تضمين عبارة On Error Resume Next قبل حلقة إضافة العناصر إلى المجموعة. عند مواجهة قيمة مكررة، يتجاهل محرك VBA الخطأ المتولد ويكمل دورته نحو السجل التالي بسلاسة. وعلى الرغم من أن كائن المجموعة يفتقر إلى بعض الخصائص المتقدمة المتاحة في القاموس (مثل خاصية التحقق المباشر من وجود المفتاح Exists دون إثارة خطأ، أو استخراج مصفوفة المفاتيح دفعة واحدة)، إلا أنه يوفر حلاً برمجياً أصيلاً وخفيف الوزن وعالي الاعتمادية للمهام الأتمتية متوسطة الحجم، ويتيح فرز العناصر برمجياً قبل طباعتها في خلايا الورقة.
9.3 إنشاء دالة مخصصة (UDF) لإرجاع القيم المميزة
لتحقيق أقصى درجات التكامل بين البرمجة النصية وواجهة المستخدم، يتيح محرك VBA تصميم دوال معرفة من قبل المستخدم (User-Defined Functions – UDF) تعمل تماماً كأي معادلة رياضية مدمجة يمكن كتابتها مباشرة داخل خلايا ورقة العمل. يمكن تصميم دالة مخصصة تحمل اسماً دالاً مثل =GetDistinct(SourceRange)، بحيث تتلقى النطاق المستهدف كمعامل إدخال، وتتولى في خلفيتها البرمجية تدوير العناصر وتنقيتها عبر كائن القاموس أو المجموعة، ثم استرجاع مصفوفة من العناصر غير المكررة.
في الإصدارات الحديثة من إكسيل، تتميز الدوال المخصصة التي ترجع مصفوفات بقدرتها على استغلال محرك الانسكاب الديناميكي تلقائياً، حيث تتدفق نتائج الدالة المخصصة في الخلايا الرأسية المجاورة تماماً كما تفعل دالة UNIQUE الرسمية. ولضمان الأمان والامتثال الأكاديمي، يجب توثيق كود الدالة المخصصة بعناية، وحفظ المصنف بصيغة تدعم وحدات الماكرو (مثل .xlsm أو .xlsb)، والتأكد من توافق إعدادات مركز التوثيق (Trust Center) لتشغيل الأكواد البرمجية البرمجية دون تعريض سلامة الأنظمة الحوسبية لأي مخاطر أمنية غير موثوقة.
10. المقارنة المعيارية، استكشاف الأخطاء، وأفضل الممارسات
10.1 معالجة حساسية حالة الأحرف والمسافات البيضاء الخفية
تواجه عمليات استخراج القيم المميزة وتدقيقها في إكسيل عقبات تقنية دقيقة غالباً ما تؤدي إلى تشويه النتائج وظهور قيم تبدو مكررة بالعين المجردة لكن إكسيل يعاملها كقيم مميزة مستقلة. يتصدر هذه الإشكالات وجود المسافات البيضاء الخفية (Leading and Trailing Spaces)، وهي مسافات فارغة غير مرئية تسبق النص أو تلحقه، وتنشأ غالباً عند تصدير البيانات من أنظمة إدارة قواعد البيانات (DBMS) أو عبر النسخ من صفحات الويب. في هذه الحالة، فإن النص "بيانات" يختلف جذرياً في المعمارية الثنائية للحاسوب عن النص "بيانات " (مع مسافة لاحقة)، مما يجعل إكسيل يحتفظ بكلا المدخلين كقيمتين مميزتين.
لتفادي هذا الخلل، يتعين تطبيق بروتوكول تطهير استباقي صارم باستخدام دالة TRIM لحذف المسافات الزائدة في البداية والنهاية، ودالة CLEAN لحذف الأحرف غير القابلة للطباعة وعلامات فواصل الأسطر البرمجية، وفق الصيغة التركيبية: =TRIM(CLEAN(A2)). أما فيما يتعلق بحساسية حالة الأحرف في النصوص الإنجليزية (Case Sensitivity)، فإن دوال إكسيل وأداة إزالة التكرارات لا تفرق افتراضياً بين “EXCEL” و”excel”. فإذا تطلب البحث التمييز الصارم بينهما، يجب بناء صيغ متقدمة تعتمد على دالة المطابقة الدقيقة EXACT المضمنة داخل معادلات فحص مصفوفية، لضمان استخراج القيم المميزة مع احترام الحالة البنيوية الدقيقة لكل حرف.
10.2 مصفوفة المفاضلة بين الأساليب المختلفة وفق حجم البيانات
يقتضي التدقيق الأكاديمي والمهني الرصين عدم الاعتماد على وسيلة واحدة لكافة المهام، بل إجراء مفاضلة معيارية شاملة تزن حسنات ومثالب كل أسلوب تم استعراضه وفقاً لمتطلبات المشروع وحجم البيانات والبنية التحتية البرمجية المتاحة. يلخص التحليل المنهجي المقارن الأبعاد التقنية لهذه الأساليب في الجدول والتحليل التالي:
- دالة UNIQUE الديناميكية: تمثل الخيار النموذجي والحديث في بيئات Microsoft 365 و Excel 2021 وما بعدها. تتسم بالسرعة الفائقة، والقدرة على التحديث التلقائي اللحظي، وعدم المساس بالبيانات المصدرية، مما يجعلها الخيار الأول بلا منازع للوحات القيادة والنماذج الإحصائية الديناميكية ذات الحجم المتوسط حتى 200,000 صف.
- أداة إزالة التكرارات (Remove Duplicates): ممتازة للمهام السريعة وغير المتكررة لمرة واحدة (Ad-hoc) على عينات بيانات محدودة. ميزتها السهولة المطلقة دون كتابة معادلات، ولكن يعيبها طابعها التدميري الذي يحذف البيانات واستحالة تحديثها تلقائياً عند إضافة سجلات جديدة.
- محرر Power Query: يتربع على قمة الأساليب الموصى بها للمشاريع الضخمة، والبيانات المتجاوزة لنصف مليون صف، والبيئات المؤسسية ذات السجلات المتجددة دورياً. يتميز بحفظ خطوات التحويل كمسار مؤتمت بالكامل، وفصل البيانات الخام عن المعالجة، والقدرة على دمج جداول متعددة بكفاءة تشغيلية لا تؤثر على سرعة إكسيل اليومية.
- الجداول المحورية (Pivot Tables): الحل المتوازن الذي يجمع بين التلخيص الإحصائي السريع وتحديد التوزيعات التكرارية (Distinct Count) عبر نموذج البيانات. ممتاز للمحللين الماليين والإحصائيين، مع إمكانية التحديث اليدوي وتوفير موارد الذاكرة عبر ذاكرة Pivot Cache.
- الصيغ القديمة (INDEX/MATCH/COUNTIF): بطيئة جداً ومجهدة للمعالج، ولا يوصى بها نهائياً إلا تحت وطأة الاضطرار للعمل على نسخ برمجية قديمة جداً تفتقر للبدائل الحديثة.
- البرمجة بلغة VBA: توفر أقصى درجات التخصيص والأتمتة المعقدة للمستخدمين المحترفين الذين يحتاجون إلى دمج استخراج القيم المميزة ضمن مسار عمل برمجي متكامل يشتمل على تصدير ملفات، أو إرسال تقارير، أو التفاعل مع واجهات خارجية.
10.3 توصيات أكاديمية وتطبيقية لضمان سلامة التحليل
لضمان أعلى درجات النزاهة العلمية والدقة الحسابية عند معالجة وتدقيق البيانات في برنامج إكسيل، يتعين على الباحثين ومحللي البيانات الالتزام بمجموعة من التوصيات الإجرائية والمعيارية الصارمة، والتي تضمن استقرار النماذج وقابلية مراجعتها وتدقيقها المستقل:
- مبدأ الفصل الصارم بين الطبقات (Separation of Concerns): تجنب إجراء عمليات تنقية البيانات أو استخراج القيم المميزة في نفس الخلايا أو الأعمدة التي تحتضن البيانات الخام الأصلية. يجب دائماً الحفاظ على طبقة بيانات خام غير ممسوسة (Raw Data Layer)، وطبقة منفصلة للمعالجة والتنقية (Transformation Layer)، وطبقة مستقلة للمخرجات وعرض النتائج (Presentation Layer).
- التوثيق المنهجي لبروتوكول المعالجة: يجب أن يتضمن أي تقرير إحصائي أو ورقة بحثية فصلاً تفصيلياً يوضح الأداة الدقيقة المستخدمة في استخلاص القيم، والأسس المنطقية التي تم بناءً عليها استبعاد التكرارات، وما إذا كان الاستخلاص يتبع منطق القيم المميزة (Distinct) أو الفريدة (Unique)، إلى جانب توثيق معايير تنظيف النصوص وحساسية الأحرف.
- إجراء اختبارات التدقيق المتبادل (Cross-Validation Checks): ينصح دائماً بالتحقق من صحة النتائج المستخلصة بمقارنة أسلوبين مختلفين؛ كأن يتم استخراج القيم المميزة عبر دالة
UNIQUEومقارنة عدد مفرداتها الناتج مع عدد الصفوف المستخلصة عبر جدول محوري أو استعلام Power Query لنفس العمود. إن التطابق التام بين مخرجات الأداتين يمنح المحلل اليقين الرياضي القاطع بصحة النتائج وخلوها من أي تشوهات مجهولة.
خاتمة
إن استخراج القيم المميزة في برنامج إكسيل ليس مجرد إجراء حسابي روتيني أو نقرة زر عابرة في واجهة البرنامج، بل هو ممارسة منهجية عميقة الأثر ترتبط مباشرة ببنية وجودة البيانات في كافة مستويات التحليل الكمي والبحث التطبيقي. إن التطور المتسارع الذي شهدته بيئة إكسيل البرمجية – لا سيما مع ابتكار محرك المصفوفات الديناميكية وإدماج أدوات التحويل المتقدمة كـ Power Query ونماذج البيانات – قد منح الباحثين ترسانة تقنية قوية تتيح استخلاص المعرفة من الركام الرقمي بأعلى درجات الدقة والكفاءة الحسابية.
يتطلب التحليل الرشيد إدراكاً واعياً للفروق المفاهيمية بين القيم المميزة والقيم الفريدة، وفهماً معمقاً لآليات عمل كل أداة، مع الحرص الدائم على حماية البيانات المصدرية وتوثيق مسارات المعالجة وفق أعلى المعايير الأكاديمية والمؤسسية. ومن خلال تبني أفضل الممارسات الموضحة في هذا الدليل، من تطهير النصوص وإزالة العوائق والتدقيق المتبادل، يستطيع المحلل ضمان موثوقية نماذجه القياسية ونزاهة استنتاجاته، محولاً جداول البيانات من مساحات تخزين صامتة إلى أدوات معرفية رصينة تدعم اتخاذ القرارات السليمة والمستندة إلى براهين رقمية لا يرقى إليها الشك.
المراجع
Duff, K. M. (2012). Evidence-Based Indicators of Neuropsychological Change in the Individual Patient: Relevant Concepts and Methods. Archives of Clinical Neuropsychology. https://doi.org/10.1093/arclin/acr120
Lankton, N. K., McKnight, D. H., & Tripp, J. F. (2015). Technology, Humanness, and Trust: Rethinking Trust in Technology. Journal of the Association for Information Systems. https://doi.org/10.17705/1jais.00411
Nijhawan, T., Attigeri, G. V., & Thalengala, A. (2022). Stress detection using natural language processing and machine learning over social interactions. Journal of Big Data. https://doi.org/10.1186/s40537-022-00575-6
Schyns, P. G. (1991). A Modular Neural Network Model of Concept Acquisition. Cognitive Science. https://doi.org/10.1016/0364-0213(91)80016-x
Teodoridis, F., Bikard, M. A., & Vakili, K. (2018). Creativity at the Knowledge Frontier: The Impact of Specialization in Fast- and Slow-paced Domains. Administrative Science Quarterly. https://doi.org/10.1177/0001839218793384