
تعتبر مرحلة فحص واستكشاف البيانات الأولية حجر الزاوية في أي بحث علمي أو تحليل إحصائي رصين؛ إذ إن بناء النماذج الإحصائية المعقدة واختبار الفرضيات الأكاديمية لا يمكن أن يستقيما دون التحقق التام من نزاهة البيانات المدخلة وبنيتها الهيكلية. وفي بيئة نظام التحليل الإحصائي (SAS – Statistical Analysis System)، يمثل إجراء PROC PRINT الأداة المعيارية واللبنة الأساسية الأولى التي يعتمد عليها محللو البيانات والباحثون لمعاينة سجلات البيانات والتحقق من صحة المتغيرات. إن الغاية الجوهرية من هذا الإجراء ليست استنتاج المؤشرات المعلمية أو النماذج التنبؤية، بل تقديم تمثيل بصري دقيق ومجدول للبيانات المخزنة دون إحداث أي تغيير على حالتها الفيزيائية في الذاكرة أو وسائط التخزين.
تاريخياً، يعود تأسيس هذا الإجراء إلى البدايات الأولى لتطوير نظام ساس في منتصف ستينيات القرن العشرين، وتحديداً من خلال الجهود الرائدة التي قادها كل من أنتوني بار وجيمس غودنايت وجون سال وجين هيلويغ، والتي تكللت بإصدار الدليل المرجعي الكلاسيكي للنظام عام 1976 بتأسيس شركة SAS Institute Inc. ومنذ ذلك الحين، حافظ هذا الإجراء على مكانته كأحد أكثر الإجراءات استخداماً وتكراراً في برمجيات SAS بفضل سرعته الفائقة، وبساطة صياغته النحوية، وقدرته العالية على التكامل مع مختلف خيارات التنسيق والتصنيف التي توفرها منظومة معالجة البيانات الحديثة.
يقدم هذا المقال دليلاً شاملاً وتفصيلياً لكيفية توظيف إجراء PROC PRINT بأسلوب منهجي وتطبيقي؛ حيث سنستعرض خلفيته النظرية وآليات عمله الحاسوبية، والبنية النحوية لعباراته البرمجية، بالإضافة إلى بناء مجموعة بيانات تطبيقية من واقع الأداء الرياضي لاختبار حالات الاستخدام المختلفة. كما سيتناول المقال طرائق استعراض البيانات المتقدمة، وضبط نطاق المشاهدات، وانتقاء المتغيرات، وإجراء عمليات الفرز والتجميع، وتوثيق المخرجات بجودة صالحة للنشر العلمي، مع التركيز على تجنب الأخطاء الشائعة وتحسين كفاءة استهلاك الذاكرة في الأنظمة الكبيرة.
1. مقدمة إلى إجراء PROC PRINT وأهميته في بيئة SAS التحليلية
1.1 مفهوم إجراء PROC PRINT ودوره الأساسي في فحص البيانات
يُعرَّف إجراء PROC PRINT وظيفياً بأنه إجراء مخرجات في بيئة ساس الأساسية (Base SAS) صُمم خصيصاً لسرد وطباعة قيم المشاهدات والمتغيرات المخزنة في مجموعات بيانات ساس على هيئة جداول منسقة وواضحة. يتجلى الدور الأساسي لهذا الإجراء في مرحلة الفحص المبدئي والاستكشافي للبيانات الخام؛ حيث تتيح المعاينة البصرية السريعة للمحلل التحقق من نجاح عمليات الاستيراد، وصحة تموضع السجلات، وسلامة أسماء المتغيرات وأنماطها سواء كانت رقمية أم نصية.
من الناحية الإبستيمولوجية والمنهجية، يجب التمييز بشكل قاطع بين عرض البيانات لأغراض التدقيق والفحص البصري، وبين إجراء التحليلات الإحصائية الاستدلالية أو حتى الوصفية المتقدمة. إن إجراء PROC PRINT ليس أداة لاختبار الفرضيات، ولا يقوم بحساب المتوسطات الحسابية أو الانحرافات المعيارية أو قيم الدلالة الإحصائية ($p$-values) أو حجوم الأثر؛ بل هو أداة تدقيق حسابية وتقنية تقرأ السجلات تباعاً لإنتاج وثيقة مرئية. أما التحليلات الإحصائية فتتطلب إجراءات مخصصة مثل PROC MEANS وPROC UNIVARIATE وPROC REG.
تعتمد طبيعة المخرجات الافتراضية التي يولدها الإجراء على نظام تسليم المخرجات (ODS – Output Delivery System)، والذي يقوم بتحويل البيانات الخام من بنية التخزين الثنائية الداخلية إلى جداول بصرية مصفوفية متطابقة تماماً مع بنية الجدول المخزن، بحيث يعكس كل صف مشاهدة حقيقية، ويمثل كل عمود متغيراً من المتغيرات المعرفة في مصفوفة البيانات الأصلية، مع ترقيم تسلسلي قياسي للمشاهدات يظهر في العمود الأيسر من الجدول.
1.2 المكانة المنهجية للإجراء ضمن خطوات معالجة البيانات الإحصائية
يتمركز إجراء PROC PRINT في موقع حيوي ضمن دورة حياة معالجة البيانات الإحصائية، وتحديداً في المساحة الفاصلة بين خطوة إعداد البيانات (DATA Step) وخطوات النمذجة الرياضية والتحليل المتقدم (PROC Steps). فبعد تنفيذ عمليات دمج الجداول، أو إعادة هيكلتها، أو اشتقاق متغيرات جديدة، تنشأ حاجة ملحة للتأكد من أن الشيفرات البرمجية قد أدت وظيفتها بدقة ودون حدوث أخطاء منطقية خفية؛ وهنا يأتي دور الإجراء كأداة تحقق ومطابقة فورية للتأكد من سلامة العمليات المنفذة في خطوة البيانات.
علاوة على ذلك، يسهم الإجراء بصورة فعالة في الرصد البصري الأولي للقيم الشاذة والمتطرفة (Outliers) والقيم المفقودة (Missing Values). فعلى سبيل المثال، عند فحص السجلات المتعلقة بمقاييس الاستجابة النفسية أو السلوكية، يمكن للباحث من خلال إلقاء نظرة على الأسطر المطبوعة اكتشاف وجود إدخالات خاطئة مثل رموز ترميزية غير معرفة، أو أرقام سالبة في متغيرات يجب أن تكون موجبة، أو انقطاع في تسلسل البيانات؛ مما يتيح تصحيح المسار قبل الشروع في بناء النماذج الانحدارية المعقدة التي قد تتأثر بشدة بتلك التشوهات.
وعلى الصعيد الأكاديمي والتوثيقي، يكتسب PROC PRINT أهمية بالغة في إعداد الملاحق البحثية وتوثيق عينات البيانات في الدراسات التجريبية؛ حيث يسهل مشاركة جداول معاينة مصغرة تبرز بنية التجربة والترميز المستخدم للمشاركين للمحكمين والزملاء الباحثين، مما يعزز معايير الشفافية العلمية وقابلية تكرار الدراسات (Replicability).
1.3 متطلبات التشغيل والتكامل البرمجي داخل بيئة SAS
يتميز إجراء PROC PRINT بتوافقه الشامل وغير المشروط مع كافة بيئات ومنصات تشغيل ساس، بدءاً من البيئات السحابية الحديثة الموجهة للتعليم والبحث الأكاديمي مثل SAS OnDemand for Academics، ومروراً بواجهات العمل التفاعلية المتطورة مثل SAS Enterprise Guide وSAS Studio، ووصولاً إلى واجهات الأوامر النصية التقليدية في حواسيب الأطر الرئيسية (Mainframes) وخوادم Linux المؤسسية. هذا التوافق يجعل من الإجراء لغة مشتركة بين جميع مستخدمي النظام بمختلف مستوياتهم التقنية.
من الناحية المعمارية، يشترط الإجراء توفر جدول بيانات معرف مسبقاً، سواء كان ذلك الجدول مخزناً في الذاكرة العشوائية المؤقتة ضمن مكتبة العمل الافتراضية (WORK Library) التي تنتهي صلاحيتها بانتهاء الجلسة البرمجية، أو ضمن مكتبة مخصصة دائمة مرتبطة بمسار فيزيائي محدد على القرص الصلب (Permanent Library). وإذا لم يحدد المستخدم مساراً خاصاً، فإن محرك ساس يتوجه تلقائياً إلى معالجة الجدول الأحدث تكويناً في الذاكرة.
تعتمد آلية تفسير المحرك البرمجي لأمر العرض على تمرير البيانات من وسيط التخزين إلى ما يعرف بمتجه بيانات البرنامج (Program Data Vector – PDV). يقوم هذا المتجه بقراءة السجلات سجلاً تلو الآخر، ثم يرسلها بالتتابع إلى نواة نظام تسليم المخرجات (ODS)، والتي تتولى بدورها تطبيق معايير العرض وتنسيقات الجداول لتوليد مخرجات بهيئة HTML أو PDF أو RTF حسب رغبة المستخدم وإعدادات البيئة التشغيلية دون حجز مساحات تخزين إضافية غير مبررة.
2. البنية التركيبية وصياغة الكود لإجراء PROC PRINT
2.1 الصيغة النحوية العامة (Syntax) ومكوناتها الإلزامية
تتسم الصياغة النحوية لإجراء PROC PRINT بالوضوح والاتساق المنطقي مع المعايير العامة للغة برمجة ساس. تبدأ الشيفرة البرمجية بالعبارة المفتاحية الافتتاحية المكونة من الكلمة المحجوزة PROC PRINT، والتي تعطي إيعازاً للمفسر ببدء استدعاء الإجراء المخصص لعرض البيانات. ويتبع هذه الكلمة عادة خيار تحديد مجموعة البيانات المستهدفة بصيغة DATA=dataset_name؛ حيث يرشد هذا الخيار المترجم إلى اسم وموقع الملف المراد قراءته.
تعتبر الفاصلة المنقوطة (Semicolon – ;) ركيزة الإلزام النحوي الأكثر أهمية في بيئة ساس عموماً وفي هذا الإجراء خصوصاً؛ إذ إن نسيانها في نهاية عبارة الإجراء أو أي عبارة تابعة يؤدي إلى دمج العبارات المنفصلة وتوليد أخطاء تفسيرية تعوق المعالجة. ويُختتم قالب الإجراء دائماً بعبارة RUN; التنفيذية، وهي الأمر الحاسم الذي يشير إلى اكتمال تعليمات الإجراء وبدء خطوة المعالجة الحاسوبية الفعلية في النظام وتفريغ المخرجات في النافذة المخصصة.
في الحالات التي يغفل فيها المبرمج إدراج خيار DATA= في السطر الافتتاحي، يعتمد محرك SAS قاعدة السلوك الافتراضي المتمثلة في استخدام مجموعة البيانات المرجعية الأخيرة المعروفة داخلياً باسم _LAST_. ورغم أن هذا السلوك يوفر مرونة طفيفة في الكتابة السريعة، إلا أنه يعتبر ممارسة غير مستحسنة في الكتابة البرمجية الأكاديمية والمهنية؛ إذ قد يؤدي إلى طباعة جدول خاطئ في حال تم إنشاء جدول مؤقت غير مقصود أثناء تنفيذ الأوامر السابقة، مما يوجب التصريح الدقيق باسم الجدول دائماً.
2.2 العبارات والخيارات المرافقة المحددة لسلوك الإجراء
يتكامل السلوك الافتراضي لإجراء PROC PRINT عبر منظومة من العبارات المساعدة الاختيارية التي تحول عملية الطباعة من مجرد تدفق خام للبيانات إلى تقرير مصقول ودقيق. تشمل هذه العبارات عبارة VAR لحصر وترتيب المتغيرات المراد عرضها، وعبارة BY لتقسيم التقرير إلى مجموعات تصنيفية متجانسة، وعبارة ID لاستبدال عمود الترقيم التلقائي بمعرف مميز، وعبارة WHERE لفلترة الحالات وفق شروط منطقية، وعبارة SUM لحساب المجاميع العددية التراكمية.
يميز المعمار الداخلي لنظام SAS بين نوعين من الخيارات المحددة لسلوك الإجراء: الخيارات العامة التي تكتب مباشرة داخل عبارة PROC PRINT (مثل خيار NOOBS لإلغاء الترقيم، أو خيار LABEL لإظهار العناوين التوضيحية)، والخيارات الموضعية لمجموعة البيانات (Dataset Options) التي توضع بين قوسين مباشرة بعد اسم الجدول في عبارة DATA=، مثل قيد حصر المشاهدات (OBS=n) أو قيد بداية القراءة (FIRSTOBS=n). الخيارات الموضعية تتحكم في آلية قراءة السجلات من المصدر، بينما تتحكم خيارات الإجراء العامة في آلية عرض وتنسيق تلك السجلات.
يخضع تنفيذ هذه الأوامر إلى تسلسل هرمي دقيق داخل محرك SAS الإحصائي؛ حيث يبدأ المحرك بقراءة قيود الفتح والوصول للبيانات (Dataset Options)، ثم يعالج شروط الانتقاء المنطقي للحالات (WHERE Statements)، وبعد ذلك ينفذ بنية التجميع المكاني (BY Groups)، ثم يوجه الأعمدة المطلوبة وفق محددات العرض (VAR & ID Statements)، وأخيراً يحسب المجاميع التجميعية ويرسل النتائج إلى محرك العرض ODS لإنتاج الجدول النهائي المنسق.
3. إنشاء مجموعة البيانات التطبيقية في SAS
3.1 بناء خطوة البيانات (DATA Step) للمثال التطبيقي
لتحقيق الفائدة التعليمية القصوى وربط المفاهيم النظرية بالتطبيق العملي الرصين، سنقوم ببناء مجموعة بيانات تطبيقية تحاكي أداء مجموعة من لاعبي كرة السلة المحترفين ضمن فرق مختلفة. يتيح هذا السياق الرياضي الجمع المتوازن بين المتغيرات النصية التصنيفية والمتغيرات العددية الكمية، مما يمنحنا أرضية مثالية لاختبار كافة إمكانيات PROC PRINT. سنطلق على مجموعة البيانات اسم my_data ضمن مكتبة العمل المؤقتة.
يبدأ بناء خطوة البيانات باستخدام العبارة DATA my_data;، متبوعة بعبارة الإدخال INPUT التي تحدد تركيبة الأعمدة وترتيب قراءتها. في لغة SAS، تُعرف المتغيرات افتراضياً كمتغيرات عددية، ما لم تُلحق بعلامة الدولار ($) التي تُعد الإشارة البرمجية الإلزامية لتعريف المتغير كنص (Character Variable). بناءً على ذلك، يتم تعريف متغير الفريق team $ ومتغير المركز الميداني للاعب position $ كمتغيرات نصية، بينما يُعرّف متغير النقاط المسجلة points ومتغير التمريرات الحاسمة assists كمتغيرات رقمية كمية تمثل مؤشرات الأداء الرياضي التنافسي.
تضمن هذه الخطوة توفير هيكل بيانات متزن، حيث تحتوي البيانات على متغيرات نصية صالحة لإجراءات التصنيف والفرز المقارن، إلى جانب متغيرات كمية صالحة لعمليات الجمع وحساب المجاميع الفرعية، مما يتيح استعراض إمكانات البرنامج خطوة بخطوة عبر سيناريوهات واقعية ومحاكاة دقيقة للبحوث التطبيقية.
3.2 إدخال أسطر المشاهدات عبر عبارة DATALINES
تُستخدم عبارة DATALINES; (أو ما يرادفها تاريخياً باسم CARDS;) لإعلام مفسر SAS بأن الأسطر البرمجية التالية وحتى الوصول إلى علامة الإنهاء تمثل بيانات خام يتم إدخالها مباشرة في محرر النصوص البرمجية دون الحاجة لاستيراد ملف خارجي. نقوم بهيكلة أسطر المشاهدات وتوزيعها بعناية، بحيث يمثل كل سطر مشاهدة كاملة ومستقلة للاعب معين، مع الفصل بين المتغيرات بمسافات فارغة منتظمة لقراءتها بصيغة الإدخال الحر (Free-Format Input).
تم تمثيل الفرق بحروف أبجدية (مثل الفريق A، والفريق B، والفريق C) لتمكين المقارنات المجموعاتية لاحقاً، وتم تحديد مراكز اللاعبين بالاختصارات المعتمدة دولياً، مثل حارس الهجوم (Guard – G) والمهاجم (Forward – F). ولضمان صحة البنية، تُختتم كتلة إدخال البيانات المباشرة بعلامة فاصلة منقوطة مستقلة في سطر منفرد، تعقبها مباشرة عبارة RUN; لإنهاء دورة خطوة البيانات وحفظ الجدول في الذاكرة.
يمكن صياغة الشيفرة الكاملة لإنشاء مصفوفة البيانات التطبيقية كما يلي:
DATA my_data;

  INPUT team $ position $ points assists;

  DATALINES;

A G 15 8

A F 22 4

A G 18 7

A F 14 3

B G 25 9

B F 30 5

B G 12 6

B F 20 2

C G 19 8

C F 26 4

;

RUN;
يتأكد المبرمج في هذه المرحلة من خلو المصفوفة من الفراغات المزدوجة غير المنضبطة أو غياب إحدى القيم، لضمان استقرار قراءة المؤشرات المكانية داخل متجه بيانات البرنامج (PDV) واستقرار مصفوفة المخرجات عند استدعاء أوامر الطباعة التالية.
4. الطريقة الأولى: طباعة وعرض مجموعة البيانات بالكامل
4.1 تنفيذ الاستدعاء الافتراضي الشامل للجدول
يعد الاستدعاء الافتراضي الشامل أبسط صور استخدام إجراء PROC PRINT وأكثرها شيوعاً في الممارسات البرمجية التمهيدية؛ حيث يقوم بطباعة الجدول كاملاً بجميع صفوفه وأعمدته دون أي قيود أو شروط فلترة. وتتمثل الشيفرة البرمجية الأساسية لتنفيذ هذا الاستدعاء في الأسطر التالية:
PROC PRINT DATA=my_data;

RUN;
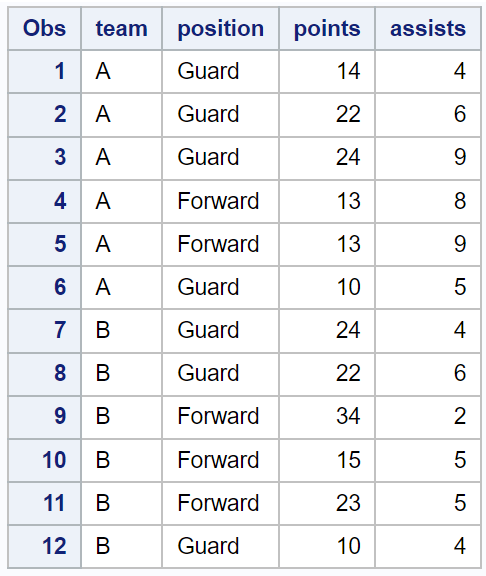
بمجرد إرسال هذه الشيفرة إلى محرك المعالجة، يتولى نظام تسليم المخرجات (ODS) إنشاء جدول شبكي منسق يعكس بدقة المحتويات المحفوظة في my_data. ومن أبرز السمات الافتراضية التي يلاحظها المستخدم في هذا المخرج ظهور عمود إضافي في أقصى الجانب الأيسر معنون باسم Obs (اختصاراً لكلمة Observation). هذا العمود ليس متغيراً حقيقياً تم تخزينه ضمن ملف البيانات، بل هو عداد ترقيمي متسلسل يضيفه نظام SAS تلقائياً أثناء توليد المخرجات للإشارة إلى الموقع النسبي لكل سجل في الملف.
يتم ترتيب الأعمدة تلقائياً من اليسار إلى اليمين وفق التسلسل الزمني لتعريفها الأصلي داخل عبارة INPUT في خطوة البيانات (أي: team ثم position ثم points وأخيراً assists)، وتُعرض قيم المتغيرات النصية بمحاذاة اليسار افتراضياً، بينما تُعرض قيم المتغيرات الرقمية بمحاذاة اليمين، مما يعطي مظهراً جداولياً قياسياً يسهل قراءته بالعين المجردة.
4.2 تحليل مخرجات العرض الشامل وتقييم ملاءمتها
يوفر التحليل البصري لمخرجات الاستدعاء الشامل مصفوفة واضحة تمكن الباحث من التأكد من أن جميع المشاهدات العشر الخاصة باللاعبين قد تم استيعابها بالكامل دون سقوط أي صف أثناء خطوة القراءة. يمكن تدقيق كل سطر ومقارنة قيم النقاط والتمريرات لكل لاعب بحسب فريقه ومركزه، والتأكد من عدم حدوث أي انزياح مكاني للبيانات (Column Shifting) قد يؤدي إلى قراءة الأرقام كنصوص أو العكس.
رغم الفائدة الجلية لهذا الخيار في فحص مجموعات البيانات التدريبية والمصفوفات التجريبية الصغيرة، إلا أن تطبيقه يواجه قيوداً منهجية وتقنية حاسمة عند الانتقال إلى البيئات الواقعية الضخمة ومشاريع البيانات الكبيرة (Big Data) التي قد تضم ملايين المشاهدات ومئات المتغيرات. إن استدعاء طباعة شاملة لملف يحتوي على مليون سجل يؤدي إلى إغراق نافذة المخرجات (Output Log)، واستهلاك مكثف للذاكرة المؤقتة للبرنامج، واستنزاف لموارد وحدة المعالجة المركزية (CPU) في تنسيق آلاف الصفحات دون طائل تحليلي؛ بل قد يؤدي في كثير من الأحيان إلى تجميد واجهة الاستخدام وانهيار الجلسة البرمجية بالكامل.
لذا، تنص القواعد الإرشادية الاحترافية لكتابة أكواد SAS على تجنب استدعاء العرض الشامل غير المقيد إلا في الحالات التي يكون فيها حجم الجدول صغيراً ومحدداً سلفاً، والاعتماد بدلاً من ذلك على استراتيجيات التقييد والاستقطاع التي سنستعرضها في الأقسام اللاحقة.
5. الطريقة الثانية: تحديد عدد المشاهدات المعروضة عبر خيار OBS
5.1 آلية حصر الطباعة في أول N مشاهدة
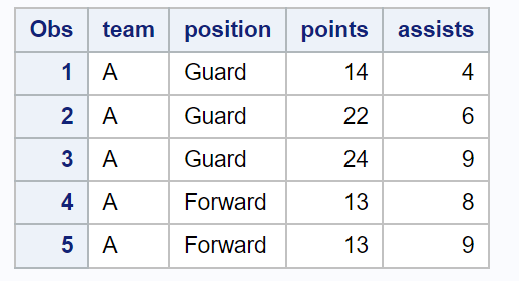
لمواجهة المعضلة التقنية الناجمة عن استعراض مجموعات البيانات الكبيرة، يوفر نظام SAS خياراً موضعياً فائق الفعالية هو خيار (OBS=n)، والذي يُلحق مباشرة باسم مجموعة البيانات داخل قوسين. يعمل هذا الخيار على إيقاف معالجة وقراءة السجلات بمجرد وصول محرك ساس إلى رقم المشاهدة المحدد بواسطة المتغير العددي n. فإذا أردنا حصر عملية الطباعة في المشاهدات الخمس الأولى فقط من بيانات اللاعبين، نستخدم الصياغة التالية:
PROC PRINT DATA=my_data(OBS=5);

RUN;
تتمثل الفائدة التقنية المركزية لهذه الصياغة في تحسين إدارة الموارد وتوفير زمن التنفيذ؛ إذ إن المحرك البرمجي لا يجهد نفسه بقراءة بقية السجلات الموجودة في الملف، بل يكتفي بالمرور على أول 5 سجلات متتالية من القرص، ثم يغلق مؤشر الوصول ويُنشئ الجدول فوراً. يتيح ذلك للباحث إجراء “فحص سلامة” (Sanity Check) سريع وموثوق للتحقق من أن أسماء الأعمدة والتنسيقات ونماذج القيم تسير وفق الخطة المرسومة دون الحاجة للانتظار حتى ينتهي استعراض الملف الكامل.
يجدر التأكيد هنا على أن خيار OBS=5 لا يعني اختيار عينة عشوائية ممثلة إحصائياً لمجتمع الدراسة، بل هو استقطاع ميكانيكي بحت لأول خمسة أسطر مسجلة في الترتيب المادي للملف؛ وعليه، فإن استخدامه مقصور على أغراض التدقيق والبرمجة وفحص الاتساق الهيكلي، ولا يجوز استخدامه لاستخلاص استنتاجات بحثية تعميمية.
5.2 التكامل بين خياري FIRSTOBS وOBS للتحكم بالنطاق
تتعزز مرونة الاستعراض الانتقائي في SAS عند دمج خيار FIRSTOBS= مع خيار OBS= في نفس الجملة البرمجية. يحدد الخيار FIRSTOBS=m رقم السجل الذي تبدأ عنده عملية القراءة الفعلية، متجاوزاً كافة السجلات التي تسبقه في الملف. وعند اقترانه بخيار OBS=n، يتحول السلوك البرمجي إلى استعراض نافذة وسيطة من السجلات تمتد من المشاهدة رقم m إلى المشاهدة رقم n.
على سبيل المثال، إذا رغب الباحث في فحص المشاهدات الواقعة بين السجل رقم 4 والسجل رقم 8 حصراً من جدول اللاعبين، يمكنه كتابة الكود البرمجي الآتي:
PROC PRINT DATA=my_data(FIRSTOBS=4 OBS=8);

RUN;
في جدول المخرجات الناتج، ستظهر المشاهدات الخمس المطلوبة فقط، وسيعكس عمود الترقيم التلقائي Obs الأرقام الحقيقية للسجلات في الملف الأصلي (أي سيبدأ الترقيم في المخرجات من الرقم 4 وينتهي بالرقم 8)، مما يسهل على المحلل تتبع المشاهدة بدقة والرجوع إليها مباشرة في مصدر البيانات في حال وجود أي خطأ يستوجب المراجعة.
يمثل هذا التكامل أداة عملية ممتازة لفحص السجلات الشاذة التي يتم كشفها عبر التحليلات التشخيصية المتقدمة (مثل القيم المتبقية العالية المسجلة في فحص الانحدار الخطي)، حيث يمكن التوجه مباشرة نحو شريحة المشاهدات التي تتضمن الحالات المشبوهة واستعراضها تفصيلياً دون إثقال بيئة العمل بعرض السجلات السليمة التي لا تحتاج إلى تدقيق إضافي.
6. الطريقة الثالثة: تخصيص المتغيرات المستهدفة باستخدام عبارة VAR
6.1 انتقاء أعمدة محددة للعرض واستبعاد المتغيرات الفائضة
في كثير من الدراسات الإحصائية والمشاريع الميدانية، تحتوي مجموعات البيانات على عشرات أو مئات المتغيرات، مثل البيانات الديموغرافية والبيانات التعريفية وتواريخ المعالجة والأرقام التسلسلية. وفي مثل هذه الحالات، يؤدي العرض الشامل إلى مخرجات متكدسة ومتباعدة يصعب قراءتها. تتيح عبارة VAR (اختصاراً لكلمة Variables) للباحث تحديد قائمة دقيقة بالأعمدة المراد إدراجها في الجدول المطبوع، مع استبعاد بقية المتغيرات تماماً من المخرج البصري.
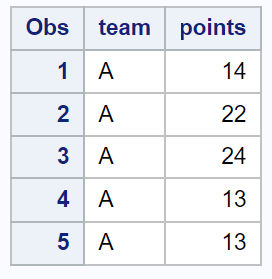
لتطبيق ذلك عملياً، إذا أردنا التركيز حصراً على مؤشر الفريق team ومؤشر النقاط points مع استبعاد متغير المركز ومتغير التمريرات، نستخدم الشيفرة البرمجية التالية:
PROC PRINT DATA=my_data;

  VAR team points;

RUN;
ينتج عن هذا الاستدعاء جدول مقتضب ومركّز يضم فقط عمود الفريق وعمود النقاط إلى جانب عمود الترقيم التلقائي. يسهم هذا التقليص الهادف في حماية المحلل من التشتت البصري والتركيز المباشر على الظواهر أو المؤشرات الخاضعة للفحص، كما يسهل عملية تصدير وتضمين الجدول ضمن التقارير الرسمية والمقالات الموجهة للمجلات العلمية المحكمة التي تفرض حدوداً صارمة على أبعاد الجداول وعرضها.
من المهم الإشارة إلى أن عبارة VAR لا تحذف المتغيرات الأخرى من مجموعة البيانات الأصلية المخزنة على القرص أو في الذاكرة، بل تقتصر وظيفتها على حجب تلك المتغيرات عن نافذة العرض فقط؛ فالبيانات في أصلها تظل كاملة دون مساس.
6.2 التحكم في تسلسل وترتيب الأعمدة في جدول المخرجات
بالإضافة إلى انتقاء المتغيرات، تمنح عبارة VAR الباحث تحكماً كاملاً ومباشراً في ترتيب ظهور الأعمدة في جدول المخرجات؛ حيث يلتزم محرك SAS بعرض الأعمدة وفق الترتيب التسلسلي الذي كُتبت به أسماؤها داخل عبارة VAR من اليسار إلى اليمين، بصرف النظر تماماً عن ترتيبها المادي الأصلي في خطوة تكوين البيانات (DATA Step).
فلو افترضنا أن الباحث يرغب في فحص التمريرات الحاسمة أولاً ثم النقاط ثم اسم الفريق لخدمة فرضية بحثية تركز على صناعة اللعب قبل التسجيل، يمكنه صياغة العبارة كما يلي:
PROC PRINT DATA=my_data;

  VAR assists points team;

RUN;
سيظهر جدول المخرجات عمود assists أولاً، يليه عمود points، ثم عمود team في النهاية. تتيح هذه الخاصية للمحلل إعادة تشكيل منظور قراءة البيانات وتنسيق الجداول المقارنة بحرية تامة دون الحاجة إلى إعادة بناء ملف البيانات الأصلي أو كتابة خطوات تحويلية معقدة، مما يعزز المرونة المنهجية أثناء التفاعل مع المخرجات.
تتجلى هذه الميزة بوضوح عند الرغبة في وضع المتغير التابع (Dependent Variable) بجوار المتغيرات المستقلة المفسرة (Independent Variables) مباشرة في دراسات النمذجة الإحصائية لإجراء المقارنات المباشرة بين المتغيرات المترابطة مفاهيمياً.
6.3 التعامل مع المتغيرات المتعددة ومجموعات المتغيرات المتصلة
توفر بيئة SAS اختصارات كتابية متقدمة عند التعامل مع أعداد كبيرة من المتغيرات داخل عبارة VAR، مما يوفر الجهد البرمجي ويقلل من احتمالية ارتكاب الأخطاء الإملائية. من أبرز هذه الاختصارات إمكانية استدعاء نطاقات المتغيرات العددية المتسلسلة باستخدام واصلة الربط، مثل كتابة item1-item20 للإشارة إلى كافة المتغيرات الممتدة من المتغير الأول وحتى العشرين دون الحاجة لطباعة كل اسم على حدة، وهو نمط شائع جداً في استطلاعات الرأي ومقاييس ليكرت في البحوث السلوكية والاجتماعية.
كذلك تتيح اللغة استخدام نطاقات التموضع المادي في الجدول باستخدام علامتي شرطتين متتاليتين (Double Hyphen)، مثل first_var--last_var، والتي تشير إلى تضمين جميع المتغيرات الواقعة مابين المتغير المحدد كبداية والمتغير المحدد كنهاية بحسب ترتيبها الفعلي في مصفوفة البيانات، أياً كانت أسماؤها أو أنواعها.
عند صياغة عبارة VAR، يجب الحذر الشديد من الوقوع في خطأ إدخال اسم متغير غير موجود بالملف أو كتابة حروفه بطريقة غير دقيقة؛ إذ يؤدي ذلك إلى إيقاف تنفيذ الإجراء بالكامل وظهور رسالة خطأ صريحة في سجل التشغيل (SAS Log) تفيد بأن المتغير غير معرف (Variable not found). لذا، ينصح بالرجوع إلى إجراء PROC CONTENTS مسبقاً لمراجعة القائمة الدقيقة لأسماء المتغيرات المخزنة قبل استدعائها في التقارير المتقدمة.
7. الطريقة الرابعة: تجميع وتصنيف المخرجات باستخدام عبارة BY وإجراء PROC SORT
7.1 إلزامية الفرز المسبق للبيانات عبر إجراء PROC SORT
تعتبر المعالجة المجمعة عبر الفئات والتصنيفات من أقوى ميزات بيئة SAS، ويتم تفعيلها في إجراء PROC PRINT من خلال عبارة BY. إلا أن هناك قاعدة منهجية حاسمة وصارمة يجب إدراكها جيداً: لا يمكن أبداً تطبيق عبارة BY في أي إجراء من إجراءات SAS ما لم تكن مجموعة البيانات مرتبة ومفروزة مسبقاً وفق المتغيرات المحددة في تلك العبارة، أو ما لم تكن البيانات تمتلك فهرساً مرتباً (Index) مبنياً على تلك المتغيرات.
إذا حاول المبرمج استخدام عبارة BY team; مباشرة على بيانات غير مفروزة، فإن النظام سيوقف العملية فوراً ولن ينتج أي جدول، وسيقوم بتسجيل رسالة خطأ قاتلة (Fatal Error) في سجل التشغيل تفيد بأن البيانات ليست مرتبة تصاعدياً وفق المتغير المطلوب (ERROR: Data set ... is not sorted in ascending sequence). لتفادي هذا الإخفاق، يتعين علينا دائماً استدعاء إجراء الفرز الإحصائي المخصص PROC SORT كخطوة تحضيرية إلزامية قبل استدعاء إجراء الطباعة.
تتم صياغة كود الفرز الأولي لبيانات اللاعبين بحسب متغير الفريق team كما يلي:
PROC SORT DATA=my_data;

  BY team;

RUN;
يقوم هذا الإجراء بإعادة تنظيم أسطر المشاهدات فيزيائياً داخل الجدول، بحيث تتجمع كافة سجلات الفريق A أولاً، تليها سجلات الفريق B، ثم سجلات الفريق C في ترتيب تصاعدي منضبط، مما يمهد الطريق بنجاح للمعالجة المجمعة اللاحقة.
7.2 تطبيق عبارة BY داخل إجراء PROC PRINT
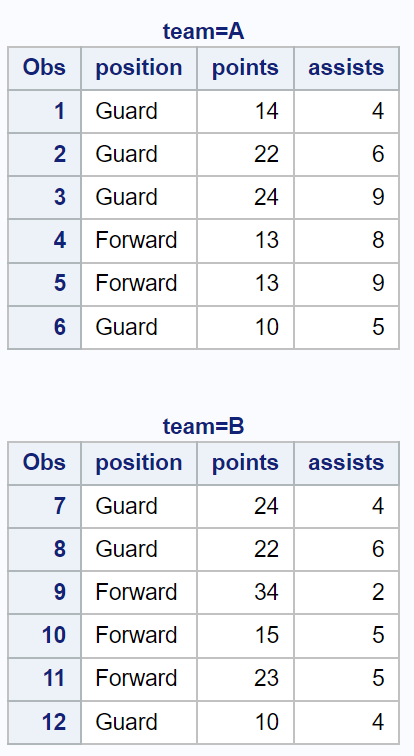
بعد إتمام خطوة الفرز بنجاح، يصبح بالإمكان تضمين عبارة BY داخل إجراء PROC PRINT بكل سلاسة. تقوم هذه العبارة بتفكيك المخرج الموحد الكبير إلى سلسلة من الجداول الفرعية المستقلة؛ حيث ينفرد كل جدول فرعي بعرض مشاهدات فئة واحدة من فئات المتغير المصنف، مسبوقاً بعنوان فرعي واضح يحمل اسم المتغير وقيمته المحددة (مثل: team=A ثم team=B وهكذا).
تتضح هذه الآلية من خلال كتابة الشيفرة التالية:
PROC PRINT DATA=my_data;

  BY team;

RUN;
عند تنفيذ هذا الكود، تتولد ثلاثة جداول منفصلة وواضحة تمثل الفرق A وB وC. يبرز هذا النمط من العرض الفروق الهيكلية بين الفرق في مؤشرات النقاط والتمريرات بشكل منظم؛ حيث يستطيع المحلل قراءة أداء لاعبي كل فريق في سياقهم الخاص دون تداخل مع بيانات الفرق الأخرى، مع الحفاظ على الترقيم المستقل أو المتصل للمشاهدات وفق الإعدادات المختارة.
تتيح هذه الهيكلة المجدولة للمدربين أو الباحثين الرياضيين مقارنة التركيبة الميدانية لكل فريق، وملاحظة الفوارق الفردية بين اللاعبين في نفس المركز ضمن الفريق الواحد بشكل مرئي وسهل الاستيعاب.
7.3 المزايا المنهجية للتحليل الاستكشافي المقارن بين المجموعات
يتجاوز استخدام عبارة BY مجرد التنسيق الجمالي للمخرجات؛ إذ يمثل أداة استكشافية منهجية للمقارنة بين المجموعات في البحوث التجريبية والوصفية. ففي الدراسات السريرية على سبيل المثال، يمكن استخدام BY Treatment_Group; لعرض استجابات المرضى في المجموعة التجريبية بمعزل عن المجموعة الضابطة، مما يتيح الرصد المباشر للاختلافات في نسب التحسن أو الآثار الجانبية قبل الشروع في بناء اختبارات “ت” (t-tests) أو تحليلات التباين (ANOVA).
كذلك تتيح لغة SAS إمكانية التجميع عبر أكثر من متغير تصنيفي واحد بالتسلسل الهرمي المتداخل، مثل كتابة BY team position; (بشرط فرز البيانات مسبقاً بنفس الترتيب: PROC SORT; BY team position; RUN;). في هذه الحالة، سيقوم النظام بتقسيم التقرير إلى مستويات تفصيلية؛ فيعرض حراس الفريق A أولاً، ثم مهاجمي الفريق A، ثم ينتقل لحراس ومهاجمي الفريق B، وهكذا دواليك.
يوفر هذا المستوى المتقدم من التصنيف قدرة عالية على تفكيك التفاعلات المعقدة بين المتغيرات الديموغرافية والتجريبية، ويهيئ للباحث فهماً معمقاً لطبيعة البيانات ومحدداتها قبل الدخول في مراحل التنميط الإحصائي المتقدم.
8. الطريقة الخامسة: توثيق وتنسيق المخرجات بإضافة العناوين والتذييلات
8.1 إضافة العناوين الرئيسية والفرعية عبر عبارة TITLE
تعتبر العناوين الموثقة من أهم متطلبات العرض الأكاديمي الرصين؛ فالجدول الإحصائي الخالي من عنوان واضح يعد جدولاً ناقص القيمة العلمية لكونه يترك القارئ في حيرة حول ماهية الأرقام وسياقها التجريبي. في بيئة SAS، تُستخدم عبارة TITLE لإدراج عناوين توضيحية أعلى جداول المخرجات. تدعم اللغة ما يصل إلى عشرة مستويات متسلسلة من العناوين تبدأ من TITLE1 (وهو العنوان الرئيسي الأكبر حجماً) وحتى TITLE10 للعناوين الفرعية والملاحظات التوضيحية الدقيقة.
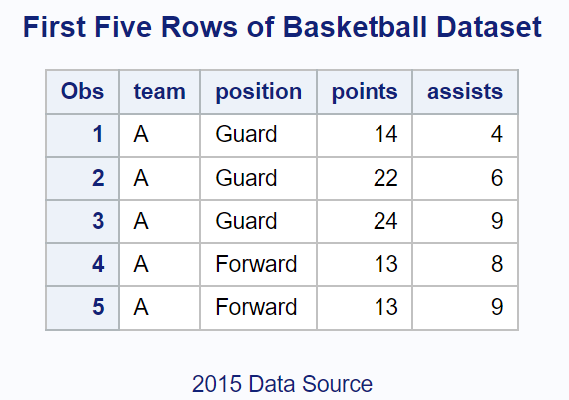
لتطبيق عنوان رئيسي دقيق على مخرجات بيانات كرة السلة المقتطعة، نستخدم الشيفرة التالية:
TITLE1 'First Five Rows of Basketball Dataset';

TITLE2 'Exploratory Inspection of Performance Metrics';

PROC PRINT DATA=my_data(OBS=5);

RUN;
يضمن هذا التنسيق أن تتوج الجداول المطبوعة ببيانات توضيحية تلخص بدقة طبيعة السجلات المعروضة، مما يرفع من جودة التقرير الإحصائي ويجعله جاهزاً للأرشفة أو المشاركة المباشرة مع اللجان الأكاديمية والمشرفين على الأبحاث دون حاجة لشروحات شفهية جانبية.
8.2 إدراج التذييلات التوثيقية باستخدام عبارة FOOTNOTE
بالمثل، تمثل الهوامش والتذييلات أداة لا غنى عنها في التوثيق العلمي لنقل المعلومات الإسنادية ومصادر البيانات وتفسير الرموز المختصرة المستخدمة في رؤوس الأعمدة. توفر بيئة SAS عبارة FOOTNOTE الموازية لعبارة العنوان، والتي تدعم أيضاً عشرة مستويات متدرجة من FOOTNOTE1 إلى FOOTNOTE10 لطباعة نصوص تذييلية أسفل الجدول المخرج.
يمكننا توثيق مصدر بيانات اللاعبين وتفسير اختصارات المراكز الميدانية من خلال الشيفرة الآتية:
FOOTNOTE1 'Source: 2015 Sports Analytics Archive';

FOOTNOTE2 'Note: G indicates Guard, F indicates Forward';

PROC PRINT DATA=my_data(OBS=5);

RUN;
تسهم هذه الهوامش التوثيقية في تعزيز النزاهة العلمية للبحث من خلال الإسناد الواضح للبيانات، وتضمن فهم المتلقي للمصطلحات والرموز بدقة متناهية، متفادية أي سوء تفسير للأرقام أو الفئات الواردة في التقرير التحليلي.
8.3 إدارة دورة حياة العناوين وتفريغها لمنع التداخل الإحصائي
تتميز عبارتي TITLE وFOOTNOTE في لغة SAS بخاصية تقنية تعرف بـ “الاستمرارية العامة” (Global Persistence)؛ وتعني هذه الخاصية أن أي عنوان أو هامش يتم تعريفه في خطوة برمجية معينة يظل نشطاً ونافذاً ويظهر في مخرجات كافة الإجراءات والتحليلات اللاحقة التي يتم تشغيلها في نفس الجلسة، ما لم يقم المبرمج بتغييره صراحة أو إلغائه تماماً.
قد تؤدي هذه الخاصية إلى مشكلة إحصائية وتوثيقية شائعة، حيث يظهر عنوان خاص بتحليل انحدار مثلاً أعلى جدول خاص باختبار مربع كاي في إجراء لاحق، مما يسبب تداخلاً مربكاً في التقارير المجمعة. ولتفادي ذلك، يجب على المبرمج الحريص إغلاق دورة حياة العناوين وتفريغها فور الانتهاء من الإجراء المخصص لها عن طريق كتابة عبارات العناوين والهوامش فارغة دون أي نصوص، كما في الصياغة القياسية الآتية:
TITLE;

FOOTNOTE;
يؤدي تشغيل هذين السطرين إلى إعادة تعيين إعدادات العناوين والتذييلات إلى حالتها الافتراضية الصامتة، مما يضمن استقلالية تقرير كل إجراء تحليلي ونظافة المخرجات الموالية من أي رواسب نصية سابقة.
9. خيارات متقدمة لتخصيص جداول المخرجات وحساب الإجماليات
9.1 إلغاء عمود الترقيم التلقائي باستخدام خيار NOOBS
على الرغم من الفائدة التدقيقية لعمود الترقيم التلقائي Obs، إلا أنه قد يبدو في كثير من الأحيان عنصراً غير مرغوب فيه من الناحية الجمالية عند إعداد الجداول النهائية لتقارير النشر الأكاديمي، خاصة عندما تمتلك مجموعة البيانات في الأصل عموداً خاصاً يمثل هوية المشاهدة أو رقم تسجيل المشارك (مثل Subject_ID أو Player_ID). تتيح SAS خيار NOOBS (اختصاراً لـ No Observation Numbers) لحذف هذا العمود تماماً من مصفوفة العرض.
يُكتب هذا الخيار مباشرة في متن عبارة استدعاء الإجراء على النحو التالي:
PROC PRINT DATA=my_data NOOBS;

RUN;
وعند الرغبة في اعتماد معرف مميز بدلاً من الترقيم التلقائي، يمكن استخدام عبارة ID وتحديد المتغير المعرّف (مثل ID team;). من الجدير بالذكر أن تفعيل عبارة ID يؤدي تلقائياً إلى قمع عمود Obs دون الحاجة لكتابة خيار NOOBS؛ حيث يقوم النظام بتثبيت متغير الهوية كأول عمود في الجانب الأيسر، بل ويحافظ على ظهوره بشكل ثابت على اليسار في حال كانت الجداول عريضة وتطلبت عدة صفحات للعرض الأفقي، مما يسهل تتبع السجلات الطويلة بدقة فائقة.
9.2 حساب المجاميع الإجمالية والفرعية باستخدام عبارة SUM
كما أشرنا سابقاً، لا يختص إجراء PROC PRINT بحساب المؤشرات الإحصائية المتقدمة، إلا أنه يتفرد بميزة حسابية سريعة ومفيدة للغاية تتمثل في حساب حاصل الجمع الحسابي المباشر (Arithmetic Column Totals) للمتغيرات الكمية العددية من خلال عبارة SUM. تضاف هذه العبارة داخل متن الإجراء متبوعة بقائمة المتغيرات المراد حساب مجموع قيمها.
إذا أردنا حساب إجمالي عدد النقاط وإجمالي عدد التمريرات الحاسمة التي سجلها جميع اللاعبين في المجموعة التدريبية، نطبق الكود التالي:
PROC PRINT DATA=my_data NOOBS;

  VAR team position points assists;

  SUM points assists;

RUN;
يقوم النظام في هذه الحالة برسم خط فاصل أسفل آخر مشاهدة في الجدول، ويكتب سطراً مخصصاً للإجمالي يحتوي على المجموع الحسابي التراكمي لعمود النقاط وعمود التمريرات. وتتجلى القوة المنهجية لهذه العبارة عند دمجها مع عبارة BY التصنيفية (بعد الفرز المسبق)؛ حيث يتكفل نظام SAS تلقائياً بحساب مجاميع فرعية (Subtotals) لكل فئة من الفئات المجمعة (مثل إجمالي نقاط وتمريرات لاعبي الفريق A بشكل منفرد، ثم الفريق B، ثم C)، مع اختتام التقرير بالمجموع الكلي العام (Grand Total) لكافة المشاهدات، مما يوفر أداة سريعة للتحقق من الاتساق العددي ومطابقة المجاميع مع السجلات والدفاتر الرسمية للبيانات.
9.3 تطبيق التسميات التوضيحية وتنسيق الأرقام عبر LABEL وFORMAT
عادة ما تُعرّف أسماء المتغيرات البرمجية داخل بيئات التحليل باختصارات مقتضبة باللغة الإنجليزية لتسهيل كتابتها في الأكواد (مثل points وassists). إلا أن هذه الاختصارات قد تبدو مبهمة أو غير ملائمة عند إعداد التقارير الإدارية والأكاديمية. يتيح إجراء PROC PRINT استبدال هذه المسميات البرمجية بملصقات نصية شارحة باستخدام عبارة LABEL مقترنة بتفعيل خيار LABEL في عبارة الإجراء الافتتاحية:
PROC PRINT DATA=my_data LABEL;

  LABEL points  = 'Total Scored Points'

        assists = 'Total Assists Recorded';

RUN;
إذا رغب المحلل في كسر التسميات الطويلة لتظهر على سطرين أو أكثر داخل رأس العمود لتفادي زيادة عرض الجدول بشكل مفرط، يمكنه تفعيل خيار التقسيم SPLIT='character'، كأن يحدد علامة النجمة (*) كفاصل لكسر السطر (مثل LABEL points = 'Total*Scored*Points'; مع كتابة SPLIT='*' في خيارات الإجراء).
وبالمثل، تمثل عبارة FORMAT وسيلة محورية لتحديد أشكال ظهور الأرقام والتواريخ دون المساس بقيمتها الرياضية الحقيقية المخزنة؛ كأن يتم تنسيق المتغيرات العشرية لتظهر بعدد محدد من الخانات العشرية، أو تنسيق القيم النقدية لتظهر مع علامة العملة والفواصل الآلافية (مثل DOLLAR10.2)، أو تحويل الأرقام المتسلسلة إلى تواريخ تقويمية مقروءة، مما يجعل الجدول مخرجاً نهائياً عالي الاحترافية والمقروئية.
10. الأخطاء الشائعة واستراتيجيات استكشافها وتصحيحها في PROC PRINT
10.1 معالجة أخطاء الفرز وفقدان البيانات وسوء تحديد الأسماء
أثناء التعامل اليومي مع إجراء PROC PRINT، يواجه المطورون والمحللون مجموعة متكررة من الأخطاء البرمجية التي تظهر في سجل التشغيل (SAS Log). يتصدر هذه الأخطاء غياب الفرز المسبق عند استخدام عبارة BY؛ ويتمثل الحل الجذري والوحيد لهذه المعضلة في إدراج خطوة PROC SORT بكامل معطياتها وتمرير نفس ترتيب المتغيرات المصنفة قبل استدعاء PROC PRINT مباشرة.
من الأخطاء الشائعة الأخرى إدخال أسماء متغيرات تحتوي على أخطاء إملائية داخل عبارات VAR أو SUM أو ID؛ الأمر الذي ينتج عنه رسالة تحذيرية صريحة توقف تنفيذ الكود. ولمعالجة ذلك، يجب التحقق دائماً من الأسماء الحقيقية للمتغيرات إما عبر نافذة خصائص الجدول في واجهة ساس أو من خلال مخرجات إجراء استعراض محتويات المكتبات PROC CONTENTS.
كذلك ينبغي الحذر عند تطبيق شروط التصفية عبر عبارة WHERE الملحقة بالإجراء؛ فمن الأخطاء المتكررة محاولة مطابقة متغير رقمي مع قيمة نصية بين علامات تنصيص، أو محاولة فلترة متغير نصي دون مراعاة حساسية حالة الأحرف (Case Sensitivity) في مدخلات لغة SAS، حيث إن كتابة WHERE team = 'a'; لن تجلب أي سجلات إذا كانت الحروف مخزنة في الملف كحروف كبيرة 'A'، مما يستدعي توحيد حالة الأحرف برمجياً أو الانتباه التام لقيم البيانات الأصلية.
10.2 تحسين الأداء وإدارة الذاكرة عند معالجة الملفات الضخمة
تمثل إدارة موارد الحواسيب والذاكرة تحدياً تقنياً حقيقياً عند التعامل مع بيئات البيانات الكبيرة ومستودعات البيانات المؤسسية. من الأخطاء الكارثية في هذا السياق كتابة أمر PROC PRINT DATA=huge_table; RUN; دون وضع قيود مشددة على عدد المشاهدات، مما يضع الخوادم تحت ضغط معالجة لا مبرر له قد يتسبب في تعطيل الخدمات المشتركة على نفس الشبكة.
تتمثل الاستراتيجية المثلى لتحسين الأداء في الالتزام الدائم بحصر المعاينة باستخدام الخيار الموضعي (OBS=50) مثلاً، وتحديد المتغيرات الأساسية فقط داخل عبارة VAR للحد من استهلاك الذاكرة المخصصة لمعالجة الأعمدة في متجه بيانات البرنامج (PDV). كما يمكن إيقاف نظام تسليم المخرجات للشاشات الافتراضية وتوجيه النتائج مباشرة إلى ملف نصي خفيف أو إغلاق وجهات العرض الرسومية الثقيلة عبر توجيهات ODS المناسبة لتقليل زمن المعالجة.
علاوة على ذلك، يجب على المبرمج تنظيف الذاكرة المؤقتة دورياً من خلال حذف الجداول الوسيطة غير المستخدمة عبر إجراء PROC DATASETS، وتفادي تكرار عمليات القراءة والكتابة لنفس الجداول الضخمة دون داعٍ إحصائي مباشر.
10.3 أفضل الممارسات الأكاديمية والتوثيقية لكتابة أكواد SAS
تتطلب الكتابة البرمجية الرصينة في الأوساط الأكاديمية والمؤسسية الالتزام بمعايير صارمة لضمان سهولة قراءة الأكواد وصيانتها والتحقق من صحتها من قبل المراجعين الخارجيين. أولى هذه الممارسات هي استخدام التعليقات التوضيحية (Comments) بكثافة ووضوح، سواء باستخدام علامة النجمة والفاصلة المنقوطة (* comment ;) أو كتل التعليقات الممتدة (/* comment */) لشرح الهدف المنهجي من كل خيار أو عبارة برمجية مستخدمة في الكود.
ثانياً، يجب مراعاة التنسيق الجمالي والمسافات البادئة (Indentation) بشكل منتظم؛ حيث تبدأ العبارات الافتتاحية والختامية مثل PROC PRINT وRUN عند بداية السطر البرمجي، بينما تتم إزاحة العبارات التابعة والمكملة (مثل VAR وBY وTITLE) بمقدار مسافتين أو أربع مسافات للداخل، مما يبرز التبعية الهيكلية للأوامر بصرياً ويسهل مراجعة الكود واكتشاف الفواصل المنقوطة المفقودة.
وأخيراً، تنص القواعد العلمية الصارمة على ضرورة الفحص المعمق لسجل تشغيل ساس (SAS Log) بعد كل عملية تنفيذ حتى وإن ظهرت الجداول المخرجة بشكل طبيعي؛ إذ قد يحمل السجل رسائل تنبيه خفية (Notes & Warnings) تشير إلى عمليات تحويل ضمنية للبيانات أو قيم مفقودة تم تجاوزها، وتعتبر القراءة الناقدة لهذا السجل هي المعيار الحقيقي الذي يميز الباحث الإحصائي المتمرس عن المستخدم العادي للبرمجيات الإحصائية.
خاتمة
في ختام هذا العرض التفصيلي لإجراء PROC PRINT، يتجلى لنا بوضوح أن هذا الإجراء، رغم بساطته المفاهيمية وغياب العمليات الاستدلالية المعقدة عنه، يمثل الركيزة التقنية والمنهجية الأولى التي لا غنى عنها لأي محلل بيانات أو باحث علمي يعمل داخل بيئة SAS. إن الوظيفة الاستكشافية والتدقيقية التي يوفرها الإجراء تسد الفجوة الحرجة بين خطوة استيراد البيانات وهيكلتها الخام وبين خطوة النمذجة الإحصائية المتقدمة؛ مما يمنح الباحث الثقة الكاملة في سلامة مدخلاته واتساق متغيراته قبل اتخاذ القرارات التحليلية المصيرية.
لقد استعرضنا خلال هذا المقال الطرائق المتعددة لتوظيف الإجراء؛ بدءاً من الاستدعاء الافتراضي الشامل، مروراً بضبط نطاقات المشاهدات باستخدام خياري OBS وFIRSTOBS، واختيار الأعمدة وإعادة ترتيبها عبر عبارة VAR، وصولاً إلى التصنيف المجمّع المقارن بواسطة إجراء PROC SORT وعبارة BY، وتوثيق المخرجات بجودة علمية عبر العناوين والهوامش وحساب الإجماليات واستبعاد الترقيم التلقائي. إن الإلمام العميق بهذه الأدوات يتيح للمحلل صياغة تقارير فحص عالية الدقة والجمالية تخدم معايير الشفافية والنزاهة العلمية.
ختاماً، إن التميز في استخدام البرمجيات الإحصائية المتقدمة مثل SAS لا ينبع من مجرد حفظ الشيفرات النمطية، بل من إدراك الفلسفة المعمارية التي تقوم عليها هذه البرامج والالتزام بأفضل الممارسات التوثيقية والبرمجية. ومع التطور المستمر في منصات الحوسبة والبيانات الضخمة، يظل التحكم الواعي والمنضبط في آليات فحص البيانات عبر PROC PRINT مهارة أساسية ومستدامة تضمن جودة المخرجات وصحة الاستنتاجات العلمية في شتى مجالات البحث والمعرفة.
المراجع
- Barr, A. J., Goodnight, J. H., Sall, J. P., & Helwig, J. T. (1976). A user’s guide to SAS 76. SAS Institute Inc.
- SAS Institute Inc. (2020). Base SAS procedures guide: The PRINT procedure. SAS Institute Inc. https://documentation.sas.com
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- Cody, R. (2018). Cody’s data cleaning techniques using SAS (3rd ed.). SAS Institute Inc.