
يشهد ميدان التحليل الإحصائي ومعالجة البيانات تطوراً متسارعاً تفرضه متطلبات التعامل مع التدفقات الهائلة من المعلومات، والبيانات المعقدة ذات الأبعاد المتعددة. وفي خضم هذا المشهد الحوسبي، تتبوأ بيئة نظام التحليل الإحصائي (SAS) مكانة ريادية راسخة باعتبارها إحدى أقوى المنظومات البرمجية التي أرست معايير الصرامة المنهجية والدقة التحليلية منذ نشأتها التاريخية الأولى. لا تقتصر قوة هذه البيئة على تنفيذ النماذج التنبؤية المتقدمة أو الاختبارات الاستدلالية المعقدة فحسب، بل تمتد لتشمل قدراتها الفائقة في إدارة البيانات، وتلخيصها، وهيكلتها عبر إجرائيات أساسية صُممت بعناية لتوفير أعلى درجات الكفاءة التشغيلية والدقة الحسابية.
وتبرز إجرائية تلخيص البيانات المعروفة باسم PROC SUMMARY كأداة حجر الزاوية ضمن حزمة “ساس” الأساسية (Base SAS)، حيث تضطلع بمهمة محورية تتمثل في اختزال آلاف وملايين السجلات الخام إلى جداول ملخصة تكشف عن الاتجاهات المركزية ومقاييس التشتت للمتغيرات الكمية عبر الفئات التصنيفية المختلفة. ومع ذلك، فإن الطبيعة الافتراضية لهذه الإجرائية تقوم على توليد شبكة متداخلة ومكثفة من التباديل والتوافيق الإحصائية التي تشمل المجاميع الكلية والهامشية والفرعية، مما قد يشكل تحدياً برمجياً وتحليلياً كبيراً للباحثين والمحللين عند رغبتهم في استخلاص المستوى التفصيلي النهائي فقط دون الغرق في مستويات التجميع الوسيطة.
من هذا المنطلق المنهجي، يأتي خيار NWAY ليمثل أحد أهم الخيارات البرمجية وأكثرها تأثيراً في ضبط سلوك إجرائية PROC SUMMARY؛ إذ يعمل كمرشح حسابي يوجه محرك التحليل إلى حصر المخرجات في أعلى مستوى تجميعي ممكن لمتغيرات التصنيف، ملغياً بذلك كافة التجمعات الهامشية والمجاميع الشاملة تلقائياً. تهدف هذه الدراسة الأكاديمية الشاملة إلى تقديم تفكيك نظري وتطبيقي معمق لآليات عمل هذا الخيار، وتوضيح أبعاده الرياضية والبرمجية، واستكشاف سلوكه عبر الأمثلة العملية المقارنة، مع ربط ذلك بأفضل الممارسات التحليلية في إدارة البيانات الكبيرة وتطبيقات البحوث الكمية والسلوكية المتقدمة.
1. مقدمة في إجرائية PROC SUMMARY ودورها في التحليل الإحصائي عبر ساس
1.1 ماهية إجرائية PROC SUMMARY وأهميتها في معالجة البيانات الضخمة
تمثل إجرائية PROC SUMMARY داخل بيئة ساس إحدى الركائز الخوارزمية المخصصة لتكثيف البيانات واستخراج المؤشرات الإحصائية الوصفية بدقة متناهية. ترجع الجذور التاريخية لمنظومة ساس إلى عام 1966 في جامعة ولاية كارولاينا الشمالية، بمساهمات تأسيسية من أنتوني بار (Anthony J. Barr)، وجيمس غودنايت (James H. Goodnight)، وجون سال (John Sall)، وجين هيلويغ (Jane Helwig)، قبل أن تتأسس شركة SAS Institute رسمياً في عام 1976. ومنذ تلك الحِقبة التأسيسية المبكرة، وُضعت لبنات إجرائيات التلخيص لتتعامل مع مجموعات البيانات الزراعية والبيومترية الكبيرة بكفاءة عالية، مما رسخ حضورها في صلب المعالجة الإحصائية الحديثة.
تتمثل الوظيفة الجوهرية لإجرائية PROC SUMMARY في اختزال الأبعاد وقراءة السجلات المفردة لتحويلها إلى مصفوفات موجزة تتضمن مقاييس النزعة المركزية (كالوسط الحسابي، والوسيط) ومقاييس التشتت (كالانحراف المعياري، والخطأ المعياري، والمدى). ومن الناحية الهيكلية، يخلط العديد من الباحثين المبتدئين بين إجرائية PROC MEANS وإجرائية PROC SUMMARY؛ والحقيقة أن الإجرائيتين تشتركان في نفس المحرك الحسابي الداخلي، إلا أن الفرق الأساسي يكمن في الإخراج الافتراضي: فبينما توجه PROC MEANS مخرجاتها تلقائياً إلى نافذة النتائج أو تقارير العرض المباشرة، فإن PROC SUMMARY تفترض ضمناً أن الهدف هو إنتاج جدول بيانات داخلي جديد (Output Dataset) دون طباعة النتائج في تقرير مرئي ما لم يُطلب ذلك صراحة عبر خيار الطباعة PRINT.
تكتسب هذه الإجرائية أهمية استثنائية في سياق معالجة البيانات الضخمة (Big Data) وتجهيزها للنمذجة المتقدمة؛ حيث يُعد تلخيص المشاهدات خطوة تحضيرية لا غنى عنها قبل بناء نماذج الانحدار الخطي أو اللوجستي، أو تطبيق نماذج المعادلات البنائية والتحليلات العاملية. وتتجلى القدرة الاستيعابية الفائقة للإجرائية في استيعاب مئات المتغيرات المصنفة عبر طبقات هرمية معقدة، مما يمنح الباحث السلوكي أو المحلل الإحصائي فهماً عميقاً للأنماط الموزعة داخل البيانات قبل الانتقال إلى مرحلة النمذجة الاستدلالية الصارمة.
1.2 البنية التركيبية الأساسية للأوامر البرمجية في PROC SUMMARY
تعتمد البرمجة الإجرائية في ساس على بنية نحوية دقيقة تضمن توجيه العمليات الحوسبية خطوة بخطوة. يبدأ الإجراء بجملة الاستدعاء الرئيسية التي تحدد مجموعة البيانات المصدرية عبر التعليمة DATA=، متبوعة بجمل مساعدة تضبط مدخلات ومخرجات المعالجة. ومن بين هذه الجمل، تبرز جملة VAR (Analysis Variables) بوصفها الأداة التي يعين من خلالها الباحث المتغيرات الكمية أو المتصلة المراد إخضاعها للعمليات الحسابية، مثل درجات الاختبارات، أو الأوزان، أو المقاييس الفسيولوجية، حيث يمتنع البرنامج عن احتساب الإحصاءات لغير المتغيرات المدرجة فيها.
في المقابل، تؤدي جملة CLASS دوراً بنيوياً في تقسيم المشاهدات إلى فئات ومجموعات فرعية وفق متغيرات تصنيفية نوعية أو فئوية، مثل الجنس، أو المجموعة التجريبية، أو التصنيف الجغرافي. تقوم جملة CLASS بتمكين التحليل التقاطعي بين المتغيرات دون الحاجة إلى فرز البيانات مسبقاً، وهو ما يميزها جوهرياً عن جملة BY التي تشترط ترتيباً مسبقاً للبيانات عبر إجرائية PROC SORT، مما يوفر وقتاً حوسبياً كبيراً عند التعامل مع عينات ضخمة.
أما المحطة الختامية في هيكل الأوامر فتتمثل في جملة OUTPUT OUT=، وهي الجملة المسؤولة عن توجيه المؤشرات المستخرجة إلى جدول دائم أو مؤقت داخل بيئة العمل. تتيح هذه الجملة مرونة فائقة؛ إذ يمكن للمبرمج أن يحدد أسماء المتغيرات الإحصائية الجديدة التي ستحتوي على المتوسطات الحسابية، والحدود الدنيا، والقصوى، والتكرارات. بدون هذه الجملة، تفقد إجرائية PROC SUMMARY غايتها الأساسية في توليد جداول ملخصة موجهة للتحليلات الإحصائية المتسلسلة.
1.3 الحاجة المنهجية لضبط مستويات التلخيص وتجنب التكرار
عندما تُنفذ إجرائية PROC SUMMARY باستخدام جملة CLASS دون وضع محددات إضافية، يتبع محرك ساس سلوكاً شمولياً يقوم على توليد جميع مستويات التلخيص الممكنة رياضياً. ينتج عن هذا السلوك ظهور صفوف تمثل العينة الكلية الشاملة، متبوعة بصفوف تمثل المجاميع الهامشية لكل متغير تصنيفي على حدة، ثم صفوف التفاعلات الثنائية، وصولاً إلى التقاطعات التفصيلية الكاملة. هذا التضخم في المخرجات يفرز جداول بيانات متضخمة تحتوي على تكرارات إحصائية قد لا يحتاجها الباحث في سياق دراسته المتخصصة.
تخلق هذه الجداول المتضخمة تحديات تحليلية ومنهجية واضحة؛ فوجود قيم ملخصة تمثل مستويات تجميع مختلفة داخل نفس الجدول قد يؤدي إلى أخطاء فادحة إذا استُخدم الجدول مباشرة في عمليات الرسم البياني أو النمذجة اللاحقة. على سبيل المثال، قد يتعامل الباحث غير المنتبه مع صف “المجموع الكلي” كأنه فئة مستقلة ضمن فئات المتغير، مما يشوه النتائج ويضاعف حجم العينة ظاهرياً بشكل غير صحيح.
من هنا تنبثق الضرورة المنهجية لضبط مستويات التلخيص واستهداف المستوى النهائي بدقة تامة. يتطلب التكامل التحليلي في البحوث المتقدمة أن يتطابق كل صف في جدول المخرجات مع وحدة تحليل محددة وفريدة ومتبادلة حصرياً. ولتحقيق ذلك، يتحتم على المبرمج الإحصائي التحكم في خيارات الإجرائية لتقليص الهدر الحسابي وتفادي إنتاج بيانات وسيطة تشوش على قراءة العلاقات الإحصائية بين المجموعات التجريبية أو الضابطة.
2. الفلسفة البنيوية لإجراء PROC SUMMARY: المتغيرات الافتراضية ومستويات التجميع
2.1 المتغير الافتراضي _TYPE_ وآلية تفسير قيمه العددية
لتنظيم المستويات المتعددة للتجميع الإحصائي، يولد نظام ساس تلقائياً متغيراً نظامياً افتراضياً يُعرف بالرمز _TYPE_. يمثل هذا المتغير مفتاحاً رياضياً بالغ الدقة لفهم الرتبة التجميعية لكل صف داخل جدول المخرجات. يعتمد المتغير _TYPE_ على ترميز ثنائي (Binary Encoding) ضمني يعكس مشاركة أو استبعاد كل متغير من متغيرات جملة CLASS في تكوين الصف الإحصائي المعني، حيث يُخصص لكل متغير خانة ثنائية تأخذ القيمة (1) عند مشاركته في التجميع والقيمة (0) عند استبعاده.
بناءً على هذا التمثيل الرياضي، فإن القيمة الصفرية للمتغير (_TYPE_ = 0) تشير دائماً إلى الملخص الإجمالي الشامل لكامل العينة المدروسة دون تقسيمها بأي من متغيرات التصنيف؛ أي أنها تمثل تفريغاً كلياً لقيم المتغير التابع على مستوى المجتمع الإحصائي المتاح. ومع زيادة عدد المتغيرات داخل جملة CLASS، تتزايد قيم _TYPE_ تصاعدياً؛ فإذا تضمنت الجملة متغيرين تصنيفيين، فإن قيم _TYPE_ ستتراوح بين 0 و3، ممثلة على التوالي: المجموع العام (0)، والمجاميع الهامشية للمتغير الثاني (1)، والمجاميع الهامشية للمتغير الأول (2)، والتقاطع الكامل بين المتغيرين (3).
يعد الخلط المنهجي بين هذه القيم أحد أبرز مصادر الخطأ في التحليلات الإحصائية للمبتدئين؛ فقراءة قيمة معينة لمتوسط متغير ما دون التحقق الصارم من قيمة _TYPE_ المقابلة قد يؤدي إلى تبني تقديرات هامشية جزئية وتفسيرها على أنها فروق فئوية حقيقية، أو العكس، مما يبرز أهمية الفهم المعمق لهذا المتغير الهيكلي في تفكيك بنية جداول ساس.
2.2 المتغير الافتراضي _FREQ_ وأهميته في تدقيق المجموعات
يتكامل المتغير _TYPE_ مع متغير نظامي افتراضي آخر لا يقل أهمية يُدعى _FREQ_. يقوم هذا المتغير بوظيفة الرصد العددي الدقيق لحجم العينة أو التكرار المطلق (Frequency) للمشاهدات التي ساهمت فعلياً في احتساب المؤشرات الإحصائية الموضحة في ذلك الصف. لا يقتصر دور _FREQ_ على مجرد الإحصاء الوصفي لأعداد المشاركين أو المفردات، بل يُعد أداة تدقيق منهجي بالغة الأهمية لتقييم مدى توازن المجموعات التصنيفية وصلاحية العينات الفرعية للتحليل الاستدلالي.
من خلال فحص قيم _FREQ_، يستطيع الباحث الإحصائي اكتشاف تأثير القيم المفقودة (Missing Values) في المتغيرات المصنفة أو المستهدفة؛ إذ يؤدي غياب البيانات في بعض السجلات إلى تقليص التكرار الفعلي المحسوب في الصفوف التقاطعية مقارنة بالحجم الكلي الموثق. وتكتسب هذه الرقابة أهمية حاسمة في الدراسات الطبية والسلوكية حيث يؤدي عدم تكافؤ المجموعات (Cell Imbalance) إلى فقدان قوة الاختبارات الإحصائية وزيادة التحيز في التقديرات المعلمية، كما تظهره الدراسات الكمية حول تباينات التقارير الذاتية في البيئات التطبيقية (Stein, 2019).
علاوة على ذلك، يُستخدم _FREQ_ في التحقق من التكرارات النسبية والمطلقة لكل فئة فرعية قبل اعتماد وتصدير النتائج النهائية. إن التأكد من أن كل خلية تقاطعية تحتوي على عدد كافٍ من المشاهدات يُعد شرطاً منهجياً مسبقاً لاعتماد المتوسطات والانحرافات المعيارية كمؤشرات ممثلة لخصائص الفئات المدروسة، وتجنب التعميمات المبنية على عينات ضئيلة غير كافية إحصائياً.
2.3 الهيكلية الافتراضية لجدول المخرجات بدون محددات إضافية
تتجلى الفلسفة البنيوية لإجراء PROC SUMMARY في غياب المحددات البرمجية من خلال إنشاء هيكل بيانات هرمي شامل يجمع كافة التباديل والتوافيق الإحصائية الممكنة بين المتغيرات. إذا افترضنا وجود $k$ من المتغيرات في جملة CLASS، فإن الإجرائية الافتراضية تقوم بحساب $2^k$ مستوى مختلفاً من مستويات التجميع. هذا المنطق التوليدي يعني أنه في حال وجود ثلاثة متغيرات تصنيفية فقط، فإن الجدول سينتج ثمانية مستويات تجميعية متراكبة عمودياً.
تؤدي هذه الآلية إلى تداخل إحصائي ملحوظ بين المجاميع الهامشية (Marginal Totals)، والمجاميع الكلية (Grand Totals)، والمجاميع التقاطعية الدقيقة (Cross-classified Cells). يظهر الجدول الناتج في صورة مصفوفة متراكمة تتضمن سطوراً ذات مستويات تفصيل متفاوتة تشترك في نفس أسماء الأعمدة؛ مما يفرض عبئاً توثيقياً كبيراً على المستخدم ويزيد من احتمالية وقوع أخطاء برمجية عند محاولة استخراج نتائج فئة محددة.
تبعاً لذلك، تصبح هناك حاجة حتمية لكتابة جمل تصفية برمجية معقدة في الخطوات اللاحقة (كاستخدام شروط WHERE _TYPE_ = ...) لعزل الخلايا المطلوبة واستبعاد المجاميع غير المرغوب فيها. هذه الخطوات الإضافية، وإن كانت قابلة للتنفيذ برمجياً، إلا أنها تستهلك جهداً تحليلياً وتزيد من احتمالية حدوث أخطاء كتابية، فضلاً عن استهلاكها موارد المعالجة في حساب وتخزين أسطر يُتخلص منها لاحقاً، وهو ما يمهد الطريق مباشرة لاستدعاء الحلول البرمجية الأكثر كفاءة والمتمثلة في خيار NWAY.
3. مفهوم وتأثير خيار NWAY في التحكم بمخرجات التلخيص الإحصائي
3.1 التعريف الأكاديمي والتقني لخيار NWAY
يُعرف خيار NWAY في الأدبيات التقنية لمنظومة ساس بأنه تعليمة توجيهية حوسبية (Procedural Directive Option) تُدرج ضمن السطر الافتتاحي لإجرائية PROC SUMMARY أو PROC MEANS لتعديل خوارزمية التجميع الافتراضية. يحيل المصطلح لغوياً وبرمجياً إلى “المسار النوني” للتحليل، حيث يرمز الحرف $N$ إلى العدد الكلي للمتغيرات المصنفة المدرجة في جملة CLASS. وتتلخص وظيفته الجوهرية في توجيه الإجرائية نحو إقصاء كافة الحسابات التجميعية للمستويات الصفرية والهامشية، واقتصار الإخراج النهائي على مستوى التفاعل الكامل بين جميع المتغيرات.
من الناحية الأكاديمية الصرفة، يمثل خيار NWAY تطبيقاً لمبدأ الاختزال الهيكلي الفوري (In-line Structural Reduction)؛ حيث يتم توجيه مصفوفات التجميع الرياضي لتجاوز المستويات الدنيا مسبقاً، واستهداف أعلى مستوى تقاطعي ممكن (Highest Level of Interaction). إن استخدام هذا الخيار يعني تحويل إجرائية التلخيص من أداة توليد هرمي شاملة إلى أداة تجميع فئوي مستهدفة تحاكي من حيث المخرجات استخدام جملة BY ولكن بمزايا حوسبية تتفوق عليها في عدم اشتراط ترتيب البيانات المسبق.
يسهم هذا الخيار بشكل مباشر في إزالة الغموض الدلالي الذي قد يصاحب مخرجات التلخيص؛ إذ يضمن الباحث بمجرد تطبيقه أن كل صف إحصائي يظهر في جدول البيانات يمثل تقاطعاً كاملاً ومحدداً لجميع المتغيرات دون أي خلط مع المتوسطات العامة للمجتمع الإحصائي، مما يوفر بيئة بيانات نقية تلبي متطلبات التحليلات اللاحقة بدقة موثوقة.
3.2 الميكانيزم الرياضي لخيار NWAY أثناء المعالجة الحوسبية
يقوم الميكانيزم الحسابي لخيار NWAY على فك شفرة البنية الثنائية لعملية التلخيص في معالج النظام؛ ففي الأحوال العادية، يمرر المعالج الحسابي السجلات عبر خوارزمية تحسب المجاميع التراكمية لكل فئة وفق جدول احتمالات التوافيق الممكنة $2^k$. غير أن تفعيل خيار NWAY يؤدي إلى تغيير مسار تخصيص الذاكرة المؤقتة (Buffer Management)؛ إذ يُعطل المعالج جداول التراكم المخصصة للمستويات الهامشية التي تقل رتبتها عن $k$.
رياضياً، تستند هذه العملية إلى مقارنة رتبة التجميع الآنية بالرتبة القصوى المتاحة. في التمثيل الثنائي لـ _TYPE_، يمثل المستوى النهائي تشغيلاً لكافة البتات (Bits) لتصبح جميعها بالقيمة (1)، وهو ما يعادل عددياً القيمة $2^k – 1$. عندما يعمل خيار NWAY، فإنه يقوم بإسقاط كافة الحسابات والصفوف التي تكون فيها قيمة _TYPE_ أقل قطيعاً من $2^k – 1$.
يوفر هذا الميكانيزم كفاءة حوسبية هائلة، لا سيما عند التعامل مع مجموعات بيانات تتضمن ملايين السجلات وعشرات المتغيرات التصنيفية؛ إذ إن تجاهل حساب وحفظ التباديل الجزئية والمجاميع العامة يقلل من حجم العمليات الحسابية المتزامنة، ويخفض استهلاك دورات المعالجة المركزية (CPU Cycles)، مما يسرع عملية إنتاج الجداول دون المساس بدقة المتوسطات والانحرافات المحسوبة في الخلايا النهائية المستهدفة.
3.3 المزايا الإجرائية والتخزينية لتطبيق خيار NWAY
تتجاوز فوائد تطبيق خيار NWAY الجانب النظري لتنعكس إيجاباً على الأداء التشغيلي لمنظومة ساس وإدارة التخزين. أولى هذه المزايا تكمن في التقليص الدراماتيكي للحجم النهائي لجداول البيانات الناتجة في ذاكرة النظام الدائمة أو المؤقتة؛ حيث يؤدي استبعاد الصفوف الهامشية والمجاميع الكلية إلى حذف نسبة هائلة من السجلات الزائدة التي كانت لتشغل مساحات تخزينية بلا طائل تحليلي مباشر.
كما يسهم خيار NWAY في تقليل زمن المعالجة وزمن الإدخال والإخراج (I/O Time) المرتبط بكتابة البيانات على القرص الصلب أو استرجاعها؛ فعندما يقتصر الإخراج على الصفوف المطلوبة فقط، تنخفض وتيرة عمليات الكتابة وتوزيع السجلات، مما يجعل تدفق العمليات البرمجية المتسلسلة (Batch Processing) أكثر سرعة وسلاسة، وهو اعتبار بالغ الأهمية في بيئات الحوسبة السحابية والمؤسسات التي تدير قواعد بيانات فائقة الضخامة.
أما من الناحية الإجرائية، فإن خيار NWAY يبسط بشكل جذري بنية الجداول ويجعلها مهيأة فوراً للتصدير أو الدمج مع جداول أخرى دون الحاجة لتطبيق خطوات تصفية برمجية وسيطة. تتيح هذه الهيكلية المبسطة إمكانية تمرير البيانات الملخصة مباشرة إلى إجرائيات الرسوم البيانية، أو لوحات مؤشرات الأداء، أو تصديرها إلى برمجيات أخرى دون الخوف من تسرب صفوف المجاميع الكلية وتشويش النتائج المعروضة.
4. المقارنة التحليلية بين المخرجات الافتراضية واستخدام خيار NWAY
4.1 مقارنة عدد الصفوف وتوزيع المخرجات
توضح المقارنة التحليلية المباشرة بين جدول البيانات الناتج بالوضع الافتراضي والجدول المستخرج بعد تطبيق خيار NWAY تبايناً ملموساً في الحجم الكلي والتوزيع الهيكلي للصفوف. في المخرجات الافتراضية الموسعة، يتحدد عدد الصفوف الكلي بمجموع عدد الفئات لكل مستوى تجميعي مضافاً إليه صف المجموع الكلي؛ أي أنه يمثل دالة تجميعية لجميع التباديل المحتملة للفئات الفرعية والمجاميع الهامشية.
في المقابل، يقتصر جدول بيانات NWAY المركز على عدد الصفوف الذي يمثل التقاطعات الفعلية الفريدة بين المتغيرات فقط. رياضياً، يمكن احتساب عدد الصفوف المحذوفة نتيجة تطبيق الخيار من خلال المعادلة التالية:
عدد الصفوف المحذوفة = 1 (صف المجموع الكلي) + مجموع أعداد الفئات لجميع التوليفات الهامشية ذات الرتب الأقل من $k$.
تؤدي هذه المعادلة إلى تلاشي كامل لصفوف الإحصاءات العامة الشاملة لكامل العينة (المقابلة لـ _TYPE_ = 0)، وكذلك صفوف التلخيص الجزئي الأحادي (المقابلة للرتب الهامشية الوسيطة). ويوضح الجدول التحليلي التالي الفروق الهيكلية الجوهرية بين النمطين عند تلخيص متغير كمي باستخدام متغيرين تصنيفيين ($A$ و$B$):
- النمط الافتراضي (بدون NWAY): يُنتج $1$ صف للمجموع العام، وصفوفاً لكل فئة من فئات المتغير $A$ بمفردها، وصفوفاً لكل فئة من فئات المتغير $B$ بمفردها، وصفوفاً لتقاطعات $A \times B$. تتراوح قيم
_TYPE_بين 0 و3. - نمط خيار NWAY: يُنتج حصرياً صفوف التقاطعات الفعلية $A \times B$ فقط، مع تثبيت قيمة
_TYPE_عند أعلى قيمة ممكنة (3)، وحذف جميع الصفوف الأخرى تلقائياً من جدول المخرجات.
4.2 تأثير الخيار على تفسير المؤشرات الإحصائية الفرعية
يمتد أثر خيار NWAY إلى جودة ودقة تفسير المؤشرات الإحصائية الوصفية؛ فالجداول التي تنتجها الإجرائية الافتراضية قد تخلق حالة من التشويش الدلالي عند محاولة مقارنة المتوسطات الفرعية بوجود المتوسط العام والمجاميع الهامشية في ذات العمود الإحصائي. إن دمج هذه المستويات المتفاوتة في سياق جدولي واحد يتطلب حذراً فائقاً من المحلل الإحصائي لتجنب الخلط بين تباين العينة الكلية وتباين المجموعات الجزئية.
من خلال تفعيل NWAY، يستعيد التحليل الإحصائي وضوحه ونقاءه المنهجي؛ حيث تقتصر المخرجات على المقارنات البينية الصافية بين الفئات المستقلة تماماً. يتيح ذلك للباحث التركيز بدقة على رصد الفروق الفئوية وتشتت البيانات والانحرافات المعيارية لكل مجموعة على حدة، دون وجود أي صفوف تجميعية وسيطة قد تؤثر خطأً على الحسابات الوزنية أو التقديرات البعدية.
إضافة إلى ذلك، يلغي هذا الخيار بصورة قاطعة احتمالية احتساب المتوسط العام للمجتمع كأنه فئة تجريبية أو تصنيفية مستقلة؛ وهو خطأ إجرائي شائع الحدوث عند تصدير الجداول الأولية مباشرة إلى برمجيات التحليل المتقدمة التي تقرأ السطور دون تمييز لطبيعة التشفير الثنائي لـ _TYPE_، مما يحمي مصداقية الاستنتاجات العلمية من التفسيرات الخاطئة.
4.3 المعايير المنهجية لاختيار التلخيص الشامل مقابل NWAY
تخضع المفاضلة المنهجية بين استخدام التلخيص الافتراضي الشامل وتطبيق خيار NWAY لطبيعة الأهداف البحثية والاحتياجات التحليلية المحددة. يكون التلخيص الافتراضي الشامل مطلوباً ومبرراً عندما يكون الهدف هو إعداد تقارير مالية أو إدارية هرمية تستوجب استعراض الأداء على المستويات الكلية والقطاعية في آن واحد، كمعرفة المبيعات الإجمالية للشركة إلى جانب مبيعات الفروع الفردية والمناطق الجغرافية.
في المقابل، يُعد خيار NWAY إلزامياً ومفضلاً منهجياً في معظم أبحاث العلوم السلوكية، والطبية، والقياسات الحيوية، والتحليلات الأكاديمية الصارمة التي تسعى لاختبار فرضيات تجريبية مقارنة؛ حيث تنصب الفرضيات العلمية على دراسة التفاعل بين العوامل المستقلة على المتغيرات التابعة دون حاجة للمجاميع الهامشية التي تزيد من تشتت الانتباه التحليلي وتشغل مساحات حوسبية غير مستغلة.
تقتضي المعايير المنهجية الرصينة من المحلل الإحصائي إجراء موازنة دقيقة بين شمولية المخرجات وسهولة قراءتها ومعالجتها لاحقاً. فإذا كانت الخطوة التالية تتمثل في إدخال القيم الملخصة كأوزان ترجيحية في نمذجة متقدمة أو تمثيلها في مخططات بيانية تفاعلية، فإن اعتماد NWAY يمثل الخيار المعياري الأمثل لضمان الاتساق الهيكلي للبيانات ومنع حدوث أخطاء المعالجة.
5. التطبيق العملي: استكشاف مجموعة بيانات Fish في نظام ساس
5.1 الخصائص الوصفية لمجموعة بيانات Fish المدمجة
لتطبيق هذه المفاهيم البرمجية تطبيقاً عملياً صارماً، نستعين بمجموعة البيانات الشهيرة المدمجة في مكتبة ساس المسماة sashelp.Fish. تُعد هذه المجموعة من البيانات التعليمية والبحثية الكلاسيكية المعتمدة دولياً لتدريب الإحصائيين والمبرمجين على إجرائيات التلخيص والنمذجة الخطية المتقدمة في بيئة ساس، لما تمتاز به من تنوع في الخصائص المورفومترية واحتوائها على تصنيفات واضحة ومتغيرات مستمرة تتطابق مع مواقف القياس الواقعية.
تتضمن عينة هذه الدراسة قياسات مورفومترية دقيقة لـ 159 عينة سمكية جُمعت من بحيرة لافكايارفين (Lake Laengelmaevesi) في فنلندا. تشتمل البيانات على قياسات متعددة تشمل وزن السمكة بالجرام (Weight)، وأطوالها المختلفة (Length1, Length2, Length3)، وارتفاعها كنسبة مئوية (Height)، وعرضها (Width)، موزعة جميعها عبر متغير تصنيفي رئيسي يمثل الأنواع البيولوجية (Species).
يتوزع مجتمع العينة البالغ 159 مشاهدة على سبعة أنواع بيولوجية متميزة تشمل: الرامح (Pike)، والفرخ (Perch)، والدنيس (Bream)، والروش (Roach)، والسمك الأبيض (Whitefish)، والسمك الصغير (Smelt)، والبارك (Parkki). يتيح هذا التباين العددي والنوعي بين الفئات بيئة اختبار مثالية لدراسة سلوك إجرائيات التلخيص ومراقبة كيفية تعامل خيار NWAY مع الفئات غير المتكافئة في الحجم التكراري.
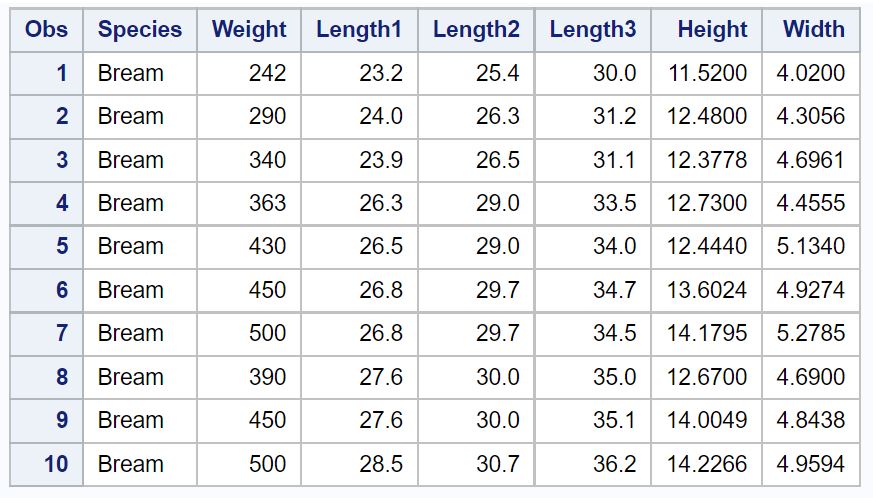
5.2 المعاينة الأولية للبيانات باستخدام إجرائية PROC PRINT
قبل الشروع في تطبيق عمليات التلخيص الإحصائي، يقتضي البروتوكول التحليلي الصارم إجراء فحص أولي ومعاينة بصرية مباشرة لبنية البيانات وسجلاتها. يتم ذلك في ساس عبر إجرائية العرض الطباعي PROC PRINT مع تحديد عدد محدود من المشاهدات لتجنب إغراق شاشة المخرجات بسجلات العينة كاملة. تُصاغ الأوامر البرمجية لمعاينة المشاهدات العشر الأولى كما يلي:
PROC PRINT DATA=sashelp.Fish (OBS=10);

RUN;
يسمح هذا الفحص الأولي بالتدقيق البصري المباشر لمتغير الوزن (Weight) ومتغير الأنواع (Species) والتحقق من طريقة ترميزهما وتخزينهما في النظام. كما يساعد الفحص في التأكد من اتساق المدخلات، وغياب المشكلات الهيكلية الفادحة مثل النصوص المشوهة أو الفواصل العشرية الخاطئة، ورصد وجود أي قيم مفقودة مبكرة قد تستلزم معالجة خاصة أثناء خطوة التلخيص اللاحقة.
تؤكد المعاينة الأولية أن المتغير Species متغير نصي تصنيفي بامتياز، في حين يمثل Weight متغيراً كمياً متصلاً خاضعاً لقوانين القياس الإحصائي، مما يجعلهما المرشحين النموذجيين لتمثيل جملتي CLASS وVAR على التوالي في إجرائية PROC SUMMARY المنشودة.
5.3 تحديد أهداف التلخيص الإحصائي لمجموعة البيانات
تتمثل الخطوة التمهيدية التالية في صياغة الأهداف الإحصائية للتحليل الاستكشافي بدقة علمية. يتلخص التساؤل المنهجي الرئيسي في الآتي: “ما هي الخصائص الوصفية الدقيقة (المتوسط الحسابي، التشتت، التكرار، الحدود الدنيا والقصوى) لأوزان الأسماك موزعة حسب الأنواع البيولوجية المختلفة ضمن العينة؟”
يتطلب هذا التساؤل تعيين دور كل متغير في المعالجة الإجرائية؛ إذ يُحدد متغير الأنواع Species بوصفه المتغير التصنيفي المستقل الذي سيوضع في جملة CLASS، بينما يُحدد متغير الوزن Weight بوصفه المتغير التابع المستهدف بالحسابات الوصفية ويوضع في جملة VAR. ويكون الهدف النهائي هو إنتاج مصفوفة بيانات ملخصة يمكن الاعتماد عليها في استخلاص استنتاجات وصفية واضحة ومقارنة الأوزان بين الأنواع دون تداخل أو تشويش حسابي.
وفق هذا المسار، يتوقع المحلل الإحصائي بنية هيكلية محددة لجدول المخرجات؛ فالمطلوب ليس فقط الحصول على الأرقام المجردة، بل الحصول على جدول منظم يتضمن سطراً واحداً فقط لكل نوع من الأنواع السبعة، مع المؤشرات الإحصائية المقابلة لكل منها، وهو ما يشكل المحك العملي لاختبار الفارق بين تنفيذ الإجرائية بوضعها الافتراضي مقارنة بتنفيذها مقترنة بخيار NWAY.
6. البرمجة الإجرائية: حساب الإحصاءات الوصفية بدون NWAY وتفسير النتائج
6.1 كتابة وتنفيذ الكود الأساسي لتلخيص متغير الوزن
نبدأ أولاً بتطبيق البرمجة الإجرائية الافتراضية عبر استدعاء إجرائية PROC SUMMARY دون تضمين خيار NWAY، وذلك بهدف دراسة السلوك التلقائي للبرنامج ومراقبة بنية الجدول الناتج. يُكتب الكود البرمجي وفق البنية المعيارية لنظام ساس على النحو التالي:
PROC SUMMARY DATA=sashelp.Fish;

    CLASS Species;

    VAR Weight;

    OUTPUT OUT=summaryWeightDefault;

RUN;
PROC PRINT DATA=summaryWeightDefault;
RUN;
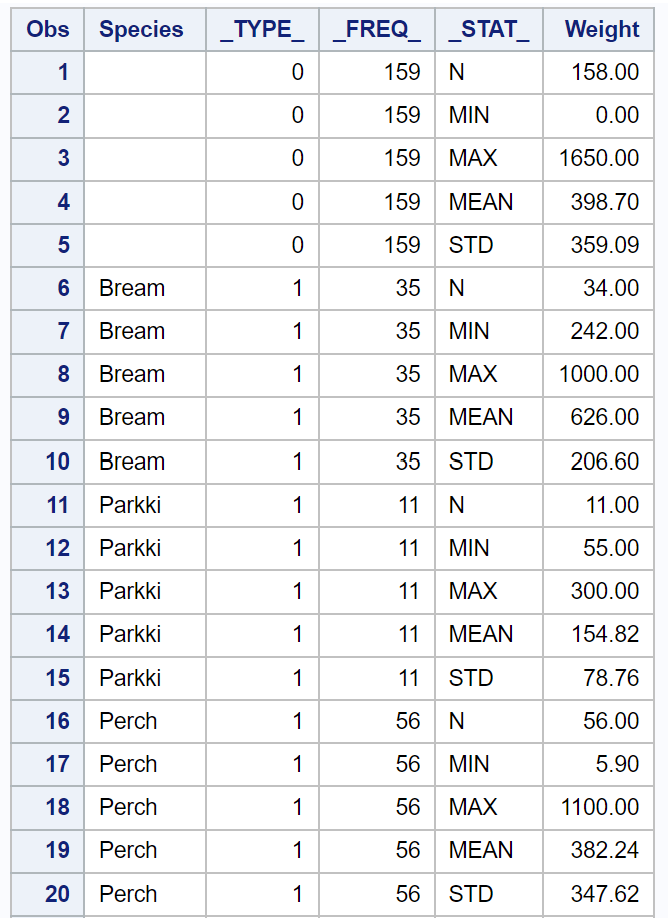
في هذا المقطع البرمجي، تم استدعاء مجموعة البيانات المصدرية من مكتبة النظام sashelp.Fish، وحُدد المتغير Species كمتغير تقسيم تصنيفي ضمن جملة CLASS، والمتغير Weight كمتغير قياس كمي ضمن جملة VAR. وجرى توجيه المخرجات الإحصائية لتُخزن في جدول بيانات جديد أُطلق عليه اسم summaryWeightDefault، متبوعاً بأمر الطباعة لاستعراض محتويات الجدول بالكامل في نافذة النتائج.
عند تنفيذ هذه الأوامر، يقوم محرك ساس بقراءة السجلات وحساب الخصائص الإحصائية الأساسية الخمس تلقائياً (وهي: حجم العينة $N$، والمتوسط الحسابي Mean، والانحراف المعياري Std Dev، والحد الأدنى Min، والحد الأقصى Max) لكافة مستويات التجميع الممكنة، ثم حفظها في الجدول المطلوب وعرضها للمستخدم.
6.2 التفكيك التحليلي لجدول المخرجات الافتراضي
عند التدقيق في جدول المخرجات summaryWeightDefault الناتج عن تنفيذ الكود السابق، يظهر التفاوت الهيكلي جلياً للمحلل؛ فالجدول لا يتكون من سبعة صفوف فقط (وهو عدد أنواع الأسماك الحقيقي في العينة)، بل يضم ثمانية صفوف إحصائية. يكمن التفسير المنهجي لهذا العدد في الصف الإضافي الذي يضعه ساس دائماً في مقدمة الجدول كملخص إجمالي شامل.
يتميز هذا الصف الأول بظهور القيمة الصفرية للمتغير الافتراضي (_TYPE_ = 0)، مع فراغ تام في عمود المتغير التصنيفي Species (حيث تظهر نقطة أو فراغ نصي). وعند قراءة قيمة المتغير _FREQ_ في هذا الصف، نجد أنها تطابق تماماً العدد الإجمالي الكلي لمشاهدات العينة البالغ 159 مشاهدة. يمثل هذا الصف الإحصاءات العامة لكامل مجتمع الأسماك المدروسة بغض النظر عن تمايز أنواعها البيولوجية.
تلي ذلك الصفوف السبعة الأخرى، والتي تتخذ جميعها القيمة (_TYPE_ = 1)، حيث يمثل كل صف منها نوعاً واحداً من الأنواع السبعة (Bream, Parkki, Perch, Pike, Roach, Smelt, Whitefish) مصحوباً بتكراره الفعلي ومؤشراته الإحصائية المستقلة. يمثل هذا المشهد النموذج الافتراضي الصرف؛ حيث تجتمع الإحصاءات الكلية مع الإحصاءات الفئوية في جدول موحد، مما ينشئ إرباكاً إحصائياً إذا ما قُرئ الجدول كوحدة تصنيفية متجانسة.
6.3 تداعيات بقاء الملخص الإجمالي في التحليلات اللاحقة
يترتب على بقاء الصف ذي القيمة _TYPE_ = 0 في الجداول الإحصائية تداعيات منهجية وبرمجية بالغة الخطورة عند الانتقال إلى مراحل التحليل اللاحقة. فإذا حاول الباحث، على سبيل المثال، تمرير جدول summaryWeightDefault مباشرة إلى إجرائية رسم بياني مثل PROC SGPLOT لإنشاء مخطط أعمدة لمقارنة متوسطات الأوزان حسب النوع، فإن ساس سيتعامل مع الصف الإجمالي كأنه نوع ثامن من الأسماك ليس له اسم، مما يشوه المخطط البياني بوجود عمود غير منطقي يمثل المجموع العام إلى جانب الفئات الفردية.
علاوة على ذلك، يضطر المحلل الإحصائي لتلافي هذه المشكلة إلى كتابة أوامر برمجية ترشيحية إضافية عبر جمل WHERE (مثل: WHERE _TYPE_ = 1;) في كل مرة يرغب فيها في استخدام هذا الجدول، وهو ما يرفع من معدلات التعقيد في الأكواد البرمجية ويعرض سلاسل التحليل لمخاطر النسيان أو السهو البشري، مما يقود في نهاية المطاف إلى استنتاجات خاطئة تماماً تعتمد على خلط المجاميع الكلية بالمجاميع الجزئية.
ولا تقتصر التداعيات على الجانب التحليلي فحسب، بل تمتد إلى كفاءة إدارة موارد النظام؛ إذ إن حفظ وتمرير صفوف تجميعية فائضة عبر قواعد بيانات عملاقة تتضمن مليارات السجلات يؤدي إلى استنزاف غير مبرر لذاكرة النظام المؤقتة ومساحات التخزين، مما يؤكد الحاجة الماسة إلى تقنية حاسمة تلغي هذه الصفوف من مرحلة التوليد ذاتها.
7. البرمجة الإجرائية: دمج خيار NWAY لاحتساب إحصاءات المجموعات فقط
7.1 الصياغة البرمجية الصحيحة لتضمين خيار NWAY في ساس
للتغلب الجذري على مشكلة التضخم الهيكلي وإلغاء توليد الملخص الإجمالي الشامل والمجاميع الهامشية، يُدمج خيار NWAY في البنية البرمجية لإجرائية PROC SUMMARY. تتطلب القواعد النحوية الصارمة للغة ساس إدراج هذا الخيار في السطر الافتتاحي للإجرائية مباشرة، بعد تحديد مجموعة البيانات المصدرية وقبل الفاصلة المنقوطة الختامية للسطر الأول. تُصاغ الأوامر المعيارية كما يلي:
PROC SUMMARY DATA=sashelp.Fish NWAY;

    CLASS Species;

    VAR Weight;

    OUTPUT OUT=summaryWeightNway;

RUN;
PROC PRINT DATA=summaryWeightNway;
RUN;
يوضح هذا النموذج البرمجي التكامل الوظيفي المباشر بين خيار NWAY وجمل الإجرائية المختلفة؛ فالخيار لا يلغي عمل جملة CLASS أو جملة VAR، بل يضبط سلوك محرك المعالجة الداخلي ليوجه نتائج هاتين الجملتين نحو الهدف التحليلي المحدد. يُخزن الناتج هنا في جدول بيانات جديد ومستقل يُدعى summaryWeightNway لتمكين المقارنة المنهجية بينه وبين الجدول السابق.
من المهم جداً ملاحظة الموقع النحوي الدقيق للخيار؛ فوضعه في أي جملة أخرى داخل الإجرائية (كوضعه خطأً داخل جملة OUTPUT أو جملة VAR) سيؤدي إلى إصدار رسالة خطأ صريحة في سجل النظام (SAS Log) وفشل تنفيذ المهمة، مما يؤكد الطبيعة التوجيهية العامة لـ NWAY كخيار حاكم للإجراء ككل وليس لأمر فرعي منه.
7.2 تحليل مخرجات جدول البيانات بعد تطبيق NWAY
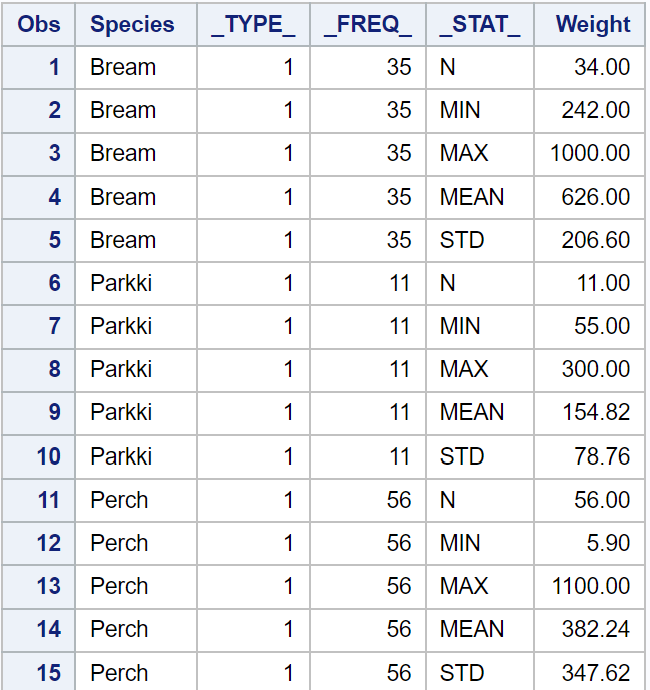
عند استعراض جدول البيانات summaryWeightNway المتولد بعد تنفيذ الكود المحسن، يلحظ المحلل الإحصائي فوراً تحولاً بنيوياً في شكل ومحتوى المخرجات. أولى هذه الملاحظات وأبرزها هي الاختفاء التام للصف الإجمالي ذي القيمة _TYPE_ = 0؛ فلم يعد للرتبة الصفرية أي أثر داخل الجدول، واقتصرت كافة السجلات المعروضة على القيمة (_TYPE_ = 1) فقط.
يتطابق عدد الصفوف الناتجة في الجدول الجديد تطابقاً رياضياً تاماً مع العدد الفعلي للأنواع البيولوجية المدروسة داخل العينة، وهو سبعة صفوف فقط تمثل الأنواع السبعة للأسماك دون أي زيادة أو تكرار. يمثل كل صف الآن وحدة تحليل نقية ومنفصلة تماماً، مصحوبة بتكرارها العددي الحقيقي الموضح في عمود _FREQ_، ومقاييسها الوصفية الخاصة بمتغير الوزن.
يوفر هذا التحول راحة منهجية وتحليلية كبيرة؛ فالجدول الناتج أصبح مصفوفة إحصائية متجانسة وموحدة الرتبة، حيث يعبر كل سطر عن كيان بيولوجي محدد بدقة، مما يتيح القراءة الفورية المباشرة لمتوسط وزن سمك “الدنيس” (Bream) مقارنة بمتوسط وزن سمك “الرامح” (Pike) دون خوف من التداخل مع أوزان العينة العامة أو متوسطات الفئات الأخرى.
7.3 التحقق المنهجي من صحة ودقة النتائج الملخصة
تقتضي معايير التدقيق الأكاديمي الصارم التحقق من أن تفعيل خيار NWAY لم يؤدِ إلى أي مساس أو تشويه في القيم الحسابية الأصلية لمتوسطات وانحرافات الفئات المدروسة. ومن خلال المقارنة الرقمية الدقيقة بين الصفوف المقابلة للأنواع في جدول summaryWeightDefault والصفوف المتطابقة في جدول summaryWeightNway، يثبت التحليل المنهجي التطابق التام والمطلق لكافة المؤشرات الإحصائية.
إن تطبيق خيار NWAY لا يغير في خوارزميات الحساب الرياضي للمتوسطات أو الانحرافات المعيارية أو التكرارات قيد أنملة، بل ينحصر تأثيره الكلي في حجب الفئات الهامشية وإسقاط السجلات غير المرغوب فيها من ملف التخزين النهائي. وبالتالي، فإن الدقة الإحصائية تظل محفوظة بأعلى معايير الصرامة المعمول بها في بيئة ساس.
بذلك، يعتمد الباحث الجدول النهائي summaryWeightNway كقاعدة بيانات نقية وجاهزة بنسبة 100% للتصدير، أو الرسم البياني المباشر، أو الدمج مع متغيرات أخرى، محققاً الكفاءة البرمجية القصوى والأمان التحليلي المطلوب لضمان متانة النتائج البحثية وسلامة تأويلها.
8. تطبيق NWAY في التحليلات المتقدمة ذات التصنيفات المتعددة (Multi-way)
8.1 إدارة مستويات التفاعل عند وجود أكثر من متغير في جملة CLASS
تتعاظم الأهمية المنهجية والتقنية لخيار NWAY عند الانتقال من النماذج التصنيفية الأحادية البسيطة إلى التحليلات المتقدمة متعددة الأبعاد (Multi-way Classifications)، حيث يُدرج أكثر من متغير مستقل داخل جملة CLASS. في مثل هذه السيناريوهات المعقدة، يتصرف محرك PROC SUMMARY الافتراضي بطريقة تؤدي إلى تضاعف أسي في عدد السجلات وفق متوالية القوى $2^k$.
فإذا افترضنا قيام باحث بدراسة تجريبية تتضمن متغيرين تصنيفيين في جملة CLASS، مثل نوع السمكة (Species) والجنس (Sex)، فإن الإجرائية الافتراضية ستقوم بحساب أربعة مستويات مختلفة للمتغير _TYPE_ تمتد من 0 إلى 3:
- _TYPE_ = 0: يمثل الملخص الإجمالي العام لكافة الأسماك في العينة.
- _TYPE_ = 1: يمثل المجاميع الهامشية للمتغير الثاني (الجنس) مستقلاً عن النوع.
- _TYPE_ = 2: يمثل المجاميع الهامشية للمتغير الأول (النوع) مستقلاً عن الجنس.
- _TYPE_ = 3: يمثل التقاطع التفاعلي الكامل بين النوع والجنس ($Species \times Sex$).
في مثل هذه الحالات المعقدة، يُظهر خيار NWAY قوته التحليلية الفائقة؛ إذ يقوم فوراً بفلترة وإسقاط المستويات 0 و1 و2 من المخرجات، ويحتفظ حصرياً بالمستوى 3 فقط. يضمن هذا الإجراء قصر جدول البيانات على الخلايا التقاطعية الكاملة، مما يوفر للباحث إمكانية دراسة الفروق الإحصائية بين ذكور وإناث كل نوع على حدة دون التشويش الناجم عن المجاميع الهامشية المنفصلة.
8.2 المقارنة الوظيفية بين خيار NWAY وعبارة WAYS
يوفر نظام ساس أداة برمجية موازية للتحكم في مستويات التجميع تُعرف باسم عبارة WAYS (WAYS Statement). تتيح هذه العبارة للمحلل الإحصائي مرونة يدوية مطلقة في تعيين الرتب التجميعية المحددة التي يرغب في تضمينها داخل جدول المخرجات، كأن يحدد كتابة: WAYS 1 2; للحصول على المجاميع الهامشية والتفاعلات الثنائية فقط دون المجموع الكلي أو التفاعلات الثلاثية.
من الناحية الوظيفية والرياضية، يمثل خيار NWAY حالة خاصة ومباشرة من عبارة WAYS؛ حيث يعادل برمجياً كتابة عبارة WAYS k; (حيث $k$ يمثل الحد الأقصى لعدد متغيرات جملة CLASS). يكمن الفارق الجوهري في أن خيار NWAY يتميز بديناميكية تلقائية؛ إذ لا يتطلب من المبرمج عدّ متغيرات التصنيف أو تعديل الكود إذا أضاف متغيراً تصنيفياً جديداً إلى النموذج، بل يتكيف ذاتياً ليستهدف دائماً أعلى رتبة ممكنة.
يُفضل استخدام عبارة WAYS في الحالات التحليلية الاستكشافية المعقدة التي تتطلب استخراج مستويين تجميعيين محددين في نفس الجدول (مثل رغبة الباحث في مقارنة المجاميع الهامشية لمتغير ما بالتوازي مع التفاعلات الثنائية دون تضمين المجموع الكلي)، في حين يظل خيار NWAY هو الحل الأسرع والأكثر كفاءة وأناقة برمجية عندما يكون الهدف منحصراً بدقة في الخلايا التقاطعية النهائية.
8.3 التعامل مع المشاهدات المفقودة (Missing Values) في التصنيفات المركبة
تفرض المشاهدات المفقودة (Missing Values) في متغيرات التصنيف تحديات إحصائية بالغة الحساسية عند تطبيق خيار NWAY في التصنيفات المركبة. في السلوك الافتراضي لإجرائية PROC SUMMARY، يتم استبعاد أي مشاهدة تحتوي على قيمة مفقودة في أي من المتغيرات المدرجة داخل جملة CLASS استبعاداً كلياً من التحليل، وهو ما يُعرف بالحذف الإجمالي للحالة (Listwise Deletion).
قد يؤدي هذا الاستبعاد التلقائي إلى تآكل حجم العينة الفعلي وتشويه التمثيل الإحصائي للمجموعات، لا سيما في البيانات الميدانية والمسحية حيث ترتفع معدلات عدم الاستجابة الجزئية. وللتغلب على هذا التحدي البرمجي، يُدمج خيار MISSING إلى جانب خيار NWAY في جملة الإجراء كما في النموذج التالي:
PROC SUMMARY DATA=sashelp.Fish NWAY MISSING;

    CLASS Species Sex;

    VAR Weight;

    OUTPUT OUT=summaryClean;

RUN;
يؤدي هذا الدمج المتكامل إلى توجيه النظام لمعاملة القيم المفقودة كفئة تصنيفية قائمة بذاتها، مما يضمن احتساب مشاهداتها ضمن التقاطعات النهائية في جدول NWAY بدلاً من إسقاطها من الحسابات كلياً. يسهم هذا الإجراء المنهجي في الحفاظ على الشفافية الإحصائية وتوثيق حجم البيانات المفقودة بدقة تامة ضمن عمود _FREQ_، مما يدعم موثوقية الاستنتاجات العلمية الناتجة.
9. الأخطاء الشائعة واستكشاف المشكلات البرمجية أثناء تطبيق خيار NWAY
9.1 الموقع الخاطئ لخيار NWAY وتأثيره على التنفيذ البرمجي
يعد الخطأ النحوي في تموضع خيار NWAY أحد أكثر العثرات البرمجية شيوعاً بين الإحصائيين والمحللين الجدد في بيئة ساس. ينشأ هذا الخطأ غالباً من محاولة إدراج الخيار كمعلمة داخل جملة OUTPUT، مثل كتابة: OUTPUT OUT=result NWAY; بدلاً من وضعه في السطر الافتتاحي لإجرائية PROC SUMMARY.
عند وقوع هذا الخطأ، يقوم مفسر الأوامر في ساس بوقف المعالجة وإصدار رسائل تحذير وخطأ واضحة باللون الأحمر في نافذة السجل (SAS Log)، تنص عادة على أن خيار NWAY غير صالح أو غير معرّف داخل سياق جملة OUTPUT (Syntax error: The option NWAY is not recognized in this statement). يؤدي ذلك إلى إحباط خطوة التلخيص برمتها وعدم إنشاء جدول المخرجات المطلوب.
لتصحيح هذا الخطأ وضمان التنفيذ السليم، يجب دائماً تذكر القاعدة البنيوية في لغة ساس: الخيارات التي تحكم الهيكل العام للإجراء وخوارزمية التجميع الشاملة توضع دائماً في جملة البداية (Procedure Statement)، بينما تقتصر خيارات جملة OUTPUT على تحديد أسماء الجداول، والمؤشرات المستخرجة، وتسميات الأعمدة الجديدة فقط.
9.2 سوء تفسير قيمة المتغير _TYPE_ في الجداول المتقدمة
ينطوي الخطأ الثاني على افتراض منهجي خاطئ يقع فيه الكثير من الباحثين، ومفاده أن قيمة المتغير _TYPE_ بعد استخدام خيار NWAY تساوي دائماً الرقم (1). ينشأ هذا اللبس من حقيقة أن النماذج الأحادية البسيطة (التي تتضمن متغيراً واحداً فقط في جملة CLASS) تنتج بالفعل _TYPE_ = 1 عند تطبيق NWAY.
غير أن هذه القاعدة تتغير جذرياً بمجرد إضافة متغيرات أخرى؛ فالقيمة القصوى لـ _TYPE_ تحسب رياضياً بالعلاقة $2^k – 1$. ففي حال وجود ثلاثة متغيرات في جملة CLASS، فإن تطبيق خيار NWAY سينتج جدولاً تكون فيه قيمة _TYPE_ مساوية حصرياً للرقم (7)، وليس (1). وإذا تضمن التحليل أربعة متغيرات، فستكون القيمة المقابلة هي (15).
يترتب على سوء الفهم هذا خطأ برمجي جسيم إذا قام المبرمج بكتابة كود لاحق يعتمد على قيد شرطي ثابت مثل WHERE _TYPE_ = 1;؛ حيث سيؤدي ذلك إلى استرجاع جدول فارغ تماماً من المشاهدات في التحليلات المتعددة، مسبباً توقف سلاسل المعالجة اللاحقة. إن الفهم الدقيق للترميز الثنائي الكامن خلف هذا المتغير يقي الباحث من الوقوع في مثل هذه التناقضات التحليلية.
9.3 إسقاط الإحصاءات الإجمالية عند الحاجة الفعلية إليها
على الرغم من الفوائد التحليلية الكبرى لخيار NWAY في تنقية البيانات، إلا أن تطبيقه غير المدروس قد يقود إلى خطأ منهجي موازٍ يتمثل في فقدان الإحصاءات الإجمالية الكلية الشاملة للمجتمع المدروس عند الحاجة الفعلية إليها لبناء المقارنات المعيارية أو حساب النسب المئوية للمجموعات بالنسبة للكل.
فعند تفعيل خيار NWAY، تُحذف بيانات المستوى الإجمالي (_TYPE_ = 0) حذفاً نهائياً من مصفوفة الإخراج، مما يحرم الباحث من معرفة المتوسط العام للمجتمع ما لم يقم بإجراء حسابي منفصل. ولتلافي هذا النقص المنهجي، تبرز استراتيجيتان برمجيتان معتمدتان في ممارسات ساس المتقدمة:
- الاستراتيجية الأولى: تشغيل إجرائية PROC SUMMARY مرتين؛ الأولى بخيار NWAY لتوليد جدول الفئات الدقيقة، والثانية بدون متغيرات
CLASSلتوليد جدول المجموع الكلي الصافي، ومن ثم دمج الجدولين برمجياً بكفاءة. - الاستراتيجية الثانية: الاستغناء عن خيار NWAY مؤقتاً، وتوليد الجدول الشامل، ثم استخدام جملة
OUTPUTمتعددة الأوجه أو استخدام خطوة معالجة لاحقة (DATA Step) لفصل السجلات بناءً على قيم_TYPE_وتخزين كل مستوى في جدول منفصل تماماً، مما يضمن الاحتفاظ بالمؤشرات الكلية والفئوية معاً بأعلى درجات النقاء الهيكلي.
10. أفضل الممارسات المنهجية والتوصيات لتحسين الأداء الحوسبي في SAS
10.1 تحسين استخدام الموارد الحوسبية والذاكرة المؤقتة
في عصر البيانات الفائقة والتحليلات الضخمة، لم يعد ضبط الكود البرمجي مقتصراً على استخراج النتائج الصحيحة فحسب، بل امتد ليشمل ترشيد استخدام موارد الذاكرة العشوائية وسرعة المعالجة الحوسبية. ولتحقيق الأداء الأقصى عند استخدام إجرائية PROC SUMMARY، يُنصح بدمج خيار NWAY مع خيارات متقدمة أخرى تعزز كفاءة المعالجة الداخلية.
من هذه الخيارات خيار CHARTYPE، الذي يغير التمثيل الداخلي لقيم المتغير _TYPE_ من الصيغة الرقمية القياسية إلى سلسلة نصية ثنائية (مثل: ’01’, ’11’)، مما يقلل من عمليات التحويل الرياضي ويسرع قراءة السجلات. كما يُعد تقييد المتغيرات المستخرجة باستخدام تعليمات KEEP= أو DROP= ضمن جملة OUTPUT ممارسة حتمية لمنع تصدير الأعمدة غير الضرورية، مما يخفض بشكل حاسم حجم التخزين المطلوب على وحدات التخزين السريعة.
بالإضافة إلى ذلك، يلعب خيار NWAY دوراً جوهرياً في تحسين استعلامات قواعد البيانات الضخمة (Big Data Analytics)؛ فحجب المستويات الوسيطة يخفف الضغط على الذاكرة الافتراضية المؤقتة (Work Library Utilities)، ويقلل من عمليات الفرز المؤقتة التي قد تجريها خوارزمية التلخيص في خلفية النظام، مما يضمن معالجة سلسة حتى عند تجاوز حجم الملفات الأصلية ملايين المشاهدات.
10.2 التكامل البرمجي مع الإجراءات التحليلية والبيانية اللاحقة
تتمثل القيمة المضافة الحقيقية لخيار NWAY في تسهيل التكامل البرمجي الانسيابي مع الإجرائيات التحليلية والبيانية المتقدمة داخل منظومة ساس. إن إنتاج جدول ملخص نظيف يخلو من التكرارات الهامشية يسمح بتمريره مباشرة وبثقة تامة إلى إجرائيات الرسوم البيانية المتطورة، مثل PROC SGPLOT أو PROC SGPANEL، لتوليد مخططات بيانية مقارنة ذات دقة نشر أكاديمية عالية.
كما تشكل الجداول الملخصة المستخرجة عبر NWAY مدخلات مثالية لإجراء اختبارات الفروق المعنوية والتحليلات البعدية المتقدمة (Post-hoc Tests)، حيث يمكن استخدام التكرارات الفئوية الدقيقة _FREQ_ والانحرافات المعيارية المحسوبة كأوزان احتمالية (Sampling Weights) في النمذجة الرياضية دون الحاجة لإعادة قراءة ملف البيانات الخام الضخم مجدداً.
علاوة على ذلك، يُعتمد على جداول NWAY بصورة واسعة في بناء وتغذية لوحات التحكم ومؤشرات الأداء المؤسسية (Dashboards)؛ حيث تتطلب هذه المنظومات تدفقات بيانات موجزة، وسريعة القراءة، ومحددة الأبعاد، تعكس الأداء الفعلي لكل قطاع أو وحدة تشغيلية بصورة مباشرة ومستقلة تماماً عن المجاميع التراكمية العامة.
10.3 معايير التوثيق الأكاديمي لجداول البيانات الملخصة في البحوث العلمية
تفرض المنهجية العلمية الرصينة ومعايير النشر الأكاديمي الدولية (مثل معايير جمعية علم النفس الأمريكية APA) متطلبات صارمة عند توثيق وعرض نتائج التلخيص الإحصائي المستخرجة عبر برمجيات التحليل المتقدمة. يقتضي البروتوكول الأكاديمي الإفصاح المنهجي الواضح والشفاف عن المعايير البرمجية المستخدمة في تجميع وتلخيص البيانات، مع الإشارة صراحة إلى استخدام خيارات عزل التجمعات الهامشية مثل خيار NWAY.
يجب على الباحثين توثيق التكرارات الفعلية الدقيقة لكل مجموعة تصنيفية، وهي القيم الممثلة في عمود _FREQ_، وتضمينها بوضوح في جداول الإحصاءات الوصفية المنشورة؛ وذلك لتمكين القارئ والمحكم الأكاديمي من تقييم كفاية أحجام العينات الفرعية والتحقق من افتراضات الاختبارات الإحصائية اللاحقة. إن إخفاء تكرارات الفئات أو الاعتماد على نسب مئوية مبهمة يتعارض مع مبادئ الشفافية والنزاهة العلمية.
كما يُوصى الباحثون بالاحتفاظ بسجلات الأكواد البرمجية (SAS Logs and Syntax) كجزء من الملاحق المنهجية للدراسات؛ لضمان إمكانية إعادة إنتاج النتائج (Reproducibility) بدقة من قِبل باحثين آخرين، وهو المعيار الذهبي الذي يميز البحوث الكمية المتينة ويسهم في تراكم المعرفة العلمية الرصينة في مجالات القياس والتحليل الإحصائي المتقدم.
خلاصة واستنتاجات منهجية
أظهرت هذه الدراسة التفصيلية أن خيار NWAY داخل إجرائية PROC SUMMARY في بيئة ساس ليس مجرد إضافة برمجية شكلية، بل هو أداة ضبط منهجي ومعماري ذات أثر بالغ في التحكم بكفاءة وهيكلية المخرجات الإحصائية. من خلال قدرته الحسابية الصارمة على إسقاط المستويات الهامشية والمجاميع الكلية وتوجيه المعالجة نحو أعلى رتبة تجميعية ممكنة، يوفر هذا الخيار حلاً جذرياً لمشكلة التضخم الجدولي، ويضمن نقاء مصفوفات البيانات من التكرارات المشوشة.
لقد أثبتت المقارنات التطبيقية عبر مجموعة بيانات sashelp.Fish أن الاعتماد على الخيار يقلص الجداول إلى أبعادها الواقعية الدقيقة دون المساس بصحة المؤشرات الرياضية كالوسط الحسابي والانحراف المعياري، مما يرفع من جودة البيانات ويجعلها مهيأة فورياً للعرض البياني والنمذجة المتقدمة. إن استيعاب هذا السلوك البرمجي، وفهم المتغيرات الافتراضية مثل _TYPE_ و_FREQ_، يمثل ركيزة جوهرية لا غنى عنها لكل إحصائي ومحلل بيانات يسعى لتطوير ممارسات برمجية تتسم بالرصانة والدقة والكفاءة الحوسبية القصوى.
المراجع
Stein, G. L. (2019). Discrepancies in Perceived Friendship Intimacy as a Predictor of Adolescent Alcohol Use. Carolina Digital Repository (University of North Carolina at Chapel Hill). https://doi.org/10.17615/mk3k-sh38