
تُعد بيئة نظام التحليل الإحصائي (SAS) إحدى المنصات الرائدة عالمياً في إدارة ومعالجة البيانات المعقدة والتحليلات الإحصائية المتقدمة، حيث تعتمد عليها المؤسسات الأكاديمية والبحثية والصناعية الكبرى لضمان دقة ونزاهة الاستنتاجات العلمية. في قلب هذه البيئة المتطورة، يبرز إجراء الاستعلام الهيكلي (PROC SQL) كجسر يربط بين فلسفة لغة الاستعلام البنيوية (SQL) والقدرات الحوسبية المتينة لنظام ساس، مقدماً للمحللين والباحثين وسيلة فائقة الفعالية للتعامل مع البيانات العلائقية ومصفوفات المشاهدات الضخمة.
إن معالجة البيانات وتنقيتها تمثل المرحلة الأساسية التي يُبنى عليها أي تحليل إحصائي موثوق؛ فوجود التكرارات غير المبررة أو السجلات المزدوجة الناتجة عن أخطاء القياس أو دمج المصادر المتعددة قد يؤدي إلى انحيازات كارثية في تقدير المعلمات الإحصائية وتضخيم الدلالة المعنوية وتشويه التوزيعات الاحتمالية. من هنا تكتسب عبارة SELECT DISTINCT أهمية منهجية قصوى، إذ لا تقتصر وظيفتها على مجرد تقليص حجم الجداول، بل تمتد لتكون آلية رياضية لتحقيق التفرد المنطقي وضمان اتساق المشاهدات وفق أسس الجبر العلائقي المعياري.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفكيك نظري وتطبيقي معمق لكيفية توظيف عبارة SELECT DISTINCT ضمن إجراء PROC SQL في نظام ساس. سنتناول بالدراسة والتحليل الأسس الجبرية والمنطقية لعمليات التصفية، والآليات الحوسبية التي يدير بها محرك ساس الذاكرة وخوارزميات الفرز والتجزئة، وصولاً إلى المقارنات المنهجية مع أدوات ساس التقليدية، مع التركيز على التطبيقات المتقدمة في معالجة بيانات البحوث الميدانية والمسوح السلوكية لضمان موثوقية النتائج وإمكانية إعادة إنتاجها علمياً.
1. مقدمة نظرية لإجراء PROC SQL وعبارة SELECT DISTINCT في بيئة ساس (SAS)
1.1 مفهوم إجراء PROC SQL وأهميته في استعلامات البيانات الإحصائية
يمثل إجراء PROC SQL داخل نظام ساس تجسيداً للتكامل الفريد بين المعايير القياسية للغة الاستعلام البنيوية (ANSI SQL) ونظام معالجة الملفات الخاص بساس. وعلى خلاف خطوات معالجة البيانات التقليدية المعروفة باسم DATA Step، والتي تعتمد في جوهرها على منطق معالجة متسلسل يقرأ ويسجل سطراً بسطر عبر حلقة تكرارية ضمنية (Program Data Vector – PDV)، يتبنى إجراء PROC SQL مدخلاً تصريحياً كلياً يقوم على التحديد المباشر للنتائج المرجوة دون الحاجة إلى توصيف خوارزمية المرور التفصيلية. يتيح هذا التحول المنهجي للمحللين صياغة استعلامات معقدة تنطوي على عمليات دمج متعدد، وتجميع فئوي، وتصفية منطقية في تعليمة برمجية واحدة تتسم بالإيجاز والوضوح الرياضي.
تتجلى أهمية هذا الإجراء عند إعداد مصفوفات البيانات الموجهة للنمذجة الإحصائية المتقدمة ونماذج الانحدار وتحليل التباين؛ إذ تتطلب هذه النماذج تنقية تامة للمتغيرات التصنيفية والمستمرة قبل الشروع في تقدير المؤشرات. يوفر PROC SQL محرك تحسين داخلي (SQL Optimizer) يعمل على تفكيك بنية الاستعلام وإعادة ترتيب خطوات التنفيذ الحسابية لتحقيق أقصى كفاءة ممكنة في استهلاك موارد المعالج والذاكرة، وهو ما يجعله أداة استثنائية في التعامل مع الجداول الحجمية التي تتجاوز فيها السجلات ملايين المشاهدات ضمن بيئات العمل البحثية ومستودعات البيانات المؤسسية الكبرى.
بالإضافة إلى ذلك، يمنح الإجراء مرونة استثنائية في الربط البيني لقواعد البيانات الخارجية عبر محركات الوصول (SAS/ACCESS)، مما يمكن الباحث من توجيه استعلامات SQL القياسية مباشرة إلى أنظمة إدارة قواعد البيانات العلائقية مثل Oracle أو PostgreSQL واسترداد النتائج المصفاة مباشرة إلى بيئة ساس دون تكبد أعباء التحويل الوسيط وتكرار نقل البيانات الضخمة عبر الشبكات.
1.2 الأساس المنطقي والرياضي لمفهوم التفرد وتصفية التكرارات
يستند مفهوم التفرد في قواعد البيانات العلائقية إلى نظرية المجموعات الكانتورية والجبر العلائقي الذي وضعه إدغار كود (E. F. Codd). ففي الفضاء الرياضي المجرد، تُعرّف المجموعة بأنها بنية تحتوي على عناصر متمايزة تماماً لا تقبل التكرار؛ وبالتالي، فإن وجود سجلين متطابقين تماماً داخل علاقة رياضية يمثل خرقاً لبديهية الهوية. ومع ذلك، نظراً لأن الجداول العملية في أنظمة الحوسبة تمثل “مجموعات متعددة” (Multisets أو Bags) تسمح بوجود التكرارات لضرورات تشغيلية، تبرز الحاجة إلى عوامل تصفية جبرية تعيد فرض شرط التفرد الرياضي.
يقوم التمييز المنطقي في معالجة البيانات بين مستويين من التطابق: التطابق المطلق للكيان (Tuple-level identity)، وفيه تتطابق كافة قيم المتغيرات عبر جميع الأعمدة بين صفين أو أكثر؛ والتطابق الجزئي أو الإسنادي (Attribute-level identity)، وفيه تتطابق قيم مجموعة فرعية محددة من الأعمدة مع اختلاف بقية القيم. إن الفشل في رصد وإدارة هذه التكرارات ينعكس سلباً بصورة مباشرة على الدقة الإحصائية؛ فالتكرار غير المضبوط يقلل من التباين الظاهري، ويزيد بشكل مصطنع من حجم العينة الفعلي (Effective Sample Size)، مما يؤدي بدوره إلى تضييق فترات الثقة وزيادة احتمالية ارتكاب الخطأ من النوع الأول (Type I Error) عبر رفض الفرضية الصفرية الصائبة.
لتحقيق التفرد الحسابي، تعتمد الخوارزميات الداخلية لمحرك ساس إما على استراتيجيات الفرز الرياضي (Sort-Merge) أو على جداول التجزئة (Hash Tables) في الذاكرة العشوائية؛ حيث يتم تقييم كل سجل ومقارنته بالمدخلات السابقة لبناء مصفوفة أحادية لا تشتمل إلا على التوليفات الفريدة، محققة بذلك الاتساق التام مع مفاهيم الاستقلال الإحصائي للمشاهدات الملاحظة.
1.3 الصياغة النحوية العامة لعبارة SELECT DISTINCT
تأتي عبارة SELECT DISTINCT كإضافة بنيوية على تعليمة الاسترجاع الأساسية SELECT ضمن إجراء PROC SQL، وتتمثل صياغتها المعيارية في التموضع المباشر بعد الكلمة المفتاحية SELECT وقبل قائمة المتغيرات المطلوب استرجاعها. يحدد النحو البرمجي الصارم للنظام أن تطبيق DISTINCT ينصرف إلى كامل التركيبة الناتجة من الأعمدة المذكورة في الاستعلام، وليس إلى متغير منفرد بمعزل عن جواره، ما لم يتم استخدام دوال تجميعية خاصة كما سنفصل لاحقاً.
يكمن الفارق الدلالي الجوهري بين عبارة SELECT الاعتيادية وعبارة SELECT DISTINCT في آلية معالجة التدفق البياني؛ فالأولى تفترض افتراضياً إرجاع جميع الصفوف المطابقة لمعايير الاستعلام بما في ذلك النسخ المتطابقة (وهو السلوك المكافئ صراحة لخيار SELECT ALL)، في حين تُجبر الثانية محرك التنفيذ على إقحام مرحلة معالجة وسيطة مخصصة لاستبعاد التكرار، تتطلب إما فرز السجلات المسترجعة وفق جميع أعمدة الإسقاط أو بناء فهرس تجزئة ديناميكي في الذاكرة لفحص تكرار كل صف يتم إنشاؤه.
من الناحية التركيبية، تُعد تعليمة SELECT DISTINCT حلقة ضمن استعلام قد يتضمن عبارات أخرى كـ FROM وWHERE وGROUP BY وHAVING وORDER BY. ومن القواعد الملزمة في ساس والتي يقع فيها العديد من المبتدئين ضرورة إنهاء إجراء PROC SQL باستخدام أمر QUIT؛ فالإجراء يُعد من الإجراءات التفاعلية المستمرة (Interactive Procedures) التي تظل مفتوحة في خلفية النظام تستقبل الاستعلامات المتعاقبة حتى يتم إنهاؤها صراحة، بخلاف الإجراءات الإحصائية التقليدية التي تكتفي بأمر RUN لإتمام المعالجة وإغلاق الجلسة الإجرائية.
2. البنية التركيبية الأساسية وتجهيز بيئة البيانات في ساس
2.1 إنشاء مجموعة البيانات التجريبية باستخدام خطوة DATA Step
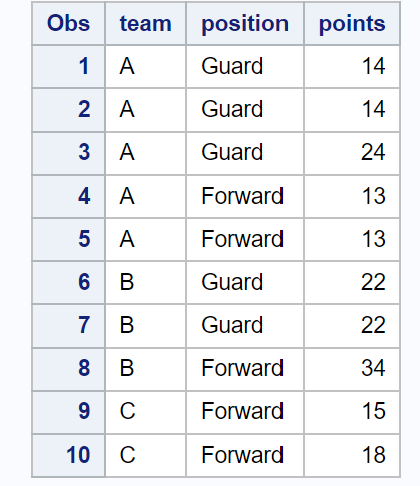
لتوضيح الآليات البرمجية الدقيقة لعبارة SELECT DISTINCT، يتعين بناء مصفوفة بيانات تجريبية خاضعة للرقابة تحتوي على تكرارات مقصودة عبر متغيرات نصية ورقمية تحاكي دراسة مسحية سلوكية. تستخدم خطوة DATA Step بالتكامل مع مدخلات البيانات السطرية (DATALINES) لتأسيس هذا الجدول، مع تحديد أطوال المتغيرات وأنماط قياسها بعناية لضمان عدم حدوث اقتطاع في السلاسل النصية أو تشويه في الدقة الرقمية أثناء المعالجة.
يتضمن تصميم مجموعة البيانات المقترحة معرفات للمشاركين (Participant_ID)، ومجموعات التدخل التجريبي (Intervention_Group)، ومستويات القياس النفسي، والدرجات المحرزة. ويتم إدخال بعض السجلات بصورة مكررة تطابقاً تاماً لمحاكاة أخطاء التقديم المزدوج، وسجلات أخرى تتشارك في المعرف والفئة مع اختلاف في الدرجة لمحاكاة تكرار القياس الطولي، وسجلات تتضمن قيماً مفقودة لدراسة سلوك التصفية في ظل غياب البيانات.
بعد إتمام مرحلة الإنشاء الأولي، يأتي دور إجراء PROC PRINT كخطوة معاينة منهجية موثقة؛ حيث يسمح للمحلل باستعراض جدول الإدخال الخام، وتوثيق عدد الصفوف الكلي ومطابقتها للتصميم التجريبي الموضوع، مما يوفر خط أساس تجريبي (Empirical Baseline) يمكن الاحتكام إليه لمقارنة النتائج وحساب عدد السجلات التي سيتم استبعادها بدقة عبر مراحل التصفية اللاحقة.
2.2 استدعاء إجراء PROC SQL وفتح قنوات الاستعلام
يبدأ التفاعل مع محرك الاستعلام من خلال استدعاء العبارة التمهيدية PROC SQL، والتي تؤدي إلى تهيئة بيئة الحوسبة وتخصيص قنوات الاتصال بمكتبة العمل المؤقتة WORK أو المكتبات الدائمة المحددة مسبقاً في جلسة ساس. بمجرد تفعيل هذا الإجراء، يخصص النظام مساحات تخزين ديناميكية في الذاكرة العشوائية المتاحة (Buffers) لاستقبال صفحات البيانات أثناء تنفيذ الاستعلام ومعالجة الجداول الوسيطة دون الحاجة إلى كتابتها مبدئياً على القرص الصلب.
تتم إدارة الذاكرة هنا وفق محددات خيارات النظام مثل SORTSIZE وSUMSIZE، واللذين يحددان الحد الأقصى للموارد التي يمكن لمحرك SQL استغلالها قبل اللجوء إلى إنشاء ملفات مساعدة مؤقتة (Utility Files) على وحدات التخزين الفيزيائية. إن فهم هذه الآلية أمر بالغ الحيوية عند معالجة الجداول الضخمة، حيث تلعب كفاءة استغلال الذاكرة دوراً حاسماً في تقليص زمن التنفيذ الكلي وتجنب مشكلات الاختناق في قراءة وكتابة البيانات المتبادلة.
وكما أشرنا سلفاً، فإن الطبيعة التفاعلية لإجراء PROC SQL تفرض استخدام أمر الإنهاء QUIT لغلق قناة المعالجة وتحرير الموارد المحجوزة. إن استخدام أمر RUN بمفرده يؤدي إلى تنفيذ الاستعلام المكتوب مع إبقاء إجراء SQL نشطاً، وهو ما قد يقود إلى تداخل غير مرغوب فيه في حال تلو ذلك خطوات معالجة تقليدية دون إغلاق محكم، مما يؤكد على ضرورة الالتزام الصارم بهذا التقليد البرمجي في كتابة تعليمات ساس النظيفة.
2.3 فحص وتقييم التكرارات المبدئية قبل المعالجة
قبل الشروع المباشر في تشغيل استعلامات التصفية، تملي قواعد المنهجية العلمية والتحليل الإحصائي الرصين إجراء فحص استكشافي وتشخيصي لطبيعة التكرارات الموزعة عبر صفوف البيانات. فالهدف لا يقتصر على مجرد التخلص الآلي من الصفوف المتطابقة، بل يمتد إلى فهم وتصنيف الجذور المولدة لهذا التكرار؛ والتفريق الحاسم بين كونه ناتجاً عن أخطاء إدخال فنية غير نظامية (Random Input Errors) أو أنه يعكس سمة أصيلة في تصميم البحث، كالملاحظات التتبعية المتكررة لنفس المفحوصين عبر فترات زمنية متباينة.
يتم هذا التدقيق من خلال توثيق حجم العينة الإجمالي وعدد المشاهدات الفعلي، واستخدام استعلامات تجميعية أولية تفحص التكرار التكراري (Frequency Counts) للمفاتيح المعرفية. يساعد هذا الإجراء التوثيقي في صياغة مصفوفة قرار منهجية: هل يتطلب المسار التحليلي استبقاء القياسات المتكررة كجزء من النماذج ذات التأثيرات المختلطة (Mixed-Effects Models)، أم أن الهدف هو عزل الخصائص الديموغرافية الثابتة للمفحوصين لبناء إطار معاينة مجرد يتطلب إزالة التكرار تماماً؟
إن تسجيل هذه المؤشرات التشخيصية في مذكرات المعالجة يضمن شفافية التحليل ويمنع حدوث انزياحات غير مرئية في العينة، مما يوفر ضمانة أكاديمية تؤكد أن التصفية اللاحقة بواسطة SELECT DISTINCT جاءت تطبيقاً لخطة إحصائية واعية وليست معالجة عشوائية قد تحذف قياسات أصيلة تهم الباحث في تفسير الظاهرة محل الدراسة.
3. استخراج الصفوف الفريدة بالكامل باستخدام رمز النجمة (*)
3.1 الدلالة البرمجية لرمز النجمة مع عبارة DISTINCT
يحمل استخدام رمز النجمة (*) في لغة SQL دلالة الإسقاط الشامل (Universal Projection)، حيث يوجه النظام إلى قراءة واسترجاع كافة الأعمدة والمتغيرات المكونة للجدول دون استثناء. وعند اقتران هذا الرمز بعبارة التصفية في الصياغة التركيبية SELECT DISTINCT *، يتحول المفهوم المنطقي للاستعلام إلى فحص شامل للتفرد على مستوى السجل الكامل (Tuple-Level Uniqueness).
بموجب هذا الاقتران، لا يُعتبر الصف مكرراً ويُستبعد إلا إذا كانت كل خلية في ذلك الصف متطابقة بنسبة مئة في المئة مع نظيرتها في صف آخر عبر جميع الأعمدة الرقمية والنصية والتاريخية المعرفة في الجدول. إذا اختلف السجلان في متغير واحد فقط—وليكن طابعاً زمنياً دقيقاً أو متغيراً تقييمياً فرعياً—فإن محرك ساس سيتعامل معهما ككيانين مستقلين تماماً، وسيتم تضمينهما معاً في جدول المخرجات المسترجع دون أي حذف.
يترتب على هذا الفحص الشامل عبء حسابي مرتفع مقارنة بفحص الأعمدة المحددة، حيث يتعين على الخوارزمية إجراء مقارنة ثنائية موسعة لكافة البايتات المكونة للسجل عبر مسارات الفرز. ومع ذلك، تُعد هذه الصياغة الأداة المثلى في مراحل المعالجة الأولية الموجهة لمعالجة السجلات المكررة كلياً الناتجة عن مشكلات إعادة تصدير البيانات أو تكرار استيراد ملفات الإدخال من مصادر متعددة، حيث يُراد تنقية المصفوفة من أي توأمة ببيانات مطابقة تماماً.
3.2 التطبيق العملي وفحص الكود البرمجي التنفيذي
لتطبيق هذه المعالجة عملياً، يُكتب الاستعلام المباشر عبر تمرير أمر الاسترجاع الشامل مقيداً بعبارة التفرد من الجدول المصدر. ينبغي على المحلل أثناء تشغيل هذا الكود توجيه اهتمام بالغ لمراقبة سجل النظام الداخلي (SAS Log)، والذي يمثل الأداة التشخيصية الأساسية في بيئة ساس لمتابعة كفاءة التنفيذ وتتبع تدفق البيانات.
يقدم سجل النظام إفادات دقيقة تتضمن عدد الصفوف التي تمت قراءتها من الجدول الأصلي، وعدد الصفوف الفريدة التي استوفى الاستعلام شروطها وتمت إعادتها إلى شاشة العرض أو توجيهها إلى جدول جديد. إذا أظهر السجل أن الجدول الأصلي يحتوي على 100 مشاهدة وأن الاستعلام أعاد 85 مشاهدة، فإن ذلك يمثل دليلاً حسابياً مباشراً على وجود 15 سجلاً مكرراً تطابقاً تاماً استبعدتها الخوارزمية تلقائياً.
يساعد التفسير المنهجي للمخرجات المجدولة ومقارنتها بمصفوفة الإدخال في التحقق من أن الهيكل العام للأعمدة لم يطرأ عليه أي تغيير؛ فالترتيب الفيزيائي للمتغيرات وخصائصها التنسيقية تظل محفوظة ومطابقة تماماً للأصل، مع اختفاء التوأمة الزائدة، مما يمنح الباحث ثقة إجرائية في سلامة التحويل البرمجي وانضباطه.
3.3 مقارنة النتائج والتحقق من سلامة البيانات المستخرجة
تستدعي معايير ضبط الجودة الإحصائية إجراء تقييم مقارن بين مصفوفة البيانات قبل التصفية ومصفوفة المخرجات المستخلصة. يبدأ هذا الفحص بتحليل الانخفاض العددي لحجم العينة؛ فالتغير في عدد الحالات لابد أن يتطابق مع الإحصاء اليدوي أو التشخيصي الأولي للتكرارات التامة الذي تم إجراؤه في خطوة الفحص الاستكشافي المبدئي، لضمان عدم حدوث أي استبعاد شاذ ناجم عن سوء تخصيص الشروط.
كذلك يجب التحقق الصارم من عدم فقدان أي معلومة فريدة؛ ويتأتى ذلك من خلال فحص التوزيعات التكرارية للمتغيرات التصنيفية الحاكمة ومقارنة المجاميع الإجمالية للمتغيرات المستمرة. إن الحذف الناتج عن SELECT DISTINCT * يجب ألا يغير من القيم الفريدة الفعلية الموجودة في فضاء العينة، بل يقتصر حصراً على تقليص التكرارات الزائدة لذات القيم الملاحظة مسبقاً.
يُختتم هذا التدقيق بالتأكد من احتفاظ المتغيرات بخصائص القياس (Measurement Levels) وأنماط العرض المحددة (Formats) والتسميات التوضيحية (Labels)، دون حدوث أي تحوير ضمني للبيانات. يوثق هذا التدقيق كخطوة ضبط نوعية في مسار البحث لضمان استقرار وموثوقية البيانات التي ستعتمد عليها النماذج الإحصائية الاستدلالية اللاحقة.
4. تصفية التكرارات على مستوى متغيرات محددة (Column-Specific Distinct)
4.1 استخراج القيم الفريدة لمتغير أحادي وتطبيقاته
في كثير من السياقات التحليلية، لا يكون الهدف هو تصفية الصف بأكمله، بل ينصب التركيز على استكشاف الفضاء التصنيفي لمتغير معين؛ كحصر المستويات التجريبية الفريدة لمتغير تصنيفي اسمي أو ترتيبي. يتحقق ذلك بصياغة استعلام موجه يحدد اسم المتغير المستهدف حصراً بعد عبارة SELECT DISTINCT، كما في حالة استخراج كافة التشخيصات النفسية المسجلة في دراسة إكلينيكية دون تكرار.
يؤدي هذا الاستعلام النوعي إلى تقليص هائل في زمن المعالجة واستهلاك موارد النظام الحوسبية؛ إذ يقتصر محرك ساس جهده الفرزي والتنقيبي على قراءة ومقارنة عمود واحد فقط وتجاهل بقية المتغيرات العريضة في الجدول. ينتج عن هذا الإجراء قائمة مرجعية مقتضبة تتضمن فئات المتغير فقط، وتُعد هذه القوائم حجر الزاوية في بناء جداول المعايرة الإحصائية والتحقق من صلاحية الفئات واستبعاد القيم المدخلة خطأً التي قد تظهر بسبب عدم اتساق تسجيل البيانات الميدانية.
من الأمور الفنية الدقيقة التي يجب الانتباه إليها عند التعامل مع المتغيرات النصية تأثير المسافات البادئة واللاحقة (Leading and Trailing Blanks)؛ فمحرك SQL في ساس يقارن السلاسل النصية متضمناً هذه الفراغات إلا إذا تم استخدام دوال التهذيب النصي المناسبة مثل TRIM أو STRIP، حيث إن وجود مسافة بيضاء إضافية في نهاية سلسلة نصية قد يجعل النظام يتعامل معها كقيمة فريدة مختلفة عن ذات السلسلة الخالية من المسافات، وهو ما يستدعي التنظيف النصي الدقيق لضمان دقة استخلاص الفئات المتفردة.
4.2 تحديد التوافيق الفريدة بين متغيرات متعددة
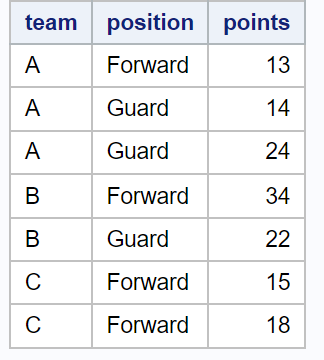
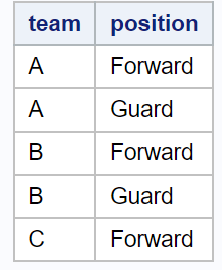
يمتد مفهوم التفرد في إجراء PROC SQL ليشمل التوافيق والتقاطعات المشتركة لمتغيرات متعددة، وهو ما يمثل تطبيقاً متقدماً لمفهوم السجل المركب (Composite Tuple). يتم ذلك عبر سرد عدة أعمدة مفصولة بفواصل بعد عبارة DISTINCT (على سبيل المثال: SELECT DISTINCT Treatment_Group, Dose_Level). في هذه الحالة، يتسع نطاق تقييم التفرد ليشمل التركيبة الثنائية أو المتعددة لتلك المتغيرات مجتمعة، دون اشتراط تفرد كل متغير بشكل مستقل.
على سبيل المثال، قد يتكرر اسم المجموعة العلاجية عدة مرات، وقد يتكرر مستوى الجرعة في عدة صفوف، ولكن الاستعلام سيعيد فقط التوليفات الفريدة والمميزة التي التقى فيها هذا المستوى بتلك المجموعة معاً في بيانات البحث الميدانية. يُعد هذا الإجراء في غاية الأهمية المنهجية لتصميم التجارب العاملية والتحليلات الإحصائية متعددة المستويات، حيث يمكن الباحث من التحقق السريع من اكتمال خلايا التصميم التجريبي (Orthogonal Factorial Design) ورصد أي خلايا فارغة أو مفقودة في مصفوفة التقاطعات قبل البدء في حساب تباين المجموعات.
تتم كتابة هذه الاستعلامات بسلاسة تركيبية عبر تمرير قائمة الأعمدة، ويقوم محرك الاستعلام بإنشاء مفتاح مركب مؤقت في الذاكرة لتنفيذ عمليات المقارنة والفرز. يتيح هذا النهج أيضاً للمحللين تلخيص التركيبات الديموغرافية الفريدة للمشاركين (مثل: الجنس، والطبقة العمرية، والمنطقة الجغرافية) في خطوة واحدة دون الحاجة إلى تشغيل خطوات تلخيصية مفرطة التعقيد.
4.3 تأثير تحديد الأعمدة على أبعاد جدول المخرجات
يُحدث حصر الأعمدة بعد عبارة SELECT DISTINCT تغييراً بنيوياً عميقاً في أبعاد مصفوفة البيانات؛ إذ يتجاوز الأمر مجرد تقليص عدد السجلات المشاهدة (الصفوف) ليشمل اقتطاعاً واختزالاً في عدد المتغيرات (الأعمدة)، وهو ما يُعرف في الأدبيات الجبرية بعملية الإسقاط مع التصفية (Projection with Elimination). يترتب على هذا الإسقاط تداعيات إحصائية وتفسيرية جوهرية لابد للباحث من استيعابها بدقة.
إن إسقاط المتغيرات غير المحددة في الاستعلام يعني بالضرورة فصل البيانات المسترجعة عن سياقها الفردي التفصيلي؛ فالقائمة المستخرجة للتوافيق الفريدة للمجموعات العلاجية ومستويات الجرعة لن تتضمن بعد الآن معرفات الأفراد أو درجاتهم المحرزة. يتحول الجدول الناتج بالتالي من جدول بيانات تفصيلي (Microdata) إلى جدول تصنيفي هيكلي أو تلخيصي يصف الإطار العام للأبعاد التجريبية دون خصائص العناصر الفردية المكونة لها.
يخدم هذا التحول البنيوي أغراضاً محددة، مثل بناء مصفوفات المعايرة، أو إنشاء جداول الإحالة للربط اللاحق، أو تجهيز أطر العينات المستهدفة. ومع ذلك، ينبغي تجنب استخدام المخرجات المختزلة كبديل للبيانات الأصلية في الحسابات التوزيعية الدقيقة، نظراً لأن اقتطاع الأعمدة يلغي الأوزان التكرارية الطبيعية لكل فئة ما لم يتم إقرانها بدوال العد التجميعي لحفظ التكرارات المقترنة بكل توليفة فريدة.
5. إنشاء وحفظ مجموعات البيانات الفريدة في بيئة ساس
5.1 استخدام عبارة CREATE TABLE لتخزين النتائج المستخرجة
يقوم السلوك الافتراضي لإجراء PROC SQL عند تنفيذ استعلام SELECT DISTINCT على إرسال النتائج المصفاة مباشرة إلى نافذة المخرجات المجدولة (SAS Results/Output Window) للمعاينة السريعة دون حفظها فيزيائياً في الذاكرة التخزينية. ولتحويل هذه النتائج إلى أصل بياني دائم يمكن استخدامه في التحليلات الإحصائية اللاحقة ونماذج النمذجة المتقدمة، يتعين دمج تعليمة الإنشاء الفيزيائي CREATE TABLE مع تعليمة الاستعلام.
تتم الصياغة البرمجية المنهجية بكتابة CREATE TABLE متبوعة باسم الجدول الجديد ثم الكلمة المفتاحية AS، يليها استعلام SELECT DISTINCT المحدد. يوجه هذا الدمج محرك ساس إلى حجز مساحة تخزينية وبناء بنية جدول جديد متكامل السمات يستوعب فقط البيانات المصفاة، محولاً نتائج الاستعلام من مجرد تقرير مرئي مؤقت إلى مجموعة بيانات قياسية تتبع قواعد التخزين المعيارية الخاصة بنظام ساس.
يخضع اختيار اسم الجدول الجديد للضوابط النحوية المعيارية لنظام ساس، والتي تشترط ألا يتجاوز طول الاسم 32 حرفاً، وأن يبدأ بحرف هجائي أو شريطة سفلية، وألا يحتوي على مسافات أو رموز خاصة. يضمن الالتزام بهذه الضوابط سلامة دمج الجدول الناتج في البرامج اللاحقة وحمايته من أخطاء التسمية غير الصالحة أثناء مراحل التنفيذ المؤتمتة.
5.2 إدارة التخزين في مكتبات ساس الدائمة والمؤقتة
تتطلب الإدارة الاحترافية للبيانات التمييز الصارم بين التخزين في المكتبة المؤقتة WORK والتخزين في المكتبات الدائمة المخصصة للمشروع البحثي (User-Defined Permanent Libraries). عند كتابة اسم الجدول مجرداً دون بادئة مكتبية في تعليمة CREATE TABLE، يوجه ساس المخرجات تلقائياً إلى مكتبة WORK؛ وهي مساحة تخزين افتراضية مؤقتة تُمسح محتوياتها بالكامل بمجرد إنهاء جلسة العمل الحالية، مما يجعلها مثالية للتحولات البيانية السريعة والجداول الوسيطة التي لا تتطلب أرشفتها المستمرة.
أما في مشاريع البحوث المشتركة والتحليلات المعتمدة التي تتطلب توثيقاً تاريخياً وسلامة استبقاء طويلة الأمد، فيتعين توجيه الجدول المصفى إلى مكتبة دائمة تم تعريفها مسبقاً عبر عبارة LIBNAME (مثل: CREATE TABLE mylib.unique_patients AS…). يضمن هذا الإجراء كتابة البيانات فيزيائياً على مسار التخزين المخصص على الأقراص الصلبة، مما يتيح استدعاءها لاحقاً عبر جلسات التحليل المختلفة ومشاركتها مع فرق العمل الإحصائي المعنية.
تفرض الحوكمة البيانية الرشيدة مراقبة دقيقة لمساحات التخزين المستهلكة؛ فعلى الرغم من أن SELECT DISTINCT تقلص عدد الصفوف عادة، إلا أن إنشاء جداول دائمة متعددة دون تفريغ دوري للجداول الوسيطة غير الضرورية قد يستنزف وحدات التخزين، خاصة عند التعامل مع مجموعات البيانات الطولية الهائلة، مما يبرز أهمية إدارة دورة حياة الجداول وحذف المؤقت منها بمجرد استيفاء أهدافه التحليلية.
5.3 فهرسة الجداول الجديدة وتوثيق خصائصها الميتاداتا
لا تتوقف عملية حفظ الجداول المصفاة عند مجرد كتابة الصفوف الفريدة، بل تمتد لتشمل تحسين وتوثيق خصائصها الميتاداتا لضمان سرعة معالجتها واستقرار استدعائها اللاحق. من الخطوات المتقدمة في هذا السياق إنشاء فهارس بحثية (Indexes) على الأعمدة المفتاحية الفريدة داخل الجدول المنشأ، مما يمنح محركات البحث والاستعلام اللاحقة قدرة الوصول الفوري للسجلات دون الحاجة للمسح الشامل للجدول في كل مرة يُجرى فيها اختبار أو تصفية إضافية.
يتكامل هذا الإجراء مع استدعاء إجراء الخصائص الوصفية PROC CONTENTS، والذي يُعد الأداة المعيارية في ساس لفحص وتوثيق السمات الميتاداتا للجدول المنشأ حديثاً. يوفر هذا الإجراء تقريراً تفصيلياً يعرض اسم الجدول وتاريخ إنشائه وعدد المتغيرات والصفوف المتبقية بعد التصفية، بالإضافة إلى التشفير المستخدم والخصائص التنسيقية للأعمدة.
يمثل التقرير الصادر عن PROC CONTENTS وثيقة ضبط جودة تثبت التزام المحلل بالبروتوكول الإحصائي المتفق عليه، مما يسهل عمليات المراجعة النظيرة وتدقيق البيانات في المنشورات العلمية، حيث يتيح للباحثين الآخرين التحقق من مطابقة عدد المشاهدات الفريدة مع الأرقام المعلنة في قسم المنهجية وعينة الدراسة في البحوث المنشورة.
6. تكامل SELECT DISTINCT مع الدوال التجميعية (Aggregate Functions)
6.1 حساب عدد القيم المتفردة باستخدام دالة COUNT(DISTINCT)
تمثل دالة COUNT(DISTINCT column_name) إحدى أكثر الأدوات قوة وتداولاً في التحليلات الاستكشافية وتجهيز البيانات المسحية والطبية. من الناحية الحسابية، تختلف هذه الدالة جذرياً عن الدالة التقليدية COUNT(*)؛ فالأخيرة تحسب إجمالي عدد الصفوف المسترجعة بصرف النظر عن تكرار القيم بداخلها، في حين تُجري COUNT(DISTINCT) مسحاً متقدماً يستثني كافة التكرارات ليحسب فقط عدد العناصر المتفردة والخاصة الموجودة في عمود محدد.
يكتسب هذا التمييز الرياضي أهمية جوهرية عند تقييم التنوع العددي للمشاركين؛ ففي دراسات المتابعة الطولية حيث يكرر المريض زياراته للعيادة مسجلاً عشرات القياسات، يُعيد استخدام COUNT(*) عدد الزيارات الكلي للمركز الصحي، بينما يعيد COUNT(DISTINCT Patient_ID) العدد الفعلي الدقيق للمرضى المستفيدين دون تضخيم ناتج عن تكرار التردد. ينعكس هذا الفارق بصورة حاسمة على دقة حساب معدلات الوقوع والانتشار في الوبائيات والدراسات السلوكية.
تتميز محركات ساس الحديثة بقدرتها على تنفيذ هذه الدالة بكفاءة متناهية، على الرغم من أن بعض قواعد البيانات العلائقية القديمة كانت تفرض قيوداً على استخدامها مع دوال تجميعية متعددة في استعلام واحد. تسمح بيئة ساس بدمج COUNT(DISTINCT) بسلاسة فائقة، متيحة للمحلل رصد عدد المفردات الفريدة لكل متغير في خطوة استعلامية موجزة ومباشرة.
6.2 تطبيق DISTINCT مع المقاييس الإحصائية المجمعة
يمتد تطبيق خيار DISTINCT إلى الدوال الإحصائية المجمعة الأخرى مثل SUM وAVG، وتتجلى صياغتها في عبارات مثل SUM(DISTINCT score) أو AVG(DISTINCT score). عند استخدام هذه الصيغة، يتغير المنطق الحسابي لعملية التجميع؛ إذ لا يتم جمع أو حساب متوسط كافة القيم المشاهدة في العمود، بل يقتصر المحرك على أخذ نسخة واحدة فقط من كل قيمة عددية فريدة متكررة واستبعاد باقي التكرارات من العملية الحسابية تماماً.
تستخدم هذه التقنية في سياقات نظرية وتطبيقية نوعية لتفادي الانحياز الحسابي؛ كأن تكون هناك بيانات موزعة هرمياً أدت إلى تكرار تسجيل مقياس ثابت على مستوى الفئة (مثل ميزانية المدرسة التي تتكرر أمام سجل كل طالب داخل تلك المدرسة). فإذا أراد الباحث حساب إجمالي الميزانيات المخصصة للمدارس دون تكرار احتساب ميزانية المدرسة الواحدة مئات المرات بعدد طلابها، فإن استخدام SUM(DISTINCT School_Budget) يضمن تجميع القيمة مرة واحدة فقط لكل مستوى مدرسي متفرد.
ومع ذلك، تفرض الأمانة العلمية تحذيراً منهجياً صارماً عند توظيف DISTINCT مع المقاييس المجمعة للمتغيرات المستمرة الحقيقية؛ إذ إن استبعاد الدرجات المتطابقة التي حدثت بصورة طبيعية بين أفراد مستقلين (كأن يحصل طالبان مستشهدان حقيقة على نفس درجة الذكاء 115) سيؤدي إلى تشويه التوزيع الاحتمالي وحساب متوسط مضلل لا يمثل العينة، مما يوجب قصر هذا الاستخدام على المتغيرات الهيكلية التجميعية وتجنب تطبيقه العشوائي على بيانات الاستجابة الفردية.
6.3 التفاعل التركيبي بين DISTINCT وعبارة GROUP BY
يكتسب التحليل الإحصائي عمقاً مضاعفاً عند الجمع بين عبارة DISTINCT وخاصية التقسيم الطبقي المتمثلة في عبارة GROUP BY. يتيح هذا التفاعل التركيبي تفتيت فضاء البيانات إلى مجموعات فرعية متجانسة وحساب المؤشرات الفريدة لكل طبقة بصورة منفصلة، مما يقدم قراءة إحصائية شديدة الدقة للتباينات الكامنة عبر المستويات التصنيفية المختلفة.
تظهر القوة الوظيفية لهذا الدمج في استعلامات مثل حساب عدد المشاركين الفريدين الذين استجابوا لكل نوع من أنواع التدخل العلاجي، حيث تُكتب الصياغة عبر طلب استرجاع متغير المجموعة التصنيفية مقترناً بعدّ المعرفات المتفردة COUNT(DISTINCT Subject_ID)، متبوعاً بعبارة GROUP BY Treatment_Group. يقوم محرك التنفيذ بعزل بيانات كل مجموعة علاجية، وبناء مصفوفة تفرد داخلية خاصة بها، ثم إرجاع ملخص رقمي دقيق يكشف فوراً عن أي عدم توازن في أعداد الخاضعين للتجربة بين الأذرع العلاجية.
من المهم برمجياً تجنب الخلط بين استخدام SELECT DISTINCT الشامل في رأس الاستعلام مع GROUP BY؛ إذ إن استخدام GROUP BY بمفردها يؤدي أصلاً إلى تقليص المخرجات لمستوى فئات التجميع الفريدة، مما يجعل إضافة DISTINCT في أول الاستعلام غير ذات جدوى إلا إذا كان القصد تطبيقها داخل الدوال التجميعية المرفقة ذاتها، وهو ما يقتضي وعياً تركيبياً بالبنية الوظيفية لكل عبارة تفادياً لكتابة تعليمات برمجية زائدة لا طائل منها.
7. التعامل مع القيم المفقودة (Missing Values) وأثرها على التصفية
7.1 المنطق البرمجي لساس في تصنيف القيم المفقودة كقيم فريدة
تعتمد بيئة ساس فلسفة برمجية صارمة ومحددة بدقة في التعامل مع القيم المفقودة (Missing Values)، وتنعكس هذه الفلسفة بصورة مباشرة على سلوك استعلامات SELECT DISTINCT. في لغة ساس، تُعامل القيمة العددية المفقودة، والمشار إليها بنقطة (.)، كقيمة نظامية معروفة تمثل أدنى قيمة عددية ممكنة في سلم الترتيب الرياضي—أي أنها رياضياً أصغر من أصغر عدد سالب يمكن تمثيله في النظام الحسابي للبرنامج. أما في المتغيرات النصية، فتُعامل القيمة الفارغة (Blank) كسلسلة نصية ذات طول صفري تأتي في مقدمة الترتيب الأبجدي.
بناءً على هذا التأطير البرمجي، يتعامل محرك PROC SQL مع القيمة المفقودة كقيمة فريدة صالحة وقائمة بذاتها ضمن نطاق المقارنة. إذا كانت مجموعة البيانات تحتوي على عدة سجلات تشتمل على قيم مفقودة في المتغير المستهدف بالتصفية، فإن استعلام SELECT DISTINCT لن يتجاهل هذه السجلات أو يستبعدها، بل سيقوم بتجميع كافة القيم المفقودة معاً وإرجاع صف واحد مخصص يمثل القيمة المفقودة المتفردة إلى جانب بقية القيم الفعلية الملاحظة.
يمثل هذا السلوك ميزة تشخيصية بالغة الأهمية؛ إذ ينبه المحلل فوراً إلى وجود حالات فقد في المتغير المفحوص، إلا أنه في الوقت ذاته قد يؤدي إلى انحياز إحصائي إذا تم التعامل مع الصف المفقود كفئة تجريبية حقيقية أثناء إعداد التقارير التصنيفية، مما يفرض ضرورة اتخاذ قرارات منهجية واعية لاستبعاد أو معالجة هذه الفراغات قبل اعتماد النتائج التوزيعية النهائية.
7.2 استبعاد وتصفية القيم المفقودة باستخدام شروط WHERE
لمنع تدفق القيم المفقودة إلى جداول المخرجات المصفاة، يتم الدمج المنهجي بين عبارة التصفية SELECT DISTINCT والعبارة الشرطية المسبقة WHERE. تعمل عبارة WHERE كمرشح أولي يعمل على مستوى قراءة السجلات من المصدر الأصلي قبل وصولها إلى مرحلة الفرز واستخراج التفرد، مما يرفع الكفاءة التشغيلية ويحمي جداول النتائج من التلوث بالبيانات الناقصة.
تتطلب الصياغة الاحترافية تطبيق الشروط المنطقية المناسبة لنوع البيانات؛ ففي المتغيرات العددية يُستخدم الشرط المعياري WHERE Column_Name IS NOT MISSING (أو الشرط المكافئ Column_Name IS NOT NULL وفق قواعد SQL المعيارية)، في حين يتم التعامل مع المتغيرات النصية باستخدام شرط التحقق من خلو السلسلة من الفراغات مثل WHERE Column_Name NE ” أو استخدام الدوال الوظيفية مثل WHERE NOT MISSING(Column_Name) التي تعمل بمرونة عالية مع كلا النمطين الرقمي والنصي على حد سواء.
يحقق هذا الفرز الشرطي المسبق وفرة ملحوظة في زمن المعالجة واستهلاك الذاكرة العشوائية؛ إذ يُعفى محرك ساس من تخصيص مساحات تخزين ومقارنة لمئات أو آلاف الصفوف الفارغة، وتقتصر عمليات استخلاص التفرد على السجلات ذات المدخلات المكتملة، مما يضمن أن تكون قائمة النتائج الفريدة ممثلة حصراً للمشاهدات الحقيقية الخاضعة للدراسة والتقييم.
7.3 التدقيق المنهجي لنسب الفقد بعد تصفية التكرارات
لا تنتهي معالجة الفقد عند مجرد استبعاده برمجياً، بل توجب المعايير المنهجية المتقدمة في البحث الكمي تدقيقاً إحصائياً للنسب والأنماط التي تشكلت نتيجة هذا الاستبعاد. يجب على الباحث إجراء مقارنة دقيقة بين عدد الحالات المفقودة المستبعدة وعدد السجلات المتكررة التي تمت تصفيتها، لضمان عدم وجود ارتباط منهجي خفي بين التكرار والفقد؛ كأن تكون السجلات المكررة ناتجة عن محاولات فاشلة للمستجيبين لإعادة ملء استبيان أدى في النهاية إلى تركه فارغاً.
يتضمن هذا التدقيق فحص آليات الفقدان وفق تصنيفات روبن الإحصائية المعتمدة: هل الفقد يحدث بصورة عشوائية تامة (Missing Completely at Random – MCAR)، أم يرتبط بمتغيرات مستقلة أخرى في مصفوفة البيانات (Missing at Random – MAR)؟ إن استبعاد القيم المفقودة عبر شروط التصفية دون تقييم هذا النمط قد يؤدي إلى انكماش حجم العينة الفعال إلى مستويات تهدد القوة الإحصائية للاختبارات اللاحقة (Statistical Power).
يساعد توثيق هذه الفحوصات في إعداد جداول تدفق العينة المعتمدة دولياً في تقارير البحوث المحكمة (مثل مخططات معايير CONSORT أو STROBE)، حيث يتم الإفصاح بشفافية كاملة عن عدد المشاهدات الأصلية، وعدد السجلات المستبعدة بسبب التكرار الكامل، وتلك المستبعدة بسبب نقص البيانات، مما يرسخ النزاهة العلمية للتحليل ويعزز إمكانية الوثوق بمخرجاته وتعميم نتائجه.
8. المقارنة المنهجية بين PROC SQL وأدوات ساس البديلة لإزالة التكرار
8.1 المقارنة التقنية مع إجراء PROC SORT وخياري NODUPKEY وNODUPRECS
يُمثل إجراء فرز البيانات PROC SORT الأداة التقليدية الأكثر شهرة في بيئة ساس لإدارة وتصفية التكرارات، وتستند المقارنة التقنية بينه وبين استعلامات PROC SQL إلى فروق هيكلية في إدارة الذاكرة وطريقة معالجة السجلات. يوفر PROC SORT خيارين رئيسيين لحذف التكرار: خيار NODUPRECS الذي يتطابق وظيفياً مع تعليمة SELECT DISTINCT *، حيث يفحص التطابق التام عبر جميع متغيرات السجل؛ وخيار NODUPKEY الذي يتطابق منطقياً مع فحص التفرد المستند إلى مفاتيح محددة (BY Variables).
يكمن الفارق الجوهري الأول في المتطلبات الإجرائية؛ إذ يشترط PROC SORT صراحة تحديد متغيرات الفرز عبر عبارة BY ويلزم النظام بإعادة الترتيب الفيزيائي لكامل مجموعة البيانات على القرص أو في الذاكرة لإنتاج مصفوفة مرتبة، في حين يمتلك محرك PROC SQL مرونة تصريحية أعلى؛ حيث يستطيع استخدام خوارزميات التجزئة في الذاكرة (Hash Algorithms) لاستخلاص السجلات الفريدة دون فرض إعادة كتابة فيزيائية كاملة للجدول في حال عدم طلب ترتيب النتائج عبر عبارة ORDER BY.
من ناحية أخرى، يتفوق خيار NODUPKEY في قدرته على استبقاء أول سجل مصادف لكل مفتاح وإسقاط باقي السجلات حتى لو تضمنت المتغيرات الأخرى غير المذكورة في عبارة BY قيماً مختلفة، وهو سلوك لا يمكن تحقيقه مباشرة في SQL بعبارة SELECT DISTINCT وحدها دون اللجوء إلى استعلامات فرعية مجمعة أو دوال نوافذ تحليلية، مما يجعل لكل أداة نطاقها الأمثل تبعاً للهدف التحليلي وطبيعة المخرجات المطلوبة.
8.2 المقارنة مع تقنيات خطوة المعالجة DATA Step (المتغيرات المؤقتة FIRST. وLAST.)
تتيح خطوة المعالجة التقليدية DATA Step للمبرمجين التحكم الأدق على الإطلاق في تصفية التكرارات عبر استخدام المتغيرات المنطقية المؤقتة FIRST.variable وLAST.variable. تتطلب هذه التقنية فرز البيانات مسبقاً وفق المتغير الحاكم، ثم الدخول في حلقة قراءة تفصيلية يولد فيها ساس متغيرات منطقية ثنائية تشير إلى بداية ونهاية كل كتلة متطابقة من القيم، مما يمنح الباحث مرونة غير محدودة في تحديد شروط الاستبقاء والاستبعاد.
تتفوق خطوة DATA Step في سيناريوهات التصفية الشرطية المعقدة؛ كأن يقرر الباحث: “إذا تكرر المفحوص، فاستبقِ السجل الذي يحمل أعلى درجة تقييمية، أو السجل الأحدث تاريخاً”، حيث يمكن التعبير عن هذه القواعد بجمل شرطية IF-THEN بسيطة داخل المعالجة السطرية. في المقابل، يتطلب إنجاز ذات المهمة داخل PROC SQL بناء استعلامات فرعية مترابطة (Correlated Subqueries) أو عمليات ربط ذاتي متعددة تزيد من التعقيد الشكلي للكود البرمجي وتستهلك موارد حوسبية إضافية.
ومع ذلك، تبرز الأفضلية المطلقة لعبارة SELECT DISTINCT في PROC SQL عندما يكون الهدف مجرد عزل وتجريد القيم أو التوليفات الفريدة دون حاجة لمنطق استبقاء شرطي؛ فالصياغة الموجزة لـ SQL تنجز التصفية بسطرين برمجية دون حاجة للفرز المسبق الإلزامي أو تعريف متغيرات مساعدة، مما يقلص أخطاء الترميز البشري ويسرع عمليات التنقيب الأولي عن البيانات.
8.3 قياس الأداء الحاسوبي وسرعة المعالجة (Benchmarking)
تخضع المفاضلة بين PROC SQL وPROC SORT لمعايير الأداء الحاسوبي ومحددات استهلاك وقت المعالج المركزي (CPU Time) وعمليات الإدخال والإخراج المتبادلة مع وحدات التخزين (I/O Operations). تشير نتائج قياسات الأداء المعيارية (Benchmarking) في بيئات ساس إلى أن إجراء PROC SORT يكون عموماً أكثر كفاءة وأسرع تنفيذاً عند التعامل مع مجموعات البيانات الضخمة جداً التي تتجاوز سعة الذاكرة العشوائية وتتطلب تصفية وفق مفاتيح محددة (NODUPKEY)، وذلك بفضل خوارزميات الفرز متعدد المسارات المحسنة فائقاً عبر عقود من التطوير البرمجي في ساس.
في المقابل، يظهر إجراء PROC SQL كفاءة موازية أو متفوقة في مجموعات البيانات الصغيرة إلى المتوسطة الحجم، أو عندما تكون البيانات المصدرية مفهرسة مسبقاً (Indexed) عبر الأعمدة المستهدفة بالتصفية. في هذه الحالة، يتخطى محرك SQL الحاجة لأي عمليات فرز مستهلكة للموارد، ويقوم باستخلاص القيم الفريدة مباشرة من شجرة الفهرس الرياضية، محققاً زمناً تنفيذياً يقترب من الصفر الحسابي.
يوصى الخبراء في هذا المضمار بمراقبة مؤشرات الأداء من خلال تفعيل خيارات النظام التشخيصية FULLSTIMER وSTIMER في جلسة ساس، مما يتيح تتبعاً دقيقاً لملفات التعريف الحوسبية لكل استعلام، ومقارنة استهلاك الموارد لاختيار الاستراتيجية البرمجية المثلى التي تضمن أعلى سرعة معالجة وأقل إجهاد ممكن للبنية التحتية للخوادم ومستودعات البيانات.
9. الأخطاء الشائعة واستراتيجيات استكشاف الأخطاء وتصحيحها (Troubleshooting)
9.1 الخلط بين التكرار الكلي للبيانات والتكرار الجزئي للأعمدة
من أكثر الأخطاء المفاهيمية والبرمجية شيوعاً بين محللي البيانات المبتدئين في ساس الافتراض الخاطئ بأن عبارة SELECT DISTINCT يمكن تطبيقها لعزل تفرد عمود معين مع استرجاع بقية الأعمدة دون تجميع أو تقييد. يؤدي هذا الخلط غالباً إلى كتابة استعلامات تتضمن أرقام تسلسلية عشوائية أو معرفات فريدة تلقائية (Row IDs / Transaction Keys) في قائمة الأعمدة، متوقعين تصفية البيانات وفق اسم المشارك فقط.
تكون النتيجة الحتمية لمثل هذا التضمين إبطال مفعول التصفية تماماً؛ فنظراً لأن كل سجل يمتلك معرفاً فريداً خاصاً به في ذلك العمود الثانوي، فإن محرك SQL سيقيم الصف ككل كصف فريد ولن يحذف أي سجل مكرر ضمنياً في الأعمدة الأساسية، وهو ما يقود إلى تضخم النتائج المرجعة واستمرار وجود تكرارات الفئات دون أن يفطن المحلل لسبب المشكلة الظاهرية في المخرجات.
تتمثل استراتيجية التصحيح المنهجية في إجراء تنقية واعية لقائمة المتغيرات المضمنة بعد عبارة SELECT؛ والتمييز الحاسم بين الأعمدة الجوهرية المحددة لكينونة الكيان التحليلي، وتلك الأعمدة الهامشية التي يجب استبعادها من استعلام التفرد، أو تحويل الاستعلام إلى استعلام تجميعي يستخدم GROUP BY مع دوال استخلاص القيم القصوى أو الدنيا للتعامل مع المتغيرات الفرعية بوعي وتحديد منضبط.
9.2 إغفال الترتيب العشوائي للبيانات وغياب عبارة ORDER BY
يقوم مبدأ راسخ في نظرية قواعد البيانات العلائقية على أن العلاقات الرياضية والمجموعات المسترجعة لا تمتلك أي ترتيب متأصل أو مضمون؛ وبالتالي، فإن عبارة SELECT DISTINCT تضمن فقط تفرد السجلات في جدول المخرجات، لكنها لا تضمن إطلاقاً ترتيباً تصاعدياً أو تنازلياً محدداً للصفوف المعادة. إن الاعتماد على أن البيانات المخرجة ستأتي مرتبة تلقائياً وفق العمود الأول هو مغالطة إجرائية خطيرة تقود إلى تقارير مشوشة وغير قابلة للمقارنة المباشرة.
قد يتغير ترتيب السجلات الناتجة عن نفس الاستعلام بين تشغيل وآخر تبعاً لخوارزمية التحسين التي يختارها محرك ساس في تلك اللحظة؛ فإذا اعتمد المحرك على جدول التجزئة (Hash Table)، فستخرج البيانات بترتيب التوزيع العشوائي لمفاتيح التجزئة، وإذا اعتمد على خوارزمية الفرز والدمج (Sort-Merge)، فستخرج بترتيب تصاعدي لمتغيرات الفرز الداخلي. هذا التباين التشغيلي قد يربك الباحثين عند مراجعة الجداول أو ربطها بملفات مطابقة لاحقة.
يقتضي الحل المهني دائماً إقران استعلامات SELECT DISTINCT بعبارة الترتيب الصريح ORDER BY كلما كانت النتائج موجهة للاستعراض البشري أو إعداد التقارير الإحصائية النهائية. يتيح التحديد الصريح لمتغيرات الترتيب واتجاهه (ASC للترتيب التصاعدي أو DESC للترتيب التنازلي) إنتاج مخرجات متسقة بصرياً ومنهجياً تدعم المقارنة المعيارية الدقيقة بين فئات العينة ومجموعاتها الفرعية.
9.3 تحليل رسائل التحذير والأخطاء في سجل ساس (SAS Log)
يمثل سجل النظام (SAS Log) المرجع التشخيصي الأول لاستكشاف الأخطاء وتصحيح المسارات البرمجية، وتتطلب القراءة الأكاديمية للسجل تمييزاً دقيقاً بين رسائل الأخطاء النحوية الصريحة (Syntax Errors)، والتحذيرات التشغيلية (Warnings)، والملاحظات الإجرائية (Notes). ومن أبرز الأخطاء الشائعة إغفال الفواصل بين المتغيرات في قائمة SELECT أو كتابة كلمات مفتاحية في مواقع غير صحيحة نحوياً مما يؤدي إلى توقف التنفيذ البرمجي فوراً.
كذلك يجب الانتباه للتحذيرات المتعلقة باستهلاك الذاكرة أو إنشاء مساحات فرز مساعدة ضخمة على القرص، والتي تشير بوضوح إلى أن خوارزمية الفرز تواجه ضغطاً حوسبياً قد يؤدي لبطء شديد في التنفيذ. ولمعالجة مثل هذه التحديات وفهم الآليات التحتية للاستعلام، توفر بيئة ساس خيارات تشخيصية متقدمة تُمرر مع أمر الاستدعاء، مثل خياري _METHOD و_TREE؛ حيث يقوم خيار _METHOD بطباعة الرموز التشغيلية للخوارزميات المستخدمة في السجل (مثل استخدام خوارزمية sqxhsh للتجزئة أو sqxsort للفرز)، كاشفاً للمحلل الآلية الفيزيائية التي نفذ بها ساس استعلام التفرد.
تتيح دراسة هذه الخيارات التشخيصية للمبرمجين المتقدمين إعادة كتابة وتعديل الاستعلامات المعقدة وتوزيع الموارد البرمجية بكفاءة، مما يحول عملية استكشاف الأخطاء من مجرد محاولات تجريبية عشوائية إلى ممارسة هندسية منهجية تستند إلى الفهم العميق لفيزياء محرك الاستعلام وتفاعلاته الحوسبية.
10. تطبيقات متقدمة وتوصيات منهجية للباحثين ومحللي البيانات
10.1 تطبيقات تصفية البيانات في المسوح الميدانية والبيانات السلوكية
تواجه البحوث المسحية الميدانية والدراسات السلوكية عبر الإنترنت تحديات منهجية متزايدة ترتبط بنزاهة البيانات المجمعة، ويأتي في مقدمتها ظاهرة التقديم المتكرر للاستبانات الإلكترونية من قبل المستجيبين أنفسهم، سواء كان ذلك بدافع الحصول على حوافز المشاركة المادية أو بسبب أخطاء الاتصال الشبكي التي تدفع المستخدم لإرسال الاستجابة عدة مرات متتالية. يؤدي هذا التكرار إلى تلويث مصفوفة البيانات وتضخيم وهمي لدرجات الاستجابة لبعض الفئات المدروسة.
يمثل إجراء SELECT DISTINCT خط الدفاع التقني والمنهجي الأول لتنقية هذه المسوح؛ حيث يُوظف لعزل وتصفية الاستجابات بالاعتماد على مصفوفة من المتغيرات المعرفية الحاكمة—مثل الجمع بين معرف المستخدم المشفر، وعنوان بروتوكول الإنترنت (IP Address)، والبصمة الزمنية، والخصائص الديموغرافية الثابتة. إن استخلاص الحالات الفريدة يحمي التحليل العاملي وتحليلات المسار (Structural Equation Modeling) من الارتباطات المصطنعة التي قد تفرزها المشاهدات المكررة لنفس الأفراد.
تتكامل هذه الممارسة مع التوثيق المنهجي الصارم لبروتوكولات الاستبعاد في تقارير البحوث المنشورة؛ حيث يتعين على الباحث الإفصاح عن عدد الاستجابات التي تم رصدها كنسخ مكررة ونسبتها المئوية من إجمالي العينة الأصلية، وتقديم تبرير إحصائي يوضح أن استبعاد هذه الحالات عبر استعلامات التفرد لم يخل بالتمثيل الديموغرافي للعينة ولم يقدم تحيزاً استجابياً جديداً يؤثر على مصداقية النتائج الإحصائية.
10.2 دمج SELECT DISTINCT في عمليات الربط المعقدة بين الجداول (SQL Joins)
تُعد معالجة التكرار التضاعفي الناتج عن عمليات ربط الجداول (SQL Joins) من أكثر التطبيقات المتقدمة التي تبرز فيها القيمة الوظيفية لعبارة SELECT DISTINCT. ففي قواعد البيانات الطبية والنفسية العلائقية، كثيراً ما تتواجد البيانات في جداول متعددة ترتبط بعلاقات متعدد إلى متعدد (Many-to-Many Relationships)، كأن يرتبط جدول تشخيصات المرضى بجدول الوصفات الدوائية المصروفة لهم عبر فترات زمنية مختلفة.
عند إجراء ربط داخلي (INNER JOIN) أو ربط يساري (LEFT JOIN) بين هذه الجداول لدمج الخصائص الديموغرافية بالتشخيصات، يؤدي وجود سجلات علاجية متعددة لكل تشخيص إلى انفجار تضاعفي في عدد الصفوف الناتجة (Fan-Out / Cartesian Expansion)، بحيث يتكرر تشخيص المريض الواحد عشرات المرات في الجدول المدمج بعدد الأدوية التي تناولها. إذا استُخدم هذا الجدول المدمج مباشرة لتقدير معدل انتشار المرض، فستكون النتيجة تضخيماً إحصائياً مضللاً تماماً.
يأتي دمج SELECT DISTINCT كحل علاجي حاسم لإعادة ضبط مصفوفة المخرجات الناتجة عن الربط؛ حيث يُصاغ الاستعلام لاسترجاع التركيبات الفريدة لمعرفات المرضى وتشخيصاتهم فقط، مسقطاً التكرار الناتج عن جدول الأدوية التابع، مما يعيد العلاقة الإحصائية إلى حجمها الطبيعي المتزن ويضمن أن النمذجة اللاحقة ستقوم على وحدات تحليلية مستقلة وممثلة للواقع السريري بدقة متناهية.
10.3 الممارسات الاحترافية الموصى بها لكتابة كود ساس قابل لإعادة الإنتاج
تقتضي معايير العلم المفتوح وقابلية إعادة الإنتاج الإحصائي (Reproducibility) الالتزام بأفضل الممارسات البرمجية عند كتابة وتوثيق استعلامات تصفية البيانات في بيئة ساس. تشمل هذه الممارسات كتابة تعليمات برمجية نظيفة وجيدة التنسيق (Clean Code)، واستخدام المسافات البادئة المنظمة التي تعكس هرمية الاستعلام، وتضمين تعليقات توضيحية شاملة تبرز الأساس المنطقي وراء استبعاد التكرارات واختيار المتغيرات المفتاحية المعتمدة في تصفية التفرد.
ومن التوصيات الفنية المتقدمة بناء وتطوير وحدات برمجية نمطية وقابلة لإعادة الاستخدام باستخدام لغة ماكرو ساس (SAS Macro Facility). تتيح هذه الوحدات المؤتمتة تمرير اسم الجدول المصدر، وقائمة المتغيرات المفتاحية، واسم جدول المخرجات كمعلمات ديناميكية تنفذ عمليات التصفية وفحص الجودة وإعداد التقارير التشخيصية آلياً عبر مختلف مجموعات البيانات في المشاريع الكبرى، مما يقلص التدخل اليدوي المتكرر ويحد من احتمالات الخطأ البشري.
أخيراً، يجب الموازنة المنهجية بين رغبة المحلل في اختزال الأكواد البرمجية وسهولة قراءتها ومراجعتها من قبل مقيمين خارجيين؛ فالكود الموثق بوضوح والذي يشرح لماذا تم استخدام SELECT DISTINCT بدلاً من الأدوات البديلة يعزز من شفافية البحث ويسهل التدقيق الأكاديمي، محولاً معالجة البيانات من مجرد إجراءات فنية صامتة إلى جزء لا يتجزأ من المنهجية العلمية الرصينة للدراسة.
خاتمة
استعرض هذا المقال الأكاديمي الشامل الأبعاد النظرية والتطبيقية لاستخدام عبارة SELECT DISTINCT ضمن إجراء PROC SQL في نظام التحليل الإحصائي ساس (SAS). لقد تبين لنا أن إدارة التفرد وتصفية التكرارات ليست مجرد مهمة تقنية لاختزال البيانات، بل هي عملية منهجية وإحصائية بالغة الأهمية تستند إلى أصول الجبر العلائقي ونظرية المجموعات، وتهدف إلى ضمان سلامة وموثوقية المؤشرات الإحصائية المستخلصة وتفادي الانحيازات الناتجة عن التكرار غير المنضبط.
من خلال الفحص التفصيلي، تعرفنا على كيفية تطبيق التصفية الشاملة على مستوى السجل الكامل باستخدام رمز النجمة (*)، وكيفية توجيه الاستعلام لحصر التفرد في متغيرات محددة وتوليفات مركبة، فضلاً عن الآليات المتطورة لتخزين الجداول الناتجة وفهرستها في المكتبات الدائمة والمؤقتة. كما تم تسليط الضوء على الأنماط التفاعلية المتقدمة مع الدوال التجميعية مثل COUNT(DISTINCT) ومعالجة الفقدان البياني، وصولاً إلى مقارنة الأداء الحوسبي مع الأدوات البديلة مثل PROC SORT وDATA Step.
إن إتقان هذه المهارات البرمجية والالتزام بالممارسات الاحترافية في التوثيق واستكشاف الأخطاء وتصميم الأكواد القابلة لإعادة الإنتاج يمثل ركيزة لا غنى عنها للباحثين ومحللي البيانات الكمية. يضمن هذا النهج المتكامل تحويل مصفوفات البيانات الأولية الصامتة إلى مدخلات إحصائية نقية وموثوقة تدعم اتخاذ القرارات العلمية والتطبيقية الدقيقة في مختلف مجالات المعرفة الإنسانية والتطبيقية.
المراجع
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Date, C. J. (2004). An introduction to database systems (8th ed.). Addison-Wesley.
- SAS Institute Inc. (2019). SAS® 9.4 SQL procedure user’s guide (4th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). Base SAS® 9.4 procedures guide: Statistical procedures. SAS Institute Inc.
- Stoltzfus, J. C. (2011). Data management and data cleaning: Basic concepts for clinical and operational research. Academic Emergency Medicine, 18(10), 1099–1104. https://doi.org/10.1111/j.1553-2712.2011.01186.x