
يمثل التمثيل البياني الدقيق للبيانات التجريبية ركيزة جوهرية في منظومة البحث العلمي الرصين، حيث لا يقتصر دور المخططات الإحصائية على مجرد تلخيص النتائج وتكثيفها بصرياً، بل يمتد ليكون أداة استدلالية تمكّن الباحثين من تقييم الفرضيات العلمية وملاحظة الفروق الجوهرية بين المجموعات التجريبية. وفي سياق العلوم السلوكية والطبية الحيوية والاجتماعية، تتجاوز الحاجة إلى عرض المتوسطات الحسابية المجردة لتفرض إدراج مقاييس دقيقة لحجم عدم اليقين ومقدار التباين العيني المحيط بتلك المتوسطات. يُعد الخطأ المعياري للمتوسط (Standard Error of the Mean – SEM) المقياس الأكثر شيوعاً واعتماداً في المنشورات الأكاديمية المحكمة للإشارة إلى مدى الدقة الإحصائية لتقديرات العينة مقارنة بالمجتمع الإحصائي الأصلي، مما يجعل التعبير عنه بواسطة أشرطة الخطأ (Error Bars) مطلباً منهجياً لا غنى عنه.
يقدم نظام التحليل الإحصائي (SAS – Statistical Analysis System) بيئة برمجية متكاملة وفائقة المرونة للتعامل مع هذا التحدي الإحصائي والبياني، إذ يجمع بين القوة الحسابية الخارقة في إدارة مجموعات البيانات المعقدة والكبيرة من جهة، والقدرات البصرية المتقدمة المتمثلة في منظومة الرسوم البيانية الإحصائية (ODS Graphics) من جهة أخرى. تتيح أدوات ساس، ولا سيما الإجراءان البارزان PROC SQL وPROC SGPLOT، الانتقال بسلاسة متناهية من مرحلة البيانات الخام المستخرجة من التصاميم التجريبية، مروراً بعمليات التجميع الرياضي واشتقاق فترات الخطأ المعياري، وانتهاءً بتوليد مخططات بيانية متقدمة تلبي أدق المعايير المفروضة من قبل جمعيات النشر الأكاديمي العالمية، مثل دليل النشر الصادر عن رابطة علم النفس الأمريكية (APA).
يهدف هذا الدليل المرجعي الموسع إلى تقديم معالجة منهجية وتطبيقية شاملة لكيفية حساب ورسم المتوسطات الحسابية معززة بأشرطة الخطأ المعياري داخل بيئة ساس. سنستعرض بعمق المفاهيم النظرية الإحصائية التي تحكم سلوك التوزيعات العينية، ونبين الاختلافات الفاصلة بين مقاييس التشتت ومقاييس الدقة التقديرية، ثم ننتقل إلى تفكيك البنية البرمجية لكتابة الاستعلامات الحسابية وهندسة الطبقات الرسومية داخل برمجية ساس. إن الإحاطة بهذه المهارات تمثل ضرورة معرفية لكل باحث يسعى إلى ترقية جودة تقاريره العلمية، وتجنب التفسيرات المضللة للبيانات، وضمان الشفافية وقابلية التكرار في الأبحاث المنشورة دولياً.
1. المفاهيم الإحصائية الأساسية للمتوسطات وأشرطة الخطأ المعياري
1.1 الأسس النظرية للخطأ المعياري ودوره في الاستدلال العلمي
يستند الاستدلال الإحصائي في جوهره إلى محاولة الوصول إلى استنتاجات موثوقة حول خصائص ومعالم مجتمعات دراسية واسعة انطلاقاً من ملاحظة عينات محدودة الحجم مستخلصة منها. في هذا السياق، يُعرّف الخطأ المعياري لمتوسط العينة كمعيار إحصائي لمدى دقة تقدير متوسط العينة ($ bar{X} $) لمتوسط المجتمع الحقيقي المجهول ($ mu $). رياضياً، ينبثق الخطأ المعياري من نظرية النهاية المركزية (Central Limit Theorem)، حيث يمثل الانحراف المعياري للتوزيع العيني الافتراضي لجميع المتوسطات الممكن استخراجها لو تكرر سحب عينات عشوائية متساوية الحجم ($ N $) من المجتمع نفسه مرات لا نهائية. يتحدد الخطأ المعياري بالمعادلة الكلاسيكية:
$$SEM = \frac{s}{\sqrt{N}}$$
حيث يشير ($ s $) إلى الانحراف المعياري المقدر للعينة، بينما يشير ($ N $) إلى حجم العينة الفعلي. تبرز المعادلة بوضوح العلاقة العكسية بين الخطأ المعياري والجذر التربيعي لحجم العينة؛ فكلما ازداد حجم العينة التجريبية، تضاءل مقدار عدم اليقين حول موضع المتوسط الحقيقي، وبالتالي تقلص طول شريط الخطأ المعياري، مما يعكس دقة قياس استدلالية أعلى.
من الضروري للغاية التمييز المنهجي الصارم بين الانحراف المعياري كمقياس وصفي بحت لتشتت درجات الأفراد حول متوسط العينة الحالية في وحدات القياس الأصلية نفسها، وبين الخطأ المعياري الذي يعمل حصراً كمقياس استدلالي لدقة التقدير. إن الخلط بين هذين المفهومين في التقارير الإحصائية يقود إلى استنتاجات مشوهة؛ فالانحراف المعياري لا يتقلص مع زيادة حجم العينة بل يستقر مقترباً من تباين المجتمع، بينما يتجه الخطأ المعياري نحو الصفر كلما كبرت العينة. تتجلى أهمية استخدام أشرطة الخطأ المعياري بوضوح في الأبحاث النفسية والتجريبية المقارنة، مثل دراسات اليقظة النفسية الحركية وتأثير الحرمان من النوم (Jewett et al., 1999)، حيث يتطلب تقييم الفروق بين مجموعات التدخل رصد استقرار التقديرات الإحصائية عبر الزمن ومستويات المعالجة المتنوعة.
أما من منظور التفسير الاحتمالي لفترات التداخل البصري بين أشرطة الخطأ، فإن النظرة الساذجة تفترض أن التباعد البصري المطلق بين شريطي خطأ مجموعتين يمثل حتماً دلالة إحصائية عند مستوى ألفا ($ p < 0.05 $)، غير أن الواقع الرياضي أكثر تعقيداً. عندما يتلامس طرفا شريطي خطأ معياريين بمقدار$ pm 1 SEM $ لمجموعتين مستقلتين متساويتي الحجم، فإن القيمة الاحتمالية لاختبار الفروق ($ t $-test) تقارب عملياً ($ p approx 0.16 $)، وليست دالة إحصائياً بالمعيار المعتاد ($ p < 0.05 $). لكي تصل الفروق إلى عتبة الدلالة التقليدية، يجب أن يبتعد الشريطان عن بعضهما بمسافة تعادل تقريباً نصف طول شريط الخطأ الواحد، وهو ما يجعل الفهم العميق للأسس الرياضية لأشرطة الخطأ شرطاً مسبقاً لتفادي الانزلاق في التفسيرات البصرية المتسرعة للرسوم البيانية.
1.2 متطلبات العرض البياني للأبحاث الأكاديمية والنشر العلمي
تفرض الهيئات الأكاديمية والمجلات المفهرسة، وعلى رأسها الجمعيات المتخصصة كجمعية علم النفس الأمريكية، معايير بالغة الصرامة في صياغة الأشكال والمخططات البيانية (APA 7th Edition Standards). تنص هذه المعايير على ضرورة أن يحقق الشكل البياني الاكتفاء الذاتي من الناحية التفسيرية، بحيث يتسنى للقارئ المتخصص استيعاب المعنى الإحصائي للرسم ومحتوياته دون الحاجة الإلزامية للرجوع إلى النص الأساسي للمقالة. يشمل ذلك وجوب التوضيح الصريح في التعليق المصاحب للشكل لنوع المؤشر الممثل بواسطة أشرطة الخطأ، كأن يُذكر صراحة: “تمثل أشرطة الخطأ الخطأ المعياري للمتوسط ($ pm 1 SEM $)” أو “تمثل فترات الثقة 95% للمتوسط”، مع تفصيل أحجام العينات لكل مستوى تجريبي.
إن إغفال تزويد المتوسطات الحسابية بأشرطة الخطأ في البحوث المقارنة يفتح الباب واسعاً أمام التفسيرات المضللة؛ إذ قد يبدو الفرق البصري بين متوسطين كبيراً جداً في مخطط الأعمدة البيانية (Bar Charts) المجردة نتيجة للتلاعب بتدريج المحور الرأسي، في حين يكشف تضمين أشرطة الخطأ المعياري عن تباين داخلي ضخم يجعل ذلك الفرق الظاهري مجرد صدفة عشوائية غير ذات دلالة. ومن ناحية أخرى، تبرز المفاضلة المنهجية بين استخدام أشرطة الخطأ المعياري واستخدام فترات الثقة (Confidence Intervals). ففي حين يُعد الخطأ المعياري مناسباً لإظهار الدقة النسبية للمتوسطات داخل التصاميم التجريبية المتوازنة والمقارنات المعملية المعقدة (Lo et al., 2012)، تفضل دراسات التحليل البعدي وحجم التأثير والتقييمات الوبائية استخدام فترات الثقة بنسبة 95%؛ نظراً لارتباطها المباشر باختبار الفرضيات الصفرية، حيث إن عدم تداخل فترة الثقة مع الصفر يعكس دلالة إحصائية صريحة عند مستوى ($ p < 0.05 $).
تؤثر جودة العرض البياني ووضوحه وسلامته التأثير المباشر على قرارات قبول الفرضيات البحثية؛ فالرسم البياني ليس حيلة تزيينية، بل هو أداة تفكير تشاركية بين الباحث ومجتمعه الأكاديمي. إن غياب أشرطة الخطأ أو تطبيقها بأساليب غير قياسية يثير شكوك المراجعين حول نزاهة المعالجة الإحصائية، ويحجب مقدار “عدم اليقين” الذي يلازم أي ظاهرة تجريبية مقاسة، وهو ما يبرهن على أن إتقان بناء هذه المخططات داخل بيئات حوسبية قوية مثل برمجية ساس يمثل كفاءة بحثية أساسية لا تقبل الإهمال.
1.3 بيئة نظام التحليل الإحصائي (SAS) وإمكانيات الرسوم البيانية الإحصائية
شهدت منظومة الرسم البياني داخل نظام التحليل الإحصائي (SAS) قفزات نوعية كبرى عبر العقود الأخيرة، متوجة بإطلاق وتطوير نظام الرسوم البيانية الإحصائية للمخرجات (Output Delivery System Graphics – ODS Graphics). بعد أن كانت الرسوم البيانية في الإصدارات القديمة تعتمد على بيئة SAS/GRAPH التقليدية المعقدة التي تفتقر للمظهر المعاصر وتتطلب ضبطاً يدوياً شاقاً للإحداثيات عبر إجراءات مثل PROC GPLOT، أحدثت منظومة ODS ثورة برمجية أتاحت إنتاج مخططات مجهزة للنشر بمظهر بصري متميز وأداء فائق الدقة عبر أوامر نصية مختصرة ومنطقية.
تكمن القوة الاستثنائية لنظام ساس في التكامل الوظيفي العميق واللحظي بين معالجة وتحويل البيانات الضخمة وبناء التصورات البصرية المتقدمة؛ حيث يستطيع الباحث صياغة أنابيب معالجة بيانات (Data Pipelines) تسحب السجلات الخام من مستودعات التخزين، وتجري عمليات التدقيق والتنقية وحساب المقاييس التجميعية، ثم تحول تلك المخرجات مباشرة إلى أشكال بيانية جاهزة للطباعة، دون أدنى حاجة لتصدير البيانات إلى برمجيات خارجية كجداول إكسل أو برامج الرسوم البيانية الأخرى. يضمن هذا النهج البرمجي النصي قابلية الإنتاج المتكرر (Reproducibility) الكاملة للتجارب العلمية؛ إذ يمكن إعادة تطبيق الشيفرة البرمجية بأكملها على مجموعات بيانات جديدة أو مستحدثة والحصول الفوري على النتائج والمخططات الإحصائية نفسها بدقة متطابقة وموثوقة.
تعتمد المنهجية المثلى داخل ساس لرسم المتوسطات مع أشرطة الخطأ المعياري على المزاوجة بين أداتين قويتين: إجراء الاستعلام البنيوي المهيكل PROC SQL وإجراء الرسم الإحصائي PROC SGPLOT. يتولى إجراء PROC SQL مسؤولية الحساب الإحصائي الفائق للمتوسطات وللخطأ المعياري واشتقاق الحدود الدنيا والعليا برمجياً في خطوة تجميعية واحدة، في حين يتولى إجراء PROC SGPLOT، بوصفه العمود الفقري لمنظومة ODS Graphics، مهام الرسم متعدد الطبقات، حيث يستقبل الجدول التلخيصي ليعيد بناء المتوسطات كنقاط مركزية مدمجة بأشرطة خطأ رأسية دقيقة وخطوط اتجاه متسلسلة تحقق أرفع متطلبات النشر العلمي.
2. إعداد وهيكلة البيانات التجريبية داخل بيئة ساس
2.1 بناء مجموعات البيانات باستخدام خطوة البيانات (DATA Step)
تبدأ أي معالجة إحصائية داخل ساس بخطوة البيانات (DATA Step)، وهي البيئة المخصصة لتعريف المتغيرات وقراءة السجلات وتشكيل مصفوفة البيانات في مكتبة العمل المؤقتة (Work Library). في التصاميم التجريبية، تتألف البيانات عادة من متغير مستقل فئوي يمثل مجموعات المعالجة أو الشروط التجريبية، ومتغير تابع كمي متصل يمثل درجات الأداء أو القياس المستهدف. تستخدم عبارة INPUT لتحديد أسماء وطبيعة المتغيرات، حيث يُضاف الرمز ($) عقب اسم المتغير إذا كان نصياً فئوياً، بينما تُترك المتغيرات الرقمية دون رموز لاحقة، وتتبع بعبارة DATALINES أو CARDS التي تحتوي على القيم الخام المرصودة.
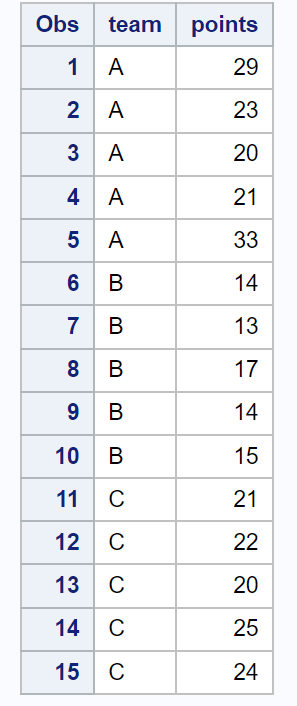
يتيح الكود البرمجي التالي إنشاء جدول بيانات تجريبي يمثل أداء عينة من المشاركين موزعين على ثلاث مجموعات تجريبية في دراسة نفسية تقارن أثر استراتيجيات التنظيم الانفعالي على زمن الاستجابة:
DATA Work.ExperimentalData;

  INPUT Group $ ResponseTime;

  DATALINES;

Control 245

Control 255

Control 260

Control 240

Control 250

Strategy_A 210

Strategy_A 215

Strategy_A 205

Strategy_A 220

Strategy_A 225

Strategy_B 180

Strategy_B 195

Strategy_B 185

Strategy_B 190

Strategy_B 175

;

RUN;
تضمن خطوة البيانات هذه تعيين الخصائص الهيكلية للبيانات بنجاح؛ حيث يتم حجز مواقع المتغيرات وتخصيص نوعها المناسب في ذاكرة النظام. بعد تنفيذ هذا الكود، يتحقق سجل ساس (SAS Log) من عدد السجلات والمتغيرات المقروءة، مؤكداً سلامة بناء الجدول وخلوه من أخطاء القراءة أو التحويل غير المتوافق، ليصبح الجدول جاهزاً للعمليات الإحصائية اللاحقة.
2.2 تنظيم المتغيرات الفئوية والكمية للتجارب النفسية
يتطلب الإعداد المنهجي للبيانات في البحوث النفسية والسريرية إيلاء عناية فائقة بترميز مستويات المتغيرات المستقلة الفئوية. يجب أن تعكس التسميات طبيعة المعالجة بدقة، مثل التمييز بين المجموعة الضابطة (Control Group) والمجموعات العلاجية المتنوعة، مع الحفاظ على اتساق الأحرف الكبيرة والصغيرة في الترميز النصي، نظراً لأن برمجية ساس تعد المتغيرات النصية حساسة لحالة الأحرف عند إجراء عمليات التجميع والفرز؛ فالسلسلة “Control” تختلف في المعالجة البنيوية عن “control”، وأي تباين غير مقصود سيؤدي إلى إنشاء فئات زائفة تشوه الحسابات التجميعية.
علاوة على ذلك، يستحسن دائماً في إطار الممارسات القياسية إدراج التسميات الوصفية الموسعة (Labels) للمتغيرات داخل خطوة البيانات أو عبر إجراء PROC DATASETS. تسهم التسميات الوصفية في استبدال الأسماء البرمجية المختصرة بتعريفات مفصلة تظهر تلقائياً على محاور المخططات البيانية لاحقاً، مما يغني الباحث عن إعادة كتابة عناوين المحاور في أوامر الرسم. على سبيل المثال، يمكن استخدام عبارة LABEL Group = "المجموعة التجريبية" ResponseTime = "زمن الاستجابة (مللي ثانية)"; لربط المتغيرات بهويتها الظاهراتية، وهو ما يدعم دراسات الأداء المعرفي والإبداعي التي تتطلب فحص الشبكات الدلالية واستجابات الأفراد بدقة تجريبية محكمة (Kenett et al., 2014).
2.3 فحص اتساق البيانات والتعامل مع القيم المفقودة والمتطرفة
قبل الشروع في اختزال البيانات الخام إلى متوسطات وأخطاء معيارية، يبرز واجب منهجي يتمثل في الفحص الشامل لاتساق السجلات والتحقق من التوزيعات التكرارية. تؤثر القيم المفقودة (Missing Values) تأثيراً مباشراً على حسابات الخطأ المعياري؛ فغياب بعض الملاحظات يؤدي إلى خفض حجم العينة الفعلي ($ N $) داخل الفئة المتأثرة، مما يترتب عليه تضخم قيمة الخطأ المعياري لتلك الفئة بالمقارنة مع الفئات المكتملة. توفر ساس آليات تصفية استباقية لاستبعاد الحالات غير المكتملة أو معالجتها، مثل إضافة عبارة الشرط WHERE ResponseTime IS NOT MISSING; لضمان استقرار العينة التحليلية.
كذلك تفرض الفرضيات الكلاسيكية للخطأ المعياري اعتدالية التوزيع داخل كل خلية تجريبية؛ فالقيم الشاذة والمتطرفة (Outliers) تمارس سحباً جارفاً للمتوسط الحسابي باتجاهها، وتؤدي إلى تضخيم الانحراف المعياري بدرجة غير متناسبة، الأمر الذي ينعكس على هيئة أشرطة خطأ مفرطة الطول توحي زوراً بارتفاع عدم اليقين في حين أن المشكلة تكمن في تشوه التوزيع العيني. يمكن للباحث توظيف إجراء الاستكشاف الأولي PROC UNIVARIATE لفحص مؤشرات الالتواء (Skewness) والتفرطح (Kurtosis) واكتشاف القيم الشاذة، مما يتيح اتخاذ قرارات تصحيحية مبنية على براهين صلبة قبل الانتقال إلى مرحلة التلخيص الإحصائي والرسم.
3. حساب المتوسطات والخطأ المعياري باستخدام إجراء PROC SQL
3.1 هيكلة استعلامات التجميع وحساب المقاييس الإحصائية
يعد إجراء الاستعلام الهيكلي PROC SQL في بيئة ساس أحد أكثر الأدوات فاعلية وأناقة في معالجة البيانات وتلخيصها؛ لكونه يدمج بين القوة الحسابية للمحرك الإحصائي لساس وقواعد لغة SQL القياسية المعترف بها دولياً. لحساب المتوسطات الحسابية والأخطاء المعيارية لكل مجموعة تجريبية بصورة فورية ومباشرة، يوفر ساس دوال تجميعية مدمجة مخصصة، أهمها دالة MEAN لحساب الوسط الحسابي، ودالة STDERR لحساب الخطأ المعياري للمتوسط مباشرة من البيانات غير المجمعة دون حاجة لحساب التباين يدوياً ثم قسمته على الجذر التربيعي.
تتم هيكلة الاستعلام عبر صياغة عبارة إنشاء جدول جديد (CREATE TABLE) يستقبل المخرجات الحسابية ليكون مهيئاً كمدخل لإجراء الرسم البياني، مع تطبيق جملة التجميع GROUP BY وفق المتغير الفئوي الممثل للشروط التجريبية، كما يوضح النموذج البرمجي التالي:
PROC SQL;

  CREATE TABLE Work.SummaryStats AS

  SELECT Group,

         COUNT(ResponseTime) AS N_Count,

         MEAN(ResponseTime) AS Mean_Response,

         STDERR(ResponseTime) AS SE_Response

  FROM Work.ExperimentalData

  GROUP BY Group;

QUIT;
يضمن هذا الاستعلام تنفيذ تجميع دقيق للبيانات؛ حيث يحسب متوسط زمن الاستجابة والخطأ المعياري وحجم العينة الفعلي لكل مستوى من مستويات المتغير الفئوي، ويخزن النتائج التلخيصية في جدول يحمل اسم SummaryStats، محققاً بذلك الكفاءة الحسابية وتجنب تكرار العمليات في خطوات برمجية متعددة.
3.2 اشتقاق الحدود الدنيا والعليا لأشرطة الخطأ برمجياً
على الرغم من أن بعض الإجراءات الرسومية المتخصصة في ساس تمتلك قدرة على حساب أشرطة الخطأ تلقائياً من البيانات الخام، إلا أن النشر العلمي الدقيق يتطلب من الباحث التحكم الكامل والمطلق في الإحداثيات الرياضية لأطراف أشرطة الخطأ. يتأتى ذلك من خلال اشتقاق المتغيرات الممثلة للحد الأدنى (Lower Limit) والحد الأعلى (Upper Limit) لشريط الخطأ صراحة عبر العمليات الحسابية داخل استعلام PROC SQL، وذلك بطرح قيمة الخطأ المعياري من المتوسط الحسابي للوصول للحد الأدنى، وجمعها معه لتحديد الحد الأعلى:
PROC SQL;

  CREATE TABLE Work.PlotReadyData AS

  SELECT Group,

         Mean_Response,

         SE_Response,

         (Mean_Response - SE_Response) AS Lower_Limit,

         (Mean_Response + SE_Response) AS Upper_Limit

  FROM Work.SummaryStats;

QUIT;
يمنح هذا الاشتقاق الصريح الباحث مرونة مطلقة في التعامل مع البيانات؛ إذ يمكنه التحقق من التناظر الرياضي لشريط الخطأ حول المتوسط الحسابي، كما يسمح في الحالات المتقدمة بحساب حدود غير متناظرة إذا كانت البيانات خاضعة لتحويلات لوغاريتمية أو توزيعات لا معلمية تتطلب تحويلاً عكسياً للمقاييس، مما يجعل جدول البيانات جاهزاً بنسبة 100% للربط البرمجي المباشر مع وسائط إجراء الرسم البياني.
3.3 التحقق من صحة المخرجات الحسابية لجدول التلخيص
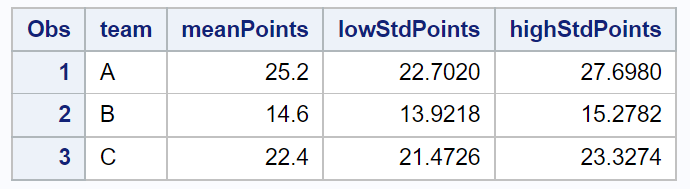
يمثل التدقيق الإحصائي للمخرجات وسيطاً إلزامياً بين مرحلة المعالجة الرقمية ومرحلة التمثيل البصري. يُستخدم إجراء العرض الطباعي السريع PROC PRINT لفحص محتويات الجدول الملخص ومطابقة القيم الناتجة مع الفهم المنطقي للظاهرة المدروسة وحجم التأثير المتوقع (Van Yperen et al., 2014):
PROC PRINT DATA=Work.PlotReadyData NOOBS;

RUN;
يتيح هذا الإجراء مراجعة فورية لقيم المتوسطات وحدود أشرطة الخطأ في سجل النتائج؛ حيث يتم فحص التناسق العددي والتأكد من خلو الجدول من أي قيم مفقودة في أعمدة الحدود (Lower_Limit وUpper_Limit). إن وجود قيمة مفقودة أو غير معرفة في هذه الحقول، سواء نتيجة وجود عينة ذات حجم واحد ($ N=1 $) يستحيل معها حساب الخطأ المعياري رياضياً أو نتيجة أخطاء كتابية، سيقود حتماً إلى فشل إجراء PROC SGPLOT في رسم شريط الخطأ للفئة المعنية، مما يؤدي إلى ظهور رسوم بيانية مبتورة تشوه مصداقية العرض العلمي.
4. الأساليب البديلة لحساب المؤشرات الإحصائية في ساس
4.1 توليد المتوسطات والأخطاء المعيارية بواسطة إجراء PROC MEANS
إلى جانب القوة البنيوية لإجراء PROC SQL، يوفر نظام ساس أدوات إحصائية كلاسيكية شديدة التخصص تبرع في استخراج المقاييس الوصفية بسرعة فائقة، ويأتي في مقدمتها إجراء PROC MEANS. يمتلك هذا الإجراء بنية مكرسة للتحليل الوصفي تتيح تحديد المتغيرات الفئوية المقسمة عبر عبارة CLASS، والمتغيرات الكمية المستهدفة عبر عبارة VAR، مع إمكانية استدعاء المؤشرات الرياضية المطلوبة بالاسم مباشرة مثل MEAN وSTDERR وN.
لتصدير النتائج التلخيصية من PROC MEANS إلى جدول بيانات هيكلي يصلح للرسم المباشر، تُستخدم عبارة OUTPUT OUT= مع ربط المؤشرات بمسميات أعمدة واضحة ومحددة:
PROC MEANS DATA=Work.ExperimentalData NOPRINT;

  CLASS Group;

  VAR ResponseTime;

  OUTPUT OUT=Work.MeansOutput(WHERE=(_TYPE_=1))

         MEAN=Mean_Response

         STDERR=SE_Response

         N=Sample_Size;

RUN;
تتميز هذه الطريقة بإجراء حسابات الإحصاء الوصفي بكفاءة حسابية استثنائية، كما تتيح عبر وسيطة التصفية _TYPE_=1 استبعاد الصف الإجمالي الذي يمثل متوسط العينة الكلية الشاملة، والاحتفاظ فقط بالصفوف الممثلة للمجموعات التجريبية المستقلة، مما يوفر جدولاً فائق الترتيب يماثل تماماً في محتواه جدول PROC SQL السابق.
4.2 استخراج الإحصاءات التلخيصية باستخدام إجراء PROC SUMMARY
يتشابه إجراء PROC SUMMARY تشابهاً هيكلياً وتطابقياً كبيراً مع إجراء PROC MEANS في المحرك التحليلي الداخلي، إلا أنه صُمم في الأساس ليعمل كأداة حوسبية صامتة موجهة لإنتاج ملفات البيانات المخرجة دون إرسال جداول مطبوعة إلى نافذة المخرجات (Output Window)، مما يجعله الخيار المفضل في أتمتة العمليات البرمجية الواسعة والأنظمة التحليلية الكبيرة. يمتاز PROC SUMMARY بالدعم التلقائي لخيار NWAY، وهو خيار جوهري يوجز العمليات ويأمر ساس بحصر المخرجات في أعلى مستويات التقسيم الفرعي فقط وتجاهل التجميعات الهرمية الدنيا تلقائياً.
يبرز النموذج التالي كيفية توظيف PROC SUMMARY بكفاءة تامة:
PROC SUMMARY DATA=Work.ExperimentalData NWAY;

  CLASS Group;

  VAR ResponseTime;

  OUTPUT OUT=Work.SummaryOutput(DROP=_TYPE_ _FREQ_)

         MEAN=Mean_Response

         STDERR=SE_Response;

RUN;
يمنح تطبيق خيار DROP=_TYPE_ _FREQ_ الباحث مصفوفة بيانات نظيفة وخالية من المتغيرات النظامية الإدارية التي يولدها ساس عادة، مما يسهل دمج الجدول في سلاسل الأوامر اللاحقة لبناء الرسوم البيانية المتطورة بسلاسة برمجية عالية.
4.3 مقارنة الكفاءة الحسابية بين الأساليب المختلفة للبيانات الضخمة
عند التعامل مع مجموعات بيانات تجريبية بالغة الضخامة تشتمل على ملايين الملاحظات، كما هو الحال في تسجيلات الإشارات الفسيولوجية العصبية أو مقاييس التتبع الزمني عالي التردد (Roebuck et al., 2013)، تغدو المفاضلة بين أساليب التلخيص الحسابي مسألة كفاءة حيوية تؤثر في استهلاك الذاكرة العشوائية وسرعة المعالجة المركزية (CPU Time). يقدم الجدول المقارن التالي تقييماً شاملاً للمنهجيات الثلاث المتاحة داخل ساس:
- إجراء PROC SQL: يتميز بأعلى درجات المرونة المنطقية في الدمج والاشتقاق الحسابي المباشر للحدود العليا والدنيا في خطوة واحدة، ولكنه قد يستهلك ذاكرة افتراضية أكبر ويتطلب وقتاً أطول في الفهرسة عند معالجة الجداول العملاقة غير المفهرسة.
- إجراء PROC MEANS: يقدم توازناً مثالياً للمجموعات المتوسطة والصغيرة مع توفير خيارات إحصائية إضافية متعددة كالمئينات والانحرافات الربيعية، غير أنه يتطلب تحكماً دقيقاً في تصفية متغيرات النظام (_TYPE_).
- إجراء PROC SUMMARY: يمثل الخيار الأكثر تفوقاً وسرعة في معالجة البيانات الضخمة (Big Data) عند اقترانه ببيانات مفرزة مسبقاً بواسطة إجراء PROC SORT، حيث يحقق أدنى معدلات استهلاك للذاكرة وأسرع زمن استجابة حوسبي.
تقتضي أفضل الممارسات التوثيقية في الأبحاث العلمية الرصينة كتابة تعليقات تفسيرية داخل الكود تشرح سبب اختيار طريقة حسابية محددة، مما ييسر على فرق المراجعة والتدقيق الخارجي إعادة إنتاج التحليلات الإحصائية الوصفية وتكرار النتائج بثقة تامة.
5. التمثيل البياني للمتوسطات وأشرطة الخطأ بواسطة PROC SGPLOT
5.1 المبادئ المعمارية لإجراء الرسم الإحصائي PROC SGPLOT
يمثل إجراء PROC SGPLOT (Statistical Graphics Plot) الركيزة الأساسية لمنظومة الرسوم الإحصائية الحديثة في ساس، حيث يستند في جوهره إلى مفهوم “الطبقات البصرية المتراكبة” (Layered Visual Architecture). بموجب هذه الفلسفة المعمارية، يتعامل الإجراء مع الرسم البياني كلوحة رسم رقمية ثلاثية الأبعاد، تبدأ بمحاور إحداثية أساسية، ثم تضاف فوقها طبقات متتابعة من العناصر البيانية مثل النقاط (Points)، وخطوط التوصيل (Series)، وأشرطة الخطأ (Error Bars)، ونطاقات الثقة (Bands)، والمضلعات التوضيحية، بترتيب هندسي متسق يضمن عدم حجب البيانات الحيوية.
يبدأ الإجراء بتحديد جدول البيانات المدخل الحاوي على المتوسطات والحدود المشتقة عبر عبارة DATA=. تتولى العبارات اللاحقة قراءة المتغيرات وتوزيعها على المحاور؛ فالمحور الأفقي ($ X $) يمثل عادة المتغير المستقل الفئوي، في حين يخصص المحور الرأسي ($ Y $) للمتغير التابع المقاس. إن التدفق المنطقي لتنفيذ العبارات داخل SGPLOT هو ما يحدد أسبقية الظهور البصري؛ إذ تُرسم العناصر المحددة في العبارات الأولى في الخلفية، بينما تطفو العناصر المحددة في العبارات المتأخرة على السطح، وهو مبدأ حاسم لتحقيق التنسيق البصري المتوازن للمخطط النهائي.
5.2 توظيف عبارة SCATTER لتمثيل النقاط وأشرطة الخطأ المعياري
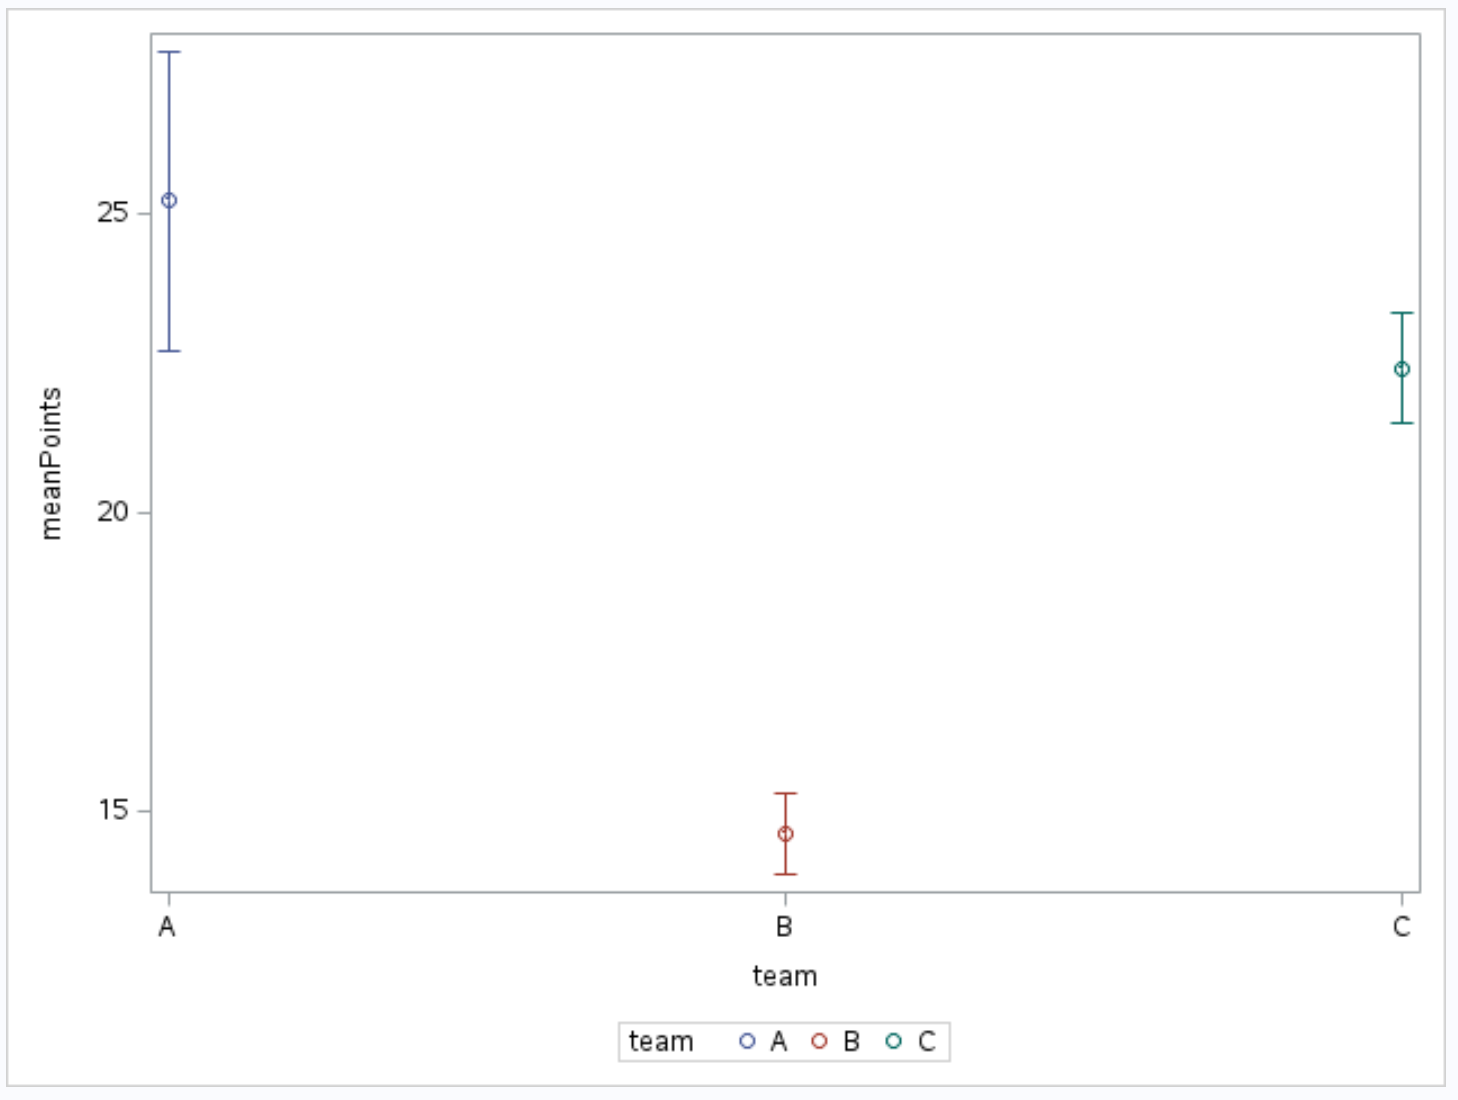
تعد عبارة SCATTER الأداة المثلى والأكثر دقة لتمثيل المتوسطات الحسابية كنقاط إحداثية مركزية مترافقة مع أشرطة الخطأ الرأسية. تتميز هذه العبارة بوجود خيارات مدمجة فائقة التخصيص تسمح بالربط الرياضي المباشر مع متغيرات الحدود الدنيا والعليا التي جرى اشتقاقها سابقاً، وذلك باستخدام الوسيطتين المخصصتين: YERRORLOWER=Lower_Limit وYERRORUPPER=Upper_Limit.
يوضح الكود التالي البنية البرمجية الأساسية لتوليد هذا الرسم البياني:
PROC SGPLOT DATA=Work.PlotReadyData;

  SCATTER X=Group Y=Mean_Response /

          YERRORLOWER=Lower_Limit

          YERRORUPPER=Upper_Limit

          MARKERATTRS=(SYMBOL=CircleFilled SIZE=9pt COLOR=DarkBlue)

          ERRORBARATTRS=(THICKNESS=1.5pt COLOR=DarkBlue CAPSHAPE=Bracket);

RUN;
يحقق هذا الكود التموضع الدقيق للنقاط المركزية؛ حيث يعرض المتوسط كدائرة مصمتة أنيقة بواسطة SYMBOL=CircleFilled، ويمد شريط خطأ متماثل عمودياً ينطلق من الحد الأدنى وحتى الحد الأعلى، مع ضبط شكل قبعات أشرطة الخطأ عبر CAPSHAPE=Bracket لتوفير نهايات خطية أفقية بارزة تسهل المقارنة البصرية للمستويات بدقة، بما يتوافق بالكامل مع أرقى متطلبات الإخراج الفني للمجلات العلمية العالمية.
5.3 تفعيل خيارات التصنيف والمجموعات عبر وسيطة GROUP
تزداد التصاميم التجريبية تعقيداً عند اشتمالها على مستويات تصنيفية متعددة، كأن يتم قياس درجات المشاركين تحت ظرفين تجريبيين مختلفين عبر مجموعات متعددة. توفر عبارة SCATTER وسيطة بالغة القوة هي GROUP=، تتيح فرز البيانات وتصنيفها تلقائياً بالاعتماد على متغير فئوي إضافي، مما يؤدي إلى منح كل مجموعة فرعية لوناً وشكلاً هندسياً متمايزاً للرموز وأشرطة الخطأ المرافقة لها.
عند تفعيل وسيطة GROUP، يتولى نظام ODS ربط العناصر البصرية تلقائياً بوسيلة الإيضاح (Legend)، مع الحفاظ على الاتساق اللوني للأشرطة والنقاط التابعة للمجموعة الواحدة. علاوة على ذلك، يمنع هذا التصنيف التلقائي حدوث أي التباس في تعيين القيم؛ حيث يتم عزل المتوسطات وحساب أخطائها لكل فئة فرعية على حدة وبدقة رياضية محكمة، مما يوفر رؤية تحليلية واضحة للتنوع البنيوي الكامن داخل العينات التجريبية.
6. إضافة خطوط الاتجاه وتنسيق المسارات التجريبية
6.1 دمج عبارة SERIES للربط الخطي بين المتوسطات
في العديد من الدراسات النفسية والسلوكية التي تتناول قياسات متتابعة أو تجارب متعددة المراحل، لا يكفي عرض النقاط المنفصلة للمتوسطات، بل يتطلب التحليل البصري تتبع مسار التغير والتحول عبر الزمن أو الشروط التجريبية المتصاعدة. يتحقق ذلك في إجراء PROC SGPLOT عبر دمج عبارة SERIES مع عبارة SCATTER في خطوة برمجية واحدة متكاملة، حيث تتولى عبارة SERIES رسم خط متصل يصل بين قيم المتوسطات المتتالية لكل مجموعة.
يتطلب هذا الدمج فهماً دقيقاً لقواعد ترتيب الطبقات داخل الإجراء الرسومي، كما يظهر في النموذج الآتي:
PROC SGPLOT DATA=Work.PlotReadyData;

  SERIES X=Group Y=Mean_Response /

         LINEATTRS=(THICKNESS=2pt PATTERN=Solid COLOR=SlateGray);

  SCATTER X=Group Y=Mean_Response /

          YERRORLOWER=Lower_Limit

          YERRORUPPER=Upper_Limit

          MARKERATTRS=(SYMBOL=SquareFilled SIZE=8pt COLOR=Crimson)

          ERRORBARATTRS=(THICKNESS=1.5pt COLOR=Crimson);

RUN;
إن وضع عبارة SERIES أولاً قبل عبارة SCATTER يضمن هندسياً رسم خط الاتصال في الطبقة السفلية، لتعلوه بعد ذلك علامات المتوسطات وأشرطة الخطأ المعياري دون أن يخترق الخط الهندسي النقاط المركزية أو يطمس معالمها البصرية، مما يوفر مظهراً احترافياً فائق النقاء يسهل قراءة التغير في الأداء عبر الشروط التجريبية المختلفة.
6.2 إدارة التباعد البصري وتفادي تداخل أشرطة الخطأ
تتمثل إحدى العقبات البصرية الكبرى عند تمثيل مجموعات تجريبية متعددة مقاسة عند النقاط التجريبية نفسها في ظاهرة “التداخل البصري” (Visual Overlap)، حيث تتطابق الإحداثيات الأفقية للنقاط، مما يؤدي إلى ركوب أشرطة الخطأ فوق بعضها البعض وطمس معالم التباين الفردي لكل مجموعة. يقدم إجراء PROC SGPLOT حلاً هندسياً عبقرياً لهذه المشكلة من خلال تفعيل خيار العرض العنقودي GROUPDISPLAY=CLUSTER المقترن بخيار ضبط التباعد CLUSTERWIDTH=.
يعمل هذا الخيار على إحداث إزاحة أفقية طفيفة ومنظمة (Jittering / Offsetting) لمواقع المجموعات المتجاورة عند كل تصنيف، مما يؤدي إلى فصل أشرطة الخطأ رأسياً جنباً إلى جنب بمسافة يحددها الباحث بدقة. يتيح هذا الفصل الحركي للقارئ مقارنة أطوال أشرطة الخطأ المعياري ومواضع المتوسطات في لمح البصر دون أي غموض أو تشويش ناتج عن التراكب، وهو أمر جوهري في توضيح التباين الداخلي وتفادي التفسيرات الإحصائية المغلوطة.
6.3 تخصيص أنماط الخطوط وسمكها لتعزيز الجودة البصرية
تفرض المجلات الأكاديمية معايير مشددة تراعي إمكانية طباعة المخططات بالأبيض والأسود أو عبر التدرجات الرمادية، الأمر الذي يتطلب الاعتماد على تنويع أنماط الخطوط وليس فقط الألوان لتمييز المسارات التجريبية. يتيح ساس عبر خيار LINEATTRS= تحكماً دقيقاً في نمط الخطوط؛ حيث يمكن تخصيص نمط خط مصمت (Pattern=Solid) للمجموعة الضابطة، ونمط متقطع (Pattern=Dash) أو منقط (Pattern=Dot) للمجموعات التجريبية والعلاجية.
علاوة على ذلك، ينبغي موازنة سمك الخطوط (Thickness) وحجم العلامات (Size) ليتناسب مع أبعاد المخطط النهائي؛ فالخطوط شديدة الرقة تختفي عند تصغير المخطط ليناسب مقاسات أعمدة المجلات، في حين تؤدي الخطوط المفرطة في السماكة إلى إرباك العين وحجب التفاصيل الإحصائية الدقيقة. يتيح ساس أيضاً التحكم في الشفافية اللونية (Transparancy) للعناصر البيانية، مما يمنع حجب البيانات الخلفية ويضفي عمقاً جمالياً يتماشى مع التقاليد البصرية الراسخة في المطبوعات العلمية الرصينة.
7. التحكم المتقدم في المحاور والعناصر الجمالية للمخطط
7.1 تنسيق المحور الرأسي (YAXIS) وتحديد حدود القياس
يمثل المحور الرأسي ($ Y $) الحاضن الأساسي لقيم المتغير التابع، وأي سوء تقدير في ضبط خصائصه قد يقود إلى تشويه الحقائق العلمية. تعتمد الممارسة الإحصائية الأخلاقية على تجنب التلاعب بتدريج المحور الرأسي، والبدء بالقيمة الصفرية كلما كان ذلك منطقياً لطبيعة القياس، لمنع المبالغة البصرية غير الواقعية في حجم التأثير المقاس. ومع ذلك، في المقاييس النفسية ذات المجالات المحددة مسبقاً (مثل مقاييس ليكرت ذات الخمس أو السبع نقاط)، يفضل ضبط الحدين الأدنى والأعلى ليتوافقا مع المدى الفعلي للمقياس.
تستخدم عبارة YAXIS لضبط هذه الإعدادات المتقدمة، كما يوضح المثال التالي:
YAXIS LABEL="متوسط زمن الاستجابة (مللي ثانية)"

      MIN=150 MAX=300

      VALUES=(150 TO 300 BY 25)

      GRID

      LABELATTRS=(SIZE=10pt WEIGHT=Bold);
يراعى هنا تضمين خياري MIN= وMAX= بمدى يتسع لاحتواء أطراف أشرطة الخطأ العليا والدنيا بكامل امتدادها؛ إذ إن حصر نطاق المحور الرأسي في مدى ضيق جداً قد يؤدي إلى “اقتصاص” أطراف أشرطة الخطأ العلوية أو السفلية واختفائها من الرسم، مما يولد شكلاً مشوهاً يوحي بوجود خطأ في التحليل الإحصائي. وتسهم إضافة خطوط الشبكة الإرشادية عبر خيار GRID في مساعدة القارئ على إسقاط القيم رقمياً وتقدير الفروق بالعين المجردة بدقة وموثوقية.
7.2 تخصيص المحور الأفقي (XAXIS) وتنسيق الفئات التجريبية
يختص المحور الأفقي ($ X $) باستعراض الفئات التجريبية أو التسلسل الزمني للمتغير المستقل. توفر عبارة XAXIS تحكماً شاملاً في ترتيب ظهور المجموعات، وهو أمر حاسم لترتيب الشروط وفق منطق التجربة؛ كأن تظهر المجموعة الضابطة أولاً تليها المعالجات بتسلسل ارتقائي أو زمني مدروس، بدلاً من الاعتماد على الترتيب الأبجدي التلقائي الذي قد يفرضه البرنامج بصورة عشوائية.
يتيح الكود التالي تنسيق خصائص المحور الأفقي بدقة متناهية:
XAXIS LABEL="الشروط التجريبية"

      DISCRETEORDER=DATA

      FITPOLICY=Rotatethin

      VALUEATTRS=(SIZE=9pt);
يضمن خيار DISCRETEORDER=DATA احترام ترتيب الفئات كما وردت هيكلياً في جدول البيانات الأصلي. كما يتيح خيار FITPOLICY=Rotatethin مرونة استثنائية في التعامل مع التسميات النصية الطويلة للفئات؛ حيث يمنع تداخل النصوص عبر تدويرها بزوايا مدروسة أو مباعدتها بنظام، مع حذف العلامات التدريجية الزائدة (Tick Marks) للحفاظ على التناسق البصري والأناقة التعبيرية للمخطط.
7.3 تنسيق وسيلة الإيضاح (Legend) وعناوين المخطط
تكتمل الجودة الشكلية للرسم الإحصائي بضبط وسيلة الإيضاح والعناوين والحواشي السفلية عبر عبارات KEYLEGEND وTITLE وFOOTNOTE. يتطلب التنسيق الأكاديمي الرصين استبعاد وسيلة الإيضاح إذا كان المخطط يتناول بعداً تصنيفياً واحداً مبيناً بوضوح على المحور الأفقي، تجنباً للحشو البصري المشتت للانتباه. أما عند وجود مجموعات متعددة، فيفضل وضع وسيلة الإيضاح في موضع مدروس، سواء أعلى المخطط أفقياً أو داخل المساحة البيضاء الشاغرة في منطقة الرسم لتقليل المساحات المهدورة.
تعتبر الحاشية السفلية المنسقة عبر عبارة FOOTNOTE من المتطلبات المنهجية التي لا يمكن الاستغناء عنها في أبحاث العلوم السلوكية؛ إذ تتولى توثيق المعنى الرياضي الدقيق للشكل، كما يبرز في الكود التالي:
TITLE BOLD "أثر استراتيجيات التنظيم الانفعالي على كفاءة الأداء المعرفي";

FOOTNOTE J=Left "ملاحظة: تمثل النقاط المركزية المتوسطات الحسابية؛ تمثل أشرطة الخطأ الخطأ المعياري للمتوسط (±1 SEM).";

KEYLEGEND / POSITION=Top NOBORDER;
يضمن هذا الإفصاح المنهجي الصريح استيفاء معايير الشفافية الدولية؛ حيث يتم توضيح طبيعة المؤشر البصري وحجم عدم اليقين بأسلوب رصين يرفع من القيمة الأكاديمية للمخطط المنشور.
8. التطبيق العملي على التصاميم التجريبية في العلوم النفسية
8.1 تمثيل تجارب القياسات المتكررة وعبر الزمن (Repeated Measures)
تحظى تصاميم القياسات المتكررة بمكانة مركزية في البحوث النفسية والسريرية؛ لكونها تتيح رصد التغير في السمات والاضطرابات السلوكية لدى الأفراد أنفسهم عبر نقاط زمنية متعددة (مثل: القياس القبلي، القياس البعدي، والمتابعة). ومع ذلك، تواجه هذه التصاميم إشكالية إحصائية كبرى عند رسم أشرطة الخطأ المعياري للمتوسطات؛ فالخطأ المعياري الكلاسيكي ($ SEM $) يفترض استقلالية المشاهدات تماماً، في حين أن القياسات المأخوذة من المشارك نفسه عبر الزمن ترتبط فيما بينها بتباين مشترك (Covariance) وثيق (Curran & Hussong, 2003).
إن تجاهل هذا الارتباط وحساب الخطأ المعياري بالطريقة التقليدية بين المجموعات (Between-Subjects SE) يؤدي إلى تضخيم شريط الخطأ بصورة زائفة، مما يخفي الدلالة الحقيقية للتغير النمائي أو العلاجي عبر الزمن. للتغلب على هذه المعضلة، يلجأ الباحثون المتمرسون داخل بيئة ساس إلى حساب الخطأ المعياري داخل الأفراد (Within-Subjects SE) بعد إزالة التباين الفردي الثابت بين المشاركين (Subject-level Variance) باستخدام نماذج خطية عامة عبر إجراء PROC GLM أو PROC MIXED، ومن ثم تصدير المتوسطات المعدلة والأخطاء المعيارية الناتجة إلى جدول تلخيصي يُرسم بواسطة PROC SGPLOT، مما يعكس بصدق مسارات التطور المعرفي أو الانفعالي الحقيقي دون تشويش إحصائي.
8.2 رسم تفاعلات العوامل التجريبية المتعددة (Factorial Designs)
تعتبر التصاميم العاملية (مثل التصميم العاملي $ 2 times 2 $ أو $ 2 times 3 $) حجر الزاوية في الكشف عن التفاعلات المعقدة بين المتغيرات؛ كأن يتم فحص أثر نوع التدخل العلاجي (علاج سلوكي جدلي مقابل علاج المعالجة المعرفية) عبر مستويات متباينة من شدة الصدمة النفسية (Bohus et al., 2020). يمثل الرسم البياني في هذه الدراسات الوسيلة الأبلغ لفهم وتفسير التأثير التفاعلي (Interaction Effect)؛ إذ يشير تقاطع خطوط المتوسطات أو اختلاف ميلها دلالياً عبر الشروط إلى وجود تفاعل معنوي حاسم بين المتغيرين المستقلين.
تتم هيكلة كود ساس لعرض هذه التفاعلات عبر تعيين أحد العوامل على المحور الأفقي وتعيين العامل الآخر كمتغير تجميعي في وسيطة GROUP= داخل عبارات SERIES وSCATTER:
PROC SGPLOT DATA=Work.FactorialPlotData;

  SERIES X=InterventionType Y=Mean_PTSD_Score /

         GROUP=TraumaSeverity

         LINEATTRS=(THICKNESS=2pt);

  SCATTER X=InterventionType Y=Mean_PTSD_Score /

          GROUP=TraumaSeverity

          YERRORLOWER=Lower_Limit

          YERRORUPPER=Upper_Limit

          GROUPDISPLAY=Cluster CLUSTERWIDTH=0.25

          MARKERATTRS=(SIZE=8pt);

RUN;
يسهم التنسيق العنقودي في فك التداخل عند نقاط الالتقاء، مما يتيح فحص التباين والخطأ المعياري لكل تركيبة عاملية على حدة، ويزود الباحثين بأداة بصرية حاسمة تدعم نتائج تحليلات التباين متعددة الاتجاهات (Factorial ANOVA).
8.3 تطبيقات الفروق بين الجنسين والمجموعات الإكلينيكية
تكتسي المقارنات الإكلينيكية بين المرضى المشخصين باضطرابات نفسية كالقلق الحاد أو الاكتئاب والمجموعات الضابطة غير الإكلينيكية أهمية قصوى في التشخيص وتطوير البروتوكولات العلاجية (James et al., 2015). في كثير من هذه التطبيقات، تواجه الدراسات معضلة “التصاميم غير المتوازنة” (Unbalanced Designs)، حيث يكون حجم العينة الإكلينيكية المتاحة صغيراً نسبياً مقارنة بالعينة الضابطة الواسعة، كما يلاحظ في الدراسات الوبائية ومراجعات الطوارئ النفسية للأطفال والمراهقين (Madigan et al., 2023).
ينعكس عدم توازن حجم العينات مباشرة على الرسوم البيانية الإحصائية؛ فالشريحة الإكلينيكية ذات الحجم الصغير ($ N $) ستظهر حتماً بشريط خطأ معياري طويل يعبر عن تراجع دقة التقدير، بينما ستظهر المجموعة الضابطة بشريط خطأ دقيق وقصير. إن إبراز هذا التباين في أطوال أشرطة الخطأ داخل المخطط المنتج ببرمجية ساس يعكس الشفافية العلمية المطلقة؛ فهو يضع القارئ والممارس الإكلينيكي في الصورة الحقيقية لمقدار عدم اليقين المصاحب للمؤشرات السريرية، ويحول دون تعميم الاستنتاجات الطبية بناءً على فروق مظهرية هشة تفتقر للصلابة الإحصائية.
9. تشخيص واستكشاف الأخطاء الشائعة وحلولها البرمجية
9.1 معالجة أخطاء التجميع وبناء الجداول في PROC SQL
أثناء مرحلة التجميع الحسابي داخل إجراء PROC SQL، كثيراً ما يواجه المبرمجون والباحثون رسائل تحذيرية أو أخطاء تعطل تدفق التحليل في سجل ساس (SAS Log). من أشهر هذه الأخطاء غياب عبارة GROUP BY عند استدعاء الدوال التجميعية مثل MEAN وSTDERR؛ ففي حال نسيان تحديد متغير المجموعات الفئوي، يقوم ساس بتطبيق الدالة التجميعية على كامل الجدول وحساب متوسط العينة الكلية الشاملة، ثم يعيد دمج هذا المتوسط الشامل مكرراً أمام كل سجل مفرد، مما يولد جدولاً هجيناً يشوه الحسابات اللاحقة تماماً.
تتمثل المشكلة الشائعة الأخرى في حدوث تعارض بين أسماء المتغيرات المستحدثة والمتغيرات الأصلية عند إعادة التسمية بواسطة AS، أو ارتكاب أخطاء في التحويل الضمني بين المتغيرات النصية والرقمية؛ كأن يكون متغير المجموعات مخزناً كنص مشوب بفراغات بادئة أو لاحقة تؤدي إلى تجزئة الفئة الواحدة إلى مستويات متعددة في التجميع. لحل هذه الإشكالية، يجب دائماً استخدام دالة التنظيف النصي STRIP(Group) في جمل الاستعلام، ومراجعة سجل ساس بدقة للتأكد من خلوه من رسائل التحذير (WARNING) التي تشير إلى عمليات دمج قسري أو إعادة تدوير غير متوقعة للبيانات.
9.2 استكشاف أخطاء الرسم البياني في إجراء PROC SGPLOT
تتنوع الأعطال البصرية في إجراء PROC SGPLOT بين أخطاء برمجية صريحة توقف تنفيذ الكود وأخطاء خفية تؤدي إلى إنتاج رسوم ناقصة أو غير صحيحة. يأتي في مقدمة المشكلات الخفية “اختفاء أشرطة الخطأ” تماماً من الرسم رغم ظهور النقاط المركزية؛ ويعود السبب في الغالب إلى عدم تطابق أسماء الأعمدة المحددة في وسائط YERRORLOWER وYERRORUPPER مع المسميات الفعلية المخزنة في جدول المخرجات، أو وجود قيم مفقودة (Missing) في تلك الأعمدة في جدول البيانات.
كما تبرز مشكلة شائعة أخرى تتمثل في “اقتصاص نهايات أشرطة الخطأ” أو تشويه قبعاتها؛ وتنشأ هذه المعضلة عندما يقوم الباحث بضبط الحدين MIN= وMAX= في عبارة YAXIS ليتناسبا فقط مع مجال قيم المتوسطات الحسابية، متناسياً أن أشرطة الخطأ تمتد لمسافة إضافية للأعلى والأسفل. يؤدي هذا الضيق إلى قيام المحرك الرسومي بقطع ما يقع خارج النطاق المحدد قسراً دون إشعار الباحث بوجود خطأ منهجي. يكمن الحل البرمجي الجذري في حساب القيمة الدنيا المطلقة للحد الأدنى والقيمة القصوى للحد الأعلى عبر خطوة استعلامية استباقية وضبط نطاق المحور ليتجاوز تلك القيم بهامش أمان بصري مريح.
9.3 التأكد من التوافق البرمجي وإدارة بيئة العمل الإحصائي
تتطور منظومة ODS Graphics باستمرار عبر إصدارات ساس المتتابعة (مثل إصدارات SAS 9.4 المتتالية وبيئة SAS Viya السحابية). قد يؤدي استخدام خيارات متقدمة مدعومة فقط في حزم الصيانة الحديثة (Maintenance Releases) على خوادم أو أجهزة تعمل بإصدارات أقدم إلى توليد أخطاء بناء تركيبي (Syntax Errors) تمنع تشغيل الأكواد، مثل بعض الخيارات المتقدمة لضبط نهايات أشرطة الخطأ أو التوزيعات العنقودية المحسنة.
علاوة على ذلك، تتراكم الإعدادات الرسومية في جلسات العمل الطويلة داخل ذاكرة النظام المؤقتة، مما قد يسبب تداخلاً غير مرغوب فيه بين خيارات الرسوم السابقة والرسوم الحالية. ولمنع هذه التداخلات البرمجية، تقتضي أفضل الممارسات البرمجية بدء الشيفرات التحليلية دائماً بأمر إعادة ضبط البيئة الرسومية:
ODS GRAPHICS RESET=All;

GOPTIONS RESET=All;
يضمن هذا الإجراء تفريغ الكتالوجات المؤقتة وإلغاء أي خيارات متبقية من إجراءات سابقة، ليعمل إجراء الرسم البياني في بيئة قياسية نقية تضمن الاستقرار التام وتكرارية النتائج المبرمجة بدقة متناهية.
10. تصدير وتوثيق المخططات الإحصائية للنشر في المجلات المحكمة
10.1 ضبط دقة وتنسيق الصور الناتجة عبر نظام تسليم المخرجات (ODS)
تضع دور النشر العلمية العالمية ومجلات النخبة الأكاديمية (مثل منشورات Elsevier وSpringer وNature وWiley) متطلبات تقنية صارمة لجودة الأشكال البيانية المقدمة للنشر. ترفض هذه الدور بشكل قاطع المخططات الناتجة عن التقاط لقطات الشاشة أو حفظ الرسوم البيانية بدقة العرض التقليدية للشاشات (72-96 نقطة في البوصة)، وتشترط ألا تقل الدقة الطباعية عن 300 إلى 600 نقطة في البوصة (DPI – Dots Per Inch) لضمان وضوح الأرقام والخطوط عند الطباعة الورقية والتكبير الرقمي.
يتيح نظام ODS داخل ساس تحكماً كاملاً ومباشراً في خصائص الملفات المصدرة عبر بيئة ODS LISTING؛ حيث يمكن توجيه المخرجات إلى مجلد محدد، واختيار الصيغة التنسيقية المعتمدة (مثل تنسيق TIFF أو PNG عالي الجودة أو PDF المتجهي)، وتعيين الأبعاد الدقيقة للمخطط بالبوصة أو السنتيمتر لتناسب مساحة الأعمدة التحريرية، كما يوضح الكود التطبيقي التالي:
ODS _ALL_ CLOSE;

ODS LISTING GPATH="/MyProject/Publications/Figures/"

            IMAGE_DPI=300;

ODS GRAPHICS / RESET=All

              IMAGENAME="Figure1_Means_SEM"

              OUTPUTFMT=TIFF

              WIDTH=16cm

              HEIGHT=10cm

              BORDER=Off;
/* استدعاء إجراء الرسم البياني */
PROC SGPLOT DATA=Work.PlotReadyData;
/* تفاصيل الرسم */
RUN;
ODS LISTING CLOSE;
ODS HTML; /* إعادة فتح القناة الافتراضية */
ينتج هذا الكود ملفاً احترافياً بصيغة TIFF بدقة 300 DPI وبأبعاد هندسية تبلغ 16×10 سم دون إطارات خارجية زائدة، ليكون الملف مهيئاً للإيداع المباشر في منظومات التحكيم والنشر الدولية دون حاجة لأي تعديل وسيط ببرمجيات معالجة الصور.
10.2 صياغة الشروح التفسيرية والتعليقات المرافقة للمخطط
يعد التعليق التفسيري المرافق للشكل البياني (Figure Caption) جزءاً لا يتجزأ من البنية الاستدلالية للبحث الأكاديمي؛ إذ تقتضي المعايير المنهجية أن يكون النص الوصفي شارحاً لكل رمز ومتغير معروض في الشكل بوضوح لا لبس فيه. يجب أن يبدأ التعليق برقم الشكل وعنوان مقتضب وواضح، يليه شرح صريح لطبيعة النقاط الممثلة (“تمثل النقاط المتوسطات الحسابية لدرجات الأداء”)، وتحديد دقيق لنوع أشرطة الامتداد (“تمثل أشرطة الخطأ الخطأ المعياري للمتوسط: $\pm 1 SEM$“).
بالإضافة إلى ذلك، يلزم الإفصاح الصريح عن أحجام العينات الكلية والفرعية لكل مجموعة تجريبية في متن التعليق، وربط القراءة البصرية بنتائج الاختبارات الدلالية المرافقة الموضحة في المتن (مثل اختبار $F$ في تحليلات التباين أو اختبارات $t$ البعدية)، مع الإشارة إلى مستويات المعنوية الإحصائية بالرموز النجمية القياسية ($* p < 0.05$, $** p < 0.01$). يحذر المنهجيون دائماً من إطلاق أحكام قاطعة حول وجود فروق حاسمة بالاعتماد الحصري على التباعد البصري لأشرطة الخطأ، بل يجب أن يظل العرض البياني مكملاً ومفسراً للنمذجة الرياضية الصارمة وليس بديلاً عنها.
10.3 التكامل مع برمجيات معالجة النصوص وإعداد التقارير الأكاديمية
تتكامل مخرجات ساس الرسومية بسلاسة متناهية مع محررات النصوص الأكاديمية المتقدمة مثل مايكروسوفت وورد أو أنظمة تنضيد النصوص الاحترافية مثل لاتك (LaTeX). عند العمل ضمن بيئة LaTeX المفضلة في الرياضيات والإحصاء الحوسبي، يُنصح دائماً بتصدير الأشكال من ساس بصيغة PDF المتجهية (Vector PDF) عبر خيار OUTPUTFMT=PDF؛ حيث تضمن هذه الصيغة بقاء النصوص والخطوط متناهية الحدة بصرف النظر عن مستويات التكبير والطباعة، وتمنع تشوه الخطوط المنقطة وأشرطة الخطأ المعياري.
ومن ناحية أخرى، تقتضي قواعد العلم المفتوح (Open Science) والنزاهة الأكاديمية الاحتفاظ بالشيفرة البرمجية المصدرية لساس (SAS Script) وبيانات التلخيص المشتقة ضمن المواد التكميلية للدراسة (Supplementary Materials). يتيح هذا الإيداع للباحثين والمراجعين المستقلين تدقيق خوارزميات التجميع والتأكد من عدم وجود تلاعب في حدود المحاور أو اختيار مقاييس الخطأ، مما يعزز الثقة في النتائج المنشورة ويرسخ المعايير العلمية الرفيعة التي تقوم عليها الممارسات البحثية المعاصرة.
خاتمة واستنتاجات
استعرض هذا الدليل المتعمق الأبعاد الإحصائية والتقنية لكيفية رسم المتوسطات الحسابية معززة بأشرطة الخطأ المعياري داخل بيئة نظام التحليل الإحصائي (SAS). لقد اتضح بجلاء أن أشرطة الخطأ ليست مجرد إضافات شكلية لتزيين المخططات، بل هي أدوات استدلالية جوهرية تعكس مقدار الدقة وعدم اليقين في تقديرات العينة التجريبية، وتمثل حداً فاصلاً بين القراءة البصرية العلمية الرصينة والتفسيرات الظاهرية المضللة. إن الإلمام بالفروق الجوهرية بين الانحراف المعياري كمقياس وصفي والخطأ المعياري كمقياس استدلالي يشكل الأساس النظري الإلزامي لأي باحث يتصدى لمعالجة البيانات المقارنة.
على الصعيد البرمجي، أثبتت الشراكة الوظيفية بين إجراء الاستعلام البنيوي PROC SQL وإجراء الرسم الإحصائي المتقدم PROC SGPLOT كفاءة استثنائية في تبسيط تدفق العمل؛ حيث أتاحت لغة SQL تجميع البيانات واشتقاق فترات الخطأ المعياري بدقة متناهية وفي خطوة واحدة، بينما تولى إجراء SGPLOT تجسيد تلك البيانات في طبقات بصرية شديدة النقاء والجاذبية. إن استثمار الباحث في إتقان هذه الأدوات البرمجية المتقدمة، وضبط خيارات التباعد العنقودي، والتحكم الصارم في خصائص المحاور وتصدير الصور بدقة طباعية فائقة (300 DPI)، يضمن إنتاج مخططات إحصائية ذات جودة رفيعة تتطابق مع أدق متطلبات المجلات العلمية المحكمة، وتكرس مبادئ الشفافية والصلابة المنهجية وقابلية التكرار في المجتمع العلمي الدولي.
المراجع
Bohus, M., Kleindienst, N., Hahn, C. J., Müller‐Engelmann, M., Ludäscher, P., Steil, R., et al. (2020). Dialectical Behavior Therapy for Posttraumatic Stress Disorder (DBT-PTSD) Compared With Cognitive Processing Therapy (CPT) in Complex Presentations of PTSD in Women Survivors of Childhood Abuse. JAMA Psychiatry. https://doi.org/10.1001/jamapsychiatry.2020.2148
Curran, P. J., & Hussong, A. M. (2003). The Use of Latent Trajectory Models in Psychopathology Research. Journal of Abnormal Psychology. https://doi.org/10.1037/0021-843x.112.4.526
James, A. C., James, G., Cowdrey, F. A., Soler, A., & Choke, A. (2015). Cognitive behavioural therapy for anxiety disorders in children and adolescents. Cochrane Database of Systematic Reviews. https://doi.org/10.1002/14651858.cd004690.pub4
Jewett, M. E., Dijk, D., Kronauer, R. E., & Dinges, D. F. (1999). Dose-response Relationship Between Sleep Duration and Human Psychomotor Vigilance and Subjective Alertness. SLEEP. https://doi.org/10.1093/sleep/22.2.171
Kenett, Y. N., Anaki, D., & Faust, M. (2014). Investigating the structure of semantic networks in low and high creative persons. Frontiers in Human Neuroscience. https://doi.org/10.3389/fnhum.2014.00407
Lo, J. C., Groeger, J. A., Santhi, N., Arbon, E. L., Lázár, A. S., Hasan, S., et al. (2012). Effects of Partial and Acute Total Sleep Deprivation on Performance across Cognitive Domains, Individuals and Circadian Phase. PLoS ONE. https://doi.org/10.1371/journal.pone.0045987
Madigan, S. L., Korczak, D. J., Vaillancourt, T., Racine, N. M., Hopkins, W. G., Pador, P., et al. (2023). Comparison of paediatric emergency department visits for attempted suicide, self-harm, and suicidal ideation before and during the COVID-19 pandemic: a systematic review and meta-analysis. The Lancet Psychiatry. https://doi.org/10.1016/s2215-0366(23)00036-6
Roebuck, A., Monasterio, V., Gederi, E., Osipov, M., Behar, J. A., Malhotra, A., et al. (2013). A review of signals used in sleep analysis. Physiological Measurement. https://doi.org/10.1088/0967-3334/35/1/r1
Van Yperen, N. W., Blaga, M., & Postmes, T. (2014). A Meta-Analysis of Self-Reported Achievement Goals and Nonself-Report Performance across Three Achievement Domains (Work, Sports, and Education). PLoS ONE. https://doi.org/10.1371/journal.pone.0093594