
تُعد عملية استيعاب وإدخال البيانات الخطوة الحاسمة الأولى في مسار التحليل الإحصائي وهندسة البيانات ضمن بيئة نظام التحليل الإحصائي (SAS – Statistical Analysis System). فلا يمكن لأعقد النماذج التنبؤية أو أدق الاختبارات الاستدلالية أن تؤتي ثمارها ما لم ترتكز على بيانات تم استيرادها بدقة متناهية، وبنية هيكلية تحتفظ بالخصائص النوعية والكمية للمتغيرات دون تشويه أو اقتطاع. ومن هنا تنبع الأهمية المحورية لإجراء PROC IMPORT، الذي طورته شركة SAS Institute ليكون المحرك القياسي الرائد والأكثر مرونة لتحويل الملفات الخارجية بمختلف امتداداتها وصيغها إلى جداول بيانات مهيكلة وقابلة للمعالجة الفورية.
يتناول هذا الدليل الشامل تشريحاً تفصيلياً معمقاً لإجراء PROC IMPORT، مبيناً آليات عمله الداخلية، ومسلطاً الضوء على الفروق الجوهرية بينه وبين خطوات الإدخال البرمجية اليدوية التقليدية. وسنستعرض عبر أقسام هذا المرجع العلمي التطبيقي كافة المعلمات الأساسية والمتقدمة، بدءاً من التحكم في الترويسات وتحديد صفوف البداية، مروراً بإدارة أنواع الملفات الشائعة مثل ملفات القيم المفصولة بفواصل (CSV)، ومصنفات إكسيل (Excel Workbooks)، والملفات النصية ذات المحددات المخصصة، وصولاً إلى استراتيجيات الضبط الدقيق لأنماط المتغيرات والتغلب على مشكلات اقتطاع النصوص والبيانات الزمنية المعقدة.
يهدف هذا الطرح الأكاديمي والتقني إلى تزويد الباحثين الإحصائيين، ومحللي البيانات، ومطوري حلول ذكاء الأعمال بالمعرفة النظرية والمهارات التطبيقية اللازمة لاستثمار أقصى طاقات هذا الإجراء البرمجي. إن الإحاطة بمفاهيم هذا الإجراء تمثل ركيزة جوهرية لضمان سلامة مسارات تدفق البيانات (Data Pipelines)، وتقليص الهدر الزمني الناجم عن أخطاء القراءة والتوافقية، وتحقيق أعلى درجات الدقة والموثوقية في النتائج التحليلية اللاحقة.
1. مدخل نظري إلى إجراء PROC IMPORT وأهميته في بيئة SAS
1.1 مفهوم استيراد البيانات الخارجية ودوره في التحليل الإحصائي
تمثل عملية استيراد البيانات الخارجية الخطوة التأسيسية التي لا غنى عنها في دورة حياة البيانات داخل بيئة نظام التحليل الإحصائي SAS. ففي بيئات العمل الواقعية ومؤسسات البحوث الأكاديمية والسريرية، نادراً ما تنشأ البيانات بصورة أصلية داخل صيغ SAS المدمجة (sas7bdat). بل تأتي البيانات عادة من مصادر شديدة التنوع؛ مثل قواعد البيانات العلائقية، ومنظومات تخطيط موارد المؤسسات، واستطلاعات الرأي الإلكترونية، أو حتى مخرجات الأجهزة المخبرية وأجهزة الاستشعار الرقمية. وتتجلى أهمية التعامل مع هذه الصيغ المتباينة في تمكين المحلل الإحصائي من بناء جسور رقمية متينة تستوعب شتات البيانات وتصهرها في بوتقة تحليلية واحدة، دون إجبار الباحث على إعادة إدخالها يدوياً، وهو ما كان يشكل تاريخياً عبئاً زمنياً جسيماً.
يوفر إجراء PROC IMPORT هذا الجسر التكاملي المحوري عبر واجهة استدعاء موحدة وقوية، قادرة على قراءة الملفات من وسائط التخزين المتعددة وفك تشفير هياكلها السطرية والعمودية ونقلها إلى بيئة الذاكرة المخصصة لنظام SAS. كما يسهم هذا الإجراء المؤتمت مساهمة جوهرية في تقليص احتمالية حدوث الأخطاء البشرية العفوية التي تقترن دوماً بالنقل اليدوي، كإسقاط الفواصل العشرية، أو عكس ترتيب الصفوف، أو الخطأ في تعيين محارف النصوص. إن الاستيراد المؤتمت لا يضمن فقط سرعة المعالجة بل يدعم مبدأ “قابلية تكرار النتائج العلمية” (Reproducibility)، حيث يمكن إعادة تطبيق مسار التحليل ذاته بدقة تامة وبنقرة زر واحدة على أي حزم بيانات محدثة تأتي مستقبلاً.
1.2 مقارنة وظيفية بين الإجراءات المؤتمتة وكتابة شيفرات الإدخال البرمجية
تبرز المقارنة الوظيفية بين إجراء PROC IMPORT وخطوات خطوة البيانات التقليدية (DATA STEP) تبايناً واضحاً في فلسفة التعامل مع البيانات. فبينما تتطلب خطوة DATA STEP كتابة تعليمات مفصلة وصريحة مثل INFILE وINPUT وتحديد أطوال المتغيرات (LENGTH) وتنسيقات قراءتها (INFORMAT)، يقوم إجراء PROC IMPORT بأتمتة هذه العملية بالكامل. يعتمد الإجراء على محركات استدلال ذكية تقوم بفحص الملف المصدري سلفاً، وتخمين طبيعة المتغيرات وما إذا كانت رقمية أو نصية، وتقدير أطوالها المناسبة بصورة ذاتية، مما يمنح المحلل مرونة فائقة وسرعة في استكشاف البيانات دون الحاجة إلى الإلمام المسبق بتفاصيل بنيتها الداخلية الدقيقة.
ومع ذلك، فإن هذه الأتمتة المريحة تقابلها حدود وظيفية يجب إدراكها بحذر؛ فالإجراء قد يواجه صعوبات في الملفات ذات الهياكل غير المنتظمة أو السجلات ذات الأطوال المتغيرة التي تحتوي على بيانات وصفية متناثرة في مواضع غير قياسية. في مثل هذه الحالات المعقدة، تظل خطوة DATA STEP هي الملاذ الأكثر تحكماً ورسوخاً، لأنها تمنح المبرمج سلطة مطلقة في التحكم في مؤشر القراءة سطراً بسطر وحرفاً بحرف، وتطبيق شروط التحقق المنطقي أثناء عملية القراءة المباشرة، مما يوضح أن كلا النهجين يكمل أحدهما الآخر في بيئة العمل الاحترافية.
1.3 المتطلبات الأساسية وإعداد بيئة العمل لتنفيذ إجراء PROC IMPORT
يتطلب التنفيذ الناجح والمستقر لإجراء PROC IMPORT استيفاء جملة من الشروط والضوابط التمهيدية في بيئة العمل الحسابية. أول هذه المتطلبات يتعلق بالتحقق الصارم من صلاحيات الوصول (Read Permissions) إلى المسارات المادية أو الشبكية التي تستضيف الملفات المصدرية، سواء كانت مخزنة على أقراص صلبة محلية أو على خوادم سحابية مشتركة، لتجنب توقف المعالجة بسبب أخطاء الوصول الممنوع. إضافة إلى ذلك، يلعب التوافق بين بنية نظام SAS (32 بت مقابل 64 بت) ومحركات الاتصال بالحواسيب الشخصية (SAS/ACCESS Interface to PC Files) دوراً حاسماً، ولا سيما عند استيراد ملفات التطبيقات المكتبية المعقدة كجداول إكسيل، حيث يتطلب الأمر تثبيت وتطابق المحركات البرمجية الوسيطة المناسبة لضمان قراءة الجداول بسلاسة.
علاوة على ذلك، يبرز ضبط الترميز اللغوي (Encoding) كعنصر بالغ الحساسية لا يحتمل الإغفال، وخصوصاً عند التعامل مع نصوص متعددة اللغات أو نصوص تتضمن محارف عربية. يجب التأكد من توافق ترميز جلسة عمل SAS (مثل UTF-8 أو WDATALATIN1) مع ترميز الملف المصدري، لمنع حدوث التلف المحرفي (Mojibake) الذي يفقد النصوص قيمتها الدلالية ويؤدي إلى انهيار المعالجة التحليلية للنصوص. إن التهيئة الدقيقة لهذه البيئة تعصم المحلل من الرسائل التحذيرية المبهمة وتضمن سلاسة انتقال البيانات من صيغتها الخام إلى جداول SAS الجاهزة للتحليل الإحصائي المتقدم.
2. البنية التركيبية الأساسية والمعلمات الجوهرية لأمر PROC IMPORT
2.1 تشريح الشيفرة المصدرية والقواعد النحوية الأساسية
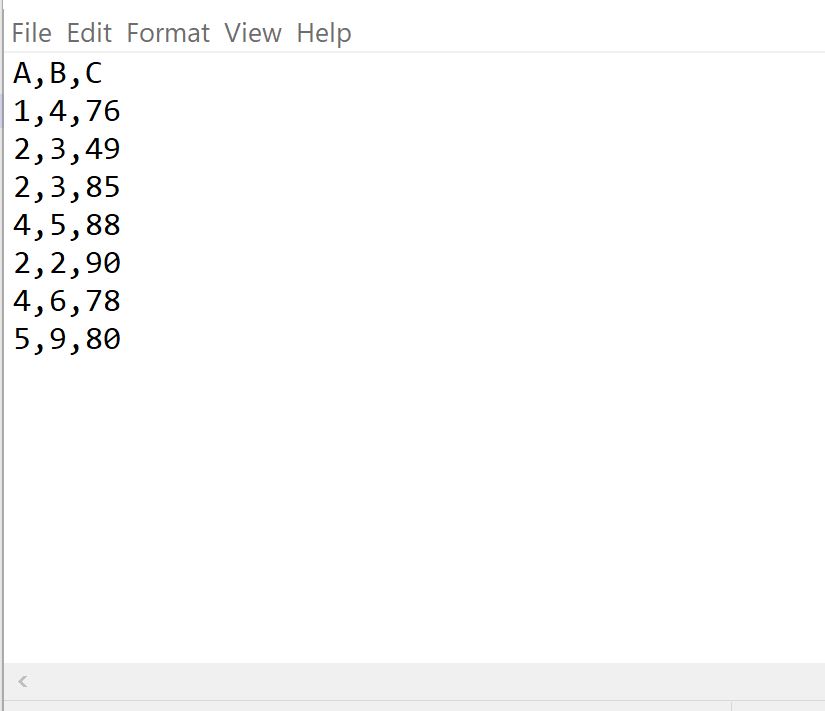
تتميز البنية النحوية والتركيبية لإجراء PROC IMPORT بالأناقة المنطقية والإيجاز البرمجي، حيث تتبع نسقاً قياسياً يسهل استيعابه وتطبيقه. تنطلق الشيفرة دوماً بالعبارة المفتاحية PROC IMPORT، والتي تمثل إشارة البدء لمترجم لغة SAS لتحميل محرك الاستيراد المناسب في الذاكرة الحية. تلي هذه العبارة مجموعة من المعلمات المحددة مسبقاً، والتي تنظم علاقة الارتباط بين مصدر البيانات الخارجي والجدول المستهدف إنشاؤه داخل النظام، مصحوبة بتعليمات اختيارية تضبط مسار المعالجة.
يختتم الإجراء وجوباً بالتعليمة الصريحة RUN;. تكمن الأهمية الجوهرية لتعليمة RUN في أنها تعمل كنقطة ارتكاز تنفيذية (Step Boundary)، توجه النظام للبدء الفعلي في معالجة وتجميع كتلة الأوامر السابقة، وتطبيق خوارزميات الاستقراء والتفسير على الملف المصدري وتوليد مخرجات الجدول المحددة. إن إغفال هذه التعليمة قد يترك بيئة العمل معلقة في انتظار استكمال الأوامر، مما يربك سير تنفيذ البرامج المجمعة أو وحدات الماكرو اللاحقة، وهو ما يجعل الالتزام الصارم بالبنية التركيبية أمراً حيوياً لاستقرار العمليات البرمجية في SAS.
2.2 تحديد الوجهة ومصدر البيانات: المعلمتان OUT وDATAFILE
تعد المعلمتان DATAFILE وOUT قطبي الرحى في بنية إجراء PROC IMPORT؛ فالمعلمة DATAFILE تحدد بدقة متناهية المسار الجغرافي أو الرقمي للملف المراد استيراده على وسيط التخزين. يتعين كتابة المسار بصيغة نصية كاملة ومحاطة بعلامات اقتباس، مع ضرورة تضمين الاسم الكامل للملف وامتداده الفعلي (مثل: .csv أو .xlsx أو .txt). يدعم النظام استخدام المسارات المطلقة التي تبدأ من جذر القرص الصلب، وكذلك المسارات النسبية المتصلة بمجلد العمل الحالي لجلسة SAS، مع مراعاة الفروق الدقيقة في كتابة الفواصل بين أنظمة التشغيل (مثل الفواصل المائلة للأمام في بيئات Linux مقارنة بالفواصل المائلة للخلف في بيئات Windows).
في المقابل، تتولى المعلمة OUT مهمة تسمية جدول البيانات الناتج داخل بيئة SAS وتحديد مكتبة الحفظ المخصصة له. فإذا تم تحديد الاسم مجرداً (مثل: OUT=mydata)، يقوم النظام افتراضياً بحفظ الجدول كملف مؤقت داخل مكتبة WORK، مما يعني أنه سيُحذف تلقائياً فور إنهاء جلسة العمل. أما إذا رغب المستخدم في استبقاء البيانات بصورة دائمة، فيتعين عليه ربط الجدول بمكتبة مخصصة محددة مسبقاً عبر تعليمة LIBNAME (مثل: OUT=mylib.mydata). يتيح هذا الفصل المنظم بين مسار الإدخال ومسار الإخراج للمحلل إدارة حزم بياناته بكفاءة استثنائية وبما يتوافق مع سياسات حوكمة البيانات المؤسسية.
2.3 تحديد نسق الملف وإدارة الاستبدال: المعلمتان DBMS وREPLACE
تضطلع المعلمة DBMS (وهي اختصار لمصطلح DataBase Management System) بدور الموجه التقني الذي يرشد نواة إجراء PROC IMPORT إلى نوع الهيكلية التقنية للملف المستورد والبروتوكول الواجب اعتماده لقراءته. يوفر نظام SAS حزمة واسعة من المعرفات المدعومة؛ فعلى سبيل المثال يشير المعرف CSV إلى ملفات القيم المفصولة بفواصل، بينما يوجه المعرف XLSX النظام لاستخدام محرك حزم مايكروسوفت إكسيل الحديثة، في حين يخصص المعرف TAB لقراءة النصوص المفصولة بمسافات جدولة، والمعرف DLM للمحددات العامة المخصصة. إن اختيار المعرف الصحيح يضمن استدعاء خوارزميات التحليل النحوي الدقيقة المتوافقة مع طبيعة تنظيم البايتات داخل الملف المستهدف.
أما المعلمة التبديلية REPLACE، فتعتبر بمثابة ترخيص إجرائي يمنح النظام صلاحية الكتابة فوق أي جدول بيانات سابق يحمل الاسم نفسه في مكتبة SAS المستهدفة. تكتسب هذه المعلمة أهمية قصوى في البرامج والسكربتات التي يُعاد تشغيلها بصفة دورية، حيث يؤدي غيابها إلى توقف تنفيذ الإجراء وإطلاق رسالة خطأ في السجل تفيد بأن الجدول موجود بالفعل ولا يمكن استبداله. ومع ذلك، ينطوي استخدام REPLACE على مخاطر تشغيلية تتطلب قدراً عالياً من الحيطة والحذر؛ إذ إنها ستمحو محتويات الجدول القديم بلا رجعة، مما قد يتسبب في فقدان نتائج تحليلية سابقة إذا لم يكن المستخدم متيقظاً لأسماء الجداول المتداولة.
3. التحكم في أسماء المتغيرات وقراءة الصفوف الأولى
3.1 معالجة الترويسات بواسطة تعليمة GETNAMES
تعد تعليمة GETNAMES الأداة المفتاحية للتحكم في كيفية تفسير محتوى الصف الأول من البيانات المصدرية. عند ضبط هذه المعلمة على القيمة الافتراضية GETNAMES=YES، يُعامل إجراء PROC IMPORT السطر الأول من الملف باعتباره ترويسة تتضمن العناوين الاسمية للأعمدة، فيقوم بتحويل هذه النصوص تلقائياً إلى أسماء للمتغيرات (Variables) في جدول SAS الناتج. يسهم ذلك في الحفاظ على الدلالات الأصلية للبيانات وتسهيل التعرف على القياسات المختلفة فور انتهاء عملية الاستيراد.
وعلى النقيض من ذلك، يبرز الاحتياج العملي إلى ضبط المعلمة على القيمة GETNAMES=NO في السيناريوهات البحثية التي تخلو فيها الملفات الأصلية من أي ترويسة، وتبدأ المشاهدات الإحصائية الفعلية مباشرة من الصف الأول. في هذه الحالة، يتولى نظام SAS توليد أسماء افتراضية قياسية للمتغيرات بصيغة رقمية تسلسلية (مثل: VAR1, VAR2, VAR3 وهكذا). يمنع هذا الضبط المسبق ضياع السجل الأول من البيانات، إذ إن قراءته خطأً كترويسة تؤدي إلى حذفه من مصفوفة المشاهدات الحسابية واحتسابه ضمن مصفوفة التعريفات الوصفية، مما يؤثر سلباً على نتائج التحليل الإحصائي وسلامة حجوم العينات.
3.2 تحديد صف البداية باستخدام تعليمة DATAROW
تمنح تعليمة DATAROW المحلل الإحصائي تحكماً جراحياً دقيقاً في تعيين رقم الصف الذي ينبغي للنظام أن يبدأ منه استخلاص وتخزين المشاهدات (Observations) الفعلية. ففي كثير من التطبيقات العملية، تتضمن الملفات المصدرية هوامش علوية، أو بيانات وصفية (Metadata)، أو ملاحظات قانونية، أو تواريخ استخراج غير مهيكلة تمتد لعدة أسطر قبل أن يبدأ جدول البيانات الحقيقي. ومن خلال تحديد القيمة الرقمية لـ DATAROW (مثل: DATAROW=5)، يتجاوز محرك القراءة كافة الأسطر التمهيدية غير المرغوب فيها، وينطلق مباشرة إلى معالجة السجلات الحقيقية.
يتحقق التناغم التشغيلي الأقصى من خلال الموازنة الذكية بين قيمتي GETNAMES وDATAROW. فعند تعيين GETNAMES=YES، يفترض النظام افتراضياً أن الترويسة تقع في الصف الأول وأن البيانات تبدأ من الصف الثاني (DATAROW=2). أما إذا كانت الترويسة تقع استثنائياً في الصف الثالث وتبدأ البيانات من الصف الرابع، فإن الضبط اليدوي الدقيق لقيمة DATAROW=4 يمنع تكرار قراءة الترويسة كسطر بيانات رقمي، وهو ما كان سيتسبب في توليد أخطاء تحويل الأنماط (Type Mismatch Errors) أو إدخال قيم مفقودة مضللة في المشاهدات الأولى.
3.3 معالجة وتحويل أسماء الأعمدة غير المتوافقة برمجياً
تخضع تسمية المتغيرات في بيئة SAS لمعايير اصطلاحية ونحوية محددة تتطلب أن تبدأ الأسماء بحرف أو شرطة سفلية، وألا تتجاوز أطوالاً معينة، وأن تخلو من المسافات والفواصل والرموز الخاصة مثل النواقص وعلامات النسبة المئوية. وعند استيراد ملفات مصممة في بيئات مكتبية حرة كملفات إكسيل، كثيراً ما تواجه هذه المعايير صدمة مع ترويسات تتضمن مسافات (مثل: “Customer Age”) أو رموزاً خاصة (مثل: “Sales_$”). ولمعالجة هذا التعارض، يعتمد إجراء PROC IMPORT على الخيار النظامي المتقدم VALIDVARNAME للتحكم في آلية التوفيق بين النصوص الأصلية وقواعد النظام.
عند ضبط هذا الخيار على النسق الكلاسيكي الصارم VALIDVARNAME=V7، يقوم النظام تلقائياً بتنظيف أسماء الأعمدة واستبدال كافة المسافات والرموز المحظورة بعلامات سفلية (Underscores)، ليتحول المتغير “Customer Age” بسلاسة إلى “Customer_Age”. أما إذا تم ضبط الخيار على النسق الممتد VALIDVARNAME=ANY، فإن النظام يكتسب مرونة فائقة تسمح له بالحفاظ على الأسماء الأصلية بكل ما فيها من فراغات ورموز استثنائية، شريطة استخدام محددات الأسماء الحرفية (Name Literals بصيغة ‘Column Name’n) في الشيفرات اللاحقة. تضمن هذه الآلية مرونة استيعاب التصاميم المعقدة دون المساس باستقرار البنية الرياضية للمتغيرات.
4. استيراد ملفات القيم المفصولة بفواصل (CSV) وتطبيقاتها التحليلية
4.1 الخصائص التقنية لملفات CSV والمعلمة DBMS=CSV
تحتل ملفات القيم المفصولة بفواصل، المعروفة اصطلاحاً بملفات CSV، صدارة الصيغ المستخدمة في نقل وتبادل البيانات على الصعيد الدولي، نظراً لبساطة تركيبها النصي وخفتها الحسابية واستقلاليتها التامة عن أي منصة تشغيلية محددة. ومع ذلك، فإن هذه البساطة الظاهرية تخفي وراءها تحديات معقدة في التنقيب عن البيانات؛ إذ تعتمد بنية السجل فيها على فواصل قياسية تفصل بين الحقول، مما يجعل أي ظهور غير محسوب لفاصلة داخل نص ما مصدراً محتملاً لخلل بنيوي يؤدي إلى انزياح الأعمدة عن مواضعها المنطقية.
عند تفعيل المعرف التقني DBMS=CSV داخل إجراء PROC IMPORT، يُطلق نظام SAS محرك قراءة عالي الكفاءة صُمم خصيصاً للتعامل مع بروتوكولات ملفات الفواصل. يمتلك هذا المحرك ذكاءً اصطلاحياً يمكنه من استيعاب وفك دلالات الحقول النصية المحاطة بعلامات اقتباس مزدوجة (“Text, with comma”)، حيث يُدرك أن الفاصلة المضمنة هنا هي جزء أصيل من المعنى الحرفي للنص وليست فاصلاً فاصلاً بين المتغيرات. تتكفل هذه الخاصية بحماية سلامة السجلات المعقدة، مثل العناوين البريدية أو الأوصاف السريرية، دون الحاجة إلى تدخل يدوي شاق لإعادة تشكيل وتأهيل البنية النصية للملف المصدري.
4.2 تطبيق عملي: استيراد بيانات قياسية خطوة بخطوة
لتطبيق هذه المعايير واقعياً، يمكن النظر في سيناريو تحليلي يتضمن استيراد ملف بيانات ديموغرافية لعملاء مؤسسة ما مخزن تحت المسار العام للمشروع. تبدأ صياغة الشيفرة بتعريف أمر الاستيراد وتمرير مسار الملف إلى المعلمة DATAFILE، مع توجيه المخرجات عبر المعلمة OUT إلى جدول تحليلي جديد في مكتبة العمل، واعتماد المعرف DBMS=CSV متبوعاً بأمر الاستبدال REPLACE لتيسير إعادة المعالجة، كما يتضح في البنية الإجرائية الآتية:
PROC IMPORT DATAFILE="/data/projects/demographics.csv"

    OUT=WORK.CLIENT_DATA

    DBMS=CSV

    REPLACE;

    GETNAMES=YES;

    DATAROW=2;

RUN;
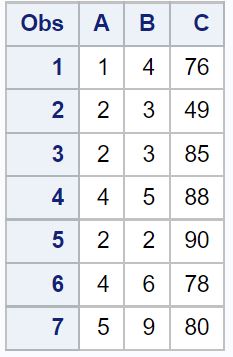
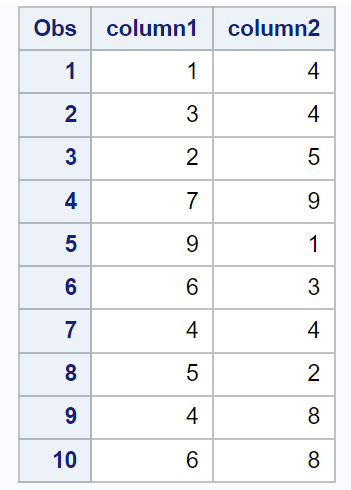
عقب انتهاء التنفيذ الحسابي، لا ينبغي للمحلل الاكتفاء باختفاء الأخطاء الظاهرة، بل يتعين عليه فحص سجل النظام المرجعي (SAS Log) بعناية، للتأكد من الرسالة التأكيدية التي توضح عدد المشاهدات التي تم استيرادها بنجاح وعدد المتغيرات المستخلصة. ولتتويج هذا التدقيق، يوصى دائماً بتشغيل إجراء الاستعراض السريع PROC PRINT على عينة من الصفوف الأولى (OBS=10) للمعاينة البصرية المباشرة للجدول المتشكل، ورصد أي انحرافات غير متوقعة في توزيع الخلايا، فضلاً عن تقييم أي إشارات تحذيرية قد تشير إلى مشاكل طفيفة تم التغاضي عنها آلياً.
4.3 إدارة الفراغات والبيانات المفقودة في ملفات CSV
تشكل البيانات المفقودة (Missing Values) تحدياً جوهرياً في التحليلات الإحصائية، إذ تختلف سيكولوجية تمثيلها في ملفات الفواصل باختلاف طبيعة المتغير. ففي المتغيرات الرقمية، يفسر نظام SAS الفاصلتين المتتاليتين الخاليتين من أي قيمة رقمية (,,) باعتبارهما قيمة رقمية مفقودة قياسية يرمز لها بنقطة فردية (.) في جدول المخرجات. أما في المتغيرات النصية أو الحرفية، فإن المساحة الخالية بين الفاصلتين تُترجم فورياً إلى سلسلة نصية فارغة (Blank String)، وهو ما يضمن الحفاظ على محاذاة الأعمدة اللاحقة في السطر دون إزاحة عشوائية.
تزداد القضية تعقيداً إذا تصادف أن الحقول الأولى في الملف المصدري تبدأ بقيم مفقودة لعدة صفوف متتابعة؛ إذ قد يميل المحرك الاستدلالي الافتراضي في نظام SAS إلى تصنيف المتغير برمته خطأً كمتغير رقمي بسبب غياب المحارف النصية، مما يفضي إلى فشل قراءة الكلمات أو الحروف التي قد تظهر متأخرة في الصفوف اللاحقة واحتسابها قيماً تالفة. ولتطويق هذا الخلل الإحصائي، يبرز استخدام التعليمة التحسينية GUESSINGROWS كصمام أمان حاسم، حيث تجبر النظام على فحص مساحة أعمق وأشمل من الصفوف لضمان الوقوف على الهوية الحقيقية للمتغيرات قبل اعتماد نمط تخزينها النهائي.
5. التعامل المتقدم مع مصنفات وجداول إكسيل (Excel Workbooks)
5.1 استخدام المحرك DBMS=XLSX ومميزاته التقنية
تاريخياً، كان التعامل مع مصنفات مايكروسوفت إكسيل داخل أنظمة التحليل الإحصائي محفوفاً بالتعقيدات البرمجية، ولا سيما مع الصيغ الثنائية القديمة (XLS) التي كانت تستلزم تثبيت محركات توافقية وسيطة وربما استدعاء خدمات DDE أو ODBC المعقدة. ولكن مع التحول العالمي إلى حزم المستندات المفتوحة وقواعد XML المضغوطة وظهور صيغ XLSX الحديثة، أحدث نظام SAS نقلة نوعية عبر تطوير المحرك المتخصص DBMS=XLSX، والذي أصبح جزءاً لا يتجزأ من بيئات العمل المعاصرة.
تكمن الميزة التقنية الفارقة للمحرك DBMS=XLSX في قدرته على قراءة الملفات مباشرة ككتل حزم مضغوطة دون أدنى حاجة لوجود برمجيات Microsoft Office مثبتة على خادم المعالجة أو محطة العمل، كما أنه يعمل بكفاءة تامة عبر مختلف أنظمة التشغيل سواء كانت Windows أو Linux أو UNIX. كما يوفر هذا المحرك كفاءة استثنائية في إدارة استهلاك الذاكرة الحية ومعالجة تدفق البيانات، مما يتيح للباحثين استيراد ملفات مالية أو مصرفية ضخمة الحجم تتألف من مئات الآلاف من الصفوف وعشرات الأعمدة، بسرعة فائقة واستقرار عملياتي لا تشوبه انقطاعات الذاكرة.
5.2 استيراد أوراق عمل محددة عبر تعليمة SHEET
نادراً ما تأتي مصنفات إكسيل المؤسسية في هيئة ورقة عمل وحيدة؛ بل الغالب أن يتألف المصنف الواحد من حزمة متكاملة من أوراق العمل التخصصية (Sheets) التي تفصل الأقسام أو الفترات المالية أو المجموعات التجريبية. ولمواجهة هذه الطبيعة التشعبية، يقدم إجراء PROC IMPORT التعليمة البنيوية SHEET، والتي تتيح للمستخدم استهداف ورقة عمل بعينها بدقة مطلقة واستخلاص محتواها المستقل دون المساس ببقية أجزاء المصنف.
تتم كتابة التعليمة بإسناد الاسم النصي الدقيق لورقة العمل كما هو مدرج في إكسيل (مثل: SHEET=”Q4_Financials”;). وفي حال احتوى اسم الورقة على مسافات فاصلة أو رموز خاصة، فإن إحاطة التسمية بعلامات اقتباس يضمن قراءتها بسلام. وإذا أهمل المستخدم تمرير هذه التعليمة صراحة، فإن السلوك الافتراضي المبرمج لنظام SAS يدفعه إلى استيراد الورقة الأولى فقط من المصنف؛ وهو سلوك قد ينطوي على تداعيات تحليلية خطيرة إذا افترض الباحث خطأً أن كامل المصنف قد تم استيعابه، مما يستوجب التدقيق الحذر في الشيفرات والتحقق من بنية البيانات عبر الاستيراد التسلسلي للأوراق المتباينة.
5.3 تحديد النطاقات المخصصة باستخدام تعليمة RANGE
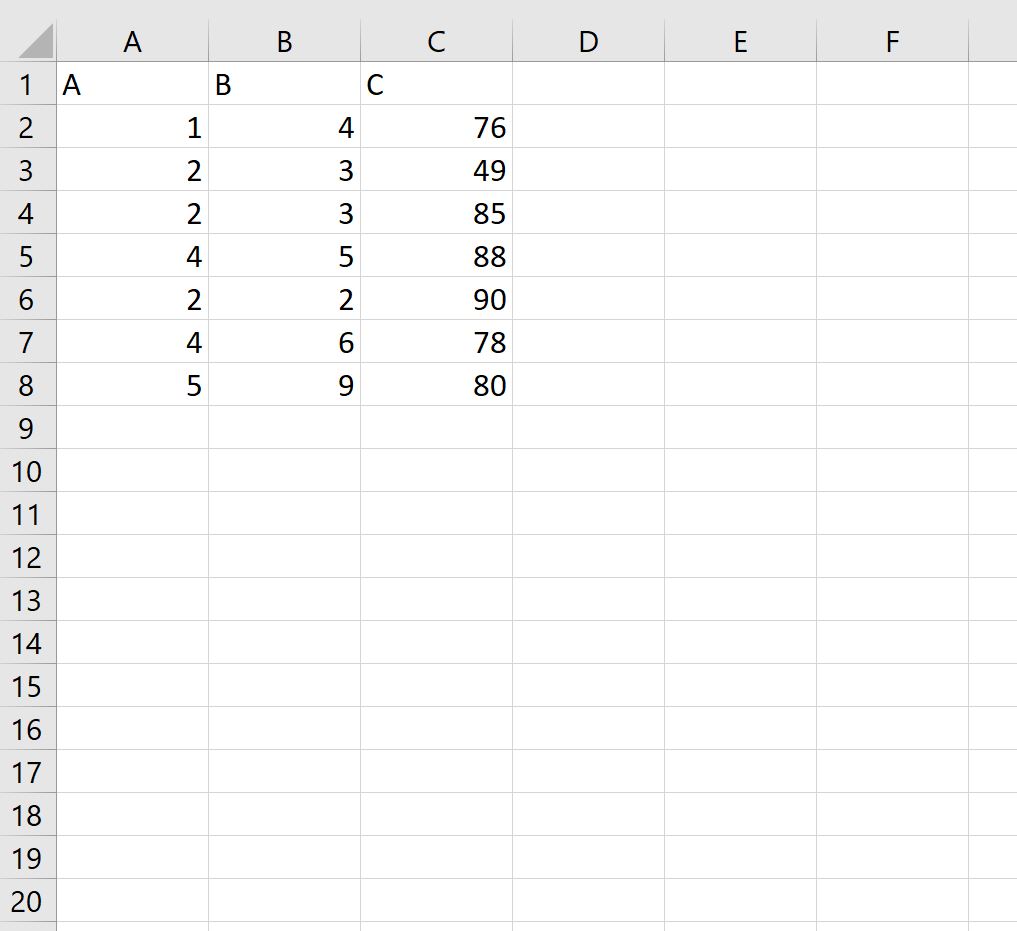
في كثير من التطبيقات الإحصائية والمالية، لا يتم تصميم ورقة العمل بأسلوب الجداول النقية التي تبدأ من الزاوية العليا اليسرى، بل قد تتضمن الورقة شعارات مؤسسية، وملخصات تنفيذية علوية، وجداول متباينة موزعة أفقياً وعمودياً في الصفحة الواحدة. وهنا تبرز القوة التحويلية لتعليمة RANGE، التي تمكن الباحث من عزل مساحة هندسية محددة من الخلايا واستيرادها بمعزل تام عن التشويش المحيط بها في بقية المصنف.
تعتمد التعليمة صياغة إحداثية قياسية متطابقة مع أعراف جداول البيانات، حيث يُحدد اسم الورقة متبوعاً برمز الدولار ومجال الخلايا المستهدفة (مثل: RANGE=”SalesData$C5:L150″;). يسمح هذا التحديد الحصري لنظام SAS بمعاملة الخلية العلوية في النطاق كترويسة جديدة مستقلة (عند تفعيل GETNAMES)، وتجاهل كافة النصوص الحسابية أو التوضيحية الواقعة خارج هذا المربع الجغرافي. إن هذا الأسلوب يختصر على المحلل مراحل لاحقة مضنية من تصفية البيانات وتنظيف السجلات الشاردة، ويوفر بيئة استيراد فائقة النقاء تلبي المعايير المنهجية للتحليل الدقيق.
5.4 معالجة التباين في تنسيقات خلايا إكسيل
يعد تباين التنسيقات داخل العمود الواحد أحد أكبر التحديات التقنية التي تواجه استيراد ملفات إكسيل؛ حيث تسمح بنية إكسيل المرنة للمستخدمين بدمج الخلايا عمودياً أو أفقياً، والخلط العشوائي بين الأرقام والنصوص والتواريخ في الحقل نفسه. عند اصطدام إجراء PROC IMPORT بالخلايا المدمجة (Merged Cells)، فإنه يحتفظ بالقيمة الإحصائية في الخلية الأولى فقط بينما تُسجل بقية الخلايا المدمجة كقيم مفقودة، مما يتطلب معالجة لاحقة بالغة الحذر لتفادي تحيز النتائج.
أما في الأعمدة ذات الأنماط المختلطة، فيلجأ محرك SAS إلى استقراء نمط الأغلبية الغالبة على خلايا العمود؛ فإذا كانت الغالبية نصية اعتمد المتغير كمتغير حرفي وحوّل الأرقام إلى نصوص مقابلة، أما إذا اعتُمد كمتغير رقمي فإن أي خلية نصية عارضة ستتحول حتماً إلى قيمة مفقودة مشوهة. وفيما يتعلق بالتواريخ، يتولى المحرك البرمجي مهمة الترجمة الرياضية الحساسة بين نظام تقويم إكسيل (الذي يبدأ احتساب الأيام تسلسلياً من الأول من يناير لعام 1900) ونظام تقويم SAS (الذي يبدأ من الأول من يناير لعام 1960)، محولاً إياها إلى قيم أرقام تسلسل صحيحة قابلة للعمليات الحسابية الزمنية ومكسوة بتنسيقات العرض الإحصائي الملائمة.
6. استيراد الملفات النصية المفصولة بمحددات (Delimited Files)
6.1 الاستيراد بالمحددات العامة بواسطة DBMS=DLM وتعليمة DELIMITER
على الرغم من الانتشار الواسع لملفات الفواصل، تفضل العديد من المنظومات الإحصائية والمصرفية الضخمة استخدام ملفات نصية ذات محددات خاصة ومتباينة لتخزين ونقل البيانات واسعة النطاق، تحسباً لاحتمال احتواء البيانات الحرفية نفسها على فواصل طبيعية قد تربك محركات التحليل. ولمعالجة هذه البيانات، يتيح نظام SAS استخدام المعرف العام DBMS=DLM مقترناً بالتعليمة التخصيصية DELIMITER، والتي تتيح للمحلل الإحصائي تعيين أي رمز محدد يرغب فيه كفاصل رسمي بين المتغيرات.
يمكن للمستخدم تحديد علامات شائعة كالخط العمودي المعروف بالأنبوب (DELIMITER=”|”;)، أو الفاصلة المنقوطة (DELIMITER=”;”;)، أو علامة التلدة (DELIMITER=”~”;). ولا يقف الأمر عند المحارف المكتوبة الظاهرة؛ بل يمتد ليشمل الرموز غير المرئية أو الرموز التحكمية الصعبة عبر استخدام تمثيلاتها بالنظام الست عشري (Hexadecimal)، مثل الرمز ’09’x للجدولة أو ’20’x للمسافة الفردية. إن توثيق المحدد المستخدم صراحة في متن الشيفرة لا يضمن فقط نجاح القراءة الآنية، بل يعزز أيضاً من وثوقية البرنامج وإمكانية إعادة إنتاجه وتشغيله بأمان عبر منصات ومختبرات تحليلية متعددة.
6.2 معالجة ملفات القيم المفصولة بعلامات الجدولة (Tab-Delimited)
تتمتع الملفات النصية المفصولة بعلامات الجدولة، والتي تحمل عادة امتدادات مثل .txt أو .tab، بتقدير رفيع في الأوساط البحثية والمعلوماتية الحيوية (Bioinformatics)؛ نظراً لأن محرف الجدولة الأفقي غير مرئي ولا يتداخل إطلاقاً مع النصوص البشرية أو التراكيب اللغوية الوصفية. يقدم نظام SAS لهذه الفئة محركاً تخصصياً فائق الكفاءة يتم تفعيله عبر المعرف DBMS=TAB، والذي يقوم فورياً بإعداد مؤشرات القراءة لتقسيم السجلات بناءً على وثبات مسافات الجدولة التلقائية.
يتميز هذا المحرك بسرعة فائقة في معالجة السجلات الحسابية المعقدة مقارنة بمحددات الفواصل الكلاسيكية، لكونه أقل عرضة لاشتباه النصوص المحاطة باقتباسات مركبة. بيد أن الخطأ الأكثر شيوعاً الذي يقع فيه الممارسون في هذا الصدد ينبع من محاولات التعديل اليدوي العشوائي للملف المصدري في محررات النصوص البسيطة، حيث يتم أحياناً استبدال علامة الجدولة بمسافات فردية متتالية مساوية لها في العرض الظاهري؛ وهو تداخل شكلي يؤدي إلى انهيار قراءة الأعمدة في SAS وتراكم المتغيرات في خانة وحيدة، مما يبرز ضرورة التأكد المسبق من نقاء محارف الجدولة عبر المحررات الاحترافية.
6.3 التحكم في المحددات المتعددة والمسافات البيضاء المتتالية
تواجه مهام تنقيب واستيراد البيانات أحياناً ملفات معقدة ذات بنية غير معيارية، تستخدم توليفات من محددات متعددة في السطر الواحد (كأن يفصل بين بعض المتغيرات بفاصلة وبين أخرى بمسافة أو نقطتين رأسيتين)، أو تلك التي تعتمد على مسافات بيضاء عشوائية تفصل بين الأعمدة لتنسيق مظهرها البصري. في مثل هذه الظروف، يتيح استخدام المعلمة DELIMITER تمرير سلسلة من الرموز مجتمعة بين علامتي اقتباس (مثل: DELIMITER=”, ;”;)، مما يرشد محرك الاستيراد إلى معاملة أي رمز من هذه الرموز المذكورة كقاطع رسمي بين المتغيرات فور وروده.
علاوة على ذلك، تتجلى أهمية التعامل الحذر مع المسافات البيضاء المتتابعة، إذ قد يفسرها المحرك كفواصل متعددة تفصل بينها متغيرات فارغة مفقودة، مما يولد مشاهدات شاردة تضاعف أبعاد الجدول وتفسد مصفوفة الحسابات الإحصائية. ولمجابهة ذلك، يتضمن المحرك الداخلي لإجراء PROC IMPORT معالجات تحكمية لمعاملة الفراغات البيضاء المتتالية كفاصل واحد موحد، مما يعيد ضبط المحاذاة الهيكلية للجدول ويحمي الباحث من الأخطاء الحسابية المتسلسلة الناتجة عن تباعدات التنسيق الطباعي في الملف المصدري الأصلي.
7. الضبط الدقيق لأنواع البيانات عبر تعليمة GUESSINGROWS
7.1 الخوارزمية الافتراضية لتخمين أنواع وحجوم المتغيرات
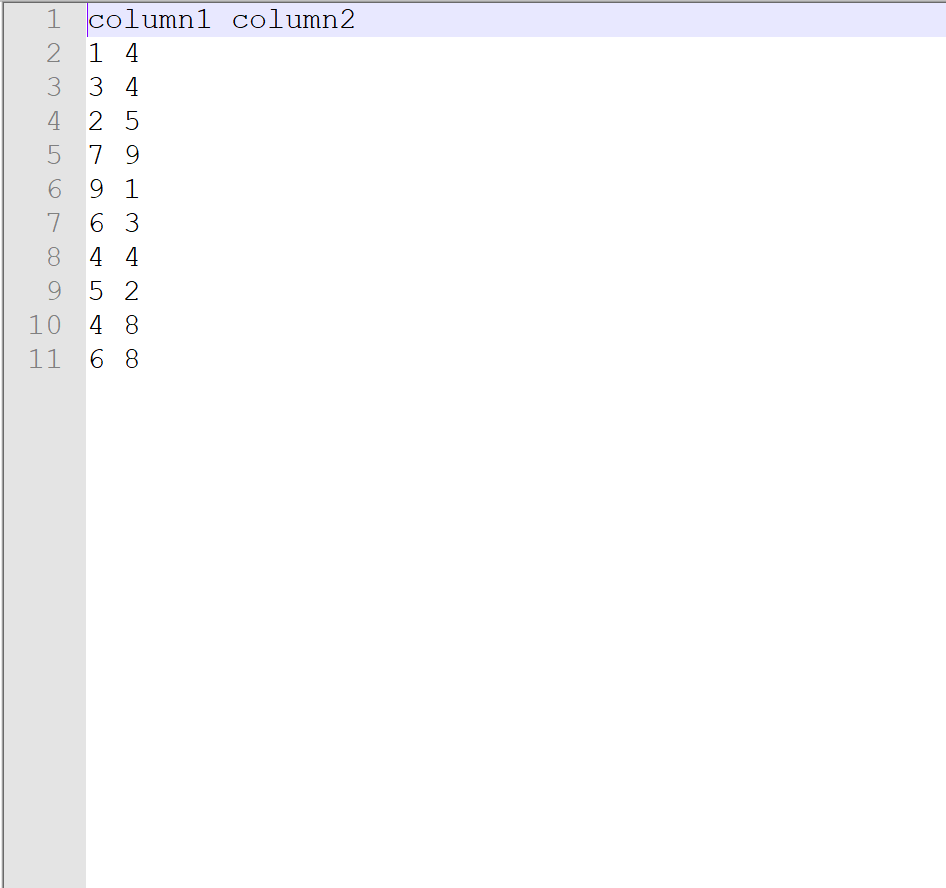
لكي يتمكن إجراء PROC IMPORT من إنشاء جدول SAS منظم دون تدخل بشري ملزم، فإنه يوظف خوارزمية ذكية تقوم بعملية مسح واستقراء أولي للملف المصدري لتخمين الخصائص البنيوية لكل حقل. تقوم هذه الآلية بقراءة عينة أولية محددة من الصفوف، وفحص قيم كل متغير لاختبار ما إذا كانت تتألف حصراً من أرقام، أو فواصل عشرية، أو إشارات سالبة وموجبة لاعتبارها متغيراً رقمياً (Numeric)، أو أنها تشتمل على محارف أبجدية ورموز لغوية لتصنيفها كمتغير حرفي (Character)، إلى جانب حساب أطول نص مسجل لتحديد حجم المتغير في الذاكرة (Length).
يكمن المأزق العملي لهذه الخوارزمية في أن عدد الصفوف التي تفحصها افتراضياً في النسخ القياسية يقتصر على أول 20 صفاً فقط من الملف. فإذا كانت البيانات المجمعة تتسم بعدم التجانس، أو إذا كانت بعض المتغيرات تبدأ بقيم عددية وجيزة في بداياتها قبل أن تتحول إلى نصوص تفصيلية مطولة في الصفوف اللاحقة، فإن الاعتماد على هذا النطاق الضيق يقود حتماً إلى ظاهرة اقتطاع النصوص (Data Truncation) الكارثية، حيث يحدد النظام طول المتغير وفق أطول نص في العشرين سجلاً الأولى، مما يؤدي إلى بتر أي نصوص أطول ترد بعد ذلك وفقدان قيمتها التحليلية دون إشعار توقفي حاسم.
7.2 توسيع نطاق التخمين لتحقيق الدقة التحليلية
لتفادي الوقوع في شباك اقتطاع النصوص وأخطاء التصنيف النمطي غير الدقيق، وفر مطورو SAS التعليمة الاستراتيجية البالغة الأهمية GUESSINGROWS. تتيح هذه التعليمة للمحلل الإحصائي إعادة توجيه الخوارزمية الاستقرائية وإجبارها على مسح آلاف السجلات قبل اتخاذ القرار النهائي بشأن طبيعة المتغير وحجمه؛ فيمكن على سبيل المثال ضبطها على النحو: GUESSINGROWS=5000; لتوسيع أفق الفحص ليشمل خمسة آلاف صف كاملة تغطي مختلف التباينات الإحصائية الممكنة في العينة.
بل إن النظام يتيح للمحلل استخدام الخيار المطلق GUESSINGROWS=MAX، والذي يدفع المحرك إلى قراءة وفحص كل صف مفرد في الملف المصدري من البداية وحتى السطر الأخير قبل كتابة الجدول إلى وسيط التخزين. ورغم أن هذا الضبط الشامل يضمن الدقة التحليلية الكاملة ويستأصل مخاطر الاقتطاع تماماً، فإنه يتطلب موازنة واعية مع استهلاك الموارد الزمنية والحسابية ووقت المعالج (CPU Time)، وخصوصاً عند التعامل مع حزم البيانات الضخمة التي تحتوي على ملايين السجلات، حيث قد يتسبب المسح الكامل في إبطاء تدفق مسارات العمل الحسابية إلى مستويات قد لا تبررها الزيادة الطفيفة في الدقة المكتسبة.
7.3 التعامل مع البيانات الزمنية والتواريخ المعقدة
تمثل المتغيرات الزمنية والتقاويم التاريخية أحد أصعب ميادين الفحص الاستدلالي في معالجة البيانات، نظراً لتعدد الصيغ العالمية المستخدمة لتدوين التواريخ؛ فبينما يعتمد النسق الأمريكي ترتيب (شهر/يوم/سنة)، يعتمد النسق الأوروبي ومعظم الدول العربية ترتيب (يوم/شهر/سنة)، بينما تفرض المنظومات التقنية والقواعد القياسية الدولية نسق (سنة-شهر-يوم: ISO 8601). عند استقراء هذه التدوينات، يحاول إجراء PROC IMPORT مطابقة الأنماط مع مكتبة قوالب القراءة الزمنية (INFORMATS) المخزنة في نواة النظام لتحويلها إلى أرقام تعبر عن عدد الأيام المنقضية منذ نقطة الصفر الزمنية لـ SAS.
تنشأ التعقيدات عندما تتضمن الأيام الأولى من الشهر قيماً رقمية تلتبس مع الأشهر (مثل تاريخ 05/06/2023)، حيث يسهل وقوع خوارزمية التخمين في خطأ قراءة اليوم كشهر أو العكس إذا لم يتم توسيع نطاق GUESSINGROWS لرصد تواريخ تتجاوز قيمتها العددية الرقم 12 لتصحيح المسار الاستدلالي. وعقب استيراد التواريخ بنجاح، يقع على عاتق المحلل تطبيق التنسيقات الإحصائية اللاحقة الملائمة عبر تعليمة FORMAT (مثل: FORMAT Date_Var DATE9.; أو YYMMDD10.) لضمان ظهور هذه المتغيرات بأشكال مقروءة وذات معنى بياني للمستخدمين وصناع القرار في التقارير الإحصائية النهائية.
8. استكشاف الأخطاء البرمجية وإصلاحها وقراءة سجل النظام (SAS Log)
8.1 تحليل رسائل الخطأ الشائعة وتفسير دلالاتها
يعد سجل النظام، المعروف باسم SAS Log، النافذة التشخيصية والمختبر التحليلي الأول الذي ينبغي للمبرمج التوجه إليه فور تنفيذ أي استدعاء لإجراء PROC IMPORT. تتلون الرسائل في هذا السجل عادة بين رسائل الملاحظات الزرقاء (Notes)، والرسائل التحذيرية الخضراء (Warnings)، ورسائل الخطأ الحمراء الصريحة (Errors). ومن بين أكثر أخطاء الاستيراد شيوعاً تبرز رسالة “ERROR: Physical file does not exist”، والتي تعني عجز النظام عن الوصول إلى المسار الممرر في المعلمة DATAFILE، وغالباً ما ترجع إلى خطأ طباعي في كتابة المسار أو امتداد الملف، أو غياب صلاحيات القراءة على المجلد المستهدف.
كما يواجه المحللون تكرار رسائل التعارض التشغيلي “File is in use by another application”، والتي تظهر بجلاء عند محاولة استيراد مصنف إكسيل مفتوح وقيد التعديل في الوقت ذاته بواسطة مستخدم آخر على نظام التشغيل، مما يتطلب إغلاق التطبيق الخارجي أولاً لتحرير قفل الملف. أما رسائل التحذير من نمط “WARNING: One or more data lines were truncated”، فهي الإنذار المبكر لوقوع ظاهرة اقتطاع المحارف النصية، مما يستدعي التوقف الفوري وتعديل معلمات التخمين قبل الاسترسال في بناء النماذج الإحصائية على بيانات مشوهة جزئياً.
8.2 فحص الكود المولد تلقائياً في السجل وفك غموضه
من أعمق الأسرار المعمارية لإجراء PROC IMPORT، والتي تغيب عن أذهان الكثير من الممارسين، أنه لا يقوم بقراءة الملفات مباشرة عبر كود ثنائي غامض، بل يعمل في جوهره كمولد ذكي لشيفرات خطوة البيانات التقليدية (SAS DATA Step Generator). فعند تتبع سجل النظام بعناية عقب التنفيذ، يجد المحلل أن SAS قد قامت تلقائياً بطباعة الكود المصدري الكامل الذي أنشأته خلف الكواليس لإنجاز مهمة الاستيراد، مشتملاً على عبارات INFILE وINPUT وLENGTH وكافة قوالب التنسيق والقراءة.
يوفر هذا الكود المولد كنزاً معرفياً وتشخيصياً استثنائياً؛ إذ يسمح للمبرمج بتدقيق الخيارات التي استقر عليها النظام تلقائياً ومعرفة الأحجام المخصصة لكل متغير ومواضع الفواصل التي اعتمدها. وعلاوة على ذلك، يمكن للمحلل نسخ هذا الكود المولد من السجل ولصقه مباشرة في نافذة التحرير البرمجي، ليتحول من مجرد مستخدم لإجراء مؤتمت إلى متحكم مطلق في خطوة DATA STEP صريحة، يستطيع تعديلها يدوياً لتثبيت أطوال مخصصة، أو إضافة شروط منطقية، أو تجاوز أخطاء التخمين المستعصية، مما يجعل إجراء الاستيراد منصة انطلاق لبناء أكواد برمجية بالغة النضج والصلابة.
8.3 التحقق من صحة واكتمال البيانات بعد الاستيراد
لا تنتهي عملية الاستيراد بمجرد ظهور مؤشر اكتمال العملية بنجاح في السجل، بل تبدأ مرحلة توكيد جودة واكتمال البيانات المستوردة (Data Quality Assurance). تتطلب هذه المرحلة مقارنة رقمية صارمة بين إجمالي عدد السجلات المذكورة في تقرير سجل النظام والعدد الفعلي لصفوف الملف الأصلي، مع الانتباه إلى أن وجود فارق سطر واحد يعكس في الغالب احتساب الترويسة العلوية، في حين يشير وجود فوارق أكبر إلى سقوط مشاهدات بسبب فواصل شاردة أو سطور فارغة تم استبعادها بصورة غير متوقعة.
ولإتمام الفحص الهيكلي، يُعد استدعاء الإجراء المرجعي التوثيقي PROC CONTENTS خطوة جوهرية لا غنى عنها؛ حيث يستعرض هذا الإجراء مصفوفة البيانات الوصفية الكاملة للجدول الناتج، كاشفاً عن قائمة المتغيرات وأنواعها وأطوالها التخزينية في الذاكرة. يتيح هذا الاستعراض للمحلل رصد أي شذوذ في الهيكل، مثل اكتشاف متغيرات رقمية صُنفت خطأً كمتغيرات حرفية، أو العثور على معدلات مرتفعة وغير مبررة من القيم المفقودة في أعمدة حيوية، مما يمكنه من تصحيح مسار الاستيراد في المهد وقبل ضخ البيانات إلى مستودعات التحليل والنمذجة النهائية.
9. دراسة مقارنة: PROC IMPORT في مواجهة كتل DATA STEP المخصصة
9.1 المقارنة من حيث سهولة الاستخدام وسرعة الإنجاز
عند تقييم كفاءة بيئة العمل الإحصائية، تتفوق أداة PROC IMPORT تفوقاً كاسحاً في مراحل التحليل الاستكشافي الأولي ومشاريع النماذج السريعة؛ حيث تكفي أسطر برمجية معدودة لا تتجاوز أصابع اليد الواحدة لقراءة ملفات معقدة تتألف من مئات المتغيرات، موفرة ساعات طويلة من الجهد والترميز المضني الذي كان سيُبذل في كتابة إعلانات المتغيرات وتحديد أطوالها وتنسيقاتها يدوياً. ينعكس هذا الإيجاز في صغر حجم الشيفرة المصدرية وسهولة صيانتها وقراءتها من قبل فرق العمل المشتركة.
إلا أن هذه السرعة والسهولة في الإنجاز قد تقابلها تحديات في المشاريع البحثية والسريرية الخاضعة لرقابة صارمة، كالتجارب الدوائية المعتمدة لدى هيئات الغذاء والدواء العالمية؛ حيث تشترط البروتوكولات التوثيقية الصارمة معرفة دقيقة ومحددة سلفاً لكل بايت يتم حجزه في الذاكرة. في تلك البيئات المتقدمة، يُنظر إلى آليات التخمين التلقائي في PROC IMPORT بعين الحذر، ويفضل المطورون الاعتماد على خطوات صريحة مدونة بوضوح لضمان ثبات الهيكل البياني وعدم تغيره الفجائي في حال طرأت تعديلات طفيفة على حزم البيانات الواردة دورياً.
9.2 المقارنة من حيث التحكم الدقيق والمرونة التحويلية
تتجلى القوة المطلقة لكتل DATA STEP المقترنة بالتعليمة الجوهرية INFILE عندما تبلغ تعقيدات البيانات درجات قصوى تعجز أمامها الأتمتة الإجرائية؛ كالملفات التي تتضمن سجلات متداخلة غير منتظمة (Hierarchical Data)، أو السجلات التي تعتمد شروطاً تفريعية تحدد قراءة السطر بناءً على قيمة محرف البداية، أو تلك التي تتطلب قراءة عدة أسطر لتركيب مشاهدة واحدة مستقرة. تمنح خطوة DATA STEP المبرمج مفاتيح التوجيه الدقيق عبر محددات مثل @@ و@، وتسمح بالتحكم المجهري في مؤشر القراءة حركة وتراجعاً.
فضلاً عن ذلك، تمكن خطوة DATA STEP المحلل من دمج التحويل والتصفية في لحظة القراءة المباشرة دون إهدار للذاكرة؛ فيمكن تطبيق عبارات الفرز الشرطي (IF statements)، وإنشاء متغيرات مشتقة، وتطبيق دوال التعامل مع النصوص والمطابقة الحرفية قبل كتابة المشاهدة إلى القرص الصلب. وعلى النقيض من ذلك، يقتصر دور PROC IMPORT على القراءة الصماء لكامل البيانات كما هي، مرجئاً أي عمليات تحوير أو تصفية إلى خطوات برمجية تالية، مما يجعله أقل مرونة في التعامل مع المتطلبات الحسابية المركبة ذات المسار الواحد.
9.3 معايير اختيار الأداة الأنسب بحسب متطلبات المشروع التحليلي
يتطلب اتخاذ القرار البرمجي الرشيد بالمفاضلة بين استخدام PROC IMPORT أو صياغة كتل DATA STEP مخصصة إخضاع بيئة المشروع لمصفوفة معايير هندسية متكاملة. يبرز حجم البيانات المصدري كأول هذه المعايير؛ فإذا كانت الملفات فائقة الضخامة وتفرض قيوداً صارمة على الذاكرة وزمن المعالجة المركزية، فإن DATA STEP تكون الأنسب لقدرتها على استبعاد الأعمدة والصفوف غير الضرورية أثناء القراءة وتجنب عبء عمليات المسح الاستقرائي لـ GUESSINGROWS.
أما المعيار الثاني فيرتبط بمستوى ثبات واستقرار نسق البيانات عبر الزمن؛ ففي خطوط الإنتاج المؤتمتة (Data Pipelines) التي تتلقى ملفات دورية من جهات خارجية قد يتغير فيها طول النصوص من شهر لآخر، تشكل كتابة DATA STEP بأطوال ثابتة حصناً منيعاً يضمن استقرار البنية التخزينية. في حين تظل PROC IMPORT الخيار الذي لا يُعلى عليه في التعامل مع الملفات المكتبية كجداول إكسيل، أو في مراحل الاستكشاف والتدقيق السريع، حيث تكون المرونة والإنتاجية الزمنية الفورية هي الهدف الاستراتيجي الأسمى لفريق التحليل.
10. أفضل الممارسات المنهجية وتحسين الأداء عند استيراد البيانات الضخمة
10.1 التحضير المسبق لملفات البيانات قبل مرحلة الاستيراد
تبدأ الممارسة التحليلية الرشيدة خارج بيئة SAS، وتحديداً في مرحلة التحضير المسبق والتنقية الأولية للملفات المصدرية لضمان استيراد خفيف وسلس وخالٍ من التعقيدات المفاجئة. يتضمن ذلك الفحص المبدئي للترويسات وتجريدها من المسافات الزائدة، وتفادي استخدام الكلمات المحجوزة في لغات البرمجة كعناوين للأعمدة، واستبعاد الرموز الخاصة المعقدة كعلامات العملات والأقواس والنواقص، مما يقلل من حاجة محرك SAS لإجراء تحويلات تصحيحية قسرية قد تشوه دلالة الأسماء الأصلية.
كما يُنصح بشدة بتوحيد صيغ وأنساق تسجيل التواريخ والقيم الرقمية داخل الملف المصدري قبل تمريره للإجراء؛ حيث إن توحيد تدوين الكسور العشرية (باستخدام النقطة بدلاً من الفاصلة) وفصل القيم الإحصائية النقية عن أي حواشٍ أو تعليقات نصية تفسيرية ملحقة بالخلايا، يحمي خوارزميات الاستقراء من الوقوع في شرك التوصيف النمطي الخاطئ. إن تنقية المصدر لا تختصر فقط زمن المعالجة وتحد من الرسائل التحذيرية في سجل النظام، بل ترسخ مبادئ النزاهة الهيكلية التي تنبني عليها كافة التحليلات الإحصائية المتقدمة لاحقاً.
10.2 تحسين استهلاك الذاكرة وزمن المعالجة في البيئات المؤسسية
عندما تقتحم مهام التحليل نطاق البيانات الضخمة (Big Data) في المؤسسات المصرفية والطبية الكبرى، تصبح كفاءة استهلاك موارد الذاكرة الحية ووحدات المعالجة المركزية ضرورة استراتيجية قصوى. في هذه البيئات، ينبغي للمحلل تجنب استخدام القيمة المطلقة GUESSINGROWS=MAX إلا في حالات الضرورة القصوى، واستبدالها بحساب عينة استقرائية إحصائية كافية (مثل فحص 2000 إلى 5000 صف)، تضمن تمثيل كافة المتغيرات دون إجبار النظام على قراءة ملايين السجلات مرتين متتاليتين.
علاوة على ذلك، يبرز تفعيل خيارات ضغط الجداول المدمجة في SAS كإحدى أقوى الاستراتيجيات التحسينية عند حفظ المخرجات الكبرى؛ حيث يمكن تمرير خيار الضغط عبر المعلمة OUT (مثل: OUT=WORK.BIGDATA(COMPRESS=YES);)، مما يقلص الحجم الفيزيائي النهائي للجدول على وسائط التخزين بنسب قد تصل إلى 70%. يسهم هذا التقليص في تسريع عمليات القراءة والكتابة اللاحقة (I/O Operations) وتخفيف الاختناقات الشبكية، محققاً التوازن الأمثل بين كفاءة الإجراء وسرعة تدفق النظم الحسابية المؤسسية.
10.3 بناء شيفرات استيراد قابلة لإعادة الاستخدام والأتمتة
يتطلب التحول من الاستخدام الفردي المتقطع لإجراء PROC IMPORT إلى النضج البرمجي المؤسسي صياغة الشيفرات بأسلوب نمطي مرن وقابل للأتمتة عبر توظيف لغة الماكرو المتقدمة في SAS (SAS Macro Language). ومن خلال تغليف الإجراء داخل وحدات ماكرو ديناميكية، يستطيع المطور تمرير مسارات الملفات وأسماء الجداول كمتغيرات وسيطة (Parameters)، مما يتيح معالجة واستيراد عشرات أو مئات الملفات المتتابعة دفعة واحدة عبر حلقات تكرارية محكمة البناء، كما هو موضح في الصياغة المنهجية الآتية:
%MACRO ImportBatch(FileName=, OutDS=);

    PROC IMPORT DATAFILE="&FileName"

        OUT=&OutDS

        DBMS=CSV

        REPLACE;

        GETNAMES=YES;

        GUESSINGROWS=5000;

    RUN;

%MEND ImportBatch;
إن ترسيخ هذا النهج المؤتمت يُلزم الباحث أيضاً بتوثيق المعلمات والخيارات المستخدمة توثيقاً منهجياً صارماً في مقدمة السكربتات البرمجية. يضمن ذلك الامتثال لمعايير التدقيق المؤسسي والرقابة التحليلية، ويتيح للفرق البحثية اللاحقة استيعاب مبررات خيارات الاستيراد المعتمدة، وإعادة تشغيل خطوط البيانات التراكمية بسلاسة متناهية، وبما يضمن موثوقية واستدامة الحلول الإحصائية المنفذة عبر هذا الإجراء التقني الرصين.
خاتمة
يمثل إجراء PROC IMPORT حجر الزاوية والركيزة التشغيلية الأساسية لاستيعاب وتنظيم البيانات الخارجية في بيئة نظام SAS التحليلي. ومن خلال استعراضنا الشامل لأبعاده النظرية وتطبيقاته العملية، يتضح أن قوة هذا الإجراء لا تكمن فقط في الإيجاز البرمجي وسهولة الاستخدام، بل في الذكاء المعماري الذي يمتلكه للتكيف مع باقة واسعة من الهياكل والصيغ البيانية، بدءاً من ملفات CSV وجداول إكسيل المعقدة، ووصولاً إلى الملفات النصية المحددة برمزيات خاصة.
إن الاحتراف الحقيقي في استخدام هذا الإجراء يتجلى في الإدراك العميق لحدوده وإمكانياته؛ وذلك من خلال الضبط الدقيق لخيارات القراءة المتقدمة كتعليمة GUESSINGROWS لتلافي اقتطاع البيانات، والتحكم الواعي في الترويسات وصفوف البداية عبر GETNAMES وDATAROW، فضلاً عن القراءة النقدية المتفحصة لسجل النظام (SAS Log) لضمان مطابقة الهيكل المستورد للمعايير الإحصائية المستهدفة. ومع تعاظم أحجام البيانات وتنوع مصادرها في العصر الرقمي، يظل التمكن من هذا الإجراء مهارة لا غنى عنها لكل مشتغل في حقل الإحصاء وهندسة البيانات لضمان تدفق تحليلي موثوق، رصين، وقابل للتكرار بدقة متناهية.
المراجع
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Statements: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). Base SAS 9.4 Procedures Guide (7th ed.). SAS Institute Inc. https://support.sas.com
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc.
- Burlew, M. M. (2014). SAS Macro Programming Made Easy (3rd ed.). SAS Institute Inc.