
تُعد معالجة البيانات الإحصائية وتلخيصها من الركائز الأساسية التي يقوم عليها اتخاذ القرار العلمي والتحليلي في مختلف حقول المعرفة، بدءاً من العلوم الاقتصادية والإدارية ووصولاً إلى العلوم الحيوية والاجتماعية. وعند التعامل مع مجموعات ضخمة من المشاهدات والقياسات الرقمية، يبرز التوزيع التكراري بوصفه إحدى أكثر الوسائل كفاءة في اختزال هذا السيل المتدفق من الأرقام الأولية الخام ضمن فئات وجداول منتظمة وموجزة تمنح الباحث رؤية كلية واضحة للخصائص العامة للبيانات. غير أن هذا التلخيص، على أهميته، يخلق تحدياً إحصائياً دقيقاً؛ فالبيانات حينما تُجمع داخل فئات تفقد قيمها الفردية الدقيقة، وتصبح ممثلة فقط بنقاط مركزية وأعداد تكرارية ترصد كثافة المشاهدات داخل كل فئة.
ينشأ عن ذلك الاحتياج إلى أدوات رياضية قادرة على تقدير معالم المجتمع أو العينة استناداً إلى هذه البيانات المجمعة، وعلى رأس تلك المعالم مقاييس النزعة المركزية ومقاييس التشتت. وإذا كان المتوسط الحسابي المرجح يمثل نقطة الارتكاز والتوازن لهذه التوزيعات، فإن الانحراف المعياري يظل المقياس السيادي الأكثر دقة وموثوقية في تبيان درجة تشتت المشاهدات وتمايزها حول ذلك المركز. وتزداد أهمية هذا المقياس في البيئات التطبيقية عند الحاجة إلى التحقق من تجانس العينات، واختبار فرضيات الجودة، وبناء نماذج التنبؤ، وقياس المخاطر المالية.
يمثل برنامج مايكروسوفت إكسل (Microsoft Excel) الأداة البرمجية الأكثر انتشاراً في العالم للتعامل مع الجداول الحسابية والبيانات الإحصائية. غير أن دوال الانحراف المعياري الجاهزة في إكسل، مثل STDEV.S أو STDEV.P، مصممة في الأصل للتعامل الحصري مع البيانات المفردة غير المبوبة (Raw Data) الموزعة في خلايا فردية؛ مما يعني أن إدخال جدول توزيع تكراري مباشرة في هذه الدوال سيعطي نتائج خاطئة تماماً تعبر عن انحراف التكرارات نفسها أو مراكز الفئات المجردة، وليس الانحراف المعياري للظاهرة الأصلية الخاضعة للدراسة. من هنا، تبرز الحاجة المنهجية إلى تفكيك المسألة رياضياً وإعادة بناء خطوات خوارزمية الحساب اليدوي داخل بيئة إكسل من خلال أعمدة مساعدة وصيغ مركبة تعيد إحياء الأوزان الإحصائية بدقة رياضية متناهية. يستعرض هذا الدليل الأكاديمي الشامل الأسس النظرية والممارسات التطبيقية لحساب الانحراف المعياري للبيانات المبوبة في جداول تكرارية خطوة بخطوة عبر إكسل.
1. الأسس النظرية للانحراف المعياري في التوزيعات التكرارية
1.1 مفهوم التوزيع التكراري وأهميته في التحليل الإحصائي
يمثل التوزيع التكراري أداة إحصائية منهجية لتنظيم البيانات الخام غير المرتبة وتلخيصها في مصفوفة حسابية تعرض الفئات المتتالية وأعداد المفردات (التكرارات) الواقعة ضمن حدود كل فئة. في الممارسات البحثية والتجريبية، غالباً ما يجد المحلل نفسه أمام آلاف القراءات المنفصلة التي يصعب استخلاص استنتاجات سريعة منها بمجرد المعاينة البصرية المباشرة؛ لذا يُعد تحويل هذه القراءات من بيانات فردية غير مبوبة إلى بيانات مجمعة داخل فئات رقمية ذات مدى محدد وسيلة حيوية لرسم الملامح الهيكلية للتوزيع، والوقوف على شكل التماثل أو الالتواء، وتحديد أنماط التركز الجغرافي أو الرقمي للظاهرة.
تكمن الفروق الجوهرية بين البيانات الفردية غير المبوبة والبيانات التكرارية في درجة التفصيل؛ فالبيانات غير المبوبة تحتفظ بالقيمة الأصلية لكل مشاهدة، مما يتيح حساب المؤشرات الإحصائية بدقة متناهية، في حين تتنازل البيانات المبوبة عن هذه الخصوصية التفصيلية لصالح الكفاءة التلخيصية. ويتيح هذا التمثيل المجمع إبراز معالم النزعة المركزية ومستوى التشتت العام عبر مجموعات البيانات، إلا أنه يفرض في الوقت عينه حدوداً رياضية حتمية؛ حيث يُفترض ضمنياً أن جميع المشاهدات الواقعة ضمن نطاق فئة معينة تتطابق في قيمتها مع نقطة المنتصف أو المركز الرياضي لتلك الفئة، مما يترتب عليه قدر طفيف من فقدان الدقة يُعرف إحصائياً بخطأ التجميع (Grouping Error).
1.2 دور الانحراف المعياري كمقياس للتشتت الإحصائي
يُعرَّف الانحراف المعياري (Standard Deviation) رياضياً بأنه الجذر التربيعي لمتوسط مربعات انحرافات القيم عن متوسطها الحسابي، وهو ما أرسى دعائمه العالم الإحصائي كارل بيرسون (Karl Pearson) في عام 1894 كبديل دقيق لمفاهيم سابقة مثل الخطأ المتوسط. وتبرز أهميته الحاسمة مقارنة بمقاييس التشتت الأخرى كونه يعالج القصور الجوهري في مقياس “المدى” الذي يقتصر على قياس الفرق بين القيمتين القصوى والدنيا متجاهلاً التوزيع الداخلي للمشاهدات، ويتجاوز مشكلة “التباين” الذي يُعبَّر عنه بوحدات مربعة يصعب تفسيرها عملياً مقارنة بوحدة القياس الأصلية للظاهرة المدروسة.
يمتلك الانحراف المعياري تطبيقات جوهرية تمتد إلى تقييم موثوقية المقاييس وثباتها، وحساب حدود الثقة الإحصائية، وضبط الجودة الإحصائية في خطوط الإنتاج عبر قياس الاستقرار حول القيمة المستهدفة. كما تتأثر القيمة المقدرة للانحراف المعياري تأثراً مباشراً بكل من حجم العينة الكلي وكثافة التكرارات الفئوية؛ حيث يؤدي اتساع حجم العينة وتكرار المشاهدات المتسق حول المتوسط إلى تقليل الخطأ المعياري للتقدير وتقديم صورة بالغة الثبات عن بنية التشتت الإحصائي العام لمجتمع الدراسة.
1.3 الفرق بين انحراف المجتمع وانحراف العينة في البيانات المبوبة
يستند التمييز الإحصائي بين انحراف المجتمع وانحراف العينة إلى الغاية التحليلية وتوافر البيانات الكاملة. فعندما تغطي البيانات المدروسة كامل مفردات المجتمع الإحصائي دون استثناء، يُستخدم الانحراف المعياري للمجتمع ويرمز له بالرمز الإغريقي سيجما ($\sigma$)، وتُقسَّم فيه مجموع مربعات الانحرافات المرجحة على إجمالي حجم المجتمع ($N$). غير أن دراسة المجتمعات الإحصائية الكاملة نادراً ما تكون متاحة عملياً نظراً لكبر حجمها أو تكلفتها الباهظة؛ مما يقتضي الاعتماد على العينات العشوائية واستخدام الانحراف المعياري للعينة ويرمز له بالرمز اللاتيني ($s$).
عند تقدير تشتت المجتمع انطلاقاً من بيانات العينة، يميل التباين المحسوب بالصيغة التقليدية إلى أن يكون مقدراً متحيزاً نحو النقصان (Underestimated)؛ نظراً لأن انحرافات مفردات العينة تُحسب بالنسبة إلى المتوسط الحسابي للعينة ذاتها وليس بالنسبة إلى المتوسط الحقيقي للمجتمع غير المعلوم. ولتصحيح هذا التحيز الرياضي وتوفير مقدر غير متحيز، يُطبق تصحيح بيسل (Bessel’s Correction) الذي وضعه العالم فريدريش فيلهلم بيسل (Friedrich Wilhelm Bessel)، حيث يُقسَّم مجموع المربعات على درجات الحرية ($N – 1$) بدلاً من ($N$). ويترتب على هذا الفارق الحسابي اختيار دقيق للصيغ الرياضية ومسارات الدوال المنفذة في إكسل لتفادي الوقوع في خطأ التحيز الإحصائي.
2. الصياغة الرياضية المعتمدة لحساب الانحراف المعياري التكراري
2.1 تفكيك معادلة المتوسط الحسابي للتوزيع التكراري
يمثل المتوسط الحسابي للتوزيع التكراري عتبة الأساس الحسابية التي تستند إليها جميع مقاييس التشتت اللاحقة، وهو يُحسب وفق مفهوم المتوسط المرجح بالأوزان التكرارية. بالنظر إلى أن المفردات الفردية لكل فئة لم تعد معلومة بصورة منفصلة، يُعتمد مركز الفئة ($m_i$ أو $x_i$) كنقطة نموذجية تمثل القيمة المركزية التي تتجمع حولها مشاهدات الفئة. وتتحدد الصيغة الرياضية للمتوسط الحسابي المرجح ($\bar{x}$) للبيانات المبوبة بالمعادلة التالية:
$$\bar{x} = \frac{\sum_{i=1}^{k} n_i \cdot m_i}{\sum_{i=1}^{k} n_i} = \frac{\sum_{i=1}^{k} n_i \cdot m_i}{N}$$
حيث تمثل $k$ إجمالي عدد الفئات في الجدول التكراري، ويرمز $n_i$ إلى التكرار المرصود في الفئة ذات الترتيب $i$، بينما يمثل $m_i$ المركز الرياضي لتلك الفئة، في حين يعبر $N$ عن الحجم الإجمالي للعينة الناتج عن حاصل جمع التكرارات كافة ($\sum n_i$). تضمن هذه الصياغة منح كل مركز فئة وزناً نسبياً يكافئ بدقة حجم المشاهدات التي تتضمنها تلك الفئة داخل مجمل التوزيع، متفادية الخلل الناشئ عن حساب متوسط حسابي بسيط لمراكز الفئات المجردة بمعزل عن أوزانها الحقيقية.
2.2 تفكيك صيغة الانحراف المعياري التكراري للعينة
لحساب الانحراف المعياري التكراري لعينة إحصائية مبوبة، ينبغي فحص المسار الرياضي الذي يقيس بعد مراكز الفئات عن المتوسط الحسابي المرجح المحسوب سلفاً. تتطلب المعادلة إيجاد الفارق بين مركز كل فئة والمتوسط العام ($m_i – \bar{x}$)، ثم تربيع هذا الفارق $(m_i – \bar{x})^2$. وتتجلى أهمية خطوة التربيع في تحييد الإشارات السالبة الناتجة عن القيم التي تقل عن المتوسط؛ إذ إن مجموع الفروق البسيطة دون تربيع يساوي صفراً دائماً استناداً إلى الخصائص الجبرية للمتوسط الحسابي.
عقب تربيع الفروق، تُضرب كل قيمة ناتجة في تكرار الفئة المقابلة ($n_i$) لإعطائها وزنها الحجمي الفعلي في تكوين التشتت العام، ثم تُجمع هذه الحواصل للحصول على مجموع مربعات الانحرافات المرجحة. وتكتمل الصيغة الرياضية بقسمة هذا المجموع على درجات الحرية ($N – 1$) لاستخراج تباين العينة، ثم إدخال المقدار بأكمله تحت الجذر التربيعي لإلغاء أثر التربيع الأولي واستعادة وحدة القياس الطبيعية الأصلية للبيانات، كما توضح المعادلة العامة:
$$s = \sqrt{\frac{\sum_{i=1}^{k} n_i \cdot (m_i – \bar{x})^2}{N – 1}}$$
وتجدر الإشارة إلى وجود صيغة جبرية مكافئة ومختصرة تُعرف بالصيغة الحسابية (Computational Formula) لا تتطلب حساب المتوسط الفعلي أولاً، بل تعتمد على مجموع حواصل ضرب التكرارات في مربعات المراكز، وتأخذ الشكل التالي:
$$s = \sqrt{\frac{\sum n_i m_i^2 – \frac{(\sum n_i m_i)^2}{N}}{N – 1}}$$
3. الخطوة الأولى: إعداد وتنظيم البيانات التكرارية في ورقة عمل إكسل
3.1 هيكلة الأعمدة الأساسية لجدول التوزيع
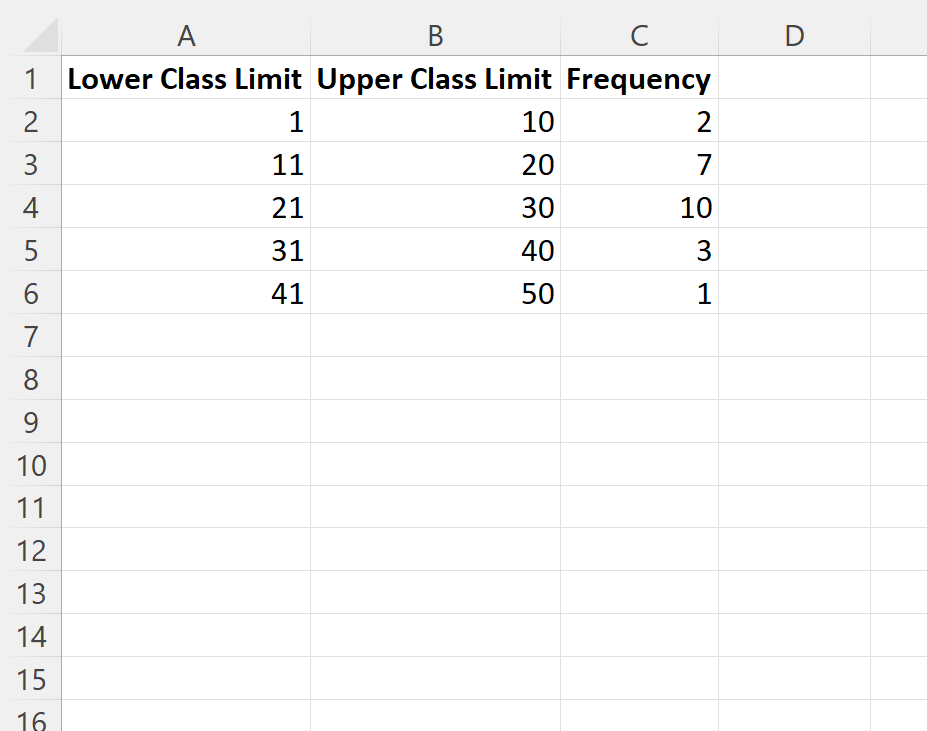
تتطلب المعالجة الحسابية الناجحة في برنامج إكسل تخطيطاً صارماً وتنسيقاً بيانياً متسقاً لصفوف ورقة العمل وأعمدتها. يبدأ العمل بإنشاء هيكل جدولي مكرس لحمل القياسات المدخلة؛ حيث يُخصص العمود الأول (العمود A) للحد الأدنى لكل فئة (Lower Class Limit)، والعمود الثاني (العمود B) للحد الأعلى للفئة (Upper Class Limit)، بينما يُفرد العمود الثالث (العمود C) لإدراج التكرارات الفعلية المرصودة المقابلة لكل فئة ($n_i$ أو $f_i$).
يُعد فصل حدي الفئة في عمودين مستقلين بدلاً من كتابتهما معاً في خلية واحدة بنسق نصي (مثل: “10 – 20”) خطوة هندسية حاسمة لا غنى عنها؛ إذ إن دوال إكسل الحسابية تعجز عن إجراء العمليات الرياضية على الخلايا المحتوية على نصوص أو فواصل شرطية. ومن الضروري تسمية رؤوس الأعمدة بوضوح تام، مثل “الحد الأدنى”، و”الحد الأعلى”، و”التكرار”، مع التأكد من ضبط تنسيق الخلايا الرقمية تحت فئة “رقم” (Number) عبر تبويب الصفحة الرئيسية، لضمان استجابتها لجميع الصيغ الحسابية التي ستُبنى عليها لاحقاً دون إطلاق رسائل الخطأ البرمجية المتعلقة باختلاف الصيغ.
3.2 فحص سلامة الفئات والتكرارات المدخلة
قبل الانتقال إلى أي خطوة حسابية، يجب إجراء تدقيق بيانات صارم على جدول التوزيع التكراري. يشمل هذا التدقيق التحقق المنهجي من عدم وجود أي تداخل بين حدود الفئات المتجاورة؛ بحيث ينتهي الحد الأعلى للفئة الحالية تماماً عند النقطة التي يبدأ منها الحد الأدنى للفئة التالية في البيانات المتصلة، أو يترك فارقاً متسقاً ومنظماً في البيانات المنفصلة، لضمان عدم احتساب أي مشاهدة إحصائية مرتين داخل الجدول.
يجب أيضاً مراجعة انتظام طول الفئة الحسابية عبر كل فئات التوزيع؛ حيث يُحسب طول الفئة بطرح حدها الأدنى من حدها الأعلى. ورغم أن التوزيعات غير متساوية الطول يمكن معالجتها رياضياً، إلا أن انتظام الأطوال يمثل المعيار الأضمن لتفادي الانحرافات المعقدة في مراكز البيانات. ولمنع وقوع أخطاء الطباعة الشائعة كإدخال أرقام سالبة في خانات التكرارات أو تضمين حروف نصية غير مقصودة، يُنصح بتطبيق ميزة “التحقق من صحة البيانات” (Data Validation) من تبويب “بيانات” في إكسل، وتعيين قيود تلزم المستخدم بإدخال أعداد صحيحة موجبة فقط في عمود التكرارات.
4. الخطوة الثانية: حساب مراكز الفئات (Midpoints) في إكسل
4.1 الأساس الرياضي لحساب مركز الفئة
يستند مفهوم مركز الفئة ($m_i$) إلى الفرضية الإحصائية الكلاسيكية القائلة بأن المشاهدات التكرارية تتوزع توزيعاً متجانساً ومنتظماً داخل النطاق العددي للفئة الواحدة؛ وبالتالي فإن القيمة الحسابية التي تتوسط الحدين الأدنى والأعلى تمثل النقطة المثلى لتمثيل كافة مفردات تلك الفئة دون تحيز رياضي نحو أحد الطرفين. يُحسب مركز الفئة رياضياً بجمع الحد الأدنى للفئة مع حدها الأعلى ثم قسمة الناتج على اثنين، وهو ما يكافئ حساب المتوسط الحسابي البسيط لطرفي المدى.
تتضاعف أهمية مراكز الفئات في كونها تحول المدى الفئوي الممتد إلى قيمة رقمية متفردة تمكّن برامج الجداول الإلكترونية من حساب العزوم الإحصائية المختلفة كالمتوسط والتباين والانحراف المعياري. وفي حالات نادرة تتضمن فئات مفتوحة الطرفين (كأن تبدأ الفئة بـ “أقل من 10” أو تنتهي بـ “أكثر من 100”)، يتعذر تحديد مركز رياضي دقيق دون افتراض طول مماثل للفئات المجاورة، لذا يُستحسن دوماً في التصاميم التجريبية إغلاق الفئات بصورة قطعية لضمان استقرار العمليات الحسابية ودقتها في ورقة العمل.
4.2 تطبيق معادلة مركز الفئة باستخدام دوال إكسل
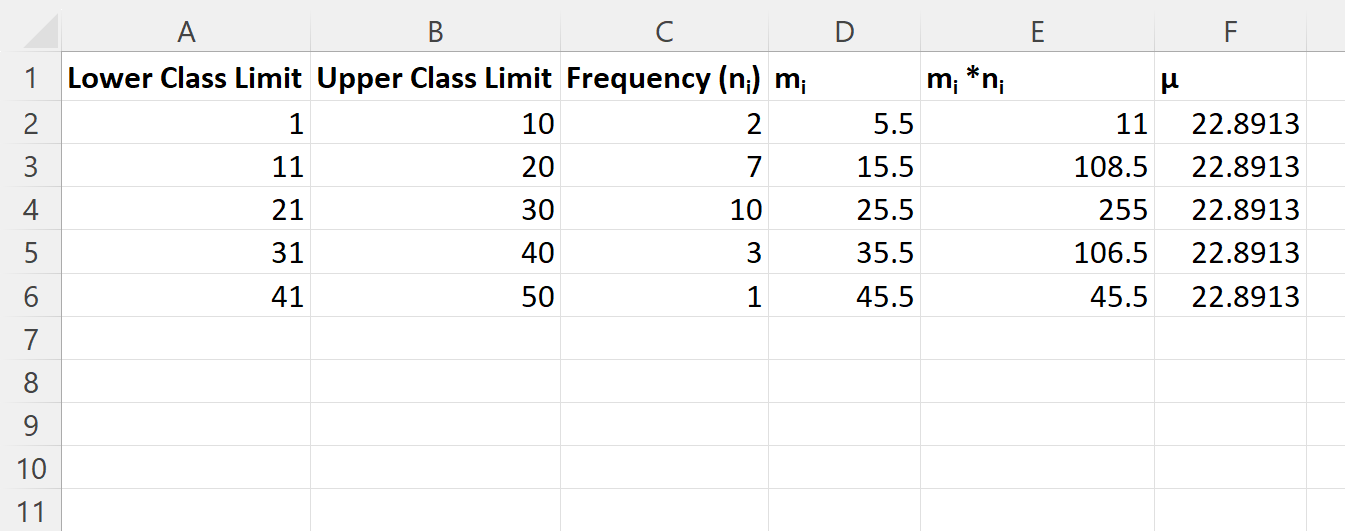
لحساب مراكز الفئات برمجياً داخل إكسل، يُخصص العمود الرابع (العمود D) في ورقة العمل ويُعنون برأس عمود واضح مثل “مركز الفئة (m)”. بافتراض أن الصف الأول مخصص للرؤوس، وأن الفئة الأولى تبدأ في الصف الثاني؛ حيث يقع حدها الأدنى في الخلية A2 وحدها الأعلى في الخلية B2، تُكتب إحدى الصيغتين التاليتين في الخلية D2:
الصيغة المباشرة الأولى باستخدام دالة المتوسط:
=AVERAGE(A2:B2)
أو الصيغة الجبرية التقليدية مع مراعاة الأقواس لضمان ترتيب العمليات الحسابية:
=(A2+B2)/2
عقب الضغط على مفتاح الإدخال (Enter)، يظهر المركز الرياضي للفئة الأولى مباشرة. لتطبيق هذه الصيغة على كافة الفئات المتبقية على نحو آلي، يُوجَّه مؤشر الفأرة إلى الزاوية السفلية اليسرى (أو اليمنى وفقاً للغة واجهة البرنامج) للخلية D2 حتى يتحول المؤشر إلى علامة التقاطع السوداء المعروفة بـ “مقبض التعبئة التلقائية” (Fill Handle). يُنقر عندئذ بالزر الأيسر ويُسحب المؤشر للأسفل ليغطي جميع صفوف الفئات المسجلة في الجدول (حتى الخلية D6 في جدول مكون من خمس فئات على سبيل المثال). تضمن هذه الخطوة، بفعل خاصية المراجع النسبية في إكسل، أن يتم تحديث مراجع الصفوف تلقائياً في كل فئة، مما ينتج عنه عمود كامل ودقيق لمراكز الفئات.
5. الخطوة الثالثة: حساب حاصل ضرب مراكز الفئات في التكرارات
5.1 الهدف الإحصائي من وزن المراكز بالتكرار
لا يمكن للمحلل الإحصائي معاملة مراكز الفئات كقيم مطلقة متكافئة الأثر؛ فالفئة التي يتكرر حدوثها خمسين مرة تحمل في طياتها ثقلاً معلوماتياً وتأثيراً مضاعفاً على خصائص التوزيع مقارنة بفئة أخرى لم تتكرر سوى مرتين اثنتين. من هذا المنطلق، يبرز وزن المراكز بتكراراتها كخطوة رياضية لازمة لتحديد العزم الأول للتوزيع الإحصائي وبناء البسط الرياضي لحساب المتوسط الحسابي المرجح.
إن إغفال هذا الترجيح التكراري يؤدي بالضرورة إلى تحيز فادح، حيث تصبح النتيجة النهائية ممثلة لمتوسط المدى الهندسي المجرد للفئات بدلاً من أن تكون معبرة عن سلوك الظاهرة الفعلية وموقع تركز كتلها البشرية أو المادية. ومن خلال إجراء هذه العملية الجبرية لكل صف على حدة، يتم تحويل كل فئة إلى حصة رقمية تسهم بنصيبها المحدد في الحجم التراكمي الإجمالي للمشاهدات، مما يمهد الطريق لاحتساب مؤشرات التشتت حول مركز ثقل حقيقي ومتوازن.
5.2 كتابة وتعميم صيغة الضرب في إكسل
يُخصص العمود الخامس (العمود E) في الجدول وتوضع له التسمية التوضيحية “حاصل ضرب المركز في التكرار (m * n)”. لحساب هذه القيمة للفئة الأولى الواقعة في الصف الثاني، يتم الانتقال إلى الخلية E2 وتُكتب الصيغة الرياضية البسيطة التي تضرب قيمة مركز الفئة الواقعة في العمود D بقيمة التكرار المقابلة في العمود C:
=D2*C2
بمجرد الضغط على Enter، يُحسب الحاصل المرجح لتلك الفئة. وبالنظر إلى اعتماد الصيغة على “المراجع النسبية” (Relative References)، فإن سحب مقبض التعبئة من الخلية E2 نحو الأسفل ليشمل نطاق الخلايا الممتد حتى نهاية جدول البيانات (مثل E6) سيؤدي تلقائياً إلى تحديث مراجع الخلايا في كل صف لتصبح =D3*C3، ثم =D4*C4، وهكذا دواليك. وللتأكد من سلامة التنفيذ وتجنب أي خطأ خفي في مصفوفة البيانات، يُنصح باختيار خلية عشوائية من العمود والضغط على مفتاح F2 لإظهار الخلايا الأصلية الداخلة في عملية الضرب والتحقق من تطابقها اللوني والمنطقي.
6. الخطوة الرابعة: حساب المتوسط الحسابي للتوزيع التكراري في إكسل
6.1 حساب المجموع الكلي للتكرارات وحواصل الضرب
تتطلب الصياغة الرياضية للمتوسط الحسابي استخراج قيمتين إجماليتين رئيسيتين: المجموع الكلي للتكرارات، والذي يمثل حجم العينة الكلي ($N = \sum n_i$)، والمجموع الكلي لحواصل ضرب مراكز الفئات في التكرارات ($\sum n_i \cdot m_i$). يُفضّل تنظيم هذه الإجماليات بإضافة صف تجميعي أسفل الجدول أو حجز خلايا مستقلة وواضحة خارج النطاق التكراري لتفادي اختلاط صفوف الفئات بالقيم التراكمية.
لحساب المجموع التراكمي للتكرارات، ننتقل إلى الخلية الواقعة أسفل عمود التكرارات مباشرة (ولتكن الخلية C7 بافتراض انتهاء الفئات عند الصف السادس)، ونُدخل دالة الجمع التلقائي التالية:
=SUM(C2:C6)
وبالمثل، لحساب المجموع التراكمي لمرجحات المراكز، ننتقل إلى الخلية أسفل عمود الضرب (الخلية E7) ونُدرج صيغة الجمع الخاصة بها:
=SUM(E2:E6)
يمنح هذا التوثيق للمجاميع المستقلة مرونة حسابية عالية؛ إذ يمكن استخدامها لاحقاً كخلايا مرجعية مركزية يتم استدعاؤها في مختلف دوال قياس التشتت وعزم الالتواء والتفرطح دون الحاجة إلى إعادة صياغة نطاقات الجمع في كل معادلة جديدة.
6.2 تطبيق صيغة المتوسط المرجح التكراري
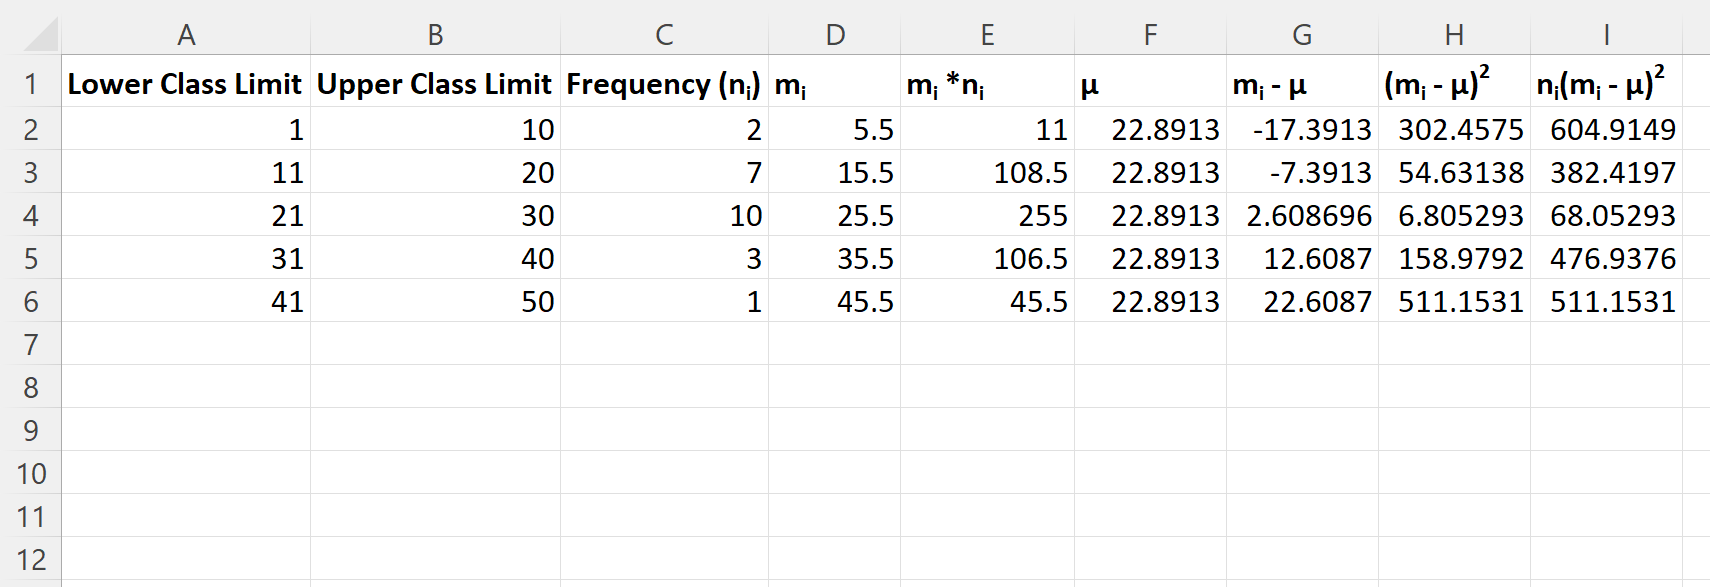
عقب تجهيز حواصل الجمع اللازمة، يُحسب المتوسط الحسابي المرجح للتوزيع. هناك خياران تنظيميّان لتنفيذ ذلك في إكسل: إما حسابه في خلية منفصلة واحدة واستدعاؤها كمرجع مطلق، أو عرضه في عمود مخصص (العمود F) يتكرر فيه المتوسط أمام كل صف. يُعد الخيار الثاني بالغ الفائدة البيداغوجية والعملية لتسهيل إجراء حسابات انحرافات كل فئة على حدة بصورة بصرية واضحة ومباشرة.
لإنشاء هذا العمود، يُعنون العمود F بـ “المتوسط الحسابي ($\bar{x}$)”، وتُكتب في الخلية F2 معادلة قسمة مجموع حواصل الضرب على مجموع التكرارات. ونظراً لأننا نرغب في نسخ هذه المعادلة عبر كافة الصفوف دون أن تتحرك مراجع خلايا المجاميع إلى أسفل، فإنه يتحتم استخدام علامة الدولار ($) لتثبيت المراجع وجعلها مراجع مطلقة (Absolute References):
=$E$7/$C$7
أو يمكن دمج دالتي الجمع مباشرة داخل صيغة الخلية F2 كالتالي:
=SUM($E$2:$E$6)/SUM($C$2:$C$6)
عند سحب مقبض التعبئة للخلية F2 نزولاً حتى F6، ستعرض كافة خلايا العمود نفس القيمة الثابتة بدقة متناهية؛ وهي تمثل المتوسط الحسابي المرجح للبيانات. يتيح هذا الوجود الثابت للمتوسط في كل صف بناء صيغ الفروق المربعة لاحقاً بالاعتماد على خلايا تقع على نفس المستوى الأفقي، مما يقلل احتمالات الخطأ أثناء تحرير المعادلات الرياضية.
7. الخطوة الخامسة: حساب مربعات الانحرافات المرجحة بالتكرار
7.1 صياغة معادلة انحراف المراكز عن المتوسط الحسابي
تمثل هذه المرحلة النواة الحسابية لقياس تشتت البيانات حول نقطة الاتزان المركزية؛ حيث يتم قياس مدى ابتعاد مركز كل فئة عن المتوسط العام للتوزيع وفق الصيغة الرياضية $(m_i – \bar{x})$. وكما أشرنا في الأسس النظرية، فإن مجموع هذه الانحرافات دون تربيع سيتلاشى جبرياً نتيجة إلغاء القيم السالبة (للفئات الواقعة يسار المتوسط) للقيم الموجبة (للفئات الواقعة يمينه)، مما يحتم إجراء عملية الرفع إلى القوة التربيعية $(m_i – \bar{x})^2$ لتحويل كافة الفروق إلى مقادير موجبة مطلقة تعبر عن مسافات تشتت مجردة.
ولا يقف البناء الرياضي عند تربيع الفارق الهندسي، بل يجب ضرب هذا المربع في تكرار الفئة المقابلة ($n_i$)؛ وذلك لأن كل مشاهدة تقع داخل نطاق تلك الفئة تسهم بنفس المسافة التشتتية المربعة عن المتوسط. ويعبر الناتج $n_i \cdot (m_i – \bar{x})^2$ عن المساهمة النسبية الإجمالية لتلك الفئة في تكوين التباين الكلي للعينة. فكلما تباعدت الفئة عن المتوسط وكان تكرارها كبيراً، تعاظم مقدار مساهمتها في رفع قيمة التشتت النهائي للبيانات، مما يجعل هذا العمود المرجح مرآة حقيقية لتوزيع التشتت عبر فئات المتغير.
7.2 تطبيق الصيغة المتقدمة في خلايا إكسل
لتنفيذ هذه الخطوة المركبة داخل ورقة العمل، يُنشأ العمود السابع (العمود G) تحت عنوان وصفي محدد مثل “مربعات الانحرافات المرجحة: n*(m – mean)^2”. في الخلية G2، يتم دمج عمليات الطرح، والتربيع، والضرب في صيغة واحدة متكاملة تستفيد من ترتيب أسبقية العمليات الحسابية في إكسل (حيث تُنفذ العمليات بين الأقواس أولاً، تليها الأسس، ثم الضرب):
=C2*(D2-F2)^2
تستخدم هذه الصيغة رمز الأقحوان أو علامة الإقحام (^) المتوفرة عبر الضغط على Shift + 6 لرفع الفارق إلى الأس 2. وتأخذ الصيغة قيمة التكرار من الخلية C2، وتطرح قيمة المتوسط في F2 من مركز الفئة في D2، ثم تُربع الناتج وتضربه مباشرة في التكرار.
عقب إدخال الصيغة، يتم سحب مقبض التعبئة من G2 نزولاً إلى G6 لتعميم الحساب على بقية الصفوف. هنا تجدر الملاحظة والتدقيق: يجب أن تكون جميع المخرجات الرقمية في العمود G قيماً موجبة تماماً (أو صفراً في حال تطابق مركز الفئة صدامياً مع المتوسط الحسابي)؛ فظهور أي قيمة سالبة في هذا العمود يشير بصورة قاطعة إلى وجود خطأ في كتابة الصيغة، كأن يكون عامل التربيع قد تم وضعه خارج نطاق الأقواس أو بصيغة جبرية غير صحيحة.
8. الخطوة السادسة: حساب الانحراف المعياري النهائي للتوزيع التكراري
8.1 تجميع مربعات الانحرافات وتحديد درجات الحرية
بعد استخراج مساهمات الفئات الفردية في عمود مربعات الانحرافات المرجحة، نصل إلى محطة التجميع النهائي لحساب تباين العينة ($s^2$). يتطلب ذلك جمع كافة القيم المحسوبة في العمود G للحصول على البسط الرياضي الكامل، وهو ما يتم بتطبيق دالة الجمع في الخلية G7:
=SUM(G2:G6)
يمثل هذا المجموع بسط معادلة التباين ($\sum n_i(m_i – \bar{x})^2$). لتحديد المقام، يجب العودة إلى الحجم الكلي للعينة ($N$) المحسوب سلفاً في الخلية C7 وتطبيق تصحيح بيسل بطرح واحد صحيح للحصول على درجات الحرية المطلوبة للعينة:
=C7-1
عند قسمة بسط التباين في G7 على درجات الحرية ($N – 1$)، ينتج التباين التكراري للعينة. وإذا كان الهدف الأكاديمي أو التجريبي يتطلب حساب انحراف المجتمع الإحصائي الكامل ($\sigma$)، فإن المقام يُترك حينئذ مساوياً لحجم المجتمع الكلي $N$ الموجود في الخلية C7 دون إجراء عملية الطرح، التزاماً بالمفاهيم النظرية التي تم تأصيلها سابقاً.
8.2 تطبيق دالة الجذر التربيعي واستخراج النتيجة النهائية
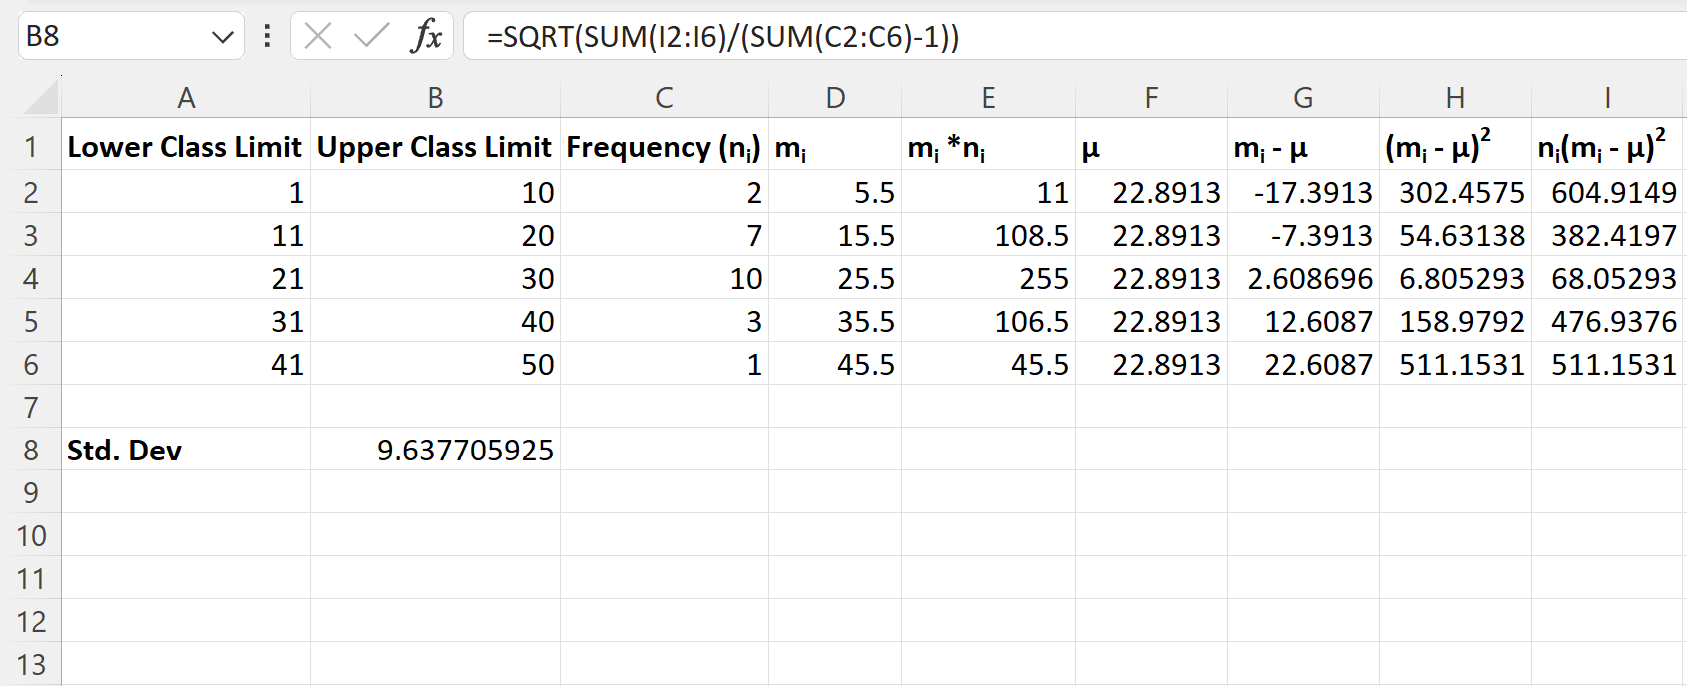
يُمثل الانحراف المعياري الجذر التربيعي الموجب لقيمة التباين المستخرجة. لحساب هذه القيمة النهائية في خطوة واحدة جامعة داخل خلية مستقلة نطلق عليها “الانحراف المعياري للعينة (s)” (ولتكن الخلية D10)، نستخدم دالة الجذر التربيعي SQRT محتضنةً كسر التباين التكراري بأكمله وفق المعادلة الشاملة التالية:
=SQRT(SUM(G2:G6)/(SUM(C2:C6)-1))
أو بالاعتماد على الخلايا التجميعية المحسوبة في أسفل الجدول:
=SQRT(G7/(C7-1))
بمجرد الضغط على زر الإدخال، يعرض إكسل القيمة الرقمية النهائية للانحراف المعياري التكراري. ولإضفاء المظهر المهني والأكاديمي الرصين على النتائج، يُنصح بتنسيق الخلية الناتجة عبر تقليل المنازل العشرية إلى منزلتين أو ثلاث منازل عشرية كحد أقصى باستخدام أداة “تقليل المنازل العشرية” من شريط الأدوات الرئيسي. وتُفسر هذه القيمة الناتجة بأنها متوسط المسافة المعيارية التي تتشتت بها قراءات ومفردات العينة الأصلية حول متوسطها الحسابي المرجح، معبرة عنها بنفس وحدة قياس المتغير الأصلي (مثل كيلوغرام، أو سنة، أو متر) مما يسهل استيعابها وتوظيفها التفسيري.
9. طرق بديلة وصيغ مصفوفية متقدمة في إكسل لحساب الانحراف التكراري
9.1 استخدام دوال المصفوفات لحساب النتيجة في خلية واحدة
على الرغم من الأهمية الإيضاحية والتعليمية الكبيرة لطريقة الأعمدة المساعدة المفصلة خطوة بخطوة، فإن بيئات الأعمال والتحليلات المتقدمة قد تفضل اختزال هذا البناء الهندسي الواسع داخل خلية رياضية واحدة فائقة الكفاءة. يتيح برنامج إكسل للمحلل دمج الدوال الجبرية عبر المتجهات باستخدام دالة حاصل ضرب المصفوفات SUMPRODUCT مع دالة الجذر التربيعي SQRT للوصول إلى الانحراف المعياري للبيانات المبوبة دون الحاجة لإنشاء الأعمدة E و F و G.
بافتراض أن التكرارات مدرجة في النطاق C2:C6 وأن مراكز الفئات قد حُسبت مسبقاً في النطاق D2:D6، يمكن كتابة صيغة مصفوفية مركبة في خلية مفردة لحساب انحراف العينة كالتالي:
=SQRT(SUMPRODUCT(C2:C6, (D2:D6 - (SUMPRODUCT(C2:C6, D2:D6) / SUM(C2:C6)))^2) / (SUM(C2:C6) - 1))
في الإصدارات الحديثة من إكسل الداعمة للمصفوفات الديناميكية (Dynamic Arrays في Microsoft 365 و Excel 2021 وما بعدها)، يمكن الضغط مباشرة على Enter لتعمل الصيغة بسلاسة. أما في الإصدارات الأقدم من إكسل، فيتحتم إدخال هذه الصيغة كصيغة مصفوفية تقليدية عبر الضغط المتزامن على مفاتيح Ctrl + Shift + Enter، حيث يُحيطها البرنامج تلقائياً بأقواس معقوفة { }. توفر هذه الطريقة اختصاراً زمنياً كبيراً وتحافظ على نظافة ورقة العمل من الجداول المتفرعة، وإن كانت تتطلب من المحلل فهماً متعمقاً لكيفية معالجة المتجهات الرقمية داخل ذاكرة البرنامج.
9.2 التحقق من دقة التقدير الإحصائي المجمع
عند توفر البيانات الأصلية الخام غير المبوبة إلى جانب الجدول التكراري، فإن المقارنة بين الانحراف المعياري المحسوب من البيانات الفردية الأصلية باستخدام دالة STDEV.S التقليدية وبين الانحراف المعياري المحسوب من الجدول التكراري تكشف عادة عن وجود فارق رقمي ضئيل. يعود هذا التباين إلى خطأ التجميع وافتراض استقرار المشاهدات عند مراكز الفئات بدلاً من توزعها الفعلي الحقيقي.
في الحالات التي تكون فيها الفئات متسعة المدى والمتغير الخاضع للقياس متصلاً، يميل التباين التكراري المقدر إلى الزيادة الطفيفة المصطنعة؛ وهي ظاهرة رياضية فسرها الإحصائي ويليام شيبارد، ووضع لعلاجها ما يُعرف بـ “تصحيح شيبارد” (Sheppard’s Correction). وينص هذا التعديل على خصم قيمة ثابتة من التباين التكراري المحسوب تعتمد على مربع طول الفئة الحسابية ($h$) وفق المعادلة:
$$s^2_{\text{corrected}} = s^2 – \frac{h^2}{12}$$
ثم يُستخرج الجذر التربيعي للتباين المصحح للحصول على انحراف معياري أكثر دقة وقرباً من الواقع غير المبوب. ومع ذلك، يشترط الإحصائيون لتطبيق تصحيح شيبارد أن يكون التوزيع التكراري متماثلاً تقريباً وذا ذيول مستقرة ومتناقصة تدريجياً، مع تجنب استخدامه تماماً في التوزيعات شديدة الالتواء أو الجداول ذات الفئات المفتوحة وغير المتساوية تجنباً لإحداث تحيزات عكسية غير مرغوبة.
10. معالجة الأخطاء الشائعة وضمان الدقة الإحصائية في إكسل
10.1 أخطاء المراجع الحسابية والخلط بين النسبي والمطلق
يواجه المحللون أثناء بناء جداول التوزيع التكراري في إكسل مجموعة من الأخطاء التشغيلية الأكثر شيوعاً، ويأتي في مقدمتها إغفال تثبيت المراجع المطلقة باستخدام رمز $ عند الإشارة إلى خلايا المجاميع الكلية أو خلايا المتوسط الحسابي. فعند كتابة معادلة الانحراف بصيغة =C2*(D2-F2)^2 وسحبها للأسفل، إذا لم تكن الخلية F2 مثبتة أو لم تكن ممتدة في عمود موازٍ، فإن المرجع ينزاح في الصفوف التالية مشيراً إلى خلايا فارغة؛ مما يؤدي إلى نتائج حسابية وهمية وغير صحيحة دون أن يصدر البرنامج رسالة تحذيرية واضحة.
ومن الأخطاء البرمجية الصريحة التي قد تظهر:
- خطأ
#DIV/0!: ويحدث عند محاولة القسمة على الصفر؛ وينشأ عادة في خلية التباين إذا نسي المستخدم إدخال قيم التكرارات أو كان مجموع التكرارات مساوياً لواحد في صيغة العينة ($1 – 1 = 0$). - خطأ
#VALUE!: ويحدث عند وجود مسافات نصية مخفية أو أحرف هجائية داخل خلايا حدود الفئات أو التكرارات؛ مما يعطل المعالجة الحسابية لدوالSUMوSQRT. - أخطاء عدم تطابق أبعاد المصفوفات: عند استخدام الدوال المتقدمة مثل
SUMPRODUCT، يؤدي تباين عدد الخلايا في نطاق المراكز عن نطاق التكرارات (كأن يكون الأول 5 خلايا والثاني 6 خلايا) إلى فشل الصيغة الرياضية بالكامل وظهور رمز الخطأ#N/Aأو#VALUE!.
ولحل هذه المعضلات، يُنصح بالاعتماد على أدوات “تدقيق الصيغ” (Formula Auditing) المتاحة في تبويب “صيغ” في شريط إكسل؛ حيث تتيح أداتي “تتبع السوابق” (Trace Precedents) و”تتبع التوابع” (Trace Dependents) رسم أسهم بيانية ملونة توضح مسار تدفق البيانات عبر الخلايا، بالإضافة إلى استخدام أداة “تقييم الصيغة” (Evaluate Formula) التي تقوم بتفكيك المعادلة الحسابية المعقدة وحلها خطوة بخطوة أمام المستخدم، كاشفةً على الفور عن موقع الخلل الرقمي أو المرجعي المحدد.
10.2 التفسير الإحصائي السليم لنتائج الانحراف المعياري في التحليلات التجريبية
لا تكتمل القيمة المعرفية لحساب الانحراف المعياري بمجرد استخراج رقم مجرد في ورقة عمل إكسل، بل تكمن القيمة في التفسير الإحصائي المنهجي لذلك الرقم وربطه بالظاهرة موضع البحث. لا يمكن تقييم ما إذا كان الانحراف المعياري “كبيراً” أو “صغيراً” بمعزل عن المتوسط الحسابي للتوزيع؛ لذا يلجأ المحللون إلى حساب مقياس التشتت النسبي المعروف بـ “معامل الاختلاف” (Coefficient of Variation – CV) بقسمة الانحراف المعياري للعينة على متوسطها الحسابي وضرب الناتج في مائة:
$$CV = \left(\frac{s}{\bar{x}}\right) \times 100%$$
تتيح هذه النسبة المئوية للمحلل مقارنة تشتت متغيرات ذات وحدات قياس مختلفة تماماً أو مقارنة استقرار مجموعات بيانات تتفاوت تفاوتات شاسعة في أبعادها الرقمية والمتوسطة.
علاوة على ذلك، يُستخدم الانحراف المعياري التكراري في فحص مدى اقتراب التوزيع من خصائص “التوزيع الطبيعي” (Normal Distribution) من خلال التحقق من القاعدة التجريبية؛ والتي تفترض أن حوالي 68% من مجمل المشاهدات تقع ضمن نطاق انحراف معياري واحد حول المتوسط ($\bar{x} \pm 1s$)، وأن نحو 95% يقع ضمن انحرافين معيارين ($\bar{x} \pm 2s$). كما يتيح الانحراف المحسوب تحويل القيم الفردية إلى درجات معيارية مقننة (Z-Scores) عبر الصيغة $Z = (X – \bar{x})/s$ لتحديد المواقع النسبية للظواهر واكتشاف المشاهدات الشاذة أو المتطرفة، مما يعزز موثوقية القرارات والتقارير الأكاديمية المبنية على هذه التحليلات الإحصائية.
خاتمة
يمثل حساب الانحراف المعياري للبيانات المبوبة في التوزيعات التكرارية نموذجاً عملياً للتكامل بين النظرية الإحصائية الكلاسيكية والتطبيقات التقنية لبرمجيات الجداول الإلكترونية. وعلى الرغم من غياب دالة مباشرة ومدمجة في برنامج مايكروسوفت إكسل مخصصة لحساب انحراف الجداول التكرارية بنقرة زر واحدة، فإن البناء المنهجي المنظم عبر الأعمدة المساعدة – بدءاً من استخراج مراكز الفئات، مروراً بوزنها التكراري وحساب المتوسط المرجح، ووصولاً إلى استخلاص مربعات الانحرافات المرجحة وتطبيق تصحيح بيسل تحت الجذر التربيعي – يمنح الباحث والمحلل فهماً إحصائياً عميقاً لبنية البيانات وطبيعة تشتتها الداخلي. وسواء اعتمد المحلل على المسار المرحلي التفصيلي لضمان الشفافية وقابلية التدقيق الحسابي، أو وظف صيغ المصفوفات المركبة كدالتي SUMPRODUCT و SQRT لتحقيق الكفاءة الإجرائية، فإن الالتزام الصارم بقواعد تثبيت المراجع وتدقيق اتساق الفئات يظل الضمانة الأساسية للوصول إلى مؤشرات تشتت إحصائية تتسم بأعلى درجات الدقة والموثوقية العلمية.
المراجع
- Bessel, F. W. (1816). Untersuchungen über die scheinbare und wahre Bahn des im Jahre 1807 erschienenen grossen Kometen. Königlich Preussische Akademie der Wissenschaften.
- Doane, D. P., & Seward, L. E. (2011). Measuring skewness: a forgotten statistic?. Journal of Statistics Education, 19(2), 1-18. https://doi.org/10.1080/10691898.2011.11889611
- Kendall, M. G., & Stuart, A. (1977). The Advanced Theory of Statistics: Distribution Theory (Vol. 1, 4th ed.). Charles Griffin & Company.
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110. https://doi.org/10.1098/rsta.1894.0003
- Sheppard, W. F. (1898). On the calculation of the most probable values of frequency-constants, for data arranged according to equidistant division of a scale. Proceedings of the London Mathematical Society, 29(1), 353–380. https://doi.org/10.1112/plms/s1-29.1.353