
تمثل إدارة البيانات في جداول إكسل حجر الزاوية في التحليل الكمي المعاصر، سواء في بحوث العلوم السلوكية والقياسات النفسية أو في قطاعات الأعمال وإدارة العمليات المؤسسية. وتعد مسألة تكرار المعرفات الرقمية أو النصية لنفس الكيان (كالعميل، أو المريض، أو المفحوص التجريبي) إحدى الإشكاليات الهيكلية الأكثر شيوعاً عند التعامل مع قواعد البيانات الخام. تنشأ هذه الحالة عندما تسجل القياسات المتكررة أو المعاملات التراكمية في صفوف متعددة منفصلة، مما يستدعي إجراء تحويل منهجي دقيق ينقل مستوى وحدة التحليل من “مستوى المعاملة أو المحاولة الفردية” إلى “مستوى الكيان الموحد”، وذلك بالاستناد إلى مبادئ هيكلة البيانات المنظمة المعروفة أكاديمياً بـ Tidy Data التي صاغها هادلي ويكهام (Hadley Wickham, 2014).
يتطلب التحول من مصفوفة سجلات مفككة إلى جدول مدمج ومتسق فهماً عميقاً لطبيعة المتغيرات المراد معالجتها؛ إذ يختلف المسار الإجرائي جذرياً بين الحاجة إلى تجميع كمي (كحساب مجموع المبيعات أو متوسط الاستجابات) وبين الحاجة إلى الضم النصي للملاحظات التفسيرية، أو إعادة الهيكلة من النمط الطولي (Long Format) إلى النمط العريض (Wide Format). وعلاوة على ذلك، تحذر الأدبيات المنهجية المتخصصة في حفظ ونزاهة البيانات الحسابية، مثل دراسة برومان ووو (Broman & Woo, 2018)، من استخدام أدوات الحذف البسيطة التي تؤدي إلى إتلاف السجلات، مؤكدة ضرورة استخدام آليات غير مدمرة وقابلة لإعادة الإنتاج لدمج الصفوف المتطابقة بالمعرف بدقة بالغة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل منهجي وتطبيقي متكامل لاستيعاب وتنفيذ عمليات دمج الصفوف المشتركة في المعرف داخل بيئة مايكروسوفت إكسل (Microsoft Excel). سنستعرض كافة الطرق المتاحة؛ بدءاً من الأدوات الكلاسيكية مثل أداة توحيد البيانات (Consolidate) والجداول المحورية (Pivot Tables)، مروراً ببيئة المعالجة والتحويل المتقدمة Power Query، ووصولاً إلى صيغ المصفوفات الديناميكية الحديثة ولغة البرمجة النصية فيجوال بيسك للتطبيقات (VBA). كما سنغطي معايير ضبط الجودة، ومطابقة المجاميع، والتوثيق التحليلي لضمان موثوقية المخرجات وخلوها من الأخطاء الإحصائية.
1. الإطار النظري والمفاهيمي لتكرار المعرفات في جداول بيانات إكسل
1.1 أسباب ظهور المعرفات المكررة في قواعد البيانات وسجلات العمل
إن تكرار المعرفات الفريدة (Identifiers – IDs) في جداول البيانات لا يمثل بالضرورة خطأً في الإدخال، بل هو في كثير من الأحيان انعكاس طبيعي لبنية جمع البيانات الزمنية أو المعاملاتية. ففي قواعد البيانات التشغيلية، يسجل النظام كل عملية تجارية أو تفاعل إجرائي كسجل مستقل؛ وبالتالي، فإن قيام العميل ذاته بعدة عمليات شراء على مدار فترات زمنية متمايزة يؤدي حتماً إلى تكرار رقمه التعريفي بعدد المرات التي نفذ فيها معاملة. يولد هذا النمط ما يُعرف في تصميم قواعد البيانات بالعلاقة “واحد إلى متعدد” (One-to-Many Relationship)، حيث يرتبط الكيان الفردي بسجلات فرعية تراكمية متعددة تعكس نشاطه الزمني وتفاصيل تعاملاته الدقيقة عبر دورات العمل المتلاحقة.
يتجلى السبب الثاني في عمليات دمج مجموعات البيانات المتعددة الواردة من مصادر غير مركزية، مثل الفروع الجغرافية المستقلة، أو منصات التجارة الإلكترونية المتعددة، أو أدوات الاستبيان الرقمية المنفصلة. عند تجميع هذه المصادر في مصنف عمل مركزي دون إخضاعها لمعايير توحيد مسبقة، تتكرر معرفات المشاركين أو العناصر نتيجة لتسجيل كل مصدر لنشاط الكيان نفسه بصورة مستقلة. تفتقر هذه التدفقات في كثير من الأحيان إلى مفاتيح ربط أساسية موحدة، مما يؤدي إلى تشعب البيانات الأفقية والعمودية وظهور تكرارات هيكلية تتطلب معالجة لاحقة لإعادة ضبطها وضمان اتساقها الشامل.
ويكمن السبب الثالث في اعتماد نظم التوثيق على أسلوب الفواتير الممتدة أو السجلات الفرعية المجزأة (Itemized Sub-records)؛ حيث تفرد الأنظمة المحاسبية صفاً مستقلاً لكل صنف أو بند مشمول ضمن الفاتورة أو المعاملة ذاتها. وفي هذا السياق، يتكرر معرف الفاتورة الرئيسي أو معرف العميل في كل صف من صفوف البنود المشتراة. ورغم أن هذا التصميم يخدم الأغراض اللوجستية وتتبع المخزون اللحظي، فإنه يشكل عائقاً مباشراً أمام التحليلات التجميعية التي تتطلب احتساب إجمالي الإنفاق أو متوسط الاستهلاك على مستوى العميل الواحد ككيان تحليلي مستقل ومكتمل الخصائص.
1.2 التحديات التحليلية والإحصائية الناجمة عن تكرار المعرفات
يفرز التكرار غير المنضبط للمعرفات تشوهات إحصائية جوهرية تؤثر سلباً على تقدير مقاييس النزعة المركزية (كالوسط الحسابي والوسيط) ومقاييس التشتت (كالانحراف المعياري والتباين). فعند حساب متوسط المبيعات أو استجابات الاستبيان على عمود يحتوي على تكرار للمعرفات، يتم ترجيح أوزان المشاركين ذوي السجلات الأكثر عدداً بصورة غير عادلة وغير ممثلة، مما يقود إلى انحياز العينة (Sample Bias) وإعطاء قراءات مضللة لا تعكس متوسط سلوك المجتمع الأصلي المدروس بدقة وموضوعية، فضلاً عن انتهاك فرضية استقلالية المشاهدات الإحصائية الضرورية لاختبارات الفروض المعلمية.
تتعاظم التحديات التقنية عند محاولة ربط هذه الجداول بجداول مرجعية أخرى عبر دوال البحث والاسترجاع الشهيرة مثل VLOOKUP أو الصيغ الأحدث مثل XLOOKUP وINDEX/MATCH. فبطبيعتها التصميمية، تميل هذه الدوال إلى إرجاع القيمة المقابلة للتطابق الأول فقط الذي تصادفه في طريق البحث من أعلى الجدول إلى أسفله، متجاهلة تماماً السجلات اللاحقة التي تحمل نفس المعرف. يؤدي هذا السلوك الحسابي إلى فقدان منهجي لكافة القيم والمعاملات المالية أو الإجرائية اللاحقة للسجل الأول، وهو ما يقود إلى قرارات خاطئة مبنية على بيانات مبتورة تفتقر إلى الاكتمال الإحصائي والتاريخي اللازم لدقة النتائج.
يمتد الأثر السلبي لتكرار المعرفات إلى الأداء الحاسوبي لمصنفات إكسل؛ إذ يؤدي تضخم السجلات المتكررة دون مبرر تركيبي إلى زيادة غير ضرورية في حجم الملفات واستهلاك موارد الذاكرة العشوائية (RAM). يتسبب ذلك في انخفاض حاد في سرعة المعالجة وإعادة الحساب التلقائي، لاسيما عند تطبيق صيغ المصفوفات المعقدة أو الحسابات التكرارية المشروطة على عشرات أو مئات الآلاف من الصفوف. كما يزداد احتمال تعليق التطبيق أو تعرضه للانهيار المفاجئ، مما يعرقل مسارات العمل ويضعف الإنتاجية التحليلية العامة للمؤسسة أو الفريق البحثي.
1.3 أهمية التلخيص والدمج وفق المعرف الموحد في إدارة البيانات
تمثل عملية تلخيص ودمج الصفوف المتكررة وفق معرف موحد خطوة مفصلية في هندسة البيانات؛ حيث تهدف إلى نقل السجلات الأولية المشتتة من مستواها المعاملاتي الأدنى إلى مؤشرات أداء متكاملة وذات معنى إداري واستراتيجي واضح. من خلال دمج الصفوف، يتحول جدول المعاملات الخام إلى جدول ملخص يمثل فيه كل صف كياناً فريداً يحمل مجاميع دقيقة، ومتوسطات حقيقية، ومؤشرات كمية مجمعة تعبر عن كامل التاريخ العملياتي لهذا الكيان، وهو ما يوفر رؤية شمولية لصناع القرار والمحللين الماليين والإحصائيين على حد سواء.
يحقق هذا الدمج المنهجي مبدأ “اتساق السجلات المفردة” (Entity Integrity)، والذي يشكل الركيزة الأساسية في قواعد البيانات العلائقية ومستودعات البيانات المتطورة. فعند توحيد الصفوف بناءً على المفتاح الأساسي (Primary Key)، تنتفي احتمالية التناقض بين الخصائص المسجلة لنفس الكيان عبر الزمن، مثل تباين العناوين أو الفئات المسجلة بالخطأ في فترات مختلفة. يتيح ذلك للباحثين والمحللين بناء نماذج تنبؤية وتصنيفية ذات موثوقية عالية، حيث تتطابق وحدات الملاحظة مع وحدات التحليل الحقيقي المستهدفة في البحث.
علاوة على ذلك، يعد الدمج التجميعي خطوة تمهيدية إلزامية لتجهيز قواعد البيانات للنمذجة الرياضية، وتحليلات التعلم الآلي، وتوليد لوحات المعلومات التنفيذية التفاعلية (Executive Dashboards). فمعظم خوارزميات الانحدار والتصنيف والتجميع الإحصائي تفترض هيكلياً أن كل سطر في مصفوفة البيانات يمثل كائناً مستقلاً ومكتملاً ولا يحتوي على قياسات مكررة لنفس المفحوص موزعة عشوائياً بين الصفوف. ومن ثم، فإن إتقان تقنيات التلخيص يضمن الحفاظ على السلامة المنهجية لمسار استخراج المعرفة بأكمله دون المساس بجوهر الأرقام الأصلية.
2. الإعداد المنهجي للبيانات وتنظيفها قبل إجراء عملية الدمج
2.1 التحقق من اتساق أنماط البيانات وتنسيق المعرفات
تعد مرحلة تنظيف البيانات وضبط اتساق التنسيق خطوة أولية حاسمة تسبق أي محاولة لدمج الصفوف؛ فمحرك الحسابات في إكسل يتعامل بحساسية بالغة مع أنواع البيانات المختلفة. من أبرز المشاكل التي تقوض دقة الدمج تخزين بعض المعرفات كأرقام حقيقية (Numeric) وتخزين أخرى كنصوص (Text)، كأن يُخزن المعرف “10025” كقيمة عددية في صف، وبجانبه إشارة خضراء تفيد بحفظه كنص في صف آخر. يترتب على هذا التباين إخفاق خوارزميات التجميع ومحركات البحث في مطابقة هذين السجلين معاً، مما يؤدي إلى معاملتهما ككيانين مختلفين تماماً، وبالتالي الإبقاء على تكرار الصفوف المدمجة وتشويه المخرجات النهائية بصورة غير مرئية للمستخدم العادي.
تشكل المسافات البيضاء الزائدة وغير المرئية عائقاً متكرراً يعطل نجاح عمليات المطابقة الآلية. وتنشأ هذه المسافات عادة في بداية المعرفات أو في نهايتها نتيجة لأخطاء الإدخال اليدوي أو كآثار جانبية لتصدير البيانات من أنظمة تخطيط موارد المؤسسات (ERP). لمعالجة هذه المعضلة منهجياً، ينبغي تمرير حقول المعرفات عبر الدالتين TRIM لإزالة المسافات الزائدة البادئة واللاحقة، وCLEAN لإزالة الرموز والترميزات غير القابلة للطباعة (Non-printable characters) التي تتخلل السجلات المستوردة من خوادم قديمة أو ملفات نصية مشفرة بأنماط غير قياسية.
بالإضافة إلى ذلك، يجب توحيد حالة الأحرف (Case Sensitivity) وتنسيق الرموز الخاصة في المعرفات النصية المركبة (مثل: “EMP-01-a” مقابل “emp-01-A”). على الرغم من أن بعض دوال إكسل التقليدية لا تفرق بين الحروف الكبيرة والصغيرة، إلا أن محركات الاستعلام المتقدمة مثل Power Query ولغات البرمجة المدمجة قد تعاملها كمفاتيح مختلفة تماماً. يتطلب الإعداد الرصين استخدام دالة UPPER أو LOWER لتوحيد نمط الحروف بالكامل، مع تنقية المعرفات من الواصلات المزدوجة والفواصل غير المنطقية لضمان وجود معيار موحد فريد يخضع له كل سجل دون استثناء.
2.2 معالجة القيم المفقودة والخلايا الفارغة في الأعمدة المراد دمجها
تمثل القيم المفقودة (Missing Values) والخلايا الفارغة في الأعمدة الرقمية أو الوصفية تهديداً حقيقياً لسلامة العمليات الحسابية اللاحقة للدمج. فعند الرغبة في جمع القيم التراكمية، قد تثير الخلايا التي تحوي نصوصاً فارغة أو مسافات أخطاء حسابية مثل #VALUE! في بعض الصيغ، أو تؤدي إلى استبعاد غير مبرر للصفوف بأكملها. لذلك، يقتضي المنهج العلمي السليم فحص هذه الفراغات وتطبيق استراتيجية استبدال واضحة، كملء الفراغات في الحقول الكمية بالقيمة “0” عندما تعبر الخلية عن انعدام المعاملة المالية أو النشاط الإجرائي في تلك الفترة المحددة، وذلك لضمان التدفق السلس للعمليات الرياضية.
في المقابل، تتطلب الصفوف التي تفتقر كلياً إلى المعرف الأساسي (Blank IDs) عزلها الفوري واستبعادها من مصفوفة الدمج؛ إذ يستحيل منطقياً ربط معاملة أو قياس تجريبي بكيان مجهول الهوية. يتم ذلك عبر تصفية النطاق واستخراج تلك السجلات لفحصها مستقلاً أو مراجعة مصادرها الأصلية، تفادياً لتجميع كافة القياسات مجهولة الهوية في صف واحد مدمج يحمل معرفاً فارغاً، وهو ما يولد مؤشراً مشوهاً يجمع قياسات تخص أطرافاً متنافرة ولا رابط حقيقي يجمع بينها على أرض الواقع، مما يخل بنزاهة التقرير النهائي.
يتعين كذلك دراسة أثر الفراغات في الحقول الفئوية والوصفية (Categorical Fields) المراد دمجها نصياً أو الاحتفاظ بها كمعايير تصفية. فقد يؤدي تجاهل فراغ معين إلى قصور في تسلسل النصوص المدمجة، أو خلق فواصل فارغة متتالية تسيء إلى مقروئية النتائج. يتطلب البروتوكول الأكاديمي الصارم إما إحلال مصطلح موحد مثل “غير محدد” أو “غير متوفر” (N/A) مكان القيمة الشاغرة، أو ضبط خوارزميات الدمج لتتخطى الفراغات بذكاء وتمنع تشوه النصوص المجمعة كما سيتم استعراضه لاحقاً في قسم المعالجات النصية.
2.3 التفرقة بين إزالة التكرارات الحرفية والدمج التجميعي
يقع كثير من مستخدمي إكسل في خطأ فادح ناجم عن الخلط المفاهيمي بين أداة “إزالة التكرارات” (Remove Duplicates) المدمجة في البرنامج، وبين مفهوم “الدمج التجميعي المنهجي” (Aggregative Merging). تقوم أداة إزالة التكرارات بالبحث عن السجلات التي تتطابق في حقول محددة، ثم تحتفظ بالصف الأول كلياً وتقوم بحذف كافة الصفوف المتطابقة اللاحقة بصورة نهائية ودائمة من ورقة العمل. هذه الآلية تعد كارثية ومحفوفة بمخاطر جسيمة إذا كانت الصفوف اللاحقة تحمل بيانات مالية، أو كميات مباعة، أو أوقات استجابة ينبغي أن تدخل ضمن الحسابات الإجمالية للكيان المعني.
إن حذف السجل يعني عملياً إتلاف البيانات وضياع حقوق ومؤشرات حيوية؛ فإذا كان لعميل معين ثلاثة صفوف تتضمن مبيعات بقيم 100، 250، و400 دولار، فإن تطبيق خيار “إزالة التكرار” بناءً على رقم العميل سيحتفظ بالصف الأول (100 دولار) ويمحو كلياً القيمتين الأخريين، مهدراً 650 دولاراً من السجلات المحاسبية الرسمية. هذا الإجراء ينتهك بصورة صريحة معايير حفظ النزاهة الهيكلية للبيانات التي نصت عليها دراسة برومان ووو (Broman & Woo, 2018)، والتي تؤكد على عدم تدمير البيانات الأولية والحفاظ على سجلاتها كاملة أثناء مسارات التحويل والتلخيص.
على النقيض من ذلك، يسعى الدمج التجميعي إلى حفظ كافة القيم والمعلومات التراكمية ودمجها حسابياً أو وصفياً داخل الصف النهائي الممثل للمعرف. في هذا المسار، يتم اتخاذ قرارات مبنية على طبيعة كل عمود؛ فالحقول المالية والكمية تُدمج عبر الجمع الرياضي، وحقول التواريخ يتم تحديد أحدثها أو أقدمها، بينما تُدمج الأعمدة النصية والتوصيفية عبر صيغ الربط والضم المتتالية. من هنا تبرز الحاجة لتحديد مصفوفة اتخاذ القرار مسبقاً قبل الشروع في أي تدخل تحويلي على جدول البيانات.
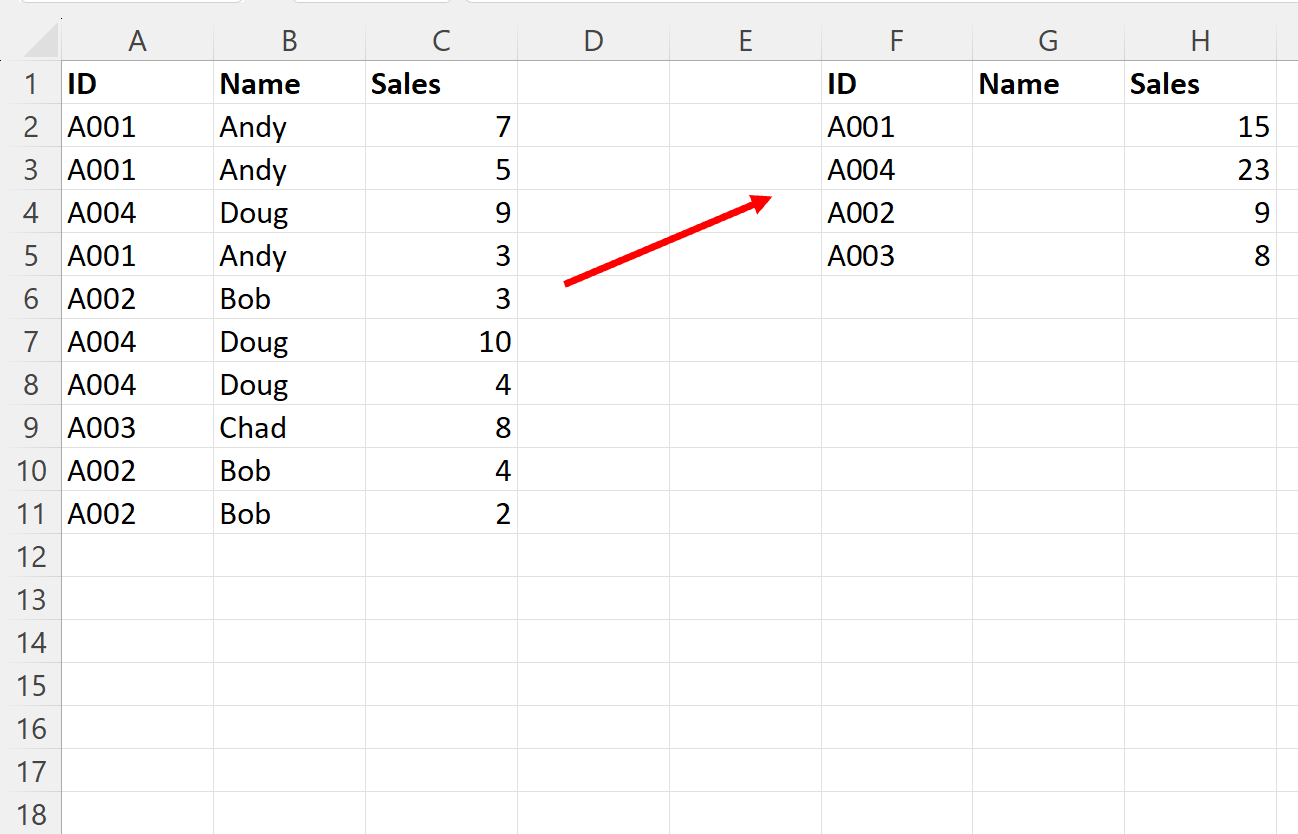
3. دمج الصفوف باستخدام أداة توحيد البيانات (Consolidate)
3.1 الأسس التقنية لخاصية توحيد البيانات في إكسل
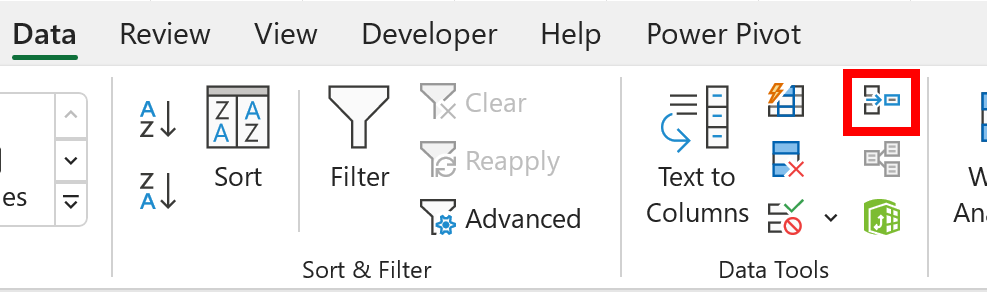
تعتبر أداة “توحيد البيانات” (Consolidate) إحدى أقدم وأعرق الأدوات المدمجة في بيئة إكسل، حيث تقع تقنياً ضمن تبويب “بيانات” (Data) داخل مجموعة “أدوات البيانات” (Data Tools). صُممت هذه الخاصية لمعالجة مصفوفات البيانات المتفرقة سواء كانت موزعة في أوراق عمل متعددة ضمن نفس المصنف أو مصفوفة ضمن نطاق واسع في نفس الورقة، وتهدف أساساً إلى تلخيص ودمج السجلات بناءً على معرفات وتسميات مرجعية موحدة تتطابق في الصفوف أو الأعمدة لتطبيق نماذج تجميعية متعددة في خطوة واحدة.
تعتمد الأداة على محرك حسابي يقرأ النطاقات المحددة ويحلل التسميات الرأسية والأفقية، حيث يوفر للمستخدم القدرة على تطبيق دوال رياضية متنوعة تشمل المجموع (Sum)، المتوسط الحسابي (Average)، الانحراف المعياري (StdDev)، الحد الأقصى (Max)، الحد الأدنى (Min)، وعدد العناصر (Count). وتقوم الخوارزمية بمضاهاة النصوص الموجودة في العمود المرجعي (المعرفات) ومطابقتها ذاتياً، ثم تجميع كافة الخلايا الرقمية المقابلة لكل معرف وحساب المحصلة المطلوبة بناءً على الدالة المختارة بدقة ميكانيكية سريعة.
تتميز هذه الخاصية باعتمادها المباشر على التسميات المرجعية (Reference Labels)، ما يعني أنها لا تلتزم بترتيب مسبق للصفوف أو الأعمدة داخل النطاق المصدر، بل تقوم بمسح كامل للنطاق، وتوليد قائمة فريدة من المعرفات في الموضع المستهدف، ورصف القيم التجميعية المحسوبة في الأعمدة المتطابقة مع تسميات الجدول المصدر، مما يوفر حلاً أولياً مناسباً لدمج السجلات المالية والإحصائية البسيطة التي تخلو من التعقيدات النصية أو الارتباطات الديناميكية المتغيرة.
3.2 خطوات التطبيق العملي لأداة التوحيد لدمج المبيعات
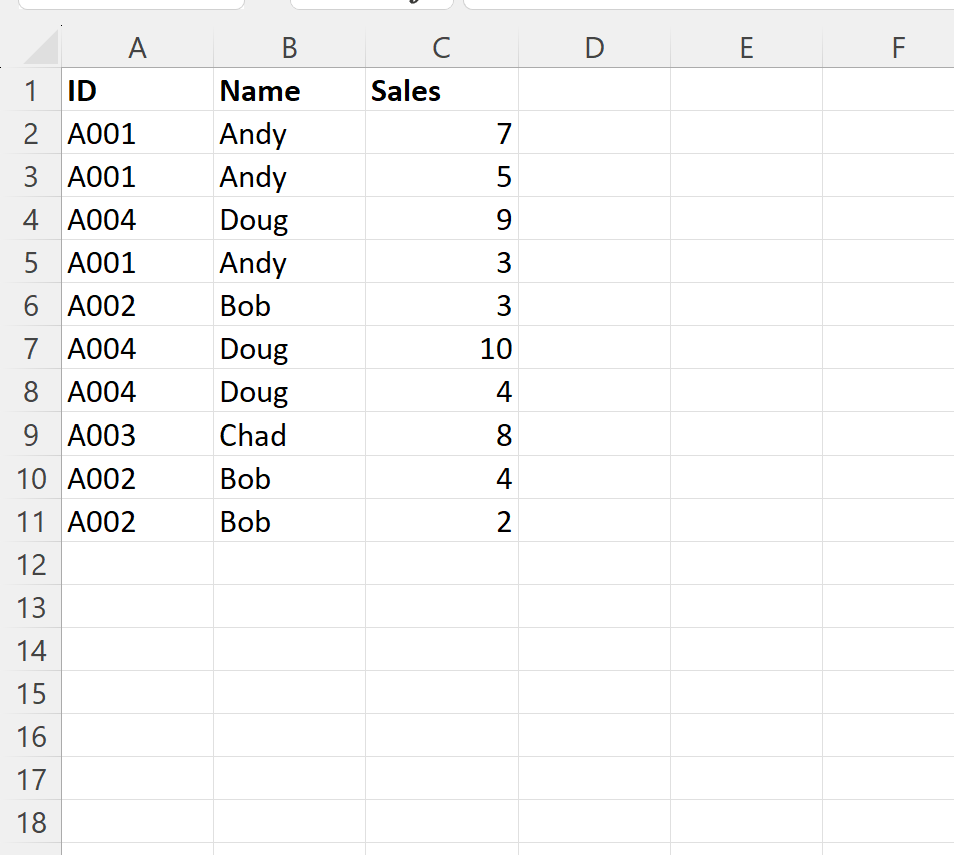
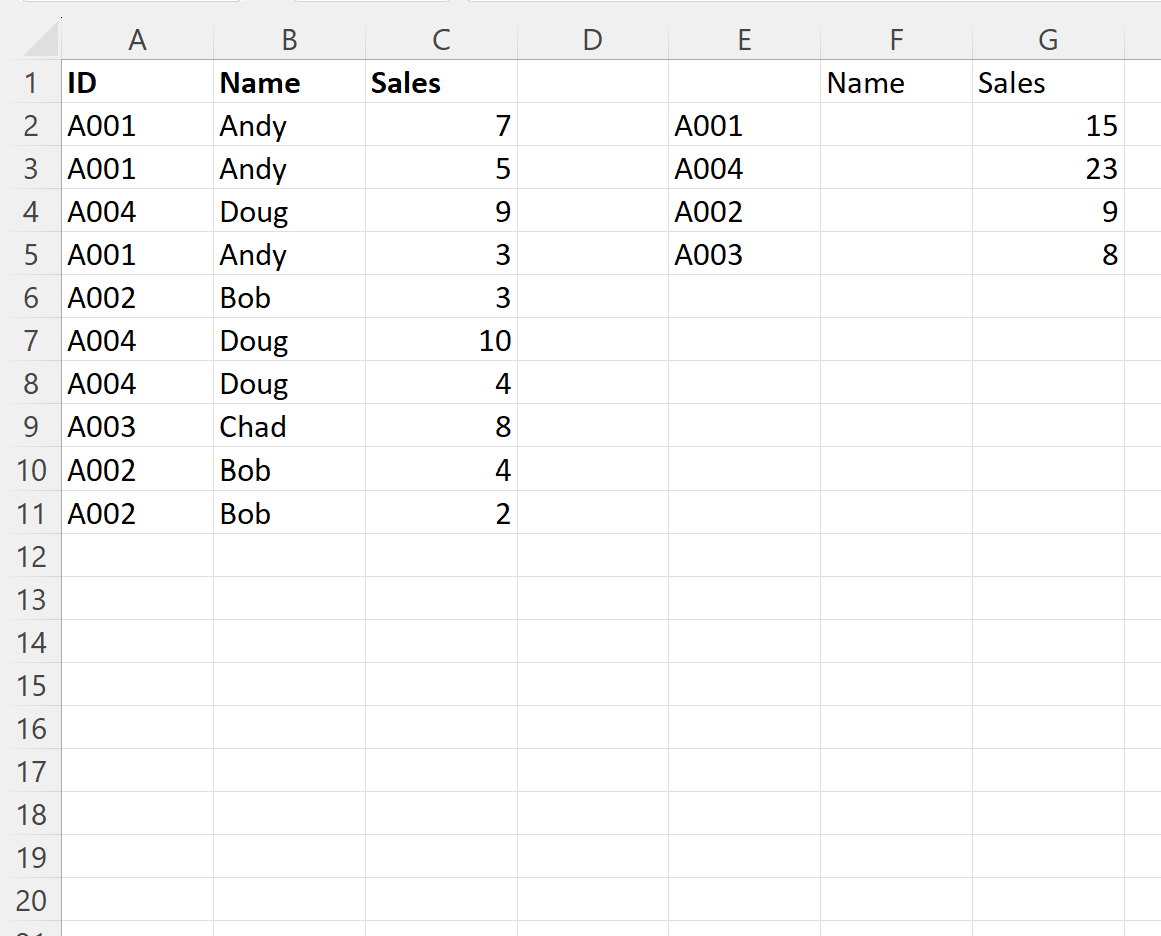
لتطبيق أداة التوحيد لدمج صفوف المبيعات المتكررة حسب المعرف، يتم أولاً تحديد خلية فارغة في ورقة العمل لتكون نقطة البداية للمصفوفة الملخصة الناتجة، ويفضل أن تكون في ورقة عمل مستقلة أو في نطاق جانبي متسع لمنع الكتابة فوق البيانات القائمة. بعد تحديد الخلية، يتوجه المستخدم إلى شريط الأدوات الرئيسي، ويختار تبويب “بيانات” (Data)، ثم يضغط على أيقونة “توحيد” (Consolidate) لتفتح له النافذة الحوارية المخصصة لضبط معايير الدمج.
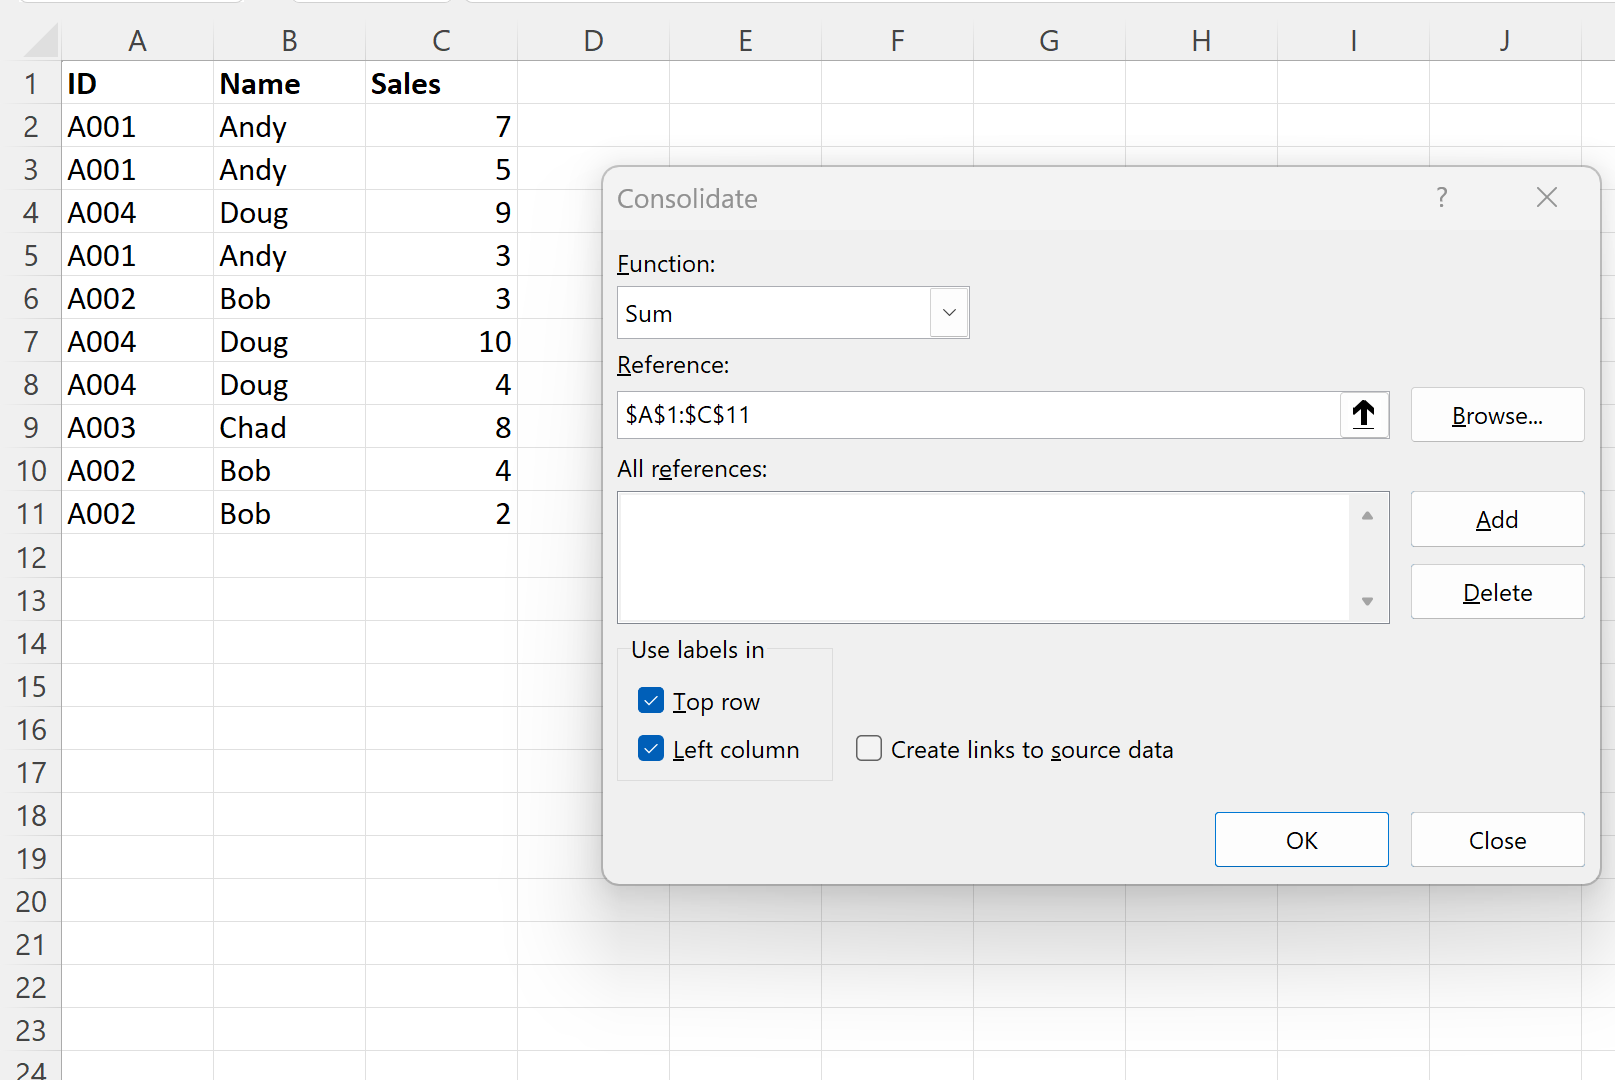
داخل النافذة، يتم تحديد الدالة الحسابية المطلوبة من القائمة المنسدلة، ولتكن دالة “المجموع” (Sum) لدمج الكميات والمبيعات النقدية. بعد ذلك، يتم الانتقال إلى حقل “المرجع” (Reference) لتحديد النطاق المصدري كاملاً، ويشترط هنا أن يبدأ التحديد من عمود المعرفات كأقصى عمود في الجانب الأيمن (للواجهات العربية) أو الأيسر (للواجهات الإنجليزية) وصولاً إلى نهاية الأعمدة الرقمية المراد تلخيصها، مع تضمين صف العناوين العلوي كاملاً في نطاق التحديد، ثم النقر على زر “إضافة” (Add) لإدراج النطاق ضمن قائمة المراجع المعتمدة.
الخطوة الجوهرية لضمان نجاح العملية هي تفعيل خيارات الاستناد إلى التسميات الموجودة أسفل النافذة، وتحديداً خيار “الصف العلوي” (Top row) لنقل أسماء الأعمدة، وخيار “العمود الأيسر” (Left column) أو العمود الأيمن بحسب لغة واتجاه ورقة العمل للتعرف على المعرفات وتجميعها بناءً عليه. عند الضغط على زر “موافق” (OK)، ينفذ إكسل عملية مسح فوري للنطاق، ويدمج كافة الصفوف المتشابهة في المعرف، ليعرض جدولاً نهائياً يحتوي على المعرفات كقيم فريدة وبجوارها مجموع المبيعات والكميات التراكمية المقابلة لكل معرف بدقة متناهية.
3.3 حدود ومحاذير استخدام أداة Consolidate
على الرغم من السرعة التي توفرها أداة توحيد البيانات، إلا أنها تنطوي على أوجه قصور هيكلية تحد من استخدامها في المشاريع الإحصائية المتقدمة. يبرز في مقدمة هذه العيوب غياب التحديث التلقائي الفوري؛ فالأداة تولد مخرجات ثابتة (Static Values)، ما يعني أن أي تعديل، أو إضافة، أو حذف يطرأ على البيانات المصدرية لا ينعكس بتاتاً على الجدول المدمج إلا إذا قام المستخدم بحذف النتائج وإعادة تشغيل خطوات المعالجة يدوياً من جديد، وهو ما يتعارض مع مبادئ النمذجة الحديثة التي تفضل الحلول التفاعلية الديناميكية.
يتمثل العيب التقني الثاني في اقتصار قدرات المعالجة داخل أداة التوحيد على الحقول الرقمية الصرفة. تعجز الأداة كلياً عن التعامل مع الحقول النصية أو التفسيرية المصاحبة للمعرفات (كأسماء العملاء، التوصيفات الجغرافية، أو ملاحظات التحصيل)؛ حيث تقوم الأداة بتجاهل النصوص أو استبدالها بأصفار أو قيم فارغة في الجدول النهائي. وبالتالي، إذا كانت بياناتك تتطلب الاحتفاظ بوصف تفصيلي أو تصنيف وصفي مرافق لكل معرف، فإن أداة Consolidate ستفشل في الحفاظ على هذا السياق وتؤدي إلى فقدان حتمي للبيانات الوصفية.
أخيراً، تتسم الأداة بحساسية فائقة لموقع عمود المعرف في النطاق المحدد؛ إذ تفترض الخوارزمية دائماً أن عمود التصنيف الأساسي يقع في الطرف المقابل لاتجاه القراءة (العمود الأول في النطاق). فإذا كان المعرف يقع في المنتصف وتحيط به أعمدة وصفية أو أرقام غير مراد دمجها، فإن الأداة تفشل في التعرف عليه وتقوم بالدمج وفق أول عمود مصادف في التحديد، مما يضطر المستخدم إلى إعادة ترتيب أعمدة الجدول المصدر يدوياً قبل البدء، وهو تصرف غير مرغوب فيه لما قد يسببه من إرباك في اتساق النماذج القائمة.
4. دمج الصفوف المتطابقة بالمعرف عبر الجداول المحورية (Pivot Tables)
4.1 بنية الجدول المحوري ودوره في تجميع المعرفات الفريدة
تعد الجداول المحورية (Pivot Tables) إحدى أقوى وأرقى الأدوات التحليلية داخل إكسل لتنظيم ودمج مجموعات البيانات الضخمة التي تعاني من التكرار. يعتمد المنهج الأكاديمي والمهني الرصين عند استخدام الجداول المحورية على تحويل نطاق البيانات الأولي أولاً إلى “جدول إكسل ديناميكي” رسمي عبر اختصار لوحة المفاتيح Ctrl+T. يضمن هذا الإجراء إضفاء المرونة الهيكلية على البيانات، بحيث تشمل التوسعات المستقبلية التلقائية أية صفوف إضافية تُدرج لاحقاً ضمن قاعدة البيانات دون الحاجة لإعادة تعريف أبعاد النطاق يدوياً في كل مرة.
لبناء الدمج المنطقي، يُدرج الجدول المحوري في ورقة عمل جديدة أو مجاورة عبر تبويب “إدراج” (Insert). يتم إسقاط حقل المعرف الفريد (ID) في منطقة “الصفوف” (Rows) داخل لوحة حقول الجدول المحوري. بمجرد إتمام هذه الخطوة، يقوم المحرك الداخلي للجدول المحوري بتطبيق خوارزمية فرز فريدة ومباشرة، حيث يتم التخلص اللحظي من كافة التكرارات الظاهرية وعرض كل معرف مرة واحدة فقط كعنصر فريد في العمود الرأسي، مؤصلاً بذلك الهيكل التلخيصي المطلوب ومحدداً وحدة التحليل بصورة لا لبس فيها.
عقب تحديد المعرفات، يتم سحب الأعمدة الكمية والتراكمية (كالمبيعات، ساعات العمل، أو درجات الاختبار) وإسقاطها في منطقة “القيم” (Values). يقوم الجدول المحوري افتراضياً بتطبيق دالة الجمع (Sum) على هذه الأعمدة، مما ينتج عنه دمج تلقائي لكافة السجلات المتناثرة المقابلة لكل معرف وحساب محصلتها الإجمالية بجانبه بدقة متناهية، محولاً آلاف الصفوف المعقدة إلى مصفوفة أنيقة تلخص نشاط كل كائن في سطر واحد دون فقدان لأي قيمة حسابية.
4.2 تخصيص العمليات الحسابية وتعديل صيغ التجميع
يوفر الجدول المحوري مرونة فائقة تتجاوز مجرد الجمع البسيط للبيانات؛ إذ يتيح للمحلل التبديل السلس بين النماذج الرياضية المختلفة لتلخيص الصفوف المدمجة. عبر النقر بزر الفأرة الأيمن على أي رقم داخل منطقة القيم واختيار “تلخيص القيم حسب” (Summarize Values By)، يمكن الانتقال الفوري من دالة المجموع (Sum) إلى دالة المتوسط الحسابي (Average) لدراسة معدلات الأداء، أو دالة الحد الأقصى (Max) والحد الأدنى (Min) لرصد القيم المتطرفة لكل معرف عبر الزمن، أو دالة “العدد” (Count) لمعرفة تكرار المعاملات المسجلة لهذا الكيان بدقة.
تتعزز القدرات التحليلية بإمكانية إنشاء “الحقول المحسوبة” (Calculated Fields) من خلال تبويب “تحليل الجدول المحوري” (PivotTable Analyze) ثم “الحقول والعناصر والمجموعات” (Fields, Items, & Sets). تتيح هذه الميزة صياغة معادلات رياضية متقدمة تجرى مباشرة على مخرجات الصفوف المدمجة، مثل احتساب صافي القيمة بعد الضريبة، أو استخراج النسب المئوية للنمو والانحرافات المعيارية المخصصة لكل معرف دون المساس بالبيانات المصدرية الأصلية ودون الحاجة لكتابة معادلات متفرقة خارج نطاق الجدول المحوري.
بالإضافة إلى ذلك، يلعب تنسيق عرض الأرقام دوراً جوهرياً في التفسير الإحصائي والمالي السليم. يوفر الجدول المحوري عبر خيار “تنسيق الأرقام” (Number Format) ضبطاً موحداً ودائماً لعرض العملات، الفواصل العشرية، ونسب المئوية عبر العمود المدمج بأكمله. يتميز هذا التنسيق بثباته حتى عند تغيير تخطيط الجدول أو إجراء عمليات التصفية وإعادة الفرز، مما يضمن خروج المؤشرات الإحصائية المدمجة بمظهر مهني يتوافق مع المعايير الدولية لإعداد التقارير المالية والبحثية.
4.3 إدارة تحديث البيانات والمزايا الديناميكية للجداول المحورية
تتفوق الجداول المحورية على أدوات التلخيص الثابتة بقدرتها الفائقة على إدارة التحديثات التكرارية والربط الحي مع مصادر البيانات. لضمان بقاء البيانات المدمجة متزامنة دائماً مع السجلات اليومية، يمكن للمستخدم النقر بزر الفأرة الأيمن واختيار “تحديث” (Refresh)، أو ضبط إعدادات الجدول المحوري المتقدمة عبر تفعيل خيار “تحديث البيانات عند فتح الملف” (Refresh data when opening the file)، مما يضمن أن كافة التعديلات المدخلة على المعرفات تترجم فورياً إلى مجاميع مدمجة محدثة دون تدخل برمجي معقد.
تكتمل المزايا التفاعلية للجدول المحوري بإدراج “مقسمات البيانات” (Slicers) ومخططات الخط الزمني (Timelines) المتاحة في تبويب التحليل. تمكن هذه المقسمات المستخدمين غير التقنيين والمدراء التنفيذيين من تصفية المعرفات المدمجة وفق أبعاد تصنيفية متعددة (كالفترات الزمنية، التصنيفات الإقليمية، أو طبيعة الحسابات) بنقرة زر واحدة؛ حيث تتكيف الصفوف المدمجة وتتغير مجاميعها بصورة بصرية لحظية فائقة السلاسة تخدم العروض التقديمية التحليلية المعقدة.
تتمثل إحدى أهم المزايا الاستقصائية والرقابية للجداول المحورية في خاصية “الاستخراج التفصيلي” (Drill-Down). فعند التشكك في دقة المجموع المدمج لأي معرف معين، لا يحتاج المحلل للعودة والبحث في الجدول الأصلي؛ بل يكفيه النقر المزدوج (Double-Click) على الخلية الرقمية المجمعة للمعرف، ليقوم إكسل تلقائياً بتوليد ورقة عمل جديدة مؤقتة تحتوي حصرياً على كافة الصفوف الفردية الأولية التي شكلت هذا المجموع، مما يجعلها أداة تدقيق لا غنى عنها في مراجعة الحسابات وضمان خلو الدمج من التداخلات غير المقصودة.
5. استخدام محرر الاستعلامات المتقدم (Power Query) لدمج الصفوف
5.1 استيراد البيانات وتهيئتها داخل بيئة Power Query
يعد محرر الاستعلامات المتقدم (Power Query) المحرك الأقوى والأحدث لعمليات استخراج وتحويل وتحميل البيانات (ETL) داخل إكسل الحديث، وهو الخيار الأكاديمي الأمثل للتعامل مع متطلبات المعالجة غير المدمرة والتوثيق المنهجي لخطوات التحويل. تبدأ العملية بتحديد جدول البيانات والتوجه إلى تبويب “بيانات” (Data) والضغط على “من جدول/نطاق” (From Sheet/Table/Range)، ليتم تصدير نسخة من البيانات إلى بيئة المحرر المستقلة التي تعزل العمل التحليلي تماماً عن البيانات المصدرية الخام لضمان سلامتها المطلقة من أي عبث أو تلف.
بمجرد فتح نافذة المحرر، يتعين على المحلل فحص وتدقيق خطوة “نوع التغيير” (Changed Type) التلقائية التي ينفذها المحرك افتراضياً. يجب التأكد الصارم من تعيين الحقل الحامل للمعرفات بالنوع الصحيح، ويفضل في معظم التحليلات تعيين المعرفات كـ “نص” (Text) حتى وإن كانت أرقاماً متسلسلة، لمنع النظام من تطبيق عمليات الجمع الرياضي غير المقصودة عليها، وللحفاظ على الأصفار البادئة (Leading Zeros) التي غالباً ما تفقدها الأنظمة الرقمية، بينما تُعين حقول المبيعات والكميات كأرقام عشرية أو صحيحة.
تتضمن التهيئة المنهجية المسبقة تنقية السجلات من الانحرافات؛ كإزالة الصفوف الفارغة بالكامل أو تطبيق تحويلات تنظيف النصوص القياسية مثل Trim وClean المتاحة بنقرة زر ضمن قائمة “تحويل” (Transform). تسهم هذه الخطوات الاستباقية في ضمان أن محرك التجميع لن يواجه تناقضات برمجية أثناء دمج المعرفات المتطابقة، مما يمهد الطريق لبناء استعلام قوي وخالٍ من الثغرات يمكن تكراره آلياً على آلاف الملفات المستقبلية بنفس الكفاءة.
5.2 تطبيق ميزة التجميع حسب (Group By) لتوحيد المعرفات
تمثل ميزة “التجميع حسب” (Group By) في Power Query الأداة الجوهرية المكافئة لعبارة GROUP BY في لغة الاستعلامات البنيوية (SQL)، وهي القلب النابض لعملية دمج الصفوف حسب المعرف المشترك. للوصول إليها، يحدد المستخدم عمود المعرف ثم يضغط على زر “تجميع حسب” الموجود في تبويب “الصفحة الرئيسية” أو “تحويل”. تفتح هذه النافذة بيئة تتيح ضبطاً فائق الدقة لكيفية تلخيص كافة الأعمدة المتبقية ودمجها في صف واحد متناسق.
في نافذة التجميع، يختار المستخدم الخيار المتقدم (Advanced) إذا كان يمتلك عدة أبعاد وصفية ثابتة للمعرف ويرغب في الإبقاء عليها مدمجة (مثل دمج الصفوف حسب “معرف العميل” و”اسم العميل” معاً لضمان عدم فقدان الاسم). بعد ذلك، يبدأ المستخدم في إضافة عمليات التجميع المتعددة للأعمدة الكمية؛ فيمكن إنشاء عمود جديد باسم “إجمالي المبيعات” عبر اختيار دالة “المجموع” (Sum) وتوجيهها لعمود المبيعات، وإنشاء عمود ثانٍ باسم “متوسط الكمية” باستخدام دالة (Average)، وعمود ثالث باسم “آخر تاريخ معاملة” باختيار دالة “الحد الأقصى” (Max) لعمود التاريخ.
القدرة الاستثنائية لميزة Group By تكمن في خيار تجميع “كافة الصفوف” (All Rows)؛ حيث تتيح هذه العملية حفظ كافة السجلات المصاحبة لكل معرف داخل خلية مجمعة تحتوي على جدول فرعي كامل (Table Object). يتيح هذا النمط البرمجي المتقدم للمحللين استخراج أقصى درجات المرونة، حيث يمكن لاحقاً استخراج قياسات إحصائية متقدمة، أو إجراء تجميعات مخصصة، أو ضم نصوص السجلات الفرعية باستخدام لغة المعادلات M المدمجة كما سيتم تفصيله في المحاور المتقدمة من هذا الدليل.
5.3 تحميل البيانات المحولة إلى ورقة العمل ومزامنتها
بعد الانتهاء من ضبط معايير التجميع والتأكد من انحسار السجلات المتكررة وظهور كل معرف في صف فريد متكامل البيانات، يتم التوجه إلى خيار “إغلاق وتحميل إلى…” (Close & Load To…) في أعلى يسار المحرر. يفضل دائماً توجيه المخرجات إلى ورقة عمل جديدة كـ “جدول” (Table) أو الاكتفاء بإنشاء “اتصال فقط” (Only Create Connection) إذا كان الهدف هو تغذية نموذج بيانات أكبر (Data Model) عبر Power Pivot، مما يمنع تكدس المصنف بالبيانات المكررة غير الضرورية.
تتميز مخرجات Power Query بكونها منظومة مؤتمتة وقابلة للتكرار (Reproducible Pipeline) بالكامل؛ فكل خطوة نُفذت حُفظت بدقة متناهية ضمن شريط “الخطوات المطبقة” (Applied Steps) في الاستعلام. هذا يعني أنه بمجرد ورود بيانات جديدة في المستقبل تحتوي على تكرارات إضافية لنفس المعرفات، يكفي النقر على زر “تحديث الكل” (Refresh All) في إكسل ليقوم Power Query بسحب البيانات وتمريرها تلقائياً عبر نفس مسار التنظيف والدمج التجميعي، وتحديث الجدول النهائي في ثوانٍ معدودة دون أي تدخل بشري إضافي.
يوفر هذا النموذج المعماري مسار تدقيق أكاديمي رصين (Audit Trail) يتيح لأي باحث أو مدقق مستقل فحص كود الاستعلام المكتوب بلغة M، والتحقق من المنهجية التي اتبعت في احتساب الأرقام المدمجة، وهو ما يحقق متطلبات الشفافية العلمية والموثوقية المؤسسية. كما يجنب المحلل المخاطر البشرية الناتجة عن تكرار العمليات اليدوية كل شهر أو دورة تحليل، مما يرسخ الاستقرار الإحصائي للنتائج على المدى الطويل.
6. تقنيات الدمج باستخدام الدوال والمعادلات الديناميكية الحديثة
6.1 استخراج قائمة المعرفات الفريدة باستخدام الدالة UNIQUE
أحدثت ثورة “المصفوفات المنسكبة” (Dynamic Spill Arrays) في الإصدارات الحديثة من إكسل تحولاً جذرياً في كتابة الصيغ الحسابية، وأتاحت استخراج المعرفات المدمجة برمجياً دون الحاجة للجداول المحورية أو لغات البرمجة. يمثل استخدام الدالة UNIQUE الخطوة التأسيسية الأولى لدمج الصفوف عبر المعادلات؛ حيث تتيح هذه الدالة مسح عمود المعرفات المكررة بالكامل وتوليد مصفوفة أحادية العمود تحتوي حصرياً على المعرفات الفريدة، وتنسكب تلقائياً في الخلايا السفلية دون الحاجة لسحب الصيغة يدوياً.
تتعزز فاعلية الاستخراج بربط دالة UNIQUE بدوال إضافية مثل الدالة SORT لضمان خروج المعرفات الفريدة في ترتيب تصاعدي أو تنازلي منظم يسهل قراءته ومطابقته، كأن تُكتب الصيغة على النحو التالي: =SORT(UNIQUE(A2:A500)). ينشئ هذا التركيب قائمة مصفوفية ديناميكية تتكيف ذاتياً مع أي توسع يطرأ على البيانات الأصلية، مشكلة الأساس الصلب الذي ستستند إليه باقي معادلات التجميع والدمج الحسابي المشروط في الأعمدة المجاورة.
من أهم المفاهيم التقنية المرتبطة بهذه المصفوفات هو استخدام “عامل الإسناد المنسكب” (Spill Range Operator) المتمثل في رمز الهاشتاج (#). عند الرغبة في الإشارة إلى كامل نطاق المعرفات الفريدة المنسكبة في الخلية المجاورة، يكتفي المحلل بكتابة مرجع الخلية الأولى متبوعاً بالرمز # (مثل: G2#). تضمن هذه التقنية أن أية معادلة لاحقة ستتمدد أو تنكمش تلقائياً لتطابق حجم مصفوفة المعرفات المدمجة دون أي خطر لقصور المعادلات أو ترك خلايا فارغة بلا حسابات.
6.2 تجميع البيانات الرقمية المشروطة عبر الدالة SUMIFS
بمجرد اكتمال عمود المعرفات الفريدة باستخدام مصفوفة UNIQUE، يتم دمج القيم الكمية والمالية التراكمية المقابلة لكل معرف باستخدام دالة الجمع المشروط المتعدد SUMIFS. تتميز هذه الدالة بقدرتها العالية على مسح النطاق المصدر وتجميع كافة الأرقام التي تستوفي شرط التطابق مع المعرف المحدد في كل صف من صفوف المصفوفة الجديدة، مما يولد عملية دمج رياضي فائقة الدقة والسرعة في بيئة العمل اليومية.
تبنى صيغة الدمج بتحديد نطاق الجمع المصدري (Sum Range) أولاً وتثبيته بالمراجع المطلقة (مثل: $C$2:$C$500)، يليه نطاق معيار المعرف (Criteria Range) وتثبيته أيضاً ($A$2:$A$500)، وأخيراً تحديد الخلية الحاملة للمعرف الفريد في المصفوفة المنسكبة. إذا تم استخدام مرجع المصفوفة المنسكبة المباشر مثل: =SUMIFS($C$2:$C$500, $A$2:$A$500, G2#)، فإن دالة SUMIFS نفسها ستنسكب تلقائياً في عمود كامل محاذٍ للمعرفات الفريدة، حاسبة المجموع المدمج لكل معرف دفعة واحدة دون الحاجة للنسخ المتكرر للصيغة عبر الخلايا السفلية.
تتيح دالة SUMIFS إضافة معايير فرز وتجميع مشروطة متعددة في آن واحد؛ فيمكن للمحلل دمج الصفوف وفق المعرف مع حصر الجمع على فترة زمنية محددة فقط (كالعمليات المنفذة في عام 2024)، أو قصر الدمج على المعاملات الناجحة واستبعاد المعاملات الملغاة. يوفر هذا الجمع المشروط دقة تحليلية بالغة الأهمية تفصل القياسات المتجانسة وتمنع تلوث البيانات المدمجة بأرقام خارج النطاق الزمني أو الإجرائي المستهدف بالدراسة والتحليل.
6.3 تطبيق الدوال التجميعية المساعدة مثل COUNTIF و AVERAGEIF
لا يقتصر دمج الصفوف على الجمع التراكمي فحسب، بل يتطلب في كثير من الأحيان استخلاص أبعاد إحصائية إضافية توضح طبيعة تكرار المعرف. في هذا السياق، تطبق دالة COUNTIF لاحتساب وتيرة تكرار كل معرف في قاعدة البيانات الأصلية، عبر الصيغة =COUNTIF($A$2:$A$500, G2#). يقدم هذا العمود المدمج مؤشراً محورياً لحجم نشاط الكيان (مثل عدد زيارات المريض، أو عدد طلبات العميل)، وهو ما يمنح الأرقام المالية دلالة أعمق عند تقييم متوسط قيمة المعاملة الواحدة.
بالتوازي مع ذلك، تستخدم دالة AVERAGEIF أو AVERAGEIFS لاستخراج المتوسط الحسابي المشروط للمتغيرات الكمية المصاحبة لكل معرف بدلاً من مجموعها. يفيد هذا الدمج الإحصائي في مجالات قياس الأداء والبحوث التجريبية؛ حيث يفضل الباحثون دمج استجابات المفحوص المتكررة في رقم واحد يعبر عن متوسط زمن رد الفعل أو متوسط الدرجات المعيارية عبر كافة المحاولات التجريبية، مع تجنب الانحياز الناجم عن جمع المحاولات المتفاوتة في العدد بين الأفراد.
لضمان صلابة النموذج الرياضي وتفادي تشوه الجداول بالأخطاء التقنية، يجب تغليف هذه الدوال بصيغ المعالجة المنطقية مثل IFERROR أو استخدام الصيغ الحديثة كـ LET لبناء حسابات مركبة ومنظمة برمجياً داخل نفس الخلية. تمنع هذه الممارسات ظهور أخطاء القسمة على صفر #DIV/0! في حال غياب المشاهدات، وتضمن بقاء الجدول التلخيصي المدمج نقياً، ومتسقاً، وجاهزاً للعرض الأكاديمي أو التصدير إلى حزم البرمجيات الإحصائية المتقدمة كـ SPSS أو R.
7. دمج النصوص والبيانات الوصفية غير الرقمية للصفوف المكررة
7.1 التحديات التقنية المرتبطة بدمج النصوص متعددة الصفوف
إذا كانت العمليات الرياضية مثل الجمع والمتوسط توفر حلاً مباشراً للأعمدة الرقمية، فإن دمج الأعمدة النصية والتفسيرية (كالملاحظات، والمسميات التشخيصية، وأسماء المنتجات) يمثل أحد أصعب التحديات التقنية في إكسل. تفتقر الدوال الرياضية التقليدية كلياً إلى القدرة على تجميع الحروف والكلمات، مما يدفع المستخدمين غير المتمرسين إلى ارتكاب أخطاء فادحة عبر حذف الصفوف المكررة عشوائياً، وهو ما يقود إلى ضياع كامل للسياق التاريخي والسردي المسجل في الحقول الوصفية التابعة لنفس المعرف.
تتمثل المعضلة الكبرى في كيفية تنظيم النصوص المجمعة داخل خلية واحدة بصورة منظمة ومقروءة؛ فمجرد لصق الكلمات متجاورة يؤدي إلى تداخل المفاهيم وصعوبة فرزها لاحقاً. يتطلب الدمج الأكاديمي والمهني إدراج فواصل مخصصة بدقة (كالفواصل النقطية، أو الشرطات، أو فواصل الأسطر البرمجية CHAR(10)) للفصل الواضح بين الملاحظات التي تم تسجيلها في أوقات مختلفة، مما يحافظ على التمايز الدلالي لكل معلومة مدخلة ضمن إطار المعرف الموحد.
بالإضافة إلى ذلك، تبرز مشكلة النصوص المتكررة حرفياً لنفس المعرف؛ فعلى سبيل المثال، إذا اشترى العميل نفس المنتج خمس مرات في تواريخ متفرقة، فإن الدمج النصي الساذج سيؤدي إلى تكرار اسم المنتج خمس مرات في الخلية الواحدة، مشكلاً تلوثاً بصرياً وحشواً لا طائل منه. يتطلب التعامل المنهجي مع هذه الحالات تقنيات فرز متقدمة قادرة على استخلاص القيم النصية الفريدة لكل معرف قبل ربطها، وهو ما تتيحه التراكيب البرمجية والصيغ المتقدمة كما سنفصل في الفقرات التالية.
7.2 استخدام دالتي TEXTJOIN و FILTER لضم النصوص المكررة
قدمت ميزة التكامل بين دالتي TEXTJOIN وFILTER في إكسل الحديث حلاً هندسياً بالغ الأناقة للتغلب على معضلة دمج النصوص المتعددة المقابلة لمعرف مشترك. تقوم دالة FILTER بمسح عمود النصوص المصدري وعزل وتصفية كافة النصوص التي يقابلها تطابق مع المعرف المطلوب حصرياً، مسترجعة مصفوفة مؤقتة في الذاكرة تحتوي على كافة الأوصاف أو القياسات التابعة لهذا المعرف فقط دون غيره من السجلات.
بعد ذلك، تتدخل دالة TEXTJOIN لتجميع عناصر هذه المصفوفة المسترجعة في سلسلة نصية واحدة متماسكة داخل خلية واحدة. تتميز دالة TEXTJOIN بامتلاكها وسيطات تحكم فائقة الأهمية؛ الوسيطة الأولى تحدد نوع “الفاصل” (Delimiter) المراد إدراجه بين النصوص (مثل: ", " أو علامة السطر الجديد)، بينما تخصص الوسيطة الثانية للتحكم المنطقي في “تجاهل الخلايا الفارغة” (Ignore Empty Cells)، وضبطها على القيمة TRUE يمنع تكون فواصل متتالية مشوهة للمظهر عند وجود بيانات مفقودة في السجلات الأصلية.
لصياغة هذه المعادلة عملياً بجوار مصفوفة المعرفات الفريدة، تُكتب الصيغة على النمط التالي: =TEXTJOIN(", ", TRUE, FILTER($B$2:$B$500, $A$2:$A$500 = G2, ""))، حيث يمثل النطاق الأول عمود النصوص المراد ضمها، والنطاق الثاني عمود المعرفات الأصلي، وG2 يمثل المعرف المستهدف. تعمل هذه الصيغة على توليد دمج نصي فوري يسرد كافة الأحداث أو الملاحظات المصاحبة للمعرف في خلية واحدة متقنة، مما يتيح التلخيص الشامل للمتغيرات النوعية والوصفية بأعلى درجات الكفاءة.
7.3 دمج النصوص المتقدم عبر كود لغة M في Power Query
على الرغم من براعة صيغة TEXTJOIN، إلا أن بيئة Power Query ولغة البرمجة M تظل الحل المؤسسي الأكثر قوة واستدامة عند التعامل مع قواعد البيانات الضخمة التي تتطلب دمجاً نصياً متقدماً يتضمن الترتيب الزمني وإلغاء التكرار الداخلي. ينفذ هذا المسار بالدخول إلى Power Query، واستخدام خاصية “التجميع حسب” (Group By)، مع اختيار دالة التجميع “كافة الصفوف” (All Rows) لتخزين سجلات كل معرف في حقل جدولي مستقل.
عقب هذه الخطوة، يضاف عمود مخصص (Custom Column) يتم فيه تطبيق دالة لغة M المتخصصة Text.Combine. يمكن استخراج عمود النصوص من الجدول الفرعي، وتمريره عبر الدالة List.Distinct لتصفية الأسماء المكررة أولاً، ثم دمجه بالفواصل المطلوبة، عبر صياغة تعبير برمجي شبيه بالتالي: Text.Combine(List.Distinct([AllData][Notes]), "; "). يضمن هذا الإجراء أن تكون النصوص المدمجة فريدة تماماً وتخلو من أي تكرار غير مفيد للملاحظات ذاتها التابعة لنفس المعرف.
تتفوق لغة M بإمكانية دمج خوارزميات الترتيب الزمني المسبق للسجلات النصية؛ إذ يمكن تعديل الكود لفرز السجلات وفق عمود التاريخ تصاعدياً قبل ضم النصوص، مما يكفل قراءة الملاحظات المدمجة كسرد تاريخي منطقي ومتسلسل يوضح تطور حالة المعرف عبر الزمن (كالمسار المرضي للمفحوص أو تدرج الملاحظات الائتمانية للعميل). يمثل هذا التكامل أعلى مستويات النضج التحليلي في دمج الصفوف الوصفية المعقدة في بيئة الأعمال المعاصرة.
8. الأتمتة الشاملة للدمج عبر وحدات الماكرو ولغة VBA
8.1 تصميم الخوارزمية البرمجية لمعالجة الصفوف المكررة
عند التعامل مع مجموعات البيانات فائقة الضخامة التي تتجاوز مئات الآلاف من الصفوف، قد تصبح الصيغ التقليدية بطيئة وتستهلك موارد المعالجة بصورة مفرطة، وهنا تبرز الحاجة إلى الأتمتة الشاملة عبر لغة البرمجة فيجوال بيسك للتطبيقات (VBA). يعتمد التصميم الخوارزمي المتقدم لمعالجة الصفوف المكررة على توظيف هيكل بيانات متطور يُعرف بـ “القاموس التخزيني” (Scripting.Dictionary). يعمل هذا الكائن في الذاكرة العشوائية بصيغة جدول تجزئة (Hash Map)، مما يمنحه سرعة استثنائية في الوصول للمفاتيح والبحث بزمن حسابي شبه ثابت O(1) مقارنة بالبحث الخطي البطيء في أوراق العمل.
تقتضي أفضل الممارسات البرمجية تفادي القراءة والكتابة المباشرة خليةً بخلية على شاشة إكسل، إذ يعد التفاعل المباشر مع واجهة المستخدم المصدر الأساسي لبطء الأداء وتجمد التطبيق. تقوم الخوارزمية المصممة أكاديمياً بنسخ كامل النطاق المصدري في خطوة واحدة إلى “مصفوفة ثنائية الأبعاد في الذاكرة” (Memory Array). بعد ذلك، تتولى حلقة التكرار مسح المصفوفة الداخلية، وإسقاط المعرفات الفريدة كمفاتيح (Keys) داخل القاموس، وتخزين المجاميع والمؤشرات التراكمية في العناصر المقابلة (Items) لكل مفتاح بصورة حسابية لحظية فائقة السرعة.
يتيح هذا التصميم الخوارزمي تطبيق شروط تراكمية دقيقة أثناء المرور على الصفوف؛ فيمكن للكود تحديث المجاميع المالية، واحتساب متوسط القيم عبر تتبع العدادات التراكمية، وفي الوقت ذاته ضم الملاحظات النصية في سلاسل مستمرة لكل معرف فريد. وبذلك تتكامل عمليات الجمع الحسابي والضم النصي في دورة مسح واحدة للبيانات، مما يقلل البصمة الحسابية ويضمن الانتهاء من دمج ملايين السجلات في أجزاء من الثانية وبأعلى درجات الكفاءة التشغيلية الممكنة.
8.2 بناء الكود البرمجي وتنفيذه خطوة بخطوة
لبناء وحدة الماكرو الإجرائية، يتم فتح محرر الأكواد عبر الضغط على Alt+F11، وإدراج موديول برمجي قياسي جديد (Standard Module). يبدأ الإجراء البرمجي بتعريف المتغيرات والمصفوفات بصرامة برمجية (Strict Typing)؛ مثل تعريف متغيرات النطاقات، والمصفوفات الحسابية، وكائن القاموس عبر الربط المتأخر CreateObject("Scripting.Dictionary") لضمان عمل الكود عبر مختلف الأجهزة والإصدارات دون الحاجة لتفعيل مراجع خارجية يدوياً في مكتبات النظام.
يتضمن الإجراء في مستهله أمراً حاسماً لإيقاف تحديث الشاشة وتعطيل الحسابات التلقائية مؤقتاً: Application.ScreenUpdating = False وApplication.Calculation = xlCalculationManual. تمنع هذه الأوامر إكسل من إعادة رسم الخلايا أو تنفيذ المعادلات أثناء تشغيل الماكرو، مما يوفر قفزة هائلة في سرعة التنفيذ. بعد ذلك، تمر حلقة التكرار For...Next على صفوف مصفوفة البيانات في الذاكرة؛ حيث تفحص وجود المعرف في القاموس، فإذا كان جديداً يُضاف وتبدأ مجاميعه، وإذا كان موجوداً مسبقاً، تُجمع القيمة الجديدة فوق القيمة التراكمية المخزنة للمعرف تلقائياً.
في المرحلة النهائية، يتم تفريغ محتويات القاموس المدمجة دفعة واحدة في ورقة العمل المستهدفة عبر تحويل مفاتيح وعناصر القاموس إلى مصفوفة مخرجات وإسقاطها على النطاق المستهدف بأمر واحد، كاستخدام التابع Resize. يعقب ذلك استعادة إعدادات التطبيق الطبيعية بإعادة تفعيل تحديث الشاشة والحساب التلقائي، ليجد المستخدم أمامه جدولاً نظيفاً، مدمجاً، ومحسوباً بدقة متناهية دون أدنى استهلاك للوقت أو الجهد اليدوي.
8.3 معالجة الاستثناءات وتدقيق أمان التنفيذ البرمجي
تتطلب الأكواد البرمجية الموجهة للأغراض المؤسسية والبحثية بنية تحتية قوية لالتقاط الأخطاء ومعالجة الاستثناءات (Error Handling). يتم تضمين جمل برمجية مثل On Error GoTo ErrorHandler لضمان أنه في حال مواجهة بيانات مشوهة، أو نصوص في خلايا رقمية، أو قيم خطأ مسبقة في الجدول (مثل #DIV/0!)، فإن الماكرو لا يتوقف فجأة بصورة مباغتة، بل يقفز إلى روتين مخصص يقوم بتسجيل رقم الصف المسبب للمشكلة وإعادة تشغيل إعدادات الشاشة المعطلة بأمان تام.
يعد مبدأ الأمان الوقائي للبيانات ركيزة إلزامية في المعالجة البرمجية؛ فالكتابة المباشرة للماكرو على نفس البيانات الأصلية تمثل خطراً تشغيلياً لا يمكن تصحيحه عبر أمر التراجع (Undo). تفرض أفضل الممارسات الأكاديمية برمجة الماكرو ليكتب مخرجات الدمج في ورقة عمل جديدة كلياً أو حجز نسخة احتياطية من النطاق المصدر تلقائياً في مصنف مؤقت قبل الشروع في التعديل، حماية للسجلات الأولية من أية احتمالات للتلف أو الفقدان غير المقصود أثناء المعالجة.
أخيراً، يجب توثيق الكود البرمجي بوضع تعليقات توضيحية مفصلة تشرح وظيفة كل كتلة برمجية والمتغيرات المستخدمة، وفق متطلبات قابلية الصيانة البرمجية (Maintainability). يضمن هذا التوثيق للمحللين والباحثين المستقبليين فهم المسار الرياضي والمنطقي الذي اتبعه الماكرو لدمج الصفوف، ويتيح للمؤسسة مراجعة وتحديث الخوارزمية كلما تغيرت هياكل البيانات أو استجدت متطلبات تنظيمية إضافية على قواعد البيانات المعتمدة.
9. معايير المفاضلة المنهجية بين أساليب الدمج المختلفة
9.1 مقارنة الأداء وفق حجم البيانات وسرعة المعالجة الحسابية
تتفاوت الأساليب المتاحة لدمج الصفوف في إكسل تفاوتاً جوهرياً من حيث استهلاك موارد المعالجة وسرعة الإنجاز؛ لذا تقتضي الحكمة التحليلية اختيار الأداة المناسبة وفق حجم البيانات المطروحة. في الجداول البسيطة والمحدودة (التي تقل عن 5,000 صف)، تعمل أداة “توحيد البيانات” (Consolidate) أو الجداول المحورية بكفاءة شبه لحظية دون فرض أي ضغط ملموس على الذاكرة. غير أن أداة التوحيد تفقد بريقها سريعاً كلما تعقدت العلاقات بين الأعمدة وازدادت القيود الهيكلية للملف.
عند الانتقال إلى البيانات المتوسطة والضخمة (ما بين 10,000 إلى 500,000 صف)، تتفوق بيئة Power Query بوضوح كاسح على كافة أدوات إكسل السطحية. تعتمد Power Query على محرك استعلامات داخلي قوي يعتمد الحوسبة في الذاكرة المضغوطة، مما يجعله قادراً على معالجة ملايين السجلات دون التأثير على استقرار مصنف العمل ودون التسبب في تضخم حجم الملف (File Bloat). في المقابل، يؤدي تطبيق صيغ المصفوفات المنسكبة مثل SUMIFS وUNIQUE على هذه الأحجام إلى بطء خانق في عملية إعادة الحساب وتجمد متكرر لحركة المؤشر عند أي تعديل طفيف في البيانات.
أما في سيناريوهات المعالجة القصوى وحزم البيانات العملاقة التي تتطلب تكرار عمليات التجميع المعقدة دورياً في زمن قياسي، يتربع كود VBA المستند إلى القواميس التخزينية (Dictionaries) والمصفوفات الداخلية على قمة الأداء الحسابي والسرعة؛ إذ يتجاوز واجهة المستخدم الرسومية ويختزل ملايين المعاملات في بضع ثوانٍ. ومع ذلك، يتطلب استخدام VBA مهارات برمجية عميقة لا تتوفر لعموم المحللين، مقارنة بواجهة Power Query الرسومية سهلة الإدارة والتعديل.
9.2 معيار الديناميكية وقابلية التحديث التلقائي
يشكل معيار الديناميكية عاملاً حاسماً في المفاضلة بين الأدوات؛ ويقصد به مدى قدرة المخرجات المدمجة على الاستجابة الفورية والذاتية للتعديلات التي تطرأ على البيانات المصدرية. في هذا المضمار، تعد “صيغ المصفوفات المنسكبة” (Dynamic Spill Formulas) الخيار الأكثر ديناميكية على الإطلاق؛ فأي تعديل في معرف، أو حذف لصف، أو إضافة لقيمة في الجدول الأصلي ينعكس في الجزء من الثانية على مصفوفة UNIQUE والمعادلات المجاورة لها دون حاجة لأي تدخل يدوي أو ضغط على أزرار التحديث.
تأتي الجداول المحورية وPower Query في المرتبة التالية من حيث الديناميكية؛ فهما لا يتحدثان فورياً من تلقاء أنفسهما بشكل افتراضي بل يتطلبان إجراء أمر “التحديث” (Refresh) إما يدوياً أو برمجياً عند فتح المصنف. ومع ذلك، تعد هذه الدرجة من شبه الديناميكية مرغوبة ومفضلة جداً في بيئات الأعمال والمحاسبة؛ إذ يتيح التحديث المتحكم فيه للمحللين مراجعة التغييرات والتدقيق في التعديلات الجديدة قبل اعتماد النتائج المدمجة في التقارير الرسمية، مما يمنع التحولات الفجائية غير المراقبة في الأرقام.
في المقابل، تمثل أداة “توحيد البيانات” (Consolidate) وأكواد VBA البسيطة أساليب ثابتة تماماً (Static Snapshot). مخرجات هذه الطرق تمثل لقطة جامدة للبيانات عند لحظة التنفيذ فقط؛ وبالتالي فإن أي تعديل يطرأ لاحقاً يتطلب إعادة تطبيق الإجراء كاملاً أو تشغيل الماكرو مجدداً، وهو ما يجعلها خياراً غير ملائم لبناء لوحات المعلومات التفاعلية المباشرة (Live Dashboards) التي تعتمد على تدفقات بيانات مستمرة ومتجددة على مدار الساعة.
9.3 مصفوفة اتخاذ القرار لاختيار الأسلوب الأنسب للمحلل
لتسهيل اختيار الأداة المثلى في الميدان العملي، يتعين على المحلل الاستناد إلى مصفوفة قرار منهجية ترتكز على ثلاثة محاور رئيسية: طبيعة البيانات المراد دمجها، والمستوى التقني لفريق العمل، وبيئة الأمان المؤسسية الحاكمة. إذا كانت البيانات تقتصر على معرفات وأرقام فقط، والمطلوب هو مجرد تلخيص سريع وسهل الاستعراض، فإن “الجداول المحورية” (Pivot Tables) تظل الحل القياسي الأول والأكثر أماناً وموثوقية لمعظم حالات العمل الروتينية لمرونتها وسهولة استيعابها من الجميع.
إذا كانت عملية الدمج تتضمن ضم نصوص وملاحظات وصفية متعددة، أو تتطلب تنظيفاً عميقاً واستبعاداً لأنماط محددة وإعادة هيكلة من النمط الطولي للعريض، فإن “Power Query” يصبح الخيار الإلزامي والوحيد القادر على استيعاب هذه التعقيدات بنجاح. يوفر Power Query للمحلل خط أنابيب متكامل ومرئي يلغي الحاجة إلى كتابة معادلات طويلة ومعقدة، ويسهل مراجعته وتعديله من قبل أي عضو آخر في الفريق التقني دون مواجهة شفرات برمجية معقدة ومبهمة.
أما إذا فرضت السياسات المؤسسية قيوداً صارمة على استخدام وحدات الماكرو لأسباب أمنية تتعلق بمكافحة البرمجيات الخبيثة، فيجب استبعاد حلول VBA تماماً والاعتماد على صيغ إكسل الحديثة مع الجداول المحورية. وفي حال كانت النماذج تتطلب حساسية لحظية تفاعلية فائقة لعرض المؤشرات على شاشات المراقبة المباشرة، فإن صيغ المصفوفات الديناميكية كـ UNIQUE وSUMIFS تمثل المسار الأنسب للتنفيذ، شريطة أن تبقى أحجام البيانات ضمن الحدود المعقولة التي تضمن استقرار وكفاءة الأداء.
10. أفضل الممارسات الأكاديمية لضمان دقة ونزاهة البيانات بعد الدمج
10.1 إجراءات التدقيق والمطابقة الرياضية (Reconciliation)
لا تنتهي عملية دمج الصفوف بمجرد ظهور الجدول التلخيصي؛ بل تبدأ بعدها مرحلة التدقيق والمطابقة الرياضية (Reconciliation) التي تمثل صمام الأمان لضمان سلامة العمليات التحليلية. يقتضي البروتوكول الأكاديمي الصارم إنشاء خلية تحقق ومطابقة مستقلة تقوم بحساب إجمالي الحقول الرقمية (كالكميات والقيم المالية) في الجدول الأولي، ومقارنتها بالإجمالي العام الظاهر في الجدول المدمج النهائي عبر معادلة منطقية تفحص التساوي الدقيق: =SUM(Original_Sales) = SUM(Merged_Sales).
في حال ظهور أي فرق رقمي، مهما كان ضئيلاً، يجب التوقف فوراً وعدم اعتماد النتائج؛ إذ يشير هذا الفارق حتماً إلى وجود خلل في آلية الدمج؛ كإسقاط صفوف تحتوي على معرفات فارغة، أو وجود قيم نصية غير مقروءة في حقول الجمع، أو عجز الأداة المستخدمة عن معالجة التكرارات الاستثنائية. تضمن هذه المطابقة الرياضية الصفرية التأكد من أن عملية التحويل كانت تجميعية ونزيهة بنسبة 100%، ولم تسفر عن أي تسريب أو هدر غير مقصود في البيانات المحاسبية والإحصائية للكيانات.
يتعين كذلك مطابقة عدد المعرفات الفريدة الناتجة مع مخرجات الحصر الإحصائي المنفصل للبيانات المصدرية. يمكن التحقق من ذلك باستخدام معادلة العد الفريد المستقلة ومقارنتها بعدد صفوف الجدول المدمج. يعزز هذا الفحص المزدوج الطمأنينة بأن كافة الكيانات قد تم تمثيلها بعدالة ودون حذف، مع تطبيق أدوات “التنسيق الشرطي” (Conditional Formatting) لتمييز وتلوين أي تكرار شاذ أو متبقٍ في عمود المعرفات المدمجة لضمان النقاء المطلق لمصفوفة التحليل النهائي.
10.2 التوثيق المنهجي لإجراءات التحويل والدمج
تعد قابلية إعادة الإنتاج والتدقيق المستقل (Reproducibility) الركن الأساسي في المنهج العلمي وإدارة البيانات الموثوقة. يقتضي ذلك توثيقاً كتابياً دقيقاً لكافة الخطوات التي اتخذت لدمج الصفوف؛ بحيث يخصص المحلل ورقة عمل وصفية (Metadata / ReadMe Sheet) ضمن المصنف تشرح بالتفصيل مصدر البيانات الأولي، والمعايير التي اتبعت لتنظيف المعرفات، والمنطق الحسابي المستخدم في دمج كل عمود على حدة (أي الأعمدة خضعت للجمع، وأيها للمتوسط، وأيها للضم النصي والفواصل المعتمدة).
يجب كذلك توثيق الأكواد البرمجية وصيغ المعادلات بوضوح تام، وتحديد نطاقات الخلايا التي تم تطبيق الدمج عليها؛ فإذا استخدم Power Query، يجب إرفاق شفرة لغة M كملحق نصي يوضح خطوات التجميع المطبقة. يتيح هذا التوثيق للمدققين الداخليين والخارجيين، وكذلك للباحثين المناظرين، فهم الكيفية التي تم بها بناء الجدول النهائي والتأكد من توافقه مع المعايير الأخلاقية والمحاسبية المعتمدة، وتفادي الشبهات المرتبطة بالتلاعب غير المبرر بالأرقام والنتائج الإحصائية.
يرتبط التوثيق بمبدأ المحافظة على “مرجعية البيانات الخام” وعدم الكتابة فوقها مطلقاً (Non-destructive Processing). يجب أن تظل البيانات الأصلية مجمدة ومحفوظة في حالتها الأولية دون أدنى تعديل على مستوى قيمها الفردية، بحيث تكون عملية الدمج عبارة عن طبقة تحويل إضافية تستقي منها وتصب في موضع مستقل. يوفر هذا الفصل المعماري حماية لا غنى عنها تتيح العودة للأصل ومراجعة مسار التحويل في حال ظهور أي استفسار أو تشكيك في دقة المجاميع المستخلصة لاحقاً.
10.3 إدارة النسخ الاحتياطية وتأمين مسار التدقيق التاريخي للبيانات
تشكل إدارة النسخ الاحتياطية وتأمين مسار التدقيق التاريخي (Audit Trail) خط الدفاع الأخير لحماية الأصول المعلوماتية للمؤسسات والمشاريع البحثية. قبل الشروع في تطبيق أي عملية دمج، خاصة تلك التي تعتمد على وحدات الماكرو أو التدخلات الهيكلية الشاملة، يجب أخذ نسخة أرشيفية كاملة ومجمدة (Frozen Archive Copy) من مصنف البيانات وحفظها برقم إصدار زمني واضح (مثل: Dataset_Raw_20241025.xlsx) في مستودع سحابي أو خادم آمن ومحمي من التعديل العرضي.
يستلزم مسار التدقيق التاريخي تسجيل بيانات وصفية متكاملة تتضمن تاريخ ووقت إجراء عملية الدمج، وهوية المستخدم أو المحلل المنفذ للإجراء، والهدف التشغيلي أو البحثي من وراء عملية التلخيص. تسهم هذه السجلات في تتبع المسار التطوري للبيانات بدقة، مما يسهل رصد أية انحرافات زمنية ومحاسبة الأطراف المعنية في حال وقوع أي انتهاك لبروتوكولات إدارة الجودة والسلامة المعلوماتية المعتمدة مؤسسياً.
ختاماً، يتعين تفعيل ميزات الحماية والتأمين المدمجة في إكسل بعد استكمال دمج الصفوف بنجاح؛ وذلك عبر تفعيل خيار “حماية ورقة العمل” (Protect Sheet) وتأمين الخلايا الحاملة للنتائج المدمجة والمعادلات الحسابية بكلمة مرور مشفرة، مع السماح للمستخدمين بتحديد الخلايا وإجراء التصفية فقط دون تعديل محتواها الرياضي. يضمن هذا الإجراء الوقائي تحصين المصفوفة المدمجة من أي حذف أو تعديل عرضي غير مقصود أثناء تداول الملف بين الأقسام والإدارات المختلفة، مؤكداً استقرار التقارير وصحتها الرقمية على الدوام.
خاتمة
استعرضنا في هذا الدليل المنهجي المتكامل الأبعاد النظرية والتقنية لعملية دمج الصفوف التي تشترك في نفس المعرف عبر برنامج مايكروسوفت إكسل. ولقد تبين بوضوح أن هذه العملية تمثل تحويلاً جوهرياً لوحدة التحليل الإحصائي يهدف إلى توحيد السجلات وضمان النزاهة الهيكلية للبيانات التزاماً بمبادئ البيانات المرتبة (Tidy Data)، بعيداً عن أساليب الحذف السطحية التي تهدد بضياع السجلات التراكمية والتاريخية للكيانات.
إن تنوع الأدوات المتاحة داخل بيئة إكسل—بدءاً من الأدوات الكلاسيكية كأداة التوحيد والجداول المحورية، مروراً بقدرات Power Query المتقدمة ومصفوفات الدوال الديناميكية الحديثة، ووصولاً إلى الأتمتة المتقدمة عبر VBA—يمنح المحلل مرونة واسعة للاختيار. وتتوقف كفاءة الحل المختار على طبيعة البيانات، وأحجامها، ومستوى الديناميكية المطلوب، مما يحتم الاستناد إلى مصفوفة المفاضلة المنهجية التي تم تفصيلها بدقة لضمان سرعة المعالجة واستقرار النماذج الحسابية.
في الختام، تظل إجراءات المطابقة الرياضية والتدقيق الصارم ومبدأ الحفاظ على البيانات الخام في مسار غير مدمر حجر الزاوية لأي ممارسة تحليلية ناجحة. إن إتقان هذه المنهجيات والالتزام الصارم ببروتوكولات التوثيق والأرشفة يضمن للمحللين والباحثين إنتاج مؤشرات أداء ذات موثوقية عالية، تؤسس لاتخاذ قرارات تنفيذية واعية ومبنية على أرضية صلبة من الدقة الإحصائية والموضوعية العلمية.
المراجع
- Broman, K. W., & Woo, K. H. (2018). Data Organization in Spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989
- Microsoft. (2024). Consolidate data in multiple worksheets. Microsoft Support. https://support.microsoft.com/en-us/office/consolidate-data-in-multiple-worksheets-007554a9-e46f-4811-a813-810a469f3c7e
- Microsoft. (2024). Create a PivotTable to analyze worksheet data. Microsoft Support. https://support.microsoft.com/en-us/office/create-a-pivottable-to-analyze-worksheet-data-a9a84538-bfe9-40a9-a8e9-f99134456576
- Microsoft. (2024). Group rows in Power Query. Microsoft Learn. https://learn.microsoft.com/en-us/power-query/group-by
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10