
تحظى عملية معالجة النصوص وتدقيق البيانات في بيئة مايكروسوفت إكسل (Microsoft Excel) بأهمية بالغة في مختلف التخصصات العلمية والتطبيقية، لا سيما في مجالات العلوم الاجتماعية، والبحوث النفسية السلوكية، وإدارة قواعد البيانات الضخمة. فعند التعامل مع مصفوفات هائلة من المدخلات النوعية، والاستجابات المفتوحة للمشاركين في الاستبيانات، والسجلات الأرشيفية المعقدة، يواجه المحلل الحصيف تحدياً مستمراً يتمثل في استخلاص المقاطع الفرعية، والتحقق من صحة المعرفات، وتوحيد الصيغ التركيبية. ومن هنا تبرز الحاجة الماسة إلى أدوات برمجية متقنة تمكّن من التفتيش داخل السلاسل النصية وتحديد مواضع الأحرف بدقة رياضية لا تحتمل الخطأ.
تتركز المنظومة الأساسية للبحث الموضعي عن النصوص داخل برنامج إكسل في دالتين رئيسيتين: دالة التفتيش SEARCH ودالة الإيجاد FIND. وعلى الرغم من أن هاتين الدالتين تتطابقان ظاهرياً في بنيتهما النحوية وتتشاركان في الهدف العام الرامي إلى إرجاع فهرس رقمي يبين موضع بداية مقطع نصي مستهدف داخل سلسلة حاضنة، إلا أن الفروق الجوهرية الدقيقة بينهما تحدد مسار المعالجة البيانية برمته. إن تجاهل هذه الفروق ليس مجرد هفوة تقنية عابرة، بل هو مأزق منهجي قادر على إفساد خطوط إنتاج البيانات، وإحداث انقطاعات تشغيلية صامتة، وتوليد أخطاء حسابية متتالية تؤثر بصورة مباشرة على مصداقية التحليلات اللاحقة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة تأصيلية ومقارنة تقنية معمقة بين دالتي SEARCH وFIND في مايكروسوفت إكسل. سنعمل من خلال هذا العرض المفصل على تشريح البنية المنطقية والرياضية لكلتا الدالتين، وفحص آليات التعامل مع حساسية حالة الأحرف الأجنبية ودعم المحارف البديلة (أحرف البدل)، واستعراض أساليب معالجة شفرات الأخطاء الشائعة مثل (#VALUE!)، إلى جانب تبيان التكامل الوظيفي المتقدم مع دوال الاستقطاع النصي، وقياس الكفاءة الحوسبية في مجموعات البيانات الكبيرة. كما يستعرض المقال تطبيقات عملية ونماذج تطبيقية في تفكيك المتغيرات البحثية، مختتماً بدليل معياري يوجه الباحث والمحلل نحو الاختيار البرمجي الأسلم وفقاً لطبيعة البيانات ومتطلبات التجربة العلمية.
1. مقدمة تأصيلية لمعالجة النصوص في مايكروسوفت إكسل
1.1 أهمية الدوال النصية في استرجاع وتدقيق البيانات النوعية
تمثل الدوال النصية ركيزة بنيوية لا غنى عنها في هندسة البيانات وإعدادها لمراحل التحليل المتقدمة، حيث تشير التقديرات الإحصائية في علوم البيانات إلى أن الباحثين والمحللين يقضون ما يربو على ثمانين بالمئة من وقتهم في تنظيف البيانات الخام وإعادة تشكيلها. وفي سياق البحوث المسحية والتجريبية، غالباً ما تحتوي أوراق العمل على استجابات حرة أو كتل نصية مركبة تتضمن أسماء المشتركين، وأرقام المعرفات التجريبية، والتسجيلات الوصفية، والرموز المشفرة للمتغيرات المستقلة والتابعة. إن تحويل هذه المواد الخام غير المهيكلة إلى مصفوفات رقمية أو فئوية صالحة للاختبارات الإحصائية يتطلب قدرة فائقة على تحديد مواقع مقاطع الكلمات والرموز بدقة حاسوبية مطلقة.
تكمن الأهمية العملية في أن الدوال النصية تمكّن من استئصال الضوضاء البيانية وعزل المتغيرات المربكة؛ فالدقة المتناهية في رصد الفواصل، وعلامات الترقيم، وبوادئ المعرفات تمثل الخطوة الأولى لضمان عدم اختلاط البيانات بين المجموعات التجريبية والضابطة. ومن خلال التحديد الدقيق لفهارس السلاسل الفرعية، يستطيع المحلل فرز الاستجابات النوعية بدقة منهجية تفوق بمراحل عمليات التدخل اليدوي المعرضة للخطأ البشري، مما يعزز الموثوقية التكرارية للدراسات ويدعم سلامة الاستدلال العلمي المستند إلى قواعد بيانات نقية وخالية من الشوائب الإدخالية.
1.2 البنية التركيبية العامة لدوال البحث الموضعي عن النصوص
تقوم دوال البحث الموضعي في برمجيات الجداول الحسابية، وعلى رأسها مايكروسوفت إكسل، على مبدأ رياضي بسيط ولكنه بالغ الدقة: تحويل المشكلة النوعية المتمثلة في وجود كلمة أو رمز معين إلى قيمة كمية تمثل “الإزاحة الموضعية” أو الفهرس الحسابي للمحرف الأول من تلك السلسلة. تعتمد بيئة إكسل في هذا الصدد نظام الفهرسة الأحادية (1-based indexing)، وهو نظام يبدأ فيه ترقيم محارف السلسلة النصية من الرقم 1 لأول محرف في السلسلة، خلافاً للعديد من لغات البرمجة الحديثة (مثل بايثون أو سي) التي تتبنى نظام الفهرسة الصفرية (0-based indexing) حيث يمثل الصفر موضع المحرف الأول.
يتجلى التشابه الوظيفي السطحي بين دالتي SEARCH وFIND في كونهما تشتركان في نفس الهدف الأساسي ونفس الهيكل العام للمعاملات؛ إذ تستقبل كل منهما النص المراد البحث عنه، والسلسلة النصية التي يتم البحث داخلها، مع إمكانية تحديد موضع بدء القراءة اختيارياً. ويؤدي كلا الأمرين إلى إرجاع عدد صحيح موجب يوضح موقع البداية إذا ما تحقق التطابق. غير أن هذا التماثل الشكلي يخفي وراءه تمايزاً منطقياً معقداً في طريقة تفسير المحارف وتطبيق قواعد المطابقة، مما يجعل المقارنة بينهما ضرورة برمجية أساسية لفهم سلوك محرّك الحساب النصي في إكسل.
1.3 الإشكالية التقنية: متى تقتضي الضرورة المنهجية التمييز بينهما؟
تنشأ الإشكالية التقنية عندما يتم التعامل مع دالتي SEARCH وFIND على أنهما بديلان متطابقان يمكن استخدام أحدهما مكان الآخر عشوائياً؛ فهذا الافتراض الخاطئ يمثل مصدراً رئيسياً لظهور ما يُعرف بـ “الأخطاء البرمجية الصامتة” (Silent Failures) أو الأخطاء الكارثية المباشرة في قواعد البيانات. فالخطأ الصامت يحدث عندما تسترجع الدالة موضعاً نصياً غير مقصود للمقطع، كأن تلتقط كلمة شائعة بدلاً من اختصار مشفر بسبب تجاهل حالة الأحرف، مما يؤدي إلى اقتطاع نصوص مشوهة أو تمرير قيم غير صحيحة إلى معادلات إحصائية تبنى عليها قرارات حساسة دون أن يلحظ المحلل وجود خطأ فني مباشر.
تقتضي معايير الحوكمة والتحقق من جودة النماذج الحسابية في أوراق العمل فهماً عميقاً للفروق المنطقية المسببة لهذه التباينات. فعند تدقيق استمارات مقننة أو فحص معرفات موحدة، يترتب على الاختيار غير المدروس فقدان تام لبيانات المشاركين أثناء مراحل الاستخراج، أو إرجاع رسائل خطأ تؤدي إلى توقف المصنفات عن الحساب التلقائي. إن التمييز بين الدالتين يرتبط مباشرة بنوعية البيانات المدخلة؛ فإذا كانت البيانات تتطلب صرامة تامة ومطابقة نمطية متطابقة حرفياً يتم اللجوء إلى مسار برمجي مغاير تماماً للبيانات الحرة التي تتطلب مرونة استيعابية للأخطاء الإملائية وتنوع صياغات الإدخال.
2. التشريح النحوي والوظيفي لدالة البحث FIND
2.1 الصيغة المعيارية لدالة FIND ومتغيراتها الإلزامية
تُعرّف دالة FIND البرمجية في بيئة مايكروسوفت إكسل بصفتها أداة بحث نصي صارمة وحساسة لحالة الأحرف، وتُكتب صيغتها المعيارية بالهيكل الرياضي التالي:
=FIND(find_text, within_text, [start_num])
تتضمن هذه الصيغة وسيطين إلزاميّين يجب تزويد الدالة بهما لكي تتمكن من إتمام دورتها الحسابية بنجاح. المعامل الإلزامي الأول هو نص البحث المستهدف find_text، وهو المقطع النصي أو المحرف الفردي المراد البحث عن موقعه داخل السلسلة الأكبر. ويمكن أن يكون هذا المعامل نصاً صريحاً محاطاً بعلامتي تنصيص مزدوجتين مثل (“ID”)، أو مرجعاً لخلية تحوي قيمة نصية مثل (A2).
أما المعامل الإلزامي الثاني فهو السلسلة النصية الحاضنة within_text، والتي تمثل الكتلة النصية الكلية الخاضعة لعملية التفتيش والمسح. تفرض الدالة قيوداً منطقية صارمة على هذه المدخلات؛ حيث يجب أن تكون البيانات مفسرة نصياً، وفي حال الإشارة إلى خلايا فارغة، فإن إكسل يتعامل معها بوصفها نصوصاً خالية الطول (“”)، الأمر الذي ينعكس بشكل مباشر على نتيجة الفهرسة. إن إغفال أي من هذين المعاملين يؤدي فوراً إلى رفض الصيغة الحسابية من قبل محرك البرنامج وإظهار تنبيه بوجود خلل في البنية التركيبية للمعادلة.
2.2 توظيف المعامل الاختياري لموضع البدء [start_num]
يُمثل المعامل الثالث [start_num] أداة تحكم متقدمة تتيح للمستخدم توجيه مؤشر القراءة الداخلي للدالة للبدء من محرف معين بدلاً من الانطلاق الافتراضي من المحرف الأول (الموضع 1). يحمل هذا المعامل طبيعة اختيارية؛ ففي حال تم حذفه من الصيغة، يفترض البرنامج تلقائياً أن قيمة موضع البدء تساوي 1، ويبدأ التفتيش من أقصى طرف السلسلة. وتبرز الفائدة المنهجية لهذا المعامل عند الرغبة في تجاوز تكرارات سابقة غير مرغوبة للبحث عن التكرار الثاني أو الثالث لمقطع محدد، كما في حالات استخراج المقاطع الواقعة بعد الفواصل المتعددة في الأسماء أو العناوين.
يخضع المعامل [start_num] لشروط رياضية صارمة لتفادي الأعطال الحسابية؛ فإذا تم إسناد قيمة عددية سالبة أو مساوية للصفر (0 >= start_num)، فإن الدالة تفشل تماماً وترجع رمز الخطأ (#VALUE!). وبالمثل، إذا كانت القيمة المحددة تتجاوز الطول الإجمالي الفعلي للسلسلة النصية الحاضنة within_text (start_num > LEN(within_text))، فإن الدالة ترجع نفس شفرة الخطأ لعدم وجود نطاق حوسبي يمكن للمؤشر التحرك ضمنه. تستخدم هذه التقنية في المعادلات المتداخلة عبر تمرير ناتج دالة FIND سابقة مضافاً إليها واحد رياضي (FIND(…) + 1) كنقطة انطلاق جديدة لاصطياد المحارف المتكررة.
2.3 الطبيعة الصارمة لدالة FIND في حساسية حالة الأحرف
تعتبر الطبيعة الصارمة في حساسية حالة الأحرف (Case Sensitivity) السمة البارزة والجوهرية لدالة FIND؛ إذ تم تصميم خوارزمية الدالة لتطابق القيمة الثنائية الدقيقة (Binary/ASCII representation) لكل محرف. بناءً على ذلك، تفرق الدالة تفرقة قاطعة بين الأحرف الإنجليزية الكبيرة (Uppercase) ونظيراتها الصغيرة (Lowercase). فإذا طُلب من الدالة البحث عن الحرف الكبير (“A”) داخل كلمة تحتوي على الحرف الصغير (“a”) فقط، فإن الدالة لن تعتبر ذلك تطابقاً على الإطلاق، وستتجاهل وجود المحرف وتصدر شفرة خطأ تفيد بعدم العثور على القيمة المستهدفة.
يمتد هذا السلوك الصارم عند معالجة النصوص متعددة اللغات أو الحاوية على تشكيل دقيق؛ حيث تنظر الدالة إلى المحارف المشكولة أو المتنوعة بصرياً بصفتها محارف مستقلة بذاتها. وتعود الأسباب البرمجية لاعتماد هذا النهج المتشدد إلى متطلبات التطابق المطلق في الأنظمة المحاسبية والإدارية وقواعد البيانات الدوائية والأكاديمية، حيث قد يدل الحرف الكبير على تصنيف بيولوجي أو ديموغرافي مغاير تماماً لنظيره الصغير. تمنح هذه الصرامة دالة FIND ميزة معيارية هامة عندما يتعلق الأمر بالتحقق والتدقيق الصارم للبيانات الحساسة للتسجيل.
3. التشريح النحوي والوظيفي لدالة البحث SEARCH
3.1 البنية النحوية لدالة SEARCH ومحدداتها المعيارية
تُعد دالة SEARCH النظير المرن لدالة FIND داخل مصنفات إكسل، حيث تتقاطع معها في البناء التركيبي الخارجي وتختلف عنها جذرياً في المنطق الإجرائي الداخلي. تُصاغ دالة SEARCH معمارياً بالصورة التالية:
=SEARCH(find_text, within_text, [start_num])
تتشابه الوسائط الهيكلية الثلاث للدالة في التسمية والترتيب مع وسائط دالة FIND، حيث يمثل find_text القيمة المطلوب رصدها، ويمثل within_text النطاق الحاضن، ويشير [start_num] الاختياري إلى نقطة انطلاق الفهرسة. وعلى الرغم من هذا التماثل السطحي، فإن طريقة معالجة المعامل find_text تتسم بمرونة حوسبية فائقة تسمح بتفسير النصوص بطرق لا تتطابق حرفياً مع النص الأصلي، خاصة عند إدراج أرقام مدمجة ضمن نصوص أو رموز تعبيرية غير متجانسة.
تستطيع دالة SEARCH استيعاب المدخلات الرقمية والنصية بمرونة عالية، حيث تقوم تلقائياً بتحويل الأرقام إلى سلاسل نصية ضمنية أثناء عملية المسح دون الحاجة لاستخدام دوال التحويل الصريح مثل TEXT. وتعتبر هذه الخاصية مفيدة للغاية في معالجة الاستمارات البحثية التي تحتوي على معرفات هجينة تجمع بين الحروف اللاتينية والأرقام التسلسلية، حيث تضمن الدالة فحص المحتوى بدقة دون التأثر بتنسيق الخلايا الأساسي (سواء كانت منسقة كأرقام عامة أو نصوص صريحة).
3.2 تجاهل حالة الأحرف كخاصية جوهرية للدالة
الميزة البنيوية الأهم لدالة SEARCH هي كونها غير حساسة لحالة الأحرف (Case-Insensitive)؛ حيث تساوي الخوارزمية الداخلية مساواة منطقية كاملة بين الحرف في صيغته الكبيرة (Uppercase) وصيغته الصغيرة (Lowercase). فعند البحث عن السلسلة النصية (“data”)، فإن الدالة سترجع موضع المطابقة بغض النظر عما إذا كانت مكتوبة بالصيغة (“DATA”) أو (“Data”) أو (“dAtA”) أو أي توليفة محرفية أخرى. تهدف هذه الخاصية إلى تخفيف حساسية المدخلات وتوفير طبقة حماية برمجية ضد تباينات الإدخال الناتجة عن اختلاف المستخدمين في طريقة الكتابة.
تتجلى كفاءة دالة SEARCH الاستثنائية في بيئات المسح السريع للبيانات المفتوحة، مثل تفريغ إجابات عينات الدراسات النفسية والاجتماعية غير المقيدة، حيث لا يمكن إلزام المشاركين بنمط معين في تنسيق الأحرف اللاتينية أو الرموز الإملائية. ويشير باحثون مثل بريسبارت ونيو (Brysbaert & New, 2009) في دراستهما المتخصصة حول معايير تكرار الكلمات اللغوية إلى التباين الواسع في الصياغات النصية عبر السياقات التعبيرية المختلفة؛ وعليه، فإن استخدام أدوات مسح مرنة مثل SEARCH يحول دون إسقاط الاستجابات اللفظية الحرة لمجرد اختلاف حالة الحرف الطباعي، مما يحفظ اكتمال العينات الإحصائية.
3.3 إدارة نطاق التفتيش عبر المعامل الاختياري [start_num]
تعمل إدارة نطاق التفتيش عبر المعامل الاختياري [start_num] في دالة SEARCH وفق القواعد الرياضية العامة المنظمة لبيئة إكسل، حيث يتيح للباحث تخطي البوادئ الاصطلاحية الشائعة. فعلى سبيل المثال، إذا كانت سجلات المرضى أو المفحوصين تبتدئ جميعها برمز موحد مثل “SUBJ-“، يمكن للمحلل توجيه الدالة للبدء مباشرة من المحرف السادس لتجنب استرجاع هذا النمط الأولي والتركيز على المقطع اللاحق المتغير الذي يحدد هوية المشارك الفعلية.
ولتحقيق أقصى درجات الديناميكية في التحليل، يتم تنسيق المعامل [start_num] بالتكامل مع دوال القياس النصي مثل LEN؛ إذ يمكن صياغة معادلات تفاضلية تقيس طول سلسلة معينة وتبدأ البحث بعدها مباشرة. وكما هو الحال مع نظيرتها، تتطلب دالة SEARCH التقيد بحدود النص؛ إذ تؤدي القيمة الأقل من 1 أو الأكبر من الطول الفعلي للكتلة النصية إلى ظهور الخطأ الشهير (#VALUE!)، مما يستوجب ضبط المتغيرات بعناية هندسية فائقة لتفادي توقف السلاسل الحسابية الطويلة.
4. الفارق الجوهري الأول: حساسية حالة الأحرف وتطبيقاتها العملية
4.1 التحليل المقارن للسلوك البرمجي تجاه الأحرف اللاتينية
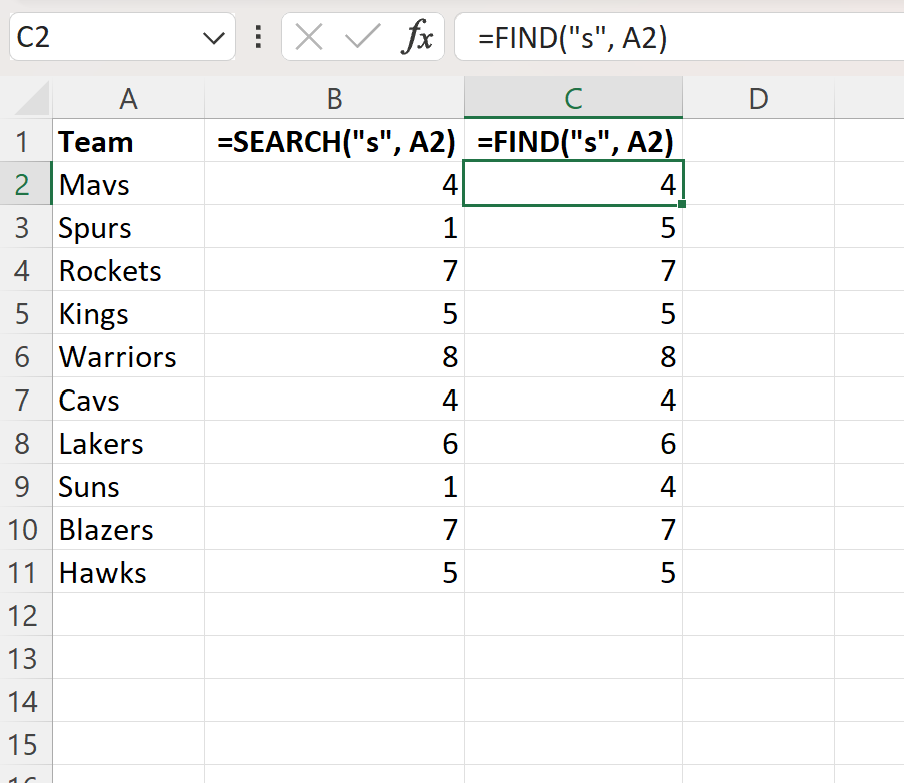
لتوضيح الفارق العملي الجوهري في حساسية حالة الأحرف بين الدالتين، نأخذ مثالاً حوسبياً كلاسيكياً يبرز التباين الحاد في النتيجة: لنفترض وجود اسم الفريق الرياضي اللاتيني “Spurs” في الخلية A1، وأردنا البحث عن موضع الحرف الصغير (‘s’) باستخدام الدالتين على النحو التالي:
إذا طبقنا دالة SEARCH عبر المعادلة =SEARCH(“s”, A1)، فإن الدالة تبدأ القراءة من المحرف الأول من جهة اليسار. وبما أنها تتجاهل تماماً حالة الأحرف ولا تفرق بين ‘S’ الكبيرة و’s’ الصغيرة، فإنها تكتشف مطابقة فورية عند المحرف الأول “S”، فتتوقف عن متابعة الفحص وترجع فوراً القيمة الرقمية 1.
وعلى النقيض تماماً، إذا استخدمنا دالة FIND عبر المعادلة =FIND(“s”, A1)، فإن الخوارزمية الصارمة تفحص المحرف الأول “S” وتعتبره غير مطابق للحرف الصغير المطلوب “s”. فتواصل الدالة مسح بقية المحارف (‘p’، ثم ‘u’، ثم ‘r’) دون تطابق، حتى تصل إلى المحرف الخامس والأخير، فتجد فيه الحرف الصغير “s” مطابقاً تماماً، فترجع القيمة الرقمية 5. يُظهر هذا المثال البسيط كيف يؤدي اختلاف حرف طباعي واحد في خوارزمية الدالة إلى تغيير النتيجة الحسابية جذرياً من أقصى بداية الكلمة إلى أقصى نهايتها.
4.2 التطبيقات الميدانية لاختلاف حساسية الأحرف
تتعدد التطبيقات الميدانية التي تفرض الاختيار الحصري بين الدالتين بناءً على معيار حساسية الأحرف. ففي المختبرات البحثية وقواعد البيانات النفسية الحيوية، كثيراً ما تُستخدم معرفات عينات مشفرة دولياً تستند إلى ترميزات مثل “p” للدلالة على مريض تجريبي (Patient) و”P” للدلالة على بروتوكول محدد (Protocol)؛ وفي مثل هذه البيئات المعقدة، يعتبر استخدام دالة SEARCH خطأً منهجياً جسيماً لأنه يخلط بين الفئتين حتماً، في حين تضمن دالة FIND التحقق الدقيق من هوية الرمز المشفر دون لبس.
من جانب آخر، تبرز الحاجة إلى دالة FIND عند استكشاف الاختصارات الأكاديمية المصوغة بحروف كبرى والمضمنة داخل نصوص وصفية عامة؛ كالبحث عن متلازمة الإرهاق الرياضي في التقارير الطبية للأبطال الرياضيين والتي قد ترمز اختصاراً بأحرف كبيرة تميزها عن الكلمات اللغوية الشائعة، وهو سياق يتفق مع توصيات ريردون وزملائه (Reardon et al., 2019) في إقرار معايير التوافق الدولية للصحة النفسية لدى الرياضيين والتي تتطلب دقة مطلقة في توثيق الحالات السريرية. في المقابل، تُفضل دالة SEARCH عند تصنيف المحتوى المسحي العريض واسترجاع الاستجابات اللفظية التلقائية التي يدونها المشاركون دون التزام بنسق محدد للحروف.
4.3 التبعات الإحصائية والتحليلية لاختيار الدالة الخاطئة
يترتب على الاختيار الخاطئ للدالة مخاطر إحصائية ومنهجية بالغة التعقيد قد تمتد لتصيب نتائج الدراسات التجريبية بالتحيز المنهجي. فعندما يقفز مؤشر البحث فوق الموضع المستهدف ويلتقط موضعاً سابقاً أو لاحقاً بسبب إشكالية حالة الأحرف، فإن كافة معادلات الاقتطاع الرياضي المتصلة (مثل LEFT أو MID) ستقتطع أجزاء خاطئة ومبتورة من النصوص، مما يولد فجوات تشغيلية في مصفوفات البيانات ويؤدي إلى تصنيف الأفراد في مسارات تجريبية مغايرة لمساراتهم الحقيقية.
تؤدي هذه الانزلاقات إلى إنتاج قيم مفقودة كاذبة (Pseudo-missing values) أو إدراج أرقام محرفة في نماذج الانحدار الخطي واللوجستي، الأمر الذي يضعف القوة الإحصائية للاختبارات ويقلل من موثوقية المقاييس المستخدمة. ولتفادي هذه التبعات، يجب أن يتضمن بروتوكول جمع البيانات وتحليلها خطوة استباقية تحدد معايير اختيار الدوال؛ بحيث يُعتمد الاستخدام الصارم لدالة FIND فقط في السلاسل المشفرة مسبقاً، بينما تُعتمد SEARCH في تحليل البيانات غير المنظمة لتلافي بتر الاستجابات الإيجابية غير النمطية.
5. الفارق الجوهري الثاني: دعم أحرف البدل ومطابقة الأنماط
5.1 مفهوم أحرف البدل (Wildcards) المعتمدة في بيئة إكسل
تُعرف أحرف البدل (Wildcards) في بيئة مايكروسوفت إكسل بأنها رموز محرفية خاصة تُستخدم للتمثيل الرمزي لمجموعة من المحارف المجهولة أو المتغيرة، مما يمنح صيغ البحث مرونة حوسبية تفوق قيود المطابقة الحرفية المباشرة. يعتمد إكسل ثلاثة رموز قياسية لأحرف البدل، يؤدي كل منها وظيفة محددة في التعبير عن الأنماط النصية:
- علامة الاستفهام (?): تُمثل محرفاً فردياً واحداً غير محدد في الموضع المخصص؛ فالمقطع “B?ll” يتطابق مع “Bill” و”Ball” و”Bell”، دون أن يتطابق مع الكلمات التي تحتوي على أكثر من محرف في المنتصف.
- علامة النجمة (*): تُمثل سلسلة نصية ممتدة ذات طول غير محدد، بدءاً من انعدام المحارف (صفر محرف) وحتى أي عدد عشوائي من المحارف المتتالية؛ فالبحث عن “Re*ch” يتطابق مع “Reach” و”Research” و”Reinforcearch”.
- علامة المدة (~): تعمل بصفتها أداة إفلات منطقية (Escape Character)، وتُوضع حصراً قبل علامتي الاستفهام أو النجمة لإلغاء وظيفتهما الرمزية وإجبار المحرك على البحث عنهما بوصفهما رمزين حرفيين أصليين (كالبحث عن “~?” للعثور على علامة الاستفهام الحقيقية).
5.2 قدرات دالة SEARCH المتقدمة في مطابقة الأنماط النصية
تتميز دالة SEARCH بدعمها الكامل والتلقائي لكافة أحرف البدل سالفة الذكر، مما يجعلها أداة استثنائية لمطابقة الأنماط المعقدة دون الحاجة إلى استخدام خوارزميات التعبيرات النمطية (Regular Expressions) الخارجية المعقدة. فإذا رغب الباحث في العثور على موضع كود مشفر يبتدئ بالحرف “X” وينتهي بالرقم “9” بغض النظر عن عدد الأحرف الواقعة بينهما، يكفي كتابة المعادلة بالصيغة التالية: =SEARCH(“X*9”, A1)، وستقوم الدالة برصد أول ظهور لهذا النمط التركيبي وإرجاع فهرسه الحسابي بدقة تامة.
تمتد هذه الإمكانية لتشمل حقول الملاحظات والبيانات الاستبيانية الحرة، حيث يمكن استخراج الكلمات المركبة أو المصطلحات المفتاحية حتى مع وجود تباينات إملائية ناتجة عن إهمال المشاركين في وضع المسافات أو الفواصل. تمنح هذه المرونة المحلل القدرة على أتمتة تصنيف مئات الآلاف من السجلات النصية وتصفيتها وفق معايير ديناميكية تلتقط البنى اللغوية العامة بكفاءة برمجية عالية وسرعة فائقة في التنفيذ.
5.3 عجز دالة FIND البنيوي عن معالجة المحارف البديلة
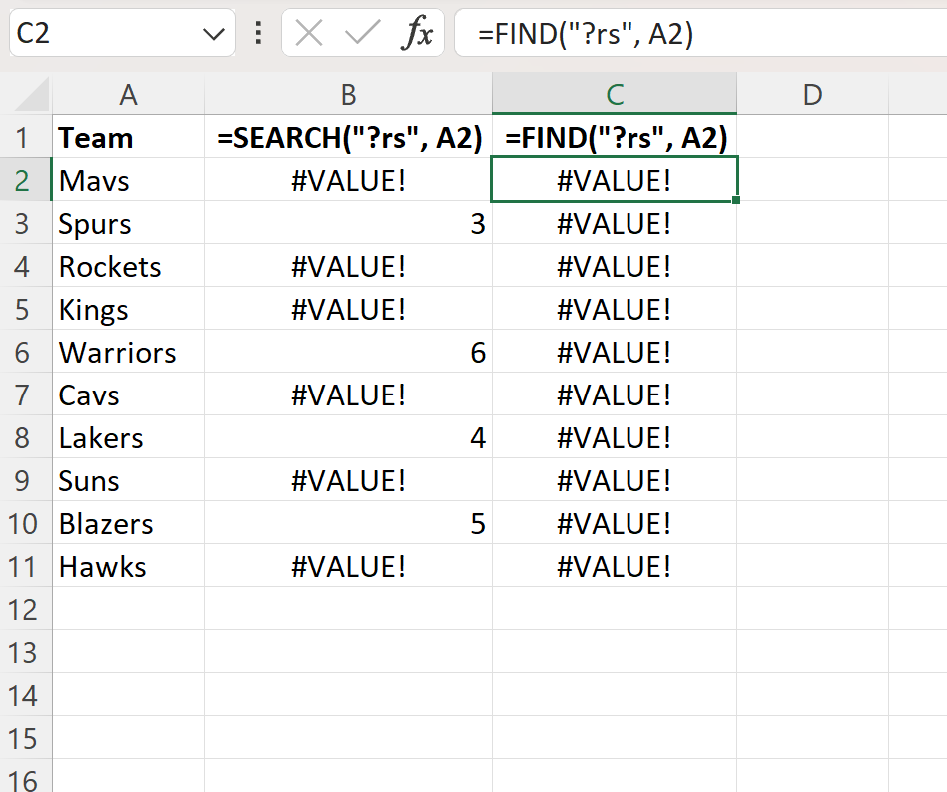
يقابل مرونة SEARCH عجزٌ بنيوي متعمد ومقصود في تصميم دالة FIND؛ إذ تفتقر هذه الدالة تماماً إلى آلية تفسير أحرف البدل، وتتعامل مع الرموز مثل (?) و(*) بوصفها محارف مطبعية حرفية بحتة لا تحمل أي بعد رمزي أو وظيفي. فإذا قمت بكتابة الصيغة =FIND(“B?ll”, A1)، فإن دالة FIND لن تبحث عن أي كلمة تبدأ بحرف B وتنتهي بـ ll وبينهما حرف مجهول، بل ستبحث حرفياً عن سلسلة مكونة من أربعة محارف متتالية هي الحرف B يليه رمز علامة الاستفهام نفسه ثم المحرفان ll.
يترتب على هذا الفارق استحالة تنفيذ البحث شبه المطابق (Fuzzy Matching) أو مطابقة الأنماط المتغيرة باستخدام دالة FIND بصورة منفردة. ومع ذلك، فإن هذا “العجز” البنيوي يتحول إلى ميزة برمجية فائقة الأهمية عند الرغبة الصريحة في البحث عن علامات الترقيم والرموز الخاصة؛ فإذا كانت قاعدة البيانات تحتوي على علامات استفهام تدل على بيانات ناقصة أو غير محسومة، فإن دالة FIND توفر أقصر الطرق وأبسطها لاصطياد هذا الرمز دون الحاجة إلى تضمين محارف الإفلات المعقدة التي تشترطها دالة SEARCH، مما يجعل FIND الخيار الأبسط والأنقى عند تعقب الرموز الحرفية المجردة.
6. إدارة الأخطاء الشائعة وتحليل شفرة الخطأ (#VALUE!)
6.1 الأسباب الهيكلية لظهور خطأ القيمة #VALUE! في الدالتين
يُعد خطأ القيمة الشهير #VALUE! من أكثر النتائج شيوعاً عند التعامل مع دالتي SEARCH وFIND، وهو ناتج عن إخفاقات بنيوية محددة في تلبية الشروط الحسابية للدالتين. يكمن السبب الأكثر تكراراً في الإخفاق الكامل في العثور على النص المستهدف داخل السلسلة الحاضنة؛ فمحرك إكسل لا يُرجع القيمة صفر أو القيمة المنطقية FALSE كما يعتقد كثير من المبتدئين عند تعذر العثور على التطابق، بل يقطع السلسلة الحسابية فوراً بإصدار الخطأ المذكور تعبيراً عن فشل المعاملة في إنتاج فهرس رقمي صحيح.
أما السبب الهيكلي الثاني فيتعلق بإساءة ضبط المعامل الاختياري [start_num]؛ فإذا أُسندت إليه قيمة صفرية أو رقم سالب، يُصدر المحرك خطأ #VALUE! فوراً لامتناع وجود فهرس أقل من 1. كما يتولد الخطأ نفسه عندما يتجاوز هذا المعامل الطول الإجمالي الفعلي للنص المراد فحصه، كأن يتم توجيه الدالة للبدء من المحرف العشرين في جملة لا يتجاوز طولها الكلي عشرة محارف. إن فهم هذه المسببات هو المدخل الحاسم لبناء نماذج بيانات منيعة ضد الانهيار البرمجي المفاجئ.
6.2 بناء دروع الحماية البرمجية باستخدام الدوال الوقائية
لتأمين استمرارية الحسابات الرياضية في مصنفات البيانات الكبرى، يتوجب على المحلل تحصين دوال البحث بأغلفة برمجية وقائية تمنع تصدير شفرات الأخطاء إلى الخلايا المجاورة. ويتمثل النهج الكلاسيكي الأكثر انتشاراً في استخدام الدالة الوقائية IFERROR، والتي تسمح بالتقاط الخطأ واستبداله بمخرج بديل محدد، مثل نص دلالي مقروء أو خلية فارغة تماماً، كما يظهر في التركيبة البرمجية التالية:
=IFERROR(SEARCH(“Target”, A2), “”)
وعند الرغبة في بناء مؤشرات فرز ثنائية (Boolean Flags) لاختبار وجود النص من عدمه، يُعتمد على التركيبة المركبة الفائقة الدقة التي تجمع بين الدالتين ISNUMBER وSEARCH أو FIND وفق الصيغة المعيارية:
=ISNUMBER(FIND(“Target”, A2))
تقوم دالة ISNUMBER بفحص المخرج المباشر؛ فإذا نجحت دالة FIND في إرجاع موضع رقمي (مثلاً: 4)، تتحول النتيجة تلقائياً إلى القيمة المنطقية TRUE، بينما إذا أخفقت وأرجعت خطأ #VALUE!، تبتلع دالة ISNUMBER هذا الخطأ وتحوله بسلاسة إلى القيمة المنطقية FALSE دون التسبب في تعطيل ورقة العمل. يمكن بعد ذلك دمج هذه التركيبة كشرط اختباري داخل دالة IF لتنفيذ سيناريوهات ثنائية التفرع للتعامل مع البيانات المتطابقة وغير المتطابقة بمستوى عالٍ من الاحترافية الحوسبية.
6.3 التدقيق اللغوي والمسافات البيضاء المخفية المسببة للأخطاء
تُمثل المسافات البيضاء المخفية ومحارف التباعد الزائدة أحد أخطر العوامل الخفية المسببة لفشل المطابقة وظهور خطأ #VALUE! دون سبب ظاهري واضح؛ فوجود مسافة عادية في نهاية النص المراد البحث عنه أو بدايته داخل الخلية يحول تقنياً دون تطابقه مع السلسلة الحاضنة، لأن إكسل يتعامل مع المسافة كأحد المحارف المستقلة التي تمتلك وزناً وفهرساً نصياً كاملاً. تتضاعف هذه الإشكالية في المسوح الميدانية التي تجمع استجابات المستجيبين عبر نماذج الويب التي قد تدمج مسافات غير مرئية عند النسخ واللصق.
ولمعالجة هذه المعضلة الحوسبية، ينبغي دمج دالة التطهير النصي TRIM لتجريد السلاسل النصية من كافة المسافات الزائدة في البدايات والنهايات وتقليص المسافات البينية إلى مسافة واحدة مفردة قبل تمريرها لمعاملات البحث، كما في المعادلة:
=SEARCH(TRIM(B1), TRIM(A1))
كما تجدر الإشارة إلى سلوك تقني دقيق يتعلق بإسناد علامات تنصيص فارغة تماماً (“”) كمعامل للنص المستهدف find_text؛ ففي هذه الحالة، ترجع كلتا الدالتين (SEARCH وFIND) القيمة 1 تلقائياً (أو قيمة start_num إن وُجدت)، لأن السلسلة الصفرية تعتبر متطابقة افتراضياً عند عتبة المحرف الأول للنص، وهو سلوك يجب الانتباه إليه لتفادي توجيه مؤشرات الاستقطاع نحو مواقع زائفة.
7. التكامل الوظيفي: دمج SEARCH وFIND مع دوال الاستقطاع المتقدمة
7.1 الاستقطاع الطرفي المتقدم بالاقتران مع دالتي LEFT وRIGHT
تكتسب دوال التفتيش قيمتها التشغيلية القصوى عندما تعمل بوصفها “حساسات قياس موضعية” لصالح دوال الاستقطاع الطرفي الكلاسيكية مثل LEFT وRIGHT. فعند الرغبة في فصل الأسماء الأولى أو البوادئ التعريفية من سجلات مفردة ذات أطوال متباينة، لا يمكن تحديد عدد ثابت للمحارف المستقطعة؛ وهنا تتدخل دالة SEARCH أو FIND لتحديد موضع أول مسافة فاصلة ديناميكياً، وتمرير هذا الموضع ناقصاً واحداً إلى دالة LEFT لاقتطاع الكلمة الأولى بدقة تامة:
=LEFT(A2, FIND(” “, A2) – 1)
وعلى المنوال نفسه، يمكن إنجاز الاستقطاع الطرفي الأيمن لاستخراج المقاطع الختامية (مثل ألقاب العائلات أو امتدادات الملفات) من خلال دمج دالة الحساب الحجمي LEN مع دالة FIND؛ حيث يتم حساب إجمالي طول السلسلة الكلية ثم طرح موضع المحرف الفاصل منه لتحديد عدد المحارف المتبقية في الطرف الأيمن، وفق الصيغة الحسابية المتقنة:
=RIGHT(A2, LEN(A2) – FIND(” “, A2))
تتيح هذه المصفوفة التركيبية معالجة مئات الآلاف من الأسماء المتفاوتة الطول والمقاطع المتنوعة بمرونة حوسبية مطلقة وبمعادلة واحدة تعيد تشكيل بنيتها تلقائياً لكل صف على حدة.
7.2 استخراج النصوص الفرعية المحصورة بالتعاون مع دالة MID
يُمثل استخلاص المقاطع النصية المحصورة بين رمزين محددين (كالنصوص الواقعة داخل أقواس هلالية أو بين علامتي شارحة) أحد أهم التحديات التقنية في إعداد وتجهيز البيانات. يتم إنجاز هذا المطلب عبر التكامل الوظيفي بين دالة الاقتطاع الأوسط MID ودالتي البحث الموضعي؛ حيث تُستخدم دالة البحث الأولى لتحديد نقطة انطلاق الاقتطاع (موضع الرمز الأول زائداً طول الرمز لتجاوزه)، بينما تُستخدم دالة بحث ثانية لحساب الطول الصافي للشريحة المطلوب عزلها بطرح موضع الفاصل الأول من موضع الفاصل الثاني.
تتضح هذه الآلية المتقدمة عند استخراج كود تشخيصي محصور بين قوسين مربعين مثل “[F43.1]” داخل جملة توصيفية، حيث تصاغ المعادلة المعيارية بالشكل التالي:
=MID(A2, FIND(“[“, A2) + 1, FIND(“]”, A2) – FIND(“[“, A2) – 1)
تقوم هذه المعادلة المركبة بمسح النص، وحساب المسافة الحرفية الفاصلة بين القوسين بدقة حسابية مطلقة، ومن ثم عزل الرمز المشفر دون الأقواس. ويعد هذا الأسلوب بالغ الأهمية في الدراسات الإكلينيكية والطبية النفسية؛ حيث يُعتمد عليه في تفكيك الملاحظات السريرية وفرز الرموز التشخيصية لاضطرابات مثل الأرق، بما يتوافق مع المعايير التصنيفية المقننة التي فصلها إدينغر وزملاؤه (Edinger et al., 2004) في استخلاص معايير التشخيص البحثية للاضطرابات النفسية من السجلات المكتوبة بحرية.
7.3 عزل المعرفات وعناوين البريد الإلكتروني كنماذج واقعية معقدة
يبرز عزل مكونات عناوين البريد الإلكتروني أو المعرفات الرقمية الأكاديمية (مثل معرفات التوزيع الجغرافي للمشاركين) كنموذج تطبيقي واقعي معقد للجمع بين هذه الدوال. فعند الرغبة في عزل اسم النطاق الجامعي أو المؤسسي من عنوان بريدي في الخلية A2 لتصنيف المشاركين بحسب انتماءاتهم الأكاديمية، يتم استهداف علامة الآت المرجعية (“@”) كعلامة ارتكاز حاسمة باستخدام دالة FIND، نظراً لأن هذا الرمز محرف مفرد قياسي لا يتكرر في البريد الواحد:
=RIGHT(A2, LEN(A2) – FIND(“@”, A2))
تستخرج هذه الصيغة اسم المؤسسة بالكامل تلقائياً (مثلاً: “university.edu”)، كما يمكن استخراج اسم المستخدم الشخصي بتمرير نفس نقطة الارتكاز إلى دالة LEFT:
=LEFT(A2, FIND(“@”, A2) – 1)
وفي تدفقات العمل المتقدمة، يُمكن أتمتة هذه العمليات لتفكيك كتل نصية ثلاثية الأبعاد تحتوي على الاسم، ومعرف المشارك، ونطاقه الجغرافي دفعة واحدة، مما يتيح ترحيل البيانات المنقاة مباشرة إلى برمجيات التحليل الإحصائي دون الحاجة إلى معالجات يدوية مضنية قد تؤثر سلباً على سلامة البيانات ونزاهة الاختبارات المطبقة عليها.
8. الأداء الحسابي والكفاءة المعالجاتية في مجموعات البيانات الكبيرة
8.1 المقارنة الحوسبية للسرعة وزمن المعالجة (CPU Cycles)
عند الانتقال من معالجة أوراق العمل المحدودة إلى السجلات المليونية وقواعد البيانات الضخمة (Big Data) داخل بيئة إكسل، يغدو زمن المعالجة واستهلاك دورات المعالج المركزي (CPU Cycles) معياراً هندسياً حاسماً لاختيار الدالة الملائمة. من الناحية الحوسبية النظرية والتطبيقية، تمتلك دالة FIND تفوقاً طفيفاً وملموساً في سرعة الإنجاز وزمن الاستجابة الحسابي مقارنة بدالة SEARCH؛ ويعود هذا التمايز إلى بساطة الخوارزمية الداخلية لدالة FIND، والتي تقتصر على فحص التطابق الثنائي المباشر لكل بايت محرفي بالتسلسل ومقارنته بجدول المحارف بدقة صارمة دون المرور بأي عمليات تحويل وسيطة.
في المقابل، تفرض دالة SEARCH عبئاً حوسبياً إضافياً على المعالج المركزي ناتجاً عن مستويين من التحليل الخوارزمي: أولهما استدعاء خوارزميات توحيد حالة الأحرف (Case Normalization) لمطابقة كل حرف صغير مع نظيره الكبير في الذاكرة الحية قبل إقرار التطابق، وثانيهما الفحص المستمر لقواعد أحرف البدل ومطابقة الأنماط الاحتمالية في كل موضع محرفي عبر السلسلة. وعلى الرغم من أن هذا الفارق الزمني لا يتعدى أجزاء من الملي ثانية في الصفوف الفردية، إلا أنه يتراكم بشكل ملحوظ عند إعادة حساب مصنفات معقدة تحتوي على نصف مليون صف أو أكثر، مما يجعل FIND الخيار الأسرع حوسبياً عند استقرار وتجانس صيغ النصوص المدخلة.
8.2 التوافق مع صيغ المصفوفات الديناميكية والحساب المتجهي
مع التحديثات الجوهرية التي أدخلتها مايكروسوفت على محرك الحساب في إكسل وإطلاق مصفوفات الحساب الديناميكية (Dynamic Arrays)، أصبحت كلتا الدالتين (SEARCH وFIND) تدعمان تمرير النطاقات المتجهية (Array Arguments) كمعاملات مباشرة بدلاً من الاقتصار على الخلايا الفردية. تتيح هذه الخاصية الحديثة تطبيق معادلة بحث واحدة في الخلية العليا لتنسكب المخرجات الرقمية تلقائياً عبر مئات الصفوف المتتالية عبر ما يُعرف بخاصية الانسكاب التلقائي (Spill Feature)، مما يقلل بشكل ملموس من حجم المصنف البرمجي ويزيل الحاجة إلى نسخ الصيغ عبر السحب العمودي التقليدي.
يتجلى السلوك المتجهي المتقدم في قدرة الباحث على تمرير مصفوفة من نصوص البحث المختلفة إلى دالة SEARCH دفعة واحدة لفحص خلية نصية مفردة بحثاً عن أي من المصطلحات المستهدفة، كما في المعادلة المصفوفية:
=SEARCH({“sad”, “anxious”, “depressed”}, A2)
تُرجع هذه المعادلة مصفوفة أفقية متزامنة من النتائج العددية وشفرات الأخطاء؛ وعند لف هذه المصفوفة بدوال مساندة مثل COUNT أو MIN أو IFERROR، يمكن للمحلل التحقق من وجود أي مصطلح من قائمة المصطلحات المحددة بضربة حوسبية واحدة وبأعلى كفاءة في استغلال خيوط المعالجة المتوازية (Multi-threading) التي يوفرها إكسل الحديث دون إجهاد الذاكرة العشوائية للجهاز.
8.3 استراتيجيات التحسين للحد من استهلاك موارد الذاكرة
تتطلب إدارة قواعد البيانات البحثية المعقدة تبني استراتيجيات صارمة للحد من الاستهلاك المفرط لموارد الذاكرة المؤقتة وتجنب تجمد المصنفات الحسابية أثناء إجراء التحليلات الاستكشافية. وتتمثل الاستراتيجية الذهبية الأولى في تحويل الصيغ النصية المعقدة التي تحوي دوال SEARCH وFIND إلى قيم حسابية ثابتة (Paste Values) فور الانتهاء من مراحل تنظيف البيانات وتوليد المتغيرات المستخلصة، حيث يؤدي الاحتفاظ بآلاف الدوال النصية النشطة إلى إعادة حسابها باستمرار مع كل تعديل يطرأ على أي خلية داخل المصنف.
كما يُنصح منهجياً بتفضيل استخدام دالة FIND كلما كان هناك ضمان مطلق لتجانس المدخلات المكتوبة (كالأكواد المشفرة أو النصوص التي تمت معالجتها وتوحيدها مسبقاً بدوال مثل UPPER أو LOWER)، وذلك لإراحة المعالج من عبء مطابقة الأنماط الزائدة لدالة SEARCH. أضف إلى ذلك أهمية تجنب التداخلات الحسابية المتكررة داخل نفس الصيغة؛ فبدلاً من استدعاء FIND خمس مرات متتالية داخل دالة شرطية واحدة لحساب أطوال المقاطع، يُفضل تخصيص أعمدة مساعدة (Helper Columns) تختزن مؤشرات البداية والنهاية المؤقتة، مما يقلل الحسابات المكررة ويعزز استدعاء البيانات من الذاكرة الخبيئة (Cache Memory) بسلاسة فائقة.
9. حالات دراسية وتطبيقات تحليلية متقدمة في البحث العلمي
9.1 تحليل وتصنيف الاستجابات المفتوحة في الاستبيانات النفسية والتربوية
تُشكل الاستجابات اللفظية المفتوحة في الاستبيانات الميدانية مادة خام غنية ولكنها تتسم بالفوضوية وغياب النمطية التركيبية، مما يتطلب استراتيجيات أتمتة دقيقة لتصنيفها وترميزها كمياً. لنفترض أن باحثاً في علم النفس الإيجابي يدرس تأثير المشاعر الوجدانية الإيجابية على التكيف والنمو الشخصي، مستنداً إلى النماذج النظرية الرصينة التي أرستها ليوبوميرسكي وزملائها (Lyubomirsky et al., 2005) في دراستهم حول فوائد المشاعر الإيجابية المتكررة، أو ما استعرضه براتي وبيترانتوني (Prati & Pietrantoni, 2009) في التحليل التلوي حول التفاؤل واستراتيجيات المواجهة المسهمة في النمو بعد الصدمة؛ فإن مثل هذه الأطر تتطلب رصد مؤشرات التفاؤل والأمل داخل مدونات المشاركين الاسترجاعية.
لتحقيق ذلك عملياً داخل إكسل، تُوظف دالة SEARCH بالاقتران مع أحرف البدل لبناء موازين ترميز ثنائية ترصد المفردات الإيجابية بصرف النظر عن موقعها أو تصريفاتها اللغوية، عبر معادلة متقدمة مثل:
=IF(ISNUMBER(SEARCH(“optimis*”, A2)), 1, 0)
تستطيع هذه المعادلة رصد الكلمات المشتقة كافة، مثل “optimism” و”optimistic” و”optimist”، متجاهلة كلياً حالة الحرف وسياق وروده في الجملة. يُسهم هذا الإجراء المؤتمت في تحويل الكتل النصية الضخمة إلى متغيرات قياسية تابعة ومستقلة صالحة للتحليل الإحصائي، مما يلغي التحيزات الناتجة عن الترميز اليدوي الذاتي للملاحظين ويوفر اتساقاً مطلقاً في تطبيق شروط التصنيف العلمي.
9.2 استخلاص المتغيرات الديموغرافية من الكتل النصية غير المهيكلة
في كثير من المسوح الميدانية السريعة أو التدخلات الصحية المجتمعية، تُجمع الخصائص الديموغرافية للمشاركين في حقول وصفية موحدة لتسهيل سرعة الجمع؛ كأن تُكتب بيانات المشارك في خلية واحدة بالنمط: “العمر: 34؛ الجنس: أنثى؛ الحالة: متزوج”. ويبرز هذا التحدي بصورة خاصة في المسوح الصحية المعقدة والمناطق ذات الموارد المحدودة؛ حيث أظهرت دراسات فان جينيكن وزملائها (van Ginneken et al., 2013) حول تدخلات الكوادر الصحية غير المتخصصة في رعاية الاضطرابات النفسية في البلدان منخفضة ومتوسطة الدخل الحاجة الماسة إلى نظم تسجيل عملية مرنة يمكن فرزها وتصنيفها حوسبياً بأقل قدر من الأخطاء التشغيلية.
لتفكيك هذا السجل المركب وفصل متغير “العمر” كمتغير كمي مستقل في عمود مخصص، يتم الاعتماد على دالة FIND لاستكشاف الرموز الفاصلة الثابتة مثل النقطتين الرأسيتين وعلامة الفاصلة المنقوطة، ومن ثم توجيه دالة MID لاقتطاع المحتوى الواقع بينهما بدقة تامة وفق المعادلة:
=TRIM(MID(A2, FIND(“العمر:”, A2) + 6, FIND(“;”, A2, FIND(“العمر:”, A2)) – (FIND(“العمر:”, A2) + 6)))
تضمن هذه المعادلة المنسوجة بعناية قراءة قيمة العمر الرقمية حصراً وتطهيرها من أي مسافات فراغية مرافقة، تمهيداً لحساب المتوسطات الحسابية والانحرافات المعيارية للعينة دون أي تشويه في توزيع البيانات الديموغرافية، فضلاً عن التحقق الآلي من اكتمال عناصر الاستمارة وسلامة بنيتها التسجيلية.
9.3 إدارة السجلات الأرشيفية المعقدة ومطابقة الأنماط الرقمية
تمثل معالجة السجلات الأرشيفية والأرقام التعريفية المشفرة اختباراً حقيقياً لصرامة دوال البحث النصي؛ فالبيانات الأرشيفية المستقاة من التجارب السلوكية المعملية تتضمن سلاسل شفرية معقدة تجمع بين زمن الاستجابة، ونوع المثير البصري، ودقة الإجابة (مثل: “T12_RT540_CORRECT”). وفي مثل هذه السياقات المختبرية، يتعين عزل زمن الرجع (Reaction Time) الواقع مباشرة بعد المحرفين “RT” وقبل أول شرطة سفلية لاحقة.
تتفوق دالة FIND في هذا السيناريو المعملي نظراً لحاجتنا إلى مطابقة الرمز الكبير “RT” حصراً دون التأثر بأي محارف لاتينية صغيرة قد ترد عرضاً في سياقات أخرى من الملاحظات. تتيح صياغة معادلة محكمة تجمع FIND مع MID تحديد موقع بادئة زمن الرجع والتقاط القيمة الحسابية التالية لها بدقة رياضية متناهية:
=MID(A2, FIND(“_RT”, A2) + 4, FIND(“_”, A2, FIND(“_RT”, A2) + 1) – (FIND(“_RT”, A2) + 4))
يضمن هذا الأسلوب استخراج أزمنة الرجع بدقة ميللي-ثانية دون أي تشويه للأرقام، مما يدعم موثوقية التحليلات التجريبية المتكررة ويحافظ على النزاهة العلمية للبيانات المعملية التي تُبنى عليها الاستنتاجات النظرية الدقيقة في علم النفس المعرفي والإدراكي.
10. الدليل المعياري لاتخاذ القرار: مصفوفة الاختيار بين SEARCH وFIND
10.1 مصفوفة المفاضلة الشاملة وفق طبيعة المهمة ونوعية البيانات
لتيسير مهمة الباحث ومحلل البيانات في اتخاذ القرار البرمجي الأسلم، يوضح الجدول المعياري التالي مقارنة شاملة ومفصلة بين دالتي SEARCH وFIND تغطي كافة المعايير الهيكلية والوظيفية وسيناريوهات التطبيق المثلى:
| المعيار الوظيفي / التقني | دالة FIND | دالة SEARCH |
|---|---|---|
| حساسية حالة الأحرف (Case Sensitivity) | حساسة وصارمة تماماً (تفرق بدقة بين A و a) | غير حساسة ومحايدة تماماً (تساوي بين A و a) |
| دعم أحرف البدل (Wildcards) | غير مدعومة نهائياً (تتعامل مع ? و * كرموز حرفية) | مدعومة بالكامل وبكفاءة عالية (?, *, ~) |
| سرعة المعالجة واستهلاك الذاكرة | أسرع نسبياً وأخف حملاً في البيانات المليونية | تتطلب عمليات فحص إضافية تؤثر طفيفاً على السرعة |
| المخرجات عند النجاح في التطابق | فهرس رقمي لموضع البداية بنظام الفهرسة الأحادية | فهرس رقمي لموضع البداية بنظام الفهرسة الأحادية |
| المخرجات عند الإخفاق أو الخطأ | شفرة الخطأ المرجعية (#VALUE!) | شفرة الخطأ المرجعية (#VALUE!) |
| السيناريو التطبيقي الأمثل والحتمي | الرموز المشفرة الصارمة، المعرفات الحساسة للأحرف، والبحث عن علامات الترقيم بذاتها | تحليل النصوص الحرة غير المنظمة، واستخراج الأنماط المتغيرة، والمسوح الاستبيانية المفتوحة |
10.2 توصيات منهجية لتأمين موثوقية معالجة النصوص وحمايتها من التلف
لضمان حماية قواعد البيانات البحثية من التلف والتآكل المنطقي أثناء معالجة النصوص وتدويرها في بيئة إكسل، يوصى بتبني بروتوكول تدقيق قياسي صارم يقوم على أربعة مرتكزات منهجية أساسية:
- التدقيق الاستكشافي المسبق: إجراء فحص بصري وإحصائي لعينة عشوائية من البيانات للتعرف على مستويات التجانس النصي، وحالة الأحرف، ووجود مسافات خفية أو محارف خاصة غير قياسية قبل كتابة الصيغ الحسابية.
- توحيد الترميز اللغوي (Character Encoding): ضمان حفظ وتصدير ملفات البيانات بصيغة نصية قياسية مدعومة بترميز دولي موحد مثل UTF-8، لتفادي الانهيارات الحسابية الناتجة عن تشوه محارف اللغات التي تستخدم التشكيل أو الرموز الخاصة كاللغة العربية.
- بناء طبقات الدفاع الاستباقية: الامتناع التام عن استخدام SEARCH أو FIND بصورة منفردة ومكشوفة في خطوط الإنتاج النهائية، وتطويقها دائماً بدوال الفحص الوقائي مثل ISNUMBER أو IFERROR لضمان مخرجات واضحة ونظيفة.
- التوثيق الأكاديمي الصارم للمصنفات الحسابية: تدوين كافة المعادلات النصية المستخدمة ومنطق بنائها في ملحق منهجي مرفق بالتقرير البحثي؛ لضمان الشفافية وقابلية التكرار الأكاديمي (Replicability) بما يمكن الباحثين المستقلين من مراجعة خطوات المعالجة والتحقق من سلامتها.
إن الالتزام بهذه الموجهات المعيارية يمنع حدوث الأخطاء الإدراكية والتطبيقية الشائعة في معالجة المعلومات، ويدعم دقة الاستنتاجات العلمية؛ كما يتوازى مع تحذيرات كيرشنر وفان ميرينبوير (Kirschner & van Merriënboer, 2013) حول ضرورة تفنيد المسلمات الحسابية غير المدعومة بالدليل التجريبي، والتحوط المنهجي ضد الأوهام التقنية الشائعة في معالجة البيانات، إلى جانب الإدراك المعرفي لآليات الحماية والتعزيز الذاتي التي فصلها أليكي وسيديكيدس (Alicke & Sedikides, 2009) في مراجعتهم النظرية، والتي تؤكد في سياقنا العملي على أهمية نزاهة أدوات الفحص وتجردها من الانحيازات الإدخالية.
10.3 أفق المعالجة الحديثة: موقع SEARCH وFIND إزاء دوال إكسل المستحدثة
مع التطور المتسارع لمنظومة مايكروسوفت إكسل وتدشين مجموعة حديثة من الدوال النصية الذكية والمتخصصة، مثل TEXTBEFORE وTEXTAFTER وTEXTSPLIT، يتبادر إلى أذهان المشتغلين بالبيانات تساؤل جوهري حول الجدوى المستقبلية لدالتي SEARCH وFIND. لا شك أن هذه الدوال المستحدثة وفرت اختصارات هائلة لاقتطاع وفصل النصوص دون الحاجة لتركيبات MID المعقدة؛ غير أن هذا التطوير لا يلغي الدور المحوري والريادي لدالتي البحث الموضعي التقليديتين، بل يعيد تموضعهما في بنية أكثر تخصصاً واستقراراً.
تظل دالتا SEARCH وFIND الخيار التقني الأمثل والأكثر ثباتاً عند الحاجة إلى استرجاع الإحداثي الحسابي الدقيق (الفهرس الرقمي الصرف) لموضع المقطع، وهو ما لا توفره الدوال الحديثة التي ترجع النص المستقطع مباشرة دون إبانة موقعه الرقمي في المصفوفة. كما تمثل الدالتان الأساس المتين الذي يضمن التوافق الرجعي (Backward Compatibility) للمصنفات عبر كافة إصدارات إكسل التاريخية وأنظمة التشغيل المختلفة، فضلًا عن تطبيقاتها المعرفية والنفسية الحيوية في قياس الفروق الفردية في سرعة الرصد النصي، كما تتناوله الدراسات المنشورة في مجلات علم النفس الرصينة مثل دراسة ستويز (Stoesz, 2016) في دورية Frontiers in Psychology. وعليه، فإن الإتقان العميق للفروق المنطقية بين SEARCH وFIND يظل مهارة حوسبية أساسية وركناً منهجياً راسخاً لكل باحث يسعى للتحكم الكامل في بنيته البيانية، وضمان متانة تدفقاته التحليلية في الحاضر والمستقبل.
خاتمة
ختاماً لهذا العرض التأصيلي، يتضح بجلاء أن التمايز بين دالتي SEARCH وFIND في مايكروسوفت إكسل يتجاوز مجرد التفاصيل التقنية الهامشية؛ إنه يعكس فلسفتين مختلفتين في معالجة البيانات النوعية: فلسفة الصرامة والمطابقة الحرفية المطلقة التي تجسدها دالة FIND، وفلسفة المرونة واستيعاب الأنماط المتغيرة التي تمثلها دالة SEARCH. إن الإحاطة بمفاهيم حساسية الأحرف، وآليات أحرف البدل، وإدارة الأخطاء الوقائية، والتكامل مع دوال الاستقطاع تمثل ترسانة الأدوات الضرورية لأي باحث أو محلل بيانات يطمح إلى تأسيس استدلالاته العلمية على قواعد رقمية صلبة وموثوقة تتوافق مع أعلى المعايير المنهجية العالمية.
المراجع
Alicke, M. D., & Sedikides, C. (2009). Self-enhancement and self-protection: What they are and what they do. European Review of Social Psychology, 20(1), 1–48. https://doi.org/10.1080/10463280802613866
Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods, 41(4), 977–990. https://doi.org/10.3758/brm.41.4.977
Edinger, J. D., Bonnet, M. H., Bootzin, R. R., Doghramji, K., Dorsey, C. M., Espie, C. A., et al. (2004). Derivation of Research Diagnostic Criteria for Insomnia: Report of an American Academy of Sleep Medicine Work Group. SLEEP, 27(8), 1567–1596. https://doi.org/10.1093/sleep/27.8.1567
Kirschner, P. A., & van Merriënboer, J. J. G. (2013). Do Learners Really Know Best? Urban Legends in Education. Educational Psychologist, 48(3), 169–183. https://doi.org/10.1080/00461520.2013.804395
Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin, 131(6), 803–855. https://doi.org/10.1037/0033-2909.131.6.803
Prati, G., & Pietrantoni, L. (2009). Optimism, Social Support, and Coping Strategies As Factors Contributing to Posttraumatic Growth: A Meta-Analysis. Journal of Loss and Trauma, 14(5), 364–388. https://doi.org/10.1080/15325020902724271
Reardon, C. L., Gouttebarge, V., Kroshus, E., Baron, D. A., Bahr, R., Blauwet, C. A., et al. (2019). Mental health in elite athletes: International Olympic Committee consensus statement (2019). British Journal of Sports Medicine, 53(11), 667–699. https://doi.org/10.1136/bjsports-2019-100715
Stoesz, B. M. (2016). Frontiers in Psychology. Frontiers in Psychology. https://doi.org/10.3389/fpsyg
van Ginneken, N., Tharyan, P., Lewin, S. A., Rao, G. N., Meera, S. M., Pian, J., et al. (2013). Non-specialist health worker interventions for the care of mental, neurological and substance-abuse disorders in low- and middle-income countries. Cochrane Database of Systematic Reviews, 2013(11), CD009149. https://doi.org/10.1002/14651858.cd009149.pub2