
تمثل معالجة البيانات النصية وتطهيرها إحدى الركائز الجوهرية في هندسة البيانات وتحليلها داخل بيئات العمل الحاسوبية المختلفة، ولا سيما في برمجيات الجداول الحسابية كبرنامج مايكروسوفت إكسل (Microsoft Excel). فعلى الرغم من أن البرنامج صُمم في أصله لإجراء العمليات الحسابية والمالية المعقدة، إلا أن الواقع العملي في المؤسسات البحثية والأكاديمية والتجارية يفرض التعامل مع كميات هائلة من النصوص والسجلات غير المهيكلة؛ كقوائم الأسماء المركبة، والعناوين الجغرافية، والرموز التعريفية للأجهزة، ومدخلات الاستبيانات الميدانية. وتبرز في هذا السياق معضلة استخراج المقاطع الطرفية من النصوص، وتحديداً عزل الكلمة الأخيرة أو استخراج المحارف الواقعة في أقصى اليمين حتى أول مسافة فاصلة، كإحدى أكثر العمليات طلباً وتحدياً من الناحية الرياضية والمنطقية.
تكتسب هذه العملية أهمية قصوى في مراحل الإعداد الأولي للبيانات (Data Preprocessing)؛ حيث تتطلب النمذجة الإحصائية والتحليل المتقدم تجزئة النصوص المدمجة إلى متغيرات ذرية قابلة للمقارنة والفرز والتصنيف. إن غياب محددات ثابتة للأطوال النصية وتفاوت عدد الكلمات داخل الخلية الواحدة يحول دون استخدام دوال الاقتطاع البسيطة ذات المعاملات الثابتة، مما يستدعي توظيف حلول خوارزمية ذكية تتفاعل مع ديناميكية النص وموقع الفواصل فيه. ومن هنا، تبلورت عبر عقود من استخدام إكسل تقنيات وصيغ قياسية مركبة تجمع بين دوال التكرار والاستبدال والاقتطاع والتطهير لتحقيق هذا المقصد بدقة متناهية.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك هذه المسألة التقنية تفكيكاً بنيوياً معمقاً. وسنتناول بالدراسة التحليلية الصيغة الكلاسيكية العريقة القائمة على مصفوفة الدوال TRIM وRIGHT وSUBSTITUTE وREPT، مروراً بالتطورات الحديثة التي طرأت على محرك إكسل في بيئة مايكروسوفت 365 بإدخال دوال مبتكرة مثل TEXTAFTER، وصولاً إلى استراتيجيات معالجة البيانات الضخمة بواسطة أداة تحويل البيانات Power Query. كما سنستعرض التحديات الهيكلية للمسافات غير المرئية، وآليات تحسين الأداء الحسابي، ومصفوفات اتخاذ القرار الفني التي تضمن تكامل البيانات وموثوقيتها عبر مختلف سيناريوهات العمل الاحترافي.
1. مقدمة نظرية لمعالجة النصوص وسلاسل البيانات في برنامج إكسل
1.1 طبيعة البيانات النصية والتحديات الهيكلية للمسافات الفاصلة
تُعرّف السلاسل النصية (Strings) في علوم الحاسوب وهندسة البرمجيات بأنها متتاليات مرتبة من المحارف (Characters) التي يتم تخزينها في الذاكرة وفق أنظمة ترميز معيارية محددة. في بيئة مايكروسوفت إكسل، تتعامل نواة الحساب مع النصوص ككتل خطية مفهرسة برمجياً تبدأ من المحرف الأول في أقصى اليسار (أو اليمين بحسب اتجاه واجهة المستخدم ولغة الإدخال) وتنتهي بالمحرف الأخير. وتعتبر المسافة الفاصلة (Space)، والتي تمثل في نظام الترميز المعياري للتبادل المعلوماتي رمز الآسكي رقم 32 (ASCII 32)، محرفاً نصياً قائماً بذاته يشغل حيزاً تخزينياً مكافئاً لأي حرف هجائي أو رقمي، وله موقع مفهرس محدد داخل السلسلة.
يكمن التحدي الرياضي الأبرز في معالجة الجداول غير المتجانسة في عدم ثبات مواقع المسافات بين الخلايا المختلفة داخل العمود الواحد. فعلى خلاف الحقول الرقمية ذات الأطوال المعيارية الثابتة، تتسم النصوص بالتباين العشوائي في أطوال كلماتها وترتيب مقاطعها؛ إذ قد تحتوي خلية ما على نص يتألف من كلمتين فقط بمسافة فاصلة واحدة، بينما تحتوي خلية مجاورة في السجل اللاحق على نص من خمس كلمات تتخلله أربع مسافات متباعدة بمواقع متفاوتة. هذا التباين الهيكلي يجعل من المستحيل تطبيق دوال الاقتطاع ذات الإحداثيات المكانية الجامدة لاستخراج المقطع الأخير بمفرده.
تتجلى أهمية التحديد الدقيق للحدود الفاصلة في ضمان تكامل البيانات المستخرجة (Data Integrity)؛ حيث إن أي خطأ في تحديد موقع المسافة الأخيرة يؤدي حتماً إلى بتر الكلمة المستهدفة جزئياً أو جلب أحرف إضافية من الكلمة السابقة لها، مما يقود إلى تلوث قاعدة البيانات. يتطلب هذا التحدي بناء معادلات ديناميكية تتكيف ذاتياً مع الطول الإجمالي للنص وموقع الفراغ الأخير، بحيث تضمن عملية الاقتطاع عزل المقطع النصي الطرفي عزلاً تاماً بصرف النظر عن التغيرات في السجلات النصية السابقة أو اللاحقة داخل المصنف الحسابي.
1.2 الدواعي التحليلية لاستخراج الكلمات والمقاطع الطرفية
تتعدد الدواعي التحليلية والتطبيقية التي تفرض على محللي البيانات والباحثين استخراج المقاطع الطرفية من السلاسل النصية في بيئات الأعمال والدراسات الميدانية. يأتي في مقدمة هذه الدواعي التفكيك المنهجي للأسماء المركبة وقوائم الأفراد لاستخلاص اللقب أو اسم العائلة (Surname/Last Name). ففي العديد من الثقافات والأنظمة الإدارية، يوضع اسم العائلة في نهاية السلسلة الاسمية، وتتطلب معايير الأرشفة، والفرز الأبجدي، والمراسلات الرسمية عزل هذا الاسم في عمود مستقل لإنشاء معرفات موحدة أو إجراء عمليات الربط بين الجداول (Table Joining) استناداً إلى اسم الأسرة.
يمتد هذا الاحتياج إلى قطاعات إدارة سلاسل الإمداد ومستودعات البيانات، حيث تُلحق الرموز التعريفية، وأكواد التصنيع، والأرقام التسلسلية بنهايات الأوصاف النصية للمنتجات. فعلى سبيل المثال، قد يُسجل صنف معين باسم “محرك كهربائي تيار متناوب V450″؛ وتقتضي الضرورة التشغيلية عزل الكود “V450” لإجراء عمليات التسعير التلقائي، أو التحقق من مستويات المخزون، أو مطابقة المواصفات الفنية مع أنظمة تخطيط موارد المؤسسات (ERP). وبالمثل، يُعد عزل الأرقام الواردة في ذيل السجلات المالية والبنكية ركيزة أساسية لتسوية الحسابات ومراجعة المعاملات المؤتمتة.
علاوة على ذلك، يمثل استخراج الكلمات الأخيرة وسيلة لا غنى عنها في تنظيف البيانات الجغرافية وقواعد البيانات الديموغرافية والرياضية غير المنظمة. ففي السجلات التي تدمج اسم المدينة والولاية أو الرمز البريدي في حقل واحد، يشكل عزل المقطع الأخير الخطوة الأولى نحو تطبيع البيانات وتصنيفها إقليمياً. وفي التحليلات الرياضية والتجارية، يتيح استخلاص اللقب الأخير للكيانات أو الفرق الرياضية توحيد المصطلحات وتسهيل عمليات التجميع الإحصائي عبر فترات زمنية متباعدة تعاقبت فيها أنماط مختلفة من التسميات الرسمية.
1.3 معايير التنظيف الأولي للسلاسل النصية قبل المعالجة
تقتضي الرصانة المنهجية في التعامل مع قواعد البيانات الشروع في مرحلة تنظيف تمهيدي صارم للسلاسل النصية الخام قبل إخضاعها لأي معادلات اقتطاع معقدة. تنبع هذه الضرورة من حقيقة أن البيانات المستوردة من مصادر خارجية—مثل ملفات النصوص المفصولة بفواصل (CSV)، أو مخرجات نماذج الويب، أو قواعد البيانات المركزية القديمة—غالباً ما تكون محملة بشوائب نصية وفراغات خفية غير مرئية للعين المجردة تؤدي إلى تشويه المنطق الحسابي لأي خوارزمية اقتطاع لاحقة.
يعد وجود المسافات البادئة (Leading Spaces) أو المسافات الختامية الزائدة (Trailing Spaces) في أقصى أطراف النص من أخطر العوامل المسببة لفشل صيغ الاستخراج الطرفي. فإذا كانت الخلية تنتهي بمسافة فراغية غير مقصودة نشأت عن خطأ في الإدخال البشري، فإن أي صيغة مصممة للاقتطاع من جهة اليمين حتى أول مسافة ستعتبر تلك المسافة الختامية هي الفاصل المستهدف، مما يسفر عن استخراج سلسلة نصية فارغة تماماً بدلاً من الكلمة المطلوبة. ومن ثم، يصبح الفحص الاستباقي والتنظيف المبدئي متطلباً إلزامياً لا غنى عنه لضمان صحة المخرجات التحليلية.
تتضمن استراتيجيات الفحص الاستباقي توحيد أنماط التباعد بين الكلمات باستخدام أدوات المعالجة المنطقية، والتخلص من تكرار المسافات البينية المزدوجة داخل المتن النصي، وإزالة محارف التنسيق غير القابلة للطباعة (Non-printable Characters) مثل فواصل الأسطر والترميزات الخاصة. إن إرساء هذه المعايير وضمان سريانها على كامل نطاق البيانات يقلل من احتمالية حدوث أخطاء غير مبررة أثناء المعالجة، ويوفر بنية نصية قياسية ومستقرة تتيح لدوال الاقتطاع العمل بكفاءة رياضية مطلقة دون الحاجة إلى معالجة استثناءات فردية متكررة.
2. التشريح التركيبي للصيغة القياسية: دمج TRIM وRIGHT وSUBSTITUTE وREPT
2.1 الدور الوظيفي لدالة REPT في مضاعفة الفراغات النصية
ترتكز الصيغة الكلاسيكية الأكثر شهرة واعتمادية في تاريخ برنامج إكسل لاستخراج المقطع الأخير على فكرة هندسية بارعة تتجاوز قصور الدوال التقليدية عن تحديد الفاصل الأخير مباشرة. يقوم هذا الحل العبقري على إنشاء حواشي نصية اصطناعية بالغة الاتساع بين الكلمات، وتلعب دالة REPT الدور المحوري في تنفيذ هذه الخطوة التأسيسية. تُستخدم الدالة لتكرار محرف نصي معين عدداً محدداً من المرات، وبنيتها التركيبية تتحدد في المعادلة التالية:
=REPT(text, number_times)
في سياق الصيغة المركبة، يتم توجيه الدالة لتكرار المسافة الفارغة (” “) بعدد من المرات يعادل عادة الطول الإجمالي للنص الأصلي أو قيمة عددية ثابتة مثل 255. تكمن الفلسفة الرياضية لهذه الخطوة في تفجير المسافات الفاصلة وتحويل كل مسافة مفردة كانت تفصل بين كلمتين إلى صحراء نصية شاسعة تتكون من مئات الفراغات المتتالية. هذا التوسيع المتعمد للبنية النصية لا يغير من الترتيب التسلسلي للمحارف أو الكلمات الأصلية، ولكنه يباعد بينها بمسافات تفوق طول أي كلمة مفردة قد يحتويها النص، وهو الأساس الذي تبنى عليه الخطوات اللاحقة للاقتطاع.
إن تحديد وسيط التكرار ليكون مساوياً لطول السلسلة الأصلية عبر دالة LEN(A1) يضمن بطريقة برمجية ديناميكية أن تكون الحاشية الفراغية المستحدثة أكبر قطعاً من أطول كلمة محتملة في الخلية. هذا الأثر البنائي يضمن عزل المقطع الأخير عزلاً فيزيائياً كاملاً داخل الذاكرة المؤقتة، بحيث تصبح الكلمة الأخيرة محاطة بكتلة ضخمة من الفراغات تفصلها بوضوح عن الكلمة التي تسبقها، مما يمهد الطريق أمام دوال الاقتطاع لاقتناصها بدقة تامة دون أدنى تداخل مع المقاطع المجاورة.
2.2 آلية عمل دالة SUBSTITUTE في استبدال الفواصل الفردية
بمجرد توليد كتلة الفراغات الضخمة بواسطة دالة REPT، يأتي الدور التكتيكي لدالة الاستبدال SUBSTITUTE لإدماج هذه الكتل داخل السلسلة النصية الأصلية. تتمثل الوظيفة الجوهرية لدالة الاستبدال في البحث عن محرف معين أو مقطع نصي واستبداله بمقطع آخر داخل النص المستهدف، وصيغتها القياسية هي:
=SUBSTITUTE(text, old_text, new_text, [instance_num])
في تركيبتنا المعنية، يُترك الوسيط الاختياري الأخير [instance_num] فارغاً، مما يعطي أمراً صريحاً للمحرك باستبدال كل مسافة مفردة أصلية (” “) تظهر في النص بحاشية المسافات المضاعفة الناتجة عن دالة التكرار REPT(" ", LEN(A1)). ينتج عن هذا الإجراء تحول جذري في شكل السلسلة النصية؛ فإذا كان النص الأصلي يتألف من ثلاث كلمات تفصل بينها مسافتان، فإن النص الجديد سيتحول إلى الكلمة الأولى متبوعة بمئات المسافات، ثم الكلمة الثانية متبوعة بمئات المسافات، ثم الكلمة الثالثة والأخيرة.
يحافظ هذا الاستبدال الشامل على الترتيب الهيكلي للسلسلة مع تغيير أبعادها المكانية تغييراً جذرياً. ومن الأهمية بمكان إدراك أن غياب وسيط التكرار المحدد يحول كل نقطة اتصال بين الكلمات إلى حاجز فراغي شاسع وموحد العرض عبر النص بأكمله. هذا التحويل الهيكلي ينقل المشكلة من محاولة رياضية معقدة لحساب موضع المسافة الأخيرة إلى مسألة ميكانيكية بسيطة تتعلق بالاقتطاع من كتلة فراغية معلومة الأبعاد والحجم، مما يسهل عملية استخلاص الطرف الأيمن بسهولة بالغة.
2.3 تقييم نافذة الاقتطاع عبر دالة RIGHT
بعد إعادة هيكلة النص وتوسيع فراغاته الداخلية، تتدخل دالة الاقتطاع من اليمين RIGHT لتنفيذ المهمة الاستخلاصية المباشرة. تعمل هذه الدالة على إرجاع عدد محدد من المحارف بدءاً من المحرف الأخير الواقع في أقصى الطرف الأيمن للسلسلة النصية والتحرك يساراً، وتأخذ البنية التالية:
=RIGHT(text, [num_chars])
في هذه المرحلة من الصيغة، يتم ضبط وسيط عدد المحارف [num_chars] ليكون متطابقاً تماماً مع وسيط التكرار المستخدم في دالة REPT، أي LEN(A1). وهنا يتجلى العبقري في هذا التصميم الرياضي: فنظراً لأننا نستقطع من أقصى اليمين نافذة يبلغ طولها عدداً من المحارف مساوياً لطول النص الأصلي بالكامل، ونظراً لأن المسافة الفاصلة بين الكلمة الأخيرة وسابقتها قد تم تضخيمها لتصبح بهذا الطول نفسه، فإن نافذة الاقتطاع يستحيل منطقياً وفيزيائياً أن تصل إلى أي حرف من أحرف الكلمة السابقة.
تستقر نافذة الاقتطاع الناتجة عن دالة RIGHT في هذه الحالة على بنية محددة بدقة: تتضمن الكلمة الأخيرة المستهدفة كاملة في طرفها الأيمن، وتكون مسبوقة من جهة اليسار بعدد من الفراغات المصطنعة التي استقطعتها الدالة من الحاشية الواسعة. وبذلك نكون قد ضمنا احتواء المقطع المقتطع على كامل حروف الكلمة الأخيرة دون نقص أو تشويه، مع تجنب ابتلاع أي أحرف غريبة من الكلمات السابقة، وتتبقى فقط مهمة التخلص من الفراغات الاصطناعية المصاحبة لتلك الكلمة المستخرجة.
2.4 التطهير النهائي للفراغات باستخدام دالة TRIM
تمثل دالة التطهير TRIM الخاتمة المثالية والضرورية لتشغيل هذه المنظومة الخوارزمية المتكاملة. تختص هذه الدالة في برنامج إكسل بإزالة جميع الفراغات الزائدة من السلسلة النصية؛ حيث تجتث المسافات البادئة والمسافات الختامية اجتثاثاً كاملاً، بينما تختزل المسافات المتعددة الواقعة بين الكلمات إلى مسافة مفردة قياسية. وتتميز الدالة ببساطتها التركيبية؛ إذ لا تتطلب سوى وسيط واحد:
=TRIM(text)
عند تغليف مخرجات دالة RIGHT داخل دالة TRIM، تقوم الأخيرة بفحص السلسلة المقتطعة التي تتكون من مئات الفراغات البادئة المصطنعة متبوعة بالكلمة الأخيرة المستهدفة. وبحكم منطقها البرمجي، تقوم TRIM بحذف كافة تلك الفراغات الزائدة السابقة للكلمة، كاشفة النقاب عن الكلمة الأخيرة وحدها بنقاء تام وبكامل حروفها الأصلية، لتعود السلسلة إلى شكلها الطبيعي النظيف دون أي زيادات تشوه مظهرها أو تؤثر على قيمتها النصية.
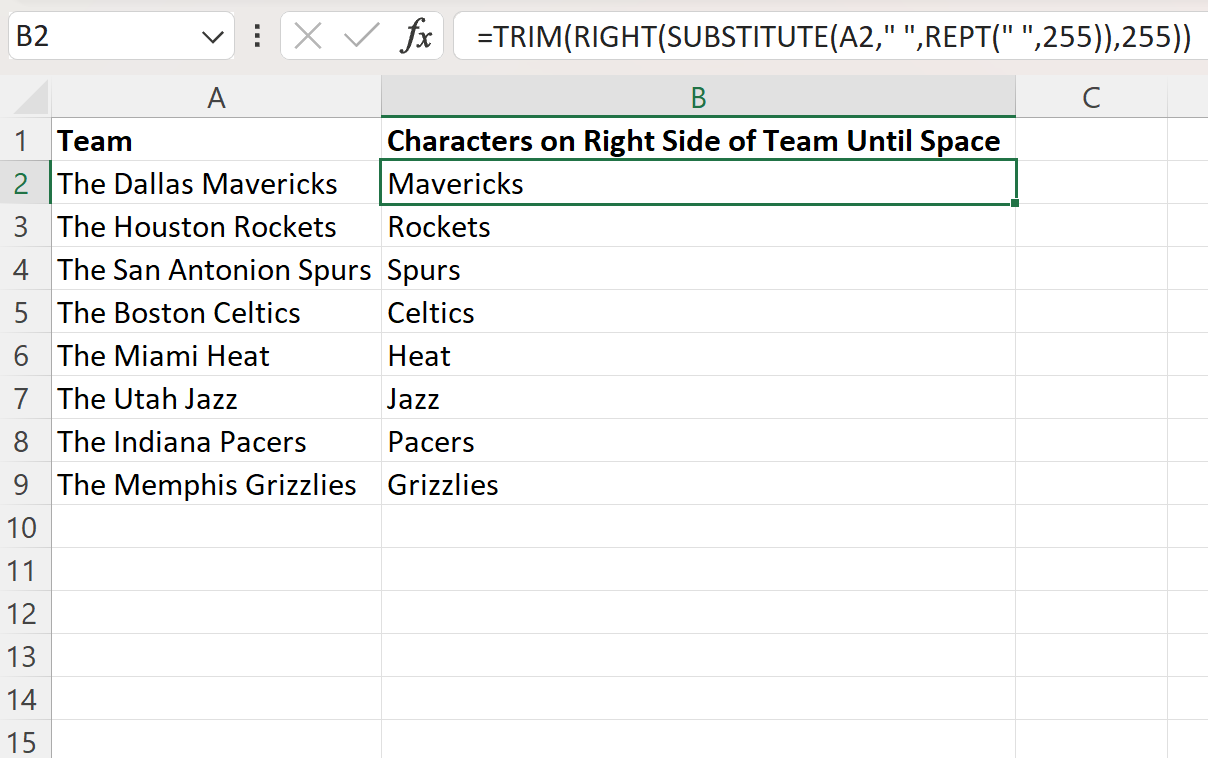
يضمن هذا التطهير النهائي خلو المخرج من أي محارف مسافة قد تعرقل المقارنات المنطقية أو الصيغ البحثية اللاحقة مثل VLOOKUP أو XLOOKUP. وبذلك تكتمل الصيغة القياسية الشاملة في مظهرها النهائي الأكثر شيوعاً وتداولاً بين خبراء البيانات حول العالم:
=TRIM(RIGHT(SUBSTITUTE(A1, " ", REPT(" ", LEN(A1))), LEN(A1)))
وتجسد هذه الصيغة تضافراً هندسياً نموذجياً لأربع دوال أساسية، صُممت كل واحدة منها لأداء وظيفة ميكانيكية جزئية تندمج بسلاسة فائقة لتحقيق هدف تحليلي بالغ الصعوبة والتعقيد.
3. التحليل الرياضي والتسلسلي لخطوات تنفيذ الصيغة المركبة
3.1 المحاكاة البصرية لتدفق البيانات داخل الخلية
لفهم الآلية التشغيلية للصيغة المركبة فهماً حاسوبياً عميقاً، يمكننا إجراء محاكاة تتبعية دقيقة لتدفق البيانات عبر مراحل التقييم اللحظي، تماماً كما يرصدها محرك إكسل عبر نافذة تقييم الصيغة (Evaluate Formula). لنفترض أن الخلية المصدرية A1 تحتوي على النص التالي المكون من تسعة أحرف بما فيها المسافة: “علم البيانات” (Data Science). هنا يبلغ الطول الإجمالي للنص عبر دالة LEN(A1) تسعة محارف، ويوجد فراغ فاصل واحد يتوسط الكلمتين بموقع الإندكس رقم 4.
تبدأ العملية بتنفيذ الجزء الداخلي REPT(" ", 9)، فينشئ المحرك سلسلة تتكون من 9 مسافات فارغة متتالية. ينتقل التنفيذ فوراً إلى دالة الاستبدال: SUBSTITUTE("علم البيانات", " ", " "). في هذه اللحظة، يتحول النص الأصلي إلى الكلمة الأولى “علم” متبوعة بتسع مسافات كاملة ثم الكلمة الثانية “البيانات”. أصبح الطول الإجمالي للنص داخل الذاكرة المؤقتة 17 محرفاً (3 أحرف للكلمة الأولى + 9 مسافات مستحدثة + 8 أحرف للكلمة الثانية بما فيها الألف واللام).
في الخطوة التالية، تتدخل دالة RIGHT(النص_الموسع, 9) لتقتطع آخر 9 محارف من جهة اليمين. تتكون الكلمة الأخيرة “البيانات” من 8 أحرف، وبالتالي فإن اقتطاع 9 محارف سيسفر عن جلب مسافة فراغية واحدة من كتلة التسع مسافات تليها حروف كلمة “البيانات” الثمانية كاملة: ” البيانات”. وأخيراً، تطبق دالة TRIM(" البيانات") لتستأصل تلك المسافة البادئة الوحيدة، ليكون المخرج النهائي المستقر في الخلية هو الكلمة النقية “البيانات” دون نقص أو زيادة، مما يثبت الإحكام الرياضي لهذه الهندسة النصية الذكية.
3.2 الأساس المنطقي لاختيار المعامل العددي 255
يلاحظ المتابع للمنتديات التقنية والأدبيات التاريخية لبرنامج إكسل أن العديد من الخبراء يميلون إلى استبدال الدالة الديناميكية LEN(A1) بمعامل عددي ثابت محدد بالقيمة 255، فتصبح الصيغة على النحو التالي:
=TRIM(RIGHT(SUBSTITUTE(A1, " ", REPT(" ", 255)), 255))
يرجع الأساس المنطقي لاختيار الرقم 255 إلى الجذور التاريخية لعلوم الحاسوب وبنية المعالجات القديمة؛ حيث يمثل الرقم 255 القيمة القصوى التي يمكن تخزينها في بايت فردي واحد (1 Byte يتكون من 8 بت، مما يتيح نطاقاً من 0 إلى 28 ناقص 1، أي 255). في الإصدارات المبكرة جداً من برمجيات الجداول، كان الحد الأقصى لطول السلسلة النصية في الخلية الواحدة يقتصر على 255 محرفاً، مما جعل هذا الرقم بمثابة “القيمة الآمنة المطلقة” التي تغطي أي نص محتمل داخل بيئة البرنامج دون مخاطرة.
تتمثل ميزة استخدام المعامل الثابت 255 في بساطة كتابة الصيغة واختصار وسائطها وتوفير عملية حسابية طفيفة كان المحرك سيجريها لاستخراج طول النص عبر دالة LEN. ومع ذلك، ينطوي هذا النهج التقليدي على مخاطر هيكلية في بيئات العمل الحديثة؛ فإذا تجاوز طول الكلمة الأخيرة المستهدفة 255 محرفاً—وهو أمر وارد في الروابط الإلكترونية الطويلة (URLs) أو المخرجات الجينية المشفرة—فإن دالة الاقتطاع ستبتر الكلمة حتماً. لذا، يجمع علماء البيانات في العصر الحالي على أن الاعتماد على LEN(A1) يمثل الخيار المنهجي الأرصن لكونه يوفر حماية ديناميكية تتكيف آلياً مع طول أي سلسلة نصية مهما بلغت ضخامتها.
3.3 ديناميكية التوسع والانكماش في معالجة السلاسل
تثير هذه التقنية تساؤلاً جوهرياً حول كفاءة استهلاك الذاكرة وسرعة المعالجة الحاسوبية؛ إذ تعتمد في جوهرها على مبدأ التوسيع الهائل للنص الأصلي ثم إعادة تقليصه وانكماشه في جزء ضئيل من الثانية. عندما تحتوي الخلية على نص طويل نسبياً يتألف من 50 كلمة ومئة مسافة فاصلة، فإن استبدال كل مسافة بكتلة من الفراغات يعادل طول النص يؤدي إلى تضخيم السلسلة النصية داخل الذاكرة الوسيطة (RAM Buffer) لتصل إلى آلاف المحارف للحظات معدودة قبل أن تجتث دالة TRIM هذا التضخم المصطنع تماماً.
تتميز خوارزميات إدارة الذاكرة في محرك مايكروسوفت إكسل الحديث بقدرتها الفائقة على التعامل مع هذه العمليات التوسيعية المؤقتة بسرعة خارقة دون التسبب في تسريب للذاكرة (Memory Leaks). فنظراً لأن هذا التوسع محصور داخل نطاق تقييم الخلية المنفردة، يتم تحرير المساحة التخزينية فور اكتمال دورة الحساب وإرجاع القيمة النهائية المصمتة إلى واجهة المستخدم، مما يحافظ على استقرار المصنف وتماسكه.
عند مقارنة هذه الآلية الرياضية بالحلول البرمجية البديلة، مثل الدوال الحلقية المعقدة (Looping Formulas) أو التعليمات البرمجية المكتوبة بلغة الفيجوال بيسك (VBA)، يتضح التفوق الخوارزمي الصريح لهذه الطريقة. فمحرك الدوال المدمجة في إكسل كُتب بلغة سي بلس بلس عالية الأداء، وهو ما يمنح عمليات التبديل والاقتطاع النصية ميزة السرعة الفائقة المعالجة على مستوى النواة، متفوقة على أي كود مخصص قد يعاني من بطء عمليات الترجمة والتكرار عبر آلاف الخلايا والصفوف.
4. التطبيق العملي: دراسات حالة لنصوص فردية ومتعددة المسافات
4.1 استخراج المسميات الرياضية والتجارية (نموذج فرق السلة)
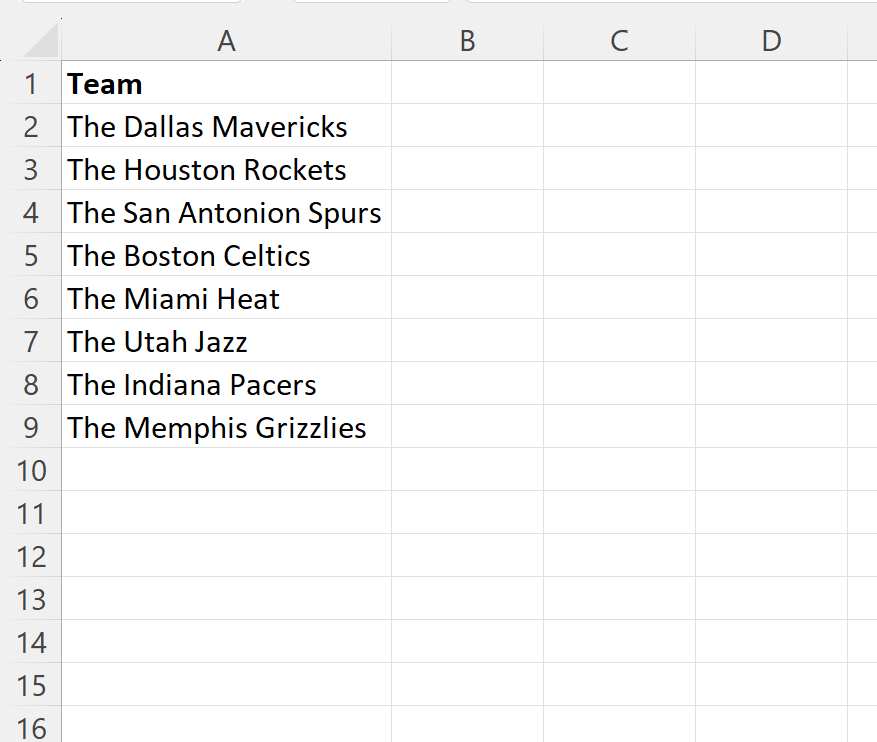
لتطبيق هذه الصيغة تطبيقاً عملياً يبرز قدرتها على مواجهة التحديات الواقعية، نلقي الضوء على معالجة قواعد البيانات الرياضية التي توثق أسماء أندية دوري كرة السلة الأمريكي للمحترفين (NBA). تتسم مسميات هذه الفرق بتركيبة لغوية فريدة تتألف من اسم المدينة أو الولاية متبوعاً باللقب الرسمي للفريق، مع تباين كبير في عدد المسافات الفاصلة بين فريق وآخر، مما يجعلها بيئة اختبار نموذجية لقياس مرونة الحل الرياضي المقترح.
لنتأمل السجلات الثلاثة التالية المدخلة في العمود A:
- الخلية
A2: “Miami Heat” (تتضمن مسافة واحدة واسم الفريق يتألف من مقطع واحد). - الخلية
A3: “The Dallas Mavericks” (تتضمن مسافتين واسم الفريق مسبوق بأداة تعريف). - الخلية
A4: “Portland Trail Blazers” (تتضمن مسافتين واسم الفريق نفسه مركب من كلمتين: Trail Blazers، لكننا نستهدف الكلمة الأخيرة “Blazers”).
عند كتابة الصيغة القياسية في الخلية B2:
=TRIM(RIGHT(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), LEN(A2)))
وتعميمها بسحب مقبض التعبئة التلقائية (Auto-fill handle) على كامل العمود، نلاحظ بدقة استخراج الكلمات: “Heat” للخلية الأولى، و”Mavericks” للخلية الثانية، و”Blazers” للخلية الثالثة. يبرهن هذا النجاح العملي على أن تباين عدد الكلمات السابقة لم يؤثر قيد أنملة على دقة رصد الكلمة الواقعة في أقصى اليمين، حيث استطاعت الحواشي الفراغية الضخمة ابتلاع الفوارق المكانية بين المسافات وحفظت للمحلل استقرار النتائج وموثوقيتها عبر كامل الجدول.
4.2 عزل الأسماء الأخيرة من الهياكل الاسمية المركبة
تمثل إدارة الموارد البشرية وشؤون الطلاب في الجامعات بيئة كلاسيكية تتجلى فيها القيمة التحليلية لهذه التقنية. في هذه السجلات، غالباً ما تُسجل الأسماء بالصيغة الثلاثية أو الرباعية في حقل نصي مدمج مثل: “محمد عبد الله إبراهيم السالم” أو “أحمد حسن خليل”. يكمن التحدي الإداري في الحاجة المستمرة لفرز قوائم الخريجين أو الموظفين وفقاً للقب العائلة الواقع في نهاية الاسم الرباعي أو الثلاثي بشكل مؤتمت بالكامل دون تدخل بشري.
تتكامل صيغتنا الرياضية مع هذا السيناريو بمرونة متناهية؛ فعند تطبيق المعادلة على الاسم “محمد عبد الله إبراهيم السالم”، يتم تضخيم الفراغات الثلاثة الفاصلة بين الأسماء الأربعة، لتقتطع دالة RIGHT مساحة كافية لاحتواء الكلمة الأخيرة فقط، وتتولى TRIM مسح ما تبقى من فراغات، لتستقر النتيجة على اللقب “السالم” دون أي أثر للأسماء الثلاثة الأولى. ويتحقق الأمر عينه مع الاسم الثلاثي “أحمد حسن خليل” لينتج عنه “خليل” بدقة تامة.
بالمقارنة مع أدوات التقسيم التقليدية الثابتة (مثل أداة Text to Columns التي تقسم النص استناداً إلى كل مسافة)، تُجنبنا هذه الصيغة مشكلة تشظي البيانات؛ حيث إن تقسيم الأسماء بالأداة التقليدية يؤدي إلى تناثر الألقاب عبر أعمدة متعددة ومتباينة (العمود الثالث للأسماء الثلاثية والعمود الرابع للأسماء الرباعية)، مما يتطلب عملاً يدوياً مضنياً لإعادة تجميعها. أما صيغة الاستخراج الطرفي المركبة، فتحافظ على تدفق النتائج في عمود موحد ومنتظم جاهز لعمليات الفهرسة والتصنيف المباشر.
4.3 تفكيك عناوين المعرفات الرقمية وسجلات الأجهزة
في البيئات التقنية والهندسية، تتعامل أقسام تقنية المعلومات مع سجلات الأجهزة والشبكات ومحطات العمل، والتي تتبع في العادة أنماطاً دمجية تسرد نوع الجهاز، وطرازه، متبوعاً بمعرف فريد أو رقم منفذ تشغيلي مفصول بمسافة في نهاية السلسلة النصية، مثل: “Server Cluster Alpha Node-04” أو “Cisco Switch Core Gig0/1”. تتطلب عمليات الصيانة والمراقبة البرمجية استخلاص هذا الكود النهائي لعزله وتمريره إلى نصوص برمجية خارجية.
عند تغذية هذه السجلات التقنية في صيغتنا المستعرضة، يتم استخلاص الأكواد “Node-04″ و”Gig0/1” بسلاسة مطلقة. ومما يضفي قيمة مضاعفة على هذه الآلية هو قدرتها على التعامل مع السلاسل النصية التي تدمج الحروف بالأرقام والرموز الخاصة (كالشُّرَط والشرطات المائلة) دون المساس بتركيبتها الداخلية؛ إذ تعامل الدالة هذه المقاطع المركبة ككتلة نصية موحدة طالما أنها لا تحتوي على مسافات بينية تفصل أجزاءها.
إضافة إلى ذلك، تضمن هذه المعالجة عدم تحويل الأكواد المستخرجة تلقائياً إلى صيغ غير مرغوبة؛ فإذا كان المقطع الأخير عبارة عن كود رقمي مثل “00452”، فإن استخراجه عبر دوال النصوص المدمجة يحفظ له الصفر البادئ ويحميه من محاولات إكسل التلقائية لتحويله إلى قيمة عددية مصمتة تمحو الصفر (452)، مما يحافظ على المعنى الدلالي الدقيق للرمز التشغيلي ويمنع تلف السجلات الرقمية الحساسة.
5. معالجة الشواذ النصية والمشكلات الهيكلية في البيانات الخام
5.1 تحييد المسافات غير المرئية ومحارف المسافة غير القابلة للكسر
تتعرض عمليات تنظيف البيانات لإخفاقات متكررة عند التعامل مع السجلات المستخرجة من صفحات الويب (Web Scraping) أو قواعد البيانات المستندة إلى لغة ترميز النص الفائق (HTML). ينشأ هذا الفشل عن حقيقة تقنية مغفلة تتمثل في وجود نوعين مختلفين جوهرياً من الفراغات: المسافة القياسية الناتجة عن لوحة المفاتيح والمسجلة برمز الآسكي CHAR(32)، والمسافة غير القابلة للكسر (Non-Breaking Space) المعروفة في لغة الويب بالرمز وتُخزن برمز الآسكي CHAR(160).
لا تستطيع دالة SUBSTITUTE عند برمجتها للبحث عن المسافة العادية " " رصد مسافة الويب CHAR(160) على الإطلاق؛ لكونهما محرفين منفصلين تماماً في جدول الترميز الثنائي، مما يجعل الصيغة عاجزة عن تضخيم الفراغات وتفشل بالتالي في استخراج الكلمة الأخيرة بالشكل الصحيح. للتغلب على هذه المشكلة الخبيثة، يتحتم إجراء تحصين مسبق للصيغة بدمج دالة استبدال أولية تُحول مسافات الويب إلى مسافات عادية، بالإضافة إلى استخدام دالة CLEAN لإزالة محارف التحكم الخفية غير القابلة للطباعة.
تتم إعادة هندسة الصيغة لتصبح محصنة ضد هذه الشوائب البرمجية عبر التركيب التالي:
=TRIM(RIGHT(SUBSTITUTE(SUBSTITUTE(A1, CHAR(160), " "), " ", REPT(" ", LEN(A1))), LEN(A1)))
يقوم هذا التداخل الوظيفي بالتقاط أي مسافة غير نمطية وتجريدها من ترميزها الخاص وتحويلها إلى مسافة طبيعية تامة التوافق، قبل أن تبدأ دورة التكرار والاستبدال والاقتطاع، مما يضمن تدفق عمليات الاستخراج بنجاح مطلق حتى في أكثر بيئات البيانات تلوثاً وتعقيداً.
5.2 سلوك الصيغة عند انعدام وجود أي مسافة في الخلية الأصلية
من المعايير الصارمة لتقييم رصانة أي صيغة حاسوبية هو قدرتها على معالجة الحالات الحدية (Edge Cases) دون الانهيار أو إرجاع رسائل أخطاء برمجية مشوهة للواجهة (مثل #VALUE! أو #N/A). وتبرز حالة انعدام وجود أي مسافة فاصلة في الخلية الأصلية—بأن تحتوي الخلية على كلمة مفردة واحدة مثل “الرياض” أو رمز مشفر منفرد—كاختبار حقيقي لاستقرار المعادلة المطبقة عبر آلاف الصفوف المتنوعة.
عند تتبع السلوك الرياضي للصيغة في هذا الموقف الاستثنائي، نجد أن دالة SUBSTITUTE تبحث عن مسافة فارغة في النص “الرياض” فلا تجد شيئاً لاستبداله، ومن ثم تعيد النص الأصلي كما هو دون أي تعديل ودون توليد أدنى خطأ. بعد ذلك، تتدخل دالة RIGHT(A1, LEN(A1)) لتقتطع عدداً من المحارف مساوياً لطول النص الأصلي من جهة اليمين، فتحصل بالضرورة على الكلمة كاملة وبطولها الصافي، ثم تمر عبر دالة TRIM لتعود القيمة الأصلية للخلية بنجاح واستقرار مذهل.
يحمل هذا السلوك التلقائي أهمية بالغة لمحللي البيانات؛ إذ يضمن استمرارية معالجة السجلات المختلطة في خطوة واحدة دون الحاجة إلى وضع شروط مسبقة أو بناء صيغ شرطية مرهقة مثل IF(ISNUMBER(SEARCH(...))) للتأكد من وجود مسافة من عدمه. تمنح هذه المرونة المحلل ثقة مطلقة في أن العمود المستخرج سيعيد الكلمة المفردة إن وُجدت وحيدة، أو يستخلص الكلمة الأخيرة إن تعددت الكلمات، دون توقف لتدفق العمل التحليلي.
5.3 معالجة المسافات الطرفية الزائدة وتأثيرها على منطق الاستخراج
تُعد المسافات الختامية الزائدة (Trailing Spaces) المتمركزة في أقصى يمين النص من أخطر عيوب الإدخال البشري غير المنضبط. فإذا كتب المستخدم الاسم “خالد عبد الرحمن ” مع الضغط سهواً على مفتاح المسافة في نهاية الإدخال، فإن هذا الفراغ الختامي يتحول في منطق السلسلة النصية إلى المحرف الأخير الفعلي. وعند تطبيق الصيغة الكلاسيكية المباشرة، ستبحث دالة الاقتطاع عن الفراغ الأخير لتجده في أقصى الطرف الأيمن، فتعتبره الفاصل المستهدف، وينتهي الأمر بالمعادلة إلى إرجاع سلسلة فارغة أو نتائج مشوهة تماماً.
لمواجهة هذا الخلل الهيكلي المتكرر، يقتضي البرتوكول المنهجي تنظيف السلسلة المصدرية من المسافات الهامشية قبل الشروع في أي خطوة أخرى داخل المعادلة. ويتحقق ذلك بإخضاع مرجع الخلية المستهدفة A1 لدالة تطهير داخلية TRIM(A1) في كل موضع يظهر فيه المرجع داخل الصيغة الأساسية، مما ينتج عنه معادلة دفاعية متقدمة قادرة على الصمود أمام أخطاء الإدخال العشوائية.
تتبلور الصيغة الدفاعية المحصنة في الصورة الهندسية التالية:
=TRIM(RIGHT(SUBSTITUTE(TRIM(A1), " ", REPT(" ", LEN(TRIM(A1)))), LEN(TRIM(A1))))
من خلال هذا التدخل الاستباقي، يتم تجريد النص من أي مسافات زائدة في بدايته أو نهايته لحظياً قبل بدء عمليات التوسيع والاقتطاع، مما يضمن أن تكون المسافة المستهدفة هي الفاصلة الحقيقية بين الكلمتين الأخيرتين، ويحمي التحليل الإحصائي من التشوهات الناتجة عن الأخطاء المطبعية العفوية.
6. المقارنة المنهجية مع دوال النصوص الحديثة في Microsoft 365
6.1 استخدام دالة TEXTAFTER بمثابة البديل المعاصر المباشر
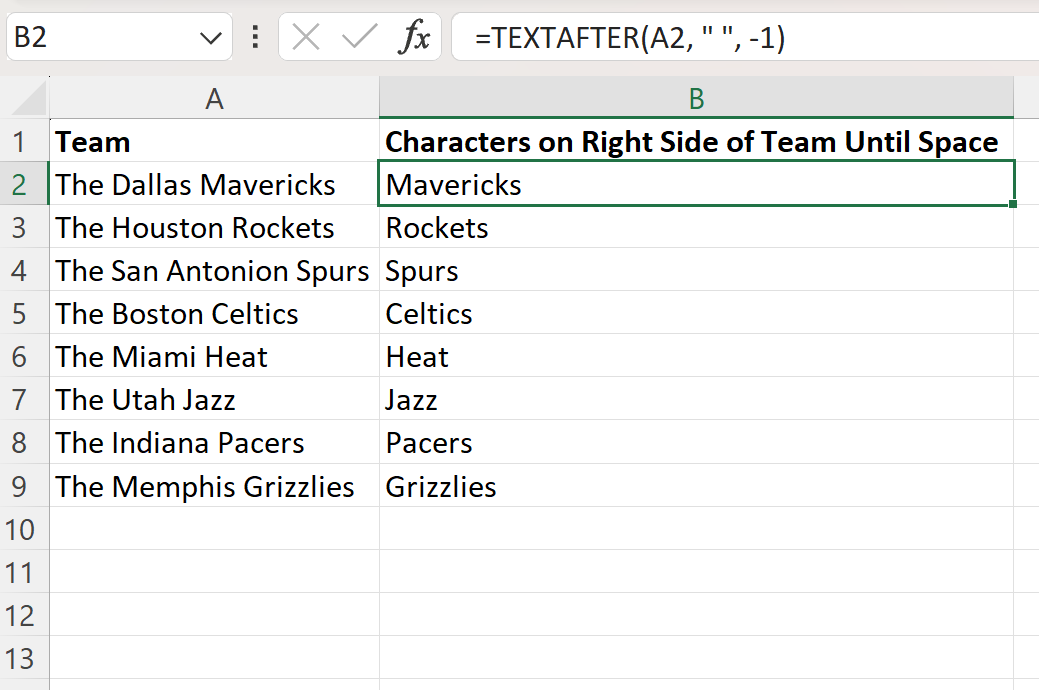
شهدت منظومة برمجيات مايكروسوفت إكسل تحولاً جذرياً في مارس 2022 عندما أعلن جو ماكديد (Joe McDaid) من فريق هندسة إكسل عن إطلاق حزمة متطورة من دوال معالجة النصوص في قنوات التحديث لمشتركي Microsoft 365. وكان في صدارة هذه الثورة البرمجية دالة TEXTAFTER، التي صُممت خصيصاً للقضاء على التعقيد التركيبي للصيغ القديمة وتقديم حل مباشر وأنيق لمسألة استخراج المقاطع النصية المحصورة بعد محددات معينة.
تتحدد البنية التركيبية لدالة TEXTAFTER بالصيغة التالية:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
ويكمن المفتاح العبقري في هذه الدالة في وسيطها الثالث [instance_num]؛ حيث يتيح للمستخدم تمرير قيمة سالبة. فعند تزويد الدالة بالمعامل السلبي -1، يتلقى محرك البحث أمراً برمجياً صريحاً بالبدء في مسح السلسلة النصية من أقصى اليمين نحو اليسار، والتقاط أول مسافة يواجهها والرجوع بكافة المحارف الواقعة بعدها مباشرة. وبذلك تختزل الصيغة الأسطورية الرباعية القديمة في معادلة مقتضبة وبديهية للغاية:
=TEXTAFTER(A1, " ", -1)
ترفع هذه الدالة الحديثة من مستويات المقروئية (Readability) والصيانة الهندسية للنصوص البرمجية داخل المصنفات المالية والتحليلية. فبدلاً من تفكيك معادلة تحتوي على أربع دوال متداخلة يصعب على المحللين المبتدئين استيعاب مسارها المنطقي، تقدم TEXTAFTER حلاً صريحاً يعلن عن هدفه الوظيفي بوضوح، مما يقلل بشكل ملموس من زمن المراجعة والتدقيق ويوفر بيئة عمل تتسم بالسلاسة والاحترافية المعاصرة.
6.2 توظيف دالتي TEXTSPLIT وCHOOSEROWS في المعالجة المصفوفية
لم تتوقف الابتكارات الحديثة عند حدود دالة TEXTAFTER، بل امتدت لتشمل بيئة المعالجة المصفوفية الديناميكية (Dynamic Arrays) عبر دمج دالتي TEXTSPLIT وCHOOSEROWS (أو دالة TAKE). تتيح دالة TEXTSPLIT تفكيك السلسلة النصية بالكامل إلى أجزاء ذرية بناءً على محدد المسافة، وتحويلها إلى مصفوفة خطية عمودية أو أفقية تتدفق بسلاسة داخل ذاكرة الحساب.
لاستخراج الكلمة الأخيرة باستخدام هذه التقنية المصفوفية، يمكن صياغة المعادلة بطريقتين؛ الأولى بالاعتماد على دالة TAKE لاقتطاع العنصر الأخير:
=TAKE(TEXTSPLIT(A1, " "), , -1)
أو استخدام دالة CHOOSEROWS في حال تقسيم النص إلى صفوف عمودية:
=CHOOSECOLS(TEXTSPLIT(A1, " "), -1)
تتعامل هذه الصياغة مع النص ككيان متجهي، حيث تقوم الدالة بتقسيم العبارة “جامعة الملك سعود” إلى مصفوفة من ثلاثة عناصر: {“جامعة”، “الملك”، “سعود”}، ثم يتدخل المؤشر السلبي -1 ليلتقط العنصر الأخير مباشرة من المتجه.
وعلى الرغم من الأناقة البرمجية لهذا النهج، يقتضي التحليل الأكاديمي التنبيه إلى أن استخدام الدوال المصفوفية لتفكيك ملايين الخلايا قد يفرض عبئاً طفيفاً على استهلاك الذاكرة المخصصة لإدارة المصفوفات الديناميكية مقارنة بدالة TEXTAFTER التي تكتفي بالمسح الاتجاهي دون الحاجة إلى تشييد كائنات مصفوفية متكاملة في الذاكرة الوسيطة، مما يجعل TEXTAFTER الخيار الأرجح في بيئات الحوسبة المكثفة.
6.3 معايير التوافقية وقابلية التشغيل البيني بين الإصدارات
تفرض بيئات الأعمال المؤسسية المتعددة الأطراف قيوداً صارمة على اعتماد الدوال الحديثة؛ حيث لا تزال العديد من الشركات، والمؤسسات الحكومية، والجهات الأكاديمية تعتمد على إصدارات دائمة الترخيص مثل Excel 2016 وExcel 2019 وحتى Excel 2021 التي تفتقر تماماً لدوال النصوص الحديثة كـ TEXTAFTER وTEXTSPLIT. وتعتبر مسألة التوافقية العكسية (Backward Compatibility) عاملاً حاسماً يحكم قرار المهندس المالي أو محلل البيانات عند كتابة النماذج المشتركة.
إذا قام المحلل ببناء نموذج تحليلي يعتمد على دالة TEXTAFTER(A1, " ", -1) ثم أرسل المصنف إلى شريك عمل يستخدم إصداراً قديماً من إكسل، فسيواجه المتلقي انهياراً كاملاً في النتائج وظهور رسالة الخطأ الشهيرة #NAME?، مما يعني عجز البرنامج عن التعرف على الدالة وفشل العمليات الحسابية المرتبطة بها بالكامل. هذا الخطر التشغيلي يجعل من التمسك بالصيغة الكلاسيكية القائمة على TRIM وRIGHT وSUBSTITUTE وREPT ضرورة استراتيجية في مشاريع البيانات ذات النطاق الواسع أو المشتركة بين كيانات متعددة.
يقودنا هذا الواقع إلى ضرورة تبني استراتيجية توافق مزدوجة: فإذا كان المصنف مخصصاً لبيئة عمل سحابية موحدة وتحت مظلة Microsoft 365 حصرية، فإن TEXTAFTER تمثل الحل الأمثل بلا منازع؛ أما إذا كان المصنف قابلاً للتداول الخارجي أو يُنشر كأداة عامة للمستخدمين، فإن الصيغة الكلاسيكية تظل الدرع الواقي والضمانة المطلقة للتشغيل البيني المستقر دون مفاجآت تقنية معطلة للإنتاج.
7. الحلول البديلة المتقدمة: أداة Power Query وتقنية الفلاش فيل (Flash Fill)
7.1 الاستخراج التلقائي التكيفي عبر التعبئة السريعة (Flash Fill)
تعتبر ميزة التعبئة السريعة (Flash Fill)، التي أطلقتها مايكروسوفت لأول مرة في إصدار Excel 2013، إحدى أكثر الأدوات ثورية وسرعة في استخراج البيانات دون كتابة سطر واحد من الصيغ الحسابية. تعتمد هذه التقنية على خوارزميات الاستدلال النمطي والذكاء الاصطناعي الاستقرائي (Programming by Example)؛ حيث يقوم المستخدم بإدخال المخرج المستهدف يدوياً في الخلية الأولى بجوار العمود المصدر، لتقوم الأداة بتخمين القاعدة المنطقية تلقائياً وتطبيقها على كامل العمود بالضغط على مفتاحي Ctrl + E.
تتجلى الميزة اللحظية للتعبئة السريعة في إنقاذ المحلل من العبء المعرفي المصاحب لتركيب الصيغ المعقدة عندما تكون المهمة عاجلة وتتعلق بتنظيف سجلات لمرة واحدة فقط (One-off task). بمجرد كتابة الكلمة الأخيرة من أول سجل وضغط اختصار التشغيل، يملأ إكسل آلاف الصفوف بلمح البصر، مستنبطاً رغبة المحلل في عزل الكلمة الختامية ببراعة فائقة وتكيف مدهش مع مختلف أطوال النصوص.
ومع ذلك، تواجه التعبئة السريعة مآخذ علمية حاسمة تمنع اعتمادها في النماذج المؤسسية المستدامة؛ فالقيم الناتجة عنها قيم نصية ثابتة ومصمتة (Static Values) تفتقر تماماً إلى خاصية الديناميكية والتحديث التلقائي. فإذا تغير النص في الخلية المصدرية الأصلية لاحقاً، لن يطرأ أي تغيير على الخلية المستخرجة، مما يخلق فجوة في تكامل البيانات ويفتح الباب للأخطاء الصامتة الكارثية. ومن ثم، يجب حصر استخدام الفلاش فيل في مهام التنقيب الاستكشافي السريع والمعالجات الفردية المؤقتة.
7.2 تفكيك النصوص بواسطة محول البيانات Power Query
تمثل بيئة أداة تحويل وتجهيز البيانات المتطورة Power Query (المعروفة بـ Get & Transform) الخيار الصناعي الأقوى لإجراء المعالجات الحجمية الضخمة واستخراج النصوص من ملايين السجلات بكفاءة تامة ودون إرهاق شبكة الخلايا بالمعادلات الثقيلة. تتيح هذه البيئة بناء تدفقات عمل تنظيف مؤتمتة وقابلة للتكرار بضغطة زر واحدة (Refreshable ETL Pipelines).
لتحقيق هدف استخراج الكلمة الأخيرة داخل واجهة محرر Power Query، يمكن اتباع تسلسل قياسي مباشر:
- تحديد العمود المستهدف ثم الانتقال إلى تبويب Transform أو Add Column.
- اختيار أداة Split Column ثم النقر على خيار By Delimiter.
- تحديد المسافة (Space) كمحدد فاصل، وتفعيل الخيار الاستراتيجي المتقدم: Right-most delimiter (المحدد الموجود في أقصى اليمين).
يؤدي هذا الإجراء الذكي إلى تقسيم النص إلى عمودين فقط عند آخر مسافة تظهر في السلسلة، بحيث يحتوي العمود الجديد المستحدث على الكلمة الأخيرة المطلوبة حصراً وبشكل آلي منظم. وتكمن الميزة التشغيلية الكبرى لهذه الأداة في تحويل خطوات التنظيف إلى مسار عمل مبرمج ومحفوظ ومستقل عن طبقة العرض في إكسل، مما يتيح تحديث مصفوفات البيانات الكبرى باستمرار عند تدفق بيانات جديدة دون المساس بالصيغ الحسابية أو التسبب في تباطؤ تجاوب أوراق العمل.
7.3 بناء تعبيرات مخصصة بلغة M لاستخراج الأطراف النصية
للمحترفين الساعين وراء التحكم البرمجي المطلق داخل Power Query، توفر لغة الصيغ التأسيسية المدمجة (M Code) مكتبة غنية من الدوال لمعالجة السلاسل النصية مباشرة عبر إنشاء أعمدة مخصصة (Custom Columns). بدلاً من الاعتماد الكلي على الواجهة الرسومية للأداة، يمكن كتابة تعبير خوارزمي دقيق يوظف دالتي Text.Split وList.Last في خطوة برمجية ذرية واحدة.
تتمثل الصيغة المكتوبة بلغة M في محرر الأعمدة المخصصة كما يلي:
List.Last(Text.Split([ColumnName], " "))
تعمل دالة Text.Split على تفكيك النص في كل سطر إلى قائمة (List) برمجية بناءً على محدد المسافة، ثم تتولى دالة List.Last التقاط العنصر الأخير من تلك القائمة وإرجاعه كقيمة نهائية للخلية في العمود الجديد. يتميز هذا التعبير بأنه يتعامل تلقائياً وبأناقة مطلقة مع الحالات التي تحتوي فيها الخلية على كلمة وحيدة؛ حيث تعيد Text.Split قائمة بعنصر واحد، وتلتقطه List.Last دون أي خطأ برمجي.
تتفوق هذه المعالجة البرمجية بلغة M من حيث الكفاءة الحسابية عند معالجة الجداول المتضخمة التي تضم ملايين السجلات المستوردة؛ حيث يتم استهلاك موارد المعالج وذاكرة الوصول العشوائي بكفاءة هيكلية متطورة ضمن محرك الماش أب (Mashup Engine)، متفوقة على أداء شبكة خلايا إكسل الاعتيادية ومحققة استقراراً مثالياً لتقارير ذكاء الأعمال المتقدمة.
8. تحليل الأخطاء الشائعة وحلول استكشاف الأعطال وإصلاحها
8.1 مشكلة بتر الكلمات الطويلة التي تتجاوز قيمة المعامل المحدد
تعتبر ظاهرة بتر الكلمات الطويلة (String Truncation) من أكثر العيوب الشائعة والخفية التي تظهر عند الاعتماد على الصيغة الكلاسيكية المكتوبة بمعامل عددي ثابت مثل 255. تحدث هذه المشكلة عندما يتجاوز طول المقطع النصي الأخير المستهدف هذا الحد الرقمي، أو في الحالات التي يتم فيها تحديد معامل تعسفي صغير كأن يكتب المستخدم 50 أو 100 لتسريع العملية ظناً منه أن الكلمات لن تتجاوز هذا الطول أبداً.
إذا احتوت الخلية على مسار لملف رقمي طويل أو رابط إنترنت يتجاوز 300 محرف في طرفه الأيمن دون مسافات، فإن نافذة الاقتطاع المحددة بـ 255 حرفاً عبر دالة RIGHT ستقتطع المحارف الـ 255 الأخيرة فقط، متخلية عن الجزء الأيسر من الكود أو الرابط، مما يؤدي إلى خروج بيانات مشوهة وغير صالحة للاستخدام دون أن يطلق إكسل أي تحذير بوجود خطأ حسابي.
يكمن العلاج الجذري والوحيد لهذه المعضلة في التطوير التكيفي للمعادلة من خلال دمج دالة LEN لتوليد معامل ديناميكي يعكس بدقة متناهية حجم السلسلة المعالجة في كل سطر على حدة. تصبح الصيغة التكيفية المقاومة للبتر كما يلي:
=TRIM(RIGHT(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), LEN(A2)))
في هذا التركيب المتطور، يتسع حجم حاشية الفراغات المستحدثة وحجم نافذة الاقتطاع تلقائياً ليعادل طول السجل الإجمالي، مما يجعل وقوع خطأ البتر مستحيلاً هندسياً ورياضياً مهما تضخمت أطوال الكلمات المستخرجة.
8.2 التداخل بين علامات الترقيم والأحرف في الكلمة الأخيرة
من المشكلات الهيكلية المعقدة في معالجة النصوص الأدبية والاستطلاعات الميدانية تداخل علامات الترقيم (Punctuation Marks) كالنقطة (.) والفواصل (,) وعلامات التعجب والاستفهام مع الكلمة الأخيرة في الجملة نتيجة عدم وجود مسافة عازلة تفصلها عن المحرف الأخير، مثل: “انتهى المشروع بنجاح.” حيث تلتصق النقطة بكلمة “بنجاح” مباشرة.
عند تشغيل صيغة الاستخراج، تعتبر الدوال المقطع “بنجاح.” كلمة واحدة لعدم وجود فاصل فراغي، وتستخرجه حاملاً النقطة الختامية في ذيله. يشوه هذا التداخل التحليلات الإحصائية، كأن يقوم برنامج التحليل بالتعامل مع الكلمة “بنجاح.” على أنها مدخل مختلف تماماً عن الكلمة “بنجاح” النقية، مما يفسد نتائج التكرارات وجداول التوزيع التكراري.
لحل هذه المعضلة وتطهير المخرجات من الشوائب الترقيمية، يتعين دمج دوال تنظيف إضافية عبر استبدال علامات الترقيم الشائعة قبل الاقتطاع أو تجريدها لاحقاً. ويمكن بناء صيغة متقدمة تعقم النص المستخرج عبر استبدال النقطة الختامية بسلسلة فارغة:
=SUBSTITUTE(TRIM(RIGHT(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), LEN(A2))), ".", "")
كما يمكن التوسع في هذه الصياغة لتشمل مصفوفة من علامات الترقيم لضمان نقاء المخرج وخلوه التام من الرموز العشوائية التي تشوش النماذج الإحصائية وتحليلات التعدين النصي.
8.3 أخطاء تثبيت مراجع الخلايا وانزلاق النطاقات عند السحب
ينزلق العديد من الممارسين المبتدئين في أخطاء فنية تتعلق بكيفية تثبيت مراجع الخلايا (Cell References) عند كتابة الصيغ وسحبها رأسياً عبر الأعمدة. تتطلب معادلتنا المركبة مرونة تامة في الانتقال بين الصفوف لمتابعة كل سجل على انفراد، مما يستوجب استخدام المراجع النسبية الدقيقة (Relative References) مثل A2 بدلاً من المراجع المطلقة (Absolute References) المزودة بعلامات الدولار مثل $A$2.
إذا قام المستخدم سهواً بتثبيت الصف عبر كتابة $A$2 داخل الصيغة في الخلية B2، ثم سحب مقبض التعبئة حتى الصف الألف، فإن كافة الخلايا الناتجة ستكرر استخراج الكلمة الأخيرة من الخلية A2 وحدها دون الالتفات لمحتوى الصفوف المناظرة لها، وهو ما يمثل خطأ فادحاً في إدارة البيانات يسهل تفاديه بالانتباه لطبيعة المراجع أثناء الصياغة الأولية.
لتجنب هذه الانزلاقات، يُنصح دائماً بتحويل نطاق البيانات إلى “جدول إكسل منظم” (Excel Table بالضغط على Ctrl + T)؛ حيث يتيح الجدول استخدام المراجع الهيكلية الذكية (Structured References) مثل [@ColumnName]. وتتجلى الصيغة داخل الجدول بهذه الصورة الاحترافية الواضحة:
=TRIM(RIGHT(SUBSTITUTE([@FullText], " ", REPT(" ", LEN([@FullText]))), LEN([@FullText])))
يضمن هذا الأسلوب تطبيق المعادلة آلياً على كامل العمود وعلى أي سجلات جديدة تُضاف مستقبلاً إلى نهاية الجدول مع صيانة تامة لسلامة المراجع وعدم انزلاقها مطلقاً.
9. تحسين الكفاءة الحسابية وتقليل العبء الإدراكي لمحلل البيانات
9.1 تأثير بنية الصيغ الحسابية على العبء المعرفي وسرعة المراجعة
تؤكد أدبيات هندسة البرمجيات والتصميم المؤسسي على أن قابلية صيانة الكود وتدقيقه ترتبط ارتباطاً وثيقاً بمدى بساطته وانخفاض العبء المعرفي (Cognitive Load) الملقى على عاتق المراجع البشري. ففي البيئات المالية والمصرفية الصارمة، لا يُكتفى بصحة النتائج الرقمية فحسب، بل يجب أن تكون مسارات استخراج البيانات واضحة ويسهل تدقيقها من قِبل مدققي الحسابات وأعضاء الفريق الآخرين دون الحاجة لفك شفرات معادلات معقدة وسريالية التكوين.
تشكل الصيغة الكلاسيكية الرباعية المركبة تحدياً إدراكياً حقيقياً للمحللين غير المتمرسين في أعماق إكسل؛ إذ تتطلب فهماً تجريدياً لكيفية تفاعل الحواشي الفراغية وتضخيمها واقتطاعها، مما قد يثير الشكوك حول سلامتها الرياضية أثناء جلسات التدقيق الخارجي. في المقابل، يمثل الانتقال نحو الدوال الحديثة كـ TEXTAFTER أو استخدام الأسماء المعرفة (Named Formulas) خطوة جوهرية لتخفيض هذا العبء وتحسين بيئة العمل التحليلية.
تقتضي الممارسة المهنية الرصينة إرفاق توثيق منهجي موجز داخل ورقة العمل (Documentation Sheet) أو إضافة تعليق توضيحي على ترويسة العمود يشرح المنطق الرياضي المتبع لاستخراج الكلمات، مع توضيح سبب اختيار تلك الصيغة المحددة ومواءمتها مع متطلبات التوافقية المؤسسية، مما يرفع من شفافية النموذج ويبني ثقة متبادلة بين فرق العمل المختلفة.
9.2 كفاءة إعادة الاحتساب في الجداول الكبيرة ومصفوفات البيانات الضخمة
عندما تتسع رقعة البيانات لتصل إلى مئات الآلاف أو ملايين الصفوف في مصنفات العمل الحسابية، تصبح الكفاءة الخوارزمية وسرعة إعادة الاحتساب (Recalculation Speed) العامل الحاسم في تحديد نجاح النموذج أو فشله التشغيلي. فالصيغ التي تستخدم دوالاً تتطلب تخصيصاً مكثفاً للسلاسل النصية في الذاكرة الوسيطة مثل SUBSTITUTE مع REPT قد تسفر عن تباطؤ ملحوظ وتجميد مؤقت للواجهة عند كل عملية إدخال أو تعديل في المصنف.
يرجع سبب هذا العبء الحسابي إلى أن المحرك يضطر مع كل دورة احتساب إلى تخصيص مساحات جديدة في الذاكرة لتخزين النصوص الموسعة، ومعالجة ملايين الفراغات الافتراضية، ثم استدعاء دوال الحذف والتطهير، مما يرهق المعالج المركزي (CPU) ويزيد من وقت تشغيل المصنف. في مثل هذه الظروف الحجمية القاسية، تتفوق دالة TEXTAFTER تفوقاً ساحقاً؛ لكونها مبرمجة برمجياً للبحث المباشر والمسح السريع للأحرف وصولاً للفاصل المطلوب دون أي تضخيم أو تلاعب مكلف بأبعاد السلسلة النصية.
لتحسين أداء المصنفات الضخمة التي تفرض ظروف العمل فيها التمسك بالصيغ الكلاسيكية، يُنصح بتعطيل ميزة الحساب التلقائي وتحويلها إلى الحساب اليدوي (Manual Calculation) أثناء عمليات الإدخال والاستيراد، أو اللجوء إلى خيار تثبيت القيم وتحويل الأعمدة المحسوبة إلى نصوص صامتة بعد اكتمال الاستخراج عبر النسخ ولصق القيم (Paste as Values)، مما يحرر موارد النظام ويحفظ للمصنف سرعته وانسيابيته العالية.
9.3 إنشاء دوال مخصصة قابلة لإعادة الاستخدام عبر دالة LAMBDA
قدمت مايكروسوفت لمجتمع محللي البيانات إحدى أقوى أدوات التجريد الرياضي في تاريخ الجداول الحسابية من خلال دالة LAMBDA، والتي تسمح للمستخدمين بتصميم وبناء دوال مخصصة تماماً (Custom Reusable Functions) وتسميتها بأسماء دلالية واضحة دون الحاجة لكتابة كود VBA أو إتقان لغات البرمجة الخارجية.
يمكننا الاستفادة القصوى من دالة LAMBDA لتغليف المعادلة الكلاسيكية المعقدة وتحويلها إلى دالة أنيقة وبسيطة تحمل اسماً معبراً مثل ExtractLastWord. يتم ذلك بالانتقال إلى مدير الأسماء (Name Manager) وتعريف اسم جديد بالقيمة التالية:
=LAMBDA(text_input, TRIM(RIGHT(SUBSTITUTE(text_input, " ", REPT(" ", LEN(text_input))), LEN(text_input))))
بمجرد حفظ هذا التعريف داخل المصنف، تختفي الصيغة المعقدة تماماً من شبكة الخلايا، ويصبح بإمكان المحلل استدعاء الدالة المخصصة في أي مكان داخل الجدول تماماً كأي دالة مدمجة في إكسل وبمنتهى البساطة والوضوح:
=ExtractLastWord(A2)
يحقق هذا النهج قفزة نوعية في المعمارية التقنية للنماذج الحسابية؛ حيث يعزل المنطق المعقد في بيئة مركزية واحدة يسهل تعديلها وصيانتها وتطويرها لاحقاً دون الحاجة للمرور على مئات الخلايا في أوراق العمل، مما يمنح النماذج مظهراً برمجياً احترافياً يرتقي بمستوى العمل التحليلي المؤسسي إلى أرقى المعايير العالمية.
10. التوصيات المنهجية ودليل اتخاذ القرار لمعالجة السلاسل النصية
10.1 مصفوفة المفاضلة بين الحلول التلقائية واليدوية والمبرمجة
تتطلب الإدارة الرشيدة لمشاريع تحليل البيانات اتباع دليل علمي منهجي لاتخاذ القرار التقني الصائب عند اختيار الأداة المثالية لاستخراج الكلمات والمقاطع الطرفية. فالخيارات المتعددة—بين الدوال الكلاسيكية، والدوال الحديثة، وأداة Power Query، والتعبئة السريعة—ليست حلولاً متنافسة بقدر ما هي أدوات متكاملة تتفاوت جدواها بحسب حجم البيانات، وديناميكية التحديث، والبيئة التشغيلية المشتركة.
تتجسد مصفوفة المفاضلة في المعايير الأساسية التالية:
- التعبئة السريعة (Flash Fill): تُعتمد حصرياً في التحليلات الاستكشافية السريعة والمهام الفردية المؤقتة التي لا تتطلب تحديثاً تلقائياً لمخرجاتها مستقبلاً.
- دالة TEXTAFTER الحديثة: تمثل الخيار الأول والمطلق عندما تكون بيئة العمل بالكامل مدارة عبر اشتراكات Microsoft 365 أو Excel على الويب مع الرغبة في صياغة أنيقة وسريعة.
- الصيغة الكلاسيكية (TRIM + RIGHT + SUBSTITUTE + REPT): الحل الإلزامي عند بناء نماذج تشغيلية عامة أو مالية حساسة تشترك في استخدامها جهات متعددة تتباين فيها إصدارات إكسل.
- محول البيانات Power Query: الخيار الصناعي الأوحد عند معالجة ملفات وقواعد بيانات ضخمة تتجاوز مئات الآلاف من السجلات وتتطلب خطوط معالجة وتطهير مؤتمتة ومستدامة.
إن تبني هذه المصفوفة يحمي المنظمة من الارتجال التقني ويضمن استغلال الموارد الحاسوبية بأقصى كفاءة ممكنة بما يتناسب مع متطلبات كل مهمة ومحدداتها المؤسسية.
10.2 بروتوكول التحقق من جودة وموثوقية البيانات المستخرجة
لا تنتهي مهمة محلل البيانات باستخراج المقاطع النصية وحسب، بل تكتمل بتطبيق بروتوكول تدقيق وتحقق صارم لضمان خلو المخرجات من أي تشوهات أو فراغات خفية قد تفسد نتائج التحليلات اللاحقة. يتضمن هذا البروتوكول إنشاء أعمدة اختبار منطقية متزامنة (Audit Columns) تقوم بفحص السجلات ومقارنة المخرجات بالمواصفات الفنية المعتمدة.
يشتمل بروتوكول التحقق على ثلاث خطوات فحص أساسية:
- فحص الفراغات المتبقية: التأكد من أن الكلمة المستخرجة لا تتضمن أي مسافات داخلية أو هامشية عبر استخدام شرط منطقي:
=ISERROR(FIND(" ", B2))، والذي يجب أن يعيد القيمةTRUEلجميع السجلات. - التحقق من الأطوال المفرطة: فحص طول السلسلة الناتجة عبر دالة
LEN(B2)للتأكد من أنها تقع ضمن الحدود المنطقية للكلمات ولا تتضمن جملاً كاملة مقتطعة نتيجة خطأ في تحديد المسافة. - المطابقة العكسية: التأكد من أن الكلمة المستخرجة تتطابق تماماً مع ذيل النص الأصلي باستخدام دالة الاقتطاع المباشر
=RIGHT(A2, LEN(B2)) = B2.
كما يُنصح بتطبيق قواعد التنسيق الشرطي (Conditional Formatting) لتمييز الخلايا الشاذة أو الفارغة بألوان تحذيرية تسترعي الانتباه الفوري للمراجع، مما يسهم في اكتشاف الأخطاء ومعالجتها استباقياً قبل رفع التقارير النهائية لمتخذي القرار.
10.3 خارطة طريق لتطوير مهارات التلاعب بالنصوص في بيئات الأعمال الحديثة
إن إتقان عملية استخراج الأحرف من اليمين حتى المسافة الفاصلة في برنامج إكسل يمثل مجرد نقطة انطلاق أساسية نحو بناء عقلية تحليلية فذة قادرة على التلاعب بالنصوص غير المنظمة والسيطرة عليها. يجب على المحلل الطموح النظر إلى هذه المسألة كمقدمة لفهم البنية المكانية والمنطقية للبيانات، وتوسيع مداركه تدريجياً لتبني أدوات ولغات أكثر تطوراً وتخصصاً.
تتمثل خارطة الطريق المهنية في الانتقال التراكمي من فهم المنطق الرياضي للدوال المدمجة الكلاسيكية إلى التعمق في التعبيرات النمطية (Regular Expressions – RegEx)، والتي تمثل القوة المطلقة في معالجة وتطهير الأنماط النصية المعقدة في لغات البرمجة المتقدمة كبايثون (Python) ولغة آر (R). يتيح هذا التدرج للمحلل القدرة على التفاعل مع البيانات الضخمة وفهم أعمق لآليات ترميز المحارف وهندسة البيانات النصية في مستودعات البيانات السحابية الحديثة.
وفي الختام، يظل برنامج إكسل بيئة العمل التحليلية الأكثر مرونة وشعبية حول العالم؛ حيث تبرهن قدرته المستمرة على التجدد وتقديم الحلول المبتكرة—بدءاً من براعة التلاعب بالفراغات في الصيغ الكلاسيكية وصولاً إلى الإمكانات الذكية لبيئة الحوسبة المصفوفية الحديثة—على أن الفهم النظري والرياضي العميق للمحرك الحسابي هو السلاح الحقيقي الذي يميز مهندس البيانات المحترف عن غيره من مستخدمي البرمجيات التقليديين.
خاتمة
تناول هذا المقال المعمق مسألة هندسية وتحليلية دقيقة في بيئة برنامج مايكروسوفت إكسل تتمثل في استخراج الأحرف والمقاطع النصية من جهة اليمين حتى أول مسافة فاصلة. استعرضنا عبر محاوره المختلفة البنية التركيبية الكلاسيكية المعتمدة على الرباعية الحسابية المكونة من دوال TRIM وRIGHT وSUBSTITUTE وREPT، وقمنا بتحليل تدفق البيانات داخل الذاكرة المؤقتة، مع إيضاح دور كل دالة في بناء الحواشي الفراغية واقتطاع المقطع الأخير وتطهيره من الشوائب.
كما وازن المقال بين تلك التقنية العريقة والبدائل المعاصرة المقدمة في إصدارات Microsoft 365 الحديثة كدالة TEXTAFTER والدوال المصفوفية الديناميكية، بالإضافة إلى الحلول التحويلية الصناعية عبر بيئة Power Query وخوارزميات لغة M. إن إتقان هذه المنهجيات والوعي بالفوارق التوافقية ومخاطر البتر ومحارف المسافات غير النمطية يمنح الباحث ومحلل البيانات قدرة فائقة على بناء نماذج محاسبية وإحصائية فائقة الدقة والموثوقية تضمن تكامل البيانات واستدامة نتائجها عبر مختلف المنصات المؤسسية.
المراجع
Microsoft. (n.d.). TEXTAFTER function. Microsoft Support. https://support.microsoft.com/en-us/office/textafter-function-2de3b224-5bc9-4b18-a40d-09493c6e9d10
Microsoft. (n.d.). RIGHT, RIGHTB functions. Microsoft Support. https://support.microsoft.com/en-us/office/right-rightb-functions-240267ee-9afa-4639-a02b-f19e1786cf2f
Microsoft. (n.d.). SUBSTITUTE function. Microsoft Support. https://support.microsoft.com/en-us/office/substitute-function-6434944e-a904-4336-a9b0-1e58df3bc332
Microsoft. (n.d.). TRIM function. Microsoft Support. https://support.microsoft.com/en-us/office/trim-function-410388fa-c5df-49c6-b16c-9e5630b479f9
Microsoft. (n.d.). Split columns by delimiter in Power Query. Microsoft Learn. https://learn.microsoft.com/en-us/power-query/split-columns-delimiter
McDaid, J. (2022, March 16). Announcing new text and array functions in Excel. Microsoft Community Hub. https://techcommunity.microsoft.com/t5/excel-blog/announcing-new-text-and-array-functions-in-excel/ba-p/3257864