
تمثل البيانات الرقمية في عصرنا الراهن الركيزة الأساسية التي تستند إليها المؤسسات الأكاديمية والشركات التجارية في بناء استراتيجياتها واتخاذ قراراتها المصيرية. وفي ظل التدفق الهائل للمعلومات، تشكل السجلات النصية النصيب الأكبر من قواعد البيانات، حيث تتصدر عناوين البريد الإلكتروني قائمة البيانات التعريفية الأكثر استخداماً في التواصل، والتحقق، والتحليل الإحصائي. إن عنوان البريد الإلكتروني ليس مجرد وسيلة اتصال، بل هو وثيقة رقمية مركبة تختزل في بنيتها دلالات مؤسسية وجغرافية وتنظيمية عميقة. غير أن الاستفادة القصوى من هذه الثروة المعلوماتية تظل رهينة بالقدرة المنهجية على تفكيك هذه السلاسل النصية واستخلاص المكونات ذات القيمة التحليلية العالية، وعلى رأسها اسم النطاق المؤسسي أو التجاري.
يواجه المحللون والباحثون تحديات تقنية معقدة عند التعامل مع مجموعات البيانات الضخمة التي تحتوي على آلاف، بل مئات الآلاف، من السجلات غير المتجانسة؛ إذ تتداخل أسماء المستخدمين مع امتدادات النطاقات المتنوعة والرموز الفاصلة بطرق تستعصي على الفرز اليدوي التقليدي. وهنا تبرز برمجية مايكروسوفت إكسل (Microsoft Excel) كبيئة حوسبية مرنة ومتطورة تقدم حلولاً خوارزمية وحسابية تمتد من الصيغ النصية الكلاسيكية وصولاً إلى أدوات الذكاء الاصطناعي وهندسة البيانات الحديثة. إن التحكم في آليات تفكيك النصوص داخل إكسل لا يقتصر على إتقان بعض الدوال، بل يتطلب فهماً رياضياً وبنيوياً لكيفية تعامل محرك الجداول مع الرموز والفواصل ومواقع المحارف داخل السلسلة النصية.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دراسة معمقة وتطبيقية لكافة المناهج الرياضية، والبرمجية، والتفاعلية المتاحة لاستخراج النطاق من عنوان البريد الإلكتروني في برنامج إكسل. سنستعرض التطور التاريخي للأدوات بدءاً من الدوال الحسابية الكلاسيكية القائمة على حساب الإزاحة والمواضع، مروراً بالدوال الحديثة الموجهة بالمصفوفات الديناميكية في بيئة مايكروسوفت 365، ووصولاً إلى تقنيات معالجة البيانات المتقدمة عبر محرك Power Query ولغة البرمجة VBA. إن هذا الدليل مصمم ليكون مرجعاً منهجياً متكاملاً للمحللين والباحثين الساعين إلى رفع كفاءة تنقية البيانات وضمان دقة النمذجة الإحصائية وفق أعلى المعايير التقنية.
1. الإطار المفاهيمي لمعالجة البيانات النصية وعناوين البريد الإلكتروني في إكسل
1.1 البنية التركيبية للبريد الإلكتروني وأهمية عزل النطاق
يتأسس الهيكل المعياري لعنوان البريد الإلكتروني على محددات تقنية صارمة صاغتها مذكرات طلب التعليقات الدولية، وتحديداً المعيارين RFC 5321 وRFC 5322. من الناحية التركيبية، يتألف العنوان من ثلاثة أجزاء متتابعة لا غنى عنها: الجزء المحلي المتمثل في اسم المستخدم (Local-part)، والمحدد النصي الفاصل وهو رمز علامة الربط (@)، والجزء المتبقي الذي يمثل اسم النطاق المؤهل بالكامل (Fully Qualified Domain Name – FQDN). يحمل اسم المستخدم طابعاً فردياً يخص صاحب الحساب داخل المنظومة، بينما يمثل النطاق الهوية المؤسسية أو المزود التقني الذي يستضيف هذا الحساب البريدي على شبكة الإنترنت.
تنبع الأهمية المنهجية لفصل النطاق وعزله عن بقية السلسلة النصية من الرغبة في تصنيف الكيانات والمؤسسات. فعند التعامل مع قواعد بيانات تضم شركاء، أو عملاء، أو باحثين أكاديميين، يفقد اسم المستخدم قيمته التحليلية التجميعية، وتتحول الأهمية بالكامل نحو النطاق الذي يعكس الانتماء المؤسسي؛ مثل تمييز الجامعات ذات الامتداد التعليمي (.edu)، أو المؤسسات الحكومية (.gov)، أو الهيئات غير الربحية (.org)، وصولاً إلى الشركات التجارية الخاصة (.com). يتيح هذا العزل للباحثين فرصة تجميع البيانات في فئات هيكلية ذات دلالة سياقية واضحة تسهم في إزالة الضجيج الإحصائي المرتبط بالأسماء الشخصية.
علاوة على ذلك، يؤدي عزل النطاقات إلى تعزيز كفاءة نمذجة البيانات وتحليل الاتجاهات التواصلية بدرجة كبيرة. فعندما تُختزل ملايين السجلات الفردية إلى مئات النطاقات المؤسسية، يصبح بالإمكان رصد كثافة التفاعل مع جهات محددة، واكتشاف الأنماط المؤسسية في استجابات الاستبيانات، وتحديد الثقل النسبي لكل قطاع تنظيمي بدقة فائقة. وقد تناولت دراسات تحليل الأنظمة وتفاعل الأفراد مع التكنولوجيا، مثل تلك التي درسها لانكتون وزملاؤه، كيف تسهم الثقة في الأنظمة التقنية في تحديد آليات التفاعل التنظيمي وتبادل المعلومات المؤسسية (Lankton et al., 2015). إن هذا التحول من المستوى الفردي إلى المستوى التنظيمي يرفع من كفاءة المعالجة الخوارزمية ويحد من التعقيد الحسابي داخل نماذج اتخاذ القرار.
1.2 دواعي استخراج النطاقات في سياق البحوث وتحليل البيانات
تتعدد الدواعي العلمية والعملية التي تفرض على محلل البيانات الأكاديمي والمهني عزل النطاقات البريدية. يتصدر هذه الدواعي هدف تنقية قواعد البيانات الضخمة وتطهيرها من المدخلات المشتركة، أو الحسابات العشوائية، أو حسابات البريد المجاني العام مثل Gmail وYahoo وHotmail. في الدراسات السوقية أو الأكاديمية الموجهة لقطاع الأعمال، غالباً ما تُستبعد النطاقات العامة لضمان أن العينة البحثية تمثل حصرياً ممثلي المؤسسات والشركات، مما يمنع التحيز الإحصائي الناتج عن مشاركات مجهولة المصدر أو غير موثقة بالانتماء المهني المطلوب.
كما يمثل فرز العينات البحثية وتصنيفها وفق الانتماء الوظيفي والقطاعي ضرورة حتمية في تصميم الدراسات المسحية واسعة النطاق. يتيح استخراج النطاق إجراء تصنيف طبقي آلي (Stratified Sampling) يضمن تمثيل مختلف القطاعات—كالقطاع الصحي، والتعليمي، والصناعي—بنسب متوازنة تحاكي الواقع المجتمعي. هذا التصنيف يختصر مئات الساعات من العمل اليدوي في المطابقة، حيث يمكن عبر عمليات ربط رقمية بسيطة مطابقة النطاق المستخرج مع قواعد بيانات السجلات التجارية المفتوحة للحصول على حجم المؤسسة، وموقعها الجغرافي، وإيراداتها المالية السنوية.
أخيراً، يسهل استخراج النطاق عمليات التحقق والتدقيق الإحصائي لقوائم البريد الإلكتروني قبل إطلاق المراسلات أو معالجة الاستجابات. يتيح فحص النطاقات المستخرجة اكتشاف الأخطاء المطبعية الشائعة التي يقع فيها المستخدمون عند إدخال بياناتهم يدوياً، مثل كتابة “gmai.com” أو “yaho.co”. من خلال عزل النطاق، تظهر هذه الأخطاء المعزولة كقيم شاذة (Outliers) ضمن تكرارات التوزيع التكراري، مما يتيح تصحيحها مسبقاً، وضمان سلامة التواصل البحثي ورفع معدلات الاستجابة الميدانية.
1.3 التحديات التقنية في معالجة السلاسل النصية غير المتجانسة
على الرغم من بساطة المفهوم الظاهري، إلا أن معالجة السلاسل النصية لبريد إلكتروني داخل إكسل تنطوي على تحديات برمجية وهندسية بالغة الدقة. يكمن التحدي الأول في التباين الهائل في أطوال أسماء المستخدمين والنطاقات؛ إذ يمكن لاسم المستخدم أن يتألف من حرف واحد وصولاً إلى 64 حرفاً، في حين تتنوع النطاقات بين نطاقات أحادية المستوى ونطاقات فرعية معقدة تتضمن امتدادات جغرافية مركبة (مثل dept.research.university.ac.uk). هذا التنوع الشديد يجعل من المستحيل استخدام أساليب الاقتطاع ذات الأطوال الثابتة، ويفرض الاعتماد على تقنيات الاقتطاع القائمة على المواضع النسبية للمحددات.
يتجسد التحدي الثاني في مشكلات تلوث البيانات الناتجة عن المسافات البادئة واللاحقة (Leading and Trailing Spaces)، وتواجد الرموز غير المرئية أو أحرف التحكم التي تتسلل إلى ورقة العمل عند تصدير البيانات من استمارات الويب أو ملفات النص البسيط (CSV). هذه الشوائب النصية تعطل عمل خوارزميات البحث وتؤدي إلى تشويه نتائج الاقتطاع، أو إرجاع قيم فارغة غير مرغوب فيها، أو حتى إفشال عمليات المطابقة اللاحقة بين النطاقات المستخرجة وسجلات المؤسسات الرسمية.
لذلك، تبرز الأهمية القصوى لاختيار الأداة الحسابية الدقيقة والمتوافقة مع طبيعة البيانات وحجمها لتجنب فقدان أجزاء جوهرية من النص أثناء المعالجة. فاختيار دالة لا تراعي الحالات الاستثنائية، أو لا تتعامل بحذر مع غياب رمز المحدد، يمكن أن يؤدي إلى توقف المصنف بالكامل وظهور رسائل خطأ حسابية تربك الباحثين وتؤثر سلباً على موثوقية التحليل النهائي. يتطلب ذلك من المحلل تبني منهجية رصينة تبدأ بفحص سلامة المدخلات وتمر بتنفيذ الاقتطاع وتنتهي بالتحقق الصارم من صحة النتائج.
2. استخدام الدالة الحديثة TEXTAFTER: المفهوم الرياضي والبرمجي
2.1 ماهية دالة TEXTAFTER وتطورها في بيئة Microsoft 365
في مارس 2022، أعلن فريق مطوري مايكروسوفت إكسل عن قفزة نوعية في هندسة معالجة النصوص البرمجية داخل الجداول الحسابية، تمثلت في إطلاق حزمة جديدة من الدوال النصية المتقدمة وعلى رأسها دالة TEXTAFTER، والتي أصبحت متاحة لمستخدمي Microsoft 365 ونسخة Excel 2024 وإكسل للويب. مثل هذا الإعلان تحولاً جذرياً في فلسفة التعامل مع البيانات النصية، حيث وضعت حداً لعقود من الاعتماد الإجباري على تركيب معادلات رياضية معقدة ومتداخلة تتطلب حساب أطوال النصوص وإزاحات المحارف للوصول إلى جزء نصي بسيط يقع بعد فاصل محدد.
تعتمد آلية عمل محرك دالة TEXTAFTER على مسح السلسلة النصية المدخلة بصورة خطية للبحث عن المحدد النصي المعين من قِبل المستخدم. وبمجرد رصد هذا المحدد داخل الذاكرة المؤقتة لمحرك الحساب، تقوم الدالة باقتطاع كافة المحارف التي تلي المحدد وصولاً إلى نهاية السلسلة، متجاهلة تماماً كل ما يسبقه دون الحاجة لمعرفة طول النص المسبق أو موضع البداية يدوياً. هذا المنطق الداخلي الموجه نحو “الهدف مباشرة” يعزز من سرعة المعالجة الحسابية بنسبة ملحوظة ويوفر موارد المعالج المركزي أثناء تنفيذ الحسابات على مجموعات البيانات العملاقة.
بالإضافة إلى ذلك، صُممت دالة TEXTAFTER لتدعم بالكامل بنية المصفوفات الديناميكية (Dynamic Arrays)، وهي السمة الهيكلية الأبرز في إصدارات إكسل الحديثة. يعني هذا الدعم أن تطبيق الدالة لم يعد محصوراً في إرجاع قيمة خلية مفردة، بل يمكنها استقبال نطاق كامل من الخلايا كمعامل إدخال، لتفيض النتائج (Spill) تلقائياً في الخلايا المجاورة دون الحاجة لسحب الصيغة يدوياً. هذا الاندماج الهندسي بين الدوال المتخصصة والمصفوفات المرنة رسخ مكانة الدالة كمعيار ذهبي جديد ومباشر لمعالجة السلاسل النصية.
2.2 بناء الجملة النحوية (Syntax) للدالة ومعاملاتها الأساسية والفرعية
تتمتع دالة TEXTAFTER ببنية نحوية متينة تجمع بين البساطة في الاستخدام الأساسي والمرونة الفائقة في الضبط المتقدم لحالات الاستخدام المعقدة. تتكون الصيغة الرياضية للدالة من وسيطتين إلزاميتين وأربع وسائط اختيارية، وتُكتب وفق الهيكل التالي في إكسل:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
تتمثل الوسيطة الإلزامية الأولى (text) في مرجع الخلية أو السلسلة النصية المستهدفة التي تحتوي على عنوان البريد الإلكتروني الأصلي المراد استخراج النطاق منه (مثل الخلية A2). أما الوسيطة الإلزامية الثانية (delimiter)، فهي الرمز أو المحرف الفاصل الذي يُستند إليه في نقطة التقسيم، وفي سياق البريد الإلكتروني، يتمثل هذا المحدد دائماً في علامة الربط القياسية المضمنة بين علامتي اقتباس مزدوجتين (“@”). بمجرد تزويد الدالة بهاتين الوسيطتين فقط، تصبح قادرة على إنجاز عملية استخراج النطاق بكفاءة متناهية.
أما الوسائط الاختيارية فتمنح المستخدم سيطرة متقدمة على منطق الاقتطاع؛ حيث تسمح الوسيطة الثالثة (instance_num) بتحديد رقم تكرار المحدد المراد الاقتطاع بعده، وقيمتها الافتراضية هي 1 (أي بعد أول ظهور للمحدد)، ولكن يمكن ضبطها للتعامل مع نصوص تحتوي فواصل متعددة. وتتحكم الوسيطة الرابعة (match_mode) في حساسية حالة الأحرف، في حين تحدد الوسيطة الخامسة (match_end) سلوك الدالة إذا طابقت نهاية السلسلة. وتعد الوسيطة السادسة (if_not_found) بالغة الأهمية لمعالجة الأخطاء الاستباقية؛ إذ تتيح تحديد القيمة المعادة في حال خلو النص من المحدد، مما يمنع ظهور أخطاء الاحتساب القياسية ويعزز نظافة البيانات.
2.3 المقارنة المنهجية بين TEXTAFTER والبدائل التاريخية في إكسل
لإدراك القيمة الوظيفية التي قدمتها دالة TEXTAFTER، لا بد من عقد مقارنة منهجية مع الحلول التقليدية التي استمرت لعقود. في السابق، كان استخراج النطاق يتطلب دمج دالتين أو ثلاث دوال مختلفة معاً مثل RIGHT مع LEN وFIND، أو استخدام MID مع FIND. كان على المحلل أن يستدعي دالة لحساب الطول الكلي، ثم دالة أخرى لاكتشاف الموضع الرقمي للفاصل، ثم إجراء عملية طرح جبرية داخل وسائط دالة اقتطاع طرفية. هذا التعدد في الخطوات كان يستهلك جهداً ذهنياً ويزيد من احتمالية تعطل الصيغة الرياضية.
أدى اختزال هذه الخطوات المتراكبة في دالة مفردة ومباشرة إلى انخفاض دراماتيكي في معدلات الخطأ البشري أثناء صياغة المعادلات؛ حيث تشير ممارسات التدقيق البرمجي في الجداول الإلكترونية إلى أن نسبة وقوع الخطأ تتناسب طردياً مع عدد الدوال المتداخلة داخل الخلية الواحدة. عبر إقصاء وسائط حساب الإزاحات والأطوال، تم تقليص مساحة الالتباس المفاهيمي الذي كان يقع فيه العديد من الممارسين، لا سيما فيما يتعلق بإضافة أو طرح خانة رقمية واحدة (+1 أو -1) لضبط نقطة بدء الاقتطاع بدقة.
علاوة على الموثوقية التقنية، حققت دالة TEXTAFTER نقلة نوعية في قابلية قراءة النماذج المالية والبحثية ومراجعتها الأكاديمية (Auditing and Readability). فعندما يطّلع باحث أو مدقق مستقل على خلية تحتوي على الدالة الحديثة، يفهم على الفور الغرض الوظيفي للمعادلة بمجرد قراءة اسمها دون الحاجة لتفكيك العلاقات الرياضية التبادلية بين الدوال المتداخلة. هذا الوضوح الدلالي يسهم في تسريع مراجعة الأقران وتوثيق خطوات معالجة البيانات بما يتماشى مع متطلبات النزاهة العلمية والشفافية المنهجية.
3. التطبيق العملي خطوة بخطوة لاستخراج النطاق باستخدام TEXTAFTER
3.1 إعداد ورقة العمل وتنظيم بنية البيانات الأولية
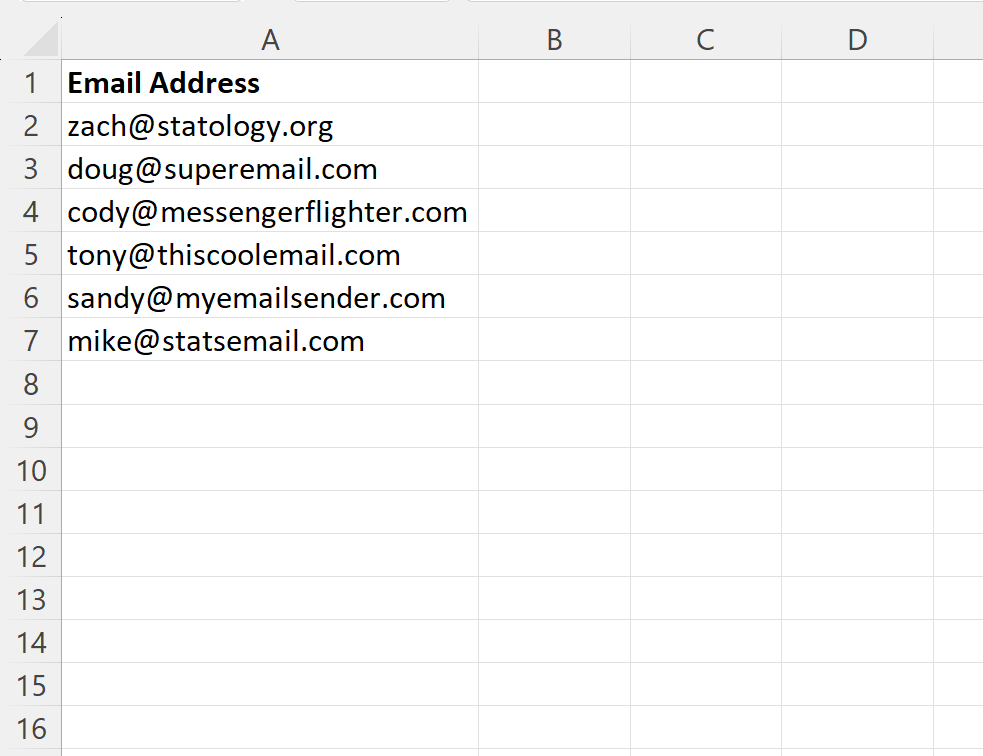
تبدأ الممارسة التحليلية السليمة بالتحضير الهيكلي الدقيق لورقة العمل قبل الشروع في كتابة أي معادلة رياضية. يتعين أولاً تحديد عمود الإدخال الذي يضم السجلات الخام لعناوين البريد الإلكتروني، ولنفترض أنه العمود A بدءاً من الخلية A2 لتجنب صف الترويسة (Header). يجب فحص تنسيق الخلايا والتأكد من أنها معرفة بنمط “عام” (General) أو “نص” (Text) لمنع إكسل من محاولة تفسير الرموز كنصوص تشعبية نشطة قد تعيق التحرير المتسلسل، مع التحقق من استقامة البيانات وخلو الترويسة من أي دمج غير مبرر للخلايا.
تتمثل الخطوة التالية في إنشاء عمود مجاور ومخصص لاستقبال مخرجات النطاقات المستخرجة، وليكن العمود B، مع منحه اسماً وصفياً واضحاً مثل “اسم النطاق” أو “Domain”. يساعد هذا الفصل المكاني بين العمود المصرفي الخام وعمود المعالجة في حماية البيانات المصدرية من أي تعديل عرضي غير مقصود، كما يسهل المقارنة البصرية الفورية والتحقق من صحة النتائج لكل سجل بمحاذاة مدخله الأصلي.
قبل إطلاق الصيغة، يُوصى بتطبيق فحص أولي سريع لمجموعة البيانات لرصد وجود خلايا فارغة بالكامل، أو نصوص معطوبة تفتقر للمحدد القياسي، أو قيم تحتوي على رموز عشوائية. يمكن إجراء ذلك بتفعيل مرشح التصفية التلقائي (AutoFilter) واستعراض القيم الفريدة، مما يعطي المحلل تصورا مبدئيا عن نقاء البيانات ويحدد ما إذا كان ينبغي استخدام الصيغة البسيطة أو التوجه مباشرة نحو الصيغ المعززة بوسائط إدارة الاستثناءات.
3.2 إدخال الصيغة الأساسية وتفسير المعطيات خطوة بخطوة
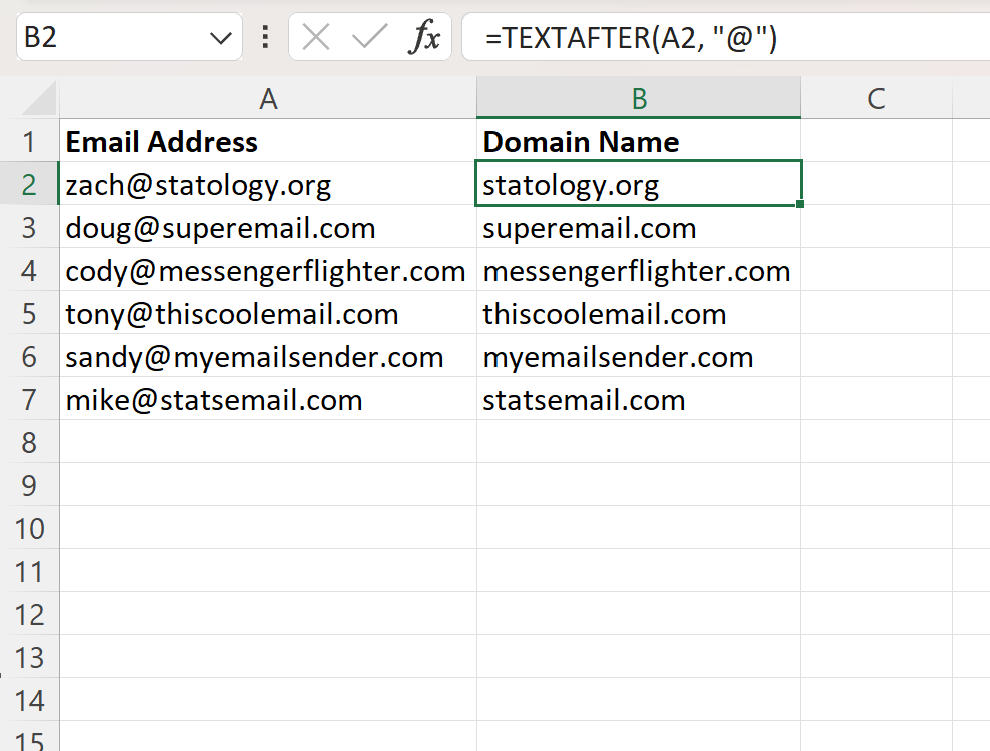
لتطبيق استخراج النطاق وفق المنهجية المباشرة، يتم التوجه إلى الخلية B2 وكتابة الصيغة المعيارية التالية بدقة:
=TEXTAFTER(A2, “@”)
عند الضغط على مفتاح الإدخال Enter، يبدأ محرك الحساب الداخلي لإكسل بتفسير هذا الأمر؛ حيث يقرأ الخلية A2 ويحدد محتواها كنص الهدف، ثم يفسر المعامل الثاني المضمن بين علامتي الاقتباس المزدوجتين (“@”) باعتباره المحدد الحرفي الفاصل. تحيط علامتا الاقتباس بالرمز لتنبيه المترجم الحسابي إلى أن المعامل هو محرف نصي صريح وليس اسماً لنطاق مسمى أو متغيراً رياضياً معرفاً داخل بيئة العمل، وهو تمييز أساسي يفرضه بروتوكول لغة الصيغ في إكسل.
بمجرد التقاط الرمز، تقوم الدالة آلياً بحجب كافة المحارف السابقة له وحذف الرمز نفسه من الناتج النهائي، لتعيد مباشرة كافة الأحرف المتبقية حتى نهاية السلسلة. فإذا كانت القيمة في الخلية A2 هي “[email protected]”، ستكون النتيجة المباشرة المعروضة في الخلية B2 هي “oxford.ac.uk”. يتميز هذا الإجراء بضمان استخلاص النطاق كاملاً بجميع امتداداته دون تعرض الأطراف لأي بتر غير مقصود، محققاً الهدف التحليلي في خطوة واحدة فائقة البساطة.
3.3 آليات التعميم والسحب التلقائي على مجموعات البيانات الضخمة
عقب التأكد من سلامة ناتج الخلية الاختبارية الأولى، تأتي مرحلة تعميم الصيغة على كامل السجلات في العمود. يمكن تحقيق ذلك بسرعة فائقة من خلال وضع مؤشر الفأرة على مقبض التعبئة (Fill Handle) الواقع في الزاوية اليسرى السفلية للخلية B2 (في الواجهة العربية) حتى يتحول المؤشر إلى علامة الجمع السوداء المزدوجة، ثم النقر المزدوج السريع. ترسل هذه النقرة أمراً للبرنامج بنسخ الصيغة ديناميكياً إلى أسفل العمود بالتوازي مع الخلايا المشغولة في العمود A دون تجاوز آخر سجل مدخل.
إذا كان المحلل يعمل في بيئة Microsoft 365 ويرغب في استثمار الطاقة الكاملة للمصفوفات الديناميكية المتدفقة، فيمكنه الاستغناء كلياً عن مقبض التعبئة واستبدال الصيغة السابقة بصيغة مصفوفية شاملة تُكتب في الخلية B2 فقط، كالتالي:
=TEXTAFTER(A2:A50000, “@”)
بمجرد إدخال هذه الصيغة الفردية، سيقوم إكسل بحساب مصفوفة النتائج بالكامل وتوزيعها تلقائياً على نطاق الخلايا من B2 إلى B50000 في أجزاء من الثانية. يحافظ هذا الأسلوب على خفة حجم الملف، ويمنع تجزئة الصيغ، ويضمن استقرار الأداء الحسابي وسرعة الاستجابة حتى عند التعامل مع مصفوفات ضخمة تتجاوز عشرات الآلاف من السجلات، مما يعزز إنتاجية المحلل ويجنبه عناء السحب اليدوي الممل.
4. استخراج النطاق عبر الدوال الكلاسيكية (RIGHT وLEN وFIND)
4.1 تكامل الدوال النصية التقليدية لفهم منطق المعالجة الحسابية
على الرغم من التطور التقني الهائل الذي وفرته الدوال الحديثة، إلا أن استيعاب التكامل الحسابي بين الدوال الكلاسيكية—مثل RIGHT وLEN وFIND—يظل متطلباً تعليمياً ومنهجياً بالغ الأهمية؛ فهو يمثل الأساس المنطقي الذي شُيدت عليه معالجة النصوص الرقمية منذ إصدار إكسل 2.0 في ثمانينيات القرن الماضي. يرتكز هذا التكامل على مبدأ التفكيك والتركيب الحسابي، حيث تعمل الدوال الثلاث في تناغم رياضي دقيق لاقتطاع السلاسل النصية بناءً على خوارزمية قياس الأطوال والإزاحات النسبية.
تتولى دالة FIND في هذا المزيج مهمة “المستشعر المكاني”؛ حيث تقوم بمسح الخلية حرفاً بحرف من اليسار إلى اليمين لتحديد الموقع العددي الدقيق لأول ظهور لمحرف علامة الربط (@). تعيد هذه الدالة رقماً صحيحاً يمثل ترتيب المحرف داخل السلسلة. فإذا كانت السلسلة تتكون من “[email protected]”، فإن دالة FIND ترصد الرمز في الموقع التاسع (9)، مما يحدد النقطة المفصلية التي ينتهي عندها الجزء المحلي من العنوان البريدي.
في المقابل، تضطلع دالة LEN بدور “المقياس الكلي”؛ إذ تقوم بحساب العدد الإجمالي الشامل لكافة المحارف المكونة للسلسلة النصية، بما في ذلك الحروف، والأرقام، والرموز، والمسافات البينية. في المثال السابق، تحسب الدالة إجمالي طول النص ليبلغ 20 محرفاً. يمهد هذان الرقمان—الموقع الكلي والموقع النسبي للفاصل—السبيل لتنفيذ العملية الرياضية الجوهرية التي تفصل بين الجزء غير المرغوب فيه والنطاق المستهدف بدقة مطلقة.
4.2 صياغة المعادلة المركبة وتفكيك مكوناتها الهندسية
تُصاغ المعادلة الكلاسيكية المركبة لفك شفرة النطاق ودمج الدوال الثلاث ضمن خلية واحدة على النحو التالي:
=RIGHT(A2, LEN(A2) – FIND(“@”, A2))
لتفكيك المكونات الهندسية لهذه المعادلة وفهم ديناميكيتها، يجب النظر إليها من الداخل إلى الخارج. تمثل العملية الحسابية الطرحية المتمثلة في:
LEN(A2) – FIND(“@”, A2)
قلب المعادلة الرياضي؛ حيث يؤدي طرح الموضع العددي لعلامة @ (المحسوب بواسطة FIND) من إجمالي عدد محارف النص (المحسوب بواسطة LEN) إلى الحصول بدقة متناهية على عدد المحارف المتبقية على يمين علامة الربط، وهي المحارف التي تشكل حصرياً اسم النطاق المؤسسي دون أي زيادة أو نقصان.
تأتي بعد ذلك دالة RIGHT لتستقبل ناتج هذه العملية الرياضية كمعامل ثانٍ لها. تقوم هذه الدالة بالاقتطاع من السلسلة النصية الأصلية بالبدء من أقصى اليمين والتحرك يساراً بمقدار عدد المحارف الناتج عن عملية الطرح السابقة. وبذلك، تعيد الدالة النص المقابل تماماً للنطاق المطلوب. يضمن هذا التوافق الرياضي أن المعادلة ستعمل بنجاح تام بصرف النظر عن طول اسم المستخدم أو تباين طول النطاق، مما يجعلها إحدى أكثر الصيغ المركبة استقراراً في تاريخ برمجيات الجداول الإلكترونية.
4.3 الفروق الجوهرية بين دالتي FIND وSEARCH في بناء الصيغة
غالباً ما يتبادر إلى أذهان محللي البيانات تساؤل منهجي حول إمكانية استبدال دالة FIND بدالة SEARCH داخل هذه المعادلة التقليدية، وما إذا كان لهذا الاستبدال أثر تشغيلي على النتائج. تكمن الفروق الجوهرية بين الدالتين في خاصيتين تقنيتين رئيستين: حساسية حالة الأحرف (Case Sensitivity)، ودعم استخدام محارف البدل (Wildcard Characters). إن فهم هذه الفروق يعد أمراً حاسماً لبناء صيغ برمجية متينة ومحصنة ضد الأخطاء غير المتوقعة.
تتميز دالة FIND بأنها حساسة لحالة الأحرف تماماً ولا تدعم محارف البدل مثل النجمة (*) أو علامة الاستفهام (؟)، مما يجعلها خياراً دقيقاً وصارماً عند البحث عن نصوص محددة. أما دالة SEARCH، فهي غير حساسة لحالة الأحرف وتدعم محارف البدل بصورة كاملة. ومع ذلك، في سياق استخراج النطاق البريدي عبر البحث عن الرمز المجرد “@”، فإن مسألة حساسية حالة الأحرف تغدو غير ذات أثر وظيفي؛ فالرمز هو رمز خاص لا يمتلك حالة أحرف كبيرة (Uppercase) أو صغيرة (Lowercase) كما هو الحال في الأبجديات اللاتينية.
ورغم أن الدالتين تؤديان الغرض ذاته بنجاح عند البحث عن علامة الربط، إلا أن أفضل الممارسات المنهجية توصي بالاعتماد الحصري على دالة FIND في هذا السيناريو المحدد. يعود ذلك إلى أن عدم دعم FIND لمحارف البدل يمنحها سرعة حسابية أعلى بهامش طفيف مقارنة بـ SEARCH، كما يقي الصيغة من أي تفسيرات خاطئة في حال احتواء السلسلة على رموز شاذة قد تُفسر كمحارف بحث متقدمة، مما يحفظ الاستقرار البرمجي للمصنفات الكبرى.
5. بدائل الدوال النصية الكلاسيكية المتقدمة (MID مع FIND)
5.1 هندسة صيغة دالة MID لاستخلاص الأجزاء الطرفية للنص
تمثل دالة MID بديلاً كلاسيكياً متقدماً وعالي المرونة لاستخراج النطاقات البريدية، لا سيما في البيئات التقنية التي تتطلب اقتطاع نصوص من وسط السلسلة وصولاً إلى نهايتها دون الاعتماد على دالة الاقتطاع اليميني. تتطلب دالة MID بطبيعتها الهندسية تزويدها بثلاث وسائط متتابعة: النص الأصلي المستهدف، ورقم موضع البداية الذي سينطلق منه الاقتطاع، والعدد الإجمالي للمحارف المراد جلبها بدءاً من تلك النقطة.
عند توظيف MID لعزل النطاق، تتم صياغة المعادلة الرياضية على النحو المعياري التالي:
=MID(A2, FIND(“@”, A2) + 1, LEN(A2))
تتجلى هندسة هذه الصيغة في تحديد نقطة الانطلاق عبر الوسيطة الثانية؛ حيث تُستخدم دالة FIND لرصد موضع علامة @، ثم يُضاف الرقم واحد (+1) إلى الناتج. تضمن هذه الإضافة الحسابية إزاحة موضع الاقتطاع بمقدار خانة واحدة نحو اليمين لتبدأ المعالجة مباشرة من الحرف الأول لاسم النطاق، مما يضمن استبعاد علامة @ نفسها من النص المستخرج بشكل تام ونظيف.
أما الوسيطة الثالثة المتمثلة في تمرير دالة LEN(A2)، فهي تعكس “حيلة برمجية” شائعة ومأمونة في هندسة صيغ إكسل؛ إذ تتطلب دالة MID معرفة عدد المحارف المطلوب استخراجها، وبما أن طول النطاق يظل متغيراً ومجهولاً، فإن تمرير الطول الكلي للسلسلة الأصلية (LEN) يضمن أن الدالة ستستمر في الاقتطاع حتى نهاية النص مهما بلغ طوله. فقواعد إكسل البرمجية تنص على أنه إذا تجاوز عدد المحارف المطلوب طول النص المتبقي بعد نقطة البداية، فإن الدالة تجلب ببساطة كل ما تبقى دون التسبب في أي خطأ، مما يجعل الصيغة مرنة وشاملة.
5.2 التحليل المقارن بين صياغة MID وصياغة RIGHT
عند إخضاع صيغة MID وصيغة RIGHT للتقييم الفني في مشاريع نمذجة البيانات المعقدة، تظهر مجموعة من الفروق الدقيقة التي يسترشد بها المحللون. من حيث استهلاك الموارد الحسابية وسرعة المعالجة، تتقارب الصيغتان بصورة شبه متطابقة؛ إذ تعتمد كلاهما على استدعاء دالتين مساعدتين (FIND وLEN) بالتزامن مع دالة الاقتطاع الرئيسية. ومع ذلك، تشير اختبارات الكفاءة في المصنفات الضخمة التي تضم ملايين الصفوف إلى أن صياغة MID قد تتطلب عمليات معالجة داخلية أقل طردياً نظراً لبساطة حساب نقطة البداية (مجرد عملية جمع +1) مقارنة بحساب الإزاحة التناقصية في RIGHT.
من زاوية الوضوح الهندسي وقابلية الفهم والتدقيق، يعتبر العديد من مبرمجي إكسل المستقلين أن صيغة MID أكثر منطقية وبداهة؛ فالانتقال إلى موضع العلامة ثم التحرك خانة واحدة إلى الأمام يعكس التسلسل الفكري الطبيعي لقراءة السلاسل النصية من البداية إلى النهاية. هذا المنطق يقلل من الارتباك الذهني الذي قد يواجهه بعض المحللين المبتدئين عند محاولة فهم سبب طرح FIND من LEN في صيغة دالة RIGHT.
تثبت صيغة MID جدارتها الفائقة عند التعامل مع النطاقات المعقدة التي تحتوي على نطاقات فرعية ممتدة أو امتدادات شديدة الطول؛ حيث توفر الوسيطة LEN هامش أمان متسع يمنع أي اقتطاع مبتور قد ينتج عن خطأ في حساب طول الجزء الأيمن. يمنح هذا الثبات المحلل ثقة مطلقة في أن كل حرف يقع بعد علامة الربط سيتم استخلاصه بدقة بالغة، مما يعزز موثوقية قواعد البيانات المحللة.
5.3 سيناريوهات الاستخدام والتوافق مع الإصدارات السابقة من إكسل
تبرز الأهمية القصوى للصيغ الكلاسيكية (سواء MID أو RIGHT) في السيناريوهات المؤسسية المقيدة تقنياً، حيث تعمل العديد من المؤسسات والقطاعات الحكومية والمصرفية على إصدارات قديمة ومستقرة من إكسل، مثل Excel 2010 و2013 و2016 وحتى Excel 2019 المستقل. هذه الإصدارات تفتقر بطبيعتها التأسيسية لدعم دالة TEXTAFTER؛ وبالتالي، فإن محاولة فتح ملف يعتمد على الدوال الحديثة داخل تلك البيئات سيؤدي فوراً إلى انهيار الصيغ وظهور رسالة الخطأ الشهيرة (#NAME?)، مما يعطل العمليات التحليلية تماماً.
لضمان التوافقية العابرة للمنصات (Cross-Version Compatibility)، يتحتم على محلل البيانات الأكاديمي، عند إعداد نماذج عمل مشتركة مخصصة للتحكيم أو التداول مع جهات خارجية غير معلومة التجهيز التقني، الاعتماد على الصيغ الكلاسيكية العالمية. فهذه الصيغ مضمونة العمل بنسبة 100% على كافة نسخ إكسل الصادرة منذ أكثر من ثلاثة عقود، فضلاً عن توافقها الكامل مع برمجيات الجداول الإلكترونية البديلة مثل Google Sheets وLibreOffice Calc دون أي حاجة للتعديل.
تتطلب أفضل الممارسات في مثل هذه السيناريوهات تطبيق استراتيجيات توثيق داخلي صارمة داخل مصنف العمل؛ حيث يُستحسن تدوين ملاحظة منهجية في صفحة التوثيق (Documentation Sheet) تشرح الصيغة الكلاسيكية المستخدمة، وتوضح أنها صُممت عن قصد لضمان أقصى درجات التوافق التاريخي مع إصدارات البرمجيات المختلفة، مما يضفي صبغة احترافية على العمل ويجنب المستخدمين والمدققين الخلط بين القيود التقنية وخيارات التصميم المتعمدة.
6. الأدوات التفاعلية المدمجة لاستخراج النطاق دون كتابة صيغ
6.1 تطبيق أداة تحويل النص إلى أعمدة (Text to Columns)
توفر برمجية إكسل أدوات تفاعلية مدمجة تتيح تفكيك البيانات النصية بدقة متناهية دون الحاجة إلى كتابة أي معادلات أو دوال حسابية، وتتصدر أداة “تحويل النص إلى أعمدة” (Text to Columns) هذه الخيارات. لتطبيق هذه الميزة، يقوم المحلل بتحديد نطاق الخلايا المحتوي على عناوين البريد الإلكتروني في عمود المصدر، ثم يتوجه مباشرة إلى شريط الأدوات العلوي، وتحديداً إلى تبويب “بيانات” (Data)، ومن ثم ينقر على أيقونة “النص إلى أعمدة” لتفعيل المعالج التفاعلي المخصص.
في الخطوة الأولى من معالج التحويل، يتم اختيار نوع الفصل عبر تحديد خيار “محدد” (Delimited)، مما يتيح تجزئة النص بناءً على أحرف خاصة. عند الانتقال إلى الخطوة الثانية، يقوم المستخدم بإلغاء تحديد كافة المحددات الافتراضية المقترحة (مثل المسافة، أو الفاصلة المنقوطة، أو علامة الجدولة) وتفعيل خيار “أخرى” (Other)، ويكتب في المربع المجاور رمز علامة الربط (@). يظهر المعالج فوراً في الجزء السفلي معاينة حية توضح انشطار السلسلة النصية إلى عمودين مستقلين؛ الأول لاسم المستخدم والآخر لاسم النطاق.
تتمثل الخطوة الثالثة والحرجة في تحديد وجهة الإخراج وتنسيق الأعمدة الناتجة؛ لتفادي الكتابة فوق البيانات المصدرية وإتلاف عناوين البريد الأصلية، يجب تغيير مرجع “الوجهة” (Destination) ليشير إلى عمود فارغ مجاور (مثل B2 بدلاً من A2). كما يمكن للمحلل النقر على العمود الأول وتحديده كـ “عدم استيراد العمود (تخطي)” إذا كان الهدف ينحصر فقط في جلب النطاقات دون أسماء المستخدمين. عند الضغط على “إنهاء” (Finish)، تُنجز عملية الفصل فورياً في ورقة العمل بكفاءة عالية وبساطة متناهية.
6.2 ميزة التعبئة السريعة (Flash Fill) المعتمدة على التعلم النمطي
تمثل ميزة التعبئة السريعة (Flash Fill)، التي ظهرت تجارياً لأول مرة في إصدار Excel 2013، إحدى أروع ثمار أبحاث الذكاء الاصطناعي وتوليد البرامج الاستقرائي (Inductive Program Synthesis). ترجع هذه التقنية الثورية إلى الأبحاث التأسيسية التي قادها العالم سوميت جولواني (Sumit Gulwani) وفريقه في مركز أبحاث مايكروسوفت، ونُشرت في ورقتهم التاريخية عام 2011 في مؤتمر ACM SIGPLAN حول أتمتة معالجة النصوص عبر الأمثلة المدخلة والمخرجة.
تعتمد آلية التعبئة السريعة على مراقبة سلوك المستخدم لاكتشاف الأنماط النصية ضمنياً دون أي برمجة صريحة. لتطبيق هذه الميزة في استخراج النطاق، يقوم المحلل بالتوجه إلى الخلية المجاورة لأول بريد إلكتروني (B2) ويكتب النطاق يدوياً وبدقة تامة (مثلاً: “harvard.edu” للعنوان “[email protected]”)، ثم ينتقل إلى الخلية التالية B3 ويكرر العملية لكتابة نطاق العنوان الثاني. يعمل هذا الإدخال كعينات تدريبية (Training Examples) تمكن خوارزمية الاستقراء الداخلي من استنتاج القاعدة المنطقية المرادة، وهي اقتطاع كافة المحارف الواقعة بعد علامة @.
بمجرد إدراك النمط، يعرض إكسل اقتراحاً رمادياً خافتاً يملأ بقية العمود؛ يكفي حينها الضغط على مفتاح Enter لقبول المقترح، أو تفعيل الميزة قسرياً في أي وقت بالضغط على الاختصار الشهير (Ctrl + E) أو النقر على أيقونة Flash Fill في تبويب بيانات. ورغم الفاعلية المذهلة لهذه الأداة، إلا أن لها قيوداً تقنية خطيرة؛ فالخوارزمية قد تصاب بالانحراف النمطي (Pattern Drift) إذا واجهت عناوين شاذة تحتوي علامات ترقيم متعددة، كما أنها تنتج قيماً نصية ثابتة غير مرتبطة بديناميكية البيانات الأصلية، مما يتطلب تدقيقاً بصرياً دقيقاً للمخرجات للتأكد من عدم حدوث استنتاجات خاطئة.
6.3 الموازنة المنهجية بين الأدوات الثابتة والصيغ الديناميكية
تفرض الحوكمة المنهجية للبيانات على المحلل المفاضلة الدقيقة بين توظيف الأدوات التفاعلية الثابتة (مثل النص إلى أعمدة والتعبئة السريعة) واستخدام الصيغ الرياضية الديناميكية (سواء الحديثة أو الكلاسيكية). تتجسد الفجوة الجوهرية بين المسارين في خاصية “الاستجابة للتحديث التلقائي”؛ فالصيغ البرمجية ترتبط ارتباطاً وثيقاً ببيانات المصدر، وتحدث نتائجها تلقائياً وبأجزاء من الثانية بمجرد تعديل عنوان البريد أو إضافة سجلات جديدة، وهو ما تفتقر إليه الأدوات التفاعلية تماماً، حيث تتطلب إعادة تشغيل المعالج يدوياً في كل مرة تتغير فيها المدخلات.
من ناحية أخرى، تؤثر هذه المفاضلة تأثيراً مباشراً على حجم ملف العمل وسرعة استجابته الحاسوبية. فالصيغ الرياضية الممتدة على مئات الآلاف من الصفوف تستهلك جزءاً من الذاكرة الحية (RAM) لتحديث الحسابات التلقائية عند كل فتح للمصنف أو تعديل في أي خلية، مما قد يسبب تباطؤاً ملحوظاً في الملفات المليونية. في المقابل، فإن الأدوات التفاعلية تُلقي بقيم نصية بحتة ومجردة داخل الخلايا دون حفظ أي علاقات حسابية في الخلفية، مما يبقي حجم الملف خفيفاً وسريع الفتح والمعالجة.
بناءً على هذه المعطيات، تتلخص التوصيات المنهجية في اعتماد قاعدة ذهبية واضحة: تُفضل الأدوات التفاعلية الثابتة (النص إلى أعمدة وFlash Fill) في مهام الفرز الاستكشافي السريع، وتنقية البيانات المنفذة لمرة واحدة (Ad-hoc Tasks) حيث لا يُتوقع تحديث السجلات مستقبلاً. أما إذا كان مصنف العمل يمثل نموذجاً تشغيلياً مستمراً، أو لوحة مؤشرات تفاعلية (Dashboard)، أو قاعدة بيانات دورية التحديث، فإن الاعتماد على الصيغ الديناميكية يصبح خياراً حتمياً لضمان استدامة المعالجة ودقة التقارير دون الحاجة لتدخل بشري متكرر.
7. معالجة الأخطاء وتنقية البيانات الشاذة في عناوين البريد الإلكتروني
7.1 التعامل المنهجي مع أخطاء القيمة والغياب (#VALUE! و#N/A)
في المجموعات الحقيقية للبيانات البحثية والتسويقية، نادراً ما تكون السجلات مثالية ونقية بالكامل؛ إذ كثيراً ما تحتوي قواعد البيانات على أخطاء مدخلة ناجمة عن سهو بشري أو مشاكل تصدير تقنية، مثل تسجيل رقم هاتف في حقل البريد، أو كتابة اسم دون علامة الربط القياسية. عند تطبيق صيغ الاقتطاع المباشرة على مثل هذه الحالات الشاذة، تنفجر واجهة العمل برسائل الخطأ الشهيرة، حيث تعيد دالة FIND الخطأ (#VALUE!) عند عجزها عن العثور على الرمز، في حين تعيد دالة TEXTAFTER الخطأ (#N/A) للدلالة على غياب المحدد المستهدف.
يعد التعامل المنهجي مع هذه الأخطاء متطلباً أساسياً لحماية المظهر العام للتقارير ومنع تعطل الدوال التحليلية اللاحقة. في الصيغ الكلاسيكية، يكمن الحل القياسي في تطويق المعادلة بالكامل بدالة تصيد الأخطاء الشاملة IFERROR، لتتم كتابتها بالهيكل التالي:
=IFERROR(MID(A2, FIND(“@”, A2) + 1, LEN(A2)), “بريد غير صالح”)
تعمل هذه الدالة كحاجز حماية برمجي؛ فإذا نجحت العمليات الحسابية الداخلية، تمرر النطاق المستخرج بنجاح، أما إذا أطلقت أي دالة داخلية إشارة خطأ لأي سبب، تلتقط IFERROR الاستثناء وتعيد بدلاً منه الرسالة التنبيهية المحددة أو نصاً فارغاً (“”) بناءً على رغبة المحلل.
أما في بيئة دالة TEXTAFTER الحديثة، فقد وفر مهندسو مايكروسوفت حلاً مدمجاً وفائق الأناقة دون الحاجة لاستدعاء دوال خارجية، وذلك عبر توظيف الوسيطة الاختيارية السادسة (if_not_found). يمكن كتابة الصيغة على النحو التالي:
=TEXTAFTER(A2, “@”, 1, , , “محدد مفقود”)
إذا رصدت الدالة غياب علامة @ تماماً من الخلية المدخلة، فإنها تعيد مباشرة القيمة المحددة في الوسيطة السادسة بدلاً من إظهار الخطأ (#N/A). يتيح هذا النهج للمحلل إنشاء تقارير تدقيق استباقية تسرد السجلات المعطوبة التي تتطلب مراجعة بشرية دون أن تتشوه الواجهة برسائل الخطأ التقنية المزعجة.
7.2 تنظيف السلاسل النصية من الفراغات والرموز الخفية
تمثل مشكلة الشوائب النصية غير المرئية أحد أخطر مصادر التلوث في قواعد البيانات الرقمية؛ فالكثير من عناوين البريد الإلكتروني التي تُنسخ من ملفات الـ PDF أو مواقع الويب تتضمن مسافات بادئة أو لاحقة غير مقصودة، أو فواصل ناتجة عن المسافة غير القابلة للكسر (Non-breaking space: ASCII 160)، بالإضافة إلى أحرف التحكم الخفية غير القابلة للطباعة (ASCII من 0 إلى 31). إن وجود هذه الشوائب قبل أو بعد علامة @ أو في أطراف السلسلة يؤدي إلى تشويه النطاق المستخرج وإفشال عمليات المطابقة الإحصائية اللاحقة.
لمواجهة هذا التحدي التقني، تزخر برمجية إكسل بدالتين تنظيفيتين بالغة الأهمية: دالة TRIM ودالة CLEAN. تتولى دالة TRIM إزالة كافة المسافات البادئة واللاحقة من النص، مع تقليص أي مسافات متكررة في الوسط لتصبح مسافة مفردة واحدة. بينما تتخصص دالة CLEAN في فحص السلسلة النصية وحذف كافة الرموز وأحرف التحكم غير القابلة للطباعة التي تنشأ عادة عن عمليات النقل عبر خوادم الويب وقواعد البيانات غير المتوافقة.
تتمثل الممارسة الأكاديمية الرصينة في بناء صيغة متكاملة تدمج التنظيف والاقتطاع ومعالجة الأخطاء في خطوة معمارية موحدة، كما في الصيغة التالية:
=IFERROR(TEXTAFTER(TRIM(CLEAN(A2)), “@”), “بيانات تالفة”)
في هذا البناء المتماسك، تقوم الدالتان CLEAN وTRIM بتطهير السلسلة النصية في الخلية A2 من أي رموز خفية أو فراغات طفيلية مسبقاً، ثم تمرر النص النقي إلى دالة TEXTAFTER لاقتطاع النطاق بأمان، وتتولى IFERROR إدارة أي استثناء متبقٍ. يضمن هذا الدمج تنقية البيانات ومعالجتها وفق أعلى معايير الجودة الرقمية قبل الدخول في مراحل التحليل المتقدمة.
7.3 تأسيس قواعد التحقق من صحة البيانات (Data Validation) لمنع الأخطاء
تعتبر الوقاية الاستباقية عند نقطة الإدخال أرقى منهجيات حوكمة البيانات وأقلها كلفة من الناحية التشغيلية؛ إذ إن منع تدفق السجلات المعطوبة إلى ورقة العمل ابتداءً يغني المحلل عن تخصيص موارد زمنية هائلة للمعالجة اللاحقة وتنقية الأخطاء. يتحقق ذلك في إكسل عبر تفعيل أداة “التحقق من صحة البيانات” (Data Validation) لتأسيس شروط حوكمة صارمة تمنع المستخدمين من حفظ أي عنوان بريدي لا يمتثل للبنية التركيبية الأساسية للبريد الإلكتروني.
لتطبيق هذه الرقابة، يتم تحديد عمود إدخال البريد الإلكتروني، والتوجه إلى تبويب “بيانات”، ثم اختيار “التحقق من صحة البيانات”. في مربع معايير التحقق، يتم تغيير نمط السماح من “أي قيمة” إلى “مخصص” (Custom)، وإدخال صيغة منطقية تفرض وجود علامة الربط وحظر المسافات العشوائية، مثل الصيغة التالية:
=AND(ISNUMBER(FIND(“@”, A2)), ISERROR(FIND(” “, A2)))
تختبر هذه الصيغة شرطين متلازمين: الأول يوجب أن تسفر دالة FIND عن رقم موجب يؤكد وجود الرمز @ داخل الخلية، والثاني يضمن أن يفشل البحث عن المسافة الفارغة، مما يعني خلو العنوان من أي فراغات داخلية غير قانونية وفق معايير الاتصال الدولية.
يكتمل هذا التأسيس بتخصيص رسالة تنبيهية عند الخطأ (Error Alert) عبر التبويب الفرعي للأداة؛ حيث يُصاغ عنوان تنبيهي مثل “تنسيق بريد إلكتروني غير صالح”، وتُرفق رسالة توجيهية تشرح للمدخل ضرورة كتابة العنوان بصيغة قياسية تشتمل على علامة @ وخالية من الفراغات. يؤدي هذا الإجراء التوجيهي إلى رفع كفاءة إدخال البيانات في الاستمارات الحية وتوفير ساعات من التحليل الإحصائي لاحقاً، مما يكرس مبادئ الجودة الشاملة للمعلومات المؤسسية.
8. الأتمتة المتقدمة لاستخراج النطاقات باستخدام Power Query
8.1 استيراد البيانات وتجهيزها في محرك Power Query
عندما تتسع مجموعات البيانات لتتحول إلى تدفقات دورية تضم مئات الآلاف أو الملايين من السجلات الموزعة عبر ملفات وقواعد بيانات خارجية، تصبح الطرق التقليدية داخل أوراق العمل قاصرة عن مجاراة متطلبات الكفاءة والأتمتة. هنا يبرز محرك باور كويري (Power Query)—المدمج في إكسل تحت مسمى “الحصول على البيانات وتحويلها” (Get & Transform Data)—كأقوى أداة معمارية لإدارة خطوط أنابيب معالجة البيانات النصية واستخراج النطاقات بأسلوب مؤتمت واحترافي.
تبدأ دورة العمل بتحويل النطاق المصدري لعناوين البريد الإلكتروني في ورقة العمل إلى جدول إكسل ديناميكي رسمي عبر الضغط على الاختصار (Ctrl + T)، وهي خطوة تأسيسية هامة تسمح بتتبع نمو البيانات تلقائياً. بعد ذلك، يتم استيراد الجدول إلى محرك الاستعلام بالنقر على خيار “من جدول/نطاق” (From Sheet/Table) داخل تبويب بيانات. يُفتح حينها محرر Power Query في نافذة مستقلة ومعزولة تضمن حماية البيانات الأصلية في ورقة العمل من أي تلف أو تعديل غير قابل للتراجع أثناء المعالجة.
داخل بيئة المحرر، يتعرف النظام تلقائياً على أنواع البيانات؛ حيث يجب التأكد من تعيين نوع عمود البريد كـ “نص” (Text) لضمان عدم تعرض المحارف لأي تشويه. وتقتضي الممارسات التحليلية الحكيمة إنشاء نسخة مكررة من العمود الأصلي بالنقر بزر الفأرة الأيمن واختيار “Duplicate Column”؛ يضمن هذا الإجراء حماية العمود المصدري لاستخدامه في عمليات التحقق أو التواصل اللاحق، وتكريس العمود المكرر لتنفيذ عمليات الانشطار والاقتطاع المتقدمة.
8.2 تطبيق عملية تقسيم الأعمدة بواسطة المحدد في واجهة الاستعلام
تتميز واجهة Power Query بقدرتها على تنفيذ أكثر عمليات تحويل النصوص تعقيداً عبر واجهة مستخدم رسومية بديهية تُترجم فورياً في الخلفية إلى لغة M البرمجية المتقدمة. لاستخراج النطاق، يتم تحديد العمود المستهدف ثم التوجه إلى تبويب “الصفحة الرئيسية” (Home) أو تبويب “تحويل” (Transform) واختيار أداة “تقسيم العمود” (Split Column)، وتحديد الخيار الفرعي “بواسطة المحدد” (By Delimiter).
في النافذة التفاعلية للتقسيم، يتم تعيين المحدد كـ “مخصص” (Custom) وإدخال الرمز القياسي (@). يقدم المحرك خيارات استراتيجية دقيقة لموضع الانفصال؛ حيث يُوصى بتحديد خيار “المحدد في أقصى اليمين” (Right-most delimiter). تكتسب هذه التوصية أهمية حاسمة لمعالجة الحالات الشاذة والنادرة التي قد تحتوي فيها أسماء المستخدمين المعقدة على علامة @ مضمنة بين علامتي اقتباس داخل الجزء المحلي؛ فاختيار المحدد في أقصى اليمين يضمن أن التقسيم سينفذ حصرياً عند الفاصل الحقيقي الذي يسبق النطاق المؤهل مباشرة.
ينشئ هذا الإجراء تلقائياً تعليمة برمجية بلغة M تستدعي الدالة الشهيرة:
Text.AfterDelimiter([EmailColumn], “@”)
تتم إعادة تسمية العمود الناتج فوراً إلى “اسم النطاق” (Domain)، مع إمكانية حذف العمود الذي يحتوي على أسماء المستخدمين بنقرة واحدة إذا لم تكن هناك حاجة تحليلية إليه. تظهر كل خطوة من هذه الخطوات مسجلة بتسلسل زمني دقيق في لوحة “الخطوات المطبقة” (Applied Steps) في يمين الشاشة، مما يتيح مراجعتها أو تعديل منطقها في أي وقت بسهولة تامة.
8.3 مزايا التحديث المتكرر والربط التلقائي بقواعد البيانات الخارجية
تكمن القوة التحويلية الحقيقية لمحرك Power Query في ميزة “خط الأنابيب المؤتمت القابل لإعادة الاستخدام” (Automated Data Pipeline). فكافة خطوات استيراد البيانات، وتكرار الأعمدة، وتنظيف الشوائب، وتقسيم النصوص، وإعادة التسمية لا تُنفذ كعمليات يدوية ثابتة، بل تُحفظ كخوارزمية تحويل برمجية مشفرة. وبمجرد الانتهاء، ينقر المحلل على خيار “إغلاق وتحميل” (Close & Load) لترحيل البيانات المنقاة إلى ورقة عمل جديدة في جدول فائق التنسيق.
عندما تُضاف آلاف العناوين الجديدة إلى الجدول المصدري لاحقاً، أو عند ربط الاستعلام بملف خارجي أو قاعدة بيانات SQL تتلقى اشتراكات بريدية يومية، لا يضطر المحلل لتكرار أي خطوة من خطوات المعالجة النصية إطلاقاً. يكفي النقر بزر الفأرة الأيمن على جدول المخرجات واختيار “تحديث” (Refresh)، أو الضغط على الاختصار (Ctrl + Alt + F5)، ليقوم المحرك في الخلفية بإعادة تشغيل كامل خوارزمية الاستخراج على السجلات المضافة حديثاً، وتحديث قائمة النطاقات في ثوانٍ معدودة.
يوفر هذا النهج المؤسسي أعلى مستويات الكفاءة والموثوقية، حيث يقلص الاعتماد على التدخل البشري المستمر إلى الصفر، ويزيل احتمالات الخطأ اليدوي في معالجة القوائم الدورية. إن أتمتة خطوط معالجة النصوص عبر Power Query تمثل المعيار الصناعي الحديث لإدارة قواعد البيانات الضخمة، مما يمكن فرق العمل التحليلية من تكريس جهودها نحو التحليل الاستراتيجي وتفسير النتائج بدلاً من الغرق في المهام التكرارية العقيمة.
9. الاستخراج البرمجي للنطاقات باستخدام لغة VBA ووظائف الماكرو المخصصة
9.1 برمجة دالة مخصصة (User-Defined Function) لاستخلاص النطاق
في البيئات المتقدمة لتطوير تطبيقات إكسل، توفر لغة البرمجة المدمجة فيجوال بيسك للتطبيقات (VBA) أفقاً لا محدوداً للتحكم البرمجي والأتمتة المتخصصة. يسمح محرر VBA للمطورين بإنشاء “دوال معرفة بواسطة المستخدم” (User-Defined Functions – UDFs) تسد الفجوات الوظيفية وتدمج العمليات المعقدة في كلمة استدعاء برمجية واحدة. تمثل برمجة دالة مخصصة لاستخراج النطاق حلاً مثالياً للشركات التي تستخدم إصدارات قديمة لا تدعم TEXTAFTER وترغب في الوقت ذاته في تجنب المعادلات الكلاسيكية المعقدة والطويلة.
لإنشاء هذه الدالة، يتم فتح محرر الأكواد عبر الضغط على المفتاحين (Alt + F11)، ثم إدراج وحدة برمجية قياسية جديدة (Module) من قائمة Insert، وكتابة الكود المعياري المتين التالي:
Function GetDomain(EmailAddress As String) As String
    Dim Parts() As String
    On Error GoTo ErrorHandler

    If InStr(EmailAddress, "@") > 0 Then
        Parts = Split(Trim(EmailAddress), "@")
        GetDomain = Parts(UBound(Parts))
    Else
        GetDomain = ""
    End If
    Exit Function

ErrorHandler:
    GetDomain = "خطأ في المعالجة"
End Function
يعتمد هذا الكود البرمجي على دالة Split المدمجة في VBA، والتي تقوم بتفكيك السلسلة النصية إلى مصفوفة ذات بعد واحد استناداً إلى المحدد (@). وباستخدام التابع UBound(Parts)، تجلب الدالة دائماً العنصر الأخير في المصفوفة، وهو ما يضمن استخراج النطاق الصحيح حتى لو كانت هناك علامات شاذة سابقة. بمجرد إغلاق المحرر، تصبح الدالة =GetDomain(A2) متاحة للاستخدام داخل خلايا ورقة العمل كأي دالة قياسية مدمجة في إكسل، مما يمنح المصنف أناقة معمارية فريدة وسهولة مطلقة في التطبيق.
9.2 بناء ماكرو تنفيذي لمعالجة البيانات الضخمة بنقرة زر واحدة
عندما يتعلق الأمر بمعالجة جداول عملاقة تحتوي على مئات الآلاف من السجلات البريدية، قد يصبح استخدام الدوال والصيغ داخل الخلايا عبئاً ثقيلاً على الذاكرة الحية للجهاز. في مثل هذه الظروف، يمثل بناء ماكرو تنفيذي مستقل (Subroutine) الخيار الهندسي الأمثل لمعالجة البيانات بنقرة زر واحدة دون ترك أي معادلات نشطة داخل ورقة العمل. يقوم هذا الماكرو بقراءة البيانات، ومعالجتها في الذاكرة عبر مصفوفات برمجية فائقة السرعة، ثم إلقاء النتائج كنصوص صامتة في ثوانٍ معدودة.
يوضح الكود التالي كيفية بناء هذا الماكرو المتطور مع تطبيق أفضل ممارسات تحسين الأداء:
Sub ExtractDomainsBatch()
    Dim ws As Worksheet
    Dim LastRow As Long
    Dim DataRange As Variant
    Dim ResultRange As Variant
    Dim i As Long
    Dim AtPos As Long

    Set ws = ActiveSheet
    LastRow = ws.Cells(ws.Rows.Count, "A").End(xlUp).Row
    If LastRow < 2 Then Exit Sub

    ' تسريع التنفيذ عبر تعطيل تحديث الشاشة والحسابات
    Application.ScreenUpdating = False
    Application.Calculation = xlCalculationManual

    ' تحميل البيانات في مصفوفة داخل الذاكرة
    DataRange = ws.Range("A2:A" & LastRow).Value
    ReDim ResultRange(1 To UBound(DataRange, 1), 1 To 1)

    For i = 1 To UBound(DataRange, 1)
        If VarType(DataRange(i, 1)) = vbString Then
            AtPos = InStr(DataRange(i, 1), "@")
            If AtPos > 0 Then
                ResultRange(i, 1) = Mid(DataRange(i, 1), AtPos + 1)
            Else
                ResultRange(i, 1) = "بريد غير صالح"
            End If
        Else
            ResultRange(i, 1) = ""
        End If
    Next i

    ' تفريغ النتائج دفعة واحدة في العمود المجاور
    ws.Range("B2:B" & LastRow).Value = ResultRange

    ' استعادة إعدادات التطبيق
    Application.Calculation = xlCalculationAutomatic
    Application.ScreenUpdating = True
    MsgBox "اكتمل استخراج النطاقات بنجاح!", vbInformation, "إنجاز العملية"
End Sub
يتميز هذا الإجراء التقني بتعطيل تحديثات الشاشة والحسابات التلقائية مؤقتاً، وتفريغ المعالجة بالكامل داخل الذاكرة العشوائية السريعة عبر المصفوفات المتغيرة (Variant Arrays)، مما يمكنه من معالجة أكثر من 100,000 سجل في غضون ثانية أو ثانيتين فقط، متجاوزاً بمراحل أي أداء يمكن تحقيقه عبر الدوال الحسابية المباشرة داخل الخلايا.
9.3 الموازنة الأمنية والتشغيلية بين الأكواد البرمجية والصيغ المدمجة
رغم القوة البرمجية الفائقة والسرعة المذهلة التي تتيحها أكواد VBA، إلا أن اللجوء إلى الحلول البرمجية يفرض مجموعة من القيود الأمنية والتشغيلية الصارمة التي يجب على المحلل الأكاديمي والمهني إدراكها بوضوح. يتصدر هذه القيود ضرورة حفظ ملف العمل بتنسيق يدعم الماكرو (مثل .XLSM أو .XLSB)؛ إذ إن محاولة حفظ الملف بالصيغة الافتراضية الشائعة (.XLSX) ستؤدي فوراً ودون إنذار إلى حذف كافة الوحدات النمطية والأكواد البرمجية التي تمت كتابتها.
علاوة على ذلك، تفرض بيئات العمل المؤسسية والحكومية سياسات أمان معلوماتية مشددة (Group Policies) تقوم افتراضياً بحظر تشغيل وحدات الماكرو لمنع التهديدات السيبرانية والبرمجيات الخبيثة المضمنة. وبالتالي، فإن إرسال ملف يحتوي على وظائف UDF مخصصة إلى عميل خارجي أو مراجع أكاديمي قد يواجه برفض أمني يمنع تشغيل الأكواد، مما يترك خلايا العمل مليئة بأخطاء التعرف الحسابية ويشل قدرة المستلم على الاستفادة من النموذج.
لذلك، تقتضي أفضل الممارسات التشغيلية حصر استخدام حلول VBA في النظم الداخلية المؤتمتة الخاصة بالباحث أو المؤسسة المغلقة، أو عند معالجة ملفات بيانات خام ضخمة تتطلب تفريغ نتائج نصية فورية بنقرة واحدة. أما في حال كانت مخرجات العمل موجهة للنشر العام، أو التداول المشترك بين باحثين متعددي المؤسسات، فإن تفضيل الصيغ الرسمية المدمجة (مثل TEXTAFTER في البيئات الحديثة أو الدوال الكلاسيكية في البيئات المتنوعة) يظل هو الخيار الأكثر أماناً وموثوقية لضمان سلامة العمل وقابليته للتشغيل الفوري دون أي عوائق أمنية.
10. أفضل الممارسات التحليلية والخطوات التالية بعد استخراج النطاق
10.1 تحليل توزيع النطاقات وتصنيفها المؤسسي والتجاري
لا يمثل استخراج النطاق محطة النهاية في رحلة معالجة البيانات، بل هو نقطة الانطلاق الفعلية نحو تحليلات استكشافية وتصنيفية أعمق تضفي قيمة استراتيجية على البيانات المجمعة. الخطوة التحليلية الأولى التي يُنصح بتطبيقها هي بناء “الجداول المحورية” (Pivot Tables) لتلخيص السجلات المستخرجة؛ حيث يتم وضع حقل “اسم النطاق” في منطقة الصفوف، وسحب نفس الحقل إلى منطقة القيم مع تطبيق دالة العد (Count) لمعرفة التكرار الإحصائي لكل نطاق بدقة.
يتيح هذا التلخيص للمحلل التعرف الفوري على أكثر النطاقات شيوعاً وهيمنة داخل العينة البحثية أو السوقية. يمكن بعد ذلك تصنيف النطاقات المستخرجة عبر دوال المطابقة الشرطية (مثل IFS أو XLOOKUP المدمجة مع جداول مرجعية) إلى فئات رئيسية متباينة: مزودات البريد التجاري العام (مثل gmail.com وoutlook.com)، والنطاقات التعليمية والبحثية، والشركات والمؤسسات الخاصة. هذا التصنيف يساعد في عزل الحسابات الفردية وتوجيه الحملات أو الدراسات نحو ممثلي المؤسسات المستهدفة حصراً.
يُتوج هذا التحليل الإحصائي برسم مخططات بيانية تفاعلية تلخص التوزيع الهيكلي للنطاقات؛ حيث يتيح استخدام المخططات الشريطية (Bar Charts) لعرض النطاقات العشرة الأكثر تكراراً، أو استخدام المخططات الدائرية (Pie Charts) لعرض الحصص النسبية للفئات المؤسسية الكبرى، تحويل الجداول النصية الجافة إلى قصص بصرية غنية بالدلالات يسهل استيعابها وعرضها في التقارير الأكاديمية والمهنية المتقدمة.
10.2 عزل امتدادات المستوى الأعلى (TLDs) لتحليل جغرافي وقطاعي أعمق
لتحقيق فهم أعمق للتركيبة الجيوسياسية والقطاعية لقواعد البيانات، يمكن للمحلل الانتقال إلى مستوى أكثر تقدماً عبر تفكيك النطاق المستخرج نفسه لاستخلاص ما يُعرف في بروتوكولات الإنترنت بـ “امتداد المستوى الأعلى” (Top-Level Domain – TLD). يتضمن هذا الامتداد الرموز النهائية مثل .com، و.org، أو الامتدادات الجغرافية للدول مثل .uk، و.sa، و.eg، والتي تحمل معلومات قطاعية وإقليمية بالغة القيمة التحليلية.
يمكن استخراج هذه الامتدادات بسهولة في إكسل الحديث عبر تطبيق دالة TEXTAFTER مرة ثانية لاقتطاع النص الواقع بعد آخر نقطة في النطاق، باستخدام المعامل (-1) للبحث العكسي من اليمين، كما في الصيغة التالية:
=TEXTAFTER(B2, “.”, -1)
أو استخدام الدالة الكلاسيكية المعتمدة على RIGHT وFIND المركبة للحصول على نفس النتيجة في الإصدارات الأقدم. يتيح عزل هذه الامتدادات فرز قاعدة البيانات وفق التوزيع الجغرافي للجمهور المستهدف دون الحاجة لسؤال المستخدمين صراحة عن بلدانهم في استمارات التسجيل، مما يوفر بيانات جيومكانية تلقائية تعزز دقة التحليل السكاني.
علاوة على ذلك، يسهم فحص طبيعة هذه الامتدادات في تقييم موثوقية مصادر البيانات؛ فالامتدادات التي تقتصر حصراً على الهيئات المعتمدة رسمياً (مثل .gov للجهات الحكومية أو .edu و.ac للجامعات المعتمدة) تمنح الباحث ثقة إحصائية مطلقة في أن الاستجابات المسجلة تمثل مجتمعات أكاديمية ورسمية حقيقية، مما يرفع من جودة عينات البحث وموثوقية الاستنتاجات العلمية المشتقة منها.
10.3 حوكمة البيانات والامتثال لأخلاقيات حماية الخصوصية
تفرض البيئة الرقمية المعاصرة التزاماً صارماً بالتشريعات الدولية والمحلية المنظمة لسرية المعلومات وخصوصية الأفراد، وفي مقدمتها اللائحة العامة لحماية البيانات في الاتحاد الأوروبي (GDPR). في هذا السياق القانوني والأخلاقي، ينطوي عنوان البريد الإلكتروني الشخصي الكامل (مثل [email protected]) على صفة “البيانات المحددة للهوية الشخصية” (Personally Identifiable Information – PII)، والتي تخضع لضوابط جمع وتخزين ومعالجة بالغة الحساسية والتعقيد.
هنا تبرز فائدة منهجية استثنائية لعملية عزل واستخراج النطاقات؛ فعند حذف اسم المستخدم والاحتفاظ فقط باسم النطاق المؤسسي، تتحول السجلات الفردية الحساسة إلى بيانات مجمعة ومجهولة المصدر (Aggregated & Anonymized Data) لا تدل بشكل مباشر على شخصية الفرد الطبيعي. يتيح هذا التحويل للمحللين والباحثين تداول قواعد البيانات، ومشاركتها مع فرق العمل المشتركة، وإجراء التحليلات الإحصائية الموسعة ونشرها دون الوقوع في أي انتهاك تشريعي لحقوق الخصوصية.
ومع ذلك، يجب أن تترافق هذه الإجراءات مع تطبيق بروتوكولات حوكمة داخلية صارمة؛ تشمل حفظ وتأمين السجلات الأصلية في مساحات تخزين مشفرة ومحمية بكلمات مرور، وقصر صلاحيات الوصول إلى العناوين الكاملة على الباحثين المخولين فقط وفق مبدأ “الحاجة إلى المعرفة” (Need-to-Know Principle). إن التوفيق الواعي بين استخلاص الأنماط المؤسسية المفيدة والامتثال الصارم لمعايير الأخلاقيات والخصوصية يمثل معيار النضج التحليلي في المؤسسات الأكاديمية والمهنية المتقدمة.
خاتمة
لقد استعرض هذا المقال الأكاديمي الشامل الأبعاد المفاهيمية، والرياضية، والتقنية المرتبطة بعملية استخراج النطاق من عنوان البريد الإلكتروني في برنامج مايكروسوفت إكسل. إن التعامل مع البيانات النصية لم يعد مجرد مهمة مكتبية روتينية، بل هو علم تطبيقي يستند إلى الفهم الدقيق للبنية الهيكلية للمحددات، وإتقان التوظيف الحسابي للدوال المعيارية، والقدرة على التعامل الاستباقي مع تشوهات البيانات والأخطاء الشاذة لضمان الحصول على قواعد بيانات نقية وموثوقة.
أظهرت دراستنا أن إكسل يوفر بيئة متكاملة تتعدد فيها المسارات لتناسب كافة المتطلبات والبيئات التشغيلية؛ فبينما تقدم الدالة الحديثة TEXTAFTER قمة البساطة والأناقة البرمجية لمستخدمي السحابة ومايكروسوفت 365، تظل الدوال الكلاسيكية المركبة (مثل RIGHT وMID وFIND) الصخرة الثابتة التي تضمن التوافقية الشاملة عبر مختلف الإصدارات والمنصات. وفي الوقت ذاته، تمنح أدوات الذكاء الاصطناعي كالتعبئة السريعة (Flash Fill)، والميزات التحويلية كأداة تحويل النص إلى أعمدة ومحرك Power Query، ولغة البرمجة VBA، مرونة فائقة لأتمتة معالجة البيانات الضخمة بدقة واحترافية متناهية.
إن الخطوة التالية لأي محلل بيانات وباحث طموح هي الانتقال من مجرد تطبيق هذه الصيغ إلى تبني منهجية متكاملة لحوكمة البيانات وتنظيفها وتصنيفها المؤسسي. إن الاستثمار في إتقان هذه المهارات التقنية لا يوفر الوقت والجهد فحسب، بل يرتقي بجودة المخرجات البحثية وصنع القرار المؤسسي، محولاً السجلات النصية الأولية إلى رؤى استراتيجية تقود الابتكار وتدعم مسيرة المعرفة في المجتمع الرقمي الحديث.
المراجع
Lankton, N. K., McKnight, D. H., & Tripp, J. F. (2015). Technology, Humanness, and Trust: Rethinking Trust in Technology. Journal of the Association for Information Systems, 16(10), 880–918. https://doi.org/10.17705/1jais.00411