
تُعد معالجة السلاسل النصية غير المهيكلة واستخلاص البيانات الحيوية منها واحدة من أكثر المهام تعقيداً وأهمية في بيئات الأعمال الحديثة والبحوث الأكاديمية على حد سواء؛ إذ تتراكم في كثير من الأحيان كميات هائلة من النصوص الوصفية غير المنتظمة داخل جداول البيانات، محتوية في ثناياها على معلومات اتصال بالغة الحساسية والأهمية، مثل عناوين البريد الإلكتروني. ولا تقتصر صعوبة هذه العملية على مجرد العثور على عنوان بريد إلكتروني، بل تمتد لتشمل عزله بدقة فائقة وتجريده من الشوائب والرموز المحيطة به، وضمان تكامله مع قواعد البيانات دون إتلاف بنيتها أو التأثير على اتساق السجلات التشغيلية.
يمثل برنامج مايكروسوفت إكسل (Microsoft Excel)، منذ انطلاقته التاريخية على أجهزة ماكنتوش في عام 1985 ثم على أنظمة ويندوز في عام 1987، المنصة الأكثر انتشاراً في التعامل مع البيانات الجداولية؛ ومع ذلك، ظل التعامل مع النصوص المختلطة يمثل تحدياً تقنياً يواجه المحللين والإداريين. إن مواجهة كتلة نصية تحتوي على أسماء، وملاحظات، وأرقام هواتف، وعناوين بريد إلكتروني مدمجة دون فواصل منتظمة، تتطلب فهماً عميقاً لآليات المعالجة النصية داخل إكسل، بدءاً من توظيف الصيغ المركبة الكلاسيكية، ومروراً بالدوال المصفوفية الديناميكية الحديثة، ووصولاً إلى تقنيات البرمجة والتعابير النمطية.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تشريح أكاديمي وإجرائي شامل لكيفية استخراج عنوان البريد الإلكتروني من أي سلسلة نصية داخل برنامج إكسل. سنعمل عبر أقسام هذا المقال على تفكيك المنطق الرياضي والوظيفي للمعادلات النصية المركبة، وشرح آليات رصد الرموز، وتحليل تقنيات التوسيع الفضائي، وتقديم الحلول البديلة عبر الأدوات المدمجة والبرمجة النصية، مع معالجة كافة الاستثناءات والبيانات المفقودة، لضمان وصول القارئ إلى كفاءة احترافية مطلقة في إدارة قواعد البيانات الرقمية وتنقيتها بأعلى معايير الدقة والموثوقية.
1. مدخل نظري وأهمية استخراج عناوين البريد الإلكتروني في إكسل
1.1 مفهوم تنقية البيانات النصية وأهميتها في المعالجة الآلية
تشير تنقية البيانات النصية (Text Data Cleansing) إلى مجموع العمليات الخوارزمية والإجرائية الهادفة إلى رصد الأخطاء، والتناقضات، والتنسيقات غير القياسية، وتصحيحها أو استخلاص العناصر المستهدفة منها لتحويلها من صيغ فوضوية غير مهيكلة إلى بيانات منتظمة وذات قيمة عملية وقابلة للتحليل الإحصائي أو الحوسبي. في سياق المؤسسات المعاصرة، يشكل عنوان البريد الإلكتروني المعرف الرقمي الأساسي للتواصل الأكاديمي، والتسويقي، والتشغيلي. إن عزل هذا المعرف بدقة من داخل النصوص الحرة يسهم مباشرة في بناء قواعد بيانات مؤسسية تتمتع بدرجة عالية من النزاهة وتكامل البيانات (Data Integrity).
تكمن الأهمية المنهجية لعملية العزل في إتاحة الفرصة لأنظمة إدارة علاقات العملاء (CRM)، ومنصات التواصل المؤسسي، وبرمجيات التدقيق، للوصول الفوري والمؤتمت إلى وسيلة الاتصال المعتمدة للشخص المعني دون الحاجة إلى تدخل بشري عرضة للخطأ والسهو. وقد بينت الدراسات المعنية بهندسة البيانات أن التدخل اليدوي في نسخ البيانات ونقلها يرفع احتمالية الخطأ المطبعي بنسب تتجاوز مستويات التسامح المسموح بها في البيئات المهنية. ومن هنا، تبرز المعالجة الآلية كركيزة أساسية لا غنى عنها في تحسين كفاءة تدفق العمل وخفض التكاليف التشغيلية الناتجة عن إرسال الرسائل إلى عناوين غير صحيحة أو مشوهة بنيوياً.
علاوة على ذلك، ترتبط جودة الاتصال المؤسسي ارتباطاً وثيقاً بمدى مطابقة العنوان المستخرج للمعايير القياسية العالمية. فظهور مسافة بيضاء غير مقصودة، أو رمز ترقيم زائد ملتصق بنهاية النطاق البريدي، يؤدي حتماً إلى ارتداد الرسائل وفشل حملات التواصل. إن استخدام الأساليب المؤتمتة الصارمة يضمن تجريد العنوان من كل ما يخالف تركيبه القياسي، مما ينعكس إيجاباً على سمعة النطاق المرسل واستدامة الاتصال بين المنظمات والأفراد، ويؤسس لبيئة رقمية خالية من الشوائب المعيقة لتدفق المعلومات.
1.2 طبيعة السلاسل النصية المختلطة وتحديات التجزئة
تتسم السلاسل النصية غير المهيكلة (Unstructured Text Strings) بالتباين الشديد في تركيبها النحوي والشكلي، حيث تلتقي الكلمات الأبجدية بالأرقام، وعلامات الترقيم، والأقواس، والرموز الخاصة ضمن سياق سردي حر. ففي كثير من الحالات، يسجل الموظفون الملاحظات بطرق متباينة، كأن يكتب أحدهم: “يرجى التواصل مع المشرف عبر بريده: [email protected] للاستفسار”، في حين يكتب آخر: “[email protected] (بريد رسمي)”. هذا التباين الحاد في موضع علامة (@) وطبيعة الكلمات المحيطة بها يفرض تحديات تقنية معقدة على أدوات التجزئة التقليدية.
تتعاظم الصعوبة عند وجود مسافات بيضاء غير مرئية (Non-breaking Spaces) أو محارف تحكم مخفية قد تنتقل إلى جداول البيانات عند النسخ من مصادر خارجية مثل المتصفحات أو ملفات PDF. هذه المحارف، على الرغم من عدم ظهورها للعين المجردة، تعامل برمجياً كعناصر نصية حقيقية تؤدي إلى كسر الصيغ التقليدية وتشويه عمليات القياس والقص النصي. تتجلى هذه المشكلة عند محاولة تحديد أطوال النصوص أو البحث عن الفواصل الفاصلة بين الكلمات.
إن الأدوات التقليدية المبنية على الافتراضات الثابتة، مثل أدوات القص ذات الأطوال المحددة مسبقاً، تقف عاجزة تماماً أمام هذه التراكيب العشوائية. فالبريد الإلكتروني لا يأتي بطول ثابت، ولا يبدأ بعد عدد محدد من المحارف، ولا يقع في مكان معلوم من الجملة. وبالتالي، فإن الاعتماد على تقنيات استخراج تتسم بالمرونة الخوارزمية والقدرة على التكيف مع التباين الديناميكي للمواقع والأطوال يصبح ضرورة تقنية لا ترفاً اختيارياً لمعالجة البيانات بكفاءة واقتدار.
2. البنية المنهجية للصيغة المركبة المخصصة للاستخراج
2.1 التحليل التركيبي للصيغة الشاملة
تعتمد المنهجية الكلاسيكية لاستخراج عنوان البريد الإلكتروني في برمجية إكسل على بناء صيغة متداخلة تجمع بين مجموعة من الدوال النصية والحسابية في تناغم تركيبي فريد. لا تعمل أي دالة من هذه الدوال بمعزل عن الأخرى، بل تعمل كأجزاء ميكانيكية مترابطة داخل محرك الاستخلاص. تأخذ الصيغة القياسية الشائعة في الأوساط المتقدمة لمعالجة البيانات الشكل التالي: دمج دالتي القص الجانبي مع دالتي الإحلال والتكرار الفضائي، مطوقة بدالة تشذيب المسافات ودالة لاحتواء الأخطاء.
يتطلب فهم هذه الصيغة الغوص في تسلسل التنفيذ المنطقي داخل برنامج إكسل، والذي يبدأ دوماً من النواة الداخلية ثم يتدرج خروجاً نحو الدوال المحيطية. تبدأ الدورة الخوارزمية برصد موقع علامة الارتكاز، ثم حساب طول النص المستهدف، يليه خلق بيئة فراغية موسعة تعزل الكلمات المتجاورة، يعقب ذلك اقتطاع الشريحة الحاوية للبريد، وأخيراً تفريغ الحيز الإضافي وحذف الفراغات الزائدة لإنتاج العنوان المستقل. إن هذا التكامل بين الجبر الحسابي ومعالجة المحارف هو ما يمنح الصيغة قوتها الاستثنائية أمام النصوص شديدة العشوائية.
لتأمين استقرار هذه الصيغة، تُستخدم الدالة المحيطية لمعالجة القيم غير الصحيحة أو الفارغة. فعند غياب العنوان من النص الأصلي، ينهار التسلسل الحسابي الداخلي لعدم توافر شروط البحث، مما يولد رسائل خطأ تشوه الجداول. إن إحاطة البنية المنطقية بصمام أمان وظيفي يضمن تحييد هذه الاستثناءات تلقائياً، مقدماً جدولاً نهائياً نظيفاً يلبي أعلى متطلبات التوثيق وعرض المؤشرات المؤسسية بوضوح تام وتناسق مريح للمستخدم النهائي.
2.2 الدور المحوري لرمز (@) كنقطة ارتكاز محورية
وفقاً لمعايير بروتوكولات الإنترنت التاريخية والتأسيسية، وتحديداً معيار RFC 822 الذي صاغه ديفيد كروكر (David H. Crocker) في عام 1982، والمعيار المحدث RFC 5322 الذي حرره بيتر ريزنيك (Peter W. Resnick) في عام 2008، يمثل رمز (@) الفاصل البنيوي الإلزامي والفريد الذي يفصل بين الجزء المحلي لعنوان البريد (Local-part) واسم النطاق (Domain name). هذا التوصيف المعياري الصارم يجعل من علامة (@) نقطة الارتكاز الوحيدة التي لا يمكن لعنوان بريد إلكتروني صالح أن يتواجد بدونها في أي مكان في العالم.
تستغل خوارزميات الاستخلاص هذا المعيار التقني باعتباره “المرساة الدلالية” للبحث؛ حيث يتم توجيه دوال القياس للبحث الحصري عن إحداثيات هذا الرمز داخل السلسلة النصية. فبمجرد تحديد موقعه العددي، يتحول التحدي من البحث في فضاء نصي عشوائي لا نهائي إلى مهمة مقيدة هندسياً: التوسع يميناً ويساراً من هذا الإحداثي للوصول إلى الحدود التي تنتهي عندها بنية العنوان البريدي وتبدأ عندها الكلمات السياقية العادية المحيطة به.
ومع ذلك، يبرز شرط أساسي لاستقرار هذا البحث، وهو التعامل مع النصوص التي قد تفتقر أصلاً لهذا الرمز، أو النصوص النادرة التي قد تشمل الرمز في سياقات أخرى غير بريدية، أو تكراره داخل السلسلة الواحدة. إن بناء خوارزمية استخراج متينة يقتضي وضع افتراضات مسبقة تضمن عدم انزلاق مؤشر القراءة النصي في إكسل عند غياب العلامة، مع تحديد سلوك محكم يضمن ثبات المؤشر على نقطة الارتكاز الصحيحة لتحقيق أعلى درجات الدقة في التحديد الموضعي للعناوين.
3. التفكيك الوظيفي لدوال تحديد المواقع والقياس (FIND و LEN)
3.1 الاستخدام المتقدم لدالة FIND لرصد المواقع الحرجة
تؤدي دالة FIND في إكسل الدور الرصدي الحاسم، إذ تكمن وظيفتها الأساسية في إرجاع الموقع الترتيبي لحرف معين أو نص فرعي داخل سلسلة نصية مستهدفة، مع مراعاتها الصارمة لحساسية حالة الأحرف، وهي ميزة حيوية تجعلها دقيقة وخالية من التداخلات غير المرغوبة. في المرحلة الأولى من خوارزمية الاستخراج، تُستخدم هذه الدالة لتحديد الإحداثي العددي الدقيق لموقع علامة (@)، مما يؤسس للإحداثي الأولي الذي ستنطلق منه باقي الدوال التشغيلية.
لا يتوقف دور الدالة عند رصد نقطة الارتكاز فحسب، بل يمتد إلى رصد المسافة الفارغة الأولى التي تلي علامة (@). ويتحقق ذلك من خلال توظيف معامل بدء البحث (Start_num) المتاح داخل دالة FIND؛ حيث نطلب منها البحث عن أول مسافة (” “) تبدأ بعد موقع علامة (@). يتيح هذا الإجراء الذكي تحديد النقطة التي ينتهي عندها عنوان البريد الإلكتروني بدقة متناهية، إذ إن المعايير القياسية تحظر وجود مسافات داخل العناوين البريدية الصحيحة، وبالتالي فإن أول فراغ تالٍ للرمز يمثل بالضرورة نهاية النطاق البريدي.
ولتجنب تعطل الدالة وانهيار الصيغة إذا كان عنوان البريد الإلكتروني واقعاً في أقصى نهاية النص دون أن تليه مسافة، تبرز حيلة تقنية بالغة البراعة تتمثل في دمج مسافة وهمية افتراضية في نهاية السلسلة عبر معامل الربط النصي (& ” “). يضمن هذا الدمج الخوارزمي أن دالة FIND ستعثر دوماً على مسافة تالية حتى لو كان العنوان يختتم الخلية، مما يمنع تولد خطأ التعذر العددي (#VALUE!) ويمنح مصفوفة البحث استقراراً تشغيلياً مطلقاً عبر جميع الاحتمالات النصية الممكنة.
3.2 حساب أطوال النصوص وتأثير دالة LEN في ديناميكية العمل
تقيس دالة LEN الطول الإجمالي للسلسلة النصية بعدد المحارف المكونة لها، بما في ذلك الحروف والأرقام والفواصل والمسافات البيضاء. في سياق استخراج النصوص المتغيرة، تلعب دالة LEN دور “معامل الأمان المتغير”؛ إذ إن النصوص المدخلة في قواعد البيانات تختلف أطوالها جذرياً من خلية لأخرى، مما يجعل استخدام أرقام ثابتة في عمليات القص أمراً مستحيلاً ومؤدياً حتماً إما لاقتطاع أجزاء من العنوان البريدي أو جلب نصوص مجاورة غير مرغوب فيها.
تتكامل دالة LEN داخل الصيغة لتقديم مقياس ديناميكي مرن، حيث يُستخدم الطول الكلي للسلسلة كمحدد لحجم التوسيع الفضائي ومقدار الاقتطاع اللاحق. يضمن هذا الإجراء أن تكون نافذة الاقتطاع كافية دائماً لاحتواء أطول عنوان بريد إلكتروني محتمل داخل الخلية المعنية، أياً كان امتداد نطاقه أو عدد محارف الجزء المحلي منه، متجاوزة بذلك القيود الناتجة عن تباين أحجام السجلات المدخلة.
علاوة على ذلك، يشكل قياس الطول الإجمالي ركيزة أساسية في ضبط إزاحة المؤشر الداخلي داخل دوال التجزئة. فعند الربط الرياضي بين طول النص الأصلي ومواقع الفواصل، يتولد معامل نسبي يتيح للدوال التالية معرفة المقدار الحقيقي للحجم النصي الواجب الاحتفاظ به، والمقدار الواجب حذفه وإسقاطه. يمثل هذا التوظيف لدالة LEN نموذجاً بارزاً للتفكير الحوسبي داخل إكسل، حيث تتحول الأطوال المطلقة إلى مؤشرات مرجعية تقود منطق الاستخلاص التلقائي بأمان تام وبدون أي تدخل يدوي.
4. آليات القص والتوسيع النصي (LEFT و RIGHT و REPT و SUBSTITUTE)
4.1 عزل الجزء الأمامي للسلسلة عبر دالة LEFT
بعد أن تنجح دوال الرصد والقياس في تحديد موقع نهاية البريد الإلكتروني (عبر رصد الفراغ الأول بعد الرمز)، تتدخل دالة LEFT لتنفيذ المرحلة الأولى من التجريد النصي. وظيفة هذه الدالة هي اقتطاع عدد معين من المحارف بدءاً من أقصى الطرف الأيمن أو الأيسر للنص بحسب لغة الخلية واتجاه السلسلة؛ وفي حالة النصوص اللاتينية القياسية للبريد، يتم الاقتطاع من بداية النص وصولاً إلى نهاية النطاق البريدي المستهدف.
تعتمد دالة LEFT على ناتج معادلة FIND السابقة كمعامل لتحديد عدد المحارف المطلوب عزلها. وبطرح القيمة الرقمية (1) من إحداثي المسافة التالية، تسحب دالة LEFT كتلة نصية متصلة تبدأ من أول حرف في الخلية وتنتهي عند الحرف الأخير للبريد الإلكتروني مباشرة، مع استبعاد كل ما يلي البريد من كلمات استدلالية، أو تعليقات لاحقة، أو أرقام إضافية، مما يؤدي إلى تضييق مساحة البحث وإلغاء نصف التعقيد المتواجد في الخلية.
إن تطبيق هذا الطرح الرياضي الدقيق يحول السلسلة المعقدة إلى نص مبتور ينتهي تماماً عند النقطة المحددة لعنوان البريد. وعلى الرغم من أن هذا الجزء المستخرج يظل محتوياً على الكلمات التي سبقت البريد الإلكتروني في الخلية، إلا أن التحكم المسبق في استبعاد المقاطع اللاحقة يعد خطوة تمهيدية محورية لا غنى عنها، إذ تهيئ الكتلة النصية لدخول مرحلة المعالجة الأكثر تقدماً: مرحلة التوسيع الفضائي والقص العكسي.
4.2 مفهوم التوسيع الفضائي عبر دالتي SUBSTITUTE و REPT
يمثل التوسيع الفضائي (Spatial Padding) الحيلة العبقرية الأكثر إثارة للإعجاب في تاريخ صياغة معادلات إكسل الكلاسيكية. تواجه المعادلات التقليدية مأزقاً في تحديد نقطة بداية البريد الإلكتروني إذا سبقته كلمات متعددة مفصولة بمسافات؛ وهنا يأتي الدور المشترك لدالتي SUBSTITUTE و REPT لتحويل هذه المسافات الفاصلة بين الكلمات إلى فجوات مكانية شاسعة تجعل من عملية الفصل الرياضي أمراً يسيراً وقاطعاً.
تستخدم دالة REPT لتكرار محرف المسافة (” “) لعدد ضخم من المرات، ويتم ضبط معامل التكرار رياضياً ليكون مساوياً لطول السلسلة النصية الأصلية المقاس بدالة LEN. فإذا كان طول النص الأصلي 100 محرف، تُنتج دالة REPT كتلة مسافات فارغة يبلغ طولها 100 مسافة متصلة. بعد ذلك، تأتي دالة SUBSTITUTE لتستبدل كل مسافة فردية وحيدة موجودة في النص المقتطع السابق بتلك الكتلة الفضائية الضخمة المكونة من 100 مسافة.
ينتج عن هذه العملية تباعد هائل بين الكلمات؛ حيث يبتعد النص السابق عن عنوان البريد الإلكتروني بفجوة هوائية تتكون من عشرات المسافات المتتابعة. إن هذا التوسيع الفضائي يلغي التلاصق النصي، ويجعل عنوان البريد الإلكتروني يطفو في الطرف النهائي للسلسلة ككتلة مستقلة محاطة بهامش أمان فارغ، مما يمهد الطريق لدالة القص العكسي لاقتطاعه دون أدنى خشية من التقاط أي أحرف تابعة للكلمات المجاورة السابقة له.
4.3 الاستخلاص العكسي والتنقية عبر RIGHT و TRIM
بمجرد اكتمال التوسيع الفضائي للنص، تتدخل دالة RIGHT لاستخلاص الكتلة الأخيرة من السلسلة الموسعة. وبما أن معامل التوسيع كان مساوياً لطول النص الأصلي (المحسوب بواسطة LEN)، يُطلب من دالة RIGHT سحب عدد محارف من نهاية السلسلة الموسعة مساوٍ تماماً لهذا الطول القياسي. ونظراً لأن عنوان البريد الإلكتروني يستقر في نهاية السلسلة، فإن هذا الاقتطاع يجلب العنوان ومعه جزء كبير من الفراغات الهوائية الموسعة التي سبق إدخالها قبله، دون أن يصل إلى الكلمات السابقة التي دُفعت بعيداً خارج نطاق الاقتطاع.
تصل السلسلة في هذه المرحلة إلى شكلها شبه النهائي: عنوان بريد إلكتروني نقي من النصوص الأخرى، لكنه يسبح وسط محيط متسع من المسافات الفارغة المكررة. وهنا يتجلى الدور التطهيري الحاسم للدالة القياسية TRIM. صُممت دالة TRIM خصيصاً لتفحص النصوص وإزالة كافة المسافات الزائدة في بدايتها ونهايتها، بالإضافة إلى اختزال أي مسافات متكررة بين الكلمات إلى مسافة واحدة فقط.
عند تمرير النص المقتطع عبر دالة TRIM، تقوم الدالة بلحظة واحدة بابتلاع كافة المسافات الفضائية الهائلة التي صنعناها عمداً عبر دالة REPT، لتترك وراءها فقط عنوان البريد الإلكتروني مجرداً، ومتماسكاً، وخالياً من أي شوائب نصية أو تشوهات فراغية. تضمن هذه الخطوة النهائية تحقيق مخرجات نقية بنسبة مئة بالمئة، متطابقة مع المعايير القياسية للإدخال البريدي، وجاهزة فوراً للاستخدام التشغيلي والتحليلي.
5. دليل التطبيق الإجرائي العملي للصيغة خطوة بخطوة
5.1 إعداد جدول البيانات وتجهيز المدخلات الخام
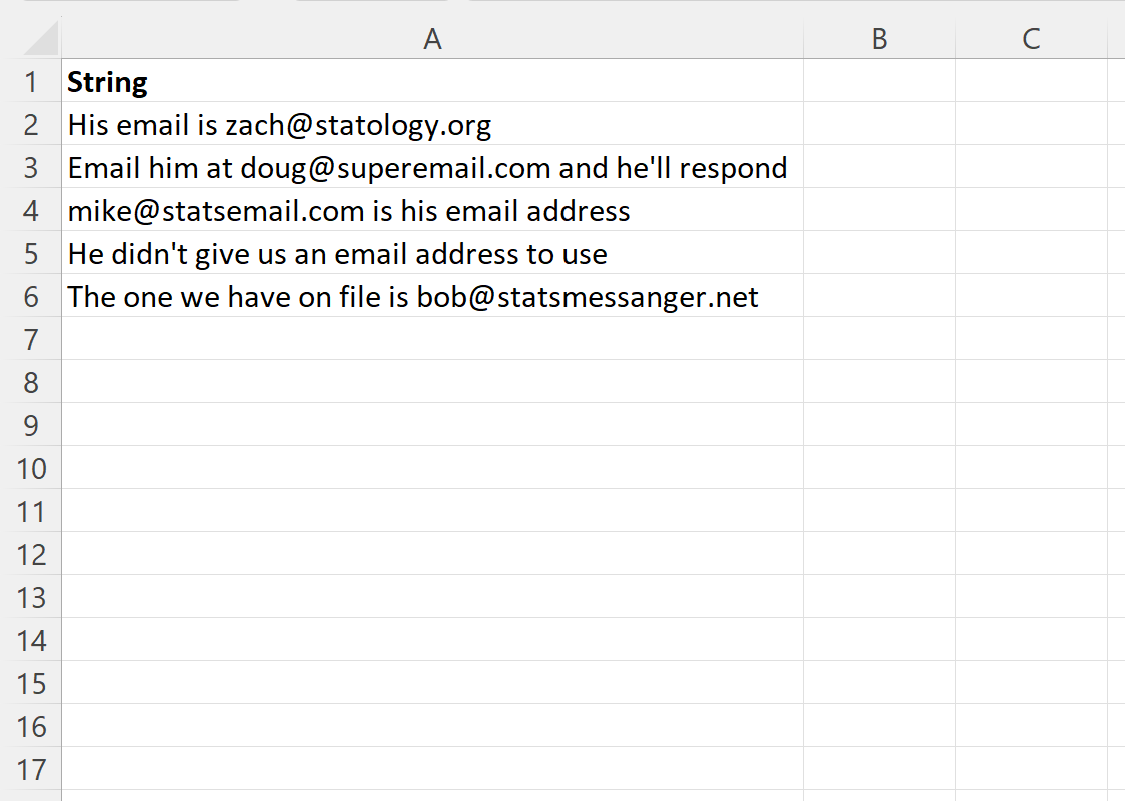
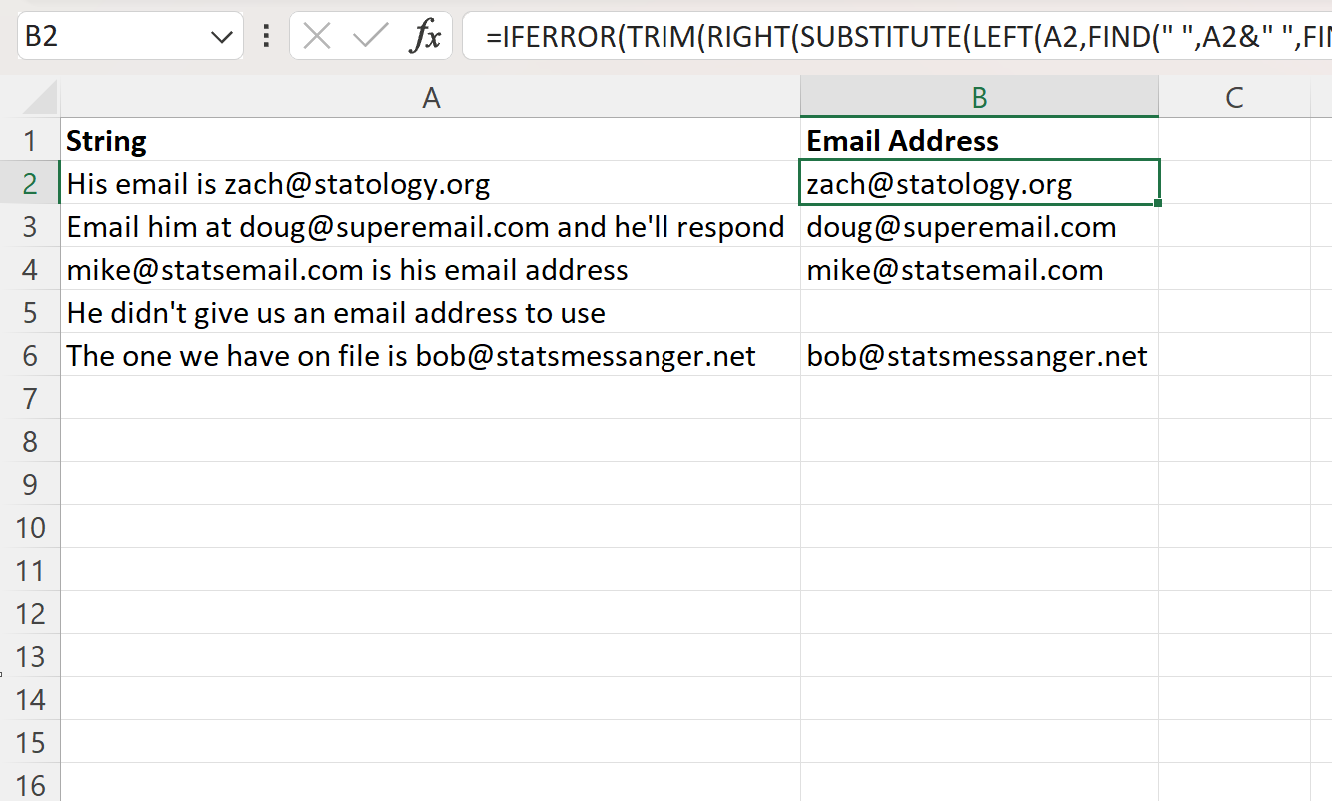
يتطلب النجاح الإجرائي لعمليات المعالجة النصية تهيئة بيئة العمل داخل ورقة عمل إكسل بدرجة عالية من التنظيم الهيكلي. قبل الشروع في كتابة أي صيغة رياضية، يجب تخصيص عمود مستقل للبيانات الخام غير المعالجة، وليكن العمود (A)، مع تسميته ترويسة واضحة مثل “النص_المختلط”. ويُخصص عمود ملاصق له، وليكن العمود (B)، لاستقبال النتائج، وتسميته “البريد_المستخرج”. يحظر تماماً محاولة إجراء المعالجة في نفس الخلية الأصلية لتفادي التدمير غير القابل للتراجع في البيانات المصدرية.
في الخلية المستهدفة الأولى، ولتكن الخلية B2، يتم تركيب الصيغة المركبة الشاملة بدقة فائقة، مع التحقق من صحة أسماء الدوال والفواصل وفقاً للإعدادات الإقليمية للنظام المشغل (استخدام الفاصلة العادية `,` أو الفاصلة المنقوطة `;` حسب لغة واجهة النظام). تأخذ الصيغة التركيبية الكلاسيكية التطبيقية النموذج التالي:
=TRIM(RIGHT(SUBSTITUTE(LEFT(A2, FIND(” “, A2 & ” “, FIND(“@”, A2)) – 1), ” “, REPT(” “, LEN(A2))), LEN(A2)))
يجب فحص مراجع الخلايا والتأكد من أنها مراجع نسبية (A2 بدون علامات الدولار $)، وذلك للسماح للصيغة بالحركة السلسة عند نسخها لأسفل الجدول. بعد كتابة الصيغة والضغط على مفتاح الإدخال (Enter)، يتم تدقيق المخرج في الخلية B2 بصرياً للتأكد من أن الصيغة قامت باستخلاص البريد الإلكتروني المعني دون زيادة أو نقصان، وأنها استجابت بشكل صحيح للمدخل الأولي قبل الانتقال إلى مرحلة التعميم الإجمالي.
5.2 تعميم المعادلة وتقييم استجابة البيانات
بعد التحقق من استقرار الصيغة في الصف الأول، يتم تعميمها على امتداد قاعدة البيانات. يتحقق ذلك بسهولة عبر تحديد الخلية B2 وتوجيه مؤشر الفأرة نحو الزاوية السفلية اليسرى (أو اليمنى حسب اتجاه الواجهة) للخلية حتى يتحول الرمز إلى مقبض التعبئة المتقاطع (+)، ثم النقر المزدوج السريع، أو السحب والإفلات اليدوي لأسفل العمود حتى آخر سجل مدخل في العمود المقابل.
تبدأ في هذه اللحظة مرحلة المراقبة النوعية لتقييم استجابة الصيغة مع الأنماط النصية المختلفة. ينبغي على المحلل مراجعة عينات عشوائية تغطي تنوع البيانات: تفحص الحالات التي يأتي فيها البريد في بداية الجملة، وتلك التي يقع فيها في نهايتها تماماً، والحالات التي تتضمن نطاقات بريدية مركبة ومعقدة مثل نطاقات المؤسسات الأكاديمية (مثل edu.sa أو ac.uk). تؤكد الملاحظة الدقيقة قدرة الصيغة على التكيف مع التباينات البنيوية دون أدنى تكسر في النتائج.
إن توثيق هذا الإجراء وقياس الفارق الزمني بين المعالجة اليدوية والمعالجة الآلية يبرز الفائدة الهائلة للصيغ المركبة؛ فما كان يستغرق ساعات طوال من المراجعة البشرية المضنية والتركيز المجهد يتم إنجازه في أجزاء من الثانية بدقة حسابية مطلقة، مما يخفض الهدر التشغيلي ويحرر الموارد البشرية للمهام التحليلية الأكثر استراتيجية داخل المنظمة.
6. استراتيجيات معالجة القيم الاستثنائية والبيانات المفقودة
6.1 تأمين النتائج ومنع رسائل الخطأ بواسطة IFERROR
في قواعد البيانات الواقعية، نادراً ما تأتي المدخلات بصفاء تام؛ فمن الشائع جداً أن تحتوي بعض السجلات على نصوص وصفية تفتقر تماماً إلى أي عنوان بريد إلكتروني، أو تشمل أرقام هواتف فقط، أو قيوداً فارغة أهمل مدخلو البيانات ملأها. في هذه الحالة، تفشل دالة FIND الداخلية في رصد علامة الارتكاز (@)، مما يتسبب فوراً في توليد رسالة الخطأ الشهيرة (#VALUE!)، والتي تتسلل إلى السطح وتفسد المظهر الاحترافي لورقة العمل، بل وتتسبب في إيقاف العمليات الحسابية والتقارير المعتمدة على هذا العمود.
لمواجهة هذا الخلل الهيكلي وتأمين سلامة المخرجات، تُدمج دالة IFERROR كدرع وقائي يحيط بالصيغة المركبة بأكملها. تعمل دالة IFERROR كشرط حارس؛ فإذا سارت العمليات الحسابية وفق مسارها الطبيعي وأسفرت عن استخراج سليم للبريد، تُمرر النتيجة دون تدخل. أما إذا تعثرت أي دالة داخلية وتولد خطأ من أي نوع، تعترض دالة IFERROR مسار التنفيذ وتستبدل رسالة الخطأ بقيمة افتراضية مسبقة يحددها المستخدم بدقة.
يتم تطبيق هذا التامين عبر صياغة المعادلة كالتالي: إدراج الصيغة السابقة داخل معامل الفحص لدالة IFERROR، وتحديد القيمة البديلة كسلسلة نصية فارغة (“”) أو عبارة تدقيقية مثل “غير متوفر”. تأخذ الصيغة المطورة التشكيل التالي:
=IFERROR(TRIM(RIGHT(SUBSTITUTE(LEFT(A2, FIND(” “, A2 & ” “, FIND(“@”, A2)) – 1), ” “, REPT(” “, LEN(A2))), LEN(A2))), “”)
يمنح هذا التضمين ورقة العمل مظهراً بصرياً متناسقاً وخالياً تماماً من المؤشرات المشوهة، مما يسمح باستخدام العمود المستخرج مباشرة في جداول التلخيص المحورية (Pivot Tables) ولوحات التحكم التفاعلية (Dashboards) دون إحداث فجوات أو أخطاء حسابية متتالية في البنية المتقدمة للمصنف.
6.2 التعامل مع الخلايا الخالية والمحتويات غير الصالحة
بالإضافة إلى حالات غياب علامة (@)، تفرض الخلايا الخالية تماماً من النصوص تحدياً يتطلب ترشيد استهلاك طاقة المعالجة في إكسل. فعندما تواجه الصيغة خلية فارغة تماماً، فإن تطبيق سلسلة من عمليات البحث والقص وتوسيع المسافات يشكل هدراً حسابياً للذاكرة العشوائية والمعالج، لا سيما في المصنفات التي تتجاوز عشرات الآلاف من الصفوف. ولتفادي ذلك، يمكن استخدام دالة التحقق الشرطي المسبق IF مع دالة ISBLANK لتخطي السجلات الفارغة فوراً.
يتجسد التحدي الثاني في النصوص التي قد تحتوي على رمز (@) منفرد أو مستخدم كرمز قياسي بديل (مثل استخدامه للإشارة إلى السعر “5 items @ $10″). في هذه السيناريوهات الاستثنائية، ستقوم دالة FIND برصد الرمز وستحاول استخراج ما حوله، مما ينتج عنه نص مشوه لا يمثل عنوان بريد صالحاً كأن يكون “10$@5″. يتطلب التغلب على هذه الحالات الشاذة تعزيز البنية الشرطية بمعايير تحقق إضافية، مثل فحص احتواء النتيجة المستخرجة على نقطة الامتداد (.) في اسم النطاق البريدي.
إن وضع معايير تدقيق لاحقة يمثل خطوة أساسية في إدارة جودة قواعد البيانات. يمكن تطبيق قواعد التحقق من صحة البيانات (Data Validation) أو التنسيق الشرطي (Conditional Formatting) على العمود المستخرج لتلوين وتحديد أي ناتج يقل طوله عن المعايير المعقولة لأقصر عنوان بريد (مثل [email protected] المكون من 6 محارف)، مما يمكن فريق العمل من إجراء فحص استدراكي سريع للقيم الشاذة ومعالجتها قبل تصدير البيانات إلى الأنظمة السحابية والتشغيلية المعتمدة.
7. إدارة السلاسل النصية المعقدة وتعدد العناوين
7.1 سلوك الصيغة عند وجود أكثر من بريد في الخلية الواحدة
من القيود الجوهرية الملازمة للصيغة المركبة الكلاسيكية اعتمادها على منطق البحث الأحادي؛ إذ إن دالة FIND تبدأ مسح الخلية بطبيعتها الافتراضية من المحرف الأول باتجاه اليسار (في النصوص الإنجليزية)، وتتوقف فور العثور على أول ظهور لعلامة (@). يترتب على هذا السلوك البرمجي قيد صارم: تقتصر الصيغة على استخراج عنوان البريد الإلكتروني الأول المتواجد في السلسلة النصية، وتتجاهل تماماً أي عناوين بريدية أخرى قد تليه داخل نفس الخلية.
يشكل هذا القيد خطراً داهماً في البيئات التي تتطلب التوثيق المزدوج، كأن تحتوي الملاحظة على البريد الإلكتروني للشخص وبريد بديل أو بريد المشرف المباشر. في مثل هذه الظروف، يؤدي الاعتماد الأعمى على الصيغة المنفردة إلى فقدان البيانات الثانوية غير المستخرجة، وهو ما قد يتسبب في انقطاع قنوات الاتصال الاحتياطية وتشويه التقييمات الإحصائية لحجم السجلات الفعلية المتوفرة.
للتغلب على هذه المشكلة وتطوير الصيغة للتعامل مع العناوين اللاحقة، يمكن هندسة معادلات إزاحة متقدمة تستخدم ناتج موقع نهاية البريد الأول كنقطة بداية (Start_num) لعملية بحث جديدة في دالة FIND ثانية داخل عمود إضافي. ومع ذلك، فإن هذا الحل يرفع من درجة تعقيد الورقة الحسابية ويجعل صيغها شديدة الطول وصعبة الصيانة، مما يفتح الباب أمام الحلول المعتمدة على المصفوفات الديناميكية الحديثة أو الأكواد البرمجية المتخصصة لتفكيك النصوص المتعددة بسلاسة أكبر ومرونة منهجية أوسع.
7.2 معالجة النصوص المحاطة بعلامات ترقيم وأقواس
غالباً ما يقع عنوان البريد الإلكتروني في النصوص السردية محاطاً بتراكيب لغوية تقييدية، كأن يوضع بين قوسين معقوفين مثل `<[email protected]>`، أو هلاليين `([email protected])`، أو يختتم بنقطة الجملة النهائية أو فاصلة تالية ملتصقة بالنطاق مباشرة دون مسافة فاصلة `[email protected].` إن الصيغة الكلاسيكية تبحث عن المسافة التالية للرمز، وإذا كانت علامة الترقيم ملتصقة بالبريد قبل المسافة، فسيتم اقتطاعها كجزء من العنوان، مما يفسد صحة النطاق البريدي ويجعله غير صالح للإرسال.
يتطلب علاج هذا التشوه اللغوي ترقية المعادلة عبر دمج دالة الإحلال والتطهير SUBSTITUTE لتجريد الناتج النهائي من الرموز الملتصقة الشائعة. يمكن إحاطة المخرج المستخلص بسلسلة متتابعة من دوال الاستبدال التي تستهدف تحييد علامات الترقيم والأقواس الملاصقة لحواف البريد، كأن يتم استبدال الأقواس الزاوية `<` و `>` بسلاسل نصية فارغة لضمان عدم احتوائها ضمن البريد المستخرج.
علاوة على ذلك، يمكن توظيف دالة التعديل النصي لفحص الحرف الأخير من الناتج؛ فإذا كان هذا الحرف عبارة عن نقطة أو فاصلة ملحقة بنهاية الجملة، يتم تقليص طول السلسلة المستخرجة بمقدار محرف واحد لعزل علامة الترقيم عن الامتداد البريدي (مثل تحويل `.com.` إلى `.com`). يضمن هذا التطهير الهيكلي المتطور رفع جودة المدخلات، وتفادي الأخطاء التي تظهر لاحقاً في خوادم البريد والتي ترفض العناوين المنتهية برموز ترقيم تخالف مواصفات بنية النطاقات العالمية الصارمة.
8. البدائل الوظيفية المدمجة: التعبئة السريعة وأدوات التقسيم
8.1 توظيف أداة التعبئة السريعة (Flash Fill) في الاستخراج الفوري
في عام 2013، أحدثت مايكروسوفت نقلة نوعية في معالجة البيانات النصية بإطلاق أداة “التعبئة السريعة” (Flash Fill) ضمن إصدار إكسل 2013، والتي تستند إلى أبحاث متقدمة في مجال التخليق البرمجي الاستقرائي (Inductive Program Synthesis) طورها مختبر Microsoft Research ضمن إطار عمل يُعرف تقنياً باسم (FlashExtract). تتيح هذه التقنية الثورية للمستخدم استخراج عناوين البريد الإلكتروني دون الحاجة لكتابة حرف واحد من الصيغ الرياضية أو الأكواد البرمجية المعقدة.
تعتمد آلية التعبئة السريعة على التعلم الآلي الموضعي للأنماط؛ حيث يقوم المستخدم بكتابة عنوان البريد الإلكتروني المستخرج يدوياً في الخلية الأولى المجاورة للنص الأصلي لتقديم نموذج تدريبي أولي للأداة، ثم ينتقل للخلية التالية ويكتب نموذجاً ثانياً. يتعرف إكسل فوراً على النمط المستهدف، ويكتشف أن المطلوب هو عزل النص المتمركز حول علامة (@)، فيقوم بإنشاء خوارزمية استخراج خفية وتطبيقها آلياً عبر تقديم معاينة تملأ كامل العمود بالنتائج المستخرجة، والتي يمكن تثبيتها بمجرد الضغط على مفتاح الإدخال أو بالضغط على الاختصار الشهير (Ctrl + E).
على الرغم من السرعة الفائقة والراحة الهائلة التي توفرها التعبئة السريعة في توفير الوقت والجهد، إلا أنها تعاني من قيد تقني بنيوي جوهري: إنها أداة “تحويل ثابت” وليست صيغة “ديناميكية تفاعلية”. وهذا يعني أن النتائج المستخرجة عبر التعبئة السريعة تصبح قيماً نصية جامدة لا تتأثر بتغير البيانات الأصلية؛ فإذا تم تعديل النص المختلط في الخلية المصدرية أو إضافة سجلات جديدة في أسفل الجدول، فلن يتم تحديث عمود البريد الإلكتروني تلقائياً، مما يستوجب إعادة تشغيل الأداة يدوياً دورياً، وهو ما يحد من ملاءمتها لقواعد البيانات الحية التي تشهد تدفقاً مستمراً للبيانات المتغيرة.
8.2 استخدام أداة تحويل النص إلى أعمدة (Text to Columns)
تمثل أداة “تحويل النص إلى أعمدة” (Text to Columns) المدمجة في إكسل أحد الحلول الكلاسيكية الراسخة لمعالجة النصوص وتجزئتها بناءً على فواصل محددة. تعتمد هذه الأداة على فكرة تجزئة السلسلة النصية الكاملة إلى مقاطع متفرقة يتم تفريغ كل مقطع منها في عمود منفصل، مستندة في ذلك إلى المسافة (” “) أو الفواصل المخصصة كمعيار للانفصال البنيوي بين الكلمات.
تتلخص خطوات تطبيق هذه الأداة في تحديد عمود النصوص، والانتقال إلى تبويب “بيانات” (Data)، واختيار “النص إلى أعمدة”، ثم تحديد خيار “محدد” (Delimited) واختيار “المسافة” كفاصل رئيسي. يؤدي هذا الإجراء إلى نشر كافة كلمات الجملة الأصلية عبر عشرات الأعمدة المتجاورة، بحيث يقع عنوان البريد الإلكتروني في أحد هذه الأعمدة المنفصلة، تمهيداً لفرز البيانات وعزل العمود الحاوي للبريد وحذف الأعمدة الفائضة الأخرى.
ومع ذلك، تفرض هذه الطريقة سلبيات منهجية بالغة التعقيد في حالات النصوص العشوائية غير المتساوية. فإذا كان البريد يمثل الكلمة الخامسة في صف معين، والكلمة العاشرة في صف آخر، والكلمة الأولى في صف ثالث، فسيتشتت البريد الإلكتروني عبر أعمدة متعددة وغير متطابقة، مما يتطلب مجهوداً يدوياً شاقاً لإعادة تجميعها في مسار واحد. بالإضافة إلى ذلك، فإن الأداة تؤدي إلى الكتابة فوق البيانات المجاورة إذا لم يُفرغ لها مساحة كافية، فضلاً عن افتقارها الكامل للديناميكية التلقائية، مما يجعلها خياراً تراجعياً لا يُوصى به إلا في النصوص متجانسة التنسيق تماماً.
9. الحلول المتقدمة عبر البرمجة النصية والتعابير النمطية (VBA & RegEx)
9.1 بناء دالة مخصصة (UDF) باستخدام برمجيات فيجوال بيسك
عندما تصل الدوال التقليدية إلى حدودها القصوى في التعامل مع السيناريوهات المعقدة، تبرز لغة فيجوال بيسك للتطبيقات (VBA) المدمجة داخل إكسل كخيار هندسي قوي لتوسيع إمكانيات المعالجة. يتيح محرر VBA للمطورين والمحللين بناء “دوال معرفة من قِبل المستخدم” (User Defined Functions – UDFs)، تُدمج في دفتر العمل وتعمل تماماً كالدوال الأصلية لإكسل، مستبدلة المعادلات المركبة الطويلة بكلمة دلالية واحدة فائقة البساطة وسهلة الاستدعاء مثل `=ExtractEmail(A2)`.
يعتمد منطق بناء الدالة المخصصة على تجزئة النص الداخلي باستخدام خوارزميات الحلقات التكرارية والتقسيم المدمجة في اللغة مثل دالة `Split`. تقوم الدالة بتقطيع النص الأصلي إلى مصفوفة من الكلمات بناءً على المسافات، ثم تدور حلقة تكرارية برمجية (For Each Loop) لفحص كل كلمة في المصفوفة بشكل فردي؛ فإذا تبين أن الكلمة تحتوي على علامة (@) وتتطابق مع شروط البريد الأساسية، تعزلها الدالة فوراً وتعيدها للمستخدم كناتج نهائي نظيف وتتوقف عن مواصلة البحث، مما يوفر جهداً حوسبياً كبيراً.
تتمتع هذه الدوال بمرونة تشغيلية فائقة؛ إذ يمكن إدراجها داخل وحدات نمطية قياسية (Modules) في ملفات بصيغة المصنفات الممكنة لوحدات الماكرو (.xlsm)، أو حتى تضمينها في ملفات الإضافات الإضافية المخصصة (.xlam) لتصبح متاحة عبر كافة دفاتر العمل في حاسوب المستخدم. يسهم هذا النهج البرمجي في توحيد معايير الاستخراج داخل المؤسسة، ويسهل مراجعة الكود البرمجي وصيانته من قبل خبراء تقنية المعلومات دون الخوف من تشويه المعادلات الحسابية من قبل مدخلي البيانات العاديين.
9.2 تطبيق التعابير النمطية (Regular Expressions) لضمان الدقة المطلقة
تعود الجذور النظرية للتعابير النمطية (Regular Expressions – RegEx) إلى عالم الرياضيات الأمريكي ستيفن كول كلين (Stephen Cole Kleene) الذي صاغ أسسها المنطقية في خمسينيات القرن العشرين، قبل أن يقتبسها رائد علوم الحاسوب كين تومبسون (Ken Thompson) في عام 1968 لتطوير خوارزميات البحث النصي في أنظمة يونكس. تمثل التعابير النمطية ذروة الدقة في مطابقة الأنماط النصية المعقدة والتحقق منها حوسبياً.
في بيئة إكسل، يمكن توظيف التعابير النمطية تاريخياً عبر استدعاء كائن `VBScript.RegExp` في بيئة VBA، أو عبر الطفرة النوعية الكبرى التي أطلقتها مايكروسوفت لمشتركي Microsoft 365 في عام 2024 بطرح دالة أصلية مدمجة باسم `REGEXEXTRACT`. تستخدم هذه الأدوات نمطاً برمجياً صارماً ومتوافقاً مع مواصفات RFC للبريد الإلكتروني، يأخذ صياغة التعبير النمطي القياسي التالي في الدالة الحديثة:
=REGEXEXTRACT(A2, “[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+.[a-zA-Z]{2,}”)
تتضمن الدوال الحديثة في Microsoft 365 منظومة متكاملة، تشمل الدوال النصية الديناميكية التي طُرحت عام 2022 مثل `TEXTSPLIT` و `TEXTBEFORE` و `TEXTAFTER`، والتي تتيح صيغاً عبقرية مثل دمج دالتي التقسيم والتصفية: `=FILTER(TEXTSPLIT(A2, ” “), ISNUMBER(SEARCH(“@”, TEXTSPLIT(A2, ” “))))`. إلا أن دالة `REGEXEXTRACT` تتفوق على جميع المحاولات السابقة، بقدرتها ليس فقط على العثور على البريد الإلكتروني، بل والتحقق الصارم من تكوينه الداخلي، واستبعاد الأقواس وعلامات الترقيم الملتصقة تلقائياً، والقدرة على جلب كافة العناوين المتعددة وصبها في مصفوفة ممتدة عمودياً أو أفقياً بدقة مطلقة تخلو من أي هامش للخطأ.
توضح دراسات تنظيم البيانات وتصنيفها المنهجي، مثل أبحاث مارتا موريرا ماركيز وفريقها (Marta Moreira Marques et al., 2020)، أن استخدام النظم الأنطولوجية والمعايير الصارمة لتعريف البيانات وتوصيفها يسهم جذرياً في رفع كفاءة التحليل واستبعاد التناقضات التصنيفية. وينطبق هذا المبدأ العلمي بدقة على استخدام التعابير النمطية مقارنة بالصيغ البدائية؛ حيث تضمن القواعد المنهجية الصارمة للتعبير استخراج ما يتطابق جوهرياً مع الطبيعة الوظيفية للبريد الإلكتروني دون أدنى التباس مع التراكيب النصية العشوائية الأخرى.
10. المقارنة المعيارية، الأداء، وأفضل الممارسات الأكاديمية
10.1 تقييم الكفاءة الحسابية وتأثير الحجم على الأداء
عند التعامل مع قواعد بيانات ضخمة تحتوي على مئات الآلاف أو ملايين السجلات، تصبح الكفاءة الحسابية واستهلاك موارد الذاكرة العشوائية (RAM) ووحدة المعالجة المركزية (CPU) المعيار الحاسم للمفاضلة بين أدوات الاستخراج المختلفة. تفرض الصيغ المركبة المعتمدة على التوسيع الفضائي عبر SUBSTITUTE و REPT حملاً تشغيلياً مضاعفاً، حيث يقوم إكسل بتخليق سلاسل نصية افتراضية شاسعة داخل الذاكرة المؤقتة لكل خلية على حدة قبل تقليصها، مما يرفع زمن إعادة الحساب ويؤدي في كثير من الأحيان إلى تجميد البرنامج وبطء استجابته عند التمرير.
في المقابل، تتمتع الدوال المصفوفية الحديثة مثل `REGEXEXTRACT` و `FILTER` بكفاءة خوارزمية عالية تعتمد على المعالجة الرياضية المباشرة في الذاكرة دون الحاجة لتوليد مساحات نصية وهمية وسيطة. ومع ذلك، فإن الدوال البرمجية المخصصة (UDF) المبنية عبر VBA تعاني من عيب تشغيلي آخر يتمثل في كونها أحادية المسار (Single-threaded) في معظم تطبيقاتها التقليدية، مما يعني عجزها عن استغلال المعالجات متعددة الأنوية الحديثة بالكامل، مما يجعل أداءها يتراجع بشكل ملحوظ مقارنة بالدوال الحسابية المكتوبة بلغة C++ والمدمجة في صلب محرك إكسل الأصلي.
لتقليل الحمل الحسابي والحفاظ على أداء انسيابي للمصنفات الضخمة، يُوصى دوماً باتباع استراتيجية “المعالجة ثم التثبيت”. تتلخص هذه الممارسة الهندسية في تطبيق الصيغ الحسابية أو التعابير النمطية لاستخلاص البيانات وتدقيقها بالكامل، ثم نسخ العمود المستخرج ولصقه فوق نفسه كـ “قيم فقط” (Paste as Values). يؤدي هذا الإجراء الحكيم إلى تحرير الذاكرة من عبء إعادة احتساب الدوال عند كل نقرة أو تعديل في المصنف، وتأمين بقاء البيانات في حالة استقرار خفيفة وسريعة التصدير والتحليل المستقبلي.
تسلط الأبحاث المنهجية التي تتناول البيانات الطولية الضخمة، كدراسة كاريل موندنيتش وزملائه (Karel Mundnich et al., 2020) في تتبع البيانات السلوكية والفسيولوجية للكوادر الطبية، الضوء على أهمية الحفاظ على سلامة قنوات التتبع والاتصال ونظافة السجلات النصية الضخمة لضمان موثوقية الرصد واستقرار المعالجة الإحصائية. إن ترشيد آليات استخراج البيانات وتثبيتها يعزز من متانة البنية التحتية للمشاريع التحليلية ويوفر بيئة حوسبية مستقرة ومحمية من الانهيارات الفنية غير المتوقعة.
10.2 توصيات منهجية لإدارة وتنظيف قواعد البيانات
إن أفضل طريقة للتعامل مع مشكلات استخراج البيانات النصية غير المهيكلة هي السعي لتقليل نشأتها في المقام الأول. يتطلب ذلك من المؤسسات والباحثين اعتماد استراتيجيات صارمة لإدارة إدخال البيانات في الخطوط الأمامية. يجب تصميم استمارات جمع البيانات ونماذج الإدخال الرقمية بحيث تفرض فصلاً بنيوياً مسبقاً بين حقول الأسماء والملاحظات وعناوين البريد الإلكتروني، وتطبيق قواعد التحقق من الصحة (Data Validation) لمنع دمج هذه العناصر داخل سلاسل نصية حرة.
تؤكد الأدبيات الأكاديمية المقارنة في علم البيانات واللسانيات الحاسوبية، مثل أعمال كريستوف ريمسكي وفريقه البحثي (Christoph Rzymski et al., 2020) في توثيق وتحليل قواعد البيانات التعددية اللغوية المقارنة، على أن تنقية السلاسل النصية وتوحيد قواميس البيانات يمثلان الركيزة الأساسية للحد من التفسيرات المشوهة وضمان إمكانية تكرار النتائج ودقة الربط بين المتغيرات. إن تطبيق سياسات موحدة لإدارة السجلات الرقمية داخل المنظمات يقضي على الفوضى التنسيقية ويعزز من كفاءة خطوط تدفق العمل الرقمي بصورة جذرية ومستدامة.
ختاماً، توضح خارطة الطريق التالية المعايير المثلى لاختيار الأداة البرمجية المناسبة وفقاً لحالة الاستخدام وحجم العمل التقني:
- الحالة الأولى: استخراج سريع ولمرة واحدة لقاعدة بيانات صغيرة لا تتطلب التحديث التلقائي؛ يُوصى هنا بالاعتماد على أداة التعبئة السريعة (Flash Fill) نظراً لسرعتها الفائقة وعدم حاجتها لكتابة أي معادلات.
- الحالة الثانية: قواعد بيانات متغيرة وتعمل على إصدارات إكسل القديمة (2019 وما قبلها) بدون اشتراكات سحابية؛ الخيار الأنسب هو الصيغة المركبة الكلاسيكية المدعومة بدالة IFERROR مع تقنية التوسيع الفضائي.
- الحالة الثالثة: العمل المؤسسي الحديث على بيئات Microsoft 365؛ يُعد استخدام الدوال النمطية الأصلية (REGEXEXTRACT) الخيار المعياري الذهبي المطلق الذي يجمع بين الدقة المطلقة ومطابقة شروط RFC والخفة الحوسبية الفائقة.
- الحالة الرابعة: معالجة مهام أتمتة مؤسسية شاملة تتضمن فتح مئات الملفات الخارجية دورياً وتصدير النتائج إلى خوادم مركزية؛ يُلجأ هنا إلى برمجة الدوال المخصصة عبر VBA ووحدات الماكرو المؤتمتة.
خاتمة
استعرض هذا المقال الموسع تشريحاً شاملاً لكيفية استخراج عنوان البريد الإلكتروني من السلاسل النصية داخل برنامج إكسل، متدرجاً من المنطق الرياضي الكامن وراء الدوال النصية التقليدية إلى أحدث التقنيات المستندة إلى التعابير النمطية المتقدمة. لقد تبين لنا بوضوح أن العملية لا تقوم على الصدفة أو التجربة العشوائية، بل تستند إلى بنية هندسية دقيقة تستغل المعايير الدولية لهيكلة البريد الإلكتروني ونقاط ارتكازه النصية لعزل العناصر المستهدفة بدقة متناهية.
إن امتلاك هذه الأدوات والمهارات المنهجية ينقل المحلل الأكاديمي والمهني من موقع المستهلك المتردد للأدوات الجاهزة إلى موقع المهندس المتحكم في تدفقات البيانات؛ حيث تصبح السلاسل النصية الأكثر عشوائية مادة خاماً سهلة الترويض والترتيب. ومع تسارع وتيرة التحول الرقمي وتضخم السجلات المعلوماتية، يظل الإتقان المنهجي لتنقية النصوص وضبط صيغها داخل إكسل أحد أهم المهارات الأساسية الضامنة لجودة البيانات، ونزاهة الاتصال، واستدامة اتخاذ القرار المؤسسي المستنير على أسس تقنية راسخة وقوية.
المراجع
- Christoph Rzymski, Tiago Tresoldi, Simon J. Greenhill, Mei-Shin Wu, Nathanael E. Schweikhard, Maria Koptjevskaja‐Tamm, et al. (2020). The Database of Cross-Linguistic Colexifications, reproducible analysis of cross-linguistic polysemies. Scientific Data. https://doi.org/10.1038/s41597-019-0341-x
- Karel Mundnich, Brandon M. Booth, Michelle L’Hommedieu, Tiantian Feng, Benjamin Girault, Justin L’Hommedieu, et al. (2020). TILES-2018, a longitudinal physiologic and behavioral data set of hospital workers. Scientific Data. https://doi.org/10.1038/s41597-020-00655-3
- Marta Moreira Marques, Rachel Carey, Emma Norris, Fiona Evans, Ailbhe N. Finnerty, Janna Hastings, et al. (2020). Delivering Behaviour Change Interventions: Development of a Mode of Delivery Ontology. Wellcome Open Research. https://doi.org/10.12688/wellcomeopenres.15906.1