
يمثل استخلاص الحرف الأول من كل كلمة في السلاسل النصية إحدى المهام الخوارزمية المركزية في ميدان معالجة البيانات وتوحيد معاييرها داخل برمجيات الجداول الحسابية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel). تتجاوز هذه العملية مجرد التنسيق الشكلي لتلامس صلب هندسة البيانات، حيث تبرز الحاجة الملحة إلى اختزال المدخلات النصية الطويلة، مثل أسماء الأفراد، والمؤسسات، والتوصيفات المهنية، والعناوين الأكاديمية، إلى رموز تعريفية مقتضبة وموحدة تسمى بالأسماء التاجية أو المختصرات الاستهلالية (Acronyms/Initials). يتيح هذا التحويل التقني للمحللين والمطورين إنشاء مفاتيح فريدة ومؤشرات تصنيفية تسهم في تعزيز البنية الهيكلية لقواعد البيانات، ورفع كفاءة عمليات الربط الإحصائي، وتقليل استهلاك مساحات التخزين، فضلًا عن تيسير عمليات المطابقة الآلية في النظم الرقمية المتقدمة.
تكمن الصعوبة التقنية في بيئة إكسل في طبيعة البيانات غير المهيكلة؛ فالمدخلات النصية نادرًا ما تأتي بصيغة متجانسة من حيث عدد الكلمات أو توزيع الفواصل والمسافات. يتطلب التعامل مع هذه المتغيرات فهماً عميقاً للترسانة الوظيفية التي يوفرها البرنامج، بدءاً من الصيغ التقليدية المعقدة التي تعتمد على محاكاة معايير لغة الترميز القابلة للامتداد (XML)، مروراً بالدوال المصفوفية الديناميكية الحديثة التي أحدثت نقلة نوعية في معالجة النصوص، وصولاً إلى أدوات البرمجة النصية بلغة التطبيقات المكتبية (VBA) ومحرك معالجة واستعلام البيانات (Power Query). إن اختيار الأداة المناسبة يتوقف على حجم البيانات المعالجة، والبيئة التقنية المشغلة للبرنامج، ومتطلبات الأداء العام للمصنف الحسابي.
يقدم هذا المرجع الأكاديمي الشامل تحليلاً ميكانيكياً وتقنياً دقيقاً لكافة المنهجيات المعاصرة والكلاسيكية المتبعة لاستخراج أوائل الحروف من النصوص متعددة المفردات. سنفصل البنية الرياضية والمنطقية لكل حل، مسلطين الضوء على التحديات اللغوية المعقدة التي تفرضها اللغة العربية وخصائصها الإملائية والتركيبية، فضلاً عن تقديم إرشادات تطبيقية صارمة لمعالجة وتفادي الأخطاء البرمجية الناتجة عن عدم توافق المنصات أو تداخل الرموز غير المرئية، بما يضمن بناء نماذج حسابية متينة تتوافق مع أرقى معايير إدارة البيانات في المؤسسات البحثية والمهنية.
1. مدخل نظري وأهمية استخراج الحروف الأولى في تحليل البيانات
1.1 المفهوم الرياضي والمنطقي لتوليد الاختصارات النصية
ترتكز عملية توليد الاختصارات النصية في جوهرها الحسابي على مفهوم “التجزئة الدلالية والمحرفية” (Semantic and Character Tokenization)، وهي تقنية معالجة لغوية تهدف إلى تفكيك الكتلة النصية المصمتة إلى وحدات بنائية دنيا (المفردات)، ثم إخضاع كل وحدة لعملية فرز موضعي تُعزل بموجبها الإحداثيات المكانية للمحرف الأول. في الفضاء الرياضي لإكسل، يتم تمثيل النص كسلسلة متتابعة من المحارف داخل مصفوفة أحادية البعد ذات فهارس متسلسلة تبدأ من الموقع الأول. تهدف الخوارزمية إلى تعيين الفهارس التي تلي علامات التباعد (المسافات البيضاء أو الفواصل)، ثم تطبيق معامل الاقتطاع الرياضي لعزل الرمز المستهدف، وإعادة دمجه عبر معامل التجميع المتجهي لتوليد اختصار مكثف.
تحظى هذه العملية بأهمية بالغة في إدارة نظم البيانات الضخمة؛ إذ تؤدي إلى ضغط الحجم الأبجدي للنصوص الطويلة وتحويلها إلى مصفوفات كثيفة تسهل عمليات الفهرسة والتصنيف (Indexing and Categorization). يقلل هذا التقليص من العبء الحسابي لعمليات الفرز المقارن ومطابقة السلاسل النصية بنسبة ملحوظة، مما يتيح لمحركات قواعد البيانات إجراء استعلامات التجميع والربط المتقاطع (Joins) بسرعات فائقة. علاوة على ذلك، يمثل استخراج الحروف الأولى خطوة تمهيدية حيوية في توليد دوال التجزئة الرياضية (Hashing) غير المتشابكة، وتطوير البنى الهرمية لحقول التعريف في المستودعات الإحصائية والمصنفات المعقدة.
1.2 تطبيقات استخراج الحرف الأول في البيئات الإدارية والأكاديمية
تتعدد التطبيقات العملية لهذه المنهجية الخوارزمية في السياقات المؤسسية والتعليمية بصورة تجعل منها أداة لا غنى عنها لمهندسي البيانات ومسؤولي النظم الإدارية. في البيئات الأكاديمية والمختبرات البحثية، تُستخدم خوارزميات استخراج الحروف الأولى لتوليد معرفات فريدة مجهولة المصدر للمشاركين في الدراسات التجريبية؛ حيث يتم دمج الحرف الأول من الاسم واللقب مع أرقام عشوائية لضمان خصوصية البيانات وفق معايير الأخلاقيات البحثية الصارمة. كما تسهم المنهجية ذاتها في صياغة أكواد التصنيف للمقررات الدراسية، والأقسام العلمية، والمشاريع الممولة، معتمدة على التسميات اللاتينية أو العربية الرسمية بصورة آلية تخلو من التدخل البشري.
أما في القطاعات الإدارية والصناعية، فتتجلى فاعلية هذه التقنية في صياغة معرفات المنتجات وأكواد التخزين (SKUs) ومحددات المشاريع الاستراتيجية وفرق العمل المشتركة. فبدلاً من كتابة المسميات المطولة للشركات التابعة أو خطوط الإنتاج، يُعتمد الرمز الاستهلالي كعنصر تكويني أساسي في بناء هيكلية التوثيق المؤسسي وإصدار أرقام الفواتير وسجلات المعاملات المالية. إن أتمتة هذا الإجراء تقضي تماماً على التباينات الناشئة عن الأخطاء المطبعية التي يقع فيها موظفو إدخال البيانات، وتؤسس لنمط موحد من البيانات المعيارية يعزز من موثوقية تقارير ذكاء الأعمال وجودة مخرجاتها.
1.3 التحديات التقنية المرتبطة بالنصوص غير المتجانسة
تنشأ الصعوبات البرمجية الحقيقية أثناء محاولة صياغة معادلة معالجة شاملة بسبب تباين التركيب الداخلي للسلاسل النصية؛ حيث تفشل الدوال التقليدية فور مواجهتها لنصوص تتفاوت في عدد الكلمات بصورة غير نمطية داخل العمود الواحد. فالصيغة المصممة لاستخلاص حرفين من اسم ثنائي تنهار أو ترجع مخرجات ناقصة إذا طُبقت على اسم ثلاثي أو رباعي، ما لم تكن خوارزمية الاستخراج متكيفة ذاتياً ومبنية على مبدأ المعالجة المصفوفية غير المحدودة بطول زمني أو كمي للمفردات.
تتضاعف هذه الإشكالية بوجود العيوب الهيكلية الشائعة في البيانات، وأبرزها تداخل المسافات البيضاء المتعددة بين الكلمات، أو وجود مسافات بادئة وخاتمة غير مرئية نتجت عن استيراد ملفات غير معالجة جيداً. تؤدي هذه الفراغات إلى انزياح الفهارس المحرفية وخطأ تحديد نقطة بداية الكلمة التالية. يُضاف إلى ذلك التحدي البنيوي اللغوي الناجم عن معالجة النصوص متعددة اللغات؛ حيث تفرض اللغة العربية قيوداً تتصل باتجاه النص المعكوس (RTL)، وعلامات التشكيل التي تحتل حيزاً رقمياً مستقلاً في ترميز الحروف، ووجود حروف الربط وسوابق التعريف التي قد تشوه الغاية الدلالية للاختصار إذا عوملت ككلمات مستقلة.
2. الصيغة الكلاسيكية المتقدمة: دمج دالتي FILTERXML و CONCAT
2.1 الصياغة العامة للمعادلة ودور كل مكون برمجي
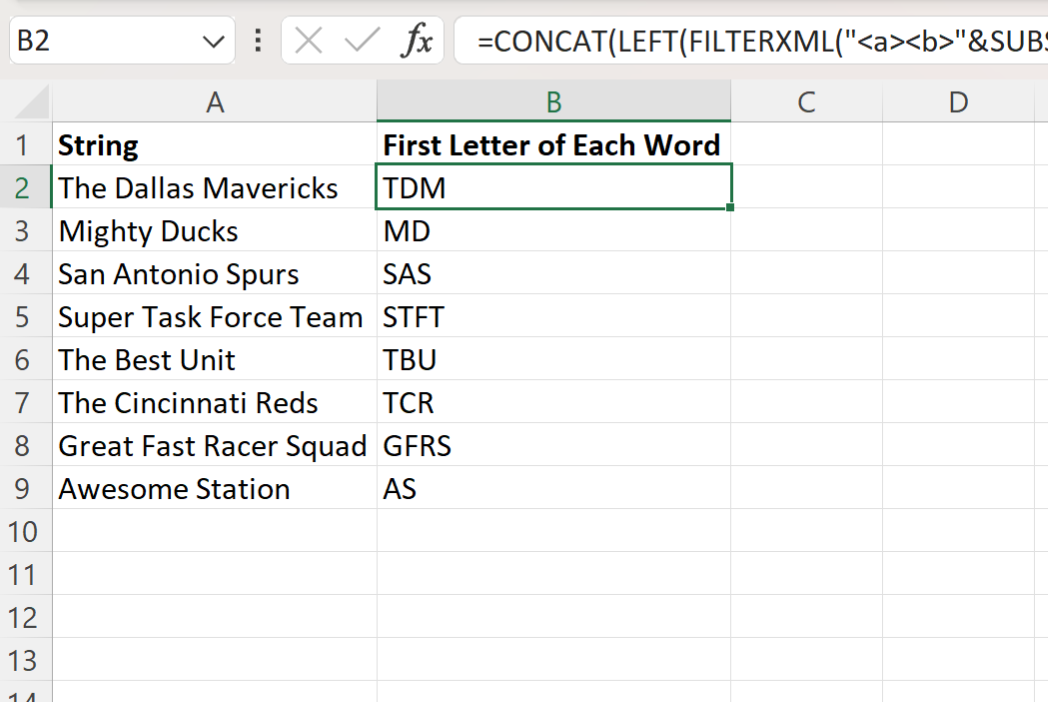
قبل ظهور الدوال المصفوفية فائقة الحداثة في إكسل، طوّر خبراء تحليل البيانات صيغة هجينة عبقرية تستغل قدرات محرك تحليل لغة الترميز القابلة للامتداد لمعالجة النصوص الديناميكية داخل بيئة ويندوز. تعتمد هذه المعادلة على الاستدعاء المتسلسل للدوال: FILTERXML وCONCAT وLEFT وSUBSTITUTE وTRIM. يُكتب الهيكل العام لهذه الصيغة المعيارية على النحو التالي:
=CONCAT(LEFT(FILTERXML("<a><b>" & SUBSTITUTE(TRIM(A2), " ", "</b><b>") & "</b></a>", "//b"), 1))
تقوم دالة TRIM بتنظيف السلسلة الأصلية، ثم تعمد دالة SUBSTITUTE إلى تحويل الفواصل المسافية إلى فواصل وسوم متوافقة مع قواعد لغة XML، لتبني دالة FILTERXML شجرة المستند المؤقتة وتفككها إلى مصفوفة نصوص في ذاكرة المعالجة. عند هذه المرحلة، تتدخل دالة LEFT لاقتطاع المحرف الأول برمجياً من كل عنصر داخل هذه المصفوفة الناتجة، لتتولى دالة CONCAT مهمة تجميع الحروف المعزولة ودمجها في سلسلة نصية موحدة ومصمتة تُعرض داخل الخلية دون الحاجة إلى اللجوء إلى صيغ المصفوفات القديمة (CSE).
2.2 تحويل النص إلى بنية وسوم XML باستخدام دالة SUBSTITUTE
يكمن الابتكار الخوارزمي في هذه المنهجية في طريقة استغلال دالة SUBSTITUTE؛ إذ يتم توظيفها كأداة تحويلية تنقل النص من مجرد أحرف اعتيادية إلى كود تركيبي يخضع لمعايير لغة XML العالمية. تفترض الخوارزمية أن كل كلمة مفردة يجب أن تسكن داخل عقدة بيانات مستقلة. ولتحقيق ذلك، يُستبدل الفراغ الفاصل بين أي كلمتين بترميز إغلاق العقدة السابقة وفتح العقدة اللاحقة عبر التعبير النصي "</b><b>".
لكي تصبح وثيقة XML صالحة للإعراب النحوي والتحليل الخوارزمي البرمجي (Well-formed XML Document)، تُلزم المعايير بوجود عنصر جذر حاوٍ لجميع العناصر الفرعية. بناءً على هذا القيد التقني، يُدمج النص المحول عبر معامل الربط النصي (&) بحيث يُسبق بوسم الجذر ووسم فتح العقدة الأولى "<a><b>"، ويُختتم بوسم إغلاق العقدة الأخيرة وإغلاق الجذر "</b></a>". ينتج عن هذا التعديل الميكانيكي مستند XML متكامل من الناحية الهيكلية، تُمثل فيه كل كلمة من النص الأصلي عقدة ابن شرعية تحمل المسمى <b> داخل العنصر الرئيسي <a>، مما يهيئ السلسلة النصية لمرحلة الاستعلام البرمجي المتقدم.
2.3 استخراج العقد النصية عبر مسار XPath
بمجرد اكتمال البناء الهيكلي لوثيقة XML المؤقتة داخل الذاكرة، تُمرر السلسلة الناتجة إلى دالة FILTERXML مقترنة بوسيط مسار البحث النصي (XPath Query). يُستخدم المسار القياسي "//b" كمعيار للاستعلام؛ حيث يشير الرمز المزدوج للخط المائل إلى البحث الشامل على امتداد كافة مستويات الشجرة النصية للعثور على أي عنصر يحمل الوسم b بصرف النظر عن موقعه الهرمي، واستخلاص المحتوى النصي المحصور بداخله.
تقوم الخوارزمية الداخلية للدالة بتفكيك كتل الوسوم وإرجاع مصفوفة نصوص أحادية البعد في ذاكرة إكسل العشوائية، تتألف عناصرها حصراً من الكلمات المستقلة التي تم عزلها. تتميز هذه الخطوة بمرونة استثنائية؛ إذ تتكيف تلقائياً مع طول الجملة الأصلية، فإذا كانت الجملة مكونة من كلمتين تُنشئ مصفوفة من عنصرين، وإذا كانت مؤلفة من عشر كلمات تتمدد المصفوفة ذاتياً لاستيعاب العقد العشر. وبذلك تكسر هذه الآلية الحاجز التقليدي الذي كان يجبر المستخدمين على تحديد مواقع الفواصل يدوياً بدوال البحث المحدودة.
3. التحليل الميكانيكي الدقيق لمراحل تنفيذ الصيغة في الذاكرة
3.1 المرحلة الأولى: تهيئة النص والتطهير المبدئي
تبدأ دورة المعالجة الحسابية فور استقبال محرك إكسل للأمر، حيث تمر السلسلة النصية الخام المخزنة في الخلية المستهدفة بمرحلة غربلة وتطهير حاسمة. تعمل دالة TRIM على اقتلاع أي مسافات زائدة قد تتواجد في مستهل النص أو نهايته، إضافة إلى اختزال أي توالٍ متكرر للمسافات البينية إلى مسافة أحادية فاصلة. تُعد هذه الخطوة خط دفاع أولياً لحماية الشفرة؛ إذ إن ترك مسافتين متتاليتين سينتج عنه إنشاء عقدة وسوم فارغة من النوع <b></b>، مما يؤدي لاحقاً إلى توليد قيم نصية عديمة الطول تخل بدقة الاستخراج النهائي.
عقب التنظيف المبدئي، يشرع محرك النصوص في تطبيق الاستبدال الهيكلي. وهنا يظهر تحدٍ حرج يتعلق بالرموز المحجوزة في لغة XML؛ فإذا تضمن النص الأصلي علامة العطف اللاتينية (&) أو علامات المقارنة الرياضية (> أو <)، فإن محرك التفكيك سينهار حتماً ويعيد الخطأ المشهور #VALUE!. لذلك، تتطلب المعالجة المتقدمة التأكد من تطهير هذه الرموز الحساسة أو تشفيرها مسبقاً، لتحويل النص إلى مصفوفة محارف متوافقة مع مواصفات وثائق البيانات القابلة للتحليل.
3.2 المرحلة الثانية: الاستعلام المتقاطع وتفكيك العناصر
في المرحلة الثانية، تُسلم السلسلة المشفرة إلى المحرك الداخلي لتحليل وثائق XML في نظام تشغيل ويندوز (MSXML Parser) الذي تستدعيه دالة FILTERXML مباشرة. يقوم المحرك ببناء شجرة العناصر في حيز مخصص من الذاكرة المؤقتة للعمليات الحسابية، ويبدأ في مسح المستند وتطبيق استعلام مسار XPath الموجه. يتم تجريد الكلمات كلياً من كافة الوسوم المحيطة بها، وتُسجل كمخرجات داخل مصفوفة مجردة تتبع نمط الترتيب الطوبولوجي لأسبقية الظهور في النص الأصلي.
يتم فرز المفردات وتسكين كل كلمة في خانة مصفوفية مستقلة (Index Array Element) داخل بنية مكدس البيانات (Data Stack). يضمن هذا العزل المنطقي تحييد الفوارق الطولية بين الكلمات؛ فلا يهم إن كانت الكلمة تتكون من حرفين أو خمسة عشر حرفاً، إذ يتم التعامل معها في هذه اللحظة كعنصر مستقل في متجهة نصية متسلسلة، مما يوفر بيئة مثالية للخطوة اللاحقة التي تعتمد على المعالجة الرياضية المتجهية.
3.3 المرحلة الثالثة: الاقتطاع والتجميع النهائي
تنتقل المعالجة بعد ذلك إلى مستوى الدوال الاقتطاعية، حيث تُمرر المصفوفة المتشكلة بالكامل كمعامل مدخل لدالة LEFT مع تحديد طول الاستقطاع بقيمة محرف واحد (Num_chars = 1). ونظراً لأن المدخل مصفوفة وليس نصاً مفرداً، فإن دالة LEFT تنفذ عملية تحويل متجهية لحظية؛ فتقتطع الحرف الأول من كل كلمة على حدة وبشكل متزامن، لتعيد مصفوفة أحادية جديدة متطابقة في الطول مع المصفوفة السابقة ولكنها محملة برؤوس الكلمات فقط.
تصل العملية إلى محطتها النهائية عندما تلتقط دالة CONCAT هذه المصفوفة المصغرة من الحروف المفردة. تقوم الدالة بضم العناصر المتعاقبة بإلغاء الفواصل البينية كلياً، وضغط الحروف المستخلصة في كتلة نصية متراصة. تُفرغ هذه السلسلة النهائية داخل الخلية الحسابية، وتتحرر مساحات الذاكرة المؤقتة التي احتضنت شجرة XML ومصفوفاتها الوسيطة، معلنةً اكتمال دورة الحساب بإرجاع الرمز الاستهلالي المطلوب بكفاءة فائقة.
4. تطبيق عملي منهجي على نماذج بيانات متنوعة
4.1 إعداد بيئة العمل وجدول البيانات التجريبي
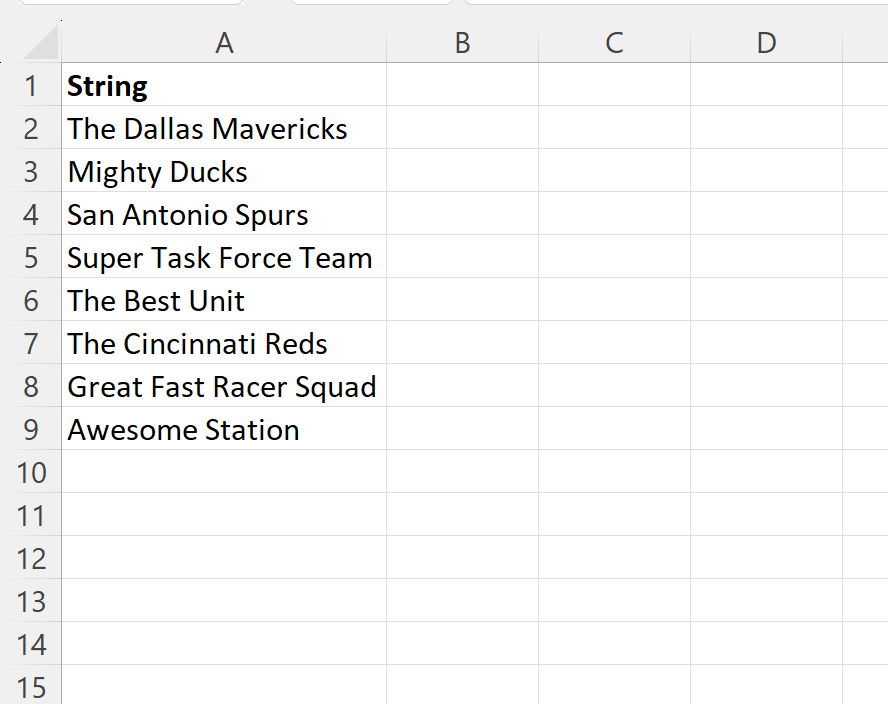
لتطبيق هذه المنهجية التطبيقية بدقة، يجب تصميم بيئة عمل متسقة تحاكي مشروعات المؤسسات الواقعية. نفترض وجود جدول بيانات يحتوي في العمود الأول (النطاق A2:A100) على قائمة متباينة من أسماء الكيانات، تشمل أسماء مؤسسات تعليمية وشركات تجارية وفرق عمل تقنية. تتراوح مدخلات هذا النطاق بين مسميات ثنائية مثل “المستقبل الرقمي” ومسميات ثلاثية كـ “جامعة القاهرة الدولية” وعبارات متعددة الألفاظ كـ “معهد بحوث الاتصالات وتكنولوجيا المعلومات المتقدمة”.
تُدرج الصيغة المركبة في الخلية B2 المحاذية للمدخل الأول. يجب التحقق من تنسيق الخلية لتكون من النوع “نص” (Text) أو “عام” (General)، مع ضبط اتجاه العرض ومحاذاة النص بما يتناسب مع طبيعة اللغة المعالجة تجنباً لتشوهات العرض المرئي. بعد التحقق من استخراج القيمة الأولى بنجاح، تُسحب مقبض التعبئة التلقائية (AutoFill Handle) أو يتم النقر المزدوج عليه لنشر المعادلة عبر كافة صفوف العمود المستهدف، مما يُفعّل الحساب التلقائي اللحظي لكامل المصفوفة الجدولية.
4.2 دراسة حالات تطبيقية وتحليل النتائج المستخرجة
عند إخضاع الصيغة للتدقيق التحليلي على حالات نصية متنوعة، تظهر قدرتها الاستثنائية على التكيف؛ ففي الحالة اللاتينية للمسمى “World Health Organization”، تُفكك الدالة النص إلى ثلاث عقد، وتقتطع الحروف W وH وO، وتدمجها لتنتج الاختصار القياسي WHO. وفي حال تباينت حالة الأحرف اللاتينية، يمكن تطعيم المعادلة بدالة UPPER لإجبار المخرجات على التحول إلى أحرف كبيرة موحدة تضمن الاتساق التام لأكواد المؤسسات.
وعلى صعيد المدخلات الثنائية والرباعية، مثل “Artificial Intelligence” أو “North Atlantic Treaty Organization”، تتعامل المعادلة مع السلسلة وتنتج بدقة AI في الحالة الأولى وNATO في الحالة الثانية، دون الحاجة إلى تعديل معاملات الصيغة يدوياً. تؤكد هذه الاستجابة المرنة تفوق المنهج القائم على XML على الحلول التقليدية البدائية التي كانت تتطلب سلاسل طويلة ومعقدة من دوال IF وSEARCH المتداخلة، والتي كانت تعجز بنيوياً عن تخطي حدود عدد الكلمات المبرمجة مسبقاً داخلها.
4.3 مقارنة الأداء الحسابي في الجداول الكبيرة
على الرغم من الرقي الهيكلي لصيغة FILTERXML، إلا أن تطبيقها المكثف على مجموعات البيانات الضخمة (التي تتجاوز عشرات الآلاف من الصفوف الحسابية) يفرض ضريبة أداء ملموسة على المعالج المركزي وموارد النظام. يرجع هذا التباطؤ إلى الكلفة التشغيلية العالية لبناء شجرة كائنات المستند النصي (DOM) ثم إعرابها واستدعاء محرك مسار XPath لكل خلية على حدة بصورة مستقلة ومتكررة.
يؤدي هذا الاستدعاء المستمر لمكتبة التحليل إلى إبطاء ملحوظ في سرعة إعادة الحساب (Workbook Recalculation Time) عند تعديل أي قيمة داخل المصنف. ولمعالجة هذا العائق التشغيلي في بيئات الإنتاج الكبرى، يُنصح بإيقاف الحساب التلقائي مؤقتاً أثناء التحرير، أو تطبيق استراتيجية “الحساب والتجميد”، والتي تقتضي نسخ المخرجات المحسوبة وإعادة لصقها كقيم نصية مصمتة ثنائية (Paste as Values). تضمن هذه الخطوة التخلص النهائي من المعادلات الثقيلة بعد استيفاء الغرض منها، وحماية المصنف من التباطؤ واستهلاك الذاكرة العشوائية.
5. المعالجات المتقدمة في إصدارات Microsoft 365 والدوال الديناميكية
5.1 استخدام دالة TEXTSPLIT لتقسيم النصوص الحديثة
أحدثت منصة Microsoft 365 ثورة جذرية في البنية الحسابية لمعالجة النصوص بإطلاقها لعائلة الدوال المصفوفية الديناميكية، وفي مقدمتها دالة TEXTSPLIT. استغنت هذه الدالة الحديثة تماماً عن الحيل الالتفافية المعقدة المعتمدة على محاكاة وسوم لغة XML، موفرة آلية برمجية صريحة وسريعة لتجزئة السلاسل النصية استناداً إلى أي محدد فاصل. تُصاغ المعادلة المعاصرة في بيئة الحوسبة الحديثة لإكسل بالصورة التالية:
=TEXTJOIN("", TRUE, LEFT(TEXTSPLIT(TRIM(A2), " "), 1))
أو بصورة بديلة تعتمد على دالة الدمج المصمتة:
=CONCAT(LEFT(TEXTSPLIT(TRIM(A2), " "), 1))
في هذا التركيب البرمجي الانسيابي، تضطلع دالة TEXTSPLIT بتفكيك النص النظيف إلى مصفوفة أفقية متدفقة من الكلمات المنفصلة دون وسائط ترميز إضافية. تُمرر هذه المصفوفة المتولدة مباشرة إلى دالة LEFT التي تقتطع بدورها الحرف الأول من كل عنصر مصفوفي، لتختتم دالة TEXTJOIN أو CONCAT المسار بدمج النتائج لحظياً. يوفر هذا النموذج كفاءة حسابية فائقة، ويخفض احتمالية الأخطاء التركيبية، ويقدم صيغة تتميز بقابلية قراءة ممتازة وسهولة فائقة في الصيانة والتطوير.
5.2 توظيف الدوال التكرارية والمصفوفية: BYROW و LAMBDA
ارتقت التحديثات الأخيرة في إكسل بمستوى التجريد الوظيفي عبر إدراج بيئة البرمجة الوظيفية الممثلة في دالة LAMBDA جنباً إلى جنب مع الدوال التكرارية المتقدمة مثل BYROW. يتيح هذا الاقتران صياغة حلول شاملة لمعالجة نطاقات بيانات متكاملة من خلال خلية وحيدة فقط، متفادية بذلك الحاجة إلى سحب المعادلات يدوياً عبر آلاف الصفوف ومجنبة المصنف خطر تلف الصيغ الجزئي. يمكن كتابة المعادلة الشاملة للنطاق كاملاً على النحو الآتي:
=BYROW(A2:A100, LAMBDA(row, TEXTJOIN("", TRUE, LEFT(TEXTSPLIT(TRIM(row), " "), 1))))
يقوم المعالج عبر دالة BYROW بتمرير كل صف في النطاق المعين كمتغير مستقل يدعى row إلى دالة LAMBDA، والتي تطبق الخوارزمية النصية كاملة على كل مدخل، ليفيض الناتج النهائي تلقائياً في صورة عمود مصفوفي متدفق (Spilled Array). ولتحقيق أقصى درجات الاحترافية الهندسية، يمكن حفظ هذا التعبير البرمجي داخل “مدير الأسماء” (Name Manager) تحت اسم دالة مخصصة مثل ExtractInitials، مما يمكن المستخدمين من استدعاء الوظيفة المعقدة لاحقاً في أي موضع بمجرد كتابة اسم الدالة متبوعاً بعنوان الخلية، تماماً كأي دالة مدمجة في صلب البرنامج.
5.3 المقارنة التقنية بين منهجية FILTERXML ومنهجية المصفوفات الديناميكية
تفرض المقارنة بين هاتين المدرستين التحليليتين ضرورة فحص محددات التوافقية والأداء؛ فمنهجية FILTERXML تتمتع بميزة تاريخية حاسمة تتمثل في دعمها للتوافق العكسي (Backward Compatibility) مع الإصدارات المكتبية القديمة لنظام ويندوز بدءاً من إصدار 2013 وحتى 2019. تضمن هذه الميزة تشغيل المصنف بأمان على أجهزة المستخدمين الذين لم ينتقلوا بعد إلى الاشتراكات السحابية، إلا أن عيبها الجوهري يكمن في ثقل أدائها الحسابي وغياب دعمها التام في بيئات إكسل لماك وإكسل ويب.
في المقابل، تتفوق منهجية المصفوفات الديناميكية الحديثة القائمة على TEXTSPLIT في معايير سرعة التنفيذ الحسابي؛ إذ يتم تقييم الدوال في الطبقة البرمجية التحتية المباشرة لمحرك إكسل المطور دون الحاجة لاستدعاء مكتبات إعراب خارجية، مما يوفر سرعات معالجة تفوق الصيغة القديمة بأضعاف مضاعفة. علاوة على ذلك، توفر الدوال الحديثة توافقاً شاملاً ومتكاملاً عبر جميع أنظمة التشغيل والمنصات السحابية، وإن كانت تشترط العمل حصراً ضمن بيئات Microsoft 365 أو Office 2021 وما يليهما، حيث يؤدي فتحها على الإصدارات القديمة إلى انهيار الحساب وظهور الخطأ #NAME?.
6. التحديات اللغوية والخصوصية التركيبية للنصوص العربية
6.1 التعامل مع أداة التعريف (الـ) والسوابق اللغوية
تفرض اللغة العربية تحديات صرفية وتركيبية فريدة عند معالجة نصوصها داخل بيئة الجداول الحسابية؛ إذ تقف “أل” التعريف عائقاً جوهرياً أمام دقة استخراج الأحرف الاستهلالية الحقيقية للمفردات. فعند تطبيق دوال الاقتطاع المباشر على أسماء أو مؤسسات عربية تبدأ بكلمات معرفة، مثل “المملكة العربية السعودية”، فإن الخوارزمية تقتطع محرف الألف “ا” من كل كلمة بصورة متكررة، لينتج الاختصار المشوه “ا ع س” بدلاً من الحروف الدلالية المستهدفة “م ع س” (المقابلة لجذور الكلمات: مملكة، عربية، سعودية).
للتغلب على هذا التشوه الدلالي في النظم الأكاديمية والتوثيقية الدقيقة، يتحتم هندسة مرحلة تنقية استباقية تسبق تجزئة النصوص. يمكن إنجاز ذلك بدمج دوال استبدال متعددة تبحث عن سوابق التعريف الواقعة في بدايات الكلمات (سواء سبقتها مسافة أو كانت في مطلع الجملة) وتستبدلها بمسافات خالية، أو اعتماد منهجيات برمجية تفكك الكلمات أولاً ثم تفحص وجود المقطعين “الـ” في صدر كل كلمة لعزلهما قبل استخلاص الحرف الأول الصامت. يضمن هذا الإجراء الصرفي الموجه استخراج الاختصارات المعبرة عن الجواهر الدلالية للمفردات العربية دون الوقوع في شرك تكرار حرف الألف التعريفي.
6.2 تأثير علامات التشكيل والتطويل على دقة المعالجة
يمتد التحدي الإملائي ليشمل علامات التشكيل الإعرابي (الفتحة، الضمة، الكسرة، السكون، والتنوين) التي تُعامل في معايير الترميز الدولي الموحد (Unicode) كمحارف مستقلة تُدمج فوق أو تحت الحرف الأساسي السابق لها. إذا احتوت الكلمة المدخلة في مطلعها على حرف مشكول (كأن يُكتب الاسم “مُحَمَّد”)، فإن بعض إصدارات البرمجيات أو الدوال النصية الدقيقة قد تحتسب الحركة الإعرابية كمحرف قائم بذاته أو تفشل في عزل الحرف الصامت بحركته، مما قد يؤدي إلى استخراج مخرجات مشوهة وغير موحدة في قواعد البيانات المجمعة.
يتشابه هذا الأثر السلبي مع محرف التطويل أو “الكشيدة” (ـ) الذي يُدرج أحياناً لأغراض التنسيق الجمالي للنص المكتوب. في حال وُضعت الكشيدة في موقع غير منضبط أو تداخلت مع محارف البدء، فإنها تتسبب في احتساب محرف التطويل كأول عنصر نصي. ولمجابهة هذه الاختلالات، يتعين تضمين خوارزميات تطهير وتجريد نصي متقدمة تعمل على تجريد السلاسل العربية من كافة الحركات الإعرابية ومحارف المد والتطويل مسبقاً قبل دفعها إلى مسار التجزئة الموضعي، مما يؤمن اتساق وسلامة الحروف المستخلصة بنسبة مطلقة.
6.3 التعامل مع المسافات غير المرئية والفواصل العربية
تعد المسافات الشاذة من أكثر المشكلات استعصاءً في مرحلة تنظيف البيانات النصية العربية؛ إذ كثيراً ما تستورد الجداول نصوصاً محملة بما يُعرف بـ “المسافة غير المنكسرة” (Non-Breaking Space) المشفرة برقم المحرف 160 (CHAR(160)) والناتجة عن عمليات النسخ من صفحات الويب ومستندات HTML. تتمثل خطورة هذا المحرف في أن دالة TRIM القياسية في إكسل مبرمجة تقنياً للتعامل حصراً مع المسافة العادية ذات الرمز 32 (CHAR(32))، وتتجاهل كلياً المسافة 160، مما يترك فراغات خفية تفسد عملية التجزئة وتؤدي لظهور عناصر مصفوفية فارغة.
علاوة على ذلك، كثيراً ما يعتمد المحررون في اللغة العربية على الفاصلة التقليدية “،” بدلاً من المسافة للفصل بين الكلمات أو التوصيفات، مما يجعل دالة التجزئة الموجهة للمسافات فقط تعامل الجملة المتصلة بفواصل كأنها كتلة واحدة مصمتة. ولمعالجة هذه الثغرات، تقتضي أفضل الممارسات تمرير النص أولاً عبر دالة استبدال مركبة تقوم بتحويل الفاصلة العربية (،) والمسافة غير المنكسرة إلى مسافات قياسية عبر الصياغة:
SUBSTITUTE(SUBSTITUTE(A2, CHAR(160), " "), "،", " ")
يكفل هذا التحصين التحويلي تجانس بيئة التجزئة وضمان استقرار الخوارزمية أمام مختلف طرائق التحرير والتدوين البشري غير المنضبط.
7. أتمتة الاستخراج عبر البرمجة النصية: Visual Basic for Applications (VBA)
7.1 بناء دالة مخصصة (UDF) لاستخراج الحروف الأولى
يمثل تطوير الدوال المخصصة للمستخدم (User-Defined Functions) عبر بيئة التطوير المدمجة Visual Basic for Applications حلاً استراتيجياً فائق القوة للأفراد والمؤسسات الراغبة في توحيد عمليات استخراج الحروف وتغليف التعقيدات الحسابية داخل دالة مخصصة سهلة الاستخدام. يتيح محرر VBA مرونة مطلقة في التعامل مع الحلقات التكرارية والمنطق الشرطي وتفكيك النصوص، متفوقاً على القيود التي قد تفرضها صيغ الخلايا الصرفة. يمكن صياغة الدالة المخصصة داخل وحدة برمجية قياسية (Standard Module) باتباع الهيكلية البرمجية الموضحة أدناه:
تعتمد هندسة هذه الدالة على استقبال النص كمتغير من النوع السلسلي، وتطبيق عملية تطهير مبدئية تحذف المسافات المتطرفة عبر دالة Trim. بعد ذلك، تستدعي الشفرة دالة التفكيك Split لتقسيم السلسلة بالاعتماد على الفراغ كفاصل طبيعي، مما يسفر عن تكوين مصفوفة نصوص محلية في الذاكرة. وباستخدام حلقة تكرارية مرنة من طراز For Each، يتم مسح كل عنصر في هذه المصفوفة والتحقق من عدم كونه نصاً صفري الطول (لتجنب تأثير المسافات البينية المزدوجة)، ثم اقتطاع المحرف الأول وإلحاقه بالمتغير التراكمي للنتيجة. تُختتم الدالة بتحويل السلسلة النهائية إلى أحرف كبيرة، وتفريغها في واجهة ورقة العمل بكل انسيابية وسرعة.
7.2 توظيف التعابير النمطية (Regular Expressions) المتقدمة
للتعامل مع متطلبات المعالجة النصية بالغة التعقيد، والتي تتجاوز حدود التباعد بالمسافات التقليدية، يُعد استدعاء مكتبة التعابير النمطية (RegEx) عبر كائن النظام VBScript.RegExp في بيئة VBA الذروة التقنية في معالجة السلاسل. توفر التعابير النمطية محرك بحث نمطياً يسمح بتحديد وتصيد الحروف الأولى استناداً إلى المعايير اللغوية وحدود الكلمات المحرفية (Word Boundaries)، بصرف النظر عن نوع المحددات الفاصلة بينها، سواء كانت مسافات، أو شرطات، أو علامات ترقيم متعددة اللغات.
يتم تفعيل هذا المنهج بإنشاء كائن النمط وتعيين الخاصية الشاملة Global = True لضمان استمرار المسح عبر كامل النص. يُستخدم النمط الخوارزمي المعياري "bw"، حيث يرمز b إلى التموضع الدقيق عند الحد الفاصل بين الفراغ والمحرف، بينما يحدد الرمز w استهداف المحرف الأبجدي الرقمي الأول مباشرة. ينفذ المحرك عملية مطابقة متجهة تسفر عن مجموعة كائنات (Matches Collection)، يتم المرور عليها بحلقة سريعة لتجميع قيم الحروف المتطابقة. يتميز هذا الأسلوب بقدرته الفائقة على معالجة الأسماء الموصولة بشرطات (Hyphenated Names) والنصوص متعددة اللغات دون الحاجة لأي عمليات استبدال نصية مسبقة، مما يجعله الحل الأمثل للبيانات الأرشيفية المعقدة.
7.3 مقارنة الكفاءة بين دوال أوراق العمل والشفرات البرمجية
تخضع المفاضلة بين الاعتماد على دوال أوراق العمل الحسابية المباشرة واستخدام الدوال البرمجية المكتوبة بلغة VBA لمعايير هندسية ترتبط بسياسات أمان المؤسسة وأهداف الأداء وسهولة النشر؛ إذ تمتاز دوال أوراق العمل (سواء صيغة FILTERXML أو دوال Microsoft 365 الديناميكية) بكونها حلولاً طبيعية أصيلة لا تتطلب تفعيل وحدات الماكرو، مما يسمح بحفظ المصنفات بالامتداد القياسي الآمن .xlsx دون التعرض لحظر سياسات الأمان أو التهديدات السيبرانية المتعلقة بالبرمجيات الخبيثة، إضافة إلى سهولة مشاركتها مع أطراف خارجية دون قيود تقنية.
على الجانب الآخر، توفر دوال VBA المخصصة بساطة بصرية استثنائية للمستخدم النهائي الذي يحتاج فقط لكتابة اسم الدالة دون التورط في فهم أو صيانة صيغ مركبة تتجاوز مئات المحارف. غير أن هذه الراحة تقابلها تكلفة تشغيلية تتعلق بالسرعة؛ إذ إن دوال VBA تُنفذ عبر طبقة ترجمة برمجية أبطأ نسبياً من المحرك الحسابي المكتوب بلغة C++ والمدمج في صلب إكسل. كما أن دوال VBA المخصصة تصبح في كثير من الأحيان دوالاً متقلبة وغير مستقرة في استدعاءات التوازي عند تشغيلها عبر معالجات متعددة الأنوية، مما يرجح كفة صيغ الدوال الأصيلة في المشاريع الضخمة التي تستهدف معالجة مئات الآلاف من الصفوف في أجزاء من الثانية.
8. معالجة البيانات الضخمة عبر أداة تحويل البيانات Power Query
8.1 استيراد البيانات وتفكيك الأعمدة في محرر Power Query
تتربع أداة استخراج وتحويل وتحميل البيانات (Power Query) على قمة الأدوات المؤسسية المخصصة للتعامل مع البيانات الضخمة وتنفيذ عمليات التطهير الهيكلي المتكررة داخل إكسل. تتمثل الخطوة الأولى في هذه المنهجية في استيراد الجدول النصي إلى بيئة المحرر بالانتقال إلى تبويب “بيانات” (Data) واختيار “من جدول/نطاق” (From Sheet/Table). يتحقق المحرك تلقائياً من أنواع البيانات ويعزل حقل النصوص المستهدف في بيئة عمل معزولة كلياً عن ورقة العمل المباشرة.
يتيح محرر الاستعلامات خيارات متعددة لتفكيك النصوص؛ حيث يمكن استخدام واجهة المستخدم الرسومية لتقسيم العمود بالاستناد إلى محدد المسافة (Split Column by Delimiter). غير أن الممارسة المتقدمة تفضل تفكيك النص مباشرة داخل محرر الأعمدة المخصصة للحفاظ على بنية السجل الواحد كصف مستقل وتفادي تشظي البيانات وتضخم عدد الصفوف، مما يمهد الطريق لكتابة خطوة تحويلية مدمجة تعتمد على محرك لغة M البرمجي الفعال.
8.2 استخدام لغة M لاستخراج الحرف الأول وتجميع النتائج
تتألق لغة M بقدراتها الوظيفية المتطورة لمعالجة السلاسل النصية والمصفوفات عبر مجموعة دوال Text وList عالية الكفاءة. لتوليد عمود الاختصارات النصية بحركة إجرائية واحدة، يُضاف عمود مخصص (Custom Column) وتُكتب فيه صيغة التحويل الخوارزمية التالية:
Text.Combine(List.Transform(Text.Split(Text.Trim([Company_Name]), " "), each Text.Start(_, 1)))
تحلل هذه الصيغة المتكاملة من الداخل إلى الخارج بسلاسة منهجية؛ حيث تبدأ دالة Text.Trim بتطهير السلسلة من الشوائب الفراغية، ثم تقوم دالة Text.Split بتمزيق النص عند كل مسافة منتجةً قائمة برمجية (List) بالكلمات المستقلة. تستقبل دالة List.Transform هذه القائمة وتطبق تعبيراً وظيفياً تكرارياً على كل عنصر فيها عبر Text.Start(_, 1) لاقتطاع المحرف الأول، لتختتم دالة Text.Combine المسار بدمج قائمة الأحرف المعزولة في سلسلة نصية موحدة ومصمتة تُسجل في الحقل الجديد للجدول المعالج.
8.3 مزايا التحويل عبر Power Query في المشاريع المتكررة
يقدم التحويل عبر بيئة Power Query ميزات استراتيجية لا تضاهيها أي من المنهجيات السابقة، وخاصة في سياق المشاريع المؤسسية المتكررة وخطوط إمداد البيانات الآلية (ETL Pipelines). يتمثل التفوق الأكبر في عزل الحسابات الثقيلة خارج بيئة الشبكة الحسابية لورقة العمل، مما يمنع تجمد المصنف أثناء إدخال البيانات أو استعراض التقارير، فضلاً عن قدرة الأداة على حفظ خطوات التحويل وتكرارها بنقرة زر واحدة عند استلام ملفات دورية متجددة أو الاتصال بقواعد بيانات خارجية ضخمة مثل SQL Server.
يضاف إلى ذلك ميزة التكامل العميق مع نموذج البيانات الداخلي (Data Model) ومحرك Power Pivot؛ حيث يمكن تغذية الجداول المعالجة والمحملة برموز الاختصارات مباشرة إلى الذاكرة دون الحاجة لتفريغها في خلايا ورقة العمل العادية. يوفر هذا الأسلوب مساحات شاسعة من الذاكرة، ويمنح محللي البيانات منصة صلبة لبناء لوحات القياس الإحصائية ومؤشرات الأداء المؤسسية المعتمدة على الرموز التاجية الموحدة بأعلى معايير الدقة والسرعة الممكنة في معالجة البيانات الضخمة.
9. الأخطاء الشائعة واستراتيجيات استكشاف المشكلات وإصلاحها
9.1 تشخيص وحل الخطأ #VALUE! المرتبط ببنية الوسوم
يعد الخطأ #VALUE! أكثر الأعطال شيوعاً وإرباكاً عند الاعتماد على معادلة FILTERXML الكلاسيكية؛ إذ يرتبط ظهوره ارتباطاً وثيقاً بانهيار التحليل النحوي لشفرة XML المكونة داخل الذاكرة. السبب الأكثر تواتراً لهذا الخلل هو احتواء السلسلة النصية الأصلية على محارف خاصة محجوزة في لغة XML، وتحديداً علامة العطف & (Ampersand)، وعلامة أصغر من <، وعلامة أكبر من >. إن وجود أي من هذه الرموز دون تشفير يدفع محرك MSXML إلى اعتبار الوثيقة مشوهة ومخالفة للمواصفات القياسية، فيتوقف فوراً عن التنفيذ ويرجع الخطأ المذكور.
لتطويق هذه الإشكالية وتأمين استقرار الصيغة، يجب تنقيح السلسلة عبر استبدال المحارف المحجوزة بكياناتها الترميزية المعيارية (XML Entities) قبل إرسالها للوسوم. يمكن تحقيق ذلك بدمج دالة SUBSTITUTE إضافية لتحويل علامة & إلى التعبير النصي & على النحو التالي:
SUBSTITUTE(A2, "&", "&")
كما يظهر الخطأ ذاته إذا كانت الخلية المصدر فارغة أو لا تحتوي إلا على مسافات فقط؛ حيث يُبنى مستند XML يفتقر إلى محتوى نصي داخل العقد. يُعالج هذا العائق بتغليف الصيغة بدالة تدقيق استباقية مثل IF(ISBLANK(A2), "", ...) أو استخدام دالة صيد الأخطاء الشاملة IFERROR لضمان إرجاع مخرجات فارغة أنيقة بدلاً من عرض الأخطاء الحسابية في التقارير النهائية.
9.2 التعامل مع عدم توافق دالة FILTERXML في بيئات العمل المختلفة
يقع الكثير من مستخدمي إكسل في فخ عدم التوافقية متعددة المنصات عند مشاركة المصنفات المعتمدة على صيغة FILTERXML؛ إذ إن هذه الدالة تعتمد في تكوينها البرمجي على الربط مع مكتبات نظام التشغيل ويندوز، ولذا فهي غير مدعومة نهائياً ومفقودة في إصدارات إكسل المخصصة لنظام ماك (Excel for Mac)، وكذلك في نسخة الويب السحابية (Excel for the Web). يؤدي فتح المصنف في هذه البيئات غير المتوافقة إلى فشل المعادلة وظهور الخطأ #VALUE! أو #NAME?، مما يعطل مسار العمل في المؤسسات التي تعتمد بيئات تشغيل مختلطة.
لضمان التوافقية الشاملة في غياب اشتراكات Microsoft 365 الحديثة، يتعين على مديري النظم اعتماد استراتيجيات بديلة تعتمد على دوال النصوص الكلاسيكية المحايدة مثل MID وFIND وSEARCH، وإن كانت تقتصر على معالجة عدد محدد مسبقاً من الكلمات. فبالنسبة للنصوص الثنائية الثابتة، يُمكن توظيف الصيغة العالمية الآمنة عبر المنصات:
=LEFT(A2, 1) & MID(A2, FIND(" ", A2 & " ") + 1, 1)
تضمن هذه الصيغة استخراج الحرف الأول والثاني في كافة أنظمة التشغيل والنسخ السحابية بأمان تام، مع تجنب الاعتماد على أي دوال متخصصة بنظام تشغيل محدد ما لم يكن هناك تأكيد قاطع بأن كافة المستخدمين النهائيين يعملون حصراً عبر بيئة ويندوز المكتبية.
9.3 تصحيح أخطاء المسافات غير المنتظمة والفواصل المخفية
تتسلل الأخطاء الحسابية الخفية إلى مخرجات دوال الاستخراج نتيجة وجود محارف تحكم غير قابلة للطباعة (Non-printable Control Characters) في البيانات الواردة من قواعد البيانات القديمة أو الملفات النصية المصدرة بأنظمة غير موحدة. تشمل هذه المحارف فواصل الأسطر، ومحارف الرجوع للبداية (Carriage Returns: CHAR(13))، والانتقال لسطر جديد (Line Feeds: CHAR(10))، والتي قد تفصل الكلمات دون وجود مسافة حقيقية واضحة، مما يضلل محرك التجزئة ويدفعه لاحتساب محرف التحكم كأنه بداية الكلمة التالية أو دمج كلمتين معاً.
يتمثل الدرع الوقائي الحاسم لتفادي هذه المشكلة في دمج دالة التطهير CLEAN ضمن مسار المعالجة الأولي للخلية. تعمل هذه الدالة المتخصصة على استئصال المحارف غير المطبوعة ذات الأرقام الثنائية من 0 إلى 31 في جدول ASCII. وعند اقترانها بدالة TRIM، وإخضاع السلسلة لمعادلة استبدال تحول محارف السطور إلى مسافات قياسية، تتشكل مصفاة بيانات ثلاثية الطبقات تضمن تنقية النصوص من الفواصل والمسافات المشوهة، وتوفر مدخلات نقية بنسبة مئة بالمئة تسمح لدوال الاقتطاع بإنجاز مهامها بأعلى مستويات الموثوقية والدقة الرياضية.
10. أفضل الممارسات المنهجية لتوثيق وصيانة نماذج البيانات في إكسل
10.1 بناء نماذج حسابية تتسم بالمتانة وقابلية القراءة
تعد قابلية القراءة والصيانة من الركائز الأساسية التي تفصل بين النماذج الحسابية العشوائية وتلك المبنية باحترافية هندسية رصينة داخل المؤسسات الكبرى. إن كتابة صيغ نصية متداخلة تتجاوز مئات المحارف تجعل عملية تتبع الأخطاء أو التعديل المستقبلي كابوساً برمجياً لأي محلل يتقلد صيانة الملف لاحقاً. لتحقيق المتانة المطلوبة، ينبغي تقسيم الصيغ الطويلة عبر توظيف الأعمدة المساعدة المنطقية (Helper Columns) متى كان ذلك ممكناً، بحيث يُخصص عمود لتنقية النص وتطهيره، ويعقبه عمود للتجزئة، وآخر للاستخلاص والتجميع النهائي.
بالإضافة إلى ذلك، يُوصى بشدة بالاعتماد على ميزة النطاقات المسماة (Named Ranges) أو الجداول الرسمية في إكسل (Excel Tables – ListObjects). يتيح هذا النهج استخدام المراجع الهيكلية الصريحة مثل [@Customer_Name] بدلاً من العناوين المبهمة مثل A2، مما يضفي وضوحاً دلالياً فائقاً على بنية المعادلات. كما يجب إلحاق ورقة عمل خاصة بالتوثيق (Documentation Sheet) تتضمن معجماً يشرح منطق الدوال المعقدة المستعملة، وطبيعة المدخلات المتوقعة، وقيود النظام، بما يضمن استمرارية واستدامة النموذج الحسابي عبر مختلف دورات العمل المؤسسي.
10.2 تحسين الأداء والكفاءة في النماذج الإحصائية المعقدة
يشكل ضبط الأداء الحسابي وترشيد استهلاك موارد المعالج والذاكرة أولوية هندسية قصوى عند بناء النماذج الإحصائية التي تستوعب مصفوفات تتجاوز عشرات الآلاف من السجلات النصية. تتطلب النماذج الرصينة تجنب الإفراط في استخدام “الدوال المتقلبة” (Volatile Functions) داخل السلاسل النصية التي تفرض إعادة حساب الخلية قسراً مع كل نقرة أو حركة ماوس داخل المصنف، مما يسبب بطئاً وتجمداً ملحوظاً في واجهة الاستخدام.
كما يُنصح بالتقييم الدوري للحاجة الحقيقية للحساب اللحظي المباشر؛ فإذا كانت البيانات النصية المدخلة بيانات تاريخية ساكنة لا تتغير قيمها باستمرار (مثل أسماء العملاء أو المشاريع المنتهية)، فإن الإبقاء على مئات الآلاف من الصيغ المصفوفية الحية يعد هدراً حسابياً غير مبرر. تقتضي أفضل الممارسات في هذه الحالة تحويل نتائج المعادلات عبر الأمر “نسخ ولصق كقيم” لتثبيت النصوص المستخرجة، مما يخفض حجم الملف الرقمي بنسب هائلة، ويسرع عمليات فتح وحفظ المصنف، ويحرر دورات المعالجة لتوجيهها نحو التحليلات الإحصائية وعمليات النمذجة المتقدمة.
10.3 معايير اختيار الطريقة المثلى وفق متطلبات المشروع
لتيسير اتخاذ القرار التقني في اختيار الأداة الأنسب لاستخراج الحروف الأولى، يوضح الجدول التحليلي التالي مقارنة شاملة بين مختلف المنهجيات المعروضة استناداً إلى المعايير الهندسية والتشغيلية المعتمدة في بيئات العمل الاحترافية:
| المنهجية المتبعة | الإصدارات المتوافقة | سرعة المعالجة الحسابية | مستوى التعقيد البرمجي | حجم البيانات المستهدف | الاستخدام الموصى به |
|---|---|---|---|---|---|
| صيغة FILTERXML الكلاسيكية | إكسل 2013-2019 (ويندوز فقط) | متوسط (كلفة استدعاء محرك XML) | مرتفع (تتطلب فهم وسوم XML وXPath) | صغير إلى متوسط (أقل من 20,000 صف) | المصنفات التي تتطلب توافقاً عكسياً مع إصدارات ويندوز السابقة |
| دوال Microsoft 365 الديناميكية | M365 / Office 2021 وما يليهما | فائق السرعة (محرك نصوص داخلي أصيل) | منخفض إلى متوسط (صيغ واضحة وقابلة للقراءة) | متوسط إلى كبير (حتى 100,000 صف) | البيئات السحابية والحديثة المعتمدة على الحساب التفاعلي السريع |
| دوال البرمجة النصية المخصصة (VBA) | كافة إصدارات سطح المكتب المعتمدة | متوسط (مقيد بسرعة طبقة مفسر الكود) | مرتفع (يتطلب كتابة وصيانة وحدات ماكرو) | متوسط (حتى 50,000 صف) | المصنفات الموجهة لمستخدمين مبتدئين تتطلب دالة بصرية موحدة |
| أداة استعلام البيانات (Power Query) | إكسل 2016+ والإضافات لـ 2010/2013 | مرتفع جداً (معالجة تدفقية خارج واجهة الرسم) | متوسط (يعتمد على خطوات M الوظيفية) | ضخم جداً (مئات الآلاف إلى ملايين الصفوف) | عمليات التطهير الدورية المؤتمتة ومشاريع استيراد البيانات الضخمة (ETL) |
يتضح من مصفوفة المفاضلة المنهجية أن اختيار الحل التقني ليس قراراً اعتباطياً، بل ينبع من تقييم هندسي دقيق لبيئة الاستخدام، وحجم البيانات، والبنية التحتية البرمجية للمؤسسة. يضمن هذا النهج الدقيق توازناً مثالياً بين سرعة التنفيذ، وسهولة الصيانة، ودقة المخرجات التحليلية.
خاتمة
إن استخراج الحرف الأول من كل كلمة في إكسل يمثل نموذجاً مصغراً لكيفية تطور هندسة البيانات والمعالجة النصية داخل بيئات الجداول الحسابية عبر العقود الأخيرة. من خلال الاستعراض الشامل لكافة المنهجيات، يتجلى التحول الجذري من الصيغ الحسابية الالتفافية المعقدة كصيغة FILTERXML، التي مثلت ذروة الإبداع المنطقي لتخطي قصور الإصدارات القديمة، إلى العصر الحديث المدعوم بالدوال المصفوفية الديناميكية الفائقة مثل TEXTSPLIT وLAMBDA، والتي أعادت تعريف قدرات إكسل كبيئة حوسبة وظيفية متطورة وسريعة.
كما بينت الدراسة التحليلية أن النجاح التطبيقي في معالجة السلاسل النصية لا يقف عند حدود معرفة صياغة المعادلات الرياضية فحسب، بل يتطلب إدراكاً عميقاً بالخصائص البنيوية والتحديات الإملائية الخاصة بلغة البيانات، كما تجلى في الخصوصية التركيبية للنصوص العربية من حيث تأثير أداة التعريف، وعلامات التشكيل، والمحارف غير المنكسرة. إن تبني أسلوب المعالجة الاستباقية لتنظيف البيانات وضمان توافقية النماذج عبر المنصات المختلفة يُعد الفيصل في نجاح استقرار النظم الإحصائية والإدارية في كبرى المؤسسات.
في الختام، يجب على مهندس البيانات ومحلل النظم أن ينظر إلى ترسانة الحلول المتوفرة—سواء كانت صيغاً أصيلة، أو شفرات VBA مخصصة، أو مسارات استعلامات Power Query—كنقاط قوة تكاملية يُفاضل بينها وفق مصفوفة علمية تأخذ بعين الاعتبار حجم البيانات، والأداء الحاسوبي، وسهولة الصيانة، مما يكفل تحويل البيانات النصية الخام إلى أصول رقمية منظمة وموثوقة تسهم في دعم القرار المؤسسي بكفاءة واقتدار.
المراجع
- Alexander, M., Kusleika, D., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- Billings, E. (2021). Data Cleaning and Transformation with Power Query in Excel and Power BI. Packt Publishing.
- Friedl, J. E. (2006). Mastering Regular Expressions (3rd ed.). O’Reilly Media.
- Jelen, B. (2022). Microsoft Excel 365 Formulas and Functions. Microsoft Press.
- Microsoft Corporation. (2023). TEXTSPLIT function documentation. Microsoft Support. https://support.microsoft.com/office/textsplit-function-b15e1e49-051a-4048-b11b-f8bc332363cb
- Microsoft Corporation. (2023). FILTERXML function documentation. Microsoft Support. https://support.microsoft.com/office/filterxml-function-4df72efc-11ec-4951-86f5-c1374812f5b7
- Puls, K., & Escobar, M. (2016). M Is for (Data) Monkey: A Guide to the M Language in Excel Power Query. Holy Macro! Books.
- Walkenbach, J. (2015). Excel VBA Programming For Dummies (4th ed.). John Wiley & Sons.