
تمثل معالجة البيانات النصية وسلاسل المحارف في برمجية مايكروسوفت إكسل (Microsoft Excel) ركيزة جوهرية من ركائز هندسة البيانات وتنقيتها، حيث تشكل النصوص غير المهيكلة جزءاً واسعاً من قواعد البيانات الواردة من الأنظمة المؤسسية، واستطلاعات الرأي، وسجلات النظم الإدارية والأكاديمية. وتبرز إشكالية استخراج النص الواقع بعد المسافة الأخيرة كواحدة من أكثر المسائل التقنية تكراراً وأشدها حساسية؛ إذ تتطلب من المحلل استخلاص عناصر حاسمة مثل الاسم الأخير للأفراد، أو الكود البريدي الملحق بالعناوين الجغرافية، أو الرمز التعريفي الختامي في السلاسل المركبة، وذلك من نصوص تتباين تبايناً جذرياً في أطوالها وعدد كلماتها وتوزيع المسافات الفاصلة ضمنها.
تاريخياً، شكّل هذا الإجراء تحدياً برمجياً تطلب صياغة معادلات مصفوفية متداخلة وشديدة التعقيد، تجمع بين دوال حساب الأطوال والبحث والاستبدال وتكرار المسافات؛ مما كان يفرض عبئاً إدراكياً ملحوظاً ويرفع من احتمالية الخطأ البشري أثناء كتابة الصيغ وصيانتها. ومع التحديثات الجذرية التي طرأت على محرك الحساب الديناميكي في بيئة إكسل وتدشين حزمة الدوال النصية الحديثة، شهدت معمارية معالجة النصوص قفزة نوعية أتاحت تنفيذ هذه العمليات المعقدة بدقة متناهية وبأقل قدر من التعليمات البرمجية، متيحة للمحللين تركيز جهودهم على تفسير البيانات بدلاً من استنزاف الوقت في تطهيرها الشكلي.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك الأبعاد النظرية والتطبيقية لعملية استخراج النص بعد المسافة الأخيرة في إكسل، من خلال دراسة مقارنة ومفصلة تستعرض كلاً من الحلول الحديثة المستندة إلى دالة TEXTAFTER والبدائل التقليدية الراسخة في الإصدارات الأقدم، مع استعراض استراتيجيات إدارة المسافات الزائدة والشاذة، ومعالجة الاستثناءات والأخطاء، وتكامل الصيغ ضمن مصفوفات ديناميكية مؤتمتة تسهم في ترقية كفاءة البنية التحتية لمعالجة البيانات المؤسسية والبحثية.
1. المقدمة المنهجية لمعالجة النصوص وسلاسل المحارف في إكسل
1.1 أهمية تجزئة النصوص في تحليل البيانات الأكاديمية والتطبيقية
تحتل عمليات تجزئة السلاسل النصية مكانة محورية في مسار إعداد البيانات (Data Wrangling)، حيث تعد المدخل الضروري لضمان جودة التحليلات الإحصائية ونمذجة العلاقات بين المتغيرات. في كثير من الأحيان، تُجمع البيانات الأولية في حقول نصية مدمجة تحوي أسماء متعددة المقاطع، أو عناوين مركبة، أو تعليقات وصفية تنتهي بتصنيفات نوعية. إن الإبقاء على هذه البيانات بصورتها الهجينة يعيق تطبيق خوارزميات الفرز والتجميع والتصفية، ويحد من القدرة على إنشاء مفاتيح الربط الأولية (Primary Keys) اللازمة لدمج الجداول المتعددة داخل نماذج البيانات العلائقية.
تسهم المعالجة الدقيقة للسلاسل المحرفية في خفض هوامش الخطأ التحليلي؛ حيث أشار باحثون في هندسة البيانات اللغوية والمعالجة الآلية للنصوص، ومنهم ألتوف وزملاؤه (Althoff et al., 2016)، إلى أن التحديد الدقيق لحدود الكلمات والرموز المفتاحية ضمن النصوص الحوارية أو التوثيقية يعد شرطاً أساسياً لاستخلاص الأنماط وتقليل التشويش الدلالي في مصفوفات البيانات الضخمة. وبالتالي، فإن عزل الكلمة الأخيرة بدقة متناهية ينقل السجل البياني من مرحلة النص غير المهيكل إلى بنية جدولية منتظمة تخضع لمعايير الضبط القياسية، مما يدعم دقة المقاييس الوصفية والتحليلات اللاحقة.
علاوة على ذلك، يعتمد اتساق قواعد البيانات المؤسسية على التوحيد المعياري للمخرجات. فعند التعامل مع قواعد بيانات تضم مئات الآلاف من السجلات، يؤدي تباين عدد الكلمات داخل الحقل الواحد إلى فشل الحلول المعتمدة على القطع الثابت (Fixed-width splitting). من هنا، تنبع الحاجة إلى تبني منهجيات مرنة قادرة على التكيف مع التباين البنيوي للنصوص، والتعرف تلقائياً على المحددات الفاصلة كالمسافات، واستهداف الموقع النسبي المطلوب بدقة متناهية تحول دون تداخل الحقول أو فقدان البيانات الحيوية.
1.2 تطور وظائف معالجة النصوص في بيئة برمجية إكسل
شهدت بيئة مايكروسوفت إكسل تحولاً جذرياً في بنيتها الحسابية على مدار العقود الثلاثة الماضية. في الإصدارات الكلاسيكية، التي تعود جذورها إلى بدايات البرنامج وحتى إصدارات مثل إكسل 2016 و2019، كان التعامل مع النصوص محكوماً بحزمة محدودة من الدوال النصية القياسية مثل LEFT وRIGHT وMID وFIND وSEARCH وLEN وSUBSTITUTE. كانت هذه الأدوات، على الرغم من قوتها الرياضية، تفرض على المستخدم بناء صيغ متداخلة ومعقدة للغاية لتنفيذ مهام تبدو بسيطة ظاهرياً، مثل استخراج كلمة تقع بعد فاصل محدد يتكرر عدة مرات.
مع إطلاق محرك الحساب الديناميكي في تحديثات مايكروسوفت 365 (Microsoft 365) والإصدارات اللاحقة مثل إكسل 2024، أعادت شركة مايكروسوفت هندسة المنظومة الحسابية بالكامل عبر إدخال دوال المصفوفات الديناميكية وإطلاق حزمة متخصصة من الدوال النصية في عام 2022، تصدرتها دالة TEXTAFTER وشقيقاتها TEXTBEFORE وTEXTSPLIT. مثّل هذا التدشين نقطة تحول محورية أنهت الاعتماد القسري على الحيل الحسابية المعقدة، واستبدلتها بدوال ذات بناء نحوي مباشر يعكس القصد التحليلي للمستخدم بصورة واضحة ومباشرة.
إن أثر هذه الدوال الحديثة لم يقتصر على تقليل حجم الصيغ وتسهيل قراءتها فحسب، بل امتد ليشمل تعزيز الأداء الحاسوبي الداخلي للبرنامج؛ حيث تُنفذ العمليات النصية عبر كود مبني بلغة تجميع منخفضة المستوى ومحسنة داخل نواة إكسل، مما يختصر زمن المعالجة ودورات استهلاك المعالج المركزي (CPU Cycles) عند التعامل مع جداول البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف، فضلاً عن تقليص زمن إعادة الحساب (Recalculation Time) بصورة ملحوظة مقارنة بالمعادلات المركبة التقليدية.
1.3 التحديات الهيكلية في التعامل مع المسافات داخل النصوص
تعد المسافة الفاصلة (Space Character) من أكثر محارف النصوص إثارة للتعقيد في بيئات الجداول الإلكترونية، ويرجع ذلك بالدرجة الأولى إلى كونها محرفاً غير مرئي يحمل وزناً بنيوياً حاسماً. يكمن التحدي الهيكلي الأول في التباين العشوائي لأطوال الكلمات وعدد المسافات داخل السجلات المختلفة؛ فبينما قد يحتوي سجل معين على مسافة واحدة تفصل بين اسمين، قد يحتوي سجل آخر ضمن نفس العمود على ثلاث أو أربع مسافات فاصلة تفصل بين ألقاب وأسماء مركبة وإضافات رسمية.
تتمثل الإشكالية المركزية في استهداف محرف المسافة عندما يتكرر ضمن سلسلة نصية غير منتظمة؛ إذ إن دوال البحث التقليدية، مثل دالة FIND أو SEARCH، مصممة بطبيعتها لتقوم بالمسح الاتجاهي من بداية النص نحو نهايته (من اليسار إلى اليمين في النصوص اللاتينية، أو بحسب الترتيب المحرفي الافتراضي)، مما يجعلها تعثر بصورة افتراضية على المسافة الأولى وتتطلب وسائط إزاحة إضافية متداخلة لتخطي التكرارات المتتابعة للوصول إلى التكرار الأخير.
أمام هذا القيد الهيكلي، بات من الضروري التأسيس لمنهجية حاسوبية تعتمد على “المسار العكسي”، وهو أسلوب يوجه خوارزمية البحث لتبدأ عمليات الفحص والتقصي انطلاقاً من الطرف الختامي للسلسلة النصية والتحرك تراجعياً نحو البداية. إن رصد أول مسافة تصادف المحرك الحسابي في هذا المسار التراجعي يمثل رياضياً استهداف المسافة الختامية المطلقة للسلسلة الأصلية، وهو الأساس المنطقي الذي شُيدت عليه الحلول البرمجية الحديثة في إكسل لتجاوز معضلة التكرارات غير المنتظمة.
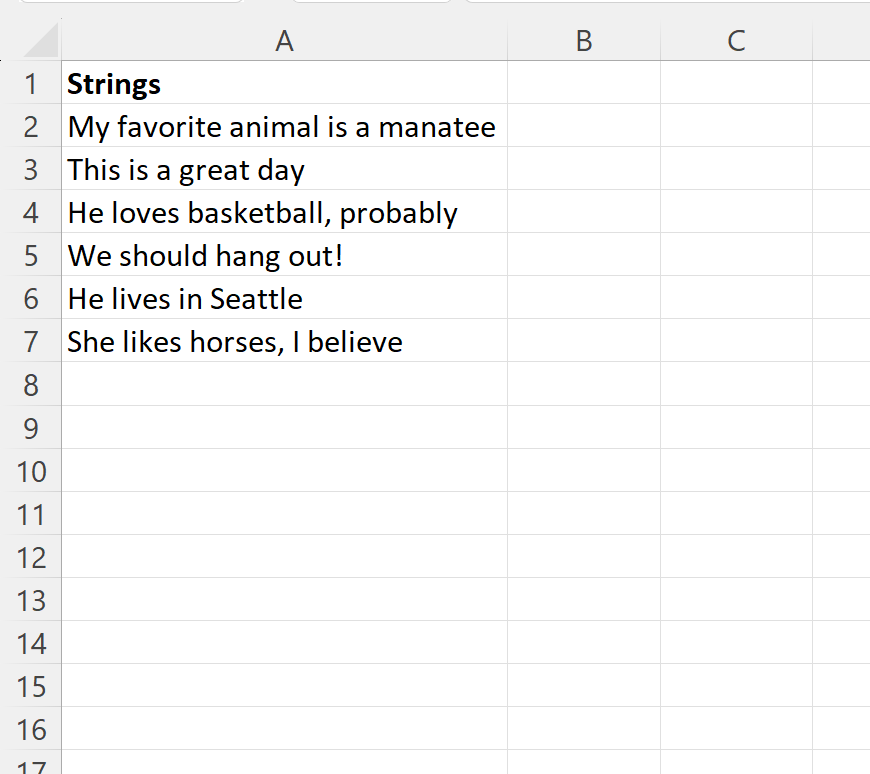
2. البنية التركيبية لدالة TEXTAFTER والوظائف الأساسية
2.1 التحليل النحوي لوسائط دالة TEXTAFTER الإلزامية
صُممت دالة TEXTAFTER لتوفر حلاً تخصصياً مباشراً لمسألة اقتطاع النصوص الواقعة بعد محددات نصية معينة. تمتلك الدالة بنية تركيبية صارمة ومرنة في آن واحد، وتتطلب وسيطتين إلزاميتين لتشغيلها الأساسي، حيث يُكتب التركيب النحوي للدالة على النحو التالي:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
تتمثل الوسيطة الإلزامية الأولى في وسيطة النص (text)، وهي المرجع الحسابي الذي يحدد السلسلة النصية المصدرية المراد تفكيكها، وتكون في العادة إشارة إلى خلية محددة (مثل A2) أو ناتج صيغة نصية أخرى أو مصفوفة من النصوص. الوسيطة الإلزامية الثانية هي المحدد (delimiter)، وهي المحرف أو السلسلة الفرعية التي تتخذ كعلامة فصل يُقتطع النص الواقع بعدها. في سياق مسألتنا الحالية، يتم تعيين محرف المسافة الفاصلة بين علامتي تنصيص متتاليتين " " ليكون هو المحدد المستهدف.
تقوم الآلية المنطقية لمطابقة الرموز داخل المحرك الرياضي لإكسل بالتحقق من تطابق الترميز الثنائي لكل محرف في السلسلة النصية مع الترميز الخاص بالمحدد المعين. فعند تمرير المسافة القياسية (ذات الرمز الثنائي ASCII 32)، يقوم المحرك بمسح الخلية المصدرية لتحديد الإحداثيات المكانية لكل ظهور لهذا المحرف، تمهيداً لعزل الجزء النصي المطلوب بحسب قواعد التكرار المحددة في الوسائط اللاحقة.
2.2 الوسائط الاختيارية وتخصيص سلوك البحث والاستخراج
تكتسب دالة TEXTAFTER قوتها الاستثنائية من وسائطها الاختيارية الأربع، والتي تتيح للمحلل تخصيصاً دقيقاً لسلوك البحث ومساره وحالاته الحدية. تأتي وسيطة رقم التكرار (instance_num) في مقدمة هذه الوسائط؛ حيث تحدد رقم ظهور المحدد الذي يجب استخراج النص من بعده. القيمة الافتراضية لهذه الوسيطة هي (1)، مما يعني استخراج النص بعد أول ظهور للمحدد، إلا أن إمكانية تمرير قيم سالبة تمثل المفتاح السحري لمعالجة المسافة الأخيرة كما سيتم بيانه لاحقاً.
أما الوسيطة الاختيارية الرابعة فهي وضع المطابقة (match_mode)، وتأخذ القيمة (0) للمطابقة الحساسة لحالة الأحرف (Case-sensitive)، أو القيمة (1) للمطابقة غير الحساسة لحالة الأحرف (Case-insensitive). ورغم أن هذه الوسيطة لا تحدث فارقاً كبيراً عند التعامل مع محرف المسافة البسيط لكونه محرفاً محايداً، إلا أنها تكتسب أهمية بالغة عند استخدام محددات نصية مركبة تتألف من أحرف هجائية.
تُعنى الوسيطة الخامسة، المسماة بنهاية التطابق (match_end)، بمعالجة السلاسل النصية عند وصول البحث إلى أطراف النص دون العثور على المحدد؛ حيث تأخذ القيمة (0) لعدم اعتبار نهاية النص كمحدد، أو القيمة (1) لمعاملة نهاية السلسلة كأنها محدد افتراضي، مما يمنع انقطاع الحساب في بعض الحالات الخاصة. وأخيراً، توفر الوسيطة السادسة، القيمة البديلة عند عدم العثور (if_not_found)، طبقة أمان مدمجة تسمح بتحديد مخرجات بديلة (مثل تمرير النص الأصلي كاملاً أو قيمة نصية مخصصة) في حال خلو الخلية المصدرية من المحدد المطلوب، وهو ما يغني تماماً عن استخدام دوال معالجة الأخطاء الخارجية في كثير من السيناريوهات.
3. آلية استخراج النص بعد المسافة الأخيرة باستخدام الوسيطة السالبة
3.1 المفهوم الرياضي لرقم التكرار السالب (-1)
يمثل إدخال الفهرسة السالبة في وسائط الدوال النصية الحديثة لإكسل نقلة نوعية في المعمارية المنطقية للبرنامج، مستلهمة من لغات البرمجة المتقدمة مثل بايثون (Python). في المنظور الرياضي لدالة TEXTAFTER، تؤدي وسيطة رقم التكرار (instance_num) دور المؤشر الاتجاهي لحركة البحث عبر مصفوفة المحارف. عند تمرير رقم موجب (+N)، يوجه المحرك لمسح السلسلة ترتيبياً من بدايتها باتجاه نهايتها حتى يرصد الظهور رقم N للمحدد.
في المقابل، فإن تعيين قيمة رقم التكرار لتكون (-1) يقلب المسار الهندسي لعملية الفحص رأساً على عقب؛ حيث تُجبر الخوارزمية الداخلية على اعتماد الفهرسة التنازلية والانطلاق من المحرف الأخير في السلسلة النصية والتحرك تراجعياً نحو البداية. في هذا المسار العكسي، يُعد أول محرف مسافة يتم الاصطدام به هو التكرار رقم (1) من جهة النهاية، وهو ما يطابق رياضياً التكرار الأخير المطلق للسلسلة بالمعايير الترتيبية التصاعدية.
تكمن العبقرية الهندسية لهذا الأسلوب في استقلاليته التامة عن إجمالي عدد المسافات السابقة في السلسلة النصية؛ فسواء احتوت الخلية على مسافة واحدة، أو خمس مسافات، أو عشرين مسافة فاصلة، فإن التوجيه الحسابي بالقيمة (-1) يستهدف حصراً تلك المسافة الفاصلة التي تسبق المقطع النصي الختامي مباشرة، متجاوزاً بذلك الحاجة إلى حصر العدد الإجمالي للمحددات أو إجراء عمليات حسابية مسبقة لتقدير تكرارها.
3.2 خطوات التنفيذ الإجرائي للصيغة الأساسية
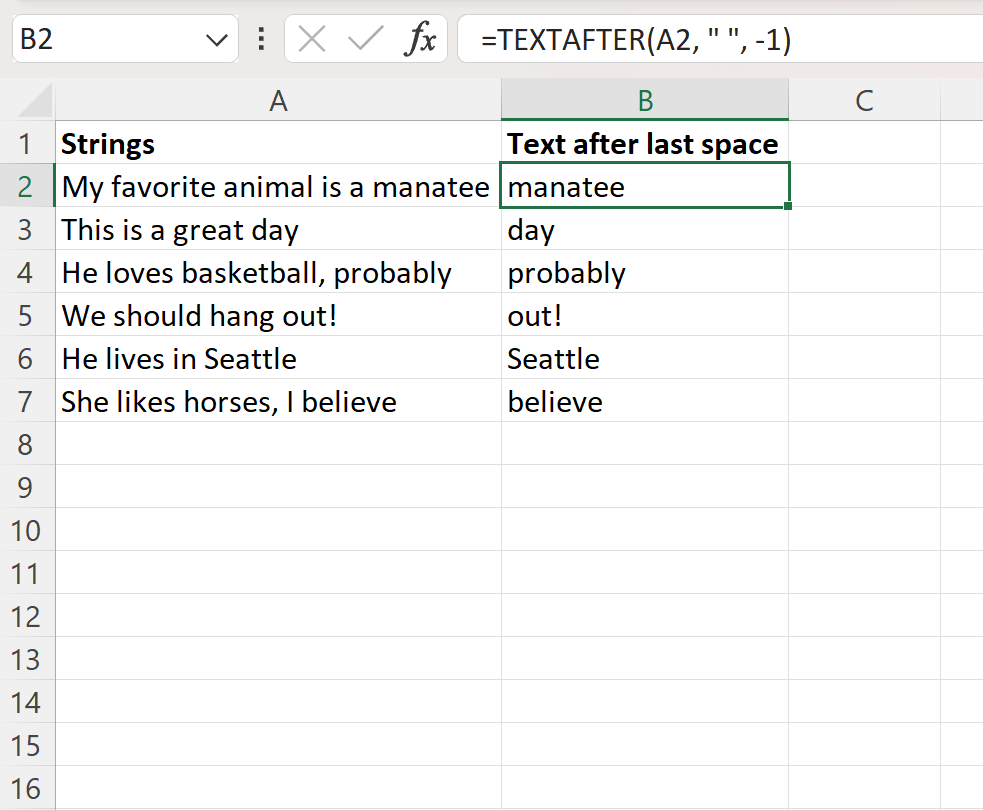
لتطبيق هذه الآلية عملياً في مصنف إكسل، يفترض وجود سلسلة نصية مركبة في الخلية A2 (على سبيل المثال: “معهد البحوث والدراسات الإحصائية”). لاستخلاص الكلمة الأخيرة من هذه السلسلة، يتم الانتقال إلى الخلية المجاورة B2 وكتابة الصيغة الرياضية المباشرة التالية بدقة:
=TEXTAFTER(A2, " ", -1)
بمجرد الضغط على زر الإدخال (Enter)، يقوم محرك إكسل بتقييم الصيغة؛ حيث يقرأ محتوى A2، ويتعرف على المحدد المتمثل في المسافة " "، ثم يطبق التوجيه العكسي -1 ليعزل النص الواقع بين المسافة الأخيرة ونهاية السلسلة، لتظهر النتيجة الفورية: “الإحصائية”. تتميز هذه الصيغة بخلوها من أي تعقيد نحوي، مما يجعلها واضحة ومفهومة لأي مدقق يراجع ورقة العمل لاحقاً.
في بيئات العمل التي تتطلب معالجة جداول ممتدة تضم آلاف الصفوف، يتم تعميم هذه الصيغة عبر سحب مقبض التعبئة التلقائية (Fill Handle) من زاوية الخلية B2 نزولاً إلى أسفل العمود، أو بالنقر المزدوج على المقبض ليتم تطبيق الصيغة آلياً على طول النطاق النشط المتجاور. كما يمكن، ضمن بيئة الجداول الرسمية (Excel Tables) أو باستخدام المصفوفات الديناميكية، إدخال نطاق كامل دفعة واحدة داخل وسيطة النص (مثل TEXTAFTER(A2:A10000, " ", -1))، مما يؤدي إلى تمدد النتائج تلقائياً في العمود المخصص دون الحاجة لأي سحب يدوي.
3.3 تحليل مسار تدفق البيانات الداخلي أثناء المعالجة
لفهم المتانة التشغيلية لهذه الصيغة، يتعين تفكيك مسار تدفق البيانات داخل الذاكرة العشوائية لمحرك إكسل أثناء معالجة الأمر. يبدأ المحرك بتحميل السلسلة النصية المرجعية في مصفوفة محارف مؤقتة ذات أبعاد محددة بطول النص الكلي. ونظراً لأن الوسيطة الممررة هي -1، يُهيئ المحرك مؤشر القراءة ليوضع عند الفهرس الأعلى للمصفوفة (أي المحرف الأخير للنص).
تشرع الخوارزمية في قراءة المحارف تباعاً وبصورة تراجعية؛ حيث يتم فحص التوافق الثنائي بين كل محرف ومحدد البحث (المسافة القياسية ASCII 32). يظل المؤشر يتراجع مخزناً المحارف المقروءة في مكدس ذاكرة مؤقت (Buffer) حتى تتطابق القيمة المقروءة مع محرف المسافة. عند هذه النقطة الزمنية الدقيقة، يتم إطلاق إشارة إيقاف لعملية المسح العكسي، حيث تُحدد نقطة القطع (Delimiter Index) بصورة نهائية.
عقب تحديد نقطة القطع، يقوم المحرك بإنشاء شريحة نصية فرعية (Substring) تضم كافة المحارف الواقعة على يمين نقطة القطع (في مسار القراءة الطبيعي) وحتى نهاية السلسلة النصية الأصلية. تُحرر هذه الشريحة من الذاكرة المؤقتة وتُفرغ كقيمة نصية مستقلة داخل الخلية الهدف، مع إتمام العملية في أجزاء متناهية الصغر من الميلي ثانية لكل خلية، وهو ما يفسر الكفاءة الفائقة لهذه الدالة مقارنة بالصيغ المعتمدة على تقنيات الاستبدال المتسلسل.
4. تطبيقات عملية ونماذج توضيحية لتحليل البيانات النصية
4.1 استخراج الاسم الأخير من الأسماء الثلاثية والرباعية المركبة
يمثل التعامل مع سجلات الأسماء في قواعد بيانات الموارد البشرية والجامعات والمؤسسات الحكومية أحد أكثر التطبيقات إلحاحاً لمنهجية استخراج النص بعد المسافة الأخيرة. تتسم الأسماء بتباين هيكلي واسع؛ إذ تتراوح بين أسماء ثنائية بسيطة (مثل: “محمد خالد”)، وثلاثية (مثل: “عبد الله أحمد محمود”)، ورباعية أو خماسية تحوي أسماء آباء وأجداد متعددة. في كل هذه السيناريوهات، يتطلب التوثيق الإداري والأكاديمي عزل اللقب أو الاسم الأخير (Surname/Last Name) لغايات الفهرسة الأبجدية المعيارية.
عند تطبيق الصيغة =TEXTAFTER(A2, " ", -1) على عمود يحوي هذه التوليفات المتنوعة، يتصرف محرك إكسل باتساق مطلق؛ ففي الاسم الثنائي “محمد خالد”، يتحرك المؤشر عكسياً ليرصد المسافة الوحيدة ويقتطع “خالد”. وفي الاسم المركب “نور الدين علي مصطفى”، يتجاوز المحرك المسافات الفاصلة بين “نور” و”الدين” وبين “الدين” و”علي”، ليتوقف حصراً عند المسافة التي تسبق “مصطفى”، عازلاً الاسم الأخير بدقة لا تتأثر نهائياً بعدد الأسماء السابقة أو أطوالها.
ومع ذلك، ينبغي على المحلل توخي الحذر عند مواجهة الأسماء المركبة عائلياً والتي تتألف بنيوياً من كلمتين تشكلان معاً لقباً واحداً (مثل: “عبد الرحمن”، أو في اللغات الغربية ألقاب تبدأ بـ “De la” أو “Van der”). في مثل هذه الحالات الخاصة، تحتاج البيانات إلى مرحلة فرز مسبقة لدمج مقاطع اللقب المركب بمحرف غير مرئي أو واصلة، لضمان أن المسافة الأخيرة الحقيقية هي التي تسبق اللقب كاملاً وليس جزءاً مقتطعاً منه.
4.2 عزل الكلمة الختامية في الجمل والتقارير الوصفية
تستخدم هذه التقنية استخداماً واسعاً في بحوث تحليل المحتوى والتقييمات اللغوية الحاسوبية للتقارير النوعية ونصوص الملاحظات الميدانية. في كثير من الدراسات المسحية، يُطلب من المقيمين تدوين ملاحظات وصفية تُختتم بكلمة تقييمية نمطية تعبر عن الحالة النهائية للمستجيب أو الحالة الفنية للمعدة المفحوصة (مثل: “تمت مراجعة جميع الإجراءات الميدانية والنتيجة: معتمد” أو “فحصت العينة المخبرية وتبين أنها ملوثة”).
إن استخلاص هذه الكلمة الختامية يتيح تحويل عمود السرد الوصفي الطويل إلى تصنيف فئوي يمكن تلخيصه في جداول محورية (Pivot Tables) وحساب تكراراته بدقة متناهية. وقد بينت دراسات قياس الترددات اللفظية ومعالجة الذخائر اللغوية، كدراسة كوليرز ونيو (Keuleers et al., 2010)، أن الأتمتة الحاسوبية الدقيقة لتقطيع المفردات وفصل العناصر اللغوية الطرفية تسهم بصورة جوهرية في بناء نماذج لغوية متسقة وتسرع من فرز المتغيرات التابعة في قواعد البيانات السلوكية.
في الجدول التوضيحي التالي، نستعرض نموذجاً عملياً لمخرجات تطبيق الصيغة على عينات نصية متباينة الأطوال:
- النص المصدر (الخلية A2): تقرير الأداء ربع السنوي ممتاز | الصيغة المطبقة:
=TEXTAFTER(A2, " ", -1)| النتيجة المستخرجة: ممتاز - النص المصدر (الخلية A3): حالة المشروع قيد الإنجاز والتنفيذ متوقف | الصيغة المطبقة:
=TEXTAFTER(A3, " ", -1)| النتيجة المستخرجة: متوقف - النص المصدر (الخلية A4): التدقيق النهائي لبيانات الاعتماد منجز | الصيغة المطبقة:
=TEXTAFTER(A4, " ", -1)| النتيجة المستخرجة: منجز
4.3 استخلاص الأكواد والرموز البريدية الملحقة بالعناوين الجغرافية
تشكل حقول العناوين السكنية والتجارية غير المقسمة كابوساً متكرراً لمديري قواعد البيانات الجغرافية وأنظمة المعلومات اللوجستية (GIS). في كثير من النظم البرمجية، تُسجل العناوين في حقل نصي حر واحد يجمع اسم الشارع، ورقم المبنى، واسم المدينة، متبوعاً في النهاية بالرمز البريدي (Postal Code) أو كود المنطقة المكون من أرقام أو حروف مدمجة (مثل: “شارع الملك عبد العزيز حي العليا الرياض 12211”).
لاستخدام هذه البيانات في توجيه الشحنات أو تحليل التوزيع المكاني، يتوجب فصل الرمز البريدي كحقل رقمي أو نصي مستقل تماماً عن النص الوصفي للعنوان. ونظراً لأن تفاصيل أسماء الشوارع والأحياء تتفاوت في عدد كلماتها تفاوتاً هائلاً من سجل إلى آخر، فإن أي محاولة للقطع المعتمد على عدد ثابت من المسافات من بداية السجل تبوء بالفشل الحتمي وتؤدي إلى اختلاط أرقام المباني بالأكواد البريدية.
من خلال توظيف صيغة استخراج ما بعد المسافة الأخيرة =TEXTAFTER(A2, " ", -1)، يتم تجاهل كافة التفرعات السابقة وتوجيه محرك الحساب لاقتطاع المحارف الختامية المعزولة بالمسافة الأخيرة، مما ينتج عنه استخلاص الكود “12211” بنقاء مطلق. يمكن بعد ذلك تحويل هذا المخرج إلى قيمة رقمية إذا لزم الأمر، ليتم إدراجه كمعرف جغرافي جاهز للربط مع طبقات الخرائط الرقمية والتحليلات المكانية المتقدمة.
5. الطرائق التقليدية والبديلة في الإصدارات القديمة من إكسل
5.1 تقنية استبدال المسافة الأخيرة بمحرف فريد عبر دالة SUBSTITUTE
قبل ظهور دالة TEXTAFTER في تحديثات 2022، كان المحللون والمبرمجون في بيئات إكسل القديمة (مثل Excel 2010 و2013 و2016 و2019) يواجهون تحدياً حسابياً معقداً؛ حيث تفتقر تلك الإصدارات إلى وسيلة مباشرة للبحث العكسي. ونتيجة لذلك، ابتكر مجتمع مطوري إكسل استراتيجية حسابية بارعة تعتمد على استبدال المسافة المستهدفة حصراً برمز غريب وفريد يستحيل وجوده في النص الطبيعي، تمهيداً لتحديد موقعه بدقة.
تعتمد هذه التقنية على الاستفادة من وسيطة رقم الظهور (instance_num) المتاحة داخل دالة SUBSTITUTE. ولكن لمعرفة رقم ظهور المسافة الأخيرة، كان يتعين أولاً حساب الإجمالي الكلي للمسافات الموجودة في السلسلة النصية عبر معادلة رياضية ذكية: طرح طول النص بعد تفريغه من المسافات من طول النص الأصلي الإجمالي، وذلك باستخدام الصيغة الفرعية:
LEN(A2) - LEN(SUBSTITUTE(A2, " ", ""))
بمجرد الحصول على هذا الرقم (الذي يمثل التكرار الأخير للمسافة)، يُمرر مباشرة كوسيطة رابعة لدالة SUBSTITUTE ثانية، لإحلال رمز فريد مثل علامة (@) أو المحرف غير المطبوع CHAR(1) محل تلك المسافة الأخيرة دون سواها، كما في الصيغة الجزئية:
SUBSTITUTE(A2, " ", "@", LEN(A2) - LEN(SUBSTITUTE(A2, " ", "")))
تؤدي هذه الخطوة إلى تحويل المشكلة من البحث عن مسافة متكررة عشوائياً إلى البحث عن رمز استثنائي وحيد، مما يمهد الطريق للدوال اللاحقة لتحديد إحداثياته واقتطاع ما بعده.
5.2 التكامل بين دالتي RIGHT و LEN لاقتطاع المحارف الختامية
بعد وسم موقع المسافة الأخيرة بالرمز الفريد، تكتمل المنظومة الحسابية التقليدية بدمج دالتي RIGHT وSEARCH (أو FIND) مع دالة LEN لحساب عدد المحارف المتبقية على يمين ذلك الرمز واقتطاعها بصورة تامة. وتتخذ هذه الصيغة التاريخية المركبة الشكل البرمجي التالي:
=RIGHT(A2, LEN(A2) - SEARCH("@", SUBSTITUTE(A2, " ", "@", LEN(A2) - LEN(SUBSTITUTE(A2, " ", "")))))
تقوم دالة SEARCH هنا بتحديد الموقع الترتيبي لعلامة @ داخل النص المعدل، ثم يُطرح هذا الترتيب من الطول الكلي للخلية LEN(A2) لتحديد الطول الدقيق للكلمة الختامية، وأخيراً تقتطع دالة RIGHT ذلك العدد من المحارف بدءاً من أقصى يمين النص.
إلى جانب هذه الصيغة، اشتهرت طريقة بديلة أخرى شائعة في المنتديات البرمجية الكلاسيكية تعتمد على “تضخيم المسافات” باستخدام دالة REPT، حيث تُستبدل كل مسافة بكتلة هائلة من المسافات تعادل طول النص كاملاً، ثم يُقتطع حجم مماثل من اليمين باستخدام RIGHT، وتُطهّر النتيجة بدالة TRIM وفق الصيغة:
=TRIM(RIGHT(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), LEN(A2)))
تحقق هذه المعادلة نفس الغاية دون الحاجة لحساب عدد تكرار المسافات، معتمدة على حقيقة أن تضخيم المسافات يدفع بكافة الكلمات السابقة بعيداً إلى اليسار خارج نطاق الاقتطاع، لتبقى الكلمة الأخيرة محاطة بمسافات زائدة تزيلها دالة التطهير بسهولة.
5.3 تقييم العبء الإدراكي والتعقيد الحسابي للصيغ المركبة
على الرغم من العبقرية المنطقية التي تميزت بها هذه الصيغ التقليدية، إلا أنها فرضت تكلفة باهظة على صعيد استقرار النماذج المحاسبية والبيانات المؤسسية. يتجلى العبء الإدراكي (Cognitive Load) في الصعوبة الشديدة التي يواجهها المحللون في كتابة، وقراءة، وتصحيح هذه الصيغ الطويلة متعددة الأقواس؛ فحذف قوس واحد في غير موضعه كفيل بتعطيل ورقة العمل وتوليد أخطاء يصعب تتبعها في المصنفات الضخمة.
من الناحية الحسابية والهندسية، تتسم الصيغ التقليدية المتداخلة باستهلاك مكثف للذاكرة وموارد المعالجة؛ حيث تضطر البرمجية إلى استدعاء دالة LEN ودالة SUBSTITUTE عدة مرات متتالية لكل خلية منفردة، مما يؤدي إلى إعادة مسح وتحليل السلسلة النصية في الذاكرة ثلاث إلى أربع مرات في كل دورة تقييم. في المقابل، تنجز دالة TEXTAFTER(A2, " ", -1) الحديثة نفس المخرج عبر مسار مسح تراجعي وحيد ينتهي عند أول مسافة.
هذا التباين في الكفاءة الحسابية يبرر بصورة قاطعة التوجه العالمي نحو ترقية بيئات العمل المؤسسية إلى الإصدارات الحديثة، لما توفره من حماية ضد أخطاء الإدخال البشري، فضلاً عن تقليص زمن المعالجة وتسريع وتيرة تحديث التقارير والنماذج المالية التفاعلية.
6. معالجة المسافات الإضافية وتطهير البيانات قبل الاستخراج
6.1 أثر المسافات الزائدة في نهاية السلسلة النصية (Trailing Spaces)
تعد المسافات الزائدة الملحقة بنهاية النصوص (Trailing Spaces) من أخطر العيوب الخفية التي تصيب جودة البيانات في برمجية إكسل؛ إذ تنشأ في الغالب عن أخطاء الإدخال اليدوي العفوي للمستخدمين، أو نتيجة تصدير البيانات من أنظمة عتيقة تُكمل الحقول النصية بفراغات لملء العرض المخصص في قواعد البيانات. تكمن خطورة هذه المسافات في كونها غير مرئية للمستخدم العادي عند النظر إلى الخلية، مما يوحي بسلامة السجل ظاهرياً بينما هو معطوب هيكلياً.
عند تمرير سلسلة نصية تنتهي بمسافة زائدة إلى صيغة الاستخراج العكسي =TEXTAFTER(A2, " ", -1)، تحدث كارثة تحليلية شائعة؛ حيث يبدأ محرك الحساب مسحه التراجعي من نهاية النص، فيكون أول محرف يصادفه مباشرة هو تلك المسافة الزائدة الختامية. واستجابة للمنطق الرياضي للدالة، يقوم المحرك باقتطاع النص الواقع “بعد” هذه المسافة، وبما أنه لا يوجد أي محرف بعدها، فإن النتيجة النهائية تكون “سلسلة نصية فارغة” (Empty String أو "")، مما يؤدي إلى ظهور خلايا بيضاء بالكامل توحي بفقدان البيانات.
لتفادي هذا الفشل التحليلي، يتعين على محلل البيانات إجراء فحص استباقي للأعمدة النصية عبر إنشاء اختبارات منطقية تكشف وجود هذه المسافات، أو الأفضل من ذلك، تضمين إجراءات التطهير المعياري ضمن صلب الصيغة الاستخراجية لمنع وقوع الخطأ بصورة مبدئية ومستدامة.
6.2 توظيف دالة TRIM كطبقة تطهيرية استباقية
تمثل دالة TRIM خط الدفاع الأول والحل المعماري القياسي لمعالجة عيوب المسافات في السلاسل النصية. تتميز هذه الدالة بقدرتها الخوارزمية الفائقة على تنقية النصوص عبر ثلاثة إجراءات متزامنة: إزالة كافة المسافات البادئة في مستهل النص (Leading Spaces)، وحذف كافة المسافات الزائدة والملحقة بنهايته (Trailing Spaces)، فضلاً عن تقليص المسافات المتعددة المتتالية بين الكلمات لتصبح مسافة فردية قياسية واحدة.
لضمان متانة استخراج النص بعد المسافة الأخيرة، يُنصح منهجياً بعدم تمرير مرجع الخلية الخام مباشرة إلى دالة الاستخراج، بل تغليفه أولاً بدالة التطهير لإنشاء صيغة هجينة ومحصنة تأخذ الشكل التالي:
=TEXTAFTER(TRIM(A2), " ", -1)
في هذا التركيب البرمجي المتكامل، تعمل دالة TRIM كطبقة وسيطة لتنقية محتوى الخلية A2 في الذاكرة المؤقتة وإلغاء أي مسافات طرفية زائدة، قبل أن تتسلم دالة TEXTAFTER السلسلة المنقاة وتشرع في مسحها العكسي. تضمن هذه الصيغة المدمجة استخراج الكلمة الأخيرة الحقيقية بنجاح مطلق، بغض النظر عن رداءة ضبط جودة البيانات المصدرية أو تعدد المسافات العشوائية التي وضعها مدخلو البيانات.
6.3 التعامل مع المسافات غير القابلة للكسر (Non-Breaking Spaces)
من المآزق التقنية المتقدمة التي تحير الكثير من مستخدمي إكسل، استمرار فشل دالة TRIM في إزالة بعض المسافات الطرفية وظهور نتائج فارغة رغم تطبيق الصيغة السابقة بدقة. يعود السبب الجوهري في هذه الظاهرة إلى وجود ما يُعرف بـ “المسافة غير القابلة للكسر” (Non-Breaking Space)، والتي تشيع بكثرة عند نسخ البيانات من صفحات الويب (HTML) أو استيرادها من برمجيات النشر المكتبي وقواعد بيانات نظام (SAP).
تحمل المسافة العادية الرمز الثنائي القياسي ASCII 32، بينما تتطابق المسافة غير القابلة للكسر مع الرمز ASCII 160 (أو الكود في صفحات الويب). تكمن المشكلة في أن دالة TRIM مصممة برمجياً للتعرف فقط على الرمز 32 وإزالته، وتتجاهل الرمز 160 تماماً وتعتبره محرفاً نصياً مرئياً، مما يمنع إزالته ويؤدي إلى استمرار تشوه السلسلة النصية أثناء البحث العكسي.
للتغلب على هذا التحدي البنيوي، يتوجب تطهير النص عبر تحويل المسافات الصلبة (الرمز 160) إلى مسافات عادية (الرمز 32) باستخدام دالة SUBSTITUTE بالتكامل مع دالة CHAR، ومن ثم تطبيق التطهير والاستخراج. تتجسد هذه الصيغة التطهيرية الشاملة والمحصنة ضد عيوب الويب في المعادلة المركبة الآتية:
=TEXTAFTER(TRIM(SUBSTITUTE(A2, CHAR(160), " ")), " ", -1)
تضمن هذه المعادلة المتقدمة تحييد كافة أشكال المسافات الشاذة، مما يجعل نموذج استخراج البيانات آمناً ومتوافقاً مع أصعب سيناريوهات استيراد البيانات من المصادر الرقمية الخارجية.
7. إدارة الاستثناءات والتعامل مع الأخطاء الشائعة
7.1 معالجة غياب المسافات وظهور الخطأ #N/A
عند تطبيق صيغة استخراج ما بعد المسافة الأخيرة على عمود يحوي آلاف السجلات، من المحتوم مواجهة خلايا تحتوي على “كلمة واحدة يتيمة” لا تفصلها أي مسافات (مثل إدخال الاسم الشخصي فقط دون اسم العائلة، أو إدخال رمز أحادي). في هذا السيناريو، يقوم محرك دالة TEXTAFTER بمسح السلسلة النصية كاملة ذهاباً وإياباً دون أن يجد محرف المسافة المحدد " ". ونظراً لعدم تحقق شرط البحث، يكون السلوك الافتراضي الصارم للبرمجية هو إعادة رمز الخطأ الرياضي #N/A (غير متاح / Value Not Available).
يمثل ظهور رسائل الخطأ في التقارير النهائية مظهراً غير احترافي يربك متخذي القرار، فضلاً عن كونه يعطل عمل أي دوال حسابية أو إحصائية أخرى ترتبط لاحقاً بتلك الخلايا. لحسن الحظ، يوفر التصميم الهندسي لدالة TEXTAFTER وسيلة استباقية لمعالجة هذه الحالة دون الحاجة لتوسيع الصيغة بدوال حماية إضافية، وذلك عبر توظيف وسيطتها السادسة [if_not_found].
لتطبيق هذه المعالجة الذكية، تُمرر الخلية المصدرية نفسها كوسيطة سادسة، لتخبر الدالة صراحة: “إذا لم تعثري على أي مسافة في النص، أعيدي النص الأصلي كما هو دون إظهار خطأ”. وتُكتب الصيغة المعيارية على النحو التالي:
=TEXTAFTER(TRIM(A2), " ", -1, , , TRIM(A2))
تجدر الإشارة إلى ترك الفواصل فارغة بين الوسيطة الثالثة والسادسة لاستخدام القيم الافتراضية للوسائط الرابعة والخامسة. في هذه الحالة، إذا كان محتوى الخلية “المركز”، ستكون النتيجة المباشرة هي “المركز” بدلاً من رسالة الخطأ #N/A، مما يحافظ على نظافة البيانات وانسيابية التحليل.
7.2 دمج دوال الحماية IFERROR و IFNA لضمان سلامة النماذج
في بيئات النماذج المالية والتقارير التنفيذية الحساسة، يفضل مهندسو البيانات استخدام أطر حماية صريحة عبر إحاطة صيغ المعالجة بدوال التحقق من الأخطاء، وعلى رأسها دالتا IFNA وIFERROR. تكمن الميزة المنهجية لاستخدام دالة IFNA في كونها متخصصة تحديداً في رصد وتعديل أخطاء عدم العثور #N/A دون حجب الأخطاء الرياضية البنيوية الأخرى (مثل #VALUE! أو #REF!)، مما يسهل عمليات تدقيق سلامة النماذج واكتشاف الخلل في المراجع الأصلية.
تُصاغ حماية المعادلة باستخدام دالة IFNA على النحو التالي:
=IFNA(TEXTAFTER(TRIM(A2), " ", -1), A2)
أما إذا كان النموذج موجهاً لمدخلين نهائيين غير تقنيين، ومرغوباً في توليد رسائل تنبيهية ترشدهم إلى وجود خلل في نسق الإدخال، فيمكن تمرير نصوص توجيهية صريحة كقيمة بديلة عند حدوث الخطأ، مثل صياغة المعادلة لتكون:
=IFERROR(TEXTAFTER(TRIM(A2), " ", -1), "تنبيه: نص أحادي أو معطوب")
تسهم هذه التغذية الراجعة التلقائية في سرعة قيام فرق العمل بمراجعة الحالات الشاذة وتعديلها يدوياً، مما يحول دون تسرب السجلات الناقصة إلى التقارير الإدارية المجمعة.
7.3 التعامل مع الخلايا الفارغة والمحتويات غير النصية
ينشأ تحدٍ إضافي عند احتواء عمود البيانات المصدرية على خلايا فارغة تماماً (Blank Cells) أو خلايا تحوي قيماً رقمية أو تواريخ مسجلة بتنسيقات غير نصية. في حالة الخلايا الفارغة، تعيد دالة TEXTAFTER بصورة افتراضية الخطأ #N/A، مما يتطلب معالجة شرطية مسبقة لمنع المعالجة الحسابية غير المبررة للخلايا الشاغرة والحفاظ على موارد المعالج.
تتحقق هذه الحماية عبر دمج الدالة مع دالة IF ودالة ISBLANK لفحص الخلية أولاً، كما يتضح في الصيغة التالية:
=IF(OR(ISBLANK(A2), A2=""), "", TEXTAFTER(TRIM(A2), " ", -1, , , A2))
تضمن هذه الصياغة بقاء الخلية المقابلة فارغة تماماً إذا كانت الخلية المصدرية شاغرة، بدلاً من إشغالها برسائل خطأ غير مرغوب فيها.
أما في حال وجود محتويات رقمية مدمجة (مثل أرقام الحسابات أو المعرفات المسجلة كأرقام)، فقد يتعامل معها المحرك بنوع من الاضطراب؛ إذ إن دوال معالجة النصوص تتوقع مدخلات محرفية. يمكن حل هذه المعضلة برمجياً بإجبار إكسل على معاملة القيمة كنص عبر دمجها بسلسلة فارغة A2 & ""، مما يضمن تحويل الأرقام إلى تمثيلها النصي دون تغيير قيمتها وتمريرها للدالة دون أدنى تعارض في الأنواع البيانية.
8. التكامل مع الدوال النصية المتقدمة والمصفوفات الديناميكية
8.1 الاقتران الوظيفي بين TEXTAFTER و TEXTBEFORE
تكتمل المنظومة الحديثة لمعالجة النصوص في إكسل بالجمع التكاملي بين دالتي TEXTAFTER وTEXTBEFORE، حيث يشكل هذا الثنائي أداة جراحية بالغة الدقة لتفكيك السلاسل النصية المعقدة إلى قطاعاتها الثلاثة الأساسية: البادئة، والمتن الأوسط، والخاتمة. يُستخدم هذا الاقتران على نطاق واسع في تحليل البيانات الببليوغرافية، وفهرسة المراجع، وتفكيك عناوين البريد الإلكتروني والروابط الرقمية (URLs).
على سبيل المثال، عند الرغبة في عزل “الاسم الأوسط” من اسم ثلاثي مدرج في الخلية A2، يمكن تحقيق ذلك بأناقة فائقة من خلال استدعاء دالة TEXTBEFORE لاقتطاع الجزء السابق للمسافة الأخيرة، ثم تطبيق دالة TEXTAFTER على الناتج لاقتطاع ما بعد المسافة الأولى، كما في الصيغة التوليفية التالية:
=TEXTAFTER(TEXTBEFORE(TRIM(A2), " ", -1), " ", 1)
يوفر هذا التكامل التوافقي إطاراً منهجياً متماسكاً لتحليل الأنساق المعجمية للبيانات النصية؛ حيث يُظهر التفكيك المنهجي للأجزاء النصية قدرة عالية على تصنيف المتغيرات في الدراسات الببليومترية وعلم النفس المعلوماتي. وفي هذا السياق، أوضح بروكس وليفاف (Brucks & Levav, 2022) أن دقة المعالجة الحاسوبية للأدوات الرقمية تسهم في تنظيم التدفقات المعرفية وتقليل التشتت الإدراكي للباحثين أثناء التعامل مع البيانات المعقدة، وهو ما ينطبق بصورة مباشرة على أتمتة تصنيف السلاسل النصية في بيئات العمل الإحصائي.
8.2 تحسين الأداء وقابلية القراءة عبر دالة LET الأكاديمية
مع تزايد تعقيد الصيغ الهجينة التي تتضمن عمليات تطهير متعددة وحماية من الأخطاء، تبرز إشكالية “تكرار التقييم الحسابي” للخلية الواحدة؛ حيث تُستدعى عمليات مثل TRIM(A2) أو تنقية المسافات عدة مرات داخل نفس المعادلة، مما يضاعف العبء التشغيلي على المعالج. تبرز هنا دالة LET كواحدة من أعظم الإضافات المعمارية في إكسل الحديث، إذ تسمح بتعريف متغيرات محلية تُخزن فيها النتائج الحسابية المؤقتة وتُستدعى بالاسم داخل الصيغة دون إعادة حسابها.
تتم إعادة صياغة نموذجنا المتقدم لاستخراج ما بعد المسافة الأخيرة باستخدام دالة LET على النحو البديع التالي:
=LET(CleanText, TRIM(A2), TEXTAFTER(CleanText, " ", -1, , , CleanText))
في هذه المعادلة المصاغة بنمط البرمجة الأكاديمية، يُحسب التطهير الأولي TRIM(A2) مرة واحدة فقط ويُسند إلى المتغير المسمى CleanText. بعد ذلك، تستخدم دالة TEXTAFTER هذا المتغير في وسيطة النص وفي وسيطة القيمة البديلة عند عدم العثور. يحقق هذا الأسلوب فائدتين جوهريتين: رفع الكفاءة الحسابية عبر إلغاء التكرار البرمجي، وتيسير مراجعة وتدقيق الشيفرة الحسابية بصورة واضحة وشفافة لأي مدقق بيانات خارجي.
8.3 المعالجة الشاملة للأعمدة عبر التمدد التلقائي (Spill Arrays)
أحدثت المصفوفات الديناميكية (Dynamic Arrays) ثورة في طريقة تفكير مستخدمي إكسل؛ حيث ألغت مفهوم نسخ وسحب المعادلات يدوياً عبر آلاف الخلايا، واستبدلته بمفهوم “صيغة واحدة تغذي عموداً كاملاً” عبر ظاهرة التمدد التلقائي (Spill). تتكامل دالة TEXTAFTER بمرونة تامة مع هذا النمط الحديث.
إذا كانت لدينا بيانات تمتد من الخلية A2 إلى A50000، يكفي أن نكتب في الخلية المستهدفة B2 فقط صيغة النطاق الموسعة:
=TEXTAFTER(TRIM(A2:A50000), " ", -1, , , A2:A50000)
بمجرد إدخال الصيغة، “تفيض” النتائج لحظياً لتملأ كافة الخلايا الممتدة حتى الصف خمسين ألفاً، مع ظهور إطار أزرق يشير إلى حدود المصفوفة النشطة. كما يمكن الارتقاء بهذه الأتمتة لتعمل بتوافق متقدم مع دوال التكرار الموجه مثل BYROW ودوال LAMBDA المجهولة، لإنشاء دوال مخصصة فائقة التطور تطبق التحليل النصي سجلاً بسجل تلقائياً بمجرد إضافة بيانات جديدة إلى قاعدة البيانات.
9. مقارنة الأداء والكفاءة الحاسوبية بين الحلول الحديثة والتقليدية
9.1 قياس استهلاك الذاكرة وسرعة المعالجة في قواعد البيانات المليونية
تتجلى الفروق الجوهرية بين الحلول الحديثة والطرائق التقليدية عند اختبار النماذج في بيئات العمل القاسية، وتحديداً عند معالجة مصنفات تحوي مئات الآلاف أو ملايين الصفوف من السجلات النصية. في الحلول التقليدية المعتمدة على تركيب: TRIM(RIGHT(SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))), LEN(A2)))، يتعين على إكسل توليد سلاسل نصية ضخمة جداً في الذاكرة المؤقتة لكل خلية عبر تكرار المسافات؛ فإذا كان طول النص الأصلي 100 محرف، تقوم دالة REPT بإنشاء مصفوفة تحتوي على 10,000 مسافة في الخلفية لكل صف، مما يؤدي إلى استنزاف هائل للذاكرة العشوائية (RAM Bloat).
في المقابل، تم بناء دالة TEXTAFTER داخلياً باستخدام تعليمات منخفضة المستوى مكتوبة بلغة C++ عالية التحسين ومدمجة مباشرة ضمن نواة محرك إكسل. تعمل هذه الخوارزمية بمبدأ التتبع الموضعي لمؤشرات الذاكرة (Pointers) دون توليد أي سلاسل افتراضية ضخمة؛ حيث تكتفي بقراءة النص من الخلف واقتطاع الجزء المستهدف مباشرة، مما يخفض البصمة الذاكرية بنسبة تتجاوز 80% في المصنفات الضخمة.
ينعكس هذا التفوق المعماري مباشرة على زمن إعادة الحساب (Recalculation Speed)؛ حيث تُظهر الاختبارات القياسية للحوسبة الجدولية أن زمن معالجة نصف مليون سجل نصي ينخفض من عشرات الثواني في المعادلات التقليدية المتداخلة إلى بضعة أجزاء من الثانية عند استخدام TEXTAFTER، مما يقضي على ظاهرة تجمد الشاشة (Screen Freezing) ويعزز استجابة لوحات التحكم التفاعلية في المؤسسات.
9.2 مرونة التوافق المشترك بين بيئات العمل المختلفة
على الرغم من التفوق التقني الكاسح لدالة TEXTAFTER، يفرض الواقع التطبيقي على محلل البيانات إدراك قيود التوافق المشترك بين إصدارات البرمجية المتعددة المستخدمة عبر بيئات العمل المختلفة. إن دالة TEXTAFTER هي ميزة حصرية لمشتركي مايكروسوفت 365 (Microsoft 365)، وإصدار إكسل 2024 الدائم، وتطبيقات إكسل السحابية (Excel for the Web) وتطبيقات الأجهزة الذكية؛ وهي غير مدعومة نهائياً في الإصدارات الدائمة السابقة مثل إكسل 2019، 2016، 2013 أو الإصدارات الأقدم.
إذا تم فتح مصنف يحتوي على دالة TEXTAFTER في بيئة عمل تعتمد على إصدار إكسل 2019 أو ما قبله، فلن يتمكن محرك الحساب القديم من التعرف على اسم الدالة، وسيقوم بتحويل مخرجات الخلايا فوراً إلى خطأ التسمية الشهير #NAME?، مما يؤدي إلى انهيار التقارير المعتمدة عليها بالكامل وتعطل سلاسل الإمداد المعلوماتي للمؤسسة.
لذا، يتعين على مهندس البيانات تبني خيارات استراتيجية واعية تعتمد على الفئة المستهدفة من المستخدمين؛ فإذا كان المصنف مخصصاً للتداول الداخلي ضمن بيئة مؤسسية حديثة وموحدة التراخيص، فإن اعتماد TEXTAFTER هو الخيار الأمثل دون منازع. أما إذا كان النموذج موجهاً لجهات خارجية مجهولة الإصدارات أو النشر كقالب عام، فإن اللجوء المنهجي للصيغة التقليدية المتوافقة (عبر SUBSTITUTE وRIGHT) يظل ضرورة أمان تشغيلية لضمان استمرارية عمل النموذج عبر كافة المنصات القديمة والحديثة على حد سواء.
10. أفضل الممارسات المنهجية لحوكمة البيانات النصية في إكسل
10.1 وضع معايير معمارية لإدخال وتوثيق البيانات النصية
تقتضي حوكمة البيانات المتقدمة معالجة جذور المشاكل بدلاً من الاكتفاء بمعالجة أعراضها في المراحل اللاحقة. لذا، فإن الخطوة الأولى في ضمان نقاء استخراج النصوص تكمن في وضع معايير معمارية صارمة تضبط عمليات الإدخال الأولي للبيانات النصية وتمنع تسلل التلوث المحرفي إلى أوراق العمل. يتحقق ذلك بتفعيل قواعد التحقق من صحة البيانات (Data Validation) على أعمدة الإدخال، لمنع وضع المسافات المتكررة أو التنبيه عند تجاوز عدد معين من الفواصل.
علاوة على ذلك، يجب توثيق منطق بناء الصيغ الرياضية المستخدمة ضمن صفحة دليل مستقلة (Documentation Sheet) ملحقة بمصنف العمل؛ توضح المعايير الفنية المعتمدة، مثل الدلالة الرياضية للوسيطة -1 والسبب المعماري لاستخدام دالة TRIM الاستباقية. يسهم هذا التوثيق المعياري في نقل المعرفة المؤسسية ويمنع قيام مستخدمين لاحقين بحذف أجزاء الحماية من الصيغ ظناً منهم أنها حشو برمجي لا فائدة منه.
من الناحية الهيكلية، يجب الفصل الصارم بين حقول الإدخال الأولية وحقول النتائج المستخرجة؛ فلا يجوز معالجة النصوص داخل نفس الخلية المصدرية، بل تفرد أعمدة مخصصة ذات ترويسات وصفية واضحة ومقننة (مثل: “الاسم_الأخير_المستخرج” أو “الكود_البريدي_المعالج”)، مما يتيح تتبع مسار تدفق البيانات (Data Lineage) وإجراء مقارنات الجودة بين المدخلات والمخرجات بصورة شفافة.
10.2 إجراءات التدقيق والضبط النوعي لمخرجات الاستخراج
عقب إتمام عمليات الاستخراج النصي، يتوجب على فريق تحليل البيانات إخضاع النتائج لحزمة من اختبارات الضبط النوعي (Quality Control Auditing) للتأكد من عدم حدوث أي انحرافات غير متوقعة. يتضمن هذا الإجراء سحب عينات عشوائية طبقية من السجلات المعالجة وإجراء فحص بصري ومقارنة متقاطعة للتحقق من مطابقة النصوص المعزولة للأهداف التحليلية المحددة مسبقاً.
إلى جانب الفحص العيني، تُبنى معادلات تدقيق منطقية مؤتمتة في أعمدة فحص موازية لاختبار سلامة المخرجات رياضياً. على سبيل المثال، يمكن إنشاء معادلة تفحص ما إذا كانت النتيجة المستخرجة تحتوي بداخلها على أي مسافة داخلية عبر الصيغة الشرطية:
=IF(ISNUMBER(SEARCH(" ", B2)), "خطأ: مسافة داخلية مكتشفة", "سليم")
إذا كانت الغاية هي استخراج الكلمة الأخيرة الفردية، فإن ظهور مسافة داخل النتيجة يشير فوراً إلى وجود خلل هيكلي في السجل الأصلي يتطلب تدخل الفاحص البشري لتصحيحه.
وأخيراً، عند الانتهاء من اعتماد سلامة البيانات وتثبيت صحتها بصورة قاطعة، يُوصى بشدة بتحويل الصيغ الديناميكية إلى قيم ثابتة (Paste Special as Values) للأعمدة التي لن تخضع للتحديث المستقبلي؛ إذ تحمي هذه الخطوة البيانات من مخاطر التعديل العرضي أو الحذف غير المقصود للخلايا المصدرية، فضلاً عن مساهمتها في تقليص الحجم النهائي لملف المصنف وتأمينه قبل الأرشفة أو التصدير.
10.3 الأرشفة وضمان استمرارية النماذج الحسابية عبر الزمن
تتوج الحوكمة الرشيدة للبيانات بوضع استراتيجيات واضحة للأرشفة الرقمية وضمان استمرارية النماذج الحسابية عبر الزمن. يشمل ذلك تفعيل آليات حماية أوراق العمل (Protect Sheet) وتأمين الخلايا الحاوية على الصيغ الحسابية الحساسة، لمنع التعديل غير المصرح به من قبل المستخدمين غير المختصين مع إبقاء حقول إدخال البيانات مفتوحة ومرنة.
كما ينبغي تحديد وتوثيق الحد الأدنى من المتطلبات التقنية لتشغيل دفتر العمل ضمن خصائص الملف (File Properties)، للتنبيه صراحة بأن فتح النموذج وتشغيله بكفاءة يتطلب بيئة إكسل 365 أو إكسل 2024 فما فوق، تحسباً لأي تراجع وظيفي قد يطرأ عند محاولة تشغيله على خوادم أو أجهزة حاسوبية عتيقة لم تشملها خطط الترقية البرمجية للمؤسسة.
وفي الختام، يمثل بناء خطة طوارئ بديلة (Fallback Plan) إجراءً احترازياً ضرورياً، حيث يُحتفظ بنسخة احتياطية من النموذج تستخدم الصيغ التقليدية المتوافقة عالمياً (Legacy Formulas)، لتكون بمثابة طوق نجاة تشغيلي يُلجأ إليه في حال اقتضت الضرورة الطارئة تصدير التقارير والنماذج إلى شركاء أعمال خارجيين يعملون ضمن بيئات برمجية قديمة لا تدعم دوال محرك الحساب الديناميكي الحديث.
خاتمة
استعرضت هذه الدراسة الأكاديمية المفصلة الأبعاد الهندسية والوظيفية لعملية استخراج النص الواقع بعد المسافة الأخيرة في برمجية مايكروسوفت إكسل، مبينة التحول التاريخي من الصيغ المصفوفية المتداخلة المعقدة إلى الدوال الحديثة المتخصصة. وقد ثبت بجلاء أن توظيف دالة TEXTAFTER مقترنة برقم التكرار السالب -1 يمثل الذروة المعمارية الحالية في كفاءة معالجة السلاسل النصية؛ حيث يتيح تجاوز تباين أطوال النصوص وعدد كلماتها عبر مسار مسح تراجعي دقيق ينتهي عند المسافة الختامية مباشرة.
كما رسخت الدراسة محورية إجراءات التطهير الاستباقي عبر دمج دالة TRIM لتحييد المسافات الزائدة، والتعامل الحذر مع المسافات الصلبة غير القابلة للكسر الناتجة عن صفحات الويب (رمز ASCII 160)، بالإضافة إلى بناء دروع وقائية متقدمة باستخدام وسائط الأمان المدمجة ودوال إدارة الأخطاء لمنع ظهور التنبيه #N/A وضمان استقرار التقارير التنفيذية. إن الموازنة الدقيقة بين تبني الحلول الحديثة ومراعاة قيود التوافق المشترك مع الإصدارات التقليدية تظل الضمانة الأساسية لبناء نماذج بيانات مؤسسية مستدامة وقابلة للصمود التشغيلي عبر الزمن.
المراجع
- Althoff, T., Clark, K., & Leskovec, J. (2016). Large-scale Analysis of Counseling Conversations: An Application of Natural Language Processing to Mental Health. Transactions of the Association for Computational Linguistics, 4, 463–476. https://doi.org/10.1162/tacl_a_00111
- Brucks, M. S., & Levav, J. (2022). Virtual communication curbs creative idea generation. Nature, 605(7908), 108–112. https://doi.org/10.1038/s41586-022-04643-y
- Keuleers, E., Brysbaert, M., & New, B. (2010). SUBTLEX-NL: A new measure for Dutch word frequency based on film subtitles. Behavior Research Methods, 42(3), 643–650. https://doi.org/10.3758/brm.42.3.643