
تُمثّل معالجة السلاسل النصية وتفكيك بنيتها الخطية إحدى الركائز الجوهرية في هندسة البيانات وإدارتها عبر بيئات الحوسبة الجدولية، وفي مقدمتها برنامج ميكروسوفت إكسل (Microsoft Excel). فعلى النقيض من الحسابات العددية البحتة التي تستند إلى خواص جبرية مباشرة، تتطلب معالجة النصوص نمذجة دقيقة لمواضع المحارف، وفهماً عميقاً للذاكرة الرقمية وطرق الفهرسة الموضعية. إن الحاجة المستمرة لاستخلاص البيانات الجزئية من حقول مركبة — كعزل الأسماء الصريحة عن البوادئ الوظيفية، أو تجريد المعرفات الرقمية من الأكواد التصنيفية — فرضت تطوراً مستمراً في خوارزميات الاقتطاع والدوال النصية منذ البدايات الأولى للحوسبة الشخصية.
تاريخياً، تعود الجذور المفاهيمية لدوال معالجة النصوص المعتمدة اليوم في الجداول الإلكترونية إلى بدايات لغة البرمجة “بيسيك” (BASIC)، التي طورها العالمان جون كيميني وتوماس كورتز في كلية دارتموث عام 1964؛ حيث قُدمت لأول مرة دوال استقطاع النصوص الشهيرة مثل LEFT$ وMID$ وRIGHT$ لتحديد واستخراج المقاطع الحرفية استناداً إلى مواقعها المفهرسة. ومع نشأة برمجيات الجداول الإلكترونية الرائدة مثل “فيزيكالك” (VisiCalc) على يد دان بريكلن وبوب فرانكستون عام 1979، مروراً ببرنامج “لوتس 1-2-3” (Lotus 1-2-3) عام 1983، ترسخت البنية المنطقية للتعامل مع السلاسل النصية. وعندما أطلقت شركة مايكروسوفت برنامج إكسل لنظام ماكنتوش عام 1985 ثم لنظام ويندوز عام 1987، دُمجت هذه الدوال التاريخية ضمن محرك الحسابات المجدولة، لتصبح أدوات قياسية لا غنى عنها في تنظيف وتجهيز البيانات المعقدة قبل إخضاعها للتحليل الإحصائي أو النمذجة الرياضية.
في السياقات البحثية والأكاديمية، لا سيما في مجالات القياس النفسي، والعلوم الاجتماعية الحسابية، وتحليل النظم الإدارية، تمثل عملية “استخراج النص بعد الحرف رقم n” (Extracting Text After nth Character) إجراءً حاسماً في مرحلة إعداد البيانات وتنقيتها (Data Wrangling). إن تحويل السجلات الخام غير المهيكلة إلى متغيرات صالحة للدراسة يستلزم عزل المقاطع النصية بدقة رياضية متناهية لتفادي أخطاء الإزاحة التي قد تفسد قواعد البيانات الضخمة. يسعى هذا الدليل المنهجي الموسع إلى تفكيك هذه العملية بأسلوب علمي رصين، مستعرضاً الأسس النظرية للفهرسة، والبنى التركيبية للمعادلات الكلاسيكية والمستحدثة، مع مناقشة مستفيضة للاعتبارات المعمارية المرتبطة بأنظمة التشفير وكفاءة الأداء الحسابي في بيئات العمل الضخمة.
1. مقدمة نظرية لمعالجة النصوص وسلاسل المحارف في برنامج إكسل
1.1 مفهوم السلاسل النصية ومواضع المحارف الرقمية
تُعرّف السلسلة النصية (String) في علوم الحاسوب وهندسة البرمجيات بأنها متتالية خطية مرتبة من المحارف (Characters) المخزنة في خلايا الذاكرة بشكل متتابع. وفي بيئة برمجيات الجداول الإلكترونية مثل إكسل، تتعامل الخلية مع النص بوصفه مصفوفة أحادية البعد من الرموز التي تخضع لنظام الفهرسة المبني على الأساس واحد (1-based Indexing). يختلف هذا النظام الحسابي جذرياً عن لغات البرمجة الحديثة الشائعة مثل سي (C) وبايثون (Python)، التي تستخدم الفهرسة الصفرية (0-based Indexing)؛ ففي إكسل يُعطى المحرف الأول في السلسلة دائماً القيمة الموضعية 1، بينما يأخذ المحرف الثاني القيمة 2، وهكذا دواليك حتى نهاية النص.
تتعامل خوارزميات محرك إكسل مع كافة المدخلات النصية بموجب معايير متكافئة بغض النظر عن طبيعة المحرف الفيزيائية؛ حيث تتساوى المحارف الأبجدية، والأرقام التي تُعامل كنصوص، والرموز الخاصة، وعلامات الترقيم، وحتى المسافات البيضاء المفردة والمزدوجة في حجز موقع فهرسي متكامل داخل السلسلة. هذا التجريد الرياضي يعني أن المسافة الفارغة بين كلمتين ليست مجرد فراغ بصري في واجهة المستخدم، بل هي كيان رقمي يحمل معرّفاً مكانياً مستقلاً في جدول ترميز المحارف. وبالتالي، فإن التعامل مع أي سلسلة يتطلب وعياً تاماً بأن موقع المحرف $n$ يمثل إحداثياً حسابياً مطلقاً يشير إلى خانة محددة ضمن البنية المتسلسلة للنص.
إن إدراك هذه الفهرسة الخطية يعد المدخل الضروري لتطبيق خوارزميات التجزئة النصية؛ فحين يطلب الباحث أو محلل النظم استهداف الحرف رقم $n$ كنقطة قطع، فإن النظام يحدد العنوان الموضعي لذلك المحرف عبر مسح تسلسلي يبدأ من اليسار إلى اليمين (أو وفق المنطق التخزيني الداخلي للملف). يترتب على ذلك أن كل تحرك داخل السلسلة النصية هو بمثابة إزاحة رقمية موجهة، مما يجعل عمليات الاقتطاع الرياضي خاضعة لقوانين حسابية صارمة لا تقبل التقريب أو الاحتمال، وهو ما يضمن استقرار النتائج الحسابية عند معالجة كميات هائلة من النصوص المتشابهة في الهيكل البنيوي.
1.2 التحديات الشائعة في تنظيف البيانات النصية وتجزئتها
تواجه عمليات معالجة البيانات المجمعة من مصادر متباينة، كالاستبيانات الإلكترونية، وسجلات المستشفيات، والأنظمة المؤسسية القديمة، تحديات بنيوية كبرى تتعلق بعدم اتساق أطوال النصوص داخل الحقول المستهدفة. تظهر المشكلة بوضوح عندما تتضمن البيانات سلاسل تحتوي على بادئات تعريفية (Prefixes) أو معرفات تشغيلية ذات أطوال ثابتة ولكنها متبوعة بنصوص متغيرة الطول؛ الأمر الذي يجعل استخدام أدوات القص البسيطة محفوفاً بمخاطر بتر المعلومات أو استخراج نصوص مشوهة وغير مكتملة الدلالة السياقية.
تتفاقم هذه الإشكالية بوجود البوادئ الاصطلاحية والرموز الثابتة غير المرغوب فيها، والتي تُدرج تلقائياً لأغراض التتبع اللوجستي أو التخزين الميداني؛ مثل إضافة كود جغرافي أو زمني يسبق الاسم الحقيقي للحالة المدروسة. محاولة إزالة هذه البوادئ يدوياً عبر تقنيات النسخ واللصق أو التعديل المباشر في قواعد البيانات الكبيرة لا تستهلك وقتاً هائلاً فحسب، بل تفتح الباب واسعاً أمام الأخطاء البشرية القاتلة الناتجة عن تشتت الانتباه وسهو المدخلين، مما يؤدي إلى انحراف النتائج الإحصائية وتدهور موثوقية التحليلات اللاحقة الناتجة عن تلك المدخلات المصابة بالتشوه.
من هنا تبرز الأهمية القصوى لأتمتة عمليات الاقتطاع والتجزئة باستخدام الدوال والمعادلات الرياضية القياسية داخل إكسل. تتيح الأتمتة المعيارية بناء أنابيب معالجة مسبقة (Data Processing Pipelines) تتسم بالاتساق الرياضي والقدرة على إعادة الإنتاج (Reproducibility). فعندما تُصاغ قاعدة التجزئة رياضياً استناداً إلى موضع المحرف $n$، فإن النظام يطبق ذات المعيار الدقيق على السجل الأول والسجل المليون دون أدنى تفاوت، مما يضمن تقليص هامش الخطأ البشري إلى الصفر، وتوفير بيئة صلبة وموثوقة يمكن البناء عليها في مراحل الاستدلال الإحصائي والتحليل التنبؤي.
1.3 أهمية عزل النصوص بعد نقطة قطع محددة (الحرف n)
يمثل عزل النصوص بعد نقطة قطع محددة إجراءً محورياً في مجموعة واسعة من التطبيقات التطبيقية والأكاديمية، لا سيما في إدارة البيانات المعيارية وتوحيد المفاهيم القياسية. ففي البيئات الصناعية والطبية، تُصدّر المنتجات أو العينات برموز تعريفية مركبة تتكون من مقطع أولي يحدد الدفعة أو القسم، يليه الاسم الفعلي للمركب أو المادة. يتيح الاقتطاع المحوسب بعد الحرف $n$ للمحللين عزل الأسماء النقية والتعريفات الأساسية بضربة واحدة، مما يتيح تصنيف البيانات بصورة مستقلة عن هياكل الترميز الإدارية المؤقتة.
كذلك تظهر الأهمية المنهجية لهذه التقنية في بروتوكولات حماية البيانات وتجهيز مجموعات العمل البحثية؛ حيث يُلزم الباحثون في العلوم الاجتماعية والنفسية بإلغاء الهوية الصريحة للمشاركين (De-identification) عبر فصل المعرفات الشخصية المدمجة مع أكواد المشاركة التجريبية. فمن خلال عزل النص بعد الموضع $n$، يمكن تجريد المتغيرات المستقلة والتابعة من أية بيانات تتبعية تكشف خصوصية المفحوصين، وتحويل السجلات إلى مصفوفات نقية جاهزة للمعالجة دون الإخلال بمتطلبات الأخلاقيات البحثية الصارمة المتعلقة بسرية المعلومات.
علاوة على ذلك، يُسهم هذا الإجراء الفني في رفع كفاءة الفهرسة والربط بين الجداول المختلفة (Data Joins) ضمن قواعد البيانات العلاقية الكبيرة؛ فالتباين في تنسيق البوادئ بين نظامين مختلفين قد يمنع محركات البحث والمطابقة، مثل دوال VLOOKUP أو XLOOKUP، من إيجاد السجلات المشتركة. يؤدي التخلص من أول $n$ محرف وتوحيد بنية النص المتبقي إلى تحسين جودة البيانات المدخلة وتسهيل تكاملها مع أدوات التحليل الإحصائي المتقدمة كحزم SPSS وR ولغة بايثون، مما يوفر منصة متجانسة تزيد من دقة المؤشرات الحسابية وموثوقية مخرجات النمذجة.
2. البنية التركيبية الأساسية لمعادلة استخراج النص بعد الحرف n
2.1 تفكيك دالة MID ودورها الرياضي في اقتطاع النصوص
تُعد دالة MID إحدى أكثر الدوال النصية الكلاسيكية قوة واستقراراً في تاريخ برمجيات الجداول الإلكترونية، حيث يرجع أصلها الوظيفي إلى بنية لغات البرمجة الإجرائية الأولى. تقوم الدالة بمهمة رياضية محددة: اقتطاع نافذة جزئية من سلسلة نصية أصلية بناءً على إحداثيات خطية صارمة. تتكون البنية التركيبية لدالة MID من ثلاثة وسائط إجبارية تأخذ الشكل النمطي: MID(text, start_num, num_chars)، ويعمل كل وسيط منها كمتغير دقيق في معادلة الإزاحة المكانية للمحارف.
يختص الوسيط الأول، text، بتحديد السلسلة النصية المصدرية المراد معالجتها، وغالباً ما يكون مرجعاً لخلية محددة (مثل A2) أو قيمة نصية ثابتة بين علامتي تنصيص. أما الوسيط الثاني، start_num، فيمثل الإحداثي الموضعي للمحرف الأول الذي ستبدأ من عنده عملية الاقتطاع الفعلي. يمثل هذا الوسيط قيمة عددية صحيحة موجبة تعبر عن الفهرس المطلق داخل النص؛ فإذا كانت قيمته 4، فإن الدالة تتجاهل تلقائياً المحارف الثلاثة الأولى، وتضع مؤشر القراءة مباشرة فوق المحرف الرابع لتبدأ عملية النسخ البرمجي منه.
أما الوسيط الثالث، num_chars، فيحدد بدقة الكمية أو عدد المحارف المطلوب سحبها واستخراجها انطلاقاً من نقطة البدء المحددة بالوسيط الثاني. تعمل الدالة على التقدم إلى الأمام بمقدار هذه القيمة التراكمية، ناسخة كل محرف تمر عليه حتى استيفاء العدد المطلوب. إذا صادف محرك الحسابات نهاية النص قبل أن يستوفي عدد المحارف المحدد في num_chars، فإن الدالة تتوقف تلقائياً عند آخر محرف متاح دون أن تُلقي خطأ برمجياً، وهو سلوك تصميمي مقصود يمنح الدالة مرونة تشغيلية فائقة سنستغلها في حل معضلة استخراج النصوص ذات الأطوال المجهولة.
2.2 دور دالة LEN في توفير حد أقصى مرن لعدد المحارف
تتمثل الصعوبة المركزية في اقتطاع النصوص التي تلي المحرف $n$ في أن النصوص المتبقية تختلف في أطوالها عبر السجلات المختلفة؛ فالاسم المتبقي قد يتكون من خمسة محارف في سجل، ومن خمسين محرفاً في سجل آخر. هنا يبرز الدور الذكي لدالة LEN، وهي دالة قياس الطول الحسابي التي تعود أيضاً إلى الجذور البنيوية لدوال لغة “بيسيك” الكلاسيكية. تُرجع الدالة LEN(cell) القيمة الإجمالية المطلقة لعدد المحارف المشكّلة للسلسلة النصية الموجودة في الخلية، متضمنة كافة الحروف، والأرقام، والرموز، والمسافات الداخلية والطرفية.
عند دمج دالة LEN كوسيط ثالث ضمن دالة MID، فإننا نمنح الخوارزمية مدى ديناميكياً يضمن شمولية الاقتطاع حتى آخر نقطة في النص. المنطق الرياضي الكامن وراء هذا الدمج يقوم على مبدأ المتراجحات الحسابية البديهية: إن الطول الكلي لأي سلسلة نصية (مقاساً بواسطة LEN) هو حتماً وأبداً أكبر من طول أي جزء مقتطع منها بعد استبعاد أول $n$ محرف. بتعبير رياضي، إذا كان طول السلسلة هو $L$، فإن الجزء المتبقي بعد النقطة $n$ يساوي طوله الحقيقي $L – n$، وبما أن $L > L – n$ دائماً لأي قيمة موجبة لـ $n$، فإن تمرير القيمة $L$ الكاملة إلى الوسيط num_chars يضمن تغطية المتبقي بالكامل وزيادة.
يوفر هذا التقدير الديناميكي حلاً شاملاً لتجنب مشكلة بتر النصوص الطويلة (Text Truncation). بدلاً من تخمين رقم اعتباطي كبير كعدد محارف مطلوب (مثل وضع 999 أو 10000)، والذي قد يؤدي في بعض البيئات البرمجية القديمة إلى هدر الذاكرة أو إنتاج أخطاء تجاوز السعة المؤقتة (Buffer Overflow)، فإن استخدام LEN(A2) يوفر حداً أعلى مخصصاً بدقة لكل سجل على حدة. يقرأ محرك إكسل الطول الكلي، ويبدأ السحب من الموضع المستهدف، وعندما يصل إلى النهاية المنطقية للسلسلة يتوقف بسلام، مقدماً المقطع المطلوب بنقاء رياضي واكتمال مطلق.
2.3 المنطق الحسابي لصيغة البداية (n + 1)
يكمن السر الرياضي والمنطقي في نجاح معادلة الاستخراج في فهم طبيعة الإزاحة الموضعية لنقطة البداية، والمعبر عنها رياضياً بالصيغة $(n + 1)$. في المسائل اللغوية والهندسية، عندما يُطلب “استخراج النص الواقع بعد الحرف رقم $n$“، فإن ذلك يعني بالضرورة الاستبعاد الكامل للمحارف من الفهرس 1 وصولاً إلى الفهرس $n$. المحرف ذو الرتبة $n$ هو الحد الأخير من المقطع المنوي حذفه، وبالتالي فإن المقطع المطلوب لا يبدأ منه، بل يبدأ من المحرف المجاور له مباشرة باتجاه مسار القراءة.
إذا افترضنا جدلاً أننا نرغب في استخراج النص الواقع بعد الحرف الثالث ($n = 3$)، وأدخلنا الرقم 3 في وسيط نقطة البداية start_num، فإن محرك إكسل سيبدأ الاقتطاع متضمناً الحرف الثالث نفسه، مما يُبقي جزءاً من البادئة المشوهة داخل المخرجات المستهدفة. لتفادي هذا التداخل الحدودي، يُضاف الرقم 1 إلى رتبة المحرف المستبعد لتعديل إحداثي مؤشر القراءة ليقفز فوق الحافة الفاصلة، مستقراً فوق المحرف رقم 4، وهو المحرف الاستهلالي الحقيقي للنص المنقى المطلوب الحصول عليه.
تتكامل هذه المكونات الثلاثة لتنتج الصيغة الرياضية القياسية المعتمدة عالمياً في هندسة الجداول الإلكترونية:
=MID(A2, n + 1, LEN(A2))
تمثل هذه المعادلة نموذجاً أنيقاً للتكامل الخوارزمي في إكسل؛ حيث تُحدد A2 الحاوية المصدرية للبيانات، وتضبط الإزاحة $(n + 1)$ بوابة العبور المباشرة إلى المحتوى النظيف متجاوزة البادئة بدقة جراحية، في حين تتولى LEN(A2) فتح نافذة الاقتطاع بمدى يتسع لكافة المحارف المتبقية حتى الإغلاق الطبيعي للسلسلة النصية، محققة بذلك أعلى درجات الكفاءة التعبيرية والاستقرار الرياضي.
3. التطبيق العملي خطوة بخطوة لاستخراج النصوص بعد الحرف الثالث
3.1 إعداد جدول البيانات ونمذجة الحالات التجريبية
يبدأ التطبيق العملي المنهجي بتصميم بنية الجدول المصدر واختيار عينات تجريبية تغطي مختلف التحديات الاحتمالية التي قد تطرأ أثناء المعالجة الحقيقية. يُخصص العمود الأول A في ورقة العمل ليكون عمود الإدخال الأولي، وتُعطى الخلية A1 تسمية وصفية مثل “النص_المصدري”، بينما يُخصص العمود B لاستقبال النتائج المستخرجة بتسمية مثل “المقطع_المستخرج_بعد_الحرف_3”. يتطلب إعداد البيانات في هذه المرحلة التأكد من ضبط تنسيق الخلايا لتكون بنمط “نص” (Text) أو “عام” (General)؛ حيث يمنع التنسيق النصي القياسي إكسل من محاولة تفسير الرموز أو الأرقام كمعادلات حسابية تلقائية، مما يحمي المدخلات من التشوهات التنسيقية.
لبناء نموذج تجريبي متماسك، يُستحسن إدخال أنماط متنوعة من السلاسل النصية التي تبدأ جميعها ببادئة مكونة من ثلاثة محارف متبوعة بالنص المراد استخلاصه؛ على سبيل المثال: إدخال الكود “EMP45892” (حيث البادئة تمثل كود موظف يليها الرقم الفعلي)، وإدخال “REF-Alpha” (حيث البادئة تمثل اختصار مرجعي تليها شرطة وكلمة)، وإدخال “ID#109283” (بادئة تحتوي رمزاً خاصاً). هذا التنويع المتعمد يتيح اختبار سلوك المعادلة الرياضية عبر مختلف تصنيفات المحارف، والتحقق من عدم تأثر دقة الاقتطاع بنوع المحرف الموجود في المواضع الثلاثة الأولى.
يجب كذلك تضمين بعض الحالات الحدية (Edge Cases) ضمن الجدول التجريبي؛ مثل إدخال نص يتكون من ثلاثة محارف فقط مثل “ABC”، وسجل آخر فارغ، وسجل يحتوي على مسافات بيضاء ضمن البادئة. يتيح هذا التصميم للباحث والمحلل مراقبة كيفية تفاعل الصيغة الحسابية مع الأطوال المقتضبة أو الاستثنائية، ويوفر بيئة فحص آمنة تضمن كفاءة الخوارزمية المعتمدة قبل نشرها وتعميمها على قواعد بيانات العمليات المؤسسية الضخمة التي تحتوي على مئات الآلاف من القيود.
3.2 كتابة المعادلة وتطبيقها على الخلية المرجعية الأولى
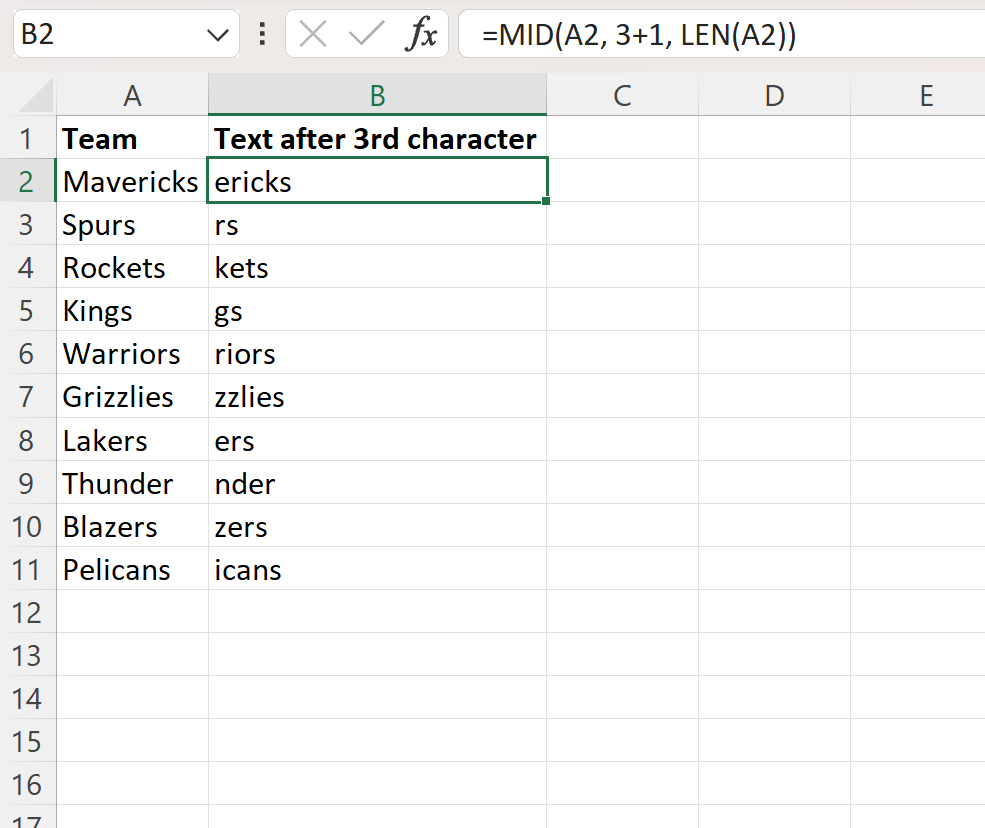
بمجرد اكتمال تجهيز البيئة الاختبارية، ننتقل إلى الخلية B2 للبدء في تركيب الصيغة الرياضية الفعلية. يضع المستخدم مؤشر الإدخال ويكتب علامة المساواة البدئية لإبلاغ محرك إكسل ببدء صياغة حسابية: =MID(A2, 3 + 1, LEN(A2)). يمكن كتابة المعامل الحسابي الموضعي مباشرة كرقم مجموع 4، ولكن يُفضل في سياق النمذجة المنهجية والأغراض التعليمية الإبقاء على التركيب 3 + 1؛ إذ يعزز ذلك الشفافية الوثائقية للمعادلة ويوضح للمراجعين المستقبليين أن الرقم يمثل إزاحة مباشرة بعد الحرف الثالث وليس مجرد رقم اعتباطي مقطوع من سياقه.
عقب إدخال الصيغة والضغط على مفتاح الإدخال (Enter)، يقوم محرك إكسل بتنفيذ سلسلة العمليات في أجزاء من الثانية: يستدعي محتوى A2، ويحسب طوله الإجمالي عبر LEN(A2)، ثم يوجه مؤشر القراءة في MID إلى المحرف الرابع متخطياً أول 3 محارف بالتمام والكمال، ليعيد النص المتبقي كاملاً إلى الخلية B2. إذا كان الإدخال الأصلي “EMP45892″، فإن النتيجة الفورية الناتجة في الخلية ستكون “45892”، محققة الانفصال التام بين كود الفئة والبيان الرقمي المستهدف دون أدنى فقد في محارف الذيل.
يتعين في هذه الخطوة فحص النتيجة البصرية ومقارنتها بالقيمة المصدرية للتأكد من خلوها من أي تشوهات إزاحية. إذا لوحظ وجود جزء من البادئة متبقياً في الناتج، فإن ذلك يشير فوراً إلى وجود خطأ في حساب المعامل $n$ أو وجود مسافة غير مرئية سابقة للنص في الخلية المصدرية. أما في حال ظهور نتائج فارغة تماماً عند تطبيق المعادلة على سلاسل قصيرة (مثل النصوص التي يقل طولها عن 4 محارف)، فإن هذا يُعد سلوكاً طبيعياً ومتوقعاً لمحرك إكسل؛ حيث يجد المؤشر نفسه خارج النطاق الفيزيائي للسلسلة فيعيد سلسلة نصية فارغة ترمز لها البرمجية بـ "" دون التسبب في انهيار ورقة العمل.
3.3 تعميم المعادلة عبر التعبئة التلقائية ومراقبة النتائج
بعد التحقق من استقرار المعادلة وسلامة نتائجها في الخلية الفردية B2، تأتي مرحلة التعميم الإحصائي على امتداد عمود المخرجات بأكمله. يتم ذلك تقنياً بالوقوف على الخلية B2 وتحريك مؤشر الفأرة نحو الزاوية اليسرى السفلية (أو اليمنى السفلية بحسب اتجاه واجهة البرنامج ولغته) حتى يتحول المؤشر إلى علامة التقاطع السوداء المعروفة بمقبض التعبئة (Fill Handle). يتيح النقر المزدوج السريع على هذا المقبض، أو سحبه يدوياً إلى الأسفل، نشر الصيغة عبر كامل النطاق الموازي للعمود A بمعدل زمني فائق.
يرتكز نجاح هذا التعميم على المفهوم الجوهري لـ “المراجع النسبية” (Relative Cell References) في إكسل؛ فحين تُسحب المعادلة من الصف الثاني إلى الصف الثالث، تتحول المراجع تلقائياً من A2 إلى A3، ومن ثم إلى A4، وهكذا دواليك على طول العمود. هذا السلوك الديناميكي يعني أن كل صف يقوم بقياس طول سلسلته الخاصة عبر LEN، ويقتطع من محتواه الخاص عبر MID، مع بقاء معامل الإزاحة $n+1$ ثابتاً ومستقراً وموجهاً حصرياً لاستبعاد المحارف الثلاثة الأولى في كل عملية حسابية منفصلة.
تتوج هذه المرحلة بإجراء تدقيق عيني وإحصائي لمخرجات العمود الجديد؛ لمراقبة اتساق النتائج عبر مختلف الأطوال والأنماط النصية. يُظهر التدقيق الناجح تجريداً موحداً لجميع النصوص، حيث تختفي الأحرف الثلاثة الاستهلالية من كافة السجلات مع الحفاظ الصارم على تماسك باقي المقاطع النصية بغض النظر عن مدى قصرها أو طولها. يثبت هذا الاتساق صحة الخوارزمية الحسابية المعتمدة وملاءمتها لمعالجة آلاف السجلات دفعة واحدة وبشكل آلي وموثوق بنسبة مئة بالمائة.
4. تخصيص المعادلة لمواضع محارف مختلفة ومتغيرة
4.1 تعديل المعامل n للاقتطاع بعد مواضع محارف متقدمة
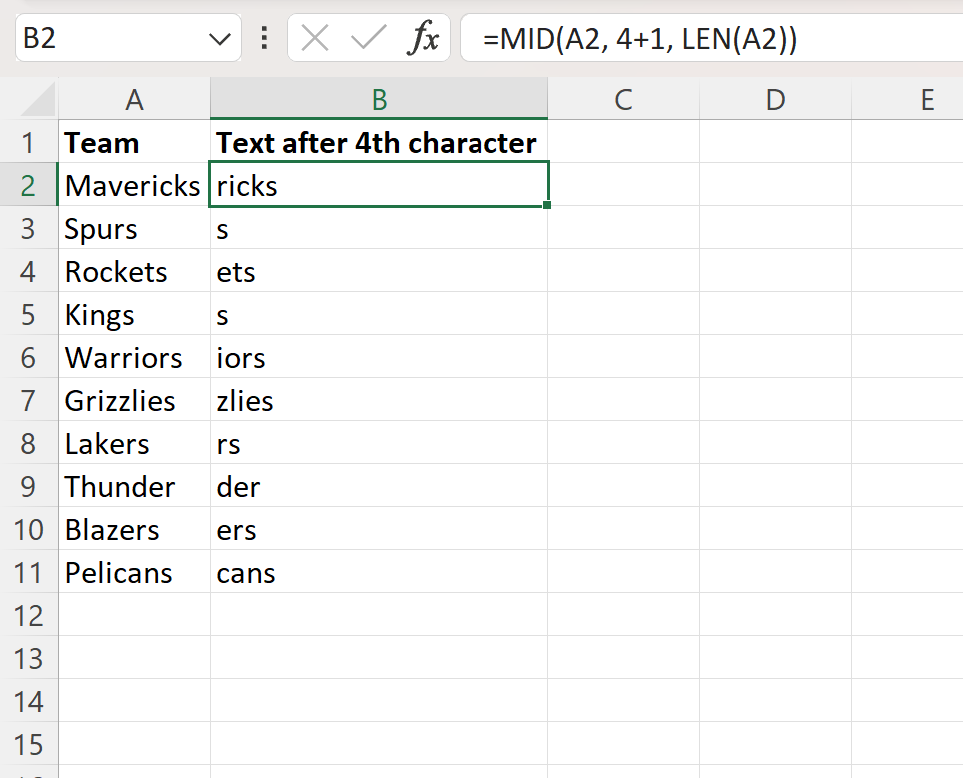
لا تقتصر متطلبات معالجة البيانات على التخلص من ثلاث محارف فحسب؛ فالأنظمة التشغيلية وقواعد البيانات تختلف وتتنوع في أطوال البوادئ تبعاً لتعقيد المعايير المستخدمة. تتجلى مرونة الخوارزمية المعتمدة على MID في بساطة التكيف مع أي نقطة قطع أخرى عبر تعديل قيمة المعامل $n$ بما يطابق رتبة المحرف النهائي للبادئة. إذا كانت البادئة مكونة من أربعة محارف، كما في بعض أرقام الحسابات المصرفية المصنفة دولياً، تصبح الصيغة الحسابية الموجهة بدقة: =MID(A2, 4 + 1, LEN(A2))، حيث يبدأ محرك الحسابات عملية السحب انطلاقاً من المحرف الخامس مباشرة.
بالمثل، عند التعامل مع بادئات النطاق المتوسط التي قد تبلغ خمسة أو سبعة أو حتى عشرة محارف—كالطوابع الزمنية المركبة بنمط “YYYY-” أو المعرفات العسكرية واللوجستية المعقدة—يُستبدل المعامل بالرتبة المحددة مضافاً إليها واحد، لتكون الصيغة للموضع السابع مثلاً: =MID(A2, 7 + 1, LEN(A2)). تظل دالة LEN تعمل كصمام أمان ديناميكي يمد يد الاقتطاع إلى النطاق النهائي للسلسلة دون حاجة لتعديل وسيط الطول، مما يحافظ على التوازن البنيوي للتركيب الحسابي مهما ابتعدت نقطة البداية نحو عمق السلسلة النصية.
من الضروري فهم التأثير الميكانيكي الناتج عن الحالات الشاذة التي تتجاوز فيها قيمة $n$ الطول الكلي الفعلي للنص الموجود في الخلية؛ فعلى سبيل المثال، إذا طُبقت صيغة الاقتطاع بعد الحرف العاشر =MID(A2, 10 + 1, LEN(A2)) على خلية تحتوي على نص من سبعة محارف فقط، فإن نقطة البداية الحسابية تصبح 11. في هذا السيناريو، يجد محرك إكسل أن إحداثي البداية يقع في فراغ الذاكرة خارج حدود السلسلة الفيزيائية المخزنة، فيُرجع نصاً فارغاً بطول صفري دون إطلاق خطأ تقني. يمثل هذا التسامح ميزة برمجية تحفظ تدفق الحسابات، ولكنه يتطلب في الوقت نفسه انتباهاً رقابياً من المحلل لمنع اعتبار البيانات المقتطعة خطأً كبيانات مفقودة في الأصل.
4.2 استخدام خلايا مرجعية ديناميكية لتحديد قيمة n
على الرغم من كفاءة التعديل اليدوي للأرقام الثابتة داخل المعادلات، إلا أن الممارسات المتقدمة في هندسة النماذج التحليلية وقواعد البيانات تفضل تجنب “الترميز الثابت” (Hard-coding) للمتغيرات. يُعتبر تثبيت الأرقام داخل المعادلات ممارسة غير مرنة قد تتسبب في أخطاء فادحة عند الحاجة لتحديث معايير الاقتطاع لمشروع كامل؛ فبدلاً من تعديل آلاف الخلايا عند تغير طول البادئة، يُنصح بربط المعامل $n$ بخلية مرجعية خارجية مستقلة تتولى دور لوحة التحكم في النطاق المستهدف بأكمله.
لتحقيق ذلك، يمكن تخصيص خلية منفصلة مثل C2 (أو خلية تحكم عليا موحدة مثل $E$1) لإدخال القيمة العددية لـ $n$. وبناءً عليه، يُعاد تركيب المعادلة لتصبح بالشكل الديناميكي التالي: =MID(A2, C2 + 1, LEN(A2)). في هذا النموذج المطور، يقرأ إكسل موضع البداية عبر استشارة محتوى الخلية المرجعية، مضيفاً إليه الرقم 1 في الزمن الحقيقي لتنفيذ العملية الحسابية. يتيح هذا النهج تغيير نقطة الاقتطاع لكامل الجدول بمجرد تعديل الرقم المكتوب في خلية التحكم، فتستجيب كافة السجلات فورياً وتُعيد حساب مخرجاتها دون المساس بالبنية الداخلية للصيغة.
تزداد هذه التقنية أهمية في لوحات المعلومات التفاعلية (Interactive Dashboards) والتطبيقات الموجهة للمستخدمين غير التقنيين؛ حيث يمكن تزويد المستخدم النهائي بقائمة منسدلة (Drop-down List) يختار منها رقم نقطة القطع $n$، فتقوم ورقة العمل بإعادة معالجة النصوص وعرض المقاطع المستهدفة تلقائياً. يُسهم هذا الفصل المنهجي بين المنطق البرمجي للمعادلة والبيانات المعلمية للمدخلات في تعزيز قابلية صيانة النموذج الرياضي وحمايته من التخريب العرضي الذي قد ينجم عن التعديل المتكرر في السلاسل البرمجية المضمنة.
4.3 معالجة التباين في أطوال البوادئ بين السجلات
في كثير من الحالات الواقعية، لا تأتي البوادئ النصية بأطوال ثابتة وموحدة عبر كافة القيود، بل تتباين بشكل ملحوظ نتيجة تنوع مصادر الإدخال أو تطور أنظمة الترميز عبر الزمن. قد يحتوي السجل الأول على بادئة من ثلاثة محارف، بينما يحمل السجل الثاني بادئة من خمسة محارف، ويحتوي الثالث على حرفين فقط. في هذه البيئات غير المتجانسة، يفقد استخدام قيمة ثابتة للمعامل $n$ جدواه المنهجية، ويصبح الاعتماد عليه سبباً رئيساً في تشويه البيانات واستخراج نصوص مبتورة أو غير نظيفة.
تتطلب مواجهة هذا التباين الانتقال من المعاملات الثابتة إلى استراتيجيات الاستدلال المرن على موضع القطع. يمكن في هذه الحالات ربط قيمة $n$ بمعادلات مساعدة تفحص بنية كل سجل على حدة، كأن يتم قياس موضع علامة مميزة تفصل بين البادئة والمتن، أو استخدام دوال التصنيف المنطقي لتحديد طول البادئة بناءً على كود معرف مسبق. تُمكّن هذه الصيغ الهجينة ورقة العمل من تقييم كل صف بصورة مستقلة تماماً، ومن ثم توليد موضع قطع متغير ($n_i$) يتطابق مع البنية النوعية للسجل قيد المعالجة.
علاوة على ذلك، يُنصح بشدة في هذه السيناريوهات بتحويل النطاقات التقليدية إلى “جداول إكسل المنظمة” (Excel Tables) المعروفة اختصاراً بكائنات ListObject. توفر الجداول المنظمة مزايا تشغيلية حاسمة تشمل استخدام “المراجع الهيكلية” (Structured References) بدلاً من المراجع المكانية، مثل استخدام: =MID([@النص_المصدري], [@طول_البادئة] + 1, LEN([@النص_المصدري])). تُطبق هذه البنية المعادلة تلقائياً على كل صف جديد يُضاف، مما يرقي التفاعل الآلي للبيانات ويضمن استمرارية المعالجة السليمة حتى في ظل التوسع المستمر لقواعد البيانات وتفاوت أطوال بادئاتها النصية.
5. البدائل التقنية المتقدمة لاستخراج النصوص في إصدارات إكسل الحديثة
5.1 استخراج النص بعد الحرف n باستخدام دالة RIGHT ودالة LEN
رغم السيادة التاريخية والعملية لدالة MID في تجزئة النصوص، إلا أن هناك بنية رياضية بديلة تحظى بتقدير واسع لدى مهندسي البيانات تعتمد على توظيف دالة الاقتطاع الأيمن RIGHT مقترنة بعملية طرح هندسية عبر دالة LEN. تأخذ هذه الصيغة البديلة الشكل الرياضي التالي: =RIGHT(A2, LEN(A2) - n). تستند هذه المعادلة إلى التفكير الحسابي المعكوس؛ فبدلاً من تحديد نقطة البداية والاتجاه إلى الأمام، تقوم الفكرة على حساب الحجم المتبقي من النص وسحبه مباشرة من الحافة النهائية (اليمنى في النصوص اللاتينية، أو الحافة الختامية للسلسلة عموماً).
تعتمد آلية عمل هذه الصيغة على تفكيك دقيق لطول السلسلة الكلي: تحسب LEN(A2) إجمالي عدد محارف النص، ثم يُطرح منه المعامل $n$ الذي يمثل عدد المحارف المطلوب التخلص منها في مقدمة السلسلة. الرقم الناتج عن عملية الطرح الرياضية $(L – n)$ يمثل بدقة بالغة عدد المحارف الصافية المتبقية التي تشكل المتن المستهدف. تقوم دالة RIGHT بعد ذلك بالتقاط هذا العدد من المحارف بدءاً من نهاية النص رجوعاً نحو نقطة القطع، لتعيد للمستخدم السلسلة المطلوبة متجردة من البادئة بدقة متناهية.
عند المقارنة المعيارية بين صيغة MID وصيغة RIGHT، نجد أن كلاهما يحقق نفس النتيجة في الحالات القياسية، إلا أن صيغة RIGHT تتطلب حذراً إضافياً في التعامل مع الحالات الحدية؛ فإذا حدث وكانت قيمة $n$ أكبر من الطول الكلي للسلسلة ($n > L$)، فإن ناتج الطرح $(L – n)$ يصبح عدداً سالباً. وحيث إن دالة RIGHT لا تقبل وسيطاً سالباً في خانة عدد المحارف، فإن المعادلة تنهار على الفور وتُرجع خطأ القيمة الشهير #VALUE!، بخلاف دالة MID التي تتعامل مع مثل هذه التجاوزات بهدوء وتُرجع نصاً فارغاً دون أخطاء برمجية، مما يجعل MID أكثر استقراراً في البيئات ذات البيانات المتقلبة.
5.2 توظيف الدوال الحديثة مثل TEXTAFTER في Excel 365
مع إطلاق التحديثات الجوهرية لحزمة Microsoft 365 وتحديثات محرك الحسابات المتقدمة عام 2022، قدمت مايكروسوفت حزمة ثورية من الدوال النصية المصممة لإنهاء عقود من التركيبات المعقدة، وكان على رأسها دالة TEXTAFTER. تتيح هذه الدالة استخراج النصوص الواقعة بعد محددات نصية أو فواصل محددة بكفاءة تعبيرية فائقة وبأقل قدر من التعقيد الرياضي، متجاوزة الحاجة إلى استخدام تركيبات الدوال المتداخلة التقليدية في كثير من السياقات الحديثة.
على الرغم من أن دالة TEXTAFTER صُممت أساساً للتعامل مع “الفواصل” (Delimiters) كالنصوص والرموز بدلاً من الفهرسة الرقمية المطلقة للمحارف، إلا أنه يمكن توظيفها بطرق متقدمة لاستخراج النصوص بعد الحرف $n$ عند اقتران نقطة القطع بفاصل مميز يتكرر بترتيب معين، أو عند دمجها مع دوال التوليد المصفوفي الحديثة. تتميز TEXTAFTER بمرونة استثنائية؛ حيث تدعم وسائط مخصصة لتحديد رقم التكرار المطلوب للفاصل، وتحديد سلوك البحث (من البداية إلى النهاية أو العكس)، وتجاهل حساسية حالة الأحرف، وتقديم خيارات مرنة لمعالجة غياب المحدد دون إنتاج أخطاء.
ورغم القوة الكبيرة التي تتمتع بها الدوال الحديثة، إلا أن استخدامها يفرض قيوداً تشغيلية واضحة ترتبط بالتوافقية العكسية (Backward Compatibility). إن الصيغ المبنية على TEXTAFTER أو شقيقاتها الحديثة لا تعمل إطلاقاً في الإصدارات القديمة والدائمة من البرنامج مثل Excel 2019 أو Excel 2016 وما قبلهما، فضلاً عن إصدارات الويب غير المحدثة أو بعض برمجيات الجداول الإلكترونية المنافسة. وبالتالي، فإن الاعتماد على البنية الكلاسيكية لدالتي MID وLEN يظل المعيار الذهبي الموصى به عالمياً لضمان قابلية تشغيل النماذج المالية والبحثية عبر مختلف المنصات والبيئات البرمجية دون مفاجآت تقنية غير مرغوبة.
5.3 المقارنة المعيارية للأداء والكفاءة الحسابية
تكتسب مسألة كفاءة الحوسبة واستهلاك الموارد أهمية قصوى عند معالجة البيانات الضخمة (Big Data) التي تتجاوز فيها مصفوفات العمل مئات الآلاف أو ملايين القيود النصية. في هذه النطاقات الواسعة، لا يعود الاختيار بين الصيغ مسألة تفضيل شكلي، بل يصبح قراراً معمارياً يؤثر مباشرة على سرعة استجابة ورقة العمل واستهلاك الذاكرة العشوائية (RAM) وسرعة إعادة حساب المصنف (Workbook Recalculation Speed).
من الناحية الخوارزمية، تُظهر المقارنات المعيارية لأداء دالة MID مقترنة بـ LEN كفاءة تشغيلية شبه مثالية تصنف رياضياً ضمن تعقيد الوقت الثابت $O(1)$ لكل عملية قراءة فردية داخل السلسلة المخزنة؛ حيث يقفز محرك إكسل مباشرة إلى عنوان الذاكرة الخاص بنقطة البدء عبر إزاحة المؤشر الداخلي، ثم ينسخ البايتات المتبقية حتى نهاية السلسلة المسجلة في جدول التخصيص. في المقابل، فإن الصيغ البديلة التي تعتمد على عمليات حسابية متكررة أو استدعاءات متداخلة لدوال تقييم النصوص قد تتطلب دورات معالجة إضافية لتقييم الشروط وطرح الأطوال، مما يُحدث تباطؤاً تراكُمياً طفيفاً يظهر جلياً عند إعادة حساب ملفات النماذج الضخمة.
توضح المقارنة الفنية استقرار دالة MID الكلاسيكية وتفوقها في التوافقية والأمان المكتبي مقارنة بالبدائل المتاحة:
- صيغة MID التقليدية
=MID(A2, n+1, LEN(A2)): استهلاك متدنٍ جداً للذاكرة، وسرعة معالجة استثنائية في الملفات الكبيرة، وتوافق بنسبة 100% مع كافة إصدارات إكسل التاريخية والحديثة دون استثناء، وتسامح آمن مع حالات تجاوز الطول. - صيغة الطرح عبر RIGHT
=RIGHT(A2, LEN(A2)-n): سرعة معالجة مكافئة، إلا أنها تستهلك وقتاً إضافياً في معالجة الأخطاء إذا كانت $n$ أكبر من طول السلسلة، مما يفرض تغليفها بدوال أمان إضافية تؤدي إلى تضخم شجرة الحسابات. - دوال التقطيع الحديثة (مثل TEXTAFTER): كفاءة تطويرية عالية وتعبير برمجي مقتضب، ولكنها تتطلب بيئة تشغيل متقدمة وحصرية لإصدارات Microsoft 365، مما يحد من انتشارها في التقارير الموجهة لجمهور خارجي متباين الأنظمة.
6. معالجة المسافات والمحارف الخاصة والمشكلات التقنية المتعلقة بالتشفير
6.1 تأثير المسافات البادئة واللاحقة على دقة الحساب
تُعد المسافات الفارغة (Spaces) أحد أكبر مصادر الأخطاء الخفية والمستعصية في عمليات معالجة النصوص وسلاسل المحارف. يكمن الخطر الأساسي في أن العين المجردة للمستخدم تميل إلى تجاهل المسافات البادئة غير المقصودة أو اعتبارها فراغاً تنسيقياً لا قيمة له، بينما يتعامل محرك إكسل مع المسافة بوصفها محرفاً قانونياً كاملاً ومستقلاً يستحوذ على موضع فهرسي محدد يحمل القيمة 32 في جدول تشفير أسكي (ASCII Code 32).
يترتب على وجود مسافة بادئة في بداية السلسلة حدوث “خطأ إزاحي” (Off-by-one Error) فادح في عملية الاقتطاع؛ فإذا كانت الخلية تحتوي على مسافة غير مرئية قبل البادئة، فإن المحرف الأول للبادئة سيحتل الموضع 2 بدلاً من الموضع 1. وعند تطبيق معادلة الاقتطاع بعد الحرف الثالث =MID(A2, 4, LEN(A2))، ستقتطع الدالة في الواقع المسافة مع أول حرفين فقط من البادئة، تاركة الحرف الثالث ملتصقاً بالنص المستهدف ومفسدة النتيجة النهائية للعملية بالكامل دون أن يُصدر البرنامج أي إشعار بالخطأ.
لتفادي هذه الكارثة التنسيقية، يجب تحصين معادلة الاقتطاع بدمج دالة التنظيف المسبق TRIM، والتي تختص بمهمة برمجية محددة: إزالة كافة المسافات الاستهلالية والختامية، وتكثيف المسافات البينية المتعددة لتصبح مسافة مفردة واحدة. تتم صياغة المعادلة الوقائية الشاملة كالتالي: =MID(TRIM(A2), n + 1, LEN(TRIM(A2))). تعمل هذه البنية المتكاملة على تنقية السلسلة أولاً وضمان استقرار محارفها في مواقعها النسبية الصحيحة قبل الشروع في حساب الأطوال وتنفيذ القفزة الموضعية، مما يوفر مناعة كاملة ضد عيوب الإدخال الشائعة.
6.2 التعامل مع الرموز وعلامات الترقيم كمحارف حسابية
في كثير من مجموعات البيانات التشغيلية واللوجستية، تتداخل الرموز التقنية وعلامات الترقيم — كالشرطات الفاصلة (-)، والشرطات السفلية (_)، والشرطات المائلة (/ والـ )، والنقاط، وعلامات الشباك (#) — مع البوادئ أو تفصل بينها وبين المتن. من المنظور الرياضي الصارم لمحرك إكسل، تُعامل هذه العلامات الترقيمية تماماً كالمحارف الهجائية؛ فكل فاصلة أو شرطة تمثل محرفاً حسابياً واحداً وتستهلك رتبة عددية مستقلة ضمن فهرس السلسلة.
إذا كان الكود المصدري يأخذ النمط “AB-9842” والمطلوب هو استخراج الرقم الصافي، فإن البادئة هنا تتكون في الحقيقة من ثلاثة محارف وليس حرفين: الحرف الأول “A” (الموضع 1)، والحرف الثاني “B” (الموضع 2)، والشرطة الفاصلة “-” (الموضع 3). بناءً على ذلك، يجب ضبط المعامل $n$ ليكون 3، فتكون صيغة الاقتطاع =MID(A2, 3 + 1, LEN(A2)) لتبدأ الاستخراج من الموضع 4 وهو بداية الرقم “9”. إن التغافل عن احتساب الشرطة كمحرف مستقل يؤدي إلى استخراجها ملتصقة بالنص المتبقي، مما يفسد تجانس البيانات الرقمية المستهدفة.
بالإضافة إلى ذلك، قد تتسرب إلى البيانات المجمعة من صفحات الإنترنت أو الأنظمة المحاسبية القديمة محارف غير مرئية وغير قابلة للطباعة (Non-printable Characters)، مثل فواصل الأسطر ومحارف التحكم التناظرية التي تحمل قيماً بين 0 و31 في نظام أسكي. للتخلص من هذه الشوائب التي قد تكسر دقة الاقتطاع الموضعي، يمكن الاستعانة بدالة CLEAN ودمجها في نسيج المعادلة لتخليص النص من المحارف غير الصالحة للعرض، مما يضمن خضوع النصوص الصافية حصرياً لعملية القياس والفهرسة الحسابية.
6.3 اعتبارات اللغات ثنائية البايت واتجاه النصوص (RTL)
تفرض معالجة النصوص في البيئات متعددة اللغات، لا سيما عند التعامل مع اللغة العربية ولغات شرق آسيا (كالصينية واليابانية والكورية)، اعتبارات معمارية معقدة تتعلق بترميز المحارف وطرق تخزينها في الذاكرة. في أنظمة الترميز التقليدية أحادية البايت (SBCS)، يحجز كل محرف بايت واحداً (8 بت) في الذاكرة. أما في اللغات ثنائية البايت (DBCS) وأنظمة التشفير الحديثة المستندة إلى يونيكود (Unicode مثل UTF-8 وUTF-16)، فإن المحارف المعقدة، كالحروف الصينية أو بعض الحروف الموسعة، قد تستهلك بايتين أو أكثر لتمثيل المحرف البصري الواحد.
لمعالجة هذا التباين، يوفر إكسل عائلتين متوازيتين من الدوال النصية: عائلة دوال المحارف القياسية وتضم MID وLEN، وعائلة دوال البايتات المخصصة وتضم MIDB وLENB. تكمن النقطة الجوهرية هنا في أن دالة MID العادية تتعامل دائماً مع المحرف المنطقي المستقل بغض النظر عن عدد البايتات المستهلكة في تشفيره خلف الكواليس؛ فحرف الضاد العربي “ض” يُحسب في دالة MID كمحرف واحد، تماماً كالحرف الإنجليزي “A”. وبالتالي، يجب التمسك الصارم باستخدام دالة MID (وليس MIDB) عند استخراج النصوص المعتمدة على تعداد المحارف في البيئات متعددة اللغات لضمان عدم شطر البايتات التكوينية للمحرف الواحد، وهو ما قد ينتج عنه تشوه بصري للمحارف المستخرجة.
أما فيما يخص النصوص المكتوبة من اليمين إلى اليسار (RTL) كاللغة العربية، فيحدث خلط شائع لدى المستخدمين بين “الاتجاه البصري للعرض” (Visual Direction) و”الترتيب المنطقي الفيزيائي في الذاكرة” (Logical Memory Order). تخزن محركات البرمجيات النصوص دائماً وفق تسلسل الإدخال الزمني من المحرف الأول إلى الأخير، بغض النظر عن اتجاه العرض الظاهر على الشاشة. المحرف الأول في الكلمة العربية “جامعة” هو حرف الجيم (الموضع 1)، يليه الألف (الموضع 2)، ثم الميم (الموضع 3). بناءً عليه، فإن تطبيق المعادلة =MID(A2, 3 + 1, LEN(A2)) على كلمة “جامعة” سيتجاوز “جام” ليبدأ الاقتطاع من حرف العين متجهاً إلى التاء المربوطة ليعيد “عة”، تماماً كما يتصرف مع النصوص الإنجليزية واللاتينية، مما يؤكد ثبات الخوارزمية واستقلاليتها التامة عن اتجاه الكتابة البصرية لبيئة المستخدم.
7. الربط الشرطي واستخراج النصوص وفق معايير ديناميكية
7.1 التحقق من طول النص باستخدام دالة IF لتفادي الفراغات غير المنطقية
على الرغم من أن دالة MID تتعامل مع النصوص القصيرة دون الانهيار البرمجي، إلا أن إرجاع سلاسل نصية فارغة (Zero-length Strings) عند معالجة خلايا لا تحقق الحد الأدنى من الطول المطلوب قد يُنشئ مشكلات تحليلية صامتة وخطيرة في المراحل اللاحقة. فالخلية التي تبدو فارغة للمستخدم قد لا تُعامل كخلية فارغة نقية (Blank) بواسطة دوال التحقق الإحصائي مثل ISBLANK، مما يربك عمليات العد والتجميع التلقائي. يتطلب الانضباط المنهجي في بناء النماذج وضع حواجز شرطية تتحقق مسبقاً من استيفاء النص للشروط المادية لعملية الاقتطاع.
تُبنى هذه الحماية الشرطية عبر إقحام دالة IF للتحقق من أن الطول الكلي للسلسلة يتجاوز رتبة المحرف المستهدف $n$. تتجسد الصيغة المتكاملة في التركيب الرياضي التالي:
=IF(LEN(A2) > n, MID(A2, n + 1, LEN(A2)), "قصير جداً")
تقوم هذه المعادلة بفحص منطقي أولي: إذا كان عدد محارف السلسلة في A2 أكبر قطعيّاً من القيمة $n$، فإن ذلك يؤكد وجود محارف فعلية قابلة للاقتطاع تلي نقطة القطع، وحينئذ يُسمح لدالة MID بالعمل واستخراج المتن النقي. أما إذا كان طول النص مساوياً لـ $n$ أو أقل منها، فإن المعادلة توقف العملية فوراً وتُرجع رسالة تنبيهية واضحة ومقننة مثل “قصير جداً” أو قيمة فارغة صريحة بحسب المتطلبات التصميمية للنموذج.
يمنح هذا التحصين الشرطي طبقة أمان إضافية لسلامة البيانات المصدرية؛ حيث يُحول المخرجات الشاذة من نصوص مفرغة غامضة إلى مؤشرات تحذيرية مرئية ترشد الباحث أو المدقق إلى وجود قيود معطوبة أو شاذة في السجلات الأصلية تحتاج إلى مراجعة استقصائية قبل اعتماد التحليل النهائي، وهو ما يعزز موثوقية وجودة التقارير الإحصائية المعتمدة على هذه الحسابات.
7.2 تحديد الموضع n بناءً على محرف فاصل باستخدام FIND أو SEARCH
تصل قوة معالجة النصوص في إكسل إلى ذروتها عندما نتحول من الفهرسة الثابتة الجامدة للمواضع إلى الفهرسة الديناميكية الذكية المستندة إلى دلالات بنيوية داخل السلسلة نفسها. في كثير من قواعد البيانات المعقدة، لا يُعرف الموضع الرقمي للقطع بدقة مسبقة، بل يُعرف بوجود رمز محدد يفصل بين البادئة والمحتوى المستهدف (كالشرطة، النقطتان، أو الفاصلة المنقوطة). هنا يُستبدل المعامل العددي $n$ بدالة تحديد المواضع FIND أو SEARCH لاكتشاف نقطة القطع آلياً لكل سجل على حدة.
تتم عملية الاستبدال عبر وضع الدالة الباحثة في مكان المعامل $n$؛ فإذا كان الفاصل المستهدف هو الشرطة العادية "-"، تتشكل المعادلة الديناميكية الهجينة كالتالي:
=MID(A2, FIND("-", A2) + 1, LEN(A2))
يقوم محرك إكسل في هذه المعادلة بحساب قيمة $n$ ديناميكياً لكل صف عبر مسح السلسلة في A2 وتحديد الموضع الفهرسي الدقيق لأول ظهور للشرطة. فإذا ظهرت الشرطة في الموضع الثالث، تصبح $n = 3$ وتقتطع المعادلة من الموضع 4؛ وإذا ظهرت في سجل آخر عند الموضع الثامن، تتغير $n$ تلقائياً إلى 8 وتقتطع المعادلة من الموضع 9، متكيفة بمرونة تامة مع التباين الهيكلي للبيانات عبر السجلات دون أي تدخل يدوي.
من الضروري في هذا السياق التمييز التقني الدقيق بين دالتي البحث الموضعي: دالة FIND ودالة SEARCH. تختص دالة FIND بكونها دالة حساسة لحالة الأحرف (Case-sensitive) ولا تدعم استخدام الرموز البديلة (Wildcards)، وهي مثالية عندما يكون الفاصل رمزاً ترقيمياً صارماً أو حرفاً يجب مطابقته بعناية في اللغات اللاتينية. في المقابل، تتميز دالة SEARCH بعدم حساسيتها لحالة الأحرف ودعمها الكامل للرموز البديلة مثل علامة الاستفهام والنجمة، مما يجعلها خياراً أكثر مرونة وتسامحاً في بيئات البحث المفتوحة التي تفتقر إلى التوحيد القياسي الصارم لحالات الحروف.
7.3 إدارة الأخطاء باستخدام دالة IFERROR لتحسين مظهر التقارير
عند بناء أنظمة معالجة البيانات المعقدة والموجهة للعرض التنفيذي أو النشر الأكاديمي، يُعد ظهور رسائل الخطأ الافتراضية للبرنامج (مثل #VALUE!، #N/A، أو #REF!) مؤشراً سلبياً يُفقد التقارير جاذبيتها المهنية ويزرع الشك في دقة النتائج المعروضة. تنشأ هذه الأخطاء عادة عند تطبيق معادلات مركبة (مثل دمج MID مع FIND) على خلايا فارغة أو خلايا تفتقر إلى الرمز الفاصل المستهدف، مما يؤدي إلى فشل دالة البحث في إيجاد تطابق وانهيار السلسلة الحسابية بأكملها.
للقضاء على هذه المشكلة الجمالية والوظيفية، تُغلف المعادلة الإجمالية بحزام الحماية الخاص بدالة معالجة الاستثناءات IFERROR. تأخذ المعادلة المحصنة البنية التركيبية التالية:
=IFERROR(MID(A2, FIND("-", A2) + 1, LEN(A2)), "غير متوفر")
تعمل دالة IFERROR كصمام أمان مزدوج: تراقب الحسابات المنفذة بداخلها لحظة بلحظة؛ فإذا سارت العمليات بنجاح واقتُطع النص دون عوائق، مررت النتيجة الطبيعية إلى الخلية مباشرة دون أي تأخير، أما إذا تعثرت العملية لأي سبب برمجياتي وأطلقت خطأً تشغيلياً، التقطت الدالة الخطأ وحجبته عن العرض، واستبدلته بالقيمة البديلة المعرفة مسبقاً في وسيطها الثاني (مثل كتابة “غير متوفر”، أو إرجاع فراغ نقي عبر علامتي التنصيص "").
يُمثل هذا التغليف الوقائي أفضل الممارسات البرمجية في بناء لوحات التحكم والمؤشرات الإحصائية في إكسل؛ إذ يضمن استمرار عمل المعادلات التابعة ومصفوفات التجميع الرياضية اللاحقة دون توقف، ويُبقي ورقة العمل نظيفة وخالية من التشوهات البصرية، مع إمكانية استخدام التنسيق الشرطي لتمييز النصوص البديلة لتوجيه انتباه المحللين إلى السجلات الاستثنائية التي تتطلب مراجعة تدقيقية متخصصة.
8. استكشاف الأخطاء الشائعة وحلولها التفصيلية
8.1 معالجة خطأ القيمة (#VALUE!) وأسبابه المحتملة
يُعد خطأ القيمة #VALUE! من أكثر الأخطاء تواتراً عند محاولة استخراج النصوص بعد موضع محدد، وهو يعكس دائماً وجود خلل منطقي أو عدم توافق في نوعية البيانات المدخلة في أحد وسائط الدالة الرياضية. يُصدر محرك إكسل هذا التنبيه الحسابي الصارم عندما يفشل في تحويل المدخلات إلى الصيغة العددية الصحيحة التي يتطلبها الحساب الموضعي الداخلي.
تتعدد الأسباب الكامنة وراء هذا الخطأ؛ وأبرزها محاولة إدخال قيمة سالبة أو مساوية للصفر في وسيط نقطة البداية start_num داخل دالة MID. فبما أن فهرسة إكسل تبدأ إلزامياً من المحرف رقم 1، فإن أي معادلة ينتج عنها ناتج إزاحة صفري أو سالب ستؤدي فوراً إلى انفجار المعادلة بظهور #VALUE!. يتكرر هذا أيضاً عند استخدام وسائط غير رقمية لتحديد الموضع $n$؛ مثل الإشارة خطأً إلى خلية مرجعية تحتوي على كلمة أو نص، مما يجعل عملية الجمع الحسابي $(n + 1)$ مستحيلة رياضياً ويوقف تنفيذ المعادلة في مهدها.
لحل هذه المعضلة وتصحيح مسار الحسابات، يمتلك المحلل أداة تشخيصية استثنائية يوفرها البرنامج في تبويب “الصيغ” (Formulas) تحت مسمى “تقييم الصيغة” (Evaluate Formula). تتيح هذه الأداة تشغيل المعادلة خطوة بخطوة بالسرعة البطيئة، مما يمكن المستخدم من مراقبة عملية استبدال المراجع بقيمها الفعلية، وتحديد النقطة المحددة التي ينقلب عندها الوسيط إلى قيمة غير صالحة. بمجرد عزل السبب، يمكن تصحيح المراجع المغذية أو استخدام دوال التحقق مثل ISNUMBER لضمان ألا يدخل في خانة الإزاحة سوى الأرقام الصحيحة الموجبة الصالحة للحساب.
8.2 تصحيح التحويل غير المقصود للأرقام المستخرجة إلى نصوص
من الفخاخ البرمجية الكبرى التي يقع فيها حتى الممارسون ذوو الخبرة في إكسل مسألة “الهوية النوعية” للمخرجات المستخلصة عبر الدوال النصية. إن القاعدة المعمارية الثابتة في تصميم برمجية إكسل تنص على أن كافة مخرجات دوال معالجة النصوص — وبلا أي استثناء، بما في ذلك MID وRIGHT وLEFT — تُنتج دائماً سلاسل نصية (Text Strings)، حتى وإن كانت النتيجة الظاهرة تتكون حصرياً من أرقام خالصة مثل “45892”.
تترتب على هذا التمايز النوعي تداعيات حسابية بالغة الخطورة؛ فالأرقام المعاملة كنصوص لا تستجيب لدوال التجميع والعمليات الرياضية الكلاسيكية؛ فمحاولة تطبيق دالة الجمع SUM على عمود يحتوي على أرقام مستخرجة بواسطة MID ستنتج صفراً مطلقاً، لأن دالة SUM تتجاهل النصوص تلقائياً في حساباتها. كما أن استخدام هذه القيم المستخرجة كمفاتيح بحث في دوال المطابقة مثل VLOOKUP أو MATCH سيفشل حتماً في العثور على أهدافها إذا كانت قواعد البيانات المصدرية تخزن تلك الأرقام بصيغة عددية حقيقية، نظراً لاختلاف بصمة التخزين الثنائية بين الرقم والنص في الذاكرة.
لتصحيح هذا التحويل غير المقصود وإعادة السلاسل المستخرجة إلى طبيعتها العددية، يجب إخضاع المخرجات النصية لعملية “إكراه نوعي” (Type Coercion). يمكن إنجاز ذلك بأناقة رياضية عبر استخدام “معامل السالب المزدوج” (Double Unary Operator) بوضعه قبل المعادلة: =--MID(A2, n + 1, LEN(A2))، حيث تجبر الإشارتان السالبتان محرك إكسل على معاملة النص كرقم عبر عملية ضرب حسابية في سالب واحد مرتين متتاليتين دون تغيير قيمته الرياضية. كبديل تقليدي مكافئ، يمكن تغليف الصيغة بدالة القيمة الصريحة: =VALUE(MID(A2, n + 1, LEN(A2)))، مما يعيد الأرقام فوراً إلى فضائها الحسابي الصحيح، لتصطف تلقائياً إلى يمين الخلية وتصبح صالحة لكافة المعادلات الإحصائية المعقدة.
8.3 مشكلة استخراج سلاسل ناقصة عند إدخال وسيط طول غير كافٍ
تنشأ مشكلة بتر النصوص المقتطعة عندما يستغني المستخدم عن الحساب الديناميكي للطول الإجمالي عبر دالة LEN، مستعيضاً عنه بإدخال رقم ثابت اعتباطي في خانة عدد المحارف num_chars بدعوى التبسيط والاختصار؛ كأن يكتب: =MID(A2, 4, 10) مفترضاً أن عشرة محارف تكفي لتغطية النص المتبقي في كافة الأحوال. يمثل هذا التخمين انتهاكاً لمبادئ هندسة البيانات الصارمة، ويفتح الباب واسعاً أمام بتر النصوص الطويلة التي تتجاوز مصادفة هذا الحد الاعتباطي.
تكمن خطورة هذا الخطأ في كونه خطأً غير صامت بصرياً؛ فالبرنامج لن يطلق أي تنبيه برمجي أو تحذير بالخطأ، لأن المعادلة من الناحية البنيوية صحيحة تماماً وتستخرج 10 محارف كما طُلب منها. ولكن عند التدقيق في النتائج، يُفاجأ المحلل بأن أسماءً أو بيانات مهمة قد قُطعت في منتصفها، مما يُفقد البيانات معناها ويفسد مصداقية النتائج دون إثارة انتباه النظام إلى وقوع خلل، وهو أسوأ أنواع الأخطاء في الدراسات الأكاديمية والتقارير التنفيذية.
إن الحل المنهجي الوحيد والدائم لهذه المشكلة هو الالتزام الصارم بتضمين دالة LEN(A2) لتحديد الحد الأقصى للمحارف. يُظهر التحليل المعماري لمحرك إكسل أنه عند إمداد دالة MID بعدد محارف يفوق الطول الفيزيائي الفعلي للنص المتبقي، فإن المحرك لا يحاول قراءة فراغات إضافية ولا يحجز مساحات مهدرة في الذاكرة، بل يكتفي بالوصول إلى علامة نهاية السلسلة (Null Terminator) ويتوقف تلقائياً بسلام وأمان. وبالتالي، فإن توفير هامش طول واسع عبر LEN يضمن حماية البيانات بنسبة مئة بالمائة من مخاطر البتر الجزئي مع الحفاظ الكامل على الكفاءة التشغيلية للمصنف.
9. دمج التقنية في أتمتة وتدفقات معالجة البيانات الضخمة
9.1 تطبيق صيغ المصفوفات الديناميكية (Dynamic Arrays)
أحدثت مايكروسوفت نقلة نوعية في محرك الحسابات المجدولة لإكسل بإدخال بنية “المصفوفات الديناميكية” (Dynamic Arrays)؛ وهي تقنية ألغت للأبد الحاجة التاريخية لإدخال صيغ المصفوفات المعقدة عبر لوحة المفاتيح بالضغط على (Ctrl + Shift + Enter). تتيح هذه البيئة الحسابية الحديثة للمعادلة الواحدة أن تعالج نطاقاً ضخماً من الخلايا دفعة واحدة، وتسكب مخرجاتها تلقائياً على امتداد النطاق المجاور فيما يُعرف برمجياً بـ “نطاق الانسكاب” (Spill Range).
لتطبيق استخراج النصوص بعد الحرف الثالث على عمود يحتوي على ألف سجل باستخدام المصفوفات الديناميكية، لم يعد المحلل بحاجة إلى كتابة الصيغة في الخلية الأولى ثم سحبها عمودياً؛ بل يكتفي بكتابة معادلة مفردة واحدة في الخلية المستهدفة الأولى B2 مستدعياً النطاق المصادري كاملاً كمتجه مصفوفي:
=MID(A2:A1001, 3 + 1, LEN(A2:A1001))
بمجرد الضغط على مفتاح الإدخال، تتولى المعادلة معالجة مصفوفة المدخلات ككتلة واحدة في الذاكرة المركزية، وتسيل النتائج المقتطعة عبر الخلايا من B2 حتى B1001 في لمح البصر. تظهر النتائج محاطة بإطار أزرق رفيع يشير إلى أنها مخرجات تابعة لصيغة انسكاب ديناميكية موحدة، ولا يمكن تعديل الخلايا التابعة بصورة منفصلة، بل يُعدل الأصل في الخلية B2 فتتحدث المنظومة بالكامل.
يوفر هذا التحول فوائد تشغيلية ومعمارية هائلة لمديري قواعد البيانات؛ فهو يقلص حجم ملف المصنف بشكل ملحوظ مقارنة بنسخ مئات الآلاف من الصيغ المستقلة وتكرارها في كل خلية، كما يُسهم في تسريع وقت المعالجة وإعادة الحساب؛ نظراً لأن محرك إكسل يتعامل مع العملية كعملية متجهية مفردة (Vectorized Operation) تستهلك عدداً أقل بكثير من دورات المعالجة المركزية، مما يمنع تجمد ورقة العمل ويحافظ على سلاسة الاستجابة في مجموعات البيانات الكبيرة.
9.2 تنفيذ الاستخراج باستخدام Power Query دون الاعتماد على الصيغ
في بيئات البيانات المؤسسية الضخمة التي تتجاوز فيها السجلات حدود ملايين القيود، تصبح المعالجة عبر الصيغ الكلاسيكية داخل ورقة العمل عبئاً كبيراً قد يؤدي إلى بطء أداء الحاسوب واستهلاك موارده الحسابية. هنا يبرز الخيار المعماري الأمثل المتمثل في توظيف محرك “باور كويري” (Power Query)، وهو المحرك التحويلي والتكاملي الفائق المدمج داخل إكسل والمتخصص في عمليات الاستخراج والتحويل والتحميل (ETL Pipelines).
يتيح Power Query تنفيذ عملية استخراج النصوص بعد الحرف $n$ دون كتابة صيغة تقليدية واحدة داخل الخلايا، وذلك باتباع الخطوات القياسية المنهجية التالية:
- تحديد جدول البيانات ونقله إلى محرر Power Query عبر النقر على خيار “من جدول/نطاق” (From Table/Range) ضمن تبويب “بيانات” (Data).
- اختيار العمود المستهدف بالاقتطاع، ثم الانتقال إلى تبويب “إضافة عمود” (Add Column) أو “تحويل” (Transform) واختيار أمر “تقسيم العمود” (Split Column) ثم تحديد “حسب عدد الأحرف” (By Number of Characters).
- في النافذة التفاعلية المنبثقة، يتم إدخال قيمة $n$ (مثل 3) في خانة عدد الأحرف، مع تحديد خيار الاقتطاع الصارم: “مرة واحدة، أقصى اليسار بقدر الإمكان” (Once, as far left as possible).
- يقوم المحرك بشطر العمود إلى عمودين؛ الأول يحمل البادئة المكونة من المحارف المستبعدة، والعمود الثاني يحمل المتن النقي المستهدف بعد الحرف $n$.
- يتم حذف عمود البادئة غير المرغوب فيه بضغطة زر، وإعادة تسمية عمود المخرجات، ثم الضغط على “إغلاق وتحميل” (Close & Load) لنقل البيانات المصفاة إلى ورقة العمل.
تتجلى الميزة الاستثنائية لحلول Power Query في قدرتها الفائقة على الحفظ الإجرائي التلقائي؛ حيث تُسجل كافة خطوات المعالجة المنجزة بلغة البرمجة الشهيرة (M Code) كأنابيب تحويل دائمة ومحفوظة ضمن المصنف. عند وصول بيانات خام جديدة في المستقبل أو تحديث السجلات المصدرية، لا يتطلب الأمر إعادة ضبط أي شيء؛ بل يكتفي المحلل بالضغط على زر “تحديث الكل” (Refresh All)، فيقوم محرك Power Query بتطبيق قواعد التجزئة والاقتطاع تلقائياً على ملايين السجلات في ثوانٍ معدودة، مستبعداً أول $n$ محرف بدقة متناهية ودون استهلاك ذاكرة الخلايا في كتابة الصيغ الحسابية.
9.3 بناء دالة مخصصة (UDF) عبر لغة Visual Basic for Applications (VBA)
على الرغم من التطور التقني للدوال المدمجة، إلا أن المؤسسات الكبرى والمراكز البحثية المتخصصة تفضل في كثير من الأحيان تبسيط واجهة العمل للمستخدمين النهائيين عبر إخفاء التعقيدات الرياضية وتطوير أدوات مصممة خصيصاً لأداء الوظائف المتكررة. يمكن تحقيق ذلك باقتدار عبر برمجة “دالة معرفة من قبل المستخدم” (User-Defined Function – UDF) باستخدام لغة البرمجة العريقة المضمنة في إكسل (VBA).
تتم برمجة الدالة عبر فتح محرر الأكواد (Alt + F11)، وإدراج وحدة نمطية جديدة (Standard Module)، ثم كتابة الكود البرمجي الصافي التالي:
Public Function ExtractAfterN(TargetCell As Range, n As Long) As String
On Error GoTo ErrorHandler
If TargetCell.Value = "" Then
ExtractAfterN = ""
Exit Function
End If
ExtractAfterN = Mid(TargetCell.Value, n + 1)
Exit Function
ErrorHandler:
ExtractAfterN = "خطأ في المعالجة"
End Function
بمجرد حفظ هذه الشيفرة البرمجية وإغلاق المحرر، تظهر الدالة الجديدة ExtractAfterN كدالة أصلية متكاملة في واجهة إكسل العادية، ويستطيع أي مستخدم استدعاؤها في خلايا ورقة العمل بكل بساطة: =ExtractAfterN(A2, 3) دون حاجة لتذكر تعقيدات دالة LEN أو حساب إزاحات الجمع يدparam>ياً؛ حيث تتولى الدالة البرمجية التعامل مع السلسلة وإرجاع المتن المطلوب فوراً مع إدارة مدمجة للأخطاء والاستثناءات.
ومع ذلك، يجب الانتباه عند المفاضلة المعمارية بين الدوال المدمجة والدوال المبنية بلغة VBA إلى فارق الأداء وسرعة التنفيذ. فالدوال الأصلية مثل MID مكتوبة بلغات منخفضة المستوى ومترجمة برمجياً داخل نواة محرك إكسل (C++) وتخضع للتنفيذ المتوازي متعدد الخيوط الحسابية (Multi-threaded Calculation). في المقابل، تُنفذ دوال VBA عبر مفسر أحادي الخيط يستلزم عبور جسور برمجية متكررة (COM Overhead) بين بيئة الورقة وبيئة المحرر، مما يجعل الدوال المدمجة أسرع بمراحل عند معالجة عشرات الآلاف من الصفوف، ويجعل خيار UDF محبذاً فقط في سياق تعزيز سهولة الاستخدام البشري في النماذج محدودة ومتوسطة الحجم.
10. أفضل الممارسات المنهجية لحوكمة وتوثيق عمليات معالجة النصوص
10.1 معايير تسمية الأعمدة وتوثيق الصيغ في الدفاتر المشتركة
تُعد حوكمة البيانات وتوثيق مسارات المعالجة الرياضية متطلباً مهنياً لا غنى عنه لضمان ديمومة النماذج المالية والبحثية وموثوقيتها عبر الزمن، لا سيما في بيئات العمل المشتركة التي يتداول فيها الملف عدة محللين ومدققين. إن إهمال التوثيق يؤدي بمرور الوقت إلى تحول ورقة العمل إلى “صندوق أسود” غامض يصعب فهم منطقه الحسابي أو تعديله دون التسبب في أخطاء تراجعية تكسر اتساق البيانات.
تبدأ هذه الحوكمة بفرض معايير صارمة وواضحة لتسمية الأعمدة الناتجة عن عمليات الاقتطاع والتجزئة النصية. يجب تجنب التسميات المبهمة أو العامة مثل “عمود 1” أو “الاسم الجديد”؛ والاستعاضة عنها بتسميات وصفية صريحة تعكس الإجراء الحسابي بدقة متناهية، مثل: المعرف_بدون_البادئة_الثلاثية أو النص_بعد_المحرف_3. تُمكن هذه التسميات الدقيقة أي مراجع خارجي من استيعاب الطبيعة البنيوية للبيانات المضمنة بمجرد إلقاء نظرة خاطفة على الترويسة الرئيسية للجدول دون حاجة لتفكيك معادلات الصفوف وتخمين أهدافها.
علاوة على ذلك، يُنصح بشدة بتوظيف أدوات التعليقات الحديثة (Comments) والملاحظات التوثيقية (Notes) داخل رؤوس الأعمدة، لشرح الأساس المنطقي للصيغ الرياضية المركبة، مع توضيح سبب اختيار نقطة القطع $n$ والمعايير المعتمدة في استبعاد البوادئ. في النماذج الكبيرة والمعقدة، يُعد من أفضل الممارسات المهنية إنشاء ورقة عمل مخصصة بعنوان “قاموس البيانات ومسار التدقيق” (Data Dictionary & Audit Trail)؛ تتضمن توثيقاً مفصلاً لكافة المعادلات المستخدمة، وتواريخ تطبيقها، وأسماء المسؤولين عن تنفيذ المعالجة المسبقة، مما يرسخ الشفافية ويسهل عمليات المراجعة والاعتماد المؤسسي.
10.2 التحقق من سلامة البيانات ومطابقتها للمعايير قبل التحليل
لا تنتهي عملية استخراج النصوص عند حدود كتابة وتعميم المعادلات الحسابية؛ بل يجب أن تتبعها مرحلة رقابية صارمة للتحقق من سلامة البيانات الناتجة (Data Validation) وخلوها من التشوهات أو الانحرافات التي قد تفسد التحليلات الإحصائية اللاحقة. إن الاعتماد الأعمى على نجاح عينة صغيرة دون فحص شامل للعمود بأكمله هو مسلك يفتقر إلى الرصانة العلمية وقد يمرر أخطاء غير مرئية تؤثر سلباً على قرارات النمذجة.
تتضمن استراتيجيات التحقق المنهجي تطبيق اختبارات التباين والاتساق على السجلات المعالجة؛ كأن يتم إنشاء عمود تدقيق جانبي مؤقت يُقاس فيه طول النص المقتطع ويقارن بالطول الأصلي باستخدام صيغة مطابقة منطقية: =LEN(B2) = (LEN(A2) - n). يجب أن تُرجع هذه المعادلة القيمة المنطقية TRUE لكافة السجلات الخاضعة للاقتطاع المنتظم؛ فإذا ظهرت القيمة FALSE في أي صف، كان ذلك دليلاً قاطعاً على وجود شذوذ بنيوي أو مسافات خفية أو محارف تشفير خاصة تتطلب فحصاً استقصائياً فورياً ومعالجة استثنائية مستقلة.
بالإضافة إلى ذلك، يُستحسن تطبيق أسلوب “العينات العشوائية الطبقية” (Stratified Random Sampling) لفحص مخرجات الاقتطاع ومطابقتها بصرياً ومفاهيمياً مع السجلات المصدرية الأصلية عبر مختلف أطياف البيانات (النصوص القصيرة، النصوص الطويلة، النصوص الحاوية على أرقام أو رموز). يضمن هذا الفحص متعدد المستويات كشف أية انزلاقات في فهرسة المحارف قبل تصدير البيانات إلى الحزم الإحصائية المتقدمة، محققاً أعلى معايير الجودة والأمان الرقمي للبحوث والدراسات التطبيقية المعتمدة على هذه البيانات.
10.3 الأرشفة الآمنة للبيانات الأصلية بعد التجريد والنقل
تتمثل القاعدة الأخلاقية والمهنية الأهم في إدارة البيانات ومعالجتها في مبدأ “عدم قابلية الرجوع السلبي” (Irreversibility Principle)؛ وهو ما يعني الحظر المطلق لحذف الأعمدة المصدرية الحاوية على النصوص الأصلية الخام بعد الانتهاء من استخراج المقاطع المنقاة. إن تدمير البيانات الأولية بدعوى تنظيم مظهر ورقة العمل يُعد خطأً إدارياً جسيماً يقطع إمكانية “تتبع الأثر” (Data Traceability)، ويمنع المراجعين المستقبليين من التأكد من صحة الاقتطاع أو إعادة إنتاج المعالجة في حال اكتشاف خطأ منهجي لاحق في تحديد موضع القطع $n$.
لتحقيق التوازن بين الحفاظ على البيانات الأصلية وتوفير مظهر عملي ونظيف للمستخدم النهائي، يُنصح بإخفاء الأعمدة المصدرية (Hide Columns) بدلاً من حذفها، أو نقلها إلى ورقة عمل أرشيفية مخصصة تُقفل وتُحمى بكلمة مرور. يحفظ هذا الإجراء سجل الحقيقة الكامل (Single Source of Truth) سليماً وقابلاً للرجوع في أي لحظة، مع إتاحة المجال لاستخدام الأعمدة المستخرجة المنقاة في العمليات الحسابية والتقارير التنفيذية دون تشويش بصري.
أخيراً، عند اكتمال التحقق من استقرار المخرجات والوصول إلى المراحل النهائية لإعداد التقارير، يُعد تحويل الصيغ الرياضية التابعة إلى “قيم ثابتة” (Copy > Paste Special as Values) خطوة حيوية لتعزيز أمان واستقرار الملف. يؤدي استبدال الصيغ بقيمها المجردة إلى قطع ارتباط الخلايا الحسابي بالبيانات الأصلية، مما يمنع حدوث أي تحلل أو إعادة حساب غير مقصودة في حال تعديل البيئة المحيطة، كما يُسهم في خفض حجم الملف وتسريع تحميله عند مشاركته عبر الشبكات المؤسسية. تُختتم هذه المنظومة بتطبيق إجراءات “حماية أوراق العمل” (Protect Sheet) لمنع التعديل العرضي على الخلايا المعتمدة، لتستقر البيانات في إطار مؤسسي متين يجمع بين الدقة الرياضية، والأمان المعلوماتي، والجاهزية الكاملة للتحليل العلمي الرصين.
خاتمة
إن عملية استخراج النص بعد الحرف رقم $n$ في برنامج إكسل تتجاوز كونها مجرد خدعة حسابية أو مهارة مكتبية عابرة؛ إنها إجراء تحويلي جوهري يقع في صلب هندسة البيانات وتجهيزها للتحليل العلمي الرصين. من خلال استعراض الجذور التاريخية لدوال معالجة السلاسل النصية ومقاربة بنيتها الرياضية الممتدة من إرث لغة دارتموث بيسيك وحقبة الجداول الإلكترونية الرائدة، اتضح لنا كيف تشكل المعادلات الكلاسيكية — القائمة على التآلف الخوارزمي الدقيق بين دالتي MID وLEN والإزاحة الموضعية $(n + 1)$ — حلولاً متينة تمتاز بالمرونة والقدرة على التكيف مع مختلف التحديات الهيكلية وتوافقية العمليات الحسابية عبر الزمن.
علاوة على ذلك، أظهر التحليل المعماري المتقدم أهمية الوعي البيئي بخصائص النصوص من مسافات خفية، ورموز خاصة، واعتبارات التشفير متعدد البايت والاتجاه المنطقي للغات العالمية، فضلاً عن تقييم الأداء الحسابي في التعامل مع البيانات الضخمة عبر التقنيات الحديثة كالمصفوفات الديناميكية ومحرك Power Query. إن تبني أفضل الممارسات المنهجية في حوكمة النماذج، والتحقق الشرطي من صحة البيانات، والتوثيق الدقيق لمسارات المعالجة، يضمن للمحللين والباحثين تحويل البيانات الخام المتباينة إلى أصول معلوماتية نقية وموثوقة، تشكل أرضية صلبة لكافة أشكال الاستدلال الإحصائي، وصنع القرار المؤسسي، والبحث العلمي المتقدم بأعلى درجات الكفاءة والموثوقية.
المراجع
- كيميني، ج.، وكورتز، ت. (1964). كتيب إرشادات لغة البرمجة بيسيك (BASIC). كلية دارتموث، هانوفر، نيو هامبشاير.
- مايكروسوفت. (2023). دالة MID: دليل المطورين والمستخدمين في إكسل. وثائق الدعم الفني لشركة مايكروسوفت. تم الاسترجاع من: https://support.microsoft.com/
- مايكروسوفت. (2023). دالة LEN ودوال قياس السلاسل النصية في برمجية الجداول المجدولة. شبكة مطوري مايكروسوفت (MSDN). تم الاسترجاع من: https://learn.microsoft.com/
- مايكروسوفت. (2022). دالة TEXTAFTER ومحركات التجزئة النصية المحدثة في Microsoft 365. مركز تعليم ودعم إكسل. تم الاسترجاع من: https://support.microsoft.com/
- مؤسسة يونيكود. (2023). المعيار القياسي لترميز المحارف الدولية الموحدة (Unicode Standard الإصدار 15.0). ماونتن فيو، كاليفورنيا: كونسورتيوم يونيكود.