
تعد معالجة السلاسل النصية وتفكيك تراكيبها المترابطة داخل بيئات جداول البيانات الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، ركيزة جوهرية في منظومة هندسة البيانات وتنقيتها. ففي سياق التحليل الإحصائي وإدارة المستودعات الرقمية، غالباً ما تتدفق البيانات بصيغ غير مهيكلة أو شبه مهيكلة، حيث تحتشد متغيرات متعددة داخل الخلية الواحدة وتفصل بينها محددات اصطلاحية، تأتي الفاصلة التقليدية في مقدمتها. ويشكل التحدي المتمثل في استخراج محتوى نصي وسيط محصور بدقة بين فاصلتين اختباراً حقيقياً لمدى كفاءة المحلل في توظيف الأدوات الحسابية والخوارزمية المتاحة.
إن الانتقال بالبيانات من حالتها النصية الخام المكتظة إلى عناصر ذرية منفصلة ليس مجرد إجراء تقني روتيني، بل هو شرط منهجي مسبق لإجراء أي نمذجة كمية رصينة أو إعداد تقارير تجارية دقيقة. فوجود قيم متعددة في حقل واحد يحول دون بناء العلاقات الجدولية السليمة، ويعطل آليات المطابقة الفهرسية، ويخلق تشوهات بنيوية في قواعد البيانات. ومن ثم، يتطلب عزل النص الواقع بين فاصلتين فهماً دقيقاً للمنطق البرمجي الذي يحكم دوال النصوص في إكسل، بدءاً من الخوارزميات الحسابية لمواقع الأحرف وصولاً إلى محركات المعالجة الديناميكية الحديثة.
تستعرض هذه الدراسة المنهجية الشاملة كافة الأبعاد الهندسية والعملية لتفكيك النصوص المحصورة بين فاصلتين، مستندة إلى أحدث ما توصلت إليه بيئة إكسل من دوال مصفوفية متطورة، مع تأصيل البدائل الكلاسيكية التي ضمنت استقرار النماذج المحاسبية والإحصائية لعقود خلت. وسيتناول الطرح تحليلاً معمقاً لكفاءة الصيغ الرياضية، والأدوات التفاعلية المدمجة، وآليات المعالجة المتقدمة لتدفقات البيانات الضخمة، لتقديم دليل تطبيقي متكامل يجمع بين الرصانة النظرية والدقة الإجرائية.
1. مقدمة منهجية لمعالجة النصوص المحددة بفواصل في إكسل
1.1 أهمية تجزئة النصوص في تنقية البيانات الرقمية
تمثل عملية تجزئة النصوص (String Parsing) مرحلة تأسيسية في مسار هندسة البيانات المعاصرة، حيث تعتمد جودة المخرجات التحليلية بصورة طردية على مدى نقاء المدخلات وهيكلتها المنطقية. في العديد من الأنظمة المؤسسية وسجلات المعاملات الرقمية، تُخزن المتغيرات المتعددة بصورة مدمجة داخل حقل نصي واحد لتوفير مساحة التخزين أو لتسهيل عمليات التصدير السريع، مثل دمج الاسم واللقب والوظيفة، أو المدينة والمقاطعة والدولة في حقل جغرافي موحد. يترتب على هذا النمط غير المهيكل عجز أدوات التحليل الإحصائي عن التعاطي مع المتغيرات المستقلة؛ إذ لا يمكن حساب مقاييس النزعة المركزية أو إجراء تصنيفات تكرارية لمتغير يقع أسيراً داخل سلسلة نصية طويلة دون فرزه وتفكيكه مسبقاً.
تكمن الأهمية الاستراتيجية لتحويل السلاسل النصية غير المهيكلة إلى حقول بيانية منتظمة في تمكين المحلل من بناء نماذج ارتباط دقيقة وتأسيس علاقات تكاملية بين الجداول عبر المفاتيح الأساسية (Primary Keys). إن تشتت البيانات داخل نصوص مركبة يؤدي إلى تدني كفاءة المعالجة الخوارزمية، حيث تضطر خوارزميات البحث إلى مسح كامل السلسلة بدلاً من استهداف الحقل المعني مباشرة. علاوة على ذلك، تسهم المعالجة المسبقة والتنقية في تقليص معدلات الخطأ الإنساني والتقني عند استيراد البيانات إلى حزم البرمجيات الإحصائية المتخصصة أو برمجيات ذكاء الأعمال ومستودعات البيانات الضخمة.
ومع ذلك، تواجه هذه العملية تحديات تقنية ناجمة عن الطبيعة غير المتجانسة للبيانات الواقعية؛ فالفواصل الرمزية قد تتفاوت مواقعها النسبية بين صف وآخر تبعاً لاختلاف أطوال الكلمات المكونة للسلسلة، مما يسقط أي افتراض يعتمد على مواقع الأحرف الثابتة. يضاف إلى ذلك احتمالية احتواء البيانات على فراغات عشوائية أو فواصل مزدوجة غير مقصودة ناتجة عن أخطاء الإدخال اليدوي. من هنا يبرز دور معايير الدقة الرياضية في عزل المتغيرات الفرعية بدقة جراحية؛ حيث يُشترط في الصيغ البرمجية المستخدمة أن تقطع النص المستهدف استناداً إلى المحددات الرمزية دون تشويه المحتوى، ودون اقتطاع أحرف أصلية أو تضمين محارف شائبة قد تفسد المعالجات اللاحقة.
1.2 الخصائص التركيبية للبيانات المعتمدة على الفاصلة كمعيار فصل
تحظى الفاصلة (Comma) بمكانة مركزية في تاريخ تمثيل البيانات الرقمية، إذ تشكل حجر الزاوية في صيغ الملفات الأكثر انتشاراً عالمياً مثل ملفات القيم المفصولة بفواصل (Comma-Separated Values – CSV). وتتميز النصوص المعتمدة على الفاصلة كمعيار فصل بتركيبة ثلاثية أو متعددة الأجزاء، حيث يُقسّم السجل إلى مقاطع دلالية متتالية؛ فالنمط الجغرافي الكلاسيكي يتألف بنيوياً من: المكون المحلي (مثل اسم الشارع)، يليه المكون الإقليمي (الولاية أو المحافظة)، ثم المكون السيادي (الدولة). وتأتي القيمة المستهدفة بالدراسة عادة في الموقع الأوسط، محصورة بدقة بين فاصلة البداية وفاصلة النهاية، وهو ما يفرض نمطاً من التعامل الحسابي يعتمد على رصد الفواصل كنقاط إسناد محورية.
يتطلب التحليل الدقيق فك الاشتباك بين الأنواع المختلفة من الفواصل الرمزية التي قد تتداخل في بيئات العمل المتعددة لغوياً وثقافياً؛ فالفاصلة الإنجليزية القياسية (ASCII 44) تختلف بنيوياً وبرمجياً عن الفاصلة العربية المقلوبة (ASCII 1544)، كما تختلف عن الفاصلة المنقوطة المستخدمة كفاصل إقليمي للمعاملات في بعض إعدادات نظام التشغيل الأوروبية. إن إغفال هذا التمايز الرمزي يؤدي إلى فشل ذريع في خوارزميات الاستخراج، حيث تبحث الدوال عن محرف غير موجود في السلسلة النصية، مما يولد أخطاء تنفيذية فورية.
يُعرف المحدد النصي (Delimiter) بأنه تسلسل محرفي يحدد الحدود الفاصلة بين مناطق مستقلة في تدفق البيانات النصية. وفي حالة استخراج النص بين فاصلتين، يؤدي المحدد دوراً مزدوجاً: فهو يمثل إشارة انتهاء للمقطع الأول، ونقطة انطلاق للمقطع الأوسط المطلوب، ثم يعود ليظهر كإشارة توقف نهائية تعزل المقطع الأوسط عن باقي السلسلة. إن فهم هذا الدور الإشاري للمحدد هو الذي يوجه صياغة المعادلات الرياضية في إكسل؛ إذ يتحول البحث من مجرد قراءة للنص إلى عملية ملاحة موضعية تتبع إحداثيات المحددات داخل المصفوفة المحرفية للخلية.
1.3 نظرة عامة على الحلول التقنية المتاحة وتطورها في بيئة إكسل
شهدت بيئة مايكروسوفت إكسل تطوراً بنيوياً هائلاً في أدوات معالجة النصوص عبر مسيرتها التاريخية الممتدة منذ ثمانينيات القرن الماضي. ففي المراحل المبكرة، كان المستخدم مقيداً بالاعتماد الحصري على دوال اقتطاع النصوص الكلاسيكية ذات المنطق الحسابي المجرد، مثل دمج دالة الاقتطاع الموضعي مع دوال البحث عن مواقع الأحرف. ورغم القوة الرياضية المطلقة لتلك الصيغ وقدرتها على العمل عبر كافة الإصدارات التاريخية للبرنامج، إلا أنها اتسمت بتعقيد تركيبي شاهق يرفع من احتمالية الخطأ الإنساني عند كتابتها ويجعل من صيانتها وتدقيقها عبئاً ذهنياً ثقيلاً على محللي البيانات.
مع إطلاق محرك الحسابات المعتمد على المصفوفات الديناميكية (Dynamic Arrays) والإعلان عن حزمة الدوال النصية الحديثة في عام 2022 لنظام مايكروسوفت 365 وإكسل للويب، حدثت قفزة نوعية في هندسة التجريد النصي. أتاحت هذه الدوال الجديدة تجريد النصوص استناداً إلى المنطق الوصفي المباشر للهدف بدلاً من التتبع الحسابي لإحداثيات المؤشرات. وإلى جانب الدوال الحسابية، تطورت واجهات الاستخدام الرسومية لتقدم أدوات تفاعلية مثل ميزة النص إلى أعمدة (Text to Columns)، وتقنيات التعلم الآلي المدمجة في التعبئة السريعة (Flash Fill)، فضلاً عن بيئة محرر الاستعلامات المتقدمة باور كويري (Power Query) المخصصة للمشاريع الكبرى.
يخضع اختيار المسار التقني الأنسب لمعايير منهجية محددة ترتبط بثلاثة عوامل حاسمة: أولها الإصدار البرمجي المتاح لدى بيئة العمل المستهدفة ومستوى التوافق المطلوب مع مستخدمين خارجيين؛ وثانيها حجم مصفوفة البيانات المعالجة، حيث تتفاوت الحلول في استهلاك الذاكرة العشوائية وموارد المعالج؛ وثالثها طبيعة تدفق البيانات، وما إذا كانت العملية تتطلب معالجة لمرة واحدة لملف ثابت أو بناء نموذج ديناميكي مستدام يتحدث تلقائياً مع تدفق السجلات الجديدة.
2. التحليل البنيوي لدالتي TEXTAFTER وTEXTBEFORE الحديثتين
2.1 الميكانيكية الوظيفية لدالة TEXTAFTER
تمثل دالة TEXTAFTER، التي طرحتها مايكروسوفت ضمن تحديثات عام 2022 في إصدار Microsoft 365، ثورة مفاهيمية في كيفية استخلاص النصوص التابعة لمحددات معينة. تقوم الميكانيكية الوظيفية للدالة على مسح السلسلة النصية المدخلة والبحث عن محدد معين، ثم اقتطاع وإرجاع كامل الجزء النصي الواقع بعد ذلك المحدد بدقة متناهية، متجاوزة الحاجة المعقدة لحساب عدد الأحرف السابقة أو تحديد فهارس المواقع بصيغ حسابية إضافية.
تستند الدالة إلى هيكل تركيبي صارم يتألف من معاملات إلزامية وأخرى اختيارية تمنحها مرونة برمجية فائقة:
- text: السلسلة النصية الأصلية المراد تجزئتها، أو المرجع الخلوي الذي يحتوي على النص المستهدف.
- delimiter: المحرف أو الرمز الفاصل الذي يُتخذ كحد مرجعي للاقتطاع، وفي حالتنا هنا هو الفاصلة
",". - instance_num: معامل اختياري يحدد رقم ظهور الفاصلة المستهدفة (الظهور الأول، الثاني، إلخ)، وتبلغ قيمته الافتراضية الرقم 1.
- match_mode: يحدد حساسية البحث لحالة الأحرف (وهو غير ذي أثر مع الفواصل لكنه حيوي مع المحددات الأبجدية).
- match_end: يعامل نهاية النص كمحدد افتراضي في حال عدم العثور على الرمز.
- if_not_found: القيمة البديلة المعادة عند تعذر إيجاد المحدد لتجنب توليد رسائل الخطأ البرمجية.
تتيح المعاملات المتقدمة للدالة تجاوز التكرارات الأولى للمحددات بكل سلاسة؛ فعند تعيين معامل رقم الظهور instance_num على القيمة 1، تتجاهل الدالة الشطر الأول من السلسلة وتقفز رأسياً فوق الفاصلة الأولى، لتعيد مصفوفة نصية تبدأ فوراً من المحرف الأول الذي يلي تلك الفاصلة. هذا السلوك الإسقاطي المباشر يلغي تماماً الحاجة لجمع الإزاحات الفهرسية ويحمي الناتج من أخطاء الانزياح بمقدار محرف واحد (Off-by-one errors) التي شاعت في الحلول الكلاسيكية.
2.2 الميكانيكية الوظيفية لدالة TEXTBEFORE
تعمل دالة TEXTBEFORE كالنظير البنيوي العكسي لدالة TEXTAFTER؛ حيث تتركز ميكانيكيتها في مسح النص المدخل وعزل واقتطاع كافة المحارف التي تسبق محدداً نصياً محدداً. وبدلاً من تتبع نهاية السلسلة، تركز الدالة على استكشاف نقطة الانقطاع الأولى أو المحددة بالمعاملات، وتقوم بتجميد الاقتطاع بمجرد ملامسة الحد الخارجي لرمز الفاصلة، لتعيد الجزء النصي الواقع إلى جهة اليسار (أو البداية) من نقطة التماس.
تتطابق معاملات TEXTBEFORE الهيكلية مع معاملات TEXTAFTER، حيث تستقبل النص الأصلي ورمز المحدد ورقم الظهور ومعاملات معالجة الأخطاء. تكمن القوة الإجرائية لهذه الدالة في قدرتها على وضع حد نهائي صارم للسلاسل النصية الممتدة. فعند تمرير نص مجتزأ إليها يحتوي على فاصلة تالية، تستطيع الدالة عبر معامل الظهور الأول قراءة المقطع المستهدف حتى الوصول إلى الفاصلة التالية، ومن ثم تسقط الفاصلة وما بعدها بالكامل من الذاكرة الحسابية للناتج النهائي المعروض في الخلية.
تضمن الخوارزمية الداخلية لدالة TEXTBEFORE سلامة البيانات من خلال الاقتطاع الحرفي التام للنصوص المحددة دون تعديل محتواها الداخلي؛ فهي لا تتدخل في المسافات أو المحارف الداخلية الواقعة ضمن نطاق الاقتطاع، بل تعيد النص بحالته الخام تماماً كما ورد قبل المحدد المذكور. هذا التناسق يجعلها أداة حاسمة في هندسة المعادلات المدمجة، حيث تعمل كمصفاة ختامية تعزل الشوائب اللاحقة بدقة رياضية متناهية.
2.3 التوافقية البرمجية ومتطلبات بيئة التشغيل
على الرغم من التفوق الوظيفي البالغ لدالتي TEXTAFTER وTEXTBEFORE، إلا أن استخدامهما مقيد ببيئات تشغيل محددة تقنياً. تتوفر هذه الدوال حصرياً في اشتراكات مايكروسوفت 365 (Microsoft 365) وإكسل للويب (Excel for the Web)، بالإضافة إلى إصدارات التجزئة الحديثة بدءاً من Office 2024 وما تلاها. ولا تدعم الإصدارات الأقدم مثل Excel 2019 أو 2016 أو 2013 هذه الدوال، حيث يؤدي فتح مصنف عمل يتضمنها في تلك الإصدارات القديمة إلى ظهور خطأ التسمية الشهير #NAME?، مما يجعل التحقق من بيئة التشغيل المستهدفة ضرورة منهجية قبل اعتماد هذه الحلول.
تعتمد هذه الدوال الحديثة بنيوياً على محرك الحساب الديناميكي المطور في إكسل، والذي يدعم مصفوفات الانسكاب (Spill Ranges). يوفر هذا المحرك كفاءة حسابية فائقة عبر استهلاك أدنى للذاكرة العشوائية (RAM) مقارنة بالصيغ الكلاسيكية المتداخلة؛ إذ يتعامل مع السلسلة النصية ككتلة معالجة واحدة موجهة نحو مؤشرات الذاكرة مباشرة، بدلاً من استدعاء دوال فرعية متكررة لحساب طول السلسلة ومواقع الأحرف في دورات معالجة منفصلة.
ينعكس هذا التحسين المعماري في تقليص زمن إعادة الحساب (Calculation Latency) داخل أوراق العمل الضخمة التي تحتوي على عشرات الآلاف من الصفوف الممتدة. فعندما تنخفض العمليات الحسابية الوسيطة من ثلاث أو أربع دوال متداخلة إلى دالتين مباشرتين، ينخفض العبء الحسابي على المعالج الدقيق (CPU)، مما يمنع تجمد واجهة البرنامج أثناء التمرير أو تحديث البيانات ويوفر استقراراً تشغيلياً عالياً للمنظومات الإحصائية والمالية المعقدة.
3. التطبيق العملي للصيغة المدمجة لاستخراج النص بين فاصلتين
3.1 تفكيك الصيغة المركبة: TEXTBEFORE مع TEXTAFTER
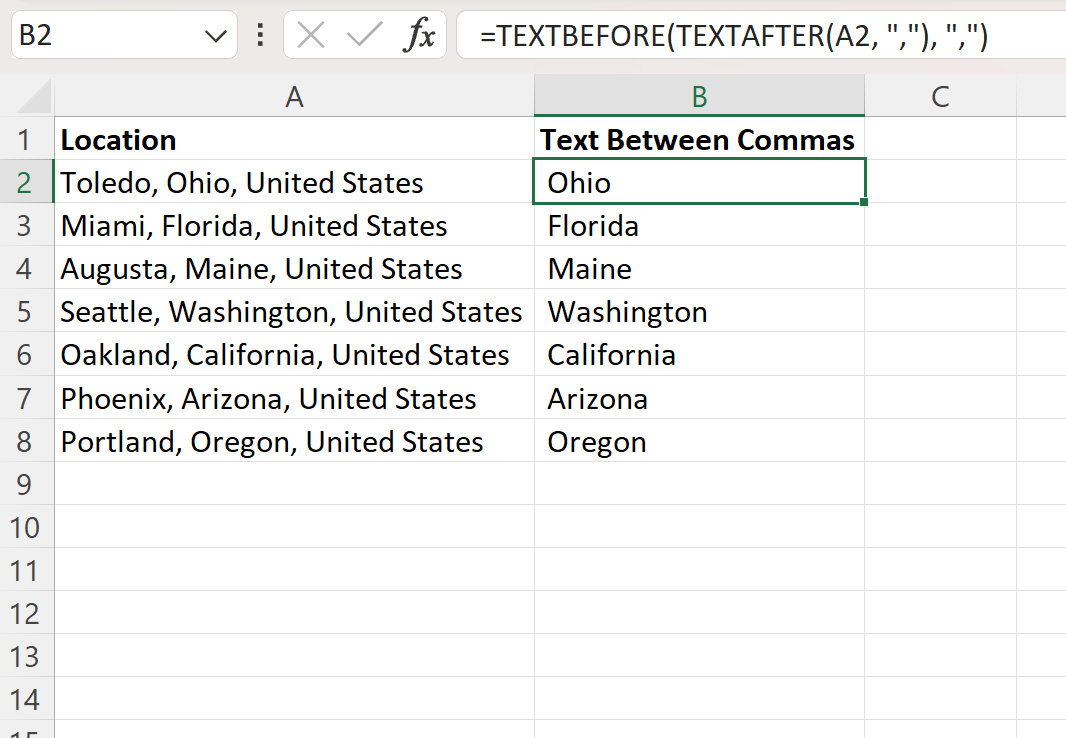
لتحقيق الغاية المنهجية بعزل النص المحصور بين فاصلتين داخل بيئة إكسل الحديثة، يتم دمج الدالتين في صيغة تركيبية متداخلة تعتمد منطق المعالجة المتسلسلة على مرحلتين. يتمثل المسار الرياضي للصيغة في توظيف الدالة الداخلية لتصفية الجزء الأولي من النص حتى الفاصلة الأولى، ثم تسليم الناتج الوسيط للدالة الخارجية لتصفيته عند الفاصلة الثانية. يوضح هذا التتابع المنطقي كيف يمكن للتراكيب البرمجية البسيطة حل أعقد المسائل النصية دون الحاجة إلى كود برمجي مخصص.
تتخذ الصيغة الرياضية النموذجية الشكل الإجرائي التالي:
=TEXTBEFORE(TEXTAFTER(A2, ","), ",")
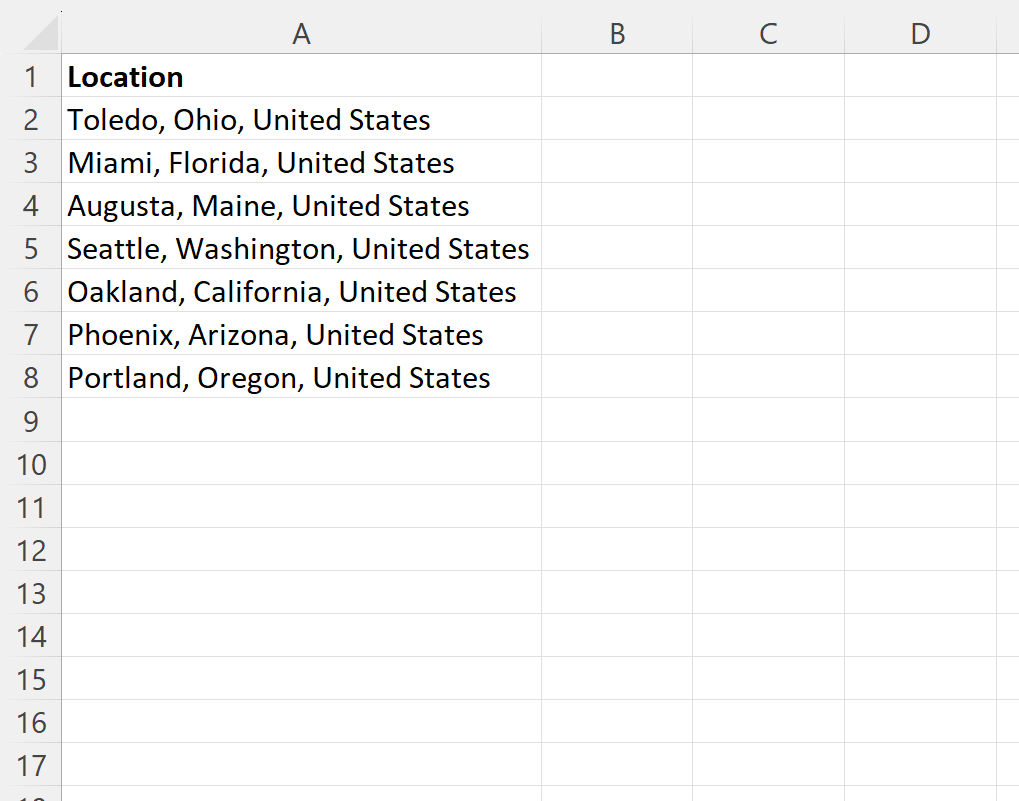
دعنا نفكك هذه الصيغة خطوة بخطوة عبر دراسة حالة تطبيقية لسجل جغرافي يقع في الخلية A2 ويحمل القيمة النصية: "شارع المعز, القاهرة, جمهورية مصر العربية":
- المرحلة الأولى (الدالة الداخلية): تُنفذ أولاً العملية
TEXTAFTER(A2, ",")، حيث تستهدف الدالة الفاصلة الأولى في السلسلة وتسقط كل ما يسبقها مع الفاصلة ذاتها. فيكون الناتج النصي الوسيط المتولد في الذاكرة هو:" القاهرة, جمهورية مصر العربية". - المرحلة الثانية (الدالة الخارجية): تستقبل الدالة
TEXTBEFOREذلك الناتج الوسيط وتتعامل معه كنص مدخل مستقل، وتبحث فيه عن الفاصلة الأولى المتاحة (والتي تمثل عملياً الفاصلة الثانية في السلسلة الأصلية). تقوم الدالة باقتطاع كل ما يقع قبل هذه الفاصلة وتتجاهل ما بعدها، ليكون الناتج النهائي المستخلص هو:" القاهرة".
هذا التكامل الرياضي الأنيق يعزل المتغير المستهدف بدقة متناهية ودون تدخل يدوي، محولاً السلسلة المعقدة إلى بيان جغرافي مفرد يمكن تصنيفه وفهرسته بصورة مستقلة تامة.
3.2 خطوات التنفيذ المنهجية وتعميم المعادلة
يتطلب التطبيق المؤسسي السليم للمعادلة اتباع مسار إجرائي منضبط يضمن دقة التنفيذ وتفادي أخطاء النقل والتعميم عبر مصفوفات البيانات الكبيرة. تبدأ الخطوات باختيار خلية الإخراج الموازية للخلية المصدرية (ولتكن B2 على سبيل المثال)، ثم إدخال الصيغة المركبة بدقة والتأكد من استخدام علامات التنصيص المزدوجة لاحتواء رمز الفاصلة "," لتعريفها كمعامل نصي وليس كفاصل بين وسائط الدالة البرمجية.
عقب إدخال الصيغة والضغط على مفتاح الإدخال (Enter)، يجب إخضاع النتيجة المستخرجة للفحص البصري الأولي للتأكد من انطباق الناتج على المعايير المستهدفة. لتعميم الصيغة على امتداد العمود البياني، يُنصح بالنقر المزدوج على مقبض التعبئة التلقائية (Fill Handle) الواقع في الزاوية اليسرى السفلى لخلية الهدف، مما يتيح لخوارزمية إكسل تكرار الصيغة تلقائياً حتى نهاية النطاق المتصل للبيانات دون الحاجة إلى السحب اليدوي المرهق والمعرض للانقطاع في المجموعات الضخمة.
يجب خلال عملية التعميم التحقق الصارم من صحة المراجع الخلوية؛ حيث تعتمد الصيغة المذكورة على المرجع النسبي A2 المجرد من علامات التثبيت الدولارية ($)، مما يسمح للصيغة بتحديث مرجع الصف ديناميكياً ليصبح A3 ثم A4 نزولاً مع كل صف إضافي. يضمن هذا الضبط المنهجي للمراجع النسبية معالجة كل سجل استناداً إلى بيانات صفه الخاص حصرياً وبأعلى درجات الموثوقية التشغيلية.
3.3 تكييف المعادلة عند وجود أكثر من فاصلتين في النص
في العديد من سيناريوهات البيانات الحقيقية، لا تقتصر السلسلة النصية على فاصلتين فقط، بل قد تمتد لتشمل بنية معقدة تحتوي على أربع أو خمس فواصل، مثل السجلات التي تتضمن: (الرقم التعريفي، الاسم الأول، اسم العائلة، المسمى الوظيفي، المدينة، الدولة). في مثل هذه البيئات المعقدة، تفشل الصيغة الافتراضية في استخراج المقاطع اللاحقة؛ لأنها مصممة مبدئياً لاقتناص النص الواقع بين الفاصلة الأولى والمطلقة والفاصلة الثانية فقط.
هنا يبرز الدور الحيوي لمعامل رقم الظهور instance_num لتوجيه مؤشرات الاقتطاع نحو النطاق المستهدف بدقة حسابية مطلقة. إذا كان الهدف المنهجي يقتضي عزل النص المحصور بين الفاصلة الثانية والفاصلة الثالثة، يتم تكييف الصيغة رياضياً بإدخال المعامل الإضافي على النحو التالي:
=TEXTBEFORE(TEXTAFTER(A2, ",", 2), ",")
يقوم المعامل الرقمي 2 في دالة TEXTAFTER بالقفز المباشر فوق الفاصلتين الأولى والثانية، متجاهلاً كافة المحارف التابعة لهما دفعة واحدة، ويبدأ السلسلة الوسيطة حصرياً من المحرف الواقع خلف الفاصلة الثانية مباشرة. بعد ذلك، تتولى دالة TEXTBEFORE اقتطاع النص الواقع قبل الفاصلة التالية مباشرة، وهي الفاصلة الثالثة في ترتيب السلسلة الأصلية الكلية.
يمكن وبالمثل توسيع هذا المنطق البرمجي لاستخراج المقطع المحصور بين الفاصلة الثالثة والرابعة عبر تعديل المعامل إلى 3، أو حتى عزل نصوص محددة بالعد العكسي من نهاية السلسلة باستخدام الأرقام السالبة (مثل -1 و-2). تمنح هذه المرونة لمحلل البيانات قدرة فائقة على تفكيك أشد السجلات النصية تعقيداً وضمان استقرار النتائج مهما تنامت أحجام السلاسل المحرفية وتعددت فواصلها داخل الخلية الواحدة.
4. معالجة المسافات البيضاء وتطهير البيانات المستخرجة
4.1 إشكالية المسافات الزائدة المحيطة بالنص المستخرج
تعد المسافات البيضاء الشاردة (Leading and Trailing Whitespace) من أخطر الملوثات الخفية في مجموعات البيانات النصية المستخرجة؛ إذ غالباً ما يُتبع الاستخدام الاصطلاحي للفاصلة في الكتابة اللغوية بمسافة مفردة تفصلها عن الكلمة اللاحقة. عند تطبيق دوال التجريد النصي مثل TEXTAFTER، فإن الدالة تقتطع النص بدءاً من المحرف التالي للفاصلة مباشرة، مما يعني استقطاع تلك المسافة كجزء أصيل من بداية النص المستخرج دون أن تكون مرئية بوضوح للعين المجردة داخل الخلية.
تتجلى الخطورة التقنية لهذه المسافات غير المرئية عند إخضاع البيانات المستخرجة لعمليات المطابقة والفهرسة الإحصائية المعتمدة على دوال الفئات والبحث، مثل VLOOKUP أو XLOOKUP أو دالتي INDEX وMATCH. تعتمد هذه الدوال على التطابق الثنائي التام للشفرات الرقمية للمحارف؛ وعليه، فإن القيمة " القاهرة" (المسبوقة بمسافة بيضاء من كود ASCII 32) تُعامل ككيان بياني مختلف كلياً ومستقل عن القيمة القياسية "القاهرة" الخالية من المسافات، مما يؤدي إلى فشل عمليات المطابقة وظهور خطأ القيمة غير المتوفرة #N/A بصورة متكررة تعطل المعالجات المؤسسية.
علاوة على ذلك، تفسد هذه المسافات غير المنتظمة عمليات الفرز الأبجدي، والتجميع في الجداول المحورية (Pivot Tables)، حيث تنقسم الفئة الجغرافية الواحدة إلى مجموعتين فرعيتين مستقلتين بسبب مسافة بادئة غير ملحوظة، مما يفقد التحليلات الإحصائية مصداقيتها ويشوه التوزيعات التكرارية للعينات المدروسة بصورة جذرية.
4.2 دمج دالة TRIM مع صيغة استخراج النصوص
لضمان التطهير المنهجي للنصوص المستخرجة وحمايتها من أخطاء المسافات المحيطة، يتحتم دمج دالة التطهير المعيارية TRIM لتطويق الصيغة التركيبية المستخرجة للنص. وتتمثل الوظيفة الحسابية لدالة TRIM في المسح الشامل لأطراف السلسلة النصية وإزالة كافة المسافات البادئة واللاحقة بصورة قطعية، مع التمييز الواعي بين تلك المسافات الشائبة والمسافات البينية التي تفصل بين الكلمات المكونة للمصطلح المركب.
يتبلور الهيكل الرياضي المطور للصيغة الشاملة على النحو التالي:
=TRIM(TEXTBEFORE(TEXTAFTER(A2, ","), ","))
تسلك دالة TRIM مساراً إجرائياً دقيقاً في معالجة مخرجات المعادلة المدمجة؛ فبعد أن تنتهي دالتا TEXTBEFORE وTEXTAFTER من حصر النص الأوسط واستخلاصه بكامل شوائبه، تتولى دالة TRIM فحص الناتج كمدخل نهائي، فتقوم بقص المسافة المتروكة خلف الفاصلة الأولى والمسافة السابقة للفاصلة الثانية على الفور.
الأمر البالغ الأهمية في السلوك الخوارزمي لدالة TRIM في إكسل هو حفاظها الصارم على المسافات المفردة الداخلية بين الكلمات؛ فإذا كان النص المحصور بين الفاصلتين اسماً مركباً مثل " نيويورك سيتي "، فإن الصيغة المطورة تزيل المسافات الخارجية التي تحيط بالاسم مع الإبقاء التام على المسافة الفاصلة بين كلمتي “نيويورك” و”سيتي”. يضمن هذا السلوك المعياري إنتاج بيانات مطهرة ومطابقة لأصول الإملاء اللغوي وقواعد النمذجة الإحصائية دون أي تدخل يدوي إضافي.
4.3 التحقق من سلامة النص المعالج مخبرياً
يقتضي المنهج الأكاديمي الصارم في إدارة البيانات إخضاع النتائج لاختبارات تحقق مخبرية تثبت كفاءة عملية التطهير وخلو المخرجات من أي محارف خفية قبل تصديرها للتحليل النهائي. يُعد الاختبار المعتمد على دالة قياس الأطوال LEN الأداة المخبرية المعيارية الأكثر دقة؛ حيث تقوم هذه الدالة بإحصاء العدد الدقيق للمحارف المكونة للسلسلة النصية متضمنة المسافات والرموز غير المرئية.
يمكن إجراء الفحص المخبري المنهجي عبر تطبيق معادلة قياس مقارنة في عمود مستقل على النحو الآتي:
=LEN(B2)
حيث يمثل B2 الخلية الحاوية على النص المستخرج والمطهر عبر دالة TRIM. تتم مقارنة الناتج الرقمي بالطول النظري الصافي للكلمة؛ فإذا كانت الكلمة المستخرجة هي “القاهرة”، يجب أن تعيد الدالة الرقم 7 تماماً. أي قيمة أعلى من ذلك (مثل 8 أو 9) تدق ناقوس الخطر بوجود مسافات لم يتم تنظيفها أو وجود محارف غير قابلة للطباعة تقتضي تدخلاً إضافياً بواسطة دوال أخرى متخصصة.
يُستكمل هذا التحقق عبر الاختبارات المنطقية الشرطية باستخدام دالة EXACT لمقارنة النص المستخرج بقيمة معيارية ثابتة:
=EXACT(B2, "القاهرة")
تضمن النتيجة المنطقية TRUE خلو المخرج من أي تباين في حالة الأحرف أو المسافات الدقيقة. إن توثيق هذه الفحوص المخبرية يمنح الباحث أو المحلل وثيقة إثبات قاطعة لجودة البيانات (Data Integrity)، وهو ما يرفع من موثوقية الدراسات الإحصائية المنشورة والتقارير التنفيذية المعدة لمتخذي القرار.
5. البدائل الكلاسيكية للإصدارات القديمة: دوال MID وFIND وSEARCH
5.1 المعادلة الكلاسيكية المركبة لتحديد مواقع الفواصل
في بيئات العمل المؤسسية التي تعتمد على إصدارات تاريخية من إكسل تسبق طرح تحديثات مايكروسوفت 365 (مثل Excel 2010 و2013 و2016 و2019)، تصبح الدوال الحديثة غير صالحة للعمل. يفرض هذا الواقع التقني اللجوء إلى المنظومة الرياضية الكلاسيكية القائمة على الدوال المثلثية والموضعية لمواقع الأحرف، وتحديداً دمج دالة الاقتطاع الموضعي MID مع التكرار الموجه لدالة البحث الفهرسي FIND.
ترتكز هذه المنهجية الكلاسيكية على حساب إحداثيات المواقع المطلقة للفواصل داخل الخلية بدقة رقمية مجردة. تبدأ العملية باستخدام دالة FIND لتحديد الموقع الترتيبي للفاصلة الأولى داخل السلسلة عبر الصيغة البسيطة:
FIND(",", A1)
تعيد هذه الدالة رقماً يمثل ترتيب الفاصلة الأولى انطلاقاً من المحرف الأول للخلية. ويكمن التحدي الأكبر في تحديد موقع الفاصلة الثانية؛ إذ لا تمتلك دالة FIND بمفردها القدرة على القفز التلقائي. للتغلب على ذلك، يتم بناء دالة FIND ثانية متداخلة مع الأولى، مع تفعيل المعامل الثالث للدالة start_num، والذي يحدد نقطة انطلاق البحث الجديد، ليتم ضبطه على موقع الفاصلة الأولى مضافاً إليه الرقم 1 لتجاوزها مباشرة:
FIND(",", A1, FIND(",", A1) + 1)
تحدد هذه التركيبة الرياضية الدقيقة الإحداثي الرقمي الحاسم للفاصلة الثانية؛ ومن ثم يصبح الفارق الحسابي بين ناتج المعادلة الثانية وناتج المعادلة الأولى مطروحاً منه الرقم 1 هو المعادل الرياضي الدقيق للطول المطلق للمقطع النصي الوسيط المحصور بينهما.
5.2 هيكلة وتطبيق دالة MID للاقتطاع الموضعي
عقب النجاح في تحديد إحداثيات البداية وحساب الطول الدقيق للمقطع، تتدخل دالة الاقتطاع الموضعي MID لتنفيذ عملية الجراحة النصية بدقة رياضية متناهية. تستقبل دالة MID ثلاثة معاملات رئيسية: النص المصدر، وموقع بداية الاقتطاع، وعدد المحارف المراد استخلاصها انطلاقاً من تلك البداية.
عند دمج كافة المكونات الحسابية السابقة ضمن صيغة موحدة ومطهرة بدالة TRIM، تتبلور الصيغة الكلاسيكية المعيارية العابرة لكافة إصدارات إكسل التاريخية بالشكل التالي:
=TRIM(MID(A1, FIND(",", A1) + 1, FIND(",", A1, FIND(",", A1) + 1) - FIND(",", A1) - 1))
تعمل هذه الصيغة المركبة عبر تناغم ميكانيكي دقيق يمكن تتبعه كالتالي:
- تحدد العبارة
FIND(",", A1) + 1نقطة البداية الدقيقة للنص المستهدف، متجاوزة الفاصلة الأولى مباشرة لتبدأ من الحرف الذي يليها. - تقوم العبارة الحسابية
FIND(",", A1, FIND(",", A1) + 1) - FIND(",", A1) - 1بحساب المسافة الفاصلة بين الفاصلتين، حيث يطرح موقع الفاصلة الأولى من موقع الفاصلة الثانية ثم يخصم الرقم 1 لضمان استبعاد الفاصلة الثانية ذاتها من مصفوفة الحساب. - تقتطع دالة
MIDعدد الأحرف المحسوب بدقة، ليقوم الغلاف الخارجي المتمثل فيTRIMبمسح أي مسافة فراغية متبقية.
تجدر الإشارة إلى الفارق المنهجي بين استخدام دالة FIND ودالة SEARCH في هذا السياق؛ فبينما تتسم FIND بحساسيتها المفرطة لحالة الأحرف (Case-sensitive)، تُعد SEARCH دالة عامة تتجاهل حالة الأحرف وتدعم استخدام الرموز البديلة (Wildcards). ومع أن هذا التمايز يظل عديم الأثر عند التعامل مع الفاصلة القياسية ","، إلا أنه يغدو مفصلياً في حال استبدال الفواصل بمحددات نصية أبجدية مركبة.
توجد صيغة كلاسيكية بديلة تعتمد على حشو المسافات (Space-Padding Method)، حيث يتم تضخيم الفواصل واستبدالها بمصفوفات طويلة من المسافات باستخدام دالتي SUBSTITUTE وREPT، ثم اقتطاع الشريحة الوسطى بواسطة MID وتطهيرها عبر TRIM:
=TRIM(MID(SUBSTITUTE(A1, ",", REPT(" ", 255)), 255, 255))
تقدم هذه الطريقة حلاً إبداعياً يتجاوز تكرار دوال FIND، مستغلة قدرة دالة TRIM الفائقة على ابتلاع مئات المسافات المتتالية وتصفية النص الأوسط بدقة.
5.3 تقييم العبء الحسابي والتعقيد التركيبي للصيغ التقليدية
رغم الكفاءة الوظيفية المطلقة للصيغة الكلاسيكية المعتمدة على MID وFIND وضمان عملها التام في أي إصدار من إكسل تم إنتاجه منذ منتصف ثمانينيات القرن الماضي وحتى اللحظة، إلا أنها تعاني من عيوب هيكلية جسيمة على صعيد الهندسة البرمجية وإدارة الموارد الحاسوبية.
يتمثل العيب الأول في التعقيد التركيبي الشاهق وصعوبة القراءة؛ حيث يصعب على مراجعي النماذج المالية ومحللي البيانات فك شفرة الصيغة بسرعة للتحقق من سلامتها المنطقية، كما ترتفع احتمالية إدخال أخطاء غير مقصودة بمعدل ينذر بالخطر عند محاولة تعديل إزاحات المؤشرات يدوياً. إن نسيان طرح الرقم 1 في نهاية معامل الطول كفيل باقتطاع الفاصلة الختامية ودمجها مع النص المستخرج، مما يفسد جودة البيانات بصمت دون توليد رسائل خطأ واضحة.
من زاوية كفاءة الأداء الحاسوبي، تفرض هذه الصيغة عبئاً مضاعفاً على وحدة المعالجة المركزية (CPU) في المصنفات الضخمة؛ إذ تتطلب الخلية الواحدة استدعاء دالة FIND ثلاث مرات منفصلة لتحديد إحداثيات ومسافات متكررة. عند تعميم هذه المعادلة على مئات الآلاف من الصفوف، تتضاعف دورات المعالجة لتصل إلى ملايين العمليات الحسابية المتزامنة، مما يؤدي إلى بطء ملحوظ في زمن إعادة حساب ورقة العمل (Workbook Recalculation Time) وزيادة استهلاك الطاقة التشغيلية للأجهزة، وهو ما يبرز التفوق الكاسح للدوال الحديثة التي تختزل هذا المسار في دورة معالجة داخلية واحدة ومباشرة.
6. استخراج النصوص بين الفواصل باستخدام أداة النص إلى أعمدة
6.1 مبادئ العمل عبر واجهة تحويل النص إلى أعمدة (Text to Columns)
تمثل أداة تحويل النص إلى أعمدة (Text to Columns) المدمجة في تبويب البيانات (Data Tab) في شريط أدوات إكسل أحد أعرق الحلول التفاعلية وأكثرها رسوخاً لتجزئة السلاسل النصية دون الحاجة إلى كتابة صيغ رياضية أو تراكيب برمجية. تعتمد فلسفة هذه الأداة على إخضاع النطاق المحدد لعملية تقسيم ميكانيكي تعتمد على المحددات الرمزية، وتوزيع المقاطع الناتجة على خلايا مجاورة ومستقلة وفق مسار توجيهي منضبط.
تتطلب البداية المنهجية لتطبيق الأداة تحديد كامل العمود البياني المراد تفكيكه، ثم النقر على أيقونة “النص إلى أعمدة” لفتح معالج التحويل التفاعلي المكون من ثلاث خطوات رئيسية. في الخطوة الأولى، يتعين على المحلل اختيار نمط الفصل المحدد بمحارف (Delimited) بدلاً من النمط ذي العرض الثابت (Fixed Width)؛ وذلك لمراعاة التباين الطبيعي في أطوال النصوص والكلمات المكونة للسجلات المختلفة.
في الخطوة الثانية من المعالج، يتم تحديد الفاصلة (Comma) كرمز رئيسي وحصري لعملية الفصل، مع إلغاء تحديد كافة الرموز الأخرى كالمسافات وعلامات الجدولة لضمان عدم تفتيت الكلمات المركبة داخل المقاطع المستهدفة. تتيح نافذة المعاينة السفلية مراجعة بصرية فورية لشكل خطوط الفصل الرأسية التي يقترحها البرنامج لتقسيم السلسلة النصية إلى ثلاثة أعمدة منفصلة: ما قبل الفاصلة الأولى، وما بين الفاصلتين، وما بعد الفاصلة الثانية.
6.2 إدارة الأعمدة الزائدة والاحتفاظ بالنص الأوسط فقط
تتجلى الحرفية المنهجية في استخدام هذه الأداة خلال الانتقال إلى الخطوة الثالثة والأخيرة من معالج التحويل؛ حيث يواجه المحلل إشكالية توليد أعمدة فائضة غير مرغوب فيها تضم المقطعين الأول والأخير المحيطين بالنص الأوسط المستهدف. يوفر إكسل خياراً برمجياً بالغ الذكاء لتجاوز هذه المعضلة عبر خاصية “عدم استيراد العمود – تخطي” (Do not import column – Skip).
لتطبيق هذا الإجراء الوقائي، يتم النقر على العمود الأول في نافذة المعاينة التفاعلية وتفعيل خيار التخطي، ثم تكرار الإجراء ذاته على العمود الثالث، مع الإبقاء على العمود الأوسط بصيغته النصية القياسية. يضمن هذا الإعداد إسقاط الأطراف الزائدة من عملية التفريغ وحجبها نهائياً عن ورقة العمل، مما يوفر مساحات الأعمدة ويمنع تشتت الهيكل العام للمصنف البياني.
بالإضافة إلى ذلك، تقتضي قواعد السلامة ضبط حقل الوجهة (Destination) بحذر شديد؛ فالإعداد الافتراضي للبرنامج يستهدف الكتابة فوق الخلية المصدرية الأصلية (A2)، مما يؤدي إلى محو البيانات الخام وتدميرها بصورة لا رجعة فيها. يجب توجيه مسار الوجهة إلى عمود فارغ مجاور (مثل B2)، مما يحافظ على السجلات الأصلية سليمة كمرجع توثيقي دائم، مع تنسيق العمود المستورد بتنسيق “نص” (Text) لحماية السجلات من أي تحويل تلقائي مشوه، كتحويل الأرقام المسبوقة بأصفار أو التواريخ إلى صيغ حسابية غير مرغوبة.
6.3 الموازنة المنهجية بين الحلول التفاعلية والصيغ الحسابية
يقوم التقييم المقارن بين أداة النص إلى أعمدة والصيغ الحسابية على موازنة دقيقة بين ثنائية السرعة الفورية وديناميكية التحديث المستمر. تتميز أداة النص إلى أعمدة بتقديم حل فوري وجذري لا يثقل كاهل مصنف العمل بأي معادلات حسابية مستمرة في الذاكرة العشوائية؛ فالبيانات الناتجة عنها هي قيم نصية ثابتة ومجردة لا تتطلب أي طاقة معالجة لاحقة.
تعد الأداة الخيار المثالي والأنسب في الحالات التي تتطلب معالجة لمرة واحدة لمصنفات تاريخية مغلقة أو عند استيراد مجموعات بيانات ضخمة لا يُتوقع إدخال أي تعديلات مستقبلية على سجلاتها. في مثل هذه البيئات الساكنة، يتفوق التحويل اليدوي في تحقيق أعلى كفاءة حفظ وأخف حجم ممكن لملف العمل.
على النقيض من ذلك، يكمن القصور الجوهري للأداة في طبيعتها الساكنة غير القابلة للتحديث التلقائي؛ فإذا طرأ أي تغيير على النص الأصلي في الخلية المصدرية أو تمت إضافة صفوف بيانية جديدة، تظل المخرجات المستخرجة مسبقاً متجمدة عند حالتها القديمة دون أي استجابة. يتطلب تدارك ذلك إعادة فتح المعالج وإجراء كامل الخطوات اليدوية من جديد، وهو ما يجعل الاعتماد عليها خطراً في النماذج التشغيلية النشطة واللوحات الرقابية اليومية، حيث ترجح كفة الصيغ الديناميكية التي تضمن التزامن اللحظي للبيانات.
7. توظيف أداة التعبئة السريعة (Flash Fill) للتعرف الذكي على الأنماط
7.1 الأسس الخوارزمية لخاصية Flash Fill في إكسل
تمثل خاصية التعبئة السريعة (Flash Fill)، التي أدرجتها مايكروسوفت لأول مرة في إصدار Excel 2013، تطبيقاً عملياً متقدماً لخوارزميات التعلم الآلي المبسط والتعرف على الأنماط (Pattern Recognition) داخل واجهة جداول البيانات. لا تعتمد هذه الخاصية على أي شفرة برمجية صريحة يكتبها المستخدم، بل تقوم على محرك ذكاء اصطناعي داخلي يراقب سلوك الإدخال ويحلل الفوارق التركيبية بين السلسلة المصدرية والمثال البشري المقدم.
لتفعيل الميكانيكية الخوارزمية للأداة لاستخراج النص الواقع بين فاصلتين، يكتفي المحلل بكتابة القيمة المستهدفة للخلية الأولى يدوياً في العمود المجاور تماماً للسجل المصدر. على سبيل المثال، إذا كانت الخلية A2 تحتوي على: "أحمد, محاسب, القاهرة"، يكتب المستخدم في الخلية B2 الكلمة الوسطى: "محاسب" حصراً، ثم ينتقل إلى الخلية B3 في الصف التالي.
بمجرد البدء في كتابة الحرف الأول من الكلمة الوسطى للسجل الثاني، أو عبر الضغط المباشر على الاختصار الكلاسيكي الفوري Ctrl + E (أو النقر على زر التعبئة السريعة في تبويب بيانات)، ينشط المحرك الخوارزمي لمسح العمود بالكامل. يقوم النظام بمقارنة المثال اليدوي بالسلسلة الأصلية، مستنتجاً أن المستخدم يرغب في اقتطاع المحتوى الواقع بدقة بين الفاصلة الأولى والفاصلة الثانية، فيقوم بتعميم هذا الاستنتاج واستخراج النصوص المقابلة لكافة الصفوف في جزء من الثانية.
7.2 شروط النجاح وحدود الاعتمادية في تحليل النصوص
تتوقف كفاءة وموثوقية أداة التعبئة السريعة على مدى تجانس البنية الهيكلية للبيانات النصية عبر كامل امتداد العمود المعالج؛ فالخوارزمية تفترض ضمناً أن النمط المكتشف في الصف الأول يمثل قاعدة عامة ومطردة تحكم كافة الصفوف اللاحقة بلا استثناء. إذا احتوت كافة السجلات على فاصلتين تفصلان بين ثلاثة عناصر متجانسة، تحقق الأداة نسبة نجاح مطلقة تقارب الكمال الحسابي.
تكمن حدود الاعتمادية ومخاطر الفشل عندما تتسلل سجلات شاذة أو غير متسقة إلى مصفوفة البيانات؛ كأن يحتوي أحد الصفوف على فاصلة واحدة فقط، أو يتضمن صف آخر أربع فواصل، أو تتداخل فواصل في نصوص فرعية محاطة بأقواس. في هذه السيناريوهات المعقدة، يعجز المحرك الاستدلالي عن التمييز المنطقي، وقد يولد نتائج خاطئة تماماً كأن يقتطع أجزاء من الاسم أو يدمج مقطعين معاً دون إشعار تحذيري صريح للمستخدم.
يفرض هذا القصور البنيوي ضرورة منهجية للتدقيق البصري الصارم وأخذ عينات عشوائية منتظمة من مختلف قطاعات العمود المستخرج للتحقق من سلامة الأنماط المنفذة. وتبرز القاعدة الأكاديمية الصارمة هنا بأنه لا ينبغي أبداً تفويض خوارزميات التعرف على الأنماط لمعالجة قواعد البيانات الحساسة أو التحليلات الطبية والمالية الحرجة دون إخضاع المخرجات لاختبارات تدقيق منطقية مؤتمتة تسند موثوقية النتائج وتستبعد الانحرافات الخوارزمية.
7.3 المقارنة التحليلية بين التعبئة السريعة والدوال البرمجية
يوضح التحليل المقارن بين التعبئة السريعة والدوال الحسابية تمايزاً جذرياً في الأهداف التشغيلية وحالات الاستخدام الأنسب داخل بيئات إدارة البيانات. تتفوق التعبئة السريعة بصورة مطلقة في عنصر السرعة وسهولة الاستخدام اللحظي؛ إذ تتيح للمستخدم إنجاز عمليات تجريد بالغة التعقيد في غضون ثوانٍ معدودة دون الحاجة لمعرفة أسماء الدوال أو التفكير في إزاحات الفهارس الرياضية وضبط معاملات المسافات.
وعلى النقيض التام من ذلك، تفتقر مخرجات التعبئة السريعة لأي شكل من أشكال الارتباط الديناميكي بمصدر البيانات؛ فالقيم الناتجة هي نصوص ميتة حسابياً ومقطوعة الصلة بالسجلات الأصلية. إذا صُحح خطأ إملائي في السجل المصدر، يظل الناتج المستخرج بالتعبئة السريعة محتفظاً بالخطأ القديم، مما يستوجب مسح العمود وإعادة التوليد يدوياً، وهو ما يتعارض كلياً مع مبادئ النماذج المستدامة.
تثبت الدوال البرمجية (سواء الحديثة أو الكلاسيكية) أفضليتها المطلقة كحل مؤسسي مستدام يضمن النزاهة الهندسية للبيانات. توفر المعادلات خط أنابيب متصل يضمن التحديث الفوري والتلقائي للمخرجات فور تعديل المدخلات، مما يجعلها الخيار الإلزامي والوحيد لبناء القوالب المتكررة، ونظم التقارير التفاعلية، ومصنفات العمل المشتركة التي تتطلب اتساقاً مطلقاً وتحديثاً ذاتياً لا يقبل الاعتماد على تدخل بشري لاحق.
8. معالجة وتحويل البيانات المتقدمة باستخدام Power Query
8.1 استيراد البيانات وتهيئة بيئة محرر Power Query
تمثل بيئة محرر Power Query الأداة الأكثر احترافية وقوة في منظومة مايكروسوفت لمعالجة وتنقية وتجهيز البيانات (ETL: Extract, Transform, Load). تختلف هذه الأداة بنيوياً عن الدوال الجداولية العادية؛ إذ توفر بيئة معزولة تماماً تتيح للمحلل إجراء تحويلات هيكلية عميقة على مجموعات البيانات الضخمة دون المساس بسلامة المصنف الأصلي أو إرهاق ذاكرة الحساب المباشرة للبرنامج.
تبدأ الخطوات المنهجية بتحويل النطاق النصي المصدر إلى جدول رسمي معتمد داخل إكسل عبر الضغط على Ctrl + T، مما يمنح البيانات هيكلية جدولية ديناميكية تتسع تلقائياً لكل صف جديد. عقب ذلك، يتم توجيه المسار إلى تبويب “بيانات” واختيار “من ورقة/جدول” (From Sheet/Table) لتدفق البيانات مباشرة إلى نافذة محرر Power Query المستقلة، حيث تبدأ رحلة التحويل المنهجي المسجل.
تعتمد قوة Power Query على لغة البرمجة المدمجة المعروفة باسم M Language، والتي تقوم بتوثيق وتسجيل كل خطوة تحويل كإجراء خوارزمي متسلسل يمكن تتبعه وتعديله في أي وقت. يوفر هذا التسجيل التلقائي ميزة الشفافية الإجرائية وإمكانية تدقيق ومراجعة خطوات التنقية بدقة أكاديمية، مع ضمان تكرار نفس المعالجات البرمجية تلقائياً على أي دفعات جديدة من البيانات في المستقبل دون أدنى تدخل بشري إضافي.
8.2 تطبيق خطوة تقسيم العمود استناداً إلى المحدد
داخل واجهة المحرر المتقدمة، يُنفذ استخراج النص المحصور بين فاصلتين عبر خطوة تقسيم العمود الممنهجة. يتم تحديد العمود المستهدف والنقر بزر الفأرة الأيمن لاختيار “تقسيم العمود” (Split Column)، ومن ثم اختيار “بواسطة المحدد” (By Delimiter). يفتح المحرر نافذة إعدادات دقيقة تسمح باختيار الفاصلة القياسية Comma كمحدد رئيسي، مع تفعيل خيار التقسيم عند “كل تكرار للمحدد” (At each occurrence of the delimiter).
بمجرد تأكيد الأمر، يقوم المحرك الخوارزمي لـ Power Query بتفكيك العمود النصي فورياً إلى ثلاثة أعمدة جديدة تحمل أسماء متسلسلة تلقائية: Column1.1 وColumn1.2 وColumn1.3. يمثل العمود الوسيط الثاني القيمة النصية المستهدفة التي كانت محصورة بدقة بين الفاصلة الأولى والفاصلة الثانية، بينما يمثل الأول والثالث الأطراف المحيطة بها.
لتحقيق أعلى معايير النقاء للبيانات المستخرجة، يُحدد العمود الأول والثالث ويتم حذفهما عبر خيار “إزالة الأعمدة” (Remove Columns)، ليبقى العمود الأوسط وحيداً في مصفوفة العرض. بعد ذلك، يتم تطبيق أوامر التنظيف المدمجة عبر النقر الأيمن على رأس العمود المتبقي والولوج لقائمة “تحويل” (Transform) لتفعيل أمرين محوريين:
- أمر التطهير (Trim): لإزالة كافة المسافات البيضاء البادئة واللاحقة المحيطة بالنص المستخرج نهائياً وبنقرة واحدة.
- أمر التنظيف (Clean): لمسح أي محارف غير قابلة للطباعة أو فواصل أسطر برمجية مخفية قد تكون عالقة بالنص الأصلي.
8.3 أتمتة التحديث وإدارة خطوط أنابيب البيانات المتكررة
عقب إتمام خطوات التجزئة والتطهير وإعادة تسمية العمود المستخرج باسم دلالي معبر (مثل: “المحافظة” أو “القسم المستهدف”)، تأتي الخطوة الختامية المتمثلة في تصدير البيانات المطهرة. يتم النقر على أيقونة “إغلاق وتحميل إلى” (Close & Load To) لاختيار تفريغ النتائج كجدول جديد في ورقة عمل مخصصة، حيث يتم إنشاء خط أنابيب بيانات متكامل ومستقل يربط المصدر الخام بالمخرج المنقى.
تتجلى القوة الهندسية الحقيقية لـ Power Query في الموثوقية العالية والأتمتة المطلقة لتحديث السجلات؛ فإذا أضاف المستخدم آلاف الصفوف الجديدة في الجدول المصدر في ورقة العمل الرئيسية، فلن يتطلب الأمر إعادة كتابة صيغ أو سحب معادلات. يكتفي المحلل بالانتقال إلى جدول المخرجات والنقر بزر الفأرة الأيمن لاختيار “تحديث” (Refresh)، أو الضغط على الاختصار Ctrl + Alt + F5.
في تلك اللحظة، يعيد المحرك استدعاء شفرة M المسجلة وينفذ كافة خطوات التقسيم والحذف والتطهير على السجلات الجديدة بسرعة فائقة، ثم يفرغ النتائج المنقاة تلقائياً في الجدول دون أدنى فرصة للخطأ الإنساني. هذا المستوى العالي من الاستقرار والأتمتة يجعل Power Query الخيار المنهجي الأوحد والمعتمد عالمياً في إدارة المشاريع الأكاديمية الضخمة، والأنظمة المالية المركزية، والبيئات المؤسسية التي تتعامل مع تدفقات بيانات حية ومستمرة.
9. معالجة الحالات الاستثنائية وتصحيح الأخطاء الشائعة
9.1 التعامل مع الخلايا التي تحتوي على فاصلة واحدة أو تفتقر للفواصل
من المسلمات المنهجية في تنقية البيانات الواقعية أن المصفوفات النصية نادراً ما تتسم بالكمال المطلق؛ إذ كثيراً ما تتسلل خلايا تفتقر إلى البنية التركيبية المفترضة، كأن تحتوي الخلية على فاصلة واحدة فقط، أو تكون عبارة عن نص مصمت خالٍ تماماً من أي فواصل، أو حتى خلية فارغة بالأساس. يؤدي تطبيق الصيغ النصية المجردة على مثل هذه السجلات الشاذة إلى انهيار المعادلة وتوليد أخطاء برمجية مثل خطأ القيمة #VALUE! في الصيغ الكلاسيكية، أو خطأ عدم التوفر #N/A أو #CALC! في الدوال الحديثة.
لتطويق هذه الإشكالية في الدوال الحديثة، يُستثمر المعامل المدمج المتقدم if_not_found المتاح داخل دالتي TEXTAFTER وTEXTBEFORE. يتيح هذا المعامل تحديد مخرج منطقي بديل ومرن يتولد تلقائياً في حال تعذر العثور على المحدد المطلوب، مما يحمي ورقة العمل من التلوث بالأخطاء البرمجية:
=TEXTBEFORE(TEXTAFTER(A2, ",", 1, , , ""), ",", 1, , , "")
يقوم هذا الضبط بإرجاع نص فارغ "" فوراً وبسلاسة تامة إذا افتقرت الخلية لأي من الفاصلتين دون أن تتوقف دورة الحساب.
أما في المنظومة الكلاسيكية المعتمدة على MID وFIND، يتحتم تغليف المعادلة بالكامل داخل دالة معالجة الأخطاء الشاملة IFERROR، لتأمين الاستقرار الحسابي للمصنف على النحو الآتي:
=IFERROR(TRIM(MID(A1, FIND(",", A1) + 1, FIND(",", A1, FIND(",", A1) + 1) - FIND(",", A1) - 1)), "بيانات غير مكتملة")
تضمن هذه الحصانة البرمجية استمرار عمل كافة العمليات التحليلية التابعة، وتوفر للمحلل مؤشراً بصرياً فورياً يحدد السجلات التي تحتاج إلى مراجعة وتدقيق يدوي لاستكمال محدداتها المفقودة.
9.2 معالجة النصوص المحتوية على فواصل اقتباس أو فواصل شاذة
من أعقد الحالات الاستثنائية التي تواجه مهندسي البيانات تلك النصوص التي تتضمن فواصل فرعية تقع داخل مقاطع محاطة بعلامات تنصيص؛ كأن يكون النص المصدر عبارة عن سجل تجاري مكتوب بصيغة: "شركة الأمل, قسم التوزيع, المبيعات والتسويق, القاهرة"، حيث تكون الفاصلة الواقعة بين “المبيعات” و”التسويق” جزءاً لغوياً من اسم القسم وليست محدد تقسيم جدولياً. إن تطبيق خوارزميات الاستخراج الافتراضية هنا سيؤدي حتماً إلى تفتيت اسم القسم واقتطاع شطر غير مقصود منه.
يتطلب الحل المنهجي لهذه المعضلة مرحلة تحويل وسيطة تعتمد على استبدال المحددات الشاذة مؤقتاً عبر دالة الاستبدال الموضعي SUBSTITUTE. يتم تحديد الفواصل الفرعية التي يجب حمايتها واستبدالها برمز نادر الوجود في النصوص الطبيعية (مثل رمز التيلدا ~ أو رمز الأنبوب |)، وذلك قبل تطبيق معادلة الاستخراج الرئيسية، ثم إعادة استرجاع الفاصلة الأصلية بعد اكتمال العزل.
تتكامل هذه المنهجية لمعالجة الفواصل اللغوية المتداخلة، مثل مواقف الخلط بين الفاصلة الإنجليزية , والفاصلة العربية المقلوبة ،. في هذه الحالات، يجب توحيد المحددات أولاً عبر صيغة تطهير استباقية تستبدل كافة الفواصل العربية بفواصل إنجليزية قياسية:
=SUBSTITUTE(A1, "،", ",")
تضمن هذه المعالجة الأولية اتساق المعيار الرمزي عبر كامل المصفوفة البيانية، مما يتيح لخوارزميات الاستخراج اللاحقة العمل بكفاءة مطلقة ودون أي انحراف عن المسار المستهدف.
9.3 معالجة تفاوت عدد المسافات والأسطر داخل الخلية
تنشأ تشوهات بصرية وهيكلية جسيمة في البيانات المستخرجة عندما تقترن الفواصل بفواصل أسطر برمجية ناتجة عن إدخال البيانات عبر اختصار الانتقال لسطر جديد داخل الخلية (Alt + Enter). يحتوي هذا النمط على محارف غير قابلة للطباعة تحمل الرمز الشفري CHAR(10) في بيئة ويندوز أو CHAR(13) في أنظمة ماكنتوش، وتظل هذه المحارف عالقة في النص حتى بعد استخدام دالة TRIM، مسببة تباعداً رأسياً مشوهاً في عرض الصفوف.
تستلزم المعالجة المنهجية لهذه الشوائب إدماج دالة التنظيف العميق CLEAN جنباً إلى جنب مع دالة TRIM. تتخصص دالة CLEAN في المسح الفوري والإلغاء الحسابي لأول 32 محرفاً غير قابل للطباعة في نظام ترميز ASCII القياسي ذي السبعة بتات، مما يزيل فواصل الأسطر نهائياً ويحول النص المستخرج إلى مصفوفة خطية متصلة.
يتبلور التكوين البرمجي المحصن بالكامل للتعاطي مع هذه البيئات الملوثة بالشكل التالي:
=TRIM(CLEAN(TEXTBEFORE(TEXTAFTER(A2, ","), ",")))
يقوم هذا التركيب الثلاثي أولاً باستخلاص النص المحصور بين الفاصلتين، ثم يزيل فواصل الأسطر والمحارف التحكمية غير المرئية عبر CLEAN، ويختتم العملية بإزالة المسافات الهامشية وتوحيد الفراغات الداخلية عبر TRIM. يضمن هذا الإجراء الصارم خروج النص في أنقى صورة ممكنة، متطابقاً تماماً مع متطلبات المعالجة الآلية وقواعد البيانات المركزية.
10. أفضل الممارسات المنهجية لضمان سلامة وجودة البيانات النصية
10.1 تصميم خطط معالجة البيانات النصية وتوثيقها
تقتضي الرصانة الأكاديمية والمهنية في مشاريع تنقية البيانات وضع خطة هندسية واضحة وموثقة قبل الشروع في كتابة أي معادلة أو تشغيل أي أداة تجزئة. تبدأ أولى القواعد الذهبية بإنشاء نسخة احتياطية مستقلة ومجمدة من ملف البيانات الخام وحفظها في مسار آمن مع حمايتها من الكتابة (Read-Only)؛ وذلك لضمان وجود مرجع أصلي دائم لا يطاله التعديل يمكن الرجوع إليه لمطابقة النتائج أو إعادة بناء المعالجات عند حدوث أخطاء غير متوقعة.
يجب أن تتضمن خطة العمل توثيقاً دقيقاً لكافة الصيغ والمسارات البرمجية المعتمدة في ورقة عمل مخصصة لتوثيق البيانات (Data Dictionary / Methodology Log). يُسجل في هذه الوثيقة المنطق البرمجي لكل معادلة، وتوضيح أسباب اختيار دوال معينة دون غيرها، وشرح كيفية التعامل مع الحالات الاستثنائية والرموز الشاذة. يسهم هذا التوثيق المؤسسي في تسهيل استيعاب النماذج وتدقيقها من قِبل محللين آخرين، ويضمن استدامة النموذج وقابليته للتطوير عند غياب منشئه الأصلي.
علاوة على ذلك، ينبغي الالتزام بنظام تسميات معياري وصارم لكافة الأعمدة المستخرجة والحقول الوسيطة؛ فبدلاً من ترك التسميات التلقائية المبهمة مثل Column1 أو مراجع الخلايا، يجب استخدام أسماء حقول ذات دلالة وصفية لا لبس فيها، مثل Cleaned_Subdivision_Name أو Middle_Token_Extracted. يعزز هذا الانضباط المعياري من مقروئية البيانات ويقلل من احتمالية توظيف الحقول الخطأ في مراحل التحليل اللاحقة.
10.2 تحسين الأداء الحسابي في مصنفات العمل الضخمة
عندما تتسع مجموعات البيانات لتشمل مئات الآلاف أو ملايين الصفوف، تصبح إدارة الأداء الحسابي مسألة وجودية للمشروع التحليلي؛ فالاحتفاظ بآلاف الصيغ النصية المعقدة في حالة عمل دائمة يستهلك قدراً هائلاً من ذاكرة النظام، ويؤدي إلى تجمد البرنامج عند كل تعديل بسيط في أي خلية نتيجة تفعيل إعادة الحساب التلقائي لكامل المصنف.
تتمثل الممارسة الفضلى بعد إتمام عمليات الاستخراج والتحقق المخبري من دقتها، في تحويل تلك الصيغ البرمجية إلى قيم نصية صامتة وثابتة. يتم ذلك عبر تحديد عمود النتائج، ونسخه (Ctrl + C)، ثم إعادة لصقه فوق النطاق ذاته كقيم حصراً (Paste Special as Values) عبر الاختصار الشهير Ctrl + Shift + V أو من خلال القوائم المخصصة. يؤدي هذا الإجراء الحاسم إلى إعفاء المعالج من أي عبء حسابي مستقبلي ويقلص حجم الملف على القرص الصلب بصورة ملموسة.
إذا كانت طبيعة العمل تفرض الإبقاء على المعادلات ديناميكية لتحديث السجلات الجديدة دورياً، يُنصح بشدة بتحويل نطاق البيانات إلى جدول إكسل رسمي (Excel Table). توفر الجداول الرسمية ميزة المراجع المهيكلة (Structured References) وتضمن نشر الصيغ تلقائياً للصفوف المستحدثة، مع إدارة محسنة لاستهلاك الذاكرة مقارنة بالنطاقات العشوائية المفتوحة. كما ينبغي تجنب استخدام الدوال المتقلبة (Volatile Functions) داخل أو بجوار معادلات التجريد النصي، لحماية المصنف من بطء دورات إعادة الحساب المتسلسلة.
10.3 دليل اتخاذ القرار لاختيار التقنية الأمثل للاستخراج
لتمكين محلل البيانات من اتخاذ القرار التقني الصائب والمفاضلة الموضوعية بين مختلف الأدوات والأساليب التي تناولتها هذه الدراسة، تم بناء مصفوفة مقارنة منهجية تحدد الأسلوب الأمثل وفقاً لظروف بيئة العمل وحجم وطبيعة تدفق البيانات المتوفرة:
| التقنية المستخدمة | الإصدار المطلوب | طبيعة المخرجات | التعقيد الحسابي | الاستخدام الأمثل والبيئة المستهدفة |
|---|---|---|---|---|
| TEXTBEFORE مع TEXTAFTER | Microsoft 365 / Excel 2024 | ديناميكية لحظية | منخفض جداً | النماذج المعاصرة النشطة والتقارير التي تتطلب صيانة مرنة وسرعة تنفيذ فائقة. |
| MID المتداخلة مع FIND | كافة الإصدارات (منذ 1985) | ديناميكية لحظية | مرتفع | المصنفات التي تتطلب توافقاً مطلقاً مع إصدارات قديمة أو بيئات عمل غير محدثة. |
| النص إلى أعمدة (Text to Columns) | كافة الإصدارات | ثابتة وساكنة | منعدم (أداة واجهة) | المهام السريعة لمرة واحدة للملفات التاريخية التي لا يُتوقع تحديث سجلاتها. |
| التعبئة السريعة (Flash Fill) | Excel 2013 والإصدارات اللاحقة | ثابتة وساكنة | منعدم (ذكاء اصطناعي) | التنقية الفورية الخفيفة لقوائم متجانسة تماماً خارج إطار التقارير الرسمية الحرجة. |
| محرر Power Query | Excel 2016+ / ملحق لـ 2010 و2013 | مؤتمتة وقابلة للتحديث | معزول في الذاكرة | المشاريع الأكاديمية الكبرى، وتدفقات البيانات المتكررة، والمستودعات المؤسسية الضخمة. |
تتلخص التوصيات الختامية في ترجيح كفة الدوال الحديثة (TEXTBEFORE وTEXTAFTER) كمعيار هندسي أول للمستخدمين المجهزين بالبيئات السحابية المحدثة لما توفره من وضوح تركيبي وصيانة برمجية خفيفة. في المقابل، يظل إتقان الصيغ الكلاسيكية القائمة على MID وFIND صمام أمان لا غنى عنه للمحلل المحترف لضمان القدرة على إدارة وصيانة النماذج المحاسبية التراثية وتأمين التوافقية العابرة للمنصات. وعندما يتعلق الأمر ببناء بنى تحتية مؤسسية دائمة لمعالجة تدفقات البيانات الضخمة، فإن محرر Power Query يبرز كحل استراتيجي متكامل لا منازع له يضمن أعلى معايير الجودة والاستقرار والأتمتة في بيئات العمل الأكاديمية والمهنية المتقدمة.
خاتمة
استعرضت هذه الدراسة الأكاديمية الشاملة الأبعاد النظرية والتطبيقية لإشكالية استخراج النص المحصور بين فاصلتين داخل برنامج مايكروسوفت إكسل، كواحدة من أدق العمليات المفصلية في مسار هندسة وتنقية البيانات الرقمية. وقد تبين بجلاء أن التعاطي الفعال مع هذه الإشكالية يتجاوز مجرد الحفظ السطحي لصيغة حسابية، ليتطلب استيعاباً عميقاً للمنطق البرمجي لحركة المؤشرات الفهرسية، وكيفية التعامل مع المحددات الرمزية، والتداعيات الحسابية المرتبطة باستهلاك موارد المعالج والذاكرة عبر مختلف إصدارات البرنامج.
وقد كشف التحليل المنهجي عن النقلة النوعية التي أحدثتها دوال استقطاع النصوص الحديثة المتمثلة في دالتي TEXTAFTER وTEXTBEFORE، وما قدمته من اختزال جذري للتعقيد التركيبي الذي لازم الصيغ الكلاسيكية لعقود عبر دمج MID وFIND. كما أظهرت المقارنة المكانة التخصصية التي تحتلها الأدوات التفاعلية كالتعبئة السريعة وميزة النص إلى أعمدة في إنجاز المهام الاستثنائية، في مقابل السيادة المطلقة لمنظومة Power Query كخط أنابيب مؤسسي مؤتمت يضمن سلامة المعالجة وجودة المخرجات في قواعد البيانات الضخمة المعرضة لتدفقات متجددة.
إن المعيار الحاسم لنجاح المحلل في إدارة هذه العمليات يكمن في قدرته على تقييم بيئة العمل وخصائص المصفوفة البيانية المستهدفة لاختيار الأسلوب التقني الأمثل، مع الالتزام الصارم بقواعد التطهير عبر إدماج دوال تنظيف المسافات والمحارف الخفية، وتوثيق المسارات الإجرائية وفق المعايير المؤسسية الرصينة. وبذلك تتحول عملية عزل النصوص من مجرد إجراء يدوي معرض للأخطاء إلى منهجية برمجية محصنة تضمن تحويل البيانات الخام المشتتة إلى ركائز معلوماتية عالية الدقة تدعم التحليلات الإحصائية وتخدم أهداف البحث العلمي وصناعة القرار الاستراتيجي.
المراجع
- Alexander, M., & Walkenbach, J. (2019). Excel Dashboards and Reports (3rd ed.). John Wiley & Sons.
- Bluttman, K. (2020). Excel Formulas and Functions For Dummies (5th ed.). John Wiley & Sons.
- Harvey, G. (2021). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
- Microsoft Corporation. (2022). TEXTBEFORE function. Microsoft Support. https://support.microsoft.com/office/textbefore-function-d099c2e7-113f-4f70-96c7-9e97a95bd8e6
- Microsoft Corporation. (2022). TEXTAFTER function. Microsoft Support. https://support.microsoft.com/office/textafter-function-290b39c0-138a-483a-bb52-24273523718f
- Microsoft Corporation. (2024). Power Query documentation. Microsoft Learn. https://learn.microsoft.com/power-query/
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.