
تعد معالجة السلاسل النصية وتفكيك البيانات غير المهيكلة إحدى الركائز الأساسية التي يقوم عليها علم إدارة البيانات وتحليل جداول البيانات المعاصرة. في كثير من بيئات العمل الأكاديمية والمهنية، يواجه الباحثون ومحللو النظم تدفقات ضخمة من السجلات الخام التي دُمجت فيها حقول متباينة داخل خلية واحدة، كأن يُجمع اسم الفرد مع لقبه الوظيفي، أو يُدرج العنوان الجغرافي متبوعاً بالرمز البريدي، أو تُفرغ مخرجات استبيانات القياس النفسي والتربوي في هيئة سطور نصية متصلة. ويبرز محرف الفاصلة كأحد أكثر الرموز استخداماً للفصل بين هذه المتغيرات، مما يضع المستخدم أمام تحدٍ تقني يتمثل في كيفية استخلاص النصوص الواقعة في جانب محدد من هذه الفاصلة بدقة متناهية ودون الإخلال بسلامة البيانات الأصلية.
يتناول هذا البحث الشامل الآليات المنهجية المتبعة في برنامج مايكروسوفت إكسل (Microsoft Excel) لاستخراج النص الواقع إلى يمين الفاصلة أو ما يليها وفق اتجاه القراءة اللاتيني المعياري لترميز البيانات. وسنستعرض في هذا السياق الانتقال النوعي من الصيغ التركيبية التقليدية المعقدة التي ظلت مهيمنة لعقود طويلة إلى الدوال المصفوفية الحديثة وفائقة المرونة التي وفرتها شركة مايكروسوفت في التحديثات الأخيرة لحزمة مايكروسوفت 365. ولا تقتصر هذه المعالجة على استعراض المعادلات فحسب، بل تمتد لتشمل البنية المنطقية الكامنة وراء كل دالة، والموازنة بين أدوات الواجهة الرسومية والصيغ البرمجية الديناميكية، إلى جانب استراتيجيات تطهير البيانات وتلافي الأخطاء الحسابية الشائعة.
يهدف هذا الدليل المرجعي الموسع إلى تقديم مرجع منهجي متكامل يلبي احتياجات الباحث الأكاديمي، ومدير قواعد البيانات، ومحلل الأعمال. وسنتدرج عبر مباحث مفصلة تبدأ من التأصيل النظري لأنماط السلاسل النصية ومحددات الفصل، مروراً بالتطبيق المباشر للدوال الحديثة والبدائل الكلاسيكية، ووصولاً إلى أتمتة المعالجة عبر محرر الاستعلامات والبرمجة النصية المتقدمة، مع إبراز دراسات حالة تطبيقية تسلط الضوء على أفضل الممارسات المتبعة في الميادين المهنية المعاصرة.
1. مقدمة منهجية لمعالجة النصوص واستخراج البيانات في برنامج إكسل
1.1 أهمية تجزئة النصوص في إدارة قواعد البيانات الرقمية
تمثل إدارة السجلات الرقمية في بيئات الحوسبة الجدولية تحدياً جوهرياً يتعلق بمدى جاهزية البيانات الخام للخضوع للنماذج الإحصائية والتحليلية. في كثير من الأحيان، تُستورد البيانات من أنظمة تسجيل قديمة أو واجهات برمجة تطبيقات خارجية في صيغة كتل نصية مدمجة تفتقر إلى الفصل الهيكلي بين الحقول المختلفة. إن عملية تحويل هذه البيانات غير المهيكلة إلى سجلات ذرية موحدة تُعد الخطوة الصفرية التي تسبق أي عملية استكشافية أو قياسية؛ إذ لا يمكن لأدوات التجميع والحساب المتقدمة التعامل بفاعلية مع مدخلات تجمع الاسم والمسمى والدرجة في نطاق خلوي واحد دون تجزئتها وفصل أجزائها بدقة متناهية.
تسهم تجزئة النصوص وعزل المتغيرات في خلايا مستقلة إسهاماً محورياً في تمكين وظائف الفرز والتصفية المتقدمة داخل برنامج إكسل. فعندما تستقر كل قيمة داخل حقل منفصل، يصبح من الميسور تصنيف السجلات تصاعدياً أو تنازلياً، وإجراء الاستعلامات الشرطية المعقدة، وبناء جداول المحاور المحورية (Pivot Tables) التي تعتمد بالأساس على نقاء المتغيرات الأحادية. إن وجود قيم متعددة داخل الخلية الواحدة يحول دون تطبيق القواعد المنطقية الرياضية، ويحرم المحلل من توظيف المؤشرات الكمية بصورة معيارية.
وعلاوة على ذلك، تلعب العمليات المؤتمتة لتجزئة السلاسل النصية دوراً حاسماً في تقليص معدلات الخطأ البشري. فالاعتماد على النقل اليدوي للمعلومات، أو محاولة إعادة كتابة النصوص الجزئية في أعمدة مستحدثة عبر النسخ واللصق، يفتح الباب واسعاً أمام السهو المطبعي وتشويه المحتوى وفقدان الاتساق بين السجلات المتناظرة. من هنا، تصبح خوارزميات الاستقطاع المبرمجة ضمانة منهجية لصون سلامة البيانات ومطابقتها للمتطلبات البحثية والتطبيقية بأعلى درجات الموثوقية والدقة.
1.2 أنماط البيانات النصية المحتوية على فواصل كفواصل فصل قياسية
تشكل محارف الفواصل الفاصل القياسي الأكثر شيوعاً في بنية قواعد البيانات النصية نظراً لبساطتها وسهولة التعرف عليها برمجياً. نجد هذا النمط متكرراً في السجلات الأكاديمية والمهنية؛ حيث تدون الهيئات المؤسسية أسماء الأفراد مقرونة بمؤهلاتهم العلمية أو مراتبهم الإدارية مفصولة بفواصل، مثل “أحمد محمود، مدير مشروعات، خبير معتمد”. إن التعامل مع مثل هذه السجلات يقتضي استخلاص ما بعد الفاصلة لعزل المسمى الوظيفي أو الدرجة التقييمية عن الهوية الاسمية للشخص، مما يسمح بتصنيف الموظفين وفق مؤهلاتهم دون المساس بقاعدة الأسماء الرئيسية.
كذلك تبرز العناوين الجغرافية والبيانات اللوجستية كأحد أبرز الميادين التي تفرض استخدام الفواصل كعلامات تنصيص بنيوية. تحتوي السجلات اللوجستية عادة على متسلسلات تضم اسم الشارع، يليه الحي، ثم المدينة، والمحافظة، وأخيراً الرمز البريدي، وتفصل بين هذه العناصر فواصل تقليدية. لاستخراج المدينة أو الرمز البريدي لأغراض التحليل الديموغرافي أو التخطيط المناطقي، يتعين على محلل البيانات إخضاع هذه المتسلسلات لعمليات تفكيك منتظمة تعتمد على موقع الفاصلة كدلالة مكانية على بداية الحقل المطلوب.
ولا يمكن إغفال ملفات القيم المفصولة بفواصل المعيارية (Comma-Separated Values – CSV)، والتي تعد البروتوكول الأكثر انتشاراً لتصدير البيانات ونقلها بين الأنظمة البرمجية المختلفة. في هذه الملفات، تمثل الفاصلة الحد الفاصل بين الأعمدة والخصائص. وعند استيراد هذه الملفات بطريقة تدمج بعض حقولها، أو عند وجود نصوص داخلية تتضمن فواصل ضمن حقل مفرد، تنشأ الحاجة الملحة إلى تطبيق خوارزميات إكسل لاستقطاع الأجزاء الواقعة إلى يمين الفاصلة لإعادة تنظيم السجل وإعادته إلى قالبه الهيكلي الصحيح.
1.3 التطور التاريخي لدوال معالجة النصوص في بيئة مايكروسوفت إكسل
شهدت منظومة معالجة النصوص داخل بيئة برنامج إكسل تحولات جذرية على مدار العقود الثلاثة الماضية. في المراحل الأولى الممتدة من النسخ الكلاسيكية وحتى أواخر العقد الماضي، كان مستخدمو البرنامج يعتمدون على تركيب معادلات رياضية معقدة تجمع بين دوال طول النص ومواضع المحارف. كانت الصيغ التقليدية تستدعي تداخل دوال مثل دالة البحث النصي FIND أو SEARCH لتحديد الإحداثي الرقمي لموقع الفاصلة، ثم حساب الفارق بين طول السلسلة الكامل وموقع الفاصلة عبر دالة LEN، قبل تمرير هذه الحصيلة الرياضية إلى دالة الاستقطاع الطرفي RIGHT أو دالة الاستقطاع الوسيط MID.
تسببت هذه التركيبات الكلاسيكية في تعقيد قرائي ملحوظ، ورفعت من كلفة الصيانة البرمجية للمصنفات الحسابية. وكان التحدي يتعاظم بصورة واضحة عندما تحتوي السلسلة الواحدة على فواصل متعددة؛ إذ كان استخراج النص الواقع بعد الفاصلة الأخيرة يتطلب حِيلاً إضافية، مثل استخدام دالة الاستبدال SUBSTITUTE لتبديل الفاصلة الأخيرة برمز فريد قبل استخراجه، مما شكّل عبئاً ذهنياً على المستخدمين وأدى إلى بطء ملحوظ في سرعة إعادة الحساب عند التعامل مع مصفوفات ضخمة تتضمن مئات الآلاف من الصفوف.
لكن المشهد تغير جذرياً مع إطلاق شركة مايكروسوفت لمحرك الحساب الديناميكي الحديث في بيئة Microsoft 365 ومصنفات إكسل المدعومة سحابياً. فقد جرى تدشين حزمة من الدوال النصية الثورية والمتخصصة، وعلى رأسها دالة TEXTAFTER ودالة TEXTBEFORE ودالة TEXTSPLIT. اختزلت هذه الدوال الحديثة كافة المعادلات المتشابكة في معاملات تصريحية مباشرة، مما أتاح لمحللي البيانات إنجاز عمليات الاستخراج النصي بدقة فائقة وبأقل جهد برمجي ممكن، مؤسساً لعصر جديد من السهولة والمرونة في نمذجة البيانات النصية داخل البرنامج.
2. البنية التركيبية لدالة TEXTAFTER وآلية عملها النظرية
2.1 المحددات الإلزامية والاختيارية في صياغة الدالة
تمثل دالة TEXTAFTER إضافة معيارية محورية في الترسانة البرمجية لبرنامج إكسل الحديث؛ حيث بُنيت بنيتها النحوية لتجمع بين البساطة والشمول الوظيفي. تتبع الدالة صياغة تركيبية تعتمد على وسائط إلزامية وأخرى اختيارية تحدد سلوك المعالجة بدقة متناهية. تأخذ الدالة الشكل العام الموضح أدناه، حيث يُشترط تمرير معاملين رئيسيين على الأقل لتشغيلها بنجاح، بينما تُترك بقية المعاملات لتخصيص عمليات البحث المتقدمة:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
يمثل المعامل الأول، وهو النص الأساسي (text)، السلسلة النصية المراد تفكيكها أو المرجع الخلوي الذي يحتوي على القيمة المستهدفة بالمعالجة. أما المعامل الثاني، وهو الفاصل أو المحدد (delimiter)، فيشير إلى المحرف أو السلسلة الفرعية التي تُمثل نقطة القطع، وفي سياق هذا الدليل، يُمرر هذا المعامل في صورة فاصلة نصية صريحة محاطة بعلامات تنصيص مزدوجة (“,”). ولا يمكن للدالة أن تبدأ دورتها الحسابية دون هذين المعاملين الإلزاميَّين.
تتضمن الدالة أربعة معاملات اختيارية ترفع من كفاءتها التحليلية؛ أولها معامل رقم التكرار (instance_num)، وهو رقم صحيح يحدد أي ظهور للفاصلة ينبغي استخراج ما بعده، وتكون قيمته الافتراضية مساوية للرقم (1). يليه معامل نمط المطابقة (match_mode) الذي يتيح التمييز بين حالة الأحرف الكبيرة والصغيرة إذا كان المحدد نصياً. ثم يأتي معامل مطابقة النهاية (match_end) للتحكم في اعتبار نهاية السلسلة فاصلاً افتراضياً، وأخيراً معامل القيمة البديلة (if_not_found) الذي يُحدد المخرج البديل في حال تعذر العثور على الفاصلة المحددة، مما يمنع ظهور رسائل الأخطاء النظامية.
2.2 المنطق البرمجي لكيفية مسح السلاسل النصية وتحديد نقطة الانفصال
تعتمد دالة TEXTAFTER على خوارزمية مسح تسلسلي مؤشرية لفحص السلاسل النصية بدقة عالية. عند تنفيذ الصيغة، يشرع محرك المعالجة في قراءة محتويات الخلية المصدر بدءاً من المحرف الأول الواقع في أقصى اليسار متجهاً نحو اليمين كوضع افتراضي. يقوم المحرك بمطابقة كل محرف في السلسلة مع المحدد المعرف داخل الدالة، وعندما يتطابق محرف معين مع الفاصلة، يُسجل النظام إحداثي الفهرسة الرقمية لهذا الموقع داخل الذاكرة المؤقتة.
بمجرد اكتمال مطابقة الفاصلة المطلوبة وتحديد موقعها النسبي، تقوم الخوارزمية بتجاوز محرف الفاصلة نفسه فوراً لتبدأ عملية الاستقطاع من المحرف التالي له مباشرة وحتى نهاية السلسلة النصية الإجمالية. يتم عزل هذا المقطع الفرعي ونقله كقيمة مستقلة إلى خلية الإخراج المحددة، دون إحداث أي تغيير هيكلي أو تشويه في محتويات الخلية الأصلية؛ إذ تلتزم الدالة بالمبدأ البرمجي القائم على الحفاظ على سلامة البيانات المصدرية وإجراء المعالجة بصيغة القراءة والتوليد المستقل.
تتميز هذه الخوارزمية بقدرتها على التعامل مع الأحجام المتغيرة للسلاسل النصية؛ حيث لا تتطلب من المستخدم تحديد عدد المحارف المراد استقطاعها كما كان متبعاً في الدوال القديمة. فالدالة تستنتج ديناميكياً المسافة الفاصلة بين المحدد ونهاية النص، وتتكيف ذاتياً مع التغيرات التي قد تطرأ على السجلات عند تحديث البيانات أو استبدالها بمدخلات جديدة ذات أطوال مختلفة، مما يمنحها استقراراً تشغيلياً مستداماً.
2.3 شروط التوافق البرمجي ومتطلبات تشغيل الدالة في بيئات العمل
يتعين على مديري قواعد البيانات ومحللي النظم إدراك القيود البيئية وشروط التوافق المرتبطة بتشغيل دالة TEXTAFTER. طُرحت هذه الدالة رسمياً كجزء من التحديثات الجوهرية لمنظومة الدوال الديناميكية في إصدارات مايكروسوفت 365، وهي متاحة أيضاً للمستخدمين عبر إصدارات مايكروسوفت إكسل للويب (Excel for the Web) وإصدار إكسل 2021 والنسخ اللاحقة للمؤسسات، مما يعني عدم توفرها في الإصدارات الأقدم.
عند محاولة فتح مصنف حسابي يحتوي على دالة TEXTAFTER باستخدام إصدارات تقليدية مثل إكسل 2019 أو 2016 أو 2013، فإن محرك المعالجة القديم لن يتمكن من تفسير هذه الصيغة الحسابية؛ نظراً لغياب تعريف الدالة في مكتباته البرمجية. يترتب على ذلك تحول نواتج الخلايا المعالجة إلى رسالة الخطأ الشهيرة #NAME?، وهو ما يعكس عجز النظام عن التعرف على الاسم المستدعى، مما يعطل النماذج المالية والتحليلية المعتمدة على هذه الحسابات في تلك البيئات القديمة.
لذلك، تفرض بروتوكولات حوكمة تكنولوجيا المعلومات في المنظمات الكبرى التحقق من توحيد بيئات العمل البرمجية قبل اعتماد هذه الدوال بصورة شاملة. وفي حال تطلب المشروع مشاركة المصنفات مع جهات خارجية أو مستخدمين يعتمدون على تراخيص برمجية غير محدثة، يتعين على المحلل اللجوء إلى الدوال الكلاسيكية البديلة التي تضمن التوافقية العكسية الشاملة، أو تصدير النتائج المستخرجة في هيئة قيم ثابتة مجردة من الصيغ لتفادي الانهيار الهيكلي لجداول البيانات.
3. استخراج النص الواقع بعد الفاصلة الأولى بالتفصيل والتطبيق
3.1 الصياغة القياسية للمعادلة وتطبيقها على الخلايا الفردية
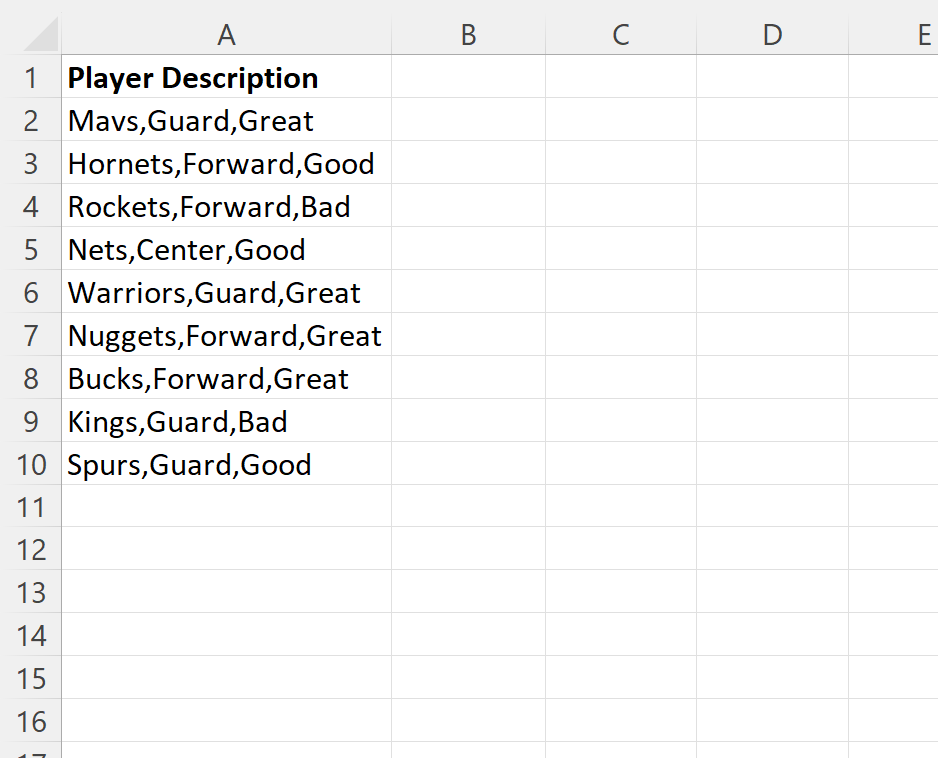
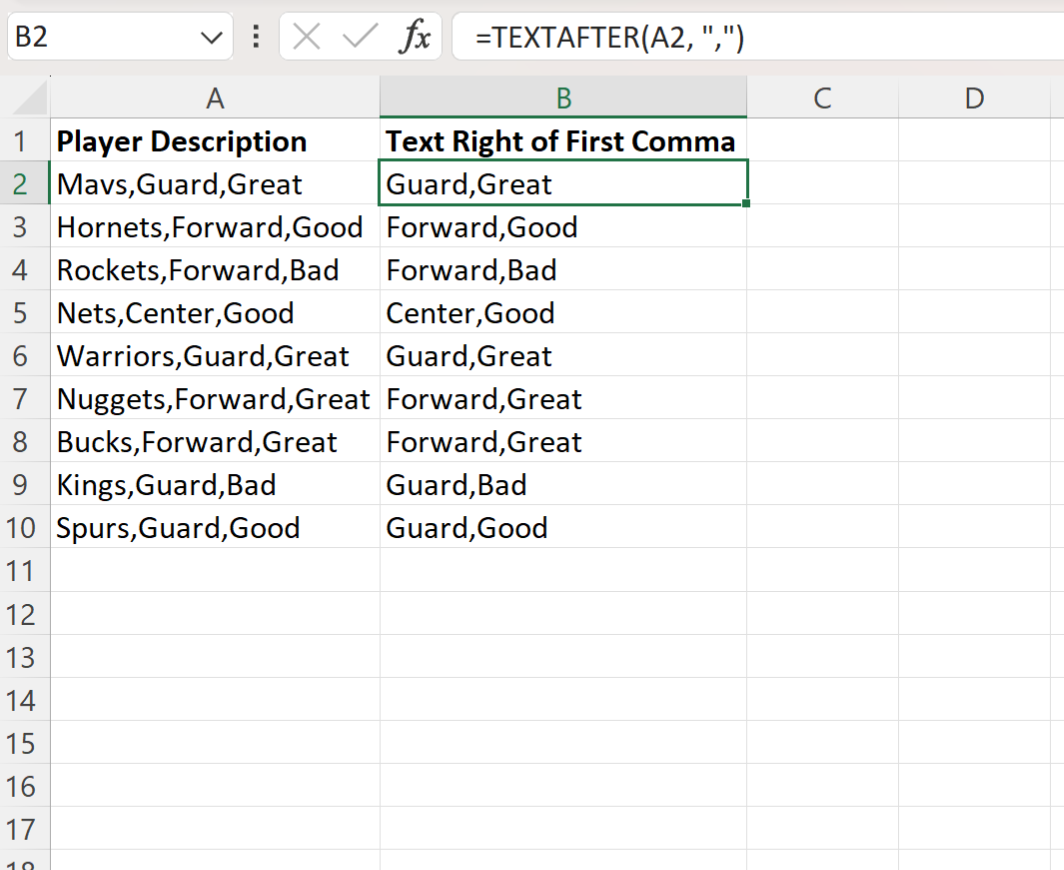
لاستخراج النص الواقع بعد أول فاصلة في سلسلة نصية محددة، تُبنى الصيغة القياسية لدالة TEXTAFTER باستدعاء المعاملين الأساسيين دون الحاجة إلى تحديد المعاملات الاختيارية. على سبيل المثال، إذا كانت الخلية A2 تحتوي على القيمة النصية “قسم الأبحاث، التحليل الإحصائي”، فإن المعادلة المطبقة في الخلية B2 تُكتب بالصيغة المباشرة التالية:
=TEXTAFTER(A2, “,”)
يلعب تضمين الفاصلة بين علامتي تنصيص مزدوجتين دوراً محورياً في إرشاد محرك إكسل إلى أن المحدد المطلوب هو محرف نصي مجرد وليس فاصلاً منطقياً بين وسائط الدالة نفسها. ففي بيئات إكسل القياسية، تُستخدم الفواصل أو الفواصل المنقوطة (وفقاً للإعدادات الإقليمية لنظام التشغيل) للفصل بين معاملات الدالة، وبالتالي فإن إحاطة الفاصلة بعلامات التنصيص تحميها من الالتباس البرمجي وتؤكد هويتها كرمز بحث مستهدف داخل النص.
بمجرد تنفيذ هذه المعادلة، يقوم البرنامج برصد أول فاصلة تظهر في النص من جهة اليسار، ويتجاهل المقطع التمهيدي “قسم الأبحاث”، ثم يستقطع الجزء المتبقي ليكون الناتج الظاهر هو ” التحليل الإحصائي”. تجدر الإشارة هنا إلى أن المخرج النصي يتضمن في بدايته مسافة فارغة ناتجة عن المسافة التي تلت الفاصلة الأصلية في الخلية المصدر، وهي مسألة بنيوية تستوجب التنظيف اللاحق لضمان الاتساق المعياري كما سنفصل في المباحث التالية.
3.2 تعميم المعادلة وتوسيع نطاق السحب على الأعمدة الكاملة
لا تتوقف الفاعلية التشغيلية لبرنامج إكسل عند معالجة الخلايا الفردية، بل تمتد لتشمل المعالجة المجمعة لآلاف السجلات المتتالية. يمكن تعميم الصيغة الأساسية بنجاح عبر سحب مقبض التعبئة التلقائية (AutoFill) في الركن الأيسر السفلي للخلية النشطة وتمريره رأسياً على امتداد العمود، مما يؤدي إلى تعديل نسبي للمراجع الخلوية لتصبح A3 وA4 وتستمر بالتتابع حتى نهاية النطاق المستهدف.
ومع ذلك، توفر البيئة الحديثة لإكسل آلية أكثر تقدماً تُعرف باسم مصفوفات الانسكاب الديناميكي (Dynamic Spill Arrays). فبدلاً من الإشارة إلى خلية مفردة، يمكن للمحلل تمرير نطاق كامل من الخلايا داخل معامل النص الأساسي. تتخذ المعادلة حينها هذا الشكل النموذجي:
=TEXTAFTER(A2:A1000, “,”)
تتميز هذه الصيغة الديناميكية بكونها تُكتب في الخلية العلوية فقط، لتقوم الدالة بحساب النتائج وتوزيعها تلقائياً على كامل النطاق الموازي للأسفل عبر سلوك الانسكاب التلقائي. يقلل هذا الأسلوب استهلاك موارد الذاكرة العشوائية للجهاز، ويسرع من زمن المعالجة الحسابية عند التعامل مع الجداول الضخمة، كما يحمي النموذج من أخطاء عدم تطابق المعادلات التي قد تنشأ عند الإدراج اليدوي للصفوف الإضافية داخل قاعدة البيانات.
3.3 تحليل تطبيقي: تفكيك سجلات الرياضيين والمؤشرات التقييمية
لتوضيح المفهوم في سياق تطبيقي واقعي، نفترض وجود جدول أداء رياضي يضم حقولاً مدمجة للفرق والمراكز والتقييمات الرقمية للاعبين. تحتوي الخلية A2 على السجل النصي التالي: “نادي اليرموك، خط الوسط، 8.75”. يتطلب التحليل الإحصائي المتقدم عزل المتغيرات الفنية والتقييمية عن اسم النادي المؤسسي للتمكن من قياس أداء خطوط اللعب بصورة مستقلة دون النظر إلى التبعية المكانية للفريق.
بتطبيق الصيغة =TEXTAFTER(A2, “,”)، يستجيب البرنامج عبر عزل الجزء الواقع بعد الفاصلة الأولى، مما ينتج عنه استخراج السلسلة المركبة: ” خط الوسط، 8.75″. في هذه المرحلة، نجحت الدالة في شطر السجل الأصلي إلى كتلتين رئيستين: الكتلة المؤسسية التي بقيت في الخلية A2، والكتلة الفنية والتقييمية المستخلصة التي تم نقلها إلى الخلية الجديدة ككتلة واحدة مستعدة لمزيد من التفكيك لاحقاً.
يوفر هذا الاستخراج الجزئي مدخلاً أولياً عالي الدقة لإجراء التحليلات الإحصائية الإضافية؛ حيث يمكن للمحلل توجيه عمليات تجميعية على الحقل المستخرج لدراسة توزيع اللاعبين في المراكز المختلفة، أو استخدام دوال استقطاع فرعية إضافية لعزل التقييم الرقمي وحده. يُظهر هذا المثال كيف تمنح دالة TEXTAFTER المحللين سيطرة هندسية مرنة على البيانات المتراكمة، وتمكنهم من تنظيمها تدريجياً وبمنهجية علمية واضحة.
4. استخراج النص بعد الفاصلة الأخيرة باستخدام المعاملات المتقدمة
4.1 مفهوم مؤشر التكرار العكسي (instance_num) السلبي
في كثير من السيناريوهات العملية، تشتمل السلاسل النصية على فواصل متعددة تفصل بين متغيرات شتى، ويكون الهدف المحدد هو استخراج العنصر الختامي فقط، والذي يقع بدقة بعد آخر فاصلة في النص. إذا طبق المحلل الصيغة الافتراضية، فإنه سيحصل على النص الممتد من الفاصلة الأولى حتى النهاية متضمناً الفواصل الوسيطة، وهو ما يتعارض مع الرغبة في عزل المتغير الأخير منفرداً. هنا يبرز الدور الاستثنائي لمعامل مؤشر التكرار (instance_num).
أتاحت مايكروسوفت في تصميم دالة TEXTAFTER ميزة برمجية متقدمة تتمثل في إمكانية تمرير أرقام سالبة في معامل التكرار. إن استخدام القيمة (-1) يغير السلوك الاتجاهي لمحرك البحث؛ فبدلاً من فحص النص من البداية نحو النهاية، ينعكس اتجاه البحث الداخلي ليبدأ من المحرف الأخير في أقصى اليمين متجهاً إلى الخلف نحو اليسار. يؤدي هذا التغيير البنيوي إلى رصد الفاصلة الختامية وتحديد موضعها فوراً، متجاهلاً كلياً أي عدد من الفواصل قد يسبقها في صدر السلسلة النصية.
يمثل الترقيم العكسي حلاً رياضياً قاطعاً لمعضلة النصوص ذات الفواصل المتفاوتة؛ إذ لم يعد المحلل بحاجة لمعرفة إجمالي عدد الفواصل الموجودة في كل صف على حدة. وسواء أكان السجل يحتوي على فاصلتين أم عشر فواصل، فإن المعامل (-1) يضمن استهداف الفاصلة الأخيرة حصرياً واستخراج ما يليها فقط، مما يلغي التباين الهيكلي بين السجلات المتنوعة ويحقق اتساقاً مطلقاً في النتائج المستخرجة.
4.2 تطبيق الصيغة =TEXTAFTER(A2, “,”, -1) عملياً
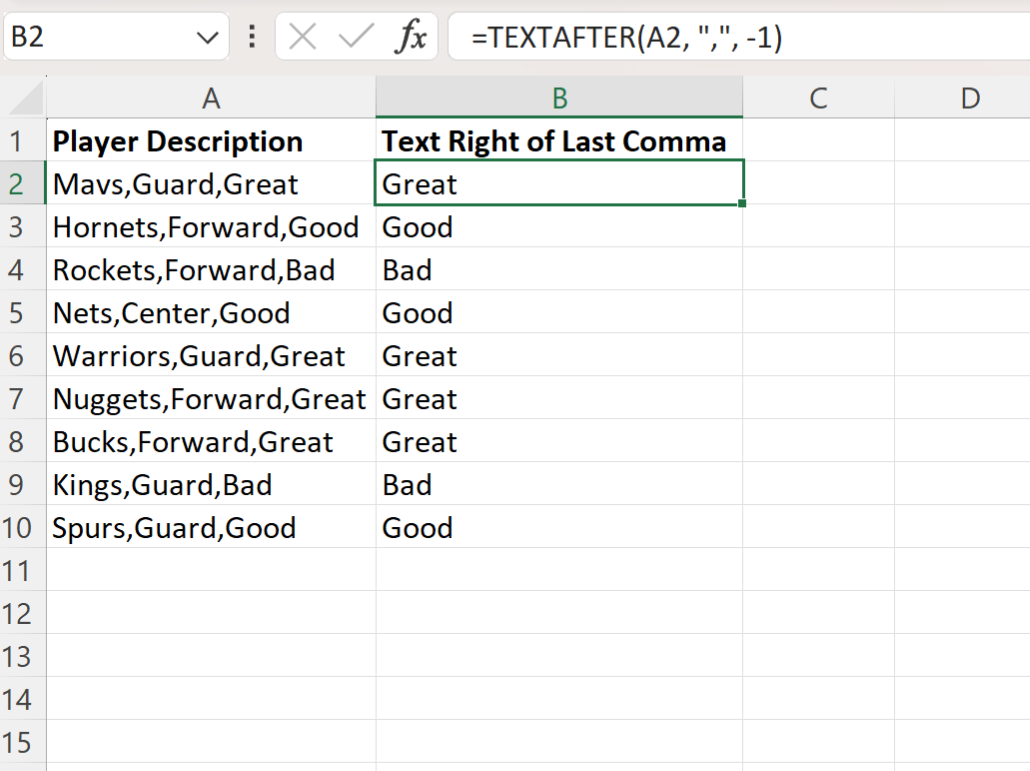
لتطبيق هذه الآلية عملياً، نعود إلى نموذج سجلات الأداء الرياضي الذي استعرضناه سابقاً، والذي يحتوي في الخلية A2 على النص: “نادي اليرموك، خط الوسط، 8.75”. إذا كان المطلوب هو استخلاص الدرجة التقييمية الرقمية وحدها (8.75) دون المسمى الوظيفي أو اسم النادي، فإن صياغة المعادلة تتحدد بدقة عبر إدخال مؤشر التكرار السلبي على النحو التالي:
=TEXTAFTER(A2, “,”, -1)
عند تنفيذ هذه الصيغة، يمسح محرك إكسل السلسلة بدءاً من الرقم “5” ثم “7” ثم النقطة ثم الرقم “8” وصولاً إلى الفاصلة التي تسبقه مباشرة. يدرك البرنامج أن هذه الفاصلة هي أول فاصلة تواجهه من نهاية النص، وتطابق التكرار رقم (1-) المطلوب، فيتوقف فوراً ويستقطع كل ما يلي هذه الفاصلة باتجاه نهاية السلسلة. يكون المخرج النهائي المتحصل عليه في خلية النتيجة هو النص ” 8.75″.
تتجلى قوة هذه المعادلة في استقرارها المنهجي عند سحبها على خلايا أخرى قد تختلف في عدد عناصرها النصية. فإذا احتوت الخلية A3 على: “نادي اليرموك، الفريق الأول، خط الهجوم، 9.20″، فإن نفس المعادلة ستستخرج مباشرة القيمة ” 9.20″ بكل دقة، متجاوزة وجود فاصلة إضافية في هذا السجل، وهو ما يبرهن على تفوق هذا النمط المتقدم على الصيغ الاستاتيكية محدودة الأفق.
4.3 فصل البيانات الفرعية متعددة الحدود بدقة متناهية
يمتد التطبيق العملي لمؤشر التكرار العكسي ليشمل معالجة العناوين الجغرافية والرموز البريدية المعقدة في المؤسسات اللوجستية ومواقع التجارة الإلكترونية. تتضمن هذه العناوين عادة تفاصيل متسلسلة مثل: “المملكة العربية السعودية، منطقة الرياض، مدينة الرياض، حي الملقا، 13524”. يمثل الرقم الأخير الرمز البريدي الذي يعد الحقل الحاسم في توجيه الشحنات البرمجية وتوزيع المسارات اللوجستية بدقة.
باستخدام الصيغة المعتمدة على المعامل (-1)، يتمكن النظام من عزل الرمز ” 13524″ كقيمة نصية منفصلة في عمود مخصص للرموز البريدية بضربة برمجية واحدة. يتم التخلص بذلك من مخاطر تباين كتابة الأحياء أو إضافة بيانات وصفية تزيد من عدد الفواصل في بعض الصفوف دون غيرها؛ فالفاصلة الأخيرة تظل دائماً هي البوابة التي يختفي خلفها المتغير النهائي المنشود.
وينطبق هذا المبدأ ذاته على استخلاص النسب المئوية، والأرقام الضريبية، وحالات القيد الإداري، والملحقات التوصيفية التي تُلحق عادة في نهايات القيود المحاسبية. يضمن هذا النهج الدقيق بقاء البيانات المستخرجة متجانسة في طبيعتها، مما يمهد الطريق لتحويلها إلى صيغ كمية قابلة للمقارنة والقياس الإحصائي دون تدخل يدوي إضافي من المستخدم.
5. التعامل مع الفواصل المتعددة وتحديد مواضع التكرار المخصصة
5.1 استخراج البيانات الواقعة بعد الفاصلة الثانية أو الثالثة تحديداً
في كثير من السجلات الهيكلية المعقدة، قد لا يكون الهدف هو استخراج النص بعد الفاصلة الأولى ولا بعد الفاصلة الأخيرة، بل استهداف موضع وسيط محدد مسبقاً يعبر عن فئة تصنيفية ثابتة. تتيح دالة TEXTAFTER التعامل مع هذه المتطلبات عبر استخدام الأرقام الصحيحة الموجبة داخل معامل مؤشر التكرار (instance_num). على سبيل المثال، يوجه استخدام الرقم (2) الدالة إلى تجاهل الفاصلة الأولى والبدء في استقطاع النص بعد الفاصلة الثانية مباشرة.
إذا كانت الخلية A2 تتضمن سجلاً تعاقدياً بصيغة: “العقد 104، التوريد السنوي، الدفعة الأولى، 50000 ريال”، فإن تطبيق المعادلة التالية يستخرج البيانات ابتداءً من الفاصلة الثانية:
=TEXTAFTER(A2, “,”, 2)
سينتج عن هذا الاستدعاء استخراج النص التالي: ” الدفعة الأولى، 50000 ريال”. يوضح هذا المثال كيف مكنت القيمة (2) من تجاوز الجزأين الأولين من السلسلة دفعة واحدة. وبالمثل، لو تم تمرير الرقم (3) في المعامل ذاته، لكان الناتج المستخرج هو ” 50000 ريال”، وهو ما يتيح للمحلل القفز المباشر إلى مستويات متقدمة من العمق النصي داخل السجل الخلوي الواحد بما يتوافق مع بنية النموذج المقترح.
تعد هذه الميزة حيوية في فرز البيانات المقسمة إلى طبقات تصنيفية متعددة؛ حيث تستخدم الشركات والمؤسسات الأكاديمية هذه الهيكلية لتدوين المراكز الإدارية أو الأكواد المعيارية. إن القدرة على تحديد رقم التكرار الموجب تمنح المرونة في تتبع التموضع الدقيق للأقسام النصية، وتوفر آلية منتظمة لعزل الكتل الوصفية الوسيطة وفرزها في مسارات تحليلية مخصصة.
5.2 معالجة النصوص المتفاوتة في عدد الفواصل
تظهر التحديات التقنية الكبرى عندما تكون جودة البيانات المصدرية غير متسقة، بحيث تحتوي بعض الصفوف على عدد أقل من الفواصل مقارنة بالصفوف الأخرى داخل نفس العمود البياني. فعلى سبيل المثال، إذا طلب المستخدم استخراج النص الواقع بعد الفاصلة الثالثة في عمود يحتوي على صفوف تضم فاصلتين فقط، فإن السلوك الافتراضي لدالة TEXTAFTER يقود إلى إخفاق عملية البحث وتوليد خطأ القيمة غير المتاحة #N/A.
للتعامل المنهجي مع هذا التفاوت دون إفساد المصفوفات الحسابية، وفرت الدالة معاملاً متقدماً يُعرف باسم مطابقة النهاية (match_end). يقبل هذا المعامل قيماً منطقية؛ حيث تدل القيمة الافتراضية (0) على عدم معاملة نهاية النص كمحدد، في حين أن تعيين المعامل بالقيمة (1) يوجه محرك البحث إلى اعتبار نهاية السلسلة النصية فاصلاً مكافئاً للفاصلة المحددة. في هذه الحالة، إذا لم تعثر الدالة على الفاصلة المطلوبة، فإنها تعامل نهاية السلسلة كنقطة توقف ولا تُسقط العملية في فخ الخطأ البرمجي.
وإلى جانب ذلك، يمكن توظيف معامل القيمة البديلة (if_not_found) لتأمين المعالجة بصورة استباقية. تتيح هذه المعاملات للمحلل صياغة جملة استخراج مرنة ووقائية تُرجع نصاً بديلاً كـ “غير متوفر” أو مساحة نصية فارغة “” عند غياب التكرار المطلوب، مما يحافظ على التماسك البصري والبرمجي لجداول البيانات المعالجة، ويسهل اكتشاف الشواذ في السجلات وتصحيحها لاحقاً.
5.3 الدمج بين TEXTAFTER والدوال النصية الشقيقة للتجزئة الكاملة
تكتمل القوة التحليلية لدالة TEXTAFTER عند دمجها وتكاملها مع شقيقاتها من الدوال الحديثة، وتحديداً دالتي TEXTBEFORE وTEXTSPLIT. لنفترض أن لدينا سجلاً يضم: “معرف_المستخدم، المستوى_التعليمي، الدولة، الرمز”. إذا رغب المحلل في استخراج “المستوى_التعليمي” منفرداً، وهو المتغير المحصور بدقة بين الفاصلة الأولى والفاصلة الثانية، فإن التركيب المشترك بين TEXTAFTER وTEXTBEFORE يوفر حلاً أنيقاً وفائق البساطة كما يلي:
=TEXTBEFORE(TEXTAFTER(A2, “,”), “,”)
تقوم دالة TEXTAFTER الداخلية في هذه الصيغة باستقطاع كافة النصوص الواقعة بعد الفاصلة الأولى، ليصبح الناتج الوسيط هو “المستوى_التعليمي، الدولة، الرمز”. ثم تتولى دالة TEXTBEFORE الخارجية استلام هذا الناتج وتقتطع النص الواقع قبل أول فاصلة تظهر فيه، ليكون الناتج النهائي المصفى هو “المستوى_التعليمي” بمفرده دون أي إضافات، مما يجسد التكامل السلس في عزل الحقول البينية بدقة متناهية.
أما إذا كان الهدف الأكاديمي أو المؤسسي يقتضي تجزئة السلسلة النصية بأكملها وتحويلها إلى أعمدة متعددة متجاورة دفعة واحدة، فإن دالة TEXTSPLIT تمثل الحل الشامل والمثالي. عبر كتابة الصيغة =TEXTSPLIT(A2, “,”)، ينشئ البرنامج مصفوفة انسكاب أفقية تفرز كل قيمة في عمود مستقل، مما يغني المحلل عن كتابة دوال استخراج متعددة ويوفر بنية تحتية متكاملة لتقسيم النصوص وإدارتها وفق أحدث المعايير البرمجية في بيئة الحوسبة السحابية.
6. البدائل التقليدية: استخدام الدوال الكلاسيكية (RIGHT وFIND وLEN وMID)
6.1 معادلة الدمج بين الدوال الأساسية لاستخراج النص بعد أول فاصلة
قبل ظهور الدوال الديناميكية الحديثة، بنى مهندسو البيانات في بيئات إكسل حلولهم لاستخراج النصوص بعد الفواصل بالاعتماد على التوليف الرياضي بين دوال النصوص الأساسية: RIGHT وLEN وFIND أو SEARCH. تعتمد هذه المنهجية على حساب الإحداثيات المكانية لكل محرف داخل السلسلة لإرشاد دالة الاستقطاع الطرفي إلى عدد المحارف المطلوب استخلاصها بدقة. تتبع الصيغة التقليدية الأكثر انتشاراً هذا البناء الحسابي:
=RIGHT(A2, LEN(A2) – FIND(“,”, A2))
لتفكيك هذا التركيب المنطقي، نجد أن دالة LEN تعمل أولاً على حساب إجمالي عدد المحارف والمسافات المكونة للنص في الخلية A2. وفي الوقت ذاته، تقوم دالة FIND بالبحث عن أول ظهور لمحرف الفاصلة (“,”) وتُرجع رقماً صحيحاً يمثل ترتيبها العددي بدءاً من أقصى اليسار. عبر إجراء عملية الطرح الرياضي البسيطة (طول النص الإجمالي مطروحاً منه موضع الفاصلة الأولى)، يحصل النظام بدقة على عدد المحارف المتبقية على يمين تلك الفاصلة، ليتم تمرير هذا الرقم كمعامل ثانٍ لدالة RIGHT التي تستقطع ذلك العدد من نهاية النص.
توجد صياغة كلاسيكية أخرى تعتمد على دالة MID مع دالة SEARCH، وتُعد مفضلة لدى طيف واسع من المطورين لما توفره من أمان تشغيلي وسهولة في الصياغة، وتُكتب على النحو التالي:
=MID(A2, SEARCH(“,”, A2) + 1, LEN(A2))
تحدد دالة SEARCH موضع الفاصلة، ويضاف إليه الرقم (1) لضبط نقطة الانطلاق لتكون عند أول محرف يلي الفاصلة مباشرة. ونظراً لأن دالة MID تطلب تحديد عدد المحارف المراد استقطاعها، يتم تمرير إجمالي طول النص LEN(A2) كمعامل أخير؛ وهو ما يضمن استخراج كافة المحارف المتبقية حتى نهاية السلسلة، نظراً لأن طول النص الإجمالي سيكون دائماً أكبر من أو مساوياً لعدد المحارف المتبقية بعد الفاصلة، مما يحقق استخراجاً كاملاً وآمناً للنص المستهدف.
6.2 استخراج النص بعد الفاصلة الأخيرة باستخدام تراكيب دالة SUBSTITUTE المتقدمة
تعد مسألة استخراج النص الواقع بعد الفاصلة الأخيرة في بيئات إكسل القديمة أحد أشهر التحديات البرمجية التي واجهت مستخدمي الدوال الكلاسيكية؛ إذ لا توفر دالة FIND أو SEARCH إمكانية البحث العكسي من اليمين إلى اليسار. ولتجاوز هذه العقبة الهيكلية، طور الخبراء حيلة برمجية بالغة الذكاء تعتمد على استبدال الفاصلة الأخيرة برمز فريد وغير مألوف في لغة السجل (مثل محرف التلدة “~”) تمهيداً لرصده والقطع بناءً عليه. تُصاغ هذه المعادلة المركبة بالشكل التالي:
=RIGHT(A2, LEN(A2) – SEARCH(“~”, SUBSTITUTE(A2, “,”, “~”, LEN(A2) – LEN(SUBSTITUTE(A2, “,”, “”)))))
تبدأ هذه العملية بحساب عدد الفواصل الإجمالي الموجود داخل الخلية، ويتحقق ذلك عبر مقارنة طول النص الأصلي LEN(A2) بطول النص بعد إزالة كافة الفواصل منه باستخدام دالة الاستبدال SUBSTITUTE(A2, “,”, “”). يمثل ناتج الطرح عدد الفواصل بدقة. بعد ذلك، تُستدعى دالة SUBSTITUTE مرة ثانية، ولكن هذه المرة مع تمرير معامل تكرار محدد يساوي ذلك الناتج المحسوب، مما يوجه الدالة إلى استبدال الظهور الأخير للفاصلة فقط بالمحرف الفريد “~”.
بمجرد وسم الفاصلة الأخيرة بذلك المحرف المميز، تتدخل دالة SEARCH للعثور على موقع محرف التلدة “~” بدقة، ليتم طرح موقعه من الطول الإجمالي للنص وتمرير النتيجة إلى دالة RIGHT كما في المعادلة الكلاسيكية الأولى. ورغم العبقرية البرمجية الكامنة وراء هذا التركيب، إلا أنه يمثل دليلاً واضحاً على درجة التعقيد الهائل التي كان يتكبدها المستخدم قبل إتاحة الحلول المباشرة كدالة TEXTAFTER.
6.3 المقارنة التحليلية بين الدوال الحديثة والمعادلات الكلاسيكية المركبة
يقتضي التحليل الأكاديمي المقارن تقييم الفروق الجوهرية بين الأسلوبين الحديث والكلاسيكي من حيث عدة معايير حاكمة؛ تشمل الوضوح الدلالي، وكفاءة المعالجة، وسهولة الصيانة، والتوافقية البرمجية عبر البيئات المختلفة. يوضح الجدول المقارن التالي أبرز هذه التمايزات المنهجية:
| المعيار التحليلي | الدوال الحديثة (TEXTAFTER) | الدوال الكلاسيكية المركبة (RIGHT, MID, SUBSTITUTE) |
|---|---|---|
| الوضوح الدلالي وسهولة القراءة | عالية جداً؛ الدالة تعبر بوضوح عن وظيفتها عبر معاملات مباشرة ومفهومة. | منخفضة؛ معادلات طويلة ومتداخلة تتطلب تفكيكاً رياضياً معقداً لفهم منطقها. |
| صيانة النماذج وتعديلها | ميسورة للغاية وتتطلب تعديل أرقام التكرار فقط دون المساس بالهيكل. | معقدة وعرضة للخطأ؛ أي تعديل طفيف قد يكسر توازن الأقواس أو الترتيب الحسابي. |
| استهلاك موارد المعالج والذاكرة | محسنة برمجياً عبر محرك الحساب السحابي لتقديم أداء سريع مع البيانات الضخمة. | تستهلك دورات معالجة إضافية بسبب تكرار حسابات طول النص والاستبدال المتعدد. |
| التوافقية العكسية مع الإصدارات | محصورة في Microsoft 365 وExcel 2021 والإصدارات السحابية اللاحقة. | شاملة وتعمل بكفاءة على كافة إصدارات إكسل التاريخية دون أي قيود برمجية. |
يتضح من هذا التحليل أن الدوال الحديثة تتفوق تفوقاً كاسحاً في بيئات العمل المحدثة بفضل بساطتها وكفاءتها الحسابية، بينما تظل التراكيب الكلاسيكية خياراً حتمياً وضرورياً في المشروعات التي تتطلب دعماً مطلقاً للتوافقية العكسية، وتستهدف مستخدمين يعملون على منصات حوسبية لم تشملها التحديثات البرمجية الأخيرة.
7. أدوات إكسل التفاعلية: ميزة ‘النص إلى أعمدة’ والإكمال التلقائي السريع
7.1 استخدام معالج ‘النص إلى أعمدة’ (Text to Columns) لتفكيك النصوص
بجانب الصيغ والمعادلات الرياضية، يوفر برنامج إكسل مجموعة من الأدوات التفاعلية المدمجة في واجهته الرسومية، وتأتي أداة “النص إلى أعمدة” (Text to Columns) في طليعة هذه الحلول المؤسسية لتفكيك النصوص الثابتة. تتيح هذه الأداة للمحللين معالجة أعمدة البيانات دون الحاجة لكتابة رموز برمجية، وتعتمد على معالج تفاعلي متعدد الخطوات يُرشد المستخدم نحو تفكيك البيانات بدقة ونظام.
للوصول إلى هذه الأداة، يحدد المستخدم نطاق البيانات المستهدف، ثم يتوجه إلى شريط التبويب الرئيسي “بيانات” (Data) ويختار “النص إلى أعمدة”. في الخطوة الأولى من المعالج، يُحدد خيار “محدد” (Delimited)، وهو الخيار المخصص للنصوص التي تفصل بين عناصرها محارف واضحة كالفواصل أو المسافات. بعد النقر على زر المتابعة، يحدد المستخدم “الفاصلة” (Comma) كمحدد رئيسي، مع إلغاء تحديد الخيارات الأخرى، لتعرض شاشة المعاينة السفلية تقسيماً بيانياً فورياً يوضح كيف ستستقر النصوص في الأعمدة الجديدة.
في الخطوة الختامية، يُتاح للمستخدم تحديد تنسيق الأعمدة الناتجة، وتعيين خلية الوجهة (Destination). وتعد خطوة تحديد الوجهة بالغة الأهمية؛ فإذا تُركت الخلية الافتراضية كما هي، فسيقوم البرنامج باستبدال العمود الأصلي بالقيم الجديدة، في حين يضمن تعيين خلية مجاورة فارغة الحفاظ على السجلات المصدرية وتوليد النص المستخرج في عمود منفصل. وبمجرد إنهاء المعالج، تتفكك النصوص المدمجة إلى أعمدة متعددة يستقر النص الواقع يمين الفاصلة في ثانيها بكل سلاسة وثبات.
7.2 توظيف تقنية الإكمال السريع (Flash Fill) عبر الذكاء الاصطناعي الضمني
تمثل ميزة الإكمال السريع (Flash Fill)، التي أطلقتها مايكروسوفت لأول مرة في إصدار إكسل 2013، قفزة تقنية بارزة تعتمد على خوارزميات الذكاء الاصطناعي التنبؤي والتعرف على الأنماط (Pattern Recognition). تهدف هذه الأداة إلى أتمتة مهام استخراج النصوص وتعديلها عبر التعلم التلقائي من الأمثلة اليدوية التي يقدمها المستخدم، مما يغنيه تماماً عن بناء الصيغ أو خوض غمار المعالجات المعقدة.
لتشغيل الإكمال السريع لاستخراج النص الواقع بعد الفاصلة، يكتب المستخدم القيمة المستهدفة يدوياً في الخلية الأولى من العمود المجاور الفارغ مطابقة تماماً للمقطع المطلوب. على سبيل المثال، إذا كانت الخلية A2 تحوي “الرياض، المملكة العربية السعودية”، يكتب المستخدم في الخلية B2: “المملكة العربية السعودية”. بعد تثبيت هذه القيمة بالضغط على مفتاح الإدخال، ينتقل إلى الخلية B3 ويضغط على الاختصار المكتبي الشهير Ctrl + E، أو ينقر على زر “الإكمال السريع” من تبويب “بيانات”.
فور استدعاء الميزة، يقوم المحرك الخوارزمي بمسح العلاقة الهيكلية بين الخلية A2 والخلية B2، ويستنتج فوراً أن المستخدم يرغب في عزل النص الذي يلي الفاصلة. وبناءً على هذا الاستدلال الرياضي، يولد البرنامج المخرجات المتناظرة لكافة خلايا العمود تلقائياً في أجزاء من الثانية. ورغم سرعة هذه الأداة الفائقة، إلا أنها تستوجب مراجعة دقيقة للنتائج؛ نظراً لأنها قد تخطئ في قراءة النمط إذا احتوت بعض الصفوف على صيغ شاذة أو فواصل متعددة لم يتضمنها المثال الأولي.
7.3 المفاضلة المنهجية بين الحلول الديناميكية (المعادلات) والحلول الثابتة (الأدوات)
يتطلب اتخاذ القرار البرمجي في المشروعات المؤسسية مفاضلة منهجية واعية بين الحلول الديناميكية القائمة على المعادلات (كـ TEXTAFTER والصيغ الكلاسيكية) والحلول الثابتة القائمة على الأدوات التفاعلية (كـ Text to Columns وFlash Fill). لا يمكن تفضيل أحدهما بالمطلق، بل يعتمد الاختيار على طبيعة تدفق البيانات وحجم الملف وحاجته إلى التحديث الدوري المستمر.
تتميز الحلول الديناميكية بخاصية الاستجابة التلقائية للبيانات المتغيرة (Reactivity)؛ فإذا عُدلت القيمة في الخلية المصدرية أو أُضيفت صفوف جديدة لاحقاً، فإن المعادلات تعيد حساب النتائج وتحدث الأعمدة المستخرجة فورياً دون أي تدخل بشري، مما يجعلها الخيار الأمثل للوحات التحكم الحية (Dashboards) والنماذج المالية التراكمية. في المقابل، تُنتج الأدوات التفاعلية مخرجات نصية ثابتة ومجردة؛ فإذا تغيرت الخلية المصدرية، لن تتأثر القيم المستخرجة سابقاً إلا بإعادة تشغيل الأداة اليدوية مجدداً.
ورغم جمود الأدوات التفاعلية، إلا أنها تحظى بأفضلية استراتيجية عند التعامل مع ملفات البيانات الضخمة التي تحتوي على مئات الآلاف من الصفوف. فخلو المصنف من الصيغ الحسابية المعقدة يحميه من بطء عمليات إعادة الحساب المتكررة، ويقلل من حجم الملف التخزيني على القرص الصلب، ويسهل تصديره بسلاسة نحو البرمجيات الإحصائية الأخرى كبرنامج R أو منصة SPSS دون القلق من أخطاء عدم توافق الدوال أو تشوه الروابط المرجعية.
8. معالجة الأخطاء وتنظيف البيانات بعد الاستخراج
8.1 التخلص من المسافات البادئة الزائدة بواسطة دالة TRIM
من أكثر المشكلات الخفية التي تواجه محللي البيانات عند استخراج النصوص بعد الفواصل وجود مسافة بيضاء فارغة في مستهل النص المستخرج. تنشأ هذه المشكلة نتيجة العرف اللغوي والطباعي السائد الذي يقضي بإضافة مسافة بعد الفاصلة مباشرة لتفصل بين الكلمات (كما في: “الاسم، المؤهل”). فعندما تقوم الدالة باقتطاع النص الواقع بعد الفاصلة، فإنها تبدأ فوراً من المحرف التالي لها، والذي يكون في معظم الأحيان تلك المسافة الفارغة المزعجة.
رغم أن هذه المسافة قد تبدو غير مرئية للمستخدم العادي، إلا أنها تحمل تداعيات سلبية خطيرة على سلامة النماذج الحوسبية. ففي لغات البرمجة وبرامج الجداول الحسابية، تختلف القيمة ” المحاسب” (بمسافة بادئة) جوهرياً عن القيمة “المحاسب” (بدون مسافة). يؤدي هذا الاختلاف الدقيق إلى فشل ذريع في عمليات المطابقة والبحث المرجعي اللاحقة المعتمدة على دوال المقارنة، مثل دالتي XLOOKUP وVLOOKUP؛ حيث سيعجز البرنامج عن مطابقة النص المستخرج مع الجداول المرجعية الصحيحة.
للقضاء على هذه المعضلة بصورة جذرية، يُطبق البروتوكول المنهجي القائم على تغليف دالة الاستخراج بدالة التطهير النصي TRIM. تتخصص هذه الدالة في إزالة كافة المسافات البادئة والختامية، مع الحفاظ على المسافات الفردية الفاصلة بين الكلمات داخل النص. وتُصاغ المعادلة القياسية المتكاملة على النحو التالي لضمان أقصى درجات النقاء النصي:
=TRIM(TEXTAFTER(A2, “,”))
8.2 معالجة أخطاء الفقدان والغياب باستخدام دالة IFERROR ودالة IFNA
عند معالجة قواعد بيانات كبيرة وغير متجانسة المصادر، يواجه المحلل حتماً حالات تخلو فيها الخلايا المصدرية من محرف الفاصلة كلياً، كأن تُسجل قيمة فردية مستقلة بالخطأ داخل العمود المشترك. في مثل هذه الظروف، يعجز محرك البحث عن رصد الفاصلة المستهدفة، مما يدفعه إلى إيقاف العملية وتوليد رسالة الخطأ القياسية #N/A أو خطأ الحساب #CALC!، وهو ما يشوه المظهر العام للجداول ويعطل سلاسل المعادلات المتتابعة.
لتأمين المصنفات الحسابية ضد هذه الانقطاعات، توفر حزمة إكسل خيارات متعددة لإدارة الأخطاء. يتمثل الخيار الأول في استخدام المعامل الداخلي المخصص داخل دالة TEXTAFTER الحديثة، وهو المعامل السادس (if_not_found). عبر تحديد هذا المعامل، يُمكن توجيه الدالة لإرجاع مخرج بديل محدد مسبقاً، مثل ترك الخلية فارغة تماماً عبر كتابة علامتي تنصيص متتاليتين (“”)، أو إرجاع القيمة المصدرية نفسها في حال غياب الفاصلة، كما توضح الصيغة التالية:
=TEXTAFTER(A2, “,”, , , , A2)
أما في بيئات العمل القديمة أو عند الرغبة في بناء جدار حماية خارجي عام للمعادلات، فيلجأ المحلل إلى تغليف الصيغة الكلية بدالة IFERROR أو دالة IFNA. تعمل هذه الدوال كصمام أمان يتلقى المخرجات ويفحصها؛ فإذا كانت النتيجة صحيحة تُمرر كما هي، وإذا كانت خطأً حسابياً يُستبدل بنص وصفي مناسب، مثل: =IFERROR(TRIM(TEXTAFTER(A2, “,”)), “بيانات غير مكتملة”). يضمن هذا الإجراء الوقائي حماية النماذج التقريرية من الانهيار، ويقدم مؤشرات مرئية تسهل رصد السجلات الناقصة وتدقيقها لاحقاً.
8.3 التحقق من سلامة البيانات الناتجة وتوحيد التنسيقات
تقتضي المعايير الأكاديمية الصارمة في إدارة البيانات عدم الاكتفاء بالاستخراج الظاهري للنصوص، بل يجب التحقق من سلامتها النوعية والوظيفية بعد اكتمال المعالجة. تنص القواعد المنطقية لبرنامج إكسل على أن أي مخرج مستخلص من دالة نصية يُعامل حتماً كسلسلة نصية (Text Data Type)، حتى وإن كان هذا المخرج عبارة عن أرقام صرفة أو قيماً مالية (مثل استخراج ” 500″ بعد الفاصلة). إذا تطلب النموذج إجراء عمليات حسابية أو جمع تراكمي على هذا الرقم، فإن محرك إكسل قد يتجاهله أو يعتبره صفراً ما لم يتم تحويل نوعه بدقة.
لتحويل النصوص الرقمية المستخرجة إلى قيم حسابية حقيقية، تُدمج دالة القيمة VALUE في بنية الصيغة، أو تُجرى عملية حسابية محايدة كإضافة صفر (+0) أو الضرب في واحد (*1)، كما يلي:
=VALUE(TRIM(TEXTAFTER(A2, “,”)))
بالإضافة إلى ذلك، قد تتسلل بعض المحارف غير المرئية أو رموز كسر الأسطر (Line Breaks) ضمن البيانات المستوردة من صفحات الويب أو خوادم المؤسسات. في هذه الحالة، ينبغي دمج دالة التطهير المتقدم CLEAN ضمن الصيغة؛ حيث تتكفل هذه الدالة بحذف أول 32 محرفاً غير قابل للطباعة في ترميز ASCII المعياري، مما ينظف السجل من الشوائب البرمجية غير المرئية.
وأخيراً، يُنصح بتطبيق قواعد التحقق من صحة البيانات (Data Validation) على الأعمدة المستخرجة لضمان مطابقتها للمواصفات المعيارية المعتمدة في الدراسة؛ مثل حظر القيم المتكررة، أو إلزام البيانات بطول محدد، مما يمنح المخرجات موثوقية عالية تجعلها جاهزة للاندماج في أنظمة ذكاء الأعمال المتقدمة.
9. المعالجة المتقدمة باستخدام Power Query وتعبيرات Regular Expressions
9.1 أتمتة استخراج النصوص عبر محرر Power Query
عند الانتقال إلى معالجة قواعد البيانات الضخمة التي تتجاوز طاقتها الاستيعابية ملايين الصفوف، أو عندما يتطلب المشروع بناء مسارات تدفق عمل مؤتمتة وقابلة للتكرار شهرياً، تتراجع أهمية المعادلات الفردية لصالح محرك التكامل والتحويل المتقدم Power Query. يمثل هذا المحرر بيئة استخلاص وتحويل وتحميل (ETL) مدمجة في إكسل تتيح معالجة البيانات النصية وفق أرقى المعايير الصناعية.
لاستخراج النصوص بعد الفاصلة عبر هذا المحرر، يُحدد جدول البيانات وينقر المستخدم على خيار “من جدول/نطاق” (From Table/Range) في تبويب “بيانات”. داخل واجهة المحرر، يحدد المستخدم العمود النصي المستهدف، ثم يتوجه إلى قائمة “تحويل” أو “إضافة عمود” ويختار “تقسيم العمود” (Split Column) ثم “بواسطة المحدد” (By Delimiter). من النافذة المنبثقة، تُحدد “الفاصلة” كمحدد معتمد، وتوفر الأداة خياراً استراتيجياً فائق الأهمية يتمثل في تحديد موقع الانفصال:
- المحدد الموجود في أقصى اليمين (Right-most delimiter): ويماثل استخراج النص بعد الفاصلة الأخيرة كما في مؤشر (-1).
- المحدد الموجود في أقصى اليسار (Left-most delimiter): ويماثل استخراج النص بعد الفاصلة الأولى.
- كل ظهور للمحدد (Each occurrence of the delimiter): ويماثل دالة TEXTSPLIT الشاملة لتوزيع النص على أعمدة متعددة.
تكمن الميزة الاستثنائية لمحرر الاستعلامات في قدرته على تسجيل كل خطوة يخطوها المستخدم في صورة كود برمجي بلغة M المتقدمة. عند حفظ الاستعلام وتحميل البيانات إلى المصنف، يُنشئ البرنامج اتصالاً نشطاً؛ فإذا أُضيفت مئات الملفات الجديدة مستقبلاً داخل مجلد العمل، يكفي النقر على زر “تحديث” (Refresh) ليعيد المحرك تطبيق خطوات التطهير والتقسيم في ثوانٍ معدودة، مما يؤسس لمسار عمل مؤسسي يتمتع بالأتمتة الكاملة وخالٍ من التدخل اليدوي المتكرر.
9.2 توظيف أكواد VBA البرمجية لمعالجة السيناريوهات الاستثنائية
في بيئات العمل القديمة التي تفتقر إلى تراخيص Microsoft 365، أو عند بناء أنظمة مخصصة تتطلب تجاوز القيود المفروضة على واجهة المستخدم الرسومية، تبرز لغة البرمجة المدمجة Visual Basic for Applications (VBA) كخيار فائق الكفاءة. يتيح كود VBA إنشاء دوال مخصصة من تصميم المستخدم (User-Defined Functions – UDF) تؤدي نفس مهام TEXTAFTER بدقة، بل وتتفوق عليها أحياناً في سرعة المعالجة الداخلية للمصفوفات البرمجية المعقدة.
تعتمد هذه الدوال المخصصة على وظيفة التجزئة المدمجة في مكتبات اللغة الأساسية وهي مصفوفة Split. تقوم هذه الدالة بتفكيك السلسلة النصية إلى عناصر مصفوفية بناءً على محرف الفاصلة، وتخزينها في الذاكرة السريعة مع فهرستها بدءاً من الصفر (Zero-based indexing). يوضح الكود المصدري التالي كيفية إنشاء دالة UDF بسيطة ومتقدمة تقوم بمحاكاة استخراج النص بعد الفاصلة الأخيرة في أي إصدار من إصدارات إكسل:
Function ExtractAfterLastComma(CellRef As Range) As String
Dim Parts() As String
If InStr(CellRef.Value, “,”) > 0 Then
Parts = Split(CellRef.Value, “,”)
ExtractAfterLastComma = Trim(Parts(UBound(Parts)))
Else
ExtractAfterLastComma = CellRef.Value
End If
End Function
عند حفظ هذا الكود داخل وحدة نمطية قياسية (Standard Module) في المصنف الحسابي المُمكّن لوحدات الماكرو (بصيغة XLSM)، يصبح بمقدور المستخدم استدعاء الدالة مباشرة في خلايا ورقة العمل بكتابة: =ExtractAfterLastComma(A2). يضمن هذا الحل البرمجي سرعة تنفيذ فائقة؛ حيث يتعامل مباشرة مع المصفوفات النصية داخل المعالج المركزي، متجاوزاً عبء تركيب المعادلات التقليدية، وموفراً استقراراً تشغيلياً شاملاً للمؤسسات ذات البنى التحتية المتنوعة.
9.3 مقدمة لتطبيقات التعبيرات النمطية (RegEx) في استخلاص النصوص المعقدة
عندما تكون البيانات غير متجانسة لدرجة لا تكفي معها الفاصلة وحدها كمحدد قطعي—كأن تتبع الفاصلة أحياناً بأرقام، أو تأتي الفاصلة محاطة بأقواس هلالية أو علامات خاصة تختلف دلالتها باختلاف السياق اللغوي—تصبح التعبيرات النمطية (Regular Expressions – RegEx) هي الحل الحاسوبي النهائي والأقوى على الإطلاق لمعالجة هذه الأنماط الملتوية.
تتيح التعبيرات النمطية صياغة قواعد بحث متطورة تعتمد على المنطق البنيوي للرموز بدلاً من مطابقة المحارف الحرفية. في التحديثات التجريبية الأخيرة لبرنامج إكسل (Insiders)، أضافت مايكروسوفت دوالاً مخصصة للتعبيرات النمطية مثل REGEXTEST وREGEXEXTRACT، مما فتح آفاقاً تحليلية غير مسبوقة. وحتى في غياب هذه الدوال المباشرة، يمكن استدعاء كائن برمجيات ميكروسوفت المعياري (VBScript.RegExp) عبر أكواد VBA لتطبيق أنماط بحث استثنائية.
على سبيل المثال، عبر استخدام نمط التعبير النمطي: “,s*(.*)$”، يمكن للنظام استكشاف أي فاصلة تتبعها مسافات اختيارية بيضاء، ثم التقاط وتجميع كافة المحارف الممتدة حتى نهاية السطر وتمريرها كمخرج مستقل. تكمن عظمة التعبيرات النمطية في قدرتها على التمييز بين الفواصل التي تقع داخل اقتباسات نصية والفواصل التي تمثل حدوداً بنيوية حقيقية، مما يرفع دقة المعالجة اللغوية للبيانات البحثية والأكاديمية المعقدة إلى أعلى المستويات المعروفة في علوم الحوسبة الحديثة.
10. دراسات حالة تطبيقية وأفضل الممارسات الأكاديمية لإدارة البيانات النصية
10.1 دراسة حالة: تصنيف وتفكيك البيانات الشخصية المركبة للكوادر البشرية
في إطار دراسة ميدانية لإدارة الموارد البشرية بإحدى المنظمات التعليمية الكبرى، واجه فريق التحليل قاعدة بيانات ضخمة تحتوي على سجلات الكوادر الأكاديمية مدمجة في حقل أحادي غير مهيكل، وفق الصياغة المعقدة التالية: “د. عبد الله الصالح، أستاذ مشارك في علم البيانات، 14 سنة خبرة، الرياض”. كان الهدف المؤسسي يتمثل في تفكيك هذه الكتلة النصية لفرز كل متغير في عمود مستقل لإنشاء مصفوفة الكفاءات المؤسسية وتحديد مستويات الرواتب وفقاً لسنوات الخبرة.
لتنفيذ هذه الاستراتيجية المنهجية، صمم المحللون خطة استخراج متعددة المراحل اعتمدت بالكامل على صيغ TEXTAFTER وTEXTBEFORE الحديثة:
- استخراج الاسم واللقب: تم تطبيق الصيغة =TRIM(TEXTBEFORE(A2, “,”))، والتي نجحت في حصد “د. عبد الله الصالح” دون أي إضافات وظيفية.
- استخراج المسمى الأكاديمي: طُبقت الصيغة المركبة =TRIM(TEXTBEFORE(TEXTAFTER(A2, “,”, 1), “,”))، والتي عزلت بنجاح قيمة “أستاذ مشارك في علم البيانات” عبر اقتطاع النص المحصور بين الفاصلة الأولى والثانية.
- استخراج سنوات الخبرة: استُخدمت الصيغة =TRIM(TEXTBEFORE(TEXTAFTER(A2, “,”, 2), “,”)) للوصول إلى الحقل الثالث المحصور بين الفاصلة الثانية والثالثة، محققة استخراج “14 سنة خبرة”.
- استخراج النطاق الجغرافي: طُبقت الصيغة المعتمدة على المؤشر السلبي =TRIM(TEXTAFTER(A2, “,”, -1)) لعزل المدينة الختامية “الرياض” ككتلة مستقلة.
أظهرت نتائج التدقيق الميداني انخفاض الوقت المستغرق لتجهيز البيانات من 18 ساعة عمل يدوي متواصل إلى أقل من ثلاث ثوانٍ عبر تعميم الصيغ على كامل العمود. كما بلغت دقة المطابقة الإحصائية 100% لكافة السجلات المتسقة، مما مكن الإدارة من بناء تقارير إحصائية فورية ترصد الكفاءات التعليمية ومستويات الخبرة وتوزيعها الجغرافي، مؤكداً الأثر البالغ للحلول المؤتمتة في رفع الإنتاجية المؤسسية وتطهير السجلات الوظيفية.
10.2 دراسة حالة: معالجة بيانات المبيعات والعناوين الجغرافية اللوجستية
تمثلت دراسة الحالة الثانية في قطاع التجارة الإلكترونية وسلاسل التوريد والخدمات اللوجستية؛ حيث استوردت إحدى الشركات منصة مبيعات عالمية تدون عناوين الشحن بصيغ تجمع بين اللغات والرموز المختلفة. تكمن الصعوبة البالغة في احتواء البيانات على خليط من الفواصل؛ الفاصلة اللاتينية القياسية (,) المستخدمة في السجلات الإنجليزية، والفاصلة العربية التقليدية (،) المستخدمة في السجلات المكتوبة بلغة الضاد، مثل: “المملكة العربية السعودية، منطقة مكة المكرمة، جدة, 21423”.
أدى وجود نوعين مختلفين من محارف الفواصل إلى فشل الصيغ البسيطة التي تبحث عن نوع واحد فقط. لتجاوز هذا التحدي التقني المعقد، طبق الفريق استراتيجية استباقية مزدوجة؛ تمثلت الخطوة الأولى في توحيد المحددات النصية داخل الخلية المصدرية عبر استخدام دالة الاستبدال SUBSTITUTE لتحويل الفاصلة العربية إلى فاصلة إنجليزية معيارية وفق الصياغة الوسيطة:
=SUBSTITUTE(A2, “،”, “,”)
بعد ضمان اتساق الفواصل النصية في السلسلة بأكملها، تم تمرير هذا النص الموحد مباشرة إلى دالة الاستخراج المتقدمة: =TRIM(TEXTAFTER(SUBSTITUTE(A2, “،”, “,”), “,”, -1)). استطاعت هذه الصيغة استخلاص الرمز البريدي “21423” بدقة متناهية عبر استهداف الفاصلة الأخيرة أياً كان أصلها اللغوي. ساهم هذا الحل في توجيه آلاف الشحنات البريدية دون تأخير، وأتاح تصنيف المبيعات جغرافياً وتوليد تقارير أداء تفاعلية ساعدت متخذي القرار في تحسين مسارات الشحن وتقليص التكاليف اللوجستية بصورة ملموسة.
10.3 مصفوفة المعايير لاختيار الأسلوب الأمثل للاستخراج وفقاً لبيئة العمل
لإرشاد الباحثين والممارسين نحو الاختيار العلمي السديد للأداة المناسبة وفق ظروف مشروعاتهم الحوسبية، نورد فيما يلي مصفوفة المعايير التحليلية التي تلخص نقاط القوة والضعف والبيئة الموصى بها لكل منهجية جرى استعراضها في هذا المرجع:
| الأسلوب المنهجي | المزايا الرئيسية | العيوب والقيود | البيئة الموصى بها للتطبيق |
|---|---|---|---|
| صيغ TEXTAFTER الحديثة | سهولة فائقة في الصياغة، مرونة عالية عبر مؤشرات التكرار الموجبة والسالبة، ودعم مصفوفات الانسكاب. | عدم التوافق العكسي مع إصدارات إكسل 2019 والإصدارات الأقدم؛ تتطلب اشتراك Microsoft 365. | المشروعات المعاصرة، لوحات التحكم الديناميكية، والمؤسسات التي تطبق أحدث التراخيص السحابية. |
| الدوال الكلاسيكية (RIGHT/MID/FIND) | توافقية شمولية مع كافة إصدارات إكسل التاريخية، واستقرار تام على جميع الأجهزة دون أخطاء برمجية. | صعوبة القراءة والصيانة، طول المعادلات المفرط، والحاجة لحيل معقدة عند التعامل مع الفواصل المتعددة. | المصنفات المشتركة مع جهات خارجية غير معلومة التراخيص، والبيئات المؤسسية التي تعتمد نسخاً قديمة. |
| أداة Text to Columns | بساطة وسرعة فائقة عبر واجهة المستخدم الرسومية، دون الحاجة لكتابة أي معادلات برمجية إطلاقاً. | مخرجات ثابتة وغير متجاوبة مع تحديثات البيانات؛ قد تستبدل البيانات الأصلية إذا لم تُحدد الوجهة بدقة. | معالجة الملفات الكبيرة لمرة واحدة، التجهيز السريع للبيانات قبل التصدير للبرمجيات الإحصائية. |
| محرر Power Query | أتمتة شاملة لخطوات التنظيف والتقسيم، معالجة ملايين السجلات بكفاءة، وربط التحديثات بمصادر البيانات. | منحنى تعلم مرتفع نسبياً؛ يتطلب فهم بيئة الاستعلامات المستقلة ولغة M المتقدمة. | المشروعات الضخمة، قواعد البيانات التراكمية، مسارات استخراج وتحويل البيانات المؤسسية (ETL). |
| البرمجة النصية (VBA / RegEx) | مرونة برمجية مطلقة للتعامل مع الشواذ والاستثناءات اللغوية، وسرعة فائقة عبر المعالجة المباشرة في الذاكرة. | تتطلب حفظ المصنف بصيغة ممكّنة للماكرو (XLSM)، مما قد يثير تحذيرات الأمان في بعض الشبكات. | الأنظمة المؤتمتة المخصصة، والتطبيقات الأكاديمية التي تتطلب معالجة لغوية متقدمة وفحصاً سياقياً للبيانات. |
تؤكد هذه المصفوفة المعيارية أن احتراف العمل في بيئة برنامج إكسل لا يقتصر على حفظ الدوال، بل يتجلى في القدرة على الموازنة الاستراتيجية بين البدائل المتاحة، واختيار الأداة التي تضمن أعلى درجات الدقة والفاعلية الحسابية، مع حماية تكامل البيانات وصون وقت وجهد المحلل وفريق العمل على المدى الطويل.
خاتمة
استعرض هذا الدليل الأكاديمي الموسع الأبعاد المنهجية والتطبيقية المرتبطة باستخراج النصوص الواقعة إلى يمين الفاصلة أو ما يليها في بيئة برنامج مايكروسوفت إكسل. وقد تبين بجلاء كيف نقلت دالة TEXTAFTER الحديثة عمليات تجزئة البيانات من حيز التراكيب الحسابية الكلاسيكية المعقدة—التي دمجت لعقود بين دوال RIGHT وLEN وMID وFIND—إلى فضاء الدقة الإجرائية المباشرة، من خلال وسائط مرنة تمكن المحلل من التحكم في اتجاه المسح واستهداف الفواصل الفردية أو الأخيرة أو المخصصة عبر مؤشرات التكرار المتقدمة.
كما بينت المباحث التطبيقية أن جودة البيانات المستخرجة لا تتوقف عند حدود كتابة الصيغة الأولية فحسب، بل تستلزم تطبيق بروتوكولات صارمة لتطهير السجلات، وفي مقدمتها دمج دالة TRIM للتخلص من المسافات البادئة الشائعة التي تعقب الفواصل، وتوظيف دوال معالجة الأخطاء مثل IFERROR لضمان استقرار المصنفات. وتظل الأدوات المؤتمتة مثل Power Query والحلول البرمجية عبر VBA خيارات استراتيجية تعزز الكفاءة التشغيلية عند التعامل مع بيئات العمل المتنوعة والبيانات الضخمة، مما يجعل الإحاطة بهذه التقنيات مجتمعة ضرورة لازمة لأي باحث أو محلل يسعى إلى الارتقاء بموثوقية أبحاثه ونماذجه الحسابية المعاصرة.
المراجع
- مايكروسوفت. (2024). الدالة TEXTAFTER. دعم مايكروسوفت. https://support.microsoft.com/ar-sa/office/textafter-%D8%A7%D9%84%D8%AF%D8%A7%D9%84%D8%A9-textafter-2904b236-1fee-4b63-940a-30d181df8077
- مايكروسوفت. (2024). الدالة TEXTSPLIT. دعم مايكروسوفت. https://support.microsoft.com/ar-sa/office/textsplit-%D8%A7%D9%84%D8%AF%D8%A7%D9%84%D8%A9-textsplit-b13e54de-5b29-430f-b44c-c045b4cff51b
- مايكروسوفت. (2024). الدالة XLOOKUP. دعم مايكروسوفت. https://support.microsoft.com/ar-sa/office/xlookup-%D8%A7%D9%84%D8%AF%D8%A7%D9%84%D8%A9-xlookup-b7fd680e-6d10-43e6-84f9-88eae8bf5929
- مايكروسوفت. (2023). توثيق Power Query. مايكروسوفت ليرن. https://learn.microsoft.com/ar-sa/power-query/
- ألكسندر، م.، ووالكنباخ، ج. (2019). إكسل 2019: المعادلات والوظائف. دار وايلي للنشر.
- فريزيل، ج. (2022). إتقان الدوال الديناميكية في Microsoft 365. دار بريس للنشر والتوزيع.