
تعد معالجة البيانات وتصنيفها حجر الزاوية في بناء النماذج التحليلية المتقدمة، سواء كان ذلك في بيئات الأعمال المؤسسية أو ضمن أطر البحوث الأكاديمية والكمية. ويمثل برنامج مايكروسوفت إكسل (Microsoft Excel) الأداة الأكثر انتشاراً لإدارة هذه البيانات، حيث تطور من مجرد جدول حسابي إلكتروني تقليدي إلى بيئة حوسبة متكاملة قادرة على معالجة ملايين السجلات وتحليلها بدقة بالغة. ومع تزايد حجم البيانات وتعقد هياكلها، باتت الحاجة ملحة لعزل قواعد البيانات الخام عن واجهات العرض والتقارير التحليلية، تجنباً للخلط التشغيلي والخطأ البشري. ومن هنا يبرز موضوع تصفية البيانات من ورقة عمل أخرى كإحدى المهارات الجوهرية والمنهجية التي تضمن تكامل النماذج المالية والتحليلية واستدامتها، متيحة للمستخدم استخلاص السجلات التي تطابق معايير محددة بمرونة فائقة وتلقائية تامة.
تاريخياً، كانت عملية استدعاء البيانات المصفاة من ورقة عمل إلى أخرى تخضع لأساليب معقدة تتسم بالجمود أو استهلاك الموارد الحاسوبية، مثل صيغ الصفائف المركبة أو أدوات التصفية اليدوية التي تتطلب تدخلاً مستمراً من المحلل لإعادة تشغيلها كلما طرأ تحديث على البيانات. غير أن الثورة التقنية التي أحدثتها شركة مايكروسوفت بإطلاق محرك الحساب الديناميكي للدوال في عام 2018 وإتاحة دالة التصفية FILTER ضمن إصدارات Microsoft 365 وExcel 2021، أعادت صياغة هندسة الجداول الحسابية برمتها. وقد تحولت التصفية بفضل هذه التحديثات من مجرد أمر ثابت يُطبق على أعمدة محددة إلى عملية برمجية فورية تعتمد على المصفوفات المنسكبة (Spilled Arrays)، مما يتيح انعكاس التغييرات الطارئة على البيانات المصدرية في شاشات التقارير ولحظة بلحظة دون أي تدخل يدوي.
يهدف هذا الدليل المرجعي الموسع إلى تقديم تشريح أكاديمي وعملي شامل لكيفية تصفية البيانات عبر أوراق العمل في بيئة إكسل. سنستعرض بالتفصيل الأسس الرياضية والمنطقية التي تحكم عمل دالة FILTER، وكيفية التعامل مع مراجع الأوراق الخارجية والصياغات المركبة المعقدة، إضافة إلى دراسة آليات استكشاف الأخطاء ومعالجتها، وسبل تعظيم الكفاءة الحاسوبية في المصنفات الضخمة. كما سيغطي المقال البدائل الكلاسيكية لمن لا يزالون يعملون على إصدارات أقدم من البرنامج، معززاً ذلك بحالات دراسية تطبيقية في مجالات الإدارة الأكاديمية والأعمال، لتزويد القارئ بفهم تطبيقي راسخ يرفع من جودة ودقة معالجة البيانات ونمذجتها.
1. الأسس النظرية لتصفية البيانات المتقاطعة بين أوراق العمل في إكسل
1.1 مفهوم التصفية الديناميكية ونشأة المصفوفات المنسكبة
شهدت معمارية الحوسبة داخل برنامج إكسل تحولاً جذرياً مع تقديم محرك “المصفوفات الديناميكية” (Dynamic Arrays)، الذي غيّر الفلسفة التقليدية لارتباط الخلية الواحدة بالصيغة الحسابية الفردية. في النموذج التقليدي المستقر لعقود، كانت الصيغة الحسابية المدخلة في خلية معينة لا تستطيع سوى إرجاع قيمة واحدة ضمن حدود تلك الخلية، ما لم يتم إدخالها كصيغة صفيف كلاسيكية عبر الضغط المتزامن على أزرار لوحة المفاتيح (Ctrl + Shift + Enter)، وهي آلية اتسمت بالتعقيد وصعوبة الصيانة وارتفاع احتمالية تلف المراجع. مع إطلاق محرك الحساب الجديد، أصبحت الدالة قادرة على توليد مصفوفة متعددة الصفوف والأعمدة تنحدر تلقائياً من خلية الجذر إلى الخلايا المجاورة في مسار غير مقيد يُعرف اصطلاحاً بنطاق الانسكاب (Spill Range).
تتجلى التصفية الديناميكية القائمة على الدوال الرياضية بوصفها نقيضاً بنيوياً لأدوات التصفية الثابتة (Static Filters) المتوفرة في واجهة المستخدم الرسومية. فأدوات التصفية التقليدية تعمل فقط على إخفاء الصفوف التي لا تطابق الشروط داخل النطاق ذاته دون نقلها، مما يجعلها عرضة للانهيار في حال تطبيق فرز جديد أو استدعاء صيغ حسابية تعتمد على مجاميع جزئية متأثرة بالرؤية. في المقابل، فإن التصفية الحسابية عبر دالة FILTER تقوم بإنشاء مجموعة بيانات جديدة ومستقلة تشتق بنيتها من النطاق المصدر دون التعديل عليه، مما يتيح للمحلل عرض البيانات المصفاة في بيئة عرض معزولة مع الاحتفاظ بسجل البيانات الأصلي كما هو دون أي تشويه أو إخفاء ميكانيكي للصفوف.
تتأكد أهمية هذا التحول عند دراسة موثوقية النماذج؛ إذ تتيح التصفية الديناميكية عزل البيانات الخام (Raw Data) في أوراق عمل مخصصة للقراءة والتسجيل فقط، بينما تُخصص أوراق عمل أخرى كواجهات تفاعلية للعرض (Presentation Layer). هذا الفصل يقلل من المخاطر التشغيلية الناتجة عن التعديل العرضي للبيانات ويوفر حماية هيكلية ضد مسح المعادلات أو تشويه ترتيب السجلات، وهو مبدأ أساسي من مبادئ الحوسبة السليمة يضمن بقاء أصول البيانات نقية وقابلة للتدقيق في أي وقت.
1.2 أهمية الربط بين أوراق العمل في النمذجة الأكاديمية والمهنية
تستند النمذجة الاحترافية في جداول البيانات إلى مبدأ راسخ مستعار من هندسة البرمجيات وقواعد البيانات العلائقية، وهو مبدأ “فصل الاهتمامات” (Separation of Concerns). يقضي هذا المبدأ بضرورة تقسيم المصنف إلى طبقات وظيفية مستقلة: طبقة تخزين البيانات الخام، وطبقة المعالجة والحسابات الوسيطة، وطبقة التقارير ولوحات التحكم (Dashboards). إن تطبيق التصفية عبر أوراق العمل المختلفة يحقق هذا المبدأ بأعلى درجات الانضباط، إذ يمكن تجميع مئات الآلاف من السجلات التاريخية في ورقة خلفية محمية، في حين تستخدم الورقة المخصصة للإدارة أو الباحث لاستعراض شرائح نوعية محددة فقط بناءً على محددات ديناميكية يجري اختيارها من قوائم منسدلة.
يسهم هذا الأسلوب المعماري في الحد من تكرار البيانات (Data Redundancy) إلى أدنى حد ممكن. فعوضاً عن قيام المستخدم بنسخ السجلات المطابقة لفرع تجاري معين أو لفئة معينة من عينة البحث في أوراق متعددة—وهو ما يقود حتماً إلى تناقض البيانات عند حدوث أي تعديل لاحق في الملف الأصلي—يتم الاحتفاظ بنسخة حقيقية واحدة للبيانات داخل الورقة المصدرية. بمجرد تعديل أي قيد أو إضافة متغيرات جديدة في تلك الورقة، تنعكس التحديثات آنياً في جميع أوراق العمل المعتمدة عليها التي تتبنى صيغ التصفية الديناميكية المتقاطعة، مما يضمن الاتساق الداخلي (Internal Consistency) للمصنف ككل.
علاوة على ذلك، يسهل هذا الترابط عمليات التدقيق والمراجعة للبيانات المعقدة ذات الأبعاد المتعددة، لا سيما في البيئات البحثية والأكاديمية التي تتطلب تتبع خطوات تنظيف وتصفية العينات بدقة؛ مثل دراسات القياس النفسي والاستبيانات متعددة المراحل. يستطيع المراجع فحص مسار الصيغة الحسابية التي تربط الورقتين والتحقق من الشروط المطبقة دون الحاجة إلى فحص يدوي للصفوف المخفية أو الاعتماد على التوثيق الخارجي، الأمر الذي يعزز من قابلية التكرار (Replicability) والشفافية في معالجة البيانات.
2. البنية التركيبية والقواعد النحوية لدالة FILTER
2.1 تحليل المعاملات الأساسية للدالة FILTER
تتأسس دالة التصفية على بنية تركيبية صارمة تتألف من ثلاثة معاملات (Arguments)، اثنان منها إجباريان والثالث اختياري، وتُكتب صياغتها الأساسية في بيئة إكسل على النحو التالي:
=FILTER(array, include, [if_empty])
حيث يؤدي كل معامل وظيفة خوارزمية محددة تضمن استخلاص البيانات وتدفقها في مصفوفة النتائج بدقة وسرعة:
- معامل المصفوفة (
array): يمثل هذا المعامل النطاق المصدر المراد استرجاع البيانات منه، وقد يكون نطاقاً أحادي العمود أو متعدداً، أو جدولاً مهيكلاً، أو حتى مصفوفة مستخرجة من دالة حسابية أخرى. يجب أن يحتوي هذا النطاق على كافة الأعمدة والصفوف التي يرغب المحلل في عرضها في النتيجة النهائية. ومن الأهمية بمكان إدراك أن هذا المعامل لا يفرض أي شروط بحد ذاته، بل يحدد فقط البيانات الخام المرشحة للعرض. - معامل الشرط (
include): هو التعبير المنطقي الذي يقود عملية التصفية الفعلية. يطلب هذا المعامل مصفوفة من القيم البوليانية (Boolean Values) المكونة حصراً من قيمتي “صواب” (TRUE) أو “خطأ” (FALSE)، الناتجة عن مقارنة نطاق معين بقيمة أو معيار محدد. تتولى الدالة مسح هذه المصفوفة واستخراج السجلات من المعامل الأول فقط عند مواضع القيم المقابلة لـTRUEوتجاهل تلك المرتبطة بـFALSE. ويشترط بصورة قطعية أن يكون هذا النطاق متطابقاً في بعده الأحادي (عدد الصفوف أو الأعمدة) مع المعامل الأول. - معامل القيمة البديلة (
[if_empty]): يُعد هذا المعامل صمام أمان لمنع انهيار النماذج الحسابية، وهو معامل اختياري يُستخدم لتعريف النتيجة التي ينبغي إرجاعها في حال أسفر فحص معامل الشرط عن عدم وجود أي سجلات مطابقة (أي عندما تكون كافة عناصر المصفوفة البوليانيةFALSE). في حال إغفال هذا المعامل وعجز الدالة عن إيجاد نتائج، ستُرجع الدالة رمز الخطأ الحسابي#CALC!، وهو ما قد يشوه المظهر العام للتقارير أو يتسبب في توقف دوال أخرى متصلة بها.
إن الفهم العميق لهذه المعاملات هو الأساس في كتابة نماذج رياضية خالية من العيوب، حيث يضمن الربط الصحيح بين معامل المصفوفة ومعامل الشرط كفاءة فائقة في استرجاع السجلات عبر أوراق العمل دون إهدار موارد المعالجة.
2.2 قواعد كتابة مراجع أوراق العمل الخارجية
عند استخدام دالة FILTER للإشارة إلى بيانات تقع في ورقة عمل مختلفة داخل نفس المصنف، يفرض إكسل قواعد نحوية (Syntax Rules) دقيقة لضبط مسارات البيانات ومنع اللبس المرجعي. تتلخص القاعدة القياسية في كتابة اسم ورقة العمل المصدرية متبوعاً مباشرة بعلامة التعجب الإنجليزية (!) ثم عنوان النطاق المستهدف، كما في النموذج التالي:
DataSheet!A2:D500
تشير هذه الصياغة بوضوح إلى النطاق الممتد من الخلية A2 إلى D500 والواقع حصراً في ورقة العمل المسماة “DataSheet”.
تتعقد القواعد النحوية قليلاً إذا كان اسم ورقة العمل الخارجية يحتوي على مسافات فاصلة (Spaces) أو رموز خاصة (Special Characters) أو يبدأ بأرقام؛ وفي هذه الحالات، يلزم وضع اسم الورقة كاملاً بين علامتي اقتباس أحاديتين (Single Quotation Marks) تسبقان علامة التعجب، على النحو التالي:
'Raw Data 2024'!A2:D500
إذا أُهملت هذه العلامات عند كتابة الصيغ يدوياً، سيفشل إكسل في تحليل المسار وسيُطلق تنبيهاً بالخطأ التركيبي للصيغة. لذا يُنصح دائماً باستخدام مؤشر الفأرة لاختيار النطاقات مباشرة من الورقة المصدرية أثناء كتابة الصيغة ليقوم إكسل بتطبيق التنسيق المعياري تلقائياً دون أخطاء كتابية.
تكتسب مسألة “تثبيت النطاقات” (Range Anchoring) أهمية كبرى عند التعامل مع المراجع الخارجية. على الرغم من أن دالة FILTER تُكتب في خلية واحدة وتنسكب تلقائياً، إلا أن تثبيت مراجع النطاقات باستخدام علامة الدولار ($) — مثل تحويل النطاق إلى 'DataSheet'!$A$2:$D$500 — يظل ممارسة موصى بها لحماية الصيغة من الانزياح غير المقصود عند سحبها إلى خلايا مجاورة لتطبيق شروط أخرى، مما يضمن اتساق حدود البحث وثباتها عبر كافة طبقات النمذجة التحليلية.
3. خطوات تطبيق التصفية من ورقة عمل أخرى عملياً
3.1 تهيئة ورقة البيانات المصدرية وضبط النطاقات
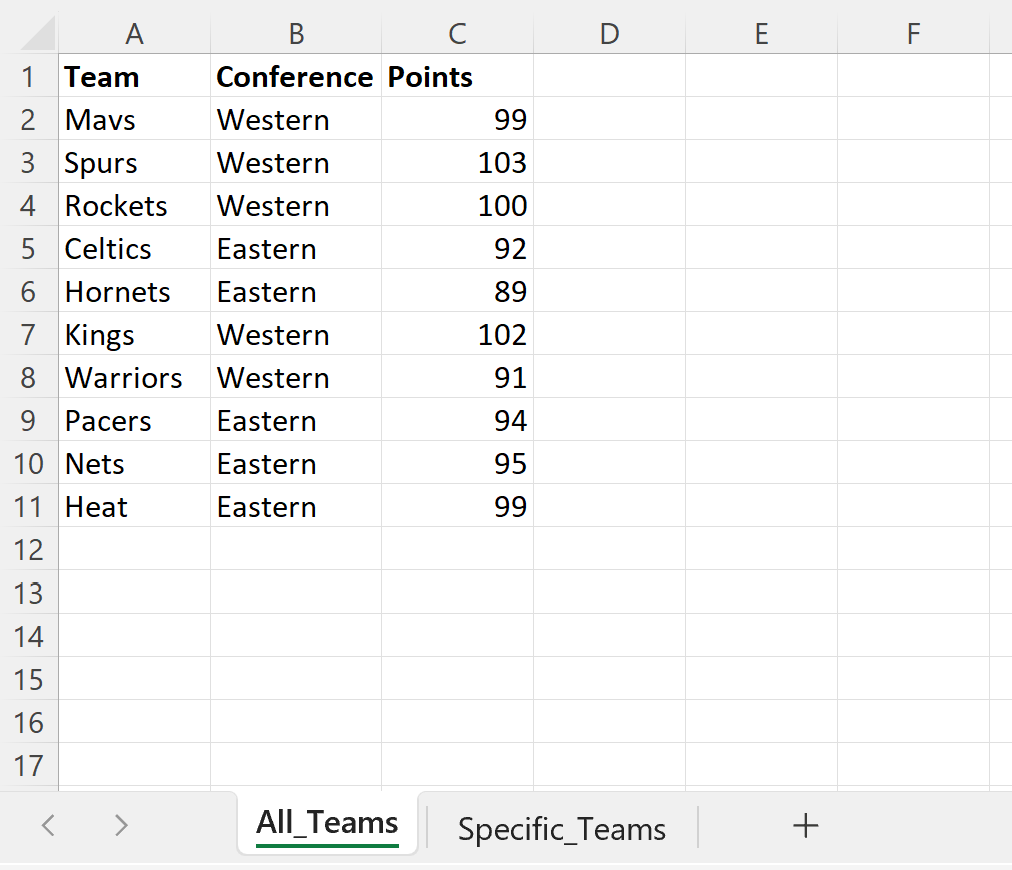
تبدأ كفاءة التصفية من جودة البيانات في ورقتها الأصلية؛ فالصيغ البرمجية تعتمد على قواعد المقارنة المنطقية الصارمة، وأي خلل بنيوي في البيانات المصدرية سيقود بالضرورة إلى مخرجات مصفاة مشوهة أو ناقصة. تتمثل الخطوة الأولى في فحص سلامة السجلات داخل الورقة المصدرية، والتحقق من عدم وجود صفوف مدمجة (Merged Cells) أو فراغات هوائية غير مبررة تفصل بين السجلات. ينبغي تنظيف النصوص من المسافات البادئة أو اللاحقة الخفية باستخدام دالة TRIM مسبقاً، إذ إن وجود مسافة واحدة في نهاية كلمة معينة في الورقة المصدرية سيجعلها غير مطابقة لنفس الكلمة المكتوبة في معيار التصفية، مما يؤدي إلى استبعاد السجل خطأً.
الخطوة الحيوية التالية هي توحيد أنماط البيانات (Data Types) داخل كل عمود. لا يمكن لإكسل إجراء تصفية ناجحة إذا كانت بعض الأرقام أو التواريخ مخزنة كنصوص داخل الورقة المصدرية؛ فعمليات المقارنة المنطقية تفشل في معاملة الرقم المخزن كنص بالطريقة ذاتها المتبعة مع القيمة الحسابية الحقيقية. يتطلب ذلك تطبيق تنسيق موحد لكامل العمود والتأكد من تحويل التواريخ إلى أرقام تسلسلية صحيحة تتبع المعيار الزمني للنظام.
أخيراً، يجب تحديد حدود النطاق المستهدف بدقة متناهية؛ إذ يُفضل استبعاد رؤوس الأعمدة (Headers) من نطاق التصفية المباشر، وتطبيق الصيغة فقط على صفوف البيانات الفعلية (مثل البدء من الصف الثاني A2:D500 بدلاً من A1:D500). يمكن نسخ رؤوس الأعمدة يدوياً إلى ورقة العرض ووضعها كثوابت نصية فوق النطاق المتوقع لانسكاب النتائج، مما يحافظ على التنسيق البصري للرؤوس ويعزلها عن أي إعادة ترتيب قد تطرأ على البيانات المسترجعة.
3.2 كتابة وتطبيق صيغة التصفية في الورقة المستهدفة
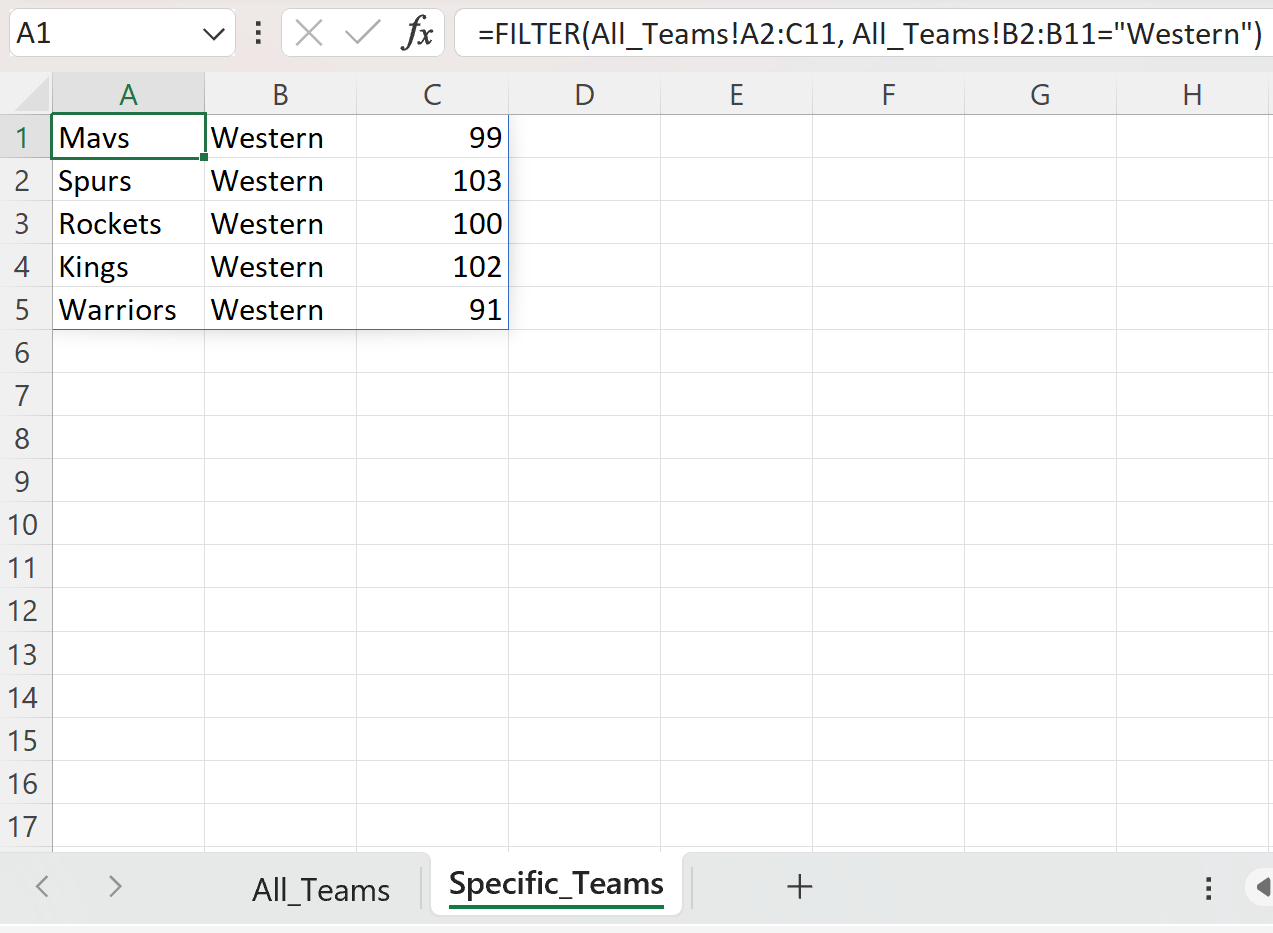
بعد تجهيز البيانات المصدرية، يتم الانتقال إلى الورقة المستهدفة (ورقة العرض أو التحليل) لاختيار الموضع الاستراتيجي لظهور البيانات المصفاة. يتم التوجه إلى الخلية العلوية اليسرى (أو اليمنى، بحسب اتجاه واجهة المصنف) التي ستكون نقطة الارتكاز لانسكاب البيانات. يُشترط خلو المنطقة الواقعة أسفل هذه الخلية ويمينها من أي نصوص أو أرقام أو تعليقات مسبقة لضمان توفير مسار انسكاب حر للمصفوفة القادمة من الورقة الأخرى.
تتم كتابة الدالة باتباع النمط القياسي للربط بين الأوراق. على سبيل المثال، إذا كانت الورقة المصدرية تسمى MasterData، ونرغب في استرجاع كافة الأعمدة من A إلى D للسجلات التي ينتمي فيها المدخل في العمود C إلى “قسم المحاسبة”، تُكتب الصيغة على النحو التالي:
=FILTER(MasterData!$A$2:$D$500, MasterData!$C$2:$C$500 = "المحاسبة", "لا توجد نتائج مطابقة")
عند الضغط على مفتاح الإدخال (Enter)، يرسل محرك الحساب إشارة إلى الورقة المصدرية لمسح النطاق المرجعي ومطابقة كل صف على حدة بالمعيار المنطقي المذكور، ليعود في أجزاء من الثانية بمصفوفة تحتوي فقط على السجلات المتوافقة.
يلاحظ المستخدم فور تنفيذ الدالة ظهور إطار أزرق رفيع يحيط بكامل مصفوفة البيانات المنسكبة في ورقة العرض؛ هذا الإطار هو مؤشر نطاق الانسكاب الديناميكي. وتكون الصيغة الفعلية محفورة فقط في الخلية الأولى التي كُتبت بها، في حين تظهر خلايا المصفوفة الأخرى الصيغة بلون رمادي باهت في شريط الصيغ غير قابلة للتعديل الفردي، مما يؤكد خضوع كامل النطاق للمعادلة الأم المنبثقة من الخلية الأولى.
3.3 تفعيل التحديث التلقائي للبيانات المصفاة
تعتبر الفورية الزمنية (Real-time Reactivity) أبرز سمات التصفية القائمة على الدوال مقارنة بالأدوات اليدوية القديمة. وبمجرد إنشاء رابط الصيغة بين الورقة المستهدفة والورقة المصدرية، يدخل مصنف إكسل في حالة رصد مستمرة؛ فإذا قام مستخدم بتعديل إحدى القيم في العمود C داخل الورقة المصدرية لتصبح “المحاسبة”، يدرك محرك الحساب أن شجرة الاعتماديات (Dependency Tree) للمصنف قد تغيرت، فيقوم فوراً بإعادة تقييم دالة FILTER وتوسيع نطاق الانسكاب في ورقة العرض ليضم السجل الجديد دون الحاجة إلى تنشيط الصيغة أو الضغط على أي زر تحديث.
تتجلى قوة هذا التحديث أيضاً في سيناريو حذف المدخلات أو تعديلها إلى قيم لا تطابق الشرط؛ حيث تتقلص مصفوفة النتائج في ورقة العرض آنياً، ويُعاد ضبط أبعاد الإطار الديناميكي ليتطابق مع عدد الصفوف المتبقية. وتعد هذه الديناميكية ميزة حاسمة تمنع تراكم المخرجات القديمة أو تداخل البيانات المحدثة مع السجلات المتقادمة، وهي علة شائعة كانت تصيب أدوات التصفية المتقدمة القديمة ومستندات الماكرو اليدوية.
ومع ذلك، ينبغي على مصممي النماذج مراقبة كفاءة التحديث الحسابي في المصنفات التي تتضمن آلاف السجلات. فالتحديث التلقائي الفوري يعني أن إكسل سيعيد فحص نطاق المقارنة المنطقي بالكامل عند حدوث أي تعديل يمس النطاقات المرجعية؛ ولذلك، يجب ضبط حدود النطاق المصدر بدقة متوازنة تكفي لاستيعاب التوسعات المستقبلية دون إغراق الذاكرة في فحص مئات الآلاف من الصفوف الفارغة، وهو ما سنفصله لاحقاً في قسم تحسين الأداء.
4. التصفية المتقدمة باستخدام الشروط المتعددة عبر أوراق العمل
4.1 تطبيق المعامل المنطقي ‘AND’ عبر الضرب الجبري
تقتضي التحليلات المعقدة عادةً إخضاع البيانات لأكثر من شرط متزامن؛ مثل تصفية المعاملات التي تمت في “الفرع الشمالي” وبلغت قيمتها أكثر من “10,000 ريال”. في دالة FILTER التقليدية، لا يمكن استخدام الدالة المنطقية القياسية AND داخل معامل الشرط include؛ والسبب الرياضي في ذلك يعود إلى أن الدالة AND تقوم باختزال مصفوفة كاملة من القيم المنطقية إلى قيمة مفردة واحدة (TRUE أو FALSE)، وهو ما يتعارض مع متطلبات الدالة التي تشترط الحصول على مصفوفة بوليانية ذات أبعاد مساوية لعدد صفوف النطاق المصدر.
لحل هذه المعضلة الهيكلية، يعتمد محرك إكسل على الجبر البولياني (Boolean Algebra) عبر استخدام عملية الضرب الحسابي بنجمة (*) بين الشروط المحاطة بأقواس. من منظور منطقي ورياضي، تعامل بيئة إكسل القيمة TRUE على أنها المكافئ الرقمي لـ 1، والقيمة FALSE على أنها 0. عند ضرب شرطين، يكون الناتج الرياضي 1 (أي TRUE) فقط إذا كان كلا الشرطين صحيحين (1 * 1 = 1)، بينما إذا سقط أحد الشرطين أو كلاهما، تصبح النتيجة صفراً (أي FALSE)، وهو التجسيد الجبري الدقيق لبوابة العطف المنطقي “AND”.
تتم صياغة التصفية متعددة الشروط عبر أوراق العمل بحصر كل تعبير شرطي بين قوسين مستقلين والربط بينهما بعلامة الضرب، كالتالي:
=FILTER(SalesData!$A$2:$E$1000, (SalesData!$B$2:$B$1000 = "الشمال") * (SalesData!$D$2:$D$1000 >= 10000), "لا توجد معاملات مطابقة")
تتيح هذه المنهجية دمج شروط نصية وزمنية وكمية بدقة متناهية، كأن يتم فحص اسم العميل وتاريخ المعاملة وقيمتها في آن واحد بالرجوع إلى أعمدة متفرقة في الورقة المصدرية.
4.2 تطبيق المعامل المنطقي ‘OR’ عبر الجمع الجبري
في حالات أخرى، يرغب المحلل في استرجاع سجلات تحقق أحد الشروط المتعددة دون اشتراط تزامنها؛ كاستدعاء المعاملات الخاصة بفرع “الرياض” أو فرع “جدة”، أو استخراج السجلات التي يكون فيها تقييم الأداء “ممتازاً” أو تتجاوز المبيعات حداً استثنائياً. وكما هو الحال مع المعامل السابق، تفشل الدالة القياسية OR للأسباب البنيوية ذاتها المتعلقة باختزال المصفوفات إلى قيمة واحدة.
البديل الرياضي المعتمد في المصفوفات الديناميكية هو الجمع الجبري باستخدام علامة الجمع (+) بين الشروط المحاطة بأقواس. في الجبر البولياني، يؤدي جمع القيم المنطقية إلى ناتج أكبر من الصفر عند تحقق أي شرط؛ فإذا تحقق أحد الشرطين (1 + 0 = 1) أو تحقق كلاهما (1 + 1 = 2)، فإن إكسل يفسر أي قيمة عددية موجبة لا تساوي الصفر على أنها TRUE، مما يسمح بمرور السجل واستدعائه إلى ورقة العرض. أما إذا فشل كلاهما (0 + 0 = 0)، فيفسر الصفر كقيمة FALSE ويُستبعد السجل.
تأخذ صياغة الاسترجاع الاختياري عبر أوراق العمل الشكل التالي:
=FILTER(SalesData!$A$2:$E$1000, (SalesData!$B$2:$B$1000 = "الرياض") + (SalesData!$B$2:$B$1000 = "جدة"), "لا توجد بيانات مطابقة")
هذا النمط يسمح بدمج فئات متباينة دون التورط في تكرار السجلات؛ إذ إن محرك الدالة يعالج الصف مرة واحدة بناءً على المجموع المنطقي، متفادياً الازدواجية التي قد تنتج لو تم نسخ وتجميع البيانات بأساليب يدوية.
4.3 دمج العمليات المنطقية المعقدة (المختلطة)
تتطلب السيناريوهات المتقدمة في نمذجة بيانات الأعمال صياغة شروط مركبة تخلط بين الإلزامية والاختيارية (Combined AND/OR Logic). على سبيل المثال: قد يتطلب التقرير استخراج بيانات المعاملات التي تمت خلال العام الحالي حصراً (شرط إلزامي)، شريطة أن تكون المعاملة تابعة لقطاع “التجزئة” أو صادرة عن فرع “الدمام” (شرط اختياري مركب). تكمن الخطورة هنا في أسبقية العمليات الحسابية؛ فالضرب يسبق الجمع في القواعد الرياضية، مما يعني أن غياب الأقواس الهيكلية سيقود إلى معالجة خاطئة تماماً للبيانات.
لضمان التنفيذ المنطقي السليم، تُستخدم الأقواس التجميعية لتغليف الأجزاء الاختيارية وفصلها عن الأجزاء الإلزامية بدقة استقرائية، كما يوضح النموذج التالي:
=FILTER(Records!$A$2:$F$2000, (Records!$C$2:$C$2000 = 2024) * ((Records!$D$2:$D$2000 = "التجزئة") + (Records!$E$2:$E$2000 = "الدمام")), "لا تنطبق الشروط")
في هذا التركيب، يُجبر إكسل على تقييم ناتج الجمع البولياني الداخلي أولاً لحسم الاختيار بين التجزئة والدمام، ثم ضرب الناتج المتبقي في الشرط السنوي الإلزامي، مما يضمن خروج البيانات وفق المحددات المستهدفة دون تشويه.
ينبغي عند بناء هذه التعبيرات المنطقية المعقدة تفكيكها تدريجياً واختبارها عبر عينات مصغرة من الورقة المصدرية؛ للتأكد من أن السلوك الحسابي يتطابق مع المنطق النظري المفترض للدراسة، مع الحفاظ على التوثيق المستمر لأبعاد الأقواس الرياضية لتفادي أخطاء التركيب المعقدة.
5. الأخطاء الشائعة في دالة FILTER واستراتيجيات معالجتها
5.1 معالجة خطأ اختلاف أحجام النطاقات (#VALUE!)
يُعد ظهور خطأ القيمة #VALUE! عند تطبيق دالة FILTER عبر أوراق العمل من أكثر المشكلات التقنية إرباكاً للمستخدمين، وتعود جذور هذا الخطأ دائماً إلى مشكلة عدم تناسق أبعاد المصفوفات (Dimension Mismatch). يحدث هذا عندما يختلف عدد الصفوف أو الأعمدة المحددة في معامل المصفوفة array عن عدد العناصر المدرجة في معامل الشرط include. فالخوارزمية المسؤولة عن التصفية تقوم بمطابقة أحادية متسلسلة بين عناصر الصفيفين، فإذا وجدت أن صفيف الشرط أقصر أو أطول من صفيف البيانات، تتعطل المقارنة وينهار التدفق الحسابي كلياً.
يتكرر هذا الخطأ بصورة خاصة عند الإشارة إلى أوراق عمل خارجية بسبب التحديث اليدوي المتقطع لأرقام الخلايا؛ كأن يُكتب النطاق المستهدف Data!A2:E500 بينما يُكتب نطاق التحقق المنطقي كـ Data!B2:B450 نتيجة خطأ مطبعي، مما يترك 50 صفاً دون معيار تقييم منطقي. لمعالجة هذا الخلل برمجياً وبصرياً، يجب مراجعة الصيغة والتأكد المطلق من تطابق إحداثيات البداية والنهاية لكلا الطرفين (مثل جعل كلا النطاقين ينتهيان بالصف 500).
تتمثل أفضل الممارسات المنهجية لتفادي هذا الخطأ في الاعتماد على تحديد الأعمدة بالكامل عبر المراجع المهيكلة للجداول أو استخدام دالة ROWS كأداة تدقيق موازية في خلية اختبارية للتحقق من أن ROWS(array) = ROWS(include)، مما يضمن استقرار البنية الهندسية للصيغة قبل اعتمادها في الواجهات النهائية للتقارير.
5.2 إدارة خطأ انسكاب البيانات (#SPILL!) وتطهير مسار النتائج
يرتبط خطأ الانسكاب #SPILL! بالطبيعة الديناميكية لمحرك الحساب الحديث في إكسل. يتولد هذا الخطأ حصرياً عندما تنجح الدالة في استخراج السجلات وتكوين مصفوفة النتائج، لكنها تجد عائقاً مادياً يمنع تفريغ هذه المصفوفة داخل خلايا ورقة العمل المستهدفة. تتمثل هذه العوائق في وجود بيانات نصية أو رقمية سابقة، أو حتى مسافة فارغة غير مرئية (Ghost Data) داخل إحدى الخلايا التي يفترض أن تتمدد فيها المصفوفة.
من المسببات الشائعة أيضاً لخطأ #SPILL! وجود خلايا مدمجة (Merged Cells) في المسار الجغرافي للانسكاب؛ إذ يرفض محرك المصفوفات الديناميكية الكتابة في بيئات الخلايا المدمجة لما تفرضه من كسر في تناسق الإحداثيات الشبكية للمصنف. ولحل هذا الإشكال، يوفر إكسل مؤشراً تحذيرياً عند النقر على خلية الخطأ، يحدد من خلاله الخط المنقط للمساحة المطلوبة للانسكاب؛ ويتعين على المحلل عندها الضغط على خيار “تحديد الخلايا المعيقة” (Select Obstructing Cells) لمسحها فوراً أو إلغاء دمجها لتتدفق النتائج بيسر.
تصميمياً، يجب اتباع قواعد صارمة عند إعداد واجهات العرض، وذلك بتخصيص مساحات شاسعة وواضحة لحركة الانسكاب، وتجنب وضع جداول أو نصوص تذييلية ثابتة أسفل خلية الدالة مباشرة، بل يُفضل دائماً وضع التداولات التلخيصية والمخططات البيانية في جوانب الصفحة أو في أوراق منفصلة تماماً لضمان عدم اعتراض مسار البيانات المصفاة في حال تزايدها المفاجئ نتيجة إدخالات جديدة في الورقة المصدرية.
5.3 التعامل مع خطأ عدم وجود نتائج مطابقة (#CALC!)
ينبثق رمز الخطأ الحسابي #CALC! عندما تنفذ دالة FILTER دورتها المنطقية كاملة عبر النطاق المرجعي في ورقة العمل المصدرية دون العثور على سجل واحد يحقق الشروط المفروضة في معامل include، مع إغفال المحلل ملء المعامل الثالث الاختياري [if_empty]. يُعد ظهور هذا الخطأ مؤشراً على فقر في التصميم الهيكلي للمصنف، إذ يعطي انطباعاً بوجود عطل في الصيغة البرمجية بدلاً من توضيح حقيقة الموقف المتمثلة في عدم توفر سجلات متوافقة.
العلاج المباشر والمهني لهذا الخطأ هو الاستثمار الواعي للمعامل الثالث للدالة. بدلاً من ترك المعامل فارغاً، تتم كتابة رسالة توجيهية صريحة محاطة بعلامتي اقتباس، مثل “لا توجد سجلات مطابقة” أو إرجاع فراغ تقني عبر استخدام علامتي اقتباس متتاليتين دون فراغ بينهما (""). على سبيل المثال:
=FILTER(SourceData!$A$2:$C$100, SourceData!$A$2:$A$100 = "قيمة_نادرة", "السجل غير موجود")
عند تعذر المطابقة، ستقوم الدالة بتعبئة الخلية الأولى بتلك العبارة الواضحة متجنبة إطلاق أي خطأ نظام.
في بيئات النمذجة المتقدمة التي تُبنى فيها دوال وسيطة أخرى فوق ناتج التصفية، يمكن أيضاً دمج الدالة IFERROR كطبقة حماية خارجية تحيط بدالة FILTER، وذلك لاعتراض أي استثناءات مفاجئة وإعادة توجيه مسار الحساب تلقائياً بما يضمن الحفاظ على تماسك اللوحات التفاعلية وعدم انقطاع الحسابات المتسلسلة.
6. تكامل دالة FILTER مع دوال المصفوفات الديناميكية الأخرى
6.1 الترتيب التلقائي للبيانات المصفاة باستخدام دالة SORT
نادراً ما تُعرض البيانات المصفاة في تقارير الأعمال بحالتها العشوائية المسترجعة من الورقة المصدرية، إذ تقتضي المنهجية التحليلية إبراز السجلات بترتيب تصاعدي أو تنازلي بحسب معيار محدد كالأقدمية الزمنية أو القيمة المالية أو الأداء الأبجدي. وهنا تتجلى قوة محرك المصفوفات عبر إمكانية تعشيش الدوال (Nesting Functions)، حيث يتم دمج دالة التصفية FILTER داخل دالة الترتيب SORT لتعملا كوحدة برمجية واحدة متكاملة.
تستقبل دالة SORT مصفوفة النتائج الصادرة من FILTER وتجري عليها عملية إعادة ترتيب لحظية بناءً على رقم العمود المستهدف، وفق البنية التركيبية التالية:
=SORT(array, [sort_index], [sort_order], [by_col])
وعند تطبيق ذلك على بيانات مستدعاة من ورقة عمل خارجية، تظهر الصيغة المركبة بالشكل الآتي:
=SORT(FILTER(DataSheet!$A$2:$E$500, DataSheet!$C$2:$C$500 = "ناجح", "لا توجد بيانات"), 4, -1)
في هذا النموذج، يتم تصفية سجلات الطلاب الناجحين من ورقة DataSheet أولاً، ثم تُسلم النتائج لدالة SORT لترتيبها بناءً على العمود الرابع (المعدل التراكمي مثلاً) مع إعطاء المعامل -1 دلالة على الفرز التنازلي من الأعلى إلى الأدنى.
يمكن أيضاً توسيع هذا الترتيب ليشمل مستويات متعددة باستخدام دالة SORTBY، حيث يتم فرز المخرجات المصفاة بحسب التاريخ أولاً، ثم بحسب الحجم المالي ثانياً، مما يمنح محلل البيانات أداة معمارية فائقة لصياغة التقارير الجاهزة للعرض التنفيذي الفوري دون الحاجة إلى تدخل يدوي لإعادة فرز الجداول.
6.2 استخراج القيم الفريدة المصفاة باستخدام دالة UNIQUE
يواجه المحللون بصورة متكررة مشكلة تكرار القيم في السجلات المستخرجة، كأن يُطلب استخراج قائمة بأسماء العملاء الذين اشتروا منتجاً معيناً خلال الشهر الماضي من ورقة تسجيل المبيعات المركزية. إذا استُخدمت دالة FILTER وحدها، فستقوم بإرجاع اسم العميل في كل مرة قام فيها بعملية شراء، مما ينتج عنه قائمة مكررة ومشوشة تعيق التحليل النوعي السليم.
يمثل التوليف المعماري بين دالتي UNIQUE وFILTER الحل الحاسم لهذه المعضلة؛ حيث يتم تغليف صيغة التصفية بدالة القيم الفريدة لقمع كل التكرارات الإحصائية وإرجاع ظهور واحد لكل مدخل يحقق المعيار الشرطي، كما يظهر في التطبيق التالي:
=UNIQUE(FILTER(Sales!$B$2:$B$1000, Sales!$D$2:$D$1000 = "منتج_خاص", "لا مشترين"))
تقوم هذه الصيغة بمسح ورقة المبيعات، واستخلاص أسماء المشترين فقط عند مطابقة المنتج المحدد، ثم تصفيتهم لتوليد قائمة بالعملاء الفريدين دون أدنى تكرار.
تكتسب هذه التقنية أهمية قصوى عند بناء القوائم المنسدلة التفاعلية التابعة (Cascading Dropdown Lists) المعتمدة على التحقق من صحة البيانات (Data Validation). فمن خلال الإشارة إلى خلية الانسكاب الفريدة الناتجة وإضافة علامة الهاشتاج (#)—مثل =A2#—يصبح نطاق القائمة المنسدلة مرناً، يمتد وينكمش ديناميكياً بحسب المدخلات المتطابقة في الورقة المصدرية.
6.3 التحكم في الأعمدة المعروضة عبر دالة CHOOSECOLS
إحدى الإشكاليات الكلاسيكية في دالة FILTER هي التزامها الصارم باسترجاع كافة الأعمدة التي يتضمنها المعامل الأول array. فإذا كان جدول البيانات في الورقة المصدرية يشتمل على عشرين عموداً من البيانات الحساسة أو التقنية، ولم نكن بحاجة في تقرير العرض سوى لثلاثة أعمدة محددة (مثل الاسم، والمنطقة، وصافي الدخل)، فإن استخدام الدالة وحدها كان يفرض استقدام النطاق بكامله أو اللجوء إلى تقسيمات مجزأة ترهق الذاكرة.
مع إدراج دالة CHOOSECOLS ضمن ترسانة دوال إكسل الحديثة، بات بإمكان المحلل التحكم الدقيق في هندسة الإسقاط العمودي (Column Projection). تتكامل الدالة مع FILTER لتقليص المصفوفة المنسكبة واختيار الأعمدة المطلوبة وتعديل ترتيب ظهورها، وفق الصيغة النموذجية الآتية:
=CHOOSECOLS(FILTER(Database!$A$2:$T$5000, Database!$C$2:$C$5000 = "نشط", "لا توجد نتائج"), 1, 4, 12)
تقوم الصيغة بفحص النطاق العريض في الورقة المصدرية، وتصفية السجلات النشطة، ثم لا تُسقط في ورقة العرض سوى العمود الأول، يليه العمود الرابع، يليه العمود الثاني عشر، متجاهلة تماماً باقي الأعمدة السبعة عشر الزائدة.
يسهم هذا الأسلوب بشكل ملموس في تعظيم الكفاءة الحاسوبية، إذ يقلل من العبء المخصص لذاكرة الوصول العشوائي (RAM) عبر حجب تدفق آلاف الخلايا غير المستهدفة إلى ورقة التقرير، فضلاً عن تعزيزه لأمان البيانات بحجب الأعمدة المحتوية على تفاصيل مصرفية أو هويات شخصية قد لا يحق لمستعرض التقرير الاطلاع عليها.
7. استخدام الجداول المهيكلة (Excel Tables) في التصفية عبر الأوراق
7.1 مزايا تحويل النطاقات التقليدية إلى جداول مهيكلة
يمثل تحويل النطاقات العادية في الورقة المصدرية إلى جداول مهيكلة رسمية—عبر الأمر (Ctrl + T) لتتحول برمجياً إلى كائنات جدولية (ListObject)—قفزة نوعية في متانة النماذج الرياضية واستدامتها. العيب القاتل في النطاقات التقليدية هو حدودها الصلبة الصامتة؛ فإذا كُتبت الدالة لتقرأ من A2:D500، ثم قام المستخدم بإدخال سجلات جديدة تبدأ من الصف 501، فلن تشعر الدالة بهذه الإضافات ولن تظهر في ورقة التصفية ما لم يتدخل المحلل لتوسيع النطاق في كل معادلة يدوياً.
تتميز الجداول المهيكلة بخاصية التوسع الذاتي التلقائي (Auto-Expansion). فبمجرد إضافة سطر جديد أسفل الجدول المصدر، يتمدد كائن الجدول ليدمج هذا السطر في بنيته فورياً، وتنتقل هذه التوسعة عبر معمارية البرنامج إلى كافة الصيغ الحسابية المرتبطة به في أوراق العمل الأخرى دون الحاجة لإعادة كتابة حرف واحد في الصيغة الأصلية، مما يمنح ملف العمل مناعة كاملة ضد أخطاء السهو ونقص السجلات.
إضافة إلى ذلك، تقضي الجداول المهيكلة على مخاطر تلف المراجع الناتجة عن عمليات القص واللصق أو إعادة ترتيب الأعمدة. ففي النطاقات العادية، قد يؤدي نقل عمود إلى تحريف ترتيب المراجع؛ بينما تحافظ الجداول المهيكلة على استقرار الروابط الداخلية بفضل مراجعها المعنونة، مما يمنع انزياح البيانات ويحمي التكامل الإشاري (Referential Integrity) بين الورقات المتباعدة داخل المصنف الواحد.
7.2 صياغة دالة FILTER بالاعتماد على أسماء الجداول والأعمدة
عند الربط بين أوراق العمل باستخدام الجداول المهيكلة، تتحول لغة كتابة الصيغ الحسابية من عناوين خلايا صامتة يصعب فك شفرتها (مثل Sheet1!A2:E500) إلى لغة دلالية ناطقة تُعرف اصطلاحاً بالمراجع المهيكلة (Structured References). في هذه المنظومة، يُستبدل اسم الورقة وعناوين الخلايا باسم الجدول الرسمي متبوعاً باسم العمود المستهدف بين أقواس معقوفة، كما يتضح من المثال التالي:
=FILTER(SalesTable, SalesTable[المنطقة] = "الغربية", "لا توجد سجلات")
يلاحظ هنا اختفاء اسم ورقة العمل من الصيغة تماماً؛ والسبب في ذلك أن كائن الجدول المهيكل يُسجل داخل بيئة إكسل كمعرف فريد عام على نطاق كامل المصنف (Workbook Scope)، مما يعني إمكانية استدعائه من أي ورقة عمل دون الحاجة لذكره باسم الورقة المضيفة له متبوعة بعلامة تعجب.
يرفع هذا الأسلوب المعماري من وضوح النماذج التحليلية وقابليتها للصيانة والتدقيق المتبادل بين فرق العمل؛ فأي مراجع مالي أو باحث يمكنه قراءة وفهم مقاصد الصيغة وتفسير منطقها بسرعة بالغة دون الحاجة للرجوع إلى الورقة المصدرية لمعاينة ما يحويه العمود C أو D.
كما تتميز المراجع المهيكلة بتفوقها على صعيد استقرار الأداء الحاسوبي؛ إذ إنها تتضمن بطبيعتها صفوف البيانات الصالحة فقط دون الرؤوس أو الصفوف الخالية الزائدة، مما يجنب محرك الحساب معالجة مساحات فارغة ويوجه العمليات المنطقية نحو حدود السجلات النشطة بدقة بالغة.
8. المناهج البديلة للتصفية عبر أوراق العمل في الإصدارات القديمة
8.1 استخدام أداة التصفية المتقدمة (Advanced Filter)
بالنسبة للمستخدمين الذين يعملون على بيئات عمل أو إصدارات إكسل التي تسبق 2021 ولا تدعم محرك المصفوفات الديناميكية، تظل أداة “التصفية المتقدمة” (Advanced Filter) هي الأداة الرسمية المدمجة لنقل البيانات المصفاة من ورقة إلى أخرى عبر الواجهة الرسومية التقليدية دون الاعتماد على برمجة الدوال التلقائية. وتعتمد هذه الأداة على إنشاء جدول مستقل لتحديد الشروط (Criteria Range) في ورقة العمل المستهدفة.
تخضع هذه التقنية لقاعدة برمجية حاسمة وصارمة يجب اتباعها لتجنب فشل العملية؛ وهي ضرورة بدء تشغيل الأمر من ورقة العمل المستهدفة (الوجهة) حصراً وليس من الورقة المصدرية. فإذا حاول المستخدم فتح أداة التصفية المتقدمة وهو موجود في ورقة البيانات الأصلية واختار “نسخ إلى موقع آخر” مع توجيه المسار إلى ورقة ثانية، سيرفض إكسل التنفيذ ويطلق رسالة خطأ قياسية تنص على: “لا يمكنك نسخ البيانات المصفاة إلا إلى الورقة النشطة”. لذلك، يتعين فتح ورقة الوجهة أولاً، ثم استدعاء الأداة عبر المسار:
بيانات (Data) $\leftarrow$ فرز وتصفية (Sort & Filter) $\leftarrow$ خيارات متقدمة (Advanced).
يتطلب إعداد جدول الشروط تضمين نفس العناوين النصية المطابقة لأعمدة الورقة المصدرية بدقة؛ فإذا كانت الشروط موضوعة في نفس الصف، يفسرها محرك الأداة كشرط عطف (AND)، بينما إذا كُتبت الشروط في صفوف مختلفة أسفل الرؤوس، يعاملها المحرك كشرط تخيير (OR). وعلى الرغم من فاعلية هذه الأداة في استخراج مصفوفات متباينة، إلا أن عيبها الهيكلي الأكبر يكمن في جمودها؛ فالمخرجات الناتجة تكون قيماً ثابتة غير قابلة للتحديث التلقائي، مما يفرض إعادة تكرار كامل الخطوات اليدوية عند كل تحديث تشهده قاعدة البيانات الأصلية.
8.2 صيغ الصفائف المعقدة القديمة (INDEX و MATCH و SMALL)
قبل ظهور دالة FILTER، ابتكر خبراء إكسل معادلة مصفوفية عبقرية من الناحية الحسابية لكنها فائقة التعقيد من حيث البنية البرمجية، تُعرف بتركيبة “Index-Small-Row-Match”. كانت هذه الصيغة هي السبيل الرياضي الوحيد لاستخراج وتصفية البيانات بين أوراق العمل وتحديثها تلقائياً في الإصدارات القديمة من خلال محاكاة عمل المصفوفات المنسكبة عبر نسخ الصيغة وسحبها يدوياً داخل نطاق واسع من الخلايا.
تعتمد هذه الصيغة المركبة على تتبع أرقام الصفوف المطابقة للشروط عبر دالة IF، ومن ثم استخدام دالة SMALL لاقتناص هذه الأرقام تسلسلياً (الأصغر فالأصغر) وتمرير رقم الصف المطابق إلى دالة INDEX لاستدعاء محتوى الخلية من الورقة الأخرى، وتُكتب عادةً وفق النموذج الرياضي الكلاسيكي التالي:
{=IFERROR(INDEX(DataSheet!$A$2:$A$500, SMALL(IF(DataSheet!$B$2:$B$500="المعيار", ROW(DataSheet!$B$2:$B$500)-ROW(DataSheet!$B$2)+1), ROWS($A$1:A1))), "")}
كان إدخال هذه الصيغة يتطلب الضغط الإلزامي على (Ctrl + Shift + Enter) لتوليد الأقواس المعقوفة المحيطة بها، ثم سحبها عمودياً وأفقياً لتغطية كامل المساحة التقديرية للنتائج.
تتمثل المشكلة الكبرى في هذا النهج الكلاسيكي في استنزافه الشديد لطاقة المعالجة المركزية (CPU Overhead)؛ فكل خلية تحتوي على هذه المعادلة تجبر إكسل على إعادة تقييم مصفوفة الشروط بالكامل مراراً وتكراراً، مما يؤدي إلى تجمد المصنفات وبطء استجابتها عند تجاوز البيانات بضعة آلاف من السجلات، فضلاً عن صعوبة صيانتها البالغة؛ إذ إن أي خطأ طفيف في تثبيت الخلايا يفسد تسلسل الاستدعاء بالكامل.
9. تحسين الأداء والكفاءة الحاسوبية في المصنفات الضخمة
9.1 تجنب الإشارات إلى كامل الأعمدة لترشيد استهلاك الذاكرة
من الأخطاء الشائعة والمدمرة لكفاءة المعالجة في النماذج الكبيرة قيام المستخدمين بكتابة مراجع النطاقات بالدلالة على كامل العمود لتفادي تعديل الصيغ مستقبلاً؛ كأن تُكتب الصيغة مستهدفة العمود DataSheet!A:D مع فحص الشرط في DataSheet!B:B. على الرغم من أن هذا النهج يبدو سهلاً وسريعاً من الناحية الظاهرية، إلا أن تكلفته الحاسوبية باهظة للغاية، ولا سيما عند التعامل مع دوال المصفوفات المتقاطعة بين الأوراق.
تتكون ورقة العمل الواحدة في إصدارات إكسل الحديثة من 1,048,576 صفاً. فعند إدخال مرجع لعمود كامل، يُجبر محرك الحساب البولياني على تخصيص مساحة في الذاكرة لفحص وتقييم أكثر من مليون عنصر في كل مصفوفة فحص، حتى وإن كانت البيانات الفعلية لا تتجاوز بضع مئات من الصفوف. يؤدي هذا السلوك إلى تضخم هائل في حجم ملف العمل المستهلك للذاكرة العشوائية (RAM)، وظهور حالات تجميد متكررة عند كل ضغطة مفتاح، فضلاً عن ارتفاع استهلاك المعالج أثناء دورة إعادة الحساب التلقائي.
ولترشيد هذا الاستهلاك وضمان سرعة الاستجابة، يجب دائماً وضع حدود واقعية للنطاقات عبر حصرها في أبعاد السجلات الفعلية مع هامش توسع مدروس (مثل A2:D5000)، أو استخدام كائنات الجداول المهيكلة التي تقوم بهذا الدور تلقائياً، أو اللجوء إلى “النطاقات الديناميكية المسماة” (Dynamic Named Ranges) بالاعتماد على دالتي OFFSET وCOUNTA لضمان توجيه طاقة الحاسوب حصراً نحو البيانات الحقيقية وتجنب إهدارها في فحص الخلايا الصامتة.
9.2 إدارة دورة إعادة الحساب التلقائي داخل إكسل
تعتمد كفاءة المصنفات التي تتضمن آلاف المعادلات الديناميكية المتقاطعة على فهم وإدارة دورة إعادة الحساب (Recalculation Cycle). في النماذج الضخمة جداً، يؤدي تراكم دوال التصفية المرتبطة بأوراق متعددة إلى بناء “شجرة اعتماديات” (Dependency Tree) عملاقة ومعقدة؛ فأي تعديل طفيف في خلية مدخلات بالورقة المصدرية يطلق سلسلة من التفاعلات الحسابية التتابعية التي تشمل إعادة تقييم التصفية، والفرز، والقيم الفريدة، وما يترتب عليها من مجاميع ورسوم بيانية في أوراق العرض المختلفة.
عند بناء أو إدخال دفعات ضخمة من البيانات في الورقة المصدرية، يُنصح بتعليق هذا التدفق الحسابي المرهق مؤقتاً عبر تحويل وضع الحساب في إكسل من “تلقائي” (Automatic) إلى “يدوي” (Manual) من خلال تبويب “صيغ” (Formulas) $\leftarrow$ “خيارات الحساب” (Calculation Options). يتيح هذا الإجراء للمحلل إدخال مئات السجلات وإجراء تعديلات هيكلية وتنسيقية بحرية وسرعة فائقة دون توقف، وعند اكتمال التحرير يتم الضغط على مفتاح (F9) لتشغيل دورة الحساب مرة واحدة وتحديث كافة أوراق التصفية دفعة واحدة.
كذلك، يمكن قياس سرعة أداء النماذج المعقدة عبر أدوات فحص وتدقيق الصيغ (Formula Auditing Tools) وعزل الدوال المتقلبة (Volatile Functions)—مثل INDIRECT أو OFFSET أو NOW—عن نطاقات التصفية المصدرية؛ حيث إن وجود دالة متقلبة واحدة ضمن مراجع التصفية سيجبر المصنف على إعادة تشغيل دالة FILTER بالكامل عند إجراء أي حركة في أي مكان داخل الملف، حتى لو لم تمس الورقة المصدرية ذات الصلة، وهو ما يقود إلى هبوط دراماتيكي في كفاءة بيئة العمل بأكملها.
10. تطبيقات وحالات دراسية في تحليل البيانات الأكاديمية والمهنية
10.1 دراسة حالة: بناء لوحة معلومات أكاديمية لأداء الطلاب
في إطار إدارة البيانات الأكاديمية وضبط جودة التعليم، تتطلب أقسام التسجيل والامتحانات الجامعية فرز نتائج الطلاب بصورة مستمرة لعزل فئات الأداء الأكاديمي، كقوائم الشرف للمتفوقين أو قوائم الإنذار الأكاديمي للطلاب المتعثرين. تتضمن هذه الدراسة بناء مصنف يتكون من ورقتين: الورقة الأولى تُسمى MasterGrades وتحتوي على البيانات الشاملة لجميع طلاب الكلية (الرقم الجامعي، الاسم، التخصص، الساعات المكتسبة، والمعدل التراكمي)، بينما تُخصص الورقة الثانية المسماة AcademicDashboard كلوحة معلومات تفاعلية للإرشاد الأكاديمي.
تطبق الورقة المستهدفة واجهة إرشادية تسمح للمشرف الأكاديمي بتحديد اسم “التخصص” في الخلية B1 واختيار “الحد الأدنى للمعدل التراكمي” في الخلية B2 عبر قوائم منسدلة. لاستخراج الطلاب الذين يحققون هذه المعايير من ورقة الدرجات العامة تلقائياً وتنسيقهم حسب الترتيب التنازلي للمعدل، كُتبت في الخلية A5 من ورقة التقرير الصيغة الهجينة المتقدمة الآتية:
=SORT(FILTER(MasterGrades!$A$2:$E$2000, (MasterGrades!$C$2:$C$2000 = $B$1) * (MasterGrades!$E$2:$E$2000 >= $B$2), "لا يوجد طلاب يطابقون المعايير المحددة"), 5, -1)
بمجرد تغيير المشرف للتخصص المكتوب في الخلية المعيارية، تنبثق فوراً قائمة الطلاب المصفاة متضمنة كامل بياناتهم ومصنفة من الأعلى معدلاً إلى الأدنى دون أي تداخل يمس سلامة قاعدة البيانات الأصلية.
ولتعزيز الأبعاد التحليلية، تم ربط ناتج هذه المصفوفة المنسكبة بحسابات إحصائية ملخصة في أعلى التقرير لحساب المتوسط الحسابي والانحراف المعياري لدرجات الفئة المصفاة فقط باستخدام مراجع الانسكاب مثل AVERAGE(E5#)، مما يوفر للمسؤول الأكاديمي لوحة تقييم استرجاعية متكاملة تتكيف ديناميكياً مع كافة سيناريوهات الاستعلام والتقييم المؤسسي.
10.2 دراسة حالة: تقارير المبيعات الجغرافية والقطاعية
تتبنى المؤسسات التجارية الكبرى استراتيجية تجميع كافة المعاملات المالية اليومية الصادرة من الفروع في دفتر أستاذ مركزي أو جدول بيانات موحد يُعرف بورقة GeneralLedger، والتي تحوي حقولاً متعددة تشمل (رقم الفاتورة، تاريخ المعاملة، المدينة، فئة المنتج، قيمة المبيعات، ومسؤول البيع). تتطلب إدارة العمليات توزيع هذه البيانات الضخمة وتفكيكها إلى تقارير جغرافية متخصصة تُعرض لمديري المناطق في أوراق عمل مخصصة كـ WesternRegion_Report دون منحهم حق الوصول المباشر للتعديل في السجل الرئيسي.
في ورقة تقرير المنطقة الغربية، يُشترط تصفية السجلات التابعة لمدينتي “مكة” أو “جدة” حصراً (منطق OR جغرافي)، شريطة أن تنتمي المعاملة لفئة منتجات “الأجهزة الإلكترونية” (منطق AND نوعي)، مع قصر العرض على أعمدة رقم الفاتورة والتاريخ وقيمة المبيعات فقط دون باقي التفاصيل اللوجستية. تم إنجاز هذا المطلب عبر دمج دوال CHOOSECOLS وFILTER في صيغة واحدة محكمة تم تثبيتها في الورقة الإقليمية:
=CHOOSECOLS(FILTER(GeneralLedger!$A$2:$G$10000, ((GeneralLedger!$C$2:$C$10000 = "جدة") + (GeneralLedger!$C$2:$C$10000 = "مكة")) * (GeneralLedger!$D$2:$D$10000 = "إلكترونيات"), "لا توجد مبيعات مسجلة"), 1, 2, 5)
تؤدي هذه الصيغة إلى استخلاص البيانات الدقيقة التي تعني إدارة المنطقة الغربية وتفصيلها فورياً متجاهلة آلاف السجلات غير المعنية.
ولإضفاء طابع احترافي تنفيذي على هذا التقرير، تم ربط نطاق الانسكاب الناتج بمخططات بيانية ديناميكية تستقي مسارها من مصفوفة التصفية مباشرة؛ فكلما سجلت نقاط البيع في مكة أو جدة مبيعات إلكترونية جديدة في ورقة البيانات العامة المركزية، امتدت صفوف التقرير في الورقة الإقليمية، وتحدثت المؤشرات الرسومية وأشرطة التقدم المالي آنياً، مما أتاح للإدارة التنفيذية اتخاذ قرارات تسعير وتوزيع مبنية على حقائق زمنية دقيقة تدعم الكفاءة الإنتاجية والتنافسية للمؤسسة.
خاتمة
يمثل إتقان مهارة تصفية البيانات من ورقة عمل أخرى في برنامج إكسل نقلة نوعية في منهجية بناء النماذج التحليلية وإدارتها. فمن خلال الانتقال من آليات الفرز الثابت والنسخ اليدوي المرهق إلى استثمار الإمكانات الهائلة لمحرك المصفوفات الديناميكية ودالة FILTER الحديثة، يكتسب المحلل القدرة على بناء بيئات عمل تتسم بأعلى معايير الدقة والسرعة وفصل طبقات التخزين عن طبقات العرض. كما يوفر هذا النهج مناعة هيكلية للمصنفات ضد أخطاء التناقض المرجعي وتكرار السجلات غير المبرر.
لقد أظهر التحليل النظري والعملي في هذا المقال أن النجاح في تطبيق هذه الدوال يتجاوز مجرد حفظ تراكيبها النحوية؛ إذ يتطلب إدراكاً عميقاً لقواعد الجبر البولياني لتركيب العمليات المنطقية المتعددة عبر الضرب والجمع، واستيعاباً دقيقاً لأسباب نشوء الأخطاء البرمجية الشائعة مثل #SPILL! و#VALUE! وكيفية تطويقها برمجياً وتصميمياً. كما يبرز التكامل الاستراتيجي بين دالة التصفية والدوال الحديثة الأخرى مثل SORT وUNIQUE وCHOOSECOLS، جنباً إلى جنب مع كائنات الجداول المهيكلة، كمنظومة برمجية متكاملة ترفع كفاءة النمذجة وتضمن سلامة التحليلات في مختلف البيئات الأكاديمية والمهنية.
المراجع
- Microsoft. (2020). FILTER function. Microsoft Support. https://support.microsoft.com/en-us/office/filter-function-f4f7cb66-82eb-4767-8f7c-4877ad80c759
- Microsoft. (2020). Dynamic array formulas and spilled array behavior. Microsoft Support. https://support.microsoft.com/en-us/office/dynamic-array-formulas-and-spilled-array-behavior-205c6b06-03ba-4151-8ab0-a1849343eed9
- Microsoft. (2020). How to fix a #SPILL! error. Microsoft Support. https://support.microsoft.com/en-us/office/how-to-correct-a-spill-error-ffe0f555-b479-4a17-a642-ef9c95977923
- Microsoft. (2022). CHOOSECOLS function. Microsoft Support. https://support.microsoft.com/en-us/office/choosecols-function-bf117976-2222-49d7-ba19-0f01bd30eb60
- Contextures. (2022). Excel Advanced Filter Introduction. Contextures Inc. https://www.contextures.com/xladvfilter01.html