
تُعد معالجة البيانات وإدارتها داخل بيئات جداول البيانات الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، ركيزة محورية في تحليلات البيانات الحديثة، والبحوث الكمية، وإدارة العمليات المؤسسية. يواجه المحللون والباحثون تحديات متزايدة ناجمة عن ضخامة السجلات وتداخل المتغيرات؛ حيث تتطلب الكثير من الإجراءات عزل سجلات معينة أو استخلاص سمات محددة ليس بناءً على قيمها الذاتية فحسب، بل استناداً إلى تطابقها مع معايير مشتقة من قوائم أو أعمدة أخرى مستقلة. يمثل هذا الإجراء، المعروف بـ «تصفية عمود بناءً على عمود آخر»، نقلة تقنية من مجرد الفرز الاستكشافي البسيط إلى مستوى النمذجة العلائقية للبيانات المترابطة، وهو ما يُتيح تقاطع المتغيرات وتنقية المؤشرات بدقة حسابية رفيعة المستوى.
تكمن الأهمية العملية والمنهجية لهذا الإجراء في تجنب الأخطاء البشرية وتقليص الهدر الزمني الناجم عن المعالجة اليدوية، علاوة على ضمان اتساق العينات في الدراسات التجريبية والمسحية. فعند التعامل مع مصفوفات ضخمة تتضمن آلاف السجلات، يصبح استخراج مجموعة جزئية من المعطيات الموجهة بقائمة معايير خارجية متطلباً أساسياً لإجراء المقارنات الإحصائية الدقيقة وعزل المتغيرات الدخيلة. يوفّر برنامج إكسل عبر ترسانته الوظيفية المتطورة أدوات متعددة لتحقيق هذا الغرض، تتراوح بين الأداة الكلاسيكية الراسخة المتمثلة في «التصفية المتقدمة» (Advanced Filter)، والصيغ الديناميكية الحديثة للمصفوفات مثل دالة FILTER، وصولاً إلى محركات التحويل المؤسسية المتقدمة مثل Power Query ولغة الفيجوال بيسك للتطبيقات (VBA).
يهدف هذا الدليل المرجعي الشامل إلى تقديم استعراض تفصيلي، منهجي، وعميق للآليات المتبعة لتنفيذ تصفية عمود بالاعتماد على عمود آخر داخل برنامج إكسل. سنناقش بالتفصيل الأسس النظرية والمنطق الرياضي الحاكم لمطابقة المصفوفات، مع تفكيك البنية التشغيلية للتصفية المتقدمة، وتوضيح كيفية صياغة المعادلات الدوالية الحديثة، واستعراض سبل تجاوز الأخطاء التقنية الشائعة، وصولاً إلى استراتيجيات الأتمتة المؤسسية المتقدمة. سيتم تناول كل ذلك بأسلوب أكاديمي دقيق يضمن تزويد القارئ بالمعرفة التقنية والمنهجية اللازمة للتعامل مع البيانات بأعلى درجات الكفاءة والموثوقية.
1. الأسس النظرية لتصفية البيانات المتقاطعة في برنامج إكسل
1.1 مفهوم التصفية العلائقية وأهميتها التحليلية
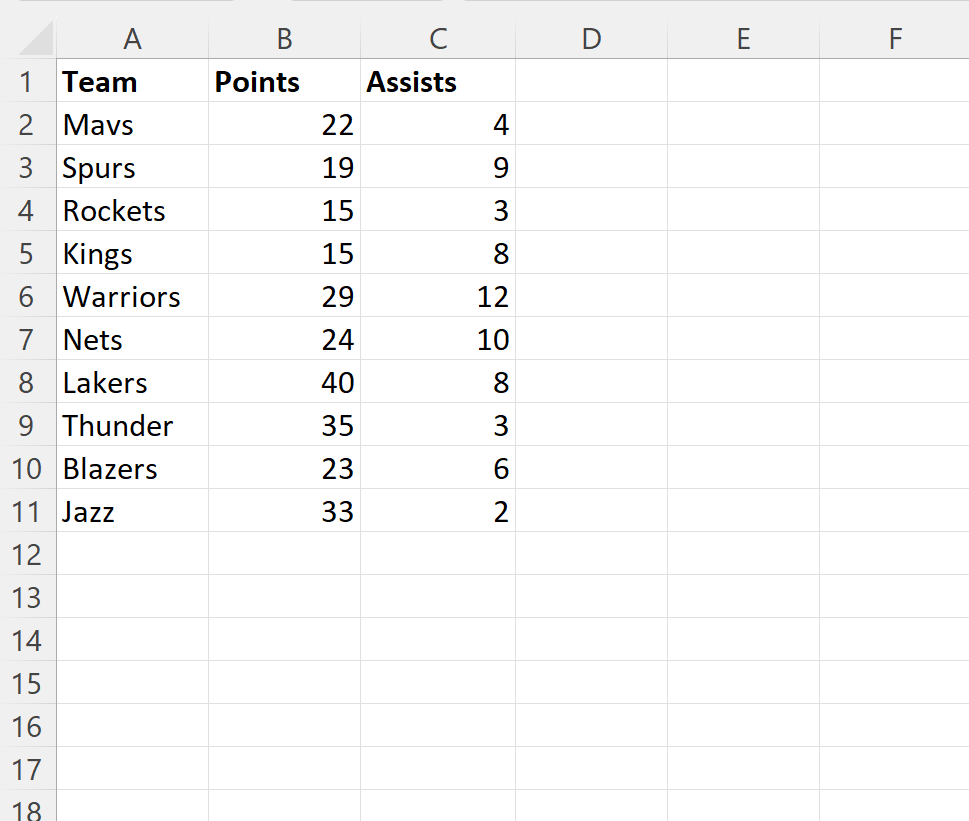
يُقصد بالتصفية العلائقية عملية استخلاص أو عزل صفوف معينة في جدول بيانات رئيسي بالاعتماد على قيم نطاق مرجعي مستقل يعمل كمعيار إسناد تقاطعي. في التحليلات المتقدمة، لا تكون معايير التصفية دائماً قيماً ثابتة مدمجة داخل العمود نفسه، بل غالباً ما تنبثق من استعلام خارجي أو عينة جزئية تم فرزها في مرحلة تجريبية سابقة؛ مما يستلزم إيجاد تقاطع منطقي بين مجموعتين مختلفتين من البيانات داخل بيئة التحليل الحسابي.
تختلف هذه المقاربة جوهرياً عن التصفية التلقائية البسيطة (AutoFilter). تعتمد التصفية البسيطة على تحديد عناصر معينة يدوياً من قائمة منسدلة داخل نفس العمود، وهي مقاربة غير فعالة عند التعامل مع معايير ديناميكية تتألف من مئات أو آلاف القيم المتغيرة. في المقابل، تتيح التصفية المرجعية تطبيق منطق المجموعات الرياضي؛ حيث يُعامل العمود المراد تصفيته كمجموعة كلية، وتُعامل القائمة المرجعية كمجموعة تقييد، مما يحافظ على التجريد المنطقي ويسهل أتمتة العمليات الحسابية دون تدخل بشري يدوي متكرر.
يتجلى الأثر المنهجي للتصفية الدقيقة في ضبط المتغيرات وتنقية البيانات الإحصائية في مختلف المجالات البحثية والكمية. إن عزل الحالات الشاذة، أو فرز المستجيبين الذين تنطبق عليهم خصائص مشتركة، أو مطابقة سجلات المرضى والعملاء بين قواعد بيانات منفصلة، يتطلب صرامة تامة في التطابق المرجعي لتجنب تلوث البيانات وتأثر المؤشرات الإحصائية العامة، كالمتوسطات والتباين ومقاييس الارتباط، بالأخطاء العرضية الناتجة عن التكرار غير المنضبط.
تمتد تطبيقات التصفية المتقاطعة لتشمل معالجة قواعد البيانات المعقدة في المؤسسات الكبرى، مثل ربط سجلات الفواتير بقوائم الموردين المعتمدين، أو مطابقة الحركات المالية بقوائم التدقيق الداخلي، أو عزل السجلات المكررة تاريخياً لتتبع اتجاهات الأداء عبر الزمن. كل هذه السيناريوهات تعتمد على فرضية أساسية: فحص وجود قيمة العمود (أ) داخل المجال الحصري للعمود (ب) بهدف تفعيل قرار الفلترة.
1.2 المنطق البرمجي والرياضي لربط المتغيرات داخل جداول البيانات
يرتكز المنطق الداخلي لربط المتغيرات ومقارنة السجلات المتناظرة رياضياً على نظرية المجموعات وعلم الجبر البولياني (Boolean Algebra). عند إجراء مقارنة متقاطعة بين عمودين، يقوم المحرك الحسابي بمقارنة كل عنصر من عناصر مصفوفة الإدخال مع جميع عناصر المصفوفة المرجعية عبر تقاطع خطي أو بحث ثنائي، وذلك لاكتشاف التطابق في المعرفات الأساسية لكل صف مسجل.
يتم هذا الإجراء استناداً إلى مبدأ التحقق الثنائي؛ حيث تُنتج المقارنة قيمة منطقية حصرية: إما صواب (TRUE) أو خطأ (FALSE). إذا تطابقت القيمة الخاضعة للفحص مع أي قيمة داخل النطاق المرجعي، يُسند إليها المنطق الرياضي القيمة (TRUE)، وبالتالي يُبقى على الصف في جدول النتائج أو يظل مرئياً. أما إذا كان التقاطع خالياً، فإن النتيجة تكون (FALSE)، مما يؤدي فورياً إلى إخفاء الصف أو استبعاده من المصفوفة الناتجة بحسب التقنية المستخدمة.
تلعب كفاءة المعالجة الحسابية دوراً حاسماً في أداء جداول البيانات الكبيرة. يتطلب تقييم الشروط الحسابية تقليل العمليات المتكررة عبر استخدام هياكل بحث فعالة، مثل خوارزميات البحث المتطابقة ذات التعقيد الحسابي المنخفض، وتفادي إعادة حساب النطاقات الثابتة في كل خطوة. إن بناء المعايير المنطقية بصورة رصينة يضمن توجيه الموارد البرمجية للبرنامج نحو السجلات المؤهلة فقط، وتفادي استهلاك الذاكرة العشوائية للجهاز في معالجة صفوف مستبعدة مسبقاً.
2. البنية المفاهيمية لأداة التصفية المتقدمة (Advanced Filter)
2.1 تشريح واجهة التصفية المتقدمة وعناصرها الأساسية
تُعد أداة التصفية المتقدمة (Advanced Filter) واحدة من أقدم وأقوى الميزات الكلاسيكية في برنامج إكسل لمعالجة الاستعلامات المعقدة. تتطلب الأداة تفكيك بيئة العمل إلى محددات رئيسية تضمن الفصل بين البيانات الخام وقواعد الاختيار المطبقة. العنصر الأول في هذه الواجهة هو «نطاق القائمة» (List Range)، وهو النطاق الممتد الذي يحتوي على كامل مصفوفة البيانات، بما في ذلك الصف العلوي الذي يمثل رؤوس الأعمدة، ويجب أن تتسم هذه السجلات بالترابط الهيكلي والخلو من الانقطاعات العرضية غير المبررة.
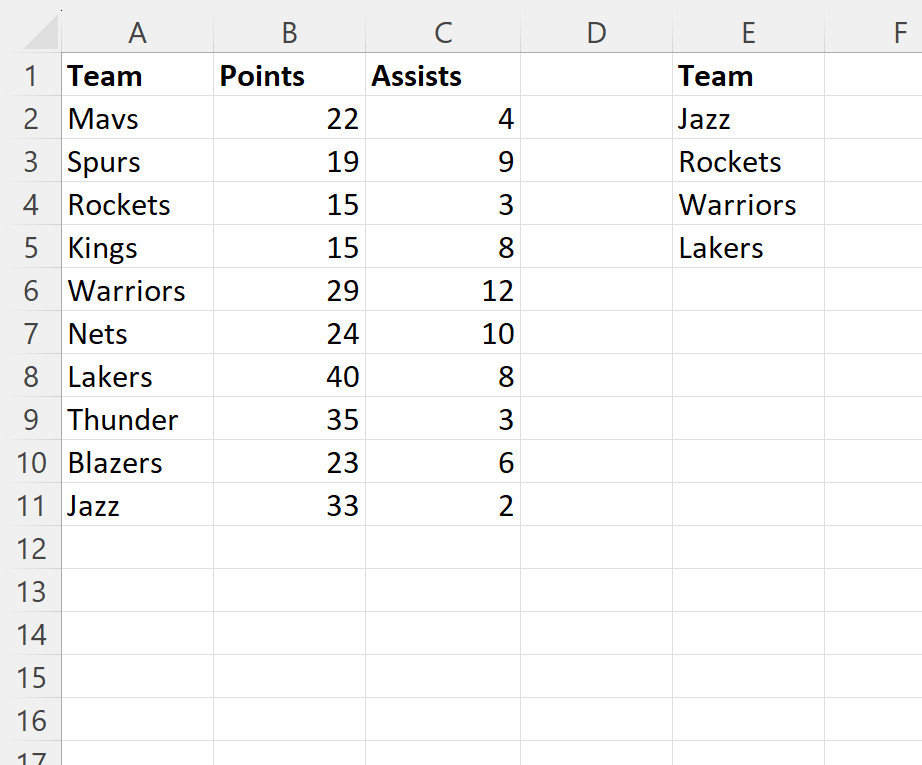
أما العنصر الثاني فهو «نطاق المعايير» (Criteria Range)، وهو مساحة منفصلة في ورقة العمل تُحدد فيها الشروط الحاكمة للتصفية. لا بد أن يتضمن هذا النطاق ترويسة واحدة على الأقل تطابق حرفياً ترويسة العمود المستهدف في الجدول الرئيسي، متبوعة بخلية أو أكثر من الخلايا المتتالية التي تمثل القيم المرجعية المراد عزلها. يلعب هذا النطاق دور المرشح المنطقي الذي يستنطق سجلات النطاق الأساسي ويملي على إكسل قواعد الإبقاء أو الاستبعاد.
تقدم الأداة خيارين إجرائيين رئيسيين لكيفية إخراج النتائج: «تصفية القائمة في نفس المكان» (Filter the list, in-place)، و«النسخ إلى موقع آخر» (Copy to another location). يؤدي الخيار الأول إلى إخفاء كافة الصفوف التي لا تطابق معايير النطاق المرجعي مع الحفاظ على البنية المكانية للجدول، في حين يتيح الخيار الثاني استخلاص السجلات المتوافقة ونقلها بالكامل إلى نطاق تخزين جديد، مما يحمي البيانات الأصلية من التعديلات أو التداخل مع عمليات الفرز اللاحقة.
2.2 آلية قراءة إكسل لنطاقات المعايير المخصصة
تستند قراءة برنامج إكسل لنطاق المعايير المخصص إلى خوارزميات تفسيرية دقيقة تستجيب لطبيعة المدخلات. عند إدراج خلية فارغة بالكامل تحت ترويسة نطاق المعيار، يفسر محرك التصفية هذا الفراغ على أنه شرط عام محايد يطابق «أي قيمة»، مما يسفر عن إلغاء تقييد التصفية وإظهار كافة السجلات. لذلك، فإن إدراج خلايا فارغة دون قصد داخل نطاق المعايير يفسد دقة التصفية المرجعية ويمنح نتائج غير مقيدة تماماً.
فيما يتعلق بالنصوص، فإن أداة التصفية المتقدمة غير حساسة افتراضياً لحالة الأحرف في اللغات اللاتينية، كما أنها تتعامل مع النصوص العربية بمطابقة دقيقة ولكن وفقاً لمستويات معالجة المحارف التشكيلية والهمزات. إذا كُتبت قيمة نصية بسيطة في المعيار مثل “أحمد”، فإن إكسل قد يُطابق السجلات التي تبدأ بهذه القيمة إلا إذا تمت صياغة الشرط الحرفي التام باستخدام معادلة نصية، مثل: ="=أحمد"، لضمان استبعاد الكلمات المركبة أو المشتقة من السياق المرجعي.
تختلف معالجة القيم الرقمية عن النصوص في صياغة شروط المقارنة؛ فالقيم الرقمية تُقرأ وفقاً لمنطق المقادير الرياضية. يمكن تضمين معاملات المقارنة الحسابية مثل التساوي، أو عدم التساوي، أو التفاوت النسبي مباشرة قبل الأرقام داخل خلايا المعيار. يتيح هذا التمييز للمستخدمين تصفية أعمدة المعرفات أو الأرقام التسلسلية إما استناداً إلى تطابق تام مع قائمة أرقام محددة، أو استناداً إلى نطاقات رقمية مشروطة تتقاطع مع قيم الأعمدة الأخرى بمرونة متناهية.
3. الشروط المسبقة وإعداد البيانات لضمان نجاح التصفية المرجعية
3.1 أهمية التطابق التام لرؤوس الأعمدة (Headers)
يعتمد نجاح التصفية المرجعية بالكامل على التطابق التام والمطلق بين ترويسة عمود المصدر في الجدول الأساسي وترويسة نطاق المعيار المستقل. يرجع ذلك إلى أن خوارزمية التصفية المتقدمة تستخدم اسم العمود كنقطة ارتكاز علائقية وحيدة لتحديد أي من أعمدة الجدول يجب إخضاعه للشروط الواردة في مصفوفة الفحص؛ وأي انحراف ولو كان طفيفاً في التسمية سيؤدي إلى فشل العملية برمتها وتجاهل المعايير.
تعد المسافات الزائدة والمحارف المخفية من أبرز الأسباب التي تقود إلى هذا الإخفاق التقني غير المرئي للمستخدم. فإدراج مسافة إضافية في نهاية الترويسة داخل نطاق المعيار (مثل: “كود_العميل “) يجعلها تختلف برمجياً عن الترويسة الأصلية (“كود_العميل”). كما قد تؤدي الأحرف غير القابلة للطباعة الناتجة عن النسخ من قواعد بيانات خارجية أو صفحات الويب إلى منع إكسل من الربط الصحيح بين الترويستين وتجاهل التصفية تماماً.
لتفادي هذه الأخطاء المنهجية، يوصى دائماً بنسخ رأس العمود المستهدف مباشرة من الجدول الرئيسي ولصقه كنطاق لمعيار التصفية بدلاً من كتابته يدوياً. كذلك يُمكن الاستعانة بالدوال النصية مثل TRIM وCLEAN لتنقية رؤوس الأعمدة من أي شوائب نصية قبل البدء في بناء نماذج التصفية المرجعية المتقدمة، لضمان تكافؤ السلاسل النصية على الصعيد البرمجي الداخلي.
3.2 تنظيف وهيكلة البيانات قبل تنفيذ الإجراء
تتطلب التصفية المرجعية الناجحة تنظيفاً شاملاً وهيكلة دقيقة للبيانات قبل التنفيذ الإجرائي، حيث تُشكل البيانات المشوهة مصدراً للخلل الإحصائي والبرمجي. يجب في المقام الأول فحص قائمة المعايير وإزالة القيم المكررة منها تماماً؛ فتكرار نفس القيمة المرجعية عدة مرات داخل نطاق المعايير لا يغير النتيجة المنطقية، ولكنه يضاعف عبء المعالجة الحسابية على البرنامج ويقود أحياناً إلى بطء ملحوظ في الأداء، لا سيما في المصنفات الضخمة.
كذلك يُشترط خلو النطاقات المعنية بالتصفية من أي خلايا مدمجة (Merged Cells). تُعد الخلايا المدمجة من أسوأ الممارسات الهيكلية في قواعد بيانات إكسل؛ إذ إن دمج الخلايا يُسند القيمة منطقياً إلى الخلية العلوية اليمنى فقط، تاركاً باقي الخلايا المدمجة فارغة برمجياً، وهو ما يعطل خوارزميات التصفية المتقدمة ويؤدي إلى حجب بيانات هامة أو إظهار صفوف غير متطابقة بصورة عشوائية.
علاوة على ذلك، لا بد من التحقق الصارم من توحيد تنسيقات البيانات (Data Formats)؛ فالأرقام المخزنة كنصوص تُعد قيمة مختلفة تماماً عن نفس الأرقام المخزنة كقيم عددية، والتواريخ المكتوبة بصيغ نصية غير قياسية تفشل في الاستجابة للمقارنات الزمنية. ينبغي استخدام أدوات التدقيق مثل “تحويل النص إلى أعمدة” (Text to Columns) لإعادة توحيد التنسيقات وضمان أن القيم في عمود المقارنة تتطابق جوهرياً وشكلياً مع القيم المناظرة في عمود المعايير.
4. التطبيق الإجرائي خطوة بخطوة: استخدام التصفية المتقدمة
4.1 إعداد ورقة العمل وبناء نطاق المعايير الخارجي
لبدء التطبيق العملي للتصفية المتقدمة، يجب تجهيز ورقة العمل بأسلوب منظم يمنع التداخل البصري والوظيفي بين مصفوفة البيانات وقائمة التصفية. يُفضل إنشاء عمود المعيار في مساحة مجاورة للجدول الأصلي تفصلها خلية فارغة واحدة على الأقل، أو نقله إلى ورقة عمل مستقلة إذا كان الهدف بناء لوحة تحكم إحصائية معزولة تضمن سلامة السجلات الأساسية من التعديلات العرضية أثناء استعراض التقارير.
تتمثل الخطوة الأولى في نسخ ترويسة العمود المستهدف (وليكن مثلاً: “رقم_المعرف”) ولصقها في موقع المعيار الخارجي (ولتكن الخلية E1). بعد ذلك، تُدرج قائمة القيم التي تمثل المعايير المراد استخدامها كمصفاة حصرية للجدول الرئيسي في الخلايا الواقعة مباشرة أسفل الترويسة (مثلاً من E2 إلى E10). يجب التأكد من عدم ترك أي أسطر فارغة بين هذه القيم، لتجنب إبطال فاعلية التصفية وجعلها تعيد كامل الجدول كما أشرنا سابقاً.
يُنصح في هذه المرحلة بتحديد نطاق المعيار وتسميته عبر مربع الاسم (Name Box) باسم معرف مثل CriteriaRange، مع تثبيت المراجع باستخدام الرمز المطلق ($) لتفادي انزياح النطاق أثناء العمليات التحليلية المعقدة. إن التثبيت المكاني للمصفوفة المرجعية يمنح الاستقرار الإجرائي اللازم ويضمن عدم حدوث أخطاء مرجعية عند تكرار الفلترة أو تحديث البيانات مستقبلاً.
4.2 تفعيل نافذة التصفية المتقدمة وضبط المحددات
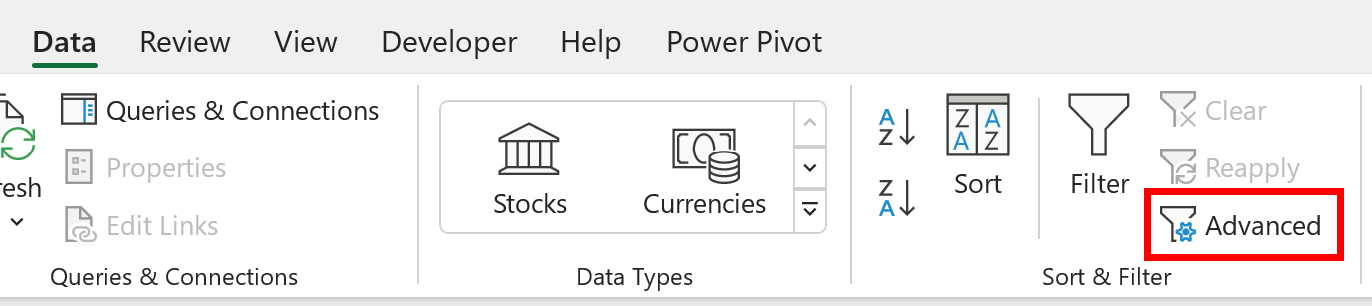
بعد تجهيز البيانات ونطاق المعايير، يتم الانتقال إلى شريط الأدوات الرئيسي واختيار علامة التبويب «بيانات» (Data)، ثم الضغط على زر «متقدم» (Advanced) الواقع ضمن مجموعة «فرز وتصفية» (Sort & Filter). يؤدي هذا الإجراء إلى فتح صندوق حوار “التصفية المتقدمة” الذي يتطلب تعبئة حقوله الإسنادية بدقة متناهية لضمان التنفيذ السليم للشروط الرياضية المحددة.
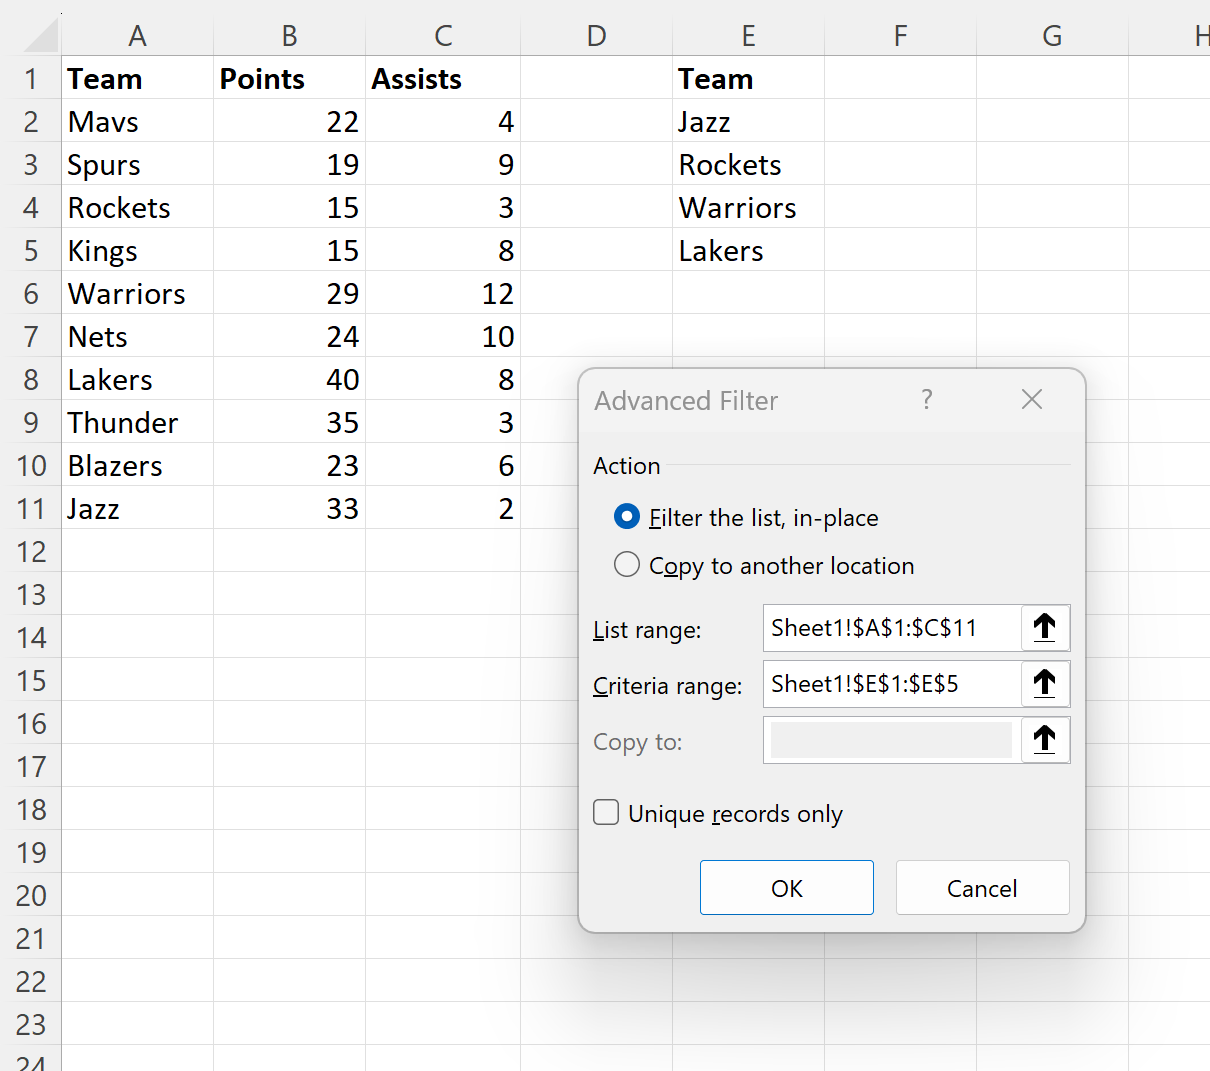
في حقل «نطاق القائمة» (List Range)، يتم تحديد كامل الجدول المراد تصفيته شاملاً صف الترويسة (على سبيل المثال: $A$1:$C$1000). من الأهمية بمكان التأكد من أن التحديد لا يشمل أي صفوف فارغة سابقة أو لاحقة للجدول. بعد ذلك، يتم الانتقال إلى حقل «نطاق المعايير» (Criteria Range) والنقر لاختيار النطاق المرجعي الذي تم إعداده مسبقاً (على سبيل المثال: $E$1:$E$10)، مع الحرص على شمول الخلية التي تتضمن الترويسة المطابقة وخلايا القيم المرجعية فقط دون أي إضافات.
يتم اختيار نمط الإجراء؛ إما “تصفية القائمة في نفس المكان” لتعديل عرض الجدول الحالي، أو “النسخ إلى موقع آخر” لتصدير النتائج إلى نطاق محدد في ورقة العمل عبر تعبئة حقل «النسخ إلى» (Copy to). بمجرد الضغط على زر “موافق” (OK)، يقوم برنامج إكسل بإخفاء الصفوف غير المتطابقة فورياً في حال التصفية الموضعية، تاركاً فقط السجلات التي تتقاطع قيم عمودها المستهدف مع عناصر قائمة المعايير المرجعية بدقة متناهية.
5. البدائل الدوالية الحديثة: التصفية الديناميكية بواسطة دالة FILTER
5.1 صياغة دالة FILTER مع دالة MATCH للاستعلام المتقاطع
مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays) من قِبل شركة مايكروسوفت في سبتمبر 2018 والإتاحة العامة لها بدءاً من يناير 2020 وتضمينها بشكل دائم في إصدار Excel 2021 وما تلاه، أصبحت دالة FILTER البديل الأكثر حداثة ومرونة للأدوات التقليدية. تتيح هذه الدالة استخلاص البيانات ديناميكياً استناداً إلى مصفوفة منطقية من القيم الثنائية، وتأتي ببنية تركيبية واضحة تتضمن وسيطة النطاق الأساسي (array)، ووسيطة شرط التضمين (include)، ووسيطة اختيارية لما يتم إرجاعه في حال عدم وجود نتائج (if_empty).
لتحقيق التصفية المتقاطعة حيث يُصفى عمود بناءً على قائمة في عمود آخر، يتم دمج دالة FILTER مع الدالتين MATCH وISNUMBER. تعمل دالة MATCH على مقارنة كل عنصر في العمود المستهدف بالقائمة المرجعية الخارجية؛ فإذا وجدت القيمة، تُرجع رقم موضعها داخل القائمة، وإن لم تجدها، تُرجع خطأ المطابقة #N/A. هنا يبرز دور دالة ISNUMBER التي تقوم بفحص هذا الناتج وتحويله إلى قيمة بوليانية صريحة: TRUE إذا كان الناتج رقماً (أي وُجدت القيمة)، أو FALSE إذا كان خطأً (أي غابت القيمة).
تتمثل الصيغة التطبيقية المثالية لهذا النموذج المتقاطع في المعادلة التالية:
=FILTER(A2:C11, ISNUMBER(MATCH(A2:A11, E2:E5, 0)), "لا توجد نتائج مطابقة")
في هذا النموذج، يقوم إكسل بفحص عناصر النطاق A2:A11، ومقارنتها بالسجلات الواردة في النطاق المرجعي E2:E5؛ فإذا تطابق المعرف، يتم إدراج السجل كاملاً ضمن النطاق المنسكب (Spill Range) تلقائياً، مع وضع نص افتراضي يحمي النموذج من رسائل الخطأ الحسابية عند انعدام التطابق.
5.2 مقارنة الكفاءة بين التصفية المتقدمة والصيغ الديناميكية
يتميز استخدام الدالة FILTER الديناميكية بقدرته على التحديث الفوري والآلي؛ فعند إضافة، أو حذف، أو تعديل أي قيمة داخل الجدول المصدر أو قائمة المعايير المرجعية، تنعكس التغييرات في الحال على مصفوفة النتائج المنسكبة دون أي تدخل يدوي. في المقابل، تفتقر أداة التصفية المتقدمة الكلاسيكية إلى هذه الديناميكية؛ حيث تتطلب من المستخدم إعادة تشغيل نافذة التصفية وإعادة تنفيذ الإجراء يدوياً في كل مرة تتغير فيها البيانات المرجعية.
ومع ذلك، فإن الصيغ الرياضية المصفوفية قد تؤثر على سرعة استجابة المصنف وحجم الذاكرة المستهلكة عند التعامل مع مجموعات بيانات ضخمة تتجاوز مئات الآلاف من الصفوف. يؤدي استدعاء دوال بحث متعددة مثل MATCH عبر مصفوفات واسعة إلى استهلاك مستمر لدورات المعالج الدقيق في كل عملية إعادة حساب للمصنف، بينما تعمل أداة التصفية المتقدمة بأسلوب المعالجة لمرة واحدة وتترك النتائج كقيم ثابتة لا تثقل كاهل المعالج أثناء تصفح الورقة.
تظل متطلبات التوافق التقني عاملاً فاصلاً في المفاضلة المنهجية بين الطريقتين؛ حيث إن دالة FILTER لا تدعمها الإصدارات القديمة من إكسل (مثل Excel 2016 وما قبله)، وتُظهر خطأ عدم التعرف على الدالة (#NAME?) عند فتح المصنف عبر بيئات عمل كلاسيكية. لذا، يتعين على المحلل تقييم البنية التقنية للمستفيدين النهائيين، واختيار أداة التصفية المتقدمة لضمان التوافق المطلق، أو اللجوء إلى الدوال الديناميكية لتوفير أقصى درجات المرونة والأتمتة السلسة في البيئات المحدثة.
6. تطبيق المعايير المنطقية المزدوجة والمتعددة (AND / OR Logic)
6.1 هندسة معايير الاختيار الأفقي والعمودي
توفر أداة التصفية المتقدمة مرونة منطقية بالغة التعقيد تتيح استجواب مجموعات البيانات وفق مبادئ الجبر البولياني، وذلك من خلال الهيكلة المكانية لنطاق المعايير. تعتمد الأداة قاعدة صارمة: الشروط المكتوبة على نفس الصف الأفقي تُعامل وفق المنطق التراكمي العاطف (AND)، مما يعني أن الصف لن يظهر في النتائج إلا إذا تحققت كافة الشروط الواردة في ذلك الصف معاً في الوقت عينه دون استثناء.
على العكس من ذلك، فإن الشروط الموزعة في صفوف رأسية متتالية أسفل الترويسة تُعامل وفق المنطق التخييري المانع (OR)؛ حيث يُكفي تحقق شرط صف واحد فقط لظهور السجل ضمن النتائج النهائية. تتيح هذه الهندسة المكانية للمحلل الجمع بين متطلبات متعددة في نموذج مرجعي واحد؛ مثل تصفية السجلات التي تنتمي لعميل محدد وفي الوقت ذاته تتجاوز مبيعاته حداً معيناً، أو تنتمي لعميل بديل دون النظر لحجم مبيعاته.
تتجلى قوة هذه المعمارية عند دمج شروط عمودين مستقلين لتصفية عمود ثالث بدقة حسابية متقدمة؛ حيث يمكن وضع ترويستين متجاورتين تمثلان عمودي “القسم” و”التقييم”، وتحديد قيم المقارنة في الصفوف المعنية. يتيح ذلك عزل المعرفات الفريدة في العمود المستهدف استناداً إلى تقاطع سمات مركبة مشتقة من حقول متعددة، مما يرفع من جودة استخراج المعطيات ويوفر مصفوفات شديدة التخصص للتحليلات اللاحقة.
6.2 استخدام المعاملات الشرطية والرموز البديلة (Wildcards)
تدعم أداة التصفية المتقدمة توظيف الرموز البديلة (Wildcards) لتمكين البحث المرن ومطابقة السلاسل النصية غير محددة البنية. يُستخدم رمز النجمة (*) للإشارة إلى أي عدد من المحارف النصية، سواء كانت معدومة، حرفاً واحداً، أو سلسلة نصية طويلة. على سبيل المثال، فإن وضع المعيار *مختبر* أسفل ترويسة معينة يسترجع كافة السجلات التي تتضمن هذه الكلمة أينما وردت داخل النص، مما يُغني عن كتابة كافة الاحتمالات الممكنة يدوياً.
كما يُستخدم رمز علامة الاستفهام (?) لتمثيل محرف فردي وحيد بموقع محدد ضمن السلسلة النصية، وهو ما يتيح فرز الرموز أو الأكواد المتباينة في حرف مفرد. فالمعيار رمز-?? يُطابق الأكواد المكونة من خمسة محارف تبدأ بـ “رمز-” وتليها خانتان فقط، متجاهلاً السجلات الأطول أو الأقصر، مما يُوفر مستوى عالياً من الدقة في تنقية البيانات الهيكلية أو المعرفات المشفرة داخل النظم الإدارية.
يمكن بالإضافة إلى ذلك دمج معاملات المقارنة الحسابية الكلاسيكية داخل خلايا المعيار النصي والعددي بفاعلية؛ مثل استخدام أكبر من (>)، أصغر من (<)، أو علامة عدم التساوي (<>). عند كتابة المعيار <>ملغى أسفل ترويسة الحالة، يقوم البرنامج فورياً باستبعاد كافة السجلات المرتبطة بالقيم الملغاة وإبقاء المعاملات السارية فقط، موفراً أداة استبعاد بالغة القوة تتكامل مع شروط الأعمدة المرجعية الأخرى.
7. تشخيص واستكشاف الأخطاء الشائعة وحلولها المعيارية
7.1 أسباب عدم استجابة التصفية المتقدمة لبيانات الإسناد
تواجه عمليات التصفية المتقدمة في كثير من الأحيان حالات إخفاق مفاجئة تظهر في هيئة عدم استجابة؛ حيث تظل كافة الصفوف ظاهرة أو تُخفى بالكامل دون إظهار السجلات المطلوبة. يرجع السبب الأكثر شيوعاً لهذه الظاهرة إلى التباين غير المرئي بين السلاسل النصية الناتج عن المسافات البادئة أو اللاحقة في عمود البيانات أو نطاق المعايير؛ مما يجعل البرنامج يعتبر القيمتين غير متطابقتين برمجياً بالرغم من تماثلهما التام ظاهرياً للمستخدم.
تتمثل المشكلة البنيوية الثانية في تباين نوع البيانات؛ وتحديداً حفظ الأرقام كقيم نصية في أحد النطاقات بينما هي مخزنة كقيم عددية في النطاق الآخر. هذا التباين الشائع عند استيراد البيانات يمنع خوارزمية البحث من إيجاد التطابق الرياضي؛ إذ يُعامل الرقم 100 كنص مغاير تماماً للقيمة الحسابية 100. يُمكن تصحيح هذا الخطأ عبر تحديد العمود المتأثر، واستخدام خيار التحويل إلى رقم عبر شارة التحذير، أو ضرب النطاق في القيمة 1 من خلال ميزة “اللصق الخاص” (Paste Special) لإعادة توحيد التنسيق.
كذلك تبرز إشكالية النطاقات غير المتكافئة أو المتداخلة؛ مثل إدخال نطاق القائمة مع تضمين خلايا من نطاق المعايير ضمنه عن طريق الخطأ أثناء التحديد السريع بالماوس، أو تجاوز التحديد للحدود الفعلية للجدول ليشمل مصفوفات مجاورة. يؤدي التداخل المكاني بين نطاق القائمة ونطاق المعايير إلى حدوث حلقات استدعاء مفرغة داخل المحرك الحسابي، مما يفشل التصفية ويستوجب فحص الإحداثيات وإعادة إدخالها بدقة متناهية.
7.2 إشكاليات بقاء الصفوف المخفية واسترجاع العرض الكامل
يشتكي المستخدمون أحياناً من بقاء أجزاء من جداول البيانات مخفية حتى بعد محاولة إلغاء التصفية، أو تجمد العرض على النتائج السابقة بعد إجراء تعديلات على السجلات. يُعالج هذا العرض التقني بالانتقال المباشر إلى تبويب «بيانات» (Data) وتنشيط أمر «مسح» (Clear) المتاح بجانب زر التصفية؛ حيث يعمل هذا الإجراء على إلغاء حالة الإخفاء وإعادة إظهار كافة صفوف المصنف دفعة واحدة مع تصفير مؤشرات المرشحات النشطة.
قد تنجم إشكالية عدم تحديث التصفية أيضاً عن ضبط خيارات الحساب داخل برنامج إكسل على الوضع “اليدوي” (Manual Calculation) بدلاً من “التلقائي” (Automatic)، وهو ما يتكرر في بيئات الأعمال التي تتعامل مع ملفات عملاقة لتجنب ثقل الحساب المستمر. في هذه الحالة، تفشل الدالات الديناميكية في تحديث مصفوفاتها المنسكبة، ويكمن الحل في الضغط على مفتاح F9 لتفعيل إعادة الحساب الفوري لورقة العمل واستعادة المظهر المحدث للبيانات المصفاة.
إذا استمرت المشكلة، فقد يكون السبب تلفاً في تعريف الجداول المهيكلة (Excel Tables) نتيجة عمليات حذف أو نقل خلايا غير متسقة عبر الأوراق؛ مما يُعطل الارتباط الداخلي للجدول. يُنصح في هذه الحالات بتحويل الجدول المهيكل مؤقتاً إلى نطاق عادي عبر أمر «تحويل إلى نطاق» (Convert to Range)، ثم مراجعة الصفوف واستعادة تماسك البيانات، ومن ثم إعادة إنشاء الجدول من جديد لضمان استقرار الخصائص البرمجية المرتبطة به.
8. استخراج وإدارة البيانات المصفاة لأغراض التحليل المتقدم
8.1 تصدير السجلات المطابقة إلى مواقع جغرافية جديدة داخل المصنف
يمثل خيار “النسخ إلى موقع آخر” (Copy to another location) في أداة التصفية المتقدمة وسيلة استثنائية لعزل البيانات المصفاة دون التعديل على بنية الجدول الأصلي أو المساس بترتيب صفوفه الحالية. يتيح هذا الخيار للمحلل تصدير السجلات المؤهلة فقط ووضعها في ورقة عمل مستقلة، مما يسهل مشاركة النتائج المحددة مع فرق العمل أو تجهيزها للإدراج في التقارير الإحصائية المعتمدة دون كشف السجلات الأخرى غير المعنية.
تتيح الأداة كذلك ميزة نوعية متقدمة تتمثل في استخراج أعمدة منتقاة فقط من السجلات المطابقة بدلاً من نسخ كامل أعمدة الجدول. لتحقيق ذلك، يقوم المستخدم بكتابة ترويسات الأعمدة المراد استخراجها فقط بشكل متجاور في الموقع المخصص للتصدير، ثم يُشير في حقل «النسخ إلى» إلى تلك الترويسات تحديداً؛ فيقوم إكسل بتجاوز باقي الأعمدة واستخلاص المعطيات المحددة بدقة بالغة تحت الترويسات المعنية.
يجب الحذر الشديد من الكتابة الفوقية العرضية (Accidental Overwriting) عند استخدام التصدير المكاني؛ حيث يقوم إكسل بمسح واستبدال أي بيانات موجودة في النطاق الواقع أسفل موقع النسخ بمجرد انسكاب السجلات الجديدة. يُنصح دائماً بتخصيص أوراق عمل فارغة ومستقلة لاستقبال المخرجات، أو التأكد من توفر مساحة كافية من الخلايا الفارغة أسفل ويمين نطاق النسخ لضمان عدم تلف السجلات أو الجداول المجاورة داخل المصنف.
8.2 استخراج السجلات الفريدة وحذف التكرارات المرجعية
تتضمن نافذة التصفية المتقدمة خياراً استراتيجياً فائق الأهمية يتمثل في مربع الاختيار «السجلات الفريدة فقط» (Unique records only). عند تفعيل هذا الخيار بالتزامن مع تطبيق شروط التصفية المرجعية، يقوم المحرك الحسابي بإلغاء إظهار أو تصدير أي صف يكرر بالكامل قيماً ظهرت في صف سابق متطابق، مما يوفر قائمة مصفاة ومجردة من التكرارات في خطوة إجرائية واحدة.
يكتسب عزل السجلات الفريدة أهمية بالغة في ضبط العينات وإعداد التقارير الإحصائية المعتمدة؛ حيث إن تكرار المعرفات لنفس المفحوصين أو العمليات يقود إلى تضخيم غير حقيقي لحجم العينة واختلال مؤشرات التشتت الإحصائي. إن ضمان فرادة السجلات المرجعية يتيح بناء نماذج قياسية موثوقة تلبي معايير الدقة البحثية، وتؤسس لمنطلقات استدلالية رصينة بعيدة عن التحيز الناجم عن ازدواجية التوثيق.
عقب إتمام الاستخراج، يتعين على المحلل تقييم سلامة العينة المستخرجة ومطابقتها لمحددات البحث الأصلية عبر استخدام دوال الفحص السريع مثل COUNTA وCOUNTIF للتأكد من أن عدد السجلات الناتجة يماثل تماماً التوقعات الرياضية المستهدفة من تقاطع مصفوفتي البيانات، مما يضمن دقة العملية وخلوها من شوائب المعالجة الآلية.
9. الأتمتة المؤسسية لعمليات التصفية المتقاطعة (Power Query و VBA)
9.1 توظيف أداة Power Query لدمج وتصفية الجداول استناداً لعمود
تُمثل أداة Power Query (المعروفة بـ Get & Transform) المنظومة الأكثر قوة واحترافية في إكسل للتعامل مع البيانات الضخمة والأتمتة المستمرة دون الحاجة إلى كتابة دوال معقدة داخل خلايا العمل. لإجراء التصفية المتقاطعة عبر هذه الأداة، يتم في البداية تحويل كل من الجدول الرئيسي وقائمة المعايير المرجعية إلى جدولين مستقلين، واستيرادهما إلى محرر Power Query عبر أمر «من ورقة/نطاق» (From Sheet/Range).
داخل محرر الاستعلامات، يتم تنفيذ عملية التصفية المرجعية من خلال دمج الاستعلامات عبر أمر «دمج كاستعلام جديد» (Merge Queries as New). يقوم المحلل بتحديد العمود المشترك في الجدول الأساسي والعمود المرجعي في جدول المعايير، مع اختيار نوع الربط ليكون «دمج داخلي» (Inner Join). يعمل هذا الدمج العلائقي على استبقاء السجلات المتطابقة فقط بين الجدولين وحذف كافة الصفوف غير المطابقة تلقائياً وبسرعة معالجة فائقة تعتمد على لغة M البرمجية المدمجة (باستخدام إجراءات التصفية مثل Table.SelectRows).
تتمثل القوة الهائلة لهذه المقاربة في بناء تدفق بيانات مؤتمت ومستدام (Data Pipeline)؛ فبمجرد تحميل النتيجة النهائية إلى ورقة العمل، لا يحتاج المستخدم إلى تكرار أي خطوة إجرائية في المستقبل. عند إضافة بيانات جديدة إلى الجدول المصدر أو تعديل قائمة المعايير، يكتفي المحلل بالنقر بزر الفأرة الأيمن على جدول النتائج واختيار «تحديث» (Refresh)، ليعيد Power Query تنفيذ التصفية والدمج فورياً وتحديث كافة السجلات والتقارير المترتبة عليها بدقة وثبات.
9.2 أتمتة العملية برمجياً باستخدام لغة فيجوال بيسك (VBA)
توفر لغة الفيجوال بيسك للتطبيقات (VBA) إمكانية التحكم البرمجي التام في أداة التصفية المتقدمة ودمجها ضمن واجهات العمل التفاعلية في المؤسسات. يمكن صياغة إجراء برمجي ينفذ التصفية المتقدمة عبر استدعاء التابع AdvancedFilter البرمجي التابع للكائن Range، مما يتيح تطبيق التصفية المعقدة بنقرة زر واحدة أو عند استيفاء شروط برمجية محددة سلفاً داخل المصنف.
يمكن تعظيم كفاءة النموذج التفاعلي عبر ربط الكود البرمجي بحدث تغيير ورقة العمل Worksheet_Change؛ بحيث تتم مراقبة الخلايا التابعة لنطاق المعيار المرجعي. فور قيام المستخدم بتعديل أو إضافة أي قيمة داخل قائمة المعايير، يلتقط المعالج البرمجي هذا التغيير ويُطلق عملية إعادة التصفية فورياً، مما يمنح المصنف سلوكاً ديناميكياً يحاكي البرمجيات المخصصة دون حاجة للتدخل اليدوي المتكرر من المستخدم.
لضمان سرعة التنفيذ وتفادي الوميض المزعج للشاشة أثناء المعالجة البرمجية لقواعد البيانات الكبيرة، يُشترط تحسين بنية الكود عبر تعطيل تحديث الشاشة وتعليق الحسابات التلقائية مؤقتاً في بداية الإجراء باستخدام:
Application.ScreenUpdating = FALSE
وإعادة تفعيلها فور اكتمال التصفية. تضمن هذه الممارسة تسريع زمن التنفيذ الحسابي وحماية واجهة المستخدم من التجميد، مما يوفر تجربة استخدام مؤسسية عالية الاعتمادية والأداء.
10. أفضل الممارسات المنهجية لحفظ ونمذجة البيانات المصفاة
10.1 توثيق معايير التصفية والبروتوكولات التحليلية
يُعد التوثيق الدقيق لمعايير التصفية ركيزة أخلاقية ومنهجية جوهرية لضمان قابلية التحقق والتدقيق العلمي في الدراسات الكمية والتقارير المؤسسية. إن تسجيل النطاقات المستخدمة، وتحديد تاريخ وساعة تنفيذ الاستعلام المتقاطع، وتوثيق المصدر الذي استُمدت منه قائمة المعايير، يتيح للباحثين والمراجعين المستقلين تكرار نفس العملية والوصول إلى ذات النتائج المطابقة بدقة؛ وهو ما يدعم معايير الشفافية العلمية المعمول بها في إدارة وتوثيق البيانات البحثية المفتوحة (Cai et al., 2022).
يتطلب تأمين نطاقات المعايير المرجعية حماية صارمة ضد التعديلات غير المقصودة؛ لذا يجب اللجوء إلى خيارات «حماية الورقة» (Protect Sheet) وقفل الخلايا التي تحتوي على رؤوس الأعمدة وقيم المعايير الثابتة. يمنع هذا الإجراء الإداري التعديلات العرضية من قِبل مدخلي البيانات، مما يحفظ اتساق معايير الفلترة ويمنع تشوه المخرجات التحليلية المترتبة عليها نتيجة إدخالات عشوائية خاطئة.
يُستحسن كذلك إعداد دليل وصفي مختصر للبيانات (Metadata) داخل ورقة عمل مخصصة تُدرج في مقدمة المصنف، يوضح الترابطات المنطقية بين الجداول المختلفة، ويبين دلالات الأكواد والرموز المرجعية المستخدمة في التصفية. يُسهم هذا الدليل الوصفي في تسهيل صيانة المصنف وفهم آليات بنائه من قِبل محللين جدد، مما يعزز استدامة النموذج الرقمي ويمنع اندثار المعرفة التقنية المؤسسية.
10.2 الحفاظ على سلامة قواعد البيانات الحساسة أثناء المعالجة
تقتضي الإدارة الرشيدة للبيانات الحساسة الاحتفاظ الدائم بنسخ احتياطية غير مصفاة ومحمية في مواقع تخزين مستقلة قبل الشروع في تطبيق أي إجراءات تصفية أو فرز معقدة. قد يؤدي تطبيق بعض آليات التصفية الحذفية أو النقل غير المحسوب إلى فقدان دائم لبيانات وسجلات أصلية لا يمكن استرجاعها، لا سيما عند العمل ضمن مصنفات ضخمة تتضمن اعتمادات مالية أو سجلات شخصية وسريرية تتطلب أعلى درجات الموثوقية (Borghouts et al., 2021).
يبرز هنا المبدأ الهيكلي الحاكم في التحليل الاحترافي: الفصل التام بين طبقة البيانات الخام (Raw Data) وطبقة المعالجة والعرض (Presentation Layer). يجب ألا تخضع ورقة البيانات المصدر لأي تصفية موضعية مستمرة قد تُربك مؤشرات الرصد اللحظي، بل يتم تصدير النتائج المصفاة إلى صفحات تقارير مستقلة، مما يضمن الحفاظ على الهيكل الأصلي لقواعد البيانات خالياً من أي تعديل غير قابل للعكس.
أخيراً، يتعين إجراء اختبارات دورية ومستقلة للتحقق من سلامة المخرجات الإحصائية؛ وذلك بسحب عينات عشوائية من البيانات المصفاة ومقارنتها يدوياً مع سجلات الجدول الرئيسي للتأكد من انطباق المعايير بدقة وعدم تسرب أي حالات استبعاد خاطئة (False Negatives) أو حالات قبول زائفة (False Positives). إن المراجعة الدورية المستمرة تؤكد متانة النظام التحليلي، وتضمن توفير مخرجات رقمية موثوقة تسند القرارات الإدارية والبحثية بأعلى مستويات النزاهة العلمية.
الخاتمة
استعرض هذا الدليل المتعمق الأبعاد المنهجية والتطبيقية لتصفية عمود بناءً على عمود آخر داخل برنامج إكسل، كأحد أهم إجراءات الربط العلائقي وضبط المتغيرات في إدارة البيانات. تناولنا بالتفصيل الأسس الرياضية للمقارنة البوليانية، وقمنا بتشريح البنية الوظيفية لأداة التصفية المتقدمة، مع توضيح الاشتراطات المسبقة لتطابق العناوين ونظافة البيانات لضمان دقة التنفيذ واستبعاد الأخطاء الشائعة.
كما فصّلنا البدائل الحديثة المعتمدة على دمج دالة FILTER مع الدالتين MATCH وISNUMBER ضمن بيئة المصفوفات الديناميكية، وقارنا مزاياها التفاعلية بالأدوات الكلاسيكية، إلى جانب استعراض الحلول المؤتمتة عبر Power Query ولغة VBA التي توفر بنية مؤسسية مستدامة لمعالجة التدفقات الكبيرة من السجلات. إن الالتزام بأفضل الممارسات الإدارية، من توثيق المعايير وحماية الجداول الأصلية، يضمن الحصول على تحليلات إحصائية رصينة تخدم أهداف البحث العلمي واتخاذ القرار المؤسسي بكفاءة واقتدار.
المراجع
Borghouts, J. W., Eikey, E. V., Mark, G. J., De Leon, C., Schueller, S. M., Schneider, M. L., et al. (2021). Barriers to and Facilitators of User Engagement With Digital Mental Health Interventions: Systematic Review. Journal of Medical Internet Research. https://doi.org/10.2196/24387
Cai, H., Yuan, Z., Gao, Y., Sun, S., Li, N., Tian, F., et al. (2022). A multi-modal open dataset for mental-disorder analysis. Scientific Data. https://doi.org/10.1038/s41597-022-01211-x