
تعد معالجة البيانات الرقمية واستنباط الأنماط التكرارية منها إحدى الركائز الجوهرية في حقول التحليل الإحصائي، وعلوم البيانات، والبحوث التطبيقية. فعند التعامل مع قواعد بيانات عريضة تتضمن مئات أو آلاف المدخلات العددية، تبرز الحاجة الملحة إلى تجاوز النظرة السطحية للأرقام والانتقال نحو تفكيك التوزيعات الاحتمالية والترددية التي تحكمها. وتأتي مسألة تحديد “القيم الأكثر تكراراً” (Most Frequent Numbers) كأحد التحديات التقنية التي تواجه المحللين والباحثين، لا سيما حين يتطلب التحليل استخراج رتب تكرارية متعددة تمتد إلى تحديد الأرقام الخمسة الأولى التي حازت أعلى نصيب من الظهور داخل العينة محل الفحص والدراسة.
يمثل برنامج مايكروسوفت إكسل (Microsoft Excel) بيئة حسابية بالغة المرونة تجمع بين البساطة الوظيفية والتعقيد البرمجي في آن واحد؛ حيث يوفر ترسانة واسعة من الأدوات الإحصائية، والصيغ المصفوفية، وخوارزميات المعالجة المنطقية القادرة على سبر أغوار البيانات الكمية. ومع ذلك، فإن التعامل مع التكرار الإحصائي لا يقف عند حدود استخراج القيمة الأكثر شيوعاً المنفردة، بل يتطلب بناء منظومات منطقية تعتمد على تقنيات الاستبعاد التكراري، وتتبع الرتب المتتالية، ومعالجة حالات التعادل الرياضي، وهي مهارات تتطلب فهماً عميقاً لكيفية تفاعل الدوال البرمجية في الذاكرة المؤقتة للحاسوب أثناء تنفيذ العمليات الحسابية المتشعبة.
يتناول هذا الدليل التخصصي الشامل تفكيك المسار الرياضي والتقني لاستخراج الأرقام الخمسة الأكثر تكراراً في إكسل، بدءاً من تأصيل المفاهيم الإحصائية التي أرساها رواد القياس، مروراً بالتشريح المنطقي للدوال المركبة والتقليدية (Legacy Formulas)، ووصولاً إلى الحلول الحديثة المستندة إلى محركات المصفوفات الديناميكية (Dynamic Arrays). كما يستعرض الدليل السيناريوهات الميدانية المعقدة، مثل غياب التكرارات، وتعادل الأوزان الترددية، وكيفية توظيف هذه النماذج في البحوث الإمبريقية، والاستبيانات السلوكية، ولوحات التحكم التفاعلية، مما يوفر للمحلل فهماً نظرياً وتطبيقياً متكاملاً يتسم بالدقة المنهجية والأداء الحسابي الرفيع.
1. الأسس النظرية لتحليل التكرار الإحصائي في برنامج إكسل
1.1 مفهوم المنوال ودوره في مقاييس النزعة المركزية
يمثل المنوال (Mode) الركيزة الوصفية الثالثة ضمن مقاييس النزعة المركزية التقليدية، إلى جانب المتوسط الحسابي (Mean) والوسيط (Median). تاريخياً، يعود التأصيل الرياضي الدقيق لمفهوم المنوال إلى عالم الإحصاء الشهير كارل بيرسون (Karl Pearson) في عام 1895، حين عرف المنوال بأنه القيمة التي تبلغ عندها كثافة التكرار ذروتها القصوى داخل التوزيع الاحتمالي. وتتجلى الأهمية الإحصائية للمنوال في قدرته الفائقة على تمثيل القيمة النموذجية الحقيقية التي تظهر في الواقع العملي، على عكس المتوسط الحسابي الذي قد ينتج قيمة تجريدية لا وجود لها في العينة الأصلية، أو الوسيط الذي يركز حصراً على الترتيب الموضعي للمفردات دون مراعاة ثقلها التكراري المباشر.
وفي إطار نظرية مستويات القياس التي طورها ستانلي سميث ستيفنز (Stanley Smith Stevens) عام 1946، يحتل المنوال مكانة فريدة؛ إذ يعد المقياس الوحيد الصالح للتعبير عن النزعة المركزية في البيانات الاسمية (Nominal Data)، فضلاً عن صلاحيته الكبيرة في المتغيرات الترتيبية (Ordinal Data) والكمية المنفصلة (Discrete Quantitative Data). ومع ذلك، يواجه التحليل المنوالي إشكاليات بنيوية حين تتعدد القمم التكرارية داخل العينة، كأن يظهر توزيع ثنائي المنوال (Bimodal) أو متعدد المناول (Multimodal)، أو حين تكون العينة متفرقة تماماً بحيث لا يتكرر فيها أي رقم. وتكتسب دراسة التكرارات المتعددة أهمية بالغة في بحوث القياس والتحليل الإحصائي، مثل تحليل أوزان تردد المفردات اللغوية في الدراسات المعرفية والنفسية، كما أظهرت أبحاث برايزبيرت ونيو في دراسة معايير تكرار الكلمات وتأثيرها على استرجاع الذاكرة والمعالجة الذهنية (Brysbaert & New, 2009).
إن الانتقال من مجرد حساب المنوال المنفرد إلى استخراج “أعلى خمسة أرقام تكراراً” يمثل في جوهره عملية فرز هرمي للتوزيع التكراري للعينة؛ حيث يتم الانتقال من النقطة المركزية القصوى إلى النقاط الفرعية التي تليها مباشرة في كثافة التردد. هذا التدرج التكراري يمنح الباحثين فهماً عميقاً لخرائط البيانات، ويتيح الكشف عن التجمعات الرقمية (Clusters) التي لا يمكن للأدوات الوصفية المعتادة رصدها، مما يعزز دقة النماذج الإحصائية التفسيرية والتنبؤية على حد سواء.
1.2 هندسة البيانات في جداول إكسل واستراتيجيات العزل الإحصائي
تتطلب الحوسبة الإحصائية الرصينة داخل برنامج إكسل صياغة معمارية منضبطة للجداول والنطاقات الرقمية. ومن الناحية المنهجية، يفضل تنظيم المتغيرات الكمية في نطاقات عمودية موحدة (Vertical Ranges) متجانسة نوعياً، حيث يحافظ العمود الواحد على نوع بيانات متطابق، مما يرفع من كفاءة خوارزميات البحث والمطابقة، ويقلل من استهلاك موارد الذاكرة العشوائية أثناء تدوير العمليات الحسابية المتجهة. إن احتواء النطاق على صفوف متصلة يخلو من الفجوات غير المبررة يتيح لمحرك الحساب في إكسل قراءة المصفوفات بطريقة خطية منتظمة تسهم في تسريع زمن التنفيذ، لا سيما في مجموعات البيانات الكبيرة.
تعتمد هندسة المعادلات الإحصائية المتطورة على الاستخدام الدقيق والمدروس للمراجع النسبية والمطلقة من خلال إشارة التثبيت ($). فبينما تشير المراجع المطلقة إلى تثبيت كامل النطاق الأصلي للبيانات لمنع انزياحه أثناء تعميم الصيغ الرياضية، تلعب المراجع شبه النسبية (أو المختلطة) دوراً حاسماً في استراتيجيات العزل التكراري؛ حيث يتم تثبيت بداية نطاق النتائج المستخرجة مع ترك نهايته حرة التوسع، مما يخلق نطاق استثناء يتمدد ديناميكياً مع كل صف جديد يتم حسابه. هذا التوسع المرحلي يمثل حاجزاً منطقياً يتم الاعتماد عليه لعزل الأرقام التي تم استخلاصها في المراحل السابقة وحرمانها من دخول المنافسة على الرتب اللاحقة.
تتكامل هذه المراجع مع الدوال المنطقية التي تؤسس “مرشحات رقمية افتراضية” (Virtual Filters) تعمل داخل الذاكرة دون الحاجة إلى تعديل الجدول الأصلي للبيانات. يهدف هذا العزل الإحصائي إلى استبعاد التكرارات التي تمت معالجتها، بحيث تقتصر حسابات الدوال التالية على القيم المتبقية غير المستخرجة. هذا التكنيك يمثل جوهر الخوارزميات التكرارية الذاتية داخل إكسل، والتي تحول الصيغة الحسابية من معادلة راكدة إلى محرك فرز ديناميكي يتكيف تلقائياً مع تسلسل الصفوف والنتائج المطلوبة.
2. البنية التركيبية لدالة MODE وتطورها في بيئة إكسل
2.1 التطور التاريخي للدالة من MODE التقليدية إلى MODE.SNGL وMODE.MULT
شهدت بيئة مايكروسوفت إكسل تطوراً ملحوظاً في كيفية التعامل مع الدوال الإحصائية عبر إصداراتها المتعاقبة. تاريخياً، كانت الدالة التقليدية MODE هي الأداة الحصرية لحساب القيمة الأكثر تكراراً في المصنفات الرقمية؛ ورغم فاعليتها الرياضية في حساب المنوال المفرد، إلا أنها عانت من قيود صارمة؛ حيث كانت تتجاهل وجود أكثر من قيمة تمتلك نفس التكرار الأقصى، مكتفية بإرجاع أول قيمة تصادفها جغرافياً في النطاق من أعلى اليمين أو اليسار إلى الأسفل، بالإضافة إلى عجزها عن التعامل مع التوزيعات متعددة المناول على نحو يتيح تصدير كافة القمم الترددية في آن واحد.
مع إطلاق إصدار إكسل 2010، أعادت مايكروسوفت هيكلة مكتبتها الإحصائية لتعزيز دقتها وتوافقها مع المعايير الدولية الصادرة عن المنظمات الإحصائية الكبرى، فظهرت دالتان بديلتان للدالة الكلاسيكية: الأولى هي MODE.SNGL، وهي الوريث المباشر للدالة التقليدية وتتبع نفس سلوكها في استخراج قيمة منوالية مفردة مع تحسينات طفيفة في خوارزميات الحساب؛ والثانية هي MODE.MULT، وهي دالة مصفوفية صُممت خصيصاً لإرجاع مصفوفة رأسية تحتوي على جميع القيم التي تشترك في أعلى تكرار إحصائي داخل النطاق المستهدف، مما مثل قفزة نوعية في تحليل البيانات ثنائية أو متعددة المنوال دون الحاجة إلى اللجوء إلى تعليمات برمجية مخصصة.
وعلى الرغم من هذا التحديث الهيكلي، فإن الاعتماد على الدالة التقليدية MODE أو MODE.SNGL يظل هو المعيار الأكثر شيوعاً عند بناء الصيغ المصفوفية المركبة الهادفة إلى استخراج “أعلى خمسة أرقام تكراراً بالتسلسل”، وذلك نظراً لقدرة هاتين الدالتين على الاندماج المرن مع الدوال المنطقية والمصفوفات الشرطية، والتعامل المستقر مع الاستدعاءات الفردية لكل خلية ضمن أعمدة الترتيب التنازلي، على عكس دالة MODE.MULT التي تتطلب حجز نطاقات مصفوفية مسبقة الحجم يصعب التحكم في تمددها التلقائي ضمن المصنفات القديمة.
2.2 قيود دالة المنوال المفردة في استخراج الرتب الإحصائية اللاحقة
تتمثل المعضلة الرياضية الأساسية لدالة المنوال الفردية في أنها دالة “عمياء” عن الرتب التالية؛ فهي مبرمجة برمجياً للبحث عن القيمة المطلقة التي تقابل أعلى تردد رقمي في المصفوفة المدخلة إليها، وبمجرد العثور عليها تتوقف خوارزمية البحث. ونتيجة لذلك، إذا قمت بسحب دالة MODE منفردة عبر خلايا عمودية متعددة، فإن النتيجة ستكون تكراراً متطابقاً لنفس الرقم الأول خمس مرات، لأن دالة المنوال لا تمتلك ذاكرة داخلية تستحضر بها ما استخرجته الخلية السابقة، ولا تملك وسيطاً داخلياً (Argument) يحدد الرتبة المطلوبة كدالة LARGE أو SMALL مثلاً.
ومن هنا، تنشأ الحاجة الرياضية الماسة لبناء حلقة ترشيح واستثناء منطقية ديناميكية تحيط بدالة MODE؛ حيث يتم إيهام الدالة في كل خطوة حسابية جديدة بأن المصفوفة الأصلية قد حُذفت منها القيمة أو القيم التي فازت بالرتب السابقة. يتطلب هذا المسار تحويل عملية الاستخراج من بحث إحصائي ساكن ومباشر إلى مسار تسلسلي هرمي (Hierarchical Pipeline)، تتغير فيه مدخلات دالة المنوال باستمرار وفقاً للنتائج التراكمية التي حققها الجدول حتى اللحظة الحسابية الراهنة.
إن بناء هذا المسار الهرمي هو ما يحول إكسل من مجرد آلة حاسبة رقمية إلى نظام منطقي متكامل لمعالجة البيانات. وبدون صياغة شروط الاستثناء التكرارية، يستحيل الانتقال من المنوال الأكبر (First Mode) إلى المنوال الثاني (Second Mode) ثم الثالث والرابع والخامس، مما يجعل تفكيك بنية الصيغ المصفوفية المركبة ضرورة تقنية لا غنى عنها لأي محلل يسعى إلى سبر أغوار المتغيرات الكمية المعقدة.
3. التشريح المنطقي للمعادلة المركبة لاستخراج الأرقام الأكثر تكراراً
3.1 تفكيك بنية الدالة: MODE مع IF وISERROR وMATCH
لتحقيق هدف استخراج الأرقام الخمسة الأكثر تكراراً دون تكرار رقمي للنتائج، يتم اللجوء إلى صياغة معادلة مصفوفية مركبة تمثل تحفة هندسية في المنطق الحسابي لبرنامج إكسل. تتكون هذه الصيغة من تضافر أربع دوال رئيسية تعمل بتكامل عضوي مدهش، وتأخذ البنية النمطية التالية:
=MODE(IF(ISERROR(MATCH($A$2:$A$24, C$1:C1, 0)),$A$2:$A$24))
ولفهم الآلية الداخلية لهذه الصيغة المركبة، يجب تفكيك الدور الوظيفي لكل لبنة برمجية على حدة:
- الدالة MATCH: تتولى هذه الدالة مهمة مسح ومطابقة كل عنصر من عناصر النطاق الأصلي للبيانات ($A$2:$A$24) مع القيم التي تم استخراجها وتدوينها مسبقاً في نطاق النتائج التراكمي (C$1:C1). تُرجع الدالة موقع القيمة كرقم نسبي إذا وجدت مطابقة، في حين تفشل وتُرجع رمز الخطأ الإحصائي الشهير (#N/A) إذا لم تكن القيمة قد ظهرت بعد في قائمة النتائج المستخرجة.
- الدالة ISERROR: تلعب دور المستشعر المنطقي للأخطاء؛ حيث تقوم بفحص مخرجات الدالة MATCH. فإذا أرجعت MATCH خطأً (#N/A) – وهو ما يعني بالضرورة أن الرقم قيد الفحص لم يسبق استخراجه – فإن ISERROR تحول هذا الخطأ إلى قيمة منطقية إيجابية هي (TRUE). أما إذا نجحت دالة المطابقة وأرجعت موقعاً رقمياً، فإن الدالة تُرجع القيمة المنطقية السلبية (FALSE).
- الدالة الشرطية IF: تعمل بمثابة البوابة المنطقية للترشيح؛ حيث تتلقى مصفوفة القيم المنطقية (TRUE/FALSE) الصادرة عن ISERROR. فإذا كانت القيمة المنطقية المقابلة لعنصر ما هي TRUE، فإن الدالة تسمح بمرور هذا الرقم الأصلي من النطاق ($A$2:$A$24) إلى المصفوفة الجديدة في الذاكرة. أما إذا كانت FALSE، فإن الخلية تستبعد الرقم ويتم استبداله بالقيمة المنطقية FALSE داخل المصفوفة المؤقتة.
- دالة المنوال MODE: تتربع في قمة الهرم التركيبي، حيث تتلقى المصفوفة الرقمية الناتجة والمصفاة حديثاً؛ وتكمن العبقرية البرمجية هنا في أن دالة MODE تتجاهل تلقائياً جميع القيم المنطقية (FALSE) داخل مصفوفات الذاكرة، وتحسب المنوال حصراً للأرقام الحقيقية المتبقية، مما يؤدي مباشرة إلى استخراج الرقم الأكثر تكراراً بين الأرقام التي لم يسبق استخراجها في الخلايا العلوية.
3.2 آلية تدفق البيانات ومعالجة المصفوفات في الذاكرة المؤقتة
تتم معالجة هذه الصيغة داخل الذاكرة المؤقتة لنظام إكسل عبر دورة حياة متسلسلة ودقيقة تمر بمراحل مصفوفية رقمية خفية. في المرحلة الأولى، يُرسل المتجه العمودي للبيانات الأصلية كاملاً إلى وسيط البحث في دالة MATCH، لتقوم الدالة بمقارنة كل عنصر من عناصر المتجه بالنطاق المرجعي العلوي. هذا يولد مصفوفة موازية في الذاكرة تتكون من أرقام مواقع وعلامات خطأ: {#N/A; 1; #N/A; #N/A; 2; …}.
في المرحلة الثانية، تتدخل الدالة ISERROR لتقوم بعملية تعيين ثنائي (Binary Mapping) يحول تلك المصفوفة المختلطة إلى مصفوفة نقية من القيم البولينية (Boolean Array)، لتأخذ الشكل البرمجي التالي: {TRUE; FALSE; TRUE; TRUE; FALSE; …}. تعكس هذه المصفوفة خريطة وجود الأرقام في نتائج الرتب السابقة بدقة متناهية؛ حيث تعني TRUE أن الرقم مؤهل للمنافسة، بينما تعني FALSE أن الرقم قد استُنفد واحتل رتبته مسبقاً.
في المرحلة الثالثة، تأخذ دالة IF هذا النمط البوليني وتضربه منطقياً في مصفوفة النطاق الأصلي، فتنتج مصفوفة رقمية مشوهة تتضمن الأرقام المؤهلة ممتزجة مع قيم FALSE في المواضع المستبعدة: {42; FALSE; 18; 42; FALSE; …}. وأخيراً، يتولى محرك حساب دالة MODE غربلة هذه المصفوفة متجاهلاً كل قيم FALSE، ليحسب التردد النسبي للأرقام المتبقية فقط، ويُرجع الرقم صاحب التردد الأقصى ليظهر كنتيجة حتمية ونهائية في الخلية النشطة.
4. الدليل التطبيقي خطوة بخطوة لاستخراج القيم الخمس الكبرى
4.1 إعداد نطاق البيانات وتجهيز أعمدة النتائج المرجعية
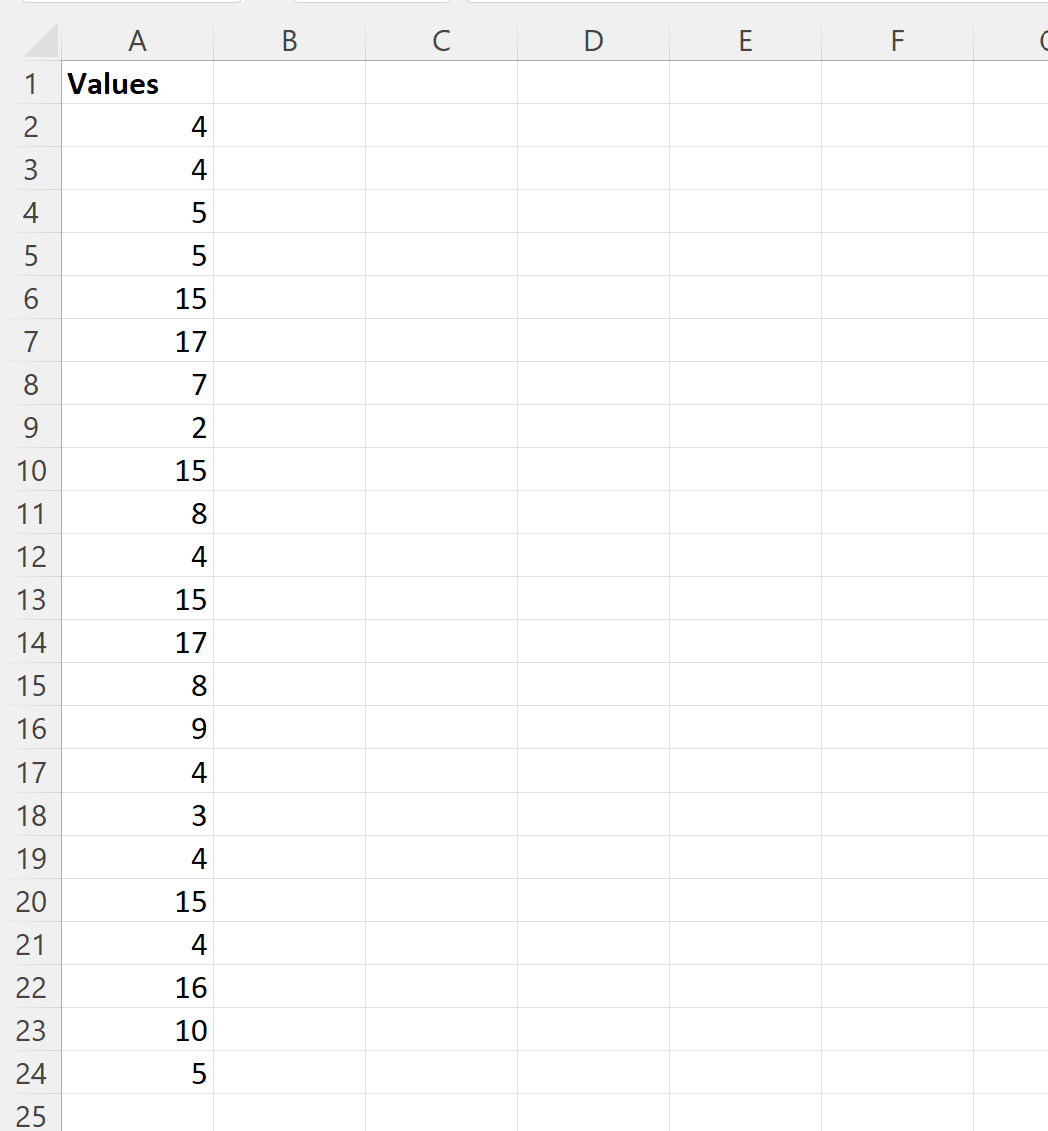
لبدء التطبيق العملي، سنفترض وجود مجموعة بيانات تجريبية تمثل استجابات عددية أو قياسات كمية مدخلة في النطاق المحجوز من الخلية A2 إلى الخلية A24. يحتوي هذا النطاق المكون من 23 صفاً على مجموعة من الأرقام الصحيحة المتكررة بدرجات متفاوتة، وهو ما يعكس بيئة إحصائية حقيقية تشبه عينات القياس الميداني التي تحتاج إلى تلخيص منظم.
يبدأ الإعداد الهندسي بتخصيص العمود (C) ليكون عمود “الأرقام الأكثر تكراراً”، والعمود (D) ليكون عمود “تكرار الرقم”. وتعتبر الخلية C1 حجر الزاوية الحرج في هذه المنظومة بأسرها؛ إذ يجب أن تحتوي هذه الخلية على تسمية نصية واضحة للعمود مثل كلمة “الرقم” أو “المنوال”، أو أن تُترك فارغة تماماً، ويحظر حظراً باتاً إدخال أي قيمة عددية داخل الخلية C1. يعود السبب في هذا الشرط الصارم إلى أن نطاق الفحص الأولي سيبدأ من C$1:C1، فإذا احتوت C1 على رقم يصادف وجوده في العينة الأصلية، فإن الدالة ستعتبره رقماً تم استخراجه مسبقاً وتستبعده فوراً من حسابات الرتبة الأولى، مما يؤدي إلى إفساد التحليل الإحصائي برمته وظهور نتائج مضللة.
4.2 كتابة الصيغة المصفوفية في الخلية المستهدفة C2
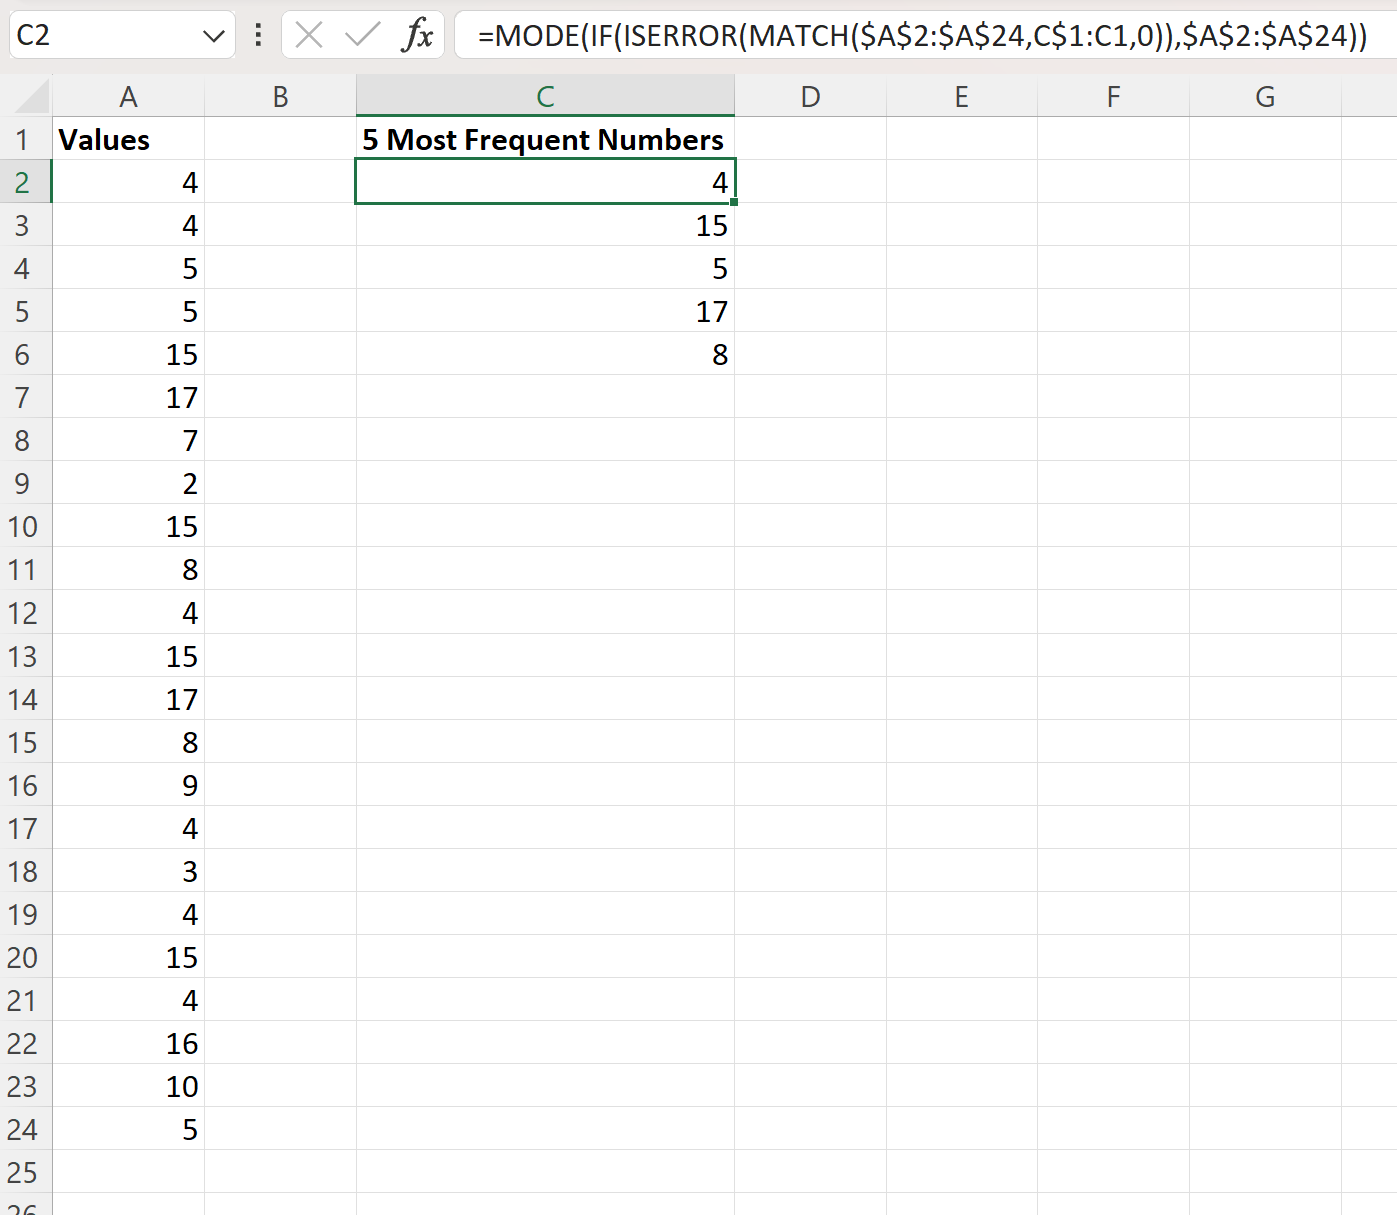
يتم الانتقال إلى الخلية C2 المخصصة لاستخراج المنوال الأول (صاحب أعلى تكرار إحصائي مطلق)، وتُكتب الصيغة الرياضية المركبة بالصيغة الحرفية الدقيقة:
=MODE(IF(ISERROR(MATCH($A$2:$A$24, C$1:C1, 0)),$A$2:$A$24))
يجب التركيز التام هنا على التباين البنيوي بين نوعي التثبيت البرمجي المستخدمين في المعادلة:
- تم تثبيت نطاق البيانات الأصلي تثبيتاً مطلقاً $A$2:$A$24 بإدراج علامتي الدولار قبل اسم العمود ورقم الصف، لضمان بقاء مجتمع البحث ثابتاً لا يتزحزح عند تعميم الصيغة على الخلايا السفلية.
- تم تثبيت النطاق المرجعي للنتائج تثبيتاً شبه نسبي C$1:C1؛ حيث تم تثبيت رقم صف البداية ($1) مع ترك رقم صف النهاية حراً ليتسع بصورة ديناميكية كلما نزلنا بالمعادلة إلى الصفوف اللاحقة.
في حال كنت تستخدم إصداراً قديماً من برنامج إكسل (ما قبل إصدار Microsoft 365 أو إصدارات إكسل التي تفتقر إلى محرك المصفوفات الديناميكية)، فإن إدخال هذه الصيغة بالضغط التقليدي على مفتاح Enter سيؤدي إلى فشلها التام أو ظهور أخطاء حسابية، ويجب بدلاً من ذلك تفعيل الصيغة عبر النقر المتزامن على مفاتيح Ctrl + Shift + Enter. تكتسب الصيغة حينها أقواس حاصرة تلقائية تبدو هكذا: {=MODE(…)}. أما في الإصدارات الحديثة الداعمة للحساب المصفوفي التلقائي، فيكفي الضغط على مفتاح Enter العادي لتتعامل بيئة البرنامج مع المصفوفة بسلاسة مطلقة، ويظهر المنوال الأول فوراً داخل الخلية C2.
4.3 السحب التلقائي وتوسيع النطاق لاستخراج المراتب من 2 إلى 5
بمجرد التأكد من صحة القيمة المستخرجة داخل الخلية C2، يتم توجيه مؤشر الفأرة نحو الزاوية السفلية اليسرى (أو اليمنى بحسب اتجاه واجهة المصنف) للخلية C2 حتى يتحول المؤشر إلى علامة التقاطع السوداء المعروفة بمقبض التعبئة (Fill Handle). يتم سحب المقبض نزولاً عبر الخلايا باتجاه الخلية C6.
خلال عملية السحب العمودي هذه، تتجلى روعة المراجع المتمددة ذاتياً؛ فعند الانتقال إلى الخلية C3، تتحول الصيغة آلياً إلى فحص النطاق (C$1:C2)، وهو ما يجبر المعادلة على استبعاد المنوال الأول المستخرج في C2 والبحث عن المنوال الأكثر تكراراً بين بقية أرقام العينة. وعند الوصول إلى الخلية C4، يتمدد نطاق الاستبعاد ليصبح (C$1:C3)، مما يعزل الرقمين الأول والثاني، وهكذا دواليك وصولاً إلى الخلية C6 التي تستخرج المنوال الخامس بعد استبعاد القيم الأربع السابقة من نطاق المنافسة عبر فحص النطاق (C$1:C5).
بانتهاء هذه الخطوة، يتولد أمام المحلل عمود رأسي متناسق يحتوي على خمسة أرقام متمايزة تمثل حصرياً هرم القيم الأكثر تكراراً في العينة، دون حدوث أي تكرار أو ازدواجية في ظهور الرقم الواحد ضمن قائمة المراتب الخمس الأولى، وهو ما يمثل نجاحاً تطبيقياً للترشيح المنطقي التراكمي.
5. قياس أوزان التكرار وحساب التردد الفعلي باستخدام دالة COUNTIF
5.1 البنية الرياضية لدالة COUNTIF في الإحصاء الوصفي
إن استخراج القيم العددية الأكثر تكراراً يظل غير مكتمل من الناحية الإحصائية ما لم يتم إقرانه بـ “التردد المطلق” (Absolute Frequency) المقابل لكل قيمة؛ فالرقم المستخرج يخبرنا بـ “ما هي” القيمة النموذجية، لكنه لا يوضح “وزنها النسبي” أو مقدار تكرارها داخل فضاء العينة المدروسة. هنا تبرز دالة العد الشرطي COUNTIF كأداة إحصائية لا غنى عنها لقياس أوزان التكرار بدقة متناهية.
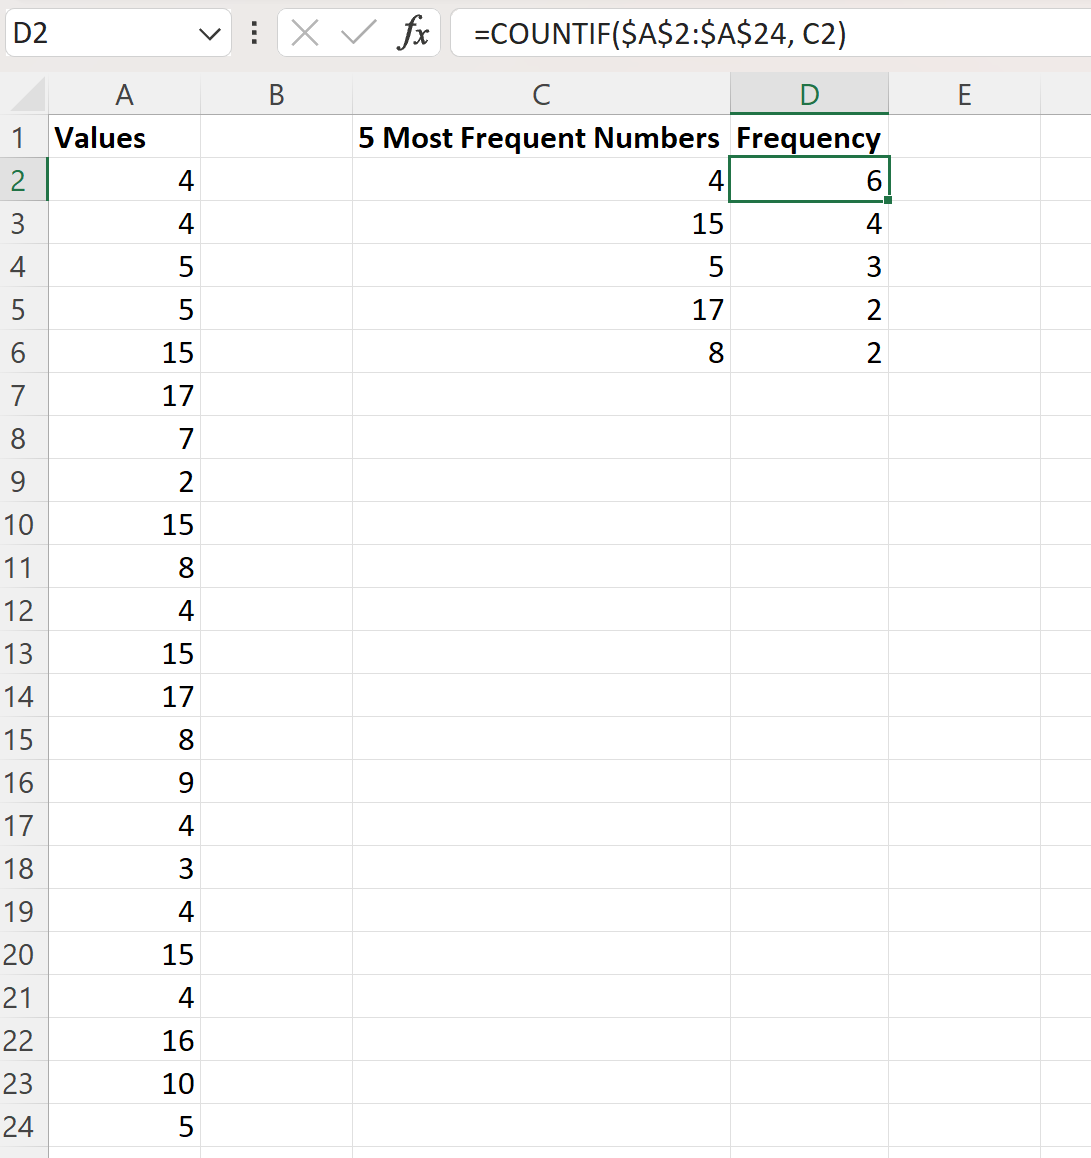
تعتمد دالة COUNTIF على وسيطين رياضيين أساسيين: الأول هو نطاق البحث الأصلي الذي تُجرى فيه عمليات التقييم، والثاني هو المعيار أو الشرط المطلوب تحقيقه وهو في حالتنا هذه الخلية التي تضم الرقم المستخرج. لتحقيق هذا القياس، يتم التوجه إلى الخلية المجاورة D2 وتُكتب الصيغة المرجعية التالية:
=COUNTIF($A$2:$A$24, C2)
يكتسي التثبيت المطلق للنطاق ($A$2:$A$24) أهمية حيوية قصوى هنا؛ إذ يمنع أي انزياح في فضاء البيانات الخاضع للعد أثناء تعميم المعادلة، في حين يُترك المرجع (C2) نسبياً بالكامل ليتحول تلقائياً إلى C3، ثم C4، وصولاً إلى C6 مع تحرك الصيغة نحو الأسفل، مما يسمح بحساب تكرار كل رتبة من الرتب الخمس على حدة وبشكل مستقل.
5.2 تفسير جدول التوزيع التكراري الناتج ومطابقته للبيانات الأصلية
عند سحب صيغة دالة COUNTIF من الخلية D2 إلى الخلية D6، يتشكل جدول إحصائي مصغر عالي الكفاءة يدمج الرتب العددية الخمس بتردداتها الفعلية داخل العينة. إن قراءة هذا الجدول الناتج تتطلب تحليلاً إحصائياً نقدياً؛ حيث يظهر الرقم المتصدر في الخلية C2 وبجواره في الخلية D2 أعلى تردد مسجل في العينة (وليكن مثلاً 6 تكرارات)، يليه الرقم الثاني بتردد مساوٍ أو أقل (وليكن 5 تكرارات)، ويتدرج هذا الانخفاض الترددي وصولاً إلى الرتبة الخامسة في C6 وترددها في D6.
للتحقق من السلامة المنهجية والمطابقة الإحصائية لهذه الحسابات، يقوم المحلل بإجراء فحص المجموع الجزئي (Subtotal Verification). يتمثل هذا الفحص في جمع الترددات المسجلة في النطاق D2:D6؛ ويجب أن يكون هذا المجموع الرياضي دائماً أقل من أو مساوياً لحجم العينة الكلي البالغ 23 عنصراً (في نطاقنا من A2 إلى A24). إذا كان المجموع مساوياً لحجم العينة، فإن هذا يعني أن كافة أفراد العينة ينحصرون حصرياً داخل هذه الفئات الرقمية الخمس دون سواها؛ أما إذا كان المجموع أقل من إجمالي العينة، فإن الفرق الحسابي يمثل الترددات المشتتة للقيم الفردية الأخرى التي لم تنل شرف التأهل إلى المراتب الخمس الأولى، وهو السلوك النمطي الطبيعي في التوزيعات الاحتمالية الحقيقية.
6. التعامل مع الحالات الإحصائية المعقدة وظاهرة تعادل التكرارات
6.1 إشكالية تساوي التكرارات بين رقمين أو أكثر (Ties)
تعد ظاهرة تعادل التكرارات (Statistical Ties) من أكثر الحالات الرياضية إثارة للجدل في مجال تحليل البيانات التكرارية؛ وتحدث عندما يتساوى رقمان أو أكثر داخل العينة في نفس عدد مرات الظهور الفعلي. على سبيل المثال، قد يتكرر الرقم (14) والرقم (29) أربع مرات لكل منهما داخل النطاق، فكيف تفصل دالة MODE ومنظومتها المصفوفية بين هذين الرقمين لتحديد أيهما يصعد إلى الرتبة الأعلى؟
تعتمد خوارزمية دالة MODE التقليدية في إكسل على “الفرز الجغرافي الأحادي” (First-Occurrence Rule) لكسر التعادل الحسابي؛ حيث تمنح الدالة الأولوية المطلقة للقيمة التي تظهر أولاً بترتيب القراءة داخل الجدول من الأعلى إلى الأسفل ومن اليمين إلى اليسار. فإذا ظهر الرقم (14) في الخلية A5 بينما ظهر الرقم (29) في الخلية A9، فإن الدالة سترفع الرقم (14) وتضعه في الرتبة السابقة، ثم تؤجل الرقم (29) إلى الرتبة اللاحقة مباشرة ما دام يمتلك تكراراً يتيح له التنافس.
تثير هذه الآلية الآلية المدمجة إشكالات منهجية تتعلق بموثوقية النتائج؛ إذ يؤدي الترتيب المكاني العشوائي للمدخلات إلى تفضيل رقم على آخر دون وجود فارق إحصائي موضوعي في الوزن الترددي. وفي البحوث الإمبريقية الرصينة، يجب على المحلل الإفصاح بشفافية عن وجود حالات تعادل تكراري (Ties)، موضحاً أن الترتيب بين القيم المتساوية في التردد خضع لأسبقية الإدخال في المصنف الرقمي، تجنباً لإعطاء انطباع زائف بتفوق إحصائي مطلق لقيمة على أخرى في الأهمية الميدانية.
6.2 معالجة التكرار الشحيح ونفاد الأرقام المتكررة في العينة
ثمة مأزق تقني آخر يواجه خوارزمية الاستخراج التسلسلية، ويتجلى في “شح التكرار” داخل العينة؛ حيث قد تتسم البيانات بالتشتت الشديد، بحيث لا تحتوي سوى على ثلاثة أرقام متكررة فقط، بينما تكون بقية مفردات العينة قيماً فريدة لم تظهر سوى مرة واحدة. في مثل هذا السيناريو، ستنجح الصيغة المصفوفية في استخراج المراتب الأولى والثانية والثالثة دون عناء؛ ولكن عند محاولة استخراج الرتبة الرابعة والخامسة، ستصطدم دالة MODE بعدم وجود أي قيمة متبقية يتجاوز تكرارها الواحد الصحيح، لأن دالة MODE مصممة رياضياً لإرجاع رمز الخطأ الشهير #N/A إذا لم تجد قيماً متكررة إطلاقاً في المصفوفة الخاضعة للفحص.
يؤدي ظهور خطأ #N/A إلى تشويه المظهر الاحترافي لتقارير التحليل ولوحات المؤشرات التفاعلية، كما يتسبب في تعطيل دوال المجموع أو الحسابات اللاحقة المعتمدة على تلك الخلايا. لحل هذه المعضلة الحسابية وتأمين المخرجات، يتم تضمين المعادلة المصفوفية بأكملها داخل دالة احتواء الأخطاء IFERROR، فتتم إعادة صياغة المعادلة في الخلية C2 بالشكل المحمي التالي:
=IFERROR(MODE(IF(ISERROR(MATCH($A$2:$A$24, C$1:C1, 0)),$A$2:$A$24)), “لا يوجد تكرار إضافي”)
تعمل الدالة IFERROR كدرع واقٍ يفحص مخرجات دالة MODE؛ فإذا أسفرت العملية الحسابية عن رقم منوالي صحيح، تسمح له بالظهور، أما إذا اصطدمت الدالة بنفاد التكرارات وتحقق الخطأ #N/A، فإنها تستبدل الخطأ بالنص البديل التوضيحي المختار، أو تترك الخلية فارغة تماماً باستخدام علامتي التنصيص المزدوجتين (“”)، مما يحافظ على نظافة التقرير وتماسكه المنهجي أمام المستخدم النهائي.
7. البدائل الحديثة في Microsoft 365: دوال المصفوفات الديناميكية
7.1 استخدام الدوال الحديثة: SORT وUNIQUE وFILTER
أحدثت البيئة السحابية لإصدارات مايكروسوفت أوفيس 365 (Microsoft 365) وإكسل 2021 ثورة تقنية كبرى في طريقة معالجة البيانات، عبر إدخال ما يعرف بمحرك المصفوفات الديناميكية (Dynamic Arrays Engine). هذا التحديث ألغى التعقيدات القديمة المرتبطة بالسحب اليدوي للمعادلات واستخدام مفاتيح الاختصار المعقدة، وسمح بصياغة حلول برمجية متطورة وفائقة الأناقة لاستخراج أعلى خمسة أرقام تكراراً في صيغة واحدة تفيض تلقائياً (Spill) لملء النطاق المطلوب.
باستخدام منظومة الدوال الحديثة، لم نعد بحاجة إلى دالة MODE أو التحايل بالدوال الشرطية المركبة؛ حيث يمكن الاعتماد على التركيبة الذكية التي تجمع بين دوال UNIQUE وSORTBY وTAKE، وفق الصيغة المتطورة المعتمدة:
=TAKE(SORTBY(UNIQUE(A2:A24), COUNTIF(A2:A24, UNIQUE(A2:A24)), -1), 5)
تتم معالجة هذه الصيغة الحديثة عبر تسلسل منطقي محكم وفائق السرعة:
- تقوم الدالة UNIQUE(A2:A24) باستخلاص قائمة مصفوفية خالية تماماً من أي تكرار لجميع القيم الفريدة الموجودة في النطاق الأصلي.
- تقوم الدالة COUNTIF(A2:A24, UNIQUE(A2:A24)) بحساب التردد الفعلي لكل قيمة من تلك القيم الفريدة في مصفوفة ترددية موازية.
- تتولى الدالة SORTBY(…, -1) ترتيب مصفوفة القيم الفريدة ترتيباً تنازلياً (-1) بالاعتماد على مصفوفة الترددات كمعيار للفرز، بحيث تصعد القيمة صاحبة أعلى تكرار إلى رأس المصفوفة.
- وأخيراً، تقتطع الدالة TAKE(…, 5) العناصر الخمسة الأولى فقط من أعلى المصفوفة المرتبة، لتفيض النتيجة تلقائياً في خمس خلايا عمودية متتالية بمجرد الضغط على Enter في خلية البداية.
7.2 توظيف الدالة LET لبناء صيغة برمجية نظيفة وعالية الكفاءة
في بيئات البيانات المتقدمة، يُنصح بشدة بالارتقاء بالصيغ الحديثة عبر استخدام الدالة البرمجية الثورية LET؛ تتيح هذه الدالة للمحلل تعريف متغيرات بأسماء محددة داخل الخلية الواحدة وتخزين نواتج الحسابات الوسيطة فيها، مما يمنع محرك إكسل من تكرار قراءة النطاق أو إعادة احتساب دالة UNIQUE أكثر من مرة، وبالتالي يتم تحسين سرعة الحساب بصورة دراماتيكية في الملفات الضخمة.
تُكتب الصيغة المعتمدة على الدالة LET بصورة برمجية منظمة تضاهي لغات البرمجة المتقدمة:
=LET(data, A2:A24, u_vals, UNIQUE(data), counts, COUNTIF(data, u_vals), TAKE(SORTBY(HSTACK(u_vals, counts), counts, -1), 5))
في هذا التركيب المعياري، تم تعريف النطاق الأصلي تحت مسمى data، وتم تخزين القيم الفريدة في المتغير u_vals، في حين تم احتساب تكراراتها مرة واحدة وتخزينها في المتغير counts. بعد ذلك، دمجت الدالة HSTACK القيم وتردداتها جنباً إلى جنب في جدول متكامل مكون من عمودين، وتم فرزهما تنازلياً بواسطة SORTBY، واقتطاع أفضل 5 صفوف عبر TAKE. ينتج عن هذا التوظيف توليد جدول التوزيع التكراري لأفضل 5 قيم مع أوزانها الحقيقية دفعة واحدة دون الحاجة إطلاقاً إلى إنشاء أعمدة مساعدة أو تكرار كتابة الدوال في خلايا مجاورة، مما يمثل ذروة الكفاءة في معمارية جداول البيانات المعاصرة.
8. المقارنة التقنية بين الصيغ المباشرة وأدوات تحليل البيانات المدمجة
8.1 استخراج التكرارات عبر الجداول المحورية (Pivot Tables)
إلى جانب الحلول القائمة على الصيغ الرياضية، يوفر برنامج إكسل أداة بصرية بالغة القوة والرسوخ لتحليل التكرارات تتمثل في “الجداول المحورية” (Pivot Tables). تعتبر الجداول المحورية حلاً مثالياً للمستخدمين الذين يفضلون البيئات التفاعلية الموجهة بالفأرة على كتابة التراكيب الرياضية المعقدة، وتقدم مساراً تحليلياً متيناً لحساب التكرارات وفرزها بدقة فائقة.
تتلخص خطوات استخراج الأرقام الخمسة الأكثر تكراراً عبر الجداول المحورية في المسار الإجرائي التالي:
- تحديد نطاق البيانات بالكامل (A1:A24) مع تضمين رأس العمود، ثم التوجه إلى علامة التبويب “إدراج” (Insert) واختيار “جدول محوري” (PivotTable).
- سحب حقل الأرقام وإفلاته داخل منطقة “الصفوف” (Rows)، مما يؤدي فوراً إلى تجميع كافة القيم المتكررة في قائمة فريدة غير مكررة.
- سحب نفس حقل الأرقام مرة ثانية وإفلاته داخل منطقة “القيم” (Values)؛ وهنا يجب النقر على إعدادات الحقل للتأكد من تلخيص القيم باستخدام دالة “العد” (Count) وليس دالة “المجموع” (Sum)، ليتحول العمود إلى قياس دقيق لتردد كل رقم.
- النقر على سهم التصفية المجاور لتسميات الصفوف، والتوجه إلى “عوامل تصفية القيم” (Value Filters)، ثم اختيار مرشح “أفضل 10” (Top 10 Filter).
- تعديل الرقم الظاهر في معالج التصفية من 10 إلى (5 عناصر)، ليتم إخفاء باقي القيم فوراً وإبقاء الأرقام الخمسة التي تمتلك أعلى تكرار إحصائي داخل الجدول.
ورغم قوة هذه الأداة وبساطتها، يكمن الفارق الجوهري بين الجداول المحورية والصيغ الرياضية في مسألة “التحديث التلقائي الفوري”؛ فالصيغ البرمجية تتفاعل لحظياً وبصورة حية مع أي تعديل يطرأ على البيانات في النطاق الأصلي، في حين تتسم الجداول المحورية بكونها كيانات ساكنة تتطلب من المحلل إجراء عملية “تحديث” يدوية (Refresh) لتحديث مخرجاتها عند طروء أي تغيير عددي.
8.2 مقارنة الأداء الحسابي وتأثير الصيغ المصفوفية على موارد النظام
عند تقييم خيارات المعالجة المتاحة في إكسل، يجب على مهندس البيانات والمحلل الإحصائي إجراء موازنة تقنية دقيقة بين الصيغ المصفوفية التقليدية، ودوال المصفوفات الديناميكية الحديثة، والجداول المحورية، من حيث استهلاك موارد وحدة المعالجة المركزية (CPU) والذاكرة العشوائية (RAM). تتميز الصيغ المصفوفية التقليدية القديمة (Legacy Array Formulas) بكونها صيغاً عالية الاستهلاك الحسابي؛ حيث تقوم الصيغة في كل خلية بإعادة فحص النطاق الأصلي كاملاً وإجراء مطابقة مصفوفية تتطلب معالجة مربعة التعقيد الحسابي (Quadratic Complexity: O(N^2)) تقريباً عند تعميمها، مما يؤدي إلى بطء ملحوظ وثقل في استجابة المصنف إذا تجاوز حجم البيانات عشرات الآلاف من الصفوف.
على النقيض من ذلك، تتمتع دوال المصفوفات الديناميكية الحديثة (مثل UNIQUE وSORTBY وLET) بأداء خوارزمي محسن للغاية ومكتوب بلغة برمجية منخفضة المستوى تدار بكفاءة داخل محرك الحساب؛ إذ تقوم بفرز البيانات وتجميعها في مسار حسابي أحادي أو لوغاريثمي التعقيد (O(N log N))، مما يقلل زمن الحساب بنسبة هائلة مقارنة بالمعادلات المركبة القديمة. أما الجداول المحورية، فتعتمد على بناء “محرك تجميعي في الذاكرة” (Pivot Cache)، وهو ما يمنحها أعلى درجات السرعة في معالجة مئات الآلاف من الصفوف دون التأثير على سرعة حركة المصنف، ولكن على حساب استهلاك مساحة إضافية من حجم الملف التخزيني.
يوضح الجدول المقارن التالي الفروق الجوهرية بين هذه التقنيات الثلاث:
| المعيار التقني | الصيغ المصفوفية التقليدية (MODE + MATCH) | دوال المصفوفات الحديثة (SORTBY + UNIQUE) | الجداول المحورية (Pivot Tables) |
|---|---|---|---|
| التحديث اللحظي للبيانات | تلقائي وحي وفوري بمجرد تعديل الأرقام | تلقائي وحي وفوري عبر محرك التدفق | يتطلب أمراً يدوياً بتحديث البيانات (Refresh) |
| التوافق مع الإصدارات | متوافقة مع كافة إصدارات إكسل القديمة والحديثة | محصورة في Microsoft 365 وإكسل 2021 وما بعده | متوافقة عالمياً عبر كافة إصدارات إكسل |
| استهلاك الذاكرة والمعالجة | مرتفع جداً في النطاقات الضخمة (قد يسبب تجمد المصنف) | متوسط ومنخفض بفضل كفاءة دالة LET ومحرك الحساب | شديد الكفاءة والسرعة الحسابية لقواعد البيانات الكبيرة |
| سهولة الإنشاء والصيانة | معقدة وتتطلب فهماً عميقاً لمنطق المصفوفات | أنيقة وموجزة جداً وسهلة المراجعة البرمجية | واجهة بصرية تفاعلية تماماً دون كتابة أكواد |
9. استكشاف الأخطاء البرمجية والمنطقية وإصلاحها
9.1 تشخيص الأخطاء الشائعة: #N/A و#VALUE! وتداخل المراجع
يتعرض المحللون أثناء تطبيق الصيغ التكرارية المركبة لظهور حزمة من الأخطاء البرمجية الشائعة التي تعيق الوصول إلى المخرجات السليمة؛ ويعد التشخيص الدقيق لجذور هذه الأخطاء الخطوة الأساسية لتصحيح المسار الحسابي. أول هذه الأخطاء هو الخطأ #VALUE!، والذي يظهر بشكل نمطي في الإصدارات القديمة من إكسل عندما يقوم المستخدم بإدخال الصيغة المصفوفية عبر الضغط على مفتاح Enter منفرداً بدلاً من التوليفة الثلاثية (Ctrl + Shift + Enter). يفسر إكسل الصيغة حينها على أنها تعامل غير صالح بين وسائط مفردة ومصفوفات متعددة، ويكمن العلاج ببساطة في الدخول إلى وضع تعديل الخلية وإعادة حفظها بالمفاتيح الثلاثية الصحيحة.
أما الخطأ #N/A، فله وجهان متمايزان: الوجه الأول يمثل مساراً طبيعياً تشير الدالة من خلاله إلى نفاد الأرقام المتكررة في العينة كما أسلفنا، ويتم علاجه بالدالة IFERROR. والوجه الثاني يمثل خطأً بشرياً ناتجاً عن عدم تطابق أبعاد النطاقات المتقاطعة؛ كأن يتم تحديد نطاق البيانات ليكون من A2 إلى A24 في دالة MATCH بينما يُكتب من A2 إلى A30 في وسيط دالة IF، مما يخلق تبايناً مصفوفياً يقود مباشرة إلى تعطل الحساب وتوليد رسالة الخطأ.
وثمة خطأ كارثي صامت يتمثل في “تداخل وانزياح المراجع”؛ ويحدث عندما ينسى المحلل تثبيت الصف الأول في نطاق الاستبعاد، فيكتب (C1:C1) بدلاً من (C$1:C1). عند سحب هذه المعادلة الخاطئة لأسفل، ينزاح النطاق ليصبح في الخلية الثالثة (C2:C2)، وهو ما يؤدي إلى نسيان وتجاوز المنوال الأول المستخرج في C2 والعودة إلى ترشيحه مجدداً كمنافس صالح، مما يؤدي إلى تكرار نفس الرقم في النتائج وانهيار المنظومة المنطقية لترتيب الرتب الخمس دون أن يصدر البرنامج أي تنبيه بوجود خطأ حسابي ظاهري.
9.2 معالجة البيانات غير المتجانسة والنصوص المضمنة والفراغات
في التطبيقات العملية، نادراً ما تأتي البيانات الخام نقية ومثالية؛ بل غالباً ما تحتوي على خلايا فارغة مشتتة، أو أرقام كُتبت عن طريق الخطأ كنصوص (Numbers stored as text) نتيجة عمليات الاستيراد من قواعد بيانات خارجية أو ملفات CSV. تبرز المشكلة في أن دالة المنوال MODE والعمليات الحسابية الملحقة بها تتجاهل تماماً الأرقام المخزنة كنصوص وتعتبرها قيماً لاغية، مما يتسبب في حرمان أرقام حيوية من الدخول في الترتيب التكراري وإفساد صدق التمثيل الإحصائي.
لمعالجة مشكلة الأرقام النصية، يجب إجراء خطوة تطهير قبلي للبيانات (Data Cleansing)؛ ويمكن تحقيق ذلك عبر ضرب النطاق بالكامل في الرقم (1) في عمود مساعد، أو استخدام دالة التحويل العددي الصريح VALUE، أو تحديد العمود واستخدام معالج “نص إلى أعمدة” (Text to Columns) لإجبار إكسل على إعادة تحويل وتعيين نوع البيانات كقيم رقمية عامة سليمة.
أما فيما يتعلق بالخلايا الفارغة، فإن وجودها داخل النطاق المستهدف ($A$2:$A$24) قد يولد تشوهات في مخرجات دالة MATCH ودوال الفحص المنطقي، حيث قد يفسرها إكسل أحياناً كأصفار متكررة. ولتحصين الصيغة المصفوفية ضد الخلايا الفارغة والنصوص الشاردة، يمكن تدعيم الشرط المنطقي الداخلي ليتضمن فحصاً إضافياً يتأكد من كون الخلية رقماً حقيقياً غير فارغ، عبر دمج الدالة ISNUMBER والشرط (<>””)، مما يضمن تدفق الأرقام الحقيقية والصحيحة حصراً إلى داخل مصفوفة الذاكرة المعالجة.
10. التطبيقات العملية المتقدمة ونماذج التحليل في البحوث الميدانية
10.1 تحليل استجابات مقاييس ليكرت والاستبيانات السلوكية
تحظى تقنيات استخراج القيم الأكثر تكراراً باهتمام واسع ومحوري في حقول العلوم النفسية، والبحوث الاجتماعية، والدراسات السلوكية؛ حيث تعتمد معظم هذه الميادين على استبانات مقننة تستخدم مقاييس ليكرت (Likert Scales) الثلاثية، أو الخماسية، أو السباعية لقياس الاتجاهات، والسمات، والاستجابات العاطفية. وتعتبر الاستجابات الرقمية الناتجة عن مقاييس ليكرت بيانات ترتيبية (Ordinal Data)، يمثل المنوال والقيم الأكثر شيوعاً المقياس الإحصائي الأنسب والأكثر صدقاً لوصف نزعتها المركزية وفقاً للقواعد التأسيسية لقياس البيانات التي وضعها ستيفنز عام 1946.
في دراسات قياس تكرار المشاعر الإيجابية وعلاقتها بالنجاح في الحياة، أظهرت أبحاث ليوبوميرسكي، كينغ، ودينر أن قياس وتتبع وتيرة تكرار الحالات الانفعالية والوجدانية الإيجابية (Frequent Positive Affect) يعد مؤشراً أكثر دقة وثباتاً في التنبؤ بالتوافق المهني والاجتماعي مقارنة بقياس شدة الانفعال اللحظي المتطرف (Lyubomirsky et al., 2005). ويتطلب تحليل مثل هذه البيانات النفسية في إكسل استخراج الاستجابات الخمس الأكثر تكراراً لتحديد الأنماط السلوكية السائدة لدى المبحوثين؛ حيث يشير تركز التكرارات في قيم محددة إلى وجود تحيز سلوكي أو نمطية استجابة (Response Bias)، مثل ميل الأفراد إلى اختيار القيم المحايدة أو التطرف نحو الموافقات المطلقة، كما تمتد هذه الأنماط الترددية إلى قياس مؤشرات الإنتاجية ومستويات الرضا لدى الأفراد في بيئات العمل الوظيفية كما حللها أوزوالد وبروتو وسغروي (Oswald et al., 2015).
إن استخراج الأرقام الأكثر تكراراً في هذا السياق يوفر للباحث النفسي والاجتماعي قدرة فائقة على تلخيص آلاف الاستجابات في مؤشرات كمية بالغة التركيز، تدعم بناء تقارير منهجية تكشف عن البنية الإدراكية للعينة محل القياس وتساعد في التحقق من ثبات المقاييس المطبقة وصدقها البنائي في الميدان العملي.
10.2 بناء لوحات مؤشرات الأداء (Dashboards) لتتبع التكرارات الديناميكية
يمتد التطبيق المتقدم لخوارزميات التكرار إلى مجال ذكاء الأعمال (Business Intelligence) وتصميم لوحات مؤشرات الأداء التفاعلية (Interactive Dashboards) داخل إكسل. في هذه البيئات الاحترافية، لا يُكتفى بعرض الأرقام الخمسة الأكثر تكراراً في جدول صامت، بل يتم ربط مخرجات الخلايا (C2:D6) بمخططات بيانية شريطية تفاعلية (Dynamic Bar Charts) تتغير أطوالها وألوانها فورياً بمجرد إدخال معاملات أو قياسات جديدة في قاعدة البيانات الأصلية.
ولتعزيز الجانب البصري، يُوظف “التنسيق الشرطي” (Conditional Formatting) بصيغ متقدمة داخل الجدول الأصلي للبيانات ($A$2:$A$24)؛ حيث يمكن كتابة قاعدة تنسيق شرطي تعتمد على الدالة MATCH للتحقق مما إذا كان الرقم في الخلية الأصلية يطابق المنوال الأول المتصدر في الخلية C2، ليتم تلوين خلاياه تلقائياً بلون أخضر مميز، وتلوين المنوال الثاني بلون أصفر خفيف، وهكذا بالنسبة لبقية الرتب الخمس. هذا الربط البصري يتيح لمتخذي القرار ومديري المشاريع تتبع الانتشار الجغرافي والموقعي للأرقام والأنماط الأكثر حدوثاً داخل مساحات البيانات الشاسعة بمجرد النظر السريع.
علاوة على ذلك، يتم دمج هذه النماذج مع تقنيات حماية الخلايا وتأمين الجداول المؤتمتة، بحيث تُبنى صفحة التقرير لتستقبل البيانات المتدفقة من استطلاعات الرأي أو أنظمة المراقبة والمبيعات دون تدخل يدوي، لتقوم المعادلات في الخلفية بتدوير دوال الفرز والتصنيف وإعادة إنتاج قائمة الخمسة الأوائل وتحديث الرسوم التوضيحية المصاحبة لها في أجزاء من الثانية، مما يحول مصنف إكسل إلى أداة برمجية تنفيذية راقية تدعم اتخاذ القرارات القائمة على الأدلة الإحصائية الدقيقة والمستمرة.
خاتمة
إن استخراج الأرقام الخمسة الأكثر تكراراً في برنامج مايكروسوفت إكسل يتجاوز كونه مجرد عملية إجرائية لحساب المنوال؛ إنه تجسيد عملي للتكامل بين النظريات الإحصائية الراسخة وميكانيكا البرمجة الرياضية في جداول البيانات. فمن خلال إدراك القيود البنيوية لدوال المنوال المنفردة، تمكنا من استعراض التشريح الدقيق للصيغ المصفوفية الكلاسيكية القائمة على الاستبعاد المتتابع والترشيح التراكمي عبر الدوال المركبة، وصولاً إلى استثمار الطفرة النوعية التي قدمتها دوال المصفوفات الديناميكية الحديثة في بيئة Microsoft 365.
سواء اختار المحلل استخدام الصيغ المصفوفية الدقيقة، أو التراكيب الحديثة المدعمة بالدالة LET، أو الاعتماد على المرونة التفاعلية للجداول المحورية، فإن المعيار الحاسم يظل دائماً هو فهم خصائص البيانات محل الدراسة، ومراعاة حجمها، وإدارة موارد المعالجة بكفاءة، والتعامل الحذر والواعي مع حالات التعادل وشح التكرارات. إن تسليح الباحث والمحلل بهذه المهارات التقنية العميقة لا يرفع فقط من كفاءة المعالجة وسرعة إنجاز التقارير، بل يضمن صياغة استنتاجات وصفية وتحليلية تتسم بأعلى درجات الصدق المنهجي، والدقة الرياضية، والاحترافية الحوسبية في كافة ميادين البحث والتطبيق.
المراجع
- Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods, 41(4), 977–990. https://doi.org/10.3758/brm.41.4.977
- Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin, 131(6), 803–855. https://doi.org/10.1037/0033-2909.131.6.803
- Oswald, A. J., Proto, E., & Sgroi, D. (2015). Happiness and Productivity. Journal of Labor Economics, 33(4), 789–822. https://doi.org/10.1086/681096