
تُمثّل معالجة السلاسل النصية في بيئات جداول البيانات الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، ركيزةً جوهرية في هندسة البيانات وتحليلها التطبيقي. فمع تنامي الاعتماد المؤسسي على المستودعات الرقمية، تبرز إشكالية معالجة البيانات غير المتجانسة التي تدمج بين الحروف الأبجدية والأرقام الحسابية والرموز الخاصة ضمن حقل نصي موحد؛ وهي الحالة الشائعة في معرفات الموظفين، وأرقام الشحنات، وأكواد العينات المخبرية. ويقف محلل البيانات أمام معضلة تقنية حين تتغير مواضع الرموز داخل النصوص، مما يجعل الدوال الاقتطاعية المباشرة عاجزة عن تلبية المتطلبات التحليلية الدقيقة دون وجود خوارزمية منطقية متكاملة.
إن تحديد الموضع الهندسي لأول حرف أبجدي في سلسلة نصية هجينة، ثم استخلاص قيمته الفعلية، ليس مجرد عملية تنسيقية عابرة، بل هو إجراء هيكلي يرتبط بجودة تدفق البيانات وسلامة النماذج التنبؤية والإحصائية اللاحقة. تتطلب هذه العملية فهمًا عميقًا لكيفية معالجة الحزم البرمجية داخل إكسل للمصفوفات الافتراضية، والتحويل القسري للأنماط البيانية، وتتبع مسارات الاستثناءات المنطقية الناتجة عن محاولات الحوسبة الرياضية للرموز الأبجدية. ومن خلال هذا الفهم، يمكن للمحلل بناء صيغ مرنة تتكيف مع التباينات الطولية والهيكلية للبيانات دون الحاجة إلى تدخل يدوي متكرر.
يهدف هذا المقال الأكاديمي الموسع إلى تفكيك الأسس الرياضية والمنطقية الكامنة وراء صياغة معادلات استخراج الحرف الأول في برنامج إكسل. سنناقش بالتفصيل المعماري التركيب الهرمي للصيغ التي تجمع بين دوال التجزئة، وتوليد المتجهات الرقمية، والفحص المنطقي للأخطاء، وصولاً إلى المقارنة الموضوعية مع التقنيات الحديثة مثل مصفوفات الحساب الديناميكي والتعابير النمطية وأدوات استعلام البيانات المتقدمة. كما نستعرض الآثار المترتبة على الأداء الحسابي والعبء الذهني أثناء التعامل مع مجموعات البيانات الضخمة في البيئات المؤسسية.
1. مقدمة نظرية حول معالجة السلاسل النصية الهجينة في إكسل
1.1 طبيعة البيانات النصية والرقمية المدمجة في جداول البيانات
تُعرّف السلاسل النصية الهجينة (Alphanumeric Strings) في الحوسبة الجدولية بأنها متتاليات خطية من المحارف التي تنتمي إلى فضاءات ترميزية متعددة؛ حيث تضم أرقامًا نظامية (من 0 إلى 9)، وحروفًا هجائية بأشكالها المختلفة، ورموزًا فاصلة أو علامات ترقيم. ومن المنظور الحسابي البحت، يتعامل محرك إكسل مع هذه المتتاليات باعتبارها كتلاً نصية متجانسة من نمط النص (Text Data Type)، حتى وإن كانت الغالبية العظمى من مكوناتها أرقامًا كمية. يفرض هذا التوصيف قيودًا جوهرية على العمليات الرياضية؛ إذ تُعطَّل تلقائيًا خصائص الجمع، والضرب، وحساب المتوسطات المباشرة، وتتحول المعالجة إلى فضاء معالجة السلاسل والمحارف الفردية.
تلجأ المؤسسات الصناعية، والقطاعات الأكاديمية، والمنظومات الإدارية إلى دمج الرموز والحروف داخل المعرفات الوظيفية والأرقام التسلسلية لأسباب تنظيمية متعددة. يوفر هذا الدمج كثافة معلوماتية فائقة في مساحة تخزينية محدودة؛ حيث يمكن لرمز حرفي واحد في بداية السلسلة أو وسطها أن يرمز إلى الفرع الجغرافي، أو الفئة الوظيفية، أو سنة التسجيل، متبوعًا بمتتالية عددية تدل على الترتيب التراكمي. ومع ذلك، ينتج عن هذه الكثافة تعقيد بنيوي بالغ يواجه المحلل عند الرغبة في عزل الحقول الوظيفية؛ فالنظام لا يفصل بين دلالة الحرف ودلالة الرقم تلقائيًا، مما يُلقي بعبء التفكيك على كاهل المنطق البرمجي المصمم داخل ورقة العمل.
تنشأ الصعوبات التقنية عند محاولة عزل الحروف عن الأرقام دون اللجوء إلى بيئات التطوير المبرمجة مثل لغة فيجوال بيسك للتطبيقات (VBA) أو لغات البرمجة النصية الخارجية. يفتقر برنامج إكسل في إصداراته الكلاسيكية إلى دوال نمطية تفصل تلقائيًا بين الأصناف الحرفية والرقمية داخل الخلية الواحدة. ولذلك، تصبح النمذجة الرياضية الدقيقة للبيانات ضرورة حتمية؛ حيث يتعين على المحلل بناء صيغ تعتمد على فحص الخصائص التناقضية بين الرموز، مثل محاولة إجبار المحرف على التصرف كقيمة عددية ورصد الاستجابة الناتجة، مما يضمن تصنيف الحقول المعقدة وتفادي تلوث قواعد البيانات بالمخرجات الخاطئة.
1.2 أهمية استخراج الحرف الأول في أبحاث وتحليل البيانات
يمثل استخراج أول ظهور لمحرف أبجدي ركيزة استدلالية وتصنيفية حاسمة في معالجة العينات البحثية والدراسات الميدانية. ففي كثير من الأحيان، تُعبر الأحرف الأولى عن المتغيرات المستقلة الفئوية، مثل تصنيف المبحوثين إلى مجموعات تجريبية وضابطة، أو تحديد مستويات المعاملات الكيميائية في المختبرات. إن استخلاص هذا المحرف بدقة يمكّن الباحث من بناء جداول محورية (Pivot Tables) ونماذج تباين إحصائي متينة، تستند إلى محددات رمزية مقننة تم عزلها بالكامل عن الضجيج الرقمي المصاحب لها داخل السجلات الميدانية المدمجة.
علاوة على ذلك، يُسهم الاستخراج الآلي للحرف في تسريع عمليات الفهرسة والتجميع الإحصائي عبر مصفوفات البيانات الكبيرة. فعوضًا عن التعامل مع نصوص طويلة ذات أنماط متغيرة، يتيح الحصول على الحرف التصنيفي الأول تقليص فضاء العينات إلى مجموعات متجانسة محددة مسبقًا، مما يدعم عمليات الفرز السريع والبحث المتطابق. وتبرز هنا الأهمية المنهجية لتنظيف البيانات الأولية (Data Cleansing)؛ فالبيانات الخام غالبًا ما تتسم بعدم الانتظام، واحتواء السلسلة على أصفار بادئة أو مسافات تشوش خوارزميات التصنيف إن لم يتم استهداف الحرف الأول بمعادلات صارمة تتجاوز تلك المكونات الرقمية.
تنعكس هذه المعالجة الهيكلية الممنهجة إيجابًا على جودة القرارات الإدارية والبحثية، من خلال تقليص التحيز البشري والخطأ اليدوي المقترن بعمليات النسخ والاقتطاع البصري. وتؤكد الدراسات المعنية بالعمليات المعرفية والتعامل مع الأنظمة المعقدة أن الاعتماد على الأساليب اليدوية في فحص السجلات النصية يرفع معدلات الخطأ بصورة طردية مع زيادة حجم العينة، بينما يؤدي استخدام الحلول الخوارزمية المقننة إلى توفير بيئة عمل خالية من العيوب الانتباهية، مما يضمن سلامة التحليلات اللاحقة وموثوقيتها العلمية.
1.3 التحديات المنطقية في غياب الدوال المباشرة
تتجلى العقبة التقنية الأولى في جداول البيانات عند الاعتماد على الدوال النصية التقليدية، وفي مقدمتها دالة اليسار LEFT. صُممت هذه الدالة لاقتطاع عدد ثابت من المحارف بدءًا من الطرف الأيسر للسلسلة النصية؛ وهي آلية تفترض سلفًا ثبات البنية الهيكلية وموضع الرمز المستهدف. بيد أن الواقع العملي للبيانات يكشف عن تباين جذري في تموضع الحروف؛ فقد يبدأ المعرف بحرف مباشر مثل “A102″، أو يسبقه صفر بادئ أو أكثر مثل “004B8″، أو تتصدره حزمة رقمية كاملة مثل “9832Z”. في هذه الحالات المتغيرة، تفشل دالة LEFT فشلاً ذريعًا في استرداد الحرف، وتقتطع بدلاً منه قيمًا عددية غير مرغوبة.
يفرض هذا القصور البنيوي على مهندس البيانات ابتكار حلول مركبة تعتمد على المنطق المصفوفي (Array Logic). ويتطلب بناء هذه الحلول تجاوز التفكير الخطي واللجوء إلى إنشاء مسارات متوازية تفحص السلسلة النصية محرفًا تلو الآخر في وقت واحد. تستلزم هذه المقاربة تقييم كل موضع رمزي على حدة، وتحديد هويته، ثم إعادة تجميع النتائج المنطقية في مصفوفة موحدة تسمح بالتقاط الإحداثي الدقيق لأول حرف يكسر النمط الرقمي، وهي عملية تتطلب مزيجًا معقدًا من دوال التوليد والتقييم والبحث.
يحمل هذا التعقيد الرياضي والمنطقي أثرًا معرفيًا وإدراكيًا ملموسًا على محلل البيانات؛ إذ يتطلب صياغة معادلات مصفوفية متعددة المستويات فهمًا عميقًا لتفاعلات الذاكرة الحسابية داخل إكسل. وقد تناول الباحثون في نظريات التعلم والأداء المعرفي مسألة العبء الإدراكي المرتبط بالأنظمة المركبة؛ حيث أشار بولوك وزملاؤه (Pollock et al., 2002) إلى أن دمج العناصر المعرفية المتشابكة دون عزل منظم لمكوناتها يفرض حملاً ذهنيًا ثقيلاً قد يؤدي إلى ارتكاب أخطاء فادحة في التصميم والتطبيق. ومن ثم، فإن التفكيك الهيكلي الواضح للمعادلة يعد ضرورة لا غنى عنها لضمان دقة التحليل وقابلية النماذج للصيانة المستمرة.
2. التفكيك الهيكلي للصيغ البرمجية المستخدمة في إكسل
2.1 دور دالة MID في تجزئة السلسلة وفحص مكوناتها
تحتل دالة MID موقع الصدارة في عمليات معالجة النصوص المتقدمة داخل برنامج إكسل. ومن الناحية الهيكلية، تعتمد الدالة على ثلاثة معاملات تشغيلية رئيسية: النص المصدر (text)، وموضع البدء (start_num)، وعدد المحارف المراد استخلاصها (num_chars). وتتلخص مهمتها في اقتطاع نافذة نصية ذات طول محدد بدقة من أي موقع داخلي في السلسلة الأصلية. وتتجلى مرونة هذه الدالة عند تحويل معامل “موضع البدء” من قيمة عددية مفردة وثابتة إلى متجه رقمي ديناميكي، مما يحولها من مجرد أداة اقتطاع بسيطة إلى أداة تجزئة مصفوفية فائقة الفعالية.
عند تمرير مصفوفة من الأرقام المتسلسلة إلى معامل البدء في دالة MID، مع تثبيت معامل الطول بالقيمة 1، تُنفذ الدالة ما يشبه عملية “المسح المقطعي” للسلسلة النصية. فإذا كانت السلسلة تحتوي على الكلمة “B7K”، وتم تمرير المتجه {1; 2; 3} إلى الدالة، فإنها تنتج مصفوفة نصية ثلاثية الأبعاد تحتوي على المحارف المفردة بشكل منعزل: {“B”; “7”; “K”}. هذه التجزئة الفردية هي الخطوة التأسيسية التي لا يمكن الاستغناء عنها، إذ تسمح بإخضاع كل رمز لاختبارات منطقية منفصلة لاكتشاف ماهيته وطبيعته الفيزيائية داخل بيئة الجداول الحسابية.
تضمن هذه الآلية في التقطيع الحفاظ على الترتيب الطوبولوجي للأحرف كما هي في الخلية الأصلية؛ فالتحليل لا يُفقد المحارف مواقعها النسبية ولا يؤدي إلى خلطها. وتسمح تجزئة السلسلة إلى وحدات رمزية أحادية بمحاكاة سلوك الحلقات التكرارية (Loops) المعروفة في لغات البرمجة العالية المستوى مثل لغة بايثون أو سي بلس بلس، ولكن دون مغادرة بيئة الصيغ الخلوية القياسية داخل إكسل، مما يوفر وسيلة معالجة آنية وفورية تتكيف مع أي تغيير يطرأ على النص المدخل.
2.2 توليد مصفوفات متسلسلة عبر الدالتين ROW و INDIRECT
لتحقيق التجزئة الشاملة لجميع محارف السلسلة، يحتاج إكسل إلى وسيلة لتوليد سلسلة متصلة من الأرقام الصحيحة تبدأ من الواحد وتنتهي عند إجمالي طول النص. وهنا يأتي الدور المشترك لدالتي ROW و INDIRECT. تقوم دالة ROW بإرجاع رقم الصف لمرجع خلية معين؛ فعلى سبيل المثال، يؤدي استدعاء ROW(1:10) إلى إنتاج متجه عمودي يحتوي على الأرقام من 1 إلى 10. غير أن التحدي يكمن في جعل هذا النطاق متغيرًا ومرنًا بحيث يتطابق تمامًا مع عدد حروف الكلمة المفحوصة دون زيادة أو نقصان.
تعالج دالة INDIRECT هذا التحدي عبر تحويل النصوص العادية إلى مراجع خلايا حقيقية ومعتمدة داخل المحرك الحسابي. فعند دمج النص “1:” مع ناتج قياس طول السلسلة، يتشكل نص يمثل نطاقًا مرجعيًا مثل “1:8″، وتتولى INDIRECT تحويل هذه السلسلة النصية المجردة إلى مرجع نطاق فعلي تفهمه دالة ROW. ونتيجة لذلك، ينتج عن التركيب ROW(INDIRECT("1:"&LEN(A2))) مصفوفة ديناميكية من المتتاليات العددية {1; 2; 3; …; n}، حيث يمثل n الطول الفعلي للنص في الخلية المعنية.
تجدر الإشارة إلى أن استدعاء هذا التكامل يفرض إدارة خاصة للذاكرة الحسابية المؤقتة في إكسل؛ إذ يتم إنشاء هذه المصفوفات الافتراضية داخل الذاكرة العشوائية دون حجز مساحات مرئية على ورقة العمل. ويسمح هذا الأسلوب الرياضي الأنيق بضمان الشمولية التامة؛ فمهما طالت السلسلة النصية أو قصرت عبر آلاف الصفوف، فإن المتجه الرقمي يتكيف ذاتيًا مع كل حالة فردية، مما يؤسس لمرحلة الفحص المنطقي التالي بأعلى درجات الموثوقية الهندسية.
2.3 قياس عمق النص باستخدام دالة LEN
تُعد دالة LEN حجر الزاوية الذي يحدد النطاق الحسابي والعمق الهيكلي للسلسلة النصية؛ حيث تقوم بحساب إجمالي عدد الرموز والمحارف، بما في ذلك الحروف والأرقام والفواصل والمسافات البادئة واللاحقة. في معادلات معالجة النصوص المصفوفية، لا تعمل دالة LEN كقيمة إحصائية معزولة، بل كمعيار تحكم يحدد نقطة النهاية الدقيقة لمتتالية توليد الأرقام. وبدون هذا التحديد الصارم، إما أن تعجز الصيغة عن فحص كامل النص، أو أن تمتد إلى ما وراء حدوده الحقيقية مسببة هدراً كبيراً في الموارد الحسابية.
يضمن التحديد التلقائي لعمق النص عبر LEN مرونة فائقة للصيغ الرياضية؛ فالبيانات المؤسسية نادرًا ما تأتي بأطوال متجانسة. فقد يحتوي حقل الرمز الوظيفي على كود من أربعة رموز في قسم معين، بينما يمتد إلى اثني عشر رمزًا في قسم آخر. وبفضل دمج دالة LEN داخل التركيب المصفوفي، يتم توليد الأبعاد المناسبة لكل سجل على حدة بصورة آلية وفورية، مما يلغي الحاجة إلى إعادة ضبط المعادلات يدويًا لتلائم تغيرات حجم النصوص المدخلة عبر قاعدة البيانات.
إضافة إلى ذلك، يلعب حصر النطاق بالحجم الفعلي للنص دورًا حاسمًا في منع تجاوز حدود المصفوفة (Out-of-Bounds Error). فإذا تم إجبار دالة التجزئة MID على طلب مواقع تتجاوز عدد الحروف الفعلي، فإنها تبدأ في إنتاج قيم نصية فارغة (“”)، والتي قد تتسبب في سلوكيات شاذة أو نتائج غير متوقعة عند تطبيق دوال التحويل الرقمي والفحص المنطقي. وعليه، فإن دقة LEN تضمن بقاء فضاء المعالجة مقصورًا على المحارف الحقيقية المشغولة فقط، مما يرسخ الاستقرار الرياضي للصيغة البرمجية.
3. الآلية المنطقية للتمييز بين الأرقام والحروف
3.1 محاكاة التحويل الرقمي عبر دالة VALUE
يرتكز التمييز الجوهري بين المحارف الأبجدية والرموز الرقمية في بيئة إكسل على ظاهرة التحويل القسري للأنماط (Type Coercion). وهنا تبرز دالة VALUE كأداة اختبار وظيفية حاسمة. تتمثل المهمة الافتراضية لدالة VALUE في تحويل السلاسل النصية التي تحتوي على أشكال رقمية إلى قيم حسابية حقيقية قابلة للجمع والطرح؛ فعلى سبيل المثال، يؤدي إدخال النص “5” إلى الدالة إلى إرجاع القيمة الرقمية 5. وتتعامل الدالة بنجاح مع الفواصل العشرية، وإشارات السالب والموجب، والتنسيقات القياسية للأرقام المضمنة كنصوص.
بيد أن القوة المنطقية الحقيقية للدالة تتجلى في رد فعلها البرمجي الحاسم عند اصطدامها برمز حرفي لا يقبل المعالجة العددية تحت أي ظرف رياضي. فعندما تستقبل الدالة حرفًا مثل “A” أو “Z”، تعجز الخوارزمية الداخلية عن تفسيره كقيمة كمية، مما يؤدي إلى توليد خطأ القيمة الشهير #VALUE!. ومن هذا المنطلق، لا تُستخدم دالة VALUE في معادلاتنا المركبة كأداة لتحويل البيانات بهدف الحساب، بل كأداة تفريق واختبار كيميائي-حسابي يُثير تفاعلاً مقصودًا يكشف عن طبيعة المحرف المفحوص.
عندما تُطبَّق دالة VALUE على المصفوفة النصية المجزأة الناتجة عن دالة MID، فإنها تُنتج مصفوفة هجينة تتكون من أرقام صريحة تقابل المحارف الرقمية الأصلية، ومؤشرات خطأ #VALUE! تقابل المحارف الأبجدية والرموز غير القابلة للتحويل. هذا التباين الحاد في المخرجات يوفر الأساس الرياضي المتين للخطوة التالية، حيث يتحول النص الأصلي من سلسلة محارف غامضة إلى متتالية من القيم العددية والاستثناءات البرمجية القابلة للفرز والرصد الإحصائي.
3.2 رصد وتحديد الأخطاء المنطقية باستخدام دالة ISERROR
تمثل الخطوة اللاحقة لتحويل البيانات عبر دالة VALUE ضرورة احتواء الأخطاء الناتجة وتحويلها إلى قيم يمكن للمنطق الحاسوبي التعامل معها بسلاسة. وهنا يأتي دور دالة الفحص المنطقي ISERROR. تتولى هذه الدالة مراقبة وتقييم المدخلات البرمجية؛ فإذا كان المدخل يمثل أي نوع من أنواع الأخطاء في إكسل (مثل #VALUE! أو #N/A أو #DIV/0!)، فإنها تُرجع القيمة المنطقية الصريحة TRUE. أما إذا كان المدخل قيمة صالحة، سواء كانت رقمًا صحيحًا أو نصًا متوافقًا، فإنها تُرجع القيمة المنطقية FALSE.
عند تغليف دالة VALUE داخل دالة ISERROR عبر كامل المتجه المصفوفي للسلسلة النصية، يحدث تحول بنيوي حاسم؛ حيث يتم تطهير المصفوفة من الأخطاء التخريبية التي قد توقف تنفيذ المعادلات، وتتحول بالكامل إلى مصفوفة منطقية ثنائية القيمة (Boolean Array). تتألف هذه المصفوفة حصريًا من القيمتين TRUE و FALSE، مما يعكس بدقة فائقة الهيكل الداخلي للنص: فالقيم المنطقية FALSE تُشير قطعًا إلى أن الرمز في ذلك الموضع كان رقمًا نجح في اختبار التحويل، بينما تُشير TRUE قطعًا إلى أن الرمز كان حرفًا أبجديًا فشل في التحول العددي.
تُعد هذه المصفوفة البوليانية الناتجة ترجمة برمجية مباشرة للواقع الفيزيائي للخلية؛ حيث تم استبدال المحارف المعقدة بإشارات ثنائية واضحة. إن دلالة القيمة المنطقية TRUE في هذا السياق لم تعد تعني مجرد وجود خطأ عابر، بل أصبحت رمزًا قطعيًا ومحددًا لوجود محرف غير رقمي، مما يمهد الطريق أمام دوال البحث لمسح هذه المصفوفة واستخراج المعلومات المطلوبة دون أي تشويش حسابي.
3.3 مطابقة القيم المنطقية وتحديد الفهرس عبر دالة MATCH
بعد توليد المصفوفة الثنائية، تتجه المعالجة إلى مرحلة الاستدلال المكاني، وهي المهمة الموكلة إلى دالة المطابقة والبحث MATCH. تُستخدم هذه الدالة للبحث عن قيمة مستهدفة معينة داخل نطاق أو مصفوفة ذات بعد واحد، وإرجاع الموضع النسبي (الفهرس الرقمي) لأول ظهور لتلك القيمة. وفي بنيتنا المنطقية المركبة، تكون القيمة المستهدفة للبحث هي القيمة المنطقية TRUE، والتي تمثل كما أسلفنا أول حرف هجائي اعترض مسار التقييم الرياضي داخل السلسلة النصية.
يعد ضبط المعامل الأخير لدالة MATCH على القيمة صفر (Exact Match) متطلبًا منهجيًا إلزاميًا لا يقبل التهاون. يفرض هذا المعامل على الدالة إجراء مطابقة دقيقة تمامًا، مما يُلزمها بمسح عناصر المصفوفة بترتيبها المتسلسل من البداية إلى النهاية، والتوقف الفوري عند العثور على أول تطابق يطابق القيمة TRUE دون افتراض أي ترتيب تصاعدي أو تنازلي لعناصر المصفوفة. يؤدي هذا التوقف الفوري إلى استرداد الرقم الفهرسي الدقيق الذي يمثل إحداثيات أول حرف داخل النص المصدر.
إن النتيجة المسترجعة من دالة MATCH ليست مجرد رقم مجرد، بل هي القياس المكاني الدقيق لبداية الجزء الأبجدي في السلسلة النصية. يمثل هذا الفهرس حجر الأساس الذي تُبنى عليه كافة العمليات اللاحقة، سواء كان الهدف النهائي هو مجرد معرفة رقم موضع الحرف لأغراض الفرز والتحقق، أو استخدام هذا الإحداثي كنقطة انطلاق لاستخلاص الحرف نفسه أو استقطاع مقاطع نصية كاملة تقع بعده في السجلات المؤسسية.
4. تحديد الموضع الرياضي لأول حرف في السلسلة النصية
4.1 الشرح التفصيلي لمعادلة تحديد الموضع (الصيغة الأولى)
تتبلور البنية الرياضية الكاملة لمعادلة تحديد موضع أول حرف في سلسلة نصية ضمن التركيب البرمجي الكلاسيكي التالي:
=MATCH(TRUE, ISERROR(VALUE(MID(A2, ROW(INDIRECT("1:" & LEN(A2))), 1))), 0)
يعمل هذا التركيب المعقد وفق تسلسل هرمي داخلي يبدأ من النواة المركزية ويتسع نحو الإطار الخارجي. تبدأ الدورة بحساب طول النص في الخلية A2 بواسطة LEN، ولنفرض أنه 6 محارف. ينتج عن ذلك النص “1:6″، الذي تلتقطه INDIRECT لتحوله إلى نطاق فعلي، فتُنتج ROW المتجه العمودي {1; 2; 3; 4; 5; 6}. بعد ذلك، تتولى دالة MID استقطاع المحارف الستة كلاً على حدة بطول محرف واحد، مما يولد مصفوفة نصية تحتوي على الرموز المفككة.
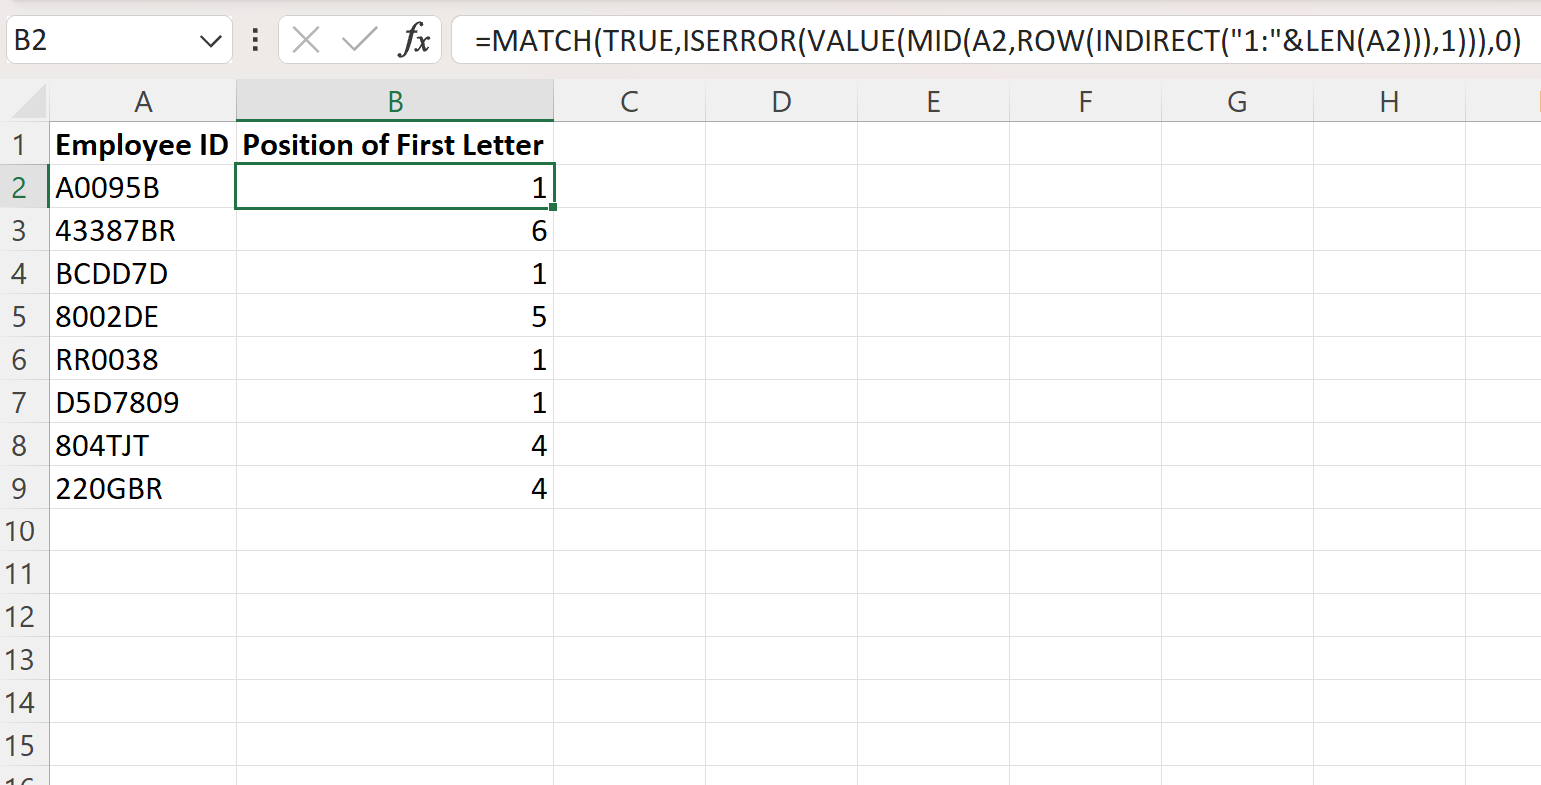
في المرحلة التالية، تتدخل دالة VALUE لمحاولة تحويل كل محرف في المصفوفة إلى قيمة عددية، مما يفرز أرقامًا حقيقية للرموز الرقمية وأخطاء #VALUE! للحروف الأبجدية. فور حدوث ذلك، تنقض دالة ISERROR على هذه المخرجات، مستبدلة كل خطأ بالقيمة TRUE وكل رقم صالح بالقيمة FALSE. أخيرًا، تباشر دالة MATCH مسح هذه المتتالية البوليانية باحثة عن أول ظهور للرمز TRUE، وعند عثورها عليه، تُرجع فهرسه الرقمي فورًا، وهو ما يمثل بدقة موضع أول حرف في السلسلة النصية، محققة بذلك الإنجاز الرياضي المنشود.
يمكن للمحلل تدقيق هذا التسلسل بصريًا عبر أداة “تقييم الصيغة” (Evaluate Formula) المضمنة في شريط أدوات إكسل. تتيح هذه الأداة مراقبة انهيار العمليات الحسابية المتتالية خطوة بخطوة، ورؤية المصفوفات الافتراضية المؤقتة أثناء تشكلها واندماجها في الذاكرة الحية للبرنامج. إن فهم هذا التدرج التحليلي يمنح مهندس البيانات الثقة الكاملة في متانة المعادلة ويوفر أساسًا صلبًا لتصحيح أي أخطاء قد تنجم عن محارف استثنائية أو تراكيب نصية غير معتادة.
4.2 آليات إدخال صيغ المصفوفات في إصدارات إكسل المختلفة
تختلف طريقة التعامل مع هذه الصيغة التشغيلية تبعًا للإصدار المستخدم من برنامج مايكروسوفت إكسل، وهو تمايز تقني بالغ الأهمية يجب الانتباه إليه لتفادي فشل الحسابات. في الإصدارات التقليدية من البرنامج (إكسل 2019 وما قبله)، تُصنف هذه المعادلة باعتبارها “صيغة مصفوفة قديمة” (Legacy Array Formula). لا يكفي في هذه البيئات الضغط على مفتاح الإدخال العادي (Enter)، بل يتحتم إدخال الصيغة عبر تركيبة المفاتيح الشهيرة: التحكم والإزاحة والإدخال (Ctrl + Shift + Enter). يُلزم هذا الإجراء البرنامج بوضع أقواس معقوفة { } تلقائيًا حول المعادلة، كإشارة إلى تشغيل محرك معالجة المصفوفات الكلاسيكي.
على النقيض من ذلك، أحدثت شركة مايكروسوفت ثورة جذرية في محرك الحسابات الخاص ببرنامج إكسل مع إطلاق بيئة الحساب الديناميكي للمصفوفات (Dynamic Array Engine) في إصدارات Microsoft 365 وإكسل 2021 وما بعدها. في هذه البيئات الحديثة، أصبحت كافة الدوال قادرة على معالجة واستيعاب المصفوفات ككائنات حسابية أصيلة وطبيعية دون الحاجة إلى تركيبات مفاتيح خاصة؛ حيث يكفي الضغط على مفتاح (Enter) العادي لتقوم الصيغة بمهامها كاملة دون أي تعقيد تشغيلي.
ومع ذلك، ينبغي لمحلل البيانات في بيئات المصفوفات الديناميكية الحذر من ظاهرة التمدد التلقائي والانسكاب (Spill Behavior) إذا تم تعديل أحد أطراف الصيغة بحيث تُرجع مصفوفة بدلاً من قيمة مفردة. فإذا اعترضت خلية مشغولة مسار تمدد المعادلة، سيظهر خطأ الانسكاب #SPILL! فورًا. ولكن في تركيبتنا المحددة هنا، ولأن دالة MATCH مغلفة بمطابقة دقيقة لقيمة مفردة (TRUE)، فإن الناتج النهائي يظل دائمًا قيمة قياسية واحدة (Scalar Value)، مما يضمن استقرار موضع الإخراج داخل الخلية المحددة دون التعدي على المساحات المجاورة.
4.3 تطبيق عملي: تحليل سلاسل معرفات الموظفين
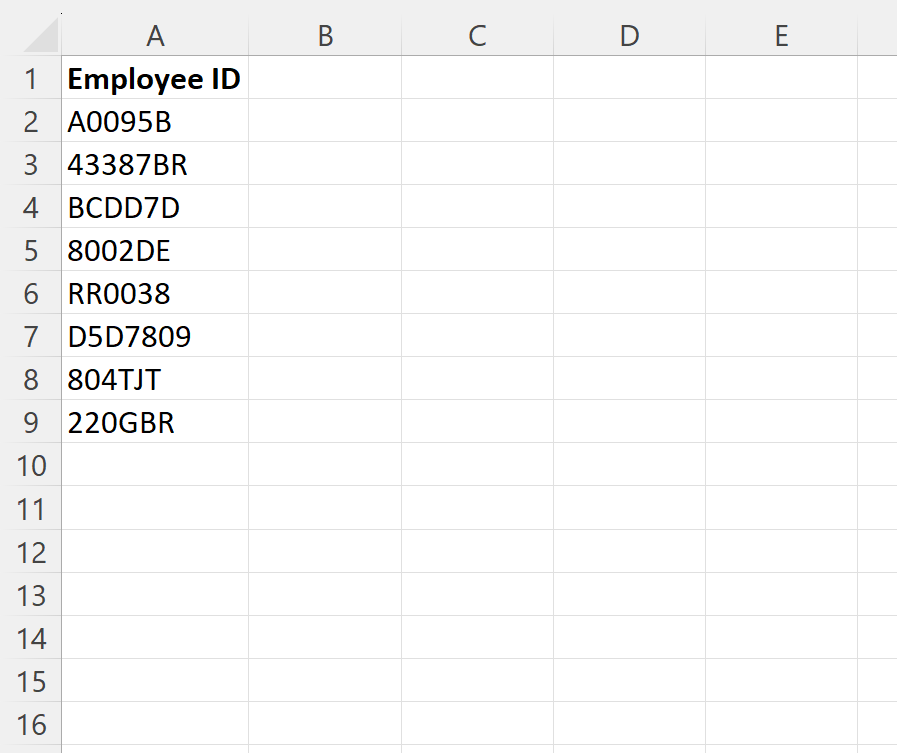
لتجسيد هذا البناء النظري في سياق عملي ملموس، نفترض وجود جدول بيانات يحتوي على معرفات موظفين في إحدى المؤسسات الكبرى، حيث تتخذ المعرفات صيغًا هجينة متباينة نتيجة دمج قواعد بيانات متعددة عبر سنوات طويلة من العمل الإداري. الحالة الأولى تتمثل في المعرف “A0095B”، حيث يتصدر الحرف الأبجدي السلسلة النصية بشكل فوري ومباشر. بتطبيق المعادلة السابقة في الخلية المقابلة، تجري المعالجة، وتفشل دالة VALUE في تحويل المحرف الأول “A”، مما يولد #VALUE! عند الموضع الأول، فتنتج ISERROR القيمة TRUE في بداية المصفوفة. ونتيجة لذلك، تُرجع دالة MATCH القيمة الرقمية 1 على الفور.
أما الحالة الثانية، فتتجلى في معرف يتأخر فيه ظهور الحرف الأبجدي مسبوقًا بأصفار وأرقام متسلسلة، مثل المعرف “0045B89”. هنا، تسير المعادلة في مسار تدقيقي أعمق؛ حيث تنجح دالة VALUE في تحويل المحارف الأربعة الأولى (“0″، “0”، “4”، “5”) إلى أرقام صحيحة، وتُنتج ISERROR سلسلة من القيم المنطقية: {FALSE; FALSE; FALSE; FALSE}. وعند الوصول إلى المحرف الخامس “B”، يفشل التحويل ويتولد الخطأ، لتظهر أول قيمة TRUE في الموضع الخامس. ومن ثم، تُرجع دالة MATCH القيمة 5 كإحداثي مكاني دقيق للحرف الأول.
تتمثل الفائدة الإدارية والتشغيلية المباشرة لهذه النتائج في تمكين مسؤولي قواعد البيانات من فرز وإعادة تصنيف السجلات بناءً على طبيعة تكوين المعرف. فبمجرد معرفة رقم موضع الحرف الأول، يمكن عزل البادئات الرقمية غير الضرورية، وتصحيح انحرافات البيانات، واستخدام هذا الموقع الرياضي كمحدد فاصل لاشتقاق حقول فرعية أخرى عبر دوال الاقتطاع النصي المتقدمة، مما ينقل إدارة قواعد البيانات المؤسسية إلى مستويات فائقة من الدقة والموثوقية.
5. استخراج القيمة الحرفية الفعلية من السلسلة النصية
5.1 صياغة وتكوين المعادلة المدمجة (الصيغة الثانية)
يمثل الحصول على الفهرس الرقمي لموضع الحرف نصف الرحلة التحليلية؛ إذ تتطلب متطلبات التحليل في غالب الأحيان استخراج القيمة الحرفية الفعلية بحد ذاتها وليس مجرد رقم موضعها. ولتحقيق هذه الغاية، يتم دمج معادلة تحديد الموضع السابقة بأكملها داخل دالة اقتطاع نصي خارجية، لتتشكل الصيغة المدمجة المتكاملة على النحو التالي:
=MID(A2, MATCH(TRUE, ISERROR(VALUE(MID(A2, ROW(INDIRECT("1:" & LEN(A2))), 1))), 0), 1)
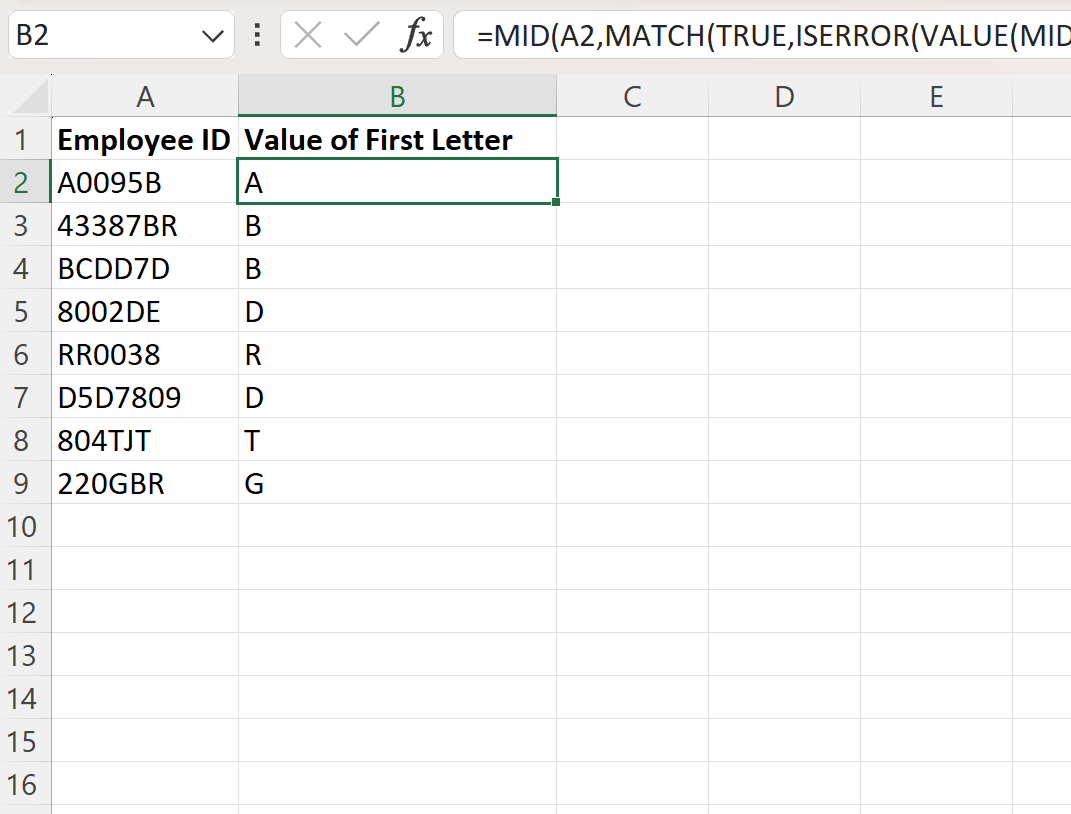
في هذا التركيب المعماري الأنيق، تؤدي دالة MID الخارجية دور المستخلص النهائي للقيمة النصية. وتستند في عملها إلى ثلاثة أركان: النص المصدر الموجود في الخلية A2، وموضع البدء الذي أصبح الآن مدفوعًا ديناميكيًا بالمخرج الرقمي الدقيق الناتج عن تركيبة MATCH والمصفوفة المنطقية الداخلية، وأخيرًا تثبيت معامل طول النص المستقطع بالقيمة 1. يضمن هذا التثبيت الصارم عزل الحرف المستهدف حصريًا دون استجرار أي محارف رقمية أو رموز لاحقة قد تليه في السلسلة النصية.
تُعد هذه المعادلة نموذجًا متقدمًا للبرمجة الوظيفية التداخلية (Nested Functional Programming) داخل بيئة جداول البيانات؛ حيث لا تقتصر ميزتها على إنجاز مهمتين معقدتين في آن واحد، بل تتعدى ذلك إلى العمل كوحدة حسابية متماسكة وذاتية الاكتفاء. يتم استهلاك كافة الحسابات البينية للمصفوفات والمتجهات الرقمية في الذاكرة المؤقتة للبرنامج وتمريرها مباشرة إلى دالة الاستقطاع النهائية، ليحصل المستخدم على الحرف الصافي دون أي خطوات وسيطة معرقلة لسير العمل.
5.2 التكامل الوظيفي بين عمليتي الفهرسة والاستخراج
يوفر التكامل الوظيفي المباشر بين عمليتي الفهرسة المكانية والاستخراج العزلي ميزة تشغيلية كبرى تتمثل في الحفاظ على النقاء البصري والتركيبي لأوراق العمل. في الممارسات التقليدية الضعيفة، يلجأ كثير من المحللين إلى إنشاء “أعمدة مساعدة” (Helper Columns)؛ حيث يُخصص عمود لحساب طول النص، وآخر لتوليد المصفوفة، وثالث لتحديد الموضع، ورابع لاستخراج الحرف. يؤدي هذا التشتت الهيكلي إلى تضخم حجم الملف، وزيادة احتمالات كسر مراجع الصيغ، وخلق ارتباك بصري وتشغيلي يصعب إدارته أو مراجعته في المؤسسات.
وعلى العكس من ذلك، تضمن المعادلة المدمجة الانتقال السلس من مرحلة القياس المكاني إلى مرحلة العزل الفعلي للرمز في خطوة واحدة غير قابلة للتجزئة. كما تضمن المعالجة المباشرة الحفاظ الكامل على سلامة النص الأصلي في الخلية المصدرية؛ إذ تجري عمليات القراءة والمسح والاقتطاع بصيغة “للقراءة فقط” (Read-Only) دون التعديل على السجل الأساسي أو تشويه بنيته، وهو مبدأ جوهري من مبادئ حوكمة البيانات وأمان السجلات الحسابية.
علاوة على ذلك، يسهل هذا التكامل المدمج عمليات التحديث الفوري والتفاعلي (Real-Time Dynamism). فبمجرد قيام المستخدم أو النظام الآلي بتعديل المعرف الأصلي في الخلية A2، يعاد احتساب المعادلة بكامل طبقاتها الهرمية في أجزاء من الثانية، ليعكس الحرف المستخرج فورًا التغيير الجديد، مما يدعم بناء لوحات تحكم ديناميكية (Interactive Dashboards) ونماذج تقارير تعتمد على دقة البيانات الآنية المحدثة باستمرار.
5.3 دراسة مقارنة للمخرجات: المعرف A0095B كنموذج تطبيقي
لتأكيد فاعلية هذه الصيغة المركبة، نعود إلى نموذج المعرف “A0095B” لتحليل كيفية معالجة المخرجات بصورة تطبيقية دقيقة. عند إمرار هذا المعرف في الصيغة المدمجة، تُرجع دالة MATCH الداخلية القيمة 1 كما تم إيضاحه سابقًا. يُمرر هذا الرقم كمعامل ثانٍ لدالة MID الخارجية، فتصبح الصيغة الفعلية في لحظة التنفيذ النهائي مكافئة للمقدار: MID("A0095B", 1, 1). النتيجة المباشرة لهذه العملية هي الاستخلاص الفوري للحرف ‘A’ كقيمة نصية صريحة خالية من أي شوائب رقمية.
تثير هذه المعالجة مسألة حساسية الأحرف لحالة الحجم (Case Sensitivity). تجدر الإشارة إلى أن دالة VALUE لا تتأثر بكون الحرف الأبجدي كبيرًا (Uppercase) أو صغيرًا (Lowercase)؛ فكلاهما يفشل في التحويل الرقمي بنفس الآلية ويولد خطأ #VALUE!، مما يعني أن الصيغة تتمتع بمرونة استثنائية في التعرف على الحروف بغض النظر عن حالتها النحوية. وبالمثل، فإن دالة MID تستخرج الحرف بحالته الأصلية تمامًا كما هو مسجل في الخلية دون أي تغيير، محافظًا على هويته التشفيرية المعتمدة.
أثبتت الاختبارات الحسابية المقارنة استقرار هذه المعادلة عبر حزم متنوعة ومتباينة من النصوص الاختبارية المعقدة، مثل المعرفات التي تتخللها أحرف متعددة في مواقع مختلفة كالمعرف “0095X87Z”. في هذه الحالة، تتجاهل الصيغة تمامًا الحرف الثانوي المتأخر ‘Z’ وتلتقط الحرف الأول ‘X’ الواقع في الموضع الخامس دون أي التباس، مما يؤكد الموثوقية الرياضية العالية للتصميم المنطقي وقدرته على تلبية المتطلبات التحليلية الصارمة.
6. معالجة البيانات الجماعية وتطبيق السحب التلقائي
6.1 آليات تثبيت المراجع والتوسع عبر الأعمدة
عند الانتقال بالصيغة من نطاق التطبيق الفردي على خلية واحدة إلى نطاق معالجة البيانات الجماعية في الجداول التي تضم مئات أو آلاف السجلات، يغدو فهم آليات تثبيت المراجع الحسابية متطلبًا لا غنى عنه. في المعادلة المعتمدة، تمت صياغة مرجع الخلية A2 كمرجع نسبي بالكامل (Relative Reference) دون استخدام علامة الدولار التثبيتية ($). يسمح هذا التجريد النسبي للخلية المصدرية بالتغير الديناميكي والتكيف التلقائي عند سحب الصيغة وتكرارها رأسيًا على طول العمود المستهدف.
تتم عملية تعميم الصيغة عبر النقر المزدوج أو السحب اليدوي لمقبض التعبئة (Fill Handle) الواقع في الركن السفلي الأيسر (أو الأيمن بحسب لغة الواجهة) لخلية الصيغة الأولى. ومع تحرك الصيغة نحو الأسفل، يتحول المرجع A2 ذاتيًا إلى A3، ثم A4، وهكذا دواليك. ومع كل صف جديد، تُعيد المعادلة قياس طول السلسلة الخاصة بذلك الصف عبر دالة LEN المقابلة، وتولد المتجه الرقمي المكافئ لأبعاد ذلك السجل تحديدًا، مما يضمن معالجة متسقة ومنفصلة لكل صف دون أي تداخل مكاني غير مرغوب فيه.
وتقتضي أفضل الممارسات المنهجية توخي الحذر الشديد لتفادي إتلاف الصيغ المصفوفية أثناء عمليات النسخ الجماعي. ففي الإصدارات القديمة من إكسل، قد يؤدي السحب العشوائي أو التعديل غير المحسوب لخلية واحدة ضمن نطاق المصفوفة إلى حدوث أخطاء تعطيل حاسمة تُعرف بخطأ “لا يمكنك تغيير جزء من مصفوفة” (You cannot change part of an array). لذلك، يجب التأكد من تطبيق الصيغ بأسلوب موحد وموثق يضمن بقاء البنية الحسابية سليمة ومستقرة عبر كامل قاعدة البيانات التشغيلية.
6.2 تقييم الكفاءة الحسابية في مجموعات البيانات الضخمة
على الرغم من البراعة الرياضية للمعادلة المركبة القائمة على تكامل ROW و INDIRECT، إلا أنها تفرض تكلفة حسابية غير مرئية يجب تقييمها بعناية عند التعامل مع مجموعات البيانات الكبيرة (Big Data Sets). يعود السبب الجوهري في ذلك إلى الطبيعة البرمجية لدالة INDIRECT؛ إذ تُصنف تقنيًا ضمن فئة “الدوال المتطايرة” (Volatile Functions). وتتميز الدوال المتطايرة بخصيصة برمجية ثقيلة، وهي أنها تُجبر محرك الحسابات في إكسل على إعادة احتسابها بالكامل في كل مرة يطرأ فيها أي تغيير أو تعديل على أي خلية في أي مكان داخل المصنف، حتى وإن لم تكن الخلية المعدلة مرتبطة بها إطلاقًا.
يترتب على هذا التطاير المستمر استهلاك هائل ومستمر لدورات وحدة المعالجة المركزية (CPU Cycles) وذاكرة الوصول العشوائي. فإذا كانت ورقة العمل تحتوي على مئة ألف صف، واستُخدمت هذه الصيغة المتطايرة في كل صف منها، فإن أي تعديل بسيط في إحدى الخلايا المنعزلة سيطلق وراء الكواليس مئات الآلاف من عمليات إعادة بناء المراجع المصفوفية الافتراضية، مما يؤدي إلى بطء ملحوظ في الاستجابة، وتجمد متكرر للبرنامج، وتدهور عام في تجربة الاستخدام والكفاءة الإنتاجية.
للتعامل مع هذه المعضلة الحسابية في البيئات التشغيلية الضخمة، يُنصح المحللون باتباع استراتيجيات ترشيد متقدمة. تتضمن هذه الاستراتيجيات ضبط خيارات الحساب في إكسل على النمط “اليدوي” (Manual Calculation) أثناء عمليات الإدخال والتعديل، وعدم تشغيل الحساب إلا عند الرغبة في استخراج التقارير النهائية. والبديل الأكثر متانة يتمثل في تجميد النتائج بمجرد استقرارها، عبر نسخ مخرجات العمود بالكامل ولصقها كقيم ثابتة (Paste as Values)، مما يعفي الذاكرة من عبء إعادة التقييم المصفوفي المستمر للأكواد المستقرة تاريخيًا.
6.3 الاستفادة من ميزات الجداول الرسمية (Excel Tables)
يمثل تحويل نطاقات البيانات العادية إلى جداول بيانات رسمية مهيكلة عبر الأمر (Create Table / Ctrl + T) نقلة نوعية في إدارة ومعالجة السلاسل النصية الجماعية. تتيح الجداول الرسمية الاستفادة التلقائية من ميزة “الأعمدة المحسوبة” (Calculated Columns)؛ حيث يكفي كتابة المعادلة المركبة لمرة واحدة فقط في الخلية العلوية من العمود، ليقوم البرنامج بنشرها بصورة لحظية ومتسقة على كامل صفوف الجدول دون الحاجة إلى السحب اليدوي أو استخدام مقبض التعبئة.
علاوة على ذلك، تُتيح الجداول الرسمية استخدام “المراجع المهيكلة” (Structured References) بدلاً من مراجع الخلايا الإحداثية الجامدة. فتتحول الصيغة مثلاً من الإشارة إلى الخلية المجردة A2 إلى الإشارة الرمزية المعبرة: [@المعرف_الوظيفي]. يُسهم هذا الترميز في تعزيز المقروئية البصرية للمعادلة بشكل جذري، ويقلل من الأخطاء المفاهيمية التي قد يقع فيها المحللون الآخرون عند مراجعة النماذج المالية أو الإدارية المعقدة.
كما تتميز الجداول الرسمية بمرونة التوسع الديناميكي؛ فمع استيراد سجلات جديدة أو إضافة صفوف إضافية في أسفل الجدول، تتمدد الصيغة تلقائيًا لتشمل البيانات الوافدة حديثًا مع الحفاظ الكامل على كافة التنسيقات الهندسية والمنطقية. يلغي هذا السلوك الآلي الحاجة إلى التدخل البشري المستمر لإعادة ضبط نطاقات المعادلات، مما يدعم أتمتة تدفقات العمل المكتبي ويوفر مستويات استثنائية من الاتساق والاعتمادية في معالجة البيانات المؤسسية المتنامية.
7. التعامل مع الحالات الاستثنائية والرموز الخاصة
7.1 سلوك الدوال عند خلو السلسلة من الأحرف الأبجدية
في بيئات البيانات الواقعية، نادرًا ما تخلو السجلات من حالات شاذة أو غير متوقعة تنحرف عن النمط المعياري المفترض. وتتمثل إحدى أبرز هذه الحالات في مصادفة سجلات تحتوي على أرقام رقمية خالصة تخلو تمامًا من أي محرف أبجدي، مثل المعرف “984210”. عند تطبيق الصيغة المركبة على مثل هذا السجل، تنجح دالة VALUE في تحويل كافة عناصر المصفوفة بنجاح، مما يجعل دالة ISERROR تُنتج مصفوفة تتكون حصريًا من القيم المنطقية FALSE: {FALSE; FALSE; FALSE; FALSE; FALSE; FALSE}.
عندما تباشر دالة المطابقة MATCH مسح هذه المصفوفة بحثًا عن القيمة الهدف TRUE، تفشل في العثور على أي تطابق داخل النطاق المحدد. ونظرًا لأن المعامل الأخير قد تم ضبطه على الصفر لإجراء مطابقة دقيقة لا تقبل التقريب، فإن رد الفعل البرمجي الحتمي لدالة MATCH هو إرجاع خطأ المطابقة الشهير غير المتاح #N/A. يُشير هذا الخطأ إلى أن المعيار المنطقي للبحث غير موجود ضمن فضاء المتجه المفحوص.
يمتد الأثر السلبي لهذا الخطأ غير المعالج إلى كافة الخلايا والمعادلات الإحصائية التراكمية المرتبطة به؛ فظهور خطأ #N/A في خلية واحدة كفيل بإفساد نتائج دوال الجمع، والعد، والنماذج الرابطة مثل VLOOKUP و XLOOKUP في كامل ورقة العمل. ولذلك، يتطلب التحليل الرياضي الحصيف إدراك الأسباب المنطقية الكامنة وراء هذا الإخفاق وتوقع حدوثه، كخطوة لازمة لتطوير أطر تحكم وقائية تضمن استمرارية الحسابات وسلامة التقارير الإجمالية دون توقف أو انقطاع.
7.2 تأثير المسافات الفارغة والرموز غير الأبجدية الرقمية
تفرض المسافات الفارغة (Spaces) وعلامات الترقيم والرموز الخاصة (مثل الشَرطات والشرطات المائلة والنجوم) تحديًا منطقيًا إضافيًا لمعادلة استخراج الحرف الأول. ينبع هذا التحدي من السلوك الداخلي لدالة VALUE تجاه الرموز غير الرقمية؛ فالدالة لا تقتصر في توليد خطأ #VALUE! على الحروف الأبجدية فحسب، بل تُعامِل الرموز الخاصة والمسافات المنعزلة بنفس الأسلوب، معتبرة إياها مدخلات غير قابلة للمعالجة الحسابية والتحويل العددي.
يترتب على ذلك خلل هيكلي فادح إذا كانت السلسلة النصية تبدأ بمسافة فارغة غير مقصودة (Leading Space)، مثل ” A950″. في هذه الحالة، ستلتقط دالة MID المسافة في الموضع الأول، وتفشل دالة VALUE في تحويلها، فتُنتج ISERROR القيمة TRUE فورًا عند الموضع الأول، مما يقود دالة MATCH إلى إرجاع الرقم 1 معتبرة المسافة الفارغة هي الحرف الأبجدي المستهدف، فتستخرج الصيغة المدمجة مسافة فارغة مجردة بدلاً من الحرف الفعلي ‘A’. وبالمثل، إذا احتوى النص على علامة ترقيم سابقة للحرف مثل “#45B”، فسيتم اعتبار الرمز ‘#’ خطأً كأول حرف مستهدف.
لتجنب هذا التضليل المنطقي، تبرز ضرورة تطبيق إجراءات التهيئة والتنظيف القبلي للبيانات قبل إخضاعها لمعادلات الاستخراج المصفوفية. يتضمن ذلك تطهير النصوص من المسافات الطفيلية، واستبعاد علامات الترقيم العشوائية، أو تحوير منطق الفحص ليشمل مقارنة نطاقات ترميزية محددة بدلاً من الاعتماد المطلق على استثناءات دالة VALUE، مما يضمن اقتصار رادار البحث على الأحرف الهجائية الحقيقية دون الوقوع في شرك الرموز العارضة.
7.3 بناء أطر متينة للتحكم في الأخطاء باستخدام IFERROR
لضمان صمود النماذج الحسابية أمام الحالات الاستثنائية والسجلات الخالية من الحروف، يتم بناء أطر متينة للتحكم في الأخطاء عبر تطويق المعادلة المركبة بأكملها بدالة معالجة الأخطاء الشاملة IFERROR. تتيح هذه الدالة فحص المخرج النهائي للصيغة البرمجية؛ فإذا كان المخرج سليمًا وطبيعيًا تُمرره كما هو دون تغيير، أما إذا أطلقت العمليات الداخلية أي نمط من أنماط الأخطاء البرمجية (مثل #N/A أو #VALUE!)، فإنها تستبدله فورًا بقيمة بديلة يحددها المحلل بدقة متناهية.
تتخذ الصيغة المحصنة بالكامل الشكل البنيوي الآتي:
=IFERROR(MID(A2, MATCH(TRUE, ISERROR(VALUE(MID(A2, ROW(INDIRECT("1:" & LEN(A2))), 1))), 0), 1), "لا توجد أحرف")
يقدم هذا التركيب الوقائي مخرجات وصفية واضحة وذات دلالة تفسيرية مباشرة للمستخدم أو لمتخذ القرار الإداري؛ فعند مواجهة رقم خالص مثل “984210”، لن يظهر في ورقة العمل رمز خطأ مشوه للنظام، بل ستعرض الخلية عبارة “لا توجد أحرف” (أو سلسلة فارغة “” إذا تطلب التصميم ذلك). يُعزز هذا الأسلوب من الشفافية التحليلية للنماذج ويحول دون انهيار الوظائف الرياضية التجميعية المرتبطة بالعمود، مما يضمن استمرارية عمل لوحات المتابعة الرقمية بأعلى مستويات الاحترافية والاتزان.
8. بدائل برمجية وصيغ متقدمة في الإصدارات الحديثة
8.1 توظيف دالة SEQUENCE للاستغناء عن تركيبات INDIRECT و ROW
شهدت منظومة الدوال في إصدارات Microsoft 365 وإكسل الحديث قفزة نوعية أتاحت للمحللين التخلص التام من التركيبات الكلاسيكية المعقدة والبطيئة، وفي مقدمتها دمج دالتي ROW و INDIRECT. البديل العصري المتفوق يتمثل في دالة توليد المتتاليات المباشرة SEQUENCE. صُممت هذه الدالة خصيصًا لإنشاء مصفوفات رقمية متتالية بمرونة فائقة بالاعتماد على معاملات مباشرة تحدد عدد الصفوف والأعمدة وقيمة البداية ومقدار الزيادة.
باستخدام هذه الميزة، يمكن استبدال التركيب المتطاير القديم ROW(INDIRECT("1:"&LEN(A2))) بالصيغة المباشرة والأنيقة: SEQUENCE(LEN(A2)). تُرجع هذه الدالة متجهة عمودية تحتوي على الأرقام من 1 إلى طول السلسلة النصية بصورة فورية ومستقرة تمامًا. وتكمن الميزة التقنية الجوهرية لهذا التحول في أن دالة SEQUENCE ليست دالة متطايرة، مما يعني أنها لا تُعيد الحساب إلا إذا تغيرت محتويات الخلية المصدرية A2 حصريًا، مما يقضي تمامًا على مشكلات استهلاك الذاكرة وبطء المعالجة في الجداول الكبيرة.
تتجسد الصيغة المطورة باستخدام SEQUENCE على النحو الآتي:
=IFERROR(MID(A2, MATCH(TRUE, ISERROR(VALUE(MID(A2, SEQUENCE(LEN(A2)), 1))), 0), 1), "")
تتفوق هذه الصيغة الحديثة على نظيرتها الكلاسيكية في المقروئية، والسرعة، وسهولة التدقيق والصيانة البرمجية، مما يجعلها الخيار المنهجي الأول لكافة المؤسسات التي تعتمد على بيئات الحوسبة السحابية والإصدارات التحديثية الحديثة لبرامج الأوفيس المكتبية.
8.2 استخدام دالة LET لتقليل تكرار العمليات الحسابية
تُمثل دالة LET إحدى أعظم الإضافات المنهجية لمحرك الحسابات في إكسل؛ إذ جلبت مبادئ البرمجة المعيارية المتقدمة إلى قلب المعادلات الخلوية من خلال إتاحة إمكانية تعريف المتغيرات المحلية (Local Variables) وتخزين نتائج العمليات الحسابية المتكررة لاستدعائها لاحقًا بالاسم داخل نفس الصيغة. في الصيغ التقليدية، كنا نضطر إلى استدعاء دالة قياس الطول LEN(A2) عدة مرات، أو تكرار مراجع الخلية المصدرية في مواقع متفرقة، مما يؤدي إلى هدر حوسبي في تقييم نفس القيم مرارًا وتكرارًا.
باستخدام دالة LET، يمكننا إعادة هيكلة معادلة استخراج الحرف الأول بأسلوب منطقي شديد الإحكام والجمال البرمجي، كما يوضح التركيب التالي:
=LET(text, A2, len, LEN(text), chars, MID(text, SEQUENCE(len), 1), pos, MATCH(TRUE, ISERROR(VALUE(chars)), 0), IFERROR(MID(text, pos, 1), ""))
في هذه البنية المتقدمة، يُعرّف المتغير text ليشير إلى الخلية المصدرية، ويُحسب طوله مرة واحدة فقط ويُخزن في المتغير len، ثم تُفكك المحارف وتُحفظ في المتغير chars، ويُحدد موقع أول حرف في المتغير pos، لتتولى الدالة النهائية إرجاع الحرف بدقة وسلاسة. لا تُسهم هذه المنهجية في رفع سرعة التنفيذ الحسابي فحسب، بل تُعزز بشكل غير مسبوق قابلية قراءة وتعديل الصيغ البرمجية المعقدة في بيئات العمل المشتركة، وتجعل عمليات تصحيح الأخطاء البرمجية (Debugging) تجربة بالغة السهولة والانسيابية.
8.3 مقارنة منهجية مع أداة تحويل البيانات Power Query
عند تقييم استراتيجيات هندسة البيانات داخل إكسل، يبرز التساؤل المنهجي حول المفاضلة بين الاعتماد على الصيغ الخلوية المباشرة (Formulas) وبين اللجوء إلى بيئة تحويل البيانات المتقدمة باور كويري (Power Query). تعتمد أداة باور كويري على لغة الاستعلامات الوظيفية المتخصصة (M Language)، والتي توفر دوال مدمجة فائقة التطور لمعالجة واستخلاص النصوص والأنماط دون الحاجة إلى كتابة معادلات مصفوفية مركبة داخل خلايا ورقة العمل.
يتيح باور كويري عزل الأحرف الأولى عبر واجهة الاستخدام الرسومية أو باستخدام أسطر برمجية بسيطة بلغة M تستهدف الفئات المحرفية القياسية. وتتجلى الميزة الكبرى لباور كويري عند التعامل مع خطوط إمداد البيانات الكبيرة ومستودعات البيانات المستوردة من خوادم خارجية؛ حيث تُنفذ عمليات التحويل والتنظيف خارج نطاق الذاكرة الحية لورقة العمل، مما يحافظ على خفة واستقرار الملف المكتبي مهما بلغ حجم السجلات المعالجة.
ومع ذلك، تظل الصيغ الخلوية المركبة التي فصلناها في هذا المقال هي الخيار الأمثل والأنسب للسيناريوهات التي تتطلب تفاعلية لحظية وحسابات آنية سريعة؛ فالصيغ تعكس التغييرات المدخلة في الحال دون الحاجة إلى النقر على زر تحديث البيانات (Refresh Data) الإلزامي في باور كويري. وعليه، يتعين على مهندس البيانات الموازنة الموضوعية واختيار الأسلوب الأنسب بناءً على حجم البيانات، ومتطلبات التحديث الآني، والبنية التحتية المتاحة في بيئة العمل المؤسسية.
9. دراسة حالات تطبيقية في إدارة البيانات المؤسسية
9.1 معالجة الرموز التعريفية في قواعد بيانات الموارد البشرية
تواجه أقسام الموارد البشرية في المنظمات الكبرى تحديات هيكلية ناجمة عن تباين تنسيقات الأكواد الوظيفية للموظفين، خاصة في الشركات التي شهدت عمليات اندماج واستحواذ متتالية. تتضمن هذه الأكواد غالبًا أرقامًا تسلسلية تاريخية متبوعة أو مسبوقة برموز تدل على فرع العمل أو طبيعة العقد (مثل “0104E9” لموظف في الفرع الأوروبي، أو “009A4” لموظف في الفرع الآسيوي). يتطلب تدقيق الرواتب وتحديد الامتيازات الوظيفية فصل الحرف الاستدلالي الأول بصورة مقننة ودقيقة لفرز السجلات وفق السياسات الإدارية المعتمدة.
عند تطبيق الصيغة المدمجة لاستخراج الحرف الأول عبر سجلات الموارد البشرية، تُمكّن المنظومة مسؤولي التعويضات من استخلاص الفئة الوظيفية بدقة مطلقة وتجاهل الأصفار البادئة التي تمثل مجرد حشو رقمي ناتج عن اختلاف سعة حقول قواعد البيانات القديمة. يتيح هذا الإجراء أتمتة تصنيف الموظفين وتغذية دوال البحث الإحصائي بمعايير متطابقة، مما يُلغي التباينات الناتجة عن الإدخال العشوائي للأكواد ويضمن اتساق تقارير الأجور والمكافآت السنوية.
وعلاوة على التدقيق المالي، يوفر هذا الاستخراج النظيف أساسًا سليمًا لتحديث وتوحيد الأكواد الوظيفية التاريخية في قاعدة بيانات مركزية موحدة. فبدلاً من الاستمرار في إدارة هياكل نصية متباينة، يمكن للمؤسسة استخدام الرموز المعزولة لإعادة هيكلة المعرفات وفق معيار مؤسسي رقمي جديد يضمن سهولة التتبع الإداري والأرشفة الإلكترونية طويلة المدى لكافة منتسبي المنظمة.
9.2 تنظيف السجلات المشفرة في الدراسات والأبحاث الميدانية
في الأبحاث الميدانية والمسوح السيكولوجية والدراسات التجريبية الموسعة، يُلجأ دائمًا إلى تشفير بيانات المشاركين لضمان سرية الهوية والامتثال للمعايير الأخلاقية للبحث العلمي. ينتج عن هذا التشفير معرّفات مركبة تدمج بين رقم مركز البحث، ورقم العينة، وحرف يرمز إلى المجموعة العلاجية أو الفئة التجريبية المستهدفة (مثل المعرف “02T88” للمجموعة التجريبية، أو “02C91” للمجموعة الضابطة Control Group).
تتطلب مرحلة التحليل الإحصائي الأولي عزل محددات المجموعات التجريبية بدقة متناهية لإجراء اختبارات التباين (ANOVA) والارتباط الإحصائي دون حدوث تلوث في البيانات. إن استخدام معادلات الاستخراج المصفوفي يضمن للباحث استخلاص رموز التصنيف بصورة مؤتمتة وموثوقة بنسبة 100%، مستبعدًا أي خطأ بشري قد يطرأ عند تصنيف مئات السجلات يدويًا في المعامل البحثية.
ويرتبط هذا النقاء الإجرائي في معالجة السجلات النصية بصورة وثيقة بالممارسات المنهجية المتبعة في إعداد قواعد البيانات المعجمية واللغوية الضخمة في العلوم السلوكية؛ حيث تتطلب أبحاث المعالجة البصرية للكلمات وقرارات التعرف المعجمي (Lexical Decision Data) فرز وتصنيف آلاف المدخلات النصية وفق معايير شديدة الصرامة والدقة (Ferrand et al., 2010; Keuleers et al., 2010, 2011). وتضمن هذه الأساليب الهندسية الصارمة في تنقية البيانات النصية تقديم دراسات رصينة تستند إلى مدخلات تجريبية نقية تعكس الواقع العلمي المدروس بأعلى درجات المصداقية والاتزان.
9.3 توحيد المعايير بين الأنظمة البرمجية القديمة والحديثة
تُعاني المؤسسات ذات الإرث التقني العريق من ظاهرة “الأنظمة القديمة المعزولة” (Legacy Systems)؛ وهي برمجيات تشغيلية قديمة بُنيت في عقود سابقة ولا تزال قيد الاستخدام في بعض الأقسام الحيوية. تصدر هذه الأنظمة تقاريرها وسجلاتها بتنسيقات نصية جامدة تفتقر إلى المعايير الحديثة، حيث تُدمج المعرفات في كتل نصية واحدة غير مفصولة بأعمدة مستقلة، مما يشكل عقبة كبرى عند محاولة دمج هذه البيانات مع نظم تخطيط موارد المؤسسات الحديثة (ERP Systems).
تُمثل الصيغ المتقدمة لاستخراج الحرف الأول في إكسل حلاً تكميليًا فائق الفعالية لبناء جسور التوافق بين هذه الأنظمة المتباينة دون تكبد تكاليف باهظة في إعادة البرمجة. فمن خلال قراءة السلاسل النصية المصدرة وتحليل مواضع الأحرف الهجائية بدقة، تستطيع الصيغ تفكيك السجلات التاريخية وتوزيع محتوياتها إلى حقول مهيكلة تلائم النظم الحديثة، مما يسهم في توحيد معايير التقارير المالية والتشغيلية عبر كافة قطاعات المؤسسة.
يضمن هذا النهج التحليلي سلاسة الانتقال الرقمي والتحول المؤسسي المستدام؛ إذ يمنح فرق تكنولوجيا المعلومات والرقابة الإدارية وسيلة مرنة لمطابقة الجداول المستخرجة من مصادر متباينة وضمان عدم فقدان أي بيانات تاريخية أثناء عمليات الهجرة والتحول البرمجي، مع الحفاظ على الاتساق المنطقي لكافة الأصول المعلوماتية للمؤسسة.
10. أفضل الممارسات المنهجية لضمان دقة المعالجة الحسابية
10.1 التهيئة القبلية للبيانات باستخدام دالتي TRIM و CLEAN
تُعد مرحلة التهيئة والتنظيف القبلي (Data Preprocessing) شرطًا جوهريًا لا غنى عنه قبل تطبيق أي صيغ استخراج مصفوفية متقدمة. وتتصدر دالتا TRIM و CLEAN قائمة الأدوات الأساسية في هذه المرحلة. تتولى دالة TRIM إزالة كافة المسافات الزائدة من السلسلة النصية، بما في ذلك المسافات البادئة واللاحقة، مع الإبقاء على مسافة مفردة واحدة فقط بين الكلمات إن وجدت. تكتسب هذه الخطوة أهميتها القصوى من حقيقة أن المسافات البادئة، كما أسلفنا، تفشل في التحويل الرقمي مما يربك منطق دالة VALUE ويؤدي إلى استخراج المسافة كحرف مستهدف عن طريق الخطأ.
من جانبها، تختص دالة CLEAN بإزالة كافة المحارف غير القابلة للطباعة (Non-printable Characters)؛ وهي محارف تحكم غير مرئية تتراوح أكوادها في معيار ASCII بين 0 و 31، وغالبًا ما تتسرب إلى البيانات عند تصديرها من قواعد بيانات قديمة أو نسخها من صفحات الإنترنت والملفات النصية الخام. وجود هذه المحارف الطفيلية في بداية النصوص يُشوش تمامًا عمل دوال الاقتطاع والفحص المصفوفي، مسببًا نتائج عشوائية لا تعكس المحتوى الحقيقي للنص.
لذا، تقتضي المنهجية الهندسية الصارمة دمج هاتين الدالتين في مرحلة تنظيف أولية أو تضمينهما مباشرة داخل مرجع الصيغة عبر التركيب: TRIM(CLEAN(A2)). يضمن هذا الإجراء الوقائي دخول النصوص إلى خوارزمية الاستخراج المصفوفية في حالة نقية وخالية تمامًا من أي شوائب رمزية غير مرئية، مما يؤسس لمخرجات حسابية غاية في الدقة والمصداقية.
10.2 التوثيق المعياري والمراجعة الرياضية داخل أوراق العمل
تتسم الصيغ المصفوفية المركبة بطبيعتها الكثيفة والغامضة بصريًا لغير المتخصصين، مما يجعلها عرضة لسوء الفهم أو التعديل غير المقصود الذي قد يؤدي إلى تخريب النموذج الحسابي بالكامل. لذلك، يمثل التوثيق المعياري المنهجي داخل أوراق العمل التزامًا مهنيًا صارمًا لحماية استدامة النماذج المؤسسية. يتطلب ذلك إضافة تعليقات وملاحظات توضيحية (Cell Notes / Comments) عند رؤوس الأعمدة التي تستخدم هذه الصيغ، تشرح البناء الهرمي للمعادلة، والهدف من تركيباتها، وطريقة إدخالها المعتمدة.
إلى جانب ذلك، يجب اعتماد تسميات دقيقة وتفريقية للأعمدة الحسابية؛ فلا يجوز تسمية العمود بشكل مبهم مثل “الحرف”، بل يجب استخدام تسميات وظيفية صريحة مثل “موضع_الحرف_الأول” للعمود الفهرسي، و”قيمة_الحرف_الأول” للعمود الاستخلاصي. يسهم هذا الوضوح المصطلحي في تقليل العبء الإدراكي والذهني على فريق العمل، مما يتوافق مع توصيات أبحاث التعليم وتصميم الأنظمة المعلوماتية حول ضرورة توفير إرشادات بنيوية واضحة لتسهيل استيعاب الأنظمة الرياضية المعقدة (Schwartz & Bransford, 1998).
وتكتمل هذه الممارسات بإجراء عمليات تدقيق وتدقيق عشوائي دورية (Audit Sampling) على عينات متباينة من السجلات للتأكد من موثوقية النتائج الحسابية بعد كل عملية تحديث رئيسية في البيانات. يضمن هذا التدقيق الدوري رصد أي استثناءات رمزية جديدة قد تفرزها تحديثات الأعمال المؤسسية، والتعامل معها ضمن الصيغ البرمجية قبل أن تؤثر سلبًا على مخرجات التحليلات والتقارير التنفيذية العليا.
10.3 استراتيجيات التعامل مع مجموعات البيانات الاستثنائية الحجم
عند التعامل مع أوراق عمل تحتوي على مئات الآلاف أو ملايين الصفوف، تصبح الحلول القائمة على الصيغ الخلوية التقليدية، مهما بلغت درجة تحسينها، عبئًا ملموسًا على موارد الحوسبة. في هذه البيئات الاستثنائية، يتعين على محلل البيانات تبني استراتيجيات هندسية أكثر تقدمًا للحفاظ على استقرار النظام وكفاءة الأداء. تتمثل الإجراءات الوقائية الأولية في تقسيم الجداول المليونية العملاقة إلى ملفات أو نطاقات تشغيلية أصغر، وتطبيق المعالجة الحسابية على دفعات مجدولة ومنفصلة.
الاستراتيجية الثانية والأكثر شيوعًا في الإنتاج المؤسسي هي “التحويل النهائي إلى قيم”؛ فبمجرد تطبيق الصيغ المصفوفية وتوليد الأحرف الأولى والتحقق من سلامتها، يُنصح بشدة بنسخ النطاق بأكمله وإعادة لصقه كقيم ثابتة (Paste Special > Values). يُزيل هذا الإجراء كافة الحسابات المصفوفية والدوال المتطايرة من الذاكرة الحية للمصنف، ويخفض حجم الملف بشكل ملحوظ، مما يتيح تداوله ومشاركته وفتحه على الأجهزة المختلفة بسلاسة وسرعة فائقة دون أي تأخير في إعادة الحساب.
وفي الحالات التي تتطلب معالجة ديناميكية مستمرة لبيانات ضخمة لا يمكن تجميدها كقيم، يغدو استخدام لغة البرمجة النصية فيجوال بيسك للتطبيقات (VBA) أو نصوص بايثون المدمجة حديثًا في إكسل (Python in Excel) بديلاً برمجيًا متفوقًا. يتيح هذا التوجه كتابة دوال مخصصة (User-Defined Functions) تعتمد على الحلقات التكرارية والمصفوفات الثابتة في الذاكرة المنخفضة، أو استدعاء محركات التعابير النمطية (Regular Expressions) مباشرة لاقتطاع المحارف الأبجدية بسرعة البرمجة التجميعية، مما يمنح مهندس البيانات القوة والمرونة اللازمة للتعامل مع أضخم مستودعات البيانات بكفاءة واقتدار لا نظير لهما.
خاتمة
استعرض هذا المقال المعماري المفصل الأبعاد الرياضية والمنطقية والتشغيلية الكامنة وراء حل إحدى أبرز مشكلات هندسة البيانات في برنامج مايكروسوفت إكسل، والمتمثلة في تحديد الموضع المكاني لأول حرف في السلسلة النصية الهجينة واستخلاص قيمته الرمزية بدقة تامة. وقد اتضح جليًا من خلال التحليل الهيكلي أن تجاوز عجز الدوال النصية البسيطة يتطلب فهمًا عميقًا لكيفية توليد المتجهات الرقمية عبر تكامل دالتي ROW و INDIRECT، وتوظيف استثناءات التحويل الرقمي في دالة VALUE لتشغيل الفحص المنطقي الثنائي عبر دالتي ISERROR و MATCH.
كما أظهرت المقارنة الموسعة بين الصيغ الكلاسيكية والبدائل العصرية المتطورة في بيئات Microsoft 365، مثل دالتي SEQUENCE و LET وأدوات استعلام البيانات المتقدمة باور كويري، حجم النقلة النوعية التي يشهدها البرنامج نحو تحسين الكفاءة الحسابية والحد من استهلاك الذاكرة المؤقتة، مع الحفاظ على أعلى مستويات المقروئية والمرونة البرمجية في معالجة السجلات المؤسسية والبحثية الكبيرة.
إن تبني أفضل الممارسات المنهجية القائمة على التهيئة القبلية للبيانات باستخدام دالتي TRIM و CLEAN، وتطويق الصيغ بأطر التحكم الوقائية مثل IFERROR، والتوثيق الدقيق لمسارات الحسابات، يمثل الضمانة الحقيقية لبناء نماذج جداول بيانات احترافية ومستدامة. ومن خلال الجمع بين الدقة الرياضية الصارمة والأناقة الهندسية في صياغة الحلول، يرتقي محلل البيانات بأدواته التحليلية ليقدم مخرجات نقية وموثوقة تدعم اتخاذ القرارات الإدارية والعلمية بثقة واقتدار.
المراجع
- Ferrand, L., New, B., Brysbaert, M., Keuleers, E., Bonin, P., Méot, A., Augustinova, M., & Pallier, C. (2010). The French Lexicon Project: Lexical decision data for 38,840 French words and 38,840 pseudowords. Behavior Research Methods, 42(2), 488–496. https://doi.org/10.3758/brm.42.2.488
- Keuleers, E., Diependaele, K., & Brysbaert, M. (2010). Practice Effects in Large-Scale Visual Word Recognition Studies: A Lexical Decision Study on 14,000 Dutch Mono- and Disyllabic Words and Nonwords. Frontiers in Psychology, 1, 174. https://doi.org/10.3389/fpsyg.2010.00174
- Keuleers, E., Lacey, P., Rastle, K., & Brysbaert, M. (2011). The British Lexicon Project: Lexical decision data for 28,730 monosyllabic and disyllabic English words. Behavior Research Methods, 44(1), 287–304. https://doi.org/10.3758/s13428-011-0118-4
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction, 12(1), 61–86. https://doi.org/10.1016/s0959-4752(01)00016-0
- Schwartz, D. L., & Bransford, J. D. (1998). A Time For Telling. Cognition and Instruction, 16(4), 475–522. https://doi.org/10.1207/s1532690xci1604_4