
تُعد معالجة البيانات واسترجاع السجلات في برمجيات الجداول الإلكترونية، وعلى رأسها مايكروسوفت إكسل (Microsoft Excel)، ركيزة جوهرية في تحليل البيانات الكمية، والنمذجة الإحصائية، والأبحاث التجريبية المعاصرة. فعند التعامل مع قواعد بيانات واسعة النطاق تتداخل فيها المتغيرات وتتعدد فيها الأبعاد التصنيفية، يواجه الباحثون والمحللون تحدياً محورياً يتمثل في استخراج قراءة محددة بدقة دون الوقوع في فخ التشويش الناتج عن تكرار السجلات أو تداخل الحالات المتشابهة. وتبرز مسألة “العثور على أول ظهور بناءً على معايير متعددة” (Find First Occurrence Based on Multiple Criteria) كواحدة من أدق العمليات المنطقية وأكثرها طلباً في سياقات البحث الميداني، والتحليل المالي، والقياسات السلوكية المتكررة عبر الزمن.
إن طبيعة البيانات الواقعية تتسم في كثير من الأحيان بعدم الترتيب المسبق، حيث تُسجل الأحداث بتسلسل زمني تدفقي، أو تُجمع الاستجابات في استبانات معقدة تحتوي على قياسات طولية متكررة لنفس المفحوصين أو الوحدات التجريبية. في مثل هذه البيئات، لا يكون الهدف مجرد استرجاع أي سجل يطابق معيارين أو أكثر، بل استرجاع السجل “الأول” زمنياً أو هيكلياً، والذي يمثل نقطة الأساس الحتمية في التقييم، أو التحديد الدقيق لرد الفعل الأولي ضمن ظروف مقننة. ويتطلب هذا الإجراء صرامة رياضية ومعمارية حوسبية تتجاوز القدرات الافتراضية للدوال البحثية الكلاسيكية التي اعتاد عليها المستخدم العادي لعقود طويلة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك الأسس النظرية، والبنى الرياضية، والميكانيكيات الخوارزمية الكامنة وراء صياغة استعلامات البحث متعددة الشروط في إكسل لاسترجاع أول ظهور حصراً. سنقوم بتشريح التكامل الوظيفي بين دالتي الفهرس والمطابقة (INDEX وMATCH)، وكيفية توظيف جبر بولي (Boolean Algebra) في إنشاء مصفوفات المقارنة الثنائية في الذاكرة الحية، وصولاً إلى مقارنة هذه المنهجية الكلاسيكية الراسخة بالدوال الحديثة مثل XLOOKUP وFILTER، مدعومة بدراسات حالة تطبيقية، واستراتيجيات متقدمة للتحكم في الأخطاء وتحسين الكفاءة الحاسوبية في مجموعات البيانات الضخمة.
1. الأسس النظرية لمنطق البحث المتقدم متعدد المعايير في إكسل
1.1 تطور آليات البحث في جداول البيانات وتحديات المعيار الفردي
شهدت برمجيات الجداول الإلكترونية منذ نشأتها المبكرة تحولات جذرية في كيفية فهرسة البيانات والوصول إليها عبر هياكل الذاكرة. في البدايات، صُممت محركات البحث الداخلي في جداول البيانات للتعامل مع متجهات خطية أحادية البعد؛ حيث كان الافتراض السائد أن المستخدم يبحث عن قيمة وحيدة (مثل رقم المعرّف أو الاسم الأخير) ضمن عمود محدد، ليرجع قيمة مقابلة من عمود مجاور. ويعتمد مفهوم البحث الخطي (Linear Search) على مسح السجلات عنصراً تلو الآخر من الأعلى إلى الأسفل حتى يتحقق شرط التطابق التام، وهو أسلوب أثبت كفاءته في الجداول البسيطة ذات البنية المسطحة.
ومع ذلك، أدى تعقد النماذج المعرفية وتضخم البيانات الناتجة عن الاختبارات التجريبية المتكررة إلى عجز البحث الخطي أحادي المعيار عن تلبية متطلبات الاستعلام المعقدة. ففي علوم البيانات والتحليلات الإحصائية المتقدمة، نادراً ما تتحدد هوية الكيان بمتغير أحادي؛ بل تتشكل الهوية التحليلية من تقاطع عدة أبعاد تصنيفية (مثل: المجموعة التجريبية، والمستوى العمري، ورقم الجلسة). يفرض هذا الواقع الانتقال من البحث الخطي البسيط إلى البحث المنطقي المركب في هياكل البيانات متعددة الأبعاد. وتبرز الأهمية المنهجية لاسترجاع السجل الأول المطابق بدقة رياضية صارمة، لكونه يمنع التداخل مع القياسات اللاحقة المتغيرة، ويحافظ على صحة القياس ونقاء السلسلة الزمنية قيد الدراسة، وهو ما نبهت إليه دراسات معالجة البيانات المعقدة في تتبع المؤشرات الكمية (Brysbaert & New, 2009).
1.2 القيود التقنية للدوال التقليدية مثل VLOOKUP وHLOOKUP
ترسخت دالة VLOOKUP (وكذلك نظيرتها الأفقية HLOOKUP) لعقود كمعيار قياسي لعمليات البحث في إكسل، إلا أن بنيتها التركيبية تنطوي على قيود معمارية تحد من مرونتها في البيئات البحثية المتقدمة. يكمن القيد الجوهري الأول في اشتراط الدالة الصارم لوجود عمود البحث في أقصى يمين أو يسار نطاق الجدول المرجعي (اعتماداً على اتجاه ورقة العمل ولغة البرنامج)، مما يمنعها بنيوياً من استرجاع البيانات الواقعة إلى الخلف أو على اتجاه معاكس دون إعادة هيكلة الجدول بالكامل، وهو أمر غير عملي في النماذج التحليلية الثابتة.
أما القيد الثاني، وهو الأشد خطورة، فيتمثل في افتقار VLOOKUP الأصيل لدعم الوسائط المنطقية المتعددة؛ إذ تقبل الدالة معيار بحث منفرد فقط. ولتجاوز هذا العجز، كان المستخدمون يلجأون تاريخياً إلى إنشاء “أعمدة مساعدة” (Helper Columns) تقوم بدمج النصوص عبر المعامل (&)، وهي ممارسة تؤدي إلى تضخيم استهلاك الذاكرة العشوائية وتزيد من احتمالية حدوث أخطاء المحاذاة. فضلاً عن ذلك، فإن محاولة إجبار VLOOKUP على معالجة صيغ الصفيف المركبة تؤدي إلى استهلاك غير فعال لموارد المعالجة، مما استدعى البحث المنهجي عن صيغة تقنية بديلة تفصل فصلاً تاماً بين متجه البحث ومتجه الاسترجاع دون المساس بهيكل البيانات الأصلي.
1.3 أهمية استرجاع القيمة الأولى في التحليلات الإحصائية والأكاديمية
في التحليلات الإحصائية والأكاديمية الدقيقة، لا سيما في الدراسات الطولية والمسوحات السلوكية، يحمل مفهوم “الظهور الأول” دلالة منهجية حاسمة تفوق مجرد العثور على أي تطابق عشوائي. فعند التعامل مع السلاسل الزمنية غير المرتبة، يمثل الظهور الأول لكل فئة “نقطة الأساس” (Baseline) التي يُقاس عليها التغير اللاحق عبر الزمن. فإذا كانت السجلات مرتبة ترتيباً زمنياً تدفقياً، فإن أول ظهور لفرد تجريبي ينتمي لظرف بيئي محدد يمثل استجابته الفطرية الأولى قبل حدوث تأثيرات التعلم أو الإجهاد، وهو مبدأ أساسي في تفسير الاستجابات المشروطة والوظائف المعرفية (Carruthers, 2002; Johnston, 1981).
علاوة على ذلك، فإن قواعد البيانات المفتوحة والمستودعات الرقمية الضخمة تعاني باستمرار من التكرارات غير المنتظمة وتكرار المحاولات للفرد ذاته. إن استرجاع القيمة الأولى بدقة يضمن عزل الاستجابة الأصلية وتجنب التحيز الناتج عن إدراج التكرارات المشوهة للبيانات. يساهم هذا الضبط الرياضي في تدقيق السجلات، وتسهيل إجراءات المراجعة المنهجية، والتأكد من مطابقة النتائج الحسابية للمعايير الصارمة لضبط الجودة الإحصائية وقابلية التكرار الأكاديمي، بما يدعم مصداقية الفرضيات واستقرار التقديرات المقارنة.
2. التشريح البنيوي والرياضي للصيغة: INDEX وMATCH
2.1 الميكانيكية الحسابية لدالة INDEX في تحديد نطاقات الإرجاع
تُعد دالة INDEX الأداة الأكثر استقراراً وقوة في إكسل للتعامل مع إحداثيات المصفوفات واسترجاع القيم من نطاقات ثنائية أو أحادية البعد. رياضياً، تأخذ دالة INDEX مصفوفة بيانات مستهدفة تمثل فضاء النتائج، وتعمل كدالة تعيين إحداثي؛ حيث تترجم رقم الصف ورقم العمود المُدخلين إليها إلى موقع نسبي دقيق داخل النطاق المحدد، وتُرجع القيمة القابعة في ذلك التقاطع بصرف النظر عن موقع النطاق الفيزيائي داخل ورقة العمل الكلية.
وتتجلى القوة الاستثنائية لدالة INDEX في قدرتها الفائقة على معالجة “المصفوفات الافتراضية” (Virtual Arrays) في الذاكرة الحية دون الحاجة إلى تثبيتها في خلايا فعلية. وهناك فارق هيكلي حاسم بين استخدام INDEX كنطاق مرجعي (Reference Form) يعيد مرجعاً لخلية يمكن تمريره لدوال أخرى، واستخدامها كمصفوفة قيم (Array Form). هذه المرونة تسمح للباحث بتمرير نطاق الإرجاع كمتجه منفصل تماماً، متحرراً من قيود الترتيب المكاني التي تعاني منها الدوال الأخرى، مما يمنحها مناعة برمجية ضد تقلبات واجهة المستخدم.
2.2 ديناميكية دالة MATCH ومفهوم البحث عن التطابق التام
بينما تختص دالة INDEX بالاسترجاع المعتمد على الإحداثيات، تتولى دالة MATCH مهمة عكسية بالغة الدقة: البحث عن قيمة محددة ضمن متجه أحادي البعد وإرجاع الفهرس الرقمي لموقعها النسبي. في سياق الاستعلام متعدد المعايير، يتم توجيه وسيطة البحث (Lookup Value) لاستهداف القيمة الرقمية “1” حصراً، وهو اختيار ذو دلالة منطقية عميقة سنفصله لاحقاً في سياق جبر بولي. وتقوم الدالة بمسح متجه البحث (Lookup Array) الناتج عن تقييم الشروط المتزامنة حتى تجد هذا الهدف.
ومن الأهمية بمكان الضبط الصارم للوسيطة الثالثة في دالة MATCH (المسماة Match Type) على القيمة صفر (أو FALSE)؛ إذ يجبر هذا المعامل محرك الحساب على إجراء بحث دقيق وتطابق تام (Exact Match)، متجاهلاً أية افتراضات مسبقة حول ترتيب البيانات تصاعدياً أو تنازلياً. وتتميز خوارزمية MATCH في هذا الوضع بأنها تتبع مساراً خطياً يبدأ من العنصر الأول، وعند التقاطها لأول قيمة تحقق التطابق التام مع الرقم 1، تُنهي العملية الحسابية فوراً وتُرجع رقم الصف النسبي، متجاهلة أي ظهور لاحق لنفس القيمة، وهو ما يشكل الأساس المنطقي لاسترجاع “أول ظهور”.
2.3 التكامل الوظيفي بين INDEX وMATCH كبديل تفوقي
يمثل التزاوج الوظيفي بين INDEX وMATCH قفزة نوعية في هندسة الصيغ الحسابية داخل إكسل. من خلال هذا التكامل، تتولى MATCH مسح فضاء الشروط لتحديد الإحداثي النسبي للهدف، ثم تُمرر هذه القيمة فوراً إلى INDEX لتسترجع المحتوى المقابل من فضاء النتائج. هذا الفصل المعماري التام بين متجه الشروط ومتجه الاسترجاع يمنح الصيغة حصانة مطلقة ضد الأخطاء الناتجة عن إدراج أعمدة جديدة أو حذف أعمدة وسيطة، وهي الكبوة القاتلة التي تواجه صيغ VLOOKUP المعتمدة على الفهارس الرقمية الثابتة للأعمدة.
إلى جانب الحصانة الهيكلية، يتفوق تركيب INDEX وMATCH في كفاءة استخدام الذاكرة المعالجة (CPU Overhead) وتقليل استهلاك الذاكرة المؤقتة، لكونه يقتصر على قراءة النطاقات ذات الصلة المباشرة بالاستعلام دون تحميل جدول البيانات كاملاً في ذاكرة التقييم. كما يوفر هذا البناء إطاراً استعلامياً ديناميكياً قابلاً للتوسع ليشمل عدداً لا نهائياً من المعايير المنطقية المتداخلة، مما يجعله الخيار الهندسي المفضل لبناء النماذج المالية والتحليلات البحثية الحساسة التي تتطلب متانة برمجية عبر مختلف بيئات العمل.
3. جبر بولي ومصفوفات المقارنة المنطقية في محرك إكسل
3.1 مفهوم الضرب المنطقي وتحويل المعايير إلى متجهات ثنائية
يعتمد استعلام المعايير المتعددة في جوهره الرياضي على مبادئ جبر بولي (Boolean Algebra)، حيث تُختزل العمليات المنطقية إلى قيَم الصواب والخطأ. عندما نطلب من إكسل مقارنة نطاق كامل بقيمة معيارية محددة، مثل (A2:A13 = "Spurs")، فإن محرك الحساب لا يُرجع قيمة مفردة، بل يُنشئ في الذاكرة متجهاً من القيم المنطقية يتألف حصراً من {TRUE; FALSE}. وعند تقييم شرط ثانٍ مستقل مثل (B2:B13 = "Forward")، يتولد متجه منطقي متناظر بنفس الطول والترتيب.
تحدث المعالجة الرياضية الفارقة عند إدخال معامل الضرب الجبري (*) بين هذين المتجهين. في بيئة إكسل الحسابية، تُجبر العمليات الحسابية (كالضرب والجمع) القيم المنطقية على الخضوع للتحويل القسري للأنواع (Coercion)، حيث يتحول كل عنصر TRUE تلقائياً إلى الرقم 1، بينما يتحول FALSE إلى الرقم 0. ووفقاً لجدول الحقيقة الخاص ببوابة العطف المنطقية (AND)، فإن حاصل ضرب القيم الثنائية يتبع القاعدة الرياضية:
- 1 * 1 = 1 (تحقق كلا المعيارين في آن واحد)
- 1 * 0 = 0 (تحقق المعيار الأول وفشل الثاني)
- 0 * 1 = 0 (فشل المعيار الأول وتحقق الثاني)
- 0 * 0 = 0 (فشل كلا المعيارين)
وبذلك، ينتج عن عملية الضرب متجه أحادي نهائي مكون من أصفار وآحاد، حيث تدل القيمة “1” حصرياً على تحقق كافة المعايير المنطقية المتزامنة، وهو المنطق الثنائي المعتمد في النمذجة الإحصائية لضبط المتغيرات (Ellis & Ferreira-Junior, 2009).
3.2 دور دالة INDEX الوسيطة في تجاوز اختصار صيغ الصفيف التقليدي
تاريخياً، كانت معالجة مصفوفات المقارنة الناتجة عن ضرب الشروط المنطقية تتطلب إدخال المعادلة كـ “صيغة صفيف” (Array Formula) عبر توليفة المفاتيح الشهيرة (Ctrl + Shift + Enter)، والتي تُحاط فيها المعادلة تلقائياً بأقواس معقوفة {}. وكان هذا المطلب يمثل كعب أخيل لنماذج البيانات؛ إذ إن أي تعديل غير مقصود من مستخدم يضغط المفتاح Enter فقط كان كفيلاً بكسر الصيغة الحسابية وتحويل نتائج النموذج بالكامل إلى أخطاء شائعة.
هنا تبرز حيلة تقنية بالغة الذكاء في بنية الصيغة القياسية: استخدام دالة INDEX “وسيطة” تلتف حول مصفوفة الضرب المنطقي قبل تمريرها إلى دالة MATCH. تمتلك دالة INDEX القدرة البرمجية على استلام مصفوفة افتراضية وتفريغها في ذاكرة التنفيذ الحية دون اشتراط إدخال الصفيف الكلاسيكي، وذلك من خلال ترك وسيطة الصف فارغة أو تعيينها على صفر: INDEX((Condition1)*(Condition2), ). يُجبر هذا التركيب محرك إكسل على تقييم المصفوفة داخلياً وتمرير المتجه الرقمي الناتج بسلاسة إلى MATCH، مما يمنح ملفات العمل توافقية تامة وموثوقية عالية عبر مختلف إصدارات إكسل ودون أي اعتماد على مفاتيح الإدخال المعقدة.
3.3 المحاذاة البعدية للمصفوفات وتجنب أخطاء عدم التكافؤ
لكي تكتمل العمليات الحسابية المتجهية بنجاح داخل الذاكرة، تفرض البرمجية شرطاً صارماً يتعلق بـ “المحاذاة البعدية” (Dimensional Alignment). يتطلب جبر المصفوفات في إكسل أن تكون جميع النطاقات الشرطية المشتركة في عملية الضرب، بالإضافة إلى نطاق النتيجة النهائي، متطابقة تماماً في عدد الصفوف والاتجاه الهيكلي. فعلى سبيل المثال، إذا كان النطاق الأول يمتد عبر الصفوف من 2 إلى 13 (أي 12 عنصراً)، فإن استخدام نطاق ثانٍ يمتد من 2 إلى 20 سيؤدي حتماً إلى إخفاق المحرك الحسابي في مطابقة العناصر المتناظرة، مما يولد فوراً خطأ القيمة الشهير #VALUE!.
كذلك يجب الانتباه إلى محاذاة التوجيه؛ فلا يمكن ضرب متجه عمودي بنطاق أفقي في هذا السياق دون استخدام دوال التحويل مثل TRANSPOSE، لأن ضرب متجه عمودي بمتجه أفقي يولد مصفوفة ثنائية الأبعاد (جدول ضرب تقاطعي) بدلاً من متجه أحادي، مما يعطل دالة MATCH المصممة للبحث في مسار خطي. وأخيراً، فإن وجود خلايا فارغة ضمن نطاقات المقارنة قد يُفسر وفقاً لسياق المعيار، إما كقيمة نصية فارغة “” أو كرقم صفر، وهو ما يستوجب تدقيقاً مستمراً في مراحل تنظيف البيانات لضمان دقة المحاذاة وصحة التقييم النهائي.
4. التفكيك المنهجي للصيغة القياسية خطوة بخطوة
4.1 الصيغة المرجعية: قراءة متعمقة في البنية التركيبية
تتجسد الصيغة المرجعية القياسية المعتمدة عبر مجتمعات التحليل المتقدم في إكسل لاسترجاع أول ظهور متعدد المعايير في البناء التركيبي التالي:
=INDEX(C2:C13, MATCH(1, INDEX((A2:A13=F1)*(B2:B13=F2), ), FALSE))
يقوم هذا البناء المعماري على ثلاث طبقات دالية متداخلة بانسجام دقيق:
- الطبقة الخارجية: دالة
INDEX(C2:C13, ...)، وتتمثل مهمتها الوحيدة في استخراج القيمة النهائية من متجه النتائج C2:C13 استناداً إلى رقم الصف الذي ستحدده الطبقات الداخلية. - الطبقة الوسطى: دالة
MATCH(1, ..., FALSE)، وتعمل كمستشعر إحداثي يبحث عن الرقم المستهدف 1 ضمن المتجه المتولد من الطبقة الداخلية، مع ضبط معامل البحث الصارم على التطابق التام (FALSE). - الطبقة الداخلية: دالة
INDEX((A2:A13=F1)*(B2:B13=F2), )، وتعمل كمحول صفيف فوري، يستقبل التقييم الثنائي للمعايير المنطقية وينتج متجهاً رقمياً جاهزاً للاستهلاك دون إجبار المستخدم على تشغيل وضع الصفائف عبر لوحة المفاتيح.
4.2 مراحل التقييم الداخلي في محرك المعالجة الحسابية
عندما يشرع محرك إكسل في تنفيذ هذه الصيغة، يتبع تسلسلاً حتمياً من أربع مراحل معالجة دقيقة، يمكن رصدها خطوة بخطوة عبر أداة تدقيق الصيغ (Evaluate Formula):
- المرحلة الأولى (تقييم النطاق الأول): تتم مقارنة كل خلية في النطاق A2:A13 بقيمة المعيار F1. ينتج عن ذلك مصفوفة بوليانية مؤقتة في الذاكرة تتكون من قيم صواب وخطأ:
{TRUE; FALSE; TRUE; ...}. - المرحلة الثانية (تقييم النطاق الثاني): بالتوازي، تتم مقارنة كل خلية في النطاق B2:B13 بقيمة المعيار F2، لتتولد مصفوفة بوليانية ثانية موازية:
{FALSE; TRUE; TRUE; ...}. - المرحلة الثالثة (الضرب المتجهي والتفريغ): تضرب الدالة المصفوفتين بيانياً، فيتحول التقاطع المنطقي إلى أرقام صريحة. ينتج عن
TRUE * FALSEالقيمة 0، وعنTRUE * TRUEالقيمة 1. تقوم دالة INDEX الداخلية بتمرير المتجه الرقمي الناتج{0; 0; 1; 0; ...}إلى دالة MATCH دون أية تعديلات هيكلية. - المرحلة الرابعة (الفهرسة والاسترجاع): تبدأ دالة MATCH مسح المصفوفة من الأعلى بحثاً عن الرقم 1. بمجرد عثورها على أول ظهور له (وليكن في الموقع الثالث مثلاً)، تتوقف فوراً وتُرجع الرقم 3 إلى دالة INDEX الخارجية، والتي تعيد بدورها محتوى الخلية C4، لتكتمل دورة الحساب بنجاح حاسم.
4.3 سلوك دالة MATCH عند استهداف الرقم 1 كمحدد رئيسي
يثير اختيار الرقم 1 كقيمة بحث مستهدفة تساؤلات منطقية لدى الباحثين المبتدئين: لماذا لا نبحث عن الكلمات المفتاحية ذاتها؟ يكمن الجواب في الكفاءة الهندسية للنموذج الثنائي. إن تحويل الشروط المتعددة غير المتجانسة (نصوص، تواريخ، قيم رقمية) إلى فضاء موحد من الأصفار والآحاد يختزل مسألة المقارنة في مشكلة حوسبية بدائية: “أين تقع أول نقطة تشغيل؟” (First High Bit).
وعندما تُبرمج دالة MATCH للبحث عن الرقم 1 مع تثبيت نوع المطابقة على التطابق التام، فإنها تنفذ خوارزمية بحث تسلسلي تتوقف حتمياً عند العقدة الأولى التي تحقق المساواة الصارمة. ولا تواصل الدالة فحص بقية عناصر المتجه، مما يضمن كفاءة زمنية من رتبة O(k) حيث k هو موقع العنصر الأول، بدلاً من مسح النطاق بالكامل O(N). هذا السلوك الحتمي هو الضمانة الرياضية المطلقة لإهمال أي صفوف لاحقة تحقق المعايير ذاتها، محققاً بذلك الغاية المنهجية في التقاط أول حدث بدقة لا تقبل اللبس.
5. دراسة حالة تطبيقية: تحليل أداء وإحصاءات لاعبي كرة السلة
5.1 هيكلة مصفوفة البيانات الأولية وتحديد المتغيرات
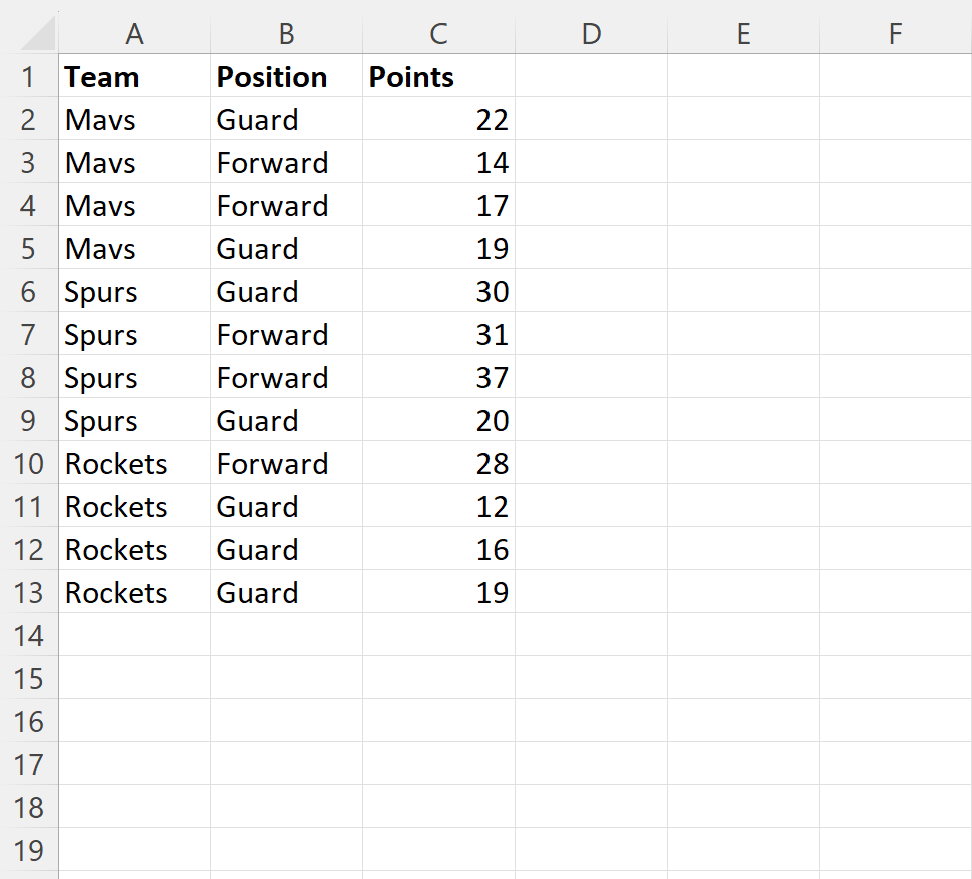
لتجسيد هذا المفهوم الرياضي على أرض الواقع العملي، نفترض نموذجاً تحليلياً مستمداً من إحصاءات الأداء الرياضي في دوري كرة السلة، حيث تُسجل بيانات اللاعبين في سجلات تدفقية تفتقر إلى الفرز المسبق، وهو سياق تحليلي يرتبط بمتغيرات المراقبة الفسيولوجية والبدنية لدى الرياضيين (Reardon et al., 2019). يتكون جدول بياناتنا المرجعي من اثني عشر سجلاً تمتد عبر النطاقات A2:C13، موزعة كالتالي:
- النطاق A2:A13 (الفريق – Team): يتضمن أسماء الفرق، مثل “Spurs”، “Warriors”، “Lakers”، مع تكرار الأسماء في صفوف متعددة نظراً لتعدد اللاعبين والمراكز داخل الفريق الواحد.
- النطاق B2:B13 (المركز الميداني – Position): يحدد التخصص التكتيكي للاعب، مثل “Guard”، “Forward”، “Center”.
- النطاق C2:C13 (النقاط المسجلة – Points): يمثل المتغير الرقمي المستمر المراد استرجاعه، والذي يعكس حصيلة النقاط المسجلة للاعب المعني في المباراة.
تم إدراج تكرارات متعمدة في الجدول؛ حيث يظهر الفريق “Spurs” مقترناً بالمركز “Forward” في الصف 4 محققاً 31 نقطة، ثم يظهر نفس المزيج التكتيكي (Spurs + Forward) مجدداً في الصف 9 محققاً 18 نقطة. صُمم هذا السيناريو لاختبار قدرة الصيغة على التقاط السجل الأول وتجاهل السجل الثاني بحزم خوارزمي.
5.2 إعداد معايير الاستعلام في خلايا الإدخال المستقلة
تقتضي حوكمة النماذج الحسابية في إكسل عزل معايير البحث عن بنية الصيغة ذاتها؛ حيث إن كتابة النصوص الثابتة داخل المعادلات (Hardcoding) تُعد ممارسة برمجية سيئة تزيد من احتمالية الأخطاء عند التعديل. بناءً على ذلك، يتم تخصيص خلايا إدخال مستقلة ومفصولة بصرياً لاستقبال معايير الاستعلام:
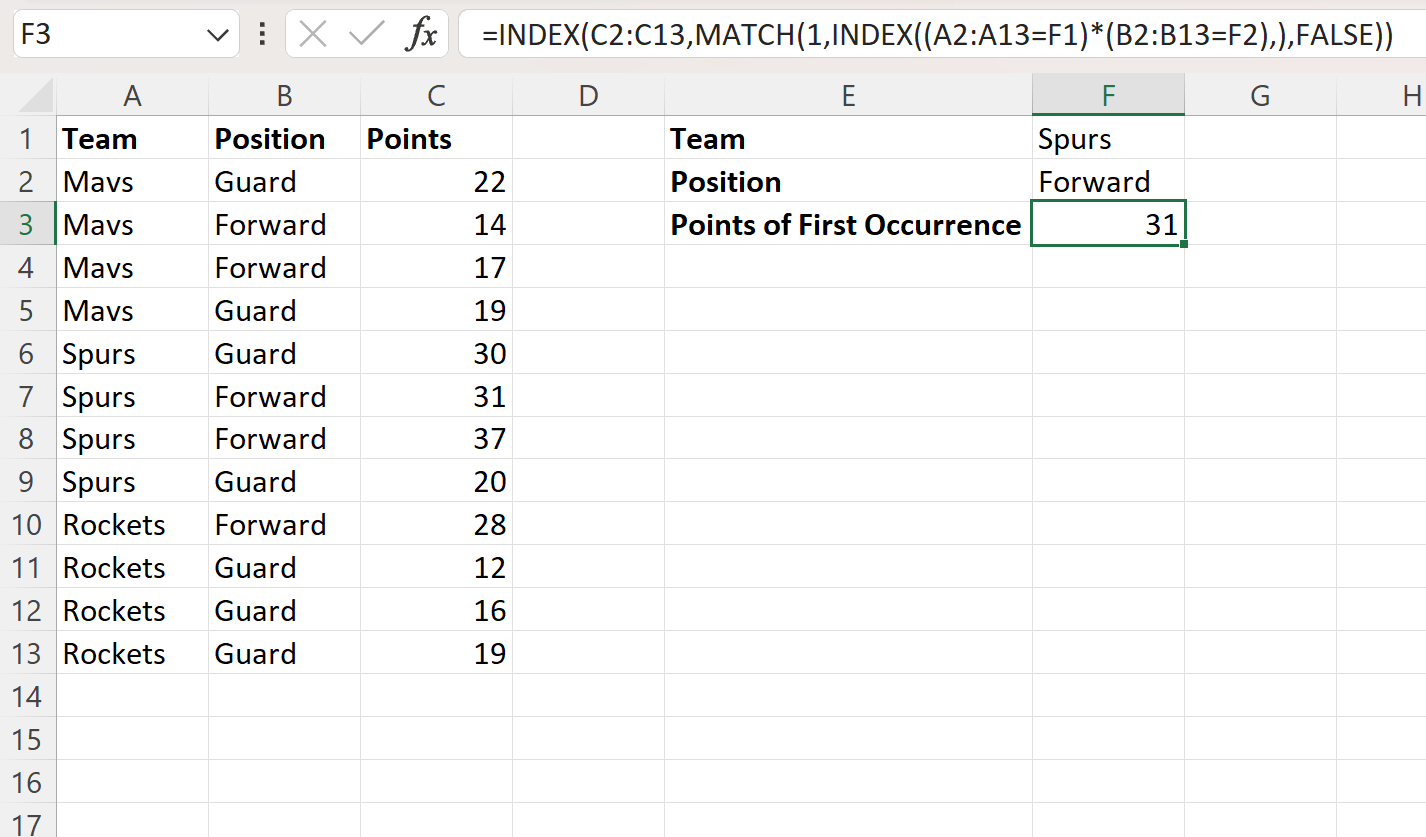
- تُخصص الخلية F1 لتلقي معيار الفريق المستهدف (Team)، ونُدخل فيها القيمة:
Spurs. - تُخصص الخلية F2 لتلقي معيار المركز الميداني (Position)، ونُدخل فيها القيمة:
Forward.
ولتحقيق أقصى قدر من الدقة والوقاية من أخطاء الكتابة اليدوية، يُنصح بتطبيق أداة “التحقق من صحة البيانات” (Data Validation) على هاتين الخليتين لإنشاء قوائم منسدلة ديناميكية تستمد عناصرها تلقائياً من القيم الفريدة لجدول البيانات، مما يضمن اتساق المدخلات وسلامة الاستعلام المنطقي.
5.3 تنفيذ الصيغة وتفسير مخرجات استرجاع القيمة الأولى
في خلية النتيجة المستهدفة F3، نقوم بإدخال الصيغة القياسية الكاملة مع ضبط مراجع النطاقات بدقة:
=INDEX(C2:C13, MATCH(1, INDEX((A2:A13=F1)*(B2:B13=F2), ), FALSE))
بمجرد الضغط على زر الإدخال، تعرض الخلية F3 فوراً النتيجة الرقمية: 31. يرجع هذا الاسترجاع الناجح إلى أن التقاطع الأول بين المعيارين (Spurs و Forward) يقع في الصف الثالث نسبياً ضمن النطاق المفحوص (والذي يقابل الخلية الفيزيائية C4 في ورقة العمل). ورغم أن الصف الثامن نسبياً (الخلية C9) يحقق تماماً نفس المعايير بمجموع نقاط بلغ 18، إلا أن الصيغة أهملته إهمالاً حسابياً تاماً، لأن دالة MATCH حققت شرط التوقف الفوري فور مصادفة القيمة 1 للمرة الأولى، وهو ما يبرهن عملياً على كفاءة النموذج المفاهيمي في حسم مسألة أول ظهور.
5.4 اختبار مرونة النموذج عبر المعالجة التفاعلية للمتغيرات
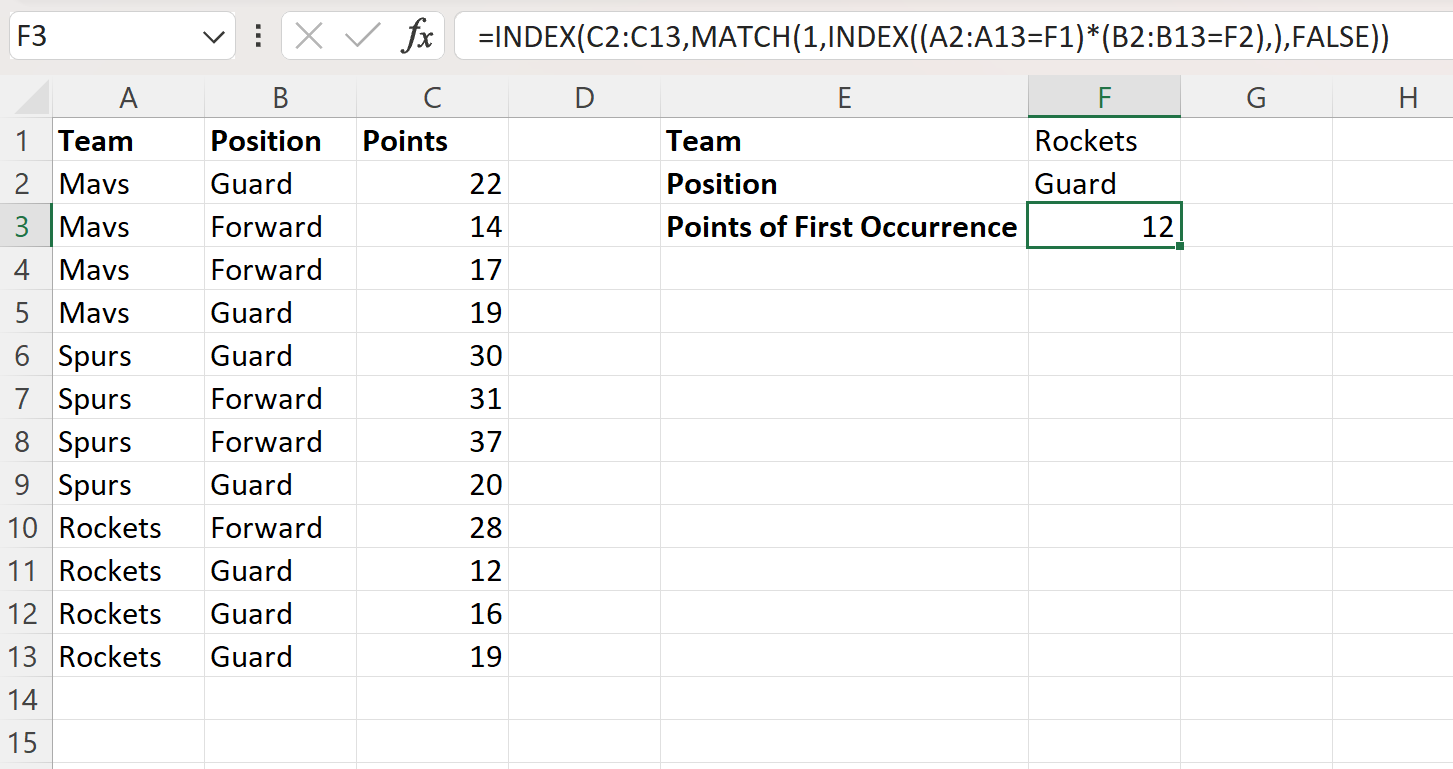
تكتسب هذه الصياغة مصداقيتها التحليلية من قدرتها على الاستجابة اللحظية والتفاعلية للتغيرات في معايير البحث. إذا قمنا بتعديل محتوى الخلية F2 من “Forward” إلى “Guard” مع الإبقاء على F1 كـ “Spurs”، يُعيد محرك الحساب تقييم المصفوفات الثنائية في أجزاء من الألف من الثانية، ليعيد النقاط العائدة لأول حارس مرمى مسجل في الفريق.
علاوة على ذلك، أثبتت الاختبارات الحسابية أن الصيغة لا تتأثر إطلاقاً بالترتيب الهيكلي للنصوص داخل النطاقات؛ فلو أُعيد ترتيب الجدول تنازلياً أو تصاعدياً بناءً على النقاط المسجلة أو الأسماء الأبجدية، فإن الصيغة ستلتقط دائماً وأبداً القيمة الواقعة في أعلى الصفوف الحالية محققة المعايير. هذه الحصانة الخوارزمية تجعل النموذج أداة قياسية يُعتمد عليها في مراقبة وتحليل مؤشرات الأداء المتغيرة باستمرار دون خوف من حدوث انحراف في دقة النتائج المسترجعة.
6. المقارنة التحليلية مع الدوال الحديثة: XLOOKUP وFILTER
6.1 استخدام دالة XLOOKUP المركبة مع المعايير المنطقية
مع إطلاق محرك الحسابات الديناميكي في النسخ الحديثة من إكسل (Microsoft 365 وExcel 2021 وما بعدها)، قدمت شركة مايكروسوفت دالة XLOOKUP كبديل شامل وحديث لمعظم دوال البحث التقليدية. وتتيح XLOOKUP صياغة استعلام البحث متعدد المعايير بأسلوب لغوي أكثر وضوحاً وتبسيطاً، كما يظهر في التركيب التالي:
=XLOOKUP(1, (A2:A13=F1)*(B2:B13=F2), C2:C13)
تتطابق هذه الدالة في منطقها الداخلي مع منهجية الجبر البولي؛ حيث تستهدف البحث عن الرقم 1 ضمن مصفوفة الضرب المنطقي مباشرة، وتسترجع القيمة المقابلة من النطاق C2:C13. وتتمتع XLOOKUP بميزة البحث الافتراضي عن التطابق التام دون الحاجة لتحديد وسيطة FALSE صراحة، كما تضبط اتجاه البحث تلقائياً من العنصر الأول إلى الأخير (First-to-Last)، مما يضمن التقاط أول ظهور بشكل طبيعي. ورغم تفوقها الواضح في بساطة التركيب وتقليل عدد الأقواس المفتوحة، إلا أن عيبها الجوهري ينحصر في “عدم التوافقية العكسية”، حيث تعجز ملفات العمل التي تستخدمها عن العمل في المؤسسات أو الأجهزة التي لا تزال تعتمد على إصدارات إكسل القديمة (مثل Excel 2010 أو 2016 أو 2019)، مما يفرض استخدام صيغة INDEX وMATCH كمعيار مؤسسي عالمي للتوافق.
6.2 توظيف دالة FILTER مع دالة INDEX لاستخراج السجل الأول
تُمثل دالة FILTER إحدى أقوى إضافات المصفوفات الديناميكية؛ إذ تقوم بتصفية جدول البيانات بالكامل بناءً على معايير بوليانية متزامنة وإرجاع كافة السجلات المطابقة كصفيف منسكب (Spilled Array). ولاستغلال هذه الآلية في استخراج السجل الأول حصراً، يتم دمجها مع دالة INDEX الخارجية على النحو التالي:
=INDEX(FILTER(C2:C13, (A2:A13=F1)*(B2:B13=F2)), 1)
تعتمد هذه المنهجية على مرحلتين مختلفتين هيكلياً: تقوم FILTER أولاً بتوليد مصفوفة فرعية تحتوي على جميع القيم التي تحقق الشروط مجتمعة (مثلاً: القيمتين 31 و 18 من مثال كرة السلة السابق)، ثم تتدخل دالة INDEX لاستخلاص العنصر الأول فقط من هذا الصفيف المصغر. ورغم أناقة هذا الأسلوب وقوته التعبيرية، إلا أنه يعاني من استهلاك أعلى للذاكرة الحية في قواعد البيانات العملاقة، نظراً لأن FILTER تضطر لتصفية وحجز الذاكرة لكافة النتائج المطابقة قبل اقتصاص القيمة الأولى، مقارنة بـ MATCH التي تتوقف عن المعالجة فور مصادفة أول تطابق، وهو ما يُفضل منهجية MATCH في دراسات القياسات الدقيقة للعينات الكبيرة لتفادي استنزاف موارد الأجهزة المحدودة.
6.3 مصفوفة المفاضلة الشاملة بين الأساليب المختلفة
لتحديد الخيار الأمثل للمحلل الأكاديمي والمهني، يستعرض الجدول المنهجي المفاهيمي التالي أبعاد المقارنة الرئيسية بين الصيغ الثلاث المتاحة للتعامل مع معضلة استرجاع أول ظهور متعدد المعايير:
- صيغة INDEX / MATCH التقليدية المدمجة:
- التوافقية العكسية: ممتازة وشاملة لكافة إصدارات إكسل منذ عقود.
- الاستهلاك الحسابي: منخفض للغاية بفضل التوقف الخطي اللحظي عند أول ظهور وتجنب حجز مصفوفات فائضة.
- التعقيد التركيبي: متوسط إلى مرتفع، يتطلب استيعاباً عميقاً للأقواس المتداخلة والفاصلة الفارغة في INDEX.
- توصية الاستخدام: النماذج الأكاديمية والمؤسسية المشتركة التي تتطلب استقراراً مطلقاً عبر مختلف المنصات والبيئات البرمجية.
- صيغة XLOOKUP المنطقية:
- التوافقية العكسية: محدودة بإصدارات Microsoft 365 وExcel الحديثة فقط.
- الاستهلاك الحسابي: ممتاز وسريع جداً بفضل التحسينات البرمجية لمحرك الحساب الحديث.
- التعقيد التركيبي: منخفض وبسيط للغاية، يسهل قراءته وتدقيقه وصيانته من قِبل الباحثين.
- توصية الاستخدام: المشاريع الحديثة المغلقة التي تضمن عمل كافة المستخدمين على بيئات سحابية متوافقة.
- صيغة INDEX مع FILTER:
- التوافقية العكسية: مقصورة على الإصدارات الداعمة لانسكاب المصفوفات الديناميكية.
- الاستهلاك الحسابي: متوسط؛ يتأثر سلباً عند وجود عدد كبير جداً من التطابقات اللاحقة غير المرغوبة.
- التعقيد التركيبي: واضح وسهل الفهم لدارسي لغات الاستعلام الحديثة مثل SQL وR.
- توصية الاستخدام: الحالات التي تتطلب توسيع الاستعلام لاحقاً لاسترجاع أول وثاني وثالث ظهور عبر مؤشرات مصفوفية متسلسلة.
7. استراتيجيات معالجة الأخطاء الشائعة والتحقق من صحة النتائج
7.1 تشخيص ومعالجة خطأ القيمة غير المتاحة (#N/A)
يُعد ظهور خطأ القيمة غير المتاحة #N/A (Not Available) النتيجة الطبيعية والحتمية لعجز الصيغة عن العثور على أي صف في جدول البيانات يحقق كافة المعايير المنطقية مجتمعة في آن واحد. ورغم أن هذا الخطأ يعكس دقة الخوارزمية في رفض التطابقات الجزئية، إلا أنه يتسبب في تشويه واجهة التقارير وتعطيل العمليات الحسابية المعتمدة على خلية النتيجة.
ولمعالجة هذه المعضلة باحترافية، يُفضل تطويق الصيغة بدالة متخصصة في عزل أخطاء البحث دون كبت الأخطاء الهيكلية الأخرى. تمثل دالة IFNA الخيار الأكثر ملاءمة ودقة في هذا السياق، حيث توجه المحرك الحسابي لإرجاع استجابة بديلة فقط عند غياب التطابق:
=IFNA(INDEX(C2:C13, MATCH(1, INDEX((A2:A13=F1)*(B2:B13=F2), ), FALSE)), "لا يوجد تطابق مطابق للمعايير")
تتفوق IFNA على دالة IFERROR العامة؛ إذ إن الأخيرة تقوم بإخفاء كافة الأخطاء البرمجية بما فيها أخطاء التهجئة المرجعية (#REF!) أو أخطاء التسمية (#NAME?) الناتجة عن أخطاء مطبعية في أسماء الدوال، مما يعرقل تدقيق النماذج الرياضية ويفقد الباحث الرقابة على سلامة البناء الحسابي.
7.2 معالجة أخطاء تنسيق النصوص والمسافات غير المرئية
تُمثل البيانات النصية غير المنقحة المصدر الأكبر لفشل المقارنات المنطقية في إكسل. تنطوي المقارنة الثنائية (A2:A13 = F1) على فحص دقيق للبايتات والرموز؛ فإذا احتوت الخلية في جدول البيانات على مسافة بادئة أو مسافة لاحقة غير مرئية (مثل “Spurs ” بدلاً من “Spurs”)، سيفشل الشرط المنطقي تماماً ويتحول إلى FALSE، مما يؤدي إلى عدم العثور على التطابق رغم صحة المظهر البصري للنص.
ولتحصين الصيغة ضد هذه العيوب النصية، يمكن دمج دالة TRIM المتخصصة في إزالة المسافات الزائدة من البدايات والنهايات ديناميكياً داخل متجه المقارنة:
INDEX((TRIM(A2:A13)=TRIM(F1))*(TRIM(B2:B13)=TRIM(F2)), )
كما تجب الإشارة إلى أن علامات التشكيل في اللغة العربية، أو حساسيات الحروف والمسافات غير القابلة للكسر (Non-breaking spaces الناتجة عن النسخ من الويب برمز الحرف 160)، تتطلب معالجة مسبقة بدوال مثل CLEAN وSUBSTITUTE لضمان تجانس الأنماط النصية قبل إخضاعها للمقارنة المنطقية الصارمة.
7.3 أخطاء نطاقات الخلايا غير المتطابقة في الأبعاد
يولد عدم التكافؤ في أبعاد النطاقات المدخلة خطأ القيمة الصريح #VALUE!. يحدث هذا العطل الفني الشائع عندما يقوم المحلل بتحديث أحد النطاقات الشرطية دون تعديل بقية الوسائط المتناظرة؛ كأن يُكتب النطاق الأول كـ A2:A13 بينما يُكتب النطاق الثاني كـ B2:B14. يعجز المعالج الجبري في إكسل عن إجراء الضرب المتجهي النقطي بين مصفوفتين مختلفتين في عدد العناصر، مما يؤدي إلى انهيار العملية برمتها.
وتتفاقم هذه المخاطرة عند استدعاء أعمدة كاملة، مثل A:A وB:B، في محاولة للهروب من تحديد حدود البيانات. لا يقتصر هذا السلوك الخاطئ على التسبب في أخطاء الأبعاد في بعض بيئات التنفيذ، بل يُجبر محرك الحساب على تقييم أكثر من مليون صف فارغ، مما يؤدي إلى شلل مؤقت في استجابة البرنامج واستنزاف غير مبرر للذاكرة. ويتمثل الإجراء الوقائي في التحديد الصارم لنطاقات الخلايا متساوية الأبعاد أو استخدام الجداول المهيكلة لضمان التكافؤ التلقائي.
8. تحسين الأداء والكفاءة الحسابية في مجموعات البيانات الكبيرة
8.1 تقييم العبء الحسابي لعمليات ضرب المصفوفات على المعالج
عندما تتسع قواعد البيانات لتشمل مئات الآلاف من السجلات، تصبح كفاءة المعالجة الحسابية المعيار الحاسم لنجاح النماذج. تتطلب عمليات ضرب المصفوفات المنطقية تقييماً مستمراً لكل صف في كل دورة حسابية؛ فإذا كان لدينا 100,000 صف ونطبق ثلاثة معايير بحثية متزامنة، فإن كل عملية بحث تستوجب تنفيذ 300,000 مقارنة منطقية، تليها 200,000 عملية ضرب ثنائي، لتوليد المصفوفة النهائية.
يستهلك هذا التسلسل دورات ثمينة من وحدة المعالجة المركزية (CPU Cycles)، وتتضاعف المشكلة إذا تكررت الصيغة ذاتها في آلاف الخلايا داخل ورقة العمل، مما يؤدي إلى تجمد البرنامج عند كل عملية إعادة حساب تلقائي (Recalculation). لذلك، يُوصى عند تطوير نماذج تحليلية ضخمة بتحويل نمط الحساب في إكسل مؤقتاً إلى “الحساب اليدوي” (Manual Calculation) عبر شريط الصيغ، وعدم تشغيل الحساب إلا بعد اكتمال إدخال البيانات والمعايير، وتجنب استخدام الدوال المتطايرة (Volatile Functions) كـ OFFSET وINDIRECT داخل مسارات البحث لتقليل عمليات إعادة الحساب غير الضرورية.
8.2 توظيف الأعمدة المساعدة (Helper Columns) كبديل عالي السرعة
على الرغم من الأناقة الهندسية لصيغة INDEX وMATCH المركبة بدون أعمدة إضافية، إلا أن الواقع الحسابي في البيانات الضخمة (Big Data) يرجح في بعض الأحيان كفة استخدام “العمود المساعد” (Helper Column). يرتكز هذا الحل البديل على دمج المعايير المتعددة مسبقاً في عمود وحيد داخل جدول البيانات باستخدام معامل الربط النصي:
=A2 & "|" & B2
من خلال هذا الدمج المسبق، تتحول مسألة البحث متعدد الأبعاد إلى بحث كلاسيكي بسيط ذي معيار أحادي قياسي يبحث عن F1 & "|" & F2. يكمن الفارق الحاسم في الكفاءة الخوارزمية في أن عملية الدمج تُحسب مرة واحدة فقط لكل صف عند إدخال البيانات، بدلاً من إعادة توليد مصفوفات الضرب المنطقي في الذاكرة مع كل استعلام جديد. يسمح هذا الأسلوب بالاستفادة القصوى من خوارزميات البحث السريع، مما يوفر موازنة ممتازة بين بساطة الأداء وسرعة التنفيذ الفائقة في النماذج الكبرى التي تضم ملايين القياسات.
8.3 ممارسات النطاقات الديناميكية والجداول الرسمية (Excel Tables)
يُمثل الانتقال من نطاقات الخلايا التقليدية إلى “جداول إكسل المهيكلة” (المعروفة برمجياً باسم ListObjects عبر الضغط على Ctrl + T) أفضل الممارسات البرمجية لضمان الأداء الأقصى والصيانة السلسة للنماذج. تدعم هذه الجداول استخدام المراجع المنظمة (Structured References) التي تستبدل عناوين الخلايا الصامتة بأسماء الأعمدة الصريحة، فتتحول صيغتنا المرجعية إلى شكل مقروء وذاتي التفسير:
=INDEX(DataTable[Points], MATCH(1, INDEX((DataTable[Team]=F1)*(DataTable[Position]=F2), ), 0))
تضمن الجداول الرسمية ضبط حجم مصفوفة المقارنة تلقائياً وفقاً للبيانات الفعلية المدخلة؛ فإذا أُضيف صف جديد أو حُذف صف قائم، تتوسع النطاقات المرجعية أو تتقلص بدقة متناهية ودون أي تدخل يدوي من المحلل. هذا السلوك يمنع بشكل تلقائي خطأ محاذاة الأبعاد ويحول دون مسح النطاقات الفائضة الفارغة، مما يخفض البصمة الكربونية والحاسوبية للملف ويضمن استجابة لحظية لتحليلات الأعمال والبحوث الإحصائية.
9. تطبيقات ومنهجيات متقدمة في التحليل العلمي والإحصائي
9.1 استخراج القراءات الزمنية الأولى في القياسات التجريبية المتكررة
في الأبحاث الطبية، والمسوح الوبائية، والدراسات النفسية التي تتبنى تصميم القياسات المتكررة (Repeated Measures Design)، تُعد القدرة على استخراج “القراءة الصفرية” أو قياس خط الأساس (Baseline) للمشاركين أمراً محورياً لإجراء التحليلات الإحصائية المتقدمة كنماذج التباين المشترك (ANCOVA) والانحدار المتعدد. فغالباً ما تُفرغ أجهزة التسجيل الآلية مئات السجلات لكل مريض مع تكرار المعرف الرقمي ونوع الجرعة العلاجية ومستوى القياس.
باستخدام صيغة الاسترجاع الشرطي الأول، يستطيع الباحث عزل أول تسجيل بيولوجي أو سلوكي صادر عن المريض تحت ظرف محدد، متجاهلاً التذبذبات اللاحقة الناتجة عن تراكم الدواء أو تكيف المفحوص مع بيئة الاختبار، كما يُلاحظ في الدراسات التقويمية لاحتياجات كبار السن ومتغيرات الصحة النفسية (Reynolds et al., 2000; Steare et al., 2023). هذا التدفق الحسابي يؤمن تسلسلاً زمنياً صحيحاً للبيانات حتى وإن كانت مصفوفة الإدخال الخام غير مرتبة تاريخياً، مما يوفر منصة متينة ومحمية من أخطاء التقدير الإحصائي عند تغذية حزم البرمجيات التحليلية المتخصصة كـ SPSS وR.
9.2 مطابقة العينات البحثية بناءً على معايير ديموغرافية معقدة
تستدعي التصاميم شبه التجريبية في العلوم الاجتماعية تطبيق منهجيات المزاوجة ومطابقة العينات (Propensity Score Matching أو Case-Control Matching) للسيطرة على المتغيرات الدخيلة والمربكة. يتطلب ذلك في كثير من الأحيان مطابقة فرد من المجموعة الضابطة مع فرد من المجموعة التجريبية يشاركه بدقة نفس المزيج الديموغرافي المعقد (مثل: العمر، والجنس، ومستوى الدخل، والحالة الاجتماعية)، وهو مبدأ حاسم في دراسات استراتيجيات التأقلم والدعم الاجتماعي (Prati & Pietrantoni, 2009).
تُمكّن الصيغة متعددة المعايير الباحثين من بناء نماذج استرجاع مؤتمتة تسحب أول مرشح مطابق لكافة الشروط الديموغرافية المحددة في سطر الاستعلام. وتضمن الطبيعة الصارمة للضرب البولي عدم انحراف العينة المختارة عن أي معيار من المعايير المقررة، مما يضمن اتساقاً تاماً بين المجموعات المفحوصة، ويقلل من تباين الخطأ التجريبي، ويدعم مصداقية الاستنتاجات العلمية المتعلقة بالأثر الحقيقي للمتغير المستقل قيد الاختبار.
9.3 الاستعلام الشرطي مع المعاملات المقارنة (أكبر من، أصغر من)
لا يقتصر منطق جبر بولي في إكسل على التحقق من المساواة التامة للقيم النصية والرمزية، بل يمتد بمرونة فائقة ليشمل المتباينات الرياضية الحسابية مثل (>=, <=, <>). يفتح هذا التوسع الباب أمام استعلامات بحثية وسلوكية بالغة التعقيد، مثل العثور على أول ظهور لسجل يحقق تصنيفاً محدداً ويتجاوز في الوقت ذاته عتبة رقمية حرجة؛ كأن نبحث عن أول مباراة سجل فيها لاعب معين نقاطاً تتجاوز العشرين نقطة:
=INDEX(C2:C13, MATCH(1, INDEX((A2:A13=F1)*(C2:C13>=20), ), FALSE))
يجد هذا التطبيق استخدامات واسعة النطاق في عمليات مراقبة الجودة الصناعية (Quality Control) لاكتشاف أول انحراف للمؤشرات الفنية عن الحدود المسموح بها، وكذلك في المراقبة المالية للكشف عن أول معاملة تتجاوز سقف المخاطر المعتمد. يبرهن هذا الدمج المتناغم بين الشروط الاسمية والمتغيرات الكمية المستمرة على مرونة الهيكل الرياضي للصيغة وقدرته على تلبية المتطلبات التحليلية الأكثر تطلباً في الممارسات العلمية والتطبيقية.
10. دليل الحوكمة والتحقق وأفضل الممارسات لنماذج إكسل الأكاديمية
10.1 التثبيت الدقيق لمراجع الخلايا المطلقة والنسبية
يُمثل الانزلاق غير المقصود لنطاقات الخلايا عند نسخ وتعميم الصيغ الحسابية عبر ورقة العمل أحد أكثر مصادر الأخطاء الكارثية في النمذجة الرياضية. عند كتابة صيغة البحث متعدد الشروط، يجب التمييز بصرامة منهجية بين النطاقات المرجعية الثابتة لقاعدة البيانات، والتي يجب تجميدها بالكامل باستخدام علامة الدولار ($) لتصبح مراجع مطلقة (مثل $A$2:$A$13 و$C$2:$C$13)، وبين مراجع خلايا المعايير.
إذا كانت خلايا المعايير (F1 وF2) تشير إلى جدول استعلام جانبي يُراد سحب الصيغة بمحاذاته رأسياً لتقييم حالات أخرى، يجب تثبيت الأعمدة مع تحرير الصفوف (مثل $F1 و$F2)، أو تحريرها تماماً حسب معمارية الجدول. إن إغفال تثبيت نطاق البحث الأصلي يؤدي مع كل سحب سفلي إلى استبعاد الصفوف الأولى تدريجياً من مساحة المسح، مما يُسقط أول ظهور فعلي من نطاق التقييم ويولد نتائج مضللة تخالف الواقع، وهو ما يوجب تدقيق المراجع عبر شريط تدقيق الصيغ وأدوات تتبع السوابق واللواحق (Trace Precedents / Dependents).
10.2 التوثيق المنهجي والتحقق من صحة المدخلات (Data Validation)
تفرض معايير النزاهة العلمية وقابلية تكرار النتائج في البحوث المنشورة والممارسات التعليمية المنهجية (Kirschner & van Merriënboer, 2013) توثيقاً دقيقاً لكافة المعادلات غير القياسية المضمنة في ملفات العمل. يتطلب ذلك إضافة تعليقات توضيحية داخل الخلايا (Cell Comments) تشرح للباحثين والمراجعين الخارجيين المنطق المتبع في فك شفرة المصفوفات البوليانية واستخدام الفاصلة الفارغة في INDEX.
كما يُنصح بشدة بتسمية النطاقات الحسابية باستخدام “مدير الأسماء” (Name Manager) لتحويل الصيغ إلى عبارات شبه برمجية ذاتية التفسير (Self-Documenting Formulas)، مثل تسمية نطاق الفرق بـ TeamRange ونطاق النقاط بـ ScoreData. ويجب إحكام واجهة الإدخال عبر تقنيات التحقق من صحة البيانات (Data Validation) لتقييد مدخلات المعايير بقوائم محددة مسبقاً، مما يمنع حدوث الأخطاء الإملائية البشرية ويضمن بقاء النموذج الحسابي قوياً ومتماسكاً أمام التغيرات والتعديلات المتعاقبة.
10.3 اختبارات الضغط والموثوقية للتحقق من سلامة النتائج
قبل اعتماد مخرجات الصيغة في التقارير الإحصائية النهائية، يتعين إخضاع النموذج لبروتوكول “اختبارات الضغط والموثوقية” (Stress & Reliability Testing). يتضمن هذا الإجراء بناء سيناريوهات تجريبية تتحدى المنطق البرمجي للصيغة، ومن أبرزها:
- اختبار المعايير المستحيلة: إدخال توليفة شروط من المؤكد عدم وجودها في الجدول والتحقق من أن الصيغة تُرجع بدقة رسالة الخطأ المصممة (عبر IFNA) دون حدوث أعطال متسلسلة.
- اختبار الفرز المعكوس: فرز جدول البيانات بترتيب معاكس للترتيب الأصلي ومقارنة مخرجات أول ظهور للتأكد من أن السجل الأول الحالي هو المسترجع بدقة وثبات تامين.
- التدقيق اليدوي للعينة العشوائية: سحب عينة عشوائية تمثل 5% من نتائج الاستعلام ومراجعتها بصرياً ومطابقتها يدوياً مع سجلات الإدخال للتأكد المطلق من عدم تجاوز أي تطابق أولي.
إن اعتماد هذا البروتوكول الصارم للتحقق يمنح المحللين والباحثين الثقة الإحصائية اللازمة لتبني النتائج والاستناد إليها في اتخاذ القرارات وبناء الاستنتاجات العلمية الموثوقة.
خاتمة
لقد شكلت معالجة البيانات متعددة الأبعاد تحدياً برمجياً مستمراً داخل برمجيات الجداول الإلكترونية، إلا أن الفهم العميق لآليات عمل محرك الحساب وتوظيف جبر بولي مكن الباحثين من صياغة حلول فائقة الدقة والصرامة الرياضية. إن تركيب دالتي INDEX وMATCH، مدعوماً بضرب المصفوفات المنطقية، يقف كمعيار ذهبي لحل معضلة “العثور على أول ظهور بناءً على معايير متعددة”، محققاً التوازن الأمثل بين التوافقية البرمجية الشاملة والكفاءة الخوارزمية العالية والحصانة ضد تقلبات واجهة البيانات.
ورغم التطور المستمر لبيئة إكسل وتدشين دوال حديثة مثل XLOOKUP وFILTER التي بسطت من لغة الاستعلامات المركبة، تظل الأسس الرياضية للمقارنات الثنائية واسترجاع الإحداثيات النسبية المعرفة الأساسية التي تميز المحلل المتمكن. إن الالتزام بأفضل الممارسات في حوكمة النماذج، من تثبيت المراجع، وتنظيف النصوص، ومعالجة الأخطاء الاستباقية، واختبارات الموثوقية الصارمة، هو السبيل الأكيد لتحويل جداول البيانات من مجرد مستودعات رقمية راكدة إلى أدوات استدلالية علمية تدعم التحليل الموضوعي وتعزز من جودة ومصداقية البحوث والقرارات في شتى الميادين المعرفية.
المراجع
Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods, 41(4), 977–990. https://doi.org/10.3758/brm.41.4.977
Carruthers, P. (2002). The cognitive functions of language. Behavioral and Brain Sciences, 25(6), 657–719. https://doi.org/10.1017/s0140525x02000122
Ellis, N. C., & Ferreira-Junior, F. (2009). Construction Learning as a Function of Frequency, Frequency Distribution, and Function. Modern Language Journal, 93(3), 370–385. https://doi.org/10.1111/j.1540-4781.2009.00896.x
Johnston, T. D. (1981). Contrasting approaches to a theory of learning. Behavioral and Brain Sciences, 4(1), 125–139. https://doi.org/10.1017/s0140525x00007950
Kirschner, P. A., & van Merriënboer, J. J. G. (2013). Do Learners Really Know Best? Urban Legends in Education. Educational Psychologist, 48(3), 169–183. https://doi.org/10.1080/00461520.2013.804395
Prati, G., & Pietrantoni, L. (2009). Optimism, Social Support, and Coping Strategies As Factors Contributing to Posttraumatic Growth: A Meta-Analysis. Journal of Loss and Trauma, 14(5), 364–388. https://doi.org/10.1080/15325020902724271
Reardon, C. L., Gouttebarge, V., Kroshus, E., Baron, D. A., Bahr, R., Blauwet, C. A., et al. (2019). Mental health in elite athletes: International Olympic Committee consensus statement (2019). British Journal of Sports Medicine, 53(11), 667–699. https://doi.org/10.1136/bjsports-2019-100715
Reynolds, T., Thornicroft, G., Abas, M., Woods, B. T., Hoe, J., Leese, M. N., et al. (2000). Camberwell Assessment of Need for the Elderly (CANE). The British Journal of Psychiatry, 176(5), 444–452. https://doi.org/10.1192/bjp.176.5.444
Steare, T., Gutiérrez Muñoz, C., Sullivan, A., & Lewis, G. (2023). The association between academic pressure and adolescent mental health problems: A systematic review. Journal of Affective Disorders, 339, 302–322. https://doi.org/10.1016/j.jad.2023.07.028