
يمثل تحليل البيانات الرقمية في عصر المعلومات ركيزة أساسية لصناعة القرار المؤسسي والأكاديمي، حيث تتطلب النماذج التحليلية المتقدمة تنقية مستمرة وتجريداً دقيقاً للمدخلات المتراكمة. وفي بيئات جداول البيانات الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، يشكل التمييز بين المدخلات المتكررة والظهور الأول لكل عنصر مسألة جوهرية تحكم دقة المعالجات الإحصائية والنمذجة الرياضية. إن القدرة على تعقب وتسجيل النقطة الزمنية أو المكانية التي يبرز فيها مُعامل أو متغير للمرة الأولى ليست مجرد تفضيل تنظيمي، بل هي ضرورة هيكلية لفرز الكيانات الفريدة، وإعادة هيكلة مصفوفات البيانات الضخمة، وضمان خلو العينات التجريبية من الانحياز الناتج عن التكرار غير المبرر.
تتعدد التطبيقات التي تستدعي تحديد الظهور الأول للقيمة؛ بدءاً من معالجة البيانات التجريبية في أبحاث القياس السلوكي والعلوم المعرفية—مثل عزل أول استجابة حسية للمفحوص في تجارب زمن الرجع (Reaction Time) أو تحديد أول نقطة تثبيت بصرية في سجلات تتبع حركة العين—وصولاً إلى النماذج المالية واللوجستية التي تتطلب تتبع أول معاملة تجارية للعميل أو أول توريد لمادة خام ضمن سلاسل الإمداد. إن غياب آلية محكمة لفرز وتصنيف هذا الظهور يفتح الباب أمام تشوهات إحصائية جسيمة، من شأنها تضخيم أحجام العينات الافتراضية والتأثير سلباً على حساب المتوسطات التراكمية والانحرافات المعيارية الممثلة للظواهر المدروسة.
يتناول هذا الدليل الشامل والمعمق الأبعاد النظرية والتطبيقية لتقنيات العثور على أول ظهور لقيمة في عمود بيانات داخل برنامج إكسل. سنستعرض البنية الخوارزمية للدوال التقليدية والحديثة، ونفكك الأساس الرياضي للمراجع المتوسعة، ونقارن بين الكفاءة الحسابية لمنهجيات العد والمطابقة، بالإضافة إلى دراسة معمقة لمعالجة الأخطاء الهيكلية وتحسين الأداء عند التعامل مع مصفوفات ضخمة تتجاوز مئات الآلاف من الصفوف، مدعومة بإرشادات حوكمة البيانات وأتمتة العمليات لضمان أقصى درجات النزاهة التحليلية.
1. المدخل المفاهيمي لتحديد الظهور الأول للقيم في جداول البيانات
1.1 أهمية تمييز السجلات الفريدة في معالجة البيانات الضخمة
في إطار علم البيانات وهندسة المعلومات، يُعد التمييز بين السجل الأولي ومكرراته اللاحقة الفارق الجوهري بين تحليل البيانات الخام والبيانات المهيكلة الصالحة للاستدلال. عندما تتدفق البيانات من مصادر متعددة كأنظمة التتبع الآلي أو استطلاعات الرأي الطولية، تتكدس السجلات بتكرارات حتمية. إن إبقاء هذه التكرارات دون تعليم أو تصنيف يؤدي إلى ما يُعرف بخلل التمثيل النسبي؛ حيث تكتسب المتغيرات المتكررة وزناً إحصائياً مصطنعاً يغير من خصائص التوزيع التكراري للبيانات، مما يقود الباحث إلى استنتاجات مضللة حول النزعة المركزية والتشتت.
من الناحية المنهجية، يتيح عزل الظهور الأول للقيم ضبطاً صارماً لسلامة النماذج التحليلية. فعلى سبيل المثال، عند بناء نماذج التنبؤ أو مصفوفات الارتباط، يجب أن تقتصر بعض المعاملات على القياس القاعدي الأول (Baseline Measurement) لتفادي الارتباط الذاتي للأخطاء. كما يسهم تحديد الكيان الفريد في تأسيس مفاتيح الربط العلائقي الأولية (Primary Keys) اللازمة لدمج الجداول وتطبيع قواعد البيانات المنبثقة عن جداول البيانات المسطحة، مما يحسن من كفاءة استرجاع المعلومات ويوحد لغة التخاطب بين الأنظمة التحليلية المختلفة.
إضافة إلى ذلك، يلعب هذا الإجراء دوراً محورياً في الحسابات التراكمية وحساب معدلات التحول والانتشار؛ إذ إن قياس زمن البقاء أو تكرار الأحداث يتطلب نقطة إسناد صفرية ثابتة تتمثل في لحظة الظهور الأول للمتغير داخل السلسلة الزمنية. وبدون هذه العلامة، تصبح النماذج الرياضية عاجزة عن التفريق بين الحدث التأسيسي والتوابع العرضية، مما يقوض الاعتمادية العلمية للمخرجات الإحصائية برمتها.
1.2 التحديات الهيكلية في تعقب التكرارات داخل الأعمدة الفردية
على الرغم من بساطة المفهوم ظاهرياً، إلا أن التطبيق العملي داخل بيئات الجداول الممتدة يواجه عوائق هيكلية معقدة تنبع من طبيعة البيانات المدخلة وطريقة معالجة البرمجيات للنصوص والأرقام. أول هذه التحديات يتمثل في عشوائية الترتيب الزمني والمنطقي للبيانات؛ ففي كثير من الأحيان، تأتي السجلات مبعثرة وغير مرتبة تسلسلياً بحسب تاريخ الإنشاء، مما يفرض على الخوارزمية فحص السجل الحالي في سياق كل ما سبقه حصراً، دون الاعتماد على افتراض الترتيب المسبق الذي قد تبنى عليه خوارزميات البحث الثنائي السريعة.
يتضاعف هذا التحدي عند التعامل مع مدخلات نصية تحتوي على تباينات غير مرئية للمستخدم البشري، مثل المسافات البيضاء البادئة أو اللاحقة، والحروف ذات المحارف المتعددة، والرموز الخاصة غير المطبوعة الناتجة عن عمليات تصدير البيانات من قواعد بيانات علائقية قديمة. في هذه الحالات، يتعامل محرك المقارنة المنطقية في إكسل مع قيمتين متطابقتين ظاهرياً ككيانين منفصلين تماماً، مما يؤدي إلى فشل رصد التكرار واعتبار المكرر ظهوراً أولاً زائداً عن الحاجة، وهو ما يدمر موثوقية التحليل.
علاوة على ذلك، تقف محدودية الفرز اليدوي والتدقيق البصري حاجزاً لا يمكن تجاوزه عندما تمتد الأعمدة لتشمل مئات الآلاف من الصفوف. فالاعتماد على التحقق البصري ليس فقط مضيعة للجهد ومصدراً مستمراً للخطأ البشري، بل هو غير قابل للتكرار البرمجي (Non-reproducible)، وهو ما يتنافى مع معايير الشفافية والتدقيق الأكاديمي الصارم التي تتطلب صياغة معادلات رياضية مؤتمتة وموثقة تثبت فعاليتها بصرف النظر عن حجم البيانات.
2. التحليل المنطقي والرياضي لصيغة دالة COUNTIF ذات النطاق المتوسع
2.1 بنية النطاق المتوسع وآلية التثبيت النسبي والمطلق
تعد دالة COUNTIF المقترنة بنطاق مرجعي متوسع (Expanding Range) من أكثر الحلول كفاءة وأناقة برمجية لتحديد الظهور الأول لكل عنصر في عمود ما. تعتمد هذه المنهجية على الجمع العبقري بين نوعين من مراجع الخلايا: المرجع المطلق (Absolute Reference) والمرجع النسبي (Relative Reference). يتم تمثيل الصيغة الهيكلية للخلية الأولى في نطاق التحليل بالشكل التالي: $A$2:$A2، حيث يكمن السر الحسابي في استخدام رمز التثبيت ($).
يقوم رمز الدولار في الجزء الأول من النطاق $A$2 بقفل إحداثيات الخلية الابتدائية قفلاً تاماً يشمل العمود ورقم الصف، مما يجعل نقطة انطلاق العد ثابتة لا تتغير مهما تم سحب الصيغة أو نسخها رأسياً إلى الأسفل. في المقابل، يُترك الجزء الثاني من النطاق $A2 بنصف تثبيت للعمود وتحرير كامل لرقم الصف، مما يسمح للطرف النهائي للنطاق بالتمدد التدريجي صفاً بصف بمحاذاة الصف الذي تتم فيه المعالجة الحسابية اللحظية.
من زاوية السلوك الحسابي الداخلي، يبدأ النطاق كخلية مفردة في الصف الأول ($A$2:$A2)، ليمثل قطاع بيانات أحادي البعد يقتصر على مدخل الخلية ذاتها. وعند الانتقال إلى الصف التالي، يتوسع النطاق تلقائياً ليصبح ($A$2:$A3)، شاملاً السجل الحالي وكافة السجلات التي سبقته تاريخياً ومكانياً. هذا التصميم التراكمي يلغي الحاجة إلى فحص العمود بأكمله بصورة شمولية مسبقة، ويحصر نطاق البحث في البيانات المتراكمة زمنياً حتى لحظة الفحص، مما يحاكي تماماً التدفق المنطقي لعمليات المعالجة التتابعية في هندسة البرمجيات.
2.2 المقارنة المنطقية واشتقاق القيم البوليانية
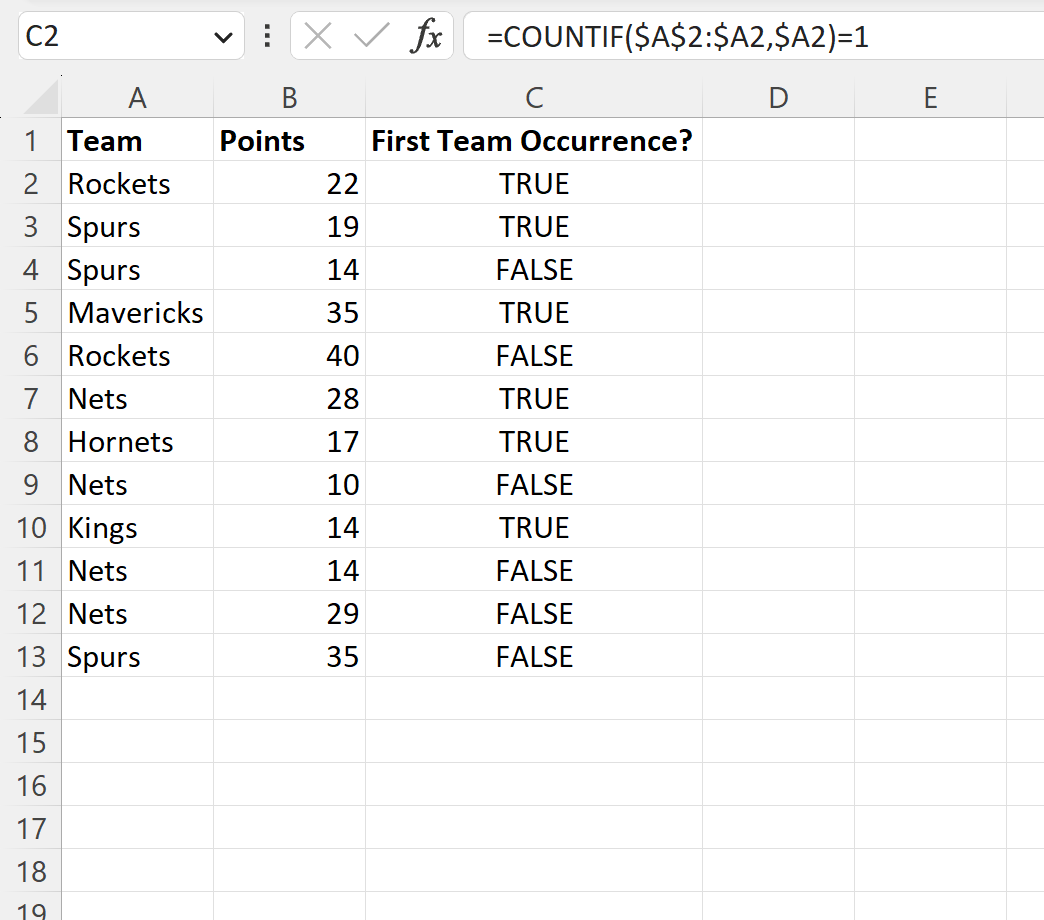
لا تقتصر العملية على مجرد استخدام دالة العد الشرطي، بل تتطلب استخلاص قرار منطقي ثنائي يحسم طبيعة المدخل. يتم ذلك عن طريق صياغة معادلة اختبار منطقي متكاملة تقارن ناتج العد بالقيمة الرقمية واحد: =COUNTIF($A$2:$A2,$A2) = 1. تستند هذه الصياغة إلى الجبر البولياني، حيث تُخضع كل خلية لشرط تحقق كمي صارم.
عندما يصادف محرك الحساب قيمة معينة لأول مرة داخل النطاق المتوسع، فإن دالة COUNTIF تبحث عن تطابق للقيمة $A2 ضمن المجال المحصور بين بداية الجدول والصف الحالي. وبما أن القيمة لم تظهر سابقاً في أي من الصفوف العلوية، فإن ناتج العد التراكمي اللحظي سيكون حتماً مساوياً للرقم (1). في هذه اللحظة بالذات، يتحقق شرط التساوي (1 = 1)، ويُرجع إكسل القيمة المنطقية صواب (TRUE)، وهي العلامة الدالة بيقين قطعي على أن هذا الصف يمثل التواجد الأولي والفريد لهذا المدخل حتى تلك النقطة من المصفوفة.
وعلى العكس من ذلك، إذا تكررت نفس القيمة في صفوف لاحقة (وليكن الصف العاشر مثلاً)، ستقوم الدالة بحساب عدد مرات الظهور داخل النطاق الموسع $A$2:$A10. وستجد الخوارزمية أن القيمة قد ظهرت في الصف الثاني وتكررت الآن في الصف العاشر، فيكون ناتج العد مساوياً للرقم (2) أو أكثر. وعند مطابقة هذا الناتج مع الشرط المنطقي (2 = 1)، يسقط الشرط الرياضي ويُرجع البرنامج تلقائياً القيمة المنطقية خطأ (FALSE). وبذلك تكتسب كل خلية هوية بوليانية دقيقة تعزل الظهور التأسيسي عن كافة التكرارات الفرعية واللاحقة بدقة رياضية متناهية.
3. التطبيق العملي خطوة بخطوة لصيغة القيم المنطقية
3.1 إعداد بيئة العمل وهيكلة الأعمدة التحليلية
يتطلب التنفيذ السليم في بيئة العمل الواقعية إعداداً منهجياً لصفحة البيانات لتفادي التداخل في الحسابات المرجعية وضمان نقاء التحليل. يبدأ ذلك بتحديد العمود المصدري الذي يحتوي على البيانات الخام المراد تنقيتها—سواء كانت رموزاً تعريفية للمشاركين، أو أرقاماً تسلسلية للمنتجات، أو سجلات لنصوص نصية—وضمان وجود ترويسة واضحة ومميزة في الصف الأول (مثل “المعرف” أو “الرمز”).
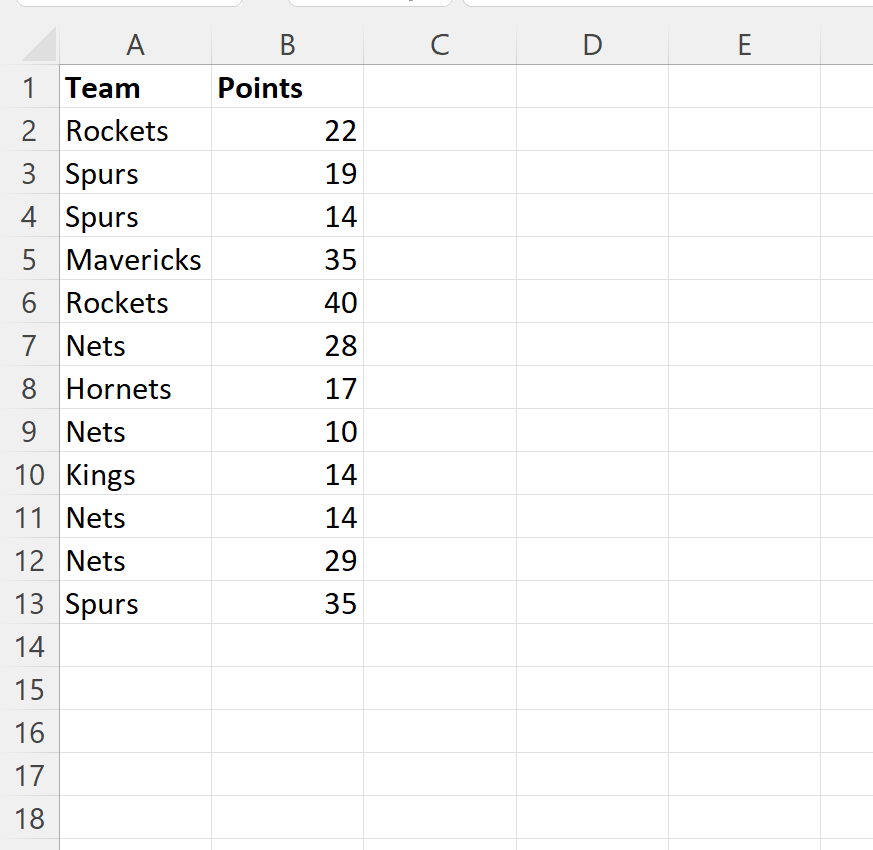
الخطوة التالية تتمثل في إنشاء عمود تحليلي مستقل ومجاور تماماً للعمود المصدري، ويُنصح بتسميته باسم يعكس بدقة طبيعة المخرج الحسابي، مثل “مؤشر_الظهور_الأول” أو “Is_First_Occurrence”. إن تخصيص عمود إضافي مكرس لهذه المهمة هو إجراء معياري في هندسة البيانات يمنع التعديل المباشر أو التخريب غير المقصود في البيانات الأصلية، ويتيح التحقق المستقل من صحة العمليات الحسابية لكل سجل على حدة.
بعد تجهيز الترويسات، يتم الانتقال إلى الخلية الأولى المخصصة للبيانات في العمود المساعد، والتي تقابل مباشرة الصف الأول للبيانات المصدرية (وليكن الصف 2). في هذه الخلية (مثلاً B2)، يتم إدخال الصيغة الدقيقة: =COUNTIF($A$2:$A2, A2)=1. يجب التأكد من وضع علامة المساواة الافتتاحية بدقة، والتثبت من كتابة علامات الدولار المحددة لتثبيت الخلية الابتدائية $A$2 حصراً، مع ترك الخلية الثانية والوسيط المرجعي بنمط حر مرن.
3.2 تعميم الصيغة واختبار مخرجات المطابقة
بمجرد تثبيت الصيغة في الخلية التحليلية الأولى، تأتي مرحلة نشرها عبر كامل امتداد السجلات. يتم ذلك تقنياً من خلال استخدام “مقبض التعبئة” (Fill Handle)—وهو المربع الصغير الكائن في الزاوية اليسرى أو اليمنى السفلية من الخلية النشطة بحسب اتجاه واجهة البرنامج—عن طريق النقر المزدوج عليه لإرسال الصيغة فورياً لأسفل العمود حتى آخر صف نشط، أو بسحبه يدوياً عبر النطاق المحدد.
عقب التعميم، يتعين إجراء فحص منهجي لمخرجات الصيغة للتحقق من سلامة الأداء الوظيفي. يتم التحقق عبر مسح عيني موجه لصفوف معروفة مسبقاً بالتكرار؛ حيث يجب أن يُظهر السجل الأول لكل مجموعة بيانات فريدة القيمة TRUE، بينما تتبدل المخرجات تلقائياً إلى FALSE أمام كل مكرر لنفس المدخل يقع في الصفوف التالية. كما يجب فحص شريط الصيغة عند الانتقال بين الصفوف المختلفة لمراقبة التمدد الديناميكي للطرف الحر للنطاق (مثل تحوله إلى $A$2:$A50 في الصف 50) وتطابقه مع خلية الفحص المستهدفة في نفس الصف.
تتميز هذه المنهجية بمرونة فائقة عند التعامل مع التغيرات الهيكلية للجدول؛ فإذا ما تم إدراج صفوف بيانات جديدة في منتصف النطاق، يقوم محرك الجداول في إكسل بتعديل المراجع تلقائياً للمحافظة على التتابع المنطقي، شريطة أن تكون البيانات مهيكلة ضمن “جدول إكسل رسمي” (Excel Table) عبر الأمر Ctrl + T، حيث تُعمم الصيغ المحسوبة ذاتياً وتكتسب ديناميكية مضاعفة تستوعب أي مدخلات لاحقة دون تدخل يدوي إضافي.
4. التحويل العددي الثنائي للمخرجات المنطقية
4.1 الدافع الحسابي للتحويل إلى النظام الثنائي (واحد وصفر)
على الرغم من الكفاءة المنطقية للقيم البوليانية (TRUE/FALSE)، إلا أن العديد من النماذج الإحصائية والتحليلية المتقدمة تفضل التعامل مع المخرجات في صورتها الرقمية المباشرة؛ أي التمثيل الثنائي الذي يتخذ من الرقم (1) دلالة على الإيجاب والصحة، ومن الرقم (0) دلالة على النفي والخطأ. يتيح هذا التمثيل العددي للمحلل إجراء عمليات رياضية تجميعية فورية دون الحاجة إلى دوال وسيطة معقدة.
إن الميزة الأبرز للترميز الثنائي تكمن في القدرة على حساب إجمالي عدد القيم الفريدة داخل العمود بمجرد تطبيق دالة الجمع البسيطة SUM على عمود المؤشر الثنائي؛ حيث إن جمع الآحاد المتفرقة يعطي فوراً التعداد الدقيق للمفردات غير المكررة. إضافة إلى ذلك، فإن المخرجات الرقمية تتكامل بانسيابية لا تقارن مع البرمجيات والمنصات التحليلية الخارجية مثل بيئات بايثون (Python)، ولغة آر (R)، ونظم ذكاء الأعمال (Power BI)، التي تتعامل مع المصفوفات الثنائية (Binary Vectors) بكفاءة معالجة وسرعة تخزينية تفوق الحقول النصية أو البوليانية المجردة.
كما يعزز التحويل الثنائي من قابلية قراءة البيانات في لوحات التحكم التنفيذية (Dashboards)؛ حيث يفضل صناع القرار والباحثون رؤية مؤشرات كمية واضحة تسهل قراءتها بنظرة سريعة، بدلاً من النصوص المنطقية الطويلة التي قد تزدحم بها الشاشات وتعيق الاستيعاب البصري السلس لاتجاهات البيانات وتوزعها.
4.2 الصياغة الجبرية للتحويل التلقائي في إكسل
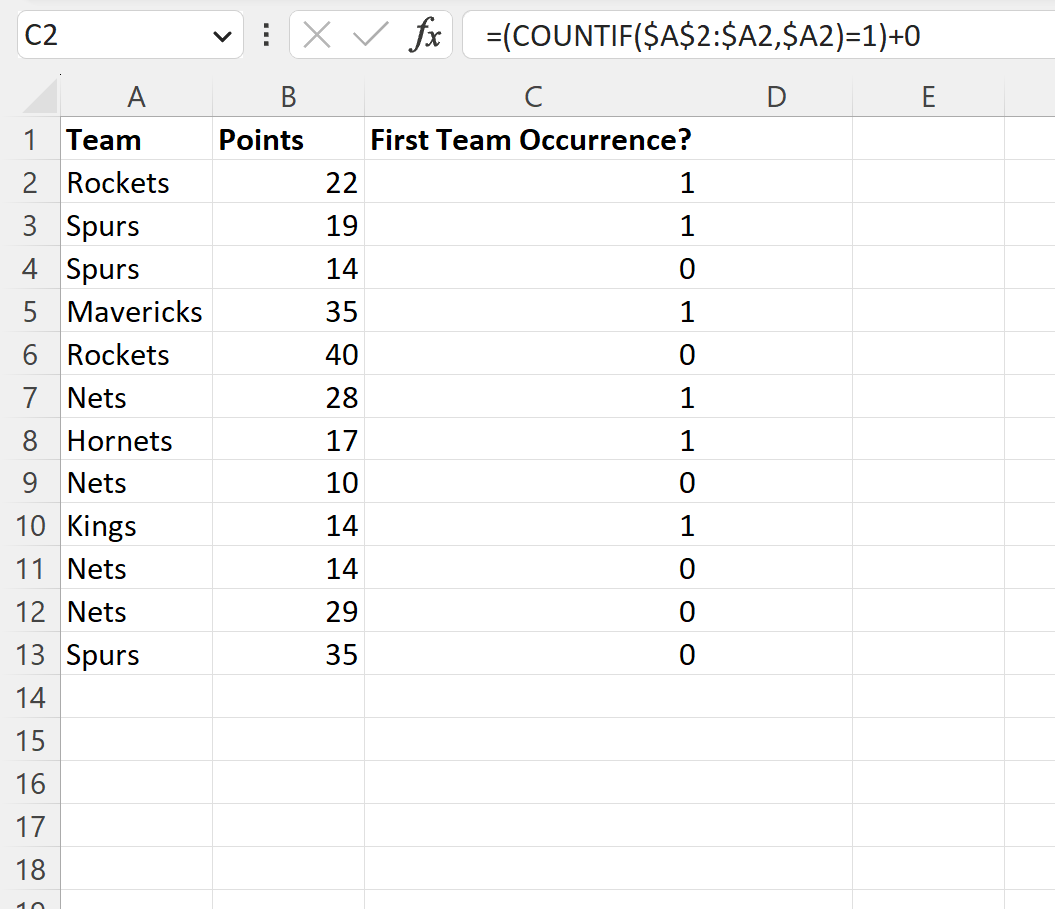
يوفر برنامج إكسل تقنيات جبرية مدمجة لتحويل القيم البوليانية إلى أرقام ثنائية بصورة قسرية دون التأثير على جوهر النتيجة المنطقية. أشهر هذه الطرق وأكثرها تفضيلاً في أوساط المطورين هي استخدام عامل السالب المزدوج (Double Unary Operator) المتمثل في الرمز --. تتم صياغة المعادلة على النحو التالي: =--(COUNTIF($A$2:$A2, A2) = 1).
يعمل السالب الأول رياضياً على إجبار إكسل على تحويل القيمة المنطقية TRUE إلى نظيرها العددي السالب (-1)، وقيمة FALSE إلى (0)، نظراً لأن العمليات الحسابية لا يمكن تطبيقها على كائنات غير رقمية. ثم يأتي السالب الثاني ليعكس الإشارة الرياضية مجدداً، محولاً القيمة إلى (+1) للمدخل الإيجابي ومبقياً على (0) للمدخل السلبي، وتتميز هذه الطريقة بسرعة معالجة بالغة في الذاكرة مقارنة بغيرها.
توجد بدائل جبرية مكافئة تؤدي نفس الغرض الوظيفي، ومنها إضافة الصفر الجبري للمعادلة كالتالي: =(COUNTIF($A$2:$A2, A2) = 1) + 0، أو ضرب الناتج المنطقي في الرقم واحد: =(COUNTIF($A$2:$A2, A2) = 1) * 1. كذلك يمكن توظيف دالة الشرط الكلاسيكية IF لتحديد مخرجات مخصصة بحسب الرغبة: =IF(COUNTIF($A$2:$A2, A2) = 1, 1, 0)، مع الإشارة إلى أن الأخيرة تستهلك قدراً ضئيلاً إضافياً من المعالجة نظراً لاستدعائها بنية اتخاذ قرار شرطية كاملة بدلاً من الإسناد الجبري المباشر.
5. دراسة حالة نموذجية: تتبع أول ظهور للفرق في سجلات الأداء الرياضي
5.1 تصميم مصفوفة البيانات المرجعية
لتجسيد هذا المفهوم بصورة تطبيقية ملموسة، نفترض سيناريو بحثياً لتحليل سجلات بطولة رياضية تشمل جولات تنافسية متعددة عبر جدول زمني ممتد. يحتوي سجل البيانات على أربعة أعمدة رئيسية: “معرف المباراة” في العمود A، و”تاريخ الجولة” في العمود B، و”اسم الفريق المشارك” في العمود C، و”النقاط المحرزة” في العمود D. نظراً لأن كل فريق يخوض مباريات متعاقبة طوال الموسم، فإن أسماء الفرق تتكرر حتماً عشرات المرات على مدار العمود C.
يتمثل الهدف التحليلي في بناء آلية لتحديد اللحظة التي يدخل فيها كل فريق إلى المنافسة للمرة الأولى، لعزل القياسات الافتتاحية للأداء وتقييم أثر “الظهور الأول” مقارنة بالمباريات اللاحقة. إن عزل هذا المتغير بدقة يتيح للباحث الرياضي دراسة عوامل التكيف النفسي، وتذبذب اللياقة البدنية البدئية، دون تلويث العينة ببيانات الفرق المخضرمة التي استقرت نتائجها بعد جولات عديدة.
في هذا النموذج، يمثل المتغير المستهدف بالعزل الحصري عمود “اسم الفريق” (العمود C). ولتنفيذ الدراسة، نقوم بإنشاء عمود إضافي خامس في العمود E ونمنحه العنوان: “مؤشر_أول_ظهور_للفريق”. يجب التأكد التام من فرز السجلات مبدئياً بحسب عمود التاريخ (العمود B) تصاعدياً من الأقدم إلى الأحدث، لضمان أن يعبر الترتيب الرأسي للصفوف عن التسلسل الزمني الحقيقي للمنافسات الميدانية.
5.2 تطبيق المعادلة وتحليل النتائج المستخلصة
نبدأ بتطبيق الصيغة الثنائية المعتمدة في الخلية الأولى لبيانات المؤشر الرياضي (الخلية E2): =--(COUNTIF($C$2:$C2, C2) = 1). عند سحب هذه الصيغة لأسفل، يظهر السلوك التحليلي بوضوح تام؛ ففي الجولة الأولى، وعندما يظهر “فريق النجوم” في الصف 2، يتم احتساب النتيجة كرقم (1) دالاً على الظهور الأولي. وعندما يتنافس نفس الفريق مجدداً في الجولة الرابعة الموثقة في الصف 15، يتحول المؤشر تلقائياً إلى (0)، مؤكداً أن هذا السجل يمثل تكراراً للمشاركة وليس تدشيناً أولياً لها.
يوضح الجدول التوضيحي التالي المحاكاة الرقمية لنتائج هذا التطبيق الرياضي:
| رقم الصف | تاريخ الجولة | اسم الفريق (العمود C) | النقاط المحرزة | صيغة التتبع (العمود E) | المؤشر الثنائي الناتج |
|---|---|---|---|---|---|
| 2 | 2023-01-10 | فريق الصقور | 85 | =--(COUNTIF($C$2:$C2, C2)=1) |
1 |
| 3 | 2023-01-10 | فريق اليرموك | 78 | =--(COUNTIF($C$2:$C3, C3)=1) |
1 |
| 4 | 2023-01-15 | فريق الصقور | 92 | =--(COUNTIF($C$2:$C4, C4)=1) |
0 |
| 5 | 2023-01-18 | فريق الفرسان | 65 | =--(COUNTIF($C$2:$C5, C5)=1) |
1 |
| 6 | 2023-01-22 | فريق اليرموك | 88 | =--(COUNTIF($C$2:$C6, C6)=1) |
0 |
بتحليل مخرجات هذا الجدول، نجد أن التصفية السريعة للأرقام (1) في العمود E تستخلص على الفور قائمة حصرية بالفرق المشاركة في البطولة دون تكرار وبحسب ترتيب ظهورها الزمني الحقيقي. علاوة على ذلك، يتيح هذا المؤشر حساب معدل فترات الراحة والانقطاع الزمني بين الظهور الأول والتكرارات اللاحقة لكل فريق، مما يوفر أداة نمذجة رياضية متكاملة لتقييم استدامة الأداء الفني في البحوث الرياضية التطبيقية.
6. المقارنة التقنية بين دالة COUNTIF والبدائل الوظيفية في إكسل
6.1 استخدام دالة المطابقة MATCH لتحديد الموقع المطلق
تمثل دالة المطابقة MATCH الركيزة الخوارزمية الأكثر كفاءة وسرعة لتحديد المواقع المطلقة للقيم في إكسل. تعمل الدالة وفق الصيغة المعيارية: =MATCH(lookup_value, lookup_array, [match_type]). ومن الخصائص الجوهرية الراسخة في التصميم البرمجي لدالة MATCH—عند ضبط وسيط المطابقة الثالث على القيمة الصفرية 0 للمطابقة التامة—أنها تبدأ الفحص المتسلسل من أعلى النطاق وتتوقف فورياً بمجرد العثور على أول تطابق مطابق للهدف، متجاهلة أي تكرارات لاحقة في أسفل العمود.
ولتوظيف هذه الدالة في تعقب الظهور الأول لكل صف، نقارن رقم الصف النسبي الذي ترجعه دالة MATCH برقم الصف الفعلي الحالي للبيانات. تتم صياغة المعادلة على النحو الآتي: =MATCH(A2, $A$2:$A$1000, 0) = ROW() - ROW($A$2) + 1، أو بالصيغة المبسطة المقابلة لموقع النطاق. الفكرة هنا هي أن دالة MATCH ستُرجع دوماً رقم الموقع النسبي للظهور الأول حصراً؛ فإذا كانت القيمة تخضع للفحص في صفها الأول، سيتطابق رقم صفها النسبي مع مخرج MATCH فتكون النتيجة TRUE. أما في التكرارات اللاحقة، فستظل الدالة تُرجع موقع الظهور الأول القديم، في حين يكون رقم الصف الحالي قد تقدم، مما يؤدي لعدم التطابق وإرجاع FALSE.
تتفوق هذه الطريقة حاسوبياً على دالة COUNTIF في مجموعات البيانات الكبيرة جداً؛ نظراً لأن دالة MATCH تتوقف خوارزمياً (Early Termination) بمجرد رصد التطابق الأول، في حين تضطر دالة COUNTIF إلى استكمال مسح كامل النطاق الفرعي حتى نهايته للتأكد من عدم وجود قيم أخرى مساوية لمعيار العد، وهو ما يمنح MATCH أفضلية حاسمة في استهلاك الذاكرة وسرعة المعالجة.
6.2 التوظيف المتقدم لدوال البحث الحديثة XLOOKUP و INDEX
مع إطلاق الإصدارات الحديثة من برنامج إكسل (Microsoft 365 و Excel 2021 وما بعدها)، برزت دالة XLOOKUP كأداة بحث وتحليل ثورية تجبّ ما قبلها من القيود التاريخية لدوال البحث التقليدية. تمتلك هذه الدالة وسيطاً مدمجاً لتحديد اتجاه البحث (Search Mode)؛ حيث يضمن الوسيط الافتراضي [search_mode] = 1 إجراء بحث تتابعي صارم يبدأ من العنصر الأول نحو العنصر الأخير، متوقفاً بطبيعته عند أول ظهور للمدخل المطابق تماماً.
تتجلى قوة XLOOKUP في إمكانية استرجاع قيم مرافقة للظهور الأول من أعمدة أخرى بصورة مباشرة دون الحاجة لإنشاء أعمدة مؤشرات مساعدة، وفق الصيغة: =XLOOKUP(A2, $A$2:$A$1000, $B$2:$B$1000, "غير موجود", 0, 1). تضمن هذه الصياغة الحصول على القيمة المقابلة للظهور الأول حصراً وتفادي أخطاء الإسناد الناتجة عن إزاحة الأعمدة، وهي الميزة التي كانت تُنفذ تاريخياً عبر التركيب الشهير بين دالتي الفهرسة والمطابقة INDEX / MATCH بالصيغة: =INDEX($B$2:$B$1000, MATCH(A2, $A$2:$A$1000, 0)).
توفر هذه الدوال الحديثة حماية بنيوية قوية للنماذج الرياضية ضد أخطاء المراجع الشائعة؛ حيث تقبل مصفوفات ديناميكية مستقلة دون الحاجة لربط النطاقات بكتل جدولية صلبة، كما تدعم معالجة القيم غير المعثور عليها مباشرة من خلال وسائطها الداخلية، مما يقلل الحاجة إلى تغليف المعادلات بدوال حماية إضافية مثل IFERROR ويوفر بنية برمجية نقية وسهلة التدقيق والتعديل الأكاديمي.
6.3 تقييم الكفاءة واختيار الأسلوب الأنسب للمهام الكبيرة
يعتمد الاختيار الاستراتيجي بين دالة COUNTIF ذات النطاق المتوسع وبدائل المطابقة المباشرة على الموازنة الدقيقة بين بساطة التعبير والتعقيد الخوارزمي في بيئات الحوسبة. من منظور علم التعقيد الحسابي (Computational Complexity)، يتبع النطاق المتوسع لدالة COUNTIF نمط التعقيد التربيعي المتصاعد O(N^2)، نظراً لأن كل صف جديد يتطلب إعادة مسح كافة الصفوف التي سبقته في متوالية حسابية تراكمية تستهلك موارد وحدة المعالجة المركزية (CPU).
يوضح الجدول المقارن التالي أبرز الفروق الجوهرية والتقنية بين المناهج الثلاثة الرئيسية:
| معيار التقييم | دالة COUNTIF المتوسعة | دالة MATCH النسبية | دالة XLOOKUP الحديثة |
|---|---|---|---|
| صيغة البناء الأساسية | =COUNTIF($A$2:$A2, A2)=1 |
=MATCH(A2, $A$2:A2, 0)=ROW()-ROW($A$2)+1 |
=XLOOKUP(A2, $A$2:$A$N, $B$2:$B$N, , 0, 1) |
| التعقيد الحسابي | تربيعي تراكمي O(N^2) |
خطي متوقف O(N) |
خطي مباشر ومحسن O(N) |
| سرعة التنفيذ (أكثر من 100 ألف صف) | بطيئة ومستهلكة للذاكرة | عالية جداً | فائقة مع معالجة المصفوفات |
| التوافق مع إصدارات إكسل | توافق شامل (جميع الإصدارات) | توافق شامل (جميع الإصدارات) | إكسل 365 وإكسل 2021+ فقط |
| الهدف الأساسي للاستخدام | تمييز السجلات وإضافة مؤشرات ثنائية | تحديد مواقع الظهور الأول بدقة | استرجاع البيانات المرافقة للظهور الأول |
بناءً على هذه المعطيات، يُوصى باستخدام صيغة COUNTIF في المشاريع الصغيرة والمتوسطة التي لا يتجاوز حجم سجلاتها بضعة آلاف من الصفوف، نظراً لوضوحها وسهولة تدقيقها وملاءمتها لقواعد التنسيق الشرطي. بينما يتحتم الانتقال الصارم إلى صيغ MATCH أو الاستعلام عبر محركات البيانات المتقدمة عند معالجة المصفوفات المليونية الضخمة لتفادي تجميد نظام الحساب في البرنامج وتحقيق أفضل كفاءة تشغيلية ممكنة.
7. التكامل مع أدوات التنسيق الشرطي وعزل البيانات بصرياً
7.1 بناء قواعد التنسيق الشرطي القائمة على الصيغة
لا تتوقف فائدة صيغ تعقب الظهور الأول عند إنشاء أعمدة مساعدة، بل تمتد لتشكل المحرك المنطقي لقواعد التنسيق الشرطي (Conditional Formatting) في إكسل. تتيح هذه الميزة للمحلل تمييز السجلات الجديدة والفريدة بصرياً فور إدخالها داخل الجدول، مما يوفر تنبيهاً بصرياً فورياً يسهل رصد الأنماط الشاذة والبيانات غير المسبوقة بمجرد التدقيق بالعين المجردة.
لتطبيق هذه القاعدة، يتم أولاً تظليل نطاق البيانات المستهدف بالكامل—وليكن النطاق من A2 إلى A1000—مع مراعاة أن تكون الخلية الأولى النشطة في التحديد هي الخلية العلوية المستهدفة (A2). بعد ذلك، يتم فتح نافذة “قاعدة تنسيق جديدة” (New Formatting Rule) واختيار خيار “استخدام صيغة لتحديد الخلايا التي سيتم تنسيقها” (Use a formula to determine which cells to format).
يتم إدخال الصيغة المنطقية الدقيقة في حقل الصيغ الشرطية: =COUNTIF($A$2:$A2,$A2)=1. يجب الانتباه البالغ هنا لعدم تثبيت رقم الصف في الوسيط الثاني $A2؛ لكي يسمح المحرك الداخلي للتنسيق الشرطي بإزاحة شرط الفحص ومطابقته لكل صف على حدة بالتوازي عبر النطاق المحدد. ثم يتم اختيار نمط التمايز اللوني—كتعبئة الخلية بلون أخضر هادئ أو تغيير نمط الخط إلى عريض (Bold)—لتسليط الضوء على أول ظهور لكل كيان فريد بمجرد تحقق الشرط الحسابي.
7.2 تفعيل التصفية المتقدمة واستخراج القوائم النقية
يمهد تعيين مؤشر الظهور الأول (سواء كان بوليانياً أو ثنائياً) الطريق لاستخدام أدوات التصفية الفورية والمتقدمة لعزل البيانات النقية. عند تطبيق “عامل التصفية التلقائي” (AutoFilter) عبر الاختصار Ctrl + Shift + L، يستطيع المحلل فتح قائمة التصفية في عمود المؤشر وتحديد القيمة TRUE أو الرقم 1 فقط. في تلك اللحظة، تختفي كافة التكرارات من واجهة العرض فورياً، ويتحول الجدول إلى قائمة حصرية تضم العناصر الفريدة فقط.
تكتسب هذه الخطوة أهمية بالغة عند الرغبة في تصدير البيانات أو نسخها؛ حيث يمكن للمستخدم نسخ النتائج المصفاة ولصقها في ورقة عمل مستقلة لتوليد جدول مرجعي نقي خالٍ تماماً من التكرار، وهو ما يضمن الحفاظ على سلامة الجداول المتقاطعة ونماذج التحليل الفرعية دون الحاجة إلى استخدام أدوات الإزالة المباشرة للبيانات التي قد تدمر السجلات التاريخية دون رجعة.
إضافة إلى ذلك، يشكل هذا العمود المفلتر رافداً استثنائياً لأداة الجداول المحورية (Pivot Tables)؛ فعند استخدام عمود مؤشر الظهور الأول كمعيار للتصفية على مستوى التقرير (Report Filter) أو وضعه في خانة القيم التجميعية كدالة جمع SUM، يمكن للباحث توليد إحصاءات فورية تلخص أعداد المكونات الفريدة الموزعة على مختلف الفئات والأطر الزمنية بدقة متناهية وسرعة حسابية فائقة.
8. معالجة الأخطاء الشائعة وحالات الشذوذ في البيانات المدخلة
8.1 مشكلات التنسيق غير المرئي والمسافات الزائدة
تعد عيوب التنسيق الخفية من أكثر الأسباب شيوعاً لإخفاق معادلات الظهور الأول في إرجاع نتائج صحيحة. يرجع ذلك إلى حساسية محرك المقارنة المنطقية في إكسل للمسافات البيضاء والرموز الخفية؛ فوجود مسافة بادئة أو لاحقة في إحدى الخلايا يجعل النص " أحمد" مختلفاً اختلافاً جذرياً عن النص "أحمد" من منظور البرنامج، مما يؤدي إلى تصنيف المدخل الثاني كظهور أول جديد ومستقل بالرغم من تطابقهما الدلالي التام.
للتغلب على هذه المعضلة المنهجية، يتعين تنظيف البيانات المصدرية مسبقاً قبل إخضاعها لمعادلات الفرز، وذلك باستخدام دالة إزالة الفراغات الزائدة TRIM، المقترنة بدالة تنظيف الرموز غير المطبوعة CLEAN. يمكن بناء عمود تصحيحي يطبق الصيغة: =TRIM(CLEAN(A2))، مع الانتباه لمعالجة الفراغات غير المنقسمة (Non-breaking Spaces) الناتجة عن استيراد نصوص الويب عبر دالة الاستبدال: =SUBSTITUTE(A2, CHAR(160), " ").
كذلك يجب التحقق من وحدة التنسيق النمطي؛ حيث يؤدي خلط الأرقام المخزنة كنصوص مع الأرقام الحقيقية إلى تكرار زائف للمؤشرات. فإذا كان الحقل المصدري يحتوي على أرقام تعريفية، يجب توحيدها قسرياً إما بتحويل النصوص إلى أرقام عبر دالة VALUE أو بتوحيد الأرقام كنصوص متسلسلة باستخدام دالة TEXT لضمان تطابق أنماط البيانات على مستوى البتات البرمجية قبل تطبيق المقارنة التراكمية.
8.2 الأخطاء الناجمة عن الإسناد المرجعي وتعديل الصفوف
تنشأ مجموعة أخرى من الأخطاء الحرجة عن سوء التعامل مع مراجع الخلايا أثناء صياغة وتعديل ورقة العمل. الخطأ الأكثر فداحة يتمثل في نسيان رمز التثبيت $ للخلية الابتدائية في النطاق المتوسع، كأن تُكتب الصيغة بالشكل: =COUNTIF(A2:A2, A2)=1. في هذا السيناريو، يتحرك النطاق بالكامل مع حركة السحب نحو الأسفل ليصبح دائماً عبارة عن خلية مفردة تفحص نفسها فقط، والنتيجة الحتمية هي ظهور القيمة TRUE في كافة صفوف الجدول بلا استثناء، مما يفقد العملية معناها التحليلي تماماً.
كما تشكل عمليات حذف الصفوف العلوية خطراً محدقاً على سلامة النموذج التحليلي؛ فحذف الصف المصدري المرجعي الأول الذي يحتوي على الخلية $A$2 يؤدي مباشرة إلى انهيار سلسلة الحسابات وظهور خطأ المرجع الشهير #REF! عبر كافة خلايا العمود المساعد. لتفادي هذا الانهيار في النماذج المؤسسية المعرضة للتعديل المستمر، يُنصح بتثبيت المرجع الابتدائي ديناميكياً باستخدام دالة الفهرسة المرجعية: =INDEX($A:$A, 2)، لضمان صمود المعادلة أمام عمليات الحذف والإدراج الهيكلية.
أخيراً، يجب معالجة الخلايا الفارغة الواقعة ضمن عمود التحليل؛ حيث يؤدي وجود خلية فارغة إلى اعتبارها قيمة مستقلة بواسطة دالة COUNTIF، فترجع لها القيمة TRUE عند أول فراغ وFALSE للفراغات اللاحقة، وهو سلوك قد يفسد الإحصاءات الإجمالية. يتم تحصين الصيغة ضد هذا الشذوذ بتغليفها بشرط تحوطي يختبر فراغ الخلية أولاً: =IF(A2="", "", --(COUNTIF($A$2:$A2, A2)=1)).
9. تحسين الأداء الحسابي في مجموعات البيانات الضخمة والمعقدة
9.1 تقليل العبء التشغيلي للصيغ التكرارية
عندما تتسع مجموعات البيانات لتتجاوز عشرات الآلاف من السجلات، يتحول استخدام الدوال التكرارية التراكمية مثل COUNTIF ذات النطاق المتوسع إلى عبء تشغيلي هائل يستنزف قدرات المعالجة في الحاسوب. يعود ذلك إلى أن البرنامج يعيد تقييم مئات الملايين من تقاطعات الخلايا مع كل تعديل طفيف يطرأ على ورقة العمل، مما يصيب البرنامج ببطء شديد وتوقف مؤقت عن الاستجابة (Screen Freezing).
للتعامل مع هذا التحدي الحسابي في جداول البيانات العملاقة، يُعد تحويل الصيغ إلى قيم ثابتة استراتيجية كلاسيكية ذات أثر بالغ وفوري. بعد تعميم المعادلة واستقرار نتائج مؤشرات الظهور الأول، يقوم المحلل بنسخ العمود التحليلي بالكامل ولصقه في نفس مكانه باستخدام أمر “لصق كقيم” (Paste as Values). هذا الإجراء يزيل عبء الحساب الديناميكي نهائياً عن الذاكرة المؤقتة، محولاً النتائج إلى بيانات صلبة لا تتطلب أي معالجة إضافية في دورات الحساب اللاحقة.
إضافة إلى ذلك، يُنصح بتعطيل ميزة “الحساب التلقائي” (Automatic Calculation) مؤقتاً أثناء مرحلة إدخال وبناء المصفوفات الضخمة، والتحول إلى وضع “الحساب اليدوي” (Manual Calculation) عبر خيارات البرنامج أو الاختصار F9. هذا يمنع إكسل من إطلاق دورات إعادة الحساب الشاملة مع كل ضغطة زر أو تعديل على خلية مفردة، مما يوفر بيئة عمل سلسة ومستقرة للمحلل أثناء تجهيز النماذج الكبيرة.
9.2 البدائل التخزينية باستخدام أدوات نمذجة البيانات
في مشاريع معالجة البيانات الحديثة، لم يعد الاعتماد على صيغ الخلايا التقليدية هو الخيار الأمثل للتعامل مع البيانات الضخمة؛ حيث يوفر محرك Power Query المدمج في إكسل بيئة استخراج وتحويل وتجهيز (ETL) تتفوق بمراحل على الدوال في كفاءة إدارة الذاكرة. يتيح Power Query تحديد وتصفية السجلات المكررة وعزل الظهور الأول قبل تحميل البيانات إلى شبكة الخلايا أصلاً.
تتم العملية داخل Power Query بخطوات نقية وخالية من الدوال المتوسعة: أولاً، يتم فرز الجدول بحسب الترتيب الزمني المطلوب. ثانياً، يتم استخدام ميزة “إزالة التكرارات” (Remove Duplicates) على العمود المستهدف، والتي تعتمد في كود لغة M البرمجية خوارزمية ذكية تحتفظ بالصف الأول تلقائياً وتلغي ما سواه. كما يمكن إنشاء عمود مؤشر مخصص يعتمد على إضافة عمود فهرس ترتيبي (Index Column) ثم إجراء دمج ذاتي (Self-Join) يلتقط أصغر رقم فهرس لكل قيمة فريدة بسرعة معالجة لحظية تتجاهل تعقيد المصفوفات التقليدية.
كذلك يوفر نموذج البيانات المتقدم (Data Model) عبر لغة DAX في أداة Power Pivot بدائل فائقة لحساب المفردات الفريدة دون الحاجة لأعمدة مساعدة مطلقاً، من خلال توظيف دوال متخصصة مثل DISTINCTCOUNT. تعمل هذه الأدوات على ضغط البيانات في مخازن أعمدة فائقة الكفاءة (xVelocity Engine)، مما يقلل حجم ملف العمل بنسبة تصل إلى 90% ويسرع زمن الاستجابة التحليلية بشكل هائل يتجاوز حدود جداول إكسل التقليدية بملايين المرات.
10. الأطر المتقدمة والأتمتة في إدارة تكرارات البيانات وتتبعها
10.1 أتمتة عملية التحقق البرمجي باستخدام نصوص الماكرو
توفر البرمجة النصية عبر لغة تطبيقات الفيجوال بيسك (VBA) إمكانات متقدمة لأتمتة عمليات رصد الظهور الأول للقيم، متفوقة على الصيغ التقليدية بقدرتها على معالجة البيانات دون تكديس الذاكرة بمعادلات دائمة. تتيح كتابة كود ماكرو متخصص فحص ملايين الخلايا في جزء من الثانية باستخدام كائنات قواميس الذاكرة المتقدمة (Scripting.Dictionary)، التي تتميز بسرعة وصول خوارزمية لحظية O(1) لا تعتمد على مسح النطاقات المتكررة.
يوضح النص البرمجي التالي كيفية بناء إجراء ماكرو يقوم بتعيين المؤشر الثنائي للظهور الأول تلقائياً بضغطة زر:
Sub FlagFirstOccurrences()
    Dim ws As Worksheet
    Dim lastRow As Long
    Dim dict As Object
    Dim dataRange As Variant
    Dim resultRange() As Variant
    Dim i As Long

    Set ws = ActiveSheet
    Set dict = CreateObject("Scripting.Dictionary")

    ' تحديد آخر صف نشط في العمود A
    lastRow = ws.Cells(ws.Rows.Count, "A").End(xlUp).Row
    If lastRow < 2 Then Exit Sub

    ' قراءة البيانات إلى مصفوفة ذاكرة لتسريع المعالجة
    dataRange = ws.Range("A2:A" & lastRow).Value
    ReDim resultRange(1 To UBound(dataRange, 1), 1 To 1)

    ' فحص القيم وتوليد المؤشر الثنائي
    For i = 1 To UBound(dataRange, 1)
        If Not dict.exists(dataRange(i, 1)) Then
            dict.Add dataRange(i, 1), True
            resultRange(i, 1) = 1 ' الظهور الأول
        Else
            resultRange(i, 1) = 0 ' تكرار لاحق
        End If
    Next i

    ' طباعة النتائج في العمود B دفعة واحدة
    ws.Range("B2:B" & lastRow).Value = resultRange

    Set dict = Nothing
    MsgBox "تم تعيين مؤشرات الظهور الأول بنجاح!", vbInformation
End Sub
يمكن أيضاً ربط هذا الإجراء البرمجي بمشغلات الأحداث اللحظية في ورقة العمل (Event Handlers) مثل الحدث Worksheet_Change؛ بحيث يُفحص أي سجل جديد يتم إدخاله في نهاية الجدول بصورة استباقية وآلية، وتُسجل علامته الثنائية في الخلية المجاورة دون أي تدخل يدوي من المستخدم، مما يرسخ نمط المعالجة المؤتمتة المستدامة في تدفقات العمل المؤسسية.
10.2 بناء قواعد حوكمة البيانات والتحقق الاستباقي من الإدخال
تمثل حوكمة البيانات في المنظمات الحديثة السياج الرقابي الذي يحفظ دقة الأنظمة ونزاهة تقاريرها الاستراتيجية. إن تطبيق آليات تعقب الظهور الأول يكتسب قيمته القصوى عندما يتحول من مجرد تشخيص لاحق (Post-hoc Analysis) إلى أداة وقائية استباقية (Proactive Prevention) تمنع دخول التكرارات والبيانات الملوثة إلى النظام منذ البداية.
يتحقق هذا التحول الوقائي من خلال دمج صيغ النطاقات المتوسعة ضمن أداة التحقق من صحة البيانات (Data Validation) المتاحة في إكسل. عند تطبيق قاعدة تحقق مخصصة عبر الصيغة: =COUNTIF($A$2:$A2, A2)<=1 على خلايا عمود الإدخال، يتم إجبار النظام على رفض أي مدخل مكرر فور محاولة المستخدم إدخاله؛ حيث يُطلق البرنامج نافذة تحذيرية مخصصة تفيد بأن هذه القيمة مسجلة مسبقاً في الجدول، مما يقفل الباب نهائياً أمام الأخطاء البشرية الشائعة.
تتكامل هذه الضوابط الإجرائية مع المعايير المؤسسية للأرشفة وحفظ السجلات؛ حيث تتطلب حوكمة الأبحاث توثيقاً تاريخياً واضحاً لكل تعديل وتحديداً لا يقبل اللبس للنقطة الزمنية التي دخل فيها المتغير إلى النموذج البياني. إن اعتماد هذه المنهجيات الموثقة يعزز من قابلية تدقيق النماذج (Model Auditability)، ويحقق التوافق التام مع متطلبات الامتثال وضمان الجودة المتبعة في المؤسسات الأكاديمية والمالية الكبرى.
خاتمة
يمثل إتقان مهارة العثور على أول ظهور لقيمة في عمود داخل برنامج إكسل نقطة تحول حقيقية في كفاءة المحلل والباحث، متنقلاً به من مستوى التعامل السطحي مع الجداول إلى آفاق المعالجة الخوارزمية والهيكلية للبيانات. ومن خلال هذا العرض الاستقصائي، تبين أن دالة COUNTIF ذات النطاق المتوسع تظل الأداة الأكثر مرونة وسهولة في بناء المؤشرات المنطقية والثنائية والتكامل مع قواعد التنسيق الشرطي والتصفية الفورية لمجموعات البيانات الصغيرة والمتوسطة.
ومع ذلك، تفرض طبيعة البيانات الضخمة التزاماً منهجياً بالانتقال نحو دوال المطابقة المباشرة مثل MATCH وXLOOKUP، أو الاستعانة بمحركات تحويل البيانات الأكثر قوة مثل Power Query ونصوص VBA، لضمان أعلى درجات الكفاءة التشغيلية وسرعة الحساب دون التضحية بالدقة الرياضية. إن الاختيار السليم للتقنية المناسبة هو وليد الفهم العميق لخصائص المصفوفة، وأهداف التحليل، ومتطلبات الحوكمة، مما يضمن في النهاية بناء نماذج بيانات قوية، موثوقة، وقابلة للاستدلال الأكاديمي وصناعة القرار الاستراتيجي الرشيد.
المراجع
- Alexander, M., & Kusleika, D. (2020). Excel 2019 Bible. John Wiley & Sons.
- Microsoft Support. (n.d.). COUNTIF function. Microsoft. https://support.microsoft.com/en-us/office/countif-function-e0de10c6-f885-4e71-abb4-1f464816df34
- Microsoft Support. (n.d.). MATCH function. Microsoft. https://support.microsoft.com/en-us/office/match-function-e8dffd45-c762-47d6-bf89-533f4a37673a
- Microsoft Support. (n.d.). XLOOKUP function. Microsoft. https://support.microsoft.com/en-us/office/xlookup-function-b7fd680e-6d10-43e6-84f9-88eae8bf5929
- Walkenbach, J. (2015). Microsoft Excel 2016 Formulas. John Wiley & Sons.