
تُعد معالجة النصوص والبيانات السلسية (String Manipulation) في بيئات الجداول الحسابية أحد الركائز الجوهرية التي يعتمد عليها محللو البيانات، ومهندسو النظم، والباحثون في شتى الحقول التطبيقية. ويحتل برنامج مايكروسوفت إكسل (Microsoft Excel) مكانة مركزية في هذا الإطار بوصفه الأداة الأكثر انتشاراً لإجراء العمليات الحسابية وتدقيق السجلات وتحويل هياكل البيانات الأولية إلى معلومات قابلة للتفسير والتحليل الإحصائي الدقيق. غير أن التعامل مع البيانات غير المنظمة أو شبه المنظمة يفرض تحديات تقنية تستوجب فهماً عميقاً للوظائف الرياضية والخوارزميات النصية المضمنة في البرنامج، لا سيما عندما يتعلق الأمر بالبحث الموضعي عن محارف أو نصوص فرعية تتوزع عشوائياً ضمن نصوص أطول.
تأتي دالة FIND في مقدمة الأدوات النصية التي تتيح الاشتقاق الموضعي الدقيق للمحارف بناءً على مؤشرات عددية ذات أساس يبدأ من الرقم واحد (1-based index). ورغم القوة الحسابية التي تتمتع بها هذه الدالة في تحديد الإحداثيات المكانية للنصوص، فإن بنيتها التقليدية مصممة هندسياً للتعامل مع معيار بحث فردي أحادي القيمة؛ الأمر الذي يوقع المستخدم في معضلات تركيبية معقدة عند محاولة توسيع نطاق البحث ليشمل معايير متعددة بصيغة الاختيار المنطقي (Logical OR). تتجلى هذه المعضلة الحسابية بوضوح عندما تتطلب معالجة النصوص رصد الظهور الأسبق لأي رمز من مجموعة رموز محددة، مثل علامات الترقيم، أو فواصل السجلات، أو الحروف الدلالية، مما يستوجب تجاوز المعمارية الأحادية للدالة عبر نماذج تركيبية متقدمة.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك الأسس الهيكلية والرياضية لدالة FIND، واستعراض الاستراتيجيات المتقدمة لتوظيفها في معالجة سيناريوهات البحث متعدد المعايير. وسنتناول بالتحليل المعمق أساليب الإحلال النصي المتراكب باستخدام دالة SUBSTITUTE، والتحليل المصفوفي الحديث المدعوم بدوال التقليص الحسابي مثل دالة MIN، إضافة إلى بروتوكولات تحصين المعادلات ضد الأخطاء النظامية مثل الخطأ القيمي المشهور. كما سنقارن بين هذه الحلول التنسيقية والأدوات البرمجية الأكثر مرونة مثل بيئة Power Query ولغة VBA، لتقديم دليل منهجي متكامل يضمن دقة وسلامة تدفق البيانات الحسابية في المصنفات المعقدة والضخمة.
1. الأسس النظرية والبنية التركيبية لدالة FIND في إكسل
1.1 التعريف الوظيفي والنمذجة الرياضية للدالة
تُعرّف دالة FIND برمجياً وحسابياً بأنها اقتران نصي قطعي يقوم بمسح سلسلة نصية مستهدفة لتحديد نقطة البداية العددية لمجموعة فرعية من المحارف، معيداً مؤشراً رقمياً صحيحاً موجباً يعبر عن الترتيب التراكمي للمحرف الأول من النص المبحوث عنه. تخضع الدالة لمعمارية رياضية محددة يتم تمثيلها اصطلاحياً وفق البنية الثلاثية: FIND(find_text, within_text, [start_num]). تتطلب هذه الصيغة وجود وسيطين إلزاميين؛ الأول هو النص المراد رصده (find_text)، والثاني هو السلسلة النصية الشاملة أو المرجع الخليوي الذي تجري فيه عملية الفحص (within_text). أما الوسيط الثالث (start_num)، فهو متغير اختياري يحدد المؤشر العددي الذي تنطلق منه خوارزمية الفحص، وتفترض الدالة قيمته تلقائياً بالرقم واحد عند إغفاله.
تعتمد النمذجة الرياضية للدالة على منطق الفهرسة الموضعية ذات الترتيب المتزايد بدءاً من اليسار إلى اليمين في النصوص اللاتينية، أو وفق تدفق المحارف المشفرة في الذاكرة بصرف النظر عن اتجاه العرض المرئي. وتعتبر المخرجات الرقمية للدالة قيماً ذات طبيعة قطعية؛ إذ تعيد الدالة الترتيب المكاني المجرد ولا تقوم بأي معالجة إضافية للمحتوى. وتكتسب هذه القيمة الرقمية الناتجة أهمية قصوى داخل المنظومات الحسابية المركبة؛ حيث تمثل المدخل الأساسي لدوال الاقتطاع الرياضي والتجزئة النصية. على سبيل المثال، إذا كان الهدف هو فصل النصوص عند فاصلة معينة، فإن المخرج الرقمي لدالة FIND يمثل الحد الجبري الدقيق الذي تستند إليه دوال استخلاص السلاسل لتحديد أطوال المقاطع النصية المستخرجة بعناية فائقة وتجنب إزاحة المحارف غير المقصودة.
إن فهم سلوك الوسيط start_num يمثل ركيزة جوهرية للتحكم في مسار خوارزمية البحث الداخلي. عند تعيين قيمة لهذا الوسيط تفوق الواحد الصحيح، فإن الدالة تتجاهل كافة التطابقات الواقعة قبل هذا المؤشر دون إحداث أي تغيير في نظام الفهرسة النهائي؛ بمعنى أن الرقم المسترجع يعكس دائماً الموقع النسبي للمحرف محسوباً من أول السلسلة النصية بأكملها وليس من نقطة انطلاق الفحص المحدد. ويوفر هذا السلوك الحسابي ميزة جوهرية عند الرغبة في إجراء عمليات مسح متعاقبة لرصد التكرارات اللاحقة لنفس المعيار النصي، عبر توظيف نتائج البحث السابقة كنقاط انطلاق ديناميكية في خطوات المعالجة التالية.
1.2 حساسية حالة الأحرف والخصائص التمييزية للدالة
تتميز دالة FIND بخاصية بنيوية جوهرية تفرقها عن نظيراتها من دوال المعالجة النصية داخل إكسل، وهي حساسيتها المطلقة لحالة الأحرف (Case Sensitivity). في بيئات الحوسبة واللغات التي تعتمد على التمييز بين الحروف الكبيرة (Uppercase) والصغيرة (Lowercase)، تتعامل دالة FIND مع المحرفين “A” و”a” بوصفهما كائنين منفصلين تماماً لا يتقاطعان في فضاء المطابقة. يرجع هذا التباين إلى اعتماد الدالة على المطابقة المباشرة لقيم الترميز الثنائية المقابلة لكل محرف في جداول الترميز القياسية، مما يجعلها أداة تدقيق صارمة تتجاوز مجرد البحث النصي السطحي إلى التحقق من البنية الحرفية الدقيقة للمدخلات.
يبرز التباين الأكاديمي والعملي بين دالتي FIND وSEARCH في هذا السياق تحديداً؛ حيث صُممت دالة SEARCH لتتجاهل حالة الأحرف وتدعم استخدام المحارف البديلة (Wildcards) مثل علامة النجمة وعلامة الاستفهام، في حين تفتقر دالة FIND عمداً إلى هذه المرونة لتوفير بيئة فحص دقيقة لا تقبل الاحتمالات المتقاطعة. تتجلى الأهمية التطبيقية لحساسية الأحرف في سيناريوهات تدقيق البيانات المالية والأكاديمية والتقنية، حيث تشير الحروف الكبيرة غالباً إلى اختصارات قياسية أو رموز تصنيفية محددة تختلف دلالتها جذرياً عن نظيراتها الصغيرة؛ مما يمنع الوقوع في أخطاء التصنيف الناجمة عن التطابقات الزائفة في السجلات المعقدة، وهو ما يتوافق منهجياً مع مبادئ التمييز البصري واللغوي في معالجة الرموز بدقة متناهية (Brysbaert & New, 2009).
علاوة على ذلك، يمتد تأثير هذه الحساسية إلى تدقيق ترميز السلاسل النصية وضمان اتساقها البرمجي. فعند استيراد قواعد بيانات ضخمة من أنظمة تخطيط موارد المؤسسات (ERP) أو خوادم قواعد البيانات العلائقية، قد تشتمل السجلات على مفاتيح مشفرة تتمايز فيها الأنماط الحرفية لتحديد مستويات الوصول أو فئات المعاملات. يوفر استخدام دالة FIND في هذه الحالات ضمانة حاسوبية بعدم دمج الفئات المتباينة، مما يجعلها مرشحاً مثالياً لبناء خوارزميات التدقيق النصي التي تتطلب مطابقة دقيقة لا تحتمل التقريب أو التجاوز غير المنضبط لحالة الرموز الحرفية.
1.3 القيود الافتراضية للدالة الأحادية في معالجة السلاسل المعقدة
على الرغم من الدقة العالية التي توفرها دالة FIND، فإنها تعاني من قصور هيكلي متأصل يتمثل في عجزها التشغيلي عن قبول وسائط بحث متعددة بشكل مباشر ضمن تركيبتها الفردية القياسية. صُممت الدالة بطبيعتها لاستقبال قيمة نصية سلمية مفردة (Scalar String) في وسيط find_text، وحينما يحاول المستخدم تمرير نطاق من الخلايا أو مصفوفة من المحارف دون تغليفها بصيغ مصفوفية متقدمة، فإن الدالة تفشل في إجراء تقييم منطقي تجميعي، وتكتفي باختبار العنصر الأول فقط أو توليد اضطراب حسابي يمنع استخلاص المواقع المتعددة للرموز المستهدفة بشكل سليم ومتزامن.
ينشأ عن هذا القصور عائق تشغيلي رئيسي يتمثل في آلية توليد رمز الخطأ #VALUE!؛ حيث تُسقط الدالة الحساب فوراً وتُرجع هذا الخطأ الصريح في ثلاث حالات رئيسية: إذا تعذر العثور تماماً على النص المبحوث عنه داخل السلسلة المستهدفة، أو إذا كانت قيمة start_num عدداً سالباً أو مساوياً للصفر، أو إذا تجاوزت قيمة هذا الوسيط الطول الإجمالي للنص المفحوص. يشكل هذا الانقطاع الحسابي عقبة كبرى أمام تدفق العمليات في جداول البيانات، إذ يؤدي خطأ القيمة في خلية واحدة إلى شل حركة كافة الصيغ والمعادلات المترابطة التي تعتمد على تلك الخلية كمصدر لمدخلاتها الحسابية.
تفرض هذه القيود البنيوية على محلل البيانات ضرورة مغادرة النطاق البسيط للدالة الأحادية، واللجوء إلى الهندسة التركيبية للمعادلات عبر دمج دالة FIND في أطر تكاملية هجينة. يستدعي هذا التوجه بناء استراتيجيات حسابية تتضمن إما تحويل مسألة البحث متعدد المعايير إلى مسألة مكافئة رياضياً عبر التوحيد المسبق للرموز المستهدفة، أو إخضاع وسائط الدالة لمنطق التقييم المصفوفي القادر على معالجة متجهات البحث المتعددة في دورة معالجة واحدة؛ وهو ما يمهد لتطوير نماذج متقدمة قادرة على الصمود أمام تعقيدات البيانات الواقعية وتنوع أنماطها.
2. إشكالية البحث المتعدد: استقراء الدوافع والتحديات الحسابية
2.1 تعريف معضلة التحقق متعدد المعايير في النصوص
تتمحور معضلة البحث متعدد المعايير داخل السلاسل النصية حول الحاجة الخوارزمية إلى رصد أول ظهور زمني أو موضعي لأي رمز من قائمة محددة سلفاً من الرموز المحتملة. تتكرر هذه المعضلة بصورة دورية في سيناريوهات هندسة البيانات وتنقيتها؛ ومن أمثلة ذلك الرغبة في استخراج الجزء الأول من عنوان بريد إلكتروني أو نص تركيبي يفصل بين أجزائه محارف مختلفة مثل النقطة، أو الفاصلة المنقوطة، أو الشرطة المائلة، أو المسافة الفارغة. في مثل هذه الحالات، لا يكون موقع الفاصل ثابتاً، ولا يكون نوع الفاصل معلوماً على وجه التحديد قبل إجراء المسح، مما يفرض على الخوارزمية اختبار وجود كافة الفواصل المحتملة والتقاط الرمز الأسبق ظهوراً.
تكمن الصعوبة الرياضية في هذه المسألة في ضرورة الحفاظ على الترتيب الطوبولوجي للسلسلة النصية؛ حيث لا يكفي مجرد إثبات وجود الرموز المستهدفة عبر دالة منطقية، بل يتعين تحديد نقطة التقاطع المكانية الأدنى التي يظهر عندها أول رمز بين تلك المجموعة المحددة. يتطلب هذا التحدي التفريق الدقيق بين عمليتي “التحقق المنطقي المشروط” (Conditional Logical Verification) التي تكتفي بإرجاع قيمة صواب أو خطأ، و”البحث الموضعي التسلسلي” (Sequential Positional Search) الذي يقتضي اشتقاق فهرس عددي يعبر عن الإحداثي الدقيق للمحرف الأسبق؛ وهو ما يضع عبئاً حسابياً مضاعفاً على دوال النصوص التقليدية التي لم تُبنَ في الأصل لمعالجة الاحتمالات المتفرعة.
علاوة على ذلك، تزداد المعضلة تعقيداً عند تباين تكرار المعايير داخل نفس النص؛ فقد تحتوي السلسلة المفحوصة على عدة محارف مطابقة للمجموعة المستهدفة ولكن في مواقع متباعدة وغير منتظمة. يتطلب حل هذه المشكلة ضمان عدم تجاوز المؤشر الحسابي للظهور الأول، وتجنب الخلط بين رصد المحارف المختلفة ورصد التكرارات المتعددة لنفس المحرف؛ الأمر الذي يستوجب بناء صيغ رياضية تمتلك القدرة على فرز المصفوفات الناتجة وترتيبها لاختيار القيمة الصغرى المطلقة التي تمثل الظهور الفيزيائي الأول لأي من المعايير في الفضاء النصي للخلية.
2.2 التداعيات الهيكلية لظهور خطأ القيمة #VALUE!
يمثل التوليد الفوري لخطأ القيمة #VALUE! أحد أبرز العوائق التي تعترض بناء صيغ البحث متعدد المعايير عند استخدام دالة FIND بصورة بدائية. من الناحية الرياضية والمعمارية داخل محرك إكسل، صُممت دالة FIND لتتوقف عن التنفيذ الحسابي وتقطع مسار المعالجة فور فشل الخوارزمية في رصد المعيار المكتوب في النص؛ حيث لا تعيد الدالة القيمة صفر أو قيماً فارغة للدلالة على عدم التطابق، بل تُسقط استثناءً نظامياً صريحاً (System Exception) يعكس إخفاق العملية برمتها. وعند تطبيق مسح متعدد يبحث عن مصفوفة تحتوي على محارف غير موجودة بالكامل في النص، يتحول هذا الاستثناء إلى عائق يعطل احتساب المعادلة بالكامل.
تمتد التداعيات الهيكلية لهذا الخطأ لتشمل ما يُعرف بظاهرة “انتشار الخطأ المتسلسل” (Cascading Error Propagation)؛ حيث تنتقل قيمة الخطأ الناتجة عن دالة FIND تلقائياً إلى كافة الدوال المغلفة لها، مثل دوال الاقتطاع MID أو LEFT أو دوال المقارنة المنطقية، مما يؤدي إلى شلل تحليلي شامل في ورقة العمل. لا يقتصر الضرر هنا على تشويه العرض المرئي للبيانات فحسب، بل يمتد إلى إفساد مؤشرات المجاميع الإحصائية، وتعطيل التنسيقات الشرطية، وتوقف خوارزميات الفرز والتصفية التلقائية التي تعتمد على مخرجات تلك الأعمدة، مما يقوض موثوقية النموذج المالي أو الإحصائي بأكمله.
لمواجهة هذه المعضلة، تبرز الحاجة المنهجية لتطبيق استراتيجيات المعالجة المسبقة للاستثناءات والتحصين الحسابي. تتضمن هذه المنهجيات إما استخدام تقنيات “الإلحاق النصي الوقائي” التي تضمن وجود المحارف المستهدفة حتماً لتفادي توليد الخطأ البرمجي في المقام الأول، أو تضمين هياكل الاعتراض المنطقي عبر دوال الفحص المخصص. يضمن هذا النهج تدفقاً سلساً للبيانات عبر مسارات بديلة تُبقي العمليات الحسابية قيد التشغيل وتوفر قراءات دقيقة تعكس الواقع الفعلي للبيانات دون انقطاع، مما يسهم في تعزيز كفاءة واستقرار بيئات التحليل المتقدمة وتجنيب المحللين الوقوع في ثغرات الانقطاع الحاسوبي المفاجئ.
3. استراتيجية التعويض التراكمي: دمج دالتي FIND وSUBSTITUTE المتداخلة
3.1 الأساس المنطقي لتوحيد المعايير عبر الإحلال النصي
ترتكز استراتيجية التعويض التراكمي على مبدأ رياضي أنيق يُعرف في علوم الحاسوب بـ “إعادة الصياغة التحويلية” (Transformational Reformulation)؛ حيث يتم تحويل مسألة البحث متعدد المعايير المعقدة إلى مسألة بحث أحادي مكافئة تماماً من حيث النتيجة الحسابية. ينطلق هذا الأساس المنطقي من فكرة مفادها: إذا كان الهدف النهائي هو رصد موقع أول ظهور لأي محرف ضمن مجموعة محددة (مثل a أو b أو c)، فإنه يمكن استبدال كافة تلك المحارف برمز معياري موحد ومحدد مسبقاً، ثم توجيه دالة FIND الأحادية للبحث عن هذا الرمز الموحد فقط، بدلاً من إجهاد المحرك الحسابي في تتبع عدة مسارات بحث متوازية متنافرة.
تتحقق هذه الاستراتيجية من خلال توظيف دالة SUBSTITUTE التي تمتلك القدرة على استبدال نص قديم بنص جديد داخل سلسلة معينة بدقة متناهية. وعند إجراء عملية الإحلال النصي، يُشترط استبدال كل حرف مستهدف برمز يتطابق تماماً في الطول والخصائص الفهرسية، وفي الغالب يتم اختيار أحد أحرف مجموعة البحث نفسها ليكون هو الرمز المرجعي المشترك. يضمن هذا الإجراء الحفاظ الصارم على الطول الكلي للسلسلة النصية وعلى الإحداثيات المكانية الدقيقة لكافة المحارف الأخرى دون حدوث أي إزاحة إيجابية أو سلبية في الفهارس العددية للخلايا؛ مما يحافظ على التناظر الهندسي الكامل للنص الأصلي أثناء المعالجة.
يتميز هذا التكتيك بتجاوزه التام لمعضلة توليد خطأ القيمة في مرحلة البحث المسبق؛ إذ إن دالة SUBSTITUTE مصممة بطبيعتها لتجاهل السلاسل الفرعية غير الموجودة دون إطلاق أي أخطاء، فإذا لم يتضمن النص المحرف المستهدف بالاستبدال، تعيد الدالة النص الأصلي كما هو دون تعديل ودون توقف. يتيح هذا السلوك الهادئ تمرير النص عبر سلسلة متتابعة من طبقات الإحلال المتداخلة، لتخرج في النهاية سلسلة منقحة تم فيها “صهر” كافة المعايير المتعددة في معيار موحد، لتلتقطه دالة FIND الأحادية في خطوة نهائية واحدة بمنتهى السلاسة والموثوقية الحسابية.
3.2 التفكيك التحليلي للصيغة المركبة
لتوضيح الآلية الدقيقة لاستراتيجية التعويض التراكمي، نستعرض التفكيك الهيكلي للصيغة الكلاسيكية التالية المصممة للبحث عن أول ظهور لأي من الأحرف “a” أو “b” أو “c” داخل الخلية A2:
=FIND("a", SUBSTITUTE(SUBSTITUTE(A2, "b", "a"), "c", "a"))
تعتمد هذه المعادلة على نظام التقييم المتداخل المتعاقب الذي يبدأ من النواة الأكثر عمقاً ويتجه تدريجياً نحو الغلاف الخارجي. يبدأ مسار التنفيذ الحسابي من دالة SUBSTITUTE الداخلية: SUBSTITUTE(A2, "b", "a"). تقوم هذه الدالة بفحص محتوى الخلية A2 بالكامل؛ فإذا وجدت أي ظهور للمحرف “b”، فإنها تستبدله فوراً بالمحرف “a”، معيدةً نسخة معدلة جزئياً من النص تحتفظ بمواقع المحارف الأصلية بدقة، مع تحييد وجود المحرف “b” وتحويله شكلياً إلى المحرف المستهدف المرجعي “a”.
في المرحلة التالية، يُمرر هذا النص الناتج كمدخل وسيطي مباشر إلى دالة SUBSTITUTE الخارجية: SUBSTITUTE(..., "c", "a"). تتولى هذه الطبقة الثانية فحص النص المعدل القادم من المرحلة الأولى، وتبحث فيه عن أي وجود للمحرف “c”، وعند العثور عليه تستبدله هو الآخر بالمحرف “a”. وبانتهاء هذه العملية، تصبح السلسلة النصية الناتجة خالية تماماً من الحرفين “b” و”c”، بعد أن تحول كل ظهور لهما في النص الأصلي إلى الحرف “a”، دون أي تغيير في الفواصل الزمنية أو الترتيب الموضعي للمحارف المحيطة.
أخيراً، تتلقى دالة FIND الخارجية النص النهائي المعالج، وتبدأ خوارزمية الفحص بالبحث عن الموضع الأول لظهور المحرف “a”. ونظراً لأن كل حرف أصلي من فئة “b” أو “c” قد تمت صياغته ليصبح “a”، فإن دالة FIND سترصد بالضرورة الموقع المكاني لأول حرف ظهر في السلسلة الأصلية سواء كان في الأصل “a” أو “b” أو “c”. يعيد هذا المسار المركب النتيجة الرقمية الصحيحة بنجاح، مما يعكس تناغماً وظيفياً فائق الدقة بين آليات التحويل النصي وخوارزميات الرصد الفهرسي.
3.3 تقييم الكفاءة وقابلية التوسع لأسلوب التعويض
على الرغم من النجاح الوظيفي الملموس لأسلوب التعويض التراكمي في حل معضلة المعايير المتعددة، فإن التقييم الهندسي والبرمجي لهذه الاستراتيجية يكشف عن قيود جوهرية تتعلق بقابلية التوسع والصيانة البرمجية. تتجلى المشكلة الأولى في “التعقيد التركيبي المتصاعد”؛ حيث تتطلب إضافة كل معيار بحث جديد إدراج طبقة تداخل إضافية لدالة SUBSTITUTE. فإذا كان المطلوب البحث عن عشرة معايير نصية مختلفة، فإن المعادلة ستتحول إلى كتلة هائلة من الأقواس المتداخلة بعمق يصل إلى عشر مستويات، مما يجعل قراءتها وفهمها أمراً شاقاً للغاية على محللي البيانات ويزيد من احتمالية الأخطاء التركيبية عند كتابة الفواصل والأقواس المغلقة.
يرتبط بهذا التعقيد عائق آخر يتعلق بكفاءة التعديل وديناميكية النماذج؛ إذ تفتقر هذه الصيغة إلى المرونة في مواكبة تغير المعايير. فإذا طرأ تغيير على قائمة الرموز المستهدفة بالبحث، يضطر المستخدم إلى إعادة بناء الصيغة يدوياً وتعديل كافة طبقات الاستبدال الداخلية، مما يتعارض مع مبادئ التصميم النموذجي لجداول البيانات التي تفترض فصل المعايير والمتغيرات عن البنية الرياضية الثابتة للمعادلات. كما أن كثرة الدوال المتداخلة تفرض حملاً إضافياً على مفسر الصيغ داخل إكسل، حيث يتعين عليه إنشاء نسخ نصية وسيطة متعددة في الذاكرة المؤقتة لكل خلية على حدة قبل الوصول إلى النتيجة النهائية.
بناءً على ذلك، يمثل أسلوب التعويض التراكمي خياراً تكتيكياً فعالاً وسريعاً في الحالات التي يكون فيها عدد معايير البحث محدوداً جداً (معيارين أو ثلاثة معايير على الأكثر)، وتكون فيها بنية البيانات ثابتة لا تتطلب تعديلات مستمرة. أما في الحالات التي تتسع فيها مصفوفة المعايير لتشمل قوائم طويلة من الرموز أو الكلمات، فإن الاعتماد على هذا الأسلوب يصبح غير مستدام، مما يستوجب الانتقال نحو الحلول المصفوفية الأكثر مرونة أو اللجوء إلى بيئات المعالجة الأكثر تقدماً التي تتيح التعامل مع متجهات النصوص بمرونة برمجية فائقة.
4. دراسة حالة تطبيقية: معالجة وتصنيف سلاسل البيانات النصية
4.1 بناء النموذج التجريبي وإعداد البيانات الأولية
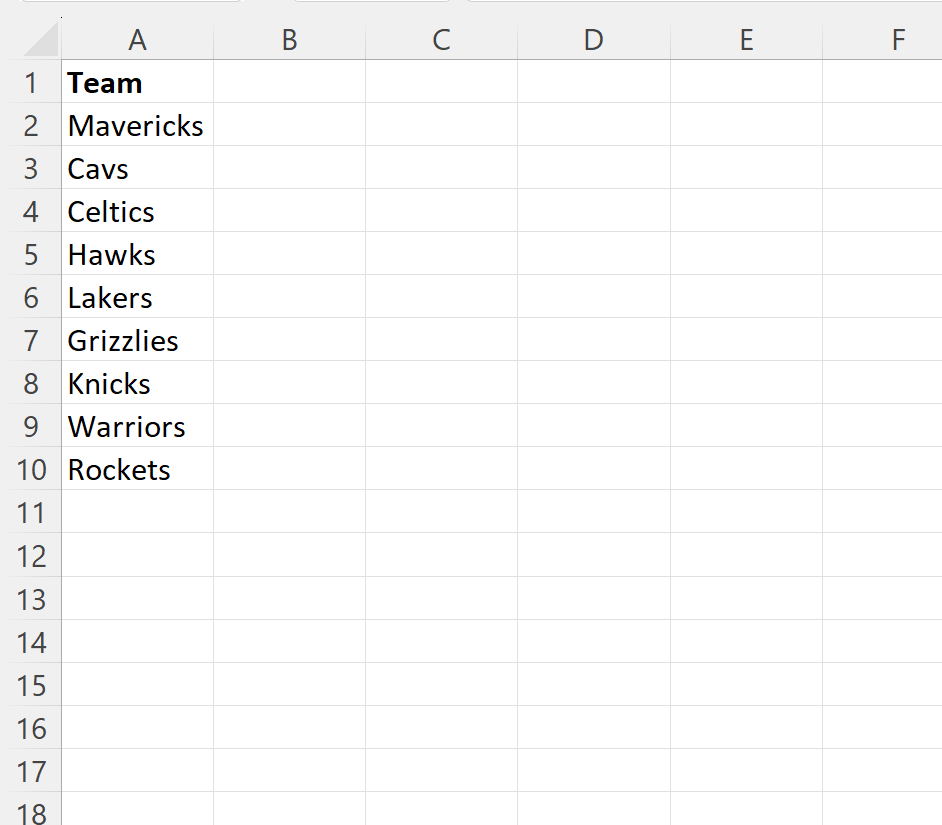
لإرساء التطبيق العملي على أسس واقعية، نقوم ببناء نموذج تجريبي يعكس التحديات اليومية لمعالجة وتصنيف السجلات النصية. نفترض وجود جدول بيانات يتضمن سجلات تشغيلية لأسماء فرق رياضية وأكواد تشغيلية تتوزع في العمود A بدءاً من الخلية A2 وحتى A6. تتميز هذه السلاسل النصية بتباين بنيوي ملحوظ، حيث تحتوي على نصوص تتداخل فيها الحروف اللاتينية والرموز بتركيبات مختلفة، والمطلوب هو رصد أول ظهور لأي من الأحرف الصغيرة الثلاثة التالية: {“a”, “b”, “c”}، لتحديد موقع أول كود فرعي لأغراض التصنيف المؤسسي.
يوثق الجدول التالي هيكل البيانات الأولية للنموذج التجريبي المقترح:
- الخلية A2: تحتوي على السلسلة النصية
"Mavs"(نص مجرد يتضمن الحرف a في موضع مبكر). - الخلية A3: تحتوي على السلسلة النصية
"Hawks"(نص يتضمن الحرف a مسبوقاً بمحرف آخر). - الخلية A4: تحتوي على السلسلة النصية
"Celtics"(نص يتضمن الحرف c كحرف أخير صغير، بينما الحرف الأول كبير C). - الخلية A5: تحتوي على السلسلة النصية
"Nets"(سلسلة نصية خالية تماماً من الأحرف a أو b أو c). - الخلية A6: تحتوي على السلسلة النصية
"Bobcats"(سلسلة نصية تبدأ بحرف B كبير وتتضمن الحرفين b و c و a في مواضع متفرقة).
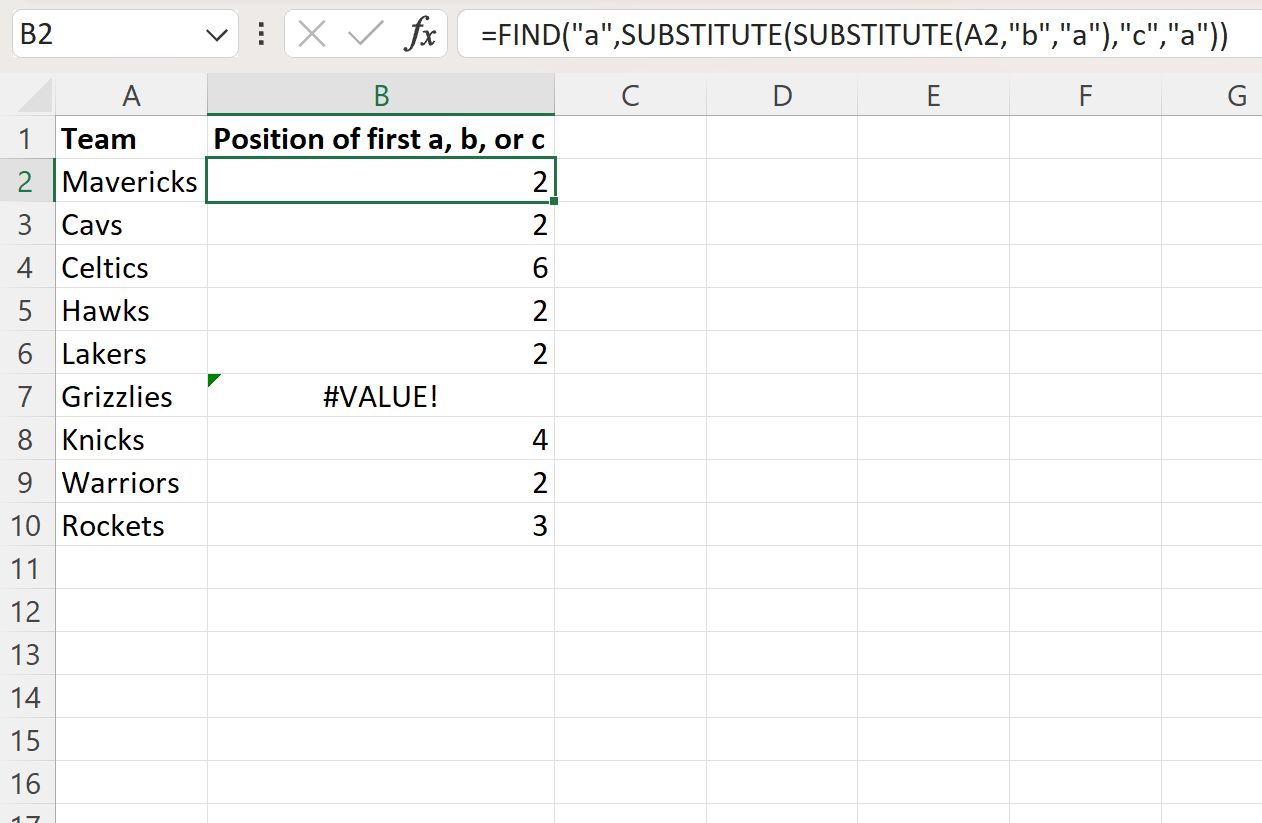
يوفر هذا النموذج التجريبي تنوعاً بنيوياً يتيح اختبار سلوك الدالة في مختلف السيناريوهات الممكنة: وجود معيار فردي مبكر، ووجود المعيار في منتصف السلسلة، وتداخل الحروف الكبيرة مع الصغيرة لاختبار حساسية الأحرف، والغياب الكامل لكافة المعايير المحددة، وأخيراً التواجد المتزامن لعدة معايير متنافسة داخل نفس النص؛ مما يشكل أرضية مثالية لتحليل مسار تنفيذ المعادلات وتقييم مخرجاتها بدقة علمية رصينة.
4.2 التنفيذ الإجرائي للصيغة وتحليل خطوات التقييم
لتطبيق خوارزمية البحث الموضعي المتعدد عبر أسلوب التعويض التراكمي، نقوم بإدراج الصيغة التالية في الخلية النشطة B2، ثم تعميمها على باقي صفوف النطاق (من B2 إلى B6) باستخدام مقبض التعبئة التلقائي:
=FIND("a", SUBSTITUTE(SUBSTITUTE(A2, "b", "a"), "c", "a"))
عند تقييم الصيغة في الخلية B2 المقابلة للسلسلة "Mavs"، تفحص الدالة النص وتجد أن الحرفين b و c غير موجودين، فتبقى السلسلة كما هي، ثم ترصد دالة FIND الحرف “a” في الموضع الثاني؛ وتكون النتيجة الرقمية المسترجعة هي (2). في الخلية B3 المقابلة لـ "Hawks"، تجري نفس الخطوات ويرصد المحرف “a” في الموضع الثاني أيضاً، لتعيد الدالة القيمة (2) بدقة تعكس الموضع الفيزيائي الفعلي للحرف.
تتجلى قوة الصيغة في الخلية B4 المقابلة للسلسلة "Celtics"؛ حيث لا تحتوي السلسلة على المحرف “b”، لكن دالة SUBSTITUTE الخارجية ترصد الحرف الصغير “c” الواقع في نهاية الكلمة وتستبدله بالحرف “a”، لتتحول السلسلة داخلياً إلى "Celtisa". تقوم دالة FIND برصد المحرف “a” المستحدث في الموضع السابع؛ فتعيد الدالة القيمة الرقمية (7). يوضح هذا الإجراء العملي نجاح استراتيجية التعويض في استقطاب المعيار “c” وتحويله للرمز المشترك، مع مراعاة حساسية حالة الأحرف؛ حيث تم تجاهل الحرف الأول “C” لكونه حرفاً كبيراً لا يطابق المعيار المستهدف بدقة.
أما في الخلية B6 المقابلة للسلسلة "Bobcats"، فإننا نشهد تنافساً بين عدة معايير مستهدفة؛ إذ تحتوي الكلمة على الحرف “b” في الموضع الثالث، والحرف “c” في الموضع الرابع، والحرف “a” في الموضع الخامس. تقوم دوال SUBSTITUTE المتداخلة بتحويل الحرفين “b” و”c” إلى الحرف “a”، لتصبح السلسلة الافتراضية داخل الذاكرة: "Boaaats". عند تنفيذ دالة FIND، تلتقط الدالة أول ظهور للمحرف “a” والذي يقع في الموضع رقم (3)؛ وهو الموضع الأصلي للحرف “b”. تثبت هذه النتيجة قدرة المعادلة على فرز المعايير المتعددة واستخلاص الموقع الأسبق ظهوراً بدقة رياضية مطلقة تتطابق مع الترتيب التسلسلي للنص.
4.3 مناقشة الحالات الاستثنائية وتفسير النتائج الشاذة
تكشف دراسة الحالة التطبيقية عن سلوك استثنائي حاسم يستوجب التوقف الأكاديمي والتحليل البرمجي المعمق؛ ويتجلى ذلك في الخلية B5 المقابلة للنص "Nets". عند تطبيق الصيغة على هذه الخلية، تفشل دوال SUBSTITUTE المتداخلة في العثور على أي من الحروف المستهدفة (“b” أو “c”)، فيمر النص كما هو دون أي تغيير إلى دالة FIND الخارجية. تبحث دالة FIND عن المحرف “a” فلا تجد له أي أثر في السلسلة، مما يؤدي فوراً إلى انهيار العملية الحسابية وتوليد رمز الخطأ الصريح #VALUE! في الخلية B5.
يفسر هذا الانقطاع الرياضي الطبيعة الصارمة لدوال إكسل التقليدية؛ فالخطأ هنا ليس دليلاً على خلل تركيبي في كتابة المعادلة، بل هو استجابة نظامية حتمية لعدم تحقق شرط الوجود الموضعي لأي من المعايير الثلاثة المحددة. يوضح هذا الشذوذ ضرورة عدم إطلاق الصيغ المركبة في بيئات العمل الحقيقية دون تحصين استباقي؛ إذ إن ظهور هذا الخطأ في صف واحد قد يؤدي إلى تعطيل العمليات اللاحقة، مثل محاولة استخراج المقاطع النصية بناءً على تلك المؤشرات، مما يولد سلسلة لا تنتهي من الأخطاء في أوراق العمل المترابطة.
تستخلص من هذه الحالة دروس معيارية بالغة الأهمية لتنقيح البيانات؛ فالبيانات الواقعية نادراً ما تتطابق بنسبة 100% مع التوقعات النظرية لمحلل البيانات. ومن ثم، فإن اعتماد صيغة التعويض التراكمي بمفردها يظل ناقصاً ما لم يتم تغليف المعادلة ببروتوكولات إدارة الأخطاء، أو اللجوء إلى تقنيات الإلحاق النصي الوقائي التي تضمن إرجاع قيمة تدل على الغياب بدلاً من إسقاط الخطأ البرمجي، وهو ما سنفصله في المحاور المتقدمة اللاحقة لضمان استقرار وموثوقية النماذج الحسابية.
5. المنهجية المصفوفية الحديثة: استخدام FIND مع مصفوفات الثوابت
5.1 الأسس النظرية للصيغ المصفوفية في البحث النصي
تمثل المنهجية المصفوفية الحديثة قفزة نوعية في هندسة المعادلات الحسابية داخل إكسل؛ حيث تتجاوز القيود السلمية الصارمة عبر تمرير متجهات وثوابت مصفوفية متعددة داخل الوسائط الفردية للدوال. في سياق البحث النصي متعدد المعايير، تقوم هذه المنهجية على تمرير مصفوفة ثوابت نصية (Array Constant) محاطة بأقواس معقوفة مباشرة داخل وسيط البحث، مثل: {"a", "b", "c"}. يوجه هذا التكوين المصفوفي محرك الحساب لتكرار عملية الفحص الموضعي بشكل متوازٍ لكافة عناصر المصفوفة ضد السلسلة النصية المستهدفة في خطوة تقييم موحدة.
ينتج عن هذا التقييم المتوازي مصفوفة رقمية متطابقة في الأبعاد مع مصفوفة المعايير المدخلة؛ حيث يعبر كل عنصر في المصفوفة الناتجة عن الموضع المكتشف للمعيار المقابل له، أو يسجل رمز الخطأ في حال غيابه. وقد شهدت هذه التقنية تحولاً جذرياً مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays Engine) في الإصدارات الحديثة من إكسل (Microsoft 365 وExcel 2021 وما بعدها)؛ حيث باتت البيئة الحسابية تدعم تدفق المصفوفات وتوليد النتائج المتعددة تلقائياً عبر الخلايا المجاورة (Spill Mechanism) دون الحاجة إلى التثبيت القديم والشهير بمفاتيح (Ctrl + Shift + Enter).
تتميز الصيغ المصفوفية بقدرتها على تحرير كفاءة المعالج الحاسوبي؛ فبدلاً من استدعاء دوال متعددة وتوليد هياكل وسيطة متكررة في الذاكرة كما يحدث في تراكب دوال SUBSTITUTE، يُجري المحرك عملية تقييم واحدة تتسم بالكفاءة وتتعامل مع المتجه النصي ككتلة بيانات متكاملة. يتيح هذا الأساس النظري لمحللي البيانات بناء استعلامات نصية فائقة المرونة والسرعة، قادرة على استيعاب عشرات المعايير المتزامنة دون إحداث تضخم أو تشويه في البنية التركيبية للمعادلة في أوراق العمل.
5.2 دمج دالة MIN لتحديد أول ظهور رياضي
لتحويل المصفوفة الرقمية الناتجة عن عملية البحث المتعدد إلى مؤشر موضعي فردي يعكس أول ظهور فيزيائي لأي من المحارف المستهدفة، يتم دمج دالة FIND المصفوفية مع دالة التقليص الحسابي MIN، مع تطبيق تقنية برمجية فائقة الذكاء تُعرف بـ “الإلحاق النصي الوقائي” (Defensive Text Concatenation). تتجسد هذه المعادلة التكاملية في الصيغة المعيارية التالية:
=MIN(FIND({"a", "b", "c"}, A2 & "abc"))
يكمن السر الرياضي والمنطقي لهذه المعادلة في المقطع A2 & "abc"؛ حيث يتم دمج مصفوفة المعايير المستهدفة ذاتها في نهاية السلسلة النصية الأصلية المفحوصة بشكل افتراضي ومؤقت داخل مسار الحساب. يؤدي هذا الإلحاق المتعمد إلى غرض محوري: ضمان وجود كافة المعايير المستهدفة حتماً داخل السلسلة الممتدة، مما يمنع دالة FIND نهائياً وبشكل قاطع من توليد رمز الخطأ #VALUE!؛ إذ ستجد الدالة كل محرف تبحث عنه بالتأكيد، إما في موضعه الحقيقي داخل النص الأصلي A2، أو في الموضع الافتراضي الإلحاقي في نهاية النص.
تنتج دالة FIND في هذه الحالة مصفوفة ثلاثية تتضمن ثلاثة مواقع رقمية حتمية. وهنا يبرز الدور الحاسم لدالة MIN؛ حيث تقوم هذه الدالة بفرز عناصر المصفوفة الرقمية واشتقاق القيمة الصغرى المطلقة بينها. إذا كان أي من المحارف المبحوث عنها موجوداً بالفعل داخل النص الأصلي A2، فإن موقعه الرقمي سيكون حتماً أصغر من موقع الأحرف الملحقة في الذيل الافتراضي، وبالتالي تعيد دالة MIN موضع الظهور الأسبق للمحرف الحقيقي بدقة رياضية متناهية وبتجاوز تلقائي لأي احتمال للتعطل الحسابي.
ولمعالجة الحالة التي تغيب فيها كافة المعايير عن النص الأصلي، يمكن ضبط المعادلة لتكتشف ما إذا كانت القيمة الصغرى المسترجعة تتجاوز الطول الفعلي للخلية A2؛ فإذا كانت النتيجة أكبر من LEN(A2)، فهذا برهان رياضي قاطع على أن كافة المعايير غير موجودة في النص الأصلي وأن الرقم المسترجع يعود إلى الذيل الإلحاقي، مما يتيح استبدال النتيجة بسهولة بقيمة صفر أو نص توضيحي يدل على عدم العثور على أي تطابق، موفراً بذلك حلاً حسابياً متكاملاً يتسم بالحصانة المطلقة والصلابة الهيكلية.
5.3 مقارنة دقة الصيغ المصفوفية مقابل تقنية SUBSTITUTE المتداخلة
عند إجراء مقارنة معيارية بين المنهجية المصفوفية وتقنية التعويض التراكمي عبر SUBSTITUTE، تتفوق الصيغ المصفوفية بوضوح في معايير المرونة وقابلية التوسع (Scalability). تتيح الصيغة المصفوفية للمحلل إمكانية توسيع قائمة معايير البحث من ثلاثة معايير إلى عشرين معياراً بمجرد إضافة الرموز داخل القوسين المعقوفين للمصفوفة دون المساس بالبنية الخارجية للمعادلة. بل وأكثر من ذلك، يمكن استبدال مصفوفة الثوابت {"a", "b", "c"} بمرجع لنطاق خلايا خارجي منفصل يحتوي على قائمة المعايير، مثل $F$2:$F$10، مما يفصل منطق التحليل كلياً عن مدخلات المستخدم ويتيح تعديل معايير البحث لحظياً دون الحاجة لتعديل المعادلات الحسابية إطلاقاً.
يوضح الجدول المقارن التالي الفروق الهندسية والتشغيلية بين الاستراتيجيتين:
- سهولة الصيانة والتعديل: تتميز الصيغة المصفوفية بمرونة فائقة؛ حيث تقتصر التعديلات على تحديث عناصر المصفوفة أو النطاق المرجعي. في المقابل، تتطلب تقنية SUBSTITUTE إعادة كتابة الأقواس وتعديل مستويات التداخل يدوياً لكل معيار إضافي.
- الأداء الحاسوبي وسرعة المعالجة: تتفوق الصيغ المصفوفية في السرعة الحسابية على النطاقات الكبيرة، نظراً لمعالجة المتجهات ككتلة واحدة في دورة معالجة معيارية، بينما تستهلك تقنية SUBSTITUTE دورات معالجة متتالية لإنشاء سلاسل نصية وسيطة متعددة في الذاكرة المؤقتة.
- مقاومة الأخطاء المدمجة: تتطلب تقنية المصفوفات إلحاقاً نصياً وقائياً لتفادي أخطاء الغياب، ولكنها بمجرد تحصينها توفر استقراراً تاماً. أما تقنية SUBSTITUTE، فهي مقاومة للأخطاء أثناء التبديل، لكنها تسقط فوراً في فخ خطأ FIND الخارجي عند الغياب التام للمعايير.
- التوافق مع إصدارات إكسل القديمة: تعمل تقنية SUBSTITUTE المتداخلة بسلاسة وبشكل كلاسيكي على كافة إصدارات إكسل دون شروط مسبقة. في حين تحتاج الصيغ المصفوفية على الإصدارات السابقة لعام 2019 إلى تثبيت خاص عبر اختصار لوحة المفاتيح المعقد (CSE)، مما قد يربك المستخدمين المبتدئين.
يتضح من هذا التقييم أن المنهجية المصفوفية تمثل الخيار الهندسي الأمثل للنماذج المتقدمة والأنظمة الضخمة، بينما تظل تقنية التعويض التراكمي حلاً تكتيكياً مناسباً للسيناريوهات البسيطة والمصنفات التراثية التي تتطلب توافقية تشغيلية شاملة مع الإصدارات القديمة من البرنامج دون الاعتماد على ميزات المصفوفات الحديثة.
6. بروتوكولات إدارة الأخطاء وتحصين الصيغ الحسابية
6.1 تضمين دوال التحقق الشرطي IFERROR وISNUMBER
يمثل تحصين الصيغ الحسابية ضد الأخطاء الركيزة الأساسية لضمان سلامة النماذج المالية والتحليلية في بيئات العمل الاحترافية. وتأتي دالة IFERROR في صدارة أدوات التحصين التكتيكي؛ حيث توفر آلية تغليف انسيابية وفعالة تحيط بالمعادلات المركبة لاعتراض أي استثناء حسابي فور وقوعه واستبداله بمخرج بديل محدد مسبقاً. في سياق البحث متعدد المعايير، يضمن تغليف دالة FIND بدالة IFERROR استبدال رمز الخطأ القيمي #VALUE! بقيمة رقمية آمنة (مثل الصفر) أو قيمة نصية تدل على غياب التطابق (مثل “غير موجود”)، مما يحول دون توقف تدفق الحسابات في النماذج المعقدة.
تُصاغ المعادلة المحصنة باستخدام تقنية التعويض التراكمي ودالة IFERROR على النحو التالي:
=IFERROR(FIND("a", SUBSTITUTE(SUBSTITUTE(A2, "b", "a"), "c", "a")), 0)
تضمن هذه البنية الهندسية استمرار تدفق البيانات بسلاسة؛ فإذا احتوت الخلية A2 على أي من المعايير المستهدفة، تعيد الدالة الفهرس العددي الحقيقي بدقة. أما في حال الغياب التام لكافة المعايير (كما في حالة السلسلة "Nets")، تعترض دالة IFERROR الخطأ المتولد فوراً وتعيد الرقم (0) كإشارة واضحة تدل على عدم التطابق، مما يحمي الدوال التابعة التي قد تعتمد على هذه الخلية لإجراء عمليات جمع أو تصنيف لاحقة.
إلى جانب ذلك، تلعب دالة ISNUMBER دوراً مكملاً بالغ الأهمية عند بناء مخرجات التحقق المنطقي لأغراض التصفية والتصنيف التلقائي؛ حيث تقوم باختبار المخرج الرقمي لدالة FIND وإرجاع قيمة منطقية صريحة: صواب (TRUE) إذا تم العثور على المعيار والحصول على مؤشر موضعي، أو خطأ (FALSE) إذا فشلت العملية وتولد رمز خطأ. يتيح هذا الدمج توظيف نتائج البحث الموضعي داخل وسائط دالة IF الشرطية لاشتقاق تصنيفات نوعية وتوجيه مسارات القرارات التحليلية بدقة بالغة، بما يعزز موثوقية النماذج وتماسكها البرمجي والمنطقي.
6.2 المعالجة المتقدمة للنتائج السلبية وفصل البيانات الشاذة
تتجاوز إدارة الأخطاء المتقدمة مجرد قمع الاستثناءات عبر IFERROR إلى التمييز النوعي الدقيق بين طبيعة الأخطاء وأسبابها الحقيقية. في معالجة السجلات الضخمة، يتعين على محلل البيانات التمييز الصارم بين حالتين متباينتين جوهرياً: حالة “النتيجة السلبية الطبيعية” التي تعني أن السلسلة النصية سليمة تماماً ولكنها لا تحتوي على أي من المعايير المستهدفة بالبحث، وحالة “البيانات الشاذة أو الفاسدة” الناتجة عن إدخال قيم خاطئة، كأن تكون الخلية تحتوي على مسافات بيضاء غير مرئية، أو قيماً فارغة، أو أخطاء حسابية مسبقة منقولة من مصادر خارجية.
لتحقيق هذا الفصل المتقدم، يتم بناء مسارات استعلامية هجينة تعتمد على الجمع بين دوال التحقق المسبق مثل ISBLANK وTRIM وCLEAN قبل تمرير النصوص إلى خوارزميات FIND المركبة. يضمن هذا الإجراء تنقية النصوص من الشوائب غير المرئية وضمان صلاحية السلسلة للمعالجة الفهرسية. كما يمكن بناء صيغ شرطية متفرعة توجه السجلات الشاذة إلى أعمدة تدقيق مستقلة لإخضاعها للمراجعة اليدوية أو الاستبعاد الإحصائي، مما يمنع تشويه التحليلات التنبؤية بالقيم الصفرية المضللة أو النتائج الإيجابية الزائفة.
يسهم هذا النهج التحصيني الصارم في تأمين استقرار وموثوقية النماذج المؤسسية الكبرى؛ حيث تظل خطوط المعالجة محمية ضد التوقف المفاجئ، وتتحول مخرجات دالة FIND من مجرد مؤشرات نصية بسيطة إلى مقاييس موثوقة تُبنى عليها مؤشرات الأداء والتحليلات التنبؤية المعقدة بأعلى درجات الدقة والأمان الحسابي المعمول بها في الأوساط التحليلية والمهنية المتقدمة.
7. التحليل المقارن: المفاضلة المعيارية بين دالتي FIND وSEARCH
7.1 مقارنة السلوك المنطقي في سياق تعدد المعايير
تعتبر المقارنة المنهجية بين دالتي FIND وSEARCH من الموضوعات التأسيسية التي تحسم دقة المعالجة النصية داخل بيئة إكسل؛ حيث تتشابه الدالتان تماماً في البنية التركيبية للوسائط ومطابقة المخرجات الفهرسية، لكنهما تتباينان جذرياً في فلسفة المطابقة المنطقية. تكمن الفجوة الهيكلية الأولى في “حساسية حالة الأحرف” (Case Sensitivity)؛ فبينما تتعامل FIND مع الحروف بدقة ثنائية تفصل بين الكبير والصغير، تتجاهل SEARCH هذا التمايز تماماً، وتعتبر الحرفين “A” و”a” متطابقين منطقياً وتعاملهما ككيان نصي واحد دون أدنى تفريق.
يتجسد التباين الهيكلي الثاني في دعم دالة SEARCH الفطري لاستخدام “المحارف البديلة” (Wildcards)؛ حيث يمكن استخدام علامة الاستفهام (?) لتمثيل أي محرف فردي مفرد، وعلامة النجمة (*) لتمثيل أي عدد تسلسلي من المحارف غير المحددة، وهو ما تفتقر إليه دالة FIND تماماً لكونها مصممة للمطابقة الميكانيكية الحرفية. في سياق البحث متعدد المعايير، يمنح هذا الدعم دالة SEARCH ميزة وظيفية كبرى تتيح لها اختصار العديد من المعايير في نمط بحث تركيبي واحد؛ فالبحث عن النمط "b*c" داخل SEARCH يغني عن تفكيك السلاسل للبحث عن الحرفين بصورة منفصلة إذا كان النمط العام هو المستهدف.
ومع ذلك، فإن هذه المرونة الواسعة لدالة SEARCH تمثل سيفاً ذو حدين؛ إذ يتعين على محلل البيانات التمسك الصارم بدالة FIND متى ما كانت دقة البيانات تتطلب تمايزاً لا يحتمل اللبس. تبرز هذه الضرورة بصورة خاصة عند تدقيق المفاتيح المشفرة، وأكواد التصنيف الكيميائية، والمعرفات البرمجية، والمختصرات الطبية والمالية؛ حيث يحمل تغير حالة الحرف دلالة نوعية حاسمة تغير المعنى الوظيفي للرمز برمته، مما يجعل أي تجاهل لحالة الأحرف سبباً مباشراً في الوقوع في أخطاء التطابق الزائف وتضخيم النتائج المسترجعة دون وجه حق.
7.2 دراسة مقارنة للمخرجات وفق متطلبات سلامة البيانات
تتطلب إدارة سلامة البيانات (Data Integrity) تقييماً دقيقاً للمخاطر المترتبة على اختيار أداة البحث الموضعي داخل أوراق العمل. إن الاعتماد غير المنضبط على دالة SEARCH في بيئات العمل التي تتطلب فرزاً دقيقاً قد يؤدي إلى استرجاع مؤشرات خاطئة تماماً؛ فإذا كان المعيار المستهدف هو رصد كود الوحدة الذي يبدأ بحرف صغير “m” (للإشارة إلى الميلي)، فإن دالة SEARCH سترصد أول ظهور لحرف “M” الكبير (الذي قد يرمز للميجا) وتعيد موقعه كمطابقة صحيحة، مما يتسبب في إزاحة موضع الاقتطاع اللاحق وتشويه الحسابات الكمية المبنية عليه بصورة كارثية.
يوضح التحليل الإحصائي المقارن للمخرجات أن استخدام دالة FIND يقلل معدل النتائج الإيجابية الزائفة (False Positives) إلى الصفر المطلق في مهام التمييز الحرفي؛ مما يضمن أن كل فهرس رقمي مسترجع يعكس تطابقاً حقيقياً ومقصوداً بنسبة 100%. ولهذا التمييز أثر بالغ على سلامة العمليات اللاحقة، مثل عمليات التجزئة والاستقطاع عبر دوال MID أو SPLIT الحديثة؛ حيث إن خطأً مقداره محرف واحد في تحديد موقع البداية كفيل ببتر الكلمات واستخراج أجزاء ناقصة أو مشوهة من السجلات النصية المستهدفة.
بناءً على ذلك، تقضي الممارسات المعيارية المعتمدة في هندسة البيانات باعتماد دالة FIND كخيار افتراضي متى ما كانت البيانات تتضمن أكواداً تقنية أو أحرفاً مختلطة تستوجب تدقيقاً صارماً. في المقابل، يُنصح بحصر استخدام دالة SEARCH في معالجة النصوص اللغوية الحرة، والأسماء العامة، والمقالات، والبيانات الوصفية غير المنظمة التي يغلب عليها التباين العشوائي في كتابة الحروف الكبيرة والصغيرة دون أن يترتب على ذلك أي تغيير في الدلالة الموضوعية للنص.
8. التطبيقات التراكمية: استخراج النصوص الفرعية بناءً على مؤشرات FIND
8.1 التكامل الوظيفي مع دوال الاستقطاع MID وLEFT وRIGHT
لا تتوقف القيمة العملية لدالة FIND عند حدود استخراج المؤشرات الرقمية المجردة لمواضع المحارف، بل تتجلى قوتها الحقيقية عندما تعمل كـ “عين موجهة” للمنظومة التكاملية المسؤولة عن اقتطاع وتجزئة النصوص داخل إكسل، والتي تتألف من دوال الاستخلاص النصي الشهيرة: MID وLEFT وRIGHT. تعتمد هذه الدوال على مدخلات عددية لتحديد نقطة انطلاق الاقتطاع وعدد المحارف المراد استخلاصها، وتوفر دالة FIND تلك المدخلات بصورة ديناميكية تتكيف تلقائياً مع تباين أطوال النصوص ومواضع الفواصل في كل صف من صفوف الجدول.
تظهر الصيغة التالية نموذجاً للتكامل الوظيفي بين دالتي LEFT وFIND لاستخراج المقطع النصي الذي يسبق أول ظهور لأي من المعايير الثلاثة المحددة (a أو b أو c):
=LEFT(A2, FIND("a", SUBSTITUTE(SUBSTITUTE(A2, "b", "a"), "c", "a")) - 1)
في هذا التركيب الحسابي، تقوم الصيغة المدمجة لدالتي FIND وSUBSTITUTE بتحديد الموضع الدقيق لأول محرف يطابق المعايير المستهدفة. ومن خلال طرح الرقم واحد (- 1) من هذا الموضع المكتشف، نشتق رياضياً الطول الدقيق للمقطع السابق للفهرس المستهدف. تتلقى دالة LEFT هذا البعد العددي وتقتطع الأحرف المطلوبة من بداية الخلية A2 وحتى الحرف السابق للمعيار مباشرة، محققة بذلك فصلاً ديناميكياً خالياً من أي شائبة وبمنتهى الإتقان البرمجي ودون الحاجة لتحديد أطوال ثابتة للنصوص.
يسهم هذا التكامل في أتمتة عمليات تنظيف وتفكيك السجلات المعقدة الواردة من مصادر خارجية مثل ملفات CSV المصدرة من قواعد البيانات الضخمة. تتيح هذه الصيغ فصل أرقام الهواتف عن مفاتيح الدول، وتجريد أسماء النطاقات من مسارات الروابط التشعبية، وعزل الأسماء الأولى عن الألقاب، مما يوفر ساعات طويلة من العمل اليدوي المرهق ويمنع الأخطاء البشرية الشائعة التي تصاحب عمليات المعالجة اليدوية للسجلات النصية الطويلة والمتشابكة.
8.2 نمذجة حالات الاستخراج عند تعدد الفواصل النصية
تواجه عمليات هندسة البيانات تحدياً بنيوياً متكرراً يتمثل في التعامل مع السلاسل النصية التي تشتمل على فواصل ترقيمية متباينة وغير منتظمة؛ كأن تحتوي البيانات على سجلات تفصل بين عناصرها تارة بالفاصلة العادية (,)، وتارة بالفاصلة المنقوطة (;)، وتارة أخرى بشرطة مائلة (/) أو مسافة فارغة. في مثل هذه البيئات غير المتجانسة، يفشل الاقتطاع الثابت المبني على معيار واحد، ويصبح بناء نموذج استخراج مرن يستند إلى مؤشرات FIND متعددة المعايير ضرورة ملحة لاستخلاص البيانات بدقة وحيادية تامة.
يتطلب هذا النمط المعقد بناء صيغ تستخدم دالة MID بالتعاون مع دالة FIND متعددة المعايير لاستخراج المقاطع النصية المحصورة بين فاصلين غير متجانسين؛ حيث يتم توظيف المعادلة المصفوفية المدعومة بـ MIN لتحديد موضع الفاصل الأول، ثم توظيف نفس البنية مع استخدام وسيط start_num لتحديد موضع الفاصل الثاني الذي يليه مباشرة. يتيح الفارق الجبري بين المؤشرين اشتقاق الطول الصافي للمقطع النصي الأوسط واستخراجه بنجاح دون تضمين علامات الترقيم المحيطة به.
تجد هذه النمذجة تطبيقات واسعة في عزل السجلات الشخصية وفك تشفير الرموز الفنية في قطاعات الرعاية الصحية والخدمات المالية والتصنيع؛ حيث تشتمل معرفات المرضى أو أكواد قطع الغيار على أنماط ترميزية متداخلة تستوجب استخلاص الأرقام التسلسلية المغمورة بين فواصل عشوائية. تضمن هذه الحلول المتطورة الحفاظ على اتساق قواعد البيانات وتسهيل تصديرها إلى برمجيات التحليل الإحصائي المتقدمة دون فقدان أو تشويه للمعلومات الجوهرية المضمنة في السجلات الأصلية.
9. الأداء الحاسوبي وهندسة الكفاءة في المصنفات الضخمة
9.1 العبء التشغيلي للمعادلات المتداخلة والمصفوفية
تكتسب مسألة الأداء الحاسوبي (Computational Performance) وزمن الاستجابة أهمية بالغة عند الانتقال بالصيغ الحسابية من النماذج التجريبية المحدودة إلى بيئات العمل التشغيلية الضخمة التي تضم مئات الآلاف من الصفوف. في هذه البيئات الموسعة، يشكل استخدام المعادلات المتداخلة مثل SUBSTITUTE المتعددة أو صيغ المصفوفات الديناميكية عبئاً ملموساً على موارد النظام، ويتجلى ذلك في استهلاك مكثف لدورات المعالجة المركزية (CPU Cycles) وزيادة زمن إعادة الحساب التلقائي (Recalculation Latency) داخل المصنف عند إجراء أي تعديل على البيانات.
ينشأ هذا الإجهاد الحاسوبي في أسلوب SUBSTITUTE المتداخل من اضطرار المحرك النصي إلى إنشاء سلاسل نصية افتراضية متعددة في ذاكرة الوصول العشوائي (RAM) لكل صف على حدة؛ فإذا كان لدينا مصنف يحتوي على 500,000 صف وتتضمن المعادلة خمس طبقات تداخل، فإن المحرك يقوم بتخليق ومعالجة 2.5 مليون سلسلة نصية وسيطة قبل التوصل إلى موضع FIND النهائي. يؤدي هذا التراكم النصي المؤقت إلى حدوث اختناقات في إدارة الذاكرة وتراجع ملحوظ في سرعة استجابة واجهة المستخدم، مما قد يتسبب في تجميد البرنامج مؤقتاً أثناء عمليات التحديث الشاملة.
وعلى الجانب الآخر، تفرض الصيغ المصفوفية واسعة النطاق التي تطبق دالة FIND مع MIN تحديات تتعلق بإدارة مصفوفات البيانات اللحظية؛ فعلى الرغم من سرعتها الفائقة مقارنة بالنصوص الوسيطة، إلا أن تكرار تقييم المصفوفات على نطاقات ممتدة يتطلب من محرك إكسل إجراء عمليات تحويل متجهي مستمرة تستهلك قدراً غير قليل من الذاكرة اللحظية. وتزداد المشكلة حدة إذا كانت المصنفات تتضمن دوال أخرى متطايرة (Volatile Functions) تجبر البرنامج على إعادة تقييم أعمدة البحث النصي بالكامل مع كل حركة أو إدخال جديد داخل ورقة العمل، مما يستوجب ضبطاً هندسياً واعياً لبنية المصنف لتفادي هذه الاختناقات التقنية.
9.2 استراتيجيات التحسين والضبط الهيكلي
لضمان استقرار المصنفات الضخمة والحفاظ على سلاسة المعالجة الحسابية، يتعين على مهندسي البيانات تطبيق حزمة من الممارسات المعيارية الموجهة للتحسين والضبط الهيكلي. تأتي في مقدمة هذه الإجراءات استراتيجية “التثبيت الحسابي للبيانات التاريخية”؛ حيث يُنصح بتحويل نتائج الصيغ الحسابية المركبة (مثل نتائج FIND والاقتطاع اللاحق) إلى قيم نصية ورقمية ثابتة عبر خاصية (Paste Special as Values) فور انتهاء مرحلة تدقيق وتنقية البيانات، مما يعفي المعالج من عبء إعادة تقييم مئات الآلاف من المعادلات المعقدة في المستقبل ويوفر موارد الذاكرة للعمليات التحليلية النشطة.
تتمثل الاستراتيجية الثانية في توظيف “الأعمدة المساعدة المؤقتة” (Staging Columns) بذكاء منهجي؛ فعلى الرغم من أن المحللين يفضلون غالباً كتابة صيغ مدمجة في عمود واحد لأسباب جمالية، إلا أن تفكيك المعادلة المعقدة إلى مرحلتين عبر عمود مساعد وسيط يقلل في كثير من الأحيان من عمق التداخل الحسابي ويسمح لمحرك إكسل باستغلال قدرات المعالجة متعددة الخيوط (Multi-threaded Calculation) بكفاءة أكبر، مما يقلص الزمن الإجمالي لإعادة الحساب بصورة ملحوظة ويوفر بيئة أسهل للتدقيق وتتبع الأخطاء.
علاوة على ذلك، تشمل أفضل الممارسات إيقاف خاصية “الحساب التلقائي” (Manual Calculation Mode) أثناء مراحل إدخال ومعالجة البيانات الضخمة، وإعادة تفعيلها فقط عند الرغبة في تحديث النتائج دفعة واحدة. كما يتعين تجنب إدراج النطاقات المفتوحة غير المحددة (مثل البحث في كامل العمود A:A) والالتزام بحصر وسائط الدوال في النطاقات المستغلة فعلياً أو استخدام الجداول المهيكلة (Excel Tables) التي تتوسع تلقائياً مع حجم البيانات وتمنع استهلاك موارد المعالج في فحص ملايين الخلايا الفارغة في قاع ورقة العمل دون طائل.
10. الحلول البرمجية والبدائل المتقدمة: توظيف Power Query وVBA
10.1 استخدام لغة M في Power Query للبحث المتعدد
عندما تتجاوز متطلبات معالجة البيانات النصية حدود القدرات الوظيفية للصيغ التقليدية داخل الخلايا، تبرز بيئة Power Query كحل مؤسسي متقدم ومثالي لإجراء عمليات التحويل والتنقية المعقدة خارج فضاء ورقة العمل التقليدي. تتيح هذه البيئة المدمجة في إكسل، والتي تعمل بواسطة محرك لغة M المتطور، التعامل مع ملايين السجلات النصية بكفاءة استثنائية وبمعزل تام عن قيود الأداء التي تعاني منها الدوال الحسابية المضمنة في واجهة الجداول.
توفر لغة M دوال نصية غاية في القوة للمطابقة وتحديد المواضع متعددة المعايير، وتأتي في مقدمتها دالة Text.PositionOfAny. تتميز هذه الدالة بقدرتها الفطرية والأصلية على استقبال مصفوفة أو قائمة من المحارف المستهدفة دفعة واحدة والبحث عنها مباشرة داخل السلسلة النصية في خطوة برمجية واحدة، دون الحاجة إلى ابتكار استراتيجيات تعويض تراكبي أو إلحاق نصي مصطنع. تُكتب الصيغة التعبيرية في Power Query لإضافة عمود مخصص يرصد أول ظهور لأي من الحروف “a” أو “b” أو “c” داخل عمود السجلات النصية [TextData] بالصيغة القياسية التالية:
Text.PositionOfAny([TextData], {"a", "b", "c"}, Occurrence.First)
تتفوق هذه المنهجية البرمجية بشكل ساحق على كافة معادلات الخلايا التقليدية لعدة أسباب؛ أولها أنها تعيد فهرساً موضعياً دقيقاً يبدأ من الصفر (0-based index) يعبر عن الموضع الأول دون توليد أخطاء استثنائية عند الغياب، حيث تعيد الدالة القيمة (-1) تلقائياً عند عدم العثور على أي من المعايير المحددة، مما يقضي على ظاهرة الأخطاء البرمجية المتسلسلة تماماً. وثانياً، تتيح بيئة Power Query إنشاء خطوط أنابيب آلية لتنظيف البيانات (ETL Pipelines) تدعم التحديث اللحظي لجميع السجلات بمجرد النقر على زر “تحديث” (Refresh)، مما يجعلها الأداة المثلى لإدارة تدفقات البيانات الضخمة في المؤسسات وقواعد البيانات الحيوية المتصلة.
10.2 تطوير دوال مخصصة (UDF) بواسطة برمجية VBA
يمثل تطوير الدوال المخصصة للمستخدم (User-Defined Functions – UDF) عبر بيئة Visual Basic for Applications (VBA) البديل البرمجي الكلاسيكي الأكثر مرونة داخل المصنفات التي تتطلب بقاء المعادلات في متناول المستخدم النهائي المباشر. تتيح هذه التقنية صياغة دوال حاسوبية ذكية تقوم بامتصاص كافة التعقيدات التركيبية لأكواد البحث المتعدد وإخفائها خلف دالة مخصصة بسيطة وموحدة يستدعيها المستخدم في الخلايا كما يستدعي أي دالة قياسية أخرى في إكسل.
يوضح النموذج البرمجي التالي كيفية هندسة دالة مخصصة باسم MultiFIND تتولى البحث الموضعي عن مصفوفة من المحارف المستهدفة، مع مراعاة حساسية حالة الأحرف وإدارة الأخطاء بمرونة فائقة:
Function MultiFIND(SearchRange As Variant, WithinText As String) As Long

    Dim TargetChar As Variant

    Dim MinPos As Long

    Dim CurrentPos As Long

    MinPos = 0

    For Each TargetChar In SearchRange

        CurrentPos = InStr(1, WithinText, CStr(TargetChar), vbBinaryCompare)

        If CurrentPos > 0 Then

            If MinPos = 0 Or CurrentPos < MinPos Then

                MinPos = CurrentPos

            End If

        End If

    Next TargetChar

    MultiFIND = MinPos

End Function
تستخدم هذه الدالة البرمجية التكرار الحلقي (For Each) وخاصية InStr مع خيار المطابقة الثنائية vbBinaryCompare لضمان الحفاظ الصارم على حساسية الأحرف كما في دالة FIND الأصلية. تختبر الدالة موقع كل حرف مستهدف، وتقوم بتحديث المتغير MinPos تدريجياً للاحتفاظ بالموقع الأسبق ظهوراً. وإذا لم يتم العثور على أي محرف، تعيد الدالة القيمة (0) بكل هدوء ودون توليد أي أخطاء قيمية تعطل ورقة العمل، مما يتيح للمستخدم استدعاءها في الخلية بسهولة بالغة عبر كتابة: =MultiFIND({"a","b","c"}, A2)، محققاً بذلك أعلى درجات التوازن بين البساطة الوظيفية والقوة البرمجية.
10.3 دليل اتخاذ القرار لاختيار الأسلوب التقني الأمثل
يتطلب اتخاذ القرار الهندسي الصائب لاختيار أسلوب البحث النصي متعدد المعايير في إكسل موازنة دقيقة بين ثلاثة أبعاد رئيسية: حجم وحساسية البيانات المعالجة، والخبرة التقنية المتاحة للمستخدم النهائي المشغل للنموذج، والبيئة التشغيلية المشتركة التي سيعمل فيها المصنف (مثل بيئات العمل السحابية Excel Online مقارنة بنسخ سطح المكتب المتكاملة). إن الفهم العميق لمتطلبات المنظومة هو الذي يحدد التكتيك الأمثل بين الصيغ المركبة أو الأساليب البرمجية المتقدمة.
يوفر الدليل الإرشادي المعياري التالي خارطة طريق حاسمة لاختيار المسار التقني الأنسب:
- اختيار تقنية التعويض المتداخل (SUBSTITUTE + FIND): يُنصح بها حصرياً عندما يكون حجم البيانات محدوداً (أقل من بضعة آلاف من الصفوف)، ويكون عدد معايير البحث لا يتجاوز 2 إلى 3 رموز ثابتة لا تتغير، وتكون التوافقية مع إصدارات إكسل القديمة جداً شرطاً أساسياً لتشغيل الملف لدى مستخدمين متنوعين.
- اختيار المنهجية المصفوفية (MIN + FIND مع الإلحاق النصي): يمثل الخيار النموذجي لمعظم المحللين المحترفين على إصدارات Microsoft 365؛ حيث يوفر أعلى مرونة في تحديث قوائم المعايير وتوسيعها، مع المحافظة على بقاء المعادلات الحسابية ديناميكية ومباشرة داخل أوراق العمل دون الحاجة لأي برمجة أو تثبيتات إضافية.
- اختيار بيئة Power Query (لغة M): يمثل الحل القياسي الحتمي عند التعامل مع مجموعات البيانات الضخمة (عشرات أو مئات الآلاف من السجلات)، أو عند استيراد البيانات دورياً من أنظمة خارجية تستوجب مراحل تنقية وتفكيك شاملة (ETL) قبل وصولها للمستخدم، مما يعزل العبء الحسابي تماماً عن موارد ورقة العمل.
- اختيار الأكواد المخصصة (VBA UDF): يوصى بها في بيئات العمل الداخلية المستقرة التي تتطلب صيغاً مبسطة وسهلة الاستخدام لموظفين ذوي خبرة محدودة، مع ضرورة مراعاة حفظ الملف بالامتدادات التي تدعم وحدات الماكرو (مثل XLSM)، والانتباه لقيود الأمان البرمجية التي قد تعطل الماكرو عند تشغيل الملفات عبر متصفحات الويب أو الشبكات السحابية المشتركة.
تؤكد هذه التوصيات المنهجية أن الكفاءة في معالجة البيانات لا تتوقف عند معرفة كتابة المعادلات فحسب، بل تمتد إلى القدرة على تقييم السياق المؤسسي واختيار الأداة التي تضمن استدامة النماذج الحسابية، وسهولة صيانتها، وتحصينها ضد الأخطاء، مع توفير أقصى درجات السرعة والموثوقية لتحقيق الأهداف التحليلية بدقة واحترافية متناهية تتوافق مع أرقى الممارسات المعتمدة في إدارة ومعالجة البيانات المعقدة.
خاتمة
استعرض هذا المقال دراسة تقنية وتأصيلية شاملة لكيفية تطويع واستخدام دالة FIND في برنامج مايكروسوفت إكسل لمعالجة سيناريوهات البحث النصي متعدد المعايير. انطلاقاً من الأسس الهيكلية والرياضية للدالة وخصائصها التمييزية الصارمة كحساسية حالة الأحرف وآلية الفهرسة الموضعية، اتضح أن القصور البنيوي للدالة في صيغتها الفردية القياسية لا يشكل نهاية المطاف، بل يمثل نقطة انطلاق لبناء حلول تركيبية وهندسية مبتكرة تمكن المحلل من قهر قيود الدالة وتوسيع نطاق وظائفها بكفاءة عالية.
لقد أظهر التحليل المقارن أن استراتيجية التعويض التراكمي عبر دمج دوال SUBSTITUTE المتداخلة تمثل أسلوباً رياضياً ذكياً لإعادة صياغة المسألة وتوحيد المعايير في بيئات العمل البسيطة والمصنفات التقليدية، بينما تتربع المنهجية المصفوفية الحديثة المدعومة بدالة MIN وتقنيات الإلحاق النصي الوقائي على قمة الحلول التنسيقية الأكثر مرونة وقابلية للتوسع في إصدارات إكسل الحديثة. وتكتمل هذه المنظومة بالتحصين البرمجي ضد الأخطاء النظامية مثل الخطأ القيمي، لضمان استمرارية تدفق الحسابات وتفادي الانقطاعات المفاجئة في النماذج التنبؤية والمالية الحساسة.
ختاماً، إن التطور المتسارع في منصات معالجة البيانات يفرض على محللي البيانات ورواد الأعمال التسلح بفهم متكامل للأدوات المتاحة؛ فبينما تحافظ الدوال الحسابية داخل الخلايا على قيمتها الفورية في التحليل التفاعلي السريع، تبرز بيئات المعالجة الحديثة مثل Power Query وأكواد VBA كأدوات استراتيجية لا غنى عنها لإدارة خطوط البيانات الكبيرة وتفكيك السجلات النصية المعقدة بأعلى معايير الدقة والسرعة. ويظل الاختيار المتوازن بين هذه التقنيات رهناً بمتطلبات الدقة، وحجم السجلات، وقابلية الصيانة، لضمان بناء نماذج حوسبية متماسكة وقادرة على تلبية احتياجات اتخاذ القرار في البيئات المؤسسية المعاصرة.
المراجع
- Brysbaert, M., & New, B. (2009). Moving beyond Kučera and Francis: A critical evaluation of current word frequency norms and the introduction of a new and improved word frequency measure for American English. Behavior Research Methods. https://doi.org/10.3758/brm.41.4.977