
تُعد معالجة السلاسل النصية وهندسة البيانات النصية غير المنظمة داخل بيئة جداول بيانات مايكروسوفت إكسل (Microsoft Excel) إحدى الركائز التحليلية الأكثر أهمية في مجالات تدقيق البيانات، وعلوم المعلومات، وإدارة العمليات المؤسسية المعاصرة. ورغم أن البرنامج قد صُمم تاريخياً بوصفه بيئة حسابية موجهة أساساً للأرقام والعمليات الرياضية والمالية، فإن طبيعة تدفقات البيانات الضخمة التي تواجه المؤسسات اليوم تفرض التعامل المكثف مع المعرفات الأبجدية-الرقمية، ومسارات الملفات، والروابط الشبكية، والنصوص التوصيفية ذات الفواصل المتعددة، مما يجعل التحكم في تموضع المحارف مسألة تقنية بالغة الأهمية والدقة.
تكمن المعضلة التقنية المركزية التي يواجهها المحللون في محدودية أدوات البحث النصي التقليدية عند محاولة رصد التموضع النهائي أو التكرار الأخير لمحرف أو رمز محدد داخل سلسلة نصية معقدة. فبينما توفر دوال البحث القياسية مساراً مباشراً لتحديد التكرار الأول انطلاقاً من بداية النص، فإن حركة الاستكشاف المعكوسة من نهاية السلسلة إلى بدايتها تتطلب بناء نماذج رياضية مركبة أو توظيف دوال مصفوفية حديثة. وقد أدى هذا التحدي إلى ظهور مدرستين أساسيتين في بيئة إكسل: مدرسة الصيغ الكلاسيكية القائمة على استبدال الحارس النصي وموازنة الفروق الطولية، ومدرسة الدوال الحديثة المعتمدة على الدوال الديناميكية الموجهة للنصوص والتي تم تدشينها لتيسير العمليات المعقدة وتقليص زمن المعالجة.
يستعرض هذا الدليل الأكاديمي الشامل الأسس النظرية والرياضية والعملية لكيفية استخراج وتحديد موضع الظهور الأخير لحرف أو فاصل داخل سلسلة نصية في إكسل. سنناقش بالتفصيل الرياضي المعمق كلاً من المنهجيات الحديثة المعتمدة على دالة اقتطاع النص قبل الفاصل ودوال قياس الإزاحة، والبدائل الكلاسيكية المستقرة الصالحة لكافة الإصدارات القديمة، بالإضافة إلى استكشاف الحلول المتقدمة عبر البرمجة النصية ومصفوفات الحوسبة المؤتمتة، مع مراعاة حساسية حالة الأحرف، واستراتيجيات تفادي الأخطاء، وحالات الاستخدام في قطاعات الأعمال.
1. مقدمة منهجية لتحليل السلاسل النصية في إكسل
1.1 مفهوم السلاسل النصية وأهمية تحديد مواقع الأحرف
تُعرّف السلسلة النصية في بيئة الحوسبة وجداول البيانات بأنها متتالية خطية أحادية البعد تتألف من مجموعة مرتبة من المحارف (Characters) التي تخضع لنظام فهرسة موضعي يبدأ عادةً من الرقم واحد في بيئات مثل إكسل (1-based indexing)، بخلاف بعض لغات البرمجة العامة التي تعتمد الفهرسة الصفرية. هذا الترتيب الخطي يعني أن كل رمز يحمل إحداثياً رقمياً مطلقاً يحدد موقعه الدقيق بالنسبة لبداية السلسلة، وهو ما يشكل الأساس الحسابي لكافة عمليات التقطيع والتعديل والمطابقة، ولذلك فإن فهم التمثيل الحاسوبي للنصوص يعد مدخلاً جوهرياً لنمذجة البيانات واستيعابها تحليلياً، وهو ما يتسق مع النماذج الحسابية في تمثيل النصوص ومعالجتها ذهنياً وبرمجياً التي وثقها باحثون متخصصون في نمذجة المعالجة النصية (Tzeng et al., 2005).
تكتسب عملية تحديد الإحداثيات النصية الدقيقة أهمية استراتيجية عند الشروع في عمليات تجريف البيانات (Data Scraping) وتنظيفها، حيث لا تكون النصوص مجرد كلمات مقروءة، بل حوامل لهياكل بيانات مركبة تتطلب الاستخلاص الدقيق للكيانات المضمنة. وتجدر الإشارة هنا إلى وجود فرق جوهري بين الترتيب الظاهري للأحرف كما يراه المستخدم على الشاشة والتمثيل الثنائي الرقمي المخزن في ذاكرة البرنامج وفق معايير التشفير الدولية مثل أسكي (ASCII) ويونيكود (Unicode)، إذ يؤثر هذا التمثيل على كيفية احتساب المسافات والفواصل والمحارف الخاصة غير المرئية، مما يجعل الفهرسة الصارمة وسيلة لتحويل البيانات العشوائية غير المهيكلة إلى حقول رقمية ونوعية قابلة للتحليل والفرز الإحصائي.
1.2 التحديات التقنية في تحديد التكرار الأخير مقارنة بالتكرار الأول
ينبع القصور الهيكلي في معالجة التكرار الأخير داخل برمجية إكسل من التصميم التاريخي للدوال النصية القياسية؛ فدوال البحث المرجعية مثل FIND وSEARCH قد صُممت هندسياً لتنفيذ مسح خطي يبدأ حصرياً من اليسار إلى اليمين (أو من أول السلسلة إلى نهايتها حسب اللغة والاتجاه الافتراضي). ولا تحتوي هذه الدوال الكلاسيكية على وسيطة اختيارية تتيح عكس اتجاه المسح الموضعي للبدء من أقصى اليمين، الأمر الذي يجعل رصد الظهور الأخير مسألة شديدة التعقيد الحسابي مقارنة برصد الظهور الأول الذي تنجزه الدالة عبر أول تطابق تصادفه.
يتضاعف هذا التعقيد عند التعامل مع سلاسل نصية متعددة التكرار المتطابق لمحرف الهدف، كالشرطات المائلة في الروابط أو الفواصل في السجلات، حيث تتفاوت أطوال النصوص بصورة عشوائية داخل العمود الواحد، مما يحرم المحلل من الاعتماد على إحداثيات ثابتة لتحديد نقطة النهاية المرجعية. وتزداد الصعوبة عند التحول من البحث عن محارف فردية إلى سلاسل نصية فرعية مركبة، إذ يتطلب الأمر ضبطاً دقيقاً لحدود المقارنة لتفادي التداخل في المقاطع النصية واحتساب الإزاحات بطريقة غير منضبطة تؤدي إلى تشويه المخرجات التحليلية للنماذج الحسابية المعقدة.
1.3 تطبيقات عملية لمعالجة البيانات وفصل المسارات النصية
تتعدد التطبيقات الواقعية التي تتطلب تحديد الظهور الأخير للمحارف في بيئات العمل المهنية والأكاديمية، ولعل أبرزها تفكيك مسارات الملفات الرقمية في أنظمة التشغيل (مثل مسارات ويندوز أو لينكس)؛ حيث يحتاج المحلل غالباً إلى عزل المسار المصدري عن الاسم النهائي للملف مع امتداده، وهو ما يستوجب حصراً تحديد موضع آخر شرطة مائلة أو شرطة مائلة عكسية في السلسلة النصية لفصل الحقول بدقة آلية متناهية.
يمتد هذا الاحتياج إلى تحليل الروابط الإلكترونية المعقدة (URLs)، حيث تسعى المنظمات إلى استخراج المعلمات الاستعلامية الفرعية (Query Parameters) أو المجلد السحابي الأخير دون التأثر بعدد المجلدات الفرعية السابقة في الهيكل البنائي للموقع. وفي القطاعات الصناعية وسلاسل الإمداد، تُكتب أرقام الدفعات وسجلات القياس والأرقام التسلسلية بصيغ مدمجة تفصل بينها محارف خاصة كالفواصل والشرطات المائلة، مما يجعل الفهرسة العكسية الأداة الأساسية لاستخلاص رمز التصنيع النهائي ومطابقته بدقة في قواعد البيانات، فضلاً عن تطبيقات إدارة السجلات الديموغرافية والأكاديمية لتنسيق الأسماء المركبة وتجريد العناوين البريدية من محدداتها الزائدة.
2. التشريح النظري والرياضي لمعادلة البحث الحديثة
2.1 البنية الوظيفية لدالة TEXTBEFORE وآلية عمل الوسيطة العكسية
شهدت منظومة إكسل تطوراً جذرياً مع إطلاق تحديثات مايكروسوفت 365 (Microsoft 365) التي تضمنت حزمة متقدمة من الدوال الموجهة للتعامل مع النصوص، وفي مقدمتها دالة TEXTBEFORE. تعمل هذه الدالة في جوهرها على اقتطاع واستخراج الجزء النصي الواقع قبل فاصل محدد، متفوقة على الأدوات التاريخية بفضل وسائطها البرمجية المتعددة التي تمنح المستخدم قدرة فائقة على ضبط مسار البحث، ومطابقة الأنماط، وتحديد سلوك التعامل مع غياب المحرف المستهدف، مما يعكس تحولاً نحو تعزيز تجربة المستخدم الرقمية وتحسين كفاءة الأنظمة الإجرائية للبرمجيات التعليمية والتحليلية (Alexiou & Schippers, 2018).
تتمثل النقلة النوعية في هذه الدالة في قدرتها الفريدة على قبول وسيطة سالبة لتحديد رقم التكرار (instance_num)؛ فعند تمرير القيمة الرياضية (-1) كوسيطة لهذا المعيار، توجه الدالة خوارزمية البحث لتبدأ الفحص من نهاية السلسلة النصية متجهة نحو البداية، بدلاً من الفحص التقليدي من البداية إلى النهاية. ونتيجة لذلك، تقوم الدالة باقتطاع واسترجاع كافة المحارف التي تسبق الظهور الأخير للفاصل بدقة تامة، متجاوزة الحاجة إلى بناء معادلات تركيبية متداخلة كانت تستنزف الموارد الحاسوبية والذهنية للمستخدمين في الإصدارات السابقة.
2.2 دور دالة الطول LEN في قياس الإزاحة النصية
ترتكز الهندسة الحسابية لتحديد موضع الحرف على دمج المخرجات النصية الناتجة عن دالة TEXTBEFORE مع دالة الطول المتري LEN؛ إذ تقوم دالة LEN بحساب إجمالي عدد الوحدات النصية المكونة للنص المقتطع بدقة رياضية مطلقة. ومن خلال هذا القياس، يتم تحديد المسافة المترية أو ما يُعرف بالإزاحة الخطية (Displacement) التي تفصل بداية السلسلة النصية الكلية عن النقطة الدقيقة التي ينتهي عندها الجزء المستقطع، وهو ما يمثل الحد الفاصل قبل محرف الهدف مباشرة.
تتعامل دالة الطول المرجعية مع كل محرف بوصفه وحدة إحصائية مستقلة، بما في ذلك المسافات البيضاء المخفية، والأرقام، والرموز النقطية، وعلامات الترقيم المختلفة؛ ولذلك فإن الطول الناتج يعكس بدقة متناهية عدد الخانات المشغولة قبل التكرار المستهدف. هذا التكامل القياسي بين استقطاع النصوص الموجه وقياس طولها يلغي احتمالات الخطأ الناتجة عن تباين أطوال النصوص المختلفة في السجلات المجدولة، ويؤسس لقاعدة إزاحة كمية متسقة يمكن الاعتماد عليها في إتمام العمليات الموضعية اللاحقة دون أي تدخل يدوي.
2.3 المنطق الرياضي لإضافة الرقم واحد لتحديد الموضع المطلق
تستند الخطوة النهائية في هذه الخوارزمية الحديثة إلى تطبيق منطق الاستقراء الرياضي المباشر لحل إشكالية الفهرسة الأحادية؛ فالنص المسترجع عبر دالة TEXTBEFORE عند استخدام الوسيطة (-1) ينتهي عند المحرف الذي يسبق الرمز المستهدف مباشرة، مما يعني أن قياس طول هذا النص عبر دالة LEN يمنحنا الفهرس الرقمي لآخر محرف يسبق الفاصل وليس فاصل الهدف ذاته. ووفقاً للبديهيات الرياضية المرتبطة بفهرسة المصفوفات الخطية، فإن موضع الرمز الأخير يساوي بالضرورة طول النص المقتطع مضافاً إليه وحدة صحيحة واحدة تمثل خانة الرمز المستهدف.
تتجلى هذه المعادلة في الصورة الرياضية العامة: موضع الرمز الأخير = LEN(TEXTBEFORE(Text, Delimiter, -1)) + 1. ويمنع هذا الجمع المنطقي للرقم واحد الوقوع في أخطاء الانزياح الحسابي الشهيرة المعروفة في علوم الحاسوب والبرمجيات باسم “أخطاء الانزياح بفارق محرف واحد” (Off-by-one errors)؛ فإذا كانت لدينا سلسلة نصية بطول عشرة محارف ويقع الفاصل الأخير في الخانة السابعة، فإن الجزء المقتطع السابق له سيتألف حتماً من ستة محارف، وتؤدي إضافة الرقم واحد إلى ناتج LEN(6) للحصول على الرقم سبعة بدقة رياضية قطعية لا تقبل اللبس أو التأويل.
3. التطبيق الإجرائي العملي للصيغة خطوة بخطوة
3.1 إعداد جدول البيانات وتهيئة نطاق الإدخال
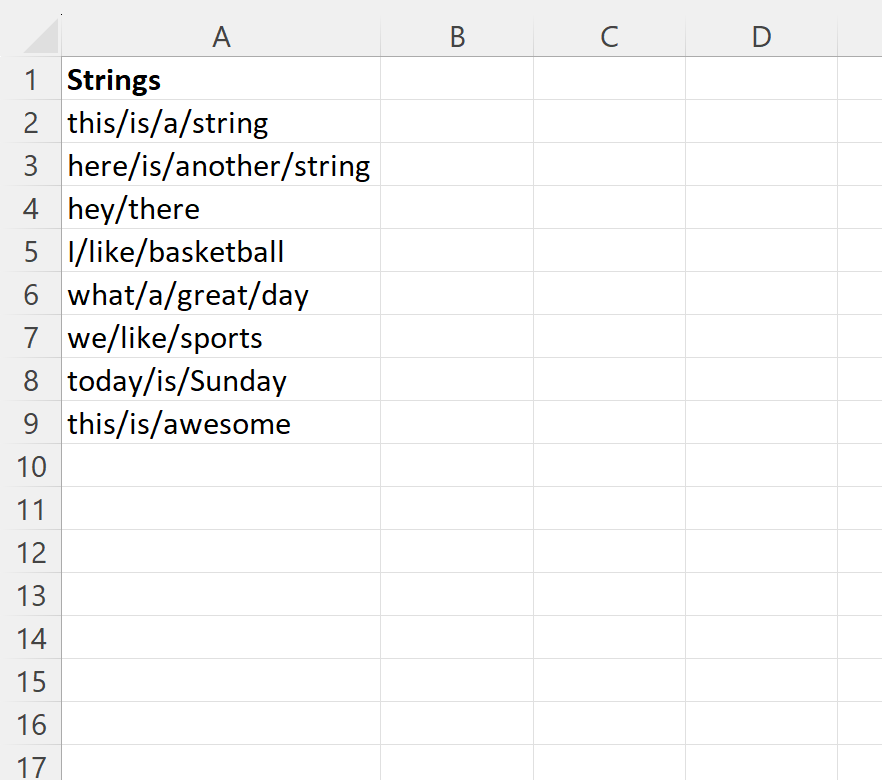
يتطلب التحليل الدقيق تهيئة منهجية لنطاق البيانات داخل ورقة عمل إكسل لضمان استقرار العمليات الحسابية ومنع التداخل بين المدخلات والمخرجات. تبدأ الخطوة الأولى بتصميم جدول اختباري يتألف من أعمدة محددة الوظائف: العمود الأول يحتوي على السلاسل النصية الأصلية المراد تحليلها، والعمود الثاني يحدد رمز الفصل المستهدف، بينما يُخصص العمود الثالث لاحتواء الصيغة الرياضية لحساب موضع التكرار الأخير، مما يسهل المتابعة البصرية والتدقيق الحسابي للنتائج.
قبل الشروع في كتابة الصيغ، يُعد تنظيف البيانات الأولية خطوة احترازية بالغة الأهمية لتطهير النصوص من المحارف غير المطبوعة أو المسافات الطفيلية؛ ويتحقق ذلك بتمرير النصوص عبر دالتي CLEAN وTRIM داخل أعمدة مساعدة لضمان خلو النصوص من مسافات البداية والنهاية غير المقصودة التي قد تشوه نتائج القياس المتري. كما يجب تنويع حالات الاختبار لتشمل نصوصاً تحتوي على تكرار وحيد للمحرف، وأخرى تضم تكرارات متعددة متتالية ومتباعدة، بالإضافة إلى اختبار نصوص تفتقر للمحرف تماماً لتقييم متانة المعالجة البرمجية قبل تعميمها.
3.2 كتابة الصيغة وتطبيقها على مسارات الرموز والشرطات
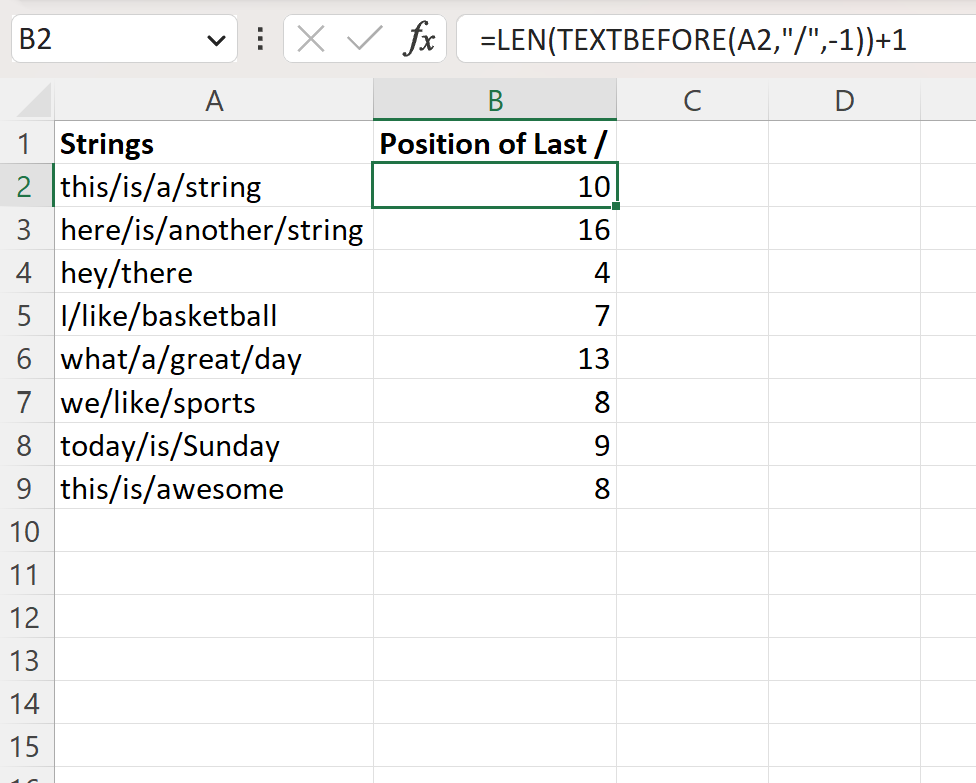
لتطبيق هذه المنهجية عملياً، نقوم بتحديد الخلية المستهدفة لكتابة النتيجة الحسابية (ولتكن الخلية C2 المقابلة للنص الأصلي في الخلية A2)، ثم نُدرج المعادلة القياسية وفق التنسيق المعتمد لإصدارات مايكروسوفت 365 الحديثة على النحو الآتي:
=LEN(TEXTBEFORE(A2, “/”, -1)) + 1
يُنصح المحلل بتفعيل أداة “تقييم الصيغة” (Evaluate Formula) المدمجة في تبويب “صيغ” بشريط الأدوات لمراقبة خطوات الاحتساب التتابعية؛ حيث سيعرض إكسل أولاً ناتج دالة TEXTBEFORE المستخرجة للنص السابق للشرطة المائلة الأخيرة، ثم ينتقل لتطبيق دالة LEN لقياس طول هذه السلسلة الفرعية، ثم يُجري أخيراً عملية الجمع الرياضي للرقم واحد لتوليد الفهرس النهائي. وتثبت هذه الطريقة مرونة تامة عند استبدال الشرطة المائلة برموز أخرى، كالفاصلة المنقوطة أو النقطة، مما يبرهن على تكيفها مع مختلف الهياكل النصية دون أي تعديل في البنية الجوهرية للمعادلة.
3.3 السحب التلقائي وتوسيع النطاق الحسابي في الأعمدة
عقب التأكد من سلامة النتيجة في الخلية الأولى، يتم تعميم الصيغة على امتداد السجلات النصية عبر توظيف مقبض التعبئة التلقائي (Fill Handle) بسحبه إلى الأسفل أو النقر المزدوج عليه لتطبيق الحساب الآلي على كافة الصفوف المتجاورة. تستفيد هذه العملية من نظام المراجع النسبية للخلايا في إكسل، حيث تتحول الإشارة تلقائياً من الخلية A2 إلى A3 ثم A4 وهكذا دواليك، مع احتفاظ الصيغة بثبات وسائط التكرار والجمع المنطقي، مما يتيح معالجة آلاف الصفوف في بضع ثوانٍ معدودة.
لتحقيق أعلى درجات الكفاءة المؤسسية، يُوصى بتحويل نطاق البيانات التقليدي إلى “جدول إكسل ديناميكي” (Excel Table) عبر اختصار لوحة المفاتيح المخصص؛ إذ يتيح هذا النمط التوليد الفوري والمؤتمت للأعمدة المحسوبة (Calculated Columns). وبموجب ذلك، تُكتب المعادلة مرة واحدة وتنعكس تلقائياً على كافة الصفوف القائمة وما يُستجد مستقبلاً من سجلات، فضلاً عن تحسين استخدام الموارد الحاسوبية والذاكرة المؤقتة للبرنامج مقارنة بالنطاقات التقليدية غير المهيكلة.
4. الحلول البديلة للإصدارات الكلاسيكية السابقة لـ Microsoft 365
4.1 معادلة استبدال المحرف الأخير برمز فريد عبر SUBSTITUTE
تفتقر الإصدارات الكلاسيكية المستقرة من برنامج إكسل (مثل Excel 2010 و2013 و2016 و2019) إلى دالة TEXTBEFORE، مما فرض على الخبراء والمحللين ابتكار حيلة رياضية عبقرية تعتمد على تقنية “الحارس النصي الفريد” (Sentinel Character). تعتمد الخطوة الأولى في هذه المنهجية على حساب إجمالي عدد مرات تكرار المحرف المستهدف داخل السلسلة النصية عبر معادلة الفروق الطولية: LEN(A2) – LEN(SUBSTITUTE(A2, “/”, “”))؛ حيث يُقاس طول النص الأصلي ويُطرح منه طول النص بعد حذف كافة تكرارات المحرف المستهدف عبر استبدالها بفراغ نصي فارغ.
تتمثل النواة الابتكارية للحل في توظيف الوسيطة الرابعة الاختيارية لدالة SUBSTITUTE وهي وسيطة “رقم التكرار” (instance_num)؛ فعند تمرير ناتج الفرق الطولي المحسوب سابقاً لهذه الوسيطة، نأمر الدالة صراحةً بعدم مساس كافة التكرارات الأولى للمحرف، والتركيز حصراً على استبدال التكرار الأخير فقط برمز حارس فريد وغير مألوف داخل السلسلة النصية الأصلية، مما يمهد الطريق لتحديده بدقة في المرحلة التالية.
4.2 توظيف دالة FIND لحساب الموقع بعد الاستبدال الفردي
بمجرد وسم التكرار الأخير بالمحرف الحارس المختار بدقة، يتم دمج دالة FIND للعثور على الإحداثي الموضعي المطلق لهذا الرمز الجديد؛ ونظراً لأن الرمز الحارس أصبح يتكرر مرة واحدة فقط داخل النص بأكمله، فإن دالة البحث القياسية التي تبدأ مسحها من اليسار ستتوجه مباشرة ودون أي لبس إلى موقعه المحدد، وهو الموقع عينه الذي كان يشغله التكرار الأخير للمحرف المستهدف قبل عملية الاستبدال الموضعي الفردية.
تتكامل هذه الأجزاء لتشكل واحدة من أشهر الصيغ التركيبية الكلاسيكية في تاريخ إكسل، والتي تُكتب بالصيغة الهندسية التراكمية التالية:
=FIND(CHAR(1), SUBSTITUTE(A2, “/”, CHAR(1), LEN(A2) – LEN(SUBSTITUTE(A2, “/”, “”))))
يُفضل استخدام المحرف غير القابل للطباعة CHAR(1) كحارس نصي بدلاً من الرموز العادية مثل علامة النسبة المئوية أو التلدة؛ وذلك لضمان انعدام وجوده مسبقاً في النص الأصلي، وتفادي حدوث أخطاء الالتباس الموضعي (Collision Errors) الناتجة عن تكرار الرمز الحارس ذاته في محتوى البيانات محل التحليل.
4.3 المقارنة المعيارية للأداء بين الأسلوب الحديث والأسلوب الكلاسيكي
عند إجراء مقارنة معيارية (Benchmarking) بين الأسلوب الحديث والأسلوب الكلاسيكي، تبرز فروق واضحة في كفاءة التنفيذ وسهولة الصيانة البرمجية؛ فالأسلوب الحديث المعتمد على دالة TEXTBEFORE يستهلك دورات معالجة أقل نسبياً نظراً لبساطة الشجرة الحسابية للمعادلة ومباشرة خوارزميات الاستقطاع العكسي المكتوبة بلغة C++ التحتية في محرك إكسل الحديث، بينما تتطلب الصيغة الكلاسيكية معالجة متعددة المراحل تشمل حساب الطول ثلاث مرات وتنفيذ عمليتي استبدال واستدعاء دالة بحث نصي لكل سجل على حدة.
من زاوية الهندسة البرمجية والعبء الإدراكي للمحللين، تتفوق الصيغة الحديثة بوضوح في سهولة القراءة (Readability) وتقليل احتمالات الأخطاء الإنسانية أثناء التحرير والمراجعة؛ غير أن الصيغة الكلاسيكية تظل الخيار الأكثر شمولاً وتوافقية للمؤسسات التي تعمل في بيئات تقنية مختلطة تضم إصدارات سطح مكتب قديمة أو تتطلب تبادل المصنفات مع جهات خارجية لا تملك اشتراكات Microsoft 365 النشطة، مما يجعل الإلمام بالنموذجين ضرورة ملحة لكافة المتخصصين في تحليل البيانات.
5. التعامل مع حساسية حالة الأحرف والمحارف المعقدة
5.1 الفروق الدقيقة بين دالتي FIND و SEARCH في التمييز الحرفي
تتطلب عمليات البحث عن الأحرف الأبجدية اللاتينية (كالتي تتكرر في مسارات البرمجة، وعناوين الويب، ورموز المنتجات الدولية) فهماً عميقاً للاختلافات الهيكلية بين دالتي البحث الأساسيتين في إكسل؛ إذ تتسم دالة FIND بحساسية صارمة لحالة الأحرف (Case-Sensitive)، مما يعني أنها تميز بدقة بين الحرف الصغير (Lowercase) والحرف الكبير (Uppercase)، وتتعامل معهما بوصفهما كيانين مختلفين تماماً من حيث الكود الثنائي.
في المقابل، توفر دالة SEARCH مرونة كاملة عبر تجاهلها التام لحالة الأحرف، مما يجعلها مثالية للبحث عن الحروف دون الاكتراث بطريقة كتابتها في السجلات التاريخية للعملاء؛ أما في دالة TEXTBEFORE الحديثة، فإن التحكم في حساسية الأحرف يتم بسلاسة فائقة عبر وسيطة متطورة تُسمى (match_mode). فعند تمرير القيمة (0) تلتزم الدالة بالحساسية التامة لحالة الحرف، بينما يؤدي تمرير القيمة (1) إلى تعطيل الحساسية تماماً ومطابقة الحرف أياً كانت صورته المكتوبة، مما يمنح المحلل تحكماً منطقياً كاملاً دون الحاجة للتبديل بين دوال بحث متعددة.
5.2 معالجة الرموز الخاصة والمحارف غير المطبوعة ومحارف المسافات
تواجه عمليات معالجة البيانات النصية تعقيدات إضافية عند البحث عن محارف بيضاء أو رموز تحكم خاصة غير مرئية للمستخدم العادي؛ فالبحث عن موضع المسافة الأخيرة يتطلب تمرير مسافة مفردة (” “) كفاصل نصي، ولكن قد تنشأ أخطاء فادحة نتيجة وجود ما يُعرف بـ “المسافة غير القابلة للكسر” (Non-breaking space) شائعة الورود في البيانات المنسوخة من صفحات الويب ومستندات PDF، والتي تحمل الكود البرمجي CHAR(160) بدلاً من المسافة التقليدية ذات الكود CHAR(32).
ينطبق الأمر ذاته على محارف الانتقال لسطر جديد داخل الخلية الواحدة (Line Breaks)، والتي تظهر بكثرة في سجلات العناوين البريدية وملاحظات خدمة العملاء؛ ويتطلب تحديد موضع آخر انتقال لسطر جديد تمرير الدالة الرمزية CHAR(10) في بيئات ويندوز، أو CHAR(13) في بيئات أخرى. لذا، يتعين على المحلل فحص وتوحيد السلاسل النصية عبر إحلال المسافات القياسية محل المسافات الخاصة قبل تطبيق خوارزميات قياس الإزاحة الموضعية لضمان الدقة الكاملة للنتائج.
5.3 إبطال مفعول الرموز البديلة (Wildcards) أثناء البحث الموضعي
تتمتع بعض الدوال النصية مثل SEARCH بقدرة افتراضية على تفسير بعض الرموز بوصفها رموزاً بديلة أو ما يُعرف بمحارف البدل (Wildcards)؛ حيث تُعامل علامة الاستفهام (?) كبديل لأي محرف فردي، وتُعامل علامة النجمة (*) كبديل لأي عدد من المحارف المتتالية. ورغم فائدة هذه الرموز في مطابقة الأنماط، إلا أنها تتحول إلى مصدر تشويش جسيم عندما يكون الرمز المراد البحث عن ظهوره الأخير هو ذاته علامة النجمة أو الاستفهام الواردة في العمليات الحسابية أو السجلات المالية.
لإبطال مفعول التفسير الديناميكي لهذه الرموز وتحييدها لتبحث الدالة عنها كمحارف نصية جامدة، يُستخدم محرف التلدة (~) كرمز إلغاء يسبق الرمز المستهدف مباشرة (كتابة “~*” أو “~؟”). وفي دالة TEXTBEFORE، يمكن ضبط وسائط المطابقة لتجنب التأويل التلقائي للرموز البديلة عند عدم الحاجة إليها، مما يضمن تحديد الموقع الفعلي للرمز المادي في السلسلة النصية دون الوقوع في أخطاء مطابقة الأنماط العشوائية التي تؤثر سلباً على سلامة البيانات المجمعة.
6. تقنيات معالجة الأخطاء والتحقق الاستباقي من صحة المدخلات
6.1 تحليل أسباب خطأ القيمة (#VALUE!) وخطأ عدم التوفر (#N/A)
تولد دوال البحث النصي أخطاء حسابية صريحة عند فشل خوارزمية البحث في العثور على أي تطابق للمحرف المستهدف داخل السلسلة النصية المحددة؛ حيث تُرجع دالتا FIND وSEARCH خطأ القيمة الشهير (#VALUE!) إذا لم يظهر الرمز في النص إطلاقاً، في حين تُرجع دالة TEXTBEFORE خطأ عدم التوفر (#N/A) في ظل الغياب الكامل لمحرف الفصل مع انعدام وجود وسائط إضافية لتوجيه سلوك المعالجة عند الإخفاق.
تكمن خطورة ظهور هذه الأخطاء في قدرتها على الانتشار التسلسلي داخل ورقة العمل (Error Propagation)؛ فتعطل خلية واحدة بسبب خطأ في النص يؤدي تلقائياً إلى توقف كافة الصيغ الرياضية والإحصائية التراكمية المعتمدة عليها، مثل دوال الجمع والعد والمتوسطات الحسابية في التقارير الختامية. ومن هذا المنطلق، يتعين التمييز الدقيق بين أخطاء بنية البيانات الناتجة عن خلايا خالية من الرموز المحددة، وأخطاء منطق المعادلات الحسابية الناتجة عن صياغة غير منضبطة للأقواس أو وسائط الدوال المستخدمة.
6.2 دمج دالة IFERROR لتأمين مخرجات الحسابات
يمثل بناء الصيغ الدفاعية (Defensive Formulas) نهجاً قياسياً في بيئات العمل الاحترافية لحماية المصنفات من الانهيار الحسابي؛ ويتحقق ذلك بإحاطة الصيغة الأصلية بدالة المعالجة الوقائية IFERROR أو دالة IFNA لتأمين المخرجات وتحديد سلوك استباقي في حال عدم العثور على المحرف المستهدف، كما يتضح من التركيب البرمجي التالي للمصنفات الحديثة:
=IFERROR(LEN(TEXTBEFORE(A2, “/”, -1)) + 1, 0)
يمنح هذا التضمين للمحلل حرية تحديد القيمة الافتراضية البديلة التي تتناسب مع منطق العمل؛ كإرجاع القيمة صفر للإشارة الرياضية إلى انعدام وجود الرمز، أو إرجاع نص تفسيري صريح مثل “الرمز غير موجود”، أو استرجاع طول النص كاملاً إذا كان المطلوب افتراض أن النص كتلته واحدة غير مفصولة. كما تبرز أفضلية دالة IFNA في بعض السياقات لأنها تعترض حصراً أخطاء عدم العثور على النص دون حجب الأخطاء الحسابية الأخرى التي قد تنشأ عن كتابة أسماء الدوال بصورة خاطئة، مما يسهل عمليات تنقيح ومراجعة الأخطاء.
6.3 التحقق المسبق من وجود المحرف باستخدام دالة ISNUMBER
ينطوي البديل المنهجي الأكثر انضباطاً من الناحية المعمارية على استخدام أسلوب “التحقق المسبق” بدلاً من اعتراض الأخطاء بعد وقوعها؛ ويتم ذلك عبر بناء شرط منطقي مركب يستعلم عن وجود المحرف أولاً باستخدام دالتي IF وISNUMBER بالتكامل مع دالة البحث، وفق النمط الحسابي الموضح أدناه:
=IF(ISNUMBER(SEARCH(“/”, A2)), LEN(TEXTBEFORE(A2, “/”, -1)) + 1, “المحدد مفقود”)
يوفر هذا الفصل الإجرائي بين مرحلة فحص الوجود ومرحلة قياس الموضع مزايا تشغيلية وتحليلية ملموسة، إذ يتيح للمحلل عزل وتصنيف السجلات الشاذة التي تفتقر للمحددات الهيكلية المتوقعة، ووضع علامات بصرية أو رسائل تنبيهية بجوارها، مما يدعم بناء لوحات تحكم ديناميكية تبرز مواطن الخلل في جودة البيانات المدخلة قبل تصديرها إلى المستودعات المركزية للمؤسسة.
7. تطبيقات متقدمة: استخراج وتجزئة النصوص بناءً على الموضع الأخير
7.1 استخراج أسماء الملفات من المسارات الطويلة عبر دالة RIGHT و MID
إن تحديد موقع التكرار الأخير لمحرف الفصل ليس غاية في حد ذاته في معظم المشاريع التحليلية، بل هو خطوة وسيطة بالغة الأهمية تتبعها عمليات استقطاع نصية متقدمة؛ وأبرز هذه التطبيقات عزل اسم الملف مع امتداده النهائي من المسارات التخزينية المعقدة عبر طرح إحداثي الموضع الأخير من الطول الإجمالي للسلسلة النصية، مما يمنحنا بدقة عدد محارف الجزء المتبقي بعد الفاصل النهائي.
بمجرد حساب هذا الفارق المتري، يتم توظيف دالة القطع اليميني RIGHT لاسترجاع اسم الملف بدقة، كما يمكن استخدام دالة MID لقص المقاطع النصية المحصورة بين فواصل وسيطة وفواصل نهائية؛ ورغم أن دالة TEXTAFTER الحديثة قد وفرت حلاً مباشراً باستخراج النص الواقع بعد التكرار (-1) بضربة واحدة، فإن فهم بنية التكامل بين موقع الفاصل ودوال RIGHT وMID يظل متطلباً أساسياً لبناء نماذج مرنة قادرة على العمل ببراعة داخل أي إصدار تاريخي لبرنامج إكسل دون مواجهة مشاكل انقطاع التوافقية.
7.2 عزل النطاقات وامتدادات العناوين في قواعد البيانات الرقمية
تعتمد هندسة تحليل البيانات الرقمية على تحديد موضع آخر نقطة (.) داخل أسماء النطاقات وعناوين الشبكات لعزل الامتدادات الدولية (مثل .com أو .org أو .edu.sa) بدقة؛ نظراً لأن أسماء النطاقات غالباً ما تحتوي على نقاط متعددة تفصل النطاقات الفرعية عن النطاق الرئيسي، مما يجعل الفهرسة من بداية النص عديمة الجدوى وعاجزة عن تحديد نقطة الامتداد الحقيقية.
يتيح تحديد موقع النقطة الأخيرة أتمتة تصنيف المواقع والروابط الإلكترونية في جداول استقصائية، وفرز السجلات وفق الامتداد الجغرافي أو النوعي للمؤسسات، فضلاً عن تنظيف مسارات التخزين المؤقت في قواعد البيانات من المعرفات الإضافية والرموز العشوائية المتتالية؛ وهو ما يسهم في تسريع بناء نماذج تحليل حركة البيانات (Traffic Analysis) بدقة عالية تقلل الاعتماد على أدوات المعالجة الخارجية وتكتفي بالإمكانات الرياضية المدمجة في جداول إكسل.
7.3 اقتطاع الألقاب والأسماء العائلية من الأسماء الثلاثية والرباعية
يشكل فرز وتنسيق الأسماء الشخصية أحد التحديات المعقدة في إدارة السجلات الأكاديمية والمهنية نتيجة للتفاوت الكبير في عدد مقاطع الأسماء بين الأفراد، حيث يمتلك بعضهم أسماء ثنائية بينما يمتلك آخرون أسماء ثلاثية أو رباعية مفصولة بمسافات؛ ولذلك فإن محاولة استخراج الاسم الأخير (اسم العائلة) بالاعتماد على الفهرسة المباشرة تفشل تماماً في استيعاب هذه التباينات البنيوية.
يبرز الحل الجذري لهذه المشكلة في استخدام خوارزمية تحديد موضع المسافة الأخيرة داخل السلسلة النصية؛ فمن خلال معرفة نقطة التوقف النهائية للمسافات، تستطيع دوال التجزئة اقتطاع اللقب أو الاسم الأخير بدقة متناهية أياً كان عدد المقاطع التي تسبقه، مما يمكن إدارات الموارد البشرية وشؤون الطلاب من توليد فهارس أبجدية معيارية للأسماء تعتمد على اسم العائلة، وتنسيق الخطابات الرسمية آلياً وفق الألقاب الأكاديمية والمهنية المقررة بدقة متسقة.
8. الحلول المتقدمة عبر المصفوفات الديناميكية والبرمجة النصية
8.1 تطبيق الدالة عبر مصفوفات ديناميكية كاملة باستخدام BYROW و LAMBDA
أحدثت محركات الحساب المصفوفي الحديثة في إكسل ثورة في كيفية معالجة البيانات، حيث بات بالإمكان التخلص التام من الحاجة للسحب اليدوي للصيغ عبر الصفوف، من خلال توظيف الدالتين المتقدمتين BYROW وLAMBDA لصياغة معادلة مصفوفية واحدة في الخلية الأولى تفيض تلقائياً (Spill) بالنتائج على كامل العمود، كما هو موضح بالصيغة المصفوفية الآتية:
=BYROW(A2:A100, LAMBDA(row, IFERROR(LEN(TEXTBEFORE(row, “/”, -1)) + 1, 0)))
تحقق هذه المنهجية المركزية فوائد معمارية بالغة الأهمية؛ فهي تضمن سلامة المصنف من التعديلات اليدوية العرضية، حيث تُحفظ الصيغة وتُعدل في خلية مفردة واحدة، وتمنع أخطاء الانسكاب (#SPILL!) عبر استهلاك النطاقات بمرونة كاملة. كما تسهم في تسريع زمن استجابة وتحديث الحسابات داخل أوراق العمل الكبيرة الحجم عبر إدارة دورات المعالجة بكفاءة رياضية موحدة وموجهة.
8.2 كتابة دالة مخصصة (UDF) باستخدام VBA عبر دالة InStrRev
بالنسبة للمستخدمين الذين يفضلون الحلول المبرمجة المباشرة لتفادي تعقيد الصيغ الطويلة على واجهة ورقة العمل، توفر بيئة البرمجة المدمجة فيجوال بيسك للتطبيقات (Visual Basic for Applications – VBA) حلاً برمجياً أصيلاً يتمثل في دالة InStrRev المخصصة للمسح النصي العكسي المباشر؛ حيث يتم بناء “دالة مخصصة بواسطة المستخدم” (User Defined Function – UDF) عبر محرر الأكواد على النحو البرمجي الموضح في الوصف التالي:
تقوم الدالة المصممة، والتي يمكن تسميتها FindLastChar، باستقبال نطاق الخلية النصية والرمز المستهدف كمدخلات، ثم تُمرر هذه المعلمات مباشرة إلى دالة InStrRev الداخلية في لغة VBA، والتي تبدأ تلقائياً مسح السلسلة النصية من اليمين إلى اليسار وتُرجع الترتيب الموضعي الدقيق للرمز المستهدف برقم فهرسة يبدأ من واحد، دون الحاجة لحساب فروق أطوال السلاسل أو استبدال الأحرف. ويتطلب اعتماد هذا الحل المبرمج حفظ مصنف العمل بصيغة تدعم وحدات الماكرو البرمجية (مثل صيغة .xlsm أو .xlsb) لضمان بقاء الأكواد قيد التشغيل عند إعادة فتح الملف مستقبلاً.
8.3 المفاضلة المعمارية بين دوال ورقة العمل والبرمجة النصية عبر VBA
تخضع المفاضلة بين صيغ ورقة العمل المباشرة وأكواد البرمجة الخلفية عبر VBA لمعايير تشغيلية وأمنية دقيقة؛ فالصيغ الأصلية المباشرة (سواء الحديثة أو الكلاسيكية) تتميز بسرعة تنفيذ فائقة، وتوافق كامل مع بيئة الحوسبة السحابية عبر الإنترنت (Excel Online)، وتعمل بكفاءة دون إثارة تحذيرات الأمان المتعلقة بتعطيل الماكرو التي تفرضها السياسات الأمنية الصارمة في معظم المؤسسات المالية والحكومية المعاصرة.
على الجانب الآخر، توفر الدوال البرمجية المخصصة عبر VBA واجهة استخدام مبسطة للغاية للمستخدم النهائي، وتمنع التشتت الذهني الناتج عن مطالعة صيغ طويلة ومعقدة في شريط المعادلات؛ غير أنها تفقد قدرتها على العمل في متصفحات الويب السحابية، وتتطلب مهارات صيانة تقنية متقدمة عند رغبة الفريق في تطويرها. لذا، يميل الخبراء إلى حصر استخدام VBA في أتمتة العمليات المكتبية المعقدة، والاعتماد على دوال ورقة العمل الأصلية في بناء نماذج النشر والتحليل المالي القياسية لضمان أقصى درجات المرونة والتوافقية عبر المنصات المختلفة.
9. دراسات حالة تطبيقية في بيئات الأعمال والمؤسسات
9.1 تنظيف وفهرسة سجلات عناوين البريد الإلكتروني للشركات
في بيئات إدارة علاقات العملاء (CRM) وقواعد بيانات الموارد البشرية، تبرز الحاجة الملحة لمعالجة عناوين البريد الإلكتروني المجمعة لتصحيح الهياكل المشوهة وفصل المكونات التشغيلية؛ حيث تتضمن بعض السجلات أسماء موظفين مركبة بنقاط متعددة تفصل بين الاسم الأول والاسم الأوسط واسم العائلة قبل رمز (@)، مثل: [email protected].
يتيح توظيف خوارزميات رصد الموضع الأخير للنقطة الواقعة حصراً قبل رمز (@) استخراج الألقاب العائلية بدقة وأتمتة تهيئة الأسماء في المراسلات الرسمية. كما يُستخدم رصد الموضع الأخير للنقطة بعد رمز (@) لتحديد النطاقات الفرعية لشركات الاستضافة وفرز عملاء المؤسسة جغرافياً ومؤسسياً، مما يسهم في رفع كفاءة الحملات التسويقية والتحقق الاستباقي من صلاحية البنية الهيكلية للبيانات قبل رفعها إلى الخوادم السحابية للمؤسسة.
9.2 معالجة رموز التعريف المخزني (SKU) والباركود الصناعي
تستخدم قطاعات التوزيع وسلاسل الإمداد رموز تعريف مخزني (Stock Keeping Units – SKU) تتألف من سلاسل مركبة من الحروف والأرقام تفصل بينها شرطات دلالية تشير إلى القسم، وخط الإنتاج، والمصنع، ونوع التغليف، وتاريخ الدفعة؛ ومثال ذلك الرمز الصناعي: PROD-NORTH-2024-B4-XL.
يواجه محللو المخزون تحدي عزل كود المقاس أو كود الدفعة النهائية (XL في هذا المثال)؛ حيث تتفاوت الأكواد السابقة في عدد محارفها وعدد فواصلها. ومن خلال تطبيق معادلة تحديد الظهور الأخير للشرطة، يتم عزل المعرف النهائي بمرونة كاملة وأتمتة عمليات المطابقة مع فواتير الموردين وسجلات الجرد الدوري، مما يقلص معدلات الخطأ اليدوي بنسب هائلة، ويوفر مئات الساعات التشغيلية التي كانت تُهدر في مراجعة الأرقام المطبوعة على الملصقات الصناعية.
9.3 فرز وتحليل سجلات خوادم الويب ومسارات قواعد البيانات
يقوم مهندسو ومحللو تكنولوجيا المعلومات باستخراج سجلات الوصول لخوادم الويب (Web Server Access Logs) التي تحتوي على مسارات الصفحات الرقمية المليئة بالشرطات المائلة الممثلة للمجلدات البرمجية المتداخلة؛ وتتطلب عمليات تحسين محركات البحث (SEO) وتدقيق أمان الخوادم فحص أسماء الصفحات النهائية المعروضة للمستخدمين وعزلها عن المسار الجذري للموقع.
يسمح تحديد التكرار الأخير للشرطة المائلة في سجلات السيرفر باستخراج اسم الصفحة المنتهي بامتداد php أو html، وحساب عمق التصفح (Crawl Depth) عبر قياس عدد الفواصل في المسار الكلي. وتتيح هذه التحليلات لقسم النظم والمعلومات رصد الروابط المعطلة، وتتبع مسارات الهجمات الإلكترونية العشوائية، وتقديم تقارير دورية ترفع من كفاءة البنية الرقمية واستقرار منصات المؤسسة على شبكة الإنترنت.
10. أفضل الممارسات الأكاديمية لتحسين أداء النماذج الحسابية في إكسل
10.1 كفاءة استهلاك الذاكرة وسرعة إعادة الحساب في الجداول الكبرى
عند بناء نماذج حسابية مصممة للتعامل مع مئات الآلاف من الصفوف في بيئات البيانات الضخمة، تصبح كفاءة استهلاك الذاكرة العشوائية وسرعة معالجة محرك الحسابات في إكسل مسألة حاسمة لاستقرار التطبيق؛ وتبرز هنا الأفضلية المطلقة للابتعاد التام عن “الدوال المتقلبة” (Volatile Functions) كدالة OFFSET وINDIRECT، والاعتماد الحصري على الدوال النصية الموجهة والمحددة مسارياً كدالة TEXTBEFORE أو تركيبات INDEX وMATCH.
تكمن مشكلة الدوال المتقلبة في أنها تجبر إكسل على إعادة احتساب كافة خلايا العمود مع كل حركة أو إدخال جديد في أي مكان داخل ورقة العمل، مما يؤدي إلى تجميد البرنامج وبطء استجابته؛ في حين تعمل الدوال النصية القياسية وفق مبدأ “شجرة التبعية المباشرة” (Direct Dependency Tree)، حيث لا يُعاد حساب موضع الحرف إلا إذا طرأ تعديل فعلي على الخلية الأصلية التي تغذي المعادلة. كما يُوصى بتحويل نتائج الصيغ النصية المعالجة إلى قيم ثابتة (Paste Special as Values) بعد اكتمال مرحلة التنظيف الأولية لتقليص حجم الملف وتوفير الموارد الحسابية للعمليات اللاحقة.
10.2 توثيق الصيغ النصية المركبة لتسهيل التدقيق والمراجعة
تشير دراسات التفاعل بين الإنسان والأنظمة الحاسوبية وتصميم واجهات التعليم وحل المشكلات إلى أن تعقيد الهياكل البنائية دون توثيق كافٍ يرفع من معدلات الأخطاء الإدراكية والتنفيذية (Fotaris & Mastoras, 2022)، وتتضاعف هذه المخاطر عند فحص السلوك الإنساني والأنماط المعرفية في تحليل الرموز والنصوص المشفرة (Bräuer et al., 2020). ولذا فإن النماذج التحليلية المؤسسية في إكسل تتطلب توثيقاً دقيقاً للصيغ المركبة تفادياً للأخطاء التشغيلية التي قد يقع فيها المحللون الآخرون عند التدقيق والمراجعة اللاحقة للمصنفات المالية والإحصائية.
يتحقق التوثيق المنهجي عبر توظيف دالة التخصيص المنطقي LET في إصدارات إكسل الحديثة، والتي تتيح للمحلل تسمية أجزاء المعادلة بأسماء دلالية واضحة (مثل تعريف المتغير TextString وDelimiter ثم تطبيق الحساب)، مما يجعل الصيغة شبيهة بالبرمجة المتقدمة سهلة القراءة. ويتكامل ذلك مع إدراج التعليقات الخلوية وشرح المنطق الرياضي لإضافة الرقم واحد، وبناء دليل تشغيلي داخلي يضمن استدامة المصنف وانتقال مهام إدارته بسلاسة بين موظفي المؤسسة دون انقطاع، مما يعكس نضجاً هندسياً وإدارياً رفيعاً.
10.3 إرشادات التوافقية التقنية بين إصدارات إكسل المختلفة
تفرض بيئات العمل المعاصرة توازناً دقيقاً بين الرغبة في الاستفادة من التحديثات التكنولوجية المتسارعة والحاجة للحفاظ على تشغيل مستقر للأنظمة القديمة؛ ولذلك يجب على مطوري النماذج التحليلية فحص البنية التحتية البرمجية للمؤسسة وكافة الجهات المشتركة في مراجعة التقارير قبل اعتماد الصيغ النصية المتقدمة.
إذا كانت المصنفات موجهة للنشر العام أو التداول مع مستخدمين يعملون على إصدارات دائمة مثل Office 2016 أو 2019، فإن الخيار الأكاديمي والمهني الحكيم هو بناء ورقة العمل بالاعتماد على صيغة SUBSTITUTE الكلاسيكية مع الحارس النصي، لضمان عملها الفوري دون أخطاء التوافق (#NAME?). أما في البيئات المؤسسية الموحدة التي تستخدم أحدث إصدارات Microsoft 365 السحابية، فإن الانتقال لدوال TEXTBEFORE وTEXTAFTER يمثل الخيار الأمثل لتعظيم الإنتاجية وتقليل احتمالات التعقيد الإنشائي في شريط الصيغ.
خاتمة
يُمثل إيجاد آخر ظهور لحرف أو فاصل في سلسلة نصية داخل إكسل نموذجاً حياً لتطور الحلول الخوارزمية داخل برمجيات جداول البيانات؛ حيث انتقلت هذه المهمة من معادلة تركيبية بالغة التعقيد تستلزم قياس الفروق الطولية واستبدال المحارف عبر الحراس النصيين، إلى دالة هندسية مباشرة ورشيقة تقرأ النصوص في الاتجاه المعاكس بمجرد تمرير وسيطة سالبة واحدة.
إن إتقان كلا المنهجين—الحديث المعتمد على دالة TEXTBEFORE مع دالة الطول والإزاحة الموضعية، والكلاسيكي المعتمد على SUBSTITUTE ودالة FIND—يمنح المحلل المالي ومطور قواعد البيانات ميزة معرفية تضمن له حل المشكلات المعقدة مهما تباينت بيئات العمل والإصدارات التكنولوجية المتاحة. ومع مراعاة اعتبارات حساسية الأحرف، والتحقق الاستباقي من صحة البيانات، وإدارة كفاءة الذاكرة، تتحول جداول إكسل من مجرد دفاتر حسابية تقليدية إلى محركات متكاملة وقوية لمعالجة وهندسة البيانات النصية غير المنظمة بكفاءة واحترافية عالية.
المراجع
- Alexiou, A., & Schippers, M. C. (2018). Digital game elements, user experience and learning: A conceptual framework. Education and Information Technologies. https://doi.org/10.1007/s10639-018-9730-6
- Bräuer, J., Hanus, D., Pika, S., Gray, R. D., & Uomini, N. (2020). Old and New Approaches to Animal Cognition: There Is Not “One Cognition”. Journal of Intelligence. https://doi.org/10.3390/jintelligence8030028
- Fotaris, P., & Mastoras, T. (2022). Room2Educ8: A Framework for Creating Educational Escape Rooms Based on Design Thinking Principles. Education Sciences. https://doi.org/10.3390/educsci12110768
- Tzeng, Y., van den Broek, P., Kendeou, P., & Lee, C. (2005). The computational implementation of the landscape model: Modeling inferential processes and memory representations of text comprehension. Behavior Research Methods. https://doi.org/10.3758/bf03192695