
تُعد معالجة البيانات واستخلاص المؤشرات الإحصائية المتقدمة إحدى الركائز الأساسية التي يعتمد عليها الباحثون وصناع القرار في مختلف البيئات الأكاديمية والمؤسسية. فعند التعامل مع قواعد البيانات الضخمة التي تحتوي على تقييمات كمية وسجلات اسمية، تبرز الحاجة الملحة إلى فرز العناصر المتميزة وتحديد الصفوف العليا بدقة رياضية متناهية. لا يقتصر هذا الاحتياج على مجرد استخراج الأرقام القصوى، بل يمتد ليشمل الربط البنيوي الصارم بين تلك القيم العددية والكيانات النصية المعبرة عنها، مثل أسماء الطلاب المتفوقين، أو الباحثين الأكثر إنتاجية، أو مؤشرات الأداء الوظيفي والسريري في الدراسات السيكومترية والمسوح الميدانية.
منذ أن وضع دان بريكلن وبوب فرانكستون اللبنات الأولى لبرمجيات الجداول الحسابية عبر تطبيق VisiCalc عام 1979، وصولاً إلى إطلاق شركة مايكروسوفت لبرنامج مايكروسوفت إكسل لنظام ماكنتوش عام 1985 ثم لنظام ويندوز عام 1987، شهدت الحوسبة الجدولية تطوراً جذرياً في فلسفة التعامل مع البيانات. وقد تحولت الجداول من مجرد دفاتر قيد إلكترونية ساكنة إلى منصات حوسبة ديناميكية قادرة على تنفيذ خوارزميات الفرز المعقدة والمطابقة المكانية اللحظية. وتبرز في هذا السياق مسألة استخراج “أعلى 5 قيم وأسماء مقابلة لها” كمسألة منهجية كلاسيكية تجسد تلاقي الدوال الإحصائية مع دوال البحث والفهرسة المرجعية.
يتناول هذا الدليل الشامل تفكيكاً نظرياً وتطبيقياً متعمقاً لكافة الآليات البرمجية المتاحة في بيئة إكسل لإنجاز هذه المهمة الحسابية بكفاءة وموثوقية مطلقة. سنستعرض الرحلة التقنية بدءاً من البنية التحتية لتنظيم البيانات المعيارية وتطبيق الإسناد المرجعي المطلق، مروراً بالتشريح الرياضي لدوال الترتيب الكلاسيكية مثل LARGE وتوليد التعداد التلقائي عبر ROWS، وصولاً إلى منظومة الفهرسة المتطورة INDEX وMATCH. كما سنعالج التحدي الإحصائي المزمن المتمثل في كسر التعادل عند تساوي الدرجات، ونختتم بالحلول المعاصرة القائمة على المصفوفات الديناميكية مثل SORT وTAKE التي أحدثت ثورة في بيئات العمل الحديثة.
1. مقدمة منهجية لتحليل البيانات وتحديد القيم العليا في إكسل
1.1 أهمية استخراج المؤشرات المتقدمة في التقييم الأكاديمي والتحليلي
يمثل تحديد القيم القصوى في التحليل الإحصائي ركيزة لا غنى عنها لفهم الخصائص التوزيعية للمجموعات البيانية؛ إذ يتيح عزل النطاقات العليا من الدرجات للباحثين والمحللين قراءة واضحة لمستويات التفوق الإحصائي وحساب مقاييس النزعة المركزية والشتات بدقة أكبر. ففي التقييم الأكاديمي، لا يُنظر إلى الدرجات النهائية بوصفها أرقاماً مصمتة، بل تعبيراً كمياً عن مخرجات تعليمية ومنحنيات جدارة تتطلب التمييز الدقيق بين الأداء المتوسط والأداء الاستثنائي. إن عزل أعلى خمس قيم في مصفوفة النتائج يسهم في بناء مؤشرات موضوعية تضمن عدالة المعايير عند اتخاذ قرارات التكريم الأكاديمي، أو تخصيص المنح البحثية، أو ترشيح الكفاءات لبرامج الرعاية المتقدمة.
علاوة على ذلك، تلعب الأتمتة الرياضية داخل البرمجيات التحليلية دوراً حاسماً في تقليص هامش الخطأ البشري الذي يقترن عادة بعمليات الفرز اليدوي والمراجعة البصرية للدفاتر والقوائم الورقية. فعندما تُجرى عمليات استخلاص المراتب العليا عبر صيغ برمجية محكمة، تنتفي احتمالات السهو، أو الإزاحة غير المقصودة، أو التحيز في إدخال البيانات، مما يمنح المخرجات موثوقية علمية وقانونية تفي بمتطلبات الحوكمة وضمان الجودة الأكاديمية والمؤسسية.
1.2 التحديات الحسابية الشائعة عند التعامل مع المصفوفات الرقمية والاسمية
على الرغم من بساطة الفكرة ظاهرياً، إلا أن التعامل المتزامن مع مصفوفات هجينة تجمع بين السجلات النصية والبيانات الرقمية ينطوي على تحديات بنيوية معقدة في بيئات الجداول الإلكترونية. أول هذه التحديات يتمثل في إشكالية مطابقة البيانات النصية بالقيم الرقمية غير المصنفة؛ فالقيم الرقمية تتبع منطقاً ترتيبياً قابلاً للمقارنة المباشرة (أكبر وأصغر)، في حين تخضع النصوص لمنطق المعرّفات الاسمية الفريدة. وبمجرد استخراج قيمة رقمية عليا من عمود ما، يواجه المستخدم معضلة البحث العكسي لتحديد السجل الاسمي الذي أنتج هذه القيمة بالذات دون إخلال بالسياق الهيكلي للمصفوفة الأصلية.
وتتفاقم هذه الصعوبة عند إجراء عمليات فرز تقليدية على أجزاء مجتزأة من الجدول دون شمول النطاق بأكمله، مما يؤدي إلى ما يُعرف بظاهرة “انفصال السجلات” (Record Desynchronization)، حيث يُعاد ترتيب الدرجات بمعزل عن الأسماء، فتُنسب درجات المتفوقين إلى طلاب آخرين بالخطأ. وتتضاعف هذه المخاطر في قواعد البيانات ذات الطبيعة الحية والمستمرة، والتي تشهد إدخالات يومية وتعديلات متكررة تجعل من محاولات الفرز اليدوي عملاً هابط الكفاءة ومستنزفاً للموارد وقابلاً للانهيار مع أول تحديث للبيانات.
1.3 نظرة عامة على الحلول المتاحة: بين الدوال التقليدية والدوال المركبة
استجابة لهذه التحديات، طور مهندسو برمجيات الحوسبة الجدولية مسارات متعددة لمعالجة الفرز واسترجاع السجلات. ينقسم المشهد التقني في إكسل إلى مقاربتين رئيستين: المقاربة التقليدية المعتمدة على الفرز والتصفية اليدوية أو استخدام الجداول ذاتية التنسيق، والمقاربة البرمجية المعتمدة على بناء معادلات مركبة وديناميكية. ورغم أن الجداول التلقائية توفر أدوات فرز سريعة، إلا أن عيبها الجوهري يكمن في جمودها؛ فهي تتطلب تدخلاً بشرياً لإعادة تشغيل الفرز عند تعديل أي مدخل رقمي، كما أنها تغير ترتيب المصفوفة الأصلية بالكامل.
في المقابل، تقدم الصيغ المركبة حلاً متقدماً يضمن بقاء البيانات المصدرية في ترتيبها الأصلي الآمن، مع توليد مصفوفة استخلاص منفصلة ومحدثة لحظياً. يرتكز هذا الحل الكلاسيكي على الربط المتناغم بين الدوال الإحصائية المتخصصة في قياس الرتب، مثل دالة LARGE ودالة ROWS، ودوال الفهرسة والمطابقة المكانية مثل INDEX وMATCH. هذا الجمع الوظيفي يُمكّن المحلل من بناء نموذج استدلالي قادر على قراءة المصفوفة واستنتاج القيم العليا واستدعاء النصوص المرتبطة بها في جزء من الثانية وبأعلى درجات الاستقرار البرمجي.
2. البنية الهيكلية لبيانات العينة وتجهيز بيئة العمل
2.1 تنظيم مصفوفة الدرجات والأسماء في جداول إكسل المعيارية
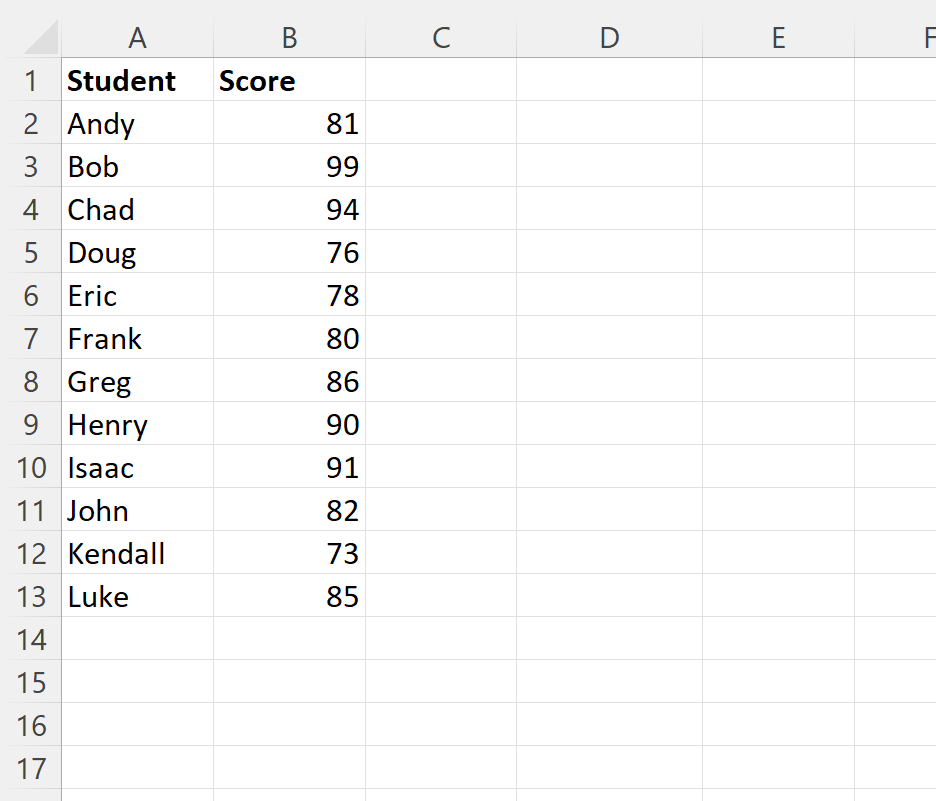
يتطلب التحليل الحسابي الرصين تصميماً هيكلياً منضبطاً لجدول البيانات الأولي؛ فالخوارزميات البرمجية لا تعمل بكفاءة إلا إذا كانت المدخلات مطابقة للمعايير القياسية لإدارة قواعد البيانات العلائقية داخل الجداول. لتطبيق هذه المنهجية عملياً، نقوم بتأسيس مصفوفة بيانات نموذجية تمثل تقييماً أكاديمياً لمجموعة من الطلاب، حيث نخصص النطاق الرأسي الممتد من الخلية A2 إلى الخلية A13 لاحتواء السجلات الاسمية الكاملة للطلاب، في حين نخصص النطاق المقابل له في العمود المجاور من B2 إلى B13 لتسجيل الدرجات الرقمية المقابلة لكل طالب بدقة تامة.
من الضروري قبل الشروع في كتابة أي معادلة رياضية التأكد من خلو هذا النطاق الخام من أي فجوات هيكلية، مثل الصفوف الفارغة كلياً أو الخلايا التي تحتوي على مسافات نصية غير مرئية نتجت عن أخطاء الإدخال اليدوي. كما يجب التحقق من تجانس نوع البيانات في العمود B، بحيث تكون كافة المدخلات قيماً عددية صريحة وليست أرقاماً مخزنة بتنسيق نصي، حيث يؤدي تباين التنسيق إلى عجز الدوال الإحصائية عن التعرف على القيم الرقمية واستبعادها تلقائياً من خوارزميات الترتيب.
2.2 تطبيق التثبيت المطلق للنطاقات المرجعية لتفادي أخطاء الإزاحة
تعتمد مرونة الجداول الحسابية في جوهرها على مفهوم “الإسناد النسبي” (Relative Referencing)، حيث تتغير عناوين الخلايا تلقائياً عند سحب المعادلات وتطبيقها على خلايا مجاورة. ومع ذلك، تصبح هذه الميزة نقطة ضعف خطيرة عند بناء صيغ استخلاص المصفوفات، إذ يؤدي نسخ معادلة تبحث داخل النطاق B2:B13 صفاً واحداً إلى الأسفل إلى انزلاق النطاق ليصبح B3:B14، مما يعني استبعاد الطالب الأول من نطاق البحث وإقحام خلية فارغة من الأسفل، وهو ما يقود إلى نتائج إحصائية مضللة وفاسدة رياضياً.
لمنع هذا الانزلاق المرجعي غير المقصود، يجب توظيف آلية “الإسناد المطلق” (Absolute Referencing) عبر إدراج رمز الدولار ($) قبل معرّف العمود ورقم الصف لكل من نقطتي البداية والنهاية في النطاق المستهدف، ليصبح التعبير البرمجي الدقيق هو $B$2:$B$13 لمصفوفة الدرجات، و$A$2:$A$13 لمصفوفة الأسماء. يضمن هذا الإجراء إغلاق حدود المصفوفة بإحكام في الذاكرة الحسابية لإكسل، مما يتيح للمحلل سحب الصيغة وتكرارها عبر مئات الصفوف دون أن يطرأ أي تحريف على النطاق المصدر المعتمد.
2.3 تحديد مجالات الإخراج المنفصلة للنتائج المستخرجة
تقتضي النزاهة الهيكلية لتحليل البيانات الفصل التام والواضح بين مصفوفة الإدخال المصدرية ومصفوفة الإخراج التحليلية؛ إذ إن خلط نتائج الاستخراج داخل الأعمدة الأصلية يؤدي إلى تداخل المراجع الحسابية وتشويش البنية البصرية للبيانات. بناءً على ذلك، يتم تخصيص نطاق إخراج تحليلي مستقل تماماً، يبدأ بتخصيص العمود D لعرض المراتب العليا للدرجات المستخرجة مرتبة تنازلياً من المركز الأول إلى المركز الخامس في الخلايا من D2 إلى D6.
وبالمثل، يتم تخصيص العمود E في النطاق من E2 إلى E6 ليكون مهيأً لاسترجاع الأسماء المطابقة للدرجات المفرزة في العمود D. ولإضفاء طابع منهجي وأكاديمي رصين على ورقة العمل، يتم تزويد هذه النطاقات بترويسات توضيحية قطعية في الصف الأول؛ كأن يسمى العمود D “الدرجات العليا الخمس”، ويسمى العمود E “أسماء المتفوقين”، بينما يمكن تخصيص العمود C كعمود مرجعي لحساب الرتب أو ترك ترويسته باسم “الرتبة الترتيبية”، مما يسهل قراءة التقرير وتدقيقه من قبل المراجعين الخارجيين.
3. التشريح الرياضي لدالة LARGE ودورها في فرز القيم العليا
3.1 المفهوم الإحصائي لمعامل الرتبة (k) في دالة LARGE
تنتمي دالة LARGE إلى فئة الدوال الإحصائية الترتيبية في إكسل، وتتمثل وظيفتها الجوهرية في مسح مصفوفة بيانات رقمية وإرجاع القيمة التي تحتل مركزاً متقدماً محدداً بناءً على معامل نسبي يُعرف رياضياً بالمعامل $k$. تأخذ الدالة وسيطين إجباريين في بنيتها التركيبية، وتُكتب برمجياً على النحو التالي: LARGE(array, k)؛ حيث يمثل الوسيط الأول array نطاق الخلايا الرقمية المراد فحصها، بينما يمثل الوسيط الثاني k الرتبة الموضعية المطلوبة داخل تلك المصفوفة مقاسة من القمة نزولاً.
يكمن الفارق الإحصائي الجوهري بين دالة MAX ودالة LARGE في محدودية الأولى ومرونة الثانية؛ فدالة MAX هي دالة أحادية البعد تختزل المصفوفة برمتها في أعلى رقم مفرد (وهو ما يعادل تماماً كتابة LARGE(array, 1))، دون أن تمتلك القدرة البرمجية على استرجاع ثاني أو ثالث أو رابع أعلى رقم. ومن ثم، فإن دالة LARGE تمثل تعميماً رياضياً أشمل لدوال القيمة القصوى، حيث تتيح للمحلل تفكيك قمة الهرم التوزيعي للبيانات واستعراض طبقات التفوق بتدرج ترتيبي محكم عبر تغيير قيمة المتغير $k$.
3.2 صياغة المعادلة المعيارية لاستخراج القيمة القصوى الأولى
لتطبيق الدالة تطبيقاً استدلالياً مباشراً، نبدأ بكتابة الصيغة الأساسية لاستخراج العلامة القصوى التي تتصدر كامل مصفوفة الدرجات في جدول دراساتنا. في الخلية المستهدفة D2، يتم إدخال المعادلة بالصيغة الآتية: =LARGE($B$2:$B$13, 1). عند معالجة هذه الصيغة، يقوم المحرك الحسابي الداخلي لبرنامج إكسل بتحميل قيم النطاق $B$2:$B$13 في الذاكرة المؤقتة، وترتيبها افتراضياً من الأكبر إلى الأصغر، ثم اقتطاع العنصر الذي يطابق الفهرس الموضعي الأول وإرجاعه كقيمة نهائية للخلية، ولتكن الدرجة 99 في نموذجنا التجريبي.
وعلى الرغم من أن إدخال الرقم 1 مباشرة داخل الدالة يؤدي الغرض الحسابي للخلية الأولى بنجاح، إلا أنه يمثل ممارسة برمجية قاصرة تُعرف في هندسة البرمجيات باسم “الترميز الثابت” (Hard-coding). يفرض هذا الأسلوب على المستخدم تعديل المعادلة يدوياً في الخلية التالية لتصبح =LARGE($B$2:$B$13, 2)، وتكرار ذلك للخلية الثالثة والرابعة والخامسة، وهو نهج بدائي يفتح الباب واسعاً للأخطاء الإملائية والرياضية ويفقد النموذج مرونته التشغيلية والأتمتة المطلوبة في التحليلات الأكاديمية الاحترافية.
3.3 سلوك دالة LARGE مع الأرقام المتطابقة والمتطرفة
تتميز خوارزمية دالة LARGE بالصرامة الإحصائية عند معالجة القيم العددية المكررة، حيث لا تتجاهل الدالة أي رقم متكرر ولا تدمجه في رتبة واحدة، بل تعامل كل خلية كمدخل إحصائي مستقل. فإذا افترضنا أن مصفوفة الدرجات تحتوي على درجتين متساويتين بقيمة 95 تحتلان المركزين الثاني والثالث، فإن تطبيق الدالة بالمعامل k=2 سيعيد القيمة 95، وتطبيقها بالمعامل k=3 سيعيد أيضاً القيمة 95. يضمن هذا السلوك عدم ضياع أي تكرار عددي، وهو أمر بالغ الأهمية عند احتساب مراتب التفوق المشترك وتحديد المقاعد التنافسية بدقة متناهية.
بالإضافة إلى ذلك، تظهر الدالة مناعة قوية تجاه الفجوات الرقمية الكبيرة والقيم المتطرفة (Outliers) الإيجابية والسلبية؛ إذ تعتمد الخوارزمية على “الترتيب التتابعي للمواقع” وليس على المسافات الحسابية الفاصلة بين الأرقام. فسواء كان الفارق بين المركز الأول والثاني درجة واحدة أو خمسين درجة، فإن الدالة تنتقل إلى الرتبة التالية بدقة دون أن تتأثر بمدى التشتت العددي للمصفوفة، مما يمنحها موثوقية عالية في التوزيعات غير الاعتيادية، كالبيانات الملتوية التواءً حاداً أو البيانات الخاضعة لقوانين القوة (Power Laws).
4. ديناميكية التعداد التلقائي باستخدام دالة ROWS
4.1 آلية التوسيع التدريجي للنطاق المرجعي عبر ROWS
للتغلب على قصور الإدخال اليدوي لمعامل الرتبة $k$ داخل دالة LARGE، يتم توظيف دالة ROWS كعداد ديناميكي ذكي يولد تسلسلاً حسابياً تصاعدياً متوافقاً تماماً مع مسار السحب الرأسي. تعمل دالة ROWS على إحصاء عدد الصفوف الموجودة ضمن نطاق مرجعي محدد وتمريره كقيمة عددية صحيحة عبر تركيبتها القياسية: ROWS(array). وتتجلى العبقرية البرمجية عند بناء نطاق هجين يجمع بين التثبيت المطلق والتوسيع النسبي التراكمي، مثل الصيغة: ROWS($C$2:$C2).
عند تقييم هذه الصيغة في الخلية المرجعية الأولى D2، يكون النطاق الممرر إلى الدالة هو من الخلية C2 إلى الخلية C2، أي نطاق يشتمل على صف واحد فقط، مما يجعل ناتج الدالة مساوياً للرقم 1 تلقائياً، وهو ما يطابق بدقة الرتبة المطلوبة للمركز الأول. وعند سحب المعادلة نحو الخلية الأدنى D3، يظل الطرف الأول للنطاق ثابتاً بفضل علامة $، بينما يتمدد الطرف الثاني حراً ليصبح النطاق $C$2:$C3، فتُرجع الدالة الرقم 2، ويتوالى هذا التمدد الديناميكي لينتج 3 و4 و5 تباعاً، ملغياً الحاجة نهائياً لأي تعديل يدوي للمعاملات.
4.2 مقارنة دالة ROWS مع دالة ROW وبدائل الترقيم الأخرى
يخلط كثير من مستخدمي إكسل بين دالتي ROWS وROW، ويعتمد بعضهم على دالة ROW() لتوليد الأرقام التسلسلية كبديل سريع، وهو خطأ هندسي يهدد استقرار النماذج الحسابية على المدى الطويل. تُرجع دالة ROW() رقم الصف المطلق للورقة ذاتها، فإذا كُتبت الصيغة في الخلية D5، فإنها تُرجع الرقم 5 حتى وإن كانت تلك الخلية تمثل المركز الأول في جدول النتائج المستخرجة، مما يضطر المستخدم إلى إضافة معادلات جبرية معقدة لضبط الإزاحة مثل ROW()-4 لموازنة الناتج.
الأخطر من ذلك هو هشاشة دالة ROW() أمام التعديلات الهيكلية في المصنف؛ ففي حال قيام الباحث أو المحلل بإدراج صفوف جديدة في أعلى الجدول لإضافة ترويسة مؤسسية أو شعار أو بيانات وصفية إضافية، ستنزاح أرقام الصفوف بأكملها، مما يؤدي إلى انهيار التسلسل الحسابي وتلف معادلة LARGE بالكامل. في المقابل، تتمتع دالة ROWS($C$2:$C2) بحصانة برمجية تامة ضد عمليات إدراج أو حذف الصفوف الخارجية، لأنها تقيس طول النطاق الداخلي كفارق مسافة نسبي مجرد، مما يجعلها الخيار المعياري المعتمد لدى خبراء هندسة البيانات المالية والأكاديمية.
4.3 مرونة اختيار النطاق المرجعي التعسفي في دالة ROWS
من السمات الفنية المتقدمة لدالة ROWS أنها دالة قياس أبعاد هندسية بحتة لا تكترث بنوع أو محتوى البيانات المخزنة داخل الخلايا التي تقيسها؛ بل تركز حصرياً على فضاء الإحداثيات الرأسية للنطاق الممرر إليها. بناءً على هذه الحقيقة الرياضية، يمكن للمحلل اختيار أي عمود في ورقة العمل ليكون مرجعاً لتوليد التعداد التصاعدي، سواء كان النطاق $C$2:$C2، أو $A$2:$A2، أو حتى نطاقاً في ورقة عمل مغايرة تماماً، طالما تم تطبيق قاعدة التثبيت الجزئي بنجاح.
يقع الاختيار الشائع على النطاق $C$2:$C2 لمجرد المواءمة البصرية والتنظيمية لقربه المكاني من عمود النتائج D، كما أن الخلايا في هذا النطاق المرجعي قد تكون فارغة تماماً دون أن يؤثر ذلك قيد أنملة على صحة الترقيم؛ فالنطاق يُستخدم هنا بوصفه “مسطرة مسافية” وليس مصدراً للقيم. ويتمثل الشرط الفني الصارم والوحيد لضمان استقامة هذه الآلية في المحافظة الصارمة على إغلاق النقطة المرجعية الأولى برمز التثبيت $C$2 وإبقاء النقطة المرجعية الثانية طليقة تماماً $C2، لتسمح لمحرك الحسابات بتمديد المسطرة بمقدار وحدة قياس واحدة مع كل انتقال نحو الأسفل.
5. التطبيق العملي لاستخراج أعلى 5 درجات خطوة بخطوة
5.1 كتابة المعادلة المركبة الشاملة في الخلية المستهدفة D2
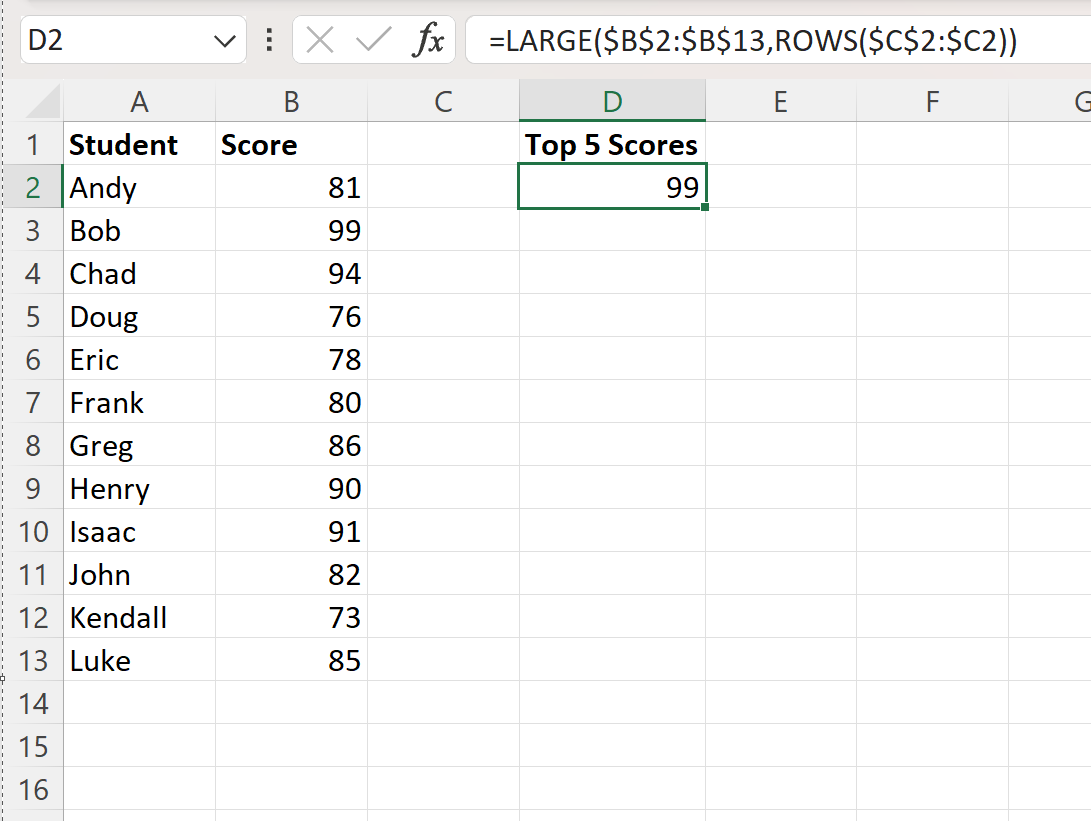
بعد إرساء القواعد النظرية وتجهيز البيئة الحسابية، نشرع في التنفيذ الإجرائي الفعلي لاستخراج الدرجات الخمس العليا عبر دمج الوظائف الإحصائية المتقدمة في صيغة متسقة ومدمجة. نتوجه مباشرة إلى الخلية D2، وهي الخلية المخصصة لعرض متصدر القائمة، ونقوم بإدخال المعادلة المركبة التالية بدقة:
=LARGE($B$2:$B$13, ROWS($C$2:$C2))
عند الضغط على مفتاح الإدخال Enter، يبدأ محرك إكسل في تقييم الصيغة من الداخل إلى الخارج؛ حيث يتم استدعاء دالة ROWS($C$2:$C2) أولاً لتُنتج القيمة العددية 1، وتتحول المعادلة فورياً في الذاكرة الحسابية إلى =LARGE($B$2:$B$13, 1). تقوم الدالة الإحصائية بفرز مصفوفة الدرجات وتقييم المراتب العليا، لتظهر في الخلية D2 على الفور النتيجة 99، وهي الدرجة القصوى المسجلة في بيانات العينة. يجب هنا فحص شريط الصيغة بعناية فائقة للتأكد من انغلاق الأقواس البرمجية بصورة صحيحة وتطابق علامات التثبيت المرجعي $ في كافة المواضع المحددة.
5.2 تعميم المعادلة عبر مقبض التعبئة لاستخراج المراتب التالية
بمجرد التحقق من صحة ناتج الخلية الأولى، ننتقل إلى مرحلة التعميم الآلي للمعادلة على بقية المراكز التنافسية. يتم ذلك عن طريق تحديد الخلية D2، ووضع مؤشر الفأرة على الزاوية السفلية اليسرى (أو اليمنى بحسب اتجاه واجهة البرنامج) حتى يتحول المؤشر إلى علامة تقاطع سوداء صغيرة تُعرف فنياً باسم “مقبض التعبئة” (Fill Handle). نقوم بالنقر مع السحب الرأسي المستمر نزولاً عبر الخلايا D3 وD4 وD5 وصولاً إلى الخلية D6، ثم نقوم بالإفلات.
خلال عملية السحب هذه، يُجري إكسل عملية استنساخ ديناميكي للصيغة مع مواءمة المراجع النسبية لحظياً. ففي الخلية D3 تصبح الصيغة =LARGE($B$2:$B$13, ROWS($C$2:$C3))، مما يمرر المعامل k=2 ويستخرج ثاني أعلى درجة (وليكن 96). وفي الخلية D4 يتمدد العداد إلى ROWS($C$2:$C4) ليمرر المعامل k=3 ويستخرج الدرجة 94. وتتوالى العملية بدقة لتستخرج الخلية D5 الدرجة 91، وتستقر الخلية D6 على استخراج الدرجة 88 ممثلةً الترتيب الخامس، مما يولد قائمة رقمية متكاملة ومستقرة في العمود D تعكس نخبة الدرجات الأكاديمية للمصفوفة.
5.3 التدقيق الحسابي للقيم المستخرجة والتحقق من سلامتها
تفرض المنهجية الأكاديمية الصارمة عدم التسليم المطلق بالمخرجات البرمجية دون إخضاعها لاختبارات التدقيق الإحصائي والمطابقة العكسية. نقوم في هذه الخطوة بإجراء مقارنة بصرية وتحليلية شاملة بين القيم الخمس المنسكبة في النطاق D2:D6 والبيانات الأصلية المبعثرة في العمود B. يجب التحقق أولاً من أن السلسلة المستخرجة تتبع متوالية تنازلية صارمة، حيث تكون كل قيمة مساوية للتي تسبقها أو أصغر منها ($D2 ge D3 ge D4 ge D5 ge D6$)، إذ إن أي خلل في هذا الترتيب يشير فوراً إلى خطأ في تثبيت نطاقات الخلايا أو تكرار غير مقصود في عدادات الصفوف.
كما يُختبر سلوك المعادلة عند سحبها تعسفياً إلى الخلية D14 (وهي رتبة تتجاوز الحجم الكلي للمصفوفة المكونة من 12 طالباً فقط) للتأكد من أن النظام يتعرف على الحدود القصوى لقاعدة البيانات؛ حيث يُتوقع في هذه الحالة أن ترجع الدالة رمز الخطأ المعياري #NUM!، مما يؤكد أن الدالة تقرأ أبعاد المصفوفة بدقة ولا تولد قيماً اصطناعية من خارج فضاء العينة. بعد اكتمال التحقق بنجاح، يُحذف أي تمديد تجريبي ليظل النطاق مقصوراً على المراكز الخمسة المطلوبة حصراً.
6. دمج دالتي INDEX و MATCH لمطابقة الأسماء بالقيم المستخرجة
6.1 المفهوم الهيكلي والوظيفي لدالة الفهرسة المكانية INDEX
بعد أن تمكنا بنجاح من استخراج القيم الرقمية القصوى، تبرز المرحلة المحورية الأكثر أهمية وحساسية، وهي استرجاع السجلات الاسمية الملازمة لتلك القيم. يكمن الحل البرمجي المتفوق لهذه المسألة في توظيف دالة الفهرسة المكانية INDEX، والتي تتجاوز بمرونتها القيود البنيوية المعروفة لدالة VLOOKUP التقليدية. تعمل دالة INDEX وفق النموذج الإحداثي الديكارتي، حيث تستقبل مصفوفة بيانات معينة، ثم تُرجع محتوى الخلية التي تقع عند تقاطع رقم صف محدد ورقم عمود محدد وفق الصيغة: INDEX(array, row_num, [column_num]).
في سياق مسألتنا الحالية، نقوم بتمرير مصفوفة أسماء الطلاب بأكملها $A$2:$A$13 كوسيط أول للدالة، لتصبح هي نطاق الإرجاع المستهدف. لا تعبأ دالة INDEX بموقع عمود الأسماء بالنسبة لعمود الدرجات، سواء كان يقع إلى يمينه أو إلى يساره، وهو ما يحل جذرياً عجز دالة VLOOKUP الكلاسيكية التي تشترط أن يكون عمود البحث دائماً على يسار عمود الإرجاع في بيئات اللغات اللاتينية (أو أقصى اليمين في الواجهات المعربة)؛ مما يجعل INDEX الدعامة المثالية لبناء استعلامات الفهرسة متعددة الاتجاهات في قواعد البيانات المعقدة.
6.2 آلية عمل دالة المطابقة الدقيقة MATCH بنمط البحث الصفري
لكي تؤدي دالة INDEX وظيفتها في جلب الاسم، فإنها تحتاج إلى معرفة الإحداثي الرأسي الدقيق، أي “رقم الصف” الذي يجلس فيه الطالب صاحب تلك الدرجة. وهنا يبرز الدور التكاملي لدالة MATCH، وهي أداة مسح واستكشاف تقوم بالبحث عن قيمة محددة داخل مصفوفة أحادية البعد وتحدد موضعها الترتيبي النسبي كقيمة عددية صحيحة، وتُكتب بنيتها على النحو الآتي: MATCH(lookup_value, lookup_array, [match_type]).
تتطلب هذه الصيغة ثلاثة محددات وظيفية بالغة الدقة:
- قيمة البحث (
lookup_value): وهي الدرجة الرقمية القصوى التي تم استخراجها (النتيجة القادمة من دالةLARGEأو قيمة الخلية في العمودD). - مصفوفة البحث (
lookup_array): وهو نطاق درجات الطلاب الأصلي والمثبت بالكامل$B$2:$B$13. - نوع التطابق (
match_type): ويُضبط إلزامياً بالرقم 0، وهو المعامل البرمجي الذي يفرض على المحرك إجراء بحث قطعي عن “المطابقة التامة” (Exact Match). يمنع هذا المعامل إكسل من اعتماد التقريب أو افتراض أن العمود مرتب مسبقاً، مما يضمن ألا تُرجع الدالة سوى الموضع الحقيقي للدرجة المطابقة بنسبة 100%، ويحمي التحليل من استرجاع أسماء خاطئة ناتجة عن المقاربات التقريبية.6.3 الصياغة الهندسية التراكمية للمصفوفة المركبة الشاملة
تصل المنهجية إلى ذروة تكاملها البرمجي عندما ندمج العناصر السابقة في صيغة متداخلة موحدة وعالية الاعتمادية، بحيث تُغذي كل دالة الدالة التي تعلوها بالبيانات اللحظية دون الحاجة لخلايا وسيطة. يتم ذلك بوضع دالة
LARGE(مدعومة بعدادهاROWS) داخل موضع قيمة البحث في دالةMATCH، ثم تضمين ناتجMATCHبأكمله كمعامل لرقم الصف في دالةINDEXالرئيسية، لتبدو البنية الهندسية الشاملة للمعادلة كما يلي:=INDEX($A$2:$A$13, MATCH(LARGE($B$2:$B$13, ROWS($C$2:$C2)),$B$2:$B$13, 0))يعمل هذا التركيب التراكمي وفق خط إنتاج برمجي دقيق: تقوم
ROWSبتوليد الرقم 1، فتستخرجLARGEأعلى درجة من العمودB(وهي 99)، فتتلقف دالةMATCHهذه الدرجة وتبحث عنها داخل النطاق$B$2:$B$13لتكتشف أنها تقع مثلاً في الموضع النسبي الثالث من المصفوفة، فترسل الرقم 3 إلى دالةINDEX، والتي تتوجه بدورها مباشرة إلى العنصر الثالث في مصفوفة الأسماء$A$2:$A$13وتستخرج اسم الطالب صاحب المركز الأول، لينسكب الاسم في خلية التقرير في زمن حوسبي لا يتجاوز بضعة أجزاء من الألف من الثانية.7. التطبيق العملي لاستخراج الأسماء المقابلة لأعلى 5 قيم
7.1 إدخال صيغة الاستعلام المتداخلة في خلية الاسم الأولى E2
نبدأ التفعيل الميداني لمنظومة الربط الاسمي بالانتقال إلى الخلية
E2، المخصصة لعرض اسم الطالب الحائز على المركز الأول بجوار درجته المستخرجة فيD2. يمكن للمحلل هنا اتباع مسارين برمجين متكافئين؛ إما استخدام الصيغة التراكمية الكاملة المستقلة المشروحة في البند السابق، أو الاستفادة من القيمة الجاهزة المحسوبة مسبقاً في الخليةD2لتبسيط الصياغة وتقليل الحمل الحسابي، فتُكتب المعادلة على النحو الآتي:=INDEX($A$2:$A$13, MATCH(D2, $B$2:$B$13, 0))بمجرد إدخال المعادلة واعتمادها بمفتاح
Enter، يقوم محرك الحسابات بمطابقة الدرجة 99 الموجودة فيD2مع سجلات العمودB، وتحديد موقع الطالب المقترن بها في العمودA، ليظهر فوراً في الخليةE2الاسم الدقيق للطالب المتفوق (وليكن “أحمد محمود”). يجب في هذه الخطوة مراجعة التوافق المرجعي للمصفوفات؛ والتأكد الحاسم من أن نطاق الأسماء$A$2:$A$13ونطاق الدرجات$B$2:$B$13يبدآن وينتهيان عند نفس أرقام الصفوف بدقة متطابقة (من الصف 2 إلى الصف 13)، إذ إن أي تفاوت في طول النطاقات المرجعية سيؤدي إلى إزاحة في المؤشر المكاني وظهور اسم طالب آخر غير صاحب الدرجة الحقيقي.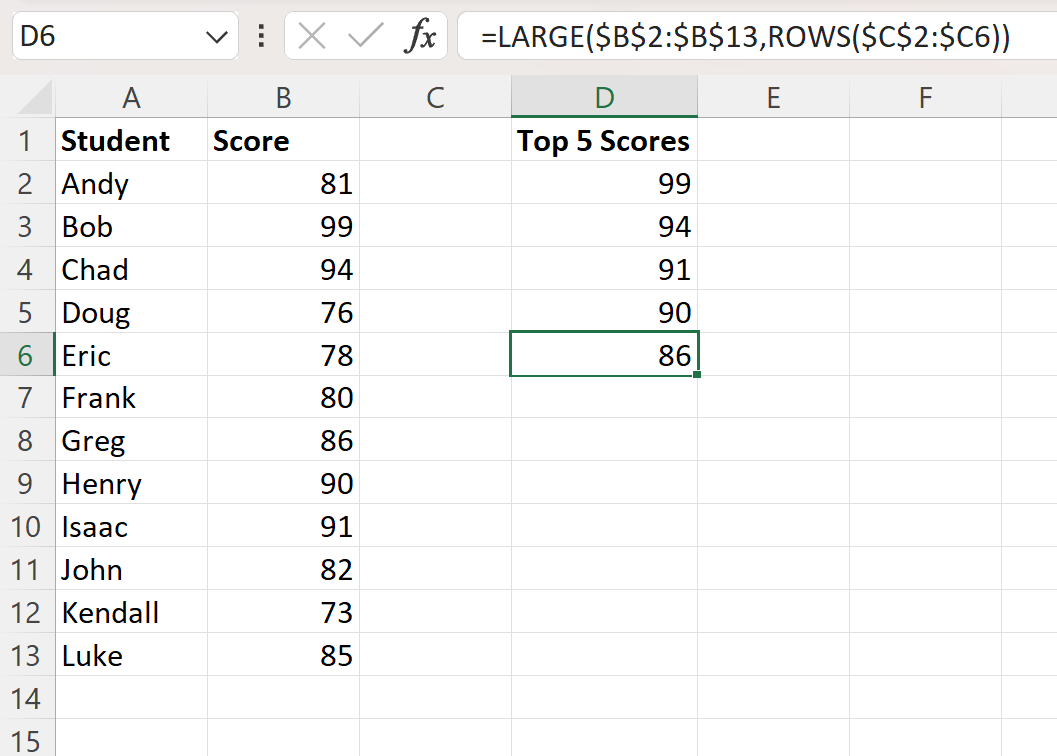
7.2 توسيع النطاق وسحب المعادلة لاستيفاء الأسماء الخمسة
بعد نجاح عملية المطابقة الاسمية للمركز الأول، نقوم بتعميم المعادلة رأسياً لاستيفاء بقية منظومة الخمسة الأوائل. نحدد الخلية
E2، ونقبض على مقبض التعبئة التلقائية ونسحبه بسلاسة نحو الأسفل عبر الخلاياE3وE4وE5حتى نقف عند الخليةE6. تتيح هذه الحركة لمحرك إكسل نسخ العلاقة المنطقية مع تعديل مرجع البحث تلقائياً ليتوافق مع كل صف؛ حيث تبحث الخليةE3عن القيمةD3، وتبحث الخليةE4عن القيمةD4، وهكذا دواليك.تستجيب خلايا النطاق
E2:E6لهذا التوسيع بإظهار الأسماء المطابقة للدرجات المجاورة لها في العمودDبالتزامن والترتيب اللحظي. يكتمل بهذا الإجراء المشهد الهيكلي لجدول المخرجات النهائي، حيث يقف في العمودDتسلسل رقمي متناقص يمثل أعلى 5 درجات مسجلة في التقييم، ويقابله في العمودEتسلسل اسمي متطابق يحدد بدقة متناهية هوية الطلاب الحاصلين على تلك المراتب الأكاديمية العليا، في صورة جدول إحصائي متكامل وجاهز للعرض الإداري أو التوثيق الأكاديمي.7.3 التحقق المرجعي من صحة التوافق بين الاسم والدرجة المقابلة
يتطلب الالتزام بالمعايير العلمية تدقيقاً تقاطعياً (Cross-Verification) للتأكد من سلامة هذا الاقتران الاسمي الرقمي وعدم حدوث أي إزاحة رأسية خفية أثناء عمليات السحب والتعبئة. يتم هذا التحقق باختيار عينات عشوائية من جدول النتائج المفرز في
D2:E6والرجوع بها يدوياً إلى جدول المصدر فيA2:B13؛ كأن نتحقق من أن الطالب صاحب الترتيب الرابع في الخليةE5قد سجل بالفعل الدرجة الموضحة فيD5في القيد الأصلي للبيانات دون زيادة أو نقصان.كما يتضمن التدقيق فحص سلامة استجابة النظام للتعديلات الآنية (Dynamic Sensitivity)؛ حيث يقوم المحلل بتغيير إحدى الدرجات في العمود الأصلي
Bبشكل تجريبي؛ كأن نرفع درجة طالب متأخر لتصبح 100، ومراقبة سلوك جدول الاستخراج في العمودينDوE. إذا كان البناء الهندسي سليماً، فسينتقل هذا الطالب الجديد فوراً إلى المركز الأول في الخليةD2، وتتغير الخليةE2تلقائياً لتحمل اسمه، بينما يتراجع متصدر القائمة القديم إلى المركز الثاني بسلاسة مطلقة. وبعد التأكد من هذا التزامن التلقائي الكامل، تتم استعادة البيانات الأصلية لتوثيق الجداول واعتمادها بصورة نهائية.8. معالجة التحديات الإحصائية لمشكلة تكرار الدرجات وتشابه المراكز
8.1 التشريح المنهجي لمشكلة التكرار (Tie-breaking) في دالة MATCH
على الرغم من الرصانة التقنية لمنظومة
INDEXوMATCH، إلا أنها تشتمل على نقطة ضعف خوارزمية حرجة تُعد من أشهر المعضلات الحسابية في إكسل؛ وتُعرف بـ “معضلة التعادل” (The Tie-breaking Problem). تنشأ هذه الإشكالية عندما يشترك طالبان أو أكثر في نفس الدرجة المستخرجة، كأن يحصل الطالبان “عمر” و”خالد” على المركز الثاني مكرر بالدرجة 95. في هذه الحالة، ستنجح دالةLARGEفي إظهار الرقم 95 في الخليتينD3وD4بشكل صحيح وإحصائي سليم، لكن الخلل يقع داخل دالةMATCH.تعتمد خوارزمية
MATCH(..., 0)مسار مسح رأسي يبدأ من قمة المصفوفة متجهاً إلى أسفلها، وبمجرد عثورها على أول ظهور للقيمة المستهدفة 95، فإنها تُنهي عملية البحث فوراً وتُرجع رقم صف الطالب الأول “عمر”. وعندما تُستدعى الدالة في الخلية التالية للبحث عن الرقم 95 المكرر، فإنها تعيد تكرار نفس مسار المسح من البداية وتتوقف عند نفس السجل الأول؛ مما يؤدي إلى ظهور اسم “عمر” مرتين في جدول المتفوقين في الخليتينE3وE4، واختفاء اسم الطالب الحقيقي الآخر “خالد” تماماً من قائمة التكريم، وهو تشويه خطير لمصداقية ونزاهة التقييم الأكاديمي.8.2 تقنية كسر التعادل عبر إضافة مرجح رقمي دقيق باستخدام COUNTIF
لمعالجة هذا القصور الخوارزمي في الإصدارات الكلاسيكية من إكسل، يلجأ مهندسو البيانات إلى تقنية رياضية ذكية تُعرف باسم “عمود الترجيح المساعد” (Helper Column Tie-Breaker). ترتكز هذه التقنية على توليد تمايز رقمي متناهي الصغر بين الدرجات المتطابقة لفك الارتباط الموضعي، دون إحداث أي تغيير ملموس في القيمة الحقيقية للدرجة أو تشويه الترتيب العام للمصفوفة. يتم ذلك بإنشاء عمود إضافي مجاور للدرجات (وليكن العمود
C) وكتابة صيغة موازنة تعتمد على دالة العد الشرطيCOUNTIFأو الترقيم الموضعيROW.تُصاغ معادلة كسر التعادل في الخلية
C2على النحو التالي:=B2 + (ROW(B2) / 1000000)أو بصيغة ترجيحية معتمدة على التكرار التراكمي:
=B2 - (COUNTIF($B$2:B2, B2) - 1) * 0.0001تتلخص الآلية الرياضية هنا في إضافة كسر عشري ميكروسكوبي يرتبط برقم صف الخلية؛ فإذا تساوى الطالبان في الدرجة 95، سيحصل الطالب في الصف الثالث على قيمة مرجحة تساوي
95.000003، بينما يحصل الطالب في الصف الرابع على95.000004. عند توجيه دالتيLARGEوMATCHللتعامل مع هذا العمود المرجح بدلاً من عمود الدرجات الخام، تصبح كل قيمة فريدة تماماً ومتميزة عن غيرها، مما يمكن دالةMATCHمن التمييز بين السجلين واستدعاء كلا الاسمين على حدة في موقعهما الصحيح دون أدنى تكرار خاطئ.8.3 استخدام المصفوفات الديناميكية كحل منهجي للتعامل مع التشابهات
في بيئات العمل المتقدمة، يُمكن الاستغناء عن الأعمدة المساعدة وتقنيات الترجيح الكسري من خلال الاستعانة بدوال التصفية المنطقية الشاملة وعلى رأسها دالة
FILTER. تتيح هذه الدالة معالجة حالات التعادل الجمعي بصورة منهجية تتيح استيعاب كافة الطلاب المتساوين في مرتبة معينة ضمن قالب تقريري متناسق، حيث تُكتب صيغة الاستعلام بالشكل التالي:=FILTER($A$2:$A$13, $B$2:$B$13 = D2)تتميز هذه المقاربة بقدرتها على استرجاع كافة الأسماء التي تقاسمت نفس الدرجة المحددة في
D2، وتفريغها تلقائياً إما في خلايا رأسية متتالية أو دمجها نصياً في خلية واحدة باستخدام دالةTEXTJOINكأن يظهر في تقرير التكريم: “أحمد محمود، وخالد عبد الله”. تمنح هذه الحلول الحديثة الباحث حرية واسعة في التعامل مع سيناريوهات تشابه المراكز، وتضمن التوافق التام مع المعايير المؤسسية التي تقتضي عدم إقصاء أي طالب يشترك في المركز الأخير المحدد ضمن قائمة الخمسة الأوائل.9. البدائل الحديثة في الإصدارات المتقدمة (Microsoft 365)
9.1 فرز واستخراج السجلات المتكاملة باستخدام دالة SORTBY المباشرة
أحدث إطلاق محرك الحسابات المعتمد على “المصفوفات الديناميكية” (Dynamic Array Engine) عام 2018 نقله نوعية في تاريخ برمجيات إكسل، حيث تخلصت المنصة من قيود المعادلات الفردية الجامدة لصالح صيغ قادرة على معالجة البيانات وانسياب مخرجاتها تلقائياً عبر نطاق من الخلايا (Spill Range). ومن أبرز هذه الأدوات المعاصرة دالتا
SORTوSORTBYاللتان تتيحان فرز وتصفية السجلات دون الحاجة لبناء تراكيب معقدة تجمع بين دوال الترتيب والبحث التقليدية.باستخدام دالة
SORTBY، يمكن للمحلل إعادة هيكلة مصفوفة الأسماء والدرجات معاً بخطوة حوسبية واحدة وبصيغة مفردة تُكتب في خلية واحدة فقط كالتالي:=SORTBY(A2:B13, B2:B13, -1)يحدد المعامل الأول
A2:B13نطاق البيانات المستهدف بالكامل شاملاً الأسماء والدرجات، بينما يحدد المعامل الثانيB2:B13عمود المعيار الذي سيتم الترتيب بناءً عليه، ويشير المعامل الأخير-1إلى الفرز التنازلي من الأكبر إلى الأصغر. بمجرد الضغط على مفتاحEnter، تتدفق النتائج لتغطي عمودين كاملين بالترتيب الصحيح، مع المحافظة التلقائية على اقتران الاسم بالدرجة، ومعالجة حالات التعادل بسلاسة دون أدنى تداخل في الأسماء، مما يمثل تفوقاً هندسياً ساحقاً على الطرق الكلاسيكية القديمة.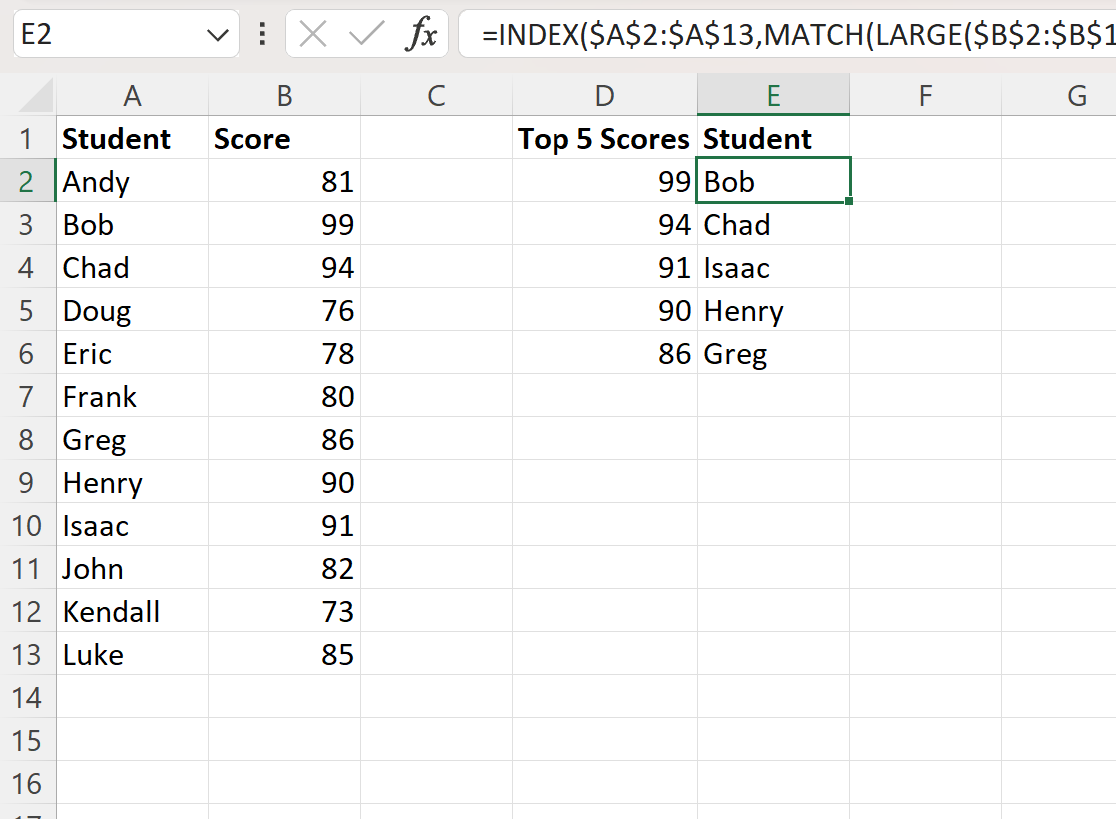
9.2 تقييد المخرجات بالخمسة الأوائل عبر دالتي CHOOSEROWS وTAKE
على الرغم من قوة دالة
SORTأوSORTBY، إلا أن ناتجها الافتراضي يستعرض كامل بيانات الجدول المصدر (كافة الطلاب الاثني عشر). ولحصر المخرجات في نخبة الخمسة الأوائل حصراً، قدمت مايكروسوفت في التحديثات الموسعة لعام 2020 دالتي التقطيع المصفوفي المباشرTAKEوCHOOSEROWS. تُعد دالةTAKEالخيار الأكثر بساطة وفاعلية لاقتطاع عدد محدد من الصفوف أو الأعمدة من بداية أو نهاية أي مصفوفة.لتحقيق هدفنا الأكاديمي باستخراج أعلى 5 قيم وأسماء بمعادلة حديثة متكاملة ووحيدة، ندمج دالتي
TAKEوSORTفي صيغة واحدة فائقة القوة تُكتب في الخليةD2على النحو التالي:=TAKE(SORT(A2:B13, 2, -1), 5)يقوم هذا التركيب الحديث بفرز النطاق
A2:B13بناءً على العمود الثاني (عمود الدرجات) بترتيب تنازلي-1، ثم تأتي دالةTAKEلتقطع الصفوف الخمسة العليا فقط من تلك المصفوفة المرتبة. تفرز هذه الصيغة المفردة عمودين متجاورين في آن واحد (العمود الأول للأسماء والعمود الثاني للدرجات)، بدون سحب، وبدون خلايا تثبيت، وبدون أي احتمال لوقوع أخطاء التكرار الاسمي الناجمة عن تطابق الدرجات، مما يجسد أرقى ما وصلت إليه تكنولوجيا الجداول الحسابية الحديثة.9.3 تقييم الكفاءة الحسابية واستهلاك الموارد بين المناهج المختلفة
يقتضي التحليل الهندسي المقارن الموازنة بين متطلبات الكفاءة الحسابية وسرعة معالجة البيانات، ومسألة التوافقية التقنية (Backward Compatibility) مع بيئات العمل المتنوعة. يوضح الجدول الاستدلالي التالي أبرز الفروق الجوهرية بين الحلول الكلاسيكية المركبة والحلول المصفوفية الديناميكية الحديثة:
- المنهج الكلاسيكي (
LARGE + INDEX/MATCH):- المزايا: توافقية كاملة ومطلقة مع كافة إصدارات إكسل التاريخية منذ تسعينيات القرن الماضي وحتى أحدث النسخ؛ استقرار تشغيلي عبر مختلف البرمجيات المتوافقة.
- العيوب: تعقيد هيكلي في بناء المعادلات؛ استهلاك متزايد للذاكرة الحسابية عند تكرار البحث في قواعد البيانات الكبيرة؛ العجز عن حل مشكلة تشابه المراكز دون أعمدة مساعدة.
- المنهج الحديث (
TAKE + SORT):- المزايا: بساطة صياغية فائقة وصيغة واحدة تكفي لتوليد كافة المخرجات؛ كفاءة خوارزمية عالية تعتمد على محرك الذاكرة اللحظي؛ حل تلقائي وجذري لمشاكل التكرار وتطابق القيم.
- العيوب: عدم التوافق مع الإصدارات القديمة من إكسل (مثل Excel 2016 و2013 وما قبلهما)، مما قد يسبب ظهور خطأ
#NAME?عند فتح المصنف على أجهزة لا تدعم هذه الدوال.
وبناءً على ذلك، يتعين على الباحث أو المحلل اختيار المنهجية التي تتلاءم مع طبيعة الجمهور المستهدف ونظام العمل المؤسسي؛ فإذا كان التقرير موجهاً لبيئة حاسوبية موحدة تعتمد حزمة Microsoft 365، فإن الصيغ الحديثة توفر أداءً لا يضاهى، بينما يظل المنهج الكلاسيكي صمام الأمان الإلزامي عند بناء نماذج تتطلب توزيعاً واسعاً على مؤسسات أو أجهزة ذات بنى تحتية برمجية متباينة.
10. أفضل الممارسات الأكاديمية لإدارة وضمان جودة البيانات التحليلية
10.1 استراتيجيات استكشاف وتصحيح الأخطاء الشائعة (#N/A و #VALUE!)
تتعرض النماذج الحسابية في بيئات العمل الواقعية لمجموعة من الأعطال والرموز التحذيرية التي تشير إلى خلل في المدخلات أو مسار المعالجة. من أشهر هذه الأخطاء رمز
#N/A، والذي يظهر عادة عندما تفشل دالةMATCHفي العثور على القيمة المستهدفة في عمود البحث، أو عند عدم تطابق نوع البيانات؛ كأن تكون القيمة المبحوث عنها عدداً بينما قيم العمود مخزنة كنصوص. ولتأمين المخرجات ضد هذا التشويه البصري، يُنصح بتطويق الصيغ المتقدمة بدالة الحماية الشرطيةIFERROR، كالتالي:=IFERROR(INDEX($A$2:$A$13, MATCH(D2, $B$2:$B$13, 0)), "قيمة غير مطابقة")أما رمز الخطأ
#VALUE!فينشأ في الغالب عن عدم التناسق في أبعاد المصفوفات الممررة؛ كأن يُمرر إلى دالةINDEXنطاق عمودي مكون من 12 صفاً، بينما يُمرر إلىMATCHنطاق من 15 صفاً، مما يُحدث إرباكاً في مصفوفة الإحداثيات المتقاطعة. ويتطلب تجنب هذه الأخطاء التدقيق الصارم في اتساق حدود النطاقات، واستخدام أدوات “تدقيق الصيغ” (Formula Auditing) المدمجة في إكسل، وتحديداً خاصية “تقييم الصيغة” (Evaluate Formula) التي تتيح للباحث تفكيك مسار الحساب خطوة بخطوة لرصد النقطة المحددة التي يتولد عندها الخطأ الحسابي ومعالجتها فوراً.10.2 التنسيق الشرطي وعرض النتائج بصورة بصرية احترافية
لا تنتهي مهمة تحليل البيانات عند حدود استخراج الأرقام الصامتة، بل تمتد لتشمل الإخراج البصري الجمالي الذي يبرز الدلالات الإحصائية للنتائج ويسهل قراءتها لصناع القرار واللجان الأكاديمية. في هذا الإطار، يُعد “التنسيق الشرطي” (Conditional Formatting) أداة محورية لتعزيز التفاعل البصري بين جدول الاستخراج والبيانات الأصلية؛ إذ يمكن تطبيق قاعدة تلوين تلقائية على العمود
Bلتظليل درجات الطلاب الخمسة المتفوقين بألوان مميزة بمجرد ظهورها في جدول النتائج المستخرج في العمودD.كما يُستحسن إدراج “أشرطة البيانات” (Data Bars) داخل خلايا العمود
Dلتمثيل التباين الكمي بين المراكز الخمسة الأولى بصرياً، مما يتيح للناظر ملاحظة الفوارق الرقمية النسبية بين المتصدر وبقية زملائه بلمحة سريعة. تسهم هذه المعالجات التصميمية في تحويل جداول البيانات من مجرد سجلات جافة إلى تقارير تقييمية تنبض بالحياة، وتلبي المعايير الاحترافية المتبعة في إعداد لوحات المؤشرات الإحصائية الموجهة للقيادات الأكاديمية والتنفيذية.10.3 إجراءات الحماية والتوثيق لقواعد البيانات المفرزة
تمثل حماية النماذج الحسابية وصيغ الاستخراج خط الدفاع الأخير لضمان استمرارية النزاهة العلمية للبيانات وسلامتها من التعديلات العشوائية غير المقصودة. يقتضي البروتوكول الأكاديمي قفل الخلايا التي تحتوي على معادلات معقدة مثل
INDEXوMATCHوLARGEعبر تفعيل ميزة “حماية الورقة” (Protect Sheet) في إكسل، مع السماح للمستخدمين بتعديل وتحديث خلايا الإدخال الأصلية فقط في النطاقA2:B13دون المساس بالبنية البرمجية المحركة للتقرير.علاوة على ذلك، يجب تطبيق مبادئ الحوكمة والتوثيق الداخلي عبر تضمين تعليقات وصفية (Comments/Notes) داخل ترويسات الأعمدة تشرح الآلية الحسابية المتبعة، ونوع دوال الترتيب المستخدمة، وكيفية معالجة حالات التعادل والترجيح. يضمن هذا التوثيق الدقيق إمكانية مراجعة المصنف وتدقيقه وإعادة إنتاجه علمياً من قبل باحثين أو مراجعين خارجيين بكل يسر وموثوقية، محققاً بذلك المعايير العليا للحوكمة الرقمية والشفافية المؤسسية في إدارة وتقييم البيانات التحليلية.
خاتمة
إن عملية استخراج أعلى 5 قيم وأسماء مقابلة لها في مايكروسوفت إكسل تتجاوز كونها مجرد حيلة جدولية سريعة؛ لتشكل نموذجاً تطبيقياً متكاملاً لمنهجيات معالجة ومطابقة البيانات الهجينة. فمن خلال الفهم العميق للبنية الهيكلية للمصفوفات وتطبيق آليات الإسناد المرجعي المطلق، استطعنا تفكيك السلوك الرياضي لدوال الترتيب الكلاسيكية مثل
LARGEوتوليد مؤشرات الرتب الديناميكية عبرROWS، ودمجها بانسجام مطلق مع قدرات الفهرسة الاستعلامية لدالتيINDEXوMATCHبنمط المطابقة التامة.كما قدم الدليل معالجة جذرية للتحديات الإحصائية المتصلة بتكرار القيم وتشابه المراكز، مستعرضاً تقنيات كسر التعادل المرجحة كحلول كلاسيكية عبقرية، وصولاً إلى الحلول الحديثة التي وفّرتها منظومة المصفوفات الديناميكية مثل
SORTوTAKEفي الإصدارات المعاصرة. إن إتقان هذه المهارات المتدرجة يسلّح الباحث والمحلل بالأدوات البرمجية اللازمة لبناء نماذج تقييمية تتسم بأعلى درجات الدقة، والكفاءة، والحصانة ضد الأخطاء، مما يرفع من جودة القرارات الأكاديمية والمؤسسية المبنية على التحليل الكمي الرصين.المراجع
- Bricklin, D., & Frankston, B. (1979). VisiCalc: The first computer spreadsheet program. Software Arts.
- Microsoft Corporation. (2020). Excel functions: LARGE, ROWS, INDEX, MATCH, and dynamic array formulas (SORT, FILTER, TAKE). Microsoft Support. https://support.microsoft.com/en-us/excel
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible: The comprehensive tutorial resource. John Wiley & Sons.
- Alexander, M., & Kusleika, R. (2019). Excel 2019 formulas and functions. John Wiley & Sons.
- المنهج الكلاسيكي (