
تعد معالجة السلاسل النصية واستخلاص المؤشرات الكمية من البيانات الوصفية أحد الركائز الجوهرية في نظم إدارة قواعد البيانات وتحليل جداول البيانات الإلكترونية المعاصرة. في بيئات الأعمال والمؤسسات الأكاديمية والبحثية، تتدفق البيانات في كثير من الأحيان بصيغ غير مهيكلة أو شبه مهيكلة؛ حيث تشتمل السجلات المدخلة على كتل نصية مركبة، مثل عناوين البريد الإلكتروني، والرموز التعريفية للمنتجات، والبيانات التعريفية الجغرافية، ونصوص الاستبانات المفتوحة. إن تحويل هذه النصوص المجردة إلى مؤشرات عددية قابلة للقياس والتحليل الإحصائي لا يمثل مجرد عملية تقنية تكميلية، بل هو مسار تحويلي لا غنى عنه لإرساء قواعد حوكمة البيانات وضمان دقتها المنهجية وجودتها التشغيلية.
وعلى الرغم من التطور المتسارع في منصات ذكاء الأعمال المتقدمة ولغات البرمجة المتخصصة في علم البيانات، يظل برنامج مايكروسوفت إكسل (Microsoft Excel) المنصة الأكثر انتشاراً واعتماداً في الأوساط المهنية لإجراء عمليات تدقيق البيانات والمعالجات الرياضية السريعة. غير أن المستخدمين، باختلاف مستويات خبراتهم التقنية، يصطدمون بعقبة بنيوية بارزة عند محاولة حصر عدد مرات ظهور رمز معين أو حرف محدد داخل عمود من البيانات النصية؛ إذ لا توجد في برنامج إكسل دالة نمطية مفردة ومباشرة تحمل اسماً صريحاً مثل “COUNTCHAR” لتنفيذ هذه المهمة بنقرة واحدة، كما هو الحال في دوال العد الشرطي الشائعة للحقول الكاملة.
يتطلب تجاوز هذا القصور البنيوي فهماً عميقاً للتفاعل الوظيفي بين دوال قياس طول النصوص ودوال الإحلال والاستبدال، فضلاً عن كيفية استثمار دوال الحساب الصفيفي والمصفوفات الديناميكية لمعالجة نطاقات خلوية واسعة النطاق. يستعرض هذا الدليل التحليلي الموسع الأسس النظرية والميكانيكية الرياضية الدقيقة لكيفية عد أحرف وسلاسل نصية معينة في عمود داخل برنامج إكسل، متدرجاً من تحليل بنية الخلايا الفردية إلى النماذج الشاملة للأعمدة الكاملة، مع مراعاة الفروق الدقيقة في حساسية حالة الأحرف، وخصوصية المعالجة اللغوية للنصوص العربية واللاتينية، واستعراض استراتيجيات استكشاف الأخطاء وتحسين كفاءة استهلاك الذاكرة في بيئات العمل الضخمة.
1. الأسس النظرية لمعالجة النصوص وحساب الرموز في برنامج إكسل
1.1 أهمية التحليل الكمي للبيانات النصية في الجداول الإلكترونية
يمثل التحليل الكمي للبيانات النصية مدخلاً أساسياً لتحويل الحقول الوصفية غير المهيكلة إلى متغيرات رقمية يمكن إخضاعها للنمذجة الإحصائية المتقدمة. عند التعامل مع حقول البيانات التي تتضمن نصوصاً حرة أو معرّفات مركبة، لا تكفي المقاييس الوصفية العامة لتوصيف جودة البيانات؛ بل يتعين تفكيك النصوص إلى مكوناتها الأولية من خلال مطابقة الأنماط النصية وحساب تكرار الرموز المفتاحية. تسهم هذه المعالجة في التحقق من صحة المعرفات القياسية وأرقام التسجيل المؤسسية، مثل الأرقام الدولية للحسابات المصرفية (IBAN) أو الرموز القياسية للسلع (SKUs)، حيث يشير غياب أو تكرار فاصلة معينة أو شرطة مائلة إلى خطأ بنيوي في الإدخال يعيق عمليات الربط والدمج اللاحقة.
علاوة على ذلك، يكتسب عد الرموز والأحرف أهمية استثنائية في مجالات اللغويات الحاسوبية والتنقيب عن النصوص ضمن بيئة الجداول الإلكترونية؛ إذ تعتمد دراسات التكرار المعجمي وتحليل المحتوى على استخراج تكرارات الحروف والمقاطع لتقدير الكثافة النصية والخصائص المعجمية للمفردات (Brysbaert et al., 2013). ويشكل هذا التكميم الرياضي للمدخلات النصية حجر الزاوية في بناء لوحات التحكم ومؤشرات الأداء التشغيلية، حيث تصبح كثافة بعض الرموز (كالرموز النقطية أو الفواصل) دلالة كمية على طول السجل أو عدد العناصر المندرجة في الحقل الواحد، مما يسهل عمليات الفلترة والتصنيف المؤتمت دون الحاجة إلى كتابة خوارزميات برمجية معقدة خارج بيئة إكسل.
1.2 التحديات البنيوية في التعامل مع السلاسل النصية داخل بيئة إكسل
تواجه معالجة النصوص داخل جداول إكسل تحديات تقنية ناجمة عن الطبيعة المعمارية لتخزين الرموز والترميز الدولي مثل UTF-8 وUnicode. في الأنظمة الحديثة، يتم تمثيل كل حرف بنقطة كودية (Code Point) محددة، ولكن النصوص المستوردة من مصادر خارجية متعددة، مثل واجهات برمجة التطبيقات (APIs) أو الملفات النصية المفصولة بفواصل (CSV)، غالباً ما تحمل معها محارف تحكم غير مطبوعة، ومسافات بيضاء غير مرئية (مثل المسافة غير القابلة للكسر ذات الرمز 160)، وفواصل أسطر متباينة بين أنظمة التشغيل المختلفة. يؤدي وجود هذه الرموز الخفية إلى تشويه دقة عمليات العد والقياس، حيث يعتبرها البرنامج عناصر نصية ذات طول حقيقي رغم خفائها البصري عن المستخدم.
وتتعقد هذه المعضلة البنيوية بسبب التمايز الصارم بين اللغات من حيث حساسية حالة الأحرف والخصائص الصرفية؛ فاللغات اللاتينية تميز بوضوح بين الأحرف الكبيرة (Uppercase) والصغيرة (Lowercase)، بينما تنفرد اللغة العربية بتغير شكل الرمز الواحد تبعاً لموقعه في الكلمة وبوجود علامات التشكيل والحركات القصيرة كرموز تشفيرية منفصلة. بالإضافة إلى ذلك، تفرض بيئة الحساب في إكسل قيوداً على الدوال الإحصائية المباشرة؛ إذ صُممت دوال مثل COUNT وCOUNTA وCOUNTIF للتعامل مع الخلايا كوحدات كلية مستقلة (سواء أكانت الخلية تحقق شرطاً أم لا)، وتعجز تماماً عن النفاذ إلى المحتوى الداخلي للخلية لتفكيك الحروف والرموز المفردة وحساب تكرارها ضمن السلسلة الواحدة، مما يستدعي بناء مسار حسابي مركب لتجاوز هذه القيود التقليدية.
1.3 خارطة الدوال المتخصصة في تتبع وتحليل تكرار الرموز
لسد الفجوة الناتجة عن غياب دالة عد نصي مباشرة، يعتمد محللو البيانات على نموذج رياضي تركيبي يعيد صياغة المشكلة النصية في قالب حسابي تفاضلي. تتصدر هذا النموذج دالة قياس طول النص LEN، والتي تؤدي دور المسبار الرياضي الدقيق لقياس الحجم الكلي للسلسلة النصية بعدد البايتات أو الأحرف. وإلى جانبها، تأتي دالة الإحلال الموجه SUBSTITUTE لتلعب دور الأداة التطهيرية التي تعزل الرمز المستهدف وتستبعده تماماً من السلسلة النصية عبر استبداله بنص فارغ ذي طول صفري، مما يولد متغيراً نصياً جديداً متقلص الطول.
وحتى لا تقتصر هذه المعالجة على خلية مفردة، تبرز دالة SUMPRODUCT كأداة تجميعية صفيفية متقدمة؛ حيث تمتلك هذه الدالة القدرة البنيوية على إخضاع نطاقات وأعمدة كاملة من الخلايا لعمليات التبديل والقياس الرياضي المتزامن داخل الذاكرة المؤقتة، ومن ثم جمع الفروق الحسابية دون الحاجة إلى تشغيل صيغ المصفوفات التقليدية المعقدة (CSE). إن التكامل الوظيفي بين هذه الدوال يمثل منظومة خوارزمية بديعة: حيث تحول الفرق بين طول النص الأصلي وطول النص بعد الاستبعاد إلى مؤشر رقمي دقيق يمثل عدد مرات ظهور الرمز، مما يوفر منصة متينة لمعالجة البيانات الضخمة داخل بيئة إكسل بكفاءة موثوقة.
2. التشريح الدقيق لدالة قياس طول النص LEN
2.1 الميكانيكية البرمجية ومعاملات دالة LEN
تعد دالة LEN (المشتقة من كلمة Length) إحدى أبسط وأقوى الدوال النصية الأساسية في مايكروسوفت إكسل، حيث تستند في جوهرها النحوي إلى صيغة قياسية أحادية المعامل تُكتب كالتالي: LEN(text). تتلقى الدالة مدخلاً واحداً يمثل النص المراد قياسه، والذي يمكن أن يكون سلسلة نصية صريحة محاطة بعلامات اقتباس مزدوجة، أو مرجعاً لخلية محددة، أو حتى مخرجات مصفوفة ناتجة عن دالة أخرى. تقوم الآلية الداخلية للدالة بقراءة السلسلة النصية عبر تفكيكها إلى محارف فردية وحساب عدد النقاط الكودية المكونة لها، وإرجاع قيمة عددية صحيحة تمثل الطول الكلي.
ولا تقتصر استجابة دالة LEN على النصوص الصرفة فحسب، بل تمتد لتشمل القيم الرقمية والمنطقية؛ حيث يجري محرك إكسل تحويلاً ضمنياً وتلقائياً للنوع (Type Coercion) لأي قيمة رقمية تدخل إلى الدالة، محولاً إياها إلى تمثيلها النصي القياسي قبل حساب طولها. فعلى سبيل المثال، يؤدي إدخال الرقم 1250 إلى إرجاع القيمة 4، بينما يؤدي قياس القيمة المنطقية TRUE إلى إرجاع 4 أيضاً نظراً لتمثيلها الحرفي المكون من أربعة رموز. وتعتبر هذه المرونة البرمجية عاملاً حاسماً في قدرة الدالة على التعامل مع البيانات الهجينة دون توليد أخطاء في الصيغ، شريطة الانتباه للتنسيقات الرقمية المخصصة التي قد لا تعكس المحتوى الداخلي الحقيقي للخلية.
2.2 سلوك دالة LEN مع المسافات والرموز غير المرئية
من أهم السمات الفنية التي ينبغي لمحلل البيانات إدراكها عند توظيف دالة LEN هي أنها تتعامل مع المسافات البيضاء والرموز الخفية كأحرف قائمة بذاتها ذات وزن حجمي كامل. تحتسب الدالة المسافات البادئة التي تسبق النص، والمسافات اللاحقة التي تعقبه، والمسافات المتعددة المتداخلة بين الكلمات، باعتبار كل مسافة منها حرفاً مستقلاً يضيف واحداً صحيحاً إلى الناتج الإجمالي. هذا السلوك يمتد ليشمل فواصل الأسطر اليدوية المدرجة داخل الخلية باستخدام الاختصار (Alt + Enter)، حيث يتم تخزين فاصل السطر كرمز تحكم ذي نقطة كودية محددة تعادل CHAR(10) في أنظمة ويندوز، وتحسبه دالة LEN كرمز منفصل تماماً.
ولتفادي الوقوع في تقديرات مضللة لطول السلسلة النصية، تبرز ضرورة دمج دوال تنظيف البيانات قبل الشروع في عمليات القياس والعد الدقيقة. يؤدي استخدام دالة TRIM إلى إزالة كافة المسافات البادئة واللاحقة واختزال المسافات المتعددة بين الكلمات إلى مسافة فردية واحدة، بينما تتكفل دالة CLEAN بإزالة أول 32 رمز تحكم غير مطبوع في جدول ASCII. يوضح الجدول التالي مقارنة دقيقة بين سلوك دالة LEN بمفردها مقابل دمجها مع دوال التطهير النصي على عينات نصية شائعة:
| النص التجريبي داخل الخلية A1 | الوصف الفني للمدخلات | نتيجة الصيغة: LEN(A1) | نتيجة الصيغة: LEN(TRIM(A1)) |
|---|---|---|---|
| “Data” | نص قياسي مجرد من أي زيادات | 4 | 4 |
| ” Data “ | نص محاط بمسافتين بادئتين ومسافتين لاحقتين | 8 | 4 |
| “Big Data” | نص يفصل بين كلمتيه مسافتان قياسيتان | 9 | 8 |
| “DatanAnalysis” | نص يحتوي على فاصل أسطر يدوي CHAR(10) | 13 | 13 |
2.3 حدود الاستخدام المنفرد لدالة LEN
على الرغم من الدقة الرياضية الفائقة لدالة LEN في قياس حجم السلاسل النصية، إلا أن استخدامها المنفرد يظل عاجزاً بنيوياً عن حل معضلة إحصاء رموز محددة داخل الخلية. تقيس الدالة الكتلة النصية ككل مصمت، دون أن تمتلك أي مجسات تمييزية لتحديد ماهية الحروف المكونة للنص، أو مواقعها النسبية، أو أنماط تكرارها النوعية؛ فهي لا تستطيع إفادتنا بما إذا كان النص يتكون من أحرف هجائية أو أرقام أو رموز خاصة، ولا تفصح عن عدد مرات تكرار حرف بعينه كالرمز “@” أو الفاصلة الملتوية.
ومن هذا المنظور، تبرز الحاجة المنهجية إلى مقاربة رياضية مزدوجة، تعتمد على المقارنة التفاضلية لأطوال النصوص في حالتين متباينتين: الحالة الأصلية، والحالة المعدلة بعد إخضاع النص لعملية تشذيب اصطفائي. تتأسس هذه المقاربة على جعل دالة LEN طرفاً رئيسياً في معادلة طرح تقيس الفارق الحجمي الناتج عن إزالة الرمز المستهدف؛ فبدون شريك وظيفي يتولى إقصاء الرمز من السلسلة النصية، تظل دالة LEN أداة إحصائية عامة غير قادرة على النفاذ إلى العمق التوزيعي للمحارف.
3. دالة الاستبدال SUBSTITUTE وخصائصها التقنية في عزل الأحرف
3.1 الوسائط التشغيلية لدالة SUBSTITUTE وبنيتها الهيكلية
تختص دالة SUBSTITUTE بإجراء عمليات الإحلال والاستبدال النصي الموجه بناءً على مطابقة المحتوى الحرفي، بدلاً من الاعتماد على المواقع الرقمية للأحرف كما تفعل دالة REPLACE. تستند البنية النحوية للدالة إلى أربعة وسائط تشغيلية تُصاغ رياضياً كالتالي: SUBSTITUTE(text, old_text, new_text, [instance_num]). يمثل الوسيط الأول (text) السلسلة النصية الأصلية المراد معالجتها، في حين يعبر الوسيط الثاني (old_text) عن الحرف أو السلسلة الفرعية المطلوب البحث عنها واستبعادها من النص.
أما الوسيط الثالث (new_text)، فيمثل القيمة البديلة التي ستحل محل النص القديم؛ وفي سياق خوارزميات عد الأحرف، يُسند إلى هذا الوسيط نص فارغ تماماً يُرمز له بعلامتي اقتباس متتاليتين دون أي مسافة بينهما ""، مما يؤدي وظيفياً إلى تفريغ الرمز وحذفه دون ترك أي فراغ مكانه. ويظل الوسيط الرابع (instance_num) اختيارياً، وهو مخصص لتحديد رقم تكرار معين يراد استبداله بمفرده؛ غير أن إسقاط هذا الوسيط وإهماله في المعادلة يفعل سلوك الاستبدال الشامل، مما يدفع الدالة إلى استئصال كافة تكرارات الحرف المستهدف أينما وردت في السلسلة النصية، وهو السلوك التقني المطلوب لإنجاح عملية العد الإحصائي.
3.2 خاصية حساسية حالة الأحرف وتأثيراتها الحسابية
تتميز دالة SUBSTITUTE بخاصية برمجية صارمة تتمثل في حساسيتها الدقيقة لحالة الأحرف (Case Sensitivity) عند التعامل مع اللغات ذات الأبجديات اللاتينية. تفرق الدالة على مستوى البايت والمحرف بين الحرف الكبير والحرف الصغير؛ فحرف “A” يختلف تماماً في القيمة التشفيرية عن حرف “a”، وبالتالي فإن توجيه الدالة لاستبدال الحرف الصغير لن يؤثر بأي شكل من الأشكال على الحروف الكبيرة المناظرة له داخل النص نفسه.
يترتب على هذا التمايز الصارم نتائج حسابية حرجة يجب أخذها بالحسبان عند الرغبة في حساب إجمالي تكرار حرف معين بغض النظر عن حالته؛ فالاستدعاء المباشر للدالة مع استهداف حرف صغير سيتجاهل الحروف الكبيرة، مما يسفر عن احتساب ناقص للتكرارات وخلل في مخرجات التحليل الإحصائي. تتطلب معالجة هذا القصور استراتيجيات تقنية تسبق عملية الاستبدال، مثل تحييد حالة النص عبر تحويله كلياً إلى حالة موحدة، لتفادي الفجوات الناتجة عن تباين التشفير بين الحروف المتطابقة لفظاً ودلالة والمتباينة رسماً وحجماً.
3.3 تقنية الحذف الافتراضي للحرف المستهدف
تقوم تقنية الحذف الافتراضي على مفهوم رياضي مفاده أن استبدال حرف مستهدف بنص فارغ "" يؤدي بالضرورة إلى تقليص الحجم الإجمالي للسلسلة النصية بمقدار يتناسب طردياً مع عدد مرات ورود هذا الحرف وطوله. إذا كانت السلسلة النصية تحتوي على الرمز المستهدف، فإن مخرجات دالة SUBSTITUTE ستكون نصاً مضغوطاً تلاشت منه كافة تكرارات هذا الرمز، مع الحفاظ الكامل على ترتيب ووجود باقي المحارف الأخرى دون أدنى تعديل.
هذا الانكماش في الحجم الفيزيائي للنص يمثل النواة الصلبة التي تُبنى عليها خوارزميات القياس اللاحقة؛ فالنص الناتج عن عملية الحذف الافتراضي يُهيأ تماماً ليكون مدخلاً لدالة قياس الطول LEN. ومن خلال مقارنة هذا الطول المنكمش بالطول الأصلي المسجل قبل التدخل البرمجي، يتحول فعل الحذف النصي الافتراضي إلى متغير إحصائي محسوس يكشف بدقة رياضية متناهية عن كمية المادة اللغوية المحذوفة، مما يمهد الطريق لبلورة المعادلة الرياضية التكاملية لحساب تكرار الحروف.
4. النموذج الرياضي لحساب تكرار حرف في خلية مفردة
4.1 الأساس المنطقي لخوارزمية الطرح النصي القياسي
ينطلق الأساس المنطقي لخوارزمية الطرح النصي القياسي من فكرة رياضية بديهية ومبرهنة في علوم الحوسبة ومعالجة اللغات الطبيعية؛ حيث يُعرف عدد تكرارات رمز مفرد داخل نص ما بأنه الفرق الحسابي المطلق بين عدد محارف النص الكامل والعدد المتبقي من المحارف بعد شطب جميع تكرارات ذلك الرمز تحديداً. تتجلى هذه الخوارزمية في الصيغة الرياضية المركبة الشهيرة:
= LEN(Text) – LEN(SUBSTITUTE(Text, Character, “”))
يقوم البرهان الرياضي لهذه المعادلة على معادلة خطية بسيطة: بافتراض أن السلسلة النصية تتكون من عدد كلي من المحارف يُرمز له بالرمز $L_1$، وأن الرمز المستهدف يشغل طولاً قدره وحدة واحدة ويتكرر بمقدار $N$ مرة؛ فإن استئصال جميع تكرارات هذا الرمز باستخدام دالة SUBSTITUTE وتفريغها ينتج عنه سلسلة نصية جديدة ذات طول $L_2$، بحيث يكون:
L_2 = L_1 – (N times 1)
وبإعادة ترتيب طرفي المعادلة رياضياً لحساب المجهول $N$، نجد أن:
N = L_1 – L_2
تثبت هذه العلاقة الرياضية صحتها المطلقة في كافة الحالات الفردية؛ فإذا كان الرمز غير موجود في النص، فإن $L_2$ سيتطابق تماماً مع $L_1$ ويكون الناتج صفراً، وإذا تكرر الرمز خمس مرات، سينكمش النص بمقدار خمس وحدات ويكون الفارق الحسابي مساوياً للرقم خمسة تماماً.
4.2 التطبيق الإجرائي للصيغة الحسابية خطوة بخطوة
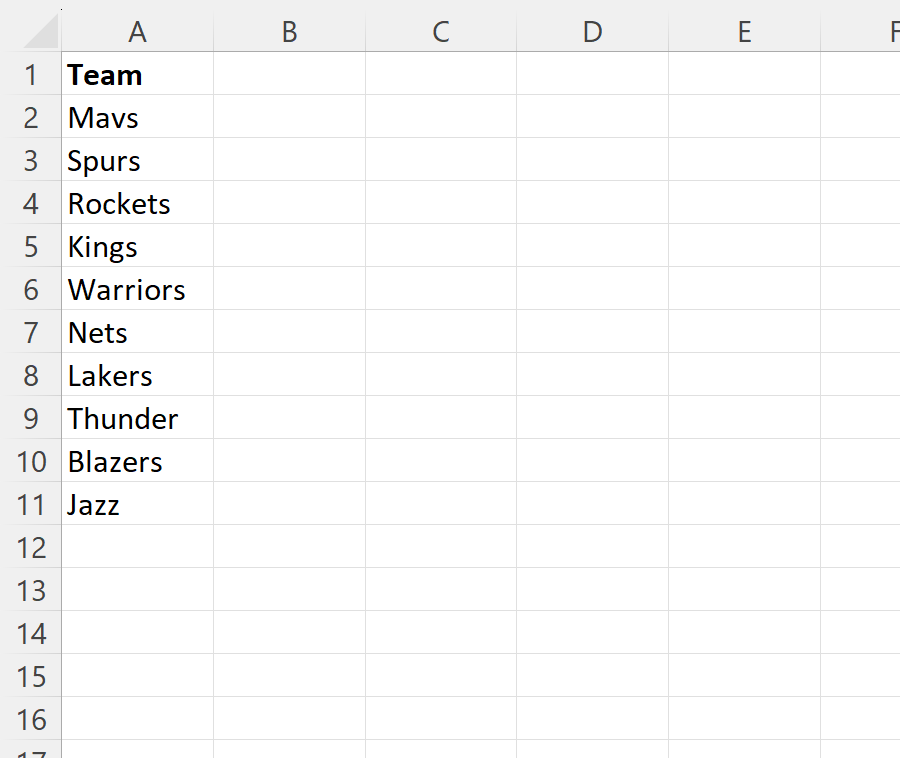
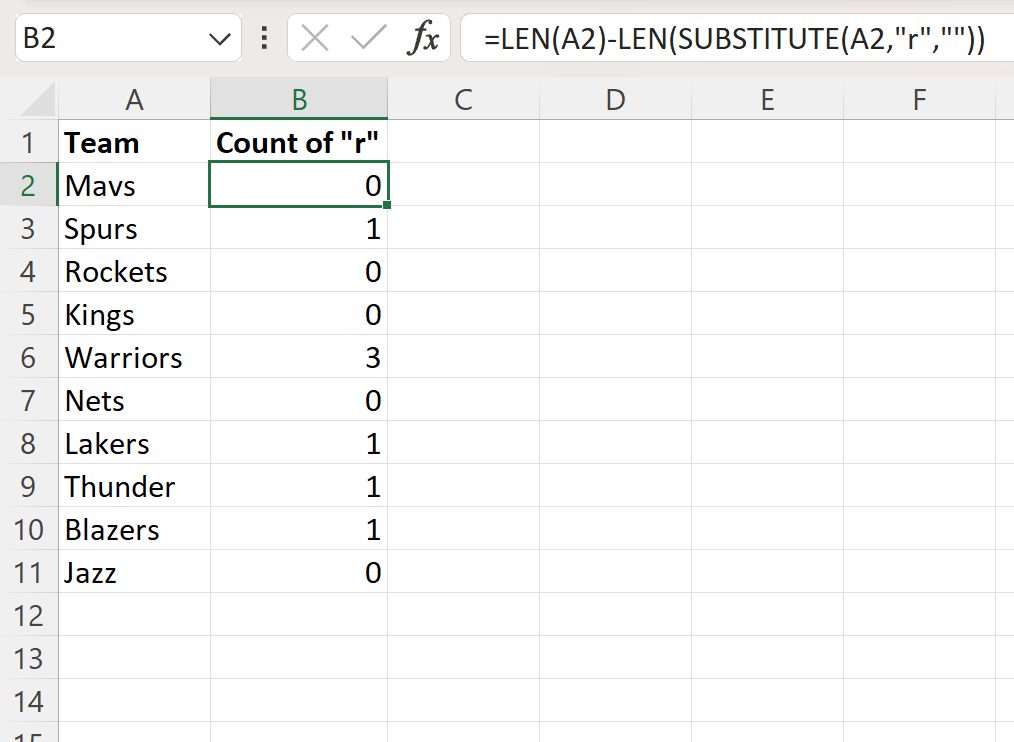
لتطبيق هذه الخوارزمية إجرائياً داخل ورقة عمل إكسل، يفترض أن لدينا قائمة من السجلات النصية تبدأ من الخلية A2 وحتى أسفل العمود A، ونرغب في حساب عدد مرات ظهور حرف محدد، وليكن الحرف اللاتيني “e”، داخل كل سجل نصي على حدة. تبدأ الخطوات باختيار خلية مجاورة في نفس الصف، ولتكن الخلية B2، ثم إدخال الصيغة المعيارية بالصيغة التالية:
=LEN(A2)-LEN(SUBSTITUTE(A2, “e”, “”))
يعتمد نجاح هذه الصيغة على استخدام مرجع الخلية النسبي A2، مما يضمن عند سحب مقبض التعبئة التلقائية (AutoFill Handle) عمودياً نحو الأسفل أن تتغير مراجع الخلايا تلقائياً لتصبح A3 وA4 وهكذا دواليك، لتغطي سائر سجلات العمود بنجاح. وفي حال الرغبة في جعل الحرف المستهدف ديناميكياً وقابلاً للتعديل الفوري دون الحاجة إلى تعديل صيغ الخلايا يدوياً، يمكن تخصيص خلية إدخال منفصلة للحرف المستهدف، ولتكن الخلية $C$1، مع تثبيتها كمرجع مطلق باستخدام علامات الدولار، لتصبح المعادلة كالآتي:
=LEN(A2)-LEN(SUBSTITUTE(A2, $C$1, “”))
4.3 دراسة حالات تطبيقية على نصوص وأسماء حقيقية
لتوضيح المخرجات العملية لهذه الصيغة الرياضية على أرض الواقع، نستعرض جدولاً تحليلياً يوضح نتائج تطبيق صيغة عد تكرار الحرف “a” (الصغير) على عينة من الأسماء وسلاسل البيانات المتنوعة داخل بيئة إكسل، مع تفكيك الخطوات الحسابية الوسطية التي ينفذها المحرك الرياضي:
| النص الأصلي (الخلية A) | LEN الأصلي | النص بعد الاستبدال SUBSTITUTE(…, “a”, “”) | LEN بعد الاستبدال | النتيجة النهائية (الفارق) | التفسير التحليلي للنتيجة |
|---|---|---|---|---|---|
| “banana” | 6 | “bnn” | 3 | 3 | تكرار الحرف “a” ثلاث مرات في الكلمة |
| “Apple” | 5 | “Apple” | 5 | 0 | غياب الحرف “a” الصغير؛ نظراً لأن الحرف الأول كبير “A” |
| “database” | 8 | “dtbse” | 5 | 3 | ثلاثة تكرارات موزعة داخل السلسلة النصية |
| “EXCEL” | 5 | “EXCEL” | 5 | 0 | نتيجة صفرية لانعدام وجود الحرف بحالته الصغيرة |
| “data-analysis” | 13 | “dt-nlysis” | 9 | 4 | أربعة تكرارات لحرف “a” مع وجود فواصل خاصة |
5. معالجة حساسية حالة الأحرف والتوافق مع النصوص متعددة اللغات
5.1 تجاوز حساسية الأحرف اللاتينية باستخدام الدوال التحويلية
كما تم إيضاحه آنفاً، فإن دالة SUBSTITUTE تلتزم بدقة صارمة بحالة الأحرف، مما يجعل حساب تكرار حرف لاتيني مثل “A” يغفل تماماً ظهور نظيره الصغير “a”. لمعالجة هذه الإشكالية وضمان شمولية العد بصرف النظر عن حالة المحارف في النص المدخل، يتم اللجوء إلى الدوال التحويلية لتسوية النص قبل إخضاعه للقياس. تبرز هنا دالتا LOWER وUPPER كأداتين مثاليتين لإعادة توحيد التشفير الحرفي لكافة عناصر السلسلة النصية.
تتم الصياغة الرياضية للمعادلة الهجينة غير الحساسة لحالة الأحرف عبر إدراج دالة LOWER داخل وسائط الدالة الأصلية؛ حيث يتم تحويل كل من النص الأصلي والحرف المستهدف إلى حالتهما الصغيرة بصورة مسبقة، كما يتضح في الصيغة التالية:
=LEN(A2)-LEN(SUBSTITUTE(LOWER(A2), LOWER(“A”), “”))
في هذا النموذج، تقوم دالة LOWER(A2) بتحويل كافة الحروف اللاتينية داخل الخلية إلى أحرف صغيرة، وتضمن دالة LOWER("A") أن يكون الرمز المبحوث عنه في حالته الصغيرة أيضاً (“a”). يؤدي هذا التوافق الإجرائي إلى استئصال كافة تكرارات الحرف بنوعيه الكبير والصغير في عملية مرور واحدة. وعلى الرغم من أن إضافة الدوال التحويلية تزيد من الحمل الحسابي على محرك إكسل بدرجة طفيفة، إلا أن هذا الأثر يظل غير محسوس إلا في أوراق العمل العملاقة التي تتجاوز مئات الآلاف من الصفوف المترابطة، وهو حل موثوق لرفع مستوى الاتساق في معالجة البيانات المعقدة (Lankton et al., 2015).
5.2 خصوصية معالجة الحروف والرموز في اللغة العربية
تنطوي معالجة اللغة العربية داخل الجداول الإلكترونية على تحديات بنيوية تتجاوز مفهوم حساسية حالة الأحرف الشائع في اللغات اللاتينية، وترتبط بظاهرة التنوع الشكلي والرسمي للرمز الواحد في النظام الطباعي العربي. ومن أبرز هذه التحديات التمايز البرمجي بين أشكال حرف الألف؛ حيث يعتبر محرك إكسل الألف المهموزة قطعاً من الأعلى (أ)، والمهموزة من الأسفل (إ)، والألف الممدودة (آ)، وألف الوصل المجردة (ا) محارف برمجية مستقلة تماماً، لكل منها نقطة كودية يونيكود خاصة بها لا تتطابق مع الأخرى.
يمتد هذا التباين الإملائي والتقني ليشمل نهايات الكلمات، وتحديداً في التمييز بين الياء المهملة غير المنقوطة (ى) والألف المقصورة، وبين التاء المربوطة (ة) والهاء الأخيرة (هـ). وإذا طُلب من دالة SUBSTITUTE البحث عن حرف الهاء المربوطة، فإنها لن تحتسب التاء المربوطة إطلاقاً. يفرض هذا الواقع المعقد ضرورة إجراء عملية “توحيد قياسي” (Standardization / Normalization) للنصوص العربية قبل الشروع في حساب تكرار الأحرف، وذلك بتمرير النصوص عبر سلسلة متتابعة من دوال الاستبدال لإزالة الهمزات وتوحيد التاءات والياءات إلى شكل نمطي موحد، لضمان الحصول على قياسات إحصائية دقيقة تعكس الواقع اللغوي الحقيقي للمحتوى.
5.3 حساب وتتبع علامات التشكيل والتنقيط
تتعامل معايير الترميز الدولي مع علامات التشكيل والحركات العربية (كالفتحة والضمة والكسرة والسكون والشدة وتنويناتها) باعتبارها نقاط تشفير مستقلة تُعرف باسم “رموز التشكيل الجمعية” (Combining Marks). تُرسم هذه العلامات فوق أو تحت الحرف الأساسي دون أن تشغل مساحة أفقية إضافية في العرض البصري، ولكنها داخل الذاكرة الحاسوبية لبرنامج إكسل تُحسب كرموز إضافية منفصلة تماماً، مما يعني أن دالة LEN تحتسب الحركة كحرف قائم بذاته يرفع من الطول الإجمالي للكلمة.
يتيح هذا التوصيف التقني للمحلل إمكانية تطويع معادلة العد لحصر كثافة التشكيل أو تتبع حركات بعينها في النصوص المشكولة؛ فلحساب عدد علامات الشدة في نص معين يقع بالخلية A2، يمكن استدعاء الرمز التشفيري الخاص بها أو إدراجه مباشرة بين علامتي اقتباس، كما في الصيغة الآتية:
=LEN(A2)-LEN(SUBSTITUTE(A2, “ّ”, “”))
وتكتسب هذه القدرة البرمجية أهمية محورية في الأبحاث اللغوية الحاسوبية وتحليل نصوص القراءات والمتون التراثية؛ حيث تتيح للباحثين استخراج المؤشرات الصرفية وتحديد كثافة الضبط بالشكل وتتبع تكرار الأدوات النحوية في المقاطع النصية بدقة رياضية متناهية (Wesche & Paribakht, 2000).
6. توسيع النطاق: حساب تكرار الحرف عبر عمود كامل باستخدام دالة SUMPRODUCT
6.1 قصور الدوال الجمعية التقليدية أمام العمليات النصية الصفيفية
عند الانتقال من معالجة خلية فردية إلى استخلاص التكرار الكلي لرمز معين عبر عمود كامل يضم مئات أو آلاف الصفوف، يواجه المستخدم عجزاً صريحاً في الدوال الجمعية التقليدية. تُخفق دالة العد الشرطي الشهيرة COUNTIF تماماً في أداء هذه المهمة؛ لأن منطقها البرمجي مصمم لعد الخلايا التي تحقق شرطاً يطابق محتوى الخلية كلياً أو جزئياً (باستخدام محارف البدل مثل النجمة)، ولا تمتلك القدرة على احتساب التكرارات المتعددة للرمز داخل نفس الخلية الواحدة، فإذا تكرر الرمز ثلاث مرات في خلية ما، ستحسبه COUNTIF كوحدة واحدة فقط لأن الخلية حققت الشرط.
ومن جهة أخرى، تعجز دالة الجمع البسيطة SUM في إصدارات إكسل التقليدية عن معالجة المعادلات المركبة التي تتضمن نطاقات خلايا مثل LEN(A2:A100) دون تفعيل خاص بصيغ المصفوفات عبر الضغط على (Ctrl + Shift + Enter). إن محاولة استخدام دوال الجمع العادية دون نمذجة صفيفية تسفر عادة عن إرجاع خطأ القيمة #VALUE! أو احتساب الخلية الأولى فقط في النطاق؛ مما يجعل من الضروري البحث عن دالة تمتلك هندسة داخلية مهيأة للتعامل مع المصفوفات الحسابية بصورة تلقائية وأصلية.
6.2 الهندسة الرياضية لدالة SUMPRODUCT في سياق معالجة النصوص
صُممت دالة SUMPRODUCT في الأصل لإجراء عمليات الضرب التبادلي بين مصفوفتين أو أكثر ومن ثم جمع نواتج الضرب؛ غير أن الميزة الاستثنائية التي جعلتها الأداة المفضلة لدى خبراء إكسل هي قدرتها الفطرية على معالجة المصفوفات (Arrays) في الذاكرة الحية دون الحاجة إلى تشغيل صيغ المصفوفات المعقدة أو التقيد باختصارات لوحة المفاتيح الخاصة. عندما يتم تزويد دالة SUMPRODUCT بمدخل حسابي مصفوفي مفرد، فإنها تتصرف كدالة جمع مصفوفية عليا، منفذة الحسابات المطلوبة داخل كل عنصر في النطاق على حدة قبل تجميع الحصيلة النهائية.
في سياق معالجة البيانات النصية، تتعامل دالة SUMPRODUCT مع النطاق الرأسي للأعمدة كسلسلة متتابعة من المتجهات؛ حيث تقوم بتمرير كل صف في العمود المستهدف بشكل مستقل عبر معادلتي LEN وSUBSTITUTE، واختزال النتائج الجزئية في مصفوفة أحادية البعد مؤلفة من أرقام صحيحة داخل الذاكرة المؤقتة للبرنامج. بعد اكتمال هذه العمليات الحسابية المتزامنة، تتولى الدالة جمع هذه القيم العددية فوراً وإرجاع رقم مفرد يمثل المجموع الإجمالي لتكرار الرمز المستهدف عبر كامل النطاق العمودي المحدد دون استهلاك موارد المعالجة الرسومية للجدول.
6.3 تطبيق الصيغة الشاملة للنطاق الكامل
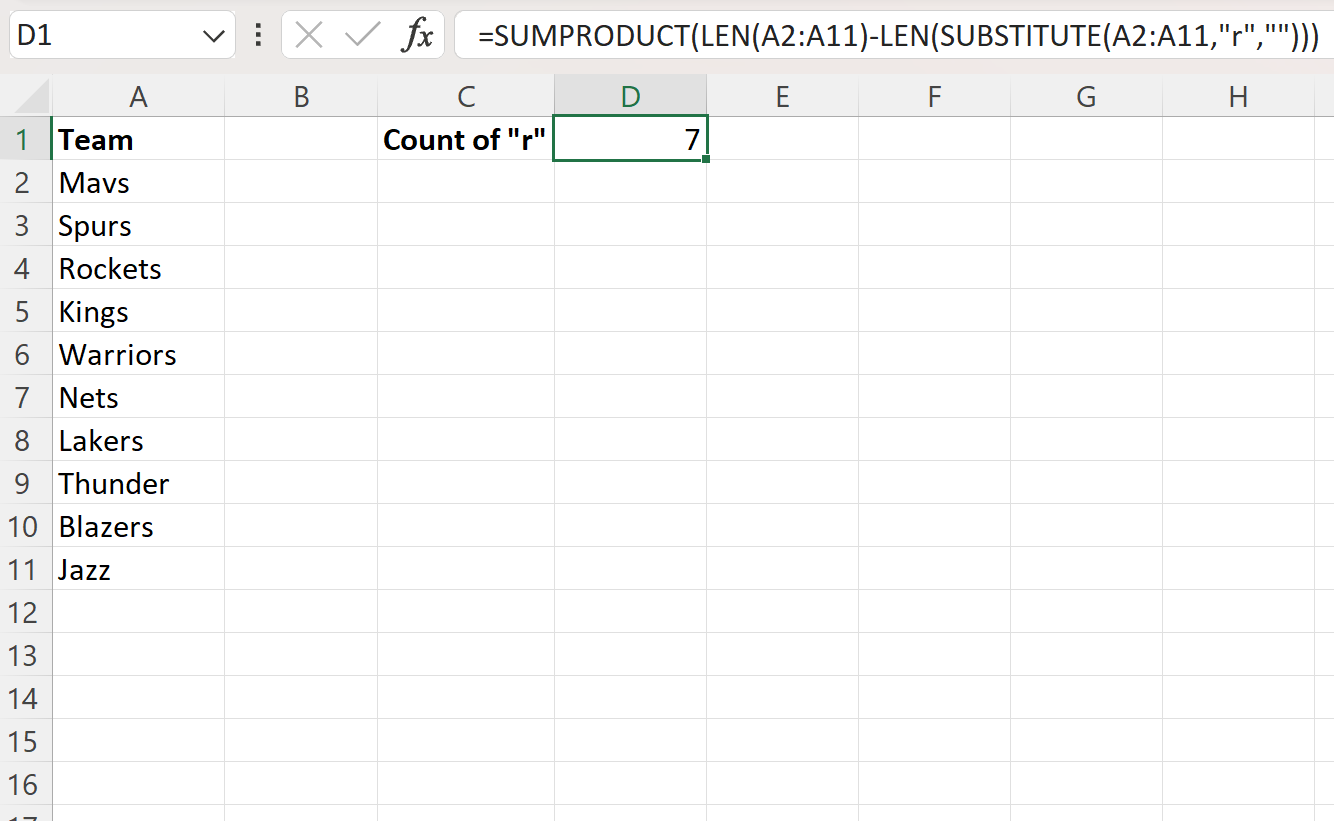
لبناء الصيغة الشاملة القادرة على حصر تكرار حرف محدد (وليكن الشرطة المائلة “/”) عبر عمود كامل يمتد من الخلية A2 إلى A1000، تتم كتابة المعادلة التكاملية في خلية إحصائية منفصلة كما يلي:
=SUMPRODUCT(LEN(A2:A1000) – LEN(SUBSTITUTE(A2:A1000, “/”, “”)))
تتم ميكانيكية تنفيذ هذه المعادلة عبر مسار حسابي داخلي متعدد المراحل يمكن تفكيكه برمجياً كالآتي:
- المرحلة الأولى: يولد الشق
LEN(A2:A1000)مصفوفة عمودية في الذاكرة تضم أطوال كافة النصوص الأصلية في كل خلية على حدة. - المرحلة الثانية: يقوم التعبير
SUBSTITUTE(A2:A1000, "/", "")باستئصال الرمز المستهدف من كل خلية في النطاق، مولداً مصفوفة من النصوص المنكمشة. - المرحلة الثالثة: يحسب التعبير
LEN(...)الثاني أطوال السلاسل النصية الجديدة بعد حذف الرمز المستهدف لكل عنصر في المصفوفة. - المرحلة الرابعة: تُجرى عملية الطرح الحسابي المصفوفي بين مصفوفة الأطوال الأصلية ومصفوفة الأطوال المنكمشة، لتنتج مصفوفة أرقام صحيحة تحتوي على عدد تكرارات الرمز في كل صف.
- المرحلة الخامسة: تقوم دالة
SUMPRODUCTبجمع كافة عناصر مصفوفة الفروق للحصول على الناتج الإجمالي لعدد الرموز في العمود ككل.
تتفوق هذه الصيغة على أسلوب “الأعمدة المساعدة” (Helper Columns) من حيث الحفاظ على نظافة الهيكل التنظيمي للمصنف وتوفير مساحات العرض، فضلاً عن رفع كفاءة الصيانة البرمجية للنظم المالية والبيانات الكبيرة.
7. البدائل والتقنيات الحديثة في بيئة إكسل 365 ومحرك الحسابات الديناميكي
7.1 توظيف الدوال الديناميكية المنسكبة لحساب الرموز
مع إطلاق محرك المصفوفات الديناميكية (Dynamic Array Engine) في بيئة مايكروسوفت إكسل 365 والإصدارات اللاحقة، طرأت نقلة نوعية في منهجيات الحساب النصي أتاحت التخلي عن دالة SUMPRODUCT لصالح دالة الجمع المباشرة SUM. في البيئة الحديثة، أصبحت دالة SUM قادرة على استيعاب النطاقات النصية كمدخلات مصفوفية تلقائياً دون أي تشغيل مخصص؛ حيث يمكن ببساطة كتابة الصيغة التالية لتحقيق نفس النتيجة التجميعية السابقة:
=SUM(LEN(A2:A1000) – LEN(SUBSTITUTE(A2:A1000, “X”, “”)))
علاوة على ذلك، أتاح التحديث البرمجي توظيف دوال التكرار والمسح الذاتي المتطورة مثل دالتي MAP وLAMBDA، والتي تسمح بالمرور على نطاق العمود خلية تلو الأخرى بكفاءة برمجية عالية تحاكي الحلقات التكرارية في لغات البرمجة المتقدمة. توفر صيغة MAP مع LAMBDA إمكانية إنشاء مخرجات منسكبة ديناميكياً (Spill Range) تظهر عدد الأحرف لكل خلية دون الحاجة إلى نسخ الصيغ يدوياً، كما في الصياغة المتقدمة التالية:
=MAP(A2:A100, LAMBDA(row, LEN(row) – LEN(SUBSTITUTE(row, “X”, “”))))
7.2 استخدام دالة TEXTSPLIT لتفكيك النصوص وإحصاء العناصر
قدمت ميكروسوفت في إكسل 365 دالة تفكيك النصوص الثورية TEXTSPLIT، والتي غيرت الفلسفة المتبعة في تتبع الفواصل والمحارف البنيوية. تعتمد هذه الدالة على مبدأ تجزئة السلسلة النصية إلى مصفوفة عناصر منفصلة بالاعتماد على محدد أو فاصل يتم تعريفه صراحة (Delimiter). وعند تعيين الحرف المستهدف كفاصل للتفكيك، تتجزأ السلسلة النصية إلى عدد من المقاطع يزيد بمقدار واحد عن عدد مرات ظهور هذا الفاصل.
وبناءً على هذه الخاصية، يمكن اشتقاق خوارزمية بديلة لعد الأحرف من خلال حساب عدد الأجزاء الناتجة عن عملية التقسيم باستخدام دالة COUNTA أو دالتي ROWS وCOLUMNS ومن ثم طرح واحد صحيح من الناتج، وفق الصيغة التوضيحية التالية للخلية المفردة:
=COUNTA(TEXTSPLIT(A2, “-“)) – 1
وعلى الرغم من الأناقة البرمجية لطريقة التفكيك النصي عبر TEXTSPLIT، إلا أنها تظل أقل كفاءة حسابية من طريقة الطرح النصي القياسي عبر LEN وSUBSTITUTE عند التطبيق على أعمدة ضخمة؛ نظراً لأن تقسيم النصوص إلى مصفوفات متفرقة يستهلك كتل ذاكرة إضافية لإدارة النصوص الفرعية، بينما تتعامل طريقة الطرح النصي مع قيم عددية مجردة لا ترهق موارد الذاكرة العشوائية للجهاز.
7.3 معايير اختيار الطريقة المثلى وفق مواصفات المشروع
يتطلب اتخاذ القرار البرمجي في بيئات العمل المؤسسية موازنة دقيقة بين ثلاثة معايير أساسية: التوافقية العكسية مع الإصدارات المختلفة، والسرعة التشغيلية لمحرك الحساب، وسهولة القراءة والصيانة البرمجية للنظم. يقدم الجدول التحليلي التالي مقارنة شاملة بين الطرق الأربع الأكثر شيوعاً في إكسل لحساب الرموز في الأعمدة:
| المنهجية المستخدمة | الصيغة النمطية المعتمدة | التوافق مع إصدارات إكسل القديمة | استهلاك موارد الذاكرة والسرعة | أبرز مجالات الاستخدام المثلى |
|---|---|---|---|---|
| SUMPRODUCT الكلاسيكية | SUMPRODUCT(LEN – LEN(SUBSTITUTE)) | متوافقة تماماً مع كافة الإصدارات | كفاءة ممتازة واستهلاك منخفض للموارد | المصنفات المؤسسية المشتركة وقواعد البيانات التاريخية |
| SUM الحديثة (Dynamic Array) | SUM(LEN – LEN(SUBSTITUTE)) | مقتصرة على Excel 365 وExcel 2021+ | فائقة السرعة ومحسنة للبيانات الضخمة | المشاريع الحديثة المعتمدة على السحابة والتحليلات الآنية |
| MAP وLAMBDA الوظيفية | MAP(Range, LAMBDA(…)) | مقتصرة حصرياً على بيئات Excel 365 | متوسطة إلى عالية بحسب حجم النطاق | بناء الدوال المخصصة وتوليد النتائج المنسكبة برمجياً |
| TEXTSPLIT التجزيئية | COUNTA(TEXTSPLIT) – 1 | مقتصرة حصرياً على بيئات Excel 365 | استهلاك ذاكرة مرتفع مع النصوص الطويلة | تفكيك النصوص المعقدة المترافقة بفرز المحتوى الفرعي |
8. التعامل مع السلاسل النصية متعددة الحروف والكلمات المحددة
8.1 المعادلة المعدلة لحساب السلاسل التي تزيد عن حرف واحد
تتعقد المشكلة الحسابية عندما لا يكون الهدف حصر رمز منفرد طوله حرف واحد، بل كلمة كاملة أو سلسلة نصية فرعية مؤلفة من عدة حروف، مثل الكلمات المفتاحية أو المقاطع الدلالية في قواعد البيانات النصية (van Heuven et al., 2013). في هذه الحالة، يؤدي تطبيق معادلة الطرح النصي البسيطة إلى نتائج مضللة وضخمة جداً؛ لأن استئصال كلمة تتكون من أربعة حروف (مثل كلمة “data”) يؤدي إلى انكماش طول النص بمقدار أربعة أحرف لكل مرة ترد فيها الكلمة، وليس بمقدار حرف واحد فقط.
ولمعالجة هذا التوسع الخطي في الفارق الحجمي، يتعين إدخال تعديل جوهري على النموذج الرياضي يتمثل في قسمة ناتج الفارق الحسابي بين الطولين على طول الكلمة المستهدفة نفسها. تصاغ المعادلة المعدلة للخلية الفردية كالتالي:
=(LEN(A2) – LEN(SUBSTITUTE(A2, Target_Text, “”))) / LEN(Target_Text)
يضمن هذا الإجراء الرياضي تحييد أثر طول السلسلة المستهدفة؛ فإذا تكررت كلمة مكونة من 5 حروف مرتين في السلسلة، سينكمش النص بمقدار 10 محارف؛ وبقسمة الرقم 10 على طول الكلمة (5) ينتج الرقم 2 بدقة متناهية، وهو عدد مرات الورود الفعلي للكلمة في السجل.
8.2 تطبيق المعادلة على مستوى العمود بالكامل
عند تعميم معادلة السلاسل متعددة الحروف على نطاق عمود كامل، يتم دمج مقام القسمة داخل البنية الصفيفية لدالة SUMPRODUCT. وتبرز هنا أفضل الممارسات المنهجية التي تنص على ربط النص المستهدف بخلية مرجعية خارجية مستقلة (وليكن المرجع $C$1)، بدلاً من تضمين الكلمة نصياً داخل المعادلة، مما يمنح نموذج التحليل مرونة فائقة وقابلية للتعديل اللحظي. وتُكتب الصيغة التجميعية للعمود على النحو الآتي:
=SUMPRODUCT((LEN(A2:A1000) – LEN(SUBSTITUTE(A2:A1000, $C$1, “”))) / LEN($C$1))
ولكن هذا النموذج ينطوي على ثغرة برمجية حرجة يجب التحوط لها؛ ففي حال كانت الخلية المرجعية $C$1 فارغة لأي سبب، فإن معامل طولها LEN($C$1) سيساوي صفراً، مما يقود حتماً إلى انهيار المعادلة وظهور خطأ القسمة على الصفر الشهير #DIV/0!. ولتأمين المعادلة برمجياً ضد هذا السلوك، يُنصح بتغليف المقام بدالة شرطية تمنع القسمة الصفرية، أو استخدام دالة IF للتحقق من امتلاء الخلية المرجعية قبل إطلاق الحساب التجميعي:
=IF($C$1=””, 0, SUMPRODUCT((LEN(A2:A1000) – LEN(SUBSTITUTE(A2:A1000, $C$1, “”))) / LEN($C$1)))
8.3 تحديد حدود الكلمات وتفادي التداخل في المقاطع الجزئية
يتمثل التحدي الجوهري الأكثر تعقيداً في التنقيب عن الكلمات عبر الجداول الإلكترونية في معضلة “التداخل المعجمي” (Sub-string Overlap). تحدث هذه الظاهرة عندما ترد الكلمة المستهدفة كجزء تركيبي مدمج داخل كلمات أخرى أطول؛ كأن نبحث عن تكرار كلمة “cat” اللاتينية، فتقوم المعادلة باحتسابها عند ورودها ضمن كلمات أخرى مثل “caterpillar” أو “catalog” أو “vacation”. يؤدي هذا السلوك إلى تضخيم غير مقصود في أرقام التكرار المخصصة للمفردة المستقلة بذاتها (Brysbaert et al., 2018).
وللحد من هذا التداخل الدلالي وضمان حساب الكلمة فقط عند ورودها كوحدة لغوية مستقلة، يتم اللجوء إلى تقنية “الحصر بالمسافات” (Space Padding)؛ حيث تُحاط الكلمة المستهدفة بمسافة بادئة ومسافة لاحقة داخل وسائط الاستبدال، مع إضافة مسافات مماثلة في بداية ونهاية النص الأصلي لضمان التقاط الكلمات الواقعة في أطراف الجمل. تتبلور هذه التقنية المتقدمة في الصيغة التالية:
=(LEN(” ” & A2 & ” “) – LEN(SUBSTITUTE(” ” & A2 & ” “, ” ” & $C$1 & ” “, “”))) / LEN(” ” & $C$1 & ” “)
ورغم الفاعلية العالية لهذه الصيغة في النصوص البسيطة، إلا أنها تظل محدودة القدرة أمام علامات الترقيم الملتصقة بالكلمات كالفواصل والنقاط وعلامات التعجب، ما يتطلب معالجة تنظيفية مسبقة لإزالة علامات الترقيم واستبدالها بمسافات لضمان عزل الكلمات بصورة مثالية.
9. استكشاف الأخطاء ومعالجة الثغرات الحسابية الشائعة
9.1 أخطاء القيم غير النصية والبيانات المفقودة
من أكثر المشكلات البرمجية إحباطاً عند تطبيق معادلات الحساب النصي على الأعمدة الممتدة ظهور خطأ القيمة الشهير #VALUE!، والذي ينتقل بصورة متسلسلة ليعطل عمل الدوال الجمعية مثل SUMPRODUCT. ينشأ هذا الخطأ غالباً عن احتواء العمود المستهدف على خلايا تحمل مسبقاً قيماً خاطئة (مثل #N/A أو #DIV/0! أو #REF!)، حيث تعجز الدوال النصية عن معالجة كائنات الأخطاء، مما يؤدي إلى توقف المعالجة الصفيفية برمتها وإرجاع الخطأ ذاته كناتج كلي للعمود.
كذلك تثير الخلايا ذات القيم المنطقية الصرفة أو البيانات الرقمية غير المحولة هفوات في الأداء في بعض بنيات إكسل القديمة. ولتعزيز متانة النموذج البرمجي وضمان صموده أمام المدخلات المشوهة، يتم توظيف دوال الحماية والفحص مثل IFERROR أو ISTEXT. وفي إصدارات إكسل 365، يمكن استثمار دالة FILTER لعزل الخلايا النصية السليمة واستبعاد الخلايا التي تحتوي على أخطاء قبل تمرير النطاق إلى دوال العد، مما يوفر حصانة رياضية متكاملة لبيئة الحساب التجميعي.
9.2 معالجة المسافات البيضاء المخفية والرموز غير القياسية
عندما تُستورد جداول البيانات من قواعد بيانات شبكية أو صفحات الويب (Web Scraping)، تظهر في كثير من الأحيان فجوة خفية تُفسد دقة معادلات عد المسافات؛ حيث يلاحظ المستخدم احتواء النص على مسافات ظاهرة للعين المجردة، لكن معادلة عد المسافات العادية تسفر عن نتائج صفرية. يكمن التفسير العلمي لهذه الظاهرة في وجود ما يُعرف بـ “المسافة غير القابلة للكسر” (Non-Breaking Space)، والتي تشغل النقطة الكودية رقم 160 في جدول المحارف، في حين تمثل المسافة العادية الرمز رقم 32.
لا تستطيع دالة SUBSTITUTE(A2, " ", "") التقاط الرمز 160 إطلاقاً لأنه يمثل محرفاً مغايراً برمجياً؛ كما أن دالة TRIM القياسية تعجز بطبيعتها عن حذف هذا النوع من المسافات. لحل هذه المعضلة بدقة، يجب تطويع دالة CHAR لاستبدال المسافات ذات الكود 160 بمسافات نظامية أو استئصالها مباشرة، عبر إدراج التعبير التطهيري التالي ضمن مصفوفة المعالجة:
=SUBSTITUTE(A2, CHAR(160), “”)
وبالمثل، يوصى دائماً بدمج دالة CLEAN لإزالة محارف التحكم الخفية التي تتراوح أكوادها بين 0 و31، لضمان عدم وجود أي أحجام ميتة تؤثر على دقة قياسات دالة LEN.
9.3 تحسين كفاءة استهلاك الذاكرة في أوراق العمل الضخمة
يقع كثير من مستخدمي إكسل في خطأ برمجي شائع يؤثر سلباً على أداء النظام وسرعة إعادة الحساب (Workbook Calculation Time)، وهو الإشارة إلى الأعمدة المفتوحة كاملة دون تحديد نهاياتها الحقيقية، مثل كتابة: SUMPRODUCT(LEN(A:A) - ...). يؤدي هذا الاستدعاء غير الرشيد إلى إجبار محرك الحساب على حجز مساحات في الذاكرة لفحص ومعالجة ما يزيد عن 1.048.576 صفاً، حتى لو كانت البيانات الفعلية لا تتعدى بضع مئات من الصفوف، الأمر الذي يتسبب في بطء شديد وتجمد مؤقت للبرنامج.
ولتحقيق الاستغلال الأمثل لموارد الحاسوب ورفع سرعة الاستجابة الحسابية، يجب استبدال مراجع الأعمدة الكاملة بإحدى التقنيتين التاليتين:
- الجداول المهيكلة الرسمية (Excel Tables): تحويل نطاق البيانات إلى جدول رسمي عبر الضغط على (Ctrl + T) واستخدام المراجع المنظمة؛ مثل
Table1[ColumnName]، مما يحصر الحساب تلقائياً في الصفوف المأهولة بالبيانات فقط ويتوسع ديناميكياً مع إضافة أي سجلات جديدة. - النطاقات الديناميكية المسماة (Dynamic Named Ranges): بناء نطاقات معرفة عبر دالة
INDEXودالةCOUNTAلتحديد حدود البيانات الفعلية بدقة رياضية متناهية تضمن عدم إهدار أي بايت من الذاكرة المؤقتة.
10. التطبيقات المتقدمة ودراسات الحالة العملية لتحليل الأعمدة النصية
10.1 تدقيق جودة البيانات وترميز المعرفات الرقمية والرمزية
تمثل تقنيات حساب الأحرف داخل الأعمدة أداة تدقيقية فائقة الفاعلية في مجال حوكمة وتطهير البيانات المؤسسية (Data Hygiene). تتضمن العديد من حقول السجلات القياسية قواعد هيكلية صارمة يجب عدم الإخلال بها؛ فعلى سبيل المثال، يتطلب التحقق من سلامة البنية التكوينية لعناوين البريد الإلكتروني احتواء الحقل على رمز “@” واحد فقط دون زيادة أو نقصان؛ إذ تشير النتائج الصفرية إلى عنوان مفقود الرمز، بينما تكشف القيم الأكبر من واحد عن وجود خطأ طباعي متكرر.
وبالمثل، يمكن توظيف دالة SUMPRODUCT لفحص سلاسل التوريد والرموز الشريطية الدولية؛ حيث يتم التحقق من صحة أرقام الحسابات البنكية أو أرقام الهواتف الدولية عبر عد فواصل الفئات أو الشُرط الفاصلة للتأكد من اتساقها الشكلي قبل ترحيلها إلى قواعد البيانات السحابية المركزية. وتوضح الصيغة التطبيقية التالية آلية التحقق الشرطي من التزام السجلات بالمعيار المطلوب عبر رصد الانحرافات التنسيقية بصورة آلية تامة:
=IF(LEN(A2)-LEN(SUBSTITUTE(A2, “-“, “”)) = 3, “مطابق للمعايير”, “خطأ في التنسيق”)
10.2 تحليل تكرار الكلمات والمفردات في استبانات المسوح الميدانية
في مجالات العلوم السلوكية وأبحاث السوق المعاصرة، تشكل إجابات الاستبانات المفتوحة حقلاً غنياً بالرؤى النوعية، إلا أن تحليلها يتطلب تحويل المضامين اللفظية إلى مؤشرات كمية قابلة للرصد والتقييم (Shull et al., 2001). يتيح توظيف معادلات حساب المقاطع النصية للباحثين إحصاء تكرار مفردات نوعية تعبر عن انطباعات المستهلكين (مثل كلمات: “ممتاز”، “رديء”، “تأخير”، “دعم”) عبر عمود كامل من الملاحظات والآراء النصية المسترجعة من الميدان.
ولا يقتصر هذا التطبيق التحليلي على المفردات اللغوية التقليدية، بل يمتد في العصر الراهن ليشمل رصد كثافة الرموز التعبيرية (Emojis) وعلامات الترقيم الانفعالية كعلامات الاستفهام والتعجب المتكررة، والتي تعد مؤشرات قوية على درجات رضا أو احباط العملاء تجاه الخدمات المقدمة (McRae et al., 2005). إن ربط نواتج معادلات العد النصي بمقاييس ليكرت أو النماذج الرياضية الرقمية يُمكّن المؤسسات من بناء مؤشرات أداء نوعية دون الحاجة إلى الاستعانة ببرمجيات التشفير النوعي المستقلة والباهظة الثمن (Lété et al., 2004).
10.3 بناء لوحة مؤشرات تفاعلية للتحليل النصي التلقائي
تتوج الممارسات المتقدمة في إكسل بدمج خوارزميات عد الرموز ضمن لوحات التحكم والمؤشرات التفاعلية (Interactive Dashboards)؛ حيث يتم ربط المعادلات بعناصر التحكم التفاعلية في النماذج مثل القوائم المنسدلة (Data Validation Dropdowns) وصناديق الاختيار. يتيح ذلك لمدير النظام أو محلل البيانات اختيار أي حرف أو رمز أو مصطلح من القائمة المنسدلة، لتقوم الصيغة المصفوفية للعمود بإعادة حساب وعرض إجمالي التكرارات بصورة فورية على لوحة المؤشرات.
تكتمل هذه المنظومة التفاعلية بتطبيق قواعد “التنسيق الشرطي” (Conditional Formatting) على العمود المستهدف؛ حيث تتم صياغة قواعد تظليل تلقائية بالاعتماد على معادلة الطرح النصي LEN - LEN(SUBSTITUTE) لتمييز الخلايا التي يرتفع فيها تكرار الرمز المستهدف عن حد معين بألوان دلالية مميزة. وتُربط هذه النتائج بمخططات بيانية ديناميكية تعرض التوزيع التكراري للرموز والألفاظ عبر الأقسام المختلفة، مما يحول جدول البيانات التقليدي إلى نظام استخباري متكامل لتحليل النصوص واتخاذ القرارات الإدارية بناءً على براهين رقمية موثوقة (Burch, 2002).
خاتمة
استعرض هذا المقال المعالجة التقنية والمنهجية لمسألة حساب وتتبع تكرار الأحرف والرموز المحددة في أعمدة برنامج مايكروسوفت إكسل؛ وهي المسألة التي تبرز كيف يمكن لتكامل الدوال البسيطة أن يولد حلولاً حاسوبية فائقة القوة تسد الفجوات الوظيفية في البرمجيات الرقمية. إن الانتقال من مجرد قياس أحادي عبر دالة LEN إلى بناء نموذج طرح نصي تركيبي مدعوم بدالة SUBSTITUTE، ثم تعميم هذا النموذج عبر مصفوفات دالة SUMPRODUCT أو محركات إكسل 365 الحديثة، يعكس عمق المرونة البرمجية المتاحة لمحلل البيانات المعاصر.
وقد أظهر التحليل الدقيق أن النجاح المهني في معالجة البيانات النصية لا يتوقف عند حفظ الصيغ الرياضية، بل يتطلب إدراكاً شاملاً للبيئة التشفيرية للحروف، بما في ذلك التعامل الحذر مع المسافات الخفية ورموز التحكم، ومراعاة حساسية حالة الأحرف في الأبجديات اللاتينية، واستيعاب الخصائص الإملائية والشكلية الفريدة لحروف وتشكيلات اللغة العربية. ومع التطور المستمر الذي يشهده محرك الحسابات في إكسل، يظل الإلمام بهذه القواعد الرياضية والمنطقية الأساس المتين لبناء نماذج معالجة وتنظيف بيانات تتسم بأعلى درجات الدقة والفاعلية والموثوقية المؤسسية.
المراجع
Brysbaert, M., Mandera, P., McCormick, S. F., & Keuleers, E. (2018). Word prevalence norms for 62,000 English lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-018-1077-9
Brysbaert, M., Warriner, A. B., & Kuperman, V. (2013). Concreteness ratings for 40 thousand generally known English word lemmas. Behavior Research Methods. https://doi.org/10.3758/s13428-013-0403-5
Burch, S. (2002). Signs of Resistance. New York University Press eBooks. https://doi.org/10.18574/nyu/9780814789988.001.0001
Lankton, N. K., McKnight, D. H., & Tripp, J. F. (2015). Technology, Humanness, and Trust: Rethinking Trust in Technology. Journal of the Association for Information Systems. https://doi.org/10.17705/1jais.00411
Lété, B., Sprenger-Charolles, L., & Colé, P. (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560
McRae, K., Cree, G. S., Seidenberg, M. S., & McNorgan, C. (2005). Semantic feature production norms for a large set of living and nonliving things. Behavior Research Methods. https://doi.org/10.3758/bf03192726
Shull, R. L., Gaynor, S. T., & Grimes, J. A. (2001). RESPONSE RATE VIEWED AS ENGAGEMENT BOUTS: EFFECTS OF RELATIVE REINFORCEMENT AND SCHEDULE TYPE. Journal of the Experimental Analysis of Behavior. https://doi.org/10.1901/jeab.2001.75-247
van Heuven, W. J. B., Mandera, P., Keuleers, E., & Brysbaert, M. (2013). Subtlex-UK: A New and Improved Word Frequency Database for British English. Quarterly Journal of Experimental Psychology. https://doi.org/10.1080/17470218.2013.850521
Wesche, M. B., & Paribakht, T. S. (2000). Reading‐Based Exercises in Second Language Vocabulary Learning: An Introspective Study. Modern Language Journal. https://doi.org/10.1111/0026-7902.00062