
تمثل معالجة السلاسل النصية وتجزئتها إحدى الركائز الجوهرية في هندسة البيانات وإدارتها داخل بيئات جداول البيانات الإلكترونية الحديثة، وعلى رأسها برنامج مايكروسوفت إكسل (Microsoft Excel). فعلى الرغم من أن الجداول الحسابية صُممت في الأصل لمعالجة البيانات الرقمية والعمليات المحاسبية والمالية المعقدة، إلا أن التوسع الهائل في جمع البيانات وتنوع مصادرها الميدانية والمسحية أفضى إلى تكدس سجلات نصية مركبة تتطلب فرزاً وتنقية دقيقة قبل إخضاعها للتحليل الإحصائي أو النمذجة المتقدمة. وتأتي عملية استخراج الكلمة الأولى من الخلية النصية في مقدمة هذه الإجراءات الحيوية، حيث تسهم مباشرة في عزل المعرفات اللغوية، وفرز الأسماء الشخصية، وتصنيف الأكواد التشغيلية وتفكيك المتغيرات المعقدة.
يتناول هذا البحث التقني الشامل والمدعوم بالتحليل الأكاديمي الرصين الأطر النظرية والعملية الكامنة وراء هندسة النصوص داخل إكسل، مع التركيز على استخراج الكلمة الأولى كنموذج تطبيقي رئيسي. سنستعرض الآليات الرياضية والبرمجية التي تحكم عمل الدوال التقليدية العريقة، مثل دالتي LEFT و FIND، وما يكتنفها من مفاهيم إزاحة المؤشرات ومعالجة الأخطاء الشائعة كظهور خطأ #VALUE! عند معالجة النصوص أحادية الكلمة، ثم ننتقل إلى التحليل المعمق للثورة المنهجية التي أحدثتها دوال المعالجة النصية الحديثة، وفي مقدمتها دالة TEXTBEFORE المدمجة في الإصدارات المعاصرة. كما سيمتد البحث ليشمل أدوات التطهير، وتأثير الفراغات غير المرئية، وأتمتة العمليات عبر محرر الاستعلامات Power Query، وصياغة الأكواد المخصصة بلغة VBA، واستخدام التعبيرات النمطية Regular Expressions.
إن إتقان هذه المهارات البرمجية لا يقتصر أثره على توفير الوقت والجهد في إدارة الأعمال الروتينية فحسب، بل يمثل معياراً صارماً لضمان جودة ونزاهة البيانات في الأبحاث الأكاديمية والعلوم الاجتماعية والسلوكية، حيث تتطلب الدراسات اللغوية والاستقصائية معالجة نصوص استجابات المشاركين بدقة خوارزمية مطلقة تمنع حدوث أي تشويه أو بتر في المدخلات؛ وهو ما أشار إليه باحثون متخصصون في دراسة قواعد البيانات المعجمية والتحليل النصي للبيانات التفاعلية مثل دراسات (Lété et al., 2004) ودراسات التحليل الآلي للنصوص لـ (Settanni & Marengo, 2015).
1. الأسس النظرية لمعالجة النصوص وسلاسل المحارف في بيئة إكسل
1.1 مفهوم السلاسل النصية ومحددات الفصل المكانية
تُعرَّف السلسلة النصية (String) داخل بيئة إكسل بأنها تتابع خطي مرتب من المحارف (Characters) التي يتم تخزينها داخل ذاكرة الخلية في تسلسل ذي فهارس رقمية تبدأ من المحرف رقم واحد وتمتد حتى نهاية المحتوى المدخل. وتتضمن هذه المحارف الحروف الأبجدية، والأرقام التي تُعامل كنصوص، والرموز الخاصة، والمسافات البيضاء الفاصلة. وفي بنية النصوص الطبيعية المكتوبة، تلعب المسافة البيضاء المعيارية (White Space) دور المحدد الفاصل (Delimiter) الأساسي الذي يعزل الوحدات الدلالية واللغوية المستقلة؛ حيث يشير كل فراغ إلى انتهاء كيان صرفي وبداية كيان جديد.
تتمثل الصعوبة البرمجية عند محاولة استخراج الكلمة الأولى آلياً في أن الكلمات لا تخضع لطول ثابت؛ فالسجلات غير المتجانسة قد تبدأ بكلمات متباينة الطول تتراوح بين حرفين أو ثلاثة أحرف (مثل أدوات التعريف أو بعض الأسماء والرموز المختصرة) وتصل إلى سلاسل مركبة تتجاوز عشرين محرفاً. وبالتالي، فإن الاعتماد على قيم اقتطاع ثابتة ومحددة سلفاً يُعد أمراً مستحيلاً رياضياً، مما يستوجب بناء منطق حسابي مرن قادر على قياس إحداثيات موقع أول فاصل مكاني، ثم توجيه دوال الاقتطاع لسحب الجزء النصي المحصور بدقة بين بداية السلسلة وذلك الفاصل الافتراضي، مع مراعاة كافة التباينات الصرفية والبنائية في مجموعات البيانات الكبيرة.
1.2 أهمية استخراج الكلمة الأولى في تنقية البيانات وتصنيفها
تشكل تنقية البيانات وتصنيفها المرحلة الأكثر حساسية واستهلاكاً للوقت في دورة حياة البيانات؛ حيث يؤثر نقاء المدخلات بصورة طردية على دقة المخرجات والتحليلات الإحصائية اللاحقة. وفي التطبيقات الإدارية وقواعد البيانات الوظيفية، يبرز استخراج الكلمة الأولى كأداة لا غنى عنها لعزل الاسم الشخصي الأول للموظفين أو العملاء عن أسمائهم العائلية أو ألقابهم المركبة، مما يتيح تخصيص المراسلات الآلية وبناء معرفات مستخدمين متجانسة ومتسقة بنيوياً.
أما في سياق المسوح الميدانية والأبحاث السلوكية والاجتماعية، فإن الباحثين كثيراً ما يواجهون مجموعات بيانات تتضمن استجابات نصية غير مقيدة أو سجلات تجريبية تحتوي على تصنيفات مجمعة في خلية واحدة؛ مثل رقم المشارك متبوعاً بحالته التجريبية. وتتطلب بروتوكولات المعالجة المسبقة فك هذا الارتباط وتوحيد الأكواد المعيارية لضمان موثوقية التحليلات التجريبية المتسلسلة (Lewandowsky et al., 2010). إن تحسين جودة البيانات عبر استخلاص الكلمات المفتاحية الأولى يضمن خلو السجلات من التكرارات الشاذة ويسهل عمليات الربط بين الجداول المختلفة باستخدام دوال البحث المتقدمة، محققاً بذلك أعلى درجات التوافق الهيكلي داخل مستودعات البيانات الحسابية.
1.3 تطور وظائف المعالجة النصية عبر إصدارات مايكروسوفت إكسل
شهدت معالجة النصوص داخل مايكروسوفت إكسل تحولاً جذرياً يوازي التطور الحاصل في علوم البرمجيات وهندسة الخوارزميات. ففي الإصدارات التقليدية الكلاسيكية، كان المستخدمون مقيدين بالصيغ التركيبية المبنية على التداخل الرياضي المعقد؛ حيث كان يتطلب استخراج جزء نصي بسيط دمج عدة دوال معاً (مثل دمج دوال القياس والتحديد والاقتطاع)، وهو ما نتج عنه صيغ طويلة يصعب تدقيقها أو تتبع الأخطاء البرمجية الكامنة في أبعادها وتفاصيلها الحسابية.
مع إطلاق محرك الحسابات الديناميكي المتقدم في النسخ الحديثة لمايكروسوفت 365 وإصدارات إكسل الأحدث، قفزت قدرات المعالجة النصية نقلة نوعية نوعية كبرى؛ إذ أدمجت مايكروسوفت حزمة مخصصة من الدوال التخصصية التي تستهدف النصوص بشكل مباشر وتلغي الحاجة إلى احتساب المؤشرات الرقمية والفهارس يدوياً. هذا التحول البنيوي نقل مهام تقسيم النصوص من مرحلة التركيب الجبري الشاق إلى مرحلة الاستدعاء الوظيفي المباشر، مما عزز من كفاءة الأداء الحسابي وسرعة معالجة الملفات الضخمة التي تحتوي على مئات الآلاف من الصفوف المتراكمة، موفراً بذلك بنية برمجية مستقرة تدعم التحليلات المعقدة بأقل قدر ممكن من التعقيد الرياضي والرمزي.
2. التحليل البنيوي لدالة TEXTBEFORE الحديثة
2.1 التعريف الوظيفي وبناء الجملة البرمجية للدالة
تُعد دالة TEXTBEFORE إحدى أهم وأحدث الإضافات الجوهرية التي أدخلتها مايكروسوفت على مكتبة دوال معالجة النصوص، حيث صُممت خصيصاً لاقتطاع وعزل كافة المحارف الواقعة قبل محدد نصي (Delimiter) معين يتم تعريفه بدقة من قِبل المستخدم. يعتمد بناء الجملة البرمجية (Syntax) الأساسي للدالة على صيغة انسيابية تتسم بالوضوح الشديد والتكامل المنطقي:
=TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
تشتمل هذه الدالة على معاملين إلزاميّين هما: المعامل الأول text، ويمثل الخلية أو السلسلة النصية المستهدفة بالاقتطاع، والمعامل الثاني delimiter، وهو الرمز أو النص الذي يمثل علامة الفصل الفاصلة بين الأجزاء النصية. وبالمقارنة مع التركيبات الكلاسيكية المرهقة التي تتطلب احتساب طول النص وفهرس موقع المسافة، توفر TEXTBEFORE حلاً وظيفياً مباشراً يستخلص الجزء المطلوب دون الحاجة لأي عمليات حسابية مساعدة، مما يقلل بشكل ملموس من احتمالية الخطأ البشري أثناء صياغة النماذج الحسابية في المصنفات الضخمة.
2.2 المعاملات الاختيارية المتقدمة لضبط سلوك الاقتطاع
لا تقتصر كفاءة TEXTBEFORE على استخراج النصوص البسيطة، بل تمتد لتغطي سيناريوهات المعالجة المتقدمة من خلال أربعة معاملات اختيارية تمنح المحلل تحكماً مطلقاً في سلوك الاقتطاع البرمجي. المعامل الثالث instance_num يتيح تحديد رقم التكرار المطلوب للفاصل النصي؛ فإذا كان المستند يحتوي على عدة مسافات ويرغب المستخدم في استخراج النص الواقع قبل المسافة الأولى يحدد القيمة (1)، بينما يتيح تحديد قيم سالبة مثل (-1) البحث بدءاً من نهاية السلسلة باتجاه البداية، وهو أمر استثنائي في مرونته المكانية.
أما المعامل الرابع match_mode، فيتحكم في حساسية حالة الأحرف في النصوص اللاتينية؛ حيث تحدد القيمة الافتراضية (0) المطابقة الدقيقة الحساسة لحالة الأحرف، في حين توفر القيمة (1) مطابقة غير حساسة لحالة الأحرف. ويتعامل المعامل الخامس match_end مع كيفية تعاطي الخوارزمية مع نهاية النص؛ حيث يمكن توجيه الدالة لاعتبار نهاية السلسلة بمثابة محدد فاصل. وأخيراً، يوفر المعامل السادس if_not_found قيمة بديلة يتم إرجاعها تلقائياً إذا لم يتم العثور على المحدد النصي المطلوب، مما يلغي تماماً الحاجة إلى دمج دوال شرطية خارجية للتحكم في تدفق الأخطاء البرمجية المحتملة.
2.3 السلوك الرياضي للدالة عند استهداف الفاصل المعياري الأول
عند توظيف دالة TEXTBEFORE لاستخراج الكلمة الأولى من الخلية، يتم توجيه الدالة للبحث عن أول مسافة بيضاء " " كمعيار حصري للفصل. في هذه الحالة، تبدأ خوارزمية الدالة بفحص السلسلة النصية بدءاً من المحرف الأول ذي الفهرس رقم (1)، متقدمة بمقدار محرف واحد في كل دورة معالجة داخلية حتى تصل إلى أول بايت يطابق مسافة لوحة المفاتيح المعيارية (الرمز 32 في جدول ترميز الأسكي القياسي ASCII).
بمجرد تحديد إحداثي الفهرس الخاص بأول مسافة، يقوم المحرك الداخلي للدالة باقتطاع جميع المحارف ذات الفهارس الأدنى من موقع المسافة مباشرة، دون تضمين المسافة نفسها في الناتج النهائي. ولا يتطلب هذا الإجراء من المستخدم إجراء أي خصم أو طرح للمحارف. ومع ذلك، فإن السلوك الرياضي للدالة يتأثر مباشرة بوجود الرموز غير المرئية أو المسافات البديلة كالمسافة غير القابلة للكسر (الرمز 160)، حيث تعاملها الدالة كمحارف مستقلة لا تطابق المسافة المعيارية؛ وهو ما يفرض على المحلل فهماً متعمقاً لطبيعة الترميز المستخدم قبل استدعاء الدالة في العمليات الحسابية الواسعة.
3. المعالجة المنطقية للأخطاء وحالات الشذوذ النصي عبر دالة IFERROR
3.1 طبيعة الخطأ الحسابي الناتج عن الخلايا أحادية الكلمة
تواجه عمليات معالجة النصوص تحدياً كلاسيكياً يتمثل في السجلات التي تحتوي على كلمة واحدة فقط دون أي مسافات بيضاء ملحقة (مثل الاسم الأول المسجل منفرداً، أو الرموز الوظيفية الأحادية). فعندما يُطلب من دالة TEXTBEFORE البحث عن المسافة الفاصلة " " داخل خلية نصية تتألف من كلمة واحدة خالية تماماً من المسافات، فإن خوارزمية البحث تفشل منطقياً في العثور على المحدد المستهدف داخل السلسلة المدخلة.
تؤدي آلية التشغيل الافتراضية لمحرك إكسل في هذه الحالة إلى إرجاع خطأ عدم التوفر الشهير #N/A، وفي بعض الدوال التقليدية القديمة يظهر الخطأ الحسابي #VALUE!. إن ظهور هذه المؤشرات التحذيرية في أجزاء متفرقة من الجداول المحورية لا يشوه المظهر الجمالي والمهني للتقارير فحسب، بل يتسبب في تعطيل دوال الإحصاء والربط والتجميع التلقائي (مثل COUNT و VLOOKUP و XLOOKUP)، حيث ترفض معظم هذه الدوال معالجة النطاقات التي تتضمن قيماً تالفة، مما يستدعي تدخلاً منطقياً عاجلاً لاحتواء الخطأ وتصحيح مساره الحسابي.
3.2 التكامل البنيوي بين TEXTBEFORE و IFERROR
لضمان الحماية المنطقية الكاملة للعمليات الحسابية واستقرار تدفق البيانات، يبرز التكامل البنيوي بين دالة TEXTBEFORE ودالة اعتراض الأخطاء الشاملة IFERROR كواحد من أكثر الحلول الكلاسيكية موثوقية وشيوعاً بين مطوري نماذج إكسل. تعمل دالة IFERROR كدرع وقائي يراقب المخرجات الحسابية للدالة الفرعية في الزمن الحقيقي؛ فإذا نجحت العملية وأعادت الدالة الكلمة المقتطعة، يتم تمرير الناتج دون أي تعديل، أما إذا رُصد ظهور أي خطأ حسابي، تتدخل الدالة فوراً لعرض بديل آمن يحدده المستخدم.
في سياق استخراج الكلمة الأولى، يتمثل السلوك المنطقي المثالي عند مواجهة خلية أحادية الكلمة في إرجاع المحتوى الكامل للخلية الأصلية ذاتها، نظراً لأن الكلمة الوحيدة الموجودة تمثل تلقائياً الكلمة الأولى والوحيدة في السلسلة. وتتم صياغة هذا التكامل المعياري على النحو التالي:
=IFERROR(TEXTBEFORE(A2, ” “), A2)
يضمن هذا التركيب البرمجي استمرارية المعالجة الدفعية عبر آلاف الصفوف دون حدوث انقطاع غير متوقع، مانحاً الجداول الحسابية درجة عالية من النضج التشغيلي ومقاوماً كافة سيناريوهات الشذوذ البنيوي للسجلات النصية المدخلة.
3.3 المفاضلة بين IFERROR والمعامل الداخلي if_not_found
على الرغم من النجاح الواسع لتركيب دالة IFERROR مع TEXTBEFORE، إلا أن التحديثات البرمجية الأخيرة وفرت بديلاً هندسياً فائق الكفاءة يلغي الحاجة تماماً للاستعانة بدوال إضافية خارجية؛ ويتمثل ذلك في المعامل السادس المدمج أصلاً في دالة TEXTBEFORE وهو المعامل if_not_found. فبدلاً من استهلاك موارد معالج الحاسوب في بناء دالة مركبة متداخلة، يمكن ببساطة تمرير عنوان الخلية المصدر في المعامل السادس للدالة مباشرة، على النحو البرمجي الموضح أدناه:
=TEXTBEFORE(A2, ” “, , , , A2)
تُظهر الدراسات البرمجية المقارنة للأداء في بيئات الحوسبة السحابية ومصنفات البيانات الضخمة (التي تتجاوز نصف مليون صف) أن الاستغناء عن دالة IFERROR الخارجية واستخدام المعامل الداخلي المدمج يقلل من زمن المعالجة وإعادة الحساب (Recalculation Time) بنسبة ملحوظة، ويخفض من استهلاك الذاكرة العشوائية لبرنامج إكسل؛ نظراً لأن محرك الحساب الداخلي يعالج الشروط ضمن حلقة تكرار برمجية واحدة ومدمجة كودياً في ملفات النظام الثنائية دون الحاجة إلى إنشاء شجرة استدعاء مزدوجة للدوال المتداخلة.
4. دليل التطبيق الإجرائي العملي لاستخراج الكلمة الأولى
4.1 إعداد بيئة العمل وهيكلة جدول البيانات المستهدف
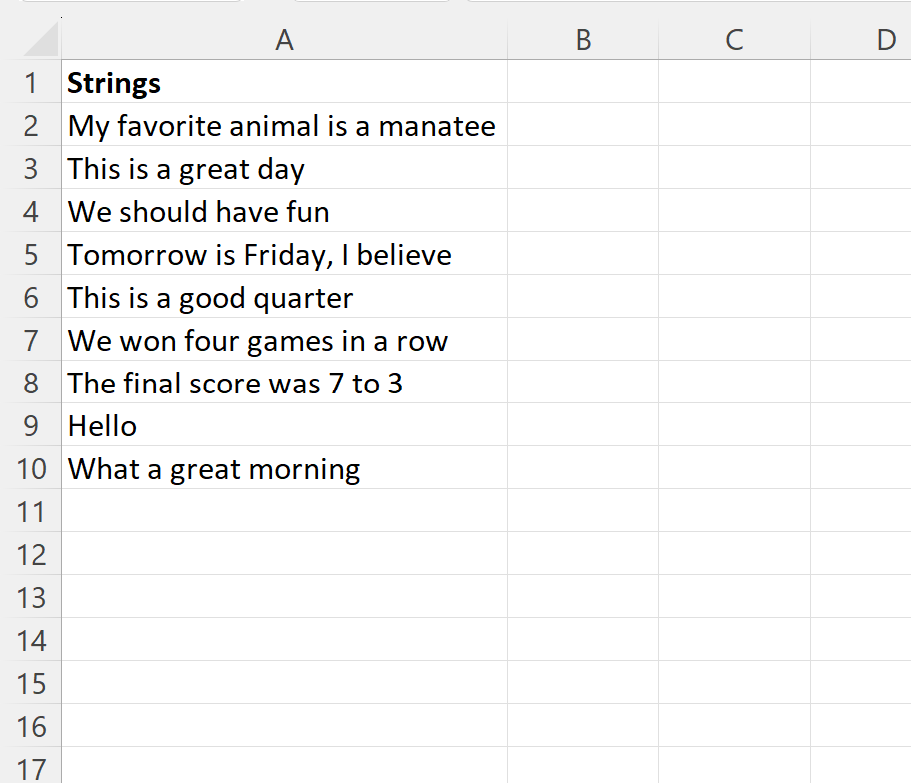
يبدأ الإجراء التنفيذي السليم بتهيئة متقنة لبيئة العمل وهندسة الأعمدة داخل ورقة الحسابات، لتفادي مشكلات تضارب أنواع البيانات أو الكتابة الفوقية غير المقصودة على السجلات القائمة. يتعين على المحلل في المقام الأول فحص العمود المصدر الحاوي على النصوص الكاملة (وليكن العمود A ابتداءً من الصف الثاني A2) والتأكد من أن تنسيق الخلايا مضبوط على الصيغة “العامة” (General) أو “النص” (Text)، مع التحقق من عدم وجود تداخلات بين النصوص وأرقام متسلسلة مخزنة بشكل تواريخ مشوهة.
يلي ذلك تخصيص عمود مجاور فارغ لاستقبال الكلمات المستخرجة (وليكن العمود B بعنوان وصفي دقيق مثل “الكلمة الأولى” أو “الاسم المستخرج”). كما يُفضل تثبيت رأس الجدول وتحويل النطاق إلى جدول إكسل رسمي (Excel Table) عبر الضغط على Ctrl + T؛ حيث توفر هذه البنية الهيكلية ميزة الإشارة البنيوية (Structured References) والتوسيع التلقائي للصيغ إلى كافة الصفوف الجديدة، مما يمنع حدوث ثغرات في تغطية المعادلات عبر كامل السجل الإحصائي.
4.2 صياغة وتطبيق المعادلة المحورية خطوة بخطوة
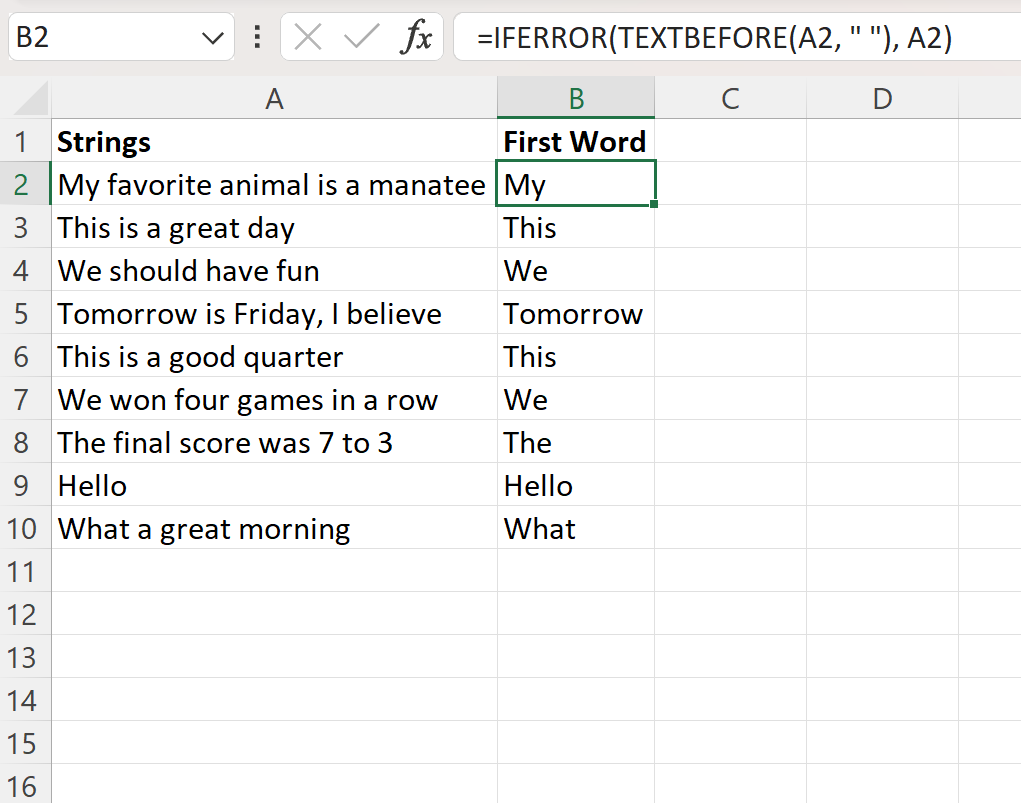
لتطبيق المعادلة المحورية واستخراج الكلمة الأولى بدقة رياضية، يتم النقر على الخلية المستهدفة B2 لبدء إدخال الصيغة. يتم أولاً كتابة علامة التساوي = لإخطار محرك الحسابات ببدء صيغة برمجية، ثم تُدرج الدالة بالشكل الآمن والمحمي ضد الأخطاء كما يلي:
=IFERROR(TEXTBEFORE(A2, ” “), A2)
أو باستخدام الصيغة المدمجة المعاصرة:
=TEXTBEFORE(A2, ” “, , , , A2)
يجب على المحلل التأكد التام من وضع مسافة بيضاء مفردة ومحايدة داخل علامتي التنصيص المزدوجتين " "، محايدة بالضغط على مفتاح المسافة على لوحة المفاتيح، والابتعاد عن استخدام الفواصل المجدولة أو المسافات الخاصة التي يتم توليدها بواسطة لغات ترميز الويب. وبعد الضغط على زر Enter، يقوم المحلل فوراً بمراجعة القيمة المعروضة في الخلية ومقارنتها بالخلية المصدرية A2، للتأكد من أن الكلمة قد تم اقتطاعها بالكامل دون اقتطاع آخر حرف منها، ودون أن تظهر مسافة بيضاء غير مرئية في نهاية القيمة المستخرجة.
4.3 تعميم المعادلة وتوسيع نطاق التطبيق ديناميكياً
بعد التحقق من سلامة النتيجة في الخلية الابتدائية B2، تأتي خطوة تعميم الصيغة على امتداد الجدول المعني. يمكن للمستخدم النقر المزدوج على مقبض التعبئة التلقائية (Fill Handle) الواقع في الركن السفلي الأيسر (أو الأيمن بحسب لغة الواجهة) للخلية B2، مما يدفع إكسل لتكرار الصيغة تلقائياً حتى آخر صف مستمر في العمود المقابل. يعتمد هذا التوسيع على مفهوم المراجع النسبية (Relative References)؛ حيث تتغير إحداثيات الخلية من A2 إلى A3 و A4 تباعاً مع حركة الانحدار الطولي.
أما في بيئات العمل المعاصرة التي تدعم مصفوفات إكسل المسكوبة (Dynamic Array Spill Ranges)، فيمكن للمحلل الاستغناء عن تكرار الصيغة عبر الصفوف وتطبيق معادلة مصفوفية واحدة في الخلية العلوية تشير إلى كامل النطاق المصدر دفعة واحدة:
=TEXTBEFORE(A2:A1000, ” “, , , , A2:A1000)
تقوم هذه الصيغة بضخ المخرجات في كامل النطاق B2:B1000 بنبضة معالجة واحدة وبكفاءة حسابية مذهلة تمنع تضخم حجم الملف وتقلل أعباء الصيانة الدورية للقوالب المؤسسية.
5. المنهجية التقليدية البديلة: دمج دالتي LEFT و FIND
5.1 التحليل النظري لآلية الجمع بين دوال القياس والاقتطاع
ظلت المنهجية المعتمدة على دمج دالتي LEFT و FIND لعقود طويلة هي الأساس البرمجي المعياري لمعالجة وتجزئة النصوص داخل إكسل، ولا تزال تحظى بأهمية قصوى لضمان التوافق العكسي (Backward Compatibility) مع إصدارات إكسل القديمة (مثل Excel 2010 و 2016 و 2019) التي تفتقر تماماً لدالة TEXTBEFORE. تقوم هذه المنهجية على تجزئة العملية إلى مستويين متكاملين: مستوى القياس ومستوى الاقتطاع.
تختص دالة FIND بقياس السلسلة النصية للبحث عن أول مسافة بيضاء وتحديد موضعها العددي (Index) بالنسبة لبداية النص كقيمة رقمية صحيحة تبدأ من المحرف رقم واحد. وفي المقابل، تمتلك دالة LEFT قدرة محددة تتمثل في اقتطاع عدد معين من المحارف بدءاً من أقصى طرف السلسلة استناداً إلى رقم عددي يتم تزويدها به. وعند الربط بين الدالتين، تُستخدم القيمة الرقمية الناتجة عن دالة القياس FIND كمعامل تغذية داخلي لدالة الاقتطاع LEFT، مما يخلق تفاعلاً خوارزمياً يسمح بتحديد حجم الكلمة الأولى بدقة آلية متناهية.
5.2 المعادلة الهيكلية وضبط معامل الإزاحة الحسابية
تتطلب الصياغة الهيكلية لهذه المنهجية ضبطاً دقيقاً لمعامل الإزاحة الحسابية الرياضي؛ حيث إن دالة FIND(" ", A2) تُرجع الترتيب الرقمي لموقع المسافة ذاته. فإذا كانت الكلمة الأولى هي “أحمد” ومتبوعة بمسافة، فإن طول الكلمة الفعلي هو (4) أحرف، بينما ستقوم دالة البحث بإرجاع الرقم (5) لأنه موضع الفراغ. وإذا تم تمرير الرقم (5) مباشرة إلى دالة LEFT، فإن النتيجة المستخرجة ستتضمن الكلمة ملحقة بمسافة في نهايتها، وهو ما يعد خللاً هيكلياً يؤثر على عمليات المطابقة اللاحقة.
لتفادي هذا الخلل، يتم إدراج عملية طرح حسابية بسيطة بمقدار واحد صحيح - 1 لتحييد المسافة من ناتج الاقتطاع، فتصبح المعادلة الكلاسيكية على النحو التالي:
=LEFT(A2, FIND(” “, A2) – 1)
يعمل هذا الطرح على نقل مؤشر الاقتطاع ليقف بدقة بالغة عند المحرف الأخير للكلمة الأولى. وتجدر الإشارة إلى أن اتجاه النص ولغة واجهة المستخدم في إكسل لا تؤثر على السلوك الداخلي لهذه الدوال؛ فدالة LEFT تبدأ دوماً من المحرف ذي الفهرس رقم (1) وتتحرك باتجاه نهاية السلسلة الرقمية بصرف النظر عن اتجاه قراءة اللغة على الشاشة سواء كانت من اليمين إلى اليسار أو العكس.
5.3 التحصين ضد الأخطاء الكلاسيكية عبر حيلة دمج المسافة الوهمية
يكمن الضعف البنيوي الخطير في الصيغة الكلاسيكية =LEFT(A2, FIND(" ", A2) - 1) في انهيارها التام عند مواجهة خلية تحتوي على كلمة واحدة خالية من الفراغات؛ إذ تقوم دالة FIND بإرجاع الخطأ #VALUE! لأنها تبحث عن محرف غير موجود في السلسلة، مما يؤدي فوراً إلى فشل الصيغة بأكملها. ورغم إمكانية حماية هذه الصيغة باستخدام دالة IFERROR، إلا أن علماء البيانات ومطوري الصيغ الكلاسيكية ابتكروا حيلة برمجية بالغة الذكاء تُعرف بتقنية “دمج المسافة الوهمية”.
تعتمد هذه التقنية على دمج مسافة بيضاء إضافية في نهاية النص داخل وسيط دالة البحث مباشرة عبر استخدام معامل الربط النصي &، لتصبح الصيغة كالتالي:
=LEFT(A2, FIND(” “, A2 & ” “) – 1)
من خلال هذه الحيلة الرياضية العبقرية، يتم ضمان وجود مسافة واحدة على الأقل دوماً داخل السلسلة المفحوصة؛ فإذا كانت الخلية تحتوي على كلمات متعددة، ستعثر دالة FIND على المسافة الأصلية الأولى وتتجاهل المسافة المضافة في الأخير، أما إذا كانت الخلية تحتوي على كلمة وحيدة، فإن الدالة ستعثر على المسافة الوهمية المدمجة في النهاية، وسيكون موقعها مساوياً لطول الكلمة زائد واحد، وعند طرح الواحد - 1 ترجع دالة LEFT الكلمة الأصلية بالكامل بنجاح مذهل ودون التسبب في إطلاق أي خطأ حسابي على مستوى المعالج.
6. الحلول التركيبية المتقدمة باستخدام دوال MID و SEARCH
6.1 توظيف دالة MID كأداة اقتطاع ذات نقطة بداية مرنة
على الرغم من الشهرة الواسعة لدالة LEFT، تبرز دالة MID كبديل تركيبي متقدم يمنح مهندسي الجداول مرونة هيكلية أعلى في بعض النماذج المعقدة. تم تصميم دالة MID أساساً لاقتطاع جزء نصي من وسط السلسلة، ولكنها تمتلك القدرة على محاكاة سلوك دالة LEFT بكفاءة كاملة عن طريق تثبيت نقطة بداية الاقتطاع (Start Number) عند المحرف رقم (1).
تتم صياغة اقتطاع الكلمة الأولى باستخدام MID وفق التكوين التالي:
=MID(A2, 1, SEARCH(” “, A2 & ” “) – 1)
يُفضل بعض الخبراء توظيف دالة MID في المشاريع الضخمة التي تتطلب نمذجة قياسية موحدة لكافة عمليات استخراج النصوص؛ حيث يمكن استخدام نفس بنية الدالة لاقتطاع الكلمة الأولى، أو الثانية، أو الثالثة بمجرد تعديل معامل نقطة البداية دون الحاجة إلى التبديل بين دوال مختلفة مثل LEFT و RIGHT، مما يحافظ على التناسق المعماري للكود الحسابي ويسهل من مراجعته آلياً بواسطة أدوات التدقيق المؤسسي.
6.2 الفروق الجوهرية بين دالتي SEARCH و FIND
يخلط العديد من ممارسي إكسل بين دالتي البحث SEARCH و FIND ويفترضون خطأً تطابقهما التام. ومع أن الدالتين تؤديان نفس الغرض عند البحث عن مسافة بيضاء مجردة " "، إلا أن هناك فروقاً تقنية وجوهرية عميقة تحكم عمل كل منهما ويجب مراعاتها عند بناء الحلول المتقدمة في البيئات الأكاديمية والتطبيقية.
تتميز دالة FIND بأنها دالة مطابقة صارمة وحساسة لحالة الأحرف (Case-Sensitive)، ولا تدعم استخدام المحارف البديلة، مما يجعلها مثالية للغات التي تفرق بين الحروف الكبيرة والصغيرة وللبحث الصارم عن مطابقات نصية حصرية. في المقابل، تُعد دالة SEARCH دالة غير حساسة لحالة الأحرف وتدعم استخدام المحارف البديلة (Wildcards) مثل النجمة * التي تمثل أي عدد من المحارف، وعلامة الاستفهام ? التي تمثل محرفاً فردياً واحداً.
هذا الدعم للرموز البديلة يجعل SEARCH خياراً استثنائياً وقوياً عند التعامل مع البيانات غير المتجانسة وعالية التعقيد؛ حيث يمكن استخدامها لاستهداف أنماط فواصل متغيرة (كالبحث عن أول مسافة أو نقطة أو فاصلة)، إلا أنه يتطلب في الوقت نفسه حذراً كبيراً لتجنب التفسير الخاطئ للرموز في حال كانت السجلات المصدرية تحتوي على رموز خاصة ترتبط بوظائف المعاملات البرمجية.
6.3 التركيب الحسابي الشامل للدوال البديلة وتقييمها
عند التعاطي مع سجلات نصية عشوائية شديدة التباين مأخوذة من مسوح بحثية غير مقيدة، قد يلجأ الباحث إلى بناء صيغ تركيبية شاملة تجمع بين دوال MID و SEARCH و ISNUMBER لإنشاء محرك اقتطاع قادر على التعرف على المحددات المتعددة وعزل الكلمة الأولى بأعلى درجات الدقة. ومع ذلك، يخضع هذا التركيب لتقييم نقدي محايد يكشف عن بعض السلبيات المعمارية التي لا يمكن إغفالها.
يتمثل العيب الأساسي للصيغ المركبة المطولة في التعقيد البصري الهائل وصعوبة الصيانة؛ إذ يؤدي تراكم الأقواس والمتغيرات إلى رفع احتمالية الخطأ البشري أثناء التعديل أو النسخ. كما يفرض صعوبات تشغيلية بالغة على فرق العمل المشتركة التي قد لا يمتلك جميع أفرادها الكفاءة البرمجية المتقدمة لفك تشفير هذه المعادلات المتداخلة. ولذلك، تنص أفضل الممارسات البرمجية على ضرورة توثيق المنطق الرياضي لهذه الصيغ داخل تعليقات الخلايا أو في صفحات توثيق مستقلة لضمان استمرارية صيانة النموذج وتطويره مستقبلاً دون المساس بسلامة الحسابات الإحصائية الكامنة.
7. تطهير البيانات ومعالجة المسافات البيضاء الشاذة
7.1 تأثير المسافات البادئة والزائدة على صحة النتائج
من الأخطاء الكارثية التي تعصف بدقة الخوارزميات النصية في جداول البيانات وجود مسافات بيضاء غير مرئية في صدارة النص (Leading Spaces) أو مسافات زائدة ومكررة بين الكلمات. تتولد هذه الشوائب عادة عند استيراد البيانات من ملفات نصية غير منسقة (مثل ملفات CSV أو TXT)، أو نتيجة لأخطاء الإدخال اليدوي الشائعة من قِبل جامعي البيانات في الدراسات الاستقصائية الميدانية.
إذا كانت الخلية المستهدفة تحتوي على مسافة بادئة في أولها (على سبيل المثال: " محمد علي")، فإن دوال البحث مثل FIND أو دالة الاقتطاع الحديثة TEXTBEFORE ستعتبر تلك المسافة البادئة الأولى هي المحدد الفاصل المنشود! ونتيجة لذلك، ستكون القيمة المستخرجة سلسلة فارغة تماماً "" خالية من أي محرف، مما يؤدي إلى تشويه التحليل وفقدان السجلات دون أن يلاحظ المحلل ذلك بصرياً في البداية. كما أن تعدد المسافات بين الكلمات يؤثر سلباً على الفهارس الرقمية، مما يبرز الأهمية القصوى لدمج طبقات التطهير الآلي المسبق قبل تنفيذ أي عملية اقتطاع نصي.
7.2 التكامل المعياري مع دالة TRIM لتنقية النصوص
تمثل دالة TRIM حجر الزاوية والمعيار الذهبي المعتمد لتطهير النصوص داخل إكسل؛ حيث تختص هذه الدالة بوظيفة محددة بالغة الأهمية: إزالة كافة المسافات البادئة من بداية النص، وإزالة جميع المسافات الختامية في نهايته، وتقليص المسافات المتعددة المتتالية بين الكلمات لتصبح مسافة واحدة معيارية فقط. وبناءً على ذلك، فإن المنهجية الأكاديمية والمهنية الصارمة تقتضي عدم استدعاء أي دالة اقتطاع على الخلية الخام مباشرة، بل دمج دالة TRIM كطبقة تنقية أولية ضمن الصيغة المحورية.
تتم صياغة هذا التكامل المعياري الآمن على النحو التالي:
=IFERROR(TEXTBEFORE(TRIM(A2), ” “), TRIM(A2))
أو باستخدام النمط التركيبي المدمج:
=TEXTBEFORE(TRIM(A2), ” “, , , , TRIM(A2))
وبالنسبة للإصدارات القديمة من إكسل، يُصاغ الحل التطهيري المتكامل عبر دمج دالة TRIM في سياق الصيغة الكلاسيكية المحصنة:
=LEFT(TRIM(A2), FIND(” “, TRIM(A2) & ” “) – 1)
يضمن هذا التكامل المتقدم تنظيف السلسلة النصية لحظياً قبل أن تبدأ خوارزميات البحث في قراءة فهارس المحارف، مما يحقق ثباتاً تاماً وموثوقية إحصائية قاطعة للمخرجات المستخلصة في جميع الظروف وسيناريوهات الإدخال العشوائي.
7.3 معالجة المسافات غير القابلة للكسر والرموز الخاصة
في حالات متقدمة من تلويث البيانات، وخاصة عند نسخ الجداول من صفحات الإنترنت أو تصديرها من بعض أنظمة تخطيط الموارد المؤسسية (ERP)، قد يواجه المحلل نوعاً خبيثاً من الفراغات يُعرف بـ “المسافة غير القابلة للكسر” (Non-Breaking Space)، والتي تحمل الرمز العشري 160 (أو الكود البرمجي في صفحات الويب). وتكمن الخطورة التقنية لهذه المسافة في أن دالة TRIM القياسية مصممة حصرياً للتعامل مع مسافة الأسكي القياسية ذات الرمز 32، وتتجاهل المسافة 160 تماماً ولا تستطيع حذفها أو تقليصها!
لتجاوز هذا العائق التقني العميق، يتم توظيف دالة SUBSTITUTE مع دالة CHAR لتحويل المسافات غير القابلة للكسر إلى مسافات عادية، بالتوازي مع استخدام دالة CLEAN لإزالة محارف التحكم والرموز غير القابلة للطباعة (ذات الرموز من 0 إلى 31). تتكامل هذه المنظومة في صيغة تطهير فائقة القوة تسبق عملية الاستخراج:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), ” “)))
إن تطبيق هذا المعيار المتقدم يحصن جداول البيانات ضد أدق أشكال التشويه النصي الخفي، ويوفر بيئة معيارية نقية تتيح لدوال استخراج الكلمة الأولى العمل بأعلى مستويات الكفاءة والموثوقية العلمية.
8. الأساليب غير البرمجية السريعة لاستخراج الكلمة الأولى
8.1 تقنية تحويل النص إلى أعمدة (Text to Columns)
إلى جانب استخدام الدوال والصيغ الحسابية، يوفر إكسل مجموعة من الأدوات التفاعلية المدمجة التي تتيح إنجاز مهام استخراج النصوص بطرق سريعة دون الحاجة إلى كتابة أي معادلات. تأتي في مقدمة هذه الأدوات ميزة “تحويل النص إلى أعمدة” (Text to Columns) المتاحة ضمن علامة التبويب “بيانات” (Data) في شريط الأدوات الرئيسي للمصنف.
تعتمد هذه التقنية على معالج تفاعلي متعدد الخطوات؛ حيث يختار المستخدم خيار “محدد” (Delimited)، ثم يحدد “المسافة” (Space) كعلامة فصل وحيدة. يتيح المعالج في خطوته الأخيرة توجيه مخرجات العمود الأول الناتج عن التقسيم إلى العمود المستهدف، مع إمكانية تحديد الأعمدة اللاحقة وتطبيق خيار “عدم استيراد هذا العمود (تخطي)” (Do not import column – Skip) عليها، مما يؤدي إلى استخلاص الكلمات الأولى وتجاهل باقي محتويات السلسلة النصية.
وعلى الرغم من كفاءة وسرعة هذه الأداة في العمليات الفورية والتجارب الاستكشافية، إلا أنها تعاني من عيب هيكلي جسيم يتمثل في كونها أداة “ساكنة” (Static Tool)؛ فالنتائج الناتجة عنها قيم ثابتة غير ديناميكية ولا تستجيب مطلقاً لأي تعديل أو تحديث يطرأ على البيانات في العمود المصدر، مما يوجب إعادة تطبيق كامل خطوات المعالج يدوياً في كل مرة تتغير فيها المدخلات الأصلية.
8.2 أداة التعبئة السريعة المعتمدة على الذكاء الاصطناعي (Flash Fill)
أحدثت مايكروسوفت طفرة بارزة في إصدار إكسل 2013 عند إدخال ميزة “التعبئة السريعة” (Flash Fill)، وهي خوارزمية ذكية لاستشعار الأنماط النصية تستند إلى مبادئ التعلم الآلي البسيط والتعرف الآلي على رغبة المستخدم بناءً على الأمثلة التوضيحية المدخلة.
لتطبيق هذه الميزة لاستخراج الكلمة الأولى، يكفي أن يقوم المستخدم بكتابة الكلمة الأولى من الخلية الأولى يدوياً في الخلية المجاورة، ثم يكرر الأمر مع الخلية الثانية كدليل نمطي إضافي. بعد ذلك، يقوم بالضغط على اختصار لوحة المفاتيح الشهير Ctrl + E، أو النقر على أيقونة التعبئة السريعة في تبويب “بيانات”. يقوم المحرك بفحص الفروق المكانية بين المدخل والمخرج، واستنتاج قاعدة استخراج الكلمة الأولى الواقعة قبل أول مسافة، ثم تطبيق هذه القاعدة بلمح البصر على امتداد آلاف الصفوف التالية.
تتميز التعبئة السريعة بسرعتها المذهلة وسهولتها التي لا تتطلب أي معرفة برمجية مسبقة، إلا أن الاعتماد عليها في الدراسات الأكاديمية والبيئات المؤسسية الحساسة ينطوي على مخاطر حقيقية؛ فالخوارزمية قد تسيء أحياناً تفسير الأنماط المعقدة في السجلات الشاذة (مثل الأسماء التي تبدأ بكلمات متباينة أو محارف غير قياسية)، كما أنها تنتج بيانات ساكنة لا تتحدث تلقائياً عند تغيير السجلات، مما يجعلها أداة تنظيف أولية لا ترقى إلى مستوى الحلول البرمجية الديناميكية الموجهة بالمعادلات.
8.3 المفاضلة المعيارية بين الحلول الديناميكية والحلول الساكنة
تتطلب هندسة جداول البيانات الناجحة مفاضلة دقيقة وعقلانية بين استخدام الحلول البرمجية الديناميكية (المعتمدة على الدوال الحية كـ TEXTBEFORE أو LEFT) واستخدام الأدوات الساكنة كالتعبئة السريعة وتحويل النص إلى أعمدة. ويستند هذا القرار إلى المعايير الموضحة في مصفوفة المقارنة التحليلية التالية:
- طبيعة المشروع: إذا كان المشروع تحليلياً استكشافياً لمرة واحدة (Ad-hoc Analysis)، فإن الأدوات الساكنة توفر سرعة إنجاز فائقة دون إرهاق المصنف بصيغ إضافية. أما في المشاريع المستمرة والتقارير الدورية (Recurring Dashboards)، فإن الصيغ الديناميكية تصبح إلزامية لضمان التحديث الآلي الفوري.
- كفاءة الذاكرة وحجم الملف: تستهلك النطاقات الحاوية على آلاف الصيغ الحسابية الديناميكية المعقدة قدراً كبيراً من الذاكرة العشوائية أثناء دورات إعادة الحساب، مما قد يسبب بطئاً في الاستجابة، في حين تمتاز القيم الساكنة بخفتها المطلقة وتثبيتها لحجم الملف.
- النزاهة الأكاديمية ومسار التدقيق: تتيح الصيغ الحسابية للمراجعين والمدققين الخارجيين تتبع المسار المنطقي للعملية (Audit Trail) وفهم كيفية اشتقاق كل كلمة من أصلها الخام، وهو مطلب جوهري في الأبحاث العلمية الرصينة ومراجعات الجودة المؤسسية التي تحظر استخدام التحويلات الغامضة غير الموثقة كودياً.
9. الأتمتة المتقدمة للمعالجة النصية: Power Query والبرمجة النصية
9.1 استخراج الكلمات الأولى عبر بيئة محرر Power Query
يمثل محرر الاستعلامات Power Query منصة استخلاص وتحويل وتحميل البيانات (ETL) الأكثر تطوراً داخل منظومة مايكروسوفت إكسل الحديثة. وتُعد هذه البيئة الخيار الاستراتيجي الأمثل للمحللين الذين يتعاملون مع مجموعات بيانات ضخمة تتجاوز حدود ورقة العمل التقليدية (التي تبلغ مليوناً وثمانية وأربعين ألف صف)، أو أولئك الذين يحتاجون إلى أتمتة خطوط تنقية البيانات المتكررة شهرياً وأسبوعياً.
لاستخراج الكلمة الأولى عبر Power Query، يتم تحميل الجدول إلى المحرر عبر النقر على “من جدول/نطاق” (From Table/Range). بعد فتح واجهة المحرر، يحدد المحلل العمود النصي المطلوب، ثم ينتقل إلى تبويب “إضافة عمود” (Add Column) أو “تحويل” (Transform)، ويختار أداة “استخراج” (Extract) متبوعة بخيار “نص قبل المحدد” (Text Before Delimiter). في النافذة المنبثقة، يقوم بإدخال المسافة " " في حقل المحدد، ومع فتح الخيارات المتقدمة يختار البحث عن المحدد بدءاً من بداية المدخلات (Start of the input).
يقوم المحرر تلقائياً بكتابة خطوة تحويل برمجية بلغة الاستعلامات M، تماثل الصيغة الموضحة:
Table.AddColumn(#”PriorStep”, “FirstWord”, each Text.BeforeDelimiter([TextColumn], ” “))
تتميز هذه المنهجية بكونها تحفظ خطوة التحويل ضمن تسلسل إجرائي دائم ومحصن؛ فعند إضافة أي بيانات جديدة في المستقبل إلى الملف المصدر، يكفي النقر على زر “تحديث” (Refresh) ليعيد Power Query تطبيق خطوات الاستخراج والتطهير آلياً وبكفاءة برمجية فائقة تتفوق بمراحل على أداء الدوال الحسابية في الأوراق المزدحمة.
9.2 صياغة دوال مخصصة بلغة VBA لإنشاء حل برمجي فريد
توفر بيئة التطوير المدمجة بلغة فيجوال بيسك للتطبيقات (VBA) إمكانية برمجية غير محدودة لبناء دوال مستخدم مخصصة (User-Defined Functions – UDFs) تلبي الاحتياجات التخصصية الدقيقة وتوفر حلولاً مرنة تتجاوز قيود الدوال الجاهزة. يمكن للمطور كتابة كود برمجي فائق السرعة يقتطع الكلمة الأولى باستخدام دالة التجزئة الداخلية Split التي تعمل على مستوى الذاكرة الأولية.
لتحقيق ذلك، يفتح المستخدم محرر الأكواد عبر الضغط على Alt + F11، ثم يدرج وحدة نمطية جديدة (Standard Module)، ويقوم بصياغة الدالة المخصصة على النحو الآتي:
Function GetFirstWord(CellRef As Range) As String
Dim CleanText As String
Dim WordsArray() As String
If CellRef.Value = “” Then
GetFirstWord = “”: Exit Function
End If
CleanText = Application.WorksheetFunction.Trim(CellRef.Value)
WordsArray = Split(CleanText, ” “)
GetFirstWord = WordsArray(0)
End Function
بمجرد حفظ هذا الكود، تصبح الدالة =GetFirstWord(A2) متاحة للاستخدام المباشر داخل أي خلية في ورقة العمل كأي دالة مدمجة أصلية. تقوم هذه الدالة بتنظيف النص أولاً، ثم تقطيعه إلى مصفوفة نصوص في الذاكرة العشوائية وإرجاع العنصر الأول ذي الفهرس صفر WordsArray(0)، وهو ما يمثل الكلمة الأولى حصراً. وعلى الرغم من الأناقة البرمجية لهذا الحل، إلا أنه يفرض حفظ المصنف بصيغة تدعم الماكرو (مثل .xlsm أو .xlsb)، ويتطلب تعطيل سياسات الأمان المقيدة للماكرو، مما قد يحد من مشاركة المصنف عبر المؤسسات التي تفرض بروتوكولات حماية إلكترونية صارمة ضد الأكواد البرمجية المضمنة.
9.3 التوظيف المتقدم للتعبيرات النمطية (Regular Expressions) في إكسل
تمثل التعبيرات النمطية (Regex) ذروة الدقة الحوسبية والرياضية في التعرف على الأنماط النصية المعقدة ومعالجتها. وفي أحدث إصدارات برنامج إكسل للمشتركين في برامج التحديث التجريبية والمؤسسية المتقدمة، دمجت مايكروسوفت دوالاً مخصصة للتعبيرات النمطية مثل REGEXEXTRACT، لتفتح آفاقاً جديدة وغير مسبوقة لمعالجة النصوص وتجاوز كافة قيود الفواصل التقليدية.
تتيح التعبيرات النمطية عزل الكلمة الأولى حتى لو كانت ملتصقة بعلامات ترقيم أو أقواس أو أرقام دون وجود أي مسافة بيضاء على الإطلاق. على سبيل المثال، يمكن استخدام الدالة المعاصرة لاستخراج أول تتابع من الحروف الهجائية بالاعتماد على النمط التعبيري ^s*(w+) وفق الصيغة التالية:
=REGEXEXTRACT(A2, “^s*(w+)”)
يفسر محرك التعبيرات النمطية هذا النمط برياضيات دقيقة: حيث تشير العلامة ^ إلى بداية السلسلة النصية، ويشير التعبير s* إلى تجاهل أي مسافات بيضاء بادئة مهما كان عددها، في حين يلتقط التعبير (w+) أول كتلة متصلة من الأحرف الأبجدية ككيان مستقل ويتوقف فوراً عند مواجهة أول رمز غير أبجدي سواء كان مسافة أو فاصلة أو رمزاً خاصاً. هذا المستوى المتطور من التحكم يمنح الباحثين في العلوم اللغوية الحوسبية والبيانات السلوكية الضخمة قوة مطلقة في تنقية النصوص وتصنيفها بدقة تقارب الصفر من حيث هامش الخطأ.
10. المقارنة التقنية الشاملة وأفضل الممارسات الأكاديمية
10.1 مصفوفة المفاضلة بين المنهجيات المتاحة
لتمكين المحللين والباحثين من اتخاذ القرار التقني الأكثر ملاءمة لطبيعة مشاريعهم وظروف البنية التحتية البرمجية المتاحة لديهم، يوضح الجدول التحليلي التالي مقارنة شاملة بين مختلف المنهجيات المعروضة في هذا البحث عبر خمسة معايير هندسية رئيسية:
| المنهجية البرمجية | إصدارات إكسل المدعومة | سرعة الأداء الحسابي | ديناميكية التحديث | مقاومة الأخطاء الشاذة | مستوى التعقيد البرمجي |
|---|---|---|---|---|---|
| دالة TEXTBEFORE | Microsoft 365, Excel 2024, Web | ممتازة جداً (محرك حديث) | ديناميكية بالكامل | عالية عبر if_not_found | منخفض وبسيط جداً |
| LEFT + FIND مع المسافة الوهمية | كافة الإصدارات بلا استثناء | عالية جداً ومستقرة | ديناميكية بالكامل | عالية مع تقنية & ” “ | متوسط ويحتاج لدقة الصياغة |
| دوال MID + SEARCH | كافة الإصدارات بلا استثناء | عالية | ديناميكية بالكامل | عالية جداً مع المحارف البديلة | متوسط إلى متقدم |
| محرر Power Query | Excel 2016 فما فوق (وإضافة لـ 2010/2013) | فائقة للبيانات المليونية | شبه ديناميكية (تتطلب تحديثاً) | مطلقة عبر خطوات التحويل | متوسط (واجهة رسومية) |
| أكواد الماكرو (VBA UDF) | إصدارات سطح المكتب فقط | عالية ولكن تمنع الـ Multithreading | ديناميكية مع التطاير | مطلقة عبر منطق الكود | مرتفع ويتطلب مهارات برمجية |
| التعبئة السريعة (Flash Fill) | Excel 2013 فما فوق | فورية بدون معادلات | ساكنة تماماً (Static) | منخفضة في الأنماط المعقدة | معدوم (اختصار لوحة مفاتيح) |
10.2 بروتوكولات التحقق من جودة وموثوقية البيانات المستخرجة
لا تنتهي عملية استخراج النصوص بمجرد كتابة وتعميم الصيغة، بل يجب أن تعقبها مرحلة تحقق وتدقيق صارمة لضمان موثوقية وجودة البيانات المستخلصة قبل اعتمادها في أي دراسة علمية أو تقرير مؤسسي. تتضمن هذه البروتوكولات تطبيق اختبارات منطقية مقارنة تعتمد على دوال الفحص الرياضي؛ مثل استخدام دالة LEN لحساب أطوال الكلمات المستخرجة والتأكد من عدم وجود قيم صفرية ناتجة عن مسافات بادئة متجاهلة.
كما يُنصح بشدة بإنشاء عمود تدقيق مؤقت يطبق اختباراً منطقياً للتحقق من عدم اشتمال الكلمة المستخرجة على أي مسافات داخلية متبقية عبر الصيغة:
=ISERROR(FIND(” “, B2))
فإذا كانت النتيجة TRUE، دل ذلك على أن الناتج يمثل كلمة نقية واحدة ومكتملة الاستقلال البنيوي. بالإضافة إلى ذلك، يتعين على المحلل حصر القيم الفريدة (Unique Values) عبر ميزة “إزالة التكرارات” أو دالة UNIQUE لفحص قائمة الكلمات الأولى المستخلصة بصرياً وإحصائياً، ورصد أي علامات ترقيم ملتسقة (كالنقط والفاصلات والأقواس) وتطهيرها لتفادي حدوث تكرارات زائفة ومضللة في نماذج التحليل النهائي.
10.3 توصيات هندسة جداول البيانات للمحللين والباحثين
بناءً على هذا التحليل الشامل والمقارنات التقنية المتقدمة، نخلص إلى جملة من التوصيات المنهجية التي تمثل أفضل الممارسات البرمجية لهندسة البيانات داخل إكسل:
- الاعتماد المعياري على الدوال الحديثة: يُوصى باعتماد دالة
TEXTBEFOREالمدمجة والمحصنة بمعاملها الداخلي if_not_found كخيار قياسي أول في كافة بيئات العمل التي تدعم Microsoft 365، لما توفره من بساطة بصرية وكفاءة حوسبية عالية تقلل من زمن معالجة المصنفات. - الالتزام بالتطهير المسبق الإلزامي: يجب إدراج دالة
TRIMكخطوة تطهير جوهرية وغير قابلة للتجاوز ضمن كافة صيغ الاستخراج، لتحييد مخاطر الفراغات البادئة والزائدة وضمان استقرار النتائج ومقاومتها للأخطاء الخفية. - التوثيق الحسابي المنهجي: عند الاضطرار لاستخدام صيغ تركيبية معقدة (مثل دمج
LEFTمعFINDوالمسافات الوهمية) لضمان التوافق مع الإصدارات القديمة، يتعين على الباحث توثيق المنطق الرياضي للصيغة وحيل الإزاحة الحسابية بوضوح داخل تعليقات المصنف لتسهيل إجراءات المراجعة المؤسسية والتدقيق الأكاديمي المستقل. - الفصل الهيكلي لمراحل خطوط البيانات: يُنصح بالفصل التام بين أوراق العمل المخصصة لتخزين البيانات الخام وتطهيرها، وأوراق العمل المخصصة لعرض التقارير ولوحات التحكم النهائية، مما يتيح استبدال الصيغ المعقدة بقيم ثابتة عند الانتهاء من المعالجة لتأمين المصنف وتقليل حجمه التشغيلي إلى أدنى حد ممكن.
إن تطبيق هذه البروتوكولات والمعادلات بدقة يضمن تحويل مهام استخراج الكلمة الأولى من مجرد إجراء يدوي معرض للأخطاء والالتباس إلى عملية خوارزمية مؤتمتة وموثوقة تتوافق مع أعلى معايير الجودة والأداء الحسابي في إدارة البيانات المتقدمة.
المراجع
- Bernard Lété, Liliane Sprenger-Charolles, Pascale Colé (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560
- Michele Settanni, Davide Marengo (2015). Sharing feelings online: studying emotional well-being via automated text analysis of Facebook posts. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2015.01045
- Stephan Lewandowsky, Klaus Oberauer, Lee-Xieng Yang, Ullrich K. H. Ecker (2010). A working memory test battery for MATLAB. Behavior Research Methods. https://doi.org/10.3758/brm.42.2.571