
تمثل معالجة السلاسل النصية ركيزة جوهرية في علوم البيانات التطبيقية وإدارة السجلات الرقمية داخل بيئات جداول البيانات؛ إذ تتجاوز هذه العمليات مجرد التعديل الشكلي لتشكل مساراً تحويلياً يعيد هيكلة البيانات غير المنتظمة إلى متغيرات قابلة للقياس والتحليل الإحصائي الدقيق. وفي إطار برمجية مايكروسوفت إكسل (Microsoft Excel)، يشكل استخراج المقاطع النصية الواقعة بعد رمز محدد، أو ما يعرف بمحدد الفواصل (Delimiter)، أحد أكثر التحديات شيوعاً وإلحاحاً لدى محللي البيانات والمشتغلين في تنقيب النصوص؛ حيث ترِد السجلات الأولية في هيئة كتل متداخلة تدمج الأسماء والرموز البرمجية والمعرفات الرقمية ضمن خلية واحدة دون وجود فصل بنيوي مسبق.
تاريخياً، ارتبطت هذه المهمة بتعقيدات برمجية استدعت دمج حزم متعددة من الدوال الكلاسيكية لبناء دوال مركبة تعتمد على حساب المواقع النسبية للأحرف، وهو ما كان يشكل عبئاً حسابياً وذهنياً ملحوظاً، ويفتح الباب واسعاً أمام الأخطاء التشغيلية غير المتوقعة عند تعقد هيكل النص. ومع التطورات الجوهرية التي أدرجتها شركة مايكروسوفت في محرك العمليات الحسابية لبرنامج إكسل، وتحديداً مع الإطلاق الرسمي لدالة TEXTAFTER ضمن تحديثات مايكروسوفت 365 (Microsoft 365)، انتقلت معالجة النصوص من مرحلة المعادلات الحسابية الالتفافية المعقدة إلى مرحلة التحديد الوظيفي المباشر والأنيق هندسياً.
يهدف هذا المقال الأكاديمي الشامل إلى تفكيك كافة الأبعاد النظرية والتطبيقية المرتبطة باستخراج النصوص بعد الرموز المحددة في إكسل. سنناقش بالتفصيل المعماري التركيب البنيوي لدالة TEXTAFTER ووسائطها الإلزامية والاختيارية، ونستعرض استراتيجيات التحكم المتقدم في تكرارات الفواصل والتعامل مع حساسية الأحرف وتخصيص استجابات الخطأ. كما سنقدم دليلاً هندسياً شاملاً للبدائل الكلاسيكية في الإصدارات القديمة من خلال تضافر دوال MID وFIND وSUBSTITUTE، وصولاً إلى استراتيجيات تحسين الأداء الحسابي في قواعد البيانات الضخمة وضمان جودة وموثوقية مخرجات البيانات المستخرجة.
1. المقدمة المنهجية لمعالجة السلاسل النصية واستخراج البيانات في إكسل
1.1 مفهوم تجزئة السلاسل النصية وأهميتها في إدارة البيانات
تُعرّف معالجة السلاسل النصية (String Manipulation) بأنها مجموعة العمليات الحسابية والمنطقية المطبقة على متتاليات من المحارف والرموز بغية تحويلها من أنماط خام غير متجانسة إلى مصفوفات هيكلية منضبطة. وفي سياق إدارة البيانات الحديثة، تمثل البيانات النصية الخام تحدياً مستمراً؛ إذ غالباً ما يتم تجميعها من مصادر متعددة مثل أنظمة تخطيط موارد المؤسسات، وسجلات استبيانات الأبحاث الميدانية، والواجهات البرمجية، فتأتي النصوص مدمجة ومحاطة بفواصل اعتباطية تعيق إجراء التحليلات المتقدمة. إن عزل المتغيرات النصية المستقلة يعد شرطاً لازماً لتغذية النماذج الإحصائية وتسهيل تطبيق عمليات التصنيف والفرز والتجميع.
تتضاعف الصعوبات التقنية عندما تتسع السجلات لتشمل ملايين المدخلات ذات الفواصل المتنوعة والمحارف المتباينة. فبينما يمكن للمستخدم العادي اللجوء إلى التجزئة اليدوية عبر النسخ واللصق، فإن هذا النهج يسقط عملياً ومنهجياً أمام ضخامة البيانات؛ نظراً لاستهلاكه وقتاً هائلاً وتعرضه للخطأ البشري الحتمي، فضلاً عن افتقاره لخاصية الديناميكية التي تضمن تحديث المخرجات فور تعديل المدخلات. من هنا تبرز الحلول المؤتمتة عبر الدوال البرمجية كوسيلة حتمية لضمان سلامة البنية التحتية للمعلومات واستقرار تدفقات المعالجة.
1.2 التطور التاريخي لدوال معالجة النصوص في بيئة إكسل
شهد برنامج إكسل عبر عقوده المتتالية تحولاً جذرياً في أسلوب التعامل مع البيانات النصية. في المراحل الأولى والإصدارات التقليدية، كان المستخدم مجبراً على تبني استراتيجيات تعتمد على الجمع بين الدوال الهندسية البسيطة لإنشاء دوال مصفوفية معقدة؛ حيث كان يتم استخدام دالة FIND أو SEARCH لتحديد الموقع الإحداثي الرقمي للحرف الفاصل داخل السلسلة، ثم تمرير هذا الموقع كرقم بداية إلى دالة MID أو RIGHT بالتكامل مع دالة LEN لحساب عدد المحارف الواجب اقتطاعها. كانت هذه الحلول تتسم بالتعقيد التركيبي العالي، وصعوبة الصيانة البرمجية، وبطء المعالجة الحسابية في مجموعات البيانات الكبيرة.
أدى ظهور محرك الحساب الحديث في مايكروسوفت 365 وإدخال مصفوفات الانسكاب الديناميكي (Dynamic Spill Arrays) إلى إعادة صياغة كفاءة العمليات النصية بشكل جذري. وكان إعلان مايكروسوفت في عام 2022 عن حزمة دوال النصوص الحديثة—وعلى رأسها دالة TEXTAFTER—نقطة تحول تاريخية أنهت الحاجة إلى الصيغ الالتفافية الطويلة. يقلل هذا التطور المعماري الحديث العبء الإدراكي الواقع على محلل البيانات، وهو ما يتسق مع المبادئ المعرفية لاستيعاب المعلومات المعقدة المنصوص عليها في الأدبيات التربوية والتقنية (Pollock et al., 2002)، فضلاً عن تقليص مساحة الأخطاء البرمجية الناتجة عن تداخل الدوال القديمة.
1.3 أهداف المقال ونطاق التطبيق التحليلي
يسعى هذا المقال إلى تأسيس مرجع تحليلي معمق يحيط بكافة التقنيات المتاحة لاستخراج النصوص الواقعة بعد أي محدد مرجعي في بيئة إكسل. لا يقتصر الهدف على استعراض الجوانب الشكلية للدوال، بل يتعدى ذلك إلى استكشاف السلوك الداخلي للخوارزميات الحسابية، وتوضيح كيفية إدارة الذاكرة، وتقديم حلول جذرية للمشكلات غير النمطية كالفواصل المزدوجة والنصوص المتغيرة الحالات والمحارف غير المرئية.
ويغطي نطاق التطبيق مسارين رئيسيين: المسار الأول يستهدف البيئات الحديثة التي تدعم دالة TEXTAFTER بكامل وسائطها الستة، والمسار الثاني يغطي بيئات العمل القديمة التي تفرض استخدام الدوال التقليدية المركبة؛ لضمان شمولية الحلول لجميع فئات الباحثين والمهندسين والمحللين بصرف النظر عن إصدار البرمجية المستخدمة في مؤسساتهم، مع التركيز الصارم على استقرار النماذج وقابليتها للتكرار البرمجي الدقيق.
2. البنية التركيبية الشاملة لدالة TEXTAFTER ودراسة وسائطها
2.1 الوسائط الإلزامية: النص المحدد والفاصل المرجعي
تقوم دالة TEXTAFTER على بنية بنيوية صارمة تبدأ بتعريف وسيطين إلزاميين لا تكتمل الصيغة الحسابية بدونهما. يتمثل الوسيط الأول في النص المصدر text، وهو السلسلة النصية المراد معالجتها، ويمكن أن يكون هذا الوسيط قيمة نصية صريحة محاطة بعلامتي تنصيص، أو مرجع خلية منفردة مثل A2، أو نطاقاً مصفوفياً كاملاً مثل A2:A100 يتيح للدالة الانسكاب تلقائياً عبر الخلايا المقابلة. يجب أن تكون البيانات المدخلة في هذا الوسيط ذات طبيعة نصية، أو أرقاماً يتم التعامل معها برمجياً كسلسلة رموز نصية متتالية.
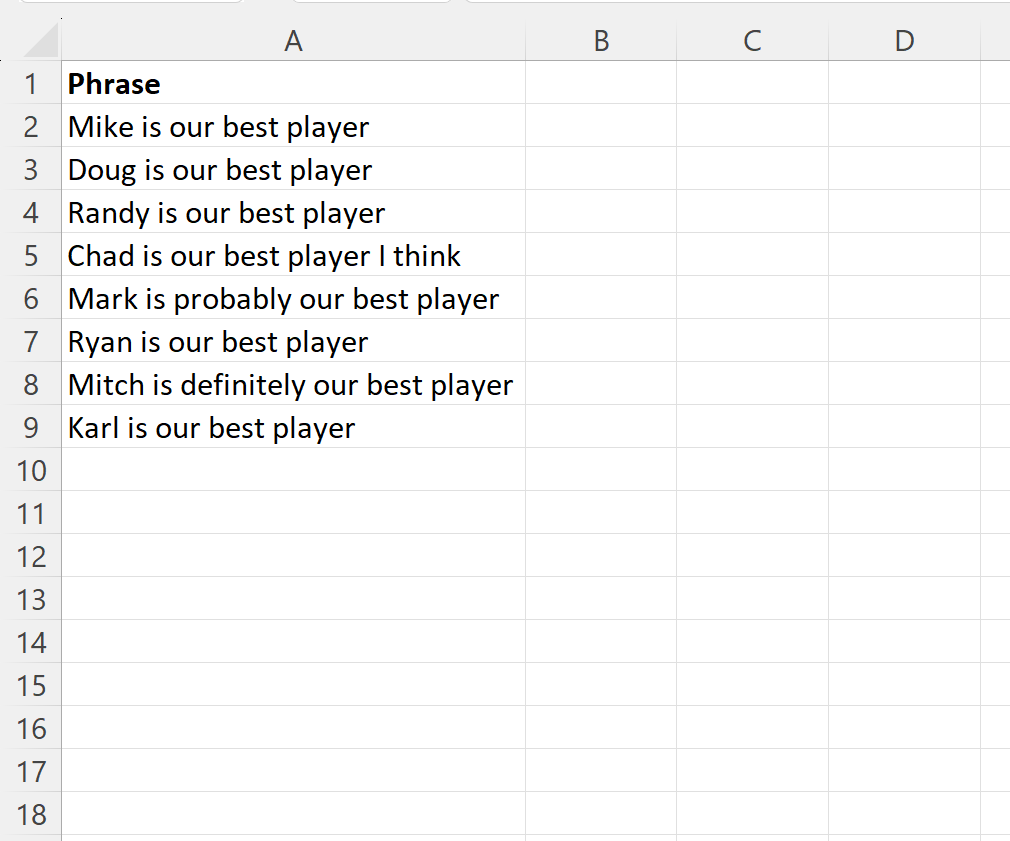
أما الوسيط الثاني فهو الفاصل المرجعي delimiter، وهو الحرف أو الكلمة أو المقطع النصي الدال على نقطة الاقتطاع المستهدفة. يقوم الفاصل بتحديد الحد الفاصل الذي تبدأ من بعده عملية الاستخراج مباشرة. عند تمرير هذين الوسيطين الإلزاميّين فقط دون إضافة وسائط أخرى، مثل الصيغة =TEXTAFTER(A2, "-")، تعتمد الدالة على السلوك الافتراضي الذي يستخرج النص الواقع بعد أول ظهور للفاصل المحدد. تتسم مخرجات الدالة دائماً بطبيعتها النصية، حتى وإن كانت النتيجة عبارة عن أرقام صرفة، ما يفرض ضرورة الوعي بتنسيق الخلية الناتجة في حال الرغبة في استخدامها لاحقاً في عمليات حسابية.
2.2 الوسائط الاختيارية لتحديد موقع الفاصل ونمط المطابقة
تستمد دالة TEXTAFTER مرونتها الهندسية العالية من احتوائها على أربعة وسائط اختيارية تمنح المحلل تحكماً دقيقاً في مسار البحث والاقتطاع. الوسيط الاختياري الأول هو instance_num، وهو عدد صحيح يحدد رتبة الفاصل المستهدف في حال تكراره داخل السلسلة النصية؛ حيث تشير القيمة 1 إلى الفاصل الأول، و2 إلى الفاصل الثاني، وهكذا، بينما تتيح القيم السالبة البحث العكسي بدءاً من نهاية السلسلة. الوسيط الثاني هو match_mode، ويتحكم في حساسية الدالة لحالة الأحرف اللاتينية، حيث تمثل القيمة 0 النمط الافتراضي الحساس لحالة الأحرف (Case-sensitive)، بينما تلغي القيمة 1 هذه الحساسية تماماً.
الوسيط الاختياري الثالث هو match_end، وهو قيمة منطقية تُحدد ما إذا كان ينبغي معاملة نهاية النص كفاصل افتراضي أم لا، حيث القيمة الافتراضية 0 تعطل هذا الخيار وتلزم الدالة بالبحث الصارم عن الفاصل فقط، بينما القيمة 1 تتيح للدالة اعتبار نهاية السلسلة فاصلاً وهمياً يمنع فشل الصيغة. وأخيراً، يبرز الوسيط if_not_found كأداة هندسية بالغة الأهمية لمعالجة الأخطاء الاستباقية؛ حيث يتيح للمحلل تعيين قيمة بديلة مخصصة (مثل قيمة نصية أو مسافة فارغة) يتم إرجاعها بدلاً من توليد خطأ #N/A القاتل في حال غياب الفاصل عن السلسلة المستهدفة.
2.3 التحليل المنطقي لمصفوفة عمل الدالة وخوارزمية البحث الداخلي
تعمل خوارزمية البحث الداخلي لدالة TEXTAFTER عبر آلية مسح خطي للمحارف تتبع نظام الفهرسة ذي الأساس الواحد (1-based indexing) المعتمد رسمياً في بيئة إكسل. عند بدء تشغيل الدالة، يقرأ محرك الحساب السلسلة النصية من اليسار إلى اليمين (أو وفق اتجاه النص المحدد في النظام)، ويقوم بمقارنة كل محرف بمحتوى الوسيط delimiter. إذا تم تمرير قيمة موجبة لوسيط instance_num، تواصل الخوارزمية الفحص وتتجاهل التطابقات الأولى حتى تصل إلى الرقم الترتيبي المطابق للقيمة المحددة، ثم تقتطع السلسلة بداية من المحرف التالي مباشرة لنهاية الفاصل وحتى نهاية السلسلة النصية الكلية.
تتم إدارة الذاكرة المؤقتة أثناء تشغيل الدالة ضمن الصيغ الديناميكية عبر تخصيص كتل ذاكرة مؤقتة تتناسب طردياً مع طول السلسلة المرجعية. وتتعامل الخوارزمية بكفاءة استثنائية مع مختلف أنواع البيانات؛ فالنصوص الصريحة تُعالج مباشرة دون تحويل نمطي، في حين تُخضع الأرقام والتواريخ لعملية تحويل داخلي قسري إلى سلاسل نصية قياسية وفق إعدادات النظام الإقليمية قبل البدء في تطبيق مسار البحث والفرز، مما يحافظ على ثبات الأداء الحسابي وسرعته القصوى حتى في الجداول متناهية الصغر أو الضخمة.
3. التطبيقات الأساسية: استخراج النصوص بعد رمز أو محدد منفرد
3.1 استخراج النصوص بعد المسافات والفواصل الشائعة
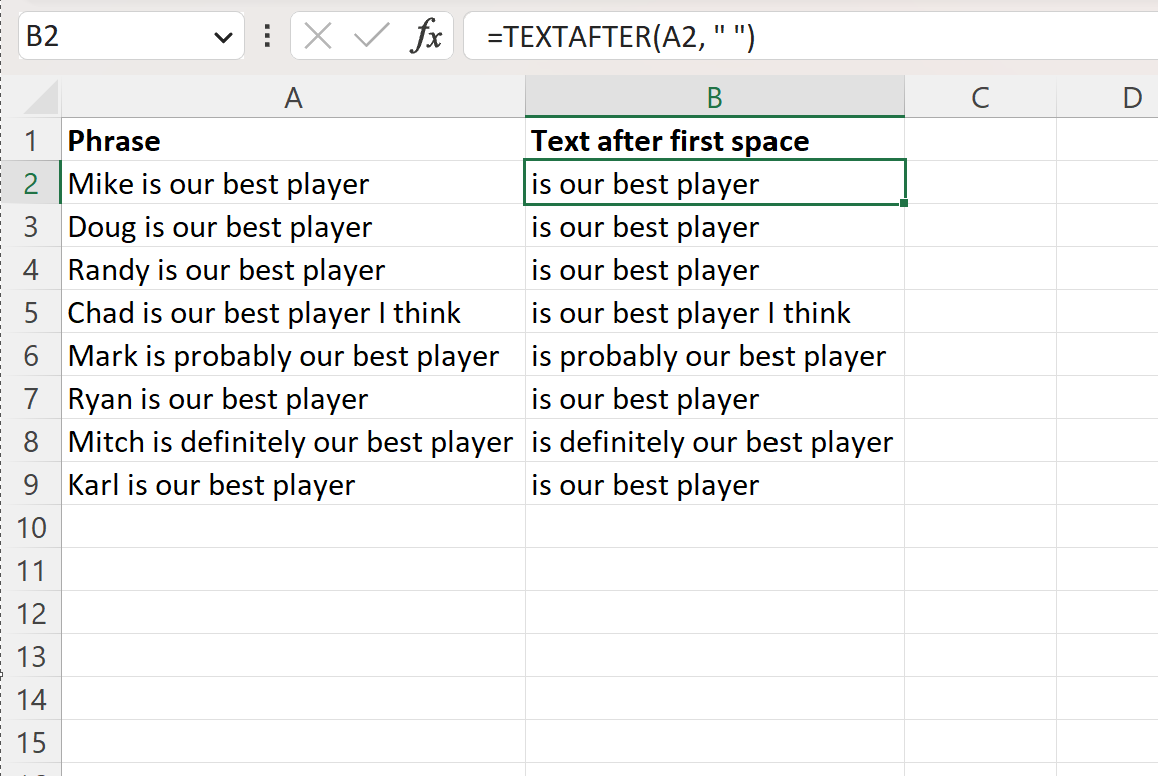
يعد عزل النصوص الواقعة بعد المسافات والفواصل الشائعة أحد أكثر الإجراءات الروتينية في معالجة سجلات الموظفين والعملاء. على سبيل المثال، عندما يتضمن العمود A أسماء ثنائية مدمجة مثل “أحمد محمود” أو “John Smith”، يمكن استخراج الاسم الأخير بمفرده عبر الصيغة البسيطة التالية:
=TEXTAFTER(A2, " ")
تقوم هذه الصيغة بمسح النص والبحث عن مسافة الفراغ الأولى، ومن ثم إرجاع كل ما يليها مباشرة بدقة تامة. وينطبق المبدأ نفسه عند التعامل مع الفواصل المنقوطة أو النقطية داخل السجلات الأرشيفية؛ فإذا كان لدينا كود أرشيفي يجمع بين التصنيف والرقم مثل “INV;98421″، فإن الصيغة =TEXTAFTER(A2, ";") ستعزل القيمة الرقمية “98421” كقيمة نصية مستقلة.
وفي سياق التعامل مع مسارات المجلدات أو الروابط الإلكترونية التي تتضمن شرطات مائلة أو واصلات مثل “REF-2026-X”، يمكن استخراج الجزء اللاحق للواصلة الأولى باستخدام =TEXTAFTER(A2, "-")، ليكون الناتج “2026-X”. إن سحب وتطبيق هذه الصيغ عبر ميزات التعبئة التلقائية في إكسل يضمن اتساق التحويل الهيكلي للأعمدة بكفاءة متناهية ودون إخلال بالبيانات المصدرية الأصلية.
3.2 استخراج النصوص بعد المقاطع النصية والكلمات الفرعية
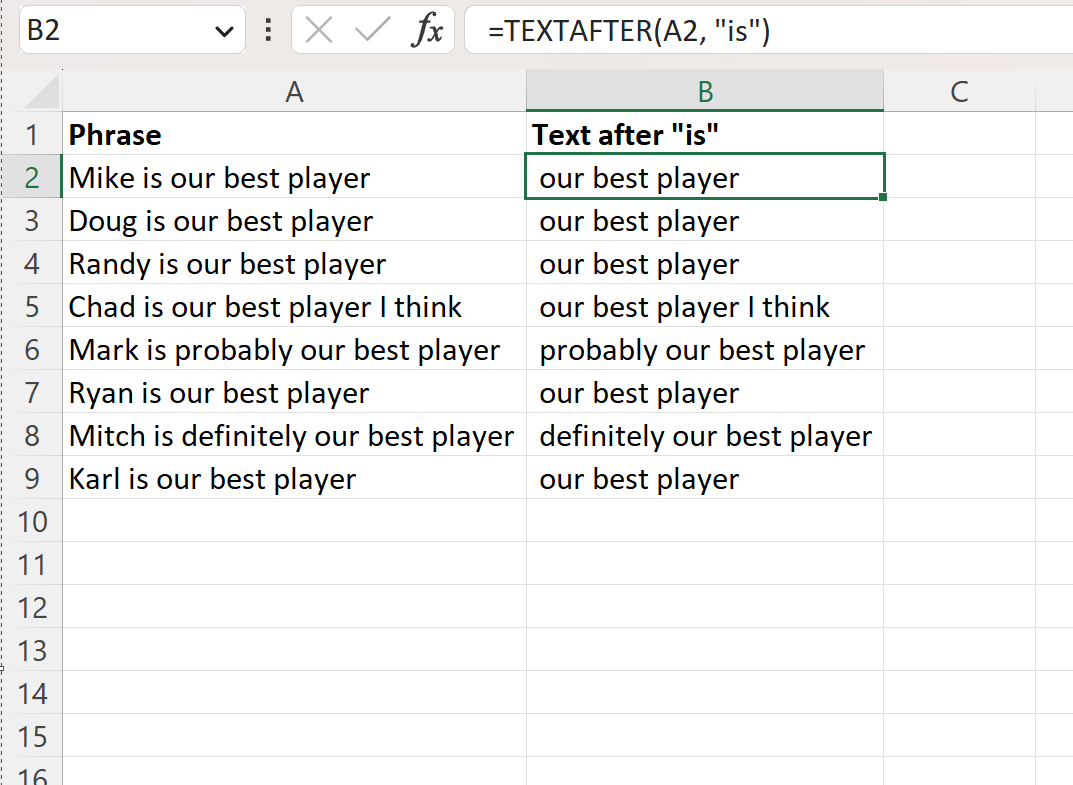
لا يقتصر محدد الفواصل في دالة TEXTAFTER على الحروف المفردة أو الرموز الخاصة، بل يمتد ليشمل الكلمات الكاملة والتسلسلات الرمزية المركبة. ففي كثير من النصوص غير المنظمة أو الملاحظات الميدانية، قد تبرز الحاجة إلى استخراج المحتوى الواقع بعد عبارة شرطية أو كلمة مفتاحية معينة. فإذا احتوت الخلية A2 على الجملة “The final score is 95″، يمكن للمحلل استخراج النتيجة الرقمية مباشرة عبر استهداف الكلمة الفرعية “is” كفاصل محدد:
=TEXTAFTER(A2, "is ")
تظهر هنا مسألة دلالية وتقنية دقيقة تتعلق بإدارة المسافات البيضاء؛ فالبحث عن “is” بدون مسافة سيجعل المخرج يبدأ بمسافة بيضاء فارغة ” 95″، بينما تضمين المسافة داخل الفاصل المرجعي المستهدف (“is “) يضمن الحصول على نص نقي يبدأ بالرقم مباشرة دون الحاجة إلى استخدام دوال إضافية لتنظيف الفراغات. وعند تكرار الكلمة الفرعية ذاتها داخل الخلية الواحدة، كأن تتكرر كلمة “due to” عدة مرات في تقرير أداء، فإن السلوك الافتراضي للدالة يلتزم دائماً بالاقتطاع بعد الظهور الأول للكلمة، ما لم يتم توجيه سلوكها عبر وسيط التكرار كما سنفصل لاحقاً.
3.3 التطبيقات العملية على المعرفات الرقمية والأكواد المنظمة
تستخدم المعرفات المنظمة في المستودعات والمنظومات المحاسبية لدمج أكواد الفئات مع الأرقام التسلسلية. ففي سلاسل توريد المنتجات، قد يحمل المنتج الرمز “SKU:778432”. لاستخراج المعرف الرقمي الخاص بالمنتج، يمكن صياغة الدالة بالصورة التالية:
=TEXTAFTER(A2, "SKU:")
تُنتج هذه الصيغة السلسلة النصية “778432”. ورغم أن هذه المخرجات تظهر للمستخدم كأرقام، إلا أن إكسل يخزنها في الذاكرة كسلسلة محارف، مما يمنع استخدامها في العمليات الرياضية مثل الجمع أو إدراجها كمتغير كمي في التحليلات الإحصائية. ولتحويل هذا النص المستخرج إلى قيمة رقمية صالحة للعمليات الحسابية، يمكن دمج الدالة مع دالة VALUE أو استخدام المعامل الحسابي المزدوج للنفي (Double Unary Operator) بالشكل التالي:
=--TEXTAFTER(A2, "SKU:")
يؤدي هذا الإجراء الحسابي البسيط إلى إجبار إكسل على تحويل نوع البيانات (Data Type Casting) من مصفوفة محارف إلى قيمة عددية قياسية قابلة للجمع والمتوسط الحسابي، مما يعزز الثقة التقنية والاعتماد المؤسسي على البيانات المستخرجة كما توضح أطر بناء الثقة في التقنيات البرمجية الحديثة (Lankton et al., 2015).
4. التحكم المتقدم في تكرارات الفواصل عبر وسيط instance_num
4.1 استهداف تكرار محدد للفاصل من بداية النص
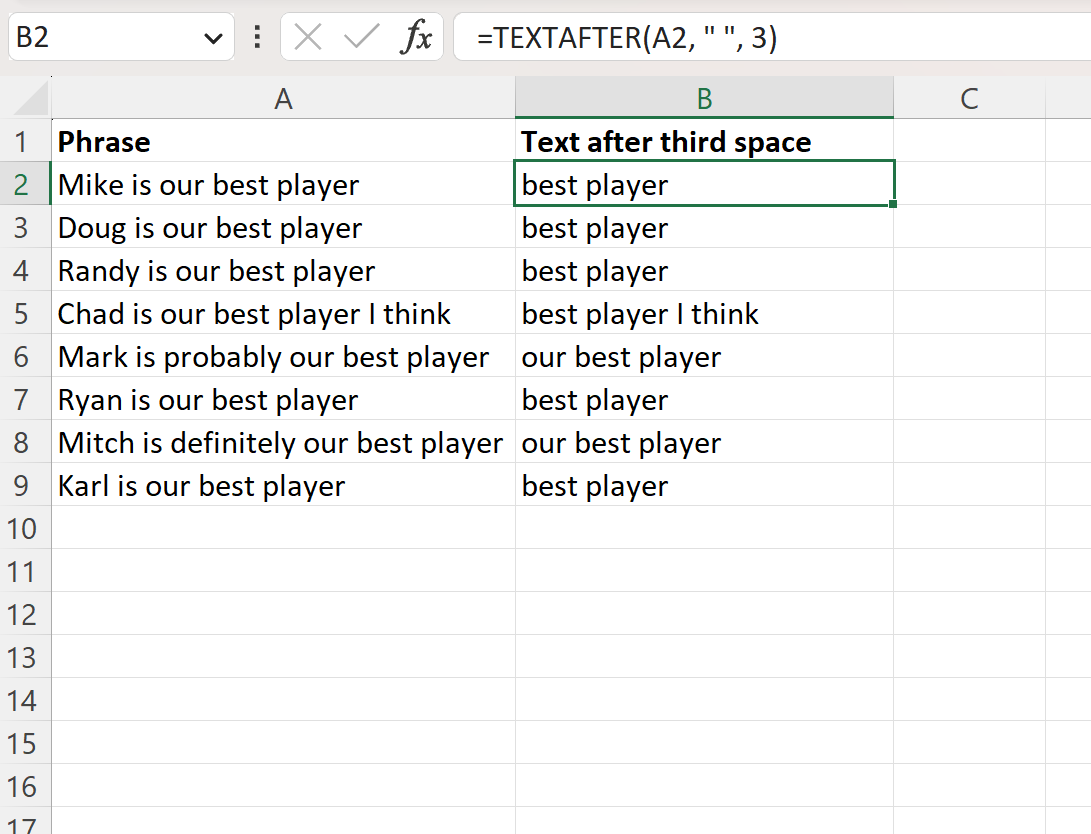
في التطبيقات الواقعية الأكثر تعقيداً، نادراً ما تقتصر النصوص على فاصل وحيد؛ إذ تزخر سجلات العناوين الجغرافية والمسارات الشبكية بتكرارات متعددة لنفس المحدد الرمزي. يتيح وسيط instance_num السيطرة الرياضية التامة على رتبة الفاصل المستهدف انطلاقاً من بداية النص عبر تزويده بأرقام صحيحة موجبة (1، 2، 3…). ففي مسار تخزين إلكتروني مثل “C:/Users/Admin/Documents/Report.xlsx”، إذا رغب المحلل في استخراج المسار الفرعي بعد المجلد الرئيسي للمستخدمين، يمكنه استهداف الفاصل المائل الثالث بالصيغة:
=TEXTAFTER(A2, "/", 3)
ستقوم الدالة في هذه الحالة بتجاوز الفاصل الأول بعد “C:” والفاصل الثاني بعد “Users”، لتنطلق في الاقتطاع مباشرة بعد الفاصل الثالث، وينتج عن ذلك النص الدقيق “Documents/Report.xlsx”. وينطبق المنطق نفسه على تجزئة العناوين الجغرافية المفصولة بفواصل عادية، مثل “المملكة العربية السعودية، الرياض، حي النخيل، شارع الملك فهد”؛ حيث يؤدي تمرير القيمة 2 إلى استخراج العنوان المحلي الواقع بعد اسم المدينة. غير أن المخاطرة الهندسية الكامنة هنا تكمن في تحديد رتبة تكرار تتجاوز عدد الفواصل الموجودة فعلياً في النص، وهو ما سيقود محرك الحساب إلى إرجاع خطأ #N/A الحتمي، مما يفرض توخي الحذر الشديد وفحص شمولية البيانات.
4.2 العد العكسي واستخراج النصوص اعتماداً على القيم السالبة
تتمثل إحدى أقوى المزايا البنيوية في دالة TEXTAFTER في دعمها للعد العكسي عبر الوسائط السالبة. فعندما نمرر القيمة -1 في وسيط instance_num، يتوقف المحرك عن المسح التقليدي ويبدأ في مسح السلسلة من نهايتها متجهاً نحو بدايتها لتحديد آخر ظهور للفاصل. تظهر الأهمية الاستثنائية لهذه الميزة في استخراج امتدادات الملفات الإلكترونية؛ حيث تحتوي أسماء الملفات أحياناً على عدة نقاط متفرقة مثل “Data_Analysis_v1.0.Final.xlsx”. فإذا استخدمنا الصيغة التالية:
=TEXTAFTER(A2, ".", -1)
تضمن الدالة بشكل قاطع استخراج الامتداد الفعلي “xlsx”، متجاوزة كافة النقاط التي سبقت في اسم الملف بصرف النظر عن عددها الإجمالي.
كما تُطبق هذه المنهجية بكفاءة عالية في معالجة الأسماء المعقدة لعزل اللقب العائلي الأخير للمشاركين في الأبحاث والمسوح؛ فإذا كان الاسم يحتوي على ثلاثة أو أربعة مقاطع متداخلة، يضمن استهداف المسافة الأخيرة عبر -1 فصل اسم العائلة الأخير بدقة متناهية. ومن الناحية الحسابية الداخلية، تتفوق هذه الخوارزمية العكسية بشكل ساحق على عمليات المسح الأمامي، إذ تختصر زمن البحث البرمجي وتقلص استهلاك المعالج بمجرد عثورها على الفاصل الأخير في بداية عملية المسح التراجعي.
4.3 التحديد الديناميكي لرتبة الفاصل باستخدام صيغ مساعدة
قد تفرض تباينات البيانات وسيناريوهات العمل المتغيرة عدم ثبات موقع الفاصل المستهدف؛ مما يستدعي التخلي عن الأرقام الثابتة وبناء صيغ تتكيف ديناميكياً مع خصائص السلسلة النصية لكل صف على حدة. لتحقيق ذلك، يمكن دمج معادلة حساب عدد مرات التكرار داخل الوسيط instance_num بالاعتماد على دالتي LEN وSUBSTITUTE. تنص النظرية الحسابية على أن الفرق بين الطول الإجمالي للنص وطول النص بعد حذف الفاصل منه يساوي تماماً إجمالي عدد مرات ظهور ذلك الفاصل في الخلية:
=LEN(A2) - LEN(SUBSTITUTE(A2, "-", ""))
يمكن تضمين هذا المقدار المحسوب تلقائياً في وسيط التكرار لدالة TEXTAFTER، أو تطبيق معادلات شرطية لاستهداف ما قبل الفاصل الأخير بمقدار خطوة واحدة عبر الصيغة:
=TEXTAFTER(A2, "-", (LEN(A2) - LEN(SUBSTITUTE(A2, "-", ""))) - 1)
يمنح هذا الدمج الهيكلي الصيغة البرمجية استقراراً مطلقاً وقدرة فائقة على التكيف مع التباين الهيكلي بين صفوف البيانات المختلفة، وهو ما يجسد أعلى معايير الأتمتة في المعالجة النصية المتقدمة لبيئات الجداول الإلكترونية.
5. إدارة حساسية حالة الأحرف والتطابق عبر وسيط match_mode
5.1 التطابق الحساس لحالة الأحرف (النمط الافتراضي 0)
في بيئات معالجة البيانات النصية اللاتينية، تمثل حالة الأحرف (Case Sensitivity) متغيراً حاسماً في تمييز المعاني والوظائف؛ إذ يعتبر الحاسوب الحرف الكبير (Uppercase) رمزاً مغايراً تماماً للحرف الصغير (Lowercase) لاختلاف قيمتهما الرقمية في جدول ترميز الأسكي (ASCII). تتبنى دالة TEXTAFTER افتراضياً النمط الحساس لحالة الأحرف، وهو ما يعادله تمرير القيمة 0 في الوسيط الرابع match_mode. يكتسب هذا النمط الافتراضي أهمية محورية عند التعامل مع الأكواد البرمجية والمفاتيح المشفرة والمختصرات التخصصية؛ حيث قد يرمز الحرف الكبير إلى قطاع وظيفي مغاير لما يرمز إليه الحرف الصغير.
على سبيل المثال، في حال تضمن السجل كوداً مثل “Part_x_Base_X_Final”، فإن استخدام الصيغة =TEXTAFTER(A2, "X", , 0) سيؤدي حصرياً إلى استخراج النص الواقع بعد حرف “X” الكبير وهو “_Final”، متجاهلاً حرف “x” الصغير الواقع في منتصف الكلمة الأولى. غير أن هذا السلوك الدقيق قد يتحول إلى مصدر رئيسي للأخطاء الحسابية في حال كان إدخال البيانات يتم يدوياً دون تقييد قبلي؛ حيث يؤدي أي خطأ طفيف في حالة الأحرف من قِبل مدخلي البيانات إلى فشل المطابقة التامة، وتوليد رسائل الخطأ، وتكرار السجلات غير المتطابقة، مما يستلزم توحيد السجلات النصية بعناية فائقة.
5.2 التطابق غير الحساس لحالة الأحرف (النمط المتقدم 1)
لتجاوز القيود الصارمة الناتجة عن تباين كتابة الأحرف الكبيرة والصغيرة في قواعد البيانات الضخمة التي يشترك في تغذيتها مستخدمون متعددون، وفرت مايكروسوفت النمط المتقدم عبر تمرير القيمة 1 في وسيط match_mode. يقوم هذا الخيار بإلغاء حساسية الدالة تجاه حالة الأحرف تماماً أثناء عملية الفحص والمقارنة؛ حيث تعامل الخوارزمية الحرفين “a” و”A” ككيان متطابق مطلق دون أي تمييز بينهما.
تتجلى الفائدة التشغيلية لهذا النمط في معالجة الكلمات المفتاحية وعناوين البريد والروابط التشعبية. فإذا رغبنا في استخراج النص الواقع بعد كلمة “test” من سجل يحتوي على تنويعات عشوائية مثل “Case_TEST_101″ و”Case_test_202” و”Case_Test_303″، تكفي صيغة واحدة مرنة لتحقيق المراد:
=TEXTAFTER(A2, "test", , 1)
ستنجح هذه الصيغة في قراءة كافة السجلات واستخراج المحتوى اللاحق دون الالتفات إلى الطريقة التي كُتبت بها الكلمة. ومع أن إلغاء حساسية الأحرف يستهلك قدراً ضئيلاً جداً من المعالجة الإضافية لمقارنة الرموز بكلا الشكلين، إلا أن هذا الأثر الحسابي يظل مهملاً تماماً مقابل الاستقرار الهيكلي الكبير الذي يضفيه على تدفقات العمل التحليلية وموثوقية استخلاص السجلات.
5.3 التعامل مع النصوص العربية وعلامات التشكيل والتطابق النصي
تطرح اللغة العربية تحديات مورفولوجية وكتابية فريدة في معالجة السلاسل النصية تتجاوز مفهوم حساسية الأحرف اللاتينية إلى إشكاليات التنوع الإملائي وعلامات التشكيل. من الناحية البرمجية، لا يؤثر وسيط match_mode في حل تباينات الحروف العربية؛ إذ يعتبر محرك إكسل الألف المهموزة (أ، إ، آ) والألف المطلقة (ا) محارف منفصلة ذات قيم ترميزية مستقلة في نظام يونيكود (Unicode)، وكذلك الأمر بالنسبة للتاء المربوطة (ة) والهاء (ه)، والياء المقصورة (ى) والمنقوطة (ي).
وبالمثل، فإن وجود علامات التشكيل والحركات (كالفتحة، الضمة، الكسرة، التنوين، والشدة) داخل النصوص الميدانية—كما في قواعد البيانات المعجمية واللغوية المتخصصة (Lété et al., 2004)—يؤدي إلى فشل التطابق المباشر في حال تضمن الفاصل محرفاً غير مشكول بينما يحتوي النص الأصلي على تشكيل. يوضح الجدول التالي أبرز التحديات الكتابية في النصوص العربية وسلوك محرك البحث النصي في إكسل حيالها:
| المتغير النصي العربي | طبيعة التحدي في إكسل | السلوك البرمجي التلقائي | استراتيجية المعالجة الموصى بها |
|---|---|---|---|
| رسم الهمزات (أ، إ، آ، ا) | اختلاف القيمة الترميزية في Unicode | تطابق غير متطابق، وتوليد خطأ #N/A |
توحيد الهمزات مسبقاً بدالة SUBSTITUTE |
| الياء والياء المقصورة (ي، ى) | محارف مستقلة بنقاط وظيفية متباينة | فشل البحث الحرفي المباشر | استبدال الياء المتطرفة بصيغ تنظيف موحدة |
| علامات التشكيل والضبط | تغيير طول السلسلة النصية ومواقع الفهارس | تجاوز المحرف المطلوب لعدم تطابق الوزن | تجريد السلسلة النصية من التشكيل برمجياً |
| الكشيدة (التطويل الأفقي: ـ) | محرف جمالي يُدرج بين الحروف المتصلة | يعيق التعرف على الكلمات الفرعية | استبعاد الرمز (تفريغ المحرف) قبل الفرز |
يتطلب التحليل الدقيق للنصوص العربية إخضاع السجلات لمرحلة تطهير إملائي مسبقة؛ لتجريد النصوص من علامات الضبط وتوحيد رسم الهمزات والأواخر قبل تمرير الفواصل المرجعية إلى دالة TEXTAFTER، لضمان أعلى درجات الدقة الإحصائية والتطابق الرياضي الصارم.
6. إدارة الحدود ومعالجة القيم المفقودة عبر وسيطي match_end و if_not_found
6.1 اعتبار نهاية النص كفاصل افتراضي باستخدام match_end
تتعرض عمليات استخراج النصوص إلى مشكلات منطقية متكررة عندما تفتقر بعض الصفوف في مجموعات البيانات إلى الفاصل المرجعي المستهدف، أو عندما يقع الفاصل في نهاية السلسلة تماماً. لمعالجة هذه الحالات الحدية (Edge Cases)، وفرت إكسل الوسيط الخامس match_end. يعمل هذا الوسيط كأداة منطقية ثنائية الخيارات؛ فعند تعيينه على القيمة 0 (الوضع الافتراضي)، تمتنع الدالة عن اتخاذ أي إجراء ما لم يظهر الفاصل المحدد بصورة فعلية في السلسلة.
أما عند تفعيل هذا الوسيط بتمرير القيمة 1، فإن محرك الحساب يتبنى فلسفة مرنة تعامل نهاية السلسلة النصية وكأنها الفاصل المطلوب في حال عدم العثور عليه داخل المتن. يظهر التطبيق الحاسم لهذا الإجراء عندما نرغب في تجزئة أكواد المنتجات التي تنتهي أحياناً ببادئة تصنيفية فقط دون لاحقة تالية، مثل “Item_Category_”; ففي مثل هذا السيناريو، فإن تفعيل خيار اعتبار نهاية النص كفاصل يمنع انهيار السلسلة الحسابية في أوراق العمل الضخمة ويوفر مساراً منطقياً بديلاً يضمن استمرارية معالجة البيانات دون انقطاع.
6.2 تخصيص استجابة الخطأ ومنع ظهور رسائل #N/A عبر if_not_found
في علم تصميم لوحات المعلومات وبناء النماذج المالية والبحثية، يمثل ظهور رسائل الخطأ البرمجية الافتراضية مثل #N/A عيباً تشغيلياً وبصرياً فادحاً يفسد جمالية التقارير ويعطل الدوال التابعة التي تتغذى على مخرجات تلك الخلايا. ينهض الوسيط السادس والأخير if_not_found بمهمة المعالجة الوقائية الشاملة لهذه الأخطاء دون الحاجة إلى تغليف الصيغة بأكملها داخل دوال شرطية إضافية مثل IFERROR أو IFNA.
يتيح هذا الوسيط تمرير قيمة بديلة مخصصة ومحددة دلالياً عند غياب الفاصل المرجعي عن الخلية المستهدفة. يمكن للمحلل تمرير سلسلة نصية فارغة "" لترك الخلية نظيفة تماماً، أو إدراج نصوص توجيهية صريحة مثل “غير متوفر” أو “بيانات غير مكتملة” كما توضح الصيغة الآتية:
=TEXTAFTER(A2, "@", , , , "بيانات ناقصة")
تقوم هذه الصيغة بالبحث عن رمز البريد الإلكتروني، وفي حال كان الحقل مسجلاً باسم مجرد دون رمز الفاصل، يتم إرجاع النص البديل فوراً بدلاً من إلقاء الخطأ البرمجي في وجه المستخدم، مما يسهل كثيراً عمليات الفلترة اللاحقة وتدقيق الجودة واستخراج الإحصاءات الوصفية.
6.3 التكامل بين التحكم في النهايات وتخصيص الأخطاء
تتحقق الكفاءة البرمجية القصوى عند دمج وسيطي match_end وif_not_found في صيغة حسابية موحدة تضمن تغطية شجرة القرارات المنطقية بالكامل مهما بلغت عشوائية الإدخال وتفاوت بنيات السجلات. لنفترض حالة استخراج النصوص الواقعة بعد علامة النقطتين الرأسيتين “:” من عمود استبيان يحتوي مدخلات متباينة للغاية: بعضها يحتوي النقطتين متبوعتين ببيان، وبعضها يحتوي النقطتين في النهاية دون نص تالٍ، وبعضها يفتقر للنقطتين تماماً:
=TEXTAFTER(A2, ":", 1, 0, 1, "لا يوجد مدخل")
يوضح الرسم الشجري المنطقي التالي آلية تدفق القرارات البرمجية داخل محرك دالة TEXTAFTER عند تكامل هذه الوسائط المتقدمة:
مسار تدفق الخوارزمية المنطقية للدالة:
- نقطة البداية: فحص السلسلة النصية في الخلية المستهدفة.
- القرار الأول: هل الفاصل المرجعي
delimiterموجود داخل النص؟- نعم: الانتقال المباشر وتطبيق وسيط
instance_numلاقتطاع النص التالي وإرجاع المخرجات فوراً. - لا: فحص حالة الوسيط الخامس
match_end.- إذا كان
match_end = 1: يتم اعتبار نهاية السلسلة فاصلاً افتراضياً وإرجاع السلسلة المقابلة وفق المحددات. - إذا كان
match_end = 0: الانتقال فوراً إلى فحص الوسيط السادسif_not_found.- إذا تم تزويد قيمة مخصصة في
if_not_found: يتم إرجاعها كقيمة نهائية آمنة للخلية. - إذا لم يتم تزويد قيمة: يتم إطلاق الخطأ البرمجي الصريح
#N/Aلعدم العثور على المحدد.
- إذا تم تزويد قيمة مخصصة في
- إذا كان
- نعم: الانتقال المباشر وتطبيق وسيط
إن تبني هذه المعمارية المزدوجة يُمكّن مهندسي ومحللي البيانات من بناء خطوط دفاع متينة في أوراق العمل تمنع انهيار النماذج وتضمن سلاسة التحليلات دون تدخل يدوي مستمر لتصحيح الأخطاء.
7. المنهجيات البديلة في الإصدارات القديمة من إكسل (MID, FIND, LEN)
7.1 الصيغة الهندسية الكلاسيكية: التكامل بين MID و FIND
في بيئات العمل التي تعتمد على الإصدارات القديمة من إكسل (مثل Excel 2019 و2016 والإصدارات السابقة) التي تفتقر لمحرك الدوال الحديثة، يُعد فهم وتطبيق الصيغة الهندسية الكلاسيكية ضرورة قصوى لمعالجة البيانات. تعتمد هذه المنهجية الكلاسيكية على التعاون الوظيفي المحكم بين ثلاث دوال رئيسية هي MID وFIND وLEN لصياغة معادلة استخراج متكاملة:
=MID(A2, FIND("-", A2) + LEN("-"), LEN(A2))
يقوم منطق عمل هذه الصيغة على تفكيك المشكلة إلى خطوات إحداثية رياضية دقيقة؛ حيث تتولى دالة FIND("-", A2) مهمة مسح السلسلة وتحديد الموقع الرقمي الترتيبي لحرف الفاصل المرجعي (على سبيل المثال، الموقع 5). ونظراً لأننا نريد استخراج النص الذي يقع بعد الفاصل مباشرة وليس الفاصل نفسه، فإننا نضيف طول الفاصل باستخدام + LEN("-")، ليصبح موقع بداية الاقتطاع هو المحرف رقم 6.
بعد ذلك، يتم تزويد دالة MID بموقع البداية المحسوب، وتُكلف باقتطاع عدد من المحارف يعادل الطول الكلي للسلسلة الأصلية LEN(A2)؛ وهي خدعة هندسية شائعة لضمان استيعاب كافة المحارف المتبقية حتى نهاية السلسلة دون الحاجة إلى حساب الطول المتبقي الفعلي بدقة مجردة. وتتميز دالة FIND بأنها حساسة لحالة الأحرف تماماً، وفي حال الرغبة في تجاهل حالة الأحرف في السلاسل اللاتينية، يتم استبدالها بدالة SEARCH كبديل وظيفي مباشر يتيح أيضاً استخدام الرموز البديلة (Wildcards).
7.2 استخراج النص بعد الفاصل الأخير عبر تقنيات الاستبدال المعقدة
إذا كان استخراج النص بعد الفاصل الأول ممكناً عبر الصيغة الكلاسيكية السابقة، فإن استخراج النص بعد الفاصل الأخير في الإصدارات القديمة كان يمثل قمة التعقيد الرياضي والتركيبي في جداول البيانات. نظراً لغياب الوسائط السالبة في دالة FIND التقليدية، كان المحللون يبتكرون حلاً التفافياً يعتمد على خلق مساحات افتراضية هائلة ثم اقتطاع الجزء الأيمن منها وفق الصيغة الشهيرة:
=TRIM(RIGHT(SUBSTITUTE(A2, "-", REPT(" ", LEN(A2))), LEN(A2)))
ترتكز هذه الهندسة الالتفافية على أربع مراحل متتابعة:
- تضخيم الفواصل: توليد كتلة ضخمة من المسافات الفارغة تعادل الطول الكلي للنص عبر
REPT(" ", LEN(A2)). - الاستبدال المكاني: استخدام دالة
SUBSTITUTEلاستبدال كل واصلة فواصل بالكتلة الضخمة من الفراغات، مما يخلق تباعداً هائلاً وشاسعاً بين الكلمات الأصلية. - الاقتطاع الطرفي: سحب كتلة محارف من أقصى يمين النص المضخم تعادل طول النص الأصلي باستخدام دالة
RIGHT، وهو ما يضمن قطع النص الواقع بعد الفاصل الأخير ومحاصرته بكمية هائلة من الفراغات البيضاء المجاورة. - التطهير النهائي: تطبيق دالة
TRIMللتخلص الصارم من كافة المسافات الفارغة المتبقية، والحصول أخيراً على الكلمة المستهدفة نقية تماماً.
ورغم عبقرية هذا التركيب الحسابي، إلا أنه يشكل عبئاً ثقيلاً على ذاكرة المعالجة في الملفات التي تضم مئات الآلاف من الصفوف، ويجعل مراجعة الصيغ وتعديلها عملية شديدة التعقيد والتكلفة الذهنية.
7.3 مقارنة معيارية بين دالة TEXTAFTER والبدائل المركبة
توضح المقارنة المعيارية الدقيقة الفارق الشاسع في الكفاءة والإنتاجية بين الحلول الحديثة والحلول الكلاسيكية الالتفافية. يوضح الجدول الآتي تحليلاً تفصيلياً يقارن بين استخدام دالة TEXTAFTER والصيغ المركبة التقليدية عبر مجموعة من المعايير التشغيلية والبرمجية الحاكمة:
| معيار التقييم | دالة TEXTAFTER (الحديثة) | الصيغ المركبة: MID / FIND (التقليدية) | صيغة التضخيم: SUBSTITUTE / RIGHT |
|---|---|---|---|
| بساطة التركيب ومقروئية الكود | عالية جداً؛ تعبير دلالي مباشر وموجز | منخفضة؛ تتطلب تداخل عدة دوال إحداثية | معقدة للغاية؛ تعتمد على منطق تضخيم المسافات |
| استهلاك الذاكرة وسرعة الحساب | مثالية ومحسنة داخلياً عبر كود C++ المجمع | متوسطة؛ تعيد تقييم طول النص وموقعه مراراً | بطيئة ومكلفة بسبب معالجة نصوص وسيطة هائلة |
| استخراج المحتوى بعد الفاصل الأخير | فوري ومباشر عبر تزويد القيمة -1 |
يتطلب صيغاً بالغة التعقيد وحسابات تكرار | مدعوم عبر اقتطاع الطرف الأيمن الموسع |
| التكامل مع معالجة الأخطاء | مدمج أصلياً عبر وسيط if_not_found |
يستلزم تغليف الصيغة بكاملها في IFERROR |
يستلزم استخدام دوال فحص شرطية إضافية |
| التوافق الرجعي مع الإصدارات | مقتصرة على مايكروسوفت 365 وإكسل 2024 | شاملة وتعمل على كافة إصدارات إكسل التاريخية | متوافقة مع كافة الإصدارات الكلاسيكية |
تُثبت هذه المقارنة أن التحول إلى دالة TEXTAFTER يمثل قفزة نوعية في هندسة جداول البيانات، ويقلل بشكل جذري من فرص حدوث الأخطاء البرمجية أثناء عمليات التعديل والتطوير المستمرة، مما يفسر التوجه المؤسسي العالمي نحو تحديث بيئات العمل البرمجية.
8. تطبيقات متقدمة وسيناريوهات واقعية في معالجة البيانات
8.1 تطهير وتجزئة البيانات الشخصية وعناوين البريد الإلكتروني
يمثل استخراج نطاقات الخوادم من عناوين البريد الإلكتروني تطبيقاً عملياً لا غنى عنه في إدارة قواعد بيانات العملاء وفرز الفئات المؤسسية. فعند وجود عمود كامل يضم عناوين بريدية غير متجانسة، يمكن استخلاص اسم النطاق بالكامل (Domain) الواقع بعد رمز “@” عبر الصيغة المباشرة:
=TEXTAFTER(A2, "@")
ولكن في التحليلات الأكثر عمقاً، قد يحتاج المحلل إلى عزل الامتداد النهائي للمؤسسة أو الدولة (مثل “com” أو “edu” أو “sa”) من داخل النطاق المستخرج ذاته؛ وهنا يتم استهداف النقطة الأخيرة عبر الجمع بين البحث العكسي واستخراج الفاصل الأخير:
=TEXTAFTER(A2, ".", -1)
تضمن هذه الصيغة تجاوز كافة النقاط التمهيدية في العنوان وعزل الامتداد الختامي بدقة. وعندما تتضمن الخلية الواحدة قائمة من العناوين البريدية المتعددة المفصولة بفاصلة منقوطة كأن تكون “[email protected]; [email protected]”، يمكن دمج الدالة مع دوال المصفوفات لتوليد مخرجات منسابة أفقياً أو رأسياً تعيد هيكلة السجل في مسارات تحليلية مفصولة ومنظمة بالكامل.
8.2 معالجة مخرجات الاستبيانات السلوكية والترميز المتعدد
في الأبحاث النفسية والاجتماعية والمسوح الميدانية السلوكية التي تعتمد مقاييس ليكرت، تُخزن الردود أحياناً في هيئة مدمجة تجمع بين الدرجة العددية والوصف النوعي المقابل لها، مثل “5 – أوافق بشدة” أو “1 – أعارض تماماً”. لإجراء التحليل الكيفي والنصي على ردود المشاركين في قواعد البيانات السلوكية—كتلك المستخدمة في تصنيف الاستجابات المفتوحة (Cai et al., 2022)—يتم عزل التعليق اللفظي عن القيمة الرقمية باستخدام:
=TEXTAFTER(A2, " - ")
كذلك تظهر الحاجة إلى هذه التقنية في معالجة السجلات الزمنية الدقيقة المستخرجة من أجهزة القياس وتجارب زمن الرجع الحركي؛ حيث تصدر البيانات مدمجة في قالب التاريخ والتوقيت معاً مثل “2026-03-30 14:45:10”. يتيح استخدام مسافة الفراغ أو الفاصل المخصص بعد التاريخ استخراج التوقيت الزمني المجرد بدقة تامة، مما يسمح بحساب الفروق اللحظية ومعدلات الاستجابة دون تشويش من المتغيرات التقويمية الأخرى.
8.3 الدمج مع الدوال المصفوفية الديناميكية المتقدمة
تصل قوة TEXTAFTER إلى ذروتها التشغيلية عند دمجها ضمن سلاسل معالجة مصفوفية متكاملة مدعومة بمحرك الدوال الحسابية المتقدمة في إكسل. على سبيل المثال، يمكن استخدام الدالة كمدخل مباشر لدالة UNIQUE أو FILTER لتصفية النصوص المستخرجة فوراً واستبعاد التكرارات دون إنشاء أعمدة مساعدة. وإذا أردنا استخراج النصوص المحصورة بدقة بين فاصلين مختلفين (كاستخراج المعرف المحصور بين القوسين “[ID:9988] Data”)، يمكن إجراء تكامل تركيبي بين دالتي TEXTAFTER وTEXTBEFORE في صيغة متداخلة أنيقة:
=TEXTBEFORE(TEXTAFTER(A2, "[ID:"), "]")
كما يمكن تطبيق الدالة على نطاقات متفرقة باستخدام دالة MAP ودوال LAMBDA الحديثة لتنفيذ استخراج نصي موجه ومعقد عبر سجلات متعددة الصفوف والأعمدة دفعة واحدة، مما يحول البيانات النصية غير المنظمة إلى جداول محكمة الصياغة والجاهزية الرياضية الصرفة.
9. الأخطاء الشائعة واستراتيجيات استكشاف المشكلات وحلها
9.1 تحليل أسباب ظهور الخطأ #N/A وطرق الوقاية منه
يُعد الخطأ #N/A (غير متوفر – Not Available) الاستجابة التلقائية الافتراضية الأكثر شيوعاً لدالة TEXTAFTER عند عجز خوارزمية البحث عن تحديد موقع الفاصل المستهدف. وتعود أسباب هذا الخطأ برمجياً إلى ثلاثة عوامل رئيسية:
- الغياب الفعلي للمحدد: عدم وجود الرمز أو المحرف الفاصل داخل السلسلة النصية للخلية المستهدفة.
- تعارض حساسية الأحرف: تعيين وسيط
match_modeعلى القيمة0(الحساس للحالة) مع كتابة الفاصل في الصيغة بحالة تختلف عن حالته الفعلية داخل النص في السلاسل اللاتينية. - تجاوز رتبة التكرار المتاحة: طلب تكرار في وسيط
instance_numيفوق العدد الفعلي لمرات ظهور الفاصل؛ كطلب الفاصل الرابع4في نص لا يحتوي سوى على فاصلين اثنين.
للوقاية من هذا الخطأ وضمان استقرار التقارير، يتعين دائماً استغلال الوسيط السادس if_not_found وتضمين قيمة افتراضية آمنة، أو تطبيق الفحص المسبق لجودة البيانات وتدقيق محتواها قبل تطبيق الصيغ على النطاقات الكبرى.
9.2 معالجة الخطأ #VALUE! ومشكلات توافق الأنظمة
ينشأ الخطأ #VALUE! في سياق معالجة النصوص البرمجية نتيجة إخفاق بنيوي في نوع البيانات الممررة إلى وسائط الدوال، أو بسبب تشغيل الملفات عبر بيئات عمل غير متوافقة برمجياً. في دالة TEXTAFTER، قد يظهر هذا الخطأ إذا تم تمرير نصوص في الوسائط التي تتطلب قيماً رقمية حصرية كـ instance_num أو match_mode، أو عند كتابة الصيغ بطريقة غير صحيحة نحوياً تتضمن وسائط سالبة غير مدعومة في بعض البرمجيات البديلة الشبيهة بإكسل.
علاوة على ذلك، يمثل تشغيل الملفات المنشأة في مايكروسوفت 365 على إصدارات أقدم من إكسل سبباً جوهرياً لظهور أخطاء مجهولة مثل #NAME?، لتحول الدالة الحديثة إلى كود غير معروف في محرك الإصدار القديم. في مثل هذه البيئات المختلطة، ينبغي على مطوري النماذج اعتماد طبقات حماية ثانوية تعتمد على دوال الفحص التقليدية كدالة IFERROR، أو بناء صيغ بديلة تضمن استمرار العمل دون انهيار تقارير العمل الحيوية.
9.3 التحديات المتعلقة بالمسافات غير المرئية والرموز المخفية
من أشد المشكلات الخفية التي تواجه عمليات معالجة البيانات النصية فشل المطابقة الحرفية نتيجة وجود محارف ومسافات غير مرئية تفصل بين الحروف أو تتصدر الكلمات. ولعل أبرز هذه المحارف هو المسافة غير القابلة للكسر (Non-breaking Space) المعروفة برمز التوصيف CHAR(160) في معايير الويب وقواعد البيانات، والتي تختلف تماماً في قيمتها الرقمية عن مسافة الفراغ العادية الناتجة عن مفتاح المسافة CHAR(32).
عندما تُنسخ البيانات من متصفحات الإنترنت أو أنظمة إدارة المحتوى، تفشل دالة TEXTAFTER(A2, " ") في التعرف على الفاصل لأنها تبحث عن CHAR(32) بينما يحتوي النص على CHAR(160). للتغلب على هذه المشكلة الجذرية، يجب تطهير السجلات مسبقاً عبر دمج دالتي CLEAN وTRIM، مع استبدال المسافة غير المرئية صراحة بالمسافة القياسية عبر الصيغة التطهيرية الآتية:
=SUBSTITUTE(A2, CHAR(160), " ")
يضمن هذا الإجراء إزالة كافة الشوائب والمحارف غير القابلة للطباعة وتوحيد نمط الفراغات، مما يعيد مطابقة الدوال النصية إلى أعلى مستويات الدقة والموثوقية.
10. أفضل الممارسات لتحسين الأداء وتوثيق الصيغ في مجموعات البيانات الكبيرة
10.1 استراتيجيات تحسين سرعة الحساب وإدارة الموارد في الملفات الضخمة
عند التعامل مع جداول عملاقة تتجاوز مئات الآلاف من الصفوف في بيئة إكسل، تصبح سرعة الحساب وإدارة استهلاك ذاكرة الوصول العشوائي (RAM) أمراً حاسماً لاستقرار البرمجية ومنع تجميد الملفات. وتتمثل أولى الممارسات الفضلى في هذا الإطار في تجنب الإفراط في تكرار العمليات الحسابية النصية الحية؛ حيث يُنصح بمجرد اكتمال استخراج البيانات وتطهيرها بنسخ النتائج المستخرجة وإعادة لصقها كقيم ثابتة (Paste as Values) إذا كانت البيانات المصدرية ثابتة ولن تخضع لتحديثات لاحقة، مما يحرر موارد المعالج من عبء إعادة التقييم المتكرر عند فتح الملف أو تحرير أي خلية أخرى.
بالإضافة إلى ذلك، ينبغي الاعتماد على ميزة الجداول الرسمية (Excel Tables) عبر النطاقات المهيكلة Table1[Column]؛ نظراً لكفاءتها العالية في إدارة مصفوفات الذاكرة وتسهيل الإشارة إلى الأعمدة، مع الحذر الشديد من استخدام الدوال المتطايرة (Volatile Functions) كدوال مساعدة في مسار الاستخراج، والاعتماد بدلاً من ذلك على مصفوفات الانسكاب الديناميكي النظيفة التي تدير كتل البيانات المستخرجة ككتلة واحدة مدمجة ومنظمة حسابياً.
10.2 التوثيق البرمجي والمعايير القياسية لبناء أوراق العمل
تتطلب أوراق العمل المصممة للاستخدام المؤسسي التوثيق الصارم لكافة التحويلات المنطقية المنفذة على النصوص لضمان سهولة صيانتها من قِبل باحثين ومحللين آخرين عبر الزمن. يُعد استخدام دالة LET أحدث وأرقى أسلوب لتحقيق هذا التوثيق البرمجي المتقدم؛ حيث تتيح الدالة تعريف متغيرات وسيطة بأسماء دلالية واضحة قبل الشروع في بناء صيغة الاستخراج النهائية كما يوضح المثال التالي:
=LET(

    SourceText, A2,

    TargetDelimiter, "-",

    CleanedText, TRIM(SourceText),

    TEXTAFTER(CleanedText, TargetDelimiter)

)
توضح هذه الصيغة المقروءة بدقة تسلسل العمليات، وتسهل اكتشاف الأخطاء وتحديث محدد الفواصل من موقع مركزي وحيد داخل المعادلة. كما ينبغي تسمية النطاقات الحيوية (Named Ranges) وتضمين التعليقات التوضيحية داخل بنية الملف، مع إعداد دليل تشغيلي داخلي يوثق قواعد التجزئة والافتراضات المستخدمة، مما يعزز إمكانية تكرار النتائج وموثوقيتها العلمية والعملية.
10.3 التدقيق ومراقبة الجودة على المخرجات النصية المستخرجة
لا تنتهي عملية استخراج النصوص بمجرد ظهور المخرجات في الأعمدة المستهدفة، بل تستوجب تطبيق دورة تدقيق ومراقبة جودة صارمة للتحقق من سلامة البيانات المستخرجة وخلوها من التشوهات الخفية. تتضمن هذه الدورة تطبيق قواعد التحقق من صحة البيانات (Data Validation) لمنع ظهور فراغات غير مقصودة، وتصميم اختبارات منطقية عبر دالتي ISNUMBER وLEN للتأكد من أن الأطوال النصية والأكواد الرقمية المستخرجة تتطابق مع التوزيع الطبيعي المتوقع لها في المنظومة التحليلية.
ويُنصح بإجراء مراجعات عشوائية منتظمة عبر عينات طبقية للمخرجات، والتحقق الحاسم من تحويل الأنواع البيانية (Data Types) بصورة سليمة؛ فالأرقام المحولة يجب التأكد من صلاحيتها للعمليات الرياضية قبل تصديرها النهائي إلى الحزم والبرمجيات الإحصائية المتقدمة (مثل SPSS أو R أو Python)، لضمان عدم حدوث تشوهات في مصفوفات البيانات أثناء التحليل الرياضي اللاحق.
خاتمة
لقد أحدثت التطورات المتسارعة في محرك حسابات مايكروسوفت إكسل نقلة نوعية في معالجة السلاسل النصية، محولةً عملية استخراج النصوص بعد المحددات من صيغ مركبة مرهقة ومحفوفة بالمخاطر الحسابية إلى عملية وظيفية أنيقة وفعالة تتصدرها دالة TEXTAFTER. ومن خلال التحكم الدقيق في وسائطها المتعددة، أصبح بمقدور محللي البيانات إدارة تكرارات الفواصل الموجبة والعكسية، وضبط حساسية الأحرف اللاتينية، ومعالجة الحالات الحدية واستباق الأخطاء باحترافية بالغة تعزز من متانة النماذج التحليلية.
وفي الوقت ذاته، يظل الإلمام بالبدائل الكلاسيكية المركبة مثل MID وFIND وSUBSTITUTE متطلباً تقنياً أصيلاً لضمان التوافقية البرمجية عبر البيئات المتنوعة وإصدارات إكسل التاريخية. إن تطبيق المعايير المنهجية الصارمة في تطهير النصوص، واستبعاد المحارف غير المرئية، وتوثيق الصيغ عبر دالة LET، ومراقبة جودة المخرجات، يشكل منظومة متكاملة تضمن تحويل البيانات الخام المبعثرة إلى أصول معلوماتية عالية القيمة تدعم اتخاذ القرارات الإدارية والبحثية الرشيدة بدقة وموثوقية مطلقة.
المراجع
- E Pollock, Paul Chandler, John Sweller (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0
- Nancy K. Lankton, D. Harrison McKnight, John F. Tripp (2015). Technology, Humanness, and Trust: Rethinking Trust in Technology. Journal of the Association for Information Systems. https://doi.org/10.17705/1jais.00411
- Bernard Lété, Liliane Sprenger-Charolles, Pascale Colé (2004). MANULEX: A grade-level lexical database from French elementary school readers. Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195560
- Hanshu Cai, Zhenqin Yuan, Yiwen Gao, Shuting Sun, Na Li, Fuze Tian, et al. (2022). A multi-modal open dataset for mental-disorder analysis. Scientific Data. https://doi.org/10.1038/s41597-022-01211-x