
تُمثّل معالجة السلاسل النصية (String Manipulation) وتنقية البيانات غير المهيكلة إحدى الركائز الجوهرية في هندسة البيانات وتحليلها عبر برمجيات الجداول الحسابية، وفي مقدمتها برنامج مايكروسوفت إكسل (Microsoft Excel). يواجه الباحثون، ومحللو البيانات، ومديرو قواعد البيانات تحدياً مستمراً يتمثل في عزل مقاطع محددة من النصوص المحاطة بفواصل خاصة، وتحديداً علامات الاقتباس المزدوجة والفردية، التي تُستخدم بصورة شائعة لتطويق الأسماء المستعارة، أو التعريفات الاصطلاحية، أو الأكواد المرجعية، أو التعليقات النوعية ضمن السجلات المجمعة. إن عملية استخلاص هذه البيانات وتحويلها من شكلها الخام غير القابل للفرز الرياضي إلى متغيرات مستقلة قابلة للتحليل الإحصائي تتطلب فهماً عميقاً للبنية المعمارية لمحرك الحسابات في إكسل والدوال المنطقية والنصية المتاحة عبر إصداراته المتعاقبة.
تاريخياً، ارتبطت عمليات معالجة النصوص داخل الجداول الممتدة بتعقيدات برمجية ناتجة عن تركيب معادلات مصفوفية هجينة تعتمد على حساب أطوال النصوص ومواضع المحارف بدقة رقمية مجردة، مما كان يفرض عبئاً ذهنياً وحسابياً كبيراً على المستخدم وعتاد الحاسوب عند التعامل مع مستودعات البيانات الضخمة. ومع الطفرة التقنية التي قادتها مايكروسوفت في الإصدارات الحديثة لبيئة العمل السحابية، وخصوصاً تحديثات Microsoft 365 وExcel 2021 وما بعدها، أُعيدت صياغة فلسفة معالجة النصوص جذرياً عبر إدخال دوال المعالجة الديناميكية التي تبسط المنطق التحليلي وتلغي الحاجة للصيغ الطويلة والمتشعبة، موفرة بذلك حلولاً برمجية مباشرة وعالية الكفاءة والسرعة.
يهدف هذا الدليل المرجعي الموسع إلى تقديم دراسة أكاديمية وتطبيقية شاملة للآليات الرياضية والبرمجية المعنية باستخراج النصوص المحصورة بين علامات الاقتباس بمختلف أشكالها داخل إكسل. سيتناول الدليل تفكيك التركيب الداخلي للدوال الحديثة مثل TEXTAFTER وTEXTBEFORE، مع المقارنة التفصيلية بالصيغ الكلاسيكية القائمة على دالتي MID وFIND، مروراً بحلول أتمتة استخراج البيانات المتقدمة عبر محرر استعلام الطاقة (Power Query) والبرمجة النصية بلغة الفيجوال بيسك للتطبيقات (VBA) والتعبيرات النمطية (Regular Expressions)، مع وضع ضوابط معيارية لمعالجة الأخطاء وتنقية البيانات وضمان تكاملها الحسابي والأكاديمي.
1. مقدمة منهجية لمعالجة النصوص واستخراج البيانات المحصورة في إكسل
1.1 أهمية عزل النصوص المقتبسة في تحليل البيانات الأكاديمية والرقمية
في بيئات البحوث التجريبية والتحليلات الكمية، نادراً ما تأتي البيانات النصية مهيكلة بصورة مثالية؛ إذ تحتوي قواعد البيانات المستوردة من واجهات برمجة التطبيقات (APIs)، أو ملفات السجلات (Log Files)، أو استبانات القياس المفتوحة، على مدخلات مدمجة تضم نصوصاً وصفية تكتنفها رموز ومحددات اصطلاحية. يبرز مفهوم استخلاص النصوص المنظمة من البيانات شبه المنظمة (Semi-structured Data) كخطوة تحضيرية حاسمة تسبق إجراء أي اختبارات إحصائية أو نمذجة تنبؤية. فعندما تُحصر الأسماء المستعارة، أو التصنيفات الفرعية، أو المتغيرات النوعية، أو الاستشهادات النصية بين علامتي اقتباس، فإن تركها مدمجة ضمن السلسلة الأصلية يُعطّل إمكانية تطبيق دوال التجميع والعد المشروط، مثل COUNTIF أو SUMIFS، ويحول دون بناء جداول محورية (Pivot Tables) دقيقة تعكس التوزيع التكراري لتلك الخصائص.
تحويل البيانات النصية الخام إلى متغيرات إحصائية قابلة للقياس والفرز الرياضي يستلزم عزل المتغير المستهدف وتطهيره من المحددات الخارجية دون إتلاف بنيته الأصلية. على سبيل المثال، في الدراسات الاجتماعية الرقمية، غالباً ما تُسجل أسماء المشتركين ملحقة بلقب حركي بين علامتي اقتباس مثل: أحمد “الصقر” محمود. إن الرغبة في إجراء تحليل شبكات اجتماعية أو تصنيف طبقي يتطلب فصل لقب “الصقر” كمتغير مستقل تماماً في عمود منفصل، ليكون قابلاً للمقارنة والربط مع قواعد بيانات أخرى. تسهم هذه المعالجة في تحسين جودة البيانات (Data Quality) وخفض معدلات التكرار غير المفيد، ما يؤدي إلى رفع الموثوقية الأكاديمية للدراسة ونتائجها.
1.2 التحديات التقنية المرتبطة بترميز علامات الاقتباس المزدوجة والفردية
تُعد معالجة علامات الاقتباس في بيئة إكسل واحدة من أكثر المهام المعقدة برمجياً بسبب التنازع الدلالي الذي يقع فيه محرك الحسابات؛ إذ تُستخدم علامة الاقتباس المزدوجة (“) كمحدد لغوي أساسي لتعريف بداية ونهاية أي سلسلة نصية داخل الصيغ الرياضية. بالتالي، عندما يُطلب من إكسل البحث عن علامة اقتباس كرمز نصي مجرد (Literal Character) وليس كمحدد لصيغة حسابية، ينشأ خطأ في بناء الجملة (Syntax Error) ما لم يتم تطبيق مفهوم تسلسل الهروب النصي (Escape Sequence). يفرض منطق إكسل مضاعفة الرمز المستهدف، بحيث يتم تمثيل علامة الاقتباس الواحدة بأربع علامات متتالية """" عند كتابتها داخل الصيغة، وهو ما يربك الباحثين المبتدئين ويزيد من احتمالية وقوع أخطاء إدخال النصوص البرمجية.
تتضاعف الصعوبة التقنية عند التمييز بين علامات الاقتباس المستقيمة القياسية وعلامات الاقتباس المائلة أو الذكية (Curly/Smart Quotes) الناتجة عن محاذاة الخطوط في محررات النصوص المكتبية مثل Microsoft Word أو أنظمة إدارة المحتوى. إن محرك إكسل يتعامل مع علامة الاقتباس المستقيمة ذات الرمز الثماني (ASCII Code 34) بوصفها محرفاً مختلفاً تماماً عن علامات الاقتباس المنحنية لليمين (U+201D) أو لليسار (U+201C). كما أن علامات الاقتباس الفردية المستقيمة (ASCII Code 39) تتقاطع بصرياً مع الفاصلة العليا الإنجليزية (Apostrophe)، مما يتطلب بناء خوارزميات فحص قادرة على تحديد هوية المحرف المستهدف بدقة لمنع فشل عمليات التطابق الحسابي.
1.3 التطور المعياري لدوال معالجة النصوص في مايكروسوفت إكسل
شهدت معالجة البيانات النصية في إكسل تحولاً جذرياً يوازي التطور الحاصل في لغات البرمجة الحديثة. لعقود طويلة، اعتمد مستخدمو إكسل على توليفات معقدة من الدوال القديمة كـ MID وLEFT وRIGHT وFIND وSEARCH. كانت هذه المعادلات تعاني من إشكالات جوهرية، أبرزها الطول الفائق للصيغة، وهشاشتها عند تغير أنماط البيانات، فضلاً عن الصعوبة البالغة في تدقيق الأخطاء (Formula Auditing). وقد أثّر ذلك سلباً على الأداء الحسابي، حيث كانت إعادة حساب المصفوفات المعقدة في ورقة عمل تحتوي على عشرات الآلاف من الصفوف تؤدي إلى استهلاك هائل لموارد الذاكرة المؤقتة (RAM) وبطء استجابة المعالج المركزي.
مع إطلاق محرك الحسابات الجديد القائم على المصفوفات الديناميكية (Dynamic Arrays) في Excel 365 وExcel 2021، قدّمت مايكروسوفت حزمة ثورية من دوال النصوص الموجهة لمعالجة المحددات، مثل TEXTAFTER وTEXTBEFORE وTEXTSPLIT. تم تصميم هذه الدوال للعمل بتوافق تام مع البنية الحديثة للبرنامج، موفرة كفاءة حسابية استثنائية وزمن استجابة يقترب من الصفر عند معالجة السجلات الكبيرة. لقد اختزلت هذه الدوال العمليات التي كانت تتطلب في السابق أسطراً من المعادلات المتداخلة إلى استدعاء دالي مباشر وبسيط، مما ساهم في تعزيز قابلية التوسع والصيانة في مشاريع إدارة البيانات المعاصرة.
2. بنية وآلية عمل دالتي TEXTAFTER وTEXTBEFORE في عزل النصوص
2.1 التشريح الدلالي والبرمجي لدالة TEXTAFTER
تُمثّل دالة TEXTAFTER إحدى الإضافات النوعية التي طرأت على مكتبة دوال إكسل، حيث تتركز وظيفتها الأساسية في إرجاع السلسلة النصية التي تلي محدداً نصياً معيناً يتم تعريفه مسبقاً. تأتي الدالة بالصيغة الهيكلية العامة التالية:
=TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
يتطلب المعامل الإلزامي الأول (text) تحديد النص المستهدف أو مرجع الخلية، في حين يُحدد المعامل الثاني (delimiter) الفاصل الحرفي المراد الاقتطاع بعده. وتكمن المرونة التشغيلية للدالة في معاملاتها الاختيارية؛ إذ يتيح المعامل instance_num تحديد أي تكرار للمحدد يجب البدء بالاقتطاع بعده، وهو ما يحل معضلة تكرار الرموز دون الحاجة لتقنيات معقدة، في حين يتحكم المعامل match_mode بحساسية حالة الأحرف (Case Sensitivity)، ويتيح if_not_found وضع قيمة بديلة آمنة تمنع ظهور رسائل الأخطاء النظامية.
تعتمد الدالة في خوارزميتها على فحص تسلسلي لبايتات السلسلة النصية حتى رصد المطابقة الأولى للمحدد، ثم تقوم باقتطاع المؤشر البرمجي ونسخ الجزء المتبقي مباشرة إلى مصفوفة الإخراج. هذا السلوك الخطي يجعل زمن التنفيذ الرياضي متناسباً طردياً مع طول السلسلة فقط، مما يمنحها استقراراً وأداءً متميزاً مقارنة بالبحث المعتمد على تكرار الدوال الرياضية القديمة.
2.2 الخصائص الهيكلية لدالة TEXTBEFORE وتطبيقاتها المعيارية
تعمل دالة TEXTBEFORE بالمنطق المعكوس المكمل تماماً لدالة TEXTAFTER؛ وتتمثل مهمتها البرمجية في فحص النص المدخل وإرجاع جميع المحارف السابقة للمحدد المستهدف، وتتطابق بنيتها التركيبية مع قرينتها تماماً في المعاملات الإلزامية والاختيارية:
=TEXTBEFORE(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found])
تتيح الدالة للمحلل إمكانية عزل النصوص حتى لحظة الوصول إلى علامة الاقتباس المستهدفة بدقة رقمية متناهية. ومن أبرز المزايا الهيكلية التي توفرها هذه الدالة إمكانية استخدام مؤشرات المعاملات السالبة في حقل instance_num؛ حيث يؤدي تعيين القيمة إلى (-1) إلى قيام الدالة بالبحث عن المحدد بدءاً من نهاية النص والتحرك نحو اليسار (أو العكس بحسب اتجاه القراءة)، وهو ما يحل التحديات المتعلقة بتفاوت مواضع علامات الإغلاق في النصوص غير القياسية.
في حال غياب المحدد المطلوب داخل السلسلة النصية المدخلة، يُسقط محرك الحسابات خطأ القيمة الحسابية #N/A كإجراء وقائي افتراضي لإشعار المستخدم بفشل التطابق. غير أن توظيف المعامل الأخير [if_not_found] يتيح تجاوز هذا الإسقاط عبر تمرير قيمة نصية فارغة "" أو نص استدراكي يوضح سبب تعذر العثور على المحدد، مما يُبقي قاعدة البيانات نظيفة ومتسقة بصرياً وتحليلياً.
2.3 التكامل التركيبي بين الدالتين لتشكيل صيغة اقتطاع محكمة
يتحقق الاستخراج الدقيق للنص المحصور بين علامتي اقتباس عبر أسلوب التداخل الدالي (Formula Nesting)، حيث تُمرر مخرجات الدالة الأولى لتصبح مدخلات إجرائية للدالة الثانية. إن التوليف المعياري يقتضي استخدام دالة TEXTAFTER أولاً لتجريد النص من كل ما يسبق علامة الاقتباس الافتتاحية (شاملة العلامة ذاتها)، لتتبقى سلسلة نصية تبدأ مباشرة بالمحتوى المطلوب وتنتهي بما تبقى من الجملة الأصلية متضمنة علامة الاقتباس الختامية وما بعدها.
في المرحلة الثانية من التدفق المنطقي، تلتف دالة TEXTBEFORE حول هذه السلسلة المستخلصة جزئياً، وتقوم بالبحث عن علامة الاقتباس التالية (التي تمثل الآن محدد النهاية المتبقي) لتقتطع كل ما يسبقها مباشرة. وبذلك، يتم إعدام علامة الاقتباس الختامية وكل ما يليها، مما يُسفر عن بقاء النص الصافي المحصور فقط داخل الخلية المستهدفة. يُوضح الجدول التالي مصفوفة المعاملات المستخدمة في عملية التكامل التركيبي:
| المرحلة الإجرائية | الدالة المستخدمة | المدخل الوظيفي | المحدد (Delimiter) | طبيعة المخرجات الحسابية |
|---|---|---|---|---|
| الطور الداخلي (النواة) | TEXTAFTER |
الخلية الأصلية الملوثة بالمحددات | علامة الاقتباس الأولى | النص المطلوب متبوعاً بالاقتباس الختامي وبقية السجل |
| الطور الخارجي (الحصر) | TEXTBEFORE |
مخرجات الطور الداخلي المعالجة | علامة الاقتباس الختامية | النص النقي المحصور حصراً بدون أي علامات تنصيص |
تتميز هذه المقاربة التداخلية بالانسيابية الفائقة؛ إذ تتم العمليات الحسابية داخل الذاكرة العشوائية السريعة دون الحاجة إلى إنشاء أعمدة وسيطة (Helper Columns)، وهو ما يرفع من موثوقية الأداء ويضمن استمرارية تحديث المخرجات بصورة فورية بمجرد تعديل بيانات السجل المصدر.
3. المنهجية التطبيقية لاستخراج النص بين علامات الاقتباس المزدوجة
3.1 الصياغة المعيارية لقاعدة علامات الاقتباس الرباعية
لتطبيق التكامل التركيبي بين دالتي TEXTAFTER وTEXTBEFORE لاستخراج النصوص المحصورة بين علامات اقتباس مزدوجة، يجب التعامل مع قاعدة ترميز الهروب النصي بدقة متناهية. إن كتابة علامة اقتباس مزدوجة مجردة كمحدد يقتضي صياغة أربع علامات اقتباس متتالية """". تُفسر علامتا الاقتباس الخارجية (الأولى والرابعة) بواسطة إكسل بأنهما الحاويتان للسلسلة النصية، بينما تُفسر العلامة الثانية بوصفها رمز هروب يشير إلى أن العلامة الثالثة هي المحرف الحرفي المطلوب معالجته كمحدد.
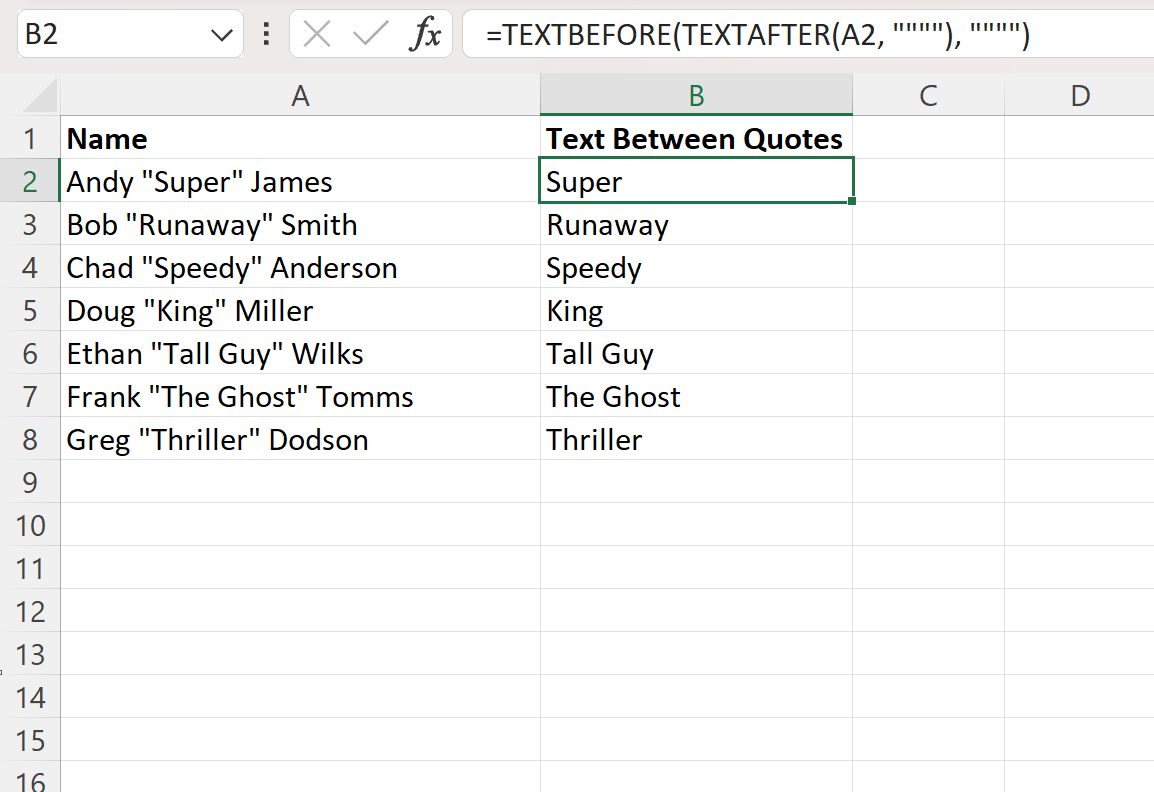
بناءً على هذه القاعدة الرياضية، تُصاغ المعادلة الشاملة لاستخلاص النص المحصور بين علامات الاقتباس المزدوجة للخلية A2 على النحو التالي:
=TEXTBEFORE(TEXTAFTER(A2, """"), """")
ويمكن التعبير عن نفس المعادلة بأسلوب بديل يُعزز من مقروئية الصيغة الحسابية ويقلل من الارتباك البصري عبر توظيف دالة المحارف CHAR، حيث يقابل الرمز 34 علامة الاقتباس المزدوجة في جدول محارف ASCII القياسي الدولي. تصبح الصيغة حينئذٍ:
=TEXTBEFORE(TEXTAFTER(A2, CHAR(34)), CHAR(34))
في كلا الخيارين، يبدأ محرك إكسل بتقييم المعادلة الداخلية، فيقتطع كل ما يقع قبل وأول علامة تنصيص مزدوجة، ثم يستلم التعبير الخارجي الناتج ليقتطع كل ما يقع قبل علامة التنصيص المزدوجة التالية، محققاً العزل التام للمحتوى بنجاح.
3.2 دراسة حالة تطبيقية: استخراج ألقاب الرياضيين والأسماء المستعارة
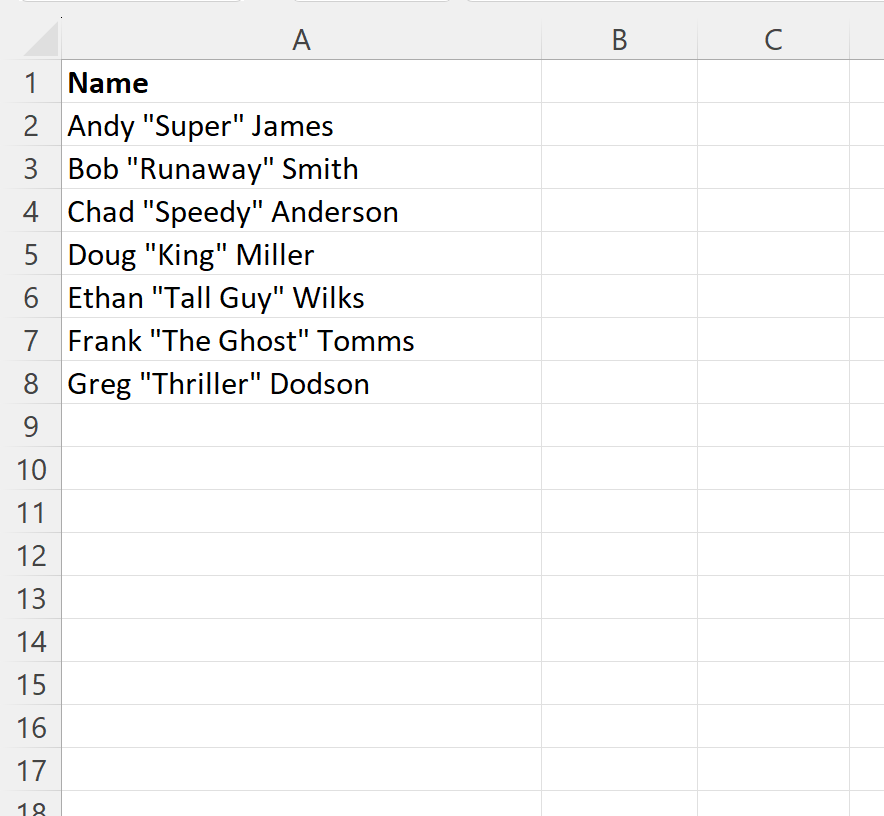
لتوضيح التطبيق العملي، نفترض وجود جدول بيانات يحتوي على سجلات لمجموعة من المتسابقين الرياضيين في سباقات الماراثون الدولية، حيث دُوّنت الأسماء بصيغة تشتمل على الاسم الشخصي، متبوعاً باللقب الميداني بين علامتي اقتباس مزدوجة، ثم اسم العائلة، كما في النموذج التوضيحي التالي:
- الخلية A2: كريم “الفهد” بناني
- الخلية A3: خالد “السهم الذهبي” المنصوري
- الخلية A4: سارة “نجمة الشمال” القحطاني
عند إدراج المعادلة =TEXTBEFORE(TEXTAFTER(A2, """"), """") في الخلية B2، يشرع محرك إكسل بتحليل الخلية A2؛ فتحدد دالة TEXTAFTER موضع الاقتباس الأول الواقع مباشرة بعد مسافة الاسم الأول، وتقص السلسلة لترجع القيمة: الفهد" بناني. تنتقل هذه القيمة فوراً إلى دالة TEXTBEFORE، التي ترصد علامة الاقتباس التي تلي كلمة “الفهد” مباشرة، فتقص كل ما بعدها، لتكون النتيجة النهائية المسجلة في الخلية B2 هي: الفهد صافية تماماً من الفراغات وعلامات الترقيم المحيطة.
وعند اختبار هذه الصيغة على سلاسل مركبة تحتوي على ألقاب تتألف من عدة كلمات مثل “السهم الذهبي” أو “نجمة الشمال”، تُثبت المعادلة استقرارها العالي، حيث تحتفظ بالمسافات الفاصلة بين الكلمات الداخلية المحصورة دون أي تشويه أو اقتطاع ناقص، مما يؤكد سلامة الاعتماد على هذه المنهجية البرمجية المعيارية.
3.3 تعميم المعادلة وأتمتة التطبيق عبر السلاسل البيانية الطويلة
لضمان تدفق العمل بسلاسة عبر مجموعات البيانات التي تضم آلاف السجلات، يتم تعميم المعادلة عمودياً بطريقتين؛ الطريقة التقليدية تعتمد على مراجع الخلايا النسبية وسحب مقبض التعبئة التلقائية (AutoFill Handle) من زاوية الخلية B2 هبوطاً على امتداد العمود النشط. وبفضل المرجعية النسبية للمدخل A2، يتم تحديث المرجع تلقائياً ليصبح A3 ثم A4 وهكذا دواليك في كل صف تالٍ.
أما الطريقة الاحترافية الحديثة المتوافقة مع بنية Excel 365، فتتمثل في تسخير قدرات صفائف الحسابات المنسكبة (Spill Ranges)، حيث يمكن تمرير نطاق كامل من الخلايا داخل معامل الدالة الأول، لتُكتب المعادلة مرة واحدة فقط في أعلى العمود كالتالي:
=TEXTBEFORE(TEXTAFTER(A2:A5000, """"), """")
تولد هذه الصيغة الفردية مصفوفة ديناميكية كاملة تنسكب تلقائياً لملء الخلايا المقابلة حتى نهاية النطاق المحدد (B2:B5000). وتتميز هذه الآلية بالحد من احتمالية تلف الصيغ عبر التعديلات اليدوية العارضة، كما توفر حماية هيكلية للورقة التحليلية وتقلل حجم الملف التخزيني الإجمالي بصورة ملحوظة نظراً لحفظ كائن الصيغة لمرة واحدة في الذاكرة الأساسية للمصنف.
4. المنهجية التطبيقية لاستخراج النص بين علامات الاقتباس الفردية
4.1 الصياغة التركيبية لمعالجة علامات الاقتباس الفردية
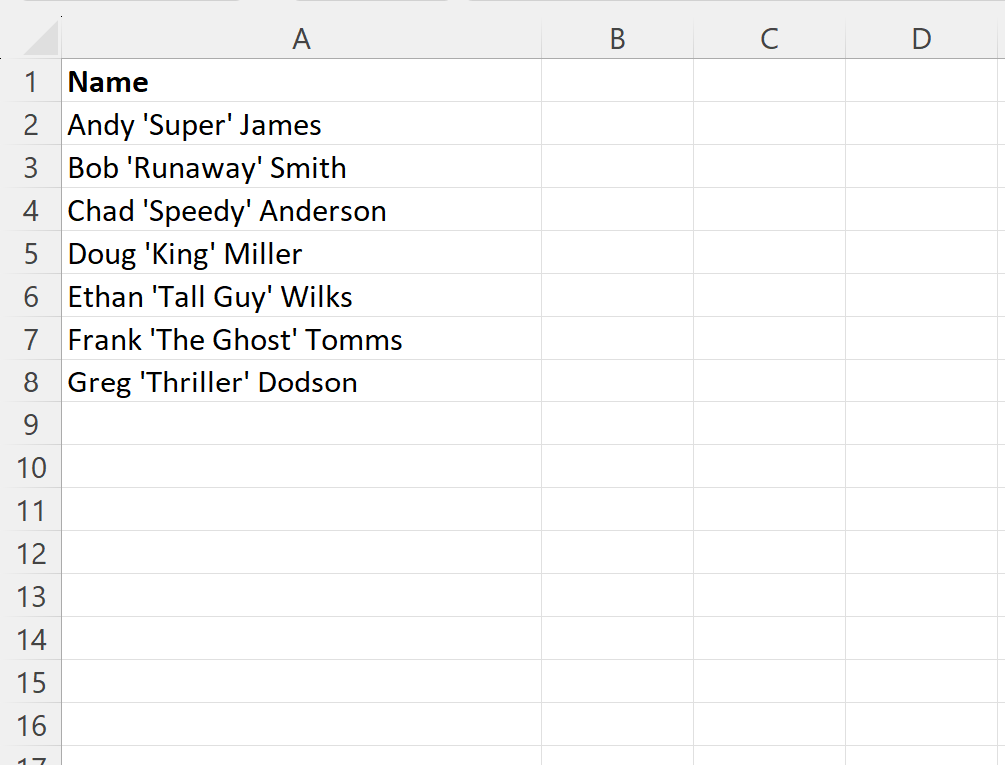
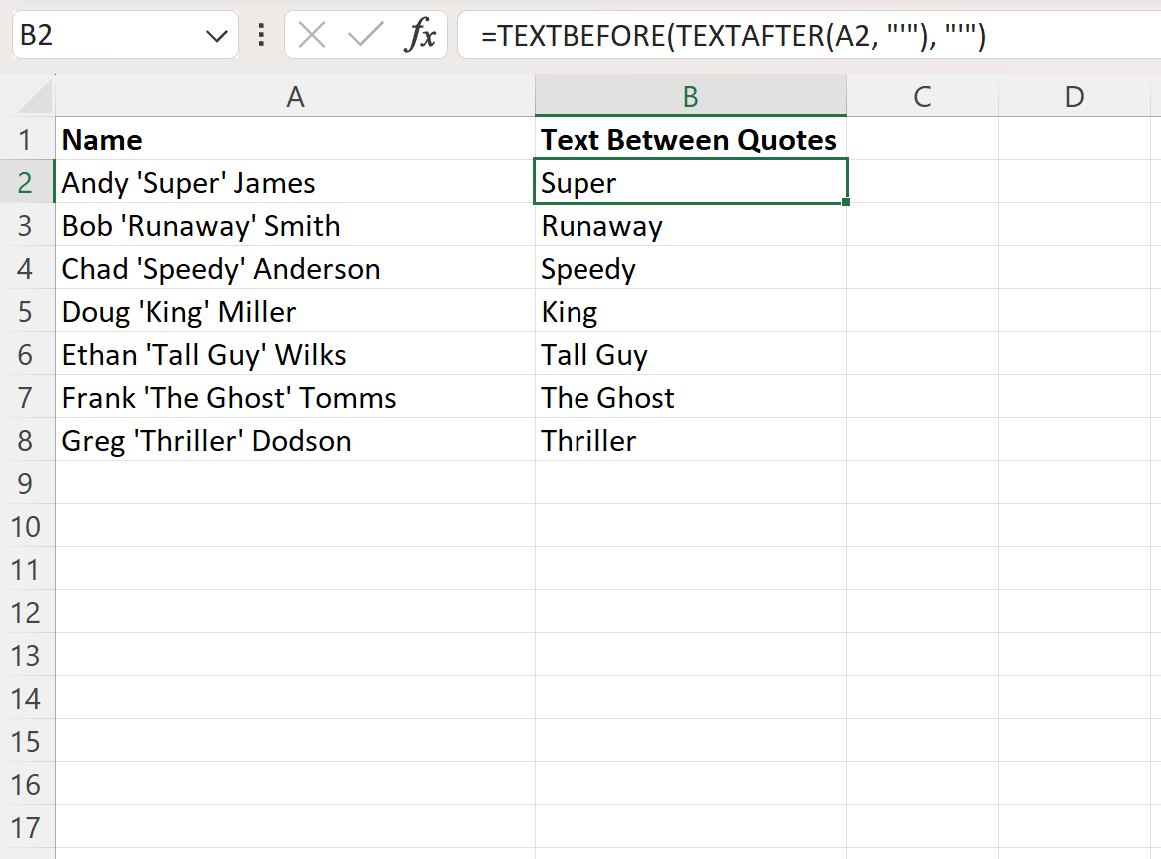
تختلف معالجة علامات الاقتباس الفردية (‘) إعرابياً في بيئة إكسل عن نظيرتها المزدوجة؛ إذ إن إكسل لا يستخدم علامة الاقتباس الفردية كمحدد نصي للصيغ الرياضية (حيث تقتصر وظيفتها الأساسية خارج الصيغ على الإشارة إلى أسماء أوراق العمل أو إجبار الخلية على معاملة الأرقام كنصوص). وبناءً عليه، تسقط الحاجة البرمجية لاستخدام تسلسل الهروب المعقد، ويمكن كتابة علامة الاقتباس الفردية كمحدد نصي عبر إحاطتها بعلامتي اقتباس مزدوجتين فقط: "'".
تتخذ المعادلة النموذجية لاستخراج النص المحاط باقتباس فردي الشكل التالي:
=TEXTBEFORE(TEXTAFTER(A2, "'"), "'")
أو بالاعتماد على دالة المحارف برمز ASCII القياسي 39 المخصص للفاصلة المفردة المستقيمة:
=TEXTBEFORE(TEXTAFTER(A2, CHAR(39)), CHAR(39))
يوفر هذا التباين الإعرابي سهولة ملحوظة في كتابة وتدقيق المعادلة، حيث لا يقع المحلل في التباس بصري ناجم عن تتابع الرموز المتماثلة، ويسهل تحديد مدخلات الدالة بالعين المجردة وبواسطة أدوات التدقيق التلقائي التابعة لبرنامج إكسل.
4.2 دراسة حالة تطبيقية: معالجة الاستشهادات والبيانات النوعية
في مشاريع البحث الأكاديمي والتحليل النوعي للمحتوى، تتضمن نصوص المراجعات الأدبية ومفرغات المقابلات نصوصاً مطعمة باقتباسات فرعية أو مصطلحات اصطلاحية مميزة محاطة بعلامات اقتباس فردية. لنفترض وجود سجل تحليلي يتضمن العبارات التالية:
- الخلية A2: أشار المفكر إلى مفهوم ‘السيولة البيروقراطية’ كعامل مؤثر في الإدارة المعاصرة.
- الخلية A3: تم تصنيف الظاهرة تحت وسم ‘الجمود الهيكلي’ وفق التقرير الفصلي.
بتطبيق المعادلة =TEXTBEFORE(TEXTAFTER(A2, "'"), "'") في العمود المخصص للمصطلحات، يُجري محرك إكسل المسح المطلوب بدقة متناهية، متجاهلاً النص التمهيدي، ليقتطع ويستخلص مصطلح السيولة البيروقراطية ومصطلح الجمود الهيكلي على التوالي.
يثور هنا تساؤل حرج حول النصوص الأجنبية المترجمة أو المدخلات ثنائية اللغة التي تحتوي على الفاصلة العليا لعلامة الملكية أو الاختصارات الإنجليزية، مثل: المصطلح هو ‘John’s Theory’ في القياس. في هذه الحالة، فإن المحدد الأول بعد دالة TEXTAFTER سيعمل بنجاح، لكن دالة TEXTBEFORE قد تقتطع النص عند فاصلة الملكية العليا، مما يعيد “John” فقط بدلاً من السلسلة الكاملة. لتفادي ذلك، يتم توظيف معامل التكرار في دالة TEXTBEFORE ليطلب الاقتطاع عند التكرار الثاني للمحدد الفردي:
=TEXTBEFORE(TEXTAFTER(A2, "'"), "'", 2)
يضمن هذا التعديل المتقدم قفز الدالة فوق فاصلة الملكية العليا والوصول إلى علامة الاقتباس الفردية الختامية الحقيقية للمصطلح العلمي المستهدف.
4.3 إدارة الحالات الهجينة والمحدّدات الفردية المتكررة
تواجه معالجة البيانات المعقدة سيناريوهات تتضمن محددات فردية متعددة تخدم أغراضاً سياقية متباينة في نفس الجملة. لحماية سلامة عمليات الاقتطاع من التداخلات غير المقصودة، ينبغي للمحلل فحص أنماط البيانات وتحديد الفهارس العددية بدقة لكل تكرار. يوفر إكسل مرونة إضافية من خلال استخدام قيم سالبة في معامل التكرار instance_num للدوال الحديثة، ما يمكننا من توجيه البحث ليعمل عكسياً بدءاً من نهاية النص.
إذا كانت الخلية تشتمل على فاصلة عليا في بدايتها يليها اقتباس فردي مستهدف في نهاية السجل، يمكن كتابة الصيغة بحيث تقص دالة TEXTAFTER بعد التكرار المحدد من البداية، في حين تقتطع دالة TEXTBEFORE ما قبل التكرار الأخير القادم من نهاية السجل:
=TEXTBEFORE(TEXTAFTER(A2, "'", 1), "'", -1)
يُمثل هذا الأسلوب الهندسي درعاً واقياً يعزل المتغيرات النوعية بدقة جراحية، ويحول دون اقتطاع أحرف مبتورة ناتجة عن التداخل بين علامات الترقيم اللغوية والمحددات الاصطلاحية المتفق عليها في نظام التكويد الخاص بقاعدة البيانات.
5. استخراج النصوص في سيناريوهات الاقتباسات المتعددة داخل الخلية الواحدة
5.1 التحكم في معامل التكرار (instance_num) لتحديد موضع الاقتباس
تحتوي سجلات قواعد البيانات في كثير من التطبيقات المتقدمة على أكثر من نص مقتبس داخل السجل الفردي الواحد؛ على سبيل المثال، قد تسجل استمارة المعاينة الطبية عبارة: أظهر المريض أعراض “الدوار الحاد” متبوعة بـ “الصداع النصفي” خلال الفحص. في هذه الحالة، يتضمن السجل زوجين منفصلين من علامات الاقتباس (أربعة محارف إجمالاً). إذا استُخدمت المعادلة البسيطة غير الموجهة، فإنها ستستخرج الاقتباس الأول حصراً (الدوار الحاد).
لاستخراج الاقتباس الثاني وتجاوز الاقتباس الأول، يتم توظيف معامل التكرار instance_num في دالتي TEXTAFTER وTEXTBEFORE. لاستخراج العبارة الثانية، يجب أن تقتطع دالة TEXTAFTER بعد علامة الاقتباس المزدوجة الثالثة، ثم تقتطع دالة TEXTBEFORE قبل علامة الاقتباس الأولى المتبقية ضمن السلسلة الناتجة، وفق التركيب البرمجي التالي:
=TEXTBEFORE(TEXTAFTER(A2, """", 3), """")
أما إذا كان الهدف الأكاديمي يقتضي استخراج الاقتباس الأخير دائماً بغض النظر عن عدد الاقتباسات التي سبقته في السلسلة النصية، فيمكن توظيف الفهارس السالبة المتقدمة؛ حيث يُشير المعامل (-2) في دالة TEXTAFTER إلى الاقتطاع بعد علامة الاقتباس قبل الأخيرة، يليه استدعاء TEXTBEFORE لحصر النص حتى علامة النهاية:
=TEXTBEFORE(TEXTAFTER(A2, """", -2), """")
5.2 استخراج جميع الاقتباسات وفصلها في أعمدة مستقلة
عندما تكون الغاية التحليلية هي تفكيك السجل بالكامل واستخراج كافة الاقتباسات وتوزيعها عبر أعمدة متجاورة لتسهيل المعالجة الإحصائية اللاحقة، تصبح دالة TEXTSPLIT الأداة المثلى لإنجاز هذه المهمة الرياضية. تقوم دالة TEXTSPLIT بتقطيع النص المدخل استناداً إلى محدد معين وتحويله إلى مصفوفة أفقية أو عمودية منسكبة.
لتجزئة الخلية A2 التي تحتوي على اقتباسات متعددة، يمكن كتابة الصيغة التالية:
=TEXTSPLIT(A2, """")
ينتج عن هذه الصيغة مصفوفة أفقية تحتوي على جميع مقاطع النص؛ حيث تُمثل الأعمدة الفردية (الأول، الثالث، الخامس…) النصوص الواقعة خارج علامات الاقتباس، في حين تُمثل الأعمدة الزوجية (الثاني، الرابع…) النصوص التي كانت محصورة داخل علامات الاقتباس. ولعزل مصفوفة النصوص المقتبسة وحدها وإقصاء المقاطع الخارجية، يمكن دمج الدالة مع دالة الترشيح المصفوفي CHOOSECOLS ودالة التتابع SEQUENCE، أو الاعتماد على تكرار الدوال البسيطة لإنشاء جدول مخرجات منسق يعزل كل اقتباس في حقل مخصص كما يوضحه الجدول التالي:
| الخلية المصدرية (A2) | صيغة الاقتباس الأول (B2) | صيغة الاقتباس الثاني (C2) |
|---|---|---|
| قال “أهلاً” ثم تمتم “وداعاً” | =TEXTBEFORE(TEXTAFTER(A2, """", 1), """") |
=TEXTBEFORE(TEXTAFTER(A2, """", 3), """") |
| النتيجة المستخرجة | أهلاً | وداعاً |
5.3 معالجة علامات الاقتباس المتداخلة (اقتباس داخل اقتباس)
تُمثل النصوص التي تشتمل على اقتباسات متداخلة هرمياً—مثل تضمين اقتباس فردي داخل اقتباس مزدوج رئيسي—تحدياً خوارزمياً فريداً؛ ومثال ذلك: صرح المتحدث بأن “الاتفاقية كانت تمثل ‘نقطة تحول’ تاريخية” خلال المؤتمر. يتطلب التفكيك التحليلي لهذه البنية تحديد المستوى المطلوب استخراجه بدقة؛ هل هو الاقتباس العام المزدوج، أم الاقتباس الداخلي المركز؟
إذا كان الهدف استخراج الاقتباس الخارجي الكلي متضمناً الاقتباس الفرعي، تُطبق صيغة علامات الاقتباس المزدوجة القياسية: =TEXTBEFORE(TEXTAFTER(A2, """"), """")، لترجع: الاتفاقية كانت تمثل ‘نقطة تحول’ تاريخية. أما إذا كان المطلوب هو استخراج العبارة المحصورة داخل الاقتباس الفردي الداخلي فقط، فيمكن تطبيق تسلسل اقتطاع ثنائي المراحل يدمج محددات الاقتباس المزدوج والفردي في صيغة واحدة محكمة:
=TEXTBEFORE(TEXTAFTER(TEXTBEFORE(TEXTAFTER(A2, """"), """"), "'"), "'")
تقوم النواة الداخلية أولاً بعزل كامل نطاق الاقتباس المزدوج، مما يزيل أي نصوص خارجية قد تحتوي على فواصل أو اقتباسات شاردة، ثم تتولى الصيغة الخارجية اقتطاع ما بين علامتي الاقتباس الفرديتين الواقعتين داخل هذا النطاق المعزول حصراً، لترجع النتيجة النظيفة النهائية: نقطة تحول دون أي شوائب نصية محيطة.
6. البدائل الكلاسيكية لاستخراج النصوص في الإصدارات القديمة من إكسل
6.1 بناء المعادلة المركبة باستخدام الدوال التقليدية (MID وFIND)
في بيئات العمل المؤسسية والمؤسسات الأكاديمية التي تستخدم إصدارات إكسل التاريخية السابقة لعام 2021 (مثل Excel 2019, 2016, 2013)، لا تتوفر الدوال الحديثة TEXTAFTER وTEXTBEFORE. ومن الضروري التنبيه إلى شائعة تقنية شائعة، وهي عدم وجود دالة قياسية مدمجة في إكسل تحمل اسم TEXTBETWEEN إطلاقاً. لذلك، كان لزاماً الاعتماد على صياغة رياضية تجمع بين دالتي MID وFIND لحساب الإحداثيات الرقمية للنص المستهدف.
تعتمد دالة MID(text, start_num, num_chars) على تزويدها بمرجع النص، ونقطة بداية الاقتطاع كفهرس رقمي، وعدد المحارف المطلوب اقتطاعها. لتحديد بداية النص المحصور، تُستخدم دالة FIND("""""", A2) + 1، حيث تحدد موضع أول علامة اقتباس وتضيف إليها (1) لتتجاوز العلامة وتبدأ بأول حرف في النص الداخلي. أما لحساب طول النص الداخلي، فيجب تحديد موضع علامة الاقتباس الثانية عبر إجراء بحث يبدأ بعد علامة الاقتباس الأولى، ثم طرح فهرس الأولى من الثانية وإسقاط محرف واحد لتعويض الفارق الرقمي.
ينتج عن هذه العمليات الحسابية المتشابكة المعادلة الكلاسيكية المعيارية التالية:
=MID(A2, FIND("""", A2) + 1, FIND("""", A2, FIND("""", A2) + 1) - FIND("""", A2) - 1)
تُعد هذه المعادلة من الروائع المنطقية في برمجة إكسل التقليدية، إلا أنها بالغة الحساسية؛ فأي خلل في أقواس التداخل أو الفهارس الحسابية سيؤدي فوراً إلى إرجاع اقتطاع مشوه يحتوي على أجزاء من علامات التنصيص أو يبتلع حروفاً أصيلة من النص المطلوب.
6.2 توظيف دالة SEARCH كبديل غير حساس لحالة الأحرف والمحارف الخاصة
في معادلة الاقتطاع الكلاسيكية المذكورة، يمكن استبدال دالة FIND بدالة SEARCH. يكمن الفارق التشغيلي الأساسي بين الدالتين في أن دالة FIND تتسم بالحساسية الصارمة لحالة الأحرف (Case-Sensitive) ولا تدعم استخدام المحارف البديلة (Wildcards)، في حين أن دالة SEARCH غير حساسة لحالة الأحرف وتدعم استخدام الرموز البديلة مثل علامة الاستفهام (?) للدلالة على محرف واحد وعلامة النجمة (*) للدلالة على أي عدد من المحارف.
على الرغم من أن علامات الاقتباس المجردة لا تشتمل على تصنيف لحالة الأحرف (كبيرة أو صغيرة)، إلا أن دالة FIND تبقى الخيار الرياضي الأفضل والأكثر كفاءة وأماناً لعمليات البحث عن علامات الترقيم. إذ إن دعم SEARCH للمحارف البديلة قد يفتح الباب أمام سلوكيات غير متوقعة عند التعامل مع نصوص تحتوي على رموز رياضية متداخلة، كما أن دالة FIND تتميز بسرعة معالجة أعلى بنسبة طفيفة نظراً لتجاوزها مراحل الفحص الموسع لحالة الأحرف والرموز البديلة في محرك الحسابات.
6.3 مقارنة معيارية بين الأساليب الكلاسيكية والدوال الحديثة
لتقييم الجدوى الفنية المفاضلة بين الاعتماد على الأساليب الكلاسيكية أو الترقية نحو الدوال الحديثة في مشاريع البيانات الضخمة، أُجريت مقارنة معيارية تستند إلى ثلاثة محاور رئيسية: قابلية التدقيق وقراءة الصيغ، الكفاءة الحسابية واستهلاك الذاكرة، والتوافق مع الإصدارات المختلفة. يوضح الجدول التالي خلاصات هذا التحليل المقارن:
| المحور المعياري | الأسلوب الحديث (TEXTAFTER / TEXTBEFORE) | الأسلوب الكلاسيكي (MID / FIND) |
|---|---|---|
| مقروئية وتدقيق الصيغة | عالية جداً؛ الدلالة اللفظية مباشرة وسهلة الفهم للمراجعين الأكاديميين. | منخفضة؛ صيغة طويلة ومعقدة تتكرر فيها الدوال وتتكدس أقواس الحساب. |
| سرعة المعالجة واستهلاك الموارد | أداء حسابي فائق السرعة مع استهلاك أمثلي للذاكرة عبر المصفوفات الديناميكية. | تكرار استدعاء دالة FIND ثلاث مرات في الخلية الواحدة يضاعف الحمل الحسابي. |
| التوافقية السابقة (Backward Compatibility) | تتطلب إصدارات حديثة (Excel 365, Excel 2021 وما يليهما). | متوافقة بنسبة 100% مع كافة إصدارات إكسل التاريخية منذ إطلاق البرنامج. |
تُظهر نتائج التحليل أنه في حال كان المصنف مخصصاً للعمل في بيئة تقنية حديثة وموحدة، فإن تبني الدوال الحديثة يمثل الخيار الهندسي الرشيد الذي يقلل من مخاطر الصيانة ويسرع زمن معالجة الملفات العملاقة.
7. تقنيات معالجة الأخطاء وتنقية البيانات المستخرجة من الشوائب
7.1 معالجة غياب علامات الاقتباس وتفادي أخطاء #CALC! و#N/A
من الإشكالات الشائعة عند تطبيق معادلات استخراج النصوص عبر آلاف السجلات وجود صفوف خالية تماماً من علامات الاقتباس، إما بسبب نقص البيانات أو أخطاء التدوين البشري. في هذه السيناريوهات، تفشل دوال TEXTAFTER وTEXTBEFORE الكلاسيكية في العثور على المحدد، مما يسفر عن ارتداد خطأ #N/A أو خطأ #CALC!، ما يشوه المظهر العام لورقة العمل ويُعطل أي معادلات تجميعية تابعة تعتمد على العمود المستخرج.
تتضمن الدوال الحديثة حلاً مدمجاً وأنيقاً يتمثل في المعامل الاختياري الأخير [if_not_found]. فعوضاً عن إحاطة المعادلة بدوال خارجية إضافية، يمكن تحديد قيمة الإرجاع في حال غياب المحدد مباشرة داخل الدالتين:
=TEXTBEFORE(TEXTAFTER(A2, """", 1, , , ""), """", 1, , , "")
أما بالنسبة للصيغ القديمة أو كإجراء وقائي بديل وشامل، فيمكن تطويق المعادلة بأكملها بواسطة دالة معالجة الأخطاء IFERROR، بحيث تُجبر الخلية على إرجاع فراغ نصي "" أو نص تحذيري محدد عند تعذر الاقتطاع:
=IFERROR(TEXTBEFORE(TEXTAFTER(A2, """"), """"), "غير متوفر")
يسهم هذا الأسلوب المنهجي في حماية سلامة العمليات التحليلية اللاحقة، ويتيح للمحلل تصفية الخلايا التي تحتوي على عبارة “غير متوفر” بسهولة لإجراء المراجعة اليدوية عليها وتصحيحها.
7.2 التخلص من المسافات الزائدة والمحارف غير القابلة للطباعة
غالباً ما تترك عمليات الاقتطاع النصي مسافات فارغة غير مرئية في مستهل النص المستخرج أو في نهايته، ناتجة عن إدخال مسافات بالخطأ من قِبل مدخلي البيانات قبل أو بعد علامات التنصيص مباشرة. فضلاً عن ذلك، قد تشتمل السجلات المستوردة من خوادم الويب أو البريد الإلكتروني على محارف تحكم خفية (Control Characters) أو فواصل أسطر مبرمجة (Line Breaks) تمنع تطابق الكلمات عند إجراء المقارنات النصية أو البحث عبر دالة XLOOKUP.
لضمان التطهير الشامل للنص المستخرج، يجب دمج دالتي TRIM وCLEAN حول صيغة الاستخراج الأساسية. تتولى دالة CLEAN إزالة المحارف غير القابلة للطباعة ذات التكويد الرقمي من 0 إلى 31 في جدول ASCII، بينما تتولى دالة TRIM حذف كافة المسافات البادئة واللاحقة مع تقليص المسافات المتعددة بين الكلمات إلى مسافة واحدة نظامية:
=TRIM(CLEAN(TEXTBEFORE(TEXTAFTER(A2, """"), """")))
يضمن تطبيق هذا القالب البرمجي خروج النصوص المستخلصة في أبهى صور النقاء والتوحيد المعياري، مما يجعلها جاهزة بصورة قطعية لعمليات الربط الإحصائي والتصنيف الآلي داخل نماذج البيانات المعقدة.
7.3 معالجة حالات علامات الاقتباس غير المغلقة أو المفردة
يحدث في كثير من الأحيان أن يحتوي السجل النصي على علامة اقتباس افتتاحية دون وجود علامة إغلاق مقابلة لها، كأن يُكتب: المشروع هو “تطوير النظم بدون إغلاق. في مثل هذه الحالات الشاذة، تنجح دالة TEXTAFTER في قص ما بعد الاقتباس الأول، لكن دالة TEXTBEFORE ستفشل في العثور على المحدد الثاني، مما ينتج عنه خطأ في القيمة أو إرجاع نص مبتور يمتد لنهاية السجل دون تحكم منطقي.
لرصد هذه الانحرافات وإطلاق تنبيهات جودة فورية، يمكن بناء فحص منطقي شرطي مسبق يعتمد على عد عدد علامات الاقتباس داخل الخلية باستخدام دالتي LEN وSUBSTITUTE. تعتمد هذه الخوارزمية الرياضية على حساب طول النص الأصلي، ثم طرح طول النص ذاته بعد تفريغه كلياً من علامات الاقتباس؛ فإذا كان الفارق عدداً فردياً (1, 3, 5…)، فهذا مؤشر قطعي على وجود علامة اقتباس غير مغلقة:
=IF(ISODD(LEN(A2) - LEN(SUBSTITUTE(A2, """", ""))), "تنبيه: علامة اقتباس غير مكتملة", TEXTBEFORE(TEXTAFTER(A2, """"), """"))
توفر هذه المعادلة الرقابية صمام أمان أكاديمي ومؤسسي متقدم يعزل السجلات المعطوبة قبل دخولها في مسارات التحليل المتقدمة، موفراً ساعات طويلة من التتبع والتدقيق اليدوي المضني.
8. أتمتة استخراج النصوص بين علامات الاقتباس باستخدام Power Query
8.1 استيراد البيانات وتحميلها إلى محرر Power Query
عندما تتعاظم أحجام مجموعات البيانات لتبلغ مئات الآلاف أو ملايين الصفوف الموزعة على ملفات نصية مجمعة (CSV أو TXT)، تفقد المعادلات الرياضية المباشرة في واجهة إكسل التقليدية كفاءتها التشغيلية، وقد تؤدي إلى بطء حركة المصنف وتجميد النظام الحسابي. يبرز هنا محرر استعلام الطاقة (Power Query) كأداة هندسية فائقة التطور تتيح إجراء عمليات الاستخراج والتطهير في طبقة معالجة خلفية معزولة لا تثقل كاهل ورقة العمل.
تبدأ العملية المنهجية بتحويل النطاق النصي إلى جدول رسمي في إكسل بالضغط على اختصار Ctrl + T، ثم الانتقال إلى تبويب بيانات (Data) واختيار من ورقة/جدول (From Sheet/Table). يُفتح حينئذٍ محرر Power Query مستعرضاً البيانات بهيكليتها الأصلية، حيث يتعرف المحرك تلقائياً على أنواع البيانات مع الحفاظ على سلامة الرموز النصية والأكواد المحرفية بدقة فائقة دون أي تشويه برمجي.
8.2 تطبيق أداة استخراج النص بين محددين (Text Between Delimiters)
يوفر Power Query واجهة رسومية متقدمة للغاية تتيح استخراج النصوص المحصورة بنقرات معدودة وبدون الحاجة لكتابة معادلات معقدة يدوياً. لإتمام عملية استخراج ما بين علامات الاقتباس:
- يتم تحديد العمود النصي المطلوب معالجته داخل نافذة المحرر.
- من شريط الأدوات، يتم التوجه إلى تبويب إضافة عمود (Add Column) لضمان الحفاظ على العمود المصدر دون تعديل، أو تبويب تحويل (Transform) لاستبدال العمود في مكانه.
- يتم النقر على أيقونة استخراج (Extract)، واختيار الأمر النص بين محددين (Text Between Delimiters).
- في النافذة المنبثقة، يتم إدخال علامة الاقتباس المزدوجة (“) أو الفردية (‘) في حقل محدد البداية (Start Delimiter)، ونفس العلامة في حقل محدد النهاية (End Delimiter).
- تتيح الخيارات المتقدمة (Advanced Options) تحديد مسح المحددات من بداية أو نهاية السجل، وتحديد عدد التكرارات المطلوب تخطيها، مما يمنح المستخدم سيطرة كاملة على السيناريوهات متعددة الاقتباسات.
يقوم المحرر تلقائياً بتوليد كود بلغة البرمجة M يعبر عن هذا التحويل عبر الدالة المعيارية Text.BetweenDelimiters، وصيغتها في شريط الصيغ كالآتي:
Table.AddColumn(#"PriorStep", "ExtractedText", each Text.BetweenDelimiters([SourceColumn], """", """"), type text)
8.3 إعادة تحميل البيانات المنقاة وجدولة التحديثات الآلية
بعد إتمام خطوة الاقتطاع والمعاينة الإجرائية للمخرجات، يتم النقر على أيقونة إغلاق وتحميل (Close & Load) لإعادة إرسال النطاق النظيف مباشرة إلى ورقة عمل جديدة في مصنف إكسل على شكل جدول بيانات مهيكل ومتناسق تماماً.
تكمن القوة الحقيقية لبيئة Power Query في مفهوم التدفق الإجرائي المؤتمت؛ فإذا أُضيفت مئات السجلات الجديدة لاحقاً في الجدول المصدر الأصلي، لا يتطلب الأمر إعادة صياغة أي معادلات أو سحب خلايا. يكتفي المحلل بالنقر بزر الفأرة الأيمن على جدول المخرجات واختيار تحديث (Refresh)، ليقوم المحرك بإعادة تنفيذ كافة خطوات الفحص والاقتطاع والتطهير في أجزاء من الثانية، متيحاً إنشاء خطوط معالجة بيانات (Data Pipelines) تتسم بأعلى درجات الاحترافية والموثوقية التقنية.
9. الحلول البرمجية المتقدمة: استخراج الاقتباسات بواسطة VBA وRegEx
9.1 إنشاء دالة معرفة من قبل المستخدم (UDF) لاستخراج النصوص المقتبسة
عند الرغبة في تبسيط تجربة المستخدم النهائي وتفادي كتابة المعادلات الطويلة أو المعقدة في ورقة العمل، يتيح محرر الفيجوال بيسك للتطبيقات (VBA) إمكانية برمجة دالة مخصصة ومعرفة من قبل المستخدم (User Defined Function – UDF). تظهر هذه الدالة في قائمة دوال إكسل كأي دالة نظامية مدمجة، وتُنجز مهمة الاقتطاع بمجرد استدعاء اسمها.
لإنشاء هذه الدالة، يتم فتح محرر VBA عبر الضغط على Alt + F11، ثم إدراج موديول برمجي جديد (Insert > Module)، وتضمين الشفرة البرمجية التالية:
Function ExtractQuote(TargetCell As Range, Optional DelimiterType As String = """") As String
    Dim CellValue As String
    Dim FirstPos As Long
    Dim SecondPos As Long

    If TargetCell.Cells.Count > 1 Then
        ExtractQuote = CVErr(xlErrValue)
        Exit Function
    End If

    CellValue = TargetCell.Value
    FirstPos = InStr(1, CellValue, DelimiterType)

    If FirstPos > 0 Then
        SecondPos = InStr(FirstPos + 1, CellValue, DelimiterType)
        If SecondPos > 0 Then
            ExtractQuote = Mid(CellValue, FirstPos + 1, SecondPos - FirstPos - 1)
            Exit Function
        End If
    End If

    ExtractQuote = ""
End Function
تتيح هذه الدالة استخراج ما بين علامات الاقتباس المزدوجة افتراضياً بكتابة =ExtractQuote(A2)، كما تتيح استخراج ما بين علامات الاقتباس الفردية بسهولة عبر تمرير المحدد في المعامل الثاني: =ExtractQuote(A2, "'")، موفرة حلاً برمجياً متيناً ومحكماً وخالياً من تعقيدات الصيغ الطويلة.
9.2 توظيف التعبيرات النمطية (Regular Expressions) لمطابقة النصوص المحصورة
تُمثل التعبيرات النمطية (Regular Expressions – RegEx) الذروة التقنية في مرونة معالجة وتدقيق النصوص البرمجية المعقدة، حيث تتيح البحث عن الأنماط الهيكلية بدلاً من الرموز الثابتة المجردة. للتعامل مع نصوص تحتوي على خليط عشوائي من الاقتباسات المزدوجة والمفردة وعلامات الترقيم المتداخلة، توفر مكتبة VBScript.RegExp حلاً لا يضاهى في الدقة.
يتم تفعيل المكتبة برمجياً داخل كود VBA لتبحث عن النمط المعياري التالي لمطابقة ما بين الاقتباس المزدوج: "([^"]*)"، حيث يُعبر الرمز [^"]* عن التقاط أي مجموعة من المحارف باستثناء علامة الاقتباس المزدوجة ذاتها، مما يمنع تجاوز الحد الختامي للاقتباس. يوضح النموذج البرمجي التالي كيفية استغلال التعبيرات النمطية عبر دالة إكسل مخصصة:
Function RegExExtractQuote(SourceText As String) As String
    Dim RegEx As Object
    Dim Matches As Object

    Set RegEx = CreateObject("VBScript.RegExp")
    With RegEx
        .Global = False
        .MultiLine = False
        .IgnoreCase = True
        .Pattern = """([^""]+)"""
    End With

    If RegEx.Test(SourceText) Then
        Set Matches = RegEx.Execute(SourceText)
        RegExExtractQuote = Matches(0).SubMatches(0)
    Else
        RegExExtractQuote = ""
    End If

    Set Matches = Nothing
    Set RegEx = Nothing
End Function
تتفوق هذه الطريقة بقدرتها المطلقة على عزل المجموعات الفرعية (Submatches) بدقة بالغة، مما يضمن خروج النص المستهدف صافياً دون أن تشوبه المحددات ذاتها أو أي علامات مصفوفية دخيلة.
9.3 معالجة الملفات النصية المجمعة عبر وحدات الماكرو التكرارية
في الحالات التي تتطلب معالجة ملفات ممتدة تشتمل على مئات الآلاف من الصفوف دون كتابة معادلات في الخلايا، يتم تصميم إجراء برمجي تكراري مستقل (Subroutine) يقوم بقراءة مصفوفة البيانات في الذاكرة دفعة واحدة، واستخلاص النصوص بين علامات الاقتباس، ثم كتابة المخرجات مباشرة كقيم ثابتة (Static Values) في العمود المجاور.
تتميز هذه التقنية بتجاوز الحمل الحسابي لمعادلات إكسل الدورية بنسبة 100%، حيث يتم استغلال تقنية مصفوفات VBA السريعة (Variant Arrays) لقراءة البيانات وكتابتها بخطوة معالجة واحدة (Block Execution)، مما يقلص زمن المعالجة لعشرات الآلاف من الخلايا من دقائق عديدة إلى أقل من ثانية واحدة، مع إدارة برمجية كاملة للأخطاء وحفظ بنية النظام من التوقف المفاجئ.
10. أفضل الممارسات الأكاديمية والتقنية لضمان سلامة البيانات المستخرجة
10.1 معايير التحقق والتدقيق المتقاطع للمخرجات النصية
تقتضي المنهجية الأكاديمية الصارمة عدم التسليم المطلق بصحة المخرجات الناتجة عن الصيغ الآلية دون إخضاعها لبروتوكولات التحقق والتدقيق المتقاطع (Cross-Validation). يُنصح ببناء أعمدة فحص منطقية موازية للتحقق من سلامة الأطوال النصية وجودة الاقتطاع؛ ومن أبرز هذه الفحوص فحص وجود علامات اقتباس متبقية في العمود المستخرج باستخدام دالة ISNUMBER(FIND("""", B2))، فإذا كانت النتيجة صحيحة (TRUE)، دل ذلك على حدوث اقتطاع جزئي شوه المخرجات.
كما يُنصح بتطبيق اختبار التوافق الطولي النسبي، حيث يجب أن يكون طول النص المستخرج أقل دائماً من طول النص الأصلي بمقدار لا يقل عن محرفين (علامتي الاقتباس). بالإضافة إلى ذلك، ينبغي سحب عينة عشوائية ممثلة إحصائياً بنسبة 5% إلى 10% من مجموع السجلات الكلية وتدقيقها بالعين المجردة للتأكد من عدم اقتطاع كلمات من سياقها الأصلي نتيجة تشابه محارف الاقتباس مع الفواصل اللغوية أو الرموز الرياضية الأخرى.
10.2 تحسين الأداء الحسابي لأوراق العمل الضخمة
عند إدارة مصنفات إكسل التي تضم آلاف الصيغ النصية، يمكن لبعض الممارسات غير المدروسة أن تؤدي إلى بطء حسابي مزمن وتجميد ورقة العمل. لتفادي هذا التدهور في الأداء، يجب الابتعاد كلياً عن استخدام الدوال المتقلبة (Volatile Functions) كأدوات مساعدة، وحصر نطاقات الصيغ المصفوفية في النطاقات المأهولة فقط دون الإشارة إلى الأعمدة الكاملة مثل A:A.
كذلك، فور انتهاء عمليات الاستخراج والتحقق الإحصائي من البيانات، يُعد تحويل الصيغ الرياضية إلى قيم ثابتة عبر أمر نسخ > لصق خاص > قيم (Paste Special Values) ممارسة تقنية فضلى وموصى بها في تقاليد حفظ البيانات الأكاديمية. يؤدي هذا الإجراء إلى تحرير الذاكرة الحسابية لإكسل بصورة نهائية، ويمنع استهلاك طاقة المعالجة في إعادة حساب نصوص ثابتة عند كل حركة يقوم بها المستخدم داخل الملف.
10.3 التوثيق المنهجي لقواعد البيانات والنماذج الحسابية في إكسل
تتطلب قابلية تكرار الأبحاث العلمية والتحليلات المؤسسية (Research Reproducibility) توثيقاً دقيقاً لكافة الخطوات والمعادلات المطبقة أثناء مراحل تنقية البيانات ومعالجتها. يجب على المحلل إنشاء ورقة عمل توثيقية مستقلة تسمى عادة دليل البيانات (Data Dictionary) أو Readme، يُسجل فيها أصل البيانات غير المعالجة، والرموز والمحددات المستخدمة، والغرض المنهجي من استخراج النصوص المحصورة بين علامات الاقتباس.
علاوة على ذلك، يتيح إكسل الحديث إدراج تعليقات توضيحية داخل بنية الصيغة الحسابية ذاتها دون التأثير على نتيجتها باستخدام دالة N() أو عبر تعليقات الخلايا (Cell Notes). إن توثيق الصيغ مثل: =TEXTBEFORE(TEXTAFTER(A2, """"), """") + N("صيغة استخراج ألقاب المشاركين") يسهل على المراجعين والباحثين المستقلين فهم المنطق الخوارزمي المتبع، مما يرفع من الموثوقية العلمية للعمل البحثي ويعزز من شفافية الإجراءات المنهجية المتبعة في تنقية البيانات.
خاتمة
تُمثّل عملية استخراج النصوص المحصورة بين علامات الاقتباس في مايكروسوفت إكسل مهارة أساسية وحاسمة في ترسانة أدوات كل محلل بيانات وباحث أكاديمي يسعى لتحويل النصوص غير المهيكلة إلى رؤى إحصائية ذات موثوقية عالية. لقد وفر التطور المعياري الذي شهدته دوال إكسل الحديثة، وتحديداً عبر إطلاق دالتي TEXTAFTER وTEXTBEFORE، حلولاً برمجية انسيابية وفائقة القوة حلت محل التوليفات الكلاسيكية المعقدة لدوال MID وFIND، ما أسهم في رفع كفاءة الحساب وتحسين مقروئية الصيغ البرمجية.
ومع ذلك، تظل المعرفة المعمقة بالبدائل التقليدية، وفهم أساليب الهروب النصي للأكواد المحرفية (مثل CHAR(34) وCHAR(39))، والقدرة على التعامل مع حالات الاقتباس المتعدد والمتداخل، ركائز لا غنى عنها لبناء نماذج بيانات متينة. وعندما تبلغ مجموعات البيانات أحجاماً مليونية، فإن الانتقال نحو أدوات المعالجة المتقدمة كـ Power Query واستخدام لغة M، أو تطوير وحدات الماكرو بلغة VBA المعززة بالتعبيرات النمطية (RegEx)، يُشكل المسار الهندسي الأمثل لضمان أتمتة العمليات وتقليص الأخطاء البشرية.
إن تبني أفضل الممارسات التقنية في تدقيق المخرجات، وتنظيف النصوص من الشوائب والمسافات الزائدة بدالتي TRIM وCLEAN، وتوثيق الخطوات الإجرائية بصورة منهجية شفافة، لا يضمن فقط دقة التحليلات الرقمية وجودتها الرياضية، بل يعزز من قابلية تكرار العمليات الأكاديمية والمهنية وتوافقها مع المعايير القياسية العالمية لإدارة وحوكمة البيانات.
المراجع
- Alexander, M., & Kusleika, D. (2022). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
- Bluttman, K. (2022). Excel Formulas and Functions For Dummies (6th ed.). John Wiley & Sons.
- Microsoft Support. (n.d.). TEXTAFTER function. Microsoft Learn. https://support.microsoft.com/en-us/office/textafter-function-c8db2546-5b51-4161-9690-c7e6722e90b4
- Microsoft Support. (n.d.). TEXTBEFORE function. Microsoft Learn. https://support.microsoft.com/en-us/office/textbefore-function-d099c28a-dba8-448e-ac6c-f086d0fa1b29
- Microsoft Support. (n.d.). MID, MIDB functions. Microsoft Learn. https://support.microsoft.com/en-us/office/mid-midb-functions-d5f9e25c-d7d6-472e-b568-4ecb12433028
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.
- Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (Office 2021 and Microsoft 365) (7th ed.). Microsoft Press.