
تُمثّل معالجة النصوص وسلاسل المحارف في برمجيات الجداول الحسابية، وعلى رأسها برنامج مايكروسوفت إكسل (Microsoft Excel)، ركيزةً جوهرية في بناء خطوط تدفق البيانات (Data Pipelines) وإعدادها للتحليل الإحصائي المتقدم. في البيئات البحثية والمؤسسية المعاصرة، نادراً ما تصل البيانات الخام في صورة نقية ومجزأة بدقة؛ بل غالباً ما ترد كمدخلات نصية مركبة تتضمن أرقام التعريف، والأسماء الكاملة، والعناوين الميدانية، والأكواد الوصفية التي تتداخل فيها الكلمات والمقاطع داخل خلية جدولية واحدة. ومن ثمّ، فإن امتلاك القدرة التحليلية على تفكيك هذه السلاسل النصية واستخلاص أجزاء محددة منها يُعد متطلباً تقنياً حاسماً لا غنى عنه لأي باحث أو محلل بيانات يسعى إلى بناء نماذج إحصائية متماسكة خالية من التشوهات المنهجية.
تتمحور إحدى أكثر العمليات الإجرائية تكراراً في هذا السياق حول مهمة “استخراج النص الواقع على يمين المسافة” (Extract Text Right of Space)، وهي العملية التي تبدو في ظاهرها يسيرة، إلا أنها تنطوي على تعقيدات برمجية وبنائية متقدمة ترتبط بآليات فهرسة المحارف، وتتبع فواصل النصوص، والتعامل مع حالات التكرار المتعددة للمسافات الفارغة. تتجسد هذه المعضلة بصورة واضحة عند الرغبة في عزل الاسم العائلي من اسم ثلاثي، أو اقتطاع الوحدات المترية من القياسات الفيزيائية، أو استخلاص الأكواد اللاحقة لمحددات نصية ضمن قواعد البيانات الضخمة، حيث تصبح الحلول اليدوية غير قابلة للتطبيق عملياً نظراً للعبء الزمني وارتفاع احتمالية الخطأ البشري.
يقدم هذا المرجع الأكاديمي الشامل تفكيكاً نظرياً وعملياً موسعاً لكافة المنهجيات الرياضية والخوارزمية المعتمدة في بيئات إكسل المختلفة لاستخراج النصوص الواقعة يمين المسافات الفارغة. يستعرض المقال التطور التقني المتسارع الذي طرأ على المنظومة الحسابية للبرنامج، بدءاً من الدوال الحديثة القائمة على محركات المصفوفات الديناميكية مثل دالة TEXTAFTER، وصولاً إلى الصياغات التركيبية الكلاسيكية المعقدة التي تجمع بين دوال RIGHT وLEN وSEARCH وSUBSTITUTE، بالإضافة إلى الأدوات المدمجة مثل معالج تحويل النص إلى أعمدة، وتقنيات الفرز الذكي عبر Power Query والتعبئة السريعة، مع تقديم معايير إرشادية دقيقة لضبط جودة البيانات وحماية النماذج من الانهيار البرمجي.
1. الأسس النظرية لمعالجة النصوص وسلاسل المحارف في إكسل
1.1 أهمية تفكيك البيانات النصية في إدارة قواعد البيانات الإحصائية
يحتل تنظيف البيانات النصية وتجزئتها مرتبة متقدمة في هرم أولويات المعالجة المسبقة للمعلومات (Data Preprocessing)، حيث يرتبط ارتباطاً وثيقاً بسلامة النتائج الإحصائية اللاحقة وجودتها. عندما تُدمج متغيرات متعددة في حقل بيانات واحد — كدمج الاسم الأول والاسم الأخير أو تسجيل القيمة الرقمية متبوعة بالوحدة الحسابية في الخلية ذاتها — فإن خوارزميات التحليل القياسي تعجز عن معاملة هذه البيانات كمتغيرات كمية أو تصنيفية مستقلة. يؤدي هذا الدمج القسري إلى نشوء أخطاء القياس المنهجية، ويحول دون تنفيذ عمليات الفرز المعياري، والتجميع الفئوي، والربط العلائقي بين الجداول المختلفة.
إن تحويل المدخلات النصية المركبة إلى أبعاد مستقلة مهيكلة يُمكّن الباحث من بناء مصفوفات بيانات تلبي شروط التحليل الإحصائي، مثل النمذجة الخطية وتحليلات التباين. كما تتيح التجزئة المعيارية عزل العناصر الشاذة وتحديد القيم المفقودة بدقة متناهية، إذ يمكن للاختلافات البسيطة في إدخال النصوص — مثل وجود مسافة إضافية أو كتابة توصيف لاحق غير منتظم — أن تعزل السجل بأكمله عن مجتمع التحليل ما لم تُطبق استراتيجيات تجزئة صارمة تعيد توحيد البنية الشكلية لسلاسل المحارف بما يضمن اتساق العمليات الحسابية والمنطقية عبر كافة السجلات الخاضعة للدراسة.
1.2 البنية الهيكلية للمسافات والفواصل في السلاسل النصية
تُعامل أنظمة الحوسبة وجداول البيانات، ومن بينها برنامج إكسل، المسافة الفارغة بوصفها محرفاً نصياً قائماً بذاته، وليست مجرد فراغ بصري مجرد. يخضع رمز المسافة القياسية لترميز الأسكي (ASCII) بالرمز الرقمي 32 (أو U+0020 في نظام الترميز الموحد Unicode). يعني هذا التعريف البرمجي الصارم أن المسافة تحتل موضعاً فهرسياً محدداً داخل مصفوفة السلسلة النصية، وتستهلك حيزاً تخزينياً ثابتاً، وتؤثر بشكل مباشر في حساب أطوال النصوص ومواضع الاقتطاع بواسطة الدوال الحسابية.
تتوزع المسافات داخل النصوص إلى ثلاثة تصنيفات رئيسية: المسافات البادئة (Leading Spaces) التي تسبق أول محرف مرئي، والمسافات اللاحقة (Trailing Spaces) التي تأتي بعد آخر محرف مرئي، والمسافات الوسطية (In-between Spaces) التي تفصل بين الكلمات والمقاطع. تتضاعف التحديات البرمجية عند تدفق البيانات من مصادر خارجية مثل استعلامات الويب وقواعد البيانات الشبكية، حيث غالباً ما تحتوي هذه السجلات على مسافات بيضاء غير قياسية، وأبرزها المسافة غير القابلة للكسر (Non-Breaking Space) المعروفة برمز ASCII 160. تكمن خطورة هذا المحرف في أنه يشبه المسافة العادية ظاهرياً تماماً، ولكنه يفلت من معالجة بعض دوال الفحص والبحث التقليدية ما لم يتم التعرف على بنيته الرقمية وتحويله استباقياً إلى مسافة قياسية.
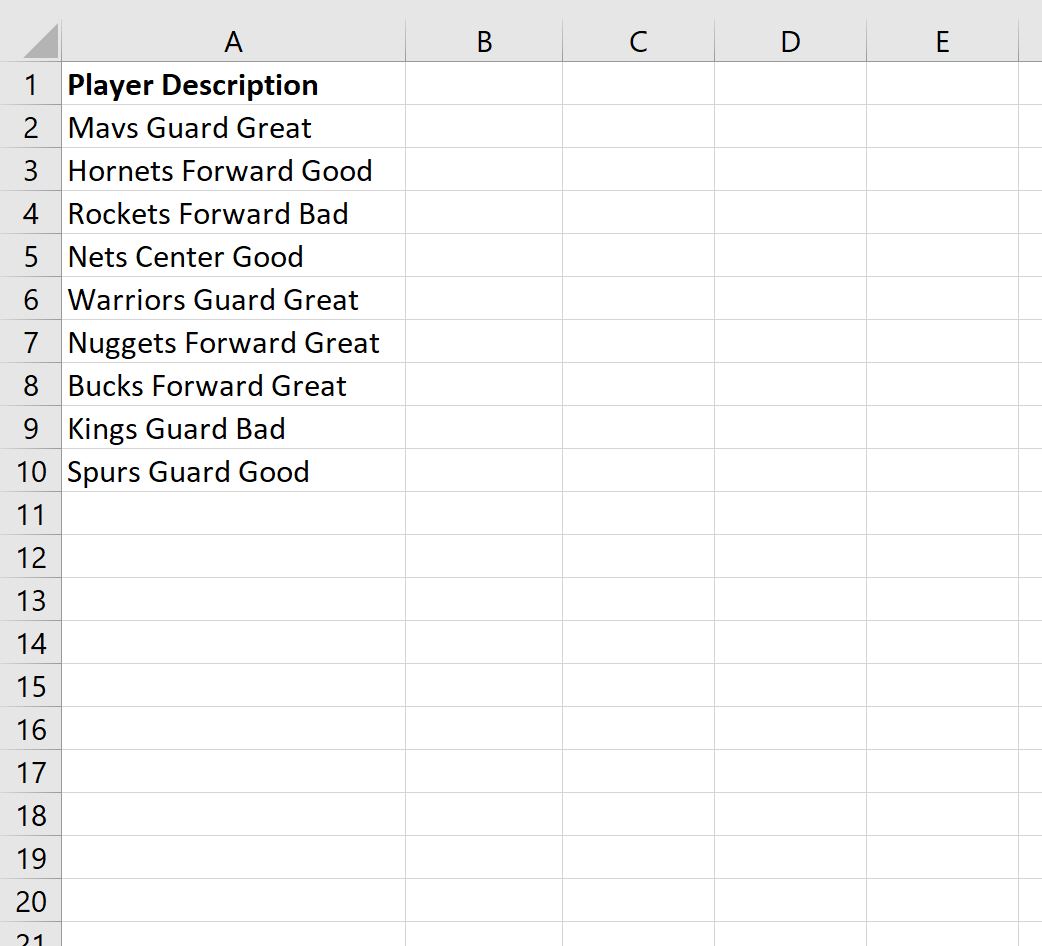
1.3 المسار التطوري لأدوات ودوال اقتطاع النصوص في بيئات إكسل
منذ إطلاق النسخ الأولى لبرنامج إكسل في منتصف ثمانينيات القرن الماضي بواسطة شركة مايكروسوفت لأنظمة ماكنتوش ثم ويندوز، اعتمد التعامل مع معالجة النصوص على ترسانة من الدوال الكلاسيكية المستقلة مثل LEFT وRIGHT وMID وLEN وFIND وSEARCH. كانت هذه الأدوات، على الرغم من رسوخها وقوتها الرياضية، تفرض عبئاً تركيبياً وإدراكياً بالغ التعقيد على المحللين؛ حيث كان استخراج نص يقع يمين محدد معين يتطلب بالضرورة بناء صيغ متداخلة متعددة المستويات، تجمع بين قياس الطول الكلي للسلسلة النصية وتحديد الموضع الفهرسي لموقع المسافة ثم إجراء عمليات طرح حسابية لاشتقاق عدد المحارف المطلوب اقتطاعها.
ظل هذا النهج الكلاسيكي سائداً لعدة عقود حتى حدث تحول نوعي مع تدشين محرك المصفوفات الديناميكية (Dynamic Arrays) في مايكروسوفت 365، والذي توج في عام 2022 بإطلاق حزمة متقدمة من دوال النصوص الموجهة مباشرة لمعالجة الأطراف والفواصل، وفي مقدمتها دالة TEXTAFTER وشقيقاتها. ألغت هذه الإضافات الحديثة الحاجة إلى تركيب المعادلات المتداخلة الطويلة، وخفضت زمن التنفيذ الحسابي عبر تحسين كفاءة المعالجة الخوارزمية داخل نواة البرنامج، مما شكل نقلة مفصلية في إدارة البيانات الضخمة وسرعة استجابة نماذج الأعمال الحسابية المعقدة.
2. الدالة الحديثة TEXTAFTER: المفهوم التقني والمعايير التركيبية
2.1 التعريف البرمجي لدالة TEXTAFTER والخصائص المعيارية
تُمثّل دالة TEXTAFTER إحدى الإضافات البرمجية النوعية التي استحدثتها شركة مايكروسوفت لإعادة صياغة آليات التعامل مع النصوص داخل إكسل. تهدف هذه الدالة وظيفياً إلى فحص السلسلة النصية المعطاة واقتطاع كافة المحارف التي تقع بعد محدد نصي (Delimiter) معين يتم تعريفه صراحة داخل وسائط الدالة. تتميز الدالة ببنيتها الرياضية المحكمة التي تجمع بين البساطة المباشرة في حالات الاستخدام القياسية، والمرونة العالية عبر معاملاتها الاختيارية للتعامل مع سيناريوهات التجزئة المعقدة.
تأخذ الدالة بصيغتها العامة البنية المعيارية التالية: TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). يمثل الوسيط الأول (text) النص الأصلي أو مرجع الخلية المراد معالجتها، في حين يحدد الوسيط الثاني (delimiter) الرمز الفاصل أو السلسلة الفرعية التي تبدأ عندها نقطة الاقتطاع المستهدفة، كالرمز المسافي القياسي " ". وتتحكم الوسائط الاختيارية الأربعة اللاحقة في تعيين رقم تكرار المحدد، وتحديد حساسية حالة الأحرف، وإدارة سلوك نهاية السلسلة، وتخصيص المخرجات البديلة عند غياب المحدد النصي لتفادي انهيار الصيغة وظهور رسائل الخطأ الحسابية.
2.2 متطلبات البيئة التشغيلية ومستوى التوافق البرمجي
يرتبط توفر دالة TEXTAFTER بطبيعة البيئة البرمجية والإصدار المشغل لحزمة أوفيس؛ حيث تم دمج الدالة حصرياً في منظومة اشتراكات مايكروسوفت 365 (Microsoft 365)، وإصدار إكسل المخصص للويب (Excel for the Web)، بالإضافة إلى الإصدار الدائم المستقل إكسل 2024. لا تدعم الإصدارات الدائمة السابقة مثل إكسل 2016، وإكسل 2019، وإكسل 2021 هذه الدالة البرمجية، مما يجعل التعرف على البيئة التشغيلية خطوة استباقية إلزامية قبل تصميم النماذج وجداول العمل.
يفرض هذا التباين في التوافق البرمجي ضرورة اتخاذ تدابير حذرة في بيئات العمل المشتركة والمشاريع البحثية الجماعية. فعند مشاركة مصنف عمل يحتوي على دالة TEXTAFTER مع مستخدم يعتمد على إصدار أقدم، ستفشل البيئة القديمة في التعرف على كود الدالة وتُرجع الخطأ البرمجي الشهير #NAME?. لذا يتعين على مهندس البيانات التحقق من التوافق التشغيلي لكافة المحطات المستخدمة، وتضمين صيغ بديلة تعتمد على الدوال الكلاسيكية المشتركة عالمياً عند الحاجة إلى ضمان استمرارية التشغيل العابر للإصدارات المتفاوتة.
2.3 المزايا الخوارزمية لدالة TEXTAFTER مقارنة بالصيغ البديلة
تتفوق دالة TEXTAFTER على البنى التركيبية القديمة في نواحٍ خوارزمية وحسابية متعددة؛ إذ تتولى معالجة المسارات المنطقية داخلياً عبر كود مجمّع ومحسّن على مستوى النواة البرمجية لإكسل (Core C++ Codebase)، بدلاً من إجبار محرك الحساب على تقييم عدة دوال مستقلة ودمج مخرجاتها تسلسلياً في الذاكرة الحية (RAM). يسهم هذا البناء الأحادي في خفض دورات المعالجة المطلوبة لإتمام عملية الاستخراج بشكل ملحوظ، وهو فارق يظهر جلياً عند التعامل مع جداول إحصائية ضخمة تضم مئات الآلاف من الصفوف السجلية.
علاوة على ذلك، تُقلل الدالة من العبء الإدراكي والذهني الواقع على مطور النماذج؛ فالصيغة الواضحة المعالم تقلل من احتمالات ارتكاب أخطاء في ترقيم الفهارس أو إغفال الأقواس المتداخلة التي تشتهر بها الصيغ الكلاسيكية الطويلة. كما تمنح الدالة مرونة فورية في التبديل بين اقتطاع النصوص استناداً إلى أول ظهور للمحدد أو آخر ظهور له عبر تغيير إشارة رقمية واحدة، مما يجعل صيانتها ومراجعتها وتدقيقها عملاً منهجياً ميسوراً مقارنة بالمعادلات القديمة الممتدة لعدة أسطر.
3. التطبيق العملي الأساسي: استخراج النص الواقع بعد أول مسافة
3.1 التركيب الإجرائي للصيغة الحسابية المباشرة
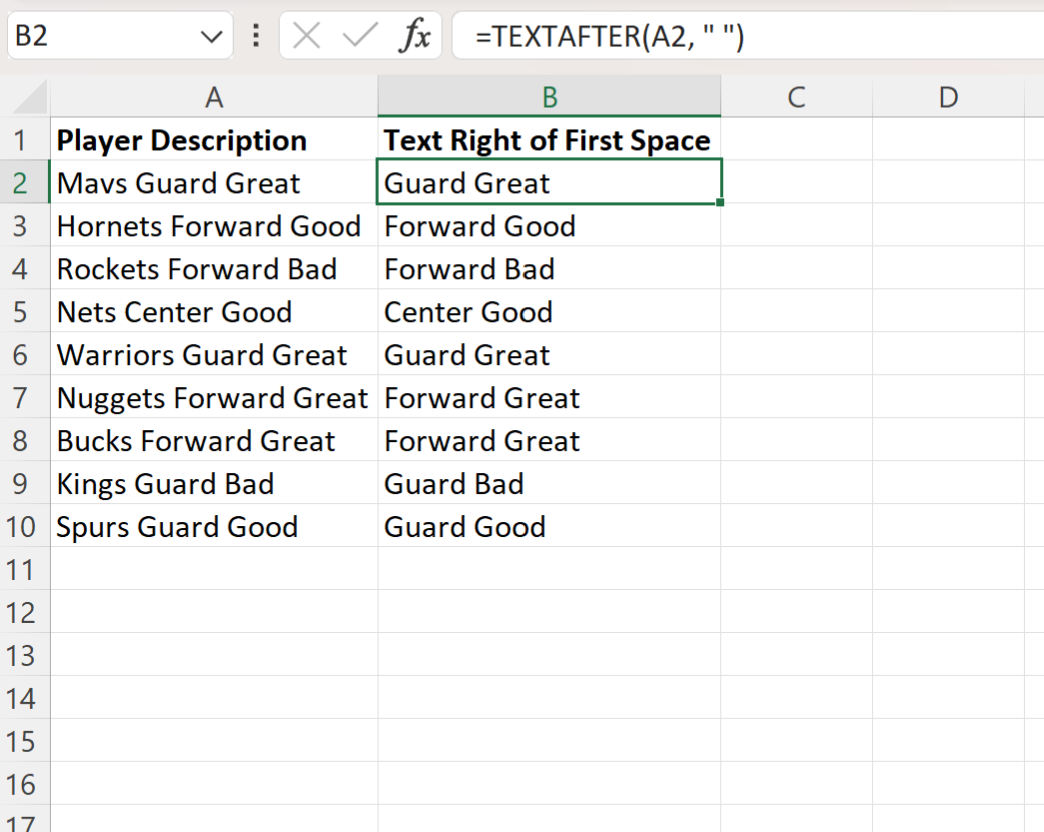
لتطبيق عملية الاقتطاع المباشر للنص الواقع على يمين أول مسافة في سلسلة نصية، تُكتب الصيغة النموذجية لدالة TEXTAFTER بأبسط صورها التعبيرية من خلال تمرير وسيطين إلزاميين فقط. إذا افترضنا أن الخلية A2 تحتوي على السلسلة النصية المستهدفة، فإن المعادلة تُصاغ على النحو التالي:
=TEXTAFTER(A2, ” “)
يقوم محرك إكسل عند تنفيذ هذه المعادلة بفحص محتويات الخلية A2 من اليسار إلى اليمين (وفق المسار الافتراضي لمعالجة السلاسل النصية الغربية واللاتينية، أو مسار تدفق المحارف الداخلي في الذاكرة). يحدد المحرك الموضع الفهرسي الدقيق لأول مسافة قياسية ذات الترميز ASCII 32 تصادفه، ثم يقوم باقتطاع وإرجاع كافة المحارف التي تلي هذه المسافة مباشرة وحتى نهاية السلسلة النصية، مع استبعاد رمز المسافة ذاته من المخرجات المسترجعة تلقائياً.
يفترض هذا النمط المباشر للمعادلة غياب أي قيم في الوسائط الاختيارية؛ وبالتالي يطبق إكسل افتراضاته القياسية التي تنص على أن قيمة وسيط رقم الظهور (instance_num) تساوي تلقائياً 1 موجبة، مما يعني استهداف نقطة التوقف الأولى للمحدد، مع تفعيل حساسية التطابق القياسي، وعدم اعتبار نهاية النص بمثابة محدد افتراضي.
3.2 نموذج تحليلي تطبيقي: تفكيك السجلات الوصفية المركبة
لتوضيح الآلية التشغيلية بدقة تطبيقية، لنفترض وجود قاعدة بيانات تجريبية تحتوي على سجلات مدمجة تضم الرقم التعريفي متبوعاً بالاسم الوصفي للمفحوص في عمود واحد، كما هو مبين في النماذج التحليلية التالية:
- الخلية
A2تحتوي على: ID402 أحمد_المنصور (المسافة فاصلة بين الكود والاسم). - الخلية
A3تحتوي على: REF-89 د. خالد السبيعي. - الخلية
A4تحتوي على: BATCH_01 قياس الضغط الشرياني المرتفع.
عند إدراج المعادلة =TEXTAFTER(A2, ” “) في الخلية B2، يتتبع النظام السلسلة "ID402 أحمد_المنصور". يمر المحرك أولاً على المحارف الخمسة الأولى (I, D, 4, 0, 2)، وعند الموضع الفهرسي السادس يكتشف محرف المسافة المستهدف " ". بناءً على المنطق البرمجي للدالة، يقتطع النظام كافة المحارف اللاحقة لهذا الموضع، لتكون النتيجة الظاهرة في الخلية B2 هي: أحمد_المنصور بدقة تامة وبدون مسافات بادئة مشوهة.
وفي الخلية A3، حيث تحتوي السلسلة على مسافات متعددة (بين الرمز واللقب، وبين اللقب والاسم الأول، وبين الاسم واللقب العائلي)، تلتزم المعادلة بالوقوف عند أول مسافة فقط تعقب الكود REF-89؛ وبالتالي تكون النتيجة المستخرجة في B3 هي: د. خالد السبيعي، محتفظة بكافة المسافات والكلمات التي وردت بعد المسافة الأولى دون أي مساس ببنيتها التركيبية، مما يبرهن على التزام الدالة بحدود الفهرسة المحددة لها سلفاً.
3.3 تعميم المعادلة وآليات التعبئة الديناميكية التلقائية
عقب إثبات كفاءة الصيغة في الخلية الفردية الأولى، تتعدد الخيارات المنهجية لتعميم هذا الإجراء الحسابي على امتداد الجدول الإحصائي. يتمثل الأسلوب الكلاسيكي في النقر المزدوج على مقبض التعبئة التلقائية (Fill Handle) الواقع في الزاوية السفلية للخلية B2، مما يؤدي إلى نسخ الصيغة نسبياً على طول العمود المتوافق مع بيانات العمود A، مع تعديل مراجع الخلايا تلقائياً (من A2 إلى A3 ثم A4 وهكذا دواليك).
غير أن المنهجية الأكثر حداثة وكفاءة في بيئة مايكروسوفت 365 تعتمد على استثمار إمكانيات “صيغ المصفوفات الديناميكية المتدفقة” (Spill Ranges). فبدلاً من الإشارة إلى خلية مفردة، يمكن للمحلل تمرير نطاق العمود بأكمله كمعامل دخل مباشر في خلية واحدة علوية فقط، كما يلي:
=TEXTAFTER(A2:A10000, ” “)
تؤدي هذه الصيغة الأحادية إلى تدفق النتائج تلقائياً في كامل النطاق الموازي من الخلية B2 وحتى B10000 دفعة واحدة دون الحاجة إلى تكرار كتابة الصيغة في كل صف. وتكمن الميزة التشغيلية الفائقة لهذا الأسلوب في كونه يلغي احتمالات العبث غير المقصود بالمعادلات في الصفوف الوسطية، فضلاً عن سرعة المعالجة واستجابة النطاق الكامل بالتحديث التلقائي اللحظي بمجرد تعديل أو إضافة أي بيانات جديدة في العمود الأصلي A.
4. التحكم المتقدم في تكرارات المسافة: استخراج النص بعد آخر مسافة
4.1 مفهوم الفهرسة العكسية باستخدام المعامل السالب
تفرض التراكيب اللغوية والسجلات الإدارية تحديات تختلف جذرياً عن مسألة الاقتطاع من أول مسافة؛ ولعل أبرز هذه التحديات الرغبة في استخراج الكلمة الأخيرة أو العنصر الختامي في سلسلة نصية غير متجانسة الأطوال ومتفاوتة في عدد كلماتها (مثل عزل اسم العائلة من قائمة أسماء تارة تكون ثنائية وتارة ثلاثية وتارة رباعية المركب). في الصيغ الكلاسيكية القديمة، كانت هذه المسألة تتطلب حِيلاً برمجية شاقة؛ إلا أن دالة TEXTAFTER قدمت حلاً خوارزمياً عبقرياً يتمثل في “الفهرسة العكسية” (Reverse Indexing).
يتحقق هذا المفهوم المتقدم من خلال تمرير قيمة سالبة في الوسيط الثالث للدالة، وهو وسيط رقم التكرار أو الظهور: [instance_num]. عندما يتلقى محرك الدالة قيمة سالبة مثل -1، فإنه يعكس مسار خوارزمية البحث تماماً؛ إذ يبدأ الفحص من المحرف الأخير الواقع في أقصى اليمين (نهاية السلسلة النصية) ويتحرك نحو اليسار (بداية السلسلة). وبمجرد ملامسة أول مسافة تقابله أثناء رجوعه العكسي، يُثبت موضعها الفهرسي ويقتطع ما يقع على يمينها حتى نهاية النص، مما يضمن استخراج الكلمة الأخيرة دائماً بصرف النظر عن عدد المسافات التي سبقتها داخل الخلية.
4.2 الصيغة التفصيلية لاستخراج النص بعد المسافة الأخيرة
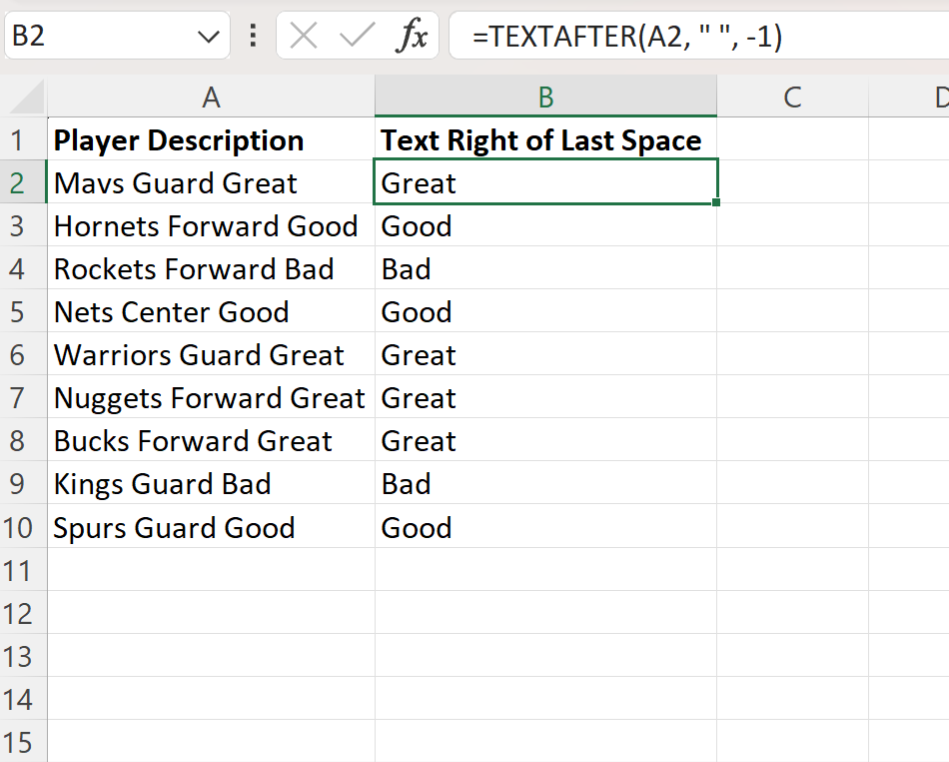
لصياغة هذه المعادلة عملياً واستهداف المحرف الواقع يمين المسافة النهائية، تُكتب المعادلة مستندة إلى مرجع الخلية المعنية ومعامل الفهرسة العكسية السالب كما يلي:
=TEXTAFTER(A2, ” “, -1)
يُمثل الرمز -1 في هذا السياق أمراً صريحاً لمحرك إكسل باستخراج المقطع النصي اللاحق للمسافة الأخيرة حصراً. لتتبع خطوات المعالجة الحسابية لهذه المعادلة، لنفترض أن الخلية A2 تحتوي على السلسلة: "جامعة الملك سعود للعلوم الصحية". تحتوي هذه السلسلة على أربع مسافات تفصل بين خمس كلمات متتالية.
إذا طُبقت المعادلة القياسية =TEXTAFTER(A2, " ")، ستكون النتيجة: "الملك سعود للعلوم الصحية". أما عند تطبيق صيغة الفهرسة العكسية =TEXTAFTER(A2, " ", -1)، فإن الدالة تتجاوز المسافات الأولى والثانية والثالثة كلياً، وتبدأ مسحها من حرف “الهاء” في كلمة “الصحية”، متجهة يساراً حتى تقع على المسافة الرابعة، فتقتطع فوراً الكلمة الأخيرة المستقلة: الصحية فقط دون سواها.
4.3 حالات الاستخدام النموذجية: استخراج الأسماء الأخيرة والمؤشرات الختامية
تتعدد التطبيقات التحليلية لحالة الفهرسة العكسية عبر دالة TEXTAFTER(A2, " ", -1) في ميادين البحوث وتدقيق السجلات الإدارية والتسويقية، ومن أبرز هذه الاستخدامات:
- عزل الألقاب العائلية: في قواعد بيانات المستجيبين للدراسات الميدانية، يُسجل المستجيبون أسماءهم بصيغ متباينة (مثل: “محمد خالد”، و”سعد عبد الله التميمي”، و”عبد الرحمن بن محمد القحطاني”). يضمن استخدام المعامل
-1استخلاص اللقب الأخير دائماً (“التميمي”، “القحطاني”) في حقل منفصل تمهيداً للدراسات الديموغرافية والفرز الهجائي المعياري. - اقتطاع القيم والوحدات الفيزيائية الختامية: في سجلات القياسات المعملية التي تُسجل بصيغة وصفية مركبة (مثل: “ضغط العينة رقم 12 بلغ 104.5 mmHg”)، يعزل هذا الإجراء الوحدة الختامية
"mmHg"أو القيمة الرقمية النهائية إذا كانت هي التي تلي المسافة الأخيرة. - تفكيك المسارات والأكواد المرجعية: عند استيراد مسارات برمجية أو أكواد تسجيل مفرغة بمسافات تفصل بين المراحل، يتيح هذا الاستخراج العكسي اقتطاع الكود النهائي المتغير دون التأثر بطول الهيكل التوصيفي السابق له.
5. استخراج النصوص استناداً إلى مواقع مخصصة للمسافات المتعددة
5.1 استهداف المسافات الوسيطة في السلاسل النصية المعقدة
في كثير من التراكيب النصية المنظمة، لا يقتصر الهدف التحليلي على اقتطاع ما بعد المسافة الأولى أو الأخيرة فقط، بل يبرز الاحتياج إلى استخراج النصوص الواقعة بعد مسافة وسطية محددة الموقع الفهرسي (كالمسافة الثانية أو الثالثة أو الرابعة). تتيح دالة TEXTAFTER التحكم الكامل في هذه العمليات من خلال تعيين قيمة عددية موجبة صريحة للوسيط الثالث [instance_num] تعكس بدقة الترتيب التسلسلي لظهور المسافة من جهة اليسار.
فإذا احتوت خلية على كود تنظيمي أكاديمي يتكون من عدة مقاطع مفصولة بمسافات، مثل: "كلية العلوم قسم الفيزياء مخبر 04"، وأردنا اقتطاع كل ما يلي اسم القسم العلمي، يمكننا استهداف المسافة الرابعة بكتابة المعادلة:
=TEXTAFTER(A2, ” “, 4)
في هذا السيناريو، يتجاهل محرك التحليل المسافات الأولى والثانية والثالثة تماماً، ويجعل من نقطة الانفصال الرابعة مرجعاً للاقتطاع، ليعيد النتيجة بدقة: "مخبر 04". يفتح هذا الأسلوب آفاقاً واسعة للتعامل مع البيانات المعيارية ذات الهياكل الثابتة التي تتبع قوالب كتابة مسبقة التصميم.
5.2 إستراتيجيات العزل المجزأ للنصوص متعددة الكلمات
تتعاظم القوة التعبيرية لهذه الأدوات عند دمج دالة TEXTAFTER مع شقيقتها المكملة TEXTBEFORE لعزل مقاطع نصية وسطية محصورة بين مسافات محددة دون غيرها. لنفترض أن الخلية A2 تتضمن السلسلة التالية: "مستوى القياس الإحصائي متقدم للعام 2024"، والمطلوب استخراج الكلمة الثالثة وحدها، وهي كلمة: "الإحصائي".
يمكن تحقيق ذلك عبر بناء صيغة هجينة ذكية تستخرج ما بعد المسافة الثانية، ثم تعزل ما قبل المسافة التالية فوراً من المخرجات المسترجعة، كما توضح المعادلة المركبة التالية:
=TEXTBEFORE(TEXTAFTER(A2, ” “, 2), ” “)
تقوم الدالة الداخلية أولاً، TEXTAFTER(A2, " ", 2)، باقتطاع النص الواقع بعد المسافة الثانية، لتكون النتيجة الفرعية المؤقتة في ذاكرة إكسل هي: "الإحصائي متقدم للعام 2024". ثم تتولى الدالة الخارجية TEXTBEFORE أخذ هذه السلسلة المؤقتة وتقتطع ما يقع قبل أول مسافة تقابلها فيها، لتعيد بدقة الكلمة المستهدفة منفردة: الإحصائي. يتيح هذا الدمج المحكم استخلاص أي مقطع نصي وسطي مهما بلغ موقعه داخل السلسلة النصية المعقدة.
5.3 حالات تباين أعداد الكلمات بين السجلات المختلفة
تنشأ إحدى أكبر المعضلات المنهجية في تنظيف البيانات عندما تُطبق صيغة تستهدف موضع مسافة ثابت (مثل المسافة الثالثة عبر كتابة instance_num = 3) على عمود يحتوي على سجلات ذات أطوال متفاوتة؛ حيث قد تشتمل بعض الصفوف على كلمتين فقط (أي مسافة واحدة)، بينما تشتمل صفوف أخرى على أربع أو خمس كلمات. في هذه الحالة، تفشل الدالة الحسابية في العثور على المسافة الثالثة في السجلات القصيرة، مما يؤدي فوراً إلى انهيار العملية وظهور خطأ عدم القيمة #N/A.
لتفادي هذه المشكلة وضمان ثبات النماذج، يجب وضع استراتيجيات للتحقق من اتساق الأنماط النصية قبل الفصل، أو استخدام المعاملات الوقائية للدالة لتوفير بدائل منطقية. من الأساليب المتقدمة في هذا المضمار فحص عدد المسافات الفعلي داخل الخلية مسبقاً باستخدام الصيغة الحسابية الكلاسيكية لقياس الفوارق الطولية:
=LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”))
تُعطي هذه المعادلة العدد الدقيق للمسافات الموجودة في السلسلة النصية؛ مما يتيح دمجها ضمن دالة شرطية مثل IF لتحديد ما إذا كان الصف المعني مؤهلاً للاقتطاع عند المسافة المستهدفة أم يجب التعامل معه بمسار بديل، مما يحافظ على تكامل الجدول البرمجي ويمنع توقف الحسابات الإحصائية الكلية.
6. المعالجة الكلاسيكية للنسخ القديمة: دمج الدوال RIGHT وLEN وSEARCH
6.1 التشريح الرياضي لمعادلة الاستخراج التقليدية
قبل ظهور الدوال الحديثة في مايكروسوفت 365، اعتمدت أجيال من محللي البيانات على بنية رياضية مركبة ثلاثية الأبعاد لاستخراج النص الواقع يمين أول مسافة، وذلك بدمج دوال RIGHT وLEN وSEARCH (أو FIND). لفهم هذه المعادلة فهماً أكاديمياً عميقاً، يجب تفكيك المنطق الرياضي الذي يحكم سلوك كل دالة داخل المنظومة المشتركة.
تتمحور الفكرة الجوهرية في قياس “المسافة المتبقية” من نهاية النص وحتى موضع الفاصل المسافي. تتولى دالة LEN(A2) قياس الطول الإجمالي لسلسلة المحارف في الخلية بدقة متناهية متضمنة الأحرف والأرقام والمسافات. وفي الوقت ذاته، تتولى دالة SEARCH(" ", A2) مسح السلسلة من بدايتها لتحديد الموضع الفهرسي الترتيبي (المرتكز على 1) لأول مسافة تظهر في النص. عندما نطرح موضع المسافة من إجمالي طول السلسلة عبر المعادلة الرياضية الفرعية:
LEN(A2) – SEARCH(” “, A2)
فإن الناتج الحسابي يمثل بدقة مطلقة “عدد المحارف المتبقية” الواقعة حصراً على يمين تلك المسافة الأولى. هنا تتدخل دالة الاقتطاع الطرفي RIGHT لتأخذ هذا العدد المحسوب وتقتطعه مباشرة من الطرف الأيمن للنص الأصلي.
6.2 التطبيق العملي للصيغة المركبة: =RIGHT(A2, LEN(A2) – SEARCH(” “, A2))
عند جمع هذه المكونات في قالب تركيبي محكم قابل للتنفيذ في أي إصدار من إصدارات إكسل منذ نسخة 1997 وحتى أحدث النسخ، تأخذ الصيغة الشكل التالي:
=RIGHT(A2, LEN(A2) – SEARCH(” “, A2))
لتتبع سير العمليات الحسابية داخل هذه الصيغة، لنفترض أن الخلية A2 تحتوي على السلسلة: "عينة A98". يمر تنفيذ الصيغة عبر المراحل المتسلسلة الآتية التي يمكن مراقبتها عبر أداة تقييم الصيغة (Evaluate Formula) في شريط أدوات الصيغ بإكسل:
- تُقيَّم دالة البحث:
SEARCH(" ", "عينة A98")فتجد أن المسافة تقع في الموضع الفهرسي رقم 5 (بعد أربعة أحرف لكلمة “عينة”). - تُقيَّم دالة الطول الكلي:
LEN("عينة A98")فتجد أن إجمالي عدد المحارف هو 8 محارف. - يُنفذ الطرح الحسابي:
8 - 5 = 3، وهو عدد المحارف المكونة للمقطع المتبقي الواقع يمين المسافة. - تُستدعى دالة الاقتطاع:
RIGHT("عينة A98", 3)، فتعود بالمحارف الثلاثة الأخيرة من النص، وهي بدقة: A98.
تثبت هذه المعادلة كفاءة تامة بغض النظر عن طول الكلمة الواقعة يمين المسافة، سواء كانت مكونة من حرفين أو مئات الأحرف، لأن عملية الطرح تتكيف ديناميكياً مع الطول المتغير للنصوص المفحوصة.
6.3 الفروق الجوهرية بين دالتي SEARCH وFIND في سياق المسافات
يثور في الأدبيات التقنية لإكسل نقاش دائم حول المفاضلة بين استخدام دالة SEARCH ودالة FIND ضمن هذه الصيغة المركبة. يتمثل الفارق الجوهري النظري بين الدالتين في أمرين: حساسية حالة الأحرف (Case Sensitivity)، ودعم المحارف البديلة (Wildcards مثل ? و*)؛ حيث تتميز SEARCH بعدم حساسيتها لحالة الأحرف ودعمها للرموز البديلة، في حين تتسم FIND بحساسية صارمة للأحرف الكبيرة والصغيرة وغياب دعم الرموز البديلة.
أما في سياق مسألتنا الحالية، وهي البحث عن “المسافة الفارغة” (Space Character)، فإن رمز المسافة في أنظمة الحاسوب يُعتبر محرفاً محايداً تماماً لا ينتمي إلى فئات الأحرف الكبيرة أو الصغيرة، ولا يتداخل مع الرموز التعبيرية المشروطة. وعليه، فإن السلوك الوظيفي لكلتا الدالتين يكون متطابقاً بنسبة 100% عند البحث عن مسافة مفردة " ". ومع ذلك، يفضل بعض المبرمجين استخدام FIND لاعتقادهم بأن خوارزميتها المباشرة والخالية من معالجة الرموز البديلة قد توفر مكاسب طفيفة للغاية وغير محسوسة في سرعة الاستجابة الحسابية عند معالجة ملايين السجلات في الملفات الضخمة.
7. استخراج النص بعد آخر مسافة في الإصدارات القديمة لإكسل
7.1 التقنية الرياضية المتقدمة لتوظيف دالة SUBSTITUTE
إذا كانت معالجة النص بعد أول مسافة في النسخ القديمة تتطلب ثلاث دوال مدمجة، فإن استخراج النص بعد المسافة “الأخيرة” في تلك الإصدارات يُعد من أبرز التحديات الخوارزمية الكلاسيكية في تاريخ إكسل، نظراً لغياب مفهوم الفهرسة العكسية عن دالتي FIND وSEARCH. وللتغلب على هذا القصور البنيوي، ابتكر خبراء جداول البيانات تقنية ذكية تعتمد على دالة الاستبدال SUBSTITUTE.
تعتمد الفكرة المبتكرة على استبدال المسافة الأخيرة فقط دون غيرها بمحرف رمزي فريد ونادر الحدوث في النصوص العادية (مثل الرمز "#" أو "@" أو الرمز الاستثنائي CHAR(1))، ثم استخدام دالة FIND للبحث عن موضع هذا الرمز الفريد وتطبيق معادلة RIGHT عليه. ولكن لكي تعرف دالة SUBSTITUTE أي مسافة هي الأخيرة تحديداً، يجب تمرير وسيط ترتيب الظهور، والذي يُحسب رياضياً عبر طرح طول النص بدون مسافات من طول النص الكلي بالمسافات: LEN(A2) – LEN(SUBSTITUTE(A2, ” “, “”))، وهو ما يعكس الفهرس الرقمي الدقيق لآخر مسافة موجودة في السلسلة.
7.2 تقنية التكرار الحجمي باستخدام دالة REPT
رغم كفاءة تقنية الاستبدال المشروط السابقة، إلا أن هناك تقنية كلاسيكية بديلة أكثر شهرة واستقراراً في التراث البرمجي لإكسل تُعرف باسم “تقنية التكرار الحجمي وتمديد المسافات” (The Space Padding Technique)، والتي توظف دالة تكرار النصوص REPT. تتميز هذه الطريقة بعدم اعتمادها على فرضيات وجود رموز نادرة قد تتصادف وجودها مصادفة داخل النصوص الأصلية.
تقوم هذه الإستراتيجية العبقرية على خطة ثلاثية الأبعاد:
- أولاً: تضخيم المسافات عبر استبدال كل مسافة مفردة في النص الأصلي بمصفوفة عريضة جداً من المسافات تعادل في طولها إجمالي طول النص الأصلي بأكمله، وذلك باستخدام الصيغة:
SUBSTITUTE(A2, " ", REPT(" ", LEN(A2))). - ثانياً: اقتطاع كتلة نصية من أقصى اليمين تعادل في حجمها نفس الطول الأصلي للنص باستخدام دالة
RIGHT، مما يضمن بالضرورة احتواء الكتلة المقتطعة على الكلمة الأخيرة بمفردها محاطة بفائض هائل من المسافات البيضاء الفارغة على يسارها، مع استحالة وصول الاقتطاع إلى الكلمة قبل الأخيرة. - ثالثاً: تنقية هذه الكتلة المقتطعة وتفريغها من كافة المسافات الزائدة الإضافية للوصول إلى الكلمة النقية عبر تطبيق دالة التهذيب الشهيرة
TRIM.
7.3 التفكيك التحليلي الكامل للمعادلة المعقدة خطوة بخطوة
تتجمع هذه المراحل الهندسية في بناء تركيبي واحد متكامل يُعد من أعظم الصياغات الكلاسيكية في تاريخ إكسل، وتأخذ الصيغة المعتمدة الشكل الآتي:
=TRIM(RIGHT(SUBSTITUTE(A2, ” “, REPT(” “, LEN(A2))), LEN(A2)))
لتشريح هذا العمل الهندسي بدقة متناهية، لنفترض أن الخلية A2 تحتوي على السلسلة: "تحليل الانحدار الخطي". يبلغ الطول الإجمالي للنص 21 محرفاً (بما في ذلك مسافتان). تسير عملية التنفيذ الداخلي وفق التسلسل الخوارزمي التالي:
- تُنشئ الدالة
REPT(" ", 21)كتلة نصية مكونة من 21 مسافة متتالية فارغة. - تستبدل الدالة
SUBSTITUTEكل مسافة من المسافتين الأصليتين بكتلة الـ 21 مسافة، ليتحول النص إلى:"تحليل"+ 21 مسافة +"الانحدار"+ 21 مسافة +"الخطي". - تقتطع الدالة
RIGHT(..., 21)آخر 21 محرفاً من هذا النص المتضخم من جهة اليمين. وبما أن كلمة “الخطي” تتكون من 5 أحرف فقط، فإن المقتطع سيكون مكوناً من 16 مسافة بيضاء تتبعها كلمة “الخطي”. - تتلقى دالة
TRIMهذه النتيجة، وتتخلص برمجياً من كافة المسافات البيضاء الممتدة على يسار الكلمة، لتستقر النتيجة النهائية النقية على الكلمة الأخيرة وحدها: الخطي.
تبرز المقارنة بين هذا الأسلوب المعقد والصيغة الحديثة =TEXTAFTER(A2, " ", -1) حجم التطور التقني الهائل الذي وفرته بيئة مايكروسوفت الحديثة، حيث اختزلت أربع دوال متداخلة وعمليات تكرار حسابية تستهلك الذاكرة إلى دالة واحدة صريحة ومباشرة وفائقة السرعة في التنفيذ.
8. إدارة الأخطاء الشائعة وضمان مرونة الصيغ الحسابية
8.1 التعامل المنهجي مع خطأ عدم توفر المحرف (#N/A و#VALUE!)
أثناء معالجة قواعد البيانات الحقيقية في التطبيقات الإحصائية والعملية، يندر أن تتطابق كافة السجلات مع النمط المتوقع؛ فكثيراً ما تصادف الصيغ الحسابية خلايا تحتوي على كلمة واحدة فقط خالية تماماً من أي مسافات، أو خلايا فارغة بالكامل. في هذه السيناريوهات، تنهار الصيغ غير المحمية وتنتج رسائل خطأ صريحة تشوه المظهر العام للجداول وتوقف عمل العمليات التحليلية اللاحقة المعتمِدة عليها.
في الصيغ الكلاسيكية القائمة على دالتي SEARCH وFIND، يؤدي غياب المسافة إلى إرجاع خطأ القيمة #VALUE! فوراً؛ لأن دالة البحث تفشل في العثور على المحرف المستهدف في السلسلة. ولحماية هذه الصيغ، يتعين تغليفها بالكامل داخل دالة التحوط للأخطاء IFERROR لتحديد مخرجات بديلة آمنة (كإرجاع النص الأصلي كما هو أو ترك الخلية فارغة):
=IFERROR(RIGHT(A2, LEN(A2) – SEARCH(” “, A2)), A2)
أما في دالة TEXTAFTER الحديثة، فإن السلوك الافتراضي عند غياب المحدد هو إرجاع خطأ عدم التوفر #N/A. بيد أن مطوري مايكروسوفت وفروا حلاً مدمجاً أنيقاً يغني عن استخدام دوال إضافية، وذلك عبر استخدام الوسيط الاختياري السادس للدالة: [if_not_found]. وبناءً عليه، يمكن كتابة المعادلة الآمنة لحماية النظام على النحو التالي:
=TEXTAFTER(A2, ” “, 1, , , A2)
تضمن هذه الصياغة أنه إذا احتوت الخلية A2 على نص بدون مسافات (مثل: “بيانات_فردية”)، فلن تُصدر الدالة خطأ برمجياً، بل ستقوم تلقائياً بإرجاع محتوى الخلية الأصلي بالكامل، مما يمنح النموذج مناعة ذاتية ضد أخطاء الإدخال غير المتجانسة.
8.2 تنقية البيانات من المسافات المزدوجة والمحارف المخفية
تُمثّل المسافات البادئة والمسافات المزدوجة العارضة الواقعة في غير موضعها الطبيعي أحد أبرز العوامل المؤدية لتشويه مخرجات دوال الاقتطاع. إذا احتوت الخلية مصادفة على مسافة بادئة سابقة للنص (مثل: " أحمد")، فإن تطبيق صيغة استخراج ما بعد المسافة الأولى سيعيد الكلمة الأولى ذاتها بدلاً من الكلمة الثانية، لأن الدالة توقفت عند المسافة البادئة الخاطئة واعتبرتها المحدد الفاصل للمحتوى.
لضمان صلابة خط التدفق البياني وجودة التحليل، يُوصى باتباع منهجية المعالجة الاستباقية لتنقية النصوص وتنظيفها وتوحيدها قبل تمريرها لدوال الاقتطاع. يتحقق ذلك من خلال دمج دالة TRIM التي تتولى مسح كافة المسافات البادئة واللاحقة وتقليص المسافات المزدوجة في وسط النص إلى مسافات فردية نقية، ودالة CLEAN التي تتولى استئصال محارف التحكم الطباعية غير المرئية (التي تقع ضمن نطاق ASCII من 0 إلى 31):
=TEXTAFTER(TRIM(CLEAN(A2)), ” “)
كما تجب الإشارة إلى معضلة مسافات الويب الخاصة غير القابلة للكسر (Non-Breaking Spaces) التي تحمل الترميز CHAR(160)؛ حيث تعجز دالة TRIM التقليدية عن التعرف عليها أو إزالتها بمفردها. في مثل هذه الحالات المعقدة، يجب اللجوء إلى استبدال هذا المحرف الخاص استباقياً بمسافة عادية قياسية قبل إجراء الاقتطاع، عبر الصيغة الاحترازية المتكاملة:
=TEXTAFTER(TRIM(SUBSTITUTE(A2, CHAR(160), ” “)), ” “)
8.3 التحقق من سلامة البيانات الناتجة وجودتها المعيارية
لا تنتهي مهمة استخراج النصوص بمجرد ظهور النتائج في الخلايا المجاورة، بل يجب أن تتبعها مرحلة منهجية للتدقيق والتحقق من الجودة الإحصائية للمخرجات (Data Quality Assurance). تتطلب هذه المرحلة تطبيق اختبارات فحص منطقية تؤكد أن كافة المخرجات المستخرجة تقع ضمن فئات البيانات المتوقعة ولم تتعرض للبتر الجزئي أو التشويه المورفولوجي.
تشمل اختبارات الفحص القياسية استخدام دوال الفحص المنطقي مثل دالة ISTEXT للتأكد من أن المخرجات تُمثل سلاسل نصية صالحة، ودالة ISBLANK لرصد الخلايا التي تحولت إلى فراغات نتيجة أخطاء الاقتطاع. بالإضافة إلى ذلك، يُنصح بقياس توزيع أطوال النصوص المستخرجة باستخدام دالة LEN؛ حيث يُعد ظهور نصوص مستخرجة بأطوال غير منطقية (كأن يكون طول الاسم المستخرج حرفاً واحداً أو صفراً) مؤشراً قوياً على وجود تشوه بنيوي في السجل الأصلي يتطلب المراجعة اليدوية أو تصحيح مسار المحدد الفاصل.
إن توثيق هذا البروتوكول الإجرائي وتنفيذه بصفة دورية يُعد ركيزة جوهرية في إرساء مبدأ “قابلية تكرار النتائج” (Reproducibility) في البحوث الكمية، ويضمن أن تكون مجموعات البيانات المجهزة جاهزة للدخول المباشر في حزم التحليل المتقدمة مثل SPSS وR وPython دون التسبب في أخطاء برمجية غير متوقعة أثناء المعالجة.
9. البدائل غير البرمجية لاستخراج النصوص يمين المسافة
9.1 التعبئة السريعة (Flash Fill) كأداة ذكاء اصطناعي مدمجة
لا تتطلب كافة المهام التحليلية بناء صيغ رياضية أو كتابة معادلات معقدة؛ ففي الحالات التي يحتاج فيها الباحث إلى معالجة سريعة لمرة واحدة دون الحاجة إلى بناء مصنف عمل ديناميكي دائم، تبرز ميزة “التعبئة السريعة” (Flash Fill) بوصفها واحدة من أقوى الأدوات المدمجة في إكسل منذ إطلاق إصدار 2013. تعتمد هذه التقنية على خوارزميات الاستقراء الآلي المتقدمة لبرمجة الأمثلة (Programming by Example)، التي طورتها أبحاث مايكروسوفت على يد الباحث سوميت جولواني وفريقه.
تتمثل آلية استخدام التعبئة السريعة في قيام المستخدم بكتابة المخرج النصي المرغوب فيه يدوياً في الخلية المجاورة لأول سجل (مثلاً: إذا كانت A2 تحتوي على “د. عبد الله”، يكتب المستخدم يدوياً في B2: “عبد الله”). ثم ينقر في الخلية التالية B3 ويضغط على المفتاح المرجعي المختصر Ctrl + E (أو من خلال التبويب: بيانات Data > التعبئة السريعة Flash Fill). يقوم محرك الذكاء الاصطناعي برصد النمط المشترك فوراً، وتخمين القاعدة المنطقية التي تمثل “استخراج ما بعد المسافة الأولى”، ثم يطبقها لحظياً على كامل امتداد العمود في ثوانٍ معدودة.
ورغم سرعتها وسهولتها الفائقة، فإن لهذه الأداة قيوداً جوهرية لا يمكن إغفالها؛ إذ تفتقر إلى “الديناميكية التلقائية”. فالقيم الناتجة عنها هي نصوص ثابتة وميتة برمجياً؛ فإذا عُدلت البيانات في العمود الأصلي A لاحقاً، فلن تتأثر البيانات المستخرجة في العمود B ولن يُعاد حسابها إطلاقاً إلا بتكرار العملية يدوياً، مما يجعلها غير ملائمة للنماذج التحليلية المتبدلة بانتظام.
9.2 معالج تحويل النص إلى أعمدة (Text to Columns)
يُعد معالج “تحويل النص إلى أعمدة” (Text to Columns Wizard) من أقدم الأدوات التحويلية الكلاسيكية المدمجة في إكسل وأكثرها موثوقية في التعامل مع ملفات البيانات المستوردة بتنسيقات CSV أو السجلات المجدولة غير المقسمة. تعمل هذه الأداة عبر مسار إجرائي نافذي يتيح للمحلل تفكيك محتويات عمود كامل إلى عدة أعمدة متجاورة بالاعتماد على محدد فيزيائي فاصل كالمسافة أو الفاصلة المنقوطة.
لتطبيق هذه الميزة لاستخراج ما بعد المسافة، يتبع الباحث الخطوات المعيارية التالية:
- تحديد نطاق البيانات النصية في العمود المستهدف.
- الانتقال إلى تبويب “بيانات” (Data) واختيار “النص إلى أعمدة” (Text to Columns).
- اختيار نوع التقسيم: “محدد” (Delimited)، ثم النقر على التالي.
- تحديد خانة “المسافة” (Space) كرمز فاصل وحيد، مع إلغاء تحديد الخيارات الأخرى، واختيار معاملة المسافات المتتالية كمحدد واحد لتجنب نشوء أعمدة فارغة عارضة.
- في نافذة المعاينة الختامية، يمكن للمستخدم تحديد تنسيق العمود الأول (النص الواقع يسار المسافة) واختيار خيار “عدم استيراد هذا العمود (تخطي)” (Do not import column – Skip) إذا كان هدفه استبقاء النصوص الواقعة يمين المسافة فقط، ثم تحديد وجهة الخلايا والضغط على “إنهاء”.
تتميز هذه الأداة بقدرتها على التعامل مع مئات الآلاف من السجلات دون إرهاق ذاكرة المعالجة اللحظية بحسابات الصيغ؛ إلا أنها، مثل التعبئة السريعة، تؤدي إلى تقسيم ساكن وثابت لا يتفاعل تلقائياً مع تحديثات البيانات اللاحقة.
9.3 توظيف أداة Power Query للاستخراج المؤتمت عالي السعة
تُمثّل بيئة باور كويري (Power Query) — المعروفة رسمياً بمحرك “الحصول على البيانات وتحويلها” (Get & Transform Data) — الخيار الأمثل والاحترافي لإدارة عمليات استخراج النصوص ومعالجتها في مشاريع البيانات الضخمة (Big Data Pipelines) والبحوث المؤسسية الموسعة. يكمن تفوق باور كويري في قدرتها على بناء مسارات تحويل مؤتمتة تسجل كل خطوة إجرائية في هيئة أوامر برمجية بلغة (M Code) تتيح إعادة التنفيذ التلقائي بنقرة واحدة بمجرد ورود بيانات خام جديدة.
لاستخراج النص الواقع يمين المسافة داخل محرر باور كويري، يُتبع المسار الآتي:
- تحديد الجدول النصي وتحميله إلى واجهة المحرر عبر التبويب: بيانات > من جدول/نطاق (From Sheet / Table/Range).
- تحديد العمود المستهدف، ثم التوجه إلى تبويب “تحويل” (Transform) أو “إضافة عمود” (Add Column) حسب الرغبة في استبدال العمود الأصلي أو إنشاء حقل جديد موازٍ.
- النقر على أداة “استخراج” (Extract)، ثم اختيار “النص بعد المحدد” (Text After Delimiter).
- في النافذة المنبثقة، تُدخل المسافة
" "في حقل المحدد (Delimiter). - في خيارات الفحص المتقدمة (Advanced Options)، يوفر المحرر إمكانية مذهلة للاختيار الدقيق لنقطة المسح: مثل استخراج النص بعد المحدد الأول مباشرة (Start of the input)، أو البحث العكسي لاستخراج ما بعد المحدد الأخير (End of the input)، مع إمكانية تجاهل عدد محدد من المسافات الوسيطة بمنتهى المرونة الرقمية.
- تطبيق التغييرات وإغلاق المحرر عبر النقر على “إغلاق وتحميل” (Close & Load) لإرجاع الجدول المعقم إلى صفحة إكسل.
تتمتع هذه الإستراتيجية بمزايا تفوق كافة الحلول السابقة عند معالجة الملفات العملاقة، حيث تفصل منطق التحويل والمعالجة عن واجهة الحسابات المباشرة، مما يمنع تجمد الشاشة ويضمن سرعة وكفاءة النمذجة الإحصائية المستمرة دون أي تدخل يدوي متكرر.
10. أفضل الممارسات المنهجية وتحسين الأداء عند معالجة البيانات الضخمة
10.1 تحسين استهلاك الذاكرة وسرعة الحساب في الملفات الضخمة
عندما تتسع قواعد البيانات لتشمل ملايين الخلايا النصية المترابطة، تصبح كفاءة استهلاك الذاكرة العشوائية وسرعة معالجة وحدة المعالجة المركزية (CPU Cycles) معياراً مصيرياً لتقييم النماذج الحسابية. إن الإفراط في استخدام الصيغ الكلاسيكية المعقدة متعددة الطبقات (مثل صيغة تمديد المسافات عبر REPT وSUBSTITUTE وTRIM) يؤدي إلى استنزاف حاد لموارد الجهاز، لأن إكسل يُجبر على تضخيم النصوص وحفظ مصفوفات نصية افتراضية هائلة الحجم في الذاكرة الحية أثناء تقييم كل صف على حدة.
لتحسين الأداء وضمان انسيابية العمل في الملفات الضخمة، يُنصح باتباع الممارسات الفنية الآتية:
- التحول الحصري نحو الدوال الحديثة: يُفضل دائماً الاعتماد على دالة
TEXTAFTERفي بيئة مايكروسوفت 365؛ نظراً لأنها مبرمجة داخلياً بلغة منخفضة المستوى تستهلك جزءاً يسيراً من الموارد مقارنة بالصيغ التركيبية التراكمية. - تحويل الصيغ إلى قيم ثابتة (Paste Values): بمجرد الانتهاء من تنفيذ عمليات الاقتطاع والتأكد من سلامة المخرجات وجودتها، يُوصى بنسخ عمود النتائج ولصقه كقيم مطلقة (Paste as Values –
Ctrl + Alt + VثمV). يلغي هذا الإجراء عبء إعادة الحساب المتكرر (Recalculation Overhead) في كل مرة يتم فيها فتح المصنف أو إدخال قيمة جديدة في أي خلية بعيدة. - تجنب استخدام الدوال المتطايرة (Volatile Functions): يجب الحذر من دمج دوال الاقتطاع النصي مع دوال تفرض إعادة الحساب الدائم مثل
INDIRECTأوOFFSET، لأن ذلك يدمر شجرة الاعتماد الحسابي المنطقي لإكسل ويجعل فتح الملف وتعديله عملية بطيئة ومجهدة للمكونات المادية للحاسوب.
10.2 دليل اتخاذ القرار المنهجي لاختيار الطريقة المثلى
لتمكين الباحث ومحلل النظم من تحديد المسار الفني الأكثر ملاءمة لمعالجة نصوصه بكفاءة، يقدم الجدول المنهجي التالي مصفوفة معايير شاملة للمفاضلة بين الطرق المختلفة استناداً إلى طبيعة البيئة، وحجم البيانات، ومتطلبات التحديث:
1. دالة TEXTAFTER الحديثة:
- البيئة البرمجية المدعومة: مايكروسوفت 365، إكسل 2024، إكسل للويب.
- طبيعة التحديث: ديناميكي تلقائي لحظي.
- مستوى التعقيد التركيبي: منخفض جداً ومباشر.
- الاستخدام المثالي: النماذج الإحصائية المعاصرة، وبناء الجداول المستمرة التي تستقبل بيانات مستمرة وتتطلب استخراجاً من أول أو آخر أو أي مسافة مخصصة.
2. الصياغات الكلاسيكية (RIGHT + LEN + SEARCH / SUBSTITUTE):
- البيئة البرمجية المدعومة: كافة إصدارات إكسل التاريخية القديمة والحديثة بلا استثناء.
- طبيعة التحديث: ديناميكي تلقائي لحظي.
- مستوى التعقيد التركيبي: مرتفع إلى شديد التعقيد.
- الاستخدام المثالي: مصنفات العمل المشتركة التي تُتداول مع جهات أو أجهزة تعمل بإصدارات قديمة (إكسل 2010، 2013، 2016، 2019) لضمان عدم توقف العمل.
3. التعبئة السريعة (Flash Fill):
- البيئة البرمجية المدعومة: من إكسل 2013 فما فوق.
- طبيعة التحديث: ساكن وثابت (لا يتحدث ذاتياً).
- مستوى التعقيد التركيبي: معدوم (يعتمد على واجهة المستخدم واختصار لوحة المفاتيح).
- الاستخدام المثالي: المهام السريعة العارضة لمعالجة قائمة بيانات صغيرة لمرة واحدة دون الحاجة لحفظ منطق الحساب البرمجي.
4. معالج تحويل النص إلى أعمدة (Text to Columns):
- البيئة البرمجية المدعومة: كافة الإصدارات.
- طبيعة التحديث: ساكن وثابت وتدميري (يستبدل أو يقتطع في الأعمدة مباشرة).
- مستوى التعقيد التركيبي: منخفض (قائم على معالج رسومي).
- الاستخدام المثالي: التفكيك الفوري للملفات النصية المصدرية الكبيرة المجدولة عند استيرادها للمرة الأولى في بيئة التحليل.
5. محرر باور كويري (Power Query):
- البيئة البرمجية المدعومة: إكسل 2016 فما فوق (وإصدار 2010/2013 عبر ملحق خارجي).
- طبيعة التحديث: تحديث مؤتمت عند الطلب (Refreshable Data Pipeline).
- مستوى التعقيد التركيبي: متوسط (واجهة رسومية مدعومة بلغة برمجة M).
- الاستخدام المثالي: مشاريع البيانات الضخمة، ومعالجة قواعد البيانات المعقدة التي تخضع لدورات استيراد دورية تتطلب أتمتة كاملة لخطوات التنظيف والتجزئة.
الخاتمة
يُمثّل استخراج النص الواقع على يمين المسافة في برنامج إكسل مهارة تقنية وفكرية جوهرية تتجاوز مجرد التعامل السطحي مع دوال الجداول الحسابية؛ إنها عملية منهجية ترتبط مباشرة بأسس إدارة وتصميم قواعد البيانات وحوكمة جودتها الإحصائية. وكما أوضح هذا المرجع المفصل، فإن ترسانة إكسل توفر حلولاً متعددة تتدرج من الدقة الخوارزمية الفائقة لدالة TEXTAFTER المعاصرة بمزايا الفهرسة العكسية والمرونة التركيبية، وصولاً إلى الرسوخ الرياضي للصيغ الكلاسيكية الهجينة التي تؤمن التوافقية العابرة لكافة الأجيال البرمجية القديمة.
إن نجاح محلل البيانات والباحث الأكاديمي في استثمار هذه الأدوات يتوقف على قدرته على التقييم الموضوعي للبيئة التشغيلية، وحجم السجلات، وطبيعة البنية الهيكلية للمسافات والفواصل، مع مراعاة احتمالات الخطأ الإدخالي والمحارف الخفية وتطبيق استراتيجيات التحوط الوقائي عبر دوال التنظيف والحماية. ومن خلال دمج الفهم النظري لترميز المحارف مع الممارسة الإجرائية الدقيقة، تتحول جداول البيانات من مستودعات للمدخلات النصية العشوائية المشوشة إلى ركائز صلبة من المتغيرات المنظمة الصالحة لتوليد المعرفة ودعم اتخاذ القرارات التحليلية الرشيدة.
المراجع
- Alexander, M., Kusleika, R., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- Gulwani, S. (2011). Automating string processing in spreadsheets using input-output examples. ACM SIGPLAN Notices, 46(1), 317–330. https://doi.org/10.1145/1925844.1926423
- Microsoft Support. (n.d.). TEXTAFTER function. Microsoft Corporation. https://support.microsoft.com/en-us/office/textafter-function-c8db23ae-bb07-4971-8187-0ee1b6fe666d
- Microsoft Support. (n.d.). RIGHT, RIGHTB functions. Microsoft Corporation. https://support.microsoft.com/en-us/office/right-rightb-functions-240267ee-9afa-4639-a02b-f19e1786cf2f
- Walkenbach, J. (2015). Excel 2016 Formulas. John Wiley & Sons.