
تُعد معالجة البيانات النصية وتنقيتها إحدى الركائز الجوهرية في علوم البيانات، وإدارة نظم المعلومات، والتحليل الإحصائي المتقدم؛ إذ تمثل الجداول الإلكترونية، وعلى رأسها برنامج مايكروسوفت إكسل (Microsoft Excel)، البيئة التشغيلية الأكثر انتشاراً لإجراء هذه العمليات الحسابية والمنطقية. وفي كثير من الأحيان، يواجه المحللون والباحثون تحديات تتعلق بفرز السجلات وتنظيمها ليس بناءً على محتواها المعجمي فحسب، بل بالاعتماد على خصائصها البنيوية والمورفولوجية، مثل عدد المحارف أو الطول الكلي للسلسلة النصية. يكتسب هذا الإجراء أهمية بالغة عند تدقيق قواعد البيانات الضخمة، والتحقق من سلامة الأكواد التعريفية، وضبط جودة المدخلات في المسوح والاستبانات، حيث يرتبط طول النص مباشرة بموثوقية المعلومة واكتمالها البنيوي.
تاريخياً، كانت تصفية البيانات استناداً إلى أطوال السلاسل النصية تتطلب بناء أعمدة مساعدة (Helper Columns) أو كتابة وحدات ماكرو معقدة بلغة الفيجوال بيسك للتطبيقات (VBA)، مما كان يشكل عبئاً حسابياً ويزيد من احتمالية وقوع الأخطاء التشغيلية وتضخم حجم الملفات. ومع التطورات الجذرية التي أدخلتها شركة مايكروسوفت على محرك الحسابات الخاص ببرنامج إكسل، ولا سيما الإعلان عن محرك المصفوفات الديناميكية (Dynamic Arrays) في خريف عام 2018، طرأت نقلة نوعية في منهجيات استرجاع البيانات وفرزها؛ إذ بات بالإمكان دمج الدوال المتقدمة واستخراج النتائج في مصفوفات منسكبة تلقائياً دون المساس بسلامة الجداول الأصلية أو إثقال الذاكرة المؤقتة للبرنامج بعمليات حسابية فائضة عن الحاجة، مما يخفف من العبء الإدراكي الواقع على عاتق المحلل عند استيعاب البيانات المعقدة وتفسيرها، كما بينت دراسات معالجة المعلومات المعرفية (Pollock et al., 2002).
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تأصيل منهجي وتطبيقي عميق لكيفية تصفية البيانات في مايكروسوفت إكسل بالاعتماد على عدد الأحرف، مع التركيز على التكامل الوظيفي بين دالة التصفية الحديثة FILTER ودالة قياس الأطوال LEN. وسيتناول البحث تفكيك البنية الرياضية لهذه المعادلات المركبة، والتعامل مع العمليات المنطقية البوليانية المعقدة، وحل مشكلات المحارف الخفية والمسافات الزائدة، فضلاً عن استعراض البدائل الكلاسيكية المتوافقة مع الإصدارات القديمة، وأفضل الممارسات المنهجية التي تضمن كفاءة المعالجة وسرعة التنفيذ في الجداول العملاقة.
1. مقدمة تأصيلية حول تصفية البيانات في إكسل بالاعتماد على طول النصوص
1.1 مفهوم دالة التصفية FILTER ودورها في معالجة البيانات الديناميكية
تمثل دالة FILTER إحدى أبرز دوال المصفوفات الديناميكية المنسكبة التي أطلقتها مايكروسوفت في سبتمبر 2018 بإشراف فريق تطوير إكسل، والتي أصبحت متاحة عموماً لمشتركي مايكروسوفت 365 بين عامي 2019 و2020، ثم دُمجت قياسياً في الإصدار الدائم إكسل 2021 وما تلاه. رياضياً ووظيفياً، تعمل هذه الدالة كمشغّل إسقاط واختيار شرطي؛ حيث تستقبل مصفوفة بيانات أولية وتُخضعها لشرط بولياني (Boolean Criterion)، لتعيد إنتاج مصفوفة فرعية تضم فقط الصفوف التي حققت الشرط بصيغة منطقية صائبة (TRUE).
إن التحول من أدوات التصفية التقليدية اليدوية (مثل التصفية التلقائية القياسية AutoFilter) إلى التصفية الآلية المعتمدة على الدوال الرياضية يمثل انتقالاً منهجياً من المعالجة الساكنة إلى النمذجة الديناميكية التفاعلية. ففي النماذج الساكنة، يضطر المستخدم إلى إعادة تطبيق الفرز يدوياً في كل مرة تتغير فيها البيانات المدخلة؛ بينما تكفل دالة FILTER تحديث النتائج آنياً وبصورة لحظية بمجرد تعديل أو إضافة أي سجل، مما يعزز موثوقية التحليلات واسترجاع السجلات بدقة متناهية دون تدخل بشري متكرر.
1.2 ماهية دالة قياس أطوال السلاسل النصية LEN وأهميتها الحسابية
تُعد دالة LEN (المشتقة من مصطلح Length) إحدى الدوال النصية التأسيسية المتواجدة في مكتبة إكسل منذ إصداراته المبكرة الأولى (Excel 2.0+). تعتمد الآلية الإحصائية لهذه الدالة على احتساب العدد الإجمالي للمحارف أو البايتات المكونة لسلسلة معينة داخل الخلية المستهدفة بصورة مجردة. ولا تقتصر الدالة على عد الحروف الهجائية الظاهرة للمستخدم، بل يمتد مداها التطبيقي ليشمل الأرقام، والفواصل، وعلامات الترقيم، والرموز الاصطلاحية الخاصة، والمسافات البيضاء الفاصلة والبادئة واللاحقة.
من الناحية التقنية، يجب التفريق بين قياس الطول الحجمي الظاهري للنص والقيم التخزينية المخصصة له في بنية الذاكرة العشوائية لبرنامج إكسل؛ إذ تتعامل الدالة مع السلسلة وفق الترميز الموحد للحروف (Unicode/ANSI) بحيث يمثل كل رمز محرفاً مستقلاً بغض النظر عن نوع المحرف أو لغته، مما يجعلها أداة معيارية دقيقة وصارمة لا تتأثر بخصائص التنسيق المرئي للخلية، وتمنح المحلل قياساً كمياً ثابتاً يعبر عن الحجم الحقيقي للمحتوى النصي.
1.3 التكامل البنيوي بين دالتي FILTER وLEN في إدارة قواعد البيانات
يتحقق التكامل البنيوي بين دالتي FILTER وLEN عبر ما يُعرف في هندسة البرمجيات بالتركيب الوظيفي (Function Composition)؛ حيث تُمرر مخرجات الدالة الأولى كمدخلات منطقية للدالة الثانية لإنشاء معيار تصفية لا يعتمد على تطابق الحروف بذاتها، بل على الخصائص المورفولوجية والكمية لتلك الحروف. يتيح هذا الدمج قدرة فريدة على فرز الجداول وفلترة المدخلات الشاذة التي تخالف المعايير القياسية الموضوعة سلفاً في دليل ترميز البيانات.
تتجلى الجدوى التطبيقية لهذا التكامل في عمليات مراجعة جودة البيانات وتنظيفها وتنقيتها قبل إخضاعها للنمذجة الرياضية. ففي سياق الأبحاث والمسوح الميدانية، يساعد هذا الفرز على استبعاد الاستجابات المبتورة أو الأكواد غير المكتملة تلقائياً، وهو ما يتماشى مع بروتوكولات ضبط البيانات المعمول بها في الأبحاث متعددة الأنماط والمسوح واسعة النطاق لضمان اتساق العينات (Cai et al., 2022). ومن ثم، يتحول إكسل من مجرد دفتر حسابي إلى محرك معالجة متقدم يتسم بالمرونة والموثوقية العالية.
2. البنية الصياغية الأساسية لمعادلة الجمع بين FILTER وLEN
2.1 تفكيك الوسائط المنطقية لدالة FILTER
تتكون دالة FILTER من ثلاثة وسائط رئيسية تُكتب بالشكل القياسي الآتي:
=FILTER(array, include, [if_empty])
يمثل الوسيط الأول array نطاق البيانات المستهدف، وهو النطاق المرجعي أو المصفوفة ثنائية الأبعاد المراد تصفيتها واسترجاع صفوفها، مثل A2:C100. ويجب أن يشمل هذا النطاق كامل الأعمدة التي يرغب المحلل في عرضها ضمن مصفوفة النتائج المستخرجة، سواء كانت عموداً واحداً أو جدولاً متعدد الأعمدة يحتوي على بيانات وصفية ورقمية متنوعة.
أما الوسيط الثاني include، فهو الشرط المنطقي الإلزامي الذي يقود عملية التصفية بأكملها. يُنتظر من هذا الوسيط أن يستقبل مصفوفة متجهة أحادية البعد تحتوي على قيم منطقية من نوع صواب (TRUE) أو خطأ (FALSE)، ويكون عدد عناصرها مساوياً تماماً لعدد صفوف وسيط النطاق الأول. ويأتي أخيراً الوسيط الثالث [if_empty] كخيار استثنائي اختياري لإدارة الحالات الرياضية التي لا يتحقق فيها الشرط، حيث يُعرض نص مخصص أو قيمة بديلة في حال أسفرت عملية التصفية عن مصفوفة فارغة، منعاً لانهيار المعادلة بظهور أخطاء غير مرغوبة.
2.2 آلية عمل الدالة LEN كمصفوفة شرطية داخل وسيط التضمين
لكي تعمل دالة LEN بكفاءة داخل وسيط التضمين include، فإنها لا تُطبق على خلية فردية بل تُوجه إلى نطاق متجهي كامل يمثل العمود المستهدف بالفحص، مثل LEN(A2:A100). في هذه الحالة، يتولى محرك المصفوفات الديناميكية تقييم الدالة على نحو متكرر لكل عنصر من عناصر النطاق على حدة، مما يؤدي إلى توليد مصفوفة داخلية مؤقتة تحتوي على أطوال النصوص العددية المقابلة لكل سجل بالترتيب المتسلسل ذاته.
بعد توليد مصفوفة الأطوال، تُجرى المقارنة الرياضية مع المعيار العددي المستهدف عبر مشغلات المقارنة؛ فعلى سبيل المثال، يؤدي التعبير LEN(A2:A100) < 5 إلى مقارنة كل قيمة عددية في المصفوفة المتولدة بالرقم خمسة. ينتج عن هذه العملية مصفوفة جديدة مكونة حصراً من القيمتين البوليانيتين TRUE وFALSE. يستجيب وسيط التضمين لهذه السلسلة اللوجستية، فيسمح بمرور الصفوف المقابلة للقيمة TRUE فقط ويسقط ما يقابل القيمة FALSE، محققاً بذلك استخلاصاً فورياً ودقيقاً للسجلات المتوافقة.
2.3 قواعد التحقق المنطقي والمطابقة الشرطية للقيم العددية
تخضع عملية الفرز لمجموعة من قواعد التحقق المنطقي والمطابقة الرياضية الصارمة؛ إذ يتاح للمحلل استخدام مشغلات المقارنة القياسية: علامة الأصغر من (<)، أو الأكبر من (>)، أو التساوي التام (=)، أو الأصغر من أو يساوي (<=)، أو الأكبر من أو يساوي (>=)، أو عدم التساوي (<>). يتطلب ضبط حساسية القياس العددي فهماً دقيقاً للمدخلات المستهدفة؛ لتفادي استبعاد السجلات التي تقع على الحدود الفاصلة بصورة غير مقصودة، كأن يُستخدم المشغل الأصغر بدلاً من الأصغر من أو يساوي.
علاوة على ذلك، يُعد شرط اتساق الأبعاد بين نطاق المصفوفة الأصلية ونطاق الفحص الشرطي أمراً غير قابل للمساومة؛ فإذا كان وسيط النطاق يمتد من الصف 2 إلى الصف 100، فإنه يتحتم على نطاق الفحص داخل دالة LEN أن يمتد بدقة عبر الصفوف من 2 إلى 100. إن أي تفاوت أو عدم محاذاة في أبعاد المتجهات يؤدي حتماً إلى إرجاع خطأ عدم توافق أبعاد المصفوفات (#VALUE!)، نظراً لعجز محرك إكسل عن مطابقة الإحداثيات المكانية للصفوف مع قيم التحقق المنطقي المقابلة لها.
3. التطبيق العملي لتصفية النصوص الأقل من طول محدد
3.1 تصميم نموذج البيانات التجريبي وتعيين نطاق القياس
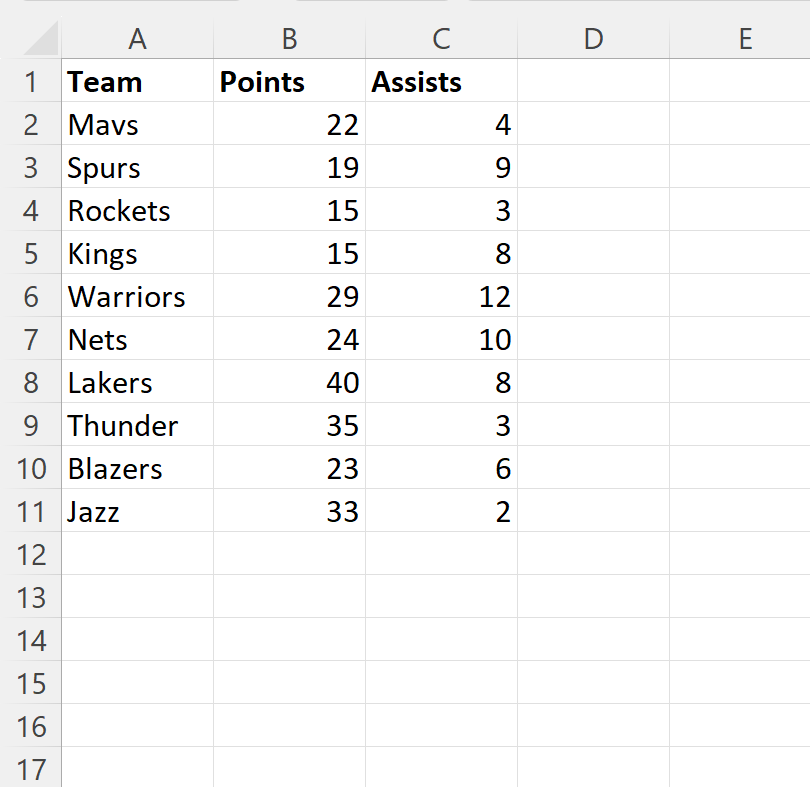
لبناء تطبيق عملي رصين، يُفترض وجود جدول بيانات تجريبي يمتد عبر النطاق A2:C20، حيث يحتوي العمود الأول A على “كود المعرّف” (Identifier Code)، والعمود الثاني B على “اسم العينة أو الصنف”، والعمود الثالث C على “الكمية أو القياس العددي”. تتميز السجلات النصية في العمود الأول بأطوال متفاوتة تتراوح بين ثلاثة أحرف وعشرة أحرف، ناتجة عن عمليات إدخال يدوي تتخللها بعض الأخطاء التكوينية.
يتطلب الإعداد المنهجي التأكد من سلامة نطاق القياس، وتجانس طبيعة الخلايا المستهدفة وخلوها المبدئي من الأخطاء البنيوية الجسيمة. يتم تحديد العمود A بوصفه المتغير الحاكم لعملية التصفية؛ والهدف الإجرائي هنا هو عزل واستخراج كافة السجلات التي يحتوي كود المعرف الخاص بها على أقل من خمسة محارف نصية، لغايات الفحص والتدقيق وإعادة التصحيح الميداني.
3.2 كتابة وتنفيذ الصيغة المنطقية للنصوص الأقصر من 5 محارف
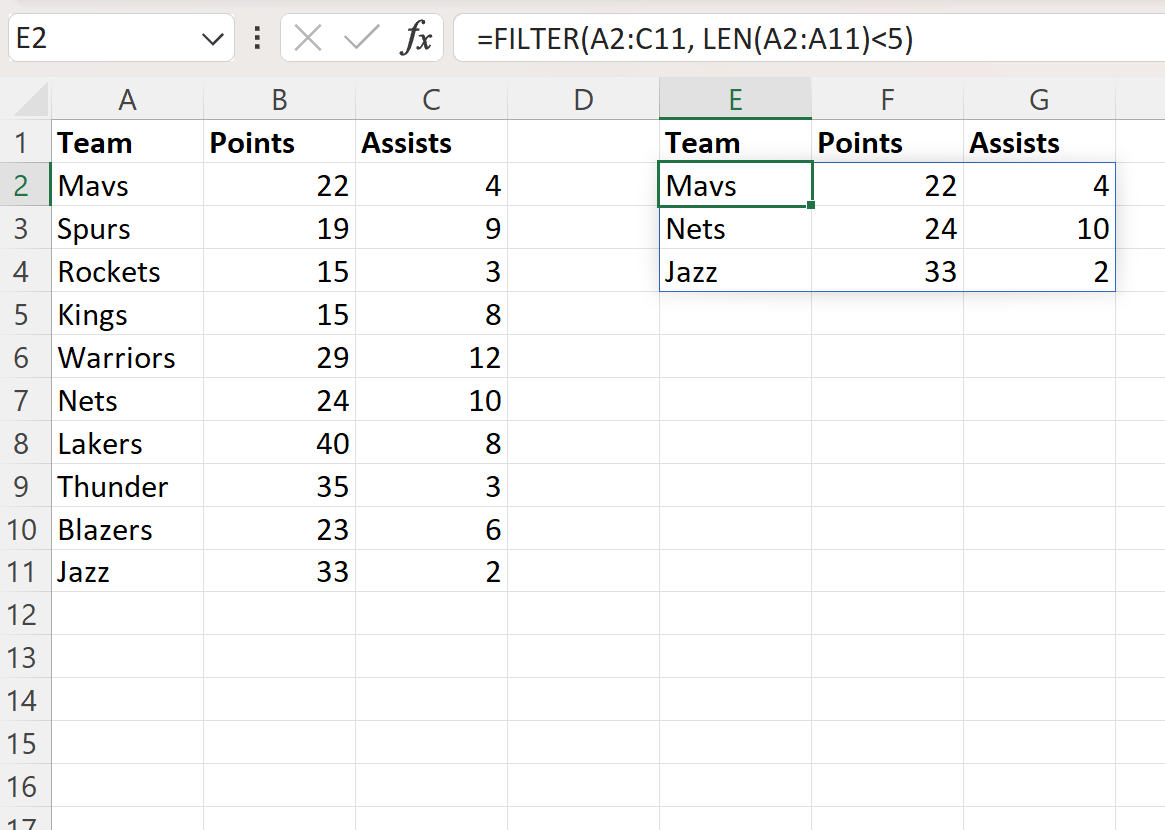
يتم الانتقال إلى خلية خالية خارج نطاق الجدول الأصلي، وليكن الموضع E2، ثم تُكتب الصيغة الرياضية المركبة بالصيغة المباشرة الآتية:
=FILTER(A2:C20, LEN(A2:A20) < 5, "لا توجد سجلات مطابقة")
عند الضغط على مفتاح الإدخال (Enter)، يشرع محرك إكسل في تقييم الصيغة خطوة بخطوة؛ فيبدأ أولاً باستدعاء الدالة LEN(A2:A20) ويستخرج متجه أطوال الأكواد؛ كأن تكون النتيجة الداخلية: {4; 7; 3; 8; 4; 6; ...}. بعد ذلك، يُجري المعالج المقارنة العددية < 5 لكل مدخل، فتتحول المصفوفة السابقة إلى مصفوفة بوليانية: {TRUE; FALSE; TRUE; FALSE; TRUE; FALSE; ...}. في المرحلة النهائية، تسحب دالة FILTER الصفوف التي توافقت مع القيمة TRUE فقط من النطاق A2:C20، لتعرض السجلات المستخلصة مرتبة بالكامل وبجميع أعمدتها داخل النطاق الجديد.
3.3 دراسة سلوك نطاق الانسكاب التلقائي (Spill Range)
تتميز الصيغ القائمة على المصفوفات الديناميكية بخاصية الانسكاب التلقائي (Spill Range)، حيث تفيض النتائج تلقائياً من خلية الصيغة E2 إلى الخلايا المجاورة أفقياً وعمودياً لتستوعب كافة السجلات المستخرجة دون الحاجة إلى سحب مقبض التعبئة يدوياً. يُحاط هذا النطاق بإطار أزرق رفيع عند تحديد الخلية الأم، مما يشير إلى أن محتويات الخلايا الفرعية مرتبطة عضوياً بتلك الخلية الأصلية.
إذا اعترض مسار هذا الانسكاب أي عائق مادي—كوجود نص قديم أو قيمة رقمية في إحدى الخلايا التي يتوجب أن تفيض إليها النتائج—فإن البرنامج يوقف العملية فوراً ويُظهر خطأ الانسكاب الشهير (#SPILL!). لحل هذا الإشكال، يكفي إفراغ الخلايا المعترضة لمسار التوسع، ليعاد تدفق البيانات بصورة آلية وطبيعية. كما يمكن للمحلل الإشارة إلى مصفوفة النتائج المنسكبة لاحقاً في أي دالة إحصائية أخرى عبر كتابة مرجع الخلية الأم متبوعاً برمز التجزئة، مثل: E2#، وهو ما يوفر مرونة استثنائية في التحليلات المتسلسلة.
4. تقنيات التصفية باستخدام شروط الطول المتعددة والمعقدة
4.1 تطبيق معامل الضرب المنطقي لمطابقة شرط المعية (AND)
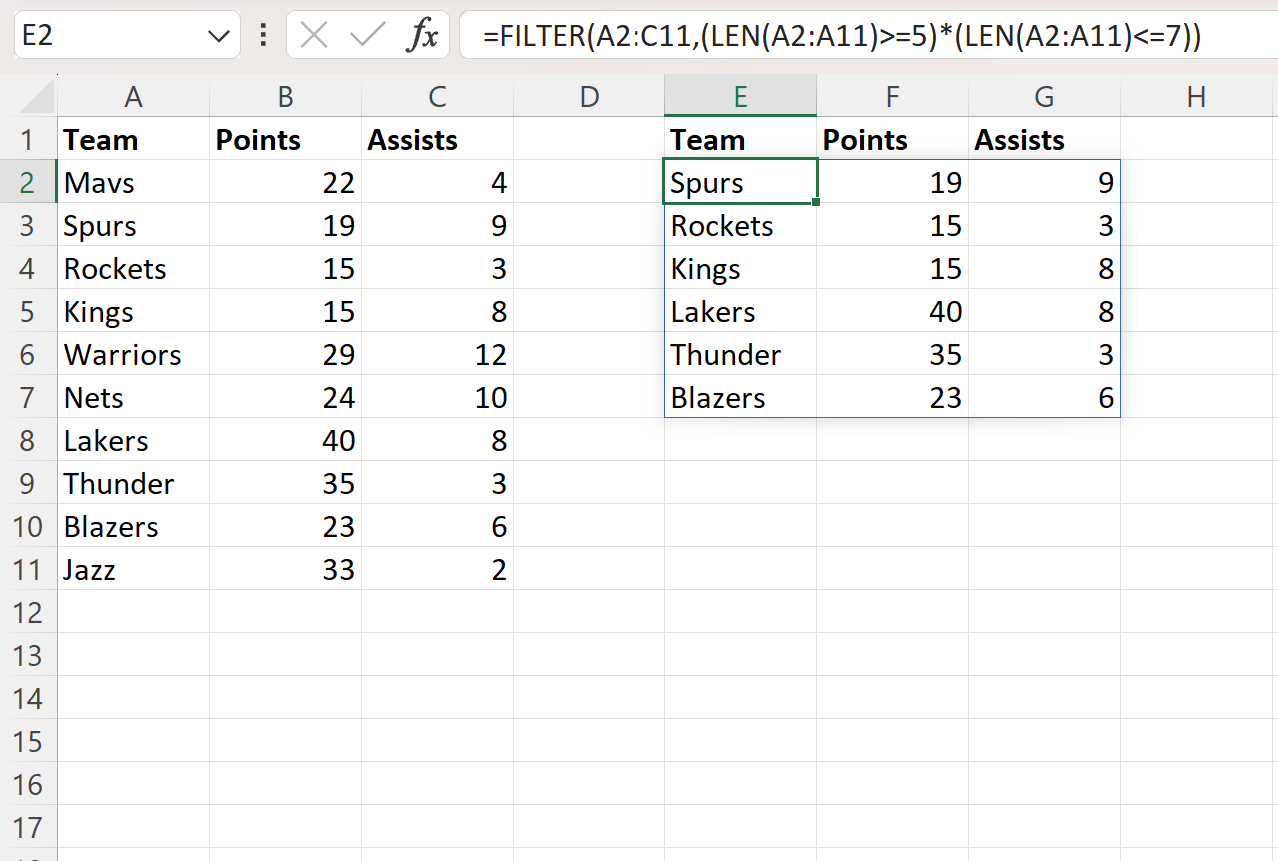
في كثير من الحالات التحليلية، لا يقتصر الهدف على فحص طرف أحادي للطول، بل يُشترط حصر أطوال النصوص ضمن مجال مغلق محدد؛ كأن يُطلب استخراج النصوص التي يتراوح طولها بين خمسة وسبعة أحرف حصراً (أي أكبر من أو تساوي 5 وأصغر من أو تساوي 7). نظراً لأن إكسل لا يسمح باستخدام الدوال المنطقية الكلاسيكية مثل AND داخل وسائط المصفوفات المنسكبة لأنها تختزل المصفوفة إلى قيمة فردية واحدة، يتم اللجوء إلى الجبر البولياني عبر معامل الضرب (*).
تُصاغ المعادلة في هذه الحالة على النحو التالي:
=FILTER(A2:C20, (LEN(A2:A20) >= 5) * (LEN(A2:A20) <= 7), "لا توجد نتائج")
رياضياً، تعمل عملية ضرب مصفوفتين منطقيتين كبوابة عطف منطقية؛ حيث يُعامل الصواب كقيمة عددية تعادل 1، ويُعامل الخطأ كقيمة صفرية 0. وحيث إن 1 * 1 = 1، فإن النتيجة النهائية لن تكون TRUE إلا إذا تحقق كلا الشرطين معاً في السجل ذاته، بينما تسفر أي حالة أخرى تتضمن صفراً عن إقصاء السجل من مصفوفة العرض النهائية.
4.2 استخدام معامل الجمع المنطقي لتطبيق شرط التخيير (OR)
على النقيض من شرط المعية، قد تتطلب استراتيجية الفحص استخراج الحالات الشاذة والمتطرفة التي تبتعد عن الطول النمطي المعتاد، مثل استخراج السجلات شديدة القصر (أقل من أربعة أحرف) أو شديدة الطول (أكثر من ثمانية أحرف) معاً في مصفوفة واحدة، بغرض دراسة التشوهات المدخلة. يتم تمثيل بوابة التخيير المنطقي (OR) في محرك المصفوفات الديناميكية باستخدام معامل الجمع الرياضي (+).
تُكتب الصيغة المنفذة لهذا الإجراء كالآتي:
=FILTER(A2:C20, (LEN(A2:A20) < 4) + (LEN(A2:A20) > 8), "البيانات متجانسة بالكامل")
تقوم هذه الآلية بجمع القيم الثنائية الناتجة عن الشرطين؛ فإذا تحقق أحد الشرطين تصبح المعادلة 1 + 0 = 1، وتتحول القيمة الرقمية الناتجة داخل وسيط التضمين إلى مكافئ منطقي لصواب، مما يسمح بإدراج الصف فوراً. ونظراً لاستحالة أن يكون طول النص الواحد أقل من أربعة وأكبر من ثمانية في آنٍ معاً، فلا يوجد أي احتمال لحدوث تداخل منطقي قد يفرز ناتج جمع يساوي 2، وتظل المصفوفة نقية وتستبعد فقط ما وقع في المجال الوسيط المقبول.
4.3 بناء معادلات مركبة تجمع بين نطاقات طولية متعددة
تزداد النماذج التحليلية تطوراً عندما تقتضي الحاجة دمج شروط متداخلة ومعقدة تعتمد على تفكيك مجالات الطول واستثناء فئات محددة في الوقت نفسه؛ كأن يرغب الباحث في استخراج الأكواد التي يتراوح طولها بين 3 و10 أحرف شريطة ألا تكون بطول 6 أحرف بالتحديد نظراً لكون هذا الطول مخصصاً لترميز قديم تم إيقافه. يتطلب هذا النمط إحكام الأقواس التنظيمية لحفظ أسبقية العمليات الجبرية والحسابية بدقة متناهية.
تُبنى هذه الصيغة المركبة وفق النموذج الآتي:
=FILTER(A2:C20, ((LEN(A2:A20) >= 3) * (LEN(A2:A20) <= 10)) * (LEN(A2:A20) <> 6), "لا تطابق")
يضمن الترتيب الهيكلي للأقواس إتمام المقارنة الداخلية الأولى لضبط المجال العام، تليها عملية الضرب في المتجه المنفي الذي يستبعد القيمة الستية بدقة؛ مما يمنع حدوث تشوهات إحصائية ويضمن انطباق المعايير متعددة المستويات على كل صف من صفوف قاعدة البيانات المستهدفة بسلاسة مطلقة.
5. تأثير المسافات والمحارف المخفية على دقة الحساب
5.1 التفاعل بين دالة TRIM ودالة LEN لتنقية المدخلات
من الأخطاء التحليلية الشائعة الاعتقاد بأن دالة LEN تقتصر على حساب الحروف الأبجدية والرقمية المرئية فقط. ففي الواقع العملي، تقوم الدالة باحتساب إجمالي البايتات والمحارف الفعلية، مما يعني أن المسافات البادئة واللاحقة غير المقصودة—والتي تنتج غالباً عن أخطاء الإدخال البشري أو تصدير البيانات من قواعد بيانات وسيطة—تُضاف آلياً إلى الطول الإجمالي للنص، مما يقود إلى تشويه نتائج التصفية وفشل السجلات في مطابقة الشروط رغم صحتها الموضوعية.
لتفادي هذا الانحراف، يتحتم إجراء تكامل وظيفي مسبق بين دالة التنقية TRIM ودالة القياس LEN داخل وسيط التضمين. تقتلع دالة TRIM المسافات الزائدة في بداية ونهاية السلسلة وتختزل المسافات المتعددة بين الكلمات إلى مسافة واحدة فقط. وبالتالي تصاغ المعادلة لتعمل على الأطوال الحقيقية الصافية كما يلي:
=FILTER(A2:C20, LEN(TRIM(A2:A20)) < 5, "لا توجد سجلات")
يضمن هذا الإجراء قياس الطول الجوهري للنص دون التأثر بالشوائب التنسيقية الهامشية، مما يرفع موثوقية استرجاع البيانات بدرجة ملحوظة.
5.2 معالجة المسافات غير القابلة للكسر والمحارف الخاصة
في كثير من الحالات المتقدمة، لا تنجح دالة TRIM التقليدية في إزالة المسافات، لا سيما عند استيراد البيانات من صفحات الويب أو محررات النصوص المتقدمة؛ حيث تكون تلك المسافات من نوع “المسافة غير القابلة للكسر” (Non-breaking space)، والتي تحمل الرمز المصدري للأسكي برقم الكود 160 (ASCII Char 160)، بينما تتعامل دالة TRIM حصراً مع المسافة القياسية ذات الكود 32.
لمعالجة هذا المحرف غير المرئي المستعصي الذي يزيد من طول النص دون أي دلالة بصرية، يجب استخدام دالة الاستبدال SUBSTITUTE مع دالة الرمز CHAR(160) لتحويله أولاً إلى مسافة قياسية، ثم إخضاعه لدالة TRIM قبل قياس الطول، كما يتضح في الصيغة التالية:
=FILTER(A2:C20, LEN(TRIM(SUBSTITUTE(A2:A20, CHAR(160), " "))) < 5, "خالٍ من التطابق")
تكفل هذه المعالجة المتعمقة تطهير السجلات النصية من الرموز البرمجية العالقة وغير الطباعية، مما يعيد ضبط معايير التصفية إلى أبعادها القياسية الحقيقية.
5.3 إدارة علامات الترقيم والأحرف الخاصة في السلاسل النصية
تؤثر علامات الترقيم (كالشرطات، والنقاط، والشرطات المائلة) بشكل مباشر على الطول الإجمالي للمدخلات النصية، خاصة في السجلات المعيارية التي تدمج بين الحروف والأرقام مثل أرقام الحسابات الدولية أو بطاقات الهوية. فإذا كان الهدف هو تصفية النصوص بناءً على المحتوى اللغوي أو الرقمي الصافي دون احتساب الرموز الفاصلة، فإن الاعتماد على دالة LEN المباشرة سيعطي قياساً مضللاً يتجاوز الطول المعتمد للبيانات النقية.
في مثل هذه التطبيقات، يتم استئصال الرموز غير المرغوب في احتسابها دورياً باستخدام دوال الاستبدال المتداخلة، أو قياس السلاسل بعد تجريدها من الفواصل الاصطلاحية؛ مما يتيح للباحث توحيد معايير الحساب في قواعد البيانات المستوردة من مصادر متعددة ومتباينة التنسيق، وتفادي استبعاد السجلات المتطابقة لغوياً لمجرد احتوائها على علامة ترقيم إضافية.
6. إدارة الأخطاء وحالات عدم التطابق في التصفية النصية
6.1 معالجة خطأ الحساب (#CALC!) عبر الوسيط البديل
عندما تُخفق جميع صفوف النطاق المستهدف في تحقيق معيار التصفية العددي، يعجز محرك إكسل عن توليد مصفوفة منسكبة صالحة؛ ونظراً لرفضه ترك الخلية خالية بصورة افتراضية، فإنه يقوم بإرجاع خطأ الحساب التشغيلي الشهير (#CALC!)، مشيراً إلى أن العملية الحسابية أنتجت مصفوفة فارغة تعذر رسم أبعادها في ورقة العمل.
لتفادي هذا السلوك غير المرغوب—خاصة عند تصميم لوحات المعلومات التفاعلية (Dashboards) الموجهة للمستخدم النهائي—قامت مايكروسوفت بتوفير الوسيط الثالث [if_empty] داخل بنية دالة FILTER. يتيح هذا الوسيط تمرير رسالة نصية مخصصة أو قيمة عددية محددة مثل "لا توجد مدخلات مطابقة للطول المطلوب" أو 0؛ حيث يتم عرض هذا النص البديل فور تحقق حالة المصفوفة الصفرية، مما يحافظ على نظافة الواجهة البصرية ويمنع انتشار مؤشرات الأخطاء البرمجية عبر الخلايا الحسابية التابعة.
6.2 التعامل مع الخلايا الفارغة وتأثيرها على القيمة الصفرية
تُظهر دالة LEN سلوكاً حسابياً خاصاً عند التعامل مع الخلايا الفارغة تماماً؛ حيث تعيد القيمة الصفرية 0 كطول افتراضي للخلية التي لا تحتوي على أي نص أو محرف. يترتب على هذا السلوك خطر منهجي فادح عند تطبيق شروط التصفية التي تبحث عن أطوال نصوص تقل عن حد معين؛ فعلى سبيل المثال، إذا تضمنت مصفوفة البيانات صفوفاً فارغة وتم تطبيق الشرط LEN(range) < 5، فسيتم احتساب جميع الصفوف الفارغة ضمن النتائج لأن طولها (0) يقل حتماً عن 5.
لحماية النموذج من هذا الإدراج غير المقصود للسجلات الفارغة، يتوجب دمج شرط نفي الفراغ ضمن مصفوفة التضمين، وذلك باستخدام التعبير المنطقي (A2:A20 <> "") متبوعاً بمعامل الضرب المنطقي، لتصبح المعادلة الوقائية كما يلي:
=FILTER(A2:C20, (A2:A20 <> "") * (LEN(A2:A20) < 5), "لا توجد نتائج صالحة")
يكفل هذا التركيب الرياضي المزدوج إقصاء الخلايا الصفرية الفارغة فوراً، واقتصار عملية التصفية الحجمية على الخلايا المأهولة بالبيانات الفعلية فقط.
6.3 استراتيجيات استكشاف وتصحيح الأخطاء التركيبية في الصيغ
عند الشروع في بناء معادلات تصفية معقدة متعددة الأطراف، قد يواجه المستخدم صعوبة في تشخيص الأسباب الكامنة وراء ظهور نتائج غير متوقعة أو أخطاء تركيبية مثل خطأ القيمة (#VALUE!) أو خطأ المرجع (#REF!). تبرز هنا أداة “تقييم الصيغة” (Evaluate Formula) المدمجة في تبويب “صيغ” (Formulas) داخل إكسل كإحدى أنجع الوسائل المنهجية لتفكيك شجرة المعالجة المنطقية.
تتيح هذه الأداة للمحلل السير خطوة بخطوة عبر مسارات التنفيذ الداخلية للمعادلة؛ مما يسمح بمراقبة المصفوفات البوليانية اللحظية الناتجة عن دالة LEN، ورؤية كيفية تفاعل معاملات الضرب والجمع المنطقية بدقة متناهية. كما يُنصح دائماً بالتحقق البصري من تماثل أبعاد النطاقات المرجعية، وتوثيق الملاحظات الفنية للمستخدمين بجوار خلايا النماذج لتقليل أخطاء التعديل البشري العرضي وضمان استمرارية عمل الصيغ المركبة دون تعطل.
7. البدائل التقليدية للتصفية وفق عدد الأحرف في الإصدارات القديمة
7.1 تقنية العمود المساعد واستخدام أدوات الفرز القياسية
في البيئات المؤسسية التي تعتمد على إصدارات إكسل الكلاسيكية السابقة لعام 2021 وما قبل ظهور المصفوفات الديناميكية، يغيب الدعم المباشر لدالة FILTER؛ مما يحتم اللجوء إلى تقنية “العمود المساعد” (Helper Column) بوصفها الحل العملي الأكثر استقراراً وموثوقية في تلك البيئات التشغيلية.
تعتمد هذه التقنية على إدراج عمود إضافي ملاصق لجدول البيانات، تُكتب فيه الدالة البسيطة =LEN(A2) وتُسحب على امتداد كافة الصفوف لاحتساب أطوال النصوص بصورة مستقلة لكل سجل. عقب ذلك، يُفعل المستخدم أداة التصفية التلقائية القياسية (AutoFilter) من شريط الأدوات، ويختار من القائمة المنسدلة للعمود المساعد خيارات “تصفية الأرقام” (Number Filters)، ثم يحدد المعيار المطلوب كـ “أصغر من” أو “يقع بين”. ورغم سهولة هذه الطريقة، إلا أن عيبها الهيكلي يكمن في كونها عملية ساكنة وغير تفاعلية؛ إذ تتطلب إعادة تطبيق الفرز يدوياً في كل مرة تتغير فيها البيانات، فضلاً عن شغلها لمساحات تخزينية إضافية تزيد من حجم المصنف الإجمالي.
7.2 صياغة دوال المصفوفات الكلاسيكية المتقدمة
لتحقيق التصفية التلقائية الديناميكية المستمرة في الإصدارات القديمة دون الاعتماد على أدوات الواجهة اليدوية، كان مطورو النماذج يلجؤون إلى بناء صيغ مصفوفية غاية في التعقيد تجمع بين دوال الفهرسة والاسترجاع؛ وأشهرها التركيب المكون من دوال INDEX وMATCH وSMALL وROW مع دالة LEN، والتي كانت تتطلب إدخالها عبر الضغط المتزامن على مفاتيح (Ctrl + Shift + Enter).
تتخذ الصيغة الكلاسيكية الشكل النموذجي المعقد التالي:
=IFERROR(INDEX($A$2:$C$20, SMALL(IF(LEN($A$2:$A$20) < 5, ROW($A$2:$A$20)-ROW($A$2)+1), ROW(A1)), 1), "")
تقوم هذه الصيغة بمسح النطاق وتوليد مصفوفة لأرقام الصفوف المحققة لشرط الطول، ثم استخراجها تصاعدياً صفاً تلو الآخر عبر الدالة SMALL. ورغم عبقرية هذه النمذجة الرياضية الكلاسيكية، إلا أنها تعاني من عيوب جسيمة تتعلق باستهلاك مكثف لدورات المعالجة المركزية (CPU) والذاكرة العشوائية؛ نظراً لأن الدالة تُجبر إكسل على إعادة حساب كافة المصفوفات المتداخلة في كل خلية على حدة، مما يؤدي إلى بطء ملحوظ وشلل شبه تام عند تطبيقها على قواعد البيانات التي تتجاوز بضعة آلاف من السجلات.
7.3 استخدام أدوات التصفية المتقدمة (Advanced Filter)
توفر أداة “التصفية المتقدمة” (Advanced Filter) في إكسل حلاً تقليدياً بديلاً يتيح عزل السجلات وفق معايير نصية معقدة وترحيل النتائج إلى موقع جديد تماماً في ورقة العمل دون استخدام الأعمدة المساعدة الدائمة. يتطلب هذا الإجراء إعداد جدول معايير منفصل يتكون من عنوان مستقل وصيغة منطقية مخصصة؛ مثل كتابة =LEN(A2)<5 في خلية الشرط الواقعة أسفل عنوان المعيار.
عقب تجهيز نطاق المعايير، يفتح المستخدم نافذة التصفية المتقدمة من تبويب “بيانات”، ويحدد نطاق الجدول الأصلي، ونطاق المعايير المُعد، مع تفعيل خيار “النسخ إلى موقع آخر” وتحديد نطاق الوجهة. تمتاز هذه الطريقة بالقدرة على استخراج نسخ مطابقة ونظيفة للسجلات، إلا أن قصورها الرئيسي يماثل أدوات التصفية اليدوية؛ حيث تظل البيانات المستخرجة ثابتة وساكنة تماماً، ولا تعكس أي تحديثات فورية تطرأ على الجدول الأصلي إلا بإعادة فتح أداة التصفية المتقدمة وتكرار خطوات التصدير من جديد.
8. التصفية المتقدمة بدمج معايير الطول مع الشروط النصية والرقمية
8.1 الجمع بين طول السلسلة وبداية النص أو نهايته
تكتسب تقنيات الفرز النصي كفاءة تشغيلية مضاعفة عند دمج مقاييس الطول مع دوال الفحص المورفولوجي لمواقع الأحرف؛ كأن يُطلب استخراج الأكواد التي تبدأ بحرف محدد وتنتهي بطول قياسي معين. يتم تحقيق هذا التكامل عبر تداخل دالتي LEFT أو RIGHT مع الدالة LEN داخل وسيط التضمين التابع لدالة FILTER.
تُصاغ هذه المعادلة المتطورة بالشكل الآتي:
=FILTER(A2:C20, (LEFT(A2:A20, 1) = "P") * (LEN(A2:A20) > 6), "لا توجد أكواد مطابقة")
يتحقق هذا التعبير المركب من شرطين متزامنين؛ أولهما أن يكون الحرف الأول من جهة اليسار في كود المعرف هو الحرف “P”، وثانيهما أن يتجاوز الطول الإجمالي للكود ستة أحرف. يجد هذا التطبيق استخدامات حيوية واسعة في تدقيق قواعد بيانات الجرد المخزني ومراجعة سجلات الأصول الثابتة؛ لضمان توافق الأكواد المسجلة مع معايير الترميز المؤسسي الموحد وعزل السجلات الشاذة التي خالفت قواعد الترقيم المعتمدة.
8.2 تداخل شروط الطول النصي مع المتغيرات الكمية المرافقة
لا تقتصر معايير التصفية المتقدمة على الخصائص النصية المجردة، بل تمتد لتشمل الموازنة المنطقية بين المتغيرات النوعية والمتغيرات الكمية المرافقة لها في السجل ذاته؛ كأن يُراد استخراج الحالات التي تتصف بقصر كود التوصيف ولكنها ترتبط في الوقت نفسه بقيم مالية أو كمية مرتفعة للغاية في عمود مجاور، مما قد يثير شكوكاً تدقيقية حول سلامة القيد المحاسبي.
تُبنى هذه المصفوفة المشتركة عبر الربط الجبري بين وسائط الطول والقيم العددية كما هو موضح في الصيغة التالية:
=FILTER(A2:C20, (LEN(A2:A20) < 4) * (C2:C20 > 10000), "البيانات متناسقة")
تخلق هذه الصيغة مرشحاً دقيقاً يسحب حصراً السجلات التي تجمع بين صفتين متناقضتين ظاهرياً: كود نصي شديد الإيجاز (أقل من أربعة أحرف) وقيمة مالية في العمود C تتجاوز عشرة آلاف وحدة. يمثل هذا التداخل المنطقي أداة استثنائية لمدققي الحسابات ومحللي المخاطر لفرز المعاملات الاستثنائية وإعداد تقارير الكفاءة والرقابة المالية بصورة فورية ومؤتمتة.
8.3 توظيف دوال البحث النصي الموضعي مع مقاييس الطول
تتضمن استراتيجيات استرجاع المعلومات أحياناً البحث عن وجود كلمة دلالية أو مقطع فرعي محدد داخل النص بالتوازي مع اشتراط عدم تجاوز النص ككل لسقف طولي معين؛ وذلك لفرز الجمل المفيدة المقتضبة واستبعاد النصوص الطويلة التي قد تشتت التحليل. يتم دمج دالتي ISNUMBER وSEARCH مع دالة LEN لتأسيس هذا المعيار الاستكشافي المتقدم.
تأتي صيغة المعادلة المركبة وفق الترتيب التالي:
=FILTER(A2:C20, ISNUMBER(SEARCH("مكتمل", B2:B20)) * (LEN(B2:B20) <= 15), "لا توجد نصوص محققة للشرط")
تقوم الدالة SEARCH بفحص الموضع المكاني لكلمة “مكتمل” ضمن نصوص العمود B، وتعيد دالة ISNUMBER القيمة المنطقية TRUE في حال العثور على الكلمة. وبفضل معامل الضرب، يتم تزامن هذا التحقق مع فحص دالة LEN للتأكد من أن الطول الكلي للوصف لا يتجاوز خمسة عشر حرفاً. يمنح هذا الأسلوب الباحثين قدرة عالية على تنقية البيانات الوصفية واستخلاص المدخلات النوعية الموجزة بدقة إحصائية فائقة تدعم عمليات التحليل النصي الاستكشافي.
9. التطبيقات الأكاديمية والمهنية لتصفية النصوص بحسب طولها
9.1 فحص البيانات المسحية والترميزات غير المكتملة
في ميدان البحوث الاجتماعية والسلوكية واستطلاعات الرأي العام، تمثل جودة البيانات المجمعة حجر الزاوية لصحة الاستنتاجات العلمية؛ حيث يواجه الباحثون معضلة ملء الاستمارات بطرق متسرعة أو مبتورة تُخل بالبناء المفاهيمي للدراسة. تتيح تصفية السجلات استناداً إلى طول النصوص وسيلة آلية بالغة الفعالية لرصد الردود المبتورة أو الأكواد التوصيفية الناقصة التي لم تستوفِ الحد الأدنى من المحارف المقررة في دليل جمع البيانات (Stoesz, 2016).
من خلال تطبيق معادلات FILTER المرتبطة بأطوال الحقول، يستطيع الباحث عزل المعرفات الرقمية المشوهة وأرقام الاستجابات التي سقطت منها بعض الخانات أثناء التفريغ، مما يسهل حصرها وتوجيه فرق التدقيق الميداني لإعادة مراجعتها ومطابقتها مع السجلات الورقية الأصلية قبل إدخالها في نماذج التحليل الإحصائي المتقدمة؛ الأمر الذي يحمي العينة من التحيزات الناتجة عن أخطاء القياس ويسهم في ضبط تباين الأخطاء البنيوية في الدراسات المسحية.
9.2 رصد الشذوذ والانحرافات في إدخال الأسماء والمعرفات
تُعد حوكمة البيانات المؤسسية وتوحيد قوالب الرصد التوثيقي من الأولويات الحتمية في نظم إدارة الموارد وقواعد بيانات شؤون العاملين والعملاء. ويبرز الشذوذ في إدخال الأسماء أو الأرقام الوطنية كأحد أبرز مؤشرات الانحراف التوثيقي؛ كأن يُسجل اسم رباعي في حقل لا يتجاوز طوله الإجمالي أربعة أحرف (مما يدل على كتابة أحرف عشوائية أو رمزية)، أو أن يُسجل حقل رقمي يتجاوز السعة القصوى المحددة لقواعد البيانات المتصلة (SQL Databases).
باستخدام التصفية الشرطية القائمة على دالة LEN، يتمكن مسؤولو النظم من استخراج الحقول التي تنحرف عن حدود التوزيع الطبيعي لأطوال المدخلات الاسمية والرمزية. يسهم هذا الفرز الميكانيكي المستمر في الحيلولة دون تمرير نصوص متضخمة قد تؤدي إلى انهيار سعة التخزين المخصصة لتلك الأعمدة في الخوادم الخلفية، مما يعزز مناعة الأنظمة ويحقق رقابة صارمة على جودة المدخلات المؤسسية وتوافقها مع المعايير القياسية.
9.3 معالجة النصوص المفتوحة وتصنيفها حسب الكثافة التعبيرية
تعتمد العديد من الدراسات النفسية والمعرفية المعاصرة على جمع استجابات مفتوحة وسردية لفهم الأنماط الدلالية والسمات البنيوية للتفكير والتعبير اللغوي لدى الأفراد، كما يظهر جلياً في بناء معايير إنتاج الخصائص الدلالية للمفاهيم المجردة والمادية (McRae et al., 2005). في هذا السياق، يصبح طول السرد النصي متغيراً حيوياً يعكس مستوى التفصيل والعمق المعرفي الذي قدمه المشارك في التجربة.
يساعد توظيف دالتي FILTER وLEN في هذا المضمار الباحثين على تصنيف التعليقات السردية وتوزيعها إلى فئات إحصائية محكمة تبعاً لكثافتها اللفظية؛ حيث تُعزل الردود السريعة الموجزة (أقل من عشرين حرفاً مثلاً) لدراستها ومقارنتها كمياً بالردود التفصيلية التي تتجاوز مئات المحارف. يسهم هذا التصنيف الأولي المؤتمت في تمهيد البيانات النصية لعمليات الترميز الموضوعي والتحليل المعجمي المتقدم (Lian et al., 2023)، مما يقلل من الوقت المستغرق في المعالجة اليدوية ويوفر أساساً متيناً لتحليل استجابات العينات البحثية بدقة وموثوقية.
10. أفضل الممارسات المنهجية وتحسين كفاءة الحساب في الجداول الكبيرة
10.1 إدارة استهلاك الذاكرة في المصفوفات المتشعبة
عند التعامل مع قواعد بيانات ضخمة تتجاوز مئات الآلاف من الصفوف في مايكروسوفت إكسل، تصبح كفاءة المعالجة وسرعة الحساب تحدياً هندسياً حقيقياً؛ إذ إن تكرار استدعاء الدالة LEN ومقارنتها عبر متجهات عملاقة يستهلك قدراً كبيراً من دورات معالج الحاسوب ويؤدي إلى ارتفاع استهلاك الذاكرة المؤقتة. ومن أشد الأخطاء شيوعاً في هذا الإطار هي الإشارة إلى الأعمدة الكاملة دون تحديد؛ كأن يكتب المستخدم A:A أو A:C داخل وسائط الدالة.
يؤدي استدعاء العمود الكامل إلى إجبار محرك إكسل على فحص أكثر من مليون وأربعة وثمانين ألف خلية، حتى وإن كانت فارغة، مما يثقل كاهل المصنف بعبء حسابي لا طائل منه. لذلك، تقضي القواعد المنهجية الصارمة بحصر النطاقات بدقة متناهية لتشمل فقط حيز البيانات المشغول فعلياً (مثل A2:C50000)، أو استخدام الصيغ التي تحدد نهاية البيانات ديناميكياً، مما يحسن من كفاءة إعادة الحساب التلقائي (Calculation Engine) داخل المصنف ويضمن استجابة البرنامج السريعة أثناء عمليات التحليل.
10.2 الاعتماد على الجداول الديناميكية المهيكلة (Excel Tables)
يُعد تحويل النطاقات المادية العادية إلى “جداول ديناميكية مهيكلة” (Excel Tables)—والمعروفة اختصاراً بجداول إكسل عبر الاختصار (Ctrl + T)—إحدى أرقى الممارسات الهندسية لإدارة مجموعات البيانات المتنامية؛ إذ يوفر الجدول الهيكلي دعماً فريداً لما يُعرف بـ “المراجع الهيكلية” (Structured References) التي تستبدل مراجع الخلايا الجامدة بتسميات الأعمدة الصريحة.
عند صياغة معادلة التصفية باستخدام المراجع الهيكلية، تكتسب الصيغة البنية التفسيرية الواضحة التالية:
=FILTER(tbl_Data, LEN(tbl_Data[Code]) < 5, "لا توجد بيانات")
يحقق هذا الأسلوب ميزتين جوهريتين: الأولى هي الرفع الفوري لقابلية قراءة المعادلات وفهمها من قبل الباحثين والمدققين دون الحاجة لتتبع حدود الصفوف يدوياً؛ والميزة الثانية هي المرونة التلقائية في التوسع؛ فبمجرد لصق أو إضافة أي صفوف جديدة إلى الجدول الأصلي tbl_Data، تتوسع مصفوفة التحقق وتحدث دالة FILTER نتائجها المنسكبة آنياً دون الحاجة إلى تعديل نطاقات الصيغة على الإطلاق، مما يحقق استدامة كاملة لنموذج التحليل الرياضي.
10.3 التوثيق البرمجي وضمان استدامة النماذج التحليلية
تتطلب النماذج التحليلية المتقدمة التي تُبنى لخدمة مؤسسات أو فرق بحثية مشتركة توثيقاً داخلياً صارماً لضمان استدامتها ونقل العمل بسلاسة بين أفراد الفريق دون انقطاع. ونظراً لأن مخرجات المصفوفات المنسكبة تعتمد على الخلية الأولى الحاوية للصيغة الأم، فإن مسح أو تعديل تلك الخلية العرضي من قِبل مستخدم غير مدرب يؤدي فوراً إلى اختفاء كامل البيانات المنسكبة في الأوراق التابعة.
لضمان حماية هذه النماذج، يُوصى بقفل الخلايا الحاضنة للصيغ وتفعيل ميزة “حماية ورقة العمل” (Protect Sheet) لمنع التعديل العرضي عليها، مع إبقاء نطاقات الإدخال الأصلية مفتوحة ومتاحة للتحديث. كما يُنصح بإدراج تعليقات توضيحية (Notes/Comments) فوق رؤوس الأعمدة المستخرجة تشرح الشروط المنطقية المطبقة وحسابات دالة LEN المستخدمة، وإجراء اختبارات تحقق دورية بمدخلات افتراضية متباينة الأطوال؛ للتأكد من استقرار عمل النماذج وتماسك مصفوفاتها المنطقية أمام أي تغييرات هيكلية مستقبلية.
خاتمة استشرافية
لقد أحدث دمج محرك المصفوفات الديناميكية مع الدوال النصية الكلاسيكية في برنامج مايكروسوفت إكسل—ولا سيما عبر التكامل الوظيفي بين دالتي FILTER وLEN—ثورة هيكلية في كيفية التعامل مع البيانات واسترجاعها وفق الخصائص البنيوية والمورفولوجية للنصوص. إن القدرة على حصر وتصفية السجلات بناءً على عدد المحارف والأطوال المحددة تمثل إحدى الركائز التحليلية بالغة الدقة لتنقية البيانات، وفرز الأخطاء التكوينية، وضبط جودة المسوح والترميزات الإحصائية دون إثقال المصنفات بأعمدة مساعدة ساكنة أو أكواد برمجية معقدة يصعب تعقبها.
ومع استيعاب آليات الجبر البولياني القائمة على معاملات الضرب والجمع، واستحضار الضوابط الصارمة لمعالجة المسافات العالقة والمحارف غير المرئية عبر دوال TRIM وSUBSTITUTE، يتحول إكسل إلى أداة نمذجة رياضية ومعجمية فائقة الكفاءة تجمع بين البساطة الصياغية والمرونة البرمجية المتقدمة. إن تبني أفضل الممارسات المنهجية، المتمثلة في ترشيد استخدام النطاقات، والاعتماد على الجداول المهيكلة، وتوثيق الصيغ المركبة، يضمن للباحثين والمحللين بناء نماذج بيانات مستدامة تمتاز بالسرعة والنزاهة الإحصائية، وقادرة على مواكبة التدفق الهائل للبيانات في مختلف البيئات الأكاديمية والمؤسسية المعاصرة.
المراجع
- Cai, H., Yuan, Z., Gao, Y., Sun, S., Li, N., Tian, F., et al. (2022). A multi-modal open dataset for mental-disorder analysis. Scientific Data. https://doi.org/10.1038/s41597-022-01211-x
- Lian, H., Lu, C., Li, S., Zhao, Y. D., Tang, C., & Zong, Y. (2023). A Survey of Deep Learning-Based Multimodal Emotion Recognition: Speech, Text, and Face. Entropy. https://doi.org/10.3390/e25101440
- McRae, K., Cree, G. S., Seidenberg, M. S., & McNorgan, C. (2005). Semantic feature production norms for a large set of living and nonliving things. Behavior Research Methods. https://doi.org/10.3758/bf03192726
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0
- Stoesz, B. M. (2016). Frontiers in Psychology. Frontiers in Psychology. https://doi.org/10.3389/fpsyg