
يمثل التحليل الإحصائي حجر الزاوية في استخلاص الاستنتاجات العلمية الرصينة ضمن حقول العلوم السلوكية والنفسية والتربوية؛ حيث يسعى الباحثون دوماً إلى فهم العلاقات المعقدة التي تربط بين المتغيرات الإنسانية وتفسيرها كمياً. ورغم توافر العديد من البرمجيات الإحصائية المتخصصة، يظل برنامج مايكروسوفت إكسل (Microsoft Excel) الأداة الأكثر انتشاراً وسهولة في متناول الباحثين والمحللين. ومع ذلك، فإن الغالبية العظمى من المستخدمين يقفون عند حدود الأدوات التمهيدية مثل خطوط الاتجاه البسيطة أو الدوال الفردية، دون النفاذ إلى العمق البرمجي والإحصائي الذي توفره البيئة الحاسوبية لإكسل عبر أدواته المصفوفية المتقدمة.
تتربع دالة LINEST (اختصاراً لعبارة Linear Estimation) على قمة الدوال الإحصائية في إكسل؛ إذ تمثل محركاً متكاملاً لإجراء تحليل الانحدار الخطي بأسلوب المربعات الصغرى العادية (Ordinary Least Squares – OLS). تكمن القوة الاستثنائية لهذه الدالة في قدرتها على تجاوز حساب المعلمات الفردية المعزولة، لتقدم مصفوفة إحصائية متكاملة ومترابطة من خمسة صفوف، تضم معاملات الانحدار، والأخطاء المعيارية، ومؤشرات جودة التوفيق، واختبارات الدلالة الإحصائية، وتحليل التباين الشامل، وكل ذلك في خطوة حسابية تفاعلية واحدة تتحدث تلقائياً مع تغير مدخلات البيانات الأصلية.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك الشفرة الرياضية والإحصائية لمخرجات دالة LINEST، ونقل الباحث من مرحلة الاستخدام الميكانيكي إلى مرحلة الفهم التفسيري العميق لكل رقم تحتويه مصفوفتها. سنتناول بالتفصيل آليات عمل الدالة، والهيكل الرياضي لأعمدتها وصفوفها، والأسس النظرية للمؤشرات المشتقة منها، مع إسقاط هذه المفاهيم على دراسات الحالة النفسية والقياس السلوكي، بما يضمن تمكين القارئ من كتابة تقارير علمية دقيقة تتوافق تماماً مع أرقى المعايير المنهجية المعتمدة دولياً، مثل معايير جمعية علم النفس الأمريكية (APA).
1. مقدمة إلى دالة LINEST ودورها في التحليل الإحصائي السلوكي والنفسي
1.1 ماهية دالة LINEST وأهميتها في النمذجة الخطية
تُعرف دالة LINEST بأنها أداة برمجية ومصفوفية متقدمة صُممت خصيصاً لحساب إحصاءات الانحدار الخطي بأسلوب المربعات الصغرى العادية (Ordinary Least Squares). يقوم هذا الأسلوب الرياضي على مبدأ إيجاد أفضل خط مستقيم (أو مستوى فائق في حالة المتغيرات المتعددة) يقلل إلى أدنى حد ممكن مجموع مربعات الفروق الرأسية بين القيم الفعلية المشاهدة والقيم التنبؤية المتوقعة. على النقيض من الحسابات التقديرية العابرة، توفر LINEST نموذجاً رياضياً صارماً يعبر عن بنية البيانات وتفاعلاتها المتبادلة بدقة بالغة.
تتجلى الأهمية الكبرى لهذه الدالة في كفاءتها الفريدة في التعامل مع نماذج الانحدار الخطي البسيط (متغير مستقل واحد) والانحدار المتعدد (عدة متغيرات مستقلة) دون أدنى حاجة لإعادة صياغة الخوارزمية الحسابية. يكفي إدخال النطاقات المحددة للمتغير التابع والمتغيرات التفسيرية، لتقوم الدالة بتطبيق الجبر المصفوفي الداخلي وحل المعادلات المتزامنة عبر مصفوفة التغاير والتباين، مما يوفر على الباحث ساعات طويلة من العمليات اليدوية المعقدة والمعرضة للخطأ البشري.
من الناحية المنهجية، يرتكب العديد من المبتدئين خطأ الاكتفاء بالتمثيل البياني لإضافة خط الاتجاه (Trendline) وقراءة معادلة الانحدار بصرياً من الرسم البياني. يفتقر هذا النهج البصري إلى الدقة الإحصائية الكافية لاختبار الفروض؛ فالرسم البياني قد يعطي انطباعاً مضللاً بوجود علاقة قوية دون الإفصاح عن الأخطاء المعيارية المحيطة بالمعاملات أو مدى معنوية النموذج إحصائياً. من هنا تنبع ضرورة الاعتماد على دالة LINEST كأداة رقمية تقدم براهين قطعية قابلة للتحقق والاختبار الرياضي الرصين.
1.2 المقارنة بين أدوات الانحدار السريعة ومصفوفة LINEST الشاملة
يوفر برنامج إكسل أدوات إحصائية منفصلة، مثل دالتي SLOPE و INTERCEPT، والتي تستخدم لحساب ميل خط الانحدار ونقطة التقاطع مع المحور الصادي على التوالي. ورغم أن هذه الدوال تؤدي الغرض في الحسابات التمهيدية البسيطة، إلا أنها تظل محدودة الأفق ومعزولة سياقياً؛ إذ تفشل تماماً في تقديم الأخطاء المعيارية المرافقة لتلك المعاملات، كما تعجز بمفردها عن التعامل مع أكثر من متغير مستقل واحد، مما يجعلها غير صالحة للنماذج التفسيرية المركبة.
تتفوق مصفوفة LINEST تفوقاً جوهرياً من خلال تقديم رؤية بانورامية تشخيصية للنموذج الإحصائي في آنٍ واحد. فالمصفوفة لا تكتفي بوضع المعاملات في عزلة، بل تربط كل معامل بخطئه المعياري المباشر في الصف الذي يليه، وتلحق ذلك بمؤشرات جودة التوفيق العامة مثل معامل التحديد (R²) واختبار فيشر (F-test)، فضلاً عن تحليل تفكيك التباين لمجموع المربعات. هذا التزامن البياني يتيح للمحلل تقييم جودة النمذجة بمجرد إلقاء نظرة على شبكة المخرجات المتكاملة.
علاوة على ذلك، تتميز دالة LINEST بالديناميكية التشغيلية؛ حيث ترتبط مخرجاتها بالبيانات المدخلة بعلاقة تفاعلية حية. فبمجرد تصحيح قيمة متطرفة، أو تعديل إدخال خاطئ في بيانات العينة النفسية أو السلوكية، تتحدث المصفوفة بأكملها تلقائياً وفي جزء من الثانية، وهو ما يمنحها ميزة تشغيلية كبرى مقارنة بأداة تحليل البيانات الإضافية (Data Analysis Toolpak) التي تنتج جداول ساكنة غير قابلة للتحديث إلا بإعادة تشغيل الإجراء كاملاً من جديد.
1.3 سياقات الاستخدام في البحوث السيكولوجية والعلوم الإنسانية
تعتمد البحوث النفسية والسلوكية اعتماداً مكثفاً على دراسة العلاقات الارتباطية والسببية بين البناءات النفسية غير الملموسة. تُستخدم دالة LINEST في هذا المضمار كأداة رئيسية لنمذجة العلاقات التنبؤية؛ مثل اختبار الفرضية القائلة بأن درجات القلق الامتحاني تسهم سلباً في التنبؤ بدرجات التحصيل الدراسي، أو التنبؤ بمستوى الاحتراق النفسي الوظيفي استناداً إلى ساعات العمل وضغوط البيئة المحيطة ومستوى الدعم التنظيمي المدرك.
يمتد توظيف الدالة بصورة جوهرية إلى ميدان دراسات التدخلات العلاجية والسلوكية، ولا سيما عند استخدام تصميمات السلاسل الزمنية أو المتابعات التتبعية ذات القياسات المستمرة. يستطيع الباحث السلوكي قياس وتيرة التغير في استجابات الأفراد (كمعدل تكرار السلوك القهري أو نوبات الهلع) على مدار جلسات العلاج المعرفي السلوكي، وتقدير معامل الميل الزمني لتحديد ما إذا كان التحسن السلوكي ذا دلالة إحصائية حقيقية تتجاوز نطاق التقلبات العشوائية الطبيعية.
كما تمثل الدالة ركيزة أساسية في دراسات القياس والتقويم السيكومتري؛ حيث يحتاج مطورو المقاييس والاختبارات النفسية إلى التحقق الصارم من الصدق التنبئي (Predictive Validity) والصدق التزامني للأدوات الجديدة. من خلال مطابقة درجات المقياس الجديد كمتغير تفسيري مع معيار سلوكي خارجي، توفر مخرجات LINEST الإحصاءات اللازمة لإثبات كفاءة الأداة وصلاحيتها للاستخدام الإكلينيكي والميداني بثقة إحصائية واضحة.
2. البنية التركيبية والصيغة العامة لدالة LINEST في إكسل
2.1 المتغيرات التابعة (known_y’s) والمتغيرات المستقلة (known_x’s)
تُكتب الصيغة الرياضية والبرمجية لدالة LINEST في بيئة إكسل وفق البنية التالية: =LINEST(known_y's, [known_x's], [const], [stats]). يمثل الوسيط الأول الإلزامي، وهو المتغير التابع (known_y’s)، مجموعة المشاهدات للظاهرة المراد التنبؤ بها أو تفسيرها. في الغالبية العظمى من التحليلات الإحصائية، يجب تنظيم هذه البيانات في عمود فردي متصل (Vector)، حيث يمثل كل صف فرداً أو حالة خاضعة للدراسة داخل العينة.
يمثل الوسيط الثاني (known_x’s) المتغيرات المستقلة أو التفسيرية التي يُفترض أنها تؤثر في المتغير التابع أو تسهم في تفسير تباينه. في حالة الانحدار الخطي البسيط، يكون هذا النطاق عموداً واحداً موازياً لنطاق المتغير التابع. أما في حالة الانحدار المتعدد، فيتم ترتيب المتغيرات المستقلة في أعمدة متجاورة. ويشترط شرطاً رياضياً صارماً أن يتساوى عدد الصفوف في نطاق المتغيرات التابعة مع عدد الصفوف في نطاق المتغيرات المستقلة تماماً، وإلا ستُرجع الدالة خطأ عدم توافق الأبعاد (#VALUE!).
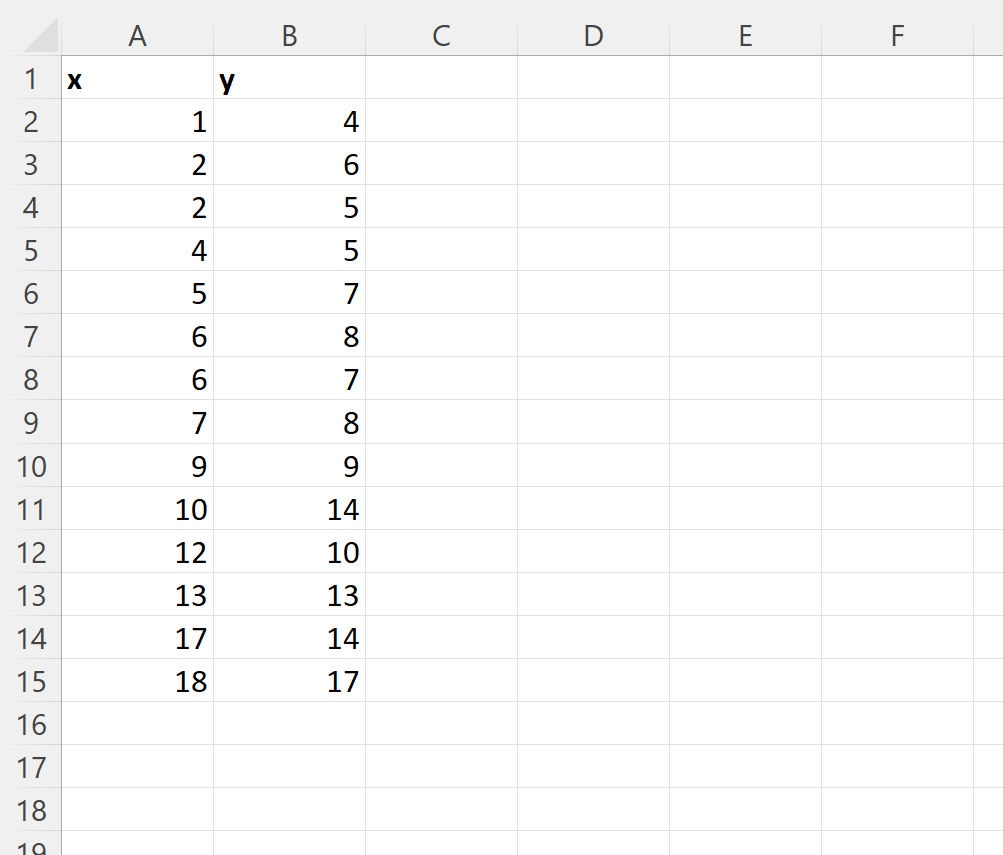
تتطلب الدقة المنهجية إدارة فائقة للبيانات المفقودة والقيم الشاذة داخل هذه المصفوفات. ترفض دالة LINEST التعامل مع النصوص، وتؤدي الخلايا الفارغة أو التي تحتوي على بيانات نصية داخل النطاقات الرقمية إلى إفشال العملية الرياضية بالكامل. لذلك، يجب على الباحث فحص مصفوفات الإدخال بدقة وتطبيق أساليب معالجة البيانات المفقودة المناسبة، مثل الحذف المنظم للحالات الناقصة (Listwise Deletion) أو استخدام طرق التعويض الإحصائي المعتمدة، قبل إدراج النطاقات في الصيغة.
2.2 خيار الثابت الإحصائي (const) وضبط نقطة التقاطع
يمثل الوسيط الثالث (const) متغيراً منطقياً (Logical Value) يتحكم في كيفية تقدير الحد الثابت في معادلة الانحدار (نقطة التقاطع مع المحور الصادي $\beta_0$). إذا تم ضبط هذه القيمة على TRUE أو تُركت فارغة افتراضياً، فإن خوارزمية الدالة تحتسب الثابت $\beta_0$ بصورة طبيعية، مما يسمح لخط الانحدار بالتقاطع مع المحور الرأسي عند النقطة التي تحقق أفضل توفيق للمربعات الصغرى وتجعل متوسط المتبقيات مساوياً للصفر تماماً.
في المقابل، إذا حُددت هذه القيمة بالخيار المنطقي FALSE، يتم إجبار النموذج على افتراض أن الثابت يساوي صفراً ($\beta_0 = 0$)، مما يعني قسر خط الانحدار على المرور إجبارياً بنقطة الأصل ذات الإحداثيات (0,0). يؤدي هذا الإجراء الرياضي إلى تغيير جوهري في كيفية تفكيك مجاميع المربعات الإحصائية، ويلغي خاصية تساوي متوسط القيم التنبؤية مع متوسط القيم الفعلية المشاهدة.
من المنظور الإبستمولوجي والمنهجي في العلوم السلوكية والنفسية، يُعد فرض الخيار FALSE خطوة شديدة الخطورة ونادراً ما تجد مسوغاً علمياً لتطبيقها. فمعظم المقاييس النفسية (مثل مقاييس الذكاء، والاكتئاب، والرضا الوظيفي) لا تمتلك صفراً مطلقاً حقيقياً يمثل انعدام الخاصية التام؛ إذ إن تسجيل صفر في مقياس الاكتئاب لا يعني الانعدام المطلق لأي ملمح انفعالي. ومن ثم، فإن إلغاء الحد الثابت يقود حتماً إلى تشويه المعاملات التقديرية وتضخيم معامل التحديد بشكل زائف، مما يحتم الإبقاء على الوسيط مضبوطاً على TRUE في كافة البحوث السلوكية القياسية تقريباً.
2.3 وسيط الإحصاءات الإضافية (stats) وتفعيل مصفوفة المؤشرات التكميلية
يتحكم الوسيط الرابع والأخير (stats) في طبيعة المخرجات النهائية وحجمها؛ فإذا اختار الباحث القيمة المنطقية FALSE أو أهمل الوسيط دون كتابة، فإن الدالة تكتفي بإخراج معاملات الانحدار فقط (الميل والثابت) في صف أفقي واحد، متجاهلة أي مؤشرات تقييمية أخرى. يعد هذا الاستخدام المحدود مضيعة للإمكانات الحقيقية التي صُممت الدالة من أجلها، ولا يقدم أي أرضية لإجراء تقييم إحصائي ذي قيمة علمية.
على العكس من ذلك، فإن تفعيل هذا الوسيط بإسناد القيمة المنطقية TRUE يطلق العنان للقدرات الكاملة للدالة؛ حيث يوجه برنامج إكسل لتوليد مصفوفة تشخيصية كاملة ومكثفة تتكون من خمسة صفوف، تضم عشرة مؤشرات إحصائية أساسية في حالة الانحدار البسيط، وتتسع أفقياً في حالة الانحدار المتعدد. هذا الإجراء يحول الخلية من مجرد وعاء لمعامل رياضي بسيط إلى لوحة تحكم إحصائية متكاملة.
يمكّن إدراج القيمة TRUE الباحث من الانتقال من مرحلة التقدير الوصفي إلى مرحلة الاستدلال الإحصائي واختبار الفروض العلمية. فالمؤشرات الإضافية المستخلصة—بدءاً من الأخطاء المعيارية للمعاملات، مروراً بمؤشرات الدقة وجودة التوفيق، وصولاً إلى إحصائية F وتحليل التباين—هي الأدوات الحيوية الوحيدة التي يستند إليها الباحث للحكم على ما إذا كانت النتائج المرصودة تعبر عن علاقات حقيقية في مجتمع الدراسة أم أنها مجرد صدفة ناشئة عن أخطاء المعاينة العشوائية.
3. الترتيب الهيكلي لمصفوفة مخرجات دالة LINEST
3.1 التوزيع الموضعي للقيم داخل شبكة الخلايا
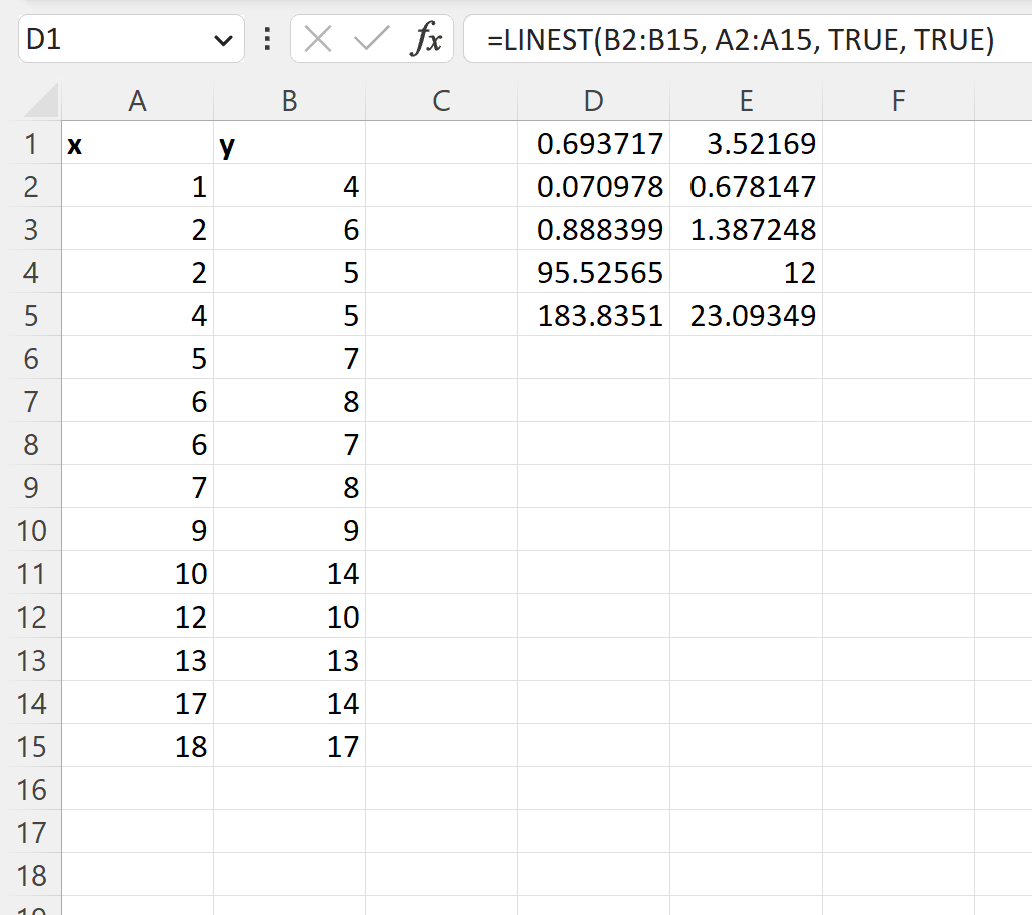
عند تنفيذ دالة LINEST مع تفعيل خيار الإحصاءات التكميلية الكاملة (stats = TRUE) في نموذج الانحدار الخطي البسيط، تُنتج الدالة شبكة منتظمة من المخرجات تتكون تحديداً من خمسة صفوف وعمودين (مصفوفة ذات أبعاد 5×2). تحتل كل معلومة إحصائية موقعاً جغرافياً ثابتاً لا يتغير داخل هذه الشبكة، ويعد حفظ وفهم هذا المخطط الهيكلي شرطاً أساسياً لتفسير النتائج بدقة وتفادي الخلط الكارثي بين المعاملات ومؤشراتها التقييمية.
في نماذج الانحدار الخطي المتعدد، التي تحتوي على $k$ من المتغيرات المستقلة، يتسع البعد الأفقي للمصفوفة ليصبح عدد الأعمدة مساوياً لـ ($k + 1$) عمود، بينما يظل البعد الرأسي ثابتاً ومستقراً عند خمسة صفوف دائماً. ترجع هذه الزيادة الأفقية إلى ضرورة إفراد عمود مخصص لكل معامل انحدار مرافق لكل متغير تفسيري مضاف، في حين يبقى العمود الأخير في أقصى اليمين مخصصاً على الدوام للحد الثابت ومعلماته التشخيصية الخاصة به.
لتجنب اللبس الشائع أثناء كتابة التقارير الإحصائية، يُمكن تحديد إحداثيات الخلايا ومحتوياتها الصريحة في الانحدار البسيط وفق الهيكل المعياري الصارم التالي:
- الصف الأول: ميل خط الانحدار للمتغير المستقل ($\beta_1$) [العمود الأول] | الحد الثابت للتقاطع ($\beta_0$) [العمود الثاني].
- الصف الثاني: الخطأ المعياري لمعامل الميل ($SE_{\beta_1}$) [العمود الأول] | الخطأ المعياري للحد الثابت ($SE_{\beta_0}$) [العمود الثاني].
- الصف الثالث: معامل التحديد الإحصائي ($R^2$) [العمود الأول] | الخطأ المعياري لتقدير قيمة المتغير التابع ($SE_y$) [العمود الثاني].
- الصف الرابع: إحصائية فيشر للنموذج ($F$) [العمود الأول] | درجات الحرية للخطأ المتبقي ($df_{resid}$) [العمود الثاني].
- الصف الخامس: مجموع مربعات الانحدار ($SS_{reg}$) [العمود الأول] | مجموع مربعات المتبقيات ($SS_{resid}$) [العمود الثاني].
3.2 إدراج الدالة كمصفوفة ديناميكية في إصدارات إكسل المختلفة
شهدت طريقة إدراج الدالة تحولاً نوعياً بفضل التحديثات التقنية في محرك الحساب الخاص ببرنامج إكسل. ففي الإصدارات الحديثة، مثل Microsoft 365 وإكسل 2021 والإصدارات الأحدث، تم دمج محرك “المصفوفات الديناميكية” (Dynamic Arrays). بفضل هذه الميزة، يكفي للباحث كتابة الصيغة في خلية مفردة واحدة والضغط ببساطة على مفتاح الإدخال (Enter)؛ لتقوم الدالة تلقائياً بالتمدد والانصباب (Spill) في نطاق الخلايا المجاور بأبعاده الخمسة في اثنين دون أي تدخل إضافي.
على النقيض من ذلك، تتطلب الإصدارات التقليدية والقديمة من إكسل (مثل Excel 2019 وما قبله) استخدام التكنيك المصفوفي التقليدي المعروف اختصاراً بصيغة (CSE). في هذا السياق القديم، يتحتم على المستخدم أولاً تحديد وتظليل نطاق مسبق ومحدد بدقة من الخلايا بمقاس خمسة صفوف وعمودين، ثم كتابة الصيغة في شريط المعادلات، وأخيراً الضغط المتزامن على مفاتيح لوحة المفاتيح: (Ctrl + Shift + Enter). يُحاط التعبير حينها بأقواس معقوفة تلقائية {...} لتأكيد صيغة المصفوفة الإلزامية.
من أكثر المشكلات البرمجية شيوعاً في الإصدارات الحديثة ظهور خطأ الانسكاب (#SPILL!). ينشأ هذا الخطأ عندما يعترض مسار تمدد المصفوفة أي خلية تحتوي على بيانات سابقة، أو نص، أو حتى مسافة فارغة غير مرئية ضمن النطاق المستهدف المكون من 5 صفوف وعمودين أو أكثر. يكمن الحل الجذري والوحيد لهذه المشكلة في فحص مسار الخلايا الواقع أسفل ويسار الخلية الأم وإخلائه بالكامل من أي مدخلات، مما يتيح للمصفوفة الانبثاق بحرية وسلاسة داخل الورقة.
3.3 قواعد قراءة المصفوفة وتحديد هوية الخلايا
من أهم القواعد الجوهرية التي يجب على كل باحث إحصائي إدراكها أن دالة LINEST تتبع قاعدة “الترتيب العكسي” الصارم في عرض معاملات المتغيرات المستقلة. فإذا قمت بإدخال ثلاثة متغيرات مستقلة بالترتيب من اليمين إلى اليسار ($X_1, X_2, X_3$)، فإن الصف الأول من المصفوفة الناتجة سيبدأ من أقصى اليسار بالمعامل التابع للمتغير الأخير ($X_3$)، يليه معامل المتغير الأوسط ($X_2$)، ثم معامل المتغير الأول ($X_1$)، ويستقر الحد الثابت ($\beta_0$) أخيراً في أقصى اليمين. يُعد هذا الترتيب المعكوس مصدراً رئيسياً للأخطاء القاتلة لدى الباحثين غير المتمرسين أثناء عزو المعاملات لمتغيراتها الحقيقية.
يتعين على المحلل التمييز البصري والفصلي الدقيق بين المستويات المختلفة للمصفوفة؛ فالصفان الأول والثاني يعبران عن “معلمات الانحدار التفصيلية” الخاصة بكل متغير على حدة، بما في ذلك تقديرات النقطة وأخطاؤها المعيارية. في المقابل، تُعبر الصفوف الثلاثة السفلية (الثالث والرابع والخامس) عن “مؤشرات النموذج الكلي”، وهي مقاييس شاملة لا تتجزأ تنطبق على أداء المعادلة الرياضية ككل، ولا تتبع أي متغير مستقل بعينه.
لتحقيق أقصى درجات المرونة البرمجية وتفادي تشويه تصميم أوراق العمل بمصفوفة كاملة، يمكن استخلاص أي قيمة مفردة مرغوبة من مصفوفة LINEST مباشرة باستخدام دالة الفهرسة INDEX. على سبيل المثال، إذا رغب الباحث في استخراج قيمة معامل التحديد ($R^2$) فقط في خلية معزولة لاستخدامها في تقرير ملخص، يمكنه صياغة التعبير التالي: =INDEX(LINEST(y_range, x_range, TRUE, TRUE), 3, 1)؛ حيث يوجه هذا الأمر البرنامج للغوص داخل مصفوفة LINEST واقتناص القيمة الواقعة بدقة في تقاطع الصف الثالث مع العمود الأول دون الحاجة لطباعة المصفوفة كاملة على الشاشة.
4. تفسير معاملات الانحدار ونقطة التقاطع (السطر الأول)
4.1 معامل الانحدار الخطي (ميل الخط) وقيمته التفسيرية
يستقر معامل الانحدار الخطي، والذي يُعرف إحصائياً بـ “ميل خط الانحدار” (Slope) ويرمز له رياضياً بالرمز $\beta_1$ أو $B_1$، في الخلية الأولى من السطر الأول للمصفوفة. يمثل هذا المعامل المعدل الرياضي المتوقع للتغير الطارئ على المتغير التابع لكل زيادة مقدارها وحدة قياس حقيقية واحدة في المتغير المستقل. إنه المؤشر الحاسم الذي يحدد مقدار القوة الدافعة أو الأثر التنبؤي الذي يمارسه المتغير التفسيري على الظاهرة السلوكية قيد القياس والتحليل.
تحمل الإشارة الجبرية لمعامل الميل دلالة بالغة الأهمية لتحديد طبيعة وتوجه العلاقة السلوكية؛ فالإشارة الموجبة تعكس علاقة طردية مباشرة تعني أن الزيادة في درجات المتغير المستقل تقترن بارتفاع متناسب في درجات المتغير التابع (كالارتباط بين الدافعية الذاتية ومستوى التحصيل الأكاديمي). في المقابل، تشير الإشارة السالبة إلى علاقة عكسية تؤكد أن ارتفاع المتغير المستقل يقود بصورة منتظمة إلى انخفاض في درجات المتغير التابع (كالارتباط العكسي بين مستويات ممارسة اليقظة الذهنية ودرجات التوتر العصبي).
من الناحية الأكاديمية الصارمة، يجب التمييز الدقيق بين المعنوية الإحصائية لمعامل الميل والأهمية العملية أو الإكلينيكية لما يسمى بحجم الأثر (Effect Size). فقد يفرز النموذج ميلاً ذا دلالة إحصائية فائقة ناتجة عن التضخم الاصطناعي لحجم العينة الكبير، في حين تكون القيمة الرقمية للميل بالغة الضآلة من الناحية الواقعية بحيث لا تحدث فارقاً سلوكياً ملموساً. لذا، فإن فحص معامل الانحدار غير المعياري يجب أن يُقرأ دائماً في سياق وحدات القياس المستخدمة في الأدوات النفسية المطبقة ميدانياً.
4.2 الحد الثابت (نقطة التقاطع مع محور الصادات) ومعناه العملي
يحتل الحد الثابت، أو ما يعرف اصطلاحاً بنقطة التقاطع مع المحور الصادي (Y-Intercept) ويرمز له رياضياً بـ $\beta_0$، الخلية الثانية من السطر الأول في مصفوفة الانحدار البسيط. يمثل هذا الرقم رياضياً القيمة المتوقعة أو التنبؤية للمتغير التابع ($Y$) عندما تكون قيمة المتغير المستقل مساوية تماماً للصفر الجبري ($X = 0$). إنه يمثل نقطة الارتكاز الأساسية التي ينطلق منها خط الانحدار في الفضاء البياني ثنائي الأبعاد.
يثير التفسير الواقعي للحد الثابت إشكاليات منهجية كبرى في أبحاث العلوم الإنسانية والسلوكية؛ ففي كثير من المقاييس النفسية، تكون قيمة “الصفر” الرياضي غير موجودة أساساً في سلم الدرجات الفعلي للأداة (كما في مقاييس معامل الذكاء IQ التي تبدأ عملياً من قيم تتجاوز 40، أو مقاييس ليكرت الخماسية التي تتراوح بين 1 و 5). في مثل هذه السياقات، لا يحمل الثابت معنى واقعياً لظاهرة نفسية قائمة، بل يعمل كمعامل تصحيحي رياضي بحت لضبط إحداثيات وموقع المعادلة في الفراغ الخطي.
ينطوي التفسير الحرفي للحد الثابت على مخاطر منهجية بالغة إذا وقع خارج النطاق الفعلي للمشاهدات التجريبية للعينة المدروسة. إذا كان نطاق درجات المتغير المستقل في العينة يتراوح بين 50 و 100، فإن التنبؤ بقيمة الظاهرة عند المستوى صفر يمثل قفزة استقرائية غير مبررة إحصائياً. ولذلك، يلجأ الباحثون المحترفون إلى إجراء تحويل إحصائي يُعرف بـ “التمركز حول المتوسط” (Centering) للمتغيرات المستقلة بطرح المتوسط الحسابي من الدرجات الخام، مما يضفي على الحد الثابت معنى واقعياً شديد الأهمية يمثل متوسط قيمة المتغير التابع عند المستوى المتوسط للمتغير المستقل.
4.3 صياغة معادلة التنبؤ الخطية المباشرة في الدراسات السلوكية
بمجرد استخراج قيمتي الميل والحد الثابت من السطر الأول لمصفوفة LINEST، تكتمل الصياغة الرياضية لمعادلة خط الانحدار القياسية للتنبؤ الفردي، والتي تأخذ الشكل الرياضي التالي:
$$\hat{Y} = \beta_0 + \beta_1(X)$$
حيث تمثل $\hat{Y}$ الدرجة التنبؤية المتوقعة للمتغير التابع، و$\beta_0$ قيمة التقاطع، و$\beta_1$ معامل الميل، و$X$ الدرجة المرصودة للمتغير المستقل. تشكل هذه المعادلة نموذجاً جبرياً مصغراً لمحاكاة العلاقة السلوكية بين الظاهرتين والتنبؤ بردود الأفعال المستقبلية.
لتطبيق هذه المعادلة إجرائياً، لنفترض أن باحثاً طبق مقياساً تمهيدياً للصلابة النفسية للتنبؤ بمستوى التكيف الجامعي، وأظهر السطر الأول لدالة LINEST المعاملات: $\beta_1 = 1.45$ و $\beta_0 = 12.30$. إذا تقدم طالب جديد وحصل على درجة (20) في مقياس الصلابة، تصبح معادلته التنبؤية المباشرة: $\hat{Y} = 12.30 + (1.45 \times 20) = 41.30$. تتيح هذه الحسابات السريعة للمرشدين والأخصائيين النفسيين إسقاط درجات السلوك المتوقعة وتوجيه التدخلات الاستباقية للطلاب الأكثر عرضة للتعثر.
مع ذلك، يجب التقيد الصارم بحدود التنبؤ الآمنة، وتجنب مغبة الوقوع في خطأ “الاستقراء الخارجي” (Extrapolation). تعني هذه القاعدة المنهجية أن صلاحية المعادلة المستخرجة تنحصر حصرياً داخل المدى الفعلي لأدنى وأعلى درجة للمتغير المستقل تم جمعها ورصدها في العينة الأصلية. فافتراض استمرار استقامة الخط البياني خارج تلك الحدود يعد مجازفة غير محسوبة، إذ غالباً ما تتحول العلاقات النفسية الإنسانية في مستوياتها المتطرفة إلى علاقات غير خطية أو منحنية تفشل المعادلات البسيطة في تمثيلها.
5. تقييم دقة المعاملات عبر الأخطاء المعيارية (السطر الثاني)
5.1 الخطأ المعياري لمعامل الميل ودلالته الإحصائية
يحتوي السطر الثاني من مصفوفة LINEST على مقاييس دقة المعلمات؛ حيث تسكن قيمة الخطأ المعياري لمعامل الميل ($SE_{\beta_1}$) في العمود الأول مباشرة أسفل قيمة الميل ذاتها. يمثل هذا المقياس الانحراف المعياري لتقديرات الميل لو كرر الباحث سحب عينات عشوائية لانهائية متطابقة الحجم من نفس مجتمع الدراسة. وبناءً عليه، يمثل هذا الخطأ مؤشر التشتت وأخذ العينات حول المعلمة الحقيقية المجهولة لمجتمع البحث.
يتأثر هذا الخطأ تأثراً حاسماً بمتغيرين رئيسيين وفق العلاقة الرياضية للخطأ المعياري في OLS:
$$SE(\hat{\beta}_1) = \frac{s}{\sqrt{\sum (X_i – \bar{X})^2}}$$
حيث يمثل $s$ الخطأ المعياري للتقدير في النموذج، ويمثل المقام مجموع مربعات انحرافات المتغير المستقل عن متوسطه. بناءً على هذا البناء الرياضي، يؤدي توسيع حجم العينة ($n$) وزيادة التباين والتنوع الإيجابي في درجات المتغير المستقل إلى تضخيم المقام، مما يقود بالضرورة إلى تقليص قيمة الخطأ المعياري للميل، وهو ما يعزز ثقة الباحث في ثبات المعامل المقدر.
يُعد الخطأ المعياري مقياس الاستقرار التقديري للأثر السلوكي؛ فالقيمة الضئيلة للخطأ المعياري تدل على أن تقدير الميل يتمتع بموثوقية فائقة وثبات كبير عبر العينات المختلفة. أما إذا كان الخطأ المعياري كبيراً ومقارباً لقيمة الميل نفسه، فهذا تحذير إحصائي صارخ بأن التقدير متذبذب ويعاني من تقلبات عشوائية حادة، مما يضعف مصداقية أي تفسير نظري يستند إليه في الميدان السيكولوجي.
5.2 الخطأ المعياري للحد الثابت
في العمود الثاني من السطر الثاني، تعرض الدالة الخطأ المعياري المخصص للحد الثابت ($SE_{\beta_0}$) تحت قيمة $\beta_0$ مباشرة. يقيس هذا المؤشر مقدار التباين الإحصائي المتوقع في تقدير نقطة التقاطع مع المحور الصادي عبر العينات المسحوبة. ونظراً لطبيعة الحد الثابت كنقطة إسقاط عند الصفر، فإن حساسيته الرياضية لأخطاء المعاينة تكون عادة أعلى بكثير من حساسية الميل.
تتأثر هذه القيمة بدرجة ابتعاد مركز درجات المتغير المستقل (متوسطه الحسابي $\bar{X}$) عن نقطة الصفر الجبري؛ فكلما كانت بيانات العينة متجمعة بعيداً في اتجاه الأرقام المرتفعة، احتاج خط الانحدار إلى مد أطول على استقامته للوصول إلى الصفر، وهو ما يؤدي إلى تضخيم ذراع الرافعة التقديرية وزيادة الخطأ المعياري للثابت بشكل ملحوظ. يجب مقارنة حجم هذا الخطأ بقيمة الثابت ذاتها لتقييم الموثوقية التقديرية لتلك النقطة الارتكازية.
تكمن التبعات المنهجية لارتفاع الخطأ المعياري للثابت في التأثير السلبي الحاد على موثوقية التنبؤات السلوكية التي تتم عند المستويات الدنيا للمتغير المستقل. إذا كان الخطأ المعياري كبيراً جداً، فإن نطاق عدم اليقين حول النواتج التنبؤية للمشاركين الذين يمتلكون درجات منخفضة في المقياس سيتسع اتساعاً هائلاً، مما يجعل التنبؤات غير آمنة للاستخدام في القرارات المصيرية مثل التشخيص النفسي أو التوزيع المهني والتربوي.
5.3 حساب إحصائية t وفترات الثقة لمعاملات النموذج
لا تعرض مصفوفة LINEST قيم إحصائية $t$ أو القيم الاحتمالية ($p$-values) المباشرة للمعاملات، ولكنها تقدم المواد الخام الدقيقة لاحتسابها فورياً. يستطيع الباحث حساب قيمة $t$ المحسوبة لأي معامل ببساطة عبر قسمة قيمة المعامل في السطر الأول على خطئه المعياري المناظر له في السطر الثاني:
$$t_{\text{calculated}} = \frac{\hat{\beta}}{SE(\hat{\beta})}$$
تُعبر هذه النسبة البسيطة عن عدد الأخطاء المعيارية التي يبتعد بها المعامل المقدر عن الصفر المفترض في الفرضية الصفرية، والتي تفترض انعدام الأثر كلياً.
لحساب فترات الثقة (Confidence Intervals) للمعاملات عند المستوى الأكاديمي المعتاد 95%، يتم استخدام دالة التوزيع التائي العكسي في إكسل لاستخراج القيمة الجدولية الحرجة: =T.INV.2T(0.05, df)؛ حيث تُمثل $df$ درجات حرية الخطأ المتبقي الواقعة في الصف الرابع والعمود الثاني من مصفوفة LINEST. تُصاغ حدود الثقة الدنيا والعليا للمعلمة وفق المعادلة الرياضية التالية:
$$\text{CI}_{95%} = \hat{\beta} \pm \left( t_{\text{critical}} \times SE(\hat{\beta}) \right)$$
يحمل هذا الإجراء دلالة استدلالية قطعية؛ فإذا كانت فترة الثقة بنسبة 95% لمعامل الميل لا تشتمل نهائياً على الرقم صفر بين حديها الأدنى والأعلى (كأن تنحصر الفترة بين [0.35 , 1.12])، فإن الباحث يستنتج بمنتهى الثقة الإحصائية أن المتغير المستقل يمارس تأثيراً دالاً إحصائياً عند مستوى دلالة $\alpha = 0.05$. أما في حال اشتملت الفترة على الصفر (كأن تكون [-0.15 , 0.85])، يُرفض الأثر وتُقبل الفرضية الصفرية لعدم إمكانية استبعاد كون العلاقة مجرد وهم ناشئ عن صدفة المعاينة.
6. تقييم جودة توفيق النموذج والخطأ التقديري العام (السطر الثالث)
6.1 معامل التحديد (R-squared) ومفهوم التباين المفسر
في العمود الأول من السطر الثالث لمصفوفة LINEST، تبرز واحدة من أهم الإحصاءات التقييمية في التحليل الخطي: معامل التحديد (Coefficient of Determination)، والمعروف عالمياً بـ $R^2$. يعبر هذا المؤشر عن النسبة المئوية الدقيقة للتباين الكلي المرصود في المتغير التابع والذي نجح النموذج الرياضي والمتغيرات المستقلة في تفسيره وتبريره خطياً، في حين يُعزى التباين المتبقي للخطأ العشوائي أو المتغيرات غير المقاسة.
يتراوح المدى العددي لمعامل التحديد دائماً بين الصفر المطلق والواحد الصحيح ($0 le R^2 le 1$). في أبحاث العلوم الطبيعية والهندسية، قد يُشترط الوصول إلى قيم تفوق 0.90 لاعتماد النماذج، ولكن الوضع يختلف جذرياً في دراسات القياس السلوكي والعلوم الإنسانية؛ إذ تُعد القيم التي تتراوح بين 0.15 و 0.40 قيماً مقبولة وذات دلالة تفسيرية ثرية في أغلب الأحيان، نظراً للتعقيد البالغ للسلوك الإنساني وتداخله مع عوامل نفسية واجتماعية وبيولوجية يتعذر ضبطها بالكامل في تصميم تجريبي واحد.
من الضروري الانتباه إلى قصور $R^2$ البسيط عند التوسع في نماذج الانحدار المتعدد؛ إذ يتسم هذا المؤشر بعيب رياضي متأصل يتمثل في ميله الحتمي للزيادة (أو على الأقل البقاء ثابتاً) كلما أضاف الباحث متغيراً مستقلاً جديداً إلى النموذج، حتى لو كان هذا المتغير عديم الفائدة وسخيفاً من الناحية العلمية. لمواجهة هذا التضخم الزائف، يعمد الباحث المحترف إلى حساب $R^2$ المعدل (Adjusted R-Square) يدوياً بالاعتماد على درجات الحرية المتوافرة في مصفوفة LINEST، لمعاقبة النموذج على تعقيده العبثي عبر الصيغة التالية:
$$R^2_{\text{adj}} = 1 – \left[ (1 – R^2) \frac{n – 1}{n – k – 1} \right]$$
6.2 الخطأ المعياري لتقدير قيمة المتغير التابع (Standard Error of Y)
يحتل الخطأ المعياري للتقدير ($SE_y$ أو $s$) العمود الثاني من السطر الثالث في مصفوفة LINEST. يمثل هذا الرقم مؤشراً دقيقاً على التشتت والانحراف المعياري للمتبقيات (الفروق بين القيم الحقيقية والقيم التنبؤية) حول خط الانحدار. بعبارة أخرى، يجسد هذا المعامل متوسط المسافة النموذجية التي تخطئ بها المعادلة الخطية عند محاولة التنبؤ بالدرجة الفعلية لأي فرد داخل العينة.
للحكم الصائب على قوة النموذج وصلاحيته التنبؤية، ينبغي مقارنة قيمة الخطأ المعياري للتقدير بالانحراف المعياري الكلي العام للمتغير التابع ($SD_y$). إذا كان النموذج الخطي ناجحاً وذا كفاءة عالية، فإن قيمة الخطأ المعياري للتقدير يجب أن تنخفض بصورة ملحوظة عن الانحراف المعياري الأصلي للدرجات الخام؛ فالانخفاض الكبير يعكس أن المعادلة استطاعت امتصاص الفروق العشوائية وتقليص مساحة عدم اليقين المحيطة بالسلوك المدروس.
يلعب هذا المقياس دوراً تطبيقياً محورياً في بناء ما يُعرف إحصائياً بـ “مجالات التنبؤ الفردية” (Prediction Intervals). فعند التنبؤ بدرجة استجابة مريض نفسي لبرنامج علاجي معين استناداً إلى معادلته الخطية، لا يقدم الباحث نقطة تنبؤية صماء، بل يصوغ مجالاً احتمالياً يتسع لدرجتين أو ثلاث درجات من الخطأ المعياري للتقدير حول القيمة المحسوبة ($\hat{Y} \pm t \times SE_y$)، مما يمنح الممارس الإكلينيكي فهماً واقعياً لحدود الخطأ المتوقعة في بيئة القياس التطبيقي.
6.3 معايير الحكم على دقة النماذج في العلوم النفسية والاجتماعية
تخضع معايير قبول دقة النماذج الإحصائية في حقول العلوم النفسية والسلوكية لضوابط تختلف جوهرياً عن المنهجيات المطبقة في العلوم الفيزيائية. إن التركيز المهووس على الحصول على قيم مرتفعة جداً لمعامل التحديد ($R^2 > 0.80$) غالباً ما يكون في علم النفس مؤشراً على وجود خلل منهجي خفي، مثل التكرار شبه الحرفي في بنود المقاييس (Tautology)، أو التداخل البنائي الشديد بين المتغير التابع والمستقل، وليس دليلاً على براعة النمذجة الإحصائية.
يتعين على المحلل النفسي الموازنة الدقيقة بين القوة التفسيرية للنموذج من جهة ومبدأ البساطة والتقتير العلمي (Parsimony) من جهة أخرى؛ فالنموذج الأفضل ليس بالضرورة هو النموذج الذي يحشد عشرات المتغيرات التفسيرية لرفع نسبة التباين بمقدار 2% إضافية، بل هو النموذج المقتصد الذي ينجح في تفسير النواة الصلبة للسلوك البشري بأقل عدد ممكن من المتغيرات النفسية ذات الأساس النظري المتين والقابلة للتدخل السلوكي العملي.
ينبغي أن تقترن المؤشرات الإحصائية الرقمية بالدلالة النظرية؛ فالنموذج الذي يقدم $R^2$ متواضعة (كأن تكون 0.20) ولكنه يربط بين متغير تدخلي بسيط (مثل تقنية تنفس استرخائي) وتحسن دال في نوبات القلق المدرسي، يعد نموذجاً فائق الأهمية العلمية والعملية مقارنة بنموذج إحصائي أصم ذي مؤشرات براقة لكنه يفسر علاقات بديهية لا تقدم أي إضافة معرفية للمجال السيكولوجي.
7. اختبار الدلالة الكلية للنموذج عبر إحصاء F ودرجات الحرية (السطر الرابع)
7.1 إحصائية فيشر (F-statistic) واختبار الفرضية الصفرية الشاملة
تستقر إحصائية فيشر ($F$)، المسماة تيمناً بالعالم الإحصائي رونالد فيشر، في العمود الأول من السطر الرابع لمصفوفة LINEST. تضطلع هذه الإحصائية بمهمة محورية تتمثل في إجراء اختبار الدلالة الكلية للنموذج الانحداري واختبار الفرضية الصفرية الشاملة ($H_0$)، والتي تنص على أن جميع معاملات الانحدار المستقلة في المجتمع الأصلي تساوي صفراً في وقت واحد ($\beta_1 = \beta_2 = dots = \beta_k = 0$)، مما يعني عجز النموذج كلياً عن تفسير أي تباين في المتغير التابع.
تُحسب إحصائية فيشر رياضياً كنسبة تباين صريحة تقارن بين قدرتين: تباين الانحدار المفسر بفعل النموذج في البسط، وتباين الخطأ العشوائي غير المفسر المتبقي في المقام؛ أي حاصل قسمة متوسط مربعات الانحدار على متوسط مربعات الخطأ المتبقي:
$$F = \frac{MS_{\text{reg}}}{MS_{\text{resid}}} = \frac{\frac{SS_{\text{reg}}}{df_{\text{reg}}}}{\frac{SS_{\text{resid}}}{df_{\text{resid}}}}$$
تُعبر هذه النسبة عما إذا كان التباين الذي التقطه النموذج يمثل كشفاً علمياً يفوق بمراحل التشتت العشوائي الطبيعي الكامن في عينات القياس الإنساني.
تشير القيمة المرتفعة لإحصائية $F$ إلى تفوق التباين المفسر تفوقاً كاسحاً على تباين الأخطاء، مما يدعم بقوة رفض الفرضية الصفرية وإثبات الفاعلية التنبؤية الحقيقية للنموذج ككل. في المقابل، فإن اقتراب قيمة $F$ من الواحد الصحيح يعكس أن المعادلة ليست أفضل من التخمين العشوائي، وأن المتغيرات المستقلة المختارة تفشل في تقديم أي قيمة إضافية لتوقع وتفسير سلوكيات الأفراد المدروسين.
7.2 درجات الحرية المتبقية (Degrees of Freedom) وأهميتها المنهجية
تظهر درجات الحرية الخاصة بالخطأ المتبقي ($df_{\text{resid}}$) في العمود الثاني من السطر الرابع لمصفوفة LINEST. تمثل درجات الحرية عدد المشاهدات المستقلة داخل العينة التي تظل حرة في التباين بعد احتساب وتقدير جميع المعلمات في المعادلة الخطية. تُحسب هذه القيمة رياضياً من خلال طرح عدد المعلمات المقدرة من إجمالي حجم العينة الخاضعة للتحليل وفق الصيغة التالية:
$$df_{\text{resid}} = n – k – 1$$
حيث تمثل $n$ الحجم الكلي للعينة، ويمثل $k$ عدد المتغيرات المستقلة المدرجة، ويمثل الرقم 1 استهلاك درجة حرية واحدة لحساب الحد الثابت للنموذج.
تعتبر درجات الحرية المتبقية مقياساً منهجياً فائق الحساسية لسلامة التحليل الإحصائي؛ فهي تؤثر تأثيراً مباشراً على القوة الإحصائية (Statistical Power) لاختبارات الفروض. فكلما تقلصت درجات الحرية بسبب صغر حجم العينة أو التوسع غير الرشيد في إدخال المتغيرات المستقلة، اتسعت فترات الثقة وارتفعت القيم الحرجة المطلوبة لإثبات المعنوية، مما يرفع احتمالية الوقوع في الخطأ الإحصائي من النوع الثاني (Type II Error) بالإخفاق في رصد العلاقات الفعلية الموجودة بالفعل.
تفرض المنهجيات البحثية في القياس النفسي متطلبات صارمة للحجم الأدنى للعينة لضمان توفير درجات حرية متبقية كافية تسمح باستقرار التقديرات. تتفق القواعد المنهجية القياسية على ضرورة ألا تقل درجات حرية الخطأ المتبقي عن 50 إلى 100 حالة في دراسات الانحدار البسيط، وأن يتسع حجم العينة بمقدار 10 إلى 20 مشاركاً على الأقل لكل متغير مستقل إضافي في الانحدار المتعدد، وذلك لحماية النموذج من الانحياز وتجنب الإفراط في مطابقة البيانات (Overfitting).
7.3 تحويل قيمة F إلى قيمة دلالة معنوية (P-value) باستخدام إكسل
من الأمور التي قد تربك الباحثين أن دالة LINEST تتوقف عند إخراج قيمة $F$ ودرجات الحرية دون إظهار القيمة الاحتمالية للدلالة المعنوية ($p$-value) المقترنة بها بصورة مباشرة. لكن برنامج إكسل يتيح تحويل هذه المخرجات إلى قيمة احتمالية بدقة متناهية من خلال استخدام دالة التوزيع التراكمي لفيشر لليمين: =F.DIST.RT(F, df1, df2)؛ حيث يُمثل $F$ القيمة في الصف الرابع العمود الأول، و$df1$ درجات حرية الانحدار (المساوية لعدد المتغيرات المستقلة $k$)، و$df2$ درجات حرية الخطأ المتبقي في الصف الرابع العمود الثاني.
تتم مقارنة القيمة الاحتمالية الناتجة ($p$-value) بمستوى الدلالة الألفي ($\alpha$) المعتمد مسبقاً في التصميم التجريبي للبحث، والذي يُحدد عادة في دراسات العلوم السلوكية والإنسانية عند مستوى 0.05 أو 0.01. إذا جاءت القيمة الاحتمالية المحسوبة أقل من مستوى الدلالة المعتمد ($p < 0.05$)، يُصدر الباحث حكمه المنهجي القاطع برفض الفرضية الصفرية، مؤكداً أن التباين الذي فسره النموذج دال إحصائياً ولا يمكن عزوه للصدفة المحضة.
عند صياغة الاستنتاج العلمي النهائي، يجب تجنب عبارات الجزم المطلق والالتزام بالمصطلحات الإحصائية الدقيقة. يُوثق الباحث النتيجة بالإشارة إلى قيمة $F$ المصحوبة بدرجات حريتها المزدوجة (درجات حرية الانحدار، ودرجات حرية المتبقي) متبوعة بالقيمة الاحتمالية؛ كأن يُكتب مثلاً: “أظهرت نتائج تحليل الانحدار دلالة النموذج التنبؤي ككل في تفسير الرضا الوظيفي، $F(1, 48) = 18.75, p < 0.001$"، وهو التوثيق الأكاديمي القياسي الكفيل بتوفير الشفافية العلمية للقارئ والناقد المتخصص.
8. تحليل تباين الانحدار: مجموع المربعات والمتبقيات (السطر الخامس)
8.1 مجموع مربعات الانحدار (SSreg) والتباين المفسر
يقع في العمود الأول من السطر الخامس لمصفوفة LINEST مجموع مربعات الانحدار (Regression Sum of Squares)، والذي يرمز له عالمياً بالرمز $SS_{\text{reg}}$. يمثل هذا المؤشر التعبير الرقمي التراكمي عن مجموع مربعات الفروق والانحرافات بين القيم التي تنبأ بها النموذج الخطي ($\hat{Y}_i$) والمتوسط الحسابي العام لبيانات المتغير التابع ($\bar{Y}$). يُحسب هذا المقياس من خلال المعادلة الرياضية التالية:
$$SS_{\text{reg}} = \sum (\hat{Y}_i – \bar{Y})^2$$
تجسد هذه القيمة الرياضية مقدار التشتت الإجمالي في الظاهرة السلوكية الذي نجح النموذج الإحصائي في تفسيره واستيعابه عبر الخط التنبؤي المصمم. فكلما ارتفعت هذه القيمة مقارنة بمجموع التشتت الكلي، كان ذلك برهاناً ساطعاً على كفاءة المتغيرات المستقلة في محاكاة التباينات الفردية بين المشاركين وإخراجها من دائرة العشوائية المجهولة إلى دائرة الانتظام الخطي القابل للتفسير المنطقي.
يُستخدم هذا المقياس كأساس مباشر لاستخراج “متوسط مربعات الانحدار” (Mean Square of Regression – $MS_{\text{reg}}$)، وذلك عن طريق قسمة قيمة $SS_{\text{reg}}$ على درجات حرية الانحدار ($df_{\text{reg}}$) المساوية لعدد المتغيرات المستقلة $k$ في النموذج:
$$MS_{\text{reg}} = \frac{SS_{\text{reg}}}{k}$$
يمثل هذا الناتج بسط معادلة اختبار فيشر ($F$)، ويشير إلى متوسط جرعة التباين التي استطاع كل متغير تفسيري مدرج أن يقدمها لإضاءة جوانب المشكلة السلوكية محل الدراسة.
8.2 مجموع مربعات المتبقيات أو الخطأ (SSresid) والتباين غير المفسر
يحتل العمود الثاني من السطر الخامس لمصفوفة LINEST مؤشر مجموع مربعات المتبقيات أو الخطأ العشوائي (Residual Sum of Squares)، والمعروف اختصاراً بـ $SS_{\text{resid}}$. يقيس هذا المجموع الفروق الرأسية الحقيقية بين المشاهدات الميدانية الفعلية التي سجلها المشاركون ($Y_i$) والدرجات التقديرية التي أسقطها النموذج الخطي لنفس هؤلاء الأفراد ($\hat{Y}_i$). تتحدد الصيغة الرياضية لحسابه على النحو التالي:
$$SS_{\text{resid}} = \sum (Y_i – \hat{Y}_i)^2$$
تحمل قيمة $SS_{\text{resid}}$ دلالة إبستمولوجية بالغة الأهمية للباحثين؛ فهي تجسد التباين الضائع أو “غير المفسر” في السلوك الإنساني الذي عجزت متغيرات الدراسة الحالية عن استيعابه. يعود هذا القصور التفسيري إلى جملة من العوامل المعقدة، تشمل المتغيرات الوسيطة أو المعدلة غير المقاسة، وأخطاء القياس السيكومتري الكامنة في أدوات الاستبيان، إضافة إلى التباينات البيولوجية والانفعالية الفردية العشوائية التي تنفلت من شباك النماذج الخطية المبسطة.
من هذا المجموع الأساسي، يشتق المحلل الإحصائي “متوسط مربعات الخطأ المتبقي” (Mean Square of Residuals – $MS_{\text{resid}}$) عبر قسمة $SS_{\text{resid}}$ على درجات حرية الخطأ المتبقي ($df_{\text{resid}}$):
$$MS_{\text{resid}} = s^2 = \frac{SS_{\text{resid}}}{df_{\text{resid}}}$$
يمثل هذا الناتج التقدير غير المتحيز لتباين الأخطاء في مجتمع البحث ($\sigma^2$)، ويعد الجذر التربيعي لهذه القيمة ($\sqrt{MS_{\text{resid}}}$) هو نفسه الخطأ المعياري لتقدير المتغير التابع ($SE_y$) الذي سبق للمصفوفة أن أظهرته في السطر الثالث العمود الثاني، مما يؤكد التناسق الرياضي الرائع الذي يربط بين كافة خلايا الدالة.
8.3 العلاقة التوفيقية بين مجاميع المربعات ومعامل التحديد
يقوم التحليل الإحصائي للانحدار على مبدأ بديهي وراسخ يتمثل في تفكيك التباين الإجمالي إلى أجزائه المكونة له؛ حيث يُعرَّف “مجموع المربعات الكلي” (Total Sum of Squares – $SS_{\text{tot}}$) بأنه حاصل الجمع الجبري الخالص لمجموع مربعات الانحدار المفسر ومجموع مربعات المتبقيات غير المفسرة:
$$SS_{\text{tot}} = SS_{\text{reg}} + SS_{\text{resid}}$$
يمثل هذا المجموع التشتت الإجمالي لدرجات المتغير التابع حول متوسطها الحسابي العام لو لم نطبق أي نموذج انحداري إطلاقاً ($\sum(Y_i – \bar{Y})^2$).
من هذه العلاقة التوفيقية البسيطة والعميقة في آنٍ واحد، ينبثق الاشتقاق الرياضي الخالص لمعامل التحديد ($R^2$)؛ حيث يتحدد تعريفياً بأنه النسبة بين مجموع التباين المفسر إلى مجموع التباين الكلي في الظاهرة:
$$R^2 = \frac{SS_{\text{reg}}}{SS_{\text{tot}}} = \frac{SS_{\text{reg}}}{SS_{\text{reg}} + SS_{\text{resid}}}$$
تتيح هذه المعادلة للباحث التحقق الذاتي واليدوي من الاتساق الرياضي الداخلي لمخرجات دالة LINEST؛ فبجمع محتويات الخليتين في السطر الخامس ثم قسمة الخلية الأولى على الناتج الإجمالي، يجب أن يحصل المحلل بالضرورة على نفس الرقم الظاهر في السطر الثالث العمود الأول كمعامل للتحديد.
يوفر استيعاب هذا السطر الخامس للباحثين والمحللين المقومات الحسابية الكاملة لبناء جدول “تحليل التباين للانحدار” (ANOVA Table) المتكامل. يحتوي هذا الجدول على مصادر التباين الثلاثة (الانحدار، المتبقيات، المجموع الكلي)، ودرجات الحرية لكل منها، ومجاميع المربعات، ومتوسط المربعات، وقيمة اختبار $F$، والدلالة الإحصائية المقترنة بها. يمثل تقديم هذا الجدول ركناً أساسياً في الأوراق البحثية المحكمة لنيل الثقة الأكاديمية ونيل إجازة النشر من المحكمين الدوليين.
9. تطبيق عملي خطوة بخطوة: نمذجة مستويات التوتر والأداء المعرفي
9.1 إعداد بيانات التجربة وتطبيق صيغة LINEST المتقدمة
لترسيخ هذه المعارف الإحصائية في سياق تطبيقي مباشر، سنفترض دراسة سيكولوجية تجريبية أُجريت على عينة قوامها 20 مشاركاً من طلبة الدراسات العليا ($n = 20$). استهدفت التجربة فحص أثر درجات التوتر النفسي كمتغير مستقل مفسر ($X$) مقاساً بواسطة مقياس علمي مقنن يمتد من 0 إلى 50 درجة، في التنبؤ بـ “زمن الاستجابة والانتباه الانتقائي” كمتغير تابع ($Y$) مقاساً بالميلي ثانية عبر مهمة معرفية حاسوبية، حيث تقع البيانات في نطاق ورقة عمل إكسل من الخلية A2 إلى B21 (المتغير التابع في العمود B والمتغير المستقل في العمود A).
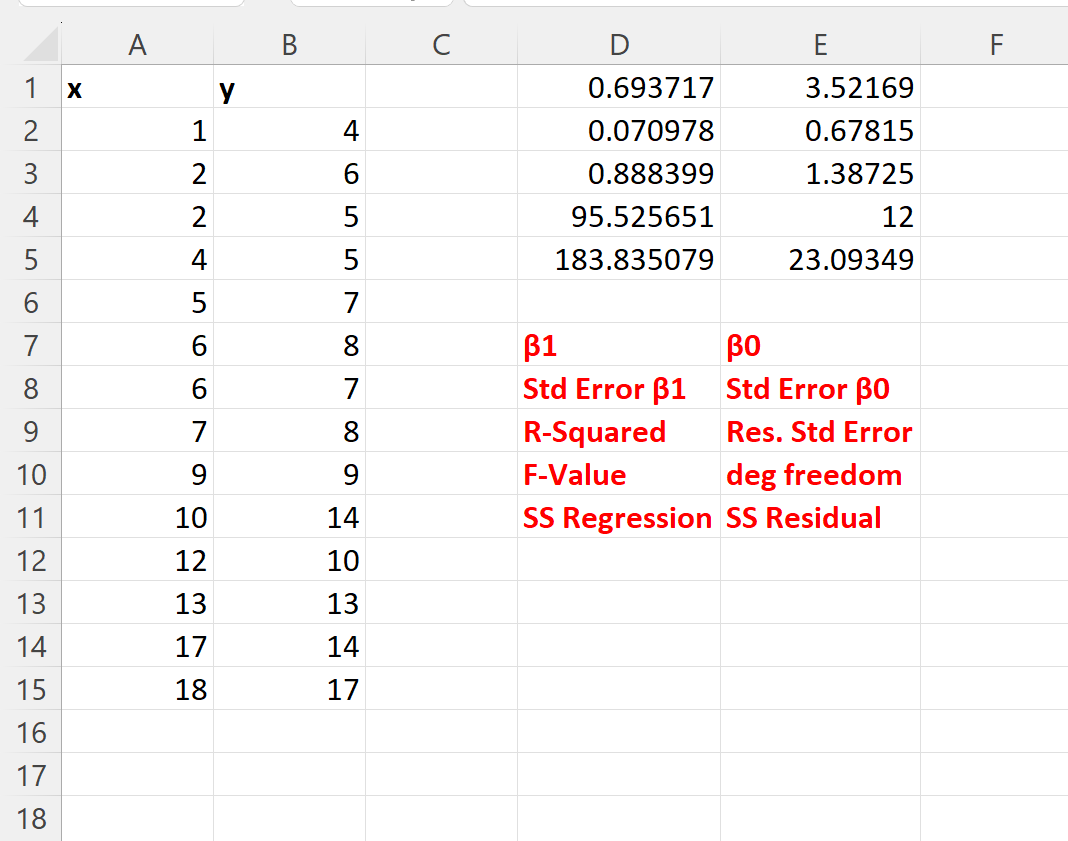
لإجراء التحليل الإحصائي الكامل، يحدد الباحث خلية فارغة في ورقة العمل (ولتكن الخلية D2)، ويكتب الصيغة الإحصائية التالية بدقة متناهية: =LINEST(B2:B21, A2:A21, TRUE, TRUE). بالضغط على زر الإدخال (Enter) في بيئة الإصدارات الحديثة، تنبثق مصفوفة المخرجات المكونة من خمسة صفوف وعمودين، لتمتد تلقائياً من الخلية D2 إلى الخلية E6 متضمنة كافة المقاييس الإحصائية المرجوة.
لنفترض أن البيانات أسفرت عن المصفوفة الرقمية التوضيحية الدقيقة التالية عبر خلايا إكسل:
- السطر الأول (المعاملات): D2 =
12.50(الميل $\beta_1$) | E2 =250.00(الحد الثابت $\beta_0$). - السطر الثاني (الأخطاء المعيارية): D3 =
2.10($SE_{\beta_1}$) | E3 =55.30($SE_{\beta_0}$). - السطر الثالث (جودة التوفيق): D4 =
0.663($R^2$) | E4 =42.15($SE_y$). - السطر الرابع (اختبار النموذج): D5 =
35.42($F$) | E5 =18($df_{\text{resid}}$). - السطر الخامس (مجاميع المربعات): D6 =
62950.00($SS_{\text{reg}}$) | E6 =31980.00($SS_{\text{resid}}$).
9.2 التفسير الإحصائي والتحليلي الشامل لكافة قيم المصفوفة
يبدأ التفسير التحليلي للنموذج من السطر الأول؛ حيث يشير معامل الميل ($\beta_1 = 12.50$) إلى وجود علاقة طردية قوية بين التوتر وزمن الاستجابة؛ فكل زيادة بمقدار درجة واحدة على مقياس التوتر النفسي تقترن بزيادة متوقعة في زمن الاستجابة المعرفية قدرها 12.50 ميلي ثانية، مما يعني تدهوراً في سرعة المعالجة والانتباه. أما الحد الثابت ($\beta_0 = 250.00$)، فيعكس أن زمن الاستجابة الأساسي المفترض لشخص يسجل صفراً في التوتر هو 250 ميلي ثانية. وتكون المعادلة التنبؤية للنموذج: $\text{Response Time} = 250.00 + 12.50 \times (\text{Stress})$.
بالانتقال للسطر الثاني لتقييم الدقة، نجد أن الخطأ المعياري للميل يبلغ 2.10 ميلي ثانية، وبقسمة الميل على خطئه المعياري نحصل على إحصائية $t$ المحسوبة للميل: $t = 12.50 / 2.10 = 5.95$. بقسمة الثابت على خطئه المعياري، نجد $t_{\text{intercept}} = 250.00 / 55.30 = 4.52$. بالرجوع لتوزيع $t$ عند 18 درجة حرية، نجد أن كلتا القيمتين تتجاوزان بكثير القيمة الحرجة ($t_{\text{crit}} = 2.101$ عند $\alpha = 0.05$)، مما يؤكد الدلالة المعنوية الفائقة لكل من الميل والحد الثابت بمفردهما ($p < 0.001$).
يبرز السطر الثالث كفاءة النمذجة؛ حيث بلغت قيمة $R^2 = 0.663$، وهو ما يكشف أن 66.3% من التباينات الفردية المرصودة في سرعة الاستجابة المعرفية للطلاب يمكن تفسيرها حصرياً بواسطة مستويات التوتر النفسي لديهم، وهي قدرة تفسيرية مرتفعة جداً في سياق القياس المعرفي. كما نجد أن الخطأ المعياري العام للتقدير يبلغ $SE_y = 42.15$ ميلي ثانية، وهو النطاق المعتاد للخطأ التنبؤي المتوقع لأي حالة فردية خارج نطاق العينة الأصلية.
يختم السطران الرابع والخامس الفحص الإحصائي؛ فإحصائية فيشر المرتفعة ($F = 35.42$) تتطابق مع درجات حرية خطأ متبقٍ قدرها 18 درجة ($20 – 1 – 1 = 18$). وباستخدام صيغة إكسل الحسابية للقيمة الاحتمالية: =F.DIST.RT(35.42, 1, 18)، نحصل على قيمة احتمالية بالغة الصغر ($p = 0.000013 < 0.001$)، مما يسقط الفرضية الصفرية بحسم ويثبت كفاءة النموذج ككل. كما يتضح أن تباين الانحدار ($SS_{\text{reg}} = 62950$) يمثل النسبة الأكبر من إجمالي التشتت الكلي ($SStot = 62950 + 31980 = 94930$)، ليعيد تأكيد قيمة معامل التحديد ($62950 / 94930 = 0.663$).
9.3 صياغة التقرير الإحصائي النهائي وفق معايير APA
يتطلب النشر الأكاديمي الرصين تحويل تلك المخرجات المصفوفية الخام إلى قالب سردي وجدولي محكم يتسق حرفياً مع دليل النشر لجمعية علم النفس الأمريكية (APA Publication Manual – الإصدار السابع). يُعرض جدول تحليل الانحدار بوضوح متضمناً المعاملات غير المعيارية ($B$)، والأخطاء المعيارية ($SE$), وقيم $t$, وفترات الثقة بنسبة 95%, ومستوى الدلالة ($p$), مع تذييل الجدول بمؤشرات النموذج الكلي ($R^2$, $F$, $df$).
تُصاغ الفقرة التفسيرية للنتائج في متن تقرير البحث بالأسلوب الأكاديمي القياسي التالي:
“أُجري تحليل الانحدار الخطي البسيط لتقييم قدرة درجات التوتر النفسي على التنبؤ بزمن الاستجابة المعرفية لدى عينة من طلبة الدراسات العليا ($N = 20$). أسفرت النتائج عن نموذج انحداري دال إحصائياً ككل، $F(1, 18) = 35.42, p < .001$، حيث نجح التوتر في تفسير ما نسبته 66.3% من التباين في سرعة الاستجابة المعرفية للمشاركين ($R^2 = .663$). وظهر أن معامل ميل التوتر يمارس تأثيراً موجباً دالاً إحصائياً، $B = 12.50, SE = 2.10, t(18) = 5.95, p < .001, 95% \text{ CI } [8.08, 16.92]$، مما يشير إلى أن زيادة التوتر بمقدار وحدة قياس واحدة ترتبط بتباطؤ في زمن الاستجابة مقداره 12.50 ميلي ثانية تقريباً."
تُربط هذه الاستنتاجات بالمحيط النظري لأبحاث الانتباه المعرفي وسيكولوجية الإجهاد؛ حيث تقدم البراهين الكمية لدعم فرضية استنزاف الموارد الانتباهية (Attentional Resource Depletion Model) التي تفترض أن الانشغالات الانفعالية المصاحبة للتوتر تستهلك قدراً معتبراً من السعة المحدودة للذاكرة العاملة، مما يترك موارد عقلية شحيحة لإنجاز مهام المعالجة الذهنية السريعة، وهو ما تجلى بوضوح في ارتفاع زمن الاستجابة الإجمالي كدالة في مستويات التوتر المتزايدة.
10. الافتراضات التشخيصية والأخطاء الشائعة في تفسير دالة LINEST
10.1 الأخطاء الشائعة في قراءة المصفوفة وتفسير اتجاه المتغيرات
يقع عدد كبير من الباحثين في فخ منهجي جسيم يتعلق بقراءة المعاملات في الانحدار المتعدد، والمتمثل في “خطأ الإزاحة والترتيب العكسي”. فبسبب ظهور معاملات المتغيرات المستقلة في مصفوفة LINEST بترتيب عكسي لترتيب أعمدتها في ورقة البيانات، يقوم بعض المحللين بربط معامل المتغير التفسيري الأول بالمتغير التفسيري الأخير، والعكس صحيح، مما ينتج عنه تقارير إحصائية مقلوبة تعزو الآثار والخصائص السلوكية لمتغيرات غير معنية، وهو ما ينسف المصداقية العلمية للبحث بأكمله.
من المزالق التحليلية الشائعة أيضاً “إغفال الأخطاء المعيارية” والتركيز الحصري على قيمة الميل وحدها. إن النظر إلى معامل ميل يبلغ مثلاً 0.85 دون الالتفات إلى خطئه المعياري البالغ 0.90 يقود الباحث إلى استنتاجات واهمة بوجود أثر قوي، في حين أن الفحص المجهري المزدوج يكشف فوراً أن المعامل غير مستقر إحصائياً ولا يتجاوز الصدفة العشوائية إطلاقاً، إذ تنحدر قيمة $t$ المقترنة به إلى ما دون الواحد الصحيح.
أما السقطة الأكاديمية الأخطر فهي “القفز من الارتباط إلى السببية” (Correlation to Causation Fallacy). إن استخراج مخرجات مكتملة لدالة LINEST تظهر نموذجاً تنبؤياً ذا دلالة معنوية فائقة لا يعني مطلقاً، من المنظور الإبستمولوجي، أن المتغير المستقل يمثل السبب الحتمي المباشر والوحيد في إحداث المتغير التابع. فما لم يكن التصميم التجريبي محكماً وقائماً على التوزيع العشوائي التام، مع التحكيم والضبط الصارم للمتغيرات الدخيلة، فإن العلاقة المرصودة قد تكون مجرد انعكاس لعامل ثالث خفي (Confounding Variable) يوجه حركة المتغيرين معاً دون وجود أي رابط سببي أصيل بينهما.
10.2 فحص افتراضات الانحدار الخطي قبل اعتماد النتائج التفسيرية
تستند خوارزمية المربعات الصغرى العادية المستخدمة في LINEST إلى منظومة صارمة من الفروض النظرية المعروفة بـ “افتراضات غاوس-ماركوف” (Gauss-Markov Assumptions). إن انهيار أي من هذه الافتراضات يسقط صلاحية المقدرات، ويجعل الأخطاء المعيارية مضللة، مما يبطل صحة اختبارات $t$ و $F$. أول هذه الافتراضات هو خطية العلاقة؛ إذ يفترض النموذج أن التغير بين المتغيرات يتخذ مساراً مستقيماً، وهو ما يتطلب التحقق البصري المسبق عبر مخططات التشتت ومخطط المتبقيات مقابل القيم التنبؤية للتأكد من خلو البيانات من الأنماط المنحنية.
يتعلق الافتراض الثاني بـ التوزيع الطبيعي للمتبقيات وتجانس التباين (Homoscedasticity). يجب أن تتوزع أخطاء التنبؤ توزيعاً اعتدالياً متماثلاً بمتوسط حسابي قدره صفر، مع ثبات تباين هذه الأخطاء عبر كافة مستويات المتغير التنبؤي دون أن تتسع فجوة التشتت صعوداً أو هبوطاً كشكل القمع (Heteroscedasticity). يؤدي انعدام تجانس التباين إلى تشويه الخطأ المعياري لتقدير المعلمات، مما يستلزم في كثير من الأحيان تطبيق تحويلات لوغاريتمية على البيانات لتثبيت التباين قبل إدراجها في صيغة LINEST.
يبرز في نماذج الانحدار المتعدد افتراض بالغ الأهمية يتمثل في ضرورة خلو النموذج من مشكلة التعدد الخطي التام أو المرتفع (Multicollinearity). تحدث هذه المعضلة عندما تتشابك المتغيرات المستقلة بارتباطات تداخلية بالغة القوة فيما بينها ($r > 0.85$). في مثل هذه الظروف الرياضية، تعجز مصفوفة دالة LINEST عن عزل الأثر الفريد والمستقل لكل متغير، وتتضخم الأخطاء المعيارية بشكل مصطنع، مما قد يدفع إكسل أحياناً إلى إسقاط بعض المتغيرات تلقائياً وإرجاع أخطاء حسابية أو معاملات ذات إشارات جبرية غير منطقية تتعارض مع النظريات السيكولوجية الراسخة.
10.3 أفضل الممارسات المنهجية للباحثين والمحللين الإحصائيين
لضمان أعلى درجات النزاهة والرصانة العلمية عند استخدام دالة LINEST، يُوصى بالدمج المتكامل بين المخرجات العددية للدالة والتشخيص البصري المتقدم عبر الرسوم البيانية المتخصصة. يتعين على الباحث دائماً استخراج مصفوفة المتبقيات وتوليد “مخطط الاحتمال الطبيعي للمتبقيات” (Normal P-P Plot) ومخطط تشتت المتبقيات في مواجهة القيم التنبؤية المحسوبة، حيث يوفر هذا الفحص البصري التكميلي صمام أمان يحمي الباحث من تمرير نماذج زائفة رياضياً.
كما يُنصح في الدراسات السلوكية المتقدمة بتطبيق تقنيات “التحقق المتقاطع” (Cross-Validation) لحماية النموذج من مشكلة الإفراط في مطابقة عينة البحث الخاصة (Overfitting). يتمثل هذا الإجراء المنهجي في تقسيم بيانات البحث إلى عينة تدريب (Training Sample) يُبنى عليها نموذج LINEST، وعينة اختبار مستقلة (Validation Sample) يُطبق عليها نفس النموذج لقياس مدى صمود قدرته التنبؤية واستقرار معامل التحديد عبر العينات المتعددة، بما يضمن إمكانية تعميم الاستنتاجات العلمية خارج حدود العينة الأصلية.
أخيراً، تقتضي قواعد الشفافية المنهجية وقابلية التكرار العلمي (Replicability) أن يوثق الباحث في ملحقات بحثه الصياغات البرمجية الدقيقة المستخدمة، وتحديد أسماء النطاقات والخلايا، مع إرفاق ورقة العمل المحمية التي تتضمن مصفوفة LINEST الكاملة. إن هذه الممارسة تتيح للمراجعين الأكاديميين والباحثين اللاحقين محاكاة الحسابات وفحص خطوات التقدير خطوة بخطوة، وهو ما يرسخ التقاليد العلمية الرصينة ويخدم تطور المعرفة في حقول العلوم النفسية والسلوكية بموثوقية كاملة.
خاتمة
تثبت دالة LINEST في مايكروسوفت إكسل أنها تتجاوز بكثير كونها مجرد صيغة حسابية مصفوفية عابرة؛ إنها منظومة تحليلية استدلالية متكاملة تضع بين يدي الباحث في العلوم السلوكية والنفسية القوة التشخيصية الكاملة لأسلوب المربعات الصغرى العادية. من خلال مصفوفة مدمجة ومتناغمة تتألف من خمسة صفوف، تقدم الدالة جسراً رياضياً متيناً يربط بين معاملات التقدير المفردة ومؤشرات الدقة وجودة التوفيق الشاملة، مما يحرر المحلل الإحصائي من التبعية للبرمجيات الإحصائية المغلقة ويوفر له بيئة تفاعلية شفافة ومباشرة لقراءة العلاقات وتفكيك تباينات الظواهر الإنسانية المعقدة.
مع ذلك، تظل القوة التحليلية لهذه الدالة رهينة الفهم العميق والمستنير لمنطق ترتيب خلاياها، والوعي الراسخ بالافتراضات الرياضية التي تشترطها النمذجة الخطية الكلاسيكية. إن الإدراك اليقظ للفروق الدقيقة بين الدلالة الإحصائية والأهمية العملية، والتحقق المستمر من خلو النماذج من مشكلات التعدد الخطي والتوزيع غير الاعتدالي للمتبقيات، هو الضمانة الحقيقية الوحيدة لتحويل الأرقام الصماء في مصفوفة إكسل إلى معرفة سيكولوجية نافعة تسهم بفاعلية في تطوير النظريات وتوجيه الممارسات السريرية والتربوية والمهنية بكفاءة واقتدار.
المراجع
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association.
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Microsoft Corporation. (n.d.). LINEST function. Microsoft Support. https://support.microsoft.com/en-us/office/linest-function-84d7d0d9-6e40-4139-812b-74c924ed3f11
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.