
تمثل معالجة البيانات النصية غير المهيكلة داخل جداول البيانات الإلكترونية، ولا سيما برنامج مايكروسوفت إكسل (Microsoft Excel)، أحد أكثر التحديات التقنية تعقيداً في حقل إدارة وتنقيب البيانات المكانية. تنشأ هذه الصعوبة بصورة جوهرية عند التعامل مع السجلات الجغرافية والعناوين المدخلة بصيغة سردية متصلة تخلو تماماً من علامات الترقيم التقليدية، كالفواصل الإنجليزية أو العربية، التي تُشكل تاريخياً المرتكز الأساسي لأدوات التجزئة القياسية. يتطلب هذا الوضع نمطاً متقدماً من التحليل الاستدلالي الذي يتجاوز الحدود البسيطة للنصوص ليصل إلى التفكيك المعرفي للمكونات الكينونية المستقلة مثل أرقام المباني، وأسماء الشوارع المركبة، والتجمعات الحضرية، والرموز البريدية المتنوعة.
تكمن المعضلة الرئيسية في أن البيانات النصية المجردة من المحددات الفاصلة لا تتبع قواعد بناء خطية منتظمة؛ فاللغات الطبيعية تتيح مرونة هائلة في التعبير عن العناوين، مما يجعل الأدوات الآلية الصارمة تعاني من اضطراب هيكلي عند محاولة توزيع العناصر في أعمدة مستقلة. فبينما يسهل على العين البشرية التمييز البديهي بين نهاية اسم الشارع وبداية اسم المدينة من خلال السياق الدلالي والمعرفي المسبق، فإن النظم الحاسوبية المصمتة تنظر إلى العنوان كمتتالية محرفية صماء تحتاج إلى قواعد استدلال صارمة، أو خوارزميات تعلم استقرائي ذكية، أو صيغ تركيبية معقدة قادرة على التنبؤ بمواقع الانتقال بين المفردات غير المتجانسة.
يهدف هذا الدليل الأكاديمي الشامل إلى تقديم دراسة منهجية وتطبيقية متعمقة لكيفية فصل العناوين غير المزودة بفواصل في بيئة إكسل، مستعرضاً الأبعاد النظرية والتطبيقات الإجرائية لأداة التعبئة السريعة (Flash Fill)، والصيغ البرمجية المعتمدة على الدوال الرياضية والنصية المركبة، إضافة إلى استثمار تقنيات الاستعلام المتقدم عبر أداة محرر الاستعلامات (Power Query) ومحركات التعبيرات النمطية (Regular Expressions) عبر لغة الفيجوال بيسك للتطبيقات (VBA). سيتم تفكيك كل مسار بدقة منهجية فائقة، تضمن استيعاب الباحثين والمحللين للآليات الخوارزمية الكامنة وراء استخراج البيانات الجغرافية دون المساس بدقة السجلات أو سلامتها الهيكلية.
1. مقدمة نظرية حول بنية النصوص الجغرافية وتحديات معالجتها في إكسل
1.1 إشكالية البيانات النصية غير المهيكلة وغياب الفواصل التنظيمية
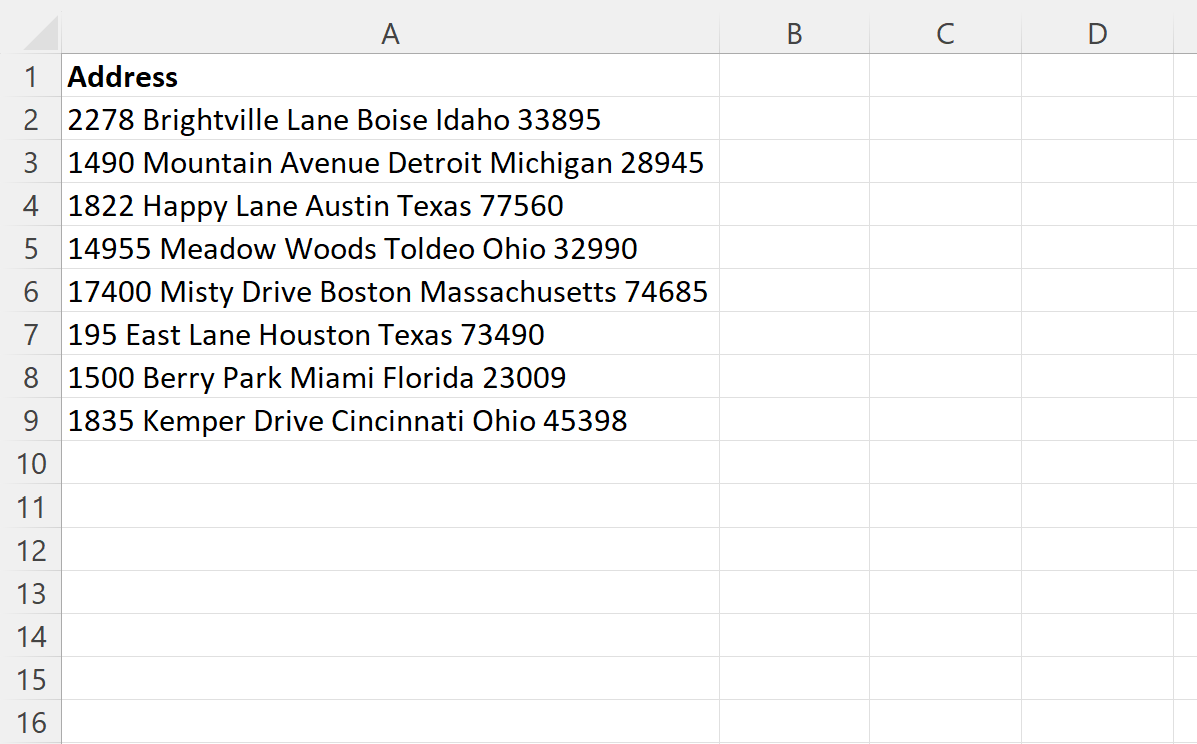
تشكل البيانات الجغرافية غير المهيكلة (Unstructured Geographic Data) تحدياً معلوماتياً حقيقياً في بيئات الأعمال والمؤسسات البحثية؛ حيث تُخزن العناوين غالباً في صيغة سلاسل نصية عشوائية تفتقر إلى أي معيار فاصل يحدد الانتقال من مكون مكاني إلى آخر. إن غياب محددات النصوص الثابتة (Fixed Delimiters) مثل الفواصل العادية والمنقوطة يحول دون استخدام الخوارزميات التقليدية البسيطة التي تعتمد على البحث المباشر عن المحارف الفاصلة لتقطيع النص. تتضاعف هذه الصعوبة نتيجة التباين الصرفي والتركيبي في أسماء الكيانات الجغرافية، حيث قد يتألف اسم الشارع من كلمة واحدة أو عدة كلمات، وقد تسبقه أو تلحقه أرقام المباني، فضلاً عن وجود اختصارات جغرافية متباينة، مما يجعل السلسلة النصية متداخلة بدرجة يصعب فصلها دون إعمال قواعد الاستدلال اللغوي المتقدم.
تتجلى أوجه القصور الهيكلية في أداة التوزيع النصي القياسية مثل خاصية تحويل النص إلى أعمدة (Text to Columns) المعتمدة على المسافات الفاصلة؛ فعند تطبيق الفصل بالاعتماد على الفراغ (Space Delimiter) على عناوين تفتقر إلى الفواصل، فإن الأداة تتسبب في تفتيت غير منضبط للسجلات عبر الأعمدة. فالعنوان الذي يضم شارعاً بكلمة واحدة مثل “شارع النيل” سيتوزع على أعمدة تختلف كلياً عن عنوان يضم شارعاً مركباً مثل “شارع جمال عبد الناصر”، الأمر الذي يقود إلى بعثرة أسماء المدن والرموز البريدية في خلايا غير متجانسة عبر الصفوف. هذا التباين الشديد يُحدث تشويشاً شاملاً في قواعد البيانات ويقود إلى انخفاض حاد في موثوقية المستودعات الرقمية، مما ينعكس سلباً على عمليات اتخاذ القرار المؤسسي واستخراج الأنماط المكانية الدقيقة.
تؤكد الدراسات المعنية بتحليل المتتاليات اللغوية وبناء المكانز المعجمية أن غياب المحددات الصريحة يفرض الانتقال نحو تحليل الكثافة الدلالية والروابط البنيوية للكلمات، وهو ما يشبه نمذجة البنى النصية في اللغات الطبيعية لدراسة اكتساب اللغات وسلوك المفردات، كما ناقش ذلك Lozano (2021) في توثيق خصائص المجموعات اللغوية وتحليل بنيتها المعقدة. إن عدم انتظام الفواصل الجغرافية لا يُعد مجرد إشكالية تنسيقية، بل هو عائق بنيوي يؤدي إلى فقدان الهوية الإدارية للبيانات، مما يحرم المؤسسات من إمكانية تصنيف العملاء مكانياً، أو إجراء تحليلات لوجستية دقيقة، أو حتى الالتزام بالمعايير القياسية لتبادل البيانات المكانية على الصعيد الدولي.
1.2 المقارنة الوظيفية بين دالة TEXTSPLIT وأدوات الاستدلال الآلي
مع إطلاق الدوال المصفوفية الديناميكية المتقدمة في إصدارات إكسل الحديثة، برزت دالة TEXTSPLIT كحل جذري لتقسيم السلاسل النصية استناداً إلى مصفوفة من المحددات المحددة سلفاً. بيد أن الكفاءة الحسابية لهذه الدالة تصطدم بعائق بنيوي غير قابل للتجاوز عند غياب الفواصل الصريحة بين حقول العناوين؛ حيث تتطلب الدالة معاملاً محدداً للفصل عبر الأعمدة أو الصفوف. وعند غياب هذا المعامل، فإن استخدام مسافة الفراغ كفاصل يوقع الدالة في نفس الفخ الكلاسيكي لأدوات التجزئة التقليدية، مما يؤدي إلى إنتاج مصفوفات متفاوتة الأبعاد لا يمكن التحكم في اتساقها الرأسي داخل جداول البيانات المعقدة.
في المقابل، تعتمد أدوات الاستدلال الآلي، وعلى رأسها خاصية التعبئة السريعة (Flash Fill)، على فلسفة مغايرة جذرياً لا تبحث عن الفواصل المحرفية، بل ترتكز على مبدأ الاستدلال التنبؤي وتوليد البرامج التلقائي (Program Synthesis). تقوم هذه الأدوات بتحليل الفروق الجوهرية بين الأنماط النصية والأرقام والمسافات النسبية، مما يسمح لها باستنباط الكيانات المستقلة حتى لو كانت مدمجة في كتلة نصية صماء. يُعد هذا التحول انتقالاً منهجياً عميقاً من النمذجة الرياضية الحتمية الصارمة إلى خوارزميات مطابقة الأنماط (Pattern Recognition)، حيث يتم استبدال الشروط المنطقية المسبقة بنماذج إحصائية استقرائية تتعرف على ماهية البيانات بناءً على موقعها وسياقها المحيط.
يتشابه هذا الاستدلال الآلي مع النماذج المعرفية التي تحاكي استنباط المعرفة الدلالية المهيكلة من خلال التنبؤ بتسلسل الكلمات والروابط المكانية ضمن النصوص غير المصنفة، وهي الآلية التي فحصها Huebner & Willits (2018) في تبيان كيفية نشوء المعرفة المنظمة تلقائياً عبر نمذجة المتتاليات اللفظية. توفر أدوات الاستدلال في إكسل مرونة فائقة لعزل المكونات الجغرافية؛ حيث تستطيع رصد التحول من نسق الحروف الأبجدية المكونة لاسم الشارع إلى الحروف التي تشير للمحافظة، ثم القفز لعزل النسق الرقمي الدال على الرمز البريدي دون الحاجة لوجود علامة ترقيم واحدة تفصل بينهم.
1.3 الأهمية المنهجية لتفكيك العناوين في نمذجة البيانات
تكتسب عملية تفكيك العناوين أهمية محورية في هندسة البيانات (Data Engineering)، حيث يُعد العنوان غير المجزأ عائقاً كبيراً أمام بناء مستودعات البيانات المتوافقة مع الصيغ المعيارية المعتمدة مثل قواعد البيانات العلائقية (Relational Databases). تتيح عملية استخلاص كل مكون مكاني على حدة—كالشارع، والحي، والمدينة، والرمز البريدي—بناء مؤشرات بحث وفهرسة عالية الكفاءة داخل محركات قواعد البيانات، مما يسهم في خفض الزمن المستغرق في تنفيذ استعلامات الفرز والتصفية الإحصائية في الدراسات التطبيقية واسعة النطاق.
علاوة على ذلك، يُعد التفكيك الدقيق حجر الزاوية لتسهيل عمليات التشفير الجغرافي (Geocoding) والربط مع نظم المعلومات الجغرافية (GIS). تعتمد واجهات برمجة التطبيقات (APIs) الخاصة بالخرائط العالمية على حقول مكانية منفصلة لتحقيق أعلى نسب مطابقة للأحداثيات المكانية؛ وبالتالي فإن تزويد هذه النظم بسجلات نصية مدمجة يرفع من معدلات الفشل في تحديد المواقع ويزيد من كلفة المعالجة الحاسوبية. إن فصل المكونات يقلل من مخاطر الغموض المكاني، ويضمن دمج السجلات المؤسسية بسلاسة مع نظم إدارة علاقات العملاء (CRM) وسلاسل الإمداد اللوجستية المتطورة.
وعلى صعيد الحوكمة المؤسسية، يُسهم الانتقال من النصوص المدمجة إلى الحقول الذرية المنفصلة في تقليل أخطاء المعالجة اليدوية التي يرتكبها موظفو الإدخال، مما يعزز موثوقية السجلات التاريخية للمنظمات. فعندما تنقسم البيانات إلى حقولها الأساسية، يصبح تطبيق قواعد التحقق الصارمة (Data Validation Rules) أمراً ممكناً، كالتأكد من مطابقة طول الرمز البريدي لعدد خانات محدد، أو التأكد من انتماء المدينة للمحافظة المحددة، مما يرفع الجودة الشاملة للمعلومات ويدعم القرارات الاستراتيجية المدعومة بالبيانات الواقعية.
2. الأسس الخوارزمية لأداة التعبئة السريعة (Flash Fill)
2.1 مبادئ البرمجة بالأمثلة والتعلم الاستقرائي
ترتكز أداة التعبئة السريعة (Flash Fill) في جوهرها الحاسوبي على إطار عمل البرمجة بالأمثلة (Program Synthesis by Example – PBE)، وهو فرع متقدم من فروع علوم الذكاء الاصطناعي الرمزي. تستند هذه التقنية إلى خوارزميات رائدة طورها الباحث سوميت جولواني (Sumit Gulwani) وفريقه البحثي في مختبرات مايكروسوفت للأبحاث، والتي تهدف إلى توليد برامج ونصوص برمجية لمعالجة السلاسل النصية تلقائياً دون حاجة المستخدم لكتابة سطر برمجي واحد. تعتمد هذه المنهجية على التعلم الاستقرائي (Inductive Learning)، حيث يقوم النظام باستخلاص نوايا المستخدم وقواعد التحويل المنطقية من خلال دراسة العلاقة التركيبية بين المدخلات الأصلية والنتائج المعطاة في النماذج الأولية.
تعمل الخوارزمية عبر فحص دقيق للبنية الهيكلية للمحارف؛ إذ تقوم بتصنيف النصوص إلى أصناف متمايزة تشمل الأبجديات، والأرقام، والمسافات البيضاء، وعلامات الترقيم إن وجدت. عند إدخال المستخدم لمثال استخلاص يدوي في الخلية المجاورة، تقوم الخوارزمية بتوليد لغة وسيطة خاصة بالمجال تسمى (Domain-Specific Language – DSL). تضم هذه اللغة عمليات قطع ونَسخ ومطابقة لسلاسل النصوص بناءً على مواقع المحارف أو التحولات النوعية بينها (كتغير النمط من حرفي إلى رقمي)، مما يمكنها من بناء شجرة نحوية للبرنامج المرشح لتفسير عملية الفصل بأعلى كفاءة منطقية ممكنة.
يختلف هذا المسار اختلافاً جذرياً عن التكرار الميكانيكي الأعمى المعتمد على تكرار الخطوات الفيزيائية؛ فالأداة لا تنسخ الحركات بل تُجري تعلماً سياقياً حقيقياً يحاكي العمليات المعرفية المقارنة. يتم اختبار آلاف التباديل والتوافيق البرمجية في أجزاء من الثانية واختيار البرنامج الأكثر عمومية وإيجازاً لضمان عدم حدوث إفراط في التخصيص (Overfitting)، مما يسمح للنموذج بالتعامل مع التباينات الطفيفة في طول الكلمات وتراكيب العناوين المعقدة عبر آلاف السجلات اللاحقة بنجاح مذهل.
2.2 التطور التقني لخوارزميات معالجة السلاسل النصية في بيئة إكسل
شكل إدراج خاصية التعبئة السريعة ضمن إصدار مايكروسوفت إكسل 2013 نقطة تحول استراتيجية في تاريخ برمجيات الجداول الحسابية؛ حيث تم نقل تقنيات توليد الشيفرات البرمجية الذكية من الأوراق الأكاديمية النظرية إلى التطبيق العملي لملايين المستخدمين حول العالم. تميز هذا التطور بالقدرة على التعامل مع التعقيد الهائل للسلاسل النصية دون استهلاك موارد المعالجة المركزية، بفضل اعتماد خوارزميات التجميع الموجه (Directed Acyclic Subgraphs) التي تتيح تمثيل عدد فلكي من البرامج التوليدية المحتملة وضغطها ضمن مساحة ذاكرية متناهية الصغر وسريعة الاسترجاع.
تم تدريب هذه المحركات التوليدية على استيعاب الخصائص اللغوية لمئات اللغات العالمية؛ إذ تتعرف الأداة بكفاءة متساوية على الأبجديات اللاتينية، والنصوص العربية المعقدة ذات الحروف المتصلة والاتجاه من اليمين إلى اليسار، مع الحفاظ على قدرة تحليل الفراغات الدقيقة التي تفصل الكلمات العربية دون فواصل. هذا التنوع التشغيلي جعل الأداة قادرة على التكيف مع التناقضات الصياغية للعناوين الإقليمية، التي تختلف في ترتيب أسمائها بين الممارسات الغربية والمحلية، مما عزز من مرونة إكسل كبيئة تحضير بيانات متكاملة.
أما من زاوية الكفاءة الحسابية، فقد صُممت الخوارزمية لتعمل وفق تعقيد حسابي خطي تقريباً بالنسبة لحجم العينة الأولى، مما يتيح استجابة فورية ومعاينة لحظية (Live Preview) أثناء طباعة المستخدم للحروف الأولى من المثال التالي. يضمن هذا الأداء خفض الحمل الحسابي على الأجهزة عند التعامل مع مجموعات البيانات الكبيرة التي تضم مئات الآلاف من الصفوف، حيث يتم تطبيق النموذج المولد دفعة واحدة عبر عمليات معالجة سريعة تتفوق بمراحل على الدوال النصية التقليدية المتداخلة التي تستهلك ذاكرة إعادة الحساب التلقائي بصورة متكررة.
2.3 شروط ومتطلبات نجاح الخوارزمية في كشف الأنماط
على الرغم من القدرات الاستدلالية المتقدمة للتعبئة السريعة، إلا أن نجاحها الخوارزمي ليس مطلقاً، بل يخضع لشروط بيئية وتنظيمية محددة يجب توافرها داخل جدول البيانات. يأتي في مقدمة هذه الشروط ضرورة الاتساق النسبي في الترتيب الهيكلي لمكونات العنوان؛ فإذا كانت بعض السجلات تبدأ برقم المبنى متبوعاً بالشارع ثم المدينة، بينما تبدأ سجلات أخرى بالمدينة متبوعة برقم الشارع، فإن الخوارزمية قد تصاب بحالة من الارتباك الدلالي يمنعها من تعميم البرنامج المستنبط بصورة موحدة وموثوقة.
يلعب انتظام الفراغات البيضاء وعلامات الترقيم البديلة دوراً حيوياً في توجيه الاستدلال الحسابي؛ حيث تستخدم الخوارزمية حدود الكلمات كعلامات ارتكاز طبيعية. إذا احتوى النص الأصلي على مسافات بيضاء غير مرئية أو مسافات مزدوجة عشوائية، فإن ذلك يؤدي إلى حسابات خاطئة لمواقع المحارف، مما يستوجب تطهيراً استباقياً للنص. وتتجلى أهمية الترتيب النصي في دراسات قياس المسافات الدلالية بين الرموز اللفظية في قواميس المعرفة المحوسبة، حيث تؤثر الفجوات التركيبية على كفاءة استرجاع المعاني والعلاقات، كما بين ذلك Maki et al. (2004) في تقييم المسافات الدلالية للنصوص الحاسوبية.
إضافة إلى ذلك، تشترط الأداة تجاوراً فيزيائياً مباشراً بين عمود البيانات الأصلية والأعمدة المستهدفة بالتعبئة؛ إذ تفحص الخوارزمية البيانات الواقعة في النطاق المحيط الملاصق (Adjacent Range) للاستدلال على أصل البيانات. يفشل محرك التعبئة السريعة في العمل إذا وُجدت أعمدة فارغة تفصل بين النص الأصلي والعمود المراد توليده، حيث يُعد هذا التجاور هو الرابط الهيكلي الذي يُمكّن النظام من قراءة السلسلة الأصلية وربطها بالمخرجات المكتوبة في الخلية التدريبية الأولى بدقة تامة.
3. الإعداد المنهجي للبيانات وتهيئة جدول العمل
3.1 فحص اتساق النصوص الأولية ومعالجة الشوائب
تتطلب المعالجة الرصينة للبيانات قبل الشروع في عمليات التجزئة إجراء فحص أولي شامل لتنقية النصوص من كافة الشوائب المحرفية التي قد تُربك نماذج الاستدلال الخوارزمي. في مقدمة هذه الشوائب تأتي المسافات الزائدة، سواء كانت فراغات في بداية النص أو نهايته أو مسافات مزدوجة بين الكلمات ناتجة عن أخطاء الإدخال البشري. يمثل استخدام دالة TRIM الإجراء الوقائي الأول لتوحيد الفراغات الفاصلة وجعلها مسافة بيضاء مفردة ومستقرة، مما يؤسس أرضية مثالية لحساب مواقع الكلمات بدقة بالغة.
كما يُوصى بدمج دالة CLEAN مع دالة TRIM لإزالة المحارف غير القابلة للطباعة (Non-printable characters) التي غالباً ما تتسلل إلى جداول البيانات عند استيراد السجلات من نظم إدارية قديمة أو نسخها من صفحات الإنترنت والملفات النصية الخارجية. هذه المحارف المخفية تُمثل نقاط انقطاع صامتة تمنع أدوات إكسل من التعرف على الامتداد الحقيقي للسلسلة النصية، مما يسبب انحرافات غير متوقعة في المخرجات المفصولة ويفسد منطق التكرار البرمجي.
ينبغي كذلك رصد الأخطاء الإملائية والطباعية الفادحة التي قد تكسر أنماط النصوص، مثل التصاق الأرقام بالحروف الأبجدية مباشرة دون مسافة فاصلة، كأن يُكتب رقم الشارع مدمجاً في اسمه. إن إغفال تصحيح هذه التشوهات الأولية يحد من كفاءة أي منهجية معتمدة لاحقاً؛ لذا يتعين توحيد السجلات الشاذة عبر استخدام أدوات الاستبدال التلقائي للوصول إلى مستوى مقبول من التجانس الشكلي الذي يُمكّن محركات التعرف من قراءة الحدود المنطقية للكلمات بيسر وسلاسة.
3.2 التخطيط الهيكلي لأعمدة الإخراج المستهدفة
يتطلب الفصل الناجح للعناوين غير المقسمة تصميماً معمارياً واضحاً لجدول العمل قبل البدء في استخلاص البيانات؛ إذ يجب تخصيص أعمدة إخراج مستقلة وواضحة لكل عنصر كينوني يُراد استخراجه من العنوان الأصلي. يتضمن المخطط المعياري الأكثر كفاءة إنشاء أربعة أعمدة متجاورة كالتالي: عمود “رقم المبنى والشارع” (Street Address)، وعمود “المدينة أو المركز” (City)، وعمود “المحافظة أو الولاية” (State / Governorate)، وعمود “الرمز البريدي” (Postal / ZIP Code).
يعد تطبيق التسميات المعيارية الموحدة في رؤوس الأعمدة (Column Headers) شرطاً تنظيمياً دقيقاً، ليس فقط لتوجيه المستخدم أثناء مراجعة البيانات، بل لتسهيل الربط المستقبلي مع نظم قواعد البيانات ونماذج ذكاء الأعمال المتقدمة. ينبغي تجنب دمج الخلايا نهائياً في نطاقات الإخراج، والتأكد من إعداد التنسيق العام (General) أو التنسيق النصي (Text) لجميع الأعمدة، وتحديداً لعمود الرمز البريدي لحمايته من فقدان الأصفار البادئة في حال احتواء بعض الرموز عليها.
من الناحية التموضعية، يجب إدراج هذه الأعمدة الجديدة على الفور بجانب عمود البيانات الخام، مع تفادي ترك أعمدة فارغة تفصل بين المنبع والمصب البياني؛ ذلك لأن تقنيات إكسل الاستدلالية تعتمد على مصفوفة التجاور المباشر لقراءة المتغيرات. إن التخطيط الدقيق للجدول يُجنب المستخدم الوقوع في أخطاء تداخل البيانات، ويمنع الكتابة التلقائية غير المقصودة فوق سجلات أخرى قد تكون متواجدة في نطاقات عمل غير مؤمنة.
3.3 صياغة المثال التدريبي المعياري في السطر الأول
يمثل السطر الأول في مصفوفة الفصل “حجر الزاوية” وحقل التدريب الأساسي الذي سيبني عليه النظام خوارزميته التوليدية بالكامل؛ وبالتالي فإن أي خطأ إملائي أو تركيبي في هذا السطر سينتشر كعدوى برمجية عبر كافة خلايا العمود اللاحقة. يتعين على المحلل اختيار سطر افتتاحي يمثل النمط العام السائد في المجموعة النصية بأعلى درجة وضوح، متجنباً البدء بالحالات الشاذة أو السجلات الاستثنائية التي قد تُربك المحرك الاستقرائي في خطوته الأولى.
يجب إدخال البيانات المجزأة يدوياً في خلايا السطر الأول بأقصى درجات الدقة والصرامة اللغوية؛ حيث يُشترط أن تكون المقاطع المكتوبة مطابقة تماماً للمقاطع الواردة في السلسلة الأصلية، بحروفها وحركاتها ومسافاتها دون أي إضافة أو حذف غير مقصود. على سبيل المثال، إذا كان العنوان الأصلي يحتوي على “شارع الرياض 11564″، فيجب نقل كلمة “شارع الرياض” بحذافيرها إلى عمود الشارع، والرمز “11564” إلى عمود الرمز البريدي دون تبديل للمواضع أو كتابة كلمات تفسيرية خارجية لم ترد في الأصل.
يؤسس هذا التطابق التام النموذج القياسي (Gold Standard) الذي تستخدمه خوارزميات مثل Flash Fill لصياغة قواعد التقطيع المتناسبة مع أطوال ومواقع السلاسل الفرعية. إن إتقان إعداد النموذج التدريبي في السطر الأول يختصر ما يزيد عن 80% من جهود التصحيح اللاحقة، ويضمن استقرار السلوك الخوارزمي في توقع الحدود الفاصلة للكيانات الجغرافية حتى في ظل الغياب التام لعلامات الترقيم الهيكلية.
4. التطبيق الإجرائي لخاصية التعبئة السريعة خطوة بخطوة
4.1 استخلاص اسم الشارع وتكرار النمط آلياً
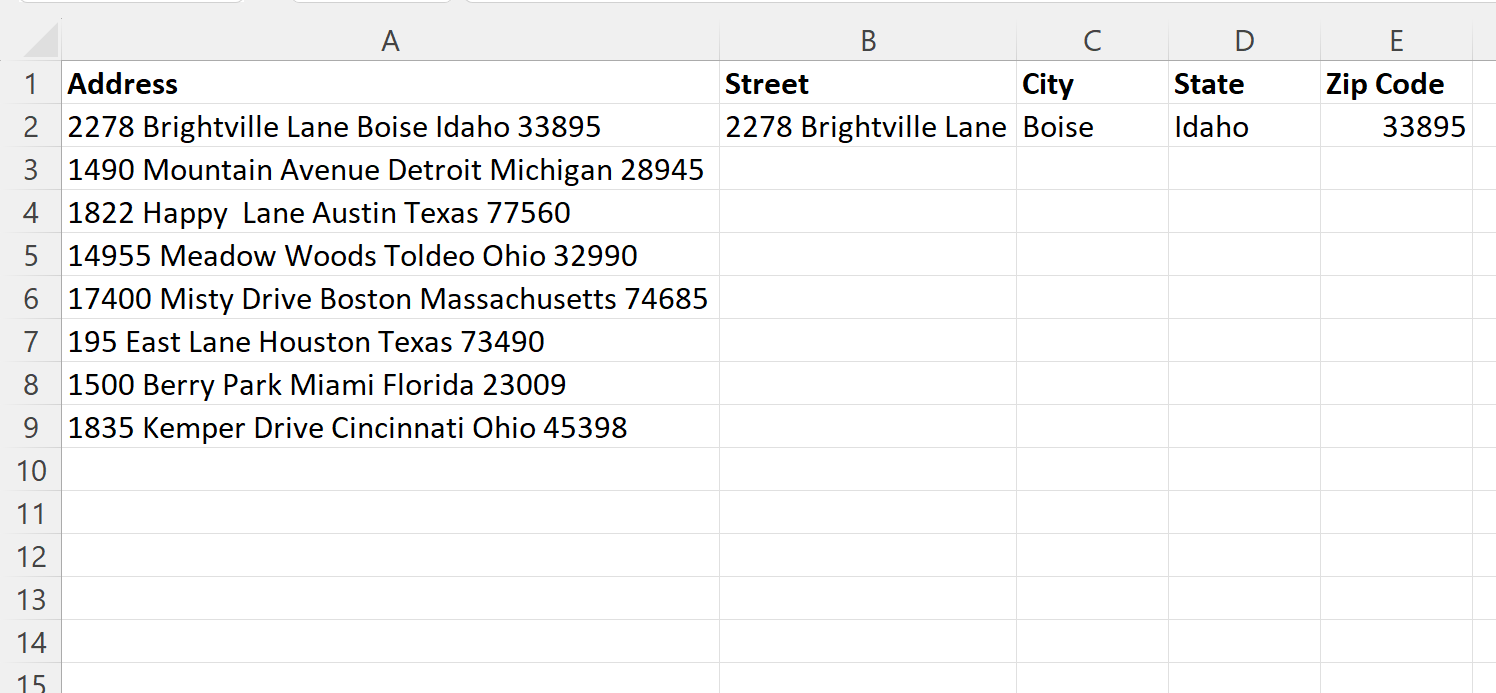
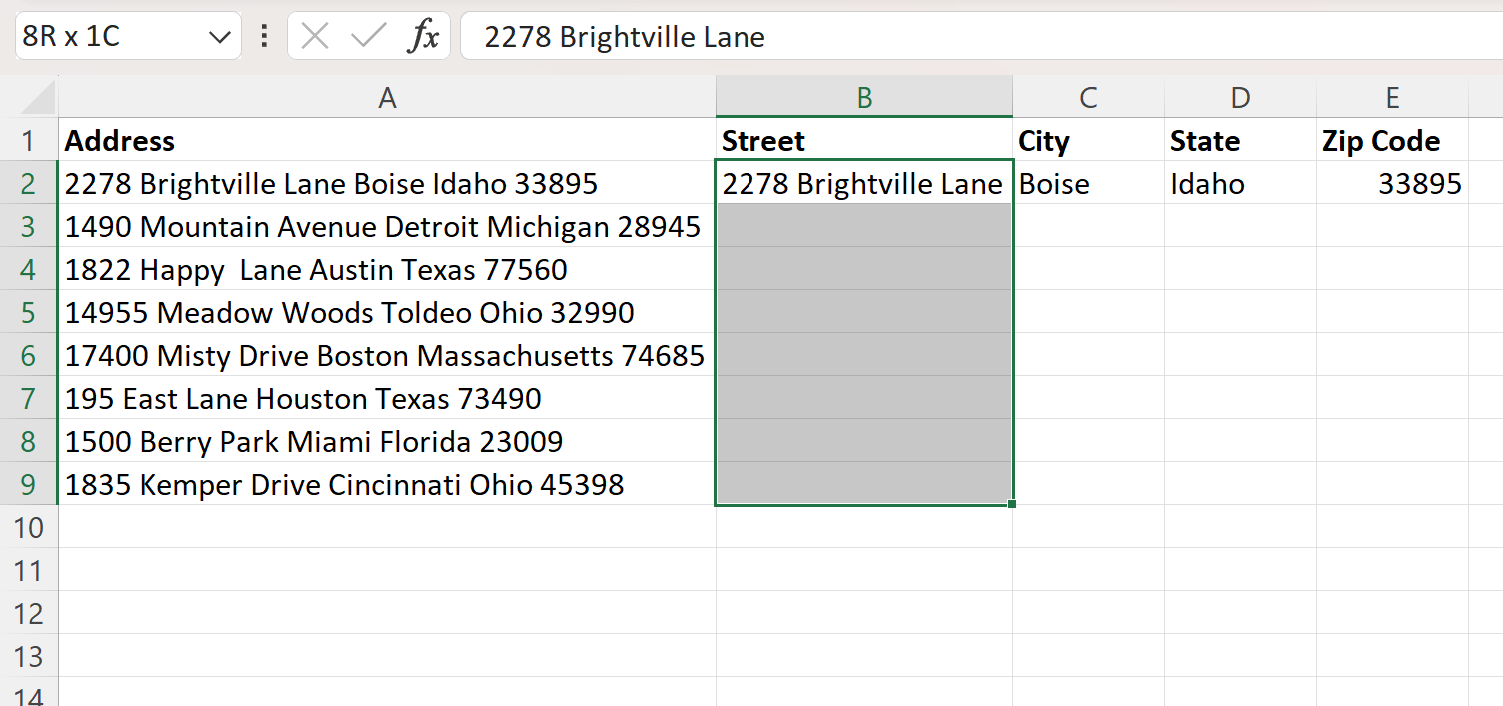
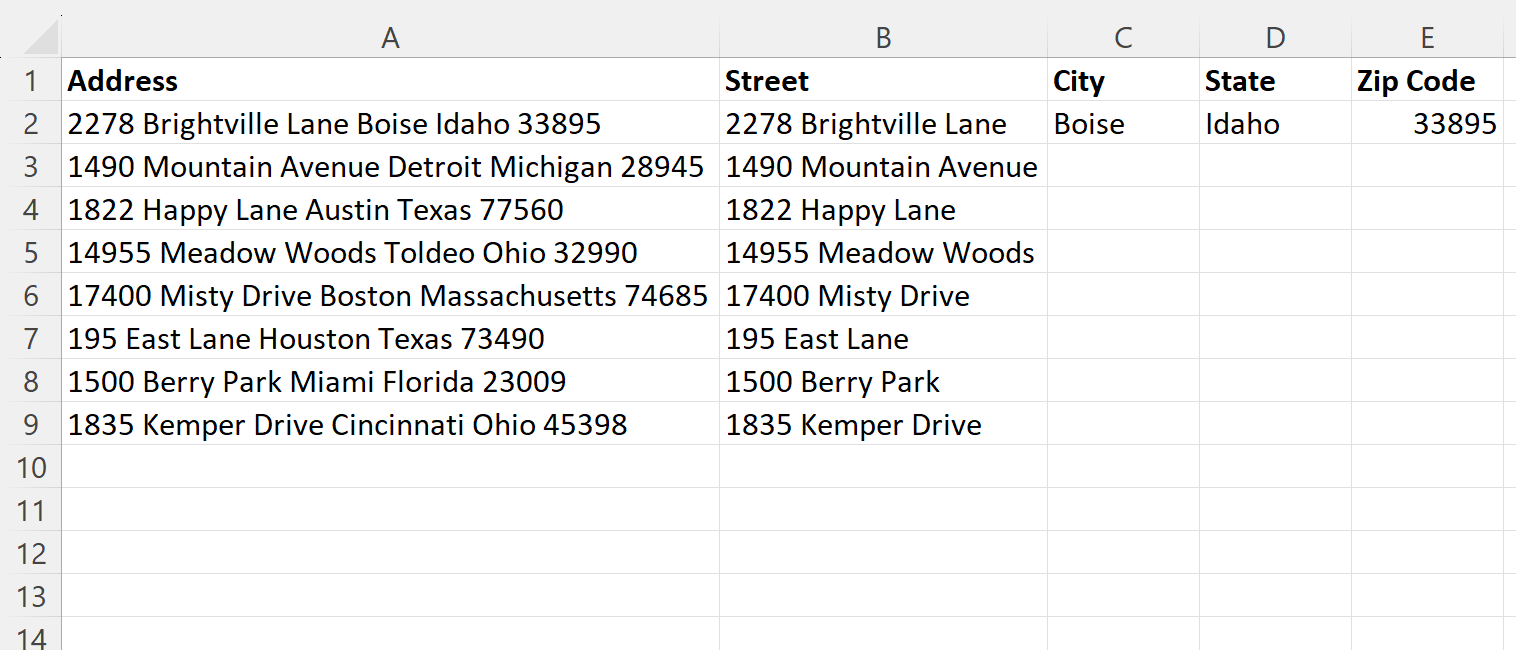
تبدأ العملية الإجرائية بالتركيز على استخراج المكون المكاني الأول، وهو اسم الشارع أو وصف الموقع، والذي يتواجد عادة في مطلع السلسلة النصية غير المقسمة. يتم التوجه إلى الخلية الأولى في عمود الشارع (المجاورة مباشرة لسطر العنوان الأصلي الأول)، ثم كتابة اسم الشارع بدقة كما ورد في الأصل. بعد تثبيت القيمة بالضغط على زر الإدخال (Enter)، ينتقل المؤشر تلقائياً إلى الخلية الثانية في ذات العمود؛ وهنا يظهر الأثر التشغيلي لقوة التنبؤ الحسابي في إكسل.
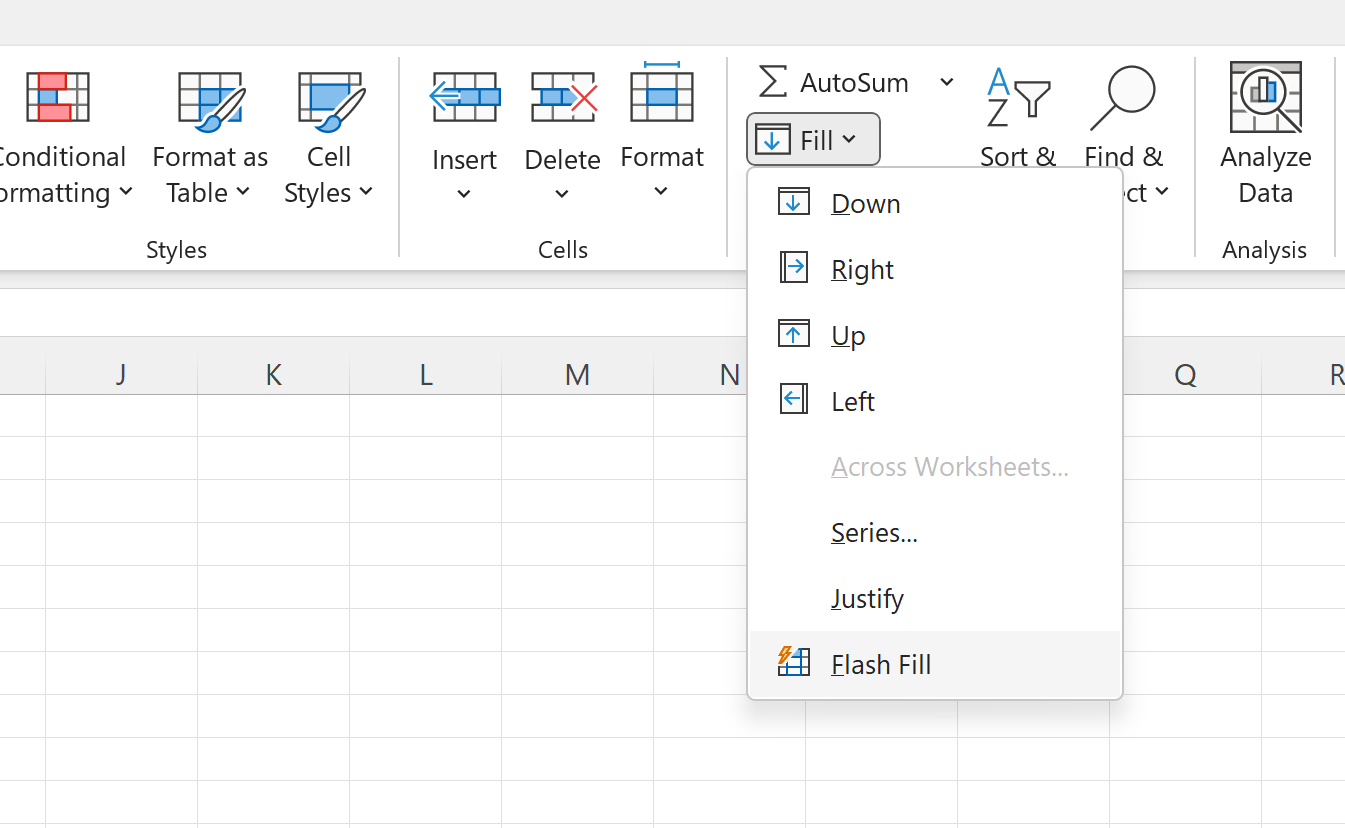
بمجرد البدء في كتابة الأحرف الأولى من اسم الشارع للسجل الثاني، يكتشف النظام التشابه البنيوي مع السجل السابق، ويُطلق ميزة “المعاينة الحية الرمادية” (Live Ghosting Preview) التي تعرض تخميناً لكامل محتويات العمود. إذا كانت المعاينة مطابقة للمطلوب، يكفي الضغط على مفتاح الإدخال ليتم تعبئة العمود بالكامل في جزء من الثانية. وفي حال عدم ظهور المعاينة التلقائية لسبب يتعلق بإعدادات البرنامج، يمكن استدعاء الأداة يدوياً عبر التوجه إلى التبويب الرئيسي (Home)، ومن مجموعة التحرير (Editing) النقر على زر التعبئة (Fill) ثم اختيار “التعبئة السريعة” (Flash Fill).
لتسريع وتيرة المعالجة الاحترافية وتفادي التعامل مع القوائم المنسدلة، يُعد الاختصار المرجعي المباشر من لوحة المفاتيح Ctrl + E الأسلوب القياسي والأنسب للتنفيذ. يتيح هذا الاختصار تفعيل المحرك البرمجي المستتر في لحظة خاطفة، مما يؤدي إلى مسح النطاق بالكامل وتطبيق شجرة القواعد النحوية على مئات السجلات دون تأخير، موفراً مخرجات واضحة المعالم لعنصر الشارع في عموده المستقل.
4.2 عزل حقل المدينة بناءً على السياق النصي
يمثل عزل حقل المدينة (City Isolation) مرحلة أكثر تعقيداً على المستوى التحليلي؛ نظراً لكون المدينة تقع عادة في المنتصف الهيكلي للسلسلة النصية، محصورة بين مكونات الشارع من جهة وتفاصيل المحافظة والرمز البريدي من جهة أخرى. في هذه الحالة، يتطلب الأمر من خوارزمية التعبئة السريعة استنتاج “الحد الفاصل الأيسر” و”الحد الفاصل الأيمن” لمقطع المدينة استناداً إلى انتهاء توصيف الشارع وبدء الأنماط الرقمية أو أسماء المقاطعات دون أي فاصل مرئي.
يتم إدخال اسم المدينة في الخلية الأولى من عمود المدينة يدوياً بما يطابق النص الأصلي تماماً، ثم الانتقال للخلية التالية واستخدام الاختصار Ctrl + E. تقوم الخوارزمية فوراً باقتطاع الجزء الأوسط من السلسلة النصية لكل صف. هنا يجب على المحلل إجراء فحص بصري سريع لمراقبة المدن ذات الأسماء المركبة مثل “شرم الشيخ” أو “أبو ظبي”؛ حيث قد تخلط الخوارزميات الضعيفة أحياناً بين المقاطع الأولى من أسماء المدن ونهايات أسماء الشوارع إذا لم يتم تدريبها عبر أمثلة كافية توضح النمط المركب.
إذا رُصد أي تداخل، يُعالج الأمر عبر كتابة مثال ثانٍ فوري في الصف الذي وقع فيه التداخل لتقويم مسار الخوارزمية؛ حيث يتعلم النظام بسرعة فائقة التمييز بين الكلمات المكونة للمدينة وتلك التابعة للشارع. يعود هذا الاستدلال السياقي الفائق إلى قدرة النماذج التوليدية على استقراء الحدود اللفظية بدقة استناداً إلى قوالب الحروف، مما يضمن في نهاية المطاف عزل الحيز الإداري للمدينة بدقة متناهية تحاكي الفرز الإنساني الخبير.
4.3 استخراج المقاطعة أو الولاية والرمز البريدي
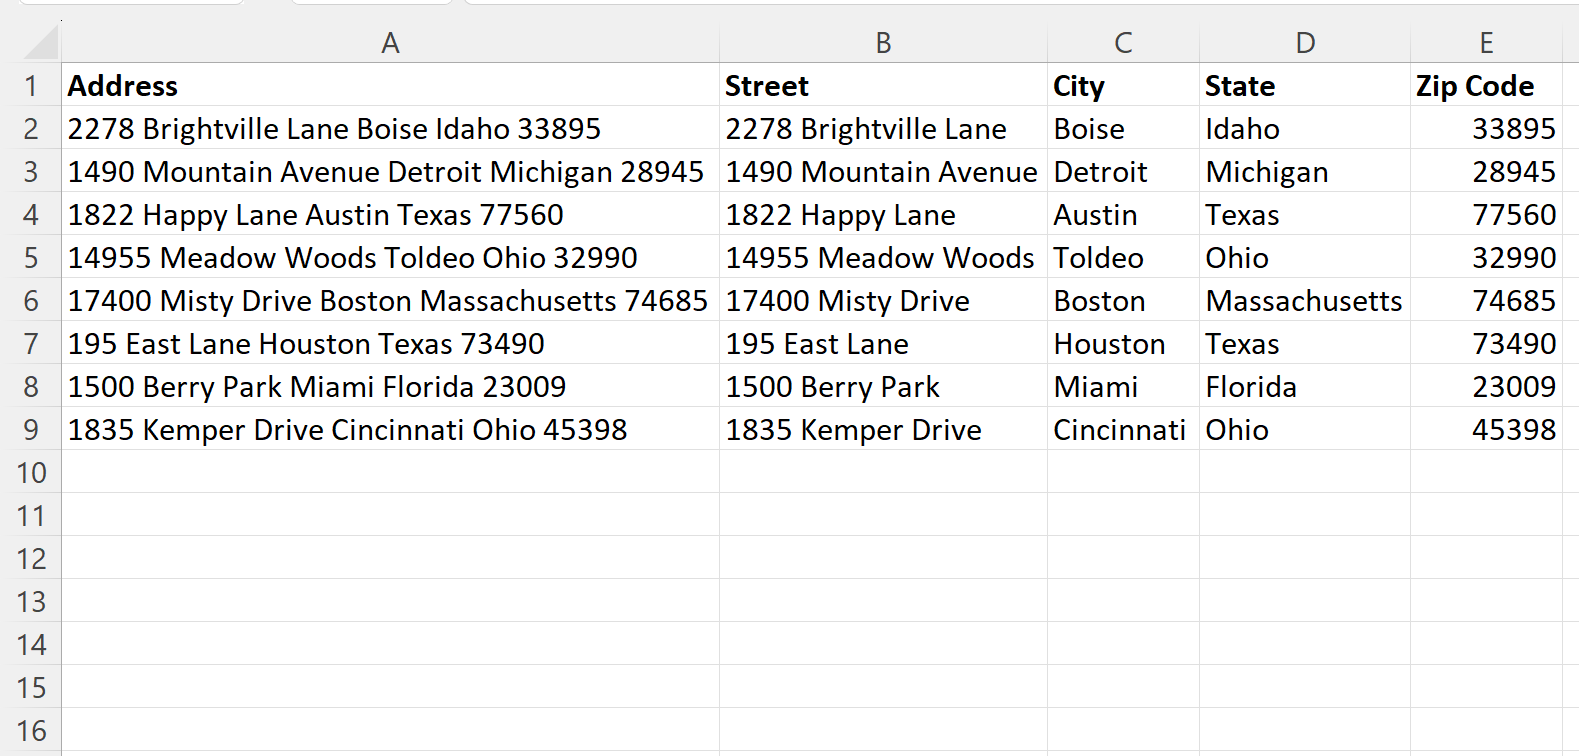
تصل العملية الإجرائية إلى مرحلتها الختامية بعزل المقاطعة أو الولاية واستخراج الرموز البريدية المرافقة، وتعد الرموز البريدية أسهل العناصر استخلاصاً في حال كانت تأتي في نهاية السلسلة وتتكون من عدد محدد من الأرقام الصرفة. يتم إدخال الرمز البريدي في العمود الرابع للسطر الأول، والضغط على Ctrl + E؛ فتتعرف الخوارزمية بشكل بديهي على النمط الرقمي المستمر المنعزل في نهاية النص، وتقوم بنسخه ونقله إلى العمود الجديد بنجاح شبه مطلق في السجلات القياسية.
أما بالنسبة للمقاطعة أو الولاية، فإذا كانت واردة في العنوان بصيغة رموز مختصرة (مثل كود يتكون من حرفين كبيرين في العناوين الدولية، أو كلمة مستقلة كاسم المحافظة)، فيتم تدريب العمود الثالث عليها بنفس الآلية. تعزل التعبئة السريعة هذا المكون الواقع بدقة بين اسم المدينة المقطوع سابقاً والرمز البريدي التالي له، من خلال طرح السلاسل التي تم التعرف عليها مسبقاً وتخصيص الجزء المتبقي للعمود المستهدف، مما يمنح عملية التجزئة تكاملاً ثلاثياً يحيط بكافة جوانب العنوان غير المقسم.
عقب إتمام هذه الخطوات، يصبح الجدول محتوياً على أربعة أعمدة ذرية مفصلة بالكامل، مما يتيح التخلص الآمن من العمود الأصلي المدمج أو إخفاءه للاحتفاظ به كمرجع تدقيقي. تثبت هذه الممارسة العملية أن خوارزميات التعلم بالأمثلة تستطيع تعويض غياب الفواصل التقليدية بمرونة غير مسبوقة، مختزلة ساعات طويلة من المعالجة اليدوية المضنية في بضع ثوانٍ من التوليد الآلي المنظم.
5. استراتيجيات التدريب التكراري وتصحيح انحراف الأنماط
5.1 معالجة التباين في البنية النصية للعناوين المعقدة
تواجه خوارزميات التنبؤ النصي تحديات بنيوية حقيقية عند تعاملها مع مجموعات بيانات تتسم بدرجة عالية من عدم التجانس؛ فالعناوين الواقعية في بيئات العمل نادراً ما تلتزم بنسق هندسي موحد. تظهر الصعوبة الأولى عند تواجد أسماء شوارع أحادية اللفظ متجاورة مع أسماء شوارع متعددة الكلمات، أو تباين صياغات الشقق والمكاتب الفرعية مثل احتواء بعض السجلات على توصيفات تفصيلية كـ “شقة 4 طابق 2” في حين تخلو سجلات أخرى من هذه الملحقات، مما يتسبب في انحراف الخوارزمية عن التمييز الصحيح لمواقع الانتقال.
يتفاقم هذا التباين بشكل ملحوظ عند غياب أحد المكونات البنيوية في بعض السجلات، كأن يرد العنوان مجرداً من الرمز البريدي، أو خالياً من اسم المحافظة. في هذه الحالة، تميل الخوارزمية المبسطة إلى تعبئة الفراغ عبر اقتطاع جزء من الحقول المجاورة لملء الحقل المستهدف تعسفياً استناداً إلى نمط الصف السابق، مما يؤدي إلى تشويه البيانات وإدراج أسماء المدن في خلايا الرموز البريدية بصورة غير مقبولة.
وللتعامل مع هذه التركيبات المعقدة، يتعين على المحلل تصنيف البيانات ذهنياً أو عبر الفرز السريع وفقاً لأشكالها الهيكلية؛ حيث يساعد فهم تنوع الأنماط في وضع استراتيجية تدريب مرنة تتوقع الانحرافات المحتملة وتستعد للتدخل الإجرائي السريع دون إفساد الهيكل البرمجي العام للتعبئة التلقائية المطبقة.
5.2 إعادة توجيه النموذج عبر التدخل التصحيحي التراكمي
تتميز أداة التعبئة السريعة في إكسل بأنها لا تُعد نظاماً معالجاً لمرة واحدة ينغلق بمجرد تنفيذه، بل هي محرك استقرائي حيوي وقابل لإعادة التوجيه (Iterative Retraining). عندما يُلاحظ المحلل وقوع خطأ في استخلاص بيانات صف معين نتيجة تباين صياغته عن الصف التدريبي الأول، يجب ألا يتم مسح العمود بالكامل والبدء من جديد، بل يكفي التوجه مباشرة إلى الخلية الخاطئة وتصحيح محتواها يدوياً لإمداد النظام بمثال مضاد ومعدل.
بمجرد قيام المستخدم بتصحيح القيمة الشاذة والضغط على زر الإدخال، يقوم محرك البرمجة بالأمثلة الكامن بإعادة موازنة النمط العام (Re-generalization). تقوم الخوارزمية بإعادة صياغة البرنامج التوليدي الوسيط ليشمل النمطين معاً: النمط القياسي الأولي والنمط الجديد المصحح، مما يؤدي إلى تحديث تلقائي شامل وفوري لكافة الخلايا السابقة واللاحقة في ذات العمود وفق المعادلة النحوية الأوسع نطاقاً.
قد يتطلب الأمر في جداول البيانات الكبيرة والشديدة التباين إدخال ثلاثة أو أربعة أمثلة تصحيحية متباعدة لتغطية كافة التنويعات اللغوية الممكنة؛ حيث تستوعب الخوارزمية في كل تدخل شروطاً شرطية خفية جديدة تمكنها من فرز الحالات المعقدة بنجاح، مما يعزز مناعة النموذج التوليدي ضد الخطأ ويرفع دقته النهائية إلى مستويات مقاربة للمعالجة البشرية الفاحصة.
5.3 اختبار استقرار النماذج النصية ضد الحالات الشاذة
عقب إتمام عمليات الفصل وإعادة التوجيه التكراري، تبرز ضرورة تطبيق منهجية رصينة لاختبار استقرار النموذج والتحقق من عدم تسرب أخطاء غير مرئية إلى أعماق قاعدة البيانات. في السجلات الضخمة التي تضم آلاف الأسطر، يصبح الفحص البصري الشامل مستحيلاً وغير عملي؛ لذا يتعين الاعتماد على تقنيات أخذ العينات العشوائية الإحصائية (Random Sampling) لفحص جودة المخرجات بدقة منهجية مقبولة.
يمكن توليد عمود فحص عشوائي باستخدام دالة RAND() لاقتطاع عينة ممثلة بنسبة 5% إلى 10% من إجمالي السجلات، ومراجعة مكوناتها المفصولة بدقة يدوية لتقييم حساسية الأداة تجاه التغييرات الطفيفة في ترتيب الكلمات ومواضع الأرقام. تتيح هذه المراجعة المستهدفة تقدير معدل الخطأ الإحصائي للنموذج واكتشاف الأنماط الفرعية الشاذة التي لم يمر بها المحرك أثناء خطوات التدريب الأولى.
ينبغي توثيق الحالات الشاذة التي تفشل الأداة قطعياً في استيعابها ضمن سجل استثناءات منفصل؛ حيث تفرض بعض العناوين بالغة التشوه عزلاً يدوياً مستقلاً أو معالجة منفصلة باستخدام نصوص برمجية خاصة. إن هذا التحقق الاستقرائي يحمي المستودعات المعلوماتية من تراكم التقديرات الخاطئة، ويضمن سلامة التحليلات الجغرافية اللاحقة المبنية على هذه البيانات.
6. الحلول البديلة المعتمدة على الصيغ والدوال المركبة
6.1 استخراج المكونات الرقمية والرموز البريدية بالدوال الرياضية
في بيئات العمل التي تتطلب ديناميكية مطلقة للبيانات—بحيث تتغير المخرجات تلقائياً بمجرد تعديل النص الأصلي دون الحاجة لإعادة تشغيل التعبئة السريعة يدوياً—تبرز الصيغ المركبة كبديل حتمي فائق الاستقرار. يُعد استخراج الرمز البريدي الواقع في نهاية السلسلة النموذج المثالي للبدء بالصيغ، حيث يمكن عزله بسهولة إذا كان قياسياً وثابت الطول، مثل الرموز المكونة من خمس خانات رقمية، عبر الاستعانة بدالة RIGHT البسيطة وفق الصياغة المباشرة:
=RIGHT(A2, 5)
غير أن المشهد يتعقد إذا كان موقع الرقم غير ثابت أو كان محاطاً بفراغات عشوائية؛ وهنا يتم توظيف معادلات المصفوفات بالتعاون مع دوال الفحص لتحديد الموقع الدقيق لبداية السلسلة الرقمية. تتيح الصيغة التركيبية التي تدمج دالة MIN مع دالة SEARCH على مصفوفة أرقام من 0 إلى 9 إمكانية العثور على موضع أول رقم في النص، كما توضح المعادلة الحسابية التالية:
=MIN(SEARCH({0,1,2,3,4,5,6,7,8,9}, A2 & "0123456789"))
بمجرد تحديد مؤشر البداية الرقمي، يمكن عزل الجزء العددي المتبقي عن السلسلة الأبجدية بدقة متناهية عبر استخدام دالة MID أو دالة LEN لطرح المواقع. توفر هذه المنهجية الرياضية دقة قطعية في استخلاص الرموز وأرقام المباني، متميزة بخلوها من الشكوك الاستقرائية التي ترافق أدوات الذكاء الاصطناعي، وثباتها الدائم كمعادلة نشطة تتفاعل حياً مع أي تعديل طارئ في سجلات الإدخال.
6.2 تفكيك النصوص باستخدام دوال النصوص التقليدية المدمجة
يتطلب تفكيك الأجزاء الأبجدية من العنوان غير المقسم الاعتماد على ترسانة دوال النصوص الكلاسيكية مثل LEFT وMID وFIND وLEN، محددةً المواقع النسبية للكلمات بالاعتماد على مواضع الفراغات البيضاء التي تفصل بينها. يمكن استخراج المكون الأول، كرقم المبنى أو الكلمة الأولى من الشارع، بالبحث عن موقع أول مسافة بيضاء واقتطاع ما قبلها عبر الصيغة الشهيرة:
=LEFT(A2, FIND(" ", A2) - 1)
لكن عند محاولة استخراج المكونات المتواجدة في قلب السلسلة النصية كاسم المدينة أو المقاطعة، تزداد المعادلات تعقيداً بشكل هائل؛ حيث تضطر لتركيب صيغ متداخلة تبحث عن الفراغ الثاني أو الثالث أو الرابع عبر استخدام دالة FIND متكررة داخل دالة MID، مع الاستعانة بدوال إزاحة الحساب مثل استبدال الفراغ رقم (N) برمز خاص باستخدام دالة SUBSTITUTE لتحديد نقطة انطلاقه.
يظهر العيب الجوهري لهذا الأسلوب الكلاسيكي في افتقاره الشديد للمرونة؛ فالصيغة التي تُصمم لشارع يتكون من كلمتين ستفشل وتقتطع أجزاء مشوهة إذا صادفت شارعاً يتكون من ثلاث كلمات، مما يجعل صيانة وتتبع هذه المعادلات الرياضية المعقدة أمراً بالغ المشقة لمحللي البيانات. وبالتالي، يظل الاعتماد على الدوال التقليدية وحدها خياراً محدود الكفاءة في معالجة العناوين الحرة غير المقسمة، مما يرجح كفة الأدوات الاستدلالية الأكثر تطوراً.
6.3 استخدام الدوال الحديثة والتعبيرات النمطية في إكسل 365
أحدثت التحديثات الأخيرة في حزمة إكسل 365 (Microsoft 365) طفرة غير مسبوقة في التعامل مع النصوص عبر تقديم دوال متطورة تجاوزت القيود التاريخية للبرنامج، ومن أبرزها دالتا TEXTBEFORE وTEXTAFTER. تتيح هذه الدوال تحديد الفواصل النصية النسبية والتحكم في رقم تكرار الفاصل (Instance Number)، مما يمكن المحلل من صياغة معادلات مقتضبة لاستخلاص النصوص الواقعة قبل أو بعد عدد محدد من المسافات بدقة ودون تعقيد الصياغات القديمة المتداخلة.
تتمثل القفزة النوعية الكبرى في إدراج دوال التعبيرات النمطية المباشرة (Regular Expression Functions) في أحدث إصدارات بيئة إكسل السحابية والتجريبية، مثل دوال REGEXEXTRACT وREGEXREPLACE وREGEXMATCH. تتيح هذه الدوال المتطورة استخراج الكيانات بناءً على القالب الهيكلي الصرف للمحارف بدلاً من البحث عن محددات جغرافية ثابتة؛ فيمكن على سبيل المثال استخلاص الرمز البريدي بنمط مباشر يبحث عن خمسة أرقام متتالية:
=REGEXEXTRACT(A2, "bd{5}b")
كما يمكن عزل اسم الولاية أو المقاطعة المكون من حرفين كبيرين بنمط "b[A-Z]{2}b" أو عزل أرقام المباني البادئة بنمط "^d+". إن هذا الجمع المنهجي بين الدوال الديناميكية الحديثة وقوة التعبيرات النمطية يوفر إطاراً حسابياً يجمع بين المرونة الخوارزمية الفائقة لأداة Flash Fill والموثوقية التفاعلية المستمرة للصيغ البرمجية، متفوقاً على كافة الحلول النصية القديمة في دقة وسرعة الإنجاز.
7. أتمتة تجزئة العناوين عبر محرر الاستعلامات (Power Query)
7.1 استيراد البيانات غير المقسمة إلى بيئة Power Query
يمثل محرر الاستعلامات المتقدم (Power Query) الأداة الأكثر احترافية وقوة داخل بيئة إكسل لبناء مسارات تحويل ومعالجة البيانات المعقدة (ETL Pipelines). تبدأ منهجية العمل بتحويل نطاق العناوين النصية غير المهيكلة إلى “جدول إكسل ديناميكي” (Excel Table) عبر النقر على مفتاحي Ctrl + T، وهي خطوة تنظيمية بالغة الأهمية لتأمين إمكانية التوسع التلقائي للبيانات عند إضافة سجلات جديدة في المستقبل.
عقب تهيئة الجدول، يتم استيراده إلى بيئة محرر الاستعلامات عبر التوجه إلى علامة التبويب “بيانات” (Data) واختيار “من ورقة/جدول” (From Sheet/Table). يؤدي هذا الإجراء إلى فتح واجهة برمجية معزولة تماماً عن ورقة العمل الأصلية، مما يتيح إجراء تعديلات وتحويلات جذرية على بنية النصوص دون المساس بسلامة البيانات الأصلية أو المخاطرة بحذفها العرضي.
داخل واجهة المحرر، يتم فحص ترميز السلسلة النصية والتأكد من تعيين نوع البيانات كـ “نص” (Text) لعمود العناوين؛ حيث يحمي هذا التحديد الأرقام المدمجة من أي تفسير رياضي مسبق. تمثل هذه البيئة المنعزلة الخيار المثالي للتعامل مع البيانات الضخمة التي تتجاوز قدرة جداول البيانات العادية على الاستجابة اللحظية، وتضع حجر الأساس لتطبيق خطوات معالجة قابلة للتكرار التلقائي في أي وقت.
7.2 توظيف تقنية ‘العمود من الأمثلة’ (Column From Examples)
تتضمن بيئة Power Query نسخة متطورة ومؤسسية من مفهوم البرمجة بالأمثلة تحت مسمى خاصية “عمود من الأمثلة” (Column From Examples)، والتي يمكن استدعاؤها من تبويب “إضافة عمود” (Add Column). تتيح هذه الخاصية للمستخدم كتابة النتيجة المتوقعة في عمود جديد موازٍ استناداً إلى الصف الأول تماماً كما هو الحال في Flash Fill، ولكن مع فارق جوهري يتعلق بالشفافية البرمجية.
عند إدخال المثال التدريبي، لا يقوم Power Query بتخزين المخرجات بصورة استاتيكية صماء، بل يقوم محرك التحليل بتوليد خطوات واضحة ومقروءة بلغة إم (M Language) في شريط الصيغ العلوي. يستخدم المحرك دوالاً مثل Text.BetweenDelimiters أو Text.Start أو Text.Select لترجمة عملية الفصل إلى منطق خوارزمي صريح يمكن للمطور أو المحلل مراجعته وتعديل معاييره يدوياً لضمان الدقة وتجنب أي غموض تفسيري قد يطرأ على البيانات.
علاوة على ذلك، يوفر المحرر خيارات إضافية بالغة الدقة لتجزئة النصوص دون فواصل عبر ميزة “تقسيم العمود حسب الانتقال المحرفي” (Split Column by Character Transition)؛ حيث يمكن تقسيم السلسلة تلقائياً عند نقطة التحول من “حرف أبجدي إلى رقم” أو من “رقم إلى حرف أبجدي”. تسهم هذه الميزة الجاهزة في فصل أرقام المباني أو الرموز البريدية الملاصقة للنصوص بضغطة زر واحدة ودون الحاجة حتى لصياغة أمثلة تدريبية، مما يوفر سرعة معالجة استثنائية للمجموعات النصية الشاقة.
7.3 بناء مسار تحويل دائم وقابل لإعادة الاستخدام
تكمن القوة الحقيقية لاعتماد محرر الاستعلامات في قدرته على تخليد خطوات التحويل كمسار أتمتة دائم (Automated Pipeline). تسجل اللوحة الجانبية “خطوات مطبقة” (Applied Steps) كل حركة فصل أو تطهير محرفي بالترتيب الدقيق، مما يعني أن المنظومة البرمجية المبتكرة تصبح قالباً تشغيلياً ثابتاً غير مرتبط بالدفعة الحالية من البيانات فحسب.
عند الانتهاء من ضبط تجزئة العناوين، يتم النقر على زر “إغلاق وتحميل” (Close & Load) لترحيل البيانات المفصولة والمنسقة بالكامل إلى ورقة عمل جديدة في جدول منمق ونظيف. تتجلى القيمة المضافة لهذا المسار عند استلام ملفات إضافية في الأشهر اللاحقة؛ حيث يكتفي المستخدم بإلصاق السجلات الجديدة في الجدول الأصلي والضغط على زر “تحديث الكل” (Refresh All) لتتكرر كافة عمليات التفكيك والفصل في ثوانٍ معدودة دون أي تدخل يدوي جديد.
تتيح هذه الإمكانية معالجة مئات الآلاف من السجلات بكفاءة ذاكرية خارقة، متجاوزة إجهاد المعالجات الذي يحدث عادة عند ملء ورقة العمل بآلاف المعادلات النصية المعقدة. إن Power Query يمثل بذلك الجسر التكنولوجي الذي ينقل عمليات معالجة الجداول الحسابية من مجرد مهام مكتبية روتينية إلى هندسة بيانات مؤسسية متينة تضمن استدامة تدفق المعلومات المكانية بأعلى معايير الدقة والموثوقية.
8. المعالجة البرمجية المتقدمة باستخدام VBA والتعبيرات النمطية (RegEx)
8.1 تأسيس دوال مخصصة (User-Defined Functions) للتعامل مع العناوين
عندما تصل أدوات واجهة المستخدم الرسومية إلى سقف إمكانياتها أمام سلاسل نصية شديدة التعقيد والتداخل، يبرز اللجوء إلى البرمجة النصية عبر لغة الفيجوال بيسك للتطبيقات (VBA) كحل جذري نهائي يمنح المحلل سلطة مطلقة للتحكم في معالجة المحارف. تتيح بيئة VBA بناء “دوال معرفة من قبل المستخدم” (User-Defined Functions – UDFs) تتكامل بسلاسة داخل خلايا إكسل تماماً كالدوال الأصلية المدمجة في البرنامج.
يتم فتح محرر التعليمات البرمجية بالضغط على مفتاحي Alt + F11، ثم إدراج وحدة برمجية قياسية جديدة (Standard Module). من خلال هذه الوحدة، يُمكن تعريف دالة تستقبل السلسلة النصية غير المقسمة كوسيط إدخال أساسي، وتُخضعها لسلسلة من الشروط والعمليات المنطقية الدقيقة التي تعزل الكلمات وتقيس المسافات البينية وتختبر نوع كل محرف، لتعيد في النهاية الجزء المستهدف فقط (كالشارع أو المدينة) إلى الخلية المستدعية.
توفر هذه الدوال المخصصة بساطة استثنائية في الاستخدام الميداني؛ إذ تختزل مئات الخطوات والمعادلات المعقدة في صيغة موجزة تطبق مباشرة داخل ورقة العمل مثل =ExtractCity(A2). يسهم هذا التجريد البرمجي في جعل واجهة الاستخدام نظيفة ومفهومة للمستخدمين العاديين، مع حصر التعقيد الخوارزمي بالكامل خلف كواليس المحرك البرمجي المؤمن للغة VBA.
8.2 تطبيق محرك التعبيرات النمطية (VBScript.RegExp)
تصل البرمجة بلغة VBA إلى ذروة قوتها عند دمجها مع محركات التعبيرات النمطية عبر استدعاء كائن VBScript.RegExp الخارجي. يتيح هذا المحرك للغة معالجة النصوص عبر قوالب التطابق الرياضي المتقدمة (Pattern Matching)، وهو الأسلوب الأكثر نجاعة لمطابقة السلاسل الجغرافية التي لا تفصلها علامات ترقيم صريحة؛ حيث يتم التركيز على الصفات الشكلية للبيانات بدلاً من مواقعها الحرفية الثابتة.
لبناء دالة قوية لعزل الرمز البريدي، يتم إنشاء كائن التعبير النمطي وتحديد نمط البحث (Pattern) بدقة، مثل صياغة النمط bd{5}b الذي يبحث حصرياً عن متتالية خماسية من الأرقام محاطة بحدود كلمات واضحة، متجاهلاً أي أرقام أخرى قد تخص أرقام المباني أو الطوابق. كما يمكن استخراج أسماء الولايات أو المقاطعات عبر أنماط متخصصة تتعرف على الأحرف الكبيرة أو القوائم المغلقة من الاختصارات الإدارية المعتمدة.
أما لاستخلاص مكونات الشارع والمدينة، فيمكن استخدام التعبيرات النمطية لاستبدال الأنماط الرقمية والمقاطعات بسلاسل فارغة، مما يؤدي إلى “تقشير” العنوان وعزل الجزء النصي المطلوب بمنتهى الحرفية. توفر هذه التقنية دقة مطلقة لا تتأثر بزيادة عدد كلمات الشارع أو تباين موضعه، وتُمثل المنهجية الأكثر متانة ومطابقة للمعايير المعمول بها في النظم البرمجية الاحترافية الكبرى.
8.3 تقييم الجدوى الفنية للأتمتة عبر الأكواد البرمجية
على الرغم من القوة والسرعة الفائقة التي توفرها حلول VBA البرمجية في معالجة البيانات المعقدة—حيث تستطيع تفكيك عشرات الآلاف من السجلات الجغرافية في ثوانٍ معدودة دون أدنى انحراف استقرائي—إلا أن تطبيقها يتطلب تقييماً دقيقاً للمخاطر الفنية والجدوى التشغيلية ضمن بيئات العمل التشاركية.
تأتي المخاطر الأمنية وتوافقية المنصات في مقدمة التحديات؛ إذ يتطلب تشغيل ملفات إكسل الحاوية على تعليمات VBA حفظ الملف بصيغة تدعم الماكرو (مثل .xlsm)، مما يؤدي في كثير من المؤسسات إلى إطلاق تحذيرات الحماية الأمنية الصارمة وقد يمنع الجدار الناري تبادل هذه الملفات عبر البريد الإلكتروني. بالإضافة إلى ذلك، فإن وحدات VBA البرمجية لا تعمل في بيئة إكسل عبر الويب (Excel for the Web) أو على تطبيقات الهواتف المحمولة، مما يحد من مرونة الوصول التشاركي السحابي للملفات المعالجة.
كما تفرض الحلول البرمجية متطلبات صيانة تقنية مستمرة؛ فأي تغيير مفاجئ في صياغة العناوين الواردة قد يتطلب تدخل مطور متخصص لتعديل أنماط RegEx أو معالجة الأخطاء الاستثنائية في الشيفرة. بناءً عليه، يُفضل قصر استخدام VBA على المشاريع المحلية المتقدمة والمهام المؤتمتة ذات الحجم الهائل التي يديرها خبراء تقنيون، مع ترجيح الحلول المدمجة مثل Power Query للبيانات المشتركة عبر الفرق لضمان الاستقرار وسهولة الاستخدام.
9. حوكمة الجودة والتحقق الإحصائي من صحة مخرجات الفصل
9.1 تقنيات التدقيق المتقاطع واكتشاف الانحرافات
تقتضي معايير إدارة البيانات الرصينة عدم الاعتماد الأعمى على أي مخرجات مستخلصة عبر الأدوات الآلية دون إخضاعها لبروتوكول تدقيق متقاطع (Cross-Validation) صارم يضمن عدم ضياع أو تشويه أي جزء من السلسلة النصية الأصلية. المنهجية الأبسط والأكثر فاعلية لتحقيق هذا التدقيق تتمثل في بناء “عمود إعادة التجميع” باستخدام دالة TEXTJOIN أو معامل الربط النصي (&)، لإعادة دمج الأعمدة المفصولة (الشارع، المدينة، المقاطعة، الرمز) في سلسلة واحدة مع إدراج مسافات موحدة بينها.
عقب إعادة تجميع السلسلة، يتم تطبيق دالة المطابقة الدقيقة EXACT لمقارنة النص المعاد تجميعه بالنص الأصلي المنظف عبر دالة TRIM، كما في الصيغة الإرشادية:
=EXACT(TRIM(A2), TEXTJOIN(" ", TRUE, B2:E2))
تعيد هذه الدالة قيمة منطقية إما TRUE للدلالة على التطابق التام، أو FALSE لكشف وجود انحراف محرفي أو فقدان لكلمة ما أثناء المعالجة الحسابية.
يتيح تطبيق عامل التصفية (Filter) على عمود التدقيق عزل كافة السجلات التي أرجعت قيمة FALSE على الفور؛ حيث يتم توجيه جهود الفحص البشري حصرياً نحو هذه السجلات الشاذة دون إضاعة الوقت في مراجعة آلاف الأسطر السليمة. يسهم هذا التدقيق المتقاطع في إكساب العملية الحسابية موثوقية علمية ويحول دون تسرب أي تشوهات نصية غير مكتشفة إلى النظم الإدارية أو التحليلات الإحصائية النهائية.
9.2 التحقق من صحة البيانات باستخدام التنسيق الشرطي
يُعد التنسيق الشرطي (Conditional Formatting) خط الدفاع البصري الثاني لضمان جودة وتناسق الحقول المفصولة؛ حيث يتيح للمحلل إبراز وتلوين الانحرافات الصياغية تلقائياً بمجرد ظهورها في الجدول. يمكن تطبيق قواعد تنسيق شرطي مخصصة لكل عمود على حدة استناداً إلى الخصائص المتوقعة للمحتوى الداخلي لكل حقل مكاني مستخلص.
في عمود “الرمز البريدي”، يمكن استخدام صيغة شرطية تعتمد على دالة طول النص LEN لتلوين أي خلية لا يتطابق عدد محارفها مع الطول القياسي للرمز (كأن يزيد أو ينقص عن 5 خانات)، بالإضافة إلى فحص كينونة المدخل عبر دالة ISNUMBER لإبراز الحالات التي تسربت فيها حروف أبجدية بالخطأ إلى عمود الأرقام. كما يمكن تطبيق قاعدة مماثلة في عمود “المدينة” لتلوين الخلايا التي تحتوي على أرقام باستخدام صيغة مطابقة معقدة، مما يشير إلى تسرب رقم المبنى أو جزء من الرمز البريدي إلى حقل الاسم الإداري للمدينة.
علاوة على ذلك، يُنصح بتطبيق قاعدة تلوين تلقائية ترصد “الخلايا الفارغة” (Blanks) في الأعمدة التي يُفترض اكتمال بياناتها بالكامل كحقل المدينة؛ حيث يتيح التمييز اللوني الفوري للباحث رؤية الفجوات المعلوماتية والتعامل معها بسرعة عبر استراتيجيات التدريب التصحيحي، مما يرفع المظهر العام للبيانات ويضمن جاهزيتها التامة للمراحل التشغيلية المتقدمة.
9.3 مؤشرات قياس دقة العمليات ومراجعة النتائج
تكتمل حوكمة الجودة بالصياغة الرياضية لمؤشرات الأداء الرئيسية (KPIs) الخاصة بكفاءة عملية معالجة النصوص الجغرافية؛ إذ يتعين على مديري البيانات حساب “معدل نجاح النموذج” (Model Success Rate) كنسبة مئوية صريحة، تُحسب بقسمة عدد السجلات التي فُصلت بدقة متناهية دون تدخل يدوي على إجمالي عدد سجلات العينة الكلية، وفق الصياغة الإحصائية المعيارية.
تسهم هذه القياسات الرقمية في تقييم الجدوى الاقتصادية والزمنية للمنهجيات المتبعة، من خلال حساب التكلفة الزمنية المستغرقة بين استخدام أدوات الاستدلال الذكي كالتعبئة السريعة ومحرر Power Query مقارنة بالوقت الافتراضي للإدخال اليدوي الكامل للسجلات. يثبت هذا التحليل الكمي عادة توفير ما يتجاوز 90% إلى 95% من وقت وجهد فرق العمل، مما يمنح الإدارة تبريراً موضوعياً لاعتماد هذه الأدوات التقنية في مختلف أقسام المؤسسة.
يتعين في نهاية المطاف تضمين هذه المؤشرات في “تقرير جودة البيانات الختامي” (Data Quality Audit Report)، الذي يوثق حجم العينة المعالجة، والنسبة المئوية للأخطاء المصححة، والحالات الاستثنائية التي تم ترحيلها للمعالجة الفردية. يمثل هذا التقرير الوثيقة المرجعية التي تعتمدها الفرق البحثية وفرق ذكاء الأعمال للتأكد من أن البيانات المغذية للوحات التحكم والتحليلات المكانية قد خضعت لأعلى درجات الضبط والتحقق المنهجي الصارم.
10. أفضل الممارسات المنهجية لإدارة وتنظيم العناوين في بيئات العمل
10.1 تأسيس بروتوكولات إدخال البيانات الموحدة
تنص الحكمة الإدارية الراسخة في علوم البيانات على أن “الوقاية خير من العلاج”؛ فالجهود الكبيرة المبذولة لمعالجة النصوص المدمجة وتفكيكها في إكسل يمكن تقليصها بدرجة جذرية عبر تأسيس بروتوكولات إدخال صارمة وموحدة عند نقطة جمع البيانات الأولى (Data Entry Point). تقع المسؤولية الأولى على عاتق مطوري النظم ومصممي نماذج الإدخال لتوفير واجهات تسجيل تمنع دمج الحقول في حقل نصي حر واحد.
يجب تصميم استمارات جمع البيانات الرقمية لتشتمل بصورة إجبارية على خانات مجزأة مسبقاً: خانة لرقم المبنى، وأخرى لاسم الشارع، وثالثة للمدينة، ورابعة للمحافظة، وخامسة للرمز البريدي. وعند العمل داخل جداول إكسل المشتركة، يمكن فرض قيود “التحقق من صحة البيانات” (Data Validation) لمنع المستخدمين من إدخال نصوص غير مطابقة للمواصفات، أو توفير قوائم منسدلة مغلقة لاختيار المدن والمحافظات لمنع التباينات الإملائية الشائعة.
يرافق هذا التطوير التقني ضرورة تدريب الكوادر الإدارية وفرق العمل الميدانية على المعايير العالمية لتدوين المعلومات الجغرافية، وتوعيتهم بالأثر التراكمي الخطير للأخطاء الإملائية والدمج العشوائي على قواعد البيانات المركزية. إن بناء بيئة تنظيمية تحترم النظافة الهيكلية للبيانات منذ لحظة ميلادها يوفر على المؤسسات مئات الساعات المهدرة في عمليات التطهير والتنقيب اللاحقة، ويعزز من انسيابية وسرعة تدفق المعلومات عبر الإدارات المختلفة.
10.2 المفاضلة المعيارية بين الحلول المتاحة وفق سيناريوهات العمل
تستلزم الإدارة الاحترافية للبيانات القدرة على اختيار الأداة المناسبة للسيناريو المطروح دون إفراط في التعقيد أو تفريط في الكفاءة؛ فبرنامج إكسل يوفر حلولاً متعددة تتفاوت في قوتها ومرونتها ومتطلبات تشغيلها. يُعد اعتماد أداة التعبئة السريعة (Flash Fill) الخيار الأمثل والأنسب للمهام الفورية المؤقتة (Ad-hoc Tasks)، والبيانات صغيرة الحجم التي لا يتجاوز حجمها بضعة آلاف من الصفوف المتجانسة، حيث توفر حلاً فورياً خارق السرعة دون كتابة صيغ أو بناء مسارات معقدة.
في المقابل، يمثل محرر الاستعلامات (Power Query) الخيار القياسي الإلزامي للعمليات المؤسسية الدورية والمستمرة، مثل معالجة التقارير الشهرية أو التدفقات البيانية المتكررة التي تتطلب أتمتة مستدامة للخطوات مع كميات بيانات ضخمة تفوق قدرة أوراق العمل العادية. كما يُعد Power Query الخيار الآمن للفرق التشاركية لكونه لا يثير أي تحذيرات أمنية ويتيح مراجعة دقيقة وتعديلاً سهلاً لخطوات لغة M التحويلية من قبل أي محلل آخر.
أما الصيغ النصية الحديثة (مثل REGEXEXTRACT وTEXTBEFORE)، فهي الحل الأمثل للبيانات التفاعلية الحية التي تتطلب تحديثاً ديناميكياً مستمراً ومتزامناً داخل الخلايا بمجرد تعديل المدخلات. ويظل اللجوء إلى أكواد VBA ومحركات RegEx المتقدمة محصوراً في السيناريوهات الاستثنائية التي تواجه نصوصاً شديدة الفوضى لا تخضع لأي قواعد قياسية، وتتطلب فحصاً عميقاً ومعالجة دفعية مؤتمتة ضمن بيئات تشغيل محلية خاضعة لرقابة تقنية دقيقة وموثوقة.
10.3 خارطة طريق استراتيجية لتنقية وتجهيز البيانات الضخمة
يتطلب التعامل الاحترافي مع السجلات الجغرافية المليونية في الشركات الكبرى تبني خارطة طريق استراتيجية تتألف من ثلاث مراحل تكاملية واضحة: مرحلة التقييم الأولي، ومرحلة المعالجة المجمعة، ومرحلة الأرشفة والتكامل. تبدأ مرحلة التقييم بفرز وتصنيف البيانات وفقاً لدرجة تجانسها الهيكلي، وعزل السجلات المتسقة عن السجلات شديدة الشذوذ للتعامل مع كل نمط عبر الأدوات الأكثر ملاءمة لطبيعته.
تنتقل المعالجة بعد ذلك إلى مرحلة المعالجة المجمعة (Batch Processing)؛ حيث يتم تطبيق أدوات التطهير والتجزئة الآلية (مثل Power Query أو خوارزميات الذكاء الاصطناعي الرمزي) على الشرائح المتجانسة ككتلة واحدة، بينما تُحال الحالات المعقدة إلى مسارات المعالجة البرمجية المتخصصة عبر محركات RegEx لفك التداخل بين نصوصها وحقولها المكانية بأعلى درجات التركيز الحسابي، مع تطبيق إجراءات حوكمة الجودة الإحصائية ومراقبة مؤشرات الأداء بصورة مستمرة طوال فترة التشغيل.
تتوج الخارطة بمرحلة الأرشفة والتكامل، حيث يتم تصدير البيانات المهيكلة والمفصولة إلى نظم إدارة قواعد البيانات العلائقية المركزية (RDBMS) أو مستودعات البيانات السحابية (Data Warehouses) في صيغ معيارية نقية وموثوقة. إن تطبيق هذا النهج الهندسي المتكامل يضمن تحويل العناوين غير المهيكلة من مجرد سجلات نصية عشوائية تسبب ارتباكاً تقنياً، إلى أصول معلوماتية نفيسة ومصنفة بدقة تدعم الرؤى التحليلية الاستشرافية وتدفع عجلة النمو المؤسسي بكفاءة واقتدار.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتقنيات التطبيقية المتقدمة لمواجهة إشكالية فصل العناوين غير المزودة بفواصل داخل برنامج مايكروسوفت إكسل؛ وهي المشكلة التي طالما شكلت عقبة كؤوداً أمام عمليات تنظيم وتحليل البيانات المكانية. اتضح من خلال الفحص المنهجي أن غياب الفواصل التقليدية لا يعني بالضرورة الاستسلام للمعالجة اليدوية المضنية والمشوبة بالأخطاء، بل يفتح الباب واسعاً أمام توظيف أحدث أدوات الاستدلال الآلي والبرمجة بالأمثلة المتمثلة في أداة التعبئة السريعة (Flash Fill)، إضافة إلى استثمار مرونة محرر الاستعلامات (Power Query) وقوة التعبيرات النمطية (RegEx) عبر لغة البرمجة VBA.
أكدت النتائج أن الاختيار الحصيف للأداة المناسبة يعتمد بصورة مباشرة على سياق العمل، وطبيعة البيانات، والهدف النهائي للتحليل؛ حيث تتكامل الحلول المرتكزة على التنبؤ الخوارزمي اللحظي مع الصيغ الرياضية الديناميكية الحديثة لتوفير بيئة عمل متكاملة تلبي تطلعات المحللين في مختلف المستويات المؤسسية. إن تطبيق بروتوكولات حوكمة الجودة والتدقيق المتقاطع يضمن سلامة هذه التحويلات المحرفية ويحمي المستودعات المعلوماتية من مخاطر الانحرافات التفسيرية، مما يحول البيانات النصية الخام إلى حقول ذرية واضحة المعالم تدعم التكامل مع النظم الجغرافية وقواعد البيانات المركزية بدقة وموثوقية بالغة.
المراجع
- Huebner, P. A., & Willits, J. A. (2018). Structured Semantic Knowledge Can Emerge Automatically from Predicting Word Sequences in Child-Directed Speech. Frontiers in Psychology. https://doi.org/10.3389/fpsyg.2018.00133
- Lozano, C. (2021). CEDEL2: Design, compilation and web interface of an online corpus for L2 Spanish acquisition research. Second Language Research. https://doi.org/10.1177/02676583211050522
- Maki, W. S., McKinley, L. N., & Thompson, A. G. (2004). Semantic distance norms computed from an electronic dictionary (WordNet). Behavior Research Methods, Instruments, & Computers. https://doi.org/10.3758/bf03195590