
تُمثّل معالجة النصوص وهندسة البيانات داخل جداول البيانات الإلكترونية حجر الزاوية في بناء النماذج التحليلية الدقيقة، حيث تبرز الحاجة الدائمة إلى تنظيم السلاسل المحرفية وتكييفها لتلائم متطلبات الفرز، والتصفية، والتحليل الإحصائي المتقدم. وعلى مدى عقود، كانت عملية الدمج النصي عبر دوال مثل CONCATENATE أو معامل الربط (&) هي الإجراء الأكثر شيوعاً لتجميع البيانات المتفرقة في حقل موحد؛ إلا أن الواقع العملي للبيانات الخام، المستخرجة من قواعد البيانات الموزعة أو منصات جمع الاستبانات، يفرض مساراً عكسياً تماماً. وتتمثل هذه العملية المعاكسة في تفكيك النصوص المندمجة وتجزئة الكتل البيانية المتكتلة في خلية واحدة إلى حقول ذرية مستقلة تخضع لقواعد المعالجة الجدولية القياسية.
إن الانتقال من بنية النص المدمج إلى الخلايا المنفصلة ليس مجرد إجراء شكلي، بل هو عملية تحويل بنيوية تستهدف تلبية شروط التوحيد القياسي للمتغيرات (Normalization). ففي سياق إدارة البيانات، يؤدي وجود قيم متعددة ضمن الحقل الواحد إلى تعقيد عمليات البحث والاستعلام، وشل قدرة الدوال الرياضية والإحصائية عن قراءة المؤشرات بدقة. ومن ثم، فإن استيعاب منطق “عكس الدمج” يمثل مهارة جوهرية لأي باحث أو محلل بيانات يسعى إلى تطهير البيانات، وإزالة التشوهات البنائية، وبناء مصفوفات بيانية رصينة وقابلة لإعادة الاستخدام في بيئات التحليل اللاحقة.
يتناول هذا الدليل الشامل والمفصل الأبعاد النظرية والتطبيقية لعملية تفكيك النصوص في برنامج مايكروسوفت إكسل (Microsoft Excel)، مستعرضاً أحدث الحلول البرمجية المتمثلة في دالة TEXTSPLIT الديناميكية، إلى جانب استقصاء الأدوات الكلاسيكية والبدائل الحسابية التراثية. وسنعمل عبر الأقسام التالية على تفكيك هذه الآليات من زوايا تركيبية وإجرائية، مع تسليط الضوء على سيناريوهات المعالجة المتقدمة ومعايير ضبط النزاهة البيانية في بيئات العمل الأكاديمية والمهنية المعقدة.
1. مفهوم عكس عملية الدمج في برنامج إكسل
1.1 التحول الهيكلي من دمج النصوص إلى تقسيمها
تقوم وظيفة الدمج الكلاسيكية، المتمثلة تاريخياً في دالة CONCATENATE وما تفرع عنها لاحقاً مثل CONCAT و TEXTJOIN، على منطق التجميع الخطي؛ حيث تأخذ سلاسل نصية متعددة متناثرة عبر أعمدة متفرقة وتوحدها في سلسلة واحدة متصلة داخل خلية مفردة. هذا التجميع، رغم فائدته في صياغة التقارير النهائية وتوليد المخرجات النصية الموجهة للقراءة البشرية، يُحدث ما يُعرف في نمذجة البيانات بفقدان “الذرية” (Atomicity)، حيث تفقد العناصر الفردية هويتها الحسابية المستقلة وتصبح جزءاً من كتلة نصية مصمتة يصعب عزل مركباتها دون أدوات متخصصة.
في المقابل، يمثل مفهوم التفكيك النصي (String Parsing or De-concatenation) النقيض الهندسي المباشر لهذه العملية. إنه يهدف إلى استعادة استقلالية العناصر الفرعية من خلال فحص التركيب النصي الشامل وتحديد الفواصل البنيوية التي تفصل بين المتغيرات المكونة له، ومن ثم إعادة توزيع هذه العناصر في فضاءات جدولية متمايزة (أفقياً عبر الأعمدة أو رأسياً عبر الصفوف). لا يقتصر هذا التحول على إعادة توزيع المحارف فحسب، بل يتجاوزه إلى إعادة تعريف الوظيفة الدلالية للبيانات؛ فالرقم المدمج داخل نص يتحول بعد التفكيك إلى قيمة عددية قابلة للقياس، والاسم الأخير الملتصق باللقب يتحول إلى متغير تصنيفي يخضع للترتيب الأبجدي المستقل.
إن التحليل المقارن بين منطق تجميع البيانات ومنطق تصنيفها يوضح أن التجميع يخدم أغراض العرض النهائي (Presentation Layer)، في حين أن التجزئة والتفكيك تمثل شرطاً أساسياً لطبقة المعالجة والتحليل (Processing Layer). فكلما كانت البيانات مجزأة ومصنفة في أدنى مستوياتها القابلة للتقسيم، ارتفعت مرونة المحلل في إعادة هيكلتها، وتطبيق المرشحات المعقدة، وربطها مع مصادر بيانات خارجية عبر المفاتيح المرجعية الفريدة التي لا يمكن تفعيلها إذا كانت محاصرة داخل نصوص مدمجة.
1.2 الأهمية المعرفية والتحليلية لتجزئة البيانات
تكتسب تجزئة البيانات أهمية منهجية بالغة عند التعامل مع الدراسات المسحية والبيانات الاستكشافية. فعندما تُجمع البيانات في حقول مدمجة، تصبح النمذجة الإحصائية عرضة لأخطاء الانحياز وسوء التصنيف؛ إذ تعتمد الخوارزميات والنماذج الخطية على عزل المتغيرات المستقلة عزلاً تاماً. فإذا احتوت الخلية الواحدة على مؤشرات متعددة، مثل الفئة العمرية والمنطقة الجغرافية معاً، تعذر على الباحث تحديد أثر كل متغير على حدة ما لم يتم تحرير هذه المتغيرات وإسناد كل منها إلى متجه بياني خاص به.
علاوة على ذلك، تُسهم تجزئة البيانات المنهجية في تبسيط إجراءات الفرز والتصفية والترميز للبيانات الأولية غير المنظمة. إن محاولة تصفية جدول يحتوي على حقول مدمجة غالباً ما تقود إلى نتائج غير دقيقة ناجمة عن المطابقات الجزئية الخاطئة؛ كأن يبحث المحلل عن رمز معين فيظهر الرمز كجزء من سلسلة نصية أخرى غير مقصودة. إن تحويل النصوص إلى حقول ذرية يُمكّن من تطبيق خوارزميات الفرز المعياري، وترميز الإجابات النوعية، وتحويلها إلى مصفوفات ثنائية أو رتبية تدعم حساب مقاييس التشتت والنزعة المركزية بفاعلية.
ومن منظور سلامة البيانات، يؤدي التفكيك إلى تقويض التشوهات الهيكلية التي تنشأ عن حشو البيانات المتعددة في خلية واحدة. هذا الحشو يكسر قواعد الأشكال الطبيعية لتصميم قواعد البيانات (Database Normalization)، ويزيد من مخاطر عدم الاتساق عند التحديث، ويجعل الصيانة اليدوية للجداول مهمة مضنية وشديدة التعرض للخطأ البشري. إن التجزئة المنضبطة تضمن أن كل معلومة تمتلك موقعاً هندسياً فريداً يمكن الإشارة إليه وتدقيقه آلياً دون التباس.
1.3 موقع الدوال المعاكسة في البيئة البرمجية لإكسل
شهدت البيئة البرمجية لبرنامج إكسل تحولاً جذرياً في فلسفة التعامل مع العمليات الحسابية والنصية مع إطلاق محرك الحساب المعتمد على المصفوفات الديناميكية (Dynamic Arrays). تاريخياً، كانت العمليات المعاكسة للدمج تتطلب من المستخدم كتابة صيغ رياضية شديدة التعقيد تعتمد على دوال الاقتطاع القديمة، أو اللجوء إلى معالجات ثابتة غير قابلة للتحديث التلقائي. لكن مع إدخال دوال المعالجة النصية الحديثة، أصبح بمقدور صيغة واحدة أن تفيض بنتائجها تلقائياً عبر نطاق من الخلايا، مما أعاد رسم العلاقة بين بنية المعادلة والمساحة الجغرافية للجدول.
هذا التحول أدى إلى تقليص الاعتماد على لغات البرمجة النصية كـ Visual Basic for Applications (VBA) التي كان يلجأ إليها المحللون لتنفيذ عمليات التفكيك الآلي للنصوص المعقدة. لقد أتاح إدماج الدوال المعكوسة الأصلية في صلب محرك الحساب تنفيذاً فورياً فائق السرعة، يتميز بالأمان، والتوافق المباشر عبر منصات التشغيل المختلفة دون الحاجة إلى تفعيل وحدات الماكرو أو القلق بشأن السياسات الأمنية للشركات والمؤسسات الأكاديمية التي غالباً ما تحظر تشغيل الأكواد الخارجية.
وينعكس هذا التطور إيجاباً على كفاءة سير العمل وإدارة الجداول الضخمة التي تحتوي على مئات الآلاف من السجلات. فالدوال الحديثة تخضع لتحسينات الأداء الداخلية الخاصة بمايكروسوفت، حيث تتكامل مع الذاكرة المؤقتة لمحرك الإكسل بكفاءة أعلى بكثير من الأكواد اليدوية، مما يضمن إعادة احتساب سريعة وديناميكية عند تغير المدخلات، ويمنح بيئة التحليل مرونة فائقة تحاكي لغات البرمجة المتقدمة المخصصة للبيانات مثل بايثون و R.
2. دالة TEXTSPLIT: النظير المباشر لدالة الدمج
2.1 البنية التركيبية والصيغة العامة للدالة
تُعد دالة TEXTSPLIT الإنجاز الهندسي الأبرز الذي قدمته مايكروسوفت ليكون النظير المباشر والمكافئ العكسي لدالتي TEXTJOIN و CONCAT. تتميز هذه الدالة بقدرتها المتأصلة على قراءة النص الخام وتفكيكه فورياً وفق قواعد محددة سلفاً. تتكون الصيغة العامة للدالة من ستة وسائط، تتدرج من الوسائط الأساسية الإلزامية وصولاً إلى الوسائط المتقدمة التي تضبط السلوك الحسابي للدالة في الحالات الاستثنائية، وصيغتها الكاملة هي:
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
المدخل الإلزامي الأول هو (text)، ويمثل السلسلة النصية المراد تفكيكها، ويمكن أن يكون نصاً ثابتاً بين علامتي تنصيص أو مرجعاً لخلية تحوي النص. المدخل الإلزامي الثاني هو (col_delimiter)، وهو المحدد الفاصل الذي يخبر الدالة بنقاط القطع التي تستوجب الانتقال إلى عمود جديد. أما المدخلات الاختيارية، فتشمل (row_delimiter) للتقسيم الرأسي، و(ignore_empty) للتعامل مع الفواصل المكررة، و(match_mode) لتحديد حساسية الأحرف، و(pad_with) لملء الفراغات في المصفوفات غير المنتظمة.
يكمن الجانب الأكثر ثورية في سلوك مخرجات الدالة في كونها مصفوفة ديناميكية متدفقة (Spilling Array). هذا يعني أن كتابة الصيغة في خلية واحدة يؤدي إلى فيضان النتائج أفقياً ورأسياً في الخلايا المجاورة دون الحاجة لتحديد النطاق مسبقاً أو استخدام معادلات المصفوفات التقليدية (Ctrl + Shift + Enter). تتولى الدالة استشعار المساحة المطلوبة ونشر العناصر بمرونة تتناغم تماماً مع حجم النص المفكك.
2.2 مفهوم المحدد الفاصل (Delimiter) وأنواعه
المحدد الفاصل (Delimiter) هو رمز، أو محرف، أو سلسلة من المحارف تعمل كعلامة مرجعية دالة على نهاية عنصر نصي وبداية عنصر آخر داخل السلسلة الواحدة. وتتنوع هذه المحددات بحسب طريقة إنشاء النص المصدر؛ فالمحددات البسيطة تشمل المسافة البيضاء (” “)، والفاصلة العادية (“,”)، والشارطة (“-“)، والفاصلة المنقوطة (“;”). يمثل المحدد نقطة الارتكاز التي تستند إليها الدالة في قراءة التركيب الداخلي للنص المدمج وإجراء عملية الفصل الفيزيائي بين مكوناته.
تتعامل دوال التفكيك المتقدمة كذلك مع المحددات المركبة والمحارف الخاصة غير المرئية. في كثير من سيناريوهات البيانات المستوردة من خوادم الويب أو قواعد البيانات التاريخية، تُفصل النصوص بمحارف مثل علامة الجدولة (Tab) التي يمثلها الدالة CHAR(9)، أو علامة السطر الجديد (Line Break) التي تمثلها الدالة CHAR(10) في نظام ويندوز أو CHAR(13) في أنظمة أخرى. إن قدرة الدالة على تمييز هذه المحددات غير المرئية يعطيها تفوقاً حاسماً على آليات الفصل اليدوية التي تعجز عن رصد هذه التباينات الدقيقة.
تعتمد آلية تفسير إكسل للمحدد الفاصل على مبدأ المطابقة والحذف؛ فعندما يتعرف البرنامج على المحدد ضمن النص، يقوم بحذفه تماماً من الناتج النهائي، مستخدماً إياه فقط كإحداثية هندسية تحدد موضع القفز إلى الخلية التالية. هذا الحذف التلقائي للمحدد يضمن بقاء القيمة النصية الصافية داخل الخلية الناتجة دون تشويه، مما يمهد الطريق لاستخدامها المباشر في العمليات الحسابية أو المقارنات المنطقية اللاحقة دون الحاجة لخطوات تنظيف إضافية لإزالة الرموز الفاصلة.
2.3 متطلبات التوافق والدعم البرمجي
على الرغم من القوة الحسابية الهائلة لدالة TEXTSPLIT، إلا أن استخدامها مقترن ببيئات تشغيلية محددة يجب أخذها بالحسبان عند مشاركة المصنفات. تتوفر الدالة حصرياً للمستخدمين الذين يمتلكون اشتراكاً نشطاً في Microsoft 365 (سواء للشركات أو الأفراد)، إلى جانب توفرها الكامل في إصدار إكسل للويب (Excel for the Web) وإصدار إكسل لـ Mac الحديث. هذه البيئات هي التي تدعم الجيل الجديد من محرك الحسابات المعتمد كلياً على المصفوفات الديناميكية.
يعود هذا الحصر التقني إلى أن دالة TEXTSPLIT تعتمد داخلياً على معمارية معالجة المتجهات (Vector Processing Engine)، وهي معمارية غير موجودة في الإصدارات الدائمة القديمة من البرنامج مثل Excel 2016، أو 2013، أو حتى 2019 و 2021 القياسية (باستثناء بعض التحديثات المتأخرة لإصدارات المؤسسات). لا تستطيع تلك الإصدارات القديمة إدارة ظاهرة “تدفق البيانات” التلقائي عبر حدود الخلية الواحدة دون تحديد مسبق ثابت للنطاق.
تفرض هذه الفجوة التوافقية تحديات تشغيلية ملموسة عند تداول ملفات التحليل بين مؤسسات أو فرق بحثية تستخدم بيئات تقنية متباينة. فعند فتح مصنف يحتوي على دالة TEXTSPLIT في إصدار قديم لا يدعمها، ستتحول المعادلة إلى الخطأ القياسي المتمثل في (#NAME?)، مما يتسبب في شلل كامل لتدفق الحسابات المعتمدة عليها. لذلك، يستلزم التخطيط المنهجي للمشاريع تقييم البنية البرمجية لكافة الأطراف المعنية قبل تبني هذه الدالة كحل حصري للتفكيك النصي.
3. خطوات التطبيق العملي لعكس الدمج خطوة بخطوة
3.1 تهيئة مصفوفة البيانات الأولية
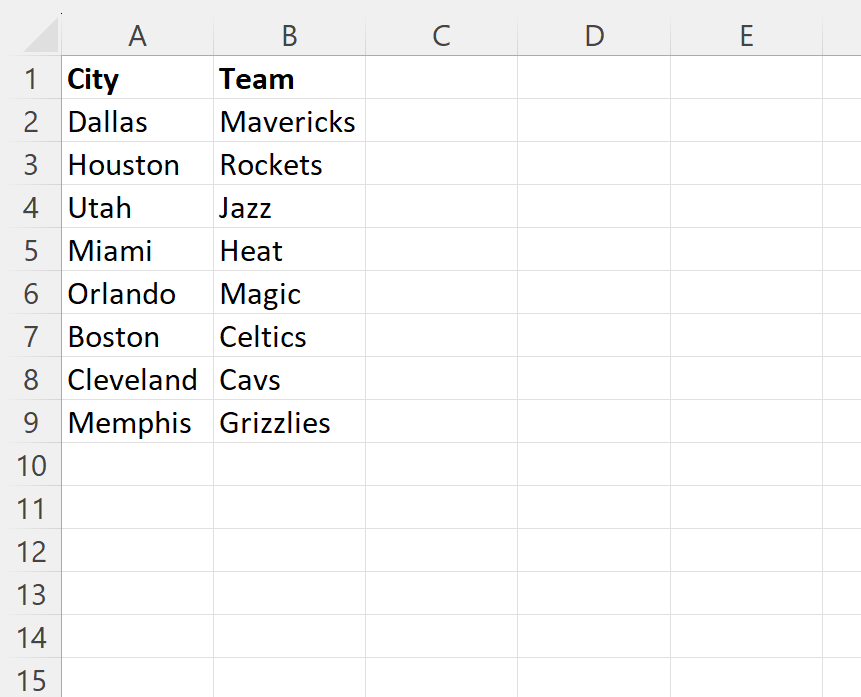
تبدأ الممارسة الرصينة لعكس الدمج بفحص دقيق وشامل لمصفوفة البيانات الأولية. إن الخطوة الأولى في هذه المرحلة هي التحقق من الاتساق الداخلي للسلاسل النصية المراد تفكيكها؛ فإذا كانت النصوص مدمجة باستخدام محدد معين، كالفاصلة المنقوطة مثلاً، فيجب التأكد من أن هذا المحدد مطبق بانتظام عبر كافة السجلات، وأن البيانات لا تحتوي على اختلافات شاذة تؤدي إلى تشويه نتائج التفكيك عند تعميم المعادلة على كامل العمود.
تتطلب الخطوة التالية إدارة المساحة الفيزيائية المحيطة بنطاق التطبيق. وبما أن دالة TEXTSPLIT هي دالة مصفوفات ديناميكية بطبيعتها، فإنها تحتاج إلى مسار فارغ تماماً من الخلايا لتتدفق النتائج داخله. يجب على المحلل التأكد من خلو الأعمدة الواقعة على يمين الخلية المستهدفة (أو الصفوف الواقعة أسفلها في حال التقسيم الرأسي) من أي بيانات، أو معادلات، أو حتى مسافات فارغة غير مرئية قد تعترض مسار التدفق وتتسبب في إيقاف عمل الصيغة وظهور أخطاء التداخل.
تكتمل مرحلة التهيئة بتوثيق التراكيب النصية المتوقعة وتصنيف أنماطها بدقة. يتضمن ذلك معرفة ما إذا كانت الخلية تحتوي على عنصرين فقط (كالاسم الثنائي المكون من اسم أول واسم عائلة)، أو عناصر متعددة غير متساوية الطول (مثل العناوين البريدية التي تدمج اسم الشارع، والمدينة، والرمز البريدي، والدولة). إن تحديد هذا النمط يتيح للمحلل تقدير عدد الأعمدة التي ستشغلها البيانات المفككة وتسمية الترويسات (Headers) مسبقاً بما يضمن استيعاب كافة المخرجات المتدفقة بنظام منهجي محكم.
3.2 كتابة وتطبيق صيغة TEXTSPLIT القياسية
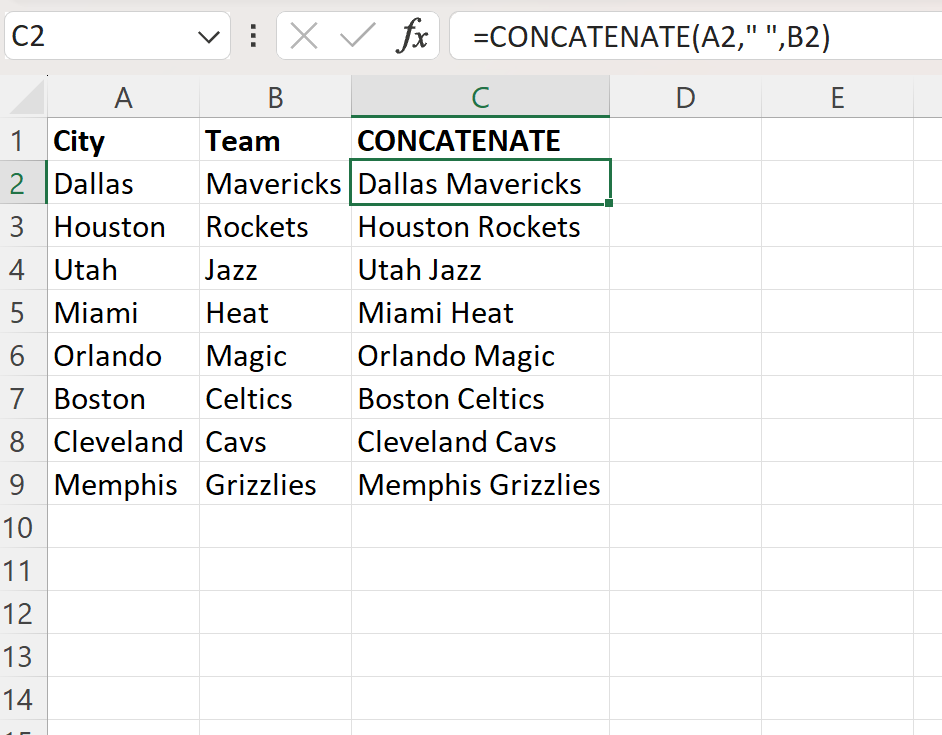
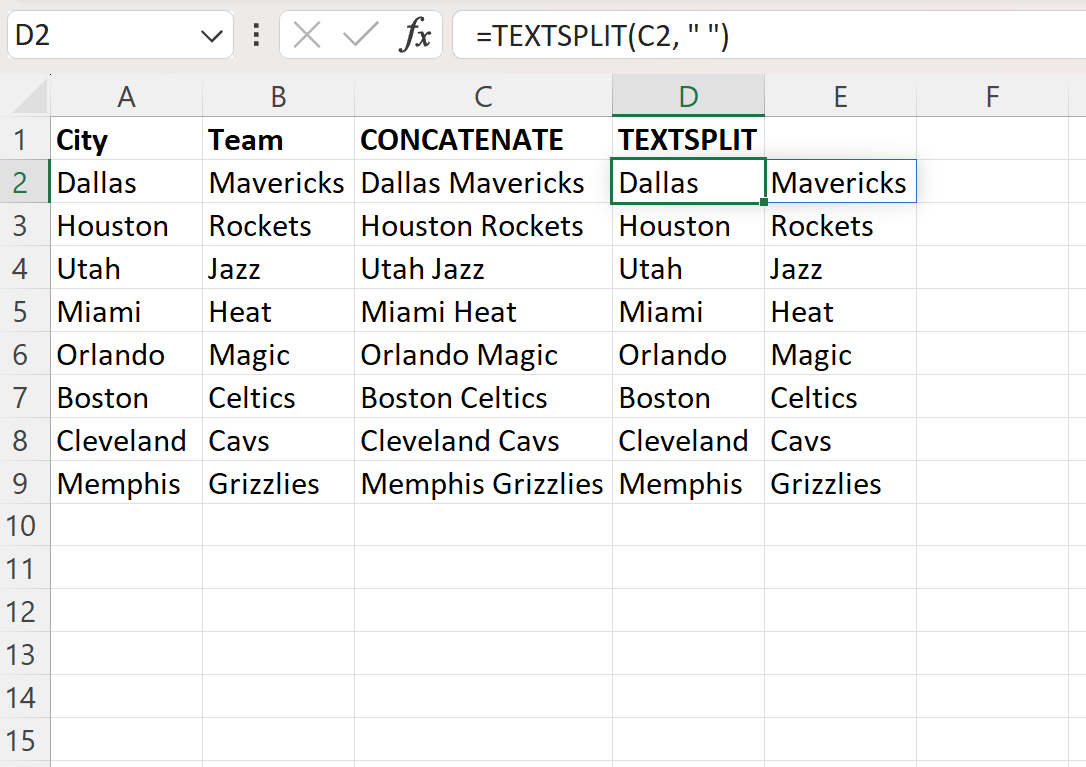
لتطبيق عملية التفكيك الأساسية، يتم التوجه إلى الخلية الفارغة المجاورة للسجل الأول، ثم كتابة الصيغة الرياضية المعيارية. على سبيل المثال، إذا كان النص المدمج يقع في الخلية C2 ويفصل بين مفرداته مسافة واحدة، تُكتب المعادلة بالشكل التالي:
=TEXTSPLIT(C2, ” “)
بمجرد إدخال المعادلة والضغط على مفتاح Enter، يتولى محرك إكسل تقييم السلسلة النصية لحظياً، ويقوم بقطعها عند كل مسافة فارغة، ونشر الكلمات الناتجة في الخلايا الأفقية المجاورة (D2, E2, F2 وهكذا) وفقاً لعدد الأجزاء المكونة للنص الأصلي دون الحاجة إلى سحب يدوي للمصفوفة عبر تلك الخلايا.
بعد التحقق من نجاح التدفق في السجل الأول، يتم تعميم الصيغة الحسابية على امتداد قاعدة البيانات. ولتحقيق ذلك، يتم تحديد الخلية الأصلية التي تحتوي على الصيغة الأم (C2 في مثالنا)، ثم استخدام مقبض التعبئة (Fill Handle) عبر النقر المزدوج عليه أو سحبه للأسفل باتجاه السجلات المتبقية. ستقوم كل خلية في العمود الجديد بتوليد مصفوفتها الأفقية المستقلة المتدفقة عبر الأعمدة المجاورة، متكيفة تلقائياً مع طول كل سلسلة نصية على حدة كما يوضح المسار المنهجي التالي:
- تحديد خلية البداية المجاورة للسجل النصي المستهدف وتفريغ النطاق المقابل لها أفقياً.
- كتابة الدالة وتحديد مرجع النص ثم المحدد الفاصل المحاط بعلامتي تنصيص:
=TEXTSPLIT(Target_Cell, "Delimiter"). - تأكيد الإدخال عبر مفتاح Enter ومراقبة إطار التدفق الأزرق المحيط بالنتائج المتولدة.
- سحب مقبض التعبئة رأسياً لتطبيق الصيغة على كامل العمود المعني بالتحليل.
3.3 التحقق المنهجي من دقة النتائج المفككة
لا تنتهي مهمة التفكيك بمجرد ظهور النتائج في الخلايا، بل تبدأ مرحلة التدقيق والتحقق المنهجي لضمان عدم حدوث انزياحات في البيانات. تتمثل الخطوة الأولى في إجراء مقارنة عينية ومتقاطعة بين الخلايا الناتجة والبيانات المرجعية الأصلية قبل الدمج؛ للتأكد من أن كل جزء نصي استقر في العمود المناسب له موضوعياً، ولم يحدث ترحيل لأحد الحقول إلى عمود آخر نتيجة وجود فاصل إضافي غير متوقع في بعض السجلات الشاذة.
كذلك يتعين على المحلل اختبار الاستجابة التفاعلية للصيغ المنشأة؛ فبما أن الدالة ديناميكية، فإن أي تعديل يطرأ على الخلية النصية الأم يجب أن ينعكس بصورة فورية وتلقائية على الخلايا المفككة المتدفقة. يمكن إجراء اختبار سريع بتغيير إحدى الكلمات أو تصحيح خطأ إملائي في الخلية الأصلية وملاحظة التحديث اللحظي في مصفوفة النتائج، مما يؤكد سلامة الروابط البرمجية بين طبقة الإدخال وطبقة التجزئة.
أخيراً، يجب تقييم دقة الفصل في الحالات التي تشهد وجود مسافات إضافية أو فراغات غير منتظمة تحيط بالمحدد الفاصل. فالنص الذي يحتوي على فاصلة متبوعة بمسافة (“, “) إذا تم تفكيكه باستخدام الفاصلة فقط كمعيار، سينتج عنه خلايا تبدأ بمسافات بيضاء غير مرئية قد تعطل عمليات البحث لاحقاً. هذا التقييم المنهجي يكشف ما إذا كانت الصيغة القياسية كافية بذاتها أم أن الحالة تتطلب الانتقال إلى خيارات التقسيم المتقدمة التي توفرها وسائط الدالة الإضافية.
4. التعامل مع المحددات المتقدمة والفواصل المعقدة
4.1 تقسيم النصوص بالاعتماد على محددات متعددة متزامنة
في العديد من سيناريوهات البيانات الواقعية، لا تلتزم السلاسل النصية بفاصل موحد؛ بل قد يجمع النص الواحد بين عدة أنواع من المحددات في آن واحد نتيجة أخطاء الإدخال البشري أو تباين مصادر الدمج. توفر دالة TEXTSPLIT ميزة استثنائية لمعالجة هذه المعضلة من خلال دعمها لتمرير “مصفوفة ثوابت” (Array Constant) من المحددات ضمن وسيط الفصل، وذلك بإحاطة المحددات بأقواس معقوفة مفصولة بفواصل، مثل الصيغة التالية:
=TEXTSPLIT(A2, {” “, “,”, “-“, “/”})
هذا التركيب البرمجي المتقدم يوجّه الدالة إلى اعتبار أي رمز من الرموز المدرجة داخل الأقواس المعقوفة بمثابة نقطة قطع معتمدة ومكافئة تماماً للرموز الأخرى. فعندما تقرأ الدالة النص، فإنها تتنقل بسلاسة؛ فتقطع عند المسافة تارة، وعند الفاصلة النحوية تارة أخرى، وعند الشارطة تارة ثالثة، مما يتيح تفكيك الجمل المعقدة التي تتشابك فيها أنماط الترقيم المختلفة دون الحاجة إلى معالجة النص بسلسلة متكررة من عمليات الاستبدال اليدوي المجهدة.
يُعد هذا الأسلوب بالغ الأهمية عند التعامل مع النصوص المستوردة من مصادر خارجية غير متسقة، مثل سجلات الأنظمة الطبية، أو البيانات الميدانية المفتوحة، أو المخرجات النصية الخام للأنظمة المصرفية القديمة. إن توحيد معايير التقسيم عبر مصفوفة محددات يمنح النموذج التحليلي مرونة استثنائية في ابتلاع التباينات الشكلية للمدخلات، وصبها في مخرجات جدولية متجانسة تخضع لنفس معايير التوزيع والتقسيم.
4.2 معالجة المحددات المتتالية وتجنب الخلايا الفارغة
من الإشكاليات المتكررة في النصوص المدمجة عشوائياً وجود محددات متتالية تفصل بينها مسافات معدومة، كأن يضغط مدخل البيانات على مفتاح المسافة مرتين أو يضع فاصلتين متتاليتين خطأً (“,,”). في الوضع الافتراضي، تفترض الدالة أن كل محدد يمثل حدود خلية، مما يدفعها إلى توليد خلية فارغة تماماً بين المحددين المتتاليين، وهو ما يتسبب في تشوه هندسي للأعمدة وتفاوت في مواقع البيانات المتناظرة بين السجلات المختلفة داخل نفس الجدول.
لمواجهة هذا التشوه، تتضمن دالة TEXTSPLIT الوسيط الاختياري الرابع المسمى (ignore_empty). يأخذ هذا الوسيط قيماً منطقية؛ حيث تمثل القيمة الافتراضية FALSE الإبقاء على الخلايا الفارغة، بينما يؤدي ضبط الوسيط على القيمة المنطقية TRUE (أو الرقم 1) إلى توجيه الدالة لتجاهل أي فواصل متجاورة ودمجها حسابياً كأنها فاصل واحد لا يتجزأ، كما يظهر في التركيب التالي:
=TEXTSPLIT(A2, ” “, , TRUE)
يضمن تفعيل هذا الوسيط الحفاظ على ثبات عدد الأعمدة الناتجة لكل سجل تحليلي، ويمنع ظهور الفراغات الهوائية المزعجة داخل المصفوفة. هذا التماسك البنيوي يُعد شرطاً لا غنى عنه إذا كانت البيانات المفككة ستخضع لعمليات تجميع كمي، أو إذا كانت ستُنقل لاحقاً إلى برمجيات إحصائية خارجية لا تتسامح مع وجود خلايا فارغة غير مبررة في وسط المتجهات البيانية المنظمة.
4.3 التحكم في حساسية حالة الأحرف والتطابق الدقيق
تكتسب مسألة حساسية حالة الأحرف (Case Sensitivity) أهمية حيوية عند التعامل مع النصوص المكتوبة باللغات الأجنبية (كالإنجليزية أو الفرنسية) أو عند استخدام محددات نصية تتألف من كلمات دلالية بدلاً من الرموز الترقيمية (مثل استخدام كلمة “AND” أو “or” كفواصل بين المتغيرات المدمجة). توفر الدالة وسيطها الخامس المسمى (match_mode) لضبط هذه الآلية بدقة رياضية متناهية.
يقبل وسيط (match_mode) قيمتين أساسيتين: القيمة (0)، وهي القيمة الافتراضية التي تجعل البحث حساساً لحالة الأحرف تماماً (Case-sensitive)، مما يعني أن المحدد “and” لن يقطع النص إذا وجد مكتوباً بالأحرف الكبيرة “AND”. في حين تؤدي كتابة القيمة (1) إلى تعطيل الحساسية وجعل البحث غير حساس لحالة الأحرف (Case-insensitive)، مما يجعل الدالة تتطابق مع المحدد بصرف النظر عن شكل رسم المحارف في النص المصدر:
=TEXTSPLIT(A2, ” and “, , , 1)
يساعد هذا التوجيه الصريح على تجنب الانقسامات الخاطئة أو الفشل في رصد المحددات نتيجة التباين في أسلوب كتابة النصوص الأجنبية. كما يُمكّن الباحث من بناء قواعد تفكيك قوية تصمد أمام التباينات الأسلوبية في كتابة النصوص، وتمنع تجاوز المحددات الحيوية التي قد يؤدي إغفالها إلى دمج حقلين منفصلين تماماً في حقل واحد خطأً، مما يضر بموثوقية التحليل اللاحق.
5. التقسيم ثنائي الأبعاد: التوزيع عبر الأعمدة والصفوف
5.1 التوزيع الأفقي مقابل التوزيع الرأسي
تتميز دالة TEXTSPLIT بمرونة هندسية فريدة تمكنها من العمل في اتجاهين متعامدين، متجاوزة بذلك القصور التاريخي للأدوات التقليدية التي كانت تحصر ناتج التفكيك في الاتجاه الأفقي فقط عبر الأعمدة. يتحقق التوزيع الأفقي من خلال تمرير المحدد في الوسيط الثاني (col_delimiter)، مما يدفع السلسلة النصية إلى الامتداد عبر أعمدة متتالية على نفس الصف، وهو ما يلائم تفكيك الحقول التي تمثل سمات متزامنة لنفس الحالة (مثل: الاسم الأول، اللقب، المدينة).
أما التوزيع الرأسي، فيتم عبر ترك الوسيط الثاني فارغاً وتمرير المحدد في الوسيط الثالث للدالة المسمى (row_delimiter). عند تفعيل هذا النمط، تقوم الدالة بقراءة السلسلة النصية ونشر عناصرها المفككة نحو الأسفل عبر صفوف متتالية داخل نفس العمود، كما توضح الصيغة الآتية:
=TEXTSPLIT(A2, , “,”)
تتجلى الأهمية التطبيقية للتقسيم الرأسي في تحويل القوائم المكتظة المجمعة في حقل واحد إلى سجلات بيانية رأسية قابلة للتحليل الإحصائي القياسي. فبدلاً من بقاء قائمة استجابات المبحوثين محشورة في خلية واحدة، يتيح التقسيم الرأسي إسناد كل استجابة إلى صف مستقل، مما يفتح الباب لاستخدام دوال العد، والمتوسطات، وجداول المحاور (Pivot Tables) على البيانات المستخرجة بكل سلاسة ويسر.
5.2 إنشاء جداول مصفوفية متكاملة من خلية واحدة
تصل القدرة البرمجية لدالة TEXTSPLIT إلى ذروتها عندما يتم استثمار الوسيطين الثاني والثالث معاً في صيغة موحدة لتوليد مصفوفة ثنائية الأبعاد (2D Matrix) تنطلق من خلية نصية مدمجة واحدة. يحدث هذا النمط المتقدم عندما يحتوي النص المصدر على هيكل جدولي مزدوج، كأن تكون الحقول مفصولة بمحدد معين وتكون السجلات مفصولة بمحدد آخر، وهو التنسيق القياسي المتبع في تخزين مصفوفات البيانات المنقولة عبر خوادم الويب وتنسيقات JSON أو استجابات واجهات برمجة التطبيقات (API).
على سبيل المثال، إذا كانت الخلية تحوي بيانات مبيعات مدمجة بهذا النمط: “أحمد,100;سعيد,150;منى,200″، حيث تفصل الفاصلة العادية بين اسم الموظف ورقم المبيعات (أعمدة)، بينما تفصل الفاصلة المنقوطة بين الموظف والآخر (صفوف)، يمكن إعادة بناء هذا الجدول المتكامل بصيغة واحدة مباشرة:
=TEXTSPLIT(A2, “,”, “;”)
ينتج عن هذه الصيغة مصفوفة متكاملة تشغل تلقائياً عمودين وثلاثة صفوف في ورقة العمل دون أدنى تدخل يدوي، حيث يتم تفكيك الأسماء والأرقام وتسكينها في إحداثياتها الصحيحة لحظياً. إن هذه الآلية تلغي الحاجة إلى الخطوات الوسيطة المعقدة لمعالجة النصوص المستوردة من واجهات الويب، وتختصر زمن تحويل البيانات الخام المجمعة إلى جداول تحليلية صريحة من ساعات من العمل اليدوي إلى أجزاء من الثانية.
5.3 إدارة المصفوفات غير المتكافئة وتعبئة القيم المفقودة
عند الشروع في بناء مصفوفة ثنائية الأبعاد من نص مدمج، يبرز تحدٍ تقني يتمثل في احتمال احتواء بعض السجلات على عدد من العناصر الفرعية يقل عن السجلات الأخرى؛ كأن يحتوي أحد الصفوف على اسم وقيمة، بينما يحتوي صف آخر على اسم فقط دون القيمة المقابلة له. في مثل هذه البيئات غير المتكافئة، يواجه محرك الحساب معضلة هندسية تتمثل في كيفية إكمال الشكل المستطيل للمصفوفة الناتجة عند تعذر العثور على قيمة تشغل الخلية المتقاطعة.
في الوضع الافتراضي، تقوم دالة TEXTSPLIT بإرجاع خطأ عدم توفر البيانات القياسي (#N/A) في كافة الخلايا التي تفتقر إلى مدخلات متناظرة، مما يفسد المظهر الجمالي للجدول ويعيق عمل الدوال الحسابية اللاحقة. لتفادي هذا القصور، زودت مايكروسوفت الدالة بوسيطها السادس والأخير المسمى (pad_with)، وهو الوسيط المخصص لملء الفراغات المتبقية في المصفوفة بقيمة افتراضية مخصصة يحددها المحلل:
=TEXTSPLIT(A2, “,”, “;”, , , “غير متوفر”)
يؤدي استخدام هذا الوسيط إلى استبدال أخطاء (#N/A) الحتمية بنص مخصص مثل “غير متوفر”، أو بقيمة صفرية (0)، أو حتى بسلسلة فارغة (“”). يضمن هذا الإجراء تماسك البنية الشكلية للجدول، ويمنع انهيار العمليات الحسابية المعتمدة على المصفوفة المتدفقة، ويمنح المخرجات طابعاً مهنياً متسقاً يلائم متطلبات التقارير الأكاديمية والتنفيذية الرفيعة.
6. البدائل الكلاسيكية لعكس الدمج في الإصدارات السابقة
6.1 أداة تحويل النص إلى أعمدة (Text to Columns)
تمثل أداة “تحويل النص إلى أعمدة” (Text to Columns) المعالج التاريخي الأعرق في برنامج إكسل لتفكيك النصوص المدمجة، وهي متوفرة في كافة إصدارات البرنامج عبر شريط تبويب “بيانات” (Data). تعمل هذه الأداة من خلال معالج تفاعلي مكون من ثلاث خطوات، يتيح للمستخدم تحديد ما إذا كان النص مقسماً وفق محددات ثابتة (Delimited) مثل الفواصل والمسافات، أو يعتمد على مسافات وعروض ثابتة (Fixed Width) للمحارف، مع إمكانية معاينة شكل المخرجات قبل تطبيقها الفعلي على الجدول.
على الرغم من الاستقرار التاريخي لهذه الأداة وشهرتها الواسعة، إلا أن الفارق المنهجي بينها وبين الدوال الحديثة يكمن في كونها أداة “ثابتة وغير ديناميكية” (Static Procedure). فالنتائج الناتجة عنها نهائية ومقطوعة الصلة بالبيانات الأصلية؛ فإذا عُدلت قيمة في الخلية المصدر، فلن تتحدث الأعمدة الناتجة تلقائياً، بل يتوجب على المستخدم إعادة تشغيل المعالج بالكامل وتكرار الخطوات يدوياً، مما يجعلها غير ملائمة للبيئات التحليلية الحية التي تخضع لتحديثات مستمرة في السجلات.
ومع ذلك، تبرز مواقف منهجية يُفضل فيها استخدام هذه الأداة اليدوية الكلاسيكية، تحديداً عند إدارة المصنفات الضخمة التي تحتوي على مئات الآلاف من السجلات والتي تستهلك طاقة المعالجة والذاكرة العشوائية بشكل حاد. فالأداة تقوم بكتابة القيم الثابتة مباشرة في الخلايا وتفرغ مساحة الذاكرة فور انتهاء العملية، دون أن تُثقل المصنف بعبء مصفوفات الحساب اللحظية المستمرة، مما يجعلها خياراً اقتصادياً في سياقات معينة.
6.2 تقنية التعبئة السريعة (Flash Fill) القائمة على الاستدلال
أحدثت مايكروسوفت قفزة نوعية في تسهيل إدارة النصوص بإدخال ميزة “التعبئة السريعة” (Flash Fill) بدءاً من إصدار إكسل 2013، وهي تقنية ذكاء استدلالي تتيح تفكيك النصوص دون كتابة صيغة حسابية واحدة. يكفي أن يقوم المستخدم بكتابة المخرج المتوقع للسجل الأول في العمود المجاور يدوياً، ثم الضغط على مفتاح الاختصار القياسي (Ctrl + E)، لتقوم الخوارزمية بتحليل النمط المكتوب ومطابقته مع بنية النص الأصلي، وتعميم نفس منطق الاستخراج التفكيكي على بقية السجلات في العمود بلمح البصر.
تستمد هذه التقنية قوتها من قدرتها على التعامل مع الأنماط المعقدة التي يصعب التعبير عنها أحياناً بصيغة نصية مباشرة، كاستخراج الأرقام المحصورة بين أقواس أو عزل الأسماء من وسط عناوين بريدية مركبة. ومع ذلك، تظل التعبئة السريعة محدودة بحدود النماذج التنبؤية الاستدلالية؛ فعندما تواجه استثناءات أو سجلات شاذة تخالف النسق العام للنصوص المدمجة، فإنها قد تخطئ في التنبؤ وتقوم بتوليد بيانات غير صحيحة بصمت ودون إظهار أي رسائل تحذيرية صريحة للمستخدم.
من هنا، ينبغي توخي الحذر الشديد عند الاعتماد على التعبئة السريعة في الأبحاث والدراسات الأكاديمية التي تتطلب معايير دقة وتوثيق صارمة. فالنتائج الناتجة عنها ثابتة كأداة تحويل النص إلى أعمدة، وتفتقر إلى الشفافية البرمجية التي تتيح للباحث توثيق الصيغة الرياضية الدقيقة في تقرير منهجيته، فضلاً عن حاجتها الدائمة لمراجعة بصرية يدوية شاقة للتأكد من خلو مخرجات الاستدلال الآلي من الانحرافات الخفية.
6.3 الصيغ المركبة التقليدية (LEFT، RIGHT، MID، FIND)
قبل ظهور TEXTSPLIT، كان المحللون يعتمدون على صياغة معادلات رياضية مركبة وشديدة التعقيد تعتمد على تداخل دوال الاقتطاع النصي (LEFT، RIGHT، MID) مع دوال رصد وتحديد مواقع المحارف (FIND، SEARCH، LEN). هذه الصيغ التراثية كانت تمثل الحل الديناميكي الوحيد الذي يضمن تحديث النتائج فورياً عند تعديل البيانات الأصلية في الإصدارات القديمة من البرنامج، مستندة إلى مبدأ قياس المسافات الرقمية للمحارف داخل السلسلة النصية.
لفصل الاسم الأول عن الاسم الأخير مثلاً في سلسلة نصية تقع في الخلية A2 ويفصل بينهما مسافة، كانت الصيغة التقليدية لاستخراج الاسم الأول تُكتب على النحو الآتي:
=LEFT(A2, FIND(” “, A2) – 1)
بينما كانت صياغة استخراج الاسم الأخير تتطلب معادلة أكثر تعقيداً تقيس طول النص الإجمالي وتطرح منه موقع المحدد الفاصل:
=RIGHT(A2, LEN(A2) – FIND(” “, A2))
تتضاعف هذه الصعوبة الرياضية والمنطقية بصورة مفرطة عندما يحتوي النص على أكثر من فاصل، أو عند الرغبة في استخراج جزء يقع في منتصف السلسلة النصية عبر دالة MID، حيث تتطلب العملية معادلات متداخلة بطول أسطر متعددة يصعب تدقيقها أو تتبع مسارات الأخطاء فيها من قِبل المستخدمين العاديين. ومع ذلك، تظل الميزة الفريدة لهذه الصيغ المركبة هي “التوافق المطلق”؛ فهي مدعومة في كل إصدارات إكسل التي أُنتجت منذ ثمانينيات القرن الماضي وحتى اليوم دون أي قيود برمجية.
7. معالجة الأخطاء الشائعة واستكشاف المشكلات وإصلاحها
7.1 تشخيص وعلاج خطأ التدفق (#SPILL!)
يُمثل خطأ التدفق (#SPILL!) العارض التشغيلي الأكثر ارتباطاً بدوال المصفوفات الديناميكية وفي مقدمتها TEXTSPLIT. يظهر هذا الخطأ عندما تشرع الدالة في نشر مصفوفة النتائج في الخلايا المجاورة، فتصطدم بوجود بيانات، أو محارف، أو حتى مسافات بيضاء غير مرئية تشغل إحدى الخلايا الواقعة ضمن المسار الهندسي المحدد لانتشار البيانات المفككة. تتوقف الدالة فوراً عن العمل احتراماً لقاعدة عدم الكتابة الفوقية على بيانات المستخدم وتُرجع هذا الرمز التحذيري.
لتشخيص هذا الخطأ وعلاجه، يوفر إكسل مؤشراً بصرياً عبارة عن إطار منقط يحيط بالنطاق المتوقع لتدفق النتائج بمجرد النقر على الخلية التي تحوي المعادلة. يتعين على المستخدم معاينة هذا النطاق، وتحديد الخلايا المعترضة، وحذف محتوياتها بالكامل. بمجرد إفراغ المسار من العوائق، تختفي رسالة الخطأ تلقائياً وتنساب المصفوفة بمرونة في فضاء الخلايا الشاغرة لتشغل مساحتها المخصصة بالكامل.
من المعوقات الهيكلية الشائعة لخطأ التدفق محاولة استخدام دالة TEXTSPLIT داخل الجداول الرسمية لإكسل (Excel Tables التي يتم إنشاؤها عبر Ctrl + T). صُممت جداول إكسل على مبدأ أن كل صف يمثل سجلاً مستقلاً ذا بنية حقول محددة سلفاً، وهي بيئة تمنع فلسفياً تدفق المصفوفات الديناميكية لتفادي تكسير حدود الأعمدة المعرفة. للالتفاف على هذا القيد، يجب كتابة المعادلة في نطاق خلايا عادي خارج الجدول الرسمي، أو استخدام بدائل التفكيك غير المصفوفية داخل الجدول.
7.2 التعامل مع خطأ القيمة (#VALUE!) ومفقودات الإدخال
يحدث خطأ القيمة (#VALUE!) غالباً عندما تعجز دالة التفكيك عن العثور على المحدد الفاصل المطلوب داخل السلسلة النصية المعالجة؛ كأن تطلب من الدالة تقسيم النص بناءً على فاصلة منقوطة في حين أن السجل مكتوب بفاصلة عادية أو خالٍ تماماً من الفواصل. في هذه الحالة، يتوقف منطق المطابقة، وتُرجع الدالة هذا الخطأ للإشارة إلى فشل العملية الحسابية في التعامل مع المدخل الممرر إليها وفق المحدد المشروط.
تتمثل المقاربة المنهجية الرصينة للتعامل مع هذا الخطأ في تطويق الدالة بصيغ إدارة الأخطاء مثل دالة IFERROR أو دالة IFNA. تتيح هذه الدوال تحديد مخرج بديل ذي مغزى في حال تعذر التفكيك، مثل إعادة النص الأصلي كما هو دون تغيير، أو وضع قيمة نصية تشير إلى الحاجة للتدقيق البشري، كما توضح الصيغة المحصنة الآتية:
=IFERROR(TEXTSPLIT(A2, “;”), A2)
تتطلب الإدارة المتقنة كذلك التعامل مع الخلايا الفارغة في عمود البيانات المصدر؛ فإذا كانت الخلية المستهدفة فارغة تماماً، فإن تطبيق الدالة عليها قد يؤدي إلى مخرجات صفرية غير مرغوبة أو إرجاع خطأ تشغيلي في بعض الإصدارات. يمكن حماية الصيغة من خلال اختبار شرطي مسبق باستخدام دالة IF، للتحقق من امتلاء الخلية قبل تمريرها لمعالج التفكيك، مما يضمن خلو قاعدة البيانات من الشوائب الحسابية الناتجة عن مفقودات الإدخال.
7.3 مشكلات المسافات المخفية والمحارف غير القابلة للطباعة
تُعد الشوائب النصية غير المرئية أحد أخطر مصادر الأخطاء الخفية في معالجة السلاسل الحرفية. ومن أشهر هذه الشوائب “المسافة غير القابلة للكسر” (Non-breaking Space) التي تحمل الرمز البرمجي CHAR(160)، والتي تنتقل بكثافة إلى الجداول عند نسخ البيانات من صفحات الإنترنت أو وثائق الـ PDF وقواعد بيانات الويب. تبدو هذه المسافة بصرياً كأي مسافة عادية، إلا أن محرك إكسل يتعامل معها كرمز مختلف تماماً عن المسافة القياسية المعرفة بالرمز CHAR(32).
إذا بُنيت صيغة التفكيك على أساس المسافة القياسية (” “)، وواجهت نصاً يحتوي على المسافة غير القابلة للكسر، فإن الدالة ستفشل تماماً في رصد المحدد الفاصل، ولن يتم تقسيم النص على الرغم من أن العين المجردة تشهد وجود مسافات واضحة بين الكلمات. هذا التناقض البصري-البرمجي يقود إلى إرباك المحلل وفشل خطوط المعالجة الآلية اللاحقة.
لحل هذه المعضلة الجذرية، يستلزم الأمر تطهير النص أولاً من خلال دمج دوال التنظيف والاستبدال. يمكن استخدام الدالة SUBSTITUTE لاستبدال المحرف الخفي CHAR(160) بمسافة طبيعية CHAR(32)، إلى جانب تطبيق دالة CLEAN للتخلص من أي محارف تحكم غير قابلة للطباعة تتراوح أكوادها بين 0 و 31، وذلك لضمان نقاء التركيب النصي وتطابقه التام مع المحددات الفاصلة المستهدفة في الصيغة الحسابية.
8. التكامل الوظيفي: تعزيز كفاءة التقسيم بدمج الدوال المساعدة
8.1 الاقتران مع دالة TRIM لإزالة الشوائب النصية
نادراً ما تأتي البيانات النصية المدمجة في غاية النقاء؛ ففي معظم الأحيان، تحيط بالكلمات مسافات بيضاء غير منتظمة، سواء كانت مسافات بادئة في مطلع النص، أو لاحقة في نهايته، أو مسافات مزدوجة تحيط بالمحدد الفاصل. إذا تم تقسيم النص بهذه الحالة، فإن تلك المسافات الزائدة ستنتقل بالتبعية إلى داخل الخلايا الجديدة الناتجة، مما يتسبب في تشويه المخرجات وفشل عمليات المطابقة والبحث اللاحقة (كأن تبحث عن “مصر” فلا تتطابق مع “مصر “).
يتحقق الحل النموذجي لهذه المشكلة عبر الاقتران الوظيفي المتداخل بين دالة التفكيك ودالة التشذيب (TRIM). تعمل دالة TRIM على إزالة كافة المسافات من أطراف النصوص وتخفيض المسافات المتعددة بين الكلمات إلى مسافة واحدة مفردة. وعند تطبيقها متداخلة، يفضل تمرير النص المشذب أولاً إلى دالة التقسيم، أو تغليف مصفوفة النتائج المتدفقة بالكامل بدالة التشذيب لضمان نقاء كافة المخرجات المتولدة:
=TRIM(TEXTSPLIT(A2, “,”))
يقوم هذا التكامل بحماية النموذج البياني من مشكلات المطابقة الدقيقة في دوال المقارنة المنطقية وعمليات الفرز، حيث يضمن أن كل خلية ناتجة تحتوي فقط على المحارف ذات المعنى دون أي زوائد هامشية تضر بجودة الفهارس والمؤشرات التحليلية للجدول.
8.2 الربط بين التقسيم ودوال البحث والمطابقة (INDEX و XLOOKUP)
في كثير من الحالات التحليلية، لا يحتاج الباحث إلى نشر كافة العناصر المكونة للسلسلة النصية عبر ورقة العمل، بل يرغب فقط في استخراج عنصر محدد من مصفوفة التفكيك؛ كأن يحتاج إلى عزل اسم المدينة فقط من عنوان مركب دون إشغال خلايا الجدول بنشر اسم الشارع والدولة. يبرز هنا التكامل الوظيفي المتقدم بين دوال التقسيم ودوال البحث والمطابقة مثل INDEX أو TAKE.
يمكن استثمار دالة INDEX لاقتناص عنصر مفرد من مصفوفة دالة TEXTSPLIT مباشرة في الذاكرة دون أن تتدفق المصفوفة عبر الجدول، وذلك بتحديد رقم الترتيب للموقع المطلوب. فالصيغة التالية تستخرج العنصر الأول مباشرة من السلسلة المفككة بمسافات:
=INDEX(TEXTSPLIT(A2, ” “), 1)
بينما يمكن استخدام الدالة الحديثة CHOOSECOLS أو TAKE لاستخراج العنصر الأخير بتمرير القيمة (-1). كما يمكن ربط ناتج التقسيم مباشرة كمدخل بحثي (Lookup Value) داخل دالة XLOOKUP، مما يسمح بالاستعلام المباشر عن البيانات في جداول خارجية بناءً على جزء نصي مستخرج من خلية مدمجة دون الحاجة إلى إنشاء أعمدة وسيطة تستهلك المساحة وتزيد من تعقيد المصنف.
8.3 الدمج مع دالة TEXTBEFORE و TEXTAFTER
بالتوازي مع دالة TEXTSPLIT، قدمت مايكروسوفت دالتين مكملتين هما TEXTBEFORE و TEXTAFTER. صُممت هاتان الدالتان لأداء مهام استخراج موجهة؛ حيث تقوم الأولى باستخراج كل ما يقع قبل محدد معين، بينما تقوم الثانية باستخراج كل ما يقع بعده. يطرح هذا الثالوث الوظيفي الجديد خيارات هندسية مرنة تتكامل مع بعضها البعض لإدارة السلاسل النصية بكفاءة فائقة.
تفضل الاستعانة بدالتي TEXTBEFORE أو TEXTAFTER عندما تكون الغاية محصورة في استخراج طرف واحد فقط من السلسلة النصية دون تفكيك بقية الأجزاء؛ مما يوفر موارد المعالجة ويمنع مشاكل تدفق المصفوفات غير المرغوبة. أما إذا كانت الحاجة تتطلب معالجة شاملة لكافة الأجزاء وإعادة هيكلتها، فإن دالة TEXTSPLIT تظل هي الخيار الطبيعي والأشمل لأداء المهمة بأكملها في خطوة حسابية واحدة.
يؤسس هذا الدمج لبيئة عمل متناسقة وموحدة تعتمد بالكامل على الجيل الجديد من دوال النصوص، متخلصة نهائياً من قيود الدوال القديمة؛ مما يمنح مصمم النماذج مرونة غير مسبوقة في صياغة الحلول البرمجية التي توازن بين الأداء الحسابي الرشيق والبنية الجدولية النظيفة.
9. التطبيقات التحليلية لعكس الدمج في معالجة البيانات الأكاديمية
9.1 تفكيك السجلات البيوغرافية والأسماء العلمية المركبة
تواجه المشاريع البحثية التي تتعامل مع قواعد البيانات البيبليوغرافية وفهارس الإنتاج العلمي تحدياً مستمراً يتعلق باختلاف أساليب دمج أسماء الباحثين ومؤلفي الدراسات. فكثيراً ما تُصدر قواعد البيانات العالمية (مثل Scopus أو Web of Science) أسماء الباحثين مدمجة في حقل واحد يضم الاسم العائلي متبوعاً بالاسم الأول والألقاب الأكاديمية (مثل: “Smith, John A., PhD”). يتطلب التحليل الببليومتري عزل هذه المكونات بدقة لتتبع مسارات النشر وتحديد شبكات التعاون العلمي.
يتيح تطبيق دالة TEXTSPLIT باستخدام مصفوفة محددات تشمل الفواصل والمسافات فرز اللقب الأكاديمي، واسم العائلة، والاسم الأول في حقول تصنيفية مستقلة. يساعد هذا العزل في معالجة التباين في عدد مقاطع الأسماء المتعددة من خلال التحكم في وسائط التعبئة، مما يحول السجلات النصية المتكتلة إلى مصفوفة بيانية قياسية تدعم الفهرسة الأكاديمية وفق معايير جمعية علم النفس الأمريكية (American Psychological Association – APA).
علاوة على ذلك، يسهل هذا التفكيك الربط المعياري لأسماء الباحثين مع معرفاتهم الرقمية الدائمة مثل ORCID، حيث يمكن مقارنة الأسماء المفككة بدقة مع السجلات المركزية دون الاصطدام بالفوارق الشكلية في طريقة كتابة الأسماء المركبة، مما يرفع من جودة ودقة دراسات تقييم الأثر العلمي للإنتاج الفكري.
9.2 معالجة بيانات الاستبيانات والترميز المفتوح
في البحوث الميدانية والمسوح السلوكية والاجتماعية، تلجأ الاستبانات الإلكترونية (مثل منصات Qualtrics و Google Forms) في أسئلة الاختيار من متعدد التي تتيح أكثر من إجابة إلى تخزين استجابات المبحوث المحددة داخل خلية واحدة مفصولة بفواصل (مثل: “قلق, أرق, إجهاد نفسي”). يمثل هذا الحقل المدمج عائقاً هائلاً أمام برامج التحليل الإحصائي؛ إذ يتعذر حساب تكرارات الاستجابات الفردية ما لم يتم تفكيك هذه الحزم النصية.
يُمكن توظيف دالة TEXTSPLIT لتقسيم هذه الإجابات متعددة الخيارات رأسياً أو أفقياً؛ مما يمهد الطريق لتحويلها عبر دوال المطابقة إلى مصفوفة ثنائية (Binary Matrix) تعتمد على الترميز الصفري والواحدي (0 و 1) لكل متغير محتمل. يتيح هذا الإجراء تنفيذ الإحصاء الوصفي، واستخراج التكرارات الحقيقية، وحساب معاملات الارتباط المتعددة بصورة دقيقة.
يسهم هذا التحويل كذلك في تسريع وتسهيل عمليات تصدير البيانات إلى البرمجيات الإحصائية المتخصصة مثل حزمة العلوم الاجتماعية (IBM SPSS Statistics) أو بيئة R Project for Statistical Computing، حيث تتدفق المتغيرات المفككة كأعمدة مستقلة ذات ترويسات معيارية لا تتطلب جهود ترميز يدوية مستهلكة للوقت داخل البيئات الإحصائية المستهدفة.
9.3 تجزئة البيانات الزمنية والمكانية المشتركة
تتضمن سجلات البيانات الميدانية والتجارب المعملية طوابع مكانية وزمنية مدمجة تسجل لحظة رصد الملاحظة؛ حيث يجمع الحقل الواحد غالباً بين التاريخ الميلادي والوقت الدقيق بنظام الساعات والدقائق والثواني في سلسلة واحدة. لإجراء التحليلات الزمنية الدورية (كتحليل الاتجاهات حسب فترات اليوم أو فصول السنة)، يتوجب فك هذا الارتباط وفصل التاريخ إلى حقل تقويمي مجرد وعزل الوقت إلى متغير زمني مستقل.
وبالمثل، تدمج البيانات الجغرافية الإحداثيات المكانية (خطوط الطول ودوائر العرض) في حقل نصي واحد مفصول بفاصلة، أو تجمع العناوين التفصيلية (الدولة، المقاطعة، المدينة، الرمز البريدي) في سلسلة متصلة. يتيح استخدام صيغ التفكيك المنضبطة تحويل هذه النصوص الجغرافية المكتظة إلى مستويات قياس هرمية متدرجة تُمكّن المحلل من تجميع الظواهر المدروسة على مستوى المدينة أو الدولة بصورة مستقلة.
إن تنقية هذه البيانات المكانية والزمنية عبر عكس الدمج يضمن استقلالية وحدات الملاحظة والقياس، ويهيئ مصفوفات البيانات للتكامل السلس مع نظم المعلومات الجغرافية (GIS)، مما يعزز من موثوقية النماذج المكانية-الزمانية ويضمن خلو التقديرات الإحصائية من الانحرافات الناتجة عن تداخل المقاييس المتباينة في الحقل الواحد.
10. أفضل الممارسات والمعايير المنهجية لإدارة النصوص في إكسل
10.1 بناء نماذج جداول مرنة وقابلة لإعادة الاستخدام
تتطلب الإدارة الاحترافية للبيانات داخل جداول إكسل التحول من الحلول العفوية المؤقتة إلى تصميم نماذج عمل معيارية قابلة لإعادة الاستخدام. ويتحقق ذلك أولاً عبر اعتماد مراجع الخلايا الديناميكية وتجنب تضمين النصوص المحددة أو الفواصل كقيم ثابتة مجردة (Hardcoding) داخل المعادلات كلما أمكن ذلك؛ حيث يُفضل تخصيص خلايا مستقلة في ورقة تحكم جانبية لتعريف المحددات الفاصلة وقواعد المعالجة، مما يسمح بتعديل منطق التقسيم لكامل النموذج من موضع واحد مركزي.
كما يُعد التوثيق المنهجي لمنطق التقسيم في ترويسات الأعمدة من المعايير الضرورية لضمان فهم المستخدمين الآخرين للهيكل الداخلي للمصنف. يجب أن تعكس مسميات الأعمدة بوضوح طبيعة البيانات المفككة (مثل: “الاسم الأول المستخرج” أو “رمز المدينة المفكك”)، مع إدراج تعليقات توضيحية (Notes) تشرح سلوك مصفوفة التدفق البرمجية وتوضح الشروط التي بُنيت عليها عملية الفصل لتسهيل أعمال التدقيق والمراجعة اللاحقة.
ينبغي كذلك تصميم قوالب العمل لتكون بمثابة قنوات معالجة آلية؛ بحيث يتم استقبال السجلات الجديدة المدمجة وتفكيكها فورياً دون الحاجة إلى إعادة كتابة الصيغ الحسابية أو تعديل نطاقات التعبئة، مما يضمن تدفقاً سلساً للبيانات عبر مراحل التحليل المختلفة بأقل قدر ممكن من التدخل البشري المعرض للخطأ.
10.2 إدارة الأداء الحسابي في المصنفات الضخمة
على الرغم من التميز البرمجي لدوال المصفوفات الديناميكية مثل TEXTSPLIT، إلا أن استخدامها على نطاق واسع في جداول تحتوي على عشرات الآلاف من السجلات يفرض عبئاً حسابياً ثقيلاً على المعالج وذاكرة الوصول العشوائي (RAM). فبرنامج إكسل يظل محتفظاً بتلك المصفوفات في حالة استعداد دائم لإعادة الحساب اللحظي عند أي تغيير في مصنف العمل، مما قد يؤدي إلى بطء ملحوظ في الاستجابة وتجمد مؤقت للبرنامج أثناء إدخال البيانات.
لتفادي هذا التدهور في الأداء، تتمثل أفضل الممارسات المنهجية في اعتماد استراتيجية التحويل إلى قيم ثابتة (Paste as Values). بمجرد اكتمال مرحلة التفكيك النصي والتحقق من دقة النتائج وسلامة توزيعها، يقوم المحلل بنسخ النطاق المفكك بالكامل ثم لصقه كـ “قيم” فوق نفس الخلايا؛ مما يؤدي إلى حذف المعادلات المتدفقة مع الاحتفاظ بالبيانات المستخرجة في صورتها النهائية الثابتة، وهو ما يحرر الذاكرة فوراً من أعباء الحساب الديناميكي المستمر.
كما يُنصح بتقليص نطاقات الصيغ وتجنب الإشارة إلى أعمدة كاملة (مثل A:A) داخل معادلات التفكيك، وحصر الإسناد بدقة في النطاق الفعلي المشغول بالبيانات (مثل A2:A5000). يسهم هذا التحديد في تسريع محرك المعالجة المتوازية للبرنامج، ويمنع استهلاك طاقة المعالجة في فحص ملايين الخلايا الفارغة التي تمتد إلى نهاية حدود ورقة العمل الافتراضية دون طائل.
10.3 ضمان سلامة ونزاهة البيانات بعد التفكيك
تُمثل مرحلة ما بعد التفكيك اختباراً حاسماً لنزاهة البيانات ومطابقتها للمعايير الأكاديمية والمهنية. تتطلب الممارسة المنهجية تطبيق أدوات التحقق من صحة البيانات (Data Validation) على الأعمدة الناتجة فور استقرارها؛ لتقييد نوع وطول المدخلات المقبولة، وضمان خلو الحقول الحساسة (مثل الأرقام الوطنية أو الرموز البريدية المفككة) من أي محارف نصية طارئة تسربت إليها أثناء التفكيك.
كذلك يجب تصميم فحوصات منطقية دورية للمطابقة والتحقق (Reconciliation Checks). ومن أبسط هذه الفحوصات المقارنة العددية؛ حيث يتم استخدام دالة COUNTA للتأكد من أن عدد السجلات الناتجة في الأعمدة المفككة يتطابق تماماً مع عدد السجلات الأصلية في عمود البيانات المدمجة، مما يضمن عدم سقوط أي سجل سهواً نتيجة خطأ تدفق أو توقف غير مقصود في الصيغة الحسابية على امتداد الجدول.
وأخيراً، تقتضي القواعد الأخلاقية والمهنية لإدارة البيانات الاحتفاظ دائماً بنسخة احتياطية غير معدلة من البيانات الأولية الخام (Raw Data) في ورقة عمل محمية ومستقلة، قبل الشروع في إجراءات التحويل والتفكيك الجذري. يضمن هذا الإجراء توفير مسار تدقيق استرجاعي (Audit Trail) يتيح للباحث العودة إلى الأصل للتثبت من صحة الاستخلاص ومقارنة السياق الدلالي الأصلي إذا ثارت أي شكوك منهجية أثناء مرحلة التحليل الإحصائي المتقدم.
خاتمة
يُشكّل استيعاب واستخدام عكس عملية الدمج في برنامج إكسل نقلة نوعية في قدرات المحلل على إدارة وتنقية البيانات المعقدة وتحويلها من كتل نصية مصمتة إلى بنيات ذرية مرنة تخضع لكافة قواعد الاستدلال والتحليل الإحصائي المتقدم. ولقد أسس طرح دالة TEXTSPLIT لمعيار جديد في كفاءة المعالجة الجدولية بفضل بنيتها المصفوفية الديناميكية التي تجاوزت قيود الأدوات الكلاسيكية والتعقيد المفرط للصيغ التراثية المركبة، مما وفر حلاً شاملاً يتكامل بمرونة مع منظومة تحليل البيانات الحديثة.
إن الاختيار المنهجي الواعي بين الحلول المتعددة—سواء كان بالاعتماد على ديناميكية TEXTSPLIT الفائقة، أو الاستعانة بثبات أداة تحويل النص إلى أعمدة لتوفير الذاكرة، أو اللجوء إلى التعبئة السريعة للاستدلال السريع، أو الاستناد إلى الصيغ الكلاسيكية لتحقيق التوافق الرجعي التام—يجب أن يرتكز دائماً على طبيعة المهمة، وحجم البيانات، والبيئة التقنية للمستخدمين. ومع اقتران هذه الأدوات بممارسات التدقيق الصارمة وتنظيف المحارف المخفية، تصبح عملية عكس الدمج حجر زاوية موثوقاً يضمن نزاهة النماذج البحثية وسلامة القرارات المستندة إليها.
المراجع
- Alexander, M., & Kusleika, D. (2022). Excel 2022 All-in-One For Dummies. John Wiley & Sons.
- Harvey, G. (2021). Excel For Dummies. John Wiley & Sons.
- Microsoft Support. (n.d.). TEXTSPLIT function. Microsoft Corporation. https://support.microsoft.com/en-us/office/textsplit-function-b13e3133-722a-4f27-a068-bb9be9b24467
- Microsoft Support. (n.d.). Split text into different columns with the Convert Text to Columns Wizard. Microsoft Corporation. https://support.microsoft.com/en-us/office/split-text-into-different-columns-with-the-convert-text-to-columns-wizard-30b14928-5550-41f5-97ca-7a3e9c363d31
- Microsoft Support. (n.d.). Using Flash Fill in Excel. Microsoft Corporation. https://support.microsoft.com/en-us/office/using-flash-fill-in-excel-3f9bcf1e-db93-4764-a4d3-b54134e2c050
- Walkenbach, J. (2015). Microsoft Excel 2016 Bible. John Wiley & Sons.