
تُعد عملية تنقية البيانات وتطهيرها إحدى الركائز الأساسية التي تسبق أي تحليل إحصائي رصين أو نمذجة رياضية دقيقة؛ إذ إن جودة المخرجات التحليلية ترتبط ارتباطاً بنيوياً بمدى نقاء المدخلات وسلامتها المنهجية من التشوهات والشوائب. وفي كثير من البيئات الأكاديمية والمهنية، يتعامل الباحثون والمحللون مع كميات هائلة من البيانات الخام التي تتسلل إليها سجلات مكررة نتيجة أخطاء الإدخال البشري، أو تكرار استجابات المبحوثين في المسوح الميدانية، أو تداخل العمليات التقنية في منصات جمع المعلومات الرقمية. ويكمن التحدي الأكبر عندما لا تقتصر الحاجة على إبقاء نسخة واحدة من السجل وإلغاء النظائر، بل تمتد إلى ضرورة الاستبعاد الجذري والكامل لكل قيمة طرأ عليها التكرار، بحيث يُحذف الأصل وجميع فروعه وتوابعه من مصفوفة التحليل النهائية.
إن التمييز بين مفهوم «القيم المتمايزة» التي تحتفظ بظهور واحد لكل مفردة، وبين مفهوم «القيم الفريدة المطلقة» التي لم تتكرر على الإطلاق داخل المتجه الرياضي للبيانات، يمثل نقطة تحول حاسمة في معالجة البيانات المتقدمة عبر برنامج مايكروسوفت إكسيل (Microsoft Excel). فعندما تفشل الاستجابات المتكررة في تقديم دلالة موثوقة—كما هو الحال في الاستبانات المزدوجة التي لا يمكن الجزم بصحة أي من نسختيها—يصبح الإبقاء على أي طرف من أطراف التكرار مصدراً مباشراً للتحيز المنهجي ولتضخيم الأوزان النسبية بصورة تعسفية، مما يقوض صدق النتائج وثباتها الإحصائي.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تفصيل منهجي وإجرائي دقيق لكيفية عزل وإزالة كل من السجلات المكررة والنسخ الأصلية المرتبطة بها في برنامج إكسيل، من خلال استعراض الأسس الرياضية والمنطقية، وتفكيك الدوال المعاصرة والتقليدية، وصولاً إلى الأتمتة المتقدمة عبر محرر الاستعلامات ولغات البرمجة النصية، بما يضمن تزويد الباحث والممارس بحلول قطعية وقابلة للتكرار في مختلف السياقات التحليلية.
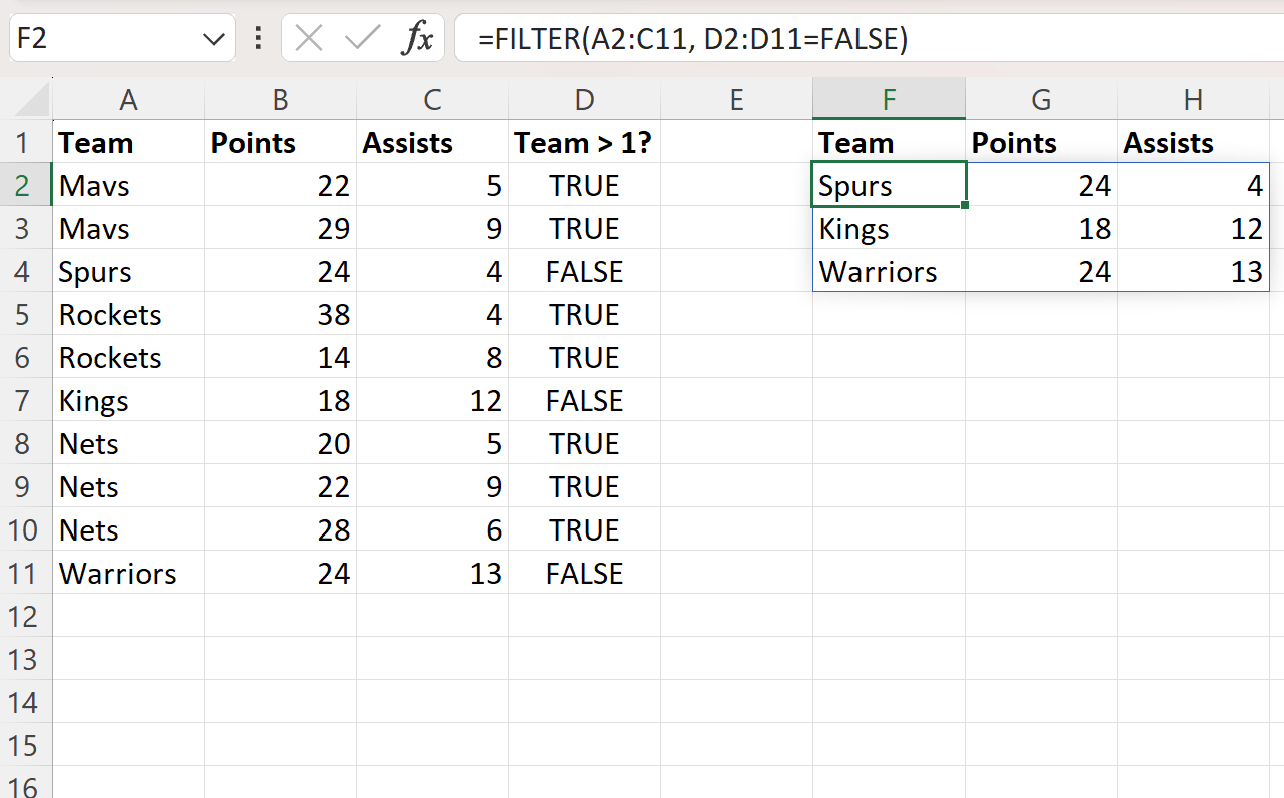
1. مقدمة منهجية لتنقية البيانات: الفرق بين حذف التكرار التقليدي والاستبعاد الجذري
1.1 التمييز المفاهيمي بين استبقاء النسخة الأولى والحذف الشامل للمكررات
يوفر برنامج مايكروسوفت إكسيل في واجهته الافتراضية أداة قياسية شهيرة تُعرف باسم «إزالة التكرارات» (Remove Duplicates)، وهي أداة بُنيت على خوارزمية تقارن الصفوف والسجلات ثم تستبقي تلقائياً أول ظهور للسجل وتتخلص من التكرارات اللاحقة. ومع أن هذا السلوك يعد ملائماً للغاية في إدارة المخازن أو تسطيح قوائم العملاء، إلا أنه يقف عاجزاً وربما مضللاً عند استخدامه في سياقات البحث العلمي والدراسات الاستقصائية المتقدمة. فالإبقاء على النسخة الأولى يفترض مسبقاً أن السجل الأول يحمل صفة الصحة والموثوقية، في حين أن التكرار بحد ذاته قد يكون مؤشراً قاطعاً على بطلان السجل برمجياً أو إحصائياً، مما يستوجب إسقاطه كلياً هو وكافة نظائره دون أي استثناء، للحصول على مصفوفة تتألف حصراً من القيم التي ظهرت بتردد يساوي واحداً صحيحاً.
من الناحية المنهجية، يرتكز الاستبعاد الجذري على التفريق الدقيق بين مصطلحين رياضيين: «القيم المتمايزة» (Distinct Values) و«القيم الفريدة المطلقة» (Strictly Unique Values). تشير القيم المتمايزة إلى قائمة تضم كل عنصر من عناصر المجموعة لمرة واحدة بصرف النظر عن تردد ظهوره في المتجه الأصلي؛ فإذا كان الرقم 5 يتكرر أربع مرات، فإن القائمة المتمايزة ستحتوي على الرقم 5 مرة واحدة. في المقابل، فإن مفهوم القيم الفريدة المطلقة يستبعد الرقم 5 كلياً من القائمة الناتجة لأن تكراره ينفي عنه صفة التفرد الأحادي. ويعد هذا التمايز ركيزة أساسية لمنع تضخيم الأوزان النسبية وخلل القياس، حيث أشار الباحثون في مجالات التحليل الإحصائي والتشخيص إلى أن دقة تصنيف النماذج واختبار كفاءتها تتأثر سلباً بوجود مدخلات مشوبة بالتكرار المجهول الأصل (Youngstrom, 2013).
إن إبقاء نسخة واحدة من البيانات المكررة في حالات تضارب السجلات يؤدي بالضرورة إلى تشويه معالم التوزيع الاحتمالي للظاهرة المدروسة؛ إذ يُحدث انحرافاً في قيم المتوسطات الحسابية والتباين والانحراف المعياري، فضلاً عن إفساده لاختبارات الدلالة الإحصائية التي تفترض استقلالية المشاهدات. ومن ثم، فإن التطهير المنهجي الصارم لا يكتفي بالتشذيب السطحي للمصفوفة، بل يعتمد سياسة الاستئصال الكلي لأي عنصر تكراري لا تتوافر براهين قطعية على صحة أحد أطرافه دون الآخرين.
1.2 أهمية التنقية الجذرية للبيانات في الدراسات والمسوح الميدانية
تكتسب عملية الاستبعاد الجذري للقيم المتكررة مع أصولها أهمية مضاعفة عند معالجة بيانات المسوح الميدانية والدراسات السلوكية والنفسية التي تُجرى عبر الإنترنت؛ حيث تواجه هذه الدراسات تحديات جسيمة مرتبطة بإعادة إرسال النماذج الرقمية من قِبل نفس المشارك عدة مرات، أو محاولات التلاعب الممنهجة عبر الروبوتات البرمجية، أو الأخطاء التقنية الناتجة عن تعليق متصفحات الويب وإعادة الإرسال القسري. وفي مثل هذه الحالات، لا يمكن للباحث تحديد أي النسختين تمثل الاستجابة الحقيقية للمشارك، مما يجعل الاعتماد على أي منهما خرقاً لصدق المحتوى وثبات الأداة البحثية.
علاوة على ذلك، يمثل تنظيف المعرفات الفريدة—مثل أرقام الهوية الوطنية، أو الأرقام الجامعية، أو عناوين البريد الإلكتروني، أو أرقام الهواتف—مرحلة بالغة الحساسية في إدارة قواعد البيانات البحثية. فإذا ارتبط معرف فريد بأكثر من صف يضم إجابات متناقضة لأسئلة الدراسة، فإن المنطق العلمي يقتضي إسقاط المعرف بكامل صفوفه من العينة النهائية لحماية استقلالية القياس. ويسهم هذا الإجراء الوقائي في تنقية المصفوفات الرياضية من الإشارات المشوشة (Noise)، مما يرفع كفاءة النمذجة الرياضية والتحليلات العاملية وخوارزميات الانحدار المتعدد التي تتأثر بشدة بالبيانات الشاذة والمتضاربة.
يمتد هذا الإجراء أيضاً إلى القطاعات الاقتصادية والتجارية الحيوية؛ فعلى سبيل المثال، في عمليات مضاهاة الحسابات البنكية ومطابقة الدفاتر المحاسبية، يتم البحث عن القيود التي تطابقت مبالغها في جانب المدين والدائن لاستبعادها تماماً وعزل القيود غير المتطابقة التي تظهر لمرة واحدة فقط لمعرفة الفروقات. إن هذا الاستبعاد الشامل للحركات المكررة يتيح للمدققين التركيز الفوري على العناصر الشاذة التي لم تقابلها عمليات تسوية، وهو ما يعكس الطابع التطبيقي الشامل لهذه المنهجية خارج الأطر الأكاديمية الصرفة.
1.3 متطلبات بيئة العمل في إكسيل وتوافق الإصدارات البرمجية
شهدت بنية الحساب الرياضي في برنامج مايكروسوفت إكسيل تحولاً جذرياً مع إطلاق محرك المصفوفات الديناميكية (Dynamic Arrays Engine) في إصدارات Microsoft 365 وإكسيل 2021 وما تلاها. وقد أحدث هذا التطور فجوة وظيفية واضحة بين الإصدارات المعاصرة والإصدارات التقليدية التراثية (مثل إكسيل 2019، 2016، والإصدارات الأقدم)؛ حيث تتيح الإصدارات الحديثة تنفيذ عمليات التصفية والاستبعاد الجذري عبر صيغ مصفوفية مدمجة تنحدر وتنسكب في خلايا مجاورة تلقائياً دون الحاجة إلى تدخل معقد من المستخدم أو استهلاك مفرط لموارد الذاكرة.
في المقابل، تفتقر الإصدارات القديمة إلى محرك الانسكاب التلقائي، وتعتمد بدلاً من ذلك على صيغ الصفيف المعقدة التي تتطلب التثبيت التقليدي عبر اختصار لوحة المفاتيح الشهير (Ctrl + Shift + Enter)، والمعروفة برمجياً بصيغ CSE. إن فهم طبيعة الإصدار المستخدم في بيئة العمل يحدد المسار المنهجي الأمثل لتطبيق الحل؛ فالاعتماد على دوال ديناميكية متقدمة مثل FILTER أو UNIQUE داخل بيئة قديمة سيؤدي حتماً إلى أخطاء تركيبية تمنع قراءة الصيغة وتؤدي إلى ظهور الخطأ #NAME?، مما يعطل سلاسل المعالجة التلقائية ويؤثر سلباً على إمكانية مشاركة الملفات بين الباحثين والمؤسسات المختلفة.
يتطلب إعداد ورقة العمل للمعالجة المنهجية تحويل نطاق البيانات الخام إلى جداول إكسيل المهيكلة (Excel Tables) باستخدام الاختصار (Ctrl + T) كلما أمكن ذلك؛ حيث يضمن هذا التحويل إشارة مرجعية مرنة تنمو تلقائياً مع إضافة صفوف جديدة، مما يجعل العمليات الحسابية والصيغ المطبقة مقاومة للانكسار أثناء تحديث البيانات، ويوفر بيئة مثالية لعمل محركات التصفية سواء كانت تعتمد على الصيغ الحسابية أو محرر الاستعلامات المتقدم.
2. الأسس الرياضية والمنطق البرمجي وراء عزل السجلات المتفردة تماماً
2.1 تحليل مصفوفة الترددات الإحصائية للبيانات الفردية
ترتكز عملية العزل الجذري على نمذجة رياضية بسيطة مستمدة من الإحصاء الوصفي، وتحديداً من تحليل التوزيع التكراري للبيانات الفردية داخل المتجه الرياضي المستهدف. ليكن لدينا متجه بيانات أحادي البعد يُرمز له بالرمز $X = [x_1, x_2, …, x_n]$، حيث يمثل $n$ إجمالي عدد المشاهدات المسجلة. تُعرَّف دالة التكرار الحسابي $f(x_i)$ بأنها عدد المرات التي يظهر فيها العنصر $x_i$ داخل المتجه $X$. وبناءً على هذه الدالة، يمكن تقسيم فضاء العينة الرياضي إلى مجموعتين فرعيتين منفصلتين تماماً:
- المجموعة الفرعية الأولى (المفردات المتكررة): وتضم كافة العناصر التي تحقق الشرط $f(x_i) > 1$.
- المجموعة الفرعية الثانية (المفردات الفريدة قطعياً): وتضم كافة العناصر التي تحقق الشرط $f(x_i) = 1$.
إن خوارزميات الاستبعاد الجذري تهدف بصورة حصرية إلى إنشاء متجه ناتج $Y$، بحيث يحتوي فقط على عناصر المجموعة الثانية، مع إسقاط عناصر المجموعة الأولى بكامل تمثيلاتها. إن إسقاط أي عنصر تكرر $k$ من المرات يعني حذف $k$ من الصفوف دفعة واحدة من مصفوفة البيانات الأصلية، وليس حذف $k-1$ كما يحدث في أدوات إزالة التكرار التقليدية. ويترتب على ذلك انكماش في حجم العينة النهائي يتناسب طردياً مع درجة تكرار المفردات وتشتتها عبر فضاء البيانات الكلي.
يساعد هذا البناء الرياضي في عزل أي مشكلات تتعلق بتكثيف البيانات حول نقاط شاذة غير مبررة؛ مما يجعل تحليل الترددات خطوة أولية لا غنى عنها لفهم طبيعة البيانات المدروسة، وتحديد المتغيرات التي تحتوي على أخطاء نظامية تؤثر في تماسك البنية الإحصائية الكلية للعينات المسحوبة.
2.2 تطبيق المنطق البوليني (Boolean Logic) في التقييم الشرطي
يعتمد الحاسوب في تقييم الشروط الرياضية داخل جداول البيانات على الجبر البوليني (Boolean Algebra)، حيث تُختزل كافة العمليات المنطقية إلى إحدى الحالتين: الصواب المطلق (TRUE) الممثل رقمياً بالرقم 1، أو الخطأ المطلق (FALSE) الممثل رقمياً بالرقم 0. وعند تطبيق استعلام شرطي لفحص تكرار البيانات في إكسيل، يتم تمرير كل مدخل عبر بوابة منطقية تحسب قيمة تردد ظهوره مقارنة بالمصفوفة المرجعية الكاملة، لينتج عن هذا الفحص متجه موازٍ من القيم المنطقية يماثل تماماً طول المتجه الأصلي للبيانات.
في إطار مسألة الاستبعاد الجذري، يُصاغ الاختبار المنطقي بطريقتين متكافئتين رياضياً وفقاً للزاوية التحليلية المتبعة:
- صيغة الاستكشاف السلبي: فحص ما إذا كان التردد أكبر من واحد ($f(x_i) > 1$). هنا، تدل القيمة المنطقية
TRUEعلى أن السجل مكرر ويجب إبادته هو وأصله، في حين تمثل القيمةFALSEالسجل الصالح للاستبقاء. - صيغة الاستكشاف الإيجابي: فحص ما إذا كان التردد يساوي واحداً تماماً ($f(x_i) = 1$). هنا، تدل القيمة المنطقية
TRUEمباشرة على أن السجل فريد قطعياً ويستحق التضمين في المخرجات النهائية.
يتيح المنطق البوليني دمج معايير فرز وتصفية متعددة عبر المعاملات الرياضية المنطقية المتمثلة في الضرب المنطقي (AND) والجمع المنطقي (OR). فإذا رغب الباحث في استبعاد التكرارات استناداً إلى تطابق حقلين مختلفين (مثل الاسم الأول واللقب معاً)، فإن إكسيل يقوم بضرب المصفوفات المنطقية الناتجة ببعضها، بحيث لا يُمنح السجل صفة الفرادة إلا إذا حقق شرط الأحادية عبر كافة المتغيرات المفحوصة في آن واحد وبدقة متناهية.
2.3 سلوك المصفوفات الديناميكية وإعادة التوسع التلقائي في إكسيل
أدى إدخال بنية المصفوفات الديناميكية في منصات إكسيل الحديثة إلى استبدال أسلوب الحساب القائم على «الخلية الفردية» بأسلوب الحساب القائم على «المصفوفة المتكاملة». وبموجب هذا المحرك الجديد، عندما تُرجع صيغة رياضية معينة مجموعة متعددة من القيم، فإن تلك القيم تتدفق تلقائياً من خلية الصيغة الأصلية لتملأ الخلايا المجاورة رأسياً وأفقياً فيما يُعرف برمجياً بسلوك الانسكاب (Spill Behavior). وتُحاط مساحة الانسكاب بحدود زرقاء تفاعلية تدل على أن كامل النطاق يُدار عبر معادلة واحدة مقيمة في الخلية العلوية الأولى المسماة بخلية المرساة (Anchor Cell).
يتطلب هذا السلوك التلقائي إدارة واعية لمساحة ورقة العمل؛ فإذا اعترضت سبيل مصفوفة الانسكاب أي بيانات نصية، أو خلايا مدمجة، أو مسافات غير مرئية، سيتوقف المحرك الرياضي عن العمل فوراً ويطلق إشعار الخطأ الحجمي #SPILL!. وبمجرد تفريغ المسار وإزالة العوائق الفيزيائية، تتوسع المصفوفة لحظياً لتغطي كامل البيانات المعالجة، مما يلغي الحاجة القديمة لسحب مقبض التعبئة التلقائي يدوياً عبر مئات آلاف الصفوف، ويمنع أخطاء عدم تطابق النطاقات.
علاوة على ذلك، تتميز هذه المنهجية الديناميكية بارتباطها اللحظي الوثيق بمصدر البيانات الأساسي؛ فبمجرد إدخال تعديل على قيمة معينة، أو مسح صف من المصدر الأصلي، يُعاد تقييم شرط التردد المنطقي تلقائياً في أجزاء من الثانية دون تدخل المستخدم. وتتسم هذه الحسابات المصفوفية المباشرة بكفاءة عالية في استهلاك موارد الذاكرة العشوائية (RAM) ووحدة المعالجة المركزية، مقارنة بالصيغ التقليدية المتكررة أو أكواد الماكرو غير المحسنة.
3. استخدام الدالة الشرطية COUNTIF لتحديد وتصنيف السجلات المكررة
3.1 صياغة دالة COUNTIF المعيارية لفحص تكرار المفردات
تُعد الدالة الإحصائية الشرطية COUNTIF إحدى الأدوات الرياضية المركزية في تقييم وتصنيف البيانات داخل جداول إكسيل. تقوم هذه الدالة بمسح نطاق مرجعي محدد وحساب عدد الخلايا التي تستوفي معياراً منطقياً معيناً. وتتكون البنية التركيبية الأساسية للدالة من وسيطين إجباريين: النطاق المرجعي للفحص (Range)، والمعيار المستهدف (Criteria). وعند تطبيقها على فحص تكرارات متجه رأسي أحادي، تُكتب الصيغة الرياضية لحساب تردد ظهور العنصر الأول كما يلي:
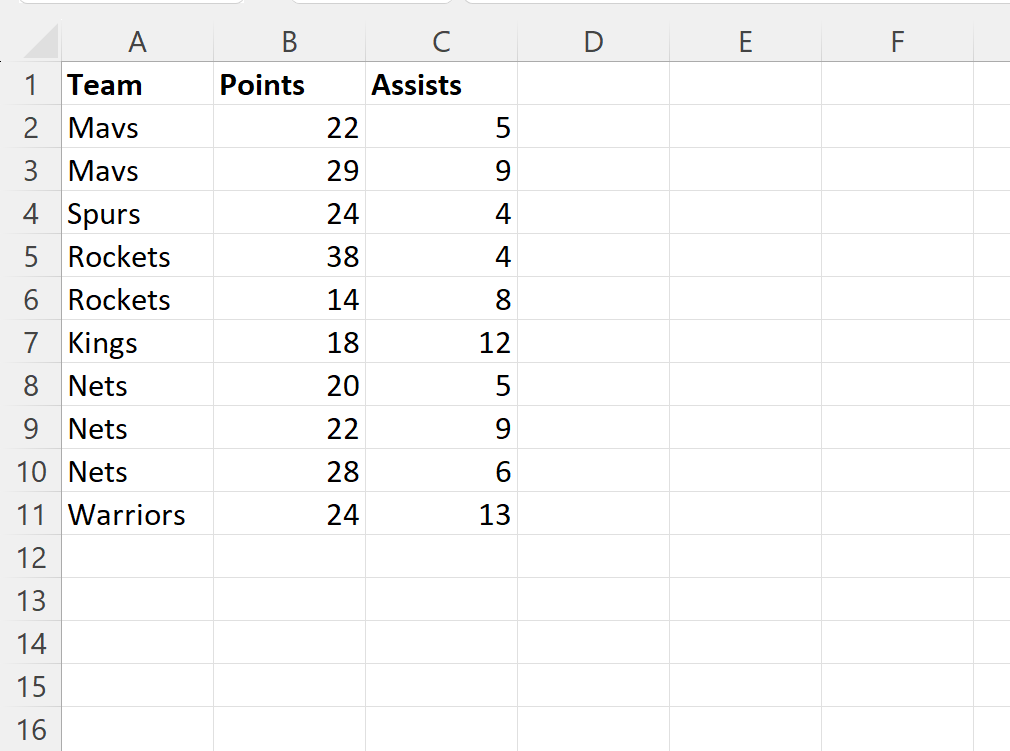
=COUNTIF($A$2:$A$11, $A2)
يقوم إكسيل في هذه الحالة بمسح كافة القيم الواقعة بين الخلية A2 والخلية A11، ويحسب عدد المرات التي تتطابق فيها محتويات تلك الخلايا مع القيمة المحددة في الخلية A2. فإذا كانت القيمة تظهر ثلاث مرات عبر النطاق المرجعي، فستُرجع الدالة القيمة العددية 3. وبتحويل هذه النتيجة الحسابية إلى تعبير مقارنة منطقي بإضافة المعامل (> 1)، تصبح الصيغة:
=COUNTIF($A$2:$A$11, $A2) > 1
تُسفر هذه الصيغة عن قيمة منطقية بولينية صريحة، حيث تُرجع TRUE إذا كان العنصر ينتمي إلى فئة المكررات المتعددة (مما يجعله هدفاً للاستبعاد التام هو وأصله)، بينما تُرجع FALSE إذا كان تردد العنصر لا يتجاوز الواحد الصحيح، مما يؤكد تفرده المطلق ويؤهله للبقاء في النسخة المنقاة من مجموعة البيانات.
3.2 الأهمية الفائقة لاستخدام المراجع المطلقة ($) في تثبيت النطاقات
يكمن النجاح المنهجي لتطبيق دالة COUNTIF في الفهم الدقيق لآليات المراجع داخل إكسيل، وتحديداً الفرق بين المراجع النسبية (Relative References) والمراجع المطلقة (Absolute References). عند بناء وسيط النطاق الأول داخل الدالة، يجب تثبيت حدود النطاق الرأسي والأفقي تثبيتاً محكماً باستخدام علامة الدولار ($) لتصبح بالشكل $A$2:$A$11. يضمن هذا التثبيت المطلق عدم انزلاق مصفوفة الفحص لأسفل عند تعميم الصيغة عبر السحب والإفلات أو النسخ إلى الصفوف اللاحقة في ورقة العمل.
على النقيض تماماً، يجب الإبقاء على الوسيط الثاني للدالة (المعيار) كمرجع نسبي جزئياً أو كلياً مثل $A2 أو A2. ويتيح هذا السلوك للمعيار التحرك بمرونة رأسية مع كل صف يتم الانتقال إليه، مما يمكّن الصيغة من تقييم العنصر الخاص بكل صف باستقلالية تامة، ولكن دائماً في مواجهة النطاق المرجعي الكامل والمغلق للبيانات. يوضح الجدول التالي الأثر التقني لاختلاف أنماط تثبيت المراجع عند تطبيق معادلات العد الشرطي:
- النطاق المطلق تماماً ($A$2:$A$11): يضمن ثبات مصفوفة المقارنة الرياضية لكافة المشاهدات دون أي انزياح في أبعاد العينة، وهو النمط الصحيح للوسيط الأول.
- النطاق النسبي المنزلق (A2:A11): يؤدي انزلاقه لأسفل إلى استبعاد الصفوف العليا تدريجياً وإدخال خلايا فارغة سفلياً، مما ينتج عنه حسابات ترددية خاطئة بالكامل تشوه تقييم التكرارات.
- المعيار المختلط تثبيتاً ($A2): يثبت عمود القراءة لمنع التشتت الأفقي مع السماح بالحركة الرأسية الحرة عبر صفوف البيانات المفحوصة، وهو السلوك الأمثل للمعيار.
إن إغفال تثبيت النطاق يعد من أشهر الأخطاء الشائعة في معالجة البيانات؛ حيث يؤدي انزياح النطاق إلى اعتبار النسخة الأولى من عنصر مكرر وكأنها تكرار أحادي إذا وقعت المقارنة بعد تجاوز النسخ السابقة، مما يفشل عملية الاستبعاد الجذري ويهدم البناء الإحصائي المستهدف للبيانات المنقاة.
3.3 إنشاء وهيكلة العمود المساعد (Helper Column) لاختبار الشروط
يعد أسلوب العمود المساعد (Helper Column) منهجاً كلاسيكياً عالي الشفافية وقابلية التدقيق، لا سيما عند العمل ضمن فرق بحثية تحتاج إلى فحص وتتبع خطوات معالجة البيانات خطوة بخطوة. يتم إنشاء العمود المساعد في حقل ملاصق تماماً لجدول البيانات الأصلي، ويُمنح اسماً وصفياً دقيقاً وذا دلالة إجرائية صريحة، مثل «حالة التكرار»، أو «Is_Duplicate»، أو «تكرار_مستبعد».
يتم إدخال الصيغة الشرطية =COUNTIF($A$2:$A$11, $A2)>1 في الخلية العلوية الأولى من هذا العمود (ولتكن الخلية D2)، ثم تُعمم على كافة الخلايا التابعة للمصفوفة حتى الخلية D11. بمجرد تنفيذ هذا الإجراء، يمتلئ العمود المساعد بمصفوفة من المخرجات البولينية (TRUE أو FALSE). وتعكس هذه القيم صورة مرئية فورية لحالة كل صف، مما يوفر منصة تدقيق بصري قبل المضي قدماً في تطبيق أدوات الحذف الفعلي أو التصفية والاستخراج.
يسهل هذا العمود المساعد عملية الفرز اليدوي والآلي، ويوفر حماية قوية ضد التدمير غير المقصود للبيانات المصدرية؛ حيث يظل الجدول الأصلي محتفظاً بتكامله الفيزيائي، بينما يتولى العمود المساعد وظيفة مؤشر التوجيه الحسابي الذي ستعتمد عليه دوال الاستخراج المتقدمة مثل FILTER أو أدوات التصفية التلقائية القياسية لاحقاً.
4. توظيف الدالة المتقدمة FILTER لاستخراج وحذف القيم المتكررة بأصولها
4.1 البنية التركيبية لدالة FILTER ومعايير الاشتقاق المصفوفي
تُمثل الدالة الديناميكية FILTER، التي أطلقتها مايكروسوفت ضمن التحديثات الجوهرية لمحرك الحساب، نقلة نوعية في قدرات استخلاص البيانات المشروطة دون المساس بسلامة الجداول المصدرية. تقوم هذه الدالة بتصفية نطاق من البيانات أو مصفوفة استناداً إلى مصفوفة منطقية بولينية موازية تُحدد العناصر المقبولة والمستبعدة. وتتألف البنية التركيبية للدالة من ثلاثة وسائط رئيسية تُكتب رياضياً على النحو التالي:
=FILTER(array, include, [if_empty])
تتكامل وسائط الدالة وظيفياً لأداء مهام التصفية الدقيقة وفق التفصيل المنهجي التالي:
- وسيط المصفوفة المصدرية (array): يمثل نطاق البيانات المراد استخلاص النتائج منه، وقد يشمل عموداً مفردة أو جدولاً كاملاً متعدد الأعمدة (مثل
A2:C11). ويستخلص محرك الدالة الصفوف المؤهلة بكافة تفاصيلها المرتبطة. - وسيط التضمين المنطقي (include): يمثل مصفوفة الشروط المنطقية التي يجب أن تتطابق أبعادها الرأسية تماماً مع عدد صفوف مصفوفة المصدر. ويقبل هذا الوسيط القيم البولينية، حيث يتم استبقاء الصف المقابل للقيمة
TRUEوإسقاط الصف المقابل للقيمةFALSE. - وسيط البديل الشرطي ([if_empty]): وسيط اختياري بالغ الأهمية يُحدد القيمة أو النص الذي يجب إرجاعه في حال لم يستوفِ أي صف في مصفوفة المصدر الشروط المحددة، مما يمنع ظهور الأخطاء التشغيلية الصامتة.
تتميز دالة FILTER بأنها لا تكتفي بقراءة البيانات بل تعيد بناء وتوليد مصفوفة مستقلة جديدة تماماً، مما يتيح للباحث عزل النتائج في موضع منفصل من ورقة العمل وتجنب تعديل البيانات الخام، وهو ما يتوافق مع معايير الشفافية ونزاهة التحليل الإحصائي.
4.2 تطبيق المعادلة الرياضية =FILTER(A2:C11, D2:D11=FALSE)
لتحقيق الاستبعاد الجذري لكافة القيم المكررة مع أصولها باستخدام العمود المساعد الذي تم إنشاؤه مسبقاً، يحدد المحلل خلية فارغة في ورقة العمل لتكون نقطة انطلاق الجدول المنقى الجديد (ولتكن الخلية F2)، ثم يدرج الصيغة الرياضية التالية:
=FILTER(A2:C11, D2:D11=FALSE)
يقوم محرك إكسيل عند تنفيذ هذه الصيغة بإجراء تقييم صفي تقاطعي؛ حيث يطابق كل صف في النطاق A2:C11 مع القيمة المنطقية المقابلة له في نطاق العمود المساعد D2:D11. ولما كانت الصياغة المنطقية قد حددت شرط التضمين بأن تكون القيمة مساوية لـ FALSE، فإن الدالة تستبعد فوراً كل صف اقترن بالقيمة TRUE. واستناداً إلى تصميم دالة COUNTIF السابقة، فإن القيمة TRUE كانت تشير إلى السجلات التي زاد تردد ظهورها عن واحد.
تتمثل النتيجة المباشرة لتنفيذ هذه المعادلة في انبثاق مصفوفة جديدة كلياً لا تتضمن أياً من السجلات المكررة ولا أياً من نسخها الأصلية الأولى، حيث تتبخر كل المدخلات المتنازع عليها من الجدول المستخرج، ولا يتبقى في المخرجات سوى السجلات التي كانت فريدة بصورة قطعية وظهرت لمرة واحدة فقط طوال فترة جمع البيانات، كما هو موضح بالمنطق الرياضي للتصفية.
4.3 معالجة استثناءات التصفية وتفادي أخطاء الحساب (#CALC!)
في الحالات الحدية التي تكون فيها كافة السجلات في مجموعة البيانات الأصلية مكررة لأكثر من مرة، أو عندما لا يتحقق شرط التضمين لأي عنصر في المصفوفة، يفشل محرك دالة FILTER في توليد أي صفوف للمصفوفة الناتجة. وفي حال عدم تعيين الوسيط الثالث، يُرجع إكسيل خطأ الحساب التشغيلي الشهير #CALC!، وهو مؤشر على محاولة توليد مصفوفة فارغة تماماً لا تحتوي على أي عناصر في الذاكرة.
لتفادي هذا العائق وضمان رصانة التقارير ولوحات التحكم التحليلية، يُستثمر الوسيط الثالث لدالة FILTER بوضع نص توجيهي مخصص يوضح طبيعة الموقف التحليلي بدقة، كما في الصيغة المطورة التالية:
=FILTER(A2:C11, D2:D11=FALSE, "لا توجد قيم فريدة مطلقة")
يمكن أيضاً تعزيز مناعة الصيغة ضد الانهيارات الحسابية بدمجها مع الدالة الوقائية IFERROR، لا سيما عند نقل النماذج الحسابية عبر بيئات برمجية متعددة. إن تضمين رسائل الاستثناء المخصصة يرفع كفاءة تواصل النظام مع المستخدم، ويمنع الخلط بين أخطاء كتابة الصيغة البرمجية والأخطاء الناتجة عن الخصائص الجوهرية للبيانات المعالجة.
5. دليل تطبيقي خطوة بخطوة: دراسة حالة عملية على بيانات رياضية
5.1 تجهيز مجموعة البيانات الأولية وهيكلة الأعمدة
لتجسيد الخطوات الإجرائية بصورة تطبيقية لا لبس فيها، نفترض وجود دراسة مسحية ترصد أداء لاعبي كرة السلة في عدة أندية رياضية، حيث يحتوي جدول البيانات الأولي على ثلاثة متغيرات رئيسية موزعة عبر الأعمدة من A إلى C في النطاق المحصور بين الصف الثاني والصف الحادي عشر، وفق التفصيل الهيكلي الآتي:
- العمود A (اسم الفريق – Team): المتغير المستهدف بالفرز والتنقية، ويحتوي على تكرارات متعددة لبعض الفرق، وظهور أحادي لفرق أخرى.
- العمود B (اسم اللاعب – Player): يحتوي على المعرف الاسمي لكل رياضي مسجل في قاعدة البيانات.
- العمود C (معدل النقاط – Points): متغير رقمي مستمر يمثل متوسط التسجيل الإحصائي لكل لاعب.
تتمثل المشكلة البحثية هنا في الرغبة في دراسة أداء الرياضيين التابعين حصراً للأندية التي لم يتكرر إدراجها في قاعدة البيانات نهائياً؛ حيث يُشتبه في أن الفرق المتكررة عانت من مشاكل في تدقيق قياسات لاعبيها، مما يقتضي استبعاد أي فريق ذُكر أكثر من مرة بجميع لاعبيه دون استبقاء أي سجل له. وقبل الشروع في إدخال المعادلات، يتم تنظيف الخلايا والتأكد من توحيد التنسيقات النصية وخلوها من المسافات الفارغة الشاذة.
5.2 التطبيق الإجرائي التفصيلي للمعادلات الشرطية
يتم تنفيذ بروتوكول الاستبعاد الجذري عبر سلسلة من الخطوات الإجرائية الصارمة والمرتبة تسلسلياً كما يأتي:
الخطوة الأولى: الانتقال إلى الخلية D2، وهي الخلية الأولى في العمود المساعد الجديد المعنون «حالة_التكرار»، وكتابة المعادلة الشرطية المعيارية التالية:
=COUNTIF($A$2:$A$11, $A2)>1
الخطوة الثانية: الضغط على مفتاح الإدخال (Enter)، ثم تعميم المعادلة لأسفل حتى الخلية D11 من خلال النقر المزدوج على مقبض التعبئة التلقائي. يُلاحظ هنا تحول مخرجات العمود D إلى مصفوفة من القيمتين TRUE و FALSE تعكس التردد الحسابي لكل فريق.
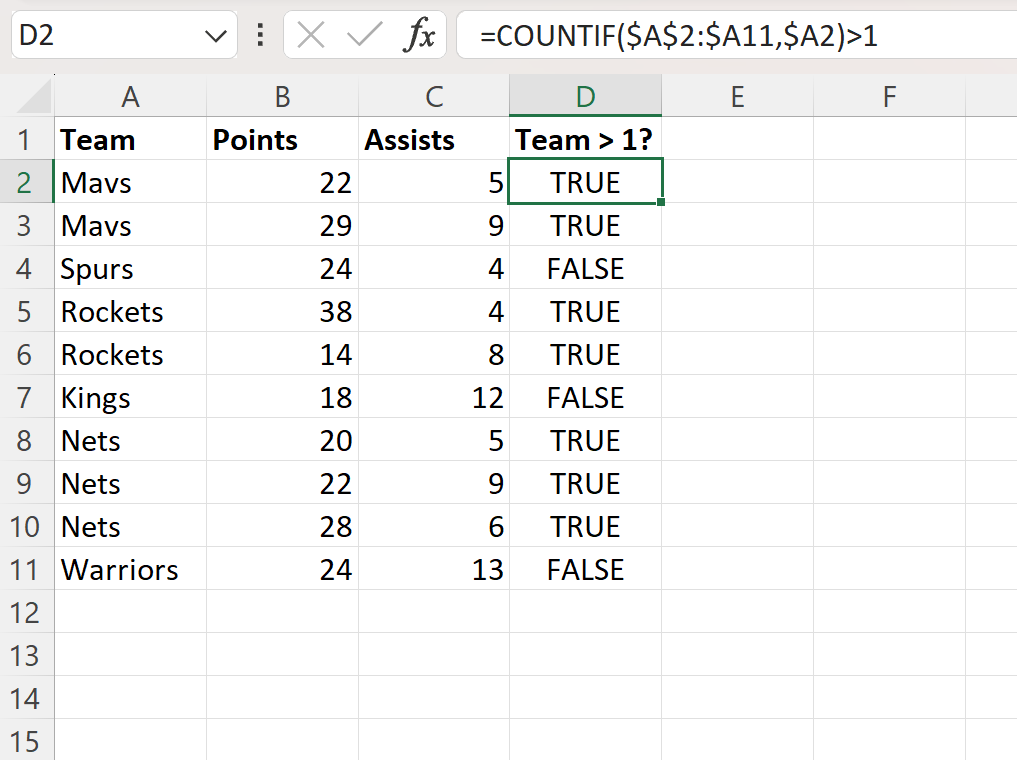
الخطوة الثالثة: تحديد الخلية F2 كنقطة ارتكاز لجدول المخرجات المصفى، وكتابة صيغة التصفية المصفوفية الديناميكية التالية:
=FILTER(A2:C11, D2:D11=FALSE, "لا توجد سجلات فريدة")
بمجرد إدخال الصيغة، تتدفق البيانات الصالحة وتنسكب في النطاق المحيط بالخلية F2، متضمنة الأعمدة الثلاثة كاملة (الفريق، اللاعب، النقاط) ومستبعدة كل صف ارتبط بشرط التكرار الإيجابي، في معالجة فورية وتلقائية متكاملة.
5.3 التحقق النوعي من دقة السجلات المتبقية والمستبعدة
لضمان سلامة الإجراءات وصلاحية المخرجات للتحليل الإحصائي اللاحق، تُجرى مراجعة تقاطعية نوعية لنتائج المعالجة ومقارنتها بالبيانات المصدرية. فإذا افترضنا أن البيانات الأصلية تضمنت فرقاً مثل “Mavs” و”Rockets” و”Nets” بمعدل ظهور بلغ مرتين لكل فريق، في حين ظهر كل من فريق “Spurs” وفريق “Warriors” مرة واحدة فقط في المصفوفة؛ فإن الجدول المنقى النهائي يجب أن يعزل تماماً فرقتي “Spurs” و”Warriors” مع بيانات لاعبيهما المقابلة، مع الاختفاء الشامل والمطلق لفرق “Mavs” و”Rockets” و”Nets” بأصولها وفروعها.
يتم حساب نسبة تقليص البيانات (Data Reduction Ratio) عبر قسمة عدد الصفوف المتبقية على إجمالي عدد الصفوف الأصلية لتوثيق أثر الاستبعاد المنهجي على حجم العينة. ويعد هذا التحقق اليدوي العشوائي خطوة رقابية إلزامية لحماية التحليلات من أي أخطاء في الصياغة المرجعية للمعادلات، وضمان أن النطاق المصفى يعكس التجريد الرياضي المطلوب بدقة متناهية.
6. دمج دالتي COUNTIF وFILTER في صيغة مركبة واحدة دون أعمدة مساعدة
6.1 هندسة الصيغ المتداخلة (Nested Formulas) لترشيد مساحة العمل
على الرغم من الفوائد التعليمية والتدقيقية للعمود المساعد، إلا أن النماذج الاحترافية المتقدمة ولوحات البيانات التنفيذية تتطلب تقليص استهلاك المساحة البصرية لورقة العمل، وتفادي تكديس الأعمدة الإضافية التي قد تربك المستخدمين النهائيين. ولتحقيق هذه الغاية، يمكن دمج المنطق الحسابي لدالة COUNTIF مباشرة داخل وسيط التضمين الخاص بدالة FILTER، منتجاً معادلة مصفوفية متداخلة ذاتية الاكتفاء تُكتب بالصيغة القياسية الآتية:
=FILTER(A2:C11, COUNTIF(A2:A11, A2:A11)=1, "لا توجد قيم فريدة")
تعتمد هذه الهندسة المركبة على معالجة إكسيل لمصفوفة المعايير بالكامل دفعة واحدة داخل الذاكرة المؤقتة الحاسوبية. فعند تمرير النطاق A2:A11 في كلا وسيطي دالة COUNTIF، يُصدر المحرك مصفوفة ترددات داخلية متزامنة تمثل تكرار كل عنصر مقابل نفسه وكافة العناصر الأخرى. ثم تتم مقارنة هذه المصفوفة فورياً بالشرط الحسابي =1، لتتحول مباشرة إلى متجه بوليني من قيم TRUE وFALSE يستقبله وسيط التضمين لدالة FILTER دون الحاجة إلى طباعته في أي خلية مادية على الورقة.
كما تجدر الإشارة إلى وجود دالة ديناميكية أخرى بديلة أضيفت لإكسيل الحديث تُعرف باسم UNIQUE، والتي تمتلك وسيطاً مدمجاً مخصصاً للاستبعاد الجذري، وتُصاغ كما يلي:
=UNIQUE(A2:A11, FALSE, TRUE)
يقوم الوسيط الثالث [exactly_once] عند تعيينه على القيمة TRUE بإلزام الدالة بإرجاع العناصر التي ظهرت لمرة واحدة فقط وإسقاط العناصر المتكررة بكافة نسخها. ومع ذلك، تتفوق صيغة FILTER المدمجة مع COUNTIF في قدرتها الفائقة على تصفية جداول كاملة متعددة الأعمدة استناداً إلى تكرار عمود مفرد محدد، وهو ما تعجز عنه دالة UNIQUE المفردة بمفردها دون تركيبات إضافية معقدة.
6.2 مقارنة الأداء الحسابي وسرعة الاستجابة في الجداول الكبيرة
عند التعامل مع مجموعات البيانات الضخمة التي تتجاوز مئات الآلاف من الصفوف في الأبحاث والمسوح الوطنية، يبرز تباين ملموس في كفاءة المعالجة وسرعة الاستجابة الحسابية بين أسلوب العمود المساعد والصيغة المدمجة المباشرة. تقوم الدالة COUNTIF(A2:A11, A2:A11) بإجراء عملية مقارنة تربيعية تُعرف في علم الخوارزميات بتعقيد زمني من الرتبة $O(N^2)$؛ حيث يمر كل عنصر في النطاق بمسح كامل عبر كافة عناصر النطاق الآخر.
في أسلوب العمود المساعد، يتم احتساب التردد وتخزينه كقيم رقمية ثابتة في خلايا العمود بمجرد إجرائه، مما يجعل عمليات التصفية اللاحقة سريعة نسبياً ولا تعيد استهلاك المعالج إلا إذا تغيرت محتويات الخلايا المصدرية. في المقابل، قد تفرض الصيغ المصفوفية المركبة عبئاً حسابياً مكثفاً ومفاجئاً على وحدة المعالجة المركزية (CPU) عند فتح الملف أو إعادة حسابه، مما قد يتسبب في تباطؤ ملحوظ لاستجابة واجهة المستخدم في حال كانت مصفوفات الفحص بالغة الضخامة.
لذلك، يوصى بالاعتماد على الصيغ المدمجة السريعة في الجداول الصغيرة والمتوسطة التي لا تتعدى عشرات الآلاف من الصفوف لأناقتها الهيكلية، بينما يُفضل اللجوء إلى تقنيات معالجة البيانات المسبقة مثل محرر الاستعلامات (Power Query) أو استخدام العمود المساعد الحسابي الثابت عند التعامل مع قواعد بيانات بحثية تتجاوز مئة ألف صف، ترشيداً لموارد النظام الحاسوبي وتفادياً لتجمد البرمجية.
6.3 آليات استكشاف الأخطاء وتفكيك الصيغ المعقدة
تتطلب إدارة الصيغ المصفوفية المركبة امتلاك مهارات تشخيصية لتفكيك أجزائها عند وقوع أخطاء تركيبية أو منطقية غير متوقعة. يوفر إكسيل أداة قوية تُعرف باسم «تقييم الصيغة» (Evaluate Formula) تقع في لسان تبويب «صيغ» (Formulas)، وتتيح للمحلل السير عبر الخطوات التنفيذية للدالة خطوة بخطوة، ومراقبة كيفية قيام البرنامج بحساب مصفوفة الترددات البينية وتحويلها إلى قيم بولينية قبل الوصول إلى المخرج النهائي.
تتمثل إحدى التقنيات اليدوية السريعة والفعالة لتشخيص الدوال المتداخلة في تظليل الجزء الداخلي المراد اختباره—مثل تظليل العبارة COUNTIF(A2:A11, A2:A11) داخل شريط الصيغة—ثم الضغط على المفتاح الوظيفي (F9) في لوحة المفاتيح. يقوم إكسيل فوراً باستبدال الصيغة المظللة بالمصفوفة الرقمية الناتجة الفعلية المحصورة بين أقواس معقوفة، مما يتيح للباحث التحقق بالعين المجردة من دقة حساب التكرارات. ويجب الانتباه دائماً إلى الضغط على مفتاح الهروب (Esc) بعد الفحص لتفادي استبدال الصيغة الحية بقيم ثابتة بشكل دائم.
من الضروري أيضاً التأكد التام من تطابق أبعاد المصفوفات؛ فإن أي اختلاف طفيف في عدد صفوف نطاق الفحص مقارنة بنطاق الاستخراج سيؤدي فورياً إلى انهيار العملية برمتها وظهور خطأ عدم تطابق الأبعاد #VALUE!. وتكتسب كتابة تعليقات توثيقية وشرح منطق المعادلة في وثائق ميتاداتا البحث أهمية بالغة لتسهيل استيعاب النموذج الرياضي وصيانته المستقبلية من قِبل باحثين آخرين (Pollock et al., 2002).
7. الحلول التقنية البديلة للإصدارات القديمة من إكسيل (Non-365 Solutions)
7.1 استخدام صيغ الصفيف التقليدية عبر دمج INDEX وMATCH وSMALL
في بيئات العمل التي تعتمد على إصدارات إكسيل الكلاسيكية التي تسبق عهد المصفوفات الديناميكية، يجد المحلل نفسه مجبراً على بناء معادلات صفيف مركبة ومعقدة لمحاكاة سلوك دالة FILTER. يعتمد هذا النهج الرياضي المتقدم على تضافر ثلاث دوال رئيسية: دالة INDEX لاستدعاء محتوى الخلية الفعلي، ودالة SMALL لفرز وترتيب أرقام الصفوف المؤهلة تسلسلياً، ودالة ROW لاشتقاق مواقع الصفوف الفيزيائية، بالاقتران مع شرط العد الأحادي للدالة COUNTIF.
تُصاغ هذه المعادلة التراثية المركبة في الخلية الأولى من جدول الاستخراج على النحو التالي:
=IFERROR(INDEX($A$2:$C$11, SMALL(IF(COUNTIF($A$2:$A$11, $A$2:$A$11)=1, ROW($A$2:$A$11)-ROW($A$2)+1), ROWS($A$2:A2)), 1), "")
ونظراً لأن هذه الصيغة صيغة صفيف كلاسيكية، فإن تثبيتها يتطلب إلزامياً الضغط المتزامن على مفاتيح (Ctrl + Shift + Enter)، مما يجعل إكسيل يحيط المعادلة تلقائياً بقوسين معقوفين { } تدليلاً على تفعيل محرك الصفيف التقليدي. بعد ذلك، يتم سحب الصيغة يدوياً عبر الأعمدة والصفوف لتعبئة الجدول المنقى. تقوم دالة IF باختبار الترددات، فإذا كان التكرار مساوياً للواحد، تُرجع رقم الصف النسبي، بينما تستدعي دالة SMALL تلك الأرقام تصاعدياً واحداً تلو الآخر مع كل صف جديد تتمدد فيه الدالة ROWS، وتتكفل دالة IFERROR بإخفاء الأخطاء وتحويلها إلى خلايا فارغة بمجرد استنفاد القيم الفريدة بالكامل.
7.2 توظيف التنسيق الشرطي (Conditional Formatting) مع أدوات الفرز اليدوي
يمثل التنسيق الشرطي وسيلة شبه آلية ممتازة وشديدة البساطة لاستبعاد المكررات بأصولها بصرياً وفيزيائياً في الإصدارات القديمة دون التورط في صيغ الصفيف الرياضية المعقدة. تعتمد هذه المنهجية على تلوين كافة الصفوف التي يتحقق فيها شرط التكرار، ثم استخدام التصفية التلقائية لحذفها يدوياً وفق التسلسل المنهجي التالي:
- أولاً: تحديد كامل نطاق البيانات المراد تنقيته (A2:C11).
- ثانياً: التوجه إلى علامة التبويب «الصفحة الرئيسية» (Home)، واختيار «تنسيق شرطي» (Conditional Formatting)، ثم النقر على «قاعدة جديدة» (New Rule).
- ثالثاً: اختيار «استخدام صيغة لتحديد الخلايا التي سيتم تنسيقها»، وإدخال الصيغة الشرطية التالية:
=COUNTIF($A$2:$A$11, $A2)>1 - رابعاً: النقر على زر «تنسيق» وتحديد لون تعبئة مميز (كاللون الأحمر الفاتح مثلاً)، ثم الضغط على موافق.
بمجرد تطبيق القاعدة، تُظلل كافة الصفوف المكررة مع خلاياها الأصلية باللون المحدد فوراً. بعد ذلك، يُفعل شريط التصفية التلقائية القياسي (Data > Filter)، ويتم تطبيق التصفية حسب اللون عبر خيار «بلا تعبئة» (No Fill) لعزل السجلات الفريدة تماماً ونسخها إلى ورقة عمل جديدة، أو اختيار التصفية حسب «اللون المعبأ» وحذف كافة الصفوف الظاهرة دفعة واحدة لتطهير الجدول الأصلي من كافة المكررات ونظائرها بشكل قطعي.
7.3 المعالجة عبر الجداول المحورية (Pivot Tables) وعزل التكرار الأحادي
تُعد الجداول المحورية (Pivot Tables) إحدى أقوى محركات التلخيص والتحليل المدمجة في إكسيل، وتوفر حلاً فعالاً للغاية للاستبعاد الجذري للسجلات المتكررة متوافقاً مع كافة الإصدارات التاريخية للبرمجية. يتميز هذا الأسلوب بعدم اعتماده على أي معادلات مكتوبة، مما يجعله محصناً تماماً ضد أخطاء التركيب الرياضي والانزياحات المرجعية.
تتلخص خطوات تطبيق هذا الحل في إدراج جدول محوري جديد يستند إلى النطاق المصدري، ثم سحب الحقل المستهدف فحصه (حقل الفريق الرياضي مثلاً) وإفلاته في منطقة «الصفوف» (Rows)، ثم سحب نفس الحقل مرة أخرى وإفلاته في منطقة «القيم» (Values). يقوم إكسيل افتراضياً بحساب التردد التكراري لكل اسم فريق باستخدام دالة العد التجميعي Count.
بعد توليد الجدول المحوري، ينقر المحلل على سهم التصفية المجاور لتسميات الصفوف، ويختار «تصفية القيم» (Value Filters) ثم يحدد شرط «يساوي» (Equals) ويضع القيمة الرقمية 1. يؤدي هذا الإجراء فوراً إلى اختفاء كافة الفرق التي زاد ترددها الإحصائي عن 1، ليبقى في الجدول المحوري حصراً الفرق ذات التردد الأحادي الصرف. يمكن بعد ذلك النقر المزدوج على أرقام القيم لتوليد ورقة عمل مستقلة تحتوي على السجلات التفصيلية النقية، أو نسخ الأسماء الناتجة لاستخدامها كمعيار موجه في مطابقة باقي أعمدة البيانات.
8. أتمتة الاستبعاد الجذري للتكرارات باستخدام محرر الاستعلامات Power Query
8.1 استيراد البيانات وتحويلها إلى بيئة Power Query المستقلة
يمثل محرر الاستعلامات (Power Query) بيئة العمل المعاصرة الأكثر تطوراً وموثوقية في هندسة وتجهيز البيانات (ETL) داخل إكسيل. وتتجلى قوته الفائقة في معالجة ملايين السجلات وعزل العمليات التحويلية في طبقة برمجية وسيطة لا ترهق ورقة العمل الحسابية. تبدأ عملية التطهير الجذري بتحويل البيانات المصدرية إلى جدول إكسيل رسمي عبر الاختصار (Ctrl + T) لضمان ثبات النطاق وديناميكيته.
عقب ذلك، يتجه المحلل إلى تبويب «بيانات» (Data) ويختار أمر «من ورقة/جدول» (From Sheet/Table)، ليتم استيراد المصفوفة وتحميلها داخل نافذة محرر الاستعلامات المستقلة. تُمثل الخطوة الأولى داخل المحرر في فحص وتأكيد أنواع البيانات (Data Types) لكل عمود على حدة، والتحقق من تعيين النصوص كنصوص صريحة والأرقام كقيم عددية صحيحة أو عشرية؛ حيث إن تباين أنواع البيانات بين النصوص والأرقام قد يمنع محرك Power Query من التعرف على التطابقات التكرارية بصورة دقيقة وسليمة.
تتميز هذه البيئة باحتفاظها بكافة خطوات التحويل المسجلة في لوحة جانبية تسلسلية، مما يتيح التراجع، والتعديل، والمراجعة البرمجية الدقيقة لخطوات التطهير، وتطبيق نفس خوارزمية الاستبعاد مستقبلاً على أي ملفات جديدة بضغطة زر واحدة ودون أدنى حاجة لإعادة كتابة أي معادلات.
8.2 تجميع الصفوف وتوليد عمود حساب التكرار (Group By)
لتحقيق الحذف الجذري للتكرارات بكافة أصولها داخل Power Query، تُستخدم ميزة التجميع الهيكلي المتقدمة المعروفة بأداة «تجميع حسب» (Group By). تتلخص الخطوات التنفيذية لهذه المرحلة في الآتي:
- أولاً: النقر على أداة «تجميع حسب» (Group By) من لسان التبويب الرئيسي لمحرر الاستعلامات.
- ثانياً: تحديد العمود المستهدف فحصه واستبعاد مكرراته (مثل عمود اسم الفريق) كحقل التجميع الأساسي.
- ثالثاً: إعداد العملية الحسابية التجميعية باختيار عملية «عد الصفوف» (Count Rows)، وتسمية العمود الإحصائي الجديد باسم دال مثل «معدل_التكرار».
- رابعاً: اختيار إضافة تجميع فرعي متقدم باستخدام خيار «كافة الصفوف» (All Rows) في حال الرغبة في استبقاء باقي أعمدة البيانات التفصيلية الملحقة داخل جداول فرعية مضمنة.
بمجرد النقر على موافق، يقوم المحرك بضغط الجدول إلى قائمة فريدة تتضمن كل عنصر مع عدد مرات ظهوره الإجمالي. وهنا، يضغط المحلل على سهم التصفية في عمود «معدل_التكرار»، ويحدد القيمة الرقمية 1 فقط، مع إلغاء تحديد كافة القيم الأخرى (2، 3، وما فوق). يؤدي هذا الفرز الحازم إلى إبادة كافة الكيانات التي طرأ عليها التكرار فوراً ومن جذورها التاريخية الأولى داخل مصفوفة التحويل.
8.3 تطبيق خطوة الاحتفاظ بالقيم غير المكررة وإعادة تحميل البيانات
عقب عزل السجلات ذات التردد الأحادي، يتم استرجاع وتوسيع باقي أعمدة الجدول الأصلي (مثل اسم اللاعب وعدد النقاط) من خلال النقر على أيقونة التوسيع المزدوجة المتواجدة في رأس عمود الجداول المضمنة، مع التأكد من إلغاء خيار «استخدام اسم العمود الأصلي كبادئة». تعود حينها البيانات إلى شكلها المسطح القياسي متعدد الأعمدة، ولكنها تكون قد خضعت لعملية فلترة جذرية شاملة أزالت كل أثر للبيانات المكررة وأصولها.
يمكن أيضاً تنفيذ هذه الخطوة بمنطق رياضي بديل يعرف بـ «الدمج المقاوم» (Anti-Join)؛ حيث يتم دمج الجدول مع نفسه، وتحديد نوع الربط ليكون «استبعاد يساري» أو «استبعاد يميني» بناءً على جدول التكرارات لعزل العناصر التي لم ترتبط بنظائر، وهو منطق مكافئ وظيفياً لمنطق التجميع العددي.
تُختتم المعالجة باختيار أمر «إغلاق وتحميل إلى» (Close & Load To) من التبويب الرئيسي، وتحديد مسار تصدير المخرجات إما إلى ورقة عمل جديدة كجدول بيانات مستقل، أو تحميلها مباشرة إلى نموذج البيانات (Data Model) لإجراء التحليلات الإحصائية المتقدمة. وتكمن الميزة التشغيلية العظمى لهذا الحل في خاصية التحديث الآلي (Refresh)؛ فعند إضافة أو تعديل البيانات المصدرية مستقبلاً، يكفي النقر على زر «تحديث الكل» ليقوم Power Query بإعادة تطبيق كامل خطوات التجميع والاستبعاد بدقة متناهية ودون أي تدخل يدوي جديد.
9. تطوير الحلول البرمجية عبر لغة Visual Basic for Applications (VBA)
9.1 تصميم خوارزمية الحذف الجذري باستخدام كائن القاموس (Scripting.Dictionary)
توفر لغة البرمجة المدمجة في تطبيقات مايكروسوفت أوفيس (VBA) إمكانات برمجية فائقة تتيح معالجة البيانات بسرعة استثنائية عبر التحكم المباشر بمساحات الذاكرة العشوائية للحاسوب. ويعد كائن القاموس البرمجي Scripting.Dictionary الهيكل البياني الأمثل لبناء خوارزمية الحذف الجذري؛ حيث يعمل بنظام أزواج المفاتيح والقيم (Key-Value Pairs)، ويتيح إجراء عمليات البحث الإحصائي بزمن تشغيلي فائق السرعة يُقارب $O(1)$ مقارنة بالبحث التكراري داخل خلايا الورقة.
تعتمد الخوارزمية المقترحة على بناء حلقة تكرارية مزدوجة: تمر الحلقة الأولى على مصفوفة البيانات لقراءة العمود المستهدف وتخزين كل عنصر فريد كمفتاح (Key) داخل القاموس، مع تعيين قيمة المفتاح (Value) لتكون عداداً تصاعدياً يحسب عدد مرات ظهور ذلك العنصر في النطاق. وعند رصد ظهور جديد لنفس المفتاح، يُزاد العداد بمقدار واحد. وبنهاية الحلقة الأولى، يحتوي القاموس على خريطة ترددية متكاملة تماثل تماماً دالة التوزيع الإحصائي التكراري لكافة مدخلات العينة.
في المرحلة اللاحقة، تستهدف الخوارزمية فقط المفاتيح التي بلغت قيمتها التكرارية واحداً صحيحاً ($Count = 1$). يتم نقل كافة الصفوف التابعة لتلك المفاتيح الفردية إلى مصفوفة إخراج مؤقتة داخل الذاكرة (Memory Output Array)، مع التجاهل التام وإسقاط أي مفتاح سجل قيمة تكرار أكبر من واحد، مما يحقق مبدأ الاستبعاد الجذري للأصل والمكررات معاً بأعلى كفاءة زمنية ممكنة.
9.2 كتابة وتنفيذ ماكرو متكامل لحذف السجلات المتكررة بأصولها
يوضح الإجراء البرمجي التالي صياغة احترافية لماكرو VBA مصمم لتنفيذ عملية التطهير الجذري بكفاءة، مع تضمين تقنيات تحسين الأداء وإلغاء تحديثات الشاشة وتسريع الحسابات أثناء التنفيذ الإجرائي:
يبدأ الكود بتعريف المتغيرات وتخصيص كائن القاموس، مع قراءة البيانات من النطاق المصدري وتفريغها في مصفوفة داخلية لتسريع المعالجة وتفادي التفاعل المباشر البطيء مع واجهة إكسيل. وتتضح معالم الإجراء التنفيذي من خلال الكود التالي:
Sub RemoveDuplicatesAndOriginals()
Dim ws As Worksheet: Set ws = ActiveSheet
Dim dict As Object: Set dict = CreateObject(“Scripting.Dictionary”)
Dim dataRange As Variant, outRange As Variant
Dim lastRow As Long, lastCol As Long
Dim i As Long, j As Long, validCount As Long
Dim targetKey As Variant
Application.ScreenUpdating = False
Application.Calculation = xlCalculationManual
lastRow = ws.Cells(ws.Rows.Count, “A”).End(xlUp).Row
lastCol = ws.Cells(1, ws.Columns.Count).End(xlToLeft).Column
dataRange = ws.Range(ws.Cells(2, 1), ws.Cells(lastRow, lastCol)).Value
For i = 1 To UBound(dataRange, 1)
targetKey = dataRange(i, 1)
If Not dict.Exists(targetKey) Then
dict.Add targetKey, 1
Else
dict(targetKey) = dict(targetKey) + 1
End If
Next i
validCount = 0
For i = 1 To UBound(dataRange, 1)
If dict(dataRange(i, 1)) = 1 Then validCount = validCount + 1
Next i
If validCount > 0 Then
ReDim outRange(1 To validCount, 1 To lastCol)
Dim outRow As Long: outRow = 1
For i = 1 To UBound(dataRange, 1)
If dict(dataRange(i, 1)) = 1 Then
For j = 1 To lastCol
outRange(outRow, j) = dataRange(i, j)
Next j
outRow = outRow + 1
End If
Next i
ws.Range(ws.Cells(2, lastCol + 3), ws.Cells(validCount + 1, lastCol + 2 + lastCol)).Value = outRange
Else
MsgBox “لم يتم العثور على أي قيم فريدة مطلقة في النطاق المحدد.”, vbInformation
End If
Application.ScreenUpdating = True
Application.Calculation = xlCalculationAutomatic
End Sub
يقوم هذا الإجراء بعد تجميع البيانات بنسخ المصفوفة النظيفة وتفريغها في ورقة العمل بمحاذاة الجدول القديم، محافظاً على البيانات الأصلية، ومنفذاً كامل عمليات الاستخراج في أجزاء ضئيلة من الثانية دون استهلاك ملحوظ للذاكرة.
9.3 تخصيص الكود البرمجي للتعامل مع معايير متعددة وديناميكية
يمكن تعديل البنية البرمجية لكود الماكرو لتشمل سيناريوهات تحليلية أكثر تعقيداً؛ مثل فحص التكرار المشترك استناداً إلى عمودين أو أكثر في آن واحد. ولتنفيذ ذلك في لغة VBA، يتم دمج قيم الحقول المستهدفة داخل نص مركب يفصل بينها محرف خاص (مثل الشرطة العمودية |) لإنشاء مفتاح مصفوفي هجين يُخزن في القاموس، كأن يُكتب برمجياً: compositeKey = dataRange(i, 1) & "|" & dataRange(i, 2).
يمنع هذا المفتاح الهجين التكرار الزائف الذي قد ينتج عن تشابه الأسماء الأولى مع اختلاف الألقاب، أو تشابه المدن مع اختلاف رموز المناطق. كما يمكن رفع مرونة الماكرو بتضمين صندوق إدخال تفاعلي Application.InputBox يتيح للمستخدم تحديد نطاق البيانات المفحوص وعمود المعيار الحاكم باستخدام مؤشر الفأرة بحرية تامة دون الحاجة لتعديل الكود البرمجي يدوياً في محرر Visual Basic Editor.
يتطلب حفظ وتشغيل هذه الأدوات المتقدمة حفظ مصنف العمل بصيغة إكسيل المدعومة بوحدات الماكرو ذات الامتداد .xlsm، مع ضبط إعدادات مركز التوثيق (Trust Center) للسماح بتشغيل الأكواد الرقمية الموثوقة، وتأمين الكود بكلمة مرور مشفرة لحماية المنطق الحسابي من التعديلات العشوائية عند مشاركة ملفات البحث الميداني بين فرق العمل المتعددة.
10. الاعتبارات الدقيقة والأخطاء الشائعة في معالجة النصوص والبيانات الرقمية
10.1 أثر المسافات الزائدة والمحارف غير المرئية على دقة الفرز
تُعد الشوائب النصية والمسافات غير المرئية العدو الأول لدقة خوارزميات التصفية والفرز في بيئات جداول البيانات؛ حيث يتعامل الحاسوب مع النصوص بمبدأ المطابقة الرمزية الصارمة لكود المحرف (Character Code). فإذا احتوت خلية على النص "Mavs " متبوعاً بمسافة فارغة زائدة في النهاية، في حين احتوت خلية أخرى على النص "Mavs" دون مسافات، فإن دالة COUNTIF وخوارزميات المقارنة ستعتبرهما قيمتين مختلفتين تماماً، مما يمنح كل منهما تكراراً مساوياً للواحد، وبالتالي يفشل النظام في استبعادهما ويسمح بتسللهما إلى مصفوفة النتائج الصالحة كبيانات فريدة مضللة.
لتفادي هذا الخلل، يجب إخضاع النصوص لمعالجة تمهيدية إجبارية باستخدام دالة TRIM التي تتولى إزالة المسافات البادئة واللاحقة وتقليص المسافات البينية المتعددة لتصبح مسافة واحدة فاصلة. كما تتطلب البيانات المستوردة من صفحات الويب وقواعد البيانات الرقمية معالجة إضافية للتخلص من المسافة غير القابلة للكسر (Non-breaking space)، والتي تحمل الرمز الكودي CHAR(160) وتعجز دالة TRIM التقليدية عن رصدها، وذلك عبر دمجها مع دالتي SUBSTITUTE وCLEAN بالصيغة التطهيرية التالية:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
يضمن بناء عمود نصي موحد ومنقى مسبقاً تطابقاً بيانياً تاماً بين السجلات المتناظرة، ويسد الثغرات التي تؤدي إلى فشل التقييم المنطقي للشروط الحسابية، مما يرفع من جودة نتائج التحليل النهائي وموثوقيتها العلمية.
10.2 حساسية حالة الأحرف في اللغات اللاتينية والترميز اللغوي العربي
تتسم دالة COUNTIF القياسية في إكسيل بسلوك افتراضي غير حساس لحالة الأحرف (Case-Insensitive)؛ مما يعني أنها تعامل الكلمة المكتوبة بحروف كبيرة مثل "DATA" بنفس المعاملة للكلمة المكتوبة بحروف صغيرة "data". وفي حين يُعد هذا السلوك مرغوباً في معظم المسوح العامة، إلا أنه قد يسبب مشاكل منهجية في الدراسات الجينية أو المعرفات البرمجية التي تتطلب تمييزاً دقيقاً لحالة الأحرف اللاتينية. وعند الحاجة لفرز حساس لحالة الأحرف، يُستعاض عن COUNTIF بصيغة مصفوفية تدمج دالة EXACT الصارمة لمطابقة النصوص بالشكل الآتي:
=SUM(--EXACT($A$2:$A$11, $A2))>1
أما في معالجة البيانات باللغة العربية، فيبرز تحدٍ منهجي مختلف يتمثل في تباين الأنماط الإملائية الشائعة لدى المدخلين؛ مثل التباين بين همزات القطع وألف الوصل (أ، إ، آ، ا)، أو الخلط بين الياء المنقوطة والألف المقصورة (ي، ى)، والتاء المربوطة والهاء (ة، هـ). ولما كان إكسيل حساساً لهذه الفروق الهجائية الدقيقة، فإن مدخلات مثل «أحمد» و«احمد» ستُعامل ككيانين مستقلين، مما يعطل فحص التكرارات المنهجي.
يتطلب التحليل الرصين توحيد الرسم الإملائي مسبقاً عبر دوال الاستبدال المتسلسلة، أو تطبيق نمط الإدخال الموحد باستخدام أدوات التحقق من صحة البيانات (Data Validation) لمنع تباين الصياغة اللغوية عند نقطة جمع البيانات، وضمان خضوع كافة المشاهدات المتماثلة لنفس القواعد المنطقية الصارمة.
10.3 أفضل الممارسات لتوثيق ومراجعة نزاهة البيانات بعد التنقية
تقتضي معايير النزاهة العلمية والشفافية الأكاديمية توثيق كافة التدخلات الإجرائية التي طرأت على مصفوفة البيانات الخام قبل نشر النتائج أو تسليم التقارير النهائية. تبدأ أفضل الممارسات في هذا السياق بالاحتفاظ الصارم بنسخة أرشيفية مجمدة ومحمية من مجموعة البيانات الأولية غير المعدلة (Raw Data Archive)، مع حظر تطبيق عمليات الحذف الفيزيائي المباشر على المصدر الأصلي تحت أي ظرف من الظروف.
علاوة على ذلك، يجب تطبيق معادلة التحقق الإحصائي التوازني (Statistical Balance Check) للتأكد من اتساق الأعداد الإجمالية للمشاهدات، حيث يُصاغ شرط التوازن الحسابي كالتالي:
إجمالي الصفوف الأصلية = عدد السجلات الفريدة المتبقية + إجمالي كافة السجلات المكررة بأصولها المستبعدة
يتم إرفاق سجل تدقيق رقمي (Audit Trail) ضمن ملاحق البحث يوضح بالتفصيل: تاريخ إجراء التنقية، والنسخة البرمجية المستخدمة في الحساب، والمعايير المنطقية المعتمدة في الاستبعاد، وأرقام الصفوف أو المعرفات التي أُسقطت ومبررات استبعادها المنهجية. كما يُنصح بحماية خلايا الصيغ المنفذة داخل أوراق العمل عبر ميزة حماية الورقة (Protect Sheet) لمنع تعديل الشروط أو حذف المعادلات سهواً من قِبل المستخدمين اللاحقين، بما يضمن استدامة النموذج الحسابي وصحة نتائجه الاستقصائية.
خاتمة
تناول هذا المقال الأكاديمي الموسع بالتشريح والتحليل المنهجي الدقيق مسألة إزالة كل من القيم المكررة والأصلية في برنامج مايكروسوفت إكسيل؛ حيث اتضح جلياً أن الاستبعاد الجذري ليس مجرد مهارة تقنية سطحية، بل هو ضرورة إحصائية وبحثية حتمية تفرضها متطلبات صدق القياس وموثوقية العينات في الأبحاث والمسوح الميدانية. فالإبقاء على نسخة واحدة من البيانات المتنازع عليها يقود بالضرورة إلى تحيزات منهجية تشوه التوزيعات الاحتمالية وتضخم الأوزان النسبية بصورة زائفة.
وقد استعرضنا كيف توفر الإصدارات الحديثة من إكسيل—المعززة بمحرك المصفوفات الديناميكية—حلولاً في غاية القوة والأناقة من خلال دمج دالتي FILTER وCOUNTIF في صيغ مصفوفية مركبة ذاتية التوسع والتحديث التلقائي، فضلاً عن توفير دالة UNIQUE بخيار الاستبعاد التام، في مقابل الحلول البديلة المستقرة للإصدارات القديمة المعتمدة على صيغ الصفيف المركبة والتنسيق الشرطي والجداول المحورية.
كما تم تسليط الضوء على الأتمتة المتقدمة عبر محرر الاستعلامات Power Query الذي يوفر بيئة معالجة قوية ومستقلة لإدارة وتنقية مئات الآلاف من الصفوف دون التأثير على استقرار الملفات، وصولاً إلى الأكواد البرمجية التخصصية المكتوبة بلغة VBA باستخدام كائن القاموس لمعالجة البيانات الضخمة في أجزاء من الثانية. وأخيراً، أكد المقال على ضرورة التحوط ضد الشوائب النصية والمسافات غير المرئية والتباينات الإملائية اللغوية، مع الالتزام الصارم بتوثيق سجلات التدقيق وحفظ البيانات الخام، بما يحقق التوازن المنشود بين البراعة الحسابية والنزاهة الأكاديمية الصارمة.
المراجع
- Baldwin, J. R., Wang, B., Karwatowska, L., Schoeler, T., Tsaligopoulou, A., & Munafo, M. R. (2023). Childhood Maltreatment and Mental Health Problems: A Systematic Review and Meta-Analysis of Quasi-Experimental Studies. American Journal of Psychiatry. https://doi.org/10.1176/appi.ajp.20220174
- Carruthers, P. (2002). The cognitive functions of language. Behavioral and Brain Sciences. https://doi.org/10.1017/s0140525x02000122
- Mahmoud, N. F., Hassan, K. A., Abdelmajeed, S. F., Moustafa, I. M., & Silva, A. G. (2019). The Relationship Between Forward Head Posture and Neck Pain: a Systematic Review and Meta-Analysis. Current Reviews in Musculoskeletal Medicine. https://doi.org/10.1007/s12178-019-09594-y
- Pollock, E., Chandler, P., & Sweller, J. (2002). Assimilating complex information. Learning and Instruction. https://doi.org/10.1016/s0959-4752(01)00016-0
- Youngstrom, E. A. (2013). A Primer on Receiver Operating Characteristic Analysis and Diagnostic Efficiency Statistics for Pediatric Psychology: We Are Ready to ROC. Journal of Pediatric Psychology. https://doi.org/10.1093/jpepsy/jst062