
تُمثّل إدارة البيانات وتنقيتها ركيزة أساسية في دراسات العلوم الحوسبية والاجتماعية والتطبيقية؛ إذ تتوقف دقة الاستدلال الإحصائي وسلامة القرارات التشغيلية على مدى موثوقية السجلات وخلوها من الشوائب والازدواجيات. في بيئات الأعمال والبحوث الأكاديمية المعاصرة، تتدفق البيانات بصورة مستمرة عبر منصات متعددة، مما يفرز ظاهرة التكرار التراكمي للمعرفات ذاتها عبر نقاط زمنية متباينة. يبرز هذا التحدي بصورة جلية عند التعامل مع بيانات القياس المتكرر، واستطلاعات الرأي الطولية، وسجلات تتبع العمليات اللوجستية، حيث لا يكون الهدف مجرد اختزال البيانات إلى قيم فريدة بصورة عشوائية، بل الحفاظ على السجل الأكثر حداثة الذي يمثل الحالة المعرفية النهائية للمتغير المدروس.
يواجه مستخدمو برنامج مايكروسوفت إكسل (Microsoft Excel) معضلة شائعة تتمثل في أن الأداة الافتراضية لإزالة التكرارات تعمل بآلية عمياء وغير مشروطة زمنياً؛ إذ تعتمد ميكانيكيتها الصارمة على الاحتفاظ بالظهور الأول للبيان واستبعاد ما يليه، بغض النظر عما إذا كان هذا السجل الأول يمثل القيد الأحدث أو الأقدم. يترتب على هذا السلوك الافتراضي تجريد مصفوفة البيانات من أحدث قراءاتها في حال لم تكن مرتبة ترتيباً دقيقاً وموجهاً، الأمر الذي يقود إلى تشويه السلاسل الزمنية، وتصدير نتائج غير دقيقة للتحليلات اللاحقة، وهدر القيمة التشغيلية المترتبة على تحديثات البيانات.
تتطلب معالجة هذه المعضلة صياغة إطار منهجي متكامل يتجاوز الإجراءات السطحية، مستنداً إلى فهم عميق للبنية الرياضية والبرمجية لبرنامج إكسل. يتناول هذا الدليل الشامل والبحث الموسع الأساليب المتنوعة لتنفيذ عملية إزالة التكرارات مع الاحتفاظ بالصف الحائز على أحدث تاريخ حصراً؛ بدءاً من الطرق الكلاسيكية القائمة على الفرز المسبق، مروراً بالمعادلات الديناميكية المتقدمة، ووصولاً إلى أتمتة الإجراءات عبر بيئة تحويل البيانات المتقدمة (Power Query) والتعليمات البرمجية المخصصة عبر لغة الفيجوال بيسك للتطبيقات (VBA). ويهدف هذا الطرح إلى تمكين الباحثين والمحللين من ترقية ممارسات إدارة البيانات، وضمان النزاهة المنهجية لمخرجاتهم الرقمية.
1. الأسس النظرية لإدارة البيانات المكررة والمقيدة زمنياً في برنامج إكسل
1.1 طبيعة مشكلة التكرار في قواعد البيانات التشغيلية
تنبع مشكلة السجلات المكررة في قواعد البيانات التشغيلية من الطبيعة التراكمية للمعاملات اليومية، حيث يتم تسجيل أنشطة الكيان ذاته—سواء كان عميلاً، أو مريضاً، أو مفردة بحثية، أو حركة مخزنية—في أوقات متفرقة وبشكل دوري. في سياق بحوث السلوك والعلوم الاجتماعية التي تستخدم أنظمة التسجيل المستمر، تتكرر معرفات المشاركين بصورة حتمية نتيجة التقاط الملاحظات المتعددة على مدار الأيام والأسابيع، كما تم توضيحه في الأدبيات المنهجية لمعالجة البيانات الأولية وتصنيفها (Kaplan et al., 2020). يتسبب هذا النمط التراكمي في خلق تضخم داخل الجداول، مما يطرح تساؤلاً جوهرياً حول أي السجلات يحمل الحقيقة التشغيلية الراهنة.
تكتسب القيمة الزمنية الأحدث أهمية حاسمة بوصفها المعيار الأوثق للدقة وصلاحية المعلومة؛ فالأصل في المتغيرات الديناميكية هو التغير والتعديل، ومن ثم فإن القيد الزمني الأخير يعكس أحدث حالة وصل إليها الكيان المستهدف. على سبيل المثال، إذا قام عميل بتحديث عنوان سكنه أو رقم هاتفه ثلاث مرات خلال عام، فإن القيود السابقة تفقد قيمتها الوظيفية وتتحول إلى بيانات أرشيفية قد تؤدي الاستعانة بها في العمليات الجارية إلى أخطاء فادحة في الاتصال أو التوزيع اللوجستي.
علاوة على ذلك، يمتد الأثر السلبي للبيانات المكررة المقيدة زمنياً إلى صلب التحليل الإحصائي وبناء النماذج التنبؤية؛ إذ يؤدي احتساب القيود القديمة إلى إرباك المقاييس الإحصائية الوصفية مثل المتوسط الحسابي، والانحراف المعياري، والوسيط، نتيجة تكرار وزن المفردة الواحدة بأوزان متعددة تخالف الواقع. يترتب على هذا التضخم الوهمي تشويه التوزيعات الاحتمالية، ورفع معدلات الخطأ من النوع الأول في اختبار الفرضيات، مما يقود في نهاية المطاف إلى اتخاذ قرارات إدارية أو أكاديمية غير سليمة ترتكز على معطيات متقادمة فاقدة للمطابقة التجريبية.
1.2 الفارق البنيوي بين الإزالة العشوائية والتصفية المشروطة زمنياً
يكمن القصور البنيوي لأداة إزالة التكرارات الافتراضية المدمجة في بيئة إكسل في تجردها التام من أي منطق استدلالي يتعلق بخصائص المتغيرات المجاورة لمعرف البحث. لا تحتوي هذه الأداة على أي خوارزمية ذكية قادرة على قراءة عمود التاريخ وتفضيل القيمة القصوى تلقائياً، بل تعتمد بدلاً من ذلك على مسح المصفوفة من الصف الأعلى إلى الصف الأدنى؛ وبمجرد أن ترصد الخوارزمية تطابقاً في المعرف المختار مع سجل سابق، تقوم بإسقاط الصف الحالي فوراً وحذفه نهائياً، مع الاحتفاظ بالسجل الذي تم رصده أولاً في البنية الهيكلية للجدول.
تفرض هذه الآلية الحتمية مفهوماً بديلاً يقوم على التصفية المشروطة زمنياً، وهو مفهوم يعرّف عملية تنقية البيانات بأنها انتقاء غائي مستند إلى تعظيم القيمة الزمنية (Time Maximization). بموجب هذا المفهوم، لا يُعامل الاحتفاظ بالسجل بوصفه نتيجة للترتيب العرضي للبيانات داخل الملف، بل كتمثيل للحالة النهائية للمتغير بعد استنفاد كافة تحديثاته التاريخية. يتطلب هذا الانتقاء فحص جميع القيود المرتبطة بالمعرف، وتحديد القيمة الزمنية العليا (Max Timestamp)، ثم عزل الصف المقترن بهذه القيمة لاستبقائه واستبعاد كافة القيود السابقة له.
يؤسس هذا الفارق المنهجي لضرورة النظر إلى عملية فرز البيانات بوصفها خطوة استباقية إلزامية ولازمة منطقياً قبل الشروع في أي حذف حتمي. إن إدراك الباحث أو المحلل لهذا الترابط الوظيفي بين الترتيب المسبق وخوارزمية الحذف يمثل الخط الفاصل بين التطهير العشوائي للبيانات الذي يبدد المعطيات الحديثة، وبين التطهير الموجه الذي يحافظ على النزاهة الهيكلية للبيانات، ويحول دون ضياع السجلات الحديثة ذات الصلة بالتحليل الراهن.
1.3 تقييم مخاطر المعالجة غير القابلة للاسترداد
تنطوي عمليات التعديل المباشر على قواعد البيانات داخل برنامج إكسل على مخاطر جسيمة ترتبط بعدم إمكانية التراجع أو استرداد البيانات بمجرد إغلاق الملف أو حفظ التغييرات فوق النسخة الأصلية. عندما يلجأ المستخدم إلى تفعيل أوامر الحذف الفيزيائي التلقائي للسجلات المكررة، يتم مسح الصفوف بصورة قطعية من مصفوفة الذاكرة المؤقتة للبرنامج، مما يلغي أي إمكانية لاستعادة التفاصيل التاريخية التي قد يحتاجها التدقيق اللاحق، أو التي قد يكتشف المحلل لاحقاً وجود أخطاء في معايير حذفها الأصلية.
تقتضي حوكمة إدارة البيانات تبني مبدأ الفصل الصارم بين البيانات الخام (Raw Data) والمخرجات الناتجة عن المعالجة والتنقيح (Cleaned Datasets). يملي هذا المنهج الاحتفاظ بمستودع البيانات غير المعدلة في ورقة عمل محمية أو ملف أرشيفي منفصل للقراءة فقط، وتطبيق كافة إجراءات الفرز، والتصفية، والتطهير على نسخ مشتقة؛ لضمان توفير خط دفاعي يحمي المنظمة أو الفريق البحثي من فقدان البيانات غير القابل للإصلاح.
إضافة إلى ذلك، تبرز الأهمية القصوى لتوثيق كل خطوة من خطوات التنقيح عبر سجلات تدقيق تفصيلية (Audit Trails). ينبغي أن تتضمن وثائق المشروع معايير الاستبعاد، والتواريخ التي تم اعتمادها كأساس للاحتفاظ بالسجلات، والصيغ البرمجية المستخدمة في التوليد؛ إذ إن توثيق هذه الإجراءات يضمن موثوقية النتائج، ويتيح للأطراف الخارجية والمراجعين تكرار التجربة الحسابية والتحقق من سلامتها بما يتوافق مع المعايير العلمية والمؤسسية الرصينة، كما يظهر في البروتوكولات المنهجية لإدارة البيانات ومعالجتها عبر التطبيقات الحسابية (Blair & Mahoney, 2021).
2. المعالجة القبلية وضمان اتساق هيكلية البيانات
2.1 توحيد النصوص وتطهير المعرفات من المسافات الزائدة
تُعد خطوة المعالجة القبلية للمعرفات النصية مدخلاً إلزامياً لضمان نجاح أي خوارزمية لإزالة التكرارات؛ ذلك أن برنامج إكسل يتعامل مع السلاسل النصية بحساسية مطلقة للمسافات الخفية والمحارف غير المرئية. فوجود مسافة بادئة سابقة للنص أو مسافة لاحقة ملحقة به، مثل المقارنة بين السلسلة النصية “ID_101 ” والسلسلة “ID_101″، يجعل المحرك الحسابي يعتبرهما قيمتين فريدتين تماماً ومنفصلتين دلالياً، الأمر الذي يؤدي إلى فشل أداة الحذف في التعرف على التكرار والإبقاء على كلا الصفين بصورة خاطئة.
لمعالجة هذا التشوه النصي، يُوصى بتطبيق دالة التطهير المزدوجة التي تدمج الدالة TRIM للتخلص من الفراغات البادئة واللاحقة والمسافات المتعددة بين الكلمات، مع الدالة CLEAN لإزالة المحارف غير القابلة للطباعة والتي غالباً ما تنتقل إلى إكسل عند تصدير البيانات من قواعد البيانات السحابية أو استبيانات الويب. يتم إنشاء عمود مساعد يُطبق الصيغة التالية:
=TRIM(CLEAN(A2))
حيث يمثل A2 خلية المعرف المستهدف. ومن ثم تُنسخ هذه القيم وتُلصق كقيم مجردة (Paste Values) فوق العمود الأصلي لتحييد أي تأثير غير مرغوب فيه للفراغات على عمليات المطابقة.
وعلاوة على المسافات، يجب توحيد حالة الأحرف اللاتينية باستخدام الدوال UPPER أو LOWER، وضبط تجانس الحروف العربية لا سيما الهمزات والتاء المربوطة والألف المقصورة. وأخيراً، يتعين إجراء فحص استقصائي للتحقق من خلو حقل المعرف الأساسي من الخلايا الفارغة أو القيم غير المعرفة؛ إذ إن ترك فراغات في عمود المعرف يؤدي إلى تجميع كافة الصفوف مجهولة المعرف وحذفها عشوائياً ككتلة واحدة مكررة، مما يبدد بيانات حيوية دون مبرر منطقي.
2.2 التحقق من صحة التمثيل التسلسلي لحقول التواريخ
يعتمد برنامج إكسل في بنيته الداخلية على نظام رقمي تسلسلي صارم لحفظ التواريخ والأوقات؛ حيث يُمثَّل تاريخ الأول من يناير عام 1900 بالرقم التسلسلي 1، بينما تُمثَّل كافة التواريخ اللاحقة بأعداد صحيحة تتزايد بمقدار وحدة واحدة لكل يوم إضافي، في حين تُعامل الأوقات بوصفها كسوراً عشرية لليوم الكامل. تكمن المعضلة الكبرى عند استيراد البيانات في أن العديد من حقول التواريخ يتم تخزينها كسلاسل نصية (Strings) مجردة تشبه التواريخ شكلياً ولكنها تفتقر إلى الطبيعة الرقمية الكامنة في نظام إكسل.
يؤدي تخزين التواريخ كنصوص إلى فشل ذريع عند محاولة الفرز التنازلي؛ حيث تُفرز النصوص أبجدياً استناداً إلى المحرف الأول، مما يجعل تاريخاً نصياً مثل “01/12/2024” يسبق تاريخاً مثل “31/01/2023” في الترتيب التنازلي، على الرغم من أن الأخير يمثل زمناً أحدث بكثير. لاكتشاف هذه المشكلة، يمكن توظيف الدالة المنطقية ISNUMBER؛ فإذا أعادت الصيغة القيمة FALSE، كان ذلك دليلاً قاطعاً على أن التاريخ نصي ولا يصلح للمقارنات الترتيبية دون معالجة قسرية.
تتم معالجة التواريخ النصية عبر عدة تقنيات، أبرزها استخدام معالج تحويل النص إلى أعمدة (Text to Columns)؛ حيث يتم تحديد عمود التاريخ، وفتح المعالج من تبويب بيانات، وتخطي الخطوتين الأوليين وصولاً إلى الخطوة الثالثة لاختيار نسق التاريخ الفعلي المكتوب به النص الأصلي (مثل DMY أو MDY). يتولى المحرك بعد ذلك إعادة كتابة القيم إلى أرقامها التسلسلية الصحيحة. كما يجب توحيد نسق عرض التواريخ داخل واجهة المستخدم لمنع الالتباس القائم بين التنسيقات الإقليمية، كالنظام الأمريكي الذي يبدأ بالشهر والنظام الأوروبي الذي يبدأ باليوم.
2.3 إنشاء النطاقات المنظمة والنسخ الاحتياطية
تمثل النطاقات العادية ذات الحدود الثابتة بيئة هشة لتنفيذ المعالجات المتقدمة، حيث يؤدي توسع البيانات أو انكماشها إلى انزياح مراجع الصيغ وحدوث أخطاء خفية. لذلك، يُعد تحويل النطاق الميداني إلى جدول بيانات رسمي عبر إكسل (Excel Table)—من خلال النقر على النطاق واستخدام الاختصار Ctrl + T—خطوة جوهرية تضمن الحفاظ على تكامل النطاق. تتيح الجداول المنظمة التوسع التلقائي للصيغ، وتسمح باستخدام المراجع الهيكلية المكتوبة (Structured References) بدلاً من مراجع الخلايا الجامدة.
قبل إجراء أي تعديل بنيوي على الجدول، تقتضي قواعد السلامة عزل المصفوفة الخام داخل ورقة عمل منفصلة وتأمينها ضد التعديل، مع منح الورقة اسماً معيارياً يوضح تاريخ ووقت النسخ (مثل Backup_RawData_2024). يُسهم هذا الإجراء في توفير نقطة ارتكاز يمكن الرجوع إليها دون عناء في حال حدوث خطأ غير مقصود أثناء تنفيذ عمليات الفرز أو الحذف التدميري.
كما يُنصح بتسمية الأعمدة بنطاقات واضحة ومعبرة، والابتعاد عن التسميات الافتراضية المبهمة. إن استخدام تسميات من قبيل Transaction_Date و Participant_ID يسهل بشكل لافت صياغة المعادلات المصفوفية المعقدة في المراحل اللاحقة، ويقلل من احتمالية الإشارة إلى العمود الخطأ أثناء استدعاء دوال البحث والمطابقة، مما يرفع من الموثوقية العامة لإجراءات التنقية الإحصائية.
3. الطريقة الكلاسيكية: الفرز المزدوج المقترن بأداة إزالة التكرارات الافتراضية
3.1 منطق عمل أداة إزالة التكرارات التلقائية (Remove Duplicates)
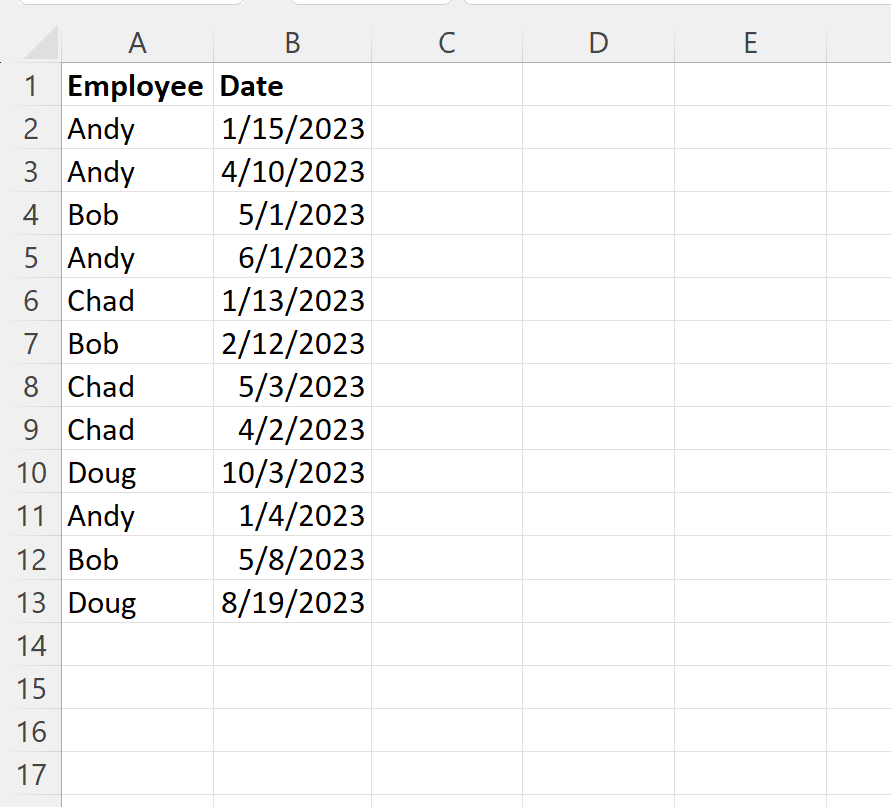
تستند أداة “إزالة التكرارات” التلقائية المتوافرة في شريط الأدوات الرئيسي لبرنامج إكسل إلى خوارزمية خطية أحادية الاتجاه. تقوم هذه الأداة بمسح البيانات من الأعلى إلى الأسفل، وتبحث عن التطابقات استناداً إلى الأعمدة التي يحددها المستخدم كمعايير للتفرد. السلوك الثابت والقطعي لهذه الأداة يتمثل في أنها تُبقي دائماً على السجل الأول الذي تقابله، وتقوم بحذف وتفريغ كافة السجلات التالية المطابقة له دون النظر إلى القيم المخزنة في باقي الأعمدة غير المحددة في عملية المقارنة.
إن استيعاب هذه الميكانيكية البسيطة يمنح المحلل القدرة على تطويع الأداة لمصلحته وتوجيه نتائجها بدقة. فبما أن الأداة تحتفظ بالصف الأول حتماً، فإن التلاعب المنطقي بترتيب البيانات قبل تشغيل الأداة يتيح للمستخدم تحديد أي السجلات سيكون في صدارة الجدول وبالتالي ينجو من مقصلة الحذف. إذا تم ترتيب الصفوف بحيث يكون أحدث تاريخ هو أول سجل يظهر للمعرف، فإن الأداة ستلتقط هذا السجل الأحدث، وتعتبر السجلات اللاحقة—التي تحمل بالضرورة تواريخ أقدم—تكرارات غير مرغوب فيها، فتقوم بإسقاطها فوراً.
يمثل هذا الأسلوب استغلالاً هندسياً لسلوك الأداة الافتراضي؛ فبدلاً من مقاومة افتقار الأداة للمنطق الزمني، يتم تكييف البيانات مسبقاً لتتطابق مع المسار الإجرائي الذي تسلكه الخوارزمية، مما يحقق الغاية النهائية المتمثلة في التخلص من البيانات التاريخية غير الضرورية مع الحفاظ المطلق على حداثة السجل النهائي للمفردة.
3.2 خطوات التنفيذ العملي للفرز المخصص التنازلي
لتطبيق هذه المنهجية بدقة وخلو من الأخطاء، يتعين اتباع تسلسل إجرائي صارم يتألف من مرحلتين رئيسيتين: الفرز متعدد المستويات، ثم الحذف المشروط للأعمدة. تتلخص الخطوات العملية فيما يلي:
- أولاً: تحديد النطاق بالكامل: يتم تظليل كامل مصفوفة البيانات، بما في ذلك صف العناوين الرئيسي. يجب تجنب تظليل عمود التاريخ أو المعرف بمفرده؛ لأن ذلك قد يؤدي إلى فرز جزئي يفكك الارتباط بين خلايا الصف الواحد ويشوه البيانات بصورة كارثية.
- ثانياً: تفعيل الفرز المتقدم (Custom Sort): من علامة التبويب “بيانات” (Data)، يتم النقر على زر “فرز” (Sort) لفتح نافذة التحكم في مستويات الترتيب، مع التأكد من تفعيل خيار “تحتوي بياناتي على رؤوس” (My data has headers).
- ثالثاً: ضبط مستويات الفرز:
- يُعين مستوى الفرز الأول (Sort by) على عمود المعرف الفريد (مثل:
Participant_ID)، مع ضبط الترتيب أبجدياً أو رقمياً (من A إلى Z). يساعد هذا في تجميع كافة السجلات العائدة لنفس الكيان في صفوف متتالية. - يُضاف مستوى فرز ثانٍ بالنقر على “إضافة مستوى” (Add Level)، ويُحدد عمود التاريخ (مثل:
Transaction_Date) كمعيار للفرز، مع تعديل اتجاه الترتيب ليصبح حصراً من الأحدث إلى الأقدم (Newest to Oldest). تضمن هذه الخطوة تصدر أحدث قيد زمني للمجموعة المحددة في القمة.
- يُعين مستوى الفرز الأول (Sort by) على عمود المعرف الفريد (مثل:
- رابعاً: تنفيذ أمر إزالة التكرارات: بعد اكتمال الفرز المزدوج، يتم التوجه مباشرة إلى أمر “إزالة التكرارات” (Remove Duplicates) في تبويب “بيانات”.
- خامساً: عزل معيار التفرد: في النافذة المنبثقة، يجب أولاً إلغاء تحديد كافة الأعمدة بالنقر على (Unselect All)، ثم تحديد عمود المعرف الفريد فقط. يُعد هذا الإجراء خطوة فارقة ومحورية؛ لأن الإبقاء على كافة الأعمدة محددة سيجعل إكسل يبحث عن التطابق الكامل في كافة الخلايا، وبما أن التواريخ متباينة، فلن يتم حذف أي صف. بالنقر على زر الموافقة، يعلن النظام عدد القيم المكررة التي تم التخلص منها وعدد القيم الفريدة المحتفظ بها، وهي التي تمثل بالضرورة السجلات الأحدث.
3.3 التقييم الفني والمحدوديات التشغيلية لهذا النهج
يحظى أسلوب الفرز المزدوج المتبوع بإزالة التكرارات بشعبية واسعة في بيئات العمل، نظراً لسرعته الفائقة وعدم حاجته إلى كتابة صيغ رياضية أو أكواد برمجية معقدة. إنه خيار مثالي لإجراء عمليات التطهير لمرة واحدة (Ad-hoc data cleaning) على مجموعات البيانات الثابتة والمغلقة التي لا تستقبل تدفقات جديدة من السجلات، مما يتيح للمحلل الحصول على مصفوفة نظيفة في غضون ثوانٍ معدودة وبأقل جهد حوسبي ممكن.
ومع ذلك، تبرز قيود فنية جسيمة تقلل من ملاءمة هذا النهج في المسارات التحليلية الاحترافية. العيب الأكبر يكمن في كونه إجراءً تدميرياً (Destructive Action) يمحو السجلات القديمة نهائياً من ورقة العمل، مما يحرم المحلل من تتبع التطور التاريخي للمتغير ما لم تكن هناك نسخ احتياطية خارجية. كما أن هذا الإجراء يعيد ترتيب المصفوفة قسرياً، وهو ما قد يتعارض مع الهيكلية الأصلية للبيانات المعتمدة على تسلسل محدد مسبقاً.
بالإضافة إلى ذلك، تفتقر هذه الطريقة تماماً إلى الاستجابة الديناميكية؛ فبمجرد إدخال صفوف جديدة في أسفل الجدول في أوقات لاحقة، لا يتم تنقيح الجدول تلقائياً، بل يقع على عاتق المستخدم تكرار عملية الفرز المزدوج والحذف اليدوي بالكامل في كل مرة يتم فيها تحديث قاعدة البيانات. هذا القصور يجعل الطريقة عرضة للأخطاء البشرية، ويجعلها غير متوافقة مع متطلبات أتمتة العمليات وقواعد الحوكمة الرامية إلى تقليل التدخلات اليدوية في إدارة السجلات البحثية والتشغيلية.
4. الاستخلاص الديناميكي المتقدم عبر دمج الدالتين UNIQUE و MAX مع IF
4.1 استخراج المعرفات المتفردة عبر الدالة UNIQUE
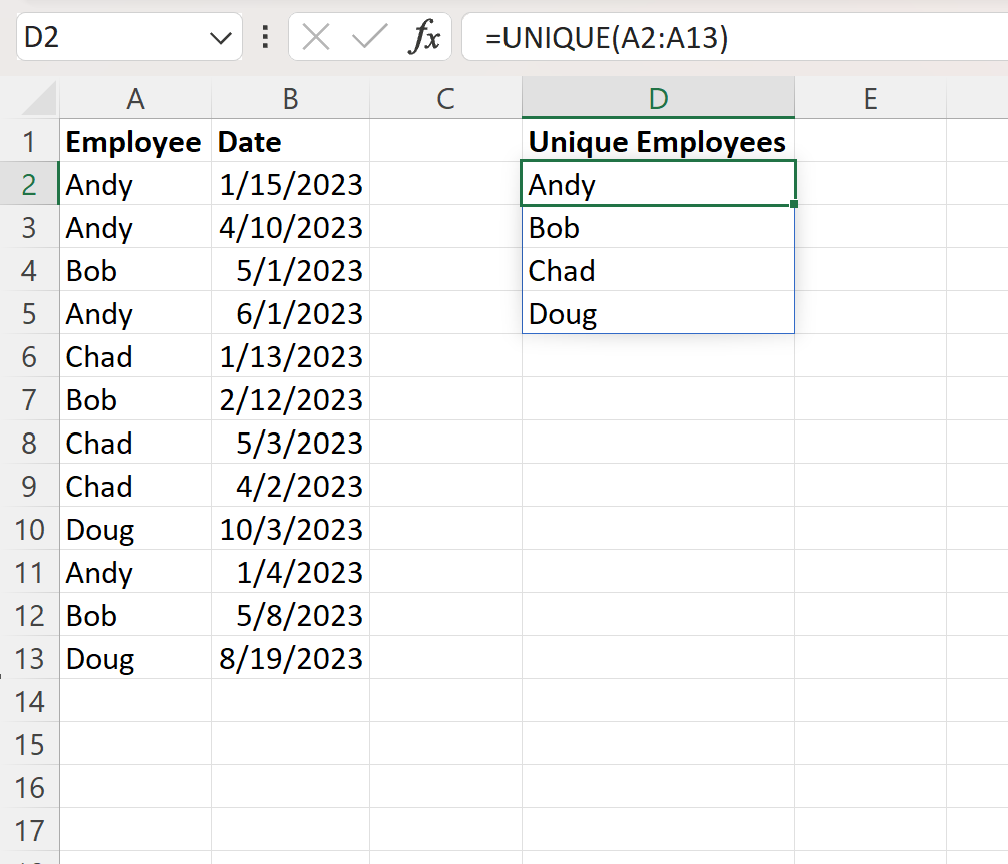
أحدثت بيئة الحساب المعتمدة على مصفوفات الانسكاب الديناميكية (Dynamic Array Formulas) في إصدارات إكسل الحديثة تحولاً جذرياً في معالجة البيانات، حيث سمحت بتجاوز الأساليب التدميرية واستبدالها بنماذج استخلاص مرنة وغير تداخلية. تمثل الدالة UNIQUE رأس الحربة في هذه الفلسفة؛ إذ تقوم بمسح نطاق الإدخال وتوليد قائمة مشتقة خالية تماماً من التكرارات، دون المساس بالجدول الأصلي أو تغيير ترتيبه الداخلي.
تتميز الدالة UNIQUE ببنيتها الصريحة؛ حيث تتطلب فقط تمرير مصفوفة المعرفات الأصلية لتتكفل بتوليد النتائج تلقائياً في عمود مخصص. تُكتب الصيغة في الخلية العلوية للنطاق الموجه على النحو الآتي:
=UNIQUE(Table1[Participant_ID])
ينساب ناتج هذه المعادلة رأسياً عبر الخلايا المجاورة لملء كافة الصفوف بالمعرفات المتفردة تلقائياً. وفي حال كانت البيانات مستندة إلى جدول رسمي، فإن أي إضافة لمفردات جديدة في الجدول الأصلي تؤدي فوراً إلى تمدد النطاق المنسكب وإدراج المعرفات الطارئة في القائمة المتفردة بصورة آنية ولحظية، مما يؤسس لمسار عمل ديناميكي متكامل.
4.2 صياغة مصفوفة المقارنة الشرطية باستخدام MAX و IF
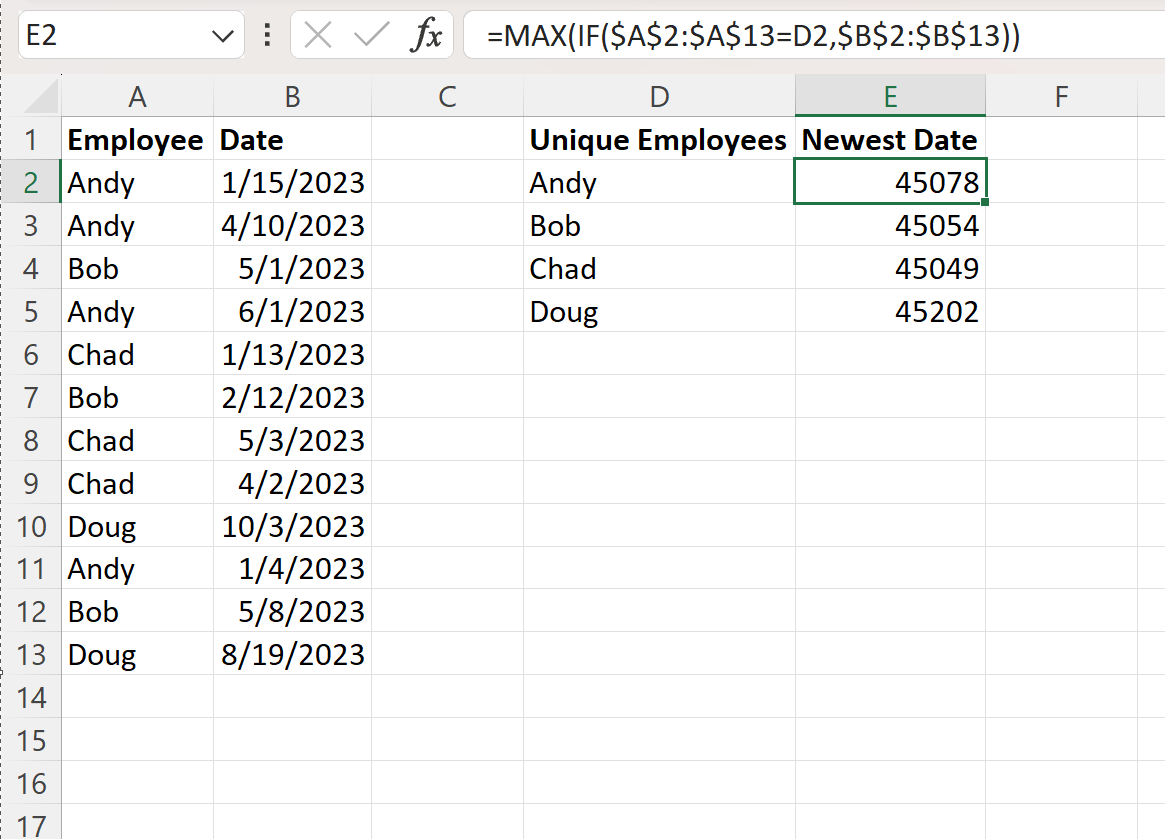
بمجرد استخراج قائمة المعرفات الفريدة، تصبح الخطوة التالية هي عزل القيمة الزمنية القصوى المقترنة بكل معرف على حدة. لتحقيق ذلك، يتم بناء صيغة مصفوفية تجمع بين دالة القيمة القصوى MAX والدالة الشرطية IF. تقوم هذه الصيغة بمقارنة كامل مصفوفة المعرفات في الجدول الأصلي مع المعرف الفريد المستخرج، وتطبيق تصفية منطقية تستبقي تواريخ السجلات المتطابقة فقط، مع استبعاد باقي السجلات تمهيداً لحساب الحد الأقصى بينها.
تُصاغ المعادلة في الخلية المجاورة لأول معرف فريد (ولتكن الخلية G2 المقابلة للمعرف في F2) بالشكل الآتي:
=MAX(IF(Table1[Participant_ID] = F2, Table1[Transaction_Date]))
في بيئات إكسل الحديثة (Excel 365 و Excel 2021)، تُحسب هذه المعادلة كمصفوفة طبيعية بالضغط على مفتاح Enter، بينما تتطلب الإصدارات التقليدية تثبيتها باستخدام المفاتيح الثلاثية Ctrl + Shift + Enter لتعمل كصيغة مصفوفة محاطة بأقواس معقوفة. أما بالنسبة للمستخدمين الذين يفضلون الصيغ الحديثة المباشرة المخصصة للمعايير المتعددة، فيمكن الاستعاضة عن هذا التركيب بالدالة المتخصصة MAXIFS التي توفر أداءً حسابياً ممتازاً وصياغة أكثر انسيابية:
=MAXIFS(Table1[Transaction_Date], Table1[Participant_ID], F2)
في كلا الخيارين، يتم سحب الصيغة أو نسخها على طول قائمة المعرفات الفريدة، مع ضرورة التأكد من استخدام المراجع المطلقة وتثبيت نطاقات الإسناد في حال عدم استخدام مراجع الجداول الهيكلية، لمنع انزياح نطاق المقارنة عند النزول رأسياً على طول العمود.
4.3 تنسيق القيم الرقمية الناتجة إلى نسق التاريخ المعتمد
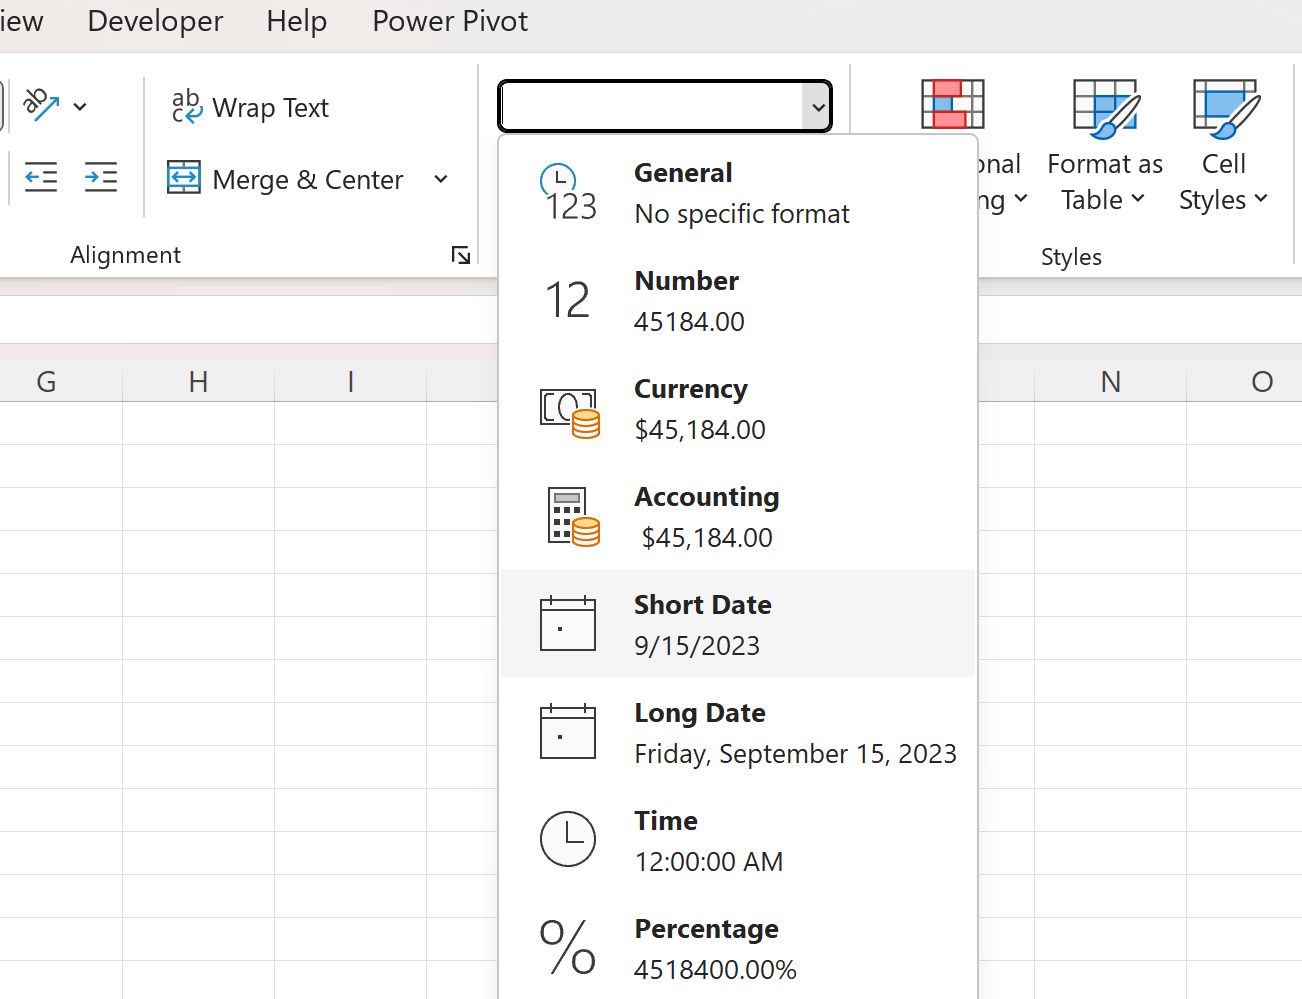
من المشكلات الشائعة التي تواجه المستخدمين عند استخراج التواريخ باستخدام دوال التجميع الرياضية مثل MAX أو MAXIFS، ظهور النتائج في صورة أرقام صحيحة أو كسور عشرية مجردة (مثل: 45293 بدلاً من 2024/01/01). ينشأ هذا العرض نتيجة للطريقة التي يخزن بها إكسل التواريخ كنظام تسلسلي داخلي؛ حيث تقوم الدوال الرياضية بحساب القيمة الخام للرقم التسلسلي واسترجاعه في خلية لم يتم تحديد نسقها الزمني بعد.
لتصحيح هذا العرض واستعادة القراءة الزمنية الصحيحة، يتم تظليل عمود النتائج بالكامل، والنقر بزر الفأرة الأيمن لاختيار “تنسيق الخلايا” (Format Cells)، أو استخدام الاختصار Ctrl + 1. ومن تبويب “رقم” (Number)، يُحدد تصنيف “التاريخ” (Date)، مع اختيار النسق المعياري المطلوب (مثل: YYYY-MM-DD أو DD/MM/YYYY) لضمان اتساق القراءة.
بعد إتمام خطوة التنسيق، يتعين إجراء فحص تدقيقي لمطابقة العينات العشوائية بين القائمة المنقحة والجدول الأصلي. يتيح هذا التحقق التأكد من أن التواريخ المستخرجة تماثل بالفعل أحدث قيد في قاعدة البيانات لكل مفردة، مما يؤكد سلامة البناء المنطقي للمعادلات المصفوفية ويمنح المحلل ثقة كاملة في موثوقية المستخرج الزمني.
5. استرداد البيانات الجدولية الكاملة المرتبطة بالسجل الأحدث
5.1 توظيف الدالة الحديثة XLOOKUP للبحث متعدد الشروط
لا يقتصر تنقيح البيانات في أغلب الحالات على استخراج المعرف وتاريخه الأحدث فحسب، بل يمتد ليشمل استرداد كافة السمات الوصفية والمتغيرات التابعة المقترنة بذلك السجل، كأرقام الهواتف، وأحجام المبيعات، والتقييمات السلوكية، والملاحظات الميدانية. تبرز الدالة الحديثة XLOOKUP كواحدة من أقوى الأدوات لتحقيق هذا التكامل؛ حيث تتيح إجراء بحث مركب استناداً إلى معيارين متزامنين هما: المعرف الفريد والتاريخ الأحدث المستخرج.
تعتمد آلية البحث المزدوج في دالة XLOOKUP على دمج شرطين منطقيين باستخدام معامل الضرب البولياني (Boolean Multiplication)، حيث تتم صياغة المعادلة لاسترداد قيمة متغير تابع (كالقسم أو المبلغ في العمود Table1[Amount]) بالصيغة الهيكلية الآتية:
=XLOOKUP(1, (Table1[Participant_ID] = F2) * (Table1[Transaction_Date] = G2), Table1[Amount], "غير متوفر")
يقوم محرك الدالة بضرب مصفوفتين منطقيتين؛ الأولى تقيّم تطابق المعرف، والثانية تقيّم تطابق التاريخ. وبما أن القيمة المنطقية TRUE تعادل 1 و FALSE تعادل 0، فإن ناتج ضرب الحالتين المحققتين معاً يعطي 1 حصراً. تبحث XLOOKUP عن الرقم 1 وتسترجع مباشرة القيمة المقابلة له من نطاق الإرجاع. يوفر الوسيط الرابع في الدالة حماية ضد رسائل الأخطاء غير المحبذة مثل #N/A، حيث يمكن تضمين قيمة نصية بديلة توضح غياب البيانات في حال حدوث أي انقطاع مرجعي.
5.2 استخدام التركيبة التقليدية INDEX و MATCH لبيئات العمل الأقدم
في بيئات المؤسسات والمنظمات التي لا تزال تستخدم إصدارات أقدم من برنامج إكسل (مثل Excel 2016 أو Excel 2013)، يغيب توافر الدالة XLOOKUP. في هذه الحالة، تصبح التركيبة التقليدية والشهيرة التي تجمع بين الدالتين INDEX و MATCH هي البديل الموثوق والأكثر متانة لتنفيذ عمليات البحث متعددة الشروط داخل مصفوفات البيانات الكبيرة.
تعتمد هذه الصيغة على قيام الدالة MATCH بحساب رقم الصف النسبي الذي تنطبق عليه الشروط المتعددة معاً، ثم تمرير هذا الرقم إلى الدالة INDEX التي تتولى بدورها استخراج القيمة المقابلة من العمود المستهدف. تُبنى المعادلة على النحو الآتي:
=INDEX(Table1[Amount], MATCH(1, (Table1[Participant_ID] = F2) * (Table1[Transaction_Date] = G2), 0))
يجب التنبيه بحزم إلى أن هذه الصيغة تعمل بصفتها صيغة مصفوفية كلاسيكية في الإصدارات القديمة، مما يتطلب إلزامياً الضغط على المفاتيح Ctrl + Shift + Enter عند إدخالها لأول مرة وعند كل تعديل لاحق عليها. يؤدي عدم اتباع هذا البروتوكول في الإصدارات السابقة إلى ظهور الخطأ #VALUE! نظراً لعجز المحرك التقليدي عن تقييم ضرب المصفوفات دون إيعاز برمجي مباشر من المستخدم.
5.3 ضمان سلامة الاتساق بين الحقول المستردة والبيانات الأصلية
عند بناء أنظمة الاسترداد المعتمدة على المفاتيح المركبة، قد تنشأ إشكالية بنيوية معقدة تتمثل في “حالات التعادل الزمني”؛ وهي الحالة التي يتطابق فيها المعرف ويسجل تاريخين متماثلين تماماً في يوم واحد ولكن بقيم مختلفة في الحقول الأخرى (كالعمليات المتكررة لنفس الشخص في ذات التاريخ). في هذا السيناريو، ستقوم دالتا XLOOKUP و MATCH باسترجاع السجل الأول الذي يقابلهما في النطاق تلقائياً، وهو ما قد يؤدي إلى استخراج بيانات لا تتطابق بالضرورة مع العملية التشغيلية الأخيرة في ذلك اليوم.
لتطويق هذه الإشكالية، يجب توسيع نطاق معايير الفصل وإدراج أختام زمنية فائقة الدقة تتضمن الساعات والدقائق والثواني بدلاً من الاعتماد على التاريخ المجرد. وإذا لم تكن الأختام الزمنية متوفرة في قواعد البيانات الأصلية، يتعين إدخال معيار ترجيحي ثانوي، كاستخدام رقم الفاتورة التسلسلي (Invoice_ID) أو رقم القيد التراكمي لفض الاشتباك بين القيود المتطابقة زمنياً.
كما تقتضي إجراءات مراقبة الجودة مقارنة مجاميع الحقول الرقمية المستردة بعد استخلاصها مع مجاميع الصفوف المستهدفة الأصلية للتأكد من عدم حدوث أي انزياح في الأسطر أو اختلاط بين بيانات مفردة وأخرى، لضمان أعلى مستويات الدقة والامتثال للسياسات الإحصائية الصارمة.
6. الأتمتة الشاملة وغير التدميرية عبر محرر الاستعلامات Power Query
6.1 استيراد البيانات وضبط النماذج النوعية للأعمدة
يُمثل محرر الاستعلامات المتقدم (Power Query) في برنامج إكسل البيئة النموذجية والأكثر احترافية لتنفيذ خطوط أنابيب تنقية البيانات وإعدادها للأغراض البحثية والمؤسسية. تتفوق هذه الأداة في قدرتها على عزل البيانات الأصلية عما يطرأ عليها من تحولات، مع تسجيل كل خطوة في صورة سيناريو تحويلي مكتوب بلغة (M) يمكن إعادة تطبيقه آلياً دون أي تدخل يدوي بمجرد النقر على زر التحديث.
تبدأ العملية بتحديد الجدول الأصلي والتوجه إلى تبويب “بيانات” (Data)، ثم النقر على “من ورقة/جدول” (From Sheet/Table) لرفع البيانات إلى واجهة محرر الاستعلامات. وفور فتح النافذة، تتجلى الخطوة المحورية الأولى في التحقق الصارم من أنواع البيانات المخصصة لكل عمود؛ حيث يجب التأكد من ضبط عمود التاريخ على نسق Date أو Date/Time الحقيقي عبر النقر على أيقونة النوع بجانب رأس العمود.
يساعد هذا التعيين النوعي الصارم في تفادي أخطاء الترتيب الأبجدي، ويضمن أن محرك Power Query سيتعامل مع التواريخ كأبعاد زمنية تسلسلية صحيحة. كذلك، يتم استغلال وجود البيانات في المحرر لإزالة أي صفوف فارغة كلياً وتصفية الفراغات لضمان نظافة المصفوفة قبل الانتقال إلى مرحلة المعالجة التجميعية.
6.2 تطبيق عملية التجميع واستخراج القيمة الزمنية القصوى
توفر أداة Power Query منهجين رئيسيين لاستبقاء السجل الأحدث: المنهج المباشر عبر الفرز وإزالة التكرار، ومنهج التجميع المتقدم (Group By) الذي يعتبر الأكثر متانة وأماناً. لتطبيق منهج التجميع المتقدم، يتبع المستخدم الخطوات الآتية:
- تحديد عمود المعرف الأساسي (مثل:
Participant_ID). - النقر على زر “تجميع حسب” (Group By) المتواجد في شريط الأدوات الرئيسي لمحرر الاستعلامات.
- في نافذة التجميع، يتم اختيار النمط “متقدم” (Advanced) لإتاحة إنشاء مقاييس إحصائية متعددة ومتزامنة.
- يُضبط المقياس الأول بتسمية العمود الجديد باسم معبر (مثل:
Latest_Date)، وتعيين العملية الإحصائية على أنها “الحد الأقصى” (Max)، وتوجيهها نحو عمود التاريخ المستهدف. - يُضاف تجميع ثانٍ باسم (مثل:
AllData)، مع ضبط العملية لتكون “كافة الصفوف” (All Rows). يؤدي هذا الإجراء الذكي إلى تكثيف كافة البيانات المرتبطة بكل معرف في صورة جدول فرعي مضمن (Nested Table) داخل الخلية، مما يمهد لاسترجاع باقي التفاصيل التشغيلية لاحقاً دون فقدان أي حقل من حقول الجدول الأصلي.
6.3 دمج الاستعلام الذاتي وتوسيع الأعمدة الإضافية
عقب إتمام خطوة التجميع، تبرز الحاجة إلى استخراج السجل الكامل المقترن بتاريخ الحد الأقصى من الجداول المضمنة في عمود AllData. تتيح لغة الاستعلام (M) تحقيق ذلك بطرق متنوعة، إلا أن أبسطها للمستخدم العادي يتمثل في استخدام عملية الدمج الداخلي (Merge Queries) بين الجدول المجمع والجدول الأصلي.
يتم اختيار “دمج الاستعلامات” (Merge Queries)، وربط الجدول مع نفسه بالاعتماد على مفتاح مركب يتألف من عمودين: تحديد عمود المعرف وعمود Latest_Date في الجدول الأول بالتزامن مع الضغط على مفتاح Ctrl، ومقابلة ذلك بتحديد عمود المعرف وعمود التاريخ في الجدول الثاني. يُحدد نوع الارتباط بصفته “داخلي” (Inner Join)، مما يعني أن المحرك سيستبعد تلقائياً كافة الصفوف التي لا تتطابق مع قيم التاريخ الأحدث للمعرف.
بعد إتمام الدمج، يظهر عمود يحتوي على جداول مضمنة متوافقة تماماً. بالنقر على أيقونة التوسيع في رأس العمود، يتم اختيار كافة الأعمدة المطلوب استعادتها (مثل: اسم المنتج، قيمة المعاملة، القسم، وملاحظات الأداء)، مع إلغاء تفعيل خيار استخدام اسم العمود الأصلي كبادئة. في هذه اللحظة، تتشكل مصفوفة متكاملة ونهائية تحتوي على المعرفات الفريدة، وأحدث التواريخ، وكافة المتغيرات الوصفية التابعة للسجل الأخير حصراً وبدقة حسابية متناهية.
6.4 استدامة تدفق العمل وتحديث البيانات بنقرة واحدة
تكتمل قوة هذه المنهجية عند تحميل الناتج النهائي إلى بيئة إكسل العادية عبر النقر على “إغلاق وتحميل إلى” (Close & Load To…)، واختيار تحميل النتائج في صورة جدول داخل ورقة عمل جديدة ومستقلة كلياً. يوفر هذا الفصل المادي حاجزاً مانعاً يحمي الجدول المعالج من أي تدخل يدوي عشوائي، ويفصل نهائياً بين مرحلة إدخال البيانات ومرحلة عرض النتائج المنقحة.
تتمثل القيمة الكبرى لمحرر Power Query في خاصية الاستدامة التلقائية (Reproducibility)؛ فإذا أضاف فريق العمل المئات من القيود الجديدة أو المعاملات اللاحقة في جدول البيانات الخام، لا يتطلب الأمر إعادة أي خطوة تحليلية على الإطلاق. كل ما على المستخدم فعله هو النقر بزر الفأرة الأيمن في أي مكان داخل الجدول المفرغ واختيار “تحديث” (Refresh)، أو الضغط على Alt + F5.
خلال أجزاء من الثانية، يقوم المحرك بإعادة تنفيذ خطوات الاستيراد، والتحقق، والتجميع، والدمج، وتوسيع الصفوف، ثم كتابة الجدول المنقح من جديد بما يعكس أحدث الحالات لجميع المعرفات. بالإضافة إلى ذلك، يتفوق محرر الاستعلامات في إدارة مجموعات البيانات الضخمة التي قد تضم مئات الآلاف من الصفوف بكفاءة استهلاك ذاكرة تفوق بكثير قدرة الصيغ المصفوفية الثقيلة التي قد تبطئ عمل الجهاز وتؤدي إلى تجمد البرنامج.
7. المعالجة البرمجية المخصصة عبر لغة Visual Basic for Applications (VBA)
7.1 هيكلة الخوارزمية البرمجية لمسح ومقارنة التواريخ
توفر لغة الفيجوال بيسك للتطبيقات (VBA) إمكانات متقدمة للتحكم في معالجة مصفوفات البيانات، لا سيما في البيئات التشغيلية المؤتمتة التي تتطلب دمج إجراء التنقية ضمن منظومة إجراءات أوسع نطاقاً. لتحقيق كفاءة حوسبية قصوى ومنع الهبوط في سرعة المعالجة عند التعامل مع قواعد بيانات كبيرة، تعتمد الهيكلة البرمجية الحديثة على نقل بيانات النطاق بالكامل إلى مصفوفات الذاكرة الافتراضية (In-Memory Arrays)، وتفادي القراءة والكتابة المباشرة خلية بخلية داخل ورقة العمل.
تبدأ الخوارزمية بحساب أبعاد النطاق الفعلي عبر تتبع الصف الأخير والعمود الأخير ديناميكياً، ثم تفريغ هذا النطاق داخل مصفوفة ثنائية الأبعاد (Variant Array). بعد ذلك، تدور حلقة تكرارية مرنة تستعرض الصفوف من البداية إلى النهاية، وتقوم بعزل المعرف والتاريخ وفحصهما برمجياً، تمهيداً لاتخاذ قرار الاحتفاظ بالسجل أو استبداله بقيد أكثر حداثة.
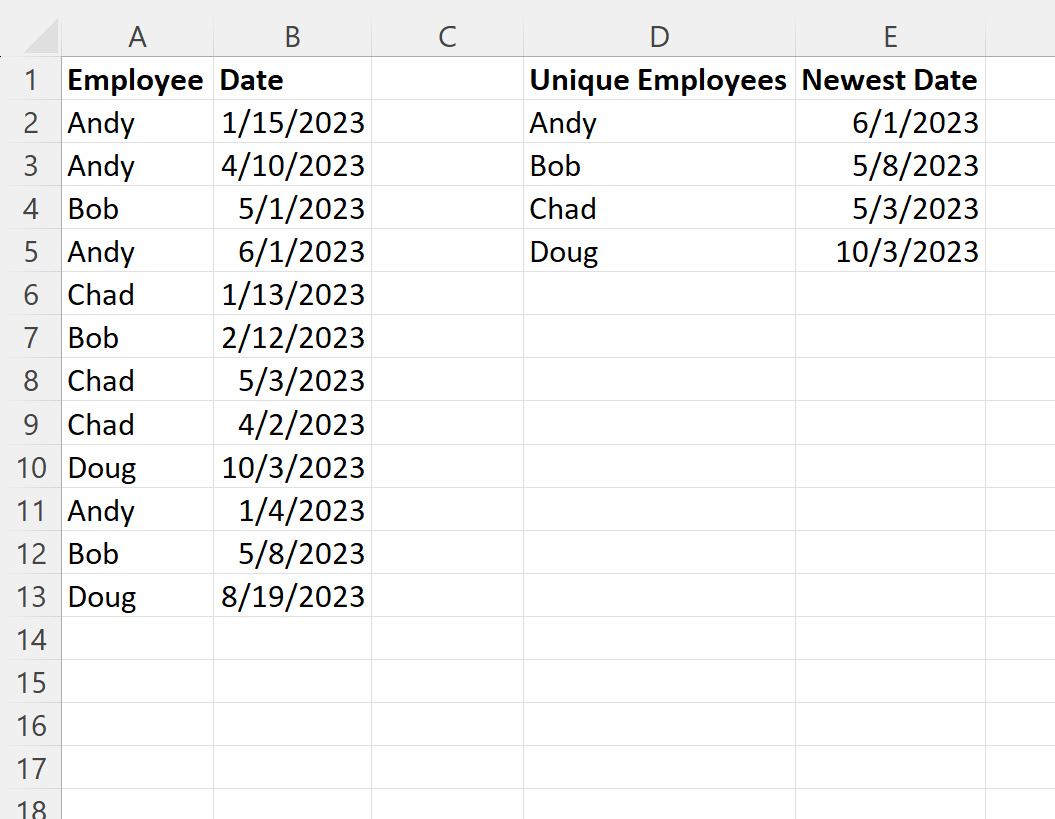
7.2 استخدام كائن القاموس البرمجي (Scripting.Dictionary)
يُعد كائن القاموس Scripting.Dictionary الأداة البرمجية الأنسب لتنفيذ عملية استبقاء السجل الأحدث بكفاءة عالية، وذلك بفضل قدرته على تخزين أزواج فريدة تتألف من المفتاح (Key) والعنصر (Item). في هذا السياق، يُستخدم معرف الكيان كمفتاح فريد للقاموس، بينما يُخزن رقم الصف أو كامل مصفوفة بيانات الصف كعنصر مرتبط بذلك المفتاح.
أثناء دوران الحلقة التكرارية على المصفوفة، يتم استدعاء خوارزمية المقارنة الشرطية التالية:
- إذا كان المعرف (المفتاح) غير موجود في القاموس، يتم تسجيله فوراً مع حفظ التاريخ المقترن به ورقم الصف التابع له.
- إذا كان المعرف مسجلاً مسبقاً، يقوم الكود بمقارنة التاريخ المخزن في القاموس مع التاريخ الموجود في الصف الحالي الذي يجري فحصه.
- إذا كان التاريخ في الصف الحالي أحدث زمنياً من التاريخ المسجل في القاموس، يتم تحديث قيمة القاموس برقم الصف الجديد والتاريخ الأحدث، مما يؤدي إلى إزاحة الصف الأقدم برمجياً والاحتفاظ بالصف الأخير فقط.
يوضح المقطع البرمجي التالي صياغة هذه الآلية، مع مراعاة نقل النتائج دفعة واحدة إلى ورقة عمل جديدة:
Sub KeepNewestRecords()

    Dim wsSource As Worksheet, wsDest As Worksheet

    Dim dataArr As Variant, outArr() As Variant

    Dim dict As Object, rCount As Long, cCount As Long

    Dim i As Long, j As Long, key As Variant, targetRow As Long

    Dim lastRow As Long, dictCount As Long
Set wsSource = ThisWorkbook.Sheets("Data")
Set wsDest = ThisWorkbook.Sheets("CleanedData")
Set dict = CreateObject("Scripting.Dictionary")
lastRow = wsSource.Cells(wsSource.Rows.Count, "A").End(xlUp).Row
cCount = wsSource.Cells(1, wsSource.Columns.Count).End(xlToLeft).Column
dataArr = wsSource.Range(wsSource.Cells(1, 1), wsSource.Cells(lastRow, cCount)).Value
For i = 2 To UBound(dataArr, 1)
key = Trim(CStr(dataArr(i, 1))) ' عمود المعرف
If Not dict.Exists(key) Then
dict.Add key, i
Else
targetRow = dict(key)
If dataArr(i, 2) > dataArr(targetRow, 2) Then ' عمود التاريخ
dict(key) = i
End If
End If
Next i
dictCount = dict.Count
ReDim outArr(1 To dictCount + 1, 1 To cCount)
For j = 1 To cCount
outArr(1, j) = dataArr(1, j)
Next j
i = 2
For Each key In dict.Keys
targetRow = dict(key)
For j = 1 To cCount
outArr(i, j) = dataArr(targetRow, j)
Next j
i = i + 1
Next key
wsDest.Cells.Clear
wsDest.Range("A1").Resize(dictCount + 1, cCount).Value = outArr
End Sub
7.3 أتمتة الحذف الفيزيائي للصفوف غير المطابقة
في بعض التطبيقات المؤسسية، قد يتطلب بروتوكول العمل إجراء حذف فيزيائي مباشر للصفوف القديمة داخل نفس ورقة العمل الأصلية، دون نسخ النتائج إلى أوراق إضافية. يمثل الحذف المباشر تحدياً برمجياً كبيراً؛ لأن حذف الصفوف الفردية واحداً تلو الآخر يؤدي إلى تحديث شاشة إكسل بصورة متكررة وإعادة حساب مراجع الخلايا باستمرار، مما يبطئ التنفيذ ويستنزف موارد المعالج بشكل حاد.
للتغلب على هذا القصور، تقوم الخوارزمية الفعالة بتحديد أرقام الصفوف الأقدم غير المرغوب فيها وتجميعها في كائن نطاق واحد موحد باستخدام الدالة Union. وقبل إطلاق عملية الحذف، يتم إيقاف خصائص التطبيق المؤثرة على الأداء عبر توجيهات برمجية واضحة:
Application.ScreenUpdating = False

Application.Calculation = xlCalculationManual

Application.EnableEvents = False
بعد اكتمال فحص كافة الصفوف وتراكم الصفوف المستهدفة داخل كائن النطاق الموحد، يُنفذ أمر الحذف بضربة واحدة:
If Not deleteRange Is Nothing Then deleteRange.EntireRow.Delete
وعقب الانتهاء، يعيد الماكرو تشغيل التحديث التلقائي للشاشة والحسابات الرياضية إلى حالتها الافتراضية. يضمن هذا النهج تقليص زمن التنفيذ من دقائق طويلة إلى أجزاء من الثانية، مع تطهير ورقة العمل من السجلات القديمة واستبقاء السجلات الحديثة حصراً في مواضعها الصحيحة.
8. استخدام الجداول المحورية (Pivot Tables) كأداة تلخيص استعراضية
8.1 إنشاء هيكل الجدول المحوري وتوزيع الحقول
تُعد الجداول المحورية (Pivot Tables) إحدى أسرع الوسائل التحليلية المتاحة في برنامج إكسل لتكثيف البيانات وتجميعها دون الحاجة إلى كتابة صيغ رياضية أو إجراء تغييرات هيكلية على مصدر الإدخال. يمكن توظيف الجداول المحورية بذكاء لعرض أحدث قيد زمني لكل معرف فريد في ثوانٍ معدودة، مما يوفر منصة استعراضية جاهزة للتحقق والتدقيق الإداري.
يبدأ الإجراء بتحديد كامل نطاق البيانات والتوجه إلى قائمة “إدراج” (Insert) ثم النقر على “جدول محوري” (PivotTable). وفي لوحة التحكم الجانبية بتوزيع الحقول:
- يتم سحب حقل المعرف الأساسي (مثل:
Participant_ID) وإسقاطه في منطقة “الصفوف” (Rows). ينتج عن هذا فوراً قائمة رأسية خالية تماماً من التكرارات لكافة المفردات المشمولة في قاعدة البيانات. - يتم سحب حقل التاريخ (مثل:
Transaction_Date) وإسقاطه في منطقة “القيم” (Values). افتراضياً، سيقوم إكسل بتعيين عملية الحساب على أنها “عدد” (Count) إذا احتوى العمود على أي نص، أو “مجموع” (Sum) في بعض الحالات، وهو ما يتطلب تعديلاً وظيفياً مباشراً. - يجب الانتباه إلى ضرورة استبعاد خاصية تجميع التواريخ التلقائي (Date Grouping) التي تدمج التواريخ إلى سنوات، وأرباع سنوية، وأشهر؛ حيث يتعين النقر بزر الفأرة الأيمن على أي تاريخ داخل الجدول المحوري واختيار “إلغاء التجميع” (Ungroup) لعرض التواريخ الفردية بدقة.
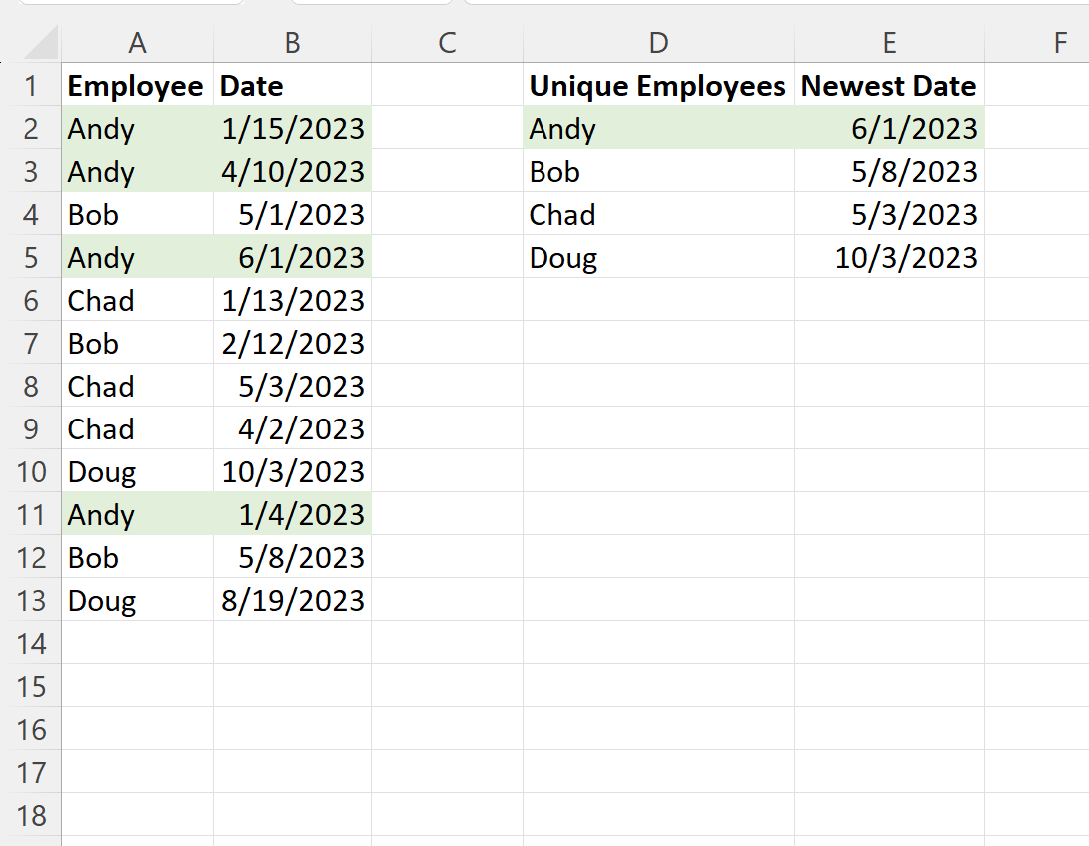
8.2 ضبط تلخيص القيم عبر الدالة الإحصائية Max
لتحويل الجدول المحوري من مجرد عارض إحصائي إلى أداة تصفية دقيقة للمعرف وتاريخه الأحدث، يجب تعديل العملية الرياضية المطبقة على حقل التاريخ في منطقة القيم. يتم ذلك من خلال النقر على السهم الصغير المجاور لحقل التاريخ في منطقة القيم، واختيار “إعدادات حقل القيمة” (Value Field Settings).
في النافذة المنبثقة، يتم تغيير عملية التلخيص من “العدد” أو “المجموع” إلى الدالة الإحصائية الحد الأقصى (Max). يؤدي هذا التغيير إلى إرغام المحرك المحوري على فحص كافة السجلات التابعة لكل معرف واختيار أعلى قيمة رقمية للتاريخ، وهي التي تعبر عن التاريخ الأحدث زمنياً بحكم البنية التسلسلية للأرقام الزمنية في إكسل.
كذلك، يتم من نفس النافذة النقر على زر “تنسيق الأرقام” (Number Format) في الزاوية السفلية، وتحديد نمط “التاريخ” بدلاً من النمط العام (General). وبمجرد تأكيد الخيارات، يتحول الجدول المحوري إلى مصفوفة أنيقة تتألف من عمودين: عمود المعرفات الفريدة، وعمود أحدث تاريخ قيد مسجل لكل معرف، مع ميزة التحديث الفوري بمجرد النقر على زر التحديث عند تعديل المصدر الأصلي.
8.3 الموازنة بين العرض التلخيصي والحاجة إلى الحذف الفعلي
يوفر استعراض البيانات عبر الجداول المحورية مزايا تشغيلية ملموسة، أهمها السرعة الفائقة والحصانة المطلقة ضد التدمير أو الحذف العرضي؛ حيث تظل البيانات الأصلية سليمة دون تغيير في بنيتها، مما يجعله الخيار الأمثل للاجتماعات التنفيذية وعمليات التدقيق السريع التي لا تتطلب إعادة هيكلة البيانات المصدرية.
ومع ذلك، تقف الجداول المحورية الكلاسيكية عاجزة أمام تلبية الاحتياجات التحليلية المعقدة التي تتطلب استرجاع الأعمدة النصية المصاحبة لكل صف (مثل اسم العميل، والمدينة، والتقييم، وملاحظات المشرف). لا يتيح الجدول المحوري إدراج الحقول النصية في منطقة القيم لعرضها بجانب التاريخ الأقصى، وإذا وُضعت هذه الحقول في منطقة الصفوف، فإنها ستؤدي إلى تفكيك المعرف وإعادة ظهور الصفوف المكررة مرة أخرى إذا تباينت النصوص في تلك الحقول.
يتطلب تجاوز هذا القصور دمج الجدول المحوري مع “نموذج البيانات” (Data Model) واستخدام لغة الاستعلامات التحليلية (DAX) لكتابة مقاييس متقدمة تسترجع النصوص المقترنة بالقيمة القصوى، أو الاكتفاء بالجدول المحوري كأداة استكشافية أولية يليها تطبيق محرر Power Query أو لغة VBA لتنفيذ عمليات الحذف والاستخلاص الشاملة.
9. تحليل الأخطاء الشائعة وحلول استكشاف الأعطال والمعالجة التصحيحية
9.1 فشل تحديد الحد الأقصى بسبب اختلاف تنسيق التواريخ
تتمثل إحدى أكثر المشكلات إرباكاً للمحللين في إخفاق دالتي MAX أو MAXIFS في استخراج التاريخ الأحدث فعلياً، أو إرجاع قيم تاريخية غير منطقية ومتقادمة. يعود السبب الجوهري وراء هذا السلوك الشاذ في أغلب الأحيان إلى وجود تفاوت نسقي خفي داخل عمود التاريخ، حيث تختلط الخلايا المحتوية على تواريخ رقمية صحيحة بخلايا أخرى دُوّنت فيها التواريخ كسلاسل نصية جامدة.
عندما تتعامل دالة MAX مع خلية نصية تشبه التاريخ (مثل “2024/05/20”)، فإنها تتجاهلها تماماً وتعتبر قيمتها الرياضية صفراً؛ مما يجعل الدالة ترصد التاريخ الرقمي الأقدم بدلاً منها طالما أنه مخزن بصيغة رقمية صحيحة، متجاوزة القيد الأحدث الذي تحول إلى نص بفعل أخطاء الاستيراد. لاكتشاف هذه الاختلالات الخفية، يُنصح بتطبيق عمود فحص مؤقت يحتوي على الصيغة التالية:
=ISNUMBER(B2)
إذا ظهرت القيمة FALSE في أي خلية، يتم التدخل لتصحيح التنسيق قسرياً. ويمكن استخدام الدالة DATEVALUE لتحويل النصوص الصريحة إلى أرقامها التسلسلية، أو استخدام عملية الضرب المحايد عبر ضرب الخلية في الرقم 1 لتحفيز المحرك الحسابي على إعادة تفسير النص كرقم تسلسلي، مما يعيد الاتساق لعمود التاريخ ويضمن كفاءة دوال التجميع القصوى.
9.2 مشكلة تطابق التواريخ المتطابقة لنفس المعرف (حالات التعادل)
تفرض “حالات التعادل الزمني” تحدياً حقيقياً لسلامة المعالجة؛ حيث تتطابق السجلات في كل من عمود المعرف وعمود التاريخ بصورة تامة، مع اختلاف القيم التشغيلية في الأعمدة التابعة. يحدث هذا التزامن عادة عند إدخال أكثر من معاملة للشخص ذاته في نفس اليوم دون تسجيل التوقيت التفصيلي بالساعات والدقائق، أو نتيجة دمج قواعد بيانات متعددة تحتوي على أزمنة مقتطعة.
في هذه السيناريوهات، تصبح خوارزميات الاسترداد المبنية على البحث المزدوج عاجزة عن التمييز الموضوعي بين الصفين، وستقوم دوال البحث مثل XLOOKUP باسترجاع السجل الذي يظهر أولاً في الجدول، مما يقحم عنصراً عشوائياً يخالف معايير الدقة العلمية. لحل هذه المعضلة حسمياً، يتعين وضع معايير ترجيحية إضافية تفك التعادل وفق أسس موضوعية واضحة:
- الاعتماد على الطابع الزمني المكتمل: استيراد البيانات مع أجزاء الوقت (hh:mm:ss) بدلاً من التاريخ المجرد.
- استخدام الرقم التسلسلي للمعاملة (Transaction ID): اعتماد رقم المعاملة الأكبر كمعيار فرز ترجيحي عند تساوي التواريخ؛ انطلاقاً من أن الرقم الأعلى يمثل الإدخال اللاحق في قاعدة البيانات.
- الترجيح المالي أو الإجرائي: اعتماد السجل الذي يحتوي على القيمة التشغيلية الأعلى، أو السجل الأخير المعتمد من قبل المراجعة البشرية، وتوثيق هذا المعيار الترجيحي بدقة ضمن سجلات المنهجية.
9.3 أخطاء مراجع النطاقات وتأثيرها على المعادلات الحسابية
تتولد جملة من الأخطاء الحسابية الشائعة عند تطبيق الدوال المتقدمة نتيجة إغفال القواعد المنطقية للتعامل مع النطاقات. يبرز الخطأ #SPILL! بحدة عند استخدام دالة UNIQUE أو دوال المصفوفات الانسكابية، ويشير بشكل قاطع إلى وجود بيانات أو نصوص أو حتى مسافات فارغة تعترض المسار الفيزيائي للخلايا التي تحتاجها المصفوفة للانسكاب إلى الأسفل. يتم تصحيح هذا الخطأ فوراً عبر تفريغ النطاق المقابل للصيغة بالكامل للسماح للنتائج بالظهور بحرية.
من الأخطاء الكلاسيكية أيضاً ظهور رسالة #N/A عند استدعاء دالتي XLOOKUP أو MATCH، وتعود هذه المشكلة غالباً إلى تباين المسافات الخفية بين القيمة المستخرجة وقيم الجدول الأصلي، أو نتيجة إغفال تثبيت مراجع النطاقات بعلامة الدولار ($) عند استخدام النطاقات العادية وسحب الصيغ رأسياً. يؤدي غياب التثبيت إلى انزياح نطاق البحث خلية واحدة إلى الأسفل مع كل صف، مما يُخرج السجلات العليا من حيز التقييم ويقود إلى فشل التطابق وظهور أخطاء الانقطاع المرجعي.
10. المفاضلة المعيارية بين المنهجيات ومعايير اختيار الحل الأمثل
10.1 معيار حجم البيانات ومتطلبات الأداء الحاسوبي
تتفاوت المنهجيات المعروضة تفاوتاً جوهرياً في استهلاكها لموارد المعالج (CPU) والذاكرة العشوائية (RAM)، مما يفرض على المحلل اختيار الأداة المتوافقة مع حجم البيانات المتاحة. في الجداول الصغيرة التي لا تتعدى بضعة آلاف من الصفوف، توفر كافة الحلول أداءً متقارباً وسلساً، ولا يشعر المستخدم بأي فارق في السرعة سواء اختار الفرز اليدوي، أو المعادلات المصفوفية، أو الأكواد البرمجية.
لكن الصورة تختلف جذرياً عند تخطي عتبة مئات الآلاف من الصفوف؛ حيث تصبح المعادلات الحسابية المركبة مثل MAXIFS المدمجة مع XLOOKUP عبئاً حوسبياً كبيراً يؤدي إلى تجمد البرنامج وتكرار إعادة الحساب الثقيلة عند كل نقرة في المستند. في هذه المصفوفات الضخمة، يُعد محرر الاستعلامات Power Query هو الحل المتفوق حوسبياً؛ بفضل اعتماده على محرك بيانات متطور يقوم بضغط البيانات ومعالجتها خارج مصفوفة الخلايا العادية بكفاءة استثنائية تمنع انهيار النظام.
كما تتميز لغة VBA بقدرات فائقة في التعامل مع المصفوفات في الذاكرة دون رسمها على الشاشة، مما يجعلها بديلاً فائق السرعة إذا كانت بيئة العمل تمنع استخدام Power Query أو تتطلب حلولاً مدمجة داخل مصنفات تقليدية محمولة.
10.2 معيار استمرارية وتكرار تدفق العمل (Workflow Automation)
يتحكم معيار تكرار العملية في تحديد الجدوى الاقتصادية والجهد المبذول لتطبيق الحل. إذا كانت مهمة تنقية البيانات تُنفذ لمرة واحدة فقط على أرشيف تاريخي ثابت لن يخضع للتحديث، فإن اللجوء إلى الفرز المزدوج التنازلي متبوعاً بأداة إزالة التكرارات الافتراضية يمثل الخيار الأكثر عقلانية؛ نظراً لسرعته وتوفيره لوقت كتابة المعادلات وبناء الاستعلامات.
أما إذا كانت البيانات تمثل دورة تدفق مستمرة (مثل السجلات اليومية للمبيعات، أو بيانات الاستطلاعات الطولية الأسبوعية، أو أنظمة الحضور والانصراف)، فإن استخدام أسلوب الحذف اليدوي يُعد خطأ تشغيلياً كبيراً يفتح الباب أمام الهفوات البشرية وهدر الساعات في إعادة الإجراءات ذاتها. في هذا السياق المتكرر، تصبح الحلول الديناميكية—وعلى رأسها Power Query—أمراً إلزامياً؛ إذ تتيح ميكنة مسار التنقية بالكامل واختزاله في عملية تحديث دورية بضغطة زر واحدة.
يتيح الجدول التالي مقارنة معيارية شاملة بين المنهجيات المختلفة لمساعدة المستخدم في تحديد الخيار الأنسب لبيئة عمله:
| المنهجية المتبعة | طبيعة المعالجة | الكفاءة مع البيانات الضخمة | سهولة الأتمتة والتحديث | المهارة المطلوبة للمستخدم | السياق الأنسب للاستخدام |
|---|---|---|---|---|---|
| الفرز المزدوج + إزالة التكرارات | تدميرية (تحذف السجلات الأصلية) | متوسطة إلى منخفضة | معدومة (تتطلب إعادة الإجراء يدوياً) | مبتدئ | المهام العرضية السريعة لمرة واحدة على ملفات ثابتة. |
| المعادلات الديناميكية (UNIQUE + MAX) | غير تدميرية (استخلاص في نطاق مستقل) | منخفضة (تبطئ الملف في الحجوم الكبيرة) | تلقائية ولحظية عند إدخال بيانات جديدة | متوسط إلى متقدم | التحليلات المرنة والتقارير اليومية ذات الأحجام الصغيرة والمتوسطة. |
| محرر الاستعلامات (Power Query) | غير تدميرية (فصل تام بين المصدر والمخرج) | عالية جداً (ضغط بيانات ومعالجة مستقلة) | فائقة (تحديث بنقرة واحدة بمجرد تغير المصدر) | متوسط | خطوط أنابيب البيانات المؤسسية، والبحوث الطولية، والملفات الضخمة. |
| البرمجة بلغة VBA والقاموس | قابلة للتشكيل (تدميرية أو استخلاصية) | عالية جداً عند استخدام مصفوفات الذاكرة | عالية (تشغيل بضغطة زر أو بأحداث تلقائية) | خبير برمجيات | الأنظمة المؤتمتة بالكامل ودمج المهام المعقدة في بيئات العمل القديمة. |
| الجداول المحورية (Pivot Tables) | استعراضية (تلخيص لا يمس المصدر) | عالية | سهلة بنقرة تحديث واحدة | مبتدئ إلى متوسط | التدقيق الإداري السريع وتوليد لوحات المعلومات التلخيصية. |
10.3 إرشادات حوكمة البيانات وتوثيق إجراءات التطهير
تفرض حوكمة البيانات المؤسسية والنزاهة العلمية في النشر الأكاديمي الامتثال لمجموعة من القواعد الصارمة التي تتجاوز مجرد الحصول على مخرجات نظيفة؛ إذ تركز على موثوقية وقابلية مراجعة العمليات الحسابية (Auditability). يجب أن تشتمل كل مؤسسة أو فريق بحثي على دليل سياسات واضح يحدد معايير استبقاء وحذف السجلات المقيدة زمنياً بدقة لا تقبل اللبس.
يتعين تسجيل كافة القواعد والافتراضات المعتمدة أثناء التطهير—مثل معالجة حالات التعادل، وكيفية التعامل مع القيم المفقودة، والصيغ البرمجية المستخدمة—ضمن كتيب توثيقي أو مستند مرفق بملف التحليل. يتيح هذا التوثيق للمدققين الداخليين والمراجعين الخارجيين تتبع سلسلة التغييرات التي طرأت على البيانات الخام وصولاً إلى المصفوفة المنقحة النهائية، مما يمنع الشكوك المنهجية التي قد تحيط بموثوقية الاستنتاجات الإحصائية.
وأخيراً، يُوصى ببناء لوحات تحكم مرجعية (Audit Dashboards) تتضمن مؤشرات وصفية سريعة؛ مثل إجمالي عدد الصفوف الأصلية، وعدد السجلات المكررة المستبعدة، وعدد القيود المتبقية، وتاريخ آخر عملية تنظيف جرت على الملف. يضمن هذا الإطار الرقابي بقاء مصفوفة البيانات في أعلى درجات الاتساق والجاهزية، ويدعم التحول الرقمي الرصين القائم على استدامة المنهجيات وجودة القرارات المستندة إلى البيانات المحدثة.
خاتمة
إن إزالة التكرارات مع الاحتفاظ بالصف الحائز على أحدث تاريخ في برنامج إكسل تتجاوز كونها مجرد نقرة زر تقليدية، لتشكل مساراً تحليلياً متكاملاً يتطلب وعياً عميقاً بآليات إدارة البيانات والتمثيل الرقمي للزمن. لقد بيّن هذا الدليل الشامل أن الاعتماد الأعمى على الأداة الافتراضية لإزالة التكرارات دون فرز مسبق يقود إلى عواقب وخيمة تتمثل في فقدان أحدث السجلات وتشويه التحليلات التراكمية، في حين يتيح الفرز المزدوج استغلال ميكانيكية الأداة بكفاءة للمهام العرضية السريعة.
ومع تطور أدوات إكسل الحديثة، فتحت الدوال الانسكابية ومحرر الاستعلامات Power Query آفاقاً غير مسبوقة لبناء خطوط أنابيب تنقية غير تدميرية، تحافظ على حرمة البيانات الأصلية وتضمن التحديث الآلي والمستدام لمجموعات البيانات المعقدة بكفاءة حسابية متناهية. إن اختيار المنهجية المثلى يظل رهناً بمتطلبات المشروع، وحجم البيانات، ومدى الحاجة إلى أتمتة الإجراءات؛ إلا أن الثابت المنهجي الوحيد يكمن في ضرورة الالتزام بقواعد حوكمة البيانات وتوثيق كافة خطوات المعالجة، لضمان أعلى معايير الشفافية والموثوقية في المخرجات التحليلية والبحثية.
المراجع
- Blair, B. J., & Mahoney, P. J. (2021). Creating Single-Subject Research Design Graphs with Google Applications. Behavior Analysis in Practice. https://doi.org/10.1007/s40617-021-00604-5
- Kaplan, D. M., Rentscher, K. E., Lim, M., Reyes, R., Keating, D., Romero, J., et al. (2020). Best practices for Electronically Activated Recorder (EAR) research: A practical guide to coding and processing EAR data. Behavior Research Methods. https://doi.org/10.3758/s13428-019-01333-y