
تُعد معالجة البيانات داخل برمجيات الجداول الحسابية، وفي مقدمتها برنامج ميكروسوفت إكسل (Microsoft Excel)، حجر الزاوية في اتخاذ القرارات الإدارية، وإجراء التحليلات الإحصائية، وبناء النماذج المالية والبحثية الدقيقة. منذ اللحظة الأولى التي وضع فيها دان بريكلين (Dan Bricklin) وبوب فرانكستون (Bob Frankston) اللبنات الأولى للجداول الحسابية عبر برنامج فيزيكالك (VisiCalc) في عام 1979، مروراً بنقلة لوتس 1-2-3 (Lotus 1-2-3) عام 1983، وصولاً إلى إطلاق ميكروسوفت إكسل لأجهزة ماكنتوش عام 1985 وأنظمة ويندوز عام 1987، تأسست الحوسبة الجدولية على مبدأ جوهري مستعار من نظرية قواعد البيانات العلائقية: السطر يمثل كياناً واحداً متكاملاً يُعرف بـ “السجل” (Record أو Tuple)، بينما تمثل الأعمدة سمات (Attributes) هذا الكيان. هذا التماسك البنيوي ليس مجرد تفضيل تنسيقي، بل هو الضامن الوحيد لمصداقية البيانات وحفظ علاقاتها المنطقية.
وعلى الرغم من البديهية الظاهرية لعملية “الفرز الأبجدي” (Alphabetical Sorting)، إلا أنها تمثل إحدى أخطر العمليات الحسابية والتشغيلية التي قد يمارسها المستخدم على الإطلاق. إن خطأً إجرائياً بسيطاً لا يتعدى ضغطة زر واحدة غير مدروسة قد يؤدي إلى فصل أسماء الأفراد عن درجاتهم الأكاديمية، أو فصل العملاء عن أرصدتهم البنكية، أو فصل المرضى عن جرعاتهم الدوائية في التجارب السريرية. هذا الفصام البياني يحول الجداول من أدوات لاتخاذ القرارات الرشيدة إلى مصادر للتضليل الكارثي؛ والسبب المباشر وراء ذلك هو الفرز الرأسي المعزول لعمود واحد دون تحريك بقية عناصر الصف المترابطة معه، وهو ما يُعرف في الأدبيات التقنية بانهيار “تكامل الصفوف” (Row Integrity).
يتناول هذا البحث الاستقصائي والدليل المرجعي الشامل الأبعاد النظرية والتقنية والتشغيلية لكيفية تنفيذ الفرز الأبجدي في برنامج إكسل مع الحفاظ التام والصارم على ترابط الصفوف ووحدتها البنيوية. سنستكشف الآليات الخوارزمية التي يعتمد عليها البرنامج في تحديد “الكتلة النشطة”، وسنقارن بين خيارات المعالجة اليدوية والأدوات المتقدمة كالجداول الرسمية، وصولاً إلى الدوال المصفوفية الديناميكية الحديثة. إن الهدف الأساسي ليس مجرد شرح الخطوات، بل تأصيل الفهم البرمجي لدى المحلل لضمان استدامة البيانات وحمايتها من التفكك عبر معايير عمل صارمة وغير قابلة للخلل.
1. مقدمة تأصيلية لمفهوم فرز البيانات وسلامة السجلات في برنامج إكسل
1.1 أهمية الفرز المنهجي في البيئات البحثية والتحليلية
في البيئات الأكاديمية والبحثية المتقدمة، لا يقتصر دور التنظيم الأبجدي على إضفاء المظهر التنسيقي المنمق، بل هو أداة استرجاع معرفي أساسية تقلل العبء الإدراكي (Cognitive Load) الواقع على عاتق الباحث أثناء تفحص مصفوفات البيانات الكبيرة (Big Data Matrices). عندما يتم ترتيب الكيانات أبجدياً بطريقة منهجية، ينخفض الوقت المستغرق في التدقيق البصري والتحقق اليدوي بنسب تتجاوز المعدلات العشوائية بأضعاف، مما يسمح بالتركيز على التفسير الإحصائي بدلاً من التيه في فوضى الصفوف المبعثرة. إن الفرز المنطقي يُسهل المقارنات التقاطعية الفورية بين الفئات المستقلة ويمنح المراجع الخارجي ثقة في رصانة الجمع الميداني.
علاوة على ذلك، يرتبط مفهوم سلامة البيانات (Data Integrity) بمصداقية التقارير العلمية ارتباطاً وجودياً. فأي خطأ في بنية السجلات يؤدي مباشرة إلى تحيز منهجي (Systematic Bias) في النتائج، وهو ما ينسف إمكانية تكرار التجربة (Replicability) وتعميم نتائجها. تُعد برمجيات الجداول الحسابية بيئة عمل قائمة على فرضية “الوحدة المعلوماتية المتكاملة”، حيث يُفترض أن كل صف أفقي يمثل حالة دراسية فريدة أو مفحوصاً واحداً أو معاملة مالية معزولة بذاتها، بحيث تشكل خلايا هذا الصف نسيجاً متماسكاً لا يجوز التلاعب بمواقعه النسبية دون تحريك الكل المركب معاً.
إن إدراك هذه الفلسفة يغير النظرة إلى ورقة العمل من كونها مجرد شبكة ثنائية الأبعاد (2D Grid) من الخلايا المستقلة إلى اعتبارها قاعدة بيانات علائقية مبسطة (Flat Database). في هذا السياق، يصبح الفرز عملية إعادة تموضع مكانية لجميع السمات بالتوازي، للحفاظ على الرابط السببي والوصفي بين المتغير المستقل (مثل اسم الشخص) والمتغيرات التابعة (مثل النتائج، القياسات، التواريخ، والملاحظات الإكلينيكية والتشخيصية المرافقة).
1.2 الفارق الجوهري بين فرز الخلايا الفردية وفرز السجلات المترابطة
يكمن الخلط التشغيلي الأكثر شيوعاً في إكسل في عدم التمييز بين معالجة متجه عمودي منفرد (Single Vector Sorting) وإعادة ترتيب مصفوفة كاملة متعددة المتغيرات (Matrix Sorting). عند عزل عمود محدد وتطبيق أمر الترتيب الأبجدي عليه بمعزل عن محيطه، فإن الخوارزمية البرمجية تقوم بتبديل المؤشرات الرأسية لقيم ذلك العمود فقط داخل الذاكرة العشوائية، متجاهلة تماماً الإحداثيات الأفقية للخلايا المجاورة. هذه العملية، وإن بدت ناجحة ظاهرياً داخل حدود العمود المستهدف، إلا أنها تسفر عن تدمير فوري وشامل لشبكة العلاقات المتقاطعة التي تربط المتغيرات ببعضها البعض داخل السجل الواحد.
يُعرَّف السجل (Record) في علم البيانات بأنه متتالية أفقية غير قابلة للتجزئة من البيانات غير المتجانسة نوعياً، والتي تصف كياناً محدداً. فالاسم (قيمة نصية)، والعمر (قيمة عددية)، وتاريخ الالتحاق (قيمة زمنية)، والمستوى الوظيفي (قيمة فئوية) تتكاتف معاً لتشكيل الحقيقة الرياضية لذلك الكيان. إن استقلالية العمود الفردي لا توجد إلا على مستوى التعريف العام للمتغير (Variable Definition)، أما على مستوى التنفيذ والتحليل، فإن وظيفته تكاملية ضمن النطاق الكلي، ولا تكتسب القيمة الفردية معناها إلا بتموضعها في نفس الصف مع بقية سماتها الخاصة بها.
عندما يفقد المحلل هذا التمييز، فإنه يعامل إكسل كلوحة رسم رقمية بدلاً من محرك معالجة منطقي. إن الفرز الرأسي المعزول هو عملياً فصل للرأس عن الجسد في الكيان المعلوماتي؛ حيث تصبح القيمة الرقمية في الصف الرابع، على سبيل المثال، منسوبة للاسم الجديد الذي صعد إلى هذا الصف نتيجة الفرز، بينما كان ينبغي أن تظل تابعة لصاحبها الأصلي الذي هبط إلى الصف العاشر أو الخمسين، مما يولد اختلالاً بنيوياً لا يمكن معالجته بمجرد النظر.
1.3 المخاطر التحليلية المترتبة على تفكك الصفوف
تتجاوز خطورة تفكك الصفوف الجانب النظري لتصل إلى عواقب مدمرة في الواقع العملي وصنع القرارات. ففي البيئات الطبية والدوائية، قد يؤدي انفصال أسماء المرضى عن عينات الدم أو الجرعات الموصوفة إلى إعطاء نتائج مضللة حول فعالية دواء معين، أو حتى إرسال تقارير علاجية كارثية. وفي القطاع المالي والمحاسبي، يتسبب الفرز الخاطئ في إسناد رواتب أو التزامات ضريبية أو أرصدة دائنة إلى حسابات عملاء آخرين، مما يعرض المؤسسة لخسائر فادحة وعقوبات قانونية صارمة نتيجة التلاعب غير المقصود بالسجلات المالية الموثوقة.
وتتعاظم هذه الكارثة بسبب الطبيعة “الصامتة” لهذا الخطأ؛ فالبيانات المشوهة الناتجة عن فرز عمود واحد دون بقية الصفوف لا تصدر رسائل خطأ برمجية صريحة مثل خطأ الدالة الشهير #REF! أو #VALUE!. تظل الأرقام والأسماء متواجدة بصرياً في خلاياها بشكل يبدو طبيعياً تماماً، ولا يلحظ غير المتمرس أي تشوه، خاصة في قواعد البيانات التي تتجاوز مئات أو آلاف الصفوف؛ حيث يستحيل التدقيق البصري اليدوي لكل حالة على حدة بمجرد انتهاء عملية الترتيب.
تترتب على هذا الخلل قرارات إدارية وبحثية استراتيجية مبنية على مقدمات خاطئة تماماً. فالموظف ذو الأداء المنخفض قد يُكافأ بسبب صعود درجات زميله المتفوق إلى صفه، والباحث الأكاديمي قد يرفض فرضية علمية صحيحة بسبب تشتت الارتباط الإحصائي بين المتغير المستقل والتابع إثر التفكك. إن فقدان “تكامل الصف” هو في حقيقته إعدام للقيمة التحليلية للمشروع بأكمله، وإهدار لكل الجهود المبذولة في مراحل الجمع والرصد والترميز الميداني الأولي.
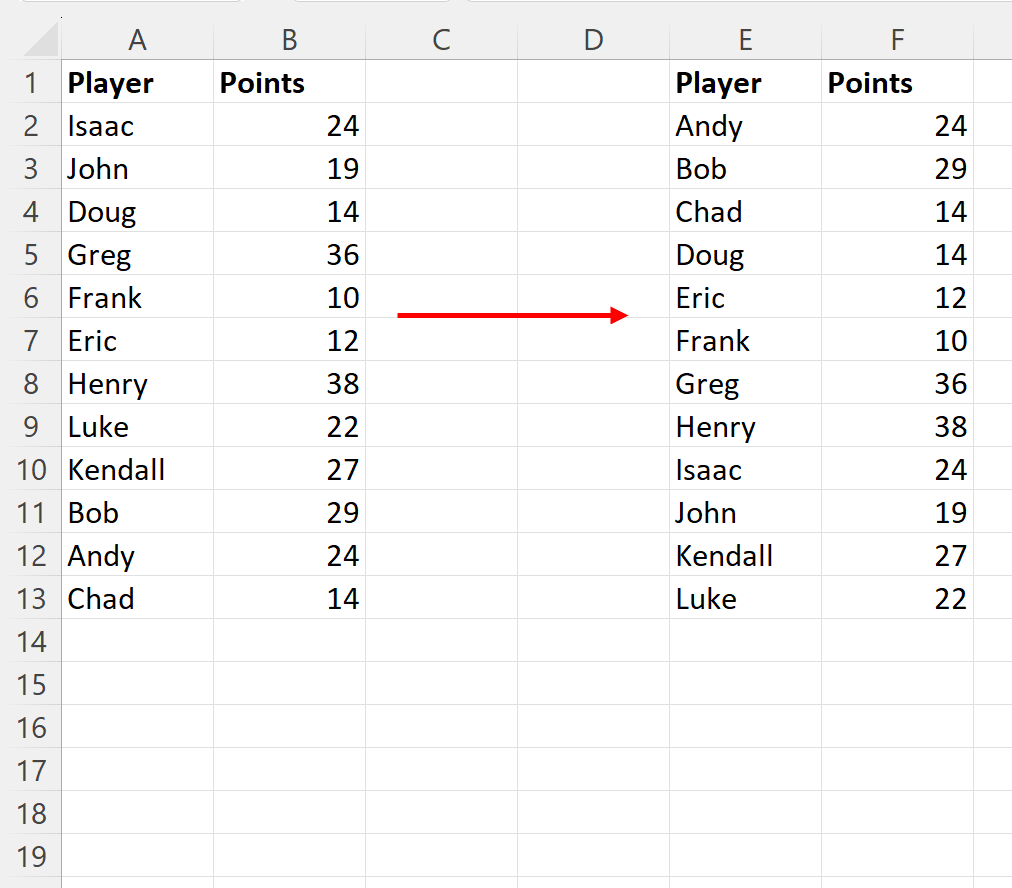
2. البنية الهيكلية لبيانات إكسل ومفهوم تكامل الصفوف (Row Integrity)
2.1 طبيعة العلاقات الأفقية والرأسية داخل جداول إكسل
تعتمد برمجية مايكروسوفت إكسل في معالجتها للملفات على بنية برمجية مبنية على الجداول المسطحة (Flat-File Structure)، حيث تتحدد هوية كل خلية عبر تقاطع إحداثي حرفي يمثل العمود وإحداثي رقمي يمثل الصف. ومع ذلك، فإن إكسل في جوهره التخزيني يتعامل مع هذه الخلايا كمصفوفة ثنائية الأبعاد (2D Array). في هذا الفضاء الرياضي، تكون العلاقة الرأسية بين خلايا العمود الواحد علاقة “تجانس نوعي”، أي اشتراك في طبيعة المتغير المقاس (كأن يكون العمود كله رواتب، أو أوزان، أو أسماء)، بينما تكون العلاقة الأفقية علاقة “تكامل كياني”، أي ارتباط وثيق يجمع قياسات متعددة لكائن مفرد في نقطة زمنية محددة.
غالباً ما يشتمل كل صف على ما يسمى في هندسة البيانات بـ “المفتاح الأساسي” (Primary Key)؛ وهو المعرف الفريد الذي يميز السجل عن غيره، كالرقم الجامعي للطالب، أو الرقم القومي للمواطن، أو الرمز الوظيفي للعامل. ترتبط بقية القيم الموجودة في نفس الصف (السمات المرافقة) بهذا المفتاح ارتباطاً تابعاً وثيقاً. إن الهيكلة السليمة للجداول تتطلب الاعتراف بهذا المفتاح كمرساة يرتكز عليها الصف بالكامل؛ فعندما يتغير الموضع المادي للمفتاح داخل الجدول، يجب بالضرورة الحتمية أن تنتقل جميع السمات التابعة له إلى الموضع الجديد، للمحافظة على التوازن الحسابي والعلاقة المنطقية داخل النموذج البياني بأكمله.
يساعد فهم هذه الهندسة على تحسين الأداء الاستعلامي واستخدام أدوات التحليل المتقدمة مثل الجداول المحورية (Pivot Tables) وعمليات الربط البرمجي. إن أي كسر في توازي هذه المصفوفة يحول البيانات من نمط متسق وقابل للمعالجة الآلية إلى كتلة غير متجانسة من المعلومات غير القابلة للاستخدام، حيث تفقد أدوات التجميع والدوال الرياضية قدرتها على تقديم مخرجات صادقة وذات دلالة إحصائية صحيحة ومعتبرة علمياً.
2.2 محددات النطاق المترابط في إدراك بيئة إكسل البرمجية
لكي يتمكن إكسل من تنفيذ العمليات التلقائية دون الحاجة إلى تدخل برمجي معقد، تعتمد خوارزمياته الداخلية على مفهوم يُسمى في كود البرمجة النصية (VBA) بـ “المنطقة النشطة” أو النطاق المترابط (Current Region). هذه الخاصية البرمجية تعني قدرة إكسل على استكشاف حدود الكتلة البيانية وتحديد أبعادها من خلال تتبع الخلايا الممتلئة المتصلة ببعضها أفقياً ورأسياً، حتى تصطدم هذه الخوارزمية بحدود بيضاء تتألف من صفوف فارغة تماماً وأعمدة فارغة تماماً، فتعتبر تلك الحدود نهاية الجدول.
تكمن المعضلة التشغيلية الكبرى هنا في وجود صفوف فارغة بالكامل (Completely Blank Rows) أو أعمدة فارغة تماماً داخل الجدول بدون قصد. إن هذه الفواصل الفارغة تؤدي وظيفة “حائط الصد الخوارزمي”؛ حيث تفصل البيانات المترابطة ظاهرياً إلى جزر معزولة برمجياً. فعندما يطلب المستخدم فرز النطاق استناداً إلى خلية في الجزء العلوي، يتعرف إكسل على حدود الكتلة حتى الصف الفارغ فقط، ويهمل النصف السفلي من الجدول إهمالاً تاماً، مما يترتب عليه فرز شطر من البيانات وبقاء الشطر الآخر ساكناً، وهو ما يدمر وحدة السجلات بالكامل.
تتطلب استراتيجيات التوحيد البنيوي للجدول ضمان استمرارية تدفق الخلايا؛ فالفراغ المسموح به هو الفراغ داخل الخلية المفردة كقيمة مفقودة (Missing Value) ضمن سجل موجود، وليس الفراغ الهيكلي الكامل لصف أو عمود يفصل مكونات المصفوفة. يوضح ذلك ضرورة إجراء مسح منهجي واستكشاف استمرارية النطاق قبل إصدار أي أمر يتعلق بإعادة ترتيب أو فرز البيانات، تجنباً لتقسيم الكيان المعلوماتي الواحد دون دراية كافية من المحلل المعني.
2.3 أهمية رؤوس الأعمدة (Headers) في الحفاظ على دقة المعالجة
تحتل رؤوس الأعمدة مكانة مفصلية في إدارة البيانات داخل إكسل، إذ تمثل البيانات الوصفية (Metadata) التي تمنح الأرقام والنصوص دلالاتها المنهجية. يتكون الصف الرأسي الأول من تسميات واضحة ومحددة تميز طبيعة كل متغير؛ ولذلك، يجب أن تكون بنية هذا الصف متمايزة هيكلياً وبصرياً عن صفوف السجلات الفعلية (Data Rows). يوفر إكسل خوارزمية ذكية لاكتشاف الرؤوس تلقائياً، مستندة إلى اختلاف التنسيق، مثل تطبيق النمط العريض (Bold)، أو استخدام لون تعبئة مختلف، أو وجود نصوص في الرؤوس تعلو أعمدة تتكون حصراً من بيانات رقمية.
إذا فشل البرنامج في التعرف على صف الرأس ككيان وصفي مستقل، أو إذا قام المستخدم بإلغاء تفعيل خيار “تتضمن بياناتي رؤوساً” (My data has headers) داخل مربعات الحوار، فإن البرنامج سيتعامل مع هذه التسميات الوصفية كقيم عادية ضمن مصفوفة الفرز. ونتيجة لذلك، سيتم سحب عنوان العمود—مثل كلمة “الاسم” أو “المعدل التراكمي”—إلى قلب الجدول ليحتل موضعاً أبجدياً بين الأسماء أو البيانات الرقمية، مما يتسبب في إرباك بنيوي للجدول وفقدان دلالة العمود من الأساس.
يضمن التعريف الدقيق لرؤوس الأعمدة أيضاً وضوح القوائم المنسدلة في نوافذ الفرز المتقدم والتصفية؛ فبدلاً من إظهار التسميات الافتراضية المبهمة مثل (Column A, Column B)، ستظهر العناوين التوضيحية الصريحة للباحث. هذا التحديد يقلل احتمالية الخطأ البشري عند اختيار عمود الترتيب الأساسي، ويضمن بقاء الصف الوصفي ثابتاً في موقعه العلوي الاستراتيجي ليؤدي وظيفته الإرشادية لجميع المستخدمين والمحللين دون أي تشويه يمس بنية قاعدة البيانات.
3. الدليل الإجرائي المعياري: الفرز الأبجدي مع تثبيت ترابط الصفوف
3.1 تحديد النطاق المستهدف والملاحظات الاحترازية
يبدأ الإجراء المعياري لحماية تكامل الصفوف من مرحلة التهيئة الفنية للنطاق المراد فرزه. القاعدة الذهبية التي يوصي بها خبراء إدارة البيانات في بيئات العمل التحليلية هي تفادي التحديد الجزئي للعمود عبر النقر على حرفه الرأسي كاملاً (مثل النقر على رأس العمود A)، لأن هذا الإجراء يوجه إشارة برمجية أولية لإكسل بأن المستخدم يرغب في عزل هذا المتغير عن سياقه الكلي. بدلاً من ذلك، فإن الممارسة الأكثر أماناً واحترافية هي النقر على خلية مفردة فقط تقع داخل عمود الفرز المرغوب وتندرج ضمن نطاق الجدول المتصل.
قبل الشروع في المعالجة، يتعين على المحلل فحص البيئة المحيطة بالنطاق للتأكد من عدم وجود بيانات ملحقة أو ملاحظات جانبية غير منتمية للجدول ملتصقة به بشكل مباشر دون عمود فاصل؛ لأن خوارزمية إكسل ستدمجها قسراً ضمن عملية الفرز إذا كانت متصلة مكانياً. يجب فحص كافة الجوانب الأربعة للكتلة البيانية والتحقق من أن الجدول معزول عن أي حواشي سفلية أو مجاميع نهائية (Grand Totals)؛ إذ إن إدراج صف المجموع الكلي ضمن الفرز الأبجدي سيؤدي حتماً إلى صعوده لأعلى أو هبوطه لأسفل بحسب ترتيبه الهجائي، مفسداً بنية العمل الحسابية.
إذا رغب المحلل في تحديد النطاق يدوياً بدلاً من الاعتماد على الاستكشاف التلقائي للبرنامج، فيتعين عليه تظليل كامل مصفوفة البيانات، بما في ذلك جميع الأعمدة التابعة ورؤوسها، بدءاً من الخلية الأولى في الزاوية اليمنى أو اليسرى العليا حتى آخر خلية مأهولة في الزاوية المقابلة، باستخدام اختصارات لوحة المفاتيح المعيارية مثل Ctrl + Shift + End أو Ctrl + * (أو Ctrl + A داخل الكتلة) لضمان عدم إغفال أي عمود فرعي في أقصى أطراف الجدول.
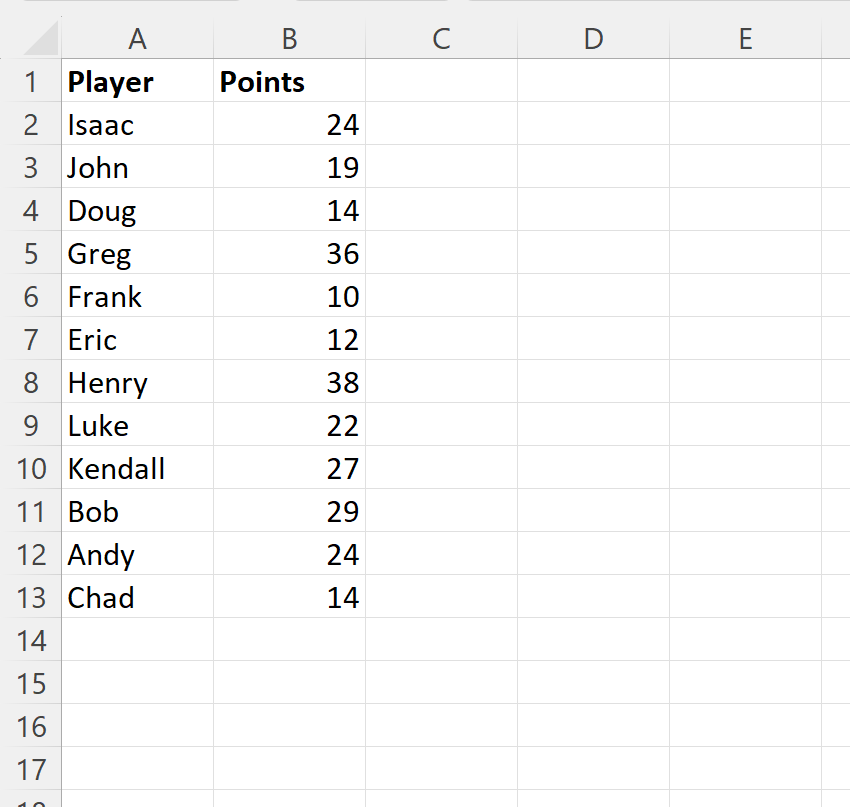
3.2 استخدام أدوات التبويب ‘بيانات’ (Data Tab)
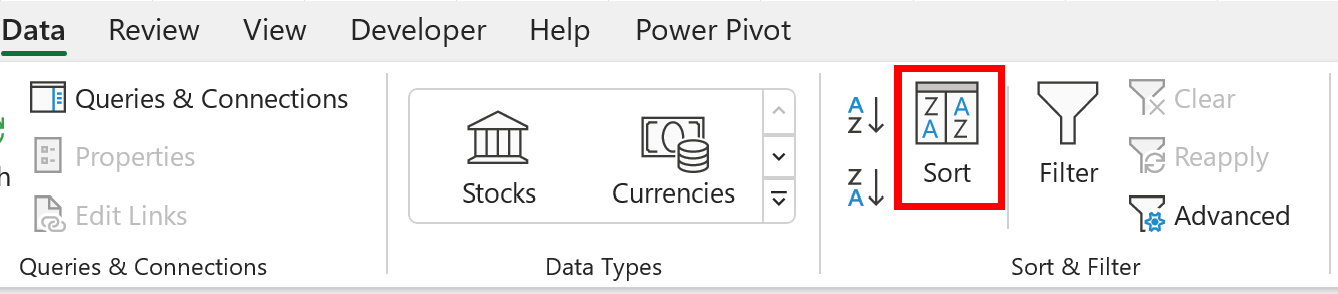
يوفر شريط الأدوات (Ribbon) في إكسل مسارات متعددة لتنفيذ أوامر الترتيب، إلا أن الاعتماد على التبويب المخصص “بيانات” (Data Tab) يمثل المنهجية التشغيلية الأكثر رصانة وانضباطاً. ضمن هذا التبويب، تستقر مجموعة أدوات “الفرز والتصفية” (Sort & Filter)، والتي تحتوي على الأيقونات المباشرة للترتيب السريع: أيقونة (A-Z) للفرز التصاعدي، وأيقونة (Z-A) للفرز التنازلي، بالإضافة إلى الزر المركزي الموسع المعنون بـ “فرز” (Sort)، والذي يفتح النافذة الحوارية متعددة الوظائف.
في الجداول البسيطة والمتصلة تماماً، يمكن استخدام أدوات الفرز السريع (A-Z أو Z-A) شريطة وضع المؤشر في خلية واحدة داخل العمود المفتاحي؛ حيث يقوم إكسل في هذه الحالة تلقائياً بنقل كامل السجلات المجاورة بما يحفظ تماسك الصفوف. ومع ذلك، في النماذج الإحصائية المعقدة أو التقارير المالية المتشابكة، يُفضل الابتعاد عن الأيقونات السريعة، وتوجيه مسار المعالجة حصراً عبر زر “فرز” المخصص (Sort Dialog Box)، لكونه يمنح المستخدم رؤية شمولية لكافة المعلمات، ويتيح التحقق الصريح من معايير المعالجة والتأكد من شمول كافة الأعمدة التابعة قبل إطلاق أمر التنفيذ المادي.
يتيح استخدام نافذة الفرز المخصصة التحكم في خيارات الأمان الداعمة، مثل التأكد من عدم تجاهل التنسيقات المكانية، ومعاينة المعايير المتعددة. هذا النهج يقلل بصورة جذرية احتمالات الأخطاء الناتجة عن التسرع، ويوفر بيئة خاضعة للمراقبة الإجرائية الواعية، تضمن التزام كل عنصر في المصفوفة بقواعد الانتقال الأفقي المتزامن.
3.3 التعامل المنهجي مع نافذة تحذير الفرز (Sort Warning)
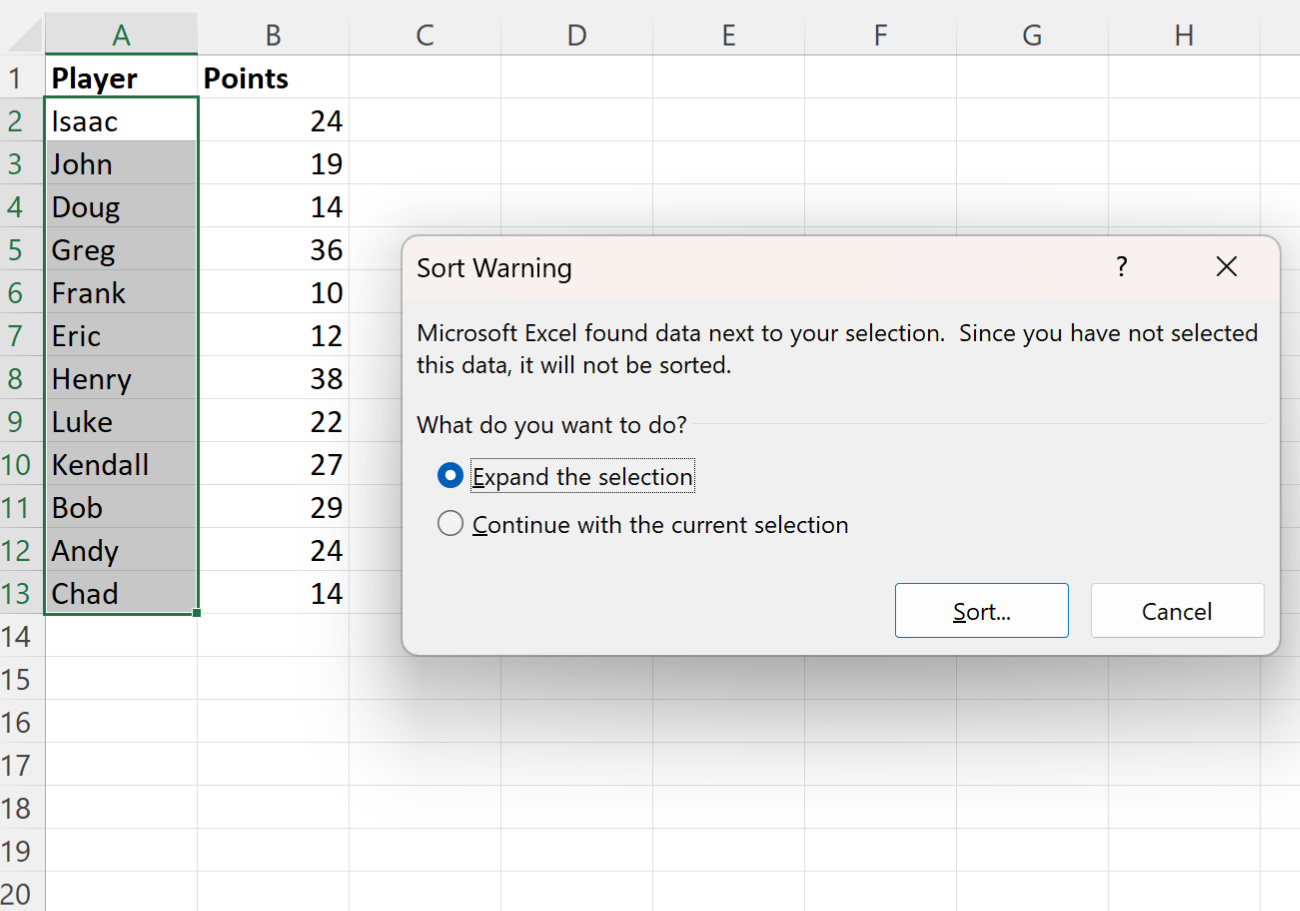
في الحالات التي يقوم فيها المستخدم بتظليل خلايا عمود واحد فقط داخل جدول يحتوي على أعمدة أخرى متلاصقة ثم ينقر على أمر الفرز، يتدخل نظام الأمان الداخلي في إكسل مطلقاً رسالة تحذيرية محورية تُعرف باسم “تحذير الفرز” (Sort Warning). تمثل هذه النافذة خط الدفاع الأخير لحماية تكاملية الصفوف، وهي مبرمجة لترصد السلوك البشري المحفوف بالمخاطر والذي يهدد بفصل البيانات عن سياقها الأصلي.
تنص الرسالة التحذيرية صراحة على اكتشاف بيانات مجاورة للتحديد لم يتم شمولها، وتضع أمام المستخدم خيارين متعارضين تماماً في المسار الهندسي:
- توسيع التحديد (Expand the selection): وهو الخيار الافتراضي والإلزامي للحفاظ على الصفوف؛ حيث يُصدر أمراً للخوارزمية بضم كافة الأعمدة المتاخمة أفقياً للخلية المستهدفة ضمن نطاق الحركة، مما يضمن تحرك الصف بكامل أجزائه كوحدة مصفوفية واحدة متماسكة.
- المتابعة بالتحديد الحالي (Continue with the current selection): وهو خيار عالي الخطورة يؤدي إلى فرز العمود المظلل حصراً، تاركاً بقية الأعمدة في أماكنها الأصلية، وهو المسبب المباشر لتشوه قواعد البيانات وفقدان العلاقات بين المتغيرات.
يجب على المحلل الحصيف ترسيخ قاعدة لا استثناء لها: عدم اختيار “المتابعة بالتحديد الحالي” إلا إذا كان العمود المعني يمثل قائمة معزولة تماماً لا علاقة رياضية أو منطقية تربطها بالخلايا المجاورة على الإطلاق. إن تفعيل خيار “توسيع التحديد” والنقر على زر “فرز” هو الإجراء الوحيد الذي يضمن انتقال كامل السجل التاريخي أو الفني لكل كائن إلى إحداثياته الجديدة في تناغم كامل ودون أي تفكك معلوماتي.
3.4 ضبط خيارات نافذة الفرز النهائية وتأكيد العملية
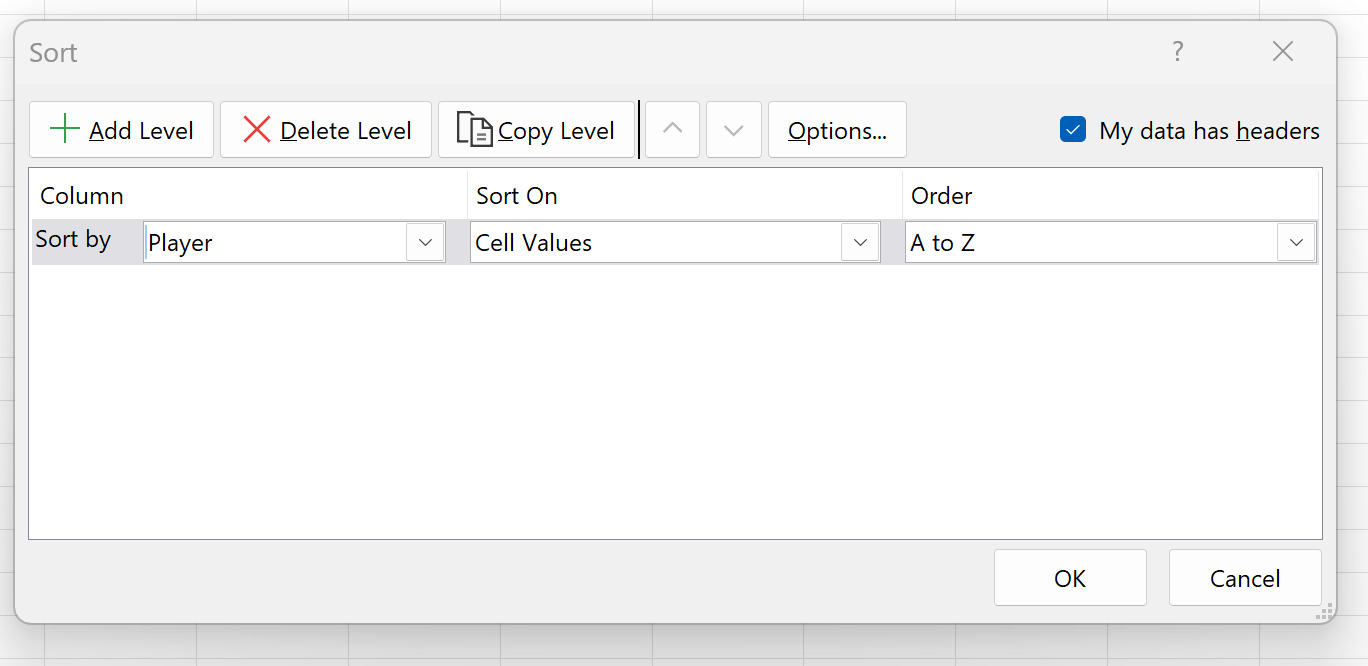
عند ولوج نافذة الفرز المخصصة، سواء عبر زر الفرز المباشر أو بعد اختيار “توسيع التحديد”، تبرز واجهة الضبط الدقيق التي تحسم معالم المعالجة. الخطوة الأولى المطلوبة منهجياً هي التحقق من تفعيل خانة الاختيار المسماة “تتضمن بياناتي رؤوساً” (My data has headers) في الزاوية العلوية؛ حيث يؤدي هذا الإجراء إلى حماية السطر الأول تلقائياً واستثناءه من حركة الترتيب، مع استبدال أسماء الأعمدة الأبجدية الافتراضية بالعناوين الدلالية الحقيقية للحقول المسجلة.
يلي ذلك الانتقال إلى القائمة المنسدلة “فرز حسب” (Sort by)؛ حيث يتعين على المستخدم تحديد العمود المفتاحي الذي سيقود عملية الترتيب الأبجدي بدقة متناهية (مثل اختيار عمود “اسم الموظف” أو “اسم الشركة”). بعد ذلك، يتم التحقق من قائمة “الفرز على” (Sort On)، والتي تُضبط في الغالبية الساحقة من الحالات على خيار “قيم الخلايا” (Cell Values)، لضمان الاعتماد على المحتوى النصي الفعلي وليس على ألوان الخطوط أو التنسيقات الشرطية، ما لم يكن هناك غرض تصنيفي محدد يتطلب خلاف ذلك.
أخيراً، يتم تحديد “الترتيب” (Order) باختيار النمط الهجائي المستهدف؛ إما تصاعدياً “من الألف إلى الياء” (A to Z) أو تنازلياً “من الياء إلى الألف” (Z to A). بمجرد النقر على زر “موافق” (OK)، ينفذ إكسل عملية إعادة الفهرسة الشاملة لجميع الصفوف بالتوازي. في هذه اللحظة، يتوجب على المحلل إجراء فحص ومطابقة بصرية سريعة للسجل الأول والسجل الأخير، للتأكد من أن الأرقام والسمات التابعة قد تحركت بالتزامن الكامل مع الأسماء المقترنة بها، بما يثبت رسوخ تكامل الصفوف ونجاح العملية الإجرائية.
4. التحليل التقني لخيار ‘توسيع التحديد’ مقابل ‘المتابعة بالتحديد الحالي’
4.1 الآلية الخوارزمية لخيار توسيع التحديد (Expand the Selection)
من الناحية البرمجية الداخلية، عندما يستقبل معالج إكسل الأمر المقترن بخيار “توسيع التحديد” (Expand the Selection)، فإنه يطلق فوراً استعلاماً هندسياً يماثل استدعاء الخاصية Range.CurrentRegion في بيئة التطوير المدمجة. تقوم هذه الخوارزمية بمسح محيط التحديد خطوة بخطوة في الاتجاهات الأربعة (أعلى، أسفل، يمين، يسار)، لتتبع حدود الخلايا غير الفارغة المتصلة بهيكلية الجدول. يتم تحديد النطاق المستهدف النهائي بوصفه مستطيلاً هندسياً شاملاً يضم كل حقول السجلات المترابطة.
بعد اكتمال بناء حدود المصفوفة، ينشئ البرنامج جدول مؤشرات افتراضي (Internal Index Map) داخل الذاكرة المؤقتة. يُحدد هذا الجدول الترتيب الهجائي الجديد لقيم العمود المستهدف بالفرز، ولكنه يربط كل قيمة بمؤشر الصف الكامل الخاص بها (Row Pointer). وبالتالي، عند تنفيذ خطوة التبديل (Swapping)، لا تتحرك الخلايا كقيم نصية مفردة، بل يتم نقل مؤشر الصف بالكامل بكل ما يحويه من مراجع نسبية وقيم نصية وثوابت رقمية وصيغ حسابية إلى الموضع الجديد، مما يضمن ثبات العلاقات الرياضية الأفقية وصمودها التام ضد التفكك.
وتحافظ هذه الآلية التوسعية على صحة المعادلات المبنية على مراجع نسبية داخل الصف ذاته؛ فإذا كان هناك عمود يحسب ناتج ضرب الكمية في السعر لنفس الصف (مثل =B2*C2)، فإن انتقال الصف الثاني إلى الموضع الخامس والعشرين يصاحبه تعديل داخلي تلقائي للمعادلة لتصبح (=B25*C25)، محافظة بذلك على دقة المخرجات التحليلية دون أي انقطاع في الروابط الحسابية المؤسسة للنموذج الرقمي.
4.2 التفكك الهيكلي الناتج عن خيار المتابعة بالتحديد الحالي
يمثل اختيار “المتابعة بالتحديد الحالي” (Continue with the current selection) التطبيق الحرفي لفرز المتجه المعزول، حيث تُعلق الخوارزمية كل آليات الاستشعار المكاني لبقية أعمدة الجدول. يُقصر إكسل عملياته في هذه الحالة على الخلايا المحددة يدوياً فقط، ويُجري عمليات التبديل والترتيب للأعلى وللأسفل داخل حدود هذا العمود الصارمة، بينما تظل كافة الأعمدة الأخرى في مواقعها الجغرافية الأصلية دون أدنى حركة، وكأنها منفصلة بنيوياً عن المتغير المستهدف.
لتوضيح الكارثة الناتجة عن هذا الخيار، يمكن تصور سيناريو أكاديمي واقعي: جدول يضم في العمود (A) أسماء الطلاب، وفي العمود (B) درجات الاختبار النهائي. إذا كان الطالب “أحمد” يحتل الصف الأول ودرجته 95، وكان الطالب “يوسف” في الصف الأخير ودرجته 50، فإن تطبيق خيار المتابعة بالتحديد الحالي على عمود الأسماء لترتيبها تصاعدياً سيبقي عمود الدرجات ساكناً. سيبقى الرقم 95 في الصف الأول والرقم 50 في الصف الأخير، ولكن بمجرد إعادة ترتيب الأسماء، قد يصعد اسم طالب آخر لا يستحق الدرجة إلى الصف الأول لينال 95، بينما قد يهبط اسم “أحمد” إلى موقع آخر ليحصل على درجة متدنية لا تخصه مطلقاً.
تمتد هذه التداعيات إلى تدمير التسلسل الزمني في قواعد البيانات التاريخية، حيث تنفصل التواريخ عن الأحداث المقترنة بها، مما يولد ارتباكاً يتعذر حله إحصائياً بعد فوات الأوان. إن أخطر ما في هذا التفكك الهيكلي هو عدم إمكانية تصحيحه آلياً بمجرد حفظ الملف وإغلاقه؛ حيث تختلط السجلات وتضيع نقطة الإسناد الأصلية إلى الأبد، مما يستلزم إعادة إدخال البيانات يدوياً من الوثائق الورقية أو المصادر الأولية الخام بتكلفة زمنية وجهد فادحين.
4.3 بروتوكول التراجع واستعادة النسق في حالات الخطأ الإجرائي
في حال ارتكاب خطأ إجرائي واختيار “المتابعة بالتحديد الحالي” دون قصد، فإن الخط الدفاعي الأول والفوري هو أمر “التراجع” (Undo) المتاح عبر الاختصار القياسي Ctrl + Z. يمتلك إكسل مكدساً تراجعياً (Undo Stack) يحتفظ بذاكرة التغييرات الأخيرة، مما يتيح إعادة المصفوفة إلى حالتها السابقة مباشرة قبل حركة الفرز الخاطئة. غير أن هذا الحل الفوري مشروط بعدم إغلاق الملف، وعدم تنفيذ عمليات حفظ لاحقة تعطل سجل التراجع، وكذلك عدم تنفيذ أوامر برمجية بلغة (VBA) تمسح ذاكرة التراجع بصورة نهائية وتلقائية فور تشغيلها.
أما إذا اكتُشف الخطأ بعد حفظ الملف أو بعد انقضاء جلسة العمل وانغلاق مسار التراجع البرمجي، فإن استعادة التماسك الأصلي تصبح شبه مستحيلة ما لم يكن المحلل قد اتخذ تدابير استباقية صارمة؛ يأتي في مقدمتها إنشاء “عمود فهرسة مرجعي” (Index Column). يُنشأ هذا العمود قبل مباشرة أي عملية فرز أو معالجة، ويُعبأ بتسلسل رقمي ثابت ومستمر (1، 2، 3، …) يمثل البصمة الترتيبية الأصلية لقاعدة البيانات الخام.
في حال حدوث أي تشوه أو ارتباك في تكامل الصفوف، يمكن للمحلل اللجوء فوراً إلى عمود الفهرس وإجراء فرز رقمي تصاعدي استناداً إليه، مما يعيد كافة السجلات إلى نسقها البدائي الأول بدقة متناهية وبضغطة زر واحدة. يُعد هذا البروتوكول الوقائي ركيزة جوهرية في إدارة المخاطر الرقمية، ويحول دون ضياع قواعد البيانات التاريخية والمؤسسية عند تعرضها للأخطاء البشرية المحتملة أثناء المعالجة اليدوية.
5. الفرز المتقدم متعدد المعايير لضمان التماسك الهرمي للسجلات
5.1 بناء مستويات الفرز المتعددة (Multi-Level Sorting)
في الكثير من التطبيقات الواقعية، لا يفي الفرز الأبجدي البسيط أحادي المعيار بمتطلبات التحليل؛ لا سيما عند التعامل مع مجموعات بيانية ضخمة تشتمل على تكرار حتمي في القيم النصية، مثل تطابق أسماء العائلات، أو وجود موظفين متعددين يتبعون نفس القسم الإداري. في مثل هذه البيئات، يبرز الفرز متعدد المستويات (Multi-Level Sorting) كأداة لا غنى عنها لضبط التماسك الهرمي للسجلات وتنظيمها الداخلي بصورة دقيقة ومنطقية لا تخل بسلامة الصفوف.
يتم تفعيل هذا النمط المتقدم عبر فتح نافذة الفرز المخصصة والنقر على زر “إضافة مستوى” (Add Level). يتيح هذا الإجراء للمحلل صياغة سلم تفضيلي تعتمد عليه الخوارزمية؛ حيث يتم تعيين المستوى الأول للفرز الأبجدي للمتغير النصي الأساسي (مثل “القسم الإداري” من الألف إلى الياء)، ثم يتم توجيه البرنامج للتعامل مع حالات التساوي عبر المستوى الثاني المندرج تحته عبر خيار “ثم حسب” (Then by)، كأن يتم فرز الأسماء أبجدياً داخل كل قسم، يليه مستوى ثالث يفرز السجلات وفق متغير رقمي تابع (مثل “تاريخ التعيين” من الأقدم إلى الأحدث).
تضمن هذه المعالجة الهرمية ثبات السجلات وتكاملها؛ فالبيانات لا يُعاد ترتيبها ككتل عشوائية عند تطابق المتغير الأولي، بل يُعاد موضعة الصف بالكامل بوحدته المتماسكة وفق القواعد الفرعية المنصوص عليها. ينتج عن ذلك مصفوفة منظمة بصرامة تعكس التفرعات الوظيفية أو التصنيفية للمؤسسة، مع بقاء كل قيمة تابعة ملتصقة تماماً بكيانها الأصلي دون أي انحراف في الإحداثيات الأفقية للصف الواحد.
5.2 فرز البيانات النصية مع مراعاة حالة الأحرف والخصائص اللغوية
يتعامل إكسل افتراضياً مع النصوص الأبجدية وفق منطق غير حساس لحالة الأحرف (Case-Insensitive)؛ مما يعني أن الكلمات الإنجليزية المكتوبة بحروف كبيرة (Uppercase) تُعامل كمعادل مطابق تماماً لنظيراتها المكتوبة بحروف صغيرة (Lowercase). ومع ذلك، في سياقات التوثيق الأكاديمي، أو عند التعامل مع المعرفات المشفرة ورموز الجينات وأكواد البرمجة، تصبح حساسية حالة الأحرف ضرورة حتمية لفرز السجلات بشكل صحيح وموثوق.
لتفعيل هذا المسار، يتم الولوج إلى زر “خيارات” (Options) داخل نافذة الفرز المتقدمة وتحديد مربع الاختيار “مطابقة حالة الأحرف” (Case sensitive). عند تفعيل هذه الخاصية، تطبق الخوارزمية معايير الترتيب المعتمدة على الجداول الرمزية (ASCII/Unicode)، حيث تُمنح الأولوية للحروف الكبيرة تليها الحروف الصغيرة، أو العكس بحسب الاتجاه المختار، مع استمرار تحريك السجل كاملاً لضمان عدم انفصال الرموز الحساسة عن بياناتها المرفقة داخل الصف.
أما على صعيد الخصائص اللغوية العامة، فإن إعدادات اللغة الإقليمية (Regional Settings) لنظام التشغيل تتدخل بشكل مباشر في توجيه خوارزمية الفرز، خاصة فيما يتعلق بالأحرف ذات العلامات التشكيلية المعقدة (Accented Characters) في اللغات اللاتينية، أو الترتيب المعتمد للحروف الصوتية. يؤدي التحديد الصارم لهذه الخصائص اللغوية إلى تفادي العشوائية في تموضع الصفوف المتشابهة، وتأكيد انتقال كافة السمات الملحقة بالسجل بالتوازي الدقيق مع حركته اللغوية المضبوطة.
5.3 فرز السجلات وفق قوائم مخصصة (Custom Lists)
قد تتعارض متطلبات العمل التحليلي أحياناً مع الترتيب الأبجدي الصرف؛ إذ توجد متغيرات فئوية تفرض طبيعتها المنطقية تسلسلاً رتبياً خاصاً لا علاقة له بأسبقية الحروف الهجائية، مثل ترتيب أيام الأسبوع، أو شهور السنة، أو المراحل التعليمية (ابتدائي، متوسط، ثانوي، جامعي)، أو المستويات الإدارية والرتب العسكرية والتقييمات الائتمانية (مثل: ممتاز، جيد جداً، جيد، ضعيف).
يتيح إكسل للمحلل إمكانية تجاوز القالب الأبجدي التقليدي عبر استخدام “القوائم المخصصة” (Custom Lists). يمكن الوصول إلى هذه الميزة من داخل نافذة الفرز، حيث يختار المستخدم من قائمة “الترتيب” خيار “قائمة مخصصة…”؛ مما يفتح واجهة تسمح باختيار سلاسل معرفة مسبقاً أو كتابة تسلسل رتبي جديد تماماً يلائم الاحتياجات الدقيقة للبحث الجاري وتخزينه في بيئة البرنامج.
الأمر الجوهري من منظور تكامل البيانات هو أن إكسل، عند تطبيق الفرز وفق القائمة المخصصة، يلتزم التزاماً كاملاً بنقل الصف كاملاً بحسب رتبة قيمته في تلك القائمة. فالسجل الذي يحمل تصنيف “ممتاز” سينتقل بكامل خلاياه وحقوله المجاورة إلى صدارة الجدول، يليه سجل “جيد جداً” بكامل تفاصيله، محققاً بذلك فرزاً رتبياً نوعياً منضبطاً يحفظ تماسك السجلات ويمنع انفصال المتغيرات التابعة عن تصنيفاتها الأصلية الحاكمة.
6. استخدام جداول إكسل الرسمية (Excel Tables) كدرع حماية ضد انفصال الصفوف
6.1 تحويل النطاق التقليدي إلى جدول رسمي (Ctrl + T)
تمثل ميزة “جداول إكسل الرسمية” (Excel Tables)، والتي تُستدعى عبر الاختصار الشهير Ctrl + T (أو من خلال تبويب “إدراج” $\rightarrow$ “جدول”)، أعظم نقلة معمارية قدمتها مايكروسوفت لضمان أمان البيانات والحيلولة دون تفكك الصفوف. عند تطبيق هذا التحويل، يتوقف إكسل عن معاملة المنطقة كخلايا متفرقة في شبكة حرة، ويُعيد تغليفها برمجياً كـ “كيان علائقي بنيوي مستقل” (Structured Database Entity) له اسم برميجي خاص وحدود جغرافية صارمة لا تقبل الانفصال.
توفر الجداول الرسمية ما يمكن تسميته بـ “الحصانة التلقائية”؛ فالبرنامج يدرك تلقائياً وبشكل دائم حدود النطاق المترابط ورؤوس الأعمدة المرتبطة به. في هذه البيئة المحمية، يستحيل على المستخدم العادي—حتى لو حاول عن طريق السهو أو الخطأ—أن يفرز عموداً واحداً بمعزل عن الأعمدة الأخرى؛ إذ يتعامل محرك الجدول مع كل صف أفقي كوحدة صلبة مصمتة غير قابلة للكسر أو التجزئة، مما يقضي جذرياً على مسببات الخطأ البشري المعتادة.
إلى جانب ذلك، تضفي الجداول الرسمية مرونة استثنائية على صعيد التنسيق المرئي التبادلي (Banded Rows)، وتوفر مراجع بنيوية (Structured References) للمعادلات بدلاً من عناوين الخلايا التقليدية المبهمة. هذه الخصائص ترفع من مستوى مقروئية البيانات وتمنح الباحثين والمحللين طبقة أمان مسبقة تُغنيهم عن القلق الدائم بشأن تداعيات الفرز اليدوي على سلامة مصفوفاتهم المعقدة.
6.2 الفرز الذاتي عبر أزرار التصفية في رؤوس الجداول
بمجرد إنشاء جدول إكسل رسمي، يُزود البرنامج تلقائياً كل رأس من رؤوس الأعمدة بزر قائمة منسدلة مدمج مخصص للفرز والتصفية السريعة (AutoFilter Dropdown). يُشكل هذا المسار الوسيلة الأكثر موثوقية وسرعة لتنفيذ الترتيب الأبجدي اليومي؛ إذ يكفي النقر على سهم رأس العمود واختيار “فرز من الألف إلى الياء” لتتم العملية في جزء من الثانية مع ضمان رياضي وبرمجي بنسبة مائة بالمائة بأن كافة السجلات قد تحركت بالتوازي التام.
تتمثل الميزة الدفاعية هنا في أن خيارات الفرز داخل رؤوس الجداول الرسمية مبرمجة لتعمل حصراً على مستوى الكيان ككل. لا توجد هنا نوافذ تحذيرية قد يخطئ المستخدم في قراءتها مثل “تحذير الفرز”، ولا توجد أزرار تتيح “المتابعة بالتحديد الحالي”؛ لأن خوارزمية الجداول الرسمية ترفض هندسياً مبدأ فرز الخلايا المعزولة، وتفرض تحريك كامل عناصر الصف بالتزامن القاطع مع المتغير المفرز.
إن تبني هذه المنهجية داخل بيئات العمل التشاركية—التي يتداول فيها عدة موظفين أو باحثين الملف ذاته—يُقلل احتمالات الخطأ الإجرائي إلى الصفر تقريباً. تظل السجلات محمية بالبنية التحتية الصلبة للجدول، ويتحول الفرز من كونه عملية محفوفة بمخاطر التفكك إلى إجراء تشغيلي روتيني آمن ومتاح بنقرة زر واحدة دون أي تبعات سلبية على تكامل البيانات.
6.3 التوسع التلقائي وتحديث النطاقات للبيانات المضافة حديثاً
من أهم العيوب في النطاقات التقليدية القديمة (Normal Ranges) عجزها عن استيعاب المدخلات الجديدة تلقائياً؛ فإذا أضاف المحلل صفوفاً جديدة في أسفل الجدول ثم أجرى فرزاً بالاعتماد على نطاق محدد مسبقاً، فإن تلك البيانات الجديدة قد تُستثنى من الترتيب تماماً لكونها تقع خارج الإحداثيات المسجلة. أما في جداول إكسل الرسمية، فإن آلية التوسع التلقائي (Automatic Range Expansion) تعالج هذه المشكلة ببراعة فائقة ودون أي تدخل يدوي.
بمجرد كتابة أي سجل جديد أسفل الجدول مباشرة أو لصق أعمدة إضافية على أطرافه، يتسع الجدول بنيوياً ليمتص هذه البيانات فوراً ويدمجها ضمن حدوده الرسمية، مع مد كافة التنسيقات والصيغ الحسابية وأزرار التصفية لتشملها تلقائياً. عند إجراء أي فرز أبجدي لاحق، تخضع هذه السجلات الحديثة فوراً لنفس القواعد الصارمة وتتحرك أفقياً ورأسياً بانسجام كامل مع بقية المنظومة المترابطة.
يوفر هذا التوسع التلقائي كفاءة تشغيلية متفوقة عند التعامل مع قواعد البيانات التراكمية، كاستطلاعات الرأي المستمرة أو سجلات المبيعات اليومية؛ إذ يضمن عدم ترك أي سجل تائهاً في الهامش خارج حدود التحليل والفرز، مما يرسخ استمرارية الجودة الإحصائية ويجنب المحلل متاعب إعادة رسم وتحديد النطاقات عند كل إضافة بيانية جديدة.
7. الفرز البرمجي الديناميكي باستخدام دوال المصفوفات الحديثة
7.1 توظيف دالة SORT للحصول على مصفوفات مرتبة وتلقائية
مع إطلاق محرك الحسابات الديناميكي في نسختي Excel 2021 وMicrosoft 365، وفرت شركة ميكروسوفت نقلة نوعية في التعامل مع البيانات عبر دوال المصفوفات الديناميكية (Dynamic Array Functions)، وعلى رأسها دالة SORT. تتيح هذه الدالة توليد مصفوفة جديدة مرتبة وموازية للجدول الخام دون المساس بالبيانات الأصلية أو تغيير مواقعها المادية؛ مما يحقق أعلى درجات الأمان من خلال الفصل الكامل بين طبقة البيانات الأولية وطبقة المخرجات والتحليل.
تتحدد البنية التركيبية القياسية للدالة بالصيغة الرياضية التالية:
=SORT(array, [sort_index], [sort_order], [by_col])
حيث يمثل المعامل الأول array كامل النطاق المستهدف بما يحتويه من أعمدة مترابطة (دون الرؤوس في الغالب)، ويمثل sort_index الرقم التسلسلي للعمود الذي سيتم الترتيب بناءً عليه (مثلاً: 1 لفرز العمود الأول، أو 2 لفرز العمود الثاني)، بينما يحدد المعامل sort_order اتجاه الترتيب (1 للتصاعدي، و-1 للتنازلي). عند كتابة هذه الدالة في خلية فارغة واحدة، فإنها تسكب النتائج (Spill) تلقائياً عبر الخلايا المجاورة لتشكل جدولاً جديداً متكاملاً.
يكمن الضمان الاستثنائي لهذه الدالة في استحالة انفصال الصفوف نهائياً؛ فالبرنامج يقرأ النطاق كاملاً كمصفوفة كتلية واحدة، ويتحرك الصف بكافة أعمدته وأرقامه متضامناً مع العمود المفتاحي في النطاق المستحدث. وفوق ذلك، تمتاز الدالة بالحيوية والتزامن اللحظي؛ فإذا تم تعديل أو إضافة أي اسم في الجدول الأصلي، يعاد حساب المعادلة فوراً لتنعكس التغييرات في مصفوفة الفرز الناتجة دون الحاجة إلى تشغيل أوامر الفرز اليدوية مجدداً.
7.2 استخدام دالة SORTBY للفرز بالاعتماد على أعمدة محددة
تُمثل دالة SORTBY التطور الأكثر تقدماً وتخصصاً في منظومة دوال الترتيب المصفوفية؛ حيث توفر للمحلل مرونة غير مسبوقة في فرز نطاق أو جدول كامل بالاعتماد على قيم عمود أو عدة أعمدة أخرى دون اشتراط وجود عمود الفرز داخل المصفوفة الناتجة، أو عند الحاجة لتطبيق مستويات متعددة ومعقدة من الترتيب الديناميكي المبرمج بضوابط صارمة.
تُصاغ الدالة برمجياً على النحو التالي:
=SORTBY(array, by_array1, [sort_order1], [by_array2, sort_order2], ...)
يقوم المعامل array بتحديد نطاق السجلات المراد إظهارها مرتبة، في حين يحدد by_array1 المتجه المستقل الذي سيقود العملية الترتيبية. تكمن القوة الهندسية هنا في قدرة الدالة على نقل الصفوف الكاملة للمصفوفة المستهدفة بتطابق دقيق وتام مع الحركة الرياضية لمتجه الترتيب، حتى لو كان هذا الأخير عموداً منفصلاً تماماً أو حساباً إحصائياً جانبياً لا يرغب المحلل في إدراجه في التقرير النهائي المعروض.
تعتمد الدالة على سلوك التوسع والانسكاب (Spill Behavior) التلقائي، مما يجعل المخرجات محصنة ضد أي تعديل يدوي جزئي قد يفسد تناسقها؛ فإذا حاول أي شخص مسح أو تعديل خلية واحدة داخل نطاق الانسكاب، فإن الدالة تطلق خطأ التجاوز #SPILL!، معلنة تعليق العرض حتى إزالة العائق، وهو ما يوفر حماية برمجية ذاتية غير قابلة للاختراق لتكامل الصفوف وتناسق بيانات السجلات المشتقة.
7.3 المقارنة التحليلية: الفرز الساكن (Manual) مقابل الفرز الديناميكي (Formula-Based)
يفرض الاختيار المنهجي بين استخدام أدوات الفرز الساكن التقليدية (عبر واجهة المستخدم وتبويب البيانات) وبين الفرز الديناميكي (عبر الدوال المصفوفية كـ SORT وSORTBY) الموازنة بين عدة أبعاد تقنية تتعلق بحجم البيانات، وكفاءة الذاكرة، والغرض النهائي من الملف. يوضح التحليل المقارن التالي الفروق الجوهرية بين المسارين لتمكين المحلل من اتخاذ القرار الأمثل:
| وجه المقارنة | الفرز الساكن اليدوي (Manual Sort) | الفرز الديناميكي بالمعادلات (Dynamic Array) |
|---|---|---|
| حالة البيانات المصدرية | تعديل مباشر على موضع الخلايا الأصلية الخام. | بقاء البيانات الأصلية ساكنة، وتوليد مخرجات جديدة بموضع آخر. |
| التحديث التلقائي | معدوم؛ يتطلب إعادة تفعيل أمر الفرز يدوياً عند كل تعديل. | فوري ولحظي؛ تتغير المخرجات بمجرد تعديل أو إضافة أي قيمة. |
| مخاطر تفكك الصفوف | واردة جداً في حال ارتكاب خطأ بشري أثناء تحديد النطاق. | مستحيلة برمجياً؛ تتحرك المصفوفة ككيان هندسي موحد. |
| استهلاك موارد الجهاز | خفيف جداً؛ تتم المعالجة لمرة واحدة وتستقر الذاكرة. | أعلى؛ يتطلب إعادة الحساب الديناميكي الدوري في الملفات الضخمة. |
| ملاءمة الاستخدام | التحضير الأولي للبيانات وقواعد البيانات الثابتة للأرشفة. | لوحات التحكم (Dashboards) والنماذج الإحصائية والتقارير التفاعلية. |
يتضح من هذا التقييم أن الفرز الساكن يظل مفضلاً في مراحل التهيئة الأولية للملفات العملاقة التي تضم مئات الآلاف من الصفوف لتفادي استهلاك قوة المعالجة المركزية، بينما يُعد الفرز الديناميكي الخيار الأرقى للتقارير والتحليلات الجاهزة للعرض وصنع القرار، حيث يضمن تكاملاً مطلقاً للصفوف وتحديثاً تلقائياً مستمراً يلغي الحاجة لأي تدخل تشغيلي يدوي لاحق.
8. التحديات اللغوية والتقنية في الفرز الأبجدي للنصوص العربية
8.1 معالجة تشوهات الترتيب الناتجة عن تباين أشكال الحروف
ينفرد الفرز الأبجدي للبيانات باللغة العربية بتحديات لغوية وبرمجية استثنائية تنبع من الخصائص الصرفية والرسم الإملائي للحروف العربية؛ حيث تؤدي التباينات الشكلية الدقيقة للرسم الواحد إلى ارتباك حاد في الترتيب الهجائي السليم، مما يدفع بالسجلات إلى مواقع غير متوقعة تؤثر سلباً على الفحص والتدقيق. تأتي إشكالية “الهمزات” في صدارة هذه التحديات؛ إذ يتعامل إكسل وفق جداول المحارف الموحدة (Unicode) مع الألف المهموزة بحالاتها (أ، إ، آ) كرموز منفصلة تماماً ومتباينة برمجياً عن الألف المجردة (ا).
يتكرر هذا التباين الترتيبي بين “الياء” في نهاية الكلمة والـ “ألف المقصورة” (ي / ى)، وكذلك بين “التاء المربوطة” و”الهاء” (ة / ه). فإذا كُتب اسم “أحمد” بهمزة قطعية في صف، وكُتب “احمد” بدون همزة في صف آخر، فلن يتجاور الاسمان في الترتيب الأبجدي، بل قد تفصل بينهما عشرات السجلات بحسب الترتيب الثنائي للأكواد البرمجية المستخدمة في النظام، مما يوحي ظاهرياً للمحلل بفقدان بعض البيانات أو تشتت تماسك الحالات المتماثلة.
لحل هذه المعضلة وضمان تماسك السجلات وترتيبها المنطقي، يُنصح بتطبيق بروتوكول توحيد النصوص (Text Normalization) على العمود المفتاحي قبل الفرز؛ وذلك باستخدام دوال المعالجة النصية المتقدمة مثل دالة الاستبدال SUBSTITUTE لتوحيد كافة أشكال الهمزات إلى ألف مجردة، وإزالة علامات التشكيل وحركات التنوين عبر الصيغ التركيبية. هذا الإجراء الفني يعيد النطاق إلى حالة من الاتساق البنيوي الصارم، مما يجعل الفرز الأبجدي اللاحق يعكس الترتيب الموضوعي الدقيق دون أي تشويه أو ارتباك معلوماتي.
8.2 أثر المسافات الزائدة والرموز غير المرئية على ترابط الصفوف
تُمثل المسافات البيضاء والرموز الخفية واحدة من أخبث المشكلات التقنية التي تواجه قواعد البيانات في إكسل؛ إذ لا تُرى بالعين المجردة، ولكنها تؤثر جوهرياً على الحسابات الرياضية والترتيبات الأبجدية. تبرز المشكلة الكبرى مع “المسافات البادئة” (Leading Spaces)؛ أي وجود مسافة فارغة قبل الحرف الأول من الاسم أو السجل النصي، غالباً بسبب أخطاء الإدخال البشري أو تصدير البيانات من أنظمة تخطيط الموارد (ERP) القديمة.
نظراً لأن الرمز البرمجي للمسافة في جدول الترميز يسبق كافة الحروف الهجائية، فإن أي سجل يحتوي اسمه على مسافة بادئة سيصعد فوراً إلى قمة الجدول متجاوزاً كافة السجلات الأخرى، حتى لو كان يبدأ بحرف الياء، محطماً بذلك الترتيب المنطقي للبيانات. يمتد التحدي أيضاً إلى “المسافات غير القابلة للكسر” (Non-Breaking Spaces) المعروفة برمز المحرف CHAR(160)، والتي تشيع في البيانات المنسوخة من صفحات الويب ومستندات الإنترنت، والتي تعجز أدوات التنظيف البسيطة عن رصدها.
يتطلب المسار الإجرائي الحصين تنظيف العمود المفتاحي بصورة جذرية؛ أولاً عبر توظيف دالة TRIM لإزالة المسافات البادئة والختامية والزائدة بين الكلمات، وثانياً عبر دمجها مع دالتي CLEAN وSUBSTITUTE للتخلص من المحارف غير القابلة للطباعة والمسافات غير القابلة للكسر وفق الصيغة المركبة:
=TRIM(CLEAN(SUBSTITUTE(A2, CHAR(160), " ")))
يضمن تطبيق هذا المعيار المسبق تحرير السجلات من الشوائب غير المرئية، مما يُفسح المجال لخوارزمية الفرز للعمل بدقة متناهية، فتتحرك الصفوف بكامل محتوياتها إلى مواقعها الصحيحة منطقياً وهندسياً دون أي شذوذ بنيوي ناتج عن المسافات المخفية.
8.3 معضلة الخلايا المدمجة (Merged Cells) وعرقلتها للفرز السليم
يُجمع خبراء هندسة البيانات وقواعد البيانات في إكسل على أن “دمج الخلايا” (Merged Cells) يمثل الممارسة الأكثر تدميراً للوظائف التحليلية على الإطلاق؛ فالدمج يُعطل المنطق الإحداثي للمصفوفة ثنائية الأبعاد التي يستند إليها البرنامج. عند دمج عدة خلايا معاً، يحتفظ إكسل بالقيمة النصية أو الرقمية في الخلية العلوية اليمنى فقط، بينما تصبح بقية الخلايا المدمجة في الذاكرة فارغة تماماً (Empty/Null)، وهو ما يضرب مفهوم تكامل الصف في مقتل.
من الناحية التشغيلية، إذا حاول المستخدم فرز نطاق يحتوي على خلايا مدمجة ذات أحجام أو أبعاد غير متطابقة، فإن إكسل سيرفض الأمر مباشرة ويطلق نافذة خطأ قاطعة تنص على: “للقيام بذلك، يجب أن تكون جميع الخلايا المدمجة بنفس الحجم” (To do this, all the merged cells need to be the same size). هذا الحاجز البرمجي يمنع الفرز تماماً، أو في حالات أسوأ—إذا كانت بعض الخلايا متطابقة الحجم—قد يُنفذ الفرز بطريقة مشوهة تقتلع البيانات التابعة وتخلط الصفوف بصورة لا يمكن تداركها.
لتجاوز هذا العائق الفني دون التضحية بالمظهر التنسيقي، ينبغي حظر الدمج تماماً والاعتماد على البديل الاحترافي الآمن المسمى “محاذاة عبر التحديد” (Center Across Selection). يُفعل هذا الخيار عبر تحديد الخلايا ثم فتح تنسيق الخلايا (Ctrl + 1) $\rightarrow$ تبويب “محاذاة” $\rightarrow$ واختيار “توسيط عبر التحديد” من القائمة الأفقية. يمنح هذا الإجراء المظهر البصري للخلايا المدمجة مع الحفاظ الكامل على الاستقلالية الهيكلية لكل خلية ولكل صف، مما يتيح لخوارزميات الفرز العمل بأمان تام وتدوير الصفوف بكامل حمولتها البيانية دون أدنى عائق برمجي.
9. إدارة الأخطاء وضمان جودة البيانات قبل وبعد الفرز الأبجدي
9.1 إنشاء عمود الفهرسة المرجعي (Index Column) كإجراء وقائي
يُعد بناء “عمود الفهرسة المرجعي” (Index Column) أو المعرف الترتيبي الأصلي القاعدة الذهبية في إدارة جودة البيانات والتحوط ضد الكوارث التحليلية. يقوم هذا المبدأ على تخصيص العمود الأول في أقصى يمين الجدول (أو يساره حسب واجهة التشغيل) وتسميته بعنوان صريح مثل “الترتيب الأصلي” أو “المعرف المرجعي”، ثم تعبئته بمتتالية عددية تبدأ من الرقم (1) وتمتد بالتتابع حتى نهاية الصفوف المأهولة.
تتمثل الفائدة الاستراتيجية لهذا العمود في تثبيت الهوية المكانية الأصلية لكافة السجلات قبل خضوعها لأي عمليات تبديل أو ترتيب أو معالجة مشتقة. وبما أن هذا العمود يُدرج كجزء لا يتجزأ من السجل المتكامل، فإنه يتحرك متضامناً مع بقية البيانات عند تنفيذ الفرز الأبجدي، محافظاً على توثيق الموقع الأصلي لكل حالة في نسقها الخام الميداني الأول.
إذا طرأ أي ارتباك أثناء الفرز اللاحق، أو ظهر تشوه ناتج عن عدم تناسق المعايير، أو طلب المشرف الأكاديمي الرجوع للترتيب الزمني الأولي للإدخال، فإن الحل يكمن ببساطة في نقرة زر واحدة: فرز الجدول تصاعدياً استناداً لعمود الفهرسة المرجعي. يؤدي هذا الإجراء التراجعي إلى إعادة بعث المصفوفة الأصلية بكافة إحداثياتها بدقة مطلقة، مما يرفع من مرونة التحليل ويجعل كافة التجارب الإحصائية والمعالجات الجدولية آمنة وغير مدمرة (Non-Destructive) للبيانات الحيوية.
9.2 فحص استمرارية الصفوف وخلوها من الانقطاعات الهيكلية
قبل الشروع في تفعيل أي أمر من أوامر الفرز داخل إكسل، يتعين على المحلل إجراء فحص شامل لاستمرارية الكتلة البيانية والتأكد من خلوها من أي انقطاعات مادية. إن وجود صف فارغ تماماً في منتصف الجدول لا يراه المحلل بسبب طول النطاق يُمثل كارثة تقنية كامنة؛ لأن خوارزمية الفرز التلقائي ستتوقف عنده، وتعتبر البيانات الواقعة أسفله جدولاً منفصلاً، مما يؤدي إلى فرز النصف العلوي فقط وتجميد النصف السفلي، متسبباً في تشويه ترابط السجلات وانفصال أجزائها.
يتم التحقق من استمرارية النطاق واكتشاف الفواصل عبر الاستعانة باختصارات التنقل البنيوي السريعة؛ وعلى رأسها الضغط على مفتاح Ctrl + السهم لأسفل (Ctrl + Down Arrow). ينتقل المؤشر بهذا الأمر فوراً إلى آخر خلية ممتلئة متصلة في العمود؛ فإذا قفز المؤشر وتوقف في منتصف الجدول بدلاً من نهايته الحقيقية، دل ذلك على وجود فجوة فارغة يجب معالجتها. تتكرر نفس العملية أفقياً باستخدام Ctrl + السهم لليسار أو اليمين للتأكد من عدم وجود أعمدة فارغة تفصل السمات عن المفاتيح الأساسية.
بالإضافة إلى ذلك، يجب توحيد أنماط البيانات داخل العمود المفتاحي؛ فالتداخل العشوائي بين القيم النصية والعددية (كأن تُخزن بعض الأرقام كنصوص وأخرى كأعداد صحيحة) يؤدي إلى خلل ترتيبي جسيم، حيث يفرز إكسل الأرقام أولاً ثم يتبعها بالنصوص. إن إجراء عمليات التدقيق المسبقة والتطهير البنيوي يمنح عملية الفرز أساساً صلباً ويضمن سريان قواعد الترتيب على كافة السجلات دون استثناء أو توقف غير مقصود في منتصف الطريق.
9.3 بروتوكول التحقق اللاحق للتأكد من بقاء الصفوف متصلة
لا تنتهي مسؤولية المحلل بإتمام ضغطة زر الفرز، بل تبدأ مرحلة حاسمة تُعرف في الأدبيات التحليلية بـ “بروتوكول التحقق اللاحق” (Post-Sorting Verification Protocol). يهدف هذا البروتوكول إلى التيقن اليقيني من بقاء العلاقات الأفقية بين المتغيرات ثابتة وسليمة دون أدنى انفصال، قبل اعتماد النتائج في التقارير النهائية أو إجراء أي حسابات تجميعية لاحقة.
تتضمن الخطوة الأولى فحص عينات عشوائية مستهدفة (Spot-Checking)؛ حيث يختار المحلل ثلاثة إلى خمسة سجلات متميزة يعرف مسبقاً قياساتها الفريدة (مثلاً: التحقق من أن أعلى درجة مسجلة لا تزال مقترنة باسم الطالب المتفوق، أو أن العميل ذو الرصيد المكشوف لا يزال مرتبطاً ببياناته البنكية ذاتها). إذا ظهر أدنى تعارض في هذه العينات، يُطلق الإنذار فوراً بوجود تفكك في الصفوف يستوجب التراجع الفوري دون تأخير.
أما في المشروعات الضخمة، فيتم التحقق عبر أدوات برمجية دقيقة، مثل استخدام دوال البحث المرجعي المتقدم كدالة XLOOKUP أو VLOOKUP لربط الجدول المفرز بنسخة أصلية احتياطية من الملف (Raw Backup Copy)، لمقارنة وتدقيق مطابقة القيم التابعة لكل مفتاح نصي آلياً. يضاف إلى ذلك تدقيق “مجاميع المراقبة” (Checksums)؛ كالتأكد من أن المجموع الكلي للقيم العددية في عمود الدرجات أو الرواتب وعدد الصفوف الإجمالي لا يزال متطابقاً تماماً مع الحالة البدائية، مما يُسقط أي احتمالية لضياع أو تداخل أي صف أثناء المعالجة التنفيذية.
10. دراسة حالة تطبيقية: فرز سجلات إحصائية متعددة الحقول خطوة بخطوة
10.1 توصيف نموذج البيانات الافتراضي (سجلات اللاعبين والنقاط)
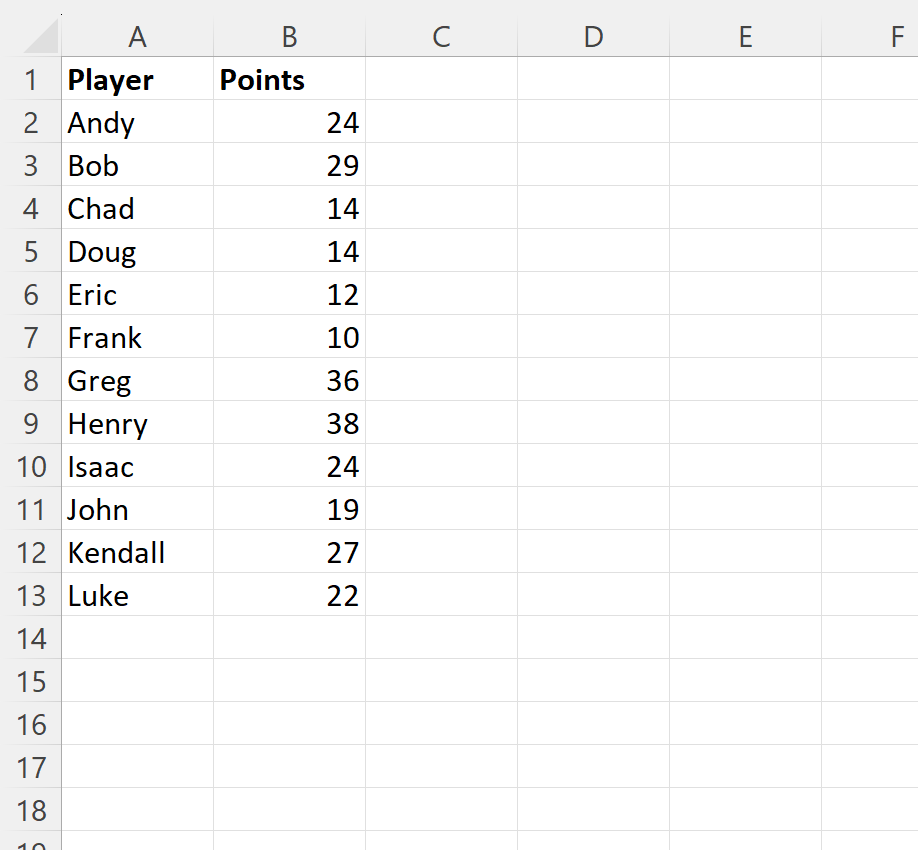
لتجسيد كافة المفاهيم التأصيلية والتقنية السابقة في سياق واقعي ملموس، نفترض وجود دراسة إحصائية تطبيقية تُعنى بتحليل أداء لاعبي كرة سلة في دوري رياضي. يضم هذا النموذج التجريبي جدولاً يتكون من أربعة متغيرات أساسية موزعة على أربعة أعمدة متجاورة، ويشتمل على سجلات تفصيلية لعدد من اللاعبين، كما هو موضح في البنية المصفوفية المبدئية التالية:
| رقم التعريف المرجعي | اسم اللاعب | الفريق | مجموع النقاط المسجلة |
|---|---|---|---|
| 101 | يوسف المنصور | الصقور | 85 |
| 102 | إبراهيم الفهد | الفرسان | 92 |
| 103 | بدر السالم | النجوم | 78 |
| 104 | أحمد الخالد | الصقور | 95 |
| 105 | خالد العلي | الفرسان | 64 |
الهدف الإجرائي الواضح هنا هو: إعادة ترتيب هؤلاء اللاعبين أبجدياً وفق أسمائهم (تصاعدياً من الألف إلى الياء)، مع ضمان قطعي بتثبيت الأرقام المرجعية، والفرق المنتمين إليها، ومجموع النقاط المكتسبة المرافقة لكل لاعب دون أي مساس بوحدة السجل. يكمن الخطر المحتمل، في حال ارتكاب خطأ الفرز المعزول لعمود “اسم اللاعب”، في صعود اسم “أحمد الخالد” إلى القمة مقترناً بالرقم المرجعي 101 وفريق “الصقور” ولكن مع نقاط “يوسف المنصور” (85 بدلاً من 95)، بينما يحصل يوسف في القاع على نقاط خالد العلي (64)، مما ينتج عنه تزوير كامل ومؤسف للأداء الرياضي الفعلي لكل لاعب إثر تفكك الصفوف.
10.2 المحاكاة التطبيقية لخطوات الفرز السليم ومراقبة التغيير
لتنفيذ هذه المحاكاة بأسلوب منهجي صارم، يتتبع المحلل الخطوات العملية التالية على نموذج البيانات الموصوف:
- تحديد موضع الخلية النشطة: ينقر المحلل نقرة واحدة داخل العمود الثاني المسمى “اسم اللاعب”، ولتكن الخلية المحتوية على “يوسف المنصور” (الخلية B2)، متجنباً تماماً تظليل العمود B كمتجه رأسي معزول.
- فتح مسار المعالجة المخصص: يتوجه إلى شريط الأدوات الرئيسي، ثم ينقر على تبويب “بيانات” (Data)، ومن مجموعة “الفرز والتصفية” يختار الأداة الموسعة “فرز” (Sort) ليظهر مربع الحوار المخصص.
- ضبط معلمات الحوار:
- التحقق من تحديد خيار “تتضمن بياناتي رؤوساً” (My data has headers) في الجزء العلوي، لضمان استبعاد صف العناوين من حركة التبديل.
- في حقل “فرز حسب” (Sort by)، يختار من القائمة المنسدلة حقل “اسم اللاعب”.
- في حقل “الفرز على” (Sort On)، يؤكد خيار “قيم الخلايا” (Cell Values).
- في حقل “الترتيب” (Order)، يختار “من الألف إلى الياء” (A to Z).
- تأكيد الفرز والتحول المصفوفي: بمجرد الضغط على زر “موافق” (OK)، ينفذ إكسل خوارزمية النقل المتزامن لجميع الأعمدة، ليعاد تشكيل الجدول بالصورة المرتبة هندسياً التالية:
| رقم التعريف المرجعي | اسم اللاعب | الفريق | مجموع النقاط المسجلة |
|---|---|---|---|
| 104 | أحمد الخالد | الصقور | 95 |
| 102 | إبراهيم الفهد | الفرسان | 92 |
| 103 | بدر السالم | النجوم | 78 |
| 105 | خالد العلي | الفرسان | 64 |
| 101 | يوسف المنصور | الصقور | 85 |
تُظهر المراقبة البصرية الدقيقة للمصفوفة الناتجة احتفاظ السجلات بكيانها الأصلي التام؛ فاللاعب “أحمد الخالد” لم يصعد بمفرده كاسم، بل حمل معه رقمه المرجعي (104)، وفريقه (الصقور)، ونقاطه الحقيقية البالغة (95). وبالمثل، هبط “يوسف المنصور” إلى ذيل القائمة ومعه كافة متعلقاته الرقمية والتنظيمية بدقة مائة بالمائة. لقد تحرك كل صف كوحدة مغلقة ومصمتة، مما يثبت نجاح بروتوكول الحفاظ على تكامل الصفوف واستقرار العلاقات الإحصائية للمتغيرات بصورة قاطعة.
10.3 الاستنتاجات المنهجية والتوصيات لحفظ سلامة قواعد البيانات
تُفضي دراسة الحالة التطبيقية والتحليلات التأصيلية السابقة إلى جملة من الاستنتاجات والتوصيات المؤسسية الإلزامية التي ينبغي ترسيخها كمعيار عمل قياسي (Standard Operating Procedure) لدى كافة المتعاملين مع جداول البيانات:
- اعتماد الجداول الرسمية كمعيار أساسي: التحول الإجباري من استخدام النطاقات التقليدية الحرة إلى “جداول إكسل الرسمية” (Excel Tables عبر
Ctrl + T) لكافة قواعد البيانات المؤسسية والبحثية، نظراً للحصانة البنيوية التلقائية التي توفرها لمنع تفكك السجلات. - حظر الفرز الجزئي المطلق: عدم النقر نهائياً على خيار “المتابعة بالتحديد الحالي” عند ظهور نافذة تحذير الفرز، وتدريب الكوادر البشرية على إدراك الأبعاد الكارثية لهذا الخيار على مصداقية التحليلات.
- تضمين عمود الفهرسة الوقائي: استحداث عمود ترقيم تسلسلي مرجعي دائم يسبق أي عملية معالجة أو فرز، ليكون بمثابة صمام أمان يضمن الاستعادة اللحظية للتسلسل الأولي في حال وقوع أي خلل غير محسوب.
- التنظيف اللغوي والتقني المسبق: إخضاع المتغيرات النصية في البيئات متعددة اللغات (وخاصة اللغة العربية) لبروتوكولات التطهير من المسافات الزائدة والخلايا المدمجة وتوحيد الهمزات قبل إطلاق أوامر الترتيب.
- الفصل بين البيانات والتقارير: التوجه نحو استخدام دوال المصفوفات الديناميكية مثل
SORTوSORTBYفي لوحات المعلومات، لتظل البيانات المصدرية ثابتة ومحمية من التعديل اليدوي، مع الحصول على مخرجات مرتبة ذاتياً وبدقة برمجية متناهية.
إن الالتزام الصارم بهذه التوجيهات المنهجية يحول ممارسة إدارة البيانات من مجرد تعامل عفوي مع خلايا متناثرة إلى إدارة هندسية منضبطة ترقى إلى المعايير الأكاديمية والعلمية العالمية، مما يصون نزاهة البحوث ويدعم كفاءة القرارات الإدارية والتشغيلية في شتى الميادين.
خاتمة
في الختام، يتبين بجلاء أن عملية “الترتيب الأبجدي مع الحفاظ على الصفوف معاً” في برنامج ميكروسوفت إكسل تتجاوز كونها مهارة تشغيلية عابرة لتشكل ركناً أساسياً من أركان الحوكمة البيانية وضمان الجودة المعلوماتية. إن فهم البنية الهندسية لورقة العمل كقاعدة بيانات مسطحة، ومعاملة الصفوف كوحدات بنيوية غير قابلة للتجزئة (Tuples)، هو الضمان الوحيد ضد التفكك الصامت الذي يهدد مصداقية النتائج والتقارير في البيئات البحثية والمؤسسية.
لقد تتبعنا عبر هذه الدراسة الشاملة المسارات الإجرائية الآمنة، انطلاقاً من الاستخدام الواعي لنوافذ الفرز المخصصة وخيار “توسيع التحديد”، مروراً بالتحصين الهيكلي عبر الجداول الرسمية، ووصولاً إلى الفرز المصفوفي الديناميكي عبر دوال الجيل الجديد. إن تبني الأدوات الوقائية كأعمدة الفهرسة المرجعية والتحقق اللاحق وتطهير المدخلات النصية يغلق الباب نهائياً أمام الأخطاء البشرية المحتملة، ويضمن تحول البيانات إلى أصول معرفية موثوقة تسهم في بناء قرارات رشيدة ترتكز على حقائق إحصائية صلبة وثابتة البنيان.
المراجع
- Alexander, M., & Kusleika, D. (2022). Excel 2021 All-in-One For Dummies. John Wiley & Sons.
- Bricklin, D., & Frankston, B. (1979). VisiCalc: The First Computerized Spreadsheet. Software Arts.
- Frye, C. (2021). Microsoft Excel 2019 Step by Step. Microsoft Press.
- Harvey, G. (2021). Excel 2021 for Dummies. John Wiley & Sons.
- Kapor, M. (1983). Lotus 1-2-3: Integrated Spreadsheet Software. Lotus Development Corporation.
- Microsoft Corporation. (2023). Sort data in a range or table. Microsoft Support. https://support.microsoft.com/en-us/office/sort-data-in-a-range-or-table-62d0b2cf-2a60-449e-8c38-8e54736f56c7
- Microsoft Corporation. (2023). SORT function. Microsoft Support. https://support.microsoft.com/en-us/office/sort-function-22f63bd0-ccc8-492f-953d-c20e8e44b86c
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.