
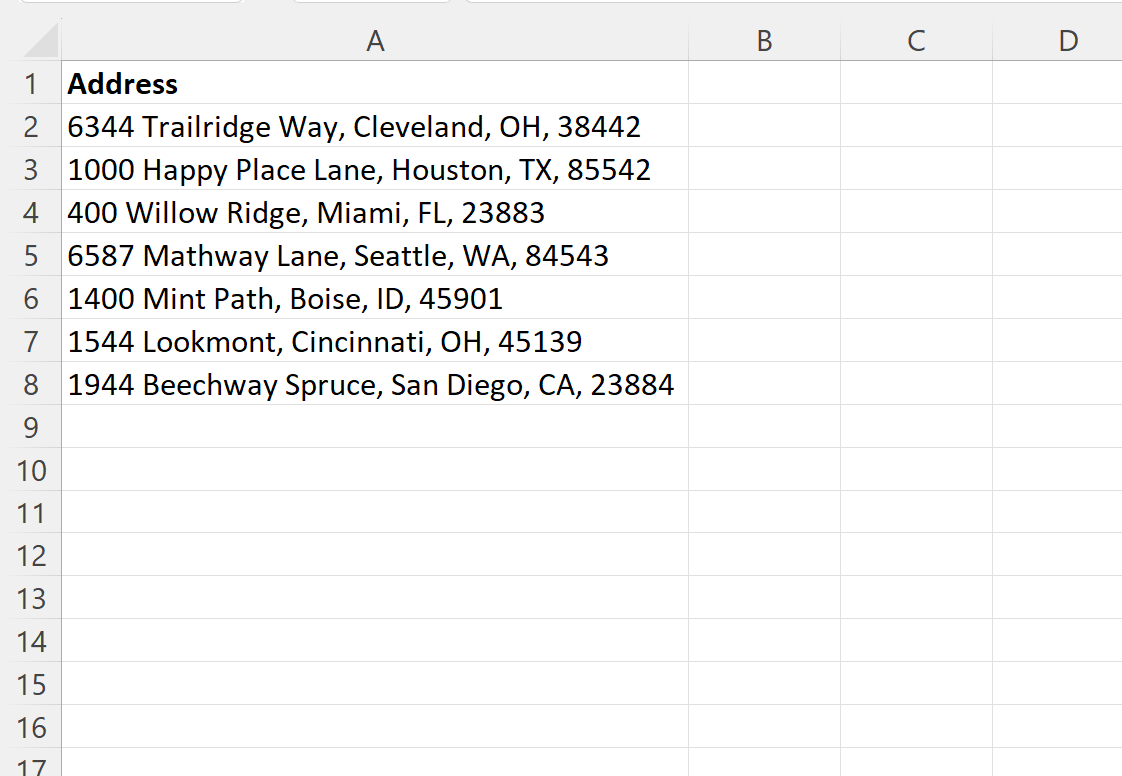
تمثل معالجة البيانات المكانية والنصية في جداول البيانات أحد أكثر التحديات التقنية إلحاحاً في بيئات الأعمال الحديثة والبحث العلمي التطبيقي؛ حيث تصل مجموعات البيانات الجغرافية غالباً في صيغ غير مهيكلة، مدمجة ضمن سلاسل نصية مفردة تحتوي على تفاصيل متباينة تشمل اسم الشارع، ورقم المبنى، والحي، والمدينة، والولاية أو المحافظة، والرمز البريدي. إن تراكم هذه العناصر غير المتجانسة في خلية واحدة يشكل عائقاً جوهرياً أمام استخلاص المؤشرات الإحصائية، وبناء لوحات المؤشرات التفاعلية، وتغذية نظم المعلومات الجغرافية (GIS)، وتكامل السجلات مع نظم إدارة علاقات العملاء (CRM) وقواعد البيانات المؤسسية (ERP). من هذا المنطلق، لم يعد فصل العناوين إلى حقول مستقلة ترفاً تنسيقياً، بل غدا ضرورة حتمية لضمان سلامة النظم البيئية للمعلومات وتحقيق الكفاءة التشغيلية المرجوة.
تاريخياً، ارتبطت معالجة السلاسل النصية في بيئة مايكروسوفت إكسل (Microsoft Excel) بمزيج معقد من الدوال الكلاسيكية الصارمة مثل دمج دوال الاقتطاع والتحديد الموضعي، مما فرض عبئاً إدراكياً ملحوظاً وتطلب مهارات متقدمة لتجنب أخطاء الإزاحة النصية. ومع التطور المتسارع للبرمجية منذ إطلاق نسختها الأولى لنظام ماكنتوش عام 1985 ثم ويندوز عام 1987، وصولاً إلى الثورة الحسابية المتمثلة في محرك المصفوفات الديناميكية (Dynamic Arrays)، شهدت بيئة إكسل تحولاً جذرياً نحو التبسيط والأتمتة. وقد توج هذا المسار في عام 2022 بإطلاق حزمة الدوال النصية الديناميكية الموجهة، وعلى رأسها دالة TEXTSPLIT، التي أعادت تعريف منهجية إدارة وتوزيع النصوص المتداخلة بصورة جذرية وفورية.
يهدف هذا الدليل المرجعي الشامل إلى استعراض الأسس النظرية والمنهجيات التطبيقية الدقيقة لتفكيك وتقسيم العناوين المعقدة إلى خلايا وأعمدة متعددة داخل إكسل. سنناقش بالتفصيل الأبعاد الرياضية والمنطقية لدالة TEXTSPLIT الحديثة، ونقارنها بالأدوات الإجرائية الكلاسيكية مثل معالج “تحويل النص إلى أعمدة” (Text to Columns)، وتقنيات التعلم بالنماذج مثل “التعبئة السريعة” (Flash Fill)، والحلول المؤسسية المتقدمة عبر محرر الاستعلامات “باور كويري” (Power Query)، مع توفير إطار عمل منهجي لضبط الجودة، وتطهير البيانات، ومعالجة الحالات الشاذة لضمان أقصى درجات الموثوقية والدقة الإحصائية.
1. الإطار المفاهيمي لمعالجة البيانات النصية والعناوين في إكسل
1.1 أهمية هيكلة العناوين في قواعد البيانات الرقمية
تحظى مسألة هيكلة البيانات النصية باهتمام بالغ في هندسة المعلومات، نظراً لأن البيانات المكانية غير المهيكلة تؤدي إلى تدني كفاءة الاستعلامات التحليلية وصعوبة نمذجة العلاقات الإحصائية. عندما يُحفظ العنوان كاملاً داخل حقل نصي واحد، تصبح محركات التحليل عاجزة عن تطبيق مقاييس التوزيع الجغرافي أو حساب الكثافات السكانية بكفاءة، مما يعطل وظائف الربط المكاني في نظم المعلومات الجغرافية. إن الانتقال من النص الحر إلى البيانات الجدولية المهيكلة يسهم بصورة مباشرة في تعزيز التماسك المفاهيمي للمتغيرات الوصفية، حيث تترابط الخصائص الجغرافية وفق تسلسل منطقي محدد يسهل معالجته حوسبياً، وهو ما يدعم استقرار النماذج التحليلية عند معالجة التباينات المكانية المعقدة كما بينت أبحاث التماسك المفاهيمي ومركزية الخصائص في تنظيم المعرفة (Sloman et al., 1998).
علاوة على ذلك، يمثل الفصل المعياري للحقول الجغرافية (مثل عزل الرمز البريدي، والمدينة، والشارع) ركيزة أساسية للحد من تكرار السجلات وتسهيل عمليات الفرز والتصفية المتقدمة. في بيئات قواعد البيانات المترابطة، يتيح توحيد الحقول تسريع عمليات الفهرسة (Indexing) وتقليل استهلاك الذاكرة العشوائية أثناء معالجة الاستعلامات المعقدة. كما يؤدي هذا الفصل إلى تقليص التدخل البشري اليدوي أثناء تدقيق السجلات، مما يحد من الخطأ البشري التراكمي ويرفع من موثوقية الأنظمة المؤسسية مثل إدارة علاقات العملاء (CRM)، التي تعتمد في جوهرها على مطابقة العناوين البريدية بدقة لأغراض الشحن، والتسويق الميداني، والامتثال الضريبي الإقليمي.
1.2 التحديات البنيوية المرتبطة بالنصوص المكانية المركبة
تنبع الصعوبة الأساسية في معالجة العناوين النصية من التباين الهائل في القواعد والأنماط التدوينية المعتمدة عبر مختلف الأقاليم الجغرافية ولدى مختلف المستخدمين. ففي حين تتبع بعض السجلات النمط الغربي التقليدي الذي يبدأ برقم المبنى يليه اسم الشارع ثم الحي فالمدينة فالرمز البريدي، تعتمد سجلات أخرى ترميزات إدارية محلية غير موحدة. يضاف إلى ذلك الاستخدام العشوائي للاختصارات المكانية، وتفاوت طرق كتابة وحدات السكن الثانوية مثل أرقام الشقق والمكاتب وصناديق البريد، مما يولد سلاسل نصية شديدة التشتت يصعب إخضاعها لقاعدة فصل برمجية وحيدة دون تهيئة مسبقة.
تتفاقم هذه الإشكالية البنيوية بوجود عيوب في الفواصل النصية نفسها، مثل غياب الفاصلة الفاصلة كلياً بين اسم المدينة والولاية، أو تكرار المسافات البيضاء، أو استخدام علامات ترقيم متباينة كالفواصل اللاتينية (,)، والفواصل العربية (،)، والشرطات (-)، والخطوط المائلة (/) في السجل نفسه. كما يشكل تداخل الرموز البريدية وأسماء الشوارع في حقل واحد خطراً تشغيلياً مضاعفاً، حيث قد تختلط الأرقام البريدية بأرقام المباني، مما يربك خوارزميات التجزئة النصية الآلية ويؤدي إلى توليد حقول مشوهة تتطلب جهوداً تصحيحية مضنية لاستعادة اتساق البيانات ومصداقيتها.
1.3 تطور أدوات المعالجة النصية داخل بيئة إكسل
عكف مهندسو البرمجيات في شركة مايكروسوفت على مدى عقود على تطوير الترسانة الحسابية لبرنامج إكسل لمواكبة متطلبات التحليل النصي المتقدم. في المراحل الأولى التي أعقبت إطلاق الإصدارات المكتبية الكلاسيكية، كان المستخدمون مقيدين بالاعتماد الحصري على تراكيب معقدة من الدوال النصية الثابتة، التي كانت تستهلك جهداً ذهنياً شاقاً لإجراء الحسابات الرياضية الدقيقة لأطوال النصوص ومواضع علامات الترقيم. هذه الصيغ، رغم دقتها النظرية، كانت عرضة للكسر والانهيار بمجرد حدوث أدنى تباين غير متوقع في طول السلسلة المدخلة، كما شكلت عائقاً كبيراً أمام استدامة الملفات ومشاركتها بين فرق العمل.
مع إطلاق محرك الحساب الديناميكي في نسخته الثورية، انتقلت المعالجة النصية إلى مستوى غير مسبوق من المرونة عبر تدشين مصفوفات الانسكاب الديناميكي (Dynamic Spill Arrays). أتاح هذا التطور إدخال دوال حديثة فائقة التخصص في عام 2022، قادرة على توليد مصفوفات نصية موزعة تلقائياً عبر الخلايا استناداً إلى صيغة وحيدة توضع في خلية الجذر. يستند الاختيار المنهجي للأداة المثلى في العصر الحالي إلى معايير صارمة تتضمن حجم العينة، ومستوى تعقيد البنية النصية، وطبيعة سير العمل سواء كان تحليلاً ثابتاً لمرة واحدة أو خط معالجة مؤسسي دوري يتطلب أتمتة وتحديثاً مستمراً.
2. الأساس النظري والرياضي لدالة TEXTSPLIT في إكسل
2.1 البنية البرمجية والمحددات الرياضية لدالة TEXTSPLIT
تمثل دالة TEXTSPLIT الإضافة الأبرز لمنظومة معالجة النصوص في بيئة Microsoft 365، حيث تم تصميم بنيتها الرياضية لتعمل كمحلل نحوي مبرمج (Token Parser) يتولى فحص السلسلة الأصلية وتفتيتها عند نقاط تقاطع محددة. تخضع الصيغة العامة للدالة للمعمارية التالية:
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
يمثل المتغير الإلزامي الأول (text) النص المراد تجزئته أو المرجع المباشر للخلية التي تحتويه، بينما يحدد المتغير الإلزامي الثاني (col_delimiter) الحرف أو مصفوفة الأحرف التي تفصل بين الأعمدة المراد توزيع البيانات عليها أفقياً عبر الصف ذاته.
تكمن القوة الحوسبية الفائقة للدالة في وسائطها الاختيارية المتقدمة؛ إذ يتيح المتغير (row_delimiter) إمكانية توزيع النص عمودياً على عدة صفوف بدلاً من الأعمدة، أو إنشاء شبكة ثنائية الأبعاد عند دمج محددات الصفوف والأعمدة معاً في صيغة موحدة. وتؤدي وسيطة (ignore_empty)، التي تأخذ قيمة منطقية (TRUE أو FALSE)، دوراً محورياً في تجاوز المحددات المتتالية ومنع إنشاء خلايا فارغة مشوهة للتوزيع. كما تتيح وسيطة (match_mode) تحديد حساسية الأحرف للتطابق، في حين توفر وسيطة ملء الفراغات (pad_with) قيمة نصية بديلة توضع تلقائياً في الخلايا الشاغرة لمنع توليد أخطاء القيمة المفقودة (#N/A) عندما تتباين أطوال السلاسل النصية المقسمة.
2.2 مفهوم المصفوفات الديناميكية وآلية التوسع التلقائي
تعتمد دالة TEXTSPLIT كلياً على بيئة الحساب الديناميكي في إكسل، والتي غيرت الفلسفة التقليدية القائمة على ارتباط كل صيغة بخلية مفردة. عند إدخال دالة TEXTSPLIT في خلية محددة، يقوم محرك الحساب بحساب أبعاد المصفوفة الناتجة بناءً على عدد المحددات المكتشفة في السلسلة النصية، ثم يقوم بنشر النتائج أو سكبها تلقائياً (Spill Behavior) عبر نطاق من الخلايا المجاورة أفقياً أو عمودياً، دون الحاجة للضغط على اختصارات مصفوفات الحساب القديمة (Ctrl + Shift + Enter).
ومع ذلك، يخضع هذا التمدد الديناميكي التلقائي لقيد حتمي يعرف بحدود النطاق الخالي؛ فإذا اعترضت مسار المصفوفة المنسكبة أي بيانات نصية، أو أرقام، أو حتى مسافات غير مرئية في الخلايا المجاورة، فإن محرك الحساب سيعلق العملية الحسابية فوراً ويُظهر رسالة الخطأ الشهيرة (#SPILL!). يُعد هذا الخطأ آلية أمان مدمجة مصممة هندسياً لمنع الاستبدال غير المقصود للبيانات التاريخية المتواجدة مسبقاً في جدول البيانات. ولتجاوز هذا الخطأ، يتعين على محلل البيانات إفراغ المسار الفيزيائي المتوقع للانسكاب، لتستأنف المصفوفة تدفقها الديناميكي بصورة آنية وشفافة.
2.3 المتطلبات التقنية وبيئة التشغيل المعتمدة
على الرغم من القدرات الاستثنائية التي تتمتع بها دالة TEXTSPLIT، إلا أن تطبيقها مقيد بالمتطلبات المعمارية لإصدارات إكسل المستخدمة. تتوفر الدالة بصورة حصرية ضمن اشتراكات مايكروسوفت السحابية (Microsoft 365) وتطبيق Excel للويب، بعد أن تم إطلاقها التجريبي لمشتركي برنامج Insider في مارس 2022، لتبلغ الإتاحة العامة المستقرة في أغسطس من العام ذاته. هذا التقييد يعني بصورة قاطعة أن مستخدمي الإصدارات الدائمة المستقلة القديمة (مثل Excel 2016، وExcel 2019، وExcel 2021) لن يتمكنوا من قراءة الصيغة أو تنفيذها، حيث ستظهر في جداولهم كرمز خطأ في التسمية (#NAME?).
من حيث كفاءة المعالجة الحسابية واستهلاك موارد النظام، تتميز دالة TEXTSPLIT بسرعة معالجة فائقة مقارنة بالصيغ الكلاسيكية المتداخلة، وذلك لأن شفرتها البرمجية تعمل مباشرة على مستوى النواة الحسابية المترجمة بلغة C++ الخاصة بإكسل. ومع ذلك، عند التعامل مع مصنفات ضخمة تحتوي على مئات الآلاف من السجلات المكانية المركبة، فإن تحديث مصفوفات الانسكاب الديناميكي عبر نطاقات واسعة متجاورة قد يسبب تباطؤاً ملحوظاً في وقت إعادة الحساب (Volatile Calculation Thread). في مثل هذه السيناريوهات المؤسسية المتقدمة، يُوصى بتحويل المخرجات المحسوبة إلى قيم نصية ثابتة بعد اكتمال مرحلة التطهير، لضمان استقرار الأداء التشغيلي للمصنف وسرعة استجابته.
3. التطبيق العملي خطوة بخطوة لاستخدام دالة TEXTSPLIT
3.1 تهيئة مصفوفة البيانات الأولية وتحديد معايير الفصل
تبدأ المعالجة المنهجية للعناوين بإجراء تدقيق استكشافي شامل لعينة ممثلة من البيانات الخام لاكتشاف بنيتها النصية وتحديد مواضع الخلل المحتملة. لنفترض أن لدينا سجلاً أولياً يقع في الخلية A2 يحتوي على العنوان التالي المكتوب بنمط مركب: "742 Evergreen Terrace, Springfield, OR, 97477". يتطلب التحضير الدقيق فحص الرمز الفاصل المعتمد في السلسلة النصية؛ وفي هذه الحالة، نلاحظ بوضوح أن الفاصلة اللاتينية (Comma) هي المحدد المنتظم الذي يفصل بين اسم ورقم الشارع، والمدينة، والولاية، والرمز البريدي.
يتضمن الإعداد الفيزيائي لجدول البيانات التأكد من توفر أعمدة فارغة تماماً إلى يمين الخلية المستهدفة A2 (الأعمدة B، وC، وD، وE). إن إغفال هذه الخطوة سيؤدي حتماً إلى تعثر عملية انسكاب المصفوفة وظهور خطأ #SPILL!. يُفضل دائماً تسمية الأعمدة المستهدفة مؤقتاً أو التأكد من إزالة أي محتويات سابقة أو تنسيقات شرطية متبقية فيها قد تتداخل مع ناتج التجزئة التلقائي.
3.2 بناء وتطبيق الصيغة القياسية لتقسيم العنوان
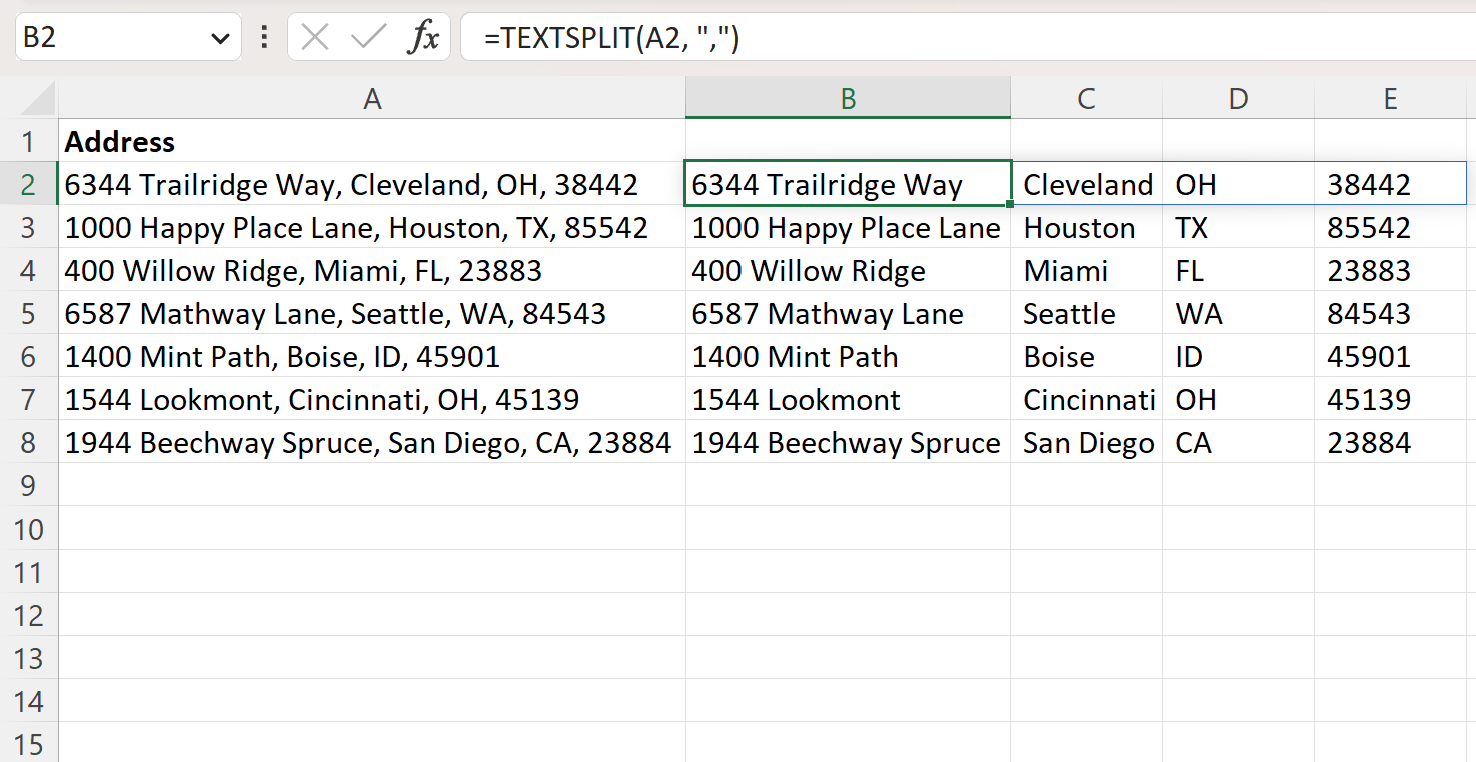
بعد التحقق من جاهزية البيئة، ننتقل إلى الخلية المجاورة B2 ونقوم بصياغة المعادلة الرياضية الأساسية بالدقة التالية:
=TEXTSPLIT(A2, ",")
بمجرد الضغط على مفتاح الإدخال (Enter)، يرسل محرك الحساب الديناميكي مخرجات التجزئة ليتم توزيعها عبر أربع خلايا متتالية في نفس الصف: تظهر القيمة 742 Evergreen Terrace في الخلية B2، والمدينة Springfield في C2، والولاية OR في D2، والرمز البريدي 97477 في E2. تتشكل هذه النتائج ككتلة مصفوفية متماسكة يحيط بها إطار انسكاب أزرق نحيف ينبه المستخدم إلى أن الخلية B2 هي الخلية الأم المالكة للصيغة، في حين تمثل الخلايا الأخرى امتداداً حسابياً تابعاً لها.
لتعميم هذا الإجراء على مصفوفة السجلات بالكامل، يمكن سحب مقبض التعبئة (Fill Handle) من زاوية الخلية B2 للأسفل باتجاه بقية صفوف الجدول، أو النقر المزدوج فوق المقبض لتوليد الصيغ رأسياً حتى نهاية النطاق النشط. وتتميز هذه الطريقة بالحيوية التامة؛ فإذا تم تعديل العنوان الأصلي في الخلية A2 لاحقاً، ستنعكس التعديلات بصورة فورية وتلقائية على كافة الخلايا الناتجة دون الحاجة لأي تدخل يدوي إضافي من المستخدم.
3.3 معالجة المسافات الهامشية وتطهير النص المخرَج
تكشف المعاينة الدقيقة للمخرجات الناتجة عن الصيغة السابقة عيباً نصياً دقيقاً وشائعاً: فعلى الرغم من نجاح الدالة في عزل الكلمات، إلا أن المحدد المستخدم كان الفاصلة فقط (",")، بينما كانت السلسلة الأصلية تحتوي على مسافة بيضاء تلي كل فاصلة مباشرة. أدى ذلك إلى احتواء الخلايا الناتجة (مثل C2، وD2، وE2) على مسافة بادئة غير مرئية تسبق النص الفعلي، مما يجعل القيمة المخزنة تبدو كـ " Springfield" بدلاً من "Springfield" النظيفة. هذه المسافات الشاردة تمثل خطراً تشغيلياً كبيراً، حيث تتسبب في فشل دوال البحث اللاحقة مثل VLOOKUP أو XLOOKUP التي تعتمد على التطابق الحرفي التام.
للقضاء على هذه المعضلة بصورة جذرية، نقوم بدمج دالة التطهير النصي TRIM في بنية رياضية مركبة تتولى فحص وتنظيف كافة عناصر المصفوفة المولدة قبل وضعها النهائي في الخلايا. تأخذ الصيغة المطورة الشكل التالي:
=TRIM(TEXTSPLIT(A2, ","))
تعمل دالة TRIM على إزالة كافة المسافات البادئة واللاحقة من كل قيمة مجزأة مع الإبقاء فقط على المسافات المفردة الفاصلة بين الكلمات داخل الحقل نفسه. يضمن هذا التطهير النصي الصارم مطابقة السجلات المكانية للمعايير القياسية لجودة البيانات، ويهيئ الحقول الناتجة لتكون متوافقة كلياً مع عمليات التحقق، والدمج، والتحليل الإحصائي اللاحقة دون أخطاء غير مرئية.
4. هيكلة المخرجات وتوحيد معايير رؤوس الأعمدة
4.1 التقسيم المعياري لمكونات العنوان الجغرافي
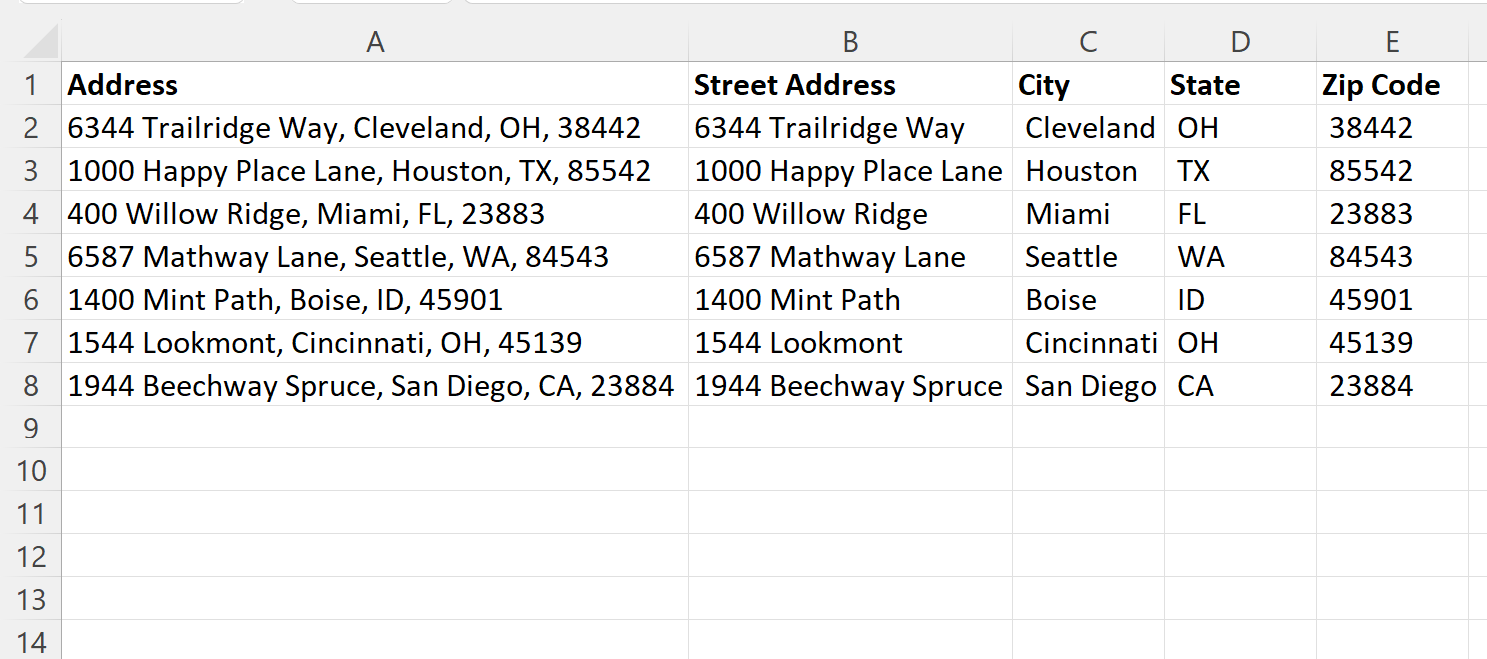
إن الهدف الأسمى من تجزئة العناوين لا يقتصر على مجرد التوزيع العشوائي للنصوص عبر الخلايا، بل يستهدف الوصول إلى نمذجة قياسية تتطابق مع أفضل الممارسات في هندسة قواعد البيانات المكانية. يتطلب هذا النهج تفكيك العنوان إلى أربعة حقول وظيفية محددة: أولاً، حقل “عنوان الشارع” (Street Address)، وهو الحقل الأساسي المخصص لتحديد الموقع الدقيق للكيان العقاري، متضمناً رقم المبنى والمسار والوصف التفصيلي. ثانياً، حقل “المدينة” (City)، الذي يعد متغيراً حاسماً في التحليلات الحضرية والديموغرافية وتجميع البيانات التراكمية.
ثالثاً، حقل “المحافظة أو الولاية” (State/Province)، الذي يمثل المستوى الإداري الإقليمي الأعلى، ويُستخدم عادة في تحديد النطاقات القضائية والضريبية واللوجستية للأنشطة المؤسسية. وأخيراً، حقل “الرمز البريدي” (Postal/ZIP Code)، وهو المتغير الأكثر حساسية رقمياً، إذ يعتمد عليه في التحقق من صحة المواقع الجغرافية، وحساب تسعيرة الشحن بدقة، وإسقاط الإحداثيات على الخرائط الرقمية. إن عزل هذه العناصر في أعمدة نقية ومستقلة يمنح المحلل القدرة على التعامل مع كل بُعد جغرافي كمتغير إحصائي قائم بذاته يخضع للفرز والتجميع والتحليل المستقل.
4.2 تصميم وتوثيق رؤوس الجداول بطريقة منهجية
يتطلب التصميم الاحترافي لجداول البيانات إدراج صف عناوين وصفي ودقيق أعلى الأعمدة المقسمة الجديدة ليعبر بوضوح عن ماهية المحتوى الداخلي لكل حقل. يجب تجنب استخدام أسماء غامضة مثل “العمود 1” أو “العمود 2″، والاستعاضة عنها بتسميات قياسية متفق عليها داخل المؤسسة، مثل: Street_Address، وCity_Name، وState_Code، وPostal_Code. يعزز هذا التوثيق التوحيدي قدرة أعضاء الفريق متعددي الوظائف على استيعاب هيكل البيانات بسرعة وبأقل جهد إدراكي ممكن.
إن الوضوح البصري للواجهات يقلل من تشوش المستخدمين ويعزز سرعة ودقة معالجة المعلومات، وهو ما يتسق مع المبادئ الحوسبية والإدراكية لنظرية الواجهات وإدراك التمثيل البياني (Hoffman et al., 2015). يوصى كذلك بتطبيق قواعد التنسيق الشرطي (Conditional Formatting) على رؤوس الأعمدة أو البيانات المفروزة لتمييز الفئات الجغرافية المختلفة بصرياً، وإرفاق قواميس البيانات (Data Dictionaries) التي تشرح الترميزات المعتمدة (كاستخدام رموز الولايات الثنائية مثل CA أو NY بدلاً من كتابة الاسم الكامل) لضمان التوافق مع الأنظمة الخارجية عند تصدير الملفات.
4.3 التحويل إلى جداول إكسل المنظمة (Excel Tables)
يعد تحويل نطاق البيانات التقليدي إلى كائن جدول إكسل رسمي (Excel Table) خطوة تأسيسية لبناء حلول مستدامة وخالية من الأخطاء التنسيقية. يتم هذا التحويل بسهولة عبر تحديد أي خلية داخل النطاق والضغط على الاختصار Ctrl + T. يمنح هذا الإجراء جدول البيانات سمات برمجية تفاعلية فائقة؛ حيث تتحول مراجع الخلايا الثابتة مثل A2 إلى مراجع مهيكلة واضحة المعالم مثل [@Full_Address]، مما يجعل الصيغ الحسابية مقروءة ذاتياً وقابلة للفهم والتدقيق البرمجي المباشر.
بالإضافة إلى ذلك، تضمن الجداول المنظمة التمدد التلقائي للمعادلات والصيغ الحسابية (Calculated Columns)؛ فعند لصق سجلات جديدة في نهاية الجدول، تتمدد مصفوفات دالة TEXTSPLIT والصيغ المرتبطة بها لتشمل الصفوف المضافة حديثاً بشكل آلي تام، ودون أدنى حاجة لسحب مقبض التعبئة يدوياً. كما يؤمن تحويل النطاق إلى جدول استقراراً متيناً لأسماء الحقول ومراجعها الحسابية عند تصدير البيانات إلى منصات الأعمال الذكية مثل Power BI أو قواعد بيانات SQL المؤسسية.
5. التعامل مع الحالات الاستثنائية والتباينات في هيكل العناوين
5.1 معالجة التباين في عدد المحددات والفواصل داخل السجل
تتميز البيانات الواقعية بالعشوائية والتفاوت البنيوي، حيث نادراً ما تلتزم كافة السجلات بالعدد الدقيق نفسه من الفواصل. فقد يحتوي عنوان معين على رقم الشقة أو اسم الحي مما يزيد عدد الفواصل إلى أربع أو خمس، في حين يفتقر عنوان آخر لاسم الحي فتقتصر فواصله على اثنتين فقط. إذا تم تطبيق الصيغة القياسية البسيطة على مثل هذه السجلات المتباينة، ستتوزع المخرجات عبر أعمدة غير متناظرة، مما يولد خللاً عمودياً في البيانات (Data Misalignment) يجعل أسماء المدن تختلط بالولايات أو الرموز البريدية.
لمواجهة تكرار الفواصل العشوائية الناتج عن أخطاء الإدخال اليدوي (مثل ظهور فاصلتين متتاليتين ",,")، يجب تفعيل وسيطة الدالة ignore_empty بضبط قيمتها على TRUE. تعمل هذه الوسيطة على معالجة المحددات المتتالية كوحدة فاصلة واحدة، متجاوزة إنشاء فراغات غير منطقية. أما في حالات تباين أطوال السجلات التي ينتج عنها نقص في عدد الأعمدة، تبرز أهمية وسيطة pad_with، التي تتيح إدراج نص استباقي محدد (مثل "غير محدد" أو "NA") لملء الخانات الشاغرة في السجلات القصيرة، مما يحافظ على التوازن الشكلي والهندسي لشبكة البيانات ويمنع انهيار البنية الجدولية للأعمدة المشتركة:
=TEXTSPLIT(A2, ",", , TRUE, , "NA")
5.2 إدارة المحددات المتعددة والمختلفة في نفس العنوان
من أكثر السيناريوهات تعقيداً في تنظيف العناوين وجود سجلات تستخدم علامات ترقيم متعددة داخل السلسلة الواحدة؛ كأن يُفصل بين الشارع والمدينة بفاصلة عادية، بينما يُفصل بين الولاية والرمز البريدي بشرطة أفقية (Hyphen)، مثل: "123 Main St, Springfield - IL - 62701". تفشل الصيغ النصية البسيطة التي تبحث عن محدد منفرد في التعامل مع هذا الخليط، وتترك أجزاء كاملة من العنوان مدمجة دون تجزئة.
تتفوق دالة TEXTSPLIT في هذا الإطار بقدرتها الفائقة على استقبال “مصفوفة ثابتة” (Array Constant) من المحددات في وسيطة col_delimiter. يتم ذلك عبر وضع المحددات المختلفة بين أقواس معقوفة {} وتفريقها بفواصل، كما يلي:
=TRIM(TEXTSPLIT(A2, {",", "-", "/"}))
تقوم هذه الصيغة بمسح السلسلة النصية فاحصة كل موقع حرفي؛ وبمجرد العثور على أي من الرموز المضمنة في المصفوفة (سواء كانت فاصلة، أو شرطة، أو خطاً مائلاً)، فإنها تعتمدها كنقطة انشطار نصي، وتقوم بتوزيع الكتل عبر أعمدة منفصلة ومن ثم تنظيفها بواسطة TRIM، مما يتيح توحيد أنماط التدوين المتنوعة وأرقام الشقق والمكاتب بصيغة موحدة وعالية المرونة.
5.3 التعامل مع الأخطاء الناتجة عن تفاوت أطوال السجلات
قد تحتوي بعض قواعد البيانات المتضخمة على سجلات تالفة بالكامل، مثل الخلايا التي تحوي نصوصاً عشوائية قصيرة خالية من أي محددات، أو خلايا تحتوي على أخطاء برمجية سابقة مثل #VALUE!. إن تطبيق عمليات التجزئة على هذه السلاسل قد يولد رسائل خطأ تشوه المظهر العام لورقة العمل وتعيق الحسابات الإحصائية التراكمية. تقتضي الهندسة الوقائية للصيغ الحسابية تطويق دالة التجزئة بدالة معالجة الأخطاء IFERROR بالشكل التالي:
=IFERROR(TRIM(TEXTSPLIT(A2, ",")), "تحقق من العنوان")
توفر هذه الحماية التقنية مساراً آمناً؛ فإذا فشلت الدالة في إجراء عملية التقسيم بسبب تلف البنية النصية، يتم إرجاع تنبيه نصي صريح يرشد المستخدم إلى ضرورة فحص العنوان يدوياً. بالتوازي مع ذلك، يُنصح ببناء عمود فحص تدقيقي يعتمد على الدوال المنطقية مثل ISNUMBER وISTEXT لاختبار صحة الحقول المستخرجة (كالتأكد من أن حقل الرمز البريدي يتكون حصراً من صيغ رقمية مقبولة)، مما يسمح بعزل السجلات الشاذة في أوراق عمل مستقلة للمراجعة اليدوية المتخصصة.
6. البدائل الإجرائية: استخدام معالج تحويل النص إلى أعمدة
6.1 آلية عمل أداة Text to Columns التقليدية
قبل ظهور المصفوفات الديناميكية، مثل معالج “تحويل النص إلى أعمدة” (Text to Columns Wizard) الأداة المعيارية الأولى لمعالجة النصوص المدمجة في إكسل، ولا يزال يحتفظ بأهميته التقنية كحل إجرائي سريع لا يعتمد على كتابة الصيغ الرياضية. يمكن الوصول إلى هذه الأداة عبر التوجه إلى شريط الأدوات العلوي، واختيار علامة التبويب “بيانات” (Data Tab)، ثم النقر فوق زر “نص إلى أعمدة” (Text to Columns) الموجود ضمن مجموعة “أدوات البيانات” (Data Tools).
يعمل المعالج عبر مسارين رئيسيين: الأول هو خيار “عرض ثابت” (Fixed Width)، وفيه يتم تقسيم النص عند مواضع عددية ثابتة للأحرف، وهو خيار غير ملائم للعناوين نظراً للتفاوت الطبيعي في أطوال أسماء الشوارع والمدن. أما المسار الثاني والملائم فهو خيار “محدد” (Delimited)، وفيه يُمنح المستخدم القدرة على تحديد الرمز الفاصل الدقيق (كالفاصلة، أو علامة الجدولة Tab، أو المسافة، أو الفاصلة المنقوطة). توفر واجهة المعالج نافذة معاينة فورية تتيح فحص تموضع الأعمدة قبل النقر على زر المتابعة، مما يمنح المحلل تحكماً بصرياً مباشراً في النتائج المترتبة على التجزئة.
6.2 تحديد أنواع بيانات الأعمدة والوجهة المستهدفة
في الخطوة الثالثة والأخيرة من معالج “نص إلى أعمدة”، تبرز واحدة من أدق التفاصيل التقنية التي قد تؤدي إلى تشويه البيانات إن لم يتم الانتباه إليها، وتحديداً ما يتعلق بتحديد نوع البيانات (Column Data Format) وموقع الوجهة (Destination). يميل إكسل بطبيعته الافتراضية إلى تحويل الحقول الناتجة إلى التنسيق “العام” (General)، وهو تنسيق يقوم بتحويل أي سلسلة تحتوي على أرقام فقط إلى صيغة عددية رقمية مباشرة.
يشكل هذا السلوك الافتراضي خطراً داهماً على الرموز البريدية التي تبدأ بالرقم صفر (كما هو الحال في بعض الولايات الأمريكية مثل ماساتشوستس ونيوجيرسي، وكذلك بعض الترميزات الدولية)، حيث يقوم إكسل بحذف الأصفار البادئة فوراً لاعتبارها غير ذات دلالة حسابية، فيتحول الرمز البريدي "02138" إلى "2138"، مما يفقده قيمته المكانية والقانونية. ولتفادي هذه المشكلة، يتعين النقر على عمود الرمز البريدي في نافذة المعاينة وتغيير تنسيقه يدوياً من “General” إلى “Text”. علاوة على ذلك، يجب تعديل خانة الوجهة (Destination) للإشارة إلى عمود فارغ مجاور (مثل $B$2) بدلاً من استبدال العمود الأصلي $A$2؛ لتفادي استبدال البيانات المصدرية وضياعها بصورة غير قابلة للتراجع.
6.3 مقارنة منهجية بين المعالج اليدوي ودالة TEXTSPLIT
يكشف التحليل المقارن بين معالج “نص إلى أعمدة” ودالة TEXTSPLIT عن فوارق وظيفية وتشغيلية جوهرية تملي على المحلل أيهما يختار وفق طبيعة المهمة:
- الديناميكية وتحديث البيانات: يفتقر المعالج الإجرائي كلياً لميزة التحديث التلقائي؛ فالمخرجات الناتجة عنه تمثل قيماً نصية ثابتة غير مرتبطة بمصدرها. وإذا أُضيفت عناوين جديدة أو تم تعديل البيانات الأصلية، يجب إعادة تشغيل خطوات المعالج يدوياً من البداية. في المقابل، تتميز دالة
TEXTSPLITبارتباطها الحسابي التفاعلي؛ حيث تتغير وتتوسع تلقائياً بمجرد تعديل المدخلات. - الأثر على حجم الملف واستهلاك الذاكرة: يتفوق المعالج اليدوي في معالجة الملفات النصية الضخمة جداً ذات الطبيعة الثابتة لمرة واحدة، نظراً لأنه لا يحجز ذاكرة حسابية للمصفوفات الديناميكية النشطة، مما يحافظ على خفة الملف وثبات سرعته. بينما قد تؤدي ملايين الدوال الحسابية المتزامنة إلى إثقال كاهل المعالج المركزي أثناء فتح المصنف.
- سهولة الصيانة وإمكانية التراجع: تتفوق دالة
TEXTSPLITفي قابليتها للمراجعة البرمجية السريعة والتحكم في وسائطها، فضلاً عن قدرتها الفائقة على الحفاظ على البيانات الأصلية في عمودها المصدر دون خطر الاستبدال الخاطئ.
7. المعالجة المتقدمة باستخدام الدوال الكلاسيكية المركبة
7.1 تفكيك النصوص باستخدام مصفوفة الدوال LEFT و RIGHT و MID
في بيئات العمل التقنية التي تعتمد على إصدارات أقدم من إكسل تفتقر لدعم الدوال الحديثة، يصبح استخدام التراكيب الرياضية الكلاسيكية المكونة من دوال الاقتطاع النصي هو السبيل الوحيد لإنجاز التجزئة البرمجية للعناوين. تعتمد هذه المنهجية على استنتاج الحدود الحرفية الدقيقة لكل مكون بالاعتماد على التوليف المتوازي لدوال LEFT، وMID، وRIGHT بالتكامل مع دوال القياس العددي مثل LEN.
لاستخراج المكون الأول من العنوان (اسم ورقم الشارع) الواقع في الخلية A2، يتم استخدام دالة LEFT لاقتطاع عدد من الحروف يبدأ من أقصى اليسار وحتى موضع أول فاصلة في النص. وتصاغ المعادلة على النحو الآتي:
=TRIM(LEFT(A2, FIND(",", A2) - 1))
أما بالنسبة للمكونات الوسطى كاسم المدينة، فتتولى دالة MID المهمة عبر تحديد نقطة البدء الحرفية مباشرة بعد الفاصلة الأولى، ثم احتساب عدد الحروف المستهدفة عن طريق طرح موقع الفاصلة الأولى من موقع الفاصلة الثانية، وهو ما يجسد العمليات الحسابية لمصفوفة الإزاحة النصية المركبة:
=TRIM(MID(A2, FIND(",", A2) + 1, FIND(",", A2, FIND(",", A2) + 1) - FIND(",", A2) - 1))
وأخيراً، يُستقطع الرمز البريدي أو الولاية الواقعة في ذيل السلسلة باستخدام دالة RIGHT مقترنة بدالة LEN لحساب الفارق بين الطول الإجمالي للنص وموقع الفاصلة الأخيرة، مما يوضح التعقيد الهيكلي المتأصل في هذه الصيغ التراثية.
7.2 تحديد مواقع الفواصل بدقة متناهية عبر SEARCH و FIND
تشكل دالتا FIND وSEARCH النواة الحسابية التي تقود خوارزميات الاقتطاع الكلاسيكية؛ حيث تتولى كل منهما إرجاع الموضع الرقمي النسبي لحرف معين داخل السلسلة النصية. يكمن الفارق الجوهري بينهما في أن دالة FIND تتسم بالحساسية التامة لحالة الأحرف (Case-Sensitive) ولا تدعم الرموز البديلة (Wildcards)، مما يجعلها خياراً مثالياً عند البحث عن علامات ترقيم ثابتة وصارمة كالفواصل. في المقابل، تتسم دالة SEARCH بالمرونة وتجاهل حالة الأحرف، مما يجعلها مفيدة في تتبع الاختصارات المكانية كالبحث عن كلمة "Apt" أو "Suite" بغض النظر عن طريقة كتابتها.
تتعقد الصياغة البرمجية تدريجياً عند محاولة تتبع الفواصل المتتالية؛ حيث يتطلب العثور على الفاصلة الثالثة أو الرابعة تضمين دالة FIND داخل دالة FIND أخرى بصورة متدرجة لتحديد نقطة انطلاق البحث الجديدة، كما يظهر في التركيب: FIND(",", A2, FIND(",", A2) + 1). يفرض هذا التداخل المتشعب عبئاً إدراكياً شاقاً على مهندسي البيانات ويزيد من احتمالات الخطأ الإجرائي عند التحرير اليدوي. إن تقليل التعقيد البرمجي في واجهات الإدخال يعزز من كفاءة الأداء التشغيلي للفرق، ويحد من نسب وقوع الأخطاء غير المقصودة الناتجة عن الحمل الذهني الزائد، وهو ما أكدته أبحاث الأداء الإجرائي وهندسة العوامل البشرية (Healey, 2004).
7.3 استراتيجيات تفضيل الدوال الكلاسيكية في البيئات القديمة
على الرغم من التعقيد الشديد الذي تتسم به الدوال الكلاسيكية، إلا أن هناك سياقات مؤسسية تلزم المحلل بالتمسك بها كخيار تقني مفضل. تبرز هذه الحاجة بصفة خاصة عند بناء نماذج مالية أو قواعد بيانات مشتركة يُتوقع تداولها واستخدامها عبر شبكات عمل غير متجانسة تضم أجهزة حاسوب تعمل بإصدارات قديمة ومستقلة مثل Excel 2013 أو Excel 2016. في مثل هذه البيئات المؤسسية المحافظة، يؤدي فتح ملف يعتمد على دالة TEXTSPLIT إلى شلل حسابي وظهور أخطاء #NAME? تعطل مسارات العمل اليومية.
لتجنب هذا الانقطاع التشغيلي، يتبع مهندسو البيانات استراتيجية الصياغة المتوافقة مع الإصدارات السابقة (Backward Compatibility). وتتطلب هذه الاستراتيجية توثيق الخوارزميات النصية بدقة متناهية، وتقسيم الصيغ الطويلة على أعمدة مساعدة (Helper Columns) يحسب كل منها موضع فاصلة معينة، بدلاً من دمجها في معادلة واحدة غير قابلة للصيانة. يسهل هذا التقسيم المعياري تدقيق الحسابات وتصحيح الانحرافات لاحقاً دون التضحية باستقرار المصنف في البيئات التقنية القديمة.
8. توظيف تقنيات التعبئة السريعة (Flash Fill) والتعرف على الأنماط
8.1 المبادئ الحوسبية لأداة التعبئة السريعة
تمثل ميزة “التعبئة السريعة” (Flash Fill) قفزة نوعية في دمج الذكاء الاصطناعي وخوارزميات تعلم الآلة ضمن المهام اليومية لبرنامج إكسل. تعود الجذور العلمية لهذه الأداة إلى أبحاث الدكتور سوميت جولواني (Dr. Sumit Gulwani) وفريقه في مركز أبحاث مايكروسوفت (Microsoft Research)، حيث تم نشر الورقة البحثية التأسيسية تحت عنوان “Automating String Processing in Spreadsheets Using Input-Output Examples” ضمن وقائع مؤتمر POPL عام 2011 الصادر عن رابطة مكائن الحوسبة (ACM SIGPLAN). تم دمج هذه التقنية تجارياً لأول مرة في إصدار Excel 2013 كأداة ثورية تتيح للمستخدمين تجزئة واستخراج النصوص دون كتابة صيغة رياضية واحدة.
تعتمد الأداة حوسبياً على نموذج “البرمجة بالنماذج” (Programming by Example – PBE)؛ حيث تقوم خوارزمية الاستدلال الاستقرائي بفحص وتحليل العلاقات الرياضية بين السلسلة النصية المدخلة في العمود الأصلي والمخرجات التي يكتبها المستخدم يدوياً في الخلية المجاورة كنموذج تدريبي. وبمجرد استنتاج النمط الحاكم وقواعد الاقتطاع، تقوم الخوارزمية بتركيب شيفرة برمجية داخلية مخصصة وتطبيقها فوراً لمعالجة بقية السجلات في العمود تلقائياً بمجرد الضغط على الاختصار Ctrl + E.
8.2 التطبيق العملي لاستخراج حقول العنوان بالتعبئة السريعة
لتطبيق التعبئة السريعة على تفكيك سجلات العناوين عملياً، يتم إنشاء عمود جديد مجاور لبيانات العنوان الأصلية ونسميه مثلاً “اسم الشارع”. في الخلية الأولى من هذا العمود (ولتكن B2)، يكتب المستخدم يدوياً الجزء الخاص بالشارع فقط المستخرج من الخلية A2 (مثل كتابة: 742 Evergreen Terrace). بعد الضغط على مفتاح الإدخال، ينتقل المستخدم إلى الخلية B3 ويبدأ في كتابة الشارع الخاص بالعنوان الثاني؛ هنا يكتشف محرك التعبئة السريعة النمط فوراً ويعرض قائمة رمادية خافتة تحتوي على التوقعات المقترحة لكافة الصفوف التالية.
إذا كانت المقترحات صحيحة، يضغط المستخدم على Enter لاعتمادها فوراً، أو يمكنه الاكتفاء بكتابة النموذج الأول فقط في الخلية B2 ثم الضغط على الاختصار Ctrl + E لإجبار الأداة على ملء كامل العمود بضغطة زر واحدة. تتكرر هذه العملية في الأعمدة التالية لعزل حقول “المدينة”، و”الولاية”، و”الرمز البريدي” كل على حدة. وإذا وقع خطأ في استنتاج نمط أحد السجلات، يمكن للمستخدم التدخل يدوياً وتصحيح القيمة الشاذة، لتقوم خوارزمية الاستدلال بإعادة ضبط نموذجها الحسابي فورياً وتعديل بقية الخلايا لتتناسب مع النمط المصحح.
8.3 تقييم المخاطر الإحصائية والحدود التشغيلية للأداة
على الرغم من السهولة والسرعة الفائقة التي توفرها أداة التعبئة السريعة، إلا أنها تحمل مخاطر إحصائية وتشغيلية لا يستهان بها في بيئات معالجة البيانات الحساسة. يتمثل العيب الهيكلي الأبرز في انعدام أي ربط ديناميكي بين البيانات الأصلية والمخرجات المولدة؛ فالقيم الناتجة عن التعبئة السريعة هي نصوص استاتيكية جامدة، لا تتحدث على الإطلاق إذا تم تعديل العنوان الأصلي، ولا تنبه المستخدم إلى عدم توافقها مع التحديثات اللاحقة.
تتمثل الخطورة الأكبر في احتمالية وقوع ما يُعرف بـ “الأخطاء الاستنتاجية الصامتة” (Silent Predictive Errors)؛ إذ قد تنجح الخوارزمية في معالجة أول خمسين سجلاً متناسقاً بدقة، ولكن عندما تصادف سجلاً يحتوي على عنوان غير قياسي (مثل احتواء اسم المدينة على مقطعين مثل New York بينما كانت النماذج السابقة لمدن ذات مقطع واحد مثل Chicago)، قد تفشل الخوارزمية بصمت وتقوم باقتطاع نصف الاسم وتوزيع النصف الآخر في عمود الولاية دون إشعار المستخدم بوجود خطأ. بناءً على ذلك، توصي المعايير المنهجية الصارمة بقصر استخدام التعبئة السريعة على العينات الصغيرة غير الحرجة، والاعتماد الحصري على الصيغ أو محرك Power Query في المشاريع الكبرى لضمان الاتساق والموثوقية.
9. الأتمتة المؤسسية لتقسيم العناوين باستخدام Power Query
9.1 استيراد بيانات العناوين إلى بيئة محرر الاستعلامات
يمثل محرك “باور كويري” (Power Query) الحل المؤسسي الأمثل والأكثر متانة لأتمتة عمليات استخراج وتحويل وتحميل البيانات (ETL) داخل إكسل، حيث يتيح إجراء تحويلات هيكلية عميقة على مجموعات البيانات دون المساس بالبيانات المصدرية أو التأثير سلباً على أداء الحساب في ورقة العمل. يبدأ العمل بتحويل نطاق العناوين إلى جدول، ثم الانتقال إلى علامة التبويب “بيانات” (Data) واختيار “من ورقة/نطاق” (From Sheet/Range) ضمن مجموعة “الحصول على البيانات وتحويلها” (Get & Transform Data)، ليفتح النظام نافذة محرر Power Query المخصصة.
تتم المعالجة داخل محرك الاستعلامات في بيئة ذاكرة معزولة كلياً ومحمية برمجياً، حيث يتم أولاً تدقيق وتحديد نوع البيانات الأولي لكل عمود لضمان قراءة السلاسل بصفتها قيماً نصية نقية (Text Data Type). تضمن هذه الخطوة التأسيسية عزل التعديلات عن الخلايا الحسابية الحية وتوفر مساراً آمناً لإجراء عمليات التطهير والتفتيت مهما بلغت درجة تعقيد السجلات.
9.2 تنفيذ عملية تجزئة العمود بواسطة المحدد (Split Column by Delimiter)
بمجرد تحميل الجدول داخل واجهة المحرر، نحدد عمود العناوين المستهدف، ثم ننتقل إلى علامة التبويب “الصفحة الرئيسية” (Home) أو “تحويل” (Transform) ونختار الأمر “تقسيم العمود” (Split Column) يليه “بواسطة المحدد” (By Delimiter). تفتح هذه الخطوة نافذة إعدادات متقدمة تمنح المستخدم دقة تحكم متناهية؛ حيث نختار “الفاصلة” (Comma) كمحدد رئيسي، ونحدد خيار التجزئة “عند كل ظهور للمحدد” (At each occurrence of the delimiter) لضمان تفكيك السلسلة إلى كافة أجزائها.
يتيح المحرر أيضاً خيارات متقدمة في غاية الأهمية؛ مثل إمكانية تحديد طريقة التقسيم إلى أعمدة جديدة (Columns) أو إلى صفوف متتالية (Rows). بعد إتمام التقسيم، نوظف أدوات التحويل المدمجة لتطبيق خطوة “اقتطاع المسافات الزائدة” (Trim) فورياً على كافة الأعمدة الناتجة بضغطة زر واحدة للتخلص من الفراغات الهامشية، تليها خطوة ضبط نوع البيانات الصريح (Data Type Casting)؛ حيث نؤكد تثبيت نوع عمود الرمز البريدي كنص (Text) صريح لضمان عدم ضياع الأصفار البادئة إطلاقاً قبل تحميل النتائج النهائية إلى ورقة العمل عبر خيار “إغلاق وتحميل” (Close & Load).
9.3 بناء نماذج تحويل مستدامة وقابلة للتكرار
تكمن العبقرية البرمجية لمحرك Power Query في سجله التوثيقي التلقائي للعمليات المعروف بقائمة “الخطوات المطبقة” (Applied Steps)؛ حيث تُسجل كل نقرة وإجراء تحويلي يتم اتخاذه على هيئة شفرة برمجية دقيقة مكتوبة بلغة M الوظيفية (M Formula Language) في خلفية النظام. يُبنى من خلال هذه الخطوات نموذج تدفق عمل مستقل ومستدام وقابل لإعادة التطبيق والتكرار الآلي اللانهائي دون أي تدخل برمجي إضافي.
إذا أضيفت مستقبلاً مئات أو آلاف العناوين الجديدة إلى الجدول المصدر الأصلي في ورقة العمل، لا يحتاج المستخدم إلى إعادة تنفيذ خطوات التقسيم أو التطهير النصي؛ بل يكفي ببساطة التوجه إلى الجدول المقسم والنقر بزر الفأرة الأيمن واختيار “تحديث” (Refresh) أو النقر على اختصار Alt + F5. سيتولى المحرك قراءة البيانات الجديدة وتمريرها عبر نفس خطوات لغة M المبرمجة وتحديث الأعمدة المقسمة في أجزاء من الثانية. هذا النمط المؤسسي في معالجة مئات الآلاف من السجلات بكفاءة استثنائية يجعل Power Query الخيار الأول لمشاريع تنظيف البيانات المتكررة والأنظمة المؤتمتة.
10. ضبط الجودة والمصادقة الإحصائية بعد تقسيم العناوين
10.1 بروتوكولات التحقق من تكامل واكتمال الحقول المفروزة
لا تكتمل المعالجة التقنية للعناوين دون إخضاع المخرجات لسلسلة من بروتوكولات ضبط الجودة والمصادقة الإحصائية للتأكد من عدم فقدان أي سجلات أثناء التحويل البرمجي. تتضمن الخطوة التأسيسية مطابقة إجمالي عدد الصفوف الأصلية مع عدد الصفوف في الجدول المقسم الجديد باستخدام دالتي ROWS أو COUNTA؛ للتأكد من أن عملية التقسيم لم تتسبب في اقتطاع أجزاء من المصفوفة أو تداخل غير مقصود في بنية الملف.
يلي ذلك استخدام دوال العد الشرطي لاكتشاف الانحرافات؛ حيث تُستخدم دالة COUNTBLANK على مستوى كل عمود من الأعمدة المقسمة الجديدة لتحديد الخلايا الفارغة غير المبررة، مما يشير إلى وجود سجلات احتوت على محددات أقل من المطلوب. علاوة على ذلك، يُنصح بتطبيق اختبار اتساق أطوال النصوص باستخدام دالة حساب الطول LEN بالتكامل مع دالتي AVERAGE وSTDEV.S لاكتشاف القيم المتطرفة والشاذة؛ فإذا ظهر سجل يمتلك طولاً نصياً ينحرف بمقدار ثلاثة انحرافات معيارية عن متوسط أطوال حقل المدينة مثلاً، فإن ذلك يمثل مؤشراً حاسماً على انزياح البيانات وتوزيع نص الشارع أو الولاية خطأً داخل حقل المدينة، مما يستدعي التدخل السريع للتصحيح.
إن تطبيق مقاييس كفاءة التشخيص والاختبارات الإحصائية يسهم بصورة مباشرة في تقليل معدلات الخطأ وضمان عدم تسلل نتائج زائفة إلى قواعد البيانات المتقدمة، وهو ما يرتبط منهجياً بأساليب التقييم التشخيصي وتحليل فاعلية القرارات الحسابية (Youngstrom, 2013).
10.2 معايير تدقيق الرموز البريدية والبيانات الرقمية
تتطلب حقول الرموز البريدية تدقيقاً رياضياً استثنائياً نظراً لكونها بيانات رقمية تمثل معلومات جغرافية دقيقة وليست قيماً كمية تخضع للعمليات الحسابية. يتمثل المعيار الأول في التحقق الصارم من التنسيق النصي للحقل؛ وذلك لضمان بقاء الأصفار البادئة (Leading Zeros) كما هي دون حذف. يمكن بناء اختبار منطقي فوري للتأكد من صحة أطوال الرموز باستخدام معادلة شرطية ترجع تنبيهاً إذا كان طول الرمز البريدي يقل عن المعيار الوطني المعتمد (مثلاً 5 خانات في الولايات المتحدة، أو 4-6 خانات في دول أخرى):
=IF(LEN(E2) <> 5, "خطأ في الرمز البريدي", "سليم")
بالإضافة إلى ذلك، يُستحسن تطبيق قواعد “التحقق من صحة البيانات” (Data Validation) داخل إكسل لمنع إدخال نصوص غير مطابقة مستقبلاً في هذا العمود، واشتراط احتواء الخلية على نصوص ذات طول محدد أو أرقام صحيحة ضمن نطاق جغرافي معروف. ولإضفاء طابع الاعتمادية المؤسسية، يمكن ربط الرموز البريدية الناتجة بقوائم جغرافية معتمدة صادرة عن الهيئات البريدية الرسمية واستخدام دوال المطابقة المتقدمة مثل XLOOKUP للتحقق المتبادل من أن الرمز البريدي المستخرج يتطابق بالفعل مع اسم المدينة والولاية المقابلين له في السجل ذاته، مما يضمن أعلى درجات الموثوقية المكانية.
10.3 التوثيق المنهجي لإجراءات المعالجة لضمان التكرارية
يشكل التوثيق المعياري الركيزة الختامية في منظومة حوكمة البيانات داخل بيئات الأعمال الاحترافية. يجب ألا تظل خوارزميات المعالجة المستخدمة وقرارات التطهير حبيسة ذهن المحلل المنفذ، بل يجب تسجيلها بدقة في ورقة عمل مستقلة تُخصص لـ “البيانات الوصفية” (Metadata Documentation). تتضمن هذه الورقة تسجيلاً شاملاً للصيغ الرياضية المطبقة، والمحددات المعتمدة، وسياق معالجة الحالات الشاذة، وتحديد النطاقات الأصلية والمستهدفة، مع إيضاح تاريخ وتوقيت المعالجة وهوية المحلل المسؤول.
كما تتضمن بروتوكولات الحوكمة ضرورة الأرشفة الصارمة للنسخ الأولية الخام من ملفات البيانات غير المعالجة وتأمينها بخاصية “القراءة فقط” (Read-Only) مع حفظ سجل التدقيق (Audit Trail) للخطوات المنفذة. يضمن هذا الإجراء الشفاف إمكانية الرجوع للسجلات المصدرية الأصلية عند نشوء أي نزاع محاسبي أو قانوني يتعلق بصحة العناوين، ويمنح المؤسسة القدرة على إعادة إنتاج التحليلات الإحصائية بدقة مطلقة (Reproducibility) في أي وقت، وبما يلبي متطلبات الامتثال لمعايير الجودة وإدارة البيانات المؤسسية المعتمدة عالمياً.
خاتمة
استعرض هذا الدليل المتعمق الأبعاد النظرية والتطبيقية لعمليات تجزئة العناوين وتحويلها من نصوص مكانية مدمجة غير مهيكلة إلى مصفوفات رقمية منظمة ومستقلة داخل برنامج مايكروسوفت إكسل. لقد تبين بوضوح أن اختيار الأداة المثلى لهذه المهمة لا يتم بصورة عشوائية، بل يرتبط ارتباطاً وثيقاً ببيئة التشغيل التقنية المتاحة، وحجم السجلات المراد معالجتها، ودرجة الديناميكية المطلوبة في تحديث النتائج.
تبرز دالة TEXTSPLIT كخيار تكنولوجي رائد يجسد قمة التطور في بيئة الحساب الديناميكي لإكسل، حيث تمنح المستخدمين حلاً برمجياً آنياً وفائق المرونة يستجيب للتغيرات تلقائياً ويتفوق على قيود الطرق الكلاسيكية. وفي المقابل، يبقى معالج “تحويل النص إلى أعمدة” أداة إجرائية لا غنى عنها للتعامل السريع مع الملفات الثابتة، في حين تقدم تقنية “التعبئة السريعة” حلاً استقرائياً ذكياً للمهام اللحظية المحدودة، ويوفر محرر “باور كويري” المنصة المؤسسية المتكاملة لبناء خطوط تحويل مؤتمتة ومستدامة وقابلة للتكرار عبر مئات الآلاف من السجلات المعقدة.
إن النجاح الحقيقي في تنظيف وهيكلة البيانات الجغرافية لا يتوقف عند مجرد تنفيذ خوارزمية التجزئة، بل يتطلب تطبيق بروتوكولات صارمة لضبط الجودة، وتطهير المسافات الهامشية، وتدقيق التنسيقات الرقمية للرموز البريدية، وتوثيق خطوات المعالجة منهجياً. إن الالتزام بهذه الممارسات الهندسية الرصينة هو ما يضمن تحويل البيانات الخام المشتتة إلى أصول معلوماتية عالية الدقة تدعم اتخاذ القرارات التحليلية، وترفع كفاءة العمليات التشغيلية، وتعزز التكامل السلس مع الأنظمة المؤسسية الحديثة.
المراجع
- Healey, A. N. (2004). Developing observational measures of performance in surgical teams. BMJ Quality & Safety, 13(suppl_1), i33–i40. https://doi.org/10.1136/qhc.13.suppl_1.i33
- Hoffman, D. D., Singh, M., & Prakash, C. (2015). The Interface Theory of Perception. Psychonomic Bulletin & Review, 22(6), 1480–1506. https://doi.org/10.3758/s13423-015-0890-8
- Sloman, S. A., Love, B. C., & Ahn, W.-K. (1998). Feature Centrality and Conceptual Coherence. Cognitive Science, 22(2), 189–228. https://doi.org/10.1016/s0364-0213(99)80039-1
- Youngstrom, E. A. (2013). A Primer on Receiver Operating Characteristic Analysis and Diagnostic Efficiency Statistics for Pediatric Psychology: We Are Ready to ROC. Journal of Pediatric Psychology, 39(2), 204–221. https://doi.org/10.1093/jpepsy/jst062