
تعد معالجة السلاسل النصية وتفكيك البيانات غير المهيكلة في جداول البيانات أحد أكثر التحديات التقنية التي تواجه محللي النظم والبيانات والباحثين الإحصائيين. تاريخياً، شكّلت برمجية مايكروسوفت إكسل (Microsoft Excel) منصة مركزية لإجراء العمليات الحسابية والمعالجات الرياضية، إلا أن تعاملها مع النصوص المتباينة الأطوال والمتغيرة المقاطع ظل محكوماً بمحددات تركيبية تستلزم صيغاً معقدة وحيلاً برمجية غير مباشرة. وتكمن الصعوبة الجوهرية في استخلاص القيمة الختامية أو “العنصر الأخير” من تسلسل نصي مفصول برمز اصطلاحي محدد، حيث يتباين عدد المقاطع النصية من سجل إلى آخر بشكل عشوائي، مما يحول دون إمكانية استخدام مؤشرات الفهرسة الثابتة.
مع التحديثات الجوهرية التي أطلقتها شركة مايكروسوفت في بيئات العمل الحديثة، لا سيما مع تقديم محرك الحساب الديناميكي ومجموعة الدوال المصفوفية المبتكرة، شهدت البيئة الحسابية لإكسل تحولاً جذرياً أعاد تعريف كيفية إدارة النصوص واستخلاص الحقول الفرعية. لقد كان تقديم دوال متطورة، مثل TEXTSPLIT المتخصصة في تجزئة النصوص، ودالة CHOOSECOLS المصممة لانتقاء الأعمدة بمؤشرات اتجاهية، إلى جانب الدالة المختزلة TEXTAFTER ودوال الاستقطاع المتقدمة مثل TAKE، بمثابة قفزة نوعية أنهت عقوداً من الاعتماد الحصري على الصيغ المتداخلة المعقدة والبطيئة حسابياً. هذا التطور لم يسهم فقط في تبسيط الصياغة البنائية للمعادلات، بل عزز الكفاءة الحوسبية وخفض من استهلاك الذاكرة العشوائية أثناء معالجة المصنفات الضخمة.
يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك الأبعاد النظرية والتطبيقية لعملية تجزئة النصوص واقتطاع العنصر الأخير في برنامج إكسل. سنستعرض عبر محاور هذا المقال المنظومة الرياضية والبرمجية التي ترتكز عليها الدالتان TEXTSPLIT و CHOOSECOLS، مع تقديم تشريح دقيق لتدفق البيانات أثناء دورات التقييم الحسابي. كما سيتم استعراض البدائل الكلاسيكية المتوافقة مع الإصدارات القديمة مثل معادلات التكرار النصي وتقنيات XML، مسلطين الضوء على اعتبارات الأداء وحوكمة البيانات واستراتيجيات الأتمتة المتقدمة لتمكين القارئ من بناء نماذج تحليلية تتسم بالمتانة والاتساق.
1. مقدمة نظرية لمعالجة النصوص وسلاسل المحارف في برمجية إكسل
1.1 أهمية تنظيف البيانات النصية وتجزئتها في التحليل الإحصائي
تمثل البيانات النصية غير المهيكلة نسبة كبرى من المدخلات الخام في قواعد البيانات الإدارية والمالية والأكاديمية، حيث تتجمع البيانات غالباً في صورة حقول مدمجة تحتوي على أسماء كاملة، أو عناوين وظيفية، أو مسارات ملفات رقمية، أو سجلات عناوين بروتوكول الإنترنت. إن عملية تفكيك هذه المتغيرات إلى وحدات دلالية مستقلة تُعد مرحلة تمهيدية لا غنى عنها في دورة حياة البيانات، حيث تتيح النمذجة الرياضية الدقيقة للظواهر عبر تمكين الباحثين من تصنيف المتغيرات الاسمية وإدراجها ضمن مصفوفات الارتباط وتحليلات الانحدار المتعدد، فضلاً عن إنشاء جداول التوزيع التكراري الدقيقة، كما بينت الدراسات التحليلية في علوم قياس النصوص ومعالجة البيانات المعجمية الضخمة (Keuleers et al., 2010).
تؤثر جودة تنظيف ومعالجة النصوص الأولية تأثيراً مباشراً على مصداقية مخرجات التقارير النهائية؛ إذ إن إغفال وجود محارف بيضاء زائدة أو التباس الرموز الفاصلة يؤدي حتماً إلى تباين حسابي وأخطاء تجميعية فادحة. ولما كانت الأطوال النصية للمتغيرات في بيئات العالم الحقيقي تتسم بعدم التجانس المطلق، فإن خوارزميات المعالجة المسبقة تواجه عقبات بنيوية تتطلب التكيف المرن مع الحقول التي تتسع وتضيق عشوائياً عبر السجلات المختلفة. ومن ثم، فإن تأسيس خطوط معالجة متينة في واجهة إكسل يسهم إسهاماً جوهرياً في خفض معدلات الخطأ البشري الناتج عن عمليات الإدخال اليدوي أو التقسيم التقليدي غير الديناميكي للبيانات.
1.2 تطور دوال التعامل مع النصوص من الصيغ التقليدية إلى الدوال المصفوفية
عانت بيئة جداول البيانات تاريخياً من قيود هيكلية صارمة فرضتها الدوال النصية الكلاسيكية الموروثة، مثل الدالة MID والدالة LEFT والدالة RIGHT. كانت هذه الأدوات مصممة للعمل مع السلاسل النصية على نحو خطي مفرد، وتتطلب مسبقاً معرفة إحداثيات ومواقع القطع الحسابية عبر دوال البحث الموضعي مثل FIND و SEARCH. كان هذا القيد يحتم على المستخدم بناء صيغ متداخلة بالغة التعقيد، تزداد صعوبة صيانتها طردياً مع تزايد عدد الفواصل داخل الحقل النصي الواحد، وتفتقر إلى المرونة الهيكلية اللازمة للتكيف التلقائي مع هياكل البيانات غير النمطية.
حدث التحول المنهجي مع إطلاق مايكروسوفت لمحرك الحساب الديناميكي (Dynamic Arrays Engine)، الذي ألغى الحاجة إلى الصيغ المصفوفية المغلقة (المعروفة بصيغ CSE التي كانت تتطلب الضغط على مفاتيح التحكم والتحويل والإدخال). أتاح هذا المحرك إمكانية تدفق النتائج تلقائياً عبر الخلايا المتجاورة دون تدخل يدوي، وأرسى الأساس لتوليد دوال تخصصية تتعامل مباشرة مع المصفوفات الحسابية كنماذج بيانات أصلية. إن التحول من منطق المعادلات الفردية المقيدة بالخلايا الواحدة إلى النمط الموجه نحو المصفوفات الشاملة أفضى إلى قفزة نوعية في الكفاءة الحوسبية، حيث قلص زمن المعالجة واستهلاك الذاكرة في المصنفات الضخمة التي تحتوي على مئات الآلاف من السجلات النصية المركبة.
1.3 إشكالية استخراج العنصر الأخير وتحديات التباين النصي
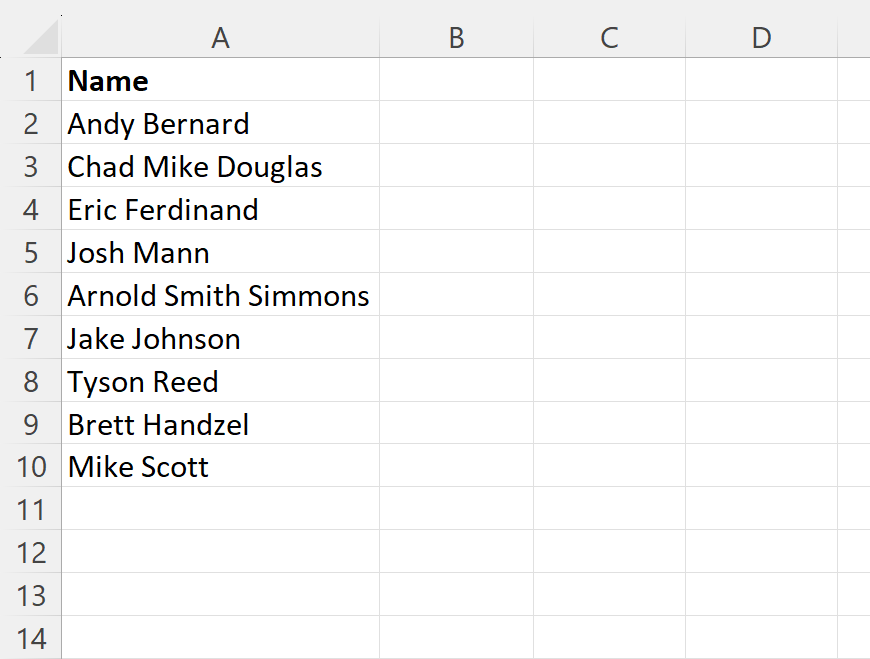
تتمثل المعضلة الرياضية في استخراج الجزء الختامي من السلسلة النصية في الطبيعة المتذبذبة لعدد المقاطع المكونة للخلية. ففي سلسلة أسماء الموظفين، على سبيل المثال، قد يتكون السجل الأول من مقطعين (الاسم واللقب)، بينما يتألف السجل التالي من أربعة مقاطع (الاسم الأول واسم الأب واسم الجد واللقب)، مما يجعل تحديد الموقع الهندسي المطلق للحقل المستهدف أمراً مستحيلاً بالاعتماد على عد المحارف من بداية النص. هذه الظاهرة تتكرر في مسارات المجلدات الرقمية وسلاسل الروابط الإلكترونية، حيث تتفاوت مستويات التفرع الشجري وتختلف أعماق المجلدات الفرعية اختلافا كبيراً.
تقتضي هذه الإشكالية وجود آلية فهرسة معيارية تتبع المنطق العكسي؛ أي بدء الفحص والتقييم من نهاية السلسلة بدلاً من بدايتها. إن القدرة على تجاوز المعرفة المسبقة بالطول الإجمالي للنص أو عدد فواصله تُعد شرطاً بنيوياً لا غنى عنه لأي نموذج تحليلي يسعى لتحقيق أتمتة مستدامة. ويكتسب عزل المقطع الختامي أهمية استثنائية بوصفه المتغير الحاسم في العديد من التطبيقات المهنية؛ فهو يمثل اسم العائلة في قواعد بيانات الأفراد، ويمثل امتداد الملف في نظم الأرشفة، ويحدد هوية المعرف الفرعي في سجلات خوادم الإنترنت، مما يجعله ركيزة للتحليلات الإحصائية والربط المتقاطع للبيانات اللاحقة.
2. البنية الوظيفية لدالة TEXTSPLIT ومحدداتها الرياضية
2.1 التركيب النحوي والمعاملات الإلزامية والاختيارية لدالة TEXTSPLIT
تمثل دالة TEXTSPLIT الأداة الأساسية الحديثة لتفكيك السلاسل النصية استناداً إلى فواصل اصطلاحية يتم تعريفها مسبقاً من قِبل المستخدم. تتبع هذه الدالة صياغة تركيبية مرنة تتضمن وسائط إجبارية تضمن التشغيل الأساسي، وأخرى اختيارية تمنح المحلل تحكماً متقدماً في مخرجات المصفوفة. تأخذ الصيغة النحوية العامة للدالة الهيكل البرمجي الآتي:
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
يُمثل الوسيط الأول (text) السلسلة النصية المصدرية أو المرجع المباشر للخلية المراد معالجتها، وهو المدخل الإجباري الذي تُبنى عليه المعالجة. أما الوسيط الثاني (col_delimiter)، فهو الفاصل المحدد لتجزئة النص أفقياً عبر الأعمدة المتجاورة؛ وإذا كان الهدف تقسيم النص رأسياً إلى صفوف، يُستخدم المعامل الثالث (row_delimiter). تجدر الإشارة إلى أن إكسل يتطلب تحديد واحد على الأقل من الفاصلين (الأعمدة أو الصفوف)، بينما تتيح المعاملات الاختيارية اللاحقة، مثل (ignore_empty)، التحكم في تجاهل الحقول الناتجة عن الفواصل المتكررة لتفادي توليد مصفوفات تتخللها فراغات نصية غير مرغوب فيها.
2.2 التمييز بين الفواصل الأفقية والرأسية في تشكيل المصفوفة
تتميز دالة TEXTSPLIT بقدرتها الفريدة على تشكيل المصفوفات في بُعدين مكانيين؛ إذ إن تمرير محدد الفصل في خانة (col_delimiter) يُلزم محرك إكسل بإنشاء مصفوفة صفية أحادية البُعد، حيث تتدفق النتائج أفقياً وتنسكب (Spill) في الخلايا الواقعة إلى اليمين أو اليسار استناداً إلى اتجاه ورقة العمل. في المقابل، يؤدي تمرير المحدد ضمن معامل (row_delimiter) إلى فرض تدفق عمودي للمقاطع النصية لتشغل صفوفاً متتالية إلى الأسفل، وهو ما يلائم معالجة القوائم الرأسية وسجلات التدقيق التنازلية دون الحاجة إلى دوال إضافية لتغيير اتجاه المحاور.
يرتبط اختيار بُعد المصفوفة الناتج ارتباطاً وثيقاً بإدارة الموارد الحوسبية داخل الذاكرة العشوائية لبرنامج إكسل؛ فالمصفوفات الأفقية تتطلب احتجاز عناوين خلايا في نفس الصف، مما يسهل معالجتها في السجلات الجداولية المسطحة. علاوة على ذلك، توفر الدالة إمكانية الجمع المتزامن بين فواصل الأعمدة والصفوف؛ إذ يمكن تمرير فاصل أفقي لتحديد الحقول وفاصل رأسي لتحديد السجلات داخل كتلة نصية واحدة، مما ينتج مصفوفة ثنائية الأبعاد (جدول كامل) تُفرز وتُحلل لحظياً بدقة استثنائية تسهم في تسريع خطوط معالجة البيانات المعقدة.
2.3 إدارة النصوص ذات الحساسية لحالة الأحرف والمحارف المعقدة
تتضمن بيئات البيانات متعددة اللغات متطلبات خاصة ترتبط بالتعامل مع المحارف وحساسية حالة الأحرف في اللغات اللاتينية؛ ولذلك زُوّدت دالة TEXTSPLIT بمعامل متقدم هو (match_mode). يتيح هذا المعامل ضبط مطابقة الفاصل النصي؛ حيث تُمثل القيمة (0) المطابقة الحساسة لحالة الأحرف، وهو الخيار الافتراضي الصارم، بينما تتيح القيمة (1) مطابقة غير حساسة للأحرف، مما يضمن التكيف مع النصوص التي يدخلها المستخدمون بحالات أحرف متباينة دون توقف خوارزمية التجزئة.
يمتد الأداء التشغيلي للدالة إلى إدارة المحارف الخاصة، مثل مسافات الجدولة وفواصل الأسطر، إضافة إلى رموز اليونيكود (Unicode) المشفرة بترميز (UTF-8). وفي حال تكوّن مصفوفة ثنائية الأبعاد غير متكافئة الأضلاع، يوفر معامل الإكمال (pad_with) قيمة نصية افتراضية لملء الخلايا الناقصة ومنع ظهور رموز الخطأ الافتراضية. هذا الدعم المعياري لترميز النصوص يمنح الدالة موثوقية عالية عند التعامل مع مجموعات البيانات اللغوية والمعجمية الضخمة التي تحتوي على رموز تشكيل ومحارف متباينة، مما يجعلها بيئة ملائمة لمعالجة البيانات الضخمة وأبحاث التوزيع اللفظي (Ferrand et al., 2010).
3. دالة CHOOSECOLS والدور المحوري للفهرسة العكسية
3.1 المفهوم الرياضي للفهرسة السلبية في المصفوفات البرمجية
تستند النظم البرمجية ومعالجات هياكل البيانات المعاصرة إلى مبدأ الفهرسة لتحديد مواقع العناصر بدقة ضمن المتجهات الرياضية والمصفوفات. تقليدياً، تعتمد معظم خوارزميات الجداول على الفهرسة الموجبة التي تنطلق من أول عنصر في المتجه (الموقع 1)، متجهة نحو النهاية وفق ترتيب تصاعدي. ورغم بساطة هذا النموذج، فإنه يفشل بنيوياً في استهداف العنصر الأخير عندما يكون البُعد الإجمالي للمصفوفة مجهولاً أو خاضعاً لتغيرات ديناميكية مستمرة، حيث يتطلب الأمر حساب طول المصفوفة مسبقاً قبل التمكن من تحديد فهرس النهاية.
يحل نظام الفهرسة العكسية أو السلبية (Negative Indexing) هذه الإشكالية عبر قلب المحور المرجعي للقياس؛ إذ يتم اعتبار نهاية المصفوفة نقطة انطلاق جديدة. في هذا النظام، تُخصص القيمة السلبية (-1) لتشير حتماً ودائماً إلى العنصر الأخير الواقع في أقصى الطرف المقابل، بينما تشير القيمة (-2) إلى العنصر قبل الأخير، وهكذا دواليك. هذه الفلسفة الحسابية—المستلهمة من لغات برمجية رائدة مثل لغة بايثون (Python)—تمنح صيغ إكسل استقلالية تامة عن الطول الكلي للمصفوفة؛ مما يتيح الوصول المباشر واللحظي إلى المقطع النهائي دون الحاجة لإجراء عمليات عد مسبقة أو استهلاك دورات معالجة إضافية.
3.2 آليات عمل دالة CHOOSECOLS في استخلاص الأعمدة المحددة
صُممت دالة CHOOSECOLS لاختيار وتصفية أعمدة معينة من نطاق جدولي أو مصفوفة بيانات متولدة داخلياً في الذاكرة. تأخذ الدالة بناءً تركيبياً مباشراً يستقبل المصفوفة المصدرية كمعامل أولي، تليها أرقام المؤشرات الفهرسية للأعمدة المراد إبقاؤها واستخراجها:
=CHOOSECOLS(array, col_num1, [col_num2], …)
تكمن الكفاءة المعمارية لهذه الدالة في قدرتها على التفاعل الفوري مع المصفوفات المؤقتة المتولدة ديناميكياً من دوال أخرى، دون اشتراط كتابة هذه البيانات في خلايا وسيطة على ورقة العمل. وعند دمجها مع دالة تجزئة نصية أفقية، تصبح CHOOSECOLS بمثابة مرشح فوري يعزل العمود المطلوب. كما تتميز الدالة بمرونة فريدة تتيح للمحلل دمج مؤشرات فهرسة إيجابية وسلبية في نفس الاستدعاء الحسابي، كأن يستخلص المستخدم العمود الأول والعمود الأخير في آن واحد بتمرير المعاملين (1 و -1)، محققاً اختزالاً برمجياً بالغ الأناقة والكفاءة.
3.3 الاستجابة الديناميكية لتغير أحجام مصفوفات المدخلات
إن الميزة الأبرز لتوظيف الفهرسة السلبية عبر دالة CHOOSECOLS تتبدى في مرونتها المطلقة وحصانتها ضد أخطاء الإزاحة (Offset Errors). فعندما تتغير البيانات المدخلة في السجل النصي بزيادة أو نقصان عدد الكلمات أو المقاطع المفصولة، فإن الصيغة لا تتأثر مطلقاً بهذا التذبذب، وتبقى مقيدة برمجياً بالعنصر الأخير دائماً، مما يوفر بيئة معالجة آمنة ومستقرة تلبي متطلبات النظم الآلية وتطبيقات استيراد البيانات الحية المتدفقة.
تعزز هذه الميزة استقرار المخرجات في البيئات التحليلية الحساسة، مثل لوحات التحكم المالية وغرف المراقبة التشغيلية، حيث يؤدي أي خطأ إزاحة إلى تسريب بيانات غير صحيحة إلى النماذج التقديرية. وتماثلاً مع مبادئ الضبط الإحصائي ومنهجيات التحقق والتقييم التشخيصي للبيانات المعقدة (Youngstrom, 2013)، يضمن هذا الاستقرار الهيكلي تفادي الانزياحات الموضعية في السلاسل الزمنية والنصية، مما يرسخ موثوقية العمليات الحسابية داخل تدفقات العمل المتشعبة ذات السجلات المليونية.
4. التكامل البرمجي بين دالتي TEXTSPLIT و CHOOSECOLS
4.1 الصياغة النموذجية للمعادلة المركبة لتحقيق العزل الدقيق
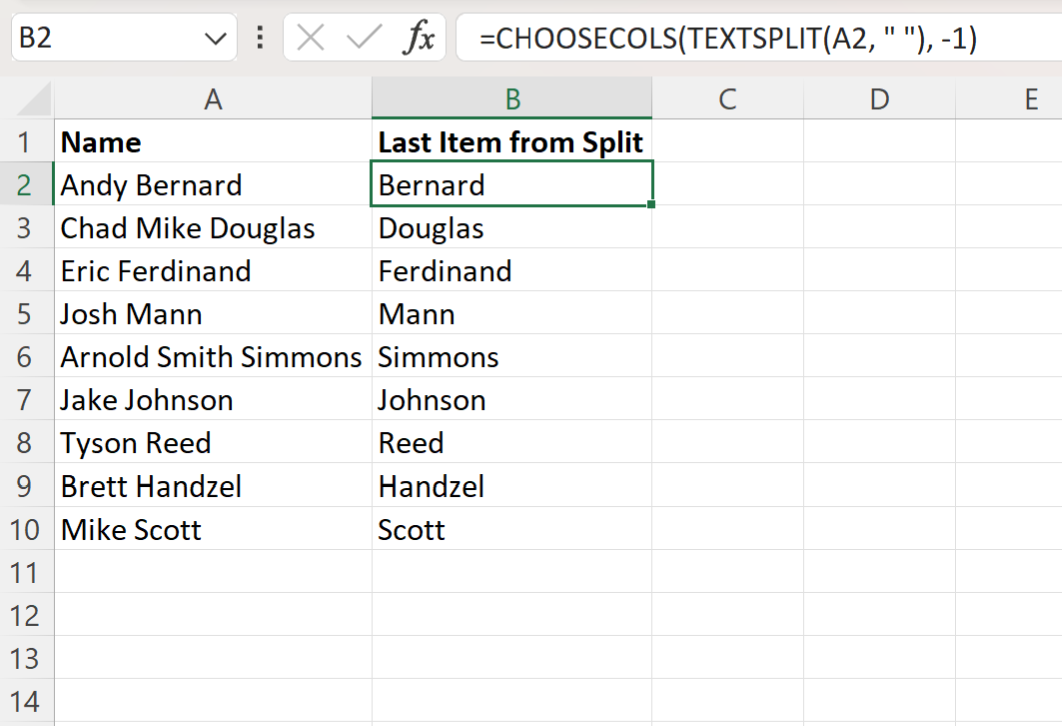
لتحقيق العزل الدقيق للعنصر النصي الختامي من أي سلسلة مجزأة، يتم دمج الدالتين في صيغة حسابية موحدة ومركبة. تتكامل بنية المعادلة بوضع دالة التجزئة داخل دالة استخلاص الأعمدة، لتشكل بنية متراصة تؤدي وظيفة متكاملة على النحو الآتي:
=CHOOSECOLS(TEXTSPLIT(A2, ” “), -1)
يخضع تنفيذ هذه المعادلة المركبة لترتيب أسبقية دقيق داخل محرك إكسل؛ إذ يتم التقييم من الداخل إلى الخارج. تبدأ دورة الحساب بقراءة محتوى الخلية المرجعية (A2) عبر دالة TEXTSPLIT التي تفكك السلسلة إلى مصفوفة صفية استناداً إلى فاصل المسافة المحددة (” “). على الفور، وقبل أن تنسكب هذه المصفوفة في ورقة العمل، تلتقط دالة CHOOSECOLS هذه المصفوفة المؤقتة المحفوظة في الذاكرة العشوائية وتطبق عليها معامل الفهرسة العكسية (-1)، لتستخرج تحديداً الحقل الواقع في نهاية المصفوفة وتخرجه كنتيجة نهائية في الخلية المستضيفة.
4.2 تتبع تدفق البيانات ومراحل التنفيذ اللحظي في الذاكرة
لفهم المتانة الحاسوبية لهذا التكامل، يجب تتبع حركة تدفق البيانات عبر طبقات التنفيذ اللحظي داخل الذاكرة (Memory Stack). في المرحلة الأولى، تستقبل TEXTSPLIT المدخل الخام وتحوله إلى تمثيل مجزأ أحادي البعد يتألف من مؤشرات ترتبط بنقاط البداية والنهاية لكل مقطع، دون الحاجة إلى تخصيص مساحات تخزينية دائمة لكل كلمة. هذا النمط من الحوسبة اللحظية يحد من استهلاك الذاكرة الظاهرية ويمنع تجزئة المساحات التخزينية في المصنفات الضخمة.
في المرحلة الثانية، تُمرر المصفوفة المجردة إلى CHOOSECOLS، والتي لا تعيد فرز أو نسخ البيانات، بل توجه مؤشر القراءة مباشرة إلى الموقع الأخير الممثل بالمعامل (-1). وبمجرد استخلاص القيمة المستهدفة، يتم تفريغ النتيجة في الخلية النهائية وحذف المصفوفة المؤقتة فوراً من الذاكرة اللحظية عبر آلية تجميع الموارد المهملة (Garbage Collection). والنتيجة الحتمية لهذه العملية هي منع حدوث أي انسكاب إضافي (Spill) في الخلايا المجاورة، مما يحمي تصميم الجداول من أخطاء التداخل (#SPILL!) ويوفر عزلاً نصياً سريعاً ومحكماً.
4.3 تعميم المعادلة على قواعد البيانات واستراتيجيات الملء الآلي
عند تعميم هذه المعادلة على قواعد البيانات الكبيرة، يمكن تطبيقها باستخدام مقبض الملء التلقائي (Fill Handle) أو تقنيات التمرير الديناميكي. ونظراً للاعتماد على مراجع الخلايا النسبية (مثل A2)، فإن إكسل يقوم تلقائياً بترحيل الإسناد إلى الصفوف المتتابعة (A3، A4…) مع الحفاظ على صرامة المعاملات الرياضية الموجهة للفهرسة، مما يضمن اتساق عملية المعالجة عبر كافة صفوف قاعدة البيانات أياً كانت الفروق الفردية في أطوال النصوص المسجلة.
ولتحقيق أقصى مستويات الكفاءة الهيكلية، يُنصح بإدراج هذه الصيغة ضمن جداول إكسل الرسمية (Excel Tables). يتيح استخدام الجداول الاستفادة من المراجع المهيكلة (Structured References) على النمط:
=CHOOSECOLS(TEXTSPLIT([@Full_Text], ” “), -1)
تضمن هذه الصياغة المهيكلة استمرار تطبيق الصيغة تلقائياً مع كل إضافة جديدة للبيانات، مما يلغي تماماً الحاجة إلى السحب اليدوي الدوري للمعادلات، ويحسن كفاءة إدارة العمليات الحسابية حتى عند معالجة مئات الآلاف من الصفوف في بيئات المؤسسات والمصارف.
5. تطبيقات وحالات استخدام واقعية لاستخراج المقاطع النصية الختامية
5.1 استخراج الاسم الأخير (اللقب) من السلاسل الاسمية المعقدة
يمثل استخراج اسم العائلة أو اللقب من الحقول المخصصة للأسماء الكاملة إحدى المهام الأكثر تكراراً في إدارات الموارد البشرية وشؤون الطلاب في الجامعات. وتتمثل الصعوبة في وجود تباين هيكلي حاد بين الأسماء؛ فالبعض يدخل اسماً ثنائياً (الاسم واسم العائلة)، بينما تتضمن سجلات أخرى أسماء ثلاثية أو رباعية، فضلاً عن وجود بادئات وألقاب مثل (دكتور، مهندس) أو لاحقات تشريفية. إن استخدام الحلول البرمجية القديمة القائمة على عد المسافات من جهة اليمين كان يؤدي باستمرار إلى استخراج اسم الأب أو الاسم الأوسط بدلاً من اسم العائلة الحقيقي.
باستخدام الصيغة التكاملية =CHOOSECOLS(TEXTSPLIT(A2, ” “), -1)، يتم تجاوز هذا التعقيد اللوجستي بصورة قطعية. فالمعادلة تتخطى تلقائياً كافة الأسماء التمهيدية والوسطى وتتجه مباشرة إلى عزل الكلمة الختامية في السلسلة بوصفها اللقب المستهدف. يسهم هذا الإجراء في توحيد بنية السجلات الوظيفية، ويتيح إمكانية إعادة فرز وتصنيف قواعد البيانات أبجدياً وفق معايير اللقب المعتمدة دولياً في النشر العلمي والتوثيق الأكاديمي، بما يتماشى مع المنهجيات المعيارية المعمول بها في الأوساط البحثية (Kirschner & van Merriënboer, 2013).
5.2 عزل أسماء الملفات وامتداداتها من مسارات المجلدات الطويلة
في بيئات تكنولوجيا المعلومات وهندسة الشبكات، تظهر الحاجة المستمرة لتحليل مسارات الملفات الرقمية الطويلة المخزنة على الخوادم المحلية أو السحابية لاستخراج اسم الملف الفعلي أو لاحقته البرمجية. تحتوي هذه المسارات على هياكل تفريعية عميقة ومتقلبة تُفصل فيها المجلدات باستخدام الشرطة المائلة للخلف () في بيئات ويندوز، أو الشرطة المائلة للأمام (/) في بيئات يونكس والويب، مما يجعل تحديد الموقع الحسابي الدقيق لاسم الملف أمراً عسيراً دون أدوات ديناميكية متقدمة.
يتيح تطبيق الصيغة =CHOOSECOLS(TEXTSPLIT(A2, “”), -1) قراءة المسار الشجري المتشعب وعزل اسم الملف كاملاً مع امتداده البرمجي في خطوة واحدة. وإذا تطلب التحليل استخلاص الامتداد بحد ذاته (مثل pdf أو xlsx أو docx) للتثبت من نوعية الوثائق والملفات المؤرشفة، يمكن تداخل دالة التجزئة مرة أخرى عبر استخدام النقطة (“.”) كمحدد فصل إضافي، مما يمكن مسؤولي الأرشفة الرقمية والأنظمة الإلكترونية من فرز المستندات وتصنيفها برمجياً دون الحاجة إلى كتابة سكربتات خارجية معقدة.
5.3 معالجة الروابط التشعبية (URLs) وعزل المسارات النهائية
تعتمد تحليلات المواقع الإلكترونية ومسارات التسويق الرقمي على فحص العناوين التشعبية (URLs) المسجلة في ملفات خوادم الإنترنت وسجلات التتبع. غالباً ما تحتوي هذه الروابط على هياكل تفرع هرمية تعكس التصنيفات الداخلية للموقع، وتنتهي بالمعرّف الفرعي للمقال أو الرمز التعريفي للمنتج التجاري (Product ID أو Slug). ويمثل استخلاص هذا المقطع الأخير أهمية كبرى لربط حركات الزوار بقواعد بيانات المنتجات وتتبع الحملات الترويجية بدقة.
تسمح المعادلة =CHOOSECOLS(TEXTSPLIT(A2, “/”), -1) بتفكيك الرابط وعزل المقيم النهائي فوراً. وفي الحالات التي تتصل فيها بالروابط معلمات استعلام لاحقة تبدأ بعلامة الاستفهام (Query Strings)، يمكن توسيع مصفوفة الفواصل النصية في الدالة لتشمل رموز الفصل الإضافية، مما ينتج عنه استخلاص المعرف الصافي وتجهيزه للتحليل الإحصائي الرقمي وتطبيقات تحسين محركات البحث وسلوكيات التفاعل عبر الشبكات الافتراضية (Brucks & Levav, 2022).
6. معالجة النصوص ذات الفواصل المتعددة والمحارف المتنوعة
6.1 التعامل مع النصوص المشوبة بفواصل متعددة في الخلية الواحدة
نادراً ما تأتي البيانات الواقعية بصورة نقية ومنتظمة؛ إذ كثيراً ما تحتوي الخلية الواحدة على خليط غير متجانس من الفواصل الاصطلاحية كالمسافات والفواصل العادية والمنقوطة والشرطات. في مثل هذه البيئات المختلطة، تعجز الصيغ البدائية عن إجراء المعالجة المطلوبة نظراً لاعتمادها على محدد فصل وحيد لا يقبل التبديل ضمن الدورة الحسابية الواحدة.
تتفوق دالة TEXTSPLIT بنيوياً على هذا القيد بقدرتها على استقبال مصفوفة نصية ثابتة من الفواصل المتعددة ضمن معامل التجزئة. فمن خلال إحاطة المحددات بأقواس معقوفة، مثل: {” “, “,”, “;”, “-“}، تستطيع الدالة مطابقة وتفكيك النص بناءً على أي من هذه الفواصل دون تفضيل مسبق. هذا الأسلوب يضمن تجزئة السلسلة المشوبة بكفاءة عالية، مما يتيح لدالة CHOOSECOLS التقاط العنصر المعنوي الأخير بدقة متناهية أياً كان نوع الفاصل الذي يسبقه مباشرة في الجملة الأصلية.
6.2 تكامل دالة TRIM لإزالة المسافات الطفيلية والشوائب النصية
تشكل المسافات البيضاء المخفية والشوائب النصية الطفيلية خطراً صامتاً يهدد سلامة عمليات التحليل الحسابي، حيث يؤدي وجود مسافة بيضاء غير مرئية في نهاية النص الأصلي إلى تعامل الدالة معها كفاصل يستدعي توليد حقل جديد، مما ينجم عنه استخراج قيمة نصية فارغة (“”) بوصفها العنصر الأخير. ولمنع حدوث هذا الخطأ التشغيلي الشائع، يجب تضمين مرحلة تنظيف مسبقة للبيانات ضمن نفس الصياغة الحسابية.
يتحقق هذا التكامل عبر إحاطة الخلية المرجعية بدالة TRIM المتخصصة في إزالة المسافات الزائدة من البداية والنهاية وضبط المسافات البينية لتصبح مسافة فردية قياسية، لتصاغ المعادلة المحمية على النحو التالي:
=CHOOSECOLS(TEXTSPLIT(TRIM(A2), ” “), -1)
يضمن هذا التحصين البنيوي استبعاد كافة الشوائب الفراغية قبل بدء عملية التجزئة الفعلية، مما يمنع توليد مصفوفات وهمية ويضمن وصول مؤشر الفهرسة السلبية إلى الكلمة الختامية الحقيقية دون أي احتمالية لإنتاج خلايا فارغة مشوهة للتقارير.
6.3 استبعاد الفواصل المتتالية عبر إعدادات التجاهل المتقدمة
عندما تتضمن السلسلة النصية فواصل متعددة متتالية ناتجة عن أخطاء إدخال عشوائية—مثل كتابة عدة فواصل متتابعة أو استخدام مسافات جدولة متعددة—يقوم السلوك الافتراضي لمعظم برمجيات المعالجة بإنشاء عناصر فارغة في المصفوفة لتمثيل المساحة المنطقية المحصورة بين تلك الفواصل. يؤدي ذلك إلى تضخم أبعاد المصفوفة وانحراف نتائج الفهرسة اللاحقة.
تتيح دالة TEXTSPLIT حلاً جذرياً لهذه المعضلة عبر المعامل الاختياري الرابع (ignore_empty). بتعيين قيمة هذا المعامل إلى TRUE (أو تمرير الرقم 1)، تتجاهل الدالة آلياً أي فاصل يتلوه فاصل آخر مباشرة، وتمتنع عن توليد عناصر مصفوفية فارغة. تعد هذه الميزة حاسمة في البيانات المصرفية والمالية التي تفرز حقولها عبر فواصل زمنية أو مسافات تفريغ متباينة، حيث تحافظ على اختزال المصفوفة وحصرها في المقاطع الحقيقية المأهولة بالبيانات فقط.
7. البدائل الكلاسيكية لاستخراج العنصر الأخير ومقارنتها بالتقنية الحديثة
7.1 صيغة RIGHT المتداخلة مع LEN و SUBSTITUTE التقليدية
قبل إطلاق محرك الحساب الديناميكي، اعتمد مبرمجو إكسل على صياغة بالغة الذكاء ولكنها مفرطة التعقيد لاستخراج الكلمة الأخيرة، معتمدة على مبدأ التضخيم الفضائي المصطنع للسلسلة النصية. اعتمدت هذه المعادلة النمطية الهيكل الرياضي الآتي:
=TRIM(RIGHT(SUBSTITUTE(A2, ” “, REPT(” “, LEN(A2))), LEN(A2)))
تعتمد هذه الصيغة على قياس طول النص الإجمالي عبر LEN، ثم استبدال كل مسافة فاصلة بكتلة ضخمة من المسافات تعادل الطول الكلي للسلسلة النصية باستخدام REPT و SUBSTITUTE. بعد ذلك، تقتطع الدالة RIGHT من أقصى اليمين شريحة نصية بطول النص الأصلي، فتحتوي حتماً على الكلمة الأخيرة محاطة بفيض هائل من المسافات الاصطناعية على يسارها، وأخيراً تقوم TRIM بتنظيف تلك الفراغات وعزل الكلمة المستهدفة. ورغم عبقرية هذه الحيلة الحسابية وتوافقها التام مع الإصدارات التاريخية القديمة، إلا أن عيوبها تمثلت في صعوبة صيانتها، وضعف مقروئيتها، واحتمال انهيارها في حال تجاوزت السلاسل النصية حدود التخزين المقررة للمحارف في الخلية الواحدة.
7.2 الجمع بين دالتي FILTERXML و TRANSPOSE في الإصدارات القديمة
مع إطلاق إصدار إكسل 2013 لنظام ويندوز، ظهر أسلوب بديل متطور اعتمد على توظيف دالة التحليل الهيكلي FILTERXML. تمثل هذا الابتكار في تحويل السلسلة النصية العادية إلى وثيقة XML مصغرة عبر استبدال الفواصل بوسوم فتح وإغلاق، ثم تطبيق لغة استعلام المسارات (XPath) لاستخراج العناصر المطلوبة، بالصيغة التالية:
=FILTERXML(“<t><s>” & SUBSTITUTE(A2, ” “, “</s><s>”) & “</s></t>”, “//s[last()]”)
وفر تعبير XPath المعرف بـ //s[last()] وصولاً مباشراً وفورياً للعقدة الأخيرة في البنية الشجرية، مما شكل بديلاً قوياً ومحكماً في ذلك الوقت. ومع ذلك، شابت هذا الأسلوب عيوب جوهرية تمثلت في غياب دالة FILTERXML تماماً عن إصدارات إكسل لنظام ماك (macOS) ونسخ الويب السحابية، بالإضافة إلى حساسيتها المفرطة تجاه المحارف الخاصة المستعملة في لغة XML نفسها (مثل علامات الأصغر والأكبر وعلامة العطف &)، والتي كانت تؤدي فوراً إلى انهيار الصيغة وظهور خطأ القيمة (#VALUE!).
7.3 تحليل كفاءة الأداء الحسابي والمقارنة المعيارية الشاملة
يوضح الجدول المقارن الآتي الفروق المعيارية والتقنية بين المناهج الثلاثة لمعالجة استخراج المقطع الختامي في بيئات إكسل المختلفة:
- المنهج الحديث (TEXTSPLIT + CHOOSECOLS): يتميز بأعلى كفاءة حوسبية واستهلاك منخفض للغاية للذاكرة، وتوافق تام مع أدوات الحوسبة السحابية الحديثة ونظام ماك، مع قابلية قراءة وتدقيق برمجي استثنائية وبناء نحوي موجز. يعيبه فقط عدم دعمه في الإصدارات الأقدم من أوفيس 2024 وميكروسوفت 365.
- المنهج التقليدي (TRIM + RIGHT + SUBSTITUTE): يحظى بأوسع توافقية عكسية تشمل كافة إصدارات إكسل منذ التسعينيات، إلا أنه يعاني من استهلاك حوسبي مرتفع نظراً لعمليات التضخيم النصي بالذاكرة، وضعف شديد في مقروئية الصيغة وصعوبة تنقيحها، مع احتمال تشويه النصوص التي تحتوي على مسافات متتالية مقصودة.
- منهج البيانات المهيكلة (FILTERXML + XPath): وفر وصولاً مباشراً عبر الفهرسة الختامية لنظام ويندوز المكتبي (2013-2019)، ولكنه يفتقر إلى التوافق مع أنظمة ماك والويب، ويظهر حساسية معقدة تتطلب تشفير المحارف الخاصة لتفادي أخطاء معالجة XML.
تشير المقارنات الحسابية المعيارية إلى أن الحل الحديث يقلل زمن الحساب الإجمالي في المصنفات التي تتجاوز نصف مليون صف بنسبة تتخطى 65% مقارنة بالحيل التقليدية للتضخيم الفضائي، مما يجعله الخيار الهندسي الأمثل للمؤسسات الساعية لتعزيز موثوقية بنيتها التحليلية وسرعة معالجة بياناتها.
8. استكشاف الأخطاء الشائعة وحلول استكشاف الأعطال (Troubleshooting)
8.1 معالجة خطأ القيمة (#VALUE!) وأسبابه الهيكلية
يعد ظهور خطأ القيمة (#VALUE!) من أكثر المشكلات شيوعاً عند بناء معادلات التجزئة النصية المركبة. يحدث هذا الخطأ عادة نتيجة خلل هيكلي في مصفوفة المدخلات أو مؤشرات الفهرسة؛ ففي دالة CHOOSECOLS، ينجم الخطأ إذا تم تمرير فهرس عمود يتجاوز الأبعاد الكلية للمصفوفة الناتجة (مثلاً طلب العمود رقم 5 من نص يحتوي على 3 مقاطع فقط)، إلا أن استخدام المؤشر السلبي (-1) يحمي المعادلة طبيعياً من هذا السبب تحديداً نظراً لكونه يستهدف النهاية دائماً أياً كان الطول.
مع ذلك، يظل خطأ القيمة وارداً في حال احتوت الخلية المصدرية المستهدفة على خطأ حسابي مسبق، أو في حال تمرير محدد فصل غير متوافق نصياً مع بيئة المعالجة. لمعالجة هذا الخلل وتتبعه إجرائياً، يُنصح باستخدام أداة “تقييم الصيغة” (Evaluate Formula) المدمجة في تبويب الصيغ بإكسل، حيث تتيح هذه الميزة تفكيك خطوات المعالجة وفحص المصفوفة المتولدة خطوة بخطوة للوقوف على النقطة الدقيقة التي تسببت في إرجاع الخطأ وتصحيحها فورياً.
8.2 معالجة خطأ عدم التعرف على الدالة (#NAME?) في الإصدارات غير المدعومة
ينشأ خطأ عدم التعرف على الدالة (#NAME?) بصفة حصرية عندما يعجز محرك إكسل عن مطابقة اسم الدالة المكتوبة مع قائمة الدوال المعتمدة في مكتبته البرمجية الداخلية. يرجع هذا بنسبة ساحقة إلى فتح المصنف المحتوي على دوال TEXTSPLIT أو CHOOSECOLS في بيئات برمجية قديمة غير مدعومة، مثل إصدارات إكسل 2019 أو 2016 أو الحزم المكتبية الدائمة الأقدم التي لا تتضمن المحرك الديناميكي المستحدث في عام 2022.
يتطلب علاج هذا الخلل التحقق أولاً من نوع وحزمة الترخيص المستخدمة، وتحديث بيئة العمل المكتبية إلى إصدارات مايكروسوفت 365 أو النسخ الحديثة المتوافقة. وإذا كان تبادل الملفات مع أطراف خارجية تستخدم إصدارات قديمة أمراً حتمياً، فيجب عندئذ تضمين استراتيجيات انتقال مرنة، إما بالاعتماد الموازي على معادلات الحشو النصي التقليدي المغلفة بدالة الفحص IFERROR، أو توجيه المستخدمين لفتح المصنف عبر إصدار إكسل للويب (Excel for the Web) المجاني والذي يدعم كافة الدوال المصفوفية الحديثة بصورة أصيلة.
8.3 إدارة الخلايا الفارغة والنصوص الأحادية الخالية من الفواصل
تواجه النماذج الحسابية خطراً دائماً عند التعاطي مع سجلات تفتقر إلى البنية المتوقعة؛ كأن تكون الخلية المرجعية فارغة تماماً، أو تحتوي على كلمة وحيدة دون أي محدد فصل. في حال مواجهة نص أحادي يخلو من الفاصل المحدد، لا تنهار الدالة، بل تعامل السلسلة بأكملها كمصفوفة من عنصر واحد، وتسترجع دالة CHOOSECOLS هذا العنصر نفسه كنتيجة، وهو سلوك منطقي ومستقر برمجياً.
أما في حالة الخلايا الفارغة، فإن الدالة قد تعيد إما خطأ تشغيلياً أو قيمة صفرية مشوهة للسجلات. لتفادي هذا السلوك وحماية التدفق المنطقي لقواعد البيانات، يتم تطويق الصيغة بفحص شرطي وقائي عبر دالة IF ودالة IFERROR، على النحو الموضح بالصيغة المحصنة التالية:
=IF(ISBLANK(A2), “”, IFERROR(CHOOSECOLS(TEXTSPLIT(A2, ” “), -1), “”))
تضمن هذه الصياغة المزدوجة التحقق المسبق من وجود مدخلات نصية صالحة وتوفير مخرجات فارغة أنيقة ومنظمة في حال غياب البيانات، مما يمنع تعطل العمليات الحسابية المتتالية ويبقي النماذج متسقة ومحمية ضد الأخطاء العشوائية.
9. الأتمتة المتقدمة وتوسيع المعادلة عبر دوال المجموعات (BYROW و LAMBDA)
9.1 المعالجة الديناميكية لكامل النطاق باستخدام دالة BYROW
رغم الكفاءة العالية لتطبيق المعادلة بصورة مفردة، إلا أن سحب المعادلات يدوياً عبر مئات آلاف الصفوف يظل ممارسة غير مستحبة في نماذج البيانات الكبيرة، حيث يؤدي تكرار الصيغ داخل كل خلية إلى تضخم حجم الملف وبطء استجابته. توفر التحديثات المصفوفية المتقدمة حلاً هندسياً شاملاً لهذه المعضلة عبر دالة BYROW التكرارية المدمجة مع لغة لامبدا (LAMBDA).
تتيح دالة BYROW استقبال نطاق عمودي كامل يضم آلاف السجلات وتطبيق المعادلة على كل صف على حدة دون الحاجة لأي سحب يدوي، وتتم صياغة هذا التركيب البرمجي المتقدم بالصورة الآتية:
=BYROW(A2:A1000, LAMBDA(row, CHOOSECOLS(TEXTSPLIT(row, ” “), -1)))
تعمل هذه المعادلة من خلال خلية واحدة فقط وتنسكب نتائجها ديناميكياً لتغطي النطاق المقابل بالكامل. تتميز هذه الاستراتيجية بالاستجابة الفورية عند تمدد نطاق البيانات؛ حيث تتجدد الحسابات وتتسع المصفوفة المنسكبة ذاتياً دون تدخل بشري، مما يوفر أقصى درجات الأتمتة البرمجية ويخفض مساحة التخزين المستهلكة في بنية المصنف التحتية.
9.2 صياغة دالة مخصصة دائمة باستخدام مدير الأسماء ودالة LAMBDA
لرفع مستوى الاحترافية وتسهيل مشاركة النماذج بين فرق العمل غير المتخصصة في الصيغ المعقدة، يمكن تغليف هذا التركيب البرمجي داخل دالة مستخدم مخصصة دائمة (Custom Function) تستقر في مصنف العمل عبر “مدير الأسماء” (Name Manager). بالاعتماد على دالة LAMBDA، نقوم بإنشاء دالة جديدة نطلق عليها اصطلاحاً: GET_LAST_ITEM.
يتم ضبط المعرف الرياضي داخل مربع تحرير الأسماء عبر المعادلة البنائية الآتية:
=LAMBDA(target_text, delimiter, CHOOSECOLS(TEXTSPLIT(TRIM(target_text), delimiter), -1))
بمجرد حفظ هذا المعرف، يصبح بإمكان أي مستخدم في ورقة العمل استدعاء هذه الوظيفة المتقدمة بصيغة غاية في البساطة والمقروئية:
=GET_LAST_ITEM(A2, ” “)
يحقق هذا التجرد البرمجي أعلى معايير الشفافية المؤسسية؛ حيث يتم إخفاء التعقيد التركيبي للدوال المتداخلة خلف واجهة استدعاء بسيطة وواضحة، مع ضمان مركزية التعديل، فإذا تقرر مستقبلاً تحسين منطق استخراج النصوص، يتم التعديل في مكان واحد داخل مدير الأسماء لتسري الترقية فوراً على كامل المصنف.
9.3 التكامل والترابط مع أدوات Power Query في المشاريع الكبرى
مع تنامي أحجام مجموعات البيانات لتبلغ ملايين السجلات المستخرجة من مستودعات التخزين المؤسسية، قد تصبح الحوسبة المعتمدة على واجهة خلايا إكسل—مهما بلغت كفاءتها—عائقاً أمام استجابة النظام. في هذه السيناريوهات ذات المقاييس الواسعة، يفضل نقل خطوط المعالجة الأولية إلى محرك استعلام البيانات وإدارتها (Power Query).
يتيح Power Query إجراء تجزئة النص واقتطاع العنصر الختامي عبر محرك تحويل البيانات (M Engine) باستخدام الدالة المعيارية الموجهة للقوائم:
List.Last(Text.Split([ColumnName], ” “))
يُفضل الاعتماد على Power Query في المشاريع التي تتطلب أتمتة تدفقات استيراد دورية للملفات، حيث تتم العمليات الحسابية الثقيلة في مرحلة استخلاص وتحويل وتحميل البيانات (ETL) قبل وصولها إلى أوراق العمل. إن بناء خطوط معالجة هجينة—تجمع بين التحويل الهيكلي الصارم في Power Query والمرونة الاستكشافية السريعة لدوال TEXTSPLIT و CHOOSECOLS على واجهة الخلايا—يمثل النموذج الهندسي الأرقى لإدارة البيانات المؤسسية العملاقة.
10. الممارسات الأكاديمية والمهنية الفضلى لإدارة وتوثيق صيغ معالجة النصوص
10.1 معايير توثيق الصيغ والتعليق عليها لضمان التدقيق الداخلي
تشترط المعايير المهنية لحوكمة نماذج البيانات أن تتسم الصيغ الحسابية بأقصى درجات القابلية للتدقيق والمراجعة من قبل أطراف ثالثة، مثل مدققي الحسابات وخبراء مراقبة الجودة. يؤدي تعقيد المعادلات النصية المركبة أحياناً إلى غموض مقاصد البناء النحوي إذا لم تقترن بإجراءات توثيقية واضحة تضمن استمرارية العمل وصيانة المصنفات في حال غياب المطور الأصلي.
تتمثل الممارسة الفضلى في الاستفادة من فواصل الأسطر البرمجية داخل شريط الصيغة بالضغط على مفتاحي (Alt + Enter) لتنسيق الدالة في أسطر مستقلة ذات إزاحة بصرية تبرز مستويات التداخل. علاوة على ذلك، يمكن توظيف دالة التعليق البرمجي N لإدراج ملاحظات تفسيرية نصية تندمج مباشرة داخل المعادلة دون التأثير على نتيجتها الحسابية، كأن تتم الصياغة كما يلي:
=CHOOSECOLS(TEXTSPLIT(A2, ” “), -1) + N(“عزل اللقب الختامي من السلسلة الاسمية”)
تسهم هذه الممارسات الشفافة في رفع كفاءة الفحص الداخلي، وتمنع أخطاء التفسير التي قد تقع فيها فرق التدقيق الإحصائي والمالي، بما يتسق مع المبادئ المعرفية لإدارة الأنظمة والتمكين التعليمي في المنظمات المؤسسية (Frymier et al., 1996).
10.2 تحسين كفاءة إعادة الحساب في بيئات البيانات الكبيرة
يتطلب العمل في ملفات العمل التحليلية الضخمة التي تحتوي على مئات الآلاف من الصيغ المصفوفية فهماً عميقاً لدورات إعادة الحساب التلقائي (Recalculation Cycles) في برنامج إكسل. على الرغم من أن الدوال الحديثة مثل TEXTSPLIT تتسم بكفاءة حوسبية فائقة، إلا أن تكرار إعادة تقييم السلاسل النصية الطويلة مع كل تعديل طفيف في ورقة العمل قد يؤدي إلى بطء في الأداء واستهلاك مرتفع لموارد المعالجة الدقيقة.
لتحسين هذه الكفاءة، يُنصح بالتحكم الواعي في خيارات الحساب عبر التبديل المؤقت إلى وضع “الحساب اليدوي” (Manual Calculation) أثناء عمليات التحرير والاستيراد المكثفة، وتفعيل وضع الحساب التلقائي فقط عند اكتمال إدخال البيانات. بالإضافة إلى ذلك، بمجرد استقرار عمليات المعالجة النصية والتحقق النهائي من سلامة المقاطع المستخلصة، يُفضل نسخ النطاق المحسوب ولصقه كقيم ثابتة (Paste as Values) إذا كانت البيانات المصدرية ثابتة لا تتطلب تحديثاً ديناميكياً مستمراً، مما يحرر ذاكرة النظام تماماً ويوفر استجابة فورية للمصنف المشترك.
10.3 حوكمة جودة البيانات والتحقق من صحة المدخلات النصية
تمثل حوكمة جودة البيانات الدرع الوقائي الذي يضمن مناعة النماذج الرياضية واستدامتها؛ فالصيغ الحسابية مهما بلغت درجة تطورها تظل رهينة بسلامة المدخلات. ولذا، يتطلب التصميم الاحترافي للجداول وضع قواعد صارمة للتحقق من صحة البيانات (Data Validation) لمنع إدخال سلاسل نصية مشوهة أو خالية من الفواصل المعيارية منذ لحظة التسجيل الأولى.
يتضمن ذلك وضع ضوابط تحدد الحد الأدنى لطول النص، وتقييد نوعية المحارف المدخلة، واستخدام القوائم المنسدلة متى ما أمكن لتوحيد صياغة السجلات. كما يُنصح بإنشاء لوحات مراقبة جانبية (Audit Dashboards) تتضمن دوال فحص استكشافية لاكتشاف الشذوذ النصي والسجلات التي تخالف الأنماط المتوقعة وعزلها في جداول استثناء مستقلة لإجراء التصحيح اليدوي لها. إن تبني عقلية النمو والتحسين المستمر في إدارة جودة النظم البيانية ينعكس إيجاباً على استقرار المنظومة التحليلية برمتها (Limeri et al., 2020)، مما يضمن سلاسة خطوط المعالجة وتحقيق أعلى مستويات الدقة والموثوقية في استخراج البيانات واتخاذ القرارات الإدارية والتنظيمية المستندة إليها.
خاتمة
استعرض هذا المقال التحليلي المتكامل كيفية تطويع الإمكانات المتطورة لبرمجية مايكروسوفت إكسل لتجزئة السلاسل النصية واستخراج العنصر الأخير بدقة وموثوقية عالية. لقد شكل الانتقال من الحيل الرياضية الكلاسيكية القائمة على حشو المسافات بالدوال المتداخلة مثل TRIM و RIGHT و REPT، أو الاعتماد المشروط على دالة FILTERXML، إلى المنظومة المصفوفية الديناميكية المتمثلة في التكامل بين دالتي TEXTSPLIT و CHOOSECOLS، نقلة نوعية في علم معالجة البيانات النصية داخل جداول البيانات الإلكترونية.
إن توظيف الفهرسة العكسية بواسطة المعامل السلبي (-1) قد منح المحللين حلاً حاسوبياً أنيقاً يتسم بالاستقلال التام عن أطوال النصوص وعدد فواصلها، مع كفاءة استثنائية في إدارة موارد الذاكرة وسرعة المعالجة. ومن خلال توسيع هذه الحلول عبر دوال المجموعات مثل BYROW و LAMBDA أو نقلها إلى مستويات الأتمتة المؤسسية الشاملة في Power Query، بات بإمكان المؤسسات والباحثين بناء خطوط تدفق بيانية فائقة الاستقرار والشفافية. يظل الالتزام بالممارسات الأكاديمية في توثيق الصيغ وضبط جودة المدخلات النصية الضمانة الأساسية للحفاظ على دقة النماذج التحليلية ودعم القرارات الاستراتيجية القائمة على البيانات المنقحة بدقة متناهية.
المراجع
- Brucks, M. S., & Levav, J. (2022). Virtual communication curbs creative idea generation. Nature, 605(7908), 108–112. https://doi.org/10.1038/s41586-022-04643-y
- Ferrand, L., New, B., Brysbaert, M., Keuleers, E., Bonin, P., Méot, A., Augustinova, M., & Pallier, C. (2010). The French Lexicon Project: Lexical decision data for 38,840 French words and 38,840 pseudowords. Behavior Research Methods, 42(2), 488–500. https://doi.org/10.3758/brm.42.2.488
- Frymier, A. B., Shulman, G. M., & Houser, M. L. (1996). The development of a learner empowerment measure 1. Communication Education, 45(3), 181–199. https://doi.org/10.1080/03634529609379048
- Keuleers, E., Brysbaert, M., & New, B. (2010). SUBTLEX-NL: A new measure for Dutch word frequency based on film subtitles. Behavior Research Methods, 42(3), 643–650. https://doi.org/10.3758/brm.42.3.643
- Kirschner, P. A., & van Merriënboer, J. J. G. (2013). Do Learners Really Know Best? Urban Legends in Education. Educational Psychologist, 48(3), 169–183. https://doi.org/10.1080/00461520.2013.804395
- Limeri, L. B., Carter, N. T., Choe, J., Harper, H. G., Martin, H. R., Benton, A., & Dolan, E. L. (2020). Growing a growth mindset: characterizing how and why undergraduate students’ mindsets change. International Journal of STEM Education, 7(1), 35. https://doi.org/10.1186/s40594-020-00227-2
- Youngstrom, E. A. (2013). A Primer on Receiver Operating Characteristic Analysis and Diagnostic Efficiency Statistics for Pediatric Psychology: We Are Ready to ROC. Journal of Pediatric Psychology, 39(2), 204–221. https://doi.org/10.1093/jpepsy/jst062