
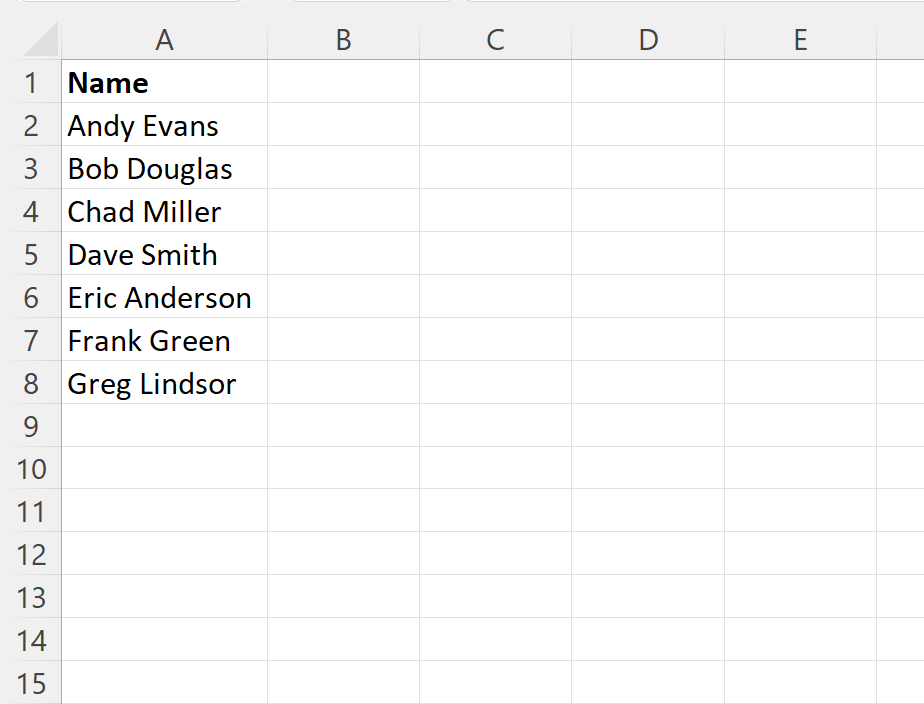
إن إدارة البيانات النصية وهيكلتها داخل جداول البيانات تمثل إحدى الركائز الأساسية في علوم نظم المعلومات وتحليل البيانات المعاصرة. فعند التعامل مع قواعد البيانات المؤسسية أو الأكاديمية، كثيراً ما يواجه الباحثون ومديرو النظم تدفقات من السجلات النصية المدخلة بصيغ غير موحدة، ومن أبرزها تسجيل أسماء الأفراد بالصيغة الطبيعية المباشرة المتمثلة في وضع الاسم الأول متبوعاً باسم العائلة دون فواصل بنيوية. ومع أن هذا النمط يبدو متوافقاً مع القراءة البشرية اليومية، إلا أنه يشكل عقبة تقنية حقيقية أمام عمليات الفرز الأبجدي الدقيق، والربط العلائقي بين الجداول، والتوافق مع المعايير الفهرسية المتبعة عالمياً.
يتطلب الانتقال من بنية البيانات الأولية إلى بنية معيارية قابلة للفرز والتحليل تطبيق عمليات معالجة دقيقة للسلاسل النصية، تُعرف في هندسة البيانات بعمليات الاستخلاص والتحويل وإعادة التركيب. وتعد بيئة مايكروسوفت إكسل (Microsoft Excel) الأداة الأكثر انتشاراً لتنفيذ هذه العمليات الحسابية والمنطقية؛ حيث تطورت عبر إصداراتها المتعاقبة لتقدم ترسانة متكاملة من الدوال الكلاسيكية والحديثة القادرة على تفكيك النصوص وإعادة صياغتها بدقة متناهية. إن الهدف الجوهري لا يقتصر فقط على قلب موضع كلمتين داخل خلية، بل يتعداه إلى ترسيخ منهجية مؤتمتة تضمن الحفاظ على سلامة البيانات، ومعالجة الاستثناءات اللغوية، وتقليل التدخل اليدوي إلى الصفر تقريباً.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم تحليل معمق وتطبيقي لكافة آليات تبديل الاسم الأول واسم العائلة وإدراج فاصلة بينهما داخل برنامج إكسل، مع التركيز على التحول البنيوي من صيغة “الاسم الأول اسم العائلة” إلى صيغة “اسم العائلة، الاسم الأول”. سنستعرض عبر محاور هذا الدليل النظريات الحاسوبية الكامنة وراء دوال اقتطاع النصوص، بدءاً من أحدث الصيغ الديناميكية ووصولاً إلى الحلول الكلاسيكية المتوافقة مع كافة الإصدارات، مروراً بتقنيات تنظيف البيانات، والأتمتة المتقدمة، وإدارة الاستثناءات المعقدة في السجلات الضخمة لضمان الموثوقية التامة للنتائج الإحصائية والتوثيقية.
1. المقدمة المنهجية لمعالجة النصوص وإعادة هيكلة الأسماء في إكسل
1.1 أهمية توحيد بنية الأسماء في قواعد البيانات الأكاديمية والمهنية
تعتمد كفاءة الأنظمة المعلوماتية الحديثة على الاتساق الداخلي للبيانات المخزنة؛ إذ يُعد غياب التوحيد القياسي في حقول النصوص مصدراً رئيساً للتناقضات التحليلية والتشغيلية. في السياقات الأكاديمية والمهنية، تفرض المعايير الفهرسية الدولية (مثل معايير النظم الببليوغرافية وفهرسة المكتبات) تقديم اسم العائلة أو اللقب على الاسم الأول مفصولاً بفاصلة نصية. هذا التنسيق ليس مجرد خيار شكلي، بل هو ضرورة خوارزمية تمكّن محركات قواعد البيانات من إجراء الفرز الأبجدي استناداً إلى الألقاب العائلية، مما يمنع التشتت الناتج عن تكرار الأسماء الأولى الشائعة، ويسهل مطابقة السجلات بدقة متناهية عبر المستودعات الرقمية المتعددة.
علاوة على ذلك، يبرز أثر التنسيق الموحد في تقليل الأخطاء الإحصائية عند معالجة العينات البحثية الضخمة؛ حيث تعتمد خوارزميات إزالة التكرار (Deduplication) والربط المتقاطع (Record Linkage) على تطابق النصوص أو استخدام المسافات الفاصلة كمحددات لتجزئة الحقول. وقد أشار باحثون في منهجيات القياس الحاسوبي وإدارة قوالب البيانات المجدولة، مثل ديلغادو-غارسيا وزملاؤه (Delgado‐García et al., 2020)، إلى أن دقة وموثوقية المعالجات اللاحقة داخل جداول إكسل تتوقف بصورة مباشرة على صرامة البنية التركيبية للبيانات المدخلة وخلوها من التباينات التنسيقية العشوائية التي قد تربك محركات التحليل الرياضي والتجميعي.
ويسهم توحيد بنية الأسماء في تحسين قابلية الربط بين قواعد البيانات المتعددة باستخدام المعرفات النصية القياسية. فعند دمج مجموعات بيانات مستخرجة من مصادر متباينة—مثل سجلات الموظفين، أو بيانات الطلاب، أو المسوح السكانية الميدانية—تصبح صيغة “اسم العائلة، الاسم الأول” مفتاحاً أساسياً أو حقلاً تركيبياً وسيطاً يمنع حدوث تضارب في علاقات الجداول (Relations)، ويقلل من الاعتماد على المعالجة اليدوية التي تكلف موارد مؤسسية هائلة وتفتح الباب واسعاً أمام الأخطاء البشرية القاتلة.
1.2 التحديات التقنية المرتبطة بالبنية النصية للأسماء
تتسم السلاسل النصية التي تمثل أسماء الأفراد بدرجة عالية من عدم التجانس، مما يجعل معالجتها آلياً تحدياً خوارزمياً حقيقياً. يكمن التحدي الأبرز في التباين البنيوي لعدد المقاطع المكونة للاسم؛ فالاسم قد يكون ثنائياً، أو ثلاثياً، أو مركباً يتضمن مقاطع إضافية مثل الأسماء الموصولة أو أدوات التعريف والنسب. بالإضافة إلى ذلك، يمثل وجود مسافات بيئية متعددة أو مسافات طفيلية غير منتظمة ناتجة عن أخطاء الرقن اليدوي عائقاً أمام دوال البحث النصي، حيث يمكن لمسافة بيضاء زائدة واحدة في بداية النص أو نهايته أو وسطه أن تغير موقع المحدد الخوارزمي وتتسبب في إزاحة موضع الاقتطاع.
وعلى صعيد السجلات الطولية وتراكم البيانات عبر الفترات الزمنية الممتدة، تصبح المعالجة اليدوية غير مجدية على الإطلاق وتستنزف الوقت والموارد بشكل غير مبرر. وفي هذا السياق، أوضح تساكاليديس وزملاؤه (Tsakalidis et al., 2022) في دراستهم حول استخلاص الأنماط الحسابية من المنشورات والسجلات النصية الطولية، أن التعامل مع كميات ضخمة من النصوص غير المهيكلة يتطلب بالضرورة استخدام نماذج حوسبة مؤتمتة وقواعد تحويل منتظمة تلغي المتغيرات العشوائية وتحافظ على دقة السياق البنيوي للنصوص عبر مختلف مراحل المعالجة.
من هنا تنبع الحاجة الملحة إلى صياغة حلول ديناميكية داخل إكسل تتكيف تلقائياً مع التحديثات المستمرة للبيانات. فالحلول الثابتة أو التعديلات الموضعية تنهار بمجرد إضافة صفوف جديدة أو تحديث أسماء قائمة، بينما تضمن النماذج المعتمدة على الدوال الموجهة إعادة الحساب التلقائي والتكيف مع أطوال النصوص المختلفة، مما يحقق استدامة العمليات التحليلية واستقرار النماذج الإحصائية المعنية بإدارة الموارد البشرية والبحثية.
1.3 نظرة عامة على المعادلة المباشرة ودورها الوظيفي
تقدم الإصدارات الحديثة من برنامج مايكروسوفت إكسل حلاً جذرياً وأنيقاً لهذه المشكلة من خلال دمج الدوال المتطورة لاقتطاع النصوص؛ وتحديداً عبر الجمع بين دالة الربط CONCAT (أو مشغل الربط النصي) والدالتين الحديثتين TEXTAFTER وTEXTBEFORE. تعمل هذه المنظومة الرياضية وفق منهجية التفكيك الانتقائي وإعادة التركيب الموجه؛ حيث تقوم دالة TEXTAFTER بمسح النص الأصلي وتحديد مسافة الفصل لاستخلاص ما بعدها مباشرة (اسم العائلة)، في حين تتولى دالة TEXTBEFORE اقتطاع المقطع الذي يسبق تلك المسافة (الاسم الأول).
عقب اكتمال مرحلة التفكيك البنيوي، يأتي دور التجميع عبر إدراج عنصر نصي ثابت يتمثل في الفاصلة تليها مسافة (“، “) ليصبح الناتج النهائي مطابقاً تماماً للمعايير الفهرسية. يمثل هذا النمط الحسابي قفزة نوعية في هندسة جداول البيانات؛ إذ يلغي الحاجة إلى احتساب أطوال النصوص يدوياً أو تتبع المواقع الفهرسية للمحارف، مما يوفر معادلة مقتضبة، سهلة القراءة، ومحصنة ذاتياً ضد أخطاء الإزاحة الشائعة في الصيغ المعقدة.
ومع ذلك، يخضع تشغيل هذه الدوال الحديثة لشروط توافق بيئية محددة؛ حيث تم توفير TEXTAFTER وTEXTBEFORE حصرياً في بيئات مايكروسوفت 365 (Microsoft 365) وإصدار إكسل 2021 وما يليهما من تطبيقات الويب الحديثة، بالاعتماد على محرك الحساب الديناميكي للمصفوفات (Dynamic Array Engine). أما في الإصدارات الأقدم، فإن تنفيذ ذات الوظيفة يتطلب محاكاة خوارزمية باستخدام الدوال الكلاسيكية التراكمية، وهو ما سيتم تفصيله ومقارنته منهجياً في الأقسام اللاحقة من هذا البحث.
2. التشريح الدقيق لدوال النصوص الحديثة المستخدمة في الحل
2.1 وظيفة الدالة TEXTAFTER وآلية تحديد المحددات النصية
تعتمد الدالة TEXTAFTER في جوهرها الرياضي على مسح السلسلة النصية المدخلة والبحث عن محدد معين (Delimiter) يتم تزويدها به في وسائطها، ثم استرجاع الجزء المتبقي من النص الذي يلي ذلك المحدد بالكامل. في مسألة تبديل الأسماء، يُعرف المحدد النصي بأنه رمز المسافة (” “). عندما تفحص الدالة القيمة النصية، فإنها تحدد الإحداثي الفهرسي لأول ظهور للمسافة، وتقوم تلقائياً باجتزاء كافة المحارف الواقعة على يمين (أو يسار بحسب اتجاه القراءة ونوع النص) هذا الإحداثي، لتعزل اسم العائلة ككتلة نصية مستقلة وجاهزة للتركيب.
تحتوي بنية الدالة على وسائط متقدمة تتيح للمستخدم ضبط سلوك البحث بدقة فائقة؛ حيث تأتي الصيغة القياسية كالتالي: TEXTAFTER(text, delimiter, [instance_num], [match_mode], [match_end], [if_not_found]). يتيح وسيط رقم المثيل (instance_num) للمستخدم تحديد أي تكرار للمحدد يجب اعتماده، وهي ميزة حاسمة عند التعامل مع الأسماء المعقدة. علاوة على ذلك، يحدد وسيط (match_mode) ما إذا كان البحث حساساً لحالة الأحرف في اللغات اللاتينية، بينما يتحكم (match_end) في سلوك الدالة في حال وصولها إلى نهاية النص دون العثور على محدد مطابق.
أما في حالات تكرار المسافات داخل الخلية الواحدة نتيجة أخطاء الإدخال، فإن السلوك الافتراضي للدالة عند تعيين instance_num بالقيمة (1) هو التوقف عند المسافة الأولى تماماً. هذا يعني أن أي كلمات أو مقاطع نصية تلي المسافة الأولى ستُعامل كجزء من المقطع الختامي، وهو ما يبرز أهمية التنظيف المسبق للبيانات لضمان عدم انقسام السلسلة في مواضع غير مقصودة، أو توظيف الوسائط العددية لتوجيه الاقتطاع نحو المسافة الأخيرة كما سنرى لاحقاً.
2.2 وظيفة الدالة TEXTBEFORE ودورها في استخراج المقاطع الأولى
تمثل الدالة TEXTBEFORE النظير الهيكلي المتكامل للدالة السابقة؛ إذ تعمل على مسح السلسلة النصية وعزل كافة المحارف التي تسبق أول ظهور للمحدد النصي المحدد. وفي إطار تطبيقنا الحالي، يؤدي استخدام رمز المسافة (” “) كمحدد إلى قيام الدالة بقراءة النص من بدايته الفهرسية حتى تلامس أول مسافة بيضاء، فتتوقف وتقتطع ما تم مسحه حتى تلك النقطة دون تضمين المسافة ذاتها ضمن المخرجات المستخرجة، مما يضمن ثبات الاسم الأول بدقة متناهية ودون وجود أي فراغات إضافية غير مرئية في نهايته.
تتجلى الأهمية الرياضية والبرمجية لهذه الدالة في تجنيب المستخدم التعقيدات القديمة المتمثلة في حساب الإحداثيات باستخدام دالة الطول ودوال البحث النصي التقليدية. فهي تتعامل داخلياً مع إدارة الذاكرة واحتساب الأطوال الافتراضية، مما يقلل احتمالية حدوث أخطاء الاقتطاع الجزئي للحروف، ولا سيما عند معالجة النصوص متعددة البايتات (Multi-byte characters) مثل الحروف العربية ذات علامات التشكيل المتنوعة أو التراكيب الإملائية الخاصة.
وفيما يخص إدارة الأخطاء الافتراضية، فإن الدالة تُرجع الخطأ الحسابي الشهير #N/A إذا فشلت في العثور على المحدد المطلوب داخل النص الأصلي (كأن يكون الاسم مدخلاً ككلمة واحدة مجردة من أي مسافة فاصلة). ولمواجهة ذلك برمجياً، توفر الدالة وسيطاً اختيارياً أخيراً هو (if_not_found)، يتيح للمحلل تمرير قيمة بديلة آمنة—كإعادة الاسم الأصلي نفسه دون تعديل أو إرجاع سلسلة فارغة—مما يحمي نموذج البيانات العام من التوقف المفاجئ أو تشوه التقارير التجميعية.
2.3 دور دالة CONCAT في التجميع البنيوي وإدراج الرمز الفاصل
تأتي دالة CONCAT لتلعب الدور التكاملي النهائي في هذه المنظومة الخوارزمية؛ حيث صُممت كبديل متطور وفعال للدالة القديمة CONCATENATE، مع تمتعها بالقدرة على دمج سلاسل نصية ونطاقات كاملة دون استهلاك مفرط لموارد الحوسبة. يتمثل دورها الوظيفي هنا في استقبال المخرج النصي لاسم العائلة المشتق من TEXTAFTER، والمخرج النصي للاسم الأول المشتق من TEXTBEFORE، ودمجهما ضمن سلسلة نصية متصلة وموحدة تشغل خلية واحدة جديدة.
لا يكتمل التوافق التنسيقي الفهرسي بمجرد عكس ترتيب الاسمين، بل يشترط إدراج الفاصلة والمسافة كعنصر نصي ثابت يفصل بين الكتلتين. يتم ذلك من خلال تمرير الفاصلة والمسافة بين علامتي تنصيص كعنصر وسيط داخل الدالة: CONCAT(TEXTAFTER(…), “, “, TEXTBEFORE(…)). تضمن هذه الصياغة ترسيخ المعايير الطباعية الدقيقة، حيث تلتصق الفاصلة بنهاية اسم العائلة مباشرة وتتبعها مسافة نظامية واحدة تسبق الاسم الأول، وهو التنسيق القياسي المعتمد في الفهارس وقواعد البيانات الببليوغرافية.
وعند مقارنة الكفاءة بين استخدام دالة CONCAT واستخدام عامل الربط التقليدي (&)، نجد أن كلاهما يحقق النتيجة التركيبية ذاتها، حيث يمكن كتابة المعادلة بالصيغة البديلة: TEXTAFTER(A2,” “) & “, ” & TEXTBEFORE(A2,” “). ومع ذلك، يفضل مهندسو البيانات استخدام دالة CONCAT في النماذج المؤسسية الكبرى لكونها تتيح قراءة أوضح لبنية الصيغة البرمجية، وتسهل دمج مصفوفات البيانات المتعددة، وتمنع الالتباس البصري الذي قد ينشأ عن كثرة علامات (&) المتداخلة مع علامات التنصيص والرموز الفاصلة.
3. الدليل الإجرائي لتطبيق معادلة تبديل الأسماء خطوة بخطوة
3.1 إعداد بيئة العمل وهيكلة أعمدة البيانات
يتطلب الشروع في تطبيق عمليات التحويل النصي تنظيماً مسبقاً لبيئة العمل داخل ورقة العمل (Worksheet)، لتفادي أي تلف في السجلات الأصلية أو تداخل غير مقصود في الصيغ. تبدأ الخطوة الأولى بإجراء فحص شامل للعمود المصدر (Source Column)—وليكن العمود A الذي يحتوي على الأسماء بصيغتها الأولية—للتأكد من خلوه التام من أي خلايا مدمجة (Merged Cells). تمثل الخلايا المدمجة إحدى كبرى الآفات الهيكلية في قواعد بيانات إكسل؛ إذ تعطل مراجع النطاقات النسبية، وتمنع تطبيق التعبئة التلقائية السليمة، وتؤدي إلى إرجاع قيم فارغة غير متوقعة.
الخطوة الإجرائية التالية تتمثل في إدراج عمود مستهدف مخصص (Target Column) مجاور للعمود المصدر، وتسميته برأس واضح يعبر عن محتواه مثل “الاسم المنسق” أو “اسم العائلة، الاسم الأول”. يفيد إنشاء هذا العمود المستقل في الحفاظ على البيانات الخام في مكانها الأصلي، مما يتيح مراجعة النتائج والتحقق من صحة التحويلات قبل اتخاذ قرار الاستغناء عن المصدر الأساسي، وذلك ترسيخاً لمبادئ الأمان الرقمي وحفظ السجلات البحثية.
أخيراً، يجب ضبط التنسيق الرقمي لخلايا العمود المستهدف عبر تعيينه صراحة كتنسيق “نص” (Text) أو تركه على التنسيق “العام” (General) مع الحذر التام من وجود تنسيقات تواريخ أو أرقام مسبقة قد تفسر الفواصل والشرطات النصية كمعاملات حسابية أو أجزاء كسرية. يضمن هذا الضبط المبدئي معالجة إكسل للمخرجات كرموز مجردة من أي افتراضات كمية، مما يمهد الطريق لكتابة المعادلة وتنفيذها بسلاسة وموثوقية عالية.
3.2 صياغة المعادلة وتطبيقها على الخلية المرجعية الأولى
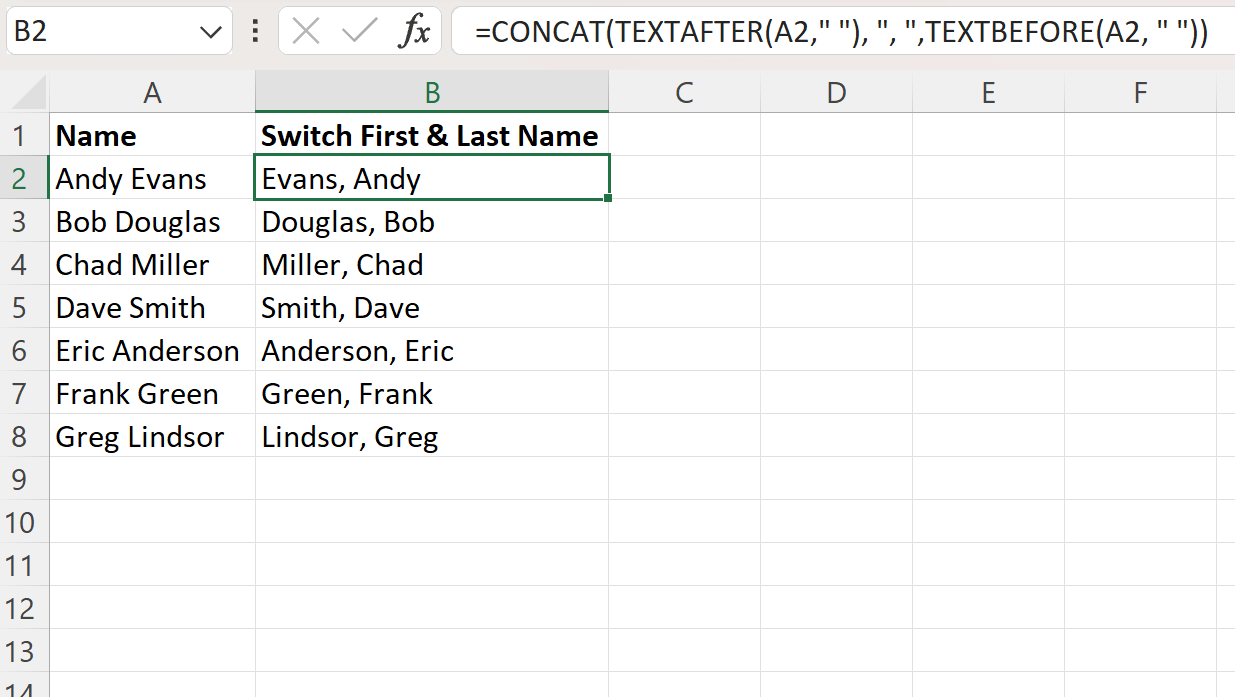
بعد إتمام تهيئة الجدول، يتم الانتقال إلى الخلية الأولى في العمود المستهدف والمحاذية لأول سجل اسم مدخل، ولتكن الخلية B2 على افتراض أن الاسم الأول يقع في الخلية A2. يقوم المستخدم بإدخال الصيغة الحسابية المتكاملة التالية:
=CONCAT(TEXTAFTER(A2, ” “), “, “, TEXTBEFORE(A2, ” “))
أو استخدام الصيغة المتكافئة وظيفياً باستخدام عامل الربط:
=TEXTAFTER(A2, ” “) & “, ” & TEXTBEFORE(A2, ” “)
بمجرد الضغط على مفتاح الإدخال (Enter)، يقوم محرك الحساب بمعالجة السلسلة النصية فورياً؛ حيث يستخلص ما بعد الفراغ ويسنده إلى الموضع الأول، ثم يدمج الفاصلة المتبوعة بمسافة، ثم يلحق به الاسم الأول المشتق من الجزء السابق للفراغ، فتتحول العبارة مثلاً من “أحمد محمود” إلى “محمود، أحمد”.
يتعين في هذه المرحلة إجراء فحص بصري دقيق للمخرج النصي للتأكد من انضباط الترتيب وتموضع الفاصلة بدقة بعد اسم العائلة مباشرة دون فراغات شاذة تفصل بين الحرف الأخير والفاصلة. كما يجب التأكد من استخدام مراجع الخلايا النسبية (Relative References) المتمثلة في كتابة A2 بدلاً من المرجع المطلق $A$2؛ حيث يعد هذا الإجراء شرطاً هندسياً لا غنى عنه للسماح للمعادلة بالانتقال الذاتي والتكيف ديناميكياً مع أرقام الصفوف التالية عند سحبها وتطبيقها على بقية السجلات.
3.3 تعميم المعادلة عبر النطاق باستخدام التعبئة التلقائية
عقب التحقق من صحة المخرج في الخلية المرجعية الأولى، يتم الانتقال إلى مرحلة التعميم عبر كامل النطاق البياني. يتم ذلك بالوقوف على الخلية B2، ثم توجيه مؤشر الفأرة نحو الزاوية اليسرى السفلى (أو اليمنى بحسب لغة الواجهة واتجاه الورقة) حتى يتحول المؤشر إلى علامة التقاطع السوداء الدقيقة المعروفة باسم “مقبض التعبئة” (Fill Handle). يتيح سحب هذا المقبض للأسفل نسخ الصيغة الرياضية رأسياً مع تعديل المراجع تلقائياً لتشمل A3 وA4 وما يليهما بصورة تسلسلية متطابقة.
وفي حالات السجلات الممتدة التي تحتوي على آلاف أو مئات الآلاف من الصفوف، يصبح السحب اليدوي غير عملي ومضيعاً للوقت. هنا يتم الاعتماد على تقنية “النقر المزدوج” (Double-Click) على مقبض التعبئة؛ إذ يستشعر إكسل النطاق الرأسي المجاور المستمر في العمود A، ويقوم بإسقاط المعادلة ومضاعفتها فورياً حتى آخر صف يحتوي على بيانات، مما يوفر جهداً شاقاً وينجز العملية في أجزاء من الثانية دون إغفال أي سجل وسيط.
تختتم هذه المرحلة الإجرائية بتطبيق مراجعة تفقدية عبر اختيار عينات عشوائية من مواضع مختلفة داخل النطاق المستهدف—خاصة في منتصف الجدول ونهايته القصوى. تهدف هذه المراجعة المنهجية إلى التأكد من ثبات التطبيق، وعدم انزياح مراجع الصفوف، والتثبت من خلو البيانات من الأخطاء التشغيلية، مما يعطي الباحث أو المحلل الضوء الأخضر للمضي قدماً في استخدام هذه البيانات المهيكلة في التحليلات اللاحقة.
4. البدائل التقليدية: استخدام دوال النصوص الكلاسيكية للإصدارات القديمة
4.1 الجمع بين دوال RIGHT وLEN وFIND لاستخراج اسم العائلة
في بيئات العمل التي تعتمد على إصدارات إكسل القديمة (مثل إكسل 2019 وما قبله)، لا تتوفر الدوال الحديثة TEXTAFTER وTEXTBEFORE، مما يفرض استخدام البدائل الحسابية التراكمية القائمة على تحديد المواضع الفهرسية للمحارف. لاستخراج اسم العائلة من سلسلة نصية مركبة، يعتمد المنهج الكلاسيكي على بنية رياضية ذكية تجمع بين ثلاث دوال أساسية هي: RIGHT وLEN وFIND (أو SEARCH). تبدأ العملية بحساب الطول الإجمالي للسلسلة النصية عبر الدالة LEN، والتي تحصي عدد المحارف بما في ذلك المسافات البيئية بدقة مطلقة.
تتولى الدالة FIND تحديد الموضع العددي لمسافة الفصل الأولى عبر مسح النص من بدايته إلى نهايته؛ حيث ترجع رقماً يمثل ترتيب محرف المسافة داخل السلسلة. بعد ذلك، تأتي العملية الحسابية الجوهرية المتمثلة في طرح موضع المسافة من الطول الكلي للسلسلة النصية: (LEN(A2) – FIND(” “, A2)). ينتج عن عملية الطرح هذه عدد المحارف الفعلي المكون لاسم العائلة بمفرده، مجرداً من طول الاسم الأول ومن مسافة الفصل ذاتها.
يمرر ناتج هذا الفارق العددي كوسيط ثانٍ للدالة RIGHT، التي تنطلق من الحرف الأخير في أقصى طرف السلسلة النصية وتقتطع باتجاه الداخل عدداً من المحارف مساوياً للناتج المحسوب. بالرغم من التعقيد النظري لهذه المعادلة المركبة، إلا أنها تمثل حلاً رياضياً كلاسيكياً متماسكاً أثبت كفاءته لعقود في التعامل مع النصوص الثنائية عبر كافة الإصدارات التاريخية لحزم البرمجيات المكتبية دون أي قيود برمجية خاصة.
4.2 استخدام دالة LEFT لاستخلاص الاسم الأول بدقة
لاستكمال التحويل وفق المنظومة الكلاسيكية، يتم توظيف الدالة LEFT لاستخلاص الاسم الأول. تعتمد هذه الدالة على اقتطاع عدد محدد من المحارف انطلاقاً من البداية الفهرسية للنص الأصلي. ولتحديد نقطة التوقف بدقة وتفادي تضمين أي أجزاء من الاسم اللاحق، يُعتمد مجدداً على دالة البحث الموضعي FIND لتحديد موقع المسافة الفاصلة بين الاسمين.
غير أن استخدام ناتج دالة FIND مباشرة داخل دالة LEFT سيتسبب في اقتطاع الاسم الأول ومعه مسافة الفصل البيضاء ملتصقة في نهايته، وهو خطأ تنسيقي غير مرئي قد يفسد عمليات الربط اللاحقة. ولتلافي هذا الخلل، يتم ضبط وسيط الطول في دالة LEFT عبر طرح رقم واحد صحيح من موضع المسافة المكتشف، لتصبح الصيغة: LEFT(A2, FIND(” “, A2) – 1). هذا الطرح المنطقي يقص المسافة ويضمن استخراج الحروف الفعلية للاسم الأول نقية تماماً.
عقب تجهيز المعادلتين الكلاسيكيتين، يتم تركيبهما معاً باستخدام عامل الربط النصي وتضمين الفاصلة والمسافة في المنتصف، لتتشكل الصيغة التقليدية المتكاملة والشاملة:
=RIGHT(A2, LEN(A2) – FIND(” “, A2)) & “, ” & LEFT(A2, FIND(” “, A2) – 1)
تمثل هذه الصيغة التوافقية حجر الزاوية في مشاريع تبادل ملفات البيانات بين المؤسسات التي تستخدم إصدارات برمجية غير متطابقة، لضمان استمرار عمل النماذج التحليلية دون أي أعطال ناتجة عن غياب التحديثات البرمجية.
4.3 مقارنة منهجية بين الحلول الحديثة والحلول الكلاسيكية المركبة
تظهر المقارنة المعرفية والبرمجية بين المنهج الحديث والمنهج الكلاسيكي فروقاً جوهرية في قابلية القراءة وسهولة الصيانة. فالصيغة الحديثة المعتمدة على TEXTAFTER وTEXTBEFORE تمتاز ببساطة الدلالة اللفظية وسهولة الفهم لأي محلل بيانات دون الحاجة لتتبع العمليات الحسابية للأطوال والمواضع، بينما تفرض الصيغة الكلاسيكية عبئاً ذهنياً متزايداً يتطلب تفكيكاً تدريجياً لفهم آليات الطرح والتعويض المكاني، مما يزيد من احتمالية الخطأ عند الكتابة اليدوية.
من زاوية استهلاك الموارد وسرعة المعالجة الحسابية، تتفوق الصيغ الحديثة بفضل استنادها إلى كود برمجي مُحسّن مسبقاً داخل النواة الحسابية لإكسل 365، مما يقلل من دورات المعالجة اللازمة لحساب أطوال النصوص ومواضعها، خاصة عند تطبيق المعادلات على مجموعات البيانات العملاقة التي تتجاوز مئات الآلاف من السجلات. ومع ذلك، تبقى الصيغ الكلاسيكية حلاً آمناً من حيث استقرار النقل عبر الشبكات السحابية المشتركة لتوافقيتها المطلقة عالمياً.
وفي جانب المرونة البرمجية وتصحيح الأخطاء، تتجلى أفضلية الدوال الحديثة بوضوح عند الحاجة لتعديل محدد الفصل؛ إذ يقتصر التعديل على تغيير رمز المسافة داخل وسيط الدالة، في حين يتطلب التعديل في الصيغة الكلاسيكية مراجعة دقيقة لعمليات الطرح والتأكد من عدم الإخلال بالتوازن الرياضي بين FIND وLEN وLEFT، مما يرجح كفة الدوال الحديثة كخيار مستقبلي مستدام.
5. التعامل المنهجي مع الأسماء المركبة والحالات النصية الخاصة
5.1 إدارة الأسماء التي تحتوي على أكثر من مسافتين
تتفاقم مشكلات تجزئة النصوص عندما تتجاوز بنية الاسم النمط الثنائي البسيط وتتحول إلى بنية ثلاثية أو رباعية تحتوي على مسافات متعددة داخل الخلية الواحدة (مثل: “محمد عبد الله السعيد”). في مثل هذه الحالات، يفشل الاعتماد على المسافة الأولى في عزل اسم العائلة الفعلي؛ إذ ستعتبر الصيغ الافتراضية الاسم الأوسط واسم العائلة كتلة واحدة ملتصقة، مما يشوه التنسيق النهائي ويفرغ عملية التحويل من غايتها الفهرسية.
يقدم محرك الدالة TEXTAFTER حلاً برمجياً عبقرياً لهذه المعضلة عبر وسيط “رقم المثيل” (instance_num). من خلال تمرير القيمة الحسابية السالبة (-1) لهذا الوسيط، يتم إجبار الدالة على عكس اتجاه مسح السلسلة النصية؛ لتبدأ بالبحث من نهاية النص نحو بدايته، والتقاط أول مسافة تصادفها من جهة النهاية (أي المسافة الأخيرة في النص الفعلي). بناءً على ذلك، يتم عزل اسم العائلة النهائي فقط بدقة بالغة مهما بلغ عدد الأسماء السابقة له، وفق المعادلة:
=TEXTAFTER(A2, ” “, -1) & “, ” & TEXTBEFORE(A2, ” “, -1)
أما في السيناريوهات البحثية التي تتطلب فرز الأسماء الثلاثية بحيث يوضع اسم العائلة أولاً متبوعاً بكلا الاسمين الأول والأوسط معاً، فإن هذه الصيغة العكسية تحقق ذلك تماماً؛ إذ تستخرج دالة TEXTBEFORE(A2, ” “, -1) كامل العبارة النصية السابقة للمسافة الأخيرة، لينتج تنسيق دقيق يضع اللقب في الصدارة يليه الاسمان الشخصيان بصورة منسجمة وفهرسية بامتياز.
5.2 معالجة الأسماء المسبوقة بألقاب أو لواحق تعريفية
تتضمن قواعد البيانات المهنية والأكاديمية في كثير من الأحيان بادئات وألقاباً تشريفية أو تخصصية تسبق الاسم (مثل: دكتور، مهندس، أستاذ، بروفيسور)، أو لواحق تصنيفية تلحق بالاسم العائلي (مثل: الابن، الثالث، الابن الأصغر). يؤدي وجود هذه الزوائد إلى اضطراب حاد في مواضع الفواصل النصية؛ حيث تعامل الدوال التقليدية اللقب الأكاديمي كاسم أول، أو تعتبر اللاحقة العائلية كاسم عائلة مستقل ومجرد من اللقب الحقيقي.
تقتضي المعالجة المنهجية لهذه الحالات تطبيق استراتيجيات تنقية مسبقة تعتمد على إزالة الألقاب أو عزلها في أعمدة خاصة قبل الشروع في التبديل الهيكلي. يمكن توظيف دالة SUBSTITUTE لحذف الألقاب الشائعة تلقائياً واستبدالها بسلاسل فارغة، أو بناء معادلات فحص منطقية مسبقة تستند إلى الدالة IF للتحقق مما إذا كانت الخلية تبدأ بلقب معين، واستبعاده من نطاق التبديل الأساسي ليُعاد دمجه لاحقاً في الموضع التوثيقي الصحيح.
أما بالنسبة للواحق العائلية المتأخرة، فيتوجب توجيه دوال الاقتطاع لتجاوز مسافة الفصل الأخيرة ودمج اللاحقة عضوياً مع اسم العائلة قبل وضع الفاصلة. هذا الضبط يتطلب تصميم نماذج تركيبية متداخلة تعيد تصنيف أجزاء الاسم، مما يضمن اتساق قواعد البيانات الببليوغرافية وتوافقها التام مع متطلبات النشر العلمي الدقيق دون تشويه للأنساق اللغوية للباحثين والمؤلفين.
5.3 تطويع الدوال لخدمة الأسماء المركبة أحادية الهوية
تتميز اللغة العربية وثقافات لغوية متعددة بوجود أسماء مركبة تمثل هوية شخصية لشخص واحد ولكنها تُكتب ككلمات منفصلة بمسافة بيضاء؛ ومن أشهرها الأسماء المعبدة (مثل: عبد الله، عبد الرحمن) والأسماء المركبة تركيباً إضافياً (مثل: نور الدين، سيف الإسلام). يؤدي التعامل الخوارزمي الأعمى مع هذه الأسماء إلى شطرها تعسفياً، فيُعامل الجزء الثاني كاسم عائلة أو يندمج بطريقة خاطئة مع الألقاب اللاحقة.
يكمن الحل التقني المتقدم لهذه الإشكالية في استخدام حيلة “الروابط النصية المؤقتة”. يتم ذلك من خلال تطبيق دالة SUBSTITUTE لاستبدال المسافة الفاصلة بين شقي الاسم المركب برمز بديل خاص وغير مكرر داخل النص (مثل الواصلة النصية “-” أو الشرطة السفلية “_”)، أو برمز مسافة غير قابلة للكسر (Non-breaking space). هذا التحويل يجعل الاسم المركب كتلة نصية مصمتة لا تحتوي على مسافات قياسية، مما يمنع دوال البحث من تجزئته.
بعد تطبيق المعادلة الأساسية وتبديل الاسم المركب الكامل مع اسم العائلة وإدراج الفاصلة، يتم إخضاع المخرج النهائي لدالة استبدال عكسية تعيد تحويل الروابط المؤقتة إلى مسافات لغوية طبيعية. يضمن هذا النهج الخوارزمي المزدوج حماية الأسماء المركبة من الانشطار البنيوي، والحفاظ على أصالة المسميات الدينية واللغوية دون المساس بدقة المعالجة الفهرسية داخل قواعد البيانات المتقدمة.
6. تنظيف البيانات المسبق لضمان سلامة مخرجات التحويل
6.1 استخدام دالة TRIM لإزالة المسافات الطفيلية والزائدة
تُعد المسافات البيئية العشوائية المكتومة في بداية النصوص أو نهاياتها من أخطر الشوائب التي تهدد دقة المعالجات النصية داخل إكسل. فعند وجود مسافة بادئة تسبق الاسم الأول، ستعتبرها دالة TEXTBEFORE دليلاً على وجود اسم فارغ وتستقطع الفراغ فقط، كما أن وجود مسافات مزدوجة بين الاسمين يؤدي إلى إدراج مسافات طفيلية تشوه المظهر النهائي. ولذلك، يعد تنظيف البيانات شرطاً تحضيرياً إلزامياً لا يمكن إغفاله.
تمثل دالة TRIM الأداة الخوارزمية المثالية لمكافحة هذه الشوائب؛ إذ تعمل على مسح السلسلة النصية وحذف كافة المسافات البادئة والختامية نهائياً، مع تقليص أي مسافات متكررة أو مزدوجة بين الكلمات إلى مسافة نظامية واحدة فقط. بدلاً من إنشاء عمود وسيط إضافي لتنظيف الأسماء، يُنصح بتضمين دالة TRIM مباشرة ضمن مرجع الخلية داخل معادلة التبديل ذاتها، بحيث تتم تصفية النص برمجياً داخل الذاكرة قبل بدء عمليات الاقتطاع.
تتحول صيغة التبديل الحديثة عند تحصينها بدالة TRIM إلى التركيب المتين التالي:
=CONCAT(TEXTAFTER(TRIM(A2), ” “), “, “, TEXTBEFORE(TRIM(A2), ” “))
يقضي هذا الدمج البنيوي على أي احتمالية لوقوع أخطاء في تحديد المحددات النصية الناتجة عن المسافات غير المرئية، مما يوفر بيئة معالجة نقية تضمن خروج النتائج بأعلى درجات الاتساق المعياري.
6.2 معالجة المحارف غير المرئية باستخدام دالة CLEAN
عند استيراد قواعد البيانات من خوادم خارجية، أو مستودعات الويب، أو سجلات الأنظمة المركزية المصدرة بتنسيقات نصية مجردة (مثل CSV أو TXT)، كثيراً ما تتسلل إلى السلاسل النصية محارف غير مرئية وغير قابلة للطباعة (Non-printable characters)، والتي تنتمي إلى شفرات آسكي (ASCII) ذات القيم من 0 إلى 31، مثل رموز فواصل الأسطر (Line Breaks) ومحارف التبويب (Tabs).
هذه المحارف غير المرئية تفلت من قدرة دالة TRIM على الحذف؛ إذ لا تصنفها البرمجية كمسافات عادية، ومع ذلك فإنها تتدخل في حسابات الأطوال وتعيق دقة دوال الاقتطاع النصي وتؤدي أحياناً إلى كسر مخرجات الخلية على سطرين أو إرجاع قيم فارغة مشوهة. هنا يأتي الدور الحيوي لدالة CLEAN، التي صُممت خصيصاً لمسح هذه المحارف الشاذة واستئصالها التام من السجلات دون المساس بالحروف الأبجدية الأصلية.
ولتحقيق أقصى درجات التحصين للبيانات الخام، يعتمد خبراء التحليل صياغة وقائية مزدوجة تجمع بين CLEAN وTRIM داخل معادلة التبديل المركزية: TRIM(CLEAN(A2)). تضمن هذه المنظومة التنظيفية الشاملة تطهير السلسلة النصية من كافة الملوثات الرقمية الخفية والمسافات الزائدة دفعة واحدة، مما يهيئ النص لعمليات التقسيم وإعادة الترتيب دون أي مفاجآت برمجية غير مرغوبة.
6.3 توحيد حالة الأحرف والخصائص اللغوية للنصوص المستخرجة
في بيئات العمل التي تتعامل مع الأسماء باللغات اللاتينية (مثل الإنجليزية أو الفرنسية)، يمثل التباين في حالة الأحرف (كتابة الاسم بأحرف صغيرة بالكامل lowercase أو كبيرة بالكامل uppercase أو خليط عشوائي منهما) مظهراً غير احترافي يضعف القيمة البصرية والتوثيقية للتقارير. يتطلب التنسيق المعياري تحويل السجلات إلى صيغة “حالة العنوان” أو الأحرف الاستهلالية الكبيرة (Title Case)، حيث يبدأ كل مقطع بحرف كبير وتتبعه أحرف صغيرة.
تتولى دالة PROPER تنفيذ هذه المعايرة الشكلية بكفاءة متناهية؛ إذ يمكن تغليف ناتج معادلة التبديل بأكمله داخلها ليتم تصحيح أوضاع الحروف تلقائياً فور إعادة التركيب، فتتحول السلسلة من صيغتها المتباينة إلى صيغة منسقة وجاهزة للعرض المباشر. كما يجب الانتباه عند التعامل مع النصوص العربية الحساسة لغوياً إلى تجنب الدوال أو الأدوات الخارجية التي قد تؤدي إلى تشويه علامات التشكيل أو تفكيك بنية الحروف المتصلة.
إن الربط المنطقي بين تنظيف البيانات ومعايرتها الشكلية يعزز من كفاءة خطوط معالجة البيانات المعقدة؛ فالبيانات المنقحة لا تخدم فقط المظهر الجمالي لجداول البيانات، بل تسهم جوهرياً في تحسين جودة التحليلات الإحصائية وتمنع انشطار الفئات المتشابهة عند بناء الجداول المحورية (Pivot Tables) أو تصدير الحقول نحو نظم التحليل الإحصائي المتقدمة.
7. البدائل غير المعتمدة على الصيغ: أدوات إكسل التفاعلية المباشرة
7.1 توظيف ميزة التعبئة السريعة (Flash Fill) للتحويل الفوري
توفر بيئة إكسل خيارات تفاعلية ذكية تتيح إعادة هيكلة النصوص دون الحاجة إلى كتابة أي معادلات أو صيغ رياضية، ويأتي في مقدمة هذه الأدوات ميزة “التعبئة السريعة” (Flash Fill). تعتمد هذه الميزة على خوارزميات متطورة للتعلم الآلي والاستقراء البرمجي (Inductive Program Synthesis)؛ حيث تقوم البرمجية بمراقبة التعديل اليدوي الذي يجريه المستخدم في عمود مجاور وتستنبط النمط التنسيقي المقصود ذاتياً لتطبيقه على بقية الصفوف.
لتنفيذ ذلك إجرائياً، يقوم المستخدم بإنشاء عمود مجاور لعمود الأسماء الأصلية، ويكتفي بكتابة نموذج واحد يدوي في الخلية الأولى يعكس التنسيق المستهدف بدقة متناهية؛ كأن يكتب في الخلية B2 الاسم بالصيغة المعكوسة متضمناً الفاصلة (مثلاً: “السعيد، أحمد”). بعد الضغط على مفتاح الإدخال، يتم استدعاء ميزة التعبئة السريعة عبر الضغط على الاختصار التفاعلي المباشر من لوحة المفاتيح (Ctrl + E)، أو بالنقر على أيقونة التعبئة السريعة في تبويب “بيانات” (Data).
يقوم إكسل في أجزاء من الثانية بمسح السجلات السفلية وتطبيق النمط المستكشف عليها بالكامل بصورة مذهلة. ومع ذلك، ينطوي الاعتماد المطلق على التعبئة السريعة على مخاطر خوارزمية صامتة؛ فالأداة تبني افتراضاتها على عينة محدودة للغاية، وعندما تصادف حالات نصية شاذة في منتصف الجدول—كالأسماء المركبة أو الثلاثية المعقدة—فإنها قد تطبق تخمينات خاطئة دون إرسال أي إشعار أو تنبيه بالخطأ للمستخدم، مما يستوجب فحصاً يدوياً واسعاً لمطابقة المخرجات.
7.2 استخدام معالج تحويل النص إلى أعمدة (Text to Columns)
يعد معالج “تحويل النص إلى أعمدة” (Text to Columns) من الأدوات التاريخية العريقة والأكثر ثباتاً في بيئة إكسل لمعالجة السلاسل النصية المفصولة بمحددات. يرتكز المفهوم التشغيلي لهذه الأداة على تفكيك العمود المصدر فيزيائياً إلى عدة أعمدة فرعية متجاورة، وذلك استناداً إلى اختيار رمز المسافة كفاصل قطعي (Delimiter) بين الكلمات المدخلة.
تبدأ العملية بتحديد نطاق الأسماء، ثم الانتقال إلى تبويب “بيانات” واختيار الأداة، وتحديد خيار “محدد” (Delimited)، ثم تعليم خانة “المسافة” (Space). يقوم المعالج فورياً بإظهار معاينة حية لكيفية انشطار النص إلى عمود يحوي الاسم الأول وعمود يحوي اسم العائلة. بعد النقر على إنهاء، تصبح أجزاء الاسم موزعة في خلايا مستقلة تماماً، مما يسهل إعادة ترتيبها.
لاستكمال التحويل إلى الصيغة المطلوبة، يتم في عمود ثالث استخدام صيغة دمج بسيطة تجمع عمود العائلة مع عمود الاسم الأول مع إقحام الفاصلة بينهما: =B2 & “, ” & A2. تتميز هذه الطريقة باستقرارها التشغيلي المطلق وتفاديها للتعقيد البرمجي للدوال المتداخلة، إلا أن عيبها الجوهري يكمن في كونها عملية تحويل استاتيكية جامدة؛ حيث تقطع الاتصال الحي بالمصدر الأصلي ولا تتحدث تلقائياً عند تعديل الأسماء أو إدراج صفوف جديدة في المستقبل.
7.3 الموازنة المعيارية: متى نعتمد الصيغ ومتى نفضل الأدوات التفاعلية؟
تتطلب حوكمة البيانات المنهجية الموازنة الدقيقة بين تبني الحلول المعتمدة على الصيغ الحسابية الديناميكية وبين الأدوات التفاعلية السريعة، حيث يخضع الاختيار لطبيعة المشروع وحجم السجلات ودورة حياة البيانات. تمثل الصيغ الرياضية (سواء الحديثة أو الكلاسيكية) الخيار الأمثل والوحيد للبيانات الحية (Live Data) واللوحات التفاعلية (Dashboards) التي تخضع لتحديثات مستمرة وإضافات دورية؛ إذ تضمن الصيغ التحديث الفوري والتلقائي للمخرجات بمجرد تعديل أو إدخال أي سجل جديد دون الحاجة لتدخل بشري إضافي.
في المقابل، تبرز الأدوات التفاعلية—مثل التعبئة السريعة ومعالج النص إلى أعمدة—كخيارات استثنائية وعملية جداً في مشاريع التنظيف السريع ذات المرة الواحدة (One-off Data Cleansing). فعند الرغبة في تجهيز قائمة مفردة لإرسال دعوات أو طباعة شهادات وتصديرها فورياً، توفر الأدوات التفاعلية الوقت والجهد وتغني عن كتابة صيغ رياضية قد تُحذف أو تُفسد لاحقاً من قبل مستخدمين غير متمرسين.
علاوة على ذلك، يؤثر هذا القرار تأثيراً مباشراً على حجم ملف العمل واستجابته الحاسوبية. فالصيغ المتراكمة عبر مئات الآلاف من الصفوف تستهلك طاقة المعالج في كل دورة إعادة حساب (Recalculation)، بينما تحافظ الأدوات التفاعلية على خفة الملف لكون مخرجاتها قيماً نصية ثابتة ومجردة من العمليات الحسابية الخفية، مما يستوجب تقييماً تقنياً مسبقاً قبل اعتماد مسار التنفيذ.
8. الأتمتة المتقدمة لمعالجة البيانات الضخمة عبر Power Query وVBA
8.1 إعادة هيكلة الأسماء باستخدام بيئة Power Query
تمثل أداة Power Query البيئة المؤسسية الأكثر قوة واحترافية لمعالجة واستخراج وتحويل وتحميل البيانات (ETL) داخل إكسل. تتيح هذه المنصة للباحثين والمحللين بناء خطوط تحويل مؤتمتة وموثقة وقابلة للتكرار بضغطة زر واحدة، مما يجعلها الخيار النموذجي لمعالجة قواعد البيانات الضخمة التي تستعصي على المعادلات التقليدية وتتجاوز السعة المريحة لجداول العمل العادية.
لإعادة هيكلة الأسماء داخل Power Query، يتم أولاً تحويل النطاق إلى جدول رسمي ثم استيراده إلى محرر الاستعلامات. داخل المحرر، يتم استخدام ميزة “تقسيم العمود” (Split Column) واختيار محدد المسافة، مع ضبط خيار التقسيم عند “المحدد الأيمن الأخير” (Right-most delimiter) لضمان عزل اسم العائلة بدقة حتى في وجود أسماء مركبة مسبقة. بعد الانشطار، يُعاد ترتيب الأعمدة بحيث يسبق اسم العائلة الاسم الأول، ثم يتم تطبيق عملية “دمج الأعمدة” (Merge Columns) مع اختيار فاصل مخصص يتكون من فاصلة ومسافة (“, “).
تكمن القوة الهائلة لهذا الأسلوب في أن كافة هذه الخطوات التحويلية تُسجل كشفرة برمجية بلغة (M) داخل الاستعلام. عند تحميل البيانات إلى ورقة العمل، يكفي النقر على خيار “تحديث” (Refresh) ليتم التقاط أي سجلات جديدة مضافة للجدول المصدر، وتمريرها عبر نفس مراحل التطهير والتقسيم والدمج فورياً، مما يوفر منصة معالجة فائقة الاستقرار ومحصنة تماماً ضد أخطاء المستخدمين الميدانيين.
8.2 برمجة دالة مخصصة أو ماكرو عبر Visual Basic for Applications (VBA)
يوفر المحرك البرمجي VBA إمكانات غير محدودة للتحكم المعماري في معالجة السلاسل النصية، متيحاً إنشاء دوال مخصصة للمستخدم (UDF) أو وحدات ماكرو تنفيذية قادرة على قراءة المصفوفات وتعديلها مباشرة داخل ذاكرة الوصول العشوائي (RAM) دون المرور ببطء الواجهة الرسومية لجداول البيانات.
يمكن صياغة كود برمجي بسيط لدالة مخصصة تقوم باستلام النص وتفكيكه وإعادة دمجه عبر مصفوفة نصية سريعة. على سبيل المثال، يمكن صياغة وحدة ماكرو تقوم بقراءة النطاق المحدد، وتستخدم دوال VBA النصية الذاتية مثل Split وJoin لقلب ترتيب العناصر النصية وإلحاق الفاصلة بينها، ثم كتابة النتائج كقيم نصوص مصمتة في النطاق المستهدف دفعة واحدة. تتيح هذه الآلية معالجة نصف مليون صف في ثوانٍ معدودة، وهو أداء يتفوق بمراحل على الدوال الحسابية الممتدة.
ومع ذلك، تفرض الأتمتة البرمجية عبر VBA التزامات أمنية وإدارية صارمة؛ حيث تتطلب حفظ ملف العمل بصيغة تدعم وحدات الماكرو (مثل XLSM أو XLSB)، وتخضع لسياسات أمان صارمة في بيئات العمل المؤسسية التي قد تحظر تشغيل الأكواد البرمجية غير الموقعة رقمياً لمنع التهديدات الأمنية، مما يفرض توثيق الأكواد ومشاركتها وفق بروتوكولات حوسبية محددة ومصرح بها.
8.3 تقييم الأداء وقابلية التوسع للبيئات المؤتمتة
إن المفاضلة المعمارية بين استخدام صيغ المصفوفات الديناميكية ومسارات Power Query وأكواد VBA تتوقف بصورة مباشرة على حجم البيانات وقابلية التوسع المطلوبة للمشروع. ففي مجموعات البيانات المتوسطة، توفر الصيغ الحسابية استجابة بصرية فورية وسهولة في الصيانة. ولكن مع تضخم السجلات إلى مئات الآلاف، يبدأ استهلاك الذاكرة العشوائية في التزايد المفرط، مما يؤدي إلى تباطؤ عمليات الحفظ والفرز الحسابي المتكرر.
وقد سلط ماير وزملائه (Mayer et al., 2024) الضوء في أبحاثهم البرمجية الحاسوبية على أهمية الكفاءة الخوارزمية وتصميم المسارات البرمجية الموفرة للموارد عند معالجة المصفوفات والسلاسل النصية المعقدة، مؤكدين أن بناء مسارات معالجة مؤتمتة ومعيارية يسهم في تقليص العبء الحسابي ورفع دقة المخرجات التحليلية بصورة جوهرية مقارنة بالحلول العشوائية المتفرقة.
لذلك، تتجه أفضل الممارسات في المؤسسات البحثية والبيانات الضخمة نحو تفضيل Power Query كبيئة مركزية لأتمتة معالجة البيانات النصية؛ لكونها تجمع بين الأداء الخوارزمي الموفر لموارد الذاكرة، وقابلية التوسع لاستيعاب ملايين السجلات دون التأثير على استقرار مصنف العمل، فضلاً عن توثيقها المعياري لخطوات التحويل بما يضمن الشفافية والقدرة على التدقيق المستقبلي للبيانات.
9. استكشاف الأخطاء الشائعة ومعالجتها وقائياً
9.1 التعامل مع خطأ القيمة (#VALUE!) وخطأ عدم التطابق (#N/A)
تتعرض نماذج معالجة النصوص البرمجية للانهيار وظهور رموز الأخطاء الصريحة عندما تصادف سجلات غير مكتملة أو مدخلات لا تتوافق مع الافتراضات الحسابية للصيغ. من أشهر هذه الأخطاء خطأ القيمة (#VALUE!) الشائع في الدوال الكلاسيكية عندما تعجز دالة FIND عن العثور على المسافة المحددة في الاسم، أو خطأ عدم التطابق (#N/A) الذي تطلقه الدالتان الحديثتان TEXTAFTER وTEXTBEFORE لنفس السبب عند غياب محدد الفصل تماماً كحالات الأسماء الفردية.
تتطلب الهندسة الوقائية لمعادلات إكسل تطويق الصيغ الأساسية باستخدام دوال اعتراض الأخطاء، وعلى رأسها دالة IFERROR أو دالة IFNA. تعمل هذه الدوال كجدار حماية ذكي يفحص ناتج المعالجة النصية؛ فإذا اكتمل التحويل بنجاح يُمرر المخرج الطبيعي، وإذا تسببت الصيغة في ظهور خطأ، يتم اعتراضه فورياً وإرجاع قيمة بديلة آمنة يحددها المحلل مسبقاً.
تتحول الصيغة التحصينية إلى النمط التالي:
=IFERROR(CONCAT(TEXTAFTER(A2,” “), “, “, TEXTBEFORE(A2,” “)), A2)
تضمن هذه المعادلة المصممة باحترافية أنه في حال تعذر إجراء التبديل بسبب عدم وجود مسافة، فإن إكسل لن يعرض رسالة الخطأ المزعجة التي تفسد المظهر العام وتوقف العمليات التجميعية، بل سيعرض الاسم الأصلي المدخل في الخلية A2 كما هو دون تغيير، مما يحافظ على نظافة مخرجات التقرير ويتيح مراجعة الحالات الشاذة لاحقاً بهدوء.
9.2 معالجة الخلايا الفارغة والنصوص الأحادية المقطع
تمثل الخلايا الفارغة والنصوص أحادية المقطع (Mononyms)—كالأسماء المفردة التاريخية أو المعرفات غير المكتملة—تحدياً منطقياً إضافياً؛ إذ يؤدي تطبيق صيغ التبديل على خلية فارغة إلى إرجاع أصفار حسابية أو رسائل خطأ تشوه اتساق الأعمدة، فضلاً عن أن الأسماء الأحادية تفقد معناها الفهرسي إذا حاول البرنامج تفكيكها استناداً إلى فراغات غير موجودة أساساً.
يتم تحصين ورقة العمل ضد هذه التداعيات عبر دمج الدالة المنطقية IF جنباً إلى جنب مع دالة الفحص ISBLANK لتقييم حالة الخلية قبل الشروع في إطلاق خوارزميات التبديل. يتم بناء شرط منطقي مركب يتحقق أولاً من أن الخلية ليست فارغة، ثم يتحقق ثانياً من احتوائها على مسافة واحدة على الأقل باستخدام الدالة ISNUMBER(SEARCH(” “, A2)).
إذا تحقق الشرطان مجتمعين، تُنفذ معادلة التبديل الفهرسي المكتملة؛ وفي حال كان الاسم أحادياً، يتم نقله كما هو دون إضافة الفاصلة الزائدة؛ أما إذا كانت الخلية فارغة تماماً، فيتم إرجاع سلسلة نصية فارغة (“”). هذا التدرج المنطقي الدقيق يوفر حماية معمارية صلبة لورقة العمل تضمن استقرار المخرجات مهما تفاوتت جودة البيانات المدخلة في العمود المصدر.
9.3 التدقيق البصري وضبط الجودة عبر التنسيق الشرطي
بعد إتمام سحب وتعميم معادلات التحويل عبر آلاف السجلات، تبرز الحاجة إلى آلية تدقيق وضبط جودة فورية تكشف للعين المجردة أي سجلات شذت عن القاعدة ولم يتم تبديلها بالشكل الصحيح. تمثل أداة “التنسيق الشرطي” (Conditional Formatting) خط الدفاع البصري الأول لإجراء هذا التدقيق الرقابي السريع.
يمكن إنشاء قاعدة تنسيق شرطي مخصصة عبر تطبيق صيغة منطقية تفحص ما إذا كانت الخلية الناتجة تحتوي على الفاصلة الإجبارية التي تمثل معيار التبديل الناجح. يتم ذلك بتحديد نطاق النتائج وإدخال الصيغة التالية في معالج التنسيق الشرطي:
=ISERROR(SEARCH(“,”, B2))
تقوم هذه القاعدة بتمييز وتلوين أي خلية بلون تحذيري (مثل الأحمر الفاتح) إذا كانت خالية من الفاصلة النصية. يشير هذا التلوين الفوري إلى أن هذا السجل إما كان اسماً أحادياً لم يتمكن النظام من تبديله، أو أنه احتوى على أخطاء هيكلية منعت تطبيق المعادلة، مما يسهل على مدقق البيانات حصر هذه الاستثناءات وتعديلها يدوياً أو برمجياً دون الحاجة لقراءة آلاف الصفوف بصرياً.
10. تثبيت النتائج وتطبيقات التوثيق الأكاديمي والإحصائي
10.1 تحويل الصيغ الحسابية إلى قيم نصية ثابتة ومستقرة
تعتبر خطوة “تثبيت النتائج” بمثابة مسك الختام في مشاريع المعالجة النصية داخل إكسل. فطالما بقيت الأسماء المنسقة معتمدة على صيغ ومعادلات ديناميكية مرتبطة بالعمود المصدر الأصلي، فإن أي تعديل طارئ، أو حذف غير مقصود للعمود A، أو تغيير في مواضع الخلايا، سيؤدي فورياً إلى تدمير النتائج وظهور أخطاء المراجع الدائرية (#REF!) في كامل ورقة العمل.
لذلك، تقتضي قواعد إدارة البيانات عزل المخرجات وتحويلها إلى قيم نصية ثابتة ومستقلة تماماً. يتم تنفيذ ذلك إجرائياً عبر تحديد العمود المستهدف الحاوي للنتائج بالكامل، ونسخه إلى الحافظة (Ctrl + C)، ثم النقر بزر الفأرة الأيمن في نفس الموضع واختيار “لصق خاص” (Paste Special)، ومن ثم تحديد خيار “قيم” (Values) عبر الاختصار التفاعلي المخصص لذلك.
تؤدي هذه العملية الحاسوبية البسيطة إلى استئصال الصيغ الرياضية من خلفية الخلايا وإبقاء النصوص المستخرجة كما هي كقيم نصية مصمتة. يترتب على ذلك حماية مطلقة للبيانات ضد التلف المستقبلي، وإمكانية حذف العمود المصدر القديم لتنظيف واجهة الملف، فضلاً عن تقليل الحجم الكلي للمصنف بنسبة ملحوظة وتسريع عمليات الإغلاق والحفظ والمشاركة عبر البريد والشبكات السحابية المشتركة.
10.2 مطابقة المخرجات مع أدلة التوثيق الأكاديمي (APA وMLA)
تحظى صيغة “اسم العائلة، الاسم الأول” بأهمية مركزية وفارقة في الأوساط الأكاديمية والبحثية؛ حيث تشترط الأدلة التوثيقية المرجعية الرائدة عالمياً—مثل دليل جمعية علم النفس الأمريكية (APA) ودليل جمعية اللغات الحديثة (MLA)—تقديم لقب المؤلف متبوعاً بفاصلة قبل الاسم الشخصي أو الحرف الأول منه في كافة قوائم المصادر والمراجع وفهارس الاستشهادات الببليوغرافية.
وفي هذا الإطار، ركز هوتشيسون وزملاؤه (Hutchison et al., 2013) في دراستهم المرجعية واسعة النطاق لبيانات معالجة النصوص والكلمات، على أن القياس الدقيق والمعالجة المتسقة للمفردات والمصطلحات تستند في جوهرها إلى توحيد المدخلات وفق معايير فهرسية صارمة تلغي الغموض البنيوي وتسهل الربط بين مجموعات البيانات الضخمة، وهو ما ينطبق تماماً على إدارة أسماء الباحثين في الفهارس الأكاديمية.
إن توظيف إكسل في إعادة صياغة مئات الأسماء دفعة واحدة يتيح للباحثين ومحرري المجلات العلمية تجهيز القوائم المرجعية وضمان خضوعها للفرز الأبجدي الدقيق بناءً على الألقاب، مما يسهل استيرادها المباشر وتصديرها نحو برمجيات إدارة المراجع المتقدمة مثل EndNote وMendeley وZotero دون حدوث أي تشويه أو تداخل في الحقول الفهرسية المعتمدة دولياً.
10.3 الخلاصة وأفضل الممارسات المستدامة في إدارة أسماء السجلات
في ختام هذا العرض المنهجي الشامل، يتضح أن إعادة هيكلة الأسماء وتبديل مواقعها في إكسل يتجاوز كونه مجرد عملية تجميلية للبيانات، ليمثل تطبيقاً هندسياً وإحصائياً بالغ الأهمية يسهم في رفع كفاءة وموثوقية قواعد البيانات. إن الوصول إلى مخرجات دقيقة يقتضي اتباع بروتوكول مؤسسي مستدام يوازن بين الدقة الخوارزمية للدوال الحديثة والتحصين الوقائي للبيانات عبر التنظيف والتدقيق.
وتتلخص أفضل الممارسات المستدامة في التوصيات الإجرائية التالية:
- الفصل الأولي منذ مرحلة الجمع: يُنصح بتصميم نماذج جمع البيانات الرقمية (استبانات، شاشات تسجيل) بحيث تطلب إدخال “الاسم الأول” و”اسم العائلة” في حقلين منفصلين تماماً من البداية، لتفادي الحاجة للمعالجات النصية المعقدة لاحقاً.
- الاحتفاظ بالنسخ الخام: الالتزام بحفظ نسخة احتياطية أصلية وغير معدلة من جداول البيانات قبل الشروع في تطبيق أي معادلات تحويلية، لضمان استرجاع الأصول في حال وقوع أي أخطاء مفاجئة.
- الدمج الوقائي للتنظيف: التثبيت الدائم لدوال TRIM وCLEAN وIFERROR كجزء لا يتجزأ من أي صيغة اقتطاع نصي لحماية محركات الحساب من الانهيار.
- التوثيق الإجرائي للخطوات: توثيق التحويلات والخيارات البرمجية المعتمدة داخل المصنف، مما يسهل على الفرق البحثية المتعاقبة فهم البنية المعمارية للبيانات ومتابعة تطويرها بكل موثوقية.
المراجع
- Delgado‐García, G., Vanrenterghem, J., Mildenberger, C., Rodríguez Gallego, L., Chicano-Gutiérrez, J. M., & Soto-Hermoso, V. M. (2020). Accuracy and reliability of a low-cost methodology to assess 3D body posture based on commercial cameras and Excel templates. Measurement, 108638. https://doi.org/10.1016/j.measurement.2020.108638
- Hutchison, K. A., Balota, D. A., Neely, J. H., Cortese, M. J., Cohen‐Shikora, E. R., Tse, C.-S., Yap, M. J., Bengson, J. J., Niemeyer, D., & Buchanan, E. M. (2013). The semantic priming project. Behavior Research Methods, 45(4), 1099–1114. https://doi.org/10.3758/s13428-012-0304-z
- Mayer, C., Tan, A., & Zuraw, K. (2024). Introducing maxent.ot : an R package for Maximum Entropy constraint grammars. Phonological Data and Analysis, 6(4), 1–32. https://doi.org/10.3765/pda.v6art4.88
- Tsakalidis, A., Chim, J., Bilal, I. M., Zirikly, A., Atzil–Slonim, D., Nanni, F., Resnik, P., & Liakata, M. (2022). Overview of the CLPsych 2022 Shared Task: Capturing Moments of Change in Longitudinal User Posts. In Workshop on Computational Linguistics and Clinical Psychology (CLPsych) (pp. 184–198). https://doi.org/10.18653/v1/2022.clpsych-1.16