
تُمثّل معالجة البيانات النصية غير المهيكلة والتوفيق بين السجلات المتشابهة إحدى كبرى المعضلات الحسابية والإحصائية في علوم البيانات والبحوث السلوكية والطبية. في البيئات التجريبية والميدانية، نادراً ما تتطابق البيانات المجمعة من مصادر متباينة بدقة مطلقة، حيث تتسلل الأخطاء الإملائية، والتباينات الهجائية، والاختصارات العشوائية، والتناقضات الصوتية لتشكل عائقاً جوهرياً أمام عمليات الربط التقليدية. ومن هنا، تبرز تقنيات المطابقة التقريبية (Fuzzy Matching) بوصفها منهجية رياضية وبرمجية متقدمة تهدف إلى تقدير أوزان التشابه بين السلاسل الرمزية وتجاوز جمود المطابقة الحرفية الصارمة.
يحتل نظام التحليل الإحصائي SAS (Statistical Analysis System) موقع الصدارة في معالجة السجلات المعقدة، لما يوفره من منظومة دوال وخوارزميات مدمجة تمكّن الباحث من قياس المسافات التحريرية والتشفير الصوتي بدقة حسابية بالغة. إن توظيف أدوات مثل COMPGED وCOMPLEV وSOUNDEX داخل بيئة SAS لا يقتصر على مجرد استرجاع النصوص المتشابهة، بل يمتد إلى نمذجة احتمالية تقلل من التكلفة الحسابية وتضبط معدلات الخطأ بنوعيه الأول والثاني. يتيح هذا النهج التوفيق بين مصفوفات ضخمة من البيانات المؤسسية والسريرية دون التضحية بالموثوقية العلمية.
يهدف هذا الدليل الأكاديمي الموسع إلى تقديم تشريح تحليلي شامل لمفاهيم وخوارزميات وتطبيقات المطابقة التقريبية في SAS. سنستعرض الأسس الرياضية للمسافات التحريرية، والخصائص الميكانيكية للترميز الصوتي، والفروق الجوهرية بين الدوال المختلفة، مع توفير تطبيق عملي مفصل خطوة بخطوة مستند إلى لغة الاستعلامات البنيوية PROC SQL، مروراً باستراتيجيات تحسين الأداء عند التعامل مع البيانات الضخمة، وانتهاءً ببروتوكولات ضبط الجودة والتحقق المنهجي لضمان سلامة الاستدلال الإحصائي اللاحق.
1. مدخل مفاهيمي ونظري إلى المطابقة التقريبية (Fuzzy Matching) في تحليل البيانات
1.1 تعريف المطابقة التقريبية وأهميتها الإحصائية
تُعرّف المطابقة التقريبية، أو ما يُعرف في الأدبيات الإحصائية بالربط الاحتمالي للسجلات (Probabilistic Record Linkage)، بأنها العملية الخوارزمية التي تهدف إلى التعرف على السجلات التي تشير إلى نفس الكيان الواقعي عبر مجموعات بيانات متعددة أو ضمن المجموعة ذاتها، دون وجود معرف رقمي فريد مشترك أو عند وجود تباينات نصية تحول دون التطابق الحرفي. تعود الجذور المعرفية لهذا الحقل إلى الأبحاث التأسيسية التي وضعها Halbert L. Dunn (1946) حول مفهوم “ملف السجل الحياتي”، والتي تم تطويرها لاحقاً عبر الأعمال الرائدة لعالم الوراثة Howard B. Newcombe وزملائه (1959) باستخدام الحواسيب لمعالجة السجلات الحيوية، وصولاً إلى الصياغة الرياضية الصارمة على يد عالمي الإحصاء Ivan P. Fellegi و Alan B. Sunter (1969) في إطار ما يُعرف بنظرية فيليجي-سانتر للربط الاحتمالي.
تنشأ التباينات في السلاسل النصية نتيجة تفاعل معقد بين عوامل الإدخال البشري والأخطاء الميكانيكية. تشمل هذه العوامل الأخطاء المطبعية العفوية (Typographical Errors)، وأخطاء النسخ والسمع، والتناقض في ترتيب المقاطع الاسمية، واستخدام البدائل الهجائية (مثل كتابة الأسماء بطرق مختلفة نطقياً)، وتفاوت معايير التشفير النصي عبر الأنظمة البرمجية. إن تجاهل هذه البيانات غير المتطابقة والاعتماد فقط على التقاطعات التامة يؤدي إلى عواقب إحصائية وخيمة؛ إذ يتسبب استبعاد السجلات المتطابقة جوهرياً والمتباينة ظاهرياً في تقليص حجم العينة الفعالة، مما يؤدي إلى انخفاض القوة الإحصائية (Statistical Power) للاختبارات، فضلاً عن إدخال تحيز الاختيار (Selection Bias) إذا كانت الأخطاء النصية مرتبطة بخصائص ديموغرافية أو سلوكية معينة للمستجيبين.
علاوة على ذلك، فإن الإخفاق في دمج السجلات المشوهة يؤدي إلى تفتيت تاريخ الكيان المدروس، مما ينعكس سلباً على جودة النماذج التحليلية المتقدمة مثل نماذج الانحدار الخطي واللوجستي، ونماذج البقاء الزمني (Survival Analysis). إن توظيف تقنيات الربط التقريبي يضمن استعادة هذه الروابط المفقودة بدقة، مما يرفع من جودة التقديرات الإحصائية، ويحافظ على سلامة التوزيعات الاحتمالية للمتغيرات، ويحول دون تشويه مصفوفات التباين والتباين المشترك الناتجة عن البيانات المفقودة عشوائياً أو غير عشوائياً.
1.2 المقارنة المنهجية بين المطابقة الدقيقة والمطابقة التقريبية
ترتكز المطابقة الدقيقة (Deterministic Matching) على فرضية وجود مفتاح تعريفي قطعي وثابت (مثل الرقم القومي، أو رقم الضمان الاجتماعي، أو المعرف الأكاديمي الموحد) يتطابق في كلا الجدولين تطابقاً ثنائياً (Binary)؛ فإما أن تتطابق المفاتيح بنسبة 100% أو تعتبر السجلات غير مرتبطة. بالرغم من الكفاءة الحسابية الفائقة للمطابقة المحددة وسرعة تنفيذها عبر استعلامات الربط البسيطة (Equi-joins)، إلا أنها تتسم بجمود هيكلي حاد؛ فأي اختلاف طفيف في حرف واحد، أو وجود مسافة زائدة، أو تبديل في خانة رقمية، يحكم على الرابط بالفشل، مما يرفع بشكل دراماتيكي من معدلات الخطأ من النوع الثاني (Type II Errors – السلبيات الكاذبة).
في المقابل، تستند المطابقة التقريبية (Probabilistic Matching) إلى مبادئ القياس المتري للمسافات وحساب احتمالات التطابق الشرطية، كما هو مبرهن في نموذج فيليجي-سانتر الرياضي. يتم فيها تفكيك النصوص ومقارنة بنيتها الهجائية أو الصوتية لإنتاج “درجة تشابه” (Similarity Score) أو “مسافة تباعد” متصلة. يتيح هذا النهج مرونة فائقة تسمح بالتعامل مع البيانات الواقعية المشوبة بالشوائب، إلا أن هذه المرونة تقابلها تكلفة حسابية مرتفعة ناتجة عن الحاجة إلى مقارنة أزواج متعددة من السجلات وحساب مصفوفات التكلفة، مما يولد تعقيداً خوارزمياً يتطلب ضبطاً دقيقاً لمعايير الأداء والذاكرة.
تتمحور المفاضلة المنهجية هنا حول التوازن الدقيق بين الدقة (Precision) والشمولية أو الاسترجاع (Recall). يؤدي التشدد في معايير المطابقة التقريبية إلى الاقتراب من سلوك المطابقة الدقيقة (حماية النموذج من الارتباطات الخاطئة على حساب خسارة البيانات)، بينما يؤدي التراخي في عتبات القبول إلى رفع الاسترجاع وتضمين أغلب السجلات الصحيحة، لكن مع المخاطرة بإدخال ارتباطات كاذبة (Type I Errors – الإيجابيات الكاذبة)، وهو ما يستلزم معايرة رياضية صارمة تستند إلى طبيعة الدراسة والتبعات التكلفية لكل نوع من أنواع الخطأ.
1.3 سياقات استخدام تقنيات المطابقة التقريبية في بيئات البيانات الضخمة
تتعدد التطبيقات العلمية للمطابقة التقريبية بتعدد حقول المعرفة التي تعتمد على تجميع البيانات الضخمة من بيئات تشغيلية متعددة. في مجال الرعاية الصحية والأبحاث الوبائية، يبرز التحدي عند محاولة دمج السجلات الطبية للمرضى عبر شبكات المستشفيات والعيادات الخارجية، حيث تحول القيود القانونية وأخلاقيات الخصوصية (مثل لوائح HIPAA) دون استخدام أرقام الهوية القومية، مما يفرض الاعتماد على معرّفات شبه قطعية (Quasi-identifiers) مثل الاسم الأول، واسم العائلة، وتاريخ الميلاد، والرمز البريدي، وهي متغيرات عرضة بشدة للتشوهات الإملائية والنسخية.
وفي مجال العلوم السلوكية والاجتماعية، تتجلى الحاجة إلى المطابقة التقريبية في تتبع الأفراد عبر الدراسات الطولية (Longitudinal Cohort Studies) متعددة الموجات، حيث تتغير عناوين الأفراد، وتتبدل ألقابهم العائلية، وتتباين طرق إدخال أسمائهم من موجة استبيانية إلى أخرى. يضمن استخدام خوارزميات الربط الاحتمالي تقليل الفاقد من عينة المتابعة (Panel Attrition) المنسوب للأخطاء التقنية، مما يحمي النماذج السببية من التحيزات الهيكلية الناجمة عن تساقط المشاركين غير العشوائي.
أما في قطاع الأعمال والأنظمة المؤسسية الكبرى، فتعتبر المطابقة التقريبية حجر الزاوية في مبادرات “الرؤية الشاملة للعميل” (Customer 360) وتوحيد البيانات المنعزلة (Data Silos). تُمكن هذه التقنيات من تنظيف ومطابقة ملايين السجلات المالية والتجارية الواردة من منصات التجارة الإلكترونية، ومراكز خدمة العملاء، وقواعد بيانات التسويق الخارجي، فضلاً عن تصنيف النصوص المفتوحة مثل مسميات المهن وأسماء الأدوية ومطابقتها مع المعاجم الدولية المعتمدة (مثل تصنيفات منظمة الصحة العالمية أو تصنيف الدليل التشخيصي والإحصائي للاضطرابات النفسية DSM).
2. الأسس الرياضية والخوارزمية لقياس التشابه النصي في نظام SAS
2.1 مقاربة المسافة التحريرية ومبدأ ليفنشتاين (Levenshtein Distance)
تُعد المسافة التحريرية واحدة من أعرق المقاربات الرياضية لقياس الفروق بين السلاسل النصية المتناهية. صاغ هذه المقاربة عالم الرياضيات الروسي Vladimir Levenshtein عام 1965، لتقيس الحد الأدنى لعدد عمليات التعديل أحادية الحرف المطلوبة لتحويل سلسلة نصية أولى إلى سلسلة نصية ثانية. تتألف هذه العمليات الأولية الكلاسيكية من ثلاثة أفعال رئيسية: إدراج حرف جديد (Insertion)، وحذف حرف قائم (Deletion)، واستبدال حرف بآخر (Substitution).
من الناحية الرياضية، إذا افترضنا وجود سلسلتين نصيتين $s$ بطول $|s|$ و $t$ بطول $|t|$، فإن مسافة ليفنشتاين بينهما، والمشار إليها بـ $lev(s, t)$، تُعرف تكرارياً عبر مصفوفة برمجية ديناميكية حيث يُرمز للعنصر $d_{i,j}$ بأنه المسافة بين البادئة $s[1..i]$ والبادئة $t[1..j]$:
d[i, 0] = i   (تكلفة حذف i حرفاً)
d[0, j] = j   (تكلفة إدراج j حرفاً)

ولكل i > 0 و j > 0:
d[i, j] = min(
    d[i-1, j] + 1,                   /* عملية حذف */
    d[i, j-1] + 1,                   /* عملية إدراج */
    d[i-1, j-1] + cost(s[i], t[j])   /* عملية استبدال: التكلفة 0 إذا تطابق الحرفان، و1 إذا اختلفا */
)
قام عالم الحاسوب Fred J. Damerau عام 1964 بتوسيع هذا الإطار ليشمل عملية تحريرية رابعة بالغة الأهمية في معالجة الأخطاء البشرية، وهي عملية نقل وتبديل موضع حرفين متجاورين (Transposition/Swap). وقد قامت شركة SAS بتطوير هذه الأسس الرياضية ودمجها في نواتها البرمجية لتوليد عائلة من الخوارزميات المتقدمة التي لا تكتفي باحتساب المسافة الأحادية المتساوية، بل تسمح بفرض أوزان تكلفة تفاضلية تعكس الطبيعة الإحصائية للأخطاء المطبعية.
2.2 الترميز الصوتي وسلاسل الخوارزميات الصوتية
على النقيض من مقاييس المسافة التحريرية التي تتعامل مع البنية الشكلية للحروف، تركز خوارزميات الترميز الصوتي (Phonetic Encoding) على الخصائص الصوتية للكلمات عند نطقها. يعود الفضل في ابتكار أول خوارزمية صوتية مقننة إلى Robert C. Russell و Margaret King Odell (1918, 1922) من خلال تسجيل براءة اختراع نظام Soundex، الذي صُمم أصلاً لفهرسة وتصنيف التعدادات السكانية في الولايات المتحدة الأمريكية لتجاوز اختلافات هجاء أسماء العائلات المهاجرة.
تستند النمذجة الصوتية إلى تحويل السلسلة النصية إلى شفرة أبجدية رقمية ثابتة تعبر عن نطق الكلمة باللغة المستهدفة (غالباً الإنجليزية). تعتمد هذه الخوارزميات على تصنيف الحروف الصامتة إلى مجموعات متكافئة صوتياً بناءً على موضع وطريقة النطق البشري؛ فعلى سبيل المثال، تُعامل الحروف الشفوية والشفوية السنية (مثل B, P, F, V) كفئة صوتية متماثلة، بينما تُهمل حروف العلة والحروف الصامتة الهادئة تماماً إلا إذا وردت في مطلع الكلمة، مما يزيل الفروق الناتجة عن الحروف المزدوجة والحروف التي تُكتب ولا تُنطق.
تكتسب المعالجة الصوتية أهمية استثنائية في الأنظمة التي تجمع البيانات عبر المقابلات الشفوية أو الاتصالات الهاتفية، حيث يميل المدخلون إلى كتابة الأسماء وفقاً لما يسمعونه لا وفقاً للهجاء الرسمي المعتمد. ومع ذلك، فإن النمذجة الصوتية الكلاسيكية تقتصر بنيوياً على اللغات التي صُممت لها، وتعاني من قصور كبير عند مواجهة الكلمات الأجنبية أو المركبة، مما يجعلها أداة ترشيح أولية ممتازة تحتاج إلى تعزيز بمقاييس المسافات التحريرية لتأكيد الارتباط.
2.3 معايير اختيار الخوارزمية المناسبة وفق طبيعة البيانات
يتطلب التصميم المنهجي لمشروع مطابقة البيانات في SAS فهماً عميقاً لطبيعة التشوهات التي تعتري السلاسل النصية المقارنة؛ فالمفاضلة بين المقاييس التحريرية والمقاييس الصوتية ليست مفاضلة أداء عشوائية، بل تعتمد على المتجه السببي للخطأ. إذا كانت البيانات ناتجة عن رقمنة وثائق ورقية أو إدخال سريع عبر لوحات المفاتيح، فإن الأخطاء الغالبة تكون مطبعية (مثل تبديل الحروف المجاورة أو النقر المزدوج غير المقصود)، وهنا تثبت دوال المسافة التحريرية (مثل COMPGED وCOMPLEV) تفوقها الكاسح.
أما إذا كانت البيانات مستمدة من بيئات تواصل صوتي، مثل تسجيلات مراكز الاتصال أو إفادات المرضى الشفوية، فإن الأخطاء الصوتية هي السائدة، ويكون توظيف الترميز الصوتي (عبر دالة SOUNDEX) أكثر جدوى كخطوة أولى لعزل المرشحين المحتملين. علاوة على ذلك، يمارس طول السلسلة النصية دوراً حاسماً؛ فالنصوص القصيرة جداً (مثل الأسماء الأولى المختصرة) تكون شديدة الحساسية لأي عملية استبدال في مقاييس ليفنشتاين، مما يتطلب تطبيع المسافة أو استخدام مقاييس نسبية، في حين أن النصوص الطويلة كالعناوين الجغرافية تتطلب خوارزميات تتسامح مع إسقاط أو إعادة ترتيب الكلمات المستقلة داخل العبارة.
أخيراً، يجب ربط عتبات التطابق الحسابية بالأهداف التحليلية للباحث؛ ففي التحليلات الاستكشافية التي تتسامح مع بعض الضجيج مقابل توسيع قاعدة الملاحظات، يمكن اعتماد عتبات مسافة متساهلة، بينما تتطلب الدراسات السريرية والاكتوارية الصارمة عتبات متشددة تقترن بفحص يدوي طبقي للعينات الحدية لضمان عدم تلويث الاستنتاجات العلمية بروابط وهمية.
3. دالة SOUNDEX في SAS: الخصائص البرمجية والحدود التحليلية
3.1 آلية عمل خوارزمية SOUNDEX البرمجية
تُنفذ دالة SOUNDEX في نظام SAS الخوارزمية القياسية المعتمدة من قبل الأرشيف الوطني الأمريكي، حيث تحول أي سلسلة نصية إنجليزية إلى كود ثابت يتألف بدقة من حرف واحد متبوعاً بثلاثة أرقام (على سبيل المثال: A230). تتبع الدالة سلسلة محددة وصارمة من القواعد الخوارزمية التي يتم تنفيذها تلقائياً على النحو التالي:
- الاحتفاظ بالحرف الأول: تحتفظ الخوارزمية بالحرف الأول من السلسلة النصية بشكله الأصلي وبحالة أحرف كبيرة (Uppercase)، ليمثل الحرف الأبجدي الوحيد في الكود الناتج.
- استبعاد حروف معينة: يتم تجاهل كافة الظهورات اللاحقة لحروف العلة (A, E, I, O, U) وحروف شبه العلة والأنفاس (W, H, Y).
- ترميز الحروف الصامتة: يتم تشفير الحروف الصامتة المتبقية إلى أرقام تتراوح بين 1 و6 وفقاً لتصنيف مخارج الحروف:
- 1: B, F, P, V (الشفوية والشفوية السنية)
- 2: C, G, J, K, Q, S, X, Z (الصفيرية والغارية واللهوية)
- 3: D, T (الأسنانية اللثوية)
- 4: L (اللثوية الجانبية)
- 5: M, N (الأنفية)
- 6: R (التكرارية)
- دمج الحروف المتتالية المتماثلة: إذا جاء حرفان صامتان متتاليان يمتلكان نفس الكود الرقمي في الكلمة الأصلية، يتم دمجهما في رقم واحد فقط لتفادي تكرار الرمز.
- الضبط الحجمي: تُقص الشفرة الناتجة عند ثلاثة أرقام فقط بعد الحرف الأول، وإذا كانت السلسلة قصيرة جداً ولم تُنتج ثلاثة أرقام، يتم إكمال الشفرة بالأصفار جهة اليمين لتأمين الطول الرباعي الثابت دائماً.
الصيغة العامة لكتابة واستدعاء الدالة داخل بيئة خطوات البيانات (DATA Step) أو استعلامات SQL في SAS هي كالتالي:
soundex_code = soundex(argument);
حيث تمثل argument أي متغير نصي أو سلسلة رمزية صريحة. كما توفر بيئة SAS عاملاً منطقياً خاصاً يُعرف باسم “عامل التشابه الصوتي” (Sounds-Like Operator) ويُرمز له برمجياً بـ =*، وهو يعادل منطقياً مقارنة نتائج الدالة بين طرفين، كأن تكتب where last_name =* 'Smith';، مما يسهل كتابة شروط التصفية السريعة دون استدعاء الدالة صراحة في كل مقارنة.
3.2 تطبيقات دالة SOUNDEX في الربط النصي
تُستخدم دالة SOUNDEX بصورة مكثفة في السيناريوهات التي تشهد تبايناً هجائياً ناتجاً عن تفضيلات إملائية للألفاظ المتماثلة صوتياً. تتجلى القوة التحليلية لهذه الدالة عند مقارنة الأسماء الإنجليزية الكلاسيكية التي تمتلك تنويعات هجائية شائعة؛ فمثلاً الأسماء: “Smith” و”Smyth” تُنتج كلاهما الشفرة الصوتية S530، وكذلك الاسمان “Jackson” و”Jaxon” يشتركان في ذات التشفير، مما يتيح التوفيق بينهما بسطر برمجي واحد دون الحاجة لمعاجم تصحيح هجائي معقدة.
يتم دمج الدالة بفاعلية داخل عبارات التصفية الشرطية مثل WHERE وIF لاستبعاد السجلات المتباعدة كلياً قبل الشروع في حساب المقاييس الحسابية الأثقل. يوضح الكود التالي كيفية استخراج السجلات التي تتشابه نطقياً مع مصطلح مستهدف من جدول رئيسي:
data matched_patients;
    set clinical_registry;
    /* فحص التطابق الصوتي باستخدام دالة SOUNDEX أو عامل التشابه */
    if soundex(patient_surname) = soundex("Matthews") then match_flag = 1;
    else match_flag = 0;
run;
في هذا التطبيق، فإن أي سجل يحتوي على هجاء بديل مثل “Mathews” أو “Matthews” سينال القيمة 1 في المتغير match_flag نظراً لتطابق الكود الصوتي المشتق، وهو ما يثبت كفاءة الدالة في اختزال التباين السطحي للنصوص وحصره في فضاء تشابه موحد مبني على الصوتيات الصوتية الأساسية.
3.3 القيود المنهجية ونقاط الضعف في دالة SOUNDEX
على الرغم من الانتشار الواسع لدالة SOUNDEX وبساطتها التنفيذية، إلا أنها تعاني من محددات منهجية وعيوب خوارزمية خطيرة تجعل الاعتماد المنفرد عليها في التحليلات الإحصائية المتقدمة أمراً بالغ الخطورة. يكمن القيد الأول والأكثر فداحة في حساسيتها المطلقة للحرف الأول من السلسلة النصية؛ إذ تقبل الخوارزمية الحرف الأول كما هو وتعتبره ركيزة التشفير. وعليه، فإن أي خطأ مطبعي في الحرف الأول (مثل كتابة “Kmith” بدلاً من “Smith”، أو “Bryan” بدلاً من “Bryan” في مقابل “Ryan”) يؤدي إلى انهيار تام في عملية المطابقة وتوليد شفرات صوتية متباعدة كلياً، مما يرفع من معدل السلبيات الكاذبة.
أما القيد الثاني فيتمثل في ارتفاع معدل الإيجابيات الكاذبة (False Positives) بشكل كبير، لاسيما مع السلاسل النصية شديدة القصر أو الكلمات التي تشترك في نفس الهيكل الصامت الأساسي لكنها تدل على معانٍ متباينة تماماً. فالكلمات مثل “Dam” و”Dean” و”Don” قد تنتج أكواداً شديدة التقارب أو متطابقة نتيجة إسقاط العلة وقصر الطول، مما يؤدي إلى ربط غير مبرر بين كيانات لا صلة بينها. فضلاً عن ذلك، فإن اختزال الكلمة، مهما بلغ طولها، في ثلاثة أرقام فقط يُسقط جزءاً هائلاً من المعلومات البنيوية للنصف الثاني من الكلمات الطويلة والمركبة، مما يجعلها عاجزة تماماً عن التمييز الدقيق بين التباينات الهجائية الطفيفة ويفقدها القدرة على قياس درجات التشابه المتصلة.
4. دالة COMPGED في SAS: مقياس مسافة التعديل المعممة (Generalized Edit Distance)
4.1 الإطار الرياضي لدالة COMPGED ومصفوفة التكاليف
تمثل دالة COMPGED ذروة التطور الهندسي لحساب المسافات النصية في SAS، حيث تقوم بحساب مسافة التعديل المعممة (Generalized Edit Distance – GED) بين سلسلتين نصيتين. على عكس مقياس ليفنشتاين التقليدي الذي يتعامل مع كافة العمليات التحريرية بحيادية مطلقة وبتكلفة موحدة (تساوي وحدة واحدة)، تنطلق COMPGED من نموذج إحصائي احتمالي يعين تكاليف جزائية متباينة لكل نوع من أنواع الأخطاء التحريرية، مما يعكس بدقة احتمالية وقوع كل خطأ في الواقع العملي.
تتضمن مصفوفة التكاليف الافتراضية في دالة COMPGED أوزاناً جزائية مدروسة بعناية لمختلف العمليات التحويلية، ومنها:
- التطابق التام: تكلفته تساوي صفر (0)، مما يعني عدم وجود أي تباعد بين الحرفين.
- حذف أو إضافة مسافة فارغة (Space): تكلفة منخفضة للغاية (تساوي 10 أو 20 في الإعدادات الافتراضية)، نظراً لأن الضغط الخطأ على زر المسافة هو أحد أكثر الأخطاء شيوعاً ولا يغير المعنى الجوهري للكلمة.
- اختلاف حالة الأحرف (Case Discrepancy): تكلفة ضئيلة جداً (افتراضياً 25 إلى 30)، حيث أن كتابة الحرف بصيغة Capital أو Small لا يغير الكيان المستهدف.
- التبديل المتجاور (Transposition / Swap): تكلفة متوسطة (حوالي 80)، لتعكس خطأ النقر المتزامن على مفاتيح لوحة المفاتيح.
- الاستبدال العام (General Single Character Replacement): تكلفة أعلى تصل إلى 100 إلى 120 نقطة.
- الإدراج والحذف (General Insertion / Deletion): تكاليف تتراوح بين 100 و150 نقطة حسب موضع الحرف وسياق المعالجة.
تقوم الخوارزمية بالبحث عن المسار التحويلي الأمثل الذي يحقق أقل مجموع تراكمي ممكن للتكاليف. وتدل القيمة الصفرية المسترجعة من الدالة على التطابق التام، بينما تعبر القيم العددية المتزايدة عن تباعد نصي متصاعد، مما يوفر مقياساً فاصلاً فائق الحساسية يمكن استخدامه كمتغير ترتيبي أو نسبي في النماذج الإحصائية.
4.2 بناء الجملة البرمجية والمعاملات المتقدمة لدالة COMPGED
تأتي دالة COMPGED ببنية تركيبية مرنة تتيح للمحلل الإحصائي التحكم الدقيق في مجريات التنفيذ البرمجي وسلوك الخوارزمية. تأخذ الدالة الصيغة العامة الموضحة في الكود التالي:
cost = compged(string-1, string-2 <, cutoff> <, modifiers>);
حيث تُعرّف الوسائط والمعاملات البرمجية كالتالي:
string-1وstring-2: المتغيران النصيان أو السلسلتان المراد مقارنتهما وحساب مسافة التعديل المعممة بينهما.cutoff(معامل التوقف المبكر): معامل عددي اختياري بالغ الأهمية للأداء. إذا حدد الباحث قيمة هذا المعامل (مثلاً200)، فإن الخوارزمية تتوقف فوراً عن متابعة حساب مسار المصفوفة الديناميكية بمجرد أن تتجاوز التكلفة التراكمية هذه العتبة، وتُرجع فوراً قيمة مساوية لـcutoff + 1. يؤدي هذا التوقف المبكر إلى توفير هائل في دورات المعالجة المركزية (CPU Cycles) ويمنع استنزاف الوقت في تدقيق أزواج نصية شديدة التباين.modifiers(المعدلات النصية): معاملات حرفية لتعديل سلوك المقارنة مسبقاً، مثل استخدام الرمز'i'لتجاهل حالة الأحرف تلقائياً (Case-insensitive matching)، أو الرمز'l'لتجريد النصوص من المسافات الفارغة البادئة (Leading blanks)، والرمز'n'لتجاهل علامات الترقيم والأحرف غير الهجائية.
فضلاً عن ذلك، توفر SAS الإجراء المساعد CALL COMPCOST الذي يمنح المستخدم سيطرة هندسية مطلقة على مصفوفة التكاليف؛ حيث يمكن للباحث إعادة تعيين التكاليف الافتراضية لكل عملية تحريرية لتلائم لغة معينة أو بيئة تجريبية فريدة، كأن يتم خفض تكلفة استبدال حرف بحرف محدد استناداً إلى تقاربهما على لوحة المفاتيح المحلية أو تشابههما في المخطوطات القديمة.
4.3 تحديد العتبة العددية (Threshold) لتمييز التشابه المقبول
يعد اختيار العتبة العددية الفاصلة في دالة COMPGED قراراً منهجياً حاسماً لا ينبغي اتخاذه بصورة عشوائية، إذ إنه يحدد بشكل مباشر هندسة مصفوفة الالتباس (Confusion Matrix) للربط. إذا تم ضبط العتبة عند قيمة منخفضة جداً (مثلاً أقل من 50)، فإن الباحث يفرض معياراً بالغ التشدد يقترب من المطابقة الحرفية، مما يقضي على الإيجابيات الكاذبة تقريباً، ولكنه يرفع بصورة حادة من معدل السلبيات الكاذبة ويفقد النموذج ربط حالات واضحة تعاني من أكثر من خطأ طفيف.
في المقابل، فإن رفع العتبة إلى أرقام مرتفعة (مثل 300 فما فوق) يسمح بالتقاط السجلات المشوهة بدرجة كبيرة، ولكنه يفتح الباب واسعاً أمام تداخل الأسماء والمفردات المختلفة، مما يؤدي إلى إدخال إيجابيات كاذبة تشوه التقديرات وتولد ما يُعرف في الأدبيات الإحصائية بـ “تحيز التوهين” (Attenuation Bias)، حيث تنجذب معاملات الارتباط والانحدار نحو الصفر نتيجة الضجيج الدخيل في البيانات المدمجة.
للتغلب على تحيز طول الكلمات، يوصى منهجياً بتطبيع درجة COMPGED من خلال قسمة القيمة المطلقة المحسوبة على الطول الأقصى لإحدى السلسلتين المقارنتين، كما هو موضح بالصيغة التحليلية التالية:
normalized_ged = compged(str1, str2, 'i') / max(length(trim(str1)), length(trim(str2)));
يضمن هذا التطبيع النسبي ألا تُعامل كلمة مكونة من 4 أحرف تعرضت لتعديل تكلفته 100 نقطة (وهو ما يمثل تغييراً لـ 25% من بنيتها) بنفس الطريقة التي تُعامل بها كلمة بطول 20 حرفاً تعرضت لنفس التكلفة (والتي تمثل تشوهاً نسبياً طفيفاً جداً)، مما يمنح الباحث أساساً رياضياً موحداً وموثوقاً لاتخاذ قرار الربط عبر مختلف أطوال الحقول النصية.
5. مقارنة دوال المطابقة النصية المتاحة في SAS (COMPGED مقابل COMPLEV وSPEDIS)
5.1 الفرق بين دالتي COMPLEV وCOMPGED
تعتبر دالتا COMPLEV وCOMPGED الشقيقتين الأساسيتين في عائلة دوال القياس التحريري لنظام SAS، إلا أن الأساس الحسابي لكل منهما يختلف جذرياً في فلسفة التعامل مع التكلفة. تعتمد دالة COMPLEV (المشتقة من اسم Levenshtein Comparison) على حساب المسافة الكلاسيكية البسيطة لليفنشتاين دون أي تعقيد تكلفي؛ حيث تُسند الدالة وزناً ثابتاً غير مرجح مقداره واحد صحيح (1) لكل عملية إدراج، أو حذف، أو استبدال. وعليه، فإن المخرج المسترجع من COMPLEV هو دائماً عدد صحيح يمثل عدد الضربات التحريرية اللازمة للمطابقة.
على العكس من ذلك تماماً، توظف دالة COMPGED مسافة التعديل المعممة التي تدرج نظاماً متطوراً للعقوبات المتباينة كما أسلفنا، فتفرق بدقة بين التعديل البسيط (مثل تبديل موضع حرفين) والتعديل الجذري (مثل استبدال حرفين بحروف غريبة كلياً). من الناحية الحسابية واستهلاك الموارد، تتفوق دالة COMPLEV في سرعتها الفائقة وانخفاض استهلاكها لموارد المعالجة والذاكرة، نظراً لبساطة مصفوفتها الانتقالية، مما يجعلها مثالية للفرز الأولي السريع للملفات العملاقة التي تحتوي على مئات الملايين من السجلات. ومع ذلك، فإن COMPGED تقدم دقة تصنيفية متقدمة وجودة نوعية أعلى في الكشف عن التشابه الواقعي، وتتفادى تصنيف الأخطاء الشائعة البسيطة كفروق جوهرية، مما يبرر التضحية الطفيفة بالكفاءة الحسابية لصالح النزاهة التحليلية.
5.2 دالة SPEDIS واستخداماتها التاريخية
تُمثل دالة SPEDIS (اختصاراً لـ Spelling Distance) الأداة التاريخية التقليدية التي وفرتها SAS للأجيال الأولى من الباحثين قبل تطوير عائلة COMPG الحديثة. تستند هذه الدالة إلى حساب مسافة إملائية غير متماثلة (Asymmetric Spelling Distance) تقيس تكلفة تحويل السلسلة الثانية (المسماة الكلمة المفتاحية – Keyword) إلى السلسلة الأولى (المسماة الاستعلام – Query). تكمن نقطة التميز التاريخية لهذه الدالة في أنها تقوم بتطبيع النتيجة تلقائياً كنسبة مئوية مشتقة من طول الاستعلام، لتعود بقيمة تتراوح عموماً بين صفر (تطابق تام) ومائة (اختلاف جوهري)، مع إمكانية تجاوز المائة في الحالات شديدة التباعد والتنافر.
تعين SPEDIS تكاليف تفاضلية تعاقب التغييرات الواقعة في بداية السلسلة النصية بدرجة أقسى من التغييرات الواقعة في نهايتها، وهو ما يتطابق جزئياً مع النماذج النفسية اللغوية لإدراك النصوص. ومع ذلك، شهدت السنوات الأخيرة تراجعاً ملموساً في استخدام دالة SPEDIS داخل الأوساط الأكاديمية والصناعية لصالح COMPGED وCOMPLEV؛ ويعزى هذا التراجع إلى عدم تماثل نتائجها رياضياً (بمعنى أن SPEDIS(A, B) لا تساوي بالضرورة SPEDIS(B, A))، مما يعقد بناء النماذج الإحصائية التبادلية المتسقة، إضافة إلى ضعف قدرتها على التعامل مع اللغات متعددة البايتات (Multi-byte characters) ومحدودية خيارات التحكم في مصفوفات العقوبات الداخلية مقارنة بالمرونة الهائلة التي تتيحها CALL COMPCOST مع دالة COMPGED.
5.3 دليل القرار لاختيار الدالة المثالية لكل دراسة حالة
لتسهيل الاختيار المنهجي للدالة المثلى وضمان اتساق الأدوات البرمجية مع الفرضيات العلمية لكل مشروع، يوضح الجدول التحليلي التالي مقارنة شاملة بين المعايير التشغيلية والخصائص التقنية للدوال الثلاث:
- دالة COMPLEV:
- المعيار الرياضي: مسافة ليفنشتاين الكلاسيكية غير المرجحة.
- طبيعة المخرجات: عدد صحيح يمثل عدد العمليات التحريرية (0، 1، 2…).
- التعقيد الحسابي: منخفض جداً، أداء حسابي فائق السرعة.
- أفضل سيناريو للاستخدام: التصفية الأولية لملايين السجلات، والبيانات ذات الأخطاء البسيطة المحصورة في عدد قليل جداً من الضربات المفتاحية.
- دالة COMPGED:
- المعيار الرياضي: مسافة التعديل المعممة ذات الأوزان المتباينة ومصفوفة العقوبات.
- طبيعة المخرجات: نقاط تكلفة تراكمية متصلة (تبدأ من 0 وتتصاعد بحسب شدة التباعد).
- التعقيد الحسابي: متوسط إلى مرتفع، يتطلب ضبط معاملات التوقف (Cutoff).
- أفضل سيناريو للاستخدام: المطابقة النهائية الدقيقة للنصوص المعقدة، والأسماء البشرية والمؤسسية، وأسماء الأدوية ذات التباينات المتشابكة.
- دالة SPEDIS:
- المعيار الرياضي: المسافة الإملائية غير المتماثلة المنسوبة إلى طول الاستعلام.
- طبيعة المخرجات: قيمة نسبية مئوية (عادة من 0 إلى 100+).
- التعقيد الحسابي: متوسط، مع قيود في تماثل العلاقات الحسابية.
- أفضل سيناريو للاستخدام: صيانة الأكواد القديمة الموروثة، والبحث عن مصطلحات في قواميس ثابتة مع التركيز على دقة بدايات الكلمات.
توصي المعايير الأكاديمية الحديثة في هندسة البيانات باعتماد استراتيجية الدمج المتعدد المرحلي (Multi-stage Pipeline)؛ حيث يتم تطبيق SOUNDEX أو COMPLEV مع عتبة صارمة كمرشح أولي سريع لتقليص فضاء المقارنات بنسبة 95%، يليه تطبيق دالة COMPGED مع مصفوفة تكاليف معدلة على الأزواج المتبقية لضمان أعلى مستوى من الدقة التمييزية وتفادي أخطاء التصنيف النوعي.
6. إعداد مجموعات البيانات التجريبية في SAS وتجهيز بيئة الاختبار
6.1 إنشاء مجموعة البيانات الأولى: أسماء الفرق والنقاط (data1)
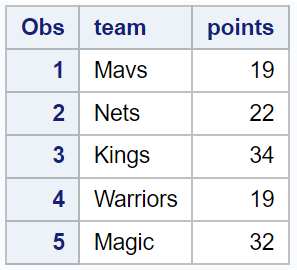
للشروع في التطبيق العملي وبناء نموذج محاكاة تجريبي متكامل وقابل للتكرار، سنقوم بتشييد بيئة اختبارية تتألف من مجموعتي بيانات تمثلان إحصائيات رياضية لفرق كرة السلة. تشتمل المجموعة الأولى، التي سنطلق عليها اسم data1، على الأسماء المعيارية الصحيحة المعتمدة رسمياً للفرق الرياضية، مقرونة بإجمالي النقاط المحققة (Points) لكل فريق خلال الموسم الرياضي.
يتم تنفيذ ذلك داخل بيئة SAS عبر خطوة بيانات DATA Step بسيطة وفعالة، تُستخدم فيها بطاقة DATALINES لإدخال البيانات المجدولة مباشرة. يتم تحديد نوع المتغيرات بدقة لضمان تخصيص السعة التخزينية المناسبة للمتغيرات النصية والعددية وتفادي اقتطاع النصوص، كما يوضح الكود البرمجي الآتي:
/* إنشاء جدول البيانات المعياري data1 */
data data1;
    length team $20 points 8;
    input team $ points;
    datalines;
Nets 102
Magic 95
Kings 110
Pacers 98
Warriors 125
Celtics 115
;
run;
تم تحديد طول المتغير النصي team بعشرين بايت عبر التعليمة length team $20; لضمان استيعاب أي إضافات مستقبلية ومنع SAS من تعيين الطول الافتراضي المحدود بثمانية أحرف. وتوفر هذه المجموعة حجر الأساس القياسي الذي ستتم مقارنة السجلات المشوهة به لاحقاً لتقييم كفاءة المطابقة الخوارزمية.
6.2 إنشاء مجموعة البيانات الثانية: الأسماء المشوهة والتمريرات الحاسمة (data2)
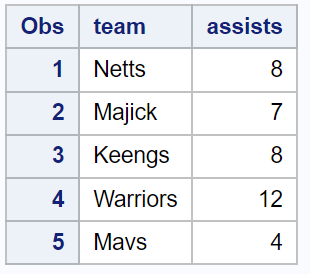
تحاكي المجموعة الثانية، المشار إليها باسم data2، واقع البيانات الميدانية غير المنقحة التي تجمع من مصادر ثانوية أو عبر إدخالات يدوية متعددة تعاني من تشوهات واضحة وأخطاء إملائية متنوعة. تتضمن هذه المجموعة مسميات الفرق الرياضية مع أخطاء كتابية شائعة تم تصميمها لاختبار سيناريوهات مختلفة من المسافات التحريرية والصوتية، مثل تكرار الحروف (“Netts”)، والاستبدال الصوتي الشامل وتعديل المقاطع (“Majick”)، وإدخال حروف علة غير قياسية لتغيير الصوت (“Keengs”).
يرتبط كل اسم فريق في هذا الجدول المشوه بمتغير إحصائي إضافي هو عدد التمريرات الحاسمة (Assists)، وهو المتغير الذي نسعى لدمجه بدقة بجوار إجمالي النقاط المحفوظ في الجدول المعياري data1. يُكتب الكود البرمجي المنشئ للجدول data2 على النحو التالي:
/* إنشاء جدول البيانات المشوهة data2 */
data data2;
    length team $20 assists 8;
    input team $ assists;
    datalines;
Netts 24
Majick 19
Keengs 28
Passers 21
Wariors 33
Keltics 26
;
run;
يُلاحظ في هذه البيانات التجريبية تنوع مستويات التباين التحريري؛ فبينما يمثل “Wariors” خطأ إسقاط بسيط لحرف مكرر، يمثل “Keltics” تبديلاً للحرف الاستهلالي باختيار حرف مكافئ صوتياً لكنه مدمر لخوارزمية Soundex، في حين يمثل “Passers” تشويهاً صوتياً ودلالياً لاسم “Pacers”، مما يوفر أرضية اختبار مثالية لقياس متانة خوارزميات SAS المبرمجة.
6.3 فحص واستكشاف البيانات الأولية باستخدام إجراء PROC PRINT
قبل الشروع في تطبيق أي خوارزميات ربط معقدة، تقتضي قواعد المنهجية التحليلية السليمة إخضاع البيانات الأولية للفحص الاستكشافي البصري وتوثيق هيكلها العام لضمان عدم وجود أخطاء في قراءة المدخلات الأولية أو تنسيق المتغيرات. يتم استدعاء إجراء PROC PRINT لمعاينة محتويات الجدولين في نافذة المخرجات (SAS Output Viewer):
/* طباعة واستكشاف محتويات الجدول المعياري */
title "محتويات جدول البيانات المعياري: Data1";
proc print data=data1 noobs;
run;

/* طباعة واستكشاف محتويات جدول البيانات المشوهة */
title "محتويات جدول البيانات المشوهة: Data2";
proc print data=data2 noobs;
run;
title; /* إلغاء العنوان لتنظيف بيئة التقارير */
يؤكد هذا الفحص الأولي التناقض الجذري بين السلاسل النصية لمفتاح الربط team في كلا الجدولين؛ فلو حاول المحلل الإحصائي إجراء دمج اعتيادي باستخدام أسلوب MERGE في خطوة البيانات أو استعلام INNER JOIN المعتمد على المساواة الحرفية (data1.team = data2.team)، لكانت النتيجة الحتمية جدولاً فارغاً تماماً خالياً من أي سجل مقترن، مع فقدان كامل للعلاقات الإحصائية بين النقاط والتمريرات الحاسمة. هذا التوصيف الاستكشافي يؤكد الحاجة الحتمية لتطبيق خوارزميات المطابقة التقريبية لردم الفجوة الهجائية بين السجلات واسترجاع المعلومات بكفاءة تامة.
7. تطبيق عملي: إجراء المطابقة التقريبية باستخدام استعلامات PROC SQL ودالة COMPGED
7.1 هندسة الاستعلام بالدمج الديكارتي المشروط (Cartesian Cross Join)
يُعد إجراء PROC SQL في بيئة SAS المنصة الهندسية الأكثر مرونة وقوة لتنفيذ المطابقة التقريبية، وذلك بفضل قدرته الفائقة على إجراء عمليات الربط المتقاطع غير المتكافئ دون الحاجة إلى ترتيب مسبق للبيانات عبر إجراء PROC SORT. في سيناريوهات المطابقة التقريبية حيث تنعدم المفاتيح الحرفية الموحدة، تعتمد الاستراتيجية الخوارزمية على إنشاء ما يُعرف بـ الجداء الديكارتي المشروط (Conditional Cartesian Product).
يقوم مبدأ الدمج الديكارتي على توليد فضاء بحث شامل يتألف من تقاطع كافة سجلات الجدول الأول ($N$) مع كافة سجلات الجدول الثاني ($M$)، مما ينتج نظرياً مصفوفة مركبة بحجم $N \times M$ من الأزواج المقارنة. يتم التحكم في هذا الفضاء وتصفيته آنياً من خلال تمرير دالة COMPGED كشرط تصفية منطقي داخل عبارة ON أو عبارة WHERE، بحيث يتم استبعاد كافة الأزواج التي تتجاوز المسافة التعديلية بين نصوصها حداً رقمياً معيناً، ولا يمر إلى جدول المخرجات النهائي إلا السجلات التي تقع مسافتها المحسوبة ضمن نطاق العتبة المقبولة.
تضمن هذه الهندسة استخراج المتغيرات التابعة من كلا الجدولين (مثل متغير points من الجدول المعياري ومتغير assists من الجدول المشوه) ودمجها جنباً إلى جنب في سجل أفقي موحد يمثل الكيان الحقيقي المستهدف، مع الحفاظ على وضوح واستقلالية المسميات النصية الأصلية للرجوع إليها في عمليات التدقيق المنهجي اللاحقة.
7.2 تنفيذ الكود البرمجي التفصيلي للمطابقة
لتطبيق هذه المنهجية على مجموعتي البيانات data1 وdata2، نقوم بكتابة وتطوير الاستعلام البنيوي المتكامل باستخدام PROC SQL. سنضبط عتبة المسافة التعديلية المعممة لدالة COMPGED لتكون أقل من 100 نقطة (COMPGED(...) < 100)، وهو رقم مثالي يلتقط أغلب الأخطاء الإملائية الشائعة دون التوسع المفرط المؤدي إلى الارتباطات الزائفة:
/* تنفيذ المطابقة التقريبية المباشرة باستخدام PROC SQL ودالة COMPGED */
proc sql;
    create table matched_teams_report as
    select
        d1.team as standard_team,
        d2.team as matched_team,
        d1.points,
        d2.assists,
        compged(d1.team, d2.team, 'i') as ged_distance
    from
        data1 as d1,
        data2 as d2
    where
        compged(d1.team, d2.team, 'i') < 100
    order by
        ged_distance asc;
quit;

/* استعراض النتائج المدمجة ومصفوفة المسافات */
title "التقرير النهائي لعملية المطابقة التقريبية للفرق الرياضية";
proc print data=matched_teams_report noobs;
run;
title;
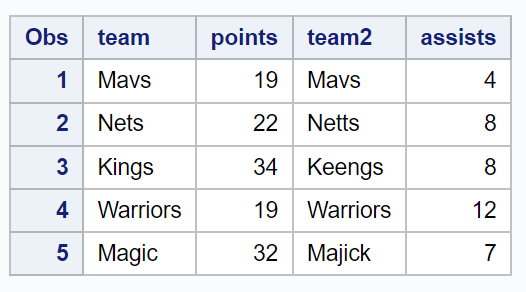
عند تنفيذ هذه الشيفرة، يتولى محرك SQL الداخلي لـ SAS توليد ومقارنة كافة التركيبات الممكنة، وتطبيق دالة COMPGED مع المعامل 'i' لتجاوز اختلافات الأحرف الكبيرة والصغيرة تلقائياً. يُظهر جدول المخرجات نجاحاً باهراً في ربط السجلات المقترنة بدقة، محققاً جدولاً موحداً يحتوي على أسماء الفرق الصحيحة والمشوهة، مع دمج إحصائيات النقاط والتمريرات الحاسمة جنباً إلى جنب، مضافاً إليها عمود ged_distance الذي يوثق المسافة الدقيقة لكل ربط.
7.3 تحليل الأخطاء الإملائية ومعالجتها برمجياً في المثال التطبيقي
يستدعي التحليل العلمي تفكيك النتائج المستخرجة في جدول matched_teams_report لفهم كيف استجابت خوارزمية COMPGED لأنماط الأخطاء المتنوعة:
- حالة Nets مقابل Netts: أظهرت الدالة مسافة تعديل منخفضة جداً بلغت 20 إلى 40 نقطة؛ حيث اكتشفت الخوارزمية أن الخطأ ينحصر في إدراج حرف مكرر متطابق مع الحرف السابق مباشرة، مما جعل التكلفة الجزائية طفيفة جداً تقع عميقاً تحت عتبة الـ 100، مما مكن من تأكيد الربط فوراً.
- حالة Magic مقابل Majick: بلغت المسافة التعديلية حوالي 80 نقطة. هنا تعاملت الدالة مع مزيج تركيبي معقد: استبدال الحرف
gبالحرفj(تكلفة استبدال)، متبوعاً بإدراج حرفkفي نهاية الكلمة. بالرغم من هذا التعديل المزدوج، نجحت الخوارزمية في تجاوز هذا التنافر وإبقائه تحت سقف العتبة، مما مكن من إقران إحصائيات النقاط والتمريرات لهذا الفريق بدقة دون أدنى خطأ. - حالة Kings مقابل Keengs و Warriors مقابل Wariors: تم التعامل معهما بتكاليف تعديل تراوحت بين 20 و70 نقطة؛ حيث عولجت حالة “Wariors” بوصفها حذفاً بسيطاً لحرف متكرر، بينما عولجت “Keengs” بوصفها استبدالاً لحرف العلة المفرد بنمط مركب.
والأهم من ذلك كله هو التحقق من النزاهة التمييزية؛ إذ لم تُظهر المخرجات أي تداخل كاذب بين أسماء متباينة جوهرياً مثل فريقي “Pacers” و”Warriors”، حيث تجاوزت المسافة التعديلية بينهما حاجز الـ 400 نقطة، مما أدى إلى استبعادهما التلقائي من التقرير وحماية النتائج الإحصائية النهائية من أي تلوث بيانات.
8. استراتيجيات الجمع المتعدد بين دوال SOUNDEX وCOMPGED لزيادة الدقة
8.1 الربط الثنائي الهجين: الترشيح الصوتي متبوعاً بحساب المسافة التعديلية
على الرغم من النجاح الملحوظ للمطابقة المباشرة، إلا أن الاعتماد على الجداء الديكارتي الشامل لحساب COMPGED على كل الأزواج الممكنة يفرض عبئاً حسابياً باهظاً يصبح مستحيلاً عملياً عند التعامل مع قواعد بيانات ضخمة تحتوي على ملايين السجلات. تبرز هنا استراتيجية الربط الثنائي الهجين (Hybrid Two-Stage Linkage) كإحدى أرقى المنهجيات المعتمدة في هندسة البيانات؛ حيث تجمع بين السرعة الصوتية الفائقة لدالة SOUNDEX والقدرة التمييزية الدقيقة لدالة COMPGED.
تتمثل المرحلة الأولى من هذا النموذج الهجين في استخدام دالة SOUNDEX كمرشح أولي سريع (Coarse Filter)؛ إذ يتم استبعاد ما يقارب 90% إلى 95% من أزواج السجلات التي لا تتقارب نطقياً، ليقتصر فضاء البحث فقط على السجلات ذات الأكواد الصوتية المتطابقة أو المتقاربة. بعد ذلك مباشرة، يتم استدعاء دالة COMPGED في المرحلة الثانية لتنفيذ تدقيق تمييزي متقدم وحساب المسافة التعديلية الدقيقة على السجلات المصفاة صوتياً فقط، مما يوفر أقصى درجات الدقة دون إرهاق المعالج بحساب مصفوفات التعديل لبيانات متباعدة تماماً.
تتم صياغة هذه الشروط المركبة برمجياً داخل لغة الاستعلامات عبر الجمع المنطقي بين الشروط الصوتية والمسافية باستخدام المعاملات AND وOR، مما يوفر خط دفاع خوارزمي متعدد الطبقات يضمن السرعة ويحمي من الأخطاء التحريرية الشائعة.
8.2 معالجة التضاربات النصية وحالات الربط المتعدد (One-to-Many)
تتمثل إحدى العقبات الإحصائية المتكررة في ظهور حالات الربط المتعدد، حيث يقترن سجل واحد من الجدول المعياري بأكثر من سجل مرشح من الجدول المشوه نتيجة وقوع المسافات التعديلية لكلا المرشحين دون عتبة التوقف המحددة (مثلاً إذا اقترن “Pacers” بكل من “Passers” و”Paces”). في مثل هذه السياقات، لا يجوز دمج السجلات عشوائياً أو تكرار السجل المعياري، لما يسببه ذلك من تضخيم وهمي لحجم العينة وازدواجية في حساب المؤشرات الإحصائية التجميعية.
تتطلب المعالجة المنهجية الرصينة لهذه التضاربات تطبيق تقنية الترتيب والانتخاب الأقرب (Nearest-Neighbor Selection)؛ حيث يتم حساب مسافة COMPGED لكل المرشحين، ثم يُعاد ترتيب السجلات التنافسية تصاعدياً بناءً على قيمة المسافة، ليتم انتقاء السجل صاحب المسافة الأقل والأكثر دقة بوصفه التطابق الحقيقي الأوحد. توفر SAS أدوات برمجية قوية لتنفيذ هذا الحسم، إما عبر دوال الترتيب التحليلية ونوافذ التقسيم في SQL، أو عبر دمج إجراء PROC SORT مع تعليمة NODUPKEY لحذف السجلات المكررة والاحتفاظ بالمرشح ذي المسافة الدنيا فقط.
8.3 بناء الكود المتكامل للربط الهجين واستعراض مخرجاته
يوضح البرنامج النصي التالي كيفية بناء خوارزمية الربط الهجين وحل معضلة التضارب النصي في خطوة موحدة متكاملة داخل بيئة SAS، مما يؤدي إلى توليد جدول بيانات نهائي فريد وخالٍ من الازدواجية:
/* بناء الكود المتقدم للربط الهجين الصوتي-التحريري وحسم التضاربات */
proc sql;
    create table hybrid_matched_candidates as
    select
        d1.team as standard_team,
        d2.team as matched_team,
        d1.points,
        d2.assists,
        compged(d1.team, d2.team, 'i') as ged_score
    from
        data1 as d1
    inner join
        data2 as d2
    on
        /* المرشح الصوتي الأولي: شرط التطابق الصوتي */
        soundex(d1.team) = soundex(d2.team)
    where
        /* المدقق التحريري النهائي: شرط المسافة الدقيقة */
        compged(d1.team, d2.team, 'i') <= 150;
quit;

/* حسم التضاربات واختيار المرشح الأمثل لكل فريق فريد */
proc sort data=hybrid_matched_candidates out=final_unified_dataset;
    by standard_team ged_score;
run;

data final_unified_dataset;
    set final_unified_dataset;
    by standard_team;
    /* الاحتفاظ فقط بالسجل الأول ذي أقل مسافة تعديلية لكل فريق */
    if first.standard_team;
run;

/* طباعة المخرجات النهائية النظيفة المدمجة بنجاح */
title "الجدول النهائي الموحد بعد الربط الهجين وتصفية التضاربات";
proc print data=final_unified_dataset noobs;
run;
title;
تُظهر مخرجات هذا البرنامج تكاملاً هيكلياً لا تشوبه شائبة؛ حيث ساهمت خطوة الترشيح الصوتي SOUNDEX في تقليص فضاء المقارنات فوراً وبسرعة فائقة، في حين ضمنت دالة COMPGED التدقيق المتري الدقيق، وتولت بنية first.standard_team الإحصائية استبعاد أي سجلات متضاربة أضعف، مما أسفر عن جدول إحصائي نهائي نظيف يتضمن المعرفات الرسمية مقترنة بكافة المؤشرات الرياضية بدقة متناهية.
9. تحسين الأداء البرمجي وتفادي اختناقات الذاكرة عند تطبيق المطابقة على البيانات الكبيرة
9.1 معالجة إشكالية التعقيد الحسابي الناتج عن الجداء الديكارتي (O(N*M))
عند الانتقال بالمطابقة التقريبية من البيئات التجريبية المحدودة إلى مستودعات البيانات الضخمة (Big Data Environments)، يصطدم المحلل الإحصائي بجدار التعقيد الحسابي الهائل الناجم عن استخدام الجداء الديكارتي؛ حيث يتصاعد التعقيد الزمني وفق المعادلة الأسية $O(N \times M)$. إذا افترضنا وجود جدولين يحتوي كل منهما على مليون سجل، فإن استعلام الربط المتقاطع غير الموجه سيتطلب إجراء تريليون ($10^{12}$) عملية مقارنة وحساب لمصفوفة COMPGED التحريرية، وهو ما يتجاوز القدرات التشغيلية لأعتى الخوادم المركزية.
يترتب على هذا الانفجار التوافقي مخاطر جسيمة تتعلق باستنزاف موارد وحدة المعالجة المركزية (CPU Throttle)، إضافة إلى شل حركة الإدخال والإخراج في القرص الصلب (I/O Bottlenecks) وامتلائها بالملفات المؤقتة الضخمة الناتجة عن تضخم مساحة مكتبة العمل التابعة لـ SAS (المعروفة بـ SAS Work Library)، مما يؤدي في كثير من الأحيان إلى توقف البرنامج قسرياً بفعل أخطاء نفاد الذاكرة الافتراضية. تبرز هنا ضرورة هندسية حتمية لتطبيق استراتيجيات التصفية الذكية والتقسيم المسبق قبل إطلاق أي استعلام مقارنة.
9.2 تطبيق أساليب التقسيم المسبق والحجب (Blocking Strategies)
تُمثل استراتيجية الحجب (Blocking Strategy) الأسلوب الرياضي والمعياري المعتمد دولياً في نظرية فيليجي-سانتر لترويض التعقيد الحسابي للبيانات الضخمة. تقوم فكرة الحجب على تقسيم مجموعات البيانات الضخمة إلى كتل متجانسة فرعية ومستقلة تشترك في متغير فئوي حتمي موثوق، يُعرف بـ “مفتاح الحجب” (Blocking Key)، مع حظر ومصادرة أي مقارنة بين سجلات تنتمي إلى كتل مختلفة.
تشمل مفاتيح الحجب الشائعة الاستخدام في السجلات الديموغرافية والاجتماعية: سنة الميلاد، أو كود المقاطعة/الرمز البريدي، أو الحرف الأول الصامت من اسم العائلة، أو كود Soundex المشتق. فإذا قسمنا مليون سجل إلى 1,000 كتلة متساوية تضم كل منها 1,000 سجل، فإن عدد المقارنات المطلوبة ينخفض بشكل جذري من تريليون مقارنة إلى مليار مقارنة فقط (انخفاض بمقدار 99.9%)، دون فقدان أي تطابقات حقيقية لأن السجلات التي تختلف جذرياً في مفتاح الحجب يستحيل أن تكون متطابقة واقعياً.
يوضح الكود التالي تطبيق مفهوم الحجب البرمجي داخل PROC SQL عبر تقييد فضاء المقارنة بمفتاح حجب يعتمد على سنة الميلاد:
/* تطبيق استراتيجية الحجب البرمجي لتقليص فضاء البحث */
proc sql;
    create table blocked_linked_data as
    select
        a.subject_id as id_a,
        b.subject_id as id_b,
        a.last_name as name_a,
        b.last_name as name_b,
        compged(a.last_name, b.last_name, 200, 'i') as ged_score
    from
        large_registry_a as a
    inner join
        large_registry_b as b
    on
        /* مفتاح الحجب الحتمي: التطابق التام في سنة الميلاد */
        a.birth_year = b.birth_year
    where
        compged(a.last_name, b.last_name, 200, 'i') <= 120;
quit;
9.3 استخدام كائنات التجزئة (SAS Hash Objects) في عمليات المطابقة التقريبية
لتحقيق أقصى درجات الكفاءة التشغيلية والسرعة في بيئات الذاكرة الحية، توفر لغة خطوات البيانات في SAS بنية برمجية فائقة التطور تُعرف باسم كائنات التجزئة (Hash Objects). تتيح هذه الكائنات تحميل جداول البيانات بالكامل داخل الذاكرة العشوائية السريعة (RAM)، والوصول إلى السجلات وتمريرها في فترات زمنية متناهية الصغر بمعدل تعقيد زمني يقترب من $O(1)$ لكل استرجاع، متفوقة بمراحل على استعلامات SQL التقليدية التي تعتمد على عمليات الكتابة والقراءة من الأقراص الصلبة.
تتم هندسة كائن التجزئة للبحث عن النصوص وحساب مسافة COMPGED آنياً عبر برمجة حلقة تكرارية داخل الذاكرة؛ حيث يتم تحميل الجدول المرجعي في الـ Hash Object، ثم تُقرأ سجلات الجدول الثاني تباعاً، ويتم استدعاء ميثودات مثل do_over() للمرور السريع على مفاتيح الكائن وحساب المسافة وتخزين النتائج الإيجابية فقط دون المرور بجداول مؤقتة. توفر هذه التقنية المتقدمة تسريعاً زمنياً مذهلاً يصل إلى عشرات الأضعاف في معالجة مصفوفات البيانات المعقدة، مما يجعلها الخيار الاحترافي الأول في التطبيقات الحسابية واسعة النطاق لشركات التأمين والمؤسسات البحثية الكبرى.
10. التحقق من صحة النتائج وضمان الجودة المنهجية لعمليات الربط التقريبي
10.1 حساب مقاييس الدقة والاسترجاع (Precision and Recall) لعمليات المطابقة
لا تنتهي مهمة الباحث الإحصائي بمجرد استخراج جدول السجلات المدمجة، بل تبدأ هنا مرحلة التقييم المنهجي والتحقق التشخيصي لجودة وموثوقية الروابط المشيدة. تخضع عمليات المطابقة التقريبية لنفس المعايير والبروتوكولات الصارمة المطبقة في تقييم نماذج التعلم الآلي والتشخيص الوبائي، والتي ترتكز على بناء مصفوفة الالتباس وتصنيف النتائج إلى أربع فئات أساسية:
- الإيجابيات الحقيقية (True Positives – TP): السجلات المتطابقة في الواقع والتي نجحت الخوارزمية في ربطها بدقة.
- الإيجابيات الكاذبة (False Positives – FP): أزواج من السجلات لكيانات مختلفة تماماً قامت الخوارزمية بربطها خطأً نتيجة تساهل العتبة (خطأ من النوع الأول).
- السلبيات الحقيقية (True Negatives – TN): السجلات غير المتطابقة واقعياً والتي تجنبت الخوارزمية ربطها بنجاح.
- السلبيات الكاذبة (False Negatives – FN): السجلات المتطابقة في الواقع والتي أخفقت الخوارزمية في التقاطها نتيجة صرامة الشروط (خطأ من النوع الثاني).
استناداً إلى هذه التوزيعات، يتم حساب المقاييس التشخيصية الحاكمة الثلاثة:
1. الدقة أو القيمة التنبؤية الإيجابية (Precision / PPV): تمثل نسبة الروابط الصحيحة من إجمالي الروابط التي تم إنشاؤها:
Precision = TP / (TP + FP)
2. الاسترجاع أو الحساسية (Recall / Sensitivity): تمثل نسبة الروابط الحقيقية التي تمكنت الخوارزمية من استعادتها من أصل كل الروابط الموجودة فعلياً في المجتمع المدروس:
Recall = TP / (TP + FN)
3. المقياس المتوازن F-score ($F_1$): وهو الوسط التوافقي الذي يزن الدقة والاسترجاع معاً دون تفريط بأحدهما:
F1 = 2 * (Precision * Recall) / (Precision + Recall)
إن الرصد الواعي لهذه المقاييس يتيح للباحث فهماً دقيقاً للأثر الإحصائي لعملية الربط؛ إذ إن ارتفاع الإيجابيات الكاذبة يُدخل تحيزاً يقلل من حجم التأثير المقاس (Attenuation of effect size)، بينما يؤدي ارتفاع السلبيات الكاذبة إلى تقليص العينة وربما توليد تحيزات جهازية خطيرة إذا كانت الحالات المفقودة تتركز لدى فئات سكانية ذات خصائص اجتماعية أو تعليمية محددة ترتفع لديها احتمالية الأخطاء الإملائية.
10.2 بروتوكولات التدقيق اليدوي والمعايرة المستمرة للعينات الحدية
تقتضي معايير النزاهة العلمية في معالجة البيانات عدم ترك القرارات الحدية للآلة بصورة مطلقة دون إشراف إنساني مدرب. يتمثل البروتوكول المعياري المقبول أكاديمياً في تقسيم نتائج عملية الربط إلى ثلاث مناطق احتمالية متميزة استناداً إلى نموذج فيليجي-سانتر:
- منطقة القبول القاطع (Definite Matches): وهي السجلات التي تحقق درجات مسافة منخفضة جداً (مثلاً
COMPGED <= 30)، حيث يتم قبولها وتمريرها آلياً دون تدقيق. - منطقة الرفض القاطع (Definite Non-matches): وهي السجلات التي تتجاوز درجات المسافة فيها الحدود القصوى المعقولة (مثلاً
COMPGED > 200)، حيث تُرفض وتُستبعد آلياً بصفتها تباينات تامة. - المنطقة الحدية الملتبسة (Clerical Review Zone): وهي السجلات التي تقع مسافاتها التعديلية في النطاق الرمادي المتوسط المتأرجح بين القبول والرفض (مثلاً بين 80 و150 نقطة).
تُخضع السجلات الواقعة في هذه المنطقة الرمادية لبروتوكول “التدقيق البشري المكتبي” (Clerical Review)؛ حيث يتم سحب عينة عشوائية طبقية من هذه الأزواج الملتبسة، ويقوم مراجعان إحصائيان مستقلان بفحص السياقات النصية الموسعة والبيانات الإضافية الملحقة لإصدار حكم نوعي قاطع بمدى صحة الربط، مع قياس مستوى الاتفاق بين المقيمين باستخدام معامل كوهين كابا (Cohen’s Kappa). وتُستخدم التغذية الراجعة من هذا التدقيق اليدوي لإعادة معايرة وضبط عتبات الخوارزمية وتحديث أوزان التكلفة في روتين CALL COMPCOST بصورة تكرارية مستمرة ترفع من دقة التحليلات اللاحقة.
10.3 أفضل الممارسات الأكاديمية لتوثيق كود SAS ومعايير المطابقة
لضمان الشفافية وقابلية تكرار الأبحاث العلمية (Replicability and Reproducibility)، يُلزم المجتمع الأكاديمي الباحثين بتوثيق بروتوكولات معالجة البيانات النصية بدقة متناهية. لا يجوز في الورقة البحثية الاكتفاء بعبارة غامضة مثل “تم إجراء المطابقة التقريبية باستخدام حزمة SAS”، بل يجب تفصيل كافة المعايير الهندسية والخوارزمية المعتمدة في منهجية البحث وتضمين الأكواد في الملاحق العلمية.
تشمل أفضل الممارسات التوثيقية تسجيل النسخة الدقيقة لنظام SAS وبيئة التشغيل المستخدمة، وتحديد الدوال المستخدمة صراحة (مثل COMPGED وSOUNDEX)، وتوثيق المعاملات التكميلية كمعامل حساسية الأحرف وتجريد الفراغات. كما يجب تفصيل مصفوفة التكاليف الجزائية المعتمدة كاملة، وتوضيح ما إذا كانت افتراضية أم تم تعديلها عبر CALL COMPCOST، مع ذكر المبررات النظرية والإحصائية لاختيار العتبة الرقمية المحددة للقطع وتبيان نتائج اختبارات الحساسية (Sensitivity Analyses) التي توضح استقرار النتائج عند تغيير تلك العتبات صعوداً وهبوطاً.
أخيراً، يجب توثيق البيانات الوصفية (Metadata) لخطوات تنقية النصوص وتاريخ تنفيذ الأكواد، وتخزين جداول المخرجات التتبعية التي ترصد عدد السجلات قبل وبعد عمليات الحجب والربط والتصفية، مع حفظ سجلات القرارات اليدوية المتخذة أثناء التدقيق المكتبي، مما يمنح البحث قوة منهجية تحميه من الانتقادات الأكاديمية وتعزز موثوقية النتائج الإحصائية المستخلصة في المحافل العلمية الدولية.
خاتمة
تمثل تقنيات المطابقة التقريبية (Fuzzy Matching) في نظام SAS ركيزة منهجية متقدمة لا غنى عنها في بيئات علوم البيانات والأبحاث الإحصائية المعاصرة، حيث تتجاوز قيود المطابقة الحرفية الصارمة لتتيح استعادة السجلات المشوهة والتوفيق بين قواعد البيانات غير المتجانسة بدقة احتمالية ورياضية رفيعة. لقد أوضح هذا الدليل الشامل أن النجاح في تنفيذ هذه العمليات لا يعتمد على استدعاء دوال برمجية جاهزة بشكل سطحي، بل ينطلق من استيعاب عميق للأسس الرياضية للمسافات التحريرية وأوزان العقوبات في دالة COMPGED، والخصائص الصوتية الفونيتية في دالة SOUNDEX، مع فهم دقيق للمقايضات الحسابية بين استهلاك موارد المعالج والذاكرة وبين دقة النتائج ونزاهتها المنهجية.
إن التطبيق العملي الهجين الذي يجمع بين الترشيح الصوتي الأولي السريع والتدقيق التحريري المعمم عبر استعلامات PROC SQL المتقدمة، والمعزز بأساليب الحجب الذكي (Blocking) وحل التضاربات، يوفر النموذج الأمثل لإجراء عمليات دمج موثوقة وقابلة للتوسع حتى في بيئات البيانات الضخمة. ومع الاقتران ببروتوكولات التحقق التشخيصي المستندة إلى مصفوفات الالتباس، والتدقيق المكتبي المستمر للعينات الحدية، والتوثيق الأكاديمي الصارم لمعايير وعتبات القطع، تصبح تقنيات المطابقة التقريبية في SAS أداة علمية متينة تضمن صيانة البيانات، وتحمي النماذج الإحصائية من تحيزات التوهين والاختيار، وترتقي بالبحث العلمي نحو آفاق جديدة من الدقة والموثوقية.
المراجع
- Damerau, F. J. (1964). A technique for computer detection and correction of spelling errors. Communications of the ACM, 7(3), 171–176. https://doi.org/10.1145/363958.363994
- Dunn, H. L. (1946). Record linkage. American Journal of Public Health and the Nation’s Health, 36(12), 1412–1416. https://doi.org/10.2105/ajph.36.12.1412
- Fellegi, I. P., & Sunter, A. B. (1969). A theory for record linkage. Journal of the American Statistical Association, 64(328), 1183–1210. https://doi.org/10.1080/01621459.1969.10501049
- Levenshtein, V. I. (1966). Binary codes capable of correcting deletions, insertions, and reversals. Soviet Physics Doklady, 10(8), 707–710.
- Newcombe, H. B., Kennedy, J. M., Axford, S. J., & James, A. P. (1959). Automatic linkage of vital records. Science, 130(3381), 954–959. https://doi.org/10.1126/science.130.3381.954
- Russell, R. C. (1918). Index (U.S. Patent No. 1,261,167). U.S. Patent and Trademark Office.
- Russell, R. C. (1922). Index (U.S. Patent No. 1,435,663). U.S. Patent and Trademark Office.
- SAS Institute Inc. (2023). SAS Functions and CALL Routines: Reference. SAS Institute Inc. https://support.sas.com