
تُعد جداول بيانات جوجل (Google Sheets) واحدة من أكثر الأدوات السحابية تطوراً وانتشاراً في بيئات الأعمال الحديثة والبحث العلمي التطبيقي، حيث أحدثت منذ إطلاقها الأولي في السادس من يونيو عام 2006—والذي استند في جوهره التقني إلى تطبيق “XL2Web” المطور من قِبل شركة “2Web Technologies” بقيادة جوناثان روشيل وفرزاد خوسروشاهي—تحولاً جذرياً في كيفية التعاون الآني ومعالجة البيانات الموزعة. ومع تعقد نماذج التحليل الإحصائي وضرورة عزل السجلات الزمنية أو الإقليمية في أوراق عمل (Tabs) منفصلة، يبرز التحدي التقني المتمثل في استخلاص المقاييس المركزية التجميعية، وعلى رأسها حساب المتوسط الحسابي عبر أوراق عمل متعددة دون المساس بسلامة البنية الهيكلية للبيانات أو التضحية بالكفاءة الحاسوبية للبرمجية السحابية.
يتطلب حساب المتوسط الحسابي عبر أوراق عمل متعددة فهماً عميقاً لطبيعة المعالجة ثلاثية الأبعاد (3D Aggregation) والمنطق البرمجي الذي يحكم دوال التجميع في جداول البيانات. إن الانتقال من التحليل ثنائي الأبعاد المحدود بصفوف وأعمدة الورقة الواحدة إلى التحليل العابر للأوراق المتعددة يفرض قيوداً رياضية وهندسية تتعلق بإدارة المراجع، والتعامل مع فجوات البيانات، وتحسين استهلاك الذاكرة العشوائية لمتصفح الويب وخوادم جوجل السحابية. يهدف هذا الدليل الأكاديمي الشامل إلى تفكيك المعضلات الحسابية والتقنية المرتبطة بحساب المتوسطات عبر أوراق عمل متعددة، مقدماً حلولاً تبدأ من الصيغ القياسية المباشرة، مروراً بالمعالجات الشرطية والمصفوفية المتقدمة، ووصولاً إلى أفضل الممارسات الهندسية لإدارة المصنفات الضخمة.
سواء كنت باحثاً تدير تجارب ميدانية متعاقبة عبر موجات زمنية مختلفة، أو محللاً مالياً تسعى لتوحيد مراكز التكلفة الموزعة على فروع الشركة، فإن امتلاك زمام المعادلات الديناميكية مثل دالة المتوسط القياسية والدوال الشرطية المدمجة يمثل ضرورة لا غنى عنها لضمان موثوقية القرارات المستندة إلى البيانات. يستعرض هذا المقال بأسلوب منهجي ومفصل الآليات الحسابية الدقيقة، والأخطاء البرمجية الشائعة وطرق تشخيصها، مع تسليط الضوء على سيناريوهات عملية مستمدة من الواقع التطبيقي لتوفير مرجع علمي وعملي رصين لمستخدمي جداول بيانات جوجل بمختلف مستوياتهم التخصصية.
1. الأسس النظرية لحساب المتوسط الحسابي عبر أوراق العمل في جداول بيانات جوجل
1.1 مفهوم تكامل البيانات ثلاثية الأبعاد (3D Data Aggregation)
يُقصد بتكامل البيانات ثلاثية الأبعاد تلك العملية الحسابية التي تتجاوز الإحداثيات الثنائية التقليدية المعتمدة على تقاطع الصفوف والأعمدة داخل مسطح ورقة العمل الواحدة، لتضيف بعداً ثالثاً يمثله عمق المصنف المكون من طبقات أوراق عمل متتالية ومتطابقة في البنية الهيكلية. في النماذج التحليلية المتقدمة، يُستخدم هذا النمط لتنظيم المسوح التتبعية التي تتكرر زمنياً (مثل الأسابيع، أو الأشهر، أو الأرباع السنوية) أو قطاعياً (مثل الفروع الجغرافية، أو الأقسام الإدارية، أو المجموعات التجريبية في الدراسات العلمية). يتيح هذا الفصل المعماري حفظ البيانات الخام في سياقها الطبيعي المستقل دون خلط، مما يسهل عمليات التدقيق الداخلي ويقلل من تلوث البيانات الناجم عن التداخل اليدوي.
تتجلى الأهمية الإحصائية لتجميع القياسات الموزعة في تمكين الباحث أو المحلل من إجراء استدلال إحصائي دقيق يعكس الصورة الكلية للظاهرة المدروسة عبر الزمن أو القطاعات. فعندما تُعزل البيانات في أوراق مستقلة، يتطلب استخراج مؤشر مركزي موحد، كالمتوسط الحسابي، إسناداً تبادلياً دقيقاً يضمن تمثيل كل وحدة قياس بوزنها الحسابي الصحيح دون تكرار أو إسقاط. إن دمج كافة البيانات قسراً في ورقة أحادية مكدسة، رغم أنه قد يبدو للوهلة الأولى تبسيطاً للحساب، غالباً ما يؤدي إلى تضخم أحجام الجداول وصعوبة قراءتها، وزيادة احتمالية حدوث أخطاء الإزاحة أثناء التعديل أو الحذف، مما يمنح هيكل المصنفات متعددة الأوراق أفضلية تنظيمية واضحة.
مع ذلك، تفرض منظومة جداول بيانات جوجل حدوداً برمجية وحاسوبية عند التعامل مع الاستعلامات ثلاثية الأبعاد مقارنة ببرمجيات الحوسبة المكتبية التقليدية. فعلى عكس ما يوفره برنامج ميكروسوفت إكسيل من دعم مباشر لما يُعرف بنطاق الإسناد ثلاثي الأبعاد المباشر (مثل كتابة الصيغة من الورقة الأولى إلى الورقة الأخيرة بفاصلة نقطية)، فإن جداول بيانات جوجل تفتقر إلى هذا التمدد الديناميكي التلقائي عبر المعرّفات المباشرة للنطاقات ثلاثية الأبعاد، وتتطلب إما إسناداً صريحاً لكل ورقة عمل على حدة، أو استدعاء دوال مساعدة ومصفوفات تجميعية قادرة على اختراق الطبقات المتعددة ومعالجتها ككتلة متجانسة عبر خوادم المعالجة السحابية.
1.2 المنطق البرمجي لدالة AVERAGE وطبيعة معالجة المدخلات
تستند دالة المتوسط الحسابي AVERAGE في جداول بيانات جوجل إلى خوارزمية إحصائية كلاسيكية، حيث تقوم بجمع كافة القيم العددية الصالحة داخل وسائطها الحسابية وقسمتها بدقة على عدد تلك القيم، معبرة عن ذلك رياضياً بالصيغة:
المتوسط = مجموع القيم / عدد القيم.
يكمن التعقيد البرمجي في كيفية تعريف البرنامج للمقام الإحصائي (العدد)؛ حيث يمتلك محرك جداول جوجل آليات فرز منطقية تفصل بين القيم الرقمية البحتة والمدخلات غير الرقمية. فعند تمرير خلايا تحتوي على نصوص أو قيم فارغة تماماً، تتجاهلها الخوارزمية كلياً ولا تُدرجها ضمن المقام، مما يحافظ على قيمة المتوسط الإحصائي الممثل للبيانات المتوفرة فقط، في حين يؤدي وجود القيمة الصفرية الصريحة (0) إلى احتسابها كقيمة قياسية فاعلة تزيد المقام بواحد وتخفض قيمة المتوسط العام.
تتم معالجة وسائط دالة AVERAGE من خلال آليات قراءة المؤشرات (Pointers) التي تستهدف عناوين الذاكرة المخصصة لمعرّفات أوراق العمل (Sheet Identifiers). يرسل محرك الحساب استعلاماً لكل معرف ورقة منفصل، مستخرجاً القيمة المخزنة في الإحداثي المحدد، ثم يجمع تلك القيم في مصفوفة داخلية مؤقتة تخضع للتحقق الرياضي من نوع البيانات. إذا أشارت الخلية إلى ورقة عمل تمت إعادة تسميتها أو حذفها، يتعطل المؤشر فوراً لعدم قدرته على حل المسار المرجعي، مما يؤكد أن الاستقرار الإنشائي للمصنف هو الضمانة الوحيدة لدقة معالجة الدالة لمدخلاتها عبر أوراق العمل المختلفة.
علاوة على ذلك، يجب مراعاة أثر حسابات النمط العائم (Floating-Point Arithmetic) وفق معيار الحوسبة الدولي IEEE 754 المعمول به في المتصفحات وخوادم جوجل السحابية. فعند تجميع متوسطات دقيقة تمتد لأجزاء عشرية متعددة مستخرجة من أوراق مختلفة، قد تظهر فروق حسابية ضئيلة جداً في المراتب العشرية المتأخرة ناتجة عن التحويل الثنائي للأرقام الكسرية. على الرغم من أن هذه الفروق نادراً ما تؤثر على التطبيقات اليومية، إلا أنها تتطلب ضبطاً منهجياً لتنسيق الخلايا وعدد المنازل العشرية المقبولة في السياقات الأكاديمية والمحاسبية لضمان سلامة المطابقة بين النتائج المجمعة والمقاييس التفصيلية.
2. البنية التركيبية للصيغة القياسية لحساب المتوسط عبر أوراق متعددة
2.1 الصياغة النحوية للإسناد المباشر للخلايا المنفردة
تُعد الصيغة القياسية القائمة على الإسناد المباشر للخلايا هي الطريقة الأكثر شفافية وشيوعاً عند التعامل مع عدد محدود من أوراق العمل. تتخذ هذه الصيغة الشكل البرمجي التالي: =AVERAGE(Sheet1!Cell, Sheet2!Cell, Sheet3!Cell). في هذا البناء الدلالي، تمثل كل وسيطة داخل قوسي الدالة إشارة مكانية محددة تتكون من شقين رئيسيين: الاسم الحرفي المعرّف لورقة العمل المصدرية، متبوعاً بإحداثي الخلية المستهدفة الذي يجمع بين الحرف العمودي والرقم الصفي (مثل B2). تُعامل الدالة هذه المدخلات كوسائط منفصلة تفصل بينها فواصل، وتقوم باستدعائها بالتتابع قبل تطبيق الخوارزمية الحسابية.
تلعب علامة التعجب (!) دوراً هيكلياً محورياً في لغة صياغة جداول بيانات جوجل، إذ تمثل الفاصل الدلالي الإلزامي بين اسم النطاق المكاني للورقة والإحداثي الداخلي للخلية. بدون علامة التعجب، سيفسر المحرك الصيغة على أنها خطأ لغوي لعدم إمكانية الفصل بين الكيان الحاوي والخلية المستهدفة. وتبرز ضرورة تقنية إضافية عندما تتضمن تسميات أوراق العمل مسافات بيضاء أو رموزاً خاصة أو تبدأ بأرقام؛ حيث يلزم إحاطة اسم الورقة بعلامات تنصيص مفردة لتفادي انهيار الصيغة، كما في المثال التالي: ='Week 1'!B2. إن إهمال هذه العلامات التنصيصية عند وجود مسافات يؤدي مباشرة إلى فشل المحرك في تحليل المرجع الرياضي وظهور أخطاء البنية التركيبية.
تتميز هذه الصياغة المباشرة بالوضوح المطلق وتسهيل تتبع التدفق الحسابي من قِبل المدققين الخارجيين، لكنها تنطوي في الوقت ذاته على محددات مرجعية حرجة. فالاعتماد على كتابة الأسماء المباشرة للأوراق يجعل المعادلة هشة أمام التعديلات الهيكلية غير المنضبطة، مثل إعادة التسمية اليدوية للأوراق دون الاعتماد على آليات التحديث التلقائي للروابط الداخلية للبرنامج، أو الحذف العرضي لإحدى أوراق الإسناد، مما يؤدي فوراً إلى كسر السلسلة المرجعية وتعطل الحساب على مستوى المصنف بأكمله.
2.2 مقارنة الكفاءة بين الإسناد المنفرد والإسناد النطاقي
عند تقييم الأداء الحسابي لجداول بيانات جوجل، يظهر تباين منهجي واضح بين استخدام الإسناد المنفرد للوسائط وإسناد النطاقات المجمعة، خاصة مع اتساع رقعة البيانات. يستهلك الإسناد المنفرد لكل خلية في ورقة مستقلة مساحة ذاكرة أكبر نسبياً داخل شجرة التحليل النحوي للمعادلة (Syntax Tree) لمحرك الحساب، نظراً لأن البرنامج ينشئ مسار استماع ومراقبة (Listener Pointer) مستقلاً لكل وسيطة على حدة لتتبع أي تعديل يطرأ عليها وإعادة تشغيل المعادلة بناءً على ذلك. في المقابل، يؤدي التعامل مع مصفوفات النطاقات المجمعة إلى تقليل عدد تلك المؤشرات الموزعة وتحسين استجابة المعالج السحابي للورقة.
من زاوية قابلية الصيانة والتدقيق المنهجي، تتميز الصيغ المبنية على استدعاءات صريحة ومنفردة بقدرتها على استيعاب تباين مواقع الخلايا في حال عدم تطابق تصميم أوراق العمل المصدرية؛ فإذا كانت قيمة المبيعات مثلاً تقع في الخلية B2 في الورقة الأولى وتقع في C4 في الورقة الثانية، يمكن للصيغة المنفردة معالجة هذا الخلل عبر تخصيص الإحداثي الدقيق لكل ورقة. إلا أن هذا التمايز يمثل عيباً توثيقياً خطيراً، إذ يعكس غياب المعيارية القياسية في جمع البيانات، ويتحول مع زيادة عدد الأوراق المفحوصة (كأن تتجاوز عشرين أو ثلاثين ورقة) إلى صيغ بالغة الطول والتعقيد يستحيل فحصها بصرياً أو تعديلها دون ارتكاب أخطاء سهو بشرية مكلفة.
علاوة على ذلك، تتجلى حدود التوسعة التلقائية في استحالة استخدام مقبض التعبئة التلقائي لتمديد الصيغة لتشمل أوراقاً جديدة دون تدخل برمجي؛ إذ إن تمديد الخلية يسحب إحداثيات الصفوف والأعمدة فقط ولا يولد أسماء أوراق إضافية ضمن وسائط دالة AVERAGE. هذا القصور يفرض على المحلل تكرار عمليات التحرير اليدوي المضنية في كل مرة تُضاف فيها فترة زمنية أو وحدة تجريبية جديدة، مما يستدعي التفكير في حلول أكثر ديناميكية تعتمد على دمج المصفوفات أو الاستعلامات غير المباشرة كما سيتم تفصيله في المحاور اللاحقة.
3. دراسة تطبيقية: تحليل متوسط أداء اللاعبين عبر أوراق الفترات الزمنية
3.1 إعداد وتوحيد الهيكل البنائي لأوراق العمل المصدرية
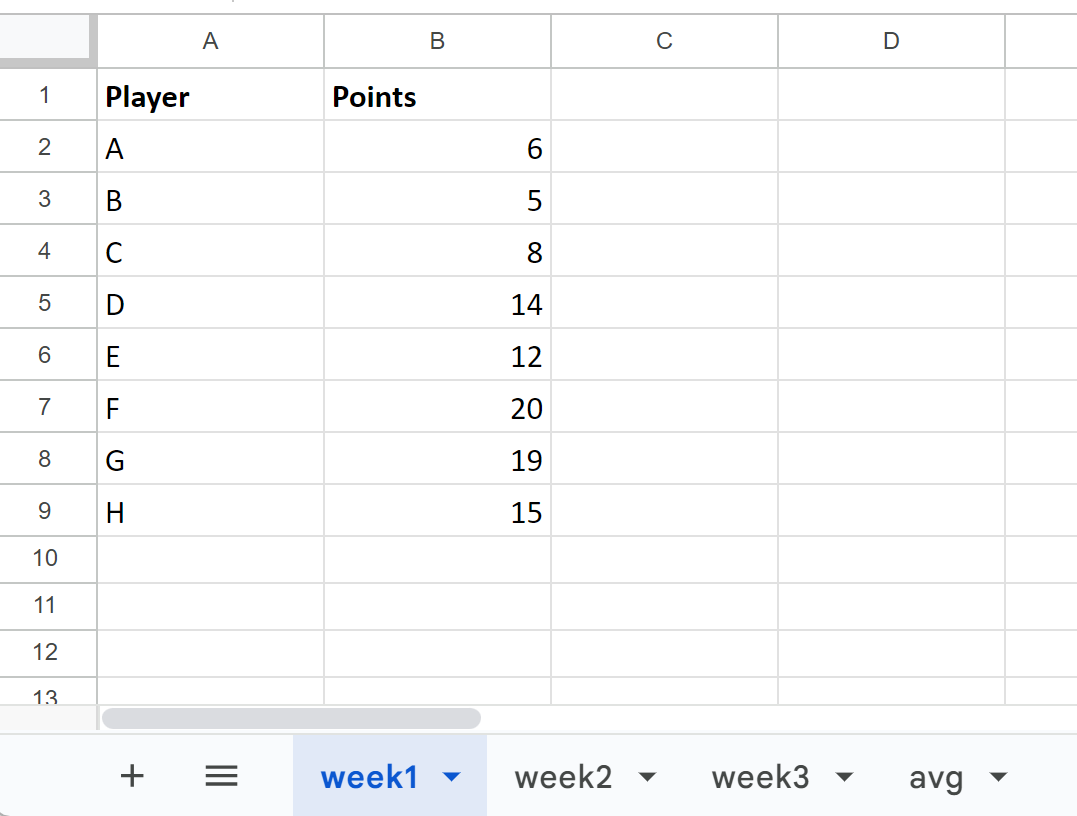
لإدراك الآليات العملية لحساب المتوسطات عبر أوراق العمل، سنعتمد في هذه الدراسة التطبيقية نموذجاً واقعياً لتحليل أداء عينة تجريبية مكونة من ثمانية رياضيين تم قياس نقاط أدائهم الأسبوعية عبر ثلاث أوراق عمل متتالية ومستقلة سُميت معيارياً بالأسماء التالية: week1، وweek2، وweek3. تتطلب المنهجية العلمية السليمة إخضاع هذه الأوراق لمبدأ التوحيد الهيكلي التام والصرامة التصميمية، بحيث تتطابق مصفوفة الخلايا توزيعاً ونمطاً؛ فيتم حجز العمود الأول (A) لمعرّف الرياضي أو اسمه الثابت، بينما يُخصص العمود الثاني (B) لتسجيل النقاط الحسابية المحرزة، وتبدأ البيانات الفعلية من الصف الثاني (الصف الأول مخصص لرؤوس الجداول المعيارية).
إن إغفال توحيد البنية التحتية للأوراق المصدرية يهدد بدخول مدخلات غير متجانسة في العمليات الحسابية المجمعة. ولضمان ثبات هذه البيئة، يتعين استخدام تقنيات التحقق من صحة البيانات (Data Validation) عبر كافة الأوراق، بتحديد النطاق المقبول للأرقام المسجلة (كنقاط موجبة صحيحة أو كسرية تقع ضمن حدود الأداء البشري المنطقي، كأن تكون بين 0 و 100)، ومنع إدخال النصوص العرضية في حقول النقاط. يوضح الجدول التالي توزيع العينة التجريبية والبيانات الرقمية المسجلة عبر الأسابيع الثلاثة:
| معرّف الرياضي (A) | الأسبوع الأول: week1 (B) | الأسبوع الثاني: week2 (B) | الأسبوع الثالث: week3 (B) |
|---|---|---|---|
| اللاعب 1 (B2) | 8 | 6 | 6 |
| اللاعب 2 (B3) | 5 | 7 | 6 |
| اللاعب 3 (B4) | 9 | 8 | 4 |
| اللاعب 4 (B5) | 6 | 6 | 6 |
| اللاعب 5 (B6) | 7 | 5 | 9 |
| اللاعب 6 (B7) | 4 | 6 | 8 |
| اللاعب 7 (B8) | 10 | 9 | 8 |
| اللاعب 8 (B9) | 3 | 5 | 4 |
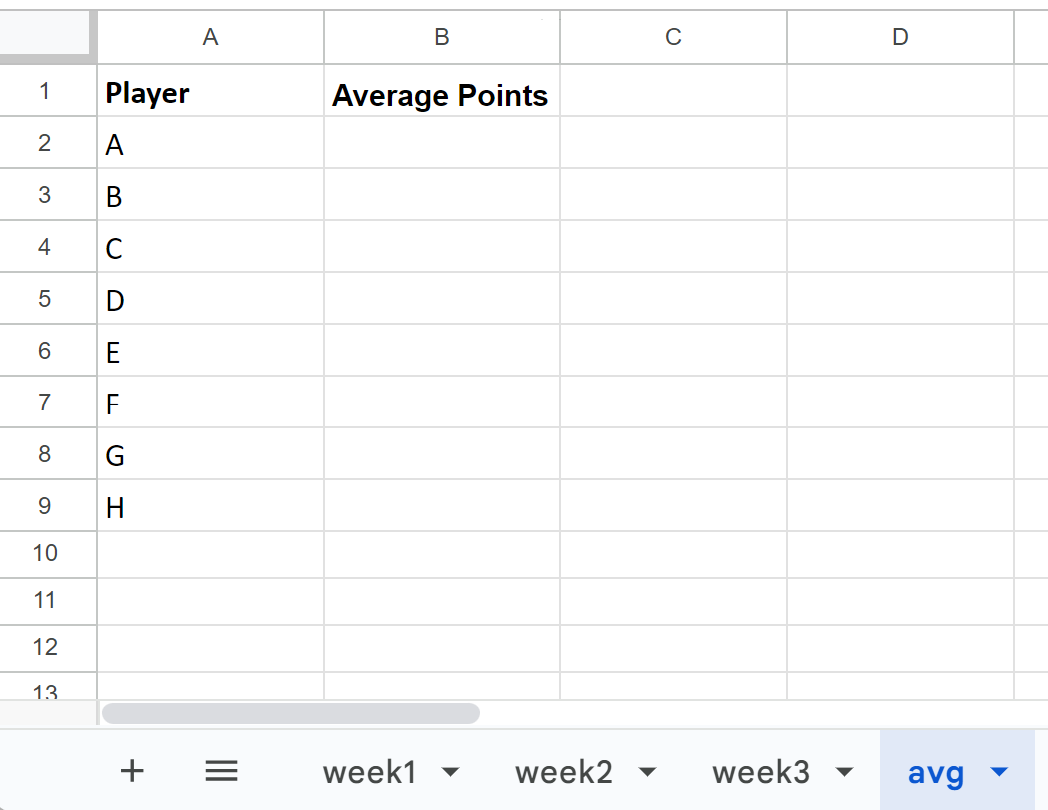
تكتمل هذه الهندسة الإنشائية بإنشاء ورقة عمل مركزية مخصصة للتحليل التجميعي وتُسمى avg. يتمثل دور هذه الورقة في استيراد البيانات الإحصائية وعرض النتائج المستخلصة دون استضافة أي بيانات خام أولية. يُعاد استنساخ عمود معرّفات الرياضيين في العمود A الخاص بالورقة avg ليكون مرآة مطابقة تماماً للمصادر، بينما يُترك العمود B فارغاً لاستقبال الصيغ الرياضية لحساب المتوسطات، محققين بذلك الفصل المنهجي الضروري بين طبقة التخزين الميداني وطبقة التجميع النهائي.
3.2 تطبيق صيغة =AVERAGE(week1!B2, week2!B2, week3!B2) وتفسير مخرجاتها
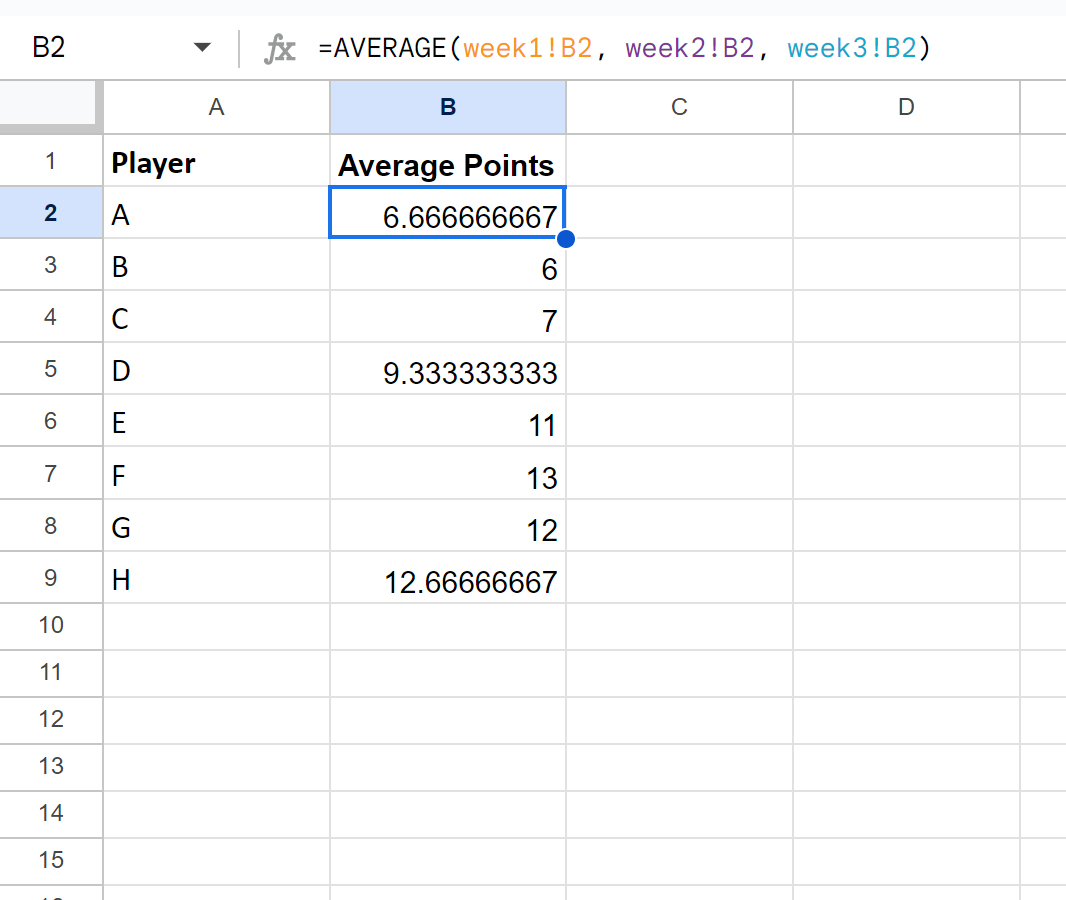
لتنفيذ المعالجة الحسابية لأداء اللاعب الأول، نتوجه إلى الخلية B2 في ورقة العمل التجميعية avg ونقوم بحقن الصيغة القياسية بدقة:
=AVERAGE(week1!B2, week2!B2, week3!B2).
يعتمد هذا الإسناد على المراجع النسبية للمواقع (حيث لم تُستخدم علامة التثبيت الدولارية $ قبل الحرف B أو الرقم 2)، مما يضمن إمكانية تعميم المعادلة تلقائياً. بعد الضغط على مفتاح الإدخال، يقوم المحرك بجمع قيم الخلية B2 من الأوراق الثلاث وهي: (8 + 6 + 6 = 20)، ثم يقسم المجموع على المقام الثلاثي الصريح، لينتج القيمة الحسابية 6.666666667.
يتم بعد ذلك سحب الصيغة عمودياً باستخدام مقبض التعبئة التلقائي لتغطية باقي أفراد العينة حتى الخلية B9. تتكيف المراجع النسبية تلقائياً مع تسلسل الصفوف؛ فتتحول صيغة اللاعب الثاني في الخلية B3 إلى =AVERAGE(week1!B3, week2!B3, week3!B3) بقيم (5 + 7 + 6 = 18) لتعطي متوسطاً قدره 6.00، وصيغة اللاعب الثالث في الخلية B4 بقيم (9 + 8 + 4 = 21) لتعطي متوسطاً دقيقاً مقداره 7.00. يبرهن هذا الاتساق على سلامة المعالجة الخوارزمية وتكافؤ الأوزان الممنوحة للمدخلات عبر كافة الفترات المقاسة.
من الناحية المنهجية المتعلقة بتمثيل النتائج والنشر العلمي، يُعد ترك الكسور العشرية تمتد بلا نهاية تشويهاً بصرياً يُضعف من كفاءة قراءة البيانات. يتعين على المحلل مواءمة المخرجات باختيار التنسيق العددي الموحد (Number Formatting) لتقريب القيم إلى منزلتين عشريتين فقط عبر أدوات الواجهة أو بتضمين دالة التقريب ROUND إن تطلب التحليل ذلك برمجياً، لتصبح نتيجة أداء اللاعب الأول 6.67. يتيح هذا التنسيق الحفاظ على الدقة الرياضية المخزنة في خلفية النظام مع تقديم قراءة سهلة ومنسجمة تلبي المعايير الأكاديمية والمهنية المعتمدة.
3.3 اختبار الموثوقية وتأكيد سلامة المخرجات الحسابية
لا تنتهي الممارسة التحليلية السليمة بحساب الأرقام، بل تتطلب الخضوع لبروتوكول صارم لاختبار الموثوقية (Reliability Testing) للتحقق من خلو العمليات من أي خطأ هيكلي خفي. تتمثل الخطوة الأولى في إجراء مقارنة يدوية معيارية عبر عينة عشوائية؛ حيث يتم حساب المتوسط الحسابي لبعض الوحدات المبحوثة باستخدام آلة حاسبة خارجية مستقلة أو بتجميع يدوي منفصل داخل خلية اختبار مؤقتة للتأكد من عدم إسقاط أي ورقة من أوراق المصدر أو حدوث خطأ إملائي غير ملحوظ في كتابة اسم إحدى الأوراق حال دون احتسابها.
تتمثل المخاطرة المنهجية الأكبر في عمليات إعادة الفرز أو الترتيب الأبجدي لقوائم اللاعبين. إذا قام مدخل البيانات بإعادة فرز الأسماء أبجدياً داخل ورقة week2 دون تطبيق الفرز ذاته وبالترتيب الدقيق نفسه داخل أوراق week1 وweek3 والورقة التجميعية avg، فإن مراجع الخلايا النسبية (مثل B2) ستشير إلى أفراد مختلفين تماماً في كل ورقة، مما يدمر الصدق الداخلي للنموذج وينتج عنه حساب متوسطات هجينة مضللة. ولمنع هذه الثغرة، يجب ربط ترتيب الصفوف في أوراق العمل بحقل رقمي ثابت يمثل المعرف التعريفي الوحيد (Unique Identifier) للوحدة، أو تأمين الجداول ضد عمليات الترتيب المستقلة.
كذلك، ينبغي الالتزام بتوثيق المنهجية الرياضية المتبعة عبر تدوين شروحات مفصلة داخل خلايا الملاحظات (Notes) الملحقة برؤوس الأعمدة في ورقة التجميع المركزية، أو تخصيص ورقة مستقلة لتوثيق التحولات الهيكلية للمصنف. يضمن هذا التوثيق إمكانية التكرارية البحثية (Research Reproducibility)، بحيث يستطيع أي محلل آخر مراجعة مسارات استدعاء البيانات والتحقق من صحة الصيغ وفهم الأسباب الهندسية الكامنة وراء اختيار هيكل أوراق العمل الموزعة.
4. التعامل المنهجي مع القيم المفقودة، الصفرية، والشواذ النصية
4.1 التفريق الإحصائي بين غياب البيانات (Null) والقيمة الصفرية (Zero)
يمثل التمييز الدلالي والرياضي بين البيانات الغائبة تماماً (Null) والقيمة الصفرية المسجلة صراحة (Zero) أحد أهم المرتكزات الإحصائية في علوم البيانات والقياسات الميدانية. في جداول بيانات جوجل، تُعامل الخلية الفارغة—التي لم تتلقَّ أي مدخلات قط أو تلك الناتجة عن محو البيانات—باعتبارها فراغاً إحصائياً غير موجود. عندما تواجه دالة AVERAGE خلية فارغة عبر إحدى أوراق العمل، فإنها تسقطها تلقائياً من بسط المجموع وتسقطها بالتزامن من مقام التكرار، مما يحافظ على القيمة النسبية للمشاهدات المتبقية دون أن يؤدي غياب القياس في تلك الفترة إلى خفض جائر لمعدل أداء المفحوص.
على النقيض من ذلك تماماً، يُعد الرقم صفر قيمة كمية فعلية تعبر عن تسجيل مستوى معدوم من الظاهرة المقاسة خلال تلك الفترة الزمنية. إذا كان أحد الرياضيين قد شارك في الأسبوع الثاني ولم يسجل أي نقاط فكُتبت القيمة “0” في خليته، فإن دالة AVERAGE تضيف صفراً إلى البسط ولكنها تزيد المقام بمقدار 1، مما يؤدي إلى انخفاض حاد ومبرر رياضياً في متوسطه العام. تبرز المشكلة عندما يقوم جامع البيانات بإدخال الأصفار كبديل عن غياب الاستجابة أو عدم حضور المفحوص أصلاً، الأمر الذي ينجم عنه تشويه منهجي فادح في التحليلات التتبعية وتحيز غير مقصود في النتائج الإحصائية.
تستدعي الممارسات المنهجية الدقيقة اللجوء إلى تقنيات المعالجة المسبقة للبيانات الغائبة (Data Imputation أو Cleansing) لتنقية السجلات قبل التجميع. في حال وجود نصوص عرضية كُتبت لوصف أسباب الغياب (مثل عبارة “غائب” أو “غير متوفر”)، فإن دالة AVERAGE تتجاهلها بصمت، وهو سلوك قد يخفي أحياناً أخطاء إدخال النصوص الرقمية. لذلك، يُفضل فحص الأوراق المصدرية بصيغ شرطية تحول الإدخالات الشاذة إما إلى فراغات حقيقية لمنع احتسابها، أو إلى أصفار واضحة إذا كان الإطار النظري للدراسة يعتبر الغياب معادلاً للفشل التام في تحقيق النقاط.
4.2 استخدام دالة AVERAGEA ودواعي الحذر المنهجي
توفر منظومة جداول بيانات جوجل دالة بديلة تُعرف باسم AVERAGEA، والتي تختلف جذرياً في فلسفتها التشغيلية عن الدالة القياسية AVERAGE. في حين تستبعد الدالة القياسية النصوص والقيم المنطقية من حساباتها، فإن AVERAGEA تدمج كافة المدخلات المتوفرة في النطاق ضمن التحليل الإحصائي؛ حيث تُترجم القيمة المنطقية TRUE رقمياً إلى 1، والقيمة المنطقية FALSE إلى 0، وتُعامل أي سلسلة نصية غير قابلة للتحويل الرياضي—بما في ذلك المسافات الفارغة الناتجة عن الصيغ النصية أو الكلمات التوضيحية—باعتبارها قيمة مساوية للصفر الحسابي (0).
يتطلب استخدام دالة AVERAGEA حذراً منهجياً استثنائياً في بيئات البحث الميداني والأكاديمي؛ فإذا استُخدمت هذه الدالة بصيغة مثل: =AVERAGEA(week1!B2, week2!B2, week3!B2) وكان الأسبوع الثاني يحتوي على تدوين نصي مثل “إجازة مرضية”، ستقوم الدالة باعتبار هذه القيمة صفراً صريحاً وستقسم مجموع الأسابيع الأخرى على 3 بدلاً من 2، مما يهبط بمتوسط الرياضي هبوطاً مصطنعاً لا يعبر عن مستواه الواقعي. تتسع هذه الإشكالية التحليلية عند استيراد البيانات من مصادر خارجية تتضمن إشارات نصية مشفرة، مما يجعل AVERAGEA أداة غير ملائمة إلا في حالات نادرة جداً ومضبوطة بدقة إحصائية مسبقة.
تقتصر الحالات العلمية المبررة لاستخدام دالة AVERAGEA على التجارب التي تتطلب فرض عقوبة إحصائية متساوية مع الصفر على عدم الإنجاز المصحوب بمبررات نصية، أو تلك التي تهدف إلى قياس نسب تحقيق الأهداف اعتماداً على حقول منطقية ثنائية (Boolean Flags) حيث يمثل TRUE الإنجاز وFALSE الإخفاق. وبخلاف هذه السياقات المقيدة، فإن الاعتماد العفوي على دالة AVERAGEA بدلاً من الدالة القياسية يمثل خطأ منهجياً متكرراً يؤدي إلى تداعيات سلبية على سلامة الاستدلالات الإحصائية وقرارات العمل المبنية عليها.
5. الأتمتة المتقدمة للأوراق المتعددة عبر الدوال الديناميكية (INDIRECT و ADDRESS)
5.1 بناء مراجع ديناميكية مرنة باستخدام دالة INDIRECT
يمثل الجمود الهيكلي أبرز عيوب الصيغ القياسية المباشرة، حيث تنهار الحاجة إلى التعديل اليدوي المستمر كلما توسع المصنف ليتضمن أوراق عمل جديدة. للتغلب على هذه العقبة، توفر جداول بيانات جوجل دالة INDIRECT التي تعمل كمترجم برمجي يحول السلاسل النصية المجردة إلى مراجع حقيقية تقبلها المحركات الحسابية. من خلال هذه الدالة، يمكن تخزين أسماء أوراق العمل الفعلية في قائمة عمودية أو أفقية داخل ورقة التحكم التجميعية، ثم استدعاء محتويات الخلايا عبر بناء ديناميكي يربط بين اسم الورقة المكتوب والإحداثي المطلوب.
يتحقق هذا التكامل من خلال دمج اسم الورقة مع رمز التعجب وإحداثي الخلية باستخدام معامل الربط النصي (&)؛ فعلى سبيل المثال، إذا كانت الخلية A2 في ورقة التجميع تحتوي على النص المجرد week1، فإن الصيغة INDIRECT(A2 & "!B2") تعود بالقيمة الرقمية المخزنة في الخلية B2 داخل ورقة week1 بدقة متناهية. وعند الرغبة في حساب المتوسط لمجموعة أوراق عمل مدرجة أسمائها تباعاً في الخلايا من A2 إلى A4، يمكن صياغة معادلة متوسط تستدعي تلك المراجع المنفصلة دون كتابة أحرف الأسماء داخل التركيب البرمجي الثابت للمعادلة.
تتجلى القوة المنهجية لدالة INDIRECT في قدرتها على التكيف الفوري مع إضافة أوراق عمل جديدة؛ فبمجرد إضافة سطر جديد يحمل اسم الورقة المضافة حديثاً وتعديل مسار الاستدعاء، يتوسع النموذج الإحصائي تلقائياً دون الحاجة إلى إعادة صياغة المعادلات المركزية المعقدة. ومع ذلك، يجب الانتباه إلى أن دالة INDIRECT تندرج تقنياً ضمن “الدوال المتطايرة” (Volatile Functions)، وهي فئة من الدوال التي يُعاد حسابها بالكامل مع كل تعديل يطرأ على أي خلية في المصنف بأكمله، مما يفرض تكلفة حاسوبية تؤثر سلباً على سرعة الاستجابة إذا استُخدمت بآلاف الخلايا في وقت متزامن.
5.2 إنشاء مصفوفات استعلامية متغيرة عبر ADDRESS و ROW
لتحقيق أقصى درجات الأتمتة البرمجية وتجريد المراجع من أي تبعية للإحداثيات اليدوية، يمكن مزج دالة INDIRECT مع دالتي ADDRESS و ROW لإنشاء مصفوفات استعلامية متغيرة ذاتية التكيف. تقوم دالة ADDRESS بتركيب عنوان نصي لأي خلية بناءً على أرقام الصفوف والأعمدة الممررة إليها، في حين تقوم دالة ROW باستخراج رقم الصف الحالي للخلية الحاضنة تلقائياً. يتيح هذا الدمج للصيغة أن تفهم موقعها المكاني بنفسها دون تدخل المستخدم.
عند دمج هذه الدوال ضمن منظومة موحدة، تتخذ الصياغة المتقدمة شكلاً تجميعياً:
=AVERAGE(INDIRECT("'" & SheetName & "'!" & ADDRESS(ROW(), COLUMN(B2)))).
يقوم هذا التوليف المتقدم باستخراج الإحداثي الأفقي والعمودي للخلية الحالية لحظياً، وتركيبه مع اسم الورقة المحددة ديناميكياً، وتمرير العنوان الناتج إلى دالة INDIRECT لقراءة القيمة، قبل أن تستقر النتيجة النهائية داخل خوارزمية AVERAGE. يعني هذا عملياً أن نسخ الصيغة وسحبها أفقياً أو عمودياً سيعيد توجيه المؤشرات تلقائياً إلى الخلايا المقابلة في كافة الأوراق المصدرية دون أدنى خلل تركيبي.
تمثل هذه الهيكلية المرنة حلاً مثالياً لقواعد البيانات سريعة النمو والتمدد، حيث تقاوم تماماً التغييرات الهيكلية الناتجة عن إزاحة الصفوف أو إدخال سجلات بينية جديدة داخل الأوراق الأصلية. يتيح ذلك للباحثين ومطوري النماذج المالية بناء منصات استدلال مستقرة تدوم لفترات تشغيلية طويلة، وتلغي تماماً الحاجة إلى التدخل البشري المستمر لإعادة ضبط المسارات الحسابية عند كل دورة إدخال بياني جديدة.
6. الحساب الشرطي للمتوسطات عبر الأوراق المتعددة (AVERAGEIF و FILTER)
6.1 صياغة المتوسطات المشروطة بمعايير متعددة عبر المصنفات
في العديد من البيئات البحثية والتشغيلية، لا يُعد حساب المتوسط الحسابي البسيط كافياً لعكس الحقيقة الإحصائية، إذ تبرز الحاجة الماسة إلى تقييد الاحتساب بمعايير وضوابط كمية أو نوعية محددة. تستجيب دالة AVERAGEIF لهذه الاحتياجات بالسماح بحساب المتوسط المشروط بالتحقق من شروط منطقية صارمة؛ مثل استبعاد القيم الصفرية، أو حساب المتوسط للقيم التي تتجاوز حداً فاصلاً، أو استبعاد القيم المتطرفة الشاذة (Outliers) التي قد تشوه النزعة المركزية للبيانات الناتجة عن أخطاء القياس الميداني أو الظروف الاستثنائية.
تظهر الصعوبة البرمجية عند محاولة تطبيق الدوال الشرطية مثل AVERAGEIF أو AVERAGEIFS عبر أوراق عمل متعددة في جداول بيانات جوجل، نظراً لأن هذه الدوال مصممة أصلاً لتقبل وسيطة نطاق (Range Argument) متصلة تقع داخل ورقة عمل واحدة حصراً، وترفض بشكل قاطع استقبال النطاقات المنفصلة ثلاثية الأبعاد المقسمة على أوراق متعددة، مظهرة رسائل خطأ دلالية تفيد بعدم ملاءمة الوسائط. هذا القصور البنيوي يمنع المحلل من كتابة صيغ تبدو منطقية نظرياً مثل استدعاء نطاق الأسبوع الأول والثاني معاً داخل شرط محدد بالصيغة المباشرة.
للالتفاف المنهجي على هذا العائق وتطبيق الشروط عبر المصنفات الموزعة، يتعين استخدام استراتيجيات المعالجة التجميعية؛ إما عبر إنشاء أعمدة وسيطة داخل كل ورقة عمل تفرز البيانات الشرطية بصورة مستقلة ومسبقة، أو بالاعتماد على دمج النطاقات الموزعة داخل مصفوفات افتراضية مسبقة التنقية يتم تمريرها إلى دوال متوافقة، مما يتيح تطبيق الشروط المركبة المعتمدة على متغيرات فرعية مصاحبة (مثل مقارنة أداء الذكور مقابل الإناث، أو فئات عمرية محددة) بكفاءة إحصائية متناهية.
6.2 تصفية البيانات الموزعة عبر دالة FILTER قبل تجميعها
تُعد دالة FILTER في جداول بيانات جوجل واحدة من أقوى الأدوات الحاسوبية لتفكيك معضلة النطاقات المشروطة عبر الأوراق المتعددة. تتمثل الفلسفة التشغيلية لهذه الدالة في استخلاص مصفوفة فرعية من نطاق بيانات أصلي بناءً على تحقق شرط منطقي واحد أو أكثر، دون المساس بالبيانات الأصلية المخزنة. عند الرغبة في حساب المتوسط المشروط لعدة أوراق، يمكن استدعاء دالة FILTER بصورة مستقلة لكل ورقة عمل، ثم دمج المصفوفات المفلترة رأسياً داخل حاضنة مصفوفية واحدة لتغذية دالة المتوسط الحسابي القياسية.
تتحقق هذه المعالجة البرمجية الرصينة بصياغة تركيبية تعتمد على الأقواس المعقوفة:
=AVERAGE({FILTER(week1!B2:B9, week1!B2:B9>0); FILTER(week2!B2:B9, week2!B2:B9>0); FILTER(week3!B2:B9, week3!B2:B9>0)}).
في هذا النموذج الرياضي، تقوم كل دالة FILTER داخل الأقواس باستخلاص القيم التي تزيد عن الصفر من ورقتها المحددة فقط، متجاهلة أي مدخلات صفرية أو سالبة. بعد ذلك، تقوم الفواصل المنقوطة (;) بدمج هذه المخرجات في عمود افتراضي موحد ومستمر، تستقبله دالة AVERAGE كمدخل أحادي متصل تحسب متوسطه بدقة متناهية ودون أي انتهاك لقواعد البنية الرياضية.
ينبغي اتخاذ تدابير احترازية للتعامل مع حالات المصفوفات الفارغة التي تؤدي إلى توليد خطأ الحساب (#CALC!)؛ فإذا لم تتحقق الشروط المحددة في إحدى أوراق العمل (كأن تكون جميع قيم الأسبوع الثالث أصفاراً)، ستفشل دالة FILTER الخاصة بتلك الورقة ويتعطل حساب المعادلة بأكملها. يُعالج هذا الاستثناء بتطويق كل استعلام مفلتر بدالة IFERROR لتمرير مصفوفة فارغة محايدة لا تؤثر على المقام النهائي، مما يرفع من متانة ومناعة النموذج الإحصائي أمام تقلبات المدخلات التجريبية.
7. المعالجة المصفوفية والاستعلام المتقدم باستخدام QUERY و ARRAYFORMULA
7.1 توظيف الأقواس المعقوفة {} لإنشاء مصفوفات عمودية وأفقية مدمجة
تمثل الأقواس المعقوفة {} في جداول بيانات جوجل أداة الهندسة المصفوفية الأساسية لبناء أبعاد ونطاقات افتراضية مخصصة داخل الذاكرة اللحظية دون الحاجة إلى شغل مساحات تخزين إضافية في أوراق العمل. تستند هذه التقنية إلى مبدأ بسيط وحاسم: تفصل الفواصل العادية (,) أو الفواصل المائلة العكسية (بحسب إعدادات المنطقة واللغة) بين عناصر المصفوفة الأفقية لتوليد صفوف ممتدة، في حين تفصل الفواصل المنقوطة (;) بين العناصر لتجميعها رأسياً في مصفوفة عمودية موحدة ذات مسار أحادي.
من خلال توظيف هذا المنطق، يمكن تغذية دالة AVERAGE بمصفوفة افتراضية موحدة وممتدة مستخرجة من أوراق متباينة بالصيغة التجميعية المباشرة:
=AVERAGE({week1!B2:B9; week2!B2:B9; week3!B2:B9}).
تقوم هذه الصيغة بفك الارتباط المكاني بين النطاقات المنفصلة وتكديس البيانات عمودياً في مسار تسلسلي مفرد يستقر مباشرة داخل مقام وبسط خوارزمية المتوسط. يحل هذا الأسلوب المصفوفي النهائي مشكلة عدم قدرة جداول بيانات جوجل على استيعاب النطاقات ثلاثية الأبعاد القياسية، مقدماً بديلاً برمجياً فائق المرونة يعالج تباين المسافات الجغرافية داخل المصنف.
يشترط لنجاح هذا البناء المصفوفي خضوع النطاقات المدمجة لقواعد التماثل الرياضي والأبعادي؛ فإذا كان الهدف تجميع المصفوفات رأسياً بالفواصل المنقوطة، يجب أن تتطابق كافة النطاقات المكونة في عدد الأعمدة، في حين يتطلب الدمج الأفقي تطابقاً دقيقاً في عدد الصفوف. إن حدوث أي خلل في أبعاد النطاقات المجمعة يمنع محرك الحساب السحابي من تشكيل المصفوفة الهجينة ويقود فوراً إلى انهيار العملية وظهور أخطاء البنية المصفوفية الممزقة.
7.2 استخدام دالة QUERY لإجراء تحليلات المتوسط الموزون والمعقد
تُمثل دالة QUERY الذروة التقنية لمعالجة وتحليل البيانات داخل جداول بيانات جوجل، إذ تدمج قدرات الاستعلام المستوحاة من لغة SQL البنائية لإجراء عمليات تصفية وتجميع وفرز بالغة التعقيد باستخدام سطر أوامري نصي واحد. تكمن القوة الاستثنائية لهذه الدالة في تعاملها السلس مع المصفوفات المجمعة عبر الأقواس المعقوفة، مما يتيح إجراء حسابات المتوسط الإحصائي الموزون والمبوب عبر أوراق عمل متعددة وبأعلى كفاءة حاسوبية ممكنة.
لبناء استعلام مركزي يستخرج المتوسط الحسابي للبيانات الموزعة، تُصاغ الدالة على النحو التالي:
=QUERY({week1!A2:B9; week2!A2:B9; week3!A2:B9}, "SELECT Col1, avg(Col2) WHERE Col2 IS NOT NULL GROUP BY Col1 LABEL avg(Col2) 'المتوسط الإجمالي'").
تقوم هذه الصيغة المتقدمة برص البيانات المكونة من أسماء الرياضيين في العمود الأول ونقاطهم في العمود الثاني من كافة الأسابيع، ثم تستخدم المعرّفات الموضعية Col1 و Col2 لتجميع السجلات تلقائياً وفق اسم كل رياضي، واستبعاد الخلايا الفارغة، وحساب المتوسط الحسابي لنقاط كل فرد عبر كافة الأوراق بضربة حاسوبية واحدة تتولد مخرجاتها في جدول جديد منظم ومصنف.
يتيح هذا النهج الاستعلامي المتطور بناء لوحات معلومات إحصائية (Dashboards) تفاعلية وديناميكية تعتمد كلياً على محرك استعلام موحد؛ فبدلاً من صيانة العشرات من معادلات المتوسط الفردية لكل رياضي وتكرارها في كل صف، تتدفق البيانات من الأوراق المصدرية المتعددة إلى مخرج دالة QUERY بصورة مركزية تضمن مناعة كاملة ضد أخطاء الإزاحة وتغيرات الترتيب الداخلي في الجداول المغذية.
7.3 التطبيق المصفوفي التلقائي عبر دالة ARRAYFORMULA
في المصنفات البحثية والمهنية الكبرى التي تستقبل تدفقات مستمرة من السجلات الجديدة، يمثل سحب الصيغ الحسابية يدوياً عبر آلاف الصفوف ممارسة بالغة الخطورة وعرضة للإغفال والخطأ الإنساني. توفر دالة ARRAYFORMULA حلاً جذرياً لهذه الإشكالية، حيث تمتلك القدرة على تعميم العمليات الحسابية والصيغ المرجعية على امتداد عمود كامل انطلاقاً من كتابتها لمرة واحدة فقط داخل الخلية الرأسية الأولى للعمود التجميعي.
لحساب المتوسط الفردي الموزع لكل صف بصورة تلقائية، يمكن الدمج بين قدرات الجمع المصفوفي المباشر وقسمتها على عدد الأوراق الفاعلة داخل إطار الدالة المصفوفية:
=ARRAYFORMULA(IF(ISBLANK(week1!A2:A9), "", (week1!B2:B9 + week2!B2:B9 + week3!B2:B9) / 3)).
تراقب هذه الصيغة عمود الأسماء، وعند رصد وجود سجل نشط، تقوم بإجراء العمليات الحسابية للأعمدة المتناظرة عبر الأوراق المحددة دفعة واحدة وإسقاط المخرجات الرياضية في الخلايا التابعة رأسياً دون الحاجة إلى كتابة أي معادلة في الصفوف التالية.
يتطلب الاستخدام الاحترافي لدالة ARRAYFORMULA تضمين شروط تحقق وقائية، مثل استخدام دالة IF مع ISBLANK، لتفادي امتداد العمليات الحسابية إلى الخلايا السفلية الفارغة لورقة العمل، مما يمنع توليد مئات المخرجات الصفرية غير المرغوبة التي تزيد من حجم الملف وتستنزف موارد المعالجة السحابية، ويضمن بقاء المصنف مستقراً وسريع الاستجابة بصرف النظر عن حجم البيانات المدارة.
8. بروتوكول تشخيص وحل الأخطاء البرمجية والحسابية الشائعة
8.1 معالجة أخطاء الإسناد والمرجعية (#REF!)
يُعد خطأ الإسناد المرجعي #REF! (Reference Error) من أكثر الأخطاء إرباكاً وشيوعاً عند التعامل مع صيغ المتوسطات العابرة لأوراق العمل. ينشأ هذا العطل الحسابي الحرج عندما تفقد الصيغة القدرة على التوصل إلى العنوان الفيزيائي لورقة العمل أو الخلية المستهدفة؛ ويحدث هذا غالباً نتيجة قيام أحد المستخدمين بحذف إحدى أوراق العمل المصدرية التي تعتمد عليها الدالة اعتماداً مباشراً، أو إجراء تعديل يدوي على اسم الورقة دون تحديث المرجع المتصل بها داخل المعادلة التجميعية المركزية.
لتشخيص هذا الخطأ بدقة منهجية، تتيح جداول بيانات جوجل استخدام أدوات فحص وتتبع التدفق الحسابي عبر وضع المؤشر فوق الخلية المصابة لقراءة التلميح البرمجي المنبثق، والذي يوضح عادة نصاً توضيحياً صريحاً (مثل “Unresolved sheet name” أو عدم العثور على الورقة المحددة). يمكن للمحلل حينها تتبع الخلايا السابقة ومسارات التغذية لتحديد الورقة المفقودة وإعادة بنائها، أو تصحيح مسار السلسلة النصية المعرفة لها في الصيغة لربط الشريان المرجعي مجدداً واستعادة تدفق البيانات المفقودة.
كإجراء وقائي هيكلي لمنع توقف المصنف بالكامل وظهور واجهات مشوهة عند حدوث هذه الأخطاء، يُنصح بتغليف الصيغ الحساسة المعرضة لتغير الأوراق بدالة المعالجة الوقائية IFERROR:
=IFERROR(AVERAGE(week1!B2, week2!B2, week3!B2), "تأكد من صحة مسار الأوراق").
كما يجب الاستفادة من ميزات حماية المصنفات (Protected Sheets and Ranges) المتاحة سحابياً، لمنع المحررين غير المصرح لهم من حذف أو إعادة تسمية أوراق الفترات الزمنية المصدرية، مع فرض أذونات صارمة تعزل طبقة المراجع الهندسية عن متناول الإدخال الميداني العشوائي.
8.2 تلافي خطأ القسمة على الصفر (#DIV/0!)
يمثل خطأ القسمة على الصفر #DIV/0! انعكاساً لمأزق رياضي بحت تواجهه دالة المتوسط الحسابي عندما تكتشف أن المقام الإحصائي الناتج عن وسائطها يساوي صفراً مطلقاً. يحدث هذا الموقف بصورة متكررة في جداول البيانات عندما تشير وسائط دالة AVERAGE عبر الأوراق المتعددة إلى خلايا فارغة تماماً، أو خلايا تحتوي على نصوص مجردة أسقطتها الدالة من حساباتها، مما يجعل إجمالي عدد القيم الرقمية الصالحة للقسمة مساوياً للصفر، وهو ما يستحيل حله في المنطق الرياضي التقليدي.
تزداد احتمالية ظهور هذا الخطأ في الفترات التشغيلية التي لا تتضمن أي نشاط مسجل للوحدات المبحوثة، كأن يكون أحد الرياضيين قد تغيب عن كافة الأسابيع الثلاثة مع بقاء خلاياه شاغرة. للتفريق المنهجي بين الغياب التام للمدخلات والناتج الإحصائي الحقيقي المسجل كصفر، يتعين بناء صيغ وقائية مشروطة تفحص وجود قيم عددية مسبقاً قبل الإقدام على تفعيل خوارزمية المتوسط الحسابي عبر توظيف دالة COUNT الإحصائية:
=IF(COUNT(week1!B2, week2!B2, week3!B2)>0, AVERAGE(week1!B2, week2!B2, week3!B2), "لا توجد بيانات").
تضمن هذه الهندسة الحسابية عدم تمرير مسار الحساب إلى دالة AVERAGE إلا إذا كانت هناك قيمة رقمية واحدة صالحة على الأقل ضمن الأوراق المصدرية، مما يحمي المصنف من امتلاء أعمدة التحليل برسائل الخطأ الجافة ويقدم للمتلقي رسالة تفسيرية تتماشى مع المعايير الاحترافية لتقارير الأعمال والبحوث الأكاديمية.
8.3 اكتشاف وتصحيح عدم تطابق أنواع البيانات (#VALUE!)
ينبثق خطأ نوع القيمة #VALUE! عند محاولة محرك الحساب السحابي إجراء عملية رياضية تفترض مدخلات رقمية متجانسة على خلايا تحتوي على أنواع بيانات غير متوافقة جوهرياً؛ مثل محاولة جمع قيم رقمية مع نصوص حرفية، أو وجود رموز غير مرئية ومسافات بيضاء مخفية محشورة داخل خلايا الأرقام تم استيرادها عن طريق الخطأ من أنظمة خارجية أو استبيانات إلكترونية رديئة التنسيق والتهيئة.
يبرز سبب خفي إضافي لهذا الخطأ يرتبط بإعدادات اللغة والمنطقة الجغرافية (Locale Settings) المعتمدة داخل مصنف جداول جوجل؛ حيث تستخدم بعض البلدان النقطة (.) كفاصل عشري رسمي، بينما تعتمد بلدان أخرى الفاصلة العادية (,) لنفس الغرض الحسابي. إذا احتوت إحدى أوراق العمل المصدرية على أرقام تستخدم فاصلاً عشرياً مخالفاً لإعدادات المصنف العام، فسيعامل البرنامج تلك الأرقام كنصوص ميتة تفشل العمليات المباشرة في معالجتها وتولد أخطاء عدم تطابق البيانات.
لتصحيح هذه التشوهات وتطهير البيانات الملوثة مسبقاً، تبرز الحاجة إلى استخدام أدوات التنظيف النصي والتحويل القسري للأنواع؛ مثل استخدام دالة TRIM لحذف كافة المسافات الزائدة، ودالة CLEAN للتخلص من الرموز غير القابلة للطباعة، وتمرير القيم النصية الممثلة للأرقام عبر دالة VALUE لتحويلها قسرياً إلى قيم عددية نقية، لضمان استقرار وسائط دالة AVERAGE عبر كافة الأوراق وتفادي التوقف المفاجئ لدوال التجميع النهائي.
9. المعايير المنهجية لتصميم وهيكلة المصنفات متعددة الأوراق
9.1 قواعد التسمية المعيارية وهندسة بنية المصنف
تمثل المعمارية الهندسية للمصنف حجر الزاوية الذي يحدد مدى استدامته وقابليته للتطوير دون أخطاء. تتطلب الممارسات المنهجية المتقدمة اعتماد نظام ترميز موحد وقابل للتنبؤ لتسمية أوراق العمل المتتابعة زمنياً؛ فبدلاً من استخدام تسميات عفوية متغيرة، يُنصح بتطبيق قوالب التسمية الزمنية القياسية المستندة إلى معايير دولية، مثل استخدام صيغة YYYY_MM_W## (على سبيل المثال: 2024_03_W01 و 2024_03_W02). يتيح هذا التوحيد الصارم التنبؤ الآلي بأسماء الأوراق داخل الدوال الديناميكية ويسهل كتابة حلقات الاستدعاء المؤتمتة.
من القواعد الهندسية الجوهرية أيضاً تجنب استخدام المسافات البيضاء والرموز الخاصة وعلامات الترقيم المركبة في تسميات أوراق العمل نهائياً؛ فبالرغم من قدرة البرنامج على معالجتها عبر علامات التنصيص المفردة، إلا أن وجودها يضاعف من احتمالات الأخطاء البرمجية أثناء كتابة الصيغ المعقدة عبر لوحات المفاتيح المختلفة. إن استخدام الشرطة السفلية (_) كفاصل وحيد يمنح التسميات استقراراً برمجياً مطلقاً يسهل معه استدعاء الأوراق مباشرة من خلال الدوال الرياضية المتقدمة دون تعقيدات شكلية إضافية.
ينبغي أن يخضع المصنف الاحترافي لمبدأ “الفصل بين الطبقات” المستوحى من هندسة البرمجيات؛ بحيث تُفصل طبقة البيانات الخام الموزعة زمنياً (Data Layer) فصلاً هيكلياً تاماً عن طبقة المعالجة والعرض التحليلي (Presentation Layer). ويتوج ذلك بإنشاء وثيقة مستقلة لقاموس البيانات (Data Dictionary) كأول ورقة عمل داخل المصنف، تتولى شرح وتفسير كافة المتغيرات المستهدفة بالمتوسط، ووحدات القياس المعتمدة، وشروط الصلاحية، لضمان قابلية مشاركة المصنف وتدقيقه المؤسسي دون غموض.
9.2 تحسين الأداء الحاسوبي وسرعة المعالجة للمصنفات الكبرى
عندما تتسع رقعة المصنفات لتشمل عشرات أوراق العمل التي تحتوي كل منها على آلاف السجلات الرقمية المترابطة، تصبح كفاءة الأداء وسرعة الاستجابة المعيار الحاكم لجدوى الحل البرمجي. تتطلب هندسة المصنفات الكبرى ترشيداً منهجياً في استخدام الدوال المتطايرة (Volatile Functions)؛ فالإفراط في استخدام دالة INDIRECT لحساب المتوسطات عبر مئات الخلايا في آن واحد يجبر خوادم جوجل على إعادة فحص وحساب المصنف بالكامل مع كل تعديل طفيف، مما يسبب بطئاً شديداً في التحديث وتأخراً ملحوظاً في مزامنة البيانات السحابية.
يتجلى التدبير الأمثل في تحديد نطاقات الحساب بدقة متناهية وإلغاء الاستدعاءات المفتوحة اللانهائية؛ فاستخدام صيغة تستهدف عموداً مفتوحاً بأكمله مثل A:A بدلاً من تحديد النطاق الفعلي للمشاهدات مثل A2:A1000 يدفع محرك الحساب إلى معالجة مئات الآلاف من الخلايا الفارغة في قاع ورقة العمل لكل ورقة على حدة، وهو ما يمثل هدراً ضخماً لموارد المعالجة المخصصة لجلسة المستخدم السحابية دون أي مبرر تحليلي سليم.
كذلك، يجب اتباع استراتيجية تجميد الحسابات التاريخية المنتهية؛ فالأوراق التي تمثل فترات زمنية سابقة أغلقت حساباتها نهائياً ولم تعد عرضة للتعديل يمكن تحويل معادلاتها الفرعية إلى قيم ثابتة مستقرة (Paste as Values) مع الاحتفاظ بالصيغة التجميعية المركزية فقط، مما يخفف الحمل الحسابي التراكمي على المصنف ويحرر ذاكرة التخزين المؤقت، مما يضمن أداءً سلساً وتفاعلياً للوحة البيانات الرئيسية مهما بلغ الحجم الإجمالي للسجلات المجمعة.
10. تطبيقات ودراسات حالة قطاعية لحساب المتوسطات المجمعة
10.1 التطبيق المالي: توحيد متوسط التكاليف التشغيلية للمراكز الربحية
في الإدارات المالية للشركات متعددة الفروع، تبرز معضلة الرقابة على النفقات التشغيلية وتقييم كفاءة التكلفة الشهرية للمراكز الربحية الموزعة جغرافياً. يُخصص في هذا النموذج ورقة عمل مستقلة لكل فرع جغرافي تسجل نفقاته التفصيلية بصورة دورية، بينما تتكفل ورقة العمل المركزية بحساب متوسط الإنفاق الموحد لكل بند من بنود التكلفة (مثل الإيجارات، الأجور، الطاقة، والتسويق) بهدف مقارنة كفاءة الفروع واكتشاف الهدر المالي مبكراً.
يتطلب التحليل المالي الاحترافي تجاوز المتوسط الحسابي البسيط في كثير من الأحيان لصالح حساب “المتوسط المرجح” (Weighted Average)؛ فاستخراج متوسط تكلفة الوحدة المباعة عبر الفروع لا يمكن حسابه بجمع متوسطات الفروع وقسمتها على عددها البسيط، إذ يتجاهل ذلك التباين الضخم في حجم الإنتاج أو المبيعات بين فرع رئيسي ضخم وفرع ريفي محدود. يُنفذ ذلك عبر صيغ مصفوفية عابرة للأوراق تقوم بضرب متوسط تكلفة كل فرع في حجم إنتاجه، ثم قسمة الناتج الإجمالي على مجموع وحدات الإنتاج الكلية المستخلصة من كافة أوراق العمل المصدرية.
تسهم هذه النماذج التجميعية الموزعة في تسريع عمليات التدقيق وإصدار تقارير المطابقة المالية الشهرية والسنوية المعتمدة، مع القدرة على رصد وتعديل الانحرافات والتقلبات الموسمية الناتجة عن اختلاف وتيرة النشاط التجاري، مما يوفر للإدارة المالية التنفيذية رؤية موحدة وموثوقة لضبط الموازنات التقديرية المستقبلية وتعظيم كفاءة تخصيص الموارد الرأسمالية المتاحة للمؤسسة.
10.2 التطبيق الأكاديمي والتربوي: قياس المتوسط التراكمي لدرجات الطلاب
يمثل قطاع التعليم العالي والإدارة المدرسية بيئة مثالية لتطبيق حساب المتوسطات العابرة للأوراق؛ حيث تحتفظ الهيئات التدريسية عادة بدفاتر درجات منفصلة لكل مقرر دراسي أو فصل فصلي داخل مصنف موحد. يبرز التحدي التربوي عند الرغبة في استخراج المعدل التراكمي الموزون (GPA) للطلاب الموزعة نتائجهم على أوراق المقررات المتعددة، مع الأخذ في الاعتبار تباين الساعات المعتمدة والوزن النسبي لكل مادة دراسية وفق اللوائح الأكاديمية الصارمة.
تتم معالجة هذه المتطلبات عبر بناء ورقة مركزية لملفات الطلاب تستدعي الدرجات المحرزة من أوراق المقررات المختلفة باستخدام الصيغ المشروطة، مع احتساب أوزان الساعات الدراسية. وفي سياق المواد الاختيارية التي قد يسجل فيها بعض الطلاب دون غيرهم، تقوم دوال التجميع الذكية بتجاوز المقررات غير المسجلة (الخلايا الفارغة) لكل طالب تلقائياً دون احتسابها كرسوب بالصفر، مما يضمن حساب المعدل التراكمي الحقيقي وفق الساعات الفعلية التي خاضها كل طالب فقط.
بالإضافة إلى ذلك، يُستخدم حساب “المتوسط المتحرك” التراكمي عبر فصول المتابعة الزمنية كأداة تشخيصية لقياس وتتبع تطور مستوى التحصيل الأكاديمي لدى الطلاب عبر مسيرتهم الدراسية، مما يمكن المرشدين الأكاديميين من اكتشاف التراجع المفاجئ في الأداء فور إدخال نتائج الفترات الجديدة، وأتمتة تصدير هذه التقارير التحليلية المجمعة مباشرة إلى أنظمة إدارة التعلم المركزية (LMS) بأعلى درجات الدقة المؤسسية.
10.3 تطبيقات البحث العلمي والمسوح الميدانية المتعددة
في الأبحاث التجريبية والمسوح الاجتماعية والميدانية، يمثل تصميم القياسات المتكررة (Repeated Measures Design) منهجاً أساسياً لدراسة تطور استجابات العينات المبحوثة عبر موجات المسح الميداني المتعاقبة زمنياً. تُسجل نتائج كل موجة مسحية أو اختبار معملي داخل ورقة عمل مستقلة لتفادي التداخل، وتُوجه الجهود بعد ذلك لحساب متوسط استجابة كل مفحوص عبر الزمن لتقييم التأثير الفعلي للمتغيرات التجريبية المستقلة.
تكمن الأهمية الإحصائية لهذه البنية في تمكين الباحث من حساب مقاييس النزعة المركزية المشتركة ومقارنة تشتت المتوسطات بين مجموعات المراقبة (Control Groups) والمجموعات التجريبية بدقة متناهية. ومن خلال الربط المصفوفي بين أوراق القياس المختلفة، يتمكن الباحث من إجراء اختبارات ثبات القياس وموثوقيته عبر الزمن (Test-Retest Reliability)، والتأكد من أن التغيرات المرصودة في المتوسط العام ناتجة عن التدخلات المنهجية وليست أخطاء عشوائية في رصد وتجميع البيانات.
تُتوج هذه الإجراءات التحليلية بإنشاء جداول تلخيصية متكاملة داخل الورقة النهائية للمصنف، تدمج متوسطات الاستجابات والانحرافات المعيارية المجمعة من كافة مراحل التجربة. تكون هذه الجداول مهيأة بصورة معيارية للتصدير المباشر والتضمين داخل الأوراق البحثية والتقارير العلمية الجاهزة للتحكيم والنشر، محققة التكامل النموذجي بين التنظيم الميداني والمعالجة الرياضية المتقدمة في بيئة جداول بيانات جوجل.
خاتمة
إن إتقان حساب المتوسط الحسابي عبر أوراق عمل متعددة في جداول بيانات جوجل يتجاوز كونه مجرد معرفة بكتابة صيغة رياضية بسيطة، ليمثل كفاءة متقدمة في الهندسة الهيكلية للمصنفات السحابية وإدارة البيانات ثلاثية الأبعاد. لقد أظهرت المقاربات التحليلية المفصلة في هذا المقال أن اختيار الأسلوب الحسابي يعتمد عضوياً على حجم وطبيعة البيانات المعالجة؛ حيث تظل الصيغ القياسية المباشرة حلاً مثالياً للمصنفات المحدودة ذات الهياكل الثابتة، في حين تبرز المصفوفات المركبة وحزم الاستعلام عبر QUERY و ARRAYFORMULA كحلول استراتيجية لا غنى عنها للمصنفات الضخمة وديناميكية التوسع.
يتطلب الاستثمار الناجح لهذه الأدوات البرمجية الالتزام بأرقى معايير الانضباط المنهجي؛ بداية من التوحيد الصارم لهياكل وتسميات أوراق العمل المصدرية، والفصل الحاسم بين البيانات الخام وطبقات المعالجة والعرض، وصولاً إلى التصدي الاستباقي لأخطاء الإسناد والقيم المفقودة وعدم تطابق الأنواع. من خلال تبني هذه المعايير الهندسية والبرمجية الرصينة، يستطيع المحللون والباحثون تحويل مصنفاتهم إلى منصات استدلال متطورة ومرنة تتمتع بأعلى درجات الموثوقية والدقة والسرعة الحاسوبية لدعم اتخاذ القرارات الرشيدة المستندة إلى البيانات.
المراجع
فيما يلي قائمة بالمصادر التوثيقية المعتمدة في توثيق آليات عمل جداول بيانات جوجل والتحليل الإحصائي للبيانات وفق نظام APA (الإصدار السابع):
- Google. (n.d.). AVERAGE function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093615
- Google. (n.d.). QUERY function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093343
- Google. (n.d.). INDIRECT function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093377
- Google. (n.d.). ARRAYFORMULA function – Google Docs Editors Help. Google Support. https://support.google.com/docs/answer/3093275
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Carlberg, C. (2014). Statistical Analysis: Microsoft Excel 2013. Que Publishing.