
تعد معالجة السجلات وتنقيتها حجر الزاوية في علم تحليل البيانات المعاصر؛ إذ تتوقف موثوقية النماذج التنبؤية ودقة الاستدلالات الإحصائية على سلامة المدخلات الأولية وخلوها من شوائب التكرار غير المنضبط. وفي بيئات الحوسبة السحابية مثل جداول بيانات جوجل (Google Sheets)، تكتسب مسألة التعرف على السجلات المفردة وإدارتها أهمية استثنائية نظرًا للطبيعة التعاونية والمرنة التي تتسم بها هذه البرمجيات، والتي تتيح تدفقًا مستمرًا للبيانات من مصادر متعددة وقنوات إدخال متباينة.
إن الحاجة إلى تحديد أول ظهور لقيمة معينة في عمود لا تنبع من مجرد الرغبة في تنظيم البيانات، بل ترتبط جوهريًا بالتحكم في المتغيرات وحساب الترددات الحقيقية ومنع التشويه الحسابي في المؤشرات الوصفية والاستدلالية. فعندما تتكرر المعرفات الرقمية أو الأسماء أو الرموز التعريفية ضمن مصفوفات البيانات الطولية أو قواعد السجلات الإدارية، يصبح التمييز بين القياس الأولي والقياسات اللاحقة شرطًا منهجيًا لا غنى عنه لصيانة صدق التحليل الداخلي والخارجي.
يقدم هذا المقال دراسة تقنية واستدلالية متعمقة لكافة الأساليب الرياضية والمنطقية المتاحة لتحديد أول ظهور للقيم داخل جداول بيانات جوجل. وسنتناول بالتشريح العلمي المنهجي النطاقات المتوسعة باستخدام الدوال الشرطية، ومصفوفات الفهرسة المتجهة، وتكاملات البحث المتقدم، بالإضافة إلى صياغة خوارزميات المصفوفات المؤتمتة، وصولًا إلى التطبيقات العملية في البحوث الاجتماعية والنفسية وسيناريوهات إدارة الأعمال الرقمية.
1. مقدمة منهجية حول تحديد الظهور الأول للبيانات في جداول بيانات جوجل
1.1 الأهمية المعرفية لفرز السجلات الفريدة في التحليل الإحصائي
يمثل عزل القياسات الأولى للوحدات التجريبية أو المفحوصين ركيزة منهجية حاسمة في تصميم الدراسات التتبعية والمسوح الميدانية المتكررة. فعند تتبع عينة عبر الزمن، يؤدي تسجيل استجابات متعددة للمشارك ذاته دون ترميز رتبة الظهور إلى تضخيم غير مبرر في حجم العينة الفعلي (Sample Size Inflation)، مما يترتب عليه تقليص اصطناعي للخطأ المعياري وزيادة احتمالية ارتكاب خطأ من النوع الأول (Type I Error) عبر رفض فرضية العدم دون وجه حق.
ويبرز هنا الفارق الجوهري بين إجراء الحذف الكامل للتكرارات (Deduplication) وبين تقنية وسم أول ظهور لقيمة محددة (Flagging First Occurrence). إن التخلص النهائي من الصفوف المكررة يؤدي إلى فقدان تسلسل الأحداث وضياع البيانات التاريخية المرتبطة بالمتغيرات التابعة المتغيرة عبر الزمن، مثل تتبع تطور الأداء السلوكي أو تكرار عمليات الشراء. في المقابل، فإن وسم السجل الأول يحافظ على الهيكل البنيوي الكامل للبيانات مع توفير مرشح منطقي يتيح للمحلل التبديل بدقة بين التحليلات المستعرضة المبنية على الحالات الفريدة والتحليلات الطولية الشاملة لكافة التفاعلات.
تتجلى التطبيقات العملية لهذه التقنية في التجارب السلوكية التي تعتمد قياسات الاستجابة؛ حيث تختلف الاستجابة الأولى للمثير النفسي نوعيًا عن الاستجابات اللاحقة التي تتأثر بالتعود والتعلم التجريبي. ومن ثم، فإن تنقية البيانات وتصنيفها المسبق يوفر بيئة معيارية تسهم في رفع مستويات الصدق التنبؤي لأي نموذج إحصائي لاحق.
1.2 إشكالية التكرار في مجموعات البيانات الكبيرة
تتفاقم مشكلات التكرار مع تزايد حجم المصفوفات الحسابية لتصل إلى آلاف السجلات؛ حيث تفقد العين المجردة والوسائل اليدوية أي فاعلية في الرصد والمطابقة. إن وجود تكرارات غير مرصودة في المتغيرات المستقلة أو المؤشرات الرقمية يخل بالحسابات المركزية مثل المتوسط الحسابي، والوسيط، والانحراف المعياري، مما ينتج عنه انحياز في تقدير المعلمات وتزييف في نتائج الاختبارات البارامترية.
علاوة على ذلك، فإن التعامل مع بيئات جمع البيانات المفتوحة، مثل نماذج الويب وقواعد البيانات المتزامنة، يفرض احتماليات مرتفعة لتكرار الإدخال نتيجة أخطاء الشبكة أو إعادة الإرسال من قِبل المستخدمين. وإذا لم يتم ضبط هذه الظاهرة عبر آليات برمجية داخل بيئة الجداول الحسابية، فإن التحليلات القطاعية اللاحقة ستعاني من تفاوتات غير منضبطة.
تتجلى الخطورة الكبرى في التحيّز الناجم عن الخلط بين القياس القاعدي والقياسات اللاحقة؛ حيث تفقد المؤشرات الزمنية قيمتها ما لم يتم ربط كل مدخل برقم ترتيبي يعكس موقعه الزمني في سلسلة التكرار. وتزداد هذه المشكلة تعقيدًا عندما تكون السجلات المكررة غير متطابقة في كافة المتغيرات التابعة، مما يجعل وسم الظهور الأول هو السبيل الوحيد لإعادة بناء التسلسل المنطقي للبيانات دون تشويه.
1.3 نظرة عامة على الحلول المنطقية المتاحة في جداول البيانات
تتيح جداول بيانات جوجل طيفًا واسعًا من الأدوات الرياضية والمنطقية المخصصة لمعالجة التكرارات وتحديد أسبقية الظهور دون المساس بهيكل المصفوفة الأصلية. ويعود أصل هذه المنظومة الحسابية إلى برمجيات الجداول الإلكترونية الأولى مثل لوتس 1-2-3 وميكروسوفت إكسيل، وصولًا إلى إطلاق جوجل لجداول بياناتها في السادس من يونيو عام 2006 إثر استحواذها على تقنية تو ويب (2Web Technologies) التي أسسها جوناثان روشيل وفارزاد خسروشاهي.
تنقسم الحلول المتاحة إلى منهجين رئيسيين: الأول يعتمد على المعادلات الحسابية المضمنة في الخلايا المساعدة، مثل توظيف دالة العد المشروط ذات النطاق التوسعي، أو الجمع بين دوال البحث والفهرسة. أما المنهج الثاني فيعتمد على الدوال المصفوفية الحديثة والصيغ البرمجية المتقدمة التي تقيّم النطاق بالكامل وتخرج النتائج دفعة واحدة.
يتطلب الاختيار بين هذه الحلول موازنة دقيقة بين بساطة الصيانة وحجم البيانات المستهدفة واستهلاك موارد الذاكرة الحسابية. فالصيغ البسيطة التي يسهل على المبتدئين فهمها قد تشكل عبئًا حسابيًا بطيئًا في الجداول العملاقة، بينما تتطلب الصيغ المصفوفية المتقدمة استيعابًا عميقًا لنظريات البرمجة التتابعية والجبر المتجهي.
2. الأساس النظري والرياضي لتوظيف دالة COUNTIF لتحديد الأسبقية
2.1 آلية عمل دالة COUNTIF ومحدداتها الهيكلية
تقوم دالة COUNTIF في جوهرها على منطق العد الاحتمالي المشروط ضمن فضاء محدد؛ حيث تستقبل وسيطين رئيسيين: نطاق الخلايا المراد فحصه (Range)، والمعيار المنطقي أو القيمة المحددة للبحث (Criterion). تقوم الخوارزمية الداخلية للدالة بمسح كل خلية ضمن النطاق المعطى ومقارنة محتواها بالمعيار، ثم تزيد عدادًا صحيحًا بمقدار واحد في كل مرة يتحقق فيها شرط التطابق.
تختلف هذه الدالة جذريًا عن أدوات العد الإجمالي (مثل COUNTA) التي تسجل كافة الخلايا غير الفارغة بصرف النظر عن محتواها؛ إذ تتضمن COUNTIF معالج تقييم منطقي داخلي يقارن القيم الرياضية والنصية. وتخزن الدالة مخرجاتها كقيمة عددية صحيحة تبدأ من الصفر في حال انعدام التطابق، وتتصاعد وفق وتيرة تراكمية تعكس كثافة ظهور القيمة داخل النطاق المستهدف.
وتكمن محدودية الدالة الهيكلية في أنها بطبيعتها صيغة ثابتة التقييم إن تم تطبيقها على نطاقات جامدة؛ مما يجعلها عاجزة عن رصد الترتيب الزمني للأحداث ما لم يتم دمجها مع مفهوم التوسع المرجعي الهندسي، وهو ما يمثل النقلة النوعية من العد الكلي للظواهر إلى تتبع ديناميكيات الظهور المتتالي.
2.2 المفهوم الرياضي للنطاقات المتوسعة (Expanding Ranges)
يعتمد المفهوم الرياضي للنطاق المتوسع على كسر التماثل في المراجع الجبرية للخلايا؛ وذلك من خلال الدمج الذكي بين المرجع المطلق (Absolute Reference) والمرجع النسبي (Relative Reference). يُرمز للمرجع المطلق في جداول البيانات برمز الدولار ($)، وهو ما يوجه المعالج الحسابي إلى تثبيت إحداثيات الخلية ومنع انزياحها عند نسخ المعادلة عبر الفضاء المتجهي للجدول.
عند كتابة نطاق بالصيغة ($A$2:$A2)، فإن نقطة البداية ($A$2) تظل مثبتة جبريًا عند الصف الثاني من العمود الأول، في حين تظل نقطة النهاية (A2) مرجعًا نسبيًا حر الحركة. وعند سحب هذه المعادلة إلى الصفوف اللاحقة، يتحول النطاق تلقائيًا ليصبح ($A$2:$A3) ثم ($A$2:$A4) وهكذا دواليك على امتداد المصفوفة.
تنتج عن هذه الآلية مصفوفة فحص تراكمية تتسع تدريجيًا بالتوازي مع النزول نحو أسفل العمود؛ حيث ترى كل خلية فقط البيانات التي سبقتها بالإضافة إلى محتواها الخاص، متجاهلة تمامًا ما يقع أسفلها في الجدول. وبهذا يتحول النطاق إلى مسح تاريخي يسجل اللحظة الزمنية الدقيقة التي تبرز فيها القيمة لأول مرة في التسلسل الرأسي.
2.3 دور الشرط المنطقي في عزل الظهور الأول
إن الناتج الحسابي لنطاق متوسع مطبق داخل دالة العد المشروط سيعطي سلسلة من الأرقام الصحيحة المتزايدة لكل قيمة: فالظهور الأول يعطي ناتج 1، والظهور الثاني لذات القيمة يعطي 2، والظهور الثالث يعطي 3. ومن هنا تنشأ الحاجة إلى تحويل هذه القيمة التراكمية إلى مؤشر ثنائي بات عبر تطبيق شرط التكافؤ الرياضي.
بإلحاق مساواة منطقية بصيغة العد عبر كتابة الشرط (=1)، يدخل المعالج الحسابي في عملية تقييم بوليانية (Boolean Evaluation). فإذا كانت القيمة التراكمية المسترجعة هي واحد تمامًا، فإن التعبير الرياضي ينتج القيمة المنطقية TRUE، والتي تعني بصورة حصرية أن هذه الخلية هي الموضع الأول والأسبق لبروز تلك البيانات في السجل.
أما في الحالات اللاحقة التي يتجاوز فيها العداد الداخلي الرقم واحد نتيجة تكرار القيمة مسبقًا في الخلايا الأعلى، فإن الشرط يسقط تلقائيًا ليعطي القيمة المنطقية FALSE. يضمن هذا الإسقاط الرياضي استبعاد كافة النظائر المكررة بصورة قاطعة، محولًا المتغير المستمر إلى مؤشر ثنائي حاسم يسهل استغلاله في التصفية والتصنيف الإحصائي اللاحق.
3. التطبيق الإجرائي للصيغة المنطقية القياسية (TRUE/FALSE)
3.1 البنية التركيبية للمعادلة الأساسية =COUNTIF($A$2:$A2,$A2)=1
تتألف المعادلة المعيارية لعزل الظهور الأول من ثلاثة مكونات ترابطية مصممة للعمل التكاملي. المكون الأول هو النطاق المتوسع ($A$2:$A2) حيث تم تثبيت مبتدأ المصفوفة بالرمز ($) لحبس نقطة الانطلاق دائمًا عند رأس حقل البيانات في الخلية A2، مع ترك الطرف الثاني حرًا ليتمدد مع كل صف إضافي يتم احتسابه.
المكون الثاني هو معيار البحث ذاته، والمتمثل في إسناد الخلية المقابلة مباشرة للصف المحسوب ($A2 أو A2). يضمن هذا الإسناد أن الدالة تفحص تكرار القيمة الحالية تحديدًا داخل الجزء الممسوح مسبقًا من العمود، ولا تفحص قيمة ثابتة أو خارجية، مما يمنح المعادلة مرونة ديناميكية في تقييم مختلف المدخلات النصية والرقمية المتنوعة داخل العمود دون تعديل يدوي للصيغة.
المكون الثالث والأخير هو الإسناد البولياني المحوري (=1)، وهو المحول المنطقي الذي ينقل وظيفة المعادلة من حساب إجمالي مرات الظهور إلى وظيفة الحراسة المنطقية (Gatekeeper). إنه يسأل المعالج الحسابي: “هل هذه هي المرة الأولى تاريخيًا التي نصادف فيها هذه القيمة منذ بداية النطاق؟”، فيكون الجواب حصريًا إما بالإيجاب المنطقي أو بالسلب.
3.2 خطوات التنفيذ العملي في بيئة جداول بيانات جوجل
لتنفيذ هذه الخوارزمية عمليًا داخل جداول بيانات جوجل، يبدأ الباحث بتحديد العمود المستهدف الذي يحتوي على المدخلات، وليكن العمود A بدءًا من الصف الثاني لتجنب صف الترويسة (Header Row). يتم إدراج عمود إضافي ملاصق ويُطلق عليه اسم دال إحصائيًا، مثل “مؤشر الظهور الأول” أو “Is_First_Occurrence”.
في الخلية B2 المقابلة لأول سجل بياني، تُدخل الصيغة القياسية:
=COUNTIF($A$2:$A2,$A2)=1
بمجرد الضغط على مفتاح الإدخال، ستعرض جداول بيانات جوجل اقتراحًا بالإكمال التلقائي (Auto-fill) لكافة خلايا العمود؛ وفي حال عدم ظهوره، يتم النقر المزدوج على المقبض الأزرق المربع في الركن السفلي الأيسر (أو الأيمن بحسب لغة الواجهة) للخلية B2 لسحب الصيغة على امتداد السجلات النشطة.
تتطلب إجراءات ضبط الجودة مراجعة دقيقة لثبات علامات الدولار؛ إذ يجب التأكد من أن الصفوف الأخيرة، كالخلية B500 مثلاً، تحتوي على الصيغة =COUNTIF($A$2:$A500,$A500)=1. إن انزياح علامة التثبيت من الطرف الأول يحول المعادلة إلى نطاق عائم ينزع عنها قدرتها على رصد التاريخ التراكمي للسجلات ويفسد النتائج كليًا.
3.3 التحليل الاستدلالي لمخرجات الصيغة
تحمل القيمة المنطقية الناتجة TRUE دلالة استدلالية قطعية؛ فهي لا تشير فقط إلى وجود البيانات، بل تشهد رياضيًا على أسبقيتها الزمنية والمكانية المطلقة في هيكل الجدول. إنها تمثل شهادة ميلاد السجل داخل قاعدة البيانات، وتعد المعيار الذي تعتمد عليه برمجيات التنقيب لاحقًا لبناء مجاميع الحالات المستقلة وحساب الترددات الحقيقية.
على الجانب الآخر، تعكس القيمة FALSE فائضًا معلوماتيًا من منظور التنوع الإحصائي للكيانات؛ فهي تشير إلى أن هذا السجل بالذات يمثل تكرارًا لقياس سابق تم رصده في صفوف أعلى. ورغم أن هذه السجلات المكررة قد تحمل قيمًا جديدة في متغيرات أخرى (كالنقاط أو تواريخ المتابعة)، إلا أنها في إطار المتغير المستهدف تفقد استقلاليتها الحسابية.
ينبغي للمحلل الحذر من حالات الشذوذ المخرجة الناجمة عن أخطاء الترميز الخفية؛ ففي بعض الأحيان قد تُمنح قيمتان متطابقتان ظاهريًا النتيجة TRUE مرتين نتيجة تباين غير مرئي، كوجود مسافة فارغة زائدة في نهاية النص بإحدى الخلايا، مما يجعل الدالة تعتبرهما كيانين منفصلين تمامًا، وهو ما يفرض إخضاع البيانات لمرحلة تنقية قبلية لضمان دقة الاستدلال.
4. التحويل الرقمي الثنائي للنتائج المنطقية (النمط 1 و 0)
4.1 مبررات الانتقال من المخرجات البوليانية إلى التمثيل الرقمي
على الرغم من الوضوح الإدراكي للقيم البوليانية (TRUE و FALSE)، إلا أن النمذجة الإحصائية المتقدمة والعمليات الحسابية التجميعية تتطلب في كثير من الأحيان تمثيل البيانات بنظام العد الثنائي (Binary Representation: 1 و 0). فالقيم المنطقية لا تقبل مباشرة بعض العمليات الجبرية في لغات البرمجة وحزم التحليل دون تحويل مسبق.
يسهل التمثيل الرقمي حساب المجموع التراكمي الفوري؛ إذ يكفي تطبيق دالة الجمع البسيطة SUM على عمود الأرقام الثنائية لمعرفة إجمالي عدد الكيانات أو الأفراد الفريدين في العينة، دون الحاجة لاستخدام دوال شرطية إضافية مثل COUNTIF(Range, TRUE).
علاوة على ذلك، تعد المتغيرات الثنائية (Dummy Variables) المعيار المعتمد لتصدير البيانات إلى برمجيات التحليل الإحصائي المتقدمة مثل SPSS والبيئة الإحصائية R؛ حيث يسهل دمجها كمتغيرات وسيطة أو مؤشرات ترجيح ضمن نماذج الانحدار الخطي واللوجستي، فضلًا عن إضفاء طابع بصري مقروء ومهني على لوحات القياس والتقارير التنفيذية.
4.2 صياغة المعادلة الرياضية =(COUNTIF($A$2:$A2,$A2)=1)+0
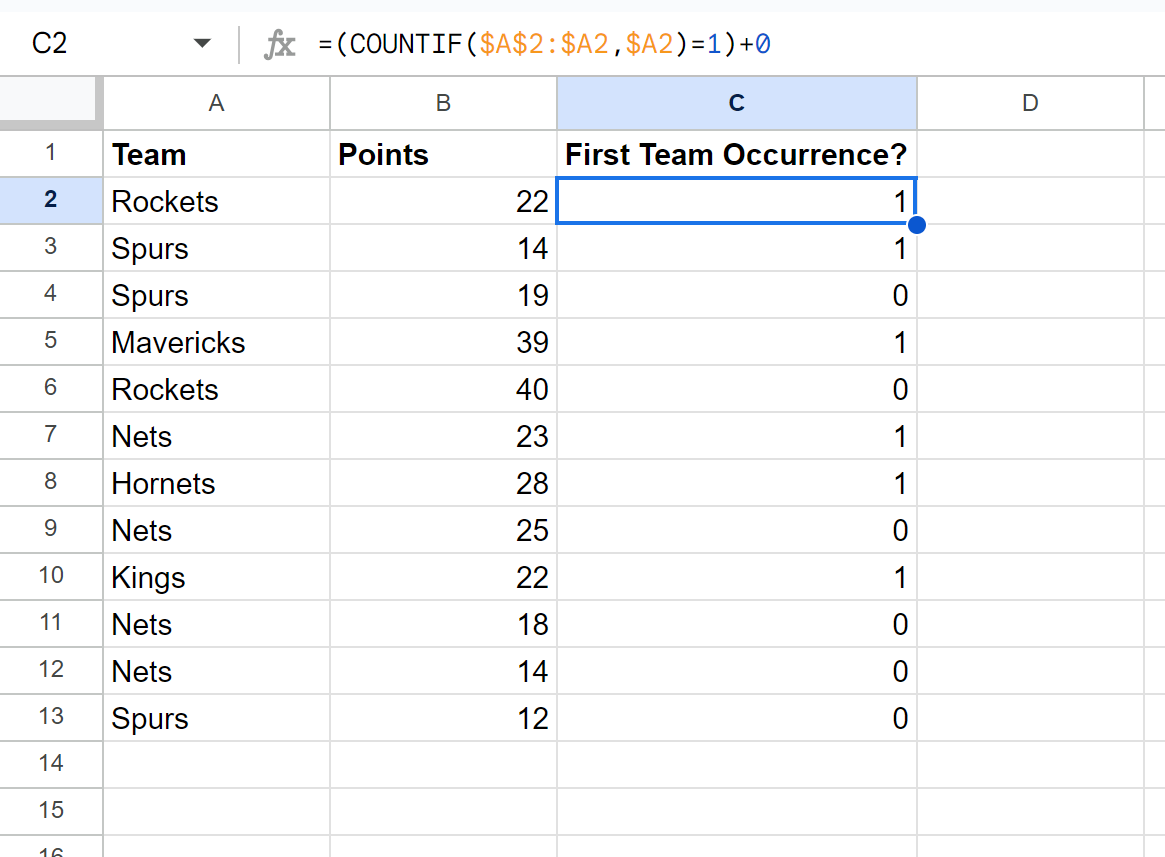
يستند التحويل من الحالة المنطقية إلى الحالة الرقمية في جداول البيانات إلى مبدأ رياضي يُعرف بـ “الإكراه القسري لنوع البيانات” (Type Coercion). وبمقتضى هذا المبدأ، إذا أُجريت عملية حسابية أولية على قيمة منطقية، فإن معالج الجداول يضطر داخليًا إلى تحويل القيمة TRUE إلى الرقم 1، والقيمة FALSE إلى الرقم 0 لإتمام العملية الرياضية.
يتم تطبيق هذا المبدأ بأبسط صوره عبر إضافة الرقم صفر إلى ناتج التعبير المنطقي كالتالي:
=(COUNTIF($A$2:$A2,$A2)=1)+0
حيث تعمل الأقواس الخارجية على حسم التقييم المنطقي أولاً، ثم يجبر الجمع مع الصفر المتغير على اتخاذ صورته العددية دون تغيير وزنه الرياضي.
توجد آلية بديلة شائعة في أوساط المطورين تؤدي الغرض ذاته بكفاءة متطابقة، وتعرف بعامل السلب المزدوج (Double Unary Operator):
=--(COUNTIF($A$2:$A2,$A2)=1)
يقوم السالب الأول بتحويل TRUE إلى -1 و FALSE إلى 0، ثم يعكس السالب الثاني الإشارة ليجعل القيمة موجبة (+1)، وهو أسلوب رياضي قياسي يفضله بعض المحللين لسرعة معالجته على مستوى البتات (Bits) الحسابية في الذاكرة.
4.3 استخدام دالة IF كبديل تحويلي وتوصيفي
تمثل دالة الشرط المباشر IF الوسيلة الأكثر مرونة وتعبيرًا لتحويل النتائج المنطقية؛ إذ تسمح للمستخدم بالتحكم الكامل في طبيعة المخرجات سواء كانت رقمية أو نصية تفسيرية، وتأخذ الصيغة الهيكلية التالية:
=IF(COUNTIF($A$2:$A2,$A2)=1, 1, 0)
تتجلى قوة هذا النهج في إمكانية تخصيص توصيفات نصية نوعية تخدم العرض المباشر في التقارير الإدارية، مثل استبدال الأرقام بعبارات صريحة:
=IF(COUNTIF($A$2:$A2,$A2)=1, "أول ظهور", "مكرر")
تسهم هذه التسميات اللفظية في تمكين متخذي القرار غير التقنيين من استيعاب دلالات الجدول بمجرد القراءة الأولية دون حاجة لفك رموز المنطق الثنائي.
ومع ذلك، من الناحية الأدائية والحسابية البحتة، تتطلب دالة IF استهلاكًا أعلى نسبيًا لدورات المعالجة مقارنة بأساليب الإكراه الرياضي المباشر (+0 أو –)؛ نظرًا لأنها تتضمن مسارًا شرطيًا تفريعيًا (Branching Logic) داخل بنية تنفيذ البرمجية، وهو فارق قد يصبح ملموسًا عند التعامل مع جداول تحتوي على مئات الآلاف من الصفوف.
5. دراسة حالة تطبيقية: تحليل نقاط لاعبي الفرق الرياضية
5.1 تصميم مصفوفة البيانات التجريبية
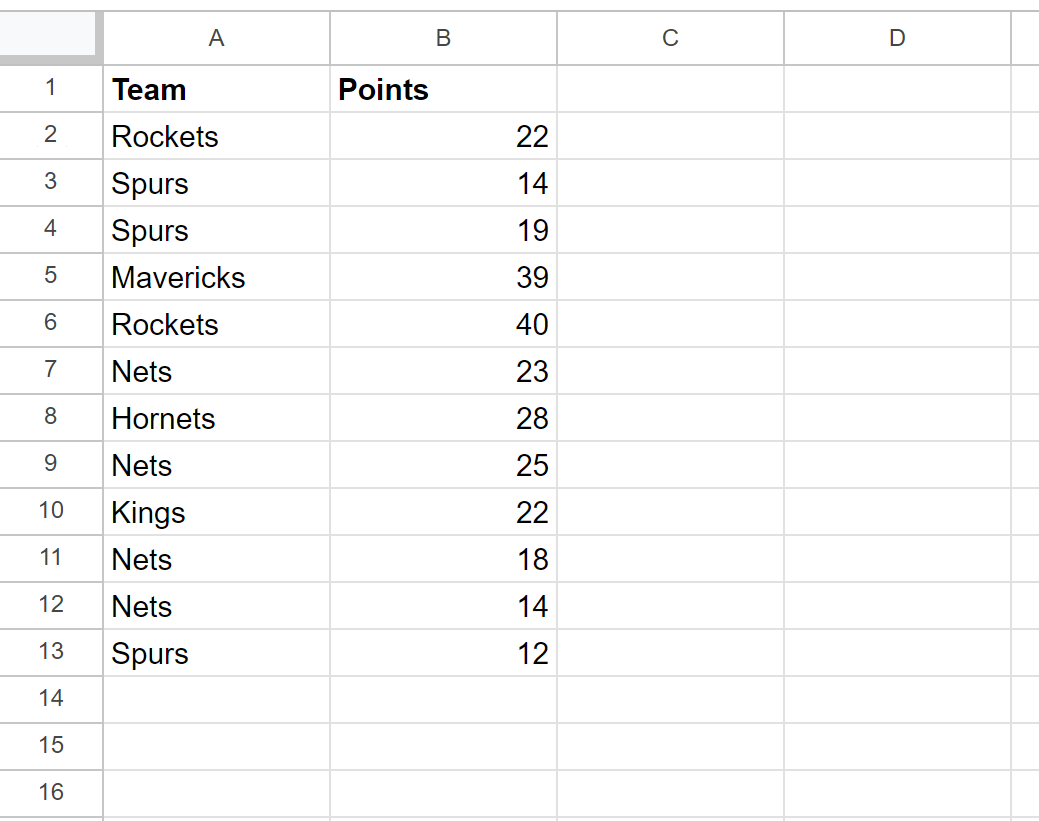
لتجسيد الأثر المنهجي للحلول المطروحة، نصمم مصفوفة بيانات افتراضية تمثل دوريًا رياضيًا للجامعات يتم فيه تسجيل إنجازات اللاعبين والفرق بصورة متتابعة زمنيًا. يتألف الجدول من ثلاثة أعمدة رئيسية: العمود A يضم “اسم الفريق”، والعمود B يضم “النقاط المسجلة”، بينما يُخصص العمود C لوسم “أول ظهور للفريق”.
تم توزيع أسماء الفرق عبر 10 صفوف متتالية بطريقة عشوائية تضمن وجود تكرارات غير متتالية لقياس كفاءة النطاق التوسعي:
الصف 2: فريق اليرموك (15 نقطة)
الصف 3: فريق القادسية (20 نقطة)
الصف 4: فريق اليرموك (18 نقطة)
الصف 5: فريق حطين (25 نقطة)
الصف 6: فريق القادسية (12 نقطة)
الصف 7: فريق اليرموك (22 نقطة)
الصف 8: فريق الفتح (30 نقطة)
الصف 9: فريق حطين (15 نقطة)
الصف 10: فريق الفتح (10 نقاط)
يهدف التصميم إلى إبراز قدرة الدالة على التعامل مع البيانات المتناثرة؛ حيث يظهر فريق اليرموك ثلاث مرات متباعدة، والهدف الإحصائي هو حصر الظهور الأول فقط لكل فريق لحساب عدد الفرق المشاركة فعليًا واستخلاص القياس المرجعي الأول للنقاط.
5.2 التنفيذ التدريجي للمعادلة ومراقبة النتائج
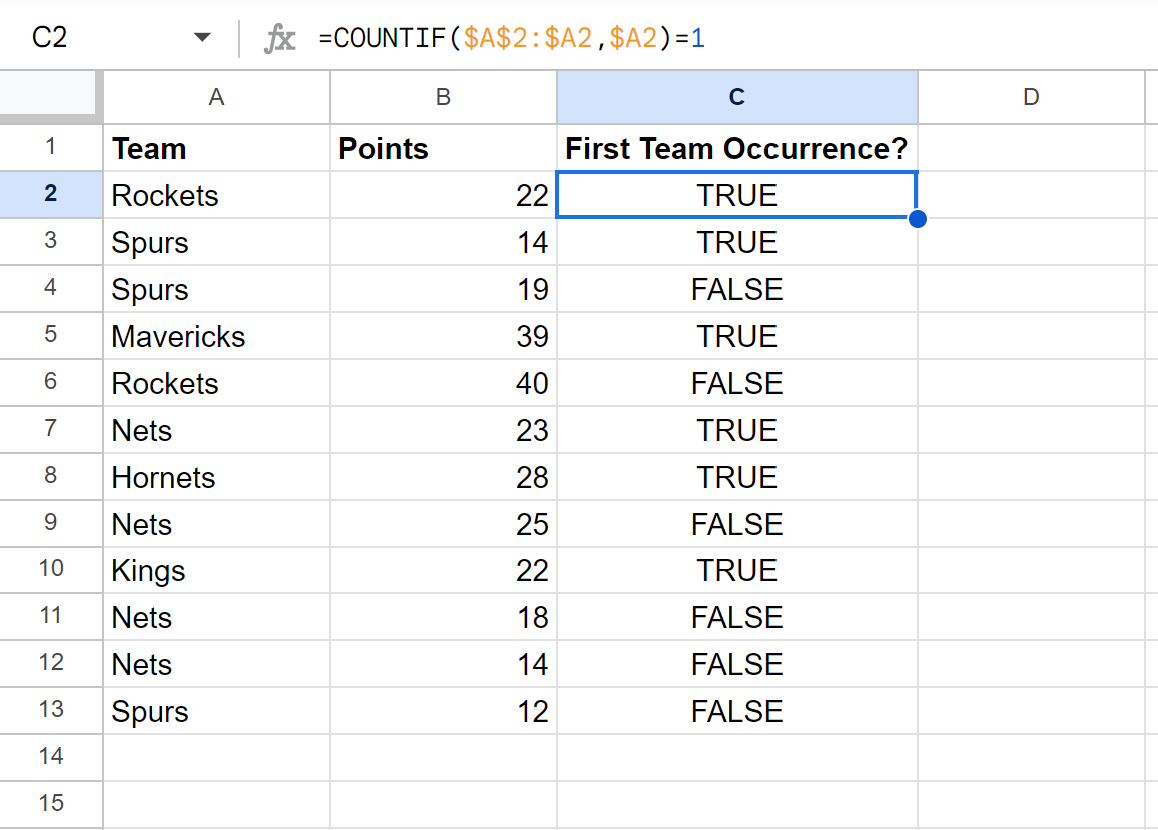
يبدأ التطبيق العملي بكتابة المعادلة المنطقية القياسية في الخلية C2 المقابلة للسجل الأول:
=COUNTIF($A$2:$A2,$A2)=1
تُرجع الخلية C2 القيمة TRUE؛ لكون نطاق الفحص لا يحتوي سوى على “فريق اليرموك” لمرة وحيدة. عند نسخ الصيغة وتمريرها إلى الخلية C3، يصبح النطاق الممسوح ($A$2:$A3) وقيمة الفحص هي A3 (“فريق القادسية”)، فتعطي الخلية TRUE أيضًا لأنه الظهور الأول للقادسية.
التحول الجوهري يظهر عند الصف الرابع (C4)؛ حيث تفحص الدالة القيمة A4 (“فريق اليرموك”) ضمن النطاق المتوسع ($A$2:$A4). ترصد الخوارزمية أن “اليرموك” ظهر مسبقًا في الخلية A2؛ مما يجعل ناتج العد يساوي 2. وبما أن الشرط هو التكافؤ مع 1، يسقط الشرط وتتحول النتيجة إلى FALSE بصورة قاطعة.
يستمر السلوك ذاته عبر بقية المصفوفة: تسجل الفرق الجديدة في ظهورها الأول (مثل حطين في الصف 5، والفتح في الصف 8) القيمة TRUE، بينما تُوسم التكرارات اللاحقة في الصفوف 6 و7 و9 و10 بالقيمة FALSE. يوثق هذا التسلسل بدقة نقطة التحول المنطقية لكل كيان على حدة.
5.3 المناقشة التحليلية للمخرجات المستخلصة
يقدم التدقيق في النتائج المستخلصة برهانًا عمليًا على قدرة هذه الصيغة على تفكيك التداخل التكراري للبيانات. بمجرد تحويل عمود المؤشر إلى صيغة عددية عبر إضافة الصفر =(COUNTIF($A$2:$A2,$A2)=1)+0، يمكننا في أسفل الجدول كتابة صيغة جمع بسيطة:
=SUM(C2:C10)
ستكون النتيجة الإجمالية هي (4)، وهو ما يطابق بالضبط عدد الفرق المستقلة المشاركة في البطولة (اليرموك، القادسية، حطين، الفتح)، متجاوزة الضوضاء التكرارية الناتجة عن تكرار السجلات العشرة.
تكمن الفائدة الإحصائية في التمكن من عزل أداء الفرق عند خط الانطلاق التنافسي الأول؛ فإذا رغبنا في حساب متوسط النقاط الابتدائية للفرق دون تأثر بنقاط الجولات اللاحقة، يمكننا دمج هذا المؤشر في دوال التجميع الشرطي، مما يمنع انحياز التقدير نحو الفرق التي لعبت مباريات أكثر، ويوفر أساسًا عادلاً للمقارنة المعيارية.
6. المناهج البديلة للبحث عن الظهور الأول باستخدام دوال الفهرسة
6.1 استخدام دالة MATCH لتحديد الموقع المطلق للظهور الأول
تمتلك دالة المطابقة MATCH خصيصة هندسية أصيلة تجعلها إحدى أقوى الأدوات في عزل التكرارات؛ فالخوارزمية المعتمدة في هذه الدالة تبدأ مسح النطاق المحدد بصورة رأسية تتابعية من أعلى إلى أسفل، وتتوقف كليًا عن البحث فور عثورها على أول تطابق مطابق للمعيار، متجاهلة أي تكرار يقع بعد ذلك في المصفوفة.
تُصاغ الدالة الأساسية كالتالي:
=MATCH(A2, $A$1:$A, 0)
حيث يشير الرقم صفر (0) إلى فرض التطابق التام (Exact Match). ترجع هذه الصيغة الفهرس النسبي لموقع أول ظهور للمحتوى ضمن النطاق المفحوص.
ولتوليد مؤشر ثنائي يكشف ما إذا كان الصف الحالي هو ذاته الظهور الأول، نقوم بمقارنة ناتج الدالة برقم الصف الحقيقي باستخدام دالة ROW()، عبر المعادلة المركبة:
=MATCH(A2, $A$1:$A, 0) = ROW()
إذا كان رقم الصف الحالي مطابقًا لموقع أول ظهور المسترجع بواسطة MATCH، تنتج الدالة TRUE، مما يثبت أن السجل هو الأول من نوعه. أما إذا كان السجل مكررًا، فإن MATCH سترجع رقم الصف الأسبق، مما يجعله غير متطابق مع رقم الصف الحالي وتكون النتيجة حتمًا FALSE.
6.2 الدمج المتقدم بين INDEX و MATCH في التحقق المقارن
يعد الثنائي الكلاسيكي INDEX-MATCH من أكثر التراكيب الموثوقة تاريخيًا في برمجيات الجداول الإلكترونية، وتعود جذوره إلى البرمجيات المبكرة مثل Lotus 1-2-3 وميكروسوفت إكسيل قبل عقود. يتيح هذا الدمج استرجاع قيم مرافقة للظهور الأول حصريًا، متجاوزًا عيوب الدوال التقليدية الأخرى.
تتميز صيغة المطابقة الرأسية عبر MATCH بأنها تتفوق أدائيًا على دالة COUNTIF التوسعية في بيئات البيانات الضخمة؛ فبينما تضطر COUNTIF إلى عد كافة المدخلات في كل مرة يتسع فيها النطاق، تنهي MATCH دورة البحث الخاصة بها بمجرد الوصول لأول تطابق، مما يوفر طاقة معالجة هائلة في مصفوفات البيانات التي تتجاوز عشرات الآلاف من الصفوف.
كما يتيح الدمج بين INDEX و MATCH معالجة متطلبات الفهرسة المتقاطعة؛ حيث يمكن استدعاء بيانات من أعمدة تقع على يمين أو يسار عمود البحث بكل سلاسة، مما يوفر آلية موحدة للتحقق من هوية السجل الأول وتوليد ملخصات بيانات آلية خالية من التشوهات الناتجة عن الإدخالات التكرارية المتأخرة.
6.3 توظيف دالة XLOOKUP الحديثة لتحديد الأسبقية
تمثل دالة XLOOKUP المعيار المتطور والجيل الأحدث لدوال البحث في جداول بيانات جوجل؛ حيث تم تصميمها لتتجاوز كافة القيود الهيكلية التي عانت منها دوال البحث التاريخية مثل VLOOKUP. وإحدى أهم مزايا XLOOKUP الجوهرية هي احتواؤها على وسيط تحكم صريح بوضع البحث (Search Mode).
في حالتها الافتراضية، تضبط الدالة وسيط وضع البحث على القيمة (1)، وهو ما يعني توجيه المعالج لإجراء الفحص بدءًا من العنصر الأول نحو العنصر الأخير والتوقف الفوري عند السجل الأول المصادف. وتُصاغ دالة فحص أول ظهور باستخدام إمكانيات الإرجاع المتوازي كالتالي:
=ROW(A2) = XLOOKUP(A2, $A$2:$A, ROW($A$2:$A))
يقوم هذا التركيب بالبحث عن القيمة A2 في كامل العمود، لكنه يسترجع فقط رقم صف أول ظهور مسجل لها؛ فإذا تطابق هذا الرقم المسترجع مع رقم صف الخلية قيد الفحص، حُسم أمر السجل كأول ظهور. وتتفوق XLOOKUP في قدرتها على التكيف مع المصفوفات المتقلبة دون التسبب في أخطاء إزاحة المراجع، مما يجعلها الخيار الأكثر حداثة وموثوقية في بناء لوحات البيانات المستدامة.
7. أتمتة الفحص باستخدام صيغ المصفوفات الديناميكية (ARRAYFORMULA)
7.1 سلبيات السحب اليدوي وضرورة الأتمتة الشاملة
ينطوي السحب اليدوي للمعادلات الحسابية أو استخدام مقبض التعبئة التلقائية على مخاطر هيكلية جسيمة في بيئات التحليل الاحترافية. فأي تدفق جديد للبيانات عبر استمارات الويب المتزامنة كـ Google Forms يدرج صفوفًا خام خالية من المعادلات المنسوخة، مما يتسبب في انقطاع متسلسلة التحليل ووقوع فجوات معلوماتية تؤثر سلبًا على التقارير التجميعية الحية.
إضافة إلى ذلك، تستهلك الصيانة الدورية للجداول الممتدة لآلاف الأسطر جهدًا بشريًا غير مبرر، وتفتح الباب أمام الخطأ البشري؛ كأن يُحذف جزء من الصيغ عن طريق السهو في بعض الخلايا الوسيطة دون انتباه المحلل، مما ينتج عنه تضارب صامت في النتائج يصعب اكتشافه بالعين المجردة.
من هنا تبرز ضرورة الانتقال إلى صيغ المصفوفات الشاملة (Dynamic Array Formulas)، والتي تتميز بكتابة المعادلة لمرة واحدة في رأس العمود فقط، لتقوم تلقائيًا بإسقاط نتائجها حسابيًا على امتداد كافة الصفوف الحالية والمستقبلية دون أي تدخل يدوي إضافي.
7.2 صياغة دالة مصفوفية لمطابقة النطاقات المتوسعة
يواجه المحللون تحديًا تقنيًا معقدًا عند محاولة دمج دالة COUNTIF ذات النطاقات المتوسعة داخل دالة ARRAYFORMULA الكلاسيكية؛ إذ تفشل COUNTIF في إدراك الطبيعة المتجهة للطرف الثاني من النطاق المتوسع ($A$2:A2) عند وضعه داخل بيئة المصفوفة العادية، وتتعامل معه كنطاق ثابت مما يجهض عملية التقييم التراكمي.
لحل هذا الإشكال المعقد، وفرت جداول بيانات جوجل دوال التطبيق المتجهي المتقدمة LAMBDA و MAP. يتيح دمج الدالتين محاكاة النطاق المتوسع بكفاءة مصفوفية مطلقة عبر الصيغة الاحترافية التالية التي توضع في الخلية C2 حصريًا:
=MAP(A2:A, LAMBDA(item, IF(item="", "", COUNTIF(INDEX(A2:item), item)=1)))
في هذه التركيبة، تقوم الدالة MAP بتمرير كل خلية من العمود A بصورة فردية تتابعية داخل الدالة المجهولة LAMBDA، وتسميها محليًا “item”. ثم تقوم دالة INDEX بإنشاء شريحة متوسعة ديناميكية تمتد بدقة من الخلية الابتدائية A2 وصولاً إلى موقع العنصر الحالي “item”، مما يتيح إجراء عد تراكمي فوري لكل صف، مع إدراج شرط وقائي يترك الخلايا المقابلة للفراغات فارغة تمامًا لتفادي تشويه الجدول.
7.3 إدارة استهلاك الذاكرة وسرعة المعالجة الحسابية
على الرغم من القوة الرياضية الفائقة للصيغ المصفوفية المؤتمتة، إلا أنها تفرض تكلفة حوسبية على متصفح الويب وعلى خوادم المعالجة السحابية لجوجل؛ فالعمليات التكرارية في النطاقات المفتوحة اللانهائية (مثل A2:A) تضطر المعالج لمسح ملايين الخلايا الفارغة افتراضيًا في قاع الجدول.
لضمان كفاءة الأداء وسرعة الاستجابة، تتطلب أفضل الممارسات البرمجية تقييد النطاق المستهدف باستخدام دوال الاستقطاع الحجمي، أو تعيين نهايات صريحة للنطاق كأن يكتب A2:INDEX(A:A, COUNTA(A:A)) لضمان توقف خوارزمية المعالجة فور انتهاء البيانات الفعلية.
تشير القياسات المعيارية للأداء إلى أن الصيغ المعتمدة على الفهرسة المباشرة عبر MATCH تتفوق بنسب ملحوظة في سرعة التنفيذ بالمقارنة مع دوال العد المشروط التراكمية، مما يحتم على مهندسي البيانات اختيار التركيب الأنسب بناءً على طبيعة المصفوفة وتكرار عمليات التحديث التي تخضع لها.
8. التكامل مع أدوات العرض والتصفية والتحليل التجميعي
8.1 التنسيق الشرطي لتمييز أول ظهور بصرياً
يمثل التنسيق الشرطي (Conditional Formatting) وسيلة إدراكية حيوية تعزز الفهم الفوري لأنماط البيانات؛ حيث يتيح للباحث والمراجع تمييز الوحدات الفريدة أو استجابات الانطلاق الأولى بصريًا عبر ألوان تلقائية تميزها عن السجلات المكررة، مما يقلل احتمالات الخطأ في التدقيق الميداني.
يتم تفعيل هذه الخاصية باختيار النطاق البياني المطلوب (مثلاً من A2 إلى A100)، ثم الانتقال إلى قائمة “تنسيق” واختيار “تنسيق شرطي”، وتحديد خيار “صيغة مخصصة هي” (Custom formula is). وتُكتب في الحقل الصيغة المرجعية النسبية التالية:
=COUNTIF($A$2:$A2,$A2)=1
تطبق بيئة جداول بيانات جوجل هذه القاعدة داخليًا على كل خلية في النطاق؛ فالخلية التي تحقق الشرط تُلون فورًا باللون المحدد مسبقًا، بينما تظل الخلايا المكررة بلونها الافتراضي. يوفر هذا الفرز اللوني الفوري وسيلة كشف بصرية سريعة لأي أخطاء إدخال، فضلًا عن مساعدة الفرق الرقابية في حصر العناصر الجديدة بمجرد إلقاء نظرة سريعة على الجدول.
8.2 استخراج القوائم المصفاة باستخدام دالة FILTER
تعد دالة FILTER إحدى أهم أدوات استخلاص البيانات الديناميكية؛ إذ تتيح بناء مصفوفة فرعية معزولة بالكامل تضم فقط السجلات الأولى مع كافة متغيراتها المرافقة، دون أي تعديل على قاعدة البيانات الأصلية، وتظل هذه المصفوفة متصلة ومحدثة آليًا بمجرد تعديل البيانات الأساسية.
بافتراض أن العمود C يحتوي على مؤشر الظهور الأول (TRUE/FALSE)، وأن بياناتنا تمتد في العمودين A و B، يمكن استخراج جدول نقي كليًا من التكرارات في موضع آخر من المصنف بكتابة:
=FILTER(A2:B, C2:C=TRUE)
كما يمكن دمج منطق الفحص مباشرة داخل دالة التصفية دون الحاجة لعمود مساعد، عبر صياغة تعبيرية متقدمة:
=FILTER(A2:B, COUNTIF(OFFSET(A2, 0, 0, ROW(A2:B)-ROW(A2)+1, 1), A2:B)=1)
تفرز هذه الصيغة جدولاً مستقلًا يحتوي فقط على الحالات الفريدة الأولى وبياناتها المصاحبة؛ مما يتيح تجهيز مجموعات بيانات نظيفة تمامًا وتصديرها مباشرة لإعداد الرسوم البيانية أو ترحيلها إلى مستودعات البيانات الخارجية.
8.3 الربط مع استعلامات QUERY لإنشاء تقارير تجميعية
تعد لغة الاستعلامات QUERY جوهرة المعالجة المتقدمة في جداول بيانات جوجل؛ لاستنادها إلى بنية مشابهة للغة الاستعلامات البنيوية (SQL). ومن خلال دمج عمود الظهور الأول كمتغير ترشيح، يمكن للمحلل بناء تقارير تجميعية ولوحات تحكم معقدة ومجردة من شوائب التكرار.
يمكن صياغة استعلام يستهدف حصر البيانات التأسيسية فقط على النحو التالي:
=QUERY(A2:D, "SELECT A, B, D WHERE C = TRUE", 0)
يقوم هذا الاستعلام باستخلاص الأعمدة المطلوبة للسجلات التي تحقق شرط السبق فقط، مما يمنع التكرار في الحسابات التجميعية كحساب المتوسطات أو الانحرافات المعيارية داخل الاستعلام نفسه عبر دوال مثل (Avg, Sum).
تسهم هذه المنهجية التشاركية في الحفاظ على سلامة “المصدر الموحد للحقيقة” (Single Source of Truth)؛ فالبيانات الخام تظل محتفظة بكامل تاريخها وتكراراتها الزمنية، في حين تتولى استعلامات QUERY المفلترة بالظهور الأول توليد الواجهات التحليلية الموجهة للإدارة والباحثين بدقة منهجية تامة.
9. التحديات التقنية ومعالجة الأخطاء الشائعة في التطبيق
9.1 تأثير المسافات الخفية وحساسية حالة الأحرف
من أكثر المشاكل التقنية شيوعًا في معالجة البيانات النصية وجود المسافات الفارغة غير المرئية، سواء كانت مسافات بادئة تسبق الكلمة، أو مسافات لاحقة تعقبها، أو مسافات مزدوجة بين الكلمات. تقيّم دوال الجداول الحسابية النصوص بمطابقة البايتات الحرفية الصارمة؛ ولذا فإن النص "أحمد" يختلف جذريًا عن "أحمد " المتبوع بمسافة.
يؤدي هذا التباين الخفي إلى إخفاق دالة COUNTIF في التعرف على التكرار، فتمنح السجل الثاني صفة الظهور الأول (TRUE) خطأً، مما يفسد التحليل التكراري. ولمعالجة هذه الظاهرة، ينبغي تنظيف البيانات مسبقًا عبر دالة TRIM، أو دمجها في صيغة الفحص كالتالي:
=COUNTIF($A$2:$A2, TRIM($A2))=1
أما فيما يتعلق بحالة الأحرف في النصوص المكتوبة باللغات اللاتينية (مثل الإنجليزية)، فإن دالة COUNTIF بطبيعتها غير حساسة لحالة الأحرف (Case-insensitive)؛ حيث ترى “DATA” و “data” كقيمة واحدة. وفي حال كان التمييز بين الحالات مطلوبًا في التجربة، فيجب حينها استبدال صيغة العد بدوال مطابقة بايتية صارمة مثل EXACT مدمجة مع صيغ مصفوفية خاصة.
9.2 إدارة الخلايا الفارغة في عمود البيانات
ينتج عن تطبيق معادلة الظهور الأول عبر عمود مفتوح سلوك برمجي إشكالي عند مصادفة أول خلية فارغة؛ إذ تتعامل COUNTIF مع الفراغ كقيمة نصية ذات طول صفري، وتمنح أول خلية فارغة النتيجة المنطقية TRUE، معتبرة إياها الظهور الأول لـ “القيمة الفارغة”، بينما تعطي الفراغات التالية FALSE.
يؤدي هذا التصنيف إلى تلوث التحليلات الإحصائية باحتساب الفراغ ككيان حقيقي ضمن إجمالي الحالات الفريدة؛ ولتفادي هذا الخلل، يجب دمج فحص وقائي مستند إلى دالة ISBLANK للتأكد من وجود بيانات فعلية في الخلية قبل الشروع في فحص تكرارها، وذلك بصياغة الشرط الوقائي التالي:
=IF(ISBLANK($A2), "", (COUNTIF($A$2:$A2, $A2)=1)+0)
تضمن هذه الصيغة الوقائية بقاء الخلية فارغة تمامًا إذا كان السجل المقابل خاليًا من البيانات؛ مما يحفظ سلامة النطاقات العددية ويمنع تشويه الرسوم البيانية أو جداول الجمع اللاحقة بمدخلات زائفة.
9.3 أخطاء التثبيت المرجعي وانزلاق النطاق
يعد إسقاط رمز التثبيت المرجعي ($) من أكثر الأخطاء الشائعة بين المحللين عند بناء النطاقات المتوسعة. فإذا كُتبت المعادلة بالصيغة =COUNTIF(A2:A2, A2)=1 دون تثبيت، فإن كلا الطرفين سينزاحان بالتساوي عند نسخ المعادلة لأسفل، ليصبح النطاق في الصف العاشر مثلاً (A10:A10).
في هذه الحالة، يتحول فضاء البحث إلى فحص الخلية مع نفسها فقط في كل صف، وبما أن أي قيمة تتطابق مع نفسها لمرة واحدة حتمًا، فإن المعادلة ستُرجع القيمة TRUE لكافة الصفوف بلا استثناء، مما يفقدها تمامًا القدرة على كشف أي تكرار عبر العمود.
كما قد تنجم أخطاء مشابهة عن عمليات قص ولصق الخلايا داخل ورقة العمل (Cut & Paste)؛ حيث تتسبب في إعادة توجيه المراجع الداخلية بصورة مشوهة. ولمواجهة هذه المخاطر، يُنصح بتطبيق بروتوكول تدقيق دوري يتضمن فحص نقاط عشوائية في أسفل الجدول والتأكد من صمود الصيغ واستقرار مراجعها المطلقة، أو الاعتماد على دوال الأتمتة الرأسية كبديل حصين ضد انزلاق المراجع.
10. التطبيقات المتقدمة في البحوث السلوكية والاجتماعية والقياس النفسي
10.1 تتبع أول مشاركة للمبحوثين في الدراسات الطولية
في التصاميم شبه التجريبية والدراسات التتبعية التي تعتمد قياسات متكررة عبر الزمن، يتم جمع البيانات عبر موجات متتابعة (Waves) لقياس تطور الظواهر النفسية أو السلوكية. وفي كثير من الأحيان، ينضم مشاركون جدد في موجات لاحقة، بينما يتخلف آخرون، مما يخلق شبكة معقدة من السجلات غير المتجانسة زمنيًا.
يعد تحديد الظهور الأول لمعرف المبحوث (Participant ID) الإجراء المنهجي الذي يتيح للباحث عزل بيانات خط الأساس (Baseline Data) بدقة؛ إذ يُفصل القياس القبلي الحقيقي لكل فرد عن قياسات المتابعة التتبعية، بصرف النظر عن الموجة الزمنية التي شهدت انضمامه للدراسة.
يسهم هذا التحديد في استبعاد الانحياز الناتج عن احتساب المشاركين المكررين كحالات جديدة عند حساب مؤشرات التشتت والنزعة المركزية القبلية. كما يمنع تضخيم فاعلية التدخل العلاجي أو البرامج الإرشادية؛ عبر ضمان احتساب الأثر السلوكي مرة واحدة فقط لكل مفحوص عند إجراء المقارنات الإحصائية بين المجموعات التجريبية والضابطة.
10.2 رصد الاستجابة السلوكية الأولى في بروتوكولات القياس
في تجارب علم النفس المعرفي والفسيولوجي التي ترصد ردود الأفعال المحفوظة في جداول ممتدة، يمثل زمن الرجع الأول (First Reaction Time) متغيرًا بالغ الأهمية؛ لكونه يعكس الاستجابة الذهنية الفطرية أو الأولية للمثير التجريبي قبل أن تخضع العمليات العقلية لتأثيرات التعود (Habituation) أو التدريب أو الإجهاد المعرفي المتراكم.
من خلال تطبيق معادلات تحديد الظهور الأول على عمود “معرّف المثير” متبوعًا بـ “معرّف المفحوص”، يستطيع الباحث عزل استجابة المواجهة الأولى بدقة رياضية متناهية، ومقارنتها كميًا بمتوسط الاستجابات اللاحقة لنفس المثير ضمن بروتوكولات التعلم الشرطي.
تسمح هذه التنقية المنطقية ببناء منحنيات التعلم الدقيقة وتحديد العتبات الفارقة للانتباه؛ حيث يتم التمييز بوضوح بين زمن المعالجة التلقائية للمعلومات وزمن المعالجة القائمة على الخبرة المكتسبة، وهو تفريق يمتد أثره إلى مجالات متنوعة كاختبارات واجهات المستخدم وتجارب الفاعلية الإعلانية وسلوك المستهلك.
10.3 إعداد قواعد بيانات معيارية لنماذج التحليل اللاحقة
تتطلب المعايير المعاصرة لإجراء البحوث العلمية وضمان موثوقيتها توثيق كافة مراحل معالجة البيانات الأولية بدقة تتيح إعادة إنتاج النتائج (Replicability). ولا يعد الحذف العشوائي للسجلات المكررة ممارسة مقبولة منهجيًا؛ لما يكتنفه من غموض يمنع الباحثين الآخرين من مراجعة مسار اتخاذ القرار التحليلي.
يمثل استخدام أعمدة الفحص المنطقي لتحديد أول ظهور الخيار المعياري الأمثل لحوكمة البيانات داخل جداول بيانات جوجل؛ حيث تبقى الملاحظات الأصلية بكامل تكراراتها سليمة وموثقة تاريخيًا، مع تدوين قواعد الفرز والتصفية كمعادلات حسابية مكشوفة وقابلة للتدقيق البرمجي.
يهيئ هذا المنهج قواعد البيانات للتصدير الآمن نحو بيئات الحوسبة الإحصائية المتقدمة كنماذج المعادلات البنائية (SEM) والتحليلات البايزية؛ إذ تتوفر مصفوفات واضحة تتيح للمحلل التبديل بدقة بين نمذجة الحالات المستقلة ونمذجة القياسات المتكررة، مما يرتقي بجودة المخرجات البحثية ويضمن التزامها بأرفع المعايير الأكاديمية العالمية.
خاتمة
إن إتقان آليات تحديد أول ظهور لقيمة في عمود داخل جداول بيانات جوجل يتجاوز كونه مجرد مهارة تقنية عابرة في التعامل مع المعادلات؛ إنه يمثل مدخلاً منهجيًا أساسيًا لضمان جودة البيانات وسلامة القرارات المبنية عليها. فمن خلال الفهم الدقيق لطبيعة النطاقات المتوسعة، والتوظيف الرشيد لدوال العد المشروط، وإتقان التحويل الرقمي الثنائي للنتائج المنطقية، يكتسب المحلل أداة تحكم قوية تمكنه من تنقية المصفوفات واستخلاص السجلات الفريدة دون الإخلال بالسياق التاريخي للأحداث.
كما تبرز البدائل التقنية المتنوعة — سواء عبر دوال الفهرسة المتطورة كـ MATCH و XLOOKUP، أو من خلال الحلول المصفوفية المؤتمتة باستخدام MAP و LAMBDA — مرونة بيئة الجداول الحسابية وقدرتها على التكيف مع مختلف أحجام البيانات ومتطلبات المعالجة المعقدة. ومع التكامل الفعال لهذه الصيغ مع أدوات التنسيق الشرطي ودوال التصفية والاستعلام المتقدم، يتحول جدول البيانات من مجرد أداة لتخزين الأرقام إلى منظومة تحليلية متكاملة قادرة على تلبية متطلبات البحوث الاجتماعية المعقدة ونماذج الأعمال الرقمية الحديثة بأعلى درجات الكفاءة والموثوقية.
المراجع
- Google. (2024). COUNTIF function help documentation. Google Docs Editors Help. https://support.google.com/docs/answer/3093480
- Google. (2024). MATCH function help documentation. Google Docs Editors Help. https://support.google.com/docs/answer/3093378
- Google. (2024). XLOOKUP function help documentation. Google Docs Editors Help. https://support.google.com/docs/answer/12405947
- Google. (2024). MAP function help documentation. Google Docs Editors Help. https://support.google.com/docs/answer/12569759
- Microsoft. (2024). Overview of formulas in Excel. Microsoft Support. https://support.microsoft.com/en-us/office/overview-of-formulas-in-excel-3ab8292c-7b97-40e1-b45b-c70e70498a9e