
تعد معالجة السلاسل النصية وهندسة البيانات الأولية حجر الزاوية في دراسات تحليل البيانات المعاصرة والأبحاث الكمية التي تعتمد على منصات العمل السحابية. يواجه الباحثون والمحللون يومياً تدفقات هائلة من البيانات غير المهيكلة أو شبه المهيكلة المستخرجة من واجهات برمجة التطبيقات، أو الاستبانات الرقمية، أو سجلات التفاعل الحاسوبي. وفي كثير من الأحيان، تأتي هذه البيانات مدمجة ضمن خلايا فردية تحتوي على معرفات مركبة، أو طوابع زمنية مقترنة بنصوص تفسيرية، أو أسماء ملحقة برموز بريدية أو تصنيفات فرعية، مما يتطلب استقطاع الأجزاء الحيوية منها بدقة إحصائية وبرمجية متناهية. إن القدرة على استخلاص النصوص الواقعة قبل حرف أو رمز معين في بيئة جداول بيانات جوجل (Google Sheets) تمثل مهارة تأسيسية لفصل المتغيرات المستقلة والتابعة وتجهيزها للمعالجة الإحصائية المتقدمة وتغذية النماذج التحليلية.
تطورت منصة جداول بيانات جوجل لتتحول من مجرد أداة حسابية مساعدة إلى بيئة معالجة بيانات سحابية متقدمة تدعم العمليات الجبرية، والتطبيقات المعتمدة على محركات التعبيرات النمطية الصارمة، والدوال المصفوفية الحديثة. تتنوع المنهجيات المتاحة لتنفيذ مهمة استخراج النصوص تِبعاً لطبيعة البيانات ومستوى تعقيدها، حيث تتدرج من الصيغ التركيبية التقليدية القائمة على دوال الاقتطاع الموضعي، وصولاً إلى خوارزميات التعبيرات النمطية المتقدمة، وصولاً إلى الدوال التخصصية الحديثة مثل دالة استقطاع النصوص المستحدثة سحابياً. إن استيعاب هذه الأدوات لا ينحصر في التطبيق الميكانيكي للصيغ الرياضية، بل يمتد إلى فهم البنية الرياضية للمحارف، والتعامل مع حالات الغموض الناتجة عن تكرار الرموز الفاصلة، وتجنب الهدر الحسابي عند التعامل مع مجموعات البيانات الضخمة التي تضم مئات الآلاف من السجلات.
يهدف هذا الدليل المرجعي الشامل إلى تفكيك الأسس النظرية والمنهجيات الإجرائية لاستخراج النصوص الواقعة قبل رمز أو مقطع محدد داخل جداول بيانات جوجل. سيتم استعراض التشريح الوظيفي لأقوى الدوال الرياضية والنمطية المستخدمة في هذا السياق، ومقارنة سلوك محركات المطابقة في التعامل مع الرموز، وتحليل آليات إدارة الأخطاء لضمان اتساق البيانات وعدم تلويث العينات الإحصائية. كما يقدم الدليل دراسات حالة تطبيقية وأطر عمل برمجية تمكن المحللين والباحثين من أتمتة هذه العمليات بالكامل عبر المصفوفات، مما يرفع من جودة المدخلات في بحوث قياس السلوك والعلوم الاجتماعية والبيانات الحسابية المعقدة.
1. المقدمة والمفاهيم النظرية لمعالجة البيانات النصية في جداول بيانات جوجل
1.1 أهمية تجزئة النصوص واستخلاص السلاسل الفرعية في التحليل الكمي
يمثل الانتقال من البيانات الخام غير المهيكلة إلى متغيرات مقيسة خطوة جوهرية في التحليل الكمي؛ إذ إن النماذج الإحصائية لا يمكنها معالجة السلاسل النصية المدمجة التي تفتقر إلى الفصل الدقيق بين دلالاتها المتباينة. في البحوث السلوكية والاجتماعية التي تعتمد على استخراج بيانات التفاعل الرقمي أو استجابات الاستبيانات المفتوحة والمقننة، تتكدس المتغيرات الديموغرافية والوظيفية ضمن سجلات نصية متصلة تفصل بينها محارف محددة كالفواصل أو الشرطات. إن استخلاص السلاسل الفرعية الواقعة قبل هذه الفواصل يسهم مباشرة في بناء فئات تصنيفية مستقلة يمكن ترميزها كمياً واختبار فروضها، مما يحد من تشوهات القياس المترتبة على تداخل البيانات النصية ويزيد من الصدق العام للأدوات التحليلية المستخدمة في معالجة الظواهر الإنسانية والرقمية.
يتطلب تنظيف البيانات الميدانية والأكاديمية معايير صارمة لتقليل أخطاء الإدخال البشري والتناقضات التركيبية الناتجة عن تباين أدوات التجميع. فالسلسلة النصية الخام قد تحتوي على رموز شائعة تفصل بين كود المستجيب ومجموعته التجريبية، وفي حال عدم عزل هذا الكود قبل الرمز الفاصل بصورة آلية ودقيقة، فإن أي تحليل إحصائي لاحق عبر الانحدار الخطي أو تحليل التباين سيؤدي إلى أخطاء في تصنيف الحالات، وهو ما أشار إليه الباحثون في مجالات تحليل البيانات الضخمة وسجلات المنصات الاجتماعية (Aldhyani et al., 2022؛ Zhang et al., 2021). تضمن تجزئة النصوص بناء متغيرات منفصلة تتمتع بالموثوقية وقابلية التكرار المعملي، مما يجعل الأتمتة السحابية داخل جداول بيانات جوجل رافعة أساسية لتعزيز كفاءة البحث التجريبي.
تتجلى التطبيقات الميدانية للمعالجة المسبقة للنصوص في دراسات استقصاء المحتوى السريري والتفاعلات اللفظية في المنصات الافتراضية، حيث تُستخرج الكلمات المفتاحية والمحددات قبل الفواصل الزمنية لتوصيف الأنماط السلوكية الحركية والنفسية، كما هو موضح في أبحاث التنقيب في سجلات الأجهزة التفاعلية وحركة السائقين (Alkinani et al., 2020). إن استخلاص المتغير قبل محرف الفصل يضمن تجريد السلسلة النصية من الملحقات السياقية غير الضرورية، وتجهيز المتغيرات التابعة لتصبح مصفوفات رقمية أو اسمية قابلة للتصدير الفوري نحو حزم التحليل الإحصائي دون الحاجة إلى تدخل يدوي مكثف قد يعرض سلامة البحث للخطأ الإنساني العشوائي.
1.2 البنية التركيبية للبيانات النصية (Strings) في جداول الحسابات السحابية
تُعرّف السلسلة النصية في علوم الحواسيب وبيئات جداول البيانات السحابية بأنها متتالية متتابعة من المحارف المرتبة وفق فهارس إحداثية تبدأ بالرقم واحد في السياق الحسابي لجداول جوجل (1-based index). كل محرف في الخلية، سواء كان حرفاً أبجدياً، أو رقماً، أو مسافة، أو رمزاً تشغيلياً، يحتل موقعاً محدداً ودقيقاً يمكن الوصول إليه رياضياً عبر دوال الإزاحة. تختلف الأنماط النصية داخل الخلايا بين بنيات ثابتة تتطابق فيها أطوال المقاطع ومواقع المحارف، وبنيات ديناميكية متغيرة تتأثر باختلاف أطوال الكلمات وتنوع أساليب التوثيق، مما يجعل الاعتماد على اقتطاع عدد ثابت من المحارف أمراً غير علمي ويفرض اللجوء إلى الدوال التي تستند إلى رصد موقع المحرف الفاصل ديناميكياً.
تفرض السلاسل النصية تحديات تقنية ناجمة عن وجود المحارف غير المرئية كفواصل الأسطر، والمسافات البيضاء المزدوجة، والمحارف الصفرية (Zero-width spaces)، والرموز الخاصة بترميز الحروف الموحد (Unicode). هذه المحارف، وإن بدت غير مرئية للمستخدم البشري، تحتل فهارس حقيقية في الذاكرة تؤثر مباشرة على نتائج دوال البحث والمطابقة. فعند محاولة استخراج نص يسبق رمزاً معيناً، قد يؤدي وجود مسافة غير مرئية أو رمز تحكم نصي إلى احتساب موضع الفهرس بصورة خاطئة، مما ينجم عنه اجتزاء ناقص للنص أو إدراج مسافات طرفية تُفسد عمليات الربط الإحصائي اللاحقة بين الجداول المتعددة.
تتعامل جداول بيانات جوجل مع النصوص عبر بنية برمجية تدعم النصوص متعددة اللغات وثنائية الاتجاه، مما يضيف بعداً تركيبياً يتعلق باتجاه قراءة السلسلة النصية (من اليمين إلى اليسار أو العكس). ورغم أن العرض المرئي قد يتبدل تِبعاً للغة، فإن ترتيب الفهارس الرياضية في المحرك الداخلي يظل منطقياً من بداية السلسلة إلى نهايتها. إن الإدراك المعمق لهذه الطبيعة الرياضية للمحارف يمنع الخلط بين الموضع البصري والموضع الإحداثي للرمز المستهدف، ويؤسس لقواعد معالجة نصية متينة لا تتأثر بتبدل واجهات المستخدم أو التنسيقات الإقليمية داخل المنظومة السحابية.
1.3 مقارنة منهجية بين الحلول الجبرية والتعبيرات النمطية (Regular Expressions)
تنقسم الحلول التقنية لمعالجة النصوص في جداول بيانات جوجل إلى مسارين رئيسيين: المسار الجبري القائم على تركيب الدوال التقليدية، والمسار النمطي المعتمد على لغات التعبيرات النمطية الصارمة. يتمثل المسار الجبري في الجمع بين دوال تحديد المواقع مثل دوال البحث والإزاحة الاقتطاعية، وهو أسلوب يتميز بالوضوح المفاهيمي للمستخدمين المبتدئين ولا يتطلب معرفة معمقة بلغات التكويد، إلا أنه يواجه قصوراً هيكلياً عند تعقد الأنماط النصية أو تكرار المحارف الفاصلة بصور غير متوقعة عبر السجلات، فضلاً عن صعوبة صيانته وتعديله عند تعقد الشروط المنطقية للاستقطاع.
في المقابل، تقدم التعبيرات النمطية حلاً رياضياً عالي التجريد يختزل العمليات المنطقية المعقدة في نمط رمزي واحد قادر على فحص وتصنيف واستخراج المحارف بناءً على سماتها الدقيقة وليس فقط مواقعها الإحداثية. تتيح هذه التعبيرات التعامل مع السيناريوهات الشاذة، مثل وجود محارف فاصلة اختيارية، أو اشتراط استخراج النصوص السابقة لحرف معين بشرط أن يكون متبوعاً برقم، أو استخراج أطول سلسلة ممكنة تسبق رمزاً متكرراً. إن الاستقرار الرياضي لمحركات التعبيرات النمطية يجعلها الخيار الأمثل في معالجة الأنماط النصية المركبة التي تفشل الدوال الموضعية المباشرة في معالجتها دون تركيبات برمجية مفرطة التعقيد تصعب مراجعتها.
تخضع المفاضلة بين هذين المسارين لمعايير منهجية ترتبط بحجم العينة ودرجة تعقيد البيانات ومتطلبات الكفاءة الحاسوبية. فبينما تتفوق الدوال الجبرية في السرعة الحسابية اللحظية ضمن الجداول البسيطة ذات البنية الموحدة، توفر التعبيرات النمطية مرونة استثنائية تقلل من عدد الأعمدة المساعدة والخطوات الوسيطة في مجموعات البيانات الكبيرة. ينبغي على الباحث والمحلل تقييم طبيعة الظاهرة النصية المبحوثة واختيار الأداة التي تضمن أعلى درجات الدقة الإجرائية مع تقليل العبء التشغيلي على ذاكرة المتصفح والخوادم السحابية المشغلة للنموذج الرياضي.
2. التشريح الوظيفي والرياضي لدالة REGEXEXTRACT
2.1 الصيغة التركيبية لدالة REGEXEXTRACT وبنيتها المنطقية
تعد دالة الاستخلاص النمطي إحدى أقوى الدوال النصية في جداول بيانات جوجل، وتأتي بصيغة تركيبية تتكون من وسيطين أساسيين: النص المستهدف بالمعالجة، والنمط التعبيري النمطي الذي يحدد قواعد المطابقة والاستخراج. رياضياً، تأخذ الدالة المدخل النصي من الخلية المحددة وتقوم بتمريره إلى خوارزمية الفحص الداخلي، حيث يُجرى مسح متتابع للمحارف لمطابقتها مع التعبير الرياضي المدخل في الوسيط الثاني، فإذا تحقق التطابق، تقوم الدالة بإرجاع المقطع الواقع ضمن أقواس الالتقاط أو كامل النص المطابق إذا لم تُحدد أقواس داخلية.
تعتمد المعالجة المنطقية الداخلية التي تجريها خوارزمية الدالة على مفهوم الحالات المحددة المنتهية، حيث يتم تحويل النمط الرمزي إلى آلة حالة تفحص السلسلة النصية محرفاً تلو الآخر. تعمل الدالة على تحديد نقطة البداية للمطابقة، ثم تتقدم عبر السلسلة إلى حين استيفاء الشروط المحددة للمقطع السابق للحرف المستهدف. وتتميز بنية الدالة باشتراط الدقة المنطقية؛ حيث إن أي انحراف طفيف في صياغة النمط يؤدي إلى فشل العملية برمتها، مما يفرض على المحلل ضبط الأقواس والمكممات الرياضية بصورة تتطابق تماماً مع الطبيعة الإحصائية والتركيبية للسلسلة النصية المراد تفكيكها.
تخضع مخرجات الدالة لشروط ومحددات صارمة في فضاء الخلية؛ حيث إنها تُرجع افتراضياً قيمة نصية واحدة تتوافق مع أول تطابق يُحققه النمط، ما لم يحتوي التعبير على مجموعات التقاط متعددة تؤدي إلى امتداد النتائج أفقياً عبر الخلايا المجاورة في الصف نفسه. هذا السلوك يتطلب تخطيطاً دقيقاً لورقة العمل، لضمان عدم وجود بيانات قائمة في الخلايا المتجاورة قد تعيق تمدد المخرجات وتتسبب في أخطاء الامتداد الحسابي، مما يعزز أهمية تصميم نماذج استخراج مغلقة تعيد النص المطلوب في خلية واحدة محددة ومعزولة.
2.2 آلية عمل محرك مطابقة الأنماط (Pattern Matching Engine) في بيئة جوجل
تعتمد جداول بيانات جوجل في معالجة التعبيرات النمطية على مكتبة محرك المطابقة مفتوحة المصدر المعروفة باسم RE2 المطورة من قِبل شركة جوجل. تختلف هذه المكتبة جوهرياً عن محركات التعبيرات النمطية التقليدية مثل PCRE المعتمدة في العديد من لغات البرمجة، حيث تم تصميم RE2 خصيصاً للقضاء على مخاطر الأداء الحسابي الكارثي الناجم عن التراجع الخلفي الأسي (Exponential Backtracking). يضمن هذا المحرك زمناً خطياً في معالجة النصوص يتناسب طردياً مع طول السلسلة النصية، مما يمنع تجمد ورقة الحسابات أو استنزاف موارد المعالجة السحابية عند تنفيذ عمليات استخراج واسعة النطاق.
ينعكس هذا التصميم المعماري للمحرك على الخصائص البرمجية المتاحة للباحث؛ حيث تفتقر مكتبة RE2 عمداً إلى بعض الميزات المتقدمة المتوفرة في محركات أخرى مثل آليات الإسناد الخلفي (Backreferences) ومحددات الفحص المسبق واللاحق المعقدة (Lookaround assertions). ومع ذلك، فإن هذه القيود لا تعيق قدرة الدالة على تنفيذ مهام استخراج النصوص السابقة للمحارف، بل توفر ضمانة أمنية وتشغيلية تتيح تطبيق الصيغ على مجموعات بيانات بحثية ضخمة تتضمن عشرات الآلاف من السجلات دون التعرض لانقطاع الاتصال بالخادم أو تجاوز حدود استهلاك الذاكرة المخصصة للعمليات السحابية.
تؤثر الآليات الحسابية لمحرك RE2 على أداء النماذج التحليلية عند معالجة البيانات النصية الضخمة؛ إذ إن كفاءة تنفيذ الصيغ تتأثر بصياغة التعبير النمطي ذاته. فالأنماط التي تستخدم مكممات غير محددة بدقة قد تزيد من عدد المقارنات المنطقية التي يجريها المحرك الداخلي قبل الوصول إلى نقطة التوقف، مما يبرز أهمية بناء تعبيرات نمطية منضبطة تلتزم بالقواعد المعيارية للمحرك، وتتجنب التكرار العشوائي للرموز، وتعتمد على الفواصل الصريحة لتوجيه مسار البحث نحو الهدف بأقل عدد ممكن من الدورات الحسابية.
2.3 إدارة المدخلات والمخرجات وسلوك الأخطاء الشائعة
يعد خطأ تعذر العثور على تطابق (#N/A) السلوك الافتراضي الأكثر شيوعاً الذي تُظهره دالة الاستخلاص النمطي عند غياب الحرف المستهدف أو فشل النمط في مطابقة أي جزء من السلسلة النصية في الخلية المصدر. يحمل هذا الخطأ دلالة برمجية واضحة تشير إلى أن القواعد المنطقية المحددة في النمط لم تجد ما يقابلها في المدخل، إلا أن بقاء هذا الخطأ مكشوفاً داخل ورقة البيانات يؤدي إلى انقطاع العمليات الحسابية اللاحقة، مثل دوال العد والإحصاء الوصفي ومصفوفات الارتباط، مما يتطلب معالجة منهجية عبر دوال الاحتواء المنطقي لعزل الأخطاء وتحويلها إلى قيم مفقودة منتظمة إحصائياً.
يتأثر سلوك الدالة أيضاً بنوعية المدخلات؛ حيث صُممت للتعامل المباشر مع القيم النصية (Text Strings). فإذا كانت الخلية المصدر تحتوي على قيم رقمية بحتة أو تواريخ تقويمية منسقة، فإن الدالة قد تفشل في قراءتها ما لم يتم تحويلها تلقائياً أو جبرياً إلى تمثيل نصي مكافئ. علاوة على ذلك، فإن التعامل مع الخلايا الفارغة يؤدي فورياً إلى توليد خطأ القيمة المفقودة، وهو ما يفرض إدراج ضوابط مسبقة تتحقق من امتلاء الخلية واحتوائها على بيانات صالحة قبل إطلاق محرك المطابقة النمطية، تجنباً لإنتاج تقارير مشوهة برسائل الأخطاء النظامية.
تلعب استراتيجيات التنسيق التلقائي لنوع البيانات المرتجعة دوراً محورياً في الحفاظ على سلامة النماذج الكمية؛ فالدالة تُرجع مخرجاتها دوماً كبيانات نصية حتى وإن كانت النصوص المستخرجة عبارة عن أرقام مجردة كانت تسبق رمزاً معيناً. هذا التوصيف النصي للمخرجات يحول دون استخدامها المباشر في العمليات الحسابية أو التحليلات الإحصائية الجمعية كالمتوسط والانحراف المعياري، مما يستدعي تدخلاً إجرائياً صريحاً لتحويل السلسلة المستخرجة إلى نوعها الرياضي الملائم عبر دوال التحويل العددي، لضمان تكاملها السلس ضمن خطوط معالجة البيانات اللاحقة.
3. تفكيك التعبيرات النمطية: الصيغة الرياضية لاستخراج ما قبل الحرف
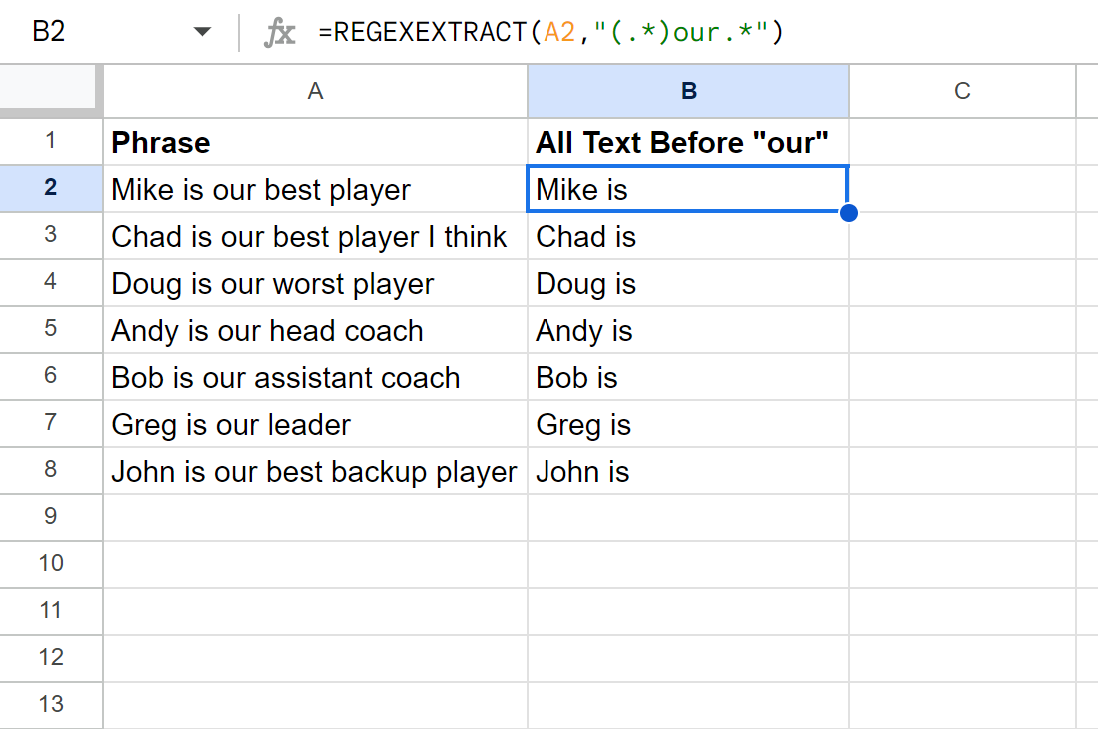
3.1 تحليل الصيغة النمطية الأساسية: =REGEXEXTRACT(A2, “(.*)our.*”)
تعتمد الصياغة الرياضية النموذجية لاستخراج النصوص السابقة لمقطع أو رمز معين عبر التعبيرات النمطية على النمط التركيبي الممثل في الصيغة العامة التي تستخدم دالة الاستخلاص مع نمط مقيد بأقواس التقاط. لفهم هذا التركيب، يجب تفكيك كل عنصر رمزي بصورة منفصلة؛ فالنقطة في التعبير النمطي تمثل بديلاً شاملاً يتطابق مع أي محرف نصي أو رقمي أو مسافة باستثناء فواصل الأسطر، مما يجعلها أداة مسح شاملة تمر عبر كافة مكونات السلسلة النصية دون استثناء، وتتيح قراءة السلسلة بغض النظر عن لغة الإدخال أو نوعية الرموز المستخدمة في الخلية المصدر.
يأتي المكمم الرياضي المتمثل في رمز النجمة ليحدد وتيرة تكرار المحرف السابق له؛ حيث يشير هذا الرمز إلى مطابقة المحرف السابق (وهو النقطة في هذه الحالة) بعدد مرات يتراوح بين الصفر وما لا نهاية. يعني هذا الارتباط الرياضي أن التعبير يبحث عن أي عدد من المحارف المتتالية مهما بلغ طولها، بدءاً من غياب المحارف تماماً وحتى استيعاب كامل السلسلة النصية. يمثل هذا التوافق بين النقطة والنجمة آلية مسح مرنة تتمدد لاستيعاب النصوص المتفاوتة في أطوالها عبر السجلات المختلفة ضمن عمود البيانات الخاضع للفحص والتحليل.
تؤدي أقواس الالتقاط الدائرية الوظيفة التشغيلية الحاسمة في حصر وتحديد المخرجات المطلوبة؛ فبينما يطابق التعبير النمطي الكامل النص بأكمله شاملاً الحرف الفاصل وما بعده، تخبر الأقواس محرك الدالة بضرورة استقطاع وتصدير ما بداخلها حصراً إلى الخلية المستهدفة. بوضع الأقواس حول الجزء الممثل للمحارف السابقة للحرف أو المقطع، يتم عزل هذا المقطع بدقة متناهية وإسقاط باقي أجزاء السلسلة النصية ومحرف الفصل نفسه من النتيجة النهائية، مما يحقق الغاية التحليلية باستخراج ما قبل الحرف بنقاء رياضي تام.
3.2 مفهوم الجشع والكسل (Greedy vs. Lazy Matching) في استخراج النصوص
يعد التمييز بين المطابقة الجشعة والمطابقة الكسولة أحد أدق المفاهيم في لغات التعبيرات النمطية وأكثرها تأثيراً على نتائج معالجة البيانات النصية. في النمط الافتراضي، يتصرف المكمم النجمي بأسلوب جشع، بمعنى أنه يحاول استهلاك ومطابقة أكبر قدر ممكن من السلسلة النصية قبل التوقف عند الحرف المستهدف. فإذا كانت السلسلة النصية تحتوي على تكرار متعدد للحرف أو المقطع الفاصل، فإن المطابقة الجشعة ستتجاوز كافة التكرارات الأولى لتتوقف عند التكرار الأخير في نهاية السلسلة، مما يؤدي إلى استخراج كل ما يسبق الظهور الأخير للمحرف، وليس الظهور الأول كما يتوقع أغلب المحللين.
لتعديل هذا السلوك وضمان التوقف الصارم عند أول ظهور للحرف أو الرمز الفاصل من بداية السلسلة، يجب تحويل المكمم من النمط الجشع إلى النمط الكسول عبر إلحاق علامة الاستفهام بالمكمم الرياضي. في هذا النمط الكسول، يقوم المحرك بمطابقة أقل عدد ممكن من المحارف والتوقف فور مصادفة أول رمز مطابق لشرط الفصل. يكتسب هذا التمييز أهمية قصوى في معالجة المعرفات الرقمية وسجلات النصوص المقننة التي تتضمن فواصل متعددة مثل الواصلات أو النقاط، حيث يؤدي الخلط بين الجشع والكسل إلى اجتزاء كميات غير مقصودة من البيانات ودمج متغيرات متعددة في خلية المخرجات.
يتضح الفارق الإجرائي جلياً عند معالجة مسار نصي يحتوي على عدة أقسام تفصل بينها شرطات مائلة؛ فالمطابقة الجشعة ستستخلص كامل المسار حتى الشرطة الأخيرة متجاهلة الأقسام الفرعية التأسيسية، بينما تضمن المطابقة الكسولة اقتطاع المقطع الأول حصراً وتثبيته كمتغير أولي. ينبغي على الباحث تحديد نقطة التوقف الدقيقة التي تتطلبها المنهجية الإحصائية المتبعة، وضبط الصيغة النمطية بإدراج أو إسقاط أدوات الكسل لضمان استقرار ومطابقة المخرجات للتعريفات الإجرائية لمتغيرات الدراسة دون انحراف.
3.3 التعامل مع المسافات البيضاء والحدود الفاصلة بين الكلمات
تمثل المسافات البيضاء الفاصلة بين الكلمات والرموز مصدراً رئيساً للتناقض في المخرجات النصية إذا لم يتم تضمينها صراحة وبدقة ضمن النمط التعبيري للدالة. فعندما يكون الحرف الفاصل محاطاً بمسافات عادية، فإن استخراج النص السابق له قد ينتج عنه إدراج مسافة زائدة في ذيل السلسلة المستخرجة إذا لم يتم تحييدها داخل النمط. ورغم أن هذه المسافة الطرفية قد تبدو خفية للعين المجردة، إلا أنها تغير من القيمة الرمزية للنص، مما يجعل المقارنات المنطقية اللاحقة وعمليات الفرز والتصنيف تفشل في مطابقة النصوص المتطابقة في مظهرها.
يتيح التعبير النمطي إدراج رمز المسافة البيضاء العام الممثل في الخط المائل العكسي متبوعاً بحرف الإس الصغير لضبط المسافات الحدودية بدقة. يمكن صياغة النمط بحيث يتطابق مع المسافة البيضاء الواقعة مباشرة قبل الحرف الفاصل ويستبعدها خارج أقواس الالتقاط، مما يضمن أن السلسلة المستخرجة تتوقف عند آخر حرف فعلي من الكلمة السابقة دون ترك فراغات ملحقة. يفيد هذا الضبط في توحيد معايير إدخال البيانات النصية وحماية النماذج من التباينات الإملائية الناجمة عن تذبذب المسافات بين المستخدمين أثناء التدوين الميداني للاستجابات.
علاوة على ذلك، توفر التعبيرات النمطية محددات الحدود الفاصلة للكلمات التي تمنع التطابق مع المقاطع النصية الجزئية التي تشبه الحرف المستهدف ولكنها تقع في جوف كلمات أخرى. يضمن استخدام محددات الحدود النصية ألا يتم اعتبار الحرف أو المقطع فاصلاً إلا إذا كان يمثل كياناً منفرداً ومحاطاً بحدود فاصلة واضحة، مما يرفع من حساسية ونوعية خوارزمية الاستخراج، ويجنب الباحث الوقوع في فخ التقطيع الخاطئ للمصطلحات اللغوية المعقدة التي تشترك في مقاطع صوتية أو كتابية مع محارف الفصل المعتمدة في تصميم الدراسة.
4. التطبيق الإجرائي خطوة بخطوة: استخراج النصوص قبل مقطع أو كلمة محددة
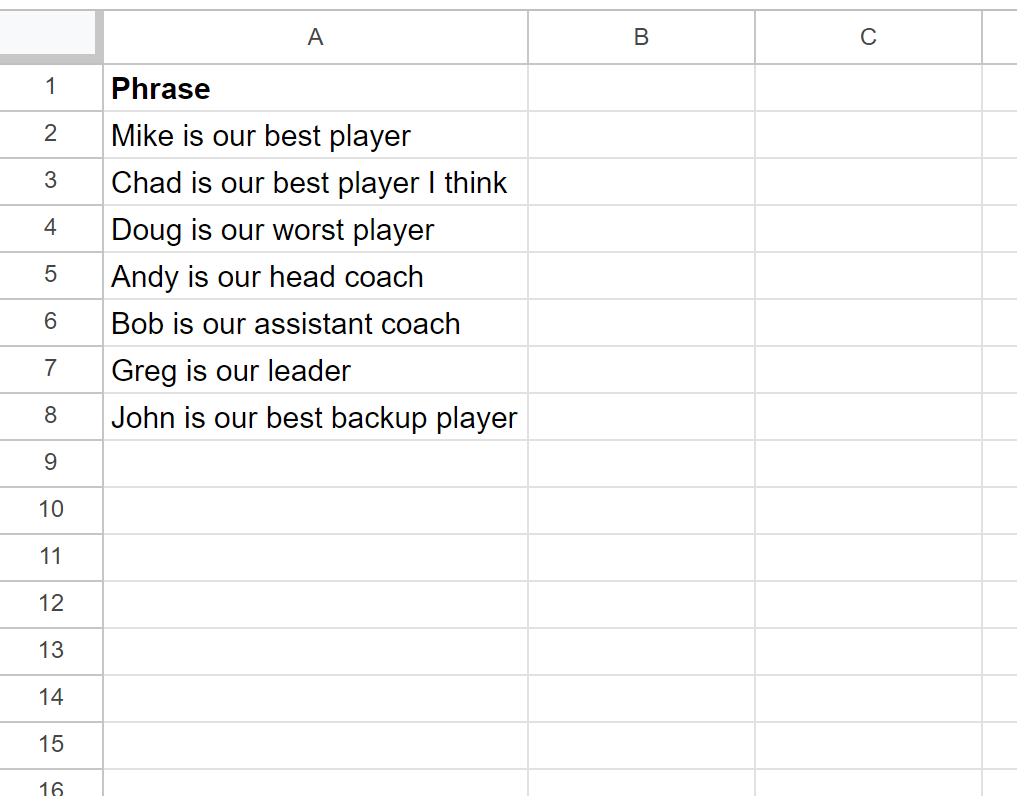
4.1 إعداد بيئة العمل وهيكلة جدول البيانات للتطبيق التجريبي
تبدأ المعالجة المنهجية للبيانات النصية بتجهيز بيئة العمل السحابية وضبط الهيكل التنظيمي لورقة البيانات لتفادي تداخل المخرجات أو تشويه البيانات الأصلية. يُخصص العمود الأول كعمود للمصدر النصي الخام، وتُراجع محتوياته للتأكد من تنسيقه كنص صريح عبر خيارات التنسيق في القائمة العلوية لتجنب أي تفسير خاطئ من المنصة للقيم التي قد تتشابه مع الأرقام أو التواريخ. يضمن هذا التنسيق المسبق أن محرك المعالجة سيتعامل مع كل إدخال كمتتالية محرفية مجردة تخضع لقواعد الفهارس النصية بدقة رياضية ثابتة.
يُنشأ العمود المجاور للعمود المصدر ويُخصص لاستقبال المخرجات المستخرجة، مع الحرص على تسمية رأس العمود بتسمية واضحة ومحددة إجرائياً تعبر عن المتغير المفصول. يُراعى عند ضبط خصائص عرض العمود الجديد توفير اتساع بصري مناسب وتفعيل خاصية التفاف النص عند الحاجة، وذلك لمراقبة النتائج اللحظية والتأكد من عدم حدوث تجاوزات مظهرية تغطي على الخلايا المجاورة. كما يجب فحص العمود المصدر بحثاً عن وجود مسافات بادئة أو محارف غير مطبوعة قد تكون تسربت من عمليات النسخ والاستيراد الخارجي، والعمل على إزالتها لتوحيد نقطة الانطلاق في كافة السجلات.
يتطلب الإعداد التجريبي الرصين عزل عينة تمثيلية عشوائية من الصفوف لفحص الصيغ واختبارها قبل تعميمها على كامل قاعدة البيانات. يتيح هذا الإجراء المعملي رصد أي حالات شاذة أو استثناءات تركيبية في النصوص الخام، مثل وجود سجلات خالية من الحرف الفاصل أو سجلات تبدأ بالحرف الفاصل مباشرة. إن التثبت من هذه الحالات الطرفية في بيئة تجريبية مصغرة يقلل من احتمالية حدوث أخطاء انتشار متسلسلة عند معالجة المصفوفات الكبيرة، ويؤكد جاهزية البيئة التشغيلية لتنفيذ الخطوات الإجرائية التالية بثقة وأمان.
4.2 بناء وتطبيق الصيغة لاستخراج النصوص السابقة لمقطع نصي محدد
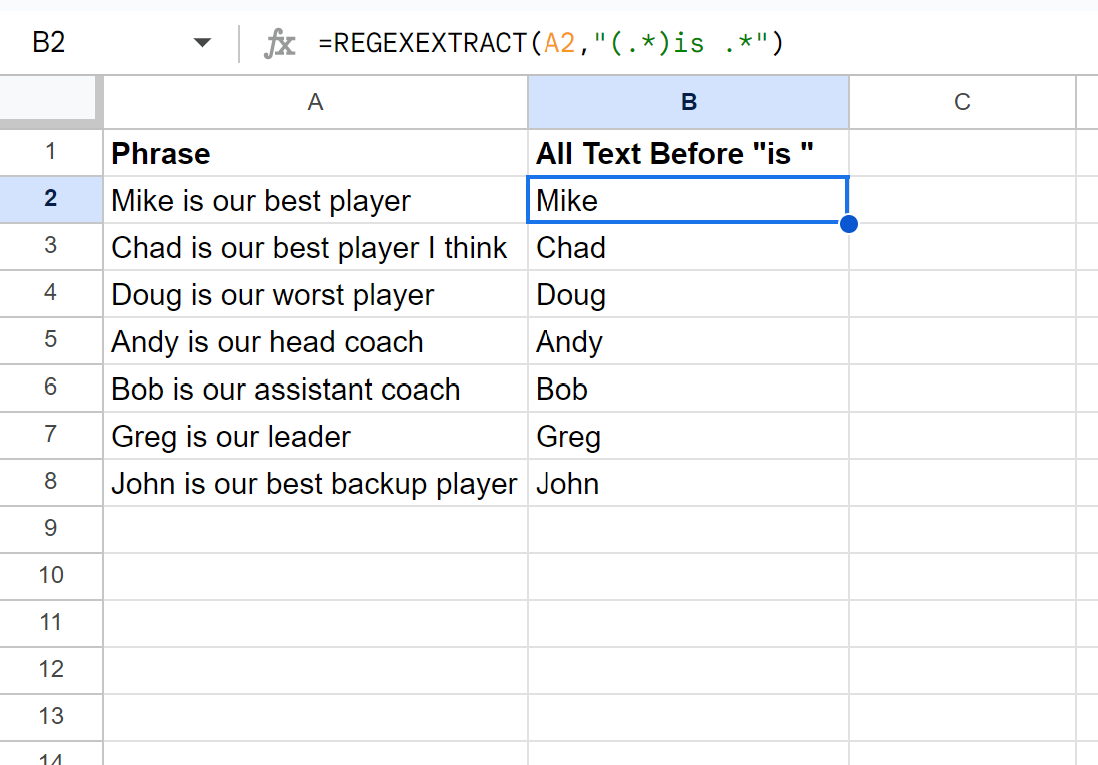
لتطبيق العملية الإجرائية لاستخراج النصوص السابقة لمقطع نصي أو كلمة محددة، يُكتب الأمر الحسابي في الخلية الأولى من عمود المخرجات بصورة دقيقة. على سبيل المثال، إذا كانت الخلية المصدر تحتوي على عبارات تشتمل على كلمة رابطة يراد استقطاع كل ما يسبقها، تُصاغ المعادلة باستدعاء دالة الاستخلاص النمطي وتمرير مرجع الخلية كمعامل أول، يليه التعبير النمطي المحصور بين علامتي تنصيص. يُكتب النمط متضمناً أقواس الالتقاط للمحارف السابقة متبوعة بالمقطع المستهدف وباقي المحارف العامة لضمان استيعاب السلسلة بالكامل وعزل الجزء المطلوب فقط داخل الخلية الحسابية.
بمجرد التأكد من صحة إرجاع الخلية الأولى للمقطع المطلوب بنجاح، يُصار إلى تعميم الصيغة على باقي صفوف عمود البيانات. يتم ذلك إما عبر النقر المزدوج على مقبض التعبئة في الزاوية السفلية اليسرى للخلية (أو اليمنى تِبعاً للغة الواجهة)، أو سحب الخلية لأسفل عبر المدى المطلوب. تعتمد هذه العملية على المراجع النسبية للخلايا؛ حيث يتغير رقم الصف تلقائياً ليتوافق مع كل سجل نصي على حدة. تظهر هنا القوة الحوسبية للنمط المكتوب، حيث يتكيف ديناميكياً مع الأطوال المتباينة للسلاسل النصية في كل صف، مستخلصاً المقطع السابق للكلمة المحددة بدقة متناهية ودون أي انحراف في موضع القطع.
يمكن تعديل المقطع النصي المستهدف في الصيغة بمرونة فائقة لتلبية متطلبات التحليل المتغيرة؛ فإذا رغب الباحث في تغيير نقطة الاستقطاع من مقطع لغوي إلى مقطع آخر، يكفي استبدال حروف المقطع داخل النمط التعبيري لتتغير المخرجات على امتداد الجدول تلقائياً. يُراعى عند كتابة المقاطع اللغوية باللغات اللاتينية التحقق من حساسية حالة الأحرف؛ حيث إن محرك المطابقة يميز بصورة افتراضية بين الحروف الكبيرة والصغيرة، مما يقتضي إما تثبيت النمط ليتطابق مع الحالة الفعلية أو استخدام وسوم تجاوز حساسية الأحرف لضمان شمولية المطابقة واستقرار النتائج المستخرجة عبر مختلف أنماط الإدخال.
4.3 التحقق المنهجي من صحة المخرجات وسلامة البيانات المستخلصة
تستلزم المنهجية العلمية في إدارة البيانات التحقق المنهجي من مخرجات عمليات الاستقطاع لضمان عدم حدوث أي حذف غير مقصود لأجزاء من المتغير الأصلي أو بقاء محارف طفيلية تشوه اتساق التحليل. تُجرى هذه المطابقة المنهجية عبر تطبيق فحص مقارن بين النص المستخرج والسلسلة النصية الأصلية. يمكن الاستعانة بدالة قياس طول السلسلة النصية لحساب عدد محارف النص المستخلص ومقارنتها رياضياً بموقع المقطع الفاصل في السلسلة الأصلية؛ حيث يجب أن يتطابق طول السلسلة المستخرجة مع فهرس بداية المقطع المستهدف مخصوماً منه أي مسافات تم تحييدها مسبقاً.
يُستكمل التحقق الإجرائي بتنفيذ اختبارات الفحص العشوائي للبيانات المتطرفة والحالات الشاذة داخل مجموعة البيانات؛ وتشمل هذه الحالات السجلات التي تحتوي على أطوال نصية قصيرة للغاية، أو تلك التي تكرر فيها المقطع المستهدف أكثر من مرة، أو السجلات التي احتوت على علامات ترقيم مجاورة للكلمة الفاصلة. يتأكد المحلل من خلال هذا الفحص المعمق من أن خوارزمية الاستخراج لم تسقط محارف هامة ولم تخلط بين الحدود الدلالية للمصطلحات، وهو ما يعزز موثوقية الأداة الإجرائية ويجعل البيانات جاهزة للانتقال إلى المراحل الأكثر تعقيداً في التحليل والنمذجة الإحصائية المتقدمة دون توجس من أخطاء البرمجة الموضعية.
يوثق الباحث خطوات التحقق ضمن تقرير مراقبة جودة البيانات؛ حيث يتم رصد معدل الحالات التي أنتجت تطابقاً صحيحاً مقارنة بالحالات التي أظهرت رسائل خطأ أو قيماً شاذة. إن بناء مصفوفة للتحقق تدمج بين المقاييس الآلية والفحص البصري المستند إلى عينات عشوائية يوفر دليلاً إمبريقياً على صدق عملية تنظيف البيانات، ويمنح المجتمع العلمي ثقة كاملة في النتائج المستخلصة لاحقاً من هذه المتغيرات، مؤكداً أن عمليات الاستقطاع عكست البنية الواقعية للظاهرة محل الدراسة بأعلى معايير الدقة والنزاهة الأكاديمية.
5. استخراج النصوص قبل الرموز الخاصة وعلامات الترقيم
5.1 مفهوم محارف الإلغاء (Escape Characters) وتطبيقاتها
تمتلك بعض المحارف والرموز دلالات وظيفية وتشغيلية خاصة ومحجوزة ضمن البنية البرمجية لمحركات التعبيرات النمطية؛ فالنقطة تمثل أي محرف، وعلامة النجمة تمثل التكرار، والأقواس تحدد مجموعات الالتقاط، وعلامة الجمع تشير إلى التكرار الإيجابي، وعلامة الاستفهام تفيد الاحتمالية أو الكسل. عندما يكون الرمز الفاصل المراد استخراج النص الواقع قبله هو أحد هذه الرموز المحجوزة ذاتها، ينشأ التباس برمجي لدى المحرك الداخلي؛ إذ يعجز عن التمييز التلقائي بين استخدام الرمز كمعامل تشغيلي واستخدامه كمحرف نصي مجرد يراد البحث عنه فعلياً داخل السلسلة النصية في الخلية.
لحل هذه المعضلة الرياضية، تُستخدم محارف الإلغاء، وتحديداً الخط المائل العكسي، الذي يوضع مباشرة قبل الرمز المحجوز لإلغاء وظيفته البرمجية وإجبار المحرك على معاملته كرمز نصي أصم. فعند الرغبة في استخراج ما قبل النقطة التقويمية أو الفاصلة العشرية، لا يمكن كتابة النقطة منفردة داخل النمط؛ لأنها ستطابق أي محرف وتفسد المنطق الحسابي، بل يجب كتابتها مسبوقة بالخط المائل العكسي. يؤدي هذا الإجراء التحييدي إلى استعادة المحرف لصفته النصية البسيطة، مما يمكن الخوارزمية من تحديد موقعه الدقيق داخل الخلية والاستقطاع بناءً عليه بأمان تام ودقة متناهية.
يعد إغفال إلغاء الرموز الخاصة أحد أبرز مصادر الأخطاء البرمجية الصامتة والظاهرة في معالجة البيانات النصية؛ حيث يؤدي أحياناً إلى توليد رسائل خطأ في بناء الجملة النمطية، أو الأسوأ من ذلك، إنتاج مخرجات خاطئة تبدو ظاهرياً كأنها صحيحة دون أن تثير تنبيهاً نظامياً. يفرض هذا التحدي على المشتغلين بتحليل البيانات النصية الإلمام الكامل بقائمة الرموز المحجوزة في محرك RE2 والتأكد دوماً من إسباقها بالخط المائل العكسي عند استهدافها كمحددات فصل، صوناً للمنطق الحسابي وحماية للجداول من الانهيارات البرمجية المتسلسلة.
5.2 استخراج النصوص السابقة لعلامات الترقيم القياسية (الفاصلة، النقطة، النقطتان)
تحتل علامات الترقيم القياسية، كالفاصلة والنقطة والنقطتين الرأسيتين، موضع الصدارة في تنظيم السجلات الأكاديمية وقوائم المراجع ومسوح استطلاع الرأي. ففي التوثيق المرجعي مثلاً، يفصل اسم العائلة للمؤلف عن باقي الاسم بفاصلة نظامية، ويتطلب استخراج الأسماء قبل الفواصل كتابة تعبير نمطي بسيط يستهدف الفاصلة كمحرف توقف صريح. بما أن الفاصلة العادية ليست من الرموز المحجوزة في معظم محركات الأنماط، فإن كتابتها لا تتطلب بالضرورة خطاً مائلاً عكسياً، إلا أن تحديد سلوك المسافات المحيطة بها يظل حاسماً لمنع ترحيل مسافات غير مرئية إلى مخرجات المتغير المستقل المفصول.
تستخدم النقطتان الرأسيتان بكثافة في تصنيف القياسات السلوكية وتسجيل الملاحظات الميدانية؛ حيث يسبق النقطتين الرأسيتين في العادة تصنيف المتغير أو الفئة التشخيصية، ويليهما الوصف التفصيلي للسلوك الملاحظ. لبناء نمط يستخرج الفئة قبل النقطتين الرأسيتين، يُصاغ النمط ليلتقط المحارف السابقة للرمز بدقة. وبالمثل، عند التعامل مع النصوص المنتهية بنقاط التوقف أو الفواصل المنقوطة، يُلغى المعنى التشغيلي للنقطة كما أسلفنا، ويُبنى النمط ليعزل المقطع الاستهلالي بدقة تضمن عدم فقدان أي جزء من التسمية الفئوية المعتمدة في الإطار المفاهيمي للبحث الميداني.
يسهم استقطاع النصوص السابقة لعلامات الترقيم في تسهيل عمليات المراجعة النقدية والتصنيف الآلي لمجموعات البيانات في الدراسات الببليومترية والتحليلات البعدية (Meta-analyses)؛ إذ يتيح توحيد أسماء الباحثين وعزل المسميات الرئيسية عن المسميات الفرعية للكتب والمقالات، وهو ما يحاكي الأساليب المتبعة في تجميع مصفوفات المراجعات المنهجية (Sardi et al., 2017؛ Veldkamp et al., 2020). إن نقاء النصوص المستخرجة قبل هذه العلامات يضمن دقة خوارزميات الربط والدمج بين جداول البيانات المتباينة دون الوقوع في أخطاء الازدواجية والتكرار غير المبرر.
5.3 التعامل مع الرموز الرياضية والحسابية وعلامات البريد الإلكتروني
يشيع في معالجة سجلات الاتصال والبيانات الإدارية استخراج أسماء المستخدمين الواقعة قبل رمز آت (@) في عناوين البريد الإلكتروني للمشاركين في البحوث. يمثل هذا الرمز محدداً مثالياً لا يتكرر في العنوان الواحد، مما يجعل استخراج ما قبله عملية مستقرة برمجياً عبر نمط يلتقط كافة المحارف السابقة للرمز. يفيد هذا التطبيق في عزل المعرفات الفردية واستخدامها كمعرفات مشفرة للمبحوثين تضمن سرية بياناتهم الشخصية وتوافقها مع المعايير الأخلاقية للبحث العلمي قبل إتاحة البيانات للتحليل الإحصائي المشترك.
تمثل المعرفات الرقمية المعقدة كالأكواد المعملية وأرقام العينات تحدياً إضافياً لاحتوائها المتكرر على واصلات شرطية (-) أو شرطات سفلية (_). نظراً لأن الواصلة قد تحمل معنى وظيفياً إذا وضعت داخل أقواس المجموعات لتحديد مجالات المحارف، فإن استهدافها كحرف فاصل يتطلب حذراً إجرائياً؛ حيث يُفضل إلغاء دلالتها بوضع الخط المائل العكسي قبلها عند الشك في السياق النمطي. يتيح ذلك تفكيك الأكواد متعددة المستويات واستخراج الجزء التأسيسي الأول الذي يعبر عن المؤسسة أو المعمل المنتج للبيانات قبل الرمز الفاصل بثبات مطلق.
يمتد هذا الإجراء الصارم إلى الرموز الحسابية والرياضية مثل إشارات الجمع والضرب وعلامات النسبة المئوية والدولار، والتي كثيراً ما تتداخل مع المتغيرات الاقتصادية والمالية المسجلة نصياً. ولأن هذه الرموز محجوزة حوسبياً بامتياز، فإن إلغاءها الصريح بالخط المائل العكسي يظل الشرط اللازم لكتابة صيغة ناجحة. إن التطبيق الصحيح لهذه المحاذير البرمجية يمنح الباحث مرونة غير محدودة في التعامل مع كافة أنماط التشفير والترميز المتبعة في بنوك البيانات المتخصصة دون المساس بسلامة المعالجة السحابية.
6. المنهجية التقليدية البديلة: الدمج الرياضي بين دالتي LEFT و FIND/SEARCH
6.1 التشريح الإجرائي للتركيبة =LEFT(A2, FIND(“حرف”, A2) – 1)
تمثل الصيغة التركيبية التي تدمج دالتي الاقتطاع الأيسر وتحديد الموضع الرياضي المنهجية الكلاسيكية الأكثر انتشاراً واستقراراً عبر تاريخ برمجيات الجداول الحسابية، قبل التوسع في دعم التعبيرات النمطية. تعتمد هذه المنهجية على منطق إحداثي بحت؛ حيث تقوم الدالة الداخلية بالبحث عن الحرف المستهدف داخل السلسلة النصية للخلية المصدرية وتحديد موقعه الرقمي الدقيق كفهرس عددي يبدأ من بداية السلسلة. يشكل هذا الرقم الإحداثي الأساس الذي تبنى عليه الخطوة الحسابية التالية لتحديد كمية المحارف المراد استخلاصها.
يكمن الأساس المنطقي الحاسم في هذه المعادلة في عملية الطرح الرياضي بمقدار واحد من ناتج دالة تحديد الموضع. فالرمز المبحوث عنه يقع عند الفهرس المكتشف، وإذا طُلب من دالة الاقتطاع الأيسر أخذ عدد من المحارف يعادل ذلك الفهرس، فإن النتيجة المستخرجة ستتضمن الحرف الفاصل ذاته في نهايتها. من هنا، فإن طرح الرقم واحد يضمن إزاحة نقطة القطع خطوة واحدة إلى الخلف، مما يؤدي إلى استبعاد الحرف الفاصل تماماً واقتصار المخرجات على المحارف الواقعة قبله حصراً، محققاً العزل النظيف للمتغير المطلوب.
تتولى الدالة الخارجية استقبال هذا البعد الإحداثي المعدل وتطبيقه على السلسلة النصية؛ حيث تبدأ العد من أول محرف في أقصى اليسار وتستمر حتى استيفاء العدد المحدد بدقة، ثم تقتطع هذا الجزء وتلقي بباقي السلسلة. تتميز هذه الطريقة الكلاسيكية بوضوح خطواتها المنطقية؛ إذ يمكن تفكيكها إلى مكونات مستقلة يسهل تتبعها وفحصها حسابياً، مما يجعلها مفضلة في البيئات التعليمية وتدريب الباحثين الجدد على مبادئ التفكير الخوارزمي وهندسة السلاسل النصية داخل جداول البيانات.
6.2 الفروق الأساسية بين دالتي FIND و SEARCH في المطابقة
عند بناء المنهجية التقليدية البديلة، يواجه المحلل خيارين لتحديد موضع الحرف الفاصل: دالة البحث الصارم ودالة البحث المرن. يكمن الفارق الجوهري الأول بينهما في حساسية حالة الأحرف عند التعامل مع اللغات الأجنبية التي تميز بين الحروف الكبيرة والصغيرة؛ فالدالة الأولى تمثل أداة مطابقة صارمة وحساسة للغاية لحالة الأحرف، ولا تعترف بالتطابق إلا إذا تطابقت الصورة الحرفية للرمز تماماً، في حين تتجاهل الدالة الثانية الفروق بين الحالات وتتعامل مع الحرف بشكله المجرد بصرف النظر عن كونه كبيراً أو صغيراً.
يتمثل الفارق الهيكلي الثاني في دعم المحارف البديلة الشاملة؛ حيث تدعم الدالة المرنة استخدام علامة النجمة كبديل لعدد غير محدد من المحارف وعلامة الاستفهام كبديل لمحرف فردي واحد، مما يمنحها مرونة شبيهة بالتعبيرات النمطية ولكن بصيغة مبسطة ومألوفة لمستخدمي برمجيات الحسابات. في المقابل، تفتقر الدالة الصارمة إلى دعم المحارف البديلة، وتتعامل مع علامات النجمة والاستفهام كمحارف نصية عادية تبحث عن وجودها الحرفي داخل السلسلة، وهو ما يجعلها خياراً مثالياً عند الرغبة في استهداف هذه الرموز تحديداً دون تفعيل سلوكها البديل.
تخضع المفاضلة بين الأداتين للمعايير التحليلية للبحث؛ فإذا كانت البيانات المجمعة تشتمل على ترميزات تتغير دلالتها بتغير حالة الحرف (مثل الرموز الكيميائية أو المعرفات الجينية)، تصبح الدالة الصارمة هي الخيار الإجباري للحيلولة دون خلط البيانات. أما إذا كانت السجلات النصية قد أدخلت يدوياً بواسطة مستجيبين متعددين دون توحيد قياسي لحالة الأحرف، فإن الدالة المرنة توفر مظلة أوسع تضمن التقاط الحرف الفاصل بصرف النظر عن التباين العرضي في أسلوب التدوين، مما يحمي النموذج من التوقف المفاجئ.
6.3 المقارنة التحليلية: REGEXEXTRACT في مواجهة LEFT + FIND والدالة الحديثة TEXTBEFORE
عند تقييم خيارات استخراج النصوص قبل حرف معين في بيئة جداول بيانات جوجل المعاصرة، تبرز ثلاثة مسارات رئيسية تتنافس في الكفاءة وسهولة الصيانة: دالة الاستخلاص النمطي، والتركيبة الكلاسيكية المزدوجة، والدالة التخصصية الحديثة لاستقطاع ما قبل النص (TEXTBEFORE) التي أطلقتها جوجل في تحديثاتها البرمجية لتوفير حل مباشر ومدمج. تتيح الدالة الحديثة إنجاز المهمة بوسيطين أساسيين فقط، مع توفير وسائط اختيارية للتحكم في تحديد تكرار الرمز المستهدف، وحساسية حالة الأحرف، ومعالجة عدم العثور على الرمز دون الحاجة إلى دوال مساعدة إضافية.
تتميز التركيبة الكلاسيكية بأعلى درجات التوافق التاريخي والبرمجي؛ فهي تعمل بسلاسة مطلقة عبر كافة إصدارات جداول الحسابات وتطبيقاتها دون أدنى احتمال لحدوث أخطاء عدم توافق النسخ. غير أن عيبها الرئيس يكمن في طول صيغتها وصعوبة قراءتها وصيانتها عند تعقد الشروط، فضلاً عن حاجتها لدوال استثناء إضافية لمعالجة الأخطاء. أما دالة الاستخلاص النمطي فتتفوق بشكل ساحق في التعامل مع الأنماط المعقدة والمتغيرة التي يصعب توصيفها بمجرد حرف ثابت، وتوفر مرونة استثنائية للمحلل المتقدم، وإن كانت تتطلب استيعاباً لقواعد لغة التعبيرات النمطية ومحركها الحسابي.
من حيث التأثير على سرعة استجابة ورقة البيانات عند معالجة عشرات الآلاف من الصفوف، تظهر الاختبارات الحوسبية أن الدالة التخصصية الحديثة والتركيبة الكلاسيكية تتمتعان بأداء خطي سريع للغاية واستهلاك منخفض للذاكرة، نظراً لبساطة عمليتهما الرياضية التي تقتصر على الفحص الإحداثي المباشر. في حين تستهلك التعبيرات النمطية قدراً أعلى قليلاً من وقت المعالجة لبناء آلة الحالة المنطقية لكل سجل نصي، مما يجعل الدالة الحديثة خياراً قياسياً للمهام اليومية المباشرة، مع الاحتفاظ بالتعبيرات النمطية للمهام المتقدمة التي تتطلب استقطاعاً مشروطاً ومعقداً لا تستوعبه الدوال الإحداثية الصماء.
7. إدارة الأخطاء وحالات عدم التطابق لضمان سلامة النماذج
7.1 تطويع دالة IFERROR للتعامل مع غياب الحرف المستهدف
يمثل بقاء رسائل الخطأ الحسابية، وتحديداً خطأ تعذر التطابق، مكشوفة داخل أوراق البيانات تهديداً مباشراً لسلامة التحليلات الإحصائية؛ إذ تؤدي هذه الأخطاء الصريحة إلى تعطل دوال التجميع والنمذجة الرياضية مثل المتوسطات، والانحرافات، وتحليلات الانحدار، مما ينجم عنه فجوات غير مقبولة في التقارير النهائية. تبرز هنا أهمية دالة إدارة الأخطاء كأداة وقائية بالغة الأهمية لتطويع وتأطير نتائج دوال الاستخراج، والتحكم في المخرجات البديلة التي ينبغي توليدها عند فشل العثور على الحرف الفاصل المبحوث عنه في السلسلة النصية المصدرية.
تُطبق هذه الدالة عبر تغليف صيغة الاستخراج الأساسية بالكامل داخلها، وتحديد القيمة الافتراضية المرتجعة في الوسيط الثاني للدالة. من بين الاستراتيجيات المنهجية الشائعة صياغة الدالة بحيث تُرجع السلسلة النصية الأصلية كاملة إذا لم يُعثر على الحرف الفاصل؛ إذ يُفترض في هذا السياق التحليلي أن غياب الرمز يعني أن المتغير المدخل يمثل وحدة واحدة غير مجزأة يجب الاحتفاظ بها دون تشويه. تضمن هذه الصياغة استمرار تدفق البيانات والحفاظ على شمولية العينة دون إسقاط أي من السجلات الميدانية المدخلة.
تتيح الدالة أيضاً توليد تنبيهات نصية مخصصة أو ترك الخلية فارغة تماماً وفقاً للبروتوكول المعياري المعتمد لإدارة البيانات في المشروع البحثي. فإذا كان غياب الحرف الفاصل يشير إلى وجود خلل إجرائي في جمع البيانات يتطلب مراجعة بشرية لاحقة، يمكن للدالة أن تُرجع قيمة تحذيرية محددة تسهل تصفية وعزل هذه الحالات لاحقاً. إن التوظيف الممنهج لهذه المعالجات الوقائية يرفع من صلابة النماذج الحسابية، ويحول دون توقف سلاسل المعالجة المؤتمتة عند مصادفة مدخلات غير نمطية.
7.2 المعالجة المسبقة للنصوص لتفادي الأخطاء الصامتة
تعد الأخطاء الصامتة أخطر أنواع العيوب التي تشوب معالجة البيانات النصية؛ لكونها لا تولد رسائل خطأ برمجية واضحة ولكنها تنتج بيانات مشوهة تؤثر سلباً على النتائج الإحصائية. تنشأ هذه الأخطاء غالباً عن تباينات خفية في المسافات البيضاء أو محارف التحكم غير القابلة للطباعة المستوردة مع البيانات الخام. لمواجهة هذه المعضلة، يتعين دمج دالة تشذيب النصوص (TRIM) ضمن الصيغة الاستخراجية لإزالة كافة المسافات الزائدة في أطراف الخلايا وقصر المسافات البينية على مسافة واحدة نقية، مما يضمن دقة رصد موقع الحرف الفاصل ومطابقته بدقة تامة.
يتكامل هذا الإجراء الوقائي مع استخدام دالة التنظيف (CLEAN) التي تتخصص في إقصاء المحارف غير المطبوعة ورموز التحكم الشائعة في الملفات النصية المستخرجة من قواعد البيانات القديمة أو عبر استخلاص صفحات الويب. هذه الرموز الخفية، التي تحتل أرقام ترميزية منخفضة في جداول المحارف، تسبب انكساراً مفاجئاً لخوارزميات المطابقة وتمنع الدوال من قراءة السلسلة النصية بصورة متصلة، ويؤدي تمرير الخلية عبر دالة التنظيف مسبقاً إلى نزع هذه الشوائب وإعادة السلسلة إلى حالتها المحرفية القياسية الصالحة للاستقطاع.
يمتد التطبيق المسبق إلى توحيد حالة الأحرف للغات الأجنبية قبل تنفيذ عمليات البحث المعقدة عبر استخدام دوال التحويل إلى الحالة الصغيرة أو الكبيرة. يفيد هذا التوحيد القياسي في تحييد تباينات الإدخال العشوائي وضمان أن دوال البحث الحساسة لحالة الأحرف ستتمكن من مطابقة الحرف الفاصل بغض النظر عن الكيفية التي دُوّن بها أصلاً. إن بناء خط معالجة نصي متكامل يجمع بين التنظيف والتشذيب والتوحيد قبل إطلاق دوال الاستخراج يمثل أفضل ممارسة احترافية لتفادي التلوث البياني وتعزيز مصداقية النتائج النهائية.
7.3 استراتيجيات التحقق من البيانات الشرطية والمنطق الاستثنائي
تتطلب إدارة البيانات البحثية المتقدمة بناء صيغ شرطية متداخلة تعتمد على الدوال المنطقية لفحص خصائص النص والتحقق من استيفائه للشروط الأولية قبل البدء في عمليات الاستخراج المعقدة. يمكن عبر دمج دالة الفحص الشرطي مع دوال العد والبحث التحقق مما إذا كان الحرف الفاصل موجوداً بالفعل داخل الخلية وما إذا كان يتكرر لمرة واحدة أو أكثر، وبناء مسارات معالجة متباينة تِبعاً لتلك الحالة، مما يجنب النظام تنفيذ عمليات نمطية مكلفة حسابياً على خلايا لا تتوافق مع المعايير المطلوبة للاستقطاع.
تشمل استراتيجيات المنطق الاستثنائي التعامل مع الحالات التي يبدأ فيها النص بالحرف الفاصل مباشرة؛ حيث إن استخراج ما قبل الحرف في هذه الحالة سيؤدي بالضرورة إلى إرجاع سلسلة فارغة طولها صفر محارف. قد تُفسر بعض التطبيقات اللاحقة هذه النتيجة الفارغة كخلل حسابي، مما يفرض إدراج شرط منطقي يكتشف هذه الحالات الطرفية ويمنحها قيمة صريحة محددة، كإسناد قيمة خالية مقننة أو استبدالها بترميز محدد يشير إلى انعدام القيمة السابقة وفقاً لقاموس الترميز المعتمد في الدراسة الميدانية.
تنعكس هذه الضوابط الشرطية إيجابياً على جودة البيانات المستخدمة في مصفوفات التحليل العاملي والتحليلات الإحصائية الوصفية والاستدلالية، حيث تضمن أن كل قيمة مستخرجة تمثل انعكاساً صادقاً للمتغير محل القياس وليست وليدة تشوه إجرائي أو تعامل غير منضبط مع الحالات الشاذة. إن التخطيط المسبق لكافة الاحتمالات المنطقية وتضمينها داخل البنية البرمجية لورقة البيانات يغلق الباب أمام التفسيرات العشوائية ويؤسس لقواعد بيانات رصينة تتوافق مع أعلى المعايير المنهجية المتعارف عليها في الأوساط الأكاديمية والمؤسسية الرائدة.
8. الأتمتة الشاملة للمعالجة النصية باستخدام ARRAYFORMULA
8.1 الانتقال من النطاق المفرد إلى المعالجة المصفوفية المتزامنة
يمثل تكرار كتابة المعادلات وسحبها يدوياً عبر آلاف الصفوف ممارسة غير فعالة تؤدي إلى تضخم حجم ملف جداول البيانات واستهلاك ذاكرة المتصفح بصورة مفرطة، فضلاً عن خطورة انقطاع الصيغ عند قيام مستخدمين متعددين بتحرير الورقة في البيئات السحابية المشتركة. تقدم دالة الصيغة المصفوفية حلاً حوسبياً متقدماً ينقل المعالجة من نطاق الخلية المفردة إلى نطاق المعالجة المصفوفية الشاملة، حيث تُكتب صيغة رياضية واحدة في رأس العمود لتتولى معالجة النطاق الرأسي بالكامل دفعة واحدة وتوزيع النتائج تلقائياً على امتداد الجدول.
لتطوير معادلة استخراج النصوص لتصبح مصفوفية، تُدمج دالة الاستخلاص النمطي داخل دالة المصفوفات، مع تحويل مرجع الخلية الفردية إلى مرجع نطاق عمودي مفتوح أو محدد. تقوم الخوارزمية الداخلية بأخذ النطاق بأكمله كمصفوفة مدخلات، وتمرير كل صف عبر محرك المطابقة النمطية، ثم ضخ النتائج تباعاً في الخلايا المقابلة. يحقق هذا الأسلوب أقصى درجات الكفاءة التشغيلية؛ حيث تتكفل صيغة واحدة بإدارة مئات الآلاف من العمليات الحسابية، مما يقلل من حجم البيانات المخزنة في بنية الملف ويسرع من زمن فتح الورقة وإعادة احتسابها سحابياً.
تضمن المعالجة المصفوفية المتزامنة التحديث التلقائي للمخرجات عند إضافة أي سجلات جديدة إلى أسفل الجدول مستقبلاً؛ إذ إن النطاق يراقب ديناميكياً ظهور أي مدخلات جديدة ويطبق عليها قواعد الاستقطاع فورياً دون حاجة لأي تدخل يدوي لتكرار الصيغة. هذه الخاصية تجعل الأتمتة المصفوفية الركيزة الأساسية لبناء لوحات التحكم المباشرة والأنظمة المتصلة باستمارات التجميع الإلكتروني التي تستقبل البيانات الميدانية على مدار الساعة وتتطلب معالجة فورية للمتغيرات النصية المستخلصة.
8.2 تقنيات التحكم في النطاقات المفتوحة وتجنب معالجة الصفوف الفارغة
ينطوي استخدام النطاقات المصفوفية المفتوحة على تحدٍ تشغيلي يتمثل في محاولة الدالة معالجة كافة الصفوف غير المستخدمة في ذيل ورقة العمل، مما يؤدي إلى ملء الخلايا الفارغة برسائل أخطاء تعذر التطابق أو إرجاع قيم فارغة وهمية تتسبب في تضخم حجم الورقة حتى الحد الأقصى المسموح به من الصفوف. للسيطرة على هذا السلوك غير المرغوب، يجب إدراج ضوابط منطقية تقيد عمل الصيغة المصفوفية وتوقفها تلقائياً عند انتهاء السجلات الفعلية المأهولة بالبيانات.
يتحقق هذا الانضباط عبر تضمين فحص شرطي في صدر التركيبة المصفوفية يتحقق مما إذا كانت الخلية المقابلة في العمود المصدر فارغة تماماً؛ فإذا تحقق الفراغ، تُرجع الدالة قيمة فارغة وتتوقف عن المعالجة، أما إذا احتوت الخلية على بيانات، فيتم تفعيل دالة الاستخراج فورياً. يضمن هذا الإجراء الوقائي بقاء الصفوف السفلية للجدول نظيفة تماماً من أي حسابات غير ضرورية، ويمنع هدر موارد المعالجة السحابية المخصصة للمستخدم، مما يحافظ على سرعة وسلاسة التصفح والتعديل داخل الملف.
يمكن تدعيم هذا التحكم باستخدام دوال التحقق من الفراغ لضبط المنطق المصفوفي بدقة أعلى. إن المحافظة على نظافة النطاقات المفتوحة وتطويقها بالشروط الاحترازية لا يخدم الجانب التشغيلي فحسب، بل يضمن أيضاً صحة الحسابات الإحصائية اللاحقة؛ حيث إن بعض دوال التحليل والفرز قد تعتبر المخرجات الناتجة عن الصيغ المصفوفية غير المنضبطة قيماً نصية تشوه أبعاد العينة وتزيد من حجم درجات الحرية في الاختبارات الإحصائية المعتمدة على تعداد الحالات النشطة.
8.3 التكامل مع دوال السلاسل المصفوفية الحديثة مثل BYROW و LAMBDA
شهدت جداول بيانات جوجل قفزة معمارية بإدخال الدوال المتقدمة المعتمدة على حساب التفاضل والتكامل اللامداوي والدوال التكرارية للسجلات مثل دالة التطبيق الصفي (BYROW). توفر هذه الدوال المعاصرة حلاً هيكلياً لبعض التحديات التاريخية؛ حيث إن بعض الدوال النصية والتعبيرات النمطية المركبة قد تواجه صعوبات في التمدد السلس عند دمجها مع دوال المصفوفات الكلاسيكية، مما يجعل استخدام بنية التكرار الصفي البديل الأكثر مرونة وموثوقية في معالجة السجلات النصية بصورة مستقلة ومضبوطة.
تعتمد آلية العمل في هذه البنية المتقدمة على تمرير النطاق العمودي إلى الدالة التكرارية التي تقوم باجتزاء كل صف كمعامل منفصل وتمريره إلى دالة برمجية مخصصة ومبنية محلياً داخل الصيغة. تُطبق دالة الاستخراج على كل سجل بصورة معزولة تماماً ثم تُجمع المخرجات في مصفوفة نهائية أنيقة دون أي تشويه في الذاكرة. يتميز هذا الأسلوب البرمجي برفع مقروئية الصيغ وتسهيل تتبع خطواتها المنطقية وصيانتها من قِبل الباحثين وفرق العمل التحليلية المتعددة.
أظهرت المقارنات الحسابية كفاءة استثنائية لهذه الدوال الحديثة في استهلاك الذاكرة وتفادي مشكلات انهيار العمليات المصفوفية عند التعامل مع السلاسل النصية المعقدة متعددة الأسطر. يمنح هذا التكامل التقني الباحثين والمحللين قدرة غير مسبوقة على بناء خطوط معالجة متقدمة تدمج بين قوة الاستخلاص النمطي والتنفيذ المصفوفي المنضبط، مما يعزز مكانة جداول بيانات جوجل كبيئة متكاملة لإعداد وتنقية البيانات الضخمة المجهزة للتحليل الإحصائي والنشر الأكاديمي الرصين.
9. تطبيقات متقدمة ودراسات حالة في الأبحاث والتحليل الواقعي
9.1 تنظيف وفصل المتغيرات في بيانات الاستبيانات النفسية والسلوكية
تشهد أبحاث العلوم النفسية والسلوكية اعتماداً متزايداً على المسوح الرقمية المقننة، والتي غالباً ما تسفر عن بيانات مركبة تتطلب تفكيكاً دقيقاً لضمان قياس السمات المستهدفة بصدق وثبات. في كثير من هذه الاستبيانات، تُدمج استجابات مقاييس ليكرت مع تفسيراتها اللفظية ضمن نفس الخلية لتبسيط واجهة الاستجابة للمستجيبين، مثل تدوين الاستجابة بصيغة رقمية متبوعة بشرطة ثم الوصف اللفظي المقابل. يستلزم التحليل الإحصائي استخراج المتغير الرقمي المستقل الواقع قبل الشرطة لعزل الدرجة الخام وتحويلها إلى مقياس كمي يخضع لنمذجة المعادلات البنائية أو التحليل العاملي التوكيدي.
يواجه الباحثون أيضاً تحدي فصل معرفات المشاركين عن رموز المجموعات التجريبية والضابطة، حيث تُشفر البيانات الميدانية في سلاسل مدمجة تضمن خصوصية المشاركين وتحدد انتماءهم البحثي في الوقت نفسه، مثل تدوين المعرف متبوعاً بنقطتين رأسيتين ثم كود المعالجة التجريبية. يتيح استخراج النص الواقع قبل هذا الرمز الفاصل استعادة الأرقام التعريفية الفردية للمستجيبين بدقة متناهية، وربطها بسجلات المتابعة الطولية أو مقاييس التتبع البعدي دون أي خلط بين أفراد العينة، وهو ما يماثل متطلبات الضبط التجريبي في دراسات التتبع السريري والتدخلات النفسية للأطفال وأسرهم (Hohlfeld et al., 2018).
يمتد التطبيق إلى معالجة التشخيصات الطبية والنفسية المركبة المستخرجة من سجلات الفحص الميداني؛ حيث تُسجل الفئات المرضية الأساسية متبوعة بفواصل تصنيفية تليها الأعراض الفرعية أو شدة الاضطراب، كما هو متبع في دراسات رصد أعراض القلق والاكتئاب عبر التطبيقات الذكية والرقمية (Ahmed et al., 2021). يسهم الاستقطاع الدقيق للنص السابق لتلك الفواصل في توليد فئات نوعية واضحة ومحددة تمكن الباحث من إجراء اختبارات مربع كاي ومقاييس التوافق والتطابق التشخيصي بين المحكمين بكفاءة إحصائية كاملة وموثوقية قياسية مثبتة.
9.2 استخراج المسارات والرموز من السجلات الرقمية وبيانات الاستخدام
تنتج منصات التفاعل الرقمي وتطبيقات المراقبة الحاسوبية سيلاً متدفقاً من ملفات السجلات التي تسجل تفاعلات المستخدمين بدقة فائقة. تتضمن هذه السجلات مسارات الروابط الرقمية (URLs) وعناوين النطاقات التي تتكدس فيها المعرفات التتبعية وأسماء الصفحات مفصولة بشرطات مائلة أو علامات استفهام تقيس معلمات الاسترجاع. يتطلب تحليل سلوك التصفح واستخلاص اهتمامات المستخدمين استقطاع المسار الأساسي الواقع قبل محدد الاستعلام الرقمي لتوصيف نمط التنقل الافتراضي وتقييم كثافة التفاعل مع الواجهات الرقمية المختلفة.
تتضح هذه الأهمية أيضاً في معالجة الطوابع الزمنية المعقدة المترتبة على استخدام أجهزة القياس السلوكي المعملي والتتبع الحركي، مثل دراسات التفاعل بين البشر والمنظومات الآلية الحديثة واستخدام الطائرات المسيرة (Tezza & Andujar, 2019). تُسجل البيانات في هذه البيئات المعملية بتوليفات تجمع بين الزمن المقيس بالثواني وأجزاء المئة متبوعاً بحرف مميز يشير إلى نوع الحركة أو الحساس النشط. يتيح استخراج النص الرقمي الواقع قبل هذا المحدد تصنيف التسلسل الزمني للأحداث ودمجه مع معدلات الاستجابة اللحظية لتحليل أوقات الرجع بدقة فيزيائية متناهية.
كما يُطبق هذا الاستخراج بصورة واسعة في تفكيك المعرفات الفريدة متعددة الأجزاء المستخدمة في قواعد البيانات الضخمة؛ حيث يُفصل كود المنطقة الجغرافية عن المعرف المتسلسل لمركز جمع البيانات قبل الرموز الفاصلة المعتمدة في بنية الترميز المؤسسي. يضمن هذا التفكيك المنهجي تسريع عمليات الفهرسة وإعداد الجداول المحورية التي ترصد الأنماط التوزيعية للمتغيرات عبر الأقاليم والمجموعات البحثية المتعددة، مما يرفع من جودة وكفاءة استخلاص المعرفة من السجلات الحاسوبية الرقمية الأولية.
9.3 التعامل مع النصوص متعددة اللغات والنصوص ثنائية الاتجاه (RTL)
يفرض التحليل الإحصائي المقارن واستقصاءات الرأي عبر الثقافات التعامل مع بيانات نصية هجينة تحتوي على مزيج من المحارف المكتوبة من اليمين إلى اليسار كاللسان العربي، والمحارف المكتوبة من اليسار إلى اليمين كاللسان الإنجليزي والأكواد الرقمية المعيارية. تنشأ عن هذا التجاور اللغوي ظاهرة بصرية خادعة تُعرف بتشوهات ثنائية الاتجاه، حيث يبدو موقع الرمز الفاصل بصرياً في مكان مغاير لموقعه الحسابي الفعلي داخل السلسلة المحرفية في الذاكرة، مما يسبب ارتباكاً كبيراً للمحللين غير المتمرسين في الهندسة النصية.
لضمان دقة الاستقطاع في هذه البيئات المعقدة، يجب التمسك بالمنطق الحسابي لترتيب الفهارس؛ فمحرك التعبيرات النمطية يقرأ المحارف وفق تسلسل تخزينها المنطقي الخام بغض النظر عن اتجاه العرض الرسومي على الشاشة. يفيد استخدام المحددات التعبيرية الصارمة في تحديد الحرف الفاصل المشترك، مثل الأقواس أو الفواصل، وعزل الجزء العربي أو اللاتيني بدقة دون أن تتأثر النتيجة باتجاه المحاذاة الافتراضية للخلية، وهو ما يضمن استقرار الكلمات المجمعة في مشاريع المعاجم ودراسات البنية المفرداتية الضخمة (Tse et al., 2016).
يتطلب هذا الاستقرار التحليلي أيضاً الانتباه إلى علامات الترقيم المشتركة التي قد تُدخل بترميزات مختلفة تِبعاً للوحة المفاتيح المستخدمة أثناء الرصد، كالفارق بين الفاصلة العربية والفاصلة اللاتينية. تتيح التعبيرات النمطية صياغة فئات محارف بديلة تضم كافة صور الفاصلة المحتملة داخل نمط واحد، مما يكفل التقاط الحرف الفاصل والاستقطاع قبله بنجاح أياً كانت لغة الإدخال. إن ضبط معايير التعامل مع التنوع اللغوي يحمي البحوث العابرة للثقافات من تشوهات العينات ويسهم في بناء نتائج قابلة للمقارنة والتعميم الإحصائي الرصين.
10. المقارنة المعيارية، أفضل الممارسات، ودليل تحسين الأداء
10.1 معايير التوثيق الأكاديمي وتسهيل صيانة ورقة الحسابات
تقتضي معايير النزاهة العلمية وقابلية إعادة الإنتاج في البحوث الكمية توثيقاً دقيقاً لكافة الخطوات الخوارزمية والصيغ الحسابية المستخدمة في تنظيف واستخلاص المتغيرات من البيانات الخام. عندما تتضمن جداول البيانات تعبيرات نمطية معقدة أو معادلات مصفوفية مركبة، يصبح من الضروري إدراج تعليقات نصية وملاحظات توثيقية شارحة للمنطق الداخلي للتعبير في رأس الأعمدة، مع بيان الغاية من كل مكمم أو رمز إلغاء تم توظيفه، مما يتيح للباحثين الآخرين والمراجعين المستقلين تتبع المعالجة وفحصها بدقة وموثوقية كاملة.
يعزز استخدام النطاقات المسماة (Named Ranges) من وضوح بنية المعادلات الحسابية وسهولة صيانتها عبر الزمن؛ فبدلاً من استخدام مراجع الخلايا المبهمة التي يصعب تتبعها في الجداول الممتدة، يمكن إطلاق تسميات وصفية دالة على أعمدة المصدر والنتائج. يرفع هذا التجريد المفاهيمي من مقروئية الصيغ الرياضية ويقلل بصورة ملموسة من احتمالية حدوث أخطاء المراجع النسبية أثناء تعديل هيكل ورقة الحسابات أو نقل أجزاء منها لدمجها مع قواعد بيانات شقيقة في مراحل لاحقة من المشروع البحثي.
ينبغي على المؤسسات البحثية والمختبرات التحليلية تطوير دليل تشغيلي داخلي يقنن قواعد المعالجة النصية الموحدة وتسمية المتغيرات وطرق استخراج النصوص السابقة للمحارف. يضمن هذا الدليل المرجعي التزام كافة المساعدين والباحثين بنفس الإجراءات القياسية، وتجنب استخدام صيغ متضاربة لمعالجة نفس الظاهرة البيانية، مما يرفع من مستوى الاتساق الداخلي للمشاريع الكبرى ويسهل عمليات التدقيق الدوري ومراجعة الجودة الشاملة للمخرجات الرقمية قبل النشر.
10.2 اختبارات الأداء وسرعة المعالجة على المجموعات الضخمة (Big Data)
تواجه جداول البيانات السحابية تحديات حوسبية حقيقية عند تصاعد حجم العينات إلى عشرات ومئات الآلاف من السجلات النصية، حيث يمكن أن تؤدي التعبيرات النمطية غير المحسنة أو الصيغ المصفوفية المفرطة إلى بطء ملحوظ في تحديث الورقة وتجاوز المهلة الزمنية المسموحة لتشغيل الخوادم السحابية. تتطلب الكفاءة التشغيلية إجراء اختبارات مقارنة معيارية لزمن التنفيذ، ورصد مدى استهلاك الذاكرة المخصصة للملف عند استخدام المنهجيات المتباينة لاختيار الأكثر ملاءمة لطبيعة وحجم البيانات المستهدفة.
تضع منصة جداول بيانات جوجل حدوداً برمجية صارمة على تعقيد الأنماط وعدد العمليات المتزامنة المسموح بها في المستند الواحد لتجنب حجب الخدمة واستهلاك الخوادم المشتركة. للتعامل الحكيم مع هذه القيود في المشاريع الضخمة، يُنصح بتطبيق استراتيجية التجميد المرحلي للبيانات عبر تحويل الصيغ الحسابية إلى قيم نصية ثابتة ومستقرة بمجرد اكتمال الاستخراج والتحقق المنهجي من دقته. يتم ذلك عبر نسخ النتائج ولصقها كقيم مجردة، مما يعفي ورقة البيانات من إعادة تشغيل محركات المطابقة النمطية في كل مرة يُعاد فيها فتح الملف أو تصفية صفوفه.
تظهر المقارنات المعيارية الميدانية في معالجة التغريدات وبيانات الشبكات التفاعلية الكبيرة أن تجميد القيم الوسيطة يقلل من زمن المعالجة الإجمالي بنسبة تتجاوز ثمانين بالمئة مقارنة بالإبقاء على الصيغ الحية متصلة بالخوادم، وهو ما يتفق مع التوصيات التقنية لرصد التفاعلات والمشاعر في البيانات المليونية الكثيفة (Safa et al., 2021). يتيح هذا النهج الهندسي الجمع بين مرونة وأتمتة الصيغ السحابية في المراحل الأولية، والاستقرار الأدائي الكامل عند الانتقال إلى التحليلات الإحصائية النهائية والنمذجة الرياضية المعقدة.
10.3 دليل استكشاف الأخطاء والحلول السريعة للحالات الشائذة
لتسهيل معالجة المشكلات التقنية التي تواجه المحللين أثناء استخراج النصوص، يوضح الجدول التحليلي التالي أبرز رسائل الأخطاء الشائعة، ودلالاتها الحوسبية المباشرة، مع تقديم الحلول المنهجية الفورية لمعالجتها وضمان استقرار النموذج:
- رسالة الخطأ #N/A (تعذر العثور على تطابق): تدل برمجياً على غياب الحرف الفاصل أو فشل النمط في مواءمة أي محرف داخل السلسلة النصية؛ وتُعالج بتغليف الصيغة بدالة إدارة الأخطاء وإرجاع القيمة الأصلية أو قيمة بديلة منضبطة.
- رسالة الخطأ #VALUE! (خطأ في نوع القيمة أو المعامل): تدل على تمرير نوع بيانات غير صالح للدالة أو كتابة نمط غير صالح يخالف قواعد محرك RE2؛ وتُعالج بالتحقق من إغلاق الأقواس وإلغاء الرموز الخاصة وضمان كون المدخل نصاً.
- رسالة الخطأ #REF! (خطأ التمدد أو المراجع): تدل على محاولة الصيغة المصفوفية أو مجموعات الالتقاط المتعددة التمدد في خلايا تحتوي مسبقاً على بيانات؛ وتُعالج بتفريغ الخلايا المجاورة أو تقييد مجموعة الالتقاط بقوس فردي محدد.
- ظهور مخرجات فارغة دون رسالة خطأ صريحة: تدل على وقوع الحرف الفاصل في مستهل السلسلة النصية مباشرة، أو وجود مسافات بيضاء غير محسوبة؛ وتُعالج بتطبيق دوال التشذيب وإدراج شروط استثنائية لرصد الحالات الاستهلالية.
- استقطاع أطول من المطلوب متجاوزاً الحرف الفاصل الأول: تدل على استخدام مكمم جشع في بيئة تتكرر فيها المحارف الفاصلة داخل الخلية الواحدة؛ وتُعالج بتحويل المكمم إلى النمط الكسول عبر إدراج علامة الاستفهام فوراً بعد مكمم التكرار.
يوصى دوماً باتباع قائمة فحص معيارية قبل اعتماد وتصدير البيانات المستخلصة نحو البرمجيات الإحصائية المتخصصة. تتضمن هذه القائمة التأكد من خلو أعمدة المخرجات من رسائل الأخطاء غير المعالجة، والتحقق من تطابق حجم العينة المستخرجة مع حجم العينة الأصلية، والتثبت من خلو النصوص من المسافات الطرفية المتسللة، وإجراء فحص إحداثي عشوائي على نسب محددة من الصفوف. إن الالتزام الصارم بهذا البروتوكول يمثل خط الدفاع الأخير لحماية النزاهة العلمية للبيانات وتأكيد مصداقية النتائج الإحصائية المشتقة منها.
الخاتمة
استعرض هذا الدليل الأكاديمي الشامل الأسس النظرية والمنهجيات الإجرائية المتقدمة لاستخراج النصوص الواقعة قبل محرف أو رمز معين في بيئة جداول بيانات جوجل. وقد اتضح من خلال التفكيك المنهجي أن التعامل مع السلاسل النصية لا يقتصر على مجرد استقطاع ميكانيكي عارض، بل هو عملية هندسية تقتضي فهماً عميقاً للبنية الرياضية للمحارف، وآليات عمل محركات التعبيرات النمطية ومكتباتها الحوسبية المتقدمة، والفروق الجوهرية بين خوارزميات المطابقة الجشعة والكسولة لضمان دقة نقطة التوقف واستقرار المخرجات عبر مختلف أنماط الإدخال المعقدة.
كما أظهرت المقارنة المعيارية تكامل المسارات التقنية المتعددة؛ حيث توفر الدوال التخصصية الحديثة والتركيبات الكلاسيكية حلولاً سريعة ومستقرة للمهام المباشرة، في حين تظل التعبيرات النمطية الأداة الأكثر تجريداً وقوة في معالجة الحالات الشاذة والأنماط المعقدة متعددة الشروط. ويمثل دمج هذه الأدوات مع الصيغ المصفوفية ودوال التكرار الصفي المعاصرة قمة الأتمتة السحابية؛ إذ ينقل معالجة البيانات من النطاق اليدوي العرضة للأخطاء إلى خطوط إنتاج بيانات ذاتية التشغيل تتسم بالسرعة والنقاء والكفاءة الحوسبية المطلوبة لإدارة البيانات البحثية والميدانية الكبيرة.
ختاماً، إن ضبط هذه المهارات البرمجية وتوثيقها وفق المعايير العلمية الصارمة يمنح الباحثين والمحللين استقلالية تامة في تجهيز متغيراتهم وتنقيتها من الشوائب الإجرائية قبل إخضاعها للتحليل الإحصائي الاستدلالي. إن سلامة الاستنتاجات العلمية وصحتها ترتبط ارتباطاً وثيقاً بسلامة ونقاء المدخلات الأولية؛ مما يجعل من إتقان أساليب معالجة السلاسل النصية داخل بيئات الحوسبة السحابية ركيزة لا غنى عنها لبناء نماذج تفسيرية وتنبؤية تتسم بالرصانة والصدق وقابلية التعميم في مختلف مجالات المعرفة الإنسانية والتطبيقية المعاصرة.
المراجع
- Ahmed, A., Ali, N., Aziz, S., Abd-Alrazaq, A. A., Hassan, A. O., Khalifa, M., et al. (2021). A review of mobile chatbot apps for anxiety and depression and their self-care features. Computer Methods and Programs in Biomedicine Update. https://doi.org/10.1016/j.cmpbup.2021.100012
- Aldhyani, T. H. H., Alsubari, S. N., Alshebami, A. S., Alkahtani, H. S., & Ahmed, Z. A. T. (2022). Detecting and Analyzing Suicidal Ideation on Social Media Using Deep Learning and Machine Learning Models. International Journal of Environmental Research and Public Health. https://doi.org/10.3390/ijerph191912635
- Alkinani, M. H., Khan, W. Z., & Arshad, Q. (2020). Detecting Human Driver Inattentive and Aggressive Driving Behavior Using Deep Learning: Recent Advances, Requirements and Open Challenges. IEEE Access. https://doi.org/10.1109/access.2020.2999829
- Hohlfeld, A., Harty, M., & Engel, M. E. (2018). Parents of children with disabilities: A systematic review of parenting interventions and self-efficacy. African Journal of Disability. https://doi.org/10.4102/ajod.v7i0.437
- Safa, R., Bayat, P., & Moghtader, L. (2021). Automatic detection of depression symptoms in twitter using multimodal analysis. The Journal of Supercomputing. https://doi.org/10.1007/s11227-021-04040-8
- Sardi, L., Idri, A., & Fernández‐Alemán, J. L. (2017). A systematic review of gamification in e-Health. Journal of Biomedical Informatics. https://doi.org/10.1016/j.jbi.2017.05.011
- Tezza, D., & Andujar, M. (2019). The State-of-the-Art of Human–Drone Interaction: A Survey. IEEE Access. https://doi.org/10.1109/access.2019.2953900
- Tse, C.-S., Yap, M. J.-M., Chan, Y.-L., Sze, W. P., Shaoul, C., & Lin, D. (2016). The Chinese Lexicon Project: A megastudy of lexical decision performance for 25,000+ traditional Chinese two-character compound words. Behavior Research Methods. https://doi.org/10.3758/s13428-016-0810-5
- Veldkamp, A., van de Grint, L., Knippels, M.-C. P. J., & van Joolingen, W. (2020). Escape education: A systematic review on escape rooms in education. Educational Research Review. https://doi.org/10.1016/j.edurev.2020.100364
- Zhang, Y., Lyu, H., Liu, Y., Zhang, X., Wang, Y., & Luo, J. (2021). Monitoring Depression Trends on Twitter During the COVID-19 Pandemic: Observational Study. JMIR Infodemiology. https://doi.org/10.2196/26769