
تعتبر معالجة السلاسل النصية (String Manipulation) وتفكيك النصوص من الركائز الجوهرية في علم إدارة البيانات والتحليل الرقمي المعاصر. في بيئات العمل الحديثة التي تعتمد على الحوسبة السحابية، تبرز منصة جداول بيانات جوجل (Google Sheets) كواحدة من أقوى الأدوات المتاحة للمحللين والمؤسسات لمعالجة البيانات الضخمة وهيكلتها بصورة منهجية. ومن بين التحديات الإجرائية المتكررة التي تواجه مديري قواعد البيانات ومحللي الأعمال، يبرز التحدي التقني المتمثل في استخلاص الوحدة المفردية الأولى أو ما يعرف بـ “الكلمة الأولى” من خلية تحتوي على نص مركب، سواء كان هذا النص اسماً كاملاً لموظف، أو وصفاً لمنتج، أو معرّفاً فريداً يتضمن حقولاً مدمجة.
يعود هذا التحدي إلى الطبيعة غير المهيكلة للبيانات المدخلة يدوياً أو المستوردة عبر واجهات برمجة التطبيقات (APIs) وملفات CSV النصية؛ حيث يتم تخزين المعلومات الحيوية ضمن سلسلة رمزية واحدة تفصل بين أجزائها مسافات بيضاء أو فواصل خاصة. إن القدرة على استخراج الكلمة الأولى بكفاءة ودقة لا تقتصر على كونها عملية تنسيقية بحتة، بل هي خطوة تحويلية أساسية لتنقية البيانات (Data Cleansing)، وتطبيع الجداول (Data Normalization)، وإعداد المدخلات لمراحل التحليل الإحصائي المتقدم والتصنيف الآلي.
يهدف هذا المقال الأكاديمي الموسع إلى تقديم دراسة معمقة وتفكيك تقني شامل لكافة السبل والآليات الرياضية والبرمجية المتاحة داخل بيئة جداول بيانات جوجل لتحقيق هذا الغرض. سنقوم بتشريح الدوال النصية التقليدية، واستكشاف المنطق التوافقي بين دالتي القص والبحث، والتعمق في الحلول المصفوفية، وتوظيف قوة محرك التعابير النمطية الحسابي (Regular Expressions). كما سيتناول الطرح استراتيجيات الحماية البرمجية لمعالجة الحالات الحدية والشاذة، بما يضمن بناء نماذج حسابية تتسم بالمرونة، وقابلية التوسع، والكفاءة العالية في إدارة موارد الذاكرة الحسابية.
1. مقدمة عامة حول معالجة النصوص واستخراج البيانات في جداول بيانات جوجل
شهدت نظم الجداول الحسابية تطوراً هائلاً منذ نشأة الفكرة الأولى للحوسبة الجدولية؛ حيث تحولت جداول بيانات جوجل منذ إطلاقها الأولي عقب الاستحواذ على تقنية XL2Web إلى بيئة حوسبة سحابية متكاملة تدير ملايين العمليات الحسابية المتزامنة يومياً. لم تعد هذه الجداول مجرد أدوات لإجراء العمليات الحسابية البسيطة والجمع والطرح، بل تطورت لتصبح محركات لمعالجة البيانات النصية المعقدة (Text Mining) وتحويل المدخلات النصية الخام إلى مخرجات ذات قيمة تحليلية وقابلة للربط العلائقي عبر مختلف قواعد البيانات.
تعتمد هندسة معالجة النصوص في بيئة جوجل على معايير ترميز المحارف العالمية، وتحديداً نظام الترميز الموحد (Unicode Transformation Format – UTF-8). يتيح هذا النظام للمنصة التعامل بمرونة مطلقة مع مختلف اللغات والأنظمة الكتابية حول العالم، بما فيها اللغات التي تُكتب من اليمين إلى اليسار مثل اللغة العربية. وتتكامل هذه البنية مع شجرة حسابية مرنة تقيّم الدوال النصية بشكل آني، مما يتيح استخراج المقاطع الجزئية بناءً على محددات مكانية أو دلالية وبأقل استهلاك ممكن للموارد المعالجة السحابية الموزعة.
2. أهمية تقسيم السلاسل النصية واستخلاص الوحدات المفردية
يمثل استخلاص الوحدات المفردية (Tokenization) الخطوة التأسيسية الأولى في معالجة اللغات الطبيعية وهندسة البيانات النصية؛ حيث تشير هذه العملية إلى تفكيك سلسلة متصلة من المحارف إلى عناصر دلالية أصغر حجماً وأكثر قابلية للتحليل والتصنيف. في سياق نظم إدارة الأعمال والمؤسسات الأكاديمية، تظهر الحاجة الملحة لعزل الكلمة الأولى بوصفها الحامل الرئيس للمعلومة المفتاحية؛ مثل الاسم الشخصي الأول في سجلات المستفيدين، أو الرمز التعريفي للمصنّع في معرفات المنتجات، أو الفعل الأساسي في تصنيفات الأوامر والعمليات الإدارية.
إن غياب الهيكلة الدقيقة للسلاسل النصية يؤدي إلى تعقيد عمليات البحث والاستعلام، وتضخم احتمالية حدوث أخطاء التطابق غير الدقيق أثناء تنفيذ عمليات الربط المتقاطع (VLOOKUP أو XLOOKUP). عندما يتم تجريد الكلمة الأولى من سياقها الموسع، يصبح بالإمكان إجراء عمليات فرز هرمي وتجميع إحصائي دقيق، ما يرفع من موثوقية قواعد البيانات ويقلل من مستويات التكرار والازدواجية في التقارير الإدارية والتنفيذية بصورة جذرية.
علاوة على ذلك، تسهم عملية تجزئة النصوص في تسهيل عمليات المزامنة بين الأنظمة غير المتجانسة. فعند نقل البيانات بين جداول بيانات جوجل وأنظمة إدارة علاقات العملاء (CRM) أو أنظمة تخطيط موارد المؤسسات (ERP)، غالباً ما تفرض تلك الأنظمة شروطاً حاسمة تقتضي فصل الاسم الأول عن الاسم الأخير أو تجزئة رموز المخازن. من هنا تتحول عملية استخراج الكلمة الأولى من مجرد مهارة تنسيقية إلى ضرورة وظيفية تضمن استمرارية تدفق البيانات دون انقطاع.
3. نظرة شمولية على البنية المنطقية للصيغة المستهدفة
ترتكز البنية المنطقية لاستخلاص الكلمة الأولى في الجداول الإلكترونية على محاكاة الإدراك البشري للنص؛ فالإنسان يتعرف على نهاية الكلمة الأولى غريزياً بمجرد وقوع بصره على أول مسافة فاصلة تفصل بين مقطعين لغويين. من المنظور الخوارزمي، تترجم هذه العملية إلى تحديد الإحداثي الرقمي (Character Index) لأول مسافة فارغة في السلسلة النصية، ثم توجيه مؤشر القراءة ليقتطع كافة المحارف الواقعة على يسار هذا الإحداثي (أو على يمينه بحسب اتجاه النص المعالج) وصولاً إلى بداية السلسلة.
تتشكل الصيغة الكلاسيكية الأكثر انتشاراً وموثوقية في بيئات الحوسبة الجدولية من تضافر وظيفي بين دالتين أساسيتين: دالة الاقتطاع النصي الأيسر ودالة البحث عن الموضع المادي للمحرف. تعمل هاتان الدالتان بتناغم تام؛ حيث تمثل إحداهما أداة المسح والقياس التي تحدد نقطة القطع بدقة متناهية، بينما تمثل الأخرى أداة التنفيذ الميكانيكي التي تقطع السلسلة وتعيد الناتج إلى الخلية المستهدفة دون تشويه للبنية الأصلية للمدخلات.
ومع ذلك، فإن هذا المنطق الرياضي الصارم يواجه مأزقاً هيكلياً عندما تتكون الخلية من كلمة مفردة لا تتبعها أي مسافة على الإطلاق. هنا تنهار خوارزمية البحث الموضعي التقليدية وتنتج أخطاء برمجية مشهورة تعيق العمليات الحسابية المتتالية. من هذا المنطلق، تتضمن البنية المنطقية المتقدمة طبقة حماية اصطناعية تعتمد على الربط النصي (Concatenation) لضمان توفير بيئة صلبة لا تفشل تحت أي ظرف من ظروف الإدخال الواقعية.
4. التشريح التركيبي والوظيفي لدالتي LEFT و FIND
يمثل الفهم العميق للبنية التحتية للدوال البرمجية في جداول بيانات جوجل الشرط المسبق لبناء صيغ حسابية مستقرة وعالية الكفاءة. تعمل دوال معالجة النصوص كصناديق سوداء خوارزمية تأخذ مدخلات محددة وتخضعها لقواعد منطقية جبرية تعيد من خلالها قيماً جديدة. ويعتبر الثنائي المتكون من دالتي الاقتطاع والبحث من أقدم الحلول الهندسية التي تم توارثها في لغات وبرمجيات الجداول عبر عقود من التطوير، ولا تزال تحافظ على مكانتها كأسرع العمليات وأقلها استهلاكاً للذاكرة المؤقتة مقارنة بمحركات النصوص المتقدمة.
تتميز كل دالة من هاتين الدالتين بمحددات بنيوية صارمة تحدد طريقة تعاملها مع المحارف والأرقام والرموز الخاصة، كما تتباين طريقة استجابتهما لنوعية البيانات المدخلة وحالة الأحرف والترميز الرقمي؛ مما يجعل دراسة كل دالة على حدة خطوة تحليلية لا غنى عنها لأي باحث أو محلل بيانات محترف.
5. الخصائص الحسابية والرياضية لدالة LEFT النصية
تُعرّف دالة LEFT في جداول بيانات جوجل بأنها دالة رياضية-نصية صُممت لاقتطاع عدد معين من المحارف بدءاً من أقصى الطرف الأيسر لسلسلة نصية معطاة. تتبع الدالة صيغة قياسية تتكون من وسيطتين: الوسيطة الأولى تمثل النص المصدر الخاضع للاقتطاع (string)، والوسيطة الثانية تمثل المعامل العددي الصحيح الذي يحدد كمية المحارف المراد استرجاعها (number_of_characters). وفي حال إغفال المعامل العددي، تفترض الدالة تلقائياً قيمته لتكون واحداً صحيحاً.
من الناحية الحسابية الداخلية، تتعامل الدالة مع السلسلة النصية كمصفوفة أحادية البعد من المحارف المرتبة تصاعدياً وفق مؤشرات رقمية تبدأ من القيمة واحد وصولاً إلى الطول الإجمالي للنص الممثل بالقيمة التي تعيدها دالة LEN. إذا كانت القيمة المطلوبة للاقتطاع مساوية للصفر، تعيد الدالة نصاً فارغاً؛ أما إذا تجاوزت القيمة العددية الطول الفعلي الإجمالي للسلسلة النصية، فإن الدالة تُظهر مرونة فائقة وتكتفي بإعادة النص كاملاً دون إطلاق أي أخطاء حسابية، وهي ميزة جوهرية سيتم استغلالها لاحقاً لتعزيز أمان الصيغ المركبة.
تجدر الإشارة إلى أن سلوك دالة LEFT يظل مرتبطاً بمفهوم الاتجاه المادي للأحرف داخل الذاكرة الحاسوبية؛ فهي تبدأ القراءة دوماً من البايت الأول الممثل للمحرف في الذاكرة بصرف النظر عن اتجاه العرض المرئي للغة داخل واجهة المستخدم. وبالتالي، فإن استخدامها يتطلب إدراكاً هندسياً لطبيعة تمثيل المحارف المكتوبة وأنظمة المحاذاة المستخدمة لضمان عدم حدوث تباين غير مقصود بين القيمة المخزنة والعرض البصري النهائي.
6. التحليل الإجرائي لدالة FIND وآلية البحث الموضعي
تختص دالة FIND بإجراء بحث دقيق وحساس لحالة الأحرف (Case-sensitive) عن سلسلة نصية فرعية ضمن سلسلة نصية مستهدفة، ثم إرجاع الموضع الرقمي الأولي الذي يبدأ عنده ظهور النص المبحوث عنه كعدد صحيح موجب. تقبل الدالة ثلاث وسائط: وسيطة نص البحث المراد إيجاده (string_to_search_for)، والنص محل البحث (text_to_search)، بالإضافة إلى وسيطة اختيارية تحدد نقطة الانطلاق أو رقم المحرف الذي تبدأ عنده عملية الفحص داخل السلسلة.
تتحرك خوارزمية دالة FIND بطريقة خطية صارمة (Linear Scan) عبر فحص محارف النص حرفاً بحرف من اليسار إلى اليمين. وعندما تجد أول تطابق للمحرف المستهدف، فإنها توقف دورة البحث على الفور وتعيد الفهرس العددي المطابق، متجاهلة أي تكرار إضافي قد يرد للنص المبحوث عنه في أجزاء لاحقة من السلسلة. وتعد هذه الخاصية المحددة هي المحرك الأساسي للاعتماد عليها في اصطياد الفاصلة البيضاء الأولى الفاصلة بين الكلمات.
تتميز دالة FIND بنظيرتها التوأم المسماة SEARCH؛ والفرق التقني الحاسم بينهما يكمن في أن دالة SEARCH غير حساسة لحالة الأحرف وتدعم استخدام المحارف البديلة (Wildcards) مثل علامة الاستفهام وعلامة النجمة. ومع ذلك، عند البحث عن محرف مسافة بيضاء اعتيادية (” “)، يتطابق أداء الدالتين وظيفياً بالكامل؛ نظراً لأن المسافات الفاصلة لا تمتلك حالة أحرف كبيرة أو صغيرة، مما يجعل استخدام أي منهما صحيحاً ومعتمداً من منظور كفاءة الصيغة المنطقية.
7. السر التقني لإلحاق المسافة الإضافية (&” “)
يمثل التعامل مع الاستثناءات الهيكلية الفارق الحقيقي بين المطور المبتدئ ومحلل البيانات المتقدم. في الواقع العملي، نادراً ما تأتي البيانات النصية بتنسيق مثالي ومنتظم؛ إذ تتضمن السجلات في كثير من الأحيان كلمات مفردة لا تحتوي على أية فواصل إطلاقاً، مثل إدخال الاسم الأول مجرداً دون اسم العائلة، أو كتابة رمز تعريفي يتكون من مقطع واحد. في مثل هذه الظروف، تواجه الصيغ البدائية انهياراً شاملاً يعطل الحسابات ويفسد المظهر الاحترافي لجدول البيانات.
يكمن الابتكار الهندسي لمعالجة هذا الخلل في تقنية بسيطة وعبقرية تُعرف بـ “تقنية حقن الفاصل الاحتياطي” أو إلحاق المسافة الإضافية عبر معامل الربط النصي (&” “). لا تتطلب هذه الحيلة استهلاك دوال شرطية إضافية تثقل كاهل المعالج، بل توظف ميكانيكية حسابية رشيقة لتأمين استمرارية التدفق الخوارزمي بغض النظر عن محتوى الخلية الأصلي.
8. تلافي خطأ القيمة المفقودة #VALUE! في الكلمات المفردة
عند بناء صيغة مركبة تبحث عن مسافة لاقتطاع الكلمة الأولى باستخدام النموذج التقليدي: =LEFT(A2, FIND(" ", A2) - 1)، ستعمل المعادلة بنجاح باهر طالما احتوت الخلية على كلمتين أو أكثر مفصولتين بمسافة واضحة. ولكن، في اللحظة التي يتم فيها تمرير خلية تحتوي على كلمة واحدة فقط (مثل: “محمد” أو “Enterprise”)، يتغير المشهد بالكامل؛ حيث تبدأ دالة FIND رحلة مسح عبر أحرف الكلمة كاملة، ولا تعثر على أي مسافة بيضاء داخل النص المصدر.
في بيئة جداول بيانات جوجل، يؤدي فشل دالة FIND أو SEARCH في العثور على القيمة المطلوبة إلى رمي الخطأ الشهير #VALUE!، مصحوباً بالرسالة التفسيرية التقنية: “Error: In FIND evaluation, text not found”. هذا الخطأ التشغيلي لا يقتصر ضرره على الخلية ذاتها، بل ينتشر في كافة الخلايا والمعادلات الحسابية والتقارير المحورية التابعة التي تعتمد على مخرجات هذه الخلية كمصدر للبيانات، مما يؤدي إلى شلل في التحليل الشامل للورقة الحسابية.
تاريخياً، كان بعض المحللين يلجأون إلى حلول برمجية باهظة التكلفة من حيث الأداء، مثل إحاطة الدالة بأكملها بدالة معالجة الأخطاء IFERROR أو إجراء فحص شرطي مسبق باستخدام الدالة الشرطية IF ودالة ISNUMBER للتأكد من وجود مسافة قبل الاقتطاع. وعلى الرغم من أن هذا النهج يحل المشكلة ظاهرياً، إلا أنه يضاعف من حجم الشيفرة الحسابية المكتوبة، ويزيد من وقت المعالجة الحسابية بنسبة تتجاوز 100%؛ نظراً لقيام النظام بتقييم محتوى الخلية عدة مرات متعاقبة لكل صف من صفوف الجدول.
9. الميكانيكية الحسابية لعملية الربط النصي وسلوك المؤشر
تتمثل المعالجة الرياضية المتفوقة في إعادة كتابة المعادلة على النحو الآتي: =LEFT(A2, FIND(" ", A2 & " ") - 1). يتمثل جوهر هذه التقنية في استدعاء معامل الربط النصي (Ampersand: &) لدمج مسافة افتراضية إضافية في نهاية النص الأصلي للخلية بصورة مؤقتة وحصرية داخل وسيطة دالة FIND، ودون إحداث أي تعديل حقيقي أو مادي على البيانات المخزنة في الخلية الأصلية A2.
من الناحية الميكانيكية، يترتب على هذا التعديل البسيط سيناريوهان حتميان لا ثالث لهما:
- السيناريو الأول (وجود مسافات أصلية): إذا كانت الخلية الأصلية تحتوي على مسافة فاصلة واحدة أو أكثر، فإن دالة FIND ستعثر حتماً على المسافة الأولى الطبيعية الواقعة ضمن النص الأصلي، وستتوقف فوراً لتعيد موقعها الرقمي. وبذلك، يتم تجاهل المسافة الاصطناعية الملحقة في النهاية تماماً وكأنها لم توجد، ويتم اقتطاع الكلمة الأولى بدقة رياضية متناهية.
- السيناريو الثاني (كلمة مفردة دون مسافات): إذا كانت الخلية تحتوي على كلمة يتيمة مجردة، فلن تعثر دالة FIND على أية مسافة داخل بنية الكلمة؛ ولكن بدلاً من إلقاء خطأ التوقف، ستجد المسافة الاصطناعية التي قمنا بإلحاقها كآخر محرف في السلسلة الممتدة. ستعيد الدالة رقماً يمثل طول الكلمة مضافاً إليه واحد.
عندما ينتقل هذا الرقم إلى دالة الاقتطاع LEFT بعد طرح القيمة 1 منه (نتيجة العملية الحسابية: - 1)، تعود القيمة العددية الناتجة لتطابق تماماً الطول الحقيقي للكلمة المفردة. وكنتيجة رياضية حتمية، تقتطع دالة LEFT محارف الكلمة بأكملها وتعيدها ناصعة دون تشويه ودون إطلاق أي استثناء أو خطأ قيمي. إن هذا التناغم يبرهن على روعة الفكر البرمجي الذي يحل المشاكل المعقدة عبر تطويع البديهيات الجبرية للغة التعامل مع البيانات.
10. التطبيق العملي للصيغة خطوة بخطوة في جداول بيانات جوجل
يتطلب التحول من مرحلة التنظير المعرفي إلى التطبيق العملي الناجح اتباع خطوات منهجية دقيقة تضمن عدم حدوث أخطاء ناجمة عن إعدادات المناطق أو الاختلافات في علامات الفصل النحوية. تتيح جداول بيانات جوجل واجهة تفاعلية مرنة، إلا أنها تفرض معايير صارمة فيما يخص بناء الصيغ (Syntax) ومحددات المراجع المادية والنسبية للخلايا.
في هذا القسم، سنقوم بتطبيق خوارزمية استخراج الكلمة الأولى باستخدام الصيغة الكلاسيكية المتقدمة، مع تقديم شرح تفصيلي لتهيئة البيئة الإجرائية وتوسيع نطاق الحساب ليشمل آلاف السجلات بكفاءة وسرعة فائقتين.
11. إعداد بيئة العمل وهيكلة جدول البيانات التجريبي
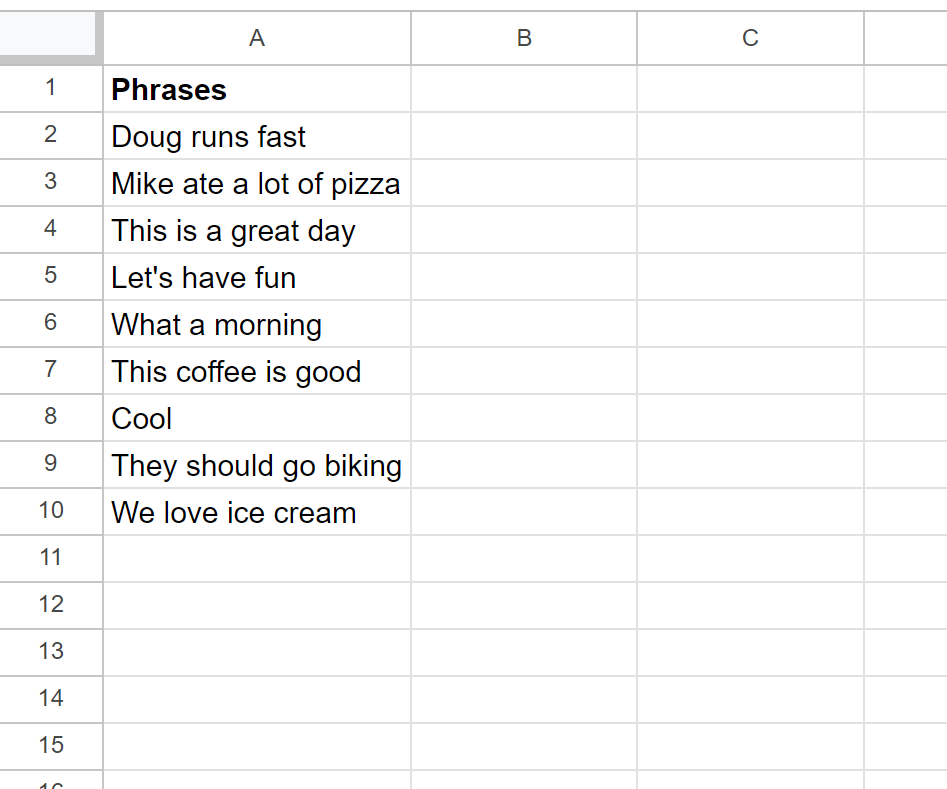
لبدء التنفيذ العملي، يجب فتح مصنف عمل جديد داخل جداول بيانات جوجل (Google Sheets). نقوم بتهيئة جدول بيانات تجريبي يضم عمودين رئيسيين؛ العمود الأول يحمل التسمية “الاسم الكامل” أو “النص المصدر” ويشغل النطاق العمودي A بدءاً من الخلية A2 إلى أسفل، بينما يحمل العمود الثاني التسمية “الكلمة الأولى المستخرجة” في العمود B.
نقوم بملء العمود المصدر بمجموعة متنوعة ومتباينة عمداً من النصوص لغرض اختبار قوة ومتانة المعادلة عبر محاكاة شتى احتمالات العالم الحقيقي، مثل:
- سلسلة نصية تقليدية متعددة الكلمات:
أحمد محمود العبداللهفي الخلية A2. - كلمة مفردة تماماً بدون مسافات إضافية:
سارةفي الخلية A3. - نص يبدأ بكلمة إنجليزية مركبة:
Google Workspace Cloudفي الخلية A4. - معرّف فني مركب يحتوي أرقاماً ورموزاً:
SKU12498 Batch401في الخلية A5.
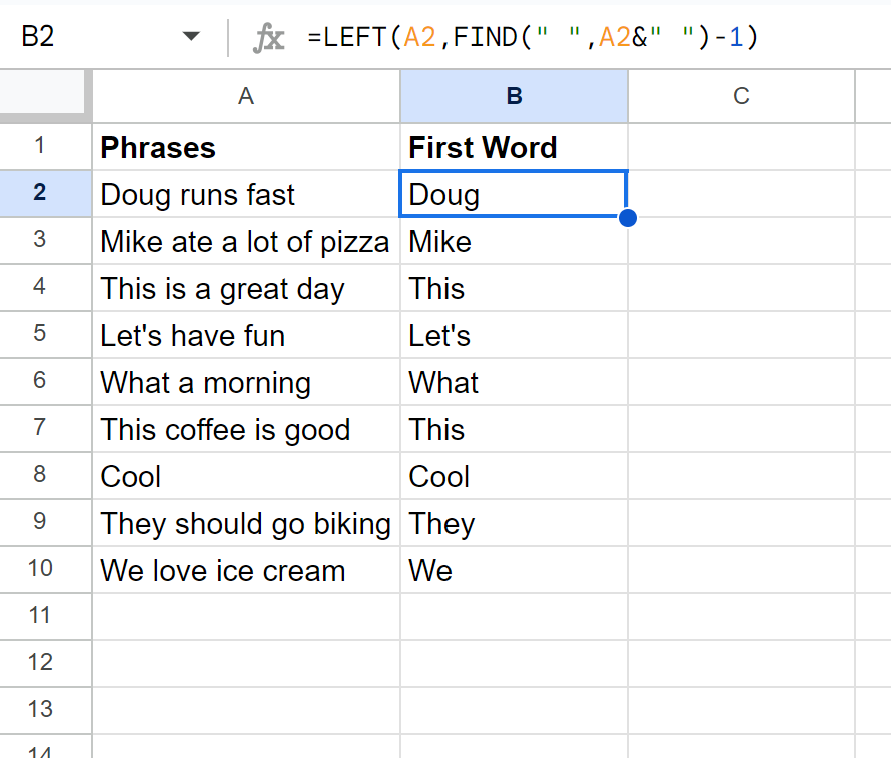
بعد إدخال البيانات، نتوجه إلى الخلية B2 ونقوم بكتابة المعادلة المتكاملة بدقة: =LEFT(A2, FIND(" ", A2 & " ") - 1). بمجرد الضغط على زر الإدخال (Enter)، يلاحظ المحلل فوراً أن الخلية تظهر القيمة “أحمد” بنجاح قطعي، مستبعدة كل ما يلي المسافة الأولى بدقة متناهية ودون وجود أي شوائب رمزية مرافقة.
12. تعميم المعادلة على الأعمدة عبر مقبض التعبئة التلقائية
بعد نجاح الصيغة الرياضية في الخلية الأولى، تأتي مرحلة تطبيقها على مجمل سجلات العمود لضمان معالجة متسلسلة للبيانات. توفر واجهة جداول بيانات جوجل عدة آليات مرنة لتنفيذ هذا الإجراء بكفاءة، وأبسطها استخدام “مقبض التعبئة” (Fill Handle). يتمثل هذا المقبض في النقطة الزرقاء الصغيرة المربعة الواقعة في الركن السفلي الأيسر (أو الأيمن بحسب لغة الواجهة) من الخلية النشطة B2.
يمكن للمستخدم النقر مع سحب هذا المقبض رأسياً باتجاه الأسفل للمرور على الخلايا من B3 حتى B5 وما يليها، أو ببساطة النقر المزدوج (Double-Click) السريع على المقبض الأزرق. عند تنفيذ النقر المزدوج، يتولى المحرك الحسابي الداخلي فحص عمق البيانات في العمود الملاصق A ونسخ المعادلة وتحديث مراجع الخلايا النسبية تلقائياً حتى آخر خلية تحتوي على نص مدخل في ذلك العمود.
عند فحص النتائج المسترجعة في الخلايا المتتالية، يظهر بوضوح الانتصار التقني لحيلة الربط النصي: فالخلية B3 تستخرج الكلمة “سارة” كاملة دون أي توقف أو أخطاء، والخلية B4 تسترجع الكلمة “Google”، بينما الخلية B5 تسترجع الرمز “SKU12498”. يبرهن هذا الأداء السلس على استقرار هذه المعادلة وجاهزيتها للتطبيق الفوري في البيئات التشغيلية المتطلبة دون أدنى خوف من الأعطال البرمجية المفاجئة.
13. البدائل المتقدمة: استخدام دالتي INDEX و SPLIT لاستخراج الكلمة الأولى
على الرغم من النجاح الواسع الذي تحققه تركيبة دالتي الاقتطاع والبحث الموضعي، إلا أن هندسة البرمجيات تقدم دوماً مسارات متعددة لحل المعضلة نفسها؛ وتتميز بيئة جداول بيانات جوجل على وجه التحديد بامتلاكها دوال حصرية بالغة القوة تمنحها تفوقاً نوعياً على البرمجيات المكتبية التقليدية. من أبرز هذه الحلول الهندسية البديلة الجمع بين دالة التفكيك التقطيعي SPLIT ودالة الفهرسة المصفوفية INDEX.
يمثل هذا النموذج الفلسفة الحديثة في التعامل مع السلاسل النصية بوصفها حزم بيانات مركبة يمكن تحويلها آنياً إلى مصفوفات هيكلية مستقلة (Arrays)، مما يسمح باستخراج العناصر عبر إحداثياتها الطوبولوجية بدلاً من إجراء عمليات حسابية تعتمد على عد المحارف واقتطاع البايتات المادية.
14. تفكيك السلاسل النصية عبر دالة SPLIT
تعتبر دالة SPLIT واحدة من أكثر الدوال أصالة وتفرداً في بيئة جداول بيانات جوجل؛ حيث تم بناؤها لتنفيذ عمليات الفصل الحرفي لسلسلة نصية معينة وتجزئتها إلى مصفوفة أفقية تمتد عبر خلايا متتالية، بالاعتماد على محرف فاصل أو مجموعة من المحددات (Delimiters). تأخذ الدالة وسائط متعددة تحدد النص الخاضع للتفكيك، والرمز الفاصل، وإعدادات معالجة الفواصل المتتالية وحساسية الأحرف.
عند تطبيق الأمر المباشر: =SPLIT(A2, " ")، تتولى خوارزمية الدالة تفتيت الجملة المدخلة إلى كلماتها المفردة وتوزيع كل كلمة في خلية مستقلة على طول الصف (Row-spill behavior). على سبيل المثال، فإن الجملة “تحليل النظم المالية” ستتوزع تلقائياً على ثلاث خلايا مجاورة: الأولى تأخذ “تحليل”، والثانية “النظم”، والثالثة “المالية”.
تتمتع دالة SPLIT بميزة ذاتية فائقة الأهمية: فهي تتجاهل بشكل افتراضي المسافات المزدوجة والمتكررة بين الكلمات، وتتعامل معها كفاصل واحد وتمنع نشوء عناصر فارغة في المصفوفة المخرجة. ومع ذلك، فإن خطورتها التشغيلية تكمن في خاصية “الانسكاب” (Spilling)؛ حيث إن استخدامها بمفردها داخل جدول ممتلئ قد يؤدي إلى مسح البيانات الموجودة في الخلايا المجاورة أو إطلاق خطأ منع التمدد #REF! إذا اصطدمت مصفوفة الانسكاب ببيانات قائمة سلفاً في الأعمدة المجاورة.
15. استرجاع العنصر الأول بالمصفوفة باستخدام دالة INDEX
لتحييد خطر الانسكاب غير المرغوب فيه وتحويل الطاقة التفكيكية لدالة SPLIT إلى أداة جراحية دقيقة تستخلص الكلمة الأولى فقط، يتم دمجها مباشرة داخل دالة الاستعلام المصفوفي INDEX وفق الهيكل البرمجي الآتي: =INDEX(SPLIT(A2, " "), 1). تعمل دالة INDEX هنا كصمام أمان وحاجز كبح مكاني، حيث تستقبل المصفوفة الافتراضية الناتجة عن SPLIT في الذاكرة المؤقتة، دون أن تسمح لها بالانسكاب الفعلي داخل خلايا ورقة العمل.
تقوم دالة INDEX بالتقاط العنصر المتموضع في الصف الأول والعمود الأول من هذه المصفوفة الحسابية الافتراضية، وهو ما يمثل بدقة مطلقة الكلمة الأولى من النص المدخل. وبعد سحب هذا العنصر المحدد، يتم التخلص فوراً من بقية محتويات المصفوفة المؤقتة ومسحها من الذاكرة الحسابية قصيرة المدى، وتُرجع النتيجة الصافية إلى الخلية الحاوية للمعادلة فقط.
يمتاز هذا الأسلوب بأناقته الرياضية وتجريده المنطقي؛ فهو لا يتطلب تتبع إحداثيات المسافات ولا يحتاج إلى طرح المحارف أو استخدام حيل الربط الإضافي & " " لتلافي الأخطاء الحسابية. فإذا كانت الخلية الأصلية تحتوي على كلمة واحدة فقط، فإن دالة SPLIT ستنشئ مصفوفة من عنصر وحيد، وستقوم دالة INDEX باسترجاع هذا العنصر الفريد دون أي تذمر برمجي، مما يجعله أحد الحلول الهندسية الأكثر تماسكاً وموثوقية في معالجة البيانات النصية غير المتجانسة.
16. استخراج الكلمة الأولى المتقدم بالتعابير النمطية REGEXEXTRACT
تمثل التعابير النمطية (Regular Expressions – Regex) ذروة التطور في هندسة معالجة النصوص البرمجية ومطابقة الأنماط الشكلية المعقدة. تم بناء جداول بيانات جوجل لتستند في معالجة التعابير النمطية إلى مكتبة محرك RE2 مفتوح المصدر والمطور داخلياً من قبل شركة جوجل، وهو محرك مشهور بسرعته الفائقة وضمانه لزمن خطي في معالجة النصوص البرمجية، ما يجعله آمناً تماماً ضد هجمات التراجع الكارثي للذاكرة (Catastrophic Backtracking) التي تصيب محركات Regex التقليدية.
يوفر محرك RE2 المدمج مجموعة من الدوال المتخصصة، وتعتبر دالة REGEXEXTRACT الأداة الاستثنائية التي تفوقت على كافة الأساليب الحسابية السابقة؛ بفضل قدرتها على استخراج الكلمات بناءً على هويتها الصرفية واللغوية، وليس فقط بالاعتماد على الفواصل الميكانيكية العادية.
17. مفاهيم التعابير النمطية ودور دالة REGEXEXTRACT
تعتمد دالة REGEXEXTRACT على صيغة مبسطة في مظهرها ولكنها غير محدودة في قدراتها التعبيرية: =REGEXEXTRACT(text, regular_expression). تقوم هذه الدالة بتطبيق النمط الرياضي المعرّف في الوسيطة الثانية على السلسلة النصية في الوسيطة الأولى، وتستخرج حصراً الجزء الذي يحقق شروط التطابق التام مع صياغة النمط الرمزي.
لاستخراج الكلمة الأولى بأعلى درجات الموثوقية والمناعة ضد الحالات الشاذة، تُستخدم الصيغة النمطية الآتية: =REGEXEXTRACT(TRIM(A2), "^[^s]+"). ولتفكيك هذا التعبير النمطي أكاديمياً وفق معايير نظرية اللغات الصورية (Formal Language Theory)، نجد أن مكوناته تؤدي المهام الآتية:
^: يسمى مرساة البداية (Start of string anchor)، وهو قيد منطقي يجبر المحرك الخوارزمي على محاذاة البحث حصرياً عند المحرف الأول للسلسلة النصية ورفض أي تطابق يقع في منتصف النص.[^s]: تمثل فئة المحارف المنفية (Negated Character Class)؛ حيث يرمز الرمزsإلى أي مسافة بيضاء بشتى صورها (مسافة اعتيادية، محرف الجدولة Tab، أو سطر جديد)، وتفيد علامة الإقحام^داخل القوسين المعقوفين نفي الفئة، مما يعني مطابقة أي محرف كائن ما كان شريطة ألا يكون مسافة بيضاء.+: مكمّل التكرار الكمي الإيجابي (Quantifier)، ويلزم المحرك بالاستمرار في مطابقة وضم كافة المحارف المتتالية التي تحقق الشرط ما دامت غير بيضاء، بمقدار محرف واحد على الأقل وبلا حد أقصى، حتى يصطدم بأول مسافة فاصلة فيتوقف فوراً ويعيد الكتلة الملتقطة.
تضمن دالة TRIM المحيطة بالنص المصدر إزالة أية مسافات بادئة غير مقصودة قد تجعل المحرف الأول بحد ذاته مسافة، مما يمنح هذه المعادلة صلابة هندسية مطلقة تتفوق بمراحل على الدوال النصية التقليدية في التعامل مع البيانات المشوهة.
18. التعامل مع النصوص متعددة اللغات وعلامات الترقيم
تتكشف العبقرية الحقيقية لاستخدام التعابير النمطية عند الانتقال إلى بيئات البيانات متعددة اللغات، أو عند معالجة نصوص تتخللها علامات ترقيم ملتصقة بالكلمات؛ مثل الفواصل اللاتينية (,)، الفواصل العربية (،)، علامات التنصيص، أو الأقواس والرموز الخاصة التي غالباً ما تلتصق بالكلمة الأولى في الاستمارات التفاعلية ونصوص المقالات المدخلة عبر الإنترنت.
إذا استخدمنا صيغة تقطيع تقليدية تعتمد على المسافات فقط مع نص مثل: "مرحباً، بالجميع في المؤتمر"، فإن الصيغة الكلاسيكية ستقتطع النص إلى أول مسافة فتعيد: "مرحباً،" متضمنة الفاصلة كجزء من الكلمة المستخرجة، وهو ما يمثل تشويهاً لنقاء البيانات المعالجة. بالمقابل، يتيح التعبير النمطي المتقدم ترويض هذه الظاهرة بدقة فائقة عبر استدعاء نمط فئات المحارف الأبجدية الرقمية:
تُمكّن الصيغة: =REGEXEXTRACT(A2, "w+") المحرك من البحث الآلي وتجاهل كافة الرموز وعلامات الترقيم البادئة، والانقضاض مباشرة على أول تكتل من المحارف الأبجدية والعددية. يدعم محرك RE2 في جداول بيانات جوجل خصائص الترميز الموحد للمحارف، مما يجعل الفئة w قادرة على التعرف التلقائي على الحروف الأبجدية للغات المعقدة كالعربية، الصينية، الكيريلية، واللاتينية دون الحاجة لتوصيف يدوي لمجموعات الحروف، لتنتج كلمة أولى نقية ومجردة بالكامل من أي علامات ترقيم محيطة.
19. أتمتة المعالجة الجماعية للأعمدة الكاملة باستخدام دالة ARRAYFORMULA
في مشاريع معالجة البيانات الحقيقية والمستودعات الرقمية الضخمة التي تحتوي على مئات الآلاف من الصفوف، يصبح السحب اليدوي للمعادلات أو النسخ المتكرر عبر مقبض التعبئة التلقائية أسلوباً بدائياً وغير مجدٍ برمجياً؛ إذ إنه يستهلك وقتاً طويلاً، ويؤدي إلى تضخم حجم الملف وزيادة استهلاك الذاكرة العشوائية لتخزين نسخ متطابقة من الشيفرة في كل خلية على حدة، فضلاً عن كونه معرضاً للخلل في حال قام أحد المستخدمين بحذف معادلة من خلية وسطية دون قصد.
لحل هذه المعضلة الهندسية، تقدم جداول بيانات جوجل بيئة المعالجة المصفوفية الديناميكية الموجهة بنطاقات من خلال الدالة الحاكمة ARRAYFORMULA، والتي تمكّن المحلل من كتابة معادلة واحدة مركزية في رأس العمود، تتولى معالجة النطاق العمودي كاملاً من أعلى الخلية الأولى وحتى نهاية ورقة العمل بصورة تلقائية وتفاعلية مستمرة.
20. تحويل الصيغة الفردية إلى مصفوفة حسابية ديناميكية
تقوم فلسفة دالة ARRAYFORMULA على إعادة توجيه مسار تنفيذ العمليات الحسابية من النمط الفردي القائم على خلية مفردة (Scalar execution) إلى النمط المتجهي الذي يعمل على مصفوفة كاملة من المدخلات (Vectorized operation). وبدلاً من تزويد الدالة بمرجع لخلية واحدة مثل A2، يتم تمرير نطاق كامل من الخلايا مثل A2:A، لتقوم الدالة بتكرار الخوارزمية ذاتها على كل سطر داخل النطاق المحدد داخلياً وتوليد النتائج دفعة واحدة في مصفوفة عمودية ممتدة.
عند الرغبة في تحويل الصيغة الكلاسيكية المأمونة إلى صيغة مصفوفية، نكتب في الخلية B2 الصيغة الآتية: =ARRAYFORMULA(LEFT(A2:A, FIND(" ", A2:A & " ") - 1)). من خلال هذا السطر البرمجي الوحيد، سيقوم محرك الجداول فوراً بحساب واستخراج الكلمة الأولى لكافة البيانات المتواجدة في العمود A دفعة واحدة ودون الحاجة لأي سحب يدوي.
وعلى نحو مماثل، يمكن تطبيق هذه الآلية المتطورة بكفاءة استثنائية عبر دمج دالة التعابير النمطية داخل النطاق المصفوفي، عبر الصياغة الآتية: =ARRAYFORMULA(REGEXEXTRACT(TRIM(A2:A), "^[^s]+")). تتميز هذه المعادلة بأداء فائق السرعة وخفة متناهية في الوزن التخزيني لملف العمل، مما يجعلها الخيار المفضل للمطورين ومحللي الأنظمة عند بناء لوحات المعلومات التفاعلية وقواعد البيانات الديناميكية التي تتغذى بمدخلات مستمرة عبر نماذج جوجل (Google Forms).
21. التحكم في الخلايا الفارغة وإيقاف المعالجة اللانهائية
على الرغم من القوة الجبارة للدوال المصفوفية، إلا أن تطبيقها غير المنضبط على نطاقات مفتوحة النهاية مثل A2:A يولد مشكلة تشغيلية خطيرة: فعندما تصل الدالة إلى الصفوف الخالية من البيانات في أسفل الجدول، ستستمر في محاولة تطبيق المنطق الحسابي على الخلايا الفارغة، مما يؤدي إما إلى ملء العمود بآلاف الأخطاء الحسابية من نوع #VALUE! أو #N/A، أو إجبار جدول البيانات على التمدد القسري وتوليد آلاف الصفوف الزائدة، وهو ما يؤدي لبطء شديد وتدهور حاد في سرعة استجابة المصنف بالكامل.
للتعامل المنهجي مع هذه المعضلة وتشييد سد حماية منطقي حول النطاق، نقوم بدمج الدالة الشرطية IF للتحقق المسبق من وجود مدخلات فعلية في خلايا المصدر قبل تفعيل محرك الاستخراج. يظهر الهيكل المتكامل للصيغة المصفوفية المحصنة كالتالي:
=ARRAYFORMULA(IF(ISBLANK(A2:A), , REGEXEXTRACT(TRIM(A2:A), "^[^s]+")))
يقوم هذا الصمام الشرطي الذكي بفحص مصفوفة الإدخال A2:A صفاً بصف عبر دالة التحقق من الفراغ ISBLANK؛ فإذا رصدت الدالة أن الخلية فارغة ولا تحتوي على أية رموز، فإنها تعيد فراغاً حقيقياً وتتوقف عن المعالجة لذلك الصف فوراً دون إطلاق أي خطأ ودون استهلاك للذاكرة. أما في حال احتواء الخلية على نص، فإنها تنفذ أمر الاستخراج النمطي بسلاسة متناهية. تضمن هذه الصياغة الاحترافية بقاء ورقة العمل نظيفة ومستقرة، وجاهزة لاستيعاب أي سجلات جديدة تضاف مستقبلاً بشكل آلي وفوري بمجرد كتابتها في العمود الأول.
22. استراتيجيات تنقية النصوص ومعالجة المسافات البيضاء الشاذة
تعد جودة المخرجات في أي نظام حوسبي رهناً مباشراً بجودة المدخلات، وهو المبدأ التقني الراسخ المعروف بـ “المدخلات الفاسدة تؤدي حتماً إلى مخرجات فاسدة” (Garbage In, Garbage Out). في ميدان العمل الواقعي، تعد المسافات البيضاء الشاذة واحدة من أكبر العقبات التي تحول دون استخراج البيانات بدقة؛ حيث تتسلل هذه المسافات غير المرئية إلى جداول البيانات نتيجة الأخطاء البشرية أثناء الإدخال السريع، أو عبر نسخ ولصق النصوص من صفحات الويب والمستندات الرقمية دون تنقيح مسبق.
إذا احتوت بداية الخلية على مسافة واحدة فارغة بطريق الخطأ، فإن خوارزميات الاقتطاع البدائية ستعتبر هذه المسافة الأولى هي “الكلمة الأولى”، لتعيد الخلية نصاً فارغاً تماماً للمحلل وتفشل العملية برمتها. لذا، فإن هندسة تنقية النصوص تستوجب بناء دروع وقائية متقدمة تسبق مرحلة التفكيك والاستخلاص لضمان نظافة المحتوى واستقامته الهيكلية.
23. إزالة المسافات البادئة والزائدة بواسطة دالة TRIM
صُممت دالة TRIM في جداول بيانات جوجل لتلعب دور المطهر الخوارزمي الصارم للبيانات النصية؛ حيث تختص هذه الدالة بمسح كافة المسافات البادئة (Leading Spaces) التي تسبق أول حرف من النص، وكافة المسافات اللاحقة (Trailing Spaces) التي تأتي في ختام السلسلة النصية دون فائدة، بالإضافة إلى تقليص كافة المسافات البينية المتكررة داخل النص لتتحول حصراً إلى مسافة واحدة مفردة ومنتظمة بين كل كلمة وأخرى.
يوضح التحليل الإجرائي ضرورة دمج دالة TRIM كغلاف أولي يحيط بمرجع الخلية قبل توجيهه لأي دالة اقتطاع أخرى؛ فبدلاً من تطبيق المعادلة الكلاسيكية على الخلية الخام A2 مباشرة، ينبغي كتابتها بالصورة الوقائية الآتية: =LEFT(TRIM(A2), FIND(" ", TRIM(A2) & " ") - 1).
تضمن هذه المعالجة الاستباقية أنه في حال قام المستخدم بإدخال النص محاطاً بمسافات عشوائية (مثل: " بيانات المشروع ")، فإن دالة TRIM ستقوم بتجريده الفوري ليصبح: "بيانات المشروع"، مما يضع الحرف الحقيقي الأول في الموضع رقم 1 على شريط الفهرسة، ويمكن دالتي FIND و LEFT من اصطياد المسافة الواقعة حقيقة بين الكلمتين واقتطاع كلمة “بيانات” بصورة صحيحة ومعيارية.
24. التعامل مع المسافات غير القابلة للكسر والمحارف الخاصة
من أشد التحديات النصية تعقيداً وخفاءً في جداول البيانات ظاهرة وجود ما يسمى بـ “المسافة غير القابلة للكسر” (Non-Breaking Space)، والتي يُرمز لها في لغات الويب بـ وتأخذ الرمز الثماني رقم 160 في جدول محارف الأسكي الممتد (ASCII Char 160 / Unicode U+00A0)، في حين أن المسافة التقليدية التي نكتبها بمسطرة المفاتيح تحمل الرمز القياسي رقم 32 (ASCII Char 32).
المشكلة الكبرى هنا تكمن في أن دالة TRIM العادية، وكذلك دالتي FIND(” “) و SPLIT المصممتين لاصطياد المسافة الاعتيادية (Char 32)، تعجز تماماً وبشكل مطلق عن التعرف على المسافة غير القابلة للكسر (Char 160) أو إزالتها؛ لأن النظام يراها محرفاً مختلفاً تماماً من حيث القيمة الرقمية والبايتات التخزينية على الرغم من تطابق شكلهما البصري للمستخدم البشري. هذا العجز التقني يؤدي في كثير من الأحيان إلى استخراج جمل كاملة بدلاً من الكلمة الأولى؛ نظراً لفشل الدوال في العثور على فاصلها المعياري.
لمواجهة هذا النوع من التلوث الرقمي للبيانات، يتعين على المحلل اللجوء إلى تقنية التطهير العميق والاستبدال الحرفي للبايتات عبر استخدام دالة SUBSTITUTE مع دالة CHAR، وذلك بتحويل كافة المسافات الخفية (Char 160) قسراً إلى مسافات عادية (Char 32) قبل الشروع في التقطيع، وفق الصيغة المتطورة الآتية:
=REGEXEXTRACT(TRIM(SUBSTITUTE(A2, CHAR(160), " ")), "^[^s]+")
تقوم دالة SUBSTITUTE في هذه الشيفرة الحسابية بمسح الخلية واستبدال كل ظهور لمحرف المسافة غير القابلة للكسر CHAR(160) بمسافة تقليدية " "، ثم تتولى دالة TRIM إزالة التكرار، وأخيراً تقتطع دالة REGEXEXTRACT الكلمة الأولى بأمان مطلق. تمثل هذه الصيغة الدرع الحصين الأقوى في جداول بيانات جوجل للتعامل مع البيانات المنسوخة من ملفات PDF وصفحات الإنترنت المعقدة دون أي تدخل يدوي إضافي.
25. تطبيقات منهجية ودراسات حالة لاستخراج الكلمة الأولى
لتجسيد القيمة العملية لهذه الأدوات والتقنيات المحسوبة، سنستعرض دراستي حالة واقعيتين تبرزان كيف يمكن للمحلل توظيف المبادئ البرمجية السابقة في حل مشكلات إدارية وتجارية متكررة تواجه المؤسسات بصورة يومية، وكيف يسهم التوظيف السليم للدوال في تحويل بيئات العمل الفوضوية إلى نظم بيانات منضبطة وقابلة للتكامل المؤسسي.
26. فصل الأسماء الأولى من الأسماء الكاملة في السجلات
تواجه أقسام الموارد البشرية وإدارات التسويق الرقمي بانتظام مشكلة تجميع الأسماء الثلاثية والرباعية في عمود واحد غير مقسم في قواعد بيانات العملاء والموظفين. عند الرغبة في إطلاق حملات بريدية تفاعلية تستخدم قوالب مخصصة موجهة للمستهلك (مثل: “مرحباً يا [الاسم الأول]، يسعدنا تواصلك”)، يصبح إرسال الاسم الكامل أمراً يفتقر إلى اللباقة التسويقية، بينما يعد استخلاص الاسم الأول يدوياً لمئات الآلاف من السجلات ضرباً من المستحيل الإجرائي.
إذا افترضنا وجود سجل بيانات يحتوي في الخلية A2 على الاسم الكامل: "د. عبد الله محمد الشمري"، فإن تطبيق الصيغة القياسية البسيطة القائمة على استخراج أول فاصلة سيؤدي إلى اقتطاع اللقب "د." باعتباره الكلمة الأولى، وهو ما يفسد الغرض التواصلي المنشود. في مثل هذه الدراسات الإجرائية، نقوم بتصميم صيغة هجينة ذكية تستثني الألقاب الشائعة أولاً ثم تقتطع الاسم الشخصي الفعلي.
تُبنى الصيغة عبر استبدال الألقاب المعروفة مسبقاً (د.، أ.، م.، المهندس، الشيخ، السيد) بنص فارغ باستخدام التعبير النمطي، ثم استخراج الكلمة التالية التي تمثل الاسم الحقيقي مباشرة عبر المعادلة المركبة:
=REGEXEXTRACT(TRIM(REGEXREPLACE(A2, "^(د.|أ.|م.|السيد|الدكتور)s+", "")), "^[^s]+")
تضمن هذه الصيغة التنفيذية الاحترافية تخطي كافة التوصيفات الرتبية والبادئات الوظيفية بدقة وذكاء، واصطياد الاسم الشخصي الأول الصافي “عبد الله” فوراً، مما يوفر على المؤسسة مئات الساعات من العمل البشري المضني ويضمن نجاح عمليات التخصيص التسويقي بأعلى كفاءة ممكنة.
27. تجزئة الأرقام التعريفية ورموز المنتجات والنصوص الفنية
في قطاع إدارة المخازن والتجارة الإلكترونية واللوجستيات، تدمج الشركات عادةً معلومات متعددة في كود تعريفي واحد يسمى وحدة حفظ المخزون (Stock Keeping Unit – SKU)؛ كأن يتكون رمز المنتج من: فئة المنتج، يليه الموديل، ثم بلد المنشأ، مفصولة بمسافات أو رموز خاصة (مثل: "ELEC-4092 Samsung Vietnam Black").
إذا رغب المحلل في استخراج كود الفئة أو العلامة التجارية الأولى لتصنيف المخزون وحساب إجمالي البضائع التابعة لكل قطاع، فإن استخدام الدوال النصية المدمجة يمثل أسرع طريقة لبناء جداول التجميع دون الحاجة إلى إنشاء أعمدة مساعدة معقدة أو كتابة برمجيات خارجية بواسطة Apps Script.
باستخدام تركيبة =INDEX(SPLIT(A2, " -"), 1)، يمكننا ضبط دالة SPLIT لتتعامل مع كل من المسافة ورمز الشرطة (-) كمحددات تفكيك متزامنة ومزدوجة، مما يمكن الدالة من عزل الجزء "ELEC" كعنصر أولي للمصفوفة واستخراجه بنجاح خاطف. يتيح هذا النهج لمديري سلاسل الإمداد إعادة هيكلة قواعد البيانات الضخمة وفهرستها خلال ثوانٍ معدودة، مما يعزز من كفاءة الرقابة على المخزون وسرعة اتخاذ القرار المؤسسي المبني على مؤشرات رقمية دقيقة.
28. أفضل الممارسات الأكاديمية لتحسين الأداء وتوثيق الصيغ الحسابية
مع تنامي حجم الأعمال وتوسع نطاق البيانات المدخلة في الحوسبة السحابية، لم يعد معيار نجاح الصيغة الحسابية مقتصراً على إعادتها للناتج الصحيح فحسب، بل أصبح يرتبط ارتباطاً وثيقاً بمدى كفاءة استهلاكها للموارد الحاسوبية (Computational Complexity)، وزمن استجابتها لعمليات إعادة الحساب التلقائية (Volatile Recalculation)، ومدى سهولة صيانتها وتوثيقها البرمجي للأجيال اللاحقة من محللي البيانات داخل المؤسسة.
إن تبني أفضل الممارسات في كتابة الدوال يضمن بقاء النماذج الرياضية خفيفة وسريعة، ويمنع تجمد واجهة المستخدم أثناء العمل التشاركي المتزامن الذي تتسم به بيئة عمل جداول بيانات جوجل السحابية.
29. مقارنة كفاءة الذاكرة وسرعة المعالجة بين الصيغ المختلفة
عند تقييم الطرق الثلاث الرئيسية لاستخراج الكلمة الأولى (دوال الاقتطاع النصي LEFT/FIND، دوال المصفوفات INDEX/SPLIT، ودوال التعابير النمطية REGEXEXTRACT) على نطاق بيانات يتجاوز 100,000 صف، تظهر فروق جوهرية في استهلاك الذاكرة وسرعة المعالجة وفقاً للتحليل التقني الآتي:
- نموذج LEFT + FIND: يعتبر الأسرع على الإطلاق من حيث المعالجة الحسابية الميكانيكية البسيطة والخيار الأقل استهلاكاً للذاكرة المؤقتة (RAM)؛ نظراً لأنه يعتمد على خوارزميات إزاحة المؤشرات الثنائية المباشرة (Direct Pointer Manipulation) دون إنشاء كائنات برمجية وسيطة في الذاكرة. يعيبه فقط طول الصيغة الظاهري وحاجته للحقن النصي الوقائي
&" ". - نموذج INDEX + SPLIT: يمثل الخيار الأكثر عبئاً على موارد النظام عند استخدامه بشكل مفرط؛ حيث تقوم دالة SPLIT ببناء كائن مصفوفي كامل لكل صف في الذاكرة لتخزين كافة الكلمات ثم استدعاء دالة INDEX لاقتطاع العنصر الأول وإتلاف الباقي. هذا التوليد والإتلاف المتكرر للمصفوفات المؤقتة يستهلك دورات إضافية من وحدة المعالجة المركزية، مما يجعله أقل كفاءة في الجداول المليونية العملاقة.
- نموذج REGEXEXTRACT المعتمد على RE2: يقدم التوازن الأمثل والأكثر كفاءة بين القوة والذكاء الاصطلاحي واستقرار الأداء. يتميز محرك RE2 الخطي بزمن تنفيذ ثابت تقريباً من الرتبة O(N)، مما يجعله محصناً ضد التباطؤ، ويوفر كفاءة معالجة استثنائية عند دمجه مع دالة
ARRAYFORMULAفي صيغة واحدة مركزية تسيطر على العمود بالكامل.
لذلك، يُوصى أكاديمياً وهندسياً باعتماد صيغة التعابير النمطية المصفوفية المحمية للشاشات ولوحات التحكم التحليلية، واستخدام صيغة الاقتطاع التقليدي LEFT/FIND في الأنظمة الحسابية الحساسة التي تتطلب سرعة استجابة ميكرو-ثانية وتخضع لقيود ذاكرة متشددة.
30. معايير التوثيق وتسمية النطاقات وصيانة جداول البيانات المتقدمة
تعد قابلية الصيانة (Maintainability) الركيزة الأساسية لاستدامة الأعمال البرمجية والتحليلية. لتفادي غموض الصيغ الحسابية المعقدة عند تسليم المشاريع للفرق الأخرى، ينبغي اتباع منهجية التوثيق المدمج المتاحة في جداول بيانات جوجل، واستخدام ميزة النطاقات المسماة (Named Ranges) لتحويل مراجع الخلايا المبهمة إلى مصطلحات دلالية ذات معنى مفهوم.
يمكن للمحلل تسمية العمود الذي يحتوي على النصوص المصدرية باسم وظيفي صريح مثل ClientFullNames بدلاً من A2:A، ومن ثم تصبح الصيغة الحسابية ناطقة بذاتها على النحو الآتي: =ARRAYFORMULA(IF(ISBLANK(ClientFullNames), , REGEXEXTRACT(TRIM(ClientFullNames), "^[^s]+"))). يقلل هذا الأسلوب الهندسي من احتمالات الخطأ عند نقل الصيغ أو تعديل هيكل الجدول لاحقاً.
علاوة على ذلك، يتيح الإصدار الحديث من جداول بيانات جوجل إمكانية تعريف دوال مخصصة تحتفظ بأسماء فريدة بواسطة ميزة “الدوال المسماة” (Named Functions) المدمجة عبر خيار البيانات. يستطيع المطور إنشاء دالة مخصصة باسم GET_FIRST_WORD(Text) وتخزين المنطق النمطي المعقد بداخلها مرة واحدة، لتصبح متاحة لكافة مستخدمي المصنف كدالة أصلية بسيطة وسهلة الاستخدام دون الحاجة لتكرار كتابة الرموز الرياضية المعقدة في كل عمود، مما يرتقي بنظام إدارة البيانات المؤسسية إلى أعلى مستويات الاحترافية والجودة الهندسية.
خلاصة شاملة واستشراف مستقبلي لمعالجة البيانات النصية
لقد أثبت التحليل المنهجي المقارن في هذا المقال أن استخراج الكلمة الأولى من خلية في جداول بيانات جوجل، وإن بدا في ظاهره مهمة روتينية بسيطة، يمثل في حقيقته مسألة هندسية غنية تتداخل فيها مبادئ الجبر الخوارزمي، وعلوم اللغات الصورية، ونظم إدارة قواعد البيانات الحوسبية السحابية. يتراوح طيف الحلول التقنية المتاحة بين الصيغ الكلاسيكية الخفيفة المعتمدة على دالتي LEFT و FIND، والحلول المصفوفية المنطقية لدالتي SPLIT و INDEX، وصولاً إلى ذروة التميز الهندسي المتمثلة في محرك التعابير النمطية المتقدم REGEXEXTRACT المدعوم بالمعالجة الشاملة لدالة ARRAYFORMULA.
إن إتقان هذه التقنيات، وفهم آليات استجابتها للبيانات الشاذة كالمسافات غير القابلة للكسر والكلمات المفردة وعلامات الترقيم، يمنح مهندس البيانات والمحلل المالي قدرة غير محدودة على التحكم في مسارات تدفق المعلومات وتنقية المدخلات بأعلى معايير الدقة والأمان. ومع استمرار تطور الحوسبة السحابية ودمج نماذج الذكاء الاصطناعي التوليدي التفاعلي داخل بيئات العمل المكتبية كأدوات Duet AI ومساعدات جوجل الذكية، ستبقى هذه الأسس الهندسية الصلبة للدوال الرياضية والقواعد النمطية هي البنية التحتية الجوهرية التي لا غنى عنها لبناء نماذج بيانات متينة، قابلة للتطوير، ومحصنة ضد الانهيار التشغيلي في عالم تحكمه البيانات الرقمية الدقيقة.
المراجع
- Google. (n.d.). Google Sheets function list. Google Docs Editors Help. https://support.google.com/docs/table/25219
- Google. (n.d.). RE2: A fast, safe, thread-friendly alternative to backtracking regular expression engines. GitHub. https://github.com/google/re2
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Friedl, J. E. (2006). Mastering Regular Expressions (3rd ed.). O’Reilly Media.
- Bluttman, K. (2020). Google Sheets for Dummies. John Wiley & Sons.