
تعد عملية تنظيم وهندسة البيانات داخل بيئات الحوسبة الجدولية الركيزة الأساسية التي تقوم عليها دقة النماذج التحليلية وكفاءة المعالجة الإحصائية. في الممارسات البحثية والميدانية المتقدمة، غالباً ما يتم تجميع البيانات عبر مراحل زمنية متعددة أو شروط تجريبية متباينة، مما يسفر عن مصفوفات معقدة تتوزع فيها القياسات والمتغيرات على امتداد أعمدة متجاورة. هذا التوزيع الأفقي الواسع، على الرغم من سهولة قراءته البشرية الظاهرية، يمثل عائقاً بنيوياً أمام البرمجيات الإحصائية الحديثة ومحركات التحليل التي تتطلب نسقاً رأسياً موحداً يُعرف بالبيانات المرتبة أو الطويلة. إن تحويل هذه النطاقات المتفرقة إلى مسار رأسي أحادي ليس مجرد إجراء تنظيمي شكلي، بل هو عملية تحول جوهرية تضمن الحفاظ على سلامة التسلسل المنطقي وسهولة تطبيق الاستعلامات المعقدة.
تاريخياً، ارتبطت أوراق العمل بتحديات تشغيلية كبيرة عند محاولة دمج السجلات المتفرقة دون المساس بسلامتها المرجعية. وتعود جذور منصة جداول بيانات جوجل (Google Sheets) إلى الاستحواذ على تقنيات شركتي 2Web Technologies التي أسسها جوناثان روشيل وفارزاد خسروشاهي عام 2005، لتنطلق المنصة رسمياً عام 2006 وتحدث ثورة في المعالجة التشاركية السحابية. ومع تزايد حجم البيانات التحليلية وتطور المتطلبات الحسابية، أعلنت المنصة في مطلع عام 2023 عن إطلاق طفرة وظيفية شملت دوال التكديس والمعالجة المصفوفية الموجهة، وعلى رأسها الدالتان VSTACK وTOCOL، لتنهي عقوداً من الاعتماد على الحيل اليدوية المعقدة وتؤسس لمرحلة جديدة من الأتمتة الديناميكية فائقة الدقة.
يهدف هذا الدليل المرجعي الشامل إلى تفكيك كافة الأبعاد النظرية والتطبيقية لعملية تكديس الأعمدة المتعددة وتحويلها إلى عمود رأسي واحد في جداول بيانات جوجل. سنستعرض بعمق المبادئ الهيكلية لتحويل البيانات، والتحليل الدقيق للبنية النحوية والمحددات البرمجية للدوال الحديثة والبديلة، فضلاً عن استراتيجيات معالجة القيم المفقودة، وإدارة النطاقات المتفاوتة، وتصميم معماريات جداول البيانات القابلة للتوسع والتدقيق المنهجي الصارم.
1. مقدمة منهجية لهيكلة البيانات وتوحيد الأعمدة في جداول بيانات جوجل
1.1 أهمية توحيد البيانات متعددة الأبعاد في تحليل البيانات
يمثل الانتقال المنهجي من “التنسيق الأفقي العريض” (Wide Format) إلى “التنسيق الرأسي الطويل” (Long Format) حجر الزاوية في المعالجة الإحصائية المعاصرة. في التنسيق العريض، تتوزع المشاهدات المستقلة للمتغير نفسه عبر أعمدة متفرقة، كأن يُسجل قياس الاستجابة في الجلسة الأولى في عمود مستقل، والجلسة الثانية في عمود آخر. يؤدي هذا التشتت إلى فرض قيود تقنية هائلة على محركات المعالجة التي تعتمد على مفهوم المتجهات العمودية الموحدة لتحقيق أقصى كفاءة حسابية. إن توحيد القياسات في عمود واحد متصل يسمح بنمذجة إحصائية متقدمة، خصوصاً عند بناء نماذج التأثيرات المختلطة الخطية (Linear Mixed-Effects Models) وتحليلات التباين للقياسات المتكررة، حيث يُشترط أن يمثل كل سطر وحدة ملاحظة منفردة تتبع تصنيفاً محدداً، مما يعزز موثوقية التقدير الحسابي ويزيل التكرار غير المبرر في تعريف المتغيرات.
علاوة على ذلك، يسهم التحول نحو الهيكل الرأسي في تحسين استرجاع المعلومات عبر قواعد البيانات المنطقية وتسهيل تشييد الجداول المحورية (Pivot Tables). فعندما تتجمع كافة القيم الرقمية أو النصية في عمود مستمر، يصبح من السهل للغاية تطبيق عوامل التصفية، والتجميع الشرطي، وتوليد الرسوم البيانية التفاعلية دون الحاجة إلى إنشاء سلاسل مخصصة لكل عمود على حدة. إن هذا التوحيد يعالج التشتت الهيكلي الناتج عن تعدد مصادر جمع المتغيرات، مثل استطلاعات الرأي الإلكترونية وتجارب الرصد المتعددة، كما أظهرت الدراسات المتعلقة بتقييم تدفق البيانات اللحظية والتحليل المتكرر أن توحيد البنية التحتية للمصفوفات يقلل من احتمالية حدوث أخطاء التخصيص المنطقي أثناء سحب البيانات نحو البرمجيات التخصصية اللاحقة (Ryu et al., 2021).
1.2 تحديات الدمج اليدوي والحدود الإجرائية للنسخ واللصق
يعد الاعتماد على العمليات اليدوية، وتحديداً بروتوكولات النسخ واللصق لتجميع الأعمدة، من أخطر الممارسات التي تهدد نزاهة البيانات في البيئات الأكاديمية والمهنية. تتجلى المشكلة الأولى في القابلية المرتفعة للخطأ البشري؛ إذ يؤدي النقل اليدوي المتكرر لعشرات النطاقات إلى السهو عن تضمين بعض الصفوف، أو تكرار إدراج صفوف أخرى، أو لصق البيانات في مواضع إزاحة غير صحيحة، مما يدمر الاتساق المنطقي للعينة المدروسة. وقد بينت الأبحاث المكرسة لدراسة التيقظ والأداء البشري في المهام المتكررة أن وتيرة الأخطاء تتصاعد طردياً مع طول فترة العمل الرتيب ونقص التغذية الراجعة التلقائية، مما يجعل التدخل اليدوي مصدراً رئيساً للتباين العشوائي غير المضبوط (Cabrall et al., 2016).
إلى جانب مخاطر التلف والخطأ، يفرض الدمج اليدوي كلفة زمنية وحسابية غير مقبولة في المشاريع الضخمة. فالبيانات المدمجة يدوياً تصبح كيانات ساكنة ومقطوعة الصلة تماماً بنطاقاتها المصدرية؛ فإذا ما طرأ أي تحديث، أو تصحيح لقيمة خاطئة، أو إضافة لمدخلات جديدة في الأعمدة الأصلية، فإن العمود المجمع يظل معزولاً عن تلك التغييرات، مما يضطر الباحث إلى إعادة إجراء عملية النسخ واللصق بالكامل من البداية. هذه القيود الإجرائية تجعل مواكبة التدفقات اللحظية أمراً مستحيلاً وتخلق ازدواجية في تخزين البيانات، فضلاً عن فقدان المسار التوثيقي التراجعي الضروري لإثبات موثوقية التحليلات وتوافقها مع المعايير العلمية الصارمة.
1.3 نظرة عامة على التطور الوظيفي لبيئة جداول بيانات جوجل
شهدت بيئة جداول بيانات جوجل نقلات نوعية متتالية في قدراتها على معالجة المتجهات الحسابية منذ إطلاقها الأولي. ففي المراحل الأولى، كان المستخدمون مقيدين بصيغ رياضية كلاسيكية تجبرهم على ابتكار حلول التفافية شديدة التعقيد للتعامل مع المصفوفات ثنائية الأبعاد، مثل الاعتماد على لغة الاستعلامات النصية، أو الربط اليدوي بواسطة الأقواس المعقوفة. ومع تزايد التعقيد في مجموعات البيانات الحديثة والضغط المعرفي الواقع على المحللين لاستيعاب الصيغ الطويلة، برزت الحاجة إلى تزويد المنصة بدوال قادرة على فهم المتجهات متعددة الأبعاد بشكل أصيل، وهو ما يتماشى مع التوجهات المعرفية نحو تقليص العبء الإدراكي في بيئات العمل الرقمية (Khan et al., 2025).
توج هذا المسار التطويري بإعلان جوجل في أوائل عام 2023 عن إدراج حزمة متقدمة من دوال التلاعب بالمصفوفات، كان أبرزها VSTACK وHSTACK وTOCOL وTOROW. هذا التحديث لم يقتصر على مجرد تقديم وظائف جديدة، بل مثل إعادة هندسة لكيفية تدفق البيانات داخل شبكة الخلايا؛ حيث أصبحت الدوال قادرة على توليد مصفوفات انسكابية ديناميكية (Dynamic Spill Arrays) تتوسع وتتقلص تلقائياً تبعاً للتغيرات في النطاقات المدخلة. هذا التكامل الوظيفي وفر حلولاً حسابية خوارزمية عالية الكفاءة دون الحاجة إلى كتابة برمجيات نصية معقدة عبر Google Apps Script، مما رسخ مكانة المنصة كأداة قوية لمعالجة البيانات المعقدة بكفاءة برمجية مدمجة.
2. الدالة VSTACK: الإطار النظري والتركيب النحوي الدقيق
2.1 التعريف العلمي للدالة VSTACK ومبدأ عملها
تُعرف الدالة VSTACK من الناحية الرياضية والحسابية بأنها مشغل تجميع مصفوفي رأسي (Vertical Array Concatenation Operator)، وتتمثل وظيفتها الأساسية في أخذ مصفوفات أو متجهات متعددة، سواء كانت أحادية أو ثنائية الأبعاد، وتجميعها تتابعياً على طول المحور الرأسي (الصفحات أو الصفوف) لإنتاج مصفوفة ناتجة واحدة. يعتمد مبدأ عمل الدالة على تتبع تسلسل الوسائط المدخلة بدقة؛ حيث تبدأ بوضع عناصر النطاق الأول كاملة، وبمجرد الوصول إلى نهايته، تُلحق به عناصر النطاق الثاني في الصف التالي مباشرة دون ترك فجوات، وتستمر هذه العملية التراكمية بصورة متسلسلة حتى استنفاد جميع النطاقات المحددة في الصيغة الرياضية.
يختلف التكديس الرأسي اختلافاً جوهرياً عن التكديس الأفقي المنفذ عبر دالة HSTACK الموازية؛ فبينما تحافظ VSTACK على العرض العرضي للنطاقات وتقوم بتمديد الطول الرأسي عبر مراكمة الصفوف، تعمل HSTACK على زيادة عدد الأعمدة عن طريق محاذاة المصفوفات جنباً إلى جنب. هذا التمييز الهيكلي مهم للغاية في علم البيانات؛ لأن توحيد الأعمدة المنفصلة في متجه عمودي واحد يتطلب صراحة تطبيق مفهوم الإلحاق الرأسي لضمان أن تظل جميع المتغيرات التابعة متطابقة في البعد الخلوي الواحد، مما يسهل معالجتها كمتغير متصل خاضع لنفس التوزيع الإحصائي والتحليلي.
2.2 البنية النحوية والوسائط المحددة للدالة
تتميز الدالة VSTACK ببنية نحوية مباشرة ومرنة للغاية في بيئة جداول بيانات جوجل، حيث تصاغ المعادلة على النحو الآتي:
=VSTACK(array1, [array2, …]).
تعتبر الوسيطة الأولى (array1) وسيطة إلزامية تمثل النطاق الابتدائي أو المصفوفة القاعدية التي سيبدأ منها التكديس، في حين تمثل الوسائط اللاحقة (array2 وما يليها) نطاقات اختيارية إضافية يمكن تمريرها بالتتابع لتكديسها أسفل المصفوفة الأولى. تدعم الدالة إمكانية تمرير عدد كبير جداً من النطاقات المستقلة، مما يمنحها قدرة استيعابية فائقة تلائم أضخم المشاريع التحليلية.
تتطلب القواعد النحوية للدالة مراعاة محددات الفصل القياسية المعتمدة في إعدادات ورقة العمل؛ ففي الأنظمة التي تعتمد الفاصلة الإنجليزية القياسية (Comma)، يتم الفصل بين النطاقات بالرمز (,)، بينما في البيئات الإقليمية التي تستخدم الفاصلة كعلامة عشرية، يُستعاض عنها بالفاصلة المنقوطة (;). ومن أهم المزايا البرمجية لدالة VSTACK هي مرونتها المطلقة في قبول مراجع الخلايا الفردية، والنطاقات المستمرة، والنطاقات غير المجاورة، فضلاً عن المصفوفات المشتقة الناتجة عن دوال أخرى مثل FILTER أو QUERY، مما يجعلها وحدة بناء مركزية في تشييد الصيغ المركبة شديدة التطور.
2.3 الشروط المسبقة لتطبيق الدالة بنجاح في ورقة العمل
لضمان نجاح دالة VSTACK في توليد المخرجات المطلوبة وتجنب انقطاع الحسابات، يجب استيفاء مجموعة من الشروط الهيكلية والبيئية داخل ورقة العمل. الشرط الأساسي والأكثر أهمية هو توفر “مساحة انسكاب” (Spill Range) خالية تماماً من أية بيانات سابقة؛ حيث إن VSTACK تنشئ مصفوفة ديناميكية تشغل عدداً من الصفوف يعادل المجموع الكلي لصفوف النطاقات المدمجة. إذا واجهت هذه المصفوفة في طريق تمددها الرأسي أي خلية تحتوي على نص، أو رقم، أو حتى مسافة فارغة غير مرئية، سيتوقف المحرك فوراً عن عرض النتائج وسيطلق خطأ التوسع الشهير (#REF!).
إضافة إلى ذلك، يجب على المحلل التحقق من اتساق الإعدادات الإقليمية وتنسيقات الأرقام والتواريخ داخل ورقة العمل؛ ذلك أن عدم توافق الفواصل العشرية أو خلط نصوص مشفرة بطرق غير متجانسة قد يؤدي إلى تفسير خاطئ للقيم داخل المتجه الموحد. يجب أيضاً استيعاب السلوك الفيزيائي للمؤشر المرجعي؛ فالصيغة الرياضية تحتل وتستقر حصرياً في الخلية العلوية الأولى (خلية الجذر Anchor Cell)، في حين أن كافة الخلايا الممتدة أسفلها هي خلايا وهمية تابعة للمصفوفة المسكوبة، ولا يمكن تعديل محتواها بشكل فردي، بل يتم التحكم الكامل بها من خلال الخلية الأم فقط.
3. التطبيق العملي لتكديس الأعمدة المتساوية في عدد الصفوف
3.1 إعداد بيئة الاختبار وتجهيز النطاقات المتوازية
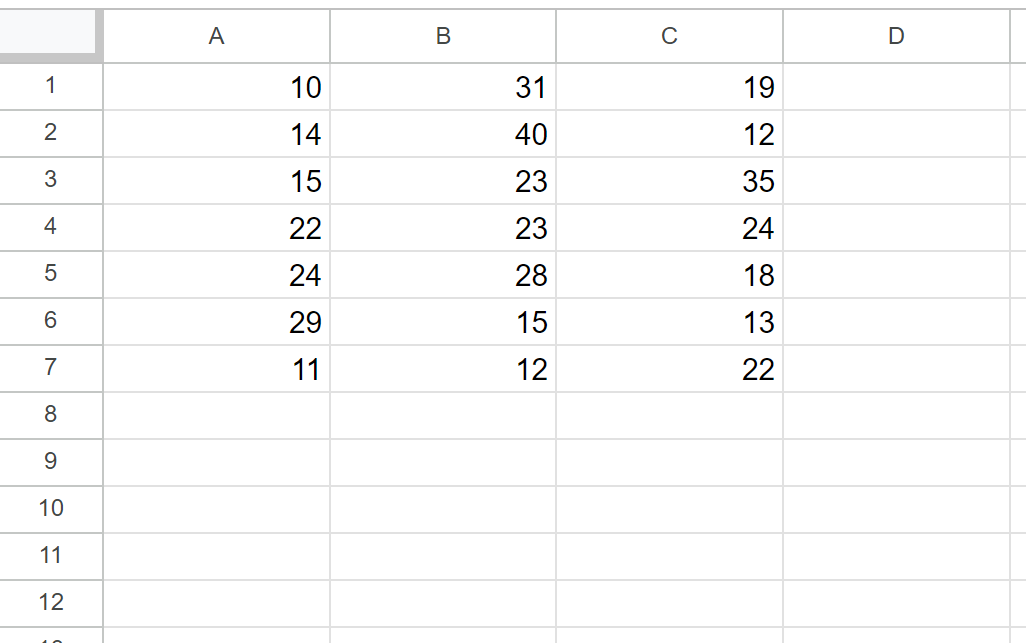
لتطبيق التكديس الرأسي عملياً وفق منهجية رصينة، ينبغي أولاً بناء جدول اختباري منظم يضم نطاقات متوازية ومتساوية في الأبعاد. لنفترض وجود دراسة ترصد استجابات المشاركين عبر ثلاثة مسارات تجريبية متماثلة: المسار الأول في النطاق A2:A10، والمسار الثاني في النطاق B2:B10، والمسار الثالث في النطاق C2:C10. يحتوي كل عمود من هذه الأعمدة على تسع مشاهدات متجانسة تمثل قياسات عددية لنفس الظاهرة. قبل الشروع في التكديس، يتحتم فحص سلامة البيانات ونوعها للتأكد من خلوها من التشوهات الإدخالية أو التضارب بين التنسيقات الرقمية والنصية.
تقتضي الخطوة التالية تحديد موقع خلية الإخراج المثالية لاستقبال العمود الموحد الناتج. يُفضل دائماً وضع خلية البداية في عمود منفصل ومستقل، مثل الخلية E2، مع ترك مسافة بصرية كافية تفصل بين جدول المدخلات الأصلي وجدول المعالجة المحدث لتجنب التداخل العرضي. يجب تجهيز ترويسة واضحة ومحددة في الخلية E1 تصف طبيعة المتغير المجمع بدقة، تمهيداً لضمان الانسياب المنطقي للبيانات وتسهيل قراءتها من قِبل أي محلل خارجي يطالع ورقة العمل لاحقاً.
3.2 خطوات إدخال صيغة التكديس الأساسية وتنفيذها
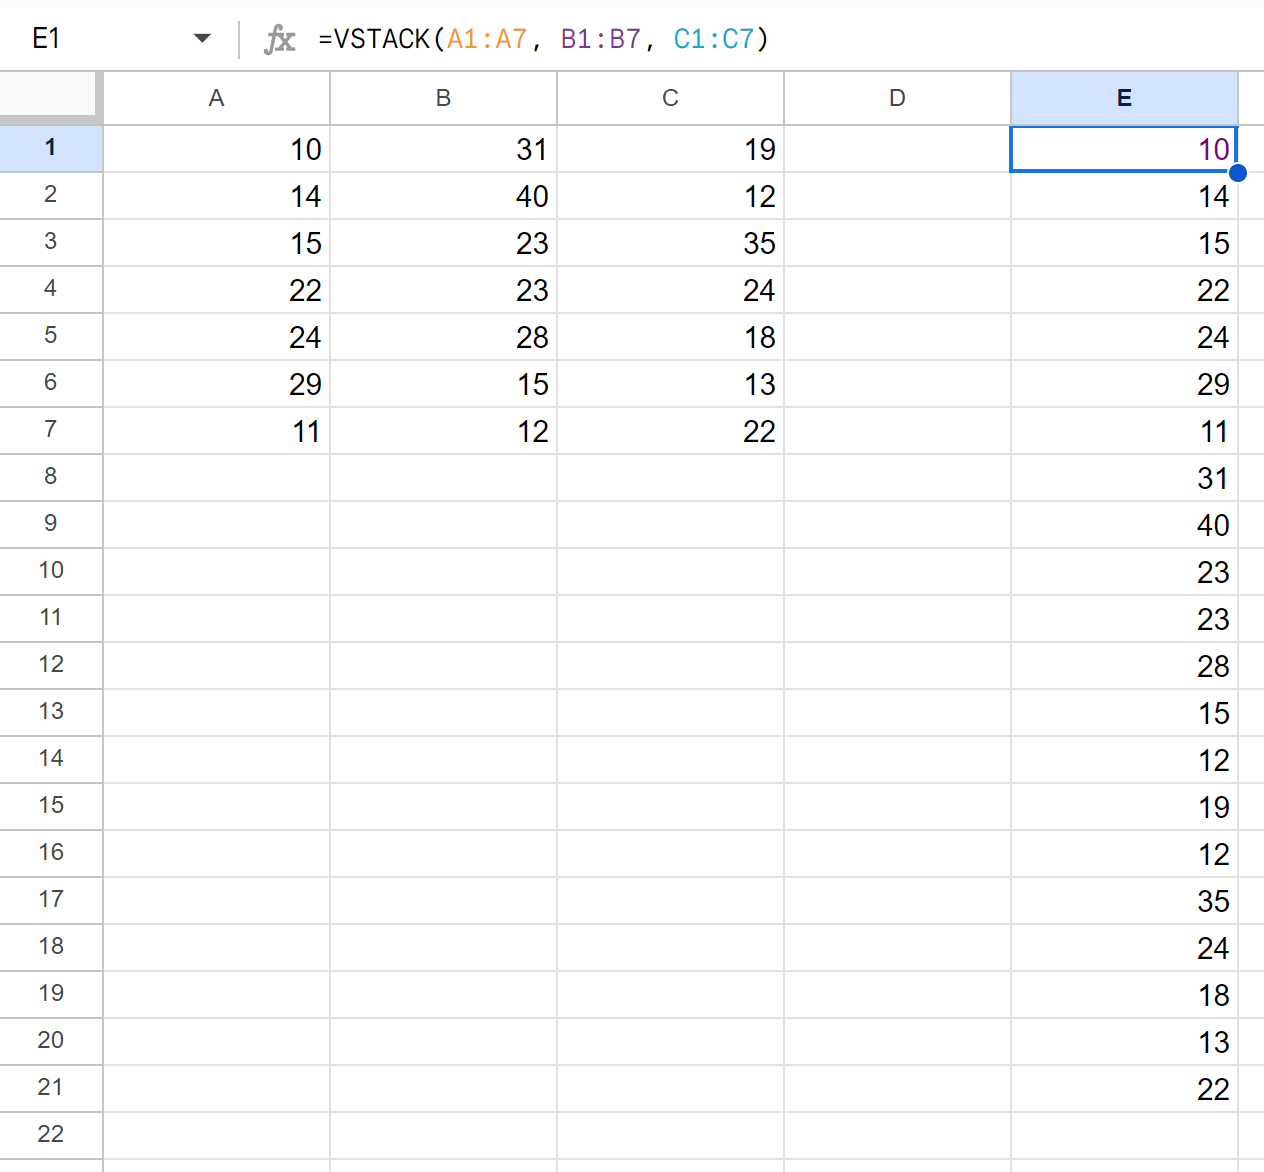
تبدأ المعالجة الفعلية بتحديد الخلية الهدف E2، ومن ثم كتابة الصيغة الرياضية بدقة متناهية بالشكل التالي:
=VSTACK(A2:A10, B2:B10, C2:C10).
بمجرد الضغط على زر الإدخال (Enter)، يرسل محرك الحساب في جداول بيانات جوجل إشارة لتشغيل مصفوفة الانسكاب التلقائي؛ حيث تُملأ الخلية E2 بقيمة الخلية الأولى من النطاق الأول A2، وتنسكب القيم الثماني المتبقية رأسياً لتشغل الخلايا حتى E10، وفور اكتمالها، تُدرج الخلية الأولى من النطاق الثاني B2 في الخلية E11 مباشرة، وتستمر العملية حتى تستقر آخر قيمة من النطاق الثالث C10 في الخلية E28.
خلال هذه اللحظة، يجب مراقبة سلوك الانسكاب وفحص المخرجات بصرياً للتأكد من عدم تجاوز النطاق المستهدف للمساحات المخصصة للجداول المجاورة أو التقاطع مع معادلات أخرى في الأسفل. تُظهر هذه الخطوة القوة الحسابية للدالة VSTACK؛ حيث تم إنجاز عملية دمج 27 قيمة متفرقة عبر نقرة زر واحدة وصيغة رياضية مقتضبة، مع بقاء كافة القيم المدمجة متصلة حركياً بالنطاقات الأصلية، مما يعني أن أي تعديل في أي رقم داخل الأعمدة الثلاثة ينعكس فورياً في العمود المجمع دون تأخير.
3.3 التحقق المنهجي من دقة التسلسل وترتيب العناصر
يتطلب العمل الأكاديمي والتحليلي إخضاع المخرجات لاختبارات تحقق صارمة لضمان مطابقتها التامة للأصول المصدرية وعدم سقوط أي بيانات أثناء المعالجة التلقائية. يبدأ التحقق الإحصائي الأساسي بمقارنة عدد الصفوف الكلي في العمود المكدس بالمجموع الحسابي لعناصر الأعمدة المدمجة؛ ففي مثالنا، يجب أن تكون النتيجة مطابقة للمعادلة الرياضية: 9 + 9 + 9 = 27 صفاً. يمكن التحقق من ذلك آلياً في ورقة العمل بكتابة صيغة الفحص:
=COUNTA(E2:E28) = (COUNTA(A2:A10) + COUNTA(B2:B10) + COUNTA(C2:C10))،
والتي يجب أن تعيد القيمة المنطقية TRUE لتأكيد الاكتمال العددي.
تتضمن المرحلة الثانية من التحقق فحص التسلسل الترتيبي، والتأكد من عدم حدوث أي اختلاط أو تداخل في تسلسل النطاقات؛ حيث يجب أن تتطابق القيمة E2 تماماً مع A2، والقيمة E10 مع A10، والقيمة E11 مع B2، وهكذا وصولاً إلى E28 التي يجب أن تطابق C10. يمكن استخدام أدوات المقارنة المنطقية المباشرة لاختبار صحة هذا التتابع تلقائياً. هذا التدقيق المنهجي يحمي الباحث من أخطاء الإزاحة غير المحسوسة ويؤسس لقاعدة بيانات صلبة وموثوقة بنسبة مئة بالمئة قبل الانتقال للعمليات الإحصائية المتقدمة.
4. إدارة تكديس الأعمدة غير المتساوية والمتباينة في الأبعاد
4.1 السلوك الحسابي لدالة VSTACK مع النطاقات متفاوتة الطول
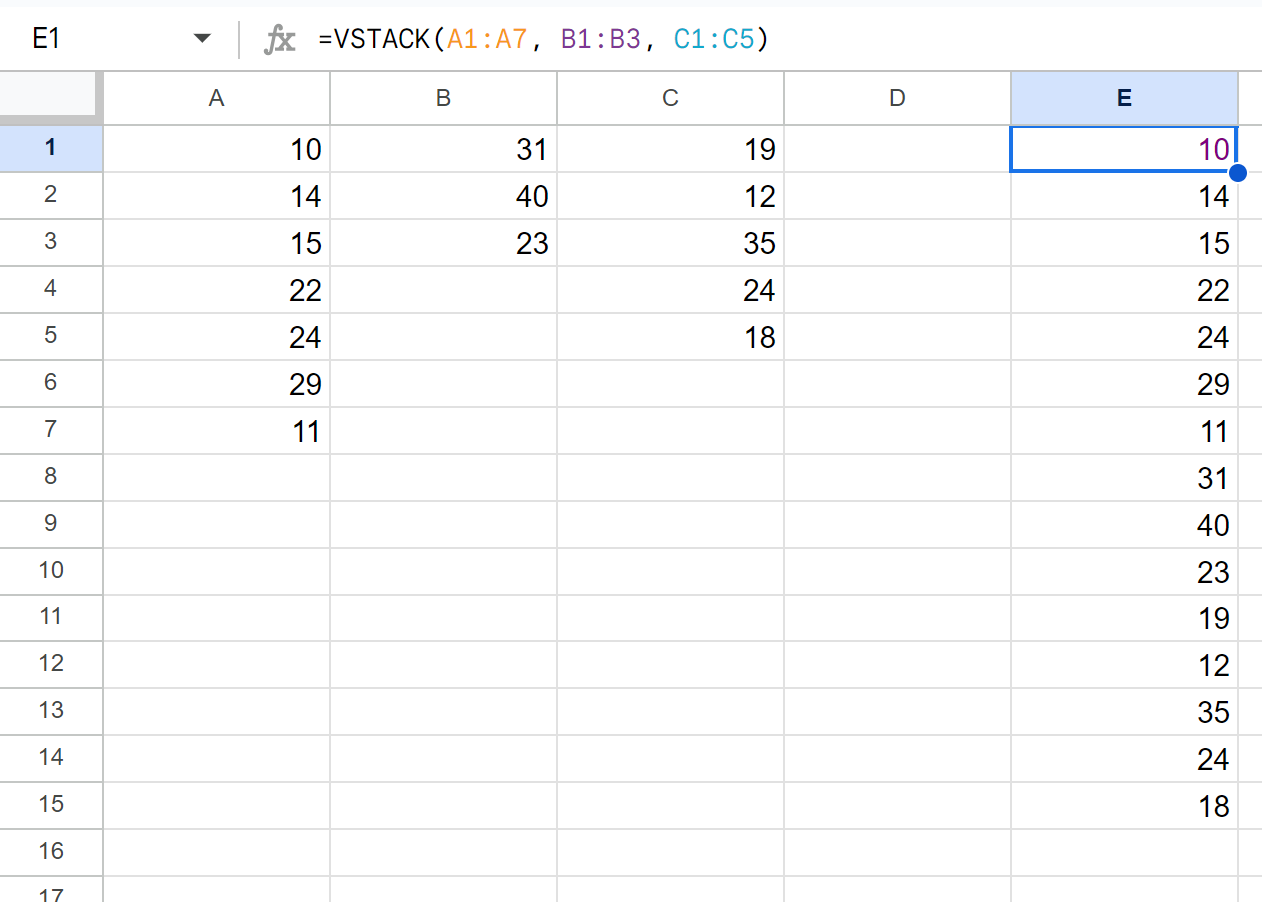
تتجلى العبقرية البرمجية لدالة VSTACK في قدرتها الفائقة على التعامل مع المصفوفات غير المتماثلة في الأبعاد الرأسية دون أدنى حاجة لتوحيد أطوالها مسبقاً. في العديد من السيناريوهات الواقعية، تكون النطاقات المراد دمجها متفاوتة في عدد الصفوف تفاوتاً كبيراً؛ كأن يحتوي العمود الأول A على سبعة صفوف (A2:A8)، بينما يقتصر العمود الثاني B على ثلاثة صفوف فقط (B2:B4)، في حين يمتد العمود الثالث C ليغطي خمسة صفوف (C2:C6). عند تطبيق الصيغة:
=VSTACK(A2:A8, B2:B4, C2:C6)،
يقوم محرك الحساب الداخلي بالتعامل مع كل نطاق ككتلة مصفوفية مستقلة ومكتملة بحد ذاتها.
خلافاً للطرق التقليدية القديمة التي كانت تنهار وتعيد أخطاء هيكلية عند اختلاف أبعاد المتجهات، تتنقل VSTACK بسلاسة تامة عبر المساحات الانتقالية؛ حيث تضع السجلات السبعة للنطاق A، وفي النقطة التي ينتهي فيها النطاق، تنتقل مباشرة لوضع سجلات النطاق B الثلاثة دون إدراج أي خلايا فارغة تعويضية أو افتراض وجود صفوف وهمية، ثم تلحق بها سجلات النطاق C الخمسة. هذا السلوك المرن يعصم ورقة العمل من أخطاء عدم تطابق أبعاد المصفوفات، ويجعل الدالة الخيار الأمثل للتعامل مع التدفقات البيانية غير المتجانسة بنيوياً.
4.2 آثار اختلاف أحجام العينات على البنية التراكمية
على الرغم من المرونة التقنية التي تبديها الدالة مع النطاقات المتباينة، إلا أن هذا الاختلاف في أحجام العينات يفرض تحديات منهجية بالغة الأهمية على بنية التراكم والتحليل لاحقاً. إن دمج نطاقات ذات أطوال متفاوتة في عمود واحد يؤدي إلى تمثيل غير متكافئ للمجموعات التجريبية أو المتغيرات داخل نفس المتجه، مما يستدعي توثيقاً دقيقاً للغاية لطول وحدود كل فئة من الفئات المدمجة. إذا لم يتم عزل وتعريف هذه الأطوال بشكل واضح، فقد يختلط الأمر على المحلل ويفترض بالخطأ أن كافة المجموعات متساوية في حجم العينة (N)، مما ينعكس سلباً على حسابات المتوسطات المرجحة وتقديرات التباين الإحصائي.
يتطلب هذا الوضع إدارة ذكية لتغير مؤشرات الترقيم المرجعي داخل العمود الموحد. فعندما تكون المجموعات غير متناظرة، لا يمكن الاعتماد على فترات رياضية ثابتة للوصول إلى بدايات ونهايات كل مجموعة (مثل القفز كل 10 صفوف). لحل هذه المعضلة وتجنب تشويه العلاقات الهيكلية بين المتغيرات، يُوصى منهجياً بإنشاء “عمود دليلي موازٍ” يتم تكديسه بالتزامن عبر دالة VSTACK موازية تحتوي على معرّفات نصية صريحة لأسماء المجموعات، مما يضمن احتفاظ كل قيمة مفردة في العمود الموحد بهويتها الأصلية وسياقها التجريبي الكامل دون أي التباس.
4.3 حالات الاستخدام الشائعة للبيانات غير المتناظرة
تبرز التطبيقات العملية للبيانات غير المتناظرة في العديد من المجالات البحثية والمهنية المعقدة. من أبرز هذه التطبيقات تجميع استجابات المجموعات التجريبية والضابطة في التجارب السلوكية والطبية؛ حيث يعاني الباحثون غالباً من ظاهرة تسرب المشاركين (Attrition)، مما ينتج عنه عينات نهائية متفاوتة العدد بين المجموعات. إن استخدام VSTACK يتيح دمج درجات هذه المجموعات في عمود قياس مستمر بسرعة فائقة مع الاحتفاظ بكافة القياسات المتاحة لكل عينة بدقة متناهية.
تشمل الحالات الشائعة أيضاً دمج سجلات الإدخال الميدانية الدورية التي تسجل أحداثاً غير منتظمة؛ مثل تجميع قراءات أجهزة الاستشعار البيئية الموزعة في محطات مختلفة حيث تعاني بعض المحطات من انقطاعات مؤقتة تجعل سجلاتها أقصر من غيرها، أو تجميع استمارات المبيعات الشهرية لمندوبين يحقق كل منهم عدداً متفاوتاً من الصفقات. كما تعد هذه الطريقة ركيزة أساسية في أبحاث التنبؤ بالانفعالات وتطبيقات التعلم الآلي القائمة على النماذج التتابعية، حيث تُجمع سلاسل زمنية متفاوتة الطول لمشاركين مختلفين وتُدمج في متجهات موحدة لتدريب الخوارزميات وتغذية النماذج العصبية المتقدمة (Paz-Arbaizar et al., 2025).
5. التعامل المتقدم مع الخلايا الفارغة والقيم المفقودة أثناء التكديس
5.1 أسباب ظهور الفراغات وتأثيرها على سلامة العمود الموحد
تمثل الخلايا الفارغة والقيم المفقودة (Missing Values) أحد أكبر التحديات التي تواجه عمليات معالجة وتكديس البيانات في جداول البيانات. تعود أسباب ظهور هذه الفراغات إلى عوامل متعددة، منها امتداد النطاق المحدد ليشمل مساحات احتياطية فارغة في أسفل الجدول، أو امتناع المبحوثين عن الإجابة على فقرات معينة في الاستبيانات، أو تعطل أدوات القياس اللحظي. تكمن الخطورة التقنية في الكيفية التي تتعامل بها جداول بيانات جوجل مع الخلايا الفارغة عند تكديسها؛ إذ غالباً ما تترجمها الدالة VSTACK إلى قيم صفرية (0) في سياقات التقييم الرقمي، أو تبقيها كخلايا فارغة تكسر الاستمرارية المنطقية للنطاق.
يمتد هذا التأثير السلبي بعمق ليطال العمليات الإحصائية والتحليلية اللاحقة. إن تسرب القيم الصفرية الناتجة عن الفراغات غير المقصودة إلى العمود الموحد يؤدي إلى تشويه جذري لمؤشرات النزعة المركزية؛ حيث ينخفض المتوسط الحسابي (Mean) انخفاضاً حاداً وزائفاً، في حين يتضخم الانحراف المعياري ومستويات التباين نتيجة اعتبار الفراغ قياساً حقيقياً مقداره صفر. ومن منظور منهجي دقيق، يجب التمييز الصارم بين “الصفر الحقيقي” كقيمة قياسية دالة تعبر عن انعدام الخاصية المقاسة، وبين “الفراغ الناتج عن فقدان البيانات”، إذ يتطلب الأخير معالجة برمجية تطهيرية حازمة تستبعده تماماً قبل تمريره لمراحل النمذجة الرياضية.
5.2 تكامل دالة VSTACK مع دالة التصفية FILTER للتخلص من الفراغات
لتجاوز معضلة الفراغات المتسربة، تقدم بيئة جداول بيانات جوجل حلاً مركباً بالغ القوة يعتمد على دمج دالة التصفية الشرطية FILTER داخل دالة التكديس VSTACK. يكمن المنطق الحسابي لهذا الحل في تطبيق تصفية مسبقة لكل نطاق مصدري على حدة، واستبعاد كافة الخلايا الفارغة منه قبل إرساله إلى دالة التكديس الرأسي. تُصاغ هذه المعادلة المركبة على النحو التالي:
=VSTACK(FILTER(A2:A, A2:A <> “”), FILTER(B2:B, B2:B <> “”), FILTER(C2:C, C2:C <> “”)).
في هذا التركيب البرمجي، تقوم الدالة FILTER بفحص العمود A واستخراج القيم التي لا تساوي فراغاً فقط (<> “”)، متجاهلة أي خلية فارغة في أسفل العمود أو بين السجلات، وتكرر نفس الإجراء بشكل مستقل ومتزامن على العمودين B وC. بعد ذلك، تتسلم دالة VSTACK المصفوفات الثلاث النقية والمطهرة بالكامل، وتقوم بتكديسها رأسياً في متجه متصل خالٍ تماماً من أية فجوات. وعلى الرغم من أن هذا الأسلوب يستهلك جزءاً يسيراً من الموارد الحسابية نظراً لتعدد عمليات التصفية الفردية، إلا أنه يضمن أعلى درجات النقاء الإحصائي ويمنع تلوث العينة بأي قيم مفقودة مضللة.
5.3 تطبيق دالة TOCOL كحل بديل مرن لتجاهل المساحات الفارغة
على الرغم من الفعالية العالية للتركيب السابق، إلا أن شركة جوجل وفرت حلاً أصيلاً فائق البساطة والسرعة عبر إطلاق دالة TOCOL (To Column) في تحديثات مطلع عام 2023. صُممت دالة TOCOL خصيصاً لأخذ مصفوفة أو شبكة ثنائية الأبعاد بالكامل وتحويلها إلى عمود رأسي واحد مع التحكم الذاتي الكامل في كيفية إدارة الخلايا الفارغة وأخطاء المعادلات، مما يجعلها بديلاً مبهراً في الكثير من سيناريوهات التكديس المباشرة. تأتي البنية النحوية للدالة كالآتي:
=TOCOL(array, [ignore], [scan_by_column]).
تكمن الميزة الاستثنائية لدالة TOCOL في وسيطتها الثانية (ignore)؛ حيث يمكن تمرير القيمة 1 لتوجيه الدالة لتجاهل كافة الخلايا الفارغة تلقائياً، أو القيمة 2 لتجاهل الأخطاء الحسابية، أو القيمة 3 لتجاهل الفراغات والأخطاء معاً. بالإضافة إلى ذلك، تتيح الوسيطة الثالثة (scan_by_column) تحديد اتجاه المسح؛ فبتمرير القيمة المنطقية TRUE، تقوم الدالة بقراءة المصفوفة من الأعلى إلى الأسفل عموداً تلو الآخر (وهو السلوك المطابق لـ VSTACK)، بينما القيمة الافتراضية FALSE تقرأ أفقياً صفا تلو الآخر. بالتالي، تصبح الصيغة التالية:
=TOCOL(A2:C50, 1, TRUE)
حلاً سحرياً مقتضباً يغني تماماً عن كتابة معادلات FILTER المركبة، حيث تجمع الأعمدة الثلاثة رأسياً مع استبعاد كافة الفراغات بمرونة حسابية متناهية.
6. تكامل VSTACK مع الدوال الإحصائية والفرز والتحليل
6.1 تنظيم المخرجات باستخدام دالة الفرز SORT
لا تتوقف المعالجة المتقدمة للبيانات عند مجرد التكديس البسيط، بل تمتد لتشمل إعادة هيكلة المصفوفة الناتجة وتنظيمها لتيسير الاستكشاف والتحليل. يمثل تكامل دالة VSTACK مع دالة الفرز SORT خطوة محورية في هذا السياق؛ إذ تتيح الصيغة المركبة ترتيب المتجه الموحد ترتيباً تصاعدياً أو تنازلياً بصورة تلقائية وفورية فور اكتمال التكديس. تصاغ هذه العملية عبر تطويق دالة VSTACK كلياً داخل وسائط دالة SORT على النحو الآتي:
=SORT(VSTACK(A2:A10, B2:B10, C2:C10), 1, TRUE).
في هذه الصيغة، تُعامل المخرجات المكدسة كمدخل مصفوفي مباشر للوسيطة الأولى في SORT، حيث يشير الرقم 1 إلى العمود الأول (وهو العمود الوحيد في المصفوفة الناتجة)، بينما تحدد القيمة المنطقية TRUE اتجاه الترتيب ليكون تصاعدياً (أو FALSE للترتيب التنازلي). تتعامل الدالة بكفاءة مذهلة مع البيانات النصية بترتيبها أبجدياً، والبيانات الرقمية بفرزها كمياً، مع الحفاظ الكامل على الحركية الديناميكية؛ فإذا أُضيفت قيمة جديدة ذات وزن منخفض في أقصى قاع العمود المصدري B، ستقوم الدالة بإعادة حساب المتجه المكدس فوراً وإدراج تلك القيمة الجديدة في موقعها الصحيح في قمة العمود المفرز دون أي تدخل يدوي.
6.2 استخراج العناصر الفريدة عبر إدماج دالة UNIQUE
في كثير من الدراسات التحليلية، يؤدي تجميع قوائم متعددة إلى ظهور تكرارات واسعة للقيم والعناصر المشتركة بين المجموعات المصدرية؛ مثل تجميع قوائم المشاركين في ورش عمل متعددة، أو توحيد رصد الكلمات المفتاحية في أبحاث تحليل المحتوى اللغوي والمعرفي التي تسعى إلى تتبع تمثيلات الذاكرة المشتركة والمفردات الدلالية (Rissman et al., 2022). للتعامل مع هذا التكرار، يمكن إدماج دالة العناصر الفريدة UNIQUE مباشرة مع دالة VSTACK لاستخلاص قائمة نقية تقتصر حصرياً على القيم غير المكررة، وفق البنية الرياضية التالية:
=UNIQUE(VSTACK(A2:A20, B2:B20, C2:C20)).
يعمل هذا الدمج البرمجي على فحص المتجه المكدس فور تشكيله، وتحديد كل قيمة تظهر لأول مرة وتضمينها في المخرجات، بينما يتم إسقاط أي ظهور متكرر لاحق لنفس القيمة تلقائياً. يتيح هذا الإجراء تشييد فهارس تصنيفية موحدة وفئات معيارية يمكن استخدامها لاحقاً كمدخلات رئيسية لقوائم التحقق المنسدلة، أو لبناء جداول التوزيع التكراري لحساب تكرار كل عنصر عبر المجموعات الأصلية. هذا التكامل يلغي الحاجة إلى إنشاء أعمدة وسيطة لتصفية التكرارات، مما يحسن النقاء الهيكلي للنموذج ويقلل من استهلاك ذاكرة المعالجة داخل المتصفح.
6.3 إجراء العمليات الحسابية المباشرة على العمود التراكمي
من أهم المزايا التي توفرها هندسة المصفوفات الحديثة في جداول بيانات جوجل هي القدرة على إجراء الحسابات الإحصائية والرياضية المركبة مباشرة “في الذاكرة” (In-Memory Processing) فوق مصفوفة VSTACK دون الحاجة الفعلية لسكب العمود في خلايا ورقة العمل. يمكن للباحث حساب المتوسط الكلي لكافة القيم الموزعة عبر نطاقات متفرقة، أو جمعها، أو تحديد قيمتها العظمى والصغرى دون تخصيص عمود فعلي في الواجهة البصرية، وذلك بتمرير دالة التكديس كوسيطة عددية داخل الدوال الإحصائية المعتادة، كالصيغة التالية:
=AVERAGE(VSTACK(A2:A10, B2:B10, C2:C10)).
تتيح هذه التقنية الحسابية توليد مؤشرات إحصائية ملخصة وفورية تُعرض في بطاقات الأداء ومؤشرات القياس الرئيسية (KPIs) دون زيادة حجم ورقة العمل بالأعمدة المساعدة المؤقتة. إن تجاوز إنشاء الأعمدة الوسيطة يخفف العبء التخزيني على خوادم المعالجة، ويقلل من عدد الخلايا النشطة في الملف (مما يحميه من الاقتراب من الحد الأقصى المسموح به للخلايا في جداول بيانات جوجل)، ويعزز من انسيابية الأداء الحسابي خصوصاً عند بناء نماذج مالية أو إحصائية معقدة تتطلب آلاف الحسابات التراكمية في الثانية الواحدة.
7. التقنيات البديلة لتكديس الأعمدة: مقارنة تحليلية موسعة
7.1 استخدام الأقواس المعقوفة والمصفوفات الثابتة التقليدية
قبل الإطلاق الرسمي لدالة VSTACK، كانت الطريقة القياسية المعتمدة لتكديس الأعمدة رأسياً تتمثل في توظيف الأقواس المعقوفة ومصفوفات البيانات الصريحة (Array Literals). يعتمد هذا النظام على صياغة مصفوفة جامعة تضم النطاقات المستهدفة مفصولة برمز الفاصلة المنقوطة (؛) كرمز تشغيلي يشير إلى الانتقال إلى صف جديد في الترتيب الرأسي، وذلك وفق الصيغة الكلاسيكية التالية:
={A2:A10; B2:B10; C2:C10}.
تعمل هذه الصيغة بكفاءة ممتازة وسرعة عالية في البيئات القياسية، وتظل خياراً مفضلاً لدى العديد من المحللين المخضرمين نظراً لأصالتها وتوافقها التام مع كافة الإصدارات التاريخية للمنصة.
ومع ذلك، يعيب هذه الطريقة التقليدية جمودها الهيكلي الصارم وفرضها لشروط متشددة فيما يتعلق بتطابق أبعاد الأعمدة؛ إذ تشترط مصفوفات الأقواس المعقوفة أن تكون كافة النطاقات المدمجة متطابقة تماماً في عدد الأعمدة، وفي حال تمرير مصفوفات غير متسقة، ينهار النظام الحسابي فوراً مطلقاً خطأً مصفوفياً حرجاً. بالمقارنة المعيارية، تتفوق VSTACK تفوقاً كاسحاً في مرونة قراءة النطاقات وقبول الوسائط غير المتجانسة والتفاعل الانسيابي مع الدوال المصفوفية المتغيرة، مما يجعلها الوريث الشرعي الأكثر تطوراً والأسهل صيانة في أوراق العمل الاحترافية المعاصرة.
7.2 استخدام دالة FLATTEN لإعادة التشكيل الأحادي
تمثل دالة FLATTEN إحدى أكثر المحطات إثارة في تاريخ جداول بيانات جوجل؛ حيث ظهرت في البداية كدالة داخلية غير موثقة رسمياً حوالي عام 2020، وسرعان ما اكتشفها مجتمع المطورين وتبناها على نطاق واسع كأقوى أداة لتسطيح النطاقات ثنائية الأبعاد وتحويلها إلى متجهات خطية أحادية عبر صيغة شديدة البساطة:
=FLATTEN(A2:C10).
تتميز هذه الدالة بقدرتها الخارقة على أخذ جدول متعدد الصفوف والأعمدة وتحويله بالكامل إلى عمود واحد بسرعة معالجة فائقة تتفوق أحياناً على معظم الدوال الأخرى.
لكن يكمن الفارق الجوهري والمنهجي بين VSTACK وFLATTEN في “منطق مسح البيانات” (Scanning Direction)؛ فبينما تقرأ دالة VSTACK النطاقات عموداً تلو الآخر وبشكل متسلسل يحافظ على تماسك المتغيرات، تعتمد دالة FLATTEN افتراضياً على المسح الأفقي سطرًا بسطر (Row by Row)، حيث تأخذ عناصر الصف الأول (A2 ثم B2 ثم C2) ثم تنتقل إلى الصف التالي، مما يؤدي إلى تداخل قيم المتغيرات المختلفة وتبادلها دورياً على طول العمود الناتج. هذا السلوك يجعل FLATTEN ممتازة لتفكيك الجداول التبادلية وتوليد التوافيق والتباديل، لكنه يجعلها غير مناسبة للتكديس التتابعي الصارم للأعمدة ما لم يتم تطبيق عمليات تدوير مصفوفي مسبقة ومعقدة.
7.3 توظيف لغة الاستعلام الفائقة عبر دالة QUERY
تعد دالة QUERY الأداة الأكثر شمولية وقوة في معالجة وتحويل البيانات في جداول جوجل، نظراً لاعتمادها على لغة استعلامية شبيهة بلغة SQL. يمكن توظيف هذه الدالة الجبارة لتكديس الأعمدة مع تطبيق عمليات تصفية وفرز وتجميع بالغة التعقيد في نفس خطوة التكديس البرمجية الواحدة، عبر دمج النطاقات داخل أقواس المصفوفات وتمريرها لنص الاستعلام كما في النموذج التالي:
=QUERY({A2:A; B2:B; C2:C}, “where Col1 is not null order by Col1 asc”, 0).
يوفر هذا النموذج حلاً متكاملاً يلغي الخلايا الفارغة تلقائياً عبر عبارة الشرط (where Col1 is not null)، ويرتب النتائج تصاعدياً، مع منح المحلل قدرة فريدة على إجراء العمليات التجميعية الحسابية وتغيير ترويسات الأعمدة بمرونة استثنائية. وعلى الرغم من هذه القوة الوظيفية الهائلة، إلا أن دالة QUERY تعاني من ارتفاع ملحوظ في “التعقيد المعرفي” لصيغتها البرمجية، فضلاً عن استهلاكها العالي للموارد الحسابية عند معالجة النطاقات الضخمة مقارنة بدالة VSTACK المتخصصة والخفيفة، مما يجعل المفاضلة بينهما معتمدة على مدى تعقيد متطلبات المعالجة المطلوبة في ورقة العمل.
8. ديناميكية النطاقات وأتمتة التكديس عند نمو البيانات المستمر
8.1 بناء نطاقات تكديس ديناميكية مفتوحة الأطراف
في بيئات العمل الإنتاجية والأبحاث المستمرة، نادراً ما تظل أحجام البيانات ثابتة؛ حيث تتدفق المدخلات الجديدة باستمرار عبر استمارات جمع البيانات أو سجلات الرصد المتجددة. لتحقيق الأتمتة الكاملة ومنع الحاجة لتعديل صيغ المعادلات يدوياً مع كل إدخال جديد، يتم الاعتماد على بناء نطاقات تكديس “مفتوحة الأطراف” (Open-ended Ranges)، حيث يتم إسقاط رقم الصف النهائي من المرجع، مثل كتابة:
=VSTACK(A2:A, B2:B, C2:C).
يضمن هذا التوصيف للمحرك الحسابي مراقبة كافة الصفوف حتى نهاية ورقة العمل واستيعاب أي مدخل مستقبلي تلقائياً.
بيد أن تطبيق النطاقات المفتوحة دون قيود احترازية يولد مشكلة تشغيلية خطيرة؛ إذ ستقوم VSTACK بقراءة آلاف الصفوف الفارغة الممتدة إلى قاع الورقة وتكديسها، مما يسفر عن عمود موحد يحتوي على مساحات فارغة هائلة تفصل بين كتل البيانات وتؤدي إلى بطء كارثي في أداء الملف. للتغلب على هذه المعضلة وتطويق النطاقات المفتوحة باحترافية، يُدمج التكديس المفتوح مع دوال تقييد النطاق الديناميكي أو التصفية الذاتية، مثل دمجها مع دالة CHOOSEROWS أو دمجها في صيغة TOCOL المفتوحة مع شرط تجاهل الفراغات، مما يؤسس لنظام حسابي مرن يتكيف ويتمدد آنياً بدقة متناهية مع تدفق البيانات الجديدة دون توليد خلايا ميتة.
8.2 التكامل مع دالة INDIRECT والنطاقات المسماة لتسهيل الإدارة
تتطلب إدارة النماذج الحسابية المعقدة التي تحتوي على مصفوفات متفرقة عبر أوراق عمل متعددة صياغة أساليب إحالة ذكية تمنع فوضى المراجع الطويلة وتقلل من احتمالية كسر الصيغ أثناء الصيانة والتحديث. يمثل استخدام “النطاقات المسماة” (Named Ranges) مدخلاً منهجياً بالغ الأهمية؛ حيث يمكن للمحلل تسمية النطاق الأول بـ “Cohort_A”، والثاني بـ “Cohort_B”، والثالث بـ “Cohort_C”، لتصبح صيغة التكديس مقروءة وواضحة المعالم:
=VSTACK(Cohort_A, Cohort_B, Cohort_C)،
مما يسهل تدقيقها المنطقي وفهمها من قِبل أي مراجع خارجي.
يتعزز هذا التكامل الوظيفي بصورة أكبر عند دمج دالة VSTACK مع دالة الإحالة غير المباشرة INDIRECT لاستدعاء النطاقات برمجياً استناداً إلى أسماء أوراق العمل المسجلة في جدول فهرس ديناميكي. يتيح ذلك بناء صيغ فائقة التطور تقوم بتجميع وتكديس أعمدة ممتدة عبر عشرات أوراق العمل المنفصلة تلقائياً بمجرد إدراج اسم الورقة في خلية التحكم، وهو ما يعد ركيزة أساسية لتشييد لوحات التحكم الأكاديمية والأنظمة المؤسسية التي تجمع مدخلات دورية من فروع أو مجموعات بحثية متعددة في جدول تحليلي مركزي واحد.
8.3 إدارة تدفق البيانات المحدثة لحظياً وتجنب بطء الحسابات
يفرض الحساب التلقائي المستمر للمصفوفات التراكمية في جداول بيانات جوجل ضغطاً متزايداً على متصفح الويب وخوادم المعالجة السحابية، خصوصاً عندما تنمو أحجام البيانات لتشمل عشرات الآلاف من السجلات المحدثة لحظياً عبر واجهات برمجة التطبيقات (APIs) أو النماذج اللحظية. يعود هذا البطء إلى أن محرك جداول جوجل يعيد بناء شجرة الحسابات التبعية (Calculation Dependency Tree) بصورة متكررة عند كل تعديل طفيف، مما قد يتسبب في حدوث تجمد مؤقت في واجهة المستخدم واستنزاف موارد النظام المعرفية والحسابية، على نحو يماثل تدهور الأداء التفاعلي في البيئات الرقمية كثيفة الحمل (Gideoni et al., 2022).
لتحسين دورات إعادة الحساب وضمان سرعة الاستجابة، يجب اتباع استراتيجيات تحسين حسابية صارمة؛ من بينها حصر نطاقات التكديس داخل أبعاد محددة ومغلقة وتجنب النطاقات اللانهائية غير المنضبطة، وتقليص استخدام الدوال المتطايرة (Volatile Functions) مثل NOW وTODAY وRAND داخل الصيغ التكديسية لأنها تجبر المحرك على إعادة التكديس مع كل ضغطة زر. وعندما تستقر البيانات وتكتمل مراحل الجمع والتدقيق التحليلي الأولي، تقتضي أفضل الممارسات المهنية تحويل العمود المكدس مؤقتاً أو نهائياً إلى “قيم ثابتة” (Paste Special > Values only) لتجميد النتائج، وتحرير الذاكرة الحسابية، وتوفير بيئة مستقرة وسريعة للغاية لتنفيذ النمذجة الإحصائية النهائية.
9. الأخطاء الشائعة وحلول استكشاف الأعطال وإصلاحها
9.1 تشخيص أخطاء التوسع والانسكاب وحلها
يعد خطأ التوسع (#REF!)، المصحوب بالرسالة التفسيرية “تعذر توسيع المصفوفة لأنها ستؤدي إلى استبدال البيانات في النطاق”، الخطأ الأكثر شيوعاً وإحباطاً للمستخدمين عند تطبيق دالة VSTACK. ينشأ هذا العطل الحسابي نتيجة وجود محتوى نصي أو رقمي، أو حتى فراغ غير مرئي ناتج عن الضغط على مفتاح المسافة، في أحد المسارات العمودية التي تحاول مصفوفة الانسكاب الانتشار من خلالها. وبما أن المنصة تتبنى مبدأ الأمان الإنشائي الصارم لمنع فقدان البيانات، فإنها توقف سكب المتجه بالكامل لحماية البيانات الموجودة في طريق التمدد من الطمس أو الكتابة الفوقية غير المقصودة.
يتطلب حل هذا العطل التشخيصي إجراء مسح ميداني سريع لمسار الانسكاب؛ حيث يتيح النقر على الخلية التي تحتضن الصيغة إظهار حدود النطاق المستهدف مظللة بلون أزرق منقط، وتحديد الخلية الدقيقة المسببة للاعتراض في نص رسالة الخطأ المنبثقة. بمجرد مسح أو إزاحة القيمة المعترضة خارج مسار المصفوفة، ستقوم VSTACK فوراً بإتمام عملية الانسكاب التلقائي بنجاح. ولتحصين مساحة الانسكاب ومنع الإدخال البشري العرضي في طريقها مستقبلاً، يُوصى بحماية نطاق المخرجات عبر أدوات حماية النطاقات (Protect Sheets and Ranges)، أو تطبيق قواعد التحقق من صحة البيانات (Data Validation) لمنع تحرير الخلايا الواقعة تحت خلية المعادلة التراكمية.
9.2 معالجة أخطاء عدم تطابق الأنواع والمصفوفات غير الصالحة
يبرز خطأ القيمة الشهير (#VALUE!) عند تمرير وسائط أو مصفوفات غير متوافقة برمجياً مع المتطلبات النحوية لدوال التكديس والتجميع. يحدث هذا الخلل عادةً عند ارتكاب أخطاء في تراكيب الأقواس، أو استخدام فواصل غير متوافقة مع الإعدادات الإقليمية للملف (مثل استخدام الفاصلة بدلاً من الفاصلة المنقوطة في المناطق المعتمدة للنظام العشري الأوروبي)، أو محاولة دمج نطاقات مشوهة تحتوي على مصفوفات ثلاثية الأبعاد غير مدعومة. كما يتسبب تمرير نطاقات فارغة بالكامل داخل دالة FILTER المدمجة في إطلاق خطأ #CALC! أو #VALUE!، نظراً لعدم عثور التصفية على أية نتائج تطابق الشرط المحدد.
لتطويق هذه الانقطاعات البرمجية غير المتوقعة واستعادة استقرار النموذج الحسابي، يجب توحيد التنسيقات الرقمية والنصية والتاريخية عبر كافة الأعمدة المصدرية لضمان انسجام التفسير المنطقي لدى المحرك. علاوة على ذلك، ينبغي احتواء الدوال المركبة داخل صيغ وقائية مدعمة بدالة معالجة الأخطاء IFERROR، مثل كتابة:
=VSTACK(IFERROR(FILTER(A2:A, A2:A <> “”), “”), IFERROR(FILTER(B2:B, B2:B <> “”), “”)).
تضمن هذه المعمارية الاحترازية أنه في حال خلو أحد الأعمدة المصدرية تماماً من البيانات، لن تنهار الصيغة التكديسية الكلية، بل سيتم التعامل مع النطاق الفارغ كفراغ آمن ويستمر تكديس بقية الأعمدة دون انقطاع.
9.3 مشكلات التحديث المرجعي والانزياح الخلوي
تتعرض صيغ التكديس المتقدمة لمخاطر التشويه المرجعي والانزياح الخلوي (Cellular Drift) عند إدخال تعديلات هيكلية على ورقة العمل المصدرية؛ مثل قيام المستخدمين بحذف صفوف علوية، أو قص ونقل نطاقات بيانات من موقع لآخر، أو إدراج أعمدة فاصلة بين النطاقات المجمعة. يؤدي هذا التعديل الفيزيائي أحياناً إلى تحول مراجع النطاقات داخل صيغة VSTACK إلى مراجع متضاربة أو ظهور خطأ #REF! نتيجة فقدان الخلية الجذرية للارتباط الأصلي، مما يفقد النموذج دقته العلمية ويقود إلى قراءات مضللة لا تعكس الواقع الميداني بدقة.
لتفادي مشكلات الانزياح الخلوي وضمان الحصانة المرجعية، يجب الاعتماد بشكل صارم على مراجع التثبيت المطلق (Absolute References) باستخدام علامة الدولار ($) لتجميد بدايات ونهايات النطاقات، مثل:
=VSTACK($A$2:$A$20, $B$2:$B$20, $C$2:$C$20).
يمنع هذا التثبيت المطلق انحراف النطاقات عند نسخ الصيغة إلى مواقع أخرى في الورقة. بالإضافة إلى ذلك، يُنصح بتفعيل أدوات التدقيق الداخلي وإظهار خطوط التبعية الخلوية بانتظام لفحص وتتبع العلاقات الرابطة بين خلايا المدخلات الأصلية وخلايا المخرجات المكدسة، مما يوفر بيئة تحليلية متماسكة ومحمية من تقلبات التحرير العرضي.
10. أفضل الممارسات المنهجية لتوثيق وتصميم أوراق العمل التحليلية
10.1 التصميم الهندسي المنفصل: فصل طبقة الإدخال عن طبقة المعالجة
تمثل المعمارية الهندسية ثلاثية الطبقات (Three-tier Architecture) المعيار الذهبي في تصميم أوراق العمل التحليلية في المؤسسات الأكاديمية والبحثية المتقدمة. يقوم هذا المبدأ على الفصل المادي والوظيفي الصارم بين ثلاث طبقات مستقلة تماماً: “طبقة إدخال البيانات الأولية” (Raw Data Layer)، و”طبقة المعالجة والتحويل الرياضي” (Processing/Staging Layer)، و”طبقة العرض ولوحات التحكم” (Presentation/Dashboard Layer). في هذا الإطار، يتم تخصيص ورقة عمل مستقلة لتجميع المدخلات الميدانية والأعمدة الخام كما وردت من مصادرها دون أدنى مساس بصيغتها الأصلية.
تستقر دالة VSTACK ودوال التكديس والفرز المشتقة حصرياً داخل ورقة عمل وسيطة تمثل طبقة المعالجة والتحويل؛ حيث تعمل هذه الورقة كمحرك خفي يتولى تنظيف البيانات، وتوحيد أبعادها، وتكديس أعمدتها رأسياً دون تدخل بشري. بعد ذلك، تستقي لوحات التحكم والتقارير النهائية بياناتها من هذا العمود الموحد المستقر في طبقة المعالجة. هذا الفصل الهندسي يحمي سلامة البيانات الأولية من أية تعديلات غير مصرح بها أو عمليات حذف خاطئة أثناء التحليل، ويوفر بيئة عمل عالية الأمان وسهلة الصيانة والتطوير بما يتماشى مع أرقى معايير الحوسبة السحابية المنظمة.
10.2 التوثيق المعرفي المنهجي داخل جداول البيانات
إن بناء أوراق عمل تحتوي على معادلات مصفوفية متطورة دون توثيق موازٍ يحولها إلى نماذج “صندوق أسود” غامضة يصعب فهمها أو مراجعتها عند غياب المصمم الأصلي. لذلك، يعد التوثيق المعرفي المنهجي ركيزة جوهرية لا غنى عنها لضمان تكرارية البحث وقابلية مراجعته علمياً. يتحقق ذلك عبر استخدام التعليقات التوضيحية المدمجة (Cell Notes and Comments) المرتبطة بخلية الصيغة الجذرية، لشرح المنطق الحسابي الذي بنيت عليه تركيبة VSTACK والهدف من دمج النطاقات وتوضيح ماهية الدوال المرافقة لها مثل FILTER أو TOCOL.
يتجاوز التوثيق الاحترافي مجرد التعليقات اللحظية ليمتد إلى إنشاء ورقة عمل افتتاحية مخصصة تمثل “قاموس البيانات والدليل الهيكلي” (Data Dictionary and Codebook). يوضح هذا السجل المعرفي تسلسل انتقال المتغيرات وتدفقها التفصيلي من الأعمدة المصدرية المتفرقة وصولاً إلى العمود التراكمي الموحد، مع تعريف محددات القياس ووحدات الرصد والتعديلات التحويلية التي خضعت لها البيانات. إن هذا التوثيق الدقيق يضمن الشفافية المنهجية المطلوبة في البحوث المنشورة ويسهل على فرق العمل متعددة التخصصات فهم الأطر التحليلية والتفاعل معها بموثوقية وكفاءة تامة.
10.3 المعايير المتقدمة لاختبار الموثوقية وقابلية التدقيق
تتوج الممارسات المنهجية الرصينة بوضع بروتوكولات صارمة لاختبار الموثوقية الحسابية والتحقق الدوري من سلامة المتجهات المكدسة قبل اعتمادها في استخلاص النتائج وتصديرها نحو بيئات التحليل الإحصائي المتقدمة كحزم R أو Python أو SPSS. تشتمل هذه المعايير على بناء خلايا فحص منطقي آلية (Automated Sanity Checks) في قمة ورقة المعالجة، تقوم بمطابقة المجاميع التراكمية، وحساب الفروق في أعداد السجلات، وإطلاق تنبيهات مرئية باستخدام التنسيق الشرطي (Conditional Formatting) عند رصد أي عدم اتساق بين حجم الأعمدة المصدرية والعمود النهائي.
تتضمن بروتوكولات الموثوقية أيضاً تطبيق اختبارات كشف الشذوذ الإحصائي، للتأكد من أن عملية التكديس لم تؤد إلى دمج بيانات من مقاييس مختلفة تماماً في المتجه نفسه دون قصد، كدمج قيم نسب مئوية مع قيم مقياس ليكرت الخماسي. إن إرساء هذه المعايير الصارمة للتدقيق يغلق الباب أمام الأخطاء الصامتة التي قد تتسلل دون أن توقف عمل المعادلات، ويضمن خروج مصفوفات مدمجة تتسم بأعلى درجات الاتساق الهيكلي والصلاحية العلمية، مما يمهد الطريق لنمذجة إحصائية رصينة ونتائج بحثية قابلة للتكرار والاعتماد في مختلف الميادين التطبيقية.
خاتمة
يمثل إتقان مهارة تكديس الأعمدة المتعددة في عمود واحد في جداول بيانات جوجل نقلة نوعية في قدرة الباحثين والمحللين على تحويل البيانات الخام المشتتة إلى أصول معلوماتية عالية الهيكلية والانسيابية. لقد أدى إطلاق الدوال المصفوفية الحديثة وعلى رأسها VSTACK وTOCOL إلى تحرير بيئة العمل من القيود التاريخية والحلول الالتفافية المعقدة، موفراً مسارات معالجة ديناميكية تجمع بين الكفاءة البرمجية العالية والسهولة النحوية، مع الحفاظ الكامل على الروابط التفاعلية الحية بين المدخلات والمخرجات.
إن تبني المنهجيات الهندسية المتقدمة التي نوقشت في هذا الدليل—بدءاً من إدارة النطاقات المتباينة والخلايا الفارغة، وصولاً إلى الفصل المعماري للطبقات وتشييد أنظمة التحقق والتوثيق الصارم—يضمن سلامة التحليلات الإحصائية وتماسك النماذج المعرفية المبنية عليها. إن التحول نحو التنسيق الرأسي المنظم ليس مجرد تفضيل جمالي في تنسيق الجداول، بل هو التزام علمي بمبادئ البيانات المرتبة التي تشكل الأساس المتين لكافة التحليلات البيانية المعاصرة والمستقبلية.
المراجع
- Cabrall, C. D. D., Happee, R., & de Winter, J. (2016). From Mackworth’s clock to the open road: A literature review on driver vigilance task operationalization. Transportation Research Part F: Traffic Psychology and Behaviour, 41, 147–164. https://doi.org/10.1016/j.trf.2016.04.001
- Gideoni, R., Honig, S., & Oron-Gilad, T. (2022). Is It Personal? The Impact of Personally Relevant Robotic Failures (PeRFs) on Humans’ Trust, Likeability, and Willingness to Use the Robot. International Journal of Social Robotics, 14(4), 1017–1032. https://doi.org/10.1007/s12369-022-00912-y
- Khan, R., Vernooij, J. C. M., Salvatori, D. C. F., & Hierck, B. P. (2025). Assessing Cognitive Load Using EEG and Eye-Tracking in 3-D Learning Environments: A Systematic Review. Multimodal Technologies and Interaction, 9(1), 99. https://doi.org/10.3390/mti9090099
- Paz-Arbaizar, L., López‐Castromán, J., Artés-Rodrı́guez, A., Olmos, P. M., & Ramírez, D. (2025). Emotion Forecasting: A Transformer-Based Approach. Journal of Medical Internet Research, 27, e63962. https://doi.org/10.2196/63962
- Rissman, L., Van Putten, S., & Majid, A. (2022). Evidence for a Shared Instrument Prototype from English, Dutch, and German. Cognitive Science, 46(4), e13140. https://doi.org/10.1111/cogs.13140
- Ryu, J., Sükei, E., Norbury, A., Liu, S. H., Campaña-Montes, J. J., Baca‐García, E., et al. (2021). Shift in Social Media App Usage During COVID-19 Lockdown and Clinical Anxiety Symptoms: Machine Learning–Based Ecological Momentary Assessment Study. JMIR Mental Health, 8(9), e30833. https://doi.org/10.2196/30833