
تُعد نسبة الأرجحية (Odds Ratio – OR) إحدى الركائز الأساسية في التحليل الإحصائي الحديث، لاسيما في المجالات الحيوية، والوبائيات، والعلوم النفسية والسلوكية. تنبع أهمية هذا المقياس من قدرته الفائقة على تكميم قوة واتجاه الارتباط بين متغيرين فئويين ثنائيي التقسيم، مما يجعله معياراً حاسماً لتحديد حجم الأثر (Effect Size) في الدراسات المقارنة والسريرية. ورغم بساطة فكرتها الرياضية التي تقوم على مقارنة أرجحية وقوع حدث معين بين مجموعتين مختلفتين، فإن تطبيقها العملي وتفسيرها يتطلبان دقة إبستيمولوجية ومنهجية بالغة لتجنب الخلط الشائع بينها وبين مفاهيم إحصائية أخرى مجاورة كالمخاطر النسبية (Relative Risk).
في إطار المعالجة الآلية للبيانات الضخمة والتصاميم التجريبية المعقدة، يبرز نظام التحليل الإحصائي SAS (Statistical Analysis System) بوصفه البيئة البرمجية الأكثر موثوقية واعتماداً لدى المؤسسات الأكاديمية والطبية وهيئات الرقابة الدوائية العالمية مثل إدارة الغذاء والدواء الأمريكية (FDA). يقدم نظام SAS أدوات متقدمة وخوارزميات فائقة الدقة لا تقتصر على حساب التقديرات النقطية لنسب الأرجحية فحسب، بل تمتد لتشمل حساب فترات الثقة الدقيقة، وضبط المتغيرات المربكة عبر نماذج الانحدار اللوجستي المتقدمة، وتقديم اختبارات الفروض المتسقة مع بنية البيانات الواقعية.
يهدف هذا الدليل المرجعي الموسع إلى تفكيك الأسس الرياضية والنظرية لنسبة الأرجحية، ثم الانتقال بصورة تطبيقية معمقة نحو تنفيذ هذه التحليلات داخل بيئة SAS البرمجية. سنستعرض كيفية هيكلة البيانات وتوظيف إجراءات النظام الإحصائي مثل PROC FREQ وPROC LOGISTIC، مع تقديم مثال سريري وسلوكي تطبيقي واقعي، وتحليل مخرجات النظام خطوة بخطوة، مسلطين الضوء على الضوابط المنهجية التي تضمن للمحلل الإحصائي والباحث الأكاديمي كتابة تقارير علمية دقيقة ومتوافقة مع أعلى المعايير المعتمدة دولياً.
1. المدخل النظري والمفاهيمي: ما هي نسبة الأرجحية ودلالتها الإحصائية؟
1.1 تعريف الأرجحية ونسبة الأرجحية في التحليل الإحصائي
يبدأ الفهم الدقيق للتحليل الإحصائي للبيانات الفئوية من التمييز الصارم بين مفهوم “الاحتمال” (Probability) ومفهوم “الأرجحية” (Odds). يُعرف الاحتمال، ويُرمز له رياضياً بالرمز p، بأنه النسبة بين عدد مرات تكرار وقوع حدث مستهدف معين وإجمالي عدد الفرص أو المحاولات الكلية الممكنة لوقوعه، وتتراوح قيمته حتماً بين الصفر والواحد الصحيح [0، 1]. في المقابل، تُعرف الأرجحية بأنها النسبة بين احتمال وقوع الحدث نفسه إلى احتمال عدم وقوعه، وتُصاغ رياضياً بالمعادلة: Odds = p / (1 – p). هذا التمايز يعني أن الأرجحية تعبر عن عدد المرات التي يُتوقع فيها أن يقع الحدث مقارنة بعدد المرات التي لا يقع فيها، ممتدة على مدى قيمي ينطلق من الصفر إلى موجب ما لا نهاية [0، ∞+).
انطلاقاً من هذا التأسيس، تبرز “نسبة الأرجحية” (Odds Ratio) كمقياس نسبي لحجم الأثر، حيث تُعبر عن النسبة الحسابية الناتجة عن قسمة أرجحية وقوع الحدث في مجموعة المعالجة (أو المجموعة المعرضة لعامل معين) على أرجحية وقوع نفس الحدث في مجموعة المقارنة أو الضبط. توفر نسبة الأرجحية معياراً موضوعياً لتقدير مدى ارتباط متغير مستقل ثنائي (مثل: تلقي علاج نفسي مقابل علاج وهمي) بمتغير تابع ثنائي (مثل: الشفاء مقابل عدم الشفاء). ونظراً لأن نسبة الأرجحية لا تعتمد على التصميم الطولي لحساب معدلات الوقوع، فإنها تعمل كمقياس متعدد الاستخدامات في مختلف المناهج البحثية، سواء كانت استرجاعية أو مستعرضة أو تجريبية.
تتميز نسبة الأرجحية بخصائص رياضية فريدة، أهمها أنها غير متماثلة خطياً حول نقطة الحياد، وهي القيمة واحد (1.0). فالقيم التي تنحصر بين الصفر والواحد تعبر عن ارتباط عكسي أو انخفاض في أرجحية الحدث، في حين أن القيم الممتدة من واحد إلى ما لا نهاية تعبر عن ارتباط طردي أو زيادة في الأرجحية. هذا التوزيع اللاتناظري يستلزم عند إجراء الاختبارات الاستدلالية المتقدمة اللجوء إلى التحويل اللوغاريتمي لنسبة الأرجحية لنقلها إلى مقياس خطي متماثل يمتد من سالب ما لا نهاية إلى موجب ما لا نهاية، وتتوسطه الصفر كقيمة تعبر عن غياب الأثر.
1.2 تفسير القيم المحسوبة لنسبة الأرجحية
إن قراءة القيمة العددية لنسبة الأرجحية تتطلب فهماً إحصائياً دقيقاً يتجاوز الحساب الرياضي المجرد إلى التفسير العملي للظاهرة قيد الدراسة. تشكل القيمة المرجعية (1.0) خط الأساس الدلالي؛ فعندما تسفر المعادلة عن نسبة أرجحية تساوي واحداً صحيحاً تماماً (OR = 1.0)، فإن ذلك يشير رياضياً وإحصائياً إلى غياب أي ارتباط بين المتغيرين قيد القياس. ويعني ذلك بعبارة تطبيقية أن أرجحية وقوع الحدث متماثلة كلياً بين المجموعتين، وأن التعرض للعامل المستقل لا يمارس أي تأثير إيجابي أو سلبي على المآل النهائي للمتغير التابع.
إذا تجاوزت نسبة الأرجحية المحسوبة القيمة واحد (OR > 1.0)، فإن النتيجة تُفسر على أن العامل المستقل يرتبط بزيادة أرجحية وقوع الحدث المستهدف مقارنة بالمجموعة المرجعية. على سبيل المثال، إذا بلغت نسبة الأرجحية 2.5 في دراسة تبحث العلاقة بين الضغوط النفسية الحادة وتطور اضطراب القلق، فإن التفسير الدقيق يقتضي القول بأن الأفراد الذين يعانون من ضغوط نفسية حادة يمتلكون أرجحية للإصابة باضطراب القلق تبلغ مرتين ونصف (أو زيادة بنسبة 150%) مقارنة بنظرائهم الذين لا يعانون من تلك الضغوط. وهنا يكتسب المتغير المستقل دلالة “عامل خطورة” (Risk Factor) يزيد من فرص التحقق السلوكي أو المرضي.
وعلى النقيض من ذلك، إذا كانت قيمة نسبة الأرجحية أدنى من الواحد الصحيح وتتراوح بين الصفر والواحد (0 < OR < 1.0)، فإن المتغير المستقل يُصنف إحصائياً وسريرياً بوصفه "عامل حماية" (Protective Factor). تشير هذه القيم إلى أن وجود هذا المتغير يرتبط بانخفاض جوهري في أرجحية وقوع الحدث السلبي؛ فإذا كانت نسبة الأرجحية تساوي 0.40 لتدخل علاجي معرفي وسلوكي في تقليل احتمالات الانتكاس، فإن ذلك يعني أن المجموعة المعالجة انخفضت لديها أرجحية الانتكاس بنسبة 60% مقارنة بالمجموعة التي لم تتلق التدخل. وتكتمل هذه المنظومة التفسيرية بالاعتماد على فترات الثقة (Confidence Intervals)، حيث إن أي فترة ثقة تتضمن القيمة واحد صحيح داخل نطاقها الأدنى والأعلى تؤدي مباشرة إلى إسقاط الدلالة الإحصائية للارتباط، مهما بدت القيمة النقطية لنسبة الأرجحية مرتفعة أو منخفضة.
1.3 الافتراضات الإحصائية لتطبيق نسبة الأرجحية
تستند موثوقية الاستدلالات الناتجة عن حساب نسب الأرجحية إلى مجموعة صارمة من الافتراضات الإحصائية المنهجية التي يجب أن تتحقق في بنية البيانات قبل الشروع في بناء النماذج وتفسيرها. أول هذه الشروط وأكثرها أهمية هو “استقلالية الملاحظات” (Independence of Observations). يفترض التحليل الإحصائي أن تكون الملاحظة الخاصة بكل فرد في العينة مستقلة تماماً عن ملاحظات الأفراد الآخرين، بحيث لا يؤثر وجود فرد في إحدى فئات الجدول على احتمالية تصنيف فرد آخر. ينهار هذا الافتراض عند استخدام القياسات المتكررة على نفس الأفراد بمرور الزمن، أو عند وجود بيانات عنقودية أو عائلية دون استخدام معالجات متقدمة كمعادلات التقدير المعممة (GEE).
يرتبط الافتراض الثاني بالطبيعة المقياسية للمتغيرات موضع التحليل؛ إذ يتطلب النموذج التقليدي لجداول التوافق الثنائية أن يكون كل من المتغير التابع والمتغير المستقل متغيرات فئوية ثنائية التقسيم (Dichotomous Categorical Variables) مقاسة وفق مستوى القياس الاسمي (Nominal). يجب أن تكون الفئات حصرية بشكل متبادل (Mutually Exclusive)، بحيث لا يمكن للفرد أن ينتمي إلى أكثر من خلية واحدة في الجدول الإحصائي، وشاملة بشكل كلي (Exhaustive) لكافة الحالات الخاضعة للرصد التجريبي أو المسحي.
أما الافتراض الثالث فيتعلق بحجم العينة والتكرارات المتوقعة داخل خلايا التوزيع المتقاطع. يستند حساب الخطأ المعياري والتقريب المقارب لنسبة الأرجحية نحو التوزيع الطبيعي إلى نظريات العينات الكبيرة، ويشترط عادةً ألا يقل التكرار المتوقع في أي خلية من خلايا جدول التوافق عن خمس ملاحظات (Expected Frequency ≥ 5). يؤدي انتهاك هذا الشرط نتيجة صغر العينة الكلية أو ندرة الحدث إلى تشوه فترات الثقة، مما يفرض منهجياً التخلي عن الاختبارات التقريبية والاعتماد على الحلول الدقيقة مثل اختبار فيشر الدقيق (Fisher’s Exact Test) أو طرق التقدير الحصينة لضمان دقة الاستنتاجات العلمية المستخلصة.
2. جداول التوافق الثنائية والأساس الرياضي لحساب نسبة الأرجحية
2.1 بنية جدول التوافق الثنائي ومكوناته
يمثل جدول التوافق الثنائي ذو البعدين (2×2 Contingency Table) المصفوفة الرياضية والأساس الحسابي لكافة التقديرات المرتبطة بنسب الأرجحية في النظم الإحصائية. يتكون الجدول من أربع خلايا رئيسية متقاطعة تُعبر عن التوزيع التكراري المشترك للمتغيرين؛ حيث تُمثل الصفوف عادةً مستويات المتغير المستقل (مثل: حالة التعرض للتدخل أو العلاج: معالجة / ضبط)، بينما تُمثل الأعمدة مستويات المتغير التابع أو المآل السريري والسلوكي (مثل: تحقق النتيجة الإيجابية: نجاح / إخفاق).
تُصنف الخلايا الإحصائية الأربع تقليدياً وفق الترميز الرياضي العالمي بالأحرف: الخلية (a) وتضم الأفراد المعرضين للتدخل والذين حققوا النتيجة؛ والخلية (b) وتضم الأفراد المعرضين الذين لم يحققوا النتيجة؛ والخلية (c) وتمثل مجموعة الضبط الذين حققوا النتيجة دون تلقي المعالجة؛ وأخيراً الخلية (d) وتضم أفراد الضبط الذين لم يحققوا النتيجة المستهدفة. يشكل مجموع كل صف ومجموع كل عمود ما يُعرف إحصائياً باسم “المجاميع الهامشية” (Marginal Totals)، وهي المحدد الرئيسي للاحتمالات الشرطية المستخدمة في الحسابات التوزيعية وتوليد التكرارات المتوقعة وفق فرضية العدم.
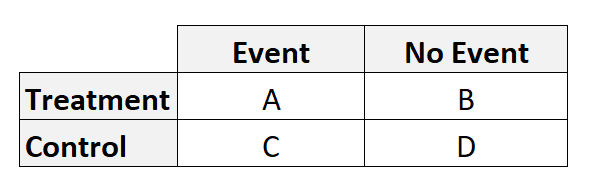
تكتسب هذه الهيكلية أهمية حاسمة في نظام SAS، حيث إن البرنامج يعتمد بنية المصفوفة لتطبيق خوارزميات الحساب. إن التحديد الدقيق لتموضع “الحدث المستهدف” مقابل “المجموعة المرجعية” هو المحرك الفعلي للعمليات الإجرائية اللاحقة؛ إذ إن أي تحول غير مدروس في ترتيب الأعمدة أو الصفوف ينعكس مباشرة على طبيعة التقدير، مما يحيل نسبة الأرجحية من قياس لأثر التدخل الإيجابي إلى مقلوبها الحسابي الذي يصف الإخفاق، وهو ما يفرض على الباحث فهم حركة الخلايا وقواعد تدفق البيانات الرقمية داخل بنية الجدول.
2.2 المعادلة الرياضية لحساب نسبة الأرجحية عبر الجداء التقاطعي
يُحسب التقدير النقطي لنسبة الأرجحية من خلال معادلة الجداء التقاطعي المتقاطع (Cross-Product Ratio)، وهي صيغة رياضية تختصر مسار حساب أرجحية كل مجموعة على حدة ثم قسمتهما. لبيان الاشتقاق: تُعرف أرجحية الحدث في المجموعة المعرضة بأنها النسبة بين احتمال النجاح واحتمال الإخفاق، وتُحسب من تكرارات الجدول المباشرة بالمعادلة: Odds1 = a / b. وبالمثل، تُحسب أرجحية الحدث في مجموعة الضبط بالمعادلة: Odds2 = c / d. وبقسمة المعادلة الأولى على المعادلة الثانية، نحصل على الصيغة الرياضية الشاملة لنسبة الأرجحية: OR = (a / b) / (c / d) = (a × d) / (b × c).
يبرهن هذا الاشتقاق الأنيق على أن النتيجة الرقمية تمثل حرفياً حاصل ضرب عناصر القطر الرئيسي مقسوماً على حاصل ضرب عناصر القطر الثانوي. ولكن بما أن التوزيع العيني لنسبة الأرجحية يعاني من التواء إيجابي شديد يقيد استقرار التقديرات الإحصائية، فإن الاستدلال الإحصائي وبناء فترات الثقة يستلزمان التحويل إلى اللوغاريتم الطبيعي (Natural Logarithm)، ويُشار إليه بـ ln(OR) أو Log-Odds. يتبع لوغاريتم نسبة الأرجحية تقريباً توزيعاً طبيعياً معيارياً في العينات الكبيرة، مما يتيح تطبيق نظرية النهاية المركزية بأمان منهجي.
لحساب حدود الثقة المعيارية بنسبة 95% لنسبة الأرجحية، يُحسب أولاً “الخطأ المعياري للوغاريتم الطبيعي” (Standard Error of Log Odds)، والذي اشتقت صيغته العالمة الإحصائية من خلال طريقة وولف (Woolf’s Method): SE[ln(OR)] = √(1/a + 1/b + 1/c + 1/d). تُبنى فترة الثقة اللوغاريتمية بالمعادلة: ln(OR) ± 1.96 × SE[ln(OR)]. وأخيراً، يتم تحويل الحدين الأدنى والأعلى للوغاريتم عكسياً باستخدام الدالة الأسية (Exponential Function: e^x) للعودة إلى المقياس الأصلي لنسبة الأرجحية، مما يوفر مدى موثوقاً يعبر عن التقدير الإحصائي الحقيقي للمجتمع المدروس.
2.3 معالجة مشكلة الخلايا الصفرية في الجداول
تواجه العمليات الحسابية لنسبة الأرجحية أزمة رياضية ومنهجية كبرى عند احتواء إحدى خلايا جدول التوافق الثنائي على القيمة صفر (Empty Cells or Zero Counts). فإذا كانت الخلية الصفرية تقع في القطر الثانوي (b أو c)، فإن المقام يصبح صفراً، مما يجعل المعادلة غير معرّفة رياضياً وتؤول نسبة الأرجحية المقدرة نحو اللانهاية (OR → ∞). وعلى العكس، إذا ظهر الصفر في القطر الرئيسي (a أو d)، فإن بسط المعادلة ينعدم، مما يجعل نسبة الأرجحية مساوية للصفر تماماً (OR = 0)، وهو ما يعطل كلياً إمكانية حساب اللوغاريتم الطبيعي، إذ إن لوغاريتم الصفر غير معرف حسابياً.
تتمثل المقاربة الكلاسيكية لمعالجة هذه المعضلة في تطبيق “تصحيح هالدين-أنسكومب” (Haldane-Anscombe Correction). يرتكز هذا الحل المنهجي على إضافة قيمة كسرية ثابتة مقدارها النصف (0.5) إلى كل خلية من خلايا الجدول الأربع، بغض النظر عما إذا كانت الخلية تحوي صفراً أو تكراراً كبيراً، لتصبح المعادلة: OR_adjusted = [(a + 0.5) × (d + 0.5)] / [(b + 0.5) × (c + 0.5)]. يزيل هذا التعديل البسيط الأزمة الرياضية، ويقلل من التحيز في التقدير النقطي عندما تكون أحجام العينات صغيرة نسبياً، كما يتيح حساب الخطأ المعياري وفترات الثقة بسلاسة تامة.
ومع ذلك، تفرض المعايير الإحصائية المتقدمة عدم الاعتماد الكلي على التصحيحات التقريبية في الحالات التي يكون فيها التشتت التكراري شديد الضآلة. فعند وجود خلايا فارغة ناجمة عن انعدام وقوع الحدث في إحدى المجموعات، يصبح الاعتماد على التقديرات المقاربة (Asymptotic Estimates) مضللاً من الناحية العلمية. وتبرز هنا الضرورة المنهجية للتحول إلى الأساليب الدقيقة القائمة على مبادئ التوزيع فائق الهندسة (Hypergeometric Distribution)، وأبرزها أسلوب الاستدلال الدقيق لاختبار فيشر وحساب فترات الثقة الدقيقة لنسبة الأرجحية (Exact Conditional Confidence Intervals)، وهو الخيار المتقدم الذي يوفره نظام SAS البرمجي بكفاءة متناهية عبر أوامره المتخصصة.
3. أهمية وتطبيقات نسب الأرجحية في البحوث النفسية والعلوم السلوكية
3.1 قياس فاعلية التدخلات العلاجية والسلوكية
تُمثل نسبة الأرجحية إحدى أهم الأدوات الكمية في تقييم فاعلية التدخلات العلاجية النفسية والبرامج السلوكية المعدلة، حيث تتيح للباحثين السريريين والممارسين النفسيين إمكانية المقارنة الإحصائية بين معدلات التعافي أو التحسن بين مجموعة تتلقى بروتوكولاً علاجياً مستحدثاً (كالبرامج المستندة إلى العلاج المعرفي السلوكي القائم على اليقظة الذهنية) ومجموعة تتلقى العلاج التقليدي المعتاد أو قائمة الانتظار. تترجم نسبة الأرجحية هذا التمايز السلوكي إلى مؤشر رقمي يسهل دمجه لاحقاً في دراسات التحليل التلوي (Meta-Analysis) لتجميع الأدلة العلمية التراكمية عبر المراكز البحثية المختلفة.
تتجلى قوة هذا المقياس في تقييم برامج التدريب المعرفي واكتساب المهارات؛ إذ يُقاس الأداء عادةً عبر مآلات ثنائية فاصلة، مثل: اجتياز اختبار الكفاءة النفسية بنجاح مقابل الإخفاق في تحقيق المعيار المحدد. ومن خلال حساب نسبة الأرجحية، يستطيع الباحث تحديد ما إذا كان البرنامج التدريبي يرفع أرجحية تحقيق النجاح بدرجة ذات قيمة عملية وفارقة بين المتدربين، مع عزل أثر التباين التكراري في أحجام المجموعات المختلفة بفضل الخصائص اللامعلمية لجدول التوافق.
إضافة إلى ذلك، تلعب نسب الأرجحية دوراً محورياً في الطب النفسي التنبؤي والوقائي، لا سيما عند تقييم مخاطر الانتكاس السلوكي أو المرضي لدى مدمني المواد المخدرة أو المرضى الذين يعانون من اضطراب الاكتئاب الجسيم بعد انتهاء فترات العلاج النشط. يتيح حساب الأرجحية للمتغيرات البيئية أو الفردية (كالالتزام الدوائي، أو الدعم الأسري) تحديد المتغيرات الأكثر إسهاماً في خفض أرجحية الانتكاس، مما يوفر معايير موضوعية توجه السياسات الإكلينيكية وخطط الرعاية التتبعية اللاحقة للمرضى بكفاءة واضحة.
3.2 دراسات الحالات والشواهد في القياس النفسي
في العديد من السياقات البحثية في العلوم النفسية وعلم النفس المرضي، يستحيل من الناحية الأخلاقية والعملية إجراء دراسات تجريبية أو دراسات حشود طولية لتتبع أثر بعض العوامل الصادمة؛ كأن يتم تعريض أطفال عمداً لصدمات نفسية أو إساءة معاملة لمعرفة ما إذا كانوا سيصابون باضطرابات الشخصية عند البلوغ. في مثل هذه السيناريوهات، تصبح “دراسات الحالات والشواهد” ذات التصميم الاسترجاعي (Retrospective Case-Control Studies) هي الخيار المنهجي الوحيد والأمثل لدراسة الظاهرة والتحري عن أسبابها الكامنة.
تكمن المعضلة الإحصائية الجوهرية في الدراسات الاسترجاعية في أن الباحث هو من يحدد بصورة مسبقة عدد الأفراد في مجموعة “الحالات” (المصابين بالاضطراب النفسي) وعدد الأفراد في مجموعة “الشواهد” (الأصحاء)، مما يعني أن المعدل الحقيقي لحدوث أو شيوع الظاهرة في المجتمع الأصلي يظل مجهولاً تماماً. ولهذا السبب الحاسم، يتعذر رياضياً حساب مقاييس الخطر المطلق أو المخاطر النسبية. وهنا تبرز نسبة الأرجحية باعتبارها المقياس الإحصائي الصالح والوحيد القابل للحساب رياضياً دون الحاجة لمعرفة معدلات الوقوع المجتمعية، لكونها تعتمد على مقارنة أرجحية وجود تاريخ الصدمة لدى الحالات النفسية مقابل أرجحية وجودها لدى الشواهد.
ومع ذلك، تواجه هذه التطبيقات تحديات منهجية تتصل باحتمالية وقوع تحيزات في المعاينة؛ كتحيز الاسترجاع التذكري (Recall Bias) حيث يميل الأفراد المصابون بالاضطراب النفسي إلى تذكر وتضخيم الخبرات السلبية السابقة مقارنة بالأصحاء. لذلك، فإن الاستخدام المتقدم لنسبة الأرجحية داخل بيئات تحليلية رصينة مثل SAS يمكن الباحثين من تفكيك هذه العلاقات المعقدة، والتحكم في المتغيرات التباسطية عبر أساليب المطابقة الإحصائية أو الانحدار اللوجستي الشرطي المخصص لمجموعات الحالات والشواهد المتناظرة.
3.3 تفسير حجم الأثر الإكلينيكي مقابل المعنوية الإحصائية
يقع الكثير من الباحثين في فخ الخلط المنهجي بين “الدلالة الإحصائية” (Statistical Significance) المعتمدة على قيمة p-value، وبين “الأهمية الإكلينيكية” (Clinical Significance) المعبرة عن القيمة العملية للتدخل في العالم الواقعي. إن الحصول على قيمة احتمالية دالة إحصائياً (p < 0.05) قد يعود ببساطة إلى الحجم الهائل للعينة المشمولة في الدراسة، دون أن ينطوي التدخل على أي أثر إيجابي حقيقي يُحدث فرقاً ملموساً في حياة المرضى. وهنا تعمل نسبة الأرجحية كمعيار موضوعي مستقل لقياس "حجم الأثر الإكلينيكي".
يمكّن التقدير الدقيق لنسبة الأرجحية الممارس النفسي من تقييم جدوى تبني علاج سلوكي جديد؛ فإذا كانت نسبة أرجحية تحسن أعراض الرهاب الاجتماعي نتيجة برنامج علاجي مكثف تبلغ 4.2، فإن هذا الرقم يعطي دلالة واضحة على أن أرجحية التحسن تفوق بأكثر من أربعة أضعاف تلك المتحققة عبر الممارسات السائدة، وهو ما يبرر تكلفة ووقت البرنامج. بالمقابل، إذا أظهرت دراسة ذات عينة ضخمة أن نسبة الأرجحية لعقار نفسي جديد تساوي 1.05 مع قيمة احتمالية دالة جداً (p = 0.001)، فإن الممارس يدرك فوراً أن هذا الأثر ضئيل وهامشي من الناحية التطبيقية ولا يبرر التحول الدوائي نظراً لضعف حجم الأثر الإكلينيكي.
علاوة على ذلك، تُشكل نسب الأرجحية اللبنة الرياضية الأولى لحساب مقاييس تطبيقية أخرى بالغة الوضوح لصناع القرار في قطاع الصحة النفسية، مثل “العدد المطلوب علاجه” (Number Needed to Treat – NNT)، والذي يحدد عدد المرضى الذين يجب إخضاعهم للتدخل السلوكي الجديد لتحقيق استجابة إيجابية لدى مريض واحد إضافي مقارنة بالعلاج الضابط. يسهم هذا التكامل الإحصائي في تقديم إجابات تطبيقية مقنعة تدعم اتخاذ القرارات القائمة على الأدلة الإكلينيكية الرصينة بعيداً عن وهم الدلالة الاحتمالية المجردة.
4. المقارنة المنهجية بين نسبة الأرجحية والمخاطر النسبية
4.1 الفروق الجوهرية في التعريف الرياضي وطرق الحساب
يشيع في الكتابات الطبية والسلوكية ارتباك منهجي متكرر بين مفهوم “نسبة الأرجحية” (Odds Ratio – OR) ومفهوم “الخطر النسبي” (Relative Risk – RR). ينشأ هذا الخلط من تشابه التسمية الظاهري وسعي كلاهما للمقارنة بين مجموعتين، إلا أن الاختلافات الرياضية بينهما جوهرية وحاسمة في الاستدلال العلمي. يُعرف الخطر النسبي بأنه نسبة بين احتمالي وقوع الحدث (Probabilities)؛ حيث يُمثل في بسطه خطر وقوع الحدث التراكمي في المجموعة المعرضة مقسوماً على خطر وقوعه في مجموعة الضبط: RR = [a / (a + b)] / [c / (c + d)].
يتضح من خلال التدقيق الرياضي في صيغة الخطر النسبي أن المقام يتضمن إجمالي حجم العينة في كل مجموعة (a + b) و (c + d)، في حين أن نسبة الأرجحية تستبعد المجاميع الإجمالية وتكتفي بمقارنة تكرارات النجاح إلى الإخفاق: OR = (a / b) / (c / d). يترتب على هذا التباين الحسابي أن نسبة الأرجحية تبتعد دوماً عن القيمة المحايدة (1.0) بدرجة أكبر مقارنة بالخطر النسبي؛ فإذا كان الارتباط إيجابياً تكون نسبة الأرجحية دائماً أكبر من الخطر النسبي (OR > RR > 1.0)، وإذا كان الارتباط عكسياً تصبح نسبة الأرجحية دائماً أصغر من الخطر النسبي (0 < OR < RR < 1.0).
تتباين استجابة المقياسين لنسبة الشيوع الأساسي للحدث في المجموعات؛ فالخطر النسبي مقيد رياضياً بنسبة الوقوع، وتتسع الفجوة العددية بينه وبين نسبة الأرجحية كلما ارتفع معدل حدوث الواقعة بين أفراد العينة. يوضح الجدول المقارن التالي أبرز السمات التمايزية بين المقياسين من النواحي الرياضية والتطبيقية:
- مفهوم الخطر النسبي (RR): نسبة بين احتمالات وقوع الحدث، ويتطلب تصميماً زمنياً للمتابعة، ويحسب حصراً في الدراسات الطولية والتجريبية، ويتأثر بمعدل الشيوع الأساسي.
- مفهوم نسبة الأرجحية (OR): نسبة بين أرجحيات وقوع الحدث، ولا يشترط تصميماً طولياً، وهو المقياس الوحيد المتاح في دراسات الحالات والشواهد، كما يشكل المقياس المباشر المعبر عن معلمات الانحدار اللوجستي.
4.2 محددات الاستخدام وفقاً لتصميم الدراسة البحثية
ترتبط المفاضلة الإحصائية الصارمة بين استخدام نسبة الأرجحية أو الخطر النسبي ارتباطاً لا ينفصم بنوعية وتصميم المنهج البحثي المستخدم في جمع البيانات. يقتضي حساب الخطر النسبي توافر معلومات دقيقة ومباشرة عن معدلات الوقوع أو الإصابات الجديدة المتراكمة (Incidence Rates) المتولدة عبر فترة زمنية محددة. وبالتالي، فإن استخدام الخطر النسبي يقتصر منهجياً على التصاميم البحثية التي تتيح تتبع الأفراد عبر الزمن؛ وأبرزها دراسات حشود الأتراب (Cohort Studies) والتجارب الإكلينيكية المعشاة المضبوطة بالشواهد (Randomized Controlled Trials – RCTs).
في المقابل، عندما يتبنى الباحث تصميماً استرجاعياً قائماً على الحالات والشواهد، يتعذر كلياً حساب الخطر النسبي بصورة رياضية مباشرة. والسبب في ذلك أن الباحث يختار عدداً ثابتاً من الأفراد المصابين وعدداً آخر من غير المصابين، مما يدمر النسبة المجتمعية الحقيقية الكامنة في المقامات (a + b) و (c + d)، محيلاً أي حساب للمخاطر النسبية في هذه الحالة إلى قيمة رقمية مشوهة لا تعكس الواقع. هنا تبرز نسبة الأرجحية بصفتها المقياس الإحصائي الوحيد الصالح رياضياً، نظراً لأن نسبة أرجحية التعرض بين الحالات والشواهد تطابق رياضياً نسبة أرجحية المرض بين المعرضين وغير المعرضين.
أضف إلى ذلك أن التحليلات متعددة المتغيرات الحديثة تعتمد بصورة كثيفة على الانحدار اللوجستي لضبط العوامل المربكة. وبما أن الانحدار اللوجستي يستخدم دالة الربط اللوغاريتمية (Logit Link Function)، فإن المعاملات الرياضية المحسوبة في النموذج (β Coefficients) تؤول طبيعياً عند أخذ الدالة الأسية لها (e^β) إلى نسب أرجحية معدلة، ولا تؤول إلى مخاطر نسبية، مما يمنح نسبة الأرجحية تفوقاً وظيفياً ومرونة فائقة في معالجة النماذج الإحصائية المعقدة.
4.3 فرضية المرض النادر وتلاقي المقياسين
على الرغم من التباعد الحسابي بين نسبة الأرجحية والخطر النسبي، إلا أن هناك حالة إحصائية فريدة تتلاقى فيها قيمتا المقياسين وتتقاربان عددياً إلى حد التطابق الشبه تام؛ تُعرف هذه الحالة في الأدبيات الوبائية باسم “فرضية المرض النادر” (Rare Disease Assumption). تنص هذه الفرضية على أنه عندما يكون الحدث أو المرض قيد الدراسة نادراً جداً في المجتمع العام، بحيث لا يتجاوز معدل وقوعه التراكمي نسبة ضئيلة جداً (عادة أقل من 5% أو 10% كحد أقصى)، فإن عدد الأفراد الذين يقع لهم الحدث في كل مجموعة يكون صغيراً جداً مقارنة بإجمالي المجموعة.
من المنظور الرياضي، عندما تقترب القيمة (a) من الصفر مقارنة بالقيمة (b)، فإن حاصل المجموع (a + b) يقترب من أن يساوي (b) تقريباً. وبالمثل، عندما تقترب القيمة (c) من الصفر مقارنة بالقيمة (d)، فإن حاصل المجموع (c + d) يقترب من أن يساوي (d) تقريباً. وبتطبيق هذا التقريب على معادلة الخطر النسبي: RR = [a / (a + b)] / [c / (c + d)] ≈ (a / b) / (c / d) = OR. عند تحقق هذا الشرط الاستثنائي، تصبح نسبة الأرجحية تقديراً غير متحيز للخطر النسبي، مما يتيح للباحثين استخدامها كبديل للمخاطر في تفسير النتائج.
إلا أن الخطر المنهجي الجسيم ينشأ عندما يتم تطبيق هذا التفسير التبادلي على ظواهر نفسية وسلوكية شائعة، مثل التوتر أو النجاح التدريبي؛ حيث تتجاوز معدلات الانتشار غالباً 30% أو 50%. في هذه السيناريوهات، تبالغ نسبة الأرجحية في تقدير الخطر النسبي بصورة دراماتيكية، وتُظهر التدخلات أو عوامل الخطورة بحجم أثر مضخم قد يضلل الممارسين السريريين وصناع القرار الصحي، وهو ما يفرض الحذر الصارم في كتابة التقارير وتجنب وصف نسبة الأرجحية بعبارات تفيد “الخطر المطلق” إلا إذا ثبتت ندرة الحدث إحصائياً.
5. إعداد وهيكلة البيانات داخل بيئة نظام التحليل الإحصائي SAS
5.1 صياغة خطوة البيانات وكتابة التكرارات المجمعة
يتطلب التحليل الإحصائي داخل بيئة نظام SAS فهماً منهجياً لدورة تدفق البيانات، والتي تنطلق إلزامياً عبر “خطوة البيانات” (DATA Step). تُعد هذه الخطوة المسؤولة عن بناء جدول البيانات، وتحديد مسميات المتغيرات وأنماطها الرقمية أو الحرفية، وتخصيص مساحات الذاكرة اللازمة للتحليل. عند التعامل مع بيانات جداول التوافق، يواجه الباحث عادةً سيناريو “البيانات المجدولة التكرارية” (Grouped/Frequency Data)، حيث تتوفر الأرقام الإجمالية لكل خلية في الجدول دون الحاجة إلى إدخال سجل مستقل لكل مفحوص.
تتم هيكلة هذه البيانات باستخدام تعليمة DATA لتسمية الجدول التحليلي، تليها تعليمة INPUT لتوصيف المتغيرات الثلاثة الحاكمة: المتغير المستقل، والمتغير التابع، ومتغير التكرار العددي الحاوي لعدد الحالات في كل خلية، متبوعاً برمز الدولار ($) إذا كانت المتغيرات اسمية أو نصية. تُستخدم تعليمة DATALINES أو CARDS لإدخال الأرقام مباشرة داخل نص البرنامج. يوضح المثال التالي التركيبة القياسية البرمجية لإنشاء جدول توافق رباعي مجمع داخل SAS:
DATA mental_health_data;
INPUT Intervention $ Outcome $ Count;
DATALINES;
CBT Recovered 45
CBT Unchanged 15
Control Recovered 20
Control Unchanged 40
;
RUN;
في هذا البناء البرمجي المباشر، تم اختصار 120 فرداً في أربعة أسطر فقط؛ حيث يعبر كل سطر عن خلية فريدة تجمع تقاطع التدخل السلوكي (العلاج السلوكي المعرفي CBT مقابل الضبط Control) مع نتيجة العلاج (معافى Recovered مقابل دون تغيير Unchanged)، مع تسجيل التكرار الدقيق (Count) الذي سيعتمد عليه SAS لاحقاً في إجراء الوزن الإحصائي الرياضي المتطابق مع البيانات الأصلية.
5.2 التعامل مع البيانات الفردية غير المجمعة
في الكثير من التطبيقات الميدانية والاستطلاعات النفسية الموسعة، تتوفر البيانات في هيئة “سجلات فردية خام” (Individual/Raw Patient-Level Records)، حيث يشكل كل سطر في قاعدة البيانات فرداً مستقلاً خضع للدراسة، محتوياً على رموزه الخاصة للمتغير المستقل والتابع، دون وجود متغير يعبر عن التكرار التراكمي. يستطيع نظام SAS التعامل المباشر مع هذه الملفات سواء أكانت مدخلة برمجياً أو مستوردة من مصادر خارجية مثل ملفات Excel أو قواعد بيانات SQL أو ملفات SPSS عبر الإجراء PROC IMPORT.
يتطلب تجهيز هذا النمط من البيانات فحصاً تدقيقياً شاملاً للقيم المفقودة (Missing Values) والتحقق من التشفير الثنائي السليم للفئات (مثل ترميز الحالة إلى 1/0 أو Yes/No). يكمن الفارق البرمجي الحاسم بين البيانات المجمعة والبيانات الفردية في أن الأخيرة لا تتطلب استخدام تعليمة الوزن الإحصائي (WEIGHT statement) داخل إجراءات التحليل؛ إذ يقوم SAS تلقائياً بعد السجلات الفردية وتصنيفها في الخلايا الأربع لإنشاء جدول التوافق داخلياً.
من الناحية الإجرائية، تتطابق النتائج الإحصائية الناتجة عن كلا النمطين تطابقاً رياضياً تاماً إذا ما عولجت البيانات بالخيارات المناسبة. إلا أن ميزة البيانات الفردية تتجلى عند الرغبة في الانتقال إلى النماذج الإحصائية المعقدة والانحدار متعدد المتغيرات، حيث تتيح الحفاظ على المتغيرات المتصلة الإضافية (مثل العمر، ودرجات مقاييس الشخصية، ومستوى دخل الأسرة) والتي تستحيل معالجتها في جداول التكرار المجمعة البسيطة.
5.3 تنظيم مستويات المتغيرات والتحكم في الفئة المرجعية
تُمثل مشكلة الترتيب التلقائي للمستويات الفئوية إحدى أكثر المسائل الدقيقة التي قد تربك الممارسين الإحصائيين عند استخدام نظام SAS. يعتمد SAS افتراضياً على الترتيب الأبجدي الميكانيكي (Alphabetical Sorting) لمستويات المتغيرات الاسمية والنصية لتحديد تموضع الفئات داخل الصفوف والأعمدة، ما لم يقم المحلل بتوجيه النظام بخلاف ذلك. على سبيل المثال، فإن كلمة “Control” ستسبق كلمة “Treatment” أبجدياً في الصفوف، وكلمة “Active” ستسبق “Placebo”، وهو ما قد يؤدي إلى جعل مجموعة الضبط هي المجموعة الأساسية، ويعكس اتجاه نسبة الأرجحية الناتجة.
للتحكم المنهجي الكامل في هذه الهيكلية وضمان توجيه المقارنة نحو الفئة المستهدفة بدقة، يوفر SAS خيار الترتيب ORDER= ضمن تعليمة الإجراء الإحصائي. يمكن استخدام خيار ORDER=DATA والذي يفرض على البرنامج اعتماد الترتيب وفق تسلسل ظهور البيانات في خطوة الإدخال الأولى، مما يتيح للباحث وضع المجموعة المعالجة في الصف الأول والحدث المستهدف في العمود الأول، لتتطابق مخرجات البرنامج بصرياً مع المعادلات الرياضية المعتمدة للجداء التقاطعي.
بالإضافة إلى ذلك، يُنصح بشدة بتوظيف تعليمة FORMAT لربط الرموز الرقمية (مثل 1 و 2) بتسميات وصفية ذات دلالة إكلينيكية صريحة. لا تقتصر وظيفة هذه الأداة على تحسين المقروءية البصرية للمخرجات فحسب، بل تمتد لتمنح المحلل القدرة على التحكم في توجيه الفئات المرجعية بدقة متناهية ودون الحاجة لتغيير هيكلية قواعد البيانات الأصلية.
6. استخدام الإجراء PROC FREQ لحساب نسبة الأرجحية: البنية البرمجية والخيارات
6.1 البنية الأساسية للإجراء وتعليمة TABLES
يُعد الإجراء PROC FREQ المحرك الإحصائي الأكثر شيوعاً وتخصصاً داخل بيئة SAS لتحليل التوزيعات التكرارية وبناء جداول التوافق ذات البعدين أو الأبعاد المتعددة. تعتمد الصياغة البرمجية لهذا الإجراء على استدعاء الأمر متبوعاً بتحديد اسم جدول البيانات قيد المعالجة عبر خيار DATA=، ومن ثم صياغة تعليمة TABLES الحاكمة التي تحدد هيكل التقاطع الإحصائي بين المتغيرات المدروسة.
تُكتب تعليمة TABLES بربط المتغير المستقل بالمتغير التابع عبر علامة الضرب الرياضية (*)، مثل: TABLES Independent * Dependent. وفقاً للعرف البرمجي الصارم في SAS، فإن المتغير المكتوب أولاً (يسار العلامة) هو الذي يتولى تكوين صفوف الجدول (Rows)، في حين أن المتغير المكتوب ثانياً (يمين العلامة) هو المسؤول عن تكوين أعمدة الجدول (Columns). يتطلب هذا الأمر انتباهاً خاصاً من الباحث؛ لأن نسبة الأرجحية تُحسب افتراضياً لمقارنة الصف الأول بالصف الثاني بالنسبة للعمود الأول كحدث مرجعي.
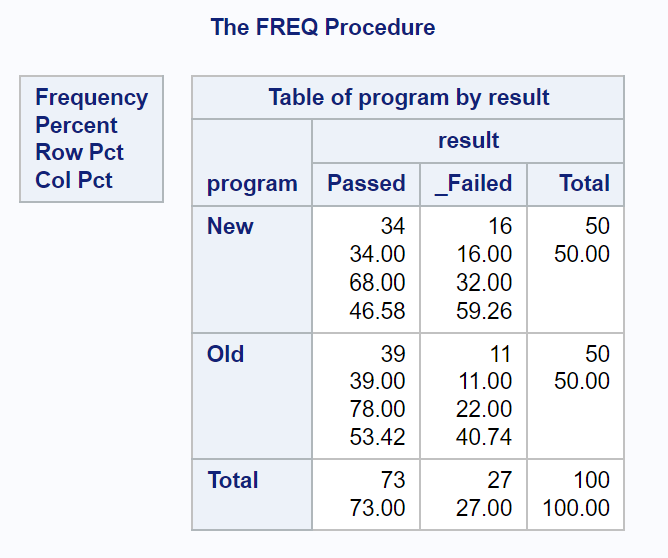
عندما تكون البيانات مجمعة تكرارياً، يصبح تضمين تعليمة الوزن (WEIGHT variable_name;) أمراً إلزامياً داخل بنية PROC FREQ. تؤدي هذه التعليمة وظيفة توجيه النظام إلى معاملة المتغير العددي المخصص بوصفه وزناً تكرارياً يحدد عدد الملاحظات الفعلية الممثلة في كل صف وعمود، وبدون هذه التعليمة سيتعامل SAS مع كل سطر تكراري في البيانات بوصفه ملاحظة فردية واحدة، مما يؤدي إلى انهيار كامل لحجم العينة والنتائج الإحصائية.
6.2 تفعيل خيارات التحليل المتقدمة: CHISQ و RELRISK
لا يقوم الإجراء PROC FREQ في بنيته الافتراضية بإنتاج نسب الأرجحية؛ إذ يقتصر مخرجه الأولي على استخراج التكرارات المشاهدة والنسب المئوية الإجمالية والهامشية داخل الخلايا. لتفعيل التحليلات الإحصائية المتقدمة لحجم الأثر واختبارات الفروض، يتم تزويد تعليمة TABLES بخيارات تكميلية توضع بعد علامة الشرطة المائلة (/)، ويأتي في مقدمتها خيارا CHISQ و RELRISK الحاسمين.
يقوم الخيار CHISQ بإجراء حزمة متكاملة من اختبارات استقلالية البيانات الفئوية، وعلى رأسها اختبار كاي سكوير لبيرسون (Pearson Chi-Square)، واختبار نسبة الإمكان (Likelihood Ratio Chi-Square)، واختبار مانتل-هانزل للاستقلالية الخطية، فضلاً عن إنتاج اختبار فيشر الدقيق في الجداول الثنائية. تتيح هذه الاختبارات تقييم الفرضية الصفرية القائلة بعدم وجود ارتباط بين المتغيرين، وتوفر القيمة الاحتمالية اللازمة لتحديد الدلالة الإحصائية للنموذج المقترح.
أما الخيار الأهم في هذا السياق فهو RELRISK، وهو الأمر الحصري المخصص داخل SAS لإنتاج تقديرات المخاطر والارتباط؛ حيث يصدر جدولاً تحليلياً شاملاً يُعرف بجدول “Estimates of the Relative Risk”. يحتوي هذا الجدول تلقائياً على التقدير النقطي لنسبة الأرجحية (Odds Ratio) مع فترات الثقة المعيارية بنسبة 95%، بالإضافة إلى تقديرات الخطر النسبي لعمودي الجدول. ولتحسين المظهر البصري لتقارير المخرجات وإلغاء النسب المئوية الزائدة التي قد تشتت الانتباه، يمكن تزويد الأمر بالخيارات المانعة: NOROW و NOCOL و NOPERCENT، مما يفرز جدولاً تكرارياً غاية في الوضوح والتركيز الإحصائي.
6.3 التحكم في اتجاه المقارنة عبر خيارات الترتيب
تتكامل البنية التحليلية لـ PROC FREQ عبر استيعاب خيارات التحكم في الترتيب الموجه للفئات. يؤثر ترتيب الفئات تأثيراً مباشراً على حساب نسبة الأرجحية؛ إذ إن الإجراء يحسب نسبة الأرجحية بمقارنة “الصف الأول بالنسبة للصف الثاني” فيما يخص احتمالية وقوع “العمود الأول بالنسبة للعمود الثاني”. إذا كان ترتيب الفئات غير موجه بعناية، فإن القيمة الناتجة قد تنقلب لتصبح مقلوب النسبة المطلوبة تماماً (أي 1/OR)، مما يقلب دلالة الأثر من عامل معزز للنجاح إلى عامل مثبط له.
لتجنب هذا الخطأ، يُدرج خيار ORDER=DATA في السطر الرئيسي لاستدعاء الإجراء: PROC FREQ DATA=dataset ORDER=DATA;. يضمن هذا الخيار التزام SAS بالترتيب الدقيق الذي تم به إدخال البيانات في خطوة الإدخال، مما يتيح للباحث وضع فئة المعالجة أولاً وفئة النجاح أولاً لضمان الحصول على نسبة أرجحية صحيحة الاتجاه تعبر عن نجاح التدخل مباشرة.
وفي سيناريوهات العينات الصغيرة أو الجداول التي تتضمن خلايا صفرية أو تكرارات متوقعة تقل عن خمسة، يتم استدعاء تعليمة التحليل الدقيق عبر إضافة سطر برمجي مستقل: EXACT OR RELRISK;. يجبر هذا الأمر المتقدم نظام SAS على تجاوز الطرق المقاربة الكلاسيكية، وتطبيق حسابات الاحتمالات الدقيقة التوافقية لإنتاج فترات ثقة دقيقة لنسب الأرجحية مستندة إلى التوزيع الشرطي الدقيق، مما يرفع موثوقية التحليلات العلمية في الظروف المنهجية الحرجة.
7. تطبيق عملي خطوة بخطوة: حساب نسبة الأرجحية لبرنامج تدريب مهاري
7.1 سيناريو التجربة السلوكية والبيانات الإحصائية
لتجسيد العمليات الإحصائية في سياق واقعي وملموس، نفترض قيام باحث في علم النفس الرياضي بتصميم دراسة تجريبية مضبوطة لتقييم فاعلية برنامج تدريب سلوكي-معرفي مكثف يهدف إلى تطوير مهارة الرمية الحرة تحت الضغط النفسي لدى لاعبي كرة السلة الواعدين. تم اختيار عينة مكونة من 100 رياضي وتوزيعهم عشوائياً وبصورة متساوية تماماً إلى مجموعتين: المجموعة الأولى (50 رياضياً) خضعت للبرنامج التدريبي السلوكي الحديث، بينما خضعت المجموعة الثانية (50 رياضياً) للبرنامج التدريبي الميداني التقليدي المعتاد.
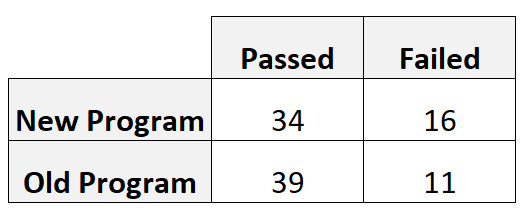
في نهاية البرنامج التدريبي، خضع جميع المشاركين لاختبار تقييم معياري موحد يحاكي بيئة الضغط الجماهيري الميداني لاختبار مهارة الرميات الحرة، وتم تصنيف النتائج السلوكية بصورة ثنائية صارمة إلى: “اجتياز المعيار بنجاح” (Pass) أو “الإخفاق في الاجتياز” (Fail). أسفر التقييم الميداني عن النتائج التكرارية التالية: في مجموعة التدريب السلوكي الحديث، نجح 35 رياضياً في اجتياز الاختبار، بينما أخفق 15 رياضياً. وفي المقابل، نجح 20 رياضياً فقط من مجموعة التدريب التقليدي في اجتياز الاختبار، بينما أخفق 30 رياضياً.
بترجمة هذه المعطيات الرقمية إلى مصفوفة جدول التوافق الثنائي (2×2)، نجد أن خلايا الجدول تتوزع على النحو التالي: الخلية (a) = 35 (تدريب حديث + نجاح)، الخلية (b) = 15 (تدريب حديث + رسوب)، الخلية (c) = 20 (تدريب تقليدي + نجاح)، والخلية (d) = 30 (تدريب تقليدي + رسوب). تهدف التجربة إلى الإجابة عن تساؤل إحصائي محدد: هل يؤدي الانخراط في البرنامج التدريبي الحديث إلى رفع أرجحية اجتياز اختبار المهارة مقارنة بالبرنامج التقليدي؟ وما هو التقدير النقطي وفترة الثقة لهذا الأثر السلوكي؟
7.2 كود SAS الكامل لتنفيذ التحليل الإحصائي
يتم تنفيذ التحليل الإحصائي الشامل لهذه التجربة داخل بيئة SAS عبر كتابة كود برمجي متكامل ومنسق منهجياً. يتضمن الكود خطوة إنشاء مصفوفة البيانات المجدولة مع التحكم في الترتيب، متبوعاً باستدعاء الإجراء PROC FREQ مع خيارات الفحص الاستدلالي المتكامل والوزن التكراري. فيما يلي الشفرة البرمجية الدقيقة المعتمدة لتنفيذ هذا التحليل:
DATA basketball_skills;
INPUT Program $ Outcome $ Count;
DATALINES;
New_Program Pass 35
New_Program Fail 15
Traditional Pass 20
Traditional Fail 30
;
RUN;
PROC FREQ DATA=basketball_skills ORDER=DATA;
TABLES Program * Outcome / CHISQ RELRISK NOROW NOCOL NOPERCENT;
WEIGHT Count;
TITLE “حساب نسبة الأرجحية والمخاطر النسبية لبرنامج التدريب السلوكي”;
RUN;
في هذه الشفرة البرمجية، يضمن استخدام ORDER=DATA أن يتعامل البرنامج مع فئة “New_Program” بوصفها الصف الأول الممثل للتدخل، وفئة “Pass” بوصفها الحدث المستهدف في العمود الأول. وتقوم تعليمة WEIGHT بتغذية خوارزميات البرنامج بالتكرارات الفعلية المشاهدة داخل الخلايا، في حين يتولى الأمر RELRISK استخراج جدول الأرجحية المطلوب، ويوفر CHISQ مصفوفة اختبارات الدلالة الإحصائية المقابلة.
7.3 التدقيق البرمجي وضمان سلامة التنفيذ
عقب إرسال الشفرة البرمجية للتنفيذ، تقتضي قواعد الرصانة الإحصائية عدم القفز مباشرة إلى نافذة النتائج المخرجة، بل التوجه الإلزامي أولاً نحو نافذة “سجل النظام الإحصائي” (SAS Log). يُعد السجل البرمجي هو الشاهد الموضوعي على سلامة العمليات الحاسوبية؛ حيث يتم التحقق من خلو السجل تماماً من أي رسائل تشير إلى أخطاء في الصياغة (Syntax Errors)، أو ملاحظات تحذيرية باللون الأحمر أو الأصفر تشير إلى فقدان قيم أو تحويلات قسرية في أنواع المتغيرات من نصية إلى رقمية.
يتعين على المحلل مطابقة السطر التوثيقي في سجل SAS الذي يوضح عدد السجلات الإجمالية المعالجة ومجموع الأوزان المجمعة. في هذا المثال، يجب أن يؤكد السجل أن الإجراء قد قام بمعالجة 4 أسطر بيانات (Observations) بإجمالي تكرارات موزونة بلغ 100 حالة (Sum of Weights = 100)، وهو ما يؤكد تطابق المدخلات البرمجية مع الحجم الفعلي للعينة الرياضية المشاركة في التجربة.
كما يتضمن التدقيق البرمجي التحقق البصري الأولي من جدول التوافق المعروض في مخرجات SAS لمطابقة محاور الصفوف والأعمدة؛ إذ يجب التأكد من أن التكرار في تقاطع (New_Program × Pass) يقرأ بدقة 35، وفي تقاطع (Traditional × Fail) يقرأ 30. إن هذا التأكيد الحذري يزيل أي احتمالية لوقوع خطأ ناجم عن الترتيب، مما يؤهل الباحث للشروع في قراءة وتفسير الجداول الاستدلالية بثقة تامة.
8. قراءة وتفسير مخرجات SAS لنسبة الأرجحية وفترات الثقة
8.1 تشريح جدول تقديرات المخاطر النسبية (Estimates of the Relative Risk)
عند تنفيذ الأمر السابق، يصدر نظام SAS جدولاً إحصائياً دقيقاً ومحورياً يحمل عنوان “Estimates of the Relative Risk (Row1/Row2)”. يتكون هذا الجدول من ثلاثة أسطر رئيسية تتضمن مقاييس الارتباط المختلفة المحسوبة للجدول؛ حيث يمثل السطر الأول ما يُصطلح عليه باسم “نسبة الأرجحية” (Odds Ratio)، متبوعاً بسطرين إضافيين مخصصين لنسب المخاطر (Relative Risks / Cohort Risk Ratios) للعمود الأول ثم للعمود الثاني.
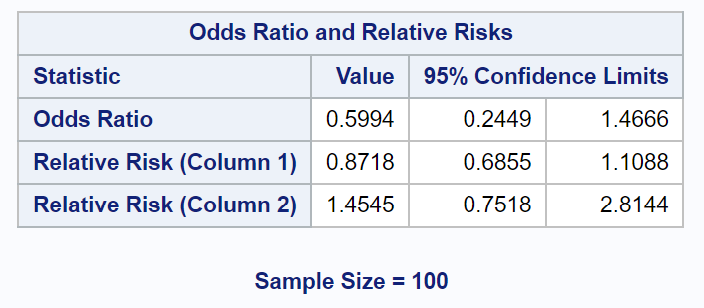
بالنظر إلى السطر الأول المسمى Odds Ratio، يستخرج المحلل القيمة النقطية لنسبة الأرجحية المقدرة للتجربة الرياضية، والتي تُحسب يدوياً وبرمجياً بالمعادلة: OR = (35 × 30) / (15 × 20) = 1050 / 300 = 3.5000. تظهر القيمة 3.50 بوضوح في عمود القيمة (Value)، وهي تشير إلى أن أرجحية اجتياز اختبار المهارة بنجاح لدى الرياضيين الذين خضعوا للبرنامج السلوكي الحديث تفوق بثلاث مرات ونصف أرجحية اجتيازه لدى نظرائهم الذين تلقوا البرنامج التقليدي.
يوفر السطران الثاني والثالث معلومات عن نسب المخاطر؛ حيث يوضح سطر “Cohort (Col1 Risk)” النسبة بين احتمالي النجاح في المجموعتين: (35/50) / (20/50) = 0.70 / 0.40 = 1.7500. يوضح هذا التمايز الرقمي الفارق الذي تم تأصيله نظرياً؛ فالخطر النسبي هنا يعكس زيادة في احتمال النجاح بمقدار 1.75 مرة، بينما تُظهر نسبة الأرجحية زيادة تفوق ذلك بمقدار 3.5 مرة، وهو ما يعكس ميل نسبة الأرجحية للتمدد والابتعاد عن الواحد الصحيح كلما كان الحدث شائعاً في العينة المشاهدة.
8.2 تفسير حدود الثقة الإحصائية (95% Confidence Limits)
لا تكتمل القراءة العلمية للنتائج بالاكتفاء بالتقدير النقطي المجرد لنسبة الأرجحية؛ إذ إن هذه القيمة تمثل عينة واحدة مسحوبة من مجتمع أكبر، وتحمل قدراً لا مناص منه من الخطأ العيني. لذلك، يوفر جدول SAS حدين إحصائيين بالغي الأهمية هما: الحد الأدنى لفترة الثقة (95% Lower Confidence Limit) والحد الأعلى لفترة الثقة (95% Upper Confidence Limit). في المثال التطبيقي المذكور، يُظهر جدول SAS أن فترة الثقة 95% لنسبة الأرجحية تنحصر بين [1.5298, 8.0076].
ينطوي التفسير العلمي لهذه الفترة على دلالة إحصائية حاسمة؛ حيث يُلاحظ أن فترة الثقة برمتها تقع أعلى من القيمة المرجعية المحايدة (1.0)، دون أن تشتمل على الواحد الصحيح بين حديها الأدنى والأعلى (1.53 > 1.0). يشير هذا الانفصال الإحصائي التام عن الواحد إلى أن الارتباط بين البرنامج السلوكي والنجاح الميداني هو ارتباط ذو دلالة إحصائية عند مستوى المعنوية المعياري α = 0.05، وهو ما يتطابق مع القيمة الاحتمالية لاختبار كاي سكوير لبيرسون الناتجة في جدول الاختبارات (χ² = 9.00, df = 1, p = 0.0027).
كما يعكس اتساع فترة الثقة [1.53 – 8.01] مدى دقة التقدير الإحصائي المرتبط بحجم العينة الحالية. فرغم ثبوت الفاعلية الإحصائية للبرنامج وتأكيد أنه يرفع أرجحية النجاح بنسبة لا تقل عن 53% في أسوأ السيناريوهات الاحتمالية، فإن اتساع المدى يشير إلى وجود تباين عيني مقبول، مما يوجه الباحث إلى التوصية بإجراء دراسات مستقبلية ذات عينات أكبر لتضييق مدى الثقة والوصول إلى تقدير أكثر تحديداً للأثر السلوكي الحقيقي في المجتمع الرياضي ككل.
8.3 الصياغة العلمية للنتائج وفق معايير الجمعية الأمريكية لعلم النفس (APA)
يتطلب توثيق النتائج الإحصائية في الأطروحات الأكاديمية والمجلات العلمية المحكمة صياغة بيانية تجمع بين الدقة الحسابية والبلاغة التفسيرية، مع الالتزام الحرفي بدليل النشر المعتمد من قبل الجمعية الأمريكية لعلم النفس (APA Style – الإصدار السابع). يُمنع في هذا السياق الاكتفاء بسرد الأرقام دون توضيح اتجاه وطبيعة الفروق السلوكية المترتبة عليها.
تتم الصياغة العلمية النموذجية لنتائج هذا التحليل على النحو التالي:
“أظهرت نتائج التحليل الإحصائي عبر جدول التوافق الثنائي وجود ارتباط دال إحصائياً بين نوع البرنامج التدريبي المتبع ومعدل اجتياز اختبار مهارة الرميات الحرة تحت الضغط النفسي، χ²(1, N = 100) = 9.00, p = .003. وقد بينت تقديرات الأرجحية أن الرياضيين الذين شاركوا في البرنامج التدريبي السلوكي-المعرفي الحديث كانت لديهم أرجحية أعلى بصورة جوهرية لاجتياز اختبار المهارة بنجاح مقارنة بالرياضيين الذين اتبعوا البرنامج التقليدي، حيث بلغت نسبة الأرجحية (OR = 3.50, 95% CI [1.53, 8.01]). وتبرهن هذه النتيجة على أن التدخل السلوكي يضاعف أرجحية النجاح المهاري للرياضيين بأكثر من ثلاث مرات مقارنة بالممارسات التدريبية السائدة، مما يعكس حجماً كبيراً للأثر السريري والتدريبي للبرنامج المستحدث.”
9. التحليلات المتقدمة: حساب نسب الأرجحية المعدلة عبر PROC LOGISTIC
9.1 دواعي الانتقال من التحليل ثنائي المتغير إلى الانحدار اللوجستي
على الرغم من الكفاءة التحليلية للإجراء PROC FREQ في فحص الجداول الثنائية المعزولة، إلا أن هذا النمط من التحليل ثنائي المتغير (Bivariate Analysis) يعاني من قصور منهجي جسيم ينبع من عجزه التام عن إدخال المتغيرات المستمرة في التحليل، أو عزل وضبط “المتغيرات المربكة” (Confounding Variables). في الأبحاث السريرية والسلوكية الواقعية، نادراً ما تقع الظواهر في فراغ تجريبي معزول؛ إذ قد يتأثر النجاح المهاري بمتغيرات متداخلة مثل: العمر الزمني للاعب، أو عدد سنوات الخبرة التنافسية، أو مستوى القلق التنافسي الأساسي.
إذا ارتبط أحد هذه المتغيرات المربكة بنوع التدخل الممنوح وارتبط في الوقت ذاته بنتيجة الاختبار، فإن نسبة الأرجحية الخام (Crude Odds Ratio) المستخرجة عبر جداول التوافق ستكون مشوهة ومضللة، إما بتضخيم حجم الأثر الحقيقي أو إخفائه كلياً نتيجة لما يُعرف إحصائياً بظاهرة سيمبسون المفارقة (Simpson’s Paradox). هنا تبرز الضرورة المنهجية الصارمة للتحول نحو النمذجة المتقدمة باستخدام الانحدار اللوجستي الثنائي (Binary Logistic Regression)، والذي يتيح فحص أثر المتغير المستقل الرئيسي مع “تثبيت وضبط” الآثار الإحصائية لكافة المتغيرات الأخرى ذات التأثير المشترك.
علاوة على ذلك، يتيح الانحدار اللوجستي دراسة “التفاعلات الإحصائية” (Statistical Interactions or Effect Modification)؛ كأن يتساءل الباحث عما إذا كانت فاعلية البرنامج السلوكي تختلف وتتفاوت بين الذكور والإناث، أو بين اللاعبين المبتدئين والمحترفين. يتيح الانتقال إلى نماذج الانحدار اللوجستي توليد ما يُعرف باسم “نسب الأرجحية المعدلة” (Adjusted Odds Ratios – aOR)، والتي تعكس الأثر المستقل والحقيقي للتدخل بعد استبعاد كافة التشوهات التجريبية المحتملة.
9.2 صياغة واستخدام الإجراء PROC LOGISTIC لتقدير الأرجحية
يُمثل الإجراء PROC LOGISTIC في نظام SAS الأداة التحليلية القياسية والأقوى لبناء نماذج الانحدار اللوجستي الثنائي والمتعدد وفوق الثنائي. يمتلك هذا الإجراء بنية برمجية متطورة تتيح للمحلل التحكم في مواصفات النموذج الإحصائي وتحديد الفئة المرجعية للحدث المستهدف بدقة مطلقة، مع استخراج جداول جاهزة لنسب الأرجحية لكل متغير تنبؤي داخل النموذج.
تتم الصياغة البرمجية لـ PROC LOGISTIC عبر تحديد خيار الحدث المستهدف داخل القوسين المرتبطين بالمتغير التابع في تعليمة MODEL، كأن يتم تحديد (EVENT=’Pass’) لتوجيه البرنامج مباشرة نحو نمذجة احتمالية النجاح بدلاً من نمذجة احتمالية الإخفاق. توفر تعليمة CLASS للمحلل إمكانية توصيف المتغيرات الفئوية وتحديد الفئة المرجعية الخاصة بكل منها صراحة عبر خيار REF=. كما توفر تعليمة ODDSRATIO المتقدمة إمكانية استخراج نسب أرجحية مخصصة للمتغيرات المتصلة أو عند وجود تفاعلات مركبة. يوضح الكود التالي كيفية إعادة تحليل بيانات كرة السلة السابقة عبر PROC LOGISTIC لإنتاج نسبة الأرجحية مباشرة:
PROC LOGISTIC DATA=basketball_skills;
CLASS Program(REF=’Traditional’) / PARAM=REF;
MODEL Outcome(EVENT=’Pass’) = Program;
FREQ Count;
ODDSRATIO Program;
TITLE “حساب نسبة الأرجحية للبرنامج السلوكي عبر الانحدار اللوجستي”;
RUN;
يُلاحظ في هذه الشفرة استخدام تعليمة FREQ بدلاً من WEIGHT، وهي التعليمة القياسية المخصصة للأوزان التكرارية الصحيحة داخل PROC LOGISTIC. كما يضمن خيار PARAM=REF تطبيق التشفير المرجعي (Reference Cell Coding) المعتمد في العلوم الطبية والنفسية بدلاً من تشفير الآثار (Effect Coding)، مما يجعل معاملات الانحدار متوافقة ومطابقة في تفسيرها المباشر لنسب الأرجحية.
9.3 مقارنة مخرجات PROC FREQ مع مخرجات PROC LOGISTIC
عند فحص المخرجات الإحصائية الصادرة عن الإجراء PROC LOGISTIC للبيانات السابقة، يتوجه المحلل إلى جدول متخصص يحمل عنوان “Odds Ratio Estimates”. يُسجل هذا الجدول بوضوح مقارنة الفئات: “Program New_Program vs Traditional”، ويُظهر في عمود التقدير النقطي القيمة 3.500، مصحوبة بفترة الثقة بنسبة 95% التي تقرأ بدقة [1.530, 8.008]. نجد هنا تطابقاً رقمياً تاماً حتى المنازل العشرية الأخيرة بين مخرجات PROC LOGISTIC ومخرجات PROC FREQ المعروضة في الأقسام السابقة.
هذا التطابق الرياضي يبرهن على وحدة الأساس النظري لكلا الإجراءين عند غياب المتغيرات الضابطة الإضافية؛ فنموذج الانحدار اللوجستي الثنائي البسيط ليس في حقيقته الإحصائية سوى صياغة معلمية رياضية متقدمة لجداول التوافق الثنائية. ولكن يتمايز PROC LOGISTIC بتوفيره جدول “Type 3 Analysis of Effects” واختبارات فالد (Wald Chi-Square Tests) ونسبة الإمكان للنموذج الكلي (-2 Log Likelihood)، مما يعطي رؤية تشخيصية أعمق لملاءمة النموذج الإحصائي ككل للبيانات.
أضف إلى ذلك أن PROC LOGISTIC يوفر إمكانية حساب فترات الثقة عبر طريقة “إمكانية الملف الجانبي” (Profile Likelihood Confidence Intervals) عبر إضافة خيار CLODDS=PL في تعليمة MODEL. تكتسب هذه الميزة تفوقاً منهجياً بالغاً في العينات المتوسطة والصغيرة وغير المتماثلة؛ إذ إن فترات ثقة الملف الجانبي لا تفترض التوزيع الطبيعي المقارب لمعاملات الانحدار كما تفعل طريقة فالد المعيارية (Wald Limits)، مما ينتج حدود ثقة أكثر مناعة ودقة ضد الانحرافات التوزيعية في البيانات السلوكية الحقيقية.
10. الأخطاء الشائعة في حساب وتفسير نسب الأرجحية في SAS وكيفية تجنبها
10.1 أخطاء الترتيب الهيكلي وانعكاس المقارنة المرجعية
يُعد الوقوع في خطأ “انعكاس النسبة المرجعية” (Inversion of Reference Group) أحد أكثر الأخطاء شيوعاً وتكراراً حتى بين الممارسين الإحصائيين ذوي الخبرة. ينجم هذا الخطأ الصامت عن عدم إدراك الكيفية التي يفرز بها SAS مستويات المتغيرات الاسمية داخلياً. إذا ترك المحلل الخيارات الافتراضية للترتيب الأبجدي، فقد يقوم النظام بحساب أرجحية “الإخفاق” بدلاً من “النجاح”، أو مقارنة “البرنامج التقليدي بالبرنامج الحديث” بدلاً من العكس، مما ينتج نسبة أرجحية مقلوبة رياضياً تبلغ: 1 / 3.50 = 0.286.
يكمن الخطر المنهجي لهذا الخطأ في أنه خطأ منطقي وتوجيهي لا يتسبب في توقف البرنامج أو إطلاق أي رسائل تحذيرية في سجل النظام؛ فالعمليات الحسابية سليمة بنسبة 100% من الناحية الجبرية، ولكن التفسير البشري للنتيجة ينقلب كلياً. فقد يقرأ الباحث النتيجة المقلوبة بشكل خاطئ تماماً ويخلص إلى أن البرنامج السلوكي المستحدث “يخفض” أرجحية النجاح بنسبة 71%، في حين أن الواقع التجريبي يثبت العكس تماماً وبأنه يرفعها بأكثر من ثلاثة أضعاف.
لتجنب هذا الخطأ الكارثي، يجب الالتزام الصارم بقاعدتي فحص أساسيتين: أولاً، إجراء “الفحص البصري للمنطق الخام” (Visual Sanity Check) بمقارنة النسب المئوية الأولية في جدول التوافق؛ حيث يُلاحظ أن 70% من متدربي البرنامج الحديث نجحوا مقابل 40% فقط في التقليدي، مما يعني بداهة أن نسبة الأرجحية يجب أن تكون بالضرورة أكبر من الواحد الصحيح. ثانياً، الاستخدام الواعي والواضح لخيارات الترتيب مثل ORDER=DATA في PROC FREQ، أو التحديد الحرفي الصريح لخيار EVENT=’Category’ وخيار REF=’Category’ داخل تعليمة CLASS في PROC LOGISTIC، لقطع الطريق أمام أي ترتيب أبجدي عشوائي قد يفرضه النظام.
10.2 أخطاء التفسير اللغوي والمفاهيمي للنتائج
ينزلق العديد من الباحثين عند كتابة مناقشة النتائج في خطأ لغوي ومفاهيمي شائع يتمثل في تفسير نسبة الأرجحية بعبارات تدل على “الاحتمال المطلق” أو “الخطر النسبي”. فالعبارة الشائعة الخاطئة: “أظهرت النتائج أن الرياضيين في البرنامج الحديث كانوا أكثر احتمالاً للنجاح بمقدار 3.5 مرة” تُمثل خلطاً علمياً غير مقبول بين مقياس الاحتمال (Probability) ومقياس الأرجحية (Odds). فكما أثبتنا في المقارنة الرياضية، فإن احتمال النجاح ارتفع بنسبة 1.75 مرة فقط (الخطر النسبي)، في حين أن الأرجحية هي التي تضاعفت بمقدار 3.5 مرة.
يتسع هذا الخطأ ويتضاعف خطره عند التقرير عن دراسات مستعرضة (Cross-Sectional Studies) أو تصاميم غير تجريبية ترصد الارتباط الإحصائي دون توافر شرط الترتيب الزمني للأحداث؛ حيث يُسقط بعض الباحثين استنتاجات تفيد “السببية المباشرة” (Causality) استناداً إلى نسب أرجحية مرتفعة. يجب التأكيد دائماً على أن نسبة الأرجحية هي مقياس “ارتباط نسبي” وليست دليلاً على علاقة سببية حتمية، ما لم يكن تصميم الدراسة تجريبياً محكماً يضمن التحكم الصارم في كافة العوامل الخارجية والمتغيرات الوسيطة.
إضافة إلى ذلك، يُعد إغفال التقرير عن فترات الثقة 95% والاكتفاء بكتابة التقدير النقطي المجرد لنسبة الأرجحية انتهاكاً جسيماً لمعايير الشفافية الإحصائية المعتمدة دولياً. إن تقديم النتيجة على هيئة (OR = 3.50) دون بيان مداها الاحتمالي [1.53, 8.01] يحرم القارئ والمحكم العلمي من تقييم مدى دقة التقدير العيني وحجم الخطأ المعياري المقترن به، مما يضعف الرصانة الأكاديمية للدراسة برمتها.
10.3 التحقق المنهجي وقائمة المراجعة قبل اعتماد النتائج
لضمان أعلى درجات الجودة والموثوقية في التحليلات الإحصائية المنفذة عبر SAS، ينبغي على كل باحث ومحلل إحصائي اعتماد “قائمة تدقيق منهجية” (Methodological Checklist) وفحص بنودها خطوة بخطوة قبل الشروع في كتابة التقرير النهائي للنتائج أو إرساله للنشر والاعتماد. تتكامل هذه القائمة عبر الخطوات المتسلسلة التالية:
- مراجعة سجل النظام البرمجي (SAS Log): التأكد القاطع من خلو السجل من رسائل التحذير والخطأ، والتحقق التام من مطابقة مجموع التكرارات الموزونة (Sum of Weights) للحجم الفعلي المخطط للعينة البحثية.
- فحص افتراض التكرارات المتوقعة (Expected Frequencies): مراجعة مخرجات خيار CHISQ والتأكد من أن جميع الخلايا المتوقعة تتجاوز القيمة 5، وفي حال عدم تحقق ذلك، التأكد من استدعاء تعليمة EXACT لإنتاج نسب الأرجحية وفترات الثقة الدقيقة لاختبار فيشر.
- التحقق من اتجاه محاور المقارنة: تدقيق موضع الحدث المستهدف والتأكد من أنه يشكل البسط الحقيقي في نسبة الأرجحية عبر مطابقة منطق المقارنة الأولية لبيانات الجدول التكراري.
- إجراء اختبارات الحساسية للبيانات المفقودة: تقييم نمط القيم المفقودة (Missing Data Patterns) والتأكد من أنها لا تتبع نمطاً غير عشوائي قد يشوه النتائج، وإجراء تحليلات الحساسية (Sensitivity Analyses) إذا كانت نسبة الفقد تستدعي ذلك.
- الالتزام الصارم بمعايير التوثيق الدولية: صياغة النتائج بتضمين التقدير النقطي لنسبة الأرجحية، وحدود فترة الثقة 95%، وقيمة الدلالة الاحتمالية المقابلة، وقيمة الاختبار الإحصائي المعتمد وفق صياغة دليل APA.
- أرشفة وتوثيق كود التحليل والبيانات: حفظ الشفرة البرمجية المصدرية وسجل النظام ومخرجات التحليل بصورة منظمة ومؤرخة داخل الملاحق الأكاديمية، بما يضمن إمكانية إعادة إنتاج التحليل ومطابقته (Reproducibility) في المستقبل.
الخاتمة والاستنتاجات العلمية
تُشكل نسبة الأرجحية أداة إحصائية غاية في القوة والمرونة لتحليل العلاقات بين المتغيرات الفئوية وقياس حجم الأثر في طيف واسع من العلوم السلوكية، والطبية، والاجتماعية. ومن خلال هذا العرض المعمق، تم تتبع المسار الكامل للتحليل؛ انطلاقاً من التأسيس الرياضي لمفهومي الاحتمال والأرجحية والاشتقاق الدقيق للجداء التقاطعي ومحددات تطبيقه، ومروراً بالتمييز المنهجي الصارم بينها وبين المخاطر النسبية ومخاطر الخلط بينهما خارج إطار فرضية المرض النادر، ووصولاً إلى التنفيذ البرمجي المتقدم داخل نظام SAS الرائد إحصائياً.
أظهرت المعالجة الإجرائية داخل بيئة SAS، سواء من خلال الإجراء الكلاسيكي PROC FREQ أو النمذجة المتقدمة عبر PROC LOGISTIC، أن القوة التقنية للنظام الإحصائي تظل رهينة الفهم المعرفي والمنهجي للمحلل ذاته. فالتحكم الدقيق في توجيه الفئات المرجعية، وضبط أوزان البيانات المجدولة، وحسن اختيار الاختبارات الدقيقة في مواجهة الخلايا الصفرية أو التكرارات الضئيلة، هي الضمانات الحقيقية التي تحول الأرقام المجردة إلى أدلة علمية موثوقة تسهم في تطوير المعرفة الإنسانية وتوجيه الممارسات الإكلينيكية والقرارات الصحية القائمة على البراهين.
المراجع
- Agresti, A. (2013). Categorical Data Analysis (3rd ed.). John Wiley & Sons.
- Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical Methods for Rates and Proportions (3rd ed.). John Wiley & Sons.
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied Logistic Regression (3rd ed.). John Wiley & Sons.
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The FREQ Procedure. SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The LOGISTIC Procedure. SAS Institute Inc. https://documentation.sas.com
- Stokes, M. E., Davis, C. S., & Koch, G. G. (2012). Categorical Data Analysis Using SAS (3rd ed.). SAS Institute Inc.
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229.