
يمثل التحليل الإحصائي متعدد المتغيرات ركيزة أساسية في استكشاف الأنماط المعقدة وفهم البنى الكامنة داخل البيانات الضخمة. وفي عصر الانفجار البياني، تجد المؤسسات البحثية والقطاعات التطبيقية نفسها أمام تدفقات هائلة من المشاهدات والقياسات الرقمية التي تفتقر إلى تصنيف مسبق أو بطاقات تعريفية معيارية توضح انتماءاتها الوظيفية أو السلوكية. هنا تبرز تقنيات التعلم غير الخاضع للإشراف (Unsupervised Learning) بوصفها أدوات استكشافية متقدمة تهدف إلى فرز البيانات وتجميعها بناءً على مقاييس التشابه البيني، دون توجيه خارجي أو فرضيات مسبقة تقيد النتائج بمسارات تصنيفية محددة سلفاً.
تعتبر بيئة التحليل الإحصائي ساس (SAS) واحدة من أرسخ المنظومات البرمجية وأكثرها موثوقية في إجراء التحليلات الرياضية والإحصائية المتقدمة للبيانات متعددة الأبعاد. ومن بين الأدوات المتخصصة التي توفرها هذه المنظومة، يبرز إجراء PROC CLUSTER كأداة قوية وفعالة لتنفيذ التحليل العنقودي الهرمي التراكمي (Hierarchical Agglomerative Clustering). يتيح هذا الإجراء للباحثين والمحللين بناء تسلسلات هرمية متكاملة تدمج المشاهدات المتماثلة في مجموعات متجانسة داخلياً ومتباينة خارجياً، معتمداً على مجموعة واسعة من خوارزميات الربط ومعايير المسافة الرياضية المدعومة باختبارات تشخيصية دقيقة.
يهدف هذا المقال الأكاديمي الشامل إلى تقديم دليل منهجي وتطبيقي متكامل لاستخدام إجراء PROC CLUSTER في نظام SAS. وسيتناول المقال تفكيك الأسس الرياضية والنظرية للتحليل العنقودي الهرمي، واستعراض آليات إعداد البيانات وتقييسها المعياري، وصولاً إلى كتابة الكود البرمجي الكامل وتطبيقه على عينة عملية واقعية مستمدة من مؤشرات الأداء الرياضي للاعبي كرة السلة. كما سيتم استعراض كيفية قراءة المخرجات الإحصائية المعقدة، وبناء مخطط الشجرة العنقودية (Dendrogram) عبر إجراء PROC TREE، وتقييم جودة النماذج لتجنب التحيزات الإحصائية الشائعة في بيئات تحليل البيانات الاحترافية.
1. مقدمة إلى التحليل العنقودي وإجراء PROC CLUSTER في نظام SAS
1.1 مفهوم التحليل العنقودي وأهميته في التنقيب عن البيانات
يُعرَّف التحليل العنقودي (Cluster Analysis) في حقل التنقيب عن البيانات والإحصاء الرياضي بأنه عملية تنظيم وتوزيع مجموعة من المشاهدات أو الحالات غير المصنفة إلى مجموعات فرعية متمايزة تُعرف باسم “العناقيد” (Clusters). يندرج هذا الأسلوب ضمن فئة التعلم الآلي غير الخاضع للإشراف، حيث لا تتوافر متغيرات تابعة (Dependent Variables) أو تصنيفات مستهدفة مسبقة تُقاس دقة النموذج بالاستناد إليها. ويتمثل الهدف الرياضي الجوهري للخوارزميات العنقودية في تصغير التباين الداخلي (Intra-cluster Variance) بين عناصر العنقود الواحد إلى أدنى حد ممكن، وفي الوقت ذاته تعظيم التباين البيني (Inter-cluster Variance) بين العناقيد المختلفة، بما يضمن تحقيق أقصى درجات التجانس الداخلي والتمايز الخارجي.
تكتسب هذه التقنية أهمية بالغة في شتى الميادين التطبيقية والبحثية، بدءاً من دراسات السوق الرامية إلى تجزئة العملاء وبناء ملفات الأنماط السلوكية الاستهلاكية، مروراً بالعلوم الطبية الحيوية لتصنيف التعبير الجيني واكتشاف السلالات الخلوية، وصولاً إلى القياسات النفسية لتحديد الأنماط الشخصية المستقرة استناداً إلى مقاييس متعددة الأبعاد. وتتيح هذه الأدوات للباحث الانتقال من حالة التشتت الناجمة عن كثرة المتغيرات والملاحظات إلى مستوى من الفهم التجريدي المنظم، مما يسهل توصيف العينات واكتشاف العلاقات البنيوية التي لا تظهر عبر الفحص الإحصائي الوصفي التقليدي.
من الضروري التمييز بدقة بين التحليل العنقودي والتصنيف الإحصائي الرقابي (Supervised Classification). ففي التصنيف الرقابي، مثل نماذج الانحدار اللوجستي أو التحليل التمييزي الخطي، تكون فئات المخرجات محددة سلفاً وتُستخدم البيانات التاريخية لتدريب دالة رياضية تهدف لتخصيص الحالات الجديدة لأحد تلك الفصول المعيارية. أما في التحليل العنقودي، فإن الفصول نفسها ليست موجودة بصورة مسبقة، بل تُستخلص استكشافياً من التباينات والمسافات الفضائية المجردة للمتغيرات، مما يجعل العناقيد مكتشفات تجريبية كاشفة عن الهيكل الطبيعي للمجتمع الإحصائي قيد الدراسة.
1.2 دور إجراء PROC CLUSTER ومكانته في بيئة SAS الإحصائية
يحظى إجراء PROC CLUSTER بمكانة تاريخية وتطبيقية رفيعة داخل منظومة برمجيات SAS الإحصائية، حيث طُوِّر هذا الإجراء ليكون المحرك المركزي لتنفيذ خوارزميات التجميع الهرمي التراكمي (Hierarchical Agglomerative Clustering). وتتميز البنية المعمارية لهذا الإجراء بصرامة خوارزمية عالية وقدرة تحليلية فريدة تتيح للباحثين اختبار طيف عريض من مقاييس التباعد وطرق الربط، مع توفير مخرجات إحصائية تشخيصية نادراً ما تتوافر متكاملة في حزم برمجية أخرى.
لتحديد موضع PROC CLUSTER مقارنة بالأدوات الإحصائية الأخرى في SAS، تجب الإشارة إلى إجراءات مثل PROC FASTCLUS و PROC MODECLUS. يُعد إجراء PROC FASTCLUS مناسباً للتعامل مع قواعد البيانات الضخمة (Big Data) التي تحتوي على عشرات الآلاف أو ملايين السجلات، حيث يعتمد على خوارزميات التجميع غير الهرمي الشبيهة بـ K-Means، والتي تفترض عدداً مسبقاً من المجموعات وتعمل بسرعة حسابية فائقة عبر التكرار التقريبي. في المقابل، يختص PROC MODECLUS بالبحث عن النتوءات الكثافية غير المعلمية (Nonparametric Density Clustering). أما PROC CLUSTER، فيركز على المعالجة الهرمية المتسلسلة ذات الدقة الحسابية العالية، مما يجعله الخيار الأمثل للبيانات متوسطة وصغيرة الحجم التي تتطلب تحليلاً بنيوياً عميقاً ودراسة تفصيلية لكيفية تكتل الحالات خطوة بخطوة.
يتكامل PROC CLUSTER بسلاسة مع أدوات العرض البياني واستخراج التقارير داخل بيئة SAS؛ إذ يقوم الإجراء عادة بحفظ نتائج عمليات الدمج المتتالية في جدول بيانات وسيط يُعرف بمصفوفة الشجرة عبر خيار OUTTREE=. ويُستخدم هذا الجدول لاحقاً كمدخل مباشر لإجراءات تكميلية مثل PROC TREE لإنشاء مخطط الشجرة العنقودية (Dendrogram) وتقطيعها عند مستويات محددة لاستخراج المتغيرات التصنيفية ودمجها مع الجداول الأصلية للتحليل اللاحق.
1.3 أهداف التحليل العنقودي ومتطلبات بناء نموذج إحصائي دقيق
تتمثل الغاية الجوهرية للتحليل العنقودي الهرمي في تحديد البنية الكامنة في البيانات متعددة الأبعاد دون التقيد بفرضيات مسبقة عن التوزيع الخطي للتصنيفات. ويهدف هذا الأسلوب إلى استنباط المجموعات الفرعية الطبيعية التي تعكس تقارباً حقيقياً في المتغيرات المقاسة. ومع ذلك، فإن تحقيق هذا الهدف يتطلب توفر مجموعة من الشروط المنهجية التي تضمن دقة النموذج وتمنع الوصول إلى استنتاجات مضللة قد تنشأ عن سوء تخصيص المدخلات.
يتطلب التحليل العنقودي بيانات خالية من التشوهات المنهجية، ويشمل ذلك الفحص الدقيق لمسألة التماثل العددي ومستويات القياس. وبما أن الإجراء يعتمد بصورة مباشرة على المسافات الرياضية، فإن أي تفاوت واسع في النطاقات القياسية للمتغيرات (Scale Inconsistency) سيؤدي حتماً إلى هيمنة المتغيرات ذات الأرقام الكبيرة على دالة المسافة وتهميش المتغيرات ذات القيم المحدودة، حتى لو كانت الأخيرة ذات دلالة جوهرية في تفسير التمايز. كما يشترط أن تكون المشاهدات ممثلة للمجتمع الحقيقي، وألا تتأثر بالعشوائية المفرطة في جمع العينات أو التسجيل الميداني غير المنضبط.
تعد مرحلة اختيار المتغيرات (Variable Selection) ركيزة حاسمة في هندسة النموذج الإحصائي؛ إذ إن إدراج متغيرات غير ملائمة أو زائدة عن الحاجة يؤدي إلى تشويش فضاء المسافة الهندسية، وهو ما يعرف إحصائياً بـ “ظاهرة التشويش بالضوضاء” (Masking by Noise Variables). ينبغي على المحلل الاعتماد على أسس نظرية موضوعية متينة ترتبط بطبيعة الإشكالية البحثية عند اختيار المتغيرات، وتجنب الزج بكافة البيانات المتاحة في النموذج لمجرد توافرها رقمياً.
2. الأسس الرياضية والإحصائية للتحليل العنقودي الهرمي
2.1 طبيعة الخوارزميات التراكمية الهرمية (Agglomerative Hierarchical)
تنطلق خوارزميات التجميع التراكمي الهرمي (Hierarchical Agglomerative Clustering) من أدنى قاعدة هرمية، حيث تُعامل كل مشاهدة منفردة من المشاهدات الإحصائية البالغ عددها $N$ على أنها عنقود قائم بذاته ذو حجم يساوي 1. في هذه النقطة المبدئية، يكون عدد العناقيد مساوياً للعدد الإجمالي للملاحظات، والمسافة الرياضية داخل كل عنقود تساوي صفراً. بعد ذلك، تبدأ الخوارزمية مساراً تصاعدياً تراكمياً عبر مصفوفة المسافات، حيث تبحث عن الزوج الأكثر قرباً أو تشابهاً من بين جميع العناقيد المتاحة وتدمجهما معاً في عنقود واحد جديد، مما يقلص عدد العناقيد إلى $N – 1$.
تتكرر هذه العملية التجميعية في خطوات متعاقبة غير قابلة للعكس (Irreversible Greedy Merges). فبمجرد دمج نقطتين أو مجموعتين في خطوة ما، لا يمكن للخوارزمية التراجع عن هذا الدمج أو إعادة تخصيص إحدى الملاحظات إلى عنقود آخر في مرحلة لاحقة. وتستمر الخوارزمية في دمج أقرب زوج من العناقيد خطوة تلو الأخرى حتى تصل في الخطوة النهائية ($N – 1$) إلى عنقود واحد كبير يضم كافة المشاهدات والملاحظات الموجودة في مصفوفة البيانات.
يوثق التسلسل الزمني لخطوات الدمج في مصفوفة رياضية تُعرف بتاريخ التجميع العنقودي (Cluster History). يتيح هذا التوثيق للمحلل مراجعة التغيرات الطارئة على قيم المسافة أو عدم التجانس عند كل اندماج، وتحديد مستوى التقطع الأمثل الذي يمثل أفضل توازن بين بساطة التصنيف وتجانس العناقيد الداخلية المشكلة.
2.2 مقاييس المسافة والتشابه الإحصائي (Distance Metrics)
يرتكز التحليل العنقودي على مفهوم قياس عدم التشابه (Dissimilarity) بين أزواج المشاهدات في الفضاء الهندسي متعدد الأبعاد، وتعد المسافة الإقليدية (Euclidean Distance) أكثر المقاييس شيوعاً واستخداماً في هذا السياق، وتُحسب المسافة الإقليدية بين النقطتين $X = (x_1, x_2, dots, x_p)$ و $Y = (y_1, y_2, dots, y_p)$ عبر الصيغة الرياضية التالية:
$$d(X, Y) = \sqrt{\sum_{i=1}^{p} (x_i – y_i)^2}$$
على الرغم من البساطة الهندسية للمسافة الإقليدية، إلا أنها شديدة الحساسية لاختلاف وحدات القياس، كما أنها تفترض تعامد الأبعاد واستقلاليتها التامة، مما قد لا يتحقق دائماً في البيانات الاقتصادية أو السلوكية الواقعية.
كبديل للمسافة الإقليدية في حالات معينة، يُستخدم مقيار مسافة مانهاتن (Manhattan Distance) أو ما يُعرف بمسافة كتل المدينة، حيث تُحسب المسافة استناداً إلى مجموع الفروق المطلقة بين الإحداثيات:
$$d(X, Y) = \sum_{i=1}^{p} |x_i – y_i|$$
تتميز مسافة مانهاتن بكونها أكثر متانة ومقاومة للتأثر بالقيم الشاذة المتطرفة مقارنة بالمسافة الإقليدية المربعة، وهي مفيدة بصورة خاصة عندما تتوزع البيانات عبر مسارات هندسية متقطعة أو عند وجود التواءات غير طبيعية في توزيع المتغيرات المستمرة.
أما مسافة ماهالانوبيس (Mahalanobis Distance)، فتعد الخيار الأكثر دقة عند وجود ارتباطات داخلية قوية (Multicollinearity) بين المتغيرات المضمنة في التحليل. تأخذ هذه المسافة في الاعتبار مصفوفة التباين والتباين المشترك (Covariance Matrix) للعينة الإحصائية، مما يتيح التخلص من تأثير الارتباط الخطي وتوحيد المقاييس تلقائياً وفق الشكل التوزيعي للمجتمع المدروس. ومع ذلك، فإن استخدام مسافة ماهالانوبيس داخل PROC CLUSTER يتطلب إجراءات تمهيدية لتحويل البيانات، نظراً لأن الإجراء يطبق الحسابات المباشرة بناءً على المقاييس الإقليدية أو مصفوفات المسافات المعدة مسبقاً.
وفيما يتعلق بالمتغيرات الاسمية أو الثنائية (Binary Variables)، توجد مقاييس تشابه متخصصة مثل معامل جاكارد (Jaccard) ومعامل دايس (Dice). وتجدر الإشارة إلى أن إجراء PROC CLUSTER مصمم في الأصل للتعامل مع البيانات الكمية المستمرة (Continuous Variables). وعند الرغبة في تحليل بيانات نوعية، يتعين على المحلل استخدام إجراءات مساعدة مثل PROC DISTANCE لحساب مصفوفة عدم التشابه الاسمية وتمريرها بعد ذلك إلى PROC CLUSTER بصيغة مصفوفة مسافات عبر خيار DATA=... (TYPE=DISTANCE).
2.3 الافتراضات الإحصائية والمحددات النظرية
على النقيض من النماذج الإحصائية الاستدلالية التقليدية كتحليل التباين أو نماذج الانحدار المعلمية، لا يفترض التحليل العنقودي الهرمي توزيعاً طبيعياً متعدد الأبعاد (Multivariate Normality) للمتغيرات، إلا أن هناك محددات رياضية وافتراضات تشغيلية جوهرية يجب مراعاتها بدقة لضمان استقرار البنية المستخرجة.
تتمثل الحساسية الأولى للخوارزميات التراكمية في تأثرها بالقيم الشاذة والمتطرفة (Outliers). فالقيمة المتطرفة في فضاء المتغيرات قد تؤدي إلى تشكيل عنقود منفرد يعيق مسار الدمج الطبيعي، أو قد تندمج قسراً في المراحل الأخيرة مع عناقيد متجانسة فتؤدي إلى تشتيت تباينها الداخلي وتشويه خصائصها المركزية. لذلك، يُعد فحص القيم الشاذة واستبعادها أو تعديلها خطوة تمهيدية لازمة قبل مباشرة التجميع الهرمي.
كما يُفترض في التحليل استقلالية الملاحظات الفردية؛ إذ إن وجود ارتباط ذاتي بين السجلات المتتالية (كبيانات السلاسل الزمنية) قد يوجه الخوارزمية نحو تجميع الحالات المتجاورة زمنياً بدلاً من تجميعها استناداً إلى سماتها الموضوعية. علاوة على ذلك، فإن وجود ارتباط خطي متعدد قوي بين متغيرين أو أكثر يمنح تلك المتغيرات وزناً ترجيحياً مضاعفاً في دالة حساب المسافة دون مبرر نظري، مما يستوجب فحص مصفوفة الارتباط وتطبيق أساليب تحليل المكونات الرئيسية (PCA) كإجراء تحويلي استباقي إذا لزم الأمر.
3. إعداد وهيكلة البيانات في SAS باستخدام خطوة DATA و PROC PRINT
3.1 بناء مجموعة البيانات التجريبية عبر خطوة DATA
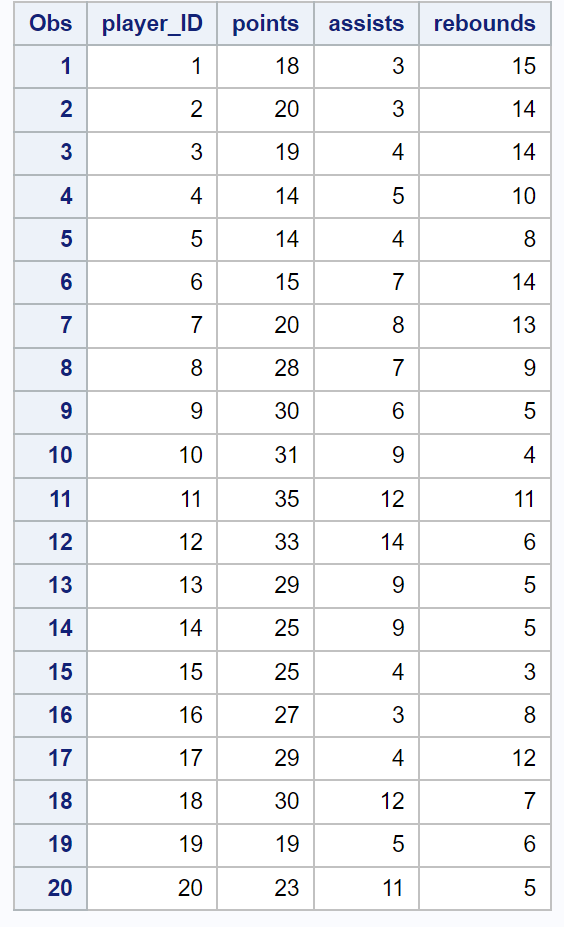
لبناء فهم تطبيقي متين لإجراء PROC CLUSTER، سنقوم بإنشاء مجموعة بيانات تجريبية تحاكي الأداء التكتيكي والبدني لعشرين لاعباً محترفاً في دوري كرة السلة للمحترفين. تتكون هذه المجموعة من ثلاثة متغيرات كمية مستمرة تمثل الأركان الأساسية لتقييم كفاءة اللاعب الميدانية: معدل النقاط المسجلة في المباراة (points)، ومعدل التمريرات الحاسمة (assists)، ومعدل المتابعات الدفاعية والهجومية للكرات المرتدة (rebounds). إضافة إلى ذلك، سنضمن متغيراً نصياً يمثل اسم اللاعب ليكون بمثابة معرّف فريد للمشاهدات داخل التحليل.
تُنفَّذ هذه الخطوة عبر لغة SAS القياسية باستخدام خطوة DATA واستدعاء تعليمة INPUT لقراءة المتغيرات، متبوعة بكتلة البيانات المباشرة DATALINES، كما يتضح في الكود البرمجي التالي:
DATA basketball_players;
   INPUT player $ points assists rebounds;
   DATALINES;
Player01 28.5  4.2  3.1
Player02 26.8  5.1  4.0
Player03 24.1  3.8  3.5
Player04 22.4  6.0  4.2
Player05 21.0  4.5  3.9
Player06 18.2  9.5  3.8
Player07 16.5  8.8  4.1
Player08 15.0 10.2  2.9
Player09 14.2  7.6  3.2
Player10 13.5  8.1  3.5
Player11 12.1  2.1 11.5
Player12 10.8  1.8 12.2
Player13 14.5  2.5 10.8
Player14  9.2  1.2 13.1
Player15 11.4  3.0  9.8
Player16 19.5  5.2  7.5
Player17 18.1  4.8  8.0
Player18 17.5  6.1  6.8
Player19  8.5  3.2  4.1
Player20  7.2  2.8  3.8
;
RUN;
تتضمن أفضل الممارسات البرمجية في محرر SAS ترتيب البيانات في أعمدة متسقة رقمياً، والحرص على استخدام المتغيرات النصية بحجم مناسب عبر وضع علامة $ خلف اسم المتغير في جملة INPUT. يعكس هذا التصميم هيكلية نموذجية لتحليل الأنماط الرياضية؛ حيث يتوقع أن تُظهر العناقيد تمايزات واضحة تعكس الأدوار الوظيفية داخل الملعب، مثل الهدافين وصناع اللعب والمدافعين.
3.2 فحص سلامة البيانات المدمجة باستخدام PROC PRINT
عقب إتمام بناء مجموعة البيانات داخل ذاكرة العمل المؤقتة (Work Library)، يتعين على المحلل فحص البيانات للتحقق من سلامة عمليات الإدخال وعدم انزياح القيم بين الأعمدة. يتحقق ذلك بتشغيل إجراء PROC PRINT البسيط لطباعة المشاهدات داخل نافذة المخرجات ومراجعتها بصرياً:
PROC PRINT DATA=basketball_players;
   TITLE "عرض أولي لبيانات أداء لاعبي كرة السلة";
RUN;
تتمثل الوظيفة التحليلية لهذه الخطوة في التحقق التام من عدم وجود قيم مفقودة (Missing Values). في خوارزميات التجميع الهرمي داخل SAS، تؤدي الملاحظة التي تحتوي على قيمة مفقودة واحدة في أي من المتغيرات المحددة في التحليل إلى استبعاد المشاهدة بالكامل من مصفوفة المسافات عبر أسلوب الحذف في الصفوف (Listwise Deletion). وقد يؤدي الحذف غير المقصود للمشاهدات إلى انخفاض غير متوقع في حجم العينة وتشويه نتائج التحليل الهرمي النهائي.
يتيح إجراء PROC PRINT التأكد من تصنيف المتغيرات الثلاثة كمتغيرات رقمية مستمرة (Numeric Variables) ومطابقتها للمتطلبات الإحصائية لحساب الفروق الهندسية. كما يقدم نظرة وصفية أولية تكشف المدى العددي التقريبي لكل متغير؛ فنرى أن النقاط تتراوح تقريباً بين 7 و28، والتمريرات الحاسمة بين 1 و10، والمتابعات بين 3 و13، وهو ما يقودنا إلى المسألة المنهجية المتعلقة بالحاجة إلى التقييس المعياري.
4. المعالجة المسبقة للبيانات والتقييس المعياري (Data Standardization)
4.1 أهمية التقييس القياسي وتأثير اختلاف وحدات القياس
يعد تباين وحدات القياس والنطاقات العددية بين المتغيرات من أكبر التحديات في تطبيق التحليل العنقودي المستند إلى المسافات الإقليدية. فإذا احتسبنا المسافة الرياضية بين لاعبين باستخدام البيانات الخام مباشرة، فإن المتغير ذو النطاق العددي الأوسع والانحراف المعياري الأكبر (مثل متغير النقاط points الذي يتراوح مداه بأكثر من 20 نقطة) سيهيمن حسابياً على مجموع الفروق المربعة في معادلة المسافة، مما يجعل المتغيرات ذات المدى المحدود (مثل التمريرات والمتابعات) عديمة التأثير عملياً في تشكيل العناقيد، بغض النظر عن أهميتها الجوهرية.
لتفادي هذا الانحياز الرياضي، تطبق عملية التقييس المعياري (Standardization)، والتي تهدف إلى تحويل المتغيرات المختلفة إلى درجات معيارية مشتركة لا بُعدية. تتم هذه العملية حسابياً عبر طرح المتوسط الحسابي للعينة ($\mu$) من كل قيمة مشاهدة ($x$) ثم قسمة الناتج على الانحراف المعياري للمتغير ($\sigma$):
$$z = \frac{x – \mu}{\sigma}$$
ينتج عن هذا التحويل متغيرات جديدة بمتوسط حسابي يساوي تماماً الصفر وبتباين وانحراف معياري يساويان الواحد الصحيح ($Mean = 0, Std = 1$). تضمن هذه المعايرة منح جميع المتغيرات وزناً متساوياً في تحديد المسافة الفاصلة بين الحالات، مما يجعل النموذج يعكس التباين النسبي لكافة السمات المقاسة دون تغليب لمتغير على آخر.
4.2 تطبيق إجراء PROC STANDARD لمعايرة المتغيرات في SAS
يوفر نظام SAS إجراءً متخصصاً لتنفيذ عمليات المعايرة المعيارية بدقة عالية وهو إجراء PROC STANDARD. يمكن كتابة وتنفيذ الكود البرمجي لإنشاء مجموعة بيانات جديدة تحتوي على المتغيرات المعايرة تمهيداً لإدخالها في التحليل العنقودي كما يلي:
PROC STANDARD DATA=basketball_players OUT=players_standardized MEAN=0 STD=1;
   VAR points assists rebounds;
RUN;
في هذا الكود، يتم توجيه البيانات المعالجة إلى جدول جديد يُدعى players_standardized مع تحديد المتوسط بالصفر والانحراف المعياري بالواحد عبر الخيارين MEAN=0 STD=1، بينما تحدد جملة VAR الأبعاد الكمية المستهدفة بالمعايرة. ويمكن التحقق من سلامة العملية الإحصائية عن طريق استدعاء إجراء PROC MEANS لمقارنة توزيع المتغيرات قبل التقييس وبعده:
PROC MEANS DATA=players_standardized MEAN STD MIN MAX;
   VAR points assists rebounds;
   TITLE "المعالم الوصفية للمتغيرات عقب التقييس المعياري";
RUN;
تجدر الإشارة إلى ميزة مهمة يوفرها إجراء PROC CLUSTER، وهي إمكانية إجراء التقييس تلقائياً داخلياً دون الحاجة لتشغيل إجراء PROC STANDARD بصورة منفصلة، وذلك عبر استخدام خيارات مدمجة في شفرة الإجراء ذاته مثل STANDARD، وهو ما يوفر مرونة برمجية واختصاراً لتدفق العمل التحليلي.
4.3 التعامل المتقدم مع القيم الشاذة والمتطرفة
تمثل القيم المتطرفة تهديداً منهجياً مباشراً لاتزان الخوارزميات الهرمية التراكمية، إذ إن وجود لاعب يسجل معدلات أداء غير واقعية مقارنة ببقية العينة قد يدفعه للبقاء كعنقود أحادي (Single-item cluster) يرفض الاندماج طوال مراحل التحليل، حتى يُجبر قسراً في الخطوة الأخيرة على الاندماج مع العنقود الأكبر، مما يشوه التباين الداخلي لذلك العنقود.
للتعامل مع هذه المشكلة المنهجية، يوصى بالاعتماد على الفحص الاستكشافي المسبق للبيانات باستخدام مخططات الصندوق (Boxplots) أو حساب المسافات الإقليدية المتطرفة. وإذا تبين أن المتغيرات تتبع توزيعات شديدة الالتواء، يمكن تطبيق تحويلات رياضية تمهيدية، كالتحويل اللوغاريتمي الطبيعي ($Log(x)$) أو تحويل الجذر التربيعي، لتلطيف الأثر التشتتي للقيم المرتفعة قبل التقييس.
في الحالات التي تثبت فيها التحليلات التشخيصية أن القيمة الشاذة ناتجة عن خطأ تجريبي أو أنها تمثل حالة فردية فريدة لا تنتمي للمجتمع البحثي المعتاد، فإن استبعادها من مجموعة البيانات يكون إجراءً مبرراً إحصائياً. يسهم استبعاد هذه الحالات في توفير شجرة تصنيفية متوازنة تعكس الأنماط العامة المشتركة بين عناصر المجتمع بصورة أكثر دقة وموثوقية.
5. الصياغة النحوية (Syntax) لإجراء PROC CLUSTER والخيارات المتاحة
5.1 البنية الأساسية للأمر والخيارات المباشرة (Options)
تتميز الصياغة البرمجية لإجراء PROC CLUSTER في SAS بالبساطة والتركيب المنطقي المباشر. يُصاغ الأمر العام للإجراء وفق النموذج البرمجي التالي:
PROC CLUSTER DATA=dataset METHOD=method options;
   VAR variables;
   ID variable;
   COPY variables;
RUN;
تحدد جملة DATA= جدول البيانات المراد إخضاعه للتحليل، في حين يحدد الخيار METHOD= الخوارزمية الرياضية المستخدمة لحساب المسافات ودمج العناقيد (مثل WARD أو AVERAGE أو COMPLETE). أما الخيار OUTTREE= فيُعد من أهم الخيارات المباشرة، حيث يقوم بتصدير جدول يوثق الشجرة الهرمية وخصائص كل اندماج بدقة، ليتم استخدامه لاحقاً في إنشاء المخططات البصرية وتحديد المجموعات.
تُستخدم جملة VAR لتحديد المتغيرات الرقمية التي ستدخل في حساب مصفوفة المسافات، ويجب التأكيد هنا على أن إدراج أي متغير غير كمي ضمن هذه الجملة سيؤدي إلى توقف تنفيذ الإجراء وظهور أخطاء برمجية في سجل النظام (SAS Log). أما جملة ID، فتسمح بتحديد متغير معرّف (مثل أسماء اللاعبين) ليظهر في جداول تاريخ التجميع وعلى أطراف مخطط الشجرة، بينما تتيح جملة COPY نقل متغيرات إضافية من الجدول الأصلي إلى جدول الشجرة دون إشراكها في حسابات المسافات العنقودية.
5.2 استخدام خيار NONORM وتأثيره على قياسات التباين
افتراضياً، يقوم إجراء PROC CLUSTER عند تطبيق عدد من خوارزميات الربط (مثل طريقة وارد) بتعديل المقاييس أو حساب مقاييس التباين استناداً إلى الانحرافات المعيارية المدمجة. وهنا يبرز دور الخيار NONORM في الصياغة البرمجية، حيث يمنع الإجراء من تطبيع أو تقييس المسافات، مجبراً الخوارزمية على استخدام المسافات الإقليدية الأصلية دون أي تعديل داخلي على التباين.
يُفضل استخدام خيار NONORM في المواقف التي يكون فيها الباحث قد أجرى تقييساً يدوياً مسبقاً بدقة عالية (مثل استخدام PROC STANDARD)، أو عندما تكون المتغيرات مقاسة في الأصل بنفس الوحدة الفيزيائية الدقيقة وذات أهمية مطلقة، كما في القياسات الهندسية بالمتر أو الجرام، حيث يكون الحفاظ على القيم المطلقة للتباين شرطاً جوهرياً لتفسير المخرجات.
في المقابل، إذا كانت المتغيرات ذات مقاييس متباينة ولم يجرِ الباحث تقييساً مسبقاً لها، فإن الامتناع عن استخدام NONORM والسماح لـ SAS بالمعالجة الافتراضية يسهم في تقليل مخاطر هيمنة متغير على آخر، على الرغم من أن الممارسة الأكاديمية الفضلى تقتضي دائماً التقييس اليدوي الواعي المسبق للتحكم الكامل في معالم البيانات.
5.3 الخيارات التقييمية المتقدمة للنموذج العنقودي
يوفر إجراء PROC CLUSTER مجموعة من المعايير الإحصائية المتقدمة التي تساعد المحلل في تحديد العدد المثالي للعناقيد، وهي إحدى أعقد المشكلات في التحليل الاستكشافي. تشمل هذه الخيارات إحصائيات تقييمية تتكامل مع بعضها لتحديد نقطة التوقف الرياضية المناسبة:
- معيار التجميع المكعب (CCC – Cubic Clustering Criterion): يُفعَّل بكتابة الخيار
CCC، ويقيس هذا المؤشر مقدار الانحراف بين تباين العناقيد المحققة وتباين متوقع افتراضي مستمد من توزيع منتظم متعدد الأبعاد. تشير القمم الإيجابية الواضحة (قيم أعلى من 2 أو 3) إلى وجود بنية عنقودية قوية ومميزة، في حين تدل القيم السالبة الحادة على غياب النمط العنقودي وتشتت البيانات عشوائياً. - إحصائية شبه مربع إف (Pseudo F Statistic): تُستدعى عبر خيار
PSEUDO، وتقيس النسبة بين التباين المفسر بين العناقيد والتباين غير المفسر داخلها. يُستدل على العدد الأمثل للعناقيد عند ظهور قمة محلية (Peak) واضحة يتبعها انخفاض مفاجئ في هذه الإحصائية. - إحصائية شبه مربع تي (Pseudo T-Squared Statistic): تدرج أيضاً عبر خيار
PSEUDO، وتقيس التغير في التباين الداخلي عند دمج آخر عنقودين. وعلى عكس إحصائية شبه F، يبحث المحلل عن قيمة منخفضة لإحصائية شبه $T^2$ تليها قفزة حادة عند خطوة الدمج التالية، مما يشير إلى أن الدمج التالي سيجمع بين مجموعتين متباينتين تماماً ويجب التوقف قبله. - خيار التحكم في المخرجات المطبوعة (PRINT=): يتيح الخيار
PRINT=nتحديد عدد أسطر تاريخ التجميع المطبوعة في التقرير النهائي، مما يسهل قراءة مخرجات العينات الكبيرة التي قد تنتج جداول تجميعية هائلة يصعب تدقيقها بالكامل.
6. طرق الربط العنقودي المتاحة في PROC CLUSTER والمقارنة بينها
6.1 طريقة وارد (Ward’s Minimum Variance Method)
تُعد طريقة وارد (المحددة عبر METHOD=WARD) الخوارزمية الأكثر انتشاراً وتفضيلاً في الأبحاث الاجتماعية والسلوكية والتطبيقية. يعتمد الأساس الرياضي لهذه الطريقة، التي ابتكرها جو هارفارد وارد عام 1963، على مبدأ تصغير التباين الإجمالي داخل العناقيد، حيث تقوم الخوارزمية في كل خطوة بحساب مجموع مربعات الانحرافات عن مركز العنقود (Error Sum of Squares – ESS)، ثم تختار دمج زوج العناقيد الذي ينتج عنه أقل زيادة ممكنة في قيمة ESS الكلية.
تتميز طريقة وارد بميلها المنهجي لإنتاج عناقيد كروية الشكل ومتساوية الحجم والكثافة تقريباً في الفضاء الرياضي، كما تظهر مقاومة ملحوظة للتشوهات العشوائية الناتجة عن التشويش، مما يجعلها أداة مستقرة لتحديد الأنماط السلوكية المتجانسة. ومع ذلك، تشترط هذه الطريقة استخدام المسافات الإقليدية المتطابقة حصراً، وتفترض ضمناً أن المجموعات الحقيقية في المجتمع تتقارب في أحجامها وكثافاتها، وهو ما قد يشكل قيداً إذا كانت العناقيد الطبيعية متداخلة أو ذات أحجام متفاوتة بدرجة كبيرة.
6.2 طرق الربط المتوسط والربط الفردي والتام (Average, Single, and Complete Linkage)
إلى جانب طريقة وارد، يوفر إجراء PROC CLUSTER مجموعة من طرق الربط الكلاسيكية، وتختلف هذه الطرق في تعريف “المسافة” الفاصلة بين عنقودين يضم كل منهما أكثر من مشاهدة واحدة:
طريقة الربط الفردي (Single Linkage – METHOD=SINGLE): وتُعرف أيضاً بطريقة الجار الأقرب (Nearest Neighbor). تُعرّف المسافة بين أي عنقودين بأنها أقصر مسافة إقليدية تفصل بين أي نقطتين تنتميان إليهما. تعاني هذه الطريقة من عيب منهجي شهير يُعرف بظاهرة “السلاسل المتصلة” (Chaining Effect)، حيث تندمج الملاحظات في سلاسل طويلة ممتدة عبر الفضاء الإحصائي دون تشكيل عناقيد متراصة، مما يحد من جدواها العملية إلا في حالات البحث عن مسارات بيانية متصلة أو كشف القيم الشاذة المنعزلة.
طريقة الربط التام (Complete Linkage – METHOD=COMPLETE): وتُعرف بطريقة الجار الأبعد (Farthest Neighbor). تُعرّف المسافة بين عنقودين على أنها أقصى مسافة تفصل بين أي زوج من المشاهدات. تؤدي هذه الخوارزمية إلى تكوين عناقيد كروية متراصة ومدمجة للغاية، وتتفوق في فصل المجموعات المتمايزة بوضوح، لكنها شديدة الحساسية للقيم المتطرفة، إذ قد تؤدي نقطة شاذة واحدة على الأطراف إلى تضخيم المسافة المحسوبة ومنع اندماج عناقيد متقاربة جوهرياً.
طريقة الربط المتوسط (Average Linkage – METHOD=AVERAGE): وتُعرف بطريقة UPGMA. تقيس المسافة بحساب متوسط كافة المسافات الثنائية بين جميع أزواج النقاط المنتمية للعنقودين، وتتميز هذه الطريقة باتزانها المنهجي، حيث تجمع بين متانة الربط التام وعدم التأثر المفرط بظاهرة السلاسل المتصلة، مما يجعلها خياراً قوياً في التصنيفات الحيوية والتصنيف المقارن.
| طريقة الربط | الرمز في SAS | الأساس الرياضي لحساب المسافة | نقاط القوة | نقاط الضعف وسياق الاستخدام |
|---|---|---|---|---|
| طريقة وارد | METHOD=WARD |
تصغير الزيادة في مجموع مربعات الخطأ (ESS) | تكوين عناقيد متجانسة ومتساوية الحجم بدقة عالية | حساسة للمسافات الإقليدية وتفترض كروية الأشكال |
| الربط الفردي | METHOD=SINGLE |
أدنى مسافة بين أي نقطتين في المجموعتين | القدرة على استكشاف العناقيد غير الخطية والقيم الشاذة | ظاهرة السلاسل المتصلة وضعف تماسك العناقيد |
| الربط التام | METHOD=COMPLETE |
أقصى مسافة بين أي نقطتين في المجموعتين | إنتاج عناقيد متراصة ومحكمة الانفصال | حساسية شديدة للقيم الشاذة عند أطراف المجموعات |
| الربط المتوسط | METHOD=AVERAGE |
متوسط كافة المسافات بين أزواج النقاط | متوازنة ومقاومة للتشوهات المفرطة في الفضاء | تميل لتقسيم العناقيد ذات التباينات غير المتساوية |
6.3 طريقة المئينات وخوارزميات الكثافة (Centroid and Density Methods)
تعتمد طريقة المركز الهندسي (Centroid Method – METHOD=CENTROID) على قياس المسافة بين المراكز الحسابية (المتوسطات متعددة الأبعاد) للعناقيد، وتتميز هذه الطريقة ببساطتها المفاهيمية وقابليتها للتطبيق في بيئات فيزيائية معينة. ومع ذلك، فإنها تنطوي على عيب رياضي خطير يُعرف بظاهرة “التراجعات” أو الانعكاسات (Reversals / Inversions). تحدث هذه التراجعات عندما تندمج نقطة مع عنقود ما، فيتحرك مركزه الهندسي الجديد ليصبح أقرب إلى عنقود ثالث من المسافة التي تم بها الدمج السابق، مما يؤدي إلى ظهور فروع متقاطعة وتراجعية في مخطط الشجرة (Dendrogram) تجعل تفسيره معقداً.
ولمعالجة أشكال البيانات المعقدة التي تفشل الطرق الهندسية القياسية في رصدها، توفر SAS طرق الكثافة غير المعلمية (Density-based methods) التي تعتمد على تقدير كثافة النواة (Kernel Density Estimation). تتيح هذه الطرق عزل البؤر الكثيفة للمشاهدات بغض النظر عن شكلها الهندسي، مما يجعلها ملائمة لتحليل الأنماط الجغرافية والخرائطية وتحديد التجمعات غير النظامية في الفضاءات الإحصائية متعددة الأبعاد.
7. التطبيق العملي: كود كامل للتحليل العنقودي لإحصائيات اللاعبين
7.1 صياغة الكود التنفيذي المتكامل في SAS
سنقوم الآن ببناء وتشغيل النموذج العنقودي الشامل باستخدام بيانات أداء لاعبي كرة السلة المعايرة مسبقاً (players_standardized)، مع تطبيق طريقة وارد لحساب التباين الأدنى وتفعيل المؤشرات التشخيصية لتحديد البنية التجميعية المثلى. يُصاغ الكود التنفيذي الكامل في SAS كما يلي:
/* تشغيل إجراء التحليل العنقودي الهرمي عبر طريقة وارد */
PROC CLUSTER DATA=players_standardized
             METHOD=WARD
             OUTTREE=work.tree_players
             CCC
             PSEUDO;
   VAR points assists rebounds;
   ID player;
RUN;
يقوم هذا الكود بتطبيق خوارزمية وارد (METHOD=WARD) على المتغيرات الرياضية المعايرة الثلاثة: النقاط والتمريرات الحاسمة والمتابعات. تم تفعيل خيار OUTTREE=work.tree_players لحفظ هيكل الشجرة التصنيفية في جدول دائم داخل مكتبة العمل، في حين تكفل الخيارات CCC و PSEUDO توليد المعايير الإحصائية التشخيصية في جدول المخرجات. كما تضمن جملة ID player ظهور الأسماء الفردية للاعبين كمعرّفات صريحة للمشاهدات أثناء مسار الاندماج.
7.2 فهم تدفق البيانات وتوليد النتائج البرمجية
عند تنفيذ هذه الشفرة البرمجية، يبدأ محرك المعالجة في SAS بقراءة جدول المدخلات وتحويل إحداثيات اللاعبين إلى مصفوفة مسافات متناظرة ذات أبعاد $20 \times 20$. تستهل الخوارزمية عملها عند المستوى الأولي مع 20 عنقوداً مستقلاً، وتشرع في دمج اللاعبين الأكثر تقارباً تكتيكياً ورقمياً وفق معيار تصغير تباين الخطأ المربع.
يتعين على المحلل متابعة سجل النظام (SAS Log) للتأكد من نجاح تنفيذ الخطوات وخلوها من رسائل التحذير (Warnings) أو الملاحظات الدالة على وجود قيم مفقودة. يُظهر السجل عادةً عدد المشاهدات المقروءة والمستخدمة، ويؤكد توليد جدول الشجرة المستهدف tree_players، والذي يحتوي على متغيرات نظامية داخلية مساعدة تشمل أسماء العناقيد المندمجة (_NAME_ و _PARENT_)، ومستوى المسافة (_HEIGHT_)، وعدد المشاهدات المنضوية في كل مرحلة (_NCL_).
8. تفسير المخرجات الإحصائية ومخطط شجرة العناقيد (Dendrogram)
8.1 قراءة جدول تاريخ التجميع العنقودي (Cluster History)
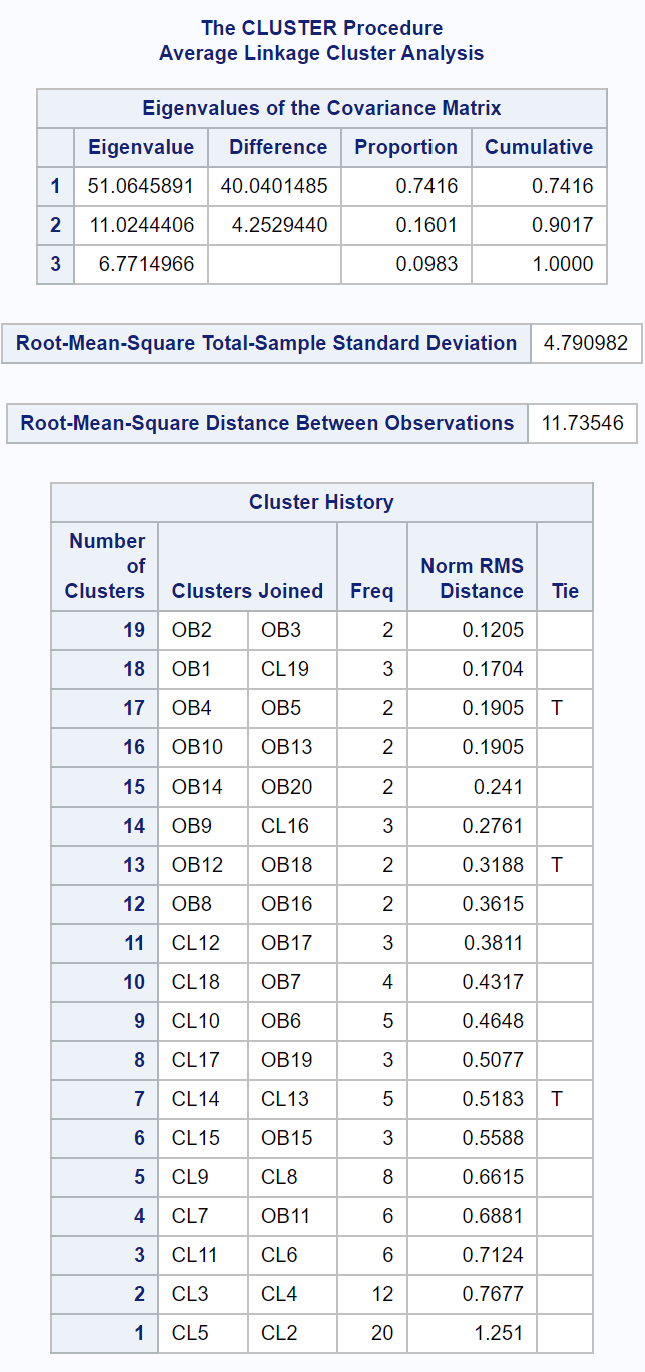
يعد جدول تاريخ التجميع العنقودي (Cluster History) النواة المركزية لمخرجات إجراء PROC CLUSTER، حيث يوثق التسلسل الزمني لعمليات الدمج من 20 عنقوداً وصولاً إلى العنقود الواحد النهائي. يتضمن الجدول مجموعة من الأعمدة الإحصائية الرئيسية:
- عدد العناقيد (Number of Clusters – NCL): يشير إلى عدد المجموعات المتبقية في العينة الإحصائية عقب إتمام خطوة الدمج الحالية، ويتدرج من $N-1$ (أي 19 في مثالنا) وصولاً إلى 1.
- العناقيد المندمجة (Clusters Joined): يوضح أسماء الحالات أو العناقيد التي اتحدت في تلك الخطوة. فعند اندماج لاعبين فرديين للمرة الأولى تظهر أسماؤهما المحددة في جملة
ID، أما عندما تندمج حالة مع عنقود سابق أو يندمج عنقودان، يطلق النظام مسميات جديدة مثلCL19للدلالة على العنقود المتشكل عند مستوى 19 عنقوداً. - التكرار (Frequency): يوضح العدد الإجمالي للمشاهدات المنضوية تحت العنقود الجديد المشكل، ويبدأ بقيمة 2 لأول دمج ويتزايد تصاعدياً حتى يبلغ حجم العينة الكلي (20) في الخطوة الختامية.
- المسافة المقيسة (Normalized Distance Measure): تعكس قيمة المسافة الفاصلة أو مقدار التباين المضاف إلى النموذج نتيجة الدمج، وتشهد هذه المسافة تزايداً تدريجياً بطيئاً في المراحل المبكرة، يعقبه تباعد حاد وقفزات رقمية واسعة عند إجبار مجموعات متمايزة جوهرياً على الاندماج في الخطوات الأخيرة.
8.2 تحليل المؤشرات التشخيصية لتحديد عدد العناقيد
يتطلب تحديد العدد المثالي للمجموعات العنقودية فحصاً متكاملاً للمؤشرات التشخيصية الثلاثة المولدة في جدول تاريخ التجميع، وذلك بالاستناد إلى القواعد المنهجية التالية:
1. قراءة معيار التجميع المكعب (CCC): نبحث في الجدول عن أعلى قيمة موجبة يبلغها المؤشر قبل أن يبدأ في الانخفاض. فإذا أظهر المؤشر ذروة واضحة عند الانتقال من 4 إلى 3 عناقيد تبلغ قيمتها مثلاً (3.42) ثم تنحدر بعد ذلك، فإن هذا يعد مؤشراً قوياً على أن تقسيم المجتمع إلى ثلاثة عناقيد يمثل البنية التجميعية الأكثر استقراراً وقوة مقارنة بالبيانات العشوائية.
2. رصد إحصائية شبه مربع إف (Pseudo F): تعمل هذه الإحصائية كمعيار لمدى جودة الفصل بين العناقيد؛ إذ تشير القمم المحلية الواضحة للإحصائية (Local Peaks) إلى تمايز متقدم بين المجموعات. فإذا سجلت الإحصائية قيمة مرتفعة عند المستوى 3 (مثلاً: 24.8) تلاها تراجع حاد عند المستوى 2، فإن النقطة المثلى للتقطيع تكمن عند 3 عناقيد.
3. تتبع إحصائية شبه مربع تي (Pseudo T-Squared): نبحث في هذا العمود عن “قفزة حادة ومفاجئة” في القيمة الرقمية. إذا كانت قيمة شبه $T^2$ منخفضة نسبياً عند الانتقال إلى 3 عناقيد (مثلاً: 4.1)، ثم قفزت قفزة عنيفة لتصل إلى (18.6) عند محاولة الانتقال إلى عنقودين، فإن هذه القفزة تشير إلى أن الخطوة التالية ستدمج مجموعتين متباعدتين للغاية، مما يستدعي التوقف فوراً عند مستوى العناقيد الثلاثة لتجنب دمج عناصر غير متجانسة.
8.3 رسم وتفسير مخطط الشجرة العنقودية عبر PROC TREE
يعد المخطط الشجري (Dendrogram) الأداة البصرية الأهم لتجسيد نتائج التحليل الهرمي وقراءة تدرجات الدمج. ولتوليد هذا المخطط وتقطيع الشجرة عند العدد المستهدف من العناقيد وحفظ النتائج في جدول جديد، نستخدم إجراء PROC TREE مستندين إلى مخرجات tree_players:
/* رسم مخطط الشجرة وتصدير التصنيف النهائي لـ 3 عناقيد */
PROC TREE DATA=work.tree_players
          OUT=work.player_clusters
          NCLUSTERS=3;
   ID player;
RUN;
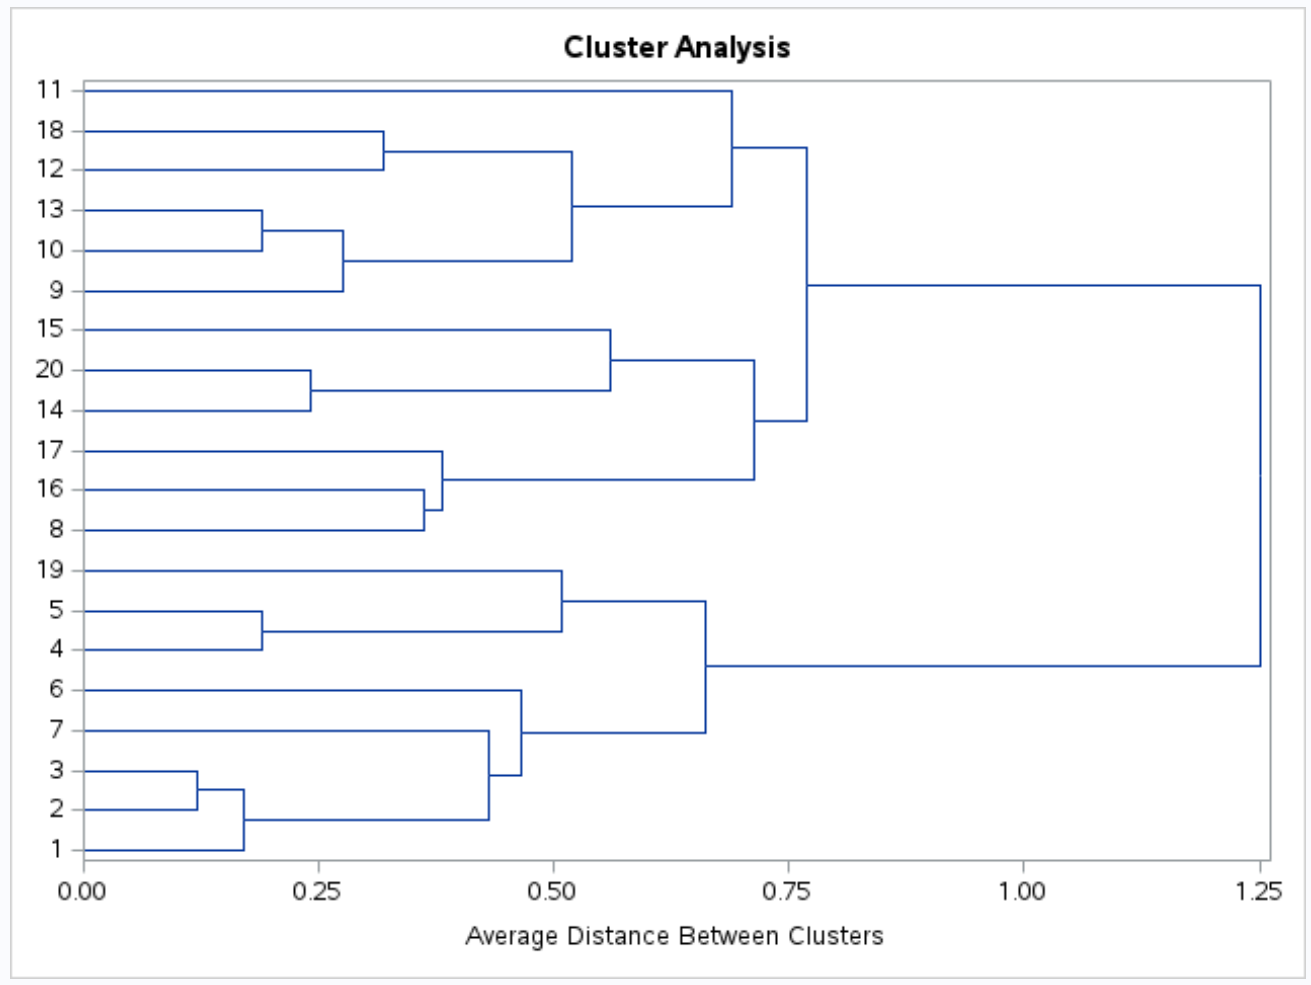
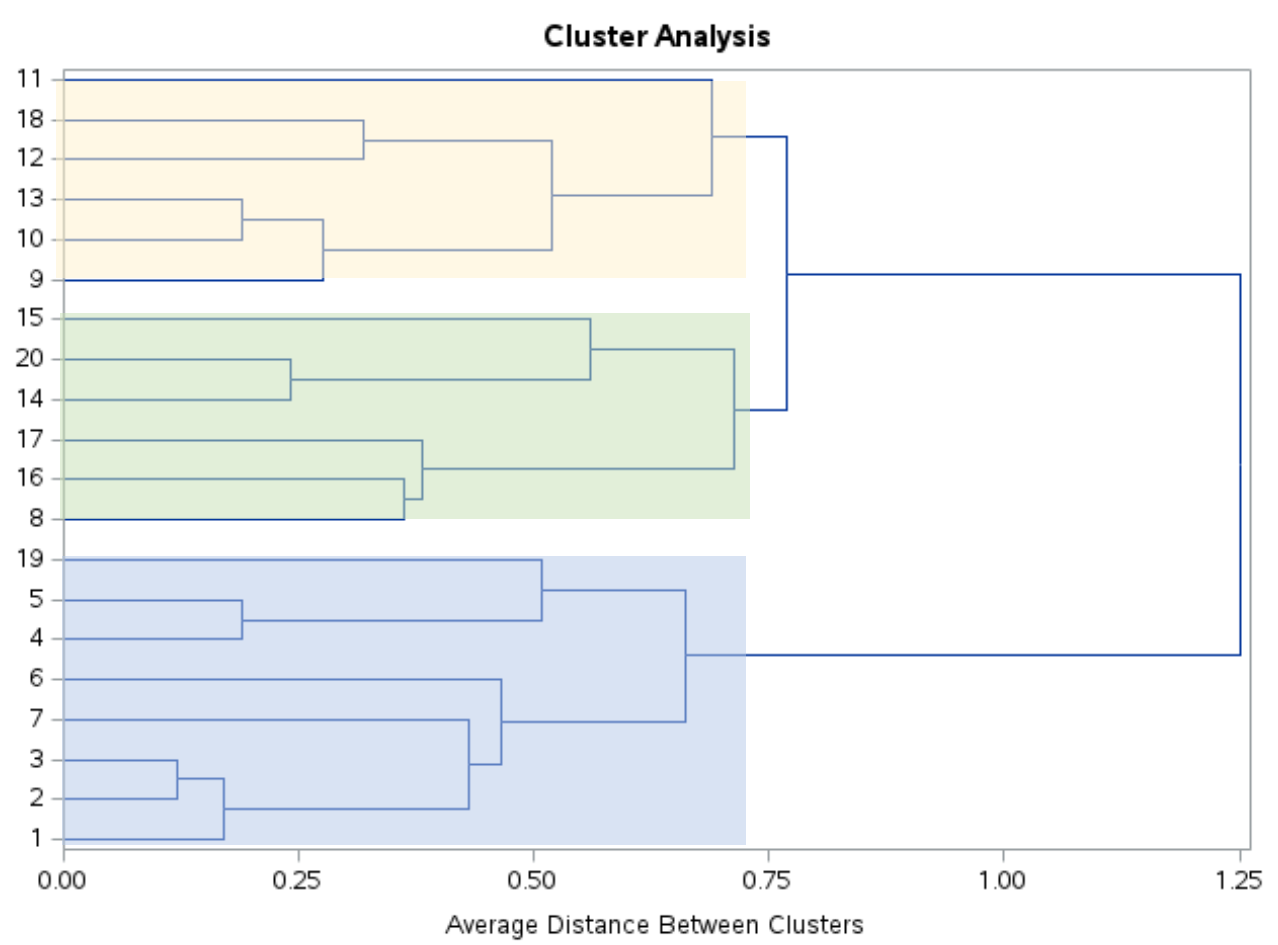
يولد هذا الإجراء رسماً بیانياً أفقياً، حيث يمثل المحور الرأسي أسماء الحالات والمشاهدات الفردية، بينما يمثل المحور الأفقي مستوى المسافة أو عدم التشابه الذي تم عنده الاندماج. ترمز الفروع المتصلة إلى مسارات الاتحاد المتتالية؛ فالخطوط التي تتحد بالقرب من قاعدة الشجرة (اليسار) تعكس مشاهدات متطابقة تقريباً، في حين تعكس التفرعات الممتدة نحو اليمين مستويات دمج أعلى في التباين.
يشير تحديد NCLUSTERS=3 في الكود إلى تمرير خط قطع تخيلي رأسي يمر عبر الشجرة عند الموضع الذي يتقاطع فيه مع ثلاثة فروع رئيسية فقط، ويقوم الإجراء تلقائياً بإنشاء جدول جديد يُدعى player_clusters يتضمن متغيراً تصنيفياً جديداً اسمه CLUSTER يُسند لكل لاعب رقماً يحدد العنقود الذي استقر فيه (1 أو 2 أو 3).
9. استخراج وتوصيف المجموعات العنقودية وتفسير سماتها
9.1 دمج تصنيفات العناقيد مع مجموعة البيانات الأصلية
عقب استخراج جدول المجموعات player_clusters من إجراء PROC TREE، تكون الخطوة التحليلية اللاحقة هي دمج هذا التصنيف الجديد مع مجموعة البيانات الأصلية غير المعايرة (basketball_players). تتيح هذه الخطوة دراسة خصائص المجموعات استناداً إلى الأرقام والوحدات الفيزيائية الأصلية (النقاط والتمريرات والمتابعات الفعلية)، مما يسهل التفسير العملي للنتائج بعيداً عن تجريد القيم المعيارية.
يتحقق هذا الدمج برمجياً عبر ترتيب الجدولين أولاً بواسطة معرف اللاعب player، ثم تنفيذ خطوة الدمج MERGE داخل خطوة DATA:
/* ترتيب البيانات الأصلية تمهيداً للدمج */
PROC SORT DATA=basketball_players;
   BY player;
RUN;

/* ترتيب بيانات العناقيد المستخرجة */
PROC SORT DATA=work.player_clusters;
   BY player;
RUN;

/* دمج التصنيف العنقودي مع البيانات الأصلية */
DATA final_clustered_players;
   MERGE basketball_players work.player_clusters;
   BY player;
RUN;
تنتج عن هذه العملية مجموعة بيانات متكاملة تحتوي على المعرف الفردي player، والمتغيرات الأصلية الثلاثة، بالإضافة إلى المتغير التصنيفي CLUSTER الذي يعبر عن الهوية الرياضية والوظيفية لكل لاعب ضمن الهيكل المستخرج.
9.2 حساب المعالم الإحصائية الوصفية لكل عنقود باستخدام PROC MEANS
لتوصيف المجموعات وفهم السمات الإحصائية المميزة لكل عنقود، نطبق إجراء PROC MEANS لحساب المتوسطات الحسابية والانحرافات المعيارية والمدى لكل متغير كمي مقسمة بحسب فئات العنقود الجديد، عبر جملة CLASS CLUSTER:
/* حساب المعالم الإحصائية التفصيلية لكل عنقود */
PROC MEANS DATA=final_clustered_players MEAN STD MIN MAX MAXDEC=2;
   CLASS CLUSTER;
   VAR points assists rebounds;
   TITLE "الملف الوصفي لسمات العناقيد الرياضية المستخرجة";
RUN;
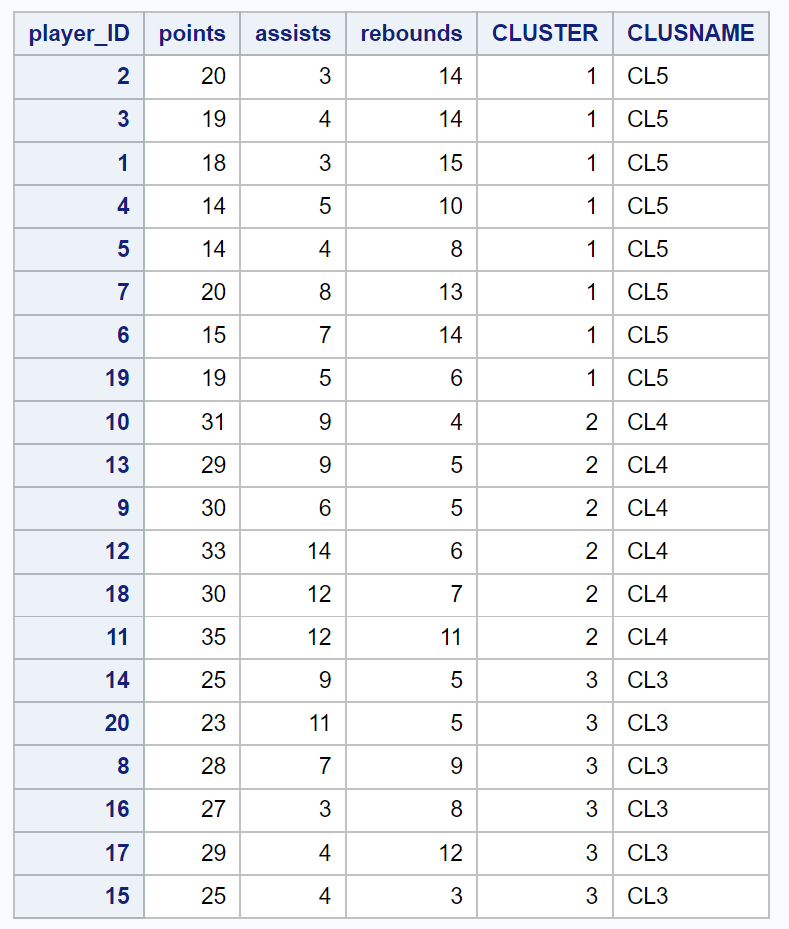
تسمح مخرجات هذا الإجراء ببناء “مصفوفة السمات المميزة” (Profile Matrix)؛ حيث يتم فحص التباين الداخلي لكل متغير ومقارنة متوسطاته عبر المجموعات المختلفة، كما يتيح التحقق من انخفاض الانحراف المعياري داخل العنقود الواحد مقارنة بالانحراف المعياري الإجمالي للعينة، وهو ما يؤكد تماسك العناصر وتجانس أدائها التكتيكي الداخلي.
9.3 التفسير العملي والموضوعي لطبيعة العناقيد المستخرجة
بتحليل المتوسطات الحسابية الناتجة عن مخرجات PROC MEANS لبيانات لاعبي كرة السلة العشرين، تبرز ثلاثة أنماط وظيفية وتكتيكية واضحة تعكس التمايز الميداني للاعبين:
- العنقود الأول (الهدافون الميدانيون – Pure Scorers): يضم هذا العنقود اللاعبين (من Player01 إلى Player05)، ويتميز بمعدل تسجيل نقاط استثنائي يتجاوز 24 نقطة في المباراة، مع معدلات تمرير ومتابعات متوسطة إلى منخفضة. يمثل هذا العنقود المهاجمين الأساسيين الذين تتركز مهمتهم الرئيسية في إنهاء الهجمات وهز الشباك.
- العنقود الثاني (صناع اللعب – Elite Playmakers): يضم اللاعبين (من Player06 إلى Player10)، ويتسم بمعدلات مرتفعة جداً في التمريرات الحاسمة تتجاوز 8 تمريرات في المباراة الواحدة، مع تسجيل متوازن للنقاط (حوالي 15 نقطة) ومتابعات محدودة. يعبر هذا العنقود بوضوح عن حراس وموزعي الكرات المنوط بهم إدارة الإيقاع وصناعة الفرص لبقية الفريق.
- العنقود الثالث (المدافعون ولاعبو الارتكاز – Rim Protectors & Rebounders): يضم اللاعبين (من Player11 إلى Player15)، وينفرد بمعدل متابعات دفاعية وهجومية مرتفع يتجاوز 11 متابعة في اللقاء، مقابل إنتاجية هجومية محدودة وتمريرات حاسمة منخفضة. يمثل هذا العنقود خط الارتكاز الدفاعي المسؤول عن حماية السلة واستعادة الكرات المرتدة.
أما اللاعبون المتبقون (من Player16 إلى Player20)، فيتوزعون بين هذه العناقيد الثلاثة وفق اقترابهم النسبي من تلك الأنماط الرئيسية. يوضح هذا التفسير التطبيقي كيف نجح التحليل العنقودي وإجراء PROC CLUSTER في ترجمة مصفوفات الأرقام المجردة إلى رؤى تكتيكية واقعية تدعم المدربين وصناع القرار الرياضي في توزيع الأدوار وبناء الخطط التنافسية المتوازنة.
10. تقييم جودة النموذج، التحقق المتقاطع، وأفضل الممارسات في SAS
10.1 تقييم ثبات واستقرار العناقيد (Cluster Stability & Validation)
لا تتوقف المهمة التحليلية عند استخراج العناقيد وتوصيف معالمها الوصفيّة، بل تقتضي المنهجية العلمية التحقق من ثبات واستقرار هذا التصنيف (Cluster Stability). نظراً لأن الخوارزميات العنقودية الاستكشافية قد تلتقط أحياناً تجمعات عشوائية ناجمة عن خصوصية العينة المختارة، فإن اختبار متانة البنية المستخرجة يعد خطوة حاسمة لضمان موثوقية النتائج.
تتمثل إحدى التقنيات المتقدمة المتبعة في إعادة أخذ العينات المعشاة (Bootstrapping)، حيث يتم سحب عينات فرعية متكررة من المجتمع الأصلي وإعادة تطبيق التحليل العنقودي عليها لقياس درجة استقرار التوزيعات الناتجة وتكرار ظهور نفس الأنماط. كما يوصى بإجراء تحليل الحساسية المنهجي (Sensitivity Analysis) من خلال إعادة تشغيل النموذج باستخدام طرق ربط بديلة مثل الربط المتوسط (METHOD=AVERAGE) ومقارنة مصفوفة التوافق التصنيفي؛ فإذا أظهرت الطرق المختلفة توافقاً كبيراً في توزيع المشاهدات، تعززت الثقة في كون العناقيد تمثل بنية واقعية كامنة في البيانات وليست مجرد تشوه ناتج عن خوارزمية بعينها.
بالإضافة إلى ذلك، يمكن تقييم التماسك الداخلي والخارجي عبر حساب معاملات التباعد مثل معامل العزل الظلي (Silhouette Coefficient)، والذي يقيس مدى اقتراب كل نقطة من عناصر عنقودها مقارنة بأقرب عنقود مجاور. وتساعد هذه المقاييس في تفادي مشكلة الإفراط في تقسيم البيانات (Over-clustering) وتجنب الدمج المفرط (Under-clustering) الذي قد يؤدي إلى فقدان التمايز بين المجموعات الفرعية.
10.2 أفضل الممارسات البرمجية والتحليلية المتقدمة في SAS
يتطلب الاستخدام المتقدم لإجراء PROC CLUSTER في بيئات العمل التحليلية الاحترافية تبني ممارسات برمجية ترفع من كفاءة المعالجة وتضمن دقة النتائج، ومن أبرز هذه الممارسات:
- أتمتة اختيار العناقيد عبر ماكرو SAS: يمكن تطوير برمجيات ماكرو (SAS Macro Facility) لأتمتة فحص قيم معيار
CCCوإحصائيات شبهFوشبهT^2، بحيث يقوم النظام تلقائياً برصد القمم والانحدارات واقتراح القيمة العددية الأنسب للتقطيع دون الحاجة للمراجعة البصرية اليدوية المطولة في قواعد البيانات الضخمة. - الانتقال إلى خوارزميات التجميع السريعة عند تضخم البيانات: عندما يتجاوز حجم العينة عدة آلاف من المشاهدات، تصبح الحسابات الهرمية التراكمية في
PROC CLUSTERمستهلكة للذاكرة التشغيلية، حيث يتطلب بناء مصفوفة المسافات فضاءً حوسبياً ينمو تربيعياً بمعدل $O(N^2)$. في هذه الحالات، يُفضل استخدام خوارزمية مختلطة: البدء بتشغيلPROC FASTCLUSلتقليص آلاف الحالات إلى بضع مئات من المراكز الأولية، ثم تطبيقPROC CLUSTERعلى تلك المراكز لبناء الشجرة الهرمية بكفاءة وسرعة عالية. - التثبيت عبر التحليل التمييزي: يُعد دمج التحليل العنقودي الهرمي مع التحليل التمييزي الخطي (عبر إجراء
PROC DISCRIM) ممارسة شائعة؛ حيث تُستخدم العناقيد المستخرجة كفئات مستهدفة في نموذج تمييزي لتقييم مدى دقة الفصل بين المجموعات وتحديد المتغيرات الأكثر مساهمة في التفريق بينها، فضلاً عن بناء دالة تنبؤية لتصنيف المشاهدات المستقبلية الجديدة.
10.3 الأخطاء الشائعة أثناء استخدام PROC CLUSTER وكيفية معالجتها
يقع بعض الباحثين ومحللي البيانات في أخطاء منهجية وبرمجية أثناء تطبيق إجراء PROC CLUSTER، وقد تؤدي هذه العثرات إلى استنتاجات خاطئة تماماً. يلخص الجدول التالي أبرز هذه الأخطاء الميدانية وكيفية تلافيها ومعالجتها بطرق إحصائية رصينة:
| الخطأ المنهجي أو البرمجي | الأثر الإحصائي المترتب | طريقة المعالجة السليمة |
|---|---|---|
| إهمال التقييس المعياري للمتغيرات | هيمنة المتغيرات ذات القيم الكبيرة وتهميش المتغيرات ذات المقاييس الصغيرة | استخدام PROC STANDARD مسبقاً أو تفعيل التقييس الداخلي في الإجراء |
| الاعتماد الحصري على فحص الشجرة بصرياً | اختيار تعسفي لعدد المجموعات وتفضيل حلول غير مستقرة إحصائياً | الدمج بين القراءة البصرية والمؤشرات الموضوعية (CCC و Pseudo F و Pseudo T-Square) |
| تجاهل تأثير القيم الشاذة والمتطرفة | تشكل عناقيد أحادية زائفة وتشتت التباين الداخلي للعناقيد الحقيقية | فحص البيانات مسبقاً عبر PROC UNIVARIATE واستبعاد أو تحويل القيم الشاذة |
| إدراج متغيرات ذات ارتباط خطي متعدد قوي | مضاعفة الوزن النسبي للمتغيرات المرتبطة وتشويه المسافة الإقليدية | فحص مصفوفة الارتباط وتطبيق تحليل المكونات الرئيسية (PCA) عند الحاجة |
| سوء معالجة القيم المفقودة | حذف تلقائي للمشاهدات من التحليل وانخفاض غير مخطط في حجم العينة | تدقيق السجلات واستخدام تقنيات التعويض الإحصائي (Imputation) المناسبة قبل التحليل |
خاتمة
يمثل إجراء PROC CLUSTER في نظام SAS أداة إحصائية متطورة لتنفيذ التحليل العنقودي الهرمي التراكمي واستكشاف البنى الكامنة في البيانات متعددة الأبعاد. ومن خلال استناده إلى خوارزميات رياضية دقيقة مثل طريقة وارد والربط المتوسط، يمنح الإجراء الباحثين والخبراء القدرة على تحويل التوزيعات الرقمية المشتتة إلى مجموعات متجانسة ومفهومة تدعم اتخاذ القرارات الموضوعية في مختلف المجالات البحثية والتطبيقية.
وقد أظهر التطبيق العملي على بيانات لاعبي كرة السلة كيف يسهم التقييس المعياري السليم واختيار المتغيرات المناسبة في بناء نموذج عنقودي متزن يفرز الأنماط السلوكية بدقة، كما أبرز التحليل أهمية الاعتماد على المؤشرات التشخيصية الصارمة (CCC و Pseudo F و Pseudo T-Squared) بالتكامل مع مخططات الشجرة عبر PROC TREE لتحديد العدد الأمثل للعناقيد دون اللجوء إلى التقديرات الذاتية.
ختاماً، يتطلب النجاح في استخدام التحليل العنقودي فهماً متكاملاً يجمع بين المعرفة بالأسس الرياضية للخوارزميات والخبرة البرمجية في كتابة الشفرات وإدارتها داخل بيئة SAS، فضلاً عن الفهم الموضوعي لطبيعة المشكلة قيد الدراسة. يضمن هذا التكامل العلمي حماية النماذج من التفسيرات المضللة ويجعل من التحليل العنقودي أداة بحثية فاعلة للتنقيب عن المعرفة وتفسير الظواهر الإحصائية المعقدة.
المراجع
- Johnson, S. C. (1967). Hierarchical clustering schemes. Psychometrika, 32(3), 241–254. https://doi.org/10.1007/BF02289588
- Milligan, G. W., & Cooper, M. C. (1985). An examination of procedures for determining the number of clusters in a data set. Psychometrika, 50(2), 159–179. https://doi.org/10.1007/BF02294245
- SAS Institute Inc. (2020). SAS/STAT 15.2 User’s Guide: The CLUSTER Procedure. Cary, NC: SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
- Sneath, P. H., & Sokal, R. R. (1973). Numerical Taxonomy: The Principles and Practice of Numerical Classification. W. H. Freeman and Company.
- Ward, J. H. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845