
تُعد عملية استدلال البيانات الإحصائية في العلوم الإنسانية والاجتماعية، وفي مقدمتها علم النفس والعلوم السلوكية، الركيزة الأساسية التي يُبنى عليها الانتقال المنهجي من مجرد ملاحظة الظواهر الفردية إلى صياغة التعميمات العلمية الرصينة. ولا يقتصر البحث السيكولوجي الرصين على جمع الدرجات ورصد الاستجابات الميدانية، بل يتطلب إخضاع هذه البيانات لاختبارات فروض صارمة تكشف عما إذا كانت الفروق المرصودة تعكس أثراً حقيقياً وتغيراً جوهرياً في البنية النفسية، أم أنها مجرد تباينات عشوائية وليدة الصدفة وتقلبات المعاينة غير المنضبطة. ويمثل اختبار T واشتقاق القيمة الاحتمالية المرتبطة به جوهر هذا المسار الاستدلالي، إذ يمنح الباحثين أداة رياضية كمية لتقييم مصداقية الفرضيات التفسيرية.
وعلى الرغم من الهيمنة المطلقة للحزم البرمجية الحديثة مثل SPSS وR ومكتبات Python الإحصائية، والتي باتت تستخرج النتائج المعقدة بضغطة زر واحدة، فإن الاعتماد الأعمى على هذه المخرجات الرقمية دون إدراك عميق للمسار الرياضي الداخلي يوقع العديد من الباحثين في فخ التفسيرات المضللة والخلط المفاهيمي بين الدلالة الإحصائية والدلالة العملية. إن الحساب اليدوي للقيمة الاحتمالية انطلاقاً من معادلة اختبار T، مروراً بحساب الخطأ المعياري ودرجات الحرية، وصولاً إلى استنطاق جداول التوزيع التكراري واستخدام تقنيات الاستيفاء الخطي، يمثل الأساس الأكاديمي الحقيقي الذي يبني الحدس الرياضي للباحث، ويحصنه ضد أخطاء الإدخال، ويعيد ربطه بجذور النظرية الاحتمالية التي أرساها رواد الإحصاء عبر التاريخ.
يهدف هذا الدليل المرجعي الموسع إلى تفكيك خطوات حساب القيمة الاحتمالية (P-Value) يدوياً من اختبار T للعينة الواحدة بدقة متناهية، من خلال استعراض الأسس الإبستمولوجية والتطبيقية للاختبار، وتوضيح كيفية صياغة الفرضيات، وإجراء العمليات الحسابية خطوة بخطوة، ثم التعامل مع الجداول الإحصائية وتطويع تقنية الاستيفاء الخطي لتجاوز قيود المجالات الاحتمالية الواسعة. سنصحبك في رحلة منهجية شاملة، معززة بسيناريو عملي تطبيقي مستمد من بيئات القياس النفسي والإكلينيكي، لتتعلم كيف تستنطق الأرقام بحرفية أكاديمية واثقة وتوثق مخرجاتك وفق أحدث المعايير الدولية المعمول بها في النشر العلمي.
1. الأسس النظرية للقيمة الاحتمالية واختبار T في البحوث النفسية
1.1 المفهوم الإحصائي للقيمة الاحتمالية (P-Value)
تُعرّف القيمة الاحتمالية (P-Value) في الإحصاء الاستدلالي بأنها احتمالية الحصول على نتائج تجريبية مساوية للنتائج الملاحظة في العينة أو أكثر تطرفاً منها، بافتراض أن الفرضية الصفرية صحيحة تماماً في مجتمع الدراسة الأصلي. إنها مقياس رياضي دقيق يعبر عن مدى التنافر أو عدم الاتساق بين البيانات التي رصدها الباحث في الميدان وبين النموذج الرياضي الذي يفترض غياب أي تأثير أو فارق جوهري. ومن ثم، فإن القيمة الاحتمالية ليست مؤشراً على احتمالية صحة الفرضية البديلة، ولا تعبر عن احتمال كون الفرضية الصفرية خاطئة، بل هي تقييم مشروط لفرصة ظهور شذوذ إحصائي في المشاهدات تحت مظلة الصدفة المحضة.
وتؤدي القيمة الاحتمالية دوراً حاسماً كمعيار لاتخاذ القرار الإحصائي والتحقق من صحة الفرضيات العلمية؛ إذ يستند إليها الباحث في رفض الفرضية الصفرية أو الإخفاق في رفضها. وهنا يبرز تفريق دقيق وضروري بين القيمة الاحتمالية ومستوى الدلالة الإحصائية المحدد مسبقاً، والمعروف برمز (ألفا $\alpha$). فمستوى ألفا يمثل العتبة المعيارية أو سقف المخاطرة الذي يقبله الباحث مقدماً للوقوع في الخطأ، في حين أن القيمة الاحتمالية هي قيمة متغيرة ومحسوبة مباشرة من واقع البيانات الفعلية للعينة المستهدفة. المقارنة الصارمة بين هاتين القيمتين هي المحرك الحسابي الذي يحسم قبول أو دحض الفرضية الصفرية.
تتضح الأهمية الإبستمولوجية لفهم المعنى الرياضي للقيمة الاحتمالية في تجنيب الباحثين الوقوع في المغالطات التفسيرية الشائعة التي تعصف بمصداقية الدراسات الإنسانية. ومن أبرز هذه المغالطات الاعتقاد الخاطئ بأن القيمة الاحتمالية المنخفضة جداً تعني بالضرورة وجود أثر علاجي أو نفسي هائل على أرض الواقع، أو أن القيمة الاحتمالية تقيس حجم الظاهرة المدروسة مباشرة. إن إدراك الطبيعة المشروطة لهذا الرقم الرياضي يمكن الباحث من التمييز الواعي بين الإثبات الإحصائي البحت والبرهان العلمي الموضوعي في دراسة السلوك الإنساني المتشابك.
1.2 طبيعة اختبار T وتوزيع ستيودنت التكراري
تعود الجذور التاريخية لتطوير توزيع ستيودنت التكراري (Student’s t-distribution) إلى عام 1908، حين نشر العالم والكيميائي البريطاني ويليام سيلي جوسيت (William Sealy Gosset) ورقته التأسيسية الشهيرة بعنوان “The Probable Error of a Mean” في دورية Biometrika. كان جوسيت يعمل كيميائياً وإحصائياً في مصنع جينيس للبيرة في دبلن، وكانت سياسة الشركة تمنع موظفيها منعاً باتاً من نشر أي بحوث علمية حمايةً لأسرارها الصناعية وجودة خمائرها والشعير المستخدم، مما دفعه إلى استخدام الاسم المستعار “Student”. جاء إنجازه الرياضي لمعالجة معضلة كبرى كانت تواجه الباحثين عند التعامل مع العينات الصغيرة حيث يكون التباين في المجتمع مجهولاً تماماً.
يتميز منحنى توزيع T بخصائص هندسية فريدة تجعله يختلف عن منحنى التوزيع الطبيعي المعياري (منحنى Z). ورغم أن كلا التوزيعين متماثل تماماً ولهما شكل ناقوسي يتوسطه الصفر، فإن توزيع T يتميز بتسطح قمته النسبية وامتلاكه أطرافاً أكثر سماكة (Heavy Tails)، وهو ما يعرف رياضياً بالتفرطح ذي الذيل الثقيل. هذه السماكة الإضافية في أطراف المنحنى تمنح الاختبار مرونة أعلى، وتأخذ في الحسبان حالة عدم اليقين المتزايدة والخطأ الإضافي الناجم عن تقدير الانحراف المعياري للمجتمع بالاعتماد فقط على بيانات عينة صغيرة الحجم.
يتطلب استخدام اختبار T استيفاء مجموعة صارمة من الشروط المنهجية لضمان سلامة الاستدلال: أولها اعتدالية التوزيع للمتغير التابع في المجتمع الإحصائي؛ وثانيها عشوائية اختيار أفراد العينة واستقلال مشاهداتهم تماماً عن بعضها البعض؛ وثالثها أن يكون مستوى قياس المتغير التابع كمياً فئوياً أو نسبياً. وتتعدد تطبيقات اختبار T في البحوث النفسية والسلوكية بصورة واسعة، حيث يُستخدم لمقارنة مستويات القلق والاكتئاب أو زمن الرجع المعرفي أو قياس الرضا المهني والفاعلية الذاتية قبل وبعد تطبيق برامج التدخل العلاجي.
1.3 أهمية الحساب اليدوي في العصر الرقمي
في عصر الحوسبة المتقدمة والذكاء الاصطناعي، قد يبدو الحساب اليدوي للاختبارات الإحصائية ضرباً من التكلف غير الضروري، إلا أن الحقيقة المنهجية تؤكد أن الحساب اليدوي هو السبيل الوحيد لبناء حدس رياضي متقدم وإدراك عميق للميكانيزمات الخفية التي تنفذها البرمجيات المعقدة خلف شاشاتها. حين يقوم الباحث بحساب التباينات والأخطاء المعيارية بيده خطوة بخطوة، يتشكل لديه فهم حسي لطبيعة الأرقام وكيف تتفاعل مع بعضها لتنتج الدلالة الإحصائية، مما يجعل تفسيره للمخرجات أكثر عمقاً وأصالة من مجرد نقل لقيم جاهزة تفرزها الخوارزميات.
علاوة على ذلك، يمنح الحساب اليدوي الباحث قدرة فائقة على اكتشاف الأخطاء البرمجية ومدخلات البيانات غير المنطقية. فالباحث الذي يفهم ميكانيكا اختبار T يستطيع بنظرة فاحصة للمتوسطات والانحرافات المعيارية وأحجام العينات أن يدرك استحالة حصول قيمة T معينة أو شذوذ قيمة الخطأ المعياري، وهو ما يفوت على مستخدم البرمجيات الذي يثق ثقة عمياء في صحة كل ما يخرجه الحاسوب دون التحقق من مطابقة المدخلات للواقع الرياضي والمنهجي السليم.
وأخيراً، يُعزز التمكن من هذه الحسابات القدرة التحليلية والنقدية للأكاديمي عند تقييم المنشورات العلمية في المجلات المحكمة؛ إذ تقع العديد من الدراسات المنشورة في أخطاء مطبعية أو حسابية في الجداول والتقارير الإحصائية. فالقدرة على مراجعة إحصائية T ودرجات الحرية والقيمة الاحتمالية المقابلة يدوياً تتيح للباحث التحقق من دقة الأبحاث التي يستند إليها في تأطير دراساته، مما يرتقي بجودة الإنتاج الأكاديمي ويحصنه ضد الاستشهادات الهشة.
2. صياغة الفرضيات الإحصائية وتحديد معالم القياس
2.1 بناء الفرضية الصفرية والفرضية البديلة
تبدأ الرحلة الإجرائية لأي اختبار إحصائي من الصياغة الدقيقة للفرضيات، حيث تنقسم إلى فرضية صفرية ($H_0$) وفرضية بديلة ($H_1$). تفترض الفرضية الصفرية عدم وجود أي أثر أو فرق حقيقي بين متوسط العينة ومتوسط المجتمع المرجعي، وتُصاغ رياضياً بافتراض المساواة التامة ($\mu = \mu_0$). وتُمثل هذه الفرضية الأساس المحايد الذي تنطلق منه الاختبارات المعلمية، حيث يُفترض ثبات الوضع الراهن حتى تثبت الأدلة التجريبية والبيانات المجمعة عدم منطقية هذا الثبات بمستوى احتمالي مقنع.
في المقابل، تمثل الفرضية البديلة التفسير المستهدف بالبحث، وتأتي إما بصيغة موجهة (Directional) تحدد اتجاه الفرق كأن يفترض الباحث زيادة أو نقصاناً في المتغير التابع، أو غير موجهة (Non-directional) تفترض وجود فرق مطلق دون تحديد اتجاهه ($\mu \neq \mu_0$). يرتبط هذا الاختيار ارتباطاً عضوياً بالتنظير السابق؛ فإذا توافرت أدبيات رصينة تدعم تحسناً حتمياً أو تراجعاً متوقعاً في القياس، فإن الباحث يصيغ فرضية موجهة، أما في غياب التوجه الواضح أو في البحوث الاستكشافية فإن الفرضية غير الموجهة تصبح الخيار المنهجي الحتمي.
على سبيل المثال، في دراسات علم النفس الإكلينيكي التي تفحص فاعلية برنامج علاجي جديد لخفض أعراض الاكتئاب المقاسة بمقياس هاملتون، مثلما ورد في تصنيفات القياس الإكلينيكي الشهيرة (Hamilton, 1960)، فإن الفرضية الصفرية تنص على أن متوسط درجات المرضى بعد البرنامج لا يختلف عن المتوسط المعياري للمجتمع، بينما تفترض الفرضية البديلة الموجهة أن متوسط درجات المرضى المعالجين سينخفض انخفاضاً دالاً عن متوسط المجتمع المرجعي. أما في دراسات علم النفس المعرفي التي تقيس الانتباه تحت تأثير مشتتات بيئية جديدة لم تُختبر من قبل، فإن الفرضية غير الموجهة تكون الأنسب لافتراض حدوث تغير في زمن الاستجابة دون الجزم بطبيعته.
2.2 تحديد مستوى الدلالة الإحصائية (Alpha Level)
يُعد تحديد مستوى الدلالة الإحصائية المعياري (Alpha Level – $\alpha$) قراراً منهجياً حاسماً يجب اتخاذه بصورة مسبقة قبل فحص البيانات وبدء الحسابات الرياضية. يمثل هذا المستوى الحد الأقصى المسموح به لمعدل الوقوع في الخطأ الإحصائي من النوع الأول (Type I Error)، وهو احتمال رفض الفرضية الصفرية بينما هي صحيحة وواقعية في المجتمع. وتعتمد الدراسات الإنسانية والنفسية مستويات معيارية متفقاً عليها أكاديمياً، وهي غالباً 0.05، أو 0.01 في السياقات الإكلينيكية الحساسة، وأحياناً 0.10 في الدراسات الاستطلاعية الميدانية الأولية.
تخضع عملية الاختيار هذه لموازنة دقيقة بين الصرامة الإحصائية وقوة الاختبار (Statistical Power). فعندما يختار الباحث مستوى دلالة صارماً جداً مثل $\alpha = 0.01$، فإنه يقلص احتمالية ارتكاب خطأ رفض الفرضية الصفرية الصادقة إلى 1% فقط، لكنه في المقابل يزيد من مخاطر الوقوع في الخطأ من النوع الثاني (Type II Error)، وهو الإخفاق في اكتشاف الأثر الحقيقي أو الفروق الفعلية الموجودة بالفعل في الواقع النفسي للمشاركين، مما قد يؤدي إلى إهدار برامج تدخل علاجية ذات جدوى فعلية.
لذلك، استقر العرف الأكاديمي في البحوث السيكولوجية والسلوكية على اعتبار مستوى $\alpha = 0.05$ معياراً توازنياً ذهبياً؛ حيث يقدم حماية معقولة من الاستنتاجات الخاطئة الناتجة عن تذبذب العينات العشوائية بنسبة 5%، وفي الوقت ذاته يحافظ على قوة إحصائية كافية لرصد الفروق المعنوية التي تُحدثها المتغيرات المستقلة في الظواهر الإنسانية المتسمة بتعدد العوامل المؤثرة وتداخلها الشديد.
2.3 استخراج المؤشرات الوصفية الأساسية للعينة
قبل الشروع في تطبيق الصيغ الاستدلالية لاختبار T، يجب حصر المؤشرات الإحصائية الوصفية الثلاثة للعينة المستهدفة: المتوسط الحسابي، والانحراف المعياري، وحجم العينة. يمثل المتوسط الحسابي للعينة ($\bar{x}$) القيمة المركزية التي تجمع استجابات الأفراد، ويُحسب بجمع كافة الدرجات الفردية وقسمتها على عدد المشاهدات الكلي ($n$). ويقارن هذا المتوسط الميداني بالمتوسط المفترض للمجتمع ($\mu$)، وهو المعلمة المرجعية الثابتة المستمدة إما من معاير قياسية وطنية أو دراسات طولية موسعة.
أما المؤشر الثاني الحاسم فهو الانحراف المعياري للعينة ($s$)، وهو التقدير الموضعي لمدى تباين وتشتت استجابات أفراد العينة حول متوسطهم الحسابي. ويُحسب يدوياً عبر إيجاد مجموع مربعات انحرافات الدرجات عن المتوسط الحسابي، ثم قسمتها على درجات الحرية للعينة ($n – 1$) لاستخراج التباين غير المتحيز، ثم استخراج الجذر التربيعي الموجب لهذا التباين وفق المعادلة المعيارية:
$$s = \sqrt{\frac{\sum (x_i – \bar{x})^2}{n – 1}}$$
ويكتمل هذا الثالوث الإحصائي بتوثيق حجم العينة ($n$) بدقة بالغة وبدون أي حذف غير مبرر للبيانات؛ فحجم العينة ليس مجرد رقم وصفي، بل هو المتغير الذي يحدد بشكل مباشر حجم الخطأ المعياري ودرجات الحرية وشكل التوزيع التكراري المستخدم. إن أي خطأ في حساب المتوسط أو الانحراف المعياري في هذه المرحلة التمهيدية سينتقل بصورة تراكمية مضاعفة إلى كافة الخطوات الاستدلالية اللاحقة، مما يفسد القيمة الاحتمالية النهائية بالكامل.
3. الحساب الرياضي لقيمة إحصائية اختبار T يدوياً
3.1 تفكيك عناصر معادلة اختبار T للعينة الواحدة
تنطلق البنية الرياضية لاختبار T للعينة الواحدة من معادلة جوهرية تقوم على مقارنة الفارق الملاحظ بين العينة والمجتمع بالخطأ المعياري المتوقع، وتُكتب الصيغة الرياضية الأساسية على النحو التالي:
$$t = \frac{\bar{x} – \mu}{SE}$$
حيث يمثل الرمز ($t$) قيمة إحصائية الاختبار المحسوبة، ويمثل ($\bar{x}$) المتوسط الحسابي المستخرج من العينة التجريبية، بينما يمثل ($\mu$) المتوسط الحقيقي أو النظري المفترض لمجتمع الدراسة، في حين يرمز ($SE$) إلى الخطأ المعياري للمتوسط.
يركز بسط المعادلة ($\bar{x} – \mu$) على قياس المقدار المطلق والنسبي للفارق التجريبي؛ فإذا كان متوسط العينة مطابقاً لمتوسط المجتمع، تصبح قيمة البسط صفراً وتتلاشى قيمة $t$ بالكامل، دلالة على الانعدام التام لأي اختلاف. وتلعب الإشارة الجبرية لهذا البسط دوراً بالغ الأهمية؛ فالإشارة الموجبة تشير إلى أن أداء العينة يفوق المتوسط المرجعي للمجتمع، مما يضع القيمة المحسوبة في الطرف الأيمن لتوزيع ستيودنت التكراري، في حين تشير الإشارة السالبة إلى تراجع أداء العينة عن المجتمع، واضعة القيمة في الطرف الأيسر للمنحنى.
إن إدراك الباحث لموقع الإشارة الجبرية يحدد بصورة جوهرية كيفية التعامل مع جداول التوزيع الإحصائي لاحقاً. فرغم أن جداول توزيع T غالباً ما تُطبع بقيم موجبة نظراً للتماثل التام للمنحنى، فإن الإشارة السالبة تحمل المعنى النفسي والسلوكي للفارق، وتلزم الباحث بالانتباه لمسار الفرضية المصاغة وموقع المساحة المظللة التي سيتم استخراج القيمة الاحتمالية منها.
3.2 حساب الخطأ المعياري للمتوسط (Standard Error)
يمثل الخطأ المعياري للمتوسط ($SE$) المقام الحيوي في معادلة اختبار T، وهو مقياس رياضي يعكس مدى تباين وتشتت متوسطات العينات الممكنة إذا كررنا سحب عينات عشوائية بنفس الحجم من مجتمع الدراسة الأصلي. ويُحسب الخطأ المعياري يدوياً بالاعتماد على المعادلة الكلاسيكية الآتية:
$$SE = \frac{s}{\sqrt{n}}$$
حيث يُقسم الانحراف المعياري المحسوب للعينة ($s$) على الجذر التربيعي لحجم العينة ($\sqrt{n}$).
يؤدي حجم العينة ($n$) دور المنظم الديناميكي لقيمة الخطأ المعياري؛ فكلما ازداد حجم العينة، ارتفعت قيمة الجذر التربيعي في المقام، مما يؤدي بالضرورة إلى تصغير قيمة الخطأ المعياري الناتج. يعكس هذا الانخفاض دقة أعلى في التقدير الإحصائي؛ إذ تصبح العينة الكبيرة أكثر تمثيلاً للمجتمع وأقل عرضة لتقلبات المعاينة العشوائية والصدفة البحتة.
وينعكس صغر الخطأ المعياري بصورة مباشرة على تضخيم قيمة إحصائية $t$ المحسوبة، فبقسمة البسط (الفارق الملاحظ) على قيمة مقام متناهية في الصغر، ترتفع قيمة $t$ وتندفع بعيداً نحو أطراف التوزيع التكراري. هذا التضخم الميكانيكي يقلص بدوره القيمة الاحتمالية المرتبطة بها، مما يرفع احتمالية رفض الفرضية الصفرية والوصول إلى دلالة إحصائية مؤكدة.
3.3 تنفيذ القسمة النهائية واستخراج قيمة T المحسوبة
بعد تحديد قيمة بسط المعادلة المتمثل في الفارق الملاحظ بين المتوسطين وحساب قيمة المقام المتمثل في الخطأ المعياري، تبدأ عملية القسمة النهائية لاستخراج قيمة إحصائية الاختبار المحسوبة ($t_{calc}$). وتتطلب هذه العملية دقة رقمية فائقة، حيث يوصى منهجياً بالاحتفاظ بما لا يقل عن أربع خانات عشرية أثناء إجراء العمليات الحسابية الوسيطة لتفادي أخطاء التراكم الرقمي الناتجة عن التقريب المتكرر.
تتم عملية القسمة بتطبيق الصيغة المباشرة: نقسم البسط $(\bar{x} – \mu)$ على الناتج الدقيق للخطأ المعياري ($SE$). فإذا كان الفارق يساوي مثلاً $3.5$ والخطأ المعياري يساوي $1.2000$، فإن حاصل القسمة يكون $2.9167$. ويتم تقريب الناتج النهائي عادة إلى منزلتين أو ثلاث منازل عشرية، لتصبح القيمة المستخرجة $t = 2.92$، وهي القيمة الجاهزة للمطابقة مع جداول توزيع ستيودنت التكراري.
إن توثيق هذه القيمة المحسوبة بدقة هو حجر الزاوية للمراحل التالية؛ إذ تمثل قيمة $t$ المحسوبة المسافة المعيارية التي تفصل متوسط العينة الملاحظ عن متوسط المجتمع المفترض، مقاسة بوحدات الخطأ المعياري. هذه المسافة هي الإحداثي الرقمي الوحيد الذي سنبحث عنه في الجداول الإحصائية لحصر المساحة الاحتمالية الواقعة تحت منحنى التوزيع بدقة وحرفية.
4. تحديد درجات الحرية وتأثيرها على شكل التوزيع
4.1 المفهوم الرياضي لدرجات الحرية (Degrees of Freedom)
يُقصد بدرجات الحرية (Degrees of Freedom – $df$) في الإحصاء الاستدلالي عدد المشاهدات أو القيم المستقلة القابلة للتغير والاختلاف بحرية داخل مصفوفة البيانات، دون أن يؤدي ذلك إلى الإخلال بالمعلمة الإحصائية المحسوبة مسبقاً. إنها تعبير عن كمية المعلومات غير المقيدة المتاحة في العينة والمخصصة لتقدير التباين والخطأ العشوائي في مجتمع الدراسة المجهول.
ويرتبط مفهوم درجات الحرية ارتباطاً منطقياً وثيقاً بحساب الانحراف المعياري؛ فعند حساب الانحراف المعياري للعينة، نكون ملزمين أولاً بتقدير المتوسط الحسابي للعينة ($\bar{x}$) واستخدامه في صيغة الحساب. يفرض هذا التقدير قيداً رياضياً حتمياً يجعل مجموع انحرافات القيم عن متوسطها يساوي صفراً دائماً ($\sum(x_i – \bar{x}) = 0$). وبسبب هذا القيد، فإن $n – 1$ من المشاهدات فقط تمتلك الحرية الكاملة في اتخاذ أي قيمة رقمية، بينما تكون المشاهدة الأخيرة مجبرة على اتخاذ قيمة ثابتة محددة مسبقاً لضمان بقاء المجموع التراكمي مطابقاً لناتج ضرب المتوسط في حجم العينة.
وبناءً على هذا المنطق الرياضي الصارم، تتحدد صيغة درجات الحرية لاختبار T للعينة الواحدة بالمعادلة البسيطة:
$$df = n – 1$$
حيث يطرح الباحث قيمة ثابتة واحدة (القيد الرياضي المفروض بتقدير المتوسط) من إجمالي عدد أفراد العينة، لتمثل النتيجة النهائية السطر الإحصائي الوحيد الذي ينبغي اعتماده عند البحث في جداول التوزيع.
4.2 العلاقة بين درجات الحرية وتسطح المنحنى الإحصائي
تؤثر درجات الحرية تأثيراً مباشراً وحاسماً على الشكل الهندسي لمنحنى توزيع ستيودنت التكراري. فكلما انخفضت درجات الحرية (نتيجة صغر حجم العينة)، ازداد تسطح قمة المنحنى وتوسعت أطرافه وسماكتها نحو الخارج. يترتب على هذه السماكة في الأطراف زيادة واضحة في المساحة الاحتمالية التراكمية المخصصة للقيم المتطرفة، وهو ما يجسد رياضياً زيادة المخاطر وعدم اليقين في تقدير معالم المجتمع عبر عينة شديدة الصغر.
وعلى النقيض من ذلك، كلما ارتفعت درجات الحرية، تقترب أطراف توزيع T تدريجياً من منحنى التوزيع الطبيعي المعياري (توزيع Z) وتبدأ قمة المنحنى في الارتفاع والتركيز. وعندما تتجاوز درجات الحرية حاجز 120 درجة وتصل إلى اللانهاية ($\infty$)، يتطابق توزيع T هندسياً ورياضياً مع التوزيع الطبيعي القياسي تماماً؛ إذ يتلاشى تأثير عدم معرفة التباين الحقيقي للمجتمع بفعل الحجم الضخم للعينة المتاحة.
لهذا السبب، فإن التحديد الصحيح لسطر درجات الحرية في الجداول الإحصائية يمثل خطوة وقائية جوهرية؛ فالخطأ في تحديد هذا السطر يعني بالضرورة قراءة مساحات احتمالية من منحنى هندسي مغاير لا يطابق توزيع العينة الفعلي، مما يقود إلى حساب قيمة احتمالية غير دقيقة تؤدي في الغالب إلى قرارات استدلالية فاسدة.
4.3 حالات خاصة في حساب درجات الحرية
تتنوع معادلات درجات الحرية بتنوع التصميم التجريبي لاختبار T المستخدم في الأبحاث النفسية. فبينما يكتفي اختبار T للعينة الواحدة بصيغة $df = n – 1$، يتطلب اختبار T لعينتين مستقلتين متجانستي التباين دمج درجات الحرية للعينتين معاً وفق المعادلة:
$$df = n_1 + n_2 – 2$$
حيث يُفقد قيد رياضي واحد من كل عينة مقابل تقدير متوسطها الحسابي الخاص بها بصورة مستقلة.
وتتعقد المسألة في حالات عدم تجانس التباين بين المجموعتين المستقلتين، حيث تنتهك فرضية تساوي التباين؛ مما يفرض اللجوء إلى صيغة رياضية أكثر تعقيداً تُعرف بمعادلة ويلش-ساترثويت (Welch-Satterthwaite Equation). تنتج هذه المعادلة درجات حرية معدلة تحتوي غالباً على كسور عشرية غير صحيحة، وتعتمد في حسابها على ترجيح تباينات العينات وأحجامها النسبية معاً.
وعند الرغبة في الحساب اليدوي واستخدام الجداول الإحصائية الورقية المطبوعة في حالات درجات الحرية الكسرية هذه، يلجأ الباحث عادة إلى قواعد التقريب الصارم؛ حيث يوصى إحصائياً بالتقريب التنازلي إلى أقرب عدد صحيح محافظ (Truncation/Rounding Down) لتفادي تضخيم درجات الحرية والمحافظة على الصرامة المنهجية للاختبار وعدم التساهل في بلوغ الدلالة الإحصائية.
5. استخدام جداول توزيع T الإحصائية لحصر القيمة الاحتمالية
5.1 هيكلية وتصميم جدول قيم توزيع T المعياري
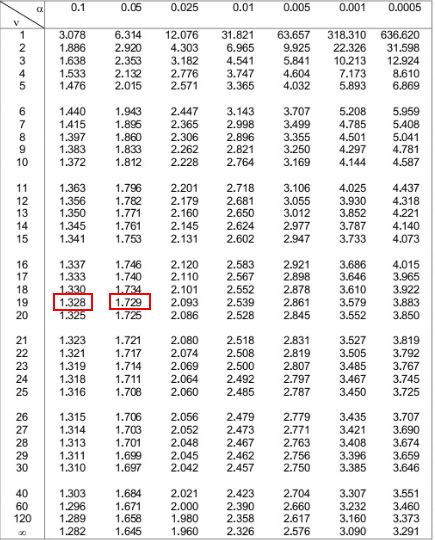
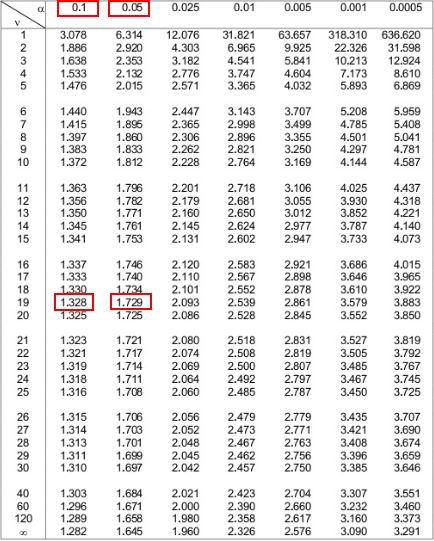
تعتمد الجداول الإحصائية المعيارية المطبوعة لتوزيع T على مصفوفة ثنائية الأبعاد صُممت لتسهيل قراءة القيم المتقاطعة بدقة وسرعة. يمثل المحور الرأسي الأيسر للجدول عمود درجات الحرية ($df$)، والذي يبدأ بالرقم 1 ويتصاعد تدريجياً وبشكل تسلسلي حتى يصل عادة إلى 30 أو 40، ثم يبدأ في القفز عبر فئات متباعدة (مثل 50، 60، 80، 100، 120) وصولاً إلى علامة اللانهاية ($\infty$).
أما المحور الأفقي الواقع في الترويسة العلوية للجدول، فيمثل المساحات الاحتمالية التراكمية الواقعة تحت المنحنى، والتي تعبر عن مستويات الدلالة الإحصائية الشائعة (مثل 0.10، 0.05، 0.025، 0.01، 0.005). ويجب على الباحث التمييز البصري الحذر بين ترويستين أساسيتين توفران قراءات الجدول: ترويسة الاختبارات أحادية الطرف (One-Tailed Probabilities)، وترويسة الاختبارات ثنائية الطرف (Two-Tailed Probabilities)، حيث تكون القيم الاحتمالية في الترويسة ثنائية الطرف ضعف نظيرتها أحادية الطرف دائماً لنفس القيمة الحرجة.
وتحتوي خلايا التقاطع الداخلية المكونة للجدول على القيم الحرجة لإحصائية T المجدولة ($t_{critical}$). هذه القيم المعيارية تمثل الحدود الهندسية على المحور الأفقي للمنحنى التي تبدأ عندها المساحات المظللة المعرفة في الترويسة العلوية، وهي المعايير التي يقارن بها الباحث قيمته المحسوبة لاستخلاص مجالات الاحتمال بدقة.
5.2 تحديد موقع قيمة T المحسوبة بين القيم الحرجة
تبدأ الخطوة الإجرائية العملية داخل الجدول بتحديد سطر درجات الحرية المستهدف مسبقاً وتتبعه أفقياً من اليسار إلى اليمين. يمسح الباحث بعينيه قيم T المجدولة المتصاعدة تدريجياً في هذا السطر حتى يحدد القيمة السابقة واللاحقة لقيمة $t_{calc}$ المحسوبة يدوياً، وبذلك ينجح في حصر قيمته المحسوبة داخل فجوة رقمية تقع بين قيمتين جدوليتين حرجتين ($t_1 < t_{calc} < t_2$).
وفي حال كانت قيمة $t_{calc}$ المحسوبة ذات إشارة سالبة نتيجة تراجع متوسط العينة عن متوسط المجتمع، فإن الباحث يعتمد كلياً على خاصية التماثل التام لمنحنى توزيع T؛ إذ إن المساحة الاحتمالية الواقعة يسار القيمة السالبة تتطابق رياضياً وبصرياً مع المساحة الاحتمالية الواقعة يمين القيمة الموجبة المقابلة لها تماماً. لذلك، يتم تحويل القيمة المحسوبة مؤقتاً إلى قيمتها المطلقة الجبرية ($|t_{calc}|$) ومطابقتها مع قيم الجدول الموجبة دون أي إخلال بصحة الاستدلال الاحتمالي.
على سبيل المثال، إذا كانت درجات الحرية تساوي 15 وقيمة $t$ المحسوبة هي 2.45، فإن تتبع سطر $df = 15$ في الجدول يوضح أن القيمة 2.45 تقع تحديداً بين القيمة المجدولة 2.131 والقيمة المجدولة 2.602. هذا التحديد الدقيق للحدين الحرجين هو الأساس الرياضي الذي سينقل الباحث من حصر إحصائية T إلى حصر القيمة الاحتمالية المقابلة لها مباشرة.
5.3 استخراج مجال القيمة الاحتمالية (P-Value Bounds)
عقب النجاح في حصر قيمة $t$ المحسوبة بين قيمتين جدوليتين، يصعد الباحث عمودياً من هذين الحدين نحو الترويسة العلوية للجدول لقراءة النسب الاحتمالية المقابلة لهما. فإذا كانت القيمة المحسوبة تقع بين $t_1$ و $t_2$، فإن القيمة الاحتمالية الفعلية ($p$) ستقع حتماً داخل المجال الاحتمالي المقابل المحصور بين النسبتين المستخرجتين من الترويسة ($p_2 < p < p_1$). وتجدر الإشارة هنا إلى العلاقة العكسية الرياضية؛ فكلما كبرت قيمة $t$ المتطرفة في الجدول، صغرت القيمة الاحتمالية المقابلة لها في ذيل المنحنى.
تتم بعد ذلك صياغة متباينة رياضية محكمة توثق هذا النطاق بدقة؛ فبالاستناد إلى المثال السابق عند $df = 15$ وقيمة محسوبة 2.45 تقع بين 2.131 (المقابلة للاحتمال ثنائي الطرف 0.05) و2.602 (المقابلة للاحتمال ثنائي الطرف 0.02)، يكتب الباحث متباينته الاحتمالية بثقة كاملة على النحو التالي:
$$0.02 < p < 0.05$$
ويُعد هذا الحصر الاحتمالي في كثير من الأحيان كافياً لاتخاذ القرار النهائي بقبول أو رفض الفرضية الصفرية، فما دامت حدود المتباينة تقع بالكامل تحت عتبة الدلالة المستهدفة ($\alpha = 0.05$)، فإن الباحث يمتلك سنداً رياضياً قاطعاً لرفض الفرضية الصفرية دون حاجة ملحة لمعرفة الرقم الدقيق لما بعد الفواصل العشرية، إلا إذا كانت الرغبة قائمة في تحقيق الدقة الحسابية الكاملة والتوافق مع متطلبات النشر الحديثة.
6. تقنية الاستيفاء الخطي للتقدير اليدوي الدقيق للقيمة الاحتمالية
6.1 مفهوم الاستيفاء الخطي (Linear Interpolation) في الإحصاء
يُعرف الاستيفاء الخطي في التحليل الرياضي والإحصائي بأنه تقنية حسابية تُستخدم لتقدير قيمة مجهولة تقع بين نقطتين معلومتين بدقة، وذلك بالاعتماد على فرضية التناسب الهندسي المنتظم ومسار الميل الخطي المستقيم الواصل بينهما. وعلى الرغم من أن منحنى توزيع ستيودنت التكراري هو منحنى غير خطي يتسم بالانحناء والديناميكية، إلا أن اقتطاع فترات رقمية متناهية في الصغر من هذا المنحنى يتيح لنا افتراض الخطية المحلية (Local Linearity) بدرجة عالية جداً من الدقة ومقاربة رياضية مقبولة عملياً.
ويلجأ الباحث الأكاديمي إلى تقنية الاستيفاء الخطي عند الحساب اليدوي عندما لا يكتفي بمجرد حصر النتيجة في متباينة واسعة مثل $0.01 < p < 0.05$، بل يحتاج إلى رقم احتمالي فردي محدد ومقرب إلى خانات عشرية واضحة ليضعه في تقريره الأكاديمي، أو عند التعامل مع مخرجات تقع على الحافة الحرجة لعتبة ألفا وتتطلب حسماً رقمياً دقيقاً لتحديد ما إذا كانت النتيجة تقع داخل منطقة الرفض أم خارجها.
إن تطبيق هذا المبدأ الرياضي العريق على جداول التوزيع يمنح الحساب اليدوي قوة تضاهي المخرجات الرقمية؛ إذ يحول الجداول الورقية المحدودة ذات الأعمدة المتباعدة إلى أداة مستمرة تمكن الباحث من تقدير الاحتمالات المرافقة لأي قيمة T كسرية مهما بلغت غرابتها دون الارتهان الكامل للبرمجيات الإحصائية الآلية.
6.2 تطبيق المعادلة الرياضية للاستيفاء خطوة بخطوة
لتطبيق الاستيفاء الخطي يدوياً، يقوم الباحث أولاً بتحديد إحداثيات النقاط الأربع المستخرجة من جدول توزيع T: الإحداثي الأول يمثل القيمة الجدولية الدنيا ($t_1$) واحتمالها المقابل ($p_1$)، والإحداثي الثاني يمثل القيمة الجدولية العليا ($t_2$) واحتمالها المقابل ($p_2$)، إضافة إلى القيمة المحسوبة المستهدفة ($t_{calc}$) والتي نبحث عن احتمالها المجهول ($p$). وتُصاغ معادلة الاستيفاء الخطي بصورتها المباشرة على النحو التالي:
$$p = p_1 + \frac{t_{calc} – t_1}{t_2 – t_1} \times (p_2 – p_1)$$
يبدأ الحل بحساب بسط الكسر عبر طرح القيمة الجدولية الصغرى من القيمة المحسوبة ($t_{calc} – t_1$) لقياس المسافة المقطوعة بين النقطتين، ثم حساب مقام الكسر بطرح القيمتين الجدوليتين من بعضهما ($t_2 – t_1$) لمعرفة الطول الإجمالي للمجال. تمثل ناتج قسمة البسط على المقام النسبة المئوية للمسافة التي قطعتها القيمة المحسوبة داخل النطاق المحدد.
تُضرب هذه النسبة الناتجة بعد ذلك في الفارق بين الاحتمالين الجدولين ($p_2 – p_1$)، ويجب الانتباه التام للإشارات الجبرية هنا؛ نظراً لأن الاحتمالات تتناقص كلما زادت قيم $t$، مما يجعل ناتج طرح الاحتمالين سالباً دائماً في هذا السياق. وأخيراً، يُجمع الناتج السالب مع الاحتمال المبدئي ($p_1$) لنحصل في النهاية على قيمة رقمية مفردة تمثل القيمة الاحتمالية التقديرية بدقة فائقة.
6.3 تحليل دقة الاستيفاء ومقارنته بالحلول الحاسوبية
يتميز الاستيفاء الخطي بقدرته على توفير تقريب فائق الدقة للقيمة الاحتمالية الحقيقية، حيث يتراوح هامش الخطأ التقديري الناتج عن انحناء المنحنى في العادة بين $\pm 0.001$ إلى $\pm 0.003$ مقارنة بالقيم التكاملية المطلقة التي تفرزها خوارزميات برامج مثل R أو SPSS عبر دوال التوزيع التراكمي المستمر (Cumulative Distribution Function – CDF).
تصل دقة الاستيفاء الخطي إلى ذروتها القصوى في المناطق الوسطى من التوزيع، وحينما تكون الفجوة الرقمية بين الأعمدة المتتالية في الجدول الإحصائي صغيرة نسبياً، حيث يقترب سلوك المنحنى الفعلي جداً من الخط المستقيم وتتلاشى تأثيرات التحدب الهندسي. في هذه الفترات، يكون الرقم المستخرج باليد متطابقاً تقريباً مع الأرقام الحاسوبية حتى الخانة العشرية الثالثة.
وعلى النقيض من ذلك، يتطلب الاستيفاء حذراً إضافياً في مناطق الأطراف القصوى المتطرفة جداً (حيث تكون قيم $t$ مرتفعة جداً وتتجاوز 3.5 أو 4.0)، إذ يزداد تقعر الذيل وتنخفض الاحتمالات بصورة لوغاريتمية سريعة. في مثل هذه الحالات المتطرفة، يميل الاستيفاء الخطي إلى إعطاء تقدير متفائل طفيف للاحتمال، إلا أنه يظل في كافة الأحوال دليلاً استدلالياً فائق الدقة يكفي لاتخاذ أصلب القرارات العلمية الرصينة.
7. التمييز الإجرائي بين الاختبارات أحادية الطرف وثنائية الطرف
7.1 الحساب اليدوي في الاختبار أحادي الطرف (One-Tailed Test)
يُطبق الاختبار أحادي الطرف عندما تنطلق الدراسة من فرضية بديلة موجهة بوضوح تؤكد حدوث أثر في مسار محدد سلفاً، كأن يتوقع الباحث النفسي حصرياً انخفاض أعراض القلق بعد جلسات التأمل، أو تحسن سعة الذاكرة العاملة بعد تناول مغذيات عصبية محددة. في هذه الحالة المنهجية، تتركز منطقة الرفض الإحصائية وحجم المخاطرة ($\alpha$) بالكامل داخل ذيل واحد فقط من طرفي المنحنى التكراري، إما في الذيل الأيمن أو الذيل الأيسر، وفقاً للمسار النظري المفترض للظاهرة.
عند الحساب اليدوي للاختبار أحادي الطرف، يقرأ الباحث القيمة الاحتمالية المباشرة المقابلة لقيمة $t$ المحسوبة من ترويسة الطرف الواحد في جدول التوزيع دون إجراء أي تعديل مضاعف أو عمليات ضرب جبرية. فالاحتمال المستخرج من الجدول يمثل بصورة نقية المساحة التراكمية المقتطعة في ذلك الذيل المحدد حصراً، وهي المساحة التي يُبنى عليها القرار مباشرة بمقارنتها بمستوى ألفا المستهدف دون وسائط إضافية.
يمنح هذا الإجراء الباحث قوة إحصائية مضاعفة؛ إذ تتجمع كامل نسبة الأخطاء المسموح بها (5% مثلاً) في طرف واحد بدلاً من تقسيمها بين طرفين، مما يؤدي إلى خفض القيمة الحرجة المطلوبة لبلوغ الدلالة. ونتيجة لذلك، يصبح من الأيسر رفض الفرضية الصفرية واكتشاف الفروق المعنوية حتى مع قيم T المحسوبة المتوسطة، شرط أن يتطابق الاتجاه التجريبي الملاحظ في العينة مع اتجاه الفرضية الموجهة التي تمت صياغتها مسبقاً.
7.2 مضاعفة المساحة الاحتمالية للاختبار ثنائي الطرف (Two-Tailed Test)
في المقابل، يُلزم الاختبار ثنائي الطرف الباحث بتبني موقف حيادي صارم عند غياب الحجج النظرية الحاسمة حول اتجاه الأثر، كأن يختبر الباحث عقاراً دوائياً جديداً على المزاج قد يؤدي إلى تحسن ملحوظ أو تدهور غير متوقع. في هذه الحالة، تتوزع المساحة الحرجة لمستوى الدلالة بالتساوي على كلا طرفي المنحنى التكراري، حيث يُخصص نصف مستوى ألفا ($\alpha / 2$) للطرف الأيمن المتطرف، بينما يُخصص النصف الآخر للطرف الأيسر لمواجهة كافة الاحتمالات السلوكية الممكنة.
وعند الحساب اليدوي للاختبار ثنائي الطرف، تبرز القاعدة الذهبية الحاسمة: إذا قرأ الباحث المساحة الاحتمالية من ترويسة الطرف الواحد في الجدول الإحصائي، فيتعين عليه إلزامياً ضرب هذه المساحة الاحتمالية في اثنين لاستخراج القيمة الاحتمالية الشاملة للاختبار وفق الصيغة الآتية:
$$p_{two-tailed} = 2 \times p_{one-tailed}$$
وتنعكس هذه المضاعفة الجبرية بالضرورة على تعديل حدود المتباينة الاحتمالية بالكامل. فإذا كانت القيمة تقع في الجدول بين مساحتين للطرف الواحد هما 0.01 و 0.025، فإن حدود المتباينة للاحتمال ثنائي الطرف تتحول مباشرة لتصبح:
$$0.02 < p_{two-tailed} < 0.05$$
إن نسيان مضاعفة القيمة الاحتمالية هو واحد من أكثر الأخطاء المفاهيمية والحسابية شيوعاً بين المبتدئين في الحساب اليدوي، وهو ما يقود إلى إعلان زائف ومضلل عن دلالة إحصائية مفرطة التفاؤل لم تتحقق شروطها الرياضية في الواقع التجريبي.
7.3 معايير الاختيار المنهجي في الدراسات النفسية والسلوكية
استقر العرف الأكاديمي الصارم في مجلات علم النفس والعلوم السلوكية الرصينة على اعتبار الاختبار ثنائي الطرف الخيار المنهجي القياسي والافتراضي لكافة الدراسات المنشورة، ما لم يقدم الباحث مبررات نظرية وتجريبية استثنائية وقاطعة تبرر اللجوء إلى الاختبار أحادي الطرف. ينبع هذا التحفظ من الرغبة في الحفاظ على النزاهة العلمية وحماية المجتمع الأكاديمي من الاستنتاجات المتعجلة في ظواهر تتسم بطبيعتها بالتقلب والتأثر بالمتغيرات الدخيلة غير المنضبطة.
وتكمن الخطورة الأخلاقية والمنهجية الكبرى في الممارسة السيئة الشائعة المعروفة بالتحول اللاحق لنوع الاختبار (Post-hoc Switching)؛ حيث يشرع الباحث في تطبيق اختبار ثنائي الطرف، وعندما يكتشف أن قيمته الاحتمالية المحسوبة هامشية ولا تبلغ الدلالة (كأن تبلغ $p = 0.07$)، يعمد خلسة إلى تحويل فرضيته إلى اختبار أحادي الطرف لتقليص القيمة إلى النصف لتصبح ($p = 0.035$) وإعلان تحقيق الدلالة المنشودة. تُعد هذه الممارسة خرقاً جسيماً للنزاهة العلمية وتزويراً لمستويات الثقة الإحصائية المصممة لحماية المعرفة من الصدفة.
لذلك، تفرض أدلة النشر الأكاديمي الدولية، وفي مقدمتها دليل جمعية علم النفس الأمريكية (APA)، توثيقاً منهجياً صارماً يوضح نوع الاختبار المختار في قسم الإجراءات والمنهجية وقبل عرض النتائج الإحصائية، مع بيان مسوغات هذا الاختيار بالأدبيات الرصينة؛ لضمان أن القيمة الاحتمالية المستخرجة يدوياً تمثل تقييماً نزيهاً وغير متحيز لفرضيات البحث المطروحة.
8. تطبيق عملي متكامل: دراسة نفسية تجريبية بحسابات يدوية كاملة
8.1 عرض سيناريو البحث النفسي ومصفوفة البيانات
لتجسيد كافة الأسس والمعادلات الرياضية السابقة في سياق تطبيقي واقعي، سنفترض سيناريو بحثياً مستمداً من مجالات العلاج النفسي الإكلينيكي والسيكولوجيا الإيجابية، وهي حقول بحثية خصبة تعتمد بصورة كثيفة على دراسة مقاييس الحالة الوجدانية والتدخلات النفسية كما ورد في دراسات علم النفس الرصينة (Lyubomirsky, King, & Diener, 2005). يرغب باحث إكلينيكي في تقييم فاعلية تقنية استرخاء واعية ومطورة على عينة تجريبية من الأفراد الذين يعانون من اضطراب القلق العام، باستخدام مقياس القلق المعياري المعترف به دولياً، والذي يمتلك متوسطاً استقرائياً ثابتاً في مجتمع المرضى العام مقداره ($\mu_0 = 24.0$) نقطة.
اختار الباحث عينة عشوائية استطلاعية مكونة من $n = 16$ مشاركاً خضعوا لبرنامج الاسترخاء المكثف لمدة أربعة أسابيع متواصلة، ثم تم قياس درجات القلق لديهم في نهاية البرنامج لجمع مصفوفة البيانات الخام التالية:
18، 21، 16، 22، 19، 17، 20، 23، 15، 18، 21، 19، 16، 20، 22، 17.
تبدأ الخطوة اليدوية الأولى بحساب المتوسط الحسابي للعينة ($\bar{x}$) بجمع هذه الدرجات الست عشرة وقسمتها على حجم العينة:
$$\sum x_i = 18 + 21 + 16 + dots + 17 = 304$$
$$\bar{x} = \frac{304}{16} = 19.00$$
نلاحظ هنا أن متوسط العينة التجريبية ($\bar{x} = 19.00$) أقل ظاهرياً من متوسط مجتمع المرضى العام ($\mu_0 = 24.00$) بمقدار 5 درجات كاملة لصالح تحسن حالات المشاركين. ولحساب الانحراف المعياري يدوياً، نقوم بحساب مربعات انحرافات كل درجة عن المتوسط المحسوب ($19.00$):
$$\sum (x_i – \bar{x})^2 = (18-19)^2 + (21-19)^2 + (16-19)^2 + dots + (17-19)^2 = 86.00$$
ثم نستخرج التباين غير المتحيز بقسمة مجموع المربعات على درجات حرية العينة ($n – 1 = 15$):
$$s^2 = \frac{86.00}{15} = 5.7333$$
ثم نأخذ الجذر التربيعي الموجب للتباين للحصول على الانحراف المعياري للعينة:
$$s = \sqrt{5.7333} = 2.3944$$
8.2 إجراء العمليات الحسابية المتتابعة يدوياً
بعد اكتمال تجهيز المؤشرات الوصفية ($n = 16$ ، $\bar{x} = 19.00$ ، $s = 2.3944$) والمتوسط المرجعي ($\mu_0 = 24.00$)، ننتقل للخطوة الاستدلالية الأولى بحساب الخطأ المعياري للمتوسط ($SE$) عبر قسمة الانحراف المعياري على الجذر التربيعي لحجم العينة:
$$SE = \frac{s}{\sqrt{n}} = \frac{2.3944}{\sqrt{16}} = \frac{2.3944}{4} = 0.5986$$
نطبق الآن معادلة اختبار T للعينة الواحدة بالتعويض المباشر بالقيم المحسوبة بدقة متناهية:
$$t = \frac{\bar{x} – \mu_0}{SE} = \frac{19.00 – 24.00}{0.5986} = \frac{-5.00}{0.5986} = -8.3528$$
القيمة المحسوبة الناتجة هي $t = -8.35$، وهي قيمة سالبة تدل على انخفاض درجات القلق لدى أفراد العينة مقارنة بالمجتمع. ونظراً للتماثل التام لتوزيع ستيودنت التكراري، فإننا نأخذ القيمة المطلقة $|t| = 8.35$ لمقارنتها بقيم الجدول المطبوعة الموجبة.
نحسب بعد ذلك درجات الحرية للاختبار:
$$df = n – 1 = 16 – 1 = 15$$
نتجه الآن مباشرة إلى جدول توزيع T الإحصائي المرفق في المراجع الأكاديمية ونحدد بدقة السطر المخصص لدرجات الحرية $df = 15$.
8.3 استخراج القيمة الاحتمالية النهائية واتخاذ القرار العلمي
بفحص سطر درجات الحرية $df = 15$ في جدول قيم T المعياري، نجد القيم الحرجة المتتالية المرصودة للاختبار ثنائي الطرف كما يلي:
- القيمة 2.131 تقابل مستوى دلالة ثنائي الطرف $p = 0.05$
- القيمة 2.602 تقابل مستوى دلالة ثنائي الطرف $p = 0.02$
- القيمة 2.947 تقابل مستوى دلالة ثنائي الطرف $p = 0.01$
- القيمة 4.073 تقابل مستوى دلالة ثنائي الطرف $p = 0.001$
وعند مطابقة قيمتنا المحسوبة البالغة المطلقة $8.35$ مع سطر الجدول، نلاحظ بوضوح أنها تفوق بأميال أقصى قيمة جدولية مطبوعة وهي 4.073 المقابلة لاحتمال $p = 0.001$. هذا الحصر يتيح لنا فوراً صياغة المتباينة الاحتمالية القاطعة:
$$p < 0.001$$
ولغرض التدريب المنهجي على استخدام معادلة الاستيفاء الخطي في هذا الدليل، لنفترض جدلاً أن القيمة المحسوبة كانت تقع في نطاق وسطي محصور، كأن تكون $t = 2.45$ لنفس سطر درجات الحرية ($df = 15$). في تلك الحالة الافتراضية، تقع القيمة 2.45 بين القيمة الدنيا $t_1 = 2.131$ ($p_1 = 0.05$) والقيمة العليا $t_2 = 2.602$ ($p_2 = 0.02$). نطبق معادلة الاستيفاء الخطي لاستخراج القيمة الاحتمالية الدقيقة:
$$p = 0.05 + \frac{2.45 – 2.131}{2.602 – 2.131} \times (0.02 – 0.05)$$
$$p = 0.05 + \frac{0.319}{0.471} \times (-0.03) = 0.05 + (0.6773 \times -0.03) = 0.05 – 0.0203 = 0.0297$$
تنتج لنا القيمة المقدرة بدقة الاستيفاء الخطي: $p = 0.030$.
وبالعودة إلى نتيجتنا الحقيقية الصادمة للدراسة ($t = -8.35, p < 0.001$) وبمقارنتها بمستوى الدلالة المعياري المعتمد سلفاً ($\alpha = 0.05$)، نجد أن القيمة الاحتمالية المحسوبة أصغر بكثير من مستوى ألفا ($p < \alpha$). بناءً على هذه البيانات الرياضية الحاسمة، يتخذ الباحث قراره المنهجي برفض الفرضية الصفرية ($H_0$) بكل ثقة، وتأييد الفرضية البديلة القائلة بأن تقنية الاسترخاء تؤدي إلى خفض دال إحصائياً في مستويات القلق لدى المرضى الخاضعين للدراسة.
9. تفسير النتيجة الإحصائية وصياغة المخرجات الأكاديمية
9.1 الربط بين القيمة الاحتمالية واتخاذ القرار العلمي
يمثل الربط المنهجي بين القيمة الاحتمالية المستخرجة يدوياً والقرار العلمي جوهر الاستدلال الإحصائي السليم. تنص القاعدة المعيارية الصارمة على أنه إذا كانت القيمة الاحتمالية المحسوبة أصغر من أو تساوي مستوى الدلالة المعتمد ($p le \alpha$)، فإن القرار الحتمي هو رفض الفرضية الصفرية واعتبار النتيجة ذات “دلالة إحصائية” (Statistically Significant). أما إذا تجاوزت القيمة الاحتمالية سقف ألفا ($p > \alpha$)، فإن الباحث “يخفق في رفض الفرضية الصفرية”، ويُمتنع منهجياً عن استخدام مصطلح “قبول الفرضية الصفرية”؛ إذ إن عدم كفاية الأدلة الإحصائية لرفض الفرضية لا يعني بأي حال من الأحوال إثبات صحتها المطلقة.
ويقتضي الحذر الأكاديمي استيعاب المعنى الحقيقي لمفهوم الدلالة الإحصائية؛ فالأخيرة لا تعني إثبات الحقيقة المطلقة للظاهرة، ولا تضمن خلو النتيجة من التحيزات الخارجية، بل تدل فقط على أن البيانات المجمعة من غير المرجح إطلاقاً أن تكون نتاج تقلبات الصدفة والمعاينة وحدها. إن النتيجة الدالة إحصائياً هي بمثابة الضوء الأخضر المنهجي الذي يسمح للباحث بمواصلة البناء النظري ومناقشة الدلالات السيكولوجية والتطبيقات الإكلينيكية لنتائجه.
ويواجه الباحثون في ميدان العلوم النفسية معضلة النتائج الحدية أو الهامشية (Marginal Results)، وهي النتائج التي تقترب فيها القيمة الاحتمالية جداً من العتبة المعيارية دون أن تتجاوزها، كأن تبلغ $p = 0.053$ أو $p = 0.058$. ويفرض العرف المنهجي الصارم عدم الادعاء بتحقيق الدلالة في مثل هذه الحالات، وتجنب العبارات الملتوية مثل “اقتربت النتيجة من الدلالة”، بل التعامل معها بشفافية باعتبارها غير دالة إحصائياً، مع التوصية المنهجية بزيادة حجم العينة مستقبلاً لرفع القوة الإحصائية للاختبار.
9.2 حساب حجم الأثر كمعيار مكمل للقيمة الاحتمالية
أدركت المدارس الإحصائية المعاصرة القصور المنهجي الشديد للاكتفاء بالقيمة الاحتمالية بمفردها لتقييم الأهمية الحقيقية لنتائج البحوث السلوكية؛ فالقيمة الاحتمالية شديدة التأثر بحجم العينة، حيث يمكن لأي فارق طفيف وضئيل جداً لا قيمة له إكلينيكياً أن يتحول إلى نتيجة ذات دلالة إحصائية فائقة لمجرد أن حجم العينة ضخم جداً. ومن هنا، يبرز حساب حجم الأثر (Effect Size) كإجراء يدوي حتمي ومكمل لا غنى عنه لقياس المقدار الحقيقي للأثر النفسي والعملي بصورة معيارية مستقلة تماماً عن حجم العينة.
ويُعد مؤشر كوهين دي (Cohen’s d) المقياس المعياري الأكثر استخداماً لاختبار T للعينة الواحدة، ويُحسب يدوياً بمعادلة غاية في البساطة تعتمد على قسمة الفارق المطلق بين المتوسطين على الانحراف المعياري للعينة وفق الصيغة التالية:
$$d = \frac{\bar{x} – \mu}{s}$$
وبالعودة إلى بيانات دراستنا التجريبية السابقة، نقوم بحساب حجم الأثر يدوياً بالتعويض المباشر:
$$d = \frac{19.00 – 24.00}{2.3944} = \frac{-5.00}{2.3944} = -2.09$$
تُفسر القيمة المطلقة لمؤشر كوهين دي وفق التصنيفات الإرشادية القياسية التي أرساها جاكوب كوهين:
- أثر صغير: $d = 0.20$
- أثر متوسط: $d = 0.50$
- أثر كبير: $d = 0.80$ فما فوق
وبما أن القيمة المطلقة المحسوبة في دراستنا بلغت $2.09$، فإنها تفوق معيار الأثر الكبير بمراحل؛ مما يؤكد أن تقنية الاسترخاء لم تحقق مجرد دلالة إحصائية مجردة ناتجة عن صدفة الأرقام، بل أحدثت أثراً إكلينيكياً عميقاً ونقلة نوعية واسعة في خفض درجات القلق لدى المشاركين، وهو ما يمنح التدخل النفسي قيمة علاجية وميدانية راسخة تبرر تعميمه وتطبيقه.
9.3 كتابة وتوثيق النتائج وفق المعايير الأكاديمية (APA)
يتطلب التوثيق الأكاديمي الرصين للنتائج الإحصائية الالتزام الصارم بالصيغ الموحدة المعتمدة من جمعية علم النفس الأمريكية (APA 7th Edition). ولا يُسمح بكتابة العبارات الإنشائية المرسلة لبيان النتائج، بل يجب توثيق رمز إحصائية الاختبار متبوعاً بدرجات الحرية بين قوسين، ثم قيمة T المحسوبة مقربة إلى منزلتين عشريتين، تليها القيمة الاحتمالية الدقيقة أو متباينتها، ثم حجم الأثر.
تُكتب الصيغة النموذجية لبيانات دراستنا التطبيقية على النحو التالي:
t(15) = -8.35, p < .001, d = 2.09
وفي حال استخدام تقنية الاستيفاء الخطي للوصول إلى رقم احتمالي فردي محدد، تُكتب القيمة بدقة متناهية دون استخدام رمز المتباينة، كأن نكتب وفق المثال الافتراضي السابق: t(15) = 2.45, p = .030, d = 0.61. ويُراعى في نسق APA عدم وضع الصفر قبل الفاصلة العشرية للقيمة الاحتمالية (مثل كتابة .001 بدلاً من 0.001)، نظراً لأن الاحتمال لا يمكن أن يتجاوز الرقم واحد صحيح رياضياً.
وتكتمل المخرجات بصياغة فقرة مناقشة علمية رصينة تدمج الدلالة الرقمية بالمعنى السيكولوجي، كأن يدون الباحث: “أظهرت نتائج اختبار T للعينة الواحدة وجود انخفاض دال إحصائياً في متوسط درجات القلق لدى المشاركين بعد خضوعهم لبرنامج الاسترخاء المكثف (M = 19.00, SD = 2.39) مقارنة بالمتوسط المعياري لمجتمع المرضى (M = 24.00)، حيث بلغت قيمة t(15) = -8.35، والقيمة الاحتمالية p < .001، مع حجم أثر كبير جداً بلغ d = 2.09. وتؤكد هذه النتائج الفرضية البديلة للدراسة، مما يشير إلى أن التدخل العلاجي يمتلك فاعلية سريرية واضحة في إعادة التوازن الانفعالي للمرضى.”
10. الأخطاء الشائعة والقيود الرياضية في الحساب اليدوي للقيمة الاحتمالية
10.1 الأخطاء الحسابية والمفاهيمية المتكررة
يقع العديد من الباحثين والطلبة عند ممارسة الحساب اليدوي لاختبار T في مجموعة من الأخطاء الحسابية والمفاهيمية القاتلة التي تبطل مصداقية النتائج برمتها. ويأتي في مقدمة هذه الأخطاء الخلط الفادح بين الانحراف المعياري للعينة ($s$) والخطأ المعياري للمتوسط ($SE$) في مقام معادلة T؛ حيث يقوم البعض بوضع الانحراف المعياري مباشرة في المقام دون قسمته على الجذر التربيعي لحجم العينة ($\sqrt{n}$)، مما يضخم المقام بصورة وهمية ويؤدي إلى انهيار قيمة $t$ المحسوبة وفقدان الدلالة الإحصائية لأثر حقيقي قائم بالفعل.
ومن الأخطاء الشائعة أيضاً نسيان مضاعفة القيمة الاحتمالية عند إجراء الاختبارات ثنائية الطرف والاعتماد على جداول الطرف الواحد، مما يجعل الباحث يقرر وجود دلالة إحصائية بناءً على نصف الاحتمال الحقيقي المسموح به. ويضاف إلى ذلك خطأ التقريب المبكر في الخطوات الوسيطة للحساب؛ حيث يؤدي تقريب الخطأ المعياري أو التباين إلى منزلة عشرية واحدة إلى انحرافات تراكمية ضخمة تظهر بوضوح في قيمة T النهائية وتشوه موقعها في الجداول الإحصائية.
كما يعاني البعض من الخلط المفاهيمي في التعامل مع إشارة السالب لقيمة T المحسوبة، حيث يحاول البعض البحث عن قيم سالبة داخل الجداول الإحصائية المطبوعة أو يعتقدون خطأً أن الإشارة السالبة تعني عدم وجود دلالة، غافلين عن المبدأ الرياضي القائم على تماثل المنحنى التكراري، وأن الإشارة الجبرية تعبر فقط عن موقع العينة بالنسبة للمتوسط ولا تؤثر إطلاقاً على حجم المساحة الاحتمالية الواقعة في أطراف التوزيع.
10.2 حدود ومحددات الاعتماد على الجداول الإحصائية المطبوعة
تواجه عملية حساب القيمة الاحتمالية يدوياً عبر الجداول الورقية المطبوعة قيوداً ومحددات تقنية فرضها التصميم التقليدي لهذه الجداول؛ فالجداول الإحصائية كُتبت بمساحات طباعية محددة تختصر الصفوف والأعمدة لتناسب أبعاد الصفحات، مما يجعلها تحتوي فقط على قيم درجات الحرية المتتالية حتى رقم 30 أو 40، ثم تبدأ في القفز عبر فترات واسعة (مثل 40، 60، 120)، مما يجبر الباحث صاحب العينات الوسيطة (مثل $n = 55$) على اللجوء إلى تقريبات غير دقيقة أو استخدام سطر درجات حرية أدنى لتفادي التقدير المتفائل.
ويتمثل القيد الثاني في صعوبة التعامل مع قيم T المتطرفة جداً والتي تقع خارج النطاق المطبوع للجدول؛ فالجداول المطبوعة تتوقف أعمدتها الاحتمالية عادة عند عتبة $p = 0.001$ أو $p = 0.0005$ كحد أقصى. وعندما يحصل الباحث على قيمة T مرتفعة للغاية (مثل قيمتنا المحسوبة سابقاً $8.35$)، فإنه يعجز عن استخراج القيمة الاحتمالية الدقيقة عبر الاستيفاء الخطي، ويكتفي فقط بصياغة المتباينة المفتوحة ($p < 0.001$)، وهو ما يحرمه من معرفة القيمة الرقمية المطلقة المتاحة عبر البرمجيات الحاسوبية.
علاوة على ذلك، تفترض الجداول الإحصائية التقليدية توافر التوزيع الطبيعي الكامل في العينة والمجتمع، وتفقد دقتها الاستدلالية عند انتهاك شرط الاعتدالية في العينات الصغيرة؛ فالانحرافات الطفيفة عن التوزيع الطبيعي تُحدث تشوهات في سماكة أطراف توزيع ستيودنت التكراري الفعلي للبيانات، مما يجعل المساحات المطبوعة في الجدول غير ممثلة تماماً لواقع البيانات الملاحظة في الميدان السلوكي المعقد.
10.3 استراتيجيات المراجعة والتحقق الذاتي من صحة الحسابات
لضمان الحصانة الأكاديمية للمخرجات المستخرجة يدوياً، يتعين على الباحث اتباع استراتيجيات صارمة للمراجعة والتحقق الذاتي قبل اعتماد وتوثيق النتائج النهائية. تبدأ هذه الاستراتيجيات بإجراء الفحص البصري للمنحنى (Visual Curve Inspection)؛ حيث يقوم الباحث برسم تخطيطي يدوي لمنحنى التوزيع ووضع متوسط المجتمع في المنتصف وتحديد موقع متوسط العينة والانحرافات المعيارية، ليرى بصرياً ما إذا كان موقع القيمة المحسوبة والمساحة الاحتمالية المقدرة يتسقان منطقياً مع الفارق الحسابي الظاهر بين المتوسطين.
وتشمل الاستراتيجيات الفعالة استخدام قواعد الإحصاء الاستدلالية المرجعية السريعة (Rules of Thumb)؛ فمن المعروف رياضياً لدرجات الحرية المتوسطة والكبيرة أن قيمة $t$ التي تتجاوز $\pm 2.0$ تقترب حتماً من مستوى الدلالة 0.05 للاختبار ثنائي الطرف، وأن القيمة التي تتجاوز $\pm 2.6$ تقترب من مستوى 0.01، وأن القيمة التي تتجاوز $\pm 3.3$ تندفع نحو مستوى 0.001. فإذا استخرج الباحث يدوياً قيمة $t = 1.2$ وادعى أن القيمة الاحتمالية بلغت 0.01، فإن هذا التعارض الفوري مع القواعد المرجعية يكشف وجود خطأ حسابي فادح في خطوات الاستيفاء أو قراءة الجدول.
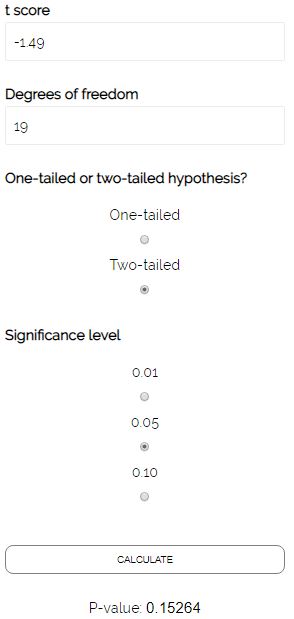
وأخيراً، يُستحسن الاستعانة بالحوسبة الرقمية كأداة تحقق لاحقة؛ فبعد الانتهاء الكامل من خطوات الحساب اليدوي وتوثيقها، يمكن إدخال البيانات إلى بيئات برمجية للتحقق من مطابقة الحسابات اليدوية وتقييم هامش الخطأ التقديري في الاستيفاء الخطي. إن هذا الدمج الواعي بين دقة الحساب اليدوي الصارم وسرعة التحقق الرقمي يمثل النموذج الأمثل للباحث الأكاديمي الحصيف في عصر المعلوماتية المعاصرة.
خاتمة
إن إتقان الحساب اليدوي للقيمة الاحتمالية من اختبار T يمثل جوهر التكوين المنهجي الرصين لأي باحث متمرس في العلوم الإنسانية والاجتماعية والسلوكية. لقد استعرض هذا الدليل المتكامل كيفية تفكيك هذا الإجراء الإحصائي وتحويله من مجرد أوامر برمجية غامضة إلى منظومة رياضية مترابطة الخطوات، تبدأ من صياغة الفرضيات الصفرية والبديلة، مروراً بحساب المتوسطات والانحرافات والأخطاء المعيارية، والتعامل الحذر مع خصائص توزيع ستيودنت التكراري ودرجات الحرية، وصولاً إلى استنطاق الجداول وتطويع تقنية الاستيفاء الخطي للحصول على تقديرات احتمالية فائقة الدقة والصرامة.
كما أبرز الدليل الأهمية الجوهرية للتمييز بين الاختبارات أحادية وثنائية الطرف، والالتزام بمعايير النشر الدولية المقرة في APA، ودعم القيمة الاحتمالية بمؤشرات حجم الأثر (مثل كوهين دي) لضمان عدم الخلط المضلل بين الدلالة الإحصائية المجردة والأهمية الميدانية والعملية للظواهر الإنسانية. إن هذه المهارات اليدوية لا تعزز كفاءة الباحث في استخراج النتائج فحسب، بل تبني لديه حساً نقدياً يمكنه من تقييم الأدبيات المنشورة واكتشاف مكامن الخلل في الدراسات العلمية، ليرتقي بإنتاجه الأكاديمي نحو أعلى درجات الرصانة والمصداقية العلمية المعتمدة عالمياً.
المراجع
Ahorsu, D. K., Lin, C.-Y., Imani, V., Saffari, M., Griffiths, M. D., & Pakpour, A. H. (2020). The Fear of COVID-19 Scale: Development and Initial Validation. International Journal of Mental Health and Addiction. https://doi.org/10.1007/s11469-020-00270-8
Barsade, S. G. (2002). The Ripple Effect: Emotional Contagion and its Influence on Group Behavior. Administrative Science Quarterly. https://doi.org/10.2307/3094912
Bartneck, C., Kulić, D., Croft, E. A., & Zoghbi, S. (2008). Measurement Instruments for the Anthropomorphism, Animacy, Likeability, Perceived Intelligence, and Perceived Safety of Robots. International Journal of Social Robotics. https://doi.org/10.1007/s12369-008-0001-3
Hamilton, M. (1960). A RATING SCALE FOR DEPRESSION. Journal of Neurology Neurosurgery & Psychiatry. https://doi.org/10.1136/jnnp.23.1.56
Lyubomirsky, S., King, L., & Diener, E. (2005). The Benefits of Frequent Positive Affect: Does Happiness Lead to Success?. Psychological Bulletin. https://doi.org/10.1037/0033-2909.131.6.803
Ohayon, M. M., Carskadon, M. A., Guilleminault, C., & Vitiello, M. V. (2004). Meta-Analysis of Quantitative Sleep Parameters From Childhood to Old Age in Healthy Individuals: Developing Normative Sleep Values Across the Human Lifespan. SLEEP. https://doi.org/10.1093/sleep/27.7.1255
Van Dongen, H. P. A., Maislin, G., Mullington, J. M., & Dinges, D. F. (2003). The Cumulative Cost of Additional Wakefulness: Dose-Response Effects on Neurobehavioral Functions and Sleep Physiology From Chronic Sleep Restriction and Total Sleep Deprivation. SLEEP. https://doi.org/10.1093/sleep/26.2.117